首页 文章 精选 留言 我的

精选列表

搜索[玩转EdgeOne],共1751篇文章
优秀的个人博客,低调大师

IDEA 中玩转 Git

Git 有很多客户端工具,不过感觉还是命令行操作最好用,方便又快捷,不过命令行操作需要小伙伴们对 Git 命令比较熟练,这可能对有的人来说会有一些难度,所以,客户端工具有时候也不能抛弃,如果非要推荐一个 Git 客户端工具,我觉得还是 IDEA 中的 Git 插件吧。其他的 Git 客户端工具松哥之前也有体验过一些,不过感觉还是 IDEA 中的用起来更加省事。 今天这篇文章算是我第二次教大家在开发工具中使用 Git 了,刚毕业的时候,松哥写过一篇文章,教大家在 Eclipse 中使用 Git,那时候在 Eclipse 中使用 Git 是真的麻烦,光是插件就要安装半天,刚刚翻了一下那篇文章,已经是七年前的事情了。 七年之后,Eclipse 也没了往日的风光,IDEA 逐渐成了开发的主流工具,咱们今天就来捋一捋 IDEA 中使用 Git。 1. 基本配置 首先你要安装 Git,这个就不需要我多说了,IDEA 上默认也是安装了 Git 插件,可以直接使用。 为了给小伙伴们演示方便,我这里使用 GitHub 作为远程仓库,如果还有人不清楚 GitHub 和 Git 的区别,可以在公众号江南一点雨底部菜单栏查看 Git 教程,看完了就明白了。 从 2021.08.13 号开始,IDEA 上配置 GitHub 有一个小小的变化,即不能使用用户名密码的方式登录了,如果你尝试用用户名/密码的方式登录 GitHub 提交代码,会收到如下提示: Support for password authentication was removed on August 13, 2021. Please use a personal access token instead. 在 IDEA 上使用用户名/密码的方法登录 GitHub 也会报如下错误: 需要我们点击右上角的 Use Token,使用令牌的方式登录 GitHub,令牌的生成方式如下: 网页上登录你的 GitHub 账号。 点击右上角,选择 Settings: 拉到最下方,选择左边的 Developer settings: 选择左边的 Personal access tokens,然后点击右上角的 Generate new token: 填一下基本信息,选一下权限即可(权限需要选择 repo 和 gist,其他根据自己的需求选择): 最后会生成一个令牌,拷贝到 IDEA 中即可,如下: 这就是基本配置。 小伙伴们在公司做开发,一般是不会将 GitHub 作为远程仓库的,那么这块根据自己实际情况来配置就行了。 2. clone 头一天上班,首先上来要先 clone 项目下来,IDEA 中有对应的 clone 工具,我们直接使用即可: 这块也可以直接选择下面的 GitHub,然后直接从自己的 GitHub 仓库上拉取新代码。 clone 完成之后,IDEA 会提示是否打开该项目,选择 yes 即可。 代码 clone 下来之后,就可以根据松哥前文介绍的 Git Flow 开始开发了。 3. 分支 假设我们先创建 develop 和 release 分支,创建方式如下,选中当前工程,右键单击,然后依次选择 Git->Repository->Branches...: 或者依次点击顶部的 VCS->Git->Branches...: 当然两个方式都比较麻烦,直接点击 IDEA 的右下角最为省事,也是最常用的办法,如下图: 选择 New Branch,然后创建新的分支,勾选上 Checkout 表示分支创建成功后,切换到该分支上,如下: 选择一个分支,然后点击 Checkout,可以切换到该分支上: 接下来我们把 develop 分支提交到远程仓库,如下: 我们没有修改代码,所以直接点击 Push 按钮提交即可。 提交完成后,develop 后面多了 origin 前缀,Remote Branches 中也多了 develop 分支,说明提交成功。 现在假设我们想从 develop 上拉一个名为 feature-login 的分支,来完成登录功能,如下: 从创建的日志中,我们能看到 feature-login 确实是来自 develop: 好啦,接下来我们就可以愉快的开启一天的工作啦~ feature-login 上的功能开发完成后,首先点击 IDEA 的右上角完成本地仓库的提交,如下图: 填入提交的 Message,下方也能看到不同版本的内容对比,点击右下角完成代码提交,注意这个只是提交到本地仓库。 由于我们并不会将 feature-login 提交到远程仓库,所以接下来我们要将 feature-login 合并到 develop 然后将最新的 develop push 到远程仓库,操作方式如下: 切换回 develop 分支。 选择 feature-login->Merge into Current 进行合并。 合并完成后,如需删除 feature-login 分支,也可以在 IDEA 日志中顺手删除: 不过上面介绍的合并是快速合并,即让 develop 的指针指向了 feature-login,很多时候我们可能需要加上 --no-ff 参数来合并,那么步骤如下: 从 feature-login 切换回 develop 分支,然后如下: 此时我们看一眼提交日志,如下: 从这日志中也可以看出,此时不是快速合并模式了! 最后,选择 develop->Push,将代码提交到远程仓库。 4. pull 在 IDEA 中,如需从远程仓库中更新代码,点击右上角的按钮即可,如下图: 好啦,这就是一个大致的流程。 当然 Git 博大精深,IDEA 中支持的功能也非常多,其他功能就需要小伙伴们自己来摸索了,有不明白的欢迎留言讨论。

优秀的个人博客,低调大师

进阶:玩转 CSS 变量

如果当年的 CSS 预处理器变量对于初入前端的我来说是开启了新世界的大门,那么 CSS 变量对于我来说无疑就是晴天霹雳。其功能不但可以优雅的处理之前 js 不好处理或不适合的业务需求。更在创造力无穷的前端开发者手中大放异彩。 基础用法 在前端的领域中,标准的实现总是比社区的约定要慢的多,前端框架最喜欢的 $ 被 Sass 变量用掉了。而最常用的 @ 也被 Less 用掉了。官方为了让 CSS 变量也能够在 Sass 及 Less 中使用,无奈只能妥协的使用 --。 <style>/*在body选择器中声明了两个变量*/body{--primary-color:red;/*变量名大小写敏感,--primary-color和--PRIMARY-COLOR是两个不同变量*/--PRIMARY-COLOR:initial;}/**同一个 CSS 变量,可以在多个选择器内声明。优先级高的会替换优先级低的*/main{--primary-color:blue;}/**使用CSS变量*/.text-primary{/* var()函数用于读取变量。*/color:var(--primary-color)}<style><!--呈现红色字体,body选择器的颜色--><divclass="text-primary">red</div><!--呈现蓝色字体,main选择器定义的颜色--><mainclass="text-primary">blue</main><!--呈现紫色字体,当前内联样式表的定义--><divstyle='--primary-color:purple"class="text-primary">purple</main> 这里我们可以看到针对同一个 CSS 变量,可以在多个选择器内声明。读取的时候,优先级最高的声明生效。这与 CSS 的"层叠"(cascade)规则是一致的。 由于这个原因,全局的变量通常放在根元素:root里面,确保任何选择器都可以读取它们。 :root{--primary-color:#06c;} 同时, CSS 变量提供了 JavaScript 与 CSS 通信的方法。就是利用 js 操作 css 变量。我们可以使用: <style>/*...和上面CSS一致*/</style><!--呈现黄色字体--><divclass="text-primary">red</div><!--呈现蓝色字体,main选择器定义的颜色--><mainid='primary'class="text-primary">blue</main><!--呈现紫色字体,当前内联样式表的定义--><divid="secondary"style='--primary-color:purple"class="text-primary">purple</main><script>//设置变量document.body.style.setProperty('--primary-color','yellow');//设置变量,jsDOM元素ID就是全局变量,所以直接设置main即可//变为红色primary.style.setProperty('--primary-color','red');//变为黄色,因为当前样式被移除了,使用body上面样式secondary.style.removeProperty('--primary-color');//通过动态计算获取变量值getComputedStyle(document.body).getPropertyValue('--primary-color')</script> 我们可以在业务项目中定义以及替换 CSS 变量,大家可以参考mvp.css[1]。该库大量使用了 CSS 变量并且让你去根据自己需求修改它。 :root{--border-radius:5px;--box-shadow:2px2px10px;--color:#118bee;--color-accent:#118bee0b;--color-bg:#fff;--color-bg-secondary:#e9e9e9;--color-secondary:#920de9;--color-secondary-accent:#920de90b;--color-shadow:#f4f4f4;--color-text:#000;--color-text-secondary:#999;--font-family:-apple-system,BlinkMacSystemFont,"SegoeUI",Roboto,Oxygen-Sans,Ubuntu,Cantarell,"HelveticaNeue",sans-serif;--hover-brightness:1.2;--justify-important:center;--justify-normal:left;--line-height:150%;--width-card:285px;--width-card-medium:460px;--width-card-wide:800px;--width-content:1080px;} 我们可以看到基于 CSS 变量,可以更友好的和设计师的设计意图结合在一起。也易于修改,在业务项目中合理使用无疑可以事半功倍。 实现默认配置 如果让我来思考,我肯定无法想象出结合 CSS 预处理器 + CSS 变量便可以实现组件样式的默认配置。这里我先介绍两个关于该功能的前置知识点: 事实上,CSS 变量的 var() 函数还可以使用第二个参数,表示变量的默认值。如果该变量此前没有定义或者是无效值,就会使用这个默认值。 /*没有设置过--primary-color,颜色默认使用#7F583F*/color:var(--primary-color,#7F583F); 虽然目前 CSS 变量不是新的属性,但终究不是所有的浏览器都支持 CSS 变量的,这里我们还是要考虑一下优雅降级。 /*对于不支持 CSS 变量的浏览器,可以采用下面的写法。*/a{/*颜色默认值*/color:#7F583F;/*不支持则不识别该条规则*/color:var(--primary);} 结合 CSS 处理器 + CSS 变量便可以实现组件样式的默认配置。这里参考了有赞的Vant Weapp[2]的做法。有赞代码**theme.less**[3]如下所示: // 先导入所有 Less 变量@import (reference) './var.less';// 利用正则去替换 Less 变量 为 CSS 变量.theme(@property, @imp) { @{property}: e(replace(@imp, '@([^() ]+)', '@{$1}', 'ig')); @{property}: e(replace(@imp, '@([^() ]+)', 'var(--$1, @{$1})', 'ig'));} 函数效果如下所示: @import '../common/style/theme.less';.van-button { // ... 其他省略 .theme(height, '@button-default-height'); .theme(line-height, '@button-line-height'); .theme(font-size, '@button-default-font-size');}// => less 编译之后生成.van-button{ // ... 其他省略 height:44px; height:var(--button-default-height,44px); line-height:20px; line-height:var(--button-line-height,20px); font-size:16px; font-size:var(--button-default-font-size,16px);} 我们可以看到每调用一次 Less 函数将会被编译成两个属性。第一个属性的设定对于不支持 CSS 变量的设备可以直接使用,如果当前设备支持 CSS 变量,则会使用 CSS 变量,但是由于当前 CSS 变量未定义,就会使用变量的默认值。虽然 '@button-default-height 虽然也是一个变量,但是该变量仅仅只是 less 变量,最终生成的代码中并没有 --button-default-height 这样的变量。此时我们就可以在使用样式的位置或者 :root 中添加变量 --button-default-height。 这种方式更适合组件开发,因为该方案不声明任何 css 变量,只是预留的 css 变量名称和默认属性。这样的话,无论开发者的选择器优先度有多低,代码都可以很容易的覆盖默认属性。因为我们仅仅使用 css 的默认值。 大家可能有时候会想,这样的话,我们不是有更多的代码了吗?其实未必,事实上我们可以直接直接在页面内部定义变量样式。其他组件直接通过 style 去使用页面内的变量。当然了,事实上书写的代码多少,重点在于想要控制默认样式的粒度大小。粒度越小,则需要在各个组件内部书写的变量越多,粒度大,我们也就不必考虑太多。 Space Toggle 逻辑切换 CSS 没有逻辑切换似乎是一种共识,但是我们可以利用选框(单选与多选)和 CSS 变量来实现判断逻辑。我们先来看看如何使用 CSS 变量。 <style>.red-box{--toggler:;--red-if-toggler:var(--toggler)red;background:var(--red-if-toggler,green);/*willbered!*/}.green-box{--toggler:initial;--red-if-toggler:var(--toggler)red;background:var(--red-if-toggler,green);/*willbegreen!*/}</style><!--宽度高度为100px的红色盒子--><divstyle="height:100px;width:100px"class="red-box"></div><!--宽度高度为100px的绿色盒子--><divstyle="height:100px;width:100px"class="green-box"></div> 这里因为一个变量 --toggler 使用空格 或者 initial 而产生了不同的结果,基于这样的结果我们不难想象我们可以触发变量的修改而产生不同的结果。 他不是一个 bug,也不是一个 hack。他的原理完完全全的在CSS Custom Properties 规范[4]中。 This value serializes as the empty string, but actually writing an empty value into a custom property, like --foo: ;, is a valid (empty) value, not the guaranteed-invalid value. If, for whatever reason, one wants to manually reset a variable to the guaranteed-invalid value, using the keyword initial will do this. 解释如下,事实上 -foo: ; 这个变量并不是一个无效值,它是一个空值。initial 才是 CSS 变量的无效值。其实这也可以理解,css 没有所谓的空字符串,空白也不代表着无效,只能使用特定值来表示该变量无效。这个时候,我们再回头来看原来的 CSS 代码。 .red-box{/*当前为空值*/--toggler:;/*因为var(--toggler)得到了空,所以得到结果为--red-if-toggler:red*/--red-if-toggler:var(--toggler)red;/**变量是red,不会使用green*/background:var(--red-if-toggler,green);/*willbered!*/}.green-box{/**当前为无效值*/--toggler:initial;/**仍旧无效数据,因为var只会在参数不是initial时候进行替换*/--red-if-toggler:var(--toggler)red;/**最终无效值没用,得到绿色*/background:var(--red-if-toggler,green);/*willbegreen!*//*根据当前的功能,我们甚至可以做到and和or的逻辑*--tog1--tog2--tog3同时为空值时是红色*/--red-if-togglersalltrue:var(--tog1)var(--tog2)var(--tog3)red;/**--tog1--tog2--tog3任意为空值时是红色*/--red-if-anytogglertrue:var(--tog1,var(--tog2,var(--tog3)))red;} 新式媒体查询 当我们需要开发响应式网站的时候,我们必须要使用媒体查询 @media。先看一下用传统的方式编写这个基本的响应式 CSS: .breakpoints-demo>*{width:100%;background:red;}@media(min-width:37.5em)and(max-width:56.249em){.breakpoints-demo>*{width:49%;}}@media(min-width:56.25em)and(max-width:74.99em){.breakpoints-demo>*{width:32%;}}@media(min-width:56.25em){.breakpoints-demo>*{background:green;}}@media(min-width:75em){.breakpoints-demo>*{width:24%;}} 同样,我们可以利用 css 变量来优化代码结构,我们可以写出这样的代码: /**移动优先的样式规则*/.breakpoints-demo>*{/**小于37.5em,宽度100%*/--xs-width:var(--media-xs)100%;/**小于56.249em,宽度49%*/--sm-width:var(--media-sm)49%;--md-width:var(--media-md)32%;--lg-width:var(--media-gte-lg)24%;width:var(--xs-width,var(--sm-width,var(--md-width,var(--lg-width))));--sm-and-down-bg:var(--media-lte-sm)red;--md-and-up-bg:var(--media-gte-md)green;background:var(--sm-and-down-bg,var(--md-and-up-bg));} 可以看出,第二种 CSS 代码非常清晰,数据和逻辑保持在一个 CSS 规则中,而不是被 @media 切割到多个区块中。这样,不但更容易编写,也更加容易开发者读。详情可以参考css-media-vars[5]。该代码库仅仅只有 3kb 大小,但是却是把整个编写代码的风格修改的完全不同。原理如下所示: /***css-media-vars*BSD2-ClauseLicense*Copyright(c)James0x57,PropJockey,2020*/html{--media-print:initial;--media-screen:initial;--media-speech:initial;--media-xs:initial;--media-sm:initial;--media-md:initial;--media-lg:initial;--media-xl:initial;/*...*/--media-pointer-fine:initial;--media-pointer-none:initial;}/*把当前变量变为空值*/@mediaprint{html{--media-print:;}}@mediascreen{html{--media-screen:;}}@mediaspeech{html{--media-speech:;}}/*把当前变量变为空值*/@media(max-width:37.499em){html{--media-xs:;--media-lte-sm:;--media-lte-md:;--media-lte-lg:;}} 其他 继CSS 键盘记录器[6]暴露了 CSS 安全性问题之后,CSS 变量又一次让我看到了玩技术是怎么样的。CSS Space Toggle 技术不但可以应用于上面的功能,甚至还可以编写 UI 库augmented-ui[7]以及 扫雷[8]游戏。这简直让我眼界大开。在我有限的开发生涯中,很难找到类似于 css 这种设计意图和使用方式差异如此之大的技术。 CSS 是很有趣的,而 CSS 的有趣之处就在于最终呈现出来的技能强弱与你自身的思维方式,创造力是密切相关的。上文只是介绍了 CSS 变量的一些玩法,也许有更多有意思的玩法,不过这就需要大家的创造力了。 源自:https://github.com/wsafight/personBlog/issues/25 声明:文章著作权归作者所有,如有侵权,请联系小编删除。 最后 欢迎关注【前端瓶子君】✿✿ヽ(°▽°)ノ✿ 欢迎关注「前端瓶子君」,回复「 算法 」,加入前端算法源码编程群,每日一刷(工作日),每题瓶子君都会很认真的解答哟! 回复「交流」,吹吹水、聊聊技术、吐吐槽! 回复「 阅读 」,每日刷刷高质量好文! 如果这篇文章对你有帮助,「在看」是最大的支持 》》面试官也在看的算法资料《《 “在看和转发” 就是最大的支持 本文分享自微信公众号 - 前端瓶子君(pinzi_com)。如有侵权,请联系 support@oschina.cn 删除。本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

优秀的个人博客,低调大师

使用Python玩转GPU

问题 随着机器学习对模型运算速度的需求越来越强烈,一直想进行GPU编程,但一直以来这些都是c++的专利一想到c++里的各种坑,就提不起劲来,毕竟这样来来回回填坑的投入产出,生产效率就会大打折扣 解决方案 让人欣喜的是,随着Python阵营的不断发展壮大,使用python进行GPU编程也越来越便捷了 那么具体有些什么样的包,能针对GPU做些啥事呢?看看一些具体的代码,就能大概明白:首先是pycuda,这是它的一个例子: mod = SourceModule(""" __global__ void multiply_them(float *dest, float *a, float *b) { const int i = threadIdx.x; dest[i] = a[i] * b[i]; } """) 由上面的代码我们可以看出,pycuda将调用gpu的c++代码做了包装,可以在python里直接使用 再看看numba: @cuda.jit def increment_by_one(an_array): pos = cuda.grid(1) if pos < an_array.size: an_array[pos] += 1 我们可以发现,numba更进一步,直接使用装饰器的办法让调用GPU的过程更简洁方便 再看看cupy: import numpy as np import cupy as cp x_gpu = cp.array([1, 2, 3]) l2_gpu = cp.linalg.norm(x_gpu) cupy的调用方法看起来更加简单清晰,直接将np替换为cp即可 比较 所以,从机器学习全流程的角度我做了下汇总: 原始框架 GPU替代包 支持GPU C/C++核函数 表达式核函数 装饰器 & Python cuda pycuda n卡 √ × × opencl pyopencl n卡 + a卡 √ × × numpy numba n卡 √ √ √ scipy cupy n卡 √ √ √ pandas cudf & modin n卡 无(自动) sklearn cuml & scikit-cuda n卡 无(自动) 目前cupy和numba对numpy的支持都不全面,可两者结合使用 从上面可以看出,基本上已经涵盖了机器学习的全流程,大部分包只支持cuda,主要都是为方便使用n卡加速部分包还是只能使用c/c++语言构建核函数,主要还是受限于cuda驱动的capability所以实际使用门槛并没有降低,只是将核函数包装到python里使用 GPU的主要优势在于大规模的并行计算,所以我又收集了一些并行计算框架,方便日后使用 框架 CPU并行计算 分布式并行计算 GPU并行计算 Multiprocess √ × × joblib √ × × dask √ √ √ ray √ √ √ 至于机器学习/深度学习框架,那就更不用说了:xgboost已经开始支持GPU,RandomForest也有GPU的版本,tensorflow, pytorch默认就是支持GPU的,这里就不再赘述 结论 没有框架时,我们希望有效率的python包能快速解决问题,可框架多了,又会出现选择困难症各种框架都宣称自己效率高,灵活好用,各种benchmark也让人眼花缭乱,目不暇接到底用哪个框架合适,我把自己的一些经验也总结下,希望能让大家少踩一些坑: 1.对于一般的并行计算任务,使用joblib就能方便完成; 2.对于需要集群或GPU的计算任务,可以选择dask或ray; 这里推荐下dask,dask于机器学习/深度学习的计算包结合的更紧密,推出了dask_ml用于处理分布式机器学习; 3.如果想快速迁移numpy/pandas的代码到gpu,可以使用cupy + cudf的组合方式; 4.如果有复杂自定义的计算以及为了追求性能,可以使用pycuda + numba的形式; 5.对于numpy的替换到底选用cupy还是numba? 这里没有严格的界限,两者对GPU的调用方式设计,实际都会有一定的编码成本 从cupy的基本例子中可以看出,对于部分调用来说cupy更简洁,但是牺牲了cpu并行和分布式并行的功能为代价 所以目前可以持续关注这两个框架 6.对于替换pandas到底选用cudf还是modin? modin本身并不是专为cuda并行化而设计,它只是底层支持了dask和ray,由此间接的支持了GPU 且到目前为止对pandas方法的支持还不全面,所以这里推荐选择cudf 思考 总之,python作为机器学习的首选语言,正在不断的开疆拓土,不断的降低并行计算的门槛短短几年前,还只能用xgboost + spark的方式进行分布式训练,转眼现在就有了多种python解决方案短短几年前,还只能用c++ cuda的方式进行GPU编程,转眼现在也有了多种纯python的框架支持短短几年前,将GPU进行集群化、虚拟化管理几乎是不可能的,转眼现在也有了可靠的解决方案…… 但是,到目前为止,还没有一款真正能充分智能化的利用并行能力计算的框架:它能综合cpu+gpu+分布式的计算能力,目标就是为了加速计算,得到结果。期待这样的框架诞生! 相信不久的将来,会有更多更强大的python框架出现,不断的加速自动化的进程让更多的生产力能从原始的轮子中解放出来,加快人工智能的进化!

优秀的个人博客,低调大师

带你玩转 Big Data

Big Data(大数据)技术简析 Big Data是近来的一个技术热点,但从名字就能判断它并不是什么新词。毕竟,大是一个相对概念。历史上,数据库、数据仓库、数据集市等信息管理领域的技术,很大程度上也是为了解决大规模数据的问题。被誉为数据仓库之父的Bill Inmon早在20世纪90年代就经常将Big Data挂在嘴边了。 然而,Big Data作为一个专有名词成为热点,主要应归功于近年来互联网、云计算、移动和物联网的迅猛发展。无所不在的移动设备、RFID、无线传感器每分每秒都在产生数据,数以亿计用户的互联网服务时时刻刻在产生巨量的交互……要处理的数据量实在是太大、增长太快了,而业务需求和竞争压力对数据处理的实时性、有效性又提出了更高要求,传统的常规技术手段根本无法应付。 在这种情况下,技术人员纷纷研发和采用了一批新技术,主要包括分布式缓存、基于MPP的分布式数据库、分布式文件系统、各种NoSQL分布式存储方案等。 10年前,Eric Brewer提出著名的CAP定理,指出:一个分布式系统不可能满足一致性、可用性和分区容忍性这三个需求,最多只能同时满足两个。系统的关注点不同,采用的策略也不一样。只有真正理解了系统的需求,才有可能利用好CAP定理。 架构师一般有两个方向来利用CAP理论。 ·Key-Value存储,如Amazon Dynamo等,可以根据CAP理论灵活选择不同倾向的数据库产品。 ·领域模型+分布式缓存+存储,可根据CAP理论结合自己的项目定制灵活的分布式方案,但难度较高。 对大型网站,可用性与分区容忍性优先级要高于数据一致性,一般会尽量朝着A、P的方向设计,然后通过其他手段保证对于一致性的商务需求。架构设计师不要将精力浪费在如何设计能满足三者的完美分布式系统,而应该懂得取舍。 不同的数据对一致性的要求是不同的。SNS网站可以容忍相对较长时间的不一致,而不影响交易和用户体验;而像支付宝这样的交易和账务数据则是非常敏感的,通常不能容忍超过秒级的不一致。 图1 memcached构成 Cache篇 缓存在Web开发中运用越来越广泛,mem-cached是danga.com(运营LiveJournal的技术团队)开发的一套分布式内存对象缓存系统,用于在动态系统中减少数据库负载,提升性能。 memcached具有以下特点: 协议简单;基于libevent的事件处理;内置内存存储方式;memcached不互相通信的分布式。 memcached处理的原子是每一个(Key,Value)对(以下简称KV对),Key会通过一个hash算法转化成hash-Key,便于查找、对比以及做到尽可能的散列。同时,memcached用的是一个二级散列,通过一张大hash表来维护。 memcached由两个核心组件组成:服务端(ms)和客户端(mc),在一个memcached的查询中,ms先通过计算Key的hash值来确定KV对所处在的ms位置。当ms确定后,mc就会发送一个查询请求给对应的ms,让它来查找确切的数据。因为这之间没有交互以及多播协议,所以memcached交互带给网络的影响是最小化的。 MemcacheDB是一个分布式、Key-Value形式的持久存储系统。它不是一个缓存组件,而是一个基于对象存取的、可靠的、快速的持久存储引擎。协议与memcached一致(不完整),所以很多memcached客户端都可以跟它连接。MemcacheDB采用Berkeley DB作为持久存储组件,因此很多Berkeley DB的特性它都支持。 图2 Greenplum数据引擎软件 类似这样的产品也很多,如淘宝Tair就是Key-Value结构存储,在淘宝得到了广泛使用。后来Tair也做了一个持久化版本,思路基本与新浪MemcacheDB一致。 分布式数据库篇 支付宝公司在国内最早使用Greenplum数据库,将数据仓库从原来的Oracle RAC平台迁移到Greenplum集群。Greenplum强大的计算能力用来支持支付宝日益发展的业务需求。 Greenplum数据引擎软件专为新一代数据仓库所需的大规模数据和复杂查询功能所设计,基于MPP(海量并行处理)和Shared-Nothing(完全无共享)架构,基于开源软件和x86商用硬件设计(性价比更高)。 分布式文件系统篇 谈到分布式文件系统,不得不提的是Google的GFS。基于大量安装有Linux操作系统的普通PC构成的集群系统,整个集群系统由一台Master(通常有几台备份)和若干台TrunkServer构成。GFS中文件备份成固定大小的Trunk分别存储在不同的TrunkServer上,每个Trunk有多份(通常为3份)拷贝,也存储在不同的TrunkServer上。Master负责维护GFS中的 Metadata,即文件名及其Trunk信息。客户端先从Master上得到文件的Metadata,根据要读取的数据在文件中的位置与相应的TrunkServer通信,获取文件数据。 图3 引自Facebook工程师的Hive与Hadoop关系图 在Google的论文发表后,就诞生了Hadoop。截至今日,Hadoop被很多中国最大互联网公司所追捧,百度的搜索日志分析,腾讯、淘宝和支付宝的数据仓库都可以看到Hadoop的身影。 Hadoop具备低廉的硬件成本、开源的软件体系、较强的灵活性、允许用户自己修改代码等特点,同时能支持海量数据存储和计算任务。 Hive是一个基于Hadoop的数据仓库平台,将转化为相应的MapReduce程序基于Hadoop执行。通过Hive,开发人员可以方便地进行ETL开发。 如图3所示,引用一张Facebook工程师做的Hive和Hadoop的关系图。 NoSQL篇 随着数据量增长,越来越多的人关注NoSQL,特别是2010年下半年,Facebook选择HBase来做实时消息存储系统,替换原来开发的Cassandra系统。这使得很多人开始关注HBase。Facebook选择HBase是基于短期小批量临时数据和长期增长的很少被访问到的数据这两个需求来考虑的。 HBase是一个高可靠性、高性能、面向列、可伸缩的分布式存储系统,利用HBase技术可在廉价PC Server上搭建大规模结构化存储集群。HBase是BigTable的开源实现,使用HDFS作为其文件存储系统。Google运行MapReduce来处理BigTable中的海量数据,HBase同样利用MapReduce来处理HBase中的海量数据;BigTable利用Chubby作为协同服务,HBase则利用Zookeeper作为对应。 图4 线上应用系统与数据平台的无缝融入 总结篇 近来NoSQL数据库的使用越来越普及,几乎所有的大型互联网公司都在这个领域进行着实践和探索。在享受了这类数据库与生俱来的扩展性、容错性、高读写吞吐外(尽管各主流NoSQL仍在不断完善中),越来越多的实际需求把人们带到了NoSQL并不擅长的其他领域,比如搜索、准实时统计分析、简单事务等。实践中一般会在NoSQL的外围组合一些其他技术形成一个整体解决方案。 准实时的统计分析 ·传输时统计分析,Stream Processing技术:FlumeBase、S4。 FlumeBase:可参考 http://flumebase.org/documentation/0.1.0/UserGuide.html中的quick start和architecture两部分。 S4:Yahoo!开源数据来流计算实时框架,可参考http://labs.yahoo.com/files/KDCloud%202010%20S4.pdf。 ·查询时统计分析,结果集较小时,可以直接在返回前做统计分析处理。 比如买家消费记录查询的HBase实现,Schema设计,rowkey=uid,column=搜索词和查询值,version=交易id。 搜索相关 ·充分利用NoSQL(比如HBase)内部数据的有序性、Row Key、Column Family、Version Timestamp。 我们用“HBase+二次索引”来实现实时营销的解决方案。也可以参考Facebook Message的解决方案:http://blog.bluedavy.com/?p=258。 ·构建一个外围系统完成索引建立。 Google MegaStore:原文链接为http://www.cidrdb.org/cidr2011/Papers/CIDR11_Paper32.pdf,中文译文链接为http://cloud.csdn.net/a/20110216/291968.html。 也有人开始尝试基于HBase的MegaStore实现,链接为https://github.com/drevell/megalon。 简单事务 ·事务处理服务 + NoSQL存储。 ·淘宝开发的千亿级海量数据库Oceanbase,通过update server角色执行将写操作限制在一台机器上,实现事务。参考链接为:http://www.nosqlnotes.net/archives/170。 ·Google MegaStore通过为用户提供机制,根据应用特点划分entity group,将事务涉及的数据分布到一台机器上,实现事务。

优秀的个人博客,低调大师

玩转Kubernetes TCP Ingress

问题 在Kuberetes应用中,一般都是通过Ingress来暴露HTTP/HTTPS的服务。但是在实际应用中,还是有不少应用是TCP长连接的,这个是否也是可以通过Ingress来暴露呢?大家知道Kubernetes社区默认带了一个Nginx的Ingress的,而它本身又是支持TCP做反向代理的。所以也就能支持TCP方式的Ingress的。 具体可以参考:https://kubernetes.github.io/ingress-nginx/user-guide/exposing-tcp-udp-services/ 原理 Ingress Controller在启动时会去watch两个configmap(一个tcp,一个 udp),里面记录了后面需要反向代理的TCP的服务以及暴露的端口。如果里面的key-value发生变换,Ingress c

优秀的个人博客,低调大师

玩转Android嵌套滚动

在Android UI开发过程中,经常会遇到嵌套滚动的需求,所谓嵌套滚动,就是父view可以滚动的情况下子view也可以滚动,例如下拉刷新(PullToRefresh)。在微信读书之前的版本中,书籍讨论圈有一个比较复杂的嵌套滚动的例子,我把它抽取出来作为今天讲解的例子: 这个例子的嵌套比较复杂,上方的header为书籍封面,下方是一个ViewPager+TabLayout组成的容器(下文简称VT容器),ViewPager中的三个item为三个列表,也是可以滚动的。业务需求是: VT容器可以滚动; 书籍封面可以滚动,并且有视差; 当VT容器滚动到顶部时,滚动列表,并且滚动可以衔接。 当列表滚动到顶部时,可以滚动书籍封面以及VT容器,并且滚动可以衔接 逻辑清楚了,接下来就看如何实现了。在android5以前,对于这种滚动,我们只能选择自己去拦截事件并处理,但在后面的某个版本,android推出了NestingScroll机制,开发者的日子就好过多了,并且android提供了一个非常好的容器类:CoordinatorLayout,极大的简化了开发者的工作。当然我们也需要投入精力去学习并运用这些新的Api了。 当然,我们也要知道如果没有这些API,我们应当如何去实现这些效果。因此本文会用三种方式去实现这个效果: 纯事件拦截与派发方案 基于NestingScroll机制的实现方案 基于CoordinatorLayout与Behavior方案的实现 示例代码放在Github上,可以clone下来结合文章观看 纯事件拦截与派发方案 这是最为原始的方案,当然也灵活性最高的了。其它的方案原理上都是系统基于它提供的封装。使用这种方案时,我们需要解决以下几个问题: view的滚动(Scroller); view的速度追踪(VelocityTracker); 当VT容器滚动到顶部时,我们如何将事件传递给ListView? 当ListView滚动到顶部时,VT容器如何拦截到事件? 1、2两点属于滚动的基础知识,这里不会做细致的讲解。而第3点为何会出现呢?因为android系统在事件派发时,如果事件被拦截,那么之后的事件都将不会传递给子view了。其解决方案也很简单:在滚动到顶部时主动派发一次Down事件: if(mTargetCurrentOffset+dy<=mTargetEndOffset){ moveTargetView(dy); //重新dispatch一次down事件,使得列表可以继续滚动 intoldAction=ev.getAction(); ev.setAction(MotionEvent.ACTION_DOWN); dispatchTouchEvent(ev); ev.setAction(oldAction); }else{ moveTargetView(dy); } 那么第4点是什么问题呢?这里就需要清楚一个坑点了:不是所用的事件都会走入onInterceptTouchEvent。有一种情况是子View主动调用parent.requestDisallowInterceptTouchEvent(true)来告诉系统说:这个事件我要了,父View不要拦截了。这就是所谓的内部拦截法。在ListView的某些时刻它会去调用这个方法。因此一旦事件传递给了ListView,外部容器就拿不到这个事件了。因此我们要打破它的内部拦截: @Override publicvoidrequestDisallowInterceptTouchEvent(booleanb){ //去掉默认行为,使得每个事件都会经过这个Layout } 方法如上,把requestDisallowInterceptTouchEvent的实现干掉就可以了。 主要的技术点已近提出来了。那么下面就看具体实现,首先看使用xml: <org.cgspine.nestscroll.one.EventDispatchPlanLayout android:id="@+id/scrollLayout" android:layout_marginTop="?attr/actionBarSize" android:layout_width="match_parent" android:layout_height="match_parent" app:header_view="@+id/book_header" app:target_view="@+id/scroll_view" app:header_init_offset="30dp" app:target_init_offset="70dp"> <View android:id="@id/book_header" android:layout_width="120dp" android:layout_height="150dp" android:background="@color/gray"/> <org.cgspine.nestscroll.one.EventDispatchTargetLayout android:id="@id/scroll_view" android:layout_width="match_parent" android:layout_height="match_parent" android:orientation="vertical" android:background="@color/white"> <android.support.design.widget.TabLayout android:id="@+id/tab_layout" android:background="@drawable/list_item_bg_with_border_top_bottom" android:layout_width="match_parent" android:layout_height="@dimen/tab_layout_height" android:fillViewport="true"/> <android.support.v4.view.ViewPager android:id="@+id/viewpager" android:layout_width="match_parent" android:layout_height="0dp" android:layout_weight="1"/> </org.cgspine.nestscroll.one.EventDispatchTargetLayout> </org.cgspine.nestscroll.one.EventDispatchPlanLayout> EventDispatchTargetLayout实现了自定义接口ITargetView: publicinterfaceITargetView{ booleancanChildScrollUp(); voidfling(floatvy); } 这是因为与具体业务抽离,我并不清楚内层盒子是怎样的(有可能就是ListView了,也有可能是ViewPager包裹ListView) 主要的实现在EventDispatchPlanLayout,使用时在xml中指定header_init_offset、target_init_offset等变量就可以了,基本上与业务逻辑独立。 其重点实现逻辑在onInterceptTouchEvent与onTouchEvent中了。个人不是很建议去动dispatchTouchEvent,虽然所有事件都会经过这里,但是这也明显会增加代码处理复杂度: publicbooleanonInterceptTouchEvent(MotionEventev){ ensureHeaderViewAndScrollView(); finalintaction=MotionEventCompat.getActionMasked(ev); intpointerIndex; //不阻断事件的快路径:如果目标view可以往上滚动或者`EventDispatchPlanLayout`不是enabled if(!isEnabled()||mTarget.canChildScrollUp()){ Log.d(TAG,"fastendonIntercept:isEnabled="+isEnabled()+";canChildScrollUp=" +mTarget.canChildScrollUp()); returnfalse; } switch(action){ caseMotionEvent.ACTION_DOWN: mActivePointerId=ev.getPointerId(0); mIsDragging=false; pointerIndex=ev.findPointerIndex(mActivePointerId); if(pointerIndex<0){ returnfalse; } //在down的时候记录初始的y值 mInitialDownY=ev.getY(pointerIndex); break; caseMotionEvent.ACTION_MOVE: pointerIndex=ev.findPointerIndex(mActivePointerId); if(pointerIndex<0){ Log.e(TAG,"GotACTION_MOVEeventbuthaveaninvalidactivepointerid."); returnfalse; } finalfloaty=ev.getY(pointerIndex); //判断是否dragging startDragging(y); break; caseMotionEventCompat.ACTION_POINTER_UP: //双指逻辑处理 onSecondaryPointerUp(ev); break; caseMotionEvent.ACTION_UP: caseMotionEvent.ACTION_CANCEL: mIsDragging=false; mActivePointerId=INVALID_POINTER; break; } returnmIsDragging; } 代码逻辑很清晰,应该不用多说。接下来看onTouchEvent的处理逻辑。 publicbooleanonTouchEvent(MotionEventev){ finalintaction=MotionEventCompat.getActionMasked(ev); intpointerIndex; if(!isEnabled()||mTarget.canChildScrollUp()){ Log.d(TAG,"fastendonTouchEvent:isEnabled="+isEnabled()+";canChildScrollUp=" +mTarget.canChildScrollUp()); returnfalse; } //速度追踪 acquireVelocityTracker(ev); switch(action){ caseMotionEvent.ACTION_DOWN: mActivePointerId=ev.getPointerId(0); mIsDragging=false; break; caseMotionEvent.ACTION_MOVE:{ pointerIndex=ev.findPointerIndex(mActivePointerId); if(pointerIndex<0){ Log.e(TAG,"GotACTION_MOVEeventbuthaveaninvalidactivepointerid."); returnfalse; } finalfloaty=ev.getY(pointerIndex); startDragging(y); if(mIsDragging){ floatdy=y-mLastMotionY; if(dy>=0){ moveTargetView(dy); }else{ if(mTargetCurrentOffset+dy<=mTargetEndOffset){ moveTargetView(dy); //重新dispatch一次down事件,使得列表可以继续滚动 intoldAction=ev.getAction(); ev.setAction(MotionEvent.ACTION_DOWN); dispatchTouchEvent(ev); ev.setAction(oldAction); }else{ moveTargetView(dy); } } mLastMotionY=y; } break; } caseMotionEventCompat.ACTION_POINTER_DOWN:{ pointerIndex=MotionEventCompat.getActionIndex(ev); if(pointerIndex<0){ Log.e(TAG,"GotACTION_POINTER_DOWNeventbuthaveaninvalidactionindex."); returnfalse; } mActivePointerId=ev.getPointerId(pointerIndex); break; } caseMotionEventCompat.ACTION_POINTER_UP: onSecondaryPointerUp(ev); break; caseMotionEvent.ACTION_UP:{ pointerIndex=ev.findPointerIndex(mActivePointerId); if(pointerIndex<0){ Log.e(TAG,"GotACTION_UPeventbutdon'thaveanactivepointerid."); returnfalse; } if(mIsDragging){ mIsDragging=false; //获取瞬时速度 mVelocityTracker.computeCurrentVelocity(1000,mMaxVelocity); finalfloatvy=mVelocityTracker.getYVelocity(mActivePointerId); finishDrag((int)vy); } mActivePointerId=INVALID_POINTER; //释放速度追踪 releaseVelocityTracker(); returnfalse; } caseMotionEvent.ACTION_CANCEL: releaseVelocityTracker(); returnfalse; } returnmIsDragging; } 或许有人会说:为何与onInterceptTouchEvent与有很多重复代码?这是因为如果事件不打断,并且子类不处理,就会走进onTouchEvent逻辑,所以这些重复处理是有意义的(其实是抄SwipeRefreshLayout的)。里面主要的逻辑就是两个: 滚动容器 TouchUp时滚动到特定位置以及fling传递 滚动容器的逻辑: privatevoidmoveTargetViewTo(inttarget){ target=Math.max(target,mTargetEndOffset); //用offsetTopAndBottom来偏移view ViewCompat.offsetTopAndBottom(mTargetView,target-mTargetCurrentOffset); mTargetCurrentOffset=target; //滚动书籍封面view,根据TargetView进行定位 intheaderTarget; if(mTargetCurrentOffset>=mTargetInitOffset){ headerTarget=mHeaderInitOffset; }elseif(mTargetCurrentOffset<=mTargetEndOffset){ headerTarget=mHeaderEndOffset; }else{ floatpercent=(mTargetCurrentOffset-mTargetEndOffset)*1.0f/mTargetInitOffset-mTargetEndOffset; headerTarget=(int)(mHeaderEndOffset+percent*(mHeaderInitOffset-mHeaderEndOffset)); } ViewCompat.offsetTopAndBottom(mHeaderView,headerTarget-mHeaderCurrentOffset); mHeaderCurrentOffset=headerTarget; } TouchUp的滚动逻辑: privatevoidfinishDrag(intvy){ Log.i(TAG,"TouchUp:vy="+vy); if(vy>0){ //向下触发fling,需要滚动到Init位置 mNeedScrollToInitPos=true; mScroller.fling(0,mTargetCurrentOffset,0,vy, 0,0,mTargetEndOffset,Integer.MAX_VALUE); invalidate(); }elseif(vy<0){ //向上触发fling,需要滚动到End位置 mNeedScrollToEndPos=true; mScroller.fling(0,mTargetCurrentOffset,0,vy, 0,0,mTargetEndOffset,Integer.MAX_VALUE); invalidate(); }else{ //没有触发fling,就近原则 if(mTargetCurrentOffset<=(mTargetEndOffset+mTargetInitOffset)/2){ mNeedScrollToEndPos=true; }else{ mNeedScrollToInitPos=true; } invalidate(); } } 当然这里会打上一些标志位,具体实现是在computeScroll中,这属于Scroller的功能,这里就不展开了。 这样大体逻辑就讲述清楚了,其它细节就请看官直接看源码了。 基于NestingScroll机制的实现方案 NestingScroll机制是在某个版本support包加入的,不过外界极少有文章介绍,所以应该大多数人并不知道这个机制。NestingScroll主要有两个接口: NestedScrollingParent NestedScrollingChild 当我们需要使用NestingScroll特性时,我们去实现这两个接口就好了。NestingScroll本质是内部拦截发然后将相应的接口开给外界。因此实现NestedScrollingChild接口是有难度的,不过像RecyclerView这些控件,官方已经帮我们实现好了NestedScrollingChild,要完成我们的需求,我们直接拿来用就好了(ListView就没办法使用了,当然你也可以去实现NestedScrollingChild接口)。并且NestedScrollingChild与NestedScrollingParent只要有嵌套关系就行了,并不一定NestedScrollingChild是直接的子View。 我们来来看看NestedScrollingParent的定义: publicinterfaceNestedScrollingParent{ //是否接受NestingScroll publicbooleanonStartNestedScroll(Viewchild,Viewtarget,intnestedScrollAxes); //接受NestingScroll的Hook钩子 publicvoidonNestedScrollAccepted(Viewchild,Viewtarget,intnestedScrollAxes); //NestingScroll结束 publicvoidonStopNestedScroll(Viewtarget); //NestingScroll进行中。重要参数dxUnconsumed,dyUnconsumed:用于表示没有被消耗的滚动量,一般是列表滚动到头了,就会产生未消耗量 publicvoidonNestedScroll(Viewtarget,intdxConsumed,intdyConsumed,intdxUnconsumed,intdyUnconsumed); //NestingScroll滚动之前。重要参数consumed:是用于告诉子View我消耗了多少。如果位全部消耗dy,那么子view就可以消耗了。 publicvoidonNestedPreScroll(Viewtarget,intdx,intdy,int[]consumed); //fling时 publicbooleanonNestedFling(Viewtarget,floatvelocityX,floatvelocityY,booleanconsumed); //fling之前:可以由父元素消耗这次fling事件 publicbooleanonNestedPreFling(Viewtarget,floatvelocityX,floatvelocityY); //获取滚动轴:x轴或y轴 publicintgetNestedScrollAxes(); } 接口是非常丰富的。有一个很重要的概念:消耗量。 比如我滑动了10dp,那么父元素先看看可以消耗多少(例如4dp),然后会把未消耗量传递给子View(6dp)。这就把嵌套滚动的问题转换为资源分配的问题了。非常机智。除此以外,官方提供了NestedScrollingParentHelper类帮我实现了一些公共方法并做好了低版本兼容,我们应当拿来用。 写在最后 虽然google提供了很多新颖好玩的接口。但这需要花费部分精力去实践这些新技术。这是非常有意义的投入。多看、多写,才能帮助我们用更少的时间写更好的代码。 本文作者:佚名 来源:51CTO

优秀的个人博客,低调大师

玩转SSH端口转发

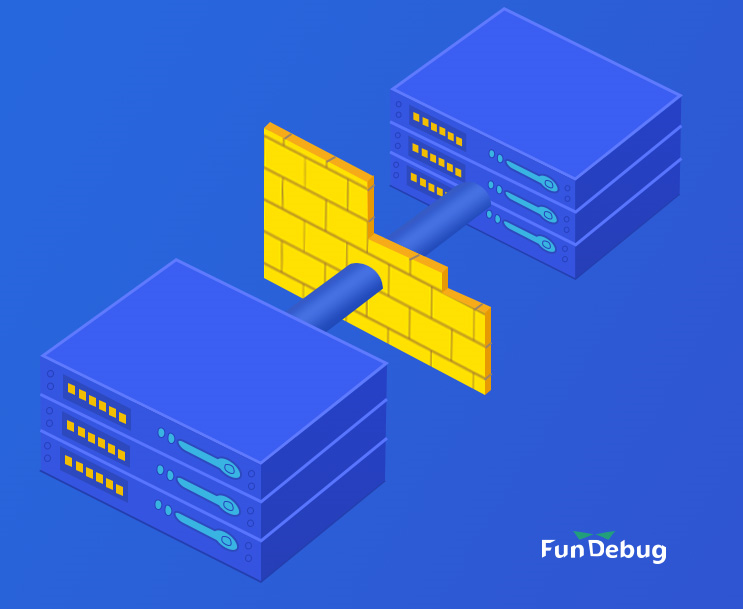
SSH有三种端口转发模式,本地端口转发(Local Port Forwarding),远程端口转发(Local Port Forwarding)以及动态端口转发(Dynamic Port Forwarding)。对于本地/远程端口转发,两者的方向恰好相反。动态端口转发则可以用于科学上网。 SSH端口转发也被称作SSH隧道(SSH Tunnel),因为它们都是通过SSH登陆之后,在SSH客户端与SSH服务端之间建立了一个隧道,从而进行通信。SSH隧道是非常安全的,因为SSH是通过加密传输数据的(SSH全称为Secure Shell)。 在本文所有示例中,本地主机A1为SSH客户端,远程云主机B1为SSH服务端。从A1主机通过SSH登陆B1主机,指定不同的端口转发选项(-L、-R和-D),即可在A1与B1之间建立SSH隧道,从而进行不同的端口转发。 本地端口转发 应用场景: 远程云主机B1运行了一个服务,端口为3000,本地主机A1需要访问这个服务。 示例为一个简单的Node.js服务: var http = require('http'); var server = http.createServer(function(request, response) { response.writeHead(200, { "Content-Type": "text/plain" }); response.end("Hello Fundebug\n"); }); server.listen(3000); 假设云主机B1的IP为103.59.22.17,则该服务的访问地址为:http://103.59.22.17:3000 为啥需要本地端口转发呢? 一般来讲,云主机的防火墙默认只打开了22端口,如果需要访问3000端口的话,需要修改防火墙。为了保证安全,防火墙需要配置允许访问的IP地址。但是,本地公忘IP通常是网络提供商动态分配的,是不断变化的。这样的话,防火墙配置需要经常修改,就会很麻烦。 什么是本地端口转发? 所谓本地端口转发,就是将发送到本地端口的请求,转发到目标端口。这样,就可以通过访问本地端口,来访问目标端口的服务。使用-L属性,就可以指定需要转发的端口,语法是这样的: -L 本地网卡地址:本地端口:目标地址:目标端口 通过本地端口转发,可以将发送到本地主机A1端口2000的请求,转发到远程云主机B1的3000端口。 # 在本地主机A1登陆远程云主机B1,并进行本地端口转发 ssh -L localhost:2000:localhost:3000 root@103.59.22.17 这样,在本地主机A1上可以通过访问http://localhost:2000来访问远程云主机B1上的Node.js服务。 # 在本地主机A1访问远程云主机B1上的Node.js服务 curl http://localhost:2000 Hello Fundebug 实际上,-L选项中的本地网卡地址是可以省略的,这时表示2000端口绑定了本地主机A1的所有网卡: # 在本地主机A1登陆远程云主机B1,并进行本地端口转发。2000端口绑定本地所有网卡 ssh -L 2000:localhost:3000 root@103.59.22.17 若本地主机A2能够访问A1,则A2也可以通过A1访问远程远程云主机B1上的Node.js服务。 另外,-L选项中的目标地址也可以是其他主机的地址。假设远程云主机B2的局域网IP地址为192.168.59.100,则可以这样进行端口转发: # 在本地主机A1登陆远程云主机B1,并进行本地端口转发。请求被转发到远程云主机B2上 ssh -L 2000:192.168.59.100:3000 root@103.59.22.17 若将Node.js服务运行在远程云主机B2上,则发送到A1主机2000端口的请求,都会被转发到B2主机上。 远程端口转发 应用场景:s 本地主机A1运行了一个服务,端口为3000,远程云主机B1需要访问这个服务。 将前文的Node.js服务运行在本地,在本地就可以通过http://localhost:3000访问该服务。 为啥需要远程端口转发呢? 通常,本地主机是没有独立的公网IP的,它与同一网络中的主机共享一个IP。没有公网IP,云主机是无法访问本地主机上的服务的。 什么是远程端口转发? 所谓远程端口转发,就是将发送到远程端口的请求,转发到目标端口。这样,就可以通过访问远程端口,来访问目标端口的服务。使用-R属性,就可以指定需要转发的端口,语法是这样的: -R 远程网卡地址:远程端口:目标地址:目标端口 这时,通过远程端口转发,可以将发送到远程云主机B1端口2000的请求,转发到本地主机A1端口3000。 # 在本地主机A1登陆远程云主机B1,并进行远程端口转发 ssh -R localhost:2000:localhost:3000 root@103.59.22.17 这样,在远程云主机A1可以通过访问http://localhost:2000来访问本地主机的服务。 # 在远程云主机B1访问本地主机A1上的Node.js服务 curl http://localhost:2000 Hello Fundebug 同理,远程网卡地址可以省略,目标地址也可以是其他主机地址。假设本地主机A2的局域网IP地址为192.168.0.100。 # 在本地主机A1登陆远程云主机B1,并进行远程端口转发 ssh -R 2000:192.168.0.100:3000 root@103.59.22.17 若将Node.js服务运行在本地主机A2上,则发送到远程云主机A1端口2000的请求,都会被转发到A2主机上。 动态端口转发 应用场景: 远程云主机B1运行了多个服务,分别使用了不同端口,本地主机A1需要访问这些服务。 为啥需要动态端口转发呢? 一方面,由于防火墙限制,本地主机A1并不能直接访问远程云主机B1上的服务,因此需要进行端口转发;另一方面,为每个端口分别创建本地端口转发非常麻烦。 什么是动态端口转发? 对于本地端口转发和远程端口转发,都存在两个一一对应的端口,分别位于SSH的客户端和服务端,而动态端口转发则只是绑定了一个本地端口,而目标地址:目标端口则是不固定的。目标地址:目标端口是由发起的请求决定的,比如,请求地址为192.168.1.100:3000,则通过SSH转发的请求地址也是192.168.1.100:3000。 -D 本地网卡地址:本地端口 这时,通过动态端口转发,可以将在本地主机A1发起的请求,转发到远程主机B1,而由B1去真正地发起请求。 # 在本地主机A1登陆远程云主机B1,并进行动态端口转发 ssh -D localhost:2000 root@103.59.22.17 而在本地发起的请求,需要由Socket代理(Socket Proxy)转发到SSH绑定的2000端口。以Firefox浏览器为例,配置Socket代理需要找到首选项>高级>网络>连接->设置: 这样的话,Firefox浏览器发起的请求都会转发到2000端口,然后通过SSH转发到真正地请求地址。若Node.js服务运行在远程云主机B1上,则在Firefox中访问localhost:3000即可以访问。如果主机B1能够访问外网的话,则可以科学上网…... 链式端口转发 本地端口转发与远程端口转发结合起来使用,可以进行链式转发。假设A主机在公司,B主机在家,C主机为远程云主机。A主机上运行了前文的Node.js服务,需要在B主机上访问该服务。由于A和B不在同一个网络,且A主机没有独立公共IP地址,所以无法直接访问服务。 通过本地端口转发,将发送到B主机3000端口的请求,转发到远程云主机C的2000端口。 # 在B主机登陆远程云主机C,并进行本地端口转发 ssh -L localhost:3000:localhost:2000 root@103.59.22.17 通过远程端口转发,将发送到远程云主机C端口2000的请求,转发到A主机的3000端口。 # 在A主机登陆远程云主机C,并进行远程端口转发 ssh -R localhost:2000:localhost:3000 root@103.59.22.17 这样,在主机B可以通过访问http://localhost:3000来访问主机A上的服务。 # 在主机B访问主机A上的服务 curl http://localhost:3000 Hello Fundebug 参考链接 SSH PortForwarding SSH隧道的原理和实现 关于Fundebug Fundebug专注于JavaScript、微信小程序、微信小游戏、支付宝小程序、React Native、Node.js和Java实时BUG监控。 自从2016年双十一正式上线,Fundebug累计处理了6亿+错误事件,得到了Google、360、金山软件等众多知名用户的认可。欢迎免费试用! 版权声明: 转载时请注明作者Fundebug以及本文地址:https://blog.fundebug.com/2017/04/24/ssh-port-forwarding/

优秀的个人博客,低调大师

玩转Arduino之开篇

之前大学时候有玩过最基本的51单片机,还记得用C语言初学者的水平,颤抖着看着键盘敲打着 "# include<stdio.h>",可能有时候还无法拼写正确include这个单词,仅仅靠着编译器的高亮才找到正确的写法。记得开始学着用Keil IDE开发套件编写一些main()函数,纯粹的面向过程的拿来主义思想,大学的生活总是这样惬意,就像单片机代码一样单纯,都没有使用复杂的指针和递归算法,总是顺利的从头开始执行到尾,最多加上个while(1)循环,连最后的return都依赖编译器给我完成了。到了大学后期,感觉对着双列直插式的芯片,写些无聊的processing。。。感觉生活需要些速度和激情,于是将51单片机架上智能小车的外壳,似乎让我有了兴趣,于是一发不可收!从简单的循迹小车,到开始运用烧复杂传感器的避障智能车,再到了研究生时期做的视频和无线互联智能小车,以后后来做的车车互联通讯的图像识别智能车。小车的造价和运用的处理单元也越来越豪华,从8位8K内存的51单片机到可以运行操作系统的ARM11处理器,从简单的手工焊接的51单片机最小系统,到Friendly ARM6410开发板,一起越来越牛逼的传感器。小车一直伴随着我离开校园步入职场,所有的实习经历和目前的工作,感觉都没有离开嵌入式开发这个主线。每次我都提醒自己,不要被“嵌入式”这个流行词给欺骗了,因为我只是个寄存器程序员,即对着各种SPEC,然后板着指头省内存空间的码农,还不是高级互联网码农。互联网码农们早已经开始用面向对象的思维看待世间万物,而我们还是刀耕火种的时代,所有的努力只是让神秘的上层不要吐槽低层的“慢”!这几天,我在无意间,看到了Arduino这玩意,其实和51单片机差不多,只是浪漫的意大利人给这个Atmega328P-PU单片机开发板取了个貌似浪漫的名字。Arduino可以看做是一套很成熟的开发套件,包括开发板在内的其他外围设备,而且最吸引人的是它有一套带UI的开发软件IDE,这个软件将枯燥的C语言进行了封装,并且隐藏了复杂的编译过程,让开发自己的程序变得乐趣无穷!这也是我在苦逼的工作之余自娱自乐的不二选择。目前,Arduino的开发环境已经搭建完毕,开发套件花费了158¥备齐,好了,废话不说了,后续开始玩起来吧~!

优秀的个人博客,低调大师

玩转 Go 链路追踪

前言 链路追踪是每个微服务架构下必备的利器,go-zero 当然早已经为我们考虑好了,只需要在配置中添加配置即可使用。 关于 go-zero 如何追踪的原理追溯,之前已经有同学分享,这里我就不再多说,如果有想了解的同学去 https://mp.weixin.qq.com/s/hJEWcWc3PnGfWfbPCHfM9g 这个链接看就好了。默认会在 api 的中间件与 rpc 的 interceptor 添加追踪,如果有不了解 go-zero 默认如何使用默认的链路追踪的,请移步我的开源项目 go-zero-looklook 文档 https://github.com/Mikaelemmmm/go-zero-looklook/blob/main/doc/chinese/12-%E9%93%BE%E8%B7%AF%E8%BF%BD%E8%B8%AA.md。 今天我想讲的是,除了 go-zero 默认在 api 的 middleware 与 rpc 的 interceptor 中帮我们集成好的链路追踪,我们想自己在某些本地方法添加链路追踪代码或者我们想在 api 发送一个消息给 mq 服务时候想把整个链路包含 mq 的 producer、consumer 穿起来,在 go-zero 中该如何做。 场景 我们先简单讲一下我们的小 demo 的场景,一个请求进来调用 api 的 Login 方法,在 Login 方法中先调用 rpc 的 GetUserByMobile 方法,之后在调用 api 本地的 local 方法,紧接着调用 rabbitmq 传递消息到 mq 服务。 go-zero 默认集成了 jaeger、zinpink,这里我们就以 jaeger 为例 我们希望看到的链路是 rpc.GetUserByMobile" data-original="https://img-blog.csdnimg.cn/910d8fbfd04b4c6196b3e38479c1679b.png"> 也就是 api 衍生出来三条子链路,api.producerMq 有一条调用 mq.Consumer 的子链路。 我们想要将一个方法添加到链路中需要两个因素,一个 traceId,一个span,当我们在同一个 traceId 下开启 span 把相关的 span 都串联起来,如果想形成父子关系,就要把 span 之间相互串联起来,因为「微服务实践」公众号中讲解原理太多,我这里就简单提一下不涉及过多,如果不是特别熟悉原理可以看文章开头推荐的文章,这里我们只需要知道 traceId 与 spanId 关系就好。 核心业务代码 1、首先 API 中 LoginLogic 代码 type LoginLogic struct { logx.Logger ctx context.Context svcCtx *svc.ServiceContext } func NewLoginLogic(ctx context.Context, svcCtx *svc.ServiceContext) *LoginLogic { return &amp;LoginLogic{ Logger: logx.WithContext(ctx), ctx: ctx, svcCtx: svcCtx, } } type MsgBody struct { Carrier *propagation.HeaderCarrier Msg string } func (l *LoginLogic) Login(req *types.RegisterReq) (*types.AccessTokenResp, error) { resp, err := l.svcCtx.UserRpc.GetUserByMobile(l.ctx, &amp;usercenter.GetUserByMobileReq{ Mobile: req.Mobile, }) if err != nil { return &amp;types.AccessTokenResp{}, nil } l.local() tracer := otel.GetTracerProvider().Tracer(trace.TraceName) spanCtx, span := tracer.Start(l.ctx, "send_msg_mq", oteltrace.WithSpanKind(oteltrace.SpanKindProducer)) carrier := &amp;propagation.HeaderCarrier{} otel.GetTextMapPropagator().Inject(spanCtx, carrier) producer := rabbit.NewRabbitmqPublisher(RabbitmqDNS) msg := &amp;MsgBody{ Carrier: carrier, Msg: req.Mobile, } b, err := json.Marshal(msg) if err != nil{ panic(err) } if err := producer.Publish(spanCtx, ExchangeName, RoutineKeys, b); err != nil { logx.Errorf("Publish Fail , msg :%s , err:%v", msg, err) } span.End() return &amp;types.AccessTokenResp{ AccessExpire: resp.User.Id, }, err } func (l *LoginLogic) local() { tracer := otel.GetTracerProvider().Tracer(trace.TraceName) _ , span := tracer.Start(l.ctx, "local", oteltrace.WithSpanKind(oteltrace.SpanKindInternal)) defer span.End() // 执行你的代码 ..... } 2、rpc 中 GetUserByMobile 的代码 func (s *Logic) GetUserByMobile(context.Context, *usercenterPb.GetUserByMobileReq) (*usercenterPb.GetUserByMobileResp, error) { vo := &amp;usercenterPb.UserVo{ Id: 1, } return &amp;usercenterPb.GetUserByMobileResp{ User: vo, }, nil } 3、mq 中 Consumer 的代码 type MsgBody struct { Carrier *propagation.HeaderCarrier Msg string } func (c *consumer) Consumer(ctx context.Context, data []byte) error { var msg MsgBody if err := json.Unmarshal(data, &amp;msg); err != nil { logx.Errorf(" consumer err : %v", err) } else { logx.Infof("consumerOne Consumer , msg:%+v", msg) wireContext := otel.GetTextMapPropagator().Extract(ctx, msg.Carrier) tracer := otel.GetTracerProvider().Tracer(trace.TraceName) _, span := tracer.Start(wireContext, "mq_consumer_msg", oteltrace.WithSpanKind(oteltrace.SpanKindConsumer)) defer span.End() } return nil } 代码详解 1、go-zero 默认集成 当一个请求进入 api 后,我们可以在 go-zero 源码中查看到 https://github.com/zeromicro/go-zero/blob/master/rest/engine.go#L92。go-zero 已经在 api 的 middleware 中帮我们添加了第一层 trace,当进入 Login 方法内,我们调用了 rpc 的 GetUserByMobile 方法,通过 go-zero 的源码 https://github.com/zeromicro/go-zero/blob/master/zrpc/internal/rpcserver.go#L55 可以看到在 rpc 的 interceptor 也默认帮我们添加好了,这两层都是 go-zero 默认帮我们做好的。 2、本地方法 当调用完 rpc 的 GetUserByMobile 之后,api 调用了本地的 local,如果我们想在整个链路上体现出来调用了本地 local 方法,那默认的 go-zero 是没有帮我们做的,需要我们手动来添加。 tracer := otel.GetTracerProvider().Tracer(trace.TraceName) _ , span := tracer.Start(l.ctx, "local", oteltrace.WithSpanKind(oteltrace.SpanKindInternal)) defer span.End() // 执行你的代码 ..... 我们通过上面代码拿到 tracer,ctx 之后开启一个 local 的 span,因为 start 时候会从 ctx 获取父 span 所以会将 local 方法与 Login 串联起父子调用关系,这样就将本次操作加入了这个链路 3、mq 的 producer 到 mq 的 consumer 我们在mq传递中如何串联起来这个链路呢?也就是形成 api.Login-&gt;api.producer-&gt;mq.Consumer。 想一下原理,虽然跨越了网络,api 可以通过 header 传递,rpc 可以通过 metadata 传递,那么 mq 是不是也可以通过 header、body 传递就可以了,按照这个想法来看下我门的代码。 tracer := otel.GetTracerProvider().Tracer(trace.TraceName) spanCtx , span := tracer.Start(l.ctx, "send_msg_mq", oteltrace.WithSpanKind(oteltrace.SpanKindProducer)) carrier := &amp;propagation.HeaderCarrier{} otel.GetTextMapPropagator().Inject(spanCtx,carrier) producer := rabbit.NewRabbitmqPublisher(RabbitmqDNS) msg := &amp;MsgBody{ Carrier: carrier, Msg: req.Mobile, } b , err := json.Marshal(msg) if err != nil{ panic(err) } if err := producer.Publish(spanCtx, ExchangeName, RoutineKeys, b); err != nil { logx.Errorf("Publish Fail, msg :%s, err:%v", msg, err) } span.End() 首先获取到了这个全局的 tracer,然后开启一个 producer 的 span,跟 local 方法一样,我们开启 producer 的 span 时候也是通过 ctx 获取到上一级父级 span,这样就可以将 producer 的 span 与 Login 形成父子 span 调用关系,那我们想将 producer 的 span 与 mq 的 consumer 中的 span 形成调用父子关系怎么做?我们将 api.producer 的 spanCtx 注入到 carrier 中,这里我们通过 mq 的 body 将 carrier 发送给 consumer,发送完成我们 stop 我们的 producer,那么 producer 的这层链路完成了。 随后我们来看 mq-consumer 在接收到 body 消息之后怎么做的。 type MsgBody struct { Carrier *propagation.HeaderCarrier Msg string } func (c *consumer) Consumer(ctx context.Context, data []byte) error { var msg MsgBody if err := json.Unmarshal(data, &amp;msg); err != nil { logx.Errorf(" consumer err : %v", err) } else { logx.Infof("consumerOne Consumer , msg:%+v", msg) wireContext := otel.GetTextMapPropagator().Extract(ctx, msg.Carrier) tracer := otel.GetTracerProvider().Tracer(trace.TraceName) _, span := tracer.Start(wireContext, "mq_consumer_msg", oteltrace.WithSpanKind(oteltrace.SpanKindConsumer)) defer span.End() } return nil } consumer 接收到消息后反序列化出来 Carrier *propagation.HeaderCarrier,然后通过 otel.GetTextMapPropagator().Extract 取出来 api.producer 注入的 wireContext,在通过 tracer.Start、wireContext 创建 consumer 的 span,这样 consumer 就是 api.producer 的子 span,就形成了调用链路关系,最终我们得到的关系就是 rpc.GetUserByMobile" data-original="https://img-blog.csdnimg.cn/910d8fbfd04b4c6196b3e38479c1679b.png"> 让我们来调用一下 Logic 方法,看下 jaeger 中的链路如果与我们预想的链路一致,so happy~ 项目地址 go-zero 微服务框架:https://github.com/zeromicro/go-zero https://gitee.com/kevwan/go-zero go-zero 微服务最佳实践项目:https://github.com/Mikaelemmmm/go-zero-looklook 欢迎使用 go-zero 并 star 支持我们! 微信交流群 关注『微服务实践』公众号并点击 交流群 获取社区群二维码。

优秀的个人博客,低调大师

管家助力,轻松玩转MaxCompute

精彩视频回顾请点击:MaxCompute管家详解以下是直播内容精华整理,主要包括以下四个方面:1.背景速览;2.功能介绍;3.案例讲解;4.新功能预告。 一、背景速览 MaxCompute(原ODPS)是一项大数据计算服务,它能提供快速、完全托管的PB级数据仓库解决方案,使用户可以经济并高效的分析处理海量数据。在购买了MaxCompute之后会有相当多而繁琐的管理和维护工作,比如如何对项目进行更精细化的管理、如何将项目与配额进行关联等等,而MaxCompute管家可以帮助用户更好地完成这些工作,它是一个为用户提供作业信息查看、资源消耗查看(涵盖CU资源和存储资源)、项目查看及调整、配额组增删改查等涉及日常MaxCompute运维能力的管理平台。目前,全球包括美国、英国、德国、印度、日本、新加坡在内的18个国家或地区(详情见官网)购买

优秀的个人博客,低调大师

怎么玩转Java线程池?

一:简介 线程的使用在java中占有极其重要的地位,在jdk1.4极其之前的jdk版本中,关于线程池的使用是极其简陋的。在jdk1.5之后这一情况有了很大的改观。Jdk1.5之后加入了java.util.concurrent包,这个包中主要介绍java中线程以及线程池的使用。为我们在开发中处理线程的问题提供了非常大的帮助。 二:线程池 线程池的作用: 线程池作用就是限制系统中执行线程的数量。 根据系统的环境情况,可以自动或手动设置线程数量,达到运行的最佳效果;少了浪费了系统资源,多了造成系统拥挤效率不高。用线程池控制线程数量,其他线程排队等候。一个任务执行完毕,再从队列的中取最前面的任务开始执行。若队列中没有等待进程,线程池的这一资源处于等待。当一个新任务需要运行时,如果线程池中有等待的工作线程,就可以开始运行了;否则进入等待队列。 为什么要用线程池: 1.减少了创建和销毁线程的次数,每个工作线程都可以被重复利用,可执行多个任务。 2.可以根据系统的承受能力,调整线程池中工作线线程的数目,防止因为消耗过多的内存,而把服务器累趴下(每个线程需要大约1MB内存,线程开的越多,消耗的内存也就越大,最后死机)。 Java里面线程池的顶级接口是Executor,但是严格意义上讲Executor并不是一个线程池,而只是一个执行线程的工具。真正的线程池接口是ExecutorService。 比较重要的几个类: ExecutorService 真正的线程池接口。 ScheduledExecutorService 能和Timer/TimerTask类似,解决那些需要任务重复执行的问题。 ThreadPoolExecutor ExecutorService的默认实现。 ScheduledThreadPoolExecutor 继承ThreadPoolExecutor的ScheduledExecutorService接口实现,周期性任务调度的类实现。 要配置一个线程池是比较复杂的,尤其是对于线程池的原理不是很清楚的情况下,很有可能配置的线程池不是较优的,因此在Executors类里面提供了一些静态工厂,生成一些常用的线程池。 newSingleThreadExecutor 创建一个单线程的线程池。这个线程池只有一个线程在工作,也就是相当于单线程串行执行所有任务。如果这个唯一的线程因为异常结束,那么会有一个新的线程来替代它。此线程池保证所有任务的执行顺序按照任务的提交顺序执行。 2.newFixedThreadPool 创建固定大小的线程池。每次提交一个任务就创建一个线程,直到线程达到线程池的最大大小。线程池的大小一旦达到最大值就会保持不变,如果某个线程因为执行异常而结束,那么线程池会补充一个新线程。 newCachedThreadPool 创建一个可缓存的线程池。如果线程池的大小超过了处理任务所需要的线程, 那么就会回收部分空闲(60秒不执行任务)的线程,当任务数增加时,此线程池又可以智能的添加新线程来处理任务。此线程池不会对线程池大小做限制,线程池大小完全依赖于操作系统(或者说JVM)能够创建的最大线程大小。 4.newScheduledThreadPool 创建一个大小无限的线程池。此线程池支持定时以及周期性执行任务的需求。 实例 1:newSingleThreadExecutor MyThread.java publicclassMyThread extends Thread { @Override publicvoid run() { System.out.println(Thread.currentThread().getName() + "正在执行。。。"); } } TestSingleThreadExecutor.java publicclassTestSingleThreadExecutor { publicstaticvoid main(String[] args) { //创建一个可重用固定线程数的线程池 ExecutorService pool = Executors. newSingleThreadExecutor(); //创建实现了Runnable接口对象,Thread对象当然也实现了Runnable接口 Thread t1 = new MyThread(); Thread t2 = new MyThread(); Thread t3 = new MyThread(); Thread t4 = new MyThread(); Thread t5 = new MyThread(); //将线程放入池中进行执行 pool.execute(t1); pool.execute(t2); pool.execute(t3); pool.execute(t4); pool.execute(t5); //关闭线程池 pool.shutdown(); } } 输出结果 pool-1-thread-1正在执行。。。 pool-1-thread-1正在执行。。。 pool-1-thread-1正在执行。。。 pool-1-thread-1正在执行。。。 pool-1-thread-1正在执行。。。 2newFixedThreadPool TestFixedThreadPool.Java publicclass TestFixedThreadPool { publicstaticvoid main(String[] args) { //创建一个可重用固定线程数的线程池 ExecutorService pool = Executors.newFixedThreadPool(2); //创建实现了Runnable接口对象,Thread对象当然也实现了Runnable接口 Thread t1 = new MyThread(); Thread t2 = new MyThread(); Thread t3 = new MyThread(); Thread t4 = new MyThread(); Thread t5 = new MyThread(); //将线程放入池中进行执行 pool.execute(t1); pool.execute(t2); pool.execute(t3); pool.execute(t4); pool.execute(t5); //关闭线程池 pool.shutdown(); } } 输出结果 pool-1-thread-1正在执行。。。 pool-1-thread-2正在执行。。。 pool-1-thread-1正在执行。。。 pool-1-thread-2正在执行。。。 pool-1-thread-1正在执行。。。 3 newCachedThreadPool TestCachedThreadPool.java publicclass TestCachedThreadPool { publicstaticvoid main(String[] args) { //创建一个可重用固定线程数的线程池 ExecutorService pool = Executors.newCachedThreadPool(); //创建实现了Runnable接口对象,Thread对象当然也实现了Runnable接口 Thread t1 = new MyThread(); Thread t2 = new MyThread(); Thread t3 = new MyThread(); Thread t4 = new MyThread(); Thread t5 = new MyThread(); //将线程放入池中进行执行 pool.execute(t1); pool.execute(t2); pool.execute(t3); pool.execute(t4); pool.execute(t5); //关闭线程池 pool.shutdown(); } } 输出结果: pool-1-thread-2正在执行。。。 pool-1-thread-4正在执行。。。 pool-1-thread-3正在执行。。。 pool-1-thread-1正在执行。。。 pool-1-thread-5正在执行。。。 4newScheduledThreadPool TestScheduledThreadPoolExecutor.java publicclass TestScheduledThreadPoolExecutor { publicstaticvoid main(String[] args) { ScheduledThreadPoolExecutor exec = new ScheduledThreadPoolExecutor(1); exec.scheduleAtFixedRate(new Runnable() {//每隔一段时间就触发异常 @Override publicvoid run() { //throw new RuntimeException(); System.out.println("================"); } }, 1000, 5000, TimeUnit.MILLISECONDS); exec.scheduleAtFixedRate(new Runnable() {//每隔一段时间打印系统时间,证明两者是互不影响的 @Override publicvoid run() { System.out.println(System.nanoTime()); } }, 1000, 2000, TimeUnit.MILLISECONDS); } } 输出结果 8384644549516 8386643829034 8388643830710 8390643851383 8392643879319 8400643939383 三:ThreadPoolExecutor详解 ThreadPoolExecutor的完整构造方法的签名是:ThreadPoolExecutor(int corePoolSize, int maximumPoolSize, long keepAliveTime, TimeUnit unit, BlockingQueue workQueue, ThreadFactory threadFactory, RejectedExecutionHandler handler) . corePoolSize - 池中所保存的线程数,包括空闲线程。 maximumPoolSize-池中允许的最大线程数。 keepAliveTime - 当线程数大于核心时,此为终止前多余的空闲线程等待新任务的最长时间。 unit - keepAliveTime 参数的时间单位。 workQueue - 执行前用于保持任务的队列。此队列仅保持由 execute方法提交的 Runnable任务。 threadFactory - 执行程序创建新线程时使用的工厂。 handler - 由于超出线程范围和队列容量而使执行被阻塞时所使用的处理程序。 ThreadPoolExecutor是Executors类的底层实现。 在JDK帮助文档中,有如此一段话: “强烈建议程序员使用较为方便的Executors工厂方法Executors.newCachedThreadPool()(无界线程池,可以进行自动线程回收)、Executors.newFixedThreadPool(int)(固定大小线程池)Executors.newSingleThreadExecutor()(单个后台线程) 它们均为大多数使用场景预定义了设置。” 下面介绍一下几个类的源码: ExecutorService newFixedThreadPool (int nThreads):固定大小线程池。 可以看到,corePoolSize和maximumPoolSize的大小是一样的(实际上,后面会介绍,如果使用无界queue的话maximumPoolSize参数是没有意义的),keepAliveTime和unit的设值表名什么?-就是该实现不想keep alive!最后的BlockingQueue选择了LinkedBlockingQueue,该queue有一个特点,他是无界的。 public static ExecutorService newFixedThreadPool(int nThreads) { return new ThreadPoolExecutor(nThreads, nThreads, 0L, TimeUnit.MILLISECONDS, new LinkedBlockingQueue<Runnable>()); } ExecutorService newSingleThreadExecutor():单线程 public static ExecutorService newSingleThreadExecutor() { return new FinalizableDelegatedExecutorService (new ThreadPoolExecutor(1, 1, 0L, TimeUnit.MILLISECONDS, new LinkedBlockingQueue<Runnable>())); } ExecutorService newCachedThreadPool():无界线程池,可以进行自动线程回收 这个实现就有意思了。首先是无界的线程池,所以我们可以发现maximumPoolSize为big big。其次BlockingQueue的选择上使用SynchronousQueue。可能对于该BlockingQueue有些陌生,简单说:该QUEUE中,每个插入操作必须等待另一个线程的对应移除操作。 public static ExecutorService newCachedThreadPool() { return new ThreadPoolExecutor(0, Integer.MAX_VALUE, 60L, TimeUnit.SECONDS, new SynchronousQueue<Runnable>()); } 先从BlockingQueue workQueue这个入参开始说起。在JDK中,其实已经说得很清楚了,一共有三种类型的queue。 所有BlockingQueue 都可用于传输和保持提交的任务。可以使用此队列与池大小进行交互: 如果运行的线程少于 corePoolSize,则 Executor始终首选添加新的线程,而不进行排队。(如果当前运行的线程小于corePoolSize,则任务根本不会存放,添加到queue中,而是直接抄家伙(thread)开始运行) 如果运行的线程等于或多于 corePoolSize,则 Executor始终首选将请求加入队列,而不添加新的线程。 如果无法将请求加入队列,则创建新的线程,除非创建此线程超出 maximumPoolSize,在这种情况下,任务将被拒绝。 queue上的三种类型。 排队有三种通用策略: 直接提交。工作队列的默认选项是 SynchronousQueue,它将任务直接提交给线程而不保持它们。在此,如果不存在可用于立即运行任务的线程,则试图把任务加入队列将失败,因此会构造一个新的线程。此策略可以避免在处理可能具有内部依赖性的请求集时出现锁。直接提交通常要求无界 maximumPoolSizes 以避免拒绝新提交的任务。当命令以超过队列所能处理的平均数连续到达时,此策略允许无界线程具有增长的可能性。 无界队列。使用无界队列(例如,不具有预定义容量的 LinkedBlockingQueue)将导致在所有corePoolSize 线程都忙时新任务在队列中等待。这样,创建的线程就不会超过 corePoolSize。(因此,maximumPoolSize的值也就无效了。)当每个任务完全独立于其他任务,即任务执行互不影响时,适合于使用无界队列;例如,在 Web页服务器中。这种排队可用于处理瞬态突发请求,当命令以超过队列所能处理的平均数连续到达时,此策略允许无界线程具有增长的可能性。 有界队列。当使用有限的 maximumPoolSizes时,有界队列(如 ArrayBlockingQueue)有助于防止资源耗尽,但是可能较难调整和控制。队列大小和最大池大小可能需要相互折衷:使用大型队列和小型池可以最大限度地降低 CPU 使用率、操作系统资源和上下文切换开销,但是可能导致人工降低吞吐量。如果任务频繁阻塞(例如,如果它们是 I/O边界),则系统可能为超过您许可的更多线程安排时间。使用小型队列通常要求较大的池大小,CPU使用率较高,但是可能遇到不可接受的调度开销,这样也会降低吞吐量。 BlockingQueue的选择。 例子一:使用直接提交策略,也即SynchronousQueue。 首先SynchronousQueue是无界的,也就是说他存数任务的能力是没有限制的,但是由于该Queue本身的特性,在某次添加元素后必须等待其他线程取走后才能继续添加。在这里不是核心线程便是新创建的线程,但是我们试想一样下,下面的场景。 我们使用一下参数构造ThreadPoolExecutor: new ThreadPoolExecutor( 2, 3, 30, TimeUnit.SECONDS, new SynchronousQueue<Runnable>(), new RecorderThreadFactory("CookieRecorderPool"), new ThreadPoolExecutor.CallerRunsPolicy()); new ThreadPoolExecutor( 2, 3, 30, TimeUnit.SECONDS, new SynchronousQueue(), new RecorderThreadFactory("CookieRecorderPool"), new ThreadPoolExecutor.CallerRunsPolicy()); 当核心线程已经有2个正在运行. 此时继续来了一个任务(A),根据前面介绍的“如果运行的线程等于或多于 corePoolSize,则Executor始终首选将请求加入队列,而不添加新的线程。”,所以A被添加到queue中。 又来了一个任务(B),且核心2个线程还没有忙完,OK,接下来首先尝试1中描述,但是由于使用的SynchronousQueue,所以一定无法加入进去。 此时便满足了上面提到的“如果无法将请求加入队列,则创建新的线程,除非创建此线程超出maximumPoolSize,在这种情况下,任务将被拒绝。”,所以必然会新建一个线程来运行这个任务。 暂时还可以,但是如果这三个任务都还没完成,连续来了两个任务,第一个添加入queue中,后一个呢?queue中无法插入,而线程数达到了maximumPoolSize,所以只好执行异常策略了。 所以在使用SynchronousQueue通常要求maximumPoolSize是无界的,这样就可以避免上述情况发生(如果希望限制就直接使用有界队列)。对于使用SynchronousQueue的作用jdk中写的很清楚:此策略可以避免在处理可能具有内部依赖性的请求集时出现锁。 什么意思?如果你的任务A1,A2有内部关联,A1需要先运行,那么先提交A1,再提交A2,当使用SynchronousQueue我们可以保证,A1必定先被执行,在A1么有被执行前,A2不可能添加入queue中。 例子二:使用无界队列策略,即LinkedBlockingQueue 这个就拿newFixedThreadPool来说,根据前文提到的规则: 如果运行的线程少于 corePoolSize,则 Executor 始终首选添加新的线程,而不进行排队。那么当任务继续增加,会发生什么呢? 如果运行的线程等于或多于 corePoolSize,则 Executor 始终首选将请求加入队列,而不添加新的线程。OK,此时任务变加入队列之中了,那什么时候才会添加新线程呢? 如果无法将请求加入队列,则创建新的线程,除非创建此线程超出 maximumPoolSize,在这种情况下,任务将被拒绝。这里就很有意思了,可能会出现无法加入队列吗?不像SynchronousQueue那样有其自身的特点,对于无界队列来说,总是可以加入的(资源耗尽,当然另当别论)。换句说,永远也不会触发产生新的线程!corePoolSize大小的线程数会一直运行,忙完当前的,就从队列中拿任务开始运行。所以要防止任务疯长,比如任务运行的实行比较长,而添加任务的速度远远超过处理任务的时间,而且还不断增加,不一会儿就爆了。 例子三:有界队列,使用ArrayBlockingQueue。 这个是最为复杂的使用,所以JDK不推荐使用也有些道理。与上面的相比,最大的特点便是可以防止资源耗尽的情况发生。 举例来说,请看如下构造方法: new ThreadPoolExecutor( 2, 4, 30, TimeUnit.SECONDS, new ArrayBlockingQueue<Runnable>(2), new RecorderThreadFactory("CookieRecorderPool"), new ThreadPoolExecutor.CallerRunsPolicy()); new ThreadPoolExecutor( 2, 4, 30, TimeUnit.SECONDS, new ArrayBlockingQueue<Runnable>(2), new RecorderThreadFactory("CookieRecorderPool"), new ThreadPoolExecutor.CallerRunsPolicy()); 假设,所有的任务都永远无法执行完。 对于首先来的A,B来说直接运行,接下来,如果来了C,D,他们会被放到queue中,如果接下来再来E,F,则增加线程运行E,F。但是如果再来任务,队列无法再接受了,线程数也到达最大的限制了,所以就会使用拒绝策略来处理。 keepAliveTime jdk中的解释是:当线程数大于核心时,此为终止前多余的空闲线程等待新任务的最长时间。 有点拗口,其实这个不难理解,在使用了“池”的应用中,大多都有类似的参数需要配置。比如数据库连接池,DBCP中的maxIdle,minIdle参数。 什么意思?接着上面的解释,后来向老板派来的工人始终是“借来的”,俗话说“有借就有还”,但这里的问题就是什么时候还了,如果借来的工人刚完成一个任务就还回去,后来发现任务还有,那岂不是又要去借?这一来一往,老板肯定头也大死了。 合理的策略:既然借了,那就多借一会儿。直到“某一段”时间后,发现再也用不到这些工人时,便可以还回去了。这里的某一段时间便是keepAliveTime的含义,TimeUnit为keepAliveTime值的度量。 RejectedExecutionHandler 另一种情况便是,即使向老板借了工人,但是任务还是继续过来,还是忙不过来,这时整个队伍只好拒绝接受了。 RejectedExecutionHandler接口提供了对于拒绝任务的处理的自定方法的机会。在ThreadPoolExecutor中已经默认包含了4中策略,因为源码非常简单,这里直接贴出来。 CallerRunsPolicy:线程调用运行该任务的 execute 本身。此策略提供简单的反馈控制机制,能够减缓新任务的提交速度。 public void rejectedExecution(Runnable r, ThreadPoolExecutor e) { if (!e.isShutdown()) { r.run(); } } public void rejectedExecution(Runnable r, ThreadPoolExecutor e) { if (!e.isShutdown()) { r.run(); } } 这个策略显然不想放弃执行任务。但是由于池中已经没有任何资源了,那么就直接使用调用该execute的线程本身来执行。 AbortPolicy:处理程序遭到拒绝将抛出运行时RejectedExecutionException public void rejectedExecution(Runnable r, ThreadPoolExecutor e) { throw new RejectedExecutionException(); } public void rejectedExecution(Runnable r, ThreadPoolExecutor e) { throw new RejectedExecutionException(); } 这种策略直接抛出异常,丢弃任务。 DiscardPolicy:不能执行的任务将被删除 public void rejectedExecution(Runnable r, ThreadPoolExecutor e) { } public void rejectedExecution(Runnable r, ThreadPoolExecutor e) { } 这种策略和AbortPolicy几乎一样,也是丢弃任务,只不过他不抛出异常。 DiscardOldestPolicy:如果执行程序尚未关闭,则位于工作队列头部的任务将被删除,然后重试执行程序(如果再次失败,则重复此过程) public void rejectedExecution(Runnable r, ThreadPoolExecutor e) { if (!e.isShutdown()) { e.getQueue().poll(); e.execute(r); } } public void rejectedExecution(Runnable r, ThreadPoolExecutor e) { if (!e.isShutdown()) { e.getQueue().poll(); e.execute(r); } } 该策略就稍微复杂一些,在pool没有关闭的前提下首先丢掉缓存在队列中的最早的任务,然后重新尝试运行该任务。这个策略需要适当小心。 设想:如果其他线程都还在运行,那么新来任务踢掉旧任务,缓存在queue中,再来一个任务又会踢掉queue中最老任务。 总结: keepAliveTime和maximumPoolSize及BlockingQueue的类型均有关系。如果BlockingQueue是无界的,那么永远不会触发maximumPoolSize,自然keepAliveTime也就没有了意义。 反之,如果核心数较小,有界BlockingQueue数值又较小,同时keepAliveTime又设的很小,如果任务频繁,那么系统就会频繁的申请回收线程。 public static ExecutorService newFixedThreadPool(int nThreads) { return new ThreadPoolExecutor(nThreads, nThreads, 0L, TimeUnit.MILLISECONDS, new LinkedBlockingQueue<Runnable>()); } 文章来源 https://yq.aliyun.com/articles/94989?utm_campaign=wenzhang&utm_medium=article&utm_source=QQ-qun&2017622&utm_content=m_23936

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

用户登录
用户注册