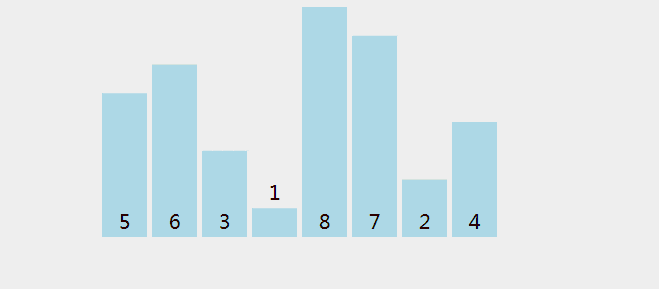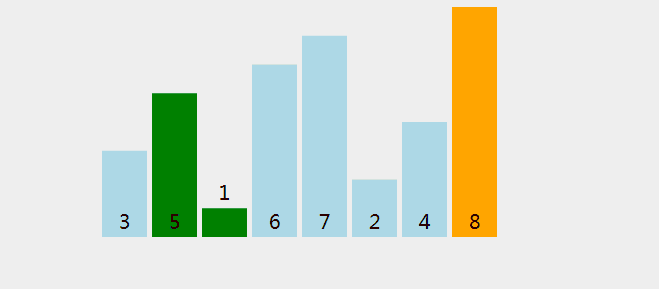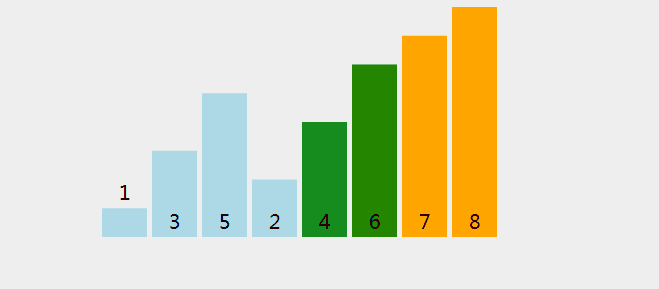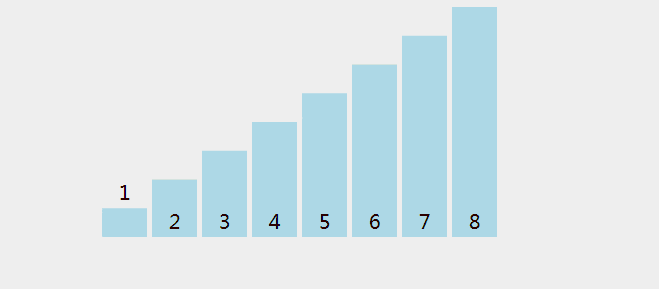首页 文章 精选 留言 我的

精选列表

搜索[玩转EdgeOne],共1751篇文章
优秀的个人博客,低调大师

iOS 开发之玩转专场动画

有空了再造个轮子,先放个链接 WWDC 2013 Session笔记 - iOS7中的ViewController切换 几句代码快速集成自定义转场效果+ 全手势驱动 TransitionAnimation 学习笔记 iOS --- 一张图看懂转场动画 iOS自定义转场动画实战讲解 iOS自定义转场动画实战讲解 iOS 视图控制器转场详解 iOS 视图控制器转场详解 iOS 转场动画探究(一) iOS 转场动画探究(二) iOS 转场动画详解 iOS自定义转场动画

优秀的个人博客,低调大师

玩转Kafka的生产者

上篇文章学习kafka的基本安装和基础概念,本文主要是学习kafka的常用API。其中包括生产者和消费者, 多线程生产者,多线程消费者,自定义分区等,当然还包括一些避坑指南。 准备工作 kafka版本:2.11-1.1.1 操作系统:centos7 java:jdk1.8 有了以上这些条件就OK了,具体怎么安装和启动Kafka这里就不强调了,可以看上一篇文章。 新建一个maven工程,需要的依赖如下: <dependency><groupId>org.apache.kafka</groupId><artifactId>kafka_2.11</artifactId><version>1.1.1</version></dependency><dependency><groupId>org.apache.kafka</groupId><artifactId>kafka-clients</artifactId><version>1.1.1</version></dependency> 主题管理 kafka的核心就是主题,学会使用kafka的脚本创建主题,也需要学习使用Java API来创建主题。 Kafka将zookeeper的操作封装成一个ZkUtils类,通过AdminUtils类来调用ZkUtils,来实现Kafka中元数据的操作。 下面一个例子是使用AdminUtils来创建主题,并同时创建指定大小的分区数。 // 连接配置 private static final String ZK_CONNECT = "10.0.90.53:2181";// session过期时间 private static final int SEESSION_TIMEOUT = 30 * 1000;// 连接超时时间 private static final int CONNECT_TIMEOUT = 30 * 1000;/** * 创建主题 * * @param topic 主题名称 * @param partition 分区数 * @param repilca 副本数 * @param properties 配置信息 */ public static void createTopic(String topic, int partition, int repilca, Properties properties) { ZkUtils zkUtils = null;try {// 创建zkutil zkUtils = ZkUtils.apply(ZK_CONNECT, SEESSION_TIMEOUT, CONNECT_TIMEOUT, JaasUtils.isZkSecurityEnabled());if (!AdminUtils.topicExists(zkUtils, topic)) {//主题不存在,则创建主题 AdminUtils.createTopic(zkUtils, topic, partition, repilca, properties, AdminUtils.createTopic$default$6()); } } catch (Exception e) { e.printStackTrace(); } finally { zkUtils.close(); } } 执行该方法,创建主题, 在centos7中查看之前创建的主题: bin/kafka-topics.sh --list --zookeeper localhost:2181 删除主题: /** * 删除主题 * * @param topic */ public static void deleteTopic(String topic){ ZkUtils zkUtils = null; try { zkUtils = ZkUtils.apply(ZK_CONNECT, SEESSION_TIMEOUT, CONNECT_TIMEOUT, JaasUtils.isZkSecurityEnabled()); AdminUtils.deleteTopic(zkUtils,topic); } catch (Exception e) { e.printStackTrace(); } finally { zkUtils.close(); } } 生产者API 在掌握了创建和删除主题之后,接下来,学习Kafka的生产者API。 Kafka中的生产者,通过KafkaProducer这个类来实现的,在介绍这个类的使用之前,首先介绍kafka的配置项,这也是实际生产中比较关心的。 消息发送流程 实例化生产者时,有三个配置是必须指定的: bootstrap.servers:配置连接代理列表,不必包含Kafka集群的所有代理地址,当连接上一个代理后,会从集群元数据信息中获取其他存活的代理信息。但为了保证能够成功连上Kafka集群,在多代理集群的情况下,建议至少配置两个代理。 (由于电脑配置有限,本文实验的是单机情况)key.serializer: 用于序列化消息Key的类 value.serializer:用于序列化消息值(Value)的类 向Kafka发送一个消息,基本上要经过以下的流程: 1.配置Properties对象,这个是必须的 2.实例化KafkaProducer对象 3.实例化ProducerRecord对象,每条消息对应一个ProducerRecord对象 4.调用KafkaProducer的send方法,发送消息。发送消息有两种,一种是带回调函数的(如果发送消息有异常,会在回调函数中返回),另一种是不带回调函数的。 KafkaProducer默认是异步发送消息,首先它会将消息缓存到消息缓冲区中,当缓存区累积到一定数量时,将消息封装成一个 RecordBatch,统一发送消息。也就是说,发送消息实质上分为两个阶段,第一将消息发送到消息缓冲区,第二执行网络I/O操作 5.关闭KafkaProducer,释放连接的资源。 了解以上的流程,那么接下来就实现Java版本的API。 代码实例 第一步: 新建一个消息实体类,模拟支付订单消息,包含消息的ID,商家名称,创建时间,备注。 public class OrderMessage {// 订单ID private String id;// 商家名称 private String sName;// 创建时间 private long createTime;// 备注 private String remake;public String getId() {return id; }public void setId(String id) {this.id = id; }public String getsName() {return sName; }public void setsName(String sName) {this.sName = sName; }public long getCreateTime() {return createTime; }public void setCreateTime(long createTime) {this.createTime = createTime; }public String getRemake() {return remake; }public void setRemake(String remake) {this.remake = remake; }@Override public String toString() {return "OrderMessage{" +"id='" + id + '\'' +", sName='" + sName + '\'' +", createTime=" + createTime +", remake='" + remake + '\'' +'}'; } } 第二步: 这里简单的发送一个消息demo,按照上面的流程,生产者例子如下: package kafka.producer;import kafka.OrderMessage;import org.apache.kafka.clients.producer.KafkaProducer;import org.apache.kafka.clients.producer.ProducerConfig;import org.apache.kafka.clients.producer.ProducerRecord;import java.util.Properties;import java.util.UUID;/** * kafka生产者 */public class ProducerSimpleDemo {static Properties properties = new Properties();//主题名称 static String topic = "myTopic";//生产者 static KafkaProducer<String, String> producer = null;//生产者配置 static {properties.put(org.apache.kafka.clients.producer.ProducerConfig.BOOTSTRAP_SERVERS_CONFIG, "10.0.90.53:9092");properties.put(org.apache.kafka.clients.producer.ProducerConfig.KEY_SERIALIZER_CLASS_CONFIG, "org.apache.kafka.common.serialization.StringSerializer");properties.put(ProducerConfig.VALUE_SERIALIZER_CLASS_CONFIG, "org.apache.kafka.common.serialization.StringSerializer");producer = new KafkaProducer<>(properties); }public static void main(String args[]) throws Exception {sendMsg(); }/** * 发送消息 * * @throws Exception */ public static void sendMsg() throws Exception { ProducerRecord<String, String> record = null;try {// 循环发送一百条消息 for (int i = 0; i < 10; i++) {// 构造待发送的消息 OrderMessage orderMessage = new OrderMessage(); orderMessage.setId(UUID.randomUUID().toString());long timestamp = System.nanoTime(); orderMessage.setCreateTime(timestamp); orderMessage.setRemake("remind"); orderMessage.setsName("test");// 实例化ProducerRecord record = new ProducerRecord<String, String>(topic, timestamp + "", orderMessage.toString());producer.send(record, (metadata, e) -> {// 使用回调函数 if (null != e) { e.printStackTrace(); }if (null != metadata) { System.out.println(String.format("offset: %s, partition:%s, topic:%s timestamp:%s", metadata.offset(), metadata.partition(), metadata.topic(), metadata.timestamp())); } }); } } catch (Exception e) { e.printStackTrace(); } finally {producer.close(); } } } 运行,结果就出现了,异常。 异常记录: 2018-07-30 18:05:10.755 DEBUG 10272 --- [ad | producer-1] o.apache.kafka.common.network.Selector : Connection with localhost/127.0.0.1 disconnected java.net.ConnectException: Connection refused: no further information at sun.nio.ch.SocketChannelImpl.checkConnect(Native Method) ~[na:1.8.0_111] at sun.nio.ch.SocketChannelImpl.finishConnect(Unknown Source) ~[na:1.8.0_111] at org.apache.kafka.common.network.PlaintextTransportLayer.finishConnect(PlaintextTransportLayer.java:51) ~[kafka-clients-0.10.1.1.jar:na] at org.apache.kafka.common.network.KafkaChannel.finishConnect(KafkaChannel.java:73) ~[kafka-clients-0.10.1.1.jar:na] at org.apache.kafka.common.network.Selector.pollSelectionKeys(Selector.java:323) [kafka-clients-0.10.1.1.jar:na] at org.apache.kafka.common.network.Selector.poll(Selector.java:291) [kafka-clients-0.10.1.1.jar:na] at org.apache.kafka.clients.NetworkClient.poll(NetworkClient.java:260) [kafka-clients-0.10.1.1.jar:na] at org.apache.kafka.clients.producer.internals.Sender.run(Sender.java:236) [kafka-clients-0.10.1.1.jar:na] at org.apache.kafka.clients.producer.internals.Sender.run(Sender.java:148) [kafka-clients-0.10.1.1.jar:na] at java.lang.Thread.run(Unknown Source) [na:1.8.0_111] 可以看到报错第一句显示:Connection with localhost/127.0.0.1 disconnected 但是可以看到自己的配置是正确的。 这里需要在kafka中修改部分配置: 在配置kafka中,首先需要修改kafka的配置server.properties中的 advertised.listeners=PLAINTEXT://:your.host.name:9092 翻译过来就是hostname和端口是用来建议给生产者和消费者使用的。 如果没有设置,将会使用 listeners的配置,如果listeners也没有配置,将使用java.net.InetAddress.getCanonicalHostName()来获取这个hostname和port,对于ipv4,基本就是localhost了。 "PLAINTEXT"表示协议,可选的值有PLAINTEXT和SSL,hostname可以指定IP地址,也可以用"0.0.0.0"表示对所有的网络接口有效,如果hostname为空表示只对默认的网络接口有效 也就是说如果你没有配置advertised.listeners,就使用listeners的配置通告给消息的生产者和消费者,这个过程是在生产者和消费者获取源数据(metadata)。 修改之后: advertised.listeners=PLAINTEXT://10.0.90.53:9092 需要注意的是,如果Kafka有多个节点,那么需要每个节点都按照这个节点的实际hostname和port情况进行设置。 修改完毕,重启Kafka服务,开启消费者,接受消息,在服务器中输入: bin/kafka-console-consumer.sh --zookeeper localhost:2181 --topic myTopic --from-beginning 可以看到服务器中的消费者: 成功接收到消息。之前提到过在生产者有回调函数,来看看回调函数的输出: offset: 0, partition:0, topic:myTopic timestamp:1533199115840 offset: 1, partition:0, topic:myTopic timestamp:1533199115850 offset: 2, partition:0, topic:myTopic timestamp:1533199115850 offset: 3, partition:0, topic:myTopic timestamp:1533199115850 offset: 4, partition:0, topic:myTopic timestamp:1533199115850 offset: 5, partition:0, topic:myTopic timestamp:1533199115850 offset: 6, partition:0, topic:myTopic timestamp:1533199115850 offset: 7, partition:0, topic:myTopic timestamp:1533199115852 offset: 8, partition:0, topic:myTopic timestamp:1533199115852 offset: 9, partition:0, topic:myTopic timestamp:1533199115852 打印出了偏移值,分区,主题,和时间戳。说明发送成功了。到此就完成第一个Helloworld操作了。 我们可以看到回调函数返回的消息,怎么都在一个分区中呢?下面来研究分区器。 自定义分区器 Kafka在底层摒弃了Java堆缓存机制,采用了操作系统级别的页缓存,同时将随机写操作改为顺序写,再结合Zero-Copy的特性极大地改善了IO性能。 这个在单机上的提高,对于集群,Kafka使用了分区,将topic的消息分散到多个分区上,并保存在不同的机器上。 但是是否分区越多,效率越高呢?也不尽然! 1.每个分区在底层文件系统都有属于自己的一个目录。该目录下通常会有两个文件: base_offset.log和base_offset.index。Kafak的controller和ReplicaManager会为每个broker都保存这两个文件句柄(file handler)。很明显,如果分区数越多,所需要保持打开状态的文件句柄数也就越多,最终可能会突破你的ulimit -n的限制。 2.消费者和生产者都会为分区缓存消息,分区越多,缓存的消息就越多,占用的内存就越大。 3.降低高可用,Kafka是通过高可用来实现高可用性的。我们知道在集群中往往会有一个leader,假设集群中有10个Kafka进程,1个leader,9个follwer,如果一个leader挂了,那么就会重新选出一个leader,如果集群中有10000个分区,那么将要花费很长的时间,这对于高可用是有损耗的。 本身kafka有自己的分区策略的,如果未指定,就会使用默认的分区策略: Kafka根据传递消息的key来进行分区的分配,即hash(key) % numPartitions。如果Key相同的话,那么就会分配到统一分区。 Kafka提供了自定义的分区器,只要实现Partitioner接口即可,下面是自定义分区的例子: package kafka.partition;import org.apache.kafka.clients.producer.Partitioner;import org.apache.kafka.common.Cluster;import java.util.Map;/** * 自定义分区器 */public class PartitionUtil implements Partitioner {// 分区数 private static final Integer PARTITION_NUM = 6;@Override public int partition(String topic, Object key, byte[] keyBytes, Object value, byte[] valueBytes, Cluster cluster) {if (null == key){return 0; } String keyValue = String.valueOf(key);// key取模 int partitionId = (int) (Long.valueOf(key.toString())%PARTITION_NUM);return partitionId; }@Override public void close() { }@Override public void configure(Map<String, ?> configs) { } } 还是刚才分区的代码,只要在之前的配置中加上 properties.put(ProducerConfig.PARTITIONER_CLASS_CONFIG, PartitionUtil.class.getName()); 运行生产者,回调函数打印如下: offset: 3, partition:5, topic:MyOrder timestamp:1533205894785 offset: 5, partition:3, topic:MyOrder timestamp:1533205893202 offset: 6, partition:3, topic:MyOrder timestamp:1533205894784 offset: 2, partition:2, topic:MyOrder timestamp:1533205894785 offset: 4, partition:1, topic:MyOrder timestamp:1533205894785 offset: 5, partition:1, topic:MyOrder timestamp:1533205894785 offset: 5, partition:0, topic:MyOrder timestamp:1533205894784 offset: 6, partition:0, topic:MyOrder timestamp:1533205894784 offset: 7, partition:0, topic:MyOrder timestamp:1533205894785 offset: 8, partition:0, topic:MyOrder timestamp:1533205894786 分区成功了,在实际生产过程中,可以根据项目的实际需要进行分区设计。 线程池生产者 在实际生产过程中,通常消息数量是比较多的,就可以考虑使用线程池。 使用线程池发送消息时,要考虑两点:1.需要结合实际情况,合理设计线程池的大小;2.使用线程池时,消息的发送是无序的,如果对消息的顺序有要求,不建议使用。 如果使用线程池,建议是只实例化一个KafkaProducer对象,这样性能最好。代码如下: 首先写一个线程类: package kafka.producer;import org.apache.kafka.clients.producer.KafkaProducer;import org.apache.kafka.clients.producer.ProducerRecord;/** * 生产者线程 */public class ProducerThread implements Runnable {private KafkaProducer<String, String> producer = null;private ProducerRecord<String, String> record = null;public ProducerThread(KafkaProducer<String, String> producer, ProducerRecord<String, String> record) {this.producer = producer;this.record = record; }@Override public void run() {producer.send(record, (metadata, e) -> {if (null != e) { e.printStackTrace(); }if (null != metadata) { System.out.println("消息发送成功 : "+String.format("offset: %s, partition:%s, topic:%s timestamp:%s", metadata.offset(), metadata.partition(), metadata.topic(), metadata.timestamp())); } }); } } 接着完成启动类,启动类中自定义了一个线程池,这里还是有一些遐思,就是没有自定义,线程创建工厂,没有指定创建的线程名称,在实际生产中,最好是自定义线程工厂。 代码如下: package kafka.producer;import kafka.OrderMessage;import kafka.partition.PartitionUtil;import org.apache.kafka.clients.producer.*;import org.apache.kafka.clients.producer.ProducerConfig;import java.util.Properties;import java.util.UUID;import java.util.concurrent.*;/** * 线程池生产者 * * @author tangj * @date 2018/7/29 20:15 */public class ProducerDemo {static Properties properties = new Properties();static String topic = "MyOrder";static KafkaProducer<String, String> producer = null;// 核心池大小 static int corePoolSize = 5;// 最大值 static int maximumPoolSize = 20;// 无任务时存活时间 static long keepAliveTime = 60;// 时间单位 static TimeUnit timeUnit = TimeUnit.SECONDS;// 阻塞队列 static BlockingQueue blockingQueue = new LinkedBlockingQueue();// 线程池 static ExecutorService service = null;static {// 配置项 properties.put(ProducerConfig.BOOTSTRAP_SERVERS_CONFIG, "10.0.90.53:9092");properties.put(ProducerConfig.PARTITIONER_CLASS_CONFIG, PartitionUtil.class.getName());properties.put(ProducerConfig.KEY_SERIALIZER_CLASS_CONFIG, "org.apache.kafka.common.serialization.StringSerializer");properties.put(ProducerConfig.VALUE_SERIALIZER_CLASS_CONFIG, "org.apache.kafka.common.serialization.StringSerializer");producer = new KafkaProducer<>(properties);// 初始化线程池 service = new ThreadPoolExecutor(corePoolSize, maximumPoolSize, keepAliveTime, timeUnit, blockingQueue); }public static void main(String args[]) throws Exception {for (int i = 0; i < 6; i++) {service.submit(createMsgTask()); } }/** * 生产消息 * * @return */ public static ProducerThread createMsgTask() { OrderMessage orderMessage = new OrderMessage(); orderMessage.setId(UUID.randomUUID().toString());long timestamp = System.nanoTime(); orderMessage.setCreateTime(timestamp); orderMessage.setRemake("rem"); orderMessage.setsName("test"); ProducerRecord<String, String> record = new ProducerRecord<String, String>(topic, timestamp + "", orderMessage.toString()); ProducerThread task = new ProducerThread(producer, record);return task; } }
优秀的个人博客,低调大师

面试 9:Java 玩转冒泡排序

面试 9:用 Java 实现冒泡排序 南尘的朋友们,新的一周好,原本打算继续讲链表考点算法的,这里姑且是卡一段。虽然在我们 Android 开发中,很少涉及到排序算法,因为基本官方都帮我们封装好了,但排序算法也是非常重要的,在面试中 归并排序 和 快速排序 一直为高频考点,但在学习它们之前,我们必须得先把三大基础算法学会,毕竟层层递进,方得始终嘛。 冒泡排序 冒泡排序恐怕是我们计算机专业课程上以第一个接触到的排序算法,也算是一种入门级的排序算法。它的基本思想是:两两比较相邻记录的关键字,如何反序则交换,直到没有反序的记录为止。 冒泡排序算法原理: 比较相邻的元素。如果第一个比第二个大,就交换他们两个。 对每一对相邻元素作同样的工作,从开始第一对到结尾的最后一对。这步做完后,最后的元素会是最大的数。 针对所有的元素重复以上的步骤,除了最后一个。 持续每次对越来越少的元素重复上面的步骤,直到没有任何一对数字需要比较。 一次比较过程如图所示: 图片来源于网络 我们通常容易想到最简单的实现代码: public class Test09 { private static void swap(int[] arr, int i, int j) { int temp = arr[i]; arr[i] = arr[j]; arr[j] = temp; } private static void printArr(int[] arr) { for (int anArr : arr) { System.out.print(anArr + " "); } } private static void bubbleSort(int[] arr) { if (arr == null) return; for (int i = 0; i < arr.length - 1; i++) { for (int j = i + 1; j < arr.length; j++) { if (arr[i] > arr[j]) swap(arr, i, j); } } } public static void main(String[] args) { int[] arr = {6, 4, 2, 1, 8, 3, 7, 9, 5}; bubbleSort(arr); printArr(arr); } } 严格地讲,上面的算法并不是冒泡排序,因为 它完全不符合两两相邻比较。它更应该是最最简单的就交换排序而已。它的思路是让每一个关键字,都和它后面的每一个关键字比较,如果大则交换,这样第一位置的关键字在一次循环后一定变成最小值。 我们不妨来看看正宗的冒泡排序算法。 public class Test09 { private static void swap(int[] arr, int i, int j) { int temp = arr[i]; arr[i] = arr[j]; arr[j] = temp; } private static void printArr(int[] arr) { for (int anArr : arr) { System.out.print(anArr + " "); } } private static void bubbleSort(int[] arr) { if (arr == null) return; for (int i = 0; i < arr.length - 1; i++) { for (int j = 1; j < arr.length - i; j++) { if (arr[j - 1] > arr[j]) { swap(arr, j - 1, j); } } } } public static void main(String[] args) { int[] arr = {6, 4, 2, 1, 8, 3, 7, 9, 5}; bubbleSort(arr); printArr(arr); } } 上述代码是否完美了呢?答案是否定的,我们假设待排序的序列是 {2,1,3,4,5,6,7,8,9},也就是说,除了第一和第二个关键字需要交换外,别的都应该是正常的顺序,当 i = 1 时,交换了 2 和 1 的位置,此时已经有序,但是算法依然不依不挠地将 i = 2 到 9 以及每一个内循环都执行了一遍,尽管没有交换数据,但之后的大量比较还是大大的多余了。所以我们完全可以设置一个标记位 isSort,当我们比较一次后都没有交换,则代表数组已经有序了,此时直接退出循环即可。 既然思路已经确定,那代码自然是很信手拈来了。 public class Test09 { private static void swap(int[] arr, int i, int j) { int temp = arr[i]; arr[i] = arr[j]; arr[j] = temp; } private static void printArr(int[] arr) { for (int anArr : arr) { System.out.print(anArr + " "); } } private static void bubbleSort(int[] arr) { if (arr == null) return; // 定义一个标记 isSort,当其值为 true 的时候代表已经有序。 boolean isSort; for (int i = 0; i < arr.length - 1; i++) { isSort = true; for (int j = 1; j < arr.length - i; j++) { if (arr[j - 1] > arr[j]) { swap(arr, j - 1, j); isSort = false; } } if (isSort) break; } } public static void main(String[] args) { int[] arr = {6, 4, 2, 1, 8, 3, 7, 9, 5}; bubbleSort(arr); printArr(arr); } } Perfect 的代码,但冒泡排序在数组长度较大的时候,效率真的很低下,所以在实际生产中,我们也很少使用这种算法。 冒泡排序时间空间复杂度及算法稳定性分析 对于长度为 n 的数组,冒泡排序需要经过 n(n-1)/2 次比较,最坏的情况下,即数组本身是倒序的情况下,需要经过 n(n-1)/2 次交换,所以其 冒泡排序的算法时间平均复杂度为 O(n²)。空间复杂度为 O(1)。 可以想象一下:如果两个相邻的元素相等是不会进行交换操作的,也就是两个相等元素的先后顺序是不会改变的。如果两个相等的元素没有相邻,那么即使通过前面的两两交换把两个元素相邻起来,最终也不会交换它俩的位置,所以相同元素经过排序后顺序并没有改变。 所以冒泡排序是一种稳定排序算法。所以冒泡排序是稳定排序。这也正是算法稳定性的定义: 排序算法的稳定性:通俗地讲就是能保证排序前两个相等的数据其在序列中的先后位置顺序与排序后它们两个先后位置顺序相同。 冒泡排序总结: 冒泡排序的算法时间平均复杂度为 O(n²)。 空间复杂度为 O(1)。 冒泡排序为稳定排序。 考虑到不少读者说每天代码量太多的问题,我们今天就只讲冒泡排序的 Java 实现,我们明天将带来三大简单排序的另外两种,选择排序 和 插入排序。 文章参考来源:https://juejin.im/post/5a96d6b15188255efc5f8bbd

优秀的个人博客,低调大师

基于AliOS Things玩转智能语音

随着AI技术的进步,智能语音开始将人机交互从手+眼睛的传统模式中解放出来。带给人们更便捷、更风趣、更有人情味的体验,让被操作对象变得不再只是一个死板的工具,而更像是一个有生命的助理。“帮我打开空调”,“明天上班需要带伞吗”,“帮我冲100块钱话费”…在万物互联的时代,你的所有需求只需要一句话便能实现。AliOS Things 集成的Link Voice SDK即可实现智能语音交互。 关于阿里智能语音服务 阿里智能语音服务为设备提供语音交互能力、丰富的音乐内容、智能家居控制等,并可进行专有设备技能定制(如:语音操控跑步机、按摩椅等设备)。包括: 通用服务:搜歌、搜栏目、搜电台、问天气、百科、四则运算等; 阿里服务:控制智能家居、充值手机费、天猫超市购物、查询电费等 (需接入账号体系,可参考SDS接入); 私有服务:操控设备、售后电话查询等 (

优秀的个人博客,低调大师

Android开发实践:玩转EditText控件

Android的EditText控件是一个非常常用的控件,用得最多的地方就是做登录、注册页面了,它能为用户提供一个直观便捷的输入框。本文简单总结下EditText控件中比较常用的一些设置,并为每一种设置提供两种方式的实现,一种是在布局文件中实现,另一种是在程序中通过代码动态的设置。 1. 如何添加一个方框 在Android的Hololight主题下,EditText控件默认是只有一条底部的蓝色横线的,怎么给你的EditText添加一个方框呢? 【布局】: 设置 android:background 属性,给它一个长方形的白***片,或者自定义一个长方形的drawable文件即可。 例如: 1 android:background= "@drawable/shape_bg" 【代码】: 1 2 EditTextmEditText=(EditText)findViewById(R.id.MyEditText); mEditText.setBackgroundResource(R.drawable.shape_bg); 2. 如何设置字体大小、颜色、加粗 【布局】: 布局中的属性依次为 android:textSize,android:textColor,android:textStyle属性 例如: 1 2 3 android:padding="15sp" android:textSize="15sp" android:textStyle="bold" 【代码】: 1 2 3 4 EditTextmEditText=(EditText)findViewById(R.id.MyEditText); mEditText.setTextSize( 15 ); mEditText.setTextColor(Color.BLACK); mEditText.setTypeface(Typeface.DEFAULT_BOLD); 3. 如何设置以密码的形式显示 【布局】: 设置 android:password 属性为 true 例如: 1 android:password="true" 【代码】: 1 2 EditTextmEditText=(EditText)findViewById(R.id.MyEditText); mEditText.setInputType(InputType.TYPE_TEXT_VARIATION_PASSWORD); 4. 如何禁止用户输入回车换行 【布局】: 设置 android:singleLine 属性为 true 例如: 1 android:singleLine="true" 【代码】: 1 2 EditTextmEditText=(EditText)findViewById(R.id.MyEditText); mEditText.setSingleLine(); 5. 如何设置没有输入时的提示信息 【布局】: 设置 android:hint 属性的值 例如: 1 android:hint="inputyourname" 【代码】: 1 2 EditTextmEditText=(EditText)findViewById(R.id.MyEditText); mEditText.setHint( "Inputyourname" ); 6. 如何在输入框的行首空几个字符 【布局】: 设置 android:paddingLeft 属性即可 例如: 1 android:paddingLeft="15sp" 【代码】: 1 2 EditTextmEditText=(EditText)findViewById(R.id.MyEditText); mEditText.setPadding( 15 , 0 , 0 , 0 ); 7. 如何限制输入的长度 【布局】: 设置 android:maxLength 属性的值即可 例如: 1 android:maxLength="10" 【代码】: 1 2 3 4 EditTextmEditText=(EditText)findViewById(R.id.MyEditText); InputFilter[]filters= new InputFilter[ 1 ]; filters[ 0 ]= new InputFilter.LengthFilter( 10 ); mEditText.setFilters(filters); 8. 如何限制输入类型为:数字,电话号码,日期,时间 【布局】: 设置 android:inputType 属性可以指定 textPassword, phone, number, date,time 等类型 例如: 1 android:inputType="text" 【代码】: 1 2 EditTextmEditText=(EditText)findViewById(R.id.MyEditText); mEditText.setInputType(InputType.TYPE_CLASS_TEXT); //InputType有很多种类型可以选择 9. 如何限制只能输入指定的字符 【布局】: 设置 android:digits 属性即可 例如: 1 android:digits="abcdef" 【代码】: 有两种方法可以实现: 方法一: 1 2 3 EditTextmEditText=(EditText)findViewById(R.id.MyEditText); Stringdigits= "abcdef" ; mEditText.setKeyListener(DigitsKeyListener.getInstance(digits)); 方法二: 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 EditTextmEditText=(EditText)findViewById(R.id.MyEditText); InputFilter[]filters= new InputFilter[ 1 ]; filters[ 0 ]= new MyInputFilter( "abcdef" ); mEditText.setFilters(filters); public class MyInputFilter extends LoginFilter.UsernameFilterGeneric{ private StringmAllowedDigits; public PopInputFilter(Stringdigits){ mAllowedDigits=digits; } @Override public boolean isAllowed( char c){ if (mAllowedDigits.indexOf(c)!=- 1 ){ return true ; } return false ; } } 10. 让密码的输入字体大小与明文的字体一致 当你设置了android:password = "true" 属性后,你会发现,它的字体大小会跟没有设置password属性的EditText的大小不一致,因此,如果期望他们表现一致的话,可以通过代码如下设置: 1 2 3 EditTextmEditText=(EditText)findViewById(R.id.MyEditText); mEditText.setTypeface(Typeface.DEFAULT); mEditText.setTransformationMethod( new PasswordTransformationMethod()); 本文转自 Jhuster 51CTO博客,原文链接:http://blog.51cto.com/ticktick/1333414,如需转载请自行联系原作者

优秀的个人博客,低调大师

玩转Android monkey之多参数实战

monkey设置间隔时间 参数throttle用来控制执行速度,如果不加我们通过上次的执行发现速度比较快,也看不清。 语法:adb shell monkey -p 包名 --throttle 设置每次随机事件的时间间隔 (毫秒)随机事件次数 moneky seed种子 seed种子是干嘛的呢?很好理解,如果你想使得两次命令的执行轨迹一样,那就加上这个参数。比如,第一次你使用发现了一个bug,现在想重现一下,如果不加seed就是随机的,可能无法重现,加上seed就可以了。 PS:每次执行时初始界面要一致 语法:adb shell monkey -p 包名 --throttle 执行速度 -s seed种子 随机事件数 monkey指定某个动作 如果想使用monkey命令来做某一个动作,而不是N个动作混杂的,那就要通过参数来指定ta的动作,比如--pct-touch点击(触摸)动作。 语法:adb shell monkey -v -p 包名 --pct-touch 执行touch动作的百分比 随机事件次数 其中-v代表查看详细的结果,我们可以看到0代表touch百分比为100%执行,其余为0%。 思考:如果不加--pct-touch执行该命令会是什么样的结果呢? 这里大家可能会问到1-10代表啥呢?其实代表的是不同的操作动作,这里来list一下: 1:手势 --pct-motion 2:缩放 --pct-pinchzoom 3:轨迹球 --pct-trackball 4:屏幕旋转 --pct-rotation 5:基本导航事件,比如手机上的上、下、左、右的操作 --pct-nav 6:主导航事件,比如返回键、菜单键 --pct-majornav 7:系统导航事件,比如手机上的home键、拨号键、音量键等 --pct-syskeys 8:切换activity --pct-appswitch 9: 键盘翻转事件,举个场景就知道了,类似点击输入框,键盘弹起,点击其他区域,键盘收起 --pct-flip 10:其他事件 --pct-anyevent monkey忽略崩溃和超时 为什么要有着两个参数呢?很简单,我们在使用app的时候经常会出现超时、卡死的状况,一旦出现这样的情况,monkey是不知道怎么办的!所以,需要我们给他指令才行, 一般就是给两个参数,忽略超时和忽略崩溃。 l 忽略超时参数:--ignore-timeouts l 忽略崩溃(异常)参数:--ignore-crashes 语法:adb shell monkey -v -p 包名 --pct-touch 100 --ignore-timeouts --ignore-crashes 随机事件次数 PS:在实际操作过程中除了上述两种情况外,可能还会出现ANR的问题,如果出现那就要找到对应的log,然后交给开发去解决 本文转自 小强测试帮 51CTO博客,原文链接:http://blog.51cto.com/xqtesting/2050469,如需转载请自行联系原作者

优秀的个人博客,低调大师

WorkBuddy 玩转 QQ 邮箱之发票整理

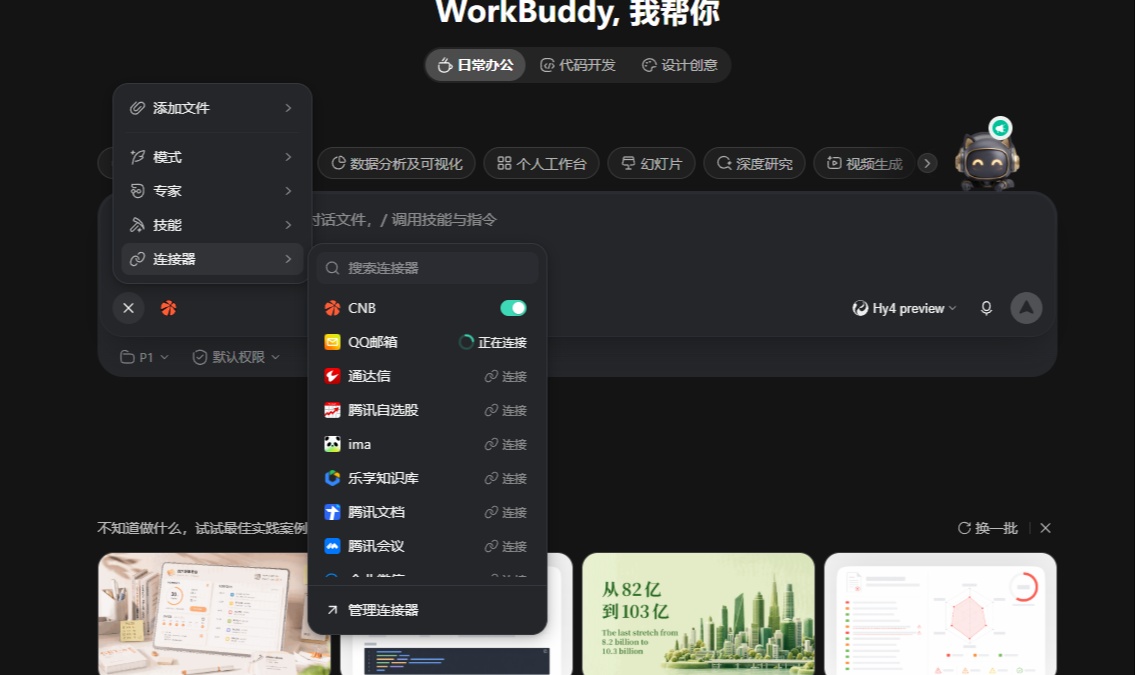
大家好!我是 Hello World! 不管是报销对账还是年底汇总,最让人头疼的就是发票。它们散落在 QQ 邮箱的各个角落,有的自己收,有的同事和客户发来,时间一长分不清谁是谁、有没有重复。手动一份份下载改名归档,想想就头大。 好在我最近在用 WorkBuddy,它有个特别实用的能力——**连接器(Connector)**:连上 QQ 邮箱后,它就能直接读邮件、下附件、做整理。今天就拿「整理发票」这个真实场景,手把手带大家跑一遍。 ## 一、先把 QQ 邮箱连上 打开 WorkBuddy 的「连接器」,找到 QQ 邮箱点击连接。它会跳转到网页,提示你用**手机版 QQ 邮箱扫码**授权。扫码确认后,再点一下「打开 WorkBuddy」,连接成功,我们就可以下指令了。 ![](https://developer.qcloudimg.com/http-save/audit-10786787/7632525b2d8e1c3d24338a1370d20485.png) ![](https://developer.qcloudimg.com/http-save/audit-10786787/512311a64b64e6d2bebed3fdc9f5e35c.png) ## 二、给 WorkBuddy 下个整理任务 接下来是重头戏。我直接给 WorkBuddy 发了一段提示词(prompt): > 帮我整理我 QQ 邮箱里今年以来的所有发票,并且按照日期把电子版发票下载到文件夹。由于很多人用我的邮箱接收发票,再在文件夹里把每个人的发票单独整理出来,并且给我一份详细记录的表格。在 `D:\Project\P1\未整理发票` 有别人发给我的一些未整理的发票,你帮我整理一下,并且把邮箱里的发票进行一个去重。 ![](https://developer.qcloudimg.com/http-save/audit-10786787/375a6091f661e112f5c383f15ff4bfce.png) ## 三、遇到坑别慌:补一个授权码 WorkBuddy 开始运行,我们耐心等着就行。但它跑完告诉我:**今年只有两份发票**。 继续追问才知道,原因是**邮箱权限不够**,需要开通 IMAP 的授权码。 ![](https://developer.qcloudimg.com/http-save/audit-10786787/b90e6ab68322aaa05d2fe46a049c760b.png) ![](https://developer.qcloudimg.com/http-save/audit-10786787/a81aefe747f1fb325356a00965e4bb01.png) 开通步骤很简单: 1. 登录 **QQ 邮箱网页版** → **设置** → **账户** 1. 找到 **IMAP/SMTP 服务** → 点击**开启** 1. 验证后会生成一串 **16 位授权码**(注意:它不是 QQ 密码) 我这里是在「安全设置」里看到 `POP3/IMAP/SMTP/Exchange/CardDAV 服务(已开启)`,直接选择**生成授权码**即可。 > ⚠️ 小提醒:授权码只显示一次,务必马上保存好,丢了就得重新生成。 ![](https://developer.qcloudimg.com/http-save/audit-10786787/5ccc935ea2aba4d4d8691240e42a7a00.png) ## 四、交还授权码,坐等结果 拿到授权码后,把它发给 WorkBuddy。收到授权码,它立刻继续干活。因为邮件量不小,这一步**会花一点时间**,大家耐心等一会儿就好。 ![](https://developer.qcloudimg.com/http-save/audit-10786787/e94b2fb672daca928a0993033ea6a240.png) ![](https://developer.qcloudimg.com/http-save/audit-10786787/41ee8f47e31bc12fa15e008b55344e81.png) ![](https://developer.qcloudimg.com/http-save/audit-10786787/ef68c314fc1bbe529ae62fe038f4bd43.png) 中间它还会弹出**批量删除**的确认——这个我们同意就可以,那是 WorkBuddy 在清理整理过程中产生的临时残留,放心点。 ![](https://developer.qcloudimg.com/http-save/audit-10786787/67048469fd64501bf1e22ff5592add6d.png) ## 五、成果:干净、分类、不重复 最终,WorkBuddy 把我**自己接收的发票**和**邮箱里的发票**全部整理出来,并做了**去重**,统一放进了 `D:\Project\P1\发票整理\` 这个文件夹。 按**日期**和**人员**两个维度分类,整整齐齐,一眼就能定位到任意一张发票。 ![](https://developer.qcloudimg.com/http-save/audit-10786787/c6222a2f30995b25ccafcd0cb3257a5c.png) ![](https://developer.qcloudimg.com/http-save/audit-10786787/5ce3496214053249041fbf90a30d51a6.png) ## 写在最后 这次整理最让我惊喜的,不是省了多少时间,而是**把一件「懒得做」的杂活,变成了一句自然的话**。你不用懂 IMAP、不用记命令,只要像跟同事交代工作一样把需求说清楚,WorkBuddy 就会一步步替你搞定,遇到权限问题还会主动提醒你补授权码。 如果你也常被发票、邮件、文件归档折磨,不妨试试 WorkBuddy 的 QQ 邮箱连接器——**连接一次,省心一整年**。欢迎在评论区告诉我,你最想让 AI 帮你整理什么,下期我们接着聊。

优秀的个人博客,低调大师

特性快闪:使用 Databend 玩转 Iceberg

作者:尚卓燃(PsiACE) 澳门科技大学在读硕士,Databend 研发工程师实习生 Apache OpenDAL(Incubating) Committer https://github.com/PsiACE 几周前,Databricks 和 Snowflake 召开了各自的年度大会,除了今年一路持续走红的 AI ,数据湖/数据仓库技术的发展仍然值得关注,毕竟数据才是基本盘。Apache Iceberg 无疑是数据湖方案的大赢家,Databricks 新推出的 UniForm 为以 Apache Iceberg 和 Hudi 表格式读取 Delta 中的数据提供了进一步的支持。而 Snowflake 也适时推出了 Iceberg Tables 更新,宣称要进一步打破数据孤岛。 Databend 最近几个月正在推动的重要新特性之一就是支持读取 Apache Iceberg 表格式的数据,尽管还没有完全落地,但已经取得了不错的进展。 今天这篇文章旨在为大家提前演示这一新特性 —— 使用 Databend 挂载并查询 Iceberg Catalog ,我们将介绍 Iceberg、表格式的一些核心概念,并且试图介绍 Databend 的解决方案(包括 Databend 的多源数据目录能力和以 Rust 从头实现的 IceLake)。当然,作为演示,我们将会提供完整的 workshop ,供大家尝鲜体验。 Apache Iceberg 时至今日,越来越多的数据进入云端,并且存储在对象存储之中,但这并不能完全适应现代分析的需求。这里有两个问题需要解决:第一个是数据以何种形式组织,也就是说,如何得到更结构化的数据存储。第二个问题还要更进一步,如何为用户提供更广泛的一致性保证以及业务中需要的模式信息,以及更多适应现代分析负载的高级特性。 数据湖往往会关注并解决第一个问题,而表格式则会致力于为第二个问题提供解决方案。 Apache Iceberg 是一种高性能的开放表格式,专为大规模分析工作负载而设计,简单而又可靠。同时支持 Spark、Trino、Flink、Presto、Hive 和 Impala 等查询引擎,并且具备模式演变(Full Schema Evolution)、时间旅行和回滚等杀手级特性。另外,Apache Iceberg 的数据分片和明确定义的数据结构还使得对数据源进行并发访问更加安全、可靠和方便。 如果你对 Iceberg 感兴趣,我们也推荐阅读像 Docker, Spark, and Iceberg: The Fastest Way to Try Iceberg! 这样的文章进行探索。 表格式初探 表格式(Table Format)是一种利用文件集合存储数据的规范。它主要包含以下三个部分的定义: 如何将数据存储在文件中 如何存储相关文件的元数据 如何存储有关表本身的元数据 表格式的文件通常存储在 HDFS、S3 或 GCS 这样的底层存储服务中,上层则会对接 Databend、Snowflake 等数据仓库。相比 CSV 或 Parquet ,表格式提供了表形式的标准的结构化数据定义,无需加载到数据仓库中就可以使用。 尽管表格式领域还有像 Delta Lake 和 Apache Hudi 这样的强劲对手,但这篇文章是关于 Apache Iceberg 的,所以,还是让我们把目光转向 Apache Iceberg ,一起了解一下它的底层文件组织结构。 上图中的 s0 、s1 代表的是表的快照信息(snapshot),也就是表在某个时刻的状态。每次 commit 都会生成一个快照,每个快照都会对应一个清单列表(manifest list),而每个清单列表可以维护多个清单文件(manifest file)的地址与统计信息,包括路径和分区范围等。清单文件中会记录当前操作生成数据文件(data file)的地址和统计信息,比如列中的最大值最小值和数据行数等。 Databend 多源数据目录 要想在 Databend 中实现 Iceberg 集成,头一件是 Databend 的多源数据目录能力。多源数据目录将会允许将原本由其他数据分析系统所管理的数据挂载到 Databend 。 从设计之初,Databend 的目标就是成为云原生的 OLAP 数据仓库,并考虑到多源数据处理的问题。Databend 中的数据按三层进行组织:catalog -> database -> table ,catalog 作为数据最大一层,会包含所有的数据库和表。 团队在此基础上设计并实现对 Hive 和 Iceberg 数据目录的支持,提供配置文件和 CREATE CATALOG 语句多种挂载形式,从而支持对相关数据进行查询。 要想挂载数据位于 S3 中的 Iceberg Catalog,只需要执行下面的 SQL 语句: CREATE CATALOG iceberg_ctl TYPE=ICEBERG CONNECTION=( URL='s3://warehouse/path/to/db' AWS_KEY_ID='admin' AWS_SECRET_KEY='password' ENDPOINT_URL='your-endpoint-url' ); IceLake - Apache Iceberg 的纯 Rust 实现 尽管 Rust 生态中近年来涌现出不少数据库、大数据分析相关的新项目,但 Rust 生态中仍然缺乏成熟的 Apache Iceberg 绑定,这为 Databend 集成 Iceberg 制造了不少困难。 Databend Labs 支持并发起的 IceLake 旨在填补这一空白,并致力于建立一个开放生态系统: 用户可以从 任何 存储服务(如 s3、gcs、azblob、hdfs 等)读写 Iceberg 表。 任何 数据库都可以集成 icelake,以支持读写 Iceberg 表。 提供原生的 arrow 格式互转换的能力。 提供多种语言绑定,使其他语言可以享有 Rust 核心带来的 Iceberg 生态支持。 当前 IceLake 已经支持读取 Apache Iceberg 存储服务中的数据(Parquet 格式)。而 Databend 的 Iceberg 数据目录能力正是由 IceLake 支撑的,其设计与实现在和 Databend 集成中得到了验证。 此外,我们还与 Iceberg 社区成员携手发起并参与 iceberg-rust 项目,旨在将 icelake 中 iceberg 相关的实现贡献给上游,目前第一个版本正紧锣密鼓的开发中,欢迎关注https://github.com/apache/iceberg-rust 。 Workshop:体验 Databend 的 Iceberg 能力 在这个 Workshop 中,我们将会展示如何准备 Iceberg 表格式的数据,并以 Catalog 的形式将其挂载到 Databend 上,并执行一些基本的查询。相关的文件和配置可以在 PsiACE/databend-workshop 中找到。 如果你本身有一些符合 Iceberg 表格式的数据存放在 OpenDAL 支持的存储服务中,我们更推荐使用 Databend Cloud ,这样你就可以跳过繁琐的服务部署和数据准备流程,轻松上手 Iceberg Catalog 。 启动服务 为了简化 Iceberg 的服务部署和数据准备问题,我们将会使用 Docker 和 Docker Compose ,你需要先安装这些组件,然后编写 docker-compose.yml 文件。 version: "3" services: spark-iceberg: image: tabulario/spark-iceberg container_name: spark-iceberg build: spark/ networks: iceberg_net: depends_on: - rest - minio volumes: - ./warehouse:/home/iceberg/warehouse - ./notebooks:/home/iceberg/notebooks/notebooks environment: - AWS_ACCESS_KEY_ID=admin - AWS_SECRET_ACCESS_KEY=password - AWS_REGION=us-east-1 ports: - 8888:8888 - 8080:8080 - 10000:10000 - 10001:10001 rest: image: tabulario/iceberg-rest container_name: iceberg-rest networks: iceberg_net: ports: - 8181:8181 environment: - AWS_ACCESS_KEY_ID=admin - AWS_SECRET_ACCESS_KEY=password - AWS_REGION=us-east-1 - CATALOG_WAREHOUSE=s3://warehouse/ - CATALOG_IO__IMPL=org.apache.iceberg.aws.s3.S3FileIO - CATALOG_S3_ENDPOINT=http://minio:9000 minio: image: minio/minio container_name: minio environment: - MINIO_ROOT_USER=admin - MINIO_ROOT_PASSWORD=password - MINIO_DOMAIN=minio networks: iceberg_net: aliases: - warehouse.minio ports: - 9001:9001 - 9000:9000 command: ["server", "/data", "--console-address", ":9001"] mc: depends_on: - minio image: minio/mc container_name: mc networks: iceberg_net: environment: - AWS_ACCESS_KEY_ID=admin - AWS_SECRET_ACCESS_KEY=password - AWS_REGION=us-east-1 entrypoint: > /bin/sh -c " until (/usr/bin/mc config host add minio http://minio:9000 admin password) do echo '...waiting...' && sleep 1; done; /usr/bin/mc rm -r --force minio/warehouse; /usr/bin/mc mb minio/warehouse; /usr/bin/mc policy set public minio/warehouse; tail -f /dev/null " networks: iceberg_net: 在上述的配置文件中,我们使用 MinIO 作为底层存储,Iceberg 提供表格式能力,至于 spark-iceberg ,可以帮助我们准备一些预置数据并执行转换操作。 接下来,我们在 docker-compose.yml 文件对应的目录下启动所有服务: docker-compose up -d 数据准备 在这个 Workshop 中,我们计划使用 NYC Taxis 数据集(纽约出租车搭乘数据),在 spark-iceberg 中已经内置了 Parquet 数据,我们只需要将其转化为 Iceberg 格式。 首先启用 pyspark-notebook : docker exec -it spark-iceberg pyspark-notebook 接下来我们就可以在 http://localhost:8888 使用 Jupyter Notebook : 这里我们需要运行一小段程序,实施数据转换的操作: df = spark.read.parquet("/home/iceberg/data/yellow_tripdata_2021-04.parquet") df.write.saveAsTable("nyc.taxis", format="iceberg") 第一行将会读取 Parquet 数据,而第二行将会将其转储为 Iceberg 格式。 为了验证数据是否成功转换,我们可以访问位于 http://localhost:9001 的 MinIO 实例,可以看到数据是按之前描述的 Iceberg 底层文件组织形式进行管理的。 部署 Databend 这里我们使用手动部署单节点 Databend 服务的形式,总体上部署过程可以参考 Databend 官方文档 ,需要注意的一些细节如下: 首先是需要为日志和 Meta 数据准备相关的目录 sudo mkdir /var/log/databend sudo mkdir /var/lib/databend sudo chown -R $USER /var/log/databend sudo chown -R $USER /var/lib/databend 其次,因为默认的 admin_api_address 已经被前面的服务占用掉,所以需要编辑 databend-query.toml 进行一些修改避免冲突: admin_api_address = "0.0.0.0:8088" 另外,我们还需要根据 Docs | Configuring Admin Users 配置管理员用户,由于只是一个 workshop ,这里选择最简单的方式,只是取消 [[query.users]] 字段以及 root 用户的注释: [[query.users]] name = "root" auth_type = "no_password" 由于我们本地部署 MinIO ,没有设置证书加密,需要使用不安全的 HTTP 协议加载数据,所以还需要更改 databend-query.toml 配置文件以允许这一行为。在生产服务中请尽可能避免开启它: ... [storage] ... allow_insecure = true ... 接下来就可以正常启动 Databend : ./scripts/start.sh 我们强烈推荐你使用 BendSQL 作为客户端,当然,我们也支持像 MySQL Client 和 HTTP API 等多种访问形式。 挂载 Iceberg Catalog 根据之前的配置文件,只需要执行下述 SQL 就可以一键挂载 Iceberg Catalog 。 CREATE CATALOG iceberg_ctl TYPE=ICEBERG CONNECTION=( URL='s3://warehouse/' AWS_KEY_ID='admin' AWS_SECRET_KEY='password' ENDPOINT_URL='http://localhost:9000' ); 为了验证是否成功,我们可以执行 SHOW CATALOGS 查看: 当然,我们也支持了 SHOW DATABASES 和 SHOW TABLES 语句,之前转换数据时的 nyc.taxis 对应在 MinIO 中是二级目录,而在 Databend 则会映射到数据库和表。 执行查询 数据已经挂载,那么就让我们执行一些简单的查询: 首先是对数据进行行数统计,可以看到一共挂载了 200 万行数据到 Databend: SELECT count(*) FROM iceberg_ctl.nyc.taxis; 让我们从其中几列试着取一些数据出来: SELECT tpep_pickup_datetime, tpep_dropoff_datetime, passenger_count FROM iceberg_ctl.nyc.taxis LIMIT 5; 下面的查询可以帮助我们探索乘客数量和旅程距离之间的相关性,这里只取其中 10 条结果: SELECT passenger_count, to_year(tpep_pickup_datetime) AS year, round(trip_distance) AS distance, count(*) FROM iceberg_ctl.nyc.taxis GROUP BY passenger_count, year, distance ORDER BY year, count(*) DESC LIMIT 10; 总结 在这篇文章中,我们介绍到 Apache Iceberg 表格式和 Databend 的相关解决方案,并且提供了一个相对完整的 workshop 供大家探索。 不难看出,尽管目前我们只为 Iceberg Catalog 提供了单机模式的目录挂载能力,但 Databend 可以胜任一些基本的查询处理任务。也欢迎大家在自己感兴趣的数据上进行尝试,并给我们提供一些反馈。

优秀的个人博客,低调大师

Apache APISIX 玩转 Tongsuo 国密插件

本文通过解读国密的相关内容与标准,呈现了当下国内技术环境中对于国密功能支持的现状。并从 API 网关 Apache APISIX 的角度,带来有关国密的探索与功能呈现。 作者:罗泽轩,Apache APISIX PMC 什么是国密 顾名思义,国密就是国产化的密码算法。在我们日常开发过程中会接触到各种各样的密码算法,如 RSA、SHA256 等等。为了达到更高的安全等级,许多大公司和国家会制定自己的密码算法。国密就是这样一组由中国国家密码管理局制定的密码算法。在国际形势越发复杂多变的今天,密码算法的国产化替代,在一些领域已经成为了一股势不可挡的潮流。 国密的官方名称为国家商用密码,简称商密,拼音缩写是 SM。这也是国密标准中 SM2/3/4/7/9 等算法名称的来源。国密算法的命名方式非常简单直接,就像“绵阳九所”、“二机部”一样,都是“分类+序号”的组合。其中 SM1 和 SM4 是对称算法,对标 AES;SM2 是非对称算法,对标 RSA、ECDSA;SM3 是摘要算法,对标 MD5;等等。由于本文并非涉及到国密的实现细节,所以不会讲得非常细,也就科普下国密算法的分类。 在基础的国密算法之上,我们可以构造一个国密的垂直生态,比如实现国密算法的硬件、提供国密支持的密码库、加入国密流程的 TLS 握手协议等等。正如安全需要纵深防御一样,基于国密的信任链也需要有全软件栈上的支持。 因此,当我们谈论国密支持时,并不仅仅单独指可以用某一种国密算法进行加解密,而是指嵌合入国密的生态,支持某种国密的应用场景。 国密的应用场景 作为国家密码管理局制定的密码算法,国密广泛应用于电子政务(包括国家政务通、警务通等重要领域)、信创及金融业的各个应用领域。 政府和金融的身份认证终端。依照现行有关规定,许多涉及政府和金融的身份认证终端(诸如 USBKey、智能 IC 卡、银行卡终端等)都需要提供对国密的支持。 国产开源操作系统。许多主打国产替代的开源操作系统,会提供基于国密的安全加固功能。比如龙蜥操作系统 (Anolis OS) 提到自己实现了全栈国密能力;OpenEuler 也在做国密相关的一些功能,比如基于国密数字证书扩展了 EFI 的数字签名。 信创产品。还有许多做信创生意的厂商,围绕国密推出符合相关标准的产品。例如支持使用国密算法做数字签名的 PDF 工具、支持国密接入标准的音视频软件等等。 基于国密 TLS 协议的生态。也是在日常开发中接触得最多的。譬如各种国产 CA 厂商、支持了国密TLS的许许多多密码库和浏览器,以及国密接入的VPN和网关等等。 APISIX 对国密的探索与支持 Apache APISIX 是一个动态、实时、高性能的 API 网关,提供负载均衡、动态上游、灰度发布、精细化路由、限流限速、服务降级、服务熔断、身份认证、可观测性等数百项功能。作为一个发迹于国内环境的 API 网关,APISIX 自然需要考虑下如何接入国密的生态圈。 由于国密更多地用在国内环境中,尚未被 OpenSSL 等国际主流项目所完全接纳。如果要使用国密的功能,就涉及到更换 APISIX 默认的 OpenSSL 库为其他 SSL 库。 为此,我们考察了以下的项目: GMSSL:北京大学开源的项目。原版基于 OpenSSL 1.0.2 修改而来。新的 GMSSL 3.0 基本上是重新开发,跟 OpenSSL 的目录结构差别很大。 gm-BoringSSL:个人开源项目,在 BoringSSL 上增加国密支持。已有两年未改动。 TaSSL:北京江南天安科技有限公司开源的项目。基于 OpenSSL 1.1.1 修改而来。 Tongsuo:蚂蚁集团开源的项目。基于 OpenSSL 3.0 修改而来,项目前身是 BabaSSL,现已 改名为铜锁/Tongsuo。 由于 GMSSL 3.0 并不基于 OpenSSL,即使能保证 API 兼容,也没办法确保能 100% 替换现有 OpenSSL 的行为,所以被首先排除。其次 gm-BoringSSL 疏于维护,也被排除。 在 TaSSL 和 Tongsuo 之中,我倾向于选择 Tongsuo[1]。因为 Tongsuo 在标准上拥有更强的话语权,比如 RFC 8998(TLS 1.3 中支持 SM 套件)就是由 Tongsuo 的开发者制定的。TaSSL 则是每出一个版本,就公布一个新的仓库。比如前一个 版本[2],感觉不太靠谱。 对于选择 Tongsuo,我个人存在一个顾虑,就是他目前基于 OpenSSL 3.0 的版本还没有发布正式的 Release 版本(第一个版本预计在 2023 年 2 月发布)。由于 Tongsuo 当前还没有一个固定的版本,因此社区决定先把国密相关的功能独立出来,以插件形式存在,有相关需求时可单独启用。 目前已在插件层面实现了服务端一侧国密双证书的支持,感兴趣的读者可以在官网查看 gm 插件介绍文档 插件介绍文档[3],自行完成 APISIX 的编译和对应插件的安装配置工作。当然,如果想即刻预览该插件的使用过程,也可以直接参考下文内容。 快速参考:APISIX 国密插件的使用 启用插件 插件要求 Apache APISIX 运行在编译了 Tongsuo 的 APISIX-Base 上。 首先需要安装 Tongsuo (此处我们选择编译出 Tongsuo 的动态链接库): # TODO: use a fixed release once they have created one. # See https://github.com/Tongsuo-Project/Tongsuo/issues/318 git clone https://github.com/api7/tongsuo --depth 1 pushd tongsuo ./config shared enable-ntls -g --prefix=/usr/local/tongsuo make -j2 sudo make install_sw 其次需要构建 APISIX-Base,让它使用 Tongsuo 作为 SSL 库: export OR_PREFIX=/usr/local/openresty export openssl_prefix=/usr/local/tongsuo export zlib_prefix=$OR_PREFIX/zlib export pcre_prefix=$OR_PREFIX/pcre export cc_opt="-DNGX_LUA_ABORT_AT_PANIC -I${zlib_prefix}/include -I${pcre_prefix}/include -I${openssl_prefix}/include" export ld_opt="-L${zlib_prefix}/lib -L${pcre_prefix}/lib -L${openssl_prefix}/lib64 -Wl,-rpath,${zlib_prefix}/lib:${pcre_prefix}/lib:${openssl_prefix}/lib64" ./build-apisix-base.sh 该插件默认是禁用状态,你需要将其添加到配置文件./conf/config.yaml 中才可以启用它: plugins: - ... - gm 由于 APISIX 的默认 cipher 中不包含国密 cipher,所以我们还需要在配置文件 ./conf/config.yaml 中设置 cipher: apisix: ... ssl: ... # 可按实际情况调整。错误的 cipher 会导致 “no shared cipher” 或 “no ciphers available” 报错。 ssl_ciphers: HIGH:!aNULL:!MD5 配置完成后,重新加载 APISIX,此时 APISIX 将会启用国密相关的逻辑。 测试插件 在测试插件之前,需要准备好国密双证书。Tongsuo 提供了生成 【SM2 双证书】 的 教程[4]。 在下面的例子中,我们将用到如下的证书: # 客户端加密证书和密钥 t/certs/client_enc.crt t/certs/client_enc.key # 客户端签名证书和密钥 t/certs/client_sign.crt t/certs/client_sign.key # CA 和中间 CA 打包在一起的文件,用于设置受信任的 CA t/certs/gm_ca.crt # 服务端加密证书和密钥 t/certs/server_enc.crt t/certs/server_enc.key # 服务端签名证书和密钥 t/certs/server_sign.crt t/certs/server_sign.key 此外,还需要准备 Tongsuo 命令行工具。 ./config enable-ntls -static make -j2 # 生成的命令行工具在 apps 目录下 mv apps/openssl .. 你也可以采用非静态编译的方式,不过就需要根据具体环境,自己解决动态链接库的路径问题了。以下示例展示了如何在指定域名中启用 gm 插件。 要在指定域名中启用 gm 插件的功能,需要先创建对应的 SSL 对象: #!/usr/bin/env python # coding: utf-8 import sys # sudo pip install requests import requests if len(sys.argv) <= 3: print("bad argument") sys.exit(1) with open(sys.argv[1]) as f: enc_cert = f.read() with open(sys.argv[2]) as f: enc_key = f.read() with open(sys.argv[3]) as f: sign_cert = f.read() with open(sys.argv[4]) as f: sign_key = f.read() api_key = "edd1c9f034335f136f87ad84b625c8f1" resp = requests.put("http://127.0.0.1:9180/apisix/admin/ssls/1", json={ "cert": enc_cert, "key": enc_key, "certs": [sign_cert], "keys": [sign_key], "gm": True, "snis": ["localhost"], }, headers={ "X-API-KEY": api_key, }) print(resp.status_code) print(resp.text) 然后将上面的脚本保存为 ./create_gm_ssl.py,运行以下命令: ./create_gm_ssl.py t/certs/server_enc.crt t/certs/server_enc.key t/certs/server_sign.crt t/certs/server_sign.key 输出结果如下: 200 {"key":"\/apisix\/ssls\/1","value":{"keys":["Yn... 完成上述准备后,可以使用如下命令测试插件是否启用成功: ./openssl s_client -connect localhost:9443 -servername localhost -cipher ECDHE-SM2-WITH-SM4-SM3 -enable_ntls -ntls -verifyCAfile t/certs/gm_ca.crt -sign_cert t/certs/client_sign.crt -sign_key t/certs/client_sign.key -enc_cert t/certs/client_enc.crt -enc_key t/certs/client_enc.key 其中,./openssl 是上文提到的 Tongsuo 命令行工具,9443 是 APISIX 默认的 HTTPS 端口。 如果一切正常,可以看到连接已经建立了起来,并输出如下信息: ... New, NTLSv1.1, Cipher is ECDHE-SM2-SM4-CBC-SM3 ... 禁用插件 如果不再使用此插件,可将 gm 插件从 ./conf/config.yaml 配置文件中移除,然后重启 APISIX 或者通过插件热加载的接口触发插件的卸载。 相关链接 如果你对该功能或者插件感兴趣,欢迎在随时在社区进行交流。 [1] https://github.com/Tongsuo-Project/Tongsuo [2] https://github.com/jntass/TASSL-1.1.1k [3] https://apisix.apache.org/zh/docs/apisix/next/plugins/gm/ [4] https://www.yuque.com/tsdoc/ts/sulazb 本文由博客一文多发平台 OpenWrite 发布!

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

用户登录
用户注册