首页 文章 精选 留言 我的

精选列表

搜索[玩转EdgeOne],共1751篇文章
优秀的个人博客,低调大师

玩转树莓派——安装系统

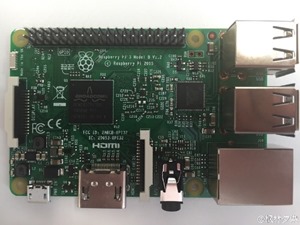
纠结了很久,终于在今年生日的时候买了个树莓派 3。拿到以后少不了各种折腾,慢慢的把折腾过程写下来吧。 有关RaspBerry Pi 3,技术参数以及对应提升,就没必要在这里赘述了,官网介绍应有尽有:https://www.raspberrypi.org/ 万能的淘宝买回一个电路板~没有选择所谓的套餐,那背离了我折腾的初衷。当然,考虑到折腾的程度,散热片和漂亮的框还是要搞一个的,电源可以用iPad的,全部到手也不到300元。 通电之前的第一件事是准备系统。有两种不同的方式来“安装”系统:直接刷tf卡,或者使用NOOBS来下载安装。 直接刷tf卡没啥可说的,Linux/MAC类用dd命令,Windows可以用一个镜像写入程序。可参考:https://www.raspberrypi.org/documentation/installation/installing-images/README.md 需要说明的是,这个镜像工具不光能写,也能将你做好的tf卡读成一个镜像文件。不过,不像ghost那样会跳过空扇区,所以会变得巨大…… 上述方式适合各种树莓派以及第三方的镜像,比如游戏机之类的,以后玩了再写。 如果不想刷卡,或者网速很快,可以选择NOOBS方式来下载安装系统。 NOOBS是树莓派的引导安装系统,可以让树莓派引导到Recovery环境,然后选择安装/下载安装需要的操作系统。 默认的版本会包含最近的树莓派操作系统——RaspBian,所以稍大。这个版本的镜像在安装的时候就直接从本地安装RaspBian了。如果你只打算安装别的系统,或者选择在线下载安装RaspBian,可以直接下载NOOBS Lite版本。 下载完成后,格式化tf卡,做成启动分区,然后将压缩包解压到tf卡即可。 将tf卡插入树莓派,上电启动,即可开始安装操作系统。 作为一个Microsoft MVP,自然对微软的系统十分有兴趣,包括运行于树莓派的Windows 10 IoT Core。树莓派系统可以直接在NOOBS支持下,下载安装Windows 10 IoT。 本文转自HaoHu 51CTO博客,原文链接:http://blog.51cto.com/haohu/1853397,如需转载请自行联系原作者

优秀的个人博客,低调大师

玩转大数据的建议

大数据成为今年李克强总理政府工作报告中提升为“互联网+”行动计划的一部分,并由此推动移动互联网、云计算、物联网等与现代制造业结合,促进电子商务、工业互联网和互联网金融健康发展,引导互联网企业拓展国际市场。可以说,大数据的存储、挖掘、分析能力已经彻底改变了传统互联网的局面。 通过大量的数据应用,我们完全可以总结出当今大数据时代如下一些数据特征: 一是数据的原始性,社会需要的是原始数据;二是数据的完整性,只要是非保密的,政府应该把掌握的数据提供给社会;三是数据的标准性,需要一个国家级标准,每个部门提供的数据,公众可以同一个标准使用;四是数据的及时性,数据拿到以后第一时间提供给社会,让创新更加及时;五是数据的可获取性,部门不能在数据的提供方面设置障碍,甚至收费赚钱。 因此,对大数据要有一个国家层面的认识,特别是应发挥政府在大数据时代的作用。既然这样,就迫切需要建立大数据资源的共建共享机制。如何做到?首先应结合目前国家的简政放权可喜形势,依托政务信息资源共享平台,把行政部门的审批职能和政务服务集中起来,提供一站式网上办理,形成横向到各委办局,纵向到各省市县区的网上办事系统。目前,国、省、市、县四级平台可实现互联互通,审批和服务事项基本实现应尽必尽。全国各省网上办事大厅系统均实现零的突破,今后逐步实现各项办事目录的数据同步和办事过程数据的交换对接,形成了网上办事全流程数据的共建共享机制。 这种机制的共建共享,首先要以需求为导向,部门的自身需求才是共建共享的真正动力;其次要加强流程再造,实行网上办事;还要开展全程督查,在推进部门信息资源共建共享过程中建立监督检查机制。 最后,对我国建立数据资源部门共建共享机制提出如下几点建议:一是尽快成立国家大数据管理局那样的机构;二是对建立大数据资源部门共建共享机制尽快立法,同时尽快出台国家层面的移动互联网信息安全法律,还要依法对数据进行挖掘和分析,同时完善安全体系;三是出台相关数据开放标准规范,指导各省开展数据资源开放工作。 本文作者:佚名 来源:51CTO

优秀的个人博客,低调大师

Zadig 快速体验,玩转本地安装!

啥是本地安装? 听过 Zadig 支持All in One 安装、基于 Kubernetes 安装、基于 Helm 安装等多种安装方式,怎么又来了个本地安装?(这么多安装方式谁听起来头不大) 别急,先看一段对话: (本对话内容基于真实场景模拟,如有雷同,实属巧合) 目标人群 需要在本地快速体验上手,不需要数据持久化保存、不需要生产环境使用。 开源项目好奇宝宝: 开源的云原生持续交付平台?赶紧让我下载安装看看你有什么花活,安装太麻烦我就放弃了。 云原生开发工程师: 虽然你有 Helm 安装,可是做云原生工程师,日常修改 YAML 已经吐了,实在不想看那么多安装的参数,我只想在自己的电脑快速体验下,我有 Docker for desktop 可以启动集群,能不能来个一键脚本给个痛快? 技术 Leader: 团队最近在做云原生持续交付平台的调研选型,听说 Zadig 很强啊,在圈内也很火,赶紧让哪个谁谁谁快速安装了解下,是否适合团队使用,调研后再决定是否上生产。 实施工程师(技术 Leader の 小弟): Leader 需要这边安装体验下 Zadig,尽快出个报告,可是申请集群资源好麻烦啊,层层审批估计疫情到时候都结束了。好烦啊,自己电脑搞个虚拟机弄个集群或者安装个 minikube 不知道能不能行? 实施工程师(技术 Leader の 小弟): Leader 需要这边安装体验下 Zadig,尽快出个报告,可是申请集群资源好麻烦啊,层层审批估计疫情到时候都结束了。好烦啊,自己电脑搞个虚拟机弄个集群或者安装个 minikube 不知道能不能行? 没关系,以上统统安排! Zadig 作为一款开源云原生持续交付产品,支持多种安装方式,每种安装方式又适用于不同的使用场景,例如基于 Helm 命令的安装方式,适用于生产使用,而且对集群资源有一定要求。而对于资源无法满足要求但又对 Zadig 感兴趣的大量开发者来说,如何实现快速体验?成为我们团队需要关注和解决的一个问题。 于是我们推出了本地安装,帮助新人在本机尝鲜和快速体验 Zadig。 如何进行本地安装? 前提 使用 minikube、KinD 等工具在本地拉起一套 K8s 集群,参考如下: a.安装 minikube[1] b.安装 docker-desktop[2] c. 更多工具请参考其官方安装文档 确保本地 K8s 集群满足至少 4C8G 的资源配置,版本满足 v1.16~v1.22。 第一步:安装 Zadig 在本地集群中执行以下脚本: 若安装成功后需要集成外部系统(比如:代码源),请确保使用的IP 地址可外网访问。 1 export IP=<本机 IP 地址>2 export PORT=<任意一合法的 K8s Node Port>3 curl -SsL https://download.koderover.com/install?type=quickstart | bash 安装成功后系统会自动初始化登录账号和密码。 第二步:访问 Zadig 小贴士: 如果使用的是 KinD 拉起的集群,由于其自身特性,需要打通本机端口到 K8s 集群 NodePort 服务的通路,参考命令如下: 1 kubectl -n zadig port-forward svc/gateway-proxy 32000:80 访问 IP: PORT,使用默认账号密码 admin/zadig 登录成功后,即可愉快玩耍了~ One More Thing 我们计划在后续的更新中,支持内置的 demo 项目,在本地安装成功后即可直接体验工作流、环境、服务部署等功能,缩短从配置到使用的路径,做到开箱即用,降低体验 Zadig 的门槛。 参考链接 [1]https://minikube.sigs.k8s.io/docs/start/ [2]https://www.docker.com/products/docker-desktop/ Zadig,让工程师更专注创造!

优秀的个人博客,低调大师

玩转 HelloGitHub 的新姿势

本文不会涉及太多技术细节和源码,请放心食用 大家好,我是 HelloGitHub 的老荀,好久不见啊! 我在完成 HelloZooKeeper 系列之后,就很少“露面了”。但是我对开源和 HelloGitHub 的热情并没有丝毫的减少。这不,逮着个机会就来输出一波,防止被大家遗忘😂。 这次带来的是我写的一款在终端浏览 HelloGitHub 的工具:hg-tui,让你双手不离开键盘就能畅游在 HG 的开源世界。功能如下: 色彩丰富、平铺展示 关键字搜索月刊往期的项目 类 Vim 的快捷键操作方式 一键直达开源项目首页 支持 Linux、macOS、Windows 地址:https://github.com/kaixinbaba/hg-tui 下面我将分享自己发起这个开源项目的缘起、构思、再到开发的全部过程,最后分享一下,我通过做这个项目对开源的一些感悟。 一、起因 我本职是做 Java 开发,但架不住 Rust 太有意思了!所以最近在学 Rust 恰好前段时间看到 HG 讲解 tui.rs 的文章。 看完后手痒得厉害,就写了一篇 tui.rs 入门文章,但感觉还不过瘾就想写一个项目练手。 因为我平时经常上 HelloGitHub 找开源项目,所以就决定用 tui.rs 做一个终端浏览 HelloGitHub 官网的工具。 官网:https://hellogithub.com/ 二、构思 首先我希望这个应用能有以下功能: 有搜索框,可以按关键词搜索 HelloGitHub 中的任意项目 通过表格按列展示搜索结果 既然是终端应用,那操作方式肯定是使用键盘方式,快捷键我采用了一些大家熟知的 Vim 快捷键 浏览项目的途中,可以随时在浏览器中打开当前浏览的项目 有了这些主要功能点的思路,下面就要想想怎么设计一个界面了,我本职工作后端一碰到画界面就头疼,几经周折大概把界面设计成了这样: 又因为是 TUI 界面层级不能太深,所以再多弄个详情页面(用来浏览文字明细)或者弹窗页面(提示消息)就差不多了。 我又想到了 GitHub 为每一种编程语言都设计了一种颜色,我也可以把这些颜色应用在我的项目里,让整个终端界面看起来没那么单调,色彩更丰富。效果如下: 主界面: 详情页: 弹窗提示: 最后为了向 TUI 妥协,按期数或类别搜索,我是通过使用搜索前缀来和普通关键词搜索作出区别。 上面展示的这些差不多已经是这个项目的全部了 三、开发 3.1 技术选型 要实现上述的那些功能,就要从 Rust 的生态中选择合适的库了 下面这些是我在这个项目中使用到的: 基础设施:anyhow、thiserror、lazy_static、better-panic 绘制 UI:tui、crossterm HTTP client:reqwest 缓存:cached HTML 解析:nipper 工具:regex、crossbeam-channel 命令行:clap 虽然 Rust 还是编程界的小学生(2011 年启动),但是经过了这些年的发展,生态已经逐渐完善,工具库已经很丰富了。再加上 Rust 是系统级的语言,值得投入时间学习! 3.2 项目结构 项目结构规划(非全部) src ├── app.rs // 统一管理整个应用的状态 ├── cli.rs // 命令行解析 ├── draw.rs // 绘制 UI ├── events.rs // UI 事件、输入事件、通知 ├── fetch.rs // HTTP 请求 ├── main.rs // 入口 ├── parse.rs // HTML 解析 ├── utils.rs // 工具 └── widget // 自定义组件 ├── ... 合理的分文件(目录)开发,可以让每个功能模块 高内聚、低耦合,并且可以很容易地分开进行单元测试。 当然这些文件也不是在项目之初就已经一股脑地建立好的,都是在完善功能的路上一点点添加进来的~ 3.3 主要代码 因为是基于 tui.rs 开发的应用,所以主流程肯定是遵循该库的设计的,首先需要定义一个 App 用来保存整个项目的状态信息。 pub struct App { /// 用户输入框 pub input: InputState, /// 内容展示 pub content: ContentState, /// 弹窗提示 pub popup: PopupState, /// 状态栏 pub statusline: StatusLineState, /// 模式 pub mode: AppMode, /// 项目明细子页面 pub project_detail: ProjectDetailState, ... } 每一个状态字段,其实就是对应一个自定义组件.要在 tui.rs 中实现自定义组件(实现方式也是我自己的理解)也很简单只要三步,我以 Input 组件为例。 /// 用户输入框组件,组件本身没有字段,是一个无状态的对象 /// 无状态对象只关心 UI 怎么绘制,不存储数据 pub struct Input {} /// 组件的状态,每一个字段就是组件需要存储的数据 #[derive(Debug)] pub struct InputState { input: String, active: bool, pub mode: SearchMode, } /// 最后为 Input 组件实现 StatefulWidget trait impl StatefulWidget for Input { type State = InputState; // 指定关联类型为 InputState /// area 绘制的区域 /// buf 缓冲区(可以直接写入字符串,如果要高度定制的话,可以理解为画笔) /// state 从这个变量中直接取绘制过程中需要的数据 fn render(self, area: Rect, buf: &amp;mut Buffer, state: &amp;mut Self::State) { // 具体绘制的逻辑 ... } } 只要是面向用户的应用,都会处理各种各样的用户输入(事件)。Rust 中一般都使用 channel 来解耦处理各种各样的事件,再利用 Rust 强大的枚举支持,定义各种各样的事件(用户输入和非用户输入)即可。 /// 定义事件枚举 #[derive(Debug, Clone)] pub enum HGEvent { /// 用户事件(键盘事件) UserEvent(KeyEvent), /// 应用内部组件的通知事件 NotifyEvent(Notify), } #[derive(Debug, Clone, PartialEq)] pub enum Notify { /// 重绘界面 Redraw, /// 退出应用 Quit, /// 弹出窗口展示消息 Message(Message), /// tick,比如一些数据需要每隔一段时间自动更新的(比如:显示的时间) Tick, } /// 弹窗的消息,分为 错误、警告、提示 #[derive(Debug, Clone, PartialEq)] pub enum Message { Error(String), Warn(String), Tips(String), } 为了区分用户事件和通知,我使用了两个不同的 channel 分别处理这两类: lazy_static! { /// 因为通知队列希望被应用内部共享,所以使用了 lazy_static 方便使用 pub static ref NOTIFY: (Sender<hgevent>, Receiver<hgevent>) = bounded(1024); } 又因为不同的事件处理,并不应该互相阻塞,所以整个应用采用了最基础的多线程模型来提高性能,这里使用的也是标准库的多线程。 pub fn handle_key_event(event_app: Arc<mutex<app>&gt;) { let (sender, receiver) = unbounded(); ... std::thread::spawn(move || loop { // 单独一个线程接收用户事件 if let Ok(Event::Key(event)) = crossterm::event::read() { sender.send(HGEvent::UserEvent(event)).unwrap(); } }); std::thread::spawn(move || loop { // 单独一个线程处理用户事件 if let Ok(HGEvent::UserEvent(key_event)) = receiver.recv() { ... } }); } 其他剩下的就是业务逻辑,完整的代码可以直接看仓库 https://github.com/kaixinbaba/hg-tui 四、心路历程 一开始我做 hg-tui 项目的时候,仅仅是为了做个实际的项目把玩一下 tui.rs 这个框架,做好之后问题层出不穷,但我深知没有与生俱来的完美,只有不断的迭代才能让它越来越好,经过 100 多次的提交后,现在用着感觉顺手多了。毕竟作者是项目的第一个用户,自己用着不舒服其他人就更不喜欢了! 我想着既然要让别人用,一定要容易安装。接着我做了基于 GitHub Action 自动编译和发布,支持 Windows、Linux、macOS 直接下载就能用。 我还做了对 homebrew 安装的支持,但因为 Star 数不够没有收录到 homecore 要求:30 forks、30 watchers、75 stars 希望大家看到这里的话能给个 star✨ 地址:https://github.com/kaixinbaba/hg-tui 五、最后 hg-tui 它从出生那一刻起,体内流淌的就是开源的血。 它很小甚至是微不足道,我本不想开源,但蛋蛋的一段话让我改变了主意:开源不是完结,仅仅只是开始。 一个开源项目可能只是作者的一个灵光乍现,也可能只是为了解决自己实际工作生活中的小小痛点,没准用完就丢到角落里了。但开源出来或许就能找到有相同需求的人,从而延续这个项目的生命,或许这就是开源的本意吧。 以上就是我做这个项目的全部心得和收获,如果你们对 hg-tui 有什么建议和问题,欢迎给我提 issue 最后,如果你喜欢本文和项目的话,欢迎点赞和 Star 爱你们哟~

优秀的个人博客,低调大师

在 BatchCompute 上玩转 Blender 渲染

本篇主要是介绍如何基于 BatchCompute 的 App,提交 Blender 渲染作业。 1. 准备工作 (1) 开通服务 开通批量计算服务(BatchCompute): https://help.aliyun.com/document_detail/127644.html 开通对象存储服务(OSS): https://oss.console.aliyun.com 开通MNS服务: https://mns.console.aliyun.com 开通容器服务: https://cr.console.aliyun.com 如果已经开通,请忽略此步骤。 (2) 地域的选择 本篇例子所有阿里云服务都需要使用相同的地域。 本篇例子使用地域: 华南1(深圳) (3) 准备OSS Bucket 请到OSS控制台 创建一个Bucket。 本篇例子假设创建的 buc

优秀的个人博客,低调大师

玩转mybatis中的类型转换

1.场景 日常java开发中经常有这种需求,用0或者1这些代码(不局限于数字)来表示某种状态。比如用0表示女性,用1来表示男性。而且写入数据库可能是一个标识,从数据库读取又还原为具体的说明。而且一般情况下为了更好理解或者消除魔法值,通常的处理方案是定义一个枚举: 有些枚举是这样定义的 public enum GenderType{ FEMALE,MALE,UNKNOWN } 那么通常很多人会这么入库(java伪代码) if(GenderType.MALE){ // 写入 1 }else if(GenderType.FEMALE){ // 写入 0 }else{ //也可能是泰国回来的 那就 2 } 读取的时候要么同样按照上面的再反向处理一次或者使用数据库sql语法case when 来直接写入DTO CASE gender WHEN 1 THEN '男' WHEN 0 THEN '女' ELSE '未知' END 这种处理方式看起来不是很优雅。而且多了很多的判断和处理逻辑,和我们的业务并不是非常相关。所以我们可以选择更好的处理方式。 2.Mybatis中的TypeHandler 如果你ORM框架用的是Mybatis。那么将很容易通过TypeHandler<T>接口解决这个问题。 2.1 TypeHandler 分析 public interface TypeHandler<T> { void setParameter(PreparedStatement ps, int i, T parameter, JdbcType jdbcType) throws SQLException; T getResult(ResultSet rs, String columnName) throws SQLException; T getResult(ResultSet rs, int columnIndex) throws SQLException; T getResult(CallableStatement cs, int columnIndex) throws SQLException; } 源码分析: setParameter 方法 通过 传入的T类型写你自己的逻辑,选择调用 PreparedStatement 对象的某个set方法将数据写入数据库。此方法用来写库。 getResult(ResultSet rs, String columnName) 通过字段名来读库并转换为T类型。 getResult(ResultSet rs, int columnIndex) 通过字段索引来读库并转换为T类型。 getResult(CallableStatement cs, int columnIndex) 调用存储过程来获取结果并转换为T类型。 2.2 EnumOrdinalTypeHandler 我们发现TypeHandler有一个实现类EnumOrdinalTypeHandler。字面意思是可以通过枚举的序号来处理类型。 @Override public void setNonNullParameter(PreparedStatement ps, int i, E parameter, JdbcType jdbcType) throws SQLException { ps.setInt(i, parameter.ordinal()); } 我们先不考虑setNull的情况。通过此方法我们发现确实存入的是枚举的顺序值(顺序从0开始),拿上面的例子来说 如果是GenderType.FEMALE是0,如果是GenderType.MALE是1,但是当GenderType.UNKNOWN时存入的是2。取的时候也是自然反向处理为具体的GenderType枚举。 2.3 EnumTypeHandler 我们还发现有另外一个枚举类型处理器。它的set方法是这样的: @Override public void setNonNullParameter(PreparedStatement ps, int i, E parameter, JdbcType jdbcType) throws SQLException { if (jdbcType == null) { ps.setString(i, parameter.name()); } else { ps.setObject(i, parameter.name(), jdbcType.TYPE_CODE); // see r3589 } } 我们不考虑jdbcType问题发现都是将Enum.name()的值写入数据库。拿上面的例子来说 如果是GenderType.FEMALE是FEMALE,如果是GenderType.MALE是MALE,但是当GenderType.UNKNOWN时存入的是UNKNOWN。读库是通过Enum.valueOf(Class<T> enumType,String name)来进行反转操作。 2.4 自定义TypeHandler 如果说我们的枚举类型或者说我们使用其他方式来处理类别转换怎么办?当然Mybatis不会帮你干这么具体的事情。需要你自己来实现了。我们还拿枚举作为例子,然后模仿上面的两种TypeHandler。 还是拿开始的例子来说通常我个人比较喜欢这么定义枚举: public enum GenderTypeEnum { /** * female. */ FEMALE(0, "女"), /** * male. */ MALE(1,"男"), /** * unknown. */ UNKNOWN(2, "未知"); private int value; private String description; GenderType(int value, String description) { this.value = value; this.description = description; } public int value() { return this.value; } public String description() { return this.description; } } 通过继承BaseTypeHandler实现该抽象类的3个钩子方法就行了: @MappedTypes({GenderTypeEnum.class}) @MappedJdbcTypes({JdbcType.INTEGER}) public class GenderTypeEnumTypeHandler extends BaseTypeHandler<GenderTypeEnum> { @Override public void setNonNullParameter(PreparedStatement ps, int i, GenderTypeEnum parameter, JdbcType jdbcType) throws SQLException { if (jdbcType == null) { ps.setInt(i, parameter.value()); } else { // see r3589 ps.setObject(i, parameter.value(), jdbcType.TYPE_CODE); } } @Override public GenderTypeEnum getNullableResult(ResultSet rs, String columnName) throws SQLException { return getGenderType(rs.getInt(columnName)); } @Override public GenderTypeEnum getNullableResult(ResultSet rs, int columnIndex) throws SQLException { return getGenderType(rs.getInt(columnIndex)); } @Override public GenderTypeEnum getNullableResult(CallableStatement cs, int columnIndex) throws SQLException { return getGenderType(cs.getInt(columnIndex)); } private GenderTypeEnum getGenderType(int value) { Class<GenderTypeEnum> genderTypeClass = GenderTypeEnum.class; return Arrays.stream(genderTypeClass.getEnumConstants()) .filter(genderType -> genderType.value() == value) .findFirst().orElse(GenderTypeEnum.UNKNOWN); } } TypeHandler 实现写好了,那么如何让其发挥作用呢?我们接着往下走。 2.5 TypeHandler的核心要点 TypeHandler作用是javaType和jdbcType相互转换。所以在声明一个TypeHandler的时候一定要明确该TypeHandler处理的这两种类型。这是必须要明确的原则。MyBatis不会通过窥探数据库元信息来决定使用哪种JDBC类型,所以你必须在参数和结果映射中指明何种类型的字段,使其能够绑定到正确的类型处理器上。MyBatis直到语句被执行时才清楚数据类型。 通过上述例子中的@MappedJdbcTypes和@MappedTypes来进行绑定类型转换关系,也可以通过xml的typeHandler元素中的jdbcType或者javaType来指定。如果同时指定,xml的优先级要高。 注意有可能你会覆盖内置的TypeHandler。所以自定义时一定要去了解Mybatis提供的一些默认处理器。避免对其他业务的影响。所以使用自定义TypeHandler很重要的一个原则就是一定要声明JavaType和JdbcType.上面这些虽然比较生涩但是对于使用好TypeHandler非常重要。接下来我们来讲讲具体的配置。 2.6 免注册TypeHandler 我们这里只讲xml中的配置: 一种在rultMap元素中声明一般用来查询。一定要注意2.5中的一些原则。 <resultMap id="StudentMap" type="cn.felord.mybatis.entity.Student"> <id column="student_id" property="studentId"/> <result column="student_name" property="studentName"/> <result column="gender" property="genderType" typeHandler="org.apache.ibatis.type.EnumOrdinalTypeHandler"/> <result column="age" property="age"/> </resultMap> 然后是在插入、更新语句中使用。它们都是相同的,这里只举一个插入例子。 <insert id="saveStu"> insert into student (student_name, gender, age) values (#{studentName}, #{genderType,javaType=cn.felord.mybatis.enums.GenderTypeEnum,jdbcType=INTEGER,typeHandler=cn.felord.mybatis.type.GenderTypeEnumTypeHandler}, #{age}) </insert> 如果注册了别名都可以使用别名。上面的好处就是不用在TypeHandlerRegistry中进行注册。 2.7 注册TypeHandler 在配置中声明注册TypeHandler,然后Mybatis根据两种类型会自动匹配。所以这里还是要强调2.5中的核心要点。 如果你是xml配置需要在Configuration配置文件中的<typeHandlers>标签中进行声明式注册 <typeHandlers> <typeHandler jdbcType="JdbcType枚举存在的枚举" javaType="typeAliases的别名或者全限定类名" handler="类全限定名"/> <package name="指定所有typeHandler所在的包的包名"/> </typeHandlers> javaConfig 方式 ,第一你可以通过SqlSessionFactory对象取到Configuration对象将typeHandler注册进去。如果你使用mybatis-spring组件,可以在SqlSessionFactoryBean 的setTypeHandlersPackage方法中配置typeHandler的集中包路径,那么框架将会自动扫描并注册他们。springboot中对应的配置属性是mybatis.typeHandlersPackage。 如果你注册了TypeHandler。在Mapper.xml中只需要声明jdbcType和javaType,无需再声明具体的typeHandler。Mybatis会自动通过jdbcType、javaType来映射到具体注册的TypeHandler上去 。就像下面的例子 <insert id="saveAutomaticStu"> insert into student (student_name, gender, age) values (#{studentName}, #{genderType,javaType=cn.felord.mybatis.enums.GenderTypeEnum,jdbcType=INTEGER}, #{age}) </insert> 3.总结 今天我们学习了mybatis开发中如何通过使用类型处理器进行类型的转换处理,如何处理枚举,如何自定义处理器并使用它。相信对你在java开发过程中会有很大的帮助。相关的代码在我的码云仓库中:https://gitee.com/felord/mybatis-test.git 多多关注我的公众号:码农小胖哥,可以得到更加及时的资讯和反馈。
优秀的个人博客,低调大师

自己动手玩转深度学习项目

自从2012年AlexNet网络在ImageNet挑战赛上取得巨大成功之后,计算机视觉和深度学习等领域再一次迎来研究热潮。计算机视觉,从字面意义上理解就是让计算机等机器也具备人类视觉,研究让机器进行图像分类、目标检测等。在这近十年里,该领域取得的成就让人大吃一惊,有些研究已经超越了人类的表现水平。对于想入门或者从事深度学习领域的工作者而言,一般是从计算机视觉入手,网上有很多资料去介绍理论方面的知识,进行相应的实践也必不可少。本文总结一些在计算机视觉和深度学习领域的一些实践项目,供读者针对自己的感兴趣点挑选并实践。如果不熟悉上述术语,可以从下面的文章中了解更多的相关信息: 一份“新奇”的深度学习介绍 两个月探索深度学习和计算机视觉 从神经科学到计算机视觉 Andrew Ng在Coursera上的计算机视觉课程 下面进行正文介绍: 1.使用Ope

优秀的个人博客,低调大师

用Python玩转时序数据

时间序列是日常生活中最常见的数据类型之一。股票价格、销售信息、气候数据、能源使用,甚至个人身高体重都是可以用来定期收集的数据样本。几乎每个数据科学家在工作中都会遇到时间序列,能够有效地处理这些数据是数据科学领域之中的一项非常重要的技能。 本文简要介绍了如何从零开始使用Python中的时间序列。这包括对时间序列的简单定义,以及对利用pandas访问伦敦市居民智能电表所获取数据的处理。可以点击此处获取本文中所使用的数据。还提供了一些我认为有用的代码。 让我们从基础开始,时间序列的定义是这样的: 时间序列是按时间的顺序进行索引、排列或者绘制的数据点的集合。最常见的定义是,一个时间序列是在连续的相同间隔的时间点上取得的序列,因此它是一个离散时间数据的序列。 时间序列数据是围绕相对确定的时间戳而组织的。因此,与随机样本相比,可能包含我们将要尝试提取

优秀的个人博客,低调大师

玩转vue的slot内容分发

vue的内容分发非常适合“固定部分+动态部分”的组件的场景,固定部分可以是结构固定,也可以是逻辑固定,比如下拉loading,下拉loading只是中间内容是动态的,而拉到底部都会触发拉取更多内容的操作,因此我们可以把下拉loading做成一个有slot的插件。 单个Slot 在children这个标签里面放Dom,Vue不会理你,也就是不会显示,类似React:this.props.children。 //父 <children> <span>12345</span>//这边不会显示 </children> //子 components: { children: { template: "<button>为了明确作用范围,所以使用button标签</button>" } } 你需要写成这样 children: { template: "<button><slot></slot>为了明确作用范围,所以使用button标签</button>" } 注意这边 slot 相当于一个坑,等着父组件给填上,这边 slot 代表的就是上面的 span 多个Slot 这边需要加name属性,说白了,多个Slot就不像上面单个,需要有个对应关系。 父-> slot="name1" 子-> <slot name="name1" //父 <children> <span slot="name1">12345</span> </children> //子 components: { children: { template: "<button> <slot name="name1"></slot> button标签 </button>" } } 这边写了一个name1,如果有多个,就插多个,比较简单。 使用场景 “下拉加载更多”的场景在移动端相对来说出现得比较多。我们知道下拉触底都要监听触底事件,触底的操作也相同(去后台拉取数据),分页算法也相同,因此我们会想到把它做成一个组件,重用这些相同的地方,让其他地方可以共用这个组件,从而减少代码量。 然而,下拉loading并不是一个可以完全重用的组件,因为列表里面的内容不同,空白页(没有内容时)的内容也可能不同,如果要做成组件,那么就要考虑到这方面的“不同”,因此我们想到利用vue的内容分发slot来做。下面是本人在开发的时候做的一个下拉loading,大家可以参考下。 组件代码: <template> <div> <slot name="list" v-if="total > 0"></slot> <slot name="empty" v-else></slot> </div> </template> <script> import Toast from 'lib/xl-toast' import Tool from 'tool/tool' export default { data() { return { page: 1, isLoading: false, busy: false, isFirstLoad: false } }, props: { pageSize: { default: 10 // 每页展示多少条数据 }, total: { default: 0 // 总共多少条记录 } }, computed: { totalPage() { return Math.ceil(this.total / this.pageSize) } }, created() { this.getList() }, mounted() { this.addScrollListener() }, methods: { addScrollListener() { // 添加监听滚动操作,用到函数防抖 this.scrollFn = Tool.throttle(this.onScroll, 30, 30) document.addEventListener('scroll', this.scrollFn, false) }, getList() { // 正在拉取数据或者没有数据了,则取消滚动监听 if(this.isLoading || this.isFirstLoad && (this.page > this.totalPage)) { document.removeEventListener('scroll', this.scrollFn, false) return } this.busy = true this.isLoading = true // 通知父组件去拉取更多数据 this.$emit("getList", this.page, () => { this.isFirstLoad = true this.isLoading = false this.page++ }, () => { Toast.show('网络错误,请稍后重试') this.total = 0 this.isLoading = false }) }, reset() { // 重新拉取数据 this.page = 1 this.total = 0 this.isLoading = false this.isFirstLoad = false this.addScrollListener() this.getList() }, onScroll() { // 到底拉取更多数据 if(Tool.touchBottom()) { this.getList() } } } } </script> 前端全栈学习交流圈:866109386,面向1-3经验年前端开发人员,帮助突破技术瓶颈,提升思维能力,群内有大量PDF可供自取,更有干货实战项目视频进群免费领取。 总之,遇到一些有想对比较固定的部分,包括js操作或者结构固定,又有一些动态的部分,我们应该就应该考虑到使用:组件+slot。 意向不到的slot另类用法 我在做需求的时候,做了一个组件,该组件分为上下两个部分,这两个部分耦合度很高(不然我怎么把它当成一个组件呢哈哈哈),如下图所示: 本来C区域是一个组件,然后产品突然说,需要把这两个部分分开,把A移到C1的位置,C1移到A的位置(心里感觉到憋屈)。 这里我的第一个想法就是拆开来做成两个组件,但是问题来了,之前这两部分的耦合度很高,如果强制把它拆开成两个组件,那么这两个组件之间的交互必然会多很多。比如,C1改变了某个东西会影响到C2,那么C1需要触发事件通知父组件,父组件再调用C2的某个方法来更新状态。这种跨组件之间的通讯在组件之间频繁交互的情况下,将会是噩梦,而我这边却需要频繁的交互,所以如果把它拆分为两个组件,那么工作量和复杂度将会大大的增加。当然,你可以想到通过Event Hub的方式来实现两个组件之间的交互,但是根本问题还是没有实质性得得到解决。 那么,有什么方法可以做到不拆分成两个组件又能移动位置的方法呢,答案就是slot。以我的例子为例,把A和B作为C的内容分发,原来是这样的: <A></A> <B></B> <C></C> 改为slot以后是这样的 <C> <A slot="c1"></A> <B slot="c2"></B> </C> 这样就能做到不把C模块拆分,又能调整位置了,以最小的代价完成需求~~。 总结 vue的slot不仅可以用来内容分发,还可以用来做位置调整。如果在需要拆分组件来做位置调整,又不想因为拆分耦合度很高的组件,可以考虑使用slot来进行位置调整。一点愚见,希望对大家有所帮助。

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册