首页 文章 精选 留言 我的

精选列表

搜索[玩转EdgeOne],共1751篇文章
优秀的个人博客,低调大师

smart-socket实战:玩转心跳消息

一、背景 在通信中设计的心跳消息,通常是为了检查网络链路是否正常。虽然TCP协议提供keep-alive机制,但需要在链路空闲2小时后才触发检测,这显然对业务非常不友好。当存在大量连接异常,而服务端却需要等2个小时后才感知到的时候,有限的系统资源会被逐渐耗尽,最终无法为新连接请求继续提供服务。 二、原理 要解决此类问题,业界的普遍做法是在应用层加入心跳机制。心跳消息可以是单向心跳也可以是双向心跳,所谓单向心跳表示由服务端或者客户端的其中一方主动发送心跳请求消息,而另一方返回响应消息(如下图)。双向心跳表示服务端与客户端相互发送心跳请求和响应。因为无论何种类型,实现方案都是一样的,本文以单向心跳为例给大家做讲解。 三、方案 心跳消息通常是周期性的发送,或者是在链路空闲一定时长后触发。如果经历几个周期后都未收到响应,则可以视为链路异常。此时可以继续尝试发送心跳,也可以执行告警并断开连接。 在 smart-socket 中我们提供了现成的心跳插件 HeartPlugin,可以很方便的实现心跳。本文是假定读者朋友对 smart-socket 已有了初步的了解,所以不会涉及 smart-socket 的基础使用,重点描述如何在服务中集成心跳插件。 3.1 HeartPlugin插件概述 3.1.1 心跳策略 在HeartPlugin中有三种心跳策略可供选择,通过选择不同的构造方案确定。 HeartPlugin(int heartRate, TimeUnit timeUnit) heartRate 表示心跳消息的发送频率;timeUnit 表示 heartRate 的数值单位。例如:heartRate=3,timeUnit=TimeUnit.SECONDS,表示每 3秒钟发送一次心跳。heartRate=2000,timeUnit=TimeUnit.MILLISECONDS,表示每 2秒钟发送一次心跳。该策略为周期性发送心跳消息,无论对方是否返回响应。 HeartPlugin(int heartRate, int timeout, TimeUnit unit) 该构造方法相较前一个多出一个参数:timeout(过期时间),必须大于heartRate。如果在timeout时长内发送的心跳消息都没有收到响应消息,则视为链路异常并且该链路会被关闭,释放资源。 HeartPlugin(int heartRate, int timeout, TimeUnit timeUnit, TimeoutCallback timeoutCallback) 该构造方法支持指定超时回调策略 timeoutCallback,其实上一个构造方法就是设置了超时断链策略。如果不满足业务所需,用户可按需定义。 3.1.2 心跳的识别与触发 心跳策略确定好后,下一步就是如何去发送心跳消息,以及如何识别收到的消息是否为响应消息。在 HeartPlugin 中已经定义了这两个接口,需要开发人员去实现处理逻辑: sendHeartRequest 发送心跳。HeartPlugin 在判断某个连接需要触发心跳后,会执行该方法。用户需要在该方法中实现心跳消息的编码并输出数据。 public void sendHeartRequest(AioSession session) throws IOException{ WriteBuffer writeBuffer = session.writeBuffer(); byte[] heartBytes = "heart_req".getBytes(); writeBuffer.writeInt(heartBytes.length); writeBuffer.write(heartBytes); writeBuffer.flush(); } isHeartMessage 请求消息识别。true:表示本次收到的是心跳消息(请求/响应);false:其他业务消息,交由MessageProcessor#processor处理。 public boolean isHeartMessage(AioSession session, String msg) { //心跳请求消息,返回响应 if("heart_req".equals(msg)){ try { WriteBuffer writeBuffer = session.writeBuffer(); byte[] heartBytes = "heart_rsp".getBytes(); writeBuffer.writeInt(heartBytes.length); writeBuffer.write(heartBytes); writeBuffer.flush(); }catch (Exception e){ } return true; } //是否为心跳响应消息 return "heart_rsp".equals(msg); } 3.2 代码演示 3.2.1 服务端 public class HeartServer { private static final Logger LOGGER = LoggerFactory.getLogger(HeartServer.class); public static void main(String[] args) throws IOException { //定义消息处理器 AbstractMessageProcessor<String> processor = new AbstractMessageProcessor<String>() { @Override public void process0(AioSession<String> session, String msg) { LOGGER.info("收到客户端:{}消息:{}", session.getSessionID(), msg); } @Override public void stateEvent0(AioSession<String> session, StateMachineEnum stateMachineEnum, Throwable throwable) { switch (stateMachineEnum) { case SESSION_CLOSED: LOGGER.info("客户端:{} 断开连接", session.getSessionID()); break; } } }; //注册心跳插件:每隔1秒发送一次心跳请求,5秒内未收到消息超时关闭连接 processor.addPlugin(new HeartPlugin<String>(1, 5, TimeUnit.SECONDS) { @Override public void sendHeartRequest(AioSession session) throws IOException { WriteBuffer writeBuffer = session.writeBuffer(); byte[] heartBytes = "heart_req".getBytes(); writeBuffer.writeInt(heartBytes.length); writeBuffer.write(heartBytes); writeBuffer.flush(); } @Override public boolean isHeartMessage(AioSession session, String msg) { //心跳请求消息,返回响应 if ("heart_req".equals(msg)) { try { WriteBuffer writeBuffer = session.writeBuffer(); byte[] heartBytes = "heart_rsp".getBytes(); writeBuffer.writeInt(heartBytes.length); writeBuffer.write(heartBytes); writeBuffer.flush(); } catch (Exception e) { } return true; } //是否为心跳响应消息 if ("heart_rsp".equals(msg)) { LOGGER.info("收到来自客户端:{} 的心跳响应消息", session.getSessionID()); return true; } return false; } }); //启动服务 AioQuickServer<String> server = new AioQuickServer<>(8888, new StringProtocol(), processor); server.start(); } } 3.2.2 客户端 client_1:接受服务端的心跳消息,不做任何回应 client_2:及时响应服务端的心跳消息 public class HeartClient { private static final Logger LOGGER = LoggerFactory.getLogger(HeartClient.class); public static void main(String[] args) throws IOException, ExecutionException, InterruptedException { AbstractMessageProcessor<String> client_1_processor = new AbstractMessageProcessor<String>() { @Override public void process0(AioSession<String> session, String msg) { LOGGER.info("client_1 收到服务端消息:" + msg); } @Override public void stateEvent0(AioSession<String> session, StateMachineEnum stateMachineEnum, Throwable throwable) { LOGGER.info("stateMachineEnum:{}", stateMachineEnum); } }; AioQuickClient<String> client_1 = new AioQuickClient<>("localhost", 8888, new StringProtocol(), client_1_processor); client_1.start(); AbstractMessageProcessor<String> client_2_processor = new AbstractMessageProcessor<String>() { @Override public void process0(AioSession<String> session, String msg) { LOGGER.info("client_2 收到服务端消息:" + msg); try { if ("heart_req".equals(msg)) { WriteBuffer writeBuffer = session.writeBuffer(); byte[] heartBytes = "heart_rsp".getBytes(); writeBuffer.writeInt(heartBytes.length); writeBuffer.write(heartBytes); LOGGER.info("client_2 发送心跳响应消息"); } } catch (Exception e) { e.printStackTrace(); } } @Override public void stateEvent0(AioSession<String> session, StateMachineEnum stateMachineEnum, Throwable throwable) { LOGGER.info("stateMachineEnum:{}", stateMachineEnum); } }; AioQuickClient<String> client_2 = new AioQuickClient<>("localhost", 8888, new StringProtocol(), client_2_processor); client_2.start(); } } 3.2.3观察控制台 服务端 客户端 总结 本文围绕着心跳原理作了简单的实践分享。现实场景中如果对接的设备数量高达几万,甚至十几万,本文的心跳方案是否依旧适用,欢迎一起交流讨论。 本文涉及到的示例代码可从smart-socket仓库中下载

优秀的个人博客,低调大师

玩转kubernetes中Pod挂载公网IP

起因 在很多业务场景里,是需要kubernetes里的Pod去调用某些公网上服务的(无论这些公网服务是自建的还是其它服务提供商的)。但是通常Pod都是通过主机上SNAT的方式做出口,这样容易被误认为是某种信息抓取程序或者是类似DDoS攻击,从而容易被封闭对应的主机IP。 另外有些服务只是对某种服务提供接入,需要设置白名单,但是kuberentes集群里又跑了多种服务,这些服务都是通过主机的SNAT出去,从而比较难限定对应的服务的白名单。如果将对应的服务固定在某几个worker节点上虽然也是一个办法,但是其灵活度以及容器弹性将收到一定的限制。 是否可以提供一个方式,让对应的服务的Pod根据需要来挂载自己独立的公网IP,从而避免上述问题呢?答案是可以的,这个就是我们kubernetes容器服务中特有的网络插件Terway的一个很好的特性。 提

优秀的个人博客,低调大师

使用docker镜像玩转steam挂卡

概述 之前我写过怎么在steam上挂卡,就是下面这篇文章 https://www.bboysoul.com/2017/10/10/%E4%BD%BF%E7%94%A8ArchiSteamFarm%E5%9C%A8%E6%A0%91%E8%8E%93%E6%B4%BE%E6%8C%82%E5%8D%A1/ 不过自从我学习了docker之后,我发现没有什么是不能用一个镜像解决的,如果不能,那就两个,所以,从现在开始我要学会用docker解决任何问题,比如找女朋友。 首先说一下什么是挂卡 当你在steam里玩游戏的时候,你会发现当你玩的时间累积到一定的时间的时候,steam会奖励你一些卡,然后这些卡你可以在市场上卖,虽然卖出去的卡赚来的钱不能取出来,但是你可以买其他游戏啊。挂卡就是帮助你保持游戏的在线时间,然后赚取这些卡片。 但是问题又来了,我挂卡需要游戏,但是我没有钱买这些游戏怎么办?这个就由我这个老司机告诉你,首先没有游戏没关系,没有钱也没有关系,steam上经常会有一些游戏限免,这些游戏可以让你的游戏库加一,然后这些游戏一般都会有卡片的,接着你去关注下面这个商店,很多时候它都会送游戏 https://www.humblebundle.com/store 拿着领取到的key在steam上激活就好了,最后关注一些其他的喜加一新闻就好了 一些前提条件 首先肯定要docker啊,这个就不说了,很简单,在我的博客里搜索下就好了,其次最好使用国外的服务器挂卡,因为你懂的,中国大陆ping不通steamcommunity.com这个地址的 操作 说了这么多废话之后说下操作,首先clone下面这个仓库地址 git clone https://github.com/bboysoulcn/ArchiSteamFarm.git 之后star下这个仓库,并且follow这个很帅气的人,接着build这个镜像,输入下面命令 cd ArchiSteamFarm docker build -t bboysoul/archisteamfarm:3.3.0.3 . 注意上面3.3.0.3后面有个点 如果你不想build这个镜像呢也没有关系,直接pull就可以了 docker pull bboysoul/archisteamfarm:3.3.0.3 之后新建一个screen会话并且运行起来 screen -S steam docker run --name archisteamfarm -it bboysoul/archisteamfarm:3.3.0.3 sh -c "/usr/bin/vim /asf/config/bboysoul.json && /asf/ArchiSteamFarm" 首先会让你输入账号和密码,之后会有输入一个steam的验证码 全部输入完成之后,并且像下面这个样子 ArchiSteamFarm git:(master) docker run --name archisteamfarm -it archisteamfarm:3.3.0.3 sh -c "/usr/bin/vim /asf/config/bboysoul.json && /asf/ArchiSteamFarm" 2018-08-22 23:08:32|ArchiSteamFarm-7|INFO|ASF|InitASF() ArchiSteamFarm V3.3.0.3 (linux-x64/61c03fef-7e4e-4e04-abbf-00d089ff014c | Linux 4.14.14-041414-lowlatency #201801201219 SMP PREEMPT Sat Jan 20 12:23:20 UTC 2018) 2018-08-22 23:08:33|ArchiSteamFarm-7|INFO|ASF|InitGlobalConfigAndLanguage() ASF will attempt to use your preferred culture, but translation in that language was completed only in 0.0 %. Perhaps you could help us improve ASF translation for your language? 2018-08-22 23:08:33|ArchiSteamFarm-7|INFO|ASF|InitGlobalDatabaseAndServices() It looks like it's your first launch of the program, welcome! 2018-08-22 23:08:43|ArchiSteamFarm-7|WARN|ASF|InitGlobalDatabaseAndServices() Please review our privacy policy section on the wiki if you're concerned about what ASF is in fact doing! 2018-08-22 23:08:49|ArchiSteamFarm-7|INFO|ASF|CheckAndUpdateProgram() ASF will automatically check for new versions every 1 day. 2018-08-22 23:08:49|ArchiSteamFarm-7|INFO|ASF|CheckAndUpdateProgram() Checking for new version... 2018-08-22 23:08:51|ArchiSteamFarm-7|INFO|ASF|CheckAndUpdateProgram() Local version: 3.3.0.3 | Remote version: 3.3.0.3 2018-08-22 23:08:51|ArchiSteamFarm-7|INFO|ASF|InitializeSteamConfiguration() Initializing SteamDirectory... 2018-08-22 23:08:51|ArchiSteamFarm-7|INFO|ASF|InitializeSteamConfiguration() Success! 2018-08-22 23:08:52|ArchiSteamFarm-7|INFO|bboysoul|Start() Starting... 2018-08-22 23:08:52|ArchiSteamFarm-7|INFO|bboysoul|Connect() Connecting... 2018-08-22 23:08:53|ArchiSteamFarm-7|INFO|bboysoul|OnConnected() Connected to Steam! 2018-08-22 23:08:53|ArchiSteamFarm-7|INFO|bboysoul|OnConnected() Logging in... <bboysoul> Please enter SteamGuard auth code that was sent on your e-mail: 5888K 2018-08-22 23:09:17|ArchiSteamFarm-7|INFO|bboysoul|OnDisconnected() Disconnected from Steam! 2018-08-22 23:09:17|ArchiSteamFarm-7|INFO|bboysoul|OnDisconnected() Reconnecting... 2018-08-22 23:09:17|ArchiSteamFarm-7|INFO|bboysoul|Connect() Connecting... 2018-08-22 23:09:20|ArchiSteamFarm-7|INFO|bboysoul|OnConnected() Connected to Steam! 2018-08-22 23:09:20|ArchiSteamFarm-7|INFO|bboysoul|OnConnected() Logging in... 2018-08-22 23:09:20|ArchiSteamFarm-7|INFO|bboysoul|OnLoggedOn() Successfully logged on as 76561198422915309/bboysoulcn. 2018-08-22 23:09:20|ArchiSteamFarm-7|INFO|bboysoul|Init() Logging in to ISteamUserAuth... 2018-08-22 23:09:22|ArchiSteamFarm-7|INFO|bboysoul|Init() Success! 2018-08-22 23:09:22|ArchiSteamFarm-7|INFO|bboysoul|IsAnythingToFarm() Checking first badge page... 2018-08-22 23:09:24|ArchiSteamFarm-7|INFO|bboysoul|StartFarming() We have a total of 12 games (39 cards) left to idle (~22 hours, 30 minutes remaining)... 2018-08-22 23:09:24|ArchiSteamFarm-7|INFO|bboysoul|Farm() Chosen idling algorithm: Complex 2018-08-22 23:09:24|ArchiSteamFarm-7|INFO|bboysoul|FarmSolo() Now idling: 550 (Left 4 Dead 2) 2018-08-22 23:09:25|ArchiSteamFarm-7|INFO|bboysoul|ShouldFarm() Idling status for 550 (Left 4 Dead 2): 3 cards remaining 2018-08-22 23:09:25|ArchiSteamFarm-7|INFO|bboysoul|FarmCards() Still idling: 550 (Left 4 Dead 2) 就表示成功了,并且正在挂卡中 ctrl+a+d离开这个会话。 总结一下 如果用上docker,那么你整个刮开流程只要四步 安装docker 执行docker pull bboysoul/archisteamfarm:3.3.0.3 执行screen -S steam 执行docker run --name archisteamfarm -it bboysoul/archisteamfarm:3.3.0.3 sh -c "/usr/bin/vim /asf/config/bboysoul.json && /asf/ArchiSteamFarm" 和以前要安装各种依赖影响宿主机来说好多了 欢迎关注Bboysoul的博客www.bboysoul.comHave Fun

优秀的个人博客,低调大师

玩转kafka中的消费者

上一篇介绍了如何使用Kafka的生产者,这一篇将介绍在实际生产中如何合理地使用Kafka的消费者API。 Kafka中消费者API分为新版和旧版,本章只介绍新版,旧版的就不做介绍了。 首发于我的个人博客:http://www.janti.cn/article/kafkaconsumer 准备工作 kafka版本:2.11-1.1.1 操作系统:centos7 java:jdk1.8 有了以上这些条件就OK了,具体怎么安装和启动Kafka这里就不强调了,可以看上一篇文章。 新建一个maven工程,需要的依赖如下: <dependency> <groupId>org.apache.kafkagroupId> <artifactId>kafka_2.11artifactId> <version>1.1.1version> dependency> <dependency> <groupId>org.apache.kafkagroupId> <artifactId>kafka-clientsartifactId> <version>1.1.1version> dependency> 简单的消费者例子 Kafka中是封装了KafkaConsumer类,消息接受都是通过该类来进行的。与生产者一样,在实例化消费者之前都是要进行配置的。 首先介绍这里面的配置: bootstrap.servers:配置连接代理列表,不必包含Kafka集群的所有代理地址,当连接上一个代理后,会从集群元数据信息中获取其他存活的代理信息。但为了保证能够成功连上Kafka集群,在多代理集群的情况下,建议至少配置两个代理。(由于电脑配置有限,本文实验的是单机情况) key.deserializer: 用于反序列化消息Key的类 value.deserializer:用于反序列化消息值(Value)的类 group.id:指定消费者所在的组 client.id:指定客户端所在组的ID enable.auto.commit:设置是否自动提交。在没有指定消费偏移量提交方式时,默认是每隔1S发送一次 auto.commit.interval.ms:自动提交偏移值的时间间 订阅消息的流程分为以下: 1.消费者参数配置 2.实例化消费者 3.订阅主题 4.从Kafka中拉取消息 按照这样的流程代码如下: package kafka.consumer; import org.apache.kafka.clients.consumer.ConsumerRecord; import org.apache.kafka.clients.consumer.ConsumerRecords; import org.apache.kafka.clients.consumer.KafkaConsumer; import java.util.Arrays; import java.util.Properties; /** * 简单的消费者 * * @author tangj */ public class KafkaSimpleDemo { static Properties properties = new Properties(); private static String topic = "MyOrder"; //poll超时时间 private static long pollTimeout = 2000; // 1.消费者配置 static { // bootstarp server 地址 properties.put("bootstrap.servers", "10.0.90.53:9092"); // group.id指定消费者,所在的组 properties.put("group.id", "order"); // 组中client 的ID名称 properties.put("client.id", "consumer"); // 在没有指定消费偏移量提交方式时,默认是每个1s提交一次偏移量,可以通过auto.commit.interval.ms参数指定提交间隔 // 自动提交要设置成true // 手动提交设置成false properties.put("enable.auto.commit", true); // 自动提交偏移值的 时间间隔 properties.put("auto.commit.interval.ms", 2000); // key序列化 properties.put("key.deserializer", "org.apache.kafka.common.serialization.StringDeserializer"); // value序列化 properties.put("value.deserializer", "org.apache.kafka.common.serialization.StringDeserializer"); } public static void main(String args[]) { consumeAutoCommit(); } /** * 消费消息自动提交偏移值 */ public static void consumeAutoCommit() { //2\. 实例化消费者 KafkaConsumer kafkaConsumer = new KafkaConsumer(properties); // 3.订阅主题 kafkaConsumer.subscribe(Arrays.asList(topic)); try { // 消费者是一个长期的过程,所以使用永久循环, while (true) { // 4.拉取消息 ConsumerRecords records = kafkaConsumer.poll(pollTimeout); for (ConsumerRecord record : records) { System.out.println("消息总数为: " + records.count()); System.out.println("收到消息: " + String.format("partition = %d, offset= %d, key=%s, value=%s%n", record.partition(), record.offset(), record.key(), record.value())); } } } catch (Exception e) { e.printStackTrace(); } finally { kafkaConsumer.close(); } } } 看了简单的消费者模式,来看看消费者中的其他知识:消费模型,分区均衡,偏移量的提交,多线程消费者。 消费模型 可以看到在配置的时候,配置了消费者组这个变量。这里主要讲讲消费模型。消费模型主要分为两种:消费者组模型,发布订阅模型 消费者组中有多个消费者,组内的消费者共享一个group.id,并且有一个单独的client.id。消费者组用来消费一个主题下的所有分区,但是每个分区只能由该组内的一个消费者消费,不会被重复消费。 发布订阅模型就是所有的消费者都可以通过订阅来获取Kafka中的消息。 分区再平衡 介绍一种情况,消费者并不是越多越好的,当消费者大于分区数时,就会有部分消费者一直空闲着。 分区再平衡,即:parition rebanlance。总的来说分区再平衡就是一个消费者原来消费的分区变成由其他消费者消费,它只发生在消费者组中。 再均衡的作用就是为了保证消费者组的高可用和伸缩性,但是再均衡期间消费者会无法读取消息,有短暂的暂停时间。 偏移量的处理 偏移量的左右就是记录已经消费的消息。之前的一个简单的demo演示了自动提交的方式,接下来介绍手动提交。 在实际生产中,消费者拉取到消息之后会进行一些业务处理,比如存到数据库,写入缓存,网络请求等,这些都会有失败的可能,所以要对偏移值进行更精细的控制。 手动提交有两种方式: 第一种是同步提交,同步提交是阻塞的,对于提交失败的处理,它会一直提交,直到提交成功。 第二种是异步提交,异步提交是非阻塞的,对于提交失败,也不会重新提交。 当然,对于手动提交的业务设计,还是要结合具体业务进行考虑和设计。手动提交之后,需要设置 enable.auto.commit为false.并且不需要设置 auto.commit.interval.ms。 下面给出一个自动提交的例子,设置没消费5次,提交一次偏移值: public static void consumeHandleCommit() { KafkaConsumer kafkaConsumer = new KafkaConsumer(properties);try {int maxcount = 5;int count = 0; kafkaConsumer.subscribe(Arrays.asList(topic));for (; ; ) {// 拉取消息 ConsumerRecords records = kafkaConsumer.poll(polltimeout);for (ConsumerRecord record : records) { System.out.println("收到消息: " + String.format("partition = %d, offset= %d, key=%s, value=%s%n", record.partition(), record.offset(), record.key(), record.value())); count++; }// 业务逻辑完成后,提交偏移量 if (count >= maxcount) { kafkaConsumer.commitAsync(new OffsetCommitCallback() {@Override public void onComplete(Map offsets, Exception exception) {if (null != exception) { exception.printStackTrace(); } else { System.out.println("偏移值提交成功"); } } }); count = 0; } } } catch (Exception e) { e.printStackTrace(); } finally { kafkaConsumer.close(); } 多线程消费者 单线程的消费者效率肯定是低于多线程的消费者的,但是消费者的多线程设计与生产者不同,KafkaConsumer是非线程安全的。 保证线程安全,每个线程,各自实例化一个KafkaConsumer对象,并且多个消费者线程只消费同一个主题,不考虑多个消费者线程消费同一个分区。 线程实体类: package kafka.consumer;import org.apache.kafka.clients.consumer.ConsumerRecord;import org.apache.kafka.clients.consumer.ConsumerRecords;import org.apache.kafka.clients.consumer.KafkaConsumer;import java.util.Arrays;import java.util.Map;import java.util.Properties;public class KafkaConsumerThread implements Runnable {//每个线程私有一个consumer实例 private KafkaConsumer<String,String> consumer;public KafkaConsumerThread(Map<String,Object> configMap,String topic) { Properties properties = new Properties(); properties.putAll(configMap);this.consumer = new KafkaConsumer<String, String>(properties);consumer.subscribe(Arrays.asList(topic)); }@Override public void run() {try {for (; ; ) {// 拉取消息 ConsumerRecords<String, String> records = consumer.poll(1000);for (ConsumerRecord<String, String> record : records) { System.out.println("收到消息: " + String.format("partition = %d, offset= %d, key=%s, value=%s%n", record.partition(), record.offset(), record.key(), record.value())); } } } catch (Exception e) { e.printStackTrace(); } finally {consumer.close(); } } } 线程启动类: package kafka.consumer;import java.util.HashMap;import java.util.Map;import java.util.concurrent.ExecutorService;import java.util.concurrent.Executors;public class KafkaConsumerExcutor {/** * kafkaConsumer是非线程安全的,处理好多线程同步的方案是 * 每个线程实例化一个kafkaConsumer对象 */ public static void main(String args[]) { String topic = "hello"; Map<String, Object> configMap = new HashMap<>(); configMap.put("bootstrap.servers", "10.0.90.53:9092");//group.id指定消费者,所在的组,保证所有线程都在一个消费者组 configMap.put("group.id", "test"); configMap.put("enable.auto.commit", true); configMap.put("auto.commit.interval.ms", 1000);// key序列化 configMap.put("key.deserializer", "org.apache.kafka.common.serialization.StringDeserializer");// value序列化 configMap.put("value.deserializer", "org.apache.kafka.common.serialization.StringDeserializer"); ExecutorService service = Executors.newFixedThreadPool(6);// 该主题总共有6个分区,那么保证6个线程 for (int i = 0; i < 6; i++) { service.submit(new KafkaConsumerThread(configMap, topic)); } } } 总结 本文介绍了kafka中的消费者,包括多线程消费者,偏移量的处理,以及分区再平衡。 切记一点,实际的生产中消费者需要根据实际业务来进行设计。

优秀的个人博客,低调大师

玩转阿里云Serverless Kubernetes新功能

Serverless Kubernetes产品介绍 还记得阿里云Serverless Kubernetes五月份正式对外邀测的激动时刻吗?还记得阿里云Serverless Kubernetes与传统Kubernetes集群的区别吗?让我们再次一起了解一下Serverless Kubernetes。 阿里云Serverless Kubernetes让您无需管理和维护集群与服务器,即可快速创建 Kuberentes 容器应用,并且根据应用实际使用的 CPU 和内存资源量进行按需付费。使用 Serverless Kubernetes,您可以专注于设计和构建应用程序,而不是管理运行应用程序的基础设施。它基于阿里云弹性计算基础架构,并且完全兼容 Kuberentes API的解决方案,充分结合了虚拟化资源带来的安全性、弹性和 Kubernete

优秀的个人博客,低调大师

【原创】5分钟玩转Markdown

希望简书支持的Markdown功能 [TOC]生成目录 PC端预览时,原文与预览同步滚动 支持公式 $$ x{yz}=(1+{\rm e}x){-2xy^w} $$ MacOS 与 Windows通吃的Markdown编辑器 typora,很好用。 支持实时预览 支持TOC生成目录 支持$$生成公式 支持快捷键设置标题 中文界面 支持快速设置表格 这里有好多其它的Markdown编辑器 Sublime Markdown Markdown Editing Markdown Preview 支持[TOC]生成目录 实时预览,LiveReload 设置Markdown Preview快捷键,复制下面内容到Sublime的Key Bindings的文件里面 { "keys": ["alt+m"], "command": "markdown_preview", "args": {"target": "browser", "parser":"markdown"} } Markdown 常用知识 标题 1级标题 # 2级标题 ## 3级标题 ### 4级标题 #### 5级标题 ##### 6级标题 ###### 分割线 *** 首行缩进 在段首输入&ensp; 首行缩进一个空格 在段首输入&emsp;首行缩进输入两个空格。 序号 直接写1.,然后加空格,写完内容回车,直接生成列表 下拉菜单 滑块 复选框 符号列表 *星号列表,星号+空格+文字,回车继续 下拉菜单 滑块 复选框 +,加号列表,与星号一样 下拉菜单 滑块 复选框 上标 <sup>与</sup>,以及^^ 简书<sup>TM</sup>, 简书TM n<sup>2</sup>=n+1, n2=n+1 H^2^O, H2O 下标 <sub>与</sub>,以及~~ H<sub>2</sub>O,H2O H~2~O, H2O 引用文字 使用>是一级引用,使用两个>,即>>,是引用里面的引用 引用文字 下一段 引用里面的引用 粗体与斜体 斜体,文字两边各写一个*星号,或斜体,文字两边各写一个_下划线 粗体,文字两边各写两个*星号,或粗体,文字两边各写两个_下划线 斜粗体,文字两边各写三个*星号,或斜粗体,文字两边各写三个_下划线 脚注 脚注[^这是一个脚注] 脚注[1] [^这是一个脚注]:这是一个脚注 行内代码-底纹 文字两边加上反引号`,比如下段文字: 在 Python 输出 Hello, world :print("Hello World") 代码块1【每句代码前加四个空格】 import dash_core_components as dcc dcc.Slider(value=4, min=-10, max=20, step=0.5, labels={-5: '-5 Degrees', 0: '0', 10: '10 Degrees'}) import dash_core_components as dcc dcc.Slider(value=4, min=-10, max=20, step=0.5, labels={-5: '-5 Degrees', 0: '0', 10: '10 Degrees'}) 代码块2【代码内容上下各加三个反引号```】 import dash_core_components as dcc dcc.Slider(value=4, min=-10, max=20, step=0.5, labels={-5: '-5 Degrees', 0: '0', 10: '10 Degrees'}) import dash_core_components as dcc dcc.Slider(value=4, min=-10, max=20, step=0.5, labels={-5: '-5 Degrees', 0: '0', 10: '10 Degrees'}) 代码块3 【```python 指定是Python格式】 def wiki_rocks(text): formatter = lambda t: "funky"+t return formatter(text) 链接 [这是一个有提示的链接](http://url.com/ "这是一个有提示的链接")这是一个有提示的链接 [这是一个没有提示的链接](http://url.com/)这是一个没有提示的链接 最简单的链接 http://url.com 引用链接: 这是一个[引用的链接][Quote] [Quote]:http://www.jianshu.com "引号前面要有个空格" 电子邮件 <dainiao@qq.com>dainiao@qq.com 图片 ![图片说明](http:https://yqfile.alicdn.com/img_f43a6604b777a30beb8a1587df2c78f9.png?imageMogr2/auto-orient/strip%7CimageView2/2/w/1240) 图片说明 表格1 姓名|语文|数学|总成绩 ---|:---|:---:|---: 张三|100|90|190 姓名 语文 数学 总成绩 张三 100 90 190 :---:代表居中对齐, ---:代表左对齐. :---代表右对齐,另外-至少要有三个 表格2 Python | Julia | Go ----|------|---- foo | foo | foo bar | bar | bar baz | baz | baz Python Julia Go foo foo foo bar bar bar baz baz baz 其他 &copy * 星号 这是一个脚注 ↩

优秀的个人博客,低调大师

从零玩转jQuery-初识jQuery

课前须知: 学习jQuery前必须先掌握JavaScript jQuery虽然属于前端技术, 但是对于后端人员(诸如Java、PHP等,也需要掌握) jQuery是什么? jQuery是一款优秀的JavaScript库,从命名可以看出jQuery最主要的用途是用来做查询(jQuery=js+Query). 在jQuery官方Logo下方还有一个副标题(write less, do more), 体现了jQuery除了查询以外,还能让我们对HTML文档遍历和操作、事件处理、动画以及Ajax变得更加简单 体验jQuery 原生JS设置背景(先不要求看懂代码,先看看谁更爽) <script> // 查询 var div = document.getElementsByTagName("div"); var one = document.getElementsByClassName("one"); var two = document.getElementById("two"); // 操作css div[0].style.backgroundColor = "red"; one[0].style.backgroundColor = "yellow"; two.style.backgroundColor = "blue"; </script> 使用jQuery设置背景 <script> $(document).ready(function () { // 查询,操作CSS一步到位 $("div").eq(0).css('background', 'red'); $(".one").eq(0).css('background', 'yellow'); $("#two").css('background', 'blue'); }); </script> 为什么要使用jQuery? 强大选择器: 方便快速查找DOM元素 如上面实例所展示一样,通过jQuery查找DOM元素要比原生js快捷很多 jQuery允许开发者使用CSS1-CSS3几乎所有的选择器,以及jQuery独创的选择器 链式调用: 可以通过.不断调用jQuery对象的方法 如上面实例所展示一样,jQuery可以通过.(点).不断调用jQuery对象的方法,而原生JavaScript则不一定 <script> // 1.原生JavaScript var div = document.getElementsByTagName("div"); // 报错,必须分开写 div[0].style.backgroundColor = "red".width = 200+"px"; // div[0].style.width = 200+"px"; // 2.jQuery $(document).ready(function () { // 不报错,后面还可以接着继续写 $("div").eq(1).css('background', 'yellow').css('width', '200px'); }); </script> 隐式遍历(迭代): 一次操作多个元素 <script> // 1.原生JavaScript var div = document.getElementsByTagName("div"); // div.style.backgroundColor = "red";// 无效 for(var i = 0; i<div.length; i++){ div[i].style.backgroundColor = "red"; } // 2.jQuery $(document).ready(function () { // 隐式遍历(迭代)找到的所有div $("div").css('background', 'yellow'); }); </script> 读写合一: 读数据/写数据使用是一个函数 <script> $(document).ready(function () { // 读取数据 var $tx = $("div").eq(0).text(); alert($tx); // 写入数据 $("div").eq(0).text("新的数据"); }); </script> 事件处理 DOM操作(C增U改D删) 样式操作 动画 丰富的插件支持 浏览器兼容(前端开发者痛点) 1.x:兼容ie678,但相对其它版本文件较大,官方只做BUG维护,功能不再新增,最终版本:1.12.4 (2016年5月20日). 2.x:不兼容ie678,相对1.x文件较小,官方只做BUG维护,功能不再新增,最终版本:2.2.4 (2016年5月20日) 3.x:不兼容ie678,只支持最新的浏览器,很多老的jQuery插件不支持这个版本,相对1.x文件较小,提供不包含Ajax/动画API版本。 应该选择几点几版本jQuery? 查看百度网页源码使用1.x 查看腾讯网页源码使用1.x 查看京东网页源码使用1.x 综上所述学习1.x,选择1.x 应该使用开发板还是生产版? 开发板: 所有代码没有经过压缩,体积更大(200-300KB) 生产版:所有代码经过压缩,提及更小(30-40KB) 初学者为了更好的理解jQuery编码时使用开发板,项目上线时为了提升访问速度使用生产版 ... ... 如何使用jQuery? 下载jQuery库 下载地址: http://code.jquery.com/ 引入下载的jQuery库 <head> <meta charset="UTF-8"> <title>01-初识jQuery</title> <script src="code/js/jquery-1.12.4.js"></script> </head> 编写jQuery代码 <script> $(document).ready(function () { // 所有jQuery代码写在这里面 alert("hello LNJ"); }); </script>

优秀的个人博客,低调大师

从零玩转jQuery-入口函数

jQuery入口函数 jQuery与JavaScript加载模式对比 多个window.onload只会执行一次, 后面的会覆盖前面的 <script> window.onload = function () { alert("hello lnj1"); // 不会显示 } window.onload = function () { alert("hello lnj2"); // 会显示 } </script> 多个$(document).ready()会执行多次,后面的不会覆盖前面的 <script> $(document).ready(function () { alert("hello lnj1"); //会显示 }); $(document).ready(function () { alert("hello lnj2"); // 会显示 }); </script> 不会覆盖的本质(了解,后面jQuery原理会详细讲解) jQuery框架本质是一个闭包,每次执行我们都会给ready函数传递一个新的函数,不同函数内部的数据不会相互干扰 <script> // 相当于这样写 var test1 = function () { alert("hello lnj1"); } var test2 = function () { alert("hello lnj2"); } $(document).ready(test1); $(document).ready(test2); </script> <script> var test3 = function () { var abc = "123"; // 因为在同一个函数中,所以456覆盖123 // var abc = "456"; alert(abc); } test3(); var test4 = function () { // 因为在不同函数中,所以不会影响 var abc = "456"; alert(abc); } test4(); </script> window.onload $(document).ready() 执行时机 必须等待网页全部加载完毕(包括 图片等),然后再执行包裹代码 只需要等待网页中的DOM结构 加载完毕,就能执行包裹的代码 执行次数 只能执行一次,如果第二次,那么 第一次的执行会被覆盖 可以执行多次,第N次都不会被上 一次覆盖 简写方案 无 $(function () { }); 为什么我们能访问$符号? 因为$符号jQuery框架对外暴露的一个全局变量 JavaScript中如何定义一个全局变量? 所有全局变量是 window 对象的属性 function test () { var customValue = 998; alert(customValue); // 1.没有如下代码customValue就不是一个全局变量,函数执行完毕之后 // customValue会被自动释放,test函数以外的地方访问不到customValue // 2.加上如下代码之后customValue就会变成一个全局变量,函数执行完毕也不 // 会被释放,test函数以外的地方可以访问customValue // window.customValue = customValue; } test(); alert(customValue); 所以jQuery框架源码实现 window.jQuery = window.$ = jQuery; 所以想要使用jQuery框架只有两种方式,一种是通过$,一种是通过jQuery jQuery入口函数的其它编写方式如下 <script> // 方式一 $(document).ready(function () { alert("hello lnj"); }); // 方式二 $(function () { alert("hello lnj"); }); // 方式三 jQuery(document).ready(function () { alert("hello lnj"); }); // 方式四 jQuery(function () { alert("hello lnj"); }); </script> 解决$符号冲突问题 为什么是window.jQuery = window.$ = jQuery;,而不是window.jQuery = jQuery; jQuery框架之所以提供了jQuery访问还提供$访问,就是为了提升开发者的编码效率 $符号冲突怎么办? 很多js的框架都提供了类似jQuery这样的便捷访问方式,所以很有可能某一天我们在使用多个框架的时,多个框架作者提供的便捷访问方式冲突(A框架通过$访问,B框架也通过$访问) ***释放$使用权 当便捷访问符号发生冲突时,我们可以释放$使用权, 释放之后只能使用jQuery <script> // 在使用jQuery之前指定自定义符号 jQuery.noConflict(); // 使用 jQuery jQuery("div p").hide(); // 使用其他库的 $() $("content").style.display = 'none'; </script> 自定义便捷访问符号 当便捷访问符号发生冲突时,我们可以自定义便捷访问符号 <script> // 在使用jQuery之前指定自定义符号 var nj = jQuery.noConflict(); // 和使用$一样通过自定义符号调用jQuery nj(function () { alert("hello lnj"); }); </script>

优秀的个人博客,低调大师

玩转Android monkey之monkey小实战

环境介绍 l 模拟器里安装手机百度APP l 本机通过monkey命令进行随机测试 l 所有的命令均在cmd命令模式下输入 执行过程 语法:adb shell monkey -p 包名 随机事件次数,如下图 PS:每个人的环境不一样,结果可能会略微有差异 如何查看包名在《手机APP测试系列视频》中讲过(http://edu.51cto.com/topic/498.html),此处不再重复 本文转自 小强测试帮 51CTO博客,原文链接:http://blog.51cto.com/xqtesting/2049603,如需转载请自行联系原作者

优秀的个人博客,低调大师

玩转树莓派——管理 Windows IoT 设备

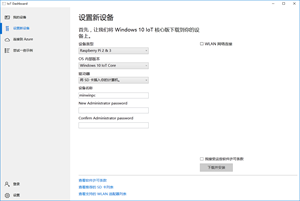
安装完树莓派只是第一步,要让Windows 10 IoT Core在树莓派上跑起来,管理系统等成套的工具必不可少。 由于Windows 10 IoT Core运行在卡片电脑上,没有设置太多的UI操作,很多操作都要通过IoT Dashboard应用和设备门户来进行。简单说说怎么管理树莓派上的Windows 10 IoT Core吧。 可以使用IoT Dashboard直接下载Windows 10 IoT的镜像进行安装,并且可以在安装时指定设备名、管理密码、wifi网络等信息。 运行在同一网络的Windows 10 IoT设备例如树莓派,能够被自动发现。在发现的设备上右键即可打开管理门户。 在管理门户里可以修改设备配置,包括更改密码。也可以查看当前运行的所有进程。 作为一个能运行UWP跨平台应用的物联网设备,管理软件App和管理硬件都很重要。 为了便于连接树莓派设备的同时又能连接Internet,Windows 10 IoT支持启用软AP的方式兼顾网络需求。为了在没有显示器的时候查看设备显示,也为了方便我截图(哈哈),微软还提供一个应用Windows IoT Remote Client来实现类似远程桌面的支持(请注意,并不是RDP协议)。 以上是我通过Remote Client看到的树莓派的显示,这些应用个都能在应用商店免费获取。细心的人会发现,我在树莓派上无法运行标准的命令行。处于安全考虑,命令行需要通过命令开启(这句话好别扭) 光有本地的管理还不够,Windows 10 IoT Core好玩的地方在于可以连接Azure云计算,以及开发运行自己的代码。后续继续介绍。 本文转自HaoHu 51CTO博客,原文链接:http://blog.51cto.com/haohu/1858596,如需转载请自行联系原作者

优秀的个人博客,低调大师

商业银行如何玩转大数据?

“大数据(Big Data)”的概念在过去几年里引起了各个行业的充分关注。以信息处理能力作为核心竞争力之一的商业银行,如能引入大数据的理念和相关技术,将有效提升自身的信息化水平,促进信息化银行的建设和发展。 因此,有必要基于商业银行经营特点和现有IT架构,对“大数据”的概念加以分析和探讨。 本文以商业银行的视角,从大数据的核心思想、数据特点、技术要领、实施要点四个方面切入,以六组问答的形式对商业银行大数据相关的思想、概念、方法、对策等进行辨析和讨论。 大数据的核心在于“大”吗? 体量大、维度高、形态多、价值高但密度低是公认的大数据四大特点(即大数据的“4V”定义)。需要指出的是,这四大特点的概括,是出于理论研究的需要,对“数据”本身特点进行的概括。 而对于商业银行的业务应用而言,则应从具体效用的角度来理解大数据思想及技术。 大数据之于商业银行,在于对既有数据分析系统的升级,显著提升数据分析和商业决策的效率。 大数据的思想追求数据在商业决策中的“无处不在”,讲求数据分析与具体业务的紧密衔接。 从商业智能(BusinessIntelligence, BI)的角度来看,大数据技术是原有BI的升级,将传统的“具体业务—商业数据—BI分析—报表—决策—具体业务”的BI流程进行了再造,压缩了整个流程的信息链条,同时提升了链条各个环节及整体的运转效率。 大数据之于商业银行,在于提供了一种有效的手段,提高商业银行对客户的理解与认知能力。 大数据技术支持商业银行对大量日志数据进行统计和建模,从而了解客户的行为习惯、风险偏好、健康情况、消费能力、渠道喜好、信用状况及人口统计学等多方面的信息,进而为客户“贴标签”、“画像”;亦可整合多种信息反馈渠道的数据,帮助商业银行实时关注、理解客户的真正业务需求。 大数据之于商业银行,在于能够低成本、批量地实现较高水准的个性化客户服务,增加客户粘性。 如能有效地将大数据分析系统与移动互联网技术、线上线下一体化服务体系进行紧密融合,就可为商业银行的客户提供“千人千面”的个性化服务。 例如,对于低净值长尾客户,可用较低的成本,批量化地通过电子渠道提供随身的知心服务,提高产品和服务的覆盖率;对于高净值客户,提供“客户经理+电子渠道”的随身贴心服务,提升客户的业务贡献。 可见,从具体效用的角度来看,衡量一个商业银行是否真正应用了大数据、发挥了大数据的价值,就是要看其大数据系统是否能够显著提升数据分析和商业决策的效率,是否能够提高对客户的理解与认知能力,是否能够低成本、批量地实现较高水准的个性化客户服务。 如果商业银行的大数据系统未能实现上述效用,那就需要认真审视自身的大数据战略并加以调整。 大数据就是外部数据吗? 在国内,以阿里、腾讯、百度为代表的互联网企业,以各自的核心业务(例如,阿里的电子商务、腾讯的社交娱乐、百度的网络搜索)为切入点,通过并购、自主开发等方式,不断推出种类繁多的网络服务,在网络空间中搭建了“全业务”的数据平台,收集了海量的客户数据,并以此为基础开发出了一系列客户征信、消费贷款、网络保险等大数据产品,向商业银行的相关产品提出挑战。 与上述互联网企业相比,商业银行在网络空间中缺少类似的“全业务”平台,因此短期内难以依靠自身的电子渠道获取类似的客户信息。对此,商业银行是否应该将大数据的战略重点放在从自身体系之外获取客户数据呢?应从以下三个角度进行分析。 数据价值的角度。京东白条、天猫分期、阿里小贷、支付宝运费险、百分点个人征信、金电联行“企业客观信用”等业务的成功实践已经验证了互联网客户大数据在维度、粒度、活性方面的优势和价值,如果这些数据能与商业银行的既有数据进行融合分析,将有望获得更加精准的数据分析结果。 自身大数据体系的建设。一方面,应以内部数据为重点,做好自身既有数据的价值深钻和分析架构的大数据改造,而不应以引入外部数据作为大数据发展的战略重点;另一方面,要放开眼界,积极引入外部数据,增强商业银行与互联网企业IT架构方面的交流,以期加快自身大数据体系的建设进度,提升其兼容性与可用性。 数据交换的合规性。客户在使用互联网服务期的行为信息、购物记录、健康信息等数据理应属于隐私数据,客户在注册期间签署的网络服务协议是否能够有效支持互联网企业采集、商用并交换,尚属法律空白。因此,商业银行在引进外部数据之前,应首先做好合规工作。 可见,对于商业银行而言,合规合理地引入外部数据,有助于提升自身数据的多样性、细化数据粒度,并可通过数据交换提升自身大数据体系的兼容性与可用性。 但是也应充分认识到,商业银行多年积累的业务数据的价值还远未完全发挥,尚待深钻、分析和应用,应将基于内部数据的分析应用作为当前自建大数据能力的核心;与此同时,也要及时开展预研预估,做好外部数据交换的合规准备工作,为“内外兼修”的大数据平台建设做好准备。 大数据是否等同于非结构化数据? “非结构化数据”是在大数据的“4V”定义中作为数据多样性的一个典型例子而被提出的,因此受到了普遍关注,在众多关于大数据的文献中,“非结构化数据”也占据着比较重要的地位。 那么,商业银行是否也应将“非结构化数据”的处理作为现阶段自建大数据体系的重点? 对于这一问题,要结合“非结构化数据”的特性进行分析。非结构化数据的本质特性是所包含信息的丰富、复杂程度远远高于结构化数据。典型的“非结构化数据”包括文本、音乐、语音、图像、视频等类型的数据,这些数据所包含的信息极其丰富,不能使用数据表进行无损耗转化。 因此,非结构化数据无法使用数据表或者类似的结构化的方式进行无损转化,所以只能以数据包、文件集的方式进行存储,也无法使用与结构化数据相同的数据分析方法进行统计、分析、建模,往往需要通过专门设计的预处理算法将其转化为结构化数据。 这就增加了数据管理和分析的难度,也提高了对数据存储、计算资源的需求。对于非结构化数据的分析,至今仍是学术界的研究热点,在学术领域尚属“进行时”,在商用领域的应用则更是凤毛麟角。 可见,现阶段自建大数据体系,对于非结构化数据应按照“量体裁衣”的原则,根据自身IT架构的存储、计算资源和技术人员投入分步实施。 对于资源紧张的商业银行,可采取“存储—外购预处理模块—自行研发”三步走的路径积累非结构化数据的分析能力。 对于资源较丰富的商业银行,则可按照“预研一批、实用一批、储备一批”的策略,采用“外购预处理模块+产学研合作+自行研发”的方式进行尝试,紧跟技术前沿,适时引入成熟的非结构化处理技术,但也应注意资源配比,不应将非结构化数据作为现阶段自建大数据体系的重点。 大数据等同于数据仓库吗? 如前所述,商业银行是否具备大数据能力,应依据数据及数据分析系统所发挥的具体效用来判断。 以“显著提升数据分析和商业决策的效率”,“显著提高对客户的理解与认知能力”,“低成本、批量地实现较高水准的个性化客户服务”三条标准来衡量,目前商业银行数据仓库建设还需在以下几个方面加以强化。 建设异构的数据仓库平台。 多年来,商业银行的数据仓库以存储业务、交易数据为主,因此采购了存储成本较高的专业数据仓库服务,数据在进入仓库之前的ETL规则相对比较严格,并采用了“时间换空间”的策略进行主题拆分以节约存储空间。 这就导致在执行诸如交易链恢复、交易场景还原等分析任务时消耗较高的计算资源,降低整体的分析效率。 与用户行为数据紧密相关的日志数据,具有典型的“数据量大、频度高但价值密度低”的特点,可针对这一需求,搭建低成本的PC集群、内存数据库等,与既有的数据仓库融合起来,构成对数据源和分析端透明的异构数据仓库,提高其响应速度和处理能力。 搭建业务指标提取逻辑的共享平台。 目前商业银行基础数据的标准化工作已经取得了长足的进展,但在实际应用中,尚存在“业务逻辑信息孤岛”现象(即由于缺乏一个共享平台,而造成不同的分析师之间无法互通业务指标的提取逻辑,每个分析师、每个数据分析部门就形成了一座座孤岛)。 这一现象不仅造成业务指标“多态”问题,也诱发了数据仓库访问请求的重复提交,影响数据分析的效率和准确性,因此需尽快搭建权限控制合理的业务指标提取逻辑分享平台,解决“业务逻辑信息孤岛”问题。 建立由信息治理部门主导、以业务部门为中心的大数据创新立项机制。大数据应用要求尽量压缩数据分析业务链条,进一步提高具体业务与数据分析环节结合的紧密程度。 对此,可以探索建立由信息治理部门主导、以业务部门为中心的大数据创新立项机制。 简言之,就是将数据分析师融入具体业务部门,由数据分析师和具体业务部门共同发起大数据应用的创新项目立项,经信息治理部门审批后,给予相应的计算资源,并依据数据应用项目在具体业务中产生的效果进行评估和激励。 大数据只需要Hadoop平台吗? Apache 软件基金会(ASF)旗下的海杜普(Hadoop)开源项目对于大数据应用无疑有着巨大的推动作用,基于Hadoop的HDFS系统也是目前主流大数据平台的重要基础设施,那么是不是有了Hadoop平台,商业银行就拥有了大数据处理能力了呢? 首先,从软硬件平台的完备性来看,还需持续投入,配置更多的软件模块,以提升大数据分析平台的能力。 Hadoop只是大数据分析平台的基础设施,除了基于Hadoop及Yarn的Hive、HBase、Pig、Storm之外,mahout、Hadoop-R、Hadoop-weka等数据分析、数据挖掘套件对于大数据分析也是必不可少的,另外速度更快、性能更高的Spark体系也在互联网企业获得了成功的应用,值得商业银行关注和借鉴。 其次,从数据的来源来看,还需改造前端,以获取更多维度、更高频次、更细粒度的数据。 商业银行的数据分析系统长期以来重视业务数据的存储,而对于系统运行状态的日志、客户个人信息的收集并不重视,而这些信息恰恰是大数据分析得以理解客户、排查业务问题的关键所在。 因此,商业银行需要系统性地进行应用前端改造,借鉴互联网企业、电商企业的做法,设法获取更多维度、更高频次、更细粒度的数据,更好地满足大数据分析对数据源的需求。 最后,从项目的执行过程来看,还须形成“数据分析+业务应用”的数据分析模式,以迭代方式优化分析结果和具体业务。 传统的BI模式下,数据分析的业务流程可以概括为:接受业务部门提出的分析需求=>数据分析=>形成报告。 而大数据分析的很多项目需要数据分析师与业务人员一起进行持续迭代,有的项目甚至很难确立一个明确的终止时间点(例如电商的推荐系统一般由一个团队持续优化),这就需要商业银行能够允许在特定的大数据分析项目上,采取“数据分析+业务应用”的数据分析模式,以迭代方式优化分析结果和具体业务。 可见,Hadoop平台并不是商业银行具备大数据能力的充要条件,商业银行不仅需要在软硬件平台上持续投入,还需要在前端设计、数据分析模式等方面加以改造,才能更加适应大数据分析的要求。 大数据只是数据分析部门的事? 如前所述,大数据能力是以数据分析为基础的,融合商业决策、客户感知、个性化服务为一体的综合竞争力,因此,大数据能力建设就不应仅由数据分析部门来承担。 要从战略层面将大数据能力建设纳入发展规划。 应做好顶层设计,把大数据能力建设与信息化银行建设结合起来,与线上线下一体化建设结合起来,与互联网金融发展战略结合起来,协同业务、渠道、科技、数据分析等多个部门,做好顶层设计和统筹规划,形成“全员大数据”的氛围,从数据源梳理、数据分析平台搭建、分析模式确立、外部数据交换规则等多个层次制定明确的方针与操作标准,加快大数据能力建设的进度。 要重视数据分析流程的效率提升。 大数据分析的效用大小,很大程度上取决于数据的活性以及分析结果投入具体业务的速度,因此,要尽可能压缩传统BI的业务链条。 可在电子渠道和自助渠道尽可能地实现数据采集与分析结果应用的一体化(例如,基于客户个性的产品关联推荐、基于场景的实时定价、自助设备界面个性化自适应等),也可在传统的BI领域中,应用大数据的处理模式,以高实时性的中间数据层为媒介,建立效率更高、实时性更强、管理者自定义程度更深的商业智能系统,实现商业报表的实时化、移动化、定制化。 要重视人才储备和技术积累。 大数据技术的发展日新月异,数据的人才储备和技术积累却不能一蹴而就,需要相当力度的持续投入。 人才储备方面,应本着“引进一批,培养一批,储备一批”的原则,引进一小批高层次技术人才,通过具体的项目实施,培养大量的存量技术人员,并通过面向高校和社会的大数据技术竞赛、资助开源社区等方式,形成广泛而有效的人才储备。 技术积累方面,应按照“开放并包,为我所用”的思路,组成大数据预研团队,积极开展开源项目的筛选、验证、吸收工作,沿着“引入并消化大数据开源项目—资助大数据开源项目—提出并主导大数据开源项目”的路径,不断强化自身在大数据技术方面的优势,形成自身的核心竞争力。 本文作者:谢尔曼 黄旭 来源:51CTO

优秀的个人博客,低调大师

阿里巴巴如何玩转大数据

我们将迈入大数据的一个新时代,敏捷、准确、低成本的数据分析和预测将成为现实。20日,阿里云发布大数据平台数加,集合了计算引擎、开发套件、可视化工具和行业解决方案,这是全球首个囊括前、中、后台的大数据一站式开发平台,可让数据分析和预测成本降至原有的10%左右。 这次阿里云发布的大数据开发平台,囊括了阿里巴巴十余年来的大数据技术,这些技术正在阿里系的各个商业场景中发挥作用,例如淘宝首页给你推荐什么样的商品、你的芝麻信用分是多少、谁可以获得更大的花呗额度,或者谁可以直接获得贷款。 “过去6年来,阿里巴巴巨大的战略投资就是放在云计算和大数据服务上。我们相信人类已经从IT时代在步入DT(Data Techonology)时代。”马云在2015年致投资者公开信中表示,“我们必须在数据技术的投入和发展上不惜一切的投入发展,我们正在努力让数据和计算能力成为普惠经济的基础。” 马云的DT技术正在变现,集成了人工智能、机器学习、智能语音等前沿技术的阿里云大数据平台数加,让没有足够技术实力的公司,也能实现从数据中提炼“石油”。权威研究机构IDC数据显示,2014年中国企业投入了约14亿美元购买商业分析软件和服务,这个数字在未来5年内将呈几何式增长。 “未来3年,大数据市场规模将达到1万亿元。”阿里云总裁胡晓明在发布会上表示,基于阿里云大数据平台数加,将有千余家合作伙伴、万名首席数据官和5万数据科学家诞生,把中国大数据市场规模拓展至万亿规模。 “大数据”一词近年来在中国十分火热,但真正的数据技术和工具平台一直缺位。“中国的数据技术起步比硅谷晚,但我们看到互联网巨头们正在大量投入研发力量,来缩短差距。”Alliance Development Group分析师David Sullivan表示,以阿里巴巴为典型的中国互联网公司正在自己的商业场景中大规模使用数据技术,技术上与硅谷几乎没有差距。 在发布会上,阿里云提及去年年底刚刚刷新的一项世界纪录。在由数据库之父Jim Gray创办的排序基准评估竞赛Sort Benchmark中,阿里云把100TB数据的排序时间缩短到了377秒,打破了此前由雅虎、微软、斯坦福大学等公司与机构保持的纪录。 从成本上来说,阿里云的大数据平台也把数据技术的使用成本拉到一个新的时代。“数据分析和预测的成本将降至原有的10%,数据技术将变成普惠的技术能力,企业可以跨过技术和资金的障碍,真正从数据中掘金。”阿里云大数据事业部资深总监徐常亮表示。 骤降的数据成本可能让IBM一类的公司倍感压力,因为这让他们提供的传统BI软件显得价格昂贵。此前,企业的数据挖掘依赖购买BI类软件,这类软件不但购买和维护费用高昂,还不能实现在线实时数据分析。 “实时数据分析和预测才是数据技术的魅力所在。”徐常亮表示,阿里云大数据平台数加将为各类机构和企业带来全新的决策依据,“企业们将实时知晓自己面对的挑战,并基于数据预测来判断下一步该往哪走。” 在不久前,阿里云公布了一项与浙江省交通厅的合作,浙江省交通厅利用阿里云的大数据平台来预测高速公路未来5到60分钟的车速情况,预测准确率稳定在91%以上。基于高速车速预测,以便交通部门更好的进行交通引导,公众也可以做出更优的路线选择。 “一开始大家关心的问题是数据运算的速度有多快,然后关心预测的速度有多快。”徐常亮表示,“现在,大家该关心的问题是我是否比竞争对手更快得到数据结果,是否比竞争对手拥有更准确的预测。我们就是想为大家提供这样更快、更准确的大数据平台。” 本文转自d1net(转载)

优秀的个人博客,低调大师

历数玩转光伏的IT巨头们

最近“能源互联网”被炒得火热,而IT企业也闻风而动,一个接一个地进军新能源产业,小编为您盘点一下,这些玩光伏的IT巨头们。IBM近期IBM公司的一只科研团队研发出一款结合光伏发电和太阳热利用的高效冷却热利用型高倍聚光光伏太阳能电池系统(简称HCPVT),该系统单位面积可聚集平时2000倍的太阳光量,研发团队声称在确保安全性的前提下,这一数据还能刷新到5000倍。 IBM本身也做能源行业,主要是上游。而IBM进入光伏也是按照这一的套路,从上游产品电池做起。几年前,IBM就曾与旺能光电(DelSolar)、SolarFrontier以及东京应化公司(TokyoOhkaKogyo)结成联盟,共同研发光伏电池技术。 同时,IBM还向数据中心提供光伏发电和直流供电系统。这种电源系统可以将数据中心的耗电量削减10%。主要提供对象是容易出现电力不足的新兴市场国家的数据中心。谷歌2011年,谷歌Google向德国勃兰登堡新建的一处太阳能设施进行了第一笔金额为350万欧元的国际投资(大约相当于500万美元,获取了项目49%的股份)。这是德国最大的此类工厂之一,其峰值容量高达18.65兆瓦,生产能量相当于5,000多户家庭用电量的总和。德国有支持可再生能源的强有力框架,并且也是本行业内许多持有领先技术的公司总部所在地。该项目所使用的太阳能电池中超过70%的部分是由德国制造商生产的。 截止目前,全球最大的互联网公司Google已经在全球范围内的16项可再生能源项目中投资了超过10亿美元,Google还仍在寻找能为更多人可用上绿色能源的更多机会。 Google表示,他们正在创造一个更好的网络,一个更有益于环境的网络。并通过高效地使用资源和支持可再生能源的方式让我们的公司变得越来越环保。这意味着,当您使用Google产品时,也是在为保护环境作出贡献。华为与恒大一出手就豪掷上千亿的资本围猎光伏的路径不同,同为太阳能光伏业的“后进生”,中国信息产业巨头华为用了两年时间进入光伏设备。华为切入这一市场主要是通过光伏电站中的核心设备光伏逆变器。美国著名能源信息咨询研究机构HIS最近公布的一项调查排名显示,在2014年的第二季度,华为凭借其组串式逆变器,首次跻身“全球十大”光伏逆变器供应商之列。 光伏逆变器是华为网络能源业务三大板块之一,在开发新产品上,最大程度地发挥华为各个跨事业部合作的优势,通过硬、软件的有效整合,在提高产品效率的同时,帮助客户提升行业竞争力。 华为进入太阳能光伏界做了三件事情:一是对光伏逆变器产品进行创新设计与改造,二是力推组串式以替代集中式,三是新的客户主张,瞬间震动了原有光伏逆变器“传统三观”。 分析人士指出,虽以逆变器为突破口进入光伏,但很显然,华为有更大的产业抱负。在已经拉开大幕的光伏应用战略中,提供光伏电站的智能解决方案也许才是华为最为关注的一个千亿级市场。苹果苹果进军新能源的策略则较为谨慎,虽然其为全球最知名的互联网企业之一,但苹果目前仍然没有想过要在数据和系统上介入光伏。苹果稳打稳扎,只建电站。 早在两年前苹果就自己建了太阳能电站,目前已经有两座20兆瓦的太阳能电站建成,第三座电站位于北卡罗莱纳州,目前正在建,另外一座在建的20兆瓦的太阳能电站在内达华州。 而就在4月中旬,苹果开始扩大范围布局进军海外光伏产业,首站选择了中国。苹果建电站的目的也很简单,只为实现其对外承诺的“苹果所有的数据中心由可再生能源“供电”。 要说苹果为何对投资可再生能源如此重视,主要有以下几点原因:一是满足自身能耗需求;二是保持天生的炫酷形象;三是财务上Hold得住;四是新产品可以搭上新能源噱头;五是能源互联网的大势。阿里阿里进入光伏是从今年才开始,算是新兵。阿里集团旗下的阿里云3月底宣布与阳光电源合作,共同发布“智慧光伏云”。而具体的表现为,未来将有数十万太阳能电站接入阿里云,变成互联网+发电站。 说白了,就是把所有光伏发电站的实时资料用来共享,并建立远程的自动化管理和设备状态预警,透过这些资料挖掘和分析从而来提高电站效率和利用率。根据双方的预测,智能光伏云预期可每年将发电站的收益提高3%-7%,这相当于1GW的太阳能发电站,每年可增加5,000万元人民币收入。 从长期来看,太阳能光伏产业与云端服务结合所带来的收益可能不仅仅是这样,云端系统可分析给出太阳能发电站所处位置的精确天气预报,可以进行跨区域的能源供给和消费调整,对降低电力传输的损耗很有帮助。 阿里的作用首先是帮助了光伏电站开发商解决融资问题。其次,在“智慧光伏云”及以后的参与中所得到的数据,还可以解决运维问题,甚至帮助电站售电。融资、运维、售电恰好形成一个闭环,这里蕴藏着巨大的市场。嗅觉敏锐的阿里当然要抢先分一杯羹。 从谷歌、苹果、IBM、阿里、华为等IT巨头纷纷进军新能源来看,历来IT企业看重的是流量和入口,而非重资产投入,联手新能源企业或许是能源互联网时代展开的前奏。能源互联网才是真正可见的风口。 本文转自d1net(转载)

优秀的个人博客,低调大师

玩转云镜像制作之packer篇

1.DevOps之基础设施即代码(Infrastracture as Code) 什么是DevOps呢?按照维基百科的定义,DevOps(Development和Operations的组合词)是一种重视“软件开发人员(Dev)”和“IT运维技术人员(Ops)”之间沟通合作的文化、运动或惯例。透过自动化“软件交付”和“架构变更”的流程,来使得构建、测试、发布软件能够更加地快捷、频繁和可靠。在缺乏DevOps能力的组织中,开发与运营之间存在着信息“鸿沟”──例如运营人员要求更好的可靠性和安全性,开发人员则希望基础设施响应更快,而业务用户的需求则是更快地将更多的特性发布给最终用户使用。这种信息鸿沟就是最常出问题的地方。而DevOps的引入能对产品交付、测试、功能开发和维护(包括──曾经罕见但如今已屡见不鲜的

优秀的个人博客,低调大师

55个必备技巧带你玩转JavaScript

1. oncontextmenu="window.event.returnValue=false" 将彻底屏蔽鼠标右键 <table border oncontextmenu=return(false)> <td>no </table> 可用于Table2. <body onselectstart="return false"> 取消选取、防止复制3. onpaste="return false" 不准粘贴4. oncopy="return false;" oncut="return false;" 防止复制5. <link rel="Shortcut Icon" href="favicon.ico"> IE地址栏前换成自己的图标6. <link rel="Bookmark" href="favicon.ico"> 可以在收藏夹中显示出你的图标7. <input style="ime-mode:disabled"> 关闭输入法8. 永远都会带着框架 <scriptlanguage="JavaScript"><!-- if(window==top)top.location.href="frames.htm";//frames.htm为框架网页 //--></script> 9. 防止被人frame <SCRIPTLANGUAGE=JAVASCRIPT><!-- if(top.location!=self.location)top.location=self.location; //--></SCRIPT> 10. 网页将不能被另存为 <noscript><***src="/*.html>";</***></noscript> 11. <input type=button value="/查看网页源代码 onclick="window.location="view-source:"+"http://www.pconline.com.cn""> 12.删除时确认 <ahref=""javascript:if(confirm("确实要删除吗?"))location="boos.asp?&areyou=删除&page=1"">删除</a> 13. 取得控件的绝对位置 //Javascript <scriptlanguage="Javascript"> functiongetIE(e){ vart=e.offsetTop; varl=e.offsetLeft; while(e=e.offsetParent){ t+=e.offsetTop; l+=e.offsetLeft; } alert("top="+t+"/nleft="+l); } </script> //VBScript <scriptlanguage="VBScript"><!-- functiongetIE() dimt,l,a,b seta=document.all.img1 t=document.all.img1.offsetTop l=document.all.img1.offsetLeft whilea.tagName<>"BODY" seta=a.offsetParent t=t+a.offsetTop l=l+a.offsetLeft wend msgbox"top="&t&chr(13)&"left="&l,64,"得到控件的位置" endfunction --></script> 14. 光标是停在文本框文字的最后 <scriptlanguage="javascript"> functioncc() { vare=event.srcElement; varr=e.createTextRange(); r.moveStart("character",e.value.length); r.collapse(true); r.select(); } </script> <inputtype=textname=text1value="123"onfocus="cc()"> 15. 判断上一页的来源 javascript: document.referrer 16. 最小化、最大化、关闭窗口 <objectid=hh1classid="clsid:ADB880A6-D8FF-11CF-9377-00AA003B7A11"> <paramname="Command"value="Minimize"></object> <objectid=hh2classid="clsid:ADB880A6-D8FF-11CF-9377-00AA003B7A11"> <paramname="Command"value="Maximize"></object> <OBJECTid=hh3classid="clsid:adb880a6-d8ff-11cf-9377-00aa003b7a11"> <PARAMNAME="Command"value="/Close"></OBJECT> <inputtype=buttonvalue="/最小化onclick=hh1.Click()> <inputtype=buttonvalue="/blog/最大化onclick=hh2.Click()> <inputtype=buttonvalue=关闭onclick=hh3.Click()> 本例适用于IE 17.屏蔽功能键Shift,Alt,Ctrl <script> functionlook(){ if(event.shiftKey) alert("禁止按Shift键!");//可以换成ALTCTRL } document.onkeydown=look; </script> 18. 网页不会被缓存 <METAHTTP-EQUIV="pragma"CONTENT="no-cache"> <METAHTTP-EQUIV="Cache-Control"CONTENT="no-cache,must-revalidate"> <METAHTTP-EQUIV="expires"CONTENT="Wed,26Feb199708:21:57GMT"> 或者<METAHTTP-EQUIV="expires"CONTENT="0"> 19.怎样让表单没有凹凸感? <inputtype=textstyle="""border:1solid#000000"> 或 <inputtype=textstyle="border-left:none;border-right:none;border-top:none;border-bottom: 1solid#000000"></textarea> 20. <div> <span>& <layer>的区别? <div>(division)用来定义大段的页面元素,会产生转行 <span>用来定义同一行内的元素,跟<div>的唯一区别是不产生转行 <layer>是ns的标记,ie不支持,相当于<div> 21.让弹出窗口总是在最上面: <bodyonblur="this.focus();"> 22.不要滚动条? 让竖条没有: <bodystyle="overflow:scroll;overflow-y:hidden"> </body> 让横条没有: <bodystyle="overflow:scroll;overflow-x:hidden"> </body> 两个都去掉?更简单了 <bodyscroll="no"> </body> 23.怎样去掉图片链接点击后,图片周围的虚线? <ahref="#"onFocus="this.blur()"><imgsrc="/logo.jpg"border=0></a> 24.电子邮件处理提交表单 <formname="form1"method="post"action=mailto:****@***.com enctype="text/plain"> <inputtype=submit> </form> 25.在打开的子窗口刷新父窗口的代码里如何写? window.opener.location.reload() 26.如何设定打开页面的大小 <bodyonload="top.resizeTo(300,200);"> 打开页面的位置<bodyonload="top.moveBy(300,200);"> 27.在页面中如何加入不是满铺的背景图片,拉动页面时背景图不动 <STYLE> body {background-p_w_picpath:url(/logo.gif);background-repeat:no-repeat; background-position:center;background-p_w_upload:fixed} </STYLE> 28. 检查一段字符串是否全由数字组成 <scriptlanguage="Javascript"><!-- functioncheckNum(str){returnstr.match(//D/)==null} alert(checkNum("1232142141")) alert(checkNum("123214214a1")) //--></script> 29. 获得一个窗口的大小 document.body.clientWidth;document.body.clientHeight 30. 怎么判断是否是字符 if(/[^/x00-/xff]/g.test(s))alert("含有汉字"); elsealert("全是字符"); 31.TEXTAREA自适应文字行数的多少 <textarearows=1name=s1cols=27onpropertychange ="this.style.posHeight=this.scrollHeight"> </textarea> 32. 日期减去天数等于第二个日期 <scriptlanguage=Javascript> functioncc(dd,dadd) { //可以加上错误处理 vara=newDate(dd) a=a.valueOf() a=a-dadd*24*60*60*1000 a=newDate(a) alert(a.getFullYear()+"年"+(a.getMonth()+1)+"月"+a.getDate()+"日") } cc("12/23/2002",2) </script> 33. 选择了哪一个Radio <HTML><scriptlanguage="vbscript"> functioncheckme() foreachobinradio1 ifob.checkedthen window.alertob.value next endfunction </script><BODY> <INPUTname="radio1"type="radio"value="/style"checked>Style <INPUTname="radio1"type="radio"value="/blog/barcode">Barcode <INPUTtype="button"value="check" </BODY></HTML> 34.脚本永不出错 <SCRIPTLANGUAGE="JavaScript"> <!--Hide functionkillErrors(){ returntrue; } window.onerror=killErrors; //--> </SCRIPT> 35.ENTER键可以让光标移到下一个输入框 <inputonkeydown="if(event.keyCode==13)event.keyCode=9"> 36. 检测某个网站的链接速度: 把如下代码加入<body>区域中: <scriptlanguage=Javascript> tim=1 setInterval("tim++",100) b=1 varautourl=newArray() autourl[1]=1000){this.resized=true;this.style.width=1000;}"align=absMiddleborder=0>www.njcatv.net" autourl[2]="javacool.3322.net" autourl[3]=1000){this.resized=true;this.style.width=1000;}"align=absMiddleborder=0>www.sina.com.cn" autourl[4]="www.nuaa.edu.cn" autourl[5]=1000){this.resized=true;this.style.width=1000;}"align=absMiddleborder=0>www.cctv.com" functionbutt(){ ***("<formname=autof>") for(vari=1;i<autourl.length;i++) ***("<inputtype=textname=txt"+i+"size=10value="/测试中……>=》<inputtype=text name=url"+i+"size=40>=》<inputtype=buttonvalue="/blog/GO onclick=window.open(this.form.url"+i+".value)><br>") ***("<inputtype=submitvalue=刷新></form>") } butt() functionauto(url){ document.forms[0]["url"+b].value=url if(tim>200) {document.forms[0]["txt"+b].value="/链接超时"} else {document.forms[0]["txt"+b].value="/blog/时间"+tim/10+"秒"} b++ } functionrun(){for(vari=1;i<autourl.length;i++)***("<imgsrc=http://"+autourl+"/"+Math.random()+"width=1height=1 onerror=auto("http://"+autourl+"")>")} run()</script> 37. 各种样式的光标 auto:标准光标 default:标准箭头 hand:手形光标 wait:等待光标 text:I形光标 vertical-text:水平I形光标 no-drop:不可拖动光标 not-allowed:无效光标 help:?帮助光标 all-scroll:三角方向标 move:移动标 crosshair:十字标 e-resize n-resize nw-resize w-resize s-resize se-resize sw-resize 38.页面进入和退出的特效 进入页面<metahttp-equiv="Page-Enter"content="revealTrans(duration=x,transition=y)"> 推出页面<metahttp-equiv="Page-Exit"content="revealTrans(duration=x,transition=y)"> 这个是页面被载入和调出时的一些特效。duration表示特效的持续时间,以秒为单位。transition表示使用哪种特效,取值为1-23: 0矩形缩小 1矩形扩大 2圆形缩小 3圆形扩大 4下到上刷新 5上到下刷新 6左到右刷新 7右到左刷新 8竖百叶窗 9横百叶窗 10错位横百叶窗 11错位竖百叶窗 12点扩散 13左右到中间刷新 14中间到左右刷新 15中间到上下 16上下到中间 17右下到左上 18右上到左下 19左上到右下 20左下到右上 21横条 22竖条 23以上22种随机选择一种 39.在规定时间内跳转 <METAhttp-equiv=V="REFRESH"content="5;URL=http://www.51js.com"> 40.网页是否被检索 <metaname="ROBOTS"content="属性值"> 其中属性值有以下一些: 属性值为"all":文件将被检索,且页上链接可被查询; 属性值为"none":文件不被检索,而且不查询页上的链接; 属性值为"index":文件将被检索; 属性值为"follow":查询页上的链接; 属性值为"noindex":文件不检索,但可被查询链接; 属性值为"nofollow":文件不被检索,但可查询页上的链接。 41、email地址的分割 把如下代码加入<body>区域中 <ahref="mailto:webmaster@sina.com">webmaster@sina.com</a> 42、流动边框效果的表格 把如下代码加入<body>区域中 <SCRIPT> l=Array(6,7,8,9,‘a‘,‘b‘,‘b‘,‘c‘,‘d‘,‘e‘,‘f‘) Nx=5;Ny=35 t="<tableborder=0cellspacing=0cellpadding=0height="+((Nx+2)*16)+"><tr>" for(x=Nx;x<Nx+Ny;x++) t+="<tdwidth=16id=a_mo"+x+"></td>" t+="</tr><tr><tdwidth=10id=a_mo"+(Nx-1)+"></td><tdcolspan="+(Ny-2)+"rowspan="+(Nx)+"></td><tdwidth=16id=a_mo"+(Nx+Ny)+"></td></tr>" for(x=2;x<=Nx;x++) t+="<tr><tdwidth=16id=a_mo"+(Nx-x)+"></td><tdwidth=16id=a_mo"+(Ny+Nx+x-1)+"></td></tr>" t+="<tr>" for(x=Ny;x>0;x--) t+="<tdwidth=16id=a_mo"+(x+Nx*2+Ny-1)+"></td>" ***(t+"</tr></table>") varN=Nx*2+Ny*2 functionf1(y){ for(i=0;i<N;i++){ c=(i+y)%20;if(c>10)c=20-c document.all["a_mo"+(i)].bgColor=""""#0000"+l[c]+l[c]+"‘"} y++ setTimeout(‘f1(‘+y+‘)‘,‘1‘)} f1(1) </SCRIPT> 43、JavaScript主页弹出窗口技巧 窗口中间弹出 <script> window.open("http://www.cctv.com","","width=400,height=240,top="+(screen.availHeight-240)/2+",left="+(screen.availWidth-400)/2); </script> ============ <html> <head> <scriptlanguage="LiveScript"> functionWinOpen(){ msg=open("","DisplayWindow","toolbar=no,directories=no,menubar=no"); msg.***("<HEAD><TITLE>哈罗!</TITLE></HEAD>"); msg.***("<CENTER><H1>酷毙了!</H1><h2>这是<B>JavaScript</B>所开的视窗!</h2></CENTER>"); } </script> </head> <body> <form> <inputtype="button"name="Button1"value="Pushme" </form> </body> </html> ============== 一、在下面的代码中,你只要单击打开一个窗口,即可链接到赛迪网。而当你想关闭时,只要单击一下即可关闭刚才打开的窗口。 代码如下: <SCRIPTlanguage="JavaScript"> <!-- functionopenclk(){ another=open(‘1000){this.resized=true;this.style.width=1000;}"align=absMiddleborder=0>http://www.ccidnet.com‘,‘NewWindow‘); } functioncloseclk(){ another.close(); } //--> </SCRIPT> <FORM> <INPUTTYPE="BUTTON"NAME="open"value="/打开一个窗口"onClick="openclk()"> <BR> <INPUTTYPE="BUTTON"NAME="close"value="/blog/关闭这个窗口"onClick="closeclk()"> </FORM> 二、上面的代码也太静了,为何不来点动感呢?如果能给页面来个降落效果那该多好啊! 代码如下: <script> functiondrop(n){ if(self.moveBy){ self.moveBy(0,-900); for(i=n;i>0;i--){ self.moveBy(0,3); } for(j=8;j>0;j--){ self.moveBy(0,j); self.moveBy(j,0); self.moveBy(0,-j); self.moveBy(-j,0); } } } </script> <bodyonLoad="drop(300)"> 三、讨厌很多网站总是按照默认窗口打开,如果你能随心所欲控制打开的窗口那该多好。 代码如下: <SCRIPTLANGUAGE="JavaScript"> <!--Begin functionpopupPage(l,t,w,h){ varwindowprops="location=no,scrollbars=no,menubars=no,toolbars=no,resizable=yes"+ ",left="+l+",top="+t+",width="+w+",height="+h; varURL="http://www.80cn.com"; popup=window.open(URL,"MenuPopup",windowprops); } //End--> </script> <table> <tr> <td> <formname=popupform> <pre> 打开页面的参数<br> 离开左边的距离:<inputtype=textname=leftsize=2maxlength=4>pixels 离开右边的距离:<inputtype=textname=topsize=2maxlength=4>pixels 窗口的宽度:<inputtype=textname=widthsize=2maxlength=4>pixels 窗口的高度:<inputtype=textname=heightsize=2maxlength=4>pixels </pre> <center> <inputtype=buttonvalue="打开这个窗口!"onClick="popupPage(this.form.left.value,this.form.top.value,this.form.width.value, this.form.height.value)"> </center> </form> </td> </tr> </table>你只要在相对应的对话框中输入一个数值即可,将要打开的页面的窗口控制得很好。 44、页面的打开移动 把如下代码加入<body>区域中 <SCRIPTLANGUAGE="JavaScript"> <!--Begin for(t=2;t>0;t--){ for(x=20;x>0;x--){ for(y=10;y>0;y--){ parent.moveBy(0,-x); } } for(x=20;x>0;x--){ for(y=10;y>0;y--){ parent.moveBy(0,x); } } for(x=20;x>0;x--){ for(y=10;y>0;y--){ parent.moveBy(x,0); } } for(x=20;x>0;x--){ for(y=10;y>0;y--){ parent.moveBy(-x,0); } } } //--> //End--> </script> 45、显示个人客户端机器的日期和时间 <scriptlanguage="LiveScript"> <!--Hiding today=newDate() ***("现在时间是:",today.getHours(),":",today.getMinutes()) ***("<br>今天日期为:",today.getMonth()+1,"/",today.getDate(),"/",today.getYear()); //endhidingcontents--> </script> 46、自动的为你每次产生最後修改的日期了: <html> <body> ThisisasimpleHTML-page. <br> Lastchanges: <scriptlanguage="LiveScript"> <!--hidescriptfromoldbrowsers ***(document.lastModified) //endhidingcontents--> </script> </body> </html> 47、不能为空和邮件地址的约束: <html> <head> <scriptlanguage="JavaScript"> <!--Hide functiontest1(form){ if(form.text1.value=="") alert("您没写上任何东西,请再输入一次!") else{ alert("嗨"+form.text1.value+"!您已输入完成!"); } } functiontest2(form){ if(form.text2.value==""|| form.text2.value.indexOf(‘@‘,0)==-1) alert("这不是正确的e-mailaddress!请再输入一次!"); elsealert("您已输入完成!"); } //--> </script> </head> <body> <formname="first"> Enteryourname:<br> <inputtype="text"name="text1"> <inputtype="button"name="button1"value="输入测试"onClick="test1(this.form)"> <P> Enteryoure-mailaddress:<br> <inputtype="text"name="text2"> <inputtype="button"name="button2"value="输入测试"onClick="test2(this.form)"> </body> 48、×××灯 <html> <head> <scriptlanguage="JavaScript"> <!--Hide varscrtxt="怎麽样!很酷吧!您也可以试试."+"Heregoesyourmessagethevisitorstoyour pagewill"+"lookatforhoursinpurefascination..."; varlentxt=scrtxt.length; varwidth=100; varpos=1-width; functionscroll(){ pos++; varscroller=""; if(pos==lentxt){ pos=1-width; } if(pos<0){ for(vari=1;i<=Math.abs(pos);i++){ scroller=scroller+"";} scroller=scroller+scrtxt.substring(0,width-i+1); } else{ scroller=scroller+scrtxt.substring(pos,width+pos); } window.status=scroller; setTimeout("scroll()",150); } //--> </script> </head> <bodyonLoad="scroll();returntrue;"> 这里可显示您的网页! </body> </html> 49、在网页中用按钮来控制前页,后页和主页的显示。 <html> <body> <FORMNAME="buttonbar"> <INPUTTYPE="button"VALUE="Back"onClick="history.back()"> <INPUTTYPE="button"VALUE="JS-Home"onClick="location=‘script.html‘"> <INPUTTYPE="button"VALUE="Next"onCLick="history.forward()"> </FORM> </body> </html> 50、查看某网址的源代码 把如下代码加入<body>区域中 <SCRIPT> functionadd() { varress=document.forms[0].luxiaoqing.value window.location="view-source:"+ress; } </SCRIPT> 输入要查看源代码的URL地址: <FORM><inputtype="text"name="luxiaoqing"size=40value="http://"></FORM> <FORM><br> <INPUTtype="button"value="查看源代码"onClick=add()> </FORM> 51、title显示日期 把如下代码加入<body>区域中: <scriptlanguage="JavaScript1.2"> <!--hide varisnMonth=new Array("1月","2月","3月","4月","5月","6月","7月","8月","9月","10月","11月","12月"); varisnDay=new Array("星期日","星期一","星期二","星期三","星期四","星期五","星期六","星期日"); today=newDate(); Year=today.getYear(); Date=today.getDate(); if(document.all) document.title="今天是:"+Year+"年"+isnMonth[today.getMonth()]+Date+"日"+isnDay[today.getDay()] //--hide--> </script> 52、显示所有链接 把如下代码加入<body>区域中 <scriptlanguage="JavaScript1.2"> <!-- functionextractlinks(){ varlinks=document.all.tags("A") vartotal=links.length varwin2=window.open("","","menubar,scrollbars,toolbar") win2.***("<fontsize=‘2‘>一共有"+total+"个连接</font><br>") for(i=0;i<total;i++){ win2.***("<fontsize=‘2‘>"+links.outerHTML+"</font><br>") } } //--> </script> <inputtype="button"onClick="extractlinks()"value="显示所有的连接"> 53、回车键换行 把如下代码加入<body>区域中 <scripttype="text/javascript"> functionhandleEnter(field,event){ varkeyCode=event.keyCode?event.keyCode:event.which? event.which:event.charCode; if(keyCode==13){ vari; for(i=0;i<field.form.elements.length;i++) if(field==field.form.elements) break; i=(i+1)%field.form.elements.length; field.form.elements.focus(); returnfalse; } else returntrue; } </script> <form> <inputtype="text"onkeypress="returnhandleEnter(this,event)"><br> <inputtype="text"onkeypress="returnhandleEnter(this,event)"><br> <textarea>回车换行 54、确认后提交 把如下代码加入<body>区域中 <SCRIPTLANGUAGE="JavaScript"> <!-- functionmsg(){ if(confirm("你确认要提交嘛!")) document.lnman.submit() } //--> </SCRIPT> <formname="lnman"method="post"action=""> <p> <inputtype="text"name="textfield"value="确认后提交"> </p> <p> <inputtype="button"name="Submit"value="提交" </p> </form> 55、改变表格的内容 把如下代码加入<body>区域中 <script***script> vararr=newArray() arr[0]="一一一一一"; arr[1]="二二二二二"; arr[2]="三三三三三"; </script> <selectonchange="zz.cells[this.selectedIndex].innerHTML=arr[this.selectedIndex]"> <optionvalue=a>改变第一格</option> <optionvalue=a>改变第二格</option> <optionvalue=a>改变第三格</option> </select> <tableid=zzborder=1> <trheight=20> <tdwidth=150>第一格</td> <tdwidth=150>第二格</td> <tdwidth=150>第三格</td> </tr> </table>

优秀的个人博客,低调大师

玩转大数据-如何搭建hadoop集群

看到题目有没有一种高大上的感觉? 毛线,当前是个人、是个公司都在说自己搞大数据,每天没有几个PB的数据入库,每天没有几个TB的分析数据产出敢说自己是大数据? 乘着大数据噱头之风,我们还是要看一下大数据所运用的工具对于我们是否有用,小编之前写项目时一直青睐于mysql,进来发现新的项目mysql已经无法适应,我们目前日数据产生量在10W级别时,mysql的查询速度和稳定性的确出现了问题,借鉴当前分布式数据库的经验,我们决定采用Hbase集群,Hadoop作为hbase的基础,被提到首要位置做研究。 我们首先看看hadoop的发展历史和主要架构: Hadoop历史 雏形开始于2002年的Apache的Nutch,Nutch是一个开源Java 实现的搜索引擎。它提供了我们运行自己的搜索引擎所需的全部工具。包括全文搜索和Web爬虫。 随后在2003年Google发表了一篇技术学术论文谷歌文件系统(GFS)。GFS也就是google File System,google公司为了存储海量搜索数据而设计的专用文件系统。 2004年Nutch创始人Doug Cutting基于Google的GFS论文实现了分布式文件存储系统名为NDFS。 2004年Google又发表了一篇技术学术论文MapReduce。MapReduce是一种编程模型,用于大规模数据集(大于1TB)的并行分析运算。 2005年Doug Cutting又基于MapReduce,在Nutch搜索引擎实现了该功能。 2006年,Yahoo雇用了Doug Cutting,Doug Cutting将NDFS和MapReduce升级命名为Hadoop,Yahoo开建了一个独立的团队给Goug Cutting专门研究发展Hadoop。 不得不说Google和Yahoo对Hadoop的贡献功不可没。 Hadoop核心 Hadoop的核心就是HDFS和MapReduce,而两者只是理论基础,不是具体可使用的高级应用,Hadoop旗下有很多经典子项目,比如HBase、Hive等,这些都是基于HDFS和MapReduce发展出来的。要想了解Hadoop,就必须知道HDFS和MapReduce是什么。 HDFS HDFS(Hadoop Distributed File System,Hadoop分布式文件系统),它是一个高度容错性的系统,适合部署在廉价的机器上。HDFS能提供高吞吐量的数据访问,适合那些有着超大数据集(large data set)的应用程序。 HDFS的设计特点是: 1、大数据文件,非常适合上T级别的大文件或者一堆大数据文件的存储,如果文件只有几个G甚至更小就没啥意思了。 2、文件分块存储,HDFS会将一个完整的大文件平均分块存储到不同计算器上,它的意义在于读取文件时可以同时从多个主机取不同区块的文件,多主机读取比单主机读取效率要高得多得都。 3、流式数据访问,一次写入多次读写,这种模式跟传统文件不同,它不支持动态改变文件内容,而是要求让文件一次写入就不做变化,要变化也只能在文件末添加内容。 4、廉价硬件,HDFS可以应用在普通PC机上,这种机制能够让给一些公司用几十台廉价的计算机就可以撑起一个大数据集群。 5、硬件故障,HDFS认为所有计算机都可能会出问题,为了防止某个主机失效读取不到该主机的块文件,它将同一个文件块副本分配到其它某几个主机上,如果其中一台主机失效,可以迅速找另一块副本取文件。 HDFS的关键元素: Block:将一个文件进行分块,通常是64M。 NameNode:保存整个文件系统的目录信息、文件信息及分块信息,这是由唯一一台主机专门保存,当然这台主机如果出错,NameNode就失效了。在Hadoop2.*开始支持activity-standy模式----如果主NameNode失效,启动备用主机运行NameNode。 DataNode:分布在廉价的计算机上,用于存储Block块文件。 MapReduce 通俗说MapReduce是一套从海量·源数据提取分析元素最后返回结果集的编程模型,将文件分布式存储到硬盘是第一步,而从海量数据中提取分析我们需要的内容就是MapReduce做的事了。 下面以一个计算海量数据最大值为例:一个银行有上亿储户,银行希望找到存储金额最高的金额是多少,按照传统的计算方式,我们会这样: Java代码 收藏代码 Long moneys[] ... Long max = 0L; for(int i=0;i<moneys.length;i++){ if(moneys[i]>max){ max = moneys[i]; } } 如果计算的数组长度少的话,这样实现是不会有问题的,还是面对海量数据的时候就会有问题。 MapReduce会这样做:首先数字是分布存储在不同块中的,以某几个块为一个Map,计算出Map中最大的值,然后将每个Map中的最大值做Reduce操作,Reduce再取最大值给用户。 MapReduce的基本原理就是:将大的数据分析分成小块逐个分析,最后再将提取出来的数据汇总分析,最终获得我们想要的内容。当然怎么分块分析,怎么做Reduce操作非常复杂,Hadoop已经提供了数据分析的实现,我们只需要编写简单的需求命令即可达成我们想要的数据。 hadoop框架 Hadoop使用主/从(Master/Slave)架构,主要角色有NameNode,DataNode,secondary NameNode,JobTracker,TaskTracker组成。 其中NameNode,secondary NameNode,JobTracker运行在Master节点上,DataNode和TaskTracker运行在Slave节点上。 1,NameNode NameNode是HDFS的守护程序,负责记录文件是如何分割成数据块的,以及这些数据块被存储到哪些数据节点上。它的功能是对内存及I/O进行集中管理。 2,DataNode 集群中每个从服务器都运行一个DataNode后台程序,后台程序负责把HDFS数据块读写到本地文件系统。需要读写数据时,由NameNode告诉客户端去哪个DataNode进行具体的读写操作。 3,Secondary NameNode Secondary NameNode是一个用来监控HDFS状态的辅助后台程序,如果NameNode发生问题,可以使用Secondary NameNode作为备用的NameNode。 4,JobTracker JobTracker后台程序用来连接应用程序与Hadoop,用户应用提交到集群后,由JobTracker决定哪个文件处理哪个task执行,一旦某个task失败,JobTracker会自动开启这个task。 5,TaskTracker TaskTracker负责存储数据的DataNode相结合,位于从节点,负责各自的task。 hadoop搭建方法: 我们接下来就看一下hadoop 2.6全分布安装是怎么完成的: 环境:centos 6.6 + hadoop2.6 虚拟机:(vmware fusion 7.0.0) 虚拟机hostname / IP地址 master / 192.168.187.102 slave01 / 192.168.187.103 slave02 / 192.168.187.104 注:前三个步骤都是准备工作,如果已经完成,可直接进入步骤四 步骤一: 先在3台虚拟机上,设置hostname及修改hosts文件 1.1 先正确设置各虚拟机的hostname sudo vi /etc/sysconfig/network 将HOSTNAME=后的内容,改成想要的机器名 1.2 修改hosts文件 sudo vi /etc/hosts 192.168.187.102 master 192.168.187.103 slave01 192.168.187.104 slave02 这样,就不用记IP了 这一步完成后,最好重启一次系统,以便生效。然后可以用ping master(或slave01、slave02)试下,正常的话,应该能ping通 注:hostname不要命名为“xxx.01,xxx.02”之类以“.数字”结尾,否则到最后hadoop的NameNode服务将启动失败。 步骤二:在3台虚拟机上安装jdk yum install java 注:hadoop是java写的,jdk是必须的。上述命令,会安装openjdk最基本的运行时,没有源码和javac等其它工具。如果要安装javac等编译工具及源码 yum install java-1.7.0-openjdk-devel yum install java-1.7.0-openjdk-src 另外openjdk安装后,不会默许设置JAVA_HOME环境变量,要查看安装后的目录,可以用命令 sudo update-alternatives --config java 看到 默认jre目录为:/usr/lib/java/jvm/jre-1.7.0-openjdk.x86_64 如要设置环境变量,可用命令 sudo vi /etc/profile 在最后添加 export JAVA_HOME=/usr/lib/jvm/java-1.7.0-openjdk-1.7.0.75.x86_64 export CLASSPATH=.:$JAVA_HOME/jre/lib/rt.jar:$JAVA_HOME/jre/lib/dt.jar:$JAVA_HOME/jre/lib/tools.jar export PATH=$PATH:$JAVA_HOME/bin 注:如果不喜欢openjdk,想安装oracle官方的jdk,可按下面步骤操作 a) rpm -qa | grep java 即:查看当前已经安装的跟java相关的包,如果显示有openjdk在其中 b) yum -y remove java 一般这样就会卸载干净,执行完以后,再运行 a)中的rpm -qa | grep java看看,如果还有残留,可运行 rpm -e --nodeps tzdata-java-2015a-1.el6.noarch (最后的部分为要删除的包名,即刚才查出来的结果) 重新安装sun jdk,先从官网下载安装文件 a) 上传rpm安装文件到虚拟机,参考下面的命令 scp jdk-7u51-linux-x64.rpm root@master:/home/hadoop/ b) 到虚拟机上,执行安装 rpm -ivh jdk-7u51-linux-x64.rpm c) 然后修改环境变量 sudo vi /etc/profile,在最后加下面三行 export JAVA_HOME=/usr/java/jdk1.7.0_51 export CLASSPATH=.:$JAVA_HOME/jre/lib/rt.jar:$JAVA_HOME/lib/dt.jar:$JAVA_HOME/lib/tools.jar export PATH=$PATH:$JAVA_HOME/bin 保存退出,然后输入 source /etc/profile 以便让新环境变量生效 注:如果机器上之前用 yum install hadoop之类的命令安装过低版本的hadoop,也必须先卸载干净 步骤三:在3台虚拟机上创建专门用户hadoop useradd hadoop (创建用户) passwd hadoop (设置密码,为简单起见,3台机器上的hadoop密码最好设置成一样,比如hadoop123) 为了方便,建议将hadoop加入root用户组,操作方法: 先以root身份登录,然后输入 usermod -g root hadoop ,执行完后hadoop即归属于root组了,可以再输入 id hadoop 查看输出验证一下,如果看到类似下面的输出: uid=502(hadoop) gid=0(root) 组=0(root) 就表示OK了 步骤四:配置ssh免密码登录 hadoop工作时,各节点要相互通讯,正常情况下linux之间通讯要提供用户名、密码(目的是保证通讯安全),如果需要人工干预输入密码,显然不方便,做这一步的目的,是让各节点能自动通过安全认证,不影响正常通讯。 4.1 先在master上,生成公钥、私钥对 以hadoop身份登录到系统 cd (进入个人主目录,默认为/home/hadoop) ssh-keygen -t rsa -P '' (注:最后是二个单引号) 即:以rsa算法,生成公钥、私钥对,-P ''表示空密码。该命令运行完后,会在个人主目录下生成.ssh目录,里面会有二个文件id_rsa(私钥) ,id_rsa.pub(公钥) 4.2 导入公钥 cat .ssh/id_rsa.pub >> .ssh/authorized_keys 执行完以后,可以在本机上测试下,用ssh连接自己,即:ssh localhost (或ssh master),如果不幸还是提示要输入密码,说明还没起作用,还有一个关键的操作 chmod 600 .ssh/authorized_keys (修改文件权限,否则不起作用) 然后再测试下 ssh localhost ,如果不需要输入密码,就连接成功,表示ok,一台机器已经搞定了。 4.3 在其它机器上生成公钥、密钥,并将公钥文件复制到master a) 以hadoop身份登录其它二台机器 slave01、slave02,执行 ssh-keygen -t rsa -P '' 生成公钥、密钥 b) 然后用scp命令,把公钥文件发放给master(即:刚才已经搞定的那台机器) slave01上: scp .ssh/id_rsa.pub hadoop@master:/home/hadoop/id_rsa_01.pub slave02上: scp .ssh/id_rsa.pub hadoop@master:/home/hadoop/id_rsa_02.pub 这二行执行完后,回到master中,查看下/home/hadoop目录,应该有二个新文件id_rsa_01.pub、id_rsa_02.pub,然后在master上,导入这二个公钥 cat id_rsa_01.pub >> .ssh/authorized_keys cat id_rsa_02.pub >> .ssh/authorized_keys 这样,master这台机器上,就有所有3台机器的公钥了。 4.4 将master上的“最全”公钥,复制到其它机器 a) 继续保持在master上, scp .ssh/authorized_keys hadoop@slave01:/home/hadoop/.ssh/authorized_keys scp .ssh/authorized_keys hadoop@slave02:/home/hadoop/.ssh/authorized_keys b) 修改其它机器上authorized_keys文件的权限 slave01以及slave02机器上,均执行命令 chmod 600 .ssh/authorized_keys 4.5 验证 在每个虚拟机上,均用 ssh 其它机器的hostname 验证下,如果能正常无密码连接成功,表示ok 小结:该步骤非常重要,主要思路是在各节点上生成公钥、私钥,然后将公钥发放其它所有节点。RSA算法是非对称加密算法,仅公布“公钥”,只要私钥不外泄,还是不能解密的,所以安全性依然有保障。 如果本步骤失败,根据我个人经验,多半是权限问题,请检查hadoop是否具有足够权限,建议将hadoop加入sudoers列表及root用户组。另外,这里也整理了一些SSH免密码设置失败的原因,请移步 ssh 免密码设置失败原因总结 步骤五:上传并解压hadoop2.6 a)在本机上,用scp命令上传hadoop2.6到master scp hadoop-2.6.0.tar.gz hadoop@master:/home/hadoop/ b) 以hadoop身份登录到master,运行以下命令解压 tar -zxvf hadoop-2.6.0.tar.gz 步骤六:修改配置 一共有7个文件要修改: $HADOOP_HOME/etc/hadoop/hadoop-env.sh $HADOOP_HOME/etc/hadoop/yarn-env.sh $HADOOP_HOME/etc/hadoop/core-site.xml $HADOOP_HOME/etc/hadoop/hdfs-site.xml $HADOOP_HOME/etc/hadoop/mapred-site.xml $HADOOP_HOME/etc/hadoop/yarn-site.xml $HADOOP_HOME/etc/hadoop/slaves 其中$HADOOP_HOME表示hadoop根目录,本文中默认为/home/hadoop/hadoop-2.6.0 a) hadoop-env.sh 、yarn-env.sh 这二个文件主要是修改JAVA_HOME后的目录,改成实际本机jdk所在目录位置 vi etc/hadoop/hadoop-env.sh (及 vi etc/hadoop/yarn-env.sh) 找到下面这行的位置,改成(jdk目录位置,大家根据实际情况修改) export JAVA_HOME=/usr/java/jdk1.7.0_51 另外 hadoop-env.sh中 , 建议加上这句: export HADOOP_PREFIX=/home/hadoop/hadoop-2.6.0 b) core-site.xml 参考下面的内容修改: 1 <?xml version="1.0" encoding="UTF-8"?> 2 <?xml-stylesheet type="text/xsl" href="configuration.xsl"?> 3 <configuration> 4 <property> 5 <name>fs.defaultFS</name> 6 <value>hdfs://master:9000</value> 7 </property> 8 <property> 9 <name>hadoop.tmp.dir</name> 10 <value>/home/hadoop/tmp</value> 11 </property> 12 </configuration> 注:/home/hadoop/tmp 目录如不存在,则先mkdir手动创建 core-site.xml的完整参数请参考 http://hadoop.apache.org/docs/r2.6.0/hadoop-project-dist/hadoop-common/core-default.xml c) hdfs-site.xml 1 <?xml version="1.0" encoding="UTF-8"?> 2 <?xml-stylesheet type="text/xsl" href="configuration.xsl"?> 3 <configuration> 4 <property> 5 <name>dfs.datanode.ipc.address</name> 6 <value>0.0.0.0:50020</value> 7 </property> 8 <property> 9 <name>dfs.datanode.http.address</name> 10 <value>0.0.0.0:50075</value> 11 </property> 12 <property> 13 <name>dfs.replication</name> 14 <value>2</value> 15 </property> 16 </configuration> 注:dfs.replication表示数据副本数,一般不大于datanode的节点数。 hdfs-site.xml的完整参数请参考 http://hadoop.apache.org/docs/r2.6.0/hadoop-project-dist/hadoop-hdfs/hdfs-default.xml d) mapred-site.xml 1 <?xml version="1.0"?> 2 <?xml-stylesheet type="text/xsl" href="configuration.xsl"?> 3 <configuration> 4 <property> 5 <name>mapreduce.framework.name</name> 6 <value>yarn</value> 7 </property> 8 </configuration> mapred-site.xml的完整参数请参考 http://hadoop.apache.org/docs/r2.6.0/hadoop-mapreduce-client/hadoop-mapreduce-client-core/mapred-default.xml e)yarn-site.xml 1 <?xml version="1.0"?> 2 <configuration> 3 <property> 4 <name>yarn.nodemanager.aux-services</name> 5 <value>mapreduce_shuffle</value> 6 </property> 7 </configuration> yarn-site.xml的完整参数请参考 http://hadoop.apache.org/docs/r2.6.0/hadoop-yarn/hadoop-yarn-common/yarn-default.xml 另外,hadoop 1.x与2.x相比, 1.x中的很多参数已经被标识为过时,具体可参考 http://hadoop.apache.org/docs/r2.6.0/hadoop-project-dist/hadoop-common/DeprecatedProperties.html 最后一个文件slaves暂时不管(可以先用mv slaves slaves.bak 将它改名),上述配置弄好后,就可以在master上启用 NameNode测试了,方法: $HADOOP_HOME/bin/hdfs namenode –format 先格式化 15/02/12 21:29:53 INFO namenode.FSImage: Allocated new BlockPoolId: BP-85825581-192.168.187.102-1423747793784 15/02/12 21:29:53 INFO common.Storage: Storage directory /home/hadoop/tmp/dfs/name has been successfullyformatted. 等看到这个时,表示格式化ok $HADOOP_HOME/sbin/start-dfs.sh 启动完成后,输入jps查看进程,如果看到以下二个进程: 5161 SecondaryNameNode 4989 NameNode 表示master节点基本ok了 再输入$HADOOP_HOME/sbin/start-yarn.sh ,完成后,再输入jps查看进程 5161 SecondaryNameNode 5320 ResourceManager 4989 NameNode 如果看到这3个进程,表示yarn也ok了 f) 修改slaves 如果刚才用mv slaves slaves.bak对该文件重命名过,先运行 mv slaves.bak slaves 把名字改回来,再 vi slaves 编辑该文件,输入 slave01 slave02 保存退出,最后运行 $HADOOP_HOME/sbin/stop-dfs.sh $HADOOP_HOME/sbin/stop-yarn.sh 停掉刚才启动的服务 步骤七:将master上的hadoop目录复制到slave01,slave02 仍然保持在master机器上 cd 先进入主目录 scp -r hadoop-2.6.0 hadoop@slave01:/home/hadoop/ scp -r hadoop-2.6.0 hadoop@slave02:/home/hadoop/ 注:slave01、slave02上的hadoop临时目录(tmp)及数据目录(data),仍然要先手动创建。 步骤八:验证 master节点上,重新启动 $HADOOP_HOME/sbin/start-dfs.sh $HADOOP_HOME/sbin/start-yarn.sh 顺利的话,master节点上有几下3个进程: 7482 ResourceManager 7335 SecondaryNameNode 7159 NameNode slave01、slave02上有几下2个进程: 2296 DataNode 2398 NodeManager 同时可浏览: http://master:50070/ http://master:8088/ 查看状态 另外也可以通过 bin/hdfs dfsadmin -report 查看hdfs的状态报告 其它注意事项: a) master(即:namenode节点)若要重新格式化,请先清空各datanode上的data目录(最好连tmp目录也一起清空),否则格式化完成后,启动dfs时,datanode会启动失败 b) 如果觉得master机器上只运行namenode比较浪费,想把master也当成一个datanode,直接在slaves文件里,添加一行master即可 c) 为了方便操作,可修改/etc/profile,把hadoop所需的lib目录,先加到CLASSPATH环境变量中,同时把hadoop/bin,hadoop/sbin目录也加入到PATH变量中,可参考下面的内容: export HADOOP_HOME=/home/hadoop/hadoop-2.6.0 export JAVA_HOME=/usr/java/jdk1.7.0_51 export CLASSPATH=.:$JAVA_HOME/jre/lib/rt.jar:$JAVA_HOME/lib/dt.jar:$JAVA_HOME/lib/tools.jar:$HADOOP_HOME/share/hadoop/common/hadoop-common-2.6.0.jar:$HADOOP_HOME/share/hadoop/mapreduce/hadoop-mapreduce-client-core-2.6.0.jar:$HADOOP_HOME/share/hadoop/common/lib/commons-cli-1.2.jar export PATH=$PATH:$JAVA_HOME/bin:$HADOOP_HOME/sbin:$HADOOP_HOME/bin

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册