首页 文章 精选 留言 我的

精选列表

搜索[数据处理],共9357篇文章
优秀的个人博客,低调大师

海量数据处理之Bloom Filter详解

一、什么是Bloom Filter Bloom Filter是一种空间效率很高的随机数据结构,它的原理是,当一个元素被加入集合时,通过K个Hash函数将这个元素映射成一个位阵列(Bit array)中的K个点,把它们置为1。检索时,我们只要看看这些点是不是都是1就(大约)知道集合中有没有它了:如果这些点有任何一个0,则被检索元素一定不在;如果都是1,则被检索元素很可能在。这就是布隆过滤器的基本思想。 但Bloom Filter的这种高效是有一定代价的:在判断一个元素是否属于某个集合时,有可能会把不属于这个集合的元素误认为属于这个集合(false positive)。因此,Bloom Filter不适合那些“零错误”的应用场合。而在能容忍低错误率的应用场合下,Bloom Filter通过极少的错误换取了存储空间的极大节省。 有人可能想知道它的中文叫法,倒是有被译作称布隆过滤器。该不该译,译的是否恰当,由诸君品之。下文之中,如果有诸多公式不慎理解,也无碍,只作稍稍了解即可。 1.1、集合表示和元素查询 下面我们具体来看Bloom Filter是如何用位数组表示集合的。初始状态时,Bloom Filter是一个包含m位的位数组,每一位都置为0。 为了表达S={x1, x2,…,xn}这样一个n个元素的集合,Bloom Filter使用k个相互独立的哈希函数(Hash Function),它们分别将集合中的每个元素映射到{1,…,m}的范围中。对任意一个元素x,第i个哈希函数映射的位置hi(x)就会被置为1(1≤i≤k)。注意,如果一个位置多次被置为1,那么只有第一次会起作用,后面几次将没有任何效果。在下图中,k=3,且有两个哈希函数选中同一个位置(从左边数第五位,即第二个“1“处)。 在判断y是否属于这个集合时,我们对y应用k次哈希函数,如果所有hi(y)的位置都是1(1≤i≤k),那么我们就认为y是集合中的元素,否则就认为y不是集合中的元素。下图中y1就不是集合中的元素(因为y1有一处指向了“0”位)。y2或者属于这个集合,或者刚好是一个false positive。 1.2、错误率估计 前面我们已经提到了,Bloom Filter在判断一个元素是否属于它表示的集合时会有一定的错误率(false positive rate),下面我们就来估计错误率的大小。在估计之前为了简化模型,我们假设kn<m且各个哈希函数是完全随机的。当集合S={x1, x2,…,xn}的所有元素都被k个哈希函数映射到m位的位数组中时,这个位数组中某一位还是0的概率是: 其中1/m表示任意一个哈希函数选中这一位的概率(前提是哈希函数是完全随机的),(1-1/m)表示哈希一次没有选中这一位的概率。要把S完全映射到位数组中,需要做kn次哈希。某一位还是0意味着kn次哈希都没有选中它,因此这个概率就是(1-1/m)的kn次方。令p = e-kn/m是为了简化运算,这里用到了计算e时常用的近似: 令ρ为位数组中0的比例,则ρ的数学期望E(ρ)=p’。在ρ已知的情况下,要求的错误率(false positive rate)为: (1-ρ)为位数组中1的比例,(1-ρ)k就表示k次哈希都刚好选中1的区域,即false positive rate。上式中第二步近似在前面已经提到了,现在来看第一步近似。p’只是ρ的数学期望,在实际中ρ的值有可能偏离它的数学期望值。M. Mitzenmacher已经证明[2],位数组中0的比例非常集中地分布在它的数学期望值的附近。因此,第一步的近似得以成立。分别将p和p’代入上式中,得: 相比p’和f’,使用p和f通常在分析中更为方便。 1.3、最优的哈希函数个数 既然Bloom Filter要靠多个哈希函数将集合映射到位数组中,那么应该选择几个哈希函数才能使元素查询时的错误率降到最低呢?这里有两个互斥的理由:如果哈希函数的个数多,那么在对一个不属于集合的元素进行查询时得到0的概率就大;但另一方面,如果哈希函数的个数少,那么位数组中的0就多。为了得到最优的哈希函数个数,我们需要根据上一小节中的错误率公式进行计算。 先用p和f进行计算。注意到f = exp(k ln(1 − e−kn/m)),我们令g = k ln(1 − e−kn/m),只要让g取到最小,f自然也取到最小。由于p = e-kn/m,我们可以将g写成 根据对称性法则可以很容易看出当p = 1/2,也就是k = ln2· (m/n)时,g取得最小值。在这种情况下,最小错误率f等于(1/2)k≈(0.6185)m/n。另外,注意到p是位数组中某一位仍是0的概率,所以p = 1/2对应着位数组中0和1各一半。换句话说,要想保持错误率低,最好让位数组有一半还空着。 需要强调的一点是,p = 1/2时错误率最小这个结果并不依赖于近似值p和f。同样对于f’ = exp(k ln(1 − (1 − 1/m)kn)),g’ = k ln(1 − (1 − 1/m)kn),p’ = (1 − 1/m)kn,我们可以将g’写成 同样根据对称性法则可以得到当p’ = 1/2时,g’取得最小值。 1.4、位数组的大小 下面我们来看看,在不超过一定错误率的情况下,Bloom Filter至少需要多少位才能表示全集中任意n个元素的集合。假设全集中共有u个元素,允许的最大错误率为є,下面我们来求位数组的位数m。 假设X为全集中任取n个元素的集合,F(X)是表示X的位数组。那么对于集合X中任意一个元素x,在s = F(X)中查询x都能得到肯定的结果,即s能够接受x。显然,由于Bloom Filter引入了错误,s能够接受的不仅仅是X中的元素,它还能够є (u - n)个false positive。因此,对于一个确定的位数组来说,它能够接受总共n + є (u - n)个元素。在n + є (u - n)个元素中,s真正表示的只有其中n个,所以一个确定的位数组可以表示 个集合。m位的位数组共有2m个不同的组合,进而可以推出,m位的位数组可以表示 个集合。全集中n个元素的集合总共有 个,因此要让m位的位数组能够表示所有n个元素的集合,必须有 即: 上式中的近似前提是n和єu相比很小,这也是实际情况中常常发生的。根据上式,我们得出结论:在错误率不大于є的情况下,m至少要等于n log2(1/є)才能表示任意n个元素的集合。 上一小节中我们曾算出当k = ln2· (m/n)时错误率f最小,这时f = (1/2)k= (1/2)mln2 / n。现在令f≤є,可以推出 这个结果比前面我们算得的下界n log2(1/є)大了log2e≈1.44倍。这说明在哈希函数的个数取到最优时,要让错误率不超过є,m至少需要取到最小值的1.44倍。 1.5、概括 在计算机科学中,我们常常会碰到时间换空间或者空间换时间的情况,即为了达到某一个方面的最优而牺牲另一个方面。Bloom Filter在时间空间这两个因素之外又引入了另一个因素:错误率。在使用Bloom Filter判断一个元素是否属于某个集合时,会有一定的错误率。也就是说,有可能把不属于这个集合的元素误认为属于这个集合(False Positive),但不会把属于这个集合的元素误认为不属于这个集合(False Negative)。在增加了错误率这个因素之后,Bloom Filter通过允许少量的错误来节省大量的存储空间。 自从Burton Bloom在70年代提出Bloom Filter之后,Bloom Filter就被广泛用于拼写检查和数据库系统中。近一二十年,伴随着网络的普及和发展,Bloom Filter在网络领域获得了新生,各种Bloom Filter变种和新的应用不断出现。可以预见,随着网络应用的不断深入,新的变种和应用将会继续出现,Bloom Filter必将获得更大的发展。 二、适用范围 可以用来实现数据字典,进行数据的判重,或者集合求交集 三、基本原理及要点 对于原理来说很简单,位数组+k个独立hash函数。将hash函数对应的值的位数组置1,查找时如果发现所有hash函数对应位都是1说明存在,很明显这 个过程并不保证查找的结果是100%正确的。同时也不支持删除一个已经插入的关键字,因为该关键字对应的位会牵动到其他的关键字。所以一个简单的改进就是 counting Bloom filter,用一个counter数组代替位数组,就可以支持删除了。 还有一个比较重要的问题,如 何根据输入元素个数n,确定位数组m的大小及hash函数个数。当hash函数个数k=(ln2)*(m/n)时错误率最小。在错误率不大于E的情况 下,m至少要等于n*lg(1/E)才能表示任意n个元素的集合。但m还应该更大些,因为还要保证bit数组里至少一半为0,则m应 该>=nlg(1/E)*lge 大概就是nlg(1/E)1.44倍(lg表示以2为底的对数)。 举个例子我们假设错误率为0.01,则此时m应大概是n的13倍。这样k大概是8个。 注意这里m与n的单位不同,m是bit为单位,而n则是以元素个数为单位(准确的说是不同元素的个数)。通常单个元素的长度都是有很多bit的。所以使用bloom filter内存上通常都是节省的。 四、扩展 Bloom filter将集合中的元素映射到位数组中,用k(k为哈希函数个数)个映射位是否全1表示元素在不在这个集合中。Counting bloom filter(CBF)将位数组中的每一位扩展为一个counter,从而支持了元素的删除操作。Spectral Bloom Filter(SBF)将其与集合元素的出现次数关联。SBF采用counter中的最小值来近似表示元素的出现频率。 五、问题实例 给你A,B两个文件,各存放50亿条URL,每条URL占用64字节,内存限制是4G,让你找出A,B文件共同的URL。如果是三个乃至n个文件呢? 根据这个问题我们来计算下内存的占用,4G=2^32大概是40亿*8大概是340亿,n=50亿,如果按出错率0.01算需要的大概是650亿个bit。 现在可用的是340亿,相差并不多,这样可能会使出错率上升些。另外如果这些urlip是一一对应的,就可以转换成ip,则大大简单了。 长按或扫描关注我们,每天分享技术内容还有学习干货资料哦!~

优秀的个人博客,低调大师

EnterpriseDB剑指Hadoop:优化数据处理

世界上领先的供应商EnterpriseDB正式发布了Hadoop的Postgres Plus(R) Connector。作为PostgreSQL衍生版本的EnterpriseDB却异军突起,近期频繁的市场动作无疑让人眼前一亮。 开源数据库:EnterpriseDB异军突起 EnterpriseDB是一家基于开源数据库PostgreSQL,提供增值服务的开源服务供应商。目前,MySQL、PostgreSQL、EnterpriseDB是全球三大开源数据库,而PostgreSQL是目前最为流行的开源数据库之一。与MySQL侧重在个人和轻量型数据库应用不同,PostgreSQL是一种面向企业级的数据库产品。EnterpriseDB所做的工作就是在PostgreSQL的基础上,集成各种组件和实用的工具,从而为PostgreSQL增加了一些高级特性,以满足各种高级需求。 EnterpriseDB有三种产品,分别是基础版、标准版和企业版。其增值主要体现在后两个版本上。标准版中提供了客户端连接驱动、连接池、地理信息支持、自动软件更新; 企业版直接支持Oracle数据库的数据类型、SQL语法、PL/SQL、触发器、序列、自定义包等。针对Oracle设计的应用几乎不需修改即可在EnterpriseDB上快速运行,并且提供一键式迁移工具EnterpriseDB Migration Studio来简化数据库迁移过程,并生成完整的迁移报告,使之更适合高性能、高数据量、企业级功能数据库的核心应用。 EnterpriseDB的产品另一个非常重要的特点是与Oracle数据库的兼容。事实上,保持与Oracle数据库的兼容性、让用户可以一键式地实现从Oracle数据库向EnterpriseDB的数据库迁移,已经成了 EnterpriseDB的一个非常重要的市场战略,而究其根源可能是想撬动Oracle帝国的根基,很显然,它把目标瞄准了Oracle数据库的潜在客户。 EnterpriseDB发布Postgres Plus(R) Connector: 剑指Hadoop EnterpriseDB发布了基于Hadoop的Postgres Plus(R) Connector。该连接器允许访问Postgres Plus(R) Advanced Server (PPAS)以及PostgreSQL数据库中的大量数据,并支持在Hadoop集群上大量处理和分析数据。Hadoop的Postgres Plus(R) Connector允许程序员使用它们熟悉的MapReduce框架来处理基于SQL的批量数据。 ▲ Hadoop是一个开源分布式的处理框架,集成了大量重要的应用程序,包括分布式文本搜索、web访问日志统计等等。Hadoop主要由三部分组成:HDFS(Hadoop Distributed File System),MapReduce与Hbase。 本文转自 taojin1240 51CTO博客,原文链接:http://blog.51cto.com/taotao1240/713485,如需转载请自行联系原作者

优秀的个人博客,低调大师

IBM大数据处理平台BigInsights(2)

1,在HDFS文件系统上创建test目录 hadoop fs -mkdir /user/biadmin/test 2,将文件copy到test目录下 hadoop fs -put /var/adm/ibmvmcoc-postinstall/BIlicense_en.txt /user/biadmin/test 3,查看test目录下是否多了这个文件 biadmin@bivm:/etc/ibmvmcoc-postinstall> hadoop fs -ls /user/biadmin/test Found 1 items -rw-r--r-- 1 biadmin biadmin 62949 2016-01-01 22:34 /user/biadmin/test/BIlicense_en.txt 4,运行一个简单的MapReduce程序 WordCount是用JAVA写的针对Hadoop MapReduce的一个小程序,用于统计文本中每个单词的出现次数,关于WordCount更多内容请参考-http://wiki.apache.org/hadoop/WordCount 执行程序是hadoop-example.jar,内容是在刚刚创建的test目录下,输出到WordCount_outpt子目录中。如果没有此目录,会自动创建。 biadmin@bivm:/etc/ibmvmcoc-postinstall>hadoop jar /opt/ibm/biginsights/IHC/hadoop-example.jar wordcount /user/biadmin/test WordCount_output 16/01/01 22:36:08 INFO input.FileInputFormat: Total input paths to process : 1 16/01/01 22:36:18 INFO mapred.JobClient: Running job: job_201601012120_0001 16/01/01 22:36:19 INFO mapred.JobClient: map 0% reduce 0% 16/01/01 22:37:58 INFO mapred.JobClient: map 100% reduce 0% 16/01/01 22:39:07 INFO mapred.JobClient: map 100% reduce 100% 16/01/01 22:39:14 INFO mapred.JobClient: Job complete: job_201601012120_0001 16/01/01 22:39:15 INFO mapred.JobClient: Counters: 29 16/01/01 22:39:15 INFO mapred.JobClient: File System Counters 16/01/01 22:39:15 INFO mapred.JobClient: FILE: BYTES_READ=33219 16/01/01 22:39:15 INFO mapred.JobClient: FILE: BYTES_WRITTEN=419738 16/01/01 22:39:15 INFO mapred.JobClient: HDFS: BYTES_READ=63073 16/01/01 22:39:15 INFO mapred.JobClient: HDFS: BYTES_WRITTEN=24073 16/01/01 22:39:15 INFO mapred.JobClient: org.apache.hadoop.mapreduce.JobCounter 16/01/01 22:39:15 INFO mapred.JobClient: TOTAL_LAUNCHED_MAPS=1 16/01/01 22:39:15 INFO mapred.JobClient: TOTAL_LAUNCHED_REDUCES=1 16/01/01 22:39:15 INFO mapred.JobClient: DATA_LOCAL_MAPS=1 16/01/01 22:39:15 INFO mapred.JobClient: SLOTS_MILLIS_MAPS=95300 16/01/01 22:39:15 INFO mapred.JobClient: SLOTS_MILLIS_REDUCES=50249 16/01/01 22:39:15 INFO mapred.JobClient: FALLOW_SLOTS_MILLIS_MAPS=0 16/01/01 22:39:15 INFO mapred.JobClient: FALLOW_SLOTS_MILLIS_REDUCES=0 16/01/01 22:39:15 INFO mapred.JobClient: org.apache.hadoop.mapreduce.TaskCounter 16/01/01 22:39:15 INFO mapred.JobClient: MAP_INPUT_RECORDS=755 16/01/01 22:39:15 INFO mapred.JobClient: MAP_OUTPUT_RECORDS=9865 16/01/01 22:39:15 INFO mapred.JobClient: MAP_OUTPUT_BYTES=102036 16/01/01 22:39:15 INFO mapred.JobClient: MAP_OUTPUT_MATERIALIZED_BYTES=33219 16/01/01 22:39:15 INFO mapred.JobClient: SPLIT_RAW_BYTES=124 16/01/01 22:39:15 INFO mapred.JobClient: COMBINE_INPUT_RECORDS=9865 16/01/01 22:39:15 INFO mapred.JobClient: COMBINE_OUTPUT_RECORDS=2322 16/01/01 22:39:15 INFO mapred.JobClient: REDUCE_INPUT_GROUPS=2322 16/01/01 22:39:15 INFO mapred.JobClient: REDUCE_SHUFFLE_BYTES=33219 16/01/01 22:39:15 INFO mapred.JobClient: REDUCE_INPUT_RECORDS=2322 16/01/01 22:39:15 INFO mapred.JobClient: REDUCE_OUTPUT_RECORDS=2322 16/01/01 22:39:15 INFO mapred.JobClient: SPILLED_RECORDS=4644 16/01/01 22:39:15 INFO mapred.JobClient: CPU_MILLISECONDS=22130 16/01/01 22:39:15 INFO mapred.JobClient: PHYSICAL_MEMORY_BYTES=538050560 16/01/01 22:39:15 INFO mapred.JobClient: VIRTUAL_MEMORY_BYTES=3549384704 16/01/01 22:39:15 INFO mapred.JobClient: COMMITTED_HEAP_BYTES=2097152000 16/01/01 22:39:15 INFO mapred.JobClient: File Input Format Counters 16/01/01 22:39:15 INFO mapred.JobClient: Bytes Read=62949 16/01/01 22:39:15 INFO mapred.JobClient: org.apache.hadoop.mapreduce.lib.output.FileOutputFormat$Counter 16/01/01 22:39:15 INFO mapred.JobClient: BYTES_WRITTEN=24073 会自动创建WordCount_output目录 biadmin@bivm:/etc/ibmvmcoc-postinstall> hadoop fs -ls WordCount_output Found 3 items -rw-r--r-- 1 biadmin biadmin 0 2016-01-01 22:39 WordCount_output/_SUCCESS drwx--x--x - biadmin biadmin 0 2016-01-01 22:36 WordCount_output/_logs -rw-r--r-- 1 biadmin biadmin 24073 2016-01-01 22:39 WordCount_output/part-r-00000 biadmin@bivm:~> hadoop fs -cat WordCount_output/*00 names, 1 national 1 nature 1 necessary 4 negligence 5 negligence, 4 negligence. 1 negligence; 2 neither 3 net 1 上面是用命令行方式来MapReduce,除此之外,IBM BigInsights还提供了基于Web界面的方式,打开Applications子选项,切换到Manage,可以看到预先定义的一些应用。在Test下面,有个WordCount应用,点开后选择“Deploy” 然切换到Run,可以看到已经有了WordCount这个应用, 选中WordCount,输入要统计文件所在的目录及输出目录,点击Run开始运行 同样地,也可以通过Web界面来操作HDFS文件系统,包括创建、删除、修改目录或者文件 用浏览器打开JobTracker(http://192.168.133.135:50030/jobtracker.jsp),显示出最近运行的MapReduce任务,点开JobID能看到更多详细信息。 所谓的JobTracker是一个master服务,Hadoop启动之后JobTracker接收Job,负责调度Job的每一个子任务task运行于TaskTracker上,并监控它们,如果发现有失败的task就重新运行它。 本文转自 taojin1240 51CTO博客,原文链接:http://blog.51cto.com/taotao1240/1735420,如需转载请自行联系原作者

优秀的个人博客,低调大师

《Storm实时数据处理》一导读

前 言 开源已经在许多方面从根本上改变了软件的原有面貌。在很多应用环境中,人们都会争论使用开源带来的好处和坏处,主要体现在支持、风险以及总体拥有成本等方面。开源在某些领域比其他领域流行,比如在研究机构中就比在大型金融服务提供商中应用得多。在某些新兴领域,比如Web服务供应商、内容供应商以及社交网络等,开源软件占据主导地位。其原因是多方面的,其中成本是一个非常大的因素。怎么说呢?如果方案要上升到网络规模,那么一般会应用“大数据”解决方案,以期获得更好的效果。凭借极佳的可用性,这些解决方案每秒处理数百万条请求,同时通过各式各样的服务为客户提供定制体验。这种规模的系统设计需要我们用不同的方式思考问题,采用不同的架构解决方案,而且要了解什么时候应该接受系统的复杂性以及什么时候应该避免这种复杂性。作为行业中人,我们应该掌握这种大规模批处理系

优秀的个人博客,低调大师

Splunk——大数据处理的实时引擎

大数据已经成为影响各行各业的热词,鉴于中国庞大的用户基础,对中国企业而言,大数据的影响也更为深刻。 2013年8月6日,Splunk公司在北京举办了探讨大数据如何落地的研讨会,分享了大数据给各个领域带来的变革、大数据技术在中国落地的前沿观点以及Splunk大数据方案的实施案例。 “数据正以几何的速度在增长,其中最复杂的也最有价值的数据细分市场是机器数据,所有这些像服务器、安全装置、传感器等基础架构产生的数据都是机器数据,这些机器数据记录了方方面面的行为。”Splunk产品营销副总裁Sanjay Mehta说道。Splunk所定义的机器数据,包括了文件或者文件目录、syslog、Windows事件日志、Windows注册表、Windows性能指标、Unix/Linux日志和指标、文件完整性监视、配置文件、OPSEC LEA、Cisco设

优秀的个人博客,低调大师

hadoop和Hive的数据处理流程

需求 场景:统计每日用户登陆总数 每分钟的原始日志内容如下: http://www.blue.com/uid=xxxxxx&ip=xxxxxx 假设只有两个字段,uid和ip,其中uid是用户的uid,是用户的唯一标识,ip是用户的登陆ip,每日的记录行数是10亿,要统计出一天用户登陆的总数。 处理流程 建表 那么我们首先要在hive里建表,建表语句如下: CREATE TABLE login ( uid STRING, ip STRING ) PARTITIONED BY (dt STRING) ROW FORMAT DELIMITED FIELDS TERMINATED BY ',' STORED AS TEXTFILE; 其实表名是login,字段之间以,隔开,存储是TEXT,其次还以dt这个字段作为分区。 创建成功之后,会看到hdfs上创建了/user/hive/warehouse/login这个目录。 格式化原始日志 将每天的每分钟的原始日志,转换成以下文件格式 123,17.6.2.6 112,11.3.6.2 ……….. 根据文件大小,合并文件,例如合并为24个文件。 入库 格式完毕,就可以把数据入库到hive了,假设今天是执行命令 LOAD DATA INPATH '/data/login/20120713/*' OVERWRITE INTO TABLE login PARTITION (dt='20120713'); 执行成功会,转换过的文件会上传到hdfs的/user/hive/warehouse/login/dt=20120713这个目录里。 分析 在hive执行以下语句 select count(distinct uid) from login where dt=’ 20120713’; 使用dt这个分区条件查询,就可以避免hive去查询其他分区的文件,减少IO操作,这个是hive分区很重要的特性,也是以天为单位,作为login表分区的重要意义。 执行完毕后,就可以在命令里出现结果,一般通过管道执行hive shell命令,读取管道的内容,把结果入库到mysql里就完成了分析了。 来源:http://www.cnblogs.com/ggjucheng/archive/2012/07/25/2608757.html#2601110 微信公众号: 猿人谷 如果您认为阅读这篇博客让您有些收获,不妨点击一下右下角的【推荐】 如果您希望与我交流互动,欢迎关注微信公众号 本文版权归作者和博客园共有,欢迎转载,但未经作者同意必须保留此段声明,且在文章页面明显位置给出原文连接。

优秀的个人博客,低调大师

浅谈Java数据处理框架Magician-DataProcessing

本项目是基于本人在开发中遇到的几个问题而着手设计的。 问题一 如果我们拿到了一个集合,需要根据里面的每一条数据去做相应的业务逻辑,那么我们一般有两种做法: 迭代一条一条地处理 迭代开启多线程处理 如果数据量很少的情况下,这两者都是一个不错的办法,但如果数据量高达成千上万的时候,这两者就都不是一个好办法了,前者会消耗太多的时间,而后者会开启太多的线程. 所以在处理的时候我们虽然还是会采用多线程,但是需要花时间精力去设计,让速度既能比一条一条处理要高,又不能开启太多的线程,有时候我们还不能异步处理,需要等所有线程结束了才能往下走。 我们可以看一下Magician-DataProcessing是如何处理的 假如有一个List需要并发处理里面的元素 List<String> dataList = new ArrayList<>(); 我们可以将它分成若干组来处理,这些组会排队执行,但是每一组在执行的时候都是并发的,里面的每一个元素都会由单独的线程去处理。需要等一组处理完了,才会处理下一组。 // 只需要将他传入syncRunner方法即可 MagicianDataProcessing.getConcurrentCollectionSync() .syncRunner(dataList, data -> { // 这里可以拿到List里的元素,进行处理 // List里的元素是什么类型,这个data就是什么类型 System.out.println(data); }, 10, // 每组多少条元素 1, // 每组之间同步等待多久 TimeUnit.MINUTES // 等待的时间单位 ); 也可以让每一组单独占一个线程,组内的元素依然采用迭代的方式一条条处理。等所有组处理完了,才会进入下一步。 // 也可以用syncGroupRunner方法 MagicianDataProcessing.getConcurrentCollectionSync() .syncGroupRunner(dataList, data -> { // 这里是每一组List for(String item : data){ // 这里可以拿到List里的元素,进行处理 System.out.println(data); } }, 10, // 每组多少条元素 1, // 每组之间同步等待多久 TimeUnit.MINUTES // 等待的时间单位 ); 问题二 有时候我们会遇到这样的业务逻辑:在同一条业务线里需要做多件事,但是这些事之间没有因果关系,不需要等前一个完成再去做下一个。 面对这样的情况,我们可以采用并发的方式将这多件事一起处理掉,如果我们自己去开启线程,管理线程,设置等待,本身并没啥问题,但如果项目里这样的情况多了以后,就会出现大量冗余的代码。 所以Magician-DataProcessing将他封装了 MagicianDataProcessing.getConcurrentTaskSync() .setTimeout(1000) // 超时时间 .setTimeUnit(TimeUnit.MILLISECONDS) // 超时时间的单位 .add(() -> { // 添加一个任务 // 在这里可以写上任务的业务逻辑 }, (result, e) -> { // 此任务处理后的回调 if(result.equals(ConcurrentTaskResultEnum.FAIL)){ // 任务失败,此时e里面有详细的异常信息 } else if(result.equals(ConcurrentTaskResultEnum.SUCCESS)) { // 任务成功,此时e是空的 } }) .add(() -> { // 添加一个任务 // 在这里可以写上任务的业务逻辑 }, (result, e) -> { // 此任务处理后的回调 if(result.equals(ConcurrentTaskResultEnum.FAIL)){ // 任务失败,此时e里面有详细的异常信息 } else if(result.equals(ConcurrentTaskResultEnum.SUCCESS)) { // 任务成功,此时e是空的 } }) .start(); 问题三 当我们在使用生产者与消费者模型的时候,如果不做一些处理,那么很大概率会出现一个问题,如果生产者不管不顾的向消费者推送,而消费者的消费能力又跟不上生产速度,那么很自然的会出现消费者队列积压,造成内存问题。 这样的积压如果时间久了又有可能会引发数据时效性的问题,可能你推送给消费者的时候,这条数据需要处理,但是等到被消费的时候又不需要处理了,这样就容易出现数据错乱的问题。 如果我们加大消费者的数量,又会在一定程度上增加线程数。 Magician-DataProcessing采用的是限制生产速度的方式来解决 当生产者生产完一批数据后,会不断地监视消费者,当发现了空闲的消费者才会生产和推送下一轮数据,并且数据只会推送给这几个空闲的消费者。 我们先创建一个生产者 public class DemoProducer extends MagicianProducer { /** * 设置ID,必须全局唯一,默认是当前类的全名 * 如果采用默认值,可以不重写这个方法 * @return */ @Override public String getId() { return super.getId(); } /** * 设置producer方法是否重复执行,默认重复 * 如果采用默认值,可以不重写这个方法 * @return */ @Override public boolean getLoop() { return super.getLoop(); } /** * 设置 是否等消费者全部空闲了才继续生产下一轮数据,默认false * 如果采用默认值,可以不重写这个方法 * @return */ @Override public boolean getAllFree() { return super.getAllFree(); } /** * 当生产者启动后,会自动执行这个方法,我们可以在这个方法里生产数据,并通过publish方法发布给消费者 * * 这边举一个例子 * 假如我们需要不断地扫描某张表,根据里面的数据状态去执行一些业务逻辑 * 那么我们可以在这个方法里写一个查询的逻辑,然后将查询到数据发送给消费者 */ @Override public void producer() { // 根据上面的例子,我们可以查询这张表里符合条件的数据 List<Object> dataList = selectList(); // 然后将他推送给消费者 // 可以推送任意类型的数据 this.publish(dataList); /* * 如果你只需要执行一次,那么到此就结束了,这个生产者也可以被回收掉了 * * 但是如果你需要不断地执行上述操作,来维护这张表里的数据,这个时候你有两种做法 * 第一种:加一个while循环 * 但是这种方式有个问题,如果消费者的消费速度跟不上,那么就很容易造成消费者队列积压,出现内存问题。 * 而数据积压太久又会影响时效性,可能你推送给消费者的时候,这条数据需要处理,但是等到被消费的时候又不需要处理了,这样容易出现数据错乱的问题。 * * 第二种:等消费者把你推给他的数据消费完了,再推送下一轮,而我们就是采用的这种 * 如果你想用这种方式,那么你不需要再写其他的任何逻辑,只需要将上面提到的getLoop方法重写一下,并返回true即可 * 当你设置为true以后,生产者在推送完一轮后会不断地监视消费者,当发现了空闲的消费者才会生产和推送下一轮数据,并且数据只会推送给这几个空闲的消费者 * * 如果你想等所有消费者都空闲了以后再推送下一轮,而不是发现一个空闲的就推送一轮 * 那么你可以重写上面提到的getAllFree方法,返回true即可 */ } } 再创建一个消费者 public class DemoConsumer extends MagicianConsumer { /** * 设置ID,必须全局唯一,默认是当前类的全名 * 如果采用默认值,可以不重写这个方法 * @return */ @Override public String getId() { return super.getId(); } /** * 心跳通知,消费者每消费一个任务,都会触发一下这个方法 * 我们可以根据他触发的频率来判断这个消费者的活跃度 * * 注意!!! * 这个方法里不可以有耗时的操作,不然会将消费者阻塞的 * 如果一定要加耗时的操作,那么务必在新线程里搞 * @param id */ @Override public void pulse(String id) { new Thread(()->{ // 如果你需要在这个方法里搞一些耗时的操作,那么务必要像这样开启一个新线程 // 不然消费者会被阻塞的 }).start(); } /** * 消费频率限制,默认10毫秒,取值范围:0 - long的最大值,单位:毫秒 * * 如果任务执行的耗时小于execFrequencyLimit,则等待execFrequencyLimit毫秒后再消费下一个任务 * * 首先这是一个生产者和消费者多对多的模型结构,我们以一个生产者对多个消费者来举例 * 生产者生产的数据只有一份,但是他会推送给多个消费者 * 而我们之所以要配置多个消费者,是因为需要他们执行不同的业务逻辑 * 多个消费者执行的业务逻辑不同,也就意味着他们需要的数据大概率会不同 * * 比如消费者A需要处理男性的数据,消费者B需要处理女性的数据 * 如果生产者刚好连续推送了几批男性的数据,那么这会导致消费者B筛选不到女性数据,那么他就不会处理业务逻辑了 * 这么一来,消费者B就会无限接近空转,而空转会引起CPU占用率过大,所以必须加以限制 * * 千万不要小看这个问题,本人曾经在实战中亲测过,做不做这个限制,CPU的占有率会达到10倍的差距 * 当然了,这跟消费者的业务逻辑还是有一定关系的,具体情况具体看待 * 如果你的消费者几乎不会出现空转,那么这里可以设置为0 * */ @Override public long getExecFrequencyLimit() { return super.getExecFrequencyLimit(); } /** * 这个方法会接收到生产者推送过来的数据 * 在里面执行相应的业务逻辑即可 * @param data */ @Override public void doRunner(Object data) { // data 可以是任何类型 // 因为能给他推送数据的消费者是固定的,所以data有可能收到的类型也是固定的 // 所以我们可以在这里自己判断,然后转化即可 // 为什么不用泛型?这是为了兼容多个生产者,因为他们推送的数据类型可能会不同 } } 然后将他们添加到同一个组内 // 创建一组生产者与消费者,而这样组可以创建无限个 // 每一组的生产者都只会把数据推送给同一组的消费者 MagicianDataProcessing.getProducerAndConsumerManager() .addProducer(new DemoProducer()) // 添加一个生产者(可以添加多个) .addConsumer(new DemoConsumer()) // 添加一个消费者(可以添加多个) .start();

优秀的个人博客,低调大师

海量数据处理利器 Roaring BitMap 原理介绍

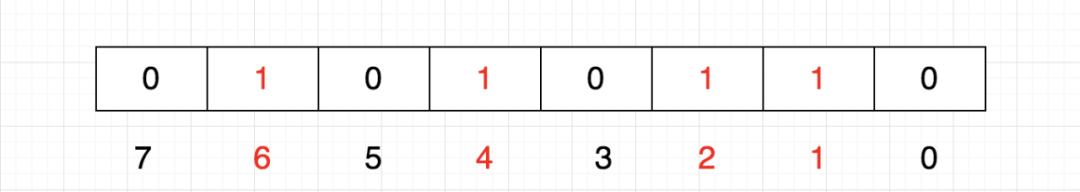
作者:来自 vivo 互联网服务器团队- Zheng Rui 本文结合个人理解梳理了BitMap及Roaring BitMap的原理及使用,分别主要介绍了Roaring BitMap的存储方式及三种container类型及Java中Roaring BitMap相关API使用。 一、引言 在进行大数据开发时,我们可以使用布隆过滤器和Redis中的HyperLogLog来进行大数据的判重和数量统计,虽然这两种方法节省内存空间并且效率很高,但是也存在一些误差。如果需要100%准确的话,我们可以使用BitMap来存储数据。 BitMap 位图索引数据结构被广泛地应用于数据存储和数据搜索中,但是对于存储较为分散的数据时,BitMap会占用比较大的内存空间,因此我们更偏向于使用 Roaring BitMap稀疏位图索引进行存储。同时,Roaring BitMap广泛应用于数据库存储和大数据引擎中,例如Hive,Spark,Doris,Kylin等。 下文将分别介绍 BitMap 和 Roaring BitMap 的原理及其相关应用。 二、BitMap原理 BitMap的基本思想就是用bit位来标记某个元素对应的value,而key就是这个元素。 例如,在下图中,是一个字节代表的8位,下标为1,2,4,6的bit位的值为1,则该字节表示{1,2,4,6}这几个数。 在Java中,1个int占用4个字节,如果用int来存储这四个数字的话,那么将需要4 * 4 = 16字节。 BitMap可以用于快速排序,查找,及去重等操作。优点是占用内存少(相较于数组)和运算效率高,但是缺点也非常明显,无法存储重复的数据,并且在存储较为稀疏的数据时,浪费存储空间较多。 三、Roaring BitMap 原理 3.1 存储方式 为了解决BitMap存储较为稀疏数据时,浪费存储空间较多的问题,我们引入了稀疏位图索引Roaring BitMap。Roaring BitMap 有较高的计算性能及压缩效率。下面简单介绍一下Roaring BitMap的基本原理。 Roaring BitMap处理int型整数,将32位的int型整数分为高16位和低16位分别进行处理,高16位作为索引分片,而低16位用于存储实际数据。其中每个索引对应一个数据桶(bucket),那么一共可以包含2^16 = 65536个数据块。每个数据桶使用container容器来存储低16位的部分,每个数据桶最多存储2^16 = 65536个数据。 如上图所示,高16位作为索引查找具体的数据块,当前索引值为0,低16位作为value进行存储。 Roaring BitMap在进行数据存储时,会先根据高16位找到对应的索引key(二分查找),低16位作为key对应的value,先通过key检查对应的container容器,如果发现container不存在的话,就先创建一个key和对应的container,否则直接将低16位存储到对应的container中。 Roaring BitMap的精妙之处在于使用不同类型的container,接下来将对其进行介绍。 3.2 container类型 1.ArrayContainer 顾名思义,ArrayContainer直接采用数组来存储低16位数据,没有采用任何数据压缩算法,适合存储比较稀疏的数据,在Java中,使用short数组来存储,并且占用的内存空间大小和数据量成线性关系。由于short为2字节,因此n个数据为2n字节。ArrayContainer采用二分查找定位有序数组中的元素,因此时间复杂度为O(logN)。ArrayContainer的最大数据量为4096, 4096 * 2b = 8kb。 2.BitMapContainer BitMapContainer采用BitMap的原理,就是一个没有经过压缩处理的普通BitMap,适合存储比较稠密的数据,在Java中使用Long数组存储低16位数据,每一个bit位表示一个数字。由于每个container需要存储2^16 = 65536个数据,如果通过BitMap进行存储的话,需要使用2^16个bit进行存储,即8kb的数据空间。 可以从下图中看出ArrayContainer和BitMapContainer的内存空间使用关系,当数据量小于4096时,使用ArrayContainer比较合适,当数据量大于等于4096时,使用BitMapContainer更佳。 因为BitMap直接使用位运算,所以BitMapContainer的时间复杂度为O(1)。 3.RunContainer RunContainer采用Run-Length Encoding 行程长度编码进行压缩,适合存储大量连续数据。Java中使用short数组进行存储。连续bit位程度越高的话越节省存储空间,最佳场景下(65536个数据全为1)只需要存储4字节。最差场景为所有数据都不连续,所有存储数据位置为奇数或者偶数,这种场景需要存储128kb。由于采用二分查找算法定位元素,因此时间复杂度为O(logN)。 行程长度编码即的原理是对连续出现的数字进行压缩,只记录初始数字和后续连续数量。 例如:[1,2,3,4,5,8,9,10]使用编码后的数据为[1,4,8,2]。 Java 里可以使用runOptinize()方法来对比RunContainer和其他两个Container存储空间大小,如果使用RunContainer存储空间更佳则会进行转化。 根据上面三个Container类型我们可以得知如何进行选择: Container默认使用ArrayContainer,当元素数量超过4096时,会由ArrayContainer转换BitMapContainer。 当元素数量小于等于4096时,BitMapContainer会逆向转换回ArrayContainer。 正常增删元素不会使Container直接变成RunContainer,而需要用户进行优化方法调用才会转换为最节省空间的Container。 3.3 Roaring BitMap 相关源码 介绍完Roaring BitMap的三种container类型以后,让我们了解一下,Roaring BitMap的相关源码。这里介绍一下Java中增加元素的源码实现。 public void add(final int x) { final short hb = Util.highbits(x); final int i = highLowContainer.getIndex(hb); if (i >= 0) { highLowContainer.setContainerAtIndex(i, highLowContainer.getContainerAtIndex(i).add(Util.lowbits(x))); } else { final ArrayContainer newac = new ArrayContainer(); highLowContainer.insertNewKeyValueAt(-i - 1, hb, newac.add(Util.lowbits(x))); } } Roaring BitMap首先获取添加元素的高16位,然后再调用getIndex获取高16位对应的索引,如果索引大于0,表示已经创建该索引对应的container,故直接添加相应的元素低16位即可;否则的话,说明该索引对应的container还没有被创建,先创建对应的ArrayContainer,再进行元素添加。值得一提的是,在getIndex方法中,使用了二分查找来获取索引值,所以时间复杂度为O(logn)。 // 包含一个二分查找protected int getIndex(short x) { // 在二分查找之前,我们先对常见情况优化。 if ((size == 0) || (keys[size - 1] == x)) { return size - 1; } // 没有碰到常见情况,我们只能遍历这个列表。 return this.binarySearch(0, size, x);} 对于元素添加,三种Container提供了不同的实现方式,下面将分别介绍。 1.ArrayContainer if (cardinality == 0 || (cardinality > 0 && toIntUnsigned(x) > toIntUnsigned(content[cardinality - 1]))) { if (cardinality >= DEFAULT_MAX_SIZE) { return toBitMapContainer().add(x); } if (cardinality >= this.content.length) { increaseCapacity(); } content[cardinality++] = x; } else { int loc = Util.unsignedBinarySearch(content, 0, cardinality, x); if (loc < 0) { // 当标签中元素数量等于默认最大值时,把ArrayContainer转换为BitMapContainer if (cardinality >= DEFAULT_MAX_SIZE) { return toBitMapContainer().add(x); } if (cardinality >= this.content.length) { increaseCapacity(); } System.arraycopy(content, -loc - 1, content, -loc, cardinality + loc + 1); content[-loc - 1] = x; ++cardinality; } } return this;} ArrayContainer把添加元素分成两种场景,一种走二分查找,另外一种不走二分查找。 第一种场景:不走二分查找。 当基数为0或者值大于container中的最大值,可以直接添加,因为content数组是有序的,最后一个是最大值。 当基数大于等于默认最大值4096时,ArrayContainer将转换为BitMapContainer。如果基数大于content的数组长度的话,需要将content进行扩容。最后进行赋值即可。 第二种场景:走二分查找。 先通过二分查找找到对应的插入位置,如果返回loc大于等于0,说明存在,直接返回即可,如果小于0才进行后续插入。后续操作同上,当基数大于等于默认最大值4096时,ArrayContainer将转换为BitMapContainer。如果基数大于content的数组长度的话,需要将content进行扩容。最后通过拷贝数组将元素插入到content数组中。 2.BitMapContainer public Container add(final short i) { final int x = Util.toIntUnsigned(i); final long previous = BitMap[x / 64]; long newval = previous | (1L << x); BitMap[x / 64] = newval; if (USE_BRANCHLESS) { cardinality += (previous ^ newval) >>> x; } else if (previous != newval) { ++cardinality; } return this;} BitMap数组为BitMapContainer的存储容器存放数据的内容,数据类型为long,在这里我们只需要找到x在BitMap中的位置,并且把相应的bit位置1即可。x/64就是找到对应long的旧值,1L<<x 就是把对应的bit位置为1,再跟旧值进行或操作,就可以得到新值,再将这个新值存回到bitmap数组即可。<="" span=""> 3. RunContainer public Container add(short k) { int index = unsignedInterleavedBinarySearch(valueslength, 0, nbrruns, k); if (index >= 0) { return this;// already there } index = -index - 2; if (index >= 0) { int offset = toIntUnsigned(k) - toIntUnsigned(getValue(index)); int le = toIntUnsigned(getLength(index)); if (offset <= le) { return this; } if (offset == le + 1) { // we may need to fuse if (index + 1 < nbrruns) { if (toIntUnsigned(getValue(index + 1)) == toIntUnsigned(k) + 1) { // indeed fusion is needed setLength(index, (short) (getValue(index + 1) + getLength(index + 1) - getValue(index))); recoverRoomAtIndex(index + 1); return this; } } incrementLength(index); return this; } if (index + 1 < nbrruns) { // we may need to fuse if (toIntUnsigned(getValue(index + 1)) == toIntUnsigned(k) + 1) { // indeed fusion is needed setValue(index + 1, k); setLength(index + 1, (short) (getLength(index + 1) + 1)); return this; } } } if (index == -1) { // we may need to extend the first run if (0 < nbrruns) { if (getValue(0) == k + 1) { incrementLength(0); decrementValue(0); return this; } } } makeRoomAtIndex(index + 1); setValue(index + 1, k); setLength(index + 1, (short) 0); return this;} RunContainer中的两个数据结构,nbrruns表示有多少段行程,数据类型为int,valueslength数组表示所有的行程,数据类型为short。 首先,使用二分查找+顺序查找在valueslength数组中查找元素k的插入位置index。如果查找到的index结果大于等于0那就说明k是某个行程起始值,已经存在,直接返回。 -index-2是为了指向前一个行程起始值的索引。 接下来是一些偏移量和索引值的判断,主要是为了确认k是否落在上一个行程里,或者外面,如果落在上一个行程里,则直接返回,否则需要新建一个行程或者就近与一个行程混合并且将行程长度加1。 3.4 BitMap 和 Roaring BitMap 存储情况对比 public static void count(Integer inputSize) { RoaringBitMap BitMap = new RoaringBitMap(); BitMap.add(0L, inputSize); //获取BitMap个数 int cardinality = BitMap.getCardinality(); //获取BitMap压缩大小 int compressSizeIntBytes = BitMap.getSizeInBytes(); //删除压缩(移除行程编码,将container退化为BitMapContainer 或 ArrayContainer) BitMap.removeRunCompression(); //获取BitMap不压缩大小 int uncompressSizeIntBytes = BitMap.getSizeInBytes(); System.out.println("Roaring BitMap个数:" + cardinality); System.out.println("最好情况,BitMap压缩大小:" + compressSizeIntBytes / 1024 + "KB"); System.out.println("最坏情况,BitMap不压缩大小:" + uncompressSizeIntBytes / 1024 / 1024 + "MB"); BitSet bitSet = new BitSet(); for (int i = 0; i < inputSize; i++) { bitSet.set(i); } //获取BitMap大小 int size = bitSet.size(); System.out.println("BitMap个数:" + bitSet.length()); System.out.println("BitMap大小:" + size / 8 / 1024 / 1024 + "MB"); } 上述代码使用了Java内置的BitMap(BitSet) 和 Roaring BitMap进行存储大小对比,输出结果如下所示。 Roaring BitMap个数:1000000000 最好情况,BitMap压缩大小:149KB 最坏情况,BitMap不压缩大小:119MB Roaring BitMap个数:1000000000 BitMap大小:128MB 可以发现,Roaring BitMap的压缩性能效果非常好,同等情况下,是BitMap占用内存的近一千分之一。在退化成BitMapContainer/arrayContainer之后也仍然比使用基本的BitMap存储效果好一些。 四、Roaring BitMap 使用 4.1 Java 中相关 API 使用 在Java中,Roaring BitMap提供了交并补差集等操作,如下代码所示,列举了Java中roaing BitMap的相关API使用方式。 //添加单个数字public void add(final int x)//添加范围数字public void add(final long rangeStart, final long rangeEnd)//移除数字public void remove(final int x)//遍历RBMpublic void forEach(IntConsumer ic)//检测是否包含public boolean contains(final int x)//获取基数public int getCardinality()//位与,取两个RBM的交集,当前RBM会被修改public void and(final RoaringBitMap x2)//同上,但是会返回一个新的RBM,不会修改原始的RBM,线程安全public static RoaringBitMap and(final RoaringBitMap x1, final RoaringBitMap x2)//位或,取两个RBM的并集,当前RBM会被修改public void or(final RoaringBitMap x2)//同上,但是会返回一个新的RBM,不会修改原始的RBM,线程安全public static RoaringBitMap or(final RoaringBitMap x1, final RoaringBitMap x2)//异或,取两个RBM的对称差,当前RBM会被修改public void xor(final RoaringBitMap x2)//同上,但是会返回一个新的RBM,不会修改原始的RBM,线程安全public static RoaringBitMap xor(final RoaringBitMap x1, final RoaringBitMap x2)//取原始值和x2的差集,当前RBM会被修改public void andNot(final RoaringBitMap x2)//同上,但是会返回一个新的RBM,不会修改原始的RBM,线程安全public static RoaringBitMap andNot(final RoaringBitMap x1, final RoaringBitMap x2)//序列化public void serialize(DataOutput out) throws IOExceptionpublic void serialize(ByteBuffer buffer)//反序列化public void deserialize(DataInput in) throws IOExceptionpublic void deserialize(ByteBuffer bbf) throws IOException 对于序列化来说,Roaring BitMap官方定义了一套序列化规则,用来保证不同语言实现的兼容性。 Java中可以使用serialize方法进行序列化,deserialize方法进行反序列化。 4.2 业务实际场景应用 Roaring BitMap可以用来构建大数据标签,针对类型特征来创建对应的标签。 在我们的业务场景中,有很多需要基于人群标签进行交并补集运算的场景,下面以一个场景为例,我们需要计算每天某个设备接口 在设备标签A上的查询成功率,因为设备标签A中的设备不是所有都活跃在网的,所以我们需要将设备标签A与每日日活人群标签取交集,得到的交集大小才能用作成功率计算的分母,另外拿查询成功的标签人群做分子来进行计算即可,查询时长耗时为1s。 假如没有使用标签保存集合之前,我们需要在hive表中查询出同时满足当天在网的活跃用户和设备A的用户数量,查询时长耗时在几分钟以上。两种方式相比之下,使用Roaring BitMap查询的效率更高。 五、总结 本文结合个人理解梳理了BitMap及Roaring BitMap的原理及使用,分别主要介绍了Roaring BitMap的存储方式及三种container类型及Java中Roaring BitMap相关API使用,如有不足和优化建议,也欢迎大家批评指正。 参考资料: Chambi S , Lemire D , Kaser O , et al. BetterBitMap performance with Roaring BitMaps[J].Software—practice & Experience, 2016, 46(5):709-719. https://RoaringBitMap.org/ https://github.com/RoaringBitMap/RoaringFormatSpec END 猜你喜欢 TiKV 源码分析之 PointGet vivo 制品管理在 CICD 落地实践 HBase Meta 元信息表修复实践 揭露 FileSystem 引起的线上 JVM 内存溢出问题 本文分享自微信公众号 - vivo互联网技术(vivoVMIC)。 如有侵权,请联系 support@oschina.cn 删除。 本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

优秀的个人博客,低调大师

OpenTURNS —— 不确定性数据处理

OpenTURNS 是一个 C++ 和 Python 库,内置专用于处理不确定性数据的模型和算法。该库的主要目标是提供处理工业应用研究中的不确定性所需的所有功能。官方表示,该软件的目标用户是所有希望在迄今为止的确定性研究中引入概率维度的工程师。 多元概率建模,包括依赖 专用于处理不确定性的数值工具 与任何类型的物理模型的通用耦合 开源,LGPL 许可,C++/Python 库

优秀的个人博客,低调大师

Python数据处理之导入导出excel数据

本文首发于公众号“AntDream”,欢迎微信搜索“AntDream”或扫描文章底部二维码关注,和我一起每天进步一点点 Python的一大应用就是数据分析了,而数据分析中,经常碰到需要处理Excel数据的情况。这里做一个Python处理Excel数据的总结,基本受用大部分情况。相信以后用Python处理Excel数据不再是难事儿! Python处理Excel数据需要用到2个库:xlwt 和 xlrd。xlwt库负责将数据导入生成Excel表格文件,而 xlrd库则负责将Excel表格中的数据取出来。 xlwt库将数据导入Excel 将数据写入一个Excel文件 wb = xlwt.Workbook() # 添加一个表 ws = wb.add_sheet('test') # 3个参数分别为行号,列号,和内容 # 需要注意的是行号和列号都是从0开始的 ws.write(0, 0, '第1列') ws.write(0, 1, '第2列') ws.write(0, 2, '第3列') # 保存excel文件 wb.save('./test.xls') 可以看到,用xlwt库操作非常简单,基本就三步走: 打开一个Workbook对象,并用add_sheet方法添加一个表 然后就是用write方法写入数据 最后用save方法保存 需要注意的是,xlwt库里面所定义的行和列都是从0开始计数的 定制Excel表格样式 表格样式一般主要有这么几块内容:字体、对齐方式、边框、背景色、宽度以及特殊内容,比如超链接、日期时间等。下面我们来分别看看用xlwt库怎么定制这些样式。 字体 xlwt库支持的字体属性也比较多,大概如下: 设置字体需要用到xlwt库的XFStyle类和Font类,代码模版如下: style = xlwt.XFStyle() # 设置字体 font = xlwt.Font() # 比如设置字体加粗和下划线 font.bold = True font.underline = True style.font = font # 然后应用 ws.write(2, 1, 'test', style) 后续几个属性的设置都是类似的,都是4步走: 拿到XFStyle 拿到对应需要的属性,比如这里的Font对象 设置具体的属性值 最后就是在write方法写入数据的时候应用就行 单元格对齐 先来看单元格对齐怎么设置 # 单元格对齐 alignment = xlwt.Alignment() # 水平对齐方式和垂直对齐方式 alignment.horz = xlwt.Alignment.HORZ_CENTER alignment.vert = xlwt.Alignment.VERT_CENTER # 自动换行 alignment.wrap = 1 style.alignment = alignment # 然后应用 ws.write(2, 1, 'test', style) 上面这个自动换行的属性还是蛮有用的,因为我们很多时候数据会比较长,最好再加上单元格的宽度属性一起使用,这样整体样式会好很多 单元格宽度设置: # 设置单元格宽度,也就是某一列的宽度 ws.col(0).width = 6666 单元格的背景色 背景色对应的属性是 Pattern # 背景色 pattern = xlwt.Pattern() pattern.pattern = xlwt.Pattern.SOLID_PATTERN # 背景色为黄色 # 0 = Black, 1 = White, 2 = Red, 3 = Green, 4 = Blue, 5 = Yellow, 6 = Magenta, # 7 = Cyan, 16 = Maroon, 17 = Dark Green, 18 = Dark Blue, 19 = Dark Yellow , # almost brown), 20 = Dark Magenta, 21 = Teal, 22 = Light Gray, 23 = Dark Gray # ... pattern.pattern_fore_colour = 5 style.pattern = pattern # 然后应用 ws.write(2, 1, 'test', style) 单元格边框 边框属性是Borders 单元格边框就2类:颜色和边框线样式 可以分别设置上下左右边框的颜色和样式 # 边框 borders = xlwt.Borders() # 边框可以分别设置top、bottom、left、right # 每个边框又可以分别设置颜色和线样式:实线、虚线、无 # 颜色设置,其他类似 borders.left_colour = 0x40 # 设置虚线,其他类似 borders.bottom = xlwt.Borders.DASHED style.borders = borders # 然后应用 ws.write(2, 1, 'test', style) 特殊内容,比如超链接和公式 特殊内容一般主要会碰到这几类:超链接、公式和时间日期 处理这些特殊内容需要用到Formula # 超链接 link = 'HYPERLINK("http://www.baidu.com";"Baidu")' formula = xlwt.Formula(link) ws.write(2, 0, formula) # 公式也是类似 ws.write(1, 1, xlwt.Formula('SUM(A1,B1)')) # 时间 style.num_format_str = 'M/D/YY' ws.write(2, 1, datetime.datetime.now(), style) 以上就是用Python将数据写入到Excel的全部内容了,下面我们再来看看怎么读取Excel中的数据做处理。 xlrd库读取Excel中的数据 读取Excel文件 同样的用xlrd库读取Excel的数据也是轻轻松松,先来看下实现代码 # 先打开一个文件 wb = xlrd.open_workbook(file_path) # 获取第一个表 sheet1 = wb.sheet_by_index(0) # 总行数 nrows = sheet1.nrows # 总列数 ncols = sheet1.ncols # 后面就通过循环即可遍历数据了 # 取数据 for i in range(nrows): for j in range(ncols): # cell_value方法取出第i行j列的数据 value = sheet1.cell_value(i, j) print(value) 总结一下,分为一下几步: 首先通过xlrd库的open_workbook方法打开Excel文件 然后通过sheet_by_index方法获取表 然后分别获取表的行数和列数,便于后面循环遍历 根据列数和行数,循环遍历,通过cell_value方法获取每个单元格中的数据 工作表的相关操作 获取一个工作表,有多种方式 # 通过索引 sheet1 = wb.sheets()[0] sheet1 = wb.sheet_by_index(0) # 通过名字 sheet1 = wb.sheet_by_name('test') # 获取所有表名 # sheet_names = wb.sheet_names() 获取某一行或某一列的所有数据 # 获取行中所有数据,返回结果是一个列表 tabs = sheet1.row_values(rowx=0, start_colx=0, end_colx=None) # 返回一行一共有多少数据 len_value = sheet1.row_len(rowx=0) row_values的三个参数分别是:行号、开始的列和结束的列,其中结束的列为None表示获取从开始列到最后的所有数据 类似的还有获取某一列的数据 cols = sheet1.col_values(colx=0, start_rowx=0, end_rowx=None) 处理时间数据 时间数据比较特殊,没发直接通过上面的cell_value方法获取。需要先转换为时间戳,然后再格式化成我们想要的格式。 比如要获取Excel表格中,格式为2019/8/13 20:46:35的时间数据 # 获取时间 time_value = sheet1.cell_value(3, 0) # 获取时间戳 time_stamp = int(xlrd.xldate.xldate_as_datetime(time_value, 0).timestamp()) print(time_stamp) # 格式化日期 time_rel = time.strftime("%Y/%m/%d", time.localtime(time_stamp)) print(time_rel) 基本也是三步走: 通过cell_value方法获取时间值 然后通过xldate_as_datetime方法获取时间戳 然后格式化一下 总结 Excel文件是用Python处理数据时常会碰到的一类场景,有了xlwt 和 xlrd的帮助可以非常快速的导入和导出Excel数据。大家可以把这篇文章收藏起来,以后碰到处理Excel文件的时候可以参考一下。

优秀的个人博客,低调大师

企业业务数据处理用“work”还是“MQ”

近期公司在做架构梳理已经项目架构方向,不知不觉就引起了使用“work”跑数据还是用“MQ”进行跑数据的争论! 对于争论这件事在各行各业都有,其实我觉得针对“争论”这个词的根源在于一件事情有很多解决方案,每个人的认知不同, 给出的解决方案也不同。然而如果有一个对实际情况都了解和对解决问题有充足认知的情况下,我想他是会权衡利弊的。 我们先列举几个已经算是比较成熟的开源框架: WORK:TBschedule、Quartz、spring schedule、JDK的time ,线程池定时等; MQ:RocketMQ、RabbitMQ、Kafka、ActiveMQ、MSMQ、ZeroMQ等等; 好,废话不多说,我们就事论事,我们就单纯的从以下几个角度来评论以下到底谁(work/mq)更有优势: 1、易用性 2、可扩展性 3、可

优秀的个人博客,低调大师

Python数据处理库pandas入门教程

pandas是一个Python语言的软件包,在我们使用Python语言进行机器学习编程的时候,这是一个非常常用的基础编程库。本文是对它的一个入门教程。 pandas提供了快速,灵活和富有表现力的数据结构,目的是使“关系”或“标记”数据的工作既简单又直观。它旨在成为在Python中进行实际数据分析的高级构建块。 入门介绍 pandas适合于许多不同类型的数据,包括: 具有异构类型列的表格数据,例如SQL表格或Excel数据 有序和无序(不一定是固定频率)时间序列数据。 具有行列标签的任意矩阵数据(均匀类型或不同类型) 任何其他形式的观测/统计数据集。 由于这是一个Python语言的软件包,因此需要你的机器上首先需要具备Python语言的环境。关于这一点,请自行在网络上搜索获取方法。 关于如何获取pandas请参阅官网上的说明:pandas Insta

资源下载

更多资源
Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册