java8学习:并行数据处理与性能
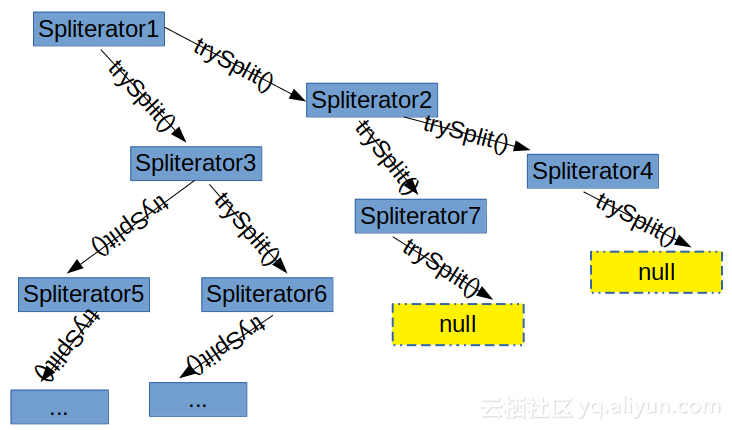
内容来自《 java8实战 》,本篇文章内容均为非盈利,旨为方便自己查询、总结备份、开源分享。如有侵权请告知,马上删除。书籍购买地址:java8实战 在java7之前实现并行处理数据集合非常麻烦 得明确的把包含数据的数据结构分成若干子部分 要给每个子部分分配一个独立的线程 在恰当的时候对他们进行同步来避免不希望出现的竞争条件,等待所有线程完成,最后把结果汇总在一起 在java7引入了fork/join框架来实现并行,在这篇文章中,将介绍利用Stream来实现并行和所需要注意的事项,并且介绍fork/join框架 之前我们提到过stream()是顺序执行,而parallelStream()是并行执行,并行流就是一个把内容分成多个数据块,并用不同的线程分别处理每个数据块的流,这样可以把压力分担给不同的内核 下面是一个例子:就是求和操作,从1加到给出的n,我们用顺序流实现一下 @Test public void test() throws Exception { long l = System.currentTimeMillis(); System.out.println(parallelSum(10_000_000)); //一千万相加 System.out.println(System.currentTimeMillis() - l); } public long sequentialSum(long n){ //237+ return Stream.iterate(0L, i -> i + 1) .limit(n) .reduce(0L,Long::sum); } 下面是并行流 public long parallelSum(long n){ //1533+ return Stream.iterate(0L, i -> i + 1) .limit(n) .parallel() //切换并行流 .reduce(0L,Long::sum); } 上面并行流将Stream内部数据分为几块,对不同的块进行归约操作后在汇总成最终结果 parallel是将顺序流转为并行流,而sequential是将并行流转为顺序流,你可能会想:利用这两个转换方法来使得更精确的控制流的,但是需要注意的是 Stream.iterate(0, i -> i + 1) .parallel() //如果贴到IDEA中,这会变灰的,也证明了它是无效的操作 .limit(n) .sequential() .reduce(0,Integer::sum); 上面只是一个例子,我们先转换为并行流然后经过操作在转换为顺序流,本以为可以精确控制流的,但最终stream是以顺序流的方式执行的,也就是说,最后调用的转换方法将影响整个stream 提到的并行流,那么他肯定需要多个线程,那么线程是从哪里来的?他有几个? 并行流内部使用了ForkJoinPool,它默认的线程数量就是自己使用的机器的处理器数量,可以通过Runtime.getRuntime().availableProcessors();得到,当然自己想改这个值的话,需要设置系统属性通过System.setProperty("java.util.concurrent.ForkJoinPool.common.parallelism","12");设置,一般是不需要修改的 测试一下性能 顺序流:上面已经测试了,时间在90ms+ fori long l = System.currentTimeMillis(); long sum = 0; for (int i = 0; i <= 10000000; i++) { sum += i; } System.out.println(sum); System.out.println(System.currentTimeMillis() - l); //7+ 并行流:上面已经测试了,时间在130ms+ 结果并不是我们期待的并行流更加快速,对于fori的结果的解释是:他的操作更加偏底层所以也更快,并且它是使用的基本类型避免了拆箱装箱的操作。提到装箱拆箱,这我们自然的就会想到变更上面顺序流和并行流中使用的Stream为基本类型Stream,测试如下 public long sequentialSum(long n){ //85+ return LongStream.iterate(0L, i -> i + 1) .limit(n) .reduce(0L,Long::sum); } public long parallelSum(long n){ //313+ return LongStream.iterate(0L, i -> i + 1) .limit(n) .parallel() .reduce(0L,Long::sum); } 结果已经提升了不少时间了,但是结果还是比较让人失望,因为相差fori还是有很大距离,那么我们下面就来详细的看一下为什么会发生这样的事情 上面Stream都是用到了iterate方法来生成数字,但是这存在问题 iterate生成的是装箱的对象,必须拆箱之后才能进行数字求和 很难把iterate分成多个独立的块来并行执行(必须意识到哪些流更容易让并行流来切分为子任务,iterate很难切分为子任务的原因是:每次应用iterate都会依赖上次生成的结果,因此如果切分成独立小块,那么他就不知道下一个会生成的是什么了(自己的理解。)) 我们之前学过一个生成数字范围的方法来我们来尝试一下,为什么要尝试这个?因为他直接生成一个数字范围并不依赖于之前的任何东西就可以生成,测试如下 public long sequentialSum(long n){ //62+ return LongStream.rangeClosed(0L,n) .reduce(0L,Long::sum); } public long parallelSum(long n){ //73 + return LongStream.rangeClosed(0L,n) .parallel() .reduce(0L,Long::sum); } 测试一亿数字相加结果:fori:43,stream:119,parallel:99.这时候并行流才会超过顺序流 好了到这基本就完事了,如果你购买了这本书,那么对于书上的并行流计算1千万,它达到的结果是1毫秒。但是对比机器我的是八核他仅仅是四核。所以对自己的测试产生了疑问,如果你现在正好看到这里,恳请您可以用自己的电脑测试一下,评论到下面:机器配置+各个的测试结果,对于您的评论将感激不尽 对于上面我们看到了,因为更改了一些api和一些基本类的stream而达到的提升是很惊人的,并行流从一秒多提升到73毫秒。所以下面将要说的是如何争取的使用并行流 对于并行中共享变量的演示 class A { public long total = 0; public void add(long value){ total += value; } } public long sum(long n){ A a = new A(); LongStream.rangeClosed(0,n).parallel().forEach(a::add); return a.total; } @Test public void test() throws Exception { System.out.println(sum(10_000_000)); } 如上的结果各式各样,原因就是total += value并不是原子性的,所以为了保证正确需要加同步,但是这又违反了并行原则。所以到这的结果就是在并行计算中避免使用共享变量 高效的使用流 下面的是书上给出的一些建议,对于流写完评价性能,请重复测试,以保证流是比较高效的 对于拆箱装箱的问题要意识到,如果有那么就有意识的使用api或者类给避免掉 对于较小的数据量不推荐并行流,因为并行流有拆分和合并的过程 考虑数据结构是否容易分解,比如上面的iterate就不容易分解,下面列出了常用的类和对应的可分解性 考虑终端操作中合并步骤的代价的大小,如果合并代价很大,那么组合每个子流产生的部分结果所付出的代价就可能会超过通过并行流得到的性能提升 注意一些api在流中的使用,比如limit和findFirst,因为他们依赖元素的顺序(并行流把数据拆分为几块,如果findFirst那么他就必须去寻找正在的数据的头元素,而不是每个子流中的任一的头元素),他们在并行流上使用代价很大,当然findAny就比findFirst快,因为随便一个子流返回一个就可以了,流中有一个操作unordered方法会将有序流转换为无序流,那么现在如果你需要流中的n个元素而不是专门要前n个元素的话,对无序并行流调用limit可能会比单个有序流更高效 考虑操作流水线的总计算成本:设N是要处理元素的数量,Q是元素通过流水线的大致处理成本,则N*Q就是这个对成本的一个估计,Q值较高就代表使用并行流的性能会更好(自己的理解:综合考虑元素合数和对每个元素处理的复杂度,复杂度越高就越推荐使用并行流,这样可以分摊到各个内核并行处理元素) | 源 | 可分解性 | | -------- |------- | | ArrayList | 极佳 | | LinkedList | 差 | | IntStream.range | 极佳 | | Stream.iterate | 差 | | TreeSet | 好 | | HashSet | 好 | 前面提到了并行流的实现就是使用了forkjoin框架,那么现在来了解一下forkjoin框架:移步到ForkJoin 了解完forkjoin,我们知道了在此框架中是如何的切分数据的,那么我们的并行流是怎么实现切分数据的呢? 能够帮助并行流切分数据的就是Spliterator机制:可分迭代器 Spliterator是java8新接口,可以用于遍历数据源中的元素,但它是为了并行执行而设计的,一般在开发中不需自己开发 接口定义 public interface Spliterator<T> { boolean tryAdvance(Consumer<? super T> action); Spliterator<T> trySplit(); long estimateSize(); int characteristics(); ... } 泛型是需要遍历的元素类型 tryAdvance:会按顺序一个个使用Spliterator中的元素,并且如果还有其他元素要遍历就返回true trySplit:专门为此接口设计的,它可以把一些元素划出去分给第二个Spliterator,由该方法返回,让两个Spliterator并行处理 estimateSize:用来估计还剩下多少元素要遍历,因为即使不那么确切,能快速算出来是一个值也有助于让拆分均匀一点 拆分过程 将Stream拆分的过程是一个递归的过程,先将最开始的Spliterator尝试trySplit拆分,生成第二个Spliterator2,然后再次对这两个Spliterator进行拆分...框架一直拆分Spliterator,直到Spliterator调用trySplit返回null,标示处理的数据结构已经不能分割,这时候此Spliterator上的拆分就终止了 拆分过程也受Spliterator本身的特性影响,而特性就是由上面定义的方法characteristics声明的 Spliterator特性 characteristics返回一个int,代表Spliterator本身特性集的编码。使用Spliterator可以通过特性来更好的控制和优化它的使用 | 特性 | 含义 | | ------------- | ------------- | | ORDERED | 元素有既定的顺序:List,因此Spliterator在遍历和划分的时候也会遵循这一规律 | | DISTINCT | 对于任意一对遍历过的元素x和y,x.equals(y)=false | | SORTED | 遍历的元素按照一个预定义的顺序排序 | | SIZED | 该Spliterator由一个一只大小的源建立:Set,因此 estimateSize返回的是准确值 | | NONNULL | 保证遍历的元素不会为null | | IMMUTABLE | Spliterator的数据源不能修改,就意味着在遍历时不能增删改任何元素 | | CONCURRENT | Spliterator的数据源可以被其他线程同时修改而无需同步 | | SUBSIZED | Spliterator和所有从它拆分出来的Spliterator都是SIZED | 实现自己的Spliterator 实现String字符串中有多少个单词 String str = "hello hello hellohello hello hello hellohello hello hello"; IntStream.range(0,str.length()).mapToObj(str::charAt).forEach(System.out::println); 如上代码结果就是str字符串被一个个输出,现在我们得到了这个流,那么我们现在就可以根据流来判断有多少个单词了,因为只要是" "那么就是遇到空格那么肯定就是一个单词出现了 现在我们需要两个值来保存状态:counter用来计算到目前为止数过的字数,还有一个Boolean记录上一个是否遇到的是空格,如下代码 public class WordCount { private final int counter;//单词累计 private final boolean lastSpace;//字符标志 public WordCount(int counter, boolean lastSpace) { this.counter = counter; this.lastSpace = lastSpace; } //接收流中的一个个char并判断 public WordCount accumulate(Character c) { if (Character.isWhitespace(c)){ //如果是true的话,那么就返回当前对象, return lastSpace ? this : new WordCount(counter,true); }else { //如果是true,那么就代表上一个字符是空格,那么就为下一个对象的累加计数器加一,并为字符标志器赋值为false代表遇到的不是空格 return lastSpace ? new WordCount(counter + 1 , false) : this; } } //合并方法:合并两个wordCounter public WordCount combine(WordCount wordCount){ return new WordCount(counter + wordCount.counter,wordCount.lastSpace); } public int getCounter() { return counter; } } accumulate定义了用哪个状态来建立新的WordCOunter,因为类中的变量是不可变的,每次遍历Stream中的一个新的Character时,就会调用此方法 combine会对作用与Character流的两个不同子部分的两个WordCounter的部分结果进行汇总,也就是将WordCounter内部计数器加起来 测试如上方法 //共用测试方法 private int countWords(Stream<Character> stream){ return stream.reduce(new WordCount(0,true),WordCount::accumulate,WordCount::combine).getCounter(); } String s = " hello hello hellohello hello hello hellohello hello hello "; Stream<Character> stream = IntStream.range(0, s.length()) .mapToObj(s::charAt); int i = countWords(stream); System.out.println("i = " + i); //顺序流并不会调用combine,因为它的累加在创建新的WordCounter类时已经累加了 我们看上面的测试方法,可以传入一个stream,如果让他调用转换为并行流的方法应该也行得通,比如 String s = " hello hello hellohello hello hello hellohello hello hello "; Stream<Character> stream = IntStream.range(0, s.length()) .mapToObj(s::charAt); int i = countWords(stream.parallel()); //注意变化 System.out.println("i = " + i); 但是失望的是结果是不对的,有个好消息就是我们知道了并行流的情况下,才会调用combine方法 结果为什么不对?因为你的字符串转换为并行流处理后,并行流并不清楚如何切分你的hello,可能把他且分为两个流中去了,比如A流有Hell,而o却跑到了B流中,以至于一个单词被算成了两个单词,我们要想办法避免并行流随机切分数据块,那么这时候就会用到Spliterator了 不让并行流随意切分的思路是:我们在切分数据的时候依旧是从数据的中间定位开始,就是index=length/2,但是我们要判断此处是否是空格,如果是的话那么直接切,不是的话,就要往前挪或者往后挪index,直到出现空格为止,所以实现代码如下 public class WordCountSpliterator implements Spliterator<Character> { private final String string; private int currentChar = 0; public WordCountSpliterator(String string) { this.string = string; } //会按顺序一个个使用Spliterator中的元素,并且如果还有其他元素要遍历就返回true @Override public boolean tryAdvance(Consumer<? super Character> action) { action.accept(string.charAt(currentChar++)); return currentChar < string.length(); } //可以把一些元素划出去分给第二个Spliterator,由该方法返回,让两个Spliterator并行处理 @Override public Spliterator<Character> trySplit() { int currentSize = string.length() - currentChar; if (currentSize < 10){ return null; } for (int splitPos = currentSize / 2 + currentChar; splitPos < string.length(); splitPos++) { if (Character.isWhitespace(string.charAt(splitPos))){ Spliterator<Character> spliterator = new WordCountSpliterator(string.substring(currentChar,splitPos)); currentChar = splitPos; return spliterator; } } return null; } //用来估计还剩下多少元素要遍历,因为即使不那么确切,能快速算出来是一个值也有助于让拆分均匀一点 @Override public long estimateSize() { return string.length() - currentChar; } //返回一个int,代表Spliterator本身特性集的编码。 @Override public int characteristics() { return ORDERED + SIZED + SUBSIZED + NONNULL + IMMUTABLE; } } 代码逻辑并不难,不要被Spliterator和并行流吓住,拿本子画一画就很清楚明白了,比如切分是这样的 测试代码 String s = "hello hello hellohello hello hello hellohello hello hello"; WordCountSpliterator spliterator = new WordCountSpliterator(s); Stream<Character> stream = StreamSupport.stream(spliterator, true); int i = countWords(stream); System.out.println("i = " + i); Spliterator代码解释 tryAdvance把String中当前位置的Character传给了Consumer,并让位置加一。这里只有一个归约函数即WordCounter类的accumulate方法。如果新的指针位置小于String的总长,且还有要遍历的Character,则tryAdvance返回true trySplit定义了拆分要遍历的数据结构的逻辑。在方法中首先定下了什么时候不在拆分,不拆分的时候返回null,需要拆分的时候,就把试探的拆分为止设在要解析的String字符串的中间,如果不是空格就往后找,避免把String错切分成两个单词。一旦找到空格那么就创建一个新的Spliterator来遍历从当前位置到拆分位置的子串,把当前位置this设置为拆分位置,因为之前的部分将由新Spliterator处理最后返回 还需要遍历的元素的estimatedSize就是这个Spliterator解析的字符串的总长度和当前遍历的位置的差 characteristics告诉框架这个SPliterator是 ORDERED:顺序就是String各个char的次序 SIZED:estimateSize方法的返回值是精确的 SUBSIZED:trySplit方法创建的Spliterator也有确切大小 NONULL:字符串中不能有null IMMUTABLE:在解析字符串时不能再添加数据,因为字符串不可变 Spliterator最后需要注意的一个功能是:就是可以在第一次遍历,第一次拆分或第一次查询估计大小时绑定元素的数据源,而不是在创建时就绑定