首页 文章 精选 留言 我的

精选列表

搜索[数据处理],共9356篇文章
优秀的个人博客,低调大师

零基础搭建Hadoop大数据处理-环境

由于Hadoop需要运行在Linux环境中,而且是分布式的,因此个人学习只能装虚拟机,本文都以VMware Workstation为准,安装CentOS7,具体的安装此处不作过多介绍,只作需要用到的知识介绍。 VMware的安装,装好一个虚拟机后利用复制虚拟机的方式创建后面几个虚拟机,省时省力,需要注意的是需要修改每个虚拟机的IP与主机名。 所有虚拟机采用NAT模式上网,而且要保证与物理主机的IP互相能访问。 需要注意的几个问题。nat如果上网首先需要查看物理机(pc机)这个服务器已经启动。上网的原理:流量是走的物理网卡,但是它的ip,却是和物理机没有关系的。也就是说,无论你怎么更换网络环境,你的虚拟机都不需要做改变。这就是它的优点。 首先在安装VMware 之后,我们会看到多了两个网卡 这个如果经过网络配置的折磨,应该能找到着两个网卡:vmnet1和vmnet8,这里讲的是vmnet8。 重点看右侧第三图你会看到ip地址,这个ip地址,因个人而异,也就是说不同网络,不同环境,这个ip变化的概率是很大的。可能是192.168.0.1等等。这里也相当于我们编程的一个变量,这里是需要你根据你的环境来赋值的,建议vmnet1到vmnet8分别设置192.168.10.1到192.168.80.1,好作区分。 上面我们通过看到的虚拟机网卡的ip,为了避免混肴,上面的虚拟网卡和本地网络适配器处于同一界面。如下图: 而下面则是在打开虚拟机之后,通过菜单弹出 弹出之后,我们在看一下虚拟机的(交换机)vmnet8. 可以看到vmnet8子网ip和虚拟机网卡是出于同一个网段的。 同时在右侧net设置界面,我们可以看到网关为:192.168.106.2,改成192.168.80.2 虚拟机的设置会用到。 Linux基础知识 Linux的学习也是一个过程,因为可能你连最简单的开机和关机命令都不会,更不要谈配置网络。这里面给大家提供刚开始学习所查阅的资料和经验总结。 首先我们需要使用一些命令,进行网络配置,但是在网络配置中,这里面又必须懂得虚拟机的一些知识,所以前面的虚拟机知识需要掌握扎实一些。 在此注意CentOS7与CentOS6的命令有些不同,会一些常用命令是必备,每次开机或启动解压安装授权都是最基本的知识,其它的可以暂时不用学。 CentOS中安装java环境 下载对应32或64位jdk,设置好JDK环境变量PATH,具体的配置可自行Google。 环境准备 修改机器名,每个系统中都要修改成这样。 打开终端,切换到root用户下修改机器名称。 $sudosu $vim/etc/sysconfig/network 在其中添加“HOSTNAME=H32” 添加每个服务器IP对应的机器名 三个ip地址都添加到各自的/etc/hosts文件中 每个系统中都要修改成这样 #编辑hosts vim/etc/hosts 关闭SELinux #编辑SELinux配置文件 vim/etc/selinux/config #改状态 SELINUX=disabled SSH设置 进入H30,查看ssh是否安装,如果有,继续,没有安装下。 rpm-qa|grepssh 时间服务器安装 这里需要安装时间服务器,其他的服务器通过这个来进行多机器时间的同步,分布式部署时机器时间不一致会导致数据错误或组件内通讯错误。 安装httpd服务 httpd是Apache超文本传输协议(HTTP)服务器的主程序。被设计为一个独立运行的后台进程,它会建立一个处理请求的子进程或线程的池。 安装yum-utils yum install yum-utils 用于在线yum安装 它是基於RPM包管理,能够从指定的服务器自动下载RPM包并且安装,可以自动处理依赖性关系,并且一次安装所有依赖的软体包,无须繁琐地一次次下载、安装。yum提供了查找、安装、删除某一个、一组甚至全部软件包的命令,而且命令简洁而又好记。(需要机器能访问外网) 准备资源和环境 下载Centos 7.2 的iso安装镜像,jdk1.8 for Linux压缩包,hadoop2.7.3压缩包(本来用hadoop3,发现后面不兼容hive的最新版本) Java基础知识 由于Hadoop框架源码都是以java来写,因此最好都以java作为开发的最佳语言,虽然说有些用C#做了封装,但性能已大打折扣。(这就是为什么说Java的学大数据有很大的优势,其它语言的还需要重新学习Java) Eclipse IDE使用 Linux和Windows下源码编译技术 还有最重要的是你的网速要好,因为安装过程中会下载依赖包,网不好会卡到你怀疑人生。 最后还需要有耐心,每台机子的环境都不一样,而且每个人下载的包的版本也有可能不一样 会导致各种问题,此时就需要耐心的去看日志,不停的尝试和仔细的对比安装步骤,可能就是少了个变量 或大小写错误或是要重启。 环境准备就这么多,下一章开始讲如何安装Hadoop集群。 本文作者:欢醉 来源:51CTO

优秀的个人博客,低调大师

大数据处理:云应用应具备哪些特征?

基于云的应用程序处理大数据时,被处理的大数据不仅具有高容量、高速度、多类型的3V特性,还必须辅以第四个V:准确性。尤其在处理属于他人的数据的时候。 在波士顿大数据创新会议上的一个对话会上,IBM云数据服务事业部产品开发副总裁迈克·奥罗克(Mike O’Rourke)表示,所有四个特性,包括在论证中的数据所有权的问题,在推动业务敏捷性上都各自扮演着一个重要角色。大部分现代云应用处理的数据都来自外部资源,在使用前必须清理。 “开发团队必须敏捷,这样他们才能迅速反应,提供应用程序的快速更新。”他说。“这意味着,在处理大数据时,你必须有不同的思考方式。”虽然奥罗克(O’Rourke)并没有过于发挥到引用阿甘的“生活就像一盒巧克力”的格言,但他明确表示,当应用程序收集、处理和存储大数据时,你永远不知道会得到什么。因此,基于云的应用程序的设计必须足够灵活,以保证无论遇到何种数据,运行不间断。 奥罗克解释4个V的概念。他说,首先,高容量是最主要的。因为云和移动应用需要处理交互的数据量,不论是事务型数据还是流数据,正从TB级到PB级飞涨。 多类型是说,应用程序必须能处理结构化和非结构化的多种形式的数据。视频数据是非结构化的,但应用程序必须了解其内容。奥罗克解释,“如果你是一个广播公司,你不希望在有许多人丧生的严重车祸的影片后,广告出现说,买一辆雪佛兰车吧。这两者放在一起违和。” 高速度,或者说动态数据,正变得越来越重要,尤其是在数据容量突飞猛进的现实情况下。奥罗克说,“物联网通过传感器收集的和社会化的海量数据,正向我们涌来,你的应用程序必须能够提供实时决策。” 收集数据供以后分析或处理的概念已经过时了,他补充道。 准确性是指在处理的数据的可靠性各异的情况下(这被称为数据的不确定性),应用程序需表现出灵活性。奥罗克举例,电池没电或突然失去通讯联系时,健身设备和手机传来的数据可能突然中断。“你的应用程序能处理这样的突发情况吗?” 传统上,无论是零售交易、工厂车间的工艺控制,或是保险的保费和效益跟踪的案例,企业都是自己收集数据、自己处理。但云时代世界不一样了。奥罗克说,“当构建应用程序或做应用分析时,可能遇到的情况是,不论你在哪间公司,大部分需要处理的数据都不是公司自己拥有的。 他举了一个批大学工程专业学生夏天在IBM实习的例子。这些学生为纽约市搭建了一个应用程序,用来精确定位不安全道路的位置。学生们利用的数据包括机动车交通事故、天气、日出、日落、空气的湿度、道路是否湿滑、道路指示牌和道路标志的地理空间信息等。所有的数据都是公共数据,来自公共领域。 在几个星期内,这组学生创建了一个应用程序,标识了需要维修或重新设计具体道路的地点,司机可能会受益于更早展示警告标志的地方,和交通信号需要改变的十字路口。 “因为大部分需要处理的数据不是你自己拥有的,所以我可以提供给开发人员的最好建议是:在检视和分析数据之前,必须有必要对数据进行清理、标记和储存。” 奥罗克总结说。 本文转自d1net(转载)

优秀的个人博客,低调大师

0基础搭建Hadoop大数据处理-集群安装

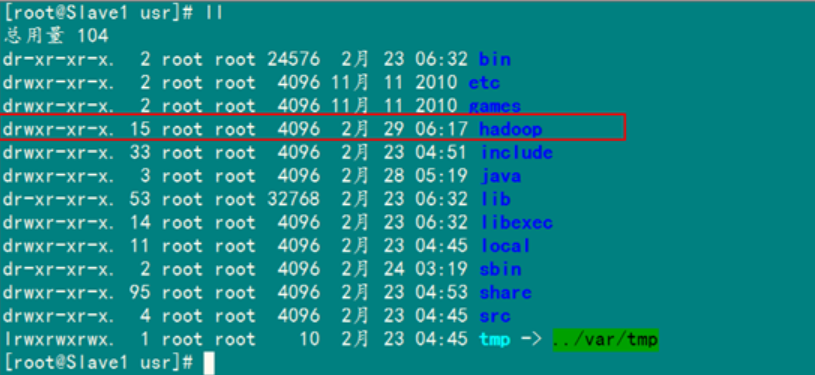
经过一系列的前期环境准备,现在可以开始Hadoop的安装了,在这里去apache官网下载2.7.3的版本http://www.apache.org/dyn/closer.cgi/hadoop/common/hadoop-2.7.3/hadoop-2.7.3.tar.gz 不需要下载最新的3.0版本, 与后续Hive最新版本有冲突,不知道是不是自己的打开方式不对。 hadoop有三种运行方式:单机、伪分布式、完全分布式,本文介绍完全分布式。 安装Hadoop 现在有三个机器,一个Master H32,两个Slaver H33、H34。 将下载的压缩包上传到解压并移动至Master机器的相应目录。 将软件放置/usr/local目录下: tar -zxvf hadoop-2.7.3.tar.gz mv hadoop-2.7.3 hadoop273 创建hadoop用户组和用户 [root@H32 local]# groupadd hadoop #添加hadoop组 [root@H32 local]# useradd -g hadoop hadoop -s /bin/false 将该hadoop文件夹的属主用户设为hadoop sudo chown -R hadoop:hadoop /usr/local/hadoop273 配置文件之前先大体介绍一下hadoop2目录中的各个文件夹,注意区分与Hadoop1中的改变。 外层的启动脚本在sbin目录 内层的被调用脚本在bin目录 Native的so文件都在lib/native目录 配置程序文件都放置在libexec 配置文件都在etc目录,对应以前版本的conf目录 所有的jar包都在share/hadoop目录下面 创建Hadoop数据目录: mkdir -p /usr/local/hadoop273/hdfs/name mkdir -p /usr/local/hadoop273/hdfs/data 若不配置,Hadoop默认将数据存储在tmp文件夹中,重启会清空tmp数据,因此单独配置其数据存储文件夹,具体使用配置在下面XML中。 配置环境变量 /etc/profile增加如下内容: export HADOOP_HOME=/usr/local/hadoop273 export PATH=$HADOOP_HOME/bin:$HADOOP_HOME/sbin:$PATH export HADOOP_MAPARED_HOME=${HADOOP_HOME} export HADOOP_COMMON_HOME=${HADOOP_HOME} export HADOOP_HDFS_HOME=${HADOOP_HOME} export HADOOP_YARN_HOME=${HADOOP_HOME} export YARN_HOME=${HADOOP_HOME} export YARN_CONF_DIR=${HADOOP_HOME}/etc/hadoop export HADOOP_CONF_DIR=${HADOOP_HOME}/etc/hadoop export HDFS_CONF_DIR=${HADOOP_HOME}/etc/hadoop export LD_LIBRARY_PATH=${HADOOP_HOME}/lib/native/:$LD_LIBRARY_PATH export HADOOP_COMMON_LIB_NATIVE_DIR=$HADOOP_HOME/lib/native export HADOOP_OPTS="-Djava.library.path=$HADOOP_HOME/lib/native" 执行执行source /etc/profile,使之生效 修改slaves文件,添加子节点服务名或IP $HADOOP_HOME/etc/hadoop/slaves(Master主机特有,子节点可以不加) H33 H34 或写对应的IP 192.168.80.33 192.168.80.34 hadoop-env.sh中配置java_home export JAVA_HOME=/usr/local/java/jdk1.8.0_101 让环境变量配置生效source source /usr/local/hadoop3/etc/hadoop/hadoop-env.sh Hadoop配置文件在conf目录下,之前的版本的配置文件主要是Hadoop-default.xml和Hadoop-site.xml。 由于Hadoop发展迅速,代码量急剧增加,代码开发分为了core,hdfs和map/reduce三部分,配置文件也被分成了三个core-site.xml、hdfs-site.xml、mapred-site.xml。 core-site.xml和hdfs-site.xml是站在HDFS角度上配置文件;core-site.xml和mapred-site.xml是站在MapReduce角度上配置文件。 core-site.xml配置如下(经过多次坑最后能稳定跑的配置,说多了都是泪) <configuration> <property> <name>fs.default.name</name> <value>hdfs://H32:9000</value> </property> <property> <name>hadoop.tmp.dir</name> <value>/usr/local/hadoop273/hadoop_tmp</value> </property> <property> <name>hadoop.proxyuser.root.hosts</name> <value>*</value> </property> <property> <name>hadoop.proxyuser.root.groups</name> <value>*</value> </property> <property> <name>hadoop.proxyuser.sqoop2.hosts</name> <value>*</value> </property> <property> <name>hadoop.proxyuser.sqoop2.groups</name> <value>*</value> </property> </configuration> 单独创建tmp文件夹hadoop_tmp 给 hadoop.tmp.dir 用于跟普通数据隔离。 hdfs-site.xml <configuration> <property> <name>dfs.namenode.secondary.http-address</name> <value>H32:9001</value> </property> <property> <name>dfs.replication</name> <value>1</value> </property> <property> <name>dfs.tmp.dir</name> <value>/usr/local/hadoop273/hadoop_tmp</value> </property> <property> <name>dfs.namenode.name.dir</name> <value>file:/usr/local/hadoop273/hdfs/name</value> </property> <property> <name>dfs.datanode.data.dir</name> <value>file:/usr/local/hadoop273/hdfs/data</value> </property> <property> <name>dfs.permissions</name> <value>false</value> </property> <property> <name>dfs.webhdfs.enabled</name> <value>true</value> </property> <property> <name>dfs.datanode.max.xcievers</name> <value>4096</value> </property> </configuration> mapred-site.xml <configuration> <property> <name>mapreduce.framework.name</name> <value>yarn</value> </property> <property> <name>mapreduce.application.classpath</name> <value>/usr/local/hadoop273/etc/hadoop,/usr/local/hadoop273/share/hadoop/common/*,/usr/local/hadoop273/share/hadoop/common/lib/*,/usr/local/hadoop273/share/hadoop/hdfs/*,/usr/local/hadoop273/share/hadoop/hdfs/lib/*,/usr/local/hadoop273/share/hadoop/mapreduce/*,/usr/local/hadoop273/share/hadoop/mapreduce/lib/*,/usr/local/hadoop273/share/hadoop/yarn/*,/usr/local/hadoop273/share/hadoop/yarn/lib/*</value> </property> <property> <name>mapreduce.jobhistory.address</name> <value>H32:10020</value> </property> <property> <name>mapreduce.jobhistory.webapp.address</name> <value>H32:19888</value> </property> <property> <name>mapreduce.map.memory.mb</name> <value>1536</value> </property> <property> <name>mapreduce.map.java.opts</name> <value>-Xmx3072M</value> </property> <property> <name>mapreduce.reduce.memory.mb</name> <value>3072</value> </property> <property> <name>mapreduce.reduce.java.opts</name> <value>-Xmx6144M</value> </property> <property> <name>mapreduce.cluster.map.memory.mb</name> <value>-1</value> </property> <property> <name>mapreduce.cluster.reduce.memory.mb</name> <value>-1</value> </property> </configuration> yarn-site.xml <configuration> <!-- Site specific YARN configuration properties --> <property> <name>yarn.resourcemanager.address</name> <value>H32:8032</value> </property> <property> <name>yarn.resourcemanager.scheduler.address</name> <value>H32:8030</value> </property> <property> <name>yarn.resourcemanager.resource-tracker.address</name> <value>H32:8031</value> </property> <property> <name>yarn.resourcemanager.admin.address</name> <value>H32:8033</value> </property> <property> <name>yarn.resourcemanager.webapp.address</name> <value>H32:8088</value> </property> <property> <name>yarn.nodemanager.aux-services</name> <value>mapreduce_shuffle</value> </property> <property> <name>yarn.nodemanager.aux-services.mapreduce.shuffle.class</name> <value>org.apache.hadoop.mapred.ShuffleHandler</value> </property> <property> <name>mapreduce.application.classpath</name> <value>/usr/local/hadoop273/etc/hadoop,/usr/local/hadoop273/share/hadoop/common/*,/usr/local/hadoop273/share/hadoop/common/lib/*,/usr/local/hadoop273/share/hadoop/hdfs/*,/usr/local/hadoop273/share/hadoop/hdfs/lib/*,/usr/local/hadoop273/share/hadoop/mapreduce/*,/usr/local/hadoop273/share/hadoop/mapreduce/lib/*,/usr/local/hadoop273/share/hadoop/yarn/*,/usr/local/hadoop273/share/hadoop/yarn/lib/*</value> </property> <property> <name>yarn.nodemanager.vmem-pmem-ratio</name> <value>3</value> </property> </configuration> 注意黄色标志,要classpath一定是绝对路径,不要用$HADOOP_HOME,运行会一直提示找不到相关类错误,至此master节点的hadoop搭建完毕。 搭建剩余节点 现在在Master机器上的Hadoop配置就结束了,剩下的就是配置Slave机器上的Hadoop。将 Master上配置好的hadoop所在文件夹"/usr/local/hadoop273"复制到所有的Slave的"/usr/local"目录下(实际上Slave机器上的slavers文件是不必要的, 复制了也没问题)。用下面命令格式进行。(备注:此时用户可以为hadoop也可以为root)把H32的hadoop目录下的logs和tmp删除,再把H32中的jdk、hadoop文件夹复制到H33和H34节点 scp -r /usr/local/hadoop273 root@H33:/usr/local 例如:从"Master.Hadoop"到"Slave1.Hadoop"复制配置Hadoop的文件。 上图中以root用户进行复制,当然不管是用户root还是hadoop,虽然Master机器上的"/usr/local/hadoop273"文件夹用户hadoop有权限,但是Slave1上的hadoop用户却没有"/usr/local"权限,所以没有创建文件夹的权限。所以无论是哪个用户进行拷贝,右面都是"root@机器IP"格式。因为我们只是建立起了hadoop用户的SSH无密码连接,所以用root进行"scp"时,扔提示让你输入"Slave1.Hadoop"服务器用户root的密码。 查看"Slave1.Hadoop"服务器的"/usr/local"目录下是否已经存在"hadoop"文件夹,确认已经复制成功。 hadoop文件夹确实已经复制了,但是我们发现hadoop权限是root,所以我们现在要给"Slave1.Hadoop"服务器上的用户hadoop添加对"/usr/local/hadoop"读权限。 以上配置完成后,将hadoop整个文件夹复制到其他机器。 启动hadoop 1.格式化namenode hdfs namenode -format 只需一次,下次启动不再需要格式化,只需 start-all.sh若没有设置路径$HADOOP_HOME/bin为环境变量,则需在$HADOOP_HOME路径下执行 bin/hdfs namenode -format 2.启动dfs及yarn start-dfs.sh 在启动前关闭集群中所有机器的防火墙,不然会出现datanode开后又自动关闭(暂未发现) service iptables stop start-yarn.sh若没有设置路径$HADOOP_HOME/sbin为环境变量,则需在$HADOOP_HOME路径下执行 sbin/start-dfs.sh sbin/start-yarn.sh或 直接start-all.sh都启动 另外还要启动history服务,不然在面板中不能打开history链接。 sbin/mr-jobhistory-daemon.sh start historyserver 停止集群 sbin/stop-dfs.sh sbin/stop-yarn.sh 或 直接stop-all.sh 下面使用jps命令查看启动进程:4504 ResourceManager4066 DataNode4761 NodeManager5068 JobHistoryServer4357 SecondaryNameNode3833 NameNode5127 Jps 打开监控页面 现在便可以打开页面http://192.168.80.32:8088及http://192.168.80.32:50070;看到下面两个页面时说明安装成功。 测试 hdfs测试: 在root中创建文件: ~/hadoop-test-data.txt 向hdfs中上传文件: bin/hadoop fs -put ~/hadoop-test-data.txt /tmp/input 查看hdfs文件目录: hdfs dfs –ls / 移除文件命令: hadoop fs -rm -r /tmp/input Yarn测试: 运行WordCount测试程序,output为输出文件。 bin/hadoop jar share/hadoop/mapreduce/hadoop-mapreduce-examples-2.7.3.jar wordcount /tmp/input output 运行过程出现下面内容,没有错误提示说明正常: 具体查看结果: 查看生成列表,会有两个文件,主要查看part-r-00000 hadoop fs -ls output/ hadoop fs -cat output/part-r-00000 结果显示: hadoop 1hello 2java 4jsp 1 到这里,hadoop-2环境搭建结束,配置文件根据具体需求,具体配置。 查看集群状态: [root@H32 hadoop273]$ ./bin/hdfs dfsadmin -report MapReduce Application Master界面: Map Task运行状况: 某个Node上各个Container状态: 扩展 以下列布署过程中遇到的几个常见问题,加了网上一些网友的内容。 解决"no datanode to stop"问题 当停止Hadoop时发现如下信息: 原因:每次namenode format会重新创建一个namenodeId,而tmp/dfs/data下包含了上次format下的id,namenode format清空了namenode下的数据,但是没有清空datanode下的数据,导致启动时失败,所要做的就是每次fotmat前,清空tmp一下的所有目录。 第一种解决方案如下: 1)先删除"/usr/hadoop/tmp"rm -rf /usr/hadoop/tmp 2)创建"/usr/hadoop/tmp"文件夹mkdir /usr/hadoop/tmp 3)删除"/tmp"下以"hadoop"开头文件rm -rf /tmp/hadoop* 4)重新格式化hadoophadoop namenode -format 5)启动hadoopstart-all.sh 使用第一种方案,有种不好处就是原来集群上的重要数据全没有了。假如说Hadoop集群已经运行了一段时间。建议采用第二种。 第二种方案如下: 1)修改每个Slave的namespaceID使其与Master的namespaceID一致。 或者 2)修改Master的namespaceID使其与Slave的namespaceID一致。 该"namespaceID"位于"/usr/hadoop/tmp/dfs/data/current/VERSION"文件中,前面蓝色的可能根据实际情况变化,但后面红色是不变的。 例如:查看"Master"下的"VERSION"文件 本人建议采用第二种,这样方便快捷,而且还能防止误删。 Slave服务器中datanode启动后又自动关闭 查看日志发下如下错误。 ERROR org.apache.hadoop.hdfs.server.datanode.DataNode: java.io.IOException: Call to ... failed on local exception: java.net.NoRouteToHostException: No route to host 解决方案是:关闭防火墙 service iptables stop 从本地往hdfs文件系统上传文件 出现如下错误: INFO hdfs.DFSClient: Exception in createBlockOutputStream java.io.IOException: Bad connect ack with firstBadLink INFO hdfs.DFSClient: Abandoning block blk_-1300529705803292651_37023 WARN hdfs.DFSClient: DataStreamer Exception: java.io.IOException: Unable to create new block. 解决方案是: 1)关闭防火墙service iptables stop 2)禁用selinux 编辑 "/etc/selinux/config"文件,设置"SELINUX=disabled" 处理速度特别的慢 出现map很快,但是reduce很慢,而且反复出现"reduce=0%"。 解决方案如下: 结合解决方案5.7,然后修改"conf/hadoop-env.sh"中的"export HADOOP_HEAPSIZE=4000" 解决hadoop OutOfMemoryError问题 出现这种异常,明显是jvm内存不够得原因。 解决方案如下:要修改所有的datanode的jvm内存大小。Java –Xms 1024m -Xmx 4096m 一般jvm的最大内存使用应该为总内存大小的一半,我们使用的8G内存,所以设置为4096m,这一值可能依旧不是最优的值。 Namenode in safe mode 解决方案如下:bin/hadoop dfsadmin -safemode leave IO写操作出现问题 0-1246359584298, infoPort=50075, ipcPort=50020):Got exception while serving blk_-5911099437886836280_1292 to /172.16.100.165: java.net.SocketTimeoutException: 480000 millis timeout while waiting for channel to be ready for write. ch : java.nio.channels.SocketChannel[connected local=/ 172.16.100.165:50010 remote=/172.16.100.165:50930] at org.apache.hadoop.net.SocketIOWithTimeout.waitForIO(SocketIOWithTimeout.java:185) at org.apache.hadoop.net.SocketOutputStream.waitForWritable(SocketOutputStream.java:159) …… It seems there are many reasons that it can timeout, the example given in HADOOP-3831 is a slow reading client. 解决方案如下: 在hadoop-site.xml中设置dfs.datanode.socket.write.timeout=0 java.net.NoRouteToHostException: No Route to Host from H32/192.168.80.32 to H30:40080 failed on socket timeout exception: java.net.NoRouteToHostException: 没有到主机的路由;关闭to H30的防火墙,或不能访问H30服务器,重启H30 This token is expired. current time is 1489243761235 found 1489239661109Note: System times on machines may be out of sync. Check system time and time zones.两个主机的时间不一致,重置两个主机的时间,重置方法网上有很多。 启动hadoop时没有NameNode的可能原因:(1) NameNode没有格式化(2) 环境变量配置错误(3) Ip和hostname绑定失败(4)hostname含有特殊符号如何.(符号点),会被误解析 地址占用报错:org.apache.hadoop.hdfs.server.namenode.NameNode: Address already in use解决方法:查找被占用的端口号对应的PID:netstat –tunl Pkill -9 PID 实在不行就killall -9 java

优秀的个人博客,低调大师

Tick 数据处理实践:从接入到系统节奏优化

作为高校金融系讲师,我曾在一次学生创业项目指导中,深入处理过 tick 数据接入问题。该项目是一个面向个人交易者的实时监控工具,起初使用分钟级数据运行良好,切换到 tick 数据后出现延迟累积和偶发丢包。本文复盘当时的解决思路,重点讨论 tick 数据在系统中的角色以及如何通过分层设计提升稳定性。 ### 创业案例:tick 数据带来的系统压力 学生团队的产品需要实时呈现美股 tick 行情,并基于价格变动触发提醒。初期实现直接同步处理每条消息,开盘时段 WebSocket 推送量激增,导致主线程阻塞,延迟从毫秒级恶化到秒级。这个案例说明,tick 数据与聚合行情有本质区别:它不是离散的响应结果,而是持续输入的事件流。 ### 数据痛点:tick 是流,不是结果集 tick 行情的特点决定了系统不能沿用请求-响应模型: - 推送频率无固定周期,瞬时流量可能极高 - 单条数据信息量小,需聚合才具备业务价值 - 网络抖动可能造成乱序或丢失 - 同步消费会迅速堆积消息,造成延迟 因此,处理 tick 数据必须引入缓冲和异步机制,将流量平滑后再交给下游。 ### 解决方案:接入、缓冲、消费三层结构 针对上述问题,我们重构为三层管道: - **接入层**:维护 WebSocket 连接,处理断线重连和心跳 - **缓冲层**:使用内存队列或消息中间件削峰,解耦上下游 - **消费层**:异步执行聚合、计算、状态更新 下面代码是接入层简化实现,重点在于快速将消息送入队列: ``` import websocket import json def on_message(ws, message): data = json.loads(message) ts = data.get("timestamp") price = data.get("price") volume = data.get("volume") # 实际系统中,这里通常会进入队列或缓存 print(f"{ts} | price={price} | vol={volume}") def on_open(ws): ws.send(json.dumps({ "action": "subscribe", "symbols": ["US.AAPL"], "type": "tick" })) ws = websocket.WebSocketApp( "wss://stream.alltick.co/v1/market", on_open=on_open, on_message=on_message ) ws.run_forever() ``` 运行后控制台持续滚动,直观呈现了 tick 数据的流式特征,也验证了缓冲层存在的必要性。 ### 成本/效率优化:统一数据格式降低维护成本 当系统需要接入多个市场时,不同数据源的 tick 字段定义、时间戳格式等差异会显著增加适配代码量。部分项目会采用提供统一 tick 数据格式的服务(标准化结构),从而减少接入层和日志层的重复工作。对于小团队或个人开发者,这种统一能有效降低长期维护成本,使精力更聚焦于业务逻辑。 tick 数据并不复杂,但它对系统设计非常诚实。稳定可靠的行情管道,始于对数据节奏的深刻理解。 ![B12F56E1-DD87-4743-8B34-E309A9BD3318_4_5005_c.jpeg](https://developer.qcloudimg.com/http-save/yehe-11974601/1cfa121d4d83841b7c0c303ca7ddaa20.jpg)

优秀的个人博客,低调大师

延迟执行与不可变,系统讲解JavaStream数据处理

最近在公司写业务的时候,忽然想不起来Stream中的累加应该怎么写? 无奈只能面向谷歌编程,花费了我宝贵的三分钟之后,学会了,很简单。 自从我用上JDK8以后,Stream就是我最常用的特性,各种流式操作用的飞起,然而这次事以后我忽然觉得Stream对我真的很陌生。 可能大家都一样,对最常用到的东西,也最容易将其忽略,哪怕你要准备面试估计也肯定想不起来要看一下Stream这种东西。 不过我既然注意到了,就要重新梳理一遍它,也算是对我的整体知识体系的查漏补缺。 花了很多功夫来写这篇Stream,希望大家和我一块重新认识并学习一下Stream,了解API也好,了解内部特性也罢,怕什么真理无穷,进一步有进一步的欢喜。 在本文中我将Stream的内容分为以下几个部分: 初看这个导图大家可能对转换流操作和终结流操作这两个名词有点蒙,其实这是我将Stream中的所有API分成两类,每一类起了一个对应的名字(参考自Java8相关书籍,见文末): 转换流操作 :例如filter和map方法,将一个Stream转换成另一个Stream,返回值都是Stream。 终结流操作 :例如count和collect方法,将一个Stream汇总为我们需要的结果,返回值都不是Stream。 其中转换流操作的API我也分了两类,文中会有详细例子说明,这里先看一下定义,有一个大概印象: 无状态 :即此方法的执行无需依赖前面方法执行的结果集。 有状态 :即此方法的执行需要依赖前面方法执行的结果集。 由于Stream内容过多,所以我将Stream拆成了上下两篇,本篇是第一篇,内容翔实,用例简单且丰富。 第二篇的主题虽然只有一个终结操作,但是终结操作API比较复杂,所以内容也翔实,用例也简单且丰富,从篇幅上来看两者差不多,敬请期待。 注 :由于我本机的电脑是JDK11,而且写的时候忘了切换到JDK8,所以在用例中大量出现的List.of()在JDK8是没有的,它等同于JDK8中的Arrays.asList()。 注 :写作过程中翻读了大量Stream源码和Java8书籍(文末),创作不易,点赞过百,马上出第二篇。 1. 为什么要使用Stream? 一切还要源于JDK8的发布,在那个函数式编程语言如火如荼的时代,Java由于它的臃肿而饱受诟病(强面向对象),社区迫切需要Java能加入函数式语言特点改善这种情况,终于在2014年Java发布了JDK8。 在JDK8中,我认为最大的新特性就是加入了函数式接口和lambda表达式,这两个特性取自函数式编程。 这两个特点的加入使Java变得更加简单与优雅,用函数式对抗函数式,巩固Java老大哥的地位,简直是师夷长技以制夷。 而Stream,就是JDK8又依托于上面的两个特性为集合类库做的 一个类库,它能让我们通过lambda表达式更简明扼要的以流水线的方式去处理集合内的数据,可以很轻松的完成诸如:过滤、分组、收集、归约这类操作,所以我愿将Stream称为函数式接口的最佳实践。 1.1 更清晰的代码结构 Stream拥有更清晰的代码结构,为了更好的讲解Stream怎么就让代码变清晰了,这里假设我们有一个非常简单的需求:在一个集合中找到所有大于2的元素 。 先来看看没使用Stream之前: List<Integer> list = List.of(1, 2, 3); List<Integer> filterList = new ArrayList<>(); for (Integer i : list) { if (i > 2) { filterList.add(i); } } System.out.println(filterList); 复制代码 上面的代码很好理解,我就不过多解释了,其实也还好了,因为我们的需求比较简单,如果需求再多点呢? 每多一个要求,那么if里面就又要加一个条件了,而我们开发中往往对象上都有很多字段,那么条件可能有四五个,最后可能会变成这样: List<Integer> list = List.of(1, 2, 3); List<Integer> filterList = new ArrayList<>(); for (Integer i : list) { if (i > 2 && i < 10 && (i % 2 == 0)) { filterList.add(i); } } System.out.println(filterList); 复制代码 if里面塞了很多条件,看起来就变得乱糟糟了,其实这也还好,最要命的是项目中往往有很多类似的需求,它们之间的区别只是某个条件不一样,那么你就需要复制一大坨代码,改吧改吧就上线了,这就导致代码里有大量重复的代码。 如果你Stream,一切都会变得清晰易懂: List<Integer> list = List.of(1, 2, 3).stream() .filter(i -> i > 2) .filter(i -> i < 10) .filter(i -> i % 2 == 0) .collect(toList()); 复制代码 这段代码你只需要关注我们最关注的东西:筛选条件就够了,filter这个方法名能让你清楚的知道它是个过滤条件,collect这个方法名也能看出来它是一个收集器,将最终结果收集到一个List里面去。 同时你可能发现了,为什么上面的代码中不用写循环? 因为Stream会帮助我们进行隐式的循环,这被称为:内部迭代,与之对应的就是我们常见的外部迭代了。 所以就算你不写循环,它也会进行一遍循环。 1.2 不必关心变量状态 Stream在设计之初就被设计为不可变的,它的不可变有两重含义: 由于每次Stream操作都会生成一个新的Stream,所以Stream是不可变的,就像String。 在Stream中只保存原集合的引用,所以在进行一些会修改元素的操作时,是通过原元素生成一份新的新元素,所以Stream 的任何操作都不会影响到原对象。 第一个含义可以帮助我们进行链式调用,实际上我们使用Stream的过程中往往会使用链式调用,而第二个含义则是函数式编程中的一大特点:不修改状态。 无论对Stream做怎么样的操作,它最终都不会影响到原集合,它的返回值也是在原集合的基础上进行计算得来的。 所以在Stream中我们不必关心操作原对象集合带来的种种副作用,用就完了。 关于函数式编程可以查阅阮一峰的函数式编程初探。 1.3 延迟执行与优化 Stream只在遇到终结操作的时候才会执行,比如: List.of(1, 2, 3).stream() .filter(i -> i > 2) .peek(System.out::println); 复制代码 这么一段代码是不会执行的,peek方法可以看作是forEach,这里我用它来打印Stream中的元素。 因为filter方法和peek方法都是转换流方法,所以不会触发执行。 如果我们在后面加入一个count方法就能正常执行: List.of(1, 2, 3).stream() .filter(i -> i > 2) .peek(System.out::println) .count(); 复制代码 count方法是一个终结操作,用于计算出Stream中有多少个元素,它的返回值是一个long型。 Stream的这种没有终结操作就不会执行的特性被称为延迟执行。 与此同时,Stream还会对API中的无状态方法进行名为循环合并的优化,具体例子详见第三节。 2. 创建Stream 为了文章的完整性,我思来想去还是加上了创建Stream这一节,这一节主要介绍一些创建Stream的常用方式,Stream的创建一般可以分为两种情况: 使用Steam接口创建 通过集合类库创建 同时还会讲一讲Stream的并行流与连接,都是创建Stream,却具有不同的特点。 2.1 通过Stream接口创建 Stream作为一个接口,它在接口中定义了定义了几个静态方法为我们提供创建Stream的API: public static<T> Stream<T> of(T... values) { return Arrays.stream(values); } 复制代码 首先是of方法,它提供了一个泛型可变参数,为我们创建了带有泛型的Stream流,同时在如果你的参数是基本类型的情况下会使用自动包装对基本类型进行包装: Stream<Integer> integerStream = Stream.of(1, 2, 3); Stream<Double> doubleStream = Stream.of(1.1d, 2.2d, 3.3d); Stream<String> stringStream = Stream.of("1", "2", "3"); 复制代码 当然,你也可以直接创建一个空的Stream,只需要调用另一个静态方法——empty(),它的泛型是一个Object: Stream<Object> empty = Stream.empty(); 复制代码 以上都是我们让我们易于理解的创建方式,还有一种方式可以创建一个无限制元素数量的Stream——generate(): public static<T> Stream<T> generate(Supplier<? extends T> s) { Objects.requireNonNull(s); return StreamSupport.stream( new StreamSpliterators.InfiniteSupplyingSpliterator.OfRef<>(Long.MAX_VALUE, s), false); } 复制代码 从方法参数上来看,它接受一个函数式接口——Supplier作为参数,这个函数式接口是用来创建对象的接口,你可以将其类比为对象的创建工厂,Stream将从此工厂中创建的对象放入Stream中: Stream<String> generate = Stream.generate(() -> "Supplier"); Stream<Integer> generateInteger = Stream.generate(() -> 123); 复制代码 我这里是为了方便直接使用Lamdba构造了一个Supplier对象,你也可以直接传入一个Supplier对象,它会通过Supplier接口的get() 方法来构造对象。 2.2 通过集合类库进行创建 相较于上面一种来说,第二种方式更较为常用,我们常常对集合就行Stream流操作而非手动构建一个Stream: Stream<Integer> integerStreamList = List.of(1, 2, 3).stream(); Stream<String> stringStreamList = List.of("1", "2", "3").stream(); 复制代码 在Java8中,集合的顶层接口Collection被加入了一个新的接口默认方法——stream(),通过这个方法我们可以方便的对所有集合子类进行创建Stream的操作: Stream<Integer> listStream = List.of(1, 2, 3).stream(); Stream<Integer> setStream = Set.of(1, 2, 3).stream(); 复制代码 通过查阅源码,可以发先 stream() 方法本质上还是通过调用一个Stream工具类来创建Stream: default Stream<E> stream() { return StreamSupport.stream(spliterator(), false); } 复制代码 2.3 创建并行流 在以上的示例中所有的Stream都是串行流,在某些场景下,为了最大化压榨多核CPU的性能,我们可以使用并行流,它通过JDK7中引入的fork/join框架来执行并行操作,我们可以通过如下方式创建并行流: Stream<Integer> integerParallelStream = Stream.of(1, 2, 3).parallel(); Stream<String> stringParallelStream = Stream.of("1", "2", "3").parallel(); Stream<Integer> integerParallelStreamList = List.of(1, 2, 3).parallelStream(); Stream<String> stringParallelStreamList = List.of("1", "2", "3").parallelStream(); 复制代码 是的,在Stream的静态方法中没有直接创建并行流的方法,我们需要在构造Stream后再调用一次parallel()方法才能创建并行流,因为调用parallel()方法并不会重新创建一个并行流对象,而是在原有的Stream对象上面设置了一个并行参数。 当然,我们还可以看到,Collection接口中可以直接创建并行流,只需要调用与stream() 对应的parallelStream()方法,就像我刚才讲到的,他们之间其实只有参数的不同: default Stream<E> stream() { return StreamSupport.stream(spliterator(), false); } default Stream<E> parallelStream() { return StreamSupport.stream(spliterator(), true); } 复制代码 不过一般情况下我们并不需要用到并行流,在Stream中元素不过千的情况下性能并不会有太大提升,因为将元素分散到不同的CPU进行计算也是有成本的。 并行的好处是充分利用多核CPU的性能,但是使用中往往要对数据进行分割,然后分散到各个CPU上去处理,如果我们使用的数据是数组结构则可以很轻易的进行分割,但是如果是链表结构的数据或者Hash结构的数据则分割起来很明显不如数组结构方便。 所以只有当Stream中元素过万甚至更大时,选用并行流才能带给你更明显的性能提升。 最后,当你有一个并行流的时候,你也可以通过sequential() 将其方便的转换成串行流: Stream.of(1, 2, 3).parallel().sequential(); 复制代码 2.4 连接Stream 如果你在两处构造了两个Stream,在使用的时候希望组合在一起使用,可以使用concat(): Stream<Integer> concat = Stream .concat(Stream.of(1, 2, 3), Stream.of(4, 5, 6)); 复制代码 如果是两种不同的泛型流进行组合,自动推断会自动的推断出两种类型相同的父类: Stream<Integer> integerStream = Stream.of(1, 2, 3); Stream<String> stringStream = Stream.of("1", "2", "3"); Stream<? extends Serializable> stream = Stream.concat(integerStream, stringStream); 复制代码 3. Stream转换操作之无状态方法 无状态方法:即此方法的执行无需依赖前面方法执行的结果集。 在Stream中无状态的API我们常用的大概有以下三个: map()方法:此方法的参数是一个Function对象,它可以使你对集合中的元素做自定义操作,并保留操作后的元素。 filter()方法:此方法的参数是一个Predicate对象,Predicate的执行结果是一个Boolean类型,所以此方法只保留返回值为true的元素,正如其名我们可以使用此方法做一些筛选操作。 flatMap()方法:此方法和map()方法一样参数是一个Function对象,但是此Function的返回值要求是一个Stream,该方法可以将多个Stream中的元素聚合在一起进行返回。 先来看看一个map()方法的示例: Stream<Integer> integerStreamList = List.of(1, 2, 3).stream(); Stream<Integer> mapStream = integerStreamList.map(i -> i * 10); 复制代码 我们拥有一个List,想要对其中的每个元素进行乘10 的操作,就可以采用如上写法,其中的i是对List中元素的变量名,→ 后面的逻辑则是要对此元素进行的操作,以一种非常简洁明了的方式传入一段代码逻辑执行,这段代码最后会返回一个包含操作结果的新Stream。 这里为了更好的帮助大家理解,我画了一个简图: 接下来是filter()方法示例: Stream<Integer> integerStreamList = List.of(1, 2, 3).stream(); Stream<Integer> filterStream = integerStreamList.filter(i -> i >= 20); 复制代码 在这段代码中会执行i >= 20 这段逻辑,然后将返回值为true的结果保存在一个新的Stream中并返回。 这里我也有一个简单的图示: flatMap() 方法的描述在上文我已经描述过,但是有点过于抽象,我在学习此方法中也是搜索了很多示例才有了较好的理解。 根据官方文档的说法,此方法是为了进行一对多元素的平展操作: List<Order> orders = List.of(new Order(), new Order()); Stream<Item> itemStream = orders.stream() .flatMap(order -> order.getItemList().stream()); 复制代码 这里我通过一个订单示例来说明此方法,我们的每个订单中都包含了一个商品List,如果我想要将两个订单中所有商品List组成一个新的商品List,就需要用到flatMap()方法。 在上面的代码示例中可以看到每个订单都返回了一个商品List的Stream,我们在本例中只有两个订单,所以也就是最终会返回两个商品List的Stream,flatMap()方法的作用就是将这两个Stream中元素提取出来然后放到一个新的Stream中。 老规矩,放一个简单的图示来说明: 图例中我使用青色代表Stream,在最终的输出中可以看到flatMap()将两个流变成了一个流进行输出,这在某些场景中非常有用,比如我上面的订单例子。 还有一个很不常用的无状态方法peek(): Stream<T> peek(Consumer<? super T> action); 复制代码 peek方法接受一个Consumer对象做参数,这是一个无返回值的参数,我们可以通过peek方法做些打印元素之类的操作: Stream<Integer> peekStream = integerStreamList.peek(i -> System.out.println(i)); 复制代码 然而如果你不太熟悉的话,不建议使用,某些情况下它并不会生效,比如: List.of(1, 2, 3).stream() .map(i -> i * 10) .peek(System.out::println) .count(); 复制代码 API文档上面也注明了此方法是用于Debug,通过我的经验,只有当Stream最终需要重新生产元素时,peek才会执行。 上面的例子中,count只需要返回元素个数,所以peek没有执行,如果换成collect方法就会执行。 或者如果Stream中存在过滤方法如filter方法和match相关方法,它也会执行。 3.1 基础类型Stream 上一节提到了三个Stream中最常用的三个无状态方法,在Stream的无状态方法中还有几个和map()与flatMap()对应的方法,它们分别是: mapToInt mapToLong mapToDouble flatMapToInt flatMapToLong flatMapToDouble 这六个方法首先从方法名中就可以看出来,它们只是在map()或者flatMap()的基础上对返回值进行转换操作,按理说没必要单拎出来做成一个方法,实际上它们的关键在于返回值: mapToInt返回值为IntStream mapToLong返回值为LongStream mapToDouble返回值为DoubleStream flatMapToInt返回值为IntStream flatMapToLong返回值为LongStream flatMapToDouble返回值为DoubleStream 在JDK5中为了使Java更加的面向对象,引入了包装类的概念,八大基础数据类型都对应着一个包装类,这使你在使用基础类型时可以无感的进行自动拆箱/装箱,也就是自动使用包装类的转换方法。 比如,在最前文的示例中,我用了这样一个例子: Stream<Integer> integerStream = Stream.of(1, 2, 3); 复制代码 我在创建Stream中使用了基本数据类型参数,其泛型则被自动包装成了Integer,但是我们有时可能忽略自动拆装箱也是有代价的,如果我们想在使用Stream中忽略这个代价则可以使用Stream中转为基础数据类型设计的Stream: IntStream:对应 基础数据类型中的int、short、char、boolean LongStream:对应基础数据类型中的long DoubleStream:对应基础数据类型中的double和float 在这些接口中都可以和上文的例子一样通过of方法构造Stream,且不会自动拆装箱。 所以上文中提到的那六个方法实际上就是将普通流转换成这种基础类型流,在我们需要的时候可以拥有更高的效率。 基础类型流在API方面拥有Stream一样的API,所以在使用方面只要明白了Stream,基础类型流也都是一样的。 注 :IntStream、LongStream和DoubleStream都是接口,但并非继承自Stream接口。 3.2 无状态方法的循环合并 说完无状态的这几个方法我们来看一个前文中的例子: List<Integer> list = List.of(1, 2, 3).stream() .filter(i -> i > 2) .filter(i -> i < 10) .filter(i -> i % 2 == 0) .collect(toList()); 复制代码 在这个例子中我用了三次filter方法,那么大家觉得Stream会循环三次进行过滤吗? 如果换掉其中一个filter为map,大家觉得会循环几次? List<Integer> list = List.of(1, 2, 3).stream() .map(i -> i * 10) .filter(i -> i < 10) .filter(i -> i % 2 == 0) .collect(toList()); 复制代码 从我们的直觉来看,需要先使用map方法对所有元素做处理,然后再使用filter方法做过滤,所以需要执行三次循环。 但回顾无状态方法的定义,你可以发现其他这三个条件可以放在一个循环里面做,因为filter只依赖map的计算结果,而不必依赖map执行完后的结果集,所以只要保证先操作map再操作filter,它们就可以在一次循环内完成,这种优化方式被称为循环合并。 所有的无状态方法都可以放在同一个循环内执行,它们也可以方便的使用并行流在多个CPU上执行。 4. Stream转换操作之有状态方法 前面说完了无状态方法,有状态方法就比较简单了,只看名字就可以知道它的作用: 方法名 方法结果 distinct() 元素去重。 sorted() 元素排序,重载的两个方法,需要的时候可以传入一个排序对象。 limit(long maxSize) 传入一个数字,代表只取前X个元素。 skip(long n) 传入一个数字,代表跳过X个元素,取后面的元素。 takeWhile(Predicate predicate) JDK9新增,传入一个断言参数当第一次断言为false时停止,返回前面断言为true的元素。 dropWhile(Predicate predicate) JDK9新增,传入一个断言参数当第一次断言为false时停止,删除前面断言为true的元素。 以上就是所有的有状态方法,它们的方法执行都必须依赖前面方法执行的结果集才能执行,比如排序方法就需要依赖前面方法的结果集才能进行排序。 同时limit方法和takeWhile是两个短路操作方法,这意味效率更高,因为可能内部循环还没有走完时就已经选出了我们想要的元素。 所以有状态的方法不像无状态方法那样可以在一个循环内执行,每个有状态方法都要经历一个单独的内部循环,所以编写代码时的顺序会影响到程序的执行结果以及性能,希望各位读者在开发过程中注意。 5. 总结 本文主要是对Stream做了一个概览,并讲述了Stream的两大特点: 不可变:不影响原集合,每次调用都返回一个新的Stream。 延迟执行:在遇到终结操作之前,Stream不会执行。 同时也将Stream的API分成了转换操作和终结操作两类,并讲解了所有常用的转换操作,下一章的主要内容将是终结操作。 在看Stream源码的过程中发现了一个有趣的事情,在ReferencePipeline类中(Stream的实现类),它的方法顺序从上往下正好是:无状态方法 → 有状态方法 → 聚合方法。 好了,学完本篇后,我想大家对Stream的整体已经很清晰了,同时对转换操作的API应该也已经掌握了,毕竟也不多😂,Java8还有很多强大的特性,我们下次接着聊~ 最后,创作不易,如果对大家有所帮助,希望大家点赞支持,有什么问题也可以在评论区里讨论😄~ 如果你觉得这篇文章对你有点用的话,麻烦请给我们的开源项目点点star: http://github.crmeb.net/u/defu 不胜感激 ! 来自 “开源世界 ” ,链接: https://ym.baisou.ltd/post/773.html


资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册