Elasticsearch 高级 RAG 技术第 1 部分:数据处理
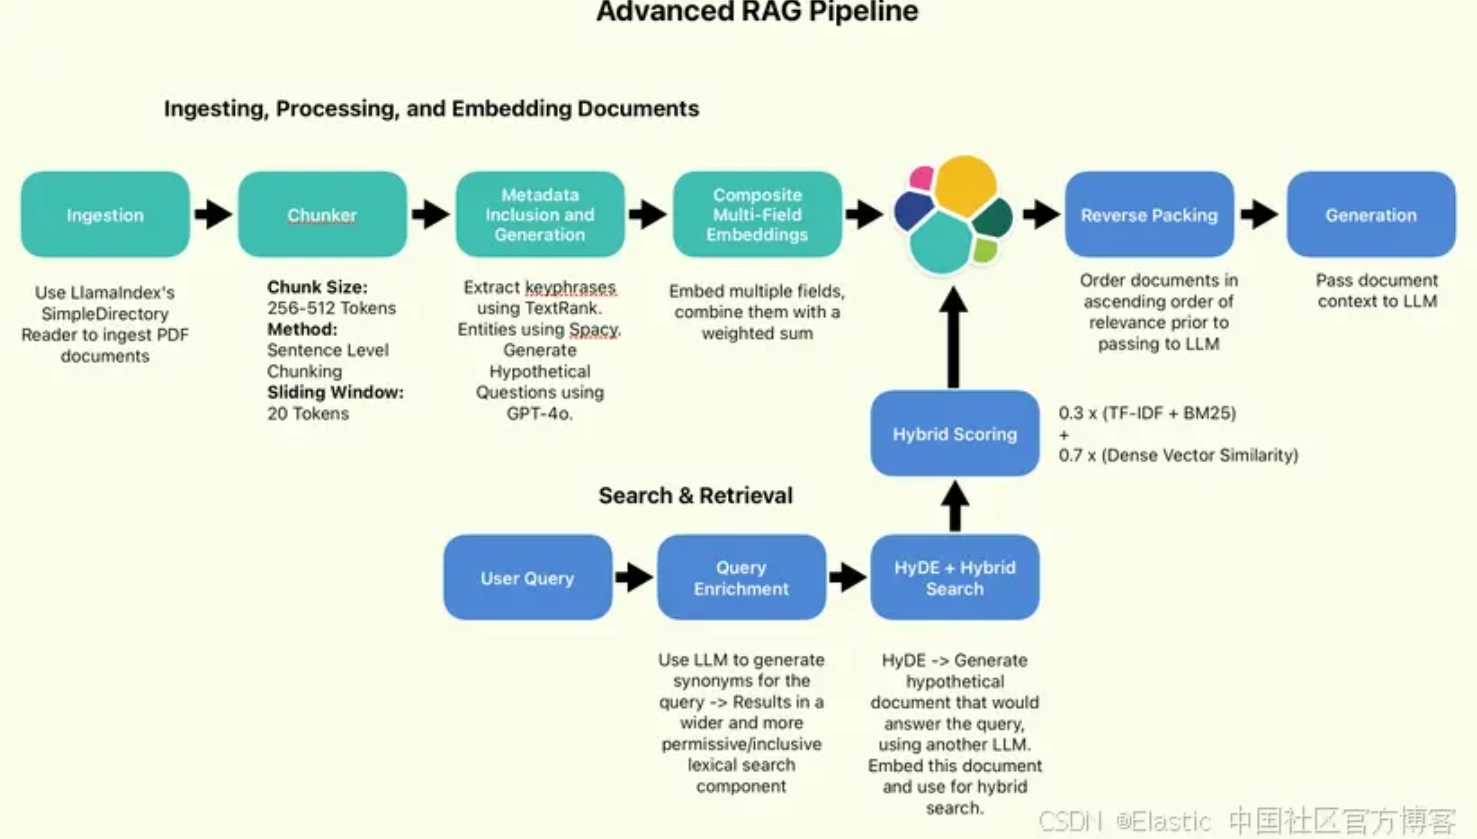
作者:来自 ElasticHan Xiang Choong 这是我们探索高级 RAG 技术的第 1 部分。单击此处查看第 2 部分! 最近的论文《寻找检索增强生成的最佳实践》通过实证评估了各种 RAG 增强技术的有效性,目的是汇集一套 RAG 的最佳实践。 我们将实施其中一些建议的最佳实践,即旨在提高搜索质量的实践(句子分块/sentence chunking、HyDE、反向打包/reverse packing)。 为简洁起见,我们将省略那些专注于提高效率的技术(查询分类和摘要)。 我们还将实施一些未涉及但我个人认为有用且有趣的技术(元数据包含/Metadata inclusion、复合多字段嵌入/Composite multi-field embeddings、查询丰富/Query enrichment)。 最后,我们将进行一个简短的测试,看看我们的搜索结果和生成的答案的质量与基线相比是否有所提高。让我们开始吧! 概述 RAG 旨在通过从外部知识库检索信息来丰富生成的答案,从而增强 LLMs。通过提供特定领域的信息,LLM 可以快速适应其训练数据范围之外的用例;比微调便宜得多,而且更容易保持最新状态。 提高 RAG 质量的措施通常侧重于两个方面: 提高知识库的质量和清晰度。 提高搜索查询的覆盖率和特异性。 这两项措施将实现提高 LLM 获得相关事实和信息的可能性的目标,从而不太可能产生幻觉或利用自己的知识 —— 这些知识可能已经过时或不相关。 方法的多样性很难用几句话来阐明。让我们直接进入实施阶段,让事情更清楚。 设置 所有代码都可以在 Searchlabs 仓库中找到。 首先,你需要以下内容: Elastic Cloud 部署 LLM API - 我们在此笔记本中使用 Azure OpenAI 上的 GPT-4o 部署 Python 版本 3.12.4 或更高版本 我们将运行 main.ipynb 笔记本中的所有代码。 继续 git clone 仓库,导航到 supporting-blog-content/advanced-rag-techniques,然后运行以下命令: # Create a new virtual environment named 'rag_env' python -m venv rag_env # Activate the virtual environment (for Unix-based systems) source rag_env/bin/activate # (For Windows) .\rag_env\Scripts\activate # Install packages listed in requirements.txt pip install -r requirements.txt 完成后,创建一个 .env 文件并填写以下字段(参考 env.example )。感谢我的合著者 Claude-3.5 提供的有益评论。 # Elastic Cloud: Found in the 'Deployment' page of your Elastic Cloud # console ELASTIC_CLOUD_ENDPOINT="" ELASTIC_CLOUD_ID="" # Elastic Cloud: Created during deployment setup or in 'Security' # settings ELASTIC_USERNAME="" ELASTIC_PASSWORD="" # Elastic Cloud: The name of the index you created in Kibana or via API ELASTIC_INDEX_NAME="" # Azure AI Studio: Found in 'Keys and Endpoint' section of your Azure # OpenAI resource AZURE_OPENAI_KEY_1="" AZURE_OPENAI_KEY_2="" AZURE_OPENAI_REGION="" AZURE_OPENAI_ENDPOINT="" # Azure AI Studio: Found in 'Deployments' section of your Azure OpenAI # resource AZURE_OPENAI_DEPLOYMENT_NAME="" # Using BAAI/bge-small-en-v1.5 because I think it is a good balance of # resource efficiency and performance. HUGGINGFACE_EMBEDDING_MODEL="BAAI/bge-small-en-v1.5" 接下来,我们将选择要提取的文档,并将其放在文档文件夹中。在本文中,我们将使用 Elastic N.V. 2023 年年度报告。这是一份相当具有挑战性且内容丰富的文档,非常适合对我们的 RAG 技术进行压力测试。 现在一切就绪,让我们开始提取。打开 main.ipynb 并执行前两个单元以导入所有包并初始化所有服务。 提取、处理和嵌入文档 数据提取 个人笔记:LlamaIndex 的便利性让我震惊。在 LLMs 和 LlamaIndex 出现之前的旧时代,提取各种格式的文档是一个痛苦的过程,需要从各个地方收集深奥的软件包。现在它简化为一个函数调用。太疯狂了! SimpleDirectoryReader 将加载 directory_path 中的每个文档。对于 .pdf 文件,它返回一个文档对象列表,我将其转换为 Python 字典,因为我发现它们更容易使用。 # llamaindex_processor.py from llama_index.core import SimpleDirectoryReader class LlamaIndexProcessor: def __init__(self): pass def load_documents(self, directory_path): ''' Load all documents in directory ''' reader = SimpleDirectoryReader(input_dir=directory_path) return reader.load_data() # main.ipynb llamaindex_processor=LlamaIndexProcessor() documents=llamaindex_processor.load_documents('./documents/') documents=[dict(doc_obj) for doc_obj in documents] 每个词典都包含在text 字段中的关键内容。它还包含有用的元数据,例如页码、文件名、文件大小和类型。 { 'id_': '5f76f0b3-22d8-49a8-9942-c2bbab14f63f', 'metadata': {'page_label': '5', 'file_name': 'Elastic_NV_Annual-Report-Fiscal-Year-2023.pdf', 'file_path': '/Users/han/Desktop/Projects/truckasaurus/documents/Elastic_NV_Annual-Report-Fiscal-Year-2023.pdf', 'file_type': 'application/pdf', 'file_size': 3724426, 'creation_date': '2024-07-27', 'last_modified_date': '2024-07-27'}, 'text': 'Table of Contents\nPage\nPART I\nItem 1. Business 3\n15 Item 1A. Risk Factors\nItem 1B. Unresolved Staff Comments 48\nItem 2. Properties 48\nItem 3. Legal Proceedings 48\nItem 4. Mine Safety Disclosures 48\nPART II\nItem 5. Market for Registrant’s Common Equity, Related Stockholder Matters and Issuer Purchases of \nEquity Securities49\nItem 6. [Reserved] 49\nItem 7. Management’s Discussion and Analysis of Financial Condition and Results of Operations 50\nItem 7A. Quantitative and Qualitative Disclosures About Market Risk 64\nItem 8. Financial Statements and Supplementary Data 66\nItem 9. Changes in and Disagreements With Accountants on Accounting and Financial Disclosure 100\n100\n101Item 9A. Controls and Procedures\nItem 9B. Other Information\nItem 9C. Disclosure Regarding Foreign Jurisdictions That Prevent Inspections 101\nPART III\n102\n102\n102\n102Item 10. Directors, Executive Officers and Corporate Governance\nItem 11. Executive Compensation\nItem 12. Security Ownership of Certain Beneficial Owners and Management, and Related Stockholder Matters \nItem 13. Certain Relationships and Related Transactions, and Director Independence\nItem 14. Principal Accountant Fees and Services 102\nPART IV\n103\n105Item 15. Exhibits and Financial Statement Schedules \nItem 16. Form 10-K Summary\nSignatures 106\ni', ... } 句子级、标记式分块 首先要做的是将文档缩减为标准长度的块(以确保一致性和可管理性)。嵌入模型具有唯一的标记(token)限制(它们可以处理的最大输入大小)。标记是模型处理的基本文本单位。为了防止信息丢失(截断或遗漏内容),我们应该提供不超过这些限制的文本(通过将较长的文本拆分为较小的段)。 分块对性能有重大影响。理想情况下,每个块都代表一个独立的信息,捕获有关单个主题的上下文信息。分块方法包括单词级分块(按字数拆分文档)和语义分块(使用 LLM 识别逻辑断点)。 单词级分块便宜、快速且简单,但存在拆分句子从而破坏上下文的风险。语义分块变得缓慢且昂贵,尤其是在处理像 116 页的 Elastic 年度报告这样的文档时。 让我们选择一种折中方法。句子级分块仍然很简单,但可以比单词级分块更有效地保留上下文,同时成本更低、速度更快。此外,我们将实现一个滑动窗口来捕获一些周围的上下文,并减轻拆分段落的影响。 # chunker.py import uuid import re class Chunker: def __init__(self, tokenizer): self.tokenizer = tokenizer def split_into_sentences(self, text): """Split text into sentences.""" return re.split(r'(?<=[.!?])\s+', text) def sentence_wise_tokenized_chunk_documents(self, documents, chunk_size=512, overlap=20, min_chunk_size=50): ''' 1. Split text into sentences. 2. Tokenize using the provided tokenizer method. 3. Build chunks up to the chunk_size limit. 4. Create an overlap based on tokens - to preserve context. 5. Only keep chunks that meet the minimum token size requirement. ''' chunked_documents = [] for doc in documents: sentences = self.split_into_sentences(doc['text']) tokens = [] sentence_boundaries = [0] # Tokenize all sentences and keep track of sentence boundaries for sentence in sentences: sentence_tokens = self.tokenizer.encode(sentence, add_special_tokens=True) tokens.extend(sentence_tokens) sentence_boundaries.append(len(tokens)) # Create chunks chunk_start = 0 while chunk_start < len(tokens): chunk_end = chunk_start + chunk_size # Find the last complete sentence that fits in the chunk sentence_end = next((i for i in sentence_boundaries if i > chunk_end), len(tokens)) chunk_end = min(chunk_end, sentence_end) # Create the chunk chunk_tokens = tokens[chunk_start:chunk_end] # Check if the chunk meets the minimum size requirement if len(chunk_tokens) >= min_chunk_size: # Create a new document object for this chunk chunk_doc = { 'id_': str(uuid.uuid4()), 'chunk': chunk_tokens, 'original_text': self.tokenizer.decode(chunk_tokens), 'chunk_index': len(chunked_documents), 'parent_id': doc['id_'], 'chunk_token_count': len(chunk_tokens) } # Copy all other fields from the original document for key, value in doc.items(): if key != 'text' and key not in chunk_doc: chunk_doc[key] = value chunked_documents.append(chunk_doc) # Move to the next chunk start, considering overlap chunk_start = max(chunk_start + chunk_size - overlap, chunk_end - overlap) return chunked_documents # main.ipynb # Initialize Embedding Model HUGGINGFACE_EMBEDDING_MODEL = os.environ.get('HUGGINGFACE_EMBEDDING_MODEL') embedder=EmbeddingModel(model_name=HUGGINGFACE_EMBEDDING_MODEL) # Initialize Chunker chunker=Chunker(embedder.tokenizer) Chunker 类采用嵌入模型的分词器来对文本进行编码和解码。我们现在将构建每个包含 512 个标记的块,其中重叠 20 个标记。为此,我们将文本拆分成句子,对这些句子进行分词,然后将标记后的句子添加到我们当前的块中,直到我们无法添加更多句子而不会超出我们的标记限制。 最后,将句子解码回原始文本以进行嵌入,并将其存储在名为 original_text 的字段中。块存储在名为 chunk 的字段中。为了减少噪音(即无用文档),我们将丢弃长度小于 50 个标记的任何文档。 让我们在我们的文档上运行它: chunked_documents=chunker.sentence_wise_tokenized_chunk_documents(documents, chunk_size=512) 并返回如下大段文本: print(chunked_documents[4]['original_text']) [CLS] the aggregate market value of the ordinary shares held by non - affiliates of the registrant, based on the closing price of the shares of ordinary shares on the new york stock exchange on october 31, 2022 ( the last business day of the registrant ’ s second fiscal quarter ), was approximately $ 6. 1 billion. [SEP] [CLS] as of may 31, 2023, the registrant had 97, 390, 886 ordinary shares, par value €0. 01 per share, outstanding. [SEP] [CLS] documents incorporated by reference portions of the registrant ’ s definitive proxy statement relating to the registrant ’ s 2 023 annual general meeting of shareholders are incorporated by reference into part iii of this annual ... ... 元数据的包含和生成 我们已经对文档进行了分块。现在是时候丰富数据了。我想生成或提取额外的元数据。这些额外的元数据可用于影响和增强搜索性能。 我们将定义一个 DocumentEnricher 类,其作用是接收文档列表(Python 字典)和处理器函数列表。这些函数将在文档的 original_text 列上运行,并将其输出存储在新字段中。 首先,我们使用 TextRank 提取关键短语(keyphrases)。TextRank 是一种基于图(graph-based)的算法,它通过根据单词之间的关系对关键短语和句子的重要性进行排序,从文本中提取关键短语和句子。 接下来,我们将使用 GPT-4o 生成潜在问题。 最后,我们将使用 Spacy 提取实体。 由于每个代码都相当冗长且复杂,因此我将避免在此处重现它。如果你有兴趣,文件已在下面的代码示例中进行了标记。 让我们运行数据丰富: # documentenricher.py from tqdm import tqdm class DocumentEnricher: def __init__(self): pass def enrich_document(self, documents, processors, text_col='text'): for doc in tqdm(documents, desc="Enriching documents using processors: "+str(processors)): for (processor, field) in processors: metadata=processor(doc[text_col]) if isinstance(metadata, list): metadata='\n'.join(metadata) doc.update({field: metadata}) # main.ipynb # Initialize processor classes nltkprocessor=NLTKProcessor() // nltk_processor.py entity_extractor=EntityExtractor() // entity_extractor.py gpt4o = LLMProcessor(model='gpt-4o') // llm.py # Initialize LLM documentenricher=DocumentEnricher() # Create new fields in the documents - These are the outputs of the processor functions. processors=[ (nltkprocessor.textrank_phrases, "keyphrases"), (gpt4o.generate_questions, "potential_questions"), (entity_extractor.extract_entities, "entities") ] # .enrich_document() will modify chunked_docs in place. # To view the results, we'll print chunked_docs in the next few cells! documentenricher.enrich_document(chunked_docs, text_col='original_text', processors=processors) 看一下结果: TextRank 提取的关键短语 这些关键短语代表了区块的核心主题。如果查询与网络安全有关,则该区块的得分会提高。 print(chunked_documents[25]['keyphrases']) 'elastic agent stop', 'agent stop malware', 'stop malware ransomware', 'malware ransomware environment', 'ransomware environment wide', 'environment wide visibility', 'wide visibility threat', 'visibility threat detection', 'sep cl key', 'cl key feature' GPT-4o 生成的潜在问题 这些潜在问题可能与用户查询直接匹配,从而提高得分。我们提示 GPT-4o 生成可以使用当前块中找到的信息来回答的问题。 print(chunked_documents[25]['potential_questions']) 1. What are the primary functions that Elastic Agent provides in terms of cybersecurity? 2. Describe how Logstash contributes to data management within an IT environment. 3. List and explain any key features of Logstash mentioned in the document. 4. How does Elastic Agent enhance environment-wide visibility in threat detection? 5. What capabilities does Logstash offer for handling data beyond simple collection? 6. In what ways does the document suggest that Elastic Agent stops malware and ransomware? 7. Can you identify any relationships between the functionalities of Elastic Agent and Logstash in an integrated environment? 8. What implications might the advanced threat detection capabilities of Elastic Agent have for organizational security policies? 9. Compare and contrast the roles of Elastic Agent and Logstash based on their described functions. 10. How might the centralized collection ability of Logstash support the threat detection capabilities of Elastic Agent? Spacy 提取的实体 这些实体的作用与关键短语类似,但会捕获组织和个人的名称,而关键短语提取可能会遗漏这些名称。 print(chunked_documents[29]['entities']) 'appdynamics', 'apm data', 'azure sentinel', 'microsoft', 'mcafee', 'broadcom', 'cisco', 'dynatrace', 'coveo', 'lucidworks' 复合多字段嵌入 现在我们已经用额外的元数据丰富了我们的文档,我们可以利用这些信息来创建更强大、更能感知上下文的嵌入。 让我们回顾一下我们目前在流程中的要点。每个文档都有四个感兴趣的字段。 { "chunk": "...", "keyphrases": "...", "potential_questions": "...", "entities": "..." } 每个字段代表文档上下文的不同视角,有可能突出显示 LLM 需要关注的关键领域。 计划是嵌入每个字段,然后创建嵌入的加权和,称为复合嵌入(Composite Embedding)。 幸运的是,除了引入另一个可调节的超参数来控制搜索行为之外,这种复合嵌入还将使系统能够更好地感知上下文。 首先,让我们使用在 main.ipynb 笔记本开头导入的本地定义的嵌入模型嵌入每个字段并就地更新每个文档。 # EmbeddingModel defined in embedding_model.py embedder=EmbeddingModel(model_name=HUGGINGFACE_EMBEDDING_MODEL) cols_to_embed=['keyphrases', 'potential_questions', 'entities'] embedding_cols=[] for col in cols_to_embed: # Works on text input embedding_col=embedder.embed_documents_text_wise(chunked_documents, text_field=col) embedding_cols.append(embedding_col) # Works on token input embedding_col=embedder.embed_documents_token_wise(chunked_documents, token_field="chunk") embedding_cols.append(embedding_col) 每个嵌入函数都会返回嵌入的字段,该字段只是带有 _embedding 后缀的原始输入字段。 现在让我们定义复合嵌入的权重: embedding_cols=[ 'keyphrases_embedding', 'potential_questions_embedding', 'entities_embedding', 'chunk_embedding'] combination_weights=[ 0.1, 0.15, 0.05, 0.7 ] 权重允许你根据用例和数据质量为每个组件分配优先级。直观地说,这些权重的大小取决于每个组件的语义值。由于块文本本身是迄今为止最丰富的,因此我分配了 70% 的权重。由于实体是最小的,只是组织或人名列表,因此我为其分配了 5% 的权重。这些值的精确设置必须根据用例逐一根据经验确定。 最后,让我们编写一个函数来应用权重,并创建我们的复合嵌入。我们还将删除所有组件嵌入以节省空间。 from tqdm import tqdm def combine_embeddings(objects, embedding_cols, combination_weights, primary_embedding='primary_embedding'): # Ensure the number of weights matches the number of embedding columns assert len(embedding_cols) == len(combination_weights), "Number of embedding columns must match number of weights" # Normalize weights to sum to 1 weights = np.array(combination_weights) / np.sum(combination_weights) for obj in tqdm(objects, desc="Combining embeddings"): # Initialize the combined embedding combined = np.zeros_like(obj[embedding_cols[0]]) # Compute the weighted sum for col, weight in zip(embedding_cols, weights): combined += weight * np.array(obj[col]) # Add the new combined embedding to the object obj.update({primary_embedding:combined.tolist()}) # Remove the original embedding columns for col in embedding_cols: obj.pop(col, None) combine_embeddings(chunked_documents, embedding_cols, combination_weights) 至此,我们完成了文档处理。我们现在有一个文档对象列表,如下所示: { 'id_': '7fe71686-5cd0-4831-9e79-998c6dbeae0c', 'chunk': [2312, 14613, ...], 'original_text': 'if an emerging growth company, indicate by check mark if the registrant has elected not to use the extended ...', 'chunk_index': 3, 'chunk_token_count': 399, 'metadata': {'page_label': '3', 'file_name': 'Elastic_NV_Annual-Report-Fiscal-Year-2023.pdf', ... 'keyphrases': 'sep cl unk\ncheck mark registrant\ncl unk indicate\nunk indicate check\nindicate check mark\nprincipal executive office\naccelerate filer unk\ncompany unk emerge\nunk emerge growth\nemerge growth company', 'potential_questions': '1. What are the different types of registrant statuses mentioned in the document?\n2. Under what section of the Sarbanes-Oxley Act must registrants file a report on the effectiveness of their internal ...', 'entities': 'the effe ctiveness of\nsection 13\nSEP\nUNK\nsection 21e\n1934\n1933\nu. s. c.\nsection 404\nsection 12\nal', 'primary_embedding': [-0.3946287803351879, -0.17586839850991964, ...] } 索引到 Elasticsearch 让我们将文档批量上传到 Elasticsearch。为此,我很久以前在 elastic_helpers.py 中定义了一组 Elastic Helper 函数。这是一段非常冗长的代码,因此我们继续查看函数调用。 es_bulk_indexer.bulk_upload_documents 可与任何字典对象列表配合使用,充分利用 Elasticsearch 便捷的动态映射。 # Initialize Elasticsearch ELASTIC_CLOUD_ID = os.environ.get('ELASTIC_CLOUD_ID') ELASTIC_USERNAME = os.environ.get('ELASTIC_USERNAME') ELASTIC_PASSWORD = os.environ.get('ELASTIC_PASSWORD') ELASTIC_CLOUD_AUTH = (ELASTIC_USERNAME, ELASTIC_PASSWORD) es_bulk_indexer = ESBulkIndexer(cloud_id=ELASTIC_CLOUD_ID, credentials=ELASTIC_CLOUD_AUTH) es_query_maker = ESQueryMaker(cloud_id=ELASTIC_CLOUD_ID, credentials=ELASTIC_CLOUD_AUTH) # Define Index Name index_name=os.environ.get('ELASTIC_INDEX_NAME') # Create index and bulk upload index_exists = es_bulk_indexer.check_index_existence(index_name=index_name) if not index_exists: logger.info(f"Creating new index: {index_name}") es_bulk_indexer.create_es_index(es_configuration=BASIC_CONFIG, index_name=index_name) success_count = es_bulk_indexer.bulk_upload_documents( index_name=index_name, documents=chunked_documents, id_col='id_', batch_size=32 ) # Initialize Elasticsearch ELASTIC_CLOUD_ID = os.environ.get('ELASTIC_CLOUD_ID') ELASTIC_USERNAME = os.environ.get('ELASTIC_USERNAME') ELASTIC_PASSWORD = os.environ.get('ELASTIC_PASSWORD') ELASTIC_CLOUD_AUTH = (ELASTIC_USERNAME, ELASTIC_PASSWORD) es_bulk_indexer = ESBulkIndexer(cloud_id=ELASTIC_CLOUD_ID, credentials=ELASTIC_CLOUD_AUTH) es_query_maker = ESQueryMaker(cloud_id=ELASTIC_CLOUD_ID, credentials=ELASTIC_CLOUD_AUTH) # Define Index Name index_name=os.environ.get('ELASTIC_INDEX_NAME') # Create index and bulk upload index_exists = es_bulk_indexer.check_index_existence(index_name=index_name) if not index_exists: logger.info(f"Creating new index: {index_name}") es_bulk_indexer.create_es_index(es_configuration=BASIC_CONFIG, index_name=index_name) success_count = es_bulk_indexer.bulk_upload_documents( index_name=index_name, documents=chunked_documents, id_col='id_', batch_size=32 ) 前往 Kibana 并验证所有文档是否都已编入索引。应该有 224 个文档。对于如此大的文档来说还不错! 猫咪休息一下 让我们休息一下,我知道这篇文章有点沉重。看看我的猫咪: 看看她有多生气 恭喜你取得如此大的成就 :) 加入我的第二部分,测试和评估我们的 RAG 管道! 附录 定义 句子分块 一种在 RAG 系统中用于将文本划分为较小且有意义单位的预处理技术。 过程: 输入: 大段文本(如文档、段落) 输出: 较小的文本片段(通常是句子或几句的组合) 目的: 创建细粒度的、特定于上下文的文本片段 允许更精确的索引和检索 提高 RAG 系统中检索信息的相关性 特征: 分段具有语义意义 可以独立索引和检索 通常保留一些上下文以确保独立的可理解性 好处: 增强检索精度 在 RAG 流程中实现更集中的增强 HyDE(Hypothetical Document Embedding - 假设文档嵌入) 一种在 RAG 系统中使用 LLM 生成假设文档来扩展查询的技术。 过程: 将输入查询提交给 LLM LLM 生成回答查询的假设文档 为生成的文档生成嵌入 使用嵌入进行向量搜索 关键区别: 传统 RAG: 将查询与文档匹配 HyDE: 将文档与文档匹配 目的: 提高检索性能,特别是针对复杂或模糊的查询 捕捉比简短查询更丰富的语义上下文 好处: 利用 LLM 的知识扩展查询 可能提高检索文档的相关性 挑战: 需要额外的 LLM 推理,增加延迟和成本 性能取决于生成的假设文档的质量 反向打包 - reverse packing 一种用于在将搜索结果传递给 LLM 之前重新排序的技术。 过程: 搜索引擎(如 Elasticsearch)按相关性降序返回文档。 排序被反转,将最相关的文档放在最后。 目的: 利用 LLM 的近期偏好,它们往往更关注上下文中最新的信息。 确保最相关的信息在 LLM 的上下文窗口中是 “最新的”。 示例: 原始顺序: [最相关,次相关,第三相关,...] 反转顺序: [...,第三相关,次相关,最相关] 查询分类 -Query Classification 一种通过确定查询是否需要 RAG 处理或可以由 LLM 直接回答来优化 RAG 系统效率的技术。 过程: 开发针对使用的 LLM 的自定义数据集 训练一个专门的分类模型 使用模型对传入查询进行分类 目的: 提高系统效率,避免不必要的 RAG 处理 将查询定向到最适合的响应机制 要求: LLM 特定的数据集和模型 持续改进以保持准确性 好处: 减少简单查询的计算开销 可能改善非 RAG 查询的响应时间 摘要 -Summarization 一种在 RAG 系统中将检索到的文档压缩的技术。 过程: 检索相关文档 生成每个文档的简明摘要 在 RAG 流程中使用摘要代替完整文档 目的: 通过关注重要信息提高 RAG 性能 减少不相关内容带来的噪音和干扰 好处: 可能提高 LLM 响应的相关性 允许在上下文限制内包含更多文档 挑战: 摘要可能导致重要细节丢失 生成摘要的计算开销增加 元数据包含 -Metadata Inclusion 一种通过额外的上下文信息丰富文档的技术。 元数据类型: 关键短语 标题 日期 作者详情 简介 目的: 增加 RAG系统可用的上下文信息 为 LLM 提供更清晰的文档内容和相关性的理解 好处: 可能提高检索精度 增强 LLM 评估文档有用性的能力 实施: 可以在文档预处理期间完成 可能需要额外的数据提取或生成步骤 复合多字段嵌入 -Composite Multi-Field Embeddings 一种用于 RAG 系统的高级嵌入技术,为不同的文档组件创建单独的嵌入。 过程: 确定相关字段(如标题、关键短语、简介、主要内容) 为每个字段生成单独的嵌入 结合或存储这些嵌入以供检索使用 与标准方法的区别: 传统方法: 整个文档的单一嵌入 复合方法: 不同文档方面的多个嵌入 目的: 创建更细致入微且具上下文意识的文档表示 从文档的更多来源捕获信息 好处: 可能提高对模糊或多面查询的表现 允许在检索中更灵活地对文档不同方面加权 挑战: 嵌入存储和检索过程的复杂性增加 可能需要更复杂的匹配算法 查询扩展 -Query Enrichment 一种通过与查询相关的词汇扩展原始查询以提高搜索覆盖范围的技术。 过程: 分析原始查询 生成同义词和语义相关短语 使用这些额外的词汇扩展查询 目的: 增加文档库中潜在匹配的范围 改善对具有特定或技术语言的查询的检索性能 好处: 可能检索与原始查询词不完全匹配的相关文档 有助于克服查询与文档之间的词汇不匹配 挑战: 如果未仔细实施,可能导致查询漂移 可能增加检索过程中的计算开销 准备好自己尝试了吗?开始免费试用吧。 Elasticsearch 集成了 LangChain、Cohere 等工具。加入我们的高级语义搜索网络研讨会,构建你的下一个 GenAI 应用程序! 原文:Advanced RAG Techniques Part 1: Data Processing — Search Labs