首页 文章 精选 留言 我的

精选列表

搜索[数据处理],共9358篇文章
优秀的个人博客,低调大师

6个大数据处理分析的最好工具

大数据是一个含义广泛的术语,是指数据集,如此庞大而复杂的,他们需要专门设计的硬件和软件工具进行处理。该数据集通常是万亿或EB的大小。这些数据集收集自各种各样的来源:传感器,气候信息,公开的信息,如杂志,报纸,文章。大数据产生的其他例子包括购买交易记录,网络日志,病历,军事监控,视频和图像档案,及大型电子商务。 在大数据和大数据分析,他们对企业的影响有一个兴趣高涨。大数据分析是研究大量的数据的过程中寻找模式,相关性和其他有用的信息,可以帮助企业更好地适应变化,并做出更明智的决策。 一、Hadoop Hadoop 是一个能够对大量数据进行分布式处理的软件框架。但是 Hadoop 是以一种可靠、高效、可伸缩的方式进行处理的。Hadoop 是可靠的,因为它假设计算元素和存储会失败,因此它维护多个工作数据副本,确保能够针对失败的节点重新分布处理。Hadoop 是高效的,因为它以并行的方式工作,通过并行处理加快处理速度。Hadoop 还是可伸缩的,能够处理 PB 级数据。此外,Hadoop 依赖于社区服务器,因此它的成本比较低,任何人都可以使用。 Hadoop是一个能够让用户轻松架构和使用的分布式计算平台。用户可以轻松地在Hadoop上开发和运行处理海量数据的应用程序。它主要有以下几个优点: ⒈高可靠性。Hadoop按位存储和处理数据的能力值得人们信赖。 ⒉高扩展性。Hadoop是在可用的计算机集簇间分配数据并完成计算任务的,这些集簇可以方便地扩展到数以千计的节点中。 ⒊高效性。Hadoop能够在节点之间动态地移动数据,并保证各个节点的动态平衡,因此处理速度非常快。 ⒋高容错性。Hadoop能够自动保存数据的多个副本,并且能够自动将失败的任务重新分配。 Hadoop带有用 Java 语言编写的框架,因此运行在 Linux 生产平台上是非常理想的。Hadoop 上的应用程序也可以使用其他语言编写,比如 C++。 二、HPCC HPCC,High Performance Computing and Communications(高性能计算与通信)的缩写。1993年,由美国科学、工程、技术联邦协调理事会向国会提交了“重大挑战项目:高性能计算与 通信”的报告,也就是被称为HPCC计划的报告,即美国总统科学战略项目,其目的是通过加强研究与开发解决一批重要的科学与技术挑战问题。HPCC是美国 实施信息高速公路而上实施的计划,该计划的实施将耗资百亿美元,其主要目标要达到:开发可扩展的计算系统及相关软件,以支持太位级网络传输性能,开发千兆 比特网络技术,扩展研究和教育机构及网络连接能力。 该项目主要由五部分组成: 1、高性能计算机系统(HPCS),内容包括今后几代计算机系统的研究、系统设计工具、先进的典型系统及原有系统的评价等; 2、先进软件技术与算法(ASTA),内容有巨大挑战问题的软件支撑、新算法设计、软件分支与工具、计算计算及高性能计算研究中心等; 3、国家科研与教育网格(NREN),内容有中接站及10亿位级传输的研究与开发; 4、基本研究与人类资源(BRHR),内容有基础研究、培训、教育及课程教材,被设计通过奖励调查者-开始的,长期 的调查在可升级的高性能计算中来增加创新意识流,通过提高教育和高性能的计算训练和通信来加大熟练的和训练有素的人员的联营,和来提供必需的基础架构来支 持这些调查和研究活动; 5、信息基础结构技术和应用(IITA ),目的在于保证美国在先进信息技术开发方面的领先地位。 三、Storm Storm是自由的开源软件,一个分布式的、容错的实时计算系统。Storm可以非常可靠的处理庞大的数据流,用于处理Hadoop的批量数据。Storm很简单,支持许多种编程语言,使用起来非常有趣。Storm由Twitter开源而来,其它知名的应用企业包括Groupon、淘宝、支付宝、阿里巴巴、乐元素、 Admaster等等。 Storm有许多应用领域:实时分析、在线机器学习、不停顿的计算、分布式RPC(远过程调用协议,一种通过网络从远程计算机程序上请求服务)、 ETL(Extraction-Transformation-Loading的缩写,即数据抽取、转换和加载)等等。Storm的处理速度惊人:经测 试,每个节点每秒钟可以处理100万个数据元组。Storm是可扩展、容错,很容易设置和操作。 四、Apache Drill 为了帮助企业用户寻找更为有效、加快Hadoop数据查询的方法,Apache软件基金会近日发起了一项名为“Drill”的开源项目。Apache Drill 实现了 Google’s Dremel. 据Hadoop厂商MapR Technologies公司产品经理Tomer Shiran介绍,“Drill”已经作为Apache孵化器项目来运作,将面向全球软件工程师持续推广。 该项目将会创建出开源版本的谷歌Dremel Hadoop工具(谷歌使用该工具来为Hadoop数据分析工具的互联网应用提速)。而“Drill”将有助于Hadoop用户实现更快查询海量数据集的目的。 “Drill”项目其实也是从谷歌的Dremel项目中获得灵感:该项目帮助谷歌实现海量数据集的分析处理,包括分析抓取Web文档、跟踪安装在Android Market上的应用程序数据、分析垃圾邮件、分析谷歌分布式构建系统上的测试结果等等。 通过开发“Drill”Apache开源项目,组织机构将有望建立Drill所属的API接口和灵活强大的体系架构,从而帮助支持广泛的数据源、数据格式和查询语言。 五、RapidMiner RapidMiner是世界领先的数据挖掘解决方案,在一个非常大的程度上有着先进技术。它数据挖掘任务涉及范围广泛,包括各种数据艺术,能简化数据挖掘过程的设计和评价。 功能和特点 免费提供数据挖掘技术和库 100%用Java代码(可运行在操作系统) 数据挖掘过程简单,强大和直观 内部XML保证了标准化的格式来表示交换数据挖掘过程 可以用简单脚本语言自动进行大规模进程 多层次的数据视图,确保有效和透明的数据 图形用户界面的互动原型 命令行(批处理模式)自动大规模应用 Java API(应用编程接口) 简单的插件和推广机制 强大的可视化引擎,许多尖端的高维数据的可视化建模 400多个数据挖掘运营商支持 耶鲁大学已成功地应用在许多不同的应用领域,包括文本挖掘,多媒体挖掘,功能设计,数据流挖掘,集成开发的方法和分布式数据挖掘。 六、 Pentaho BI Pentaho BI 平台不同于传统的BI 产品,它是一个以流程为中心的,面向解决方案(Solution)的框架。其目的在于将一系列企业级BI产品、开源软件、API等等组件集成起来,方便商务智能应用的开发。它的出现,使得一系列的面向商务智能的独立产品如Jfree、Quartz等等,能够集成在一起,构成一项项复杂的、完整的商务智能解决方案。 Pentaho BI 平台,Pentaho Open BI 套件的核心架构和基础,是以流程为中心的,因为其中枢控制器是一个工作流引擎。工作流引擎使用流程定义来定义在BI 平台上执行的商业智能流程。流程可以很容易的被定制,也可以添加新的流程。BI 平台包含组件和报表,用以分析这些流程的性能。目前,Pentaho的主要组成元素包括报表生成、分析、数据挖掘和工作流管理等等。这些组件通过 J2EE、WebService、SOAP、HTTP、Java、JavaScript、Portals等技术集成到Pentaho平台中来。 Pentaho的发行,主要以Pentaho SDK的形式进行。 Pentaho SDK共包含五个部分:Pentaho平台、Pentaho示例数据库、可独立运行的Pentaho平台、Pentaho解决方案示例和一个预先配制好的 Pentaho网络服务器。其中Pentaho平台是Pentaho平台最主要的部分,囊括了Pentaho平台源代码的主体;Pentaho数据库为 Pentaho平台的正常运行提供的数据服务,包括配置信息、Solution相关的信息等等,对于Pentaho平台来说它不是必须的,通过配置是可以用其它数据库服务取代的;可独立运行的Pentaho平台是Pentaho平台的独立运行模式的示例,它演示了如何使Pentaho平台在没有应用服务器支持的情况下独立运行;Pentaho解决方案示例是一个Eclipse工程,用来演示如何为Pentaho平台开发相关的商业智能解决方案。 Pentaho BI 平台构建于服务器,引擎和组件的基础之上。这些提供了系统的J2EE 服务器,安全,portal,工作流,规则引擎,图表,协作,内容管理,数据集成,分析和建模功能。这些组件的大部分是基于标准的,可使用其他产品替换之。 本文转自d1net(转载)

优秀的个人博客,低调大师

6个用于大数据处理分析的最好工具

大数据是一个含义广泛的术语,是指数据集,如此庞大而复杂的,他们需要专门设计的硬件和软件工具进行处理。该数据集通常是万亿或EB的大小。这些数据集收集自各种各样的来源:传感器,气候信息,公开的信息,如杂志,报纸,文章。大数据产生的其他例子包括购买交易记录,网络日志,病历,军事监控,视频和图像档案,及大型电子商务。 大数据和大数据分析,他们对企业的影响有一个兴趣高涨。大数据分析是研究大量的数据的过程中寻找模式,相关性和其他有用的信息,可以帮助企业更好地适应变化,并做出更明智的决策。 一、Hadoop Hadoop 是一个能够对大量数据进行分布式处理的软件框架。但是 Hadoop 是以一种可靠、高效、可伸缩的方式进行处理的。Hadoop 是可靠的,因为它假设计算元素和存储会失败,因此它维护多个工作数据副本,确保能够针对失败的节点重新分布处理。Hadoop 是高效的,因为它以并行的方式工作,通过并行处理加快处理速度。Hadoop 还是可伸缩的,能够处理 PB 级数据。此外,Hadoop 依赖于社区服务器,因此它的成本比较低,任何人都可以使用。 Hadoop是一个能够让用户轻松架构和使用的分布式计算平台。用户可以轻松地在Hadoop上开发和运行处理海量数据的应用程序。它主要有以下几个优点: ⒈高可靠性。Hadoop按位存储和处理数据的能力值得人们信赖。 ⒉高扩展性。Hadoop是在可用的计算机集簇间分配数据并完成计算任务的,这些集簇可以方便地扩展到数以千计的节点中。 ⒊高效性。Hadoop能够在节点之间动态地移动数据,并保证各个节点的动态平衡,因此处理速度非常快。 ⒋高容错性。Hadoop能够自动保存数据的多个副本,并且能够自动将失败的任务重新分配。 Hadoop带有用 Java 语言编写的框架,因此运行在 Linux 生产平台上是非常理想的。Hadoop 上的应用程序也可以使用其他语言编写,比如 C++。 二、HPCC HPCC,High Performance Computing and Communications(高性能计算与通信)的缩写。1993年,由美国科学、工程、技术联邦协调理事会向国会提交了“重大挑战项目:高性能计算与 通信”的报告,也就是被称为HPCC计划的报告,即美国总统科学战略项目,其目的是通过加强研究与开发解决一批重要的科学与技术挑战问题。HPCC是美国 实施信息高速公路而上实施的计划,该计划的实施将耗资百亿美元,其主要目标要达到:开发可扩展的计算系统及相关软件,以支持太位级网络传输性能,开发千兆 比特网络技术,扩展研究和教育机构及网络连接能力。 该项目主要由五部分组成: 1、高性能计算机系统(HPCS),内容包括今后几代计算机系统的研究、系统设计工具、先进的典型系统及原有系统的评价等; 2、先进软件技术与算法(ASTA),内容有巨大挑战问题的软件支撑、新算法设计、软件分支与工具、计算计算及高性能计算研究中心等; 3、国家科研与教育网格(NREN),内容有中接站及10亿位级传输的研究与开发; 4、基本研究与人类资源(BRHR),内容有基础研究、培训、教育及课程教材,被设计通过奖励调查者-开始的,长期 的调查在可升级的高性能计算中来增加创新意识流,通过提高教育和高性能的计算训练和通信来加大熟练的和训练有素的人员的联营,和来提供必需的基础架构来支 持这些调查和研究活动; 5、信息基础结构技术和应用(IITA ),目的在于保证美国在先进信息技术开发方面的领先地位。 三、Storm Storm是自由的开源软件,一个分布式的、容错的实时计算系统。Storm可以非常可靠的处理庞大的数据流,用于处理Hadoop的批量数据。Storm很简单,支持许多种编程语言,使用起来非常有趣。Storm由Twitter开源而来,其它知名的应用企业包括Groupon、淘宝、支付宝、阿里巴巴、乐元素、 Admaster等等。 Storm有许多应用领域:实时分析、在线机器学习、不停顿的计算、分布式RPC(远过程调用协议,一种通过网络从远程计算机程序上请求服务)、 ETL(Extraction-Transformation-Loading的缩写,即数据抽取、转换和加载)等等。Storm的处理速度惊人:经测 试,每个节点每秒钟可以处理100万个数据元组。Storm是可扩展、容错,很容易设置和操作。 四、Apache Drill 为了帮助企业用户寻找更为有效、加快Hadoop数据查询的方法,Apache软件基金会近日发起了一项名为“Drill”的开源项目。Apache Drill 实现了 Google’s Dremel. 据Hadoop厂商MapR Technologies公司产品经理Tomer Shiran介绍,“Drill”已经作为Apache孵化器项目来运作,将面向全球软件工程师持续推广。 该项目将会创建出开源版本的谷歌Dremel Hadoop工具(谷歌使用该工具来为Hadoop数据分析工具的互联网应用提速)。而“Drill”将有助于Hadoop用户实现更快查询海量数据集的目的。 “Drill”项目其实也是从谷歌的Dremel项目中获得灵感:该项目帮助谷歌实现海量数据集的分析处理,包括分析抓取Web文档、跟踪安装在Android Market上的应用程序数据、分析垃圾邮件、分析谷歌分布式构建系统上的测试结果等等。 通过开发“Drill”Apache开源项目,组织机构将有望建立Drill所属的API接口和灵活强大的体系架构,从而帮助支持广泛的数据源、数据格式和查询语言。 五、RapidMiner RapidMiner是世界领先的数据挖掘解决方案,在一个非常大的程度上有着先进技术。它数据挖掘任务涉及范围广泛,包括各种数据艺术,能简化数据挖掘过程的设计和评价。 功能和特点 免费提供数据挖掘技术和库 100%用Java代码(可运行在操作系统) 数据挖掘过程简单,强大和直观 内部XML保证了标准化的格式来表示交换数据挖掘过程 可以用简单脚本语言自动进行大规模进程 多层次的数据视图,确保有效和透明的数据 图形用户界面的互动原型 命令行(批处理模式)自动大规模应用 Java API(应用编程接口) 简单的插件和推广机制 强大的可视化引擎,许多尖端的高维数据的可视化建模 400多个数据挖掘运营商支持 耶鲁大学已成功地应用在许多不同的应用领域,包括文本挖掘,多媒体挖掘,功能设计,数据流挖掘,集成开发的方法和分布式数据挖掘。 六、 Pentaho BI Pentaho BI 平台不同于传统的BI 产品,它是一个以流程为中心的,面向解决方案(Solution)的框架。其目的在于将一系列企业级BI产品、开源软件、API等等组件集成起来,方便商务智能应用的开发。它的出现,使得一系列的面向商务智能的独立产品如Jfree、Quartz等等,能够集成在一起,构成一项项复杂的、完整的商务智能解决方案。 Pentaho BI 平台,Pentaho Open BI 套件的核心架构和基础,是以流程为中心的,因为其中枢控制器是一个工作流引擎。工作流引擎使用流程定义来定义在BI 平台上执行的商业智能流程。流程可以很容易的被定制,也可以添加新的流程。BI 平台包含组件和报表,用以分析这些流程的性能。目前,Pentaho的主要组成元素包括报表生成、分析、数据挖掘和工作流管理等等。这些组件通过 J2EE、WebService、SOAP、HTTP、Java、JavaScript、Portals等技术集成到Pentaho平台中来。 Pentaho的发行,主要以Pentaho SDK的形式进行。 Pentaho SDK共包含五个部分:Pentaho平台、Pentaho示例数据库、可独立运行的Pentaho平台、Pentaho解决方案示例和一个预先配制好的 Pentaho网络服务器。其中Pentaho平台是Pentaho平台最主要的部分,囊括了Pentaho平台源代码的主体;Pentaho数据库为 Pentaho平台的正常运行提供的数据服务,包括配置信息、Solution相关的信息等等,对于Pentaho平台来说它不是必须的,通过配置是可以用其它数据库服务取代的;可独立运行的Pentaho平台是Pentaho平台的独立运行模式的示例,它演示了如何使Pentaho平台在没有应用服务器支持的情况下独立运行;Pentaho解决方案示例是一个Eclipse工程,用来演示如何为Pentaho平台开发相关的商业智能解决方案。 Pentaho BI 平台构建于服务器,引擎和组件的基础之上。这些提供了系统的J2EE 服务器,安全,portal,工作流,规则引擎,图表,协作,内容管理,数据集成,分析和建模功能。这些组件的大部分是基于标准的,可使用其他产品替换之。 本文作者:佚名 来源:51CTO

优秀的个人博客,低调大师

《Spark大数据处理:技术、应用与性能优化》——导读

https://yqfile.alicdn.com/9fc1970337c275b04055dec83fdf7e27687dd205.png" > 前 言 Spark是发源于美国加州大学伯克利分校AMPLab的大数据分析平台,它立足于内存计算,从多迭代批量处理出发,兼顾数据仓库、流处理和图计算等多种计算范式,是大数据系统领域的全栈计算平台。Spark当下已成为Apache基金会的顶级开源项目,拥有庞大的社区支持,技术也逐渐走向成熟。 为什么要写这本书 大数据还在如火如荼地发展着,突然之间,Spark就火了。还记得最开始接触Spark技术时资料匮乏,只有官方文档和源码可以作为研究学习的资料。写一本Spark系统方面的技术书籍,是我持续了很久的一个想法。由于学习和工作较为紧张,最初只是通过几篇笔记在博客中分享自己学习Spark过程的点滴

优秀的个人博客,低调大师

从 LinkedIn 的数据处理机制学习数据架构

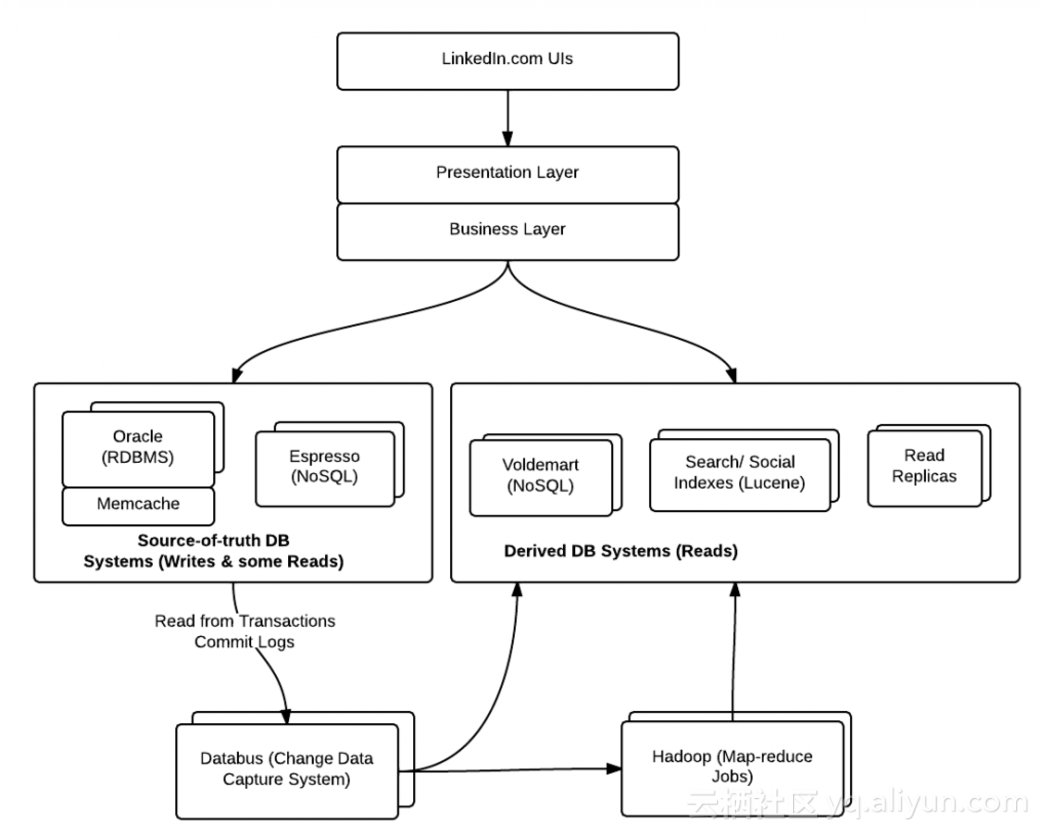
LinkedIn.com是当今最流行的专业社交网站之一,本文描述了LinkedIn.com是如何管理数据的。如你对文中的观点有异议亦或文中有遗漏的部分请随时告诉我。 LinkedIn.com数据用例 下面是一些数据用例,可能我们在浏览LinkedIn网页时都已经看到过了。 更新后的个人资料后几乎可以实时的出现在招聘搜索页面 更新后的个人资料后几乎可以实时的出现在人脉网页 分享一个更新,可以近实时的出现在新闻feed页面 然后会更新到其他只读页面,像”你可能认识的人“、”看过我资料的人“、”相关搜索“等。 令人震惊的是,如果我们使用较好的宽带,这些页面可以在数毫秒内完成加载!让我们向LinkedIn工程师团队致敬! 早期的LinkedIn数据架构 像其它初创公司一样,LinkedIn 早期也是通过单个的RDBMS (关系型数据库管理系统)的几张表来保存用户资料和人脉关系。是不是很原始?后来这个RDMBS扩展出两个额外的数据库系统,其中一个用来支撑用户个人资 料的全文搜索,另一个用来实现社交图。这两个数据库通过Databus来取得最新数据。Databus是一个变化捕捉系统,它的主要目标就是捕捉那些来至 可信源(像Oracle)中数据集的变更,并且把这些变化更新到附加数据库系统中。 但是,没过多久这种架构就已经很难满足网站的数据需求了。因为按照Brewerd的CAP理论想要同时满足下面的条件看似不太可能: 一致性:所有应用在同一时刻看到相同的数据 可用性:保证每个请求都能收到应答,无论成功或失败 分区容错性:部分系统的消息丢失或失败不影响系统系统整体的正常运行 根据上面的法则,LinkedIn工程师团队实现了他们称作为时间线一致性(或者说近线系统的最终一致性,下面会解释)以及另外两个特性:可用性和分区容错性。下面介绍目前LinkedIn的数据架构。 LinkedIn如今的数据架构 如果要支撑在不到一秒钟内处理数百万用户的相关事务,上面的数据架构已经明显不足了。因此,LinkedIn 工程师团队提出了三段式(three-phase)数据架构,由在线、离线以及近线数据系统组成。总体上讲,LinkedIn数据被存储在如下几种不同形 式的数据系统中(看下面的图): RDBMS Oracle MySQL(作为Espresso的底层数据存储) RDBMS Espresso(LinkedIn自己开发的文档型NoSQL数据存储系统) Voldemart (分布式Key-value存储系统) HDFS (存放Hadoop map-reduce任务的数据) Caching Memcached 基于Lucene的索引 存放查询、关系图等功能数据的Lucene 索引 Espresso使用的索引 图:LinkedIn数据库系统包括了DataBus、NoSQL、RDBMS以及Indexes 上面提到的数据存储库被归为三种不同类型的系统,下面会逐一解释: 在线数据库系统 在线系统处理用户的实时互动;主数据库像Oracle就属于这一类别。主数据存储用来支撑用户的写操作和少量的读操作。以Orcale为 例,Oracle master会执行所有的写操作。最近,LinkedIn正在开发另一个叫做“Espresso”的数据系统来满足日益复杂的数据需求,而这些数据看似不 应从像Oracle这类的RDBMS中获取。他们能否淘汰所有或大部分的Oracle并将数据完全转移到像Espresso这类的NoSQL数据存储系统 中去?让我们拭目以待。 Espresso是一个支持水平扩展、索引、时间线一致性、基于文档且高可用的NoSQL数据仓库,旨在代替支撑公司网页操作所使用的传统Oracle数据库。设计它的初衷是为了提高LinkedIn的InMail消息服务的可用性。目前有如下一些应用在使用Espresso作为可信源系统。能够看到NoSQL数据存储是如果被用来处理如此众多应用的数据需求很是神奇! 成员间消息, 社交动作,如:更新 文章分享 用户个人资料 公司资料 新闻文章 离线数据库系统 离线系统主要包括Hadoop和一个Teradata数据仓库,用来执行批处理和分析类的工作。之所以被称为离线是因为它对数据执行的的批处理操作。 Apache Azkaban被用来管理Hadoop和ETL任务,这些任务从主可信源系统获取数据后交由map-reduce处理,处理结果被保存在HDFS,然后通知’消费者‘(例如:Voldemart)通过合适的方式来获取这些数据并切换索引来保证能获取到最新的数据。 近线数据库系统(时间线一致性) 近线系统的目标是为了实现时间线一致性(或最终一致性),它处理类似’你可能认识的人(只读数据集)‘、搜索以及社交图这些功能,这些功能的数据会持续更新,但它们对延迟性的要求并不像在线系统那样高。下面是几种不同类型的近线系统: Voldemart,一个Key-Value存储系统,为系统中的只读页面提供服务。Voldemart的数据来源于Hadoop框架 (Hadoop Azkaban:编排Hadoop map-reduce任务的执行计划)。这就是近线系统,它们从类似Hadoop的离线系统获取数据。下面这些页面的数据都是来自于Vold emart: 你可能认识的人 看过本页面的人还在看 相关搜索 你可能感兴趣的工作 你可能感兴趣的事件 下面是几种不同的索引,这些索引由Databus-一个变化数据捕捉系统-来更新的: 供SeaS(Search-as-a-Service)使用的’成员搜索索引‘。当你在LinkedIn上搜索不同的成员时,这些数据就是来自于搜索索引。通常这个功能对招聘人员的帮助很大。 社交图索引帮助在人们的人脉关系中显示成员以及关系。通过这个索引用户几乎可以实时的得到网络关系的变化。 通过读复制集获取到的成员资料数据。这些数据会被’标准化服务‘访问。读复制集是对源数据库的复制,这样能使源数据库的更新同步到这些复制集上面。增加读复制集的最主要原因是能够通过将读操查询分散到读复制集上来减轻源数据库(执行用户发起的写操作)的压力。 下图展示了数据变化捕获事件是如何利用Databus更新到近线系统的: 用数据用例来展示它们是如何工作的 假如你更新了你个人资料中的最新技能和职位。你还接受了一个连接请求。那么在系统内部到底发生了什么: 将更新写入Oracle Master数据库 然后Databus做了如下一系列奇妙的工作来实现时间线一致性: 将资料变更,如最新技能和职位信息,更新到标准化服务。 将上面提到的变更更新到搜索索引服务。 将关系变更更新到图索引服务。 数据架构经验 如果要设计一个像LinkedIn.com一样的支持数据一致性、高扩展性且高可用性的数据架构,可以借鉴下面的经验: 数据库读写分离:你应当计划两种数据库,一种用来执行写操作的可以称为“可信源”系统,另一种执行读操作的可以称为派生数据库系统。这里的经验法则就是将由用户发起的写操作和用户读操作使用的数据库区分开来。 派生数据库系统:用户的读操作应该被分配到派生数据库或者读复制集上去。而派生数据库系统则可以建立在下面的系统之上: - Lucene 索引 NoSQL数据存储,例如:Voldemart、Redis、Cassandra、MongoDB等。 对于用户的读操作,应该尽量从主可信源数据库系统创建索引或者基于key-value的数据(来源于Hadoop map-reduce之类的系统),并且将每次由用户发起的被写入主可信源系统的变更一并更新到这些索引或派生数据(key-value)。 为确保派生数据库系统的数据是最新的,你可以选择应用复写(application-dual writes),即在应用层同时写入主数据库和派生数据库系统,或日志挖掘(读取通过批处理任务得到的主数据存储系统的事务提交日志)。 创建派生数据时,你可以针对主数据集或者变更数据集执行基于Hadoop的map-reduce任务,然后更新HDFS并且通知派生数据存储系统(类似Voldemart的NoSQL存储)来取走数据。 U对于数据一致性来说,你可以以将这些数据存储库创建为分布式系统,集群中的每个节点又都包含主从节点。所有节点都可以创建水平扩展的数据Shards。 为了保证这些分布式数据存储系统正常运行时间最大化,你可以使用像Apache Helix这一类的集群管理工具。

优秀的个人博客,低调大师

阿里云图数据库GraphDB上线,助力图数据处理

GraphDB简介 GraphDB图数据库适用于存储,管理,查询复杂并且高度连接的数据,图库的结构特别适合发现大数据集下数据之间的共性和特性,特别善于释放蕴含在数据关系之间的巨大价值。GraphDB引擎本身并不额外收费,仅收取云hbase费用。 适合的业务场景 在如下多种场景中图数据库比其他类型数据库(RDBMS和NoSQL)更合适 推荐及个性化 几乎所有的企业都需要了解如何快速并且高效地影响客户来购买他们的产品并且推荐其他相关商品给他们。这可能需要用到云服务的推荐,个性化,网络分析工具。 如果使用得当,图分析是处理推荐和个性化任务的最有效武器,并根据数据中的价值做出关键决策。举个例子,网络零售商需要根据客户过往消费记录及订单推荐其他商品给这个客户。为了能成功的达到目的,当前回话下用户浏览操作等都可以实时集成到一张图中。 图非常适合这些类似的分

优秀的个人博客,低调大师

海量数据处理:从并发编程到分布式系统

本系列文章主要围绕高并发这一话题展开,分享笔者在并发处理上的学习思路以及踩过的坑。具体思路大体分为三部分: Java多线程编程;高并发的解决思路;分布式架构中Redis、Zookeeper分布式锁的应用。 本文将重点讲解第一部分——Java多线程编程。 一、Java内存模型与线程 并发编程主要讨论以下几点: 多个线程操作相同资源 保证线程安全 合理使用资源 通常我们可以将物理计算机中出现的并发问题类比到JVM中的并发。 物理计算机处理器、高速缓存、主内存间交互关系如图: 处理器和内存的运行速度存在几个数量级别的差距,因此为解决此矛盾引入了“高速缓存”这一概念。当多个处理器的运行任务都涉及到同一块主内存区域时,就可能导致各自缓存数据的不一致问题。为解决一致性问题,需要各个处理器访问缓存时都遵循一些协议,在读写时要根据协议来进行操作。(MSI、MESI、MOSI、Synapse、Firefly及Dragon Protocol等) 处理器为提高性能,会对输入代码乱序执行(Out-Of-Order Execution) 优化。 类比Java内存模型,线程、主内存、工作内存交互关系如图: JMM定义了程序中各个变量访问规则,即在虚拟机中将内存取出和存储的底层细节。 线程A如果要跟线程B要通信的话,必须经历以下两个步骤: 线程A把本地内存A中更新过的共享变量的值刷新到主内存中; 线程B去主内存中读取A更新过的共享变量的值。 线程的工作内存中保存了该线程使用到变量的主内存副本拷贝(也可理解为此线程的私有拷贝),线程对变量的操作(读取、赋值等)都在工作内存中进行,而不能直接读写主内存中变量。不同线程之间的通信也需要通过主内存来完成。主内存对应Java堆中对象实例数据部分,而工作内存则对应虚拟机栈中部分区域。 在此还有非常重要的点需要提及! 指令重排序 执行程序时,为提高性能,编译器和处理器常常会对指令做出重排序。分三种: 编译器优化的重排序; 指令并行重排序; 内存系统重排序。 JMM的编译器会禁止特定类型的编译器重排序,对于处理器重排序(后两者),则要求Java编译器在生成指令序列时,插入特定类型的内存屏障指令,通过内存屏障指令来禁止特定类型的处理器重排序。 内存之间的交互操作 JMM中定义了8种操作来描述工作内存与主内存之间的实现细节: lock(锁定):作用于主内存的变量,它把一个变量标识为一条线程独占状态; unlock(解锁):作用于主内存的变量,它把一个处于锁定状态的变量释放出来,释放后的变量才可以被其他线程锁定; read(读取):作用于主内存的变量,它把一个变量从主内存传输到线程工作内存中,以便后边的load操作; load(载入):作用于主内存的变量,它把read操作从主内存中得到的变量值放到工作内存副本中; use(使用):作用于工作内存的变量,它把工作内存中一个变量的值传递给执行引擎,每当虚拟机遇到一个需要使用到变量的值的字节码指令时,将会执行这个操作; assign(赋值):作用于工作内存的变量,它把从执行引擎接收到的值赋给工作内存,每当虚拟机遇到一个给变量赋值的字节码指令时执行此操作; store(存储):作用于工作内存的变量,它把工作内存的变量的值传送到主内存中,以便以后的write操作使用; write(写入):作用于主内存的变量,它把store操纵从工作内存中得到的变量值放入到主内存的变量中。 JMM规定了执行上述八种操作时必须满足的规则(与happens-before原则是等效的,即先行发生原则): 不允许read和load、store和write操作之一单独出现; 不允许一个线程丢弃它的最近assign的操作,即变量在工作内存中改变了之后必须同步到主内存中; 不允许一个线程无原因地(没有发生过任何assign操作)把数据从工作内存同步回主内存中; 一个新的变量只能在主内存中诞生,不允许在工作内存中直接使用一个未被初始化(load或assign)的变量。即就是对一个变量实施use和store操作之前,必须先执行过了assign和load操作; 一个变量在同一时刻只允许一条线程对其进行lock操作,lock和unlock必须成对出现; 如果对一个变量执行lock操作,将会清空工作内存中此变量的值,在执行引擎使用这个变量前需要重新执行load或assign操作初始化变量的值; 如果一个变量事先没有被lock操作锁定,则不允许对它执行unlock操作;也不允许去unlock一个被其他线程锁定的变量; 对一个变量执行unlock操作之前,必须先把此变量同步到主内存中(执行store和write操作)。 相关JVM补充内容请查阅:JVM-攻城掠地 https://juejin.im/post/5b066aa9f265da0dbf004dde 测试工具 PostMan、Apache Bench、JMeter、LoadRunner。 二、线程安全性 原子性:提供了互斥访问,同一时刻只能由一个线程来对它进行操作。 可见性:一个线程对主内存的修改可以及时被其他线程观察到。 有序性:一个线程观察其它线程中指令执行顺序,由于指令重排序的存在,观察的结果一般为杂乱无章的。Java程序的天然有序性可以总结为——如果本线程内观察,所有的操作都是有序的;如果在一个线程观察另一个线程,所有的操作都是无序的。前者指的是线程内的串行语义,后者指的是指令重排序和工作内存和主内存同步延迟现象。 1、原子性-Atomic包 AtomicXXX: CAS、Unsafe.compareAndSwapInt 通过CAS来保证原子性,即Compare And Swap比较交换: CAS利用处理器提供的CMPXCHG指令实现,自旋CAS实现的基本思路就是循环进行CAS直到成功为止。比较内存的值与预期的值,若相同则修改预期的值。 CAS虽然可以进行高效的进行原子操作,但是CAS仍在存在三大问题: ABA问题。在Java1.5开始,JDK的Atomic包里提供了一个类AtomicStampedReference来解决ABA问题。大部分情况下ABA问题并不影响程序并发的正确性,如果需要解决ABA问题,改用传统的互斥同步可能会比原子类更加高效; 循环时间长开销大; 只能保证一个共享变量进行的原子操作。 测试: AtomicInteger 源码实现 AtomicLong与LongAdder Java内存模型要求lock、unlock、read、load、assign、use、store、write这8个操作都是具有原子性,但是对于64位的数据类型(long、double),允许虚拟机将没有被volatile修饰的64位数据的读写操作划分为两次32位的操作来进行,即允许虚拟机实现选择可以不保证64位数据类型的load、store、read和write这四个原子操作,但是可以视为原子性操作。 AtomicLong CAS中如果并发量大,则会不断进行循环调用,效率会比较低。 LongAdder实现热点数据的分离、更快,如果有并发更新可能会出现误差。底层用数组实现,其结果为数组的求和累加。 public void add(long x) { Cell[] as; long b, v; int m; Cell a; if ((as = cells) != null || !casBase(b = base, b + x)) { boolean uncontended = true; if (as == null || (m = as.length - 1) < 0 || (a = as[getProbe() & m]) == null || !(uncontended = a.cas(v = a.value, v + x))) longAccumulate(x, null, uncontended); } } /** * Equivalent to {@code add(1)}. */ public void increment() { add(1L); } AtomicBoolean 希望某件事情只执行一次。 AtomicIntegerFieldUpdater 以原子性更新类中某一个属性,这属性需要用volatile进行修饰。 AtomicStampedReference 作用是首先检查当前引用是否等于预期引用,并且检查当前标志是否等于预期标志,如果全部相等,则以原子的方式将该引用和该标志的值设置为给定的更新值。 AtomicLongArray 维护数组 2、原子性-锁及对比 synchronized:依赖JVM,不可中断锁,适合锁竞争不激烈情况下(并发相对较小),代码的可读性好。 Lock:依赖特殊的CPU指令,代码实现,ReentrantLock。可中断锁,多样化同步,竞争激烈的时候能维持常态。 Atomic:竞争激烈的时候能维持常态,比Lock性能更好,只能同步一个值。 3、线程安全-可见性 导致共享变量在线程间不可见的原因: 线程交叉执行; 重排序结合线程交叉执行; 共享变量更新后的值没有在工作内存与主内存及时更新。 JMM关于synchronizd的两条规定: 线程解锁前,必须把共享变量的最新值刷新到主内存; 线程加锁时,将清空工作内存中共享变量的值,从而使用共享变量时需要从主内存中读取最新的值。 volatile-可见性通过加入内存屏障和禁止重排序优化实现: 对volatile变量写操作时,会在写操作后加入一条store屏障指令,将本地内存共享变量的值刷新到主内存; 对volatile变量读操作时,会在读操作前加入一条load屏障指令,从主内存中读取共享变量。 必须符合以下场景才可使用: 运算结果并不依赖变量当前值,或者能够确保只有单一线程修改变量的值; 变量不需要与其他状态变量共同参与不变约束。 原因:volatile变量在各个线程工作内存中不存在一致性问题,但是Java里面的运算并非原子性操作,导致volatile变量运算在并发下一样是不安全的。(可以通过反编译来验证) volatile通常用来作为状态标记量 三、安全发布对象 发布对象:使一个对象能够被当前范围之外代码所使用。对象逸出:一种错误的发布。当一个对象还没有构造完成,就能被其它线程所见。 安全发布对象: 在静态初始化函数中初始化一个对象的引用; 将对象的引用保存到volatile类型域或者AtomicReference对象中; 对象引用保存到某个正确构造对象final类型域中; 将对象的引用保存到一个由锁保护的域中。 对此,单例模式是个很好的学习例子: 通过枚举实现单例模式 四、线程安全策略 1、不可变对象 满足条件: 对象创建以后其状态就不能修改; 对象对所有域都是final类型; 对象是正确创建的(对象在创建期间,this没有逸出); Collections.unmodifiableXXX:Collection、List、Set、Map…… Guava:ImmutableXXX:Collection、List、Set、Map…… 2、线程封闭 Ad-hoc线程封闭:程序控制实现,最糟糕,忽略; 堆栈封闭:局部变量,无并发问题; ThreadLocal线程封闭:特别好的封闭方法(实现权限管理)。 3、线程不安全写法 StringBuilder → StringBuffer SimpleDateFormat → JodaTime(推荐) ArrayList、HashSet、HashMap等Collections 先检查再执行:if(condition(a)){handle(a);} →非原子操作 4、同步容器 ArrayList → Vector,Stack HashMap → HashTable (key、value不能为null) Collections.synchronizedXXX(List、Set、Map) 注意:同步容器在某些场合并不一定可以做到线程安全。 5、线程安全-并发容器-J.U.C ArrayList → CopyOnWriteArrayList 拷贝数组过大,容易造成 young GC FUll GC; 不适用于实时读的场景,适合读取多写少的场景; 实现读写分离,满足最终一致性,使用的时候另外开辟空间; 读取未加锁,写加锁。 public void add(int index, E element) { final ReentrantLock lock = this.lock; lock.lock(); try { Object[] elements = getArray(); int len = elements.length; if (index > len || index < 0) throw new IndexOutOfBoundsException("Index: "+index+ ", Size: "+len); Object[] newElements; int numMoved = len - index; if (numMoved == 0) newElements = Arrays.copyOf(elements, len + 1); else { newElements = new Object[len + 1]; System.arraycopy(elements, 0, newElements, 0, index); System.arraycopy(elements, index, newElements, index + 1, numMoved); } newElements[index] = element; setArray(newElements); } finally { lock.unlock(); } } public E get(int index) { return get(getArray(), index); } ↑ ConcurrentSkipListSet对批量操作不能保证原子性。 参考:JDK1.8源码分析之ConcurrentSkipListSet(八) https://www.cnblogs.com/leesf456/p/5549820.html ↑ ConcurrentHashMap 效率相对而言要比 ConcurrentSkipListMap高,而同时 ConcurrentSkipListMap 则有些其不具有的特性: ConcurrentSkipListMap 的key有序 支持更高的并发 ConcurrentHashMap 相比于HashTable采取更为高效的分段锁。ConcurrentHashMap里包含了一个Segment数组,一个Segment里包含了一个HashEntry数组。 Segment是一种可重入锁,扮演锁的角色;HashEntry则用于存储键值对数据。加锁/解锁是在Segment上。 ConcurrentLinkedQueu 非阻塞算法实现线程安全的队列。由head节点和tail节点组成,每个节点Node由节点元素item和指向下一个节点的next的引用组成,节点与节点之间同个这个next关联起来,组成链表结构的队列。 参考: Java多线程(四)之ConcurrentSkipListMap深入分析 https://blog.csdn.net/guangcigeyun/article/details/8278349 探索 ConcurrentHashMap 高并发性的实现机制 https://www.ibm.com/developerworks/cn/java/java-lo-concurrenthashmap/index.html 五、J.U.C之AQS 使用Node实现FIFO队列,可以用于构建锁或者其它同步装置的基础框架; 利用了一个int类型表示状态; 使用方法是继承; 子类通过继承并通过实现它的方法管理锁的状态,对应AQS中acquire和release的方法操纵锁状态; 可以同步实现排它锁和共享锁模式(独占、共享)。 AQS同步组件 1、等待多线程完成的CountDownLatch(JDK1.5) 允许一个或多个线程等待其他线程完成操作。 其构造函数接收一个int类型的参数作为计数器,调用CountDown方法的时候,计数器的值会减1,CountDownLatch的await方法会阻塞当前线程,直到N变为零。 应用:并行计算,解析Excel中多个Sheet的数据。 2、控制并发线程数的Semaphore 用来控制同时访问特定资源线程的数量。 应用:流量控制,特别是公共资源有限的场景,如数据库连接。 3、同步屏障CyclicBarrier 让一组线程达到一个屏障(同步点)时被阻塞,直到最后一个线程到达屏障时,才会开门,所有被屏障拦截的线程才会继续执行。 应用:多线程计算数据,最后合并计算结果的场景。 CyclicBarrier和CountDownLatch的区别 CountDownLatch计数器只能使用一次,CyclicBarrier可以调用reset()方法重置。所以CyclicBarrier可以支持更加复杂的场景,如发生错误后重置计数器,并让线程重新执行。 //屏障拦截的线程数量 CyclicBarrier(int permits) //已经到达屏障 await() //CyclicBarrier阻塞线程的数量 getNumberWaiting() 4、重入锁ReentrantLock (排他锁:同时允许单个线程访问。) 支持重进入的锁,表示该锁能够支持一个线程对资源的重复加锁,即实现重进入:任意线程获取到锁之后能够再次获取该锁而不会被锁阻塞。 该锁支持获取锁时的公平和非公平性选择 public ReentrantLock(boolean fair) { sync = fair ? new FairSync() : new NonfairSync(); } 公平锁就是等待时间最长的线程最优先获取锁,也就是说获取锁的是顺序的(FIFO),而非公平则允许插队。 非公平因为不保障顺序,则效率相对较高,而公平锁则可以减少饥饿发生的概率: 提供了一个Condition类,可以分组唤醒需要唤醒的线程 提供能够中断等待锁的线程机制,lock.lockInterruptibly() 5、ReentrantReadWriteLock (读写锁,实现悲观读取,同时允许多个线程访问 在写线程访问时,所有读线程和其他写线程均被堵塞。其维护了一对锁,通过分离读锁、写锁,使得并发性比排他锁有很大提升。 适用于读多写少的环境,能够提供比排他锁更好的并发与吞吐量。 不足:ReentrantReadWriteLock是读写锁,在多线程环境下,大多数情况是读的情况远远大于写的操作,因此可能导致写的饥饿问题。 StampedLock 是ReentrantReadWriteLock 的增强版,是为了解决ReentrantReadWriteLock的一些不足。 StampedLock读锁并不会阻塞写锁,设计思路也比较简单,就是在读的时候发现有写操作,再去读多一次。StampedLock有两种锁,一种是悲观锁,另外一种是乐观锁,如果线程拿到乐观锁就读和写不互斥,如果拿到悲观锁就读和写互斥。 参考: Java8对读写锁的改进:StampedLock https://blog.csdn.net/sunfeizhi/article/details/52135136 6、Condition Condition提供了类似Object的监视器方法,依赖Lock实现等待/通知模式。 await():当前线程进入等待状态直到被通知或中断,当前线程进入运行状态且从await()方法返回; signal():唤醒一个在Condition上的线程,该线程从等待方法返回前必须获得与Condition相关联的锁。 参考:Java线程(九):Condition-线程通信更高效的方式 https://blog.csdn.net/ghsau/article/details/7481142 7、FutureTask 用于异步获取执行结果或取消执行任务的场景。(实现基于AQS) 参考: Java并发编程:Callable、Future和FutureTask https://www.cnblogs.com/dolphin0520/p/3949310.html FutureTask的用法及两种常用的使用场景 https://blog.csdn.net/linchunquan/article/details/22382487 8、Fork/Join 并行执行任务,即把大任务分割成若干小任务并行执行,最后汇总成大任务结果的框架。 工作窃取算法:指的是某个线程从其他队列里窃取任务来执行。即这个队列先干完活,再去帮别人干点。 参考:Fork/Join 模式高级特性 https://www.ibm.com/developerworks/cn/java/j-lo-forkjoin/index.html 9、BlocklingQueu 阻塞队列是一个支持两个附加操作的队列: 阻塞插入:当队列满的时候,队列会阻塞插入元素的线程,直到队列不满。 阻塞移除:当队列为空时,获取元素的线程就会等待队列变为非空。 通常用于生产者和消费者场景。生产者是向队列里添加元素的线程,消费者是从列里获取元素的线程。阻塞队列就是生产者放元素,消费者获取元素的容器。(FIFO) ArrayBlockingQueue LinkedBlockingQueue PriorityBlockingQueue DelayQueue SynchronousQueue LinkedTransferQueue LinkedBlockingDeque 参考:Java中的阻塞队列 http://www.infoq.com/cn/articles/java-blocking-queue 六、线程与线程池 最后我们聊一下线程创建的相关问题。 线程:程序中一条独立执行的线索,可以理解成进程中独立运行的子任务。 进程:一旦程序运行起来就变成了操作系统当中的一个进程。 线程的创建: 1、继承Thread类 public class TestThread extends Thread{ @Override public void run(){ } } 局限性:Java单根继承,不易于扩展。 2、实现Runnabl接口 public class TestThread implements Runnable{ @Override public void run(){ } } 3、实现Callable 运行Callable任务可以拿到一个Future对象,进行异步计算。 状态: 为了保证共享数据的完整性,Java中引入了互斥锁的概念,即每个对象对应一个“互斥锁”的标记(monitor),用来保证任何时刻只能有一个线程访问该对象。利用Java中每个对象都拥有唯一的一个监视锁(monitor),当线程拥有这个标记时才会允许访问这个资源,而未拿到标记则进入阻塞,进入锁池。每个对象都有自己的一个锁池的空间,用于存放等待线程。由系统决定哪个线程拿到锁标记并运行。 方法: currentThread():当前调用线程的相关信息; isAlive():判断当前线程是否处于活动状态; getId():线程的唯一标识; interrupted():测试当前线程是否已经中断; 注:线程终端状态由该方法清除,意味着连续两次执行此方法,第二次将返回false。 isInterrupted():测试线程是否已经中断; 注:不清楚状态标志。 run(): 线程执行的具体方法,执行完成的会进入消亡状态; start():使县城出局就绪状态,等待调用线程的对象执行run()方法; sleep():让当前线程放弃CPU时间片直接返回就绪状态。 yield():让当前线程放弃CPU时间片直接返回就绪状态。但放弃的时间片不确定,可能刚刚放弃,便立即获取。 线程通信 join(): 让当前线程邀请调用方法的线程优先执行,在被邀请的线程执行结束之前,邀请别人的线程不再执行,处于阻塞状态,直到被邀请的线程执行结束之后,进入就绪状态; interrupt(): 中断、打断线程的阻塞状态。直接让阻塞状态的线程返回就绪,由sleep()、join()导致的阻塞立刻解除; wait():使当前执行代码的线程放弃monitor并进入等待状态,直到接收到通知或被中断为止(notify)。即此时线程将释放自己的所有锁标记和CPU占用,同时进入这个对象的等待池(阻塞状态)。只能在同步代码块中调用(synchronized); notify():在等待池中随机唤醒一个线程,放入锁池,对象处于等待状态,直到获取对象的锁标记为止。 只能在同步代码块中调用(synchronized)。 4、线程池 newCachedThreadPool 创建一个可缓存线程池,如果线程池长度超过处理需要,可灵活回收空闲线程,若无可回收,则新建线程。潜在问题线程如果创建过多可能内存溢出。 newFixedThreadPool 创建一个定长线程池,可控制线程最大并发数,超出的线程会在队列中等待。 newScheduledThreadPool 创建一个定长线程池,支持定时及周期性任务执行。 newSingleThreadExecutor 创建一个单线程化的线程池,它只会用唯一的工作线程来执行任务,保证所有任务按照指定顺序(FIFO、LIFO、优先级)执行。 参考:Java 四种线程池的用法分析 https://blog.csdn.net/u011974987/article/details/51027795 暂且总结到这里。本文意在给大家提供学习的大体思路,其中有很多要点笔者并未深入剖析,比如ConcurrentHashMap,这块网络上有很多例子,可以参详。笔者也给出了很多不错的参考,大家可以根据个人需要点击阅读。如需详细了解,需具体阅读源码,多实践。 原文发布时间为:2018-06-13 本文作者:Mark 本文来自云栖社区合作伙伴“DBAplus社群”,了解相关信息可以关注“DBAplus社群”。

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册