首页 文章 精选 留言 我的

精选列表

搜索[源码学习],共10010篇文章
优秀的个人博客,低调大师

java源码-DelayQueue

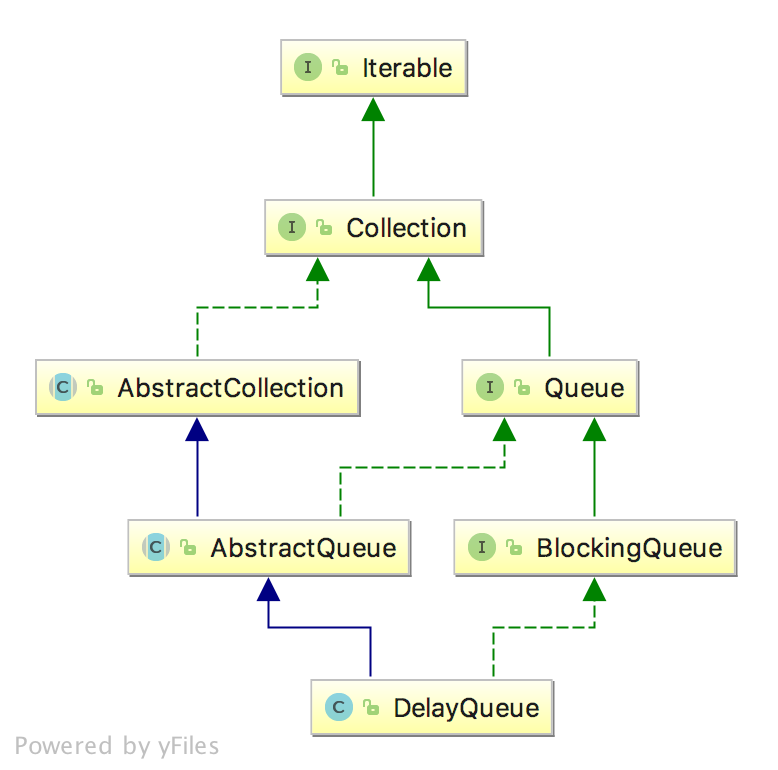
开篇 DelayedQueue是一个用来延时处理的队列,delayQueue其实就是在每次往优先级队列中添加元素,然后以元素的delay/过期值作为排序的因素,以此来达到先过期的元素会拍在队首,每次从队列里取出来都是最先要过期的元素 所谓延时处理就是说可以为队列中元素设定一个过期时间, 相关的操作受到这个设定时间的控制。 DelayQueue类图 DelayQueue类图 DelayQueue类变量和构造函数 DelayQueue的类变量当中有两个核心变量值得考虑: DelayQueue的PriorityQueue表明DelayQueue内部使用PriorityQueue的最小堆保证有序 E extends Delayed标明存入DelayQueue的变量必须实现Delayed接口,实现getDelay和compareTo接口。 public class DelayQueue<E extends Delayed> extends AbstractQueue<E> implements BlockingQueue<E> { // 相关的锁 private final transient ReentrantLock lock = new ReentrantLock(); private final PriorityQueue<E> q = new PriorityQueue<E>(); private Thread leader = null; //基于锁的状态通知变量 private final Condition available = lock.newCondition(); public DelayQueue() {} public DelayQueue(Collection<? extends E> c) { this.addAll(c); } public interface Comparable<T> { public int compareTo(T o); } public interface Delayed extends Comparable<Delayed> { long getDelay(TimeUnit unit); } DelayQueue的add过程 DelayQueue的添加元素过程如下: 执行加锁操作 把元素添加到优先级队列中 查看元素是否为队首这个地方一直没看懂 如果是队首的话,设置leader为空并唤醒所有等待的队列,这个地方一直没看懂 释放锁 public boolean add(E e) { return offer(e); } public boolean offer(E e) { final ReentrantLock lock = this.lock; lock.lock(); try { q.offer(e); if (q.peek() == e) { leader = null; available.signal(); } return true; } finally { lock.unlock(); } } public void put(E e) { offer(e); } public boolean offer(E e, long timeout, TimeUnit unit) { return offer(e); } DelayQueue的take过程 DelayQueue的获取元素过程如下: 执行加锁操作 取出优先级队列元素q的队首 如果元素q的队首/队列为空,阻塞请求 如果元素q的队首(first)不为空,获得这个元素的delay时间值 如果first的延迟delay时间值为0的话,说明该元素已经到了可以使用的时间,调用poll方法弹出该元素,跳出方法 如果first的延迟delay时间值不为0的话,释放元素first的引用,避免内存泄露 判断leader元素是否为空,不为空的话阻塞当前线程 如果leader元素为空的话,把当前线程赋值给leader元素,然后阻塞delay的时间,即等待队首到达可以出队的时间,在finally块中释放leader元素的引用 循环执行从1~8的步骤 如果leader为空并且优先级队列不为空的情况下(判断还有没有其他后续节点),调用signal通知其他的线程 执行解锁操作 public E poll() { final ReentrantLock lock = this.lock; lock.lock(); try { E first = q.peek(); if (first == null || first.getDelay(NANOSECONDS) > 0) return null; else return q.poll(); } finally { lock.unlock(); } } public E take() throws InterruptedException { final ReentrantLock lock = this.lock; lock.lockInterruptibly(); try { for (;;) { E first = q.peek(); if (first == null) available.await(); else { long delay = first.getDelay(NANOSECONDS); if (delay <= 0) return q.poll(); first = null; // don't retain ref while waiting if (leader != null) available.await(); else { Thread thisThread = Thread.currentThread(); leader = thisThread; try { available.awaitNanos(delay); } finally { if (leader == thisThread) leader = null; } } } } } finally { if (leader == null && q.peek() != null) available.signal(); lock.unlock(); } } public E poll(long timeout, TimeUnit unit) throws InterruptedException { long nanos = unit.toNanos(timeout); final ReentrantLock lock = this.lock; lock.lockInterruptibly(); try { for (;;) { E first = q.peek(); if (first == null) { if (nanos <= 0) return null; else nanos = available.awaitNanos(nanos); } else { long delay = first.getDelay(NANOSECONDS); if (delay <= 0) return q.poll(); if (nanos <= 0) return null; first = null; // don't retain ref while waiting if (nanos < delay || leader != null) nanos = available.awaitNanos(nanos); else { Thread thisThread = Thread.currentThread(); leader = thisThread; try { long timeLeft = available.awaitNanos(delay); nanos -= delay - timeLeft; } finally { if (leader == thisThread) leader = null; } } } } } finally { if (leader == null && q.peek() != null) available.signal(); lock.unlock(); } } public E peek() { final ReentrantLock lock = this.lock; lock.lock(); try { return q.peek(); } finally { lock.unlock(); } } private E peekExpired() { // assert lock.isHeldByCurrentThread(); E first = q.peek(); return (first == null || first.getDelay(NANOSECONDS) > 0) ? null : first; }
优秀的个人博客,低调大师

java源码-LinkedBlockingQueue

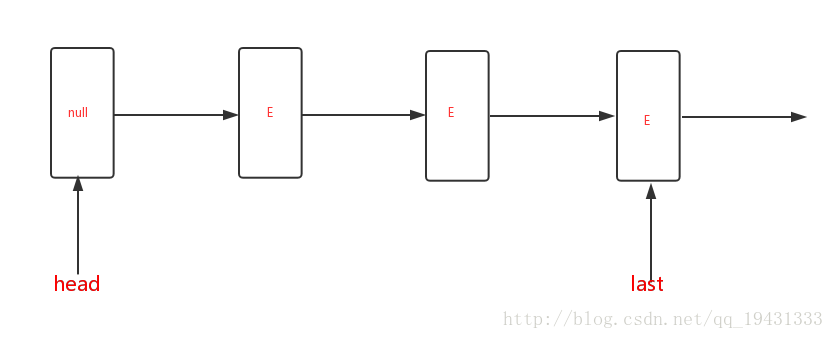
开篇 LinkedBlockingQueue是一个基于链表实现的可选容量的线程安全的阻塞队列。队头的元素是插入时间最早的,队尾的元素是最新插入的。新的元素将会被插入到队列的尾部。 LinkedBlockingQueue的容量限制是可选的,如果在初始化时没有指定容量,那么默认使用int的最大值作为队列容量。 LinkedBlockingQueue的逻辑存储效果如下图: LinkedBlockingQueue LinkedBlockingQueue类图 LinkedBlockingQueue类图 LinkedBlockingQueue类定义及构造函数 LinkedBlockingQueue的类定义当中有几个知识点需要注意一下: LinkedBlockingQueue是有容量限制的,未传参默认Integer.MAX_VALUE LinkedBlockingQueue当中保存的Node节点包含指向下一个节点的next指针 LinkedBlockingQueue包含head指针和last指针,分别指向头部和尾部元素 LinkedBlockingQueue不支持null元素,head元素不保存任何元素的,last保存最后一个元素 public class LinkedBlockingQueue<E> extends AbstractQueue<E> implements BlockingQueue<E>, java.io.Serializable { private static final long serialVersionUID = -6903933977591709194L; //存储节点的元素 static class Node<E> { E item; Node<E> next; Node(E x) { item = x; } } //容量和当前节点的个数 private final int capacity; private final AtomicInteger count = new AtomicInteger(); //头部指针和尾部指针 transient Node<E> head; private transient Node<E> last; // take操作的锁和对应的Condition private final ReentrantLock takeLock = new ReentrantLock(); private final Condition notEmpty = takeLock.newCondition(); // put操作的锁和对应的Condition private final ReentrantLock putLock = new ReentrantLock(); private final Condition notFull = putLock.newCondition(); public LinkedBlockingQueue() { this(Integer.MAX_VALUE); } public LinkedBlockingQueue(int capacity) { if (capacity <= 0) throw new IllegalArgumentException(); this.capacity = capacity; last = head = new Node<E>(null); } // LinkedBlockingQueue不支持null元素 public LinkedBlockingQueue(Collection<? extends E> c) { this(Integer.MAX_VALUE); final ReentrantLock putLock = this.putLock; putLock.lock(); // Never contended, but necessary for visibility try { int n = 0; for (E e : c) { if (e == null) throw new NullPointerException(); if (n == capacity) throw new IllegalStateException("Queue full"); enqueue(new Node<E>(e)); ++n; } count.set(n); } finally { putLock.unlock(); } } } LinkedBlockingQueue的take相关操作 take相关的操作逻辑按照下面的顺序执行: 获取锁并判断是否存在元素,如果元素个数为0则等待,否则往下执行 从queue中通过移动head指针获取元素并原子性的执行操作:获取当前元素个数并对元素执行减操作 如果减一前元素个数多于1个,那么说明还有剩余可消费元素,那么通过notEmpty.signal()通知消费 仔细想想上面的逻辑,因为put操作只会在从无到有的时候才会唤醒消费线程,而假设现在有10个消费线程等待消费元素,而10个put只有第一个put执行了唤醒,也就是说10-1=9个消费线程依旧没有唤醒,所以才通过执行take的时候连带唤醒消费线程,我自己个人的理解,网上米有类似资料 public E take() throws InterruptedException { E x; int c = -1; final AtomicInteger count = this.count; final ReentrantLock takeLock = this.takeLock; takeLock.lockInterruptibly(); try { while (count.get() == 0) { notEmpty.await(); } x = dequeue(); c = count.getAndDecrement(); if (c > 1) notEmpty.signal(); } finally { takeLock.unlock(); } if (c == capacity) signalNotFull(); return x; } public E poll(long timeout, TimeUnit unit) throws InterruptedException { E x = null; int c = -1; long nanos = unit.toNanos(timeout); final AtomicInteger count = this.count; final ReentrantLock takeLock = this.takeLock; takeLock.lockInterruptibly(); try { while (count.get() == 0) { if (nanos <= 0) return null; nanos = notEmpty.awaitNanos(nanos); } x = dequeue(); c = count.getAndDecrement(); if (c > 1) notEmpty.signal(); } finally { takeLock.unlock(); } if (c == capacity) signalNotFull(); return x; } public E poll() { final AtomicInteger count = this.count; if (count.get() == 0) return null; E x = null; int c = -1; final ReentrantLock takeLock = this.takeLock; takeLock.lock(); try { if (count.get() > 0) { x = dequeue(); c = count.getAndDecrement(); if (c > 1) notEmpty.signal(); } } finally { takeLock.unlock(); } if (c == capacity) signalNotFull(); return x; } public E peek() { if (count.get() == 0) return null; final ReentrantLock takeLock = this.takeLock; takeLock.lock(); try { Node<E> first = head.next; if (first == null) return null; else return first.item; } finally { takeLock.unlock(); } } private E dequeue() { Node<E> h = head; Node<E> first = h.next; h.next = h; // help GC head = first; E x = first.item; first.item = null; return x; } private void signalNotFull() { final ReentrantLock putLock = this.putLock; putLock.lock(); try { notFull.signal(); } finally { putLock.unlock(); } } LinkedBlockingQueue的put相关操作 put相关的操作逻辑按照下面的顺序执行: 获取锁并判断Queue是否已满,如果已满就等待notFull.await() 如果未满那么就通过移动tail指针添加元素,获取原来元素个数后对元素个数加操作,如果元素个数加操作后仍然未达到容量上限,那么连带唤醒put线程,原因也是take线程只会在从满到不满的那一刹那才会通知,同样假设10个put线程和10个消费线程,10个消费线程阻塞在put操作当中,此时有10个线程开始消费,但是仅仅第一个消费线程会进行signalNotFull通知,其他的9个put线程只有靠put连带才能继续执行。 enqueue的操作很简单,直接操作last指针即可 public void put(E e) throws InterruptedException { if (e == null) throw new NullPointerException(); int c = -1; Node<E> node = new Node<E>(e); final ReentrantLock putLock = this.putLock; final AtomicInteger count = this.count; putLock.lockInterruptibly(); try { while (count.get() == capacity) { notFull.await(); } enqueue(node); c = count.getAndIncrement(); if (c + 1 < capacity) notFull.signal(); } finally { putLock.unlock(); } if (c == 0) signalNotEmpty(); } public boolean offer(E e, long timeout, TimeUnit unit) throws InterruptedException { if (e == null) throw new NullPointerException(); long nanos = unit.toNanos(timeout); int c = -1; final ReentrantLock putLock = this.putLock; final AtomicInteger count = this.count; putLock.lockInterruptibly(); try { while (count.get() == capacity) { if (nanos <= 0) return false; nanos = notFull.awaitNanos(nanos); } enqueue(new Node<E>(e)); c = count.getAndIncrement(); if (c + 1 < capacity) notFull.signal(); } finally { putLock.unlock(); } if (c == 0) signalNotEmpty(); return true; } public boolean offer(E e) { if (e == null) throw new NullPointerException(); final AtomicInteger count = this.count; if (count.get() == capacity) return false; int c = -1; Node<E> node = new Node<E>(e); final ReentrantLock putLock = this.putLock; putLock.lock(); try { if (count.get() < capacity) { enqueue(node); c = count.getAndIncrement(); if (c + 1 < capacity) notFull.signal(); } } finally { putLock.unlock(); } if (c == 0) signalNotEmpty(); return c >= 0; } private void enqueue(Node<E> node) { // assert putLock.isHeldByCurrentThread(); // assert last.next == null; last = last.next = node; } private void signalNotEmpty() { final ReentrantLock takeLock = this.takeLock; takeLock.lock(); try { notEmpty.signal(); } finally { takeLock.unlock(); } } 迭代器 迭代器这边跟ArrayBlockingQueue差不多,就不多说了,估计看也看的懂,无非就是初始化、移动指针,返回当前元素的值。 public Iterator<E> iterator() { return new Itr(); } private class Itr implements Iterator<E> { private Node<E> current; private Node<E> lastRet; private E currentElement; Itr() { fullyLock(); try { current = head.next; if (current != null) currentElement = current.item; } finally { fullyUnlock(); } } public boolean hasNext() { return current != null; } private Node<E> nextNode(Node<E> p) { for (;;) { Node<E> s = p.next; if (s == p) return head.next; if (s == null || s.item != null) return s; p = s; } } public E next() { fullyLock(); try { if (current == null) throw new NoSuchElementException(); E x = currentElement; lastRet = current; current = nextNode(current); currentElement = (current == null) ? null : current.item; return x; } finally { fullyUnlock(); } } }

优秀的个人博客,低调大师

java源码-ArrayBlockingQueue

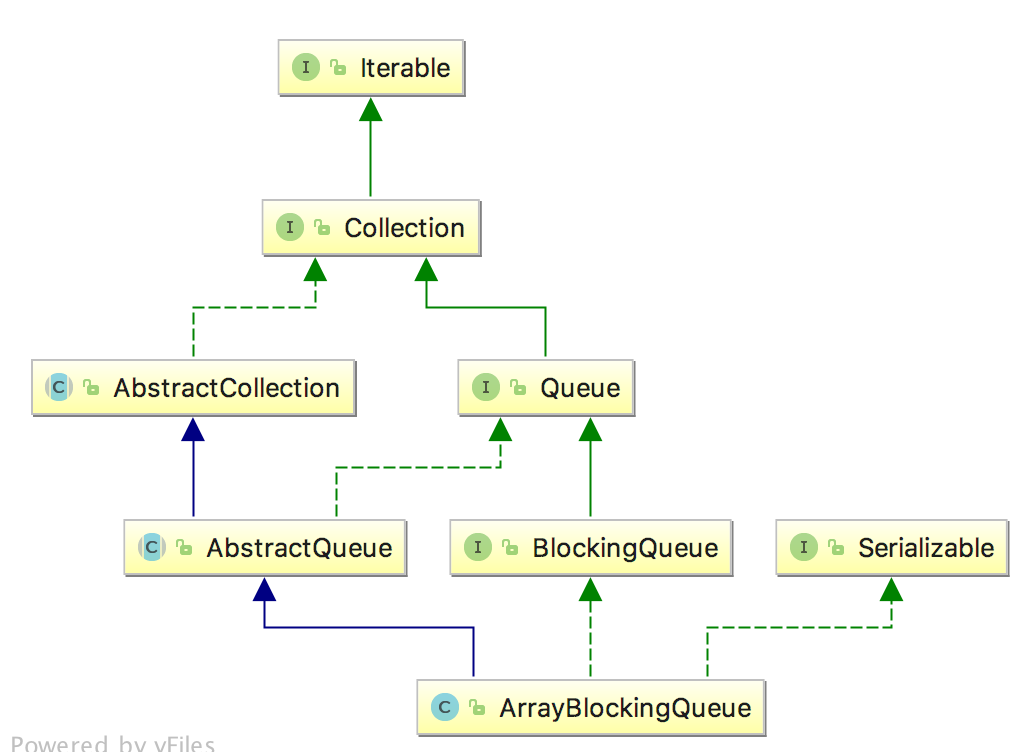
开篇 ArrayBlockingQueue是数组实现的线程安全的有界的阻塞队列。 线程安全是指ArrayBlockingQueue内部通过“互斥锁”保护竞争资源,实现了多线程对竞争资源的互斥访问。 有界是指ArrayBlockingQueue对应的数组是有界限的。 阻塞队列是指多线程访问竞争资源时,当竞争资源已被某线程获取时,其它要获取该资源的线程需要阻塞等待;而且,ArrayBlockingQueue是按 FIFO(先进先出)原则对元素进行排序,元素都是从尾部插入到队列,从头部开始返回。 ArrayBlockingQueue类图 ArrayBlockingQueue类图 ArrayBlockingQueue构造函数 ArrayBlockingQueue的构造函数信息表明以下几个信息: 线程安全 ReentrantLock lock 容量有界 this.items = new Object[capacity]; 状态同步 Condition notEmpty、Condition notFull public class ArrayBlockingQueue<E> extends AbstractQueue<E> implements BlockingQueue<E>, java.io.Serializable { final Object[] items; int takeIndex; int putIndex; int count; // 通过lock来保证线程安全,通过lock下的Condition来实现状态同步 final ReentrantLock lock; private final Condition notEmpty; private final Condition notFull; transient Itrs itrs = null; // 构造函数必须指定数组大小,所以是有界的 public ArrayBlockingQueue(int capacity) { this(capacity, false); } public ArrayBlockingQueue(int capacity, boolean fair) { if (capacity <= 0) throw new IllegalArgumentException(); this.items = new Object[capacity]; lock = new ReentrantLock(fair); notEmpty = lock.newCondition(); notFull = lock.newCondition(); } public ArrayBlockingQueue(int capacity, boolean fair, Collection<? extends E> c) { this(capacity, fair); final ReentrantLock lock = this.lock; lock.lock(); // Lock only for visibility, not mutual exclusion try { int i = 0; try { for (E e : c) { checkNotNull(e); items[i++] = e; } } catch (ArrayIndexOutOfBoundsException ex) { throw new IllegalArgumentException(); } count = i; putIndex = (i == capacity) ? 0 : i; } finally { lock.unlock(); } } } ArrayBlockingQueue常用操作 ArrayBlockingQueue的add/put/offer方法 ArrayBlockingQueue的所有add()方法其实执行的就是offer()方法,其他核心的逻辑在enqueue方法中。当然所有操作都是执行加锁操作lock.lock()。 add/offer方法是非阻塞的,如果队列满就直接返回异常 put()方法是阻塞的,如果队列满就等待,等待notFull的信号量,notFull.await()在take等方法执行的时候会触发notFull.signal()。 enqueue()方法内部就是往item数组中添加元素、计算元素个数count++、重置putIndex、通知非空信号量notEmpty.signal()。 public boolean add(E e) { return super.add(e); } // 将指定的元素插入到此队列的尾部(如果立即可行且不会超过该队列的容量),在成功时返回 true,如果此队列已满,则抛出 IllegalStateException。 public boolean offer(E e) { checkNotNull(e); final ReentrantLock lock = this.lock; lock.lock(); try { if (count == items.length) return false; else { enqueue(e); return true; } } finally { lock.unlock(); } } // 将指定的元素插入此队列的尾部,如果该队列已满,则等待可用的空间。 public void put(E e) throws InterruptedException { checkNotNull(e); final ReentrantLock lock = this.lock; lock.lockInterruptibly(); try { while (count == items.length) notFull.await(); enqueue(e); } finally { lock.unlock(); } } private void enqueue(E x) { // assert lock.getHoldCount() == 1; // assert items[putIndex] == null; final Object[] items = this.items; items[putIndex] = x; if (++putIndex == items.length) putIndex = 0; count++; notEmpty.signal(); } ArrayBlockingQueue的poll/take/peek方法 ArrayBlockingQueue的所有take相关操作最终都是执行dequeue操作的。 所有删除元素操作都是先进行加锁保证线程安全 poll()和take()方法是阻塞的 take()和poll()带时间参数是阻塞 dequeue()内部通过takeIndex参数获取待返回的参数,重置元素个数count,移动下一个元素位置takeIndex等。 public E poll() { final ReentrantLock lock = this.lock; lock.lock(); try { return (count == 0) ? null : dequeue(); } finally { lock.unlock(); } } public E take() throws InterruptedException { final ReentrantLock lock = this.lock; lock.lockInterruptibly(); try { while (count == 0) notEmpty.await(); return dequeue(); } finally { lock.unlock(); } } public E poll(long timeout, TimeUnit unit) throws InterruptedException { long nanos = unit.toNanos(timeout); final ReentrantLock lock = this.lock; lock.lockInterruptibly(); try { while (count == 0) { if (nanos <= 0) return null; nanos = notEmpty.awaitNanos(nanos); } return dequeue(); } finally { lock.unlock(); } } public E peek() { final ReentrantLock lock = this.lock; lock.lock(); try { return itemAt(takeIndex); // null when queue is empty } finally { lock.unlock(); } } private E dequeue() { // assert lock.getHoldCount() == 1; // assert items[takeIndex] != null; final Object[] items = this.items; @SuppressWarnings("unchecked") E x = (E) items[takeIndex]; items[takeIndex] = null; if (++takeIndex == items.length) takeIndex = 0; count--; if (itrs != null) itrs.elementDequeued(); notFull.signal(); return x; } ArrayBlockingQueue的内部的锁 在ArrayBlockingQueue函数内部的加锁动作,我们发现有lock和lockInterruptibly两种,lock 与 lockInterruptibly比较区别在于: lock 优先考虑获取锁,待获取锁成功后,才响应中断。 lockInterruptibly 优先考虑响应中断,而不是响应锁的普通获取或重入获取。 详细区别: ReentrantLock.lockInterruptibly允许在等待时由其它线程调用等待线程的Thread.interrupt方法来中断等待线程的等待而直接返回,这时不用获取锁,而会抛出一个InterruptedException。 ReentrantLock.lock方法不允许Thread.interrupt中断,即使检测到Thread.isInterrupted,一样会继续尝试获取锁,失败则继续休眠。只是在最后获取锁成功后再把当前线程置为interrupted状态,然后再中断线程。 ArrayBlockingQueue的内部的信号量 ArrayBlockingQueue由于数组的容量是固定的,所以需要信号量协调put和take动作。 在put的时候遇到数组满的时候通过notFull.await()实现等待,直到dequeue()方法消费一个元素后执行notFull.signal()通知可以put新元素。 在take的时候遇到数组空的时候通过notEmpty.await()实现等待,直到enqueue()方法新增一个元素后执行notEmpty.signal()通知可以take新元素。 public E take() throws InterruptedException { final ReentrantLock lock = this.lock; lock.lockInterruptibly(); try { while (count == 0) notEmpty.await(); return dequeue(); } finally { lock.unlock(); } } private void enqueue(E x) { // assert lock.getHoldCount() == 1; // assert items[putIndex] == null; final Object[] items = this.items; items[putIndex] = x; if (++putIndex == items.length) putIndex = 0; count++; notEmpty.signal(); } ---------------------------------------------------- public void put(E e) throws InterruptedException { checkNotNull(e); final ReentrantLock lock = this.lock; lock.lockInterruptibly(); try { while (count == items.length) notFull.await(); enqueue(e); } finally { lock.unlock(); } } private E dequeue() { // assert lock.getHoldCount() == 1; // assert items[takeIndex] != null; final Object[] items = this.items; @SuppressWarnings("unchecked") E x = (E) items[takeIndex]; items[takeIndex] = null; if (++takeIndex == items.length) takeIndex = 0; count--; if (itrs != null) itrs.elementDequeued(); notFull.signal(); return x; } ArrayBlockingQueue迭代器 ArrayBlockingQueue迭代器的迭代器比较简单,hasNext()判断下一个元素是否为null,next()通过移动下标获取下一个元素,中间涉及到一些下标到末尾重新从头开始。当然有一些细节代码我直接省略了不影响理解迭代过程。 public Iterator<E> iterator() { return new Itr(); } private class Itr implements Iterator<E> { private int cursor; private E nextItem; private int nextIndex; private E lastItem; private int lastRet; private int prevTakeIndex; private int prevCycles; private static final int NONE = -1; private static final int REMOVED = -2; private static final int DETACHED = -3; Itr() { lastRet = NONE; final ReentrantLock lock = ArrayBlockingQueue.this.lock; lock.lock(); try { if (count == 0) { // assert itrs == null; cursor = NONE; nextIndex = NONE; prevTakeIndex = DETACHED; } else { final int takeIndex = ArrayBlockingQueue.this.takeIndex; prevTakeIndex = takeIndex; nextItem = itemAt(nextIndex = takeIndex); cursor = incCursor(takeIndex); if (itrs == null) { itrs = new Itrs(this); } else { itrs.register(this); // in this order itrs.doSomeSweeping(false); } prevCycles = itrs.cycles; } } finally { lock.unlock(); } } private int incCursor(int index) { // assert lock.getHoldCount() == 1; if (++index == items.length) index = 0; if (index == putIndex) index = NONE; return index; } public boolean hasNext() { // assert lock.getHoldCount() == 0; if (nextItem != null) return true; noNext(); return false; } public E next() { // assert lock.getHoldCount() == 0; final E x = nextItem; if (x == null) throw new NoSuchElementException(); final ReentrantLock lock = ArrayBlockingQueue.this.lock; lock.lock(); try { if (!isDetached()) incorporateDequeues(); // assert nextIndex != NONE; // assert lastItem == null; lastRet = nextIndex; final int cursor = this.cursor; if (cursor >= 0) { nextItem = itemAt(nextIndex = cursor); // assert nextItem != null; this.cursor = incCursor(cursor); } else { nextIndex = NONE; nextItem = null; } } finally { lock.unlock(); } return x; } }

优秀的个人博客,低调大师

java源码-LinkedList

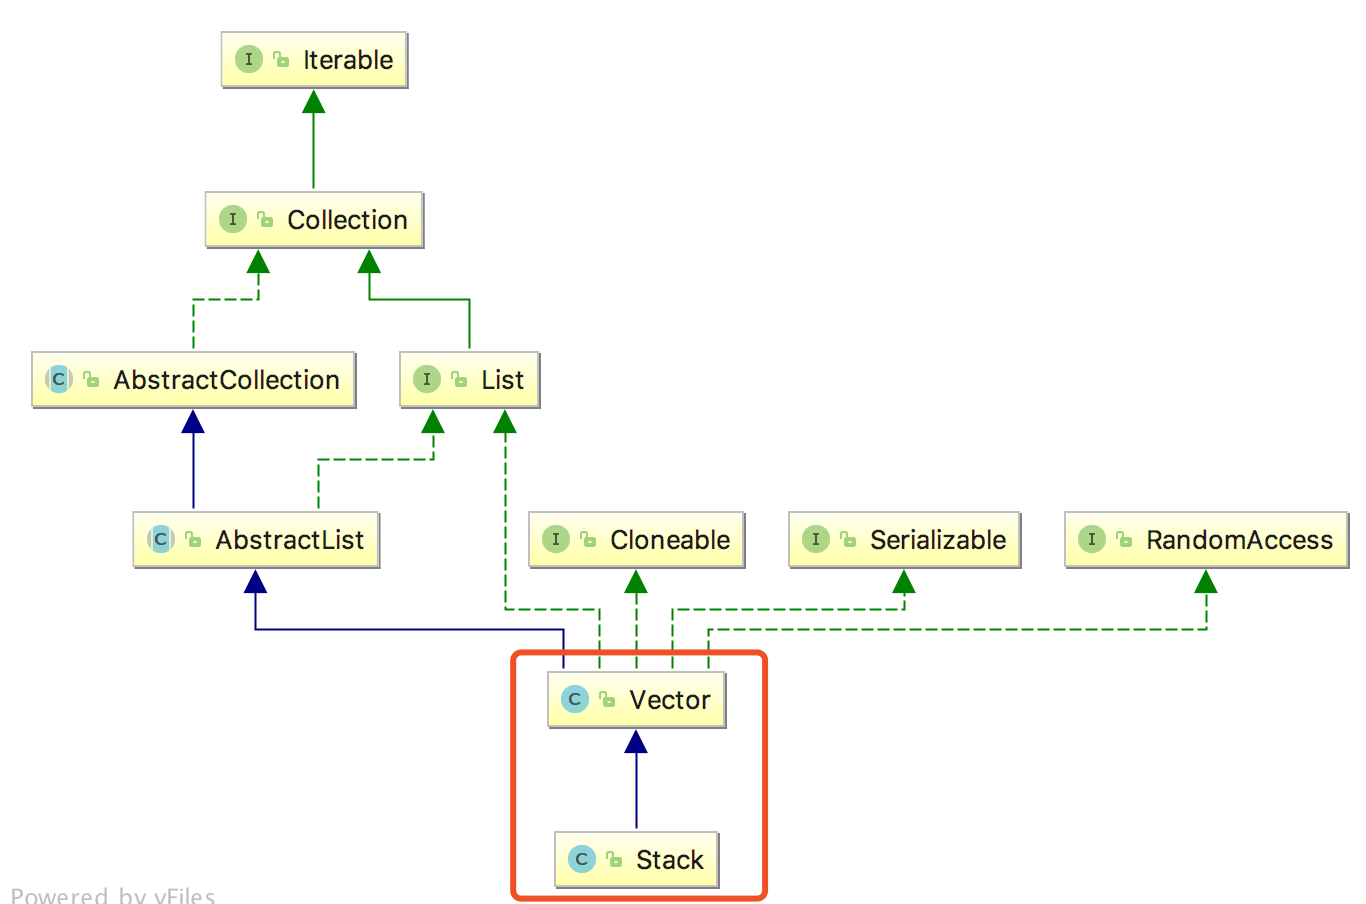
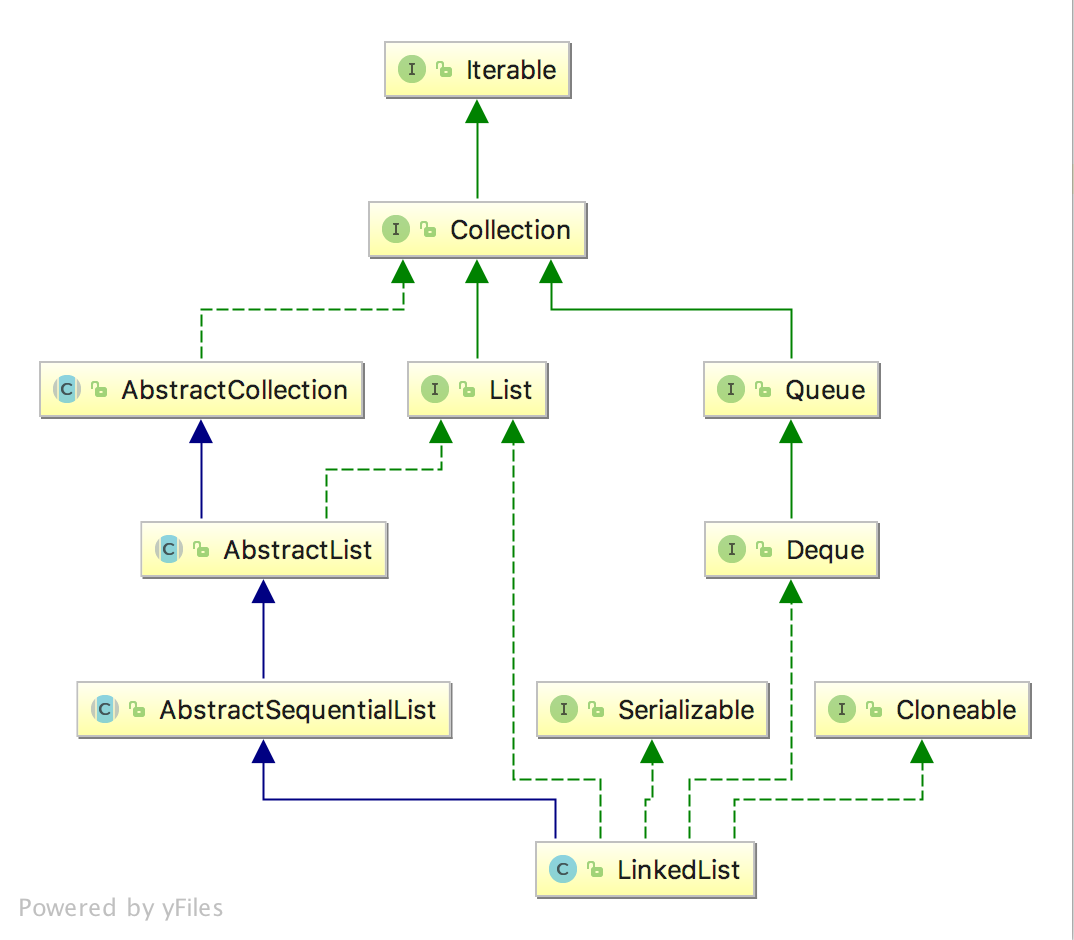
开篇 LinkedList基于链表实现,在List中间进行插入和删除的代价较低,提供了优化的顺序访问。LinkedList在随机访问方面相对比较慢,但是它的特性集较ArrayList更大。 LinkedList的实现是一个双向链表,LinkedList存储的Node节点包含指向前置后置节点的指针。 LinkedList类图 LinkedList类图 LinkedList的数据存储结构图 LinkedList类定义 LinkedList的类定义中包含first节点和last节点,通过first节点(指向头节点)和last节点(指向尾节点)将串联所有的list中的节点,看下Node的定义就知道了。 Node的prev和next节点分别指向前后节点。 public class LinkedList<E> extends AbstractSequentialList<E> implements List<E>, Deque<E>, Cloneable, java.io.Serializable { transient int size = 0; // 指向LinkedList的第一个节点 transient Node<E> first; // 指向LinkedList的最后一个节点 transient Node<E> last; private static class Node<E> { E item; Node<E> next; Node<E> prev; Node(Node<E> prev, E element, Node<E> next) { this.item = element; this.next = next; this.prev = prev; } } } LinkedList构造函数 LinkedList的构造函数非常简单,关键是看下参数为Collection的构造函数,在该构造函数当中通过addAll()方法将元素通过尾插入法添加到LinkedList当中。allAll参数的index标记从哪个位置开始插入。 public LinkedList() { } public LinkedList(Collection<? extends E> c) { this(); addAll(c); } public boolean addAll(Collection<? extends E> c) { return addAll(size, c); } public boolean addAll(int index, Collection<? extends E> c) { // 确定是否超过index的下标 checkPositionIndex(index); Object[] a = c.toArray(); int numNew = a.length; if (numNew == 0) return false; // 确定插入位置的前后节点位置,pred是前置节点,succ是后置节点 Node<E> pred, succ; if (index == size) { succ = null; pred = last; } else { succ = node(index); pred = succ.prev; } // 直接采用链表插入法插入即可 for (Object o : a) { @SuppressWarnings("unchecked") E e = (E) o; Node<E> newNode = new Node<>(pred, e, null); if (pred == null) first = newNode; else pred.next = newNode; pred = newNode; } if (succ == null) { last = pred; } else { pred.next = succ; succ.prev = pred; } size += numNew; modCount++; return true; } LinkedList常用操作 LinkedList的add方法 LinkedList的add()方法其实非常简单,就是在LinkedList的尾部进行插入,然后更新last节点就可以了。 public boolean add(E e) { linkLast(e); return true; } // 在尾部插入新的值 void linkLast(E e) { final Node<E> l = last; final Node<E> newNode = new Node<>(l, e, null); last = newNode; if (l == null) first = newNode; else l.next = newNode; size++; modCount++; } public void add(int index, E element) { checkPositionIndex(index); if (index == size) linkLast(element); else linkBefore(element, node(index)); } // 设计巧妙,力求最少时间定为索引位置 Node<E> node(int index) { // assert isElementIndex(index); if (index < (size >> 1)) { Node<E> x = first; for (int i = 0; i < index; i++) x = x.next; return x; } else { Node<E> x = last; for (int i = size - 1; i > index; i--) x = x.prev; return x; } } // 在合适的节点之前插入 void linkBefore(E e, Node<E> succ) { // assert succ != null; final Node<E> pred = succ.prev; final Node<E> newNode = new Node<>(pred, e, succ); succ.prev = newNode; if (pred == null) first = newNode; else pred.next = newNode; size++; modCount++; } LinkedList的remove方法 LinkedList的remove()的方法也非常简单,通过移除头部节点即可,然后将first节点后移即可。 public E remove() { return removeFirst(); } public E removeFirst() { final Node<E> f = first; if (f == null) throw new NoSuchElementException(); return unlinkFirst(f); } private E unlinkFirst(Node<E> f) { // assert f == first && f != null; final E element = f.item; final Node<E> next = f.next; f.item = null; f.next = null; // help GC first = next; if (next == null) last = null; else next.prev = null; size--; modCount++; return element; } LinkedList的indexOf方法 LinkedList的indexOf()方法主要从first到last进行遍历依次比较即可。 public int indexOf(Object o) { int index = 0; if (o == null) { for (Node<E> x = first; x != null; x = x.next) { if (x.item == null) return index; index++; } } else { for (Node<E> x = first; x != null; x = x.next) { if (o.equals(x.item)) return index; index++; } } return -1; } LinkedList迭代器 LinkedList的迭代器主要分为两个: iterator主要是在AbstractList类中定义,通过java的多态性调用LinkedList的size()方法和get()方法实现索引的比较和数据的获取等。 listIterator在LinkedList类中实现,通过index指定迭代器开始遍历的位置,通过前后指针进行next移动,通过index和size比较是否遍历完成。 public Iterator<E> iterator() { return new Itr(); } private class Itr implements Iterator<E> { int cursor = 0; int lastRet = -1; int expectedModCount = modCount; // 调用LinkedList的size()方法 public boolean hasNext() { return cursor != size(); } public E next() { checkForComodification(); try { int i = cursor; // get()方法调用的是LinkedList的方法 E next = get(i); lastRet = i; cursor = i + 1; return next; } catch (IndexOutOfBoundsException e) { checkForComodification(); throw new NoSuchElementException(); } } } public ListIterator<E> listIterator(int index) { checkPositionIndex(index); return new ListItr(index); } private class ListItr implements ListIterator<E> { private Node<E> lastReturned; private Node<E> next; private int nextIndex; private int expectedModCount = modCount; ListItr(int index) { // assert isPositionIndex(index); next = (index == size) ? null : node(index); nextIndex = index; } public boolean hasNext() { return nextIndex < size; } public E next() { checkForComodification(); if (!hasNext()) throw new NoSuchElementException(); lastReturned = next; next = next.next; nextIndex++; return lastReturned.item; } }

优秀的个人博客,低调大师

java源码-ArrayList

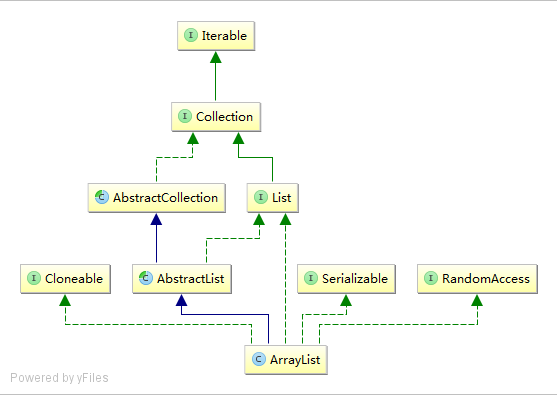
开篇 ArrayList主要由如下特性: ArrayList实际上是通过一个数组去保存数据的,当我们构造ArrayList时,如果使用默认构造函数,ArrayList的默认容量大小是10。 当ArrayList容量不足以容纳全部元素时,ArrayList会自动扩张容量,新的容量 = 1.5*原始容量。 ArrayList的克隆函数,将全部元素克隆到一个数组中,采用Arrays.copyOf方法实现。 ArrayList实现java.io.Serializable的方式。当写入到输出流时,先写入“容量”,再依次写出“每一个元素”;当读出输入流时,先读取“容量”,再依次读取“每一个元素”。 在做ArrayList的遍历的时候有3中遍历的方法,分别是随机访问遍历,用迭代器遍历和强制for循环遍历,按照效率来说最快的是随机访问遍历,最差的是迭代器遍历。 ArrayList的遍历是不安全的,在遍历的时候如果改变了集合的结构会抛出ConcurrentModificationException异常。 ArrayList类图 ArrayList类图 ArrayList类定义 ArrayList的类定义比较简单,基本上可以看出来默认值数组大小为10,数据存储通过elementData变量。 public class ArrayList<E> extends AbstractList<E> implements List<E>, RandomAccess, Cloneable, java.io.Serializable { private static final long serialVersionUID = 8683452581122892189L; // 默认初始化大小 private static final int DEFAULT_CAPACITY = 10; private static final Object[] EMPTY_ELEMENTDATA = {}; private static final Object[] DEFAULTCAPACITY_EMPTY_ELEMENTDATA = {}; //默认是package-private access,保存数据 transient Object[] elementData; //实际保存的数据量大小 private int size; } ArrayList构造函数 ArrayList的构造数非常简单,根据传入的参数initialCapacity初始化数组大小。如果不传参数就默认构建空数组。 public ArrayList(int initialCapacity) { if (initialCapacity > 0) { this.elementData = new Object[initialCapacity]; } else if (initialCapacity == 0) { this.elementData = EMPTY_ELEMENTDATA; } else { throw new IllegalArgumentException("Illegal Capacity: "+ initialCapacity); } } public ArrayList() { this.elementData = DEFAULTCAPACITY_EMPTY_ELEMENTDATA; } public ArrayList(Collection<? extends E> c) { elementData = c.toArray(); if ((size = elementData.length) != 0) { // c.toArray might (incorrectly) not return Object[] (see 6260652) if (elementData.getClass() != Object[].class) elementData = Arrays.copyOf(elementData, size, Object[].class); } else { // replace with empty array. this.elementData = EMPTY_ELEMENTDATA; } } ArrayList常用操作 ArrayList的add操作 ArrayList的add操作其实就是分两步走: 以size+1的大小去看下是否容纳的下新元素,否则就以1.5的原有空间扩容。 在扩容后的新数组的index位置插入新元素。 grow()方法内部实现扩容和旧元素的拷贝,采用Arrays.copyOf(elementData, newCapacity)实现。 public boolean add(E e) { ensureCapacityInternal(size + 1); // Increments modCount!! elementData[size++] = e; return true; } public void add(int index, E element) { rangeCheckForAdd(index); ensureCapacityInternal(size + 1); // Increments modCount!! System.arraycopy(elementData, index, elementData, index + 1, size - index); elementData[index] = element; size++; } private void ensureCapacityInternal(int minCapacity) { if (elementData == DEFAULTCAPACITY_EMPTY_ELEMENTDATA) { minCapacity = Math.max(DEFAULT_CAPACITY, minCapacity); } ensureExplicitCapacity(minCapacity); } private void ensureExplicitCapacity(int minCapacity) { modCount++; // overflow-conscious code if (minCapacity - elementData.length > 0) grow(minCapacity); } private void grow(int minCapacity) { // overflow-conscious code int oldCapacity = elementData.length; int newCapacity = oldCapacity + (oldCapacity >> 1); if (newCapacity - minCapacity < 0) newCapacity = minCapacity; if (newCapacity - MAX_ARRAY_SIZE > 0) newCapacity = hugeCapacity(minCapacity); // minCapacity is usually close to size, so this is a win: elementData = Arrays.copyOf(elementData, newCapacity); } ArrayList的remove操作 ArrayList的remove操作分两步走: 将待移除的index往后的元素拷贝至index开始的位置。 将最后一位元素置null并且size-1即可。 ArrayList的clear操作负责将数组全部置null即可。 public E remove(int index) { rangeCheck(index); modCount++; E oldValue = elementData(index); int numMoved = size - index - 1; if (numMoved > 0) System.arraycopy(elementData, index+1, elementData, index, numMoved); elementData[--size] = null; // clear to let GC do its work return oldValue; } public void clear() { modCount++; // clear to let GC do its work for (int i = 0; i < size; i++) elementData[i] = null; size = 0; } ArrayList迭代器 ArrayList的迭代器实现很简单,通过创建Itr对象。在Itr类当中将cursor初始化为0,next过程中就是返回变量同时将cursor+1,hasNext()方法只是判断cursor是否等于size的值。 public Iterator<E> iterator() { return new Itr(); } private class Itr implements Iterator<E> { int cursor; // 默认初始化值为0 int lastRet = -1; // 上一个返回值的下标 int expectedModCount = modCount; public boolean hasNext() { return cursor != size; } public E next() { checkForComodification(); int i = cursor; if (i >= size) throw new NoSuchElementException(); Object[] elementData = ArrayList.this.elementData; if (i >= elementData.length) throw new ConcurrentModificationException(); cursor = i + 1; return (E) elementData[lastRet = i]; } } 参考文章 ArrayList的特性

优秀的个人博客,低调大师

java源码-LinkedHashSet

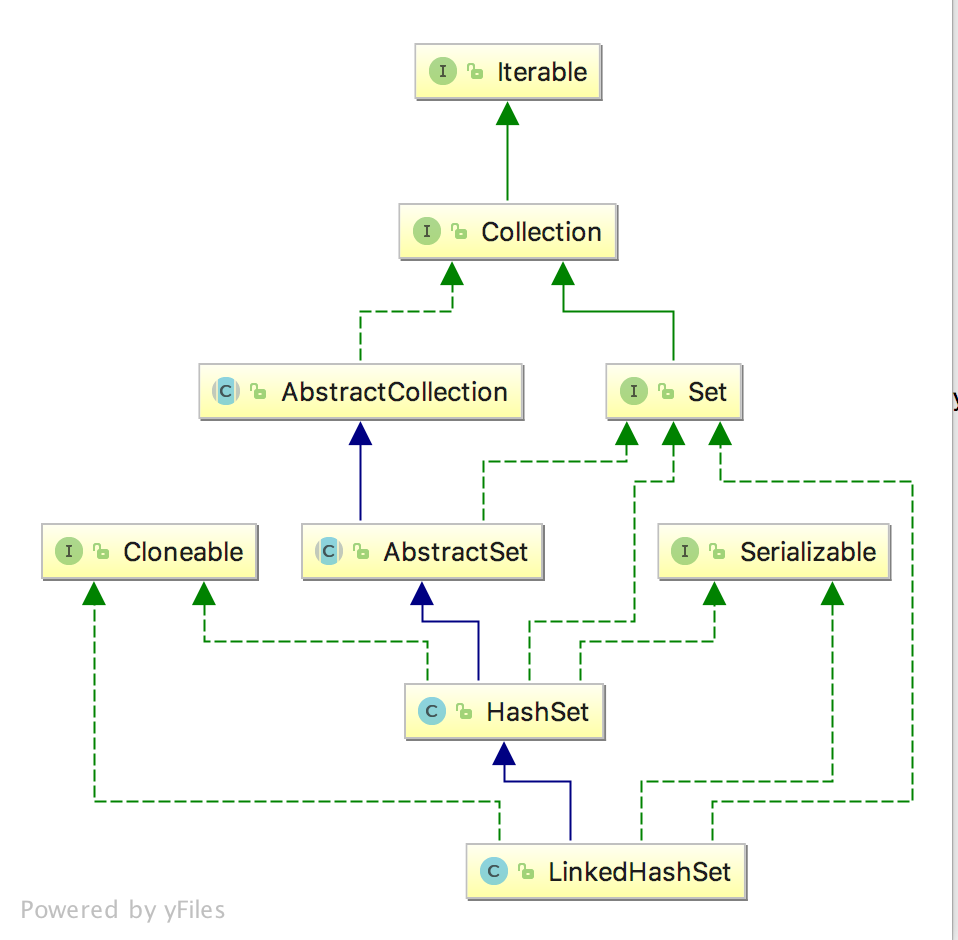
开篇 LinkedHashSet按照元素插入的顺序进行迭代,即迭代输出的顺序与插入的顺序保持一致。 LinkedHashSet类图 LinkedHashSet类图 LinkedHashSet构造函数 LinkedHashSet继承自HashSet,而在HashSet的构造函数当中我们构建了一个LinkedHashMap对象,所以LinkedHashSet的实现其实是依赖于LinkedHashMap实现的。 LinkedHashSet的构造函数当中通过super接口初始化了父类HashSet类,而HashSet的构造函数当中我们初始化了map = new LinkedHashMap<>(initialCapacity, loadFactor)对象。 LinkedHashSet对外提供的方法基本上都是HashSet内部实现的,它本身没有方法实现。 public class LinkedHashSet<E> extends HashSet<E> implements Set<E>, Cloneable, java.io.Serializable { public LinkedHashSet(int initialCapacity, float loadFactor) { super(initialCapacity, loadFactor, true); } public LinkedHashSet(int initialCapacity) { super(initialCapacity, .75f, true); } public LinkedHashSet() { super(16, .75f, true); } public LinkedHashSet(Collection<? extends E> c) { super(Math.max(2*c.size(), 11), .75f, true); addAll(c); } } public class HashSet<E> extends AbstractSet<E> implements Set<E>, Cloneable, java.io.Serializable { static final long serialVersionUID = -5024744406713321676L; private transient HashMap<E,Object> map; HashSet(int initialCapacity, float loadFactor, boolean dummy) { map = new LinkedHashMap<>(initialCapacity, loadFactor); } } LinkedHashSet常用操作 LinkedHashSet的操作基本上都是HashSet提供的接口,而HashSet的操作基本上都是map对外提供的接口,所以最终就是LinkedHashMap对外提供的接口。 public class HashSet<E> extends AbstractSet<E> implements Set<E>, Cloneable, java.io.Serializable { static final long serialVersionUID = -5024744406713321676L; private transient HashMap<E,Object> map; // Dummy value to associate with an Object in the backing Map private static final Object PRESENT = new Object(); public boolean isEmpty() { return map.isEmpty(); } public boolean contains(Object o) { return map.containsKey(o); } public boolean add(E e) { return map.put(e, PRESENT)==null; } public boolean remove(Object o) { return map.remove(o)==PRESENT; } } LinkedHashSet的迭代器 LinkedHashSet的迭代器就是LinkedHashMap内部实现的迭代器,所以基本上只需要了解LinkedHashMap的迭代器就可以了。 public class HashSet<E> extends AbstractSet<E> implements Set<E>, Cloneable, java.io.Serializable { static final long serialVersionUID = -5024744406713321676L; private transient HashMap<E,Object> map; private static final Object PRESENT = new Object(); HashSet(int initialCapacity, float loadFactor, boolean dummy) { map = new LinkedHashMap<>(initialCapacity, loadFactor); } public Iterator<E> iterator() { return map.keySet().iterator(); } } ---------------------LinkedHashMap.java--------------------- public class LinkedHashMap<K,V> extends HashMap<K,V> implements Map<K,V> { public Set<K> keySet() { Set<K> ks = keySet; if (ks == null) { ks = new LinkedKeySet(); keySet = ks; } return ks; } final class LinkedKeySet extends AbstractSet<K> { public final int size() { return size; } public final void clear() { LinkedHashMap.this.clear(); } public final Iterator<K> iterator() { return new LinkedKeyIterator(); } } final class LinkedKeyIterator extends LinkedHashIterator implements Iterator<K> { public final K next() { return nextNode().getKey(); } } abstract class LinkedHashIterator { LinkedHashMap.Entry<K,V> next; LinkedHashMap.Entry<K,V> current; int expectedModCount; LinkedHashIterator() { next = head; expectedModCount = modCount; current = null; } public final boolean hasNext() { return next != null; } final LinkedHashMap.Entry<K,V> nextNode() { LinkedHashMap.Entry<K,V> e = next; if (modCount != expectedModCount) throw new ConcurrentModificationException(); if (e == null) throw new NoSuchElementException(); current = e; next = e.after; return e; } public final void remove() { Node<K,V> p = current; if (p == null) throw new IllegalStateException(); if (modCount != expectedModCount) throw new ConcurrentModificationException(); current = null; K key = p.key; removeNode(hash(key), key, null, false, false); expectedModCount = modCount; } } }

优秀的个人博客,低调大师

java源码-TreeSet

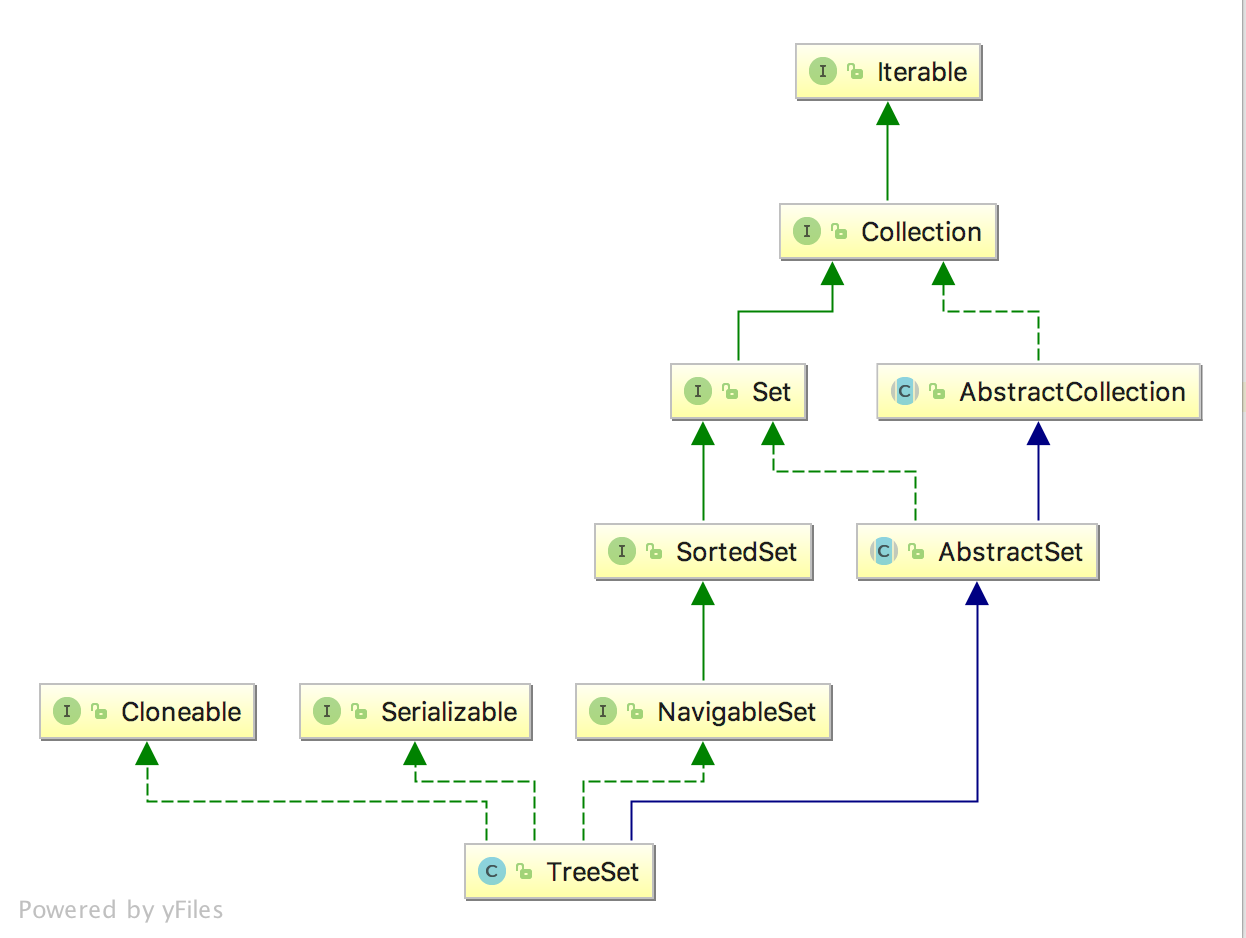
开篇 TreeSet作为HashSet的姊妹类型,TreeSet是用来排序的, 可以指定一个顺序, 对象存入之后会按照指定的顺序排列。 TreeSet类图 TreeSet类图 TreeSet类图 TreeSet秉承了HashSet的一贯做法,内部通过Map来保存key/value数据,由于Set只保存key,所以内部的Map的value公用了一个定义的Object对象PRESENT。 TreeSet由于维持有序性,所以内部通过TreeMap存储数据。 public class TreeSet<E> extends AbstractSet<E> implements NavigableSet<E>, Cloneable, java.io.Serializable { // 用于保存TreeMap的对象,会在构造函数当中赋值TreeMap对象 private transient NavigableMap<E,Object> m; // TreeMap当中所有的value都是保存的PRESENT对象 private static final Object PRESENT = new Object(); } TreeSet的构造函数 TreeSet的构造函数分为两大类: 通过创建TreeMap对象赋值给TreeSet当中NavigableMap<E,Object> m变量; 通过创建NavigableMap<E,Object> m变量并通过addAll方法方法添加到TreeMap当中。 在TreeSet的addAll()方法通过super.addAll()方法调用AbstractCollection的addAll()方法,在该方法内部最后又调用TreeSet的add()方法添加到TreeMap m当中。 TreeSet(NavigableMap<E,Object> m) { this.m = m; } public TreeSet() { this(new TreeMap<E,Object>()); } public TreeSet(Comparator<? super E> comparator) { this(new TreeMap<>(comparator)); } public TreeSet(Collection<? extends E> c) { this(); addAll(c); } public TreeSet(SortedSet<E> s) { this(s.comparator()); addAll(s); } public boolean addAll(Collection<? extends E> c) { // Use linear-time version if applicable if (m.size()==0 && c.size() > 0 && c instanceof SortedSet && m instanceof TreeMap) { SortedSet<? extends E> set = (SortedSet<? extends E>) c; TreeMap<E,Object> map = (TreeMap<E, Object>) m; Comparator<?> cc = set.comparator(); Comparator<? super E> mc = map.comparator(); if (cc==mc || (cc != null && cc.equals(mc))) { map.addAllForTreeSet(set, PRESENT); return true; } } return super.addAll(c); } public boolean add(E e) { return m.put(e, PRESENT)==null; } ----------AbstractCollection.java中代码----------- public boolean addAll(Collection<? extends E> c) { boolean modified = false; for (E e : c) if (add(e)) modified = true; return modified; } TreeSe常用操作 TreeSet常用的操作其实都是针对TreeMap进行的操作,这里就不再多做啰嗦了,基本上都是TreeMap对外提供的api而已。 private transient NavigableMap<E,Object> m; public E first() { return m.firstKey(); } public E last() { return m.lastKey(); } public E pollFirst() { Map.Entry<E,?> e = m.pollFirstEntry(); return (e == null) ? null : e.getKey(); } public E pollLast() { Map.Entry<E,?> e = m.pollLastEntry(); return (e == null) ? null : e.getKey(); } TreeSet迭代器 TreeSet的iterator本质也是TreeMap当中实现的,在TreeMap.java中的navigableKeySet()方法中创建KeySet类对象,在KeySet类iterator方法当中我们可以看出来其实就是应用了TreeMap的keyIterator()方法。 这里再一次印证了TreeSet只是使用了TreeMap的key而已。 public Iterator<E> iterator() { return m.navigableKeySet().iterator(); } ----------------TreeMap.java------------------------ public NavigableSet<K> navigableKeySet() { KeySet<K> nks = navigableKeySet; return (nks != null) ? nks : (navigableKeySet = new KeySet<>(this)); } static final class KeySet<E> extends AbstractSet<E> implements NavigableSet<E> { private final NavigableMap<E, ?> m; KeySet(NavigableMap<E,?> map) { m = map; } public Iterator<E> iterator() { if (m instanceof TreeMap) return ((TreeMap<E,?>)m).keyIterator(); else return ((TreeMap.NavigableSubMap<E,?>)m).keyIterator(); }

优秀的个人博客,低调大师

java源码-LinkedHashMap

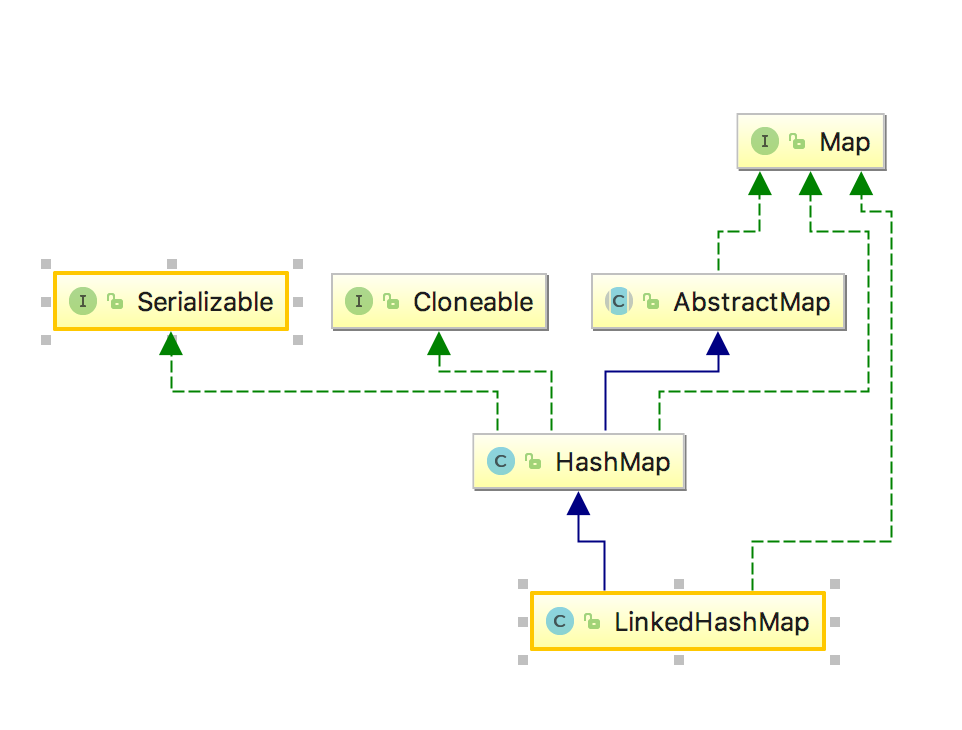
开篇 LinkedHashMap是HashMap的变种,有一些额外的特性其中最重要的就是维护数据插入的有序性,这篇文章就是为了讲清楚LinkedHashMap的实现细节。 LinkedHashMap类图 LinkedHashMap类图 LinkedHashMap和HashMap的差别 LinkedHashMap可以认为是HashMap+LinkedList,即它既使用HashMap操作数据结构,又使用LinkedList维护插入元素的先后顺序。 LinkedHashMap除了维持Map的有序性质外,其他和HashMap是一模一样的, LinkedHashMap实现细节 从LinkedHashMap的类依赖图可以看出来,LinkedHashMap其实是继承自HashMap类,所以LinkedHashMap的所有接口基本上都是继承自己HashMap类,当然也存在一个非常核心的差别。 LinkedHashMap用于存储key/value的结果是继承自己HashMap的,但是LinkedHashMap本身维护着一个有序列表。 head是LinkedHashMap的列表头,tail是LinkedHashMap的列表尾,通过这两个变量保证了维护LinkedHashMap的插入顺序。 LinkedHashMap的Entry相比HashMap.Node对象增加了before和after两个变量,由于指向前后节点。 LinkedHashMap通过重写HashMap的newNode方法,创建Entry对象并在内部初始化了HashMap当中的Node节点。 在创建Entry的newNode过程中通过linkNodeLast()方法按照put顺序维持LinkHashMap的有序性。 public class LinkedHashMap<K,V> extends HashMap<K,V> implements Map<K,V> { static class Entry<K,V> extends HashMap.Node<K,V> { Entry<K,V> before, after; Entry(int hash, K key, V value, Node<K,V> next) { super(hash, key, value, next); } } // 保存HashMap有序列表的头 transient LinkedHashMap.Entry<K,V> head; // 保存HashMap有序列表的尾 transient LinkedHashMap.Entry<K,V> tail; final boolean accessOrder; private void linkNodeLast(LinkedHashMap.Entry<K,V> p) { LinkedHashMap.Entry<K,V> last = tail; tail = p; if (last == null) head = p; else { p.before = last; last.after = p; } } Node<K,V> newNode(int hash, K key, V value, Node<K,V> e) { LinkedHashMap.Entry<K,V> p = new LinkedHashMap.Entry<K,V>(hash, key, value, e); linkNodeLast(p); return p; } private void linkNodeLast(LinkedHashMap.Entry<K,V> p) { LinkedHashMap.Entry<K,V> last = tail; tail = p; if (last == null) head = p; else { p.before = last; last.after = p; } } LinkedHashMap实际存储结构图 image.png 说明: 上述按照Entry1->Entry6的顺序进行存储的,不过这个图有些问题,正常的情况是head就是Entry1的对象,tail是Entry6的对象。 参考文章 图解LinkedHashMap原理

优秀的个人博客,低调大师

ButterKnife源码解析

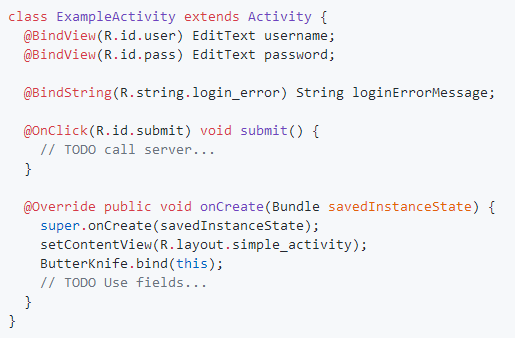
ButterKnife(https://github.com/JakeWharton/butterknife)是一款android平台的依赖注入框架,通过该工具可以实现View、OnClickListener的注入,省去了findViewById、setOnClickListener的过程。使用方法如下: 通过@BindView注解实现findViewById的功能,完成View注入;通过@OnClick完成OnClickListener点击事件的注入,给ID对应的View设置点击事件和响应函数。关于注解的定义和解析可以参照这篇文章:Java注解。ButterKnife使用的就是编译时解析注解的技术,在编译时对注解进行解析,生成中间文件,在ButterKnife.bind时引用注解编译器生成的中间文件,完成依赖注入。 注解的定义 BindView注解定义 BindView注解定义中使用了元注解@Retention(CLASS)定义了该注解只保留到编译期间,运行时会丢弃;@Target(FIELD)表示该注解只能用在成员变量上面。 OnClick注解 OnClick注解中@Target(METHOD)表示该注解只能用于方法上; ListenerClass ListenerClass是一个@Target(ANNOTATION_TYPE)类型的注解,表示ListenerClass只能用在注解上;且@Retention(RUNTIME)表示该注解可以保留到JVM中,也就是运行时能够通过反射来获取。 注解的解析 下面对@BindView和@OnClick两种注解的解析进行讲解。编译时注解的解析: 编译时 Annotation 指 @Retention 为 CLASS 的 Annotation,由编译器自动解析。需要做的 a. 自定义类集成自 AbstractProcessor(编译器在编译时自动查找所有继承自 AbstractProcessor 的类,然后调用他们的 process 方法去处理) b. 重写其中的 process 函数 ButterKnife实现了ButterKnifeProcessor来进行编译时注解的解析: ButterKnifeProcessor ButterKnifeProcessor.process()函数如下: ButterKnifeProcessor.process process函数先调用findAndParseTargets生成bindingMap,然后通过binding.brewJava老生成Java文件。findAndParseTargets的实现如下(这里只关注@BindView和@OnClick): findAndParseTargets 其中调用parseBindView对注解为@BindView的Field进行解析;findAndParseListener对@OnClick之类的Listener注解进行解析。parseBindView代码如下: parseBindView parseBindView的主要工作是创建了BindingSet.Builder。getOrCreateBindingBuilder()如下: getOrCreateBindingBuilder getOrCreateBindingBuilder内部调用了BindingSet.newBuilder。 BindingSet.newBuilder newBuilder生成了Builder对象,Builder对象定义了生成的Java文件名、mView所属对象的类型等。Builder对象生产后,parseBindView就根据@BindView注解信息生成FieldViewBinding对象,之后调用了Builder.build()函数;@BindView的解析已经完成后,最后通过BindingSet.brewJava来生成中间文件。@BindView在生成文件对应了如下: addViewBinding 生成的中间文件如下所示: 中间文件 可以看到,中间文件里完成了对Target中成员变量的注入。 那么中间文件又是在什么时候被调用的呢?答案就是ButterKnife.bind(this) bind函数根据调用的类名查找其对应的className_ViewBinding的类名,然后反射调用其构造函数。 至此,ButterKnife的@BindView的运行流程就是这样。

优秀的个人博客,低调大师

gobblin 源码分析

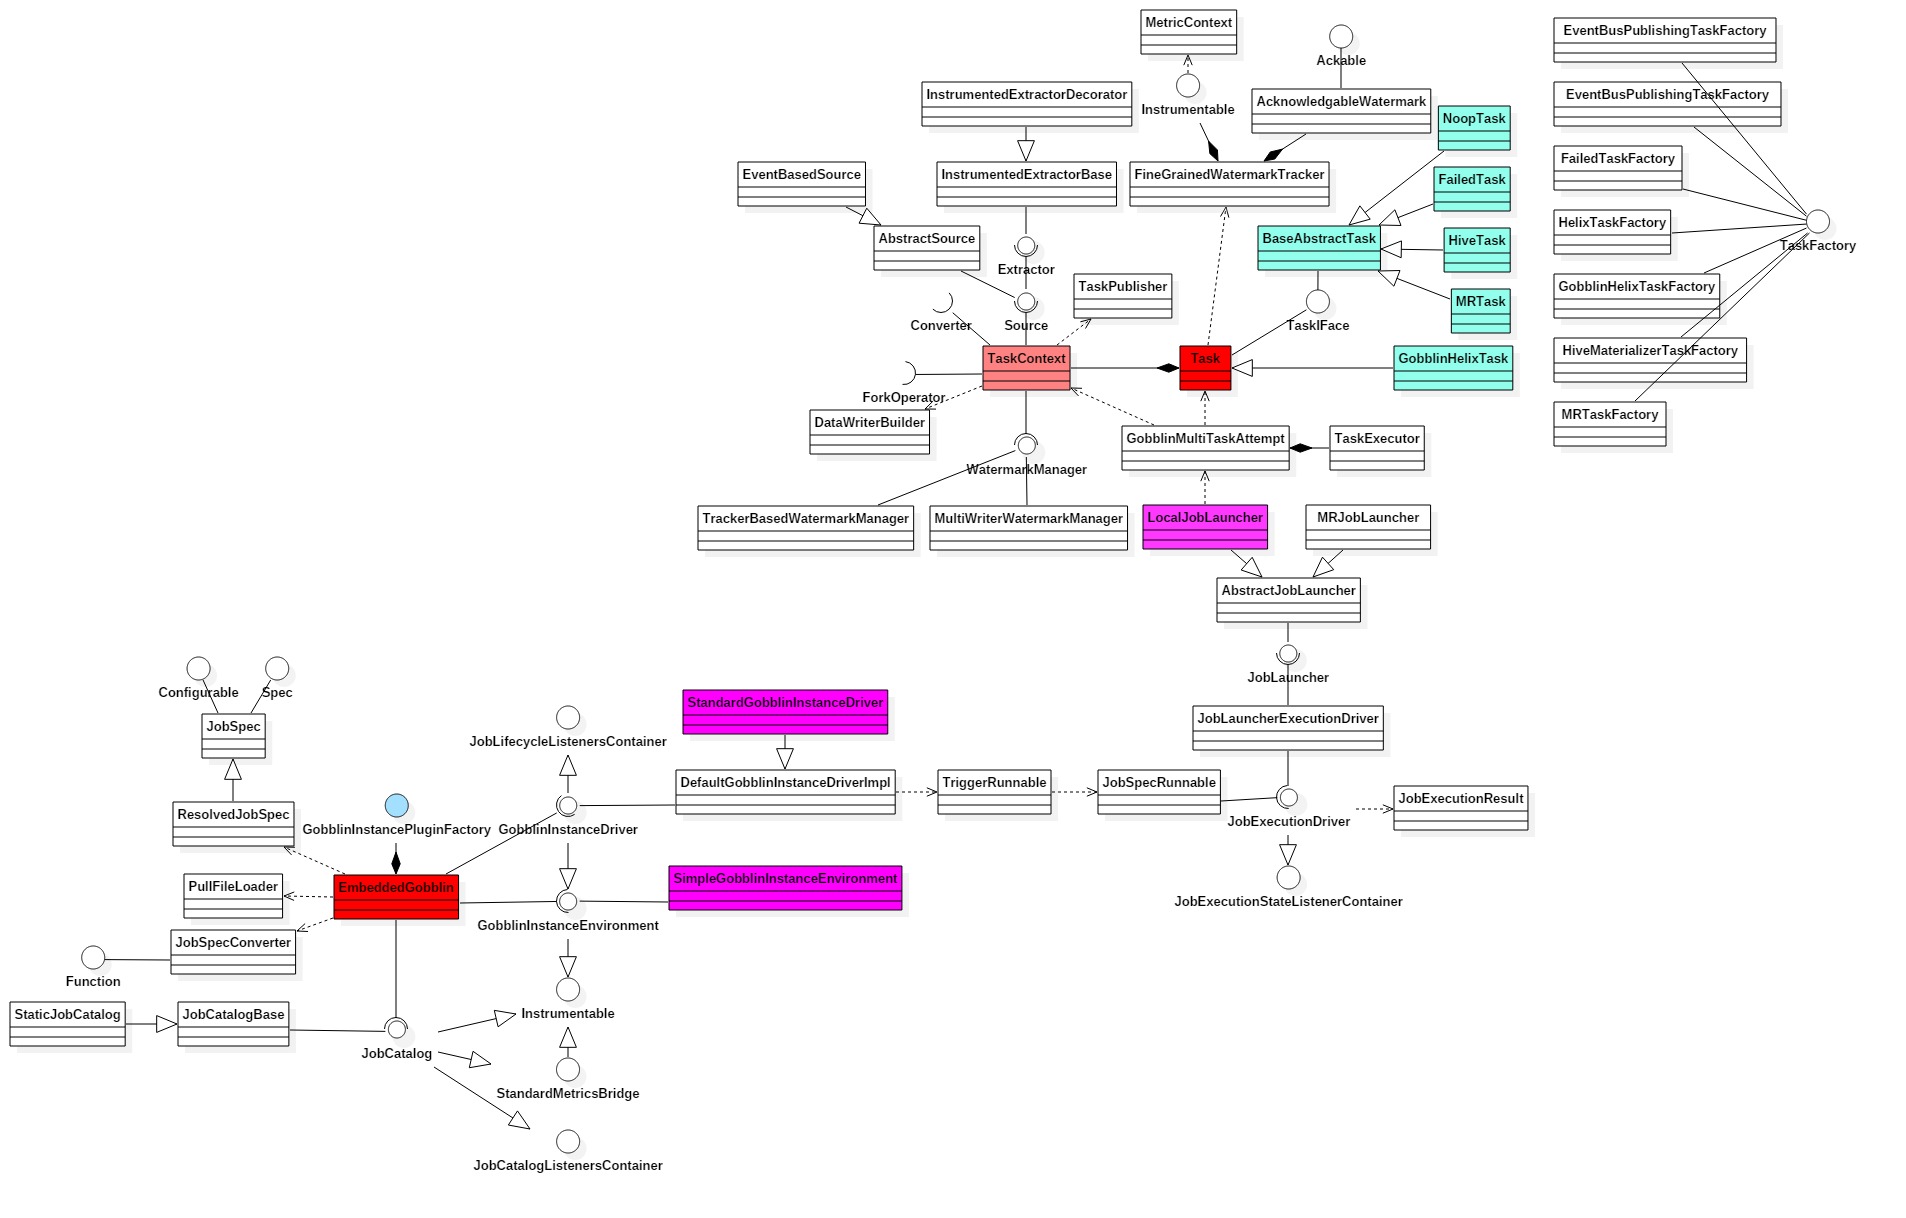
最近,开始搞些大数据相关的内容,遇到的第一个问题,就是数据入库,小白刚入手,又不想写太多代码,于是从网上找,入库手段很多: DataX,Sqoop,以及Flume 等以及直接使用 Spark 进行入库,想了下当下的场景(不是简单的倒库,要从kafka拉,然后过滤些东西,在进入库里),后来发现了 linkedin 的 gobblin ,感觉很强大的,说是国内 JD 也在用... 进入正题.... 架构分析 如下图所示, 本人使用的是独立运行的单机程序,因此使用的 EmbeddedGobblin 来启动 Job ,顺着这条路一直缕到 Gobblin 内部运行机制: 架构类图 如上图所示,EmbededGobblin 作为 Gobblin 启动项,通过 Task 的方式将 Job 管理起来,如果存在多个不同的 Fork ,分别将数据进行复制,并传递到各个 Fork 中进行进一步的计算处理。 整个过程中主要可能涉及到的是 Converter 的配置, Watermark, Writer等相关内容的应用,通过结合 Watermark 与 Writer 配合,也能做到反馈当前写到哪里,方便当前程序停掉之后,下次启动时接着这次继续运行。

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册