首页 文章 精选 留言 我的

精选列表

搜索[自然语言生成],共10009篇文章
优秀的个人博客,低调大师

自然语言处理多任务学习目标

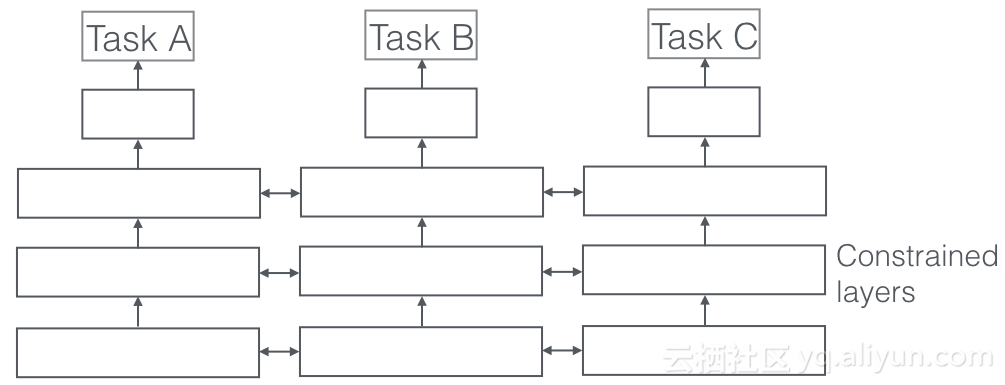
更多深度文章,请关注云计算频道:https://yq.aliyun.com/cloud 在之前的博文中,我讨论了如何利用相关任务提高多任务学习(MTL)模型的性能。在此之前,我们需要了解一下到底什么是多任务学习。 多任务学习是和单任务学习相对的一种机器学习方法。在机器学习领域,标准的算法理论是一次学习一个任务,而多任务学习是一种联合学习,多个任务并行学习,结果相互影响。简单来说,就是同时求解多个问题。例如我们经常探讨的“千人千面”这种个性化问题,就是一种典型的多任务学习问题,它可以同时学习多个用户的兴趣偏好。 多任务学习(MTL)主要是由两个部分组成:a)用于任务学习的架构、b)训练相关的辅助任务。而且这两个方面仍有很大的改进空间。此外,多任务学习有可能成为从有限数据中训练更强大的模型的关键技术:训练得到的模型可以执行更广泛的NLP任

优秀的个人博客,低调大师

如何编译运行HanLP自然语言处理包

master分支 对于master分支,编译方法如下: git clone https://github.com/hankcs/HanLP.git mvn install -DskipTests ·由于目前一些test不够规范,使用了硬编码路径下的资源,所以暂时跳过单元测试。 ·该方法不会将src/main/resources目录下的任何资源(包括hanlp.properties)打包进jar,如果需要打包资源文件,请切换到portable分支。 portable分支 git checkout portable 然后将需要的data放入src/main/resources,最后执行: mvn install -DskipTests 运行jar 目前jar包中有一些模块可以命令行执行,以感知机词法分析器为例。由于这些模块一般需要加载外部data,所以需要在运行时指定hanlp.properties。运行时,一个典型的目录结构如下: ·此处只列出了重要的目录。 ·一个良好的实践是把hanlp.properties放到resources目录下。 命令行需要指定jar包和hanlp.properties所在的目录: $ java -cp target/hanlp-1.6.0.jar:src/main/resources com.hankcs.hanlp.model.perceptron.Main -test \ <<< '华安集团胡花蕊来到纽约艺术博物馆参观' [华安/nz 集团/n]/nt 胡花蕊/nr 来到/v [纽约/ns 艺术/n 博物馆/n]/ns 参观/v ·Windows用户请使用分号java -cp target/hanlp-1.6.0.jar;src/main/resources

优秀的个人博客,低调大师

Pyhanlp自然语言处理中的新词识别

新词发现 本“新词发现”模块基于信息熵和互信息两种算法,可以在无语料的情况下提取一段长文本中的词语,并支持过滤掉系统中已存在的“旧词”,得到新词列表。 调用方法 静态方法 一句话静态调用接口已经封装到HanLP中: /** * 提取词语 * * @param text 大文本 * @param size 需要提取词语的数量 * @return 一个词语列表 */ public static List<WordInfo> extractWords(String text, int size) /** * 提取词语 * * @param reader 从reader获取文本 * @param size 需要提取词语的数量 * @return 一个词语列表 */ public static List<WordInfo> extractWords(BufferedReader reader, int size) throws IOException /** * 提取词语(新词发现) * * @param text 大文本 * @param size 需要提取词语的数量 * @param newWordsOnly 是否只提取词典中没有的词语 * @return 一个词语列表 */ public static List<WordInfo> extractWords(String text, int size, boolean newWordsOnly) /** * 提取词语(新词发现) * * @param reader 从reader获取文本 * @param size 需要提取词语的数量 * @param newWordsOnly 是否只提取词典中没有的词语 * @return 一个词语列表 */ public static List<WordInfo> extractWords(BufferedReader reader, int size, boolean newWordsOnly) throws IOException 调用示例请参考com.hankcs.demo.DemoNewWordDiscover。 值得注意的是,在计算资源允许的情况下,文本越长,结果质量越高。对于一些零散的文章,应当合并为整个大文件传入该算法。 高级参数 根据语料的长度或用词的不同,默认的参数有可能不能得到最佳的结果。我们可以通过构造不同的NewWordDiscover调整提取算法。该构造函数如下: /** * 构造一个新词识别工具 * @param max_word_len 词语最长长度 * @param min_freq 词语最低频率 * @param min_entropy 词语最低熵 * @param min_aggregation 词语最低互信息 * @param filter 是否过滤掉HanLP中的词库中已存在的词语 */ public NewWordDiscover(int max_word_len, float min_freq, float min_entropy, float min_aggregation, boolean filter) 其中: · max_word_len控制识别结果中最长的词语长度,默认值是4;该值越大,运算量越大,结果中出现短语的数量也会越多。 · min_freq控制结果中词语的最低频率,低于该频率的将会被过滤掉,减少一些运算量。由于结果是按照频率排序的,所以该参数其实意义不大。 · min_entropy控制结果中词语的最低信息熵的值,一般取0.5左右。该值越大,越短的词语就越容易被提取出来。 · min_aggregation控制结果中词语的最低互信息值,一般取50到200.该值越大,越长的词语就越容易被提取出来,有时候会出现一些短语。 · filter设为true的时候将使用内部词库过滤掉“旧词”。

优秀的个人博客,低调大师

自然语言处理的6大法宝

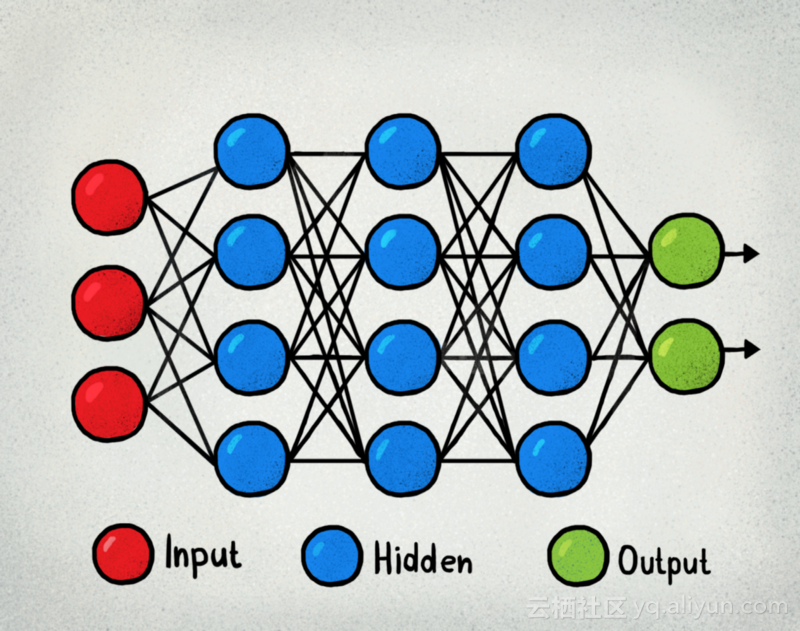
人工神经网络是一种基于大脑神经结构的非线性运算模型。它仅通过参考样本便可学习完成诸如分类、预测、决定和可视化等任务。 人工神经网络由许多神经元处理单元广泛连接而成。这些处理单元分为三类,包括输入层、隐含层(可以多于一层)和输出层。 位于输入层的神经元将信息传递到隐含层,隐含层再传递至输出层。每个神经元都有加权输入(突触)、一个激活函数(代表该神经元特定输出的函数)和一个输出。突触是将神经网络转换为参数化系统的可调参数。 激励信号由加权过的输入信号产生,再传递至激励函数以获得输出。常用的激励函数包括线性、阶跃、Sigmoid、双曲正切和线性修正单元(ReLu)函数。 线性函数 f(x)=ax 阶跃函数 Sigmoid函数 双曲正切函数 线性修正单元函数 通过训练对权值进行优化,从而达到最小化预测误差、提高预测准确率的目标。反向传播算法是一种计算损失函数

优秀的个人博客,低调大师

自然语言处理工具 nltk 安装使用

github 地址:https://github.com/nltk/nltk/ 官方地址:http://www.nltk.org/ 中文文档:http://download.csdn.net/detail/u013378306/9756747 安装及测试 Install NLTK: runsudopipinstall-Unltk Install Numpy (optional): runsudopipinstall-Unumpy Test installation: runpythonthen typeimportnltk Python NLTK库中包含着大量的语料库,但是大部分都是英文,不过有一个Sinica(中央研究院)提供的繁体中文语料库,值得我们注意。 在使用这个语料库之前,我们首先要检查一下是否已经安装了这个语料库。 下载数据文件 >>>import nltk >>>nltk.download() 总的数据有300M左右,下载很慢, 提供下载地址:https://pan.baidu.com/s/1nvfR485 nltk 数据文件结构 nltk_data ├── chunkers │ └── maxent_ne_chunker.zip ├── corpora │ ├── abc.zip │ ├── alpino.zip │ ├── biocreative_ppi.zip │ ├── brown_tei.zip │ ├── brown.zip │ ├── cess_cat.zip │ ├── cess_esp.zip │ ├── chat80.zip │ ├── city_database.zip │ ├── cmudict.zip │ ├── comtrans.zip │ ├── conll2000.zip │ ├── conll2002.zip │ ├── conll2007.zip │ ├── dependency_treebank.zip │ ├── europarl_raw.zip │ ├── floresta.zip │ ├── gazetteers.zip │ ├── genesis.zip │ ├── gutenberg.zip │ ├── ieer.zip │ ├── inaugural.zip │ ├── indian.zip │ ├── jeita.zip │ ├── kimmo.zip │ ├── knbc.zip │ ├── langid.zip │ ├── lin_thesaurus.zip │ ├── machado.zip │ ├── mac_morpho.zip │ ├── movie_reviews.zip │ ├── names.zip │ ├── nombank.1.0.zip │ ├── nps_chat.zip │ ├── oanc_masc.zip │ ├── paradigms.zip │ ├── pil.zip │ ├── pl196x.zip │ ├── ppattach.zip │ ├── problem_reports.zip │ ├── propbank.zip │ ├── ptb.zip │ ├── qc.zip │ ├── reuters.zip │ ├── rte.zip │ ├── semcor.zip │ ├── senseval.zip │ ├── shakespeare.zip │ ├── sinica_treebank.zip │ ├── smultron.zip │ ├── state_union.zip │ ├── stopwords.zip │ ├── swadesh.zip │ ├── switchboard.zip │ ├── timit.zip │ ├── toolbox.zip │ ├── treebank.zip │ ├── udhr2.zip │ ├── udhr.zip │ ├── unicode_samples.zip │ ├── verbnet.zip │ ├── webtext.zip │ ├── wordnet_ic.zip │ ├── wordnet.zip │ ├── words.zip │ └── ycoe.zip ├── grammars │ ├── basque_grammars.zip │ ├── book_grammars.zip │ ├── large_grammars.zip │ ├── sample_grammars.zip │ └── spanish_grammars.zip ├── help │ └── tagsets.zip ├── stemmers │ └── rslp.zip ├── taggers │ ├── averaged_perceptron_tagger.zip │ ├── hmm_treebank_pos_tagger.zip │ └── maxent_treebank_pos_tagger.zip └── tokenizers └── punkt.zip 数据文件存放地址(linux下的搜索路径) - '/var/www/nltk_data' - '/usr/share/nltk_data' - '/usr/local/share/nltk_data' - '/usr/lib/nltk_data' - '/usr/local/lib/nltk_data' 主要功能 使用 import nltk from nltk.corpus import sinica_treebank print(sinica_treebank.words()) 结果:['一', '友情', '嘉珍', '和', '我', '住在', '同一條', '巷子', '我們', ...] (1)来看一下NLTK中文语法树。 >>>sinica_treebank.parsed_sents()[33].draw() Python 万岁!!! (2)搜索中文文本 1 2 3 4 5 import nltk from nltk.corpus import sinica_treebank sinica_text = nltk.Text(sinica_treebank.words()) print (sinica_text.concordance( '我' )) 结果: 我 住在 同一條 巷子 我們 是 鄰居 也 是 同班 同學 我們 常常 一起 上 居 也 是 同班 同學 我們 常常 一起 上學 一起 回家 有一天 上學 時 我 到 她 家 等候 按 了 門鈴 卻 沒有 任何 動靜 正當 我 想 離開 時 天 上學 時 我 到 她 家 等候 按 了 門鈴 卻 沒有 任何 動靜 正當 我 想 離開 時 門 內 突然 傳來 急促 的 腳步聲 嘉珍 打開 了 門 大聲 突然 傳來 急促 的 腳步聲 嘉珍 打開 了 門 大聲 的 叫 著 快 點 我 媽媽 暈倒 了 嘉珍 抓起 我 的 手 急忙 往 屋 裡 跑 進入 房間 看 嘉珍 打開 了 門 大聲 的 叫 著 快 點 我 媽媽 暈倒 了 嘉珍 抓起 我 的 手 急忙 往 屋 裡 跑 進入 房間 看到 她 的 媽媽 趴 在 地 上 她 的 媽媽 趴 在 地 上 臉色 蒼白 得 像 紙 一樣 這種 情景 把 我 嚇壞 了 怎麼辦 嘉珍 不停 的 哭泣 聲音 有些 顫抖 我 的 腦海 中 這種 情景 把 我 嚇壞 了 怎麼辦 嘉珍 不停 的 哭泣 聲音 有些 顫抖 我 的 腦海 中 頓時 一片 空白 不 曉得 怎麼辦 才 好 過 了 一會兒 我 我 的 腦海 中 頓時 一片 空白 不 曉得 怎麼辦 才 好 過 了 一會兒 我 才 問 她 你 爸爸 呢 他 出差 了 嘉珍 擦 著 眼淚 我 握住 她 的 了 一會兒 我 才 問 她 你 爸爸 呢 他 出差 了 嘉珍 擦 著 眼淚 我 握住 她 的 雙手 她 的 手 又 冰 又 冷 這時 有個 念頭 突然 閃過 握住 她 的 雙手 她 的 手 又 冰 又 冷 這時 有個 念頭 突然 閃過 我 的 眼前 我 幫 她 撥 了 一一九 請 救護車 來 而且 拍拍 她 的 背 雙手 她 的 手 又 冰 又 冷 這時 有個 念頭 突然 閃過 我 的 眼前 我 幫 她 撥 了 一一九 請 救護車 來 而且 拍拍 她 的 背 安慰 她 不 撥 了 一一九 請 救護車 來 而且 拍拍 她 的 背 安慰 她 不要 著急 我 會 陪 你 的 不久 救護車 停 在 她 家 門口 醫護 人員 很 快 的 醫護 人員 很 快 的 將 她 的 媽媽 抬上 救護車 嘉珍 上車 前 對 我 說 謝謝 你 的 幫忙 我 握 著 她 的 手 說 不用 謝 我 因為 我們 她 的 媽媽 抬上 救護車 嘉珍 上車 前 對 我 說 謝謝 你 的 幫忙 我 握 著 她 的 手 說 不用 謝 我 因為 我們 是 好朋友 二 無私 的 車 前 對 我 說 謝謝 你 的 幫忙 我 握 著 她 的 手 說 不用 謝 我 因為 我們 是 好朋友 二 無私 的 愛 愛 像 火紅 的 太陽 散發 光 正 為了 缺乏 旅費 而 發愁 的 時候 員外 來 找 他 並且 對 他 說 我 看 你 悶悶不樂 是不是 進京 趕考 的 旅費 不 夠 這裡 有 一些 銀子 物 和 銀子 向 員外 道謝 時 員外 握 著 他 的 手 說 你 不用 還 我 了 我 只是 盡 一份 心力 而已 以後 有 機會 希望 你 也 能夠 幫助 銀子 向 員外 道謝 時 員外 握 著 他 的 手 說 你 不用 還 我 了 我 只是 盡 一份 心力 而已 以後 有 機會 希望 你 也 能夠 幫助 別人 身 趕考 吧 書生 用 顫抖 的 手 接過 銀子 含 著 眼淚 說 謝謝 您 我 不 知道 要 怎麼 來 報答 您 江 巡撫 說 你 不必 謝 我 也 不必 謝謝 您 我 不 知道 要 怎麼 來 報答 您 江 巡撫 說 你 不必 謝 我 也 不必 回報 我 四 快樂 的 閱讀課 上 國語課 的 時候 老師 叫 我 知道 要 怎麼 來 報答 您 江 巡撫 說 你 不必 謝 我 也 不必 回報 我 四 快樂 的 閱讀課 上 國語課 的 時候 老師 叫 我們 這一組 做 讀書 閱讀課 上 國語課 的 時候 老師 叫 我們 這一組 做 讀書 心得 報告 我 第一個 站起來 發言 我們 閱讀 的 好 書 是 小 王子 這 是 法國人 小 王子 告訴 他 在 星球 旅行 的 經過 兩 人 成為 知心 的 朋友 我 說完 之後 組長 站起來 補充 說 小 王子 是 一個 可愛 的 人 他 在 星 上 每天 照顧 會 說話 的 玫瑰花 、 清理 火山灰 而且 欣賞 落日 我 喜歡 這種 自由自在 的 生活 明珠 說 這本 書 最 精采 的 部分 遇到 的 商人 等 小 王子 不 喜歡 自大 的 人 也 不 喜歡 虛偽 的 人 我 覺得 小 王子 很 正直 最後 阿平 說 這本 書 中 有 許多 值得 思考

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册