首页 文章 精选 留言 我的

精选列表

搜索[自然语言生成],共10009篇文章
优秀的个人博客,低调大师

Hanlp自然语言处理中的词典格式说明

使用过hanlp的都知道hanlp中有许多词典,它们的格式都是非常相似的,形式都是文本文档,随时可以修改。本篇文章详细介绍了hanlp中的词典格式,以满足用户自定义的需要。 基本格式 词典分为词频词性词典和词频词典。 1、词频词性词典(如CoreNatureDictionary.txt) (1)每一行代表一个单词,格式遵从[单词] [词性A] [A的频次] [词性B] [B的频次] ...。 (2)支持省略词性和频次,直接一行一个单词。 (3).txt词典文件的分隔符为空格或制表符,所以不支持含有空格的词语。如果需要支持空格,请使用英文逗号,分割的纯文本.csv文件。在使用Excel等富文本编辑器时,则请注意保存为纯文本形式。 2、词频词典(如CoreNatureDictionary.ngram.txt) (1)每一行代表一个单词或条目,格式遵从[单词] [单词的频次]。 (2)每一行的分隔符为空格或制表符。 少数词典有自己的专用格式,比如同义词词典兼容《同义词词林扩展版》的文本格式,而转移矩阵词典则是一个csv表格。 下文主要介绍通用词典,如不注明,词典特指通用词典。 数据结构 Trie树(字典树)是HanLP中使用最多的数据结构,为此,我实现了通用的Trie树,支持泛型、遍历、储存、载入。 用户自定义词典采用AhoCorasickDoubleArrayTrie和二分Trie树储存,其他词典采用基于双数组Trie树(DoubleArrayTrie)实现的AC自动机AhoCorasickDoubleArrayTrie。关于一些常用数据结构的性能评估,请参考wiki。 储存形式 词典有两个形态:文本文件(filename.txt)和缓存文件(filename.txt.bin或filename.txt.trie.dat和filename.txt.trie.value)。 1、文本文件 ·采用明文储存,UTF-8编码,CRLF换行符。 2、缓存文件 (1)就是一些二进制文件,通常在文本文件的文件名后面加上.bin表示。有时候是.trie.dat和.trie.value。后者是历史遗留产物,分别代表trie树的数组和值。 (2)如果你修改了任何词典,只有删除缓存才能生效。 修改方法 HanLP的核心词典训练自人民日报2014语料,语料不是完美的,总会存在一些错误。这些错误可能会导致分词出现奇怪的结果,这时请打开调试模式排查问题: HanLP.Config.enableDebug(); (1)核心词性词频词典 a)比如你在data/dictionary/CoreNatureDictionary.txt中发现了一个不是词的词,或者词性标注得明显不对,那么你可以修改它,然后删除缓存文件使其生效。 B)目前CoreNatureDictionary.ngram.txt的缓存依赖于CoreNatureDictionary.txt的缓存,修改了后者之后必须同步删除前者的缓存,否则可能出错 (2)核心二元文法词典 a) 二元文法词典data/dictionary/CoreNatureDictionary.ngram.txt储存的是两个词的接续,如果你发现不可能存在这种接续时,删掉即可。 B)你也可以添加你认为合理的接续,但是这两个词必须同时在核心词典中才会生效。 (3)命名实体识别词典 a)基于角色标注的命名实体识别比较依赖词典,所以词典的质量大幅影响识别质量。 b)这些词典的格式与原理都是类似的,请阅读相应的文章或代码修改它。

优秀的个人博客,低调大师

NLP自然语言处理中的hanlp分词实例

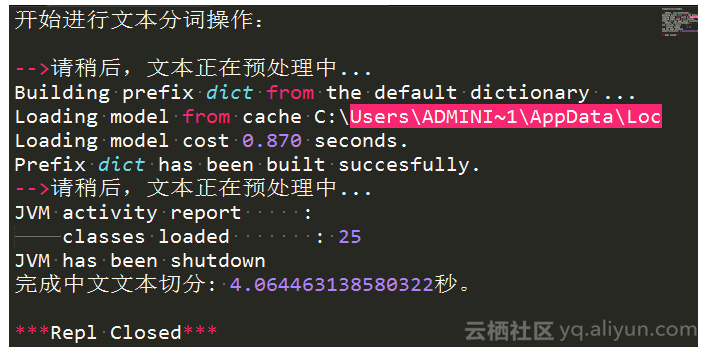
本篇分享的依然是关于hanlp的分词使用,文章内容分享自 gladosAI 的博客,本篇文章中提出了一个问题,hanlp分词影响了实验判断结果。为何会如此,不妨一起学习一下 gladosAI 的这篇文章。 学习内容 在之前的实验中得到了不在词向量里的词与分词结果,结果有500多个词不在词向量里,解决方案就是重新分词,或再追加训练这些词到词向量里。但后者相对麻烦且目前样本量不大。我跟据词向量的作者[6]所使用的分词工具来分词,会比不同工具(jieba)的效果要好,因为都是同一模式的分词,分出来的词应该都会存在于大型语料库中。实验证明思路是对的,最后结果是只有60几个词不在词向量里,其中大部分为名词,还有些为因语音翻译问题所造成的出错连词,所有这些词也只出现一次,这部分可以考虑最后删去也不会影响结果。改善未出现词是个关键步骤,因为此后模型会用到词向量,如果未出现词过多,会影响词向量效果。 问题:不过最后HANLP分词影响了实验判断结果,准确率从93%(jieba分词,同模型同参数)下降到90%。 实验:使用HanLP分词 1,前期准备,(环境ubuntu,python3)安装JAVA-10[3](hanlp是JAVA开发的,即使使用python调用pyhanlp需要借助java),jpype(python中虚拟java环境),hanlp(开源中文处理工具,不只是分词还有各种工具),hanlp的root路径配置及data数据包放置[4] 2,主要程序[5] w2v_model = KeyedVectors.load_word2vec_format(w2vpath, binary=False, unicode_errors='ignore') # 加载词向量 hanlppath=\"-Djava.class.path=/media/glados/Learning/project/NLP/hanlp/hanlp-1.6.4.jar:/media/glados/Learning/project/NLP/hanlp/" jp.startJVM(jp.getDefaultJVMPath(), hanlppath) # , "-Xms1g", "-Xmx1g") # 启动JVM, Xmx1g分配1g内存 jp.JClass('com.hankcs.hanlp.HanLP$Config').ShowTermNature = False # 关闭分词属性显示 HanLP = jp.JClass('com.hankcs.hanlp.HanLP') #普通分词模式 words = str(HanLP.segment(sentence)) #分词将结果转为str words = re.sub('[反斜杠[反斜杠],\n]', ' ', words) # 这里注意实际程序是单\,在blog里会出问题,所以用反斜杠替代 words = words.split() words = del_stopword(words) ... jp.shutdownJVM() # 最后关闭java虚拟环境 使用的是HANLP的普通分词功能,另外需注意,hanlp.segment()不能直接输出或赋值给python,因为其是java环境中数据,所以只有转为str()后,再进行处理,否则会报错#Afatalerror。(另外还有其他java与python数据对应问题,在这里没遇到,请参考其他) 词向量选用的是“Mixed-large综合”[6],其包括百度wiki百科、人民日报等,总共1293214个词。 Hanlp的中部份功能没法使用,例如精确分词CRF。另外,要先加载词向量再加载java虚拟环境。#AfatalerrorhasbeendetectedbytheJavaRuntimeEnvironment 3,实验结果 (模型使用的是特征为tfidf的lsi模型, 参数:num_topics=3, 判断是否相似阀值为0.45,即大于0.45为true相似 ) 同模型同参数下,jieba分词结果 jieba分词未出现在词向量的约500多,有些词出现了好几次,而hanlp分词只有60几个未出现,且多数为名词,只出现过一次。 4,分析 在样本中,所有样本分词结果jieba比hanlp要多分出100个词左右。所以推测因hanlp分词细粒度大,分出词少,导致较少的共现词出现(也可能是hanlp分词精度更高,分出很多虚词被停止词表过滤造成),也就是说,lsi+tfidf模型对词细粒度大、分词少的分词器不友好,所以最后hanlp出错率更大。 jieba与hanlp都是很不错的分词器,结巴使用更方便。hanlp准确度要高一些(感觉),而且与文中提到的词向量相匹配。 (我免贵姓AI,jieba:我免/贵姓/AI,hanlp:我/免/贵姓/AI,实际:我/免贵/姓AI)

优秀的个人博客,低调大师

自然语言处理 依存树的可视化

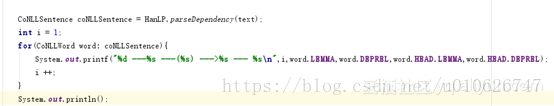
目标:NLP中依存树的可视化 首先需要准备的工具 Hanlp(借助hanlp神经网络的高性能依存句法分析器模型) Dependency Viewer可视化工具 对于一句话text,可以采用hanlp中的下图代码转化为conll格式 下图是采用了一些测试句子的结果(在conll文件中以空行隔开): 在dependency View中进行展示,打开dependency View,选择File----read Conll file打开本地的conll文件,即可看到依存树展示的结果 文章来源于醉意流年go的博客

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

用户登录
用户注册