首页 文章 精选 留言 我的

精选列表

搜索[Python],共10000篇文章
优秀的个人博客,低调大师

手把手教程:用Python开发一个自然语言处理模型,并用Flask进行部署

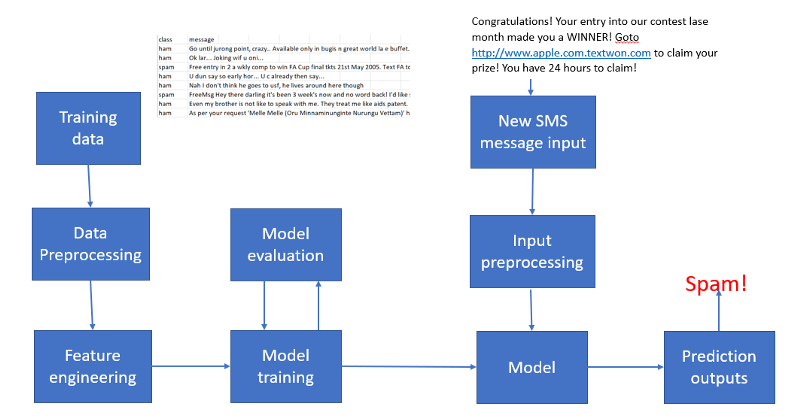
截住到目前为止,我们已经开发了许多机器学习模型,对测试数据进行了数值预测,并测试了结果。实际上,生成预测只是机器学习项目的一部分,尽管它是我认为最重要的部分。今天我们来创建一个用于文档分类、垃圾过滤的自然语言处理模型,使用机器学习来检测垃圾短信文本消息。我们的ML系统工作流程如下:离线训练->将模型作为服务提供->在线预测。 1、通过垃圾邮件和非垃圾邮件训练离线分类器。 2、经过训练的模型被部署为服务用户的服务。 当我们开发机器学习模型时,我们需要考虑如何部署它,即如何使这个模型可供其他用户使用。Kaggle和数据科学训练营非常适合学习如何构建和优化模型,但他们并没有教会工程师如何将它们带给其他用户使用,建立模型与实际为人们提供产品和服务之间存在重大差异。 在本文中,我们将重点关注:构建垃圾短信分类的机器学习模型,然后使用Fl
优秀的个人博客,低调大师

python:jieba:当你看完个这句子之后就会现发,里这词的字序是乱的

是这一个常非趣有的情事,先我出放码代:(得记要自己去pip下一jieba分词): import jieba import random as rd ctl=True while ctl: print('-'*30) msg=input('输入句子:\n') msg_words=list(jieba.cut(msg)) res=[] for word in msg_words: word=list(word) rd.shuffle(word) res.append(''.join(word)) print(''.join(res)) 我现在正在使用这个具工在IM软件上和人天聊,前目还没有人提出全完懂不看我在说什么,哈哈

优秀的个人博客,低调大师

手把手 | 用Python语言模型和LSTM做一个Drake饶舌歌词生成器

未来AI的主要应用是在建立能够学习数据然后生成原创内容的网络。这个想法已经充分应用于在自然语言处理(NLP)领域,这也是AI社区能够搭建出所谓语言模型的原因:语言模型的前提是学习句子在文章段落中的组成结构,从而生成新的内容。 在这篇文章中,我想尝试生成与很受欢迎的加拿大说唱歌手Drake(a.k.a. #6god)风格类似的说唱歌词,这肯定是件很有趣的事儿。 另外,我还想分享一下常规的机器学习项目渠道,因为我发现很多同学想做一些小项目,但不知道该从何处入手。 获取数据 首先,我们开始搜集Drake的曲库,为了节省时间我直接写了个爬虫,从网页metrolyrics.com抓取歌词。 import urllib.request as urllib2 from bs4 import BeautifulSoup import pandas a

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册