首页 文章 精选 留言 我的

精选列表

搜索[赛博朋克],共10000篇文章
优秀的个人博客,低调大师

2025年度"集邮"报告(OSCHINA博文篇)

上一篇盘点了 2025 年度整体活动情况:2025年度"集邮"报告:简简单单做个盘点 本文整理了今年在OSCHINA技术社区发表的文章,2025 年共写博客 138 篇。 下面严选 15 篇阅读数大于 1000 的文章,以供参阅。 别再用 MySQL Workbench 了,快试试 SQLark! -- 1.3W https://my.oschina.net/mysqloffice/blog/18564232 华象新闻 | PostgreSQL 18 Beta 1、17.5、16.9、15.13、14.18、13.21 发布 -- 1W https://my.oschina.net/mysqloffice/blog/18349014 openHalo 问世,全球首款基于 PostgreSQL 兼容 MySQL 协议的国产开源数据库 -- 6.6K https://my.oschina.net/mysqloffice/blog/18100166 史诗级革新 | Apache Flink 2.0 正式发布 -- 5.1K https://my.oschina.net/mysqloffice/blog/17998220 BIC-QA:国产数据库的 “咖啡伴侣” -- 3.9K https://my.oschina.net/mysqloffice/blog/18692873 GreatSQL 新版发布:MySQL 牵手 “鸭子” -- 2.9K https://my.oschina.net/mysqloffice/blog/18212071 TiDB X: 以对象存储为核心要素构建全新 AI 原生数据库 -- 2.7K https://my.oschina.net/mysqloffice/blog/18695218 SQLark 推出小百灵 AI,管理 PostgreSQL 18 更轻松 -- 2.4K https://my.oschina.net/mysqloffice/blog/18694964 金仓赵今麦的 KES RWC 集群扩缩容奇遇记 -- 2.2K https://my.oschina.net/mysqloffice/blog/17868343 NineData 社区版:从 MySQL 到 TiDB 数据复制新选择 -- 2K https://my.oschina.net/mysqloffice/blog/17928429 从 MySQL 到 TiDB:业务高速增长与数据库选型趋势 -- 1.9K https://my.oschina.net/mysqloffice/blog/17698154 TiDB x DeepSeek 打造更好用的国产知识库问答系统解决方案 -- 1.9K https://my.oschina.net/mysqloffice/blog/17531346 月黑风高单挑 MySQL 开发者认证 (1Z0-909) -- 1.8K https://my.oschina.net/mysqloffice/blog/18619156 错过一个亿,MySQL 免费认证页面下架了 -- 1.3K https://my.oschina.net/mysqloffice/blog/18326157 2025w11 | 图数据库了解一下 -- 1.2K https://my.oschina.net/mysqloffice/blog/17989626 Have a nice day ~ ☕ 👉 这里有得聊 如果对国产基础软件(操作系统、数据库、中间件)感兴趣,可以加群一起聊聊。 关注微信公众号:少安事务所,后台回复[群],即可看到入口。

优秀的个人博客,低调大师

每日一博 | 句子嵌入:交叉编码和重排序

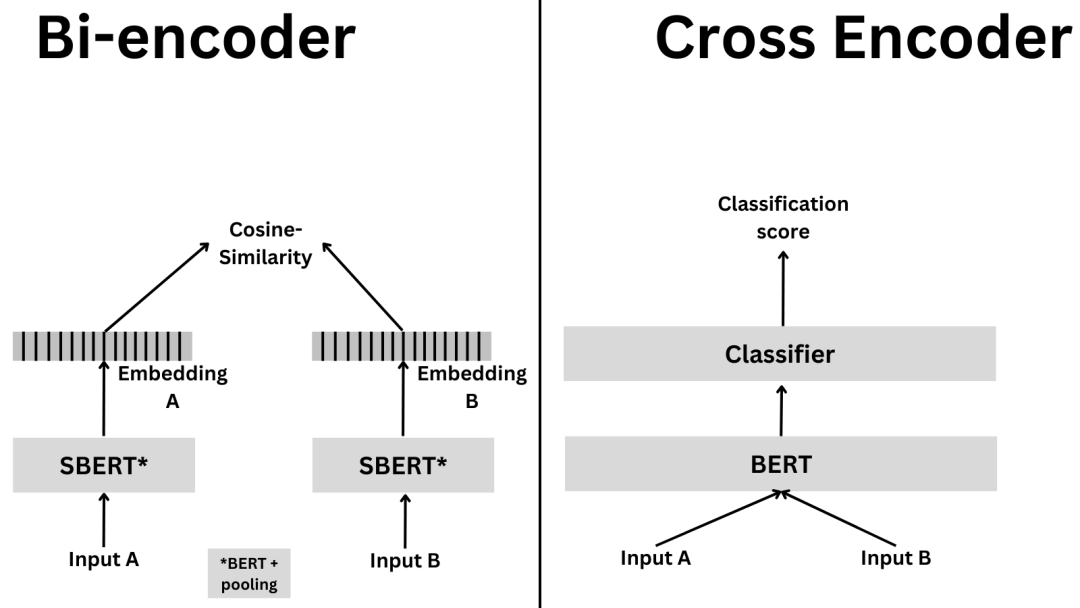
这个系列目的是揭开嵌入的神秘面纱,并展示如何在你的项目中使用它们。第一篇博客介绍了如何使用和扩展开源嵌入模型,选择现有的模型,当前的评价方法,以及生态系统的发展状态。第二篇博客将会更一步深入嵌入并解释双向编码和交叉编码的区别。进一步我们将了解 检索和重排序 的理论。我们会构建一个工具,它可以来回答大约 400 篇 AI 的论文的问题。我们会在末尾大致讨论一下两个不同的论文。 你可以在这里阅读,或者通过点击左上角的图标在 Google Colab 中运行。现在我们正式开始学习! 简短概述 Sentence Transformers 支持两种类型的模型: Bi-encoders 和 Cross-encoders。Bi-encoders 更快更可扩展,但 Cross-encoders 更准确。虽然两者都处理类似的高水平任务,但何时使用一个而不是另一个是相当不同的。Bi-encoders 更适合搜索,而 Cross-encoders 更适合分类和高精度排序。下面讲下细节 介绍 我们之前见过的模型都是双向编码器。双向编码器将输入文本编码成固定长度的向量。当我们计算两个句子的相似性时,我们通常将两个句子编码成两个向量,然后计算它们之间的相似性 (比如,使用余弦相似度)。我们训练双向编码器去优化,使得在问题和相关句子之间的相似度增加,而在其他句子之间的相似度减少。这也解释了为啥双向编码器更适合搜索。正如之前博客所说,双向编码器非常快,并且易于扩展。如果提供多个句子,双向编码器会独立编码每个句子。这意味着每个句子嵌入是互相独立的。这对于搜索来书是好的,因为我们可以并行编码数百万的句子。然而,这同样意味着双向编码器不知道任何关于句子之间的关系的知识。 当我们使用交叉编码,就会有所不同。交叉编码同时编码两个句子,并且输出一个分类分数。图示展示了它们之间的区别。 为啥使用这个而不用其他的?交叉编码更慢并且需要更多的内存,但同样更精确。一个交叉编码器对于比较几十个句子是一个很好的选择。如果我们要比较成千上万个句子,一个双向编码器是更好的选择,因为否则的话,它将会非常慢。如果你更在乎精度并且想高效的比较成千上万个句子呢?这有个当你想要检索信息的经典示例,在那个示例中,一个选择是首先使用双向编码器去减少候选数量 (比如,获取最相关的 20 个例子),然后使用交叉编码器获得最终结果。这个也叫做重排序,在信息检索中是一个常用的技术。我们将在后面学习更多关于这个的内容。 由于交叉编码更精确,它同样适用于一些微小差异很重要的任务,比如医疗或者法律文档,其中一点微小的差异可以改变句子的整个意思。 交叉编码器 正如之前所说,交叉编码器同时编码两个句子,并输出一个分类标签。交叉编码器第一次生成一个单独的嵌入,它捕获了句子的表征和相关关系。与双向编码器生成的嵌入 (它们是独立的) 不同,交叉编码器是互相依赖的。这也是为什么交叉编码器更适合分类,并且其质量更高,他们可以捕获两个句子之间的关系!反过来说,如果你需要比较上千个句子的话,交叉编码器会很慢,因为他们要编码所有的句子对。 假如你有四个句子,并且你需要比较所有的可能对: 一个双向编码器需要独立编码每个句子,所以它需要编码四个句子。 一个交叉编码器需要同时编码所的句子对,所以它需要编码六个句子对 (AB, AC, AD, BC, BD, CD)。 让我们再扩展一下,如果你要 100,000 个句子,并且你需要比较所有的可能对: 一个双向编码器需要编码 100,000 个句子。 一个交叉编码器需要编码 4,999,950,000 个句子对。(用 组合数公式: n! / (r!(n-r)!) , 这里面 n = 100,000, r = 2) 所以扩展并不好 也难怪他们会更慢! 尽管交叉编码器再分类层前有一个适度的嵌入,但这并没有用于相似性搜索。这是因为交叉编码器被训练来优化分类损失,而不是相似性损失。因此,嵌入是针对分类任务而设计的,并且不用于相似性任务。 他们可以被用于不同的任务。例如,对于段落检索 (给定一个问题和一个段落,段落是否与问题相关)。让我们看一个快速代码片段,使用一个小的交叉编码模型训练这个: !pipinstallsentence_transformersdatasets fromsentence_transformersimportCrossEncodermodel=CrossEncoder('cross-encoder/ms-marco-TinyBERT-L-2-v2',max_length=512)scores=model.predict([('HowmanypeopleliveinBerlin?','Berlinhadapopulationof3,520,031registeredinhabitantsinanareaof891.82squarekilometers.'),('HowmanypeopleliveinBerlin?','Berliniswellknownforitsmuseums.')])scores array([ 7.152365 , -6.2870445], dtype=float32) 另一个用例,用交叉编码做语义相似度,跟我们用双向编码器的结果很相似。比如,给定两个句子,他们语义上相似吗?尽管这个任务跟我们用双向编码器解决的任务是一样的,但是交叉编码器更准确,更慢。 model=CrossEncoder('cross-encoder/stsb-TinyBERT-L-4')scores=model.predict([("Theweathertodayisbeautiful","It'sraining!"),("Theweathertodayisbeautiful","Todayisasunnyday")])scores array([0.46552283, 0.6350213 ], dtype=float32) 检索和重排序 现在我们已经了解了交叉编码器和双向编码器的不同,让我们看看如何使在实践中用它们来构建一个检索和重排序系统。这是一个常见的信息检索技巧,首先检索最相关的文档然后用一个更精确的模型进行重排序。这对于高效比较成千个句子的查询是个不错的选择并且更加注重精度。 假设你有一个有 100,000 个句子的语料库并且想要对给定查询找到最相关的句子。第一步就是使用双向编码器去检索很多候选 (为了确保召回)。然后,使用交叉编码器去重新排序候选并且得到最终的带有高精度的结果。这是高层次上看这个系统的样子 让我们试一试执行一个论文搜索系统!我们将使用一个 AI Arxiv 数据集,这个是在 Pinecone 上关于重排序极好的教程 。其目的是问 AI 一个 问题,我们获得最相关的论文部分并且回答问题。 fromdatasetsimportload_datasetdataset=load_dataset("jamescalam/ai-arxiv-chunked")dataset["train"] Found cached dataset json (/home/osanseviero/.cache/huggingface/datasets/jamescalam___json/jamescalam--ai-arxiv-chunked-0d76bdc6812ffd50/0.0.0/8bb11242116d547c741b2e8a1f18598ffdd40a1d4f2a2872c7a28b697434bc96) 0%| | 0/1 [00:00<?, ?it/s]Dataset({ features: ['doi', 'chunk-id', 'chunk', 'id', 'title', 'summary', 'source', 'authors', 'categories', 'comment', 'journal_ref', 'primary_category', 'published', 'updated', 'references'], num_rows: 41584}) 如果你检查了数据集,它是一个划分切块好的 400 篇 Arxiv 论文,切块意味着每个部分被分成更小的部分,以使模型更容易处理。这里是一个样本: dataset["train"][0] {'doi': '1910.01108', 'chunk-id': '0', 'chunk': 'DistilBERT, a distilled version of BERT: smaller,\nfaster, cheaper and lighter\nVictor SANH, Lysandre DEBUT, Julien CHAUMOND, Thomas WOLF\nHugging Face\n{victor,lysandre,julien,thomas}@huggingface.co\nAbstract\nAs Transfer Learning from large-scale pre-trained models becomes more prevalent\nin Natural Language Processing (NLP), operating these large models in on-theedge and/or under constrained computational training or inference budgets remains\nchallenging. In this work, we propose a method to pre-train a smaller generalpurpose language representation model, called DistilBERT, which can then be finetuned with good performances on a wide range of tasks like its larger counterparts.\nWhile most prior work investigated the use of distillation for building task-specific\nmodels, we leverage knowledge distillation during the pre-training phase and show\nthat it is possible to reduce the size of a BERT model by 40%, while retaining 97%\nof its language understanding capabilities and being 60% faster. To leverage the\ninductive biases learned by larger models during pre-training, we introduce a triple\nloss combining language modeling, distillation and cosine-distance losses. Our\nsmaller, faster and lighter model is cheaper to pre-train and we demonstrate its', 'id': '1910.01108', 'title': 'DistilBERT, a distilled version of BERT: smaller, faster, cheaper and lighter', 'summary': 'As Transfer Learning from large-scale pre-trained models becomes more\nprevalent in Natural Language Processing (NLP), operating these large models in\non-the-edge and/or under constrained computational training or inference\nbudgets remains challenging. In this work, we propose a method to pre-train a\nsmaller general-purpose language representation model, called DistilBERT, which\ncan then be fine-tuned with good performances on a wide range of tasks like its\nlarger counterparts. While most prior work investigated the use of distillation\nfor building task-specific models, we leverage knowledge distillation during\nthe pre-training phase and show that it is possible to reduce the size of a\nBERT model by 40%, while retaining 97% of its language understanding\ncapabilities and being 60% faster. To leverage the inductive biases learned by\nlarger models during pre-training, we introduce a triple loss combining\nlanguage modeling, distillation and cosine-distance losses. Our smaller, faster\nand lighter model is cheaper to pre-train and we demonstrate its capabilities\nfor on-device computations in a proof-of-concept experiment and a comparative\non-device study.', 'source': 'http://arxiv.org/pdf/1910.01108', 'authors': ['Victor Sanh', 'Lysandre Debut', 'Julien Chaumond', 'Thomas Wolf'], 'categories': ['cs.CL'], 'comment': 'February 2020 - Revision: fix bug in evaluation metrics, updated\n metrics, argumentation unchanged. 5 pages, 1 figure, 4 tables. Accepted at\n the 5th Workshop on Energy Efficient Machine Learning and Cognitive Computing\n - NeurIPS 2019', 'journal_ref': None, 'primary_category': 'cs.CL', 'published': '20191002', 'updated': '20200301', 'references': [{'id': '1910.01108'}]} 让我们获得所有的切块,然后编码: chunks=dataset["train"]["chunk"]len(chunks) 41584 现在,我们将使用一个双向编码器来编码所有的切块到嵌入。我们将会截断过长的段落,最大不超过 512 token。注意,短文本是许多嵌入模型的缺点之一!我们将会特别使用 multi-qa-MiniLM-L6-cos-v1 模型。这是一个小模型,用来训练把问题和段落编码成小的嵌入空间。因为这是一个双向编码器模型,所以很快和易扩展。 在我这个普通的电脑上嵌入所有的 40,000+ 文章大概需要 30 秒。注意,我们只要嵌入一次,然后可以保存到磁盘并且之后加载。在生产环境中,你可以把嵌入保存到数据库中并从中加载嵌入。 fromsentence_transformersimportSentenceTransformerbi_encoder=SentenceTransformer('multi-qa-MiniLM-L6-cos-v1')bi_encoder.max_seq_length=256corpus_embeddings=bi_encoder.encode(chunks,convert_to_tensor=True,show_progress_bar=True) Batches: 0%| | 0/1300 [00:00<?, ?it/s] 真棒!现在,让我们试一个问题,搜索其相关文章。为了做到这一点,我们需要编码问题,然后计算问题和所有段落之间的相似度。开干,看看前几个结果! fromsentence_transformersimportutilquery="whatisrlhf?"top_k=25#howmanychunkstoretrievequery_embedding=bi_encoder.encode(query,convert_to_tensor=True).cuda()hits=util.semantic_search(query_embedding,corpus_embeddings,top_k=top_k)[0]hits [{'corpus_id': 14679, 'score': 0.6097552180290222}, {'corpus_id': 17387, 'score': 0.5659530162811279}, {'corpus_id': 39564, 'score': 0.5590510368347168}, {'corpus_id': 14725, 'score': 0.5585878491401672}, {'corpus_id': 5628, 'score': 0.5296251773834229}, {'corpus_id': 14802, 'score': 0.5075011253356934}, {'corpus_id': 9761, 'score': 0.49943411350250244}, {'corpus_id': 14716, 'score': 0.4931946098804474}, {'corpus_id': 9763, 'score': 0.49280521273612976}, {'corpus_id': 20638, 'score': 0.4884325861930847}, {'corpus_id': 20653, 'score': 0.4873950183391571}, {'corpus_id': 9755, 'score': 0.48562008142471313}, {'corpus_id': 14806, 'score': 0.4792214035987854}, {'corpus_id': 14805, 'score': 0.475425660610199}, {'corpus_id': 20652, 'score': 0.4740477204322815}, {'corpus_id': 20711, 'score': 0.4703512489795685}, {'corpus_id': 20632, 'score': 0.4695567488670349}, {'corpus_id': 14750, 'score': 0.46810320019721985}, {'corpus_id': 14749, 'score': 0.46809980273246765}, {'corpus_id': 35209, 'score': 0.46695172786712646}, {'corpus_id': 14671, 'score': 0.46657535433769226}, {'corpus_id': 14821, 'score': 0.4637290835380554}, {'corpus_id': 14751, 'score': 0.4585301876068115}, {'corpus_id': 14815, 'score': 0.45775431394577026}, {'corpus_id': 35250, 'score': 0.4569615125656128}] #Let'sstoretheIDsforlaterretrieval_corpus_ids=[hit['corpus_id']forhitinhits]#Nowlet'sprintthetop3resultsfori,hitinenumerate(hits[:3]):sample=dataset["train"][hit["corpus_id"]]print(f"Top{i+1}passagewithscore{hit['score']}from{sample['source']}:")print(sample["chunk"])print("\n") Top 1 passage with score 0.6097552180290222 from http://arxiv.org/pdf/2204.05862:learning from human feedback, which we improve on a roughly weekly cadence. See Section 2.3.4This means that our helpfulness dataset goes ‘up’ in desirability during the conversation, while our harmlessnessdataset goes ‘down’ in desirability. We chose the latter to thoroughly explore bad behavior, but it is likely not idealfor teaching good behavior. We believe this difference in our data distributions creates subtle problems for RLHF, andsuggest that others who want to use RLHF to train safer models consider the analysis in Section 4.4.51071081091010Number of Parameters0.20.30.40.50.6Mean Eval AccMean Zero-Shot AccuracyPlain Language ModelRLHF1071081091010Number of Parameters0.20.30.40.50.60.7Mean Eval AccMean Few-Shot AccuracyPlain Language ModelRLHFFigure 3 RLHF model performance on zero-shot and few-shot NLP tasks. For each model size, we plotthe mean accuracy on MMMLU, Lambada, HellaSwag, OpenBookQA, ARC-Easy, ARC-Challenge, andTriviaQA. On zero-shot tasks, RLHF training for helpfulness and harmlessness hurts performance for smallTop 2 passage with score 0.5659530162811279 from http://arxiv.org/pdf/2302.07842:preferences and values which are difficult to capture by hard- coded reward functions.RLHF works by using a pre-trained LM to generate text, which i s then evaluated by humans by, for example,ranking two model generations for the same prompt. This data is then collected to learn a reward modelthat predicts a scalar reward given any generated text. The r eward captures human preferences whenjudging model output. Finally, the LM is optimized against s uch reward model using RL policy gradientalgorithms like PPO ( Schulman et al. ,2017). RLHF can be applied directly on top of a general-purpose LMpre-trained via self-supervised learning. However, for mo re complex tasks, the model’s generations may notbe good enough. In such cases, RLHF is typically applied afte r an initial supervised fine-tuning phase usinga small number of expert demonstrations for the correspondi ng downstream task ( Ramamurthy et al. ,2022;Ouyang et al. ,2022;Stiennon et al. ,2020).A successful example of RLHF used to teach a LM to use an extern al tool stems from WebGPT Nakano et al.(2021) (discussed in 3.2.3), a model capable of answering questions using a search engine and providingTop 3 passage with score 0.5590510368347168 from http://arxiv.org/pdf/2307.09288:315 DiscussionHere, we discuss the interesting properties we have observed with RLHF (Section 5.1). We then discuss thelimitations of L/l.sc/a.sc/m.sc/a.sc /two.taboldstyle-C/h.sc/a.sc/t.sc (Section 5.2). Lastly, we present our strategy for responsibly releasing thesemodels (Section 5.3).5.1 Learnings and ObservationsOur tuning process revealed several interesting results, such as L/l.sc/a.sc/m.sc/a.sc /two.taboldstyle-C/h.sc/a.sc/t.sc ’s abilities to temporallyorganize its knowledge, or to call APIs for external tools.SFT (Mix)SFT (Annotation)RLHF (V1)0.0 0.2 0.4 0.6 0.8 1.0Reward Model ScoreRLHF (V2)Figure 20: Distribution shift for progressive versions of L/l.sc/a.sc/m.sc/a.sc /two.taboldstyle-C/h.sc/a.sc/t.sc , from SFT models towards RLHF.Beyond Human Supervision. At the outset of the project, many among us expressed a preference for 好极了!我们根据最高召回但低精度的双向编码器得到了最相似的切块。 现在,让我们通过高精度的交叉编码器模型重排序。我们将使用 cross-encoder/ms-marco-MiniLM-L-6-v2 模型。这个模型是在 MS MARCO 数据集上微调的,它是一个大型真实问答信息检索数据集。这使得这个模型在进行问答时非常适合决策。 我们将使用同样的问题和我们从双向编码器获得的前 10 个块。让我们看看结果!回想一下,交叉编码器需要成对的,所以我们将创建问题和每个块的对。 fromsentence_transformersimportCrossEncodercross_encoder=CrossEncoder('cross-encoder/ms-marco-MiniLM-L-6-v2')cross_inp=[[query,chunks[hit['corpus_id']]]forhitinhits]cross_scores=cross_encoder.predict(cross_inp)cross_scores array([ 1.2227577 , 5.048051 , 1.2897239 , 2.205767 , 4.4136825 , 1.2272772 , 2.5638275 , 0.81847703, 2.35553 , 5.590804 , 1.3877895 , 2.9497519 , 1.6762824 , 0.7211323 , 0.16303705, 1.3640019 , 2.3106787 , 1.5849439 , 2.9696884 , -1.1079378 , 0.7681126 , 1.5945492 , 2.2869687 , 3.5448399 , 2.056368 ], dtype=float32) 让我们增加一个新的属性 cross-score ,并将其排序! foridxinrange(len(cross_scores)):hits[idx]['cross-score']=cross_scores[idx]hits=sorted(hits,key=lambdax:x['cross-score'],reverse=True)msmarco_l6_corpus_ids=[hit['corpus_id']forhitinhits]#saveforlaterhits [{'corpus_id': 20638, 'score': 0.4884325861930847, 'cross-score': 5.590804}, {'corpus_id': 17387, 'score': 0.5659530162811279, 'cross-score': 5.048051}, {'corpus_id': 5628, 'score': 0.5296251773834229, 'cross-score': 4.4136825}, {'corpus_id': 14815, 'score': 0.45775431394577026, 'cross-score': 3.5448399}, {'corpus_id': 14749, 'score': 0.46809980273246765, 'cross-score': 2.9696884}, {'corpus_id': 9755, 'score': 0.48562008142471313, 'cross-score': 2.9497519}, {'corpus_id': 9761, 'score': 0.49943411350250244, 'cross-score': 2.5638275}, {'corpus_id': 9763, 'score': 0.49280521273612976, 'cross-score': 2.35553}, {'corpus_id': 20632, 'score': 0.4695567488670349, 'cross-score': 2.3106787}, {'corpus_id': 14751, 'score': 0.4585301876068115, 'cross-score': 2.2869687}, {'corpus_id': 14725, 'score': 0.5585878491401672, 'cross-score': 2.205767}, {'corpus_id': 35250, 'score': 0.4569615125656128, 'cross-score': 2.056368}, {'corpus_id': 14806, 'score': 0.4792214035987854, 'cross-score': 1.6762824}, {'corpus_id': 14821, 'score': 0.4637290835380554, 'cross-score': 1.5945492}, {'corpus_id': 14750, 'score': 0.46810320019721985, 'cross-score': 1.5849439}, {'corpus_id': 20653, 'score': 0.4873950183391571, 'cross-score': 1.3877895}, {'corpus_id': 20711, 'score': 0.4703512489795685, 'cross-score': 1.3640019}, {'corpus_id': 39564, 'score': 0.5590510368347168, 'cross-score': 1.2897239}, {'corpus_id': 14802, 'score': 0.5075011253356934, 'cross-score': 1.2272772}, {'corpus_id': 14679, 'score': 0.6097552180290222, 'cross-score': 1.2227577}, {'corpus_id': 14716, 'score': 0.4931946098804474, 'cross-score': 0.81847703}, {'corpus_id': 14671, 'score': 0.46657535433769226, 'cross-score': 0.7681126}, {'corpus_id': 14805, 'score': 0.475425660610199, 'cross-score': 0.7211323}, {'corpus_id': 20652, 'score': 0.4740477204322815, 'cross-score': 0.16303705}, {'corpus_id': 35209, 'score': 0.46695172786712646, 'cross-score': -1.1079378}] 你可以从上面的数据看到,交叉编码器的结果和双向编码器的结果并不一致。神奇的是,一些最前面的交叉编码器结果 (14815 和 14749) 的结果其有着最低的双向编码器分数。这很合理,因为双向编码器比较的是问题和文档在嵌入空间的相似性,但交叉编码器考虑的是问题和文档在嵌入空间的相关性。 fori,hitinenumerate(hits[:3]):sample=dataset["train"][hit["corpus_id"]]print(f"Top{i+1}passagewithscore{hit['cross-score']}from{sample['source']}:")print(sample["chunk"])print("\n") Top 1 passage with score 0.9668010473251343 from http://arxiv.org/pdf/2204.05862:Stackoverflow Good Answer vs. Bad Answer Loss DifferencePython FTPython FT + RLHF(b)Difference in mean log-prob between good and badanswers to Stack Overflow questions.Figure 37 Analysis of RLHF on language modeling for good and bad Stack Overflow answers, over manymodel sizes, ranging from 13M to 52B parameters. Compared to the baseline model (a pre-trained LMfinetuned on Python code), the RLHF model is more capable of distinguishing quality (right) , but is worseat language modeling (left) .the RLHF models obtain worse loss. This is most likely due to optimizing a different objective rather thanpure language modeling.B.8 Further Analysis of RLHF on Code-Model SnapshotsAs discussed in Section 5.3, RLHF improves performance of base code models on code evals. In this appendix, we compare that with simply prompting the base code model with a sample of prompts designed toelicit helpfulness, harmlessness, and honesty, which we refer to as ‘HHH’ prompts. In particular, they containa couple of coding examples. Below is a description of what this prompt looks like:Below are a series of dialogues between various people and an AI assistant. The AI tries to be helpful,Top 2 passage with score 0.9574587345123291 from http://arxiv.org/pdf/2302.07459:We examine the influence of the amount of RLHF training for two reasons. First, RLHF [13, 57] is anincreasingly popular technique for reducing harmful behaviors in large language models [3, 21, 52]. Some ofthese models are already deployed [52], so we believe the impact of RLHF deserves further scrutiny. Second,previous work shows that the amount of RLHF training can significantly change metrics on a wide range ofpersonality, political preference, and harm evaluations for a given model size [41]. As a result, it is importantto control for the amount of RLHF training in the analysis of our experiments.3.2 Experiments3.2.1 OverviewWe test the effect of natural language instructions on two related but distinct moral phenomena: stereotypingand discrimination. Stereotyping involves the use of generalizations about groups in ways that are oftenharmful or undesirable.4To measure stereotyping, we use two well-known stereotyping benchmarks, BBQ[40] (§3.2.2) and Windogender [49] (§3.2.3). For discrimination, we focus on whether models make disparatedecisions about individuals based on protected characteristics that should have no relevance to the outcome.5To measure discrimination, we construct a new benchmark to test for the impact of race in a law school courseTop 3 passage with score 0.9408788084983826 from http://arxiv.org/pdf/2302.07842:preferences and values which are difficult to capture by hard- coded reward functions.RLHF works by using a pre-trained LM to generate text, which i s then evaluated by humans by, for example,ranking two model generations for the same prompt. This data is then collected to learn a reward modelthat predicts a scalar reward given any generated text. The r eward captures human preferences whenjudging model output. Finally, the LM is optimized against s uch reward model using RL policy gradientalgorithms like PPO ( Schulman et al. ,2017). RLHF can be applied directly on top of a general-purpose LMpre-trained via self-supervised learning. However, for mo re complex tasks, the model’s generations may notbe good enough. In such cases, RLHF is typically applied afte r an initial supervised fine-tuning phase usinga small number of expert demonstrations for the correspondi ng downstream task ( Ramamurthy et al. ,2022;Ouyang et al. ,2022;Stiennon et al. ,2020).A successful example of RLHF used to teach a LM to use an extern al tool stems from WebGPT Nakano et al.(2021) (discussed in 3.2.3), a model capable of answering questions using a search engine and providing 棒极了!这个结果似乎跟问题相关。我们还能做些什么来改进结果? 这里我们使用了 cross-encoder/ms-marco-MiniLM-L-6-v2, 这个模型已经有三年历史了,并且很小。它是 很多年前的最好的重新排序模型之一。 对于选择模型,我建议去 MTEB leaderboard,点击 reranking,选择一个适合你需求的模型。平均列可以很好地代表总体质量,但你可能对数据集特别感兴趣 (例如,检索选项卡中的 MSMarco) 注意,模型老模型,比如 MiniLM, 并不在那里。另外,并不是所有的模型都是交叉编码器,所以总是要实验,如果增加第二阶段,更慢的重新排序器是否值得。这里有一些有趣的发现: E5 Mistral 7B Instruct (2023 年 12 月): 这是一个基于解码器的嵌入 (不同于我们之前学的基于编码器的)。这一点很有趣,因为使用解码器而不是编码器是一个新趋势,这样可以容纳更长的文本。这里是 相关论文 BAAI Reranker (2023 年 9 月): 一个高质量重排序模型,其大小适中 (只有 278M 的参数)。让我们用这个模型获得结果并比较。 #Samecodeasbefore,justdifferentmodelcross_encoder=CrossEncoder('BAAI/bge-reranker-base')cross_inp=[[query,chunks[hit['corpus_id']]]forhitinhits]cross_scores=cross_encoder.predict(cross_inp)foridxinrange(len(cross_scores)):hits[idx]['cross-score']=cross_scores[idx]hits=sorted(hits,key=lambdax:x['cross-score'],reverse=True)bge_corpus_ids=[hit['corpus_id']forhitinhits]fori,hitinenumerate(hits[:3]):sample=dataset["train"][hit["corpus_id"]]print(f"Top{i+1}passagewithscore{hit['cross-score']}from{sample['source']}:")print(sample["chunk"])print("\n") Top 1 passage with score 0.9668010473251343 from http://arxiv.org/pdf/2204.05862:Stackoverflow Good Answer vs. Bad Answer Loss DifferencePython FTPython FT + RLHF(b)Difference in mean log-prob between good and badanswers to Stack Overflow questions.Figure 37 Analysis of RLHF on language modeling for good and bad Stack Overflow answers, over manymodel sizes, ranging from 13M to 52B parameters. Compared to the baseline model (a pre-trained LMfinetuned on Python code), the RLHF model is more capable of distinguishing quality (right) , but is worseat language modeling (left) .the RLHF models obtain worse loss. This is most likely due to optimizing a different objective rather thanpure language modeling.B.8 Further Analysis of RLHF on Code-Model SnapshotsAs discussed in Section 5.3, RLHF improves performance of base code models on code evals. In this appendix, we compare that with simply prompting the base code model with a sample of prompts designed toelicit helpfulness, harmlessness, and honesty, which we refer to as ‘HHH’ prompts. In particular, they containa couple of coding examples. Below is a description of what this prompt looks like:Below are a series of dialogues between various people and an AI assistant. The AI tries to be helpful,Top 2 passage with score 0.9574587345123291 from http://arxiv.org/pdf/2302.07459:We examine the influence of the amount of RLHF training for two reasons. First, RLHF [13, 57] is anincreasingly popular technique for reducing harmful behaviors in large language models [3, 21, 52]. Some ofthese models are already deployed [52], so we believe the impact of RLHF deserves further scrutiny. Second,previous work shows that the amount of RLHF training can significantly change metrics on a wide range ofpersonality, political preference, and harm evaluations for a given model size [41]. As a result, it is importantto control for the amount of RLHF training in the analysis of our experiments.3.2 Experiments3.2.1 OverviewWe test the effect of natural language instructions on two related but distinct moral phenomena: stereotypingand discrimination. Stereotyping involves the use of generalizations about groups in ways that are oftenharmful or undesirable.4To measure stereotyping, we use two well-known stereotyping benchmarks, BBQ[40] (§3.2.2) and Windogender [49] (§3.2.3). For discrimination, we focus on whether models make disparatedecisions about individuals based on protected characteristics that should have no relevance to the outcome.5To measure discrimination, we construct a new benchmark to test for the impact of race in a law school courseTop 3 passage with score 0.9408788084983826 from http://arxiv.org/pdf/2302.07842:preferences and values which are difficult to capture by hard- coded reward functions.RLHF works by using a pre-trained LM to generate text, which i s then evaluated by humans by, for example,ranking two model generations for the same prompt. This data is then collected to learn a reward modelthat predicts a scalar reward given any generated text. The r eward captures human preferences whenjudging model output. Finally, the LM is optimized against s uch reward model using RL policy gradientalgorithms like PPO ( Schulman et al. ,2017). RLHF can be applied directly on top of a general-purpose LMpre-trained via self-supervised learning. However, for mo re complex tasks, the model’s generations may notbe good enough. In such cases, RLHF is typically applied afte r an initial supervised fine-tuning phase usinga small number of expert demonstrations for the correspondi ng downstream task ( Ramamurthy et al. ,2022;Ouyang et al. ,2022;Stiennon et al. ,2020).A successful example of RLHF used to teach a LM to use an extern al tool stems from WebGPT Nakano et al.(2021) (discussed in 3.2.3), a model capable of answering questions using a search engine and providing 让我们比较一下三个模型的排名: foriinrange(25):print(f"Top{i+1}passage.Bi-encoder{retrieval_corpus_ids[i]},Cross-encoder(MSMarco){msmarco_l6_corpus_ids[i]},BGE{bge_corpus_ids[i]}") Top 1 passage. Bi-encoder 14679, Cross-encoder (MS Marco) 20638, BGE 14815Top 2 passage. Bi-encoder 17387, Cross-encoder (MS Marco) 17387, BGE 20638Top 3 passage. Bi-encoder 39564, Cross-encoder (MS Marco) 5628, BGE 17387Top 4 passage. Bi-encoder 14725, Cross-encoder (MS Marco) 14815, BGE 14679Top 5 passage. Bi-encoder 5628, Cross-encoder (MS Marco) 14749, BGE 9761Top 6 passage. Bi-encoder 14802, Cross-encoder (MS Marco) 9755, BGE 39564Top 7 passage. Bi-encoder 9761, Cross-encoder (MS Marco) 9761, BGE 20632Top 8 passage. Bi-encoder 14716, Cross-encoder (MS Marco) 9763, BGE 14725Top 9 passage. Bi-encoder 9763, Cross-encoder (MS Marco) 20632, BGE 9763Top 10 passage. Bi-encoder 20638, Cross-encoder (MS Marco) 14751, BGE 14750Top 11 passage. Bi-encoder 20653, Cross-encoder (MS Marco) 14725, BGE 14805Top 12 passage. Bi-encoder 9755, Cross-encoder (MS Marco) 35250, BGE 9755Top 13 passage. Bi-encoder 14806, Cross-encoder (MS Marco) 14806, BGE 14821Top 14 passage. Bi-encoder 14805, Cross-encoder (MS Marco) 14821, BGE 14802Top 15 passage. Bi-encoder 20652, Cross-encoder (MS Marco) 14750, BGE 14749Top 16 passage. Bi-encoder 20711, Cross-encoder (MS Marco) 20653, BGE 5628Top 17 passage. Bi-encoder 20632, Cross-encoder (MS Marco) 20711, BGE 14751Top 18 passage. Bi-encoder 14750, Cross-encoder (MS Marco) 39564, BGE 14716Top 19 passage. Bi-encoder 14749, Cross-encoder (MS Marco) 14802, BGE 14806Top 20 passage. Bi-encoder 35209, Cross-encoder (MS Marco) 14679, BGE 20711Top 21 passage. Bi-encoder 14671, Cross-encoder (MS Marco) 14716, BGE 20652Top 22 passage. Bi-encoder 14821, Cross-encoder (MS Marco) 14671, BGE 14671Top 23 passage. Bi-encoder 14751, Cross-encoder (MS Marco) 14805, BGE 20653Top 24 passage. Bi-encoder 14815, Cross-encoder (MS Marco) 20652, BGE 35209Top 25 passage. Bi-encoder 35250, Cross-encoder (MS Marco) 35209, BGE 35250 非常有趣,我们得到了非常不同的结果!让我们简要地看一下其中的一些。 建议做类似 dataset["train"][20638]["chunk"] 的事情来打印一个特定的结果。以下是结果的快照。 双向编码器在获取有关 RLHF 的结果时表现不错,但对于获取好的,精确的关于什么是 RLHF 的响应却很困难。我看了每个模型的前 5 个结果。通过查看段落,17387 和 20638 是唯一真正回答了问题的段落。尽管三个模型中 17387 的排名都更高,但有趣的是双向编码器的 20638 的排名很低,而其他两个交叉编码器的排名都更高。你可以在下面找到这些内容: 语料库 ID 相关文本和总结 双向编码器位置 (前 10) MSMarco 位置 BGE 位置 14679 Discusses implications and applications of RLHF but no definition. 1 20 4 17387 Describes the process of RLHF in detail and applications 2 2 3 39564 This chunk is messy and is more of a discussion section intro than an answer 3 18 6 14725 Characteristics about RLHF but no definition of what it is 4 11 8 20638 “increasingly popular technique for reducing harmful behaviors in large language models” 10 1 2 5628 Discusses the reward modeling (a component) but does not define RLHF 5 3 16 14815 Discusses RLHF but does not define it 24 4 1 14749 Discusses impact of RLHF but it has no definition 19 5 15 9761 Discusses the reward modeling (a component) but does not define RLHF 7 7 5 重排序是一个频繁出现在库中的特性; llamaindex 允许你使用 VectorIndexRetriever 来检索和 LLMRerank 来重排序 (见 教程),Cohere 提供了一个 重排序端点 并且 qdrant 支持同样的功能。然而,正如你所见,这样实现起来非常简单。如果你有一个高质量的双向编码器模型,你可以使用它来进行重排序,并从中获益于它的速度。 LLMs as rerankers 一些人用生成式大模型作为重排器。例如, OpenAI 的 Coobook 有一个例子,其中他们使用 GPT-3 作为重排器,通过构建一个提示,要求模型确定文档是否与文档相关。尽管这展示了大模型惊人的能力,但这通常不是最优的该任务选择,甚至会更糟,更贵比交叉编码器更慢。 实验会证明什么工作是最适合你的数据。使用大模型作为重排器在你的文档非常长是可能会有帮助 (对于基于 BERT 的模型来说,这可能是一个挑战)。 补充: SPECTER2 如果你对科研任务的嵌入特别感兴趣,我建议你查看 AllenAI 的 SPECTER2,这是一个为科学论文生成嵌入的一组模型。这些模型可以用于预测链接、查找最近的论文、为给定查询找到候选论文、使用嵌入作为特征对论文进行分类等等!基础模型是在 scirepeval 上训练的,这是一个包含数百万个科学论文引用的数据集。在训练之后,作者使用 适配器 对模型进行了微调,这是一个参数高效微调库 (如果你不知道这是什么,不用担心)。作者将一个小型神经网络,称为适配器,连接到基础模型上。这个适配器被训练去执行一个特定的任务,但是为特定的任务训练需要的数据要比整个模型训练少得多。由于这些差异,我们需要使用 transformers 和 adapters 来进行推理,例如通过执行类似 model=AutoAdapterModel.from_pretrained('allenai/specter2_base')model.load_adapter("allenai/specter2",source="hf",load_as="proximity",set_active=True) 我建议阅读模型卡以了解更多关于模型及其使用信息。你还可以阅读 论文 以获取更多细节。 补充: 增强 SBERT 增强 SBERT 是一种用于收集数据以改善双向编码器的方法。预训练和微调双向编码器需要大量的数据,因此作者建议使用交叉编码器来标记大量输入对的集合,并将其添加到训练数据中。例如,如果你有非常少的标记数据,你可以训练一个交叉编码器,然后标记未标记的对,这可以用来训练一个双向编码器。你是如何生成对的?我们可以使用句子的随机组合,然后使用交叉编码器对它们进行标记。这将导致大多数是负对,并倾斜标签分布。为了避免这种情况,作者探索了不同的技术: 使用 **核密度估计 (KDE)**,目标是让小型的金数据集和增强数据集之间有类似的标签分布。这是通过放弃一些负对来实现的。当然,这将效率低下,因为你需要生成很多对才能得到几个正对。 BM25 是一种基于重叠的搜索引擎算法 (例如,词频、文档长度等)。基于此,作者获取最相似的句子来检索最相似的 k 个句子,然后使用交叉编码器对它们进行标记。这是高效的,但只有在句子之间重叠很少时才能捕捉到语义相似性。 语义搜索采样 在金数据上训练双向编码器,然后用来采样其他相似的对。 BM25 + 语义搜索采样 结合了前两种方法。这有助于找到词汇和语义上相似的句子。 在 Sentence Transformers 文档 中有很好的图表和示例脚本来做这件事。 增强 SBERT - 图片来自原论文 总结 好了,我们刚才学会了怎么做一件很酷的事情: 检索和重新排序,这是句子嵌入的一个非常常见的任务。我们了解了双向编码器和交叉编码器有什么不同,以及什么时候该用哪一个。还学到了一些提升双向编码器性能的技巧,比如增强 SBERT。 别担心,代码可以随便改,随便玩!如果你觉得这篇博客不错,给个 赞或者分享 一下吧,这对我来说是个很大的鼓励! 知识检查 双向编码器和交叉编码器之间有什么区别? 解释重新排序的不同步骤。 如果使用双向编码器比较 30,000 个句子,我们需要生成多少个嵌入?使用交叉编码器进行推理需要运行多少次? 有哪些技术可以改善双向编码器? 现在,你已经有了实现你的搜索系统的坚实基础。作为一个后续任务,我建议使用不同的数据集实现一个类似的检索和重新排序系统。探索改变检索和重新排序模型对结果的影响。 本文分享自微信公众号 - Hugging Face(gh_504339124f0f)。 如有侵权,请联系 support@oschina.cn 删除。 本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。
优秀的个人博客,低调大师

每日一博 | 初探分布式链路追踪

本篇文章,主要介绍应用如何正确使用日志系统,帮助用户从依赖、输出、清理、问题排查、报警等各方面全面掌握。 可观测性 可观察性不单是一套理论框架,而且并不强制具体的技术规格。其核心在于鼓励团队内化可观察性的理念,并确保由研发人员构建的应用程序具备可观察性。在学术领域中,尽管“可观测性”这一术语是近年来从控制理论中引进的新词,但实际上,它在计算机科学领域已有深厚的实践基础。学者们通常会把可观测性细化为三个更具体的研究方向:事件日志、链路追踪和聚合度量。这三个领域虽然各有侧重点,但并非完全孤立,它们之间存在着天然的交集与互补性。 日志(Logging),展现的是应用运行而产生的事件或者程序在执行的过程中间产生的一些日志,可以详细解释系统的运行状态,但是存储和查询需要消耗大量的资源。所以往往使用过滤器减少数据量。 度量(Metrics),是一种聚合数值,存储空间很小,可以观察系统的状态和趋势,但对于问题定位缺乏细节展示。这个时候使用等高线指标等多维数据结构来增强对于细节的表现力。例如统计一个服务的 TBS 的正确率、成功率、流量等,这是常见的针对单个指标或者某一个数据库的。 追踪(Tracing),面向的是请求,可以轻松分析出请求中异常点,但与日志有相同的问题就是资源消耗较大。通常也需要通过采样的方式减少数据量。比如一次请求的范围,也就是从浏览器或者手机端发起的任何一次调用,一个流程化的东西,需要轨迹去追踪。 在工业界,历经长期的竞争,日志和度量领域的主导技术已逐渐明朗。日志收集与分析方面,Elastic Stack(亦称为ELK Stack)已成为广泛采纳的技术选择。然而,追踪技术的发展路径与日志和度量领域显然不同。追踪技术高度依赖于特定的网络协议和编程语言。服务间是通过 HTTP 还是 gRPC 通信,会直接决定追踪实施的具体方法。同样,服务是否采用 Java、Golang、还是 Node.js 编写,也会影响到如何追踪进程内调用堆栈。这种依赖性使得追踪工具通常需要以插件或探针的形式进行深度集成,因而具有一定的侵入性。此外,由于追踪技术需要适应不同的语言和网络环境,追踪领域很难形成单一的主导者。相反,市场上存在多样化的产品,旨在满足各种不同技术栈的追踪需求。 本文主要探讨其中的追踪下日志内容。 链路追踪 分布式链路追踪公认的起源是 Google 在 2010 年发表的论文《Dapper : a Large-Scale Distributed Systems Tracing Infrastructure》,这篇论文介绍了 Google 从 2004 年开始使用的分布式追踪系统 Dapper 的实现原理。 论文《 Dapper : a Large-Scale Distributed Systems Tracing Infrastructure 》地址:https://static.googleusercontent.com/media/research.google.com/zh-CN//archive/papers/dapper-2010-1.pdf ▐基本原理 分布式链路追踪的基本原理就是在分布式应用的接口方法上设置一些观察点,然后在入口节点给每个请求分配一个全局唯一的标识 TraceId。当请求流经这些观察点时就会记录一行对应的链路日志(包含链路唯一标识,接口名称,时间戳,主机信息等)。最后通过 TraceId 将一次请求的所有链路日志进行组装,就可以还原出该次请求的链路轨迹。 分布式链路追踪实现请求回溯的关键点有两个:一是低成本、高质量的观察点设置,也就是链路插桩,确保追踪的信息足够丰富,能够快速定位异常根因;二是保证链路上下文在不同环境下都能够完整透传,避免出现上下文丢失导致的断链现象。 ▐基础术语 虽然分布式链路追踪的实现方式多种多样,但是仍然有一些基础术语在业界具备广泛的共识。 Trace 一条 Trace 代表一次入口请求在 IT 系统内的完整调用轨迹及其关联数据集合。其中,全局唯一的链路标识 TraceId,是最具代表的一个属性。通过 TraceId 才能将同一个请求分散在不同节点的链路数据准确的关联起来,实现请求粒度的“确定性关联”价值。 以集团的Eagleeye设计的traceId设计为例,根据这个id,可以知道这个请求在2022-10-18 10:10:40发出,被11.15.148.83机器上进程号为14031的Nginx(对应标识位e)接收到。其中的四位原子递增数从0-9999,目的是为了防止单机并发造成traceId碰撞。 Span Span是一个操作,它代表系统中一个逻辑运行单元。Span之间通过嵌套或者顺序排列建立因果关系。Span包含以下对象 Operation Name:描述了当前接口的行为语义,比如 /api/createOrder 代表执行了一次创建订单的动作。 SpanId/ParentSpanId:接口调用的层级标识,用于还原 Trace 内部的层次调用关系。 Start/FinishTime:接口调用的开始和结束时间,二者相减就是该次调用的耗时。 StatusCode:响应状态,标识当次调用是成功或失败。 Tags & Events:调用附加信息,详见下面的描述。 其中最重要的是SpanId的设计。同样以阿里的Eagleeye的spanId(rpcId)设计为例,Eagleeye设计了RpcId来区别同一个调用链下多个网络调用的顺序和嵌套层次,用0.X1.X2.X3.....Xi来表示,根节点的RpcId固定从0开始,id的位数("."的数量)表示了Span在这棵树中的层级,Id最后一位表示了Span在这一层级中的顺序。那么给定同一个Trace中的所有RpcId,便可以很容易还原出一个完成的调用链: - 0 - 0.1 - 0.1.1 - 0.1.2 - 0.1.2.1 - 0.2 - 0.2.1 - 0.3 - 0.3.1 - 0.3.1.1 - 0.3.2 Tags 如果需要进一步记录请求的行为特征,可以使用 Tags 来扩展语义。Tags 是一组由 {Key:Value} 组成的键值对集合,描述这一次接口调用的具体属性。比如Eagleeye里就有「Tags」的实现(UserData),阿里的全链路压测标识就是通过UserData里传递实现的。 在分布式追踪的上下文中,一个Trace可被视为一个有向无环图,其中每个Span代表图中的一个节点,而节点之间的连接则表示为链接。观察这样的图表,我们可以看到一个单独的Span节点可能拥有多条链接,这表明它具有多个子Span。这种结构揭示了各个操作间的父子或者因果关系,从而使得追踪整个请求的流程成为可能。 Trace定义了Span间两种基本关系: ChildOf:表示父 Span 在一定程度上依赖子 Span。 FollowsFrom:表示父 Span 完全不依赖其子Span 的结果。 ▐链路追踪的挑战 日志存储 本地存储埋点数据涉及磁盘操作,而磁盘I/O速度通常较慢。在高并发的环境中,如果采用同步刷新磁盘的方式,可能会对原有业务的性能造成显著影响。因此,在链路追踪系统中进行数据埋点时,应当尽量减少对系统的性能损耗,确保对原业务的逻辑和性能具有无侵入性。这意味着追踪系统的设计需要尽量轻量化,并采取策略如异步处理、缓存等方法来降低对业务性能的影响。 并发环形队列 集团的Eagleeye采用并发环形队列存储Trace数据,如下图所示: 环形队列确实是日志框架中实现异步日志写入的一种常用技术。在这种队列中,存在两个关键的指针,即读指针(take)和写指针(put)。 读指针(take): 它指向队列中的最旧数据,即下一条待消费的数据。 写指针(put): 它指向队列中下一个将要存放新数据的位置。 这个队列被设计为支持原子性的读写操作,以保证在多线程环境中数据的一致性。这意味着,当一个线程在执行读或写操作时,其他线程不能同时修改被操作的数据项。 读指针和写指针按同一方向(如时钟方向)移动,随着数据的不断生产和消费,这两个指针在队列中循环前进。然而,如果生产数据的速度持续超过消费速度,写指针最终会“追上”读指针,这种情况被称为“套圈”。 当出现套圈现象时,队列将根据预设的策略来处理新产生的数据。常见的处理策略包括: 丢弃即将写入的新数据,以保护队列中已存在的数据不被覆盖。 覆盖队列中最旧的数据,这意味着最先入队的数据将被新数据取代,这种策略适用于对最新数据保持最高优先级的场景。 选择哪种策略取决于具体应用场景的需求和对数据丢失的容忍度。环形队列的这种设计使得它在处理高并发日志数据时非常高效,能够在保证性能的同时减少资源占用。 Skywalking在实现上有所区别,采用分区的QueueBuffer存储Trace数据,多个消费线程通过Driver平均分配到各个QueueBuffer上进行数据消费: 在高性能的应用场景中,队列的实现方式对于整体性能有显著的影响。QueueBuffer 通常有两种不同的实现方式: 基于 JDK 的阻塞队列:这种实现方式利用了 Java 标准库中的 java.util.concurrent 包下的阻塞队列,例如 ArrayBlockingQueue 或 LinkedBlockingQueue。这些队列内部处理了线程同步的逻辑,使得在多线程环境下生产者和消费者可以安全地进行并发操作。基于 JDK 的阻塞队列通常用于服务端,因为服务端可以承受相对较重的负载,并且更注重于稳定性和线程安全。 普通数组 + 原子下标:这种实现方式使用了一个普通的数组,并结合了原子操作的下标(如 AtomicInteger)用于记录读写的位置。这种队列不是阻塞的,因此,当队列满时,它需要显式地处理生产者的等待逻辑,当队列空时,需要处理消费者的等待逻辑。SkyWalking 的 Agent 端采用这种方式,因为它相对更轻量级,且在高吞吐量场景下提供了更高的性能。Agent 端的性能尤其重要,因为它直接运行在应用程序内部,性能的任何抖动都可能影响到应用程序本身的性能。 在普通数组 + 原子下标的实现中,有一些值得关注的点: 原子性操作:通过使用原子类(如 AtomicInteger),可以确保在并发场景下修改下标时的线程安全性,避免了锁的开销。 非阻塞算法:由于不使用阻塞队列,这种实现可以采用非阻塞算法来优化性能,尤其是在高并发的生产者-消费者模型中。 回绕逻辑:当数组达到其末端时,读写下标需要回绕到数组的开始,形成一个环状结构,这就是所谓的环形缓冲区。 饱和策略:需要定义当队列满时的行为,是等待、丢弃数据还是覆盖旧数据。 总的来说,不同的 QueueBuffer 实现方式适用于不同的使用场景 日志传输 鹰眼(EagleEye)和SkyWalking采用了不同的数据采集及传输策略,每种方法都有其适用场景和相应的权衡。 鹰眼系统首先将数据存储到本地日志文件中,然后利用一个代理(agent)来收集这些日志并将其传输到服务端。这种基于日志加边车代理的方法使得数据采集可以在不直接干扰主应用逻辑的情况下进行,但这也意味着需要处理日志文件的管理和代理的维护。 相比之下,SkyWalking提供了gRPC和Kafka两种基于服务的数据传输方式,这使得数据可以更实时地传输到处理后端。gRPC是一种高性能的远程过程调用(RPC)框架,Kafka是一个分布式流处理平台,两者都能有效地处理大量的数据流。 从架构上看,SkyWalking采取了分离应用层埋点和中间件代码的策略,这在某种程度上实现了应用级别的透明性。用户不需要在应用代码中直接管理追踪逻辑,而是依赖中间件层的插件来自动完成数据的采集。然而,这种方式意味着当中间件需要升级时,相关的插件也可能需要更新,这可能在维护方面引入一些挑战。 鹰眼的埋点方法由专门的中间件团队来维护,对于上层应用来说同样是透明的,这意味着应用开发者不需要关心数据采集的具体实现细节。这种方法非常适合阿里巴巴集团内部的环境,因为它能够提供统一的标准和容易控制的集成点。 总的来说,这两种系统提供了不同的解决方案,各自的优点和挑战都值得在选择和实施追踪系统时予以考虑。 数据埋点 在分布式链路追踪系统中,方法增强(通常称为“埋点”)指的是在代码中插入额外的逻辑来捕获和记录执行信息,这是实现追踪的核心技术。Dapper,谷歌的分布式追踪系统,提出的设计原则要求方法增强必须同时满足应用级透明性和低开销这两个关键条件: 应用级透明:开发者不需要修改业务代码或仅需要极少的修改即可实现埋点,这意味着追踪逻辑对应用层是不可见或几乎不可见的。 低开销:埋点操作对系统的性能影响应当尽可能小,以避免追踪逻辑本身成为系统性能的瓶颈。 现在,我们来比较阿里巴巴的EagleEye与开源项目SkyWalking在埋点技术上的不同做法: 硬编码 EagleEye:阿里巴巴的EagleEye通过中间件层进行数据采集和追踪,通常这由集团的中间件团队负责维护。这种中间件集成方式允许上层应用无需知晓具体的追踪逻辑,因此在应用级别上保持了较高的透明度。然而,这种方法可能会在中间件升级时需要同步更新埋点逻辑,增加了维护的复杂度。 字节码增强 SkyWalking:SkyWalking提供了自动插桩的能力,通常通过Java Agent技术在运行时不侵入地修改字节码,插入追踪代码。这种方式对业务代码完全透明,开发者无需修改任何业务逻辑即可实现埋点。同时,SkyWalking旨在保持低开销,以减少对应用性能的影响。由于它是一个开源项目,SkyWalking更容易适应多样化的技术栈和快速发展的生态。 两种方法各有优势和劣势,EagleEye的中间件集成方式适合阿里巴巴这样拥有统一技术栈和强大内部支持的大型企业环境。而SkyWalking的自动插桩技术则提供了灵活性和广泛的社区支持,更适合多变的技术环境和需要快速适应新技术的公司。选择哪种埋点方式取决于企业的具体需求、技术栈的复杂性以及维护能力。 跨线程传递 在多线程并发调用环境下的数据链路埋点也是一个值得关注问题,当一个服务考虑性能问题可能会起多个线程同时调用其他不同的模块。链路系统如何保证这些调用还是符合 openTrace 规范,保证 traceId 和 spanId 有序。 目前Java生态下,普遍的思路是用父线程的ThreadLocal中拿到保存的trace信息,然后作为参数传递给子线程,子线程在初始化的时候设置trace信息来避免丢失。 值得关注的是,集团提供了InheritableThreadLocals的子类TransmittableThreadLocal,解决了InheritableThreadLocal只能再new Thread的时候传递本地变量,无法应用到线程池的问题。可以应用来作链路追踪,传递变量等用途。美团也实现了类似的子类TransmissibleThreadLocal。 日志收集和分析 日志用来记录系统运行期间发生过的离散事件,在目前复杂的分布式系统中,很难只依靠 tail、grep、awk 来从单台机器的日志中挖掘信息了,往往还要有专门的全局查询和可视化功能。此时,从打印日志到分析查询之间,还隔着收集、缓冲、聚合、加工、索引、存储等若干个步骤,如下图所示: 提到日志实时分析,大部分人第一想到是社区很火ELK Stack。ELK方案上手难度小、开源材料众多、在社区中有大量的使用案例。于此同时,阿里巴巴集团也推出了对日志场景的解决方案产品日志服务(SLS/Log) 。下面将先后介绍这两种框架并分析优劣。 ▐开源的ELK方案 ELK Stack 是一个缩略词,用来描述由三个常见项目组成的堆栈:Elasticsearch、Logstash 和 Kibana。ELK Stack 通常被称为 Elasticsearch,作用是聚合来自所有系统和应用程序的日志,分析这些日志,并创建可视化来进行应用程序和基础设施监控、更快的故障排除、安全分析等。 E = Elasticsearch Elasticsearch 是在 Apache Lucene 上构建的分布式搜索和分析引擎。对各种语言、高性能和无架构 JSON 文档的支持使 Elasticsearch 成为各种日志分析和搜索使用案例的理想选择。 L = Logstash Logstash 是一个开源数据摄取工具,允许从各种来源收集数据,转换数据,并将数据发送到希望的目标。 K = Kibana Kibana 是一种数据可视化和挖掘工具,可以用于日志和时间序列分析、应用程序监控和运营智能使用案例。 收集与缓冲 写日志是在服务节点中进行的,但我们不可能在每个节点都单独建设日志查询功能。这不是资源或工作量的问题,而是分布式系统处理一个请求要跨越多个服务节点,为了能看到跨节点的全部日志,就要有能覆盖整个链路的全局日志系统。这个需求决定了每个节点输出日志到文件后,必须将日志文件统一收集起来集中存储、索引,由此便催生了专门的日志收集器。 最初,ELK 中日志收集与下一节要讲的加工聚合的职责都是由 Logstash 来承担的,Logstash 除了部署在各个节点中作为收集的客户端(Shipper)以外,它还同时设有独立部署的节点,扮演归集转换日志的服务端(Master)角色。Logstash 有良好的插件化设计,收集、转换、输出都支持插件化定制,应对多重角色本身并没有什么困难。但是 Logstash 与它的插件是基于 JRuby 编写的,要跑在单独的 Java 虚拟机进程上,而且 Logstash 的默认的堆大小就到了 1GB。对于归集部分(Master)这种消耗并不是什么问题,但作为每个节点都要部署的日志收集器就显得太过负重了。后来,Elastic.co 公司将所有需要在服务节点中处理的工作整理成以Libbeat为核心的Beats 框架,并使用 Golang 重写了一个功能较少,却更轻量高效的日志收集器Filebeat。 日志不追求绝对的完整精确,只追求在代价可承受的范围内保证尽可能地保证较高的数据质量。一种最常用的缓解压力的做法是将日志接收者从 Logstash 和 Elasticsearch 转移至抗压能力更强的队列缓存,譬如在 Logstash 之前架设一个 Kafka 或者 Redis 作为缓冲层,面对突发流量,Logstash 或 Elasticsearch 处理能力出现瓶颈时自动削峰填谷,甚至当它们短时间停顿,也不会丢失日志数据。 加工与聚合 将日志集中收集之后,存入 Elasticsearch 之前,一般还要对它们进行加工转换和聚合处理。这是因为日志是非结构化数据,一行日志中通常会包含多项信息,如果不做处理,那在 Elasticsearch 就只能以全文检索的原始方式去使用日志,既不利于统计对比,也不利于条件过滤。 Logstash 的基本职能是把日志行中的非结构化数据,通过 Grok 表达式语法转换为上面表格那样的结构化数据,进行结构化的同时,还可能会根据需要,调用其他插件来完成时间处理(统一时间格式)、类型转换(如字符串、数值的转换)、查询归类(譬如将 IP 地址根据地理信息库按省市归类)等额外处理工作,然后以 JSON 格式输出到 Elasticsearch 中(这是最普遍的输出形式,Logstash 输出也有很多插件可以具体定制不同的格式)。有了这些经过 Logstash 转换,已经结构化的日志,Elasticsearch 便可针对不同的数据项来建立索引,进行条件查询、统计、聚合等操作的了。 存储与查询 Elasticsearch 是整个 Elastic Stack 技术栈的核心,其他步骤的工具,如 Filebeat、Logstash、Kibana 都有替代品,有自由选择的余地,唯独 Elasticsearch 在日志分析这方面完全没有什么值得一提的竞争者,几乎就是解决此问题的唯一答案。核心原因是 Elasticsearch 的优势正好与日志分析的需求完美契合: 数据特征的角度看,日志是典型的基于时间的数据流。日志虽然增长速度很快,但已写入的数据几乎没有再发生变动的可能。以按日索引为例,由于你能准确地预知明天、后天的日期,因此全部索引都可以预先创建,这免去了动态创建的寻找节点、创建分片、在集群中广播变动信息等开销 从数据价值的角度看,日志基本上只会以最近的数据为检索目标,随着时间推移,早期的数据将逐渐失去价值。这点决定了可以很容易区分出冷数据和热数据,进而对不同数据采用不一样的硬件策略。 从数据使用的角度看,分析日志很依赖全文检索和即席查询,对实时性的要求是处于实时与离线两者之间的“近实时”,即不强求日志产生后立刻能查到,但也不能接受日志产生之后按小时甚至按天的频率来更新,这些检索能力和近实时性,也正好都是 Elasticsearch 的强项。 Elasticsearch 只提供了 API 层面的查询能力,它通常搭配同样出自 Elastic.co 公司的 Kibana 一起使用,可以将 Kibana 视为 Elastic Stack 的 GUI 部分。Kibana 尽管只负责图形界面和展示,但它提供的能力远不止让你能在界面上执行 Elasticsearch 的查询那么简单。Kibana 宣传的核心能力是“探索数据并可视化”,即把存储在 Elasticsearch 中的数据被检索、聚合、统计后,定制形成各种图形、表格、指标、统计,以此观察系统的运行状态,找出日志事件中潜藏的规律和隐患。 ▐阿里的SLS方案 阿里云日志服务 SLS 基于阿里云自研灵活索引的一站式云原生可观测数据分析平台。为Log/Metric/Trace 等数据提供大规模、低成本、实时平台化服务。一站式提供数据采集、加工、分析、告警可视化与投递功能。 收集与缓存 Logtail是集团云提供的日志服务(SLS)的一个组件,它作为日志采集客户端,提供了一种高效且易于配置的方式来接入日志数据。由于Logtail是用C++语言编写的,它具有较高的性能和较低的资源消耗,适合在各种环境下运行,包括资源受限的环境。 Logtail的主要功能包括: 无侵入式采集:Logtail能够监视指定的日志文件,实时采集更新的日志数据,而无需修改现有的应用程序代码。 多种日志格式支持:除了采集标准的文本日志文件,Logtail还能够采集其他类型的日志,如MySQL的二进制日志(binlog)、HTTP数据、以及容器日志等。 容器化环境支持:Logtail提供对容器友好的支持,无论是标准容器还是处于Kubernetes集群中的容器,Logtail都能够灵活地采集日志数据。 异常处理:Logtail有一套完备的机制来处理在日志采集过程中可能出现的异常,如当遇到网络故障或服务端异常时,它可以通过主动重试或将数据缓存到本地等方式来确保数据的安全和完整性。 由于Logtail的这些特性,它成为了一个非常强大且可靠的日志采集工具,特别是在需要确保日志数据不丢失的情况下。它的无侵入性质意味着开发者或运维人员可以在不影响现有应用程序的情况下部署日志采集,而其对容器和微服务架构的友好支持则使其非常适合现代云原生应用。 Logtail作为日志采集客户端,其文件采集流程设计得非常全面,涵盖了从日志生成到传输的多个关键环节。以下是Logtail文件采集流程的六个主要步骤: 文件监听 :Logtail监控配置中指定的日志文件或目录,以便于检测文件的创建、更新或者删除事件。这通常通过文件系统的通知机制来实现,如Linux上的inotify。 文件读取 :一旦文件发生变化,Logtail会读取文件内容。对于更新的文件,Logtail保持追踪当前的读取进度,确保从上次停止的地方继续读取,避免重复或遗漏。 日志处理 :读取到的原始日志数据会经过初步处理,比如分割日志行、解析字段等,将原始文本转换为结构化的日志记录。 日志过滤 :用户可以定义过滤规则,根据日志内容或属性决定哪些日志记录应该被采集,哪些应该被忽略。这一步可以减少无用数据的传输和存储,优化成本和性能。 日志聚合 :在发送之前,Logtail可以对日志进行批处理,合并多个日志记录为一个数据包,减少网络请求的次数,提高数据传输效率。 数据发送 :聚合后的日志数据会被发送到配置的目标,例如阿里云日志服务SLS的服务器。数据发送过程中,Logtail会处理网络异常等问题,确保数据的可靠传输。 以上六个环节构成了Logtail文件采集的完整流程,每个步骤都是为了确保日志数据的准确、高效、可靠采集。在高可用性和高性能的要求下,Logtail的设计使得日志数据能够从源头到目的地的迁移过程中保持完整性和一致性。 对比开源的logstash,和logtail的对比如下: 功能项 logstash logtail 日志读取 轮询 事件触发 文件轮转 支持 支持 Failover处理 (本地checkpoint) 支持 支持 通用日志解析 支持grok(基于正则表达式)解析 支持正则表达式解析 特定日志类型 支持delimiter、key-value、json等主流格式 支持key-value格式 数据发送压缩 插件支持 LZ4 数据过滤 支持 支持 数据buffer发送 插件支持 支持 发送异常处理 插件支持 支持 运行环境 JRuby实现,依赖JVM环境 C++实现,无特殊要求 线程支持 支持多线程 支持多线程 热升级 不支持 支持 中心化配置管理 不支持 支持 运行状态自检 不支持 支持cpu/内存阈值保 总体来说,logstash支持所有主流日志类型,插件支持最丰富,可以灵活DIY,但性能较差,JVM容易导致内存使用量高。logtail占用机器cpu、内存资源最少,结合阿里云日志服务的E2E体验良好,但目前对特定日志类型解析的支持较弱。 加工与聚合 阿里云日志服务(SLS)提供的数据加工功能是一项强大的特性,使得用户能够在日志数据进入存储和分析阶段之前对其进行预处理。这些功能对于数据的清洗、转换、安全保护和增强都非常关键,尤其是在构建复杂的数据处理流水线时。以下是数据加工功能的几个关键点和它们的应用场景。 数据规整:这个功能允许用户对无结构或半结构化的日志进行字段提取和格式转换,从而得到结构化数据。这对于后续的实时处理、分析和数据仓库计算来说是非常重要的,因为结构化数据更容易进行查询和分析。 数据富化:数据富化功能可以通过字段连接(JOIN)操作,将日志数据(如订单日志)和其他维度数据(如用户信息表)相结合。这样可以为原始日志添加更丰富的上下文信息,提高数据分析的深度和准确性。 数据流转:流转功能支持跨地域的数据传输,允许用户将数据从一个地域转移到另一个地域。例如,可以将海外地域的日志数据传输到中心地域,实现日志的集中化管理和分析。 数据脱敏:数据脱敏对于符合隐私法规和公司政策是必不可少的。SLS可以在日志数据中识别并隐藏或替换敏感信息,比如密码、手机号或地址等,来保护用户隐私。 数据过滤:数据过滤允许用户基于特定条件选择性地提取日志条目。这可以用来隔离关键服务的日志,以便进行重点监控和分析。 应用场景: 数据规整(一对一):从单个源Logstore读取数据,经过加工处理后,输出到单个目标Logstore,适用于简单的加工任务。 数据分派(一对多):从单个源Logstore读取数据,根据不同的规则或条件将数据加工后分发到多个目标Logstore中,适用于需要将日志按类型或用途分开处理的场景。 数据融合(多对一):从多个源Logstore读取数据,将它们合并或加工后输出到一个目标Logstore中,适用于需要综合多个数据源进行统一分析的场景。 通过这些数据加工功能,SLS能够提供灵活、强大的数据处理能力,帮助用户更好地管理和分析日志数据,同时保护敏感信息。这对于需要实时数据洞察和快速响应的企业来说是非常有价值的。 存储和查询 阿里云日志服务(SLS)的存储引擎专门为处理可观测数据而设计,包括日志、指标和追踪数据。它旨在提供一个统一和高效的解决方案,用以满足大规模数据存储和快速查询的需求。下面是对这个存储引擎的两个关键特性的进一步解读: 统一性(Unified) 多类型数据支持:统一的存储引擎意味着它能够存储和处理多种类型的可观测数据,无论是结构化的日志数据、时间序列的指标数据还是分布式追踪的信息。这样的设计减少了需要使用和管理多个存储系统的复杂性。 统一查询接口:有了统一的存储引擎,用户可以通过一个共同的查询接口访问不同类型的数据,这提高了使用效率,并允许跨数据类型的分析和关联。 统一的管理和运维:统一存储引擎也简化了数据的管理和运维任务,因为它减少了需要学习和监控的工具和接口的数量。 性能(Fast) 高速写入:SLS的存储引擎针对高速数据写入进行了优化,以支持大数据量的实时采集。这对于高流量网站、大型分布式应用和IoT设备等场合至关重要。 高效查询:SLS存储引擎还针对快速查询进行了优化,确保即使在涉及大规模数据集时,也能够快速返回结果。 适应大规模场景:阿里云天然服务于各种规模的企业,包括那些拥有超大规模数据场景的企业。SLS的存储引擎设计考虑了这些场景的需求,保证了扩展性和稳定性。 总体来说,SLS的存储引擎通过统一和快速的写入与查询功能,为处理大规模的可观测数据提供了一个强大、高效且易于管理的解决方案。整体架构如下: 接入层协议支持: 接入层的设计非常灵活,支持多种数据写入协议,这意味着无论数据来源是什么(如应用程序、服务器、网络设备等),都能够顺利与SLS集成。 写入的数据首先被放入一个先进先出(FIFO)的管道中,这个管道模型类似于Apache Kafka的消息队列(MQ)模型,提供了高吞吐量和可靠性。 管道和数据消费: 管道不仅存储数据,还支持数据消费,允许各类下游系统(如实时分析、告警、可视化工具等)接入并处理数据。 这种设计实现了数据的异步处理,增强了系统的整体扩展性和弹性。 索引结构和存储优化: 在管道之上,存储引擎为不同类型的数据(Traces/Logs和Metrics)构建了两套索引结构。 利用倒排索引(Inverted Index)、列式存储(Columnar Storage)以及压缩(Compaction)等技术,SLS能够提供快速的查询性能,同时优化存储空间的使用效率。 统一的进程架构: 上述所有功能都在一个统一的进程内实现,这意味着可以在单一的系统中处理日志、指标和追踪数据,大大简化了运维和部署的复杂性和成本。 纯分布式框架: SLS的存储引擎基于纯分布式架构构建,支持水平扩展,可以随着数据量的增长而增加更多的存储节点。 单个存储节点(Store)能够处理极高的数据量,最多支持每天处理PB级别的数据写入,适合大规模的数据中心和云环境。 在查询方面,SLS的查询和分析引擎整合了多种查询语法和分析能力,提供了一个强大的查询环境: 关键词查询:支持对存储在SLS中的日志数据进行全文搜索,类似于其他日志管理系统中的关键词查询功能。这主要用于快速查找特定日志条目或筛选日志信息。 PromQL的语法兼容:PromQL是Prometheus查询语言,专门用于时间序列数据的查询。SLS兼容PromQL语法,使得用户能够利用PromQL进行指标数据的查询和分析。 SQL作为顶层分析语言:1、为了实现对可观测数据的深入分析,SLS扩展了SQL语言的能力,使其能够支持连接关键词查询、PromQL等语法;2、通过SQL,用户可以执行更复杂的数据操作,如聚合、排序、联接和子查询等,这为数据分析提供了极大的灵活性。 外部数据源和机器学习模型的集成:SLS的SQL扩展还允许用户连接外部数据库和机器学习模型。这意味着用户可以将SLS中的数据与其他数据源相结合,或使用机器学习算法进行高级分析。 可观测数据的融合分析:SLS使得日志、指标和追踪数据能够在一个统一的分析环境中进行关联和分析。这种融合分析能力使用户能够以多维度来理解和分析系统的行为和性能。 通过这样的设计,SLS提供了一个功能全面的查询和分析环境,可以满足从简单的文本搜索到复杂的数据挖掘和分析的各种需求。对于开发人员、运维人员和数据分析师来说,SLS的查询功能极大地提高了他们处理和分析可观测数据的效率和准确性。 ▐ELK 对比 SLS ELK的核心 ElasticSearch 基于 Lucene 全文索引实现,面向 Document 类型,构建一套完整的可观测分析平台需要组合多款服务,这其中包括 logstash、Kibana、Kafka、Flink、TSDB、Prometheus 等服务,对于规模、查询能力等方面存在一定限制,整体成本较高。 日志服务 SLS 基于阿里云自研灵活索引,支持一站式云原生可观测性,多规格多场景支持。 详细对比下两者在以下方面的差异: 性能:在同样成本的介质上部署,SLS 能够提供更低的延时、以及更稳定的查询性能。 成本:这里的成本不光是部署成本,还需要包括使用成本。要维护良好状态的 ELK 集群,需要从容量规划、稳定性保障、性能调优、数据高可用,数据如何在不同系统间关联等多个方面下功夫。SLS 全托管免运维无需花费额外人力投入。百 TB 规模下,SLS 综合成本是 ELK 的 44%。 易用性:SLS 对开源协议及组件相比 ELK 有更好的兼容性。利用 ELK 构建完整可观测分析平台需组合多款服务,这其中包括Logstash、Kibana、Kafka、Flink、TSDB、Prometheus等。SLS 在这个场景上无需多个组件搭配,支持一站式数据监控分析平台能力。 互联互通与二次开发:在可观测场景中,我们需要跨多个数据源进行关联分析SLS 可观测数据统一存储支持 log metric trace 数据存储,打通数据孤岛,并且提供开源友好的 API 接口进行使用。 附加能力(新算子、告警等):开源 ELK 仅支持指标分析聚合、分桶聚合、管道分析、矩阵分析有限的聚合算法。SLS 针对数据分析场景支持 30+ 聚合计算函数,丰富的机器学习函数以及多渠道数据源,是 ELK 提供操作符的 5 倍,充分发掘数据分析能力。除此之外,SLS 内置告警功能可以快速开箱即用,无需搭建系统。 参考文章  https://icyfenix.cn/distribution/observability/tracing.html   https://tech.meituan.com/2023/04/20/traceid-google-dapper-mtrace.html   https://tech.meituan.com/2022/07/21/visualized-log-tracing.html   https://developer.aliyun.com/article/1065820#slide-4   https://aws.amazon.com/cn/what-is/elk-stack/ 团队介绍 我们来自淘天集团的营销与平台策略技术。我们支撑大促 (双11、618 等)和日销业务;同时我们也直面竞对,深入参与淘宝好价、百亿补贴、聚划算等日销业务的价格心智打造。秉承“简单、开放、自驱”的技术文化,在使命与责任中互相成就,共同成长,践行让业务先赢,技术氛国浓郁。 ¤ 拓展阅读 ¤ 3DXR技术| 终端技术| 音视频技术 服务端技术|技术质量|数据算法 本文分享自微信公众号 - 大淘宝技术(AlibabaMTT)。 如有侵权,请联系 support@oschina.cn 删除。 本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

优秀的个人博客,低调大师

每日一博 | 小红书如何做混部?

作者:宋泽辉(小红书)、张佐玮(阿里云) 编者按: Koordinator 是一个开源项目,是基于阿里巴巴内部多年容器调度、混部实践经验孵化诞生,是行业首个生产可用、面向大规模场景的开源混部系统,致力于提升应用服务质量,优化资源使用效率。自 2022 年 4 月正式开源以来,吸引了业界众多优秀工程师的贡献参与和讨论。 小红书是 Koordinator 社区的活跃成员,自项目诞生初期就深度参与了一系列重要功能的演进。 背景介绍 随着小红书业务的高速发展,各类在线、离线业务对于计算资源的需求也在快速增长。与此同时,部分在线集群天均利用率水位却维持在较低水平,造成这一现象的主要原因有以下几点: 在线服务资源使用量随着终端用户的使用习惯呈现稳定的潮汐现象,夜间 CPU 利用率极低,导致集群均值 CPU 利用率较低; 业务保有大量的独占资源池,资源池割裂产生大量的资源碎片,拉低 CPU 利用率; 业务为了稳定性考虑,会过量囤积资源,进一步拉低 CPU 利用率。 基于以上背景,为了帮助业务降低资源使用成本,提升集群 CPU 利用率,小红书容器团队从 2022 年开始,通过规模化落地混部技术来大幅提升集群资源效能,降低业务资源成本。 技术演进 小红书混部技术演进分为以下四个阶段: 阶段一:闲置资源再利用 早期集群资源管理粗放,集群中存在大量业务独占资源池,因为资源碎片等因素存在大量低分配率的低效节点,散落在各个集群中的低效节点形成大量资源浪费。另一方面,部分基于 K8s 发布的转码类近线/离线场景,全天时段均存在大量计算资源需求。 基于以上背景,容器平台通过技术手段将集群中的闲置资源收集起来,分配给转码类业务场景使用。 我们通过 virtual-kubelet 打通元数据集群与物理集群,将闲置资源汇聚起来,在元数据集群分配给转码类场景近线/离线计算服务。策略方面,二次调度器负责巡检集群所有节点,识别为低效节点后标记出来,virtual-kubelet 获取物理集群中的低效节点可用资源作为集群闲置资源二次分配给离线转码,同时二次调度器需要保证一旦在线服务有资源需求,将会立刻驱逐离线 pod 并归还资源。 阶段二:整机腾挪分时复用 搜推广等业务的独占资源池,CPU 利用率潮汐现象明显,夜间利用率极低,资源池中的单个节点往往也只部署一个大规格业务 Pod。基于以上背景,平台通过弹性能力(HPA),在凌晨业务低峰期按比例对在线业务缩容,腾挪空出整机,并将转码、训练等离线 pod 在该时段运行起来,起到利用率“填谷”的效果。 具体实施时,需要确保在线服务能在规定的时间内全部被拉起。为此,策略方面我们实现了离线提前退场,并通过调度器抢占机制兜底,确保在线服务在业务高峰期来临之前能被全量及时拉起。 阶段三:常态混部 为了降低资源碎片率,降低业务资源持有成本,平台持续推进业务大规模合池,将业务由独占池迁至平台托管的公共混部池,通过合池、资源超卖等技术手段,CPU 分配率得到有效提升,但依旧无法解决合并后的资源池夜间利用率较低等问题。 另一方面,合池后的复杂混部场景下,整机腾挪分时混部离线的调度策略很难再继续实施,平台需要通过建设更为细粒度的资源管理与调度能力来实现均值利用率提升的目标,具体包含以下几点: 调度侧: <!----> 通过动态超卖技术获取可二次分配给离线的可用资源量,并抽象出离线资源视图让 K8s 调度器感知到,调度器调度离线负载到对应节点上,实现离线对节点利用率的“填谷”效果; 通过负载调度,尽可能避免在线服务被调度到高负载机器,让集群中节点负载更加均衡; 通过二次调度,驱逐负载热点机器上的高利用率服务,使得集群负载处于动态均衡状态。 <!----> 单机侧: <!----> 支持 QoS(Quality of service) 保障策略,根据服务的 QoS 等级提供差异化的运行时资源保障能力; 支持干扰检测、离线驱逐等能力,当离线对在线敏感服务产生干扰时,第一时间驱逐离线。 通过以上技术手段,可以有效保障服务混部时的稳定性,从而常态化的让在线离线工作负载混跑在节点上,实现利用率填谷效果的最大化。 架构设计与实现 小红书容器资源调度架构设计如图所示: 小红书各类业务场景通过各类发布平台、任务平台提交后,通过上层负载编排能力,以 pod 形式下发到统一调度系统。统一调度系统基于不同的调度需求,对在线服务提供强保障的资源交付能力,差异化的 QoS 保障能力,对离线服务提供最小资源需求的保障能力和极致的弹性能力。 调度侧: 离线调度:coscheduling; 二次调度:热点驱逐,碎片整理; 负载调度:基于 CPU 水位; 资源视图:模拟调度。 单机侧: 压制策略:bvt 压制,内存驱逐; QoS 保障:绑核,超线程干扰抑制等; Batch 资源上报:Batch 可用资源计算,上报; 指标采集(from kernel):psi,sched info 等; 干扰检测:基于 cpi、psi,业务指标的干扰检测。 离线调度资源视图 离线服务资源调度的基本原理是基于在线服务负载感知能力的动态超卖,具体实现是将节点空闲资源二次分配给离线业务: 其中离线可用资源为节点上的空闲资源(包含未分配资源和已分配未使用资源之和),扣除安全预留资源之后剩余资源,离线可用资源计算公式如下: 离线可用资源=整机资源–预留资源-在线服务实际使用量 将计算出的离线可用资源量按照时间分布后如图所示(图中绿色部分): 实际落地过程中,为了避免离线可用资源随在线服务资源使用波动而大幅波动,从而影响离线资源质量和离线服务运行稳定性,通过资源画像对上述公式中的在线服务实际使用量数据进一步处理,去除数据噪点,最终计算出一个相对稳定的离线可用资源量(图中绿色部分),如图所示: 混部 QoS 保障策略 QoS 分级 按照业务对于服务质量(QoS: Quality of Service)的需求,我们将小红书的业务类型简单的划分为三个 QoS 级别,如下表所示: Qos等级 说明 业务场景 latency-sensitive 最高Qos保障等级,延迟极为敏感服务 搜推广延迟极为敏感场景 mid 默认Qos保障等级,容忍部分干扰延迟 网关,java微服务 batch 最低Qos保障等级,延迟不敏感,资源随时可能被抢 转码,spark,flink,训练等计算场景 QoS 保障 根据服务的 QoS 需求,节点侧会做 Pod 粒度的分级资源保障,实现各个资源维度差异化 QoS 保障策略,具体的保障参数如下: 资源 特性 latency-sensitive mid batch CPU cpu burst enable enable disable 调度优先级 最高 默认 低 绑核 share(默认) share(默认) reclaimed numa 强保证 prefer(默认) none L3 cache 100% 100%(默认) 30%(默认) 内存带宽 100% 100%(默认) 30%(默认) 内存 OOM优先级 最低 默认 最高 内存回收水线 调高 默认 调低 在 CPU 核调度层面,分别设置了三种绑核类型,并设计了一套精细化 CPU 核编排策略,分配示意图如下: 三种绑核类型分别为: exclusive(不推荐) <!----> 特点:绑定 cpuset 调度域,CCD 感知,numa 绑定,独占排他 场景:极为敏感的搜推广大规格延迟敏感服务 <!----> share <!----> 特点:绑定 cpuset 调度域,CCD 感知,numa(可选)绑定,share/exlusive 排他,可与 none 类型业务共享 场景:容忍部分干扰的 Java 微服务,应用网关,web 服务 <!----> reclaimed <!----> 特点:无 cpuset 绑定,可能与非 exlusive 绑核模式业务共享核,核的分配完全交由内核,CPU 资源并非 100% 能得到满足 场景:batch 类离线服务,部分对延迟无要求的计算服务 离线驱逐 极端场景下,如整机内存使用率较高,有触发 OOM 风险,或者离线业务 CPU 长期得不到满足,单机侧支持按照离线服务内部定义的优先级配置,资源用量,运行时长等多维度综合算分排序后按序驱逐。 离线业务场景 小红书作为一个数亿用户的内容社区,其离线业务场景丰富多样,其中包含大量视频类,图片类转码场景,搜推,cv/nlp 算法推理训练,算法特征生产,数仓查询等离线场景,具体来讲,包含以下业务类型: 近离线转码场景(已容器化) Flink 流式/批式计算(已容器化) Spark 批式计算 (未容器化,on yarn) cv/nlp 算法回扫场景(已容器化) 训练场景 (已容器化) 通过提供以 K8s 为底座的在离线统一调度能力,将这些离线业务与在线服务混合部署在统一计算资源池内,为在线服务提供差异化的资源质量保障,为离线服务提供海量的低层本算力,实现资源效能的提升。 K8s 与 Yarn 混部方案 小红书内部商业化,社区搜索等业务存在大量的算法类 Spark 任务因为离线集群资源紧张导致任务堆积,不能得到及时处理,同时在线集群在业务低峰时段资源使用率较低;另一方面,相当占比的 Spark 任务资源调度仍旧运行在 Yarn 调度器上,在这样的背景下,为了降低业务迁移成本,方案选型方面,我们选择与 Kooridinator 社区合作,采用 Yarn on K8s 混部方案来快速落地 Spark 离线场景混部,具体方案如图所示: 其中容器化的在线、离线工作负载通过 K8s 链路发布到在线集群内,Spark 作业通过 Yarn ResourceManager 调度到具体节点,并由节点上的 Nodemanager 组件拉起。其中 Nodemanager 通过容器的方式部署在在线 K8s 集群内,除此之外,还涉及到以下组件: 调度侧 <!----> koord-yarn-operator :支持 K8s 与 yarn 调度器资源视图双向同步; <!----> 节点侧 <!----> copilot:NodeManager 操作代理,提供 Yarn Task 管控接口; Neptune-agent/koordlet:离线资源上报,节点离线 Pod/task 管理,冲突解决,驱逐,压制策略; 支持 K8s 与 YARN 混部的核心能力目前已经在社区研发完成,在 Koordinator 1.4 版本进行发布。 多调度器资源同步 K8s 调度器与 YARN 调度器之间原本独立且相互不感知,为了共享分配在线集群节点上的总可用离线资源,需要通过 koord-yarn-operator 组件来做两个调度器之间的资源双向同步和协调,并实现两个同步链路: K8s->YARN 调度器资源同步链路,负责同步 Yarn 视角离线资源总量,其中 YARN 离线资源总量计算如下: YARN 离线资源总量=离线总可用量-K8s 侧节点已分配 YARN->K8s 调度器资源同步链路,负责同步 YARN 已分配资源量,其中 K8s 离线资源总量计算如下: K8s 离线资源总量=离线总可用量-YARN 侧节点已分配 基于各自节点离线资源视图,两个调度器分别做出调度决策,调度 K8s 离线 Pod 与 YARN Task 到节点上,由于同步过程不适合加锁,可能会出现资源被过量分配的问题: 具体解决措施是在单机侧增加了仲裁逻辑,当节点已分配离线服务资源量长期超过节点可用离线资源,且离线使用率持续较高,存在离线服务得不到资源被饿死的可能,单机侧则会根据离线服务的优先级,资源占用量,运行时长等因素综合算分并按序驱逐。 阿里云 EMR 产品化支持 与此同时,阿里云 EMR 团队在产品层面提供了混部功能的开发支持,在兼容EMR 原有日志,监控,运维逻辑的基础上,支持了 K8s 集群弹性扩缩容 NodeManager Pod 的能力。 落地收益 截至目前,小红书混部能力覆盖数十万台机器规模,覆盖算力规模数百万核,支持数万规模在线、离线场景服务的资源调度。 通过大规模容器混部的持续推进,小红书在资源成本效能等方面都取得了显著收益,具体包含以下两方面: CPU 利用率 <!----> 在保证在线服务服务质量的前提下,在线混部集群天均 CPU 利用率提升至45% 以上,部分集群天均 CPU 利用率可稳定提升至55%。 通过在离线混部等技术手段,在线集群 CPU 利用率提升8%-15%不等,部分存储集群 CPU 利用率提升可达20% 以上。 <!----> 资源成本 <!----> 在保证离线业务稳定性的前提下,为小红书各类离线场景提供数百万核时的低成本算力。 混部集群 CPU 分配率提升至 125% 以上,相较于独占资源池,资源碎片率明显下降。 社区共建历程 小红书是早期参与 Koordinator 社区的公司之一,2022 年 4 月,Koordinator 正式开源,同年 6 月,小红书内部启动了在离线混部项目,开始参与 Koordinator 方案设计与代码提交。2022 年 8 月,小红书与社区共建了 runtime-proxy 组件,并在内部场景落地。2023 年 4 月,小红书在社区主导启动了 YARN 与 K8s 混部项目,2023 年 8 月,该方案在小红书内规模化落地。 截至目前,依托 Koordinator 的助力,小红书的混部已经覆盖公司数万台节点,提供数十万核离线资源,整体混部集群的利用率提升至 45% 以上, 取得了不错的落地效果。 总结与展望 在小红书近一年多混部技术探索过程中,我们在资源效能提升方面积累了较为丰富的落地经验,并取得了不错的提升效果,随着公司业务规模逐步增长,场景愈发复杂,我们将会面临诸多新的技术挑战。下个阶段我们的目标是建设面向混合云架构的统一资源调度能力,具体工作将围绕以下三方面展开: 混合工作负载调度能力支持: 包括大数据、AI 在内的任务型工作负载调度能力建设,满足小红书所有业务场景的资源调度功能,性能需求; 资源效能进一步提升: 面向混合云架构,推进更大规模的资源合池,推进 quota 化资源交付,通过更加激进的弹性,混部,超卖等技术手段,实现集群资源利用率的进一步提升,资源成本的大幅下降; 更高服务质量保障能力: 在更为激进的 CPU 利用率目标背景下,通过建设 QoS 感知调度能力,干扰检测能力,依托安全容器等技术手段,解决深水区混部中可能遇到的各类混部干扰问题。 Koordinator社区近期规划 再接下来的几个版本中,Koordinator 将在以下几个方面进行重点投入: 调度器性能优化: 支持等价类调度,通过合并 request 相同的 pod,避免 filter、score 等调度过程的重复计算。 Network QoS: 网络维度容器服务质量,保障高优先级带宽,设计 request/limit模型,保障最低带宽需求。 大数据负载: 支持 Gang 调度原子抢占,按分组整体抢占 Pod;面向 Hadoop YARN 任务的 QoS 策略适配。 资源干扰检测: 基于底层指标、感知容器资源竞争情况,识别异常 Pod,消除干扰并反馈调度链路。 钉钉搜索群号:33383887加入 Koordinator 社区钉钉群。

优秀的个人博客,低调大师

每日一博 | vivo 海量微服务架构最新实践

作者:来自 vivo 互联网中间件团队 本文根据罗亮老师在“2023 vivo开发者大会"现场演讲内容整理而成。公众号回复【2023 VDC】获取互联网技术分会场议题相关资料。 vivo微服务平台为全球5亿+用户背后的全网十万级机器、万级微服务提供服务,在高效实践过程中,vivo中间件平台团队输出了一套业务适用的微服务架构最佳实践--架构能力矩阵、高效的开源中间件组件全生命周期管理策略,走出了一条从开源到开源+自研的技术演进路径,通过微服务引擎升级和统一平台建设较好解决了面临的问题与挑战。 一、vivo 从 0 到 1 的微服务架构工程实践 1.1 为什么需要微服务及落地挑战 伴随业务的高速发展,业务的复杂度越来越高,用户规模和访问量也越来越大;项目的迭代速度越来越快,交付效率要求也越来越高。与此同时,服务的集群规模越来越大,部署架构越来越复杂,故障范围也越来越不可控。此外,突增的业务流量时刻考验着服务的水平扩容能力,创新业务的快速孵化也对服务的可扩展性提出了更高的要求。想要解决以上问题,业务架构会朝着微服务架构方向演进。 正是在这样的背景下,vivo于2015年开始微服务架构改造,在落地过程中碰到了以下问题: 一是:服务数量多,配置修改生效、服务发布等变更场景效率低下; 二是:业务链路长,高可用保障难,问题与故障定位耗时长,服务的维护成本高; 三是:大量的跨服务通讯,性能和访问体验优化提升难度大; 四是:一个业务链路涉及大量的上下游团队,对接沟通的协作成本高; 为了解决以上落地过程中的开发、运维、团队协作等难题,我们需要建设配套的微服务架构技术体系。 1.2 vivo 微服务架构最佳实践-架构能力矩阵 建设一套微服务架构技术体系,助力业务又快又好地构建微服务工程,需要哪些技术能力?我们对微服务架构的主要业务场景进行了分析,在业务实践过程中,微服务主要会涉及同步、异步、定时任务三大核心业务场景。 在同步调用场景:涉及的技术能力主要是RPC框架、注册中心、服务治理; 在异步调用场景:涉及的技术能力主要是消息中间件; 在定时任务场景:涉及的技术能力主要是分布式任务调度。 除了上面介绍的框架和系统,业务在微服务架构改造过程中,需要的能力全貌是怎样的? 在深度参与业务微服务架构改造过程中,我们对最佳实践能力项进行了抽象,从而形成了vivo内部的微服务架构最佳实践总结-架构能力矩阵,总计近30项能力。为了更直观的呈现这些能力,我们从接入层、服务层、数据层的三层架构分层,开发、运维等DevOps的关键环节对架构能力进行了梳理,如下图所示。 在开发环节: 在开发接口时,我们要实现内外网接口分离,保障接口的安全性,为此我们要接入网关来隔离内外网接口;在接入层和服务层,我们可以通过治理平台来实现限流、熔断、降级等能力,保障业务的高可用。 在构建内部服务时,我们要尽可能实现服务无状态,通过RPC框架实现内部接口的RPC相互调用,具备异常重试能力,提升服务的鲁棒性;在编码过程中,我们通过接入配置中心实现代码与配置分离,具备运行时动态调整配置的能力,提高服务的变更效率。 在异步调用场景,我们可以通过接入消息中间件实现业务间的相互解耦、流量削峰;在定时任务场景,我们可以通过分布式任务调度系统,实现失败任务的自动转移能力。 此外,我们可以通过落地存储与计算分离能力,实现服务层和数据层的解耦,便于分层扩容,具备面向未来更大规模业务的扩展能力。 在数据层,通过落地读写分离、冷热分离等能力,提升系统性能,节省存储成本;同时将这些能力通过研发框架进行封装,便于业务侧复用。 在运维环节: 我们可以借助CDN实现网站的动静分离访问,减小系统的请求压力;在日常运维过程中,我们要实现服务的可灰度、可回滚;服务节点无单点;同时借助容器技术快速实现弹性伸缩能力;提升系统的故障恢复速度。 在部署时,通过部署与发布分离,可以较好规避发布变更时产生的问题,即服务部署成功,并且健康检查通过后再发布到生产环境,减小故障的影响范围。 在遇到严重的系统故障时,需要具备使用备份数据从零恢复的能力,同时对所有已知的故障场景要有对应的预案,提升系统的故障应对能力。 在数据运维上,我们要确保数据属主唯一,避免多个业务对同一个数据库进行访问;同时也要实现业务数据和大数据的存储隔离,避免相互影响。 除了以上能力之外,我们还要实现业务的安全合规,建设覆盖Metric、Trace、Log的可观测能力体系,便于对故障问题的定位排查;在多机房层面,需要具备同城双活、异地多活等跨机房容灾能力。 1.3 vivo 微服务平台能力 为了更好落地以上最佳实践,我们构建了一套从接入层、服务层、消息层、框架层到存储层的平台能力,完整的平台能力地图如下图所示: 在接入层,我们提供了四层流量网关和七层微服务API网关;在服务层提供了服务/流量治理平台、配置中心、注册中心、接口管理平台、分布式任务调度等系统。 在消息层提供了消息中间件;在框架层提供了脚手架,可快速集成日志、配置、限流/熔断、MySQL/Redis等SDK,以及RPC框架。 在存储层提供了DaaS平台,包含MySQL、Redis、ElasticSearch、MongoDB、文件服务等系统能力。 为了更好排查故障问题,我们在可观测领域构建了监控中心、日志中心、调用链等系统;此外,还有更好支撑服务构建、变更发布的CICD系统和IT基础设施的配置管理系统CMDB。 截止2019年,vivo基本完成了从0到1的微服务平台能力烟囱式建设。 快速构建这些能力的过程,离不开开源组件的赋能。例如微服务API网关背后的zuul,注册中心背后的ZooKeeper和etcd,RPC框架的Dubbo和bRPC;配置中心的Apollo和Nacos,流量治理的hystrix和sentinel,消息中间件的RabbitMQ和RocketMQ,任务调度的xxl-job;如下图所示。 在此,我们也通过VDC(vivo 开发者大会)平台,感谢开源社区的赋能,助力vivo微服务架构技术体系从0到1的快速构建。 1.4 vivo 微服务现状 截止当前,vivo的微服务平台为全球分布在60+个国家/地区的5亿+用户提供服务;其中vivo现有万级的微服务,覆盖全网机器规模十万级,每天处理高达8000亿次的RPC调用次数,流量的峰值QPS达到千万级以上。 在支撑如此规模的微服务过程中,特别是在2020年以后,我们碰到了较多的问题与挑战,为了解决这些问题,我们使用了微服务引擎升级和统一平台建设的解决方案;下面来一起看看我们碰到了哪些问题与挑战? 二、微服务引擎升级与统一平台建设 2.1 面临的问题与挑战 我们知道,注册中心和配置中心是微服务架构领域的技术基石;下面给大家说明下我们在这两个基石系统实践过程中遇到的问题与挑战: 首先是注册中心,众所周知,ZK是CP特性,在注册中心场景有较多不可用的问题,此外还有跨机房多活能力缺失,集群故障半径大等问题;写性能无法水平扩展,在大规模Dubbo服务场景中,接口级注册模型注册的数据量大,在业务高频变更期间网卡的带宽峰值会超过1000Gbps。此外还有业务易混用,功能缺失;内部的多个技术栈使用不同的注册中心,跨技术栈调用的研发运维成本高等问题。 在配置中心场景,存在应用、组件配置的变更通道不统一,故障场景配置回滚慢,变更审计日志分散,业务恢复耗时长等问题;配置变更下发的时效不满足业务要求,内部存在多套配置中心,都需要和业务研发流程打通,存在审批、审计、回滚等功能没有对齐的问题;此外在功能和安全上,还需要实现内部的配置定时生效,配置加解密等需求,配置访问通道符合公司的安全要求。 从以上的问题与挑战中可以看出,基于开源组件快速构建的微服务底层引擎在vivo的内部业务场景中存在较多的可用性、性能&容量、研发运维、功能&安全问题与挑战。 2.2 注册中心引擎升级 为了解决以上的问题与挑战,我们需要进行技术升级,首先给大家介绍的是注册中心的解决方案: 针对Dubbo接口级服务发现导致ZK注册中心流量过大的问题,业界同行都在往应用级服务发现迁移来构建解决方案;通过Dubbo开源社区官网的介绍,我们可以看到,应用级服务发现是适应云原生,支持更大规模的服务发现模型; 将Dubbo接口级服务发现模型升级为应用级,可降低单机50%的内存消耗,降低注册中心集群90%的存储与推送压力,从架构上支持百万实例集群规模; 因此我们需要将Dubbo框架服务发现模型从接口级升级为应用级,彻底解决注册数据量大,对注册中心请求压力大的问题,同时具备面向云原生微服务架构的扩展能力。 此外,针对注册中心的可用性、性能&容量、研发运维等问题,我们需要建设满足AP特性、支持跨机房多活的统一注册中心,使用Session+Data分离架构,Data层持久化数据,Session层处理和客户端的长连接,无状态Session层能较好收敛客户端请求,实现读写流量隔离,具备较好的横向扩展能力,真正解决注册中心的性能、容量和扩展性问题。 综上,我们需要构建Dubbo应用级服务发现能力,构建Session+Data分离的统一注册中心,内部的项目代号为vns。 从上面的技术方案分析中,我们可以看到,通过应用级注册可以彻底解决注册中心的流量突刺问题;通过Session+Data双层分离架构可以实现业务无感知的多集群拆分,有效缩小故障半径,那如何来落地呢? 我们首先想到的就是上图左侧的技术方案,通过构建暴露gRPC协议、支持应用级注册的vns系统,海量的Dubbo服务通过双注册来实现迁移;但是在经过详细的技术分析之后,我们发现该方案存在明显的耦合问题: 首先是Dubbo应用级注册升级的进展依赖vns系统的建设进度,Dubbo框架依赖稳定的vns SDK,Dubbo框架和vns系统之间存在进度依赖问题; 其次还存在回滚依赖问题,当vns系统因灰度异常回滚时,Dubbo应用级注册升级进度也会同步回滚; 同理当Dubbo流量切换异常回滚时,vns的业务接入进度也会回退。 此外,部分不迭代的业务可能需要继续使用接口级注册,无法实现ZK注册中心的完全下线。 为了解决以上问题,我们对技术方案进行了升级,改用通过vns系统暴露和支持ZK协议,实现Dubbo应用级注册升级和vns系统的能力建设解耦;当vns系统的能力建设进展还未达到生产环境要求时,我们可以通过引入一套新的ZK集群来支持Dubbo的应用级注册模型升级;当vns的能力成熟度达到生产环境的要求后,可以对引入的ZK集群进行替代,整个过程可以根据系统建设进展和可用性保障要求,进行可控的灰度放量和回滚操作,控制变更风险;最终,vns通过暴露ZK+gRPC双协议满足业务的接入诉求。 在整个技术方案落地过程中,我们始终坚持业务导向原则,实现业务升级和迁移的零|低成本;采用稳妥、完善的升级迁移方案,确保过程可灰度、可回滚、可观测;大家可以看到,我们通过兼容ZK协议,最大限度的保障Dubbo业务的平滑升级,切换方案做到了可灰度可回滚可观测,在减少升级成本的同时,降低项目落地风险,最终实现ZK注册中心的完全下线。 2.3 配置中心引擎升级 介绍完注册中心,我们再来看看配置中心的解决方案,配置中心主要解决的是配置通道不统一,性能不达标,无法满足内部的业务需求等问题。 上图左侧是我们最新的配置中心技术架构图,右侧是统一配置通道的示意图,我们通过支持应用配置与组件配置的统一配置通道,实现了配置管理能力的收敛统一,在此基础上,建设一键审批/审计/回滚等能力,实现了和内部业务研发流程的打通,减少人力运维投入;此外,在新版配置中心上,我们也实现了较多的高可用、性能、安全、可观测能力增强等业务诉求;在配置中心升级过程中,我们追求业务的无感知升级,通过兼容原有配置中心对外开放的接口,实现了新系统的平滑升级,原有系统优雅下线。 大家可以看到,和注册中心的升级方案类似,在配置中心的技术方案设计中,我们也较好的遵循了业务导向原则。 2.4 统一微服务平台建设 介绍完注册中心和配置中心等微服务引擎的技术升级方案,我们再来看下从0到1快速构建的烟囱式微服务平台会面临哪些问题和挑战? 从上图左侧示意图中可以看到,我们快速构建的微服务平台存在10个以上的模块,每个模块都有独立的入口,用户使用平台的易用性很低;此外,这些模块在建设过程中,还需要重复对接云平台、单点登录、权限、工单、监控、CMDB等公共服务系统;系统审计日志分散,不便于快速定位因变更引起的问题;综上,烟囱式微服务平台存在多入口,功能重复对接,运维、研发成本高,故障排查与恢复效率低,易用性不足等问题。 要解决烟囱式微服务平台的问题,需要构建更合理的产品方案,我们对用户的使用现状进行了分析: 通过系统埋点数据发现,烟囱式微服务平台中用户使用频率最高的两个系统分别是配置中心、服务治理。 通过上图左侧的PV/UV饼状图数据,大家可以发现: 配置中心的用户访问主要集中在配置的【查询与变更】、【变更记录与审批】和配置变更相关的2个页面上,服务治理的用户访问主要集中在【服务概览】、【服务查询】和服务相关的2个页面上。 基于埋点数据,我们可以看到用户的访问集中在少数的几个功能上,通过整合各个系统模块高频使用的功能,建设统一的平台入口,实现系统间联动,这也给我们如何建设统一平台提供了较好的思路。 此外,在对各个模块的技术架构进行分析时,我们识别到了位于最底层、技术依赖程度最高的两个系统:配置中心、注册中心,这两个系统非常适合作为统一平台建设的技术底座。 区别于烟囱式微服务平台的多个系统模块独立对接CICD等研发平台,在统一微服务平台建设中,我们升级为统一平台对接CICD等研发平台;我们的建设思路是,以配置中心/注册中心为底座来建设统一微服务平台: 一是:基于统一的配置通道与CICD等研发平台系统进行联动,建设一键审批、回滚能力,整合研发流程,降低对接成本; 二是:通过统一平台的建设,实现平台间联动,建设高阶的自动化水平,支撑业务进一步提升持续服务能力。 2.5 引擎升级&统一平台建设总结 接下来,对我们前面讲到的内容做一个总结:在大规模、海量业务的微服务架构实践过程中,我们通过引擎升级和统一平台能力建设较好的解决了碰到的问题与挑战。 在升级和建设过程中,我们需要保证现有业务的连续性,保障不发生因底层引擎升级和平台建设导致的可用性问题。因此,引擎升级和统一平台建设的工作需要建立在高可用保障的基础上;换句话来说,可用性是我们所有工作的底座。 在这个基础上,我们实现注册中心和配置中心的引擎升级,完成应用级注册模型升级;在这个过程中,解决底层引擎的扩展性、容量、性能、可维护性和安全性等问题;最后,我们要建设统一的微服务平台能力,实现平台间联动,构建自动/自助化使用能力;赋能业务。 大家可以看到,通过完整的方案介绍,在上图右侧我们呈现了微服务架构实践过程中的价值分层逻辑,即在可用性的基础上,提升系统的扩展性、容量、性能、可维护、安全性等能力;然后再在此基础上,交付更高的研发效率,更好的用户使用体验。 三、微服务架构升级的总结与展望 介绍完我们的解决方案后,最后来说明下我们对微服务架构升级的总结与思考,以及对未来的展望。 3.1 拥抱开源的实用主义 在构建微服务架构技术体系的过程中,我们始终坚持拥抱开源,迭代业务适用的技术平台;结合内部业务的实际情况,我们走出了一条从开源到开源+自研的研发路径。 在从0到1的平台能力建设过程中,我们引入开源组件进行能力快速构建,快速交付满足业务的需求;始终坚持业务适用原则,不过度设计,支撑业务的快速迭代;以上阶段,我们称之为“拿来主义”。 在面向更大规模、海量业务实践过程中,为了解决碰到的问题与挑战,我们在开源的基础上进行增强,自研部分能力来解决亿级用户规模下内部业务的功能,性能,容量,研发流程打通等需求;这个阶段,我们称之为“实用主义”。 在技术平台迭代过程中,我们始终坚持2个原则,一是简单有效原则,坚持用最简单的解决方案来解决问题;二是迭代和演进原则,坚持平台持续迭代和演进的原则;前期基于开源组件快速搭建能力,再基于实际的业务需求和痛点来落地自研架构;在这个过程中,始终坚持业务适用,不为了技术而技术,避免大而全的技术架构。 此外,也要说明一个常见的误区,我们为什么不完全自研?vivo的微服务平台建设从开源社区获益良多,坚持不闭门造车,站在巨人肩膀上,持续引入优秀特性来支撑业务的快速发展,同时也会考虑将部分行业适用的通用优秀特性反馈给社区,和社区共同成长。 3.2中间件组件全生命周期管理 大家可以看到,vivo的微服务架构技术体系引入了较多的开源组件,在实践过程中,我们摸索出了一套完整的中间件组件全生命周期管理策略。 我们先来看看业务的诉求和底层技术的特点: 首先是业务的诉求: 业务期望更高的迭代交付效率; 快速引入新技术,使用新技术助力业务创新,但很多时候新技术往往意味着成熟度不足,可能存在较多问题; 业务的不断创新与发展,对组件的性能、容量要求越来越高; 对业务来说,高效迭代交付需求是第一位的。 然而,底层技术有它自己的特点: 技术的发展有它的客观规律,需要经历萌芽期 → 膨胀期 → 低谷期→ 复苏期→ 成熟期等多个阶段; 缺乏约束的技术体系必然随着时间推移而腐化,治理不及时会成为技术债务,阻塞业务发展; 同类中间件组件的快速引入会有重复建设的效率问题; 中间件组件的技术升级周期客观上都比较长。 实践证明,只有足够稳健的底层技术能力才能更好支撑业务的高效迭代。在这个过程中,如何兼顾效率与质量?尊重客观规律,确保整个过程都有明确的目标和方向,避免走偏,慢就是快。 我们认为,完善的中间件组件全生命周期管理策略,首先需要在所有的技术团队中形成价值共识;再通过组件扫描和组件地图等手段及时对组件全貌进行洞察;在组件的标准化治理和运营阶段实现有规范,补短板;同时在新技术引入时,通过完善的新技术引入规范,覆盖功能/性能/容量/扩展性/成熟度/使用成本等维度;在组件的版本治理上,使用基线版本治理方案,输出明确的使用标准/版本升级方案/版本收敛策略;最后,在组件的成熟度管理上,我们可以借助Gartner(高德纳)技术成熟度说明和组件能力矩阵,不断提升组件的成熟度。 综上,为更高效的支撑业务,在组件管理上我们使用了更加入宽松的引入策略,同时也会对组件的全生命周期进行严格管理,践行宽入严出策略,通过完善的中间件组件全生命周期管理助力业务跑的更快,走的更远。 3.3 引擎升级探索 展望未来,我们会坚持和践行引擎升级和平台建设的持续迭代思路: 首先是对引擎升级的探索,通过引入新技术来解决当前碰到的研发效率、成本等痛点问题: 在研发效率方向,存在的痛点问题如下: 一是,组件SDK的升级周期长,碎片化问题严重; 二是,当前vivo内部主要的是Java、C++技术栈,新业务形态孵化可能会引入新的技术栈,需能够较好解决跨技术栈的问题。 想要较好的解决以上问题,需要探索基于Java Agent/SideCar技术的标准ServiceMesh模式,将RPC、MQ等中间件能力下沉,透明化实现微服务治理、高可用等能力增强,同时组件具备热升级能力。 此外,在成本方向,存在的痛点问题如下: 一是, MQ等重资源型应用的CPU、存储资源利用率差异大; 二是,部分事件驱动场景机器资源利用率低。 要解决以上问题,我们可以通过升级MQ组件,落地存算分离技术,探索计算存储资源利用率优化方案。另外,还可以探索Serverless技术,实现平台化托管运维,降低资源成本,天然适合小程序、快应用等事件驱动业务场景。 综上,在引擎升级探索上,我们会基于业务需求和痛点问题,探索和落地ServiceMesh/Serverless/存算分离等云原生技术。 3.4 平台建设探索 讲完引擎升级探索,我们再来看看在平台建设上的探索: 作为技术平台团队,我们在持续积极的探索“平台工程”理念,从现在的DevOps实践到平台工程,也是团队协作理念的再次升级。 我们知道,DevOps于2009年出现,2015年在国内火起来,它是一种文化、方法论,是敏捷理念从开发到运维的延伸。DevOps的理念是:践行谁构建谁运行,开发运维一体化,实现业务的高效交付。 但是,DevOps在实际落地过程中存在以下问题: “DevOps团队”的中心化与去中心化取舍问题 【中心化】指的是,独立的DevOps团队,即不在业务团队中配置DevOps能力,而把DevOps人员集中起来组建团队,这种完全中心化的模式本质上和DevOps文化相矛盾。同时根据康威定律,可能会制造新的效能瓶颈。“独立的DevOps团队”在2014年被Thoughtworks“技术雷达”列为Hold (停止采用)。 【去中心化】指的是,将DevOps能力分散在业务团队,这种做法会将大量的和基础设施相关的工作职责划给业务团队;这种方式会随之出现基础设施和服务治理缺失、系统稳定性降低、研发和DevOps效能浪费等诸多问题。 因此,想要践行好DevOps,必须在中心化与去中心化之间取得平衡。 此外,从平台能力上讲,DevOps平台往往更侧重于建设流程和工具链,而在使用这些建设的工具技术平台过程中会大大增加业务开发团队的认知负荷,存在无法较好向业务开发团队屏蔽底层基础设施复杂性的问题。 平台工程的概念,是在2017年首次出现,于2022年在国内兴起。平台工程的定义是,一套用来构建和运营支持软件交付和生命周期管理的自助式内部开发者平台的机制和架构;它的特点是:平台在演进中提供足够的透明度、敏捷性,在建设过程中形成适合业务架构的高效协作模式。在这一过程中逐步将知识体系固化到平台中,从而使得工程方式标准化、流程化和规模化并持续改善;它践行的理念是:一个可用的、高效的平台并非一个技术团队埋头苦干就可以产出的;恰恰相反,一个成功的平台工程需要企业各个组织部门合作、协调、推广并根据实际使用反馈不断迭代。 在具体实践中,平台工程约定了“业务团队”和“平台团队”两个团队,其中“业务团队”负责业务研发,“平台团队”负责平台建设;“平台团队”通过将技术知识沉淀到“平台工程”,隐藏和抽象底层基础设施的复杂性,实现基础设施即代码,为“业务团队”赋能增效;同时,基于“业务团队”在使用“平台工程”的过程中的不断反馈来持续改进平台的自助化产品能力,构建一整套覆盖DevOps全链路的简单易用平台产品;可以看到,平台工程是一种最佳实践,和我们当前的团队协作模式匹配度非常高。 在平台建设的整体规划上: 当前阶段:我们构建的统一微服务平台会持续探索“平台工程”理念,沉淀配置中心、注册中心等平台的技术知识与最佳实践,构建和打磨业务自助化使用的平台能力。 展望未来:我们会通过明确的北极星指标,牵引平台提供更高的研发效率和更好的开发者体验。 在研发效率上,我们追求单位时间内更多的代码产出和需求交付;此外我们也追求更好的开发者体验,通过降低用户使用平台的打断次数和平台问题的人工支撑次数,提升业务团队和平台团队两个团队的开发体验。 在具体的落地路径上,我们始终以开发者用户为中心,针对研发工作中时间消耗较多的场景进行优化,通过北极星指标牵引,形成覆盖 IDE+PaaS 的平台工程实践路径,持续迭代优化平台能力,提升研发效率与开发者体验。 END 猜你喜欢 Spring 七种事务传播性介绍 vivo 数据库备份恢复系统演化 vivo容器平台资源运营实践 Hudi在vivo湖仓一体的落地实践 本文分享自微信公众号 - vivo互联网技术(vivoVMIC)。 如有侵权,请联系 support@oschina.cn 删除。 本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

优秀的个人博客,低调大师

每日一博 | vivo 容器平台资源运营实践

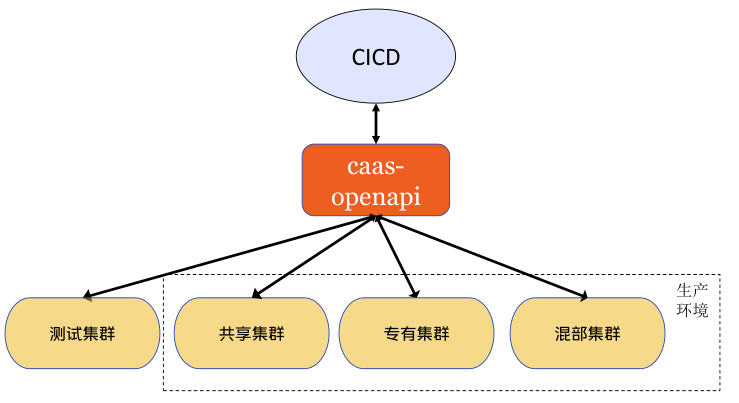
作者:vivo 互联网服务器团队 - Chen Han 容器平台针对业务资源申请值偏大的运营问题,通过静态超卖和动态超卖两种技术方案,使业务资源申请值趋于合理化,提高平台资源装箱率和资源利用率。 一、背景 在Kubernetes中,容器申请资源有request和limit概念来描述资源请求的最小值和最大值。 requests值在容器调度时会结合节点的资源容量(capacity)进行匹配选择节点。 limits表示容器在节点运行时可以使用的资源上限,当尝试超用资源时,CPU会被约束(throttled),内存会终止(oom-kill)。 总体而言,在调度的时候requests比较重要,在运行时limits比较重要。在实际使用时,容器资源规格 request 和 limit 的设置规格也一直都让Kubernetes的用户饱受困扰: 对业务运维人员:希望预留相当数量的资源冗余来应对上下游链路的负载波动,保障线上应用的稳定性。 对平台人员:集群的资源装箱率高,节点利用率低,存在大量的空闲资源无法调度,造成算力浪费。 二、现状 2.1 vivo容器平台介绍 vivo容器平台基于Kubernetes技术对内部业务提供容器服务。内部业务统一在CICD平台部署和管理容器资源,容器平台自研的caas-openapi组件提供restful接口与CICD交互。 平台通过标签,从资源维度逻辑上可以分为测试池、共享池、专有池、混部池。 测试池:为业务部署容器测试,一般非现网业务,为业务测试提供便利。 共享池:为业务不感知物理机,类似公有云全托管容器服务。 专有池:为业务独享物理机,类似公有云半托管容器服务,业务方独占资源,容器平台维护。 混部池:为业务独享物理机,在专有池基础上,混部离线业务,缓解离线资源缺口,提升整机利用率。 2.2 资源部署现状和问题 vivo容器平台的所有在线业务部署均要求设置request和limit,且request <= limit,默认情况request等于limit。在共享池中,常见业务request设置会出现如下情况: (1) 较少情况,业务设置较低的 request 值,而实际使用资源远大于它的 request 值,若大量pod调度一个节点,加剧节点热点问题影响同节点其他业务。 (2)大多情况,业务按最大资源需求设置较高的 request 值,而实际使用资源长期远小于它的 request 值。业务侧账单成本高(按request计费),且容器异常退出时,重调度时可能因为平台空闲资源碎片,导致大规格容器无法调度。这会导致,平台侧可调度资源少,但平台整体节点资源利用率偏低。 对平台和用户方,request值设置合理很重要,但平台无法直接判断用户设置request值合理性,所以无法首次部署时硬限制。 2.3 资源规格合理性思考 2.3.1 request怎么样才是合理设置 request值接近业务实际使用量,例如用户申请request为2核,limit为4核,实际真实使用量最多1核,那么合理request值设置为1核附近。但是业务真实使用量只有运行一段时间后才能评估,属于后验知识。 2.3.2 保障资源最大使用量 不修改limit值就能保障业务最大使用量符合业务预期。 三、解决方案探索 3.1 静态超卖方案 思路: 静态超卖方案是将CICD用户申请规格的request按一定比例降低,根据平台运营经验设置不同集群不同机房不同环境的静态系数,由caas-openapi组件自动修改。如下图: 优点: 首次部署时可以应用,实现简单。 缺点: 生产环境系数设置保守,导致request依然偏大,且由于内存是不可压缩资源,实际实施时为避免业务实例内存oom-kill,静态超卖只开启了cpu维度,未开启内存静态超卖。 3.2 动态超卖方案 3.2.1 方案思路 开发caas-recommender组件,基于业务监控数据的真实资源用量来修正业务request值。 从监控组件拉取各个容器资源的真实使用量。 通过算法模型得到业务申请量的推荐值。 业务重新部署时,使用推荐值修改业务request值。 3.2.2 半衰期滑动窗口模型 结合容器业务的特点,对推荐算法有如下要求: 当workload负载上升时,结果需要快速响应变化,即越新的数据对算法模型的影响越大; 当workload负载下降时,结果需要推迟体现,即越旧的数据对算法结果的影响越小。 半衰期滑动窗口模型可以根据数据的时效性对其权重进行衰减,可以满足上述要求。 详细描述参考:google Borg Autopilot的moving window模型,>" linktype="text" imgurl="" tab="outerlink" data-linktype="2">参看原论文>> 公式如下: 其中τ为数据样本的时间点,t1/2 为半衰期,表示每经过 t1/2 时间间隔,前一个 t1/2 时间窗口内数据样本的权重就降低一半。 核心理念:在参考时间点之前的数据点,离的越远权重越低。在参考时间点之后的数据点权重越高。 半衰期halfLife:经过时间halfLife后,权重值降低到一半。默认的halfLife为24小时。 数据点的时间timestamp:监控数据的时间戳。 参考时间referenceTimestamp:监控数据上的某个时间(一般是监控时间最近的零点00:00)。 衰减系数decayFactor:2^((timestamp-referenceTimestamp)/halfLife) cpu资源的固定权重:CPU 使用量数据对应的固定权重是基于容器 CPU request 值确定的。当 CPU request 增加时,对应的固定权重也随之增加,旧的样本数据固定权重将相对减少。 memory资源的固定权重:由于内存为不可压缩资源,而内存使用量样本对应的固定权重系数为1.0。 数据点权重 = 固定权重*衰减系数 例如现在的数据点的权重为1,那么24小时之前的监控数据点的权重为0.5,48小时前的数据点的权重为0.25,48小时后的数据权重为4。 3.2.3 指数直方图计算推荐值 caas-recommender每个扫描周期(默认1min)从 metrics server 或 prometheus 中获取带时间戳的样本数据,如 container 维度的 CPU、Memory 资源使用等。样本数据结合权重值,为每个workload构建指数直方图,指数直方图中每个桶的大小以指数速率逐步提升。指数直方图的样本存储方式也便于定期checkpoint保存,可以显著提升程序recover性能。如下图: 指数直方图的横轴定义为资源量,纵轴定义为对应权重,资源量统计间隔以5%左右的幅度增加。 桶的下标为N,桶的大小是指数增加的bucketSize=0.01*(1.05^N),下标为0的桶的大小为0.01,容纳范围为[0,0.01),下标为1的桶的大小为0.01*1.05^1=0.0105,容纳范围[0.01-0.0205)。[0.01,173]只需要两百个桶即可完整保存。 将每个数据点,按照数值大小丢到对应的桶中。 当某个桶里增加了一个数据点,则这个桶的权重增加固定权重*衰减系数,所有桶的权重也增加固定权重*衰减系数。 计算出W(95)=95%*所有桶的总权重,如上图仅考虑前4个桶,总权重为20,w(95)权重为19。 从最小的桶到最大桶开始累加桶的权重,这个权重记为S,当S>=W(95)时候,这个时候桶的下标为N,那么下标为N+1桶的最小边界值就是95百分位值,如上图N=3时,S>=W(95),95百分位值即为0.01*1.05^2。 比如CPU波动较大且可压缩,采用95%分位值(P95),内存采用99%分位值(P99)。最终得到workload的资源推荐值。 3.2.4 caas-recommender组件流程图 1. 启动controller:profile Controller监听profile template crd,根据profile crd创建相应维度的recommendation crd,可支持namepace\ workload\pod维度。 2. 初始化: 判断是否有checkpoint,若无,可以选择从prometheus拉取数据构建直方图。若有,由checkpoint直接recover。 3. loop循环: 从recommendation crd中判断哪些pod需要纳管(pod labels) 根据pod label从Kubernetes获取pod信息 根据pod的namespace从metrics server拉取监控数据,由container数据汇聚成pod用量数据。 构建指数直方图,填充pod用量数据和权重值。 根据直方图的分位值计算推荐值 存储推荐值和直方图chekpoint gc需要删除的recommendation crd或者直方图内存等无用数据。 4.支持原生workload常用类型,拓展支持了OpenKruise相关workload类型。 3.2.5 推荐值校正规则 推荐值 = 模型推荐值 * 扩大倍数(可配置) 推荐值 < 原生request值:按照推荐值修改 推荐值 > 原始request值: 按照原始request修改 内存是否修改可以通过配置 不修改workload的limit值 3.3 HPA利用率计算逻辑改造 Pod 水平自动扩缩(Horizontal Pod Autoscaler, 简称 HPA)可以基于 CPU/MEM 利用率自动扩缩workload的Pod数量,也可以基于其他应程序提供的自定义度量指标来执行自动扩缩。 原生Kubernetes的HPA扩缩容利用率计算方式是基于request值。若资源超卖,request值被修改后,那么业务设置的HPA失灵,导致容器不符合预期扩缩容。 关于HPA是基于request还是基于limit,目前Kubernetes社区还存在争论,相关 issue 见72811。若需要使用limit计算利用率,可以修改kube-controller-manager源码,或者使用自定义指标来代替。 vivo容器平台兼容业务物理机利用率逻辑,规定内部统一监控系统的Pod利用率均基于limit计算。 HPA改造思路:通过修改kube-controller-manager源码方式实现基于limit维度计算。 在pod annotation中记录设置值信息(request值和limit值),以及维度信息(request或limit维度)。 controller计算pod资源时,判断是否有指定annotation,若有,解析annotation记录值和维度信息计算利用率,若无,使用原生逻辑。 通过上述方式解耦HPA与pod request值,这样平台的资源超卖功能修改request不影响HPA自动扩缩预期。 3.4 专有池支持超卖能力 专有池物理机由业务自行运维管理,从平台角度,不应该随意修改业务的容器request规格。但是专有池业务也有降低容器规格,部署更多业务,复用资源,提高整机利用率的需求。平台默认所有共享池自动开启超卖能力,专有池可配置选择开启超卖能力。 可自定义开启超卖类型:静态、动态、静态+动态。 可自定义静态系数、动态超卖扩大系数。 可配置是否自动修改超卖值,当不自动生效可通过接口查询推荐值,由业务自行修改。 3.5 整体方案 首次部署: 根据先验知识评估,通过固定静态系数修改request值,再根据部署后各个pod监控用量数据,生成workload的request推荐值。 再次部署: 若有推荐值,使用推荐值部署。无推荐值或者推荐值未生效时,使用静态系数。 四、效果和收益 4.1 测试集群收益 原测试机器的静态超卖系数很低,且只缩减cpu维度资源,导致集群内存成为资源瓶颈。 开启动态超卖能力4个月后,纳管90%的workload,节点pod平均内存request由4.07Gi下降到3.1Gi,内存平台装箱率降低10%,有效缓解集群内存不足问题。 4.2 共享池生产集群收益 原生产集群静态超卖系数较高,CPU资源装箱率高,导致集群的CPU成为瓶颈。 开启动态超卖能力3个月后,纳管60%的workload,节点pod平均cpu request由2.86降低为2.35,整体cpu利用率相比未开启前提升8%左右。 五、总结与展望 vivo容器平台通过资源超卖方案,将业务容器的request降低到合理值,降低业务使用成本,缓解了集群资源不足问题,达到了提升节点利用率目的。但是当前仅在生产集群开启了CPU资源超卖,规划近期开启内存资源超卖。 未来基于上述方法,可以纳管更多维度,比如GPU卡利用率再结合GPU虚拟化能力,从而提高GPU资源共享效率。根据动态超卖推荐值可以用于构建用户画像,区分业务是计算型或内存型,方便平台更好理解用户特性,辅助资源调度等。 参考资料: 深入理解Kubernetes资源限制:CPU 深入理解Kubernetes资源限制:内存 资源画像,让容器资源规格的填写不再纠结 Autopilot: workload autoscaling at Google 深入理解 VPA Recommender END 猜你喜欢 Hudi 在 vivo 湖仓一体的落地实践 RocksDB在vivo消息推送系统中的实践 线上ES集群参数配置引起的业务异常案例分析 本文分享自微信公众号 - vivo互联网技术(vivoVMIC)。 如有侵权,请联系 support@oschina.cn 删除。 本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

优秀的个人博客,低调大师

每日一博 | GPU 架构与计算入门指南

大多数工程师对CPU和顺序编程都十分熟悉,这是因为自从他们开始编写CPU代码以来,就与之密切接触。然而,对于GPU的内部工作原理及其独特之处,他们的了解则相对较少。过去十年,由于GPU在深度学习中得到广泛应用而变得极为重要。因此,每位软件工程师都有必要了解其基本工作原理。本文旨在为读者提供这方面的背景知识。 本文作者为软件工程师Abhinav Upadhyay,他在《大规模并行处理器编程》第四版(Hwu等)的基础上编写了本文大部分内容,其中介绍了包括GPU体系结构和执行模型等内容。当然,文中GPU编程的基本概念和方法同样适用于其他供应商的产品。 (本文由OneFlow编译发布,转载请联系授权。原文:https://codeconfessions.substack.com/p/gpu-computing) 作者 | Abhinav Upadhyay OneFlow编译 翻译|宛子琳、杨婷 1 比较CPU与GPU 首先,我们会比较CPU和GPU,这能帮助我们更好地了解GPU的发展状况,但这应该作为一个独立的主题,因为我们难以在一节中涵盖其所有的内容。因此,我们将着重介绍一些关键点。 CPU和GPU的主要区别在于它们的设计目标。CPU的设计初衷是执行顺序指令[1]。一直以来,为提高顺序执行性能,CPU设计中引入了许多功能。其重点在于减少指令执行时延,使CPU能够尽可能快地执行一系列指令。这些功能包括指令流水线、乱序执行、预测执行和多级缓存等(此处仅列举部分)。 而GPU则专为大规模并行和高吞吐量而设计,但这种设计导致了中等至高程度的指令时延。这一设计方向受其在视频游戏、图形处理、数值计算以及现如今的深度学习中的广泛应用所影响,所有这些应用都需要以极高的速度执行大量线性代数和数值计算,因此人们倾注了大量精力以提升这些设备的吞吐量。 我们来思考一个具体的例子:由于指令时延较低,CPU在执行两个数字相加的操作时比GPU更快。在按顺序执行多个这样的计算时,CPU能够比GPU更快地完成。然而,当需要进行数百万甚至数十亿次这样的计算时,由于GPU具有强大的大规模并行能力,它将比CPU更快地完成这些计算任务。 我们可以通过具体数据来进行说明。硬件在数值计算方面的性能以每秒浮点运算次数(FLOPS)来衡量。NVIDIA的Ampere A100在32位精度下的吞吐量为19.5 TFLOPS。相比之下,Intel的24核处理器在32位精度下的吞吐量仅为0.66 TFLOPS(2021年)。同时,随时间推移,GPU与CPU在吞吐量性能上的差距逐年扩大。 下图对CPU和GPU的架构进行了比较。 图1:CPU与GPU的芯片设计对比。引自《CUDA C++编程指南》(NVIDIA) 如图所示,CPU在芯片领域中主要用于降低指令时延的功能,例如大型缓存、较少的算术逻辑单元(ALU)和更多的控制单元。与此相比,GPU则利用大量的ALU来最大化计算能力和吞吐量,只使用极小的芯片面积用于缓存和控制单元,这些元件主要用于减少CPU时延。 时延容忍度和高吞吐量 或许你会好奇,GPU如何能够容忍高时延并同时提供高性能呢?GPU 拥有大量线程和强大的计算能力,使这一点成为可能。即使单个指令具有高延迟,GPU 也会有效地调度线程运行,以便它们在任意时间点都能利用计算能力。例如,当某些线程正在等待指令结果时,GPU 将切换到运行其他非等待线程。这可确保 GPU 上的计算单元在所有时间点都以其最大容量运行,从而提供高吞吐量。稍后当我们讨论kernel如何在 GPU 上运行时,我们将对此有更清晰的了解。 2 GPU架构 我们已经了解到GPU有利于实现高吞吐量,但它们是通过怎样的架构来实现这一目标的呢?本节将对此展开探讨。 GPU的计算架构 GPU由一系列流式多处理器(SM)组成,其中每个SM又由多个流式处理器、核心或线程组成。例如,NVIDIA H100 GPU具有132个SM,每个SM拥有64个核心,总计核心高达8448个。 每个SM都拥有一定数量的片上内存(on-chip memory),通常称为共享内存或临时存储器,这些共享内存被所有的核心所共享。同样,SM上的控制单元资源也被所有的核心所共享。此外,每个SM都配备了基于硬件的线程调度器,用于执行线程。 除此之外,每个SM还配备了几个功能单元或其他加速计算单元,例如张量核心(tensor core)或光线追踪单元(ray tracing unit),用于满足GPU所处理的工作负载的特定计算需求。 图2:GPU的计算架构 接下来,让我们深入剖析GPU内存并了解其中的细节。 GPU的内存架构 GPU具有多层不同类型的内存,每一层都有其特定用途。下图显示了GPU中一个SM的内存层次结构。 图3:基于康奈尔大学虚拟工作坊(Virtual Workshop)的GPU内存架构 让我们对其进行剖析: 寄存器:让我们从寄存器开始。GPU中的每个SM都拥有大量寄存器。例如,NVIDIA的A100和H100模型中,每个SM拥有65536个寄存器。这些寄存器在核心之间共享,并根据线程需求动态分配。在执行过程中,每个线程都被分配了私有寄存器,其他线程无法读取或写入这些寄存器。 常量缓存:接下来是芯片上的常量缓存。这些缓存用于缓存SM上执行的代码中使用的常量数据。为利用这些缓存,程序员需要在代码中明确将对象声明为常量,以便GPU可以将其缓存并保存在常量缓存中。 共享内存:每个SM还拥有一块共享内存或临时内存,它是一种小型、快速且低时延的片上可编程SRAM内存,供运行在SM上的线程块共享使用。共享内存的设计思路是,如果多个线程需要处理相同的数据,只需要其中一个线程从全局内存(global memory)加载,而其他线程将共享这一数据。合理使用共享内存可以减少从全局内存加载重复数据的操作,并提高内核执行性能。共享内存还可以用作线程块(block)内的线程之间的同步机制。 L1缓存:每个SM还拥有一个L1缓存,它可以缓存从L2缓存中频繁访问的数据。 L2缓存:所有SM都共享一个L2缓存,它用于缓存全局内存中被频繁访问的数据,以降低时延。需要注意的是,L1和L2缓存对于SM来说是公开的,也就是说,SM并不知道它是从L1还是L2中获取数据。SM从全局内存中获取数据,这类似于CPU中L1/L2/L3缓存的工作方式。 全局内存:GPU还拥有一个片外全局内存,它是一种容量大且带宽高的动态随机存取存储器(DRAM)。例如,NVIDIA H100拥有80 GB高带宽内存(HBM),带宽达每秒3000 GB。由于与SM相距较远,全局内存的时延相当高。然而,芯片上还有几个额外的存储层以及大量的计算单元有助于掩饰这种时延。 现在我们已经了解GPU硬件的关键组成部分,接下来我们深入一步,了解执行代码时这些组件是如何发挥作用的。 3 了解GPU的执行模型 要理解GPU如何执行kernel,我们首先需要了解什么是kernel及其配置。 CUDA Kernel与线程块简介 CUDA是NVIDIA提供的编程接口,用于编写运行在其GPU上的程序。在CUDA中,你会以类似于C/C++函数的形式来表达想要在GPU上运行的计算,这个函数被称为kernel。kernel在并行中操作向量形式的数字,这些数字以函数参数的形式提供给它。一个简单的例子是执行向量加法的kernel,即接受两个向量作为输入,逐元素相加,并将结果写入第三个向量。 要在GPU上执行kernel,我们需要启用多个线程,这些线程总体上被称为一个网格(grid),但网格还具有更多的结构。一个网格由一个或多个线程块(有时简称为块)组成,而每个线程块又由一个或多个线程组成。 线程块和线程的数量取决于数据的大小和我们所需的并行度。例如,在向量相加的示例中,如果我们要对256维的向量进行相加运算,那么可以配置一个包含256个线程的单个线程块,这样每个线程就可以处理向量的一个元素。如果数据更大,GPU上也许没有足够的线程可用,这时我们可能需要每个线程能够处理多个数据点。 图4:线程块网格。引自《CUDA C++编程指南》(NVIDIA) 编写一个kernel需要两步。第一步是运行在CPU上的主机代码,这部分代码用于加载数据,为GPU分配内存,并使用配置的线程网格启动kernel;第二步是编写在GPU上执行的设备(GPU)代码。 对于向量加法示例,下图显示了主机代码。 图 5:CUDA kernel的主机代码,用于将两个向量相加。 下图为设备代码,它定义了实际的kernel函数。 图 6:包含向量相加kernel定义的设备代码。 由于本文的重点不在于教授CUDA,因此我们不会更深入地讨论此段代码。现在,让我们看看在GPU上执行kernel的具体步骤。 4 在GPU上执行Kernel的步骤 1. 将数据从主机复制到设备 在调度执行kernel之前,必须将其所需的全部数据从主机(即CPU)内存复制到GPU的全局内存(即设备内存)。尽管如此,在最新的GPU硬件中,我们还可以使用统一虚拟内存直接从主机内存中读取数据(可参阅论文《EMOGI: Efficient Memory-access for Out-of-memory Graph-traversal in GPUs》)。 2. SM上线程块的调度 当GPU的内存中拥有全部所需的数据后,它会将线程块分配给SM。同一个块内的所有线程将同时由同一个SM进行处理。为此,GPU必须在开始执行线程之前在SM上为这些线程预留资源。在实际操作中,可以将多个线程块分配给同一个SM以实现并行执行。 图 7:将线程块分配给SM 由于SM的数量有限,而大型kernel可能包含大量线程块,因此并非所有线程块都可以立即分配执行。GPU会维护一个待分配和执行的线程块列表,当有任何一个线程块执行完成时,GPU会从该列表中选择一个线程块执行。 3. 单指令多线程 (SIMT) 和线程束(Warp) 众所周知,一个块(block)中的所有线程都会被分配到同一个SM上。但在此之后,线程还会进一步划分为大小为32的组(称为warp[2]),并一起分配到一个称为处理块(processing block)的核心集合上进行执行。 SM通过获取并向所有线程发出相同的指令,以同时执行warp中的所有线程。然后这些线程将在数据的不同部分,同时执行该指令。在向量相加的示例中,一个warp中的所有线程可能都在执行相加指令,但它们会在向量的不同索引上进行操作。 由于多个线程同时执行相同的指令,这种warp的执行模型也称为单指令多线程 (SIMT)。这类似于CPU中的单指令多数据(SIMD)指令。 Volta及其之后的新一代GPU引入了一种替代指令调度的机制,称为独立线程调度(Independent Thread Scheduling)。它允许线程之间完全并发,不受warp的限制。独立线程调度可以更好地利用执行资源,也可以作为线程之间的同步机制。本文不会涉及独立线程调度的相关内容,但你可以在CUDA编程指南中了解更多相关信息。 4. Warp调度和时延容忍度 关于warp的运行原理,有一些值得讨论的有趣之处。 即使SM内的所有处理块(核心组)都在处理warp,但在任何给定时刻,只有其中少数块正在积极执行指令。因为SM中可用的执行单元数量是有限的。 有些指令的执行时间较长,这会导致warp需要等待指令结果。在这种情况下,SM会将处于等待状态的warp休眠,并执行另一个不需要等待任何结果的warp。这使得GPU能够最大限度地利用所有可用计算资源,并提高吞吐量。 零计算开销调度:由于每个warp中的每个线程都有自己的一组寄存器,因此SM从执行一个warp切换到另一个warp时没有额外计算开销。 与CPU上进程之间的上下文切换方式(context-switching)不同。如果一个进程需要等待一个长时间运行的操作,CPU在此期间会在该核心上调度执行另一个进程。然而,在CPU中进行上下文切换的代价昂贵,这是因为CPU需要将寄存器状态保存到主内存中,并恢复另一个进程的状态。 5. 将结果数据从设备复制到主机内存 最后,当kernel的所有线程都执行完毕后,最后一步就是将结果复制回主机内存。 尽管我们涵盖了有关典型kernel执行的全部内容,但还有一点值得讨论:动态资源分区。 5 资源划分和占用概念 我们通过一个称为“occupancy(占用率)”的指标来衡量GPU资源的利用率,它表示分配给SM的warp数量与SM所能支持的最大warp数量之间的比值。为实现最大吞吐量,我们希望拥有100%的占用率。然而,在实践中,由于各种约束条件,这并不容易实现。 为什么我们无法始终达到100%的占用率呢?SM拥有一组固定的执行资源,包括寄存器、共享内存、线程块槽和线程槽。这些资源根据需求和GPU的限制在线程之间进行动态划分。例如,在NVIDIA H100上,每个SM可以处理32个线程块、64个warp(即2048个线程),每个线程块拥有1024个线程。如果我们启动一个包含1024个线程的网格,GPU将把2048个可用线程槽划分为2个线程块。 动态分区vs固定分区:动态分区能够更为有效地利用GPU的计算资源。相比之下,固定分区为每个线程块分配了固定数量的执行资源,这种方式并不总是最有效的。在某些情况下,固定分区可能会导致线程被分配多于其实际需求的资源,造成资源浪费和吞吐量降低。 下面我们通过一个例子说明资源分配对SM占用率的影响。假设我们使用32个线程的线程块,并需要总共2048个线程,那么我们将需要64个这样的线程块。然而,每个SM一次只能处理32个线程块。因此,即使一个SM可以运行2048个线程,但它一次也只能同时运行1024个线程,占用率仅为50%。 同样地,每个SM具有65536个寄存器。要同时执行2048个线程,每个线程最多有32个寄存器(65536/2048 =32)。如果一个kernel需要每个线程有64个寄存器,那么每个SM只能运行1024个线程,占用率同样为50%。 占用率不足的挑战在于,可能无法提供足够的时延容忍度或所需的计算吞吐量,以达到硬件的最佳性能。 高效创建GPU kernel是一项复杂任务。我们必须合理分配资源,在保持高占用率的同时尽量降低时延。例如,拥有大量寄存器可以加快代码的运行速度,但可能会降低占用率,因此谨慎优化代码至关重要。 6 总结 我理解众多的新术语和新概念可能令读者望而生畏,因此文章最后对要点进行了总结,以便快速回顾。 GPU由多个SM组成,每个SM又包含多个处理核心。 GPU上存在着一个片外全局内存,通常是高带宽内存(HBM)或动态随机存取内存(DRAM)。它与芯片上的SM相距较远,因此时延较高。 GPU中有两个级别的缓存:片外L2缓存和片上L1缓存。L1和L2缓存的工作方式类似于CPU中的L1/L2缓存。 每个SM上都有一小块可配置的共享内存。这块共享内存在处理核心之间共享。通常情况下,线程块内的线程会将一段数据加载到共享内存中,并在需要时重复使用,而不是每次再从全局内存中加载。 每个SM都有大量寄存器,寄存器会根据线程需求进行划分。NVIDIA H100每个SM有65536个寄存器。 在GPU上执行kernel时,我们需要启动一个线程网格。网格由一个或多个线程块组成,而每个线程块又由一个或多个线程组成。 根据资源可用性,GPU会分配一个或多个线程块在SM上执行。同一个线程块中的所有线程都会被分配到同一个SM上执行。这样做的目的是为了充分利用数据的局部性(data locality),并实现线程之间的同步。 被分配给SM的线程进一步分为大小为32的组,称为warp。一个warp内的所有线程同时执行相同的指令,但在数据的不同部分上执行(SIMT)(尽管新一代GPU也支持独立的线程调度)。 GPU根据每个线程的需求和SM的限制,在线程之间进行动态资源划分。程序员需要仔细优化代码,以确保在执行过程中达到最高的SM占用率。 脚注 [1]没错,得益于超线程技术和多核处理器,CPU也可以并行执行任务。但长期以来,大量工作都致力于提高顺序执行的性能。 [2]在当前一代的NVIDIA GPU中,warp大小为32。但在未来的硬件迭代中,这个大小可能会发生改变。 其他人都在看 开源语言大模型的正确姿势 为什么开源大模型终将胜出 LoRA和QLoRA微调语言大模型 OpenAI规模经济与第二护城河 全面对比GPT-3.5与LLaMA 2微调 语言大模型推理性能工程:最佳实践 LLVM之父:我的AI基础设施软件构建理念 试用OneFlow: github.com/Oneflow-Inc/oneflow/ 本文分享自微信公众号 - OneFlow(OneFlowTechnology)。 如有侵权,请联系 support@oschina.cn 删除。 本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

优秀的个人博客,低调大师

每日一博 | vivo 网络端口安全建设技术实践

揭秘vivo互联网海量服务的研发之路报名中👇 作者:vivo 互联网安全团队 - Peng Qiankun 随着互联网业务的快速发展,网络攻击的频率和威胁性也在不断增加,端口是应用通信中的门户,它是数据进出应用的必经之路,因此端口安全也逐渐成为了企业内网的重要防线之一,然而网络端口因其数量庞大、端口开放和关闭的影响评估难度大,业务影响程度高、以及异常识别技术复杂度高等特点给网络端口安全治理带来了一定挑战,如何对端口风险进行有效治理几乎是每个企业安全团队在攻击面管理工作中持续探索的重点项。 一、网络端口简介 在网络空间中,标记一个服务资源实体最基本的两个要素就是IP和逻辑端口,二者构建服务资源实体的唯一标志符。 1. 常见的端口分布划分: (1)知名端口(Well-Known Ports) 知名端口即众所周知的端口号,范围从0到1023,这些端口号一般固定分配给一些服务。比如21端口分配给FTP服务,25端口分配给SMTP(简单邮件传输协议)服务,80端口分配给HTTP服务,135端口分配给RPC(远程过程调用)服务等等。 (2)动态端口(Dynamic Ports) 动态端口的范围从1024到65535,这些端口号一般不固定分配给某个服务,也就是说许多服务都可以使用这些端口。只要运行的程序向系统提出访问网络的申请,那么系统就可以从这些端口号中分配一个供该程序使用。比如1024端口就是分配给第一个向系统发出申请的程序。在关闭程序进程后,就会释放所占用的端口号。 2.另外,端口还会按照协议类型划分 (1)TCP端口 即传输控制协议端口,需要在客户端和服务器之间建立连接,这样可以提供可靠的数据传输。常见的包括FTP服务的21端口,Telnet服务的23端口,SMTP服务的25端口,以及HTTP服务的80端口等等。 (2)UDP端口 即用户数据包协议端口,无需在客户端和服务器之间建立连接,安全性得不到保障。常见的有DNS服务的53端口,SNMP(简单网络管理协议)服务的161端口,QQ使用的8000和4000端口等等。 3.常用的网络端口映射表 图1 常用网络端口映射表 PS:更多详细端口规范可查阅: http://www.iana.org/assignments/service-names-port-numbers/service-names-port-numbers.xhtml 二、端口利用方式 2.1 基于传输层的资源耗尽攻击(DDoS) 该攻击是非常有效的利用小流量冲击大带宽的攻击手段,也是十分常见的攻击方式。其本质还是利用TCP协议的链接建立(三次握手)及链接关闭(四次挥手)阶段机制漏洞进行攻击,链接资源耗尽攻击方式主要分为以下几个类别: (1)SYN flood SYN flood是基于TCP协议产生的,它利用三次握手机制,制造多个半连接,消耗服务器的连接数。 图2SYN flood 示意图 攻击者伪造源IP地址向服务器发送大量的SYN报文,请求建立三次握手。由于发送源IP是伪造的,所以服务器回应了SYN-ACK报文后,源IP并不会再继续回应ACK报文进行确认。这样服务器就会维持一个庞大的等待列表,不停地重试发送SYN-ACK报文,同时占用着大量的资源无法释放。这就导致,被攻击的服务器被恶意半连接占满,不再接受新的SYN请求,而合法用户无法完成三次握手建立TCP连接。另外,随着对抗技术的持续演进,攻击者通过肉鸡或Ddos服务发起大规模分布式真实IP集中进行资源耗尽攻击,此类攻击成功率更高。 (2)SYN-ACK Flood 通信双方通过三次握手建立一个TCP连接的过程中,SYN-ACK报文出现在第二次握手中,是用来确认第一次握手的。一方收到SYN-ACK报文后,首先会判断该报文是不是属于三次握手范畴之内的报文。如果都没有进行第一次握手就直接收到了第二次握手的报文,那么就会向对方发送RST报文,告知对方其发来报文有误,不能建立连接。SYN-ACK Flood攻击正是利用了这一点,攻击者利用工具或者操纵僵尸主机,向目标服务器发送大量的SYN-ACK报文,这些报文都属于凭空出现的第二次握手报文,服务器忙于回复RST报文,导致资源耗尽,无法响应正常的请求。 (3)ACK Flood 在TCP三次握手的过程中,ACK报文出现在第三次握手中,用来确认第二次握手中的SYN-ACK报文。ACK Flood攻击指的是攻击者利用工具或者操纵僵尸主机,向目标服务器发送大量的ACK报文,服务器忙于回复这些凭空出现的第三次握手报文,导致资源耗尽,无法响应正常的请求。 (4)FIN/RST Flood TCP交互过程中还存在FIN和RST报文,FIN报文用来关闭TCP连接,RST报文用来断开TCP连接。这两种报文也可能会被攻击者利用来发起DDoS攻击,导致目标服务器资源耗尽,无法响应正常的请求。 (5)TCP connection Flood TCP是面向连接的协议,通信双方必须保持连接状态,并且通过确认、重传、滑动窗口等机制,保证数据传输的可靠性和稳定性。攻击者利用TCP协议的上述特点,在TCP连接上做文章,利用TCP连接来消耗被攻击目标的系统资源。例如,攻击者与被攻击目标完成三次握手后,立刻发送FIN或RST报文,释放本端连接,同时快速发起新的连接,以此来消耗被攻击目标的系统资源,或者攻击者与被攻击目标完成三次握手后,发送很少的报文来维持连接状态,通过这种异常的TCP连接来消耗被攻击目标的系统资源。 2.2 基于应用层的资源耗尽攻击(cc) CC攻击的原理就是攻击者控制某些主机不停地发大量数据包给对方服务器造成服务器资源耗尽,一直到宕机崩溃。CC主要是用来消耗服务器资源的,每个人都有这样的体验:当一个网页访问的人数特别多的时候,打开网页就慢了,CC就是模拟多个用户(多少线程就是多少用户)不停地进行访问那些需要大量数据操作(就是需要大量CPU时间)的页面,造成服务器资源的浪费,CPU长时间处于100%,永远都有处理不完的连接直至就网络拥塞,正常的访问被中止。以下介绍一些cc攻击的常用变种。 (1)基于HTTP-header慢速cc攻击 Web应用在处理HTTP请求之前都要先接收完所有的HTTP头部,因为HTTP头部中包含了一些Web应用可能用到的重要的信息。攻击者利用这点,发起一个HTTP请求,一直不停的发送HTTP头部,消耗服务器的连接和内存资源。抓包数据可见,攻击客户端与服务器建立TCP连接后,每30秒才向服务器发送一个HTTP头部,而Web服务器再没接收到2个连续的\r\n时,会认为客户端没有发送完头部,而持续的等等客户端发送数据。 (2)基于HTTP-body慢速cc攻击 攻击者发送一个HTTP POST请求,该请求的Content-Length头部值很大,使得Web服务器或代理认为客户端要发送很大的数据。服务器会保持连接准备接收数据,但攻击客户端每次只发送很少量的数据,使该连接一直保持存活,消耗服务器的连接和内存资源。抓包数据可见,攻击客户端与服务器建立TCP连接后,发送了完整的HTTP头部,POST方法带有较大的Content-Length,然后每10s发送一次随机的参数。服务器因为没有接收到相应Content-Length的body,而持续的等待客户端发送数据。 (3)基于HTTP-read慢速cc攻击 客户端与服务器建立连接并发送了一个HTTP请求,客户端发送完整的请求给服务器端,然后一直保持这个连接,以很低的速度读取Response,比如很长一段时间客户端不读取任何数据,通过发送Zero Window到服务器,让服务器误以为客户端很忙,直到连接快超时前才读取一个字节,以消耗服务器的连接和内存资源。抓包数据可见,客户端把数据发给服务器后,服务器发送响应时,收到了客户端的ZeroWindow提示(表示自己没有缓冲区用于接收数据),服务器不得不持续的向客户端发出ZeroWindowProbe包,询问客户端是否可以接收数据。 剖析其原理,本质上还是对任何一个开放了HTTP访问的服务器HTTP服务器,先建立了一个连接,指定一个比较大的content-length,然后以非常低的速度发包,比如1-10s发一个字节,然后维持住这个连接不断开。如果客户端持续建立这样的连接,那么服务器上可用的连接将一点一点被占满,从而导致拒绝服务。 2.3基于端口发起的渗透测试 IP和端口作为应用暴露在公网的唯一入口,攻击者通常发起渗透测试的起点便是通过扫描目标IP上的开放端口来发现系统的漏洞、薄弱点或安全隐患。 往往服务器系统本身或引入的应用服务就具备一定的脆弱性,攻击者获取到目标服务器的端口列表后会逐一去比对自己的武器库进行漏洞利用尝试。 以下是整理的常见端口利用清单及攻击利用方式: 图3 常见的端口利用清单 三、基于端口利用的案例 Equifax数据泄露案落幕:七亿赔款,索赔期限延长四年 图4 EQUIFAX (图片来源:globalnews.ca) 2017年9月,Equifax系统遭到黑客攻击,导致超过1.45亿美国消费者的个人信息,以及1520万英国居民的记录和8000名加拿大用户的数据遭到泄露,其中包括姓名、地址、出生日期、身份证号、护照、驾照、信用卡等信息。事件曝光后,Equifax股票暴跌30%,相当于蒸发掉50亿美元市值,成为史上罕见大型数据泄露事件之一。2018年12月,美国国会众议院的政府改革暨监督委员会发布报告指出,因Equifax公司组织架构的缺陷,导致公司部门间的沟通失效,从而致使大量的关键系统补丁没有被及时开发,其中包括一个超19个月未做更新的漏洞。最终,黑客对Equifax进行了长达76天的攻击,先后265次从公司获取未被加密的数据。该事件最初是由于Equifax未修补针对Apache Struts的漏洞而导致的,攻击者利用该漏洞访问了Equifax的数据库,这个漏洞是通过开放的80端口进行攻击的。 爱尔兰国家医疗保健局数据泄露事件 图5 爱尔兰卫生部 (图片来源:https://www.sohu.com/a/480716983_121123851) 爱尔兰国家医疗保健局(HSE)是负责为爱尔兰居民提供医疗保健的机构。在2021年5月,该机构发生了一起数据泄露事件,影响到数百万个患者的个人信息。该事件起因于攻击者通过暴露的VPN服务端口进行攻击,成功登录了HSE的IT系统。接着,攻击者开始利用系统漏洞,并最终获取了HSE服务器的管理员权限。攻击者随后将一个WastedLocker勒索软件的恶意代码安装在服务器上,并要求赎金以释放数据。在攻击过程中,攻击者还利用了HSE的Exchange电子邮件系统,以及HSE员工用于管理患者信息的软件系统。这些系统中的漏洞使得攻击者能够访问和窃取大量患者的个人信息,包括姓名、出生日期、地址、电话号码、诊断信息和病历等。据称,该事件涉及到的患者数量达到了数百万。HSE在发现事件后,立即关闭了受影响的系统,并采取措施保护患者数据的安全。HSE还与执法部门和网络安全专家合作,以追查攻击者的身份和追回数据。截至目前,尚未有人或组织宣称对此次攻击负责。 四、端口风险防护及治理实践 4.1端口风险防护 无论是Flood还是cc防护,一般都是借助一些安全设备及安全设备提供的策略定制能力,流量级的可以依靠运营商提供的抗D服务,如云盾、云堤,流量清洗服务等,面向应用层的攻击可以借助防火墙,WAF,NIDS等安全设备/节点提供的能力。无论是借助厂商还是自身建设抗D能力,都需要摸清企业所面临的资源耗尽风险,一方面理清基础架构的脆弱点,治理脆弱点;另一方面需要熟悉攻击利用原理,制定针对性策略来进行异常检测及攻击缓解。 这里简述一些对抗思路,例如上文提到SYN Flood攻击,其本质上是利用TCP建立链接的机制漏洞,只要持续发送建立链接请求,服务端就会进行响应同时在连接池里记录一条链接,那么依据该原理,防护思路就很明确了: 1. 对发起源进行主动认证 图6 主动认证示意图 当连续一段时间内去往目标服务器的SYN报文超过告警阈值后,抗DDoS设备启动源认证机制。源认证机制启动后,抗DDoS设备将会代替服务器向客户端响应带有正确确认序号的SYN-ACK报文; 如果这个源是虚假源,是一个不存在的地址或者是存在的地址但却没有发送过SYN报文,不会做出任何响应; 如果这个源是真实客户端,则会向服务器发送ACK报文,对收到的SYN-ACK报文进行确认。抗DDoS设备收到ACK报文后,将该客户端的源IP地址加入白名单。同时,抗DDoS设备会向客户端发送RST报文,要求重新建立连接; 后续这个客户端发出的SYN报文命中白名单直接通过。 2.首包丢弃 图7 首包丢弃示意图 TCP的可靠性保证除了面向连接(三次/四次握手)之外,还体现在超时与重传机制。TCP协议规范要求发送端每发送一个报文,就启动一个定时器并等待确认信息;如果在定时器超时前还没有收到确认,就会重传报文。 首包丢弃功能就是利用了TCP的超时重传机制,Anti-DDoS系统对收到的第一个SYN报文直接丢弃,然后观察客户端是否重传。如果客户端重传了SYN报文,再对重传的SYN报文进行源认证,即反弹SYN-ACK报文,这样就可以大大减少反弹报文的数量。 混合使用,效果更佳 实际部署时,一般将首包丢弃和源认证结合使用。防御SYN Flood攻击时,先通过首包丢弃功能来过滤掉一些攻击报文,当重传的SYN报文超过告警阈值后,再启动源认证。这样就能够减少反弹的SYN-ACK报文的数量,缓解网络拥塞情况。对于虚假源攻击,尤其是对于不断变换源IP和源端口的虚假源攻击,可以达到最佳防御效果。 针对连接耗尽场景,其防御思路可以总结为以下内容: 针对此攻击会耗尽服务器的TCP连接资源的特点,对目的IP地址的新建连接速率和并发连接数分布进行统计,当新建连接速率或并发连接数大于阈值时,则触发对源IP地址的相应检查,当检查发现异常时,将异常源IP地址加入黑名单,切断其TCP流量。 源IP地址新建连接速率检查:启动源IP地址新建连接速率检查后,如果某个源IP地址在检查周期内发起的TCP新建连接数大于阈值,则将该源IP地址判定为攻击源。 源IP地址并发连接数检查:启动源IP地址并发连接数检查后,如果某个源IP地址的TCP并发连接数大于阈值,则将该源IP地址判定为攻击源。 慢速连接速率检查:启动慢速连接速率检查后,统计同一源IP地址对同一目的IP地址的连接次数,在各统计时间间隔内,如果连续多次连接数相同并超过阈值,则判定为TCP慢速连接攻击。 异常会话检查:如果在检查周期内,某个源IP地址发起的TCP异常会话的连接数大于阈值时,则将该源IP地址判定为攻击源。 判定TCP异常会话依据如下: 【空连接检查】:如果在检查周期内,在某条TCP连接上通过的报文数小于阈值,则判定该连接为异常连接。 【重传会话检查】:当某条TCP连接上重传报文数量大于阈值时,则判定该连接为异常连接。 【慢启动连接检查】:当某条TCP连接上通过的报文窗口小于阈值时,则判定该连接为异常连接。 当异常会话数超过一定数量时,将此源加入黑名单。异常会话数量可配置。 同样的,应用层CC攻击,按照相对应的原理进行内容检查,这也是一般WAF或NIDS设备提供的基础能力,这里就不再累述。 4.2端口风险治理实践 上段内容有提到的防护思路,理解协议的脆弱性原理再依据攻击者的视角进行防护措施的定制,则会有比较清晰的防护思路和防护效果,因此在端口安全治理实践上,我们通过建立常态化端口发现机制以及常态化的漏洞扫描机制,将网络端口及端口漏洞风险进行持续统一治理,同时建立基于流量的异常识别能力丰富基于行为的异常端口检测能力,再辅以脆弱性管理以及端口生命周期管理(规范与流程)来形成整个端口安全治理体系。 1. 建立常态化的端口发现机制 使用网络发现工具进行异常端口识别,设计思路是首先通过vscheduler中间件触发扫描(支持两种模式:一网段配置表全表网段扫描、二是:指定网段扫描。),调用扫描工具(以nmap为例)进行扫描,通过增加两个异步线程去读取缓冲区内容以解决缓冲区拥塞问题,通过异步线程进行缓冲区内容读取以及清理的同时通过错误缓冲区内容判断是否扫描失败。扫描结果输出xml后通过dom4j进行解析,再进行分批保存,避免大事务以及减少jvm内存占用。最后把文件删除,释放存储空间。 图8 端口扫描架构图 2.建立常态化漏洞扫描机制 结合漏洞扫描工具及端口扫描工具构建自动化漏洞扫描平台,漏扫平台架构设计思路如下图: 图9 漏扫平台架构图 该系统架构的核心功能点包括:资产收集、Web漏洞扫描、依赖包扫描、端口扫描,辅助功能包括:扫描任务管理、风险管理等。 【资产收集】: 扫描的目标是公司的网络资产,没有资产无法进行扫描,资产不全面扫描的效果也会打折扣,所以平台采集了多种途径进行资产的采集,力求做到无遗漏,持续丰富采集的手段。 【Web漏洞扫描】: 用于发现暴露在公网的站点、URL等Web资源是否存在漏洞。 【依赖包扫描】: 用于发现线上业务是否使用了高危的Java依赖包。 【端口扫描】: 用于发现公司服务器是否对公网开放了高危端口。 【扫描任务管理】: 无论是依赖包扫描、端口扫描,都是通过创建扫描任务的形式来发起的,扫描任务分为立即扫描任务和定时扫描任务两种类型,用户可以创建立即扫描任务来一次性执行扫描,也可以创建定时任务来周期性执行扫描。 【风险管理】: 对于扫描出来的Web、依赖包和端口风险,系统能够对其处理状态进行管理,以便安全工程师对风险状态进行跟踪和处理。 【工单管理】: 对于扫描出来的Web、依赖包和端口风险,运营人员可对其创建工单,工单会对接到漏洞管理系统,通过漏洞管理系统的工单体系来对跟踪风险的处理进程。 常用的漏扫工具: 【Nmap】: Nmap是一款常用的网络发现和安全审计工具,支持多种扫描技术和扫描选项,可以快速扫描本地或远程计算机上的开放端口和服务。 【Masscan】: Masscan是一款高速的端口扫描工具,可以在短时间内扫描数百万个端口,支持TCP和UDP扫描,适用于大规模网络扫描。 【Zenmap】: Zenmap是Nmap的图形用户界面(GUI)版本,可以方便地进行扫描选项配置和结果分析。 【Angry IP Scanner】: Angry IP Scanner是一款轻量级的端口扫描工具,支持多线程扫描和快速扫描本地网络和远程主机。 【SuperScan】: SuperScan是一款Windows平台上的端口扫描工具,支持TCP和UDP扫描、多线程扫描、服务版本识别等功能。 【Unicornscan】: Unicornscan是一款高速的网络扫描工具,支持TCP、UDP、ICMP等多种扫描方式和扫描选项。 【Netcat】: Netcat是一款多功能的网络工具,其中包括端口扫描功能,支持TCP和UDP扫描,可以快速扫描本地或远程计算机上的开放端口和服务。 3.建立基于流量的异常识别能力 (1)流量基线学习 流量基线一般对五元组进行配置学习,通过对比应用流量基线,发现孤立的端口流量,对比端口开放库以发现异常开放的端口,另外,可以同步建设告警能力与处置能力,在发现异常的第一时间切断风险源头。 图10 基线学习 流量基线学习的核心表: 【策略快照表】: 从离线同步过来的每个小时的服务维度的多种策略计算结果 【学习配置表】: 用于存放学习配置,包括各种策略的加解锁条件(偏离阈值+次数)、偏离告警条件(偏离阈值+次数,可以预留出来,告警下迭代做) 【当前策略集】: 服务维度自定义的的策略集 【策略状态表】: 记录各个服务节点的锁状态,偏离情况,策略生效时间等 【策略目标集】: 部分策略拥有自己的目标机器/服务结算逻辑,该表用于存放目标范围,用于定时清理不在目标集的策略 (2)异常检测 通过对上节提到的流量基线结果的数据分析来识别网络个体或群体的异常行为,一方面建立行为偏离预警机制,另一方面需要引入一些统计分析模型帮助建立阈值点,在偏离预警机制这块我们做了一些架构实践,其逻辑简单描述如下: 行为偏离比对逻辑: 总结四个关键点分别为: 配置文件,用于描述对应服务的流量特征 上锁,参数或配置文件在满足预设规则条件下或人工干预下停止动态学习行为 解锁,参数或配置文件在满足预设规则条件下或人工干预下重新开始动态学习行为 偏离,指同一服务下某一时间切片的配置文件与已上锁的配置文件的参数值对比,发生超过阈值的变化 此外便是阈值的设定问题,通过引入统计模型的使用来帮助我们制定阈值,常用的入侵检测统计模型有以下几类: 操作模型:该模型假设异常可通过测量结果与一些固定指标相比较得到,固定指标可以根据经验值或一段时间内的统计平均得到,举例来说,在短时间内多次针对某一端口尝试建立连接失败,则可能是针对端口的拒绝服务 方差:这也是常用的模型,通过计算参数的方差,设定置信区间,当测量值超过置信区间的范围时表明可能存在异常 多元模型:操作模型的扩展,通过同时分析多个参数实现异常检测 马尔柯夫过程模型:将每种类型的事件定义为系统状态,用状态转移矩阵来表示状态的变化,当一个事件发生时,如果状态矩阵中该转移的概率较小则可能是异常事件 时间序列分析:将流量切片特征提取出来按照时间排成序列,如果一个新的请求或一个新的请求集合在该时间发生的概率较低,则该事件可能是异常 在异常识别这块通常也会引入基于图的数据分析方法,针对网络个体和网络群体进行流量行为分析来发现异常行为,但应用起来相对较为复杂,也需要较高学习与实践成本,这块更多在NIDS的应用范畴,在此模块不再赘述。 需要提醒的是以上这种方法还是存在一些局限,如爬虫类服务,商业广告类服务因为其服务的特殊性,以上机制比较难进行准确的基线生成,虽说无法解决100%的问题,但也能cover住大部分的服务类型,同样的,在这个领域还需要持续探索来提升服务类型的覆盖率以及异常检测精度。 4. 健全脆弱性管理能力实现风险追踪与闭环 端口暴露的最核心问题就是脆弱性利用,因此健全基础架构的脆弱性管理能力是阻断外部威胁,有效控制风险的重要手段,我们通过建立统一的脆弱性管理平台来建立业务关系流,脆弱性库,资产三者的关联关系,针对脆弱性做到持续发现,持续修复并将脆弱性作为安全告警关联分析中的重要评价维度。脆弱性管理系统因其安全管理战略特殊性,此处只能简单介绍给读者一些建设思路: 脆弱性管理系统核心功能模块结构 另外脆弱性关联分析AVC是脆弱性管理系统的核心功能,读者可以从以下评价维度进行建设实践: 5.完善端口生命周期管理(规范与流程) (1)制定端口管理规范 规范原则 最小权限原则:端口开放遵循最小权限原则,只允许开放运行http和https的80/443端口,其他对外开放的端口必须有合理的业务理由,并且应该只开放业务需要的最小端口集合,由端口使用者提出工作联络单进行申请经审批同意后方可开放。 可审计原则:所有端口开放都必须有可追溯的对应申请依据、安全性评估依据、审批依据,不允许私自开放端口。 闭环原则:端口开放应实施闭环管理,在业务不再需要时,应及时关闭端口。 对端口进行明确定义 图11 端口定义示例 规范内容可包含端口申请规范,端口使用规范,端口关闭规范以及明确的处罚规定。 (2)端口生命周期管理 实现从端口申请到端口关闭全流程管理 应用申请 → 端口记录→ 开墙(映射)→ 安全节点纳管 → 流量反馈 → 主动关闭 → 端口映射记录清除→ 安全节点卸载→ 端口资源池回收 (3)持续评估 结合异常端口发现机制和端口开放库以及相关流程建立起持续端口风险评估机制,用以保障规范以及风险处置有效性的落地。 五、总结 端口作为应用对外暴露的主要入口,是应用暴露在公网上的标识,因此端口安全建设是企业信息安全防护体系中的重要一环,安全团队需要详细了解其内部网络中使用的所有端口,以及开放和关闭的端口数量和情况,在理解协议的脆弱性原理基础上制定合适的安全策略和措施。同时再安全策略和措施制定的过程中,通过对各类端口扫描工具的使用,安全团队可以快速获取目标网络中的端口开放情况。然后根据扫描结果,采取合适的安全策略和措施,禁止不必要端口的开放或者采取过滤、加密等方式对端口进行保护。在技术实践上,建设常态化端口发现机制以及常态化的漏洞扫描机制,将网络端口及端口漏洞风险进行持续统一治理,同时建立基于流量的异常识别能力丰富基于行为的异常端口检测能力,再辅以脆弱性管理以及端口生命周期管理(规范与流程)来形成整个端口安全治理体系。另外值得强调的是,全员网络安全意识的水位决定整体安全态势的下限,个人行为和错误配置通常是网络漏洞的一大原因,因此安全管理团队需要持续加强内部员工的网络安全教育和培训,提高其网络安全意识和知识水平,建立全员参与的安全意识文化。总的来说,可以通过规范,流程,技术和人员意识培训来构建全面的网络端口风险治理体系。 参考文献: 《网络端口安全治理的研究与实践》(姜云飞,高国权,张全超,2019) 《基于漏洞扫描的网络端口安全治理研究》(黄珂,杨明,张鹏飞,2017) 《基于流量监测的网络端口安全治理技术研究》(胡彩玲,申伟,周婷婷,2016) 《网络端口安全治理技术研究》(程显霞,郑晓宁,2014) 《网络端口安全治理策略研究》(朱绍军,李彦霞,陈琳琳,2013) vivo互联网端口开放管理规范 什么是网络端口? 【漏洞分析】DDOS攻防分析(四)——TCP篇 CC攻击原理及防范方法和如何防范CC攻击 常用的端口攻击 TCP连接耗尽攻击与防御原理 DDOS之TCP连接耗尽攻击与防御 END 猜你喜欢 Dubbo路由及负载均衡性能优化 深入理解Netty FastThreadLocal 记一次Redis Cluster Pipeline导致的死锁问题 本文分享自微信公众号 - vivo互联网技术(vivoVMIC)。 如有侵权,请联系 support@oschina.cn 删除。 本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

优秀的个人博客,低调大师

每日一博 | 同城售后系统退款业务重构心得

一、重构背景 1.1、退款 到家、小时购、天选退款有2套结构,代码逻辑混乱; 其中小时购、天选部分售后单是和平生pop交互退款,部分是和售后中台交互退款;并且兼容3套逻辑; 痛点:代码繁重,缺乏合理性的设计,后续迭代开发以及维护成本高,同时增加了系统的风险和不稳定性 1.2、金额计算 到家、小时购两套独立的逻辑结构计算,在此基础上针对退差和非退差又实现了2套逻辑; 针对商品件维度、商品行维度、售后单维度计算金额混乱,缺乏领域边界和分层设计; 痛点:售后单维度、商品行维度、拆分件维度金额计算混乱,代码缺乏层次结构;代码易读性、维护成本、后续扩展性存在问题 1.3、售后逆向账 售后单详情接口、申诉单详情接口,针对到家和小时购做了两套逻辑; 其中售后单详情接口针对小时购黑名单、小时购白名单、天选、到家退差、到家非退差做了5套逻辑处理; 并且这两个接口都是实时从拆分获取金额进行售后逆向拆分计算,可以直接从数据库中进行取值赋值,不需要进行售后单维度的拆分计算; 痛点:代码大量冗余、改动成本高、增加了系统的风险和不稳定性 二、重构思路和方案 2.1、重构思路 什么是重构呢? 名词:对软件内部结构的一种调整,目的是在不改变软件观察行为的的前提下提高其可理解性、降低其修改成本; 动词:使用一系列手法,在不改变软件可观察行为的前提下,调整其结构 重构的目的是使系统或代码更容易被理解、修改、迭代 重构秘诀:胆大心细 胆大(意味着有勇气和决心去改变和改进现有的代码。重构可能涉及对复杂的代码结构进行修改,甚至可能需要重写部分代码。胆大的开发者愿意面对这些挑战,相信通过改变可以带来更好的结果) 心细(指的是在进行重构时保持细致入微的思考和行动。这包括仔细分析代码的结构和逻辑,理解代码的功能和依赖关系,以及考虑每个重构步骤可能带来的潜在影响。心细的开发者会在重构过程中小心翼翼地处理每个细节,以确保代码的正确性和可维护性) 1. 把握好重构时机:当我发现售后退款、金额计算等业务模块代码存在质量问题、可读性差、可维护性差或存在坏味道时,并且在项目需求排期并不紧张的情况下,是进行重构的好时机; 2. 前期梳理很重要,先找到痛点 ;不宜长线作战,不宜和业务并行 3. 明确出目标和价值:售后退款、金额计算重构后能提高开发效率、降低维护、开发成本等 4. 确定重构的目标:首先要明确需要进行重构的代码块或功能,并明确重构的目标是什么。例如,可能需要提高代码的可读性、可维护性或性能。 5. 分析代码坏味道:使用代码静态分析工具或手动检查代码,识别出可能存在的代码坏味道;例如退款业务中存在1000多行的类、600多行的方法,过多的变量参数、诸多重复代码等代码坏味道。 6. 选择适当的重构技术:根据售后代码坏味道的种类和重构的目标,选择适当的重构技术。我采用的重构手法是:小规模重构-->大规模重构-->顶层设计模式;采用先小后大,从大到全的思路进行重构设计。小规模重构:提取方法、消除超大类或函数方法、提取类、重命名、合并重复代码等方法;大规模重构:采用的是分层、模块化、解耦、抽象可复用性等手法;设计模式:退款业务采用策略模式+抽象工厂;金额计算业务采用策略模式+抽象工厂+责任链模式 7. 编写测试用例:在进行重构之前,编写适当的测试用例来验证重构后的代码的正确性。测试用例应该覆盖重构的代码块或功能的各种情况。 8. 执行重构:根据选择的重构技术,逐步修改代码。确保每次修改后的代码仍然通过之前编写的测试用例。 9. 运行测试用例:在每次重构之后,运行之前编写的测试用例,确保重构后的代码仍然正确。 10. 重构后的代码评估:评估重构后的代码是否达到了预期的目标,例如是否提高了代码的可读性、可维护性或性能。 2.2、重构方案 2.2.1、重构前系统交互图 2.2.2、重构后系统交互图  退款业务强耦合到售后系统中,并且业务代码分散到各个业务层,严重缺乏系统的领域边界和分层设计,重构后退款业务逻辑不强依赖售后核心业务逻辑,做到可以独立部署。 2.2.3、重构前金额计算流程图  2.2.4、重构后金额计算流程图   将2套金额计算业务逻辑利用设计模式将其合并为1套金额计算业务逻辑,打造防腐层 2.3、重构设计类图 依据上述制定的设计方案流程图,我进行了UML类图的绘制,以下是关于金额计算业务模块的类图 2.3.1、抽象工厂+策略模式类图  2.3.2、责任链模式类图  三、系统稳定性保障 3.1、小步重构 将售后重构分成退款、金额计算、逆向账三个步骤,并在每个步骤之后运行测试用例。这样可以及时发现并修复引入的错误,避免错误在整个系统中蔓延 3.2、逐步验证 在每个重构步骤之后,进行系统的逐步验证。分批次进行上线灰度,灰度配置绝对隔离,不能复用。确保系统的各个部分在重构过程中都能正常运行,并与其他部分协调良好。 3.3、监控和性能测试 在重构完成后,进行系统的监控和性能测试,确保重构没有引入性能问题或影响系统的稳定性。如果发现问题,及时进行修复和优化。 3.4、团队代码审查和测试 在进行重构时,与团队成员进行合作,并进行代码审查。多个人的视角和经验可以帮助发现潜在的问题,并提供改进的建议;针对重构代码进行深度解刨,能更有效地保障重构的安全性。 重构业务及时通知测试人员,使测试人员能够评估到测试点,更加完善测试用例 3.5、灰度步骤 3.5.1、bcp持续比对校验 3.5.2、按照商家灰度 依据售后单量 小->中->大 的顺序逐步进行灰度切量,观察其退款、金额计算等售后单数据是否异常 四、重构成果 1. 降低开发、维护成本 2. 提升代码质量、系统稳定性 3. 系统扩展性和灵活性的加强; 4. 系统应用、业务边界定位更加清晰 5. 统一和规范售后核心业务脉络,降低业务学习成本,提升开发效率 6. 提升自己的技术能力、代码质量意识、问题解决能力、团队合作和沟通能力;经典著作《重构》这本书中有这么一段话: 一开始,我所做的重构都停留在细枝末节上。随着代码趋向简洁,我发现自己可以看到一些设计层面的东西了,这些是我以前理解不到的,如果没有重构,我达不到这种高度 五、code show 5.1、重构前金额计算 到家售后单金额计算service方法  京东售后单金额计算service方法 一个大的金额计算class类就有1000多行代码,每个方法中都有几百行代码,以下是到家售后单金额计算部分代码  5.2、重构后金额计算 到家和京东售后单金额计算用同一个接口才承接业务实现,并且使用策略+抽象工厂模式实现到家、小时购、天选业务的金额计算  策略模式获取金额拆分结果集  金额计算核心方法只有4步骤  其中金额计算的核心则采用的是责任链业务进行计算  在件维度、sku维度针对不同的业务又采用了责任链模式进行金额计算  六、参考文献 代码的坏味道: https://www.qinglite.cn/doc/87036476d565d55f9 《重构改善既有代码的设计》:[美]MartinFowler 《敏捷软件开发》:[美]RobertC.Martin 作者:京东零售 高凯 来源:京东云开发者社区 转载请注明来源

优秀的个人博客,低调大师

每日一博 | 如何充分发挥 SQL 能力?

如何充分发挥 SQL 能力,是本篇文章的主题。本文尝试独辟蹊径,强调通过灵活的、发散性的数据处理思维,就可以用最基础的语法,解决复杂的数据场景。 一、前言 1.1 初衷 如何高效地使用 MaxCompute(ODPS)SQL ,将基础 SQL 语法运用到极致。 在大数据如此流行的今天,不只是专业的数据人员,需要经常地跟 SQL 打交道,即使是产品、运营等非技术同学,也会或多或少地使用到 SQL ,如何高效地发挥 SQL 的能力,继而发挥数据的能力,变得尤为重要。 MaxCompute(ODPS)SQL 发展到今天已经颇为成熟,作为一种 SQL 方言,其 SQL 语法支持完备,具有非常丰富的内置函数,支持开窗函数、用户自定义函数、用户自定义类型等诸多高级特性,可以高效地应用在各种数据处理场景。 如何充分发挥 SQL 能力,是本篇文章的主题。本文尝试独辟蹊径,强调通过灵活的、发散性的数据处理思维,就可以用最基础的语法,解决复杂的数据场景。 1.2 适合人群 不论是初学者还是资深人员,本篇文章或许都能有所帮助,不过更适合中级、高级读者阅读。 本篇文章重点介绍数据处理思维,并没有涉及到过多高阶的语法,同时为了避免主题发散,文中涉及的函数、语法特性等,不会花费篇幅进行专门的介绍,读者可以按自身情况自行了解。 1.3 内容结构 本篇文章将围绕数列生成、区间变换、排列组合、连续判别等主题进行介绍,并附以案例进行实际运用讲解。每个主题之间有轻微的前后依赖关系,依次阅读更佳。 1.4 提示信息 本篇文章涉及的 SQL 语句只使用到了 MaxCompute(ODPS)SQL 基础语法特性,理论上所有 SQL 均可以在当前最新版本中运行,同时特意注明,运行环境、兼容性等问题不在本篇文章关注范围内。 二、数列 数列是最常见的数据形式之一,实际数据开发场景中遇到的基本都是有限数列。本节将从最简单的递增数列开始,找出一般方法并推广到更泛化的场景。 2.1 常见数列 2.1.1 一个简单的递增数列 首先引出一个简单的递增整数数列场景: 从数值 0 开始; 之后的每个数值递增 1 ; 至数值 3 结束; 如何生成满足以上三个条件的数列?即 [0,1,2,3] 。 实际上,生成该数列的方式有多种,此处介绍其中一种简单且通用的方案。 -- SQL - 1 select t.pos as a_n from ( select posexplode(split(space(3), space(1), false)) ) t; 通过上述 SQL 片段可得知,生成一个递增序列只需要三个步骤: 1)生成一个长度合适的数组,数组中的元素不需要具有实际含义; 2)通过 UDTF 函数 posexplode 对数组中的每个元素生成索引下标; 3)取出每个元素的索引下标。以上三个步骤可以推广至更一般的数列场景:等差数列、等比数列。下文将以此为基础,直接给出最终实现模板。 2.1.2 等差数列 SQL 实现: -- SQL - 2 select a + t.pos * d as a_n from ( select posexplode(split(space(n - 1), space(1), false)) ) t; 2.1.3 等比数列 SQL 实现: -- SQL - 3 select a * pow(q, t.pos) as a_n from ( select posexplode(split(space(n - 1), space(1), false)) ) t; 提示:亦可直接使用 MaxCompute(ODPS)系统函数 sequence 快速生成数列。 -- SQL - 4 select sequence(1, 3, 1); -- result [1, 2, 3] 2.2 应用场景举例 2.2.1 还原任意维度组合下的维度列簇名称 在多维分析场景下,可能会用到高阶聚合函数,如cube、rollup、grouping sets等,可以针对不同维度组合下的数据进行聚合统计。 场景描述 现有用户访问日志表 visit_log ,每一行数据表示一条用户访问日志。 -- SQL - 5 with visit_log as ( select stack ( 6, '2024-01-01', '101', '湖北', '武汉', 'Android', '2024-01-01', '102', '湖南', '长沙', 'IOS', '2024-01-01', '103', '四川', '成都', 'Windows', '2024-01-02', '101', '湖北', '孝感', 'Mac', '2024-01-02', '102', '湖南', '邵阳', 'Android', '2024-01-03', '101', '湖北', '武汉', 'IOS' ) -- 字段:日期,用户,省份,城市,设备类型 as (dt, user_id, province, city, device_type) ) select * from visit_log; 现针对省份 province , 城市 city, 设备类型 device_type 三个维度列,通过grouping sets聚合统计得到了不同维度组合下的用户访问量。问:1)如何知道一条统计结果是根据哪些维度列聚合出来的? 2)想要输出聚合的维度列的名称,用于下游的报表展示等场景,又该如何处理? 解决思路 可以借助MaxCompute(ODPS)提供的 GROUPING__ID 来解决,核心方法是对 GROUPING__ID 进行逆向实现。 一、准备好所有的 GROUPING__ID 。 GROUPING__ID bits 0 { ..., 0, 0, 0 } 1 { ..., 0, 0, 1 } 2 { ..., 0, 1, 0 } 3 { ..., 0, 1, 1 } ... ... 2n2n ... 二、准备好所有维度名称。 { dim_name_1, dim_name_2, ..., dim_name_n } 三、将 GROUPING__ID 映射到维度列名称。 对于 GROUPING__ID 递增数列中的每个数值,将该数值的 2 进制每个比特位与维度名称序列的下标进行映射,输出所有对应比特位 0 的维度名称。例如: GROUPING__ID:3 => { 0, 1, 1 } 维度名称序列:{ 省份, 城市, 设备类型 } 映射:{ 0:省份, 1:城市, 1:设备类型 } GROUPING__ID 为 3 的数据行聚合维度即为:省份 SQL 实现 -- SQL - 6 with group_dimension as ( select -- 每种分组对应的维度字段 gb.group_id, concat_ws(",", collect_list(case when gb.placeholder_bit = 0 then dim_col.val else null end)) as dimension_name from ( select groups.pos as group_id, pe.* from ( select posexplode(split(space(cast(pow(2, 3) as int) - 1), space(1), false)) ) groups -- 所有分组 lateral view posexplode(regexp_extract_all(lpad(conv(groups.pos,10,2), 3, "0"), '(0|1)')) pe as placeholder_idx, placeholder_bit -- 每个分组的bit信息 ) gb left join ( -- 所有维度字段 select posexplode(split("省份,城市,设备类型", ',')) ) dim_col on gb.placeholder_idx = dim_col.pos group by gb.group_id ) select group_dimension.dimension_name, province, city, device_type, visit_count from ( select grouping_id(province, city, device_type) as group_id, province, city, device_type, count(1) as visit_count from visit_log b group by province, city, device_type GROUPING SETS( (province), (province, city), (province, city, device_type) ) ) t join group_dimension on t.group_id = group_dimension.group_id order by group_dimension.dimension_name; dimension_name province city device_type visit_count 省份 湖北 NULL NULL 3 省份 湖南 NULL NULL 2 省份 四川 NULL NULL 1 省份,城市 湖北 武汉 NULL 2 省份,城市 湖南 长沙 NULL 1 省份,城市 湖南 邵阳 NULL 1 省份,城市 湖北 孝感 NULL 1 省份,城市 四川 成都 NULL 1 省份,城市,设备类型 湖北 孝感 Mac 1 省份,城市,设备类型 湖南 长沙 IOS 1 省份,城市,设备类型 湖南 邵阳 Android 1 省份,城市,设备类型 四川 成都 Windows 1 省份,城市,设备类型 湖北 武汉 Android 1 省份,城市,设备类型 湖北 武汉 IOS 1 三、区间 区间相较数列具有不同的数据特征,不过在实际应用中,数列与区间的处理具有较多相通性。本节将介绍一些常见的区间场景,并抽象出通用的解决方案。 3.1 常见区间操作 3.1.1 区间分割 SQL 实现: -- SQL - 7 select a + t.pos * d as sub_interval_start, -- 子区间起始值 a + (t.pos + 1) * d as sub_interval_end -- 子区间结束值 from ( select posexplode(split(space(n - 1), space(1), false)) ) t; 3.1.2 区间交叉 已知两个日期区间存在交叉 ['2024-01-01', '2024-01-03'] 、 ['2024-01-02', '2024-01-04']。问: 1)如何合并两个日期区间,并返回合并后的新区间? 2)如何知道哪些日期是交叉日期,并返回该日期交叉次数? 解决上述问题的方法有多种,此处介绍其中一种简单且通用的方案。核心思路是结合数列生成、区间分割方法,先将日期区间分解为最小处理单元,即多个日期组成的数列,然后再基于日期粒度做统计。具体步骤如下: 1)获取每个日期区间包含的天数;2)按日期区间包含的天数,将日期区间拆分为相应数量的递增日期序列; 3)通过日期序列统计合并后的区间,交叉次数。 SQL 实现: -- SQL - 8 with dummy_table as ( select stack( 2, '2024-01-01', '2024-01-03', '2024-01-02', '2024-01-04' ) as (date_start, date_end) ) select min(date_item) as date_start_merged, max(date_item) as date_end_merged, collect_set( -- 交叉日期计数 case when date_item_cnt > 1 then concat(date_item, ':', date_item_cnt) else null end ) as overlap_date from ( select -- 拆解后的单个日期 date_add(date_start, pos) as date_item, -- 拆解后的单个日期出现的次数 count(1) over (partition by date_add(date_start, pos)) as date_item_cnt from dummy_table lateral view posexplode(split(space(datediff(date_end, date_start)), space(1), false)) t as pos, val ) t; date_start_merged date_end_merged overlap_date 2024-01-01 2024-01-04 ["2024-01-02:2","2024-01-03:2"] 增加点儿难度! 如果有多个日期区间,且区间之间交叉状态未知,上述问题又该如何求解。即: 1)如何合并多个日期区间,并返回合并后的多个新区间? 2)如何知道哪些日期是交叉日期,并返回该日期交叉次数? SQL 实现: -- SQL - 9 with dummy_table as ( select stack( 5, '2024-01-01', '2024-01-03', '2024-01-02', '2024-01-04', '2024-01-06', '2024-01-08', '2024-01-08', '2024-01-08', '2024-01-07', '2024-01-10' ) as (date_start, date_end) ) select min(date_item) as date_start_merged, max(date_item) as date_end_merged, collect_set( -- 交叉日期计数 case when date_item_cnt > 1 then concat(date_item, ':', date_item_cnt) else null end ) as overlap_date from ( select -- 拆解后的单个日期 date_add(date_start, pos) as date_item, -- 拆解后的单个日期出现的次数 count(1) over (partition by date_add(date_start, pos)) as date_item_cnt, -- 对于拆解后的单个日期,重组为新区间的标记 date_add(date_add(date_start, pos), 1 - dense_rank() over (order by date_add(date_start, pos))) as cont from dummy_table lateral view posexplode(split(space(datediff(date_end, date_start)), space(1), false)) t as pos, val ) t group by cont; date_start_merged date_end_merged overlap_date 2024-01-01 2024-01-04 ["2024-01-02:2","2024-01-03:2"] 2024-01-06 2024-01-10 ["2024-01-07:2","2024-01-08:3"] 3.2 应用场景举例 3.2.1 按任意时段统计数据 场景描述 现有用户还款计划表 user_repayment ,该表内的一条数据,表示用户在指定日期区间内 [date_start, date_end] ,每天还款 repayment 元。 -- SQL - 10 with user_repayment as ( select stack( 3, '101', '2024-01-01', '2024-01-15', 10, '102', '2024-01-05', '2024-01-20', 20, '103', '2024-01-10', '2024-01-25', 30 ) -- 字段:用户,开始日期,结束日期,每日还款金额 as (user_id, date_start, date_end, repayment) ) select * from user_repayment; 如何统计任意时段内(如:2024-01-15至2024-01-16)每天所有用户的应还款总额? 解决思路 核心思路是将日期区间转换为日期序列,再按日期序列进行汇总统计。 SQL 实现 -- SQL - 11 select date_item as day, sum(repayment) as total_repayment from ( select date_add(date_start, pos) as date_item, repayment from user_repayment lateral view posexplode(split(space(datediff(date_end, date_start)), space(1), false)) t as pos, val ) t where date_item >= '2024-01-15' and date_item <= '2024-01-16' group by date_item order by date_item; day total_repayment 2024-01-15 60 2024-01-16 50 四、排列组合 排列组合是针对离散数据常用的数据组织方法,本节将分别介绍排列、组合的实现方法,并结合实例着重介绍通过组合对数据的处理。 4.1 常见排列组合操作 4.1.1 排列 已知字符序列 [ 'A', 'B', 'C' ] ,每次从该序列中可重复地选取出 2 个字符,如何获取到所有的排列? 借助多重 lateral view 即可解决,整体实现比较简单。 -- SQL - 12 select concat(val1, val2) as perm from (select split('A,B,C', ',') as characters) dummy lateral view explode(characters) t1 as val1 lateral view explode(characters) t2 as val2; perm AA AB AC BA BB BC CA CB CC 4.1.2 组合 已知字符序列 [ 'A', 'B', 'C' ] ,每次从该序列中可重复地选取出 2 个字符,如何获取到所有的组合? 借助多重 lateral view 即可解决,整体实现比较简单。 -- SQL - 13 select concat(least(val1, val2), greatest(val1, val2)) as comb from (select split('A,B,C', ',') as characters) dummy lateral view explode(characters) t1 as val1 lateral view explode(characters) t2 as val2 group by least(val1, val2), greatest(val1, val2); comb AA AB AC BB BC CC 提示:亦可直接使用 MaxCompute(ODPS)系统函数 combinations 快速生成组合。 -- SQL - 14 select combinations(array('foo', 'bar', 'boo'),2); -- result [['foo', 'bar'], ['foo', 'boo']['bar', 'boo']] 4.2 应用场景举例 4.2.1 分组对比统计 场景描述 现有投放策略转化表,该表内的一条数据,表示一天内某投放策略带来的订单量。 -- SQL - 15 with strategy_order as ( select stack( 3, '2024-01-01', 'Strategy A', 10, '2024-01-01', 'Strategy B', 20, '2024-01-01', 'Strategy C', 30 ) -- 字段:日期,投放策略,单量 as (dt, strategy, order_cnt) ) select * from strategy_order; 如何按投放策略建立两两对比组,按组对比展示不同策略转化单量情况? 对比组 投放策略 转化单量 Strategy A-Strategy B Strategy A xxx Strategy A-Strategy B Strategy B xxx 解决思路 核心思路是从所有投放策略列表中不重复地取出 2 个策略,生成所有的组合结果,然后关联 strategy_order 表分组统计结果。 SQL 实现 -- SQL - 16 select /*+ mapjoin(combs) */ combs.strategy_comb, so.strategy, so.order_cnt from strategy_order so join ( -- 生成所有对比组 select concat(least(val1, val2), '-', greatest(val1, val2)) as strategy_comb, least(val1, val2) as strategy_1, greatest(val1, val2) as strategy_2 from ( select collect_set(strategy) as strategies from strategy_order ) dummy lateral view explode(strategies) t1 as val1 lateral view explode(strategies) t2 as val2 where val1 <> val2 group by least(val1, val2), greatest(val1, val2) ) combs on 1 = 1 where so.strategy in (combs.strategy_1, combs.strategy_2) order by combs.strategy_comb, so.strategy; 对比组 投放策略 转化单量 Strategy A-Strategy B Strategy A 10 Strategy A-Strategy B Strategy B 20 Strategy A-Strategy C Strategy A 10 Strategy A-Strategy C Strategy C 30 Strategy B-Strategy C Strategy B 20 Strategy B-Strategy C Strategy C 30 五、连续 本节主要介绍连续性问题,重点描述了常见连续活跃场景。对于静态类型的连续活跃、动态类型的连续活跃,分别阐述了不同的实现方案。 5.1 普通连续活跃统计 场景描述 现有用户访问日志表 visit_log ,每一行数据表示一条用户访问日志。 -- SQL - 17 with visit_log as ( select stack ( 6, '2024-01-01', '101', '湖北', '武汉', 'Android', '2024-01-01', '102', '湖南', '长沙', 'IOS', '2024-01-01', '103', '四川', '成都', 'Windows', '2024-01-02', '101', '湖北', '孝感', 'Mac', '2024-01-02', '102', '湖南', '邵阳', 'Android', '2024-01-03', '101', '湖北', '武汉', 'IOS' ) -- 字段:日期,用户,省份,城市,设备类型 as (dt, user_id, province, city, device_type) ) select * from visit_log; 如何获取连续访问大于或等于 2 天的用户? 上述问题在分析连续性时,获取连续性的结果以超过固定阈值为准,此处归类为连续活跃大于 N 天阈值的普通连续活跃场景统计。 SQL 实现 基于相邻日期差实现( lag / lead 版) 整体实现比较简单。 -- SQL - 18 select user_id from ( select *, lag(dt, 2 - 1) over (partition by user_id order by dt) as lag_dt from (select dt, user_id from visit_log group by dt, user_id) t0 ) t1 where datediff(dt, lag_dt) + 1 = 2 group by user_id; user_id 101 102 基于相邻日期差实现(排序版) 整体实现比较简单。 -- SQL - 19 select user_id from ( select *, dense_rank() over (partition by user_id order by dt) as dr from visit_log ) t1 where datediff(dt, date_add(dt, 1 - dr)) + 1 = 2 group by user_id; user_id 101 102 基于连续活跃天数实现 可以视作基于相邻日期差实现(排序版)的衍生版本,该实现能获取到更多信息,如连续活跃天数。 -- SQL - 20 select user_id from ( select *, -- 连续活跃天数 count(distinct dt) over (partition by user_id, cont) as cont_days from ( select *, date_add(dt, 1 - dense_rank() over (partition by user_id order by dt)) as cont from visit_log ) t1 ) t2 where cont_days >= 2 group by user_id; user_id 101 102 基于连续活跃区间实现 可以视作基于相邻日期差实现(排序版)的衍生版本,该实现能获取到更多信息,如连续活跃区间。 -- SQL - 21 select user_id from ( select user_id, cont, -- 连续活跃区间 min(dt) as cont_date_start, max(dt) as cont_date_end from ( select *, date_add(dt, 1 - dense_rank() over (partition by user_id order by dt)) as cont from visit_log ) t1 group by user_id, cont ) t2 where datediff(cont_date_end, cont_date_start) + 1 >= 2 group by user_id; user_id 101 102 5.2 动态连续活跃统计 场景描述 现有用户访问日志表 visit_log ,每一行数据表示一条用户访问日志。 -- SQL - 22 with visit_log as ( select stack ( 6, '2024-01-01', '101', '湖北', '武汉', 'Android', '2024-01-01', '102', '湖南', '长沙', 'IOS', '2024-01-01', '103', '四川', '成都', 'Windows', '2024-01-02', '101', '湖北', '孝感', 'Mac', '2024-01-02', '102', '湖南', '邵阳', 'Android', '2024-01-03', '101', '湖北', '武汉', 'IOS' ) -- 字段:日期,用户,省份,城市,设备类型 as (dt, user_id, province, city, device_type) ) select * from visit_log; 如何获取最长的 2 个连续活跃用户,输出用户、最长连续活跃天数、最长连续活跃日期区间? 上述问题在分析连续性时,获取连续性的结果不是且无法与固定的阈值作比较,而是各自以最长连续活跃作为动态阈值,此处归类为动态连续活跃场景统计。 SQL 实现 基于普通连续活跃场景统计的思路进行扩展即可,此处直接给出最终 SQL : -- SQL - 23 select user_id, -- 最长连续活跃天数 datediff(max(dt), min(dt)) + 1 as cont_days, -- 最长连续活跃日期区间 min(dt) as cont_date_start, max(dt) as cont_date_end from ( select *, date_add(dt, 1 - dense_rank() over (partition by user_id order by dt)) as cont from visit_log ) t1 group by user_id, cont order by cont_days desc limit 2; user_id cont_days cont_date_start cont_date_end 101 3 2024-01-01 2024-01-03 102 2 2024-01-01 2024-01-02 六、扩展 引申出更复杂的场景,是本篇文章前面章节内容的结合与变种。 6.1 区间连续(最长子区间切分) 场景描述 现有用户扫描或连接 WiFi 记录表 user_wifi_log ,每一行数据表示某时刻用户扫描或连接 WiFi 的日志。 -- SQL - 24 with user_wifi_log as ( select stack ( 9, '2024-01-01 10:01:00', '101', 'cmcc-Starbucks', 'scan', -- 扫描 '2024-01-01 10:02:00', '101', 'cmcc-Starbucks', 'scan', '2024-01-01 10:03:00', '101', 'cmcc-Starbucks', 'scan', '2024-01-01 10:04:00', '101', 'cmcc-Starbucks', 'conn', -- 连接 '2024-01-01 10:05:00', '101', 'cmcc-Starbucks', 'conn', '2024-01-01 10:06:00', '101', 'cmcc-Starbucks', 'conn', '2024-01-01 11:01:00', '101', 'cmcc-Starbucks', 'conn', '2024-01-01 11:02:00', '101', 'cmcc-Starbucks', 'conn', '2024-01-01 11:03:00', '101', 'cmcc-Starbucks', 'conn' ) -- 字段:时间,用户,WiFi,状态(扫描、连接) as (time, user_id, wifi, status) ) select * from user_wifi_log; 现需要进行用户行为分析,如何划分用户不同 WiFi 行为区间?满足: 1)行为类型分为两种:连接(scan)、扫描(conn); 2)行为区间的定义为:相同行为类型,且相邻两次行为的时间差不超过 30 分钟; 3)不同行为区间在满足定义的情况下应取到最长; user_id wifi status time_start time_end 备注 101 cmcc-Starbucks scan 2024-01-01 10:01:00 2024-01-01 10:03:00 用户扫描了 WiFi 101 cmcc-Starbucks conn 2024-01-01 10:04:00 2024-01-01 10:06:00 用户连接了 WiFi 101 cmcc-Starbucks conn 2024-01-01 11:01:00 2024-01-01 11:02:00 距离上次连接已经超过 30 分钟,认为是一次新的连接行为 上述问题稍显复杂,可视作动态连续活跃统计中介绍的最长连续活跃的变种。可以描述为结合连续性阈值与行为序列中的上下文信息,进行最长子区间的划分的问题。 SQL 实现 核心逻辑:以用户、WIFI 分组,结合连续性阈值与行为序列上下文信息,划分行为区间。 详细步骤: 1)以用户、WIFI 分组,在分组窗口内对数据按时间正序排序;2)依次遍历分组窗口内相邻两条记录,若两条记录之间的时间差超过 30 分钟,或者两条记录的行为状态(扫描态、连接态)发生变更,则以该临界点划分行为区间。直到遍历所有记录; 3)最终输出结果:用户、WIFI、行为状态(扫描态、连接态)、行为开始时间、行为结束时间; -- SQL - 25 select user_id, wifi, max(status) as status, min(time) as start_time, max(time) as end_time from ( select *, max(if(lag_status is null or lag_time is null or status <> lag_status or datediff(time, lag_time, 'ss') > 60 * 30, rn, null)) over (partition by user_id, wifi order by time) as group_idx from ( select *, row_number() over (partition by user_id, wifi order by time) as rn, lag(time, 1) over (partition by user_id, wifi order by time) as lag_time, lag(status, 1) over (partition by user_id, wifi order by time) as lag_status from user_wifi_log ) t1 ) t2 group by user_id, wifi, group_idx ; user_id wifi status start_time end_time 101 cmcc-Starbucks scan 2024-01-01 10:01:00 2024-01-01 10:03:00 101 cmcc-Starbucks conn 2024-01-01 10:04:00 2024-01-01 10:06:00 101 cmcc-Starbucks conn 2024-01-01 11:01:00 2024-01-01 11:03:00 该案例中的连续性判别条件可以推广到更多场景,例如基于日期差值、时间差值、枚举类型、距离差值等作为连续性判别条件的数据场景。 结语 通过灵活的、散发性的数据处理思维,就可以用基础的语法,解决复杂的数据场景是本篇文章贯穿全文的思想。文中针对数列生成、区间变换、排列组合、连续判别等常见的场景,给出了相对通用的解决方案,并结合实例进行了实际运用的讲解。 本篇文章尝试独辟蹊径,强调灵活的数据处理思维,希望能让读者觉得眼前一亮,更希望真的能给读者产生帮助。同时毕竟个人能力有限,思路不一定是最优的,甚至可能出现错误,欢迎提出意见或建议。 作者 | 里戈 点击立即免费试用云产品 开启云上实践之旅! 原文链接 本文为阿里云原创内容,未经允许不得转载。

优秀的个人博客,低调大师

每日一博 | 对抗软件复杂度的战争

一、何为研发效能? 当我们谈研发效能的时候,我们在谈些什么?这个议题被抛出来,有人讨论,是因为存在问题,问题就在于实际的研发效率,已经远低于预期了。企业初创的时候,一个想法从形成到上线,一个人花两个小时就完成了,而当企业发展到数千人的时候,类似事情的执行,往往需要多个团队,花费好几周才能完成。这便造成了鲜明的对比,而这一对比产生的印象,对于没有深入理解软件工程的人来说,显得难以理解,可又往往无计可施。 细心的读者会留意到,前文我既用了“效能”一词,也用了“效率”一词。这是为了做严谨的区分,效能往往是用来衡量产品的经济绩效,而效率仅仅是指提升业务响应能力,提高吞吐,降低成本。 这里的定义引用了乔梁的《如何构建高效能研发团队》课程材料,本文并不讨论产品开发方法,因此后面的关注都在“效率”上。 本世纪 10 年代,早期的互联网从业者开发简易网站的时候,只需要学会使用 Linux、Apache、MySql、PHP(Perl)即可,这套技术有一个好记的名字:LAMP。可今天,在一个大型互联网公司工作的开发者,需要理解的技术栈上升了一个数量级,例如分布式系统、微服务、Web 开发框架、DevOps 流水线、容器等云原生技术等等。如果仅仅是这些复杂度还好说,毕竟都是行业标准的技术,以开发者的学习能力,很快就能掌握。令人生畏的复杂度在于,大型互联网公司都有一套或者多套软件系统,这些软件系统的规模往往都在百万行以上,质量有好有坏(坏者居多),而开发者必须基于这些系统开展工作。这个时候必须承担非常高的认知负荷,而修改软件的时候也会面临破坏原有功能的巨大风险,而风险的增高就必然导致速度的降低。 因此研发效率的大幅降低,其中一个核心因素就是软件复杂度的指数上升。 二、本质复杂度和偶然复杂度 Fred Brooks 在经典著作《人月神话》的「没有银弹」一文中对于软件复杂度有着精彩的论述,他将软件复杂度分为本质复杂度(Essential Complexity)和偶然复杂度(Accidental Complexity)。这里的本质和偶然两个词来源于亚里士多德的《形而上学》,在亚里士多德看来,本质属性是一个物体必然拥有的属性,偶然属性是一个物体可以拥有的属性(也可以不拥有)。例如,一个电商软件必然会包含交易、商品等业务复杂度,因此我们称它们为本质复杂度;而同一个电商软件,可以是基于容器技术实现(也可以不是),可以是基于 Java 编写的(也可以不是),因此我们称由于容器技术或者Java 技术而引入的复杂度,为偶然复杂度。 Fred Brooks 所描述的软件本质复杂度,指的就是来自问题域本身的复杂度,除非缩小问题域的范围,否则是无法消除本质复杂度的。而偶然复杂度是由于解决方案带来的,例如选择了 Java,选择了容器,选择了中台等等。 此外,我们可以从所谓问题空间(Problem Space)和方案空间(Solution Space)来理解这两个复杂度,问题空间就是现实的初始状态和期望状态,以及一系列约束规则(我们常常称之为业务),方案空间就是工程师设计实现的,一系列从初始状态达到期望状态的步骤。缺乏经验的工程师往往在还没理解清楚问题的情况下就急于写代码,这便是缺乏对于问题空间和方案空间的理解,而近年来领域驱动设计为那么多工程师所推崇,其核心原因就是它指导了大家去重视问题空间,去直面本质复杂度。Eric Evans 在 2003 年的著作《Domain Driven Design》,其副标题是 “Tackling Complexity in the Heart of Software”,我想这也不是偶然。 《人月神话》写于 1975 年,距今已经有 47 年了,Brooks 认为软件的本质复杂度是无法得到本质上的降低的,同时认为随着高级编程语言的演进,开发环境的发展演进,偶然复杂度会得到本质的降低。他的论断前半部分对了,然而后半部分是错了,我们今天的确有更高级的编程语言,功能更丰富的框架,能力更强大的 IDE,但是大家逐渐发现学习这些工具已经成为了一个不小的负担。 三、复杂度的爆炸 软件只要不消亡,只要有人用,有开发者维护,那么它的复杂度几乎必然是不断上升的。软件的生存发展意味着商业上的成功,随着时间的积累,越来越多的人使用它,越来越多的功能被加入进去,它的价值越来越大,给企业带去源源不断的收入。前面我们解释过,软件的本质复杂度实际上是问题空间(或者称之为业务)带来的,因此给软件加入越多的功能,那么它就必然会包含越多的本质复杂度。此外,每解决一个问题,就对应了一个方案,而方案的实现必然又引入新的偶然复杂度,例如为了实现支付,需要实现某种新的协议,以对接一个三方的支付系统。软件复杂度是在商业上成功的企业所必须面对的幸福的烦恼。 和Brooks的时代所不同的是,今天的软件已经从深入到人类生活的方方面面。稍有规模的互联网软件,都服务着数百万、千万级的用户。阿里巴巴的双11在2020年的峰值实现了每秒58.3万笔的交易;Netflix 在2021年Q4拥有了2.2亿的订阅用户;而 TikTok 在2021年9月宣布月活数量超过10亿。这些惊人的商业成功背后,都少不了复杂的软件系统。而所有这些复杂软件系统,都不得不面对巨大的 Scalability 的挑战,服务一个人的系统,和服务一亿人的系统,其复杂度有着天壤之别。 本质复杂度是一个方面,毕竟更多用户意味着更多的功能特性,但我们无法忽略这里的偶然复杂度,其中最典型的就是分布式系统引入的偶然复杂度。为了能够支撑如此大规模的用户量,系统需要能够管理数万机器(调度系统),需要能否管理好用户的流量(负载均衡系统),需要能够管理好不同计算单元之间的通讯(服务发现,RPC,消息系统),需要能够保持服务的稳定性(高可用体系)。这里的每一个主题都能延展开用几本书来描述,而开发者只有在初步掌握了这些知识后,才能够设计实现足够 Scalable 的系统,服务好大规模的用户。 相比于分布式系统引入的复杂度,团队的扩张更易带来偶然复杂度的急剧增长。成功产品的软件研发团队动辄数百人,有些已经达到了一两千人的规模。如果企业没有严格清晰的人才招聘标准,人员入职后没有严格的技术规范培训,当所有人以不同的风格,不同的长短期目标往代码仓库中提交代码的时候,软件的复杂度就会急剧上升。 例如,团队成员因为个人喜好,在一个全部是 Java 体系的系统中加入了 NodeJS 的组件,当该成员离开团队后,这个组件对于其他不熟悉 NodeJS 的成员来说,就是纯粹多出来的偶然复杂度; 例如,团队新人不熟悉系统,为了急于上线一个特性,又不想影响到系统的其他部分,就会很自然地在某个地方加一个 flag,然后在所有需要改动的地方加 if 判断,而不是去调整系统设计以适应新的问题空间; 例如,同一个领域概念,不同的人在系统不同的模块中使用了不同的名字,核心内涵完全一致,但又加入了差异的属性,平添了大量理解成本。 类似的复杂度都不是软件的本质复杂度,但它们会随着时间的流逝而积累,给开发者带来巨大的认知负担。如果软件存在的时间很长,那除了当前开发团队的规模之外,还得一并考虑历史上给这个软件贡献过代码的所有人,也难怪当程序员看到“祖传代码,勿动!”之类调侃的时候,会会心一笑。 我喜欢学习各种能力强大的编程语言,例如具备元编程能力的 Ruby 和 Scala,使用这些能力你可以尽情发挥自己的兴趣和创造力。但是我对在有一定团队规模的生产环境中使用这些编程语言持保留意见,因为除非花很大力气 Review 和控制代码风格,否则很可能 10 个人写出来的代码是 10 种风格,这种复杂度的增长是个灾难。相反,使用 Java 这种不那么灵活的语言,大家写代码的风格就比较难不一致。 团队的扩张还会带来另外一个问题,在大规模的团队中,关键干系人的目标事实上是影响软件复杂度的关键因素。我亲眼见过许多案例,其方案空间中明明放着简单的方案,但因为这个原因,当事人不得不选择复杂的方案,例如: 原本方案只需要直接改动系统 A,但由于负责系统 A 的团队并没有解决该问题的动力,其他人不得不绕道去修改系统 B,C,D 来解决该问题。 原本方案只需要直接改动系统 A,但迫于系统 B 负责人或者上司的压力,方案不得不演进成同时改 A,B,甚至引入 C。 更有甚者,为了各种各样的原因,提出一些完全假设出来的问题(即,事实上并不存在的本质复杂度),然后拿着软件系统一阵无谓折腾。最后个人或者某个团队的目标实现了,但软件没有提供任何增量的价值,而复杂度却不会因此而停止增长。 因此,只要软件有价值,有用户,有开发者维护,那么就不断会有功能增加,而商业上获得成功的软件必然伴随着用户量的增长和研发团队的增长,这三个因素会不断推动软件复杂度的增长直至爆炸,研发效率自然会越来越低。软件工程要解决的一个核心命题,就是如何控制复杂度,以让研发效率不至于下降的太厉害,这是一场对抗软件复杂度的战争。 四、错误的应对方式 面对效率地不断下降,研发团队的管理者必须做点什么。不幸的是,很多管理者并不明白效率的降低是由软件复杂度的上升造成的,更没有冷静地去思考复杂度蔓延直至爆炸的根因是什么,于是我们看到许多管理者其肤浅的应对方式收效甚微,甚至起到了反作用。 最常见的错误方式是设置一个不可更改的 Deadline,用来倒逼研发团队交付功能。但无数经验告诉我们,软件研发就是在质量、范围和时间这个三角中求取权衡。研发团队短期可以通过加班,牺牲假期等手段来争取一些时间(长期加班实际有百害无一利),但如果这个时间限制过于苛刻,那必然就要牺牲需求范围和软件质量。当需求范围不可缩减的时候,唯一可以被牺牲的就只有质量了,这实际就意味着在很短的时间内往系统中倾泻大量的偶然复杂度。 另一种做法是用“更先进”的技术去替换现有系统的技术,例如用 Java 的微服务体系技术去替换 PHP + Golang 体系的技术;或者用支撑过成功商业产品的中台类技术去替换原来的微服务体系技术;或者简单到用云产品去替换自建的开源服务。这些做法背后的基本逻辑是,“更先进”的技术在成功的商业场景中被验证过,因此可以被直接拿来解决现有的问题。 但在现实情况下,决策者往往忽略了当前的问题是否是“更先进”的技术可以解决的问题。如果现有的系统服务的用户在迅速增长,Scalablity 面临了严重的困境,那么这个答案是肯定的;如果现有的系统的稳定性堪忧,经常不可用且严重影响了用户体验,那么这个答案是肯定的。但是,如果现有的软件系统面临着研发效率下降问题,那么“更先进”的技术不仅帮不了什么忙,还会因为新老技术的切换给系统增加偶然复杂度。 五、正确的技术战略 前文我解释了导致复杂度增长的几个核心因素,包括业务复杂度的增长,分布式系统规模的增长,团队规模的增长,以及关键干系人目标的因素。这其中,分布式系统引入的偶然复杂度是最容易被消除的。为了更好得理解这个观点,我先简单介绍一下 Wardley Map。 Wardley Map 是一个帮助分析技术战略的工具,它以地图的方式展现,地图中的每个组件可以被理解成一个软件模块,纵坐标是价值方向,越往上越靠近用户价值,横坐标是进化方向,越往右越靠近成熟商业产品。 例如上图中,Compute 是计算资源,在今天有许多成熟的云计算公司提供,但它离图中上下文业务的用户价值非常远。Virtual Fitting(虚拟试衣)则离用户价值非常靠近,因为它可以让用户更有信心自己是否购买了合适的衣服,但是这个技术显然还谈不上是成熟产品,只是自己研发的模块,远没有达到开放商业化的阶段。 设计研发一套用来支撑百万、千万级用户的分布式系统,是非常有挑战的事情,而且会给系统引入大量的复杂度,管理好这些复杂度本身则又是一项巨大的挑战。幸运的是,今天的云厂商,包括阿里巴巴,亚马逊,谷歌和微软等,在这方面都具有丰富的经验,并且已经通过多年的积累,把这些经验通过商业产品提供给市场。 从 Wardley Map 的方式去分析,我们就会发现,几乎所有的业务,其左上角(贴近直接用户价值,不成熟)都必须是要自己研发和承担复杂度的,而只要做好正确的软件架构,那么就能把右下角的部分(远离直接用户价值,有现成商业产品)提取出来,直接购买。所以在今天,一个合格的架构师,除非自己是云厂商,否则绝对不应该自己去投入研发数据库、调度系统、消息队列、分布式缓存等软件。通过购买的方式,研发团队完全不用承担这些复杂度,也能轻松地支撑好用户规模的增长。 六、微观层面的复杂度控制 正确的技术战略能够在宏观层面帮助系统控制复杂度,在微观层面我们需要完全不同的方法。在讨论方法之前我想先引用一个来自《Grokking Simplicity》书中的一个简单例子。(有趣的是,这本书的副标题 “Taming complex software with functional thinking” 也是在表达对抗复杂度的意图。) 让我们来看两个函数(JavaScript): function emailsForCustomers(customers, goods, bests) { var emails = []; for(var i = 0; i < customers.length; i++) { var customer = customers[i]; var email = emailForCustomer(customer, goods, bests); emails.push(email); }} function biggestPurchasePerCustomer(customers) { var purchases = []; for(var i = 0; i < customers.length; i++) { var customer = customers[i]; var purchase = biggestPurchase(customer); purchases.push(purchase); }} 初看起来这两个函数没什么问题,都是准备一个返回值,写一个循环,根据具体业务逻辑提取需要的数据,差别只是在于,前一个函数的业务逻辑是获取客户的 Email,后一个函数的业务逻辑是获取客户下过的最大的单。然而就这么简单的代码来说,也是存在可以降低的复杂度的,理解阅读这两个函数,每次都需要去理解 for 循环,这个复杂度是否可以进一步被降低呢?答案是肯定的。 对于这种到处可见的逻辑,即遍历集合的每个元素,对其中每个元素做一些处理,返回一个新元素,最后装成一个新的集合,可以被抽象成一个 map 函数。在这个例子中,我假设 JavaScript 支持 map 函数,那么上面的代码可以写成: function emailsForCustomers(customers, goods, bests) { return map(customers, function(customer) { return emailForCustomer(customer, goods, bests); });} function biggestPurchasePerCustomer(customers) { return map(customers, function(customer) { return biggestPurchase(customer); });} 抛开语言语法的因素不谈,这段代码除了这个 map 函数,剩下的就是函数名了,而函数名只要是命名得当的,那它其实就是本质复杂度,就是业务逻辑。行业先辈,大家耳熟能详的 Martin Fowler、Kent Beck、Robert C. Martin,无不在他们的书籍中强调命名的重要性,都是希望代码能够清晰地沟通意图,而这里最核心的意图应当是与问题域匹配的。 这个例子中的代码是极其简单的,所有程序员都能理解,可即便在这些地方还有降低复杂度的空间。可以想象在数年日积月累的代码中,会存在多少复杂度可被消除。我又想起多年前的一位同事兼长辈的程序员的教诲,他说优秀的代码应该是: It works It is easy to understand It is safe to change 事实上要做到第二点已经是非常高的要求,这需要软件工程师精心地设计,清晰地沟通好需求,思考和遗留系统的融合,还需要压制住自己使用新技术(新语言,新的范式)的冲动。而第三点实际上是教会我们认真的写单元测试。 我不知道大家是否体验过这种感觉:在需求讨论清晰后,我编写了对应的代码和单元测试,具体是在原来的几万行 code base 上加了几百行,并原来 1000 个左右的单元测试上加入了 3-5 个单元测试,然后我在本地执行了一次 mvn clean test,这个过程也就消耗几分钟,全部测试都通过了,这时候我非常有信心把代码提交,而且我知道代码在生产环境运行出问题的概率极低。 这种感觉的核心是质量反馈,这个反馈时间越短,效率就越高,反馈时间越长,效率就越低。除了控制复杂度之外,软件工程师必须明白及时质量反馈的重要性,如果一行代码写下去,要等好几个小时,甚至好几天才知道其质量有问题,效率的低下可想而知。所以当我看到当组织自上而下提倡写单元测试,但大家实践中的一些怪现象时,常常会感到匪夷所思,这些现象会包括: 低质量的单元测试:包括不写 assert,到处是 print 语句,要人去验证。 不稳定的单元测试:代码是好的,测试是失败的,测试集无法被信任。 耗时非常长的单元测试:运行一下要几十分钟或者几小时。 用代码生成单元测试:对不起,我认为这个东西除了提升覆盖率虚荣指标外,毫无意义。 七、软件道德观 在微观层面控制软件复杂度,认真编写单元测试以保障代码编写的质量反馈,对于研发效率来说是至关重要的,但同时也是耗时耗力的。而且由于这种投入对商业的价值需要很长时间才能体现出来,因此容易被研发主管所忽视。 开发者都是在生产代码、文档、API 服务等软件中间产物,这些中间产物被逐渐组装起来成为产品,产生商业价值。软件中间产物的质量对于研发组织的整体效率是至关重要的,而复杂度得到很好控制的代码和系统,就是高质量的软件中间产物;良好的软件研发道德,或者有时候也会认为这是良好的工程师文化,就是大家形成一种以交付高质量软件中间产物为荣,以交付低质量软件中间产物为耻的共识文化。 软件研发的核心职责之一是关注软件复杂度,通过开放代码、文档,Code Review 等方式让软件复杂度的信息透明,并且让所有在增加/降低复杂度的行为透明,并且持续激励那些消除复杂度的行为。唯有如此,在微观层面的控制复杂度的方法才能得到落实。 八、系统架构对复杂度的影响 介于宏观的技术战略和微观的工程师文化之间,存在着一块重要的决策区域,也对软件复杂度有着关键的影响,我称之为系统架构。在面对需求的时候,缺乏经验的工程师会直接想着在自己熟悉的模块中直接解决,而经验丰富的工程师会先思考一下系统上下文。在《Design Docs at Google》这篇优秀的技术文档写作指导中,就重点提到了,设计文档应当写清楚系统上下文图(system-context-diagram),这背后的原因是什么呢? 我近期对一个遗留系统做了一个依赖链路的梳理分析,这个系统是负责生产环境中各类资源的管理的,包括资源的规格,版本,依赖关系等等,梳理完成后,整体的结构吓了我一跳,这个图大致是这样的: 图中蓝色的部分是控制和执行的子系统(System X,Y,Z),例如控制容器的调度,控制镜像变更的执行等等,是比较清晰的。但是其余部分就不是这样了(A1, A2, A3, C1, C2, S, E),它们都是在管理一个资源的运行态版本,包括镜像的版本,容器的规格,是否有 GPU,容器的数量,关联的网络资源等等,但却演进出了七个子系统,这实际上是非常高的偶然复杂度。当一个领域的概念被分散到这么多子系统之后,就会产生一系列问题: 不同子系统对于同一个概念有不同的名称,交互的时候会涉及各种翻译。 不同子系统承担了同一个实体的部分概念,导致修改的时候需要大范围一起修改,且容易出错。 更高的运维成本。 仔细去分析这一复杂度形成的因素,我发现这既不是技术战略的问题,也不是微观层面工程师生产低质量代码导致,而是有其他更深层次的问题。其中的最核心的因素是,这些子系统在不同时期是归属于不同的团队的,有的甚至是不同部门的,具体来说,当各个部门各个团队目标不一致的时候,而这个系统又不幸地被拆到各个团队,那么就不会有人会对系统整体的复杂度控制负责。当有的团队在负责把这套系统商业化对外输出,有的团队在负责把这套系统从虚拟机模式演进到容器模式,有的团队在负责资源的成本控制,有的团队在思考全局高可用架构,而没有一个全局的架构师从整体控制概念,控制边界的时候,系统就自然而然地腐化成这样的一个状态了。 当一个问题域没有系统架构,或者其系统架构是错误的时候,你就会发现不同的人在发明不同的语言,这就好比相隔几十公里的两个村子,常常对同一个概念有不同的用词或者发音。日常生活中语言的不精确不是问题,因为日常的沟通是充满上下文的(表情,气氛,环境等),但在计算机的世界,语言的不精确就意味着需要写代码翻译,一旦翻译错误软件就会执行出错。这也就是为什么领域驱动设计那么强调统一语言,强调限定上下文。但领域驱动设计是方法论,而知道方法并不能取代系统架构角色的缺位。 这个复杂系统是康威定律的绝佳例证,康威定律说:“任何系统设计的系统,其系统结构会复制组织的沟通结构。”这句话其实还是有些抽象的,更具体的一些阐述是: “康威定律 … 是一个合理的社会学观察。… 除非模块 A 和模块 B 的设计及实现者能有效沟通,否则这两个软件模块是无法正确对接的。因此软件系统的接口结构,就必然会和生产软件系统的社会结构及组织相对应。” 康威定律所揭示的事实,就是软件架构在很大程度上是由组织的结构和协作模式决定的,这实际上已经不再是一个软件技术问题了,而是一个组织管理问题。因此,解决系统架构层面的软件复杂度问题,就必须面对组织管理的挑战。关键问题域是否有唯一的负责人?当不同的团队在同一个问题域重复建设系统的时候,如何整合团队?当已有团队为了自己的生存,不断夸大其负责系统的重要性和特殊性,如何识别这种问题?组织如何给予大家充分的安全感,让工程师愿意为了架构的合理性,放弃自己辛苦耕作的系统模块? 讨论管理工作似乎已经超出了这篇论述软件复杂度的文章的范畴,但很多工程师或者隐隐感觉,或者思来想去最终领悟,这是我们的软件系统或优雅健壮或千疮百孔的根本因素。 小结 我曾经的大老板郭东白曾在一次 QCon 的演讲中讨论优秀架构师的特质,除了大家都很好理解的有眼光、善于思考、能感召等几个特质外,还特别强调了“有良知”,他说: 有良知,这是一个架构师随着时间的流逝,沉淀在身上最重要的品质。什么是有良知?为人正直,选择做正确的事情。很多人是非常聪明的,业务理解能力强,技术实践丰富,但他不一定为公司或为组织做最正确的事情。有良知是非常重要的一个事情,如果架构师没有素质,他会让一家公司的损失很惨重。 软件复杂度是人的行为引起的,无论是微观层面的重视质量和工程师文化,在系统架构层面让组织结构和沟通符合客观问题域,还是在技术战略层面做符合公司利益的决策,这里都存在客观无法改变的规律。如何认识到这些规律,并基于这些规律制定决策(可改变可影响),努力为公司创造价值,努力让每个工程师被尊重,是每个工程师、架构师、技术管理者所应当秉承的基本态度。本文讨论软件复杂度的初衷,就是尽量去揭示复杂度背后的客观规律,希望帮助大家认清现实,用更务实的态度去思考和决策,创造更有价值,也更让自己满足的软件系统。 参考阅读: Why choose Domain-Driven Design? 这篇文章清晰地解释了本质复杂度和领域驱动设计的关系。 《人月神话》-「没有银弹」一篇阐述了本质复杂度和偶然复杂度的概念。 《The Lean Product Playbook》- 本书的第2章清晰地解释了 Problem Space 和 Solution Space。 Wardley Map - 分析技术战略的绝佳工具,合理地选取商业产品可以帮助降低系统复杂度。 Grokking Simplicity - 在微观层面,使用函数式的思维降低软件复杂度。 Design Docs at Google Conway’s Law 警惕复杂度困局:关于软件复杂度的思考 作者|晓斌 点击立即免费试用云产品 开启云上实践之旅! 原文链接 本文为阿里云原创内容,未经允许不得转载。

优秀的个人博客,低调大师

每日一博 | 深入理解 Flutter 图片加载原理

前言 随着Flutter稳定版本逐步迭代更新,京东APP内部的Flutter业务也日益增多,Flutter开发为我们提供了高效的开发环境、优秀的跨平台适配、丰富的功能组件及动画、接近原生的交互体验,但随之也带来了一些OOM问题,通过线上监控信息和Observatory工具结合分析我们发现问题的原因是由于Flutter页面中加载的大量图片导致的内存溢出,这也是在原生开发中常见的问题之一,Flutter官方为我们提供的Image widget实现图片加载及显示,只有了解Flutter中图片的加载原理及图片内存管理方式才能真正发现问题的本质,本文将重点介绍Flutter中图片的加载原理,使用过程中有哪些需要注意的地方及优化思路和手段,希望能给大家带来一些启发和帮助。 基本使用 下面是 Image 的基本使用方法,image参数是 Image 控件中的必选参数,也是数据源类型可以是Asset、网络、文件、内存,下面将以我们常用的网络图片加载方式为例子讲解原理,基本使用如下: Image( image: NetworkImage( "https://avatars2.githubusercontent.com/u/20411648?s=460&v=4"), width: 100.0, heitht: 100.0 ) Image 控件的使用方法这里就不在展开了,控件的参数及API详情请参阅:https://api.flutter.dev/flutter/widgets/Image-class.html 图片加载流程 Flutter 的图片加载原理与原生客户端中的图片框架加载原理相似,具体可点击下方大图查看,加载步骤如下: 1、 区分数据来源生成缓存列表中数据映射的唯一key; 2、 通过key读取缓存列表中的图片数据; 3、 缓存存在,返回已存在的图片数据; 4、 缓存不存在,按来源加载图片数据,解码后同步到缓存中并返回; 5、 设置回调监听图片数据加载状态,数据加载完成后重新渲染控件显示图片; 大家可能注意到了上面流程图中的文件缓存部分是灰色的,目前官方还不支持此功能,下面我们会通过源码逐步分析加载流程及如何通过修改源码补全文件缓存功能。 源码分析 下面将通过流程图结合UML类图分析图片加载流程: 这个UML类图看起来稍微有点儿复杂,但仔细看会发现已将图片数据加载流程分成几大模块,下面将按照模块进行逐步分析,下面将以网络图片加载方式为例讲解核心类和核心方法功能。 核心类及方法介绍 启动缓存相关类 PaintingBinding:图片缓存类和着色器预加载,该类是基于框架的应用程序启动时绑定到Flutter引擎的胶水类,在启动入口main.dart的runApp方法中创建WidgetsFlutterBinding类时被初始化的,通过覆盖父类的initInstances()方法初始化内部的着色器预加载(Skia第一次在GPU上绘制需要编译相应的着色器,这个过程大概20ms~200ms)及图片缓存等,图片缓存以单例的方式(PaintingBinding.instance.imageCache)对外提供方法使用,也就是说这个图片缓存在APP中是全局的,并在这个类中还提供了图像解码(instantiateImageCodec)、缓存清除(evict)等功能。 **ImageCache:**图片缓存类,默认提供缓存最大个数限制1000个对象和最大容量限制100MB,由于图片加载过程是一个异步操作,所以缓存的图片分为三种状态:已使用、已加载、未使用,分别对应三个图片缓存列表,当图片列表超限时会将图片缓存列表中最近最少使用图片进行删除,缓存列表分别是:活跃中图片缓存列表(_cache)、已加载图片缓存列表(_pendingImages)、未活跃图片缓存列表(_liveImages),并对外提供以下方法:获取缓存(putIfAbsent)、清空缓存(clear、clearLiveImages)、驱逐单个图片(evict)、最大缓存个数限制(maximumSize)、最大缓存大小限制(maximumSizeBytes)等方法。 从源码中我们可以看到缓存列表是Map类型,Flutter中的Map创建的对象是LinkedHashMap是有序的,按键值插入顺序迭代,Flutter使用LinkedHashMap存储图片数据并实现类似LRU算法的缓存,当缓存列表中的图片被使用后会将图片数据重新插入到缓存列表的末尾,这样最近最少使用的图片始终会被放在列表的头部。 当缓存列表增加图片数据后,会通过最大缓存个数和最大缓存大小两个纬度进行检查缓存列表是否超限,若存在超限情况则通过Map的keys.first方法获取缓存列表头部最近最少使用的图片对象进行删除,直到满足缓存限制。 启动缓存小结: Flutter启动后在PaintingBinding中创建ImageCache缓存,图片缓存是全局的并以单例方式对外提供使用方法,缓存默认最大个数限制1000个对象、最大容量限制100MB,缓存中的Map列表通过key/value方式存储图片信息,并通过keys.first方法实现的类似LRU算法管理图片缓存列表,对外提供putIfAbsent()方法获取已缓存图像,若缓存中不存在则通过回调图片加载类中的load()方法加载图片数据,另外图片缓存中还提供clear()和evict()方法用来删除缓存。 图片数据加载相关类 **ImageProvider:**图片数据提供抽象类,该类定义了图像数据解析方法(resolve)、唯一key生成方法(obtainKey)、数据加载方法(load),obtainKey 和load方法均由子类实现,obtainKey方法生成的对象用于内存缓存的key值使用,load方法将按照不同数据源加载图像数据,常用的Provider子类有:NetworkImage、AssetImage、FileImage、MemoryImage,我们可以看到resolve方法返回的是图片加载对象类(ImageStream),load方法返回的是ImageStreamCompleter类用来管理图像加载状态及图像数据(ImageInfo)。 **ImageStreamCompleter:**是一个抽象类,用于管理加载图像对象(ImageInfo)加载过程的一些接口,Image控件中正是通过它来监听图片加载状态的。 **ImageStream:**图像的加载对象,可监听图像数据加载状态,由ImageStreamCompleter返回一个ImageInfo对象用于图像显示 **NetworkImage:**网络图片加载类,ImageProvider的实现类,通过URL加载网络图像,覆盖load()方法返回ImageStreamCompleter的实现类MultiFrameImageStreamCompleter,构建该类需要一个codec参数类型是Future<ui.Codec>,通过调用_loadAsync()方法下载网络图片数据获得字节流后通过调用PaintingBinding.instance.instantiateImageCodec方法对数据进行解码后获得Future<ui.Codec>对象,obtainKey方法我们发现返回的是SynchronousFuture<NetworkImage>(this)对象,正是NetworkImage自己本身,我们通过该类的==方法可以看到判断两个NetworkImage类是否相等通过runtimeType、url、scale这三个参数来判断,所以图片缓存中的key相等判断取决于图片的url、scale、runtimeType参数。 **MultiFrameImageStreamCompleter:**是ImageStreamCompleter的子类是Flutter SDK的预置类,构建该类需要一个codec参数类型是Future<ui.Codec>,Codec是处理图像编解码器的句柄也是Flutter Engine API的包装类,可通过其内部的frameCount变量获取图像帧数,分别处理单帧和多帧(动态图)图像,内部的getNextFrame()方法获取每帧的图像数据并创建Image控件中渲染需要的ImageInfo数据,调用onImage方法将ImageInfo返回给Image控件。 图像数据加载小结: 上面以网络图像加载流程分析,首先通过ImageProvider的resolve()方法创建ImageStream对象,obtainKey()方法创建图像缓存列表中的唯一key(取决于图像url和scale),通过load()方法加载图像数据并返回MultiFrameImageStreamCompleter对象,并将其设置给ImageStream中的setCompleter()方法添加监听图像加载完成状态,图像数据通过Codec处理帧数分别处理最终创建ImageInfo对象通过ImageStreamListener的onImage方法返回给Image控件。 图片渲染相关类 **_ImageState:**是Image控件创建的State类,通过调用ImageProvider的resolve()方法解析图片数据,resolve()方法返回的ImageStream对象,通过addListener()增加图片解析状态监听,通过ImageStreamListener的onImage回调中获取图片数据(ImageInfo)加载完成状态,onChunk回调监听数据加载进度,onError监听图片加载错误状态,最终通过调用setState进行数据更新绘制。 细心的同学会发现ImageProvider的实例对象(widget.image)被ScrollAwareImageProvider包装了一下又重新创建了一个provider,在ScrollAwareImageProvider内部主要是重写了其中的resolveStreamForKey()方法,Flutter SDK 1.17版本中对图片解析增加了快速滚动优化,当判断当前屏幕处在快速滚动状态时,则将图片解析过程延迟下一帧帧尾进行。 **RawImage:**RenderObjectWidget的子类,重写createRenderObject方法创建RenderObject子类。 **RenderImage:**渲染树中RenderObject的实现类,Flutter的三棵树Widget、Element、RenderObject ,而RenderObject这是负责绘制渲染的,RenderImage重写performLayout()方法度量渲染尺寸并布局,重写paint()方法获取画布Canvas,Canvas是记录图片操作的接口类,通过参数处理图片镜像、裁剪、平铺等逻辑后调用的drawImageNine()和drawImageRect()方法将图片合成到画布上最终调用Skia引擎API进行绘制。 图片渲染小结: Image控件中通过调用ImageProvider的resolve()方法获取图片数据ImageInfo对象,通过setState方法将数据更新给图片渲染控件(RenderImage),RenderImage中重写paint()方法根据传入参数对图片数据处理后绘制到Canvas画布上并调用Skia引擎API进行绘制。 总结 以上是 Image 图片加载原理及源码分析,那么我们在翻阅了Image源码后能做些什么呢?使用过程中有哪些可以优化的部分呢?让我们继续往下看。 图片缓存池大小限制优化 Flutter本身提供了定制化Cache的能力,所以优化ImageCache的第一步就是要根据机型的实际物理内存去做缓存大小的适配,通过PaintingBinding.instance.imageCache调用的maximumSize和maximumSizeBytes动态设置合理的图片缓存大小限制避免因图片过多导致OOM。 未显示图像内存优化 可结合StatefulWidget控件生命周期中的deactive()、dispose()等方法,在页面控件中的图片未显示在屏幕上或控件已销毁时调用图片缓存中的evict()方法进行资源释放。 图片预缓存处理 Image控件中提供了precacheImage()方法可以将需要显示的图片预先加载到ImageCache的缓存列表中,缓存列表中通过key值区分相同图片,在页面打开后直接从内存缓存获取,可快速显示图片。 图片文件缓存 通过查看网络图片加载类NetworkImage源码可以发现,图片数据下载和解码过程都是通过_loadAsync()方法完成的,所以我们可以通过改造这个方法中图片文件下载、读取、保存过程去增加图片文件本地存储、获取原生图片库缓存、图片下载DNS处理等功能。 自定义占位图、错误图效果 Image控件中的frameBuilder和errorBuilder参数分别为我们提供了占位图和错误图的自定义方式,也可使用FadeInImage控件提供的占位图(placeholder)、错误图imageErrorBuilder等参数,FadeInImage内部实现也是Image控件,感兴趣的同学可以查看其源码实现。 大图下载进度自定义显示 显示效果:https://flutter.github.io/assets-for-api-docs/assets/widgets/loading_progress_image.mp4 图片可拉伸区域设置(.9图片) RenderImage的paint方法中我们发现在调用Canvas API绘制前会判断centerSlice参数分别调用drawImageNine()和drawImageRect()方法,Image正式通过centerSlice参数配置图片的可拉伸区域,参考代码:centerSlice: Rect.fromLTWH(20, 20, 1, 1),L:横向可拉伸区域左边起始点位置,T:纵向可拉伸区域上边起始点位置,W:横向可拉伸区域宽度,H:纵向可拉伸区域宽度。 未来规划 本文介绍了京东APP中Flutter探索遇到的问题以及图片的加载原理和使用过程中的一些技巧,随着Flutter SDK版本迭代更新,我们将继续对图片加载框架进行优化,原生开发中的多个优秀图片框架已经经历了大量用户的考验这也一直是我们渴望在Flutter上复用的能力,所以我们也在积极探索原生和Flutter中图片内存共享方案,我们希望这个增强能力是非侵入式的,我们也在尝试外接纹理等方案,这块技术细节进展将在后续文章中继续和大家一起探讨。 参考资料 1、http://storage.360buyimg.com/pub-image/Image-source.jpg 2、https://book.flutterchina.club/chapter14/image_and_cache.html 3、https://api.flutter-io.cn/flutter/painting/ImageCache-class.html 作者:京东零售徐宏伟 来源:京东云开发者社区

优秀的个人博客,低调大师

每日一博 | 图文结合带你搞懂 GreatSQL 体系架构

往期系列回顾 图文结合系列之带你搞懂MySQL日志系列 很多小伙伴使用了GreatSQL,但是对GreatSQL的底层原理还不是很了解,今天就带大家一起揭开GreatSQL体系架构的神秘面纱! 首先来回顾一张经典的体系架构图: 图1_GreatSQL5.7 版本体系架构图 由此可以发现,GreatSQL5.7 由以下几部分组成 连接池组件 系统管理和控制工具 SQL接口组件 查询解析器 查询优化器 缓存组件 可插拔存储引擎 系统和日志文件 GreatSQL数据库区别于其他数据库的一个特点就是其可插拔的表存储引擎,特别需要注意的是,存储引擎是基于表的,而不是数据库。 然而,经典同时也意味着这幅图已经相当陈旧了。在GreatSQL8.0 及更高版本中,查询缓存这一功能已经被移除。 图2_GreatSQL8.0 版本体系架构图 总体来说,GreatSQL8.0 可以分为连接层、服务层、存储引擎层。 一、连接层(Client Connectors) 连接层又名为客户端连接器(Client Connectors)作用是提供与GreatSQL服务器建立的支持。 客户端通过TCP/IP协议与GreatSQL服务器建立连接,每个连接对应一个线程。连接管理还包括了连接池技术,以复用已经建立好的连接,减少重复建立连接的开销。 而且几乎支持所有主流的服务端编程技术,主要完成一些类似于连接处理、授权认证、及相关的安全方案。 会对从 TCP 传输过来的账号密码做身份认证、权限获取 用户名或密码不对,会收到Access denied for user错误,客户端程序结束执行 例如: $ mysql -uroot -p ERROR 1045 (28000): Access denied for user 'root'@'localhost' (using password: NO) 用户名密码认证通过,会从权限表查出账号拥有的权限与连接关联,之后的权限判断逻辑,都将依赖于此时读到的权限 二、服务层(GreatSQL Server) 服务层是GreatSQL Server的核心,主要包含连接器、分析器、优化器、执行器等,涵盖 GreatSQL 的大多数核心服务功能,以及所有的内置函数(如日期、时间、数学和加密函数等),所有跨存储引擎的功能都在这一层实现,比如存储过程、触发器、视图等。 Ⅰ.SQL Interface: SQL接口 接收用户的SQL命令,并且返回用户需要查询的结果。比如SELECT … FROM就是调用SQL Interface,GreatSQL支持DML、DDL、存储过程、视图、触发器、自定义函数等多种SQL语言接口 同时还支持NoSQL,NoSQL泛指非关系型数据库和数据存储。随着互联网平台的规模飞速发展,传统的关系型数据库已经越来越不能满足需求。从5.6版本开始,GreatSQL就开始支持简单的NoSQL存储功能。GreatSQL8.0 版本对这一功能做了优化,以更灵活的方式实现NoSQL功能,不再依赖模式(schema)。 Ⅱ.Parser: 解析器 在解析器中对 SQL 语句进行语法分析、语义分析。将 SQL 语句分解成数据结构,并将这个结构传递到后续步骤,以后 SQL 语句的传递和处理就是基于这个结构的,并且判断你输入的这个 SQL 语句是否满足 GreatSQL 语法。 Ⅲ.Optimizer: 查询优化器 在开始执行之前,还要先经过优化器的处理。 SQL语句在语法解析之后、查询之前会使用查询优化器确定 SQL 语句的执行路径,生成一个执行计划,可以使用EXPLAIN命令查看执行计划。 这个执行计划表明应该使用哪些索引进行查询(全表检索还是使用索引检索),表之间的连接顺序如何,最后会按照执行计划中的步骤调用存储引擎提供的方法来真正的执行查询,并将查询结果返回给用户。 例如下面的 JOIN 语句: SELECT * FROM tb1 JOIN tb2 USING(ID) WHERE tb1.a=1 and tb2.a=2; 那就有两种方法可以选择: 第一种,先取表 tb1 里 a=1 的记录的ID值,再根据 ID 关联表 tb2 ,然后再判断 tb2 里面 a 的值是否等于 2 第二种,先取表 tb2 里面的 a=2 记录的 ID 值,在根据 ID 值关联 tb1 ,再判断 tb1 里面 a 的值是否等于 10 执行的结果肯定是一致的,但是效率就大不相同了,所以我们要选择用小的数据集去驱动大的数据集,也就是小表驱动大表。 Ⅳ.Caches & Buffers:查询缓存组件 GreatSQL 内部维持着一些 Cache 和 Buffer,比如 Query Cache 用来缓存一条 SELECT 语句的执行结果,如果能够在其中找到对应的查询结果,那么就不必再进行查询解析、优化和执行的整个过程了,直接将结果反馈给客户端。 但是在 GreatSQL 8.0 版本及以上中删除了查询缓存功能,因为查询缓存必须要两条SQL语句完全一模一样,否则是不能触发查询缓存,非常的鸡肋~ 三、引擎层(Storage Engines) Ⅰ.存储引擎层 真正的负责了 GreatSQL 中数据的存储和提取,对物理服务器级别维护的底层数据执行操作,服务器通过API与存储引擎进行通信。 存储引擎的优势在于,各式各样的存储引擎都具备独特的特性,从而能够针对特定的应用需求建立不同存储引擎表。 GreatSQL 支持的存储引擎如下: greatsql> SHOW ENGINES; +--------------------+---------+----------------------------------------------------------------------------+--------------+------+------------+ | Engine 引擎名称 | Support 支持情况 | Comment 引擎的说明 | Transactions 事务支持 | XA 分布式事务支持 | Savepoints 保存点 | +--------------------+---------+----------------------------------------------------------------------------+--------------+------+------------+ | FEDERATED | NO | Federated MySQL storage engine | NULL | NULL | NULL | | PERFORMANCE_SCHEMA | YES | Performance Schema | NO | NO | NO | | InnoDB | DEFAULT | Percona-XtraDB, Supports transactions, row-level locking, and foreign keys | YES | YES | YES | | MEMORY | YES | Hash based, stored in memory, useful for temporary tables | NO | NO | NO | | MyISAM | YES | MyISAM storage engine | NO | NO | NO | | MRG_MYISAM | YES | Collection of identical MyISAM tables | NO | NO | NO | | BLACKHOLE | YES | /dev/null storage engine (anything you write to it disappears) | NO | NO | NO | | CSV | YES | CSV storage engine | NO | NO | NO | | ARCHIVE | YES | Archive storage engine | NO | NO | NO | +--------------------+---------+----------------------------------------------------------------------------+--------------+------+------------+ 9 rows in set (0.00 sec) 得益于 GreatSQL 数据库的开源特性,用户得以依据存储引擎接口自行编写个性化的存储引擎。当对某一种存储引擎的性能或功能存有疑虑时,可通过优化代码实现所需特性,这正展示了开源所赋予我们的便捷与力量。 Ⅱ.存储层 所有的数据,数据库、表的定义,表的每一行的内容,索引,都是存在 文件系统上,以文件的方式存在的,并完成与存储引擎的交互。当然有些存储引擎比如InnoDB,也支持不使用文件系统直接管理裸设备,但现代文件系统的实现使得这样做没有必要了。在文件系统之下,可以使用本地磁盘,可以使用DAS、NAS、SAN等各种存储系统。 总结 所以可以把 GreatSQL 的架构图简化如下: 要把架构图牢牢记住,对于以后深入理解 GreatSQL 数据库会有极大帮助! Enjoy GreatSQL :) 关于 GreatSQL GreatSQL是由万里数据库维护的MySQL分支,专注于提升MGR可靠性及性能,支持InnoDB并行查询特性,是适用于金融级应用的MySQL分支版本。 相关链接: GreatSQL社区 Gitee GitHub Bilibili GreatSQL社区: 社区有奖建议反馈: https://greatsql.cn/thread-54-1-1.html 社区博客有奖征稿详情: https://greatsql.cn/thread-100-1-1.html 社区2022年度勋章获奖名单: https://greatsql.cn/thread-184-1-1.html (对文章有疑问或者有独到见解都可以去社区官网提出或分享哦~) 技术交流群: 微信&QQ群: QQ群:533341697 微信群:添加GreatSQL社区助手(微信号:wanlidbc )好友,待社区助手拉您进群。

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册