首页 文章 精选 留言 我的

精选列表

搜索[赛博朋克],共10000篇文章
优秀的个人博客,低调大师

每日一博 | 图文结合带你搞懂 GreatSQL 体系架构

往期系列回顾 图文结合系列之带你搞懂MySQL日志系列 很多小伙伴使用了GreatSQL,但是对GreatSQL的底层原理还不是很了解,今天就带大家一起揭开GreatSQL体系架构的神秘面纱! 首先来回顾一张经典的体系架构图: 图1_GreatSQL5.7 版本体系架构图 由此可以发现,GreatSQL5.7 由以下几部分组成 连接池组件 系统管理和控制工具 SQL接口组件 查询解析器 查询优化器 缓存组件 可插拔存储引擎 系统和日志文件 GreatSQL数据库区别于其他数据库的一个特点就是其可插拔的表存储引擎,特别需要注意的是,存储引擎是基于表的,而不是数据库。 然而,经典同时也意味着这幅图已经相当陈旧了。在GreatSQL8.0 及更高版本中,查询缓存这一功能已经被移除。 图2_GreatSQL8.0 版本体系架构图 总体来说,GreatSQL8.0 可以分为连接层、服务层、存储引擎层。 一、连接层(Client Connectors) 连接层又名为客户端连接器(Client Connectors)作用是提供与GreatSQL服务器建立的支持。 客户端通过TCP/IP协议与GreatSQL服务器建立连接,每个连接对应一个线程。连接管理还包括了连接池技术,以复用已经建立好的连接,减少重复建立连接的开销。 而且几乎支持所有主流的服务端编程技术,主要完成一些类似于连接处理、授权认证、及相关的安全方案。 会对从 TCP 传输过来的账号密码做身份认证、权限获取 用户名或密码不对,会收到Access denied for user错误,客户端程序结束执行 例如: $ mysql -uroot -p ERROR 1045 (28000): Access denied for user 'root'@'localhost' (using password: NO) 用户名密码认证通过,会从权限表查出账号拥有的权限与连接关联,之后的权限判断逻辑,都将依赖于此时读到的权限 二、服务层(GreatSQL Server) 服务层是GreatSQL Server的核心,主要包含连接器、分析器、优化器、执行器等,涵盖 GreatSQL 的大多数核心服务功能,以及所有的内置函数(如日期、时间、数学和加密函数等),所有跨存储引擎的功能都在这一层实现,比如存储过程、触发器、视图等。 Ⅰ.SQL Interface: SQL接口 接收用户的SQL命令,并且返回用户需要查询的结果。比如SELECT … FROM就是调用SQL Interface,GreatSQL支持DML、DDL、存储过程、视图、触发器、自定义函数等多种SQL语言接口 同时还支持NoSQL,NoSQL泛指非关系型数据库和数据存储。随着互联网平台的规模飞速发展,传统的关系型数据库已经越来越不能满足需求。从5.6版本开始,GreatSQL就开始支持简单的NoSQL存储功能。GreatSQL8.0 版本对这一功能做了优化,以更灵活的方式实现NoSQL功能,不再依赖模式(schema)。 Ⅱ.Parser: 解析器 在解析器中对 SQL 语句进行语法分析、语义分析。将 SQL 语句分解成数据结构,并将这个结构传递到后续步骤,以后 SQL 语句的传递和处理就是基于这个结构的,并且判断你输入的这个 SQL 语句是否满足 GreatSQL 语法。 Ⅲ.Optimizer: 查询优化器 在开始执行之前,还要先经过优化器的处理。 SQL语句在语法解析之后、查询之前会使用查询优化器确定 SQL 语句的执行路径,生成一个执行计划,可以使用EXPLAIN命令查看执行计划。 这个执行计划表明应该使用哪些索引进行查询(全表检索还是使用索引检索),表之间的连接顺序如何,最后会按照执行计划中的步骤调用存储引擎提供的方法来真正的执行查询,并将查询结果返回给用户。 例如下面的 JOIN 语句: SELECT * FROM tb1 JOIN tb2 USING(ID) WHERE tb1.a=1 and tb2.a=2; 那就有两种方法可以选择: 第一种,先取表 tb1 里 a=1 的记录的ID值,再根据 ID 关联表 tb2 ,然后再判断 tb2 里面 a 的值是否等于 2 第二种,先取表 tb2 里面的 a=2 记录的 ID 值,在根据 ID 值关联 tb1 ,再判断 tb1 里面 a 的值是否等于 10 执行的结果肯定是一致的,但是效率就大不相同了,所以我们要选择用小的数据集去驱动大的数据集,也就是小表驱动大表。 Ⅳ.Caches & Buffers:查询缓存组件 GreatSQL 内部维持着一些 Cache 和 Buffer,比如 Query Cache 用来缓存一条 SELECT 语句的执行结果,如果能够在其中找到对应的查询结果,那么就不必再进行查询解析、优化和执行的整个过程了,直接将结果反馈给客户端。 但是在 GreatSQL 8.0 版本及以上中删除了查询缓存功能,因为查询缓存必须要两条SQL语句完全一模一样,否则是不能触发查询缓存,非常的鸡肋~ 三、引擎层(Storage Engines) Ⅰ.存储引擎层 真正的负责了 GreatSQL 中数据的存储和提取,对物理服务器级别维护的底层数据执行操作,服务器通过API与存储引擎进行通信。 存储引擎的优势在于,各式各样的存储引擎都具备独特的特性,从而能够针对特定的应用需求建立不同存储引擎表。 GreatSQL 支持的存储引擎如下: greatsql> SHOW ENGINES; +--------------------+---------+----------------------------------------------------------------------------+--------------+------+------------+ | Engine 引擎名称 | Support 支持情况 | Comment 引擎的说明 | Transactions 事务支持 | XA 分布式事务支持 | Savepoints 保存点 | +--------------------+---------+----------------------------------------------------------------------------+--------------+------+------------+ | FEDERATED | NO | Federated MySQL storage engine | NULL | NULL | NULL | | PERFORMANCE_SCHEMA | YES | Performance Schema | NO | NO | NO | | InnoDB | DEFAULT | Percona-XtraDB, Supports transactions, row-level locking, and foreign keys | YES | YES | YES | | MEMORY | YES | Hash based, stored in memory, useful for temporary tables | NO | NO | NO | | MyISAM | YES | MyISAM storage engine | NO | NO | NO | | MRG_MYISAM | YES | Collection of identical MyISAM tables | NO | NO | NO | | BLACKHOLE | YES | /dev/null storage engine (anything you write to it disappears) | NO | NO | NO | | CSV | YES | CSV storage engine | NO | NO | NO | | ARCHIVE | YES | Archive storage engine | NO | NO | NO | +--------------------+---------+----------------------------------------------------------------------------+--------------+------+------------+ 9 rows in set (0.00 sec) 得益于 GreatSQL 数据库的开源特性,用户得以依据存储引擎接口自行编写个性化的存储引擎。当对某一种存储引擎的性能或功能存有疑虑时,可通过优化代码实现所需特性,这正展示了开源所赋予我们的便捷与力量。 Ⅱ.存储层 所有的数据,数据库、表的定义,表的每一行的内容,索引,都是存在 文件系统上,以文件的方式存在的,并完成与存储引擎的交互。当然有些存储引擎比如InnoDB,也支持不使用文件系统直接管理裸设备,但现代文件系统的实现使得这样做没有必要了。在文件系统之下,可以使用本地磁盘,可以使用DAS、NAS、SAN等各种存储系统。 总结 所以可以把 GreatSQL 的架构图简化如下: 要把架构图牢牢记住,对于以后深入理解 GreatSQL 数据库会有极大帮助! Enjoy GreatSQL :) 关于 GreatSQL GreatSQL是由万里数据库维护的MySQL分支,专注于提升MGR可靠性及性能,支持InnoDB并行查询特性,是适用于金融级应用的MySQL分支版本。 相关链接: GreatSQL社区 Gitee GitHub Bilibili GreatSQL社区: 社区有奖建议反馈: https://greatsql.cn/thread-54-1-1.html 社区博客有奖征稿详情: https://greatsql.cn/thread-100-1-1.html 社区2022年度勋章获奖名单: https://greatsql.cn/thread-184-1-1.html (对文章有疑问或者有独到见解都可以去社区官网提出或分享哦~) 技术交流群: 微信&QQ群: QQ群:533341697 微信群:添加GreatSQL社区助手(微信号:wanlidbc )好友,待社区助手拉您进群。

优秀的个人博客,低调大师

每日一博 | 证书管理:从手工到平台化

作者:vivo 互联网运维团队- Peng Jiahong 本文介绍了vivo业务运维证书管理从手工到平台化的历程。 一、背景 以往,vivo 互联网业务的域名证书运维管理工作,严重依赖经验丰富的高级运维工程师个人专职管理,证书管理存在单点以及过于依赖的人的情况。 随着业务规模的持续扩大,以及对证书管理质量标准的要求提升,加强全网证书信息准确的收敛把控。 为此,业务运维团队决定,通过证书管理流程标准化、平台化,完成全生命周期管理证书,来消除因依赖人为管理证书问题导致业务可用性受损的痛点。 二、能力规划 全生命周期管理业务证书,我们建设的平台需具备以下特性和能力: 高效的证书申请: 新申请以及续期场景,平台引导用户自动的生成私钥和 CSR 并提交工作申请联络单,用户完成验证后自动存储证书合并私钥。 便捷的证书管理: 支持多种证书格式导入、导出功能,查看完整的证书信息。 安全的私钥存储: 使用 AES256 等 高强度算法加密存储。 证书逾期监控: 支持 30/60 天,可自定义逾期的证书监控告警。 证书变更白屏化: 覆盖 NGINX、 SLB、CDN 以及 VUA 证书变更场景。 三、设计思路 3.1 技术选型 (1)前端框架: 用基于Vue2的Element构建基础页面 (2)后端框架: 以 Go 语言为基础,快速利用gin框架提供restful的api,业务数据存储在MySQL 3.2 架构设计 证书管理平台整体架构设计: 3.3 模块设计 证书管理平台包含四个非常重要的子模块: 可视: 是整个平台最基础的模块,除基础的权限功能外,通过收敛汇总所以证书信息,实现证书总览数据分析,证书的操作的追溯以及变更审计和操作可视化。 管理: 是证书信息管理的核心功能之一,实现证书信息的可视化以及信息变更、证书申请、证书续期的能力。 变更: 提供 NGINX、SLB、CDN、VUA 证书的推送能力。 监控: 提供证书的生命周期检测、有效期提醒、线上证书扫描的能力。 四、技术实现 4.1 前端 前端是基于Vue2和Element来组建用户的操作界面,整个详细的设计图如下: 其中 main.j包含整个业务系统落地所需要的各类组件和元素,实现组件 的提供以及基础的权限校验; api的方法通过合理的封装后端的接口,提供view中呈现给用户的界面调用方法,来实现整个证书管理的业务流程操作。 在整个证书管理平台的迭代过程中,只需重点关注view中vcm前缀用户界面的代码实现即可。 4.2 后端 后端使用Go语言来编写业务逻辑和API接口。其中架构可以参考3.2设计图,管理平台核心逻辑通过代码片段展示如下: (1)基于casbin实现的权限管理:通过角色控制权限,并按需赋予用户角色默认访问权限(如下图创建角色时AddMenuAuthority、UpdateCasbin方法)。 (2)证书相关数据加密处理:获取前端用户选择的相关算法进行加密。 (3)基于证书管理标准化流程的业务代码实现,覆盖证书的信息管理&变更推送&监控告警&平台的角色权限控制。 五、平台预览 经过多个开发迭代,平台相关的核心功能如下: 5.1 证书信息概览 概览首页收敛证书管理的功能入口,以及收纳管理证书的全貌,方便管理员了解所管理的证书状态和最近的申请进度。 5.2 证书信息管理 汇总了目前内销所有证书信息,后续平台上申请的证书信息管理也会收敛于此,并提供证书私钥相关的查看和下载。 5.3 证书申请/续期 通过平台场景化证书申请续期的操作,解决过往碎片化操作以及无经验人员需通过文档阅读或者人员指导完成证书申请问题。 5.4 证书变更管理 平台覆盖云上、NGINX 集群、CDN 以及 VUA 的证书白屏化、可追溯操作历史更新能力。 5.5 证书监控 收敛在平台上管理的证书都会有逾期监控提醒,来提醒运维人员及时完成对应的证书更新管理,确保业务不受影响。 六、总结 证书管理平台的实践落地,通过流程标准化以及管理平台的建立,规范证书的信息、变更、告警、变更审计相关管理,上线后至今,也无证书管理相关的问题导致的可用性告警,解决了传统域名证书管理场景下人效、可用性隐患的痛点,是业务运维 SRE 可用性保障&运维提效的一个成功案例。 七、展望 目前我们获取的证书,依旧依赖于传统的域名证书分发模式(站点管理员需要花费金钱购买数字证书,并且证书的签发和更新需要时间和人力成本)。随着区块链和Web 3.0技术的发展,新增了去中心化身份验证和身份管理技术,在证书的分发上具备以下优势: 不可篡改性: 区块链技术保证证书的安全性和不可篡改性。因为每一个区块链节点都会对交易进行验证和记录,从而保证数据的一致性和完整性,防止伪造和篡改。 透明性: 区块链技术使得所有参与者都可以获得统一的信息,从而保证证书的透明性,避免信息不对称或不公平的情况发生,同时也可以有效地降低信息传递成本。 保密性: 区块链技术可以采用加密算法,保证证书的保密性和隐私性。同时,也可以根据需求设定只允许特定的参与者访问相关信息。 高效性: 传统的证书分发需要进行大量的人力和物力投入,而基于区块链的证书分发可以实现自动化,从而提高证书分发的效率。 可追溯性: 基于区块链的证书分发可以实现对证书的溯源和追踪,从而可以更好地防止证书的丢失或滥用。 综上所述,基于区块链的证书分发可以有效降低证书分发的成本和提高证书的安全性。 未来,基于相关技术的成熟程度,也会合理的应用和替换过往的证书申请分发模式,迭代证书管理平台相关的功能,来配合提高证书的管理效率和安全性。 END 猜你喜欢 浅析 Jetty 中的线程优化思路 “事后达尔文”—— 游戏业务效果评估方法实践 vivo 帐号服务稳定性建设之路-平台产品系列06 vivo 游戏黑产反作弊实践 本文分享自微信公众号 - vivo互联网技术(vivoVMIC)。 如有侵权,请联系 support@oschina.cn 删除。 本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

优秀的个人博客,低调大师

每日一博 | 数据平台流量回放最佳实践

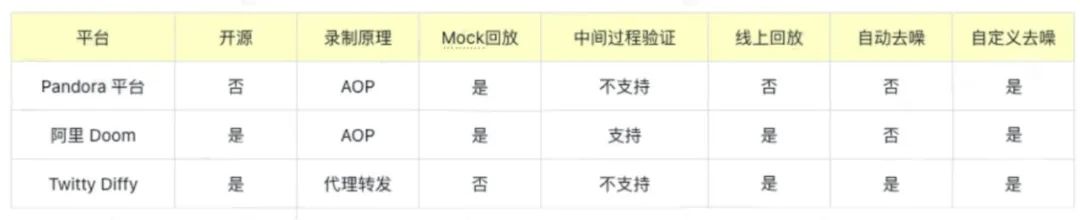
1 背景与挑战 1.1 数据平台业务背景 数据平台利用大数据智能分析、数据可视化等技术,对公司内外部经过采集、建设、管理、分析的多源异构数据进行呈现和应用,实现了数据共享、日常报表自动生成、快速和智能分析,深度挖掘数据价值,满足企业各级部门之间的数据分析应用需求。因而也具有数据量大,场景多,数据准确性要求高,查询性能要有保障等特点。 1.2 传统测试方法 基于数据平台的特点,使得我们在线下进行数据测试或者回归测试时成本比较高,难度也比较大。所以我们希望能有一种有效的手段来降低测试的成本和门槛,实现测试的标准化。一直以来我们都是通过编写自动化测试来实现的。但是传统的自动化测试其实是有很多弊端的,比如成本高,覆盖场景有限,标准化难度高等。 1.3 传统自动化的弊端 1.3.1 成本高: 人工编写、维护自动化用例成本高 较低的测开比无法跟上迭代的速度 1.3.2 覆盖场景有限: 线下构造测试场景难度大 场景覆盖度有限 1.3.3 标准化难度高: 强依赖QA个人经验和能力 开发独立排查自动化问题难度高,推动开发自测效果差 因此我们希望利用线上的流量来搭建一个流量回放的平台,与自动化测试结合,来实现一个符合数据平台特点的自动化测试体系。 2 流量回放平台介绍 流量回放的实现原理即是使用线上入口录制用户操作的真实流量,到预发环境进行回放,对比生产和预发环境录入接口的子调用、响应差异去定位代码问题,接入对象范围是只读、读写、只写接口,优点是业务代码零侵入,自动流量diff,真实链路调用,数据可查,问题定位精准,发现问题的可能性提高,缺点是面向范围有一定局限性,操作不慎可能导致回放的接口中存在写操作的子调用产生脏数据,影响业务。 2.1 流量回放平台调研 确定之后我们便立刻展开了调研,研究对比了公司的流量回放平台,阿里的Doom以及Twitty的Diffy,差异如下图。 2.2 数据平台业务特点 因为数平报表的查询特点, 导致代码中对外查询链路少,对内的维度条件业务组合多,基于这样的特点导致在使用Pandora平台录制线上流量时,流量录制不全,大多数场景无法完全覆盖。 复杂的数据平台一般都依赖大量属性配置管理、定时同步任务等,因此预发环境和生产环境配置库需要隔离,保护数据不被污染。而流量回放又依赖配置库和数据库相同,使用场景高度依赖配置数据, 导致回放落地难度大。 数据平台的流量回放,验证结果时往往需要对数据进行校验, 请求会对生产数据库造成一定查询压力,可能会影响生产环境稳定性。需要控制好回放速度和控制、监控和降级保护。 部分数据是实时的,回放结果需要计算波动率。 基于以上特点导致数据平台无法接入公司的Pandora平台,我们也在第一时间联系公司平台负责人进行沟通和提出改进需求方案。 但问题的迫切使得我们决定先小成本的进行一些工作,一方面尽快缓解我们的痛点,一方面也要方便后期接入公司平台,减少资源浪费。以此为目的,我们在一期使用脚本采集流量, 并借助开源工具Diffy快速实验了一套简易的流量回放系统。同时给平台提出适应性接入需求。在二期时,将脚本采集的流量上传至平台,接入平台进行流量回放。 这样的好处是: 流量自主可控,可根据需要定点扩充流量,无需担心流量稀疏、录制对线上环境的影响、接口覆盖不全等问题。 使用日志或埋点的方式采集流量,为流量采集提供了一种流量采集的新思路 开源工具只有部署和熟悉的资源投入,后期接入平台后可回收资源,没有浪费资源重复造轮子 基于以上背景,进行了数据平台的流量回放实现方案。 2.3 核心原理 整体思路依然是沿着线上获取流量,分别在不同代码环境进行回放,最后对接口返回结果进行比对,以达到检测被测代码准确性的目的。 这里我们将生产的流量根据时间、接口白名单和操作人等字段进行过滤,并按照窗口进行流量的去重和筛选,最后沉淀为一个稳定的流量池。任务触发后会并发的按照指定速率向预发和生产双发回放,获取接口的返回结果,经过一系列降噪操作后,根据字段对比结果统计出整体的成功率,并产出报告。 下面我会从流量采集、环境策略、执行调度、比对结果四个方面来介绍整个方案。 ~流量回放交互构架图~ 2.3.1 流量采集 通过公司的流量录制方式, 接口覆盖提升难度较大, 不太适合数平对外链路少,条件组合多的特点,因此我们想通过埋点筛选的方式进行流量采集。这样的好处是完美避免了流量录制过程中流量分布不均,降低对线上服务的性能影响,同时接口的覆盖又非常的完整。实现了自主可控,定点获取流量。 在流量采集中,我们会分批次的去生产系统上根据配置的日期和数量不断地捞取流量,对每一个批次流量根据入参和请求路径进行接口去重,并根据梳理好的接口白名单、流量操作人、接口关键字、请求类型等来过滤数据,然后需要对流量中的脏数据进行筛选、对参数中的特殊字符和多余字段进行修正。最后将清洗好的干净数据保存到本地流量池中,等待任务使用。 在后期,处理后的流量会通过接口上传至流量回放回放Pandora平台,通过我司的平台化工具更便捷高效的管理流量和执行。 上传后即可在流量回放平台查看流量,这里也可以通过excel的方式手动上传,但是每批次流量数量受限。 2.3.2 环境策略 环境采用了预发和生产两套环境对比。通过配置将预发环境的数据来源指向了生产服务。并且定时同步生产的配置库到预发环境,来解决数据和配置的Gap。 2.3.3 执行调度 调度有两种方式, 一种是配置定时触发,一种是手动调用接口触发。 任务触发后,会获取流量池中的流量,并对流量的关键字和执行数据量级再次判断是否可执行。确认执行后,将流量放入线程池中开始回放。这里采用了定长线程池和速率控制器来实现高并发和灵活的请求速率配置。 在任务执行后,也可以根据实际执行情况随时修改配置来停止任务或者调整任务的发送速率,控制对线上环境的影响。 2.3.4 比对结果 拿到生产和预发的返回结果之后就是对比两端结果,发现不一致的字段和返回,介于数平的特点,噪音点会非常的多,因此引入了AAdiff的方式,来达到自动降噪的功能。 如何降噪: a. AAdiff :在对比之前, 连续调用两次生产环境,获取结果后对比, 将不一致的字段剔除。即可去除不稳定或者有波动的字段 b. 指定字段忽略:跟对一些配置字段或者无意义字段进行手动配置忽略,降低噪点。 结果差异对比汇总后, 会根据字段进行分组汇总,对与AAdiff不通过的字段会直接置灰。点击字段即可在右侧查看字段下差异的数据。 通过点击差异详情,可进一步看到请求的path、请求体、生产和预发的返回值等信息,帮助排查定位问题。 同时在结果报表中可以观测到流量数、回放成功率等信息。 3 业务实践 这里以智能运营系统为例,对比流量回放接入前后的效能成本差异。 通过流量回放的方式,不仅快速提升了自动化的接口覆盖,降低了迭代人力投入,更是增强了回归的可靠性。 这一点通过迭代质量变化趋势也能很好的反应。 平台数据: 流量回放工具在513迭代初步使用, 但覆盖率和稳定性较差, 514迭代完善,正式投入使用。 在514迭代工具正式投入使用后,发现遗漏bug比例达25%,515迭代质量有明显提升, 连续两个迭代线上无缺陷逃逸发生。平台质量和稳定性明显提升。 目前智能运营流量回放投入使用至今,已持续支持多个迭代的日常回归测试以及日常压测工作,读接口覆盖率达86%,回放通过率稳定在98%,发现回归漏测比率达25%,大大提高了系统的稳定性和线上质量。 4 规划与展望 智能运营系统流量回放已进入维护阶段,在日常迭代中帮助测试实现冒烟、回归、压测、缓存验证等多种任务。后续将通过精准接口流量获取的方式,将少部分稀疏接口纳入覆盖。并将流量上传至流量回放平台。借助流量回放平台的能力,更加稳定、方便的执行计划和排查问题。 基于数据平台各系统以读接口为主的特点,非常适合流量回放的回归形式,后续会将各个系统按优先级陆续接入我司流量回放平台,并通过流量埋点的方式快速提升接口覆盖。 *文/卑微小季 本文属得物技术原创,来源于:得物技术官网 未经得物技术许可严禁转载,否则依法追究法律责任!

优秀的个人博客,低调大师

每日一博 | Tars-Java 网络编程源码分析

作者:vivo 互联网服务器团队- Jin Kai 本文从Java NIO网络编程的基础知识讲到了Tars框架使用NIO进行网络编程的源码分析。 一、Tars框架基本介绍 Tars是腾讯开源的支持多语言的高性能RPC框架,起源于腾讯内部2008年至今一直使用的统一应用框架TAF(Total Application Framework),目前支持C++、Java、PHP、Nodejs、Go语言。 该框架为用户提供了涉及到开发、运维、以及测试的一整套解决方案,帮助一个产品或者服务快速开发、部署、测试、上线。它集可扩展协议编解码、高性能RPC通信框架、名字路由与发现、发布监控、日志统计、配置管理等于一体,通过它可以快速用微服务的方式构建自己的稳定可靠的分布式应用,并实现完整有效的服务治理。 官方仓库地址: https://github.com/TarsCloud/Tars vivo推送平台也深度使用了该框架,部署服务节点超过一千个,经过线上每日一百多亿消息推送量的考验。 此前已在vivo互联网技术公众号发布过《Tars Java 客户端源码分析》此篇文章为续集。 Tars-java 最新稳定版1.7.2以及之前的版本都使用Java NIO进行网络编程;本文将分别详细介绍java NIO的原理和Tars 使用NIO进行网络编程的细节。 二、Java NIO原理介绍 从1.4版本开始,Java提供了一种新的IO处理方式:NIO (New IO 或 Non-blocking IO)是一个可以替代标准Java IO 的API,它是面向缓冲区而不是字节流,它是非阻塞的,支持IO多路复用。 2.1 Channels (通道) and Buffers (缓冲区) 标准的IO基于字节流进行操作的,而NIO是基于通道(Channel)和缓冲区(Buffer)进行操作。数据总是从通道读取到缓冲区中,或者从缓冲区写入到通道中,下图是一个完整流程。 Channel类型: 支持文件读写数据的FileChannel 能通过UDP读写网络中的数据的DatagramChannel 能通过TCP读写网络数据的SocketChannel 可以监听新进来的TCP连接,对每一个新进来的连接都会创建一个SocketChannel的ServerSocketChannel 。 SocketChannel: 打开 SocketChannel:SocketChannel socketChannel = SocketChannel.open(); 关闭 SocketChannel:socketChannel.close(); 从Channel中读取的数据放到Buffer:int bytesRead = inChannel.read(buf); 将Buffer中的数据写到Channel:int bytesWritten = inChannel.write(buf); ServerSocketChannel: 通过 ServerSocketChannel.accept()方法监听新进来的连接,当accept()方法返回的时候,它返回一个包含新进来的连接的SocketChannel,因此accept()方法会一直阻塞到有新连接到达。 通常不会仅仅只监听一个连接,在while循环中调用 accept()方法. 如下面的例子: 代码1: while(true){ SocketChannel socketChannel = serverSocketChannel.accept(); //do something with socketChannel...} ServerSocketChannel可以设置成非阻塞模式。在非阻塞模式下,accept() 方法会立刻返回,如果还没有新进来的连接,返回的将是null。因此,需要检查返回的SocketChannel是否是null。 代码2: ServerSocketChannel serverSocketChannel = ServerSocketChannel.open();serverSocketChannel.socket().bind(new InetSocketAddress(8888));serverSocketChannel.configureBlocking(false);while(true){ SocketChannel socketChannel = serverSocketChannel.accept(); if(socketChannel != null){ //do something with socketChannel... }} Buffer类型: ByteBuffer CharBuffer DoubleBuffer FloatBuffer IntBuffer LongBuffer ShortBuffer Buffer的分配: ByteBuffer buf = ByteBuffer.allocate(2048); Buffer的读写: 一般是以下四个步骤: 写入数据到Buffer,最大写入量是capacity,写模式下limit值即为capacity值,position即为写到的位置。 调用flip()方法将Buffer从写模式切换到读模式,此时position移动到开始位置0,limit移动到position的位置。 从Buffer中读取数据,在读模式下可以读取之前写入到buffer的所有数据,即为limit位置。 调用clear()方法或者compact()方法。clear()方法将position设为0,limit被设置成capacity的值。compact()方法将所有未读的数据拷贝到Buffer起始处,然后将position设到最后一个未读元素后面。 mark()与reset()方法 通过调用Buffer.mark()方法,可以标记Buffer中的一个特定position,之后可以通过调用Buffer.reset()方法恢复到这个position。 duplicate() 此方法返回承载先前字节缓冲区内容的新字节缓冲区。 remaining() limit减去position的值 2.2 Selector(选择器) Java NIO引入了选择器的概念,选择器用于监听多个通道的事件。单个的线程可以监听多个数据通道。要使用Selector,得向Selector注册Channel,然后调用它的select()方法。这个方法会一直阻塞到某个注册的通道有事件就绪。一旦这个方法返回,线程就可以处理这些事件。 线程使用一个selector处理多个channel 代码3: channel.configureBlocking(false);SelectionKey key = channel.register(selector,Selectionkey.OP_READ); 注意register()方法的第二个参数,这是一个监听的集合,即在通过Selector监听Channel时关注什么事件集合。 SelectionKey包含: 1) interest集合:selectionKey.interestOps()可以监听四种不同类型的事件:OP_ACCEPT、OP_CONNECT、OP_WRITE、OP_READ 2) ready集合:selectionKey.readyOps(); ready 集合是通道已经准备就绪的操作的集合,提供4个方便的方法: selectionKey.isAcceptable(); selectionKey.isConnectable(); selectionKey.isReadable(); selectionKey.isWritable(); 3) Channel:selectionKey.channel(); 4) Selector:selectionKey.selector(); 5)可选的附加对象: selectionKey.attachment();可以将一个对象或者更多信息附着到SelectionKey上,这样就能方便的识别特定的通道。 提示: OP_ACCEPT和OP_CONNECT的区别:简单来说,客户端建立连接是connect,服务器准备接收连接是accept。一个典型的客户端服务器网络交互流程如下图 selectedKeys() 一旦调用了select()方法,并且返回值表明有一个或更多个通道就绪了,然后可以通过调用selector的selectedKeys()方法,访问已选择键集(selected key set)中的就绪通道。 wakeUp() 某个线程调用select()方法后阻塞了,即使没有通道已经就绪,也有办法让其从select()方法返回。只要让其它线程在阻塞线程调用select()方法的对象上调用Selector.wakeup()方法即可。阻塞在select()方法上的线程会立马返回。如果有其它线程调用了wakeup()方法,但当前没有线程阻塞在select()方法上,下个调用select()方法的线程会立即wake up。 close() 用完Selector后调用其close()方法会关闭该Selector,且使注册到该Selector上的所有SelectionKey实例无效。通道本身并不会关闭。 通过Selector选择通道: int select()阻塞直到至少有一个通道在你注册的事件上就绪了 int select(long timeout)增加最长阻塞毫秒数 int selectNow()不会阻塞,不管什么通道就绪都立刻返回 三、 Tars NIO网络编程 了解完 Java NIO的原理,我们来看看Tars是如何使用NIO进行网络编程的。 Tars的网络模型是多reactor多线程模型。有一点特殊的是tars的reactor线程组里随机选一个线程处理网络事件,并且该线程同时也能处理读写。 核心类之间的关系如下: 3.1 一个典型的Java NIO服务端开发流程 创建ServerSocketChannel,设置为非阻塞,并绑定端口 创建Selector对象 给ServerSocketChannel注册SelectionKey.OP_ACCEPT事件 启动一个线程循环,调用Selector的select方法来检查IO就绪事件,一旦有IO就绪事件,就通知用户线程去处理IO事件 如果有Accept事件,就创建一个SocketChannel,并注册SelectionKey.OP_READ 如果有读事件,判断一下是否全包,如果全包,就交给后端线程处理 写事件比较特殊。isWriteable表示的是本机的写缓冲区是否可写。这个在绝大多少情况下都是为真的。在Netty中只有写半包的时候才需要注册写事件,如果一次写就完全把数据写入了缓冲区就不需要注册写事件。 3.2 Tars客户端发起请求到服务器的流程 Communicator.stringToProxy()根据servantName等配置信息创建通信器。 ServantProxyFactory.getServantProxy()调用工厂方法创建servant代理。 ObjectProxyFactory.getObjectProxy()调用工厂方法创建obj代理。 TarsProtocolInvoker.create()创建协议调用者。 ServantProtocolInvoker.initClient(Url url)根据servantProxyConfig中的配置信息找到servant的ip端口等进行初始化ServantClient。 ClientPoolManager.getSelectorManager()如果第一次调用selectorManager是空的就会去初始化selectorManager。 reactorSet = new Reactor[selectorPoolSize]; SelectorManager初始化构造类中的会根据selectorPoolSize(默认是2)的配置创建Reactor线程数组。线程名称的前缀是servant-proxy-加上CommunicatorId,CommunicatorId生成规则是由locator的地址生成的UUID。 启动reactor线程。 3.3 Tars服务端启动步骤 tars支持TCP和UDP两种协议,RPC场景下是使用TCP协议。 new SelectorManager()根据配置信息初始化selectorManager,线程池大小 processors > 8 ? 4 + (processors * 5 / 8) : processors + 1;线程名称前缀是server-tcp-reactor,然后启动reactor线程数组中的所有线程。 开启服务端监听的ServerSocketChannel,绑定服务端本地ip和监听的端口号,设置TCP连接请求队列的最大容量为1024;设置非阻塞模式。 选取reactor线程数组中第0个线程作为服务端监听连接OP_ACCEPT就绪事件的线程。 代码4: public void bind(AppService appService) throws IOException { // 此处略去非关键代码 if (endpoint.type().equals("tcp")) { // 1 this.selectorManager = new SelectorManager(Utils.getSelectorPoolSize(), new ServantProtocolFactory(codec), threadPool, processor, keepAlive, "server-tcp-reactor", false); // 2 this.selectorManager.setTcpNoDelay(serverCfg.isTcpNoDelay()); this.selectorManager.start(); ServerSocketChannel serverChannel = ServerSocketChannel.open(); serverChannel.socket().bind(new InetSocketAddress(endpoint.host(), endpoint.port()), 1024); // 3 serverChannel.configureBlocking(false); selectorManager.getReactor(0).registerChannel(serverChannel, SelectionKey.OP_ACCEPT); // 4 } else if (endpoint.type().equals("udp")) { this.selectorManager = new SelectorManager(1, new ServantProtocolFactory(codec), threadPool, processor, false, "server-udp-reactor", true); this.selectorManager.start(); // UDP开启的是DatagramChannel DatagramChannel serverChannel = DatagramChannel.open(); DatagramSocket socket = serverChannel.socket(); socket.bind(new InetSocketAddress(endpoint.host(), endpoint.port())); serverChannel.configureBlocking(false); // UDP协议不需要建连,监听的是OP_READ就绪事件 this.selectorManager.getReactor(0).registerChannel(serverChannel, SelectionKey.OP_READ); }} 3.4 Reactor线程启动流程 多路复用器开始轮询检查 是否有就绪的事件。 处理register队列中剩余的channel注册到当前reactor线程的多路复用器selector中。 获取已选键集中所有就绪的channel。 更新Session中最近操作时间,Tars服务端启动时会调用 startSessionManager() , 单线程每30s扫描一次session会话列表,会检查每个session的 lastUpdateOperationTime 与当前时间的时间差,如果超过60秒会将过期session对应的channel踢除。 分发IO事件进行处理。 处理unregister队列中剩余的channel,从当前reactor线程的多路复用器selector中解除注册。 代码5: public void run() { while (!Thread.interrupted()) { selector.select(); // 1 processRegister(); // 2 Iterator<SelectionKey> iter = selector.selectedKeys().iterator(); // 3 while (iter.hasNext()) { SelectionKey key = iter.next(); iter.remove(); if (!key.isValid()) continue; try { if (key.attachment() != null && key.attachment() instanceof Session) { ((Session) key.attachment()).updateLastOperationTime(); //4 } dispatchEvent(key); // 5 } catch (Throwable ex) { disConnectWithException(key, ex); } } processUnRegister(); // 6 }} 3.5IO事件分发处理 每个reactor线程都有一个专门的Accepter类去处理各种IO事件。TCPAccepter可以处理全部的四种事件(OP_ACCEPT、OP_CONNECT、OP_WRITE、OP_READ)、UDPAccepter由于不需要建立连接所以只需要处理读和写两种事件。 1.处理OP_ACCEPT 获取channel,处理TCP请求。 为这个TCP请求创建TCPSession,会话的状态是服务器已连接 会话注册到sessionManager中,Tars服务可配置最大连接数maxconns,如果超过就会关闭当前会话。 寻找下一个reactor线程进行多路复用器与channel的绑定。 代码6: public void handleAcceptEvent(SelectionKey key) throws IOException { ServerSocketChannel server = (ServerSocketChannel) key.channel(); // 1 SocketChannel channel = server.accept(); channel.socket().setTcpNoDelay(selectorManager.isTcpNoDelay()); channel.configureBlocking(false); Utils.setQosFlag(channel.socket()); TCPSession session = new TCPSession(selectorManager); // 2 session.setChannel(channel); session.setStatus(SessionStatus.SERVER_CONNECTED); session.setKeepAlive(selectorManager.isKeepAlive()); session.setTcpNoDelay(selectorManager.isTcpNoDelay()); SessionManager.getSessionManager().registerSession(session); // 3 selectorManager.nextReactor().registerChannel(channel, SelectionKey.OP_READ, session); // 4} 2.处理OP_CONNECT 获取客户端连接过来的channel通道 获取Session 与服务器建立连接,将关注的兴趣OPS设置为ready就绪事件,session中的状态修改为客户端已连接 代码7: publicvoidhandleConnectEvent(SelectionKeykey)throwsIOException{ SocketChannel client = (SocketChannel) key.channel(); // 1 TCPSession session = (TCPSession) key.attachment(); //2 if (session == null) throw new RuntimeException("The session is null when connecting to ..."); try { // 3 client.finishConnect(); key.interestOps(SelectionKey.OP_READ); session.setStatus(SessionStatus.CLIENT_CONNECTED); } finally { session.finishConnect(); }} 3.处理OP_WRITE、处理OP_READ 调用session.read()和session.doWrite()方法处理读写事件 代码8: public void handleReadEvent(SelectionKey key) throws IOException { TCPSession session = (TCPSession) key.attachment(); if (session == null) throw new RuntimeException("The session is null when reading data..."); session.read();}public void handleWriteEvent(SelectionKey key) throws IOException { TCPSession session = (TCPSession) key.attachment(); if (session == null) throw new RuntimeException("The session is null when writing data..."); session.doWrite();} 3.6 seesion中网络读写的事件详细处理过程 1.读事件处理 申请2k的ByteBuffer空间,读取channel中的数据到readBuffer中。根据sessionStatus判断是客户端读响应还是服务器读请求,分别进行处理。 代码9: protected void read() throws IOException { int ret = readChannel(); if (this.status == SessionStatus.CLIENT_CONNECTED) { readResponse(); } else if (this.status == SessionStatus.SERVER_CONNECTED) { readRequest(); } else { throw new IllegalStateException("The current session status is invalid. [status:" + this.status + "]"); } if (ret < 0) { close(); return; }}private int readChannel() throws IOException { int readBytes = 0, ret = 0; ByteBuffer data = ByteBuffer.allocate(1024 * 2); // 1 if (readBuffer == null) { readBuffer = IoBuffer.allocate(bufferSize); } // 2 while ((ret = ((SocketChannel) channel).read(data)) > 0) { data.flip(); // 3 readBytes += data.remaining(); readBuffer.put(data.array(), data.position(), data.remaining()); data.clear(); } return ret < 0 ? ret : readBytes;} ①客户端读响应 从当前readBuffer中的内容复制到一个新的临时buffer中,并且切换到读模式,使用TarsCodec类解析出buffer内的协议字段到response,WorkThread线程通知Ticket处理response。如果response为空,则重置tempBuffer到mark的位置,重新解析协议。 代码10: public void readResponse() { Response response = null; IoBuffer tempBuffer = null; tempBuffer = readBuffer.duplicate().flip(); while (true) { tempBuffer.mark(); if (tempBuffer.remaining() > 0) { response = selectorManager.getProtocolFactory().getDecoder().decodeResponse(tempBuffer, this); } else { response = null; } if (response != null) { if (response.getTicketNumber() == Ticket.DEFAULT_TICKET_NUMBER) response.setTicketNumber(response.getSession().hashCode()); selectorManager.getThreadPool().execute(new WorkThread(response, selectorManager)); } else { tempBuffer.reset(); readBuffer = resetIoBuffer(tempBuffer); break; } }} ②服务器读请求 任务放入线程池交给 WorkThread线程,最终交给Processor类出构建请求的响应体,包括分布式上下文,然后经过FilterChain的处理,最终通过jdk提供的反射方法invoke服务端本地的方法然后返回response。如果线程池抛出拒绝异常,则返回SERVEROVERLOAD = -9,服务端过载保护。如果request为空,则重置tempBuffer到mark的位置,重新解析协议。 代码11: public void readRequest() { Request request = null; IoBuffer tempBuffer = readBuffer.duplicate().flip(); while (true) { tempBuffer.mark(); if (tempBuffer.remaining() > 0) { request = selectorManager.getProtocolFactory().getDecoder().decodeRequest(tempBuffer, this); } else { request = null; } if (request != null) { try { request.resetBornTime(); selectorManager.getThreadPool().execute(new WorkThread(request, selectorManager)); } catch (RejectedExecutionException e) { selectorManager.getProcessor().overload(request, request.getIoSession()); } catch (Exception ex) { ex.printStackTrace(); } } else { tempBuffer.reset(); readBuffer = resetIoBuffer(tempBuffer); break; } }} 2.写事件处理 同样也包括客户端写请求和服务端写响应两种,其实这两种都是往TCPSession中的LinkedBlockingQueue(有界队列最大8K)中插入ByteBuffer。LinkedBlockingQueue中的ByteBuffer最终会由TCPAcceptor中的handleWriteEvent监听写就绪事件并消费。 代码12: protected void write(IoBuffer buffer) throws IOException { if (buffer == null) return; if (channel == null || key == null) throw new IOException("Connection is closed"); if (!this.queue.offer(buffer.buf())) { throw new IOException("The session queue is full. [ queue size:" + queue.size() + " ]"); } if (key != null) { key.interestOps(key.interestOps() | SelectionKey.OP_WRITE); key.selector().wakeup(); }} 四、总结 本文主要介绍了Java NIO编程的基础知识 和 Tars-Java 1.7.2版本的网络编程模块的源码实现。 在最新的Tars-Java的master分支中我们可以发现网络编程已经由NIO改成了Netty,虽然Netty更加成熟稳定,但是作为学习者了解NIO的原理也是掌握网络编程的必经之路。 更多关于Tars框架的介绍可以访问: https://tarscloud.org/ 本文分析源码地址(v1.7.x分支): https://github.com/TarsCloud/TarsJava END 猜你喜欢 vivo 自研Jenkins资源调度系统设计与实践 Dubbo 中 Zookeeper 注册中心原理分析 vivo 超大规模消息中间件实践之路 本文分享自微信公众号 - vivo互联网技术(vivoVMIC)。 如有侵权,请联系 support@oschina.cn 删除。 本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

优秀的个人博客,低调大师

每日一博 | 领域驱动设计:DDD 工程参考架构

背景 为什么要制定参考工程架构 不同团队落地DDD所采取的应用架构风格可能不同,并没有统一的、标准的DDD工程架构。有些团队可能遵循经典的DDD四层架构,或改进的DDD四层架构,有些团队可能综合考虑分层架构、整洁架构、六边形架构等多种架构风格,有些在实践中可能引入CQRS解决读模型与写模型的差异化等等。即使无法制定通用的、标准的工程应用架构,但为团队制定一个遵循领域驱动设计思想的参考架构依然有价值。基于以下原因: 为团队实践DDD的战术设计提供可以快速开始的工程参考 参考工程大量的命名和结构决策,显式的体现DDD的相关理念,有利于团队对DDD的战术实现达成一致认知 同时,参考架构有助于沉淀团队对领域驱动设计的一些思考和最佳实践 参考架构的考量因素 虽然无法制定完全通用的DDD参考架构,但制定某个特定上下文下的参考架构却具有可行性和实践价值。针对于上下文的选择要尽量贴合实际的工程实践场景并考虑多维度的因素。 本文所述参考工程架构遵循以下原则: 遵循领域驱动设计的本质思想 充分考虑业务系统建设特点 依赖最小化,保持轻量 希望工程参考架构能涵盖以下范围 分离业务域与技术域 参考架构要遵循技术和业务隔离的特性,可以参考多种架构风格。业务与技术关注点的分离并不是DDD独有的特点,在六边形、整洁架构、洋葱架构中都遵循了这一重要原则。 多限界上下文场景 大多数团队基于DDD进行微服务拆分的时候,特别是系统建设初期,对单个微服务应用内的限界上下文的粒度需要权衡。由于团队组织架构因素及微服务成本问题,单个应用容纳的限界上下文一般是多个(理想情况下是1:1)。这些限界上下文随着后续的逐步迭代有可能会迁移至独立应用。因此,参考架构将多上下文的应用场景作为重要考量因素。 明确的组件、职责边界及依赖关系 支持领域报表场景:报表场景在业务系统较为常见,DDD并没有体现该场景的处理方式。作为工程参考架构,还是希望能够从实际业务出发,体现对写模型和报表模型的显示支持 外部依赖最小化:需要排除不必要的依赖,保持工程架构的轻量化 参考架构剖析 应用的多上下文结构 基于以上原则,参考工程考虑单个应用内多上下文的场景,以期在模块化和服务粒度及成本间进行权衡折衷。应用架构对多上下文的支持的逻辑示意图如下所示,在解决方案域对限界上下文进行识别和划分之后,基于其业务内聚性和关联性,把多个上下文实现单个工程应用中。单个应用内的多个限界上下文间可能存在交互,交互的形式可以是基于事件驱动,也可以是基于进程内调用。采用事件驱动的方式上下文间的耦合性对低一些,但一般需要引入事件总线的支持,额外组件的引入必然会导致复杂性的上升。进程内调用则耦合性会高一些,但从实现角度复杂度会低一些。具体选择哪种方式开发人员可以基于实际情况进行权衡。 需要再次说明的是,这种应用架构决策是一种多因素的权衡,并没有与子域与限界上下文1:1的理想化实践保持一致。 从上图的逻辑示意图我们再深入一层,从分层的维度去剖析一下详细的应用架构的展现形式,如下图所示: 分层关注点 客户端 客户端与应用处于不同的进程,是应用能力的消费端,在实际项目中可能是APP端、PC端、小程序端、公众号端或三方的业务调用端等等。 接入层 接入层是外部系统与应用内部业务能力的中间层,接入层是应用层对外的门面,是当前应用对外暴露业务能力的入口。该层的组成可能是对外提供的HTTP接口声明、分布式定时任务调度、消息监听器、RPC服务等等。其重要职责包括对外部系统的请求进行基础的参数校验、入参适配和服务路由(转发至系一层的应用服务)以及响应数据的适配。 业务层: 该层是应用的业务逻辑所在层,整个架构风格采用模块化单体风格,在该层不同的限界上下文体现为不同的模块。在每个限界上下文内采用分层架构,独立划分为应用层、领域层和网关层。 应用层: 协调领域对象、领域服务或外部依赖服务完成业务用例,该层只做能力协调,不处理任何领域逻辑。 领域层: 领域层是整个分层的核心,与技术实现无关,主要负责领域模型、领域事件、领域服务定义,以及业务相关外部服务的接口抽象以及仓库的接口抽象等。 领域层与应用服务的本质区别是:应用层不包含领域逻辑,领域逻辑全部下沉到领域层实现。 网关层: 网关层定位是应用的出口网关,是应用与外部基础设施交互的防腐层,处理所有技术相关实现。 该组件的命名有多种方式,比如有些团队将其命名为 “rpc”,也有些团队将其命名为 “infrastructure”,不同的命名体现了团队对其背后所表达的隐喻的决策选择。在本文的参考架构中选择了 网关-Gateway这一命名,决策原因是:限界上下文自身是高内聚的,其与外部的交互需要统一出口,Gateway所表达的网关的含义恰当的表现了这种统一出口的理念。如果Facade层是应用的北向网关,是外部系统请求进入内部的入口。则此时的Gateway则表达的是限界上下文的南向网关,是内部应用连接外部的出口。 组件及依赖 从宏观的分层我们再深入一层看下每层的组件划分。如下图所示: Start组件: 整个应用的启动入口、加载应用配置信息等等。 Common组件 提供在不同的限界上下文间复用的领域模型元素的抽象,比如对Command、Query、Event、Entity、ValueObjec通用抽象等。当然,领域模型的通用抽象不是必须在Common组件内以提供复用,也可以作为一个独立的限界上下文,并以共享内核方式与其它上下文进行共享,或者也可以实现为独立的jar包组件。 API 组件 RPC类型服务的接口声明组件,以公司内部使用的JSF为例,该组件是应用对外部系统暴露的JSF API的组件。该组件可以是独立的工程,当然,有些团队会将其作为一个Module放入应用工程中。 统一门面组件:Facade 外部客户端触达应用系统的入口,也是内部应用服务的统一门面,类似于六边形架构风格下的适配器。参考架构中基于不同场景划分为 provider(RPC服务)、task(定时任务)、listener(MQ监听)、rest(http接口)等几个子包。外部请求进入系统后,由Facade组件完成入参基本校验、入参转换、服务路由以及出参转换等操作。另外,还可以承担处理登录态、鉴权以及日志等相关能力。 应用服务组件:Application Service 应用服务代表着用例以及系统行为,其通过委托到领域层和基础设施层(参考架构中的Gateway组件)完成用例的应用逻辑逻辑处理,可以理解为应用服务是领域层的客户端。该组件典型的职责: 从存储层加载领域对象、委托领域对象执行领域逻辑、保存领域对象 重要事件通知到外部 出入参转化适配 事务处理外部 非领域逻辑的服务调用 External API 应用服务的逻辑不仅仅需要协调领域层,有时还需要依赖于外部的三方服务。External API 组件负责对这些外部服务进行接口声明定义,不做具体实现。 应用服务组件不直接依赖这些外部服务实现,而是依赖其接口抽象。同时,此处的模型定义是基于该限界上下文的语义,是一种对外部模型的适配。 该组件不依赖其它组件,且仅被应用服务组件和Gateway组件依赖。网关组件依赖External API 组件的接口声明并提供底层技术实现,应用服务组件依赖其接口,并通过IOC方式将具体实现注入完成服务调用。 注意,该组件所依赖的服务不涉及领域逻辑,只是用于支撑应用服务的编排。如果是涉及了领域逻辑,则对外部服务依赖的接口定义需要下沉到Domain层。 Query Query组件解决领域相关的报表查询场景,在限界上下文内作为与应用服务对等的组件存在,两个组件分别负责业务的查询和命令逻辑。 虽然引入了Query组件对报表场景提供支持,但没有完全的引入CQRS这一模式。在很多资料中CQRS与DDD同时提及的概率比较高,因为,在DDD下我们解决了复杂的面向领域的写侧模型,但在报表场景下,这种富领域模型有可能并不是最佳选择。如果读侧和写侧都基于统一的领域模型,一般会导致领域模型的折衷设计。为了满足查询侧诉求,领域模型不得不引入额外的、领域无关的属性,由此造成领域模型的污染。 Domain Domain组件是领域逻辑核心,承担整个系统领域逻辑的实现,其定义了领域模型、领域服务、领域事件以及仓储层的抽象。该组件不依赖其它组件(除了通用的领域模型抽象组件Common之外。 上图所体现的参考架构使用了DDD的战术设计的经典建模元素,比如聚合、实体、值对象、仓储、工厂以及领域事件等。在实际落地过程中,这些设计元素的抽象具有一定的挑战,设计过程中需要经过不断分析、权衡和重构以完成建模,这正是核心设计所在。 Gateway 网关层承担整个技术相关性的实现,是内部应用的出口网关。 技术相关性是网关组件区别于其它组件的根本特性。在该组件内要处理技术实现的所有细节,比如与外部服务、中间件、DB的交互等。同时,其与Domain组件以及External API组件的接口抽象协作,共同承担了系统与外部依赖间(包括外部服务以及应用依赖的中间件、DB等基础设施)的防腐层职能,负责内部模型到外部模型转化、外部模型到内部模型转化以及具体交互。基于网关组件的特性,也非常适合在该层做统一的外部服务数据缓存及降级熔断处理。 网关层依赖于Domain、Application Service、External API和Query组件,负责上述四个组件定义的接口实现。在Gateway组件通过子包对实现进行隔离: query:查询服务组件的实现 external:External API 组件中依赖外部服务的接口实现 repository:仓储接口的实现 最后 应用架构模式的选择是系统架构设计的重要维度之一,结构不仅仅是简单的包结构和命名,其传达的是一种顶层抽象,背后包含了大量的实践和知识。制定符合团队情况的工程参考架构,并在团队成员间达成共识非常重要。领域驱动设计并没有统一的、通用的架构,试图定义标准架构是不切实际的。本文描述的工程架构只是一个参考,实践过程中应该基于团队特定情况而有所差异,但原则上都应该遵循业务域与技术域分离的核心理念。 作者:京东科技 倪新明 内容来源:京东云开发者社区

优秀的个人博客,低调大师

每日一博 | 前端开发之函数式编程实践

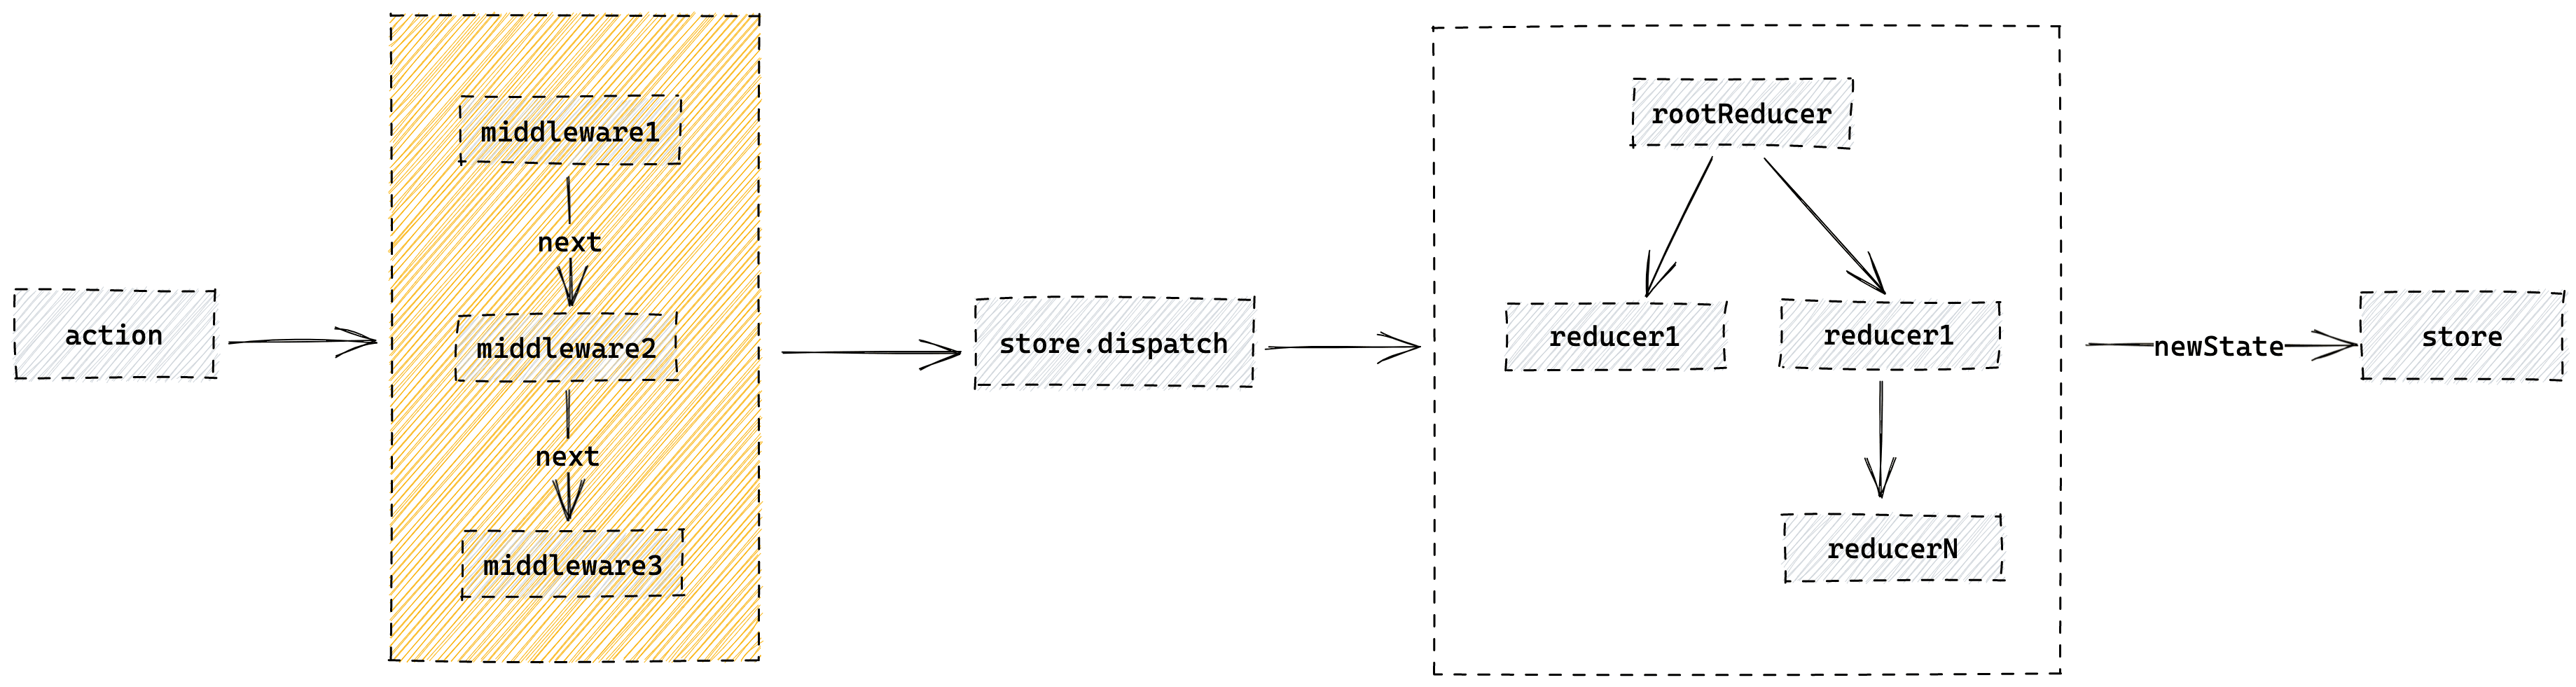
作者:京东科技牛志伟 函数式编程简介 常见应用场景 1、ES6中的map、filter、reduce等函数 [1,2,3,4,5].map(x => x * 2).filter(x => x > 5).reduce((p,n) => p + n); 2、React类组件 -> 函数式组件+hooks、Vue3中的组合式API 3、RxJS、Lodash和Ramda等JS库 4、中间件/插件,如Redux中的applyMiddleware中间件实现 const store = applyMiddleware(...middlewares)(createStore)(reducer, initialState)   什么是函数式编程 函数式编程是一种编程范式,它将程序抽象为函数和数据结构,通过函数调用来实现程序的功能,并且函数可以作为参数传递给其他函数。 在 JavaScript 中,函数式编程可以实现面向对象编程的一些功能,比如抽象、封装、继承和多态等。 它还可以使用高阶函数、柯里化、组合和延迟计算来实现函数式编程的功能。 函数式编程有哪些特性 函数是「一等公民」 • 函数可以当做参数传递给其他函数,也可以作为函数的返回值返回(高阶函数)。 惰性执行 • 惰性执行是指在代码中的某些函数调用,只有在它们的返回值被使用时才会被执行。 • 它利用了延迟计算的技术,使得函数只在被调用时才会执行,而不是在编写代码时就被执行。 • 这样可以提高性能,因为不需要无用的计算。 无副作用(纯函数) • 函数的执行不会改变程序的外部状态,也就是说函数的执行不会影响程序的其他部分。 • 因为它只是单纯的计算结果,而不会产生其他的副作用。 常见函数式概念 柯里化-currying 柯里化函数是把接受多个参数的函数变换成接受一个单一参数(最初函数的第一个参数)的函数,并且返回接受余下的参数而且返回结果的新函数的技术。 函数表达:f(a, b, c) => f(a)(b)(c) 简单实现(有兴趣的同学可以研究下Lodash和Ramda库中的实现) // 函数柯里化 function curry(fn, args){ args = args || [] return function(...params){ let _args = [...args, ...params] if(_args.length < fn.length){ return curry(fn, _args) } return fn.apply(this, _args) } } function sum(a, b, c){ return a+b+c } // 自由组合参数 const currySum = curry(sum) console.log(currySum(1)(2)(3)) //6 console.log(currySum(1)(2,3)) //6 console.log(currySum(1,2)(3)) //6 管道-pipe 管道pipe函数是一个高阶函数,它接受一系列函数作为参数,将函数串联起来,一步步将上一步的输出作为下一步的输入,这样可以更加高效地处理复杂的业务逻辑。 函数表达:pipe(f, g, t) => x => t(g(f(x)),进一步结合curry可以实现pipe(f)(g)(t) => x => t(g(f(x)) 借助reduce简单实现,支持异步和非异步函数 export const pipe: any = (...fns: Promise<Function>[]) => (input: any) => fns.reduce((chain: Promise<Function>, func: Function | Promise<Function> | any) => chain.then(func), Promise.resolve(input)); 组合-compose 组合compose指的是将多个函数组合成一个函数,这样一个函数的输出就可以作为另一个函数的输入,从而实现多个函数的链式调用。 组合compose可以提高代码的可读性和可维护性,减少重复代码的出现,更加便捷的实现函数的复用。 函数表达:compose(f, g, t) => x => f(g(t(x)),进一步结合curry可以实现compose(f)(g)(t) => x => f(g(t(x)) 借助reduceRight简单实现,和pipe的区别只是运算顺序不同 export const compose: any = (...fns: Promise<Function>[]) => (input: any) => fns.reduceRight((chain: Promise<Function>, func: Function | Promise<Function> | any) => chain.then(func), Promise.resolve(input)); 函数式编程实践 需求背景介绍 AgileBI在线报表是一款报表应用工具:易学易用,零代码,通过简单拖拽操作,制作中国式复杂报表,轻松实现报表的多样展示、交互分析、数据导出等需求, 在线体验 已有功能:在线报表中的每个单元格都可以配置相关的属性:比如扩展方向、父格、单元格格式、过滤条件、条件属性等  新增需求:需要支持批量设置单元格,其中【文本类型】单元格支持扩展方向、父格的设置;【字段类型】、【公示类型】单元格支持所有配置;  大致设计思路 1. 获取当前批量设置中,所有的配置项信息 2. 为每个配置项设计一个处理器(高阶函数):主要处理【批量设置的配置信息】和【当前单元格的配置信息】合并或替换逻辑 3. 通过管道的方式,加工每个单元格所有的配置项信息 核心实现 • pipe函数 private pipe = (...args: any) => { return (result: any, config?: any) => { return args.reduce((acc: any, fn: any) => fn(acc, config), result); }; }; • 高阶函数处理每个配置项 // 扩展方向替换 private handleExpand(expandConf: string) { return (conf: any) => { if (expandConf) { conf.expandDirection = expandConf; } return conf; }; } // 父行/父列替换 private handleParentCell(columnParentCell: any, rowParentCell: any) { return (conf: any) => { if (columnParentCell?.parentSelectType) { conf.columnParentCell = columnParentCell; } if (rowParentCell?.parentSelectType) { conf.rowParentCell = rowParentCell; } return conf; }; } // 条件属性追加 private handleCondition(conditionBatchConf: any) { return (conf: any) => { conf.conditionConf = this.mergeCondition(conf?.conditionConf || [], conditionBatchConf); return conf; }; } // 批量修改 private mergeCondition(c1: any, c2: any) { for (let j = 0; j < c1.length; j++) { // 批量删除 if ( c1[j]?.batchFlag && this.batchConf.conditionConf?.find((item: any) => item.uuid === c1[j]?.uuid) && !c2.find((item: any) => item.uuid === c1[j]?.uuid) ) { c1.splice(j, 1); } } for (let j = 0; j < c1.length; j++) { for (let i = 0; i < c2.length; i++) { // 如果字段已存在则替换 if (c2[i]?.uuid === c1[j]?.uuid) { c1.splice(j, 1); } } } return [...c1, ...c2]; } //... • 组合函数,获取每个单元格的最终配置信息 //... let handles: Array<any> = []; if (cell?.dataConf?.cellType === "文本") { handles = [ this.handleExpand(conf.expandDirection), this.handleParentCell(conf.columnParentCell, conf.rowParentCell) ]; } else if (cell?.dataConf?.cellType === "字段" || cell?.dataConf?.cellType === "公式") { handles = [ this.handleExpand(conf.expandDirection), this.handleParentCell(conf.columnParentCell, conf.rowParentCell), this.handleFormat(conf.dataFormatConf), this.handleFilter(conf.cellFilterConf), this.handleCondition(conf.conditionConf) ]; } if (handles.length > 0) { const mergeConf = this.pipe(...handles)(JSON.parse(JSON.stringify(cell.dataConf))); //... } 总结 1. 函数式编程可以可提高代码的可重用性,减少重复代码的开发时间; 2. 函数式编程可以提高代码的可读性,使得代码更容易理解和调试; 3. 函数式编程可以更容易实现函数组合,以帮助提高可维护性; 4. 组合优于继承;

优秀的个人博客,低调大师

每日一博 | Tars-Cpp 协程实现分析

作者:vivo 互联网服务器团队- Ye Feng 本文介绍了协程的概念,并讨论了 Tars Cpp 协程的实现原理和源码分析。 一、前言 Tars 是 Linux 基金会的开源项目 (https://github.com/TarsCloud),它是基于名字服务使用 Tars 协议的高性能 RPC 开发框架,配套一体化的运营管理平台,并通过伸缩调度,实现运维半托管服务。Tars 集可扩展协议编解码、高性能 RPC 通信框架、名字路由与发现、发布监控、日志统计、配置管理等于一体,通过它可以快速用微服务的方式构建自己的稳定可靠的分布式应用,并实现完整有效的服务治理。 Tars 目前支持 C++,Java,PHP,Nodejs,Go 语言,其中 TarsCpp 3.x 全面启用对协程的支持,服务框架全面融合协程。本文基于TarsCpp-v3.0.0版本,讨论了协程在TarsCpp服务框架的实现。 二、协程的介绍 2.1 什么是协程 协程的概念最早出现在Melvin Conway在1963年的论文("Design of a separable transition-diagram compiler"),协程认为是“可以暂停和恢复执行”的函数。 协程可以看成一种特殊的函数,相比于函数,协程最大的特点就是支持挂起(yield)和恢复(resume)的能力。如上图所示:函数不能主动中断执行流;而协程支持主动挂起,中断执行流,并在一定时机恢复执行。 协程的作用: 降低并发编码的复杂度,尤其是异步编程(callback hell)。 协程在用户态中实现调度,避免了陷入内核,上下文切换开销小。 2.2 进程、线程和协程 我们可以简单的认为协程是用户态的线程。协程和线程主要异同: 相同点:都可以实现上下文切换(保存和恢复执行流) 不同点:线程的上下文切换在内核实现,切换的时机由内核调度器控制。协程的上下文切换在用户态实现,切换的时机由调用方自身控制。 进程、线程和协程的比较: 2.3 协程的分类 按控制传递(Control-transfer)机制分为:对称(Symmetric)协程和非对称(Asymmetric)协程。 对称协程:协程之间相互独立,调度权(CPU)可以在任意协程之间转移。协程只有一种控制传递操作(yield)。对称协程一般需要调度器支持,通过调度算法选择下一个目标协程。 非对称协程:协程之间存在调用关系,协程让出的调度权只能返回给调用者。协程有两种控制操作:恢复(resume)和挂起(yield)。 下图演示了对称协程的调度权转移流程,协程只有一个操作yield,表示让出CPU,返回给调度器。 对称协程示意图 下图演示了非对称协程的调度权转移流程。协程可以有两个操作,即resume和yield。resume表示转移CPU给被调用者,yield表示被调用者返回CPU给调用者。 非对称协程示意图 根据协程是否有独立的栈空间,协程分为有栈协程(stackful)和无栈协程(stackless)两种。 有栈协程:每个协程有独立的栈空间,保存独立的上下文(执行栈、寄存器等),协程的唤醒和挂起就是拷贝和切换上下文。优点:协程调度可以嵌套,在内存中的任意位置、任意时刻进行。局限:协程数目增大,内存开销增大。 无栈协程:单个线程内所有协程都共享同一个栈空间(共享栈),协程的切换就是简单的函数调用和返回,无栈协程通常是基于状态机或闭包来实现。优点:减小内存开销。局限:协程调度产生的局部变量都在共享栈上, 一旦新的协程运行后共享栈中的数据就会被覆盖, 先前协程的局部变量也就不再有效, 进而无法实现参数传递、嵌套调用等高级协程交互。 Golang 中的 goroutine、Lua 中的协程都是有栈协程;ES6的 await/async、Python 的 Generator、C++20 中的 cooroutine 都是无栈协程。 三、Tars 协程实现 实现协程的核心有两点: 实现用户态的上下文切换。 实现协程的调度。 Tars 协程的由下面几个类实现: TC_CoroutineInfo 协程信息类:实现协程的上下文切换。每个协程对应一个 TC_CoroutineInfo 对象,上下文切换基于boost.context实现。 TC_CoroutineScheduler 协程调度器类:实现了协程的管理和调度。 TC_Coroutine 协程类:继承于线程类(TC_Thread),方便业务快速使用协程。 Tars 协程有几个特点: 有栈协程。每个协程都分配了独立的栈空间。 对称协程。协程之间相互独立,由调度器负责调度。 基于 epoll 实现协程调度,和网络IO无缝结合。 3.1 用户态上下文切换的实现方式 协程可以看成一种特殊的函数,和普通函数不同,协程函数有挂起(yield)和恢复(resume)的能力,即可以中断自己的执行流,并且在合适的时候恢复执行流,这也称为上下文切换的能力。 协程执行的过程,依赖两个关键要素:协程栈和寄存器,协程的上下文环境其实就是寄存器和栈的状态。实现上下文切换的核心就是实现保存并恢复当前执行环境的寄存器状态的能力。 实现用户态上下文切换一般有以下方式: 3.2 基于boost.context实现上下文切换 Tars 协程是基于 boost.context 实现,boost.context 提供了两个接口(make_fcontext, jump_fcontext)实现协程的上下文切换。 代码1: /** * @biref 执行环境上下文 */typedef void* fcontext_t;/** * @biref 事件参数包装 */struct transfer_t { fcontext_t fctx; // 来源的执行上下文。来源的上下文指的是从什么位置跳转过来的 void* data; // 接口传入的自定义的指针};/** * @biref 初始化执行环境上下文 * @param sp 栈空间地址 * @param size 栈空间的大小 * @param fn 入口函数 * @return 返回初始化完成后的执行环境上下文 */extern "C" fcontext_t make_fcontext(void * stack, std::size_t stack_size, void (* fn)( transfer_t));/** * @biref 跳转到目标上下文 * @param to 目标上下文 * @param vp 目标上下文的附加参数,会设置为transfer_t里的data成员 * @return 跳转来源 */extern "C" transfer_t jump_fcontext(fcontext_t const to, void * vp); (1)make_fcontext创建协程 接受三个参数,stack是为协程分配的栈底,stack_size是栈的大小,fn是协程的入口函数 返回初始化完成后的执行环境上下文 (2)jump_fcontext切换协程 接受两个参数,目标上下文地址和参数指针 返回一个上下文,指向当前上下文从哪个上下文跳转过来 make_fcontext 和 jump_fcontext 通过汇编代码实现,具体的汇编代码可以参考: https://github.com/TarsCloud/TarsCpp/blob/v3.0.0/util/src/asm/jump_x86_64_sysv_elf_gas.S https://github.com/TarsCloud/TarsCpp/blob/v3.0.0/util/src/asm/make_x86_64_sysv_elf_gas.S fcontext的结构 boost context 是通过 fcontext_t结构体来保存协程状态。相对于其它汇编实现的协程库,boost的context和stack是一起的,栈底指针就是context,切换context就是切换stack。 3.3 Tars协程信息类 TC_CoroutineInfo 协程信息类,包装了 boost.context 提供的接口,表示一个 TARS 协程。 其中,TC_CoroutineInfo::registerFunc 定义了协程的创建。 代码2: void TC_CoroutineInfo::registerFunc(const std::function<void ()>& callback){ _callback = callback; _init_func.coroFunc = TC_CoroutineInfo::corotineProc; _init_func.args = this; fcontext_t ctx = make_fcontext(_stack_ctx.sp, _stack_ctx.size, TC_CoroutineInfo::corotineEntry); // 创建协程 transfer_t tf = jump_fcontext(ctx, this); // context 切换 //实际的ctx this->setCtx(tf.fctx);}void TC_CoroutineInfo::corotineEntry(transfer_t tf){ TC_CoroutineInfo * coro = static_cast< TC_CoroutineInfo * >(tf.data); // this auto func = coro->_init_func.coroFunc; void* args = coro->_init_func.args; transfer_t t = jump_fcontext(tf.fctx, NULL); //拿到自己的协程堆栈, 当前协程结束以后, 好跳转到main coro->_scheduler->setMainCtx(t.fctx); //再跳转到具体函数 func(args, t);} TC_CoroutineInfo::switchCoro 定义了协程切换。 代码3 void TC_CoroutineScheduler::switchCoro(TC_CoroutineInfo *to){ //跳转到to协程 _currentCoro = to; transfer_t t = jump_fcontext(to->getCtx(), NULL); //并保存协程堆栈 to->setCtx(t.fctx);} 四、Tars 协程调度器 基于 boost.context 的 TC_CoroutineInfo 类实现了协程的上下文切换,协程的管理和调度,则是由 TC_CoroutineScheduler 协程调度器类来负责,分管理和调度两个方面来说明 TC_CoroutineScheduler 调度类。 协程管理:目的是需要合理的数据结构来组织协程(TC_CoroutineInfo),方便调度的实现。 协程调度:目的是控制协程的启动、休眠和唤醒,实现了 yield, sleep 等功能,本质就是实现协程的状态机,完成协程的状态切换。Tars 协程分为 5 个状态:FREE, ACTIVE, AVAIL, INACTIVE, TIMEOUT 代码4: /** * 协程的状态信息 */ enum CORO_STATUS { CORO_FREE = 0, CORO_ACTIVE = 1, CORO_AVAIL = 2, CORO_INACTIVE = 3, CORO_TIMEOUT = 4 }; 4.1 Tars 协程的管理 TC_CoroutineScheduler 主要通过以下方法管理协程: TC_CoroutineScheduler::create()创建TC_CoroutineScheduler对象 TC_CoroutineScheduler::init()初始化,分配协程栈内存 TC_CoroutineScheduler::run()启动调度 TC_CoroutineScheduler::terminate()停止调度 TC_CoroutineScheduler::destroy()资源销毁,释放协程栈内存 我们可以通过 TC_CoroutineScheduler::init()看到数据结构的初始化过程。 代码5: void TC_CoroutineScheduler::init(){ ... .... createCoroutineInfo(_poolSize); // _all_coro = new TC_CoroutineInfo*[_poolSize+1]; TC_CoroutineInfo::CoroutineHeadInit(&_active); TC_CoroutineInfo::CoroutineHeadInit(&_avail); TC_CoroutineInfo::CoroutineHeadInit(&_inactive); TC_CoroutineInfo::CoroutineHeadInit(&_timeout); TC_CoroutineInfo::CoroutineHeadInit(&_free); int iSucc = 0; for(size_t i = 0; i < _currentSize; ++i) { //iId=0不使用, 给mainCoro使用!!!! uint32_t iId = generateId(); stack_context s_ctx = stack_traits::allocate(_stackSize); // 分配协程栈内存 TC_CoroutineInfo *coro = new TC_CoroutineInfo(this, iId, s_ctx); _all_coro[iId] = coro; TC_CoroutineInfo::CoroutineAddTail(coro, &_free); ++iSucc; } _currentSize = iSucc; _mainCoro.setUid(0); _mainCoro.setStatus(TC_CoroutineInfo::CORO_FREE); _currentCoro = &_mainCoro;} 通过下面的 TC_CoroutineScheduler 调度类数据结构图,可以更清楚的看到协程的组织方式: Tars调度类数据结构 使用协程之前,需要在协程数组(_all_coro),创建指定数量的协程对象,并为每个协程分配协程栈内存。 通过链表的方式管理协程,每个状态都有一个链表。协程状态切换,对应协程在不同状态链表的转移。 4.2Tars 协程的调度 Tars 调度是基于epoll实现,在 epoll 循环里检查是否有需要执行的协程, 有则执行之, 没有则等待在epoll对象上, 直到有唤醒或者超时。使用 epoll 实现的好处是可以和网络IO无缝粘合, 当有数据发送/接收时, 唤醒epoll对象, 从而完成协程的切换。 Tars协程调度的核心逻辑是 TC_CoroutineScheduler::run() 代码6: void TC_CoroutineScheduler::run(){ ... ... while(!_epoller->isTerminate()) { if(_activeCoroQueue.empty() && TC_CoroutineInfo::CoroutineHeadEmpty(&_avail) && TC_CoroutineInfo::CoroutineHeadEmpty(&_active)) { _epoller->done(1000); // epoll_wait(..., 1000ms) 先处理epoll的网络事件 } //唤醒需要激活的协程 wakeup(); //唤醒sleep的协程 wakeupbytimeout(); //唤醒yield的协程 wakeupbyself(); int iLoop = 100; //执行active协程, 每次执行100个, 避免占满cpu while(iLoop > 0 && !TC_CoroutineInfo::CoroutineHeadEmpty(&_active)) { TC_CoroutineInfo *coro = _active._next; switchCoro(coro); --iLoop; } //执行available协程, 每次执行1个 if(!TC_CoroutineInfo::CoroutineHeadEmpty(&_avail)) { TC_CoroutineInfo *coro = _avail._next; switchCoro(coro); } } ... ...} 下图可以更清楚得看到协程调度和状态转移的过程。 Tars协程调度状态转移图 TC_CoroutineScheduler 提供了下面四种方法实现协程的调度: (1) TC_CoroutineScheduler::go():启动协程。 (2)TC_CoroutineScheduler::yield():当前协程放弃继续执行。并提供了两种方式,支持不同的唤醒策略。 yield(true):会自动唤醒(等到下次协程调度,都会再激活当前线程) yield(false):不再自动唤醒,除非自己调度该协程(比如put到调度器中) (3)TC_CoroutineScheduler::sleep():当前协程休眠iSleepTime时间(单位:毫秒),然后会被唤醒继续执行。 (4)TC_CoroutineScheduler::put():放入需要唤醒的协程, 将协程放入到调度器中, 马上会被调度器调度。 五、总结 本文介绍了协程的概念,并讨论了 Tars Cpp 协程的实现原理和源码分析。 TarsCpp 3.x全面启用对协程的支持,本文的源码分析是基于TarsCpp-v3.0.0版本 https://github.com/TarsCloud/TarsCpp/tree/release/3.0 END 猜你喜欢 Tars-Java网络编程源码分析 MySQL主从复制原理剖析与应用实践 本文分享自微信公众号 - vivo互联网技术(vivoVMIC)。 如有侵权,请联系 support@oschina.cn 删除。 本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

优秀的个人博客,低调大师

每日一博 | Kafka 高可靠高性能原理探究

引言 在探究 Kafka 核心知识之前,我们先思考一个问题:什么场景会促使我们使用Kafka? 说到这里,我们头脑中或多或少会蹦出异步解耦和削峰填谷等字样,是的,这就是 Kafka 最重要的落地场景。 异步解耦:同步调用转换成异步消息通知,实现生产者和消费者的解耦。想象一个场景,在商品交易时,在订单创建完成之后,需要触发一系列其他的操作,比如进行用户订单数据的统计、给用户发送短信、给用户发送邮件等等。如果所有操作都采用同步方式实现,将严重影响系统性能。针对此场景,我们可以利用消息中间件解耦订单创建操作和其他后续行为。 削峰填谷:利用 Broker 缓冲上游生产者瞬时突发的流量,使消费者消费流量整体平滑。对于发送能力很强的上游系统,如果没有消息中间件的保护,下游系统可能会直接被压垮导致全链路服务雪崩。想象秒杀业务场景,上游业务发起下单请求,下游业务执行秒杀业务(库存检查,库存冻结,余额冻结,生成订单等等),下游业务处理的逻辑是相当复杂的,并发能力有限,如果上游服务不做限流策略,瞬时可能把下游服务压垮。针对此场景,我们可以利用 MQ 来做削峰填谷,让高峰流量填充低谷空闲资源,达到系统资源的合理利用。 通过上述例子可以发现交易、支付等场景常需要异步解耦和削峰填谷功能解决问题,而交易、支付等场景对性能、可靠性要求特别高。那么,我们本文的主角Kafka能否满足相应要求呢?下面我们来探讨下。 Kafka 宏观认知 在探究 Kafka 的高性能、高可靠性之前,我们从宏观上来看下 Kafka 的系统架构 如上图所示,Kafka 由 Producer、Broker、Consumer 以及负责集群管理的 ZooKeeper 组成,各部分功能如下: Producer: 生产者,负责消息的创建并通过一定的路由策略发送消息到合适的 Broker; Broker:服务实例,负责消息的持久化、中转等功能; Consumer:消费者,负责从 Broker 中拉取(Pull)订阅的消息并进行消费,通常多个消费者构成一个分组,消息只能被同组中的一个消费者消费; ZooKeeper:负责 Broker、Consumer 集群元数据的管理等;(注意:Producer 端直接连接 Broker,不在 ZK 上存任何数据,只是通过 ZK 监听 Broker 和 Topic 等信息) 上图消息流转过程中,还有几个特别重要的概念—主题(Topic)、分区(Partition)、分段(Segment)、位移(Offset)。 topic:消息主题。Kafka 按 Topic 对消息进行分类,我们在收发消息时只需指定 Topic。 partition:分区。为了提升系统的吞吐,一个 Topic 下通常有多个 Partition,Partition 分布在不同的 Broker 上,用于存储 Topic 的消息,这使 Kafka 可以在多台机器上处理、存储消息,给 Kafka 提供给了并行的消息处理能力和横向扩容能力。另外,为了提升系统的可靠性,Partition 通常会分组,且每组有一个主 Partition、多个副本 Partition,且分布在不同的 Broker上,从而起到容灾的作用。 Segment:分段。宏观上看,一个 Partition 对应一个日志(Log)。由于生产者生产的消息会不断追加到 Log 文件末尾,为防止 Log 文件过大导致数据检索效率低下,Kafka 采取了分段和索引机制,将每个 Partition 分为多个 Segment,同时也便于消息的维护和清理。每个 Segment 包含一个.log日志文件、两个索引(.index、timeindex)文件以及其他可能的文件。每个 Segment 的数据文件以该段中最小的 Offset 为文件名,当查找 Offset 的 Message 的时候,通过二分查找快找到 Message 所处于的 Segment 中。 Offset:消息在日志中的位置,消息在被追加到分区日志文件的时候都会分配一个特定的偏移量。Offset 是消息在分区中的唯一标识,是一个单调递增且不变的值。Kafka 通过它来保证消息在分区内的顺序性,不过 Offset 并不跨越分区,也就是说,Kafka 保证的是分区有序而不是主题有序。 Kafka 高可靠性、高性能探究 在对 Kafka 的整体系统框架及相关概念简单了解后,下面我们来进一步深入探讨下高可靠性、高性能实现原理。 Kafka 高可靠性探究 Kafka 高可靠性的核心是保证消息在传递过程中不丢失,涉及如下核心环节: 消息从生产者可靠地发送至 Broker;-- 网络、本地丢数据 发送到 Broker 的消息可靠持久化; -- Pagecache 缓存落盘、单点崩溃、主从同步跨网络 消费者从 Broker 消费到消息且最好只消费一次 -- 跨网络消息传输 消息从生产者可靠地发送至 Broker 为了保障消息从生产者可靠地发送至 Broker,我们需要确保两点 1.Producer 发送消息后,能够收到来自 Broker 的消息保存成功 Ack; 2.Producer 发送消息后,能够捕获超时、失败Ack等异常Ack并做处理; Ack 策略 针对问题1,Kafka 为我们提供了三种 Ack 策略, Request.required.acks = 0:请求发送即认为成功,不关心有没有写成功,常用于日志进行分析场景。 Request.required.acks = 1:当 Leader partition 写入成功以后,才算写入成功,有丢数据的可能。 Request.required.acks= -1:ISR列表里面的所有副本都写完以后,这条消息才算写入成功,强可靠性保证。 为了实现强可靠的 Kafka 系统,我们需要设置Request.required.acks= -1,同时还会设置集群中处于正常同步状态的副本 Follower 数量 min.insync.replicas>2,另外,设置unclean.leader.election.enable=false 使得集群中 ISR 的 Follower 才可变成新的 Leader,避免特殊情况下消息截断的出现。 消息发送策略 针对问题2,Kafka 提供两类消息发送方式:同步(Sync)发送和异步(Async)发送,相关参数如下: 参数 含义 默认值 推荐值 async 是否进行异步生产,可选值:<br>0:同步生产,默认值<br>1:异步生产 0 一般情况下使用0,如果使用异步生产,需要通过channel捕捉消息生产失败的情况,并进行异步修复处理,逻辑会相对复杂。<br>对于延时比较敏感,避免生产消息导致耗时过高的场景可以考虑异步。 以 Sarama 实现为例,在消息发送的过程中,无论是同步发送还是异步发送都会涉及到两个协程--负责消息发送的主协程和负责消息分发的 Dispatcher 协程。 异步发送 对于异步发送(Ack != 0 场景,等于0时不关心写 Kafka 结果,后文详细讲解)而言,其流程大概如下 1.在主协程中调用异步发送 Kafka 消息的时候,其本质是将消息体放进了一个 Input 的 Channel,只要入 Channel 成功,则这个函数直接返回,不会产生任何阻塞。相反,如果入 Channel 失败,则会返回错误信息。因此调用 Async 写入的时候返回的错误信息是入 Channel 的错误信息,至于具体最终消息有没有发送到 Kafka 的 Broker,我们无法从返回值得知。 2.当消息进入 Input 的 Channel 后,会有另一个 Dispatcher 的协程负责遍历 Input,来真正发送消息到特定 Broker 上的主 Partition 上。发送结果通过一个异步协程进行监听,循环处理 Err Channel 和 Success Channel,出现了 Error 就记一个日志。因此异步写入场景时,写 Kafka 的错误信息,我们暂时仅能够从这个错误日志来得知具体发生了什么错,并且也不支持我们自建函数进行兜底处理,这一点在 trpc-go 的官方也得到了承认。 同步发送 同步发送(Ack != 0 场景)是在异步发送的基础上加以条件限制实现的。同步消息发送在newSyncProducerFromAsyncProducer 中开启两个异步协程处理消息成功与失败的“回调”,并使用 WaitGroup 进行等待,从而将异步操作转变为同步操作。其流程大概如下 通过上述分析可以发现,Kafka 消息发送本质上都是异步的,不过同步发送通过 WaitGroup 将异步操作转变为同步操作。同步发送在一定程度上确保了我们在跨网络向 Broker 传输消息时,消息一定可以可靠地传输到 Broker。因为在同步发送场景我们可以明确感知消息是否发送至 Broker,若因网络抖动、机器宕机等故障导致消息发送失败或结果不明,可通过重试等手段确保消息至少一次(at least once)发送到Broker。另外,Kafka(0.11.0.0版本后)还为 Producer 提供两种机制来实现精确一次(exactly once)消息发送:幂等性(Idempotence)和事务(Transaction)。 | 类别 | 开启 | 特征 | 实现原理 |注意事项 | | :--- | :--- | :---|:---|:---| | 幂等性 Producer | enable.idempotence=true | 1. 单分区幂等性:只能保证单分区上幂等性,无法实现多个分区的幂等。 2. 单会话幂等性:只能实现单会话上的冥等性,当 Producer 重启后,这种幂等性保证就失效了。 | 为每个 Producer 设置唯一的 PID,Broker 发送消息时会带上 PID 并为每个消息生产一个 Seq number,Broker 端根据 PID 和 Seq number 去重 |Broker 端不会重复写入同一 PID 的 Producer 发送的相同的消息,底层日志中只会持久化一次。 | | 事务型 Producer |enable.idempotence=true,生产者设置 Transcational.id;若要实现 consumer-transform-producer,还需设置 Consumer 端参数 Isolation.level=read_committed| 1. 跨分区事务:能够保证将消息原子性地写入到多个分区中。2. 跨会话的事务恢复:如果一个应用实例挂了,启动的下一个实例依然可以保证上一个事务完成(Commit 或者 Abort)。 |1. Kafka 引入了一个协调者组件 TransactionCoordinator 来管理 Transaction。Producer 在开始一个事务时,告诉协调者事务开始,然后开始向多个 Topic-Partition 写数据,只有这批数据全部写完(中间没有出现异常),Producer 会调用 Commit 接口进行 Commit,然后事务真正提交,否则如果中间出现异常,那么事务将会被 Abort(Producer 通过 Abort 接口告诉协调者执行 Abort 操作)。2. 引入一个全局唯一的 Transaction ID,并将 Producer 获得的 PID 和 Transaction ID 绑定。这样当 Producer 重启后就可以通过正在进行的Transaction ID 获得原来的 PID。3. TransactionCoordinator 还负责将事务状态写入 Kafka 的一个内部 Topic: __transaction_state 中,这样即使整个服务重启,由于事务状态得到保存,进行中的事务状态可以得到恢复,从而继续进行。 |1. 开启事务对性能影响很大,在使用时要充分考虑。2. 当具有相同 Transaction ID 的新的 Producer 实例被创建且工作时,旧的且拥有相同 Transaction ID 的 Producer 将不再工作。 | 小结 通过 Ack 策略配置、同步发送、事务消息组合能力,我们可以实现 exactly once 语意跨网络向 Broker 传输消息。但是,Producer 收到 Broker 的成功 Ack,消息一定不会丢失吗?为了搞清这个问题,我们首先要搞明白 Broker 在接收到消息后做了哪些处理。 发送到 Broker 的消息可靠持久化 为了确保 Producer 收到 Broker 的成功 Ack 后,消息一定不在 Broker 环节丢失,我们核心要关注以下几点: -Broker 返回 Producer 成功 Ack 时,消息是否已经落盘; -Broker 宕机是否会导致数据丢失,容灾机制是什么; -Replica 副本机制带来的多副本间数据同步一致性问题如何解决; Broker 异步刷盘机制 Kafka 为了获得更高吞吐,Broker 接收到消息后只是将数据写入 PageCache 后便认为消息已写入成功,而 PageCache 中的数据通过 Linux 的 Flusher 程序进行异步刷盘(刷盘触发条:主动调用 Sync 或 Fsync 函数、可用内存低于阀值、Dirty Data 时间达到阀值),将数据顺序写到磁盘。消息处理示意图如下: 由于消息是写入到 PageCache,单机场景,如果还没刷盘 Broker 就宕机了,那么 Producer 产生的这部分数据就可能丢失。为了解决单机故障可能带来的数据丢失问题,Kafka 为分区引入了副本机制。 Replica副本机制 Kafka 每组分区通常有多个副本,同组分区的不同副本分布在不同的 Broker 上,保存相同的消息(可能有滞后)。副本之间是“一主多从”的关系,其中 Leader 副本负责处理读写请求,Follower 副本负责从 Leader 拉取消息进行同步。分区的所有副本统称为 AR(Assigned Replicas),其中所有与 Leader 副本保持一定同步的副本(包括 Leader 副本在内)组成 ISR(In-Sync Replicas),与 Leader 同步滞后过多的副本组成 OSR(Out-of-Sync Replicas),由此可见,AR=ISR+OSR。Follower 副本是否与 Leader 同步的判断标准取决于 Broker 端参数replica.lag.time.max.ms(默认为10秒),Follower 默认每隔500ms向 Leader Fetch 一次数据,只要一个 Follower 副本落后 Leader 副本的时间不连续超过10秒,那么 Kafka 就认为该 Follower 副本与 Leader 是同步的。在正常情况下,所有的 Follower 副本都应该与 Leader 副本保持一定程度的同步,即 AR=ISR,OSR 集合为空。 当 Leader 副本所在 Broker 宕机时,Kafka 会借助ZK从 Follower 副本中选举新的 Leader 继续对外提供服务,实现故障的自动转移,保证服务可用。为了使选举的新 Leader 和旧 Leader 数据尽可能一致,当 Leader 副本发生故障时,默认情况下只有在 ISR 集合中的副本才有资格被选举为新的 Leader,而在 OSR 集合中的副本则没有任何机会(可通过设置 unclean.leader.election.enable 改变)。 当 Kafka 通过多副本机制解决单机故障问题时,同时也带来了多副本间数据同步一致性问题。Kafka 通过高水位更新机制、副本同步机制、 Leader Epoch 等多种措施解决了多副本间数据同步一致性问题,下面我们来依次看下这几大措施。 HW 和 LEO 首先,我们来看下两个和 Kafka 中日志相关的重要概念 HW 和 LEO: HW: High Watermark,高水位,表示已经提交(Commit)的最大日志偏移量,Kafka 中某条日志“已提交”的意思是 ISR 中所有节点都包含了此条日志,并且消费者只能消费 HW 之前的数据; LEO: Log End Offset,表示当前 Log 文件中下一条待写入消息的 Offset; 如上图所示,它代表一个日志文件,这个日志文件中有8条消息,0至5之间的消息为已提交消息,5至7的消息为未提交消息。日志文件的 HW 为6,表示消费者只能拉取到5之前的消息,而 Offset 为5的消息对消费者而言是不可见的。日志文件的 LEO 为8,下一条消息将在此处写入。 注意:所有副本都有对应的 HW 和 LEO,只不过 Leader 副本比较特殊,Kafka 使用 Leader 副本的高水位来定义所在分区的高水位。换句话说,分区的高水位就是其 Leader 副本的高水位。Leader 副本和 Follower 副本的HW有如下特点: Leader HW:min(所有副本 LEO),为此 Leader 副本不仅要保存自己的 HW 和 LEO,还要保存 Follower 副本的 HW 和 LEO,而 Follower 副本只需保存自己的 HW 和 LEO; Follower HW:min(Follower 自身 LEO,Leader HW)。 注意:为方便描述,下面 Leader HW 简记为 HW L ,Follower HW 简记为 HW F ,Leader LEO 简记为 LEOL ,Follower LEO 简记为 LEO F。 下面我们演示一次完整的 HW / LEO 更新流程: 1.初始状态 HWL=0,LEO L=0,HWF=0,LEO F=0。 2.Follower 第一次 Fetch Leader 收到 Producer 发来的一条消息完成存储, 更新 LEO L=1; Follower从 Leader Fetch 数据,Leader 收到请求,记录 Follower 的 LEO F =0,并且尝试更新 HW L =min(全部副本 LEO)=0; Leader 返回 HW L=0 和 LEO L=1 给 Follower,Follower 存储消息并更新 LEO F =1, HW=min(LEO F,HW L)=0。 3.Follower 第二次 Fetch Follower 再次从 Leader Fetch 数据,Leader 收到请求,记录 Follower 的 LEO F =1,并且尝试更新 HW L =min(全部副本 LEO)=1; leader 返回 HW L=1和LEO L=1 给 Follower,Leader 收到请求,更新自己的 HW=min(LEO F,HW L)=1。 上述更新流程中 Follower 和 Leader 的 HW 更新有时间 GAP。如果 Leader 节点在此期间发生故障,则 Follower 的 HW 和 Leader 的 HW 可能会处于不一致状态,如果 Follower 被选为新的 Leader 并且以自己的 HW 为准对外提供服务,则可能带来数据丢失或数据错乱问题。 KIP-101 问题:数据丢失&数据错乱 数据丢失 第1步: 1.副本 B 作为 Leader 收到 Producer 的 m2 消息并写入本地文件,等待副本 A 拉取。 2.副本 A 发起消息拉取请求,请求中携带自己的最新的日志 Offset(LEO=1),B 收到后更新自己的 HW 为1,并将 HW=1 的信息以及消息 m2 返回给 A。 3.A 收到拉取结果后更新本地的 HW 为1,并将 m2 写入本地文件。发起新一轮拉取请求(LEO=2),B 收到 A 拉取请求后更新自己的 HW 为2,没有新数据只将 HW=2 的信息返回给 A,并且回复给 Producer 写入成功。此处的状态就是图中第一步的状态。 第2步: 此时,如果没有异常,A 会收到 B 的回复,得知目前的 HW 为2,然后更新自身的 HW 为2。但在此时 A 重启了,没有来得及收到 B 的回复,此时 B 仍然是 Leader。A 重启之后会以 HW 为标准截断自己的日志,因为 A 作为 Follower 不知道多出的日志是否是被提交过的,防止数据不一致从而截断多余的数据并尝试从 Leader 那里重新同步 第3步: B 崩溃了,min.isr 设置的是1,所以 Zookeeper 会从 ISR 中再选择一个作为 Leader,也就是 A,但是 A 的数据不是完整的,从而出现了数据丢失现象。 问题在哪里?在于 A 重启之后以 HW 为标准截断了多余的日志。不截断行不行?不行,因为这个日志可能没被提交过(也就是没有被 ISR 中的所有节点写入过),如果保留会导致日志错乱。 数据错乱 在分析日志错乱的问题之前,我们需要了解到 Kafka 的副本可靠性保证有一个前提:在 ISR 中至少有一个节点。如果节点均宕机的情况下,是不保证可靠性的,在这种情况会出现数据丢失,数据丢失是可接受的。这里我们分析的问题比数据丢失更加槽糕,会引发日志错乱甚至导致整个系统异常,而这是不可接受的。 第1步: 1.A 和 B 均为 ISR 中的节点。副本 A 作为 Leader,收到 Producer 的消息 m2 的请求后写入 PageCache 并在某个时刻刷新到本地磁盘。 2.副本 B 拉取到 m2 后写入 PageCage 后(尚未刷盘) 再次去 A 中拉取新消息并告知 A 自己的 LEO=2,A 收到更新自己的 HW 为1并回复给 Producer 成功。 3.此时 A 和 B 同时宕机,B 的 m2 由于尚未刷盘,所以 m2 消息丢失。此时的状态就是第1步的状态。 第2步: 由于 A 和 B 均宕机,而 min.isr=1 并且 unclean.leader.election.enable=true(关闭 Unclean 选择策略),所以 Kafka 会等到第一个 ISR 中的节点恢复并选为 Leader,这里不幸的是 B 被选为 Leader,而且还接收到 Producer 发来的新消息 m3。注意,这里丢失 m2 消息是可接受的,毕竟所有节点都宕机了。 第3步: A 恢复重启后发现自己是 Follower,而且 HW 为2,并没有多余的数据需要截断,所以开始和 B 进行新一轮的同步。但此时 A 和 B 均没有意识到,Offset 为1的消息不一致了。 问题在哪里?在于日志的写入是异步的,上面也提到 Kafka 的副本策略的一个设计是消息的持久化是异步的,这就会导致在场景二的情况下被选出的 Leader 不一定包含所有数据,从而引发日志错乱的问题。 Leader Epoch 为了解决上述缺陷,Kafka 引入了 Leader Epoch 的概念。Leader Epoch 和 Raft 中的任期号的概念很类似,每次重新选择 Leader 的时候,用一个严格单调递增的 ID 来标志,可以让所有 Follower 意识到 Leader 的变化。而 Follower 也不再以 HW 为准,每次奔溃重启后都需要去 Leader 那边确认下当前 Leader 的日志是从哪个 Offset 开始的。下面看下 Leader Epoch 是如何解决上面两个问题的。 数据丢失解决 这里的关键点在于副本 A 重启后作为 Follower,不是忙着以 HW 为准截断自己的日志,而是先发起 LeaderEpochRequest 询问副本 B 第0代的最新的偏移量是多少,副本 B 会返回自己的 LEO 为2给副本 A,A 此时就知道消息 m2 不能被截断,所以 m2 得到了保留。当 A 选为 Leader 的时候就保留了所有已提交的日志,日志丢失的问题得到解决。 如果发起 LeaderEpochRequest 的时候就已经挂了怎么办?这种场景下,不会出现日志丢失,因为副本 A 被选为 Leader 后不会截断自己的日志,日志截断只会发生在 Follower 身上。 数据错乱解决 这里的关键点还是在第3步,副本 A 重启作为 Follower 的第一步还是需要发起 LeaderEpochRequest 询问 Leader 当前第0代最新的偏移量是多少,由于副本 B 已经经过换代,所以会返回给 A 第1代的起始偏移(也就是1),A 发现冲突后会截断自己偏移量为1的日志,并重新开始和 Leader 同步。副本 A 和副本 B 的日志达到了一致,解决了日志错乱。 小结 Broker 接收到消息后只是将数据写入 PageCache 后便认为消息已写入成功,但是,通过副本机制并结合 ACK 策略可以大概率规避单机宕机带来的数据丢失问题,并通过 HW、副本同步机制、 Leader Epoch 等多种措施解决了多副本间数据同步一致性问题,最终实现了 Broker 数据的可靠持久化。 消费者从Broker消费到消息且最好只消费一次 Consumer 在消费消息的过程中需要向 Kafka 汇报自己的位移数据,只有当 Consumer 向 Kafka 汇报了消息位移,该条消息才会被 Broker 认为已经被消费。因此,Consumer 端消息的可靠性主要和 Offset 提交方式有关,Kafka消费端提供了两种消息提交方式: | 提交方式 | 参数设置 | 功能特点 |注意事项 | | :--- | :--- | :---| :---| | 自动提交 | enable.auto.commit = true,auto.commit.interval.ms(提交间隔) | Kafka Consumer 在后台默默地为你提交位移,开发者无需在代码中显示提交 |Consumer 收到消息就返回正确给 Brocker,如果业务逻辑没有走完中断了,即消息没有消费成功,则相关消息可能丢失。这种场景适用于可靠性要求不高的业务。| | 手动提交 | enable.auto.commit = false | 开发者需要在代码中自己提交位移,Kafka Consumer 压根不管 | 该模式下,业务开发者需要在消息被处理完成后进行手动提交。如果消息处理完成后还没来得及提价位移,系统发生重启,则之前消费到未提交的消息会重新消费到,即消息会投递多次。因此,消费侧需要做幂等保障。| 正常情况下我们很难实现 exactly once 语意的消息,通常是通过手动提交+幂等实现消息的可靠消费。 Kafka高性能探究 Kafka 高性能的核心是保障系统低延迟、高吞吐地处理消息,为此,Kafaka 采用了许多精妙的设计: 异步发送 批量发送 压缩技术 Pagecach机制&顺序追加落盘 零拷贝 稀疏索引 Broker & 数据分区 多 Reactor 多线程网络模型 异步发送 如上文所述,Kafka 提供了异步和同步两种消息发送方式。在异步发送中,整个流程都是异步的。调用异步发送方法后,消息会被写入 Channel,然后立即返回成功。Dispatcher 协程会从 Channel 轮询消息,将其发送到 Broker,同时会有另一个异步协程负责处理 Broker 返回的结果。同步发送本质上也是异步的,但是在处理结果时,同步发送通过 WaitGroup 将异步操作转换为同步。使用异步发送可以最大化提高消息发送的吞吐能力。 批量发送 Kafka 支持批量发送消息,将多个消息打包成一个批次进行发送,从而减少网络传输的开销,提高网络传输的效率和吞吐量。 Kafka 的批量发送消息是通过以下两个参数来控制的: 1.Batch.size:控制批量发送消息的大小,默认值为16KB,可适当增加 Batch.size 参数值提升吞吐。但是,需要注意的是,如果批量发送的大小设置得过大,可能会导致消息发送的延迟增加,因此需要根据实际情况进行调整。 2.linger.ms:控制消息在批量发送前的等待时间,默认值为0。当Linger.ms 大于0时,如果有消息发送,Kafka 会等待指定的时间,如果等待时间到达或者批量大小达到 Batch.size,就会将消息打包成一个批次进行发送。可适当增加 Linger.ms 参数值提升吞吐,比如10~100。 在 Kafka 的生产者客户端中,当发送消息时,如果启用了批量发送,Kafka 会将消息缓存到缓冲区中。当缓冲区中的消息大小达到 Batch.size 或者等待时间到达 Linger.ms 时,Kafka 会将缓冲区中的消息打包成一个批次进行发送。如果在等待时间内没有达到 Batch.size,Kafka 也会将缓冲区中的消息发送出去,从而避免消息积压。 压缩技术 Kafka 支持压缩技术,通过将消息进行压缩后再进行传输,从而减少网络传输的开销(压缩和解压缩的过程会消耗一定的 CPU 资源,因此需要根据实际情况进行调整。),提高网络传输的效率和吞吐量。Kafka 支持多种压缩算法,在 Kafka2.1.0 版本之前,仅支持 GZIP,Snappy 和 LZ4,2.1.0 后还支持 Zstandard 算法(Facebook 开源,能够提供超高压缩比)。这些压缩算法性能对比(两指标都是越高越好)如下: 吞吐量:LZ4>Snappy>zstd和GZIP,压缩比:zstd>LZ4>GZIP>Snappy。 在 Kafka 中,压缩技术是通过以下两个参数来控制的: 1.Compression.type:控制压缩算法的类型,默认值为 None,表示不进行压缩。 2.Compression.level:控制压缩的级别,取值范围为0-9,默认值为-1。当值为-1时,表示使用默认的压缩级别。 在 Kafka 的生产者客户端中,当发送消息时,如果启用了压缩技术,Kafka 会将消息进行压缩后再进行传输。在消费者客户端中,如果消息进行了压缩,Kafka 会在消费消息时将其解压缩。注意:Broker 如果设置了和生产者不通的压缩算法,接收消息后会解压后重新压缩保存。Broker 如果存在消息版本兼容也会触发解压后再压缩。 Pagecache机制&顺序追加落盘 Kafka 为了提升系统吞吐、降低时延,Broker 接收到消息后只是将数据写入 PageCache 后便认为消息已写入成功,而 PageCache 中的数据通过 Linux 的 Flusher 程序进行异步刷盘(避免了同步刷盘的巨大系统开销),将数据顺序追加写到磁盘日志文件中。由于 Pagecache 是在内存中进行缓存,因此读写速度非常快,可以大大提高读写效率。顺序追加写充分利用顺序 I/O 写操作,避免了缓慢的随机 I/O 操作,可有效提升 Kafka 吞吐。 如上图所示,消息被顺序追加到每个分区日志文件的尾部。 零拷贝 Kafka 中存在大量的网络数据持久化到磁盘(Producer 到 Broker)和磁盘文件通过网络发送(Broker 到 Consumer)的过程,这一过程的性能直接影响 Kafka 的整体吞吐量。传统的 IO 操作存在多次数据拷贝和上下文切换,性能比较低。Kafka 利用零拷贝技术提升上述过程性能,其中网络数据持久化磁盘主要用 mmap 技术,网络数据传输环节主要使用 Sendfile 技术。 网络数据持久化磁盘之 mmap 传统模式下,数据从网络传输到文件需要 4 次数据拷贝、4 次上下文切换和两次系统调用。如下图所示 为了减少上下文切换以及数据拷贝带来的性能开销,Broker 在对 Producer 传来的网络数据进行持久化时使用了 mmap 技术。通过这种技术手段,Broker 读取到 Socket Buffer 的网络数据,可以直接在内核空间完成落盘,没有必要将 Socket Buffer 的网络数据读取到应用进程缓冲区。 网络数据传输之 Sendfile 传统方式实现:先读取磁盘、再用 Socket 发送,实际也是进过四次 Copy。如下图所示: 为了减少上下文切换以及数据拷贝带来的性能开销,Kafka 在 Consumer 从 Broker 读数据过程中使用了 Sendfile 技术。具体在这里采用的方案是通过 NIO 的transferTo/transferFrom调用操作系统的 Sendfile 实现零拷贝。总共发生 2 次内核数据拷贝、2 次上下文切换和一次系统调用,消除了 CPU 数据拷贝,如下: 稀疏索引 为了方便对日志进行检索和过期清理,Kafka 日志文件除了有用于存储日志的.log文件,还有一个位移索引文件.index 和一个时间戳索引文件.timeindex 文件,并且三文件的名字完全相同,如下 Kafka 的索引文件是按照稀疏索引的思想进行设计的。稀疏索引的核心是不会为每个记录都保存索引,而是写入一定的记录之后才会增加一个索引值,具体这个间隔有多大则通过 log.index.interval.bytes 参数进行控制,默认大小为 4 KB,意味着 Kafka 至少写入 4KB 消息数据之后,才会在索引文件中增加一个索引项。可见,单条消息大小会影响 Kakfa 索引的插入频率,因此 log.index.interval.bytes 也是 Kafka 调优一个重要参数值。由于索引文件也是按照消息的顺序性进行增加索引项的,因此 Kafka 可以利用二分查找算法来搜索目标索引项,把时间复杂度降到了 O(lgN),大大减少了查找的时间。 位移索引文件.index 位移索引文件的索引项结构如下: 相对位移:保存于索引文件名字上面的起始位移的差值,假设一个索引文件为:00000000000000000100.index,那么起始位移值即 100,当存储位移为 150 的消息索引时,在索引文件中的相对位移则为 150 - 100 = 50,这么做的好处是使用 4 字节保存位移即可,可以节省非常多的磁盘空间。 文件物理位置:消息在 log 文件中保存的位置,也就是说 Kafka 可根据消息位移,通过位移索引文件快速找到消息在 Log 文件中的物理位置,有了该物理位置的值,我们就可以快速地从 log 文件中找到对应的消息了。 下面我用图来表示 Kafka 是如何快速检索消息: 假设 Kafka 需要找出位移为 3550 的消息,那么 Kafka 首先会使用二分查找算法找到小于 3550 的最大索引项:[3528, 2310272],得到索引项之后,Kafka 会根据该索引项的文件物理位置在 Log 文件中从位置 2310272 开始顺序查找,直至找到位移为 3550 的消息记录为止。 时间戳索引文件.timeindex Kafka 在 0.10.0.0 以后的版本当中,消息中增加了时间戳信息,为了满足用户需要根据时间戳查询消息记录,Kafka 增加了时间戳索引文件,时间戳索引文件的索引项结构如下: 时间戳索引文件的检索与位移索引文件类似,如下快速检索消息示意图: Broker & 数据分区 Kafka 集群包含多个 Broker。一个 Topic 下通常有多个 Partition,Partition 分布在不同的 Broker 上,用于存储 Topic 的消息,这使 Kafka 可以在多台机器上处理、存储消息,给 Kafka 提供给了并行的消息处理能力和横向扩容能力。 多 Reactor 多线程网络模型 多 Reactor 多线程网络模型 是一种高效的网络通信模型,可以充分利用多核 CPU 的性能,提高系统的吞吐量和响应速度。Kafka 为了提升系统的吞吐,在 Broker 端处理消息时采用了该模型,示意如下: SocketServer 和 KafkaRequestHandlerPool 是其中最重要的两个组件: SocketServer:实现 Reactor 模式,用于处理多个 Client(包括客户端和其他 Broker 节点)的并发请求,并将处理结果返回给 Client。 KafkaRequestHandlerPool:Reactor 模式中的 Worker 线程池,里面定义了多个工作线程,用于处理实际的 I/O 请求逻辑。 整个服务端处理请求的流程大致分为以下几个步骤: 1.Acceptor 接收客户端发来的请求 2.轮询分发给 Processor 线程处理 3.Processor 将请求封装成 Request 对象,放到 RequestQueue 队列 4.KafkaRequestHandlerPool 分配工作线程,处理 RequestQueue 中的请求 5.KafkaRequestHandler 线程处理完请求后,将响应 Response 返回给 Processor 线程 6.Processor 线程将响应返回给客户端 其他知识探究 负载均衡 生产者负载均衡 Kafka 生产端的负载均衡主要指如何将消息发送到合适的分区。Kafka 生产者生产消息时,根据分区器将消息投递到指定的分区中,所以 Kafka 的负载均衡很大程度上依赖于分区器。Kafka 默认的分区器是 Kafka 提供的 DefaultPartitioner。它的分区策略是根据 Key 值进行分区分配的: 如果 key 不为 null:对 Key 值进行 Hash 计算,从所有分区中根据 Key 的 Hash 值计算出一个分区号;拥有相同 Key 值的消息被写入同一个分区,顺序消息实现的关键; 如果 key 为 null:消息将以轮询的方式,在所有可用分区中分别写入消息。 如果不想使用 Kafka 默认的分区器,用户可以实现 Partitioner 接口,自行实现分区方法。 消费者负载均衡 在 Kafka 中,每个分区(Partition)只能由一个消费者组中的一个消费者消费。当消费者组中有多个消费者时,Kafka 会自动进行负载均衡,将分区均匀地分配给每个消费者。在 Kafka 中,消费者负载均衡算法可以通过设置消费者组的 Partition.assignment.strategy 参数来选择。目前主流的分区分配策略以下几种: Range:在保证均衡的前提下,将连续的分区分配给消费者,对应的实现是 RangeAssignor; Round-robin:在保证均衡的前提下,轮询分配,对应的实现是 RoundRobinAssignor; 0.11.0.0版本引入了一种新的分区分配策略 StickyAssignor,其优势在于能够保证分区均衡的前提下尽量保持原有的分区分配结果,从而避免许多冗余的分区分配操作,减少分区再分配的执行时间。 集群管理 Kafka 借助 ZooKeeper 进行集群管理。Kafka 中很多信息都在ZK中维护,如 Broker 集群信息、Consumer 集群信息、 Topic 相关信息、 Partition 信息等。Kafka 的很多功能也是基于 ZK 实现的,如 Partition 选主、Broker 集群管理、Consumer 负载均衡等,限于篇幅本文将不展开陈述,这里先附一张网上截图大家感受下: 参考文献 1.https://www.cnblogs.com/arvinhuang/p/16437948.html 2.https://segmentfault.com/a/1190000039133960 3.http://matt33.com/2018/11/04/kafka-transaction/ 4.https://blog.51cto.com/u_14020077/5836698 5.https://t1mek1ller.github.io/2020/02/15/kafka-leader-epoch/ 6.https://cwiki.apache.org/confluence/display/KAFKA/KIP-101+-+Alter+Replication+Protocol+to+use+Leader+Epoch+rather+than+High+Watermark+for+Truncation 7.https://xie.infoq.cn/article/c06fea629926e2b6a8073e2f0 8.https://xie.infoq.cn/article/8191412c8da131e78cbfa6600 9.https://mp.weixin.qq.com/s/iEk0loXsKsMO_OCVlUsk2Q 10.https://cloud.tencent.com/developer/article/1657649 11.https://www.cnblogs.com/vivotech/p/16347074.html

优秀的个人博客,低调大师

每日一博 | 京东金融 Android 瘦身探索与实践

作者:京东科技 冯建华 一、背景 随着业务不断迭代更新,App的大小也在快速增加,2019年~2022年期间一度超过了117M,期间我们也做了部分优化如图1红色部分所示,但在做优化的同时面临着新的增量代码,包体积一直持续上升。包体积直接或间接地影响着下载转化率、安装时间、磁盘空间等重要指标,所以投入精力发掘更深层次的安装包体积优化是十分必要的。根据谷歌商店的内部数据,APK体积每减少10M,平均可增加~1.5%的下载转化率,如图2所示:  图1 京东金融Android版本2019-2022体积变化过程 (红色部分是期间做的部分优化,但是很快就反弹回去了)  图2 谷歌商店应用转化率增加幅度 / 10M [1] 因此2022年9月开始我们针对金融APP进行了瘦身专项整治,在不考虑增量的情况,无删减业务代码的情况下实现从117M瘦身至74M,在本次安装包瘦身过程中我们遇到了不少坑,同时也积累了些经验,在此分享给大家。 二、APK分析 接下来我们会简单分析下 Apk内各组成部分,以及 Apk 作为 ZIP,其标准结构是什么样的,为包瘦身的目标设定及任务拆解提供数据支撑。 2.1 APK内容分析  图3 APK 结构 •classes.dex APK 中可能包含一个或多个 classes.dex 文件,应用程序内的 Java/Kotlin 源码最终会以字节码的方式存在于 classes.dex 文件中。 •resources.arscaapt工具在编译资源会将一些资源或者资源索引打包成resources.arsc。 •res/ 源码工程中 res 目录下除了 values 外的资源文件,这些文件路径同时会记录在 resources.arsc 中。 •lib/ nativeLibraries,即源码工程 jni 目录下的 so 文件,二级目录为 NDK支持的 ABI。 •assets/ 与 res/ 资源目录不同,assets/ 下的资源文件不会在 resources.arsc 中生成查询条目,且 assets/ 下的资源目录可完全自定义,在程序中通过 AssetManager 对象来获取。 •META-INF/该文件夹下主要包含 CERT.SF 和 CERT.RSA 签名文件, 以及 MANIFEST.MF 清单文件。 •AndroidManifest.xml 应用清单文件,用于描述应用基本信息,主要包括应用包名、应用id、应用组件、所需权限、设备兼容性等。 2.2 SDK大小分析 通过我们自研的能效提升平台Pandora[7],可以直观地看到SDK的大小,如图4所示:  图4 SDK大小排序(包含版本号)  图5 SDK中包含的SO库列表及大小 根据SDK分析后结合业务,来判断哪些业务适合做插件化,进而直观的降低包体积。 2.3 ZIP结构分析 可以用zipinfo命令输出压缩包中每个文件的详细信息日志,用法:zipinfo -l --t --h test.apk > test.txt 输出的日志文件打开如图6所示,每个文件的压缩信息一行,包括文件名、原始大小、压缩后大小等指标:  图6 APK内文件信息大小 对以上日志信息进行逐行解析,根据解混淆后的文件名路径、文件类型进行归类统计,即可得出Apk的总览信息,包括各类型文件的数量、总大小、单一文件大小等指标,并建立文件大小索引。 三、瘦身实践 整体实施路径如图7所示,主要分为: 1.常规技术方案,通过Gradle插件(代码无侵入、自动化)在编译时期完成APP瘦身; 2.进阶技术方案,将部分业务线差别性的通过插件化或者SO动态下载的方式就行改造,业务改造的越多,收益越高; 3.业务优化方案,针对业务线的数据埋点,生成访问UV进行排名,将UV较低的业务线反馈架构委员会,评估是否可以进行下线或者通过进阶技术方案(2)进行改造,进而减小包体积。  图7 整体实施路径 3-1 常规技术方案 3-1-1 图片处理 经过上述的APP的剖析,得出占用体积第一大的还是图片,因此将APP所有含SDK内所有图片在编译打包过程中通过瘦身任务自动完成图片优化处理,整体优化方案如图8所示:  图8 图片优化方案 1.多 DPI 优化: Android 为了适配各种不同分辨率或者模式的设备,为开发者设计了同一资源多个配置的资源路径,app 通过 resource 获取图片资源时,自动根据设备配置加载适配的资源,但这些配置伴随着的问题就是高分辨率的设备包含低分辨率的无用图片或者低分辨率的设备包含高分辨率的无用图片。 一般情况下,针对国内应用市场,App 为了减少包大小,会选用市场占有率最高的一套 dpi(google 推荐 xxhdpi)兼容所有设备。而针对海外应用市场的 APP,大多会通过 AppBundle 打包上传至 Google Play,能够享受动态分发 dpi 这一功能,不同分辨率手机可以下载不同 dpi 的图片资源,因此我们需要提供多套 dpi 来满足所有设备。在项目中,我们的图片有的只有一套 dpi,有的有多套 dpi,针对上述两种场景,我们分别在打包时合并资源、复制资源,减少了包大小。 2.转换为webp格式: WebP是谷歌提供的一种支持有损压缩和无损压缩的图片文件格式,而且可以提供比JPEG或PNG更好的压缩。在Android 4.0(API level 14)中支持有损的WebP图像,在Android 4.3(API level 18)和更高版本中支持无损和透明的WebP图像 因此:我们采用插件在编译时期仅保留针对图片通过Google提供的shell程序进行格式转换,转换成功删除旧的图片,进而达到APK瘦身的效果 3.png压缩 Pngquant是一个好用的png压缩工具一个,可以进行有损图片压缩的命令行工具,因此在1和2处理结束后,可以使用Pngquant进行二次压缩,达到更优的图片瘦身。 3-1-2 R文件内联优化 DEX里是Java/Kotlin 源码编译后的字节码文件,对DEX的优化其实就是怎么优化字节码文件,DEX中包含大量的资源索引R文件,这里主要讲下如何通过资源ID内联后进行R文件删除,达到APK瘦身的目的: R文件瘦身的可行性分析 日常开发阶段,在主工程中通过R.xx.xx的方式引用资源,经过编译后R类引用对应的常量会被编译进class中。 setContentView(2131427356); 这种变化叫做内联,内联是java的一种机制(如果一个常量被标记为static final,在java编译的过程中会将常量内联到代码中,减少一次变量的内存寻址)。非主工程中,R类资源ID以引用的方式编译进class中,不会产生内联。 setContentView(R.layout.activity_main); 产生这种现象的原因是AGP打包工具导致的。具体细节,大家可以去查阅一下android gradle plugin在R文件上的处理过程。结论:R类id内联后程序可运行,但并非所有的工程都会自动产生内联现象,我们需要通过技术手段在合适的时机将R类id内联到程序中,内联完成后,由于不再依赖R类文件,则可以将R类文件删除,在应用正常运行的同时,达到包瘦身目的,如图9所示,在编译完成后会产生大量的R文件:  图9 项目R文件生成示意 整体方案如图10所示:  图10 R文件优化流程 注意事项:在替换阶段一定要加入二次检查,防止替换完,运行时出现ResourceNotFind异常,如下所示: try { int value = RManager.checkInt(type, name); }catch (Exception e){ String errorMsg = "resource is not found(I),className="+className+",fieldName="+owner+"."+name; throw new ResourceNotFoundException(errorMsg); } try { int[] value = RManager.checkIntArray(type, name); }catch (Exception e){ String errorMsg = "resource is not found(I[]),className="+className+",fieldName="+owner+"."+name; throw new ResourceNotFoundException(errorMsg); } 3-1-3 AndResGuard进行资源混淆 1.资源加载过程分析 开发过程中我们通过aapt生成的R.java中的常量来使用资源,而在编译之后使用常量的地方都会被替换为常量的值,如下所示: final View layout = inflater.inflate(2131165182, container, false); 也就是说我们通过Resource使用一个int数值来查找使用资源。那么Resource是怎么通过int数值找到具体的资源呢?我们解压apk可以看到里面有个resources.arsc文件,这个文件也是由aapt生成,文件中保存着资源id和资源key的映射关系,Resource就是按照这个映射关系找到资源的。 2.resources.arsc: 图11是resources.arsc的里存储的映射关系,resources.arsc可以理解为一个资源映射数据库,根据ID映射其中具体的路径和名称。  图11 resources.arsc解析 通过解压APK后,将资源文件名进行短链处理比如res/layout/hello.xml转换为r/l/a.xml后,然后更改resources.arsc对应的value值,达到整体的瘦身效果。 AndResGuard[5]是微信推出资源优化工具,它的基本思想类似于 ProGuard 中的混淆,可以实现以上方案。 3-1-4 7zip压缩 7zip命令解释: -t:指定压缩类型,支持7z, xz, split, zip, gzip, bzip2, tar, .... -m:指定压缩算法,默认是Deflate 具体流程如下: 第一步:使用7z命令将未签名包解压到指定目录:7za x ${未签名包} -o${7z解压目录} 第二步:首先通过7z命令对解压目录进行全部压缩:7za a -tzip -mx9 ${目标7z文件名} ${7z解压目录} 第三步:获取存储类型文件,通过Android SDK中的aapt命令获取压缩方式为Stored的文件列表:aapt l -v ${未签名包} 第四步:更新存储类型文件,通过7z命令将存储类型文件更新到第二步操作中生成的7zip安装包:7za a -tzip -mx0 ${目标7z文件名} ${存储类型文件目录} 3-1-5 配置CPU架构 根据不同的CPU架构,构建不同的类型的安装包,目前主流设备都是64位机器,因此安卓市场上主要投放的是依据arm64-v8a编译构建的安装包 ndk { abiFilters arm64-v8a } 3-1-6 arsc 压缩 resources.arsc 的压缩体积收益很高,但对其进行压缩会影响启动速度和内存指标。原因是:系统在加载 arsc 文件时,若 arsc 文件未压缩,可使用 mmap 进行内存映射;若 arsc 文件被压缩了,则需要将其解压缩后读取到RAM 缓冲区,会增加内存使用,也会拖慢启动速度。 官方出于同样的考虑,从 targetSdkVersion>=30后不能用这种方式 开始强制要求resources.arsc ,否则会直接安装失败,因此本文不在展开阐述。 3-1-7 国际化语言处理 京东金融App目前仅在国内市场运营,但是接入的大量SDK中加入了几十种语言一样,导致整个体积变大,经过评估可以通过配置 resConfigs 去除无用的语言资源。 defaultConfig { resConfigs "zh","en" } 3-1-8 shrinkResources shrinkResources:编译过程中用来检测并删除无用资源文件,也就是没有引用的资源 minifyEnabled:用来开启删除无用代码,比如没有引用到的代码,所以如果需要知道资源是否被引用就要配合minifyEnabled使用,只有两者都为true时才会起到真正的删除无效代码和无引用资源的目的。 其作用是将未被引用的资源文件替换为一个体积很小的格式文件(仍存在占位体积,同时保留了该资源条目,所以 resources.arsc 体积并不会减少),可通过 res/raw/keep.xml 文件配置 shrinkMode 和白名单。 buildTypes { release { // 不显示Log buildConfigField "boolean", "LOG_DEBUG", "false" //混淆 minifyEnabled true // 移除无用的resource文件 shrinkResources true proguardFiles getDefaultProguardFile('proguard-android.txt'), 'proguard-rules.pro' signingConfig sign.release } } 3-1-9 编码约束 •尽量少用枚举类型,因为枚举在编译成字节码后,会增加大量体积,如图12所示(22行代码编译后字节码是86行) • 图12 枚举类型编译后的字节码对比 •删除不必要的LOG日志输出 3-2 进阶技术方案 SO库动态下载和插件化技术,本质上都属于动态下载的一个范畴,两个方案可以在业务中长期持续使用,在具体使用过程中如何选择,如图13所示:  图13 业务如何选择进阶方案 3-2-1 SO库动态加载 APP中有部分业务不适合做插件化改造,经过拆解发现其中的SO库占比很大,因此可以考虑采用动态下载的方式进行改造,进而实现减小体积。 SO库加载的两种方式 第一种方式我们直接把SO库下载并放到指定目录就可以 第二种方式是通过环境变量设置的目录中进行加载SO库,因此我们需要追加指定的目录到环境变量中,就可以正常加载SO库 System.load("{安全路径}/libxxx.so") System.load("xxx") 1、如何设置APP中SO库的环境变量位置(借鉴Tinker): final Field pathListField = ShareReflectUtil.findField(classLoader, "pathList"); final Object dexPathList = pathListField.get(classLoader); final Field nativeLibraryDirectories = ShareReflectUtil.findField(dexPathList, "nativeLibraryDirectories"); List<File> origLibDirs = (List<File>) nativeLibraryDirectories.get(dexPathList); if (origLibDirs == null) { origLibDirs = new ArrayList<>(2); } final Iterator<File> libDirIt = origLibDirs.iterator(); while (libDirIt.hasNext()) { final File libDir = libDirIt.next(); if (folder.equals(libDir)) { libDirIt.remove(); break; } } origLibDirs.add(0, folder); final Field systemNativeLibraryDirectories = ShareReflectUtil.findField(dexPathList, "systemNativeLibraryDirectories"); List<File> origSystemLibDirs = (List<File>) systemNativeLibraryDirectories.get(dexPathList); if (origSystemLibDirs == null) { origSystemLibDirs = new ArrayList<>(2); } final List<File> newLibDirs = new ArrayList<>(origLibDirs.size() + origSystemLibDirs.size() + 1); newLibDirs.addAll(origLibDirs); newLibDirs.addAll(origSystemLibDirs); final Method makeElements = ShareReflectUtil.findMethod(dexPathList, "makePathElements", List.class); final Object[] elements = (Object[]) makeElements.invoke(dexPathList, newLibDirs); final Field nativeLibraryPathElements = ShareReflectUtil.findField(dexPathList, "nativeLibraryPathElements"); nativeLibraryPathElements.set(dexPathList, elements); 2、如何删除指定SO库和整个加载流程,如图14所示:  图14 SO库删除和加载流程 3-2-2 插件化 什么是插件化: 插件化是将一个Apk根据业务功能拆分成不同的子Apk(也就是不同的插件),每个子Apk可以独立编译打包,最终发布上线的是集成后的Apk。在Apk使用时,每个插件是动态加载的,插件也可以进行热修复和热更新。 •宿主:主App可以用来加载插件也成为Host •插件:插件App,被宿主加载的App,可以跟普通的App一样的Apk文件 什么形式的业务适合插件化改造: •业务相对独立,与宿主App解耦彻底 •改造成本低,收益相对较高 •占用体积较大 经过一些列评估,视频营业符合以上几点,改造后的效果如图15所示:  图15 视频营业厅插件化改造后效果 3-3 业务优化方案 随着业务越来越多,一些陈旧的业务UV越来越低,因此制定了一套业务下线优化流程,如图16所示:  图16 业务优化方案流程 四、管控 瘦身方案的实施很重要,后续的管控不反弹更重要,我们一边做瘦身治理,另一边探索常态化的管控机制,最终沉淀了一套管控规范和管控机制。管控的目的不是限制业务迭代或者新增代码,而是怎么做到在有限的代码中实现其功能,提升工程师日常编码中的瘦身意识。 4.1 SDK接入规范 为防止SDK无序扩张,制定了SDK准入规范,在保证功能的前提下严控SDK体积大小,最大程度控制APP体积反弹。 4.2 管控流程  图17 管控流程 根据增加内容、删除内容、增大内容、减小内容、重复文件、代码治理等资源文件的变动情况结合治理管控规范等进行治理,打包构建完成会跟历史版本就行差量对比,获取变化的内容来评估是否具有优化空间,并给出优化目标,待优化后重新构建打包集成。 五、成果与后续规划 5.1 成果 通过以上措施,京东金融Android版本经过两个季度5个版本的迭代,从117M到现在的74M(图18),整体一直维持在可控的范围内。同时在接下来的版本迭代中,我们会将APK瘦身常态化,始终维持包体积在可控的范围内。  图18 金融APP瘦身成果 5.2 后续规划 持续技术手段优化: 业务的不断堆积迭代,总会产生一些无用的资源,所以安装包瘦身要定期清理这些无用文件和代码; 做好各个版本的监控,对比版本之间的差异,发现可以在不影响业务情况下,使用技术手段优化。 线上管控平台搭建: 前期采用线下的管控治理,实施起来有点耗时,后续我们会完善线上管控平台的搭建,与整个App发布构建平台进行融合,形成流水线的机制,做好管控。 小结:安装包瘦身的探索还有很长的路走,本文也只是列举了一些常用的瘦身方案,对于庞大的项目除了优化外,还有做好项目之间的治理,持续对APP进行体积优化,提升用户体验。 【参考资料】 [1] 包大小与安装转化率https://medium.com/googleplaydev/shrinking-apks-growing-installs-5d3fcba23ce2 [2] ProGuardhttps://www.guardsquare.com/proguard [3] R8https://r8.googlesource.com/r8 [4] ProGuard与R8对比https://www.guardsquare.com/blog/proguard-and-r8 [5] AndResGuardhttps://github.com/shwenzhang/AndResGuard [6] AGPhttps://developer.android.com/studio/releases/gradle-plugin [7] Pandora:基于去中心化技术的研发、测试阶段能效提升工具

优秀的个人博客,低调大师

每日一博 | 透过现象看 Java AIO 的本质

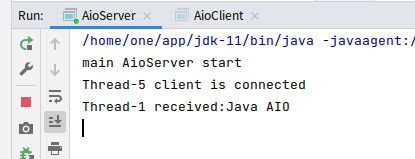
1.前言 关于Java BIO、NIO、AIO的区别和原理,这样的文章非常的多的,但主要还是在BIO和NIO这两者之间讨论,而关于AIO这样的文章就少之又少了,很多只是介绍了一下概念和代码示例。 在了解AIO时,有注意到以下几个现象: 1、 2011年Java 7发布,里面增加了AIO称之为异步IO的编程模型,但已经过去了近12年,平时使用的开发框架中间件,还是以NIO为主,例如网络框架Netty、Mina,Web容器Tomcat、Undertow。 2、 Java AIO又称为NIO 2.0,难道它也是基于NIO来实现的? 3、 Netty舍去了AIO的支持。https://github.com/netty/netty/issues/2515 4、 AIO看起来只是解决了有无,发布了个寂寞。 这几个现象不免会令很多人心存疑惑,所以决定写这篇文章时,不想简单的把AIO的概念再复述一遍,而是要透过现象, 如何分析、思考和理解Java AIO的本质。 2.什么是异步 2.1 我们所了解的异步 AIO的A是Asynchronous异步的意思,在了解AIO的原理之前,我们先理清一下“异步”到底是怎样的一个概念。 说起异步编程,在平时的开发还是比较常见,例如以下的代码示例: @Async public void create() { //TODO } ​ public void build() { executor.execute(() -> build()); } 不管是用@Async注解,还是往线程池里提交任务,他们最终都是同一个结果,就是把要执行的任务,交给另外一个线程来执行。 这个时候,可以大致的认为,所谓的“异步”,就是多线程,执行任务。 2.2 Java BIO和NIO到底是同步还是异步? Java BIO和NIO到底是同步还是异步,我们先按照异步这个思路,做异步编程。 2.2.1 BIO示例 byte [] data = new byte[1024]; InputStream in = socket.getInputStream(); in.read(data); // 接收到数据,异步处理 executor.execute(() -> handle(data)); ​ public void handle(byte [] data) { // TODO } BIO在read()时,虽然线程阻塞了,但在收到数据时,可以异步启动一个线程去处理。 2.2.2 NIO示例 selector.select(); Set<SelectionKey> keys = selector.selectedKeys(); Iterator<SelectionKey> iterator = keys.iterator(); while (iterator.hasNext()) { SelectionKey key = iterator.next(); if (key.isReadable()) { SocketChannel channel = (SocketChannel) key.channel(); ByteBuffer byteBuffer = (ByteBuffer) key.attachment(); executor.execute(() -> { try { channel.read(byteBuffer); handle(byteBuffer); } catch (Exception e) { ​ } }); ​ } } ​ public static void handle(ByteBuffer buffer) { // TODO } 同理,NIO虽然read()是非阻塞的,通过select()可以阻塞等待数据,在有数据可读的时候,异步启动一个线程,去读取数据和处理数据。 2.2.3 产生理解的偏差 此时我们信誓旦旦的说,Java的BIO和NIO是异步还是同步,取决你的心情,你高兴给它个多线程,它就是异步的。 但果真如此么,在翻阅了大量博客文章之后,基本一致的阐明了,BIO和NIO是同步的。 那问题点出在哪呢,是什么造成了我们理解上的偏差呢? 那就是参考系的问题,以前学物理时,公交车上的乘客是运动还是静止,需要有参考系前提,如果以地面为参考,他是运动的,以公交车为参考,他是静止的。 Java IO也是一样,需要有个参考系,才能定义它是同步异步,既然我们讨论的是IO是哪一种模式,那就是要针对IO读写操作这件事来理解,而其他的启动另外一个线程去处理数据,已经是脱离IO读写的范围了,不应该把他们扯进来。 2.2.4 尝试定义异步 所以以IO读写操作这事件作为参照,我们先尝试的这样定义,就是发起IO读写的线程(调用read和write的线程),和实际操作IO读写的线程,如果是同一个线程,就称之为同步,否则是异步。 显然BIO只能是同步,调用in.read()当前线程阻塞,有数据返回的时候,接收到数据的还是原来的线程。 而NIO也称之为同步,原因也是如此,调用channel.read()时,线程虽然不会阻塞,但读到数据的还是当前线程。 按照这个思路,AIO应该是发起IO读写的线程,和实际收到数据的线程,可能不是同一个线程 是不是这样呢,现在开始上Java AIO的代码。 2.3 Java AIO的程序示例 2.3.1 AIO服务端程序 public class AioServer { ​ public static void main(String[] args) throws IOException { System.out.println(Thread.currentThread().getName() + " AioServer start"); AsynchronousServerSocketChannel serverChannel = AsynchronousServerSocketChannel.open() .bind(new InetSocketAddress("127.0.0.1", 8080)); serverChannel.accept(null, new CompletionHandler<AsynchronousSocketChannel, Void>() { ​ @Override public void completed(AsynchronousSocketChannel clientChannel, Void attachment) { System.out.println(Thread.currentThread().getName() + " client is connected"); ByteBuffer buffer = ByteBuffer.allocate(1024); clientChannel.read(buffer, buffer, new ClientHandler()); } ​ @Override public void failed(Throwable exc, Void attachment) { System.out.println("accept fail"); } }); System.in.read(); } } ​ public class ClientHandler implements CompletionHandler<Integer, ByteBuffer> { @Override public void completed(Integer result, ByteBuffer buffer) { buffer.flip(); byte [] data = new byte[buffer.remaining()]; buffer.get(data); System.out.println(Thread.currentThread().getName() + " received:" + new String(data, StandardCharsets.UTF_8)); } ​ @Override public void failed(Throwable exc, ByteBuffer buffer) { ​ } } 2.3.2 AIO客户端程序 public class AioClient { ​ public static void main(String[] args) throws Exception { AsynchronousSocketChannel channel = AsynchronousSocketChannel.open(); channel.connect(new InetSocketAddress("127.0.0.1", 8080)); ByteBuffer buffer = ByteBuffer.allocate(1024); buffer.put("Java AIO".getBytes(StandardCharsets.UTF_8)); buffer.flip(); Thread.sleep(1000L); channel.write(buffer); } } 2.3.3 异步的定义猜想结论 分别运行服务端和客户端程序 在服务端运行结果里, main线程发起serverChannel.accept的调用,添加了一个CompletionHandler监听回调,当有客户端连接过来时,Thread-5线程执行了accep的completed回调方法。 紧接着Thread-5又发起了clientChannel.read调用,也添加了个CompletionHandler监听回调,当收到数据时,是Thread-1的执行了read的completed回调方法。 这个结论和上面异步猜想一致,发起IO操作(例如accept、read、write)调用的线程,和最终完成这个操作的线程不是同一个,我们把这种IO模式称之AIO, 当然了,这样定义AIO只是为了方便我们理解,实际中对异步IO的定义可能更抽象一点。 3.AIO示例引发思考的问题 1、 执行completed()方法的这个线程是谁创建的,什么时候创建的? 2、 AIO注册事件监听和执行回调是如何实现的? 3、 监听回调的本质是什么? 3.1 问题1:执行completed()方法的这个线程是谁创建的,什么时候创建的 一般,这样的问题,需要从程序的入口的开始了解,但跟线程相关,其实是可以从线程栈的运行情况来定位线程是怎么运行。 只运行AIO服务端程序,客户端不运行,打印一下线程栈(备注:程序在Linux平台上运行,其他平台略有差异) 分析线程栈,发现,程序启动了那么几个线程 1、 线程Thread-0阻塞在EPoll.wait()方法上 2、 线程Thread-1、Thread-2。。。Thread-n(n和CPU核心数量一致)从阻塞队列里take()任务,阻塞等待有任务返回。 此时可以暂定下一个结论: AIO服务端程序启动之后,就开始创建了这些线程,且线程都处于阻塞等待状态。 另外,发现这些线程的运行都跟Epoll有关系,提到Epoll,我们印象中,Java NIO在Linux平台底层就是用Epoll来实现的,难道Java AIO也是用Epoll来实现么?为了证实这个结论,我们从下一个问题来展开讨论 3.2 问题2:AIO注册事件监听和执行回调是如何实现的 带着这个问题,去阅读分析源码时,发现源码特别的长,而源码解析是一项枯燥乏味的过程,很容易把阅读者给逼走劝退掉。 对于长流程和逻辑复杂的代码的理解,我们可以抓住它几个脉络,找出哪几个核心流程。 以注册监听read为例clientChannel.read(…),它主要的核心流程是: 1、注册事件 -> 2、监听事件 -> 3、处理事件 3.2.1 1、注册事件 注册事件调用EPoll.ctl(…)函数,这个函数在最后的参数用于指定是一次性的,还是永久性。上面代码events | EPOLLONSHOT字面意思看来,是一次性的。 3.2.2 2、监听事件 3.2.3 3、处理事件 3.2.4 核心流程总结 在分析完上面的代码流程后会发现,每一次IO读写都要经历的这三个事件是一次性的,也就是在处理事件完,本次流程就结束了,如果想继续下一次的IO读写,就得从头开始再来一遍。这样就会存在所谓的死亡回调(回调方法里再添加下一个回调方法),这对于编程的复杂度大大提高了。 3.3 问题3: 监听回调的本质是什么? 先说一下结论,所谓监听回调的本质,就是用户态线程,调用内核态的函数(准确的说是API,例如read,write,epollWait),该函数还没有返回时,用户线程被阻塞了。当函数返回时,会唤醒阻塞的线程,执行所谓回调函数。 对于这个结论的理解,要先引入几个概念 3.3.1 系统调用与函数调用 函数调用: 找到某个函数,并执行函数里的相关命令 系统调用: 操作系统对用户应用程序提供了编程接口,所谓API。 系统调用执行过程: 1.传递系统调用参数 2.执行陷入指令,用用户态切换到核心态,这是因为系统调用一般都需要再核心态下执行 3.执行系统调用程序 4.返回用户态 3.3.2 用户态和内核态之间的通信 用户态->内核态,通过系统调用方式即可。 内核态->用户态,内核态根本不知道用户态程序有什么函数,参数是啥,地址在哪里。所以内核是不可能去调用用户态的函数,只能通过发送信号,比如kill 命令关闭程序就是通过发信号让用户程序优雅退出的。 既然内核态是不可能主动去调用用户态的函数,为什么还会有回调呢,只能说这个所谓回调其实就是用户态的自导自演。它既做了监听,又做了执行回调函数。 3.3.3 用实际例子验证结论 为了验证这个结论是否有说服力,举个例子,平时开发写代码用的IntelliJ IDEA,它是如何监听鼠标、键盘事件和处理事件的。 按照惯例,先打印一下线程栈,会发现鼠标、键盘等事件的监听是由"AWT-XAWT"线程负责的,处理事件则是"AWT-EventQueue"线程负责。 定位到具体的代码上,可以看到"AWT-XAWT"正在做while循环,调用waitForEvents函数等待事件返回。如果没有事件,线程就一直阻塞在那边。 4.Java AIO的本质是什么? 1、由于内核态无法直接调用用户态函数,Java AIO的本质,就是只在用户态实现异步。并没有达到理想意义上的异步。 理想中的异步 何谓理想意义上的异步?这里举个网购的例子 两个角色,消费者A,快递员B A在网上购物时,填好家庭地址付款提交订单,这个相当于注册监听事件 商家发货,B把东西送到A家门口,这个相当于回调。 A在网上下完单,后续的发货流程就不用他来操心了,可以继续做其他事。B送货也不关心A在不在家,反正就把货扔到家门口就行了,两个人互不依赖,互不相干扰。 假设A购物是用户态来做,B送快递是内核态来做,这种程序运行方式过于理想了,实际中实现不了。 现实中的异步 A住的是高档小区,不能随意进去,快递只能送到小区门口。 A买了一件比较重的商品,比如一台电视,因为A要上班不在家里,所以找了一个好友C帮忙把电视搬到他家。 A出门上班前,跟门口的保安D打声招呼,说今天有一台电视送过来,送到小区门口时,请电话联系C,让他过来拿。 此时,A下单并跟D打招呼,相当于注册事件。在AIO中就是EPoll.ctl(…)注册事件。 保安在门口蹲着相当于监听事件,在AIO中就是Thread-0线程,做EPoll.wait(…) 快递员把电视送到门口,相当于有IO事件到达。 保安通知C电视到了,C过来搬电视,相当于处理事件。 在AIO中就是Thread-0往任务队列提交任务, Thread-1 ~n去取数据,并执行回调方法。 整个过程中,保安D必须一直蹲着,寸步不能离开,否则电视送到门口,就被人偷了。 好友C也必须在A家待着,受人委托,东西到了,人却不在现场,这有点失信于人。 所以实际的异步和理想中的异步,在互不依赖,互不干扰,这两点相违背了。保安的作用最大,这是他人生的高光时刻。 异步过程中的注册事件、监听事件、处理事件,还有开启多线程,这些过程的发起者全是用户态一手操办,所以说Java AIO只在用户态实现了异步,这个和BIO、NIO先阻塞,阻塞唤醒后开启异步线程处理的本质一致。 2、Java AIO跟NIO一样,在各个平台的底层实现方式也不同,在Linux是用EPoll,Windows是IOCP,Mac OS是KQueue。原理是大同小异,都是需要一个用户线程阻塞等待IO事件,一个线程池从队列里处理事件。 3、 Netty之所以移除掉AIO,很大的原因是在性能上AIO并没有比NIO高。Linux虽然也有一套原生的AIO实现(类似Windows上的IOCP),但Java AIO在Linux并没有采用,而是用EPoll来实现。 4、 Java AIO不支持UDP 5、 AIO编程方式略显复杂,比如“死亡回调”

优秀的个人博客,低调大师

每日一博 | 订单流量录制与回放探索实践

1.背景介绍 1.1 得物pandora介绍 什么是流量录制回放?流量录制回放是应用端通过挂载注入录制器探针自动注册到服务端形成录制流量回流,将所有外部调用依赖的响应内容(如数据库、分布式缓存、外部服务响应等)进行完整记录。由平台向回放器分发流量回放指令。其核心价值是通过直接录制生产的真实数据,将生产真实数据转化成可复用、可执行的流量,快速地在测试环境中进行回放比对接口返回值和中间链路的验证。 得物版本的流量录制回放平台pandora在官方开源版本上进行了很大的拓展,支持了很多官方版本不支持的子调用和入口调用。此外,平台还对得物的中间件进行了诸多适配工作,避免了大量的回放失败噪音。 1.2 市场工具对比 目前市场上已知的流量录制回放平台大部分都是在Jvm-Sandbox-Repeater基础上进行二次开发和改造,并且多数都是只支持Java语言。核心原理也都是通过录制线上真实流量然后在测试环境进行回放,验证代码逻辑正确性。 2.实践落地 2.1 协作模式 在具体的实施层面,目前采用的是业务测试,平台研发,业务研发三方协同的模式。任务分拆如下图所示。 2.2 阶段应用 流量回放在各阶段的理想实施应用: 提测阶段卡点:聚焦核心场景,低成本验证每次提测对于核心场景的影响; 测试回归阶段卡点:全量场景,重点追求覆盖场景全面性,验证新功能对历史功能的影响; 预发环境回归:目前预发跟生产同库,未来会推动落地基于预发&生产环境的流量回放,尽可能拉近录制时环境和回放时环境的仿真差异,从而降低回放阶段的噪音影响; 在得物的整体QA体系中,流量回放短期聚焦在回归兜底保障上。 2.3 实践落地 流量回放的开展自发起后,在本域由探索尝试阶段逐渐过渡到应用场景拓展阶段。 订单流量回放模式 在经过一段时间的探索,摸索出了一套适用于本域迭代的模式。 Part1、尝试接入 团队开始开展流量回放的专项之后,通过调研,选取了40%的服务优先接入。 阶段目标 完成30%P0应用top10 接口100%场景覆盖,形成迭代落地质量卡点,完成适用性和提效分析; 增加订单域流量回放人员投入,落地质量卡点,覆盖5%回归场景; 实施方案 调研应用的特性,尝试接入流量录制回放; 梳理服务的P0接口及用例,配置对应的接口及用例标签; 用例自动沉淀到用例集后,在回归阶段尝试进行流量回放。 收益成果 完成30%应用形成落地质量卡点,落地15%用例回归场景,验证方案可行性和易用性,摸索研发测试协同机制。 Part2、探索升级 上一阶段花费大量的时间梳理接口配置标签,用例沉淀速度缓慢,并且收益与投入不成正比,因此调整了策略,应用智能化分析进行提效,快速沉淀用例,扩大用例量及覆盖的接口量。45%业务应用接入并均实现强卡点落地,配合平台侧优化,解决大部分组件适配和使用问题,迭代应用流程以及应用指标分析机制基本跑顺。 阶段目标 应用:接入的应用交由对应的服务负责人,负责对应服务的接口维护运营及沉淀、排错分析; 用例:尝试探索新的用例沉淀方式,进一步扩大用例量,增加覆盖的接口量; 排错:根据服务的用例量以及接入的时间,提升测试排错能力,阶段2结束测开排错达到五五开; 2.收益成果 从开始试点到应用卡点,沉淀的用例量也在应用热点流量方案之后开始了升级之路。接入的应用数也超过原定目标达到50%且均实现强卡点落地。 应用智能化分析策略提效效果明显,沉淀的用例数成指数型增长,接入应用的P0接口覆盖率达到100%。 测试排错能力提升,每迭代流量回放发现的bug数也在增加,新方案的可实施性和可推广性基本符合预期。 Part3、专项提速 在沉淀的用例case大量的增加、用例沉淀速度提效明显的前提下,流量回放在迭代的应用中发现更多的缺陷,规划扩大接入的应用以及覆盖的接口范围。 阶段目标 应用接入:新增40%应用接入,接入应用占比合计90%; 排错:提升测试的排错能力,新版本排错由平台研发转交业务研发,测试开发排错占比五五开; 用例量:加速沉淀用例量,扩大覆盖的范围,至少65%的应用完成全量用例沉淀; 卡点:接入应用达到100%卡点,提升排错速度,部分应用由生产卡点转为预发卡点; 全域接入应用接口维度覆盖率98%以上,接口配置完善度98%以上,全量用例路径覆盖率60%以上。 收益成果 随着应用的接入,沉淀的用例量也在扩大,发现的问题数也在增多。同时也增加覆盖率的指标来衡量流量回放用例覆盖的代码占总代码行的比值。随着对覆盖率的关注,平台采样策略也进行了一个调整,删除所有历史沉淀用例,仅沉淀新策略实施之后录制的流量。 流量回放接入90%应用,扩大应用接入和case沉淀,超预期达成目标,沉淀应用Case量是原计划的3倍,此阶段累计发现缺陷数占全域流量回放发现的bug数的45%,充分验证了落地策略的有效性; 从阶段3本域发现的缺陷统计来看,其中回归类BUG占比38%,发现线上自有/隐藏问题占比8%,迭代过程中代码问题(日志报错)和代码规范类问题占比46%,性能问题占比8%; 接口配置完善度100%;接口维度覆盖率96.49%;全量用例路径覆盖率79.32%,全量代码覆盖率平均39.8%; 3.总结分析 3.1 问题归类分析 3.1.1 累计发现的缺陷分类: 3.1.2 累计发现的缺陷来源分类: 3.1.3 典型案例: 回放时系统异常,排查之后定位为NPE类问题,如: response返回的业务字段diff对比不一致,如: 通过对缺陷以及缺陷来源的归类不难看出: 流量回放发现拦截的问题近一半都是会引起生产业务报错的,其中包括像金额不对涉及资损的问题以及字段传值不对、枚举类型取错等缺陷;作为生产发布前的最后阶段的防线之一,充分展现了流量录制回放作为对测试回归的兜底能力的补充手段的重要性。 45%左右的问题是手工测试过程中难以发现隐藏比较深的代码层面问题,例如NPE报错、入参出参字段未序列化等,这些问题如果仅仅通过前端测试或接口测试不看日志不一一对比所有字段势必会将问题带到生产环境,最终影响生产环境的稳定性。 6%左右的性能问题,例如存在重复子调用,影响接口RT,如果不在生产发布前发现解决,势必给用户体验带来一定的挑战。 从缺陷的来源上看,发现的缺陷来源还是集中在项目迭代需求和技术优化上,充分验证了流量回放整体提速后的有效性以及对测试覆盖兜底能力的补充。 通过对失败用例的排错分析经验的累积和分享培训,参与专项的测试团队的整体技术水平通过流量回放专项提速在技术氛围上有明显提升,培养了多位同学对自身负责模块的实现的代码走读能力,以及深挖缺陷的code diff能力。 3.2 适用性分析 适用场景 适用于返回数据量大、业务流量也很大,以及读取业务占比大的场景,如ToC产品。 不适用场景 挂载沙箱后开启录制会导致RT瞬间飙高,影响生产服务的稳定性。 异步场景目前流量回放平台不支持。 需要验证数据库的落地,节点的流转的链路测试,需要自动化。 先投入能迅速形成能卡点有收益的应用(迭代代码变更相对少,分层结构比较好,异步少,写操作少),把看得到的使用效果做出来。 流量回放能否完全替代手工回归以及自动化? 目前来看,答案是否定的。首先,从沙箱挂载到接口配置再到流量录制这一套流程下来,也需要较长的时间才能达到较高的用例覆盖,对于一些边界极端场景还是需要手工设计;其次,流量录制回放是后置的回归兜底,更侧重于对历史逻辑的回归验证。 1、接口覆盖不全。迭代需求新接口,未配置关联录制,不在流量回放的录制范围。 2、全量代码覆盖率不高。接口已经配置覆盖了,但是由于采样比例小场景极端等原因,接口的分支场景并没有录制到未被覆盖。 3、排错能力的高低影响。接口覆盖了,排错的时候由于新加了子调用,导致失败的用例在排错的时候容易被简单定义为代码变更。 4、平台问题。diff比对异常,显示回放成功,异步线程的回放是一个待攻克的难点。 3.3 面临的挑战 3.3.1 排错的效率 录制流量后对流量进行回放,发现回放结果比对失败的很多。经过对失败原因的排查与分析,有些是代码bug导致的失败,但更多的失败不一定是代码bug,常见噪音主要包含: 代码修改,新增或删除了子调用,导致mock失败 平台不支持的子调用,导致失败 时间戳相关的子调用,diff不一致 子调用中使用随机参数相关,导致mock匹配不上 repeater代码自身缺陷 业务自增数据差异 配置中心数据不一致 返回无序元素集合,造成结果对比误差 失败原因很多,真正有效的失败数很少。如此一来,每次回放失败的排查成本就非常高。给业务的推进造成了巨大的阻碍。 原版repeater上报的信息不够丰富,很多情况需要看日志才能排查。目前也没有公开成熟的参考的方案。平台也进行了一些初步的探索,对回放失败的场景自动进行归类,上报更丰富的数据信息提供排查指引,帮助排查人员聚焦定位问题。同时平台也针对一些噪音进行自动识别并在回放时自动过滤降噪。 3.3.2 异步线程录制回放问题 入口主线程不等子线程执行完就返回的异步场景,当前的策略是用户可配置对异步子线程的多调用忽略,只关注主线程的执行情况。这一方式虽然可以提升这种异步线程场景的回放成功率,但是损失了异步子线程业务逻辑的回归能力。 上面的案例就是由于应用开启了排查提效优先的开关,忽略了异步子线程的调用,导致diff比对异常,显示回放成功。该接口在生产发布时报了异常,String类型长度超长被try catch,埋点丢失。 4.展望&未来规划 流量录制回放作为测试领域的一个新兴事物,在诞生初期就吸引了广大测试同仁的关注,市场上也有些公司也对此进行了一些实践。我们对流量录制回放的实践还处于起步的阶段,一些问题的解法也在探索中 。 预发只读接口非mock回放 在得物预发环境是联通生产环境的数据库和下游应用,因此对于预发进行不mock的回放,特别是对只读接口进行不mock的回放能够在上线前的最后阶段进行一次兜底的回归校验。最难解决的问题是,当前是只读的接口难以保证后续的变更不会引入写操作。在当前阶段开放这一功能会引入额外的资损类风险敞口。 对此问题,每次回放前都进行人工校验可能可以解决,但是又引入了极大的效率问题。如何高效地保证在预发/灰度环境进行不mock流量回放不会产生资损风险,是一个值得探索的问题,需要研发跟测试的共同努力。 方案1-单回放(准实时回放) 方案1落地遇到的问题: 1.配置中心的数据不一致,噪音比较大 2.时效问题,有10S的时差,一些业务对时效要求比较高 方案2-双回放(实时回放) 方案2不仅避免了上面方案1的问题,另外后续规划还可以根据覆盖率沉淀有效用例集,手工添加异常用例。 通过一段时间的运行,目前已经看到了一些流量录制回放在业务迭代中产生了价值,发现了一些隐藏bug。接入流量回放明显的变化是能够将测试从繁重的回归测试、用例梳理维护等重复性高的劳动中解放出来,将重心放在测试计划的设定、思考测试策略以及自我提升的实践上,比如做些辅助排错提效的coding能力提升和加强对业务的熟悉的宽度和深度上,从而最大程度的保障业务系统的质量和稳定性。 未来期望能在不断的实践中把得物的流量录制回放体系建设得越来越完善,解放更多的生产力,产出更多的价值。 文/苏三

优秀的个人博客,低调大师

每日一博 | 解密游戏推荐系统的建设之路

作者:vivo 互联网服务器团队- Ke Jiachen、Wei Ling 本文从零开始介绍了游戏推荐项目的发展历程,阐述了大型项目建设中遇到的业务与架构问题以及开发工程师们的解决方案,描绘了游戏推荐项目的特点以及业务发展方向,有着较好的参考与借鉴意义。 一、游戏推荐的背景与意义 从信息获取的角度来看,搜索和推荐是用户获取信息的两种主要手段,也是有效帮助产品变现的两种方式,搜索是一个非常主动的行为,并且用户的需求十分明确,在搜索引擎提供的结果里,用户也能通过浏览和点击来明确的判断是否满足了用户需求。 然而,推荐系统接受信息是被动的,需求也都是模糊而不明确的。 推荐系统的作用就是建立更加有效率的连接,更有效率地连接用户与内容和服务,节约大量的时间和成本。以此背景,游戏推荐系统由此诞生。 游戏推荐系统从设计之初就作为游戏分发的平台,向公司内所有主要流量入口(游戏中心、应用商店、浏览器、jovi等)分发游戏,系统通过各种推荐算法及推荐策略,为用户推荐下载付费意愿较高且兼顾商业价值的游戏,从而为公司带来收入。发展至今天,该系统还具备类游戏内容与素材的推荐功能。 二、游戏推荐的初期模型 游戏推荐的目的是推出用户想要且兼顾商业价值的游戏,以此来提高业务的收入指标。此处的商业价值是由运营侧通过策略规则去把控的,而用户意向游戏则是通过算法排序得到的,算法排序所需要的特征数据,以及推荐效果的反馈数据则由埋点信息上报以供计算分析。 因此我们的模型可以分成四大块: 运营推荐规则配置 算法模型训练 推荐策略生效 数据埋点上报 模块间的交互如下:在策略生效前,运营会先在配置中心生成对应的配置规则,这些规则会以缓存的形式存储以供推荐高并接口调用。当用户访问app应用某些特定页面时,其后台会带着对应的场景信息来请求游戏推荐后台,推荐后台根据场景信息映射相关配置(召回,标签,过期,算法等..........)调用算法服务并进行资源排序,最终将推荐的结果反馈给app应用。 app应用在展示推荐页面的同时,也将用户相应的行为数据以及推荐数据的相关埋点进行上报。 三、业务增长与架构演进 随着接入系统带来的正向收益的提升,越来越多的业务选择接入游戏推荐系统,这使得我们支持的功能日益丰富。 目前游戏推荐覆盖的场景有分类、专题、榜单、首页、搜索等;包含的策略类型有干预、打散、资源配比、保量;支持的推荐类型更是丰富:联运游戏、小游戏、内容素材、推荐理由。 这些丰富的使用场景使得业务的复杂度成本增长,令我们在性能,扩展性,可用性上面临着新的挑战,也推动着我们架构变革。 3.1 熵增环境下的通用组合策略 在0 到 1 的过程中,游戏推荐聚焦于提高分发量,这时候考虑得更多的是怎么把游戏推出去,在代码实现上使用分层架构来划分执行的业务。 但是在1 到 2 的过程中, 我们游戏推荐不仅仅推荐游戏,也推荐内容和素材;同时在策略调用上也更加灵活,不同场景其调用的策略是不同的,执行顺序也是不同的;更重要的是加入了很多用户个性化业务与动态规则,这些都使得现有业务代码急剧膨胀,扩展起来捉襟见肘,无从下手。因此我们急需一个高复用,易扩展,低代码的策略框架去解决这些问题。 如图所示,通用组合策略负责流转的角色有两个acceptor和executor,通讯媒介是推荐上下文context。负责执行逻辑的角色有三个matcher,listener和process,它们都有多个不同逻辑的实现类。当请求游戏推荐系统时,acceptor会先从配置中动态查询策略模板进行匹配,接着listener组件会执行相应的预处理逻辑。处理后acceptor通过上下文context将任务流转给executor处理器。executor再根据配置,将process根据前置条件进行筛选并排列组合,最后埋点返回。 经过这套通用的策略,我们在实现一般业务的时候,只要扩展具体matcher和process,并在配置中心将场景和处理优先级绑定起来,就能完成大部分的场景开发,这样研发者可以更聚焦于某个逻辑流程的开发,而不用疲于梳理代码,并进行扩展设计。 3.2 多级缓存与近实时策略 游戏推荐系统服务于手机游戏用户,处于整个系统链路的下游,峰值流量在3W TPS左右 ,是个读远多于写的系统。“读”流量来自于用户在各种推荐场景,列表、搜索、下载钱下载后、榜单等,写数据主要来源于运营相关策略的变更,所以我们面临的一个重大挑战就是如何在保证可用性的前提下应对高频的读请求。 为了保证系统的读性能,我们采用了redis + 本地缓存的设计。配置更新后先写mysql,写成功后再写redis。本地缓存定时失效,使用懒加载的方式从redis中读取相关数据。这种设计能保证最终一致性,软状态时服务集群数据存在短暂不一致的情况,早期对业务影响不大,可以认为是一个逐步放量的过程。 早期原先部署节点较少,整个系统达到最终一致性的时间较短,但随着节点增加到数百台,这个时间就变得不是那么和谐了。 同时随着业务复杂度的增加,常常是多个配置策略决定这一个推荐结果,此时本地缓存的状态极大影响了测试和点检的便利,如果配置更改不能做到立马更新本地缓存,那就要等待漫长的一段时间才能开始验证逻辑。因此,我们对缓存结构做出了如下的调整: 与先前不同的是,我们加入消息队列并通过配置版本号的比对来实现策略的实时更新同步,取得了很好的效果。 3.3 高并服务的垃圾回收处理 任何一个java服务都逃离不了FGC的魔咒,高并服务更是如此。很多服务每天两位数的FGC更是家常便饭,显然这对业务的稳定性和服务性能影响是巨大的。游戏推荐这边通过不断实践总结了一套较为通用的方法很好地解决了这个问题: 可以看到起初jvm配置较为常规:1G的年轻代,2G的老年代以及一些其他常见的多线程回收的配置,其结果就是每天10次的FGC,YGC单次耗时在100ms,FGC耗时在350 - 400ms。我们知道线上接口容忍的范围一般是200ms以内,不超过300ms,这样显然是不达标的。 通过分析,我们发现高并服务的高频FGC来源于这几个方面: 大量的本地缓存(堆内)占据了老年代的空间,大大增加了老年代叠满的频率。 高并请求导致了对象的急速生成,年轻代空间不足以容纳这剧增的对象,导致其未达到存活阈值(15次)就晋升至老年代。 引入的监控组件为了性能,常常延迟 1 - 2 min再将数据上报服务端,导致这部分数据也无法在年轻代被回收。 当然这还不是问题的全部,FGC还有个致命问题就是stop the world,这会导致业务长时间无法响应,造成经济损失。反过来,就算FGC频繁,stop the world 只有1ms,也是不会对业务造成影响的,因此不能单单以FGC的频率来判断jvm服务的gc性能的好坏。经过上面的探讨,我们在实践中得到了如下的解决方案: 不常变化的缓存(小时级别)移到堆外,以此减少老年代叠满的基础阈值。 变化不那么频繁的缓存(分钟级别)更新的时候进行值对比,如果值一样则不更新,以此减少老年代的堆积。 使用G1回收器:-XX:+UseG1GC-XX:MaxGCPauseMillis=200-XX:InitiatingHeapOccupancyPercent=25-XX:MaxNewSize=3072M -Xms4608M -Xmx4608M -XX:MetaspaceSize=512M-XX:MaxMetaspaceSize=512M 其效果如上所示,调整后各项指标都有很大的进步:由于年轻代中的复制算法使其垃圾清理速度较快,所以调大其容量使对象尽量在其中回收,同时设置每次清理的时间,使得mix gc控制在200ms以内。 3.4 限流降级与兜底策略 为了保证业务的可用性,大部分业务都会引入hystrix, sentinel, resilience4j 这类熔断限流组件, 但这些组件也不能解决全部的问题。 对于游戏推荐来说,一台节点往往承载着不同的业务推荐,有些业务十分核心,有些不是那么重要,限流降级的时候不是简单的哪个服务限流多少问题,而是在权衡利弊的情况下,将有限的资源向哪些业务倾斜的问题,对此我们在分层限流上下足了功夫。 同时对于个性化业务来说,仅仅返回通用的兜底会使推荐同质化,因此我们的策略是将用户的历史数据存储下来,并在下次兜底的时候作为推荐列表进行返回。 四、精细化运营模式的探索 在经历过了0 到1 的开疆拓土 与 1 到 2 的高速增长后,游戏的推荐架构已经趋于稳定。这时候我们更加关注效能的提高与成本的下降,因此我们开始着手于系统运营的精细化设计,这对推荐系统的良性发展是意义重大的。 精细化运营不仅能提高尾量游戏的收入,提高运营人员的工作效率,还能实时快速反馈算法在线效果并立马做出调整,做到一个业务上的闭环。首先就不得不提到游戏推荐系统的分层正交实验平台,这是我们做精细化运营的基础。 4.1 多层 hash 正交实验平台 游戏推荐的关键就一个"准"字,这就需要通过精细化策略迭代来提升效率和准确度,从而不断扩大规模优势,实现正向循环。然而策略的改变并不是通过“头脑风暴”空想的,而是一种建立在数据反馈上的机制,以带来预期内的正向变化。这就需要我们分隔对照组来做A/Btest。 一般线上业务常见的A/B test是通过物理方式对流量进行隔离,这种方法常见于H5页面的分流实验,但面对复杂业务时却存在着部署较慢,埋点解析困难等问题,其典型的架构方式如下: 对于游戏推荐来说,其完成一次推荐请求的流程比较复杂,涉及到多组策略,为了保证线上流量的效率与互斥,就不能采用简单的物理分配流量的方式。 因此在业务层我们建立了一套多层hash正交实验规则来满足我们A/B test的要求。 其流量走势如下图所示, 与物理隔离流量,部署多套环境的方式不同,分层模型在分流算法中引入层级编号因子(A)来解决流量饥饿和流量正交问题。每一实验层可以划分为多个实验田,当流量经过每一层实验时,会先经过Function(Hash(A)) 来计算其分配的实验田,这样就能保证层与层之间的流量随机且相互独立。 以上就是推荐业务和一般业务实验流量隔离的不同之处,在实验设计上我们又将一个完整的实验周期分为以下几个阶段。在预备阶段需要跟根据业务指标的需求,提出实验假设,划分好基线和实验田的流量比例,并上线配置(放量)。 在实验阶段,线上流量进入后,服务会根据流量号段的匹配响应的策略进行执行,并将实验数据上报。放量一段时候后,我们会根据上报的埋点数据进行数据分析,以确定此次策略的好坏。 和实验阶段划分相对应地,我们将实验平台划分为实验配置,埋点上报和实验结果分析三个模块,在实验配置模块,我们根据实验需求来完成分流配置和业务场景的映射关系。 并在hash实验管理中将业务层级划分,以便流量的流通。 在埋点上报模块中,我们通过sdk的方式植入业务代码中,当流量进入该实验田时就会进行分析和埋点上报,我们将上报的埋点分为游戏和请求维度,节省上报流量的同时以满足不同的分析需求: 游戏维度: { "code": 0, "data": [ { "score": 0.016114970572330977, "data": { "gameId": 53154, "appId": 1364982, "recommendReason": null, }, "gameps": "埋点信息", } ], "reqId": "20200810174423TBSIowaU52fjwjjz" } 请求维度: { "reqId":"20200810142134No5UkCibMdAvopoh", "scene": "appstore.idx", "imei": "869868031396914", "experimentInfo": [ { "experimentId": "RECOMMENDATION_SCENE", "salt":"RECOMMENDATION_SCENE", "imei": "3995823625", "sinfo": "策略信息" }, { "experimentId": "AUTO_RECOMMENDATION_REASON", "salt":"RECOMMENDATION_SCENE", "imei": "1140225751", "sid": "3,4,5" } ] } 在实验结果分析模块中,我们将采集的埋点的数据上报只大数据侧,并由其进行分析计算,其结果指导这我们对实验策略进行进一步的分析迭代。对于游戏请求的上报格式,我们可以直接通过appId和gameps的信息直接分析得出该类游戏的推荐结果和用户行为的关系。同时加入请求维度的分析(包含策略信息),可以直接分析出决策对各项指标的影响。 4.2 召回优化之多路召回 召回在游戏推荐业务中就是利用一定的规则去圈选一批游戏,这是为了将海量的候选集快速缩小为几百到几千的规模。而召回之后的排序则是对缩小后的候选集进行精准排序,最终达到精准推荐的目的。 然而这种单路的召回在业务上却有着很大的缺陷: 通常为了保证计算效率,圈选的数量在几百个左右,由于数量限制其无法完全覆盖完整的目标用户候选集。 随着业务的复杂度变高,召回策略的种类也开始膨胀,其召回规则是剥离的无法统一,这也意味着在某些业务场景下,在种类上无法覆盖完全。 因此,权衡了计算效率和业务覆盖度(召回率)的问题,我们逐步上线了多路召回功能。 在业务实现上,多路召回兼容了原有的个性化召回、算法召回、游戏池召回、分类/标签/专题/同开发者)召回等召回路径,通过圈选多个游戏池做为召回策略,经过合并、过滤、补量、截断等策略最终筛选出一批进行算法预估打分的游戏。 本质上,多路召回利用各简单策略保证候选集的快速召回,从不同角度设计的策略保证召回率接近理想状态。 4.3 曝光干预之动态调参 一个推荐系统的效能如何,除了运营策略之外很大程度上取决于推荐算法的结果,而推荐算法的结果又是以曝光量,下载量,ctr等作为评价指标的。所以在游戏推荐业务的生命周期中,推荐算法一直致力于优化这些指标。 但是在开发中有个实际问题就是,从算法结果的数据反馈,到代码改进上线这个时间周期较长,对一些需要快速响应的业务场景来说是不符合要求的。因此我们需要一套规则来对线上的算法结果做动态调整,以满足业务的要求,这就是动态调参。 目前游戏业务的营收中,曝光量是个极其重要的指标,而大盘在一段时间内的曝光量是确定的,太多或太少都会严重影响业务,由此推荐算法就会根据线上实时反馈的一些数据对游戏的曝光进行调整。 经过设计, 我们先将调参游戏划分为多个等级,并将游戏的生命周期划分为几个时间段,同时在每个时间段内以游戏曝光量,评级,数量等因素作为计算因子来计算曝光的分配权重。 接着系统根据实时采集的游戏曝光信息及所计算的游戏目标曝光对实际曝光进行调整,最终实现游戏曝光的动态调控。 对于正向调控来说,动态调参就是最有效的扶持机制,增加了游戏曝光的同时提升了导流能力。对于负向调控,动态调参能对品质和要求不达标的游戏,通过减少曝光的方式进行打压,提升用户体验。 五、展望之智能化建设 经过多年的探索实践,游戏推荐系统成就了一套完整的推荐体系。 在架构上的演进使得我们能更好地应对复杂多变的业务需求,在精细化运营上的探索与建设令我们能更加敏锐地把握住市场的变化以做出响应,这些建设也很好地反馈的反馈到了业务结果中,提升了众多效能和收益指标,得到了业务方的一致好评。 但当分发效率和收入效益问题解决了之后,我们在思考自己还能做什么,原先游戏推荐做的比较多的是接入服务,在单链路上去做闭环提高效益,但这是远远不够的。 在未来我们会考虑如何打造覆盖搜广推+ 智能运营的全栈业务支撑系统(智能礼券,智能push,用户反馈智能处理系统),以提升平台和渠道的价值。

优秀的个人博客,低调大师

每日一博 | 2023 年的 Web Worker 项目实践

前言— Web Workers 是 2009 年就已经提案的老技术,但是在很多项目中的应用相对较少,常见一些文章讨论如何写 demo ,但很少有工程化和项目级别的实践,本文会结合 Web Workers 在京东羚珑的程序化设计项目中的实践,分享一下在当下的 2023 年,关于 worker 融入项目的一些思考和具体的实现方式,涉及到的 demo 已经放在 github 上附在文末,可供参考。 先简单介绍下 Web Workers,它是一种可以运行在 Web 应用程序后台线程,独立于主线程之外的技术。众所周知,JavaScript 语言是单线程模型的,而通过使用 Web Workers,我们可以创造多线程环境,从而可以发挥现代计算机的多核 CPU 能力,在应对规模越来越大的 Web 程序时也有较多收益。 Web Workers 宏观语义上包含了三种不同的 Worker:DedicatedWorker(专有worker)、 SharedWorker(共享Worker)、 ServiceWorker,本文讨论的是第一种,其他两种大家可以自行研究一下。 引入 Web Worker— 当引入新技术时,通常我们会考虑的问题有:1、兼容性如何?2、使用场景在哪? 问题 1,Web Workers 是 2009 年的提案,2012 年各大浏览器已经基本支持,11 年过去了,现在使用已经完全没有问题啦 问题 2,主要考虑了以下 3 点: Worker API 的局限性:同源限制、无 DOM 对象、异步通信,因此适合不涉及 DOM 操作的任务 Worker 的使用成本:创建时间 + 数据传输时间;考虑到可以预创建,可以忽略创建时间,只考虑数据传输成本,这里可参考 19 年的一个测试 Is postMessage slow [1] ,简要结论是比较乐观的,大部分设备和数据情况下速度不是瓶颈 任务特点:需要是可并行的多任务,为了充分利用多核能力,可并行的任务数越接近 CPU 数量,收益会越高。多线程场景的收益计算,可以参考 Amdahl 公式,其中 F 是初始化所需比例, N 是可并行数: 综上结论是,可并行的计算密集型任务适合用 Worker 来做。 不过 github 上我搜罗了一圈,也发现有一些不局限于此,颇有创意的项目,供大家打开思路: redux 挪到了 worker 内 [2] dom 挪到了 worker 内 [3] 可使用多核能力的框架 [4] Worker 实践— 介绍完 worker ,一个问题出现了:为什么一个兼容性良好,能够发挥并发能力的技术(听起来很有诱惑力),到现在还没有大规模使用呢? 我理解有 2 个原因:一是暂无匹配度完美的使用场景,因此引入被搁置了;二是 worker api 设计得太难用,参考很多 demo 看,限制多配置还麻烦,让人望而却步。本文会主要着力于第二点,希望给大家的 worker 实践提供一些成熟的工程化思路。 至于第一点理由,在如此卷的前端领域,当你手中已经有了一把好用的锤子,还找不到那颗需要砸的钉子吗? Worker 到底有多难用 下面是一个原始 worker 的调用示例,上面是主线程文件,下面是 worker 文件: //index.jsconstworker=newWorker('./worker.js')worker.onmessage=function(messageEvent){console.log(messageEvent)} //worker.jsimportScripts('constant.js')functiona(){console.log('test')} 其中问题有: postMessage 传递消息的方式不适合现代编程模式,当出现多个事件时就涉及分拆解析和解决耦合问题,因此需要改造 新建 worker 需要单独文件,因此项目内需要处理打包拆分逻辑,独立出 worker 文件 worker 内可支持定义函数,可通过 importScript 方式引入依赖文件,但是都独立于主线程文件,依赖和函数的复用都需要改造 多线程环境必然涉及同步运行多个 worker,多 worker 的启动、复用和管理都需要自行处理 看完这么多问题,有没有感觉头很大,一个设计这样原始的 api,如何舒服的使用呢? 类库调研 首先可以想到的就是借助成熟类库的力量,下面表格是较为常见的几款 worker 类库,其中我们可能会关注的关键能力有: 通信是否有包装成更好用的方式,比如 promise 化或者 rpc 化 是否可以动态创建函数——可以增加 worker 灵活性 是否包含多 worker 的管理能力,也就是线程池 考虑 node 的使用场景,是否可以跨端运行 比较之下,workerpool[5] 胜出,它也是个年纪很大的库了,最早的代码提交在 6 年前,不过实践下来没有大问题,下文都会在使用它的基础上继续讨论。 有类库加持的 worker 现状 通过使用 workerpool,我们可以在主线程文件内新建 worker;它自动处理多 worker 的管理;可以执行 worker 内定义好的函数 a;可以动态创建一个函数并传入参数,让 worker 来执行。 //index.jsimportworkerpoolfrom'workerpool'constpool=workerpool.pool('./worker.js')//执行一个worker内定义好的函数pool.exec('a',[1,2]).then((res)=>{console.log(res)})//执行一个自定义函数pool.exec((x,y)=>{returnx+y},//自定义函数体[1,2],//自定义函数参数).then((res)=>{console.log(res)}) //worker.jsimportScripts('constant.js')functiona(){console.log('test')} 但是这样还不够,为了可以舒适的写代码,我们需要进一步改造。 向着舒适无感的 worker 编写前进 我们期望的目标是: 足够灵活:可以随意编写函数,今天我想计算 1+1,明天我想计算 1+2,这些都可以动态编写,最好它可以直接写在主线程我自己的文件里,不需要我跑到 worker 文件里去改写; 足够强大:我可以使用公共依赖,比如 lodash 或者是项目里已经定义好的某些公共函数。 考虑到 workerpool 具备了动态创建函数的能力,第一点已经可以实现;而第二点关于依赖的管理,则需要自行搭建,接下来介绍搭建步骤。 抽取依赖,管理编译和更新: 新增一个依赖管理文件worker-depts.js,可按照路径作为 key 名构建一个聚合依赖对象,然后在 worker 文件内引入这份依赖 //worker-depts.jsimport*as_from'lodash-es'import*asmathfrom'../math'constworkerDepts={_,'util/math':math,}exportdefaultworkerDepts //worker.jsimportworkerDeptsfrom'../util/worker/worker-depts' 定义公共调用函数,引入所打包的依赖并串联流程: worker 内定义一个公共调用函数,注入 worker-depts 依赖,并注册在 workerpool 的方法内 //worker.jsimportworkerDeptsfrom'../util/worker/worker-depts'functionrunWithDepts(fn:any,...args:any){varf=newFunction('return('+fn+').apply(null,arguments);')returnf.apply(f,[workerDepts].concat(args))}workerpool.worker({runWithDepts,}) 主线程文件内定义相应的调用方法,入参是自定义函数体和该函数的参数列表 //index.jsimportworkerpoolfrom'workerpool'exportasyncfunctionworkerDraw(fn,...args){constpool=workerpool.pool('./worker.js')returnpool.exec('runWithDepts',[String(fn)].concat(args))} 完成以上步骤,就可以在项目任意需要调用 worker 的位置,像下面这样,自定义函数内容,引用所需依赖(已注入在函数第一个参数),进行使用了。 这里我们引用了一个项目内的公共函数 fibonacci,也引用了一个 lodash 的 map 方法,都可以在depts 对象上取到 //项目内需使用worker时constres=awaitworkerDraw((depts,m,n)=>{const{map}=depts['_']const{fibonacci}=depts['util/math']returnmap([m,n],(num)=>fibonacci(num))},input1,input2,) 优化语法支持 没有语法支持的依赖管理是很难用的,通过对 workerDraw 进行 ts 语法包装,可以实现在使用时的依赖提示: importworkerpoolfrom'workerpool'importtypeTDeptsfrom'./worker-depts'exportasyncfunctionworkerDraw<Textendsany[],R>(fn:(depts:typeofTDepts,...args:T)=>Promise<R>|R,...args:T){constpool=workerpool.pool('./worker.js')returnpool.exec('runWithDepts',[String(fn)].concat(args))} 然后就可以在使用时获取依赖提示: 其他问题 新增了 worker 以后,出现了 window和 worker 两种运行环境,如果你恰好和我一样需要兼容 node 端运行,那么运行环境就是三种,原本我们通常判断 window 环境使用的也许是 typeof window === 'object'这样,现在不够用了,这里可以改为 globalThis 对象,它是三套环境内都存在的一个对象,通过判断globalThis.constructor.name的值,值分别是'Window' / 'DedicatedWorker'/ 'Object',从而实现环境的区分 总结— 通过使用 workerpool,添加依赖管理和构建公共 worker 调用函数,我们实现了一套按需调用,灵活强大的 worker 使用方式。 在京东羚珑的程序化设计项目中,通过把 skia 图形绘制部分逐步改造为 worker 内调用,我们实现了整体服务耗时降低 75% 的效果,收益还是非常不错的。 文中涉及的代码示例都已放在 github[6] 上,内有 vite 和 webpack 两个完整实现版本,感兴趣的小伙伴可以 clone 下来参照着看~ 参考资料— [1]Is postMessage slow: https://dassur.ma/things/is-postmessage-slow/ [2]redux 挪到了 worker 内: https://blog.axlight.com/posts/off-main-thread-react-redux-with-performance [3]dom 挪到了 worker 内: https://github.com/ampproject/worker-dom [4]可使用多核能力的框架: https://github.com/neomjs/neo [5]workerpool: https://github.com/josdejong/workerpool [6]github: https://github.com/Silencesnow/worker-demo-2022 [7]MDN Web Workers API: https://developer.mozilla.org/zh-CN/docs/Web/API/Web_Workers_API [8]workerpool: https://github.com/josdejong/workerpool [9]前端项目上 Web Worker 实践: https://www.youtube.com/watch?v=AEpG-3XXrjk [10]Web Worker 文献综述: https://juejin.cn/post/6854573213297410062 本文分享自微信公众号 - 凹凸实验室(AOTULabs)。 如有侵权,请联系 support@oschina.cn 删除。 本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

优秀的个人博客,低调大师

每日一博 | 联邦 GNN 综述与经典算法介绍

作者:京东科技 李杰 联邦学习和GNN都是当前AI领域的研究热点。联邦学习的多个参与方可以在不泄露原始数据的情况下,安全合规地联合训练业务模型,目前已在诸多领域取得了较好的结果。GNN在应对非欧数据结构时通常有较好的表现,因为它不仅考虑节点本身的特征还考虑节点之间的链接关系及强度,在诸如:异常个体识别、链接预测、分子性质预测、地理拓扑图预测交通拥堵等领域均有不俗表现。 那么GNN与联邦学习的强强组合又会擦出怎样的火花? 通常一个好的GNN算法需要丰富的节点特征与完整的连接信息,但现实场景中数据孤岛问题比较突出,单个数据拥有方往往只有有限的数据、特征、边信息,但我们借助联邦学习技术就可以充分利用各方数据安全合规地训练有强劲表现的GNN模型。 读罢此文,您将获得如下知识点: •GNN经典算法原理及计算模型 •联邦学习定义与分类 •联邦GNN的两种分类方法及细节 •基于横向联邦的FedGNN模型(微软亚研,2021)、基于纵向联邦的VFGNN模型(浙大+蚂蚁,2022) 一、GNN原理 1.1 图场景及数据表示 能用图刻画的场景很多,比如:社交网络、生物分子、电商网络、知识图谱等。 图最基础且通用的分类是将其分为:同构图(一种节点+一种边)与异构图(节点类型+边类型>2),相应的示意图如下。 一般来说,原始的图数据由两部分组成:节点数据(节点类型+节点ID+节点特征)、边数据(边类型+起点+终点)。原始数据经过解析处理后载入图存储模块,图存储的基本形式为邻接矩阵(COO),但一般出于存储与计算开销考虑采用稀疏存储表示(CSC/CSR)。 1.2 GNN任务分类 GNN任务一般分为如下四类: •节点/边分类:异常用户识别。 •链接预测:user-item购物倾向、知识图谱补全。 •全图分类:生物分子性质预测。 •其他:图聚类、图生成。 1.3 GNN算法原理 我们以GraphSAGE为例讲解GNN的计算原理[1],大致包含三个过程:采样、聚合、拟合目标。GraphSAGE示意图如下: GraphSAGE算法的伪代码如下: 下面我们给合实例与公式详细说明其计算过程,下图先给出采样过程与消息传递过程的框架原理。 下图给出了具体的消息传递执行过程。 二、联邦学习 之前机器学习模型训练的经典架构是:数据中心从各客户端或机构收集原始数据后,在数据中心对收集的全体数据进行模型训练。近年来随着数据隐私保护法规的颁布和数据安全意识的提升,机构间交换明文数据就不可行了。如何综合多个用户或机构间数据来训练模型?联邦学习技术应运而生。联邦学习一般分为如下两大类[2]: •联邦学习(横向):两个机构拥有较多相同特征,但是重合样本ID很少。比如:北京医院和上海医院的病人数据。 •联邦学习(纵向):两个机构拥有较多相同样本ID,但是机构间重合特征较少。比如:北京银行和北京保险公司的客户数据。 2.1 横向联邦学习 如上图所示,左边红虚线框内是数据表示,即重合样本较少,但特征相同。右边是经典的横向FedAvg算法,每个客户端拥有同样的模型结构,初始权重由server下发至客户端,待各客户端更新本地模型后,再将梯度/权重发送至server进行聚合,最后将聚合结果下发给各客户端以更新本地模型。 2.2 纵向联邦学习 如上图所示,左边红虚线框内代表数据表示,即两方拥有较多相同样本ID,但是重合特征较少。右边是经典的两方纵向DNN模型训练架构[3],其中A方bottom层结果要发送至B方,而B方拥有label,用来计算loss及梯度,详细过程参考[4]。 三、联邦GNN 3.1 联邦GNN分类 3.1.1 图对象+数据划分 根据图数据在客户端的分布规则,具体以图对象(图、子图、节点)与数据划分(横向、纵向)角度来看,可以将联邦GNN分为四类[5]: 1)inter-graph FL 在此分类中,客户端的每条样本是图数据,最终的全局模型处理图级别的任务。此架构广泛应用在生物工程领域,通常用图来表示分子结构,其中节点表示原子,边表示原子间的化学键。在药物特性研究方面可以应用此技术,每个制药厂k都维护了自己的分子-属性数据集 ,但都不想分享给竞争对手。借助inter-graph FL技术,多家药厂就可以合作研究药物性质。在此例中,全局模型为: 2)horizontal intra-graph FL 上图中全部客户端拥有的数据构成完整的图,其中虚线表示本应存在但实际不存在的边。此类架构中,每个客户端对应的子图拥有相同的特征空间和标签空间但拥有不同的ID。在此设置下,全局GNN模型一般处理节点类任务和边任务: 3)vertical intra-graph FL 此类架构中,客户端共享相同的ID空间,但不共享特征和标签空间。上图中的垂直虚线代表拥有相同ID的节点。在此架构中全局模型不唯一,这取决于多少客户端拥有标签,同时也意味着此架构可进行multi-task learning。此架构主要用来以隐私保护的方式聚合各客户端相同节点的特征,共享相同节点的标签。如果不考虑数据对齐和数据共享问题,则相应的目标函数定义为: 此架构一般应用在机构间合作,如反洗钱。犯罪分子采用跨多个机构的复杂策略进行洗钱活动,这时可应用此架构,通过机构间合作识别出洗钱行为。 4)graph-structured FL 此架构用来表示客户端之间的拓扑关系,一个客户端相当于图中一个节点。此架构会基于客户端拓扑聚合本地模型,全局模型可以处理联邦学习领域的各种任务和目标函数。全局GNN模型旨在通过客户端之间的拓扑关系挖掘背后的隐含信息。此架构的经典应用是联邦交通流量预测,城市中的监控设备分布在不同的地方,GNN用来描述设备间的空间依赖关系。以上图为例全局GNN模型的聚合逻辑如下: 本节总结 3.1.2 二维分类法 根据参考文献[6],我们可以从2个维度对FedGNNs进行分类。第一个维度为主维度,聚焦于联邦学习与GNN如何结合;第二个维度为辅助维度,聚焦于联邦学习的聚合逻辑,用来解决不同level的图数据异构性。其分类汇总图大致如下: 1)GNN-assisted FL 借助结构化的客户端来提升联邦学习训练效果,用虚线来表示客户端之间的网络拓扑关系。此架构一般分为两种形式: •中心化架构:拥有客户端间的全局网络拓扑。可训练GNN模型提升联邦聚合效果,也可帮助客户端更新本地模型。 •非中心化架构:客户端间的全局网络拓扑必须提前给定,这样拥有子图的客户端就可以找到它在图中的邻居。 2)FL-assisted GNN 借助分散的图数据孤岛来提升GNN模型效果,具体通过联邦学习把图数据孤岛组织起来训练一个全局GNN模型。根据客户端是否有相同节点,此架构可分为如下两类: •horizontal FedGNN:各客户端拥有的重叠节点不多,有可能会丢失跨客户端的链接,通常需要较复杂的处理方法。 •vertical FedGNN:各客户端拥有相同的节点集合,但持有的特征不相同。根据特征的分区方式不同,相应的处理方法也随之变化。 3)Auxiliary taxonomy 辅助分类聚焦于解决联邦学习客户端之间的异构性问题。具体可以分为三类: •客户端拥有相同ID:可将节点特征或中间表征上传至联邦服务器进行联邦聚合。常用于vertical FedGNN和有部分重复节点的水平FedGNN。 •客户端拥有不同节点但相同网络结构:联邦聚合对象主要是模型权重和梯度。常用于GNN-assisted FL和无重复节点的horizontal FedGNN。 •客户端拥有不同网络结构:先把本地模型做成图,然后将GNN作用于图之上。联邦聚合对象是GNN权重和梯度,常用于centralized FedGNN。 3.2 FedGNN 3.2.1 问题定义 3.2.2 FedGNN原理与架构 如上图,FedGNN[7]由一个中心服务器和大量客户端组成。客户端基于其用户交互物品与邻居客户端在本地维护了一个子图。客户端基于本地子图学习user/item embedding,以及GNN模型,然后将梯度上传给中心服务器。中心服务器用来协调客户端,具体是在训练过程中聚合从多个客户端收集的梯度(基于FedAvg算法),并将聚合后的梯度回传给客户端。如下我们将依次介绍一些技术细节。 FedGNN的完整算法流程见下述Algorithm1,其中有两个隐私保护模块:其一是隐私保护模型更新(Algorithm1的9-11行),用来保护梯度信息;其二是隐私保护user-item图扩充模块(Algorithm1中第15行),用来对user和item的高阶交互进行建模。 3.2.3 隐私保护模型更新 embedding梯度和模型梯度(GNN+rating predictor)直接传输会泄露隐私,因此需要对此进行安全防护。因为每个客户端维护了全量item的embedding表,通过同态加密保护梯度就不太现实(大量的存储和通信开销),文献[7]提出两个机制来保护模型更新过程中的隐私保护。 1)伪交互物品采样 随机采样M个用户并未交互过的物品,根据交互物品embedding梯度分布随机生成伪交互物品embedding梯度。于是第i个用户的模型和embedding梯度修改为 2)采用LDP(本地差分隐私)护本地梯度 首先通过梯度的无穷范数和阈值 δ 对梯度进行截断,然后基于LDP思想采用0均值拉普拉斯噪声对前述梯度进行扰动,从而实现对用户隐私的保护。相应的公式表达为: g i=clip(g _i_​,δ)+Laplace(0,λ)。受保护的梯度再上传到中心服务器进行聚合。 3.2.4 隐私保护图扩充 客户端本地user-item图以隐私保护方式找到邻居客户端,以达到对本地图自身的扩充。在中心化存储的GNN场景中,user与item的高阶交互可通过全局user-item图方便获取。但非中心化场景中,在遵守隐私保护的前提下要想求得user-item高阶交互不是易事。文章提出通过寻找客户端的匿名邻居以提升user和item的表征学习,同时用户隐私不泄露,详细过程如下: 首先,中心服务器生成公钥并分发给各客户端。客户端收到公钥后,利用同态加密技术对交互物品ID进行加密处理。前述加密ID和用户embedding被上传至第三方服务器(不需要可信),通过PSI技术找到有相同交互物品的用户,然后为每个用户提供匿名邻居embedding。最后,我们把用户的邻居用户节点连接起来,这样就以隐私保护的方式添加了user-item的高阶交互信息,丰富了客户端的本地user-item子图。 3.3 VFGNN 3.3.1 数据假设 训练一个好的GNN模型通常需要丰富的节点特征和完整的连接信息。但是节点特征和连接信息通常由多个数据方拥有,也就是所谓的数据孤岛问题。下图我们给出图数据纵向划分的例子[8],其中三方各自拥有节点不同的特征,各方拥有不同类型的边。 3.3.2 算法架构及流程 安全性假设:数据拥有方A,B,C和服务器S都是半诚实的,并且假定服务器S和任一数据拥有方不会合谋。这个安全假设符合大多数已有工作,并且和现实场景比较契合。 上图即为VFGNN的架构图,它的计算分为两大部分: •隐私数据相关计算:一般在数据拥有方本地进行。在GNN场景中,隐私数据有:节点特征、label、边信息。 •非隐私数据相关计算:一般将计算权委托给半诚实server,主要是出于计算效率的考虑。 考虑到数据隐私性的问题,上述计算图分为如下三个计算子图,且各自承担的工作如下: •CG1:隐私特征和边相关计算。 先利用节点隐私特征生成initial node embedding,这个过程是多方协同工作的。接着通过采样找到节点的多跳邻居,再应用聚合函数生成local node embedding。 •CG2:非隐私数据相关计算。 出于效率考虑,作者把非隐私数据相关计算委托给半诚实服务器。此服务器把从各方收集的local node embedding通过不同的COMBINE策略处理生成global node embedding。接着可以进行若干明文类的操作,比如max-pooling、activation(这些计算在密文状态下不友好)。进行一系列明文处理后,我们得到最后一个隐层输出_ZL_​,然后把它发送给拥有label的数据方计算预测值。 •CG3:隐私标签相关计算。 以节点分类任务为例 ,当收到_ZL_​后可以快速计算出预测值,具体通过softmax函数进行处理。 3.3.3 重要组件 Generating Initial Node Embedding 如果各方独立生成initial node embedding(上图a),则遵循如下计算公式: 如果各方协同生成initial node emb,则可按上图b中应用MPC技术进行处理。 Generating Local Node Embedding 基于前述生成的initial node embedding,及节点的多跳邻居节点,应用聚合函数可以生成local node embedding。邻居节点的聚合操作必须在本地进行而不需要多方协同,目的是保护隐私的边信息。一个节点的邻居节点聚合操作和常规GNN一样,以GraphSAGE为例节点的聚合操作是通过采样和聚合特征形成了local node embedding,具体公式如下: GraphSAGE中,常用的聚合函数有:Mean、LSTM、Pooling。接着数据拥有方把local node embedding发送给半诚实服务器,以进行COMBINE操作及后续的非隐私数据计算逻辑。 Generating Global Node Embedding 对各方传来的local node embedding执行combine操作可以生成global node embedding。combine策略一般是可训练且高表达容量,文章给出了三种策略: 1)Concat 2)Mean 3)Regression 3.3.4 隐私保护DP 如果在前向过程中把local node embedding直接传给半诚实服务器,或在反向传播过程中直接传递梯度信息很可能造成信息泄露。本文提出了两种基于DP的方法用来保护信息发布过程,算法流程如下: 3.3.5 VFGNN前向算法 以GraphSAGE处理节点分类任务为例,VFGNN算法的前向过程描述如下: 3.4 其他算法及项目 最近四年出现的联邦GNN算法[9]: 开源项目有:FedGraphNN[10]。 参考资料 1.Hamilton W, Ying Z, Leskovec J. Inductive representation learning on large graphs[J]. Advances in neural information processing systems, 2017, 30. 2.Yang Q, Liu Y, Chen T, et al. Federated machine learning: Concept and applications[J]. ACM Transactions on Intelligent Systems and Technology (TIST), 2019, 10(2): 1-19. https://fate.readthedocs.io/en/develop/_build_temp/python/federatedml/nn/hetero_nn/README.html 4.Zhang Y, Zhu H. Additively homomorphical encryption based deep neural network for asymmetrically collaborative machine learning[J]. arXiv preprint arXiv:2007.06849, 2020. 5.Zhang H, Shen T, Wu F, et al. Federated graph learning--a position paper[J]. arXiv preprint arXiv:2105.11099, 2021. 6.Liu R, Yu H. Federated graph neural networks: Overview, techniques and challenges[J]. arXiv preprint arXiv:2202.07256, 2022. 7.Wu C, Wu F, Cao Y, et al. Fedgnn: Federated graph neural network for privacy-preserving recommendation[J]. arXiv preprint arXiv:2102.04925, 2021. 8.Chen C, Zhou J, Zheng L, et al. Vertically federated graph neural network for privacy-preserving node classification[J]. arXiv preprint arXiv:2005.11903, 2020. 9.《图联邦学习进展与应用》 史春奇 https://github.com/FedML-AI/FedML/tree/master/python/app/fedgraphnn

优秀的个人博客,低调大师

每日一博 | 9 种跨域方式实现原理

摘要:当协议、子域名、主域名、端口号中任意一个不相同时,都算作不同域。不同域之间相互请求资源,就算作“跨域”。 本文分享自华为云社区《九种跨域方式实现原理咋回事》,作者:龙哥手记 一、什么是跨域? 1.什么是同源策略及其限制内容? 同源策略是一种约定,它是浏览器最核心也最基本的安全功能,如果缺少了同源策略,浏览器很容易受到XSS、CSRF等攻击。所谓同源是指"协议+域名+端口"三者相同,即便两个不同的域名指向同一个ip地址,也非同源。 同源策略限制内容有: Cookie、LocalStorage、IndexedDB 等存储性内容 DOM 节点 AJAX 请求发送后,结果被浏览器拦截了 但是有三个标签是允许跨域加载资源: <img src=XXX> <link href=XXX> <script src=XXX> 2.常见跨域场景 当协议、子域名、主域名、端口号中任意一个不相同时,都算作不同域。不同域之间相互请求资源,就算作“跨域”。 特别说明两点: 第一:如果是协议和端口造成的跨域问题“前台”是无能为力的。 第二:在跨域问题上,仅仅是通过“URL的首部”来识别而不会根据域名对应的IP地址是否相同来判断。“URL的首部”可以理解为“协议, 域名和端口必须匹配”。 这里你或许有个疑问:请求跨域了,那么请求到底发出去没有? 跨域并不是请求发不出去,请求能发出去,服务端能收到请求并正常返回结果,只是结果被浏览器拦截了。你可能会疑问明明通过表单的方式可以发起跨域请求,为什么 Ajax 就不会?因为归根结底,跨域是为了阻止用户读取到另一个域名下的内容,Ajax 可以获取响应,浏览器认为这不安全,所以拦截了响应。但是表单并不会获取新的内容,所以可以发起跨域请求。同时也说明了跨域并不能完全阻止 CSRF,因为请求毕竟是发出去了。 二、跨域解决方案 1.jsonp 1) JSONP原理 利用 <script> 标签没有跨域限制的漏洞,网页可以得到从其他来源动态产生的 JSON 数据。JSONP请求一定需要对方的服务器做支持才可以。 2) JSONP和AJAX对比 JSONP和AJAX相同,都是客户端向服务器端发送请求,从服务器端获取数据的方式。但AJAX属于同源策略,JSONP属于非同源策略(跨域请求) 3) JSONP优缺点 JSONP优点是简单兼容性好,可用于解决主流浏览器的跨域数据访问的问题。缺点是仅支持get方法具有局限性,不安全可能会遭受XSS攻击。 4) JSONP的实现流程 声明一个回调函数,其函数名(如show)当做参数值,要传递给跨域请求数据的服务器,函数形参为要获取目标数据(服务器返回的data)。 创建一个<script>标签,把那个跨域的API数据接口地址,赋值给script的src,还要在这个地址中向服务器传递该函数名(可以通过问号传参:?callback=show)。 服务器接收到请求后,需要进行特殊的处理:把传递进来的函数名和它需要给你的数据拼接成一个字符串,例如:传递进去的函数名是show,它准备好的数据是show('我不爱你')。 最后服务器把准备的数据通过HTTP协议返回给客户端,客户端再调用执行之前声明的回调函数(show),对返回的数据进行操作。 在开发中可能会遇到多个 JSONP 请求的回调函数名是相同的,这时候就需要自己封装一个 JSONP函数。 // index.html function jsonp({ url, params, callback }) { return new Promise((resolve, reject) => { let script = document.createElement('script') window[callback] = function(data) { resolve(data) document.body.removeChild(script) } params = { ...params, callback } // wd=b&callback=show let arrs = [] for (let key in params) { arrs.push(`${key}=${params[key]}`) } script.src = `${url}?${arrs.join('&')}` document.body.appendChild(script) }) } jsonp({ url: 'http://localhost:3000/say', params: { wd: 'Iloveyou' }, callback: 'show' }).then(data => { console.log(data) }) 上面这段代码相当于向http://localhost:3000/say?wd=Iloveyou&callback=show这个地址请求数据,然后后台返回show('我不爱你'),最后会运行show()这个函数,打印出'我不爱你' // server.js let express = require('express') let app = express() app.get('/say', function(req, res) { let { wd, callback } = req.query console.log(wd) // Iloveyou console.log(callback) // show res.end(`${callback}('我不爱你')`) }) app.listen(3000) 5) jQuery的jsonp形式 JSONP都是GET和异步请求的,不存在其他的请求方式和同步请求,且jQuery默认就会给JSONP的请求清除缓存。 $.ajax({ url:"http://crossdomain.com/jsonServerResponse", dataType:"jsonp", type:"get",//可以省略 jsonpCallback:"show",//->自定义传递给服务器的函数名,而不是使用jQuery自动生成的,可省略 jsonp:"callback",//->把传递函数名的那个形参callback,可省略 success:function (data){ console.log(data);} }); 2.cors CORS 需要浏览器和后端同时支持。IE 8 和 9 需要通过 XDomainRequest 来实现。 浏览器会自动进行 CORS 通信,实现 CORS 通信的关键是后端。只要后端实现了 CORS,就实现了跨域。 服务端设置 Access-Control-Allow-Origin 就可以开启 CORS。 该属性表示哪些域名可以访问资源,如果设置通配符则表示所有网站都可以访问资源。 虽然设置 CORS 和前端没什么关系,但是通过这种方式解决跨域问题的话,会在发送请求时出现两种情况,分别为简单请求和复杂请求。 1) 简单请求 只要同时满足以下两大条件,就属于简单请求 条件1:使用下列方法之一: GET HEAD POST 条件2:Content-Type 的值仅限于下列三者之一: text/plain multipart/form-data application/x-www-form-urlencoded 请求中的任意 XMLHttpRequestUpload 对象均没有注册任何事件监听器; XMLHttpRequestUpload 对象可以使用 XMLHttpRequest.upload 属性访问。 2) 复杂请求 不符合以上条件的请求就肯定是复杂请求了。 复杂请求的CORS请求,会在正式通信之前,增加一次HTTP查询请求,称为"预检"请求,该请求是 option 方法的,通过该请求来知道服务端是否允许跨域请求。 我们用PUT向后台请求时,属于复杂请求,后台需做如下配置: // 允许哪个方法访问我 res.setHeader('Access-Control-Allow-Methods', 'PUT') // 预检的存活时间 res.setHeader('Access-Control-Max-Age', 6) // OPTIONS请求不做任何处理 if (req.method === 'OPTIONS') { res.end() } // 定义后台返回的内容 app.put('/getData', function(req, res) { console.log(req.headers) res.end('我不爱你') }) 接下来我们看下一个完整复杂请求的例子,并且介绍下CORS请求相关的字段 // index.html let xhr = new XMLHttpRequest() document.cookie = 'name=xiamen' // cookie不能跨域 xhr.withCredentials = true // 前端设置是否带cookie xhr.open('PUT', 'http://localhost:4000/getData', true) xhr.setRequestHeader('name', 'xiamen') xhr.onreadystatechange = function() { if (xhr.readyState === 4) { if ((xhr.status >= 200 && xhr.status < 300) || xhr.status === 304) { console.log(xhr.response) //得到响应头,后台需设置Access-Control-Expose-Headers console.log(xhr.getResponseHeader('name')) } } } xhr.send() //server1.js let express = require('express'); let app = express(); app.use(express.static(__dirname)); app.listen(3000); //server2.js let express = require('express') let app = express() let whitList = ['http://localhost:3000'] //设置白名单 app.use(function(req, res, next) { let origin = req.headers.origin if (whitList.includes(origin)) { // 设置哪个源可以访问我 res.setHeader('Access-Control-Allow-Origin', origin) // 允许携带哪个头访问我 res.setHeader('Access-Control-Allow-Headers', 'name') // 允许哪个方法访问我 res.setHeader('Access-Control-Allow-Methods', 'PUT') // 允许携带cookie res.setHeader('Access-Control-Allow-Credentials', true) // 预检的存活时间 res.setHeader('Access-Control-Max-Age', 6) // 允许返回的头 res.setHeader('Access-Control-Expose-Headers', 'name') if (req.method === 'OPTIONS') { res.end() // OPTIONS请求不做任何处理 } } next() }) app.put('/getData', function(req, res) { console.log(req.headers) res.setHeader('name', 'jw') //返回一个响应头,后台需设置 res.end('我不爱你') }) app.get('/getData', function(req, res) { console.log(req.headers) res.end('我不爱你') }) app.use(express.static(__dirname)) app.listen(4000) 上述代码由http://localhost:3000/index.html向http://localhost:4000/跨域请求,正如我们上面所说的,后端是实现 CORS 通信的关键。 3.postMessage postMessage是HTML5 XMLHttpRequest Level 2中的API,且是为数不多可以跨域操作的window属性之一,它可用于解决以下方面的问题: 页面和其打开的新窗口的数据传递 多窗口之间消息传递 页面与嵌套的iframe消息传递 上面三个场景的跨域数据传递 postMessage()方法允许来自不同源的脚本采用异步方式进行有限的通信,可以实现跨文本档、多窗口、跨域消息传递。 otherWindow.postMessage(message, targetOrigin, [transfer]); message: 将要发送到其他 window的数据。 targetOrigin:通过窗口的origin属性来指定哪些窗口能接收到消息事件,其值可以是字符串"*"(表示无限制)或者一个URI。在发送消息的时候,如果目标窗口的协议、主机地址或端口这三者的任意一项不匹配targetOrigin提供的值,那么消息就不会被发送;只有三者完全匹配,消息才会被发送。 transfer(可选):是一串和message 同时传递的 Transferable 对象. 这些对象的所有权将被转移给消息的接收方,而发送一方将不再保有所有权。 接下来我们看个例子: http://localhost:3000/a.html页面向http://localhost:4000/b.html传递“我爱你”,然后后者传回"我不爱你"。 // a.html <iframe src="http://localhost:4000/b.html" frameborder="0" id="frame" onload="load()"></iframe> //等它加载完触发一个事件 //内嵌在http://localhost:3000/a.html <script> function load() { let frame = document.getElementById('frame') frame.contentWindow.postMessage('我爱你', 'http://localhost:4000') //发送数据 window.onmessage = function(e) { //接受返回数据 console.log(e.data) //我不爱你 } } </script> // b.html window.onmessage = function(e) { console.log(e.data) //我爱你 e.source.postMessage('我不爱你', e.origin) } 4.websocket Websocket是HTML5的一个持久化的协议,它实现了浏览器与服务器的全双工通信,同时也是跨域的一种解决方案。WebSocket和HTTP都是应用层协议,都基于 TCP 协议。但是 WebSocket 是一种双向通信协议,在建立连接之后,WebSocket 的 server 与 client 都能主动向对方发送或接收数据。同时,WebSocket 在建立连接时需要借助 HTTP 协议,连接建立好了之后 client 与 server 之间的双向通信就与 HTTP 无关了。 原生WebSocket API使用起来不太方便,我们使用Socket.io,它很好地封装了webSocket接口,提供了更简单、灵活的接口,也对不支持webSocket的浏览器提供了向下兼容。 我们先来看个例子:本地文件socket.html向localhost:3000发生数据和接受数据 // socket.html <script> let socket = new WebSocket('ws://localhost:3000'); socket.onopen = function () { socket.send('我爱你');//向服务器发送数据 } socket.onmessage = function (e) { console.log(e.data);//接收服务器返回的数据 } </script> // server.js let express = require('express'); let app = express(); let WebSocket = require('ws');//记得安装ws let wss = new WebSocket.Server({port:3000}); wss.on('connection',function(ws) { ws.on('message', function (data) { console.log(data); ws.send('我不爱你') }); }) 5. Node中间件代理(两次跨域) 实现原理:同源策略是浏览器需要遵循的标准,而如果是服务器向服务器请求就无需遵循同源策略。 代理服务器,需要做以下几个步骤: 接受客户端请求 。 将请求 转发给服务器。 拿到服务器 响应 数据。 将 响应 转发给客户端。 我们先来看个例子:本地文件index.html文件,通过代理服务器http://localhost:3000向目标服务器http://localhost:4000请求数据。 // index.html(http://127.0.0.1:5500) <script src="https://cdn.bootcss.com/jquery/3.3.1/jquery.min.js"></script> <script> $.ajax({ url: 'http://localhost:3000', type: 'post', data: { name: 'xiamen', password: '123456' }, contentType: 'application/json;charset=utf-8', success: function(result) { console.log(result) // {"title":"fontend","password":"123456"} }, error: function(msg) { console.log(msg) } }) </script> // server1.js 代理服务器(http://localhost:3000) const http = require('http') // 第一步:接受客户端请求 const server = http.createServer((request, response) => { // 代理服务器,直接和浏览器直接交互,需要设置CORS 的首部字段 response.writeHead(200, { 'Access-Control-Allow-Origin': '*', 'Access-Control-Allow-Methods': '*', 'Access-Control-Allow-Headers': 'Content-Type' }) // 第二步:将请求转发给服务器 const proxyRequest = http .request( { host: '127.0.0.1', port: 4000, url: '/', method: request.method, headers: request.headers }, serverResponse => { // 第三步:收到服务器的响应 var body = '' serverResponse.on('data', chunk => { body += chunk }) serverResponse.on('end', () => { console.log('The data is ' + body) // 第四步:将响应结果转发给浏览器 response.end(body) }) } ) .end() }) server.listen(3000, () => { console.log('The proxyServer is running at http://localhost:3000') }) // server2.js(http://localhost:4000) const http = require('http') const data = { title: 'fontend', password: '123456' } const server = http.createServer((request, response) => { if (request.url === '/') { response.end(JSON.stringify(data)) } }) server.listen(4000, () => { console.log('The server is running at http://localhost:4000') }) 上述代码经过两次跨域,值得注意的是浏览器向代理服务器发送请求,也遵循同源策略,最后在index.html文件打印出{"title":"fontend","password":"123456"} 6.nginx反向代理 实现原理类似于Node中间件代理,需要你搭建一个中转nginx服务器,用于转发请求。 使用nginx反向代理实现跨域,是最简单的跨域方式。只需要修改nginx的配置即可解决跨域问题,支持所有浏览器,支持session,不需要修改任何代码,并且不会影响服务器性能。 实现思路:通过nginx配置一个代理服务器(域名与domain1相同,端口不同)做跳板机,反向代理访问domain2接口,并且可以顺便修改cookie中domain信息,方便当前域cookie写入,实现跨域登录。 先下载nginx,然后将nginx目录下的nginx.conf修改如下: // proxy服务器 server { listen 80; server_name www.domain1.com; location / { proxy_pass http://www.domain2.com:8080; #反向代理 proxy_cookie_domain www.domain2.com www.domain1.com; #修改cookie里域名 index index.html index.htm; # 当用webpack-dev-server等中间件代理接口访问nignx时,此时无浏览器参与,故没有同源限制,下面的跨域配置可不启用 add_header Access-Control-Allow-Origin http://www.domain1.com; #当前端只跨域不带cookie时,可为* add_header Access-Control-Allow-Credentials true; } } 最后通过命令行nginx -s reload启动nginx // index.html var xhr = new XMLHttpRequest(); // 前端开关:浏览器是否读写cookie xhr.withCredentials = true; // 访问nginx中的代理服务器 xhr.open('get', 'http://www.domain1.com:81/?user=admin', true); xhr.send(); // server.js var http = require('http'); var server = http.createServer(); var qs = require('querystring'); server.on('request', function(req, res) { var params = qs.parse(req.url.substring(2)); // 向前台写cookie res.writeHead(200, { 'Set-Cookie': 'l=a123456;Path=/;Domain=www.domain2.com;HttpOnly' // HttpOnly:脚本无法读取 }); res.write(JSON.stringify(params)); res.end(); }); server.listen('8080'); console.log('Server is running at port 8080...'); 7.window.name + iframe window.name属性的独特之处:name值在不同的页面(甚至不同域名)加载后依旧存在,并且可以支持非常长的 name 值(2MB)。 其中a.html和b.html是同域的,都是http://localhost:3000;而c.html是http://localhost:4000 // a.html(http://localhost:3000/b.html) <iframe src="http://localhost:4000/c.html" frameborder="0" onload="load()" id="iframe"></iframe> <script> let first = true // onload事件会触发2次,第1次加载跨域页,并留存数据于window.name function load() { if(first){ // 第1次onload(跨域页)成功后,切换到同域代理页面 let iframe = document.getElementById('iframe'); iframe.src = 'http://localhost:3000/b.html'; first = false; }else{ // 第2次onload(同域b.html页)成功后,读取同域window.name中数据 console.log(iframe.contentWindow.name); } } </script> b.html为中间代理页,与a.html同域,内容为空。 // c.html(http://localhost:4000/c.html) <script> window.name = '我不爱你' </script> 总结:通过iframe的src属性由外域转向本地域,跨域数据即由iframe的window.name从外域传递到本地域。这个就巧妙地绕过了浏览器的跨域访问限制,但同时它又是安全操作。 8.location.hash + iframe 实现原理: a.html欲与c.html跨域相互通信,通过中间页b.html来实现。 三个页面,不同域之间利用iframe的location.hash传值,相同域之间直接js访问来通信。 具体实现步骤:一开始a.html给c.html传一个hash值,然后c.html收到hash值后,再把hash值传递给b.html,最后b.html将结果放到a.html的hash值中。 同样的,a.html和b.html是同域的,都是http://localhost:3000;而c.html是http://localhost:4000 // a.html <iframe src="http://localhost:4000/c.html#iloveyou"></iframe> <script> window.onhashchange = function () { //检测hash的变化 console.log(location.hash); } </script> // b.html <script> window.parent.parent.location.hash = location.hash //b.html将结果放到a.html的hash值中,b.html可通过parent.parent访问a.html页面 </script> // c.html console.log(location.hash); let iframe = document.createElement('iframe'); iframe.src = 'http://localhost:3000/b.html#idontloveyou'; document.body.appendChild(iframe); 9.document.domain + iframe 该方式只能用于二级域名相同的情况下,比如a.test.com和b.test.com适用于该方式。 只需要给页面添加document.domain ='test.com'表示二级域名都相同就可以实现跨域。 实现原理:两个页面都通过js强制设置document.domain为基础主域,就实现了同域。 我们看个例子:页面a.zf1.cn:3000/a.html获取页面b.zf1.cn:3000/b.html中a的值 // a.html <body> helloa <iframe src="http://b.zf1.cn:3000/b.html" frameborder="0" onload="load()" id="frame"></iframe> <script> document.domain = 'zf1.cn' function load() { console.log(frame.contentWindow.a); } </script> </body> // b.html <body> hellob <script> document.domain = 'zf1.cn' var a = 100; </script> </body> 三、总结 CORS支持所有类型的HTTP请求,是跨域HTTP请求的根本解决方案 JSONP只支持GET请求,JSONP的优势在于支持老式浏览器,以及可以向不支持CORS的网站请求数据。 不管是Node中间件代理还是nginx反向代理,主要是通过同源策略对服务器不加限制。 日常工作中,用得比较多的跨域方案是cors和nginx反向代理 点击关注,第一时间了解华为云新鲜技术~

优秀的个人博客,低调大师

每日一博 | 云原生场景下实现编译加速

作者:京东零售 王雷 背景 云原生下的流水线是通过启动容器来运行具体的功能步骤,每次运行流水线可能会被调度到不同的计算节点上。这会导致一个问题:容器运行完是不会保存数据的,每当流水线重新运行时,又会重新拉取代码、编译代码、下载依赖包等等。在云原生场景下,不存在本地宿主机编译代码、构建镜像时缓存的作用,大大延长了流水线运行时间,浪费很多不必要的时间、网络和计算成本。 在许多流水线场景中,同一条流水线的多次执行之间是有关联的。如果能够用到上一次的执行结果,则可以大幅缩短执行时间。为了提高用户使用流水线的体验,我们加入支持缓存的功能,挂接远程储存管理构建缓存,可以实现同一个项目的编译依赖复用,在同一条流水线的多次运行中,共享同一份缓存。 目标 通过实现云原生流水线的缓存技术,实现代码编译的缓存复用,平均加速流水线3~5倍; 实现方案 我们将需要进行缓存的文件,使用zstd的方式进行压缩,通过远程挂载cfs,将构建的缓存持久化到cfs上的指定位置。当下一次构建开始的时候,判断缓存是否被命中,如果命中缓存,我们从cfs上的指定位置pull对应的缓存压缩包,解压到相应目录下。 所用工具-cfs+zstd 非用户自定义镜像,将需要的工具打到引擎的基础镜像中,作为所有镜像的基础工具。 用户自定义镜像,不和用户镜像进行强绑定,如果需要使用缓存功能,可以使用Restore缓存原子和Save缓存原子,设置缓存key和缓存目录,实现缓存功能。 1 cfs远程挂载 •将工具和启动脚本,配置文件打到基础镜像 •在开启缓存的位置,启动脚本,开始挂载cfs _, err = c.ScriptAction.Sh([]string{ "sh", "-c", "modprobe fuse;cd /export/servers/tools/cfs;sudo ./cfs-client-randomwrite -c fuse.json", }) 2 zstd压缩 针对现有的几种压缩方式进行了性能对比,最后选用了zstd进行压缩。 Zstd,全称 Zstandard,是 Facebook 于 2016 年开源的新无损压缩算法。Zstd 还可以以压缩速度为代价提供更强的压缩比,速度与压缩率的比重可通过增量进行配置。与 zlib、lz4、xz 等当前流行的压缩算法不同,Zstd 寻求一种压缩性能与压缩率通吃的方案,而实际上它也确实做到了。在由官方所列出的表格中,可以看到,Zstd 不仅具备优秀的压缩性能,在压缩率上也有非常亮眼的表现。在过去的两年里,Linux内核、HTTP协议、以及一系列的大数据工具(包括Hadoop 3.0.0,HBase 2.0.0,Spark 2.3.0,Kafka 2.1.0)等都已经加入了对zstd的支持。 常见的压缩算法性能对比: 压缩包大小对比: 依赖包的大小 465M 压缩效率 tar压缩 423M 14s左右 zstd压缩 205M 1s左右 缓存的实现 我们借鉴了github cache action,zadig,gitlab等缓存的处理方式,同时结合服务自身的特点 将整体分成三步 •检查是否命中缓存:根据缓存key,判断缓存是否命中 缓存key 缓存的唯一标识 不同语言编译原子 根据下载代码的代码库地址自动获取 设置的缓存key:home_auth/home-auth-center 用户自定义镜像 自定义缓存key •pull缓存 当缓存命中后,根据缓存路径,找到挂载到cfs上的缓存压缩包,解压到指定的缓存目录下 •push缓存:将依赖包进行压缩,放到cfs的挂载目录下 依赖包的大小 465M tar压缩 423M zstd压缩 205M 缓存的使用限制和回收策略 使用限制 目前存储缓存数没有限制,存储库中所有缓存的总大小限制是根据申请的cfs的大小限制:20G。 回收策略 我们会删除7天内未被访问的任何缓存。利用etcd的watch机制,实现缓存的回收。 etcd可以Watch 指定的键、前缀目录的更改,并对更改时间进行通知。BASE引擎中,缓存的清除策略借助etcd来实现。 缓存过期策略:在编译加速的实现中,每个需要缓存的项目都有对应的缓存key,通过etcd监控key,并且设置过期时间,例如7天,如果在7天之内再次命中key,则通过lease进行续约;7天之内key都没有被使用,key就会过期删除,通过监听对应的前缀,在过期删除的时候,调用删除缓存的方法。 storage.Watch("cache/", func(id string) { //do nothing }, func(id string) { CleanCache(id) }) 不同技术栈的最佳实践 1 Java 以Maven构建工具为例,其默认配置文件位于conf/settings.xml文件中,默认指定环境变量$M2_HOME来设置缓存目录,这样同一条流水线多次执行可以复用 ${M2_HOME}/.m2 目录 (缓存目录),甚至同一个应用下的多个分支之间都可以使用同一个缓存目录,就像本地构建一样。  BASE执行 无缓存 平均时间:5.26min 有缓存 平均时间:41.462s 提升效率 提升87.3% 缓存命中率 接近100% 2 NodeJs 在nodejs编译中,我们的缓存目录是当前用户空间,针对node_modules文件进行压缩打包,push到cfs;如果缓存命中,从cfs上pull并且解压到当前用户空间下,恢复缓存。 使用举例  BASE执行 无缓存 平均时间:58s 有缓存 平均时间:29s 提升效率 提升50% 缓存命中率 接近100% 3 Golang编译 Golang 缓存路径通过$GOCACHE环境变量控制,将$GOCACHE的内容压缩成zstd的包,上传到cfs的指定路径下。pull缓存的时候,拉取到对应的$GOCACHE。  BASE执行 无缓存 平均时间:117s 有缓存 平均时间:18s 提升效率 提升84.6% 缓存命中率 接近100% 4 GCC编译 我们使用ccache进行缓存实现。ccache(“compilercache”的缩写)是一个编译器缓存,该工具会高速缓存编译生成的信息,并在编译的特定部分使用高速缓存的信息。ccache的缓存目录:CCACHE_DIR,我们将这个目录下的文件进行压缩,push到cfs,当第二次运行并且命中缓存,从cfs上pull并解压到CCACHE_DIR指定的目录下。 总结 在不同语言的编译原子内部,默认开启缓存的设置。第一次运行流水线的时候,会进行依赖的下载,第二次运行流水线,会命中缓存,无需进行依赖的下载,提高了流水线执行的效率。缓存默认保存7天。 自定义镜像进行缓存的最佳实践 为了满足用户使用自定义镜像的方式触发流水线,我们增加了两个通用的缓存原子。 Restore缓存:恢复缓存 Save缓存:保存缓存 在编译之前,添加Restore缓存原子 在编译之后,添加Save缓存原子 使用举例 在maven编译原子中,默认开启了maven编译的缓存;同时还有nodejs的编译构建,所以我们增加了restore原子和save原子  BASE执行 无缓存 平均时间:21min57s 其中maven: 17min83s nodejs: 4min19s 有缓存 平均时间:4min20s 其中maven: 1min10s nodejs: 2min36s 缓存效率提升 maven: 93.7% nodejs:39.8%(nodejs编译中有包含单元测试) 缓存命中率 接近100% 未来规划 •不同编译原子,向用户开放配置,如是否开启缓存,设置缓存key •实现不同语言编译原子增量push缓存功能

优秀的个人博客,低调大师

每日一博 | 巧用 Golang 泛型,简化代码编写

作者 | 百度小程序团队 导读 本文整理了很多的泛型应用技巧,结合具体的实际代码示例,特别是很多直接对Go语言内置的类库的实现进行改造,再通过两者在使用上直观对比,帮助大家对泛型使用思考上提供了更多思路,定会帮助大家在应用泛型能力上有很多的提升与启发。 全文16699字,预计阅读时间42分钟。 01 前言 泛型功能是Go语言在1.18版本引入的功能,可以说是Go语言开源以来最大的语法特性变化,其改动和影响都很大, 所以整个版本的开发周期,测试周期都比以往要长很多。接下来为了大家更好的理解文章中的代码示例,先再简单介绍一下 Go语言在1.18版本加入的泛型的基本使用方法。 从官方的资料来看,泛型增加了三个新的重要内容: 函数和类型新增对类型形参(type parameters)的支持。 将接口类型定义为类型集合,包括没有方法的接口类型。 支持类型推导,大多数情况下,调用泛型函数时可省略类型实参(type arguments)。 1.1 Type Parameter 参数泛型类型(Type Parameter)可以说是泛型使用过程应用最多的场景了, 一般应用于方法或函数的形参或返回参数上。 参数泛型类型基本的使用格式可参见如下: func FuncName[P, Q constraint1, R constraint2, ...](parameter1 P, parameter2 Q, ...) (R, Q, ...) 说明: 参数泛型类定义后,可以用于函数的形参或返回参数上。 下面是一个应用参数泛型类型的代码示例: // Min return the min one func Min[E int | int8 | int16 | int32 | int64 | uint | uint8 | uint16 | uint32 | uint64 | float32 | float64 | uintptr | ~string](x, y E) E { if x < y { return x } return y } 1.2 类型集合 Type Set 类型集合是为了简化泛型约束的使用,提升阅读性,同时增加了复用能力,方式他通过接口定义的方式使用。 编写格式参见如下: type Constraint1 interface { Type1 | ~Type2 | ... } 以下示例定义了有符号整型与无符号整型的泛型约束: // Signed is a constraint that permits any signed integer type. // If future releases of Go add new predeclared signed integer types, // this constraint will be modified to include them. type Signed interface { ~int | ~int8 | ~int16 | ~int32 | ~int64 } // Unsigned is a constraint that permits any unsigned integer type. // If future releases of Go add new predeclared unsigned integer types, // this constraint will be modified to include them. type Unsigned interface { ~uint | ~uint8 | ~uint16 | ~uint32 | ~uint64 | ~uintptr } 类型集合也支持继承的方式,简化复用。使用方式也接口的继承是完全一致。 以下示例定义把Signed和Unsigned进行了组合,用于表达对整型泛型约束的定义。 // Integer is a constraint that permits any integer type. // If future releases of Go add new predeclared integer types, // this constraint will be modified to include them. type Integer interface { Signed | Unsigned } 1.3 类型推导 引入类型推导,可以简化我们代码工作,目前支持2种类型推导功能。 通过函数的实参推导出来具体的类型以前提到的Min函数为例,可能通过传入的传数类型来判断推导。 var a, b uint minUint := Min(a, b) // 不再需要这样写 Min[uint](a, b) fmt.Println(minUint) minInt := Min(10, 100) // 常量数字,go语言会默认为 int类型,不再需要这样写 Min[int](a, b) fmt.Println(minInt) 02 巧用泛型,实现通用排序函数 对一个数组进行排序是在业务开发中使用非常频繁的功能,Go语言提供了sort.Sort函数,提供高效的排序功能支持,但它要求目标数组必须要实现 sort.Interface接口。 // An implementation of Interface can be sorted by the routines in this package. // The methods refer to elements of the underlying collection by integer index. type Interface interface { // Len is the number of elements in the collection. Len() int // Less reports whether the element with index i // must sort before the element with index j. // // If both Less(i, j) and Less(j, i) are false, // then the elements at index i and j are considered equal. // Sort may place equal elements in any order in the final result, // while Stable preserves the original input order of equal elements. // // Less must describe a transitive ordering: // - if both Less(i, j) and Less(j, k) are true, then Less(i, k) must be true as well. // - if both Less(i, j) and Less(j, k) are false, then Less(i, k) must be false as well. // // Note that floating-point comparison (the < operator on float32 or float64 values) // is not a transitive ordering when not-a-number (NaN) values are involved. // See Float64Slice.Less for a correct implementation for floating-point values. Less(i, j int) bool // Swap swaps the elements with indexes i and j. Swap(i, j int) } 这样导致我们对不同元素类型的数组,都需要重复实现这个接口,编写了很多类似的代码。下面是官方给的一个排序的示例,可以看到实现这样的排序功能,要写这么多代码。 type Person struct { Name string Age int } // ByAge implements sort.Interface for []Person based on // the Age field. type ByAge []Person func (a ByAge) Len() int { return len(a) } func (a ByAge) Swap(i, j int) { a[i], a[j] = a[j], a[i] } func (a ByAge) Less(i, j int) bool { return a[i].Age < a[j].Age } func main() { people := []Person{ {"Bob", 31}, {"John", 42}, {"Michael", 17}, {"Jenny", 26}, } fmt.Println(people) // There are two ways to sort a slice. First, one can define // a set of methods for the slice type, as with ByAge, and // call sort.Sort. In this first example we use that technique. sort.Sort(ByAge(people)) fmt.Println(people) // Output: // [Bob: 31 John: 42 Michael: 17 Jenny: 26] // [Michael: 17 Jenny: 26 Bob: 31 John: 42] } 下面我们应用泛型,编写一个通用的排序功能,可以支持任何类型的数组。大致思路是封装一个接受任何类型(any)的结构体sortable,来实现sort.Interface接口,把需要扩展的部分(比较处理)进行可设置化。主要的代码如下: // 通用化的排序实现 type sortable[E any] struct { data []E cmp base.CMP[E] } func (s sortable[E]) Len() int { return len(s.data) } func (s sortable[E]) Swap(i, j int) { s.data[i], s.data[j] = s.data[j], s.data[i] } func (s sortable[E]) Less(i, j int) bool { return s.cmp(s.data[i], s.data[j]) >= 0 } 接入下来,实现一个支持泛型的排序函数,对任何类型的数组进行排序。 func Sort[E any](data []E, cmp base.CMP[E]) { sortobject := sortable[E]{data: data, cmp: cmp} sort.Sort(sortobject) } 至此,我们就已经实现一个通用的排序函数了, 应用这个函数,上面官方给出的排序实现就可以简化如下: type Person struct { Name string Age int } people := []Person{ {"Bob", 31}, {"John", 42}, {"Michael", 17}, {"Jenny", 26}, } people = Sort(people, func(e1, e2 Person) int { return e1.Age - e2.Age }) // Output: // [Michael: 17 Jenny: 26 Bob: 31 John: 42] 可以看到, 应用泛型后,只需要简单的一个函数调用就可以了。 完整的代码实现可参见:https://github.com/jhunters/goassist/blob/main/arrayutil/array.go 03 巧用泛型,简化strconv.Append系列函数 Go语言内置的strconv包的api也是日常开发经常使用的, 它提供的Append系列函数可以实现高效的字符串拼接功能,但因为Go语言不支持重载,所以会看到因为接受参数类型的不同,需要选择不同的函数。 func AppendBool(dst []byte, b bool) []byte func AppendFloat(dst []byte, f float64, fmt byte, prec, bitSize int) []byte func AppendInt(dst []byte, i int64, base int) []byte func AppendQuote(dst []byte, s string) []byte func AppendQuoteRune(dst []byte, r rune) []byte func AppendQuoteRuneToASCII(dst []byte, r rune) []byte func AppendQuoteRuneToGraphic(dst []byte, r rune) []byte func AppendQuoteToASCII(dst []byte, s string) []byte func AppendQuoteToGraphic(dst []byte, s string) []byte func AppendUint(dst []byte, i uint64, base int) []byte 所以我们不得不面临以下使用的窘境。 // append bool b := []byte("bool:") b = strconv.AppendBool(b, true) fmt.Println(string(b)) // append int b10 := []byte("int (base 10):") b10 = strconv.AppendInt(b10, -42, 10) fmt.Println(string(b10)) // append quote b := []byte("quote:") b = strconv.AppendQuote(b, `"Fran & Freddie's Diner"`) fmt.Println(string(b)) 接下来,我们用泛型来简化一下代码,让其只需要一个函数就能搞定, 直接上代码如下: // Append convert e to string and appends to dst func Append[E any](dst []byte, e E) []byte { toAppend := fmt.Sprintf("%v", e) return append(dst, []byte(toAppend)...) } 再来看看应用后的效果,修改之前的示例: // append bool b := []byte("bool:") b = conv.Append(b, true) fmt.Println(string(b)) // append int b10 := []byte("int:") b10 = conv.Append(b10, -42) fmt.Println(string(b10)) // append quote b = []byte("quote:") b = conv.Append(b, `"Fran & Freddie's Diner"`) fmt.Println(string(b)) 04 巧用泛型,实现通用heap容器,简化使用 Go语言container/heap包提供了一个优先级队列功能, 以实现在Pop数里时,总是优先获得优先级最高的节点。 同样的问题,如果要应用heap包的功能,针对不同的对象,必须要 实现 heap.Interface接口, 包括5个方法。 // The Interface type describes the requirements // for a type using the routines in this package. // Any type that implements it may be used as a // min-heap with the following invariants (established after // Init has been called or if the data is empty or sorted): // // !h.Less(j, i) for 0 <= i < h.Len() and 2*i+1 <= j <= 2*i+2 and j < h.Len() // // Note that Push and Pop in this interface are for package heap's // implementation to call. To add and remove things from the heap, // use heap.Push and heap.Pop. type Interface interface { sort.Interface Push(x any) // add x as element Len() Pop() any // remove and return element Len() - 1. } 下面的代码示例是来自Go语言官方,实现了对Int类型元素的优先级队列实现: import ( "container/heap" "fmt" ) // An IntHeap is a min-heap of ints. type IntHeap []int func (h IntHeap) Len() int { return len(h) } func (h IntHeap) Less(i, j int) bool { return h[i] < h[j] } func (h IntHeap) Swap(i, j int) { h[i], h[j] = h[j], h[i] } func (h *IntHeap) Push(x any) { // Push and Pop use pointer receivers because they modify the slice's length, // not just its contents. *h = append(*h, x.(int)) } func (h *IntHeap) Pop() any { old := *h n := len(old) x := old[n-1] *h = old[0 : n-1] return x } // This example inserts several ints into an IntHeap, checks the minimum, // and removes them in order of priority. func Example_intHeap() { h := &IntHeap{2, 1, 5} heap.Init(h) heap.Push(h, 3) fmt.Printf("minimum: %d\n", (*h)[0]) for h.Len() > 0 { fmt.Printf("%d ", heap.Pop(h)) } // Output: // minimum: 1 // 1 2 3 5 } 看到上面写了这么多的代码才把功能实现, 想必大家都觉得太繁琐了吧? 那我们用泛型来改造一下,大致思路如下: 实现一个支持泛型参数的结构体heapST,实现heap.Interface接口。 开放比较函数的功能,用于使用方来更灵活的设置排序要求。 封装一个全新的带泛型参数传入Heap结构体, 来封装Pop与Push方法的实现。 主要的代码实现如下: type heapST[E any] struct { data []E cmp base.CMP[E] } // implments the methods for "heap.Interface" func (h *heapST[E]) Len() int { return len(h.data) } func (h *heapST[E]) Less(i, j int) bool { v := h.cmp(h.data[i], h.data[j]) return v < 0 } func (h *heapST[E]) Swap(i, j int) { h.data[i], h.data[j] = h.data[j], h.data[i] } func (h *heapST[E]) Push(x any) { // Push and Pop use pointer receivers because they modify the slice's length, // not just its contents. v := append(h.data, x.(E)) h.data = v } func (h *heapST[E]) Pop() any { old := h.data n := len(old) x := old[n-1] h.data = old[0 : n-1] return x } // Heap base on generics to build a heap tree for any type type Heap[E any] struct { data *heapST[E] } // Push pushes the element x onto the heap. // The complexity is O(log n) where n = h.Len(). func (h *Heap[E]) Push(v E) { heap.Push(h.data, v) } // Pop removes and returns the minimum element (according to Less) from the heap. // The complexity is O(log n) where n = h.Len(). // Pop is equivalent to Remove(h, 0). func (h *Heap[E]) Pop() E { return heap.Pop(h.data).(E) } func (h *Heap[E]) Element(index int) (e E, err error) { if index < 0 || index >= h.data.Len() { return e, fmt.Errorf("out of index") } return h.data.data[index], nil } // Remove removes and returns the element at index i from the heap. // The complexity is O(log n) where n = h.Len(). func (h *Heap[E]) Remove(index int) E { return heap.Remove(h.data, index).(E) } func (h *Heap[E]) Len() int { return len(h.data.data) } // Copy to copy heap func (h *Heap[E]) Copy() *Heap[E] { ret := heapST[E]{cmp: h.data.cmp} ret.data = make([]E, len(h.data.data)) copy(ret.data, h.data.data) heap.Init(&ret) return &Heap[E]{&ret} } // NewHeap return Heap pointer and init the heap tree func NewHeap[E any](t []E, cmp base.CMP[E]) *Heap[E] { ret := heapST[E]{data: t, cmp: cmp} heap.Init(&ret) return &Heap[E]{&ret} } 完整的代码获取:https://github.com/jhunters/goassist/blob/main/container/heapx/heap.go 接入来可以改写之前的代码, 代码如下: // An IntHeap is a min-heap of ints. type IntHeap []int // This example inserts several ints into an IntHeap, checks the minimum, // and removes them in order of priority. func Example_intHeap() { h := heapx.NewHeap(IntHeap{2, 1, 5}, func(p1, p2 int) int { return p1 - p2 }) h.Push(3) for h.Len() > 0 { fmt.Printf("%d ", h.Pop()) } // Output: // 1 2 3 5 } 可以看到改写后,代码量大量减少,而且代码的可读性也大大提升. 完整的使用示例可参见:https://github.com/jhunters/goassist/blob/main/container/heapx/heap_test.go 05 巧用泛型,提升Pool容器可读性与安全性 Go语言内存的sync包下Pool对象, 提供了可伸缩、并发安全的临时对象池的功能,用来存放已经分配但暂时不用的临时对象,通过对象重用机制,缓解 GC 压力,提高程序性能。需要注意的是Pool 是一个临时对象池,适用于储存一些会在 goroutine 间共享的临时对象,其中保存的任何项都可能随时不做通知地释放掉,所以不适合当于缓存或对象池的功能。 Pool的框架代码如下: type Pool struct { // New optionally specifies a function to generate // a value when Get would otherwise return nil. // It may not be changed concurrently with calls to Get. New func() interface{} // contains filtered or unexported fields } // Get 从 Pool 中获取元素。当 Pool 中没有元素时,会调用 New 生成元素,新元素不会放入 Pool 中。若 New 未定义,则返回 nil。 func (p *Pool) Get() interface{} // Put 往 Pool 中添加元素 x。 func (p *Pool) Put(x interface{}) 官方Pool的API使用起来已经是非常方便,下面是摘取官方文档中的示例代码: package sync_test import ( "bytes" "io" "os" "sync" "time" ) var bufPool = sync.Pool{ New: func() any { // The Pool's New function should generally only return pointer // types, since a pointer can be put into the return interface // value without an allocation: return new(bytes.Buffer) }, } // timeNow is a fake version of time.Now for tests. func timeNow() time.Time { return time.Unix(1136214245, 0) } func Log(w io.Writer, key, val string) { b := bufPool.Get().(*bytes.Buffer) b.Reset() // Replace this with time.Now() in a real logger. b.WriteString(timeNow().UTC().Format(time.RFC3339)) b.WriteByte(' ') b.WriteString(key) b.WriteByte('=') b.WriteString(val) w.Write(b.Bytes()) bufPool.Put(b) } func ExamplePool() { Log(os.Stdout, "path", "/search?q=flowers") // Output: 2006-01-02T15:04:05Z path=/search?q=flowers } 从上面的代码,可以看到一个问题就是从池中获取对象时,要强制进行转换,如果转换类型不匹配,就会出现Panic异常,这种场景正是泛型可以很好解决的场景,我们改造代码如下, 封装一个全新的带泛型参数传入 Pool 结构体: package syncx import ( "sync" "github.com/jhunters/goassist/base" ) type Pool[E any] struct { New base.Supplier[E] internal sync.Pool } // NewPoolX create a new PoolX func NewPool[E any](f base.Supplier[E]) *Pool[E] { p := Pool[E]{New: f} p.internal = sync.Pool{ New: func() any { return p.New() }, } return &p } // Get selects an E generic type item from the Pool func (p *Pool[E]) Get() E { v := p.internal.Get() return v.(E) } // Put adds x to the pool. func (p *Pool[E]) Put(v E) { p.internal.Put(v) } 接下来,使用新封装的Pool对象改写上面的官方示例代码: var bufPool = syncx.NewPool(func() *bytes.Buffer { return new(bytes.Buffer) }) // timeNow is a fake version of time.Now for tests. func timeNow() time.Time { return time.Unix(1136214245, 0) } func Log(w io.Writer, key, val string) { b := bufPool.Get() // 不再需要强制类型转换 b.Reset() // Replace this with time.Now() in a real logger. b.WriteString(timeNow().UTC().Format(time.RFC3339)) b.WriteByte(' ') b.WriteString(key) b.WriteByte('=') b.WriteString(val) w.Write(b.Bytes()) bufPool.Put(b) } func ExamplePool() { Log(os.Stdout, "path", "/search?q=flowers") // Output: 2006-01-02T15:04:05Z path=/search?q=flowers } 完整的代码实现与使用示例可参见:https://github.com/jhunters/goassist/tree/main/concurrent/syncx 06 巧用泛型,增强sync.Map容器功能 sync.Map是Go语言官方提供的一个map映射的封装实现,提供了一些更实用的方法以更方便的操作map映射,同时它本身也是线程安全的,包括原子化的更新支持。 type Map func (m *Map) Delete(key any) func (m *Map) Load(key any) (value any, ok bool) func (m *Map) LoadAndDelete(key any) (value any, loaded bool) func (m *Map) LoadOrStore(key, value any) (actual any, loaded bool) func (m *Map) Range(f func(key, value any) bool) func (m *Map) Store(key, value any) 接入来我们要用泛型功能,给sync.Map增加如下功能: 所有的操作支持泛型,以省去对象强制转换功能 引入泛型后,保障了key与value类型的一致性,可以扩展支持 Key或Value是否存在, 查询最小最大Key或Value的功能 另外还增加了StoreAll 从另一个map导入, ToMap转成原生map结构, Clear清空map, 以数组结构导出key或value等实用功能 增加后Map的API列表如下: type Map func NewMap[K comparable, V any]() *Map[K, V] func (m *Map[K, V]) Clear() func (m *Map[K, V]) Copy() *Map[K, V] func (m *Map[K, V]) Exist(key K) bool func (m *Map[K, V]) ExistValue(value V) (k K, exist bool) func (m *Map[K, V]) ExistValueWithComparator(value V, equal base.EQL[V]) (k K, exist bool) func (m *Map[K, V]) Get(key K) (V, bool) func (m *Map[K, V]) IsEmpty() (empty bool) func (m *Map[K, V]) Keys() []K func (m *Map[K, V]) MaxKey(compare base.CMP[K]) (key K, v V) func (m *Map[K, V]) MaxValue(compare base.CMP[V]) (key K, v V) func (m *Map[K, V]) MinKey(compare base.CMP[K]) (key K, v V) func (m *Map[K, V]) MinValue(compare base.CMP[V]) (key K, v V) func (m *Map[K, V]) Put(key K, value V) V func (m *Map[K, V]) Range(f base.BiFunc[bool, K, V]) func (m *Map[K, V]) Remove(key K) bool func (m *Map[K, V]) Size() int func (m *Map[K, V]) ToMap() map[K]V func (m *Map[K, V]) Values() []V 完整的API列表在此阅读:http://localhost:4040/pkg/github.com/jhunters/goassist/container/mapx/ 部分泛型代码后的代码如下: // Map is like a Go map[interface{}]interface{} but is safe for concurrent use // by multiple goroutines without additional locking or coordination. // Loads, stores, and deletes run in amortized constant time. // By generics feature supports, all api will be more readable and safty. // // The Map type is specialized. Most code should use a plain Go map instead, // with separate locking or coordination, for better type safety and to make it // easier to maintain other invariants along with the map content. // // The Map type is optimized for two common use cases: (1) when the entry for a given // key is only ever written once but read many times, as in caches that only grow, // or (2) when multiple goroutines read, write, and overwrite entries for disjoint // sets of keys. In these two cases, use of a Map may significantly reduce lock // contention compared to a Go map paired with a separate Mutex or RWMutex. // // The zero Map is empty and ready for use. A Map must not be copied after first use. type Map[K comparable, V any] struct { mp sync.Map empty V mu sync.Mutex } // NewMap create a new map func NewMap[K comparable, V any]() *Map[K, V] { return &Map[K, V]{mp: sync.Map{}} } // NewMapByInitial create a new map and store key and value from origin map func NewMapByInitial[K comparable, V any](mmp map[K]V) *Map[K, V] { mp := NewMap[K, V]() if mmp == nil { return mp } for k, v := range mmp { mp.Store(k, v) } return mp } // Exist return true if key exist func (m *Map[K, V]) Exist(key K) bool { _, ok := m.mp.Load(key) return ok } // ExistValue return true if value exist func (m *Map[K, V]) ExistValue(value V) (k K, exist bool) { de := reflectutil.NewDeepEquals(value) m.Range(func(key K, val V) bool { if de.Matches(val) { exist = true k = key return false } return true }) return } // ExistValue return true if value exist func (m *Map[K, V]) ExistValueWithComparator(value V, equal base.EQL[V]) (k K, exist bool) { m.Range(func(key K, val V) bool { if equal(value, val) { exist = true k = key return false } return true }) return } // ExistValue return true if value exist func (m *Map[K, V]) ExistValueComparable(v base.Comparable[V]) (k K, exist bool) { m.Range(func(key K, val V) bool { if v.CompareTo(val) == 0 { exist = true k = key return false } return true }) return } // MinValue to return min value in the map func (m *Map[K, V]) MinValue(compare base.CMP[V]) (key K, v V) { return selectByCompareValue(m, func(o1, o2 V) int { return compare(o1, o2) }) } // MaxValue to return max value in the map func (m *Map[K, V]) MaxValue(compare base.CMP[V]) (key K, v V) { return selectByCompareValue(m, func(o1, o2 V) int { return compare(o2, o1) }) } // MinKey to return min key in the map func (m *Map[K, V]) MinKey(compare base.CMP[K]) (key K, v V) { return selectByCompareKey(m, func(o1, o2 K) int { return compare(o1, o2) }) } // MaxKey to return max key in the map func (m *Map[K, V]) MaxKey(compare base.CMP[K]) (key K, v V) { return selectByCompareKey(m, func(o1, o2 K) int { return compare(o2, o1) }) } 完整的代码与使用示例参见: [1]https://github.com/jhunters/goassist/blob/main/concurrent/syncx/map.go [2]https://github.com/jhunters/goassist/blob/main/concurrent/syncx/example_map_test.go 07 总结 应用泛型可以极大的减少代码的编写量,同时提升可读性与安全性都有帮助,上面提到的对于泛型的使用技巧只能是很少一部分,还有更多的case等待大家来发现。另外对泛型感兴趣的同学,也推荐大家阅读这个开源项目 https://github.com/jhunters/goassist 里面有非常多经典的泛型使用技巧,相信对大家理解与掌握泛型会有很多帮助。 ——END—— 参考资料: [1] Go语言官方泛型使用介绍: https://golang.google.cn/doc/tutorial/generics [2]《using generics in go by Ian》Go语言泛型专题分享: https://www.bilibili.com/video/BV1KP4y157rn/?p=1&share_medium=iphone&share_plat=ios&share_session_id=B63420EF-45D0-4464-A195-F27C13188C75&share_source=WEIXIN&share_tag=s_i&timestamp=1636179512&unique_k=ORZiX1 [3]专为Go语言开发者提供一套基础api库,包括了非常多的泛型应用: https://github.com/jhunters/goassist 推荐阅读: Diffie-Hellman密钥协商算法探究 贴吧低代码高性能规则引擎设计 浅谈权限系统在多利熊业务应用 分布式系统关键路径延迟分析实践 百度工程师教你玩转设计模式(装饰器模式) 百度工程师带你体验引擎中的nodejs
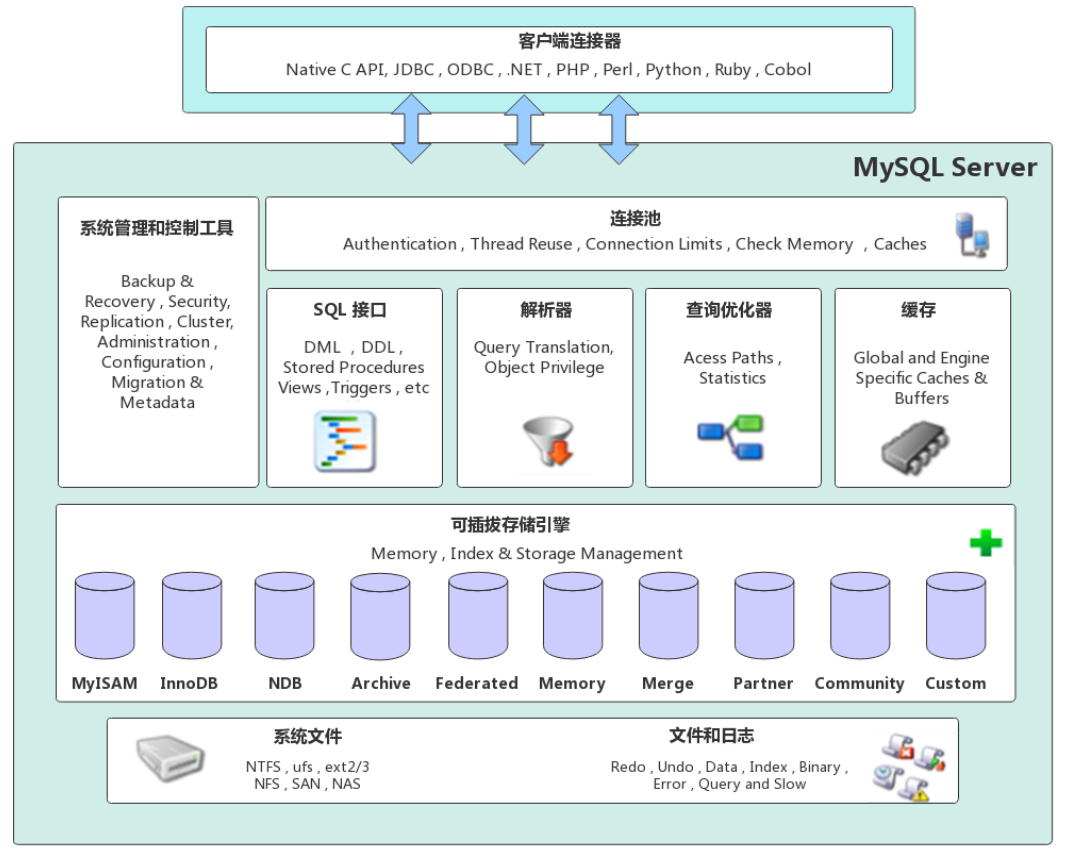
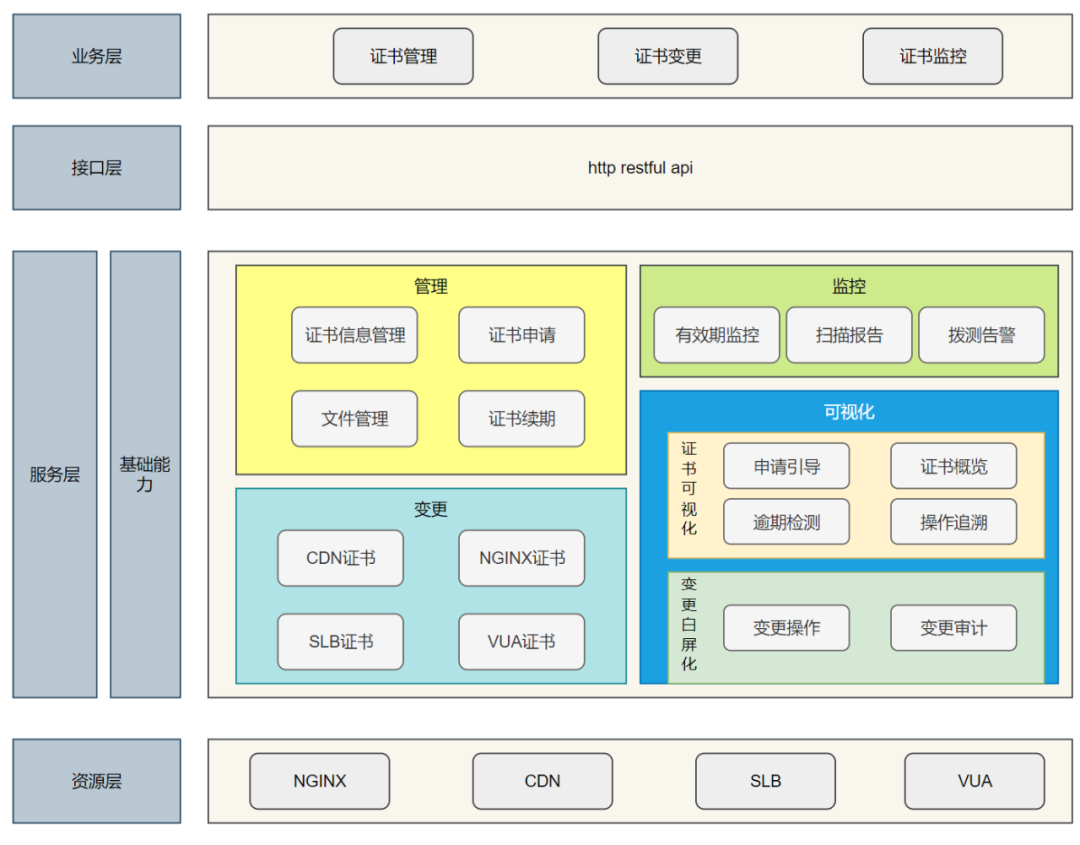
优秀的个人博客,低调大师

每日一博 | 35 张图,直观理解 Stable Diffusion

作者|Jay Alammar 翻译|杨婷、徐佳渝 最近,AI图像生成引人注目,它能够根据文字描述生成精美图像,这极大地改变了人们的图像创作方式。 Stable Diffusion 作为一款高性能模型,它生成的图像质量更高、运行速度更快、消耗的资源以及内存占用更小,是AI图像生成领域的里程碑。 在接触了AI图像生成以后,你可能会好奇这些模型背后的工作原理。 下面是对Stable Diffusion工作原理的概述。 Stable Diffusion用途多样,是一款多功能模型。首先它可以根据文本生成图像(text2img)。上图是从文本输入到图像生成的示例。除此之外,我们还可以使用Stable Diffusion来替换、更改图像(这时我们需要同时输入文本和图像)。 下面是Stable Diffusion的内部结构,了解内部结构可以让我们更好地理解Stable Diffusion的组成、各组成部分的交互方式、以及各种图像生成选项/参数的含义。 1 Stable Diffusion的组成 Stable Diffusion并不是一个单一模型,而是由多个部分和模型一起构成的系统。 从内部来看,首先我们可以看到一个文本理解组件,这个组件将文本信息转化为数字表示(numeric representation)以捕捉文本意图。 这部分主要对ML进行大概介绍,文章后续还会讲解更多细节。可以说这个文本理解组件(文本编码器)是一个特殊的Transformer语言模型(严格来说它是一个CLIP模型的文本编码器)。将文本输入到 Clip 文本编码器得到特征列表,对于文本中的每一个word/token 都有会得到一个向量特征。 然后将文本特征作为图像生成器的输入,图像生成器又由几部分组成。 图像生成器两步骤: 1-图像信息创建器(Image information creator) 图像信息创建器是Stable Diffusion特有的关键部分,也是其性能远超其他模型的原因。 图像信息创建器运行多个step生成图像信息。Stable Diffusion接口(interfaces)和库(libraries)的step参数一般默认为50或100。 图像信息创建器完全在图像信息空间(亦称潜在空间)上运行,这让Stable Diffusion比以前在像素空间(pixel space)上运行的扩散模型速度更快。从技术上讲,图像信息创建器由UNet神经网络和调度算法组成。 “扩散”一词描述了图像信息创建器中发生的事情。因为图像信息创建器对信息作了逐步处理,所以图像解码器(image decoder)才能随后产出高质量图像。 2-图像解码器(Image Decoder) 图像解码器根据图像信息创建器的信息绘制图像,它只用在过程结束时运行一次,以生成最终的像素图像。 这样就构成了Stable Diffusion的三个主要组成部分,每个部分都有自己的神经网络: ClipText:用于文本编码。输入: 文本。输出: 77个token embeddings向量,每个向量有768维。 UNet+调度程序:在信息(潜在)空间中逐步处理信息。输入: 文本embeddings和一个初始化的多维数组(结构化的数字列表,也称为张量)组成的噪声。输出:经过处理的信息数组。 自动编码解码器(Autoencoder Decoder):使用经过处理的信息数组绘制最终图像。输入:经过处理的信息数组(维数:(4,64,64))输出: 生成的图像(维数:(3,512,512),即(红/绿/蓝;宽,高))。 2 到底何为扩散(Diffusion)? 扩散是发生在粉色区域图像信息创建器组件中的过程。这一部分有一个表示输入文本的token embeddings和一个随机初始化的图像信息数组,这些数组也被称为latents,在这个过程中会产生一个信息数组,图像解码器(Image Decoder)使用这个信息数组生成最终图像。 扩散是循序渐进逐步发生的,每一步都会增加更多的相关信息。为了更加直观地了解这个过程,我们可以检查随机latents数组,看它是否转化为了视觉噪音(visual noise)。在这种情况下,视觉检查(Visual inspection)是通过图像解码器进行的。 扩散分为多个step,每个step都在输入的latents数组上运行,并且会产生另一个latents数组,这个数组更类似于输入文本以及模型在模型训练时的所有图像中获取的所有视觉信息。 我们可以对一组这样的latents数组执行可视化,看看每一步都添加了什么信息。这一过程令人叹为观止。 视频链接: 在这种情况下,步骤2和4之间发生了一些特别有意思的事情,就好像轮廓是从噪音中浮现出来的。 3 Diffusion的工作原理 扩散模型图像生成的核心是强大的计算机视觉模型。在足够大的数据集的基础上,这些模型可以学会很多复杂运算。扩散模型通过如下方式建构问题来实现图像生成: 假设我们有一个图像,我们首先生成一些噪音(noise),然后将这些噪音添加到图像上。 我们可以将这看成是一个训练示例。之后我们使用同样的公式去创建更多的训练示例,然后用这些示例去训练图像生成模型的中心组件。 虽然这个例子展示了从图像(总量0,没有噪音)到总噪音(总量4,总噪音)的一些噪音值,但是我们可以轻松控制向图像中添加的噪音,因此我们可以将其分为数十个step,为数据集中的每个图像创建数十个训练示例。 有了这个数据集,我们可以训练噪音预测器(noise predictor),并最终得到一个在特定配置下运行时可以创建图像的预测器。接触过ML的人会觉得训练步骤非常熟悉: 接下来我们来看看Stable Diffusion是如何生成图像的。 4 通过降噪绘图 经过训练的噪音预测器可以对噪音图像进行降噪处理,并且可以预测噪音。 因为样本噪音(sampled noise)被预测,所以如果我们从图像中去掉这个样本,我们得到的图像就会更接近模型训练的图像。(这个图像不是确切的图像本身,而是图像分布,也就是图像的像素排列,在像素排列中天空通常是蓝色的,高于地面,人有两只眼睛,猫有尖耳朵并且总是懒洋洋的)。 如果训练数据集中的图像比较美观,比如说Stable Diffusion训练的LAION Aesthetics , 那么训练出来的图像的可观赏性也会更高。如果我们在logo图像上对其进行训练,那么我们最终会得到一个logo生成模型。 这里总结了扩散模型处理图像生成的过程,主要如论文Denoising Diffusion Probabilistic Models所述。相信你对扩散的含义有了一定的了解,知道了Stable Diffusion、Dall-E 2和谷歌Imagen的主要组件。 值得注意的是,到目前为止我们所描述的扩散过程,没有使用任何文本数据,只需运行模型就能生成精美图像。不过我们无法控制图像的内容,它可能是一座金字塔,也可能是一只猫。接下来,我们将讨论如何将文本信息融入扩散过程以控制图片类型。 5 速度提升:在压缩(Latent)数据中扩散 为了加快图像生成过程,Stable Diffusion论文没有在像素图像上进行运行,而是在图像的压缩版本上运行。论文将这称为前往潜在空间(Departure to Latent Space)。 压缩(随后是解压缩/绘图)通过编码器完成。自动编码器使用Image Encoder将图像压缩进潜空间,然后使用Image Decoder再对压缩信息进行重构。 正向扩散在潜空间上完成。噪声信息应用于潜空间,而不是应用于像素图象。因此,训练噪声预测器(noise predictor)实际上是为了预测压缩表示(compressed representation)上的噪音,这个压缩表示也被称为潜空间(latent space)。 正向扩散是使用Image Encoder生成图像数据,来训练噪声预测器。训练一旦完成,就可以执行反向扩散,使用Image Decoder生成图像。 LDM/Stable Diffusion论文的图3中提及了这两个过程: 上图还显示了“conditioning”组件,这个组件在本例中是描述模型生成图像的文本提示词(text prompts)。接下来,我们继续探讨文本组件。 6 文本编码器:一种Transformer语言模型 Transformer语言模型作为语言理解组件,能够接受文本提示词,生成token embeddings。Stable Diffusion模型使用的是ClipText(基于GPT的模型),而论文中采用的是BERT。 Imagen论文表明,语言模型的选择相当重要。相较于较大的图像生成组件,较大的语言模型组件对生成图像的质量影响更大。 较大的/更好的语言模型对图像生成模型的质量有巨大的影响。资料来源:Saharia等人所著论文Google Imagen中的图A.5。 早期的Stable Diffusion模型仅使用了OpenAI发布的预训练模型ClipText。未来模型可能转向新发布的更大的CLIP变体OpenCLIP。(更新于2022 年 11 月,详情见 Stable Diffusion V2 uses OpenClip 。与仅含有630万文本模型参数的ClipText相比,OpenCLIP文本模型参数多达3.54亿。) 7 如何训练CLIP CLIP模型是在图像和图像说明数据集上训练的。我们可以设想这样一个数据集,它里面有4亿张图像以及这些图像说明的材料。 图像及图像说明数据集 实际上,CLIP是在网络上抓取的带有“alt”标签的图像上训练的。CLIP是图像编码器和文本编码器的结合。简单来说,训练CLIP就是分别对图像和图像文本说明进行编码。 然后,使用余弦相似度来比较生成的embeddings。刚开始训练时,即使文本正确描述了图像,相似度也会很低。 我们更新了这两个模型,这样下次嵌入它们时就可以得到相似的embeddings。 通过在数据集上重复此操作并使用大的batch size,最终使编码器能够生成图像和文本说明相似的embeddings。如 word2vec ,训练过程也需要包含不匹配的图像和文本说明作为负样本,以得到较低的相似度分数。 8 将文本信息融入图像生成过程 为了使文本融入图像生成,我们须调整噪声预测器来输入文本。 现在,在数据集中加入文本。因为我们是在潜空间中运行,所以输入的图像和预测的噪声都处于潜空间中。 为了更好地理解UNet中文本tokens的使用方式,下面我们将进一步探究UNet模型。 Unet噪声预测器的Layers(未使用文本) 首先来看没有使用文本的UNet,其输入和输出如下: 可以看到: UNet是一系列用于转换latents数组的layers 每一layer都对前一个layer的输出进行操作 Some of the outputs are fed (via residual connections) into the processing later in the network 通过残差连接(residual connections),将网络前面的layer输出送入到后面的layer进行处理 时间步长被转化为embedding向量,在网络层中使用 Unet噪声预测器中的Layers (带文本) 现在让我们看看如何改变该系统以增加对文本的关注度。 为了给文本输入提供支持,也就是专业上所说的文本条件(text conditioning),我们需要在系统的 ResNet blocks之间添加一个注意力层(attention layer)。 文本信息不直接由ResNet处理,而是通过注意力层将这些文本表示融入到latents中。这样,下一个ResNet就能在处理过程中利用融入的文本信息。 9 总结 希望本文能帮助你深入了解Stable Diffusion的运作机制。虽然还涉及到许多其他概念,但是只要熟悉了以上板块,这些概念就会变得很容易理解。下面是一些我认为很有用的资源。 资源 https://www.youtube.com/shorts/qL6mKRyjK-0 https://huggingface.co/blog/stable_diffusion https://huggingface.co/blog/annotated-diffusion https://www.youtube.com/watch?v=J87hffSMB60 https://www.youtube.com/watch?v=ltLNYA3lWAQ https://ommer-lab.com/research/latent-diffusion-models/ https://lilianweng.github.io/posts/2021-07-11-diffusion-models/ https://www.youtube.com/watch?v=_7rMfsA24Ls (本文在遵循CC BY-NC-SA 4.0协议的基础上由OneFlow编译发布,译文转载请联系获得授权。原文:Alammar, J (2018). The Illustrated Transformer [Blog post].https://jalammar.github.io/illustrated-stable-diffusion/) 其他人都在看 编程的终结;展望2023年AI系统方向 ChatGPT的一小步,NLP范式转变的一大步 2023年AI十大展望:GPT-4领衔大模型变革 李白:你的模型权重很不错,可惜被我没收了 OpenAI掌门Sam Altman:AI下一个发展阶段 比快更快,开源Stable Diffusion刷新作图速度 OneEmbedding:单卡 训练TB级推荐模型不是梦 欢迎Star、试用OneFlow最新版本:https://github.com/Oneflow-Inc/oneflow/ 本文分享自微信公众号 - OneFlow(OneFlowTechnology)。 如有侵权,请联系 support@oschina.cn 删除。 本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

优秀的个人博客,低调大师

每日一博 | ChatGPT 背后的功臣 —— RLHF 技术详解

OpenAI 推出的 ChatGPT 对话模型掀起了新的 AI 热潮,它面对多种多样的问题对答如流,似乎已经打破了机器和人的边界。这一工作的背后是大型语言模型 (Large Language Model,LLM) 生成领域的新训练范式:RLHF (Reinforcement Learning from Human Feedback) ,即以强化学习方式依据人类反馈优化语言模型。 过去几年里各种 LLM 根据人类输入提示 (prompt) 生成多样化文本的能力令人印象深刻。然而,对生成结果的评估是主观和依赖上下文的,例如,我们希望模型生成一个有创意的故事、一段真实的信息性文本,或者是可执行的代码片段,这些结果难以用现有的基于规则的文本生成指标 (如 BLUE 和 ROUGE) 来衡量。除了评估指标,现有的模型通常以预测下一个单词的方式和简单的损失函数 (如交叉熵) 来建模,没有显式地引入人的偏好和主观意见。 如果我们 用生成文本的人工反馈作为性能衡量标准,或者更进一步用该反馈作为损失来优化模型,那不是更好吗?这就是 RLHF 的思想:使用强化学习的方式直接优化带有人类反馈的语言模型。RLHF 使得在一般文本数据语料库上训练的语言模型能和复杂的人类价值观对齐。 看看 ChatGPT 是如何解释 RLHF 的: ChatGPT 解释的很好,但还没有完全讲透;让我们更具体一点吧! RLHF 技术分解 RLHF 是一项涉及多个模型和不同训练阶段的复杂概念,这里我们按三个步骤分解: 预训练一个语言模型 (LM) ; 聚合问答数据并训练一个奖励模型 (Reward Model,RM) ; 用强化学习 (RL) 方式微调 LM。 Step 1. 预训练语言模型 首先,我们使用经典的预训练目标训练一个语言模型。对这一步的模型,OpenAI 在其第一个流行的 RLHF 模型 InstructGPT 中使用了较小版本的 GPT-3; Anthropic 使用了 1000 万 ~ 520 亿参数的 Transformer 模型进行训练;DeepMind 使用了自家的 2800 亿参数模型 Gopher。 这里可以用额外的文本或者条件对这个 LM 进行微调,例如 OpenAI 对 “更可取” (preferable) 的人工生成文本进行了微调,而 Anthropic 按 “有用、诚实和无害” 的标准在上下文线索上蒸馏了原始的 LM。这里或许使用了昂贵的增强数据,但并不是 RLHF 必须的一步。由于 RLHF 还是一个尚待探索的领域,对于” 哪种模型” 适合作为 RLHF 的起点并没有明确的答案。 接下来,我们会基于 LM 来生成训练奖励模型 (RM,也叫偏好模型) 的数据,并在这一步引入人类的偏好信息。 Step 2. 训练奖励模型 RM 的训练是 RLHF 区别于旧范式的开端。这一模型接收一系列文本并返回一个标量奖励,数值上对应人的偏好。我们可以用端到端的方式用 LM 建模,或者用模块化的系统建模 (比如对输出进行排名,再将排名转换为奖励) 。这一奖励数值将对后续无缝接入现有的 RL 算法至关重要。 关于模型选择方面,RM 可以是另一个经过微调的 LM,也可以是根据偏好数据从头开始训练的 LM。例如 Anthropic 提出了一种特殊的预训练方式,即用偏好模型预训练 (Preference Model Pretraining,PMP) 来替换一般预训练后的微调过程。因为前者被认为对样本数据的利用率更高。但对于哪种 RM 更好尚无定论。 关于训练文本方面,RM 的提示 - 生成对文本是从预定义数据集中采样生成的,并用初始的 LM 给这些提示生成文本。Anthropic 的数据主要是通过 Amazon Mechanical Turk 上的聊天工具生成的,并在 Hub 上可用 (https://huggingface.co/datasets/Anthropic/hh-rlhf),而 OpenAI 使用了用户提交给 GPT API 的 prompt。 关于训练奖励数值方面,这里需要人工对 LM 生成的回答进行排名。起初我们可能会认为应该直接对文本标注分数来训练 RM,但是由于标注者的价值观不同导致这些分数未经过校准并且充满噪音。通过排名可以比较多个模型的输出并构建更好的规范数据集。 对具体的排名方式,一种成功的方式是对不同 LM 在相同提示下的输出进行比较,然后使用 Elo 系统建立一个完整的排名。这些不同的排名结果将被归一化为用于训练的标量奖励值。 这个过程中一个有趣的产物是目前成功的 RLHF 系统使用了和生成模型具有 不同 大小的 LM (例如 OpenAI 使用了 175B 的 LM 和 6B 的 RM,Anthropic 使用的 LM 和 RM 从 10B 到 52B 大小不等,DeepMind 使用了 70B 的 Chinchilla 模型分别作为 LM 和 RM) 。一种直觉是,偏好模型和生成模型需要具有类似的能力来理解提供给它们的文本。 接下来是最后一步:利用 RM 输出的奖励,用强化学习方式微调优化 LM。 Step 3. 用强化学习微调 长期以来出于工程和算法原因,人们认为用强化学习训练 LM 是不可能的。而目前多个组织找到的可行方案是使用策略梯度强化学习 (Policy Gradient RL) 算法、近端策略优化 (Proximal Policy Optimization,PPO) 微调初始 LM 的部分或全部参数。因为微调整个 10B~100B+ 参数的成本过高 (相关工作参考低秩适应 LoRA 和 DeepMind 的 Sparrow LM) 。PPO 算法已经存在了相对较长的时间,有大量关于其原理的指南,因而成为 RLHF 中的有利选择。 事实证明,RLHF 的许多核心 RL 进步一直在弄清楚如何将熟悉的 RL 算法应用到更新如此大的模型。 让我们首先将微调任务表述为 RL 问题。首先,该策略 (policy) 是一个接受提示并返回一系列文本 (或文本的概率分布) 的 LM。这个策略的行动空间 (action space) 是 LM 的词表对应的所有词元 (一般在 50k 数量级) ,观察空间 (observation space) 是可能的输入词元序列,也比较大 (词汇量 ^ 输入标记的数量) 。奖励函数是偏好模型和策略转变约束 (Policy shift constraint) 的结合。 PPO 算法确定的奖励函数具体计算如下:将提示 输入初始 LM 和当前微调的 LM,分别得到了输出文本 ,将来自当前策略的文本传递给 RM 得到一个标量的奖励 。将两个模型的生成文本进行比较计算差异的惩罚项,在来自 OpenAI、Anthropic 和 DeepMind 的多篇论文中设计为输出词分布序列之间的 Kullback–Leibler (KL) 散度的缩放,即 。这一项被用于惩罚 RL 策略在每个训练批次中生成大幅偏离初始模型,以确保模型输出合理连贯的文本。如果去掉这一惩罚项可能导致模型在优化中生成乱码文本来愚弄奖励模型提供高奖励值。此外,OpenAI 在 InstructGPT 上实验了在 PPO 添加新的预训练梯度,可以预见到奖励函数的公式会随着 RLHF 研究的进展而继续进化。 最后根据 PPO 算法,我们按当前批次数据的奖励指标进行优化 (来自 PPO 算法 on-policy 的特性) 。PPO 算法是一种信赖域优化 (Trust Region Optimization,TRO) 算法,它使用梯度约束确保更新步骤不会破坏学习过程的稳定性。DeepMind 对 Gopher 使用了类似的奖励设置,但是使用 A2C (synchronous advantage actor-critic) 算法来优化梯度。 作为一个可选项,RLHF 可以通过迭代 RM 和策略共同优化。随着策略模型更新,用户可以继续将输出和早期的输出进行合并排名。Anthropic 在他们的论文中讨论了迭代在线 RLHF,其中策略的迭代包含在跨模型的 Elo 排名系统中。这样引入策略和 RM 演变的复杂动态,代表了一个复杂和开放的研究问题。 RLHF 的未来 尽管 RLHF 取得了一定的成果和关注,但依然存在局限。这些模型依然会毫无不确定性地输出有害或者不真实的文本。这种不完美也是 RLHF 的长期挑战和动力 —— 在人类的固有领域中运行意味着永远不会到达一个完美的标准。 收集人类偏好数据的质量和数量决定了 RLHF 系统性能的上限。RLHF 系统需要两种人类偏好数据:人工生成的文本和对模型输出的偏好标签。生成高质量回答需要雇佣兼职人员 (而不能依赖产品用户和众包) 。另一方面,训练 RM 需要的奖励标签规模大概是 50k 左右,所以并不那么昂贵 (当然远超了学术实验室的预算) 。目前相关的数据集只有一个基于通用 LM 的 RLHF 数据集 (来自 Anthropic) 和几个较小的子任务数据集 (如来自 OpenAI 的摘要数据集) 。另一个挑战来自标注者的偏见。几个人类标注者可能有不同意见,导致了训练数据存在一些潜在差异。 除开数据方面的限制,一些有待开发的设计选项可以让 RLHF 取得长足进步。例如对 RL 优化器的改进方面,PPO 是一种较旧的算法,但目前没有什么结构性原因让其他算法可以在现有 RLHF 工作中更具有优势。另外,微调 LM 策略的一大成本是策略生成的文本都需要在 RM 上进行评估,通过离线 RL 优化策略可以节约这些大模型 RM 的预测成本。最近,出现了新的 RL 算法如隐式语言 Q 学习 (Implicit Language Q-Learning,ILQL) 也适用于当前 RL 的优化。在 RL 训练过程的其他核心权衡,例如探索和开发 (exploration-exploitation) 的平衡也有待尝试和记录。探索这些方向至少能加深我们对 RLHF 的理解,更进一步提升系统的表现。 参考资料 首先介绍一些相关的开源工作: 关于 RLHF 的第一个项目,来自 OpenAI: https://github.com/openai/lm-human-preferencesy 一些 PyTorch 的 repo: https://github.com/lvwerra/trl https://github.com/CarperAI/trlx https://github.com/allenai/RL4LMs 此外,Huggingface Hub 上有一个由 Anthropic 创建的大型数据集: https://huggingface.co/datasets/Anthropic/hh-rlhf 相关论文包括在现有 LM 前的 RLHF 进展和基于当前 LM 的 RLHF 工作: TAMER: Training an Agent Manually via Evaluative Reinforcement(Knox and Stone 2008) Interactive Learning from Policy-Dependent Human Feedback(MacGlashan et al. 2017) Deep Reinforcement Learning from Human Preferences(Christiano et al. 2017) Deep TAMER: Interactive Agent Shaping in High-Dimensional State Spaces(Warnell et al. 2018) Fine-Tuning Language Models from Human Preferences(Zieglar et al. 2019) Learning to summarize with human feedback(Stiennon et al., 2020) Recursively Summarizing Books with Human Feedback(OpenAI Alignment Team 2021) WebGPT: Browser-assisted question-answering with human feedback(OpenAI, 2021) InstructGPT:Training language models to follow instructions with human feedback(OpenAI Alignment Team 2022) GopherCite:Teaching language models to support answers with verified quotes(Menick et al. 2022) Sparrow:Improving alignment of dialogue agents via targeted human judgements(Glaese et al. 2022) ChatGPT: Optimizing Language Models for Dialogue(OpenAI 2022) Scaling Laws for Reward Model Overoptimization(Gao et al. 2022) Training a Helpful and Harmless Assistant with Reinforcement Learning from Human Feedback(Anthropic, 2022) Red Teaming Language Models to Reduce Harms: Methods, Scaling Behaviors, and Lessons Learned(Ganguli et al. 2022) Dynamic Planning in Open-Ended Dialogue using Reinforcement Learning(Cohen at al. 2022) Is Reinforcement Learning (Not) for Natural Language Processing?: Benchmarks, Baselines, and Building Blocks for Natural Language Policy Optimization(Ramamurthy and Ammanabrolu et al. 2022) 本文翻译自 Hugging Face 官方博客 (https://huggingface.co/blog/rlhf) 参考资料部分链接请点击原文博客查看。你也可以查看我们的直播活动回放了解更多: RLHF: From Zero to ChatGPT 本文译者: 李泺秋,浙江大学计算机科学硕士,主要研究 NLP 领域。 我们正在招募更多翻译志愿者帮助我们扩充官方公众号内容,如果你感兴趣,欢迎 点击这里 填写志愿者招募表单。谢谢!

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册