首页 文章 精选 留言 我的

精选列表

搜索[赛博朋克],共10000篇文章
优秀的个人博客,低调大师

每日一博 | 聊聊 Cookie、Session、Token 背后的故事

摘要:Cookie、Session、Token 这三者是不同发展阶段的产物 本文分享自华为云社区《Cookie、Session、Token 背后的故事》,作者: 龙哥手记。 1. 网站交互体验升级 作为网友的我们,每天都会使用浏览器来逛各种网站,来满足日常的工作生活需求。 现在的交互体验还是很丝滑的,但早期并非如此,而是一锤子买卖。 1.1 无状态的 HTTP 协议 无状态的 HTTP 协议是什么鬼? HTTP 无状态协议,是指协议对于业务处理没有记忆能力,之前做了啥完全记不住。每次请求都是完全独立互不影响的,没有任何上下文信息。 缺少状态意味着如果后续处理需要前面的信息,则它必须重传关键信息,这样可能导致每次连接传送的数据量增大。 假如一直用这种原生无状态的 HTTP 协议,我们每换一个页面可能就得重新登录一次,那还玩个球。 所以必须要解决 HTTP 协议的无状态,提升网站的交互体验,否则星辰大海是去不了的。 1.2 解决之道 整个事情交互的双方只有客户端和服务端,所以必然要在这两个当事者身上下手。 客户端来买单 客户端每次请求时把自己必要的信息封装发送给服务端,服务端查收处理一下就行。 服务端来买单 客户端第一次请求之后,服务端就开始做记录,然后客户端在后续请求中只需要将最基本最少的信息发过来就行,不需要太多信息了。 2. Cookie方案 Cookie 总是保存在客户端中。按在客户端中的存储位置,可分为内存 Cookie 和硬盘Cookie。 内存 Cookie 由浏览器维护,保存在内存中,浏览器关闭后就消失了,其存在时间是短暂的。硬盘 Cookie 保存在硬盘里,有一个过期时间。除非用户手工清理或到了过期时间,硬盘Cookie不会被删除,其存在时间是长期的。 2.1 Cookie 定义和作用 HTTP Cookie(也叫 Web Cookie 或浏览器 Cookie)是服务器发送到用户浏览器并保存在本地的一小块数据。它会在浏览器下次向同一服务器再发起请求时,被携带并发送到服务器上。 通常 Cookie 用于告知服务端两个请求是否来自同一浏览器,如保持用户的登录状态。Cookie 使基于无状态的HTTP协议记录稳定的状态信息成为了可能。 Cookie 主要用于以下三个方面: 会话状态管理(如用户登录状态、购物车等其它需要记录的信息) 个性化设置(如用户自定义设置、主题等) 浏览器行为跟踪(如跟踪分析用户行为等) 2.2 服务端创建 Cookie 当服务器收到 HTTP 请求时,服务器可以在响应头里面添加一个 Set-Cookie 选项。 浏览器收到响应后通常会保存下 Cookie,之后对该服务器每一次请求中都通过 Cookie 请求头部将 Cookie 信息发送给服务器。另外,Cookie 的过期时间、域、路径、有效期、适用站点都可以根据需要来指定。 2.3 B/S 的 Cookie 交互 服务器使用 Set-Cookie 响应头部向用户浏览器发送 Cookie信息。 一个简单的 Cookie 可能像这样: Set-Cookie: <cookie名>=<cookie值> HTTP/1.0 200 OKContent-type: text/htmlSet-Cookie: yummy_cookie=chocoSet-Cookie: tasty_cookie=strawberry 客户端对该服务器发起的每一次新请求,浏览器都会将之前保存的Cookie信息通过 Cookie 请求头部再发送给服务器。 GET /sample_page.html HTTP/1.1Host: www.example.orgCookie: yummy_cookie=choco; tasty_cookie=strawberry 我来访问下淘宝网,抓个包看看这个真实的过程: 2.4 存在的问题 Cookie 常用来标记用户或授权会话,被浏览器发出之后可能被劫持,被用于非法行为,可能导致授权用户的会话受到攻击,因此存在安全问题。 还有一种情况就是跨站请求伪造 CSRF,简单来说 比如你在登录银行网站的同时,登录了一个钓鱼网站,在钓鱼网站进行某些操作时可能会获取银行网站相关的Cookie信息,向银行网站发起转账等非法行为。 跨站请求伪造(英语:Cross-site request forgery),也被称为 one-click attack 或者 session riding,通常缩写为 CSRF 或者 XSRF, 是一种挟制用户在当前已登录的 Web 应用程序上执行非本意的操作的攻击方法。跟跨网站脚本(XSS)相比,XSS 利用的是用户对指定网站的信任,CSRF 利用的是网站对用户网页浏览器的信任。 跨站请求攻击,简单地说,是攻击者通过一些技术手段欺骗用户的浏览器去访问一个自己曾经认证过的网站并运行一些操作(如发邮件,发消息,甚至财产操作如转账和购买商品)。 由于浏览器曾经认证过,所以被访问的网站会认为是真正的用户操作而去运行。这利用了 Web 中用户身份验证的一个漏洞:简单的身份验证只能保证请求发自某个用户的浏览器,却不能保证请求本身是用户自愿发出的。 不过这种情况有很多解决方法,特别对于银行这类金融性质的站点,用户的任何敏感操作都需要确认,并且敏感信息的 Cookie 只能拥有较短的生命周期。 同时 Cookie 有容量和数量的限制,每次都要发送很多信息带来额外的流量消耗、复杂的行为 Cookie 无法满足要求。 特别注意:以上存在的问题只是 Cookie 被用于实现交互状态时存在的问题,但并不是说 Cookie 本身的问题。 试想一下:菜刀可以用来做菜,也可以被用来从事某些暴力行为,你能说菜刀应该被废除吗? 3. Session 方案 3.1 Session 机制的概念 如果说 Cookie 是客户端行为,那么 Session 就是服务端行为。 Cookie 机制在最初和服务端完成交互后,保持状态所需的信息都将存储在客户端,后续直接读取发送给服务端进行交互。 Session 代表服务器与浏览器的一次会话过程,并且完全由服务端掌控,实现分配ID、会话信息存储、会话检索等功能。 Session 机制将用户的所有活动信息、上下文信息、登录信息等都存储在服务端,只是生成一个唯一标识 ID 发送给客户端,后续的交互将没有重复的用户信息传输,取而代之的是唯一标识 ID,暂且称之为 Session-ID 吧。 3.2 简单的交互流程 当客户端第一次请求 session 对象时候,服务器会为客户端创建一个 session,并将通过特殊算法算出一个 session 的 ID,用来标识该 session 对象; 当浏览器下次请求别的资源的时候,浏览器会将 sessionID 放置到请求头中,服务器接收到请求后解析得到 sessionID,服务器找到该 id 的 session 来确定请求方的身份和一些上下文信息。 3.3 Session 的实现方式 首先明确一点,Session 和 Cookie 没有直接的关系。可以认为 Cookie 只是实现 Session 机制的一种方法途径而已,没有 Cookie 还可以用别的方法。 Session和Cookie的关系就像加班和加班费的关系,看似关系很密切,实际上没啥关系。 Session 的实现主要两种方式:Cookie 与 URL 重写,而 Cookie 是首选方式。因为各种现代浏览器都默认开通 Cookie 功能,但是每种浏览器也都有允许 Cookie 失效的设置,因此对于 Session 机制来说还需要一个备胎。 将会话标识号以参数形式附加在超链接的URL地址后面的技术称为 URL 重写 原始 URL: http://taobao.com/getitem?name=baymax&action=buy 重写后的 URL: http://taobao.com/getitem?sessionid=1wui87htentg&?name=baymax&action=buy 3.4 存在的问题 由于 Session 信息是存储在服务端的,因此如果用户量很大的场景,Session 信息占用的空间就不容忽视。 对于大型网站必然是集群化&分布式的服务器配置。如果 Session 信息是存储在本地的,那么由于负载均衡的作用,原来请求机器 A 并且存储了 Session 信息,下一次请求可能到了机器 B,此时机器 B 上并没有 Session 信息。 这种情况下要么在 B 机器重复创建造成浪费,要么引入高可用的 Session 集群方案,引入 Session 代理实现信息共享,要么实现定制化哈希到集群 A,这样做其实就有些复杂了 4. Token 方案 Token 是令牌的意思,由服务端生成并发放给客户端,是一种具有时效性的验证身份的手段。 Token 避免了 Session 机制带来的海量信息存储问题,也避免了 Cookie 机制的一些安全性问题,在现代移动互联网场景、跨域访问等场景有广泛的用途。 4.1 简单的交互流程 客户端将用户的账号和密码提交给服务器; 服务器对其进行校验,通过则生成一个 token 值返回给客户端,作为后续的请求交互身份令牌; 客户端拿到服务端返回的 token 值后,可将其保存在本地,以后每次请求服务器时都携带该 token,提交给服务器进行身份校验; 服务器接收到请求后,解析关键信息,再根据相同的加密算法、密钥、用户参数生成 sign 与客户端的 sign 进行对比,一致则通过,否则拒绝服务; 验证通过之后,服务端就可以根据该 Token 中的 uid 获取对应的用户信息,进行业务请求的响应。 4.2 Token 的设计思想 以 JSON Web Token(JWT)为例,Token主要由三部分组成: Header 头部信息:记录了使用的加密算法信息; Payload 净荷信息:记录了用户信息和过期时间等; Signature 签名信息:根据 header 中的加密算法和 payload 中的用户信息以及密钥key来生成,是服务端验证服务端的重要依据。 header 和 payload 的信息不做加密,只做一般的 base64 编码。服务端收到 token 后剥离出 header 和 payload 获取算法、用户、过期时间等信息,然后根据自己的加密密钥来生成 sign,并与客户端传来的 sign 进行一致性对比,来确定客户端的身份合法性。 这样就实现了用 CPU 加解密的时间换取存储空间,同时服务端密钥的重要性就显而易见,一旦泄露整个机制就崩塌了,这个时候就需要考虑 HTTPS 了。 4.3 Token 方案的特点 Token 可以跨站共享,实现单点登录; Token 机制无需太多存储空间。Token 包含了用户的信息,只需在客户端存储状态信息即可,对于服务端的扩展性很好; Token 机制的安全性依赖于服务端加密算法和密钥的安全性; Token 机制也不是万金油。 5. 总结 Cookie、Session、Token 这三者是不同发展阶段的产物,并且各有优缺点,三者也没有明显的对立关系,反而常常结伴出现,这也是容易被混淆的原因。 Cookie 侧重于信息的存储,主要是客户端行为。Session 和 Token 侧重于身份验证,主要是服务端行为。 三者方案在很多场景都还有生命力,了解场景才能选择合适的方案。 点击关注,第一时间了解华为云新鲜技术~

优秀的个人博客,低调大师

每日一博 | Proxyless Mesh 在 Dubbo 中的实践

背景 随着 Dubbo 3.1 的 release,Dubbo 在云原生的路上又迈出了重要的一步。在这个版本中添加了 Proxyless Mesh 的新特性,Dubbo Proxyless Mesh 直接实现 xDS 协议解析, 实现 Dubbo 与 Control Plane 的直接通信,进而实现控制面对流量管控、服务治理、可观测性、安全等的统一管控,规避 Sidecar 模式带来的性能损耗与部署架构复杂性。 什么是Service Mesh Service Mesh 又译作 “服务网格”,作为服务间通信的基础设施层。Buoyant 公司的 CEO Willian Morgan 在他的这篇文章 WHAT’S A Service Mesh? AND WHY DO I NEED ONE? 中解释了什么是 Service Mesh,为什么云原生应用需要 Service Mesh。 下面是 Willian Morgan 对 Service Mesh 的解释。 A Service Mesh is a dedicated infrastructure layer for handling service-to-service communication. It’s responsible for the reliable delivery of requests through the complex topology of services that comprise a modern, cloud native application. In practice, the Service Mesh is typically implemented as an array of lightweight network proxies that are deployed alongside application code, without the application needing to be aware. 翻译成中文 服务网格(Service Mesh)是处理服务间通信的基础设施层。它负责构成现代云原生应用程序的复杂服务拓扑来可靠地交付请求。 在实践中,Service Mesh 通常以轻量级网络代理阵列的形式实现,这些代理与应用程序代码部署在一起,对应用程序来说无需感知代理的存在。 说到 Service Mesh 一定离不开 Sidecar 经典架构模式。它通过在业务 Pod 中注入 Sidecar 容器,接管业务容器的通信流量,同时 Sidecar 容器与网格平台的控制平面对接, 基于控制平面下发的策略,对代理流量实施治理和管控,将原有服务框架的治理能力下层到 Sidecar 容器中,从而实现了基础框架能力的下沉,与业务系统解耦。 经典的 Sidecar Mesh 部署架构有很多优势,如平滑升级、多语言、业务侵入小等,但也带来了一些额外的问题,比如: Proxy 带来的性能损耗,在复杂拓扑的网络调用中将变得尤其明显 流量拦截带来的架构复杂性 Sidecar 生命周期管理 部署环境受限,并不是所有环境都满足 Sidecar 流量拦截条件 针对 Sidecar Mesh 模型的问题,Dubbo 社区自很早之前就做了 Dubbo 直接对接到控制面的设想与思考,并在国内开源社区率先提出了 Proxyless Mesh 的概念,当然就 Proxyless 概念的说法而言,最开始是谷歌提出来的。 Dubbo Proxyless Mesh Dubbo Proxyless 模式是指 Dubbo 直接与 Istiod通信,通过 xDS协议实现服务发现和服务治理等能力。 Proxyless 模式使得微服务又回到了 2.x 时代的部署架构,同 Dubbo 经典服务治理模式非常相似,所以说这个模式并不新鲜, Dubbo 从最开始就是这样的设计模式。 这样做可以极大的提升应用性能,降低网络延迟。有人说这种做法又回到了原始的基于 SDK 的微服务模式,其实非也,它依然使用了 Envoy 的 xDS API, 但是因为不再需要向应用程序中注入 Sidecar 代理,因此可以减少应用程序性能的损耗。 但相比于 Mesh 架构,Dubbo 经典服务治理模式并没有强调控制面的统一管控,而这点恰好是 Service Mesh 所强调的,强调对流量、可观测性、证书等的标准化管控与治理,也是 Mesh 理念先进的地方。 在 Dubbo Proxyless 架构模式下,Dubbo 进程将直接与控制面通信,Dubbo 进程之间也继续保持直连通信模式,我们可以看出 Proxyless 架构的优势: 没有额外的 Proxy 中转损耗,因此更适用于性能敏感应用 更有利于遗留系统的平滑迁移 架构简单,容易运维部署 适用于几乎所有的部署环境 服务发现 xDS 接入以注册中心的模式对接,节点发现同其他注册中心的服务自省模型一样,对于 xDS 的负载均衡和路由配置通过 ServiceInstance 的动态运行时配置传出, 在构建 Invoker 的时候将配置参数传入配置地址。 证书管理 零信任架构下,需要严格区分工作负载的识别和信任,而签发 X.509 证书是推荐的一种认证方式。在 Kubernetes 集群中,服务间是通过 DNS 名称互相访问的,而网络流量可能被 DNS 欺骗、BGP/路由劫持、ARP 欺骗等手段劫持,为了将服务名称(DNS 名称)与服务身份强关联起来,Istio 使用置于 X.509 证书中的安全命名机制。SPIFFE是 Istio 所采用的安全命名的规范,它也是云原生定义的一种标准化的、可移植的工作负载身份规范。 Secure Production Identity Framework For Everyone (SPIFFE) 是一套服务之间相互进行身份识别的标准,主要包含以下内容: SPIFFE ID 标准,SPIFFE ID 是服务的唯一标识,具体实现使用 URI 资源标识符 SPIFFE Verifiable Identity Document (SVID) 标准,将 SPIFFE ID 编码到一个加密的可验证的数据格式中 颁发与撤销 SVID 的 API 标准(SVID 是 SPIFFE ID 的识别凭证) SPIFFE ID 规定了形如 spiffe://<trust domain>/<workload identifier> 的 URI 格式,作为工作负载(Workload)的唯一标识。 而 Istio 在自身的生态中只使用到了 SPIFFE ID 作为安全命名,其数据格式由自己实现,通信格式采用 CNCF 支持的 xDS 协议规范(证书认证通信更具体来说是 xDS 的 SDS)。 Istio 使用形如 spiffe://<trust_domain>/ns/<namespace>/sa/<service_account> 格式的 SPIFFE ID 作为安全命名,注入到 X.509 证书的 subjectAltName 扩展中。 其中"trust_domain"参数通过 Istiod 环境变量TRUST_DOMAIN 注入,用于在多集群环境中交互。 以下是 Dubbo Proxyless Mesh 证书颁发的过程 创建 RSA 私钥(Istio 还不支持 ECDSA 私钥) 构建 CSR(Certificate signing request)模板 自签名 CSR 生成证书 创建 Kubernetes Secret 资源储存 CA 证书和私钥(CA Service处理) 案例实践 接下来我将带领大家通过一个例子使已有的项目快速跑在 Proxyless Mesh 模式下。 环境准备 安装docker https://www.docker.com/ 安装minikube 墙裂推荐:https://kubernetes.io/zh-cn/docs/tutorials/hello-minikube/ 安装istio https://istio.io/latest/docs/setup/getting-started/ ❗❗❗ 安装 Istio 的时候需要开启 first-party-jwt 支持(使用 istioctl 工具安装的时候加上 --set values.global.jwtPolicy=first-party-jwt 参数),否则将导致客户端认证失败的问题。 参考命令如下: curl -L https://istio.io/downloadIstio | sh - cd istio-1.xx.x export PATH=$PWD/bin:$PATH istioctl install --set profile=demo --set values.global.jwtPolicy=first-party-jwt -y 代码准备 xds-provider 定义一个接口 public interface GreetingService { String sayHello(String name); } 实现对应的接口 @DubboService(version = "1.0.0") public class AnnotatedGreetingService implements GreetingService { @Override public String sayHello(String name) { System.out.println("greeting service received: " + name); return "hello, " + name + "! from host: " + NetUtils.getLocalHost(); } } 编写启动类 public class ProviderBootstrap { public static void main(String[] args) throws Exception { AnnotationConfigApplicationContext context = new AnnotationConfigApplicationContext(ProviderConfiguration.class); context.start(); System.out.println("dubbo service started"); new CountDownLatch(1).await(); } @Configuration @EnableDubbo(scanBasePackages = "org.apache.dubbo.samples.impl") @PropertySource("classpath:/spring/dubbo-provider.properties") static class ProviderConfiguration { } } 编写配置信息 dubbo.application.name=dubbo-samples-xds-provider # 由于 Dubbo 3 应用级服务发现的元数据无法从 istio 中获取,需要走服务自省模式。 # 这要求了 Dubbo MetadataService 的端口在全集群的是统一的。 dubbo.application.metadataServicePort=20885 # 走xds协议 dubbo.registry.address=xds://istiod.istio-system.svc:15012 dubbo.protocol.name=tri dubbo.protocol.port=50051 # 对齐k8s pod生命周期,由于 Kubernetes probe 探活机制的工作原理限制, # 探活请求的发起方不是 localhost,所以需要配置 qosAcceptForeignIp 参数开启允许全局访问 dubbo.application.qosEnable=true dubbo.application.qosAcceptForeignIp=true 编写Deployment.yml和Service.yml apiVersion: apps/v1 kind: Deployment metadata: name: dubbo-samples-xds-provider namespace: dubbo-demo spec: replicas: 3 selector: matchLabels: app: dubbo-samples-xds-provider template: metadata: labels: app: dubbo-samples-xds-provider spec: containers: - name: server image: apache/dubbo-demo:dubbo-samples-xds-provider_0.0.1 livenessProbe: httpGet: path: /live port: 22222 initialDelaySeconds: 5 periodSeconds: 5 readinessProbe: httpGet: path: /ready port: 22222 initialDelaySeconds: 5 periodSeconds: 5 startupProbe: httpGet: path: /startup port: 22222 failureThreshold: 30 periodSeconds: 10 apiVersion: v1 kind: Service metadata: name: dubbo-samples-xds-provider namespace: dubbo-demo spec: clusterIP: None selector: app: dubbo-samples-xds-provider ports: - name: grpc protocol: TCP port: 50051 targetPort: 50051 编写Dockerfile FROM openjdk:8-jdk ADD ./target/dubbo-samples-xds-provider-1.0-SNAPSHOT.jar dubbo-samples-xds-provider-1.0-SNAPSHOT.jar CMD java -jar -agentlib:jdwp=transport=dt_socket,server=y,suspend=n,address=31000 /dubbo-samples-xds-provider-1.0-SNAPSHOT.jar xds-consumer 定义一个接口 public interface GreetingService { String sayHello(String name); } 实现对应的接口 @Component("annotatedConsumer") public class GreetingServiceConsumer { // 这里特别注意的是、由于当前 Dubbo 版本受限于 istio 的通信模型无法获取接口所对应的应用名, // 因此需要配置 providedBy 参数来标记此服务来自哪个应用。 @DubboReference(version = "1.0.0", providedBy = "dubbo-samples-xds-provider") private GreetingService greetingService; public String doSayHello(String name) { return greetingService.sayHello(name); } } 编写启动类 public class ConsumerBootstrap { public static void main(String[] args) { AnnotationConfigApplicationContext context = new AnnotationConfigApplicationContext(ConsumerConfiguration.class); context.start(); GreetingServiceConsumer greetingServiceConsumer = context.getBean(GreetingServiceConsumer.class); while (true) { try { String hello = greetingServiceConsumer.doSayHello("xDS Consumer"); System.out.println("result: " + hello); Thread.sleep(100); } catch (Throwable t) { t.printStackTrace(); } } } @Configuration @EnableDubbo(scanBasePackages = "org.apache.dubbo.samples.action") @PropertySource("classpath:/spring/dubbo-consumer.properties") @ComponentScan(value = {"org.apache.dubbo.samples.action"}) static class ConsumerConfiguration { } } 编写配置信息 dubbo.application.name=dubbo-samples-xds-consumer dubbo.application.metadataServicePort=20885 dubbo.registry.address=xds://istiod.istio-system.svc:15012 dubbo.consumer.timeout=3000 dubbo.consumer.check=false dubbo.application.qosEnable=true dubbo.application.qosAcceptForeignIp=true 编写Deployment.yml和Service.yml apiVersion: apps/v1 kind: Deployment metadata: name: dubbo-samples-xds-consumer namespace: dubbo-demo spec: replicas: 2 selector: matchLabels: app: dubbo-samples-xds-consumer template: metadata: labels: app: dubbo-samples-xds-consumer spec: containers: - name: server image: apache/dubbo-demo:dubbo-samples-xds-consumer_0.0.1 livenessProbe: httpGet: path: /live port: 22222 initialDelaySeconds: 5 periodSeconds: 5 readinessProbe: httpGet: path: /ready port: 22222 initialDelaySeconds: 5 periodSeconds: 5 startupProbe: httpGet: path: /startup port: 22222 failureThreshold: 30 periodSeconds: 10 apiVersion: v1 kind: Service metadata: name: dubbo-samples-xds-consumer namespace: dubbo-demo spec: clusterIP: None selector: app: dubbo-samples-xds-consumer ports: - name: grpc protocol: TCP port: 50051 targetPort: 50051 编写Dockerfile FROM openjdk:8-jdk ADD ./target/dubbo-samples-xds-consumer-1.0-SNAPSHOT.jar dubbo-samples-xds-consumer-1.0-SNAPSHOT.jar CMD java -jar -agentlib:jdwp=transport=dt_socket,server=y,suspend=n,address=31000 /dubbo-samples-xds-consumer-1.0-SNAPSHOT.jar ✅ 到目前为止我们的环境和代码就全都准备完毕了! 构建镜像 1、启动docker 2、启动minikube 因为minikube是一个本地的k8s,他启动需要一个虚拟引擎,这里我们用docker来管理。我们通过如下命令启动 minikube start 我们可以在docker里看到minikube 3、检查istio的状态 4、构建镜像 在本地找到代码所在位置、依次执行以下命令 # 找到provider所在路径 cd ./dubbo-samples-xds-provider/ # 构建provider的镜像 docker build -t apache/dubbo-demo:dubbo-samples-xds-provider_0.0.1 . # 找到consumer所在路径 cd ../dubbo-samples-xds-consumer/ # 构建consumer的镜像 docker build -t apache/dubbo-demo:dubbo-samples-xds-consumer_0.0.1 . 5、检查本地镜像 6、创建namespace # 初始化命名空间 kubectl apply -f https://raw.githubusercontent.com/apache/dubbo-samples/master/dubbo-samples-xds/deploy/Namespace.yml # 切换命名空间 kubens dubbo-demo 如果不创建namespace,那么会看到如下错误 部署容器 # 找到provider所在路径 cd ./dubbo-samples-xds-provider/src/main/resources/k8s # dubbo-samples-xds/dubbo-samples-xds-provider/src/main/resources/k8s/Deployment.yml # dubbo-samples-xds/dubbo-samples-xds-provider/src/main/resources/k8s/Service.yml # 部署provider的Deployment和Service kubectl apply -f Deployment.yml kubectl apply -f Service.yml # 找到consumer所在路径 cd ../../../../../dubbo-samples-xds-consumer/src/main/resources/k8s # dubbo-samples-xds/dubbo-samples-xds-consumer/src/main/resources/k8s/Deployment.yml # 部署consumer的Deployment kubectl apply -f Deployment.yml 在minikube dashboard看到我们已经部署的pod 观察consumer效果 kubectl logs xxx result: hello, xDS Consumer! from host: 172.17.0.5 result: hello, xDS Consumer! from host: 172.17.0.5 result: hello, xDS Consumer! from host: 172.17.0.6 result: hello, xDS Consumer! from host: 172.17.0.6 总结&展望 本文主要剖析了 Dubbo Proxyless Mesh 的架构、服务发现以及证书管理等核心流程,最后通过示例给大家演示了如何使用 Dubbo Proxyless。 随着 Dubbo 3.1 的 release,Dubbo 在云原生的路上又迈出了重要的一步。在今年年底,Dubbo Mesh 将发布具有服务发现能力的版本, 届时将面向所有 Dubbo 用户提供从低版本平滑迁移到 Mesh 架构的能力;在明年年初春季的时候将发布带有治理能力的版本;在明年年底前发布带热插件更新能力的版本, 希望有兴趣见证 Dubbo 云原生之路的同学可以积极参与社区贡献! </service_account></namespace></trust_domain></workload></trust>

优秀的个人博客,低调大师

每日一博 | MySQL 性能优化浅析及线上案例

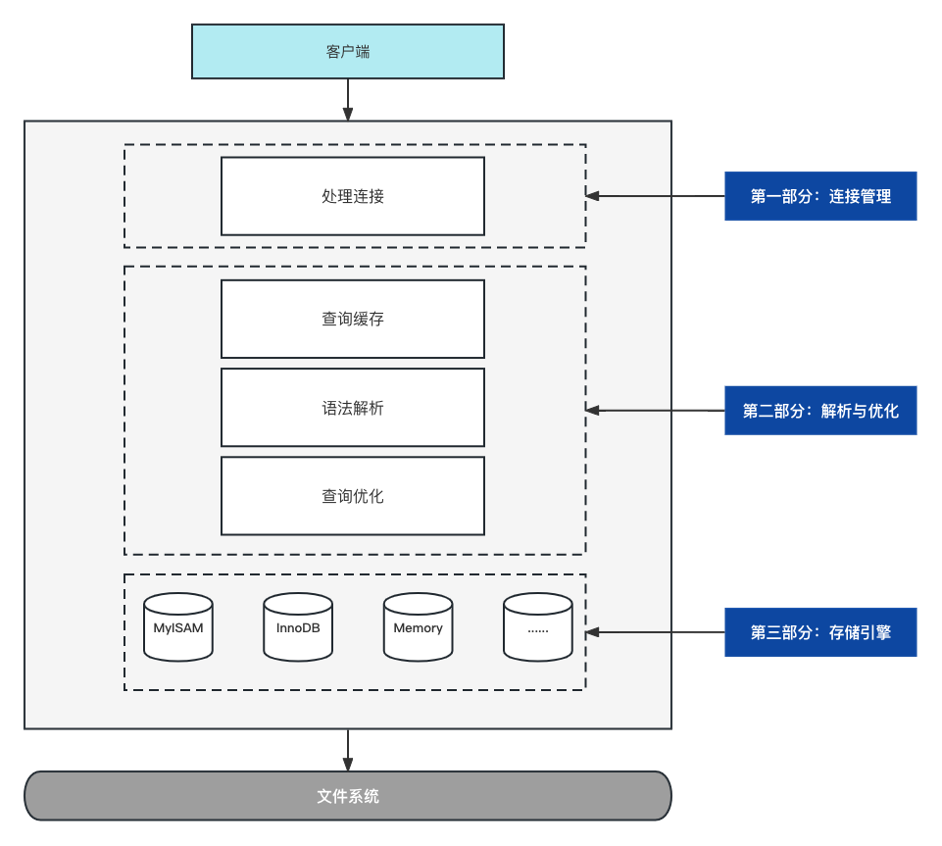
作者:京东健康 孟飞 1、 数据库性能优化的意义 业务发展初期,数据库中量一般都不高,也不太容易出一些性能问题或者出的问题也不大,但是当数据库的量级达到一定规模之后,如果缺失有效的预警、监控、处理等手段则会对用户的使用体验造成影响,严重的则会直接导致订单、金额直接受损,因而就需要时刻关注数据库的性能问题。 2、 性能优化的几个常见措施 数据库性能优化的常见手段有很多,比如添加索引、分库分表、优化连接池等,具体如下: | 序号 | 类型 | 措施 | 说明 | | 1 | 物理级别 | 提升硬件性能 | 将数据库安装到更高配置的服务器上会有立竿见影的效果,例如提高CPU配置、增加内存容量、采用固态硬盘等手段,在经费允许的范围可以尝试。 | | 2 | 应用级别 | 连接池参数优化 | 我们大部分的应用都是使用连接池来托管数据库的连接,但是大部分都是默认的配置,因而配置好超时时长、连接池容量等参数就显得尤为重要。 1、 如果链接长时间被占用,新的请求无法获取到新的连接,就会影响到业务。 2、 如果连接数设置的过小,那么即使硬件资源没问题,也无法发挥其功效。之前公司做过一些压测,但就是死活不达标,最后发现是由于连接数太小。 | | 3 | 单表级别 | 合理运用索引 | 如果数据量较大,但是又没有合适的索引,就会拖垮整个性能,但是索引是把双刃剑,并不是说索引越多越好,而是要根据业务的需要进行适当的添加和使用。 缺失索引、重复索引、冗余索引、失控索引这几类情况其实都是对系统很大的危害。 | | 4 | 库表级别 | 分库分表 | 当数据量较大的时候,只使用索引就意义不大了,需要做好分库分表的操作,合理的利用好分区键,例如按照用户ID、订单ID、日期等维度进行分区,可以减少扫描范围。 | | 5 | 监控级别 | 加强运维 | 针对线上的一些系统还需要进一步的加强监控,比如订阅一些慢SQL日志,找到比较糟糕的一些SQL,也可以利用业务内一些通用的工具,例如druid组件等。 | 3、 MySQL底层架构 首先了解一下数据的底层架构,也有助于我们做更好优化。 一次查询请求的执行过程 我们重点关注第二部分和第三部分,第二部分其实就是Server层,这层主要就是负责查询优化,制定出一些执行计划,然后调用存储引擎给我们提供的各种底层基础API,最终将数据返回给客户端。 4、MySQL索引构建过程 目前比较常用的是InnoDB存储引擎,本文讨论也是基于InnoDB引擎。我们一直说的加索引,那到底什么是索引、索引又是如何形成的呢、索引又如何应用呢?这个话题其实很大也很小,说大是因为他底层确实很复杂,说小是因为在大部分场景下程序员只需要添加索引就好,不太需要了解太底层原理,但是如果了解不透彻就会引发线上问题,因而本文平衡了大家的理解成本和知识深度,有一定底层原理介绍,但是又不会太过深入导致难以理解。 首先来做个实验: 创建一个表,目前是只有一个主键索引 CREATE TABLE `t1`( a int NOT NULL, b int DEFAULT NULL, c int DEFAULT NULL, d int DEFAULT NULL, e varchar(20) DEFAULT NULL, PRIMARYKEY(a) )ENGINE=InnoDB 插入一些数据: insert into test.t1 values(4,3,1,1,'d'); insert into test.t1 values(1,1,1,1,'a'); insert into test.t1 values(8,8,8,8,'h'); insert into test.t1 values(2,2,2,2,'b'); insert into test.t1 values(5,2,3,5,'e'); insert into test.t1 values(3,3,2,2,'c'); insert into test.t1 values(7,4,5,5,'g'); insert into test.t1 values(6,6,4,4,'f'); MYSQL从磁盘读取数据到内存是按照一页读取的,一页默认是16K,而一页的格式大概如下。 每一页都包括了这么几个内容,首先是页头、其次是页目录、还有用户数据区域。 1)刚才插入的几条数据就是放到这个用户数据区域的,这个是按照主键依次递增的单向链表。 2)页目录这个是用来指向具体的用户数据区域,因为当用户数据区域的数据变多的时候也就会形成分组,而页目录就会指向不同的分组,利用二分查找可以快速的定位数据。 当数据量变多的时候,那么这一页就装不下这么多数据,就要分裂页,而每页之间都会双向链接,最终形成一个双向链表。 页内的单向链表是为了查找快捷,而页间的双向链表是为了在做范围查询的时候提效,下图为示意图,其中其二页和第三页是复制的第一页,并不真实。 而如果数据还继续累加,光这几个页也不够了,那就逐步的形成了一棵树,也就是说索引B-Tree是随着数据的积累逐步构建出来的。 最下边的一层叫做叶子节点,上边的叫做内节点,而叶子节点中存储的是全量数据,这样的树就是聚簇索引。一直有同学的理解是说索引是单独一份而数据是一份,其实MySQL中有一个原则就是数据即索引、索引即数据,真实的数据本身就是存储在聚簇索引中的,所谓的回表就是回的聚簇索引。 但是我们也不一定每次都按照主键来执行SQL语句,大部分情况下都是按照一些业务字段来,那就会形成别的索引树,例如,如果按照b,c,d来创建的索引就会长这样。 推荐1个网站,可以可视化的查看一些算法原型: 目录: https://www.cs.usfca.edu/~galles/visualization/Algorithms.html B+树 https://www.cs.usfca.edu/~galles/visualization/BPlusTree.html 而在MySQL官网上介绍的索引的叶子节点是双向链表。 关于索引结构的小结: 对于B-Tree而言,叶子节点是没有链接的,而B+Tree索引是单向链表,但是MySQL在B+Tree的基础之上加以改进,形成了双向链表,双向的好处是在处理> <,between and等'范围查询'语法时可以得心应手。 5、MySQL索引的一些使用规范 1、 只为用于搜索、排序或分组的列创建索引。 重点关注where语句后边的情况 2、 当列中不重复值的个数在总记录条数中的占比很大时,才为列建立索引。 例如手机号、用户ID、班级等,但是比如一张全校学生表,每条记录是一名学生,where语句是查询所有’某学校‘的学生,那么其实也不会提高性能。 3、 索引列的类型尽量小。 无论是主键还是索引列都尽量选择小的,如果很大则会占据很大的索引空间。 4、 可以只为索引列前缀创建索引,减少索引占用的存储空间。 alter table single_table add index idx_key1(key1(10)) 5、 尽量使用覆盖索引进行查询,以避免回表操作带来的性能损耗。 select key1 from single_table order by key1 6、 为了尽可能的少的让聚簇索引发生页面分裂的情况,建议让主键自增。 7、 定位并删除表中的冗余和重复索引。 冗余索引: 单列索引:(字段1) 联合索引:(字段1 字段2) 重复索引: 在一个字段上添加了普通索引、唯一索引、主键等多个索引 6、 执行计划 其中常用的是: possible_keys: 可能用到的索引 key: 实际使用的索引 rows:预估的需要读取的记录条数 7、 线上案例 案例1: 在建设互联网医院系统中,问诊单表当时量级23万左右,其中有一个business_id字符串字段,这个字段用来记录外部订单的ID,并且在该字段上也加了索引,但是'根据该ID查询详情'的SQL语句却总是时好时坏,性能不稳定,快则10ms,慢则2秒左右,SQL大体如下: select 字段1、字段2、字段3 from nethp_diag where business_Id = ? 因为business_id是记录第三方系统的订单ID,为了兼容不同的第三方系统,因而设计成了字符串类型,但如果传入的是一个数字类型是无法使用索引的,因为MySQL只能将字符串转数字,而不能将数字转字符串,由于外部的ID有的是数字有的是字符串,因而导致索引一会可以走到,一会走不到,最终导致了性能的不稳定。 案例2: 在某次大促的当天,突然接到DBA运维的报警,说数据库突然流量激增,CPU也打到100%了,影响了部分线上功能和体验,遇到这种情况当时大部分人都比较紧张,下图为当时的数据库流量情况: 相关SQL语句: <!--统计医患下过去24小时内开的电子病历总数--> <select id="getCountByDPAndTime" resultType="integer"> select count(1) from jdhe_medical_record where status = 1 and is_test = #{isTest,jdbcType=INTEGER} and electric_medical_record_status in (2,3) <if test="patientId != null"> and patient_id = #{patientId,jdbcType=BIGINT} </if> <if test="doctorPin != null"> and doctor_pin = #{doctorPin,jdbcType=VARCHAR} </if> and created >#{dateStart,jdbcType=TIMESTAMP}; </select> 当时的索引情况 当时的执行计划 其实在patientId和doctor_pin两个字段上是有索引的,但是由于线上情况的改变,导致test判断没有进入,这样的通用查询导致这两个字段没有设置上,进而导致了数据库扫描的量激增,对数据库产生了很大压力。 案例3: 2020年某日上午收到数据库CPU异常报警,对线上有一定的影响,后续检查数据库CPU情况如下,从7点51分开始,CPU从8%瞬间达到99.92%,丝毫没有给程序员留任何情面。 当时的SQL语句: select rx_id, rx_create_time from nethp_rx_info where rx_status = 5 and status = 1 and rx_product_type = 0 and (parent_rx_id = 0 or parent_rx_id is null) and business_type != 7 and vender_id = 8888 order by rx_create_time asc limit 1; 当时的索引情况: PRIMARY KEY (`id`), UNIQUE KEY `uniq_rx_id` (`rx_id`), KEY `idx_diag_id` (`diag_id`), KEY `idx_doctor_pin` (`doctor_pin`) USING BTREE, KEY `idx_rx_storeId` (`store_id`), KEY `idx_parent_rx_id` (`parent_rx_id`) USING BTREE, KEY `idx_rx_status` (`rx_status`) USING BTREE, KEY `idx_doctor_status_type` (`doctor_pin`, `rx_status`, `rx_type`), KEY `idx_business_store` (`business_type`, `store_id`), KEY `idx_doctor_pin_patientid` (`patient_id`, `doctor_pin`) USING BTREE, KEY `idx_rx_create_time` (`rx_create_time`) 当时这张表量级2000多万,而当这条慢SQL执行较少的时候,数据库的CPU也就下来了,恢复到了49.91%,基本可以恢复线上业务,从而表象就是线上间歇性的一会可以开方一会不可以,这条SQL当时总共执行了230次,当时的CPU情况也是忽高忽低,伴随这条SQL语句的执行情况,从而最终证明CPU的飙升是由于这条慢SQL。当线上业务逻辑复杂的时候,你很难第一时间知道到底是由于那条SQL引起的,这个就需要对业务非常熟悉,对SQL很熟悉,否则就会白白浪费大量的排查时间。 最后的排查结果: 在头天晚上的时候添加了一条索引rx_create_time,当时没事,但是第二天却出了事故。 加索引前后走的索引不同,一个是走的rx_status(处方审核状态)单列索引,一个是走的rx_create_time(处方提交事件)单列索引,这个就要回到业务,因为处方状态是个枚举,且枚举范围不到10个,也就说线上29,000,000的数据量也就是被分成了不到10份,rx_status=5的值是其中一份,因而通过这个索引就可以命中很多行,这是业务规则,再套用MySQL的特性,主要是以下几条: 1、没加新索引rx_create_time的时候,由于order by后边没有索引,就看where条件中是否有合适的索引,查询选择器选定rx_status这个单列索引,而rx_status=5这个条件下限制的数据行在索引中是连续,即使需要的rx_id不在索引中,再回主键聚簇索引也来得及,由于order by后边没有索引,所以走磁盘级别的排序filesort,高峰积压的时候处方就1万到2万,跑到了100ms,白天低谷的时候几百单也就20ms。 2、新加索引之后,就分两种情况: 2.1、加索引是在晚上,当前命中的行数比较少,由于当天晚上的时候待审核的处方确实很少,也就是rx_status=5的确实很少,查询优化器感觉反正没多少行,排序不重要,因而就还是选择rx_status索引。 2.2、第二天白天,待审核的处方数量很多了(rx_status=5的数据量多了),当时可以命中几万数据,如果当前命中的行数比较多,查询优化器就开始算成本,感觉排序的成本会更高,那就优先保排序吧,所以就选择rx_create_time这个字段,但是这个索引树上没有别的索引字段的信息,没办法,几乎每条数据都要回表,进而引发了灾难。 8、 推荐用书 这本书以一种诙谐幽默的风格写了MySQL的一些运行机制,非常适合阅读,理解成本大幅降低。 https://item.jd.com/13009316.html https://item.jd.com/10066181997303.html 9、一些感悟 关于数据库的性能优化其实是一个很复杂的大课题,很难通过一篇帖子讲的很全面和深刻,这也就是为什么我的标题是‘浅析’,程序员的成长一定是要付出代价和成本,因为只有真的在一线切身体会到当时的紧张和压力,对于一件事情才能印象深刻,但反之也不能太过于强调代价,如果可以通过一些别人的分享就可以规避一些自己业务的问题和错误的代价也是好的。

优秀的个人博客,低调大师

每日一博 | 浅谈服务接口的高可用设计

作者:京东零售 王磊 前言 作为一个后端研发人员,开发服务接口是我正常不过的工作了,这些接口不管是面向前端HTTP或者是供其他服务RPC远程调用的,都绕不开一个共同的话题就是“高可用”,接口开发往往看似简单,但保证高可用这块实现起来却不并没有想想的那么容易,接下来我们就看一下,一个高可用的接口是该考虑哪些内容,同时文中有不足的欢迎批评指正。 到底啥是高可用 用一句简单的话来概就是我们的系统具不具备应对和规避风险的能力。 为啥做高可用 1. 程序都是有人开发的,在开发过程中会犯错从而导致线上事故的发生 2. 系统运行依赖各种运行环境:CPU、内存、硬盘、网络等等,而这些都有可能损坏 3. 业务拉新用户正在注册账号,结果注册接口挂了用户体验受影响 4. 双十一、618等大促大量用户下单,结果下单服务接口挂了GMV受影响等等 5. 其他未知因素等等 总之为了应对这些不可控因素的发生,我们必须要做高可用 高可用的关键点 我们说过高可用的本质是系统是否具备应对和规避风险的能力,那么从这个角度出发来设计高可用接口的有以下几个关键因素:Dependence(依赖)、Probability(概率)、Time(时长)、Scope(范围) 1. 依赖的资源相对少 2. 风险的概率足够低 3. 影响的范围足够小 4. 影响时长足够短 接口高可用设计的几个原则 结合这些关键点,我们来看一下具体具体注意事项 1、控制依赖 能少依赖就少依赖,能不强依赖就不强依赖 少依赖 例如:日常每分钟10个请求,查询Mysql数据即可满足,此时盲目引入Redis中间件,不仅浪费资源而且增加系统复杂性 弱依赖 例如:用户注册服务强依赖新用户优惠券发放服务,当优惠券发放服务故障后,整个注册不可用,好的方式是采用弱依赖,使用异步化的 方式,这样优惠券发送服务不可用时,不会影响注册链路。 2、避免单点 避免单点故障的核心是通过备份或者冗余快速的进行容错 1. 我们采用多机房多实力部署我们应用来保障故障风险分摊,一旦有一台服务器出现问题,其他服务仍然能够继续支撑我们的服务 2. 每次上线我们都会保留上一次上线发布版本,这样一旦上线的程序出现问题我们能够快速回滚到上一版本 3. 每个接口至少保障2人知道相关业务,一旦线上服务出现问题,其中任何一人一个能够快速处理相关线上问题 4. 不管是Mysql还是Redis等中间件都支持数据主备机群部署 类似的例子很多这里就不再一一列举了 3、负载均衡 将风险进行分摊避免分险扩散 例如:无论是Ngnix或者JSF的,其负载均衡目的就是尽量的将流量分散到不同的服务器节点上,这样可以有效的保障单节点因系统瓶颈 问题而引发一系列的风险。 像上面这个例子我想每个研发人员都知道也都会这么做,但是是不是所有的场景我们都考虑到均衡这个问题? 例如:通常为了提高读并发的能力,我们会把数据缓存到JIMDB中,但是因为缓存的key出现了热点数据导致JIMDB单分片负载过高,恰 好,这个分片上也缓存了其他数据,但是因为CPU负载过高,导致查询性能变差,大量的超时,影响了业务。所以,我们在接口设计 的时候,假如遇到类似场景,也要充分考虑数据存储的均衡性,同时针对热点数据做好监控,随时支持动态均衡。 4、资源隔离 隔离的目的将风险控制在可控范围内,避免风险扩散 例如:接口部署之间服务部署物理上是相互隔离的,避免单机房或者单服务器出现故障影响整个服务 例如:我们在存储业务数据的时候会将数据分库分表,数据通过不同分片存储,这样就不会导致某个服务器挂掉影响到整个服务 5、接口限流 限流是一种保护措施,目的是将风险控制在可控范围内 我们在开发接口的时候,一定要结合业务流量情况进行限流措施,限流一方面处于对自身服务资源的保护,同时也是对依赖资源的一种 保护措施。 目前集团JSF在流量控制这块已经有了对应的限流处理能力,同时我们也可以结合实际业务进行限流模块的开发。 6、服务熔断 熔断也是一种保护措施,目的是将风险控制在可控范围内,避免风险扩散 例如:经常我们服务A会同时调用B、C、D多个服务,当我们依赖的服务其中一个出现故障或者性能下降的时候,就是导致整体服务 可用率下降,所以我们在开发此类服务的时候,一定要注意接口之间的隔离。我们可以利用类似Hystrix组件实现,也可以借助DUCC 进行手动隔离。 其实熔断也是一种控制资源依赖的一种,将强依赖降级为弱依赖 7、异步处理 将同步操作转为异步操作 例如:用户页面领取一些权益,针对领取这个服务在大促期间因为用户流量较大,为了避免系统负载,此时采用MQ异步接收用户领取 请求然后进行优惠券发放,这样不仅极大的减少了事故的影响范围,也减少问题发生概率。 8、降级方案 服务降级属于一种问题发生后的补救措施,通过服务降级可以减少一部分风险影响范围 对于重要的服务接口我们都要具备完善的降级方案,这里需要说明的是,降级有损的,我们一定要在系统开发前就要考虑各种问题 发生的可能,降级的前提是通过降级非核心业务保证核心业务运行。 例如:大促峰值期间,一般会提前降级掉很多功能,同时限流,主要是为了保护峰值绝大部分人的交易支付体验。 9、灰度发布 通过灰度发布降低风险影响范围 例如:我们上线一个新服务,通过一定的灰度策略,让用户先行体验新版本的应用,通过收集这部分用户对新版本应用的反馈以及 对新版本功能、性能、稳定性等指标进行评论,进而决定继续放大新版本投放范围直至全量升级或回滚至老版本。根据线上反馈结果, 做到查漏补缺,发现重大问题,可回滚“旧版本” 10、混沌工程 通过提前对系统进行一些破坏性的手段,提前发现潜在问题 例如:一个复杂接口系统依赖了太多的服务和组件,这些组件随时随地都可能会发生故障,而一旦它们发生故障,会不会如蝴蝶效应 一般造成整体服务不可用呢,我们并不知道,因此我们可以借助泰山平台混沌工程进行演练,针对发生的场景制定各种预案,将风险 控制在可控范围内。

优秀的个人博客,低调大师

每日一博 | 一文读懂 Kubernetes 存储设计

在 Docker 的设计中,容器内的文件是临时存放的,并且随着容器的删除,容器内部的数据也会一同被清空。不过,我们可以通过在 docker run 启动容器时,使用 --volume/-v 参数来指定挂载卷,这样就能够将容器内部的路径挂载到主机,后续在容器内部存放数据时会就被同步到被挂载的主机路径中。这样做可以保证保证即便容器被删除,保存到主机路径中的数据也仍然存在。 与 Docker 通过挂载卷的方式就可以解决持久化存储问题不同,K8s 存储要面临的问题要复杂的多。因为 K8s 通常会在多个主机部署节点,如果 K8s 编排的 Docker 容器崩溃,K8s 可能会在其他节点上重新拉起容器,这就导致原来节点主机上挂载的容器目录无法使用。 当然也是有办法解决 K8s 容器存储的诸多限制,比如可以对存储资源做一层抽象,通常大家将这层抽象称为卷(Volume)。 K8s 支持的卷基本上可以分为三类:配置信息、临时存储、持久存储。 配置信息 无论何种类型的应用,都会用到配置文件或启动参数。而 K8s 将配置信息进行了抽象,定义成了几种资源,主要有以下三种: ConfigMap Secret DownwardAPI ConfigMap ConfigMap 卷通常以一个或多个 key: value 形式存在,主要用来保存应用的配置数据。其中 value 可以是字面量或配置文件。 不过,因为ConfigMap 在设计上不是用来保存大量数据的,所以在 ConfigMap 中保存的数据不可超过 1 MiB(兆字节)。 ConfigMap 有两种创建方式: 通过命令行创建 通过 yaml 文件创建 通过命令行创建 在创建 Configmap 的时候可以通过 --from-literal 参数来指定 key: value,以下示例中 foo=bar 即为字面量形式,bar=bar.txt 为配置文件形式。 $ kubectl create configmap c1 --from-literal=foo=bar --from-literal=bar=bar.txt bar.txt 内容如下: baz 通过 kubectl describe 命令查看新创建的名称为 c1 的这个 Configmap 资源内容。 $ kubectl describe configmap c1 Name: c1 Namespace: default Labels: <none> Annotations: <none> Data ==== bar: ---- baz foo: ---- bar Events: <none> 通过 yaml 文件创建 创建 configmap-demo.yaml 内容如下: kind: ConfigMap apiVersion: v1 metadata: name: c2 namespace: default data: foo: bar bar: baz 通过 kubectl apply 命令应用这个文件。 $ kubectl apply -f configmap-demo.yaml $ kubectl get configmap c2 NAME DATA AGE c2 2 11s $ kubectl describe configmap c2 Name: c2 Namespace: default Labels: <none> Annotations: <none> Data ==== foo: ---- bar bar: ---- baz Events: <none> 得到的结果跟通过命令行方式创建的 Configmap 没什么两样。 使用示例 完成 Configmap 创建后,来看下如何使用。 创建好的Configmap 有两种使用方法: 通过环境变量将 Configmap 注入到容器内部 通过卷挂载的方式直接将 Configmap 以文件形式挂载到容器。 通过环境变量方式引用 创建 use-configmap-env-demo.yaml 内容如下: apiVersion: v1 kind: Pod metadata: name: "use-configmap-env" namespace: default spec: containers: - name: use-configmap-env image: "alpine" # 一次引用单个值 env: - name: FOO valueFrom: configMapKeyRef: name: c2 key: foo # 一次引用所有值 envFrom: - prefix: CONFIG_ # 配置引用前缀 configMapRef: name: c2 command: ["echo", "$(FOO)", "$(CONFIG_bar)"] 可以看到我们创建了一个名为 use-configmap-env 的 Pod,Pod 的容器将使用两种方式引用 Configmap 的内容。 第一种是指定 spec.containers.env,它可以为容器引用一个 Configmap 的 key: value 对。其中valueFrom. configMapKeyRef 表明我们要引用 Configmap ,Configmap 的名称为 c2 ,引用的 key 为 foo 。 第二种是指定 spec.containers.envFrom ,只需要通过 configMapRef.name 指定 Configmap 的名称,它就可以一次将 Configmap 中的所有 key: value 传递给容器。其中 prefix 可以给引用的 key 前面增加统一前缀。 Pod 的容器启动命令为 echo $(FOO) $(CONFIG_bar) ,可以分别打印通过 env 和 envFrom 两种方式引用的 Configmap 的内容。 # 创建 Pod $ kubectl apply -f use-configmap-env-demo.yaml # 通过查看 Pod 日志来观察容器内部引用 Configmap 结果 $ kubectl logs use-configmap-env bar baz 结果表明,容器内部可以通过环境变量的方式引用到 Configmap 的内容。 通过卷挂载方式引用 创建 use-configmap-volume-demo.yaml 内容如下: apiVersion: v1 kind: Pod metadata: name: "use-configmap-volume" namespace: default spec: containers: - name: use-configmap-volume image: "alpine" command: ["sleep", "3600"] volumeMounts: - name: configmap-volume mountPath: /usr/share/tmp # 容器挂载目录 volumes: - name: configmap-volume configMap: name: c2 这里创建一个名为 use-configmap-volume 的 Pod。通过 spec.containers.volumeMounts 指定容器挂载,name 指定挂载的卷名,mountPath 指定容器内部挂载路径(也就是将 Configmap 挂载到容器内部的指定目录下)。spec.volumes 声明一个卷,而configMap.name 表明了这个卷要引用的 Configmap 名称。 然后可通过如下命令创建 Pod 并验证容器内部能否引用到 Configmap。 # 创建 Pod $ kubectl apply -f use-configmap-volume-demo.yaml # 进入 Pod 容器内部 $ kubectl exec -it use-configmap-volume -- sh # 进入容器挂载目录 / # cd /usr/share/tmp/ # 查看挂载目录下的文件 /usr/share/tmp # ls bar foo # 查看文件内容 /usr/share/tmp # cat foo bar /usr/share/tmp # cat bar baz 创建完成后,通过 kubectl exec 命令可以进入容器内部。查看容器 /usr/share/tmp/ 目录,可以看到两个以 Configmap 中 key 为名称的文本文件(foo 、bar), key 所对应的 value 内容即为文件内容。 以上就是两种将 Configmap 的内容注入到容器内部的方式。容器内部的应用则可以分别通过读取环境变量、文件内容的方式使用配置信息。 Secret 熟悉了 Configmap 的用法,接下来看下 Secret 的使用。Secret 卷用来给 Pod 传递敏感信息,例如密码、SSH 密钥等。因为虽然Secret 与 ConfigMap 非常类似,但是它会对存储的数据进行 base64 编码。 Secret 同样有两种创建方式: 通过命令行创建 通过 yaml 文件创建 通过命令行创建 Secret 除了通过 --from-literal 参数来指定 key: value,还有另一种方式。即通过 --form-file 参数直接从文件加载配置,文件名即为 key,文件内容作为 value。 # generic 参数对应 Opaque 类型,既用户定义的任意数据 $ kubectl create secret generic s1 --from-file=foo.txt foo.txt 内容如下: foo=bar bar=baz 可以看到与 Configmap 不同,创建 Secret 需要指明类型。上面的示例为命令通过指定 generic 参数来创建类型为 Opaque 的 Secret ,这也是 Secret 默认类型。需要注意的是除去默认类型,Secret 还支持其他类型,可以通过官方文档查看。不过初期学习阶段只使用默认类型即可,通过默认类型就能够实现其他几种类型的功能 $ kubectl describe secret s1 Name: s1 Namespace: default Labels: <none> Annotations: <none> Type: Opaque Data ==== foo.txt: 16 bytes 另外一点与 Configmap 不同的是,Secret 仅展示 value 的字节大小,而不直接展示数据,这是为了保存密文,也是Secret 名称的含义。 通过 yaml 文件创建 创建 secret-demo.yaml 内容如下: apiVersion: v1 kind: Secret metadata: name: s2 namespace: default type: Opaque # 默认类型 data: user: cm9vdAo= password: MTIzNDU2Cg== 通过 kubectl apply 命令应用这个文件。 $ kubectl apply -f secret-demo.yaml $ kubectl get secret s2 NAME TYPE DATA AGE s2 Opaque 2 59s $ kubectl describe secret s2 Name: s2 Namespace: default Labels: <none> Annotations: <none> Type: Opaque Data ==== password: 7 bytes user: 5 bytes 同样能够正确创建出 Secret 资源。但是可以看到通过 yaml 文件创建 Secret 时,指定的 data 内容必须经过 base64 编码,比如我们指定的 user 和 password 都是编码后的结果。 data: user: cm9vdAo= password: MTIzNDU2Cg== 除此外也可以使用原始字符串方式,这两种方式是等价,示例如下: data: stringData: user: root password: "123456" 相对而言,我更推荐使用 base64 编码的方式。 使用示例 同 Configmap 使用方式一样,我们也可以通过环境变量或卷挂载的方式来使用 Secret 。以卷挂载方式为例。首先创建 use-secret-volume-demo.yaml 内容如下: apiVersion: v1 kind: Pod metadata: name: "use-secret-volume-demo" namespace: default spec: containers: - name: use-secret-volume-demo image: "alpine" command: ["sleep", "3600"] volumeMounts: - name: secret-volume mountPath: /usr/share/tmp # 容器挂载目录 volumes: - name: secret-volume secret: secretName: s2 即创建一个名为 use-secret-volume-demo 的 Pod,而 Pod 的容器通过卷挂载方式引用 Secret 的内容。 # 创建 Pod $ kubectl apply -f use-secret-volume-demo.yaml # 进入 Pod 容器内部 $ kubectl exec -it use-secret-volume-demo -- sh # 进入容器挂载目录 / # cd /usr/share/tmp/ # 查看挂载目录下的文件 /usr/share/tmp # ls password user # 查看文件内容 /usr/share/tmp # cat password 123456 /usr/share/tmp # cat user root 可以发现被挂载到容器内部以后,Secret 的内容将变成明文存储。容器内部应用可以同使用 Configmap 一样来使用 Secret 。 作为可以存储配置信息的 Configmap 和 Secret , Configmap 通常存放普通配置, Secret 则存放敏感配置。 值得一提的是,使用环境变量方式引用 Configmap 或 Secret ,当 Configmap 或 Secret 内容变更时,容器内部引用的内容不会自动更新;使用卷挂载方式引用 Configmap 或 Secret ,当 Configmap 或 Secret 内容变更时,容器内部引用的内容会自动更新。如果容器内部应用支持配置文件热加载,那么通过卷挂载对的方式引用 Configmap 或 Secret 内容将是推荐方式。 DownwardAPI DownwardAPI 可以将 Pod 对象自身的信息注入到 Pod 所管理的容器内部。 使用示例 创建 downwardapi-demo.yaml 内容如下: apiVersion: v1 kind: Pod metadata: name: downwardapi-volume-demo labels: app: downwardapi-volume-demo annotations: foo: bar spec: containers: - name: downwardapi-volume-demo image: alpine command: ["sleep", "3600"] volumeMounts: - name: podinfo mountPath: /etc/podinfo volumes: - name: podinfo downwardAPI: items: # 指定引用的 labels - path: "labels" fieldRef: fieldPath: metadata.labels # 指定引用的 annotations - path: "annotations" fieldRef: fieldPath: metadata.annotations # 创建 Pod $ kubectl apply -f downwardapi-demo.yaml pod/downwardapi-volume-demo created # 进入 Pod 容器内部 $ kubectl exec -it downwardapi-volume-demo -- sh # 进入容器挂载目录 / # cd /etc/podinfo/ # 查看挂载目录下的文件 /etc/podinfo # ls annotations labels # 查看文件内容 /etc/podinfo # cat annotations foo="bar" kubectl.kubernetes.io/last-applied-configuration="{\"apiVersion\":\"v1\",\"kind\":\"Pod\",\"metadata\":{\"annotations\":{\"foo\":\"bar\"},\"labels\":{\"app\":\"downwardapi-volume-demo\"},\"name\":\"downwardapi-volume-demo\",\"namespace\":\"default\"},\"spec\":{\"containers\":[{\"command\":[\"sleep\",\"3600\"],\"image\":\"alpine\",\"name\":\"downwardapi-volume-demo\",\"volumeMounts\":[{\"mountPath\":\"/etc/podinfo\",\"name\":\"podinfo\"}]}],\"volumes\":[{\"downwardAPI\":{\"items\":[{\"fieldRef\":{\"fieldPath\":\"metadata.labels\"},\"path\":\"labels\"},{\"fieldRef\":{\"fieldPath\":\"metadata.annotations\"},\"path\":\"annotations\"}]},\"name\":\"podinfo\"}]}}\n" kubernetes.io/config.seen="2022-03-12T13:06:50.766902000Z" /etc/podinfo # cat labels app="downwardapi-volume-demo" 不难发现,DownwardAPI 的使用方式同 Configmap 和 Secret 一样,都可以通过卷挂载方式挂载到容器内部以后,在容器挂载的目录下生成对应文件,用来存储 key: value。不同的是 ,因为DownwardAPI能引用的内容已经都在当前 yaml 文件中定义好了,所以DownwardAPI 不需要预先定义,可以直接使用。 小结 ConfigMap 、Secret 、DownwardAPI 这三种 Volume 存在的意义不是为了保存容器中的数据,而是为了给容器传递预先定义好的数据。 临时卷 接下来我们要关注的是临时卷,即临时存储。K8s 支持的临时存储中最常用的就是如下两种: EmptyDir HostPath 临时存储卷会遵从 Pod 的生命周期,与 Pod 一起创建和删除。 EmptyDir 先来看 emptyDir 如何使用。EmptyDir 相当于通过 --volume/-v 挂载时的隐式 Volume 形式使用 Docker。K8s 会在宿主机上创建一个临时目录,被挂载到容器所声明的 mountPath 目录上,即不显式的声明在宿主机上的目录。 使用示例 创建 emptydir-demo.yaml 内容如下: apiVersion: v1 kind: Pod metadata: name: "emptydir-nginx-pod" namespace: default labels: app: "emptydir-nginx-pod" spec: containers: - name: html-generator image: "alpine:latest" command: ["sh", "-c"] args: - while true; do date > /usr/share/index.html; sleep 1; done volumeMounts: - name: html mountPath: /usr/share - name: nginx image: "nginx:latest" ports: - containerPort: 80 name: http volumeMounts: - name: html # nginx 容器 index.html 文件所在目录 mountPath: /usr/share/nginx/html readOnly: true volumes: - name: html emptyDir: {} 这里创建一个名为 emptydir-nginx-pod 的 Pod,它包含两个容器 html-generator 和 nginx 。html-generator 用来不停的生成 html 文件,nginx 则是用来展示 html-generator 生成的 index.html 文件的 Web 服务。 具体流程为,html-generator 不停的将当前时间写入到 /usr/share/index.html 下,并将 /usr/share 目录挂载到名为 html 的卷中,而 nginx 容器则将 /usr/share/nginx/html 目录挂载到名为 html 的卷中,这样两个容器通过同一个卷 html 挂载到了一起。 现在通过 kubectl apply 命令应用这个文件: # 创建 Pod $ kubectl apply -f emptydir-demo.yaml pod/emptydir-nginx-pod created # 进入 Pod 容器内部 $ kubectl exec -it pod/emptydir-nginx-pod -- sh # 查看系统时区 / # curl 127.0.0.1 Sun Mar 13 08:40:01 UTC 2022 / # curl 127.0.0.1 Sun Mar 13 08:40:04 UTC 2022 根据 nginx 容器内部 curl 127.0.0.1 命令输出结果可以发现,nginx 容器 /usr/share/nginx/html/indedx.html 文件内容即为 html-generator 容器 /usr/share/index.html 文件内容。 能够实现此效果的原理是,当我们声明卷类型为 emptyDir: {} 后,K8s 会自动在主机目录上创建一个临时目录。然后将 html-generator 容器 /usr/share/ 目录和 nginx 容器 /usr/share/nginx/html/ 同时挂载到这个临时目录上。这样两个容器的目录就能够实现数据同步。 需要注意的是,容器崩溃并不会导致 Pod 被从节点上移除,因此容器崩溃期间 emptyDir 卷中的数据是安全的。另外,emptyDir.medium 除了可以设成 {},还可以设成 Memory 表示内存挂载。 HostPath 与 emptyDir 不同,hostPath 卷能将主机节点文件系统上的文件或目录挂载到指定的 Pod 中。并且当 Pod 删除时,与之绑定的 hostPath 并不会随之删除。新创建的 Pod挂载到上一个 Pod 使用过的 hostPath时,原 hostPath 中的内容仍然存在。但这仅限于新的 Pod 和已经删除的 Pod 被调度到同一节点上,所以严格来讲 hostPath 仍然属于临时存储。 hostPath 卷的典型应用是将主机节点上的时区通过卷挂载的方式注入到容器内部, 进而保证启动的容器和主机节点时间同步。 使用示例 创建 hostpath-demo.yaml 内容如下: apiVersion: v1 kind: Pod metadata: name: "hostpath-volume-pod" namespace: default labels: app: "hostpath-volume-pod" spec: containers: - name: hostpath-volume-container image: "alpine:latest" command: ["sleep", "3600"] volumeMounts: - name: localtime mountPath: /etc/localtime volumes: - name: localtime hostPath: path: /usr/share/zoneinfo/Asia/Shanghai 要实现时间同步,只需要将主机目录 /usr/share/zoneinfo/Asia/Shanghai 通过卷挂载的方式挂载到容器内部的 /etc/localtime 目录即可。 可以使用 kubectl apply 命令应用这个文件,然后进入 Pod 容器内部使用 date 命令查看容器当前时间。 # 创建 Pod $ kubectl apply -f hostpath-demo.yaml pod/hostpath-volume-pod created # 进入 Pod 容器内部 $ kubectl exec -it hostpath-volume-pod -- sh # 执行 date 命令输出当前时间 / # date Sun Mar 13 17:00:22 CST 2022 # 上海时区 看到输出结果为 Sun Mar 13 17:00:22 CST 2022 ,其中 CST 代表了上海时区,也就是主机节点的时区。如果不通过卷挂载的方式将主机时区挂载到容器内部,则容器默认时区为 UTC 时区。 小结 临时卷内容介绍了 K8s 的临时存储方案以及应用,其中emptyDir 适用范围较少,可以当作临时缓存或者耗时任务检查点等。 需要注意的是,绝大多数 Pod 应该忽略主机节点,不应该访问节点上的文件系统。尽管有时候 DaemonSet 可能需要访问主机节点的文件系统,而且hostPath 可以用来同步主机节点时区到容器,但其他情况下使用较少,特别hostPath 的最佳实践就是尽量不使用 hostPath。 持久卷 临时卷的生命周期与 Pod 相同,当 Pod 被删除时,K8s 会自动删除 Pod 挂载的临时卷。而当 Pod 中的应用需要将数据保存到磁盘,且即使 Pod 被调度到其他节点数据也应该存在时,我们就需要一个真正的持久化存储了。 K8s 支持的持久卷类型非常多,以下是 v1.24 版本支持的卷类型的一部分: awsElasticBlockStore - AWS 弹性块存储(EBS) azureDisk - Azure Disk azureFile - Azure File cephfs - CephFS volume csi - 容器存储接口 (CSI) fc - Fibre Channel (FC) 存储 gcePersistentDisk - GCE 持久化盘 glusterfs - Glusterfs 卷 iscsi - iSCSI (SCSI over IP) 存储 local - 节点上挂载的本地存储设备 nfs - 网络文件系统 (NFS) 存储 portworxVolume - Portworx 卷 rbd - Rados 块设备 (RBD) 卷 vsphereVolume - vSphere VMDK 卷 看到这么多持久卷类型不必恐慌,因为 K8s 为了让开发者不必关心这背后的持久化存储类型,所以对持久卷有一套独有的思想,即开发者无论使用哪种持久卷,其用法都是一致的。 K8s 持久卷设计架构如下: Node1 和 Node2 分别代表两个工作节点,当我们在工作节点创建 Pod 时,可以通过 spec.containers.volumeMounts 来指定容器挂载目录,通过 spec.volumes 来指定挂载卷。之前我们用挂载卷挂载了配置信息和临时卷,而挂载持久卷也可以采用同样的方式。每个 volumes 则指向的是下方存储集群中不同的存储类型。 为了保证高可用,我们通常会搭建一个存储集群。通常通过 Pod 来操作存储, 因为 Pod 都会部署在 Node 中,所以存储集群最好跟 Node 集群搭建在同一内网,这样速度更快。而存储集群内部可以使用任何 K8s 支持的持久化存储,如上图的 NFS 、CephFS 、CephRBD 。 使用NFS 持久化挂载方式与临时卷大同小异,我们同样使用一个 Nginx 服务来进行测试。这次我们用 NFS 存储来演示 K8s 对持久卷的支持(NFS 测试环境搭建过程可以参考文章结尾的附录部分),创建 nfs-demo.yaml 内容如下: apiVersion: v1 kind: Pod metadata: name: "nfs-nginx-pod" namespace: default labels: app: "nfs-nginx-pod" spec: containers: - name: nfs-nginx image: "nginx:latest" ports: - containerPort: 80 name: http volumeMounts: - name: html-volume mountPath: /usr/share/nginx/html/ volumes: - name: html-volume nfs: server: 192.168.99.101 # 指定 nfs server 地址 path: /nfs/data/nginx # 目录必须存在 将容器 index.html 所在目录 /usr/share/nginx/html/ 挂载到 NFS 服务的 /nfs/data/nginx 目录下,在 spec.volumes 配置项中指定 NFS 服务。其中server 指明了 NFS 服务器地址,path 指明了 NFS 服务器中挂载的路径,当然这个路径必须是已经存在的路径。然后通过 kubectl apply 命令应用这个文件。 $ kubectl apply -f nfs-demo.yaml 接下来我们查看这个 Pod 使用 NFS 存储的结果: 在 NFS 节点中我们准备一个 index.html 文件,其内容为 hello nfs。 使用 curl 命令直接访问 Pod 的 IP 地址,即可返回 Nginx 服务的 index.html 内容,结果输出为 hello nfs ,证明 NFS 持久卷挂载成功。 登入 Pod 容器,通过 df -Th 命令查看容器目录挂载信息。可以发现,容器的 /usr/share/nginx/html/ 目录被挂载到 NFS 服务的 /nfs/data/nginx 目录。 现在,当我们执行 kubectl delete -f nfs-demo.yaml 删除 Pod 后,NFS 服务器上数据盘中的数据依然存在,这就是持久卷。 持久卷使用痛点 虽然通过使用持久卷,可以解决临时卷数据易丢失的问题。但目前持久卷的使用方式还存在以下痛点: Pod 开发人员可能对存储不够了解,却要对接多种存储 安全问题,有些存储可能需要账号密码,这些信息不应该暴露给 Pod 因此为了解决这些不足,K8s 又针对持久化存储抽象出了三种资源 PV、PVC、StorageClass。三种资源定义如下: PV 描述的是持久化存储数据卷 PVC 描述的是 Pod 想要使用的持久化存储属性,既存储卷申明 StorageClass 作用是根据 PVC 的描述,申请创建对应的 PV PV 和 PVC 的概念可以对应编程语言中的面向对象思想,PVC 是接口,PV 是具体实现。 有了这三种资源类型后,Pod 就可以通过静态供应和动态供应这两种方式来使用持久卷。 静态供应 静态供应不涉及 StorageClass,只涉及到 PVC 和 PV。其使用流程图如下: 使用静态供应时,Pod 不再直接绑定持久存储,而是会绑定到 PVC 上,然后再由 PVC 跟 PV 进行绑定。这样就实现了 Pod 中的容器可以使用由 PV 真正去申请的持久化存储。 使用示例 创建 pv-demo.yaml 内容如下: apiVersion: v1 kind: PersistentVolume metadata: name: nfs-pv-1g labels: type: nfs spec: capacity: storage: 1Gi accessModes: - ReadWriteOnce storageClassName: nfs-storage nfs: server: 192.168.99.101 path: /nfs/data/nginx1 --- apiVersion: v1 kind: PersistentVolume metadata: name: nfs-pv-100m labels: type: nfs spec: capacity: storage: 100m accessModes: - ReadWriteOnce storageClassName: nfs-storage nfs: server: 192.168.99.101 path: /nfs/data/nginx2 --- apiVersion: v1 kind: PersistentVolumeClaim metadata: name: pvc-500m labels: app: pvc-500m spec: storageClassName: nfs-storage accessModes: - ReadWriteOnce resources: requests: storage: 500m --- apiVersion: v1 kind: Pod metadata: name: "pv-nginx-pod" namespace: default labels: app: "pv-nginx-pod" spec: containers: - name: pv-nginx image: "nginx:latest" ports: - containerPort: 80 name: http volumeMounts: - name: html mountPath: /usr/share/nginx/html/ volumes: - name: html persistentVolumeClaim: claimName: pvc-500m 其中 yaml 文件定义了如下内容: 两个 PV:申请容量分别为 1Gi 、100m ,通过 spec.capacity.storage 指定,并且他们通过 spec.nfs 指定了 NFS 存储服务的地址和路径。 一个 PVC :申请 500m 大小的存储。 一个 Pod:spec.volumes 绑定名为 pvc-500m 的 PVC,而不是直接绑定 NFS 存储服务。 通过 kubectl apply 命令应用该文件: $ kubectl apply -f pv-demo.yaml 以上完成创建,结果查看操作则如下: 首先通过 kubectl get pod 命令查看新创建的 Pod,并通过 curl 命令访问 Pod 的 IP 地址,得到 hello nginx1 的响应结果。 然后通过 kubectl get pvc 查看创建的 PVC: STATUS 字段:标识 PVC 已经处于绑定(Bound)状态,也就是与 PV 进行了绑定。 CAPACITY 字段:标识 PVC 绑定到了 1Gi 的 PV 上,尽管我们申请的 PVC 大小是 500m ,但由于我们创建的两个 PV 大小分别是 1Gi 和 100m ,K8s 会帮我们选择满足条件的最优解。因为没有刚好等于 500m 大小的 PV 存在,而 100m 又不满足,所以 PVC 会自动与 1Gi 大小的 PV 进行绑定。 通过 kubectl get pv 来查询创建的 PV 资源,可以发现 1Gi 大小的 PV STATUS 字段为 Bound 状态。CLAIM 的值,则标识的是与之绑定的 PVC 的名字。 现在我们登录 NFS 服务器,确认NFS 存储上不同持久卷(PV)挂载的目录下文件内容。 可以看到,/nfs/data/nginx1 目录下的 index.html 内容为 hello nginx1 ,即为上面通过 curl 命令访问 Pod 服务的响应结果。 到此持久卷完成使用,我们总结下整个持久卷使用流程。首先创建一个 Pod, Pod 的 spec.volumes 中绑定 PVC。这里的 PVC 只是一个存储申明,代表我们的 Pod 需要什么样的持久化存储,它不需要标明 NFS 服务地址,也不需要明确要和哪个 PV 进行绑定,只是创建出这个 PVC 即可。接着我们创建两个 PV,PV 也没有明确指出要与哪个 PVC 进行绑定,只需要指出它的大小和 NFS 存储服务地址即可。此时 K8s 会自动帮我们进行 PVC 和 PV 的绑定,这样 Pod 就和 PV 产生了联系,也就可以访问持久化存储了。 其他 细心的你可能已经发现,前文提到静态供应不涉及 StorageClass,但是在定义 PVC 和 PV 的 yaml 文件时,还是都为其指定了 spec.storageClassName 值为 nfs-storage。因为这是一个便于管理的操作方式,只有具有相同 StorageClass 的 PVC 和 PV 才可以进行绑定,这个字段标识了持久卷的访问模式。在 K8s 持久化中支持四种访问模式: RWO - ReadWriteOnce —— 卷可以被一个节点以读写方式挂载 ROX - ReadOnlyMany —— 卷可以被多个节点以只读方式挂载 RWX - ReadWriteMany —— 卷可以被多个节点以读写方式挂载 RWOP - ReadWriteOncePod —— 卷可以被单个 Pod 以读写方式挂载( K8s 1.22 以上版本) 只有具有相同读写模式的 PVC 和 PV 才可以进行绑定。 现在我们来继续实验,通过命令 kubectl delete pod pv-nginx-pod 删除 Pod,再次查看 PVC 和 PV 状态。 从上图可以看到, Pod 删除后 PVC 和 PV 还在,这说明 Pod 删除并不影响 PVC 的存在。而当 PVC 删除时 PV 是否删除,则可以通过设置回收策略来决定。PV 回收策略(pv.spec.persistentVolumeReclaimPolicy)有三种: Retain —— 手动回收,也就是说删除 PVC 后,PV 依然存在,需要管理员手动进行删除 Recycle —— 基本擦除 (相当于 rm -rf /*)(新版已废弃不建议使用,建议使用动态供应) Delete —— 删除 PV,即级联删除 现在通过命令 kubectl delete pvc pvc-500m 删除 PVC,查看 PV 状态。 可以看到 PV 依然存在,其 STATUS 已经变成 Released ,此状态下的 PV 无法再次绑定到 PVC,需要由管理员手动删除,这是由回收策略决定的。 注意:绑定了 Pod 的 PVC,如果 Pod 正在运行中,PVC 无法删除。 静态供应的不足 我们一起体验了静态供应的流程,虽然比直接在 Pod 中绑定 NFS 服务更加清晰,但静态供应依然存在不足。 首先会造成资源浪费,如上面示例中,PVC 申请 500m,而没有刚好等于 500m 的 PV 存在,这 K8s 会将 1Gi 的 PV 与之绑定 还有一个致命的问题,如果当前没有满足条件的 PV 存在,则这 PVC 一直无法绑定到 PV 处于 Pending 状态,Pod 也将无法启动,所以就需要管理员提前创建好大量 PV 来等待新创建的 PVC 与之绑定,或者管理员时刻监控是否有满足 PVC 的 PV 存在,如果不存在则马上进行创建,这显然是无法接受的 动态供应 因为静态供应存在不足,K8s 推出一种更加方便的持久卷使用方式,即动态供应。动态供的应核心组件就是 StorageClass——存储类。StorageClass 主要作用有两个: 一是资源分组,我们上面使用静态供应时指定 StorageClass 的目前就是对资源进行分组,便于管理 二是 StorageClass 能够帮我们根据 PVC 请求的资源,自动创建出新的 PV,这个功能是 StorageClass 中 provisioner 存储插件帮我们来做的。 其使用流程图如下: 相较于静态供应,动态供应在 PVC 和 PV 之间增加了存储类。这次 PV 并不需要提前创建好,只要我们申请了 PVC 并且绑定了有 provisioner 功能的 StorageClass,StorageClass 会帮我们自动创建 PV 并与 PVC 进行绑定。 我们可以根据提供的持久化存储类型,分别创建对应的 StorageClass,比如: nfs-storage cephfs-storage rbd-storage 也可以设置一个默认 StorageClass, 通过在创建 StorageClass 资源时指定对应的 annotations 实现: apiVersion: storage.K8s.io/v1 kind: StorageClass metadata: annotations: storageclass.kubernetes.io/is-default-class: "true" ... 当创建 PVC 时不指定 spec.storageClassName ,这个 PVC 就会使用默认 StorageClass。 使用示例 仍然使用 NFS 来作为持久化存储。 首先需要有一个能够支持自动创建 PV 的 provisioner ,这可以在 GitHub 中找到一些开源的实现。示例使用 nfs-subdir-external-provisioner 这个存储插件,具体安装方法非常简单,只需要通过 kubectl apply 命令应用它提供的几个 yaml 文件即可。完成存储插件安装后,可以创建如下 StorageClass: apiVersion: storage.K8s.io/v1 kind: StorageClass metadata: name: nfs-storage provisioner: K8s-sigs.io/nfs-subdir-external-provisioner parameters: archiveOnDelete: "true" 这个 StorageClass 指定了 provisioner 为我们安装好的 K8s-sigs.io/nfs-subdir-external-provisioner。 Provisioner 本质上也是一个 Pod,可以通过 kubectl get pod 来查看。指定了 provisioner 的 StorageClass 就有了自动创建 PV 的能力,因为 Pod 能够自动创建 PV。 创建好 provisioner 和 StorageClass 就可以进行动态供应的实验了。首先创建 nfs-provisioner-demo.yaml 内容如下: kind: PersistentVolumeClaim apiVersion: v1 metadata: name: test-claim spec: storageClassName: nfs-storage accessModes: - ReadWriteOnce resources: requests: storage: 1Mi --- apiVersion: v1 kind: Pod metadata: name: "test-nginx-pod" namespace: default labels: app: "test-nginx-pod" spec: containers: - name: test-nginx image: "nginx:latest" ports: - containerPort: 80 name: http volumeMounts: - name: html mountPath: /usr/share/nginx/html/ volumes: - name: html persistentVolumeClaim: claimName: test-claim 这里我们只定义了一个 PVC 和一个 Pod,并没有定义 PV。其中 PVC 的 spec.storageClassName 指定为上面创建好的 StorageClass nfs-storage ,然后只需要通过 kubectl apply 命令来创建出 PVC 和 Pod 即可: $ kubectl apply -f nfs-provisioner-demo.yaml persistentvolumeclaim/test-claim created pod/test-nginx-pod created 现在查看 PV、PVC 和 Pod,可以看到 PV 已经被自动创建出来了,并且它们之间实现了绑定关系。 然后登录 NFS 服务,给远程挂载的卷写入 hello nfs 数据。 在 K8s 侧,就可以使用 curl 命令验证挂载的正确性了。 此时如果你通过 kubectl delete -f nfs-provisioner-demo.yaml 删除 Pod 和 PVC,PV 也会跟着删除,因为 PV 的删除策略是 Delete 。不过删除后NFS 卷中的数据还在,只不过被归档成了以 archived 开头的目录。这是 K8s-sigs.io/nfs-subdir-external-provisioner 这个存储插件所实现的功能,这就是存储插件的强大。 完成全部操作后,我们可以发现通过定义指定了 provisioner 的 StorageClass,不仅实现了 PV 的自动化创建,甚至实现了数据删除时自动归档的功能,这就是 K8s 动态供应存储设计的精妙。也可以说动态供应是持久化存储最佳实践。 附录:NFS 实验环境搭建 NFS 全称 Network File System,是一种分布式存储,它能够通过局域网实现不同主机间目录共享。 以下为 NFS 的架构图:由一个 Server 节点和两个 Client 节点组成。 下面列出 NFS 在 Centos 系统中的搭建过程。 Server 节点 # 安装 nfs 工具 yum install -y nfs-utils # 创建 NFS 目录 mkdir -p /nfs/data/ # 创建 exports 文件,* 表示所有网络上的 IP 都可以访问 echo "/nfs/data/ *(insecure,rw,sync,no_root_squash)" > /etc/exports # 启动 rpc 远程绑定功能、NFS 服务功能 systemctl enable rpcbind systemctl enable nfs-server systemctl start rpcbind systemctl start nfs-server # 重载使配置生效 exportfs -r # 检查配置是否生效 exportfs # 输出结果如下所示 # /nfs/data Client 节点 # 关闭防火墙 systemctl stop firewalld systemctl disable firewalld # 安装 nfs 工具 yum install -y nfs-utils # 挂载 nfs 服务器上的共享目录到本机路径 /root/nfsmount mkdir /root/nfsmount mount -t nfs 192.168.99.101:/nfs/data /root/nfsmount

优秀的个人博客,低调大师

每日一博 | cookie、session、token,还在傻傻分不清?

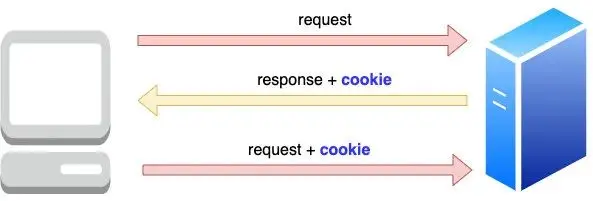
摘要:session 和 token 本质上是没有区别的,都是对用户身份的认证机制,只是他们实现的校验机制不一样而已。 本文分享自华为云社区《Session/Cookie/Token 还傻傻分不清?》,作者: 龙哥手记。 相信项目中用JWT Token的应该不在少数,但是发现网上很多文章对 token 的介绍有误,所以对 cookie,session, token 作了一下对比(文中token指jwt token)相信大家看完肯定有收获! Cookie 1991 年 HTTP 0.9 诞生了,当时只是为了满足大家浏览 web 文档的要求 ,所以只有 GET 请求,浏览完了就走了,两个连接之间是没有任何联系的,这也是 HTTP 为无状态的原因,因为它诞生之初就没有这个需求。 但随着交互式 Web 的兴起(所谓交互式就是你不光可以浏览,还可以登录,发评论,购物等用户操作的行为),单纯地浏览 web 已经无法满足人们的要求,比如随着网上购物的兴起,需要记录用户的购物车记录,就需要有一个机制记录每个连接的关系,这样我们就知道加入购物车的商品到底属于谁了,于是 Cookie 就诞生了。 Cookie,有时也用其复数形式 Cookies。类型为“小型文本文件”,是某些网站为了辨别用户身份,进行 Session 跟踪而储存在用户本地终端上的数据(通常经过加密),由用户客户端计算机暂时或永久保存的信息 。 工作机制如下 以加入购物车为例,每次浏览器请求后 server 都会将本次商品 id 存储在 Cookie 中返回给客户端,客户端会将 Cookie 保存在本地,下一次再将上次保存在本地的 Cookie 传给 server 就行了,这样每个 Cookie 都保存着用户的商品 id,购买记录也就不会丢失了 仔细观察上图相信你不难发现随着购物车内的商品越来越多,每次请求的 cookie 也越来越大,这对每个请求来说是一个很大的负担,我只是想将一个商品加入购买车,为何要将历史的商品记录也一起返回给 server ?购物车信息其实已经记录在 server 了,浏览器这样的操作岂不是多此一举?怎么改进呢 Session 仔细考虑下,由于用户的购物车信息都会保存在 Server 中,所以在 Cookie 里只要保存能识别用户身份的信息,知道是谁发起了加入购物车操作即可,这样每次请求后只要在 Cookie 里带上用户的身份信息,请求体里也只要带上本次加入购物车的商品 id,大大减少了 cookie 的体积大小,我们把这种能识别哪个请求由哪个用户发起的机制称为 Session(会话机制),生成的能识别用户身份信息的字符串称为 sessionId,它的工作机制如下 首先用户登录,server 会为用户生成一个 session,为其分配唯一的 sessionId,这个 sessionId 是与某个用户绑定的,也就是说根据此 sessionid(假设为 abc) 可以查询到它到底是哪个用户,然后将此 sessionid 通过 cookie 传给浏览器 之后浏览器的每次添加购物车请求中只要在 cookie 里带上 sessionId=abc 这一个键值对即可,server 根据 sessionId 找到它对应的用户后,把传过来的商品 id 保存到 server 中对应用户的购物车即可 可以看到通过这种方式再也不需要在 cookie 里传所有的购物车的商品 id 了,大大减轻了请求的负担! 另外通过上文不难观察出 cookie 是存储在 client 的,而 session 保存在 server,sessionId 需要借助 cookie 的传递才有意义。 session 的痛点 看起来通过 cookie + session 的方式是解决了问题, 但是我们忽略了一个问题,上述情况能正常工作是因为我们假设 server 是单机工作的,但实际在生产上,为了保障高可用,一般服务器至少需要两台机器,通过负载均衡的方式来决定到底请求该打到哪台机器上。 如图示:客户端请求后,由负载均衡器(如 Nginx)来决定到底打到哪台机器 假设登录请求打到了 A 机器,A 机器生成了 session 并在 cookie 里添加 sessionId 返回给了浏览器,那么问题来了:下次添加购物车时如果请求打到了 B 或者 C,由于 session 是在 A 机器生成的,此时的 B,C 是找不到 session 的,那么就会发生无法添加购物车的错误,就得重新登录了,此时请问该怎么办。主要有以下三种方式 1、session 复制 A 生成 session 后复制到 B, C,这样每台机器都有一份 session,无论添加购物车的请求打到哪台机器,由于 session 都能找到,故不会有问题 这种方式虽然可行,但缺点也很明显: 同一样的一份 session 保存了多份,数据冗余 如果节点少还好,但如果节点多的话,特别是像阿里,微信这种由于 DAU 上亿,可能需要部署成千上万台机器,这样节点增多复制造成的性能消耗也会很大。 2、session 粘连 这种方式是让每个客户端请求只打到固定的一台机器上,比如浏览器登录请求打到 A 机器后,后续所有的添加购物车请求也都打到 A 机器上,Nginx 的 sticky 模块可以支持这种方式,支持按 ip 或 cookie 粘连等等,如按 ip 粘连方式如下 upstream tomcats { ip_hash; server 10.1.1.107:88; server 10.1.1.132:80; } 这样的话每个 client 请求到达 Nginx 后,只要它的 ip 不变,根据 ip hash 算出来的值会打到固定的机器上,也就不存在 session 找不到的问题了,当然不难看出这种方式缺点也是很明显,对应的机器挂了怎么办? 3、session 共享 这种方式也是目前各大公司普遍采用的方案,将 session 保存在 redis,memcached 等中间件中,请求到来时,各个机器去这些中间件取一下 session 即可。 缺点其实也不难发现,就是每个请求都要去 redis 取一下 session,多了一次内部连接,消耗了一点性能,另外为了保证 redis 的高可用,必须做集群,当然了对于大公司来说, redis 集群基本都会部署,所以这方案可以说是大公司的首选了。 Token:no session! 通过上文分析我们知道通过在服务端共享 session 的方式可以完成用户的身份定位,但是不难发现也有一个小小的瑕疵:搞个校验机制我还得搭个 redis 集群?大厂确实 redis 用得比较普遍,但对于小厂来说可能它的业务量还未达到用 redis 的程度,所以有没有其他不用 server 存储 session 的用户身份校验机制呢,这就是我们今天要介绍的主角:token。 首先请求方输入自己的用户名,密码,然后 server 据此生成 token,客户端拿到 token 后会保存到本地,之后向 server 请求时在请求头带上此 token 即可。 相信大家看了上图会发现存在两个问题 1、 token 只存储在浏览器中,服务端却没有存储,这样的话我随便搞个 token 传给 server 也行? 答:server 会有一套校验机制,校验这个 token 是否合法。 2、怎么不像 session 那样根据 sessionId 找到 userid 呢,这样的话怎么知道是哪个用户? 答:token 本身携带 uid 信息 第一个问题,如何校验 token 呢?我们可以借鉴 HTTPS 的签名机制来校验。先来看 jwt token 的组成部分 可以看到 token 主要由三部分组成 header:指定了签名算法 payload:可以指定用户 id,过期时间等非敏感数据 Signature: 签名,server 根据 header 知道它该用哪种签名算法,再用密钥根据此签名算法对 head + payload 生成签名,这样一个 token 就生成了。 当 server 收到浏览器传过来的 token 时,它会首先取出 token 中的 header + payload,根据密钥生成签名,然后再与 token 中的签名比对,如果成功则说明签名是合法的,即 token 是合法的。而且你会发现 payload 中存有我们的 userId,所以拿到 token 后直接在 payload 中就可获取 userid,避免了像 session 那样要从 redis 去取的开销 画外音:header, payload 实际上是以 base64 的形式存在的,文中为了描述方便,省去了这一步。 你会发现这种方式确实很妙,只要 server 保证密钥不泄露,那么生成的 token 就是安全的,因为如果伪造 token 的话在签名验证环节是无法通过的,就此即可判定 token 非法。 可以看到通过这种方式有效地避免了 token 必须保存在 server 的弊端,实现了分布式存储,不过需要注意的是,token 一旦由 server 生成,它就是有效的,直到过期,无法让 token 失效,除非在 server 为 token 设立一个黑名单,在校验 token 前先过一遍此黑名单,如果在黑名单里则此 token 失效,但一旦这样做的话,那就意味着黑名单就必须保存在 server,这又回到了 session 的模式,那直接用 session 不香吗。所以一般的做法是当客户端登出要让 token 失效时,直接在本地移除 token 即可,下次登录重新生成 token 就好。 另外需要注意的是 token 一般是放在 header 的 Authorization 自定义头里,不是放在 Cookie 里的,这主要是为了解决跨域不能共享 Cookie 的问题 (下文详述) Cookie 与 Token 的简单总结 Cookie 有哪些局限性? 1、 Cookie 跨站是不能共享的,这样的话如果你要实现多应用(多系统)的单点登录(SSO),使用 Cookie 来做需要的话就很困难了(要用比较复杂的 trick 来实现,有兴趣的话可以看文末参考链接) 画外音: 所谓单点登录,是指在多个应用系统中,用户只需要登录一次就可以访问所有相互信任的应用系统。 但如果用 token 来实现 SSO 会非常简单,如下 只要在 header 中的 authorize 字段(或其他自定义)加上 token 即可完成所有跨域站点的认证。 2、 在移动端原生请求是没有 cookie 之说的,而 sessionid 依赖于 cookie,sessionid 就不能用 cookie 来传了,如果用 token 的话,由于它是随着 header 的 authoriize 传过来的,也就不存在此问题,换句话说token 天生支持移动平台,可扩展性好 综上所述,token 具有存储实现简单,扩展性好这些特点。 token 有哪些缺点 那有人就问了,既然 token 这么好,那为什么各个大公司几乎都采用共享 session 的方式呢,可能很多人是第一次听到 token,token 不香吗? token 有以下两点劣势: 1、 token 太长了 token 是 header, payload 编码后的样式,所以一般要比 sessionId 长很多,很有可能超出 cookie 的大小限制(cookie 一般有大小限制的,如 4kb),如果你在 token 中存储的信息越长,那么 token 本身也会越长,这样的话由于你每次请求都会带上 token,对请求来是个不小的负担 2、 不太安全 网上很多文章说 token 更安全,其实不然,细心的你可能发现了,我们说 token 是存在浏览器的,再细问,存在浏览器的哪里?既然它太长放在 cookie 里可能导致 cookie 超限,那就只好放在 local storage 里,这样会造成安全隐患,因为 local storage 这类的本地存储是可以被 JS 直接读取的,另外由上文也提到,token 一旦生成无法让其失效,必须等到其过期才行,这样的话如果服务端检测到了一个安全威胁,也无法使相关的 token 失效。 所以 token 更适合一次性的命令认证,设置一个比较短的有效期 误解: Cookie 相比 token 更不安全,比如 CSRF 攻击 首先我们需要解释下 CSRF 攻击是怎么回事 攻击者通过一些技术手段欺骗用户的浏览器去访问一个自己曾经认证过的网站并运行一些操作(如发邮件,发消息,甚至财产操作如转账和购买商品)。由于浏览器曾经认证过(cookie 里带来 sessionId 等身份认证的信息),所以被访问的网站会认为是真正的用户操作而去运行。 比如用户登录了某银行网站(假设为http://www.examplebank.com/,并且转账地址为http://www.examplebank.com/withdraw?amount=1000&transferTo=PayeeName),登录后 cookie 里会包含登录用户的 sessionid,攻击者可以在另一个网站上放置如下代码 <img src="http://www.examplebank.com/withdraw?account=Alice&amount=1000&for=Badman"> 那么如果正常的用户误点了上面这张图片,由于相同域名的请求会自动带上 cookie,而 cookie 里带有正常登录用户的 sessionid,类似上面这样的转账操作在 server 就会成功,会造成极大的安全风险 CSRF 攻击的根本原因在于对于同样域名的每个请求来说,它的 cookie 都会被自动带上,这个是浏览器的机制决定的,所以很多人据此认定 cookie 不安全。 使用 token 确实避免了CSRF 的问题,但正如上文所述,由于 token 保存在 local storage,它会被 JS 读取,从存储角度来看也不安全(实际上防护 CSRF 攻击的正确方式是用 CSRF token) 所以不管是 cookie 还是 token,从存储角度来看其实都不安全,都有暴露的风险,我们所说的安全更多的是强调传输中的安全,可以用 HTTPS 协议来传输, 这样的话请求头都能被加密,也就保证了传输中的安全。 其实我们把 cookie 和 token 比较本身就不合理,一个是存储方式,一个是验证方式,正确的比较应该是 session vs token。 总结 session 和 token 本质上是没有区别的,都是对用户身份的认证机制,只是他们实现的校验机制不一样而已(一个保存在 server,通过在 redis 等中间件获取来校验,一个保存在 client,通过签名校验的方式来校验),多数场景上使用 session 会更合理,但如果在单点登录,一次性命令认证上使用 token 会更合适,最好在不同的业务场景中合理选型,才能达到事半功倍的效果。 点击关注,第一时间了解华为云新鲜技术~

优秀的个人博客,低调大师

每日一博 | 得物染色环境落地实践

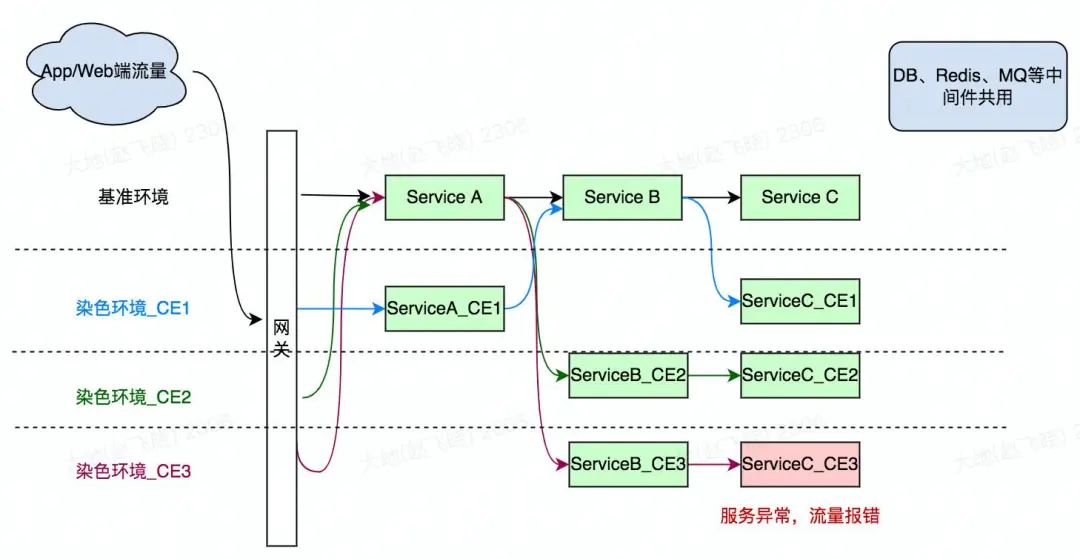
1. 背景 测试环境治理一直是各大公司非常重要的一个课题,测试环境稳定性很大程度影响迭代开发&测试效率。 综合来看,测试环境不稳定的原因主要有以下几点: 测试环境的变更非终态变更,经常会有代码发布/配置发布导致服务无法启动或者链路有问题的情况。 变更频繁,开发需要联调、测试需要迭代测试,代码需要变更,配置也需要变更,权限控制就比较难做,增加了测试环境不稳定性。 并行需求,同一时间单个应用需要多个分支同时支持多个需求的测试,测试环境资源的抢占和冲突比较明显。 得物测试环境稳定性治理也经历了几个阶段: 2020~2021:多套物理环境隔离方案(基于ECS) T0、T1、T2三套测试环境,每套环境物理隔离,无资源冲突和共享。 规划T1用于迭代测试、T0用于集成回归、T2用于独立项目分配使用,但在实际使用过程中,业务测试并行太多,冲突比较明显,环境就开始乱用了,谁有需求就随便占用一套环境使用了。结果就是没有一套稳定的环境,测试有效性无法保障,并行项目环境冲突也无法解决。 2021~2022:MF全链路容器环境方案(基于容器) 随着业务增长,3套测试环境已明显不能满足业务需求,因此去年得物基于容器快速搭建了10套MF环境用于支撑独立项目的测试。 MF环境基于T0搭建,DB和T0共享,其他所有资源均独立,目的是做到业务只需保障T0的稳定性,所有MF环境可快速基于T0同步最新服务和最新配置,做到环境随用随取,解决并行项目环境冲突问题。 实际实施过程中,项目环境冲突的问题解决了,但是MF环境的稳定性问题依旧比较严重,维护成本巨大,主要原因集中在: T0环境稳定性,并非所有域都在T0集成回归,导致T0稳定性无法保障 MF同步了T0之后会因为各种各样的原因需要二次调试验收(新增服务丢失、配置不全/错乱等) MF环境使用过程中,基础服务(sso、网关、中间件)等相关变更无法及时更新到MF环境,影响业务测试 因此在2022年下半年,开始尝试用染色环境解决环境稳定性问题。 2022年:染色环境方案(基于流量隔离) 染色环境是基于流量隔离的方案,通过流量标透传的方式,把基准环境流量和染色环境流量隔离开,实现多环境的方案,支持并行测试互不影响。 相较于MF环境而言,不需要维护多套全链路环境,维护成本降低了。所有变更的服务都在染色环境部署的话,基准环境稳定性就会提升,相当于所有环境的稳定性都提升了。 下面主要介绍得物染色环境是如何做的 2.染色环境方案 2.1 基本思路 如下图所示,最初的设想是: 服务可以按照流量标把流量路由到相应染色服务上 如果染色标对应染色环境没有此服务,则流量会走到基准环境 如果染色环境服务添加了,没有部署,或者部署了服务进程挂了,则流量会报错而并非走到基准环境(避免一些服务异常问题没有暴露) DB、MQ、Redis等中间件期望用同一套,避免浪费 基于此设想,需要从哪些地方入手去改造以支持染色环境呢?可以从设想拆解去解决: 流量标如何透传? 流量路由如何路由到染色节点? rpc接口如何路由到染色节点? MQ消息如何让染色环境consumer消费? 解决完流量标透传问题,以及染色路由问题后,需要考虑流量发起方如何把染色标带上? 2.2 实现方案 以下方案只做流量隔离,DB数据层不做隔离 1.流量标如何透传? 首先流量标在流量入口层会放到http header里面的x-infr-flowtype字段: x-infr-flowtype:<CE_ColoringEnv> ##CE_是固定前缀,为了和压测标做区分 从流量到网关后,服务链路上面流量标往下透传的方式是通过OpenTracing规范中的baggage能力,从header里面获取染色标,并塞到trace里面向下透传。 这样整个链路里面就都能拿到染色标了 2.流量路由如何路由到染色节点? 这里分两块考虑: (1)rpc调用,拿到染色标之后,如何找到染色节点?这里要解决的是怎么识别染色节点 (2)MQ消息,producer如何发送带染色标的消息,consumer如何处理带染色标的消息 服务注册--识别染色节点 首先染色环境创建的时候,会定义好染色标: 在此染色环境添加服务部署的时候,默认会把染色标注入到环境变量COLORING_ENV 容器发布配置页面会自动增加COLORING_ENV变量 至此,服务启动时已可以读到COLORING_ENV环境标变量了,下一步就看注册中心怎么去区分染色节点了. 首先服务在添加到染色环境的时候,服务会在注册中心染色场增加一个节点,标明该服务在此染色环境是有服务节点存在的。 染色场主要解决的问题是:如果染色节点挂了,染色环境流量应该判断该染色环境是否应该有染色节点,有的话就报错,没有的话才会走到基准环境。避免测试问题未暴露。 染色场:CE_< ServiceName> 染色场服务节点:<COLORING_ENV>:80 其次在服务注册时候,服务节点信息和方法注册会携带染色标<coloring_env>: 至此,注册中心就可以基于染色标识别染色节点,业务服务(基于fusion框架)可以根据Trace中的染色标结合注册中心染色节点做染色流量路由。 MQ改造--识别和处理MQ消息 MQ主要解决的是,染色环境的消息生产者producer发送的消息,只被染色环境的消费者消费,染色环境如果没有消费节点,则由基准环境消费者消费。 这里之前讨论了两种做法: 第一种是基于Topic隔离的方案,每套染色环境使用不同的topic进行通信,这样隔离性比较好,消息不容易串掉。 第二种是Topic不隔离,所有染色环境共用一个topic,生产者Producer在生产消息时候把染色标带上,consumer每套染色环境有一个,consumer在做消费时候会判断消息里面的染色标和本地染色标是否一致,如果一致则消费,如果不一致则直接返回ACK不走具体消费逻辑。 目前选择的是第二种方案,下面基于第二种方案做详细介绍: 基本流程 如图所示: ServiceB_Color1会自动注册GID_Color1_Topic消费组,监听Topic_A。Color2和Color3环境一样。 带Color1的消息由ServiceA_Color1生产,ServiceB_Color1消费。 带Color2的消息由ServiceA_Color2生产,ServiceB消费,因为ServiceB在Color2染色环境没有节点 带Color3的消息由于染色环境Color3没有ServiceA_Color3节点,则带Color3的流量会打到基准环境ServiceA,此时ServiceA会生产带Color3的消息,此消息由ServiceB_Color3消费 配合业务说明: 染色环境在启动时候,带染色标的GID会自动创建,eg:原GID是GID_AAA,染色自动创建的GID为GID_<coloring_env>_AAA 下面看消息的内容和处理逻辑: 如上图:染色消息属性里面会增加DMQ_ENV_TAG字段,添加染色标,然后对应染色环境订阅组才会消费。 看上面这张图,会发现“貌似”所有染色环境都消费了,其实是其他环境直接返回了ACK,未走具体的消费逻辑,具体可以看日志。 代码说明:基于Message里面染色标msgTag和本地服务染色标envTag进行判断做消费逻辑区分。 3.染色流量入口携带染色标 解决完染色标透传,以及染色标逻辑处理后,剩下就是如何在流量发起方把染色标给带上了,其实就是把染色标塞到header里面的x-infr-flowtype字段。 其中染色环境列表的获取由发布平台提供接口给到各流量入口方去选择。 目前业务推广过程中,主要遇到的入口方大致有以下几种: 入口流量携带染色标相对逻辑比较简单,这里就不做详细技术介绍,只做使用层面介绍 至此整个业务改造基本完成,从染色流量如何构造、流量标如何透传、染色节点如何识别以及识别后重点染色逻辑如何处理等一整套流程就清晰了。 3.业务应用效果 3.1 实施路径 染色项目整个实施路径包含几个阶段: 项目立项&中间件改造(4月-6月) 包含基架改造(统一框架、网关、注册中心、配置中心、超时中心、DMQ等)&客户端改造&发布平台改造等等,以及改造完成后基础链路验证 线上灰度&全链路服务适配(7月~8月) 7月初:5个交易&中间件相关服务升级相关jar包带上线进行验证,保证不会对染色改造不会对生产有影响。 8月份:开始推进全域应用进行染色相关jar包升级 独立项目使用(9月) 9月底之前,已经有若干独立项目应用染色环境测试验证完成 业务迭代使用(10月~11月) 10月份开始尝试推进全业务进行染色环境试用排错 试用结束,逐步推进迭代使用染色环境 3.2 业务使用效果 独立项目:目前全域的独立项目已全量切换至染色环境测试。 版本迭代:就最新的版本迭代使用结果来看,全域95%以上的需求都可以使用染色环境测试。 剩余5%的需求场景主要是涉及以下两个方面: 数据隔离:目前已有方案在支持,会涉及少量需求支撑。 前端染色:目前染色环境主要解决了后端染色的需求,部分场景需求依赖前端染色(多前端支持),方案也基本落地,会配合后端染色一起应用。 4.总结 染色环境现阶段解决了测试环境冲突和测试环境稳定性的问题,并且相较之前多套独立环境的方案,在成本上也有比较大的节省。后续得物也会尝试用染色的能力解决生产灰度发布问题,相信也会有不错的效果。 *文/大地 关注得物技术,每周一三五晚18:30更新技术干货 要是觉得文章对你有帮助的话,欢迎评论转发点赞~

优秀的个人博客,低调大师

每日一博 | 说透 IO 多路复用模型

作者:京东零售 石朝阳 在说IO多路复用模型之前,我们先来大致了解下Linux文件系统。在Linux系统中,不论是你的鼠标,键盘,还是打印机,甚至于连接到本机的socket client端,都是以文件描述符的形式存在于系统中,诸如此类,等等等等,所以可以这么说,一切皆文件。来看一下系统定义的文件描述符说明:   从上面的列表可以看到,文件描述符0,1,2都已经被系统占用了,当系统启动的时候,这三个描述符就存在了。其中0代表标准输入,1代表标准输出,2代表错误输出。当我们创建新的文件描述符的时候,就会在2的基础上进行递增。可以这么说,文件描述符是为了管理被打开的文件而创建的系统索引,他代表了文件的身份ID。对标windows的话,你可以认为和句柄类似,这样就更容易理解一些。 由于网上对linux文件这块的原理描述的文章已经非常多了,所以这里我不再做过多的赘述,感兴趣的同学可以从Wikipedia翻阅一下。由于这块内容比较复杂,不属于本文普及的内容,建议读者另行自研,这里我非常推荐马士兵老师将linux文件系统这块,讲解的真的非常好。 select模型 此模型是IO多路复用的最早期使用的模型之一,距今已经几十年了,但是现在依旧有不少应用还在采用此种方式,可见其长生不老。首先来看下其具体的定义(来源于man二类文档): int select(int nfds, fd_set *readfds, fd_set *writefds, fd_set *errorfds, struct timeval *timeout); 这里解释下其具体参数: 参数一:nfds,也即maxfd,最大的文件描述符递增一。这里之所以传最大描述符,为的就是在遍历fd_set的时候,限定遍历范围。 参数二:readfds,可读文件描述符集合。 参数三:writefds,可写文件描述符集合。 参数四:errorfds,异常文件描述符集合。 参数五:timeout,超时时间。在这段时间内没有检测到描述符被触发,则返回。 下面的宏处理,可以对fd_set集合(准确的说是bitmap,一个描述符有变更,则会在描述符对应的索引处置1)进行操作: FD_CLR(inr fd,fd_set* set) 用来清除描述词组set中相关fd 的位,即bitmap结构中索引值为fd的值置为0。 FD_ISSET(int fd,fd_set *set) 用来测试描述词组set中相关fd 的位是否为真,即bitmap结构中某一位是否为1。 FD_SET(int fd,fd_set*set) 用来设置描述词组set中相关fd的位,即将bitmap结构中某一位设置为1,索引值为fd。 FD_ZERO(fd_set *set) 用来清除描述词组set的全部位,即将bitmap结构全部清零。 首先来看一段服务端采用了select模型的示例代码: //创建server端套接字,获取文件描述符 int listenfd = socket(PF_INET,SOCK_STREAM,0); if(listenfd < 0) return -1; //绑定服务器 bind(listenfd,(struct sockaddr*)&address,sizeof(address)); //监听服务器 listen(listenfd,5); struct sockaddr_in client; socklen_t addr_len = sizeof(client); //接收客户端连接 int connfd = accept(listenfd,(struct sockaddr*)&client,&addr_len); //读缓冲区 char buff[1024]; //读文件操作符 fd_set read_fds; while(1) { memset(buff,0,sizeof(buff)); //注意:每次调用select之前都要重新设置文件描述符connfd,因为文件描述符表会在内核中被修改 FD_ZERO(&read_fds); FD_SET(connfd,&read_fds); //注意:select会将用户态中的文件描述符表放到内核中进行修改,内核修改完毕后再返回给用户态,开销较大 ret = select(connfd+1,&read_fds,NULL,NULL,NULL); if(ret < 0) { printf("Fail to select!\n"); return -1; } //检测文件描述符表中相关请求是否可读 if(FD_ISSET(connfd, &read_fds)) { ret = recv(connfd,buff,sizeof(buff)-1,0); printf("receive %d bytes from client: %s \n",ret,buff); } } 上面的代码我加了比较详细的注释了,大家应该很容易看明白,说白了大概流程其实如下: 首先,创建socket套接字,创建完毕后,会获取到此套接字的文件描述符。 然后,bind到指定的地址进行监听listen。这样,服务端就在特定的端口启动起来并进行监听了。 之后,利用开启accept方法来监听客户端的连接请求。一旦有客户端连接,则将获取到当前客户端连接的connection文件描述符。 双方建立连接之后,就可以进行数据互传了。需要注意的是,在循环开始的时候,务必每次都要重新设置当前connection的文件描述符,是因为文件描描述符表在内核中被修改过,如果不重置,将会导致异常的情况。 重新设置文件描述符后,就可以利用select函数从文件描述符表中,来轮询哪些文件描述符就绪了。此时系统会将用户态的文件描述符表发送到内核态进行调整,即将准备就绪的文件描述符进行置位,然后再发送给用户态的应用中来。 用户通过FD_ISSET方法来轮询文件描述符,如果数据可读,则读取数据即可。 举个例子,假设此时连接上来了3个客户端,connection的文件描述符分别为 4,8,12,那么其read_fds文件描述符表(bitmap结构)的大致结构为 00010001000100000....0,由于read_fds文件描述符的长度为1024位,所以最多允许1024个连接。   而在select的时候,涉及到用户态和内核态的转换,所以整体转换方式如下:   所以,综合起来,select整体还是比较高效和稳定的,但是呈现出来的问题也不少,这些问题进一步限制了其性能发挥: 文件描述符表为bitmap结构,且有长度为1024的限制。 fdset无法做到重用,每次循环必须重新创建。 频繁的用户态和内核态拷贝,性能开销较大。 需要对文件描述符表进行遍历,O(n)的轮询时间复杂度。 poll模型 考虑到select模型的几个限制,后来进行了改进,这也就是poll模型,既然是select模型的改进版,那么肯定有其亮眼的地方,一起来看看吧。当然,这次我们依旧是先翻阅linux man二类文档,因为这是官方的文档,对其有着最为精准的定义。 int poll(struct pollfd *fds, nfds_t nfds, int timeout); 其实,从运行机制上说来,poll所做的功能和select是基本上一样的,都是等待并检测一组文件描述符就绪,然后在进行后续的IO处理工作。只不过不同的是,select中,采用的是bitmap结构,长度限定在1024位的文件描述符表,而poll模型则采用的是pollfd结构的数组fds,也正是由于poll模型采用了数组结构,则不会有1024长度限制,使其能够承受更高的并发。 pollfd结构内容如下: struct pollfd { int fd; /* 文件描述符 */ short events; /* 关心的事件 */ short revents; /* 实际返回的事件 */ }; 从上面的结构可以看出,fd很明显就是指文件描述符,也就是当客户端连接上来后,fd会将生成的文件描述符保存到这里;而events则是指用户想关注的事件;revents则是指实际返回的事件,是由系统内核填充并返回,如果当前的fd文件描述符有状态变化,则revents的值就会有相应的变化。 events事件列表如下:   revents事件列表如下:   从列表中可以看出,revents是包含events的。接下来结合示例来看一下: //创建server端套接字,获取文件描述符 int listenfd = socket(PF_INET,SOCK_STREAM,0); if(listenfd < 0) return -1; //绑定服务器 bind(listenfd,(struct sockaddr*)&address,sizeof(address)); //监听服务器 listen(listenfd,5); struct pollfd pollfds[1]; socklen_t addr_len = sizeof(client); //接收客户端连接 int connfd = accept(listenfd,(struct sockaddr*)&client,&addr_len); //放入fd数组 pollfds[0].fd = connfd; pollfds[0].events = POLLIN; //读缓冲区 char buff[1024]; //读文件操作符 fd_set read_fds; while(1) { memset(buff,0,sizeof(buff)); /** ** SELECT模型专用 ** 注意:每次调用select之前都要重新设置文件描述符connfd,因为文件描述符表会在内核中被修改 ** FD_ZERO(&read_fds); ** FD_SET(connfd,&read_fds); ** 注意:select会将用户态中的文件描述符表放到内核中进行修改,内核修改完毕后再返回给用户态,开销较大 ** ret = select(connfd+1,&read_fds,NULL,NULL,NULL); **/ ret = poll(pollfds, 1, 1000); if(ret < 0) { printf("Fail to poll!\n"); return -1; } /** ** SELECT模型专用 ** 检测文件描述符表中相关请求是否可读 ** if(FD_ISSET(connfd, &read_fds)) ** { ** ret = recv(connfd,buff,sizeof(buff)-1,0); ** printf("receive %d bytes from client: %s \n",ret,buff); ** } **/ //检测文件描述符数组中相关请求 if(pollfds[0].revents & POLLIN){ pollfds[0].revents = 0; ret = recv(connfd,buff,sizeof(buff)-1,0); printf("receive %d bytes from client: %s \n",ret,buff); } } 由于源码中,我做了比较详细的注释,同时将和select模型不一样的地方都列了出来,这里就不再详细解释了。总体说来,poll模型比select模型要好用一些,去掉了一些限制,但是仍然避免不了如下的问题: 用户态和内核态仍需要频繁切换,因为revents的赋值是在内核态进行的,然后再推送到用户态,和select类似,整体开销较大。 仍需要遍历数组,时间复杂度为O(N)。 epoll模型 如果说select模型和poll模型是早期的产物,在性能上有诸多不尽人意之处,那么自linux 2.6之后新增的epoll模型,则彻底解决了性能问题,一举使得单机承受百万并发的课题变得极为容易。现在可以这么说,只需要一些简单的设置更改,然后配合上epoll的性能,实现单机百万并发轻而易举。同时,由于epoll整体的优化,使得之前的几个比较耗费性能的问题不再成为羁绊,所以也成为了linux平台上进行网络通讯的首选模型。 讲解之前,还是linux man文档镇楼:linux man epoll 4类文档 linux man epoll 7类文档,俩文档结合着读,会对epoll有个大概的了解。和之前提到的select和poll不同的是,此二者皆属于系统调用函数,但是epoll则不然,他是存在于内核中的数据结构,可以通过epoll_create,epoll_ctl及epoll_wait三个函数结合来对此数据结构进行操控。 说道epoll_create函数,其作用是在内核中创建一个epoll数据结构实例,然后将返回此实例在系统中的文件描述符。此epoll数据结构的组成其实是一个链表结构,我们称之为interest list,里面会注册连接上来的client的文件描述符。 其简化工作机制如下:   说道epoll_ctl函数,其作用则是对epoll实例进行增删改查操作。有些类似我们常用的CRUD操作。这个函数操作的对象其实就是epoll数据结构,当有新的client连接上来的时候,他会将此client注册到epoll中的interest list中,此操作通过附加EPOLL_CTL_ADD标记来实现;当已有的client掉线或者主动下线的时候,他会将下线的client从epoll的interest list中移除,此操作通过附加EPOLL_CTL_DEL标记来实现;当有client的文件描述符有变更的时候,他会将events中的对应的文件描述符进行更新,此操作通过附加EPOLL_CTL_MOD来实现;当interest list中有client已经准备好了,可以进行IO操作的时候,他会将这些clients拿出来,然后放到一个新的ready list里面。 其简化工作机制如下:   说道epoll_wait函数,其作用就是扫描ready list,处理准备就绪的client IO,其返回结果即为准备好进行IO的client的个数。通过遍历这些准备好的client,就可以轻松进行IO处理了。 上面这三个函数是epoll操作的基本函数,但是,想要彻底理解epoll,则需要先了解这三块内容,即:inode,链表,红黑树。 在linux内核中,针对当前打开的文件,有一个open file table,里面记录的是所有打开的文件描述符信息;同时也有一个inode table,里面则记录的是底层的文件描述符信息。这里假如文件描述符B fork了文件描述符A,虽然在open file table中,我们看新增了一个文件描述符B,但是实际上,在inode table中,A和B的底层是一模一样的。这里,将inode table中的内容理解为windows中的文件属性,会更加贴切和易懂。这样存储的好处就是,无论上层文件描述符怎么变化,由于epoll监控的数据永远是inode table的底层数据,那么我就可以一直能够监控到文件的各种变化信息,这也是epoll高效的基础。更多详细信息,请参阅这两篇文章:Nonblocking IO & The method to epoll's madness. 简化流程如下:   数据存储这块解决了,那么针对连接上来的客户端socket,该用什么数据结构保存进来呢?这里用到了红黑树,由于客户端socket会有频繁的新增和删除操作,而红黑树这块时间复杂度仅仅为O(logN),还是挺高效的。有人会问为啥不用哈希表呢?当大量的连接频繁的进行接入或者断开的时候,扩容或者其他行为将会产生不少的rehash操作,而且还要考虑哈希冲突的情况。虽然查询速度的确可以达到o(1),但是rehash或者哈希冲突是不可控的,所以基于这些考量,我认为红黑树占优一些。 客户端socket怎么管理这块解决了,接下来,当有socket有数据需要进行读写事件处理的时候,系统会将已经就绪的socket添加到双向链表中,然后通过epoll_wait方法检测的时候,其实检查的就是这个双向链表,由于链表中都是就绪的数据,所以避免了针对整个客户端socket列表进行遍历的情况,使得整体效率大大提升。 整体的操作流程为: 首先,利用epoll_create在内核中创建一个epoll对象。其实这个epoll对象,就是一个可以存储客户端连接的数据结构。 然后,客户端socket连接上来,会通过epoll_ctl操作将结果添加到epoll对象的红黑树数据结构中。 然后,一旦有socket有事件发生,则会通过回调函数将其添加到ready list双向链表中。 最后,epoll_wait会遍历链表来处理已经准备好的socket,然后通过预先设置的水平触发或者边缘触发来进行数据的感知操作。 从上面的细节可以看出,由于epoll内部监控的是底层的文件描述符信息,可以将变更的描述符直接加入到ready list,无需用户将所有的描述符再进行传入。同时由于epoll_wait扫描的是已经就绪的文件描述符,避免了很多无效的遍历查询,使得epoll的整体性能大大提升,可以说现在只要谈论linux平台的IO多路复用,epoll已经成为了不二之选。 水平触发和边缘触发 上面说到了epoll,主要讲解了client端怎么连进来,但是并未详细的讲解epoll_wait怎么被唤醒的,这里我将来详细的讲解一下。 水平触发,意即Level Trigger,边缘触发,意即Edge Trigger,如果单从字面意思上理解,则不太容易,但是如果将硬件设计中的水平沿,上升沿,下降沿的概念引进来,则理解起来就容易多了。比如我们可以这样认为:   如果将上图中的方块看做是buffer的话,那么理解起来则就更加容易了,比如针对水平触发,buffer只要是一直有数据,则一直通知;而边缘触发,则buffer容量发生变化的时候,才会通知。虽然可以这样简单的理解,但是实际上,其细节处理部分,比图示中展现的更加精细,这里来详细的说一下。 边缘触发 针对读操作,也就是当前fd处于EPOLLIN模式下,即可读。此时意味着有新的数据到来,接收缓冲区可读,以下buffer都指接收缓冲区: buffer由空变为非空,意即有数据进来的时候,此过程会触发通知。   buffer原本有些数据,这时候又有新数据进来的时候,数据变多,此过程会触发通知。   buffer中有数据,此时用户对操作的fd注册EPOLL_CTL_MOD事件的时候,会触发通知。   针对写操作,也就是当前fd处于EPOLLOUT模式下,即可写。此时意味着缓冲区可以写了,以下buffer都指发送缓冲区: buffer满了,这时候发送出去一些数据,数据变少,此过程会触发通知。   buffer原本有些数据,这时候又发送出去一些数据,数据变少,此过程会触发通知。   这里就是ET这种模式触发的几种情形,可以看出,基本上都是围绕着接收缓冲区或者发送缓冲区的状态变化来进行的。 晦涩难懂?不存在的,举个栗子: 在服务端,我们开启边缘触发模式,然后将buffer size设为10个字节,来看看具体的表现形式。 服务端开启,客户端连接,发送单字符A到服务端,输出结果如下: -->ET Mode: it was triggered once get 1 bytes of content: A -->wait to read! 可以看到,由于buffer从空到非空,边缘触发通知产生,之后在epoll_wait处阻塞,继续等待后续事件。 这里我们变一下,输入ABCDEFGHIJKLMNOPQ,可以看到,客户端发送的字符长度超过了服务端buffer size,那么输出结果将是怎么样的呢? -->ET Mode: it was triggered once get 9 bytes of content: ABCDEFGHI get 8 bytes of content: JKLMNOPQ -->wait to read! 可以看到,这次发送,由于发送的长度大于buffer size,所以内容被折成两段进行接收,由于用了边缘触发方式,buffer的情况是从空到非空,所以只会产生一次通知。 水平触发 水平触发则简单多了,他包含了边缘触发的所有场景,简而言之如下: 当接收缓冲区不为空的时候,有数据可读,则读事件会一直触发。   当发送缓冲区未满的时候,可以继续写入数据,则写事件一直会触发。   同样的,为了使表达更清晰,我们也来举个栗子,按照上述入输入方式来进行。 服务端开启,客户端连接并发送单字符A,可以看到服务端输出情况如下: -->LT Mode: it was triggered once! get 1 bytes of content: A 这个输出结果,毋庸置疑,由于buffer中有数据,所以水平模式触发,输出了结果。 服务端开启,客户端连接并发送ABCDEFGHIJKLMNOPQ,可以看到服务端输出情况如下: -->LT Mode: it was triggered once! get 9 bytes of content: ABCDEFGHI -->LT Mode: it was triggered once! get 8 bytes of content: JKLMNOPQ 从结果中,可以看出,由于buffer中数据读取完毕后,还有未读完的数据,所以水平模式会一直触发,这也是为啥这里水平模式被触发了两次的原因。 有了这两个栗子的比对,不知道聪明的你,get到二者的区别了吗? 在实际开发过程中,实际上LT更易用一些,毕竟系统帮助我们做了大部分校验通知工作,之前提到的SELECT和POLL,默认采用的也都是这个。但是需要注意的是,当有成千上万个客户端连接上来开始进行数据发送,由于LT的特性,内核会频繁的处理通知操作,导致其相对于ET来说,比较的耗费系统资源,所以,随着客户端的增多,其性能也就越差。 而边缘触发,由于监控的是FD的状态变化,所以整体的系统通知并没有那么频繁,高并发下整体的性能表现也要好很多。但是由于此模式下,用户需要积极的处理好每一笔数据,带来的维护代价也是相当大的,稍微不注意就有可能出错。所以使用起来须要非常小心才行。 至于二者如何抉择,诸位就仁者见仁智者见智吧。 行文到这里,关于epoll的讲解基本上完毕了,大家从中是不是学到了很多干货呢? 由于从netty研究到linux epoll底层,其难度非常大,可以用曲高和寡来形容,所以在这块探索的文章是比较少的,很多东西需要自己照着man文档和源码一点一点的琢磨(linux源码详见eventpoll.c等)。这里我来纠正一下搜索引擎上,说epoll高性能是因为利用mmap技术实现了用户态和内核态的内存共享,所以性能好,我前期被这个观点误导了好久,后来下来了linux源码,翻了一下,并没有在epoll中翻到mmap的技术点,所以这个观点是错误的。这些错误观点的文章,国内不少,国外也不少,希望大家能审慎抉择,避免被错误带偏。 所以,epoll高性能的根本就是,其高效的文件描述符处理方式加上颇具特性边的缘触发处理模式,以极少的内核态和用户态的切换,实现了真正意义上的高并发。

优秀的个人博客,低调大师

每日一博 | 优化加锁方式时竟然死锁了

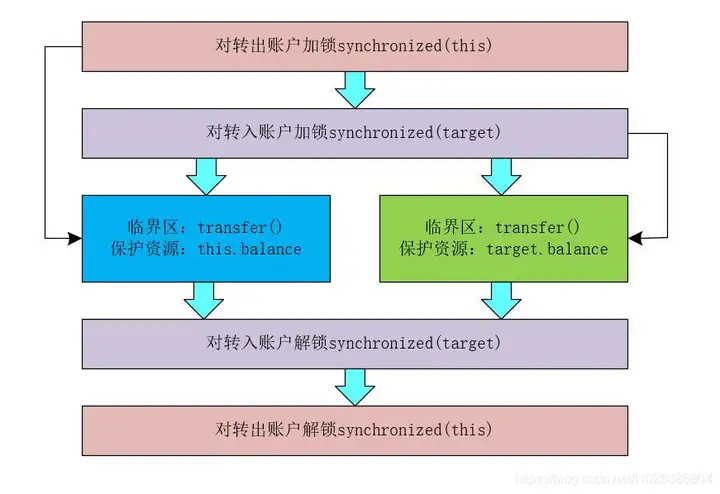
摘要:最近,在优化程序的加锁方式时,竟然出现了死锁!!到底是为什么呢?!经过仔细的分析之后,终于找到了原因。 本文分享自华为云社区《【高并发】优化加锁方式时竟然死锁了!!》,作者: 冰 河。 写在前面 最近,在优化程序的加锁方式时,竟然出现了死锁!!到底是为什么呢?!经过仔细的分析之后,终于找到了原因。 为何需要优化加锁方式? 我们在转账类TansferAccount中使用TansferAccount.class对象对程序加锁,如下所示。 public class TansferAccount{ private Integer balance; public void transfer(TansferAccount target, Integer transferMoney){ synchronized(TansferAccount.class){ if(this.balance >= transferMoney){ this.balance -= transferMoney; target.balance += transferMoney; } } } } 这种方式确实解决了转账操作的并发问题, 但是这种方式在高并发环境下真的可取吗?试想,如果我们在高并发环境下使用上述代码来处理转账操作,因为TansferAccount.class对象是JVM在加载TansferAccount类的时候创建的,所有的TansferAccount实例对象都会共享一个TansferAccount.class对象。也就是说,所有TansferAccount实例对象执行transfer()方法时,都是互斥的!!换句话说,所有的转账操作都是串行的!! 如果所有的转账操作都是串行执行的话,造成的后果就是:账户A为账户B转账完成后,才能进行账户C为账户D的转账操作。如果全世界的网民一起执行转账操作的话,这些转账操作都串行执行,那么,程序的性能是完全无法接受的!!! 其实,账户A为账户B转账的操作和账户C为账户D转账的操作完全可以并行执行。所以,我们必须优化加锁方式,提升程序的性能!! 初步优化加锁方式 既然直接TansferAccount.class对程序加锁在高并发环境下不可取,那么,我们到底应该怎么做呢?! 仔细分析下上面的代码业务,上述代码的转账操作中,涉及到转出账户this和转入账户target,所以,我们可以分别对转出账户this和转入账户target加锁,只有两个账户加锁都成功时,才执行转账操作。这样就能够做到账户A为账户B转账的操作和账户C为账户D转账的操作完全可以并行执行。 我们可以将优化后的逻辑用下图表示。 根据上面的分析,我们可以将TansferAccount的代码优化成如下所示。 public class TansferAccount{ //账户的余额 private Integer balance; //转账操作 public void transfer(TansferAccount target, Integer transferMoney){ //对转出账户加锁 synchronized(this){ //对转入账户加锁 synchronized(target){ if(this.balance >= transferMoney){ this.balance -= transferMoney; target.balance += transferMoney; } } } } } 此时,上面的代码看上去没啥问题,但真的是这样吗?我也希望程序是完美的,但是往往却不是我们想的那样啊!没错,上面的程序会出现死锁,为什么会出现死锁啊? 接下来,我们就开始分析一波。 死锁的问题分析 TansferAccount类中的代码看上去比较完美,但是优化后的加锁方式竟然会导致死锁!!!这是我亲测得出的结论!! 关于死锁我们可以结合改进的TansferAccount类举一个简单的场景:假设有线程A和线程B两个线程同时运行在两个不同的CPU上,线程A执行账户A向账户B转账的操作,线程B执行账户B向账户A转账的操作。当线程A和线程B执行到 synchronized(this)代码时,线程A获得了账户A的锁,线程B获得了账户B的锁。当执行到synchronized(target)代码时,线程A尝试获得账户B的锁时,发现账户B已经被线程B锁定,此时线程A开始等待线程B释放账户B的锁;而线程B尝试获得账户A的锁时,发现账户A已经被线程A锁定,此时线程B开始等待线程A释放账户A的锁。 这样,线程A持有账户A的锁并等待线程B释放账户B的锁,线程B持有账户B的锁并等待线程A释放账户A的锁,死锁发生了!! 死锁的必要条件 在如何解决死锁之前,我们先来看下发生死锁时有哪些必要的条件。如果要发生死锁,则必须存在以下四个必要条件,四者缺一不可。 互斥条件 在一段时间内某资源仅为一个线程所占有。此时若有其他线程请求该资源,则请求线程只能等待。 不可剥夺条件 线程所获得的资源在未使用完毕之前,不能被其他线程强行夺走,即只能由获得该资源的线程自己来释放(只能是主动释放)。 请求与保持条件 线程已经保持了至少一个资源,但又提出了新的资源请求,而该资源已被其他线程占有,此时请求线程被阻塞,但对自己已获得的资源保持不放。 循环等待条件 既然死锁的发生必须存在上述四个条件,那么,大家是不是就能够想到如何预防死锁了呢? 死锁的预防 并发编程中,一旦发生了死锁的现象,则基本没有特别好的解决方法,一般情况下只能重启应用来解决。因此,解决死锁的最好方法就是预防死锁。 发生死锁时,必然会存在死锁的四个必要条件。也就是说,如果我们在写程序时,只要“破坏”死锁的四个必要条件中的一个,就能够避免死锁的发生。接下来,我们就一起来探讨下如何“破坏”这四个必要条件。 破坏互斥条件 互斥条件是我们没办法破坏的,因为我们使用锁为的就是线程之间的互斥。这一点需要特别注意!!!! 破坏不可剥夺条件 破坏不可剥夺的条件的核心就是让当前线程自己主动释放占有的资源,关于这一点,synchronized是做不到的,我们可以使用java.util.concurrent包下的Lock来解决。此时,我们需要将TansferAccount类的代码修改成类似如下所示。 public class TansferAccount{ private Lock thisLock = new ReentrantLock(); private Lock targetLock = new ReentrantLock(); //账户的余额 private Integer balance; //转账操作 public void transfer(TansferAccount target, Integer transferMoney){ boolean isThisLock = thisLock.tryLock(); if(isThisLock){ try{ boolean isTargetLock = targetLock.tryLock(); if(isTargetLock){ try{ if(this.balance >= transferMoney){ this.balance -= transferMoney; target.balance += transferMoney; } }finally{ targetLock.unlock } } }finally{ thisLock.unlock(); } } } } 其中Lock中有两个tryLock方法,分别如下所示。 tryLock()方法 tryLock()方法是有返回值的,它表示用来尝试获取锁,如果获取成功,则返回true,如果获取失败(即锁已被其他线程获取),则返回false,也就说这个方法无论如何都会立即返回。在拿不到锁时不会一直在那等待。 tryLock(long time, TimeUnit unit)方法 tryLock(long time, TimeUnit unit)方法和tryLock()方法是类似的,只不过区别在于这个方法在拿不到锁时会等待一定的时间,在时间期限之内如果还拿不到锁,就返回false。如果一开始拿到锁或者在等待期间内拿到了锁,则返回true。 破坏请求与保持条件 破坏请求与保持条件,我们可以一次性申请所需要的所有资源,例如在我们完成转账操作的过程中,我们一次性申请账户A和账户B,两个账户都申请成功后,再执行转账的操作。此时,我们需要再创建一个申请资源的类ResourcesRequester,这个类的作用就是申请资源和释放资源。同时,TansferAccount类中需要持有一个ResourcesRequester类的单例对象,当我们需要执行转账操作时,首先向ResourcesRequester同时申请转出账户和转入账户两个资源,申请成功后,再锁定两个资源;当转账操作完成后,释放锁并释放ResourcesRequester类申请的转出账户和转入账户资源。 ResourcesRequester类的代码如下所示。 public class ResourcesRequester{ //存放申请资源的集合 private List<Object> resources = new ArrayList<Object>(); //一次申请所有的资源 public synchronized boolean applyResources(Object source, Object target){ if(resources.contains(source) || resources.contains(target)){ return false; } resources.add(source); resources.add(targer); return true; } //释放资源 public synchronized void releaseResources(Object source, Object target){ resources.remove(source); resources.remove(target); } } 此时,TansferAccount类的代码如下所示。 public class TansferAccount{ //账户的余额 private Integer balance; //ResourcesRequester类的单例对象 private ResourcesRequester requester; //转账操作 public void transfer(TansferAccount target, Integer transferMoney){ //自旋申请转出账户和转入账户,直到成功 while(!requester.applyResources(this, target)){ //循环体为空 ; } try{ //对转出账户加锁 synchronized(this){ //对转入账户加锁 synchronized(target){ if(this.balance >= transferMoney){ this.balance -= transferMoney; target.balance += transferMoney; } } } }finally{ //最后释放账户资源 requester.releaseResources(this, target); } } } 破坏循环等待条件 破坏循环等待条件,则可以通过对资源排序,按照一定的顺序来申请资源,然后按照顺序来锁定资源,可以有效的避免死锁。 例如,在我们的转账操作中,往往每个账户都会有一个唯一的id值,我们在锁定账户资源时,可以按照id值从小到大的顺序来申请账户资源,并按照id从小到大的顺序来锁定账户,此时,程序就不会再进行循环等待了。 程序代码如下所示。 public class TansferAccount{ //账户的id private Integer id; //账户的余额 private Integer balance; //转账操作 public void transfer(TansferAccount target, Integer transferMoney){ TansferAccount beforeAccount = this; TansferAccount afterAccount = target; if(this.id > target.id){ beforeAccount = target; afterAccount = this; } //对转出账户加锁 synchronized(beforeAccount){ //对转入账户加锁 synchronized(afterAccount){ if(this.balance >= transferMoney){ this.balance -= transferMoney; target.balance += transferMoney; } } } } } 总结 在并发编程中,使用细粒度锁来锁定多个资源时,要时刻注意死锁的问题。另外,避免死锁最简单的方法就是阻止循环等待条件,将系统中所有的资源设置标志位、排序,规定所有的线程申请资源必须以一定的顺序来操作进而避免死锁。 点击关注,第一时间了解华为云新鲜技术~

优秀的个人博客,低调大师

每日一博 | 轻量级的架构决策记录机制

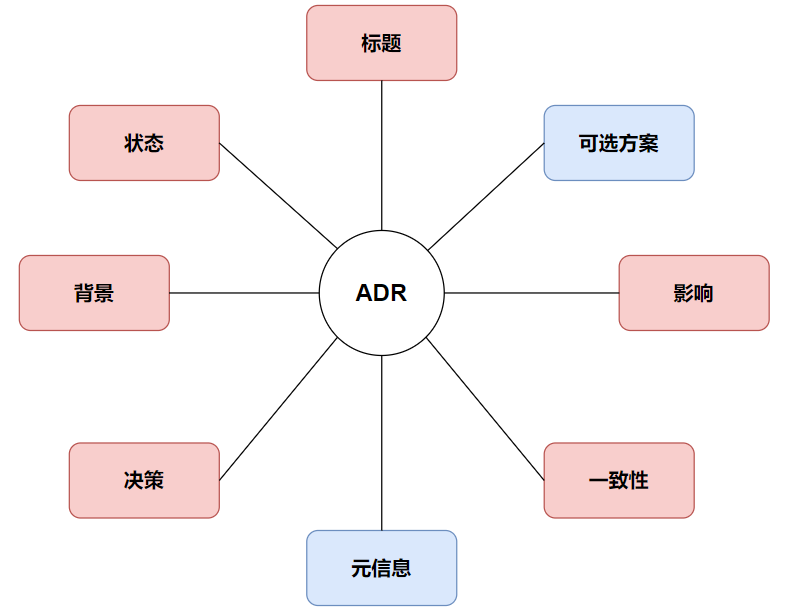
作者:倪新明 ADR是一种性价比非常高的架构决策文档化实践,团队引入和实践成本很低,却能为团队带来极大收益! 1 团队研发面临的问题 不论是在传统的IT行业,还是互联网行业,研发团队在架构决策层面或多或少的都会面临以下问题或挑战: • 新成员加入团队,对系统现有的架构决策可能会盲目遵守,只知其然,不知其所以然;或者挑战或违反约束,持续挑战当前决策,“质疑”决策的合理性和正确性,负责人需要不间断的解释、同步、推动达成共识 • 架构决策的潜在问题随着时间推移暴露,但,如果决策时进行充分分析这些问题可能会提前发现和规避 • 现有系统架构决策是如何演进?当前决策背后的动机是什么?有可能团队内已经没有人能准确的回答 • 相似架构决策场景在系统中重复出现,由于遗忘决策原因,或团队成员变化等因素,仍要花时间去分析、设计和推动干系人达成共识 • 团队内只有少部分人负责架构设计,其他团队成员无机会参与,但实际上团队成员有相应诉求,至少能够了解某项关键架构设计的决策过程 • 即使团队内部接手的项目,你能快速获取系统关键架构决策及其原因吗?你可能会从代码库中寻找架构决策的蛛丝马迹,但很难获取架构决策背后的动机以及决策的演进过程 基于以上这些问题,我们想: • 通过最小但依然高效的方式记录系统的架构决策 • 能够识别系统关键决策的演进过程 • 架构决策以及设计最佳实践能够在团队间高效同步 • 团队成员都有机会参与到架构设计决策过程中 通过文档形式记录架构决策首当其冲的问题是:文档过期!! 确实,过期问题是文档化必然面临的问题。无论通过什么机制,比如强流程、自动化更新等都存在过期风险。那为什么还要选择记录架构决策呢?基于以下两个原因: • 性价比:架构决策文档化的收益远大于维护过期带来的成本 • 轻量级:保持ADR的简短、轻量,规模越小的文档越容易保持与实际的同步。 2 ADR剖析 Architecture Decision Record,缩写ADR,即架构决策记录,该实践最先由Michael Nygard发起,是记录架构决策最有效的方式之一。简单来说,ADR是一种对架构决策的文档化记录,其目的是通过文档化的形式记录系统的架构决策、原因以及决策过程。 通过对系统架构决策进行有效记录,团队可以从以下几个层面获得收益: • 新人引导,便于快速熟悉系统新的团队成员可以快速获取系统的历史架构决策,理解决策背后的背景、决策过程以及相关影响 • 项目交接,对已有决策进行文档化积累敏捷环境强调团队对知识的快速学习,基于ADRs团队可以快速熟悉已有系统的架构演进过程 • 对齐认知通过推动落地ADRs,团队成员更容易对设计最佳实践达成一致认识和理解,进一步避免后续建设过程中的“重复造轮子”,提升设计知识在团队间复用 建议的ADR的基本结构包括标题、状态、背景、决策、影响共五个部分,一般情况下,推荐增加一致性和备注两个极具价值的额外章节作为补充。 需要说明的是,团队可以按需增加其他章节以增强ADR的表现能力,比如增加可选方案章节对可选方案进行详细描述。   标题【必选】 ADR的 “标题” 部分主要包括两部分,其一是顺序编号,其二是对架构决策的简短描述。标题的描述需要确保对架构决策进行准确描述、清晰无歧义,同时,也要保持简短明了。 例如:ADR 01. 订单服务和履约服务之间采用异步消息机制 状态【必选】 ADR的 "状态" 限定为 待审核 , 审核通过,被取代 三种状态之一。 • 待审核:决策必须被高级别决策者或ARB审核 • 审核通过:架构决策已经被审核,并已准备就绪进行实现 • 被取代:架构决策已发生变更,并被另一个ADR取代。该状态表明,之前的ADR一定是被审核通过的,处于提议状态未审核通过的ADR是不允许流向该状态。处于提议状态的ADR只能持续修改直到审核通过。被取代状态提供了一种有效的架构决策追溯机制,能够帮助团队识别架构决策的演进过程。 背景【必选】 推动架构师对此项架构决策的具体背景或问题进行描述,以及简洁扼要地表述可能的可选方案。决策背景在一定程度上也是对系统架构的一种描述。 说明:不建议在此章节进行详细的替代方案分析和说明,如果确实需要进行详细阐述,则建议增加额外的章节进行说明。 可选方案【可选】 对可选的替代方案进行详细描述,对比不同方案的优劣势 决策【必选】 该部分包含了具体的架构决策以及相应的决策依据,原则上要使用肯定式、命令式的描述方式表述具体的架构决策,不要存在主观的、消极的、模棱两可的、可能存在歧义的措辞。说明:关注Why 而非 How,理解架构决策的原因比理解怎么实现更加重要 影响【必选】 该部分描述此项架构决策的整体影响。每项决策都会或多或少的对现有系统产生影响,包括好的影响和坏的影响,通过该章节推动架构师思考这些影响是否超过架构决策的收益。 一致性【可选】 该部分并不是标准ADR元素,但同样颇具价值,其作用在于推动架构师从架构一致性的视角思考所作架构决策如何进行度量和治理。架构师必须确定该项架构决策的一致性保证是通过人工方式还是通过自动化方式实现。如果可以通过自动化方式进行,则在该章节明确说明自动化的执行方案。 备注【必选】 备注部分并不是标准ADR的结构,但是强烈推荐增加该章节。备注部分主要包含的ADR的各种元数据,例如: 原作者、审核日期、审核人、替代日期、最后修改日期、修改人、最后修改内容 说明:有些团队认为备注部分的元数据信息没有太大价值,特别是,当团队将ADRs与代码一同存储在配置库时(并不推荐该种存储方式)。但实际上,将元信息作为ADR的一部分比依赖配置库更具价值和优势。 3 ADR的组织和存储 ADR文档具体存放在什么位置,比如FTP服务器、WIKI或者同项目代码配置库,不同的团队可以根据情况进行灵活选择。原则:ADR能够被干系人便捷地获取。 方式一:基于类似Git的配置库存储 优点: • 架构决策离代码很近,方便研发人员获取 • 通过配置库的版本管理能力轻松的实现ADR的变更管理 缺点: ADR的干系人不仅仅是研发人员,还有技术经理、产品经理、业务人员等其他角色的项目干系人。基于太技术性的配置库进行存储,显然对除研发以外的角色不太友好。同时,还需要对非研发人员开通仓库权限,代码安全性也是须要考虑的因素。另外,基于配置库存储不太方便存放同一系统不同应用下通用的架构决策以及应用间的集成架构决策。 方式二:类似WIKI的在线协同编辑共享系统内 优点:干系人友好在线协作方便处理跨应用的架构决策 缺点:开发人员不友好,离开发库较远 基于对跨应用架构决策的存储,团队选择将ADR存储在在线协同文档平台,并通过合理的文件夹结构进行组织,参考以下组织形式:   4 ADR融入研发流程 如果要落地ADR,则须要将其融入到现有的研发过程中。ADR涵盖的流程活动主要是:   制定ADR • 活动名称:制定架构决策记录(ADRs) • 前置要求:无 • 干系人职责: 子系统负责人负责制定子系统作用域内的ADR,系统架构师负责跨系统架构决策制定 • 活动输入:PRD活动输出:《架构决策记录》 • 执行形式:线下,或非正式的头脑风暴 • 执行时间:属于系统设计的一个子活动,在系统设计阶段进行 评审ADR • 活动名称:评审ADR • 活动目的:评审ADR的完整性和正确性,确保架构决策的合理性 • 前置要求:已完成ADR制定 • 干系人职责:ADR指定人发起评审,系统架构师及核心研发参与评审活动 • 活动输入:ADRs • 活动输出:ADR评审记录(在ADR文档上更新评审信息) • 执行形式:正式或非正式的评审会 • 执行时间:技术方案内部评审时,对该方案相关的ADR进行评审 5 ADR实践过程中的常见疑问 问题一:写ADR的 “时间成本较高” ,延长了技术方案设计周期 ? 答:否! 该疑问可能主要来自于以下几个原因: • 写文档 = 费时间?大多数研发人员排斥文档,且没有写文档的习惯。 • 对ADR模板理解不够深入和准确,撰写过程中无从下手 • 决策缺少必要的分析习惯,对架构决策缺少必要的对比、分析,在撰写ADR时,缺少必要的依据,不得不额外查找资料,所以写的“很慢” 但实际上,如果作为架构决策者具备决策分析的习惯,特别是在技术方案设计时,进行过充分的决策分析,1-2页的ADR文档撰写不会超过 1 个小时,甚至在半个小时内完成。即使制定和评审ADR影响了一小部分设计时间,通过对关键决策的充分分析和审重决策所带来的价值远胜过返工造成额外成本 问题二:遗留系统没有必要再写ADR ? 答:否! 价值是决定是否写ADR的因素之一,切忌ADR只对当前架构决策进行记录。对于遗留系统,在团队遗忘之前,记录其关键架构决策依然具有较大价值。 问题三:ADR这种文档化机制与敏捷冲突 ? 答:否! 敏捷宣言中指出:可以工作的软件胜过面面俱到的文档。其强调左侧更有价值,但不否定右侧的价值。 因此,文档化并不一定与敏捷理念发生冲突。通过采用轻量级的文档机制,记录具有核心价值的东西,确保文档机制不会成为团队负担,本身与敏捷文化相互契合。 问题四:ADR评审是不是流程太重 ? 答:可能,但是有必要! ADR评审是引入ADR机制的重要活动之一,不可忽略!正是通过多干系人参与下的评审活动,才能产生ADR的诸多重要价值。通过这种正式或非正式的评审活动: • 提升架构决策的合理性和正确性 • 提升团队的技术氛围 • 提升团队成员的技术思考能力、技术水平、架构决策的参与感,实现架构决策在团队成员间的高效同步...... 因此,ADR的评审活动是必要的,从效率考虑,团队可以优化评审过程。 问题五:ADR模板很多,团队应该如何选择? 答:没有标准的,只有最适合的 ! ADR没有统一的模板,选择适合团队的,建议: 模板保持轻量,不要试图覆盖所有的场景,否则,ADR会成为团队成员的负担 更重要的是,ADR模板和模板元素的含义一定要在团队成员间达成一致 问题六:什么时候需要写ADR没有量化条件,所以很难落地? 答:否! 原则上:对系统产生显著影响的架构决策需要写ADR。 如何定义 "显著影响" 没有量化指标,但如果存在以下场景可能是需要写ADR的信号: • 直接影响高优先级的架构属性 • 修改对外接口:对外提供的接口修改往往需要进行充分影响分析 • 引入或者移除依赖:依赖的加入和移除往往标示着组件能力的引进和废弃 • 改变系统的通用结构:工程结构是应用架构的重要维度之一 • 迫使研发人员改变开发方式接受战略性技术债:重构影响较大的技术债往往对现有系统会有较大影响 以上场景只是可能需要写ADR的一些信号,但并不是强制约定。 是否需要写ADR的终极实践准则是:具体情况,具体分析 6 ADR撰写中的常见误区 ADR的结构虽然非常简单,但团队在开始实践过程时对于每个章节的内容表述极易出现偏差,在撰写ADR文档时常见的问题如下: 【背景】部分 典型反例: 未直接说明推动进行决策的原因:正确的方式是要明确说明进行此次架构决策的背景或动机是什么,明确 WHY对可选方案进行详细说明:ADR实践初期,团队常犯的错误式在 “背景” 部分对方案进行详细的大篇幅论述 【决策】部分 典型反例: 缺少决策依据说明:决策依据过于简单,不充分,不能推到选择当前决策的论据决策结果表述措辞不够明确、模棱两可 【可选方案】部分 典型反例:分析角度存在明显倾向性,不够客观 【一致性】部分 该章节的目的是推动架构师对如何确保决策被团队遵守进行深入思考,特别是考虑是否可以通过自动化方式进行。典型的反例词汇是:系统落地、开发实现...... 如果不能不同自动化方式进行检查,可能 设计评审、同行代码评审、专家代码评审是可能的方式如果可以通过自动化方式进行,则要说明如何进行自动化方式进行约束校验。例如,如果工程实践通过Archunit进行单测,则可以表述基于Archunit的规则代码。 7 结语 ADR不仅仅是一份文档,团队将获得以下收益: • 系统关键决策知识留存有助于新团队成员快速融入,知其然也知其所以然 • 提升团队技术氛围提升团队技术思考力和技术能力,同步最佳实践 • 提升架构决策的合理性和正确性 • 管理技术债的能力 • 更高效的架构决策沟通机制 • 减少重复性的决策讨论和分析 • 架构决策一致性推动系统架构约束自动化检查 开始团队的ADR之旅吧!

优秀的个人博客,低调大师

每日一博 | 各开发语言 DNS 缓存配置建议

作者:翟贺龙 一、背景 在计算机领域,涉及性能优化动作时首先应被考虑的原则之一便是使用缓存,合理的数据缓存机制能够带来以下收益: 1. 缩短数据获取路径,热点数据就近缓存以便后续快速读取,从而明显提升处理效率; 2. 降低数据远程获取频次,缓解后端数据服务压力、减少前端和后端之间的网络带宽成本; 从 CPU 硬件的多级缓存设计,到浏览器快速展示页面,再到大行其道的 CDN、云存储网关等商业产品,处处应用了缓存理念。 在公网领域,如操作系统、浏览器和移动端 APP 等成熟产品所具备的缓存机制,极大的消解了网络提供商如电信移动联通、内容提供商如各大门户平台和 CDN 厂商直面的服务压力,运营商的 DNS 才能从容面对每秒亿万级的 DNS 解析,网络设备集群才能轻松承担每秒 Tbit 级的互联网带宽,CDN 平台才能快速处理每秒亿万次的请求。 面对公司目前庞大且仍在不断增长的的域名接入规模,笔者所在团队在不断优化集群架构、提升 DNS 软件性能的同时,也迫切需要推动各类客户端环境进行域名解析请求机制的优化,因此,特组织团队成员调研、编写了这篇指南文章,以期为公司、客户及合作方的前端开发运维人员给出合理建议,优化 DNS 整体请求流程,为业务增效。 本文主要围绕不同业务和开发语言背景下,客户端本地如何实现 DNS 解析记录缓存进行探讨,同时基于笔者所在团队对 DNS 本身及公司网络环境的掌握,给出一些其他措施,最终致力于客户端一侧的 DNS 解析请求规范化。 二、名词解释 1. 客户端 本文所述客户端,泛指所有主动发起网络请求的对象,包括但不限于服务器、PC、移动终端、操作系统、命令行工具、脚本、服务软件、用户 APP 等。 2. DNS Domain Name System(Server/Service),域名系统(服务器/服务),可理解为一种类数据库服务; 客户端同服务端进行网络通信,是靠 IP 地址识别对方;而作为客户端的使用者,人类很难记住大量 IP 地址,所以发明了易于记忆的域名如 www.jd.com,将域名和 IP 地址的映射关系,存储到 DNS 可供客户端查询; 客户端只有通过向 DNS 发起域名解析请求从而获取到服务端的 IP 地址后,才能向 IP 地址发起网络通信请求,真正获取到域名所承载的服务或内容。 参考:域名系统 域名解析流程 3. LDNS Local DNS,本地域名服务器;公网接入环境通常由所在网络供应商自动分配(供应商有控制权,甚至可作 DNS 劫持,即篡改解析域名得到的 IP),内网环境由 IT 部门设置自动分配; 通常 Unix、类Unix、MacOS系统可通过 /etc/resolv.conf 查看自己的 LDNS,在 nameserver 后声明,该文件亦支持用户自助编辑修改,从而指定 LDNS,如公网常见的公共 DNS 如谷歌 DNS、114DNS 等;纯内网环境通常不建议未咨询IT部门的情况下擅自修改,可能导致服务不可用;可参考 man resolv.conf 指令结果。 当域名解析出现异常时,同样应考虑 LDNS 服务异常或发生解析劫持情况的可能。 参考:windows系统修改TCP/IP设置(含DNS); 4. hosts DNS 系统可以动态的提供域名和IP的映射关系,普遍存在于各类操作系统的hosts文件则是域名和IP映射关系的静态记录文件,且通常 hosts 记录优先于 DNS 解析,即本地无缓存或缓存未命中时,则优先通过 hosts 查询对应域名记录,若 hosts 无相关映射,则继续发起 DNS 请求。关于 Linux 环境下此逻辑的控制,请参考下文 C/C++ 语言 DNS 缓存介绍部分。 所以在实际工作中,常利用上述默认特性,将特定域名和特定 IP 映射关系写到 hosts 文件中(俗称“固定 hosts”),用于绕开 DNS 解析过程,对目标 IP 作针对性访问(其效果与 curl 的-x选项,或 wget 的 -e 指定 proxy 选项,异曲同工); 5. TTL Time-To-Live,生存时间值,此概念在多领域适用且可能有不同意义。 本文涉及到 TTL 描述均针对数据缓存而言,可直白理解为已缓存数据的“有效期”,从数据被缓存开始计,在缓存中存在时长超过 TTL 规定时长的数据被视为过期数据,数据被再次调用时会立刻同权威数据源进行有效性确认或重新获取。 因缓存机制通常是被动触发和更新,故在客户端的缓存有效期内,后端原始权威数据若发生变更,客户端不会感知,表现为业务上一定程度的数据更新延迟、缓存数据与权威数据短时不一致。 对于客户端侧 DNS 记录的缓存 TTL,我们建议值为 60s;同时如果是低敏感度业务比如测试、或域名解析调整不频繁的业务,可适当延长,甚至达到小时或天级别; 三、DNS 解析优化建议 1. 各语言网络库对 DNS 缓存的支持调研 以下调研结果,推荐开发人员参考,以实现自研客户端 DNS 缓存。各开发语言对 DNS 缓存支持可能不一样,在此逐个分析一下。 C/C++ 语言 (1)glibc 的 getaddrinfo 函数 Linux环境下的 glibc 库提供两个域名解析的函数:gethostbyname 函数和 getaddrinfo 函数,gethostbyname 是曾经常用的函数,但是随着向 IPv6 和线程化编程模型的转移,getaddrinfo 显得更有用,因为它既解析 IPv6 地址,又符合线程安全,推荐使用 getaddrinfo 函数。 函数原型: int getaddrinfo( const char *node, const char *service, const struct addrinfo *hints, struct addrinfo **res); getaddrinfo 函数是比较底层的基础库函数,很多开发语言的域名解析函数都依赖这个函数,因此我们在此介绍一下这个函数的处理逻辑。通过 strace 命令跟踪这个函数系统调用。 1)查找 nscd 缓存(nscd 介绍见后文) 我们在 linux 环境下通过 strace 命令可以看到如下的系统调用 //连接nscd socket(PF_LOCAL, SOCK_STREAM|SOCK_CLOEXEC|SOCK_NONBLOCK, 0) = 3 connect(3, {sa_family=AF_LOCAL, sun_path="/var/run/nscd/socket"}, 110) = -1 ENOENT (No such file or directory) close(3) 通过 unix socket 接口"/var/run/nscd/socket"连接nscd服务查询DNS缓存。 2)查询 /etc/hosts 文件 如果nscd服务未启动或缓存未命中,继续查询hosts文件,我们应该可以看到如下的系统调用 //读取 hosts 文件 open("/etc/host.conf", O_RDONLY) = 3 fstat(3, {st_mode=S_IFREG|0644, st_size=9, ...}) = 0 ... open("/etc/hosts", O_RDONLY|O_CLOEXEC) = 3 fcntl(3, F_GETFD) = 0x1 (flags FD_CLOEXEC) fstat(3, {st_mode=S_IFREG|0644, st_size=178, ...}) = 0 3)查询 DNS 服务 从 /etc/resolv.conf 配置中查询到 DNS 服务器(nameserver)的IP地址,然后做 DNS 查询获取解析结果。我们可以看到如下系统调用 //获取 resolv.conf 中 DNS 服务 IP open("/etc/resolv.conf", O_RDONLY) = 3 fstat(3, {st_mode=S_IFREG|0644, st_size=25, ...}) = 0 mmap(NULL, 4096, PROT_READ|PROT_WRITE, MAP_PRIVATE|MAP_ANONYMOUS, -1, 0) = 0x7fef2abee000 read(3, "nameserver 114.114.114.114\n\n", 4096) = 25 ... //连到 DNS 服务,开始 DNS 查询 connect(3, {sa_family=AF_INET, sin_port=htons(53), sin_addr=inet_addr("114.114.114.114")}, 16) = 0 poll([{fd=3, events=POLLOUT}], 1, 0) = 1 ([{fd=3, revents=POLLOUT}]) 而关于客户端是优先查找 /etc/hosts 文件,还是优先从 /etc/resolv.conf 中获取 DNS 服务器作查询解析,是由 /etc/nsswitch.conf 控制: #/etc/nsswitch.conf 部分配置 ... #hosts: db files nisplus nis dns hosts: files dns ... 实际通过 strace 命令可以看到,系统调用 nscd socket 之后,读取 /etc/resolv.conf 之前,会读取该文件 newfstatat(AT_FDCWD, "/etc/nsswitch.conf", {st_mode=S_IFREG|0644, st_size=510, ...}, 0) = 0 ... openat(AT_FDCWD, "/etc/nsswitch.conf", O_RDONLY|O_CLOEXEC) = 3 4)验证 #include <sys/socket.h> #include <netdb.h> #include <stdio.h> #include <stdlib.h> #include <string.h> #include <arpa/inet.h> #include <unistd.h> int gethostaddr(char * name); int main(int argc, char *argv[]) { if (argc != 2) { fprintf(stderr, "%s $host", argv[0]); return -1; } int i = 0; for(i = 0; i < 5; i++) { int ret = -1; ret = gethostaddr(argv[1]); if (ret < 0) { fprintf(stderr, "%s $host", argv[0]); return -1; } //sleep(5); } return 0; } int gethostaddr(char* name) { struct addrinfo hints; struct addrinfo *result; struct addrinfo *curr; int ret = -1; char ipstr[INET_ADDRSTRLEN]; struct sockaddr_in *ipv4; memset(&hints, 0, sizeof(struct addrinfo)); hints.ai_family = AF_INET; hints.ai_socktype = SOCK_STREAM; ret = getaddrinfo(name, NULL, &hints, &result); if (ret != 0) { fprintf(stderr, "getaddrinfo: %s\n", gai_strerror(ret)); return ret; } for (curr = result; curr != NULL; curr = curr->ai_next) { ipv4 = (struct sockaddr_in *)curr->ai_addr; inet_ntop(curr->ai_family, &ipv4->sin_addr, ipstr, INET_ADDRSTRLEN); printf("ipaddr:%s\n", ipstr); } freeaddrinfo(result); return 0; } 综上分析,getaddrinfo 函数结合 nscd ,是可以实现 DNS 缓存的。 (2)libcurl 库的域名解析函数 libcurl 库是 c/c++ 语言下,客户端比较常用的网络传输库,curl 命令就是基于这个库实现。这个库也是调用 getaddrinfo 库函数实现 DNS 域名解析,也是支持 nscd DNS 缓存的。 int Curl_getaddrinfo_ex(const char *nodename, const char *servname, const struct addrinfo *hints, Curl_addrinfo **result) { ... error = getaddrinfo(nodename, servname, hints, &aihead); if(error) return error; ... } Java Java 语言是很多公司业务系统开发的主要语言,通过编写简单的 HTTP 客户端程序测试验证 Java 的网络库是否支持 DNS 缓存。测试验证了 Java 标准库中 HttpURLConnection 和 Apache httpcomponents-client 这两个组件。 (1)Java 标准库 HttpURLConnection import java.io.BufferedReader; import java.io.InputStream; import java.io.InputStreamReader; import java.io.OutputStream; import java.net.HttpURLConnection; import java.net.URL; public class HttpUrlConnectionDemo { public static void main(String[] args) throws Exception { String urlString = "http://example.my.com/"; int num = 0; while (num < 5) { URL url = new URL(urlString); HttpURLConnection conn = (HttpURLConnection) url.openConnection(); conn.setRequestMethod("GET"); conn.setDoOutput(true); OutputStream os = conn.getOutputStream(); os.flush(); os.close(); if (conn.getResponseCode() == HttpURLConnection.HTTP_OK) { InputStream is = conn.getInputStream(); BufferedReader reader = new BufferedReader(new InputStreamReader(is)); StringBuilder sb = new StringBuilder(); String line; while ((line = reader.readLine()) != null) { sb.append(line); } System.out.println("rsp:" + sb.toString()); } else { System.out.println("rsp code:" + conn.getResponseCode()); } num++; } } } 测试结果显示 Java 标准库 HttpURLConnection 是支持 DNS 缓存,5 次请求中只有一次 DNS 请求。 (2)Apache httpcomponents-client import java.util.ArrayList; import java.util.List; import org.apache.hc.client5.http.classic.methods.HttpGet; import org.apache.hc.client5.http.entity.UrlEncodedFormEntity; import org.apache.hc.client5.http.impl.classic.CloseableHttpClient; import org.apache.hc.client5.http.impl.classic.CloseableHttpResponse; import org.apache.hc.client5.http.impl.classic.HttpClients; import org.apache.hc.core5.http.HttpEntity; import org.apache.hc.core5.http.NameValuePair; import org.apache.hc.core5.http.io.entity.EntityUtils; import org.apache.hc.core5.http.message.BasicNameValuePair; public class QuickStart { public static void main(final String[] args) throws Exception { int num = 0; while (num < 5) { try (final CloseableHttpClient httpclient = HttpClients.createDefault()) { final HttpGet httpGet = new HttpGet("http://example.my.com/"); try (final CloseableHttpResponse response1 = httpclient.execute(httpGet)) { System.out.println(response1.getCode() + " " + response1.getReasonPhrase()); final HttpEntity entity1 = response1.getEntity(); EntityUtils.consume(entity1); } } num++; } } } 测试结果显示 Apache httpcomponents-client 支持 DNS 缓存,5 次请求中只有一次 DNS 请求。 从测试中发现 Java 的虚拟机实现一套 DNS 缓存,即实现在 java.net.InetAddress 的一个简单的 DNS 缓存机制,默认为缓存 30 秒,可以通过 networkaddress.cache.ttl 修改默认值,缓存范围为 JVM 虚拟机进程,也就是说同一个 JVM 进程中,30秒内一个域名只会请求DNS服务器一次。同时 Java 也是支持 nscd 的 DNS 缓存,估计底层调用 getaddrinfo 函数,并且 nscd 的缓存级别比 Java 虚拟机的 DNS 缓存高。 # 默认缓存 ttl 在 jre/lib/security/java.security 修改,其中 0 是不缓存,-1 是永久缓存 networkaddress.cache.ttl=10 # 这个参数 sun.net.inetaddr.ttl 是以前默认值,目前已经被 networkaddress.cache.ttl 取代 Go 随着云原生技术的发展,Go 语言逐渐成为云原生的第一语言,很有必要验证一下 Go 的标准库是否支持 DNS 缓存。通过我们测试验证发现 Go 的标准库 net.http 是不支持 DNS 缓存,也是不支持 nscd 缓存,应该是没有调用 glibc 的库函数,也没有实现类似 getaddrinfo 函数的功能。这个跟 Go语言的自举有关系,Go 从 1.5 开始就基本全部由 Go(.go) 和汇编 (.s) 文件写成的,以前版本的 C(.c) 文件被全部重写。不过有一些第三方 Go 版本 DNS 缓存库,可以自己在应用层实现,还可以使用 fasthttp 库的 httpclient。 (1)标准库net.http package main import ( "flag" "fmt" "io/ioutil" "net/http" "time" ) var httpUrl string func main() { flag.StringVar(&httpUrl, "url", "", "url") flag.Parse() getUrl := fmt.Sprintf("http://%s/", httpUrl) fmt.Printf("url: %s\n", getUrl) for i := 0; i < 5; i++ { _, buf, err := httpGet(getUrl) if err != nil { fmt.Printf("err: %v\n", err) return } fmt.Printf("resp: %s\n", string(buf)) time.Sleep(10 * time.Second) # 等待10s发起另一个请求 } } func httpGet(url string) (int, []byte, error) { client := createHTTPCli() resp, err := client.Get(url) if err != nil { return -1, nil, fmt.Errorf("%s err [%v]", url, err) } defer resp.Body.Close() buf, err := ioutil.ReadAll(resp.Body) if err != nil { return resp.StatusCode, buf, err } return resp.StatusCode, buf, nil } func createHTTPCli() *http.Client { readWriteTimeout := time.Duration(30) * time.Second tr := &http.Transport{ DisableKeepAlives: true, //设置短连接 IdleConnTimeout: readWriteTimeout, } client := &http.Client{ Timeout: readWriteTimeout, Transport: tr, } return client } 从测试结果来看,net.http 每次都去 DNS 查询,不支持 DNS 缓存。 (2)fasthttp 库 fasthttp 库是 Go 版本高性能 HTTP 库,通过极致的性能优化,性能是标准库 net.http 的 10 倍,其中一项优化就是支持 DNS 缓存,我们可以从其源码看到 //主要在fasthttp/tcpdialer.go中 type TCPDialer struct { ... // This may be used to override DNS resolving policy, like this: // var dialer = &fasthttp.TCPDialer{ // Resolver: &net.Resolver{ // PreferGo: true, // StrictErrors: false, // Dial: func (ctx context.Context, network, address string) (net.Conn, error) { // d := net.Dialer{} // return d.DialContext(ctx, "udp", "8.8.8.8:53") // }, // }, // } Resolver Resolver // DNSCacheDuration may be used to override the default DNS cache duration (DefaultDNSCacheDuration) DNSCacheDuration time.Duration ... } 可以参考如下方法使用 fasthttp client 端 func main() { // You may read the timeouts from some config readTimeout, _ := time.ParseDuration("500ms") writeTimeout, _ := time.ParseDuration("500ms") maxIdleConnDuration, _ := time.ParseDuration("1h") client = &fasthttp.Client{ ReadTimeout: readTimeout, WriteTimeout: writeTimeout, MaxIdleConnDuration: maxIdleConnDuration, NoDefaultUserAgentHeader: true, // Don't send: User-Agent: fasthttp DisableHeaderNamesNormalizing: true, // If you set the case on your headers correctly you can enable this DisablePathNormalizing: true, // increase DNS cache time to an hour instead of default minute Dial: (&fasthttp.TCPDialer{ Concurrency: 4096, DNSCacheDuration: time.Hour, }).Dial, } sendGetRequest() sendPostRequest() } (3)第三方DNS缓存库 这个是 github 中的一个 Go 版本 DNS 缓存库 可以参考如下代码,在HTTP库中支持DNS缓存 r := &dnscache.Resolver{} t := &http.Transport{ DialContext: func(ctx context.Context, network string, addr string) (conn net.Conn, err error) { host, port, err := net.SplitHostPort(addr) if err != nil { return nil, err } ips, err := r.LookupHost(ctx, host) if err != nil { return nil, err } for _, ip := range ips { var dialer net.Dialer conn, err = dialer.DialContext(ctx, network, net.JoinHostPort(ip, port)) if err == nil { break } } return }, } Python (1)requests 库 #!/bin/python import requests url = 'http://example.my.com/' num = 0 while num < 5: headers={"Connection":"close"} # 开启短连接 r = requests.get(url,headers = headers) print(r.text) num +=1 (2)httplib2 库 #!/usr/bin/env python import httplib2 http = httplib2.Http() url = 'http://example.my.com/' num = 0 while num < 5: loginHeaders={ 'User-Agent': 'Mozilla/5.0 (Windows NT 5.1) AppleWebKit/537.36 (KHTML, like Gecko) Maxthon/4.0 Chrome/30.0.1599.101 Safari/537.36', 'Connection': 'close' # 开启短连接 } response, content = http.request(url, 'GET', headers=loginHeaders) print(response) print(content) num +=1 (3)urllib2 库 #!/bin/python import urllib2 import cookielib httpHandler = urllib2.HTTPHandler(debuglevel=1) httpsHandler = urllib2.HTTPSHandler(debuglevel=1) opener = urllib2.build_opener(httpHandler, httpsHandler) urllib2.install_opener(opener) loginHeaders={ 'User-Agent': 'Mozilla/5.0 (Windows NT 5.1) AppleWebKit/537.36 (KHTML, like Gecko) Maxthon/4.0 Chrome/30.0.1599.101 Safari/537.36', 'Connection': 'close' # 开启短连接 } num = 0 while num < 5: request=urllib2.Request('http://example.my.com/',headers=loginHeaders) response = urllib2.urlopen(request) page='' page= response.read() print response.info() print page num +=1 Python 测试三种库都是支持 nscd 的 DNS 缓存的(推测底层也是调用 getaddrinfo 函数),以上测试时使用 HTTP 短连接,都在 python2 环境测试。 总结 针对 HTTP 客户端来说,可以优先开启 HTTP 的 keep-alive 模式,可以复用 TCP 连接,这样可以减少 TCP 握手耗时和重复请求域名解析,然后再开启 nscd 缓存,除了 Go 外,C/C++、Java、Python 都可支持 DNS 缓存,减少 DNS查询耗时。 这里只分析了常用 C/C++、Java、Go、Python 语言,欢迎熟悉其他语言的小伙伴补充。 2. Unix/类 Unix 系统常用 dns 缓存服务: 在由于某些特殊原因,自研或非自研客户端本身无法提供 DNS 缓存支持的情况下,建议管理人员在其所在系统环境中部署DNS缓存程序; 现介绍 Unix/类 Unix 系统适用的几款常见轻量级 DNS 缓存程序。而多数桌面操作系统如 Windows、MacOS 和几乎所有 Web 浏览器均自带 DNS 缓存功能,本文不再赘述。 P.S. DNS 缓存服务请务必确保随系统开机启动; nscd name service cache daemon 即装即用,通常为 linux 系统默认安装,相关介绍可参考其 manpage:man nscd;man nscd.conf (1)安装方法:通过系统自带软件包管理程序安装,如 yum install nscd (2)缓存管理(清除): 1. service nscd restart 重启服务清除所有缓存; 2. nscd -i hosts 清除 hosts 表中的域名缓存(hosts 为域名缓存使用的 table 名称,nscd 有多个缓存 table,可参考程序相关 manpage) dnsmasq 较为轻量,可选择其作为 nscd 替代,通常需单独安装 (1)安装方法:通过系统自带软件包管理程序安装,如 yum install dnsmasq (2)核心文件介绍(基于 Dnsmasq version 2.86,较低版本略有差异,请参考对应版本文档如 manpage 等) (3)/etc/default/dnsmasq 提供六个变量定义以支持六种控制类功能 (4)/etc/dnsmasq.d/ 此目录含 README 文件,可参考;目录内可以存放自定义配置文件 (5)/etc/dnsmasq.conf 主配置文件,如仅配置 dnsmasq 作为缓存程序,可参考以下配置 listen-address=127.0.0.1 #程序监听地址,务必指定本机内网或回环地址,避免暴露到公网环境 port=53 #监听端口 resolv-file=/etc/dnsmasq.d/resolv.conf #配置dnsmasq向自定义文件内的 nameserver 转发 dns 解析请求 cache-size=150 #缓存记录条数,默认 150 条,可按需调整、适当增大 no-negcache #不缓存解析失败的记录,主要是 NXDOMAIN,即域名不存在 log-queries=extra #开启日志记录,指定“=extra”则记录更详细信息,可仅在问题排查时开启,平时关闭 log-facility=/var/log/dnsmasq.log #指定日志文件 #同时需要将本机 /etc/resolv.conf 第一个 nameserver 指定为上述监听地址,这样本机系统的 dns 查询请求才会通过 dnsmasq 代为转发并缓存响应结果。 #另 /etc/resolv.conf 务必额外配置 2 个 nameserver,以便 dnsmasq 服务异常时支持系统自动重试,注意 resolv.conf 仅读取前 3 个 nameserver (6)缓存管理(清除): 1. kill -s HUP `pidof dnsmasq` 推荐方式,无需重启服务 2. kill -s TERM `pidof dnsmasq` 或 service dnsmasq stop 3. service dnsmasq force-reload 或 service dnsmasq restart (7)官方文档:https://thekelleys.org.uk/dnsmasq/doc.html 3. 纯内网业务取消查询域名的AAAA记录的请求 以 linux 操作系统为例,常用的网络请求命令行工具常常通过调用 getaddrinfo() 完成域名解析过程,如 ping、telnet、curl、wget 等,但其可能出于通用性的考虑,均被设计为对同一个域名每次解析会发起两个请求,分别查询域名 A 记录(即 IPV4 地址)和 AAAA 记录(即 IPV6 地址)。 因目前大部分公司的内网环境及云上内网环境还未使用 ipv6 网络,故通常 DNS 系统不为内网域名添加 AAAA 记录,徒劳请求域名的 AAAA 记录会造成前端应用和后端 DNS 服务不必要的资源开销。因此,仅需请求内网域名的业务,如决定自研客户端,建议开发人员视实际情况,可将其设计为仅请求内网域名 A 记录,尤其当因故无法实施本地缓存机制时。 4. 规范域名处理逻辑 客户端需严格规范域名/主机名的处理逻辑,避免产生大量对不存在域名的解析请求(确保域名从权威渠道获取,避免故意或意外使用随机构造的域名、主机名),因此类请求的返回结果(NXDOMAIN)通常不被缓存或缓存时长较短,且会触发客户端重试,对后端 DNS 系统造成一定影响。
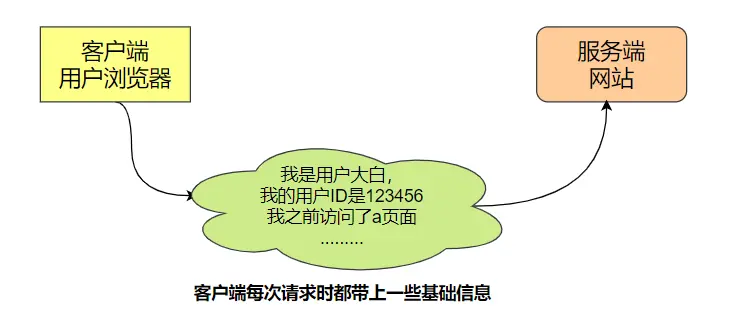
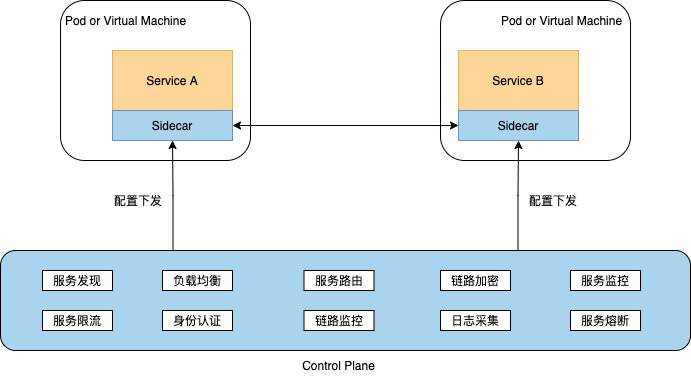
优秀的个人博客,低调大师

每日一博 | 编译器优化之 Cache 优化

摘要:本文重点介绍几种通过优化Cache使用提高程序性能的方法。 本文分享自华为云社区《编译器优化那些事儿(7):Cache优化》,作者:毕昇小助手。 引言 软件开发人员往往期望计算机硬件拥有无限容量、零访问延迟、无限带宽以及便宜的内存,但是现实却是内存容量越大,相应的访问时间越长;内存访问速度越快,价格也更贵;带宽越大,价格越贵。为了解决大容量、高速度、低成本之间的矛盾,基于程序访问的局部性原理,将更常用数据放在小容量的高速存储器中,多种速度不同的存储器分层级联,协调工作。 图1 memory hierarchy for sever [1] 现代计算机的存储层次可以分几层。如图1所示,位于处理器内部的是寄存器;稍远一点的是一级Cache,一级Cache一般能够保存64k字节,访问它大约需要1ns,同时一级Cache通常划分为指令Cache(处理器从指令Cache中取要执行的指令)和数据Cache(处理器从数据Cache中存/取指令的操作数);然后是二级Cache,通常既保存指令又保存数据,容量大约256k,访问它大约需要3-10ns;然后是三级Cache,容量大约16-64MB,访问它大约需要10-20ns;再接着是主存、硬盘等。注意,CPU和Cache是以word传输的,Cache到主存以块(一般64byte)传输的。 前文提到了程序的局部性原理,一般指的是时间局部性(在一定时间内,程序可能会多次访问同一内存空间)和空间局部性(在一定时间内,程序可能会访问附近的内存空间),高速缓存(Cache)的效率取决于程序的空间和时间的局部性性质。比如一个程序重复地执行一个循环,在理想情况下,循环的第一个迭代将代码取至高速缓存中,后续的迭代直接从高速缓存中取数据,而不需要重新从主存装载。因此,为了使程序获得更好的性能,应尽可能让数据访问发生在高速缓存中。但是如果数据访问在高速缓存时发生了冲突,也可能会导致性能下降。 篇幅原因,本文重点讨论编译器在Cache优化中可以做哪些工作,如果读者对其他内存层次优化感兴趣,欢迎留言。下面将介绍几种通过优化Cache使用提高程序性能的方法。 对齐和布局 现代编译器可以通过调整代码和数据的布局方式,提高Cache命中率,进而提升程序性能。本节主要讨论数据和指令的对齐、代码布局对程序性能的影响,大部分处理器中Cache到主存是以Cache line(一般为64Byte,也有地方称Cache块,本文统一使用Cache line)传输的,CPU从内存加载数据是一次一个Cache line,CPU往内存写数据也是一次一个Cache line。假设处理器首次访问数据对象A,其大小刚好为64Byte,如果数据对象A首地址并没有进行对齐,即数据对象A占用两个不同Cache line的一部分,此时处理器访问该数据对象时需要两次内存访问,效率低。但是如果数据对象A进行了内存对齐,即刚好在一个Cache line中,那么处理器访问该数据时只需要一次内存访问,效率会高很多。编译器可以通过合理安排数据对象,避免不必要地将它们跨越在多个Cache line中,尽量使得同一对象集中在一个Cache中,进而有效地使用Cache来提高程序的性能。通过顺序分配对象,即如果下一个对象不能放入当前Cache line的剩余部分,则跳过这些剩余的部分,从下一个Cache line的开始处分配对象,或者将大小(size)相同的对象分配在同一个存储区,所有对象都对齐在size的倍数边界上等方式达到上述目的。 Cache line对齐可能会导致存储资源的浪费,如图2所示,但是执行速度可能会因此得到改善。对齐不仅仅可以作用于全局静态数据,也可以作用于堆上分配的数据。对于全局数据,编译器可以通过汇编语言的对齐指令命令来通知链接器。对于堆上分配的数据,将对象放置在Cache line的边界或者最小化对象跨Cache line的次数的工作不是由编译器来完成的,而是由runtime中的存储分配器来完成的[2]。 图2 因块对齐可能会浪费存储空间 前文提到了数据对象对齐,可以提高程序性能。指令Cache的对齐,也可以提高程序性能。同时,代码布局也会影响程序的性能,将频繁执行的基本块的首地址对齐在Cache line的大小倍数边界上能增加在指令Cache中同时容纳的基本块数目,将不频繁执行的指令和频繁指令的指令放到不同的Cache line中,通过优化代码布局来提升程序性能。 利用硬件辅助 Cache预取是将内存中的指令和数据提前存放至Cache中,达到加快处理器执行速度的目的。Cache预取可以通过硬件或者软件实现,硬件预取是通过处理器中专门的硬件单元实现的,该单元通过跟踪内存访问指令数据地址的变化规律来预测将会被访问到的内存地址,并提前从主存中读取这些数据到Cache;软件预取是在程序中显示地插入预取指令,以非阻塞的方式让处理器从内存中读取指定地址数据至Cache。由于硬件预取器通常无法正常动态关闭,因此大部分情况下软件预取和硬件预取是并存的,软件预取必须尽力配合硬件预取以取得更优的效果。本文假设硬件预取器被关闭后,讨论如何利用软件预取达到性能提升的效果。 预取指令prefech(x)只是一种提示,告知硬件开始将地址x中的数据从主存中读取到Cache中。它并不会引起处理停顿,但若硬件发现会产生异常,则会忽略这个预取操作。如果prefech(x)成功,则意味着下一次取x将命中Cache;不成功的预取操作可能会导致下次读取时发生Cache miss,但不会影响程序的正确性[2]。 数据预取是如何改成程序性能的呢?如下一段程序: double a[n]; for (int i = 0; i < 100; i++) a[i] = 0; 假设一个Cache line可以存放两个double元素,当第一次访问a[0]时,由于a[0]不在Cache中,会发生一次Cache miss,需要从主存中将其加载至Cache中,由于一个Cache line可以存放两个double元素,当访问a[1]时则不会发生Cache miss。依次类推,访问a[2]时会发生Cache miss,访问a[3]时不会发生Cache miss,我们很容易得到程序总共发生了50次Cache miss。 我们可以通过软件预取等相关优化,降低Cache miss次数,提高程序性能。首先介绍一个公式[3]: 上述公式中L是memory latency,S是执行一次循环迭代最短的时间。iterationAhead表示的是循环需要经过执行几次迭代,预取的数据才会到达Cache。假设我们的硬件架构计算出来的iterationAhead=6,那么原程序可以优化成如下程序: double a[n]; for (int i = 0; i < 12; i+=2) //prologue prefetch(&a[i]); for (int i = 0; i < 88; i+=2) { // steady state prefetch(&a[i+12]); a[i] = 0; a[i+1] = 0; } for (int i = 88; i < 100; i++) //epilogue a[i] = 0; 由于我们的硬件架构需要循环执行6次后,预取的数据才会到达Cache。一个Cache line可以存放两个double元素,为了避免浪费prefetch指令,所以prologue和steady state循环都展开了,即执行prefetch(&a[0])后会将a[0]、a[1]从主存加载至Cache中,下次执行预取时就无需再次将a[1]从主存加载至Cache了。prologue循环先执行数组a的前12个元素的预取指令,等到执行steady state循环时,当i = 0时,a[0]和a[1]已经被加载至Cache中,就不会发生Cache miss了。依次类推,经过上述优化后,在不改变语义的基础上,通过使用预取指令,程序的Cache miss次数从50下降至0,程序的性能将会得到很大提升。 注意,预取并不能减少从主存储器取数据到高速缓存的延迟,只是通过预取与计算重叠而隐藏这种延迟。总之,当处理器有预取指令或者有能够用作预取的非阻塞的读取指令时,对于处理器不能动态重排指令或者动态重排缓冲区小于我们希望隐藏的具体Cache延迟,并且所考虑的数据大于Cache或者是不能够判断数据是否已在Cache中,预取是适用的。预取也不是万能,不当的预取可能会导致高速缓存冲突,程序性能降低。我们应该首先利用数据重用来减少延迟,然后才考虑预取。 除了软件预取外,ARMv8还提供了Non-temporal的Load/Store指令,可以提高Cache的利用率。对于一些数据,如果只是访问一次,无需占用Cache,可以使用这个指令进行访问,从而保护Cache中关键数据不被替换,比如memcpy大数据的场景下,使用该指令对于其关键业务而言,是有一定的收益的。 循环变换 重用Cache中的数据是最基本的高效使用Cache方法。对于多层嵌套循环,可以通过交换两个嵌套的循环(loop interchange)、逆转循环迭代执行的顺序(loop reversal)、将两个循环体合并成一个循环体(loop fusion)、循环拆分(loop distribution)、循环分块(loop tiling)、loop unroll and jam等循环变换操作。选择适当的循环变换方式,既能保持程序的语义,又能改善程序性能。我们做这些循环变换的主要目的是为了实现寄存器、数据高速缓存以及其他存储层次使用方面的优化。 篇幅受限,本节仅讨论循环分块(loop tiling)如何改善程序性能,若对loop interchange感兴趣,请点击查阅。下面这个简单的循环: for(int i = 0; i < m; i++) { for(int j = 0; j < n; j++) { x = x+a[i]+c*b[j]; } } 我们假设数组a、b都是超大数组,m、n相等且都很大,程序不会出现数组越界访问情况发生。那么如果b[j]在j层循环中跨度太大时,那么被下次i层循环重用时数据已经被清出高速缓存。即程序访问b[n-1]时,b[0]、b[1]已经被清出缓存,此时需要重新从主存中将数据加载至缓存中,程序性能会大幅下降。 我们如何通过降低Cache miss次数提升程序的性能呢?通过对循环做loop tiling可以符合我们的期望,即通过循环重排,使得数据分成一个一个tile,让每一个tile的数据都可以在Cache中被hint[4]。从内层循环开始tiling,假设tile的大小为t,t远小于m、n,t的取值使得b[t-1]被访问时b[0]依然在Cache中,将会大幅地减少Cache miss次数。假设n-1恰好被t整除,此时b数组的访问顺序如下所示: i=1; b[0]、b[1]、b[2]...b[t-1] i=2; b[0]、b[1]、b[2]...b[t-1] ... i=n; b[0]、b[1]、b[2]...b[t-1] ... ... ... i=1; b[n-t]、b[n-t-1]、b[n-t-2]...b[n-1] i=2; b[n-t]、b[n-t-1]、b[n-t-2]...b[n-1] ... i=n; b[n-t]、b[n-t-1]、b[n-t-2]...b[n-1] 经过loop tiling后循环变换成: for(int j = 0; j < n; j+=t) { for(int i = 0; i < m; i++) { for(int jj = j; jj < min(j+t, n); jj++) { x = x+a[i]+c*b[jj]; } } } 假设每个Cache line能够容纳X个数组元素,loop tiling前a的Cache miss次数为m/X,b的Cache miss次数是m*n/X,总的Cache miss次数为m*(n+1)/x。loop tiling后a的Cache miss次数为(n/t)*(m/X),b的Cache miss次数为(t/X)*(n/t)=n/X,总的Cache miss次数为n*(m+t)/xt。此时,由于n与m相等,那么loop tiling后Cache miss大约可以降低t倍[4]。 前文讨论了loop tiling在小用例上如何提升程序性能,总之针对不同的循环场景,选择合适的循环交换方法,既能保证程序语义正确, 又能获得改善程序性能的机会。 小结 汝之蜜糖,彼之砒霜。针对不同的硬件,我们需要结合具体的硬件架构,利用性能分析工具,通过分析报告和程序,从系统层次和算法层次思考问题,往往会有意想不到的收获。本文简单地介绍了内存层次优化相关的几种方法,结合一些小例子深入浅出地讲解了一些内存层次优化相关的知识。纸上得来终觉浅,绝知此事要躬行,更多性能优化相关的知识需要我们从实践中慢慢摸索。 参考 John L. Hennessy, David A. Patterson. 计算机体系结构:量化研究方法(第6版). 贾洪峰,译 Andrew W.Apple, with Jens Palsberg. Modern Compiler Implenentation in C http://www.cs.cmu.edu/afs/cs/academic/class/15745-s19/www/lectures/L20-Global-Scheduling.pdf https://zhuanlan.zhihu.com/p/292539074 点击关注,第一时间了解华为云新鲜技术~

优秀的个人博客,低调大师

每日一博 | Go 服务自动收集线上问题现场

前言 对于 pprof,相信熟悉 Go 语言的程序员基本都不陌生,一般线上的问题都是靠它可以快速定位。但是实际项目中,很多时候我们为了性能都不会开启它,但是出了问题又要靠它来分析。好在 go-zero 已经帮我们很好的集成进来了,我们只需要像开关一样去开启、关闭它即可,这样我们就可以配合运维监控,当出现 cpu、内存等异常情况时候,自动开始开启收集(比如大半夜你睡的正香的时候),那么第二天可以通过分析当时的采样还原现场,那我们看看 go-zero 是如何做的。 源码分析 我们可以看 go-zero 源码位置 https://github.com/zeromicro/go-zero/blob/master/core/proc/signals.go func init() { go func() { ... signals := make(chan os.Signal, 1) signal.Notify(signals, syscall.SIGUSR1, syscall.SIGUSR2, syscall.SIGTERM) for { v := &lt;-signals switch v { ... case syscall.SIGUSR2: if profiler == nil { profiler = StartProfile() } else { profiler.Stop() profiler = nil } ... } }() } 服务启动的时候,go-zero 在 init 初始化了监听信号操作(gracefulStop 也是通过这里通知的,这里不展开讲了),可以看到在接收到 syscall.SIGUSR2 信号时候,如果是第一次就开始收集,第二次就停止收集,看到这块可能瞬间就明白了,我们只需要在服务器执行 kill -usr2 <服务进程id> 就可以开始收集这个服务的 pprof 信息了,再执行一次就停止了收集,就可以将这些文件导出到本地,使用 go tool pprof 分析。 一次线上实战 我们线上有一个 mq 的服务监控告警,内存占用比较高,这时候我打开 grafana 看到服务内存累计占用的确异常,如下图: 这时候到线上找到这个服务的服务器,执行了 ps aux | grep xxx_mq,查询到了这个 mq 服务的进程 ID 是 21181,我们这时候就可以给这个 xxx_mq 服务发送信号收集 pprof 信息:kill -usr2 21181 第一次执行了这个命令后,在对应服务的 access.log 日志中可以看到 enable 了 pprof,当我们再次执行 kill -usr2 21181,access.log 日志中可以看到 disable 了 pprof 信息,这时候代表收集完成了。值得注意的是收集的信息都在 /tmp 文件夹下,以这个服务名命名的如下: - xxxx-mq-cpu-xxx.pprof - xxxx-mq-memory-xxx.pprof - xxxx-mq-mutex-xxx.pprof - xxxx-mq-block-xxx.pprof - ....... 这时候就可以下载对应的 pprof 去本地分析,可以使用 go tool pprof xxxx-mq-memory-xxx.pprof,也可以配合 graphviz 使用 web ui 查看,由于我这边通过命令行就快速定位了问题,就没用使用 web ui。 我使用 go tool pprof xxxx-**-mq-memory-xxx.pprof 然后进入命令行交互,使用 top 30 查看前面占用较高的资源。 前面基本是底层序列化等操作,发现主要问题集中在红色框中导致持续上涨的内存,因为业务同学在 mq 中消费完了消息又向下游其他的mq服务使用 publisher 发送一个 mq 消息,每次发送都调用一个 NewPublisher 然后在 defer close,恰恰这个 mq 服务又大量消息消费又特别频繁,导致内存不断上涨,最终解决方案将 NewPublisher 在 svcCtx 中初始化一个 client 就可以了,没必要每次都要 NewPublisher,世界又恢复清净了。 写在最后 想一下 go-zero 给了我们 pprof 开关,让我们很方便的实现分析问题,但是不是所有问题都是一直存在的,比如半夜突发内存、cpu 过高,早上起来服务正常了,这怎么排查?所以我们希望如果异常了,能保留问题现场,那我们是不是可以配合运维监控实现自动保存问题现场呢?比如内存、cpu 连续超过 80% 指标3分钟的话,我们就调用这个开关收集,之后我们就可以根据这个文件来分析问题了,这样就达到自动化了。 项目地址 go-zero 微服务框架: https://github.com/zeromicro/go-zero https://gitee.com/kevwan/go-zero go-zero 微服务最佳实践项目:https://github.com/Mikaelemmmm/go-zero-looklook 欢迎使用 go-zero 并 star 支持我们! 微信交流群 关注『微服务实践』公众号并点击 交流群 获取社区群二维码。</服务进程id>

优秀的个人博客,低调大师

每日一博 | 合约广告平台架构演进实践

作者 |王悦凯 导读 从事B端业务系统研发多年,不免会有这样的思考:B端系统的技术挑战是什么?什么样的业务架构算好架构?本文结合百度合约广告业务的发展历程,介绍广告投放平台从单体架构到微服务架构演进过程中碰到的问题和思考。希望通过本文的介绍,让大家更全面的理解B端系统的技术挑战。 全文11653字,预计阅读时间30分钟。 一、背景 1.1 合约广告概念 合约广告相比竞价广告,最大的特点是预先约定好广告价格,即价格是预先确定的。基于这样的特点,合约广告的投放流程大致可以概括为四个步骤:询价 -> 下单 -> 投放 -> 结算。 询价,销售根据客户的营销目标选择合适的营销产品,并提交具体的投放定向和时长,系统结合销售政策,自动计算产出各资源价格 下单,客户按照 1 中的报价结果,确认需要购买的资源和具体的付款方式,完成下单后生成订单,每个订单的金额是确认的 投放,2 中的订单完成审批后,系统按照事先约定的价格进行广告投放,客户在投中可通过系统进行投放和创意的管理,并可以实时获取投放数据 结算,合约广告按照投放模式分为按时间计费和展现量计费,两种计费方式的频次都是天,最终实现在投放周期内逐步地扣除订单全部金额。按天结算是对已产生投放部分的权益保障,毕竟合约广告存在更改甚至退款的场景。 通常来说,合约广告这种广告采买方式更适合品牌展示类广告,效果类广告更多会采用实时竞价。相比竞价广告,合约广告在业务流程上更重投前。下面结合品牌广告业务发展的三个阶段,介绍下投放平台的变化历程。 1.2业务发展 第一阶段,品牌广告业务高速发展期 2011年,品牌专区产品开始平台化售卖,并逐步建立品牌投放平台:锦囊。在2013-2018 6年间,品牌业务高速发展,诞生了Ax、Bx、Cx等10+条产品线,虽然锦囊平台做为投放的统一入口,但各产品线的投放能力仍旧是独立建设,拥有各自的独立投放平台。在这种模式下,快速灵活地应对了市场的变化和需求,但同时也造成了投放平台多,业务流程割裂的问题。 第二阶段,寻求产品整合和流程统一 2019年开始尝试对合约类平台进行整合,统一各产品售卖流程,包括产品线关停并转、投放平台融合、账户统一、资金池统一、标准化下单等项目。逐步落地合约广告一站式平台的建设 - 天启平台,真正实现合约广告的标准化投放流程,提升规模化投放效率,支撑业务发展。在这个阶段,各广告的投放平台入口逐步收敛,实现了操作入口的统一。 第三阶段,满足复杂营销场景,整合营销 随着合约整合售卖(根据营销场景选择不同广告产品的组合售卖方案,即同一个合同下可下单多类广告,并享有对应的优惠政策)整体趋势的加速增长,原本非标断点式的支持方式已经无法满足业务的增长,平台化的解决方案是整合售卖规模化的必要条件。从2021年Q3起正式启动,天启平台正式定位:统一的合约产品整合售卖平台,满足从简单场景到复杂营销场景的全投放链路服务能力。从技术视角看,旨在通过一个平台(天启),实现多资源广告售卖场景下的统一,包括一个流程、一套账户、一套资金体系、一套投放表达。 1.3架构演进 对应上述业务发展的三个阶段,合约平台的技术架构也经历了多个版本的演进,浓缩后,可以概括为2大类,2019年前的单体架构和之后的微服务架构。 单体架构 2019年前的单体架构(简称『1.0架构』)图如下所示,整体上分三层,1)统一入口层,提供用户权限管理功能;2)各类广告投放平台独立建设,服务独立部署;3)抽象并沉淀基础工具库,避免各投放平台的重复开发。 △1.0 烟囱式架构 品牌 1.0 架构本质是一个烟囱式架构,各产品线通过独立平台进行投放,开发、测试、上线互不影响,都能做到产品线维度的隔离,包括开发规范和迭代周期。这种架构配合当时品牌团队的组织架构,在品牌产品野蛮式生长的初期起到了很重要的作用,成功孵化了一些创新产品。但是烟囱式架构一个很大的弊端就是『信息孤岛』,随着业务的发展,各投放平台发散式迭代,逐步形成了一个一个的孤岛。从技术视角看,各平台大流程相似,但在实现细节上都不同,更严重的是,存在大量的重复性建设工作,从维护成本和人效上都有很大的优化空间。从业务视角看,各产品的打法也是各自为阵,横向缺少联动,没有形成1+1>2的局面,缺少整体视角的规划。 微服务架构 业务方面,合约广告场景化营销和精细化服务的需求显著;团队方面,各合约类广告平台深度融合,孤岛边界逐步打破。原本烟囱式架构无论在业务复杂度的应对,还是服务稳定性及质量的保障,亦或是研发效能的提升,都已经遇到了瓶颈。基于软件设计的最大目标:『设计符合业务的构造定律的演进方式,一种可以以最小的开发维护成本, 使业务更快更好的流动发展的方式』,19年后,合约平台架构逐步向微服务架构演进,以领域驱动设计为准则,按照合约广告的领域模型划分微服务,构建了业务前台、业务中台、技术组件、基础设施的四层业务架构。另外,基于消息机制解耦各服务,辅以组装式业务流程的理念,拆解各种繁杂的业务流程,抽象并沉淀系统的 meta feature,灵活构造多种差异化的业务解决方案,提升系统的『可玩性』,从架构层面管理了系统风险和业务复杂度(百级别不同类型的售卖和投放场景)。 说到这,有些人会有疑问,对于品牌业务,微服务架构演进是否是必须的呢?是否存在过度设计? 当然,假如不考虑性能、健壮性、可移植性、可修改性、开发成本、时间约束等因素,用任何的架构、任何的方法,系统的功能总是可以实现的,项目总是能开发完成的,只是开发时间、以后的维护成本、功能扩展的容易程度不同。从后验来看(包括系统可用性、扩展性、灵活性三方面),采用微服务架构的决策是正确的,或者说利远大于弊。 在架构的演进过程中遇到了很多技术挑战,后面的内容重点挑了几个方面进行详细阐述。 二、技术实现 2.1 服务架构 首先,整体看下合约广告平台的微服务架构,如下图: △合约广告平台微服务架构 总共分为四层,业务前台、业务中台、技术组件(PAAS)、基础设施(IAAS)。 业务前台,总共分三个模块,天启平台、运营平台、业务前台。 天启平台:面向广告主,提供合约广告询价、资源预订、资源下单、投放设置、物料制作等核心能力,支持品专矩阵、展示矩阵、品牌全景3大类产品矩阵,多达300+广告资源的售卖。 运营平台:面向销售和内部运营,帮助他们精细化运营广告售卖各阶段,目前售中的投放干预和运营管控能力建设相对完善,在开屏大促和品牌广告日常运营工作中大幅提升操作的效率和安全性,让原本一些『非标』操作通过平台能力让运营实现自助化。 业务前台:主要两个作用,1)对天启平台和运营平台的公共部分进行抽象并下沉,避免重复的业务逻辑和流程散布在两个模块,减少开发和运维成本;2) 对各业务中台的公共部分进行上抽,统一沉淀至此模块,比如批量处理,让各业务中台的职责更加纯粹,关注自己领域的建模。另外,针对跨多中台的读写逻辑也统一在这一层实现,起到业务流程编排的作用。 业务中台,按照合约广告的业务流程和领域知识,划分各业务服务,总共分为9个业务中心和2个技术中心,每个业务中心都围绕特定的业务领域展开,业务边界非常明确。需要注意的是,9大业务中心仅仅是从业务视角进行定义和划分,并不代表每个中心就只有一个服务。基于技术架构和业务职责,每个业务中心可以继续划分为多个模块,例如投放中心又被划分为 检索适配服务、物料审核服务、实验投放服务等。另外,服务之间严格划定上下游关系(按照响应数据流向定义上下游概念),下游服务可以调用上游服务,上游服务严禁调用下游服务,上游服务的变更对下游服务产生影响必须通过领域事件(异步)的方式来实现,避免服务循环依赖(在服务治理章节中会展开介绍)。因此在整体系统中大量采用异步消息的方式,将业务实体的状态变更视为事件,驱动上游服务,虽然增加了测试阶段的复杂度,但是有效保障了服务间关系的有序性。 技术组件,微服务架构后,各模块的代码库也是独立的,对于一些公共能力,如何能够让各服务低成本、无门槛的接入,从而达到统一各模块业务解决方案的目标,减缓业务架构的腐化和熵增。鉴于此,通过 springboot starter 的方式构建了品牌团队的业务中间件 brand-starters,成功收敛了30+模块的实现细节,在系统稳定性和架构健康度方面做出巨大贡献,包括消息发送和消费、异步事件处理、异常报警、分布式锁、分级缓存、常用工具及辅助类等。 基础设施,主要指部门级别的基础设施和中台,比如微服务解决方案 ,包括RPC框架、注册中心、全链路追踪、服务网关、虚拟化容器部署、FAAS。 2.2 模块结构 上一节从整体视角介绍了合约广告平台的业务架构,这节从微观视角介绍每个中台的业务架构。各业务中台采用多模块的代码结构,具体模块划分如下: 各模块的依赖关系如下: △模块结构 值得注意的是: 各模块间的依赖关系,demo-web、demo-task、demo-consumer 做为顶层模块,非常薄,这一层的主要作用是独立发布及部署,实现应用级别的隔离。顶层模块调用 demo-app,app模块作为服务的实现,存放了各个业务的实现类,主要分command和query(CQRS 理念)。demo-app 可以调用 demo-domain,也可以调用基础设施层 demo-infrastructure,domain做为领域层主要分3块,model 领域实体,可以是充血模型(DDD的概念);ability 领域能力,是领域对外暴露的服务能力;gateway 领域网关,主要是接口定义,这里的接口可以粗略的理解成一种SPI,也就是交给infrastructure层去实现的接口。 demo-client 是服务对外透出的 API,API 的实现存放于 demo-app 模块。出于运维考虑,或者读写分离的设计,可以方便的将需要独立部署的 API 从 app 模块上抽至顶层,做为独立模块进行流水线发布和部署。实现服务的隔离部署,同时又能获得共享同一个代码库的好处。 前面提到的domain和infrastructure层的依赖倒置,是一个非常有用的设计,进一步解耦了取数逻辑的实现。domain层依赖接口,不感知具体实现,例如 CustomerGateway 里定义了接口 getByById,要求 infrastructure 的实现类必须定义如何通过消费者Id获取消费者实体信息,而 infrastructure 层可以实现任何数据源逻辑,比如,从 MySQL 获取,从 Redis 获取,还是从外部 API 获取等等。 领域与功能的分包策略,每个模块的分包策略都遵循准则:先按照领域分包,再按照功能分包,这样做的其中一点好处是能将腐烂控制在该业务域内。比如消费者 customer 和订单 order两个领域,在 domain 模块下先分成 customer 和 order 两个包,然后再按照 model、ability、gateway 进行功能划分。假设 customer 和 order 是两个后端开发并行开发,两个人对于 dto,util 这些文件夹的命名习惯都不同,那么只会腐烂在各自的业务包下面,而不会将 dto,util,config 等文件夹放在一起,极容易引发文件冲突。 通过上面的应用架构划分,统一了各业务中台的分模块和分包策略,成功降低了各模块的学习和上手成本,较好控制了业务架构和模块代码的腐化程度。同时通过顶层模块的划分,灵活实现了同一代码库多应用部署的能力,从物理层面隔离web服务、定时任务、消息消费、rpc服务,使服务具备灵活按需扩展的能力,进一步提升服务的稳定性。 2.3服务治理 微服务架构后,服务之间的交互通过网络进行而非单体时代的内存方式,所以整体来说系统会变得更加脆弱,服务治理就是为了解决此类问题。常规的服务治理有四板斧:第一,一定要设置服务调用的超时时间;第二,要考虑重试的逻辑;第三,考虑熔断的逻辑,不要被下游拖死;第四,一定要有限流的逻辑,不要被上游打死。即超时、重试、熔断和限流。没错,这四板斧的确是服务治理中的常规手段,但在我看来,服务治理并不局限于此。我们以终为始,看看服务治理的终极目标是什么?我认为主要3个方面:服务可用性、系统可观测、架构防腐化。 可用性 服务可用性的建设包括系统性能优化、服务自愈和自检能力建设。 服务性能 1.微服务框架升级 服务 RPC 框架整体迁移至部门最新的云原生解决方案 gravity+starlight,取代了原先的 zookeeper+stargate。在服务性能和治理方面有了大幅提升: 通信性能提升:starlight采用新版的网络通信库与更灵活的线程池模型。提升2倍通信交互性能 稳定性增强:starlight基于gravity做更高效稳定的注册中心,定制无损升级、异常实例摘除等能力。轻松赋能达标99.99%+稳定性。 跨语言能力:starlight采用设计更合理的brpc协议作为主协议,可跨语言与C++ Go等brpc服务通信。降低跨语言通信学习成本。 云原生治理:starlight+gravity支持更云原生的治理能力,接入统一控制中心增强可控性、实现灰度发布。 日志规范排查提速:规范化的日志。秒级定位超时问题、序列化失败问题 迁移过程中,gravity 与 zk 双向同步服务注册信息,实现业务的平滑无感迁移。 2.系统性能深度优化 对合约广告系统进行了全面的性能盘点和优化,性能整体提升2倍,总结为如下7个优化点: 单元化,对单个服务进行拆分瘦身(模块结构章节中提到的顶层模块,将定时任务、消息消费与web服务剥离),实现资源隔离,降低等待获取连接的耗时 网络传输,统一团队服务部署至北方机房,平响降低60% 循环IO,IO 包括远程服务调用和数据库操作,通过批量化改造、多线程并发的手段大幅缩短耗时 多级缓存,通过本地 + redis 构建二级缓存,大幅降低读接口耗时 异步化,对于耗时的写操作,采用eventlog组件实现异步化 + 自动重试(后面一节会详细展开),例如物料送审、批量创建投放等 慢SQL,基于业务查询场景,优化数据表索引定义 接口拆分,联合前端,对于非主干流程的耗时数据进行接口拆分,实现非阻塞请求 服务自愈和自检 为了更好的保障系统的可用性,服务需要具备自愈和自检能力。服务自愈能力主要通过幂等处理 + 事件持久化 + 逻辑重试来实现,通过自愈能力的建设,可以大幅降低微服务架构升级后带来的 IO 通信不稳定问题,同时让系统对性能和稳定性较差的外部服务有更好的容忍性,有效提升系统的整体可用性。系统的自愈能力主要解决的是『偶发性』技术问题,比如网络抖动导致的远程调用失败、事务并发导致的乐观锁冲突等,对于代码bug、业务逻辑错误、数据不一致等问题无能为力。所以除了自愈能力,服务还需要具备自检能力,能够将错误自动检测出来,并及时通知到对应人员进行处理。 服务的幂等处理这里简单提一下,不做过多展开,主要有几种方案: 数据库唯一键,通过数据库的约束实现新增和删除操作的幂等。 数据库乐观锁,通过增加额外字段(版本号)实现更新操作的幂等。 防重token令牌,调用方在调用接口的时候先向后端请求一个全局ID做为token,后续请求的时候都带有此token(建议放到 Headers 中),可以解决客户端连续点击或者调用方超时重试等情况,适用于新增、更新和删除操作 下游传递唯一序列号,与3不同的是,这个唯一序列号由调用方生成,生成方式可以是无业务含义的全局ID,也可以是带有业务含义的ID,比如订单行ID。服务方通过此ID记录进行存在和不存在的操作(结合redis实现操作的记录),适用于新增、更新和删除操作 自愈能力 - eventlog 基础组件 利用 springboot-starter 机制沉淀 eventlog 基础组件,让业务方低成本接入,使服务具备自愈能力。组件整体架构图如下: △eventlog 基础组件 步骤1是同步持久化事件,由业务方引入组件后调用现成方法实现;步骤2是异步消费处理事件,整体处理流程采用模板模式+ 策略模式,通过模板模式实现处理流程的业务编排,对事件处理前、中、后都设置扩展点,兼顾业务模块的接入成本和扩展灵活度。事件处理采用策略模式,将事件类型做为策略路由,实现各类事件处理的互相隔离和高扩展性。另外通过可视化配置(amis配置,即爱速搭,低代码前端页面搭建平台),统一监控事件日志表,对超时处理的事件进行报警、清理等操作。 事件日志实体模型采用 event_type + biz_code 的二级模型,event_type 唯一标识了一类事件,是事件处理时的策略路由key,biz_code 由业务方自定义,用来唯一标识某类实体。attach是扩展字段,供业务方自定义,attach不宜过大,如果过大,建议通过biz_code后反查业务数据。 自检能力 - 核检中心 服务的自检能力主要通过核检中心来实现,核检中心功能上分两部分,核检任务 + 消息中心。核检任务按业务场景对数据进行核对校验,解决微服务架构后分布式事务造成的数据不一致,同时,端到端的核检也可以做为在线监控,第一时间感知系统bug;然后通过消息中心将异常通知到对应人员。同时,面对大量的报警信息(系统错误、数据一致性、业务正确性等),消息中心做为统一的管理端,提供了按场景分组报警、历史报警信息查询、报警优先级设定、误报热屏蔽、报警群进组热修改等功能,提升监控的有效性和处理效率。 核检中心整体模块图如下: △核检中心模块图 应用层,两块主要功能,客户端接入和可视化管理。 客户端接入,对于 springboot 应用,和 eventlog 组件相同,通过引入starter,低成本实现报警消息的通知(声明式注解和命令式sdk两种方式)。 可视化管理,通过消息中心控制台,将散布的核检任务进行收拢,大幅提升日程维护效率。同时对于历史消息,可以进行查询,做到消息的可回溯和追踪。 能力层,对应核检中心服务端,整体模块结构遵循上述提到的 COLA,并使用CQRS和事件驱动的设计理念,提升模块的可用性。在消息发送事件的处理模块中,采用策略模式实现多种类型的消息发送,大幅提升模块扩展性,遵循开闭原则。 实体层,按照十亿级别数据量进行模型设计和数据库选型。在实体设计中,抽象消息场景的业务概念,较好的聚合了一类共同特征的消息,『共同特征』完全交由业务方定义,很好的平衡了业务灵活性和消息可管理。在数据库选型方面,采用部门开源解决方案BaikalDB(一个分布式可扩展的HTAP存储系统,采用类spanner的架构,支持PB级结构化数据的随机实时读写)。 可观测 系统的可观测程度也是服务治理的一个非常重要目标。提到服务的可观测性,大家容易想到的一般都是:微服务调用关系(拓扑图呈现)、接口性能(各种分位值指标,性能优化利器)、系统异常(各种监控配置)、资源利用率、日志链路追踪(线上排查必不可少)等,这部分主要依托于部门的微服务解决方案 Jarvis平台实现,所以在这里不做过多介绍,这里主要想介绍的服务可观测主要是指上层业务应用。 企业级微服务解决方案Jarvis是商业平台部基础技术团队研发的面向复杂业务系统的应用托管平台,为商业应用提供高可用和分布式的微服务架构解决方案。Jarvis提供了一系列强大的功能,充分利用百度资源虚拟化能力,提供分布式服务框架、服务治理、统一配置管理、分布式链路跟踪、容量规划、高可用及数据化运营等功能。 前面其实已经提到过,合约广告的整体业务链路比较长,经历了售前询价 -> 下单 -> 合同审批 -> 物料制作 -> 投放 -> 计费,每个环节都可能成为广告投放的卡点,如果出现问题,比如流程阻塞,如何能够快速定位问题,甚至提前感知问题,做到整个流程的透明化、可观测呢? 整体思路是以业务实体为中心,记录实体全生命周期的变化,当某个阶段(实体状态)停留时间超出预期,就有可能存在潜在的异常,通过服务看板和消息中心,及时通知对应的运营进行处理跟进。通过追踪业务实体的生命周期,实现系统业务流程的可观测性,为后续流程优化、业务提效提供数据分析基础。 业务实体生命周期的追踪实现方案主要如下图: △业务实体生命周期追踪 总结来说就是三种方案: 通过订阅 mysql binlong,监控业务实体的核心状态字段(对应部门已有解决方案 WATT),一旦字段变更就会触发增量消息,服务端消费后持久化,再以服务看板的形式对外呈现。这种方式的优势是对业务模块无侵入,劣势是依赖业务模块的数据库设计,另外有些实体的生命周期并不一定体现在数据表的字段变更,无法通过订阅 binglog 的方式感知 通过日志打印 -> 采集 -> 解析的方式实现实体全生命周期的追踪。这个方式的优势是百度已有一整套现成的解决方案,可以直接复用;劣势是需要侵入业务代码,按照规范打印日志,同时日志采集和解析的配置门槛较高,调试较困难,不容易上手 提供用于追踪实体生命周期的埋点 sdk,在需要监控的地方埋点。这个方式的优势是灵活度非常高,可以实现任何追踪需求;劣势是侵入业务代码,需要业务模块显式进行调用 最终我们采用了 1 和 3,业务实体的追踪主要通过方案 3来实现埋点,一些额外辅助信息通过 方案 1 进行同步。 防腐化 很多科学家提到的熵增定律非常好的揭示了自然现象的本质:任何孤立系统,在没有外力作用的情况下,其总混乱度(熵)会不断增大。当然软件系统也是如此,随着软件系统的功能不断增加,系统的混乱度也在不断增大。为了降低软件系统混乱的速度,必须要对其施以外力。那么这里的『外力』可以从哪些角度入手呢? 分析每个应用的修改频次,哪些应用频繁修改,哪些应用相对稳定。对于频繁修改的应用,是否引起修改的业务需求是相同的。那么这些大概率绑定在一起修改的服务被拆分在不同的应用,是否是不合理的,值得进一步商榷。如果一个应用,无论什么需求都需要升级,那么这个应用是否已经足够小,是否需要进一步拆分,剥离变与不变,将不变的部分进行抽离和沉淀? 定期观察每个服务的调用情况,包括次数、性能和拓扑。是否存在一些冗余服务可以清理?是否存在一些服务性能呈现恶化趋势,需要及时介入优化?是否存在某些业务流程中存在重复调用的情况?如果有,需要制定计划进行治理,否则就会成立历史债务,让业务架构逐步腐化。 需要定期去扫描检查应用代码,包括重复逻辑是否散布于多个应用、是否存在不规范的代码逻辑(每个团队根据实践总结沉淀,比如 枚举类的使用、IO 循环调用等)、是否存在冗余代码需要清理、模块结构和分包策略是否符合规范 定期的CR各应用代码,是否存在跨领域的逻辑,比如报价中心处理了订单中心的逻辑(非报价域的逻辑),导致微服务的划分边界模糊 防腐化这块工作其实很重要,目前也还处于初级的摸索阶段,需要进一步结合业务实际,沉淀最佳实践。这里先以微服务循环依赖治理为例,做个简单介绍。 当微服务中的循环依赖形成闭环后会造成2类主要危害: 服务间强耦合导致各服务很难独立部署,违反了微服务『自治与隔离』的设计初衷,最终微服务架构会逐步演变为『分布式大单体』,失去了微服务架构演进的意义。 循环依赖可能会导致一些循环调用或并发问题,造成一些复杂难以定位的问题,下面以用户中心和订单中心为例来说明 △循环依赖导致的并发问题 上述图中有两个服务,订单和用户中心,蓝色箭头表示订单中心对外提供的服务 ,实现订单状态更新,其中会调用用户服务更新客户状态,标记此客户已有下单记录。红色箭头表示用户中心调用订单中心,用户服务在标记完客户状态后反过来会调用订单服务,持久化订单上客户信息。上述调用形成了闭环,最终会引起订单数据库中的版本冲突,导致更新失败。那么如何避免这种循环依赖呢?总结以下几个准则: 明确服务边界和定位,划分上下游服务,下游服务可以调用上游服务,但是上游服务不能依赖下游,如果要进行通信,采用领域事件的方式,比如消息通知。 数据不要过多冗余,尽量通过数据 id(能够唯一代表数据且不变的属性)来进行关联,即只存引用。 如果存在必须要通过上游服务同步调用下游服务才能完成的功能,得反思是否上游服务缺少了相应的业务域。如果不是,可以借业务前台来实现各服务的调用编排,或者肯能存在微服务拆分不合理,这种场景需要重新规划,拆分出一个更上游的服务供调用。 回到刚才的实际例子,治理方案是采用领域事件的改造方式,订单服务是下游服务,用户服务是上游服务,用户服务更新订单客户信息从同步调用方式改为消息通知,不感知具体的订阅方,实现解耦。 2.4 服务迭代 微服务架构改造后,原来单体架构的迭代方式已经不再适用,我们看一个实际例子: 从上述例子中可以看到,微服务架构后,一个业务需求会涉及多个模块,复杂度不尽相同,如果中台服务的每个升级无法做到向前兼容,那么势必会导致需求间的耦合,一旦并行开发的分支增多,因模块间的耦合导致的整体回滚概率将会指数级增长。仍旧是上述这个例子,如果需求1中的中台B有BUG,需要回滚,那么是否导致需求2中的所有模块都要回滚,包括中台D,即使它的改动点非常小。 总结以下,造成上述局面的2个主要原因: 迭代升级的视角只有需求维度,中台服务被割裂,缺少另一个以中台为主的视角 自动化测试能力不足,过度依赖黑盒测试会导致风险后置 针对这两个问题,我们的解法主要有3个方向: 规范需求迭代流程,强化以中台为轴的虚拟团队。 从需求评审、技术详设、开发、联调、测试到上线,制定详细的全流程规范,保障团队有序运转。同时,强调各中台的自治,迭代升级必须做到向前兼容,依赖模块的回滚不影响自身的上线计划,反复强调容错、兼容、演进式的设计理念。 加强自动化测试能力,达到自动准出标准。自动化测试能力包括各模块的单测和集成测试。模块单测通过插件集成至流水线,对于没有达到覆盖率的代码禁止合入,特殊情况下,可以说明理由,让模块负责人豁免。集成测试从业务前台出发,按照业务场景优先级逐步建设,触发方式分为每日例行任务和回归测试时的手动触发。 提供服务 mock 能力,在合适的场景下可以解耦对其他服务的依赖。落地联调中心,实现服务级别的动态 mock 能力,并通过 starter 方式让业务模块低成本接入。整体设计分为两部分,client端和server端,如下图: △mock 中心 其中,服务端的可视化 mock 规则配置支持动态规则,对于一些无法用动态规则描述的需求也可以通过低成本的代码开发实现定制化逻辑。 最终期望能够让每个中台服务达到『自治与隔离』,从而解耦各需求点的上线,如下图: 可以看到,上线粒度从需求维度细化到了中台 fetaure,使整体交付风险指数级下降。当然,对于微服务架构系统,如何做到高效联调和测试仍是一个正在不断探索的方向。 三、总结 本文主要介绍了合约广告微服务架构演进中的一些最佳实践,做一个简单的总结。 服务拆分:从实际业务出发,基于领域驱动模型的理念,建立合适的业务模型。这部分一定要深入业务细节,理解业务运转原理,抽象出业务本质。通过合理服务拆分,可以更高效地解决复杂业务问题,如果将7个业务中台类比为正交的坐标轴,那么原来低维的复杂问题(单体架构)投射到高维后(微服务架构),大概率会变得没那么复杂;另外,对于本质业务复杂度问题,通过服务拆分,可以很好的将复杂性隔离至对应领域服务,更好地管理复杂度,防止外溢。 模块结构:借鉴COLA架构,结合实际情况,制定规范,其中包含了多种设计理念:DDD、事件驱动模式、CQRS模式、依赖倒置。相比服务拆分,模块结构是从微观视角制定各微服务的代码组织,减缓腐化速度。 服务治理:总结了系统性能、业务可观测性和防腐化三个方面的一些心得和最佳实践,在我看来,一个好的业务架构,能够很好的管控业务复杂度,甄别业务中的『变』和『不变』。所以,定期梳理分析各服务的升级频率、调用关系等是非常重要的。 服务迭代:服务及架构的迭代需要平滑有序,做到容错、兼容、演进式,避免大量应用改造。同时各微服务要做到自治与隔离,降低相互之间的耦合,做到在架构演进过程中每个服务都能顺利地『死去』与『重生』,就像生物进化一样。(本文多次提到的领域事件方式是降低服务耦合的有效手段) 所以回到本文开头的2个问题,B端系统最大的技术挑战我认为是业务复杂度的治理,通过合适的技术选型在赋能业务的同时又能很好地管控技术和业务复杂度。我心目中好的业务架构标准就是提升效率,这里的效率包括交付效率、运维效率以及演进效率。 最后想说:没有完美的业务架构,贴合业务实际的就是好架构,一个好的业务架构一定是结合业务实际演进而来的。 ————END———— 推荐阅读: AI技术在基于风险测试模式转型中的应用 Go语言躲坑经验总结 PaddleBox:百度基于GPU的超大规模离散DNN模型训练解决方案 聊聊机器如何"写"好广告文案? 百度工程师教你玩转设计模式(适配器模式) 百度搜索业务交付无人值守实践与探索

优秀的个人博客,低调大师

每日一博 | C++ 的缺陷与思考(上)

导语| 本文主要总结了本人在C++开发过程中对一些奇怪、复杂的语法的理解和思考,同时作为C++开发的避坑指南。 前言 C++是一门古老的语言,但仍然在不间断更新中,不断引用新特性。但与此同时C++又甩不掉巨大的历史包袱,并且C++的设计初衷和理念造成了C++异常复杂,还出现了很多不合理的“缺陷”。本文主要有3个目的: 总结一些C++晦涩难懂的语法现象,解释其背后原因,作为防踩坑之用。 和一些其他的编程语言进行比较,列举它们的优劣。 发表一些我自己作为C++程序员的看法和感受。 来自C语言的历史包袱 C++有一个很大的历史包袱,就是C语言。C语言诞生时间很早,并且它是为了编写OS而诞生的,语法更加底层。有人说,C并不是针对程序员友好的语言,而是针对编译期友好的语言。有些场景在C语言本身可能并没有什么不合理,但放到C++当中会“爆炸”,或者说,会迅速变成一种“缺陷”,让人异常费解。 C++在演变过程中一直在吸收其他语言的优势,不断提供新的语法、工具来进行优化。但为了兼容性(不仅仅是语法的兼容,还有一些设计理念的兼容),还是会留下很多坑。 (一)数组 数组本身其实没有什么问题,这种语法也非常常用,主要是表示连续一组相同的数据构成的集合。但数组类型在待遇上却和其他类型(比如说结构体)非常不一样。 数组的复制 我们知道,结构体类型是可以很轻松的复制的,比如说: struct St { int m1; double m2; }; void demo() { St st1; St st2 = st1; // OK St st3; st1 = st3; // OK } 但数组却并不可以,比如: int arr1[5]; int arr2[5] = arr1; // ERR 明明这里arr2和arr1同为int[5]类型,但是并不支持复制。照理说,数组应当比结构体更加适合复制场景,因为需求是很明确的,就是元素按位复制。 数组类型传参 由于数组不可以复制,导致了数组同样不支持传参,因此我们只能采用“首地址+长度”的方式来传递数组: void f1(int *arr, size_t size) {} void demo() { int arr[5]; f1(arr, 5); } 而为了方便程序员进行这种方式的传参,C又做了额外的2件事: 提供一种隐式类型转换,支持将数组类型转换为首元素指针类型(比如说这里arr是int[5]类型,传参时自动转换为int*类型) 函数参数的语法糖,如果在函数参数写数组类型,那么会自动转换成元素指针类型,比如说下面这几种写法都完全等价: void f(int *arr); void f(int arr[]); void f(int arr[5]); void f(int arr[100]); 所以这里非常容易误导人的就在这个语法糖中,无论中括号里写多少,或者不写,这个值都是会被忽略的,要想知道数组的边界,你就必须要通过额外的参数来传递。 但通过参数传递这是一种软约束,你无法保证调用者传的就是数组元素个数,这里的危害详见后面“指针偏移”的章节。 分析和思考 之所以C的数组会出现这种奇怪现象,我猜测,作者考虑的是数组的实际使用场景,是经常会进行切段截取的,也就是说,一个数组类型并不总是完全整体使用,我们可能更多时候用的是其中的一段。举个简单的例子,如果数组是整体复制、传递的话,做数组排序递归的时候会不会很尴尬?首先,排序函数的参数难以书写,因为要指定数组个数,我们总不能针对于1,2,3,4,5,6,...元素个数的数组都分别写一个排序函数吧?其次,如果取子数组就会复制出一个新数组的话,也就不能对原数组进行排序了。 所以综合考虑,干脆这里就不支持复制,强迫程序员使用指针+长度这种方式来操作数组,反而更加符合数组的实际使用场景。 当然了,在C++中有了引用语法,我们还是可以把数组类型进行传递的,比 如: void f1(int (&arr)[5]); // 必须传int[5]类型 void demo() { int arr1[5]; int arr2[8]; f1(arr1); // OK f1(arr2); // ERR } 但绝大多数的场景似乎都不会这样去用。一些新兴语言(比如说Go)就注意到了这一点,因此将其进行了区分。在Go语言中,区分了“数组”和“切片”的概念,数组就是长度固定的,整体来传递;而切片则类似于首地址+长度的方式传递(只不过没有单独用参数,而是用len函数来获取) func f1(arr [5]int) { } func f2(arr []int) { } 上面例子里,f1就必须传递长度是5的数组类型,而f2则可以传递任意长度的切片类型。 而C++其实也注意到了这一点,但由于兼容问题,它只能通过STL提供容器的方式来解决,std::array就是定长数组,而std::vector就是变长数组,跟上述Go语言中的数组和切片的概念是基本类似的。这也是C++中更加推荐使用vector而不是C风格数组的原因。 类型说明符 (一)类型不是从左向右说明 C/C++中的类型说明符其实设计得很不合理,除了最简单的变量定义: int a; // 定义一个int类型的变量a 上面这个还是很清晰明了的,但稍微复杂一点的,就比较奇怪了: int arr[5]; // 定义一个int[5]类型的变量arr arr明明是int[5]类型,但是这里的int和[5]却并没有写到一起,如果这个还不算很容易造成迷惑的话,那来看看下面的: int *a1[5]; // 定义了一个数组 int (*a2)[5]; // 定义了一个指针 a1是int *[5]类型,表示a1是个数组,有5个元素,每个元素都是指针类型的。 a2是int (*)[5]类型,是一个指针,指针指向了一个int[5]类型的数组。 这里离谱的就在这个int (*)[5]类型上,也就是说,“指向int[5]类型的指针”并不是int[5]*,而是int (*)[5],类型说明符是从里往外描述的,而不是从左往右。 (二)类型说明符同时承担了动作语义 这里的另一个问题就是,C/C++并没有把“定义变量”和“变量的类型”这两件事分开,而是用类型说明符来同时承担了。也就是说,“定义一个int类型变量”这件事中,int这一个关键字不仅表示“int类型”,还表示了“定义变量”这个意义。这件事放在定义变量这件事上可能还不算明显,但放到定义函数上就不一样了: int f1(); 上面这个例子中,int和()共同表示了“定义函数”这个意义。也就是说,看到int这个关键字,并不一定是表示定义变量,还有可能是定义函数,定义函数时int表示了函数的返回值的类型。 正是由于C/C++中,类型说明符具有多重含义,才造成一些复杂语法简直让人崩溃,比如说定义高阶函数: // 输入一个函数,输出这个函数的导函数 double (*DC(double (*)(double)))(double); DC是一个函数,它有一个参数,是double (*)(double)类型的函数指针,它的返回值是一个double (*)(double)类型的函数指针。但从直观性上来说,上面的写法完全毫无可读性,如果没有那一行注释,相信大家很难看得出这个语法到底是在做什么。 C++引入了返回值右置的语法,从一定程度上可以解决这个问题: auto f1() -> int; auto DC(auto (*)(double) -> double) -> auto (*)(double) -> double; 但用auto作为占位符仍然还是有些突兀和晦涩的。 (三)将类型符和动作语义分离的语言 我们来看一看其他语言是如何弥补这个缺陷的,最简单的做法就是把“类型”和“动作”这两件事分开,用不同的关键字来表示。Go语言: // 定义变量 var a1 int var a2 []int var a3 *int var a4 []*int // 元素为指针的数组 var a5 *[]int // 数组的指针 // 定义函数 func f1() { } func f2() int { return 0 } // 高阶函数 func DC(f func(float64)float64) func(float64)float64 { } Swift语言: // 定义变量 var a1: Int var a2: [Int] // 定义函数 func f1() { } func f2() -> Int { return 0 } // 高阶函数 func DC(f: (Double, Double)->Double) -> (Double, Double)->Double { } JavaScript语言: // 定义变量 var a1 = 0 var a2 = [1, 2, 3] // 定义函数 function f1() {} function f2() { return 0 } // 高阶函数 function DC(f) { return function(x) { //... } } (四)指针偏移 指针的偏移运算让指针操作有了较大的自由度,但同时也会引入越界问题 int arr[5]; int *p1 = arr + 5; *p1 = 10// 越界 int a = 0; int *p2 = &a; a[1] = 10; // 越界 换句话说,指针的偏移是完全随意的,静态检测永远不会去判断当前指针的位置是否合法。这个与之前章节提到的数组传参的问题结合起来,会更加容易发生并且更加不容易发现: void f(int *arr, size_t size) {} void demo() { int arr[5]; f(arr, 6); // 可能导致越界 } 因为参数中的值和数组的实际长度并没有要求强一致。 (五)其他语言的指针 在其他语言中,有的语言(例如java、C#)直接取消了指针的相关语法,但由此就必须引入“值类型”和“引用类型”的概念。例如在java中,存在“实”和“名”的概念: public static void Demo() { int[] arr = new int[10]; int[] arr2 = arr; // “名”的复制,浅复制 int[] arr3 = Arrays.copyOf(arr, arr.length); // 用库方法进行深复制 } 本质上来说,这个“名”就是栈空间上的一个指针,而“实”则是堆空间中的实际数据。如果取消指针概念的话,就要强行区分哪些类型是“值类型”,会完全复制,哪些是“引用类型”,只会浅复制。 C#中的结构体和类的概念恰好如此,结构体是值类型,整体复制,而类是引用类型,要用库函数来复制。 而还有一些语言保留了指针的概念(例如Go、Swift),但仅仅用于明确指向和引用的含义,并不提供指针偏移运算,来防止出现越界问题。例如go中: func Demo() { var a int var p *int p = &a // OK r1 := *p // 直接解指针是OK的 r2 := *(p + 1) // ERR,指针不可以偏移 } swift中虽然仍然支持指针,但非常弱化了它的概念,从语法本身就能看出,不到迫不得已并不推荐使用: func f1(_ ptr: UnsafeMutablePointer<Int>) { ptr.pointee += 1 // 给指针所指向的值加1 } func demo() { var a: Int = 5 f1(&a) } OC中的指针更加特殊和“奇葩”,首先,OC完全保留了C中的指针用法,而额外扩展的“类”类型则不允许出现在栈中,也就是说,所有对象都强制放在堆中,栈上只保留指针对其引用。虽然OC中的指针仍然是C指针,但由于操作对象的“奇葩”语法,倒是并不需要太担心指针偏移的问题 void demo() { NSObject *obj = [[NSObject alloc] init]; // 例如调用obj的description方法 NSString *desc = [obj description]; // 指针仍可偏移,但几乎不会有人这样来写: [(obj+1) description]; // 也会越界 } (六)隐式类型转换 隐式类型转换在一些场景下会让程序更加简洁,降低代码编写难度。比如说下面这些场景: double a = 5; // int->double int b = a * a; // double->int int c = '5' - '0'; // char->int 但是有的时候隐式类型转化却会引发很奇怪的问题,比如说: #define ARR_SIZE(arr) (sizeof(arr) / sizeof(arr[0])) void f1() { int arr[5]; size_t size = ARR_SIZE(arr); // OK } void f2(int arr[]) { size_t size = ARR_SIZE(arr); // WRONG } 结合之前所说,函数参数中的数组其实是数组首元素指针的语法糖,所以f2中的arr其实是int *类型,这时候再对其进行sizeof运算,结果是指针的大小,而并非数组的大小。如果程序员不能意识到这里发生了int [N]->int *的隐式类型转换,那么就可能出错。还有一些隐式类型转换也很离谱,比如说: int a = 5; int b = a > 2; // 可能原本想写a / 2,把/写成了> 这里发生的隐式转换是bool->int,同样可能不符合预期。关于布尔类型详见后面章节。C中的这些隐式转换可能影响并不算大,但拓展到C++中就可能有爆炸性的影响,详见后面“隐式构造”和“多态转换”的相关章节。 (七)赋值语句的返回值 C/C++的赋值语句自带返回值,这一定算得上一大缺陷,在C中赋值语句返回值,在C++中赋值语句返回左值引用。 这件事造成的最大影响就在=和==这两个符号上,比如: int a1, a2; bool b = a1 = a2; 这里原本想写b=a1==a2,但是错把==写成了=,但编译是可以完全通过的,因为a1=a2本身返回了a1的引用,再触发一次隐式类型转换,把bool转化为int(这里详见后面非布尔类型的布尔意义章节)。 更有可能的是写在if表达式中: if (a = 1) { } 可以看到,a=1执行后a的值变为1,返回的a的值就是1,所以这里的if变成了恒为真。 C++为了兼容这一特性,又不得不要求自定义类型要定义赋值函数 class Test { public: Test &operator =(const Test &); // 拷贝赋值函数 Test &operator =(Test &&); // 移动赋值函数 Test &operator =(int a); // 其他的赋值函数 }; 这里赋值函数的返回值强制要求定义为当前类型的左值引用,一来会让人觉得有些无厘头,记不住这里的写法,二来在发生继承关系的时候非常容易忘记处理父类的赋值。 class Base { public: Base &operator =(const Base &); }; class Ch : public Base { public: Ch &opeartor =(const Ch &ch) { this->Base::operator =(ch); // 或者写成 *static_cast<Base *>(this) = ch; // ... return *this; } }; (八)其他语言的赋值语句 古老一些的C系扩展语言基本还是保留了赋值语句的返回值(例如java、OC),但一些新兴语言(例如Go、Swift)则是直接取消了赋值语句的返回值,比如说在swift中: let a = 5 var b: Int var c: Int c = (b = a) // ERR b=a会返回Void,所以再赋值给c时会报错 (九)非布尔类型的布尔意义 在原始C当中,其实并没有“布尔”类型,所有表示是非都是用int来做的。所以,int类型就赋予了布尔意义,0表示false,非0都表示true,由此也诞生了很多“野路子”的编程技巧: int *p; if (!p) {} // 指针→bool while (1) {} // int→bool int n; while (~scanf("%d", &n)) {} // int→bool 所有表示判断逻辑的语法,都可以用非布尔类型的值传入,这样的写法其实是很反人类直觉的,更严重的问题就是与true常量比较的问题 int judge = 2; // 用了int表示了判断逻辑 if (judge == true) {} // 但这里的条件其实是false,因为true会转为1,2 == 1是false 正是由于非布尔类型具有了布尔意义,才会造成一些非常反直觉的事情,比如说: true + true != true !!2 == 1 (2 == true) == false (十)其他语言的布尔类型 基本上除了C++和一些弱类型脚本语言(比如js)以外,其他语言都取消了非布尔类型的布尔意义,要想转换为布尔值,一定要通过布尔运算才可以,例如在Go中: func Demo() { a := 1 // int类型 if (a) { // ERR,if表达式要求布尔类型 } if (a != 0) { // OK,通过逻辑运算得到布尔类型 } } 这样其实更符合直觉,也可以一定程度上避免出现写成类似于if (a = 1)出现的问题。C++中正是由于“赋值语句有返回值”和“非布尔类型有布尔意义”同时生效,才会在这里出现问题。 (十一)解指针类型 关于C/C++到底是强类型语言还是弱类型语言,业界一直争论不休。有人认为,变量的类型从定义后就不能改变,并且每个变量都有固定的类型,所以C/C++应该是强类型语言。 但有人持相反意见,是因为这个类型,仅仅是“表面上”不可变,但其实是可变的,比如说看下面例程: int a = 300; uint8_t *p = reinterpret_cast<uint8_t *>(&a); *p = 1; // 这里其实就是把a变成了uint8_t类型 根源就在于,指针的解类型是可以改变的,原本int类型的变量,我们只要把它的首地址保存下来,然后按照另一种类型来解,那么就可以做到“改变a的类型”的目的。 这也就意味着,指针类型是不安全的,因为你不一定能保证现在解指针的类型和指针指向数据的真实类型是匹配的。 还有更野一点的操作,比如: struct S1 { short a, b; }; struct S2 { int a; }; void demo() { S2 s2; S1 *p = reinterpret_cast<S1 *>(&s2); p->a = 2; p->b = 1; std::cout << s2.a; // 猜猜这里会输出多少? } 这里的指针类型问题和前面章节提到的指针偏移问题,综合起来就是说C/C++的指针操作的自由度过高,提升了语言的灵活度,同时也增加了其复杂度。 (十二)后置自增/自减 如果仅仅在C的角度上,后置自增/自减语法并没有带来太多的副作用,有时候在程序中作为一些小技巧反而可以让程序更加精简,比如说: void AttrCnt() { static int count = 0; std::cout << count++ << std::endl; } 但这个特性继承到C++后问题就会被放大,比如说下面的例子: for (auto iter = ve.begin(); iter != ve.end(); iter++) { } 这段代码看似特别正常,但仔细想想,iter作为一个对象类型,如果后置++,一定会发生复制。后置++原本的目的就是在表达式的位置先返回原值,表达式执行完后再进行自增。但如果放在类类型来说,就必须要临时保存一份原本的值。例如: class Element { public: // 前置++ Element &operator ++() { ele++; return *this; } // 后置++ Element operator ++(int) { // 为了最终返回原值,所以必需保存一份快照用于返回 Element tmp = *this; ele++; return tmp; } private: int ele; }; 这也从侧面解释了,为什么前置++要求返回引用,而后置++则是返回非引用,因为这里需要复制一份快照用于返回。 那么,写在for循环中的后置++就会平白无故发生一次复制,又因为返回值没有接收,再被析构。 C++保留的++和--的语义,也是因为它和+=1或-=1语义并不完全等价。我们可以用顺序迭代器来解释。对于顺序迭代器(比如说链表的迭代器),++表示取下一个节点,--表示取上一个节点。而+n或者-n则表示偏移了,这种语义更适合随机访问(所以说随机迭代器支持+=和-=,但顺序迭代器只支持++和--)。 (十三)其他语言的自增/自减 其他语言的做法基本分两种,一种就是保留自增/自减语法,但不再提供返回值,也就不用区分前置和后置,例如Go: a := 3 a++ // OK b := a++ // ERR,自增语句没有返回值 另一种就是干脆删除自增/自减语法,只提供普通的操作赋值语句,例如Swift: var a = 3 a++ // ERR,没有这种语法 a += 1 // OK,只能用这种方式自增 类型长度 这里说的类型长度指的是相同类型在不同环境下长度不一致的情况,下面总结表格: 由于这里出现了32位和64位环境下长度不一致的情况,C语言特意提供了stdint.h头文件(C++中在cstddef中引用),定义了定长类型,例如int64_t在32位环境下其实是long long,而在64位环境下其实是long。 但这里的问题点在于: 并没有定长格式符 例如uint64_t在32位环境下对应的格式符是%llu,但是在64位环境下对应的格式符是%lu。有一种折中的解决办法是自定义一个宏: #if(sizeof(void*) == 8) #define u64 "%lu" #else #define u64 "%llu" #endif void demo() { uint64_t a; printf("a="u64, a); } 但这样会让字符串字面量从中间断开,非常不直观。 类型不一致 例如在64位环境下,long和long long都是64位长,但编译器会识别为不同类型,在一些类型推导的场景会出现和预期不一致的情况,例如: template <typename T> void func(T t) {} template <> void func<int64_t>(int64_t t) {} void demo() { long long a; func(a); // 会匹配通用模板,而匹配不到特例 } 上述例子表明,func<int64_t>和func<long long>是不同实例,尽管在64位环境下long和long long真的看不出什么区别,但是编译器就是会识别成不同类型。 格式化字符串 格式化字符串算是非常经典的C的产物,不仅是C++,非常多的语言都是支持这种格式符的,例如java、Go、python等等。 但C++中的格式化字符串可以说完全就是C的那一套,根本没有任何扩展。换句话说,除了基本数据类型和0结尾的字符串以外,其他任何类型都没有用于匹配的格式符。 例如,对于结构体类型、数组、元组类型等等,都没法匹配到格式符: struct Point { double x, y; }; void Demo() { // 打印Point Point p {1, 2.5}; printf("(%lf,%lf)", p.x, p.y); // 无法直接打印p // 打印数组 int arr[] = {1, 2, 3}; for (int i = 0; i < 3; i++) { printf("%d, ", arr[i]); // 无法直接打印整个数组 } // 打印元组 std::tuple tu(1, 2.5, "abc"); printf("(%d,%lf,%s)", std::get<0>(tu), std::get<1>(tu), std::get<2>(tu)); // 无法直接打印整个元组 } 对于这些组合类型,我们就不得不手动去访问内部成员,或者用循环访问,非常不方便。 针对于字符串,还会有一个严重的潜在问题,比如: std::string str = "abc"; str.push_back('\0'); str.append("abc"); char buf[32]; sprintf(buf, "str=%s", str.c_str()); 由于str中出现了'\0',如果用%s格式符来匹配的话,会在0的位置截断,也就是说buf其实只获取到了str中的第一个abc,第二个abc就被丢失了。 其他语言中的格式符 而一些其他语言则是扩展了格式符功能用于解决上述问题,例如OC引入了%@格式符,用于调用对象的description方法来拼接字符串: @interface Point2D : NSObject @property double x; @property double y; - (NSString *)description; @end @implementation Point2D - (NSString *)description { return [[NSString alloc] initWithFormat:@"(%lf, %lf)", self.x, self.y]; } @end void Demo() { Point2D *p = [[Point2D alloc] init]; [p setX:1]; [p setY:2.5]; NSLog(@"p=%@", p); // 会调用p的description方法来获取字符串,用于匹配%@ } 而Go语言引入了更加方便的%v格式符,可以用来匹配任意类型,用它的默认方式打印 type Test struct { m1 int m2 float32 } func Demo() { a1 := 5 a2 := 2.6 a3 := []int{1, 2, 3} a4 := "123abc" a5 := Test{2, 1.5} fmt.Printf("a1=%v, a2=%v, a3=%v, a4=%v, a5=%v\n", a1, a2, a3, a4, a5) } Python则是用%s作为万能格式符来使用: def Demo(): a1 = 5 a2 = 2.5 a3 = "abc123" a4 = [1, 2, 3] print("%s, %s, %s, %s"%(a1, a2, a3, a4)) #这里没有特殊格式要求时都可以用%s来匹配 枚举 枚举类型原本是用于解决固定范围取值的类型表示,但由于在C语言中被定义为了整型类型的一种语法糖,导致枚举类型的使用上出现了一些问题。 无法前置声明 枚举类型无法先声明后定义,例如下面这段代码会编译报错: enum Season; struct Data { Season se; // ERR }; enum Season { Spring, Summer, Autumn, Winter }; 主要是因为enum类型是动态选择基础类型的,比如这里只有4个取值,那么可能会选取int16_t,而如果定义的取值范围比较大,或者中间出现大枚举值的成员,那么可能会选取int32_t或者int64_t。也就是说,枚举类型如果没定义完,编译期是不知道它的长度的,因此就没法前置声明。 C++中允许指定枚举的基础类型,制定后可以前置声明: enum Season : int; struct Data { Season se; // OK }; enum Season : int { Spring, Summer, Autumn, Winter }; 但如果你是在调别人写的库的时候,人家的枚举没有指定基础类型的话,那你也没辙了,就是不能前置声明。 无法确认枚举值的范围 也就是说,我没有办法判断某个值是不是合法的枚举值: enum Season { Spring, Summer, Autumn, Winter }; void Demo() { Season s = static_cast<Season>(5); // 不会报错 } 枚举值可以相同 enum Test { Ele1 = 10, Ele2, Ele3 = 10 }; void Demo() { bool judge = (Ele1 == Ele3); // true } C风格的枚举还存在“成员名称全局有效”和“可以隐式转换为整型”的缺陷 但因为C++提供了enum class风格的枚举类型,解决了这两个问题,因此这里不再额外讨论。 (一)宏 宏这个东西,完全就是针对编译器友好的,编译器非常方便地在宏的指导下,替换源代码中的内容。但这个玩意对程序员(尤其是阅读代码的人)来说是极其不友好的,由于是预处理指令,因此任何的静态检测均无法生效。一个经典的例子就是: #define MUL(x, y) x * y void Demo() { int a = MUL(1 + 2, 3 + 4); // 11 } 因为宏就是简单粗暴地替换而已,并没有任何逻辑判断在里面。 宏因为它很“好用”,所以非常容易被滥用,下面列举了一些宏滥用的情况供参考: 用宏来定义类成员 #define DEFAULT_MEM \ public: \ int GetX() {return x_;} \ private: \ int x_; class Test { DEFAULT_MEM; public: void method(); }; 这种用法相当于屏蔽了内部实现,对阅读者非常不友好,与此同时加不加DEFAULT_MEM是一种软约束,实际开发时极容易出错。 再比如这种的: #define SINGLE_INST(class_name) \ public: \ static class_name &GetInstance() { \ static class_name instance; \ return instance; \ } \ class_name(const class_name&) = delete; \ class_name &operator =(const class_name &) = delete; \ private: \ class_name(); class Test { SINGLE_INST(Test) }; 这位同学,我理解你是想封装一下单例的实现,但咱是不是可以考虑一下更好的方式?(比如用模板) 用宏来屏蔽参数 #define strcpy_s(dst, dst_buf_size, src) strcpy(dst, src) 这位同学,咱要是真想写一个安全版本的函数,咱就好好去判断dst_buf_size如何? 用宏来拼接函数处理 #define COPY_IF_EXSITS(dst, src, field) \ do { \ if (src.has_##field()) { \ dst.set_##field(dst.field()); \ } \ } while (false) void Demo() { Pb1 pb1; Pb2 pb2; COPY_IF_EXSITS(pb2, pb1, f1); COPY_IF_EXSITS(pb2, pb1, f2); } 这种用宏来做函数名的拼接看似方便,但最容易出的问题就是类型不一致,加入pb1和pb2中虽然都有f1这个字段,但类型不一样,那么这样用就可能造成类型转换。试想pb1.f1是uint64_t类型,而pb2.f1是uint32_t类型,这样做是不是有可能造成数据的截断呢? 用宏来改变语法风格 #define IF(con) if (con) { #define END_IF } #define ELIF(con) } else if (con) { #define ELSE } else { void Demo() { int a; IF(a > 0) Process1(); ELIF(a < -3) Process2(); ELSE Process3(); } 这位同学你到底是写python写惯了不适应C语法呢,还是说你为了让代码扫描工具扫不出来你的圈复杂度才出此下策的呢~~ (二)共合体 共合体的所有成员共用内存空间,也就是说它们的首地址相同。在很多人眼中,共合体仅仅在“多选一”的场景下才会使用,例如: union QueryKey { int id; char name[16]; }; int Query(const QueryKey &key); 上例中用于查找某个数据的key,可以通过id查找,也可以通过name,但只能二选一。 这种场景确实可以使用共合体来节省空间,但缺点在于,共合体的本质就是同一个数据的不同解类型,换句话说,程序是不知道当前的数据是什么类型的,共合体的成员访问完全可以用更换解指针类型的方式来处理,例如: union Un { int m1; unsigned char m2; }; void Demo() { Un un; un.m1 = 888; std::cout << un.m2 << std::endl; // 等价于 int n1 = 888; std::cout << *reinterpret_cast<unsigned char *>(&n1) << std::endl; } 共合体只不过把有可能需要的解类型提前写出来罢了。所以说,共合体并不是用来“多选一”的,笔者认为这是大家曲解的用法。毕竟真正要做到“多选一”,你就得知道当前选的是哪一个,例如: struct QueryKey { union { int id; char name[16]; } key; enum { kCaseId, kCaseName } key_case; }; 用过google protobuf的读者一定很熟悉上面的写法,这个就是proto中oneof语法的实现方式。 在C++17中提供了std::variant,正是为了解决“多选一”问题存在的,它其实并不是为了代替共合体,因为共合体原本就不是为了这种需求的,把共合体用做“多选一”实在是有点“屈才”了。 更加贴合共合体本意的用法,是我最早是在阅读处理网络报文的代码中看到的,例如某种协议的报文有如下规定(例子仅供参考): 这里能看出来,整个报文有2字节,一般的处理时,我们可能只需要关注这个报文的这2个字节值是多少(比如说用十六进制表示),而在排错的时候,才会关注报文中每一位的含义,因此,“整体数据”和“内部数据”就成为了这段报文的两种获取方式,这种场景下非常适合用共合体: union Pack { uint16_t data; // 直接操作报文数据 struct { unsigned version : 4; unsigned timeout : 2; unsigned retry_times : 1; unsigned block : 1; uint8_t bus_data; } part; // 操作报文内部数据 }; void Demo() { // 例如有一个从网络获取到的报文 Pack pack; GetPackFromNetwork(pack); // 打印一下报文的值 std::printf("%X", pack.data); // 更改一下业务数据 pack.part.bus_data = 0xFF; // 把报文内容扔到处理流中 DataFlow() << pack.data; } 因此,这里的需求就是“用两种方式来访问同一份数据”,才是完全符合共合体定义的用法。 共合体应该是C语言的特色了,其他任何高级语言都没有类似的语法,主要还是因为C语言更加面相底层,C++仅仅是继承了C的语法而已。 const引用 (一)先说说const 先来吐槽一件事,就是C/C++中const这个关键字,这个名字起的非常非常不好!为什么这样说呢?const是constant的缩写,翻译成中文就是“常量”,但其实在C/C++中,const并不是表示“常量”的意思。 我们先来明确一件事,什么是“常量”,什么是“变量”?常量其实就是衡量,比如说1就是常量,它永远都是这个值。再比如'A'就是个常量,同样,它永远都是和它ASCII码对应的值。“变量”其实是指存储在内存当中的数据,起了一个名字罢了。如果我们用汇编,则不存在“变量”的概念,而是直接编写内存地址: mov ax, 05FAh mov ds, ax mov al, ds:[3Fh] 但是这个05FA:3F地址太突兀了,也很难记,另一个缺点就是,内存地址如果固定了,进程加载时动态分配内存的操作空间会下降(尽管可以通过相对内存的方式,但程序员仍需要管理偏移地址),所以在略高级一点的语言中,都会让程序员有个更方便的工具来管理内存,最简单的方法就是给内存地址起个名字,然后编译器来负责翻译成相对地址。 int a; // 其实就是让编译器帮忙找4字节的连续内存,并且起了个名字叫a 所以“变量”其实指“内存变量”,它一定拥有一个内存地址,和可变不可变没啥关系。 因此,C语言中const用于修饰的一定是“变量”,来控制这个变量不可变而已。用const修饰的变量,其实应当说是一种“只读变量”,这跟“常量”根本挨不上。 这就是笔者吐槽这个const关键字的原因,你叫个read_only之类的不是就没有歧义了么? C#就引入了readonly关键字来表示“只读变量”,而const则更像是给常量取了个别名(可以类比为C++中的宏定义,或者constexpr,后面章节会详细介绍constexpr): const int pi = 3.14159; // 常量的别名 readonly int[] arr = new int[]{1, 2, 3}; // 只读变量 (二)左右值 C++由于保留了C当中的const关键字,但更希望表达其“不可变”的含义,因此着重在“左右值”的方向上进行了区分。左右值的概念来源于赋值表达式: var = val; // 赋值表达式 赋值表达式的左边表示即将改变的变量,右边表示从什么地方获取这个值。因此,很自然地,右值不会改变,而左值会改变。那么在这个定义下,“常量”自然是只能做右值,因为常量仅仅有“值”,并没有“存储”或者“地址”的概念。而对于变量而言,“只读变量”也只能做右值,原因很简单,因为它是“只读”的。 虽然常量和只读变量是不同的含义,但它们都是用来“读取值”的,也就是用来做右值的,所以,C++引入了“const引用”的概念来统一这两点。所谓const引用包含了2个方面的含义: 作为只读变量的引用(指针的语法糖) 作为只读变量 换言之,const引用可能是引用,也可能只是个普通变量,如何理解呢?请看例程: void Demo() { const int a = 5; // a是一个只读变量 const int &r1 = a; // r1是a的引用,所以r1是引用 const int &r2 = 8; // 8是一个常量,因此r2并不是引用,而是一个只读变量 } 也就是说,当用一个const引用来接收一个变量的时候,这时的引用是真正的引用,其实在r1内部保存了a的地址,当我们操作r的时候,会通过解指针的语法来访问到a const int a = 5; const int &r1 = a; std::cout << r1; // 等价于 const int *p1 = &a; // 引用初始化其实是指针的语法糖 std::cout << *p1; // 使用引用其实是解指针的语法糖 但与此同时,const引用还可以接收常量,这时,由于常量根本不是变量,自然也不会有内存地址,也就不可能转换成上面那种指针的语法糖。那怎么办?这时,就只能去重新定义一个变量来保存这个常量的值了,所以这时的const引用,其实根本不是引用,就是一个普通的只读变量。 const int &r1 = 8; // 等价于 const int c1 = 8; // r1其实就是个独立的变量,而并不是谁的引用 (三)思考 const引用的这种设计,更多考虑的是语义上的,而不是实现上的。如果我们理解了const引用,那么也就不难理解为什么会有“将亡值”和“隐式构造”的问题了,因为搭配const引用,可以实现语义上的统一,但代价就是同一语法可能会做不同的事,会令人有疑惑甚至对人有误导。 在后面“右值引用”和“因式构造”的章节会继续详细介绍它们和const引用的联动,以及可能出现的问题。 右值引用与移动语义 C++11的右值引用语法的引入,其实也完全是针对于底层实现的,而不是针对于上层的语义友好。换句话说,右值引用是为了优化性能的,而并不是让程序变得更易读的。 (一)右值引用 右值引用跟const引用类似,仍然是同一语法不同意义,并且右值引用的定义强依赖“右值”的定义。根据上一节对“左右值”的定义,我们知道,左右值来源于赋值语句,常量只能做右值,而变量做右值时仅会读取,不会修改。按照这个定义来理解,“右值引用”就是对“右值”的引用了,而右值可能是常量,也可能是变量,那么右值引用自然也是分两种情况来不同处理: 右值引用绑定一个常量 右值引用绑定一个变量 我们先来看右值引用绑定常量的情况: int &&r1 = 5; // 右值引用绑定常量 和const引用一样,常量没有地址,没有存储位置,只有值,因此,要把这个值保存下来的话,同样得按照“新定义变量”的形式,因此,当右值引用绑定常量时,相当于定义了一个普通变量: int &&r1 = 5; // 等价于 int v1 = 5; // r1就是个普通的int变量而已,并不是引用 所以这时的右值引用并不是谁的引用,而是一个普普通通的变量。 我们再来看看右值引用绑定变量的情况: 这里的关键问题在于,什么样的变量适合用右值引用绑定? 如果对于普通的变量,C++不允许用右值引用来绑定,但这是为什么呢? int a = 3; int &&r = a; // ERR,为什么不允许右值引用绑定普通变量? 我们按照上面对左右值的分析,当一个变量做右值时,该变量只读,不会被修改,那么,“引用”这个变量自然是想让引用成为这个变量的替身,而如果我们希望这里做的事情是“当通过这个引用来操作实体的时候,实体不能被改变”的话,使用const引用就已经可以达成目的了,没必要引入一个新的语法。 所以,右值引用并不是为了让引用的对象只能做右值(这其实是const引用做的事情),相反,右值引用本身是可以做左值的。这就是右值引用最迷惑人的地方,也是笔者认为“右值引用”这个名字取得迷惑人的地方。 右值引用到底是想解决什么问题呢?请看下面示例: struct Test { // 随便写一个结构体,大家可以脑补这个里面有很多复杂的成员 int a, b; }; Test GetAnObj() { // 一个函数,返回一个结构体类型 Test t {1, 2}; // 大家可以脑补这里面做了一些复杂的操作 return t; // 最终返回了这个对象 } void Demo() { Test t1 = GetAnObj(); } 我们忽略编译器的优化问题,只分析C++语言本身。在GetAnObj函数内部,t是一个局部变量,局部变量的生命周期是从创建到当前代码块结束,也就是说,当GetAnObj函数结束时,这个t一定会被释放掉。 既然这个局部变量会被释放掉,那么函数如何返回呢?这就涉及了“值赋值”的问题,假如t是一个整数,那么函数返回的时候容易理解,就是返回它的值。具体来说,就是把这个值推到寄存器中,在跳转会调用方代码的时候,再把寄存器中的值读出来: int f1() { int t = 5; return t; } 翻译成汇编就是: push rbp mov rbp, rsp mov DWORD PTR [rbp-4], 5 ; 这里[rbp-4]就是局部变量t mov eax, DWORD PTR [rbp-4] ; 把t的值放到eax里,作为返回值 pop rbp ret 之所以能这样返回,主要就是eax放得下t的值。但如果t是结构体的话,一个eax寄存器自然是放不下了,那怎么返回?(这里汇编代码比较长,而且跟编译器的优化参数强相关,就不放代码了,有兴趣的读者可以自己汇编看结果。)简单来说,因为寄存器放不下整个数据,这个数据就只能放到内存中,作为一个临时区域,然后在寄存器里放一个临时区域的内存地址。等函数返回结束以后,再把这个临时区域释放掉。 那么我们再回来看这段代码: struct Test { int a, b; }; Test GetAnObj() { Test t {1, 2}; return t; // 首先开辟一片临时空间,把t复制过去,再把临时空间的地址写入寄存器 } // 代码块结束,局部变量t被释放 void Demo() { Test t1 = GetAnObj(); // 读取寄存器中的地址,找到临时空间,再把临时空间的数据复制给t1 // 函数调用结束,临时空间释放 } 那么整个过程发生了2次复制和2次释放,如果我们按照程序的实际行为来改写一下代码,那么其实应该是这样的: struct Test { int a, b; }; void GetAnObj(Test *tmp) { // tmp要指向临时空间 Test t{1, 2}; *tmp = t; // 把t复制给临时空间 } // 代码块结束,局部变量t被释放 void Demo() { Test *tmp = (Test *)malloc(sizeof(Test)); // 临时空间 GetAnObj(tmp); // 让函数处理临时空间的数据 Test t1 = *tmp; // 把临时空间的数据复制给这里的局部变量t1 free(tmp); // 释放临时空间 } 如果我真的把代码写成这样,相信一定会被各位前辈骂死,质疑我为啥不直接用出参。的确,用出参是可以解决这种多次无意义复制的问题,所以C++11以前并没有要去从语法层面来解决,但这样做就会让代码不得不“面相底层实现”来编程。C++11引入的右值引用,就是希望从“语法层面”解决这种问题。 试想,这片非常短命的临时空间,究竟是否有必要存在?既然这片空间是用来返回的,返回完就会被释放,那我何必还要单独再搞个变量来接收,如果这片临时空间可以持续使用的话,不就可以减少一次复制吗?于是,“右值引用”的概念被引入。 struct Test { int a, b; }; Test GetAnObj() { Test t {1, 2}; return t; // t会复制给临时空间 } void Demo() { Test &&t1 = GetAnObj(); // 我设法引用这篇临时空间,并且让他不要立刻释放 // 临时空间被t1引用了,并不会立刻释放 } // 等代码块结束,t1被释放了,才让临时空间释放 所以,右值引用的目的是为了延长临时变量的生命周期,如果我们把函数返回的临时空间中的对象视为“临时对象”的话,正常情况下,当函数调用结束以后,临时对象就会被释放,所以我们管这个短命的对象叫做“将亡对象”,简单粗暴理解为“马上就要挂了的对象”,它的使命就是让外部的t1复制一下,然后它就死了,所以这时候你对他做什么操作都是没意义的,他就是让人来复制的,自然就是个只读的值了,所以才被归结为“右值”。我们为了让它不要死那么快,而给它延长了生命周期,因此使用了右值引用。所以,右值引用是不是应该叫“续命引用”更加合适呢~ 当用右值引用捕获一个将亡对象的时候,对象的生命周期从“将亡”变成了“与右值引用共存亡”,这就是右值引用的根本意义,这时的右值引用就是“将亡对象的引用”,又因为这时的将亡对象已经不再“将亡”了,那它既然不再“将亡”,我们再对它进行操作(改变成员的值)自然就是有意义的啦,所以,这里的右值引用其实就等价于一个普通的引用而已。既然就是个普通的引用,而且没用const修饰,自然,可以做左值咯。右值引用做左值的时候,其实就是它所指对象做左值而已。不过又因为普通引用并不会影响原本对象的生命周期,但右值引用会,因此,右值引用更像是一个普通的变量,但我们要知道,它本质上还是引用(底层是指针实现的)。 总结来说就是,右值引用绑定常量时相当于“给一个常量提供了生命周期”,这时的“右值引用”并不是谁的引用,而是相当于一个普通变量;而右值引用绑定将亡对象时,相当于“给将亡对象延长了生命周期”,这时的“右值引用”并不是“右值的引用”,而是“对需要续命的对象”的引用,生命周期变为了右值引用本身的生命周期(或者理解为“接管”了这个引用的对象,成为了一个普通的变量)。 (二)const引用绑定将亡对象 需要知道的是,const引用也是可以绑定将亡对象的,正如上文所说,既然将亡对象定义为了“右值”,也就是只读不可变的,那么自然就符合const引用的语义。 // 省略Test的定义,见上节 void Demo() { const Test &t1 = GetAnObj(); // OK } 这样看来,const引用同样可以让将亡对象延长生命周期,但其实这里的出发点并不同,const引用更倾向于“引用一个不可变的量”,既然这里的将亡对象是一个“不可变的值”,那么,我就可以用const引用来保存“这个值”,或者这里的“值”也可以理解为这个对象的“快照”。所以,当一个const引用绑定一个将亡值时,const引用相当于这个对象的“快照”,但背后还是间接地延长了它的生命周期,但只不过是不可变的。 (三)移动语义 在解释移动语义之前,我们先来看这样一个例子: class Buffer final { public: Buffer(size_t size); Buffer(const Buffer &ob); ~Buffer(); int &at(size_t index); private: size_t buf_size_; int *buf_; }; Buffer::Buffer(size_t size) : buf_size_(size), buf_(malloc(sizeof(int) * size)) {} Buffer::Buffer(const Buffer &ob) :buf_size_(ob.buf_size_), buf_(malloc(sizeof(int) * ob.buf_size_)) { memcpy(buf_, ob.buf_, ob.buf_size_); } Buffer::~Buffer() { if (buf_ != nullptr) { free(buf_); } } int &Buffer::at(size_t index) { return buf_[index]; } void ProcessBuf(Buffer buf) { buf.at(2) = 100; // 对buf做一些操作 } void Demo() { ProcessBuf(Buffer{16}); // 创建一个16个int的buffer } 上面这段代码定义了一个非常简单的缓冲区处理类,ProcessBuf函数想做的事是传进来一个buffer,然后对这个buffer做一些修改的操作,最后可能把这个buffer输出出去之类的(代码中没有体现,但是一般业务肯定会有)。 如果像上面这样写,会出现什么问题?不难发现在于ProcessBuf的参数,这里会发生复制。由于我们在Buffer类中定义了拷贝构造函数来实现深复制,那么任何传入的buffer都会在这里进行一次拷贝构造(深复制)。再观察Demo中调用,仅仅是传了一个临时对象而已。临时对象本身也是将亡对象,复制给buf后,就会被释放,也就是说,我们进行了一次无意义的深复制。 有人可能会说,那这里参数用引用能不能解决问题?比如这样: void ProcessBuf(Buffer &buf) { buf.at(2) = 100; } void Demo() { ProcessBuf(Buffer{16}); // ERR,普通引用不可接收将亡对象 } 所以这里需要我们注意的是,C++当中,并不只有在显式调用=的时候才会赋值,在函数传参的时候仍然由赋值语义(也就是实参赋值给形参)。所以上面就相当于: Buffer &buf = Buffer{16}; // ERR 所以自然不合法。那,用const引用可以吗?由于const引用可以接收将亡对象,那自然可以用于传参,但ProcessBuf函数中却对对象进行了修改操作,所以const引用不能满足要求: void ProcessBuf(const Buffer &buf) { buf.at(2) = 100; // 但是这里会报错 } void Demo() { ProcessBuf(Buffer{16}); // 这里确实OK了 } 正如上一节描述,const引用倾向于表达“保存快照”的意义,因此,虽然这个对象仍然是放在内存中的,但const引用并不希望它发生改变(否则就不叫快照了),因此,这里最合适的,仍然是右值引用: void ProcessBuf(Buffer &&buf) { buf.at(2) = 100; // 右值引用完成绑定后,相当于普通引用,所以这里操作OK } void Demo() { ProcessBuf(Buffer{16}); // 用右值引用绑定将亡对象,OK } 我们再来看下面的场景: void Demo() { Buffer buf1{16}; // 对buf进行一些操作 buf1.at(2) = 50; // 再把buf传给ProcessBuf ProcessBuf(buf1); // ERR,相当于Buffer &&buf= buf1;右值引用绑定非将亡对象 } 因为右值引用是要来绑定将亡对象的,但这里的buf1是Demo函数的局部变量,并不是将亡的,所以右值引用不能接受。但如果我有这样的需求,就是说buf1我不打算用了,我想把它的控制权交给ProcessBuf函数中的buf,相当于,我主动让buf1提前“亡”,是否可以强制把它弄成将亡对象呢?STL提供了std::move函数来完成这件事,“期望强制把一个对象变成将亡对象”: void Demo() { Buffer buf1{16}; // 对buf进行一些操作 buf1.at(2) = 50; // 再把buf传给ProcessBuf ProcessBuf(std::move(buf1)); // OK,强制让buf1将亡,那么右值引用就可以接收 } // 但如果读者尝试的话,在这里会出ERROR std::move的本意是提前让一个对象“将亡”,然后把控制权“移交”给右值引用,所以才叫「move」,也就是“移动语义”。但很可惜,C++并不能真正让一个对象提前“亡”,所以这里的“移动”仅仅是“语义”上的,并不是实际的。如果我们看一下std::move的实现就知道了: template <typename T> constexpr std::remove_reference_t<T> &&move(T &&ref) noexcept { return static_cast<std::remove_reference_t<T> &&>(ref); } 如果这里参数中的&&符号让你懵了的话,可以参考后面“引用折叠”的内容,如果对其他乱七八糟的语法还是没整明白的话,没关系,我来简化一下: template <typename T> T &&move(T &ref) { return static_cast<T &&>(ref); } 哈?就这么简单?是的!真的就这么简单,这个std::move不是什么多高大上的处理,就是简单把普通引用给强制转换成了右值引用,就这么简单。 所以,我上线才说“C++并不能真正让一个对象提前亡”,这里的std::move就是跟编译器玩了一个文字游戏罢了。 所以,C++的移动语义仅仅是在语义上,在使用时必须要注意,一旦将一个对象move给了一个右值引用,那么不可以再操作原本的对象,但这种约束是一种软约束,操作了也并不会有报错,但是就可能会出现奇怪的问题。 (四)移动构造、移动赋值 有了右值引用和移动语义,C++还引入了移动构造和移动赋值,这里简单来解释一下: void Demo() { Buffer buf1{16}; Buffer buf2(std::move(buf1)); // 把buf1强制“亡”,但用它的“遗体”构造新的buf2 Buffer buf3{8}; buf3 = std::move(buf2); // 把buf2强制“亡”,把“遗体”转交个buf3,buf3原本的东西不要了 } 为了解决用一个将亡对象来构造/赋值另一个对象的情况,引入了移动构造和移动赋值函数,既然是用一个将亡对象,那么参数自然是右值引用来接收了。 class Buffer final { public: Buffer(size_t size); Buffer(const Buffer &ob); Buffer(Buffer &&ob); // 移动构造函数 ~Buffer(); Buffer &operator =(Buffer &&ob); // 移动赋值函数 int &at(size_t index); private: size_t buf_size_; int *buf_; }; 这里主要考虑的问题是,既然是用将亡对象来构造新对象,那么我们应当尽可能多得利用将亡对象的“遗体”,在将亡对象中有一个buf_指针,指向了一片堆空间,那这片堆空间就可以直接利用起来,而不用再复制一份了,因此,移动构造和移动赋值应该这样实现: Buffer::Buffer(Buffer &&ob) : buf_size_(ob.buf_size_), // 基本类型数据,只能简单拷贝了 buf_(ob.buf_) { // 直接把ob中指向的堆空间接管过来 // 为了防止ob中的空间被重复释放,将其置空 ob.buf_ = nullptr; } Buffer &Buffer::operator =(Buffer &&ob) { // 先把自己原来持有的空间释放掉 if (buf_ != nullptr) { free(buf_); } // 然后继承ob的buf_ buf_ = ob.buf_; // 为了防止ob中的空间被重复释放,将其置空 ob.buf_ = nullptr; } 细心的读者应该能发现,所谓的“移动构造/赋值”,其实就是一个“浅复制”而已。当出现移动语义的时候,我们想象中是“把旧对象里的东西移动到新对象中”,但其实没法做到这种移动,只能是“把旧对象引用的东西转为新对象来引用”,本质就是一次浅复制。 引用折叠 引用折叠指的是在模板参数以及auto类型推导时遇到多重引用时进行的映射关系,我们先从最简单的例子来说: template <typename T> void f(T &t) { } void Demo() { int a = 3; f<int>(a); f<int &>(a); f<int &&>(a); } 当T实例化为int时,函数变成了: void f(int &t); 但如果T实例化为int&和int &&时呢?难道是这样吗? void f(int & &t); void f(int && &t); 我们发现,这种情况下编译并没有出错,T本身带引用时,再跟参数后面的引用符结合,也是可以正常通过编译的。这就是所谓的引用折叠,简单理解为“两个引用撞一起了,以谁为准”的问题。引用折叠满足下面规律: 左值引用短路右值引用 简单来说就是,除非是两个右值引用遇到一起,会推导出右值引用以外,其他情况都会推导出左值引用,所以是左值引用优先。 & + & -> & & + && -> & && + & -> & && + && -> && (一)auto && 这种规律同样同样适用于auto &&,当auto &&遇到左值时会推导出左值引用,遇到右值时才会推导出右值引用: auto &&r1 = 5; // 绑定常量,推导出int && int a; auto &&r2 = a; // 绑定变量,推导出int & int &&b = 1; auto &&r3 = b; // 右值引用一旦绑定,则相当于普通变量,所以绑定变量,推导出int & 由于&比&&优先级高,因此auto &一定推出左值引用,如果用auto &绑定常量或将亡对象则会报错: auto &r1 = 5; // ERR,左值引用不能绑定常量 auto &r2 = GetAnObj(); // ERR,左值引用不能绑定将亡对象 int &&b = 1; auto &r3 = b; // OK,左值引用可以绑定右值引用(因为右值引用一旦绑定后,相当于左值) auto &r4 = r3; // OK,左值引用可以绑定左值引用(相当于绑定r4的引用源) (二)右值引用传递时失去右性 前面的章节笔者频繁强调一个概念:右值引用一旦绑定,则相当于普通的引用(左值)。 这也就意味着,“右值”性质无法传递,请看例子: void f1(int &&t1) {} void f2(int &&t2) { f1(t2); // 注意这里 } void Demo() { f2(5); } 在Demo函数中调用f2,f2的参数是int &&,用来绑定常量5没问题,但是,在f2函数内,t2是一个右值引用,而右值引用一旦绑定,则相当于左值,因此,不能再用右值引用去接收。所以f2内部调f1的过程会报错。这就是所谓“右值引用传递时会失去右性”。 那么如何保持右性呢?很无奈,只能层层转换: void f1(int &&t1) {} void f2(int &&t2) { f1(std::move(t2)); // 保证右性 } void Demo() { f2(5); } 但我们来考虑另一个场景,在模板函数中这件事会怎么样? template <typename T> void f1(T &&t1) {} template <typename T> void f2(T &&t2) { f1<T>(t2); } void Demo() { f2<int &&>(5); // 传右值 int a; f2<int &>(a); // 传左值 } 由于f1和f2都是模板,因此,传入左值和传入右值的可能性都要有的,我们没法在f2中再强制std::move了,因为这样做会让左值变成右值传递下去,我们希望的是保持其左右性 但如果不这样做,当我向f2传递右值时,右性无法传递下去,也就是t2是int &&类型,但是传递给f1的时候,t1变成了int &类型,这时t1是t2的引用(就是左值引用绑定右值引用的场景),并不是我们想要的。那怎么解决,如何让这种左右性质传递下去呢?就要用到模板元编程来完成了: template <typename T> T &forward(T &t) { return t; // 如果传左值,那么直接传出 } template <typename T> T &&forward(T &&t) { return std::move(t); // 如果传右值,那么保持右值性质传出 } template <typename T> void f1(T &&t1) {} template <typename T> void f2(T &&t2) { f1(forward<T>(t2)); } void Demo() { f2<int &&>(5); // 传右值 int a; f2<int &>(a); // 传左值 } 上面展示的是std::forward的一个示例型的代码,便于读者理解,实际实现要稍微复杂一点。思路就是,根据传入的参数来判断,如果是左值引用就直接传出,如果是右值引用就std::move变成右值再传出,保证其左右性。std::forward又被称为“完美转发”,意义就在于传递引用时能保持其左右性。 (三)auto推导策略 C++11提供了auto来自动推导类型,很大程度上提升了代码的直观性,例如: std::unordered_map<std::string, std::vector<int>> data_map; // 不用auto std::unordered_map<std::string, std::vector<int>>::iterator iter = data_map.begin(); // 使用auto推导 auto iter = data_map.begin(); 但auto的推导仍然引入了不少奇怪的问题。首先,auto关键字仅仅是用来代替“类型符”的,它并没有改变“C++类型说明符具有多重意义”这件事,在前面“类型说明符”的章节我曾介绍过,C++中,类型说明符除了表示“类型”以外,还承担了“定义动作”的任务,auto可以视为一种带有类型推导的类型说明符,其本质仍然是类型说明符,所以,它同样承担了定义动作的任务,例如: auto a = 5; // auto承担了“定义变量”的任务 但auto却不可以和[]组合定义数组,比如: auto arr[] = {1, 2, 3}; // ERR 在定义函数上,更加有趣,在C++14以前,并不支持用auto推导函数返回值类型,但是却支持返回值后置语法,所以在这种场景下,auto仅仅是一个占位符而已,它既不表示类型,也不表示定义动作,仅仅就是为了结构完整占位而已: auto func() -> int; // () -> int表示定义函数,int表示函数返回值类型 到了C++14才支持了返回值类型自动推导,但并不支持自动生成多种类型的返回值: auto func(int cmd) { if (cmd > 0) { return 5; // 用5推导返回值为int } return std::string("123"); // ERR,返回值已经推导为int了,不能多类型返回 } auto的语义 同样还是出自这句话“auto是用来代替类型说明符的”,因此auto在语义上也更加倾向于“用它代替类型说明符”这种行为,尤其是它和引用、指针类型结合时,这种特性更加明显: int a = 5; const int k = 9; int &r = a; auto b = a; // auto->int auto c = 4; // auto->int auto d = k; // auto->int auto e = r; // auto->int 我们看到,无论用普通变量、只读变量、引用、常量去初始化auto变量时,auto都只会推导其类型,而不会带有左右性、只读性这些内容。 所以,auto的类型推导,并不是“推导某个表达式的类型”,而是“推导当前位置合适的类型”,或者可以理解为“这里最简单可以是什么类型”。比如说上面auto c = 4这里,auto可以推导为int,int &&,const int,const int &,const int &&,而auto选择的是里面最简单的那一种。 auto还可以跟指针符、引用符结合,而这种时候它还是满足上面“最简单”的这种原则,并且此时指的是“auto本身最简单”,举例来说: int a = 5; auto p1 = &a; // auto->int * auto *p2 = &a; // auto->int auto &r1 = a; // auto->int auto *p3 = &p2; // auto->int * auto p4 = &p2; // auto-> int ** p1和p2都是指针,但auto都是用最简原则来推导的,p2这里因为我们已经显式写了一个*了,所以auto只会推导出int,因此p2最终类型仍然是int *而不会变成int **。同样的道理在p3和p4上也成立。 在一些将“类型”和“动作”语义分离的语言中,就完全不会有auto的这种困扰,它们可以用“省略类型符”来表示“自动类型推导”的语义,而起“定义”语义的关键字得以保留而不受影响,例如在swift中: var a = 5 // Int let b = 5.6 // 只读Double let c: Double = 8 // 显式指定类型 在Go中也是类似的: var a = 2.5 // var表示“定义变量”动作,自动推导a的类型为float64 b := 5 // 自动推导类型为int,:=符号表示了“定义动作”语义 const c = 7 // const表示“定义只读变量”动作,自动推导c类型为int var d float32 = 9 // 显式指定类型 auto引用 在前面“引用折叠”的章节曾经提到过auto &&的推导原则,有可能会推导出左值引用来,所以auto &&并不是要“定义一个右值引用”,而是“定义一个保持左右性的引用”,也就是说,绑定一个左值时会推导出左值引用,绑定一个右值时会推导出右值引用。 int a = 5; int &r1 = a; int &&r2 = 4; auto &&y1 = a; // int & auto &&y2 = r1; // int & auto &&y3 = r2; // int &(注意右值引用本身是左值) auto &&y4 = 3; // int && auto &&y5 = std::move(r1); // int && 更详细的内容可以参考前面“引用折叠”的章节。 C语言曾经的auto 我相信大家现在看到auto都第一印象是C++当中的“自动类型推导”,但其实auto并不是C++11引入的新关键在,在原始C语言中就有这一关键字的。 在原始C中,auto表示“自动变量位置”,与之对应的是register。在之前“const引用”章节中笔者曾经提到,“变量就是内存变量”,但其实在原始C中,除了内存变量以外,还有一种变量叫做“寄存器变量”,也就是直接将这个数据放到CPU的寄存器中。也就是说,编译器可以控制这个变量的位置,如果更加需要读写速度,那么放到寄存器中更合适,因此auto表示让编译器自动决定放内存中,还是放寄存器中。而register修饰的则表示人工指定放在寄存器中。至于没有关键字修饰的,则表示希望放到内存中。 int a; // 内存变量 register int b; // 寄存器变量 auto int c; // 由编译器自动决定放在哪里 需要注意的是,寄存器变量不能取址。这个很好理解,因为只有内存才有地址(地址本来指的就是内存地址),寄存器是没有的。因此,auto修饰的变量如果被取址了,那么一定会放在内存中: auto int a; // 有可能放在内存中,也有可能放在寄存器中 auto int b; int *p = &b; // 这里b被取址了,因此b一定只能放在内存中 register int c; int *p2 = &c; // ERR,对寄存器变量取址,会报错 然而在C++中,几乎不会人工来控制变量的存放位置了,毕竟C++更加上层一些,这样超底层的语法就被摒弃了(C++11取消了register关键字,而auto关键字也失去其本意,变为了“自动类型推导”的占位符)。而关于变量的存储位置则是全权交给了编译器,也就是说我们可以理解为,在C++11以后,所有的变量都是自动变量,存储位置由编译器决定。 注:点赞过30,下周五出下篇,快点赞收藏起来~ 推荐阅读 看完这篇,成为Grafana高手! 10大性能陷阱!每个C++工程师都要知道 AI绘画火了!一文看懂背后技术原理 CPU如何与内存交互?

优秀的个人博客,低调大师

每日一博 | 遗留代码处理技巧与案例演示

1 什么是遗留代码 本质是一种技术债务,产生原因一方面是业务原因:如业务本身场景繁多、流程复杂等;另一方面是技术原因:如代码不规范、设计不合理、祖传代码文档注释缺失等。它会影响我们的程序很多方面:如可读性、可修改性、可复用性、可维护性、可测试性等。 2 遗留代码处理过程拆解 划分为梳理->重构/重写->替换/验证三个阶段 2.1 梳理 遗留代码的处理是一种逆向工程,从已有的代码+数据模型+文档倒推出业务模型、交互和规则,在保真的前提下再重新构建代码+数据模型+文档。 我们这里可以参考下DDD领域驱动设计里战略设计部分常用的工具(事件风暴法)来进行这部分梳理工作。 事件风暴本质上是一种系统建模的方法,与它处于对等位置的,会有“UML建模”、“事件驱动建模”等。事件风暴跟敏捷开发里的一些理念(如用户故事)的产生背景类似,都是在理性思考无法应对变化频繁且文字难以描述的情况下,通过一些辅助性的提示卡片、视觉手段,辅以相关人员的集中、高频沟通来完成对于业务的准确把握和抽象建模。 事件风暴的过程: 通过梳理业务流程,创建相应的领域事件(Event) 补充引发每个领域事件的命令(Command) 通过实体/聚合把命令和事件关联起来 划分领域边界及事件流动线条 识别用户操作所需的关联视图及其角色 事件风暴的产物: 领域对象 即实体/聚合。这里的领域对象并非数据库模型, 而是与业务紧密联系的“对象”。因为事件风暴是一种面向对象的建模方式, 而不是面向数据库的建模方式。 领域事件 即对象在某些操作或特点时点下所产生的事件, 这些事件将决定之后多个聚合和限界上下文(BC)之间的通讯方式。 限界上下文 当所有的对象(实体/聚合)被梳理出来后,属于同一种“通用语言”的对象, 则会被归入同一个限界上下文边界内;不属于同一种“通用语言”的对象, 则会被边界给分割开,划入不同的子域或限界上下文。 梳理结果示例: 2.2 重构/重写 通过重构/重写对软件要素进行重新组织,使其不改变外部行为的情况下,提升代码的可读性或使其结构更合理。 针对不同层次的软件要素要做不同的处理和控制: 并且整个重构/重写过程有些需要遵照的原则: 单一职责:可以将依赖归拢,统一行为和控制。权责明确,场景明确。 单一原则:消除重复的数据声明、行为;因为单一所以保证了复用,统一标准 ,可装配性。 封装原则:不需要过度关心依赖类内部实现,最好一个.就能调用。 归属原则:上帝的归上帝,凯撒的归凯撒。谁提供的数据更多,归属于谁。 抽象层次:越高层的抽象越稳定,越细节的东西越容易变化。举例:接口应传递职责而非实现细节。 开闭原则:对修改关闭,对扩展开放。 kiss原则: 好理解,好维护。 清晰原则:只读小部分代码就可以知道怎么改逻辑,做扩展。而不是要通读所有代码,才能理清。 其中有两点落地细节我们具体分析下: 业务逻辑的处理 业务代码和技术代码解耦 主流程代码和附加流程代码解耦 长链路的拆解编排 关注点的分离 双向依赖:上下文之间缺少一层未被澄清的上下文,或者两个上下文其实可被合为一个; 循环依赖:任何一个上下文发生变更,依赖链条上的上下文均需要改变; 过深的依赖:自身依赖的信息不能直接从依赖者获取到,需要通过依赖者从其依赖的上下文获取并传递,依赖链路过长,依赖链条上的任何一个上下文发生变更,其链条后的任何一个上下文均可能需要改变; 2.3 替换验证 大概分为以下几个要点: 领会意图,抽取用例,增加可复测性 增加可监测性 分成小块,逐步替换 试点、看到成效 可借助过程管理工具如PDCA法进行管理 3 案例演示 3.1 案例1:针对强耦合的实现做重构 原始需求:案例为一个转账服务,用户可以通过银行网页转账给另一个账号,支持跨币种转账。同时因为监管和对账需求,需要记录本次转账活动。 原始架构:是一个传统的三层分层结构:UI层、业务层、和基础设施层。上层对于下层有直接的依赖关系,导致耦合度过高。在业务层中对于下层的基础设施有强依赖,耦合度高。我们需要对这张图上的每个节点做抽象和整理,来降低对外部依赖的耦合度。 重构关键设计点: 重构后代码特征: 业务逻辑清晰,数据存储和业务逻辑完全分隔。 Entity、Domain Primitive、Domain Service都是独立的对象,没有任何外部依赖,但是却包含了所有核心业务逻辑,可以单独完整测试。 原有的转账服务不再包括任何计算逻辑,仅仅作为组件编排,所有逻辑均delegate到其他组件。 3.2 案例2:提高老代码的复用性 原始需求:现有几个策略实现类,被很多代码使用。现在需要根据不同的业务方在每个策略执行前做不同的前置逻辑处理。 解法分析:尽量避免把逻辑耦合到已有的实现类中。引入外部类进行控制反转。这里我们使用访问者模式。 访问者模式把数据结构和作用于结构上的操作解耦合,使得操作集合可相对自由地演化。访问者模式适用于数据结构相对稳定算法又易变化的系统。因为访问者模式使得算法操作增加变得容易。若系统数据结构对象易于变化,经常有新的数据对象增加进来,则不适合使用访问者模式。访问者模式的优点是增加操作很容易,因为增加操作意味着增加新的访问者。访问者模式将有关行为集中到一个访问者对象中,其改变不影响系统数据结构。其缺点就是增加新的数据结构很困难。 具体实现: 重构后代码特征: 可以通过访问者对老代码逻辑进行编排,将修改外置,减少对老逻辑的影响 通过java8默认接口实现提供默认访问行为,避免大量策略子类的感知,只需要需要提供自己实现行为的子类对默认实现进行覆写 4 总结 遗留代码的处理能力一方面是对技术的要求,另一方面也是对业务掌握的挑战。希望我们可以跨越荆棘、穿过迷雾,顺利到达成功的彼岸! 作者:冯鸿儒

优秀的个人博客,低调大师

每日一博 | Go 语言躲坑经验总结

作者 | 百度小程序团队 导读 本文收集一些使用Go开发过程中非常容易踩坑的case,所有的case都有具体的代码示例,以及针对的代码修复方法,以避免大家再次踩坑。通常这些坑的特点就是代码正常能编译,但运行结果不及预期或是引入内存漏洞的风险。 全文7866字,预计阅读时间20分钟。 01 参数传递误用 1.1 误对指针计算Sizeof 对任何指针进行unsafe.Sizeof计算,返回的结果都是 8 (64位平台下)。稍不注意就会引发错误。 错误示例: func TestSizeofPtrBug(t *testing.T) { type CodeLocation struct { LineNo int64 ColNo int64 } cl := &CodeLocation{10, 20} size := unsafe.Sizeof(cl) fmt.Println(size) // always return 8 for point size } 建议使用示例:单独编写一个只处理值大小的函数 ValueSizeof。 func TestSizeofPtrWithoutBug(t *testing.T) { type CodeLocation struct { LineNo int64 ColNo int64 } cl := &CodeLocation{10, 20} size := ValueSizeof(cl) fmt.Println(size) // 16 } func ValueSizeof(v any) uintptr { typ := reflect.TypeOf(v) if typ.Kind() == reflect.Pointer { return typ.Elem().Size() } return typ.Size() } 1.2 可变参数为any类型时,误传切片对象 当参数的可变参数是any类型时,传入切片对象时一定要用展开方式。 appendAnyF := func(t []any, toAppend ...any) []any { ret := append(t, toAppend...) return ret } emptySlice := []any{} slice2 := []any{"hello", "world"} // bug append slice as a element emptySlice = appendAnyF(emptySlice, slice2) fmt.Println(emptySlice) // only 1 element [[hello world]] emptySlice = []any{} emptySlice = appendAnyF(emptySlice, slice2...) fmt.Println(emptySlice) // [hello world] 1.3 数组是值传递 数组在函数或方法中入参传递是值复制的方式,不能用入参的方式进函数或方法内修改数组内容进行返回的。 示例代码如下: arr := [3]int{0, 1, 2} f := func(v [3]int) { v[0] = 100 } f(arr) // no modify to arr fmt.Println(arr) // [0 1 2] 1.4 切片扩容后会新申请内存,不再与内存引用有任何关联 这里坑在,如果从一个数组中引入一个切片,一旦这个切片引发扩容后,则与原来的引用内容没有任何关系。 arr := []int{0, 1, 2} f := func(v []int) { v[0] = 100// can modify origin array v = append(v, 4) // new memory allocated v[0] = 50// no modify to origin array } f(arr) fmt.Println(arr) // [100 1 2] 上面的示例代码,扩容切片前对内容的修改可以影响到arr数组,说明是共享内存地址引用的,一旦扩容后,则是重新申请了内存,与数组不再是一个内存引用了。 1.5 返回参数尽量避免使用共享数据的切片对象,容易导致原始数据污染 这种场景就是如果通过函数返回值方式从一个大数组获取部分内部,尽量不要用切片共享的方式,可以使用copy的方式来替换。 下面的代码,通过ReadUnsafe读取切片后,修改内容同步影响原始的内容。 type Queue struct { content []byte pos int } func (q *Queue) ReadUnsafe(size int) []byte { if q.pos+size >= len(q.content) { return nil } pos := q.pos q.pos = q.pos + size return q.content[pos:q.pos] } func TestReadUnsafe(t *testing.T) { c := [200]byte{} q := &Queue{content: c[:]} v := q.ReadUnsafe(10) v[0] = 1 fmt.Println(q.content[0]) // 1 q.content值已经被修改 } 正确的修改如下,使用copy创建一份新内存: func (q *Queue) ReadSafe(size int) []byte { if q.pos+size >= len(q.content) { return nil } pos := q.pos q.pos = q.pos + size ret := make([]byte, size) copy(ret, q.content[pos:q.pos]) return ret } func TestReadSafe(t *testing.T) { c := [200]byte{} q := &Queue{content: c[:]} v := q.ReadSafe(10) v[0] = 1 fmt.Println(q.content[0]) // 0 q.content值安全 } 02 指针相关使用的坑 2.1 误保存uintptr值 uintptr保存的当前地址的一个整型值,它一旦被获取后,是不会被编译器感知的,也就是它就是一个普通变量,不会追溯内存真实地址变化。 slice := []int{0, 1, 2} ptr := unsafe.Pointer(&slice[0]) // get array element:0 pointer slice = append(slice, 3) // allocate new memory ptr2 := unsafe.Pointer(&slice[0]) // ptr is 824633770392, ptr2 is 824633762896, ptr==ptr2 result is false fmt.Println(fmt.Sprintf("ptr is %d, ptr2 is %d, ptr==ptr2 result is %v", ptr, ptr2, ptr == ptr2)) 2.2 len与cap 对空指针nil与空值返回相同 针对切片, 用len与cap操作时,空值与nil都是返回0, 针对map, 用len操作时,空值与nil都是返回0。 var slice []int = nil fmt.Println(len(slice), cap(slice)) // 0 0 var slice2 []int = []int{} fmt.Println(len(slice2), cap(slice2)) // 0 0 var mp map[int]int = nil fmt.Println(len(mp)) // 0 var mp2 map[int]int = map[int]int{} fmt.Println(len(mp2)) // 0 2.3 用new对map类型进行初始化 用new对map进行创建,编译器不会报错,但是无法对map进行赋值操作的。正确应使用make进行内存分配。 mp := new(map[int]int) f := func(m map[int]int) { m[10] = 10 } f(*mp) // assignment to entry in nil map 2.4 空指针和空接口不等价 对于接口类型是可以用nil赋值的,但如果对于接口指针类型,其值对应的并不一个空接口。Go语言编译器似乎在这个处理,会特殊处理。 // MyErr just for demotype MyErr struct{} func (e *MyErr) Error() string { return"" } func TestInterfacePointBug(t *testing.T) { var e *MyErr = nil var e2 error = e // e2 will never be nil. fmt.Println(e2 == nil) } 03 函数,方法与控制流相关 3.1 循环中使用闭包错误引用同一个变量 原因分析:闭包捕获外部变量,它不关心这些捕获的变量或常量是否超出作用域,只要闭包在使用,这些变量就会一直存在。 type S struct { A string B string C string } typ := reflect.TypeOf(S{}) funcArr := make([]func() string, typ.NumField()) for i := 0; i < typ.NumField(); i++ { f := func() string { return typ.Field(i).Name } funcArr[i] = f } fmt.Println(funcArr[0]()) // error reflect: Field index out of bounds 所以上面的示例代码,在循环中闭包函数只记录了i变量的使用,当循环结束后,i值变成了3。当调用该匿名函数时,就会引用i=3的值 ,出现越界的异常。 正确处理的方式如下,只需要闭包前处理一下把i变量赋值给一个新变量。 type S struct { A string B string C string } typ := reflect.TypeOf(S{}) funcArr := make([]func() string, typ.NumField()) for i := 0; i < typ.NumField(); i++ { index := i // assign to a new variable f := func() string { name := typ.Field(index).Name return name } funcArr[i] = f } fmt.Println(funcArr[0]()) // A 3.2 元素内容较大时,不要用range遍历 用range来操作遍历使用上非常方便,但是它的遍历中是需要进行值赋值操作,遇到元素占用的内存比较大时,性能就会影响较大。 下面是针对两种方式做了一下基准测试。 func CreateABigSlice(count int) [][4096]int { ret := make([][4096]int, count) for i := 0; i < count; i++ { ret[i] = [4096]int{} } return ret } func BenchmarkRangeHiPerformance(b *testing.B) { v := CreateABigSlice(1 << 12) for i := 0; i < b.N; i++ { len := len(v) var tmp [4096]int for k := 0; k < len; k++ { tmp = v[k] } _ = tmp } } func BenchmarkRangeLowPerformance(b *testing.B) { v := CreateABigSlice(1 << 12) for i := 0; i < b.N; i++ { var tmp [4096]int for _, e := range v { tmp = e } _ = tmp } } 测试结果如下:range方式的性能较for方式相差了近10000倍。 cpu: 11th Gen Intel(R) Core(TM) i5-1145G7 @ 2.60GHz BenchmarkRangeHiPerformance-8 9767457 1255 ns/op BenchmarkRangeLowPerformance-8 975 11513216 ns/op PASS ok withoutbug/avoidtofix 26.270s 3.3 循环内调用defer造成销毁处理延迟 在很多场景,在循环内申请资源在循环完成后释放,但是使用defer语句处理,是需要在当前函数退出时才会执行,在循环中是不会触发的,导致资源延迟释放。 func main() { for i := 0; i < 5; i++ { f, err := os.Open("./mygo.go") if err != nil { log.Fatal(err) } defer f.Close() } } 比较好的解决办法就是在for循环里不要使用defer,直接进行销毁处理。 func main() { for i := 0; i < 5; i++ { f, err := os.Open("/path/to/file") if err != nil { log.Fatal(err) } f.Close() } } 3.4 Goroutine无法阻止主进程退出 后台Goroutine无法保证在方法退出来执行完成。 func main() { gofunc() { time.Sleep(time.Second) fmt.Println("run") }() } 3.5 Goroutine 抛panic会导致进程退出 后台Goroutine执行中,如果抛panic并不进行recover处理,会导致主进程退出。 下面的代码示例: func main1() { go func() { panic("oh...") }() for i := 0; i < 3; i++ { fmt.Println(i) time.Sleep(time.Second) } fmt.Println("bye bye!") } 修正代码如下: func main2() { go func() { defer func() { recover() // should do some thing here }() panic("oh...") }() for i := 0; i < 3; i++ { fmt.Println(i) time.Sleep(time.Second) } fmt.Println("bye bye!") } 3.6 r****ecover函数 只在defer函数内生效 需要注意:在非defer函数内,调用recover函数,是不会有任何的执行,也无法来处理panic错误。 下面的示例代码,是无法处理panic的错误: func NoTestDeferBug(t *testing.T) { recover() panic(1) // could not catch } func NoTestDeferBug2(t *testing.T) { defer recover() panic(1) // could not catch } 正确的代码如下: func TestDeferFixed(t *testing.T) { defer func() { recover() }() panic("this is panic info") // could not catch } 04 并发与内存同步相关 4.1 跨Goroutine之间不支持顺序一致性内存模型 在Go语言的内存模型设计中, 内存写入顺序性只能保障在单一Goroutine内一致,跨Goroutine之间无法保障监测变量操作顺序的一致性。 下面是官方的例子: package main var msg string var done bool func setup() { msg = "hello, world" done = true } func main() { go setup() for !done { } println(msg) } 上面代码的问题是,不能保证在 main 中对 done 的写入的监测时, 会对变量a的写入也进行监测,因此该程序也可能会打印出一个空字符串。更糟的是,由于在两个线程之间没有同步事件,因此无法保证对 done 的写入总能被 main 监测到。main 中的循环不保证一定能结束。 解决办法就是使用显示同步方案, 使用通道进行同步通信。 package main var msg string var done = make(chan bool) func setup() { msg = "hello, world" done <- true } func main() { go setup() <-done println(msg) } 这样就可以保证代码执行过程中必定输出 hello,world。 更多内存同步阅读材料:https://go-zh.org/ref/mem 05 序列化相关 5.1 基于指针参数方式传递的反序列功能,都不会初始化要反序列化的对象字段 该问题经常发生的原因是基于指针参数方式传递的反序列函数其实做的只是值覆盖的功能,并不会把要反序化的对象的所有值进行初始化操作,这样就会导致未覆盖的值的保留. 像 json.Unmarshal, xml.Unmarshal 函数等。 下面是基于json对map 类型的变量进行json.Unmarshal的问题示例: package main import ( "encoding/json" "fmt" ) func main() { val := map[string]int{} s1 := `{"k1":1, "k2":2, "k3":3}` s2 := `{"k1":11, "k2":22, "k4":44}` json.Unmarshal([]byte(s1), &val) fmt.Println(s1, val) json.Unmarshal([]byte(s2), &val) fmt.Println(s2, val) } 输出: {"k1":1, "k2":2, "k3":3} map[k1:1 k2:2 k3:3] {"k1":11, "k2":22, "k4":44} map[k1:11 k2:22 k3:3 k4:44] 由于 json.UnMarshal 方法只会新增和覆盖 map 中的 key,不会删除 key。虽然第二个json字符串中没有k3的内容,但输出结果中依然保留在了k3的内容。 要解决这个问题,每次 unmarshal 之前都重新声明变量即可。 06 其它杂项 6.1 数字类型转换越界陷阱 Go语言中,任何操作符不会改变变量类型,下面示例引入一个坑, 出现位移越界。 func TestOverFlowBug(t *testing.T) { var num int16 = 5000 var result int64 = int64(num << 9) fmt.Println(result) // 4096 overflow } 修正方式如下,需要操作前对类型转换: func TestOverFlowFixed(t *testing.T) { var num int16 = 5000 var result int64 = int64(num) << 9 fmt.Println(result) // 2560000 } 6.2 map遍历是顺序不固定 map的实现是通hash表进行分桶定位,同时map的遍历引入了随机实现,所以每次遍历的顺序都可能变化。 mp := map[int]int{} for i := 0; i < 20; i++ { mp[i] = i } for k, v := range mp { fmt.Println(k, v) } ——END—— 参考资料: [1]Effective Go 英文版: https://go.dev/doc/effective_go [2]Go 语言代码风格指导: https://github.com/golang/go/wiki/CodeReviewComments 推荐阅读: PaddleBox:百度基于GPU的超大规模离散DNN模型训练解决方案 聊聊机器如何"写"好广告文案? 百度工程师教你玩转设计模式(适配器模式) 百度搜索业务交付无人值守实践与探索 分布式ID生成服务的技术原理和项目实战 揭秘百度智能测试在测试评估领域实践

优秀的个人博客,低调大师

每日一博 | 字节跳动 Flink StateBackend 性能提升之路

内容简介:StateBackend 作为 Flink 向上提供 State 能力的基石,其性能会严重影响任务的吞吐。本次分享主要介绍在字节跳动内部通过为 StateBackend 提供通用缓存层,来提高性能的相关优化。 作者|字节跳动基础架构研发工程师-李明 一、相关背景 StateBackend 是 Flink 向上提供 State 能力的基石,其性能会严重影响任务的吞吐。目前 Flink 提供的生产可用的 Statebackend 主要有两类,一类是 FsStateBackend,另一类是 RocksDBStateBackend。他们的基本原理都是提供一个 State API 给用户使用,底层会根据 StateBackend 类型选用不同的存储来存储数据。 FsStateBackend 底层实现是在内存中通过 Map 的数据结构来存储数据,把原始的数据对象直接存储到内存中。这种 StateBackend 的优点是访问速度特别快,所有操作都是在内存中进行,基本没有额外的 CPU 开销。缺点是随着状态规模的增长,JVM 的 GC 停顿时间也会越来越长,同时状态规模会受到内存的限制。 RocksDBStateBackend 底层选用了 RocksDB 来存储数据,存储的状态规模理论上受限于磁盘,序列化后的结果也会比以 Object 的形式存在内存中要小,因此支撑的状态规模比 FsStateBackend大。另外,RocksDBStateBackend 在 JVM 的 Heap 中没有额外的状态数据存储,对应的 GC 压力非常低。但是都是以二进制的形式与 RocksDBStateBackend 交互,这意味着每一次 State 访问都需要将数据进行序列化/反序列化,会带来一些额外的 CPU 开销。 我们在线上使用这两种 StateBackend 也遇到了不少痛点: 线上 SQL 作业的状态相对比较小,因此会默认配置使用 FsStateBackend 。但是随着状态的规模提升,GC 的停顿时间会越来越长,业务开始对这种停顿产生感知。 在单 Task 的状态比较大时,一般推荐使用 RocksDBStateBackend,由于 State 操作都是随机 IO 类型,在非 SSD 机器上的访问性能比较差,并且在访问过程中存在额外的序列化和反序列化开销, CPU 的使用量也会明显上升,实际使用的资源成本增加了。 业务在 StateBackend 的选型上比较困难。业务很难预估未来任务状态规模会有多大,如果发现状态规模比较大了,需要一些额外的运维操作进行 StateBackend 切换,比如需要制作一个 Savepoint,再从 Savepoint 去进行恢复,这会带来额外的运维工作。 因此我们思考是否可以将 FsStateBackend CPU 开销低和 RocksDBStateBackend 容量大的优点结合起来,解决前文提到的痛点。 社区之前提出了 SpillableStateBackend 设计思想,它是一个 Anti-Caching 的架构,通过内存+磁盘进行数据存储,在运行过程中会根据当前的GC情况,以 KeyGroup 的粒度动态地与磁盘上的数据进行交换,来调整内存占用。 当 Task 状态特别大的时候,大部分数据会被交换到磁盘上,访问性能会有较大下降,因此还是以支持小规模状态为主。另一方面,数据交换的粒度是比较粗的,假如单 Task 的 State 是 1G,分配了5个 KeyGroup,平均1个 KeyGroup 大概是 200M,它会以 200M 的粒度去控制内存中需要放入哪些 KeyGroup。而在实际场景中,单 Task 的状态可能会达到 GB 级,State 的访问可能随机到很多 KeyGroup 中。SpillableStateBackend 的设计思想并不能把热点数据充分存储到内存中,因此不适用于我们的场景。 在 Flink SQL 场景中提出了 MiniBatch 的设计思想。 在原来的 SQL 作业流式处理过程中,每来一条数据都会立刻访问 State,然后产生 Read-Update 操作。增加了 MiniBatch 之后,到来的数据并不会立刻访问 State,而是先存储在内存中,当这个 Batch 攒够或者到达设定的等待时间以后,相同 Key 的数据会一起访问 State,操作完成以后再把 Key 对应的 State 写回到 Statebackend,从而减少了 State 访问的次数。MiniBatch 的实现是以 Operator 的粒度进行,如果有新的 Operator 需要利用这个机制,还需要做额外的开发。 此外,业务实践中也在访问 State 上做了一些优化,通过在内存中增加对象缓存,减少序列化和反序列化的开销。实现上也是以 Operator 为粒度,优化后 CPU 使用有了比较明显的下降。 二、优化思路 优化思路 前文提到的优化思路更多的是面向小状态,或者单 Operator 来独立设计的。但我们希望能有一个统一的优化方案,让未来所有 Operator 都能自动使用到这样的优化。 我们的状态使用诉求比较高的核心业务场景主要是面向样本拼接或者流式消重。 在样本拼接场景中 , 推荐系统会向用户推送消息,比如一批好友、视频等,这些数据会作为推荐数据流进行输入。用户看到这些推荐消息后会产生一些操作,比如加好友、查看视频、删除视频等,这些行为会被作为用户的行为数据流输入。对这两条数据流进行数据拼接之后,发送到下游进行模型训练,推荐系统会根据模型训练结果去做一些更优的推荐。 流式消重与样本拼接类似,推荐系统向用户推荐视频文章等,用户可能会观看其中的一部分视频,系统会对已经观看的视频进行消重处理,下次推荐的视频中就不会再有已看过的视频。 在上述两种业务场景中,数据特点比较明显。 首先数据结构大部分是 PB 类型,单个 KV 是几十 KB 到上百 KB 的量级,序列化和反序列化的开销也比较高。 第二个特点是状态的规模比较大,因为它面向的用户数特别多,State 中一般会存储每一个用户操作的明细数据,单个 Task 的状态规模一般会达到 GB 级。 第三个特点是用户的行为数据大部分会在同一个时间段到来。 针对上述特点,我们的优化思路是将同一个 Key 对应多条数据的模式看作对于热点数据的访问,把这些热点数据进行缓存,这样就可以减少序列化和反序列化的开销。 第二个优化思路是从业务运维需求来的。 首先业务希望降低 StateBackend 的选型难度,不希望在未来频繁切换 StateBackend。其次,缓存功能应该是可扩展到多种 StateBackend 的,降低开发成本。 最终我们没有把 StateBackend 的缓存功能设计为一个独立的 StateBackend,而是通过在 StateBackend 和 State API 之间抽象出 Cache Layer,在这一层做了热点数据缓存。 未来底层的 StateBackend 不管怎么变化,对于我们来说都不需要额外的调整。 缓存层架构 下图是优化方案的整体架构,缓存层被拆分成了三部分。 第一部分是 CacheManager,它是 TaskManager 中的一个常驻服务,负责管理 TaskManager 中所有 Cache 的注册和释放等操作,同时也会监控 Cache 的使用情况。 第二部分是把 StateBackend 封装成了 CacheKeyedStateBackend,这一层封装只是对 StateBackend 的请求做了代理,主要负责底层 StateBackend的State 创建和注册 Cache,将 State 和 Cache 封装为 CacheKeyedState。 第三部分是比较重要的 CacheKeyedState,它是面向用户提供的 State 对象,实际是 Cache 和底层 StateBackend 提供的 State 包装,访问的时候会优先操作 Cache 中的数据,如果没有再将底层提供的 State 中的数据加载到 Cache 中,然后进行操作。 CacheManager 在模块设计上主要参考了 SpillableStateBackend 的设计思路,分为以下4个部分: 内存管理模块(MemoryManager):Cache 在初始化或者扩缩容时,都需要向 MemoryManager 发起内存请求。这个模块主要是保证 TM 中的 Cache 内存不会超过配置。 Cache 监控模块(CacheStatusMonitor):收集 TM 中所有 Cache 的运行情况,比如命中率、内存使用,这些信息会被用来进行动态扩缩容。 内存监控模块(HeapStatusManager):周期性地收集 JVM 的内存使用情况,然后触发 Cache 扩缩容。 动态扩缩容模块(ScalingManager):负责调整 TM 中所有 Cache 使用的内存大小,以达到优化内存使用、降低 GC 的目的。 CachedKeyedState 是由 Cache 和 State 封装而成, 它也分为4个部分。 第一部分是封装的 Cache,通过把热点数据缓存到 Cache,实现减少序列化/反序列化开销的目的。 第二部分是内存预估模块 (MemoryEstimator),根据当前 State 访问使用的 KV 的信息进行状态大小预估,用于估算当前 Cache 占用的内存大小。 第三部分是 PolicyStats,用于统计单个 Cache 的访问信息,并作为指标上报。用户可以根据这些指标进行 Cache 运行情况监控,根据实际情况调整 Cache 策略。 最后是 DataSynchronizer 模块,负责 Cache 和底层 StateBackend 的数据同步。这里没有由 Cache 直接去操作底层数据,主要是希望可以在这一层做一些优化,比如以 Batch 的模式去写入。 三、难点&方案 在上述方案的实现过程中,我们遇到了不少难点。 第一个难点是如何适配不同的业务场景。 这里的目标是提高缓存命中率,命中率越高优化效果就越好。但是在不同的业务场景中,因为业务数据自身的特点,缓存的策略可能是不同的。 第二个难点是如何正确进行内存管理。 如果内存管理不正确,那么开启缓存后可能会出现内存溢出或内存泄露,导致任务运行的稳定性降低。 第三个难点是如何自动调整 Cache 分配的内存。 如果 Cache 分配的内存是固定的,会导致空间上的浪费;另一方面,用户的使用门槛也会变高,用户很难评估 Cache 的大小。因此这里需要内存使用可以自动调整,降低 JVM 的 GC 压力。 最后一个难点是快照制作。 引入了 Cache 之后的快照制作时间会变长,如何降低快照制作的时间? 适配不同业务场景 针对适配不同业务场景的问题,我们把 Cache 的实现拆分成了两个部分,将 CacheStrategy 设计成可插拔的缓存策略,将数据存储抽象成一个单独的 StateStore,由 CacheStrategy 来管理 StateStore 中的数据。 StateStore 中的数据是提前内置的数据结构,用户不需要关心这些数据是如何存储和组织,可以根据不同业务场景去选择缓存策略,也支持自定义缓存策略。 内存管理 针对内存管理的问题,主要包含两个方面。 首先是控制 TaskManager 中所有 Cache 使用的内存不超过一个最大配置值, 目前用户在使用这个功能的时候需要给定一个允许 Cache 使用的内存总量最大值,这部分功能由 MemoryManager 来实现。 在 MemoryManager 中,为了方便内存管理,内存以 Block 的粒度进行了划分,在 Cache 做扩缩容或进行注册、释放操作的时候,都会通过 MemoryManager 去进行 Cache 的内存分配和回收,最终保证 Cache 使用的总内存不会超过用户配置的最大值。 当 TaskManager 中 Cache 使用的总内存有了保证之后,第二部分就是需要保证单个 Cache 使用的内存不会超过分配给它的内存, 这项功能由三个子模块来协同配合完成。 首先,访问 Cache 的 State 时,会通过 MemoryEstimator 模块进行状态大小的抽样预估,主要是根据当前访问的 KV 进行序列化操作,根据序列化结果再结合过去一段时间内访问信息的平均值,作为当前 Cache 中数据的平均大小,并将其上报到 PolicyStats 中。根据 Cache 数据平均大小以及当前 Cache 中的数据条数,就可以衡量出它的内存占用。 访问的过程中会根据当前 Cache 的内存大小做内存检查,如果当前内存已经溢出,则会根据缓存策略去增量清理一些数据。这里的增量清理是指清理时并不会一次性把所有溢出的数据全部清理掉,而是每次只清理 2~3 条数据,因为在 GC 压力很高的场景中下会触发 Cache 缩容来保证的 GC 能够快速恢复正常。如果一次性全部清理掉,服务的停顿时间比较长,业务会产生一些抖动。 动态扩缩容 针对动态调整 Cache 内存使用。我们把它拆分成三个子问题。 第一个问题是什么时候触发动态扩缩容? Cache 使用的是 JVM 的 Heap 内存,扩缩容操作需要根据 JVM 的 Heap 使用情况来决定。因此会根据 JVM 最近一段时间的 GC 情况来衡量 Heap 的内存资源是否比较紧张。 我们抽象出一个 HeapStatusMonitor 模块,它会周期性地收集 JVM 的 GC 信息。启动的时候在 JVM 中注册一个 GcNotificationListener 监听器,JVM 发生 GC 时会通过 Listener 回调给 HeapStatusMonitor。根据回调信息评估本次 GC 的耗时以及回收的内存、GC 后剩余的内存等。有了GC 结果之后,HeapStatusMonitor 会将这些信息汇总并上报给 ScalingManager,由 ScalingManager 来决定是否要进行扩缩容。 目前的判断条件是 GC 频率和 GC 耗时:我们设置了两个阈值,超过阈值则会触发缩容。如果 GC 后剩余的内存比较多,说明大部分都是生命周期比较短的数据,当 GC 后使用的内存低于阈值则进行扩容。判断时会优先判断缩容条件,以降低内存的压力。 第二个问题是本次扩缩容的大小。 主要由 ScalingManager 向 MemoryManager 发起 Scale 内存的请求。MemoryManager 会根据当前 Cache 内存的使用情况,按照一定比例来计算应该扩缩容的 Block数。 第三个问题是需要选择哪些 Cache 扩缩容。 在实际场景中,由于不同的 State 实例状态大小是不同的,因此我们对 TaskManager 中所有 Cache 进行了权重排序,最终挑选出 2~3 个权重比较高的 Cache 来进行扩缩容。 第一个权重字段是从 Statebackend 中 Load 成功的次数, 这里没有用请求次数的原因主要有两个:第一,在实际的业务场景中可能会经常去访问一些不存在的 State,导致 Cache 的命中率比较低;第二,有一些 State 虽然请求次数特别高,但是 State 的量比较小。而 Load 成功的次数更能表明当前有多少数据存储在外存中并且需要被 Load 到内存。 第二个字段是当前 Cache 分配的内存大小,Cache 越大,越不应该被继续扩容,相反在缩容的时候应该优先挑选它。 此外,我们参考 SpillableStateBackend 的权重计算方式对字段进行了归一化处理, 主要目的是消除量纲的影响。 快照制作 针对快照制作最初有两个实现方案,一是同步阶段 Flush 所有数据到底层的 StateBackend,实现比较简单但同步阶段的耗时会升高;第二个方案是类似于 FsStateBackend 的方式,利用 CopyOnWrite 的 Map 去进行异步快照,实现成本比较高。我们暂时选择了方案一来实现。 经过线上测试和验证,Cache 在分配 64MB 数据的时候,同步阶段的耗时在一秒钟之内。但是业务会根据实际场景去调整一些配置,比如把 Cache 的内存配置升高,因此我们还设计了一个高低水位线机制 : 把 Cache 中的数据划分成了三个部分,第一部分是经常修改的热点数据,第二部分是发生了修改但相对不那么频繁的数据,最后一部分是经常访问但并未进行修改或修改后已经同步到了底层的数据,并将这三部分的分界线作为高低水位线的划分区间。 当 Cache 中修改的数据量超过低水位线时,只会在 Cache 发生 Evict 事件时去做同步操作,将若干条数据同步到底层的 StateBackend 中;超过高水位线时,意味着当前更新的数据在 Cache 中占比较高,需要保证同步的数据能够快速下降,因此每次访问 Cache 时都会同步若干条数据到底层存储中,直到降低到低水位线。这样,在快照制作的同步阶段就可以保证 Cache 中的待同步数据是低于高水位线的,从而控制快照制作的同步耗时。 四、业务收益 接下来介绍一下方案上线以后取得的一些业务收益。 首先是 Benchmark 的对比。 这里直接使用了社区的 Benchmark 默认配置,Cache 设置的内存为 64M。优化的效果比较明显,在 State 点查操作的性能上可以提升三倍以上。 在线上任务中,我们对比了样本拼接和流式消重两个场景, CPU 的使用量基本上都下降50%以上,而内存使用上升了大概40%~50%,主要是因为存了更多数据到内存中,同时 JVM 需要依赖 GC 来回收这些数据,因此平均内存使用有比较明显的上升。但整体成本是下降的,因为 CPU 资源比内存资源的成本比大约是1:9,换算成总体成本,大概下降了20%~40%。 五、未来规划 我们的未来规划主要集中在以下四个方面: 第一,结合业务场景去探索一些更好的 Cache 缓存策略。 第二,提升 StateBackend 的恢复性能。 目前在超大状态的恢复性能上,主要还是沿用了社区原有的恢复机制,不管是 Savepoint 还是扩缩容场景,在 Task 状态比较大的时候,做一次恢复可能会耗时10分钟甚至20分钟。因此我们希望能够在恢复机制上做一些优化,提升恢复性能。 第三,优化流式计算场景中 Compaction 的策略。单 Task 状态很大尤其是达到 GB 级以上时,随着 Checkpoint 的制作,它会呈现出一个周期性 CPU 业务毛刺。查看 RocksDB 日志之后,发现是由于触发了多次 Compaction 导致的,因此我们希望做一些流式计算场景 Compaction 策略探索。 最后,探索新的 StatsBackend。 目前我们主要使用的还是社区提供的 StatsBackend,更适合于状态规模、并发规模相对来讲不是特别大的场景。在实际使用过程中也遇到了很多问题,比如说 HDFS 的请求数过高、磁盘 IO 打满、依赖 SSD 磁盘等。因此我们希望能够探索一些新的 StatsBackend,比如 RemoteStatsBackend,把数据存储到分布式存储中,降低本地磁盘的依赖,同时恢复的时候也不需要把数据全量拉取到本地,从而提高快照制作以及状态恢复的速度。 目前,字节跳动流式计算团队同步支持的火山引擎流式计算 Flink 版正在公测中,支持云中立模式,支持公共云、 混合云及多云部署,全面贴合企业上云策略,欢迎申请试用:https://www.volcengine.com/product/flink 获取更多产品资讯,欢迎关注公众号【字节跳动云原生计算】

优秀的个人博客,低调大师

每日一博 | 从 wepy 到 uniapp 变形记

作者:vivo 互联网前端团队-Wan Anwen、Hu Feng、Feng Wei、Xie Tao 进入互联网“下半场”,靠“人海战术”的研发模式已经不再具备竞争力,如何通过技术升级提升研发效能?前端通过Babel等编译技术发展实现了工程化体系升级,如何进一步通过编译技术赋能前端开发?或许我们 wepy 到uniapp 编译的转换实践,能给你带来启发。 一、 背景 随着小程序的出现,借助微信的生态体系和海量用户,使服务以更加便捷方式的触达用户需求。基于此背景,团队很早布局智能导购小程序(为 vivo 各个线下门店导购提供服务的用户运营工具)的开发。 早期的小程序开发工程体系还不够健全,和现在的前端的工程体系相差较大,表现在对模块化,组件化以及高级JavaScript 语法特性的支撑上。所以团队在做技术选型时,希望克服原生小程序工程体系上的不足,经过对比最后选择了腾讯出品的 wepy 作为整体的开发框架。 在项目的从0到1阶段,wepy 确实帮助我们实现了快速的业务迭代,满足线下门店导购的需求。但随着时间的推移,在技术上,社区逐步沉淀出以 uniapp 为代表的 Vue 栈体系和以 Taro 为代表的 React 栈跨端的体系,wepy 目前的社区活跃度比较低。另外随着业务进入稳定阶段,除少量的 wepy 小程序,H5 项目和新的小程序都是基于 Vue 和 uniapp 来构建,团队也是希望统一技术栈,实现更好的跨端开发能力,降低开发和维护成本,提升研发效率。 二、思考 随着团队决定将智能导购小程序从 wepy 迁移到 uniapp 的架构体系,我们就需要思考,如何进行项目的平稳的迁移,同时兼顾效率和质量?通过对当前的项目状态和技术背景进行分析,团队梳理出2个原则3种迁移思路。 2.1 渐进式迁移 核心出发点,保证项目的平稳过渡,给团队更多的时间,在迭代中逐步的进行架构迁移。希望以此来降低迁移中的风险和不可控的点。基于此,我们思考两个方案: 方案一 融合两套架构体系 在目前的项目中引入和 uniapp 的项目体系,一个项目融合了 wepy 和 uniapp 的代码工程化管理,逐步的将 wepy 的代码改成 uniapp 的代码,待迁移完成删除 wepy 的目录。这种方案实现起来不是很复杂,但是缺点是管理起来比较复杂,两套工程化管理机制,底层的编译机制,各种入口的配置文件等,管理起来比较麻烦。另外团队每个人都需要消化 wepy 到 uniapp 的领域知识迁移,不仅仅是项目的迁移也是知识体系的迁移。 方案二 设计 wepy-webpack-loader 以 uniapp 为工程体系基础,核心思路是将现有 wepy 代码融入到 uniapp 的体系中来。我们都知道 uniapp 的底层依赖于 Vue 的 cli 的技术体系,最底层通过 webpack 实现对 Vue 单组件文件和其他资源文件的 bundle。 基于此,我们可以开发一个 wepy 的 webpack 的 loader,wepy-loader 类似于 vue-loader 的能力,通过该 loader 对 wepy 文件进行编译打包,然后最终输出小程序代码。想法很简单,但我们想要实现 wepy-loader工作量还是比较大的,需要对 wepy 的底层编译器进一步进行分析拆解,分析 wepy 的依赖关系,区分是组件编译还是 page 编译等,且 wepy 底层编译器的代码比较复杂,实现成本较高。 2.2 整体性迁移 构建一个编译器实现 wepy 到 uniapp 的自动代码转换。 通过对 wepy 和 uniapp 整体技术方案的梳理,加深了对两套架构差异性的认知和理解,尤其 wepy 上层语法和 Vue 的组件开发的代码上的差异性。基于团队对编译的认知,我们认为借助 babel 等成熟编译技术是有能力实现这个转换的过程,另外,通过编译技术会极大的提升整体的迁移的效率。 2.3 方案对比 通过团队对方案的深入讨论和技术预研,最终大家达成一致使用编译转换的方式(方案三)来进行本次的技术升级。最终,通过实现 wepy 到 uniapp 的编译转换器,使原本 25人/天的工作量,6s 完成。 如下动图所示: 三、架构设计 3.1 wepy 和 uniapp 单文件组件转换 通过对 wepy 和 uniapp 的学习,充分了解两者之间的差异性和相识点。wepy 的文件设计和 Vue 的单文件非常的相似,包含 template 和 script 和 style 的三部分组成。 如下图所示, 所以我们将文件拆解为 script,template,style 样式三个部分,通过 transpiler 分别转换。同时这个过程主要是对 script 和 template 进行转换,样式和 Vue 可以保持一致性最终借助 Vue 进行转换即可。 同时 wepy 还有自己的 runtime运行时的依赖,为了确保项目对 wepy 做到最小化的依赖,方便后续完全和 wepy 的依赖进行完全解耦,我们抽取了一个 wepy-adapter 模块,将原先对于 wepy 的依赖转换为对wepy-adapter 的依赖。 整体转换设计,如下图所示: 3.2 编译器流水线构建 如上图所示,整个编译过程就是一条流水线的架构设计,在每个阶段完成不同的任务。主要流程如下: 3.2.1 项目资源分析 不同的项目依赖资源不同的处理流程,扫描项目中的源码和资源文件进行分类,等待后续的不同的流水线处理。 静态资源文件(图片,样式文件等)不需要经过当中流水线的处理,直达目标 uniapp 项目的对应的目录。 3.2.2 AST抽象语法树转换 针对 wepy 的源文件(app,page,component等)对 script,template 等部分,通过 parse 转换成相对应的AST抽象语法树,后续的代码转换都是基于对抽象语法树的结构改进。 3.2.3 代码转换实现 - Transform code 根据 wepy 和 uniapp 的 Vue 的代码实现上的差异,通过对ast进行转换实现代码的转换。 3.2.4 代码生成 - code emitter 根据步骤三转换之后最终的ast,进行对应的代码生成。 四、项目搭建 整体项目结构如下图所示: 4.1 单仓库的管理模式 使用 lerna 进行单仓库的模块化管理,方便进行模块的拆分和本地模块之间依赖引用。另外单仓库的好处在于,和项目相关的信息都可以在一个仓库中沉淀下来,如文档,demo,issue 等。不过随着 lerna 社区不再进行维护,后续会将 lerna 迁移到 pnpm 的 workspace 的方案进行管理。 4.2 核心模块 wepy-adapter - wepy运行期以来的最小化的polyfill wepy-chameleon-cli - 命令行工具模块 wepy-chameleon-transpiler - 核心的编译器模块,按照one feature,one module方式组织 4.3 自动化任务构建等 Makefile - *nix世界的标准方式 4.4 scripts 自动化管理 shipit.ts 模块的自动发布等自动化能力 4.5 单元测试 采用Jest作为基础的测试框架,使用typescript来作为测试用例的编写。 使用@swc/jest作为ts的转换器,提升ts的编译速度。 现在社区的vitest直接提供了对ts的集成,借助vite带来更快的速度,计划迁移中。 五、核心设计实现 5.1 wepy template 模版转换 5.1.1 差异性梳理 下面我们可以先来大致看一下wepy的模板语法和uniapp的模板语法的区别。 图:wepy模板和uni-app模板 从上图可以看出,wepy模板使用了原生微信小程序的wxml语法,并且在采用类似Vue的组件引入机制的同时,保留了wxml< import/ >、< include/ >标签的能力。同时为了和wxml中循环渲染dom节点的语法做区别,引入了新的< Repeat/ >标签来渲染引入的子组件,而uni-app则是完全使用Vue风格的语法来进行开发。 所以总结wepy和uni-app模板语法的主要区别有两点: wepy使用了一些特定的标签用来导入或者复用其他wxml文件例如< import >和< include >。 wxml使用了xml命名空间的方式来定义模板指令,并且对指令值的处理更像是使用模板引擎对特定格式的变量进行替换。 下表列举一些两者模板指令的对应转换关系。 此外,还有一些指令的细节需要处理,例如在wepy中wx:key="id"指令会自动解析为wx:key="{{item.id}}",这里便不再赘述。 5.1.2 核心转换设计 编译器对template转换主要就需要完成以下三个步骤: 处理wepy引入的特殊的标签例如。 将wxml中使用的指令、特殊标签等转换为Vue模板的语法。 收集引入的组件信息传递给下游的wepy-page-transform模块。 wepy特殊标签转换 首先我们会处理wepy模板中的特殊标签< import/ >、< include/ >,主要是将wxml的文件引入模式转换成Vue模板的组件引入模式,同时还需要收集引入的wxml的文件地址和展示的模板名称。由于< include/ >可以引入wxml文件中除了< template/ >和< wxs/ >的所有代码,为了保证转换后组件的复用性,我们将引入的xx.wxml文件拆成了xx.vue和xx-incl.vue两个文件,使用< import/ >标签的会导入xx.vue,而使用< include/ >标签的会导入xx-incl.vue,转换import的核心代码实现如下: transformImport() { // 获取所有import标签 const imports = this.$('import') for (let i = 0; i < imports.length; i++) { const node = imports.eq(i) if (!node.is('import')) return const importPath = node.attr('src') // 收集引入的路径信息 this.importPath.push(importPath) // 将文件名统一转换成短横线风格 let compName = TransformTemplate.toLine( path.basename(importPath, path.extname(importPath)) ) let template = node.next('template') while (template.is('template')) { const next = template.next('template') if (template.attr('is')) { const children = template.children() // 生成新的组件标签例如 // <import src="components/list.wxml" /> // <template is="subList" /> => <list is="subList" /> const comp = this.$(`<${compName} />`) .attr(template.attr()) .append(children) comp.attr(TransformTemplate.toLine(this.compName), comp.attr('is')) comp.removeAttr('is') // 将当前标签替换为新生成的组件标签 template.replaceWith(comp) } template = next } node.remove() } } 具体的WXML文件拆分方案请看WXML转换部分。 wepy 属性转换 上文中已经介绍了,wepy模板中的属性使用了命名空间+模板字符串风格的动态属性,我们需要将他们转换成Vue风格的属性。转换需要操作模板中的节点及其属性,这里我们使用了cheerio, 快速、灵活、类jQuery核心实现,可以利用jQuery的语法非常方便的对模板字符串进行处理。 上述流程中一个分支中的转换函数会处理相应的wepy属性,以保证后续可以很方便的对转换模块进行完善和修改。由于属性名称转换只是简单的做一下相应的映射,我们重点分析一下动态属性值的转换过程。 WXML中使用双中括号来标记动态属性中的变量及WXS表达式,并且如果变量是WXS对象的话还可以省略对象的大括号例如 < view wx:for="{{list}}" > {{item}} < /view >、< template is="objectCombine" data="{{for: a, bar: b}}" >< /template > 所以当我们取到双中括号中的值时会有以下两种情况: 得到WXS的表达式; 得到一个没有中括号包裹的WXS对象。此时我们可以先对表达式尝试转换,如果有报错的话,给表达式包裹一层中括号再进行转换。考虑到WXS的语法类似于Javascript的子集,我们依然使用babel对其进行解析并处理。 核心代码实现如下: /** * * @param value 需要转换的属性值 */ private transformValue(value: string): string { const exp = value.match(TransformTemplate.dbbraceRe)[1] try { let seq = false traverse(parseSync(`(${exp})`), { enter(path) { // 由于WXS支持对象键值相等的缩写{{a,b,c}},故此处需要额外处理 if (path.isSequenceExpression()) { seq = true } }, }) if (!seq) { return exp } return `{${exp}}` } catch (e) { return `{${exp}}` } } 到这里,我们已经能够处理wepy模板中绝大部分的动态属性值的转换。但是,上文也提及到了,wepy采用的是类似模板引擎的方式来处理动态属性的,即WXML支持这种动态属性< view id="item-{{index}}" >,如果这个 < view / >标签使用了wx:for指令的话,id属性会被编译成item-0、item-1... 这个问题我们也想了多种方案去解决,例如字符串拼接、正则处理等,但是都不能很好的覆盖全部场景,总会有特殊场景的出现导致转换失败。 最终,我们还是想到了模板引擎,Javascript中也有类似于模板引擎的元素,那就是模板字符串。使用模板字符串,我们仅仅需要把WXML中用来标记变量的双括号{{}}转换成Javascript中的${}即可。 5.2 Wepy App 转换 5.2.1 差异性梳理 wepy 的 App 小程序实例中主要包含小程序生命周期函数、config 配置对象、globalData 全局数据对象,以及其他自定义方法与属性。 核心代码实现如下: import wepy from 'wepy' // 在 page 中,通过 this.$parent 来访问 app 实例 export default class MyAPP extends wepy.app { customData = {} customFunction() {} onLaunch() {} onShow() {} // 对应 app.json 文件 // build 编译时会根据 config 属性自动生成 app.json 文件 config = {} globalData = {} } uniapp的 App.vue 可以定义小程序生命周期方法,globalData全局数据对象,以及一些自定义方法,核心代码实现如下: <script> export default { globalData: { text: 'text' } onLaunch: function() { console.log('App Launch,app启动') }, onShow: function() { console.log('App Show,app展现在前台') }, onHide: function() { console.log('App Hide,app不再展现在前台') }, methods: { // ..... } } <script> 5.2.2 核心转换设计 如图, 核心转换设计流程: 对 app.py 进行 parse,拆分出script和style部分,对script部分使用babel进行parse生成AST。 通过对 AST 分析出,小程序的生命周期方法,globalData全局数据,自定义方法等。 对于AST进行uniapp转换,生命周期方法和全局数据转成对象的方法和属性,对自定义方法转换到method内。 其中对 globalData 的访问,要进行替换通过 getApp()进行访问。 抽取 ast 中的 config 字段,输出到 app.json 配置文件。 抽取 wepy.config.js 中的 config 字段,传入 wepy 的 app 实例。 核心代码实现: let APP_EVENT = ['onLaunch', 'onShow', 'onHide', 'onError', 'onPageNotFound'] //.... // 实现wepy app到uniapp App.vue的转换 t.program([ ...body.filter((node: t.Node) => !t.isExportDeclaration(node)), // 插入appClass ...appClass, ...body .filter((node: t.Node) => t.isExportDeclaration(node)) .map((node: object) => { // 对导出的app进行处理 if (t.isExportDeclaration(node)) { // 提前config属性 const { appEvents, methods, props } = this.clzProperty // 重新导出vue style的对象 return t.exportDefaultDeclaration( t.objectExpression([ // mixins ...mixins, // props ...Object.keys(props) .filter((elem) => elem !== 'config') .map((elem) => this.transformClassPropertyToObjectProperty(props[elem]) ), // app events ...appEvents.map((elem) => this.transformClassMethodToObjectMethod(elem) ), // methods t.objectProperty( t.identifier('methods'), t.objectExpression([ ...methods.map((elem) => this.transformClassMethodToObjectMethod(elem) ), ]) ), ]) ) } return node }), ]) // ..... 5.2.3 痛点难点 在运行期,app.wpy 会继承 wepy.App 类,这样就会在运行期和 wepy.App 产生依赖关系,怎么最小化弱化这种关系。抽取wepy的最小化以来的polyfill,随着业务中代码剔除对wepy的api调用,最终去除对polyfill的依赖。 5.3 wepy component 转换 对于wepy component 的转换主要可以细化到对 component 中 template、script、style 三部分代码块的转换。 其中, style 部分由于已经兼容 Vue 的规范,所以我们无需做额外处理。而 template 模块主要是需要对 wepy template 中特殊的标签、属性、事件等内容进行处理,转化为适配 uni的template,上文做了详细的说明。 我们只需要专注于处理 script 模块的代码转换即可。从架构设计的思路来看,component script 的转换主要是是做以下两件事: 编译期可确定代码块的转换。 运行期动态注入代码的兼容。 wepy-component-transform 就是基于以上这两个标准设计出来的实现转换逻辑的模块。 5.3.1 差异性梳理 首先先解释一下什么是“编译期可确定代码块”,我们来看一个 wepy 和 Vue 语法对比示例: 从直观上来说,这个 script 的模板的语法大致和 Vue 语法类似,这意味着我们解析出来的 AST 结构和 Vue 文件对应的 AST 结构上类似,基于这一点来看编译转换的工作量大致有底了。 从细节来看, wpy 文件script 模块中的 API 语法和 Vue 中有声明及使用上的不同,其中包含: wepy 自身的包依赖注入及运行时依赖 props/data/methods 声明方式不同 生命周期钩子不同 事件发布/订阅的注册和监听机制不同。 ....等等 为了确定这个第5点等等还存在哪些使用场景,我们需要对 wepy 自身的逻辑和玩法有一个详尽的了解和熟悉,通过在团队内组织的 wepy 源码走读,再结合wepy 实际生产项目中的代码相互印鉴,我们最终才将 wepy 语法逻辑与 uni-app Vue 语法逻辑的异同梳理清楚。 5.3.2 核心转换设计 我们简单梳理一下 wepy-component-transform 这个模块的结构,可以分为以下三个部分: 预处理 wepy component script 代码 AST 节点部分 构建 Vue AST 通过 generate 吐出代码 1.预处理 AST 基于前文转换设计这一节我们知道, wepy 变色龙的转换器中对代码的 AST 解析主要依赖 babel AST 三板斧(traverse、types、generate)来实现,通过分析各个差异点代码语句转换后的 AST 节点,就可以通过 traverse 中的钩子来进行节点的前置处理,这里安利一下 https://astexplorer.net/,我们可以通过它快速分析代码块 AST 节点、模拟场景及验证转换逻辑: 预处理 AST,目的是提前将 wepy 源码中的代码块解析为 AST Node 节点后,按语法进行归集到预置的 clzProperty 对象中,其中: props 对象用来盛放 ClassProperty 语法的 ast 节点 notCompatibleMethods 数组用来盛放非生命周期函数白名单内的函数 AST 节点。 appEvents 数组用来盛放生命周期函数白名单内的函数 AST 节点。 listenEvents 数组用来盛放 发布/订阅事件注册的函数 AST 节点。 核心代码实现如下所示: import { NodePath, traverse, types } from '@babel/core' this.clzProperty = { props: {}, notCompatibleMethods: [], appEvents: [], listenEvents: [] } traverse() { ClassProperty: (path) => { const name = path.node.key.name this.clzPropertyprops[name] = path.node }, ClassMethod: (path) => { const methodName = path.node.key.name // 判断是否存在于生命周期白名单内 const isCompEvent = TOTAL_EVENT.includes(methodName) if (isCompEvent) { this.clzProperty.appEvents.push(path.node) } else { this.clzProperty.notCompatibleMethods.push(path.node) } }, ObjectMethod: (path: any) => { if (path.parentPath?.container?.key?.name === 'events') { this.clzProperty.listenEvents.push(path.node) } } } 这里要注意一点,由于对 wepy 来说,实际上 page 也属于 component 的一种实现,所以两者的 event 会有一定的重合,而且由于 wepy 中生命周期和 Vue 生命周期的差异性,我们需要对如 attached、detached、ready 等钩子做一些 hack。 2.构建 Vue AST buildCompVueAst 函数即为 构建 Vue AST 部分。从直观上来看,这个函数只做了一件事,即用 types.program 重新生成一个 AST 节点结构,然后将原有的 wepy 语法转换为 vue 语法。但是实际上我们还需要处理许多额外的兼容逻辑,简单罗列一下: created 重叠问题 methods 中函数的收集 events 中函数的调用处理 created 重叠问题主要是为了解决 created/attached/onLoad/onReady 这4个生命周期函数都会转换为 created 导致的多次重复声明问题。我们需要针对若存在 created 重叠问题时,将其余钩子中的代码块取出并 push 到第一个 created 钩子函数内部。代码示例如下: const body = this.ast.program.body const { appEvents, notCompatibleMethods, props, listenEvents } = this.clzProperty // 处理多个 created 生命周期重叠问题 const createIndexs: number[] = [] const sameList = ['created', 'attached', 'onLoad', 'onReady'] appEvents.forEach((node, index) => { const name: string = node.key.name if (sameList.includes(name)) { createIndexs.push(index) } }) if (createIndexs.length > 1) { // 取出源节点内代码块 const originIndex = createIndexs[0] const originNode = appEvents[originIndex] const originBodyNode = originNode.body.body // 留下的剩余节点需要取出其代码块并塞入源节点中 // 塞入完成后删除剩余节点 createIndexs.splice(0, 1) createIndexs.forEach((index) => { const targetNode = appEvents[index] const targetBodyNode = targetNode.body.body // 将源节点内代码块塞入目标节点中 originBodyNode.push(...targetBodyNode) // 删除源节点 appEvents.splice(index, 1) }) } 由于 wepy 中非 methods 中函数的特殊性,所以我们需要在转换时将独立声明的函数、events 中的函数都抽离出来再 push 到 methods 中,伪代码逻辑如下所示: buildCompVueAst() { const body = this.ast.program.body return t.program([ ...body.map((node) => { return t.exportDefaultDeclaration( t.objectExpression([ ...Object.keys(props) .map((elem) => { if (elem === 'methods') { const node = props[elem] // 1.events 内函数插入 methods 中 // 2.与生命周期平级的函数抽离出来插入 methods 中 node.value.properties.push( ...listenEvents, ...notCompatibleMethods ) } return props[elem] }) ]) ) }) ]) } events 中函数的调用处理主要是为了抹平 wepy 中发布订阅事件调用和 Vue 调用的差异性。在 wepy 中,事件的注册通过在 events 中声明函数,事件的调用通过 this.$emit 来触发。而 vue 中我们采用的是 EventBus 方案来兼容 wepy 中的写法,即手动为 events 中的函数创建 this.$on 形式的调用,并将其代码块按顺序塞入 created 中来初始化。 首先我们要判断文件中是否已有 created 函数,若存在,则获取其对应的代码块并调用 forEachListenEvents 函数将 events 中的监听都 push 进去。 若不存在,则初始化一个空的 created 容器,并调用 forEachListenEvents 函数。核心代码实现如下所示: buildCompVueAst() { const obp = [] as types.ObjectMethod[] // 获取class属性和方法 const body = node.declaration.body.body const targetNodeArray = body.filter(child => child.key.name === 'created' ) if (targetNodeArray.length > 0) { let createdNode = targetNodeArray[0] this.forEachListenEvents(createdNode) } else { const targetNode = t.objectMethod( 'method', t.identifier('created'), [], t.blockStatement([]) ) this.forEachListenEvents(targetNode) if (targetNode.body && targetNode.body.body.length > 0) { obp.push(targetNode) } } return obp } forEachListenEvents 函数主要是通过 wepy 中 声明的 events 事件名和入参,借助 babel types 手动创建对应的 AST Node,最终生成对应的形如 this.eventBus.on("canceldeposit", this.canceldeposit) 形式的监听,其中,this.canceldeposit 为原有 events 中的事件被移入 methods 后的函数,相关伪代码实现如下所示: // 根据 events 中的 methods 构建事件监听的调用 // 并塞入 created 中 forEachListenEvents(targetNode: types.ObjectMethod) { this.clzProperty.listenEvents.forEach((item) => { const methodsNode: any = item // 形如 this.$on('test', ()=>{}) if (methodsNode?.key?.name) { // 创建 this 表达式 const thisEx = t.thisExpression() // 创建 $on 表达式 const ide = t.identifier('$eventBus.$on') // 合并 this.$on 表达式 const om = t.memberExpression(thisEx, ide) // 创建事件名称参数节点 const eventNameIde = t.stringLiteral( methodsNode.key.name.toString().trim() ) // 获取方法体内代码内容节点 const meNode = t.memberExpression( t.thisExpression(), t.identifier(methodsNode.key.name.toString().trim()) ) const ceNode = t.callExpression(om, [eventNameIde, meNode]) const esNode = t.expressionStatement(ceNode) // 将合成后的代码插入到 created 中 targetNode.body.body.push(esNode) } }) } 3.emitter vue 代码生成 构建完 Vue AST 之后,我们可以调用 generate 函数生成源码字符串: transform() { const ast = this.buildCompVueAst() const compVue = this.genCode(ast) return { compVue, wxs: this.buildWxs() } } 5.4 Wepy page 转换 5.4.1 差异性梳理 上面的章节已经给大家分析了template、component的代码转换逻辑,这一节主要带大家一起看下如何转换page文件。page转换的逻辑即如何实现wepy 的 page.wpy 模块转换为 uniapp 的 page.vue 模块。 首先我们来看下wepy 的 page 小程序实例: <script> import wepy from 'wepy'; import Counter from '../components/counter'; export default class Page extends wepy.page { config = {}; components = {counter1: Counter}; data = {}; methods = {}; events = {}; onLoad() {}; // Other properties } </script> <template lang="wxml"> <view> </view> <counter1></counter1> </template> <style lang="less"> /** less **/ </style> 可以看到,wepy的page类也是通过继承来实现的,页面文件 page.wpy 中所声明的页面实例继承自 wepy.page 类,该类的主要属性介绍如下: 5.4.2 核心转换设计 基于page的api特性以及实现方案,具体的转换设计思路如下: 5.4.3 痛点难点 1.非阻塞异步与异步 在进行批量pages转换时,需要同时对pages.json进行读取、修改、再修改的操作,这就涉及到使用阻塞 IO/ 异步 IO来处理文件的读写,当使用异步IO时,会发起多个进程同时处理pages.json, 每个读取完成后单独处理对应的内容,数据不是串行修改,最终导致最终修改的内容不符合预期,因此在遇到并行处配置文件时,需要使用阻塞式io来读取文件,保障最终数据的唯一性,具体代码如下: // merge pageConfig to app config const rawPagesJson = fs.readFileSync(path.join(dest, 'src/pages.json')) // 数据操作 fs.writeFileSync( path.join(dest, 'src', 'pages.json'), prettJson(pagesJson) ) 2.复杂的事件机制 在转换过程中,我们也碰到一个比较大的痛点:page.wepy 继承至 wepy.page,wepy.page 代码较复杂,需要将明确部分单独抽离出来。例如说 events 中组件间数据传递:$broadcast、$emit、$invoke,$broadcast、$invoke需要熟悉其使用场景,转换为 Vue 中公共方法。 5.5 Wepy WXML 转换 template转换章节中提到了wepy模板中可以直接引入wxml文件,但是uni-app使用的Vue模板不支持直接引入wxml,故我们需要将wxml文件处理为uniapp可以引入的Vue文件。我们先来看一下wepy中引入的wxml文件的大致结构。 <template name="foo"> <view class="foo-content"> <text class="text1">{{item.text1}}</text> <image class="pic" src="{{pic.url}}" mode="aspectFill"></image> </view> </template> <template name="bar"> <view class="bar-content"> <image class="bar" src="{{pic.url}}" mode="aspectFill"></image> <text class="text2">{{item.text2}}</text> </view> </template> <view class="footer"> this is footer </view> <!-- index.wepy --> <!-- 引入文件 --> <import src="somePath/fooBar.wxml" /> <!-- 确定展示的template及传入属性 --> <script is="foo" data="{{item, pic}}" /> <!-- or, 此时仅会展示<template/>以外的内容即footer --> <include src="somePath/fooBar.wxml"> 5.5.1 差异性梳理 从上面的代码可以看出,一个WXML文件中支持多个不同name属性的< template/ >标签,并且支持通过在引入设置data来传入属性。从上面的示例模板中我们可以分析出,除了需要将wepy使用的WXML语法转换成vue模板语法外(这里的转换交给了template模块来处理),我们还需要处理以下的问题。 确定引入组件时的传参格式 确定组件中传入对象的属性有哪些 处理< import/ >和< include/ >引入的文件时的情况 5.5.2 核心转换设计 1.确定引入组件时的传入属性方式 首先需要将wepy组件引入形式改成Vue的组件引入方式。以上面的代码为例,即将< import/ > 、< script/ >对的引入形式改写成< component-name / > 引入方式。我们会在转换开始前对代码进行扫描,收集模板中的引入文件信息,传递给wepy-page-transform模块处理,在转换后的Vue组件的< script/ >中进行引入。并且将< script is="foo" data="{{item, pic}}" / > 转换为< FooBar is="foo" :data=(待定) / > 。这里就需要确定属性传递的方式。 从上面的代码中可以看到,在WXML文件的< template/ >会自动使用传入的data属性作为隐式的命名空间,从而不需要使用data.item来获取item属性。这里很自然的就会想到原来的< script is="foo" data="{{item, pic}}" / >可以转换成< FooBar compName="foo" :key1="val1" :key2="val2" ... / >。 其中,key1,val1,key2,val2等为原data属性对象中的键值对,compName用来指定展示的部分。这样处理的好处是,引入的WXML文件中使用相应的传入的属性就不需要做额外的修改,并且比较符合我们一般引入Vue组件时传入属性的方式。 虽然这种方案可以较少的改动WXML文件中的模板,但是由于传入的对象可能会在运行期间进行修改,我们在编译期间比较难以确定传入的data对象中的键值对。考虑到实现的时间成本及难易程度,我们没有选择这种方案。 目前我们所采用的方案是不去改变原有的属性传入方式,即将组件引入标签转换为< FooBar compName="foo" :data="{item, pic}" / >。从而省去分析传入对象在运行时的变动。这里就引出了第二个问题,如何确定组件中传入的参数有哪些。 2.确定组件中的传入的对象属性 由于Vue的模板中不会自动使用传入的对象作为命名空间,我们需要手动的找到当前待转换的模板中所使用到的所有的变量。相应的代码如下: searchVars() { const self = this const domList = this.$('template *') // 获取wxml文件中template节点下的所有text节点 const text = domList.text() const dbbraceRe = new RegExp(TransformTemplate.dbbraceRe, 'g') let ivar // 拿到所有被{{}}包裹的动态表达式 while ((ivar = dbbraceRe.exec(text))) { addVar(ivar[1]) } // 遍历所有节点的属性,获取所有的动态属性 for (let i = 0; i < domList.length; i++) { const dom = domList.eq(i) const attrs = Object.keys(dom.attr()) for (let attr of attrs) { const value = dom.attr(attr) if (!TransformTemplate.dbbraceRe.test(value)) continue const exp = value.match(TransformTemplate.dbbraceRe)[1] try { addVar(exp) } catch (e) { addVar(`{${exp}}`) } } } function addVar(exp: string) { traverse(parseSync(`(${exp})`), { // 利用babel分析表达式中的所有变量 Identifier(path) { if ( path.parentPath.isMemberExpression() && !path.parentPath.node.computed && path.parentPath.node.property === path.node ) return self.vars.add(path.node.name) // 收集变量 }, }) } } 收集到所有的变量信息后,模板中的所有变量前面需要加上传入的对象名称,例如item.hp_title需要转换成data.item.hp_title。考虑到模板的简洁性和后续的易维护性,我们把转换统一放到< script/ >的computed字段中统一处理即可: <template> <!--...--> </template> <script> export default { props: ['data', 'compName'], computed: { item() { return data.item }, pic() { return data.pic } } } </script> 3.处理 < import/ >和< include/ >两种引入方式 wepy模板有两种引入组件的方式,一种是使用< import/ >< script/ >标签对进行引入,还有一种是使用< include/ > 进行引入,< include/ > 会引入WXML文件中除了< template/ >和< wxs/ >的其他标签。这里的处理方式就比较简单,我们把< include/ > 会引入的部分单独抽取出来,生成TItem-incl.vue文件,这样即保证了生成代码的可复用性,也降低< import/ >标签引入的部分生成的TItem.vue文件中的逻辑复杂度。生成的两个文件的结构如下: <!--TItem.vue--> <template> <view> <template v-if="compName == 'foo'"> <view class="foo"> <!--...--> </view> </template> <template v-if="compName == 'bar'"> <view class="bar"> <!--...--> </view> </template> </view> </template> <script> export default { props: ['compName', 'data'], computed: { item() { return this.data.item }, pic() { return this.data.pic } } } </script> <!--TItem-incl.vue--> <template> <view> <view class="footer"> this is footer </view> </view> </template> 六、阶段性成果 截止到目前,司内的企微导购小程序项目通过接入变色龙编译器已经顺利的从 wepy 迁移到了 uniApp 架构,原本预计需要 25人/天 的迁移工作量在使用了编译器转换后缩短到了 10s。这不仅仅只是提高了迁移的效率,也降低了迁移中的知识迁移成本,给后续业务上的快速迭代奠定的扎实的基础。 迁移后的企微导购小程序项目经测试阶段验证业务功能 0 bug,目前已经顺利上线。后续我们也会持续收集其他类似的业务诉求,帮助业务兄弟们低成本完成迁移。 七、总结 研发能效的提升是个永恒的话题,此次我们从编译这个角度出发,和大家分享了从wepy到uniapp的架构升级探索的过程,通过构建代码转换的编译器来提升整体的架构升级效率,通过编译器消化底层的领域和知识的差异性,取得了不错的效果。 当然,我们目前也有还不够完善的地方,如:编译器脚手架缺乏对于部分特性颗粒度更细的控制、代码编译转换过程中日志的输出更友好等等。后续我们也有计划将 wepy 变色龙编译器在社区开源共建,届时欢迎大家一起参与进来。 现阶段编译在前端的使用场景越来越多,或许我们真的进入了Compiler is our framework的时代。

优秀的个人博客,低调大师

每日一博 | 一文理解 OpenStack 网络

摘要:如果你能理解OpenStack的网络,那么对于其他云平台的网络,应该也可以通过分析后理解掌握了。 本文分享自华为云社区《《跟唐老师学习云网络》 - OpenStack网络实现》,作者: tsjsdbd 。 整体设计 首先,OpenStack是用来管理大量的VM的“上帝”。他的目的是要像掌控物理世界一样,去管理大量的VM。即:可以给VM分组,同一个组里面的VM,在同一个网络内,可以互通通信。不同组的VM,则相当于在不同的网络中,互相不能通信。 至于为什么要分组, 1、是跟物理服务器一样,那么多机器,按照不同机房的服务器,连到不同的网络。 2、是我可以把不同组的VM,卖给不同的“用户”,这样,组1的VM属于张三,组2的VM属于李四,这样他们俩互相隔离,互不感知。于是我就可以化身成为云厂商,对外提供云平台服务了。 当然你作为云厂商,也肯定要允许一个用户,可以拥有2个网络嘛。万一该客户人傻钱多,就是买了一堆VM,分着玩呢,是吧。 逻辑视图 现实中,2个机房的服务器,网络要想连通,是要靠路由器来帮忙的。在虚拟世界中也是类似的。 所以,逻辑上,VM世界的网络就是长这个样。 张三的VM的网络,要想和李四VM的网络 互通,或者张三自己的2个独立网络互通。就得通过一个叫做 Router 的“虚拟路由器”来完成。 物理视图 上面的逻辑视图,在物理上,则是这个样子的: 至于如何在一根网线上面,同时跑多个虚拟网络的报文。这个就是在一根网线上的报文,有不同门派的意思。具体的可以回去看VLAN/VxLAN章节。 另外,这里你可以看到,虚拟网络里面的一个“Router”,其实不是什么具体的虚拟路由器设备,而仅仅是一个“网络namespace+转发规则”就达成了,下面会细讲。 简单模型 假设现在你来设计OpenStack的网络实现。 那从我们之前学到的OVS章节,可以知道,为了达成上面提到的OpenStack的网络虚拟化目的。最简单的实现是给每个物理服务器上增加一个OVS虚拟交换机;然后每个VM都连到OVS端口上,每个端口则按照分组,打上对应的VLAN标签。就可以达成基本要求。 但是,这个初始1.0版本的实现,有个不牛批的地方,就是没法给VM设置安全组。你作为想成为云平台伟大目标,平台怎么能没有安全组这个能力呢(虽然,在VM里面,可以设置firewell或者iptables规则,但是VM里面,那是已经卖给用户的了,你跑人家房间里面,去设置规则并不合适,可能和用户自己的业务规则冲突)。 所以第2个版本,改进之。我们要在VM的外面设置安全组: 于是,我们在每个VM大门口,增加一个Bridge网桥,任何VM的流量,都会经过这个Bridge。这样,通过在Bridge上面,增加iptables规则,就可以达到给VM设置安全组的目的了。(注意,这个时候,VM的报文还没有到OVS,所以报文还是没有打VLAN标签的原始报文,所以iptables规则也好实现)。 这就是咱们的OpenStack网络2.0版本。 但是,在实践中,你发现这个独苗OVS,要设置端口转发规则有2部分: 上半部分。即:给VM设置Tag标签。 每增加一台VM时,就给这个端口打标签,插拔虚拟网线等配置动作。这一部分逻辑比较固定,不怎么变化。 下半部分。即:通过物理网线,怎么给报文打“门派”标记。 这一部分变化很大,有时候物理网络,咱得走GRE,有时候要走VLAN,有时候又得VxLAN。还有时候,得走专用的网络设备。平台得根据部署的机房网线,定制不同的规则。 这样这2类OVS的规则不好管(都放openflow的转发表里面),本着程序员的“分库分表”(或者咱们写代码时的,“抽取函数”的逻辑)的思路,咱们把1个独苗OVS,分成多个VOS。分别做不同的事情。 于是,咱们到了3.0版本,这个版本就比较通用了。基本可以和实际OpenStack的网络比较接近了。不过在网络节点部分,还得再增强一下。就是咱们的VM,除了互访之外(流量还在几台物理服务器之间转悠),还得访问外网呀(流量跑机房外部去)。 所以,还得继续增强一下VM访问外部网络的能力: 这么一来,就到了差不多4.0版本了。后面咱们介绍的OpenStack网络,就是照着这个版本来的。在OpenStack网络里面,对各种ovs,bridge,接口的命名,有一套自己的规范。不像上面这么随意的取名。 控制节点 有了上面这些给VM设置虚拟网络用的模型,那么要搞成自动化(即:每创建一个VM,给它设置好配套的虚拟网线连接)。 你得写个主控程序,用来控制这些计算节点上面的行为吧。如下: 所以,按照OpenStack官方的架构,它需要有3种节点:管节点,计算节点,网络节点。 每个节点上面,部署了一堆agent,用来接收老大的控制命令。老大就是Master管理节点了。 注:之前章节也提过,分布式系统,可靠的控制都需要有个“代理商”,比如RabbitMQ(OpenStack选了这个),ETCD(Kubernetes选了这个),ZooKeeper(Hadoop选了这个)这种。 (1)首先是最上面红色的线,就是“主控逻辑”用来控制Agent干活的,简称管理面网络。 (2)然后是中间绿色的线,那就是VM们在这根网线上面,发送大量的“自己门派”的报文,即VM间互相通信,都要走的网络,数据量很大。简称数据面。 为了确保管理面和数据面隔离,互不影响(即:VM疯狂发包,别把管理命令的报文给冲没了)。每台物理服务器上面,得有2块网卡,一块用来走管理网线,一块用来走数据网线。 (3)接着就是左下角的墨绿色线,这个是VM们访问机房外部网络用的。只需要网络节点,有一个额外的网卡就行了。 (4)最后是紫色的线。你的主控逻辑,要不要包装成API接口,对外部暴露访问通道? 要的话,可以加上。不要的话,那就每次都登陆到主控节点里面,手动敲命令控制也行。 计算节点 这里咱们打开一个OpenStack的计算节点,看看它的网络构造,遥记当年(2013年,OpenStack版本Havana)我学OS网络的时候,看到一个资料,对我帮助很大,这里直接贴上来: 照着前文的“设计思路”,你应该可以看懂上图的网络逻辑了吧。命名上,一般内部的ovs叫 br-int。隧道的叫 br-tun。如果你有环境的话,在节点上面查询,使用各种网络命令(ip,ovs-vsctl,brctl等),你可以证实一下。 网络节点 同样,网络节点,网络组成如下: 其中,上部的红色虚线,表示一个 网络namespace。dnsmasq是一个DHCP服务器(自动分配IP的程序,用来给VM分配IP地址)。 这个节点也使用各种网络命令来查询查看确认。 ps,由于该网络节点上有很多网络namespace,所以记得使用 ip netns exec命令来进入到对应的ns查询这个虚拟空间里面的详情。 floating IP(EIP) VM除了有自己的虚拟网络内的IP,还可以拥有一个floating IP(注:对应云厂商,一般把这个叫做 EIP)。咱们来看下这个“浮动IP”是个什么实现逻辑。 逻辑概念 首先,浮动IP,是物理网络世界的,即OpenStack的外部网络的。它是一个真实存在的IP地址(不跟VM一样,那是你虚拟出来的IP)。 如上图,对floating IP,我总结的一句话概况就是:VM对外的名号。 当你从外部网络,访问这个“浮动IP”,就等于访问这一台VM。至于为什么要叫“浮动”这个词,是因为这个名号,会漂移。 举个例子:“护国大法师”这个名号很响亮,当你一报你要找“护国大法师”这个人时,大家都知道你要找具体的谁。但是这个“护国大法师”名号,是可以从一个人身上转移到另一个人身上的。 直接对应云厂商的EIP,是不是就好理解了。 具体实现 我们关注点,直接聚焦到网络节点的一个namespace里面。(本例的浮动IP是 192.168.101.3)。如下图: 在网络节点,查询ns。 root@netnode:/# ip netns qdhcp-a7e512cf-1ca0-4ec7-be75-46a8998cf9ca qrouter-4cdb0354-7732-4d8f-a3d0-9fbc4b93a62d 找到对应的 router 那个ns(上图五角星处),然后查询这个里面的网卡信息: root@netnode:/# ip netns exec qrouter-4cdb0354-7732-4d8f-a3d0-9fbc4b93a62d ip address 11: qg-1423ba35-7c: <BROADCAST,MULTICAST,PROMISC,UP,LOWER_UP> mtu 1500 qdisc noqueue state UNKNOWN inet 192.168.101.2/24 brd 192.168.101.255 scope global qg-1423ba35-7c inet 192.168.101.3/32 brd 192.168.101.3 scope global qg-1423ba35-7c 12: qr-9f1fa61e-1e: <BROADCAST,MULTICAST,PROMISC,UP,LOWER_UP> mtu 1500 qdisc noqueue state UNKNOWN inet 172.17.17.1/24 brd 172.17.17.255 scope global qr-9f1fa61e-1e 可以看到,有个叫qg-xx的网卡,拥有了这个 floating IP地址。 然后我们查询一下这个ns里面的iptables规则: root@netnode:/# ip netns exec qrouter-4cdb0354-7732-4d8f-a3d0-9fbc4b93a62d iptables -t nat -S 你会发现有这么2条规则: -A quantum-l3-agent-float-snat -s 172.17.17.2/32 -j SNAT --to-source 192.168.101.3 -A quantum-l3-agent-PREROUTING -d 192.168.101.3/32 -j DNAT --to-destination 172.17.17.2 第1条是SNAT规则,就是把源IP地址换掉的意思。 具体内容是:如果源IP是 172.17.17.2 的(VM的),那么把源IP换成192.168.101.3(floatingIP的)。 第2条是DNAT规则,就是把目的IP地址换掉。具体内容是:如果目的IP的192.168.101.3(floatingIP的),就把目的IP换成172.17.17.2 的(VM的)。 这样一来,报文不就统统转给了这个VM嘛。 于是,一个VM一旦拥有了floatingIP(也叫EIP),它就可以被外网访问,也可以直接访问外网。 不过,真正的外部IP,可能是有限的,得省着点用,这就有了下面的SNAT和DNAT功能。 SNAT功能 如果一台VM,想访问外部网络,但是又不给它分配floatingIP。这时候就可以使用SNAT。 还是上一节的这个ns,查询这个ns里面的网卡信息,可以看到,还有一个 101.2 的IP。 root@netnode:/# ip netns exec qrouter-4cdb0354-7732-4d8f-a3d0-9fbc4b93a62d ip address 11: qg-1423ba35-7c: <BROADCAST,MULTICAST,PROMISC,UP,LOWER_UP> mtu 1500 qdisc noqueue state UNKNOWN inet 192.168.101.2/24 brd 192.168.101.255 scope global qg-1423ba35-7c inet 192.168.101.3/32 brd 192.168.101.3 scope global qg-1423ba35-7c 12: qr-9f1fa61e-1e: <BROADCAST,MULTICAST,PROMISC,UP,LOWER_UP> mtu 1500 qdisc noqueue state UNKNOWN inet 172.17.17.1/24 brd 172.17.17.255 scope global qr-9f1fa61e-1e 还是查询一下这个ns里面的iptables规则: root@netnode:/# ip netns exec qrouter-4cdb0354-7732-4d8f-a3d0-9fbc4b93a62d iptables -t nat -S 你会发现有这么1条规则: -A quantum-l3-agent-snat -s 172.17.17.0/24 -j SNAT --to-source 192.168.101.2 该规则是,所有源IP是 172.17.17.0/24 这个网段的报文(就是该网络内的所有VM),都把源IP地址换掉的意思。 所以,一旦给一个虚拟网络设置了SNAT功能,那么这个网络里面的所有VM,都可以访问外网了。只是大家共用一个外部出口IP地址(本质还是EIP),这个就是省着点用的意思。 缺点是:只能从内部(虚拟网络)访问外部(外部网络),外部不能访问内部(毕竟,这个IP是大家共用的,不是某一台VM的)。 DNAT功能 在本着省着点用的原则下(即好多VM共享一个外部IP)。如果希望外部访问内部VM,还可以使用DNAT功能。 原理上,你应该想到了,就是在ns里面增加一条,根据不同的端口,转发不同目的IP地址的DNAT规则。 这一种省钱的办法,缺点是:只能指定对应的目的端口。比如,外部端口80,分配给VM1占用了。那么VM2就不能用80了,它只能委屈下,使用外部端口号81(或其他)了。 省钱总得要失去点什么,要不然,给每台VM都买个EIP不就完了。 Router OpenStack里面的Router,是用来将“一个网络”,连接到“另一个网络”的。可以是2个虚拟网络,也可以是1个虚拟网络+1个实际外部网络。 一个Router本质是一个 网络namespace,同上一个章节描述浮动ip一样,这个ns是一个虚拟的“中转站”。 所有的网络连接,需要先到这个中转站“休息打扮一下”,然后再前往目的网络。 注意,在同一个用户的2个网络互联,和2个不同用户的网络互联,在底层实现的技术上是一样的。不同点是不同用户的话,需要控制好权限,不然张三不就可以随便去连李四的网络了。 Router概念,对应到云厂商,一般叫 “VPC互联”。产品各式各样,比如以前的“vpc peering”,现在的“云企业网络”“企业路由”“云连接”等。 Metadata服务 metadata服务,就是允许每个VM去问上帝(OpenStack平台):“你创建我的档案上面,都写了些什么?”。 这是一个非常有意思的特性。 功能介绍 你(VM)去问上帝,你总得知道上帝在哪里把?所以在OpenStack上,将上帝的地址,写死了一个特殊的IP:169.254.169.254, 挺好记的。 询问上帝的方法: $ curl http://169.254.169.254 1.0 2007-01-19 2007-03-01 2007-08-29 2007-10-10 2007-12-15 2008-02-01 2008-09-01 2009-04-04 latest 你可以去试一下,如果发现这个IP可以访问,说明你可以证明自己的机子是一台被虚拟出来的VM,而不是一台物理机了。 举个例子,VM问:我被生出来后的启动脚本是什么? 即问自己的 “userdata信息” $ curl http://169.254.169.254/openstack/latest/user_data #!/bin/bash echo 'Extra user data here' 这个功能,还是比较有用的,特别是在做VM自动化的时候(ps,可以去查一下一个称作 cloud-init 的东西)。 metadata特性应该是来自AWS。OpenStack为了兼容AWS的这个“询问上帝”的功能(当然,肯定也是认可这个功能还是有用的)。也支持了这个 metadata服务。 具体实现 我们知道创造&管理VM的组件,是叫Nova。也就是metadata特性,要从虚拟世界(VM里面)去访问物理世界(Nova的API),经过上面的介绍,这种情况下,肯定要经过一个“中转站”的。 我们先看下VM内部,访问169.254.169.254的时候,报文去哪里了: 在VM里面敲: ip route default via 172.17.17.1 dev eth0 172.17.17.0/24 dev eth0 src 172.17.17.5 169.254.169.254 via 172.17.17.1 dev eth0 可以看到 访问“上帝”时,报文去了 VM网络的网关IP(172.17.17.1)那了。 那么网关IP在哪里?在网络节点的namespace里面: root@netnode:/# ip netns exec qrouter-4cdb0354-7732-4d8f-a3d0-9fbc4b93a62d ip address 里面有个网卡叫做: 12: qr-9f1fa61e-1e: <BROADCAST,MULTICAST,PROMISC,UP,LOWER_UP> mtu 1500 qdisc noqueue state UNKNOWN inet 172.17.17.1/24 brd 172.17.17.255 scope global qr-9f1fa61e-1e 我们再来看下,访问169.254的报文,到这个“中转站”后,被如何“拿捏”的。 root@netnode:/# ip netns exec qrouter-7a44de32-3ac0-4f3e-92cc-1a37d8211db8 iptables -S 可以看到,目的地址是169.254的报文,会转给本地的 9697端口。 -A quantum-l3-agent-PREROUTING -d 169.254.169.254/32 -p tcp -m tcp --dport 80 -j REDIRECT --to-ports 9697 -A quantum-l3-agent-INPUT -d 127.0.0.1/32 -p tcp -m tcp --dport 9697 -j ACCEPT 那么,谁在本地(这个namespace内)监听 9697端口呢?答案是上帝的代理,一个agent在这里偷听呢。 root@netnode:/# ip netns exec qrouter-7a44de32-3ac0-4f3e-92cc-1a37d8211db8 netstat -anpt tcp 0 0 0.0.0.0:9697 0.0.0.0:* LISTEN 11937/python 看下这个进程号,具体的命令:。 root@netnode:/# ps -ef | grep 11937 root 11937 1 0 08:43 ? 00:00:00 python /usr/bin/neutron-ns-metadata-proxy -metadata_proxy_socket=/var/lib/neutron/metadata_proxy 可以看到,有一个proxy进程监听者9697端口,并将“访问上帝的请求”,转给了本地 unix domain socket 的监听者(即agent)。 使用 root@netnode:/# netstat -lxp | grep metadata 或者 root@netnode:/# lsof /var/lib/neutron/metadata_proxy 查询到在监听本地unix domain socket的进程ID 然后看下这个进程ID,是不是上帝的agent: root@netnode:/# ps -ef | grep “具体进程ID” 逻辑上,整体过程如下: 具体可参考该图: 所以,关键其实还是那个 namespace中转站。 附,本段参考链接: http://niusmallnan.com/_build/html/_templates/openstack/metadata_server.html http://techbackground.blogspot.com/2013/06/metadata-via-quantum-router.html DVR(Distributed Virtual Routing) 在上面的介绍中可以看到,所有的VM虚机,要访问外网,都要经过网络节点。这样也有不好地方,1是网络节点的网络流量压力非常大;2是一旦网络节点异常,大量的VM都要受影响。所以,这里能不能把网络节点的“中转站”功能,复制一份到各个计算节点上去。然后在计算节点上面,增加判断逻辑: if (本地有“中转站”) && (符合使用条件) {使用本地“中转站”}; else {继续使用原来的网络节点的“中转站”}。 答案就是DVR了。为了降低网络节点的负载,同时提高可扩展性,OpenStack在Juno版本引入了DVR特性,DVR部署在计算节点上。计算节点上的VM使用floatingIP访问Internet,不必经过网络节点,直接从计算节点的DVR就可以访问。 这样网络节点只需要处理占到整体流量一部分的 SNAT (无 floating IP 的 vm 跟外面的通信)流量,大大降低了负载和整个系统对网络节点的依赖。 具体计算节点的if条件判断,就是通过openflow规则,来控制的。这个有点太细节了,没有细研究。可以去看看相应的文章: https://www.cnblogs.com/sammyliu/p/4713562.html https://docs.openstack.org/ocata/networking-guide/deploy-ovs-ha-dvr.html 所以你可以看到,原来网络节点的路由器,现在分散到各个计算节点上面了。原来一个人(网络节点的Router)要干的活,现在分散给很多人(各计算节点的Router)干。确实分布式路由器了。 总结 基本上,OpenStack的网络实现,是集成了目前所有的“网络虚拟化零件”,包括:ovs交换机,bridge网桥,veth网线,tap网线,patch网线,namespace空间,iptables规则等。也是唐老师我接触过最复杂的网络实现(所以本文一直拖到最后)。如果你能理解OpenStack的网络,那么对于其他云平台的网络,应该也可以通过分析后理解掌握了。 最后,基础的云网络相关的课程,唐老师就只能教到此了。毕竟咱可以是一个入门导师,也不是专门负责网络开发的。所以在入门后,如果还要继续深入研究云网络,甚至开始设计网络虚拟化方案的,还得靠你自己继续修行。骚年,加油~ 注:由于作者现阶段主要专注于云原生相关的业务(Kubernetes集群),所以OpenStack网络信息不就是最新的了。不过这个关系应该不大,因为其网络设计原理是继承的。并且,咱们的课程,主要目的就是能看懂。要设计的话,还得自己再深入学习。So,本着能看懂OpenStack网络的原则,本文还是够用的。 点击关注,第一时间了解华为云新鲜技术~

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册