首页 文章 精选 留言 我的

精选列表

搜索[赛博朋克],共10000篇文章
优秀的个人博客,低调大师

每日一博 | 攻击面分析及应对实践

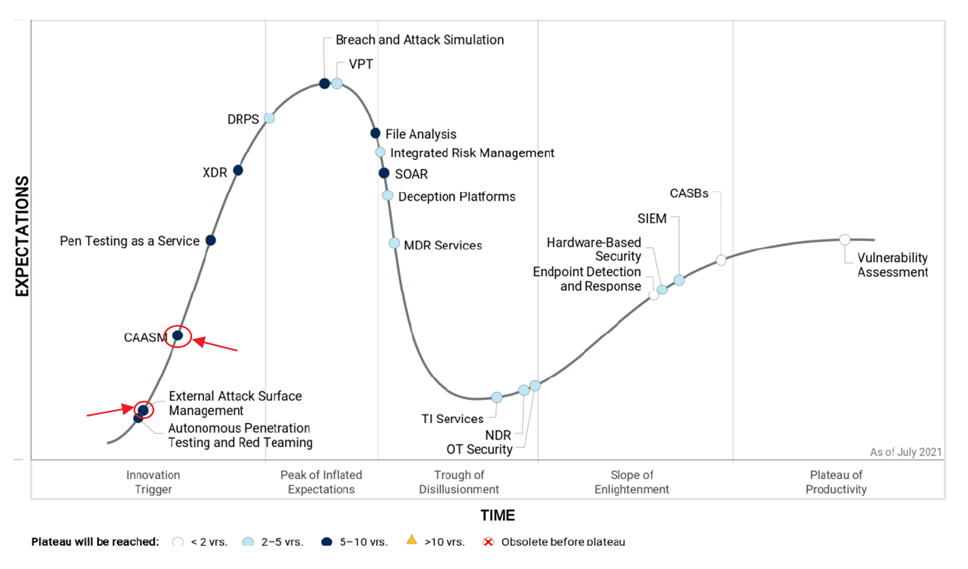
作者:vivo 互联网安全团队- PengQiankun 本文结合CASSM和EASM两个新兴的攻击面管理技术原理对资产管理,综合视图(可视化),风险评估,风险修复流程四个关键模块进行简述,为企业攻击面安全风险管理提供可落地的建设思路参考。 一、攻击面概述 攻击面是企业所有网络资产在未授权的情况下便能被访问和利用的所有可能入口的总和。 随着物联网、5G 、云计算等技术发展和社会数字化转型持续发展,当下的网络空间资产的范围和类型也发生了巨大变化,同时未来将会有更多的新兴资产和服务出现,如何去建立更加合适高效的安全技术体系来管理企业面临的攻击面安全风险将是安全运营工作面临的新挑战。 行业趋势: Gartner在 2021 年 7 月 14 日发布《 2021 安全运营技术成熟度曲线》中明确提到了攻击面的两个新兴技术:网络资产攻击面管理( Cyber assetattack surface management)和外部攻击面管理( External Attack Surface Management),目标是为了让安全团队对暴露资产以及攻击面进行科学高效的管理,从攻击者视角审视企业网络资产可能存在的攻击面及脆弱性,建立对企业网络攻击面从检测发现、分析研判、情报预警、响应处置和持续监控的全流程闭环安全分析管理机制。 从安全运营技术成熟度曲线可以看出,CAASM 和 EASM 还处于启动期,这两种技术虽然刚刚诞生,还处于概念阶段,却已经引起了外界的广泛关注。 CAASM CAASM是一项新兴技术,旨在帮助安全团队解决持续的资产暴露和漏洞问题。它使组织能够通过与现有工具的API集成来查看所有资产(包括内部和外部),查询合并的数据,识别安全控制中的漏洞和漏洞的范围,并纠正问题。其取代传统手动收集资产信息和繁琐的流程来提高资产管理的效率。 另外,CAASM通过确保整个环境中的安全控制、安全态势和资产暴露得到理解和纠正,使安全团队能够改善基本的安全能力。部署CAASM的组织减少了对自产系统和手工收集流程的依赖,并通过手工或自动化工作流来弥补差距。此外,这些组织可以通过提高可视化安全工具的覆盖率来优化可能有陈旧或缺失数据的记录源系统。 综合来说对于组织有以下优点: 对组织控制下的所有资产的全面可见性,以了解攻击表面区域和任何现有的安全控制缺口。 更快速的合规审计报告通过更准确,及时、全面的资产以及安全控制报告。 资产综合视图,减少人力投入。 EASM EASM是指为发现面向外部提供服务的企业资产,系统以及相关漏洞而部署的集流程,技术,管理为一体的服务,比如服务器,凭证,公共云服务配置错误,三方合作伙伴软件代码漏洞等。EASM提供的服务里会包含DRPS,威胁情报,三方风险评估以及脆弱性评估,以及供应商能力评估等细分服务。 EASM主要包含5个模块: 监控,持续主动扫描互联网与领域相关的环境(如云服务,面向外部的内部基础设施)以及分布式系统。 资产发现,发现并测绘面向外部的资产与系统 分析,分析资产是否存在风险或脆弱点。 优先级评估,对风险及脆弱性进行优先级评估并告警。 修复建议,提供对应风险以及脆弱性的修复建议。 从行业趋势来看,攻击面管理已经逐渐走入了各大安全厂商的商业化战略里,这不仅体现了这一技术的市场需求急迫性同时体现了一定的商业化实践价值。 从EASM和CAASM的技术定义中我们不难发现,其核心内容可以归纳为4个模块,分别是资产管理,综合视图(可视化),风险评估,风险修复流程。 这四个模块恰好与我们目前的安全能力建设思路不谋而合,因此后续主要围绕这四个模块来总结我们在攻击面风险管理上的实践心得。 二、攻击面风险管理落地实践 行业内通常把攻击面管理定义为从攻击者的角度对企业网络攻击面进行检测发现、分析研判、情报预警、响应处置和持续监控的资产安全管理方法,其最大特性就是以外部视角来审视企业网络资产可能存在的攻击面及脆弱性。 攻击面主要体现在企业暴露给攻击者各个层面的安全弱点,攻击者可利用不同手段实现攻击行为。因此对攻击面风险有效管理的“First of all”就是资产管理。 2.1 安全资产管理模块 做资产管理之前需要先对全网资产进行梳理,确认资产范围和类型框架。 2.1.1 安全资产梳理 资产梳理的思路按照业务,系统,主机以及其他四个维度来进行梳理。 业务维度 包含域名,URL,公网IP,依赖包管理资产以及应用资产。 系统维度 包含API接口,公网IP内部映射关系,公网端口内部映射关系,内网集群VIP-LVS,内网应用集群VIP-Nginx,内网端口资产,内网IP资源状态资产。 主机维度 包含主机IP资产,容器资产,k8s资产,主机端口资产,中间件资产,数据库资产,操作系统资产,账号信息资产,进程信息资产,其他应用服务资产。 其他维度 包含资产补丁状态,资产负责人及所属组织。 由于篇幅问题,以上仅包含二级项目,其实二级以下根据不同的企业场景还具有更多的分项,例如从vivo互联网来说,业务维度的域名我们细分了11项,包括管理后台域名,公网埋点域名,埋点SDK域名,DB域名,主机域名,信管域名,内网接口域名,公网接口域名,线上业务域名,静态资源域名,其他域名等。 资产梳理没有一个万能公式,最佳实践是从实际的基础架构出发结合业务场景来对全网资产定好框架。 2.1.2 构建可靠的资产信息来源库 资产库主要有三个数据来源。 CMDB:主要的资产信息供应渠道 HIDS:补充主机相关资产信息,如进程,账号,网络链接等资产信息 VCS:主动资产信息采集用以补充资产库 通常安全资产库的建设往往会面临技术上的难点,比如资产信息采集工具的适配性,采集工具的稳定性,对生产造成影响的概率最小性,资产完整的可靠性等等,但技术问题往往并不难解决,借助开源工具,商业化产品甚至自研工具都能解决绝大部分问题,而真正难以头疼的是与资产归属方(业务方)的大量复杂的沟通确认工作。 从以往的最佳实践来看,从业务方的视角来建设资产库,宣贯业务价值能够更顺畅地开展资产信息采集工作,例如资产管理系统可以绘制整个企业内多个团队的合并资产视图,其可包括业务团队、运维团队、安全团队等,大家都可以从这个视图中查询到自己关心的信息,通过价值宣导来激发协作方的支撑意愿。 2.1.3 建设资产主动发现能力 在资产管理中,往往存在资产主动上报监管难,资产变更频率高而产生的资产信息滞后以及一些非法资产接入的问题,因此需要建设资产主动发现能力来补全这一块的资产信息,有条件的话可以以此作为资产变审计体系的输入源。 流量解析:通过流量分析识别隐匿资产、老化资产、影子资产等资产信息。 扫描工具:IAST/DAST/SAST,NMAP工具等对资产进行识别补充以及维持。 安全日志及告警:梳理无标资产对资产库进行补充。 另外,需要注意的是,在资产主动发现过程中需要谨慎考虑扫描工具或引擎的工作频率以及工作时间段,避免影响生产。 2.2 综合视图模块 建设综合视图并不是为了绘图而绘图,它是经过一定的数据分析并结合业务场景的资产关联链测绘,具备良好的逻辑性及可读性的综合视图,无论是直接使用者(安全运营团队)还是非直接使用者(业务或运维)都能够通过综合视图获取各自需要的资产信息。 2.2.1 资产关系链测绘 资产关联能力建设的目的是去测绘资产关系链从而将系统各模块的安全事件进行关联,全链路分为两条分别是公网IP/域名到内网主机的关系映射链以及内网主机到内网IP/域名以及公网IP/域名的关系映射链。 2.2.2 资产全局视图 针对以上两个资产强相关模块,如果以一年期来建设的话,可以参考以下建设计划: 2.3 风险评估模块 2.3.1 风险发现 风险发现来源包含两大块: 纵深防御体系:一体化的纵深防御协防平台提供基础的告警源数据。 主动扫描:以防守方视角对全网资产脆弱性进行定期扫描,一般搭建自动化扫描系统定期持续对全网设施/节点进行漏洞扫描。 人工渗透测试:从攻击方视角组织人力配合工具从外部对信息资产进行脆弱性测试。 基线合规扫描:解决内部基线合规问题,如弱密码,root权限,外发管控等。 通过搭建自动化漏洞扫描平台对以及扫描任务进行集中管理,相关的安全人员对扫描产生的各类风险发现做进一步的确认,若确认是漏洞的风险就会通过自动创建漏洞工单,并将创建的漏洞工单同步到漏洞管理系统进行后续漏洞修复的跟踪,后续漏洞的修复进度也会同步到自动化漏洞扫描平台进行同步跟进。 值得一提的是,漏洞扫描平台并非只是一味地将扫描工具及扫描结果集成,一个能有效解决风险发现的系统必然是从场景出发,落地到实际问题上。以下是三个应用场景的举例: 2.3.2 风险评估 安全风险评估就是从风险管理角度,运用科学的方法和手段,系统地分析网络与信息系统所面临的威胁及其存在的脆弱性,评估安全事件一旦发生可能造成的危害程度,提出有针对性的抵御威胁的防护对策和整改措施,另外,风险评估的落地形态可以是一套评分规范或是数学模型,其可以从全局视角来评估整体安全态势并以具体分值的形式来呈现。 标准的风险评估过程主要有四块: 资产识别与赋值:对评估范围内的所有资产进行识别,并调查资产破坏后可能造成的损失大小,根据危害和损失的大小为资产进行相对赋值。 威胁识别与赋值:即分析资产所面临的每种威胁发生的频率,威胁包括环境因素和人为因素。 脆弱性识别与赋值:从管理和技术两个方面发现和识别脆弱性,根据被威胁利用时对资产造成的损害进行赋值。 风险值计算:通过分析上述测试数据,进行风险值计算,识别和确认高风险,并针对存在的安全风险提出整改建议。 从落地实践来看,对各个信息节点的评估赋值需要张弛有度,过细的赋值方案会难以展开,过粗的赋值方案难以有好的效果,企业应结合自身发展现状,人力,技术条件以及安全目标来制定赋值方案。 2.4 风险闭环 针对于安全运营工作来说,风险管理的实际工作本质上是漏洞管理,风险闭环是漏洞从发现再到消除的一系列管理过程,即漏洞的生命周期管理。 其实在实际的风险管理过程中,许多风险是没有形成闭环管理的,其原因大多可以归纳为以下几点: 计划制定的不切实际 没有进行原因分析 进行了原因分析但未实施对策 未检查执行效果 因此,在制定闭环策略或流程时应充分考虑以上几个问题。以下例子是按照漏洞来源制定的不同的闭环策略: 三、总结 企业攻击面梳理已变得非常重要,攻击面不清晰将导致严重后果。攻击面风险管理一方面需持续加强企业攻击面安全防护的监管指导,强化攻击面安全管理制度和流程,明确各相关主体的责任和管理要求,定期开展攻击面梳理排查,加强对企业攻击面安全防护工作的监督。建立更健全攻击面防护的立健全攻击面防护的标准规范,推动政策引导、标准约束等方面的落地实践,提升企业安全防护能力。 另一方面,需要持续强化攻击面安全防护技术的研究和应用。扩展攻击面分析研究场景,融合大数据分析、人工智能等先进技术,全面开展企业攻击面风险分析,提高攻击面检测排查能力以及应急处置能力。结合持续身份认证、细粒度访问控制、数据流安全审计、数据隐私保护等安全机制赋能攻击面预防检测工作,提升对攻击面利用类安全事件的响应能力,还应密切关注当下复杂网络安全形势下攻击面攻击和防御两方面的技术发展趋势,从资产管理基础出发,建立适应各企业开展攻击面安全治理的平台和工具。 总的来说,攻击面的应对实践方式应是从攻击面梳理着手,落地到资产梳理,同步建设网络空间测绘及风险扫描能力,配合脆弱性评估对风险进行整体评估,建设统一的风险视图对风险进行全局的把控,以及结合风险闭环工具及流程等最终对攻击面进行有效收敛。

优秀的个人博客,低调大师

每日一博 | 语雀桌面端技术架构实践

作者:易芝林(维骏) 语雀桌面端作为语雀为用户提供的生产力工具,上线两年多来一直保持高频的迭代和健康的业务增长。本次主要介绍我们在做桌面端时的一些技术架构思考和实践,同时也将分享我们沉淀的一些通用桌面应用解决方案和经验。 文章会分为四部分,首先会简单介绍语雀桌面端,然后介绍当前语雀桌面端的应用架构以及关键点,之后介绍架构中的几个架构重点项,最后在进行总结。 语雀桌面端介绍 语雀是孵化自蚂蚁体验技术部的一款笔记与文档知识库工具。我们在两年前,针对语雀用户特点,以及后续发展策略,旨在为创作者提供更好的创作体验,推出语雀桌面客户端。 相较于现有浏览器提供的产品服务而言,我们提供的桌面端产品主要考虑以下几点: 无干扰 :给用户一个沉浸式的创作体验,而不像浏览器有其他窗口、tab 进行干扰,以及用完即走的用户心智。 系统级常驻 :打开速度更快,可以一键启动或者利用各类快捷工具唤起。 集成更多操作系统能力 :提升创作效率的多窗口、系统菜单和快捷键、对文件读写、与系统软件集成等。 离线 :期望能在离线或弱网的情况下,无障碍的进行创作。 桌面端架构概览 研发测主要分为左边三层,最底层是语雀的基础设施,依赖了语雀后台提供或封装的大量云服务,以及底层依赖的安全能力和存储模块。 中间一层是比较偏应用架构的一些能力封装,上面是代码层面用的的辅助能力,还有主进程的模块,然后有给应用提供的一些管理能力和一些跟 UI 相关的功能模块,最上层就是基于底层架构搭建的业务应用。包括桌面端应用比较核心的几个模块,以及一些由子应用方式承接的业务模块(后面也会详细介绍子应用这个概念) 同时最右侧也有很多辅助研发的依赖能力,来完成语雀桌面端的发布、质量和稳定性管理。 架构概览 - 关键点 相比较普通 web 应用来说,我们觉得桌面端有以下几个能力比较重要:包括安全、软件升级、以及桌面端通用的的基础能力: 架构概览 - 安全 安全是一个生产力工具软件的生命线,特别是语雀作为一款知识管理工具,对于安全是非常看重。 基础安全 下载安装包时,需要有安全管理机制,避免下载过程中被恶意替换; 升级到最新的 Electron 版本(语雀目前紧跟官方大版本,同时也会参考微软的头部应用 (vscode),避免有没考虑到的场景; 同时用户离线下载到本地的文件,包括图片,附件等,也需要经过加密。 启动安全 杀毒软件:启动安全主要是在启动软件时的一些安全问题,例如二进制模块是否有加签名,避免被杀毒软件查杀导致无法启动,也可以联系安全厂商加白名单,同时还能提升启动速度。 禁止调试:因为软件代码都会下载到客户端,可以禁止软件在客户端浏览器进行调试。 数据库秘钥管理:本地数据库文件需要保证即使被恶意拿到,也要保证无法查看到里面的内容。我们通过生成内存安全级别的方案,确保其他非当前电脑的语雀软件即使拿到数据库文件后也无法打开。 应用安全 渲染容器设置白名单来控制不被引入恶意页面; 渲染进程关闭 Node 功能以及开启隔离模式,避免渲染进程权限过高; Electron 本身是 web 开发模式,所以 web 中遇到的安全问题,在 Electron 同样会遇到,可以统一处理。 架构概览 - 软件升级 客户端软件相比较于 web 来说,还有一个非常大的区别就是有功能更新时,有一个升级过程,不像 web 直接刷新页面即可。语雀桌面端作为迭代迅速的产品,对于升级这块也是踩了不少坑。 语雀桌面端由两大部分组成:包括 Electron 和 Node.js 等基础模块的软件包 + 以及自己的业务代码。 Mac OS:Mac 下的升级流程比较简单,软件下载完成后,利用 hdiutil来模拟用户手动安装流程,用户重启即可完成安装。 Windows:Windows 下因为环境特殊性,需要下载安装包后,通过主进程自动打开安装界面,引导用户进行手动一步一步安装。 其实这种方案很好的满足的我们早期的功能迭代,但是随着用户量上涨,也遇到了很多问题。 比如: 每次升级带宽消耗巨大:对于每次安装每个 UV 都有近 100M 的下载,每次推送版本时,都会遇到 OSS 流量告警,这背后都对应着成本; 安装体验差:Windows 下因为每次升级几乎都是一次新的安装流程,所以体验也是比较差的,经常收到用户吐槽。 所以我们就调研了一种增量更新的方案,一个 Electron 程序包括 Electron 核心包以及业务代码,其实每次变更的仅仅是业务代码,所以理论上每次更新只需要增量更新业务代码即可。 Mac 下增量直接下载到增量代码后,替换掉即可。 Windows 下比较复杂,我们主要遇到两个问题: 文件占用问题:由于 Windows 系统特性,如果某个文件在使用,会无法删除。所以说如果要替换,肯定关闭程序,然后进行删除操作后再启动。所以我们写了一个 .exe 可执行文件来做关闭程序、更新文件、启动语雀。 UAB 权限控制:文件写入另一个问题是 C 盘文件一般是需要授权才可以操作的。我们软件启动没办法拿到这么高权限。不过还在 Windows 7 及以后新增了一个 PowerShell 功能,通过这个功能执行,能引导用户授权,拿到更高级的权限。 当然过程中还碰到不少细节问题,比如替换过程中路径中英文问题、用户自定义过环境变量位置问题等等 架构概览 - 基础能力沉淀 另外我们在做软件的过程中,也沉淀了一些与业务无耦合的组件: 多窗口管理:当给用户提供提供更方便的多窗口编辑能力时,如何去管理这些窗口打开,关闭,性能监控等; Webview:不同编辑器以及子应用都是通过 Webview 来承载的,需要有一个通用的模块来维护系统中用到的各个 webview 的生命周期等; 离线在线:电脑离线和在线状态获取,虽然浏览器有提供这个状态的获取和事件监听,但是 Windows 下不太准确。我们封装了一个比较通用的模块。 桌面端架构重点 从架构上来说,相较于用了多酷炫的技术,更重要的是研发交付效率高不高,性能怎么样,稳定性高不高。我们认为以下三点是架构好坏评判的重要标准。 架构重点 - 交付效率 从桌面端功能上来说,包括编辑器在内,有超过 60% 的功能模块都是与 web 一致的,所以开始是用到了同构的方案。 同构过程中的一些经验: 通用代码移动到 Common 目录:语雀代码仓库是 monorepo模式,如果没有很清晰的目录划分,很容易造成跨端兼容问题。有了这个约定以后,业务研发同学就会注意到这个会用在移动端或者桌面端 通过 webpack alias 适配多端:这个方式比较常见,比如各端有不同的网络请求库,在组件层面使用 adapter/request。webpack 在构建时,adapter 映射到不同的端实现。 定义多端代码研发规范:梳理出不同端的一些差异点,在研发时避免采坑。 交付效率(同构问题) 虽然同构模式可以解决我们当时遇到的一些问题,但是随着业务规模和功能增加,陆续有些问题暴露出来: 迁移到 Common 目录,各种依赖问题:很多功能在桌面端之前已经上线,有些复杂组件迁移到 Common 下本身也需要耗费不少时间。 缺少动态化能力,迭代滞后(web 与桌面端功能不一致):组件在 web 发布上线后,桌面端需要发布才支持,所以经常会碰到 web 和桌面端不一致的吐槽。 容易出现多端兼容问题(环境依赖等):虽然我们定义了一些规范,但很难彻底避免出现环境依赖问题。 缺少独立沙箱,容易影响主应用(内存泄露、样式) :web 可能用完即走,可以刷新等,不太容易遇到问题,但是桌面端因为是常驻的,如果有些内存泄露或者样式污染问题,就直接影响到整体可用性。 交付效率(子应用) 考虑到上述原因,我们将代码复用架构升级成子应用模式,利用桌面端容器,嵌套一个 html 在线或者离线页面。 简单来说,子应用模式可以理解为支付宝九宫格进去的各个小程序模块。 快速迭代:提供独立的发布迭代能力,所以无需跟随桌面端整体发布。而且直接由业务同学跟进整个交付流程,无需桌面端同学参与,提升交付效率。 具备端相关能力:每个子应用默认就能使用桌面端提供的 JSBridge 能力,天然能做到跟桌面端模块一样的能力。 独立沙箱:独立于桌面端主窗口,利用桌面端的容器来完成渲染,所以能完全做到进程级别隔离,相互之间的内存开销一目了然,更好的做到管控,保证整体应用稳定性。 加载初始化:除了上述的一些优势,也会到来一些问题,比如加载速度慢等,我们通过 webview 预热、缓存等方式,一定程度上解决了这个问题。 架构重点 - 性能 性能是一个桌面端软件必须要面对的问题,是需要持续在不同角度进行优化的 主要包括这几个方面: 启动速度优化:启动速度是用户第一映像,我们主要是将主进程代码进行缓存,尽早展示 loading 避免白屏,主窗口和渲染进程的部分任务同时执行,达到并发效果; 主进程优化:主进程和渲染进程执行是同步的,如果主进程做了太多任务,会导致用户使用起来卡顿,甚至闪退。所以尽量减少主进程所做的事情; Web 优化:同时,之前很多在 web 上做的优化,一样可以拿过来使用。例如懒加载,合并模块等(组合多个模块本身也有开销); Webview 优化:例如预热 webview、并进行一些性能管控措施,避免失控。 性能(持续性任务) 性能优化其实不是说做完哪些事情就可以彻底解决,而是一个长期过程。可能我们后续新增功能时,代码里有某一个内存泄露问题,就很容易导致性能拉胯下来。所以我们也建立了一些持续性的机制: 主要包括: 日常观测:在开发模式下,建立观测性能指标能力,做到心中有数; 自动化任务:日常也会有自动化任务,模拟真实用户长时间使用,及时发现内存泄露等问题; 性能大盘:对于线上性能水位,能有一个全盘的感知能力,灰度发布过程中可重点关注。 架构重点 - 稳定性 相比较于 web 而言,桌面端的稳定性也是要求更高的。 从研发流程上看,我们主要有两块事情: 单测、集成测试:利用代码测试来辅助整体稳定性 UIA:通过模拟用户行为的 UIA 自动化测试回归来提升稳定性,及时发现异常。 注:UIA 是语雀工程师自研的自动化方案,详见 :Macaca MacOS 另外建立了稳定性大盘和实时告警,来感知到线上性能情况。 为了保证每次发布的稳定性,减少回归成本,我们利用每周一次预览版发布的敏捷研发模式,来分解大版本发布带来的集成风险。 总结 针对当前的业务体量和团队经验,选择合适的技术架构; 现在肯定有比 Electron 更新的桌面端架构,比如 flutter、tauri 等,要综合看比如团队积累以及稳定性,是否有成熟的商业化产品等; 性能和稳定性优化是持续性的过程,先建立度量和感知; 交付效率和交付质量最容易被忽视,但却是架构方案的重要考量; 架构好坏的评判标准一定是由业务效果决定的,交付效率和交付质量是衡量业务效果的手段之一。

优秀的个人博客,低调大师

每日一博 | Redis 发布订阅模式原理与运用

“65 哥,如果你交了个漂亮小姐姐做女朋友,你会通过什么方式将这个消息广而告之给你的微信好友?“ “那不得拍点女朋友的美照 + 亲密照弄一个九宫格图文消息在朋友圈发布大肆宣传,暴击单身狗。” 像这种 65 哥通过朋友圈发布消息,关注 65 哥的好友能收到通知的场景叫做「发布/订阅机制」。 今天不聊小姐姐,深入了解下 「Redis 发布/订阅机制」。的原理与实战运用。 Redis 通过 SUBSCRIBE,UNSUBSCRIBE和PUBLISH 实现发布订阅消息传递模式,Redis 提供了两种模式实现,分别是「发布/订阅到频道」和「发布\订阅到模式」。 [toc] Redis 发布订阅简介 Redis 发布订阅(Pus/Sub)是一种消息通信模式:发送者通过 PUBLISH发布消息,订阅者通过 SUBSCRIBE 订阅接收消息或通过UNSUBSCRIBE 取消订阅。 主要包含三个部分组成:「发布者」、「订阅者」、「Channel」。 发布者和订阅者属于客户端,Channel 是 Redis 服务端,发布者将消息发布到频道,订阅这个频道的订阅者则收到消息。 如下图所示,三个「订阅者」订阅「ChannelA」频道: 这时候,小组长往「ChannelA」发布消息,这个消息的订阅者就会收到消息「关注码哥字节,提升技术」: Pub/Sub 实战 废话不多说,知道基本概念以后,学习一个技术第一步先把它跑起来,接着才是探索原理,从而达到「知其然,知其所以然」的境界 。 一共有两种模式实现「发布\订阅」: 使用频道(Channel)的发布订阅; 使用模式(Pattern)的发布订阅。 需要注意的是,发布订阅机制与 db 空间无关,比如在 db 10 发布, db0 的订阅者也会收到消息。 通过频道(Channel)实现 三步走: 订阅者订阅频道; 发布者向「频道」发布消息; 所有订阅「频道」的订阅者收到消息。 订阅者订阅频道 使用 SUBSCRIBE channel [channel ...]订阅一个或者多个频道,O(n) 时间复杂度,n = 订阅的 Channel 数量。 SUBSCRIBE develop Reading messages... (press Ctrl-C to quit) 1) "subscribe" // 消息类型 2) "develop" // 频道 3) (integer) 1 // 消息内容 执行该指令后,客户端进入订阅状态,订阅者只能使用subscribe、unsubscribe、psubscribe和punsubscribe这四个属于"发布/订阅" 的指令。 客户端「肖菜鸡」订阅了 「develop」频道接受组长的消息,消息响应体分别表示: 消息类型:subscribe、message、unsubscribe 频道 消息内容:随着消息类型不同代表不同含义。 进入订阅后的客户端可以收到 3 种类型的消息回复: subscribe:订阅成功的反馈消息,第二个值是订阅成功的频道名称,第三个是当前客户端订阅的频道数量。 message:客户端接收到消息,第二个值表示产生消息的频道名称,第三个值是消息的内容。 unsubscribe:表示成功取消订阅某个频道。第二个值是对应的频道名称,第三个值是当前客户端订阅的频道数量,当此值为 0 时客户端会退出订阅状态,之后就可以执行其他非"发布/订阅"模式的命令了。 发布者发布消息 小组长使用 PUBLISH channel message 向指定 「develop」频道发布消息。 PUBLISH develop 'do job' (integer) 1 需要注意的是,发布的消息并不会持久化,消息发布之后还有新「开发」靓仔订阅的话,只能接收后续发布到该频道的消息。 好一个「不问过往,只争当下」。 订阅者接受消息 关注了「develop」频道的订阅者将会收到「do job」消息。 // 订阅 develop 频道 SUBSCRIBE develop Reading messages... (press Ctrl-C to quit) 1) "subscribe" // 订阅频道成功 2) "develop" // 频道 3) (integer) 1 // 当发布者发布消息,订阅者读取到的消息如下 1) "message" // 接受到消息 2) "develop" // 频道名称 3) "do job" // 消息内容 退订频道 订阅的反向操作,「65 哥」天天在朋友圈秀恩爱,受不了了,取消订阅他的朋友圈。 使用 UNSUBSCRIBE 命令可以退订指定的「模式」不会影响通过 `subscribe 命令订阅的频道。 同样 unsubscribe命令也不会影响通过psubscribe命令订阅的规则。 通过模式(Pattern)实现 接下来看另一种方式实现发布订阅,如下图表示当「匹配模式」与这个频道匹配的话,当消息向频道发布消息,该消息还会发布到与这个频道匹配的「模式」上,订阅这个模式的客户端也会收到消息。 smile.girl.* 模式表示「你微笑时好美」pattern,与这个模式匹配的两个频道是 smile.girls.Tina、smile.girls.maggi ,分别表示喜欢「微笑的 Tina」 和喜欢「微笑的 maggi」的粉丝。 如下图: 现在 Tina 发布动态将消息发送到 smile.girls.Tina频道的时候,除了订阅了 smile.girls.Tina 这个频道的粉丝收到消息以外,这 个消息还会发送给订阅 smile.girl.* 模式的粉丝(因为频道与模式匹配)。 这些粉丝比较贪心,所有「微笑时好美的 girls」都关注了,LSP~~,码哥可不是这样的人。 使用匹配模式,用 PUBLISH 将消息发布到订阅 smile.girls.Tina 客户端之外,还会将该「频道」与「pub/sub pattern」中的模式进行对比,如果 Channel 与某个模式匹配的话,也将这个消息发布到订阅这个模式的客户端。 订阅模式 订阅模式的指令是PSUBSCRIBE,如下表示 LSP 订阅「smile.girl.*」模式: PSUBSCRIBE smile.girls.* Reading messages... (press Ctrl-C to quit) 1) "psubscribe" // 消息类型 2) "smile.girls.*"// 模式 3) (integer) 1 //订阅数 对应的反向取消模式订阅的指令是PUNSUBSCRIBE smile.girl.*。 订阅 「smile.girls.Tina」频道: SUBSCRIBE smile.girls.Tina Reading messages... (press Ctrl-C to quit) 1) "subscribe" 2) "smile.girls.Tina" 3) (integer) 1 订阅「smile.girls.maggi」频道: SUBSCRIBE smile.girls.maggi Reading messages... (press Ctrl-C to quit) 1) "subscribe" 2) "smile.girls.maggi" 3) (integer) 1 Tina 发布消息,**关注「smile.girls.Tina」**的粉丝和订阅了与该频道匹配的「smile.girls.*」模式的粉丝收到消息。 关注 「smile.girls.*」模式的粉丝收到消息 PSUBSCRIBE smile.girls.* Reading messages... (press Ctrl-C to quit) 1) "psubscribe" 2) "smile.girls.*" 3) (integer) 1 //进入订阅状态,接收到消息 1) "pmessage" 消息类型 2) "smile.girls.*" 3) "smile.girls.Tina" 4) "love u" // 消息内容 关注「smile.girls.Tina」的粉丝收到消息 127.0.0.1:6379> SUBSCRIBE smile.girls.Tina Reading messages... (press Ctrl-C to quit) // 订阅成功 1) "subscribe" 2) "smile.girls.Tina" 3) (integer) 1 // 接收消息 1) "message" 2) "smile.girls.Tina" 3) "love u" 需要注意的是,如果一个客户端订阅了与模式匹配的模式和频道,那么客户端会收到多次消息。 比如,65 哥 订阅了「smile.girls.Tina」频道和「smile.girls.*」模式,那么当 Tina 发布动态到频道的时候,65 哥会收到两条票消息,一条消息类型是message,一条类型是pmessage。 Redisson 与 SpringBoot 实战 官方文档:https://github.com/redisson/redisson/wiki/6.-distributed-objects/#67-topic 生产者代码 /** * 发布消息到 Topic * @param message 消息 * @return 接收消息的客户端数量 */ public long sendMessage(String message) { RTopic topic = redissonClient.getTopic(CHANNEL); long publish = topic.publish(message); log.info("生产者发送消息成功,msg = {}", message); return publish; } 消费者代码 public void onMessage() { // in other thread or JVM RTopic topic = redissonClient.getTopic(CHANNEL); topic.addListener(String.class, (channel, msg) -> { log.info("channel: {} 收到消息 {}.", channel, msg); }); } 需要注意的是,发布消息与监听消息要运行在不同的 JVM,如果使用同一个 redissonClient 发布的话,不会监听到自己的消息。 原理分析 我们通过上文知道了发布订阅的概念,一共两种模式实现发布订阅。并且运用原生指令和 Redisson 进行实战。 接下来,我们要深入理解 Redis 如何实现发布订阅机制,做到知其然知其所以然。 频道(Channel)的发布/订阅如何实现的? 65 哥,如果是你会使用什么数据结构来实现基于频道来定位对应客户端? 码哥,我觉得可以字典来实现,字典的 key 对应被订阅的频道,而字典的值可以使用一个链表,链表里面保存着订阅这个频道的所有客户端。 数据结构 聪明,Redis 使用 redis.h中有一个 redisServer 结构体维护每个服务器进程表示服务器状态,pubsub_channels 属性是一个字典,用于保存订阅频道的信息。 struct redisServer { ... /* Pubsub */ dict *pubsub_channels; ... } 如下图所示,「码哥」、「靓仔」订阅了「redis-channel」,「宅男」「LSP」订阅了「枝~藤¥由*香-里」: 发送消息到频道 生产者调用 PUBLISH channel messsage 发送消息,程序先根据 channel 从 pubsub_channels 定位到字典的 key 所在的桶,接着把消息发送给这个 key 对应的 value 链表的所有客户端。 退订频道 UNSUBSCRIBE命令可以退订指定的频道:丢与字典操作来说,根据 key 找到关注链表,遍历链表,删除这个客户端,这样消息就不会发送给这个客户端了。 模式(Pattern)的发布/订阅如何实现的? 接下来,我们继续看基于模式实现的发布订阅原理…… 当使用 PUBLISH发布消息到某个频道的时候,不仅订阅这个频道的所有客户端会收到消息,与这个模式匹配的客户端也会收到消息。 源码在 server.h 文件中的redisServer.pubsub_patterns 属性定义。 struct redisServer { ... /* A dict of pubsub_patterns */ dict *pubsub_patterns; ... } 也是 dict 字典类型, key 对应「pattern」模式,value 是一个 链表类型的结构: list *clients里面包含匹配个模式的客户端列表。 当执行 PSUBSCRIBE smile.girls.*命令的时候,会执行pubsubSubscribePattern方法。 在这里我分享下如何定位关键源码,发布订阅我们根据经验搜索pubsub便能检索到 pubsub.c: 码哥使用 CLion 调试的 Redis 源码,跟我们 Java 开发用的 IDEA 出自于一家,所以快捷键都是一样的,接着使用 Command + F12 弹出方法搜索,找到 pubsubSubscribePattern 订阅模式的方法。 方法参数别分表示关注该模式的客户端 client *c,和客户端想要关注的 *pattern,方法主要逻辑如下: listSearchKey(c->pubsub_patterns,pattern):根据 pattern 从 redisServer.pubsub_patterns 字典查找是否已经存在该模式的 key,存在则调用addReplyPubsubPatSubscribed 通知客户端已经订阅过了,否则继续执行以下逻辑。 dictFind(server.pubsub_patterns,pattern):根据模式 pattern从字典 server.pubsub_patterns找到 dictEntry 哈希桶,为空就调用 listCreate()创建客户端链表 list *clients,并放到字典中,key = pattern,value = list *clients 链表。 哈希桶不为空,那么把当前客户端 client *c 添加到 list *clients链表尾节点。 所以模式实现的发布订阅也是通过字典来保存模式与客户端的关系,如下图所示: 当使用 PUBLISH 发布消息的时候,除了发布到订阅channel的客户端以外,还会将该 channel 与 pubsub_patterns 字典中查找匹配模式 key 对应的 value 中的客户端链表,并执行消息发送。 退订模式 使用 PUNSUBSCRIBE命令可以退订指定的模式, 这个命令执行的是订阅模式的反操作:根据模式从 pubsub_patterns字典中找到客户端链表,遍历链表将当前客户端删除。 总结 Redis 发布订阅功能,主要通过如下命令实现: subscribe channel [channel ...]:订阅一个或者多个频道; unsubscribe channel 退订指定频道; publish channel message 向指定频道发送消息; psubscribe pattern 订阅指定模式; punsubscribe pattern 退订指定模式。 Pub/Sub 与数据库无关,比如在 DB0 上发布, DB1的订阅者也将接收到。 基于频道实现的发布订阅信息是由服务器进程的 redisServer.pubsub_channels 字典保存,key = 被订阅的频道,value 是订阅频道的所有客户端链表。 当消息发布到频道的时候,遍历字典获取所有客户端并把消息发送到频道的客户端。 基于模式实现的发布订阅的信息保存在字典 pubsub_patterns中,key = pattern,value 是客户端链表。 当消息发布到频道的时候,除了订阅该频道的客户端收到消息以外,所有订阅了与频道匹配的模式的客户端也会收到消息。 使用场景 说了这么多,Redis 发布订阅能在什么场景发挥作用呢? 哨兵间通信 哨兵集群中,每个哨兵节点利用 Pub/Sub 发布订阅实现哨兵之间的相互发现彼此和找到 Slave,详情点击 ->《哨兵集群原理那些事》。 哨兵与 Master 建立通信后,利用 master 提供发布/订阅机制在__sentinel__:hello发布自己的信息,比如身高体重、是否单身、IP、端口……,同时订阅这个频道来获取其他哨兵的信息,就这样实现哨兵间通信。 消息队列 之前「码哥」跟大家分享过如何利用 Redis List 与 Stream 实现消息队列。 我们也可以利用 Redis 发布订阅实现轻量级简单的 MQ 功能,实现上下游解耦,需要注意点是 Redis 发布订阅的消息不会被持久化,所以新订阅的客户端将收不到历史消息。 也不支持 ACK 机制,所以当前业务不能容忍这些缺点,那就使用专业的消息队列,如果能容忍那就能享受 Redis 快带来的优势。 最后,可以在评论区叫我一声「靓仔」么?为了写这个文章,码哥看了好多微笑时好美的 girl 才写出来,原创不易。 朋友们点赞、分享、收藏支持我吧。 参考资料 1.Redis 设计与实现 2.https://redisbook.readthedocs.io/en/latest/feature/pubsub.html

优秀的个人博客,低调大师

每日一博 | 密集计算场景下的 JNI 实战

作者: vivo 互联网服务器团队-Wei Qianzi、Li Haoxuan 在 Java 发展历程中,JNI 一直都是一个不可或缺的角色,但是在实际的项目开发中,JNI 这项技术应用的很少。在笔者经过艰难的踩坑之后,终于将 JNI 运用到了项目实战,本文笔者将简单介绍 JNI 技术,并介绍简单的原理和性能分析。通过分享我们的实践过程,带各位读者体验 JNI 技术的应用。 一、背景 计算密集型场景中,Java 语言需要花费较多时间优化 GC 带来的额外开销。并且在一些底层指令优化方面,C++ 这种“亲核性”的语言有着较好的优势和大量的业界实践经验。那么作为一个多年的 Java 程序员,能否在 Java 服务上面运行 C++ 代码呢?答案是肯定的。 JNI (Java Native Interface) 技术正是应对该场景而提出的解决方案。虽然 JNI 技术让我们能够进行深度的性能优化,其较为繁琐的开发方式也不免让新人感到头疼。本文通过 step by step 的方式介绍如何完成 JNI 的开发,以及我们优化的效果和思考。 开始正文前我们可以思考三个问题: 为什么选择使用 JNI 技术? 如何在 Maven 项目中应用 JNI 技术? JNI 真的好用吗? 二、关于 JNI:为什么会选择它? 2.1 JNI 基本概念 JNI 的全称叫做 Java Native Interface ,翻译过来就是 Java 本地接口。爱看 JDK 源码的小伙伴会发现,JDK 中有些方法声明是带有 native 修饰符的,并且找不到具体实现,其实是在非 Java 语言上,这就是 JNI 技术的体现。 早在 JDK1.0 版本就已经有了 JNI,官方给 JNI 的定义是: Java Native Interface (JNI) is a standard programming interface for writing Java native methods and embedding the Java virtual machine into native applications. The primary goal is binary compatibility of native method libraries across all Java virtual machine implementations on a given platform. JNI 是一种标准的程序接口,用于编写 Java 本地方法,并且将 JVM 嵌入 Native 应用程序中。是为了给跨平台上的 JVM 实现本地方法库进行二进制兼容。 JNI 最初是为了保证跨平台的兼容性,而设计出来的一套接口协议。并且由于 Java 诞生很早,所以 JNI 技术绝大部分情况下调用的是 C/C++ 和系统的 lib 库,对其他语言的支持比较局限。随着时间的发展,JNI 也逐渐被开发者所关注,比如 Android 的 NDK,Google 的 JNA,都是对 JNI 的扩展,让这项技术能够更加轻松的被开发者所使用。 我们可以看一下在 JVM 中 JNI 相关的模块,如图 1: 图1 - JVM 内存和引擎执行关系 在 JVM 的内存区域,Native Interface 是一个重要的环节,连接着执行引擎和运行时数据区。本地接口 (JNI) 的方法在本地方法栈中管理 native 方法,在 Execution Engine 执行时加载本地方法库。 JNI 就像是打破了 JVM 的束缚,拥有着和 JVM 同样的能力,可以直接使用处理器中的寄存器,不仅可以直接使用处理器中的寄存器,还可以直接找操作系统申请任意大小的内存,甚至能够访问到 JVM 虚拟机运行时的数据,比如搞点堆内存溢出什么的:) 2.2 JNI 的功能 JNI 拥有着强大的功能,那它能做哪些事呢?官方文档给出了参考答案。 标准 Java 类库不支持应用程序所需的平台相关特性。 您已经有一个用另一种语言编写的库,并希望通过 JNI 使其可供 Java 代码访问。 您想用较低级别的语言(例如汇编)实现一小部分耗时短的代码。 当然还有一些扩充,比如: 不希望所写的 Java 代码被反编译; 需要使用系统或已有的 lib 库; 期望使用更快速的语言去处理大量的计算; 对图像或本地文件操作频繁; 调用系统驱动的接口。 或许还有别的场景,可以使用到 JNI,可以看到 JNI 技术有着非常好的应用潜力。 三、JNI 实战:探究踩坑的全过程 我们的业务中存在一个计算密集型场景,需要从本地加载数据文件进行模型推理。项目组在 Java 版本进行了几轮优化后发现没有什么大的进展,主要表现为推理耗时较长,并且加载模型时存在性能抖动。经过调研,如果想进一步提高计算和加载文件的速度,可以使用 JNI 技术去编写一个 C++ 的 lib 库,由 Java native 方法进行调用,预计会有一定的提升。 然而项目组目前也没有 JNI 的实践经验,最终性能是否能有提升,还是要打个问号。本着初生牛犊不怕虎的精神,我鼓起勇气主动认领了这个优化任务。下面就分享一下我实践 JNI 的过程和遇到的问题,给大家抛砖引玉。 3.1 场景准备 实战就不从 Hello world 开始了,我们直接敲定场景,思考该让 C++ 实现哪部分逻辑。 场景如下: 图2 实战场景 在计算服务中,我们将离线计算数据转换成 map 结构,输入一组 key 在 map 中查找并对 value 应用算法公式求值。通过分析 JVM 堆栈信息和火焰图 (flame graph),发现性能瓶颈主要在大量的逻辑回归运算和 GC 上面,由于缓存了量级很大的 Map 结构,导致占用 heap 内存很大,因此 GC Mark-and-Sweep 耗时很长,所以我们决定将加载文件和逻辑回归运算两个方法改造为 native 方法。 代码如下: /** * 加载文件 * @param path 文件本地路径 * @return C++ 创建的类对象的指针地址 */public static native long loadModel(String path); /** * 释放 C++ 相关类对象 * @param ptr C++ 创建的类对象的指针地址 */public static native void close(long ptr); /** * 执行计算 * @param ptr C++ 创建的类对象的指针地址 * @param keys 输入的列表 * @return 输出的计算结果 */public static native float compute(long ptr, long[] keys); 那么,我们为什么要传递指针呢,并且设计了一个 close 方法呢? 便于兼容现有实现的考虑:虽然整个计算过程都在 C++ 运行时中进行,但对象的生命周期管理是在 Java 中实现的,所以我们选择回传加载并初始化后的模型对象指针,之后每次求值时仅传递该指针即可; 内存正确释放的考虑:利用 Java 自身的 GC 和模型管理器代码机制,在模型卸载时显式调用 close 方法释放 C++ 运行时管理的内存,防止出现内存泄漏。 当然,这个建议只适用于需要 lib 执行时将部分数据缓存在内存中的场景,只使用 native 方法进行计算,无需考虑这种情况。 3.2 环境搭建 下面简单介绍一下我们所使用的环境和项目结构,这部分介绍的不是很多,如果有疑问可以参考文末的参考资料或者在网上进行查阅。 我们使用的是简单的 maven 项目,使用 Docker 的 ubuntu-20.04 容器进行编译和部署,需要在容器中安装 GCC,Bazel,Maven,openJDK-8 等。如果是在 Windows 下进行开发,也可以安装相应的工具并编译成 .dll 文件,效果是一样的。 我们创建好 maven 项目的目录,如下: /src # 主目录-/main--/cpp # c++ 仓库目录---export_jni.h # java 导出的文件---computer.cc # 具体的 C++ 代码---/third_party # 三方库---WORKSPACE # bazel 根目录---BUILD # bazel 构建文件--/java # java 仓库目录---/com----/vivo-----/demo------/model-------ModelComputer.java # java 代码--/resources # 存放 lib 的资源目录-/test--/java----ModelComputerTest.java # 测试类pom.xml # maven pom 3.3 实战过程 都已经准备好了,那么就直入正题: package com.vivo.demo.model;import java.io.*; public class ModelComputer implements Closeable { static { // 加载 lib 库 loadPath("export_jni_lib"); } /** * C++ 类对象地址 */ private Long ptr; public ModelComputer(String path) { // 构造函数,调用 C++ 的加载 ptr = loadModel(path); } /** * 加载 lib 文件 * * @param name lib名 */ public static void loadPath(String name) { String path = System.getProperty("user.dir") + "\\src\\main\\resources\\"; path += name; String osName = System.getProperty("os.name").toLowerCase(); if (osName.contains("linux")) { path += ".so"; } else if (osName.contains("windows")) { path += ".dll"; } // 如果存在本文件,直接加载,并返回 File file = new File(path); if (file.exists() && file.isFile()) { System.load(path); return; } String fileName = path.substring(path.lastIndexOf('/') + 1); String prefix = fileName.substring(0, fileName.lastIndexOf(".") - 1); String suffix = fileName.substring(fileName.lastIndexOf(".")); // 创建临时文件,注意删除 try { File tmp = File.createTempFile(prefix, suffix); tmp.deleteOnExit(); byte[] buff = new byte[1024]; int len; // 从jar中读取文件流 try (InputStream in = ModelComputer.class.getResourceAsStream(path); OutputStream out = new FileOutputStream(tmp)) { while ((len = in.read(buff)) != -1) { out.write(buff, 0, len); } } // 加载库文件 System.load(tmp.getAbsolutePath()); } catch (Exception e) { throw new RuntimeException(); } } // native 方法 public static native long loadModel(String path); public static native void close(long ptr); public static native float compute(long ptr, long[] keys); @Override public void close() { Long tmp = ptr; ptr = null; // 关闭 C++ 对象 close(tmp); } /** * 计算 * @param keys 输入的列表 * @return 输出的结果 */ public float compute(long[] keys) { return compute(ptr, keys); }} 踩坑1:启动时报 java.lang.UnsatisfiedLinkError 异常 这是因为 lib 文件在压缩包中,而加载 lib 的函数寻找的是系统路径下的文件,通过 InputStream 和 File 操作从压缩包中读取该文件到临时文件夹,获取其路径,再进行加载就可以了。上文中 getPath 方法作为解决办法的示例可以参考:System.load() 函数输入的路径必须是全路径下的文件名,也可以使用 System.loadLibrary() 加载 java.library.path 下的lib库,不需要 lib 文件的后缀。 保存上文的 Java 代码,通过 Javah 指令可以生成对应的 C++ 头文件,前文目录结构中的 export_jni.h 就是通过该指令生成的。 javah -jni -encoding utf-8 -classpath com.vivo.demo.model.ModelComputer -o ../cpp/extern_jni.h# -classpath 表示所在的package# -d 表示输出的文件名 打开可以看到生成出来的文件如下: #include <jni.h> // 引入的头文件, 该头文件在 $JAVA_HOME/include 下,随Java版本变化而改变#ifndef _Included_com_vivo_demo_model_ModelComputer // 宏定义 格式 _Included_包名_类名#define _Included_com_vivo_demo_model_ModelComputer#ifdef __cplusplusextern "C" { // 保证函数、变量、枚举等在所有的源文件中保持一致,这里应用于导出的函数名称不被改变#endif// 生成的loadModel函数,可以看到JNI的修饰和jlong返回值,函数名称格式为 Java_包名_类名_函数名// 函数的前两个参数是 JNIEnv 表示当前线程的 JVM 环境参数,jclass 表示调用的 class 对象,可以通过这两个参数去操作 Java 对象。JNIEXPORT jlong JNICALL Java_com_vivo_demo_model_ModelComputer_loadModel (JNIEnv *, jclass, jstring); JNIEXPORT void JNICALL Java_com_vivo_demo_model_ModelComputer_close (JNIEnv *, jclass, jlong); JNIEXPORT jfloat JNICALL Java_com_vivo_demo_model_ModelComputer_compute (JNIEnv *, jclass, jlong, jlongArray); #ifdef __cplusplus}#endif#endif 踩坑2:Javah 运行失败 如果生成失败,可以参考上面 JNI 格式的 “.h” 文件手写一个出来,只要格式无误,效果是一样的。其中 jni.h 是 JDK 路径下的一个文件,里面定义了一些 JNI 的类型,返回值, 异常, JavaVM 结构体以及一些方法(类型转化,字段获取,JVM 信息获取等)。jni.h 还依赖了一个 jni_md.h 文件,其中定义了 jbyte,jint 和 jlong,这三个类型在不同的机器下的定义是有差异的。 我们可以看下 JNI 常用数据类型与 Java 的对应关系: 图3 JNI常用数据类型 如图3,JNI 定义了一些基本数据类型和引用数据类型,可以完成 Java 和 C++ 的数据转化。JNIEnv 是一个指向本地线程数据的接口指针,通俗的来讲,我们通过 JNIEnv 中的方法,可以完成 Java 和 C++ 的数据转化,通过它,可以使 C++ 访问 Java 的堆内存。 对于基本的数据类型,通过值传递,可以进行强制转化,可以理解为只是定义的名称发生改变,和 java 基本数据类型差异不大。 而引用数据类型,JNI 定义了 Object 类型的引用,那么就意味着,java 可以通过引用传递任意对象到 C++ 中。对于像基础类型的数组和 string 类型,如果通过引用传递,那么 C++ 就要访问 Java 的堆内存,通过 JNIEnv 中的方法来访问 Java 对象,虽然不需要我们关心具体逻辑,但是其性能消耗要高于 C++ 指针操作对象的。所以 JNI 将数组和 string 复制到本地内存(缓冲区)中,这样不但提高了访问速度,还减轻了 GC 的压力,缺点就是需要使用 JNI 提供的方法进行创建和释放。 // 可以使用下列三组函数,其中 tpye 为基本数据类型,后两组有 Get 和 Release 方法,Release 方法的作用是提醒 JVM 释放内存// 数据量小的时候使用此方法,原理是将数据复制到C缓冲区,分配在 C 堆栈上,因此只适用于少量的元素,Set 操作是对缓存区进行修改Get<type>ArrayRegionSet<type>ArrayRegion// 将数组的内容拷贝到本地内存中,供 C++ 使用Get<type>ArrayElementRelease<type>ArrayElement// 有可能直接返回 JVM 中的指针,否则的话也会拷贝一个数组出来,和 GetArrayElement 功能相同GetPrimitiveArrayCriticalReleasePrimitiveArrayCritical 通过这三组方法的介绍,也就大致了解了 JNI 的数据类型转化,如果没有 C++ 创建修改 Java Object 的操作的话,那编写 C++ 代码和正常的 C++ 开发无异,下面给出了 “export_jni.h” 代码示例。 #include "jni.h" // 这里改为相对引用,是因为把 jni.h 和 jni_md.h 拷贝到项目中,方便编译#include "computer.cc"#ifndef _Included_com_vivo_demo_model_ModelComputer#define _Included_com_vivo_demo_model_ModelComputer#ifdef __cplusplusextern "C" {#endif JNIEXPORT jlong JNICALL Java_com_vivo_demo_model_ModelComputer_loadModel (JNIEnv* env, jclass clazz, jstring path) { vivo::Computer* ptr = new vivo::Computer(); const char* cpath = env->GetStringUTFChars(path, 0); // 将 String 转为 char* ptr->init_model(cpath); env->ReleaseStringUTFChars(path, cpath); // 释放String return (long)ptr; }; JNIEXPORT void JNICALL Java_com_vivo_demo_model_ModelComputer_close (JNIEnv* env, jclass clazz, jlong ptr) { vivo::Computer* computer = (vivo::Computer*)ptr; // 获取到对象 delete computer; // 删除对象 }; JNIEXPORT jfloat JNICALL Java_com_vivo_demo_model_ModelComputer_compute (JNIEnv* env, jclass clazz, jlong ptr, jlongArray array) { jlong* idx_ptr = env->GetLongArrayElements(array, NULL); // 将 array 转为 jlong* vivo::Computer* computer = (vivo::Computer*)ptr; // 获取到 C++ 对象 float result = computer->compute((long *)idx_ptr); // 执行 C++ 方法 env->ReleaseLongArrayElements(array, idx_ptr, 0); // 释放 array return result; // 返回结果 }; #ifdef __cplusplus}#endif#endif C++ 代码编译完成后,把 lib 文件放到 resource 目录指定位置,如果为了方便,可以写个 shell 脚本一键执行。 踩坑3:服务器启动时报 java.lang.UnsatisfiedLinkError异常 又是这个异常,前文已经介绍了一种解决方案,但在实际应用中仍然频繁出现,比如: 运行环境有问题(比如在 Linux 下编译在 Windows 上运行,这是不可以的); JVM 位数和 lib 的位数不一致 (比如一个是 32 位,一个是 64 位); C++ 函数名写错; 生成的 lib 文件中并没有相对应的方法。 对于这些问题,只要认真分析异常日志,便可以逐一解决,也有工具可以协助我们解决问题。 使用 dumpbin/objdump 分析 lib,更快速地解决 UnsatisfiedLinkError 对于 lib 库中的函数检查,不同操作系统也提供了不同的工具。 在 windows 下,可以使用 dumpbin 工具或者 Dependency Walker 工具分析 lib 中是否存在所编写的 C++ 方法。dumpbin 指令如下: dumpbin /EXPORTS xxx.dll 图4 dumpbin 查看 dll 文件 而 Dependency Walker 只需要打开 dll 文件就可以看到相关信息了。 图5 Dependency Walker 查看 dll 文件 在 Linux 下,可以使用 objdump 工具分析 so 文件中的信息。 objdump 指令如下: objdump-txxx.so 图6 objdump 查看 so 文件 3.4 性能分析 根据之前的调研,我们注意到 Java 对 native 方法的调用本身也存在额外性能开销,针对此我们用 JMH 进行了简单测试。图 7 展示的是 JNI 空方法调用和 Java 的对比: 图7 - 空函数调用对比 (数据源自个人机器JMH测试,仅供参考) 其中 JmhTest.code 为调用 native 空方法, JmhTest.jcode 为调用 java 空方法,从中可以看出,直接调用 java 的方法要比调用 native 方法快十倍还要多。我们对堆栈调用进行了简单分析,发现调用 native 的过程比直接调用 java 方法要繁琐一些,进入了 ClassLoad 的 findNative 方法。 // Invoked in the VM class linking code.// loader 为类加载器, name 为C++方法的 name,eg: Java_com_vivo_demo_model_ModelComputer_computestatic long findNative(ClassLoader loader, String name) { // 选择 nativeLibary Vector<NativeLibrary> libs = loader != null ? loader.nativeLibraries : systemNativeLibraries; synchronized (libs) { int size = libs.size(); for (int i = 0; i < size; i++) { NativeLibrary lib = libs.elementAt(i); // 找到 name 持有的 handel long entry = lib.find(name); if (entry != 0) // 返回 handel return entry; } } return 0;} 堆栈信息如下: 图8 调用 native 堆栈信息 find 方法是一个 native 方法,堆栈上也打印不出相关信息,但不难得出,通过 find 方法去调用 lib 库中的方法,还要再经过至少一轮的映射才能找到对应的 C++ 函数执行,然后将结果返回。瞬间回想起图一,这种调用链路,通过 Native Interface 来串起本地方法栈,虚拟机栈,nativeLibrary 和执行引擎之间的关系,逻辑势必会复杂一些,相对的调用耗时也会增加。 做了这么多工作,差点忘了我们的目标:提高我们的计算和加载速度。经过上文的优化后,我们在压测环境进行了全链路压测,发现即使 native 的调用存在额外开销,全链路的性能仍然有了较为明显的提升。 我们的服务在模型推理的核心计算上耗时降低了 80%,加载和解析模型文件耗时也降低了 60%(分钟级到秒级),GC 的平均耗时也降低了 30%,整体的收益非常明显。 图9 young GC 耗时对比 四、思考和总结:JNI 带来的收益 JNI 在一些特定场景下的成功应用打开了我们的优化思路,尤其是在 Java 上进行了较多优化尝试后并没有进展时,JNI 确实值得一试。 又回到了最初的问题:JNI 真的好用吗?我的答案是:它并不是很好用。如果是一名很少接触 C++ 编程的工程师,那么在第一步的环境搭建和编译上,就要耗费大量的时间,再到后续的代码维护,C++ 调优等等,是一个非常头疼的事情。但我还是非常推荐去了解这项技术和这项技术的应用,去思考这项技术能够给自己的服务器性能带来提升。 或许有一天,JNI 能为你所用! 参考资料: Oracle JNI Guide:Java Native Interface bazel 概述 docker hub JMH GitHub Dumpbin refrence END 猜你喜欢 HttpClient 在vivo内销浏览器的高并发实践优化 Kotlin协程解析系列(上):协程调度与挂起 Redis 定长队列的探索和实践 本文分享自微信公众号 - vivo互联网技术(vivoVMIC)。如有侵权,请联系 support@oschina.cn 删除。本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

优秀的个人博客,低调大师

每日一博 | 编程语言中索引签名是什么?

撰稿:宗喆 KusionStack: https://github.com/KusionStack/kusion KCLVM: https://github.com/KusionStack/KCLVM 1. 背景 最近在参与 KusionStack 内置的领域语言 —— KCL配置语言编译器 的开发,语言的语法中包括一个“索引签名”的概念,在参与社区讨论的时候发现很多小伙伴不明白这个“索引签名”是什么,于是自己也想了一下,发现自己也只是知道是什么样子,但是不知道“索引签名”完整的定义,因此,决定写一篇贴子来梳理一下“索引签名”到底是什么。 2.见名知意 首先,索引签名的想法并不神秘新鲜。早期Windows开发中应该见过类似的编程规范: bool(BOOL) 用b开头 bIsParent byte(BYTE) 用by开头 byFlag short(int) 用n开头 nStepCount long(LONG) 用l开头 lSum char(CHAR) 用c开头 cCount 只要看到变量和类成员的名字就知道其类型,提高了代码类型方面的可读性。但是这种约定并没有沉淀到C++语言中,如果语言能够支持定义以b开头的成员是BOOL类型这种特性就厉害了——这其实就是索引签名的朴实目的。 先从字面意义上看,“索引签名(index signature)” 包含 “索引(index)” 和“签名(signature)”两部分。 2.1 索引(index) 从开发人员的角度来看,索引,类似于C语言中指针,它像一个箭头一样可以指向一个特定的事物,出于某些原因我们可能无法直接访问这个事物,或者这个事物与其他的东西混合在一起,直接访问这个事物可能要在很多其他事物中寻找很久。因此,我们使用索引指向这个事物,可以理解为我们在我们需要的事物上绑了一根线,并且留了一个线头在身边,每当我们想要使用这个事物的时候,我们不需要再从一堆事物中去寻找它,只需要拿起这个线头,并顺着这根线就能找到这个特定的事物,这个线头就是"索引 index",并且很明显,一根线不允许分叉绑定两个事物,所以通常大家默认某个事物的"索引 index"是不会再指向另一个事物的。 因此,在开发的过程中,“索引 index”最主要的使用场景就是“在一堆事物中,查找特定的事物”。例如:最常见的数据结构-数组,就是“索引”的一个优秀案例。在数组中,索引是一个整形的数字,这个数字是数组中每个元素的位置信息,通过位置,快速的定位某个数组元素。 int a[3] = [1, 2, 3]; // 使用索引0,就可以在1,2,3三个数字中,快速的找到排在最前面的元素。 assert a[0] = 1; assert a[1] = 2; assert a[3] = 3; 除了数组,另一个使用索引的数据结构是我们常见的Hash表,只不过在有些编程语言中将哈希表中的索引叫做key。 hashtable<string, string> a; // "Jack" 就可以视作一个索引,通过名字字符串作为索引, // 在不考虑重名的情况下,它指向了一个结构实例 Person("Jack")。 a.put("Jack", new Person("Jack")) a.put("Tom", new Person("Tom")) a.put("Lee", new Person("Lee")) 再举一个例子,很多编程语言中都存在的结构struct或者类class,也使用到了索引的思想。 // 可以看做是String和Integer的集合 // 如果没有索引,我们就只知道Person内部有两个属性, // 一个类型为String表示名字, // 一个为Integer表示年龄。 struct Person{ name: String, age: Integer, } Person p = new Person(name: "Jack", age: 10); // 通过索引name我们能够轻松的获取到Person的名字Jack。 assert p.name == "Jack" // 通过索引age我们能够轻松的获取到Person的年龄10。 assert p.age == 10 综上,索引可以被看作一个指针,没有具体的格式约束,只要能唯一的指向一个事物即可,不能具有二义性,即不能指向A的同时又指向B。或者索引也可以看作一个方法,以索引值为参数,返回索引指向的事物。 注:这个概念不包括一些特殊情况,比如某些应用场景就是需要同时指向A和B的索引也是有可能的,这里讨论的是大多数的通用情况。 2.2 签名(Signature) 在编程语言领域,Signature这个词除了使用在IndexSignature中,在很多常见的编程语言中也有Signature这个概念。比如C++中的类型签名: char c; double d; // 他的签名为 (int) (char, double) int retVal = (*fPtr)(c, d); 通过上面这个类型签名,我们虽然不知道这个函数指针未来可能会指向的函数的具体定义,但是通过这个签名,我们能看到这个指针指向的函数如何使用,它以char和double为传入参数,返回值为int,并且,这个签名也对指针未来指向的函数进行了约束,它只能指向以char和double为传入参数,返回值为int的函数。相似的概念在Rust语言中也有体现。在Rust中,我们可以直接使用一个函数的签名如下: // add 方法的签名 fn(i32, i32) -> i32 fn add(left: i32, right: i32) -> i32 { left + right } // sub 方法的签名 fn(i32, i32) -> i32 fn sub(left: i32, right: i32) -> i32 { left - right } // 通过方法签名,我们可以为某一类结构相近的方法提供工厂。 fn select(name: &str) -> fn(i32, i32) -> i32 { match name { "add" => add, "sub" => sub, _ => unimplemented!(), } } fn main() { let fun = select("add"); println!("{} + {} = {}", 1, 2, fun(1, 2)); } 再来看看 Java 中的类型签名: 可以看到,核心的思想与C/C++/Rust中的类型签名一样,通过描述方法的传入参数与返回值的类型,来概述一个方法如何使用,而不需要关心这个方法的具体实现。 Python/Golang 中也有类型签名的概念,而且核心思路都一样,这里就不再赘述了。 通过了解这些编程语言的类型签名,我们知道,签名(Signature)其实与类型(Type)描述了同一个事物,类型(Type)所描述的事物是某些性质的集合,具备相同性质的事物,就可以认为它们的类型(Type)相同;而签名(Signature)可以看作由多个类型(Type)组合而成的复合类型。 举例说明: int32 a = 0; // a 的类型 (type) 是 int32 可以看到上述变量 a 的类型(type)是int32,大家只要一听到int32,就会条件反射的想到a的一些性质,比如:32位,整数,范围等等,int32就是对这些性质的总称,下次再遇到一个变量b,只要他的性质符合int32的性质,我们就可以把它们归为一类,即,它们都是类型(type)为int32的变量。 可是,编程语言的类型系统中,不仅仅有变量,还有一个很重要的东西--方法。 int add(int a, int b) { return a+b; } 现在,就需要一个东西,描述上面这个方法的类型,即,需要有一个东西来区分什么样子的方法与add方法属于同一类。名称?恐怕不行,因为下面这两个同名方法用起来感觉完全不一样。 // 两个数相加 int add(int a, int b) { return a+b; } // 两个数组合并 int[] add(int a[], int b[]) { return a.append(b); } 所以,在大佬们设计语言的的时候决定,使用返回值和参数列表的类型(type)组合起来,来定义一个方法的类型,即: // 两个数相加 // 类型为 (int, int) -> int int add(int a, int b) { return a+b; } // 两个数组合并 // 类型为 (int[], int[]) -> int[] int[] add(int a[], int b[]) { return a.append(b); } 而签名(Signature)就可以理解为将多个类型(type)组合起来形成的复合类型。这个签名用来描述方法的类型,就可以叫做方法签名(Method/Function Signature)。那么,写到现在,通过类比,也能猜出索引签名大概是个什么东西了,前面提过索引可以看做是一个方法,输入一个值,返回它指向的事物。 2.3 索引签名(IndexSignature) 上面提到,索引我们可以看作一个指针或是一个方法,签名(Signature)就可以理解为将多个类型(type)组合起来形成的复合类型,索引签名(IndexSignature)描述的就是索引的类型,写到这里我脑子里产生了点疑问,那索引签名不就是索引的类型吗,索引为什么要使用复合类型进行描述,一个普通类型(type)描述不了索引的类型吗? a[0] 这个索引的类型不就是Integer吗 ? hash.get("name") 这个索引的类型不就是String吗 ? 这个问题,源自于对索引理解的偏差, a[0] 的索引不是0,他的索引是 0->a[0]``, 即输入0,返回 [0]`. hash.get("name") 的索引也不是“name”,他的索引是 “name”->"Jack", 输入“name”返回"Jack"。 写到这里,其实使用各种编程语言的小伙伴们心里应该都能感觉自己可能或多或少都接触过索引签名这个东西,只是当时并不在意他叫什么,之所以这么说,是因为我自己在写到这里的时候,想到了之前开发java的时候使用的 hashmap: public class RunoobTest { public static void main(String[] args) { HashMap<string, string> Sites = new HashMap<string, string>(); Sites.put("one", "Google"); Sites.put("two", "Runoob"); Sites.put("three", "Taobao"); Sites.put("four", "Zhihu"); System.out.println(Sites); } } 上述代码第7行HashMap<string, string> Sites = new HashMap<string, string>()中, <string, string>就可以理解为一种索引签名,它定义了这个HashMap结构中的索引的类型,是输入一个字符串,返回一个字符串。而数组的索引签名也类似,只不过,数组的索引签名编译器帮我们自动省略了,即输入类型一定是int,不用我们手动书写了。 // 显式索引签名:Array<int, int> a = [0, 1, 2] int[] a = [0, 1, 2]; // 显式索引签名:Array<int, String> a = ["0", "1", "2"] String[] a = ["0", "1"]; 3. 一些语言中的索引签名 索引签名的思想由来已久,最早甚至可以追溯到早些年间程序员们为了程序的可读性而定下的编程规约,当我们规定一个整型变量的名称必须以i开头的时候,其实已经是在定义指向一个整型的的索引的签名了。 int i_user_id = 10; // 整型以i开头,定义了 <i开头的字符串, int> 的索引签名 float f_user_weight = 120.3; // 浮点以f开头,定义了 <f开头的字符串, float> 的索引签名 不过,规约可能并不是所有人都愿意遵守,当索引的名称成为编程元素的一部分,并且可以动态的操作的时候,将索引签名作为变成规约,就不是太合适了。 // 当出现可以动态添加索引的编程元素。 const a = { "name": "Jack" } // 你和你的小伙伴约定好,年龄的索引就是“age”。 // 他在某个地方add("age", 10)。 a.add("age", 10); // 你在某个地方,需要这个年龄。 a.get("age"); // 如果索引签名是编程规约,而不带有强制性。 // 你的小伙伴恰恰手一滑,眼一闭,写错了也没看到 warning。 a.add("aeg", 10); // 那你这边就只能看到空指针异常了。 NullPointerException: "age" is not define. 因此,为了提升程序的稳定性,避免这种不必要的风险,一些通用编程语言(如:TypeScript)和领域语言(如:KCL,CUE)开始将索引签名作为语言的特性暴露给开发者,旨在提供编程过程中的安全性和稳定性,降低上述问题产生的影响。 3.1 TypeScript 索引签名 在TS中,我们可以通过下面这种方式定义一个对象: const salary1 = { baseSalary: 100_000, yearlyBonus: 20_000 }; 根据上文我们对索引的描述,我们知道这个对象有两个索引,并且它们的类型即索引签名应该是相同的,即它们是同一类索引。 const salary1 = { baseSalary: 100_000, // 索引1 : 输入“baseSalary”,返回100_000 yearlyBonus: 20_000 // 索引2 : 输入”yearlyBonus“, 返回20_000 }; TS提供了一种特性,使得开发者可以编写这种索引签名, interface NumbersNames { [key: string]: string // 索引的类型为输入String,返回String } const names: NumbersNames = { '1': 'one', '2': 'two', '3': 'three', // etc... '5': 'five' // Error: 这个索引的输入类型为int,类型不匹配。 }; 3.2 CUE索引签名 CUE 支持在索引签名中写正则表达式,支持对索引名称的校验。 a: { foo: string // 索引foo 返回值是string类型。 [=~"^i"]: int // 以i开头的索引,返回值都是int。 [=~"^b"]: bool // 以b开头的索引,返回值都是bool。 ...string // 其他的所有的索引返回值都是string。 } b: a & { i3: 3 // 索引i3以i开头,返回值是3类型为int。 bar: true // 索引bar以b开头,返回值true类型为bool。 other: "a string" // 其他索引的返回值类型都是字符串。 } 3.3 KCL索引签名 KCL 索引签名的形式为 [<attr_name>: <index_type>]: <value_type> ,语义上表示结构中所有属性的key只能为 <index_type> 类型,值只能为 <value_type> 类型 索引签名的 `<index_type>`` 处的类型只能为 str, int, float,不能为 union 类型 <value_type> 可以为KCL任意合法的数据类型,包含schema类型和union类型等类型 <attr_name> 表示任意KCL合法的标识符,并且可以省略不写,一般用于和check结合使用 基础用法 schema定义方式 schema Map: [str]: str 注意使用了索引签名的schema默认为relaxed。 一个索引签名只能在schema当中定义一次。 高级用法 类型签名书写默认值 schema Map: [str]: str = {"default_key": "default_value"} 与schema定义混合使用,强制schema所有属性key, value类型: schema Person: name: str age: int # error, 与[str]: str语义冲突, [str]: str # schema所有属性的值只能为字符串类型 可以在 schema 中同时定义 schema 属性和索引签名,通常用于表示 schema 中额外属性的类型约束,强制除schema定义所有属性key, value类型。 schema Person: name: str age?: int [...str]: str # 表示除name, age之外,其余schema属性必须为字符串类型,属性的值也必须为字符串类型 属性名称配合check使用 schema Data: [dataName: str]: str check: dataName in ["Alice", "Bob", "John"] data = Data { Alice: "10" Bob: "12" Jonn: "8" # error Jonn not in ["Alice", "Bob", "John"] } 注意:KCL索引签名暂不支持union类型以及字面量类型等类型。 注意:索引签名暂不支持对value的的值进行校验,仅支持类型检查。 注意:索引签名暂不支持类似CUE的正则校验["$b^"] ,因为属于runtime检查,不属于类型系统的一部分,当类型检查从runtime阶段前置后不容易结合,因此暂不支持。 4. 总结 本文简单介绍了索引签名,通过梳理索引和签名的概念,并对比了一些通用编程语言和领域语言中使用到的签名的思想,泛泛的描述了一下索引签名大概的样子,希望能够帮助大家能够更加轻松的了解索引签名这个概念,文章的内容只是笔者个人对索引签名的理解,如果有不对或者不合适的地方欢迎大家指正。 参考链接 TypeScript - https://www.typescriptlang.org/ KCL - https://github.com/KusionStack/KCLVM CUE - https://cuelang.org/ Index - https://www.computerhope.com/jargon/i/index.htm Java Type Signature https://en.wikipedia.org/wiki/Type_signature#Java https://docs.oracle.com/javase/10/docs/api/com/sun/jdi/doc-files/signature.html Java Method Signature - https://www.scaler.com/topics/method-signature-in-java/ Function Signature - https://developer.mozilla.org/en-US/docs/Glossary/Signature/Function 说说我对 TypeScript 索引签名的理解 - https://segmentfault.com/a/1190000040727281 KCL索引签名 - https://kusionstack.io/docs/reference/lang/lang/tour/#%E7%B4%A2%E5%BC%95%E7%AD%BE%E5%90%8D Rust Function Signature - https://stackoverflow.com/questions/42157511/what-is-a-function-signature-and-type

优秀的个人博客,低调大师

每日一博 | StarRocks 技术内幕:向量化编程精髓

作者:康凯森,StarRocks PMC,负责查询方向的研发 本文是对我在 StarRocks 线下 MeetUp 演讲的整理,主要分为三部分:第一部分简要介绍向量化的基础知识,第二部分讲解数据库如何进行向量化,最后是 StarRocks 向量化实践后的一些粗浅思考。 #01 向量化为什么可以提升数据库性能? — 本文所讨论的数据库都是基于 CPU 架构的,数据库向量化一般指的都是基于 CPU 的向量化,因此数据库性能优化的本质在于:一个基于 CPU 的程序如何进行性能优化。这引出了两个关键问题: 1. 如何衡量 CPU 性能 2. 哪些因素会影响 CPU 性能 第一个问题的答案可以用以下公式总结:CPU Time = Instruction Number * CPI * Clock Cycle Time Instruction Number 表示指令数。当你写一个 CPU 程序,最终执行时都会变成 CPU 指令,指令条数一般取决于程序复杂度。 CPI 是 (Cycle Per Instruction)的缩写,指执行一个指令需要的周期。 Clock Cycle Time 指一个 CPU 周期需要的时间,是和 CPU 硬件特性强关联的。 我们在软件层面可以改变的是前两项:Instruction Number 和 CPI。那么问题来了,具体到一个 CPU 程序,到底哪些因素会影响 Instruction Number 和 CPI 呢? 我们知道 CPU 的指令执行分为如下 5 步: 1. 取指令 2. 指令译码 3. 执行指令 4. 内存访问 5. 结果写回寄存器 其中 CPU 的 Frontend 负责前两部分,Backend 负责后面三部分。基于此,Intel 提出了 《Top-down Microarchitecture Analysis Method》的 CPU 微架构性能分析方法,如下图所示: ​ Top-down Microarchitecture Analysis Method 的具体内容大家可以参考相关的论文,本文不做展开,为了便于大家理解,我们可以将上图简化为下图(不完全准确): ​ 即影响一个 CPU 程序的性能瓶颈主要有4大点:Retiring、Bad Speculation、Frontend Bound 和 Backend Bound,4个瓶颈点导致的主要原因(不完全准确)依次是:缺乏 SIMD 指令优化,分支预测错误,指令 Cache Miss, 数据 Cache Miss。 再对应到之前的 CPU 时间计算公式,我们就可以得出如下结论: ​ 而数据库向量化对以上 4 点都会有提升,后文会有具体解释,至此,本文从原理上解释了为什么向量化可以提升数据库性能。 #02 向量化基础知识 — 在了解数据库如何向量化之前,我们先理解一些向量化的基础知识。 注意,在第二个章节里面,向量化一词可以理解为和 SIMD 等价,仅指狭义上的 CPU SIMD 向量化,与数据库领域广义的向量化含义不同。 1、SIMD 简介 SIMD 是 Single Instruction Multiple Data 的缩写,指单个指令可以操作多个数据流,与之相对的是传统的 SISD,单指令单数据流。 ​ 如上图所示,对于最简单的 A + B = C,假如我们要计算 4 组加法,传统的 SISD 需要执行 8 次 Load 指令 (A 和 B 分别4次)、4 次 Add 指令、4 次 Store 指令。但当我们使用 128 位宽的 SIMD, 我们只需要 2 次 Load 指令、1 次 Add 指令、1 次 Store 指令,这样理论上就可以获得 4 倍的性能提升。而目前的向量化寄存器位宽已经发展到 512 位,理论上 Int 的加法操作就可以加速 16 倍。 2、如何触发向量化? 如前文所述,SIMD 指令会带来巨大的性能提升,数据库开发人员自然需要理解并掌握如何进行 SIMD 编程。 ​ 如上图所示,SIMD 触发向量化一般有 6 种方式,这 6 种方式自顶向下,对工程师的要求越来越高,需要手动编写的东西越来越多。 第一种是编译器自动向量化,代码不需要做特殊处理和改动,编译自动将默认的标量代码转换成向量化代码。但编译器默认只能处理比较简单的程序,具体支持的 Case 大家可以在网上搜索,资料很多; 第二种是我们给编译器一些 Hint,给编译器更多的信息和上下文,编译器也可以生成 SIMD 指令; 第三种是使用像 OpenMP 或者 Intel Cilk 这种并行编程 API,开发者可以加一些 Pragma 来生成 SIMD 指令; 第四种是使用一些 SIMD Intrinsics 的包装类; 第五种是直接使用 SIMD Intrinsics 编程; 最后一种是直接写汇编代码。 在 StarRocks 项目中,我们向量化的原则是尽可能触发编译器的自动向量化,也就是第一种和第二种,对于不能自动向量化但是性能又很关键的操作,我们会通过 SIMD Intrinsics 的方式手动向量化。 关于如何触发编译器的自动化,如何给编译器加 Hint 触发向量化以及如何通过 SIMD Intrinsics 的方式手动向量化大家可以参考我个人博客《数据库学习资料》向量化部分的资料,本文不再赘述。 《数据库学习资料》:https://blog.bcmeng.com/post/database-learning.html 3、如何验证程序生成了向量化代码? 当一个项目代码比较复杂时,如何确保代码触发向量化是很常见的问题。我们可以通过两种方式来检查: 第一种是给编译器加一些编译选项,编译器会输出某些代码是否触发向量化,以及没有向量化的原因。比如 GCC 编译器,我们可以加入 -fopt-info-vec-all 或者 -fopt-info-vec-optimized,-fopt-info-vec-missed,-fopt-info-vec-note 编译选项。效果如下图所示: ​ 第二种方法,我们可以直接查看最终执行的汇编代码,比如使用 https://gcc.godbolt.org/ 等网站或者 Perf、Vtune 等工具,如果汇编代码里面的寄存器是 xmm,ymm,zmm 或者指令以 v 开头,一般就说明代码触发了向量化。 #03 数据库向量化 — 1、数据库向量化的核心 StarRocks 的向量化引擎从写下第一行代码到成为一款成熟、稳定、世界领先的查询执行器,已经有 2 年多的时间,以我们的经验来看,数据库的向量化并不仅仅是触发 CPU 的 SIMD 向量化,而是一个巨大的、系统化的性能优化工程。 2、数据库向量化的挑战 数据库向量化的挑战主要有以下几点: 1. 全面的列式布局:在磁盘,内存,网络中全部都是列式布局,这意味存储引擎和计算引擎的完全重构 2. 所有算子、表达式和函数支持向量化:这意味数人年的工作 3. 算子和表达式计算尽可能使用 SIMD 指令:这意味着大量 Case By Case 的细致优化 4. 重新设计内存管理:因为处理的数据从一行变成了数千行 5. 重新设计数据结构:比如 Join、Aggregate、Sort 等核心算子的数据结构都需要进行改变 6. 整体性能提升 5 倍以上:所有的算子和表达式性能都要提升 5 倍以上,意味着全面地、系统地性能优化,所有重要的算子和表达式性能都不能有短板 3、算子和表达式向量化的关键点 数据库的向量化在工程上主要体现在算子和表达式的向量化,而算子和表达式的向量化的关键点就一句话:Batch Compute By Column, 如下图所示: ​ 对应 Intel 的 Top-down 分析方法,Batch 优化了 分支预测错误和指令 Cache Miss,By Column 优化了 数据 Cache Miss,并更容易触发 SIMD 指令优化。 Batch 这一点其实比较好做到,难点是对一些重要算子,比如 Join、Aggregate、Sort、Shuffle 等,如何做到按列处理,更难的是在按列处理的同时,如何尽可能触发 SIMD 指令的优化。每个算子的按列处理和 SIMD 指令优化我们会在之后的 《StarRocks 查询源码解析》系列文章中详细解释。 4、数据库向量化如何进行性能优化 前面提到,数据库向量化是一个巨大的、系统的性能优化工程,两年来,我们实现了数百个大大小小的优化点。我将 StarRocks 向量化两年多的性能优化经验总结为 7 个方面 (注意,由于向量化执行是单线程执行策略,所以下面的性能优化经验不涉及并发相关): 1. 高性能第三方库:在一些局部或者细节的地方,已经存在大量性能出色的开源库,这时候,我们可能没必要从头实现一些算法或者数据结构,使用高性能第三方库可以加速我们整个项目的进度。在 StarRcoks 中,我们使用了 Parallel Hashmap、Fmt、SIMD Json 和 Hyper Scan 等优秀的第三方库。 2. 数据结构和算法:高效的数据结构和算法可以直接在数量级上减少 CPU 指令数。在 StarRocks 2.0 中,我们引入了低基数全局字典,可以通过全局字典将字符串的相关操作转变成整形的相关操作。如下图所示,StarRcoks 将之前基于两个字符串的 Group By 变成了基于一个整形的 Group By,这样 Scan、Hash 计算、Equal、Memcpy 等操作都会有数倍的性能提升,整个查询最终会有 3 倍的性能提升。 ​ 3. 自适应优化:很多时候,如果我们拥有更多的上下文或者更多的信息,我们就可以做出更多针对性的优化,但是这些上下文或者信息有时只能在查询执行时才可以获取,所以我们必须在查询执行时根据上下文信息动态调整执行策略,这就是所谓的自适应优化。下图展示了一个根据选择率动态选择 Join Runtime Filter 的例子,有 3 个关键点: a. 如果一个 Filter 几乎不能过滤数据,我们就不选择; b. 如果一个 Filter 几乎可以把数据过滤完,我们就只保留一个 Filter; c. 最多只保留 3 个有用的 Filter ​ 4. SIMD 优化:如下图所示,StarRcoks 在算子和表达式中大量使用了 SIMD 指令提升性能。 ​ 5. C++ Low Level 优化:即使是相同的数据结构、相同的算法,C++ 的不同实现,性能也可能相差好几倍,比如 Move 变成了 Copy,Vector 是否 Reserve,是否 Inline, 循环相关的各种优化,编译时计算等等。 6. 内存管理优化:当 Batch Size 越大、并发越高,内存申请和释放越频繁,内存管理对性能的影响越大。我们实现了一个 Column Pool,用来复用 Column 的内存,显著优化了整体的查询性能。下图是一个 HLL 聚合函数内存优化的代码示意,通过将 HLL 的内存分配变成按 Block 分配,并实现复用,将 HLL 的聚合性能直接提升了 5 倍。 ​ 7. CPU Cache 优化:做性能优化的同学都应该对下图的数据了熟于心,清楚 CPU Cache Miss 对性能的影响是十分巨大的,尤其是我们启用了 SIMD 优化之后,程序的瓶颈就从 CPU Bound 变成了 Memory Bound。同时我们也应该清楚,随便程序的不断优化,程序的性能瓶颈会不断转移。 ​ 下面的代码展示了我们利用 Prefetch 优化 Cache Miss 的示例,我们需要知道,Prefetch 应该是最后一项优化 CPU Cache 的尝试手段,因为 Prefetch 的时机和距离比较难把握,需要充分测试。 ​ #04 StarRocks 向量化工程的粗浅思考 — 其一,很多事物的底层原理是相似的:当我深入了解到 CPU 的微架构后,发现 CPU 的微架构和数据库的整体架构也很类似,比如 CPU 和 StarRocks 都分 Frontend 和 Backend, CPU 的 Frontend 负责指令的取码和编解码,Backend 负责指令的执行和数据的交互, StarRocks的 Frontend 负责 SQL 的 Parse 和 Plan, Backend 负责 SQL 的执行和存储的交互。当你了解的系统、架构越多,你的这种感受会越深刻。 其二,打造一个高性能的数据库,需要的不仅是优秀合理的架构,还需要极致优秀的工程细节。这一点看似十分显然,其实并不是,如果你认可这一点,当你想打造一个极致性能的数据库时,你就不会像 ClickHouse 一样 Bottom-Up 地从细节和算法层面出发去设计整个系统,也不会选择 Java 或者 Go 等语言去实现查询执行层和存储层。 ​ 其三,向量化和查询编译的融合。我们知道,向量化和查询编译是查询执行的两大类方式,是正交的,并不冲突,只是目前业界大多数开源的数据库选择了向量化的做法,其实我们完全可以通过查询编译的方式,结合上下文信息,生成更强大的向量化代码。而且,近几年查询编译的本身诸多缺点业界也一直在改进。 其四,尝试 GPU、FPGA 等新硬件。我们知道,假如一件事情,做到 80 分,需要一个月的时间,那么从 80 分做到 90 分,可能就需要 1 年的时间,从 90 分做到 99 分,可能就需要 2 年的时间。虽然目前基于 CPU 架构下的性能还没到极限,但是取得大的突破可能需要比较大的精力,我们或许可以考虑在新的硬件开辟新的赛道和战场。 其五,挑战不可能。创业两年来,我们团队从零实现了向量化引擎、CBO 优化器、Pipeline 并行引擎……看着一个又一个突破和成绩,我最大的一个感受就是我们应该永远坚信自己,挑战不可能。最后我向大家推荐一本书《像火箭科学家一样思考:将不可能变为可能》,这本书比较完美地诠释了 StarRocks 团队的价值观:在 Think Big、敢想敢干的同时,如何攻坚克难、快速迭代,将一个又一个宏大的想法落地。 本期 StarRocks 技术内幕到这就结束了,好学的你肯定学会了一些新东西,或者又产生了一些新困惑,不妨扫描下方用户群二维码加入 StarRocks 社区一起交流! 关于 StarRocks StarRocks 创立两年多来,一直专注打造世界顶级的新一代极速全场景 MPP 数据库,帮助企业建立“极速统一”的数据分析新范式,助力企业全面数字化经营。 当前已经帮助腾讯、携程、顺丰、Airbnb 、滴滴、京东、众安保险等超过 110 家大型用户构建了全新的数据分析能力,生产环境中稳定运行的 StarRocks 服务器数目达数千台。 2021 年 9 月,StarRocks 源代码开放,在 GitHub 上的星数已超过 3100 个。StarRocks 的全球社区飞速成长,至今已有超百位贡献者,社群用户突破 5000 人,吸引几十家国内外行业头部企业参与共建。 ​

优秀的个人博客,低调大师

每日一博 | 负载均衡原理分析与源码解读

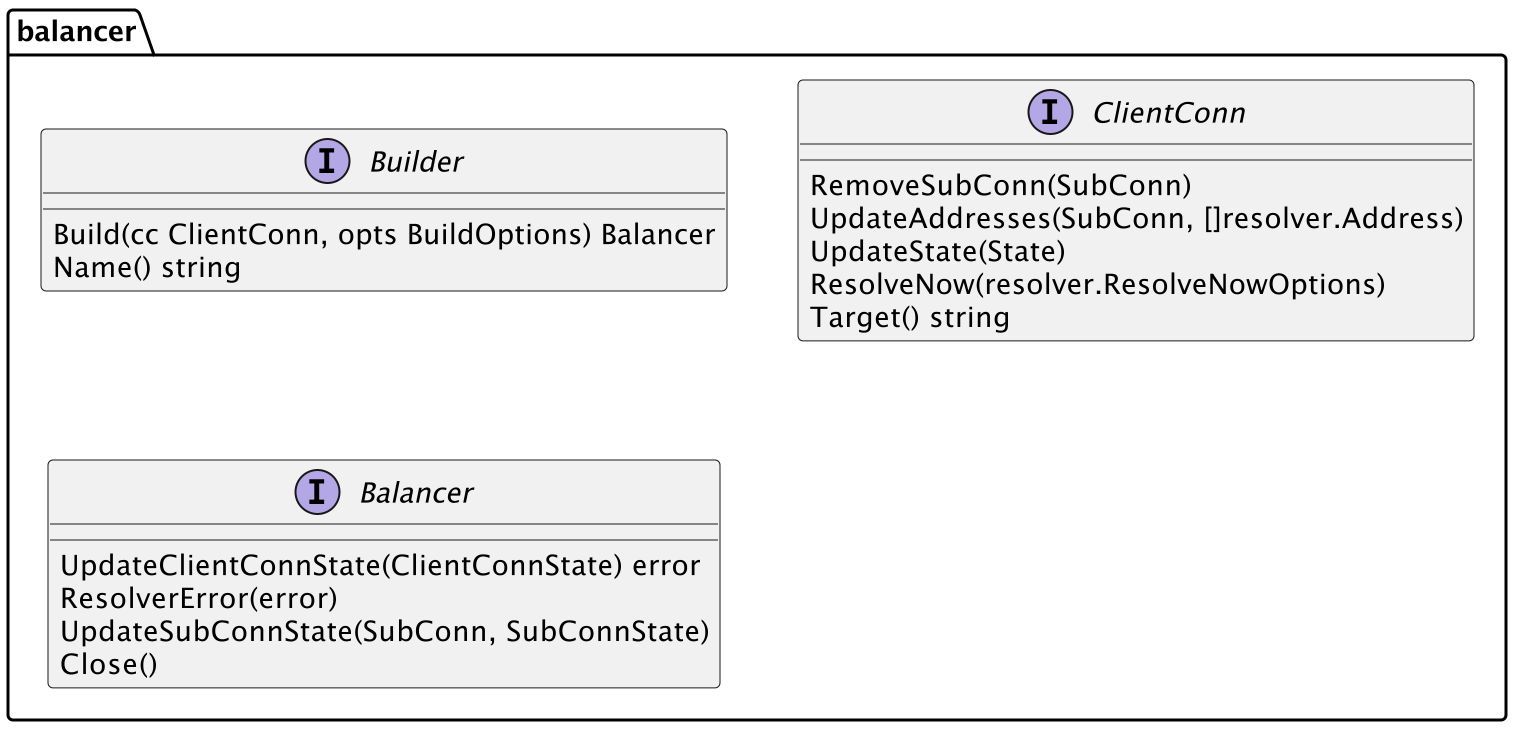
上一篇文章一起学习了Resolver的原理和源码分析,本篇继续和大家一起学习下和Resolver关系密切的Balancer的相关内容。这里说的负载均衡主要指数据中心内的负载均衡,即RPC间的负载均衡。 传送门 服务发现原理分析与源码解读 基于go-zero v1.3.5 和 grpc-go v1.47.0 负载均衡 每一个被调用服务都会有多个实例,那么服务的调用方应该将请求,发向被调用服务的哪一个服务实例,这就是负载均衡的业务场景。 负载均衡的第一个关键点是公平性,即负载均衡需要关注被调用服务实例组之间的公平性,不要出现旱的旱死,涝的涝死的情况。 负载均衡的第二个关键点是正确性,即对于有状态的服务来说,负载均衡需要关心请求的状态,将请求调度到能处理它的后端实例上,不要出现不能处理和错误处理的情况。 无状态的负载均衡 无状态的负载均衡是我们日常工作中接触比较多的负载均衡模型,它指的是参与负载均衡的后端实例是无状态的,所有的后端实例都是对等的,一个请求不论发向哪一个实例,都会得到相同的并且正确的处理结果,所以无状态的负载均衡策略不需要关心请求的状态。下面介绍两种无状态负载均衡算法。 轮询 轮询的负载均衡策略非常简单,只需要将请求按顺序分配给多个实例,不用再做其他的处理。例如,轮询策略会将第一个请求分配给第一个实例,然后将下一个请求分配给第二个实例,这样依次分配下去,分配完一轮之后,再回到开头分配给第一个实例,再依次分配。轮询在路由时,不利用请求的状态信息,属于无状态的负载均衡策略,所以它不能用于有状态实例的负载均衡器,否则正确性会出现问题。在公平性方面,因为轮询策略只是按顺序分配请求,所以适用于请求的工作负载和实例的处理能力差异都较小的情况。 权重轮询 权重轮询的负载均衡策略是将每一个后端实例分配一个权重,分配请求的数量和实例的权重成正比轮询。例如有两个实例 A,B,假设我们设置 A 的权重为 20,B 的权重为 80,那么负载均衡会将 20% 的请求数量分配给 A,80 % 的请求数量分配给 B。权重轮询在路由时,不利用请求的状态信息,属于无状态的负载均衡策略,所以它也不能用于有状态实例的负载均衡器,否则正确性会出现问题。在公平性方面,因为权重策略会按实例的权重比例来分配请求数,所以,我们可以利用它解决实例的处理能力差异的问题,认为它的公平性比轮询策略要好。 有状态负载均衡 有状态负载均衡是指,在负载均衡策略中会保存服务端的一些状态,然后根据这些状态按照一定的算法选择出对应的实例。 P2C+EWMA 在go-zero中默认使用的是P2C的负载均衡算法。该算法的原理比较简单,即随机从所有可用节点中选择两个节点,然后计算这两个节点的负载情况,选择负载较低的一个节点来服务本次请求。为了避免某些节点一直得不到选择导致不平衡,会在超过一定的时间后强制选择一次。 在该复杂均衡算法中,多出采用了EWMA指数移动加权平均的算法,表示是一段时间内的均值。该算法相对于算数平均来说对于突然的网络抖动没有那么敏感,突然的抖动不会体现在请求的lag中,从而可以让算法更加均衡。 go-zero/zrpc/internal/balancer/p2c/p2c.go:133 atomic.StoreUint64(&c.lag, uint64(float64(olag)*w+float64(lag)*(1-w))) go-zero/zrpc/internal/balancer/p2c/p2c.go:139 atomic.StoreUint64(&c.success, uint64(float64(osucc)*w+float64(success)*(1-w))) 系数w是一个时间衰减值,即两次请求的间隔越大,则系数w就越小。 go-zero/zrpc/internal/balancer/p2c/p2c.go:124 w := math.Exp(float64(-td) / float64(decayTime)) 节点的load值是通过该连接的请求延迟 lag 和当前请求数 inflight 的乘积所得,如果请求的延迟越大或者当前正在处理的请求数越多表明该节点的负载越高。 go-zero/zrpc/internal/balancer/p2c/p2c.go:199 func (c *subConn) load() int64 { // plus one to avoid multiply zero lag := int64(math.Sqrt(float64(atomic.LoadUint64(&c.lag) + 1))) load := lag * (atomic.LoadInt64(&c.inflight) + 1) if load == 0 { return penalty } return load } 源码分析 如下源码会涉及go-zero和gRPC,请根据给出的代码路径进行区分 在gRPC中,Balancer和Resolver一样也可以自定义,同样也是通过Register方法进行注册 grpc-go/balancer/balancer.go:53 func Register(b Builder) { m[strings.ToLower(b.Name())] = b } Register的参数Builder为接口,在Builder接口中,Build方法的第一个参数ClientConn也为接口,Build方法的返回值Balancer同样也是接口,定义如下: 可以看出,要想实现自定义的Balancer的话,就必须要实现balancer.Builder接口。 在了解了gRPC提供的Balancer的注册方式之后,我们看一下go-zero是在什么地方进行Balancer注册的 go-zero/zrpc/internal/balancer/p2c/p2c.go:36 func init() { balancer.Register(newBuilder()) } 在go-zero中并没有实现 balancer.Builder 接口,而是使用gRPC提供的 base.baseBuilder 进行注册,base.baseBuilder 实现了balancer.Builder 接口。创建baseBuilder的时候调用了 base.NewBalancerBuilder 方法,需要传入 PickerBuilder 参数,PickerBuilder为接口,在go-zero中 p2c.p2cPickerBuilder 实现了该接口。 PickerBuilder接口Build方法返回值 balancer.Picker 也是一个接口,p2c.p2cPicker 实现了该接口。 grpc-go/balancer/base/base.go:65 func NewBalancerBuilder(name string, pb PickerBuilder, config Config) balancer.Builder { return &baseBuilder{ name: name, pickerBuilder: pb, config: config, } } 各结构之间的关系如下图所示,其中各结构模块对应的包为: balancer:grpc-go/balancer base:grpc-go/balancer/base p2c: go-zero/zrpc/internal/balancer/p2c 在哪里获取已注册的Balancer? 通过上面的流程步骤,已经知道了如何自定义Balancer,以及如何注册自定义的Blancer。既然注册了肯定就会获取,接下来看一下是在哪里获取已经注册的Balancer的。 我们知道Resolver是通过解析DialContext的第二个参数target,从而得到Resolver的name,然后根据name获取到对应的Resolver的。获取Balancer同样也是根据名称,Balancer的名称是在创建gRPC Client的时候通过配置项传入的,这里的p2c.Name为注册Balancer时指定的名称 p2c_ewma ,如下: go-zero/zrpc/internal/client.go:50 func NewClient(target string, opts ...ClientOption) (Client, error) { var cli client svcCfg := fmt.Sprintf(`{"loadBalancingPolicy":"%s"}`, p2c.Name) balancerOpt := WithDialOption(grpc.WithDefaultServiceConfig(svcCfg)) opts = append([]ClientOption{balancerOpt}, opts...) if err := cli.dial(target, opts...); err != nil { return nil, err } return &cli, nil } 在上一篇文章中,我们已经知道当创建gRPC客户端的时候,会触发调用自定义Resolver的Build方法,在Build方法内部获取到服务地址列表后,通过cc.UpdateState方法进行状态更新,后面当监听到服务状态变化的时候同样也会调用cc.UpdateState进行状态的更新,而这里的cc指的就是 ccResolverWrapper 对象,这一部分如果忘记的话,可以再去回顾一下讲解Resolver的那篇文章,以便能丝滑接入本篇: go-zero/zrpc/resolver/internal/kubebuilder.go:51 if err := cc.UpdateState(resolver.State{ Addresses: addrs, }); err != nil { logx.Error(err) } 这里有几个重要的模块对象,如下: ClientConn:grpc-go/clientconn.go:464 ccResolverWrapper:grpc-go/resolver_conn_wrapper.go:36 ccBalancerWrapper:grpc-go/balancer_conn_wrappers.go:48 Balancer:grpc-go/internal/balancer/gracefulswitch/gracefulswitch.go:46 balancerWrapper:grpc-go/internal/balancer/gracefulswitch/gracefulswitch.go:247 当监听到服务状态的变更后(首次启动或者通过Watch监听变化)调用 ccResolverWrapper.UpdateState 触发更新状态的流程,各模块间的调用链路如下所示: 获取Balancer的动作是在 ccBalancerWrapper.handleSwitchTo 方法中触发的,代码如下所示: grpc-go/balancer_conn_wrappers.go:266 builder := balancer.Get(name) if builder == nil { channelz.Warningf(logger, ccb.cc.channelzID, "Channel switches to new LB policy %q, since the specified LB policy %q was not registered", PickFirstBalancerName, name) builder = newPickfirstBuilder() } else { channelz.Infof(logger, ccb.cc.channelzID, "Channel switches to new LB policy %q", name) } if err := ccb.balancer.SwitchTo(builder); err != nil { channelz.Errorf(logger, ccb.cc.channelzID, "Channel failed to build new LB policy %q: %v", name, err) return } ccb.curBalancerName = builder.Name() 然后在 Balancer.SwitchTo 方法中,调用了自定义Balancer的Build方法: grpc-go/internal/balancer/gracefulswitch/gracefulswitch.go:121 newBalancer := builder.Build(bw, gsb.bOpts) 上文有提到Build方法的第一个参数为接口 balancer.ClientConn ,而这里传入的为 balancerWrapper ,所以gracefulswitch.balancerWrapper实现了该接口: 到这里我们已经知道了获取自定义Balancer是在哪里触达的,以及在哪里获取的自定义的Balancer,和balancer.Builder的Build方法在哪里被调用。 通过上文可知这里的balancer.Builder为baseBuilder,所以调用的Build方法为baseBuilder的Build方法,Build方法的定义如下: grpc-go/balancer/base/balancer.go:39 func (bb *baseBuilder) Build(cc balancer.ClientConn, opt balancer.BuildOptions) balancer.Balancer { bal := &baseBalancer{ cc: cc, pickerBuilder: bb.pickerBuilder, subConns: resolver.NewAddressMap(), scStates: make(map[balancer.SubConn]connectivity.State), csEvltr: &balancer.ConnectivityStateEvaluator{}, config: bb.config, } bal.picker = NewErrPicker(balancer.ErrNoSubConnAvailable) return bal } Build方法返回了baseBalancer,可以知道baseBalancer实现了balancer.Balancer接口: 再来回顾下这个流程,其实主要做了如下几件事: 在自定义的Resolver中监听服务状态的变更 通过UpdateState来更新状态 获取自定义的Balancer 执行自定义Balancer的Build方法获取Balancer 如何创建连接? 继续回到ClientConn的updateResolverState方法,在方法的最后调用balancerWrapper.updateClientConnState方法更新客户端的连接状态: grpc-go/clientconn.go:664 uccsErr := bw.updateClientConnState(&balancer.ClientConnState{ResolverState: s, BalancerConfig: balCfg}) if ret == nil { ret = uccsErr // prefer ErrBadResolver state since any other error is // currently meaningless to the caller. } 后面的调用链路如下图所示: 最终会调用baseBalancer.UpdateClientConnState方法: grpc-go/balancer/base/balancer.go:94 func (b *baseBalancer) UpdateClientConnState(s balancer.ClientConnState) error { // ............. b.resolverErr = nil addrsSet := resolver.NewAddressMap() for _, a := range s.ResolverState.Addresses { addrsSet.Set(a, nil) if _, ok := b.subConns.Get(a); !ok { sc, err := b.cc.NewSubConn([]resolver.Address{a}, balancer.NewSubConnOptions{HealthCheckEnabled: b.config.HealthCheck}) if err != nil { logger.Warningf("base.baseBalancer: failed to create new SubConn: %v", err) continue } b.subConns.Set(a, sc) b.scStates[sc] = connectivity.Idle b.csEvltr.RecordTransition(connectivity.Shutdown, connectivity.Idle) sc.Connect() } } for _, a := range b.subConns.Keys() { sci, _ := b.subConns.Get(a) sc := sci.(balancer.SubConn) if _, ok := addrsSet.Get(a); !ok { b.cc.RemoveSubConn(sc) b.subConns.Delete(a) } } // ................ } 当第一次触发调用UpdateClientConnState的时候,如下代码中 ok 为 false: _, ok := b.subConns.Get(a); 所以会创建新的连接: sc, err := b.cc.NewSubConn([]resolver.Address{a}, balancer.NewSubConnOptions{HealthCheckEnabled: b.config.HealthCheck}) 这里的 b.cc 即为 balancerWrapper,忘记的盆友可以往上翻看复习一下,也就是会调用 balancerWrapper.NewSubConn创建连接 grpc-go/internal/balancer/gracefulswitch/gracefulswitch.go:328 func (bw *balancerWrapper) NewSubConn(addrs []resolver.Address, opts balancer.NewSubConnOptions) (balancer.SubConn, error) { // ............. sc, err := bw.gsb.cc.NewSubConn(addrs, opts) if err != nil { return nil, err } // ............. bw.subconns[sc] = true // ............. } bw.gsb.cc即为ccBalancerWrapper,所以这里会调用ccBalancerWrapper.NewSubConn创建连接: grpc-go/balancer_conn_wrappers.go:299 func (ccb *ccBalancerWrapper) NewSubConn(addrs []resolver.Address, opts balancer.NewSubConnOptions) (balancer.SubConn, error) { if len(addrs) <= 0 { return nil, fmt.Errorf("grpc: cannot create SubConn with empty address list") } ac, err := ccb.cc.newAddrConn(addrs, opts) if err != nil { channelz.Warningf(logger, ccb.cc.channelzID, "acBalancerWrapper: NewSubConn: failed to newAddrConn: %v", err) return nil, err } acbw := &acBalancerWrapper{ac: ac} acbw.ac.mu.Lock() ac.acbw = acbw acbw.ac.mu.Unlock() return acbw, nil } 最终返回的是acBalancerWrapper对象,acBalancerWrapper实现了balancer.SubConn接口: 调用流程图如下所示: 创建连接的默认状态为 connectivity.Idle : grpc-go/clientconn.go:699 func (cc *ClientConn) newAddrConn(addrs []resolver.Address, opts balancer.NewSubConnOptions) (*addrConn, error) { ac := &addrConn{ state: connectivity.Idle, cc: cc, addrs: addrs, scopts: opts, dopts: cc.dopts, czData: new(channelzData), resetBackoff: make(chan struct{}), } // ........... } 在gRPC中为连接定义了五种状态,分别如下: const ( // Idle indicates the ClientConn is idle. Idle State = iota // Connecting indicates the ClientConn is connecting. Connecting // Ready indicates the ClientConn is ready for work. Ready // TransientFailure indicates the ClientConn has seen a failure but expects to recover. TransientFailure // Shutdown indicates the ClientConn has started shutting down. Shutdown ) 在 **baseBalancer ** 中通过b.scStates保存创建的连接,初始状态也为connectivity.Idle,之后通过sc.Connect()进行连接: grpc-go/balancer/base/balancer.go:112 b.subConns.Set(a, sc) b.scStates[sc] = connectivity.Idle b.csEvltr.RecordTransition(connectivity.Shutdown, connectivity.Idle) sc.Connect() 这里sc.Connetc调用的是acBalancerWrapper的Connect方法,可以看到这里创建连接是异步进行的: grpc-go/balancer_conn_wrappers.go:406 func (acbw *acBalancerWrapper) Connect() { acbw.mu.Lock() defer acbw.mu.Unlock() go acbw.ac.connect() } 最后会调用addrConn.connect方法: grpc-go/clientconn.go:786 func (ac *addrConn) connect() error { ac.mu.Lock() if ac.state == connectivity.Shutdown { ac.mu.Unlock() return errConnClosing } if ac.state != connectivity.Idle { ac.mu.Unlock() return nil } ac.updateConnectivityState(connectivity.Connecting, nil) ac.mu.Unlock() ac.resetTransport() return nil } 从connect开始的调用链路如下所示: 在baseBalancer的UpdateSubConnState方法的最后,更新了Picker为自定义的Picker: grpc-go/balancer/base/balancer.go:221 b.cc.UpdateState(balancer.State{ConnectivityState: b.state, Picker: b.picker}) 在addrConn方法的最后会调用ac.resetTransport()真正的进行连接的创建: 当连接已经创建好,处于Ready状态,最后调用baseBalancer.UpdateSubConnState方法,此时s==connectivity.Ready为true,而oldS == connectivity.Ready为false,所以会调用b.regeneratePicker()方法: if (s == connectivity.Ready) != (oldS == connectivity.Ready) || b.state == connectivity.TransientFailure { b.regeneratePicker() } func (b *baseBalancer) regeneratePicker() { if b.state == connectivity.TransientFailure { b.picker = NewErrPicker(b.mergeErrors()) return } readySCs := make(map[balancer.SubConn]SubConnInfo) // Filter out all ready SCs from full subConn map. for _, addr := range b.subConns.Keys() { sci, _ := b.subConns.Get(addr) sc := sci.(balancer.SubConn) if st, ok := b.scStates[sc]; ok && st == connectivity.Ready { readySCs[sc] = SubConnInfo{Address: addr} } } b.picker = b.pickerBuilder.Build(PickerBuildInfo{ReadySCs: readySCs}) } 在regeneratePicker中获取了处于connectivity.Ready状态可用的连接,同时更新了picker。还记得b.pickerBuilder吗?b.b.pickerBuilder为在go-zero中自定义实现的base.PickerBuilder接口。 go-zero/zrpc/internal/balancer/p2c/p2c.go:42 func (b *p2cPickerBuilder) Build(info base.PickerBuildInfo) balancer.Picker { readySCs := info.ReadySCs if len(readySCs) == 0 { return base.NewErrPicker(balancer.ErrNoSubConnAvailable) } var conns []*subConn for conn, connInfo := range readySCs { conns = append(conns, &subConn{ addr: connInfo.Address, conn: conn, success: initSuccess, }) } return &p2cPicker{ conns: conns, r: rand.New(rand.NewSource(time.Now().UnixNano())), stamp: syncx.NewAtomicDuration(), } } 最后把自定义的Picker赋值为 ClientConn.blockingpicker.picker属性。 grpc-go/balancer_conn_wrappers.go:347 func (ccb *ccBalancerWrapper) UpdateState(s balancer.State) { ccb.cc.blockingpicker.updatePicker(s.Picker) ccb.cc.csMgr.updateState(s.ConnectivityState) } 如何选择已创建的连接? 现在已经知道了如何创建连接,以及连接其实是在 baseBalancer.scStates 中管理,当连接的状态发生变化,则会更新 **baseBalancer.scStates ** 。那么接下来我们来看一下gRPC是如何选择一个连接进行请求的发送的。 当gRPC客户端发起调用的时候,会调用ClientConn的Invoke方法,一般不会主动使用该方法进行调用,该方法的调用一般是自动生成: grpc-go/examples/helloworld/helloworld/helloworld_grpc.pb.go:39 func (c *greeterClient) SayHello(ctx context.Context, in *HelloRequest, opts ...grpc.CallOption) (*HelloReply, error) { out := new(HelloReply) err := c.cc.Invoke(ctx, "/helloworld.Greeter/SayHello", in, out, opts...) if err != nil { return nil, err } return out, nil } 如下为发起请求的调用链路,最终会调用p2cPicker.Pick方法获取连接,我们自定义的负载均衡算法一般都在Pick方法中实现,获取到连接之后,通过sendMsg发送请求。 grpc-go/stream.go:945 func (a *csAttempt) sendMsg(m interface{}, hdr, payld, data []byte) error { cs := a.cs if a.trInfo != nil { a.mu.Lock() if a.trInfo.tr != nil { a.trInfo.tr.LazyLog(&payload{sent: true, msg: m}, true) } a.mu.Unlock() } if err := a.t.Write(a.s, hdr, payld, &transport.Options{Last: !cs.desc.ClientStreams}); err != nil { if !cs.desc.ClientStreams { return nil } return io.EOF } if a.statsHandler != nil { a.statsHandler.HandleRPC(a.ctx, outPayload(true, m, data, payld, time.Now())) } if channelz.IsOn() { a.t.IncrMsgSent() } return nil } 源码分析到此就结束了,由于篇幅有限没法做到面面俱到,所以本文只列出了源码中的主要路径。 结束语 Balancer相关的源码还是有点复杂的,笔者也是读了好几遍才理清脉络,所以如果读了一两遍感觉没有头绪也不用着急,对照文章的脉络多读几遍就一定能搞懂。 如果有疑问可以随时找我讨论,在社区群中可以搜索dawn_zhou找到我。 希望本篇文章对你有所帮助,你的点赞是作者持续输出的最大动力。 项目地址 https://github.com/zeromicro/go-zero https://gitee.com/kevwan/go-zero 欢迎使用 go-zero 并 star 支持我们! 微信交流群 关注『微服务实践』公众号并点击 交流群 获取社区群二维码。
优秀的个人博客,低调大师

每日一博 | 淘宝直播全屏页重排算法实践

本文旨在分享正负反馈序列建模与多目标优化在淘宝直播排序上的实践经验。 背景介绍 直播带货是“内容+电商”这种新商业模式最火热的应用之一,传统互联网电商如PDD、JD等均已上线直播带货平台,众多内容赛道玩家如抖快也加大直播电商的投入。淘宝直播作为直播带货领域的先行者,近几年一直保持高速增长,据集团2021财报显示,淘宝直播年GMV已超过5000亿元,同比增长超90%,是集团营收的重要组成部分,同时打造出了薇娅、李佳琦等一众IP明星,形成了平台、商家、达人共赢的良好局面。 淘宝直播相比于其他内容形式,如短视频、图文等,最大的特点是实时互动,商家和达人在直播间实时进行商品展示、开展营销活动,与用户互动中完成宝贝种草、圈粉、引流转化。如何将这种实时的内容高效率地分发给相应的受众就是我们直播推荐算法团队要解决的问题,淘宝直播分发的主要场景有淘宝首页宫格的频道页、首页猜你喜欢直播feeds流等一跳场景,以及承接一跳点击进入直播间的二跳场景全屏页。全屏页提供了一个沉浸式的信息流展示形式,其承担着对用户一跳refer(引导用户进直播间的一跳点击主播)兴趣点的深度挖掘与扩展,以及对用户隐/显式正负反馈的实时感知和决策。针对前者,精排模型做了相当多的工作,保证了refer的相关性和推荐的准度,考虑到精排模型体量已经很重的情况下,如果对用户和主播实时行为建模再放到精排中就显得很臃肿,因此针对用户的正负行为反馈以及直播间实时状态的感知决策自然就落在重排阶段。 本文旨在分享正负反馈序列建模与多目标优化在淘宝直播排序上的实践经验,主要主要分为以下几个部分:第一部分描述了直播二跳场景重排序面临的一些问题以及期望达到的一些效果;第二部分基于实际的业务问题进行建模,核心优化点主要包括政府反馈序列建模和多目标优化;第三部分是模型在线上取得的真实实验效果;最后总结了算法要点,并指出下一步需要解决的重要问题。 问题描述 全屏页重排主要是解决用户和主播实时行为反馈建模的问题,在精排保证个性化和推荐准确度的基础上,能快速感知端上行为,解决用户下滑过程中对感兴趣主播和不感兴趣主播实时挖掘和决策的问题。目前全屏页推荐的请求特点是每次端上请求多个结果,正常情况下只会展示一个,每次滑动会重新发起请求,因此在这里我们使用point-wise而非List-wise的模型结构来优化效率,同时我们还期待重排模型能达到以下几点要求: 实时感知:模型能实时感知用户侧的实时观看互动行为和主播侧直播间实时粉丝互动成交状态; 正负反馈:根据用户实时的正负反馈信号决定推荐的结果,改善用户体验; 多目标:提升停留时长、点赞、关注、分享、评论等内容分发指标的同时,兼顾宝贝点击、购买等电商成交指标,突出“内容+电商”的场景特色。 根据上述几点要求,我们设计了一套基于实时正负反馈的多目标轻量级重排模型,接下来将详细阐述模型的设计思路和结构。 重排模型 整个模型的核心结构如图1所示,主要由embedding层、主播与用户兴趣表达层、多目标学习层组成。其中输入层所用到的用户和主播侧特征主要为实时特征,用户实时正负反馈的兴趣表达采用序列残差学习的方式,上层多目标学习层使用类MMOE的算法框架。下面将分别对各模块做进一步描述。 图1 多目标实时正负反馈模型 ▐实时特征 用户侧 用户侧实时特征主要是两个实时正负反馈序列,如右侧图2所示,用户实时观看的直播流以实时消息的形式发送到Flink节点中进行预处理,然后实时转储到igraph表中,最后通过HPF(High Pass Filter)选取正反馈序列positive seq;通过LPF(Low Pass Filter)过滤出负反馈序列negtive seq。两个序列作为后续进行正负兴趣表达学习的输入信号。 图2 实时正负反馈序列 主播侧 主播侧实时特征主要包含一系列直播间实时统计信息,从手淘客户端采集如观看uv、点赞、关注、评论、分享、宝贝袋点击等实时消息,然后flink节点中进行数据聚合形成直播间统计特征,另外主播正在展示和讲解的topN商品信息(宝贝类目、品牌等)也会引入到模型的特征层中丰富主播表达。 ▐正负反馈 对比残差建模 目前针对用户兴趣建模的主流方式是对用户的正向行为序列进行信息的提取与匹配,如DIN, DSIN,DIEN等,在这里我们还引入了用户隐式负反馈的信号,目的是解决用户快速滑动且停留时间很短的情况下系统还是推类似主播的问题,通过正负反馈行为的建模,实时感知用户的喜恶,并及时干预接下来的推荐内容,有效提升用户体验。如图1中红色虚线框所示,正负反馈序列在与target主播进行attention提取出匹配信息后再做差,即:,其中,MLP:多层感知机,即三层全连接层;TA:target attention[2],基于Transformer[1]改进而来的attention信息提取器,Transformer模型最早来源google的论文《Attention is all you need》,在NLP领域大放异彩,其self-attention机制不仅在语言建模上取得重大进步,在CV和搜推中的应用也逐渐扩大,其主要结构如图3所示,核心组件为multi-head self-attention,计算公式如下:, 其中 Q是Query,K是Key,V是Value。 图3 Transformer主要结构 在Transformer的encoder部分的self-attention中Q、K、V均指输入序列本身,而target attention中query是指待打分的候选主播,key和value指用户的行为序列。 label-aware triplet loss 为了更好的学习正负序列之间的区分性,在这里引入metric learning的loss function来辅助优化序列学习。考虑到待打分的主播与正负序列表达构成一个triplet组,因此自然而然想到用triplet loss[3]的形式,triplet loss是度量学习中一种重要的loss function,如图4,其原理是通过anchor与postive尽可能靠近,anchor与negative尽可能远离的度量学习方式,使得object之间的embedding表达更具有区分性。 图4 标准triplet loss学习原理 标准的triplet loss公式为,与标准triplet loss不同的是,我们的样本中正/负样本和每个样本对应的用户正负反馈序列已经确定,因此对于正样本我们可以采用标准triplet loss的形式,对于负样本则需要进行取反操作,因此在这里我们设计了一个label aware triplet loss来辅助优化序列学习(图5)。即,对于正样本为1,对于负样本为-1。 图5 label-aware triplet loss ▐多目标 为了满足推荐场景不同业务指标的要求,多目标学习基本是很多推荐场景的标配,其整体框架如图6所示。 图6 多目标学习一般框架 直播场景中存在多个业务指标优化的诉求,内容指标主要有停留时长、点赞、评论、分享等互动指标,电商指标主要有宝贝的加购、购买、gmv等指标。如何平衡多个目标之间的相关和冲突是一个值得深入研究在课题,在这里我们采用了task-specific experts结合share experts的算法机制,有效缓解传统MMOE类算法框架的“跷跷板”问题,即图7中PLE多目标学习框架[4]。同时为了减少label的稀疏性,我们将点赞、分享、评论、关注等互动行为合并成一个label,即interact;把宝贝加购、购买、成交相关的行为合并成一个label,即buy,这样既较少了模型参数,也减少了稀疏目标优化的难度。 图7 PLE多目标学习框架 线上效果 在淘宝直播场景线上AB实验,整体收益如下: 核心指标:人均时长+4% ; 互动指标:人均点赞率+5.2%,人均评论率+4.0%,人均关注率+6%,人均分享率+5% ; 成交指标:人均成交提升20%+ 目前模型已全量发布,模型在整体时长、互动指标和成交均取得正向收益。 总结&展望 以上是我们对淘宝直播全屏页重排的一个阶段性思考和总结,在淘宝直播这样一个实时互动的场景,实时行为的感知和决策是一个需要长期思考和优化的重点问题,目前随着我们对这个问题不断深入探索,不仅取得了线上效果的提升,也沉淀出了符合直播业务特点的技术思路。 在实时特征上,构建了用户正负反馈和直播间的实时感知链路;在行为序列建模上,正负反馈序列的对比残差学习实时感知用户喜恶,即时决策推荐结果,提升用户体验;在多目标学习上,引入PLE算法在互动指标上也取得效率的平衡。 未来在重排阶段将加强用户兴趣的探索与利用,在满足推荐准度的同时尝试探索用户新的兴趣点来破圈,目前随着RL在推荐领域的快速发展,基于RL的重排模型将在直播这种实时交互很强的场景具有不小的应用潜力,希望能同各位搜推广的同学一起交流反馈,在业界能有更多的技术落地点。 参考 [1] Vaswani A, Shazeer N, Parmar N, et al. Attention is all you need[C]//Advances in neural information processing systems. 2017: 5998-6008. [2] Chen Q, Zhao H, Li W, et al. Behavior sequence transformer for e-commerce recommendation in Alibaba[C]//Proceedings of the 1st International Workshop on Deep Learning Practice for High-Dimensional Sparse Data. 2019: 1-4. [3] F. Schroff, D. Kalenichenko, and J. Philbin. Facenet: A unified embedding for face recognition and clustering. In CVPR, 2015. 2, 3, 7 [4] Hongyan Tang, Junning Liu, Ming Zhao, and Xudong Gong. 2020. Progressive Layered Extraction (PLE): A Novel Multi-Task Learning (MTL) Model for Personalized Recommendations. In Fourteenth ACM Conference on Recommender Systems. 269–278. ✿拓展阅读 作者| 霁疏 编辑| 橙子君 出品|阿里巴巴新零售淘系技术 本文分享自微信公众号 - 淘系技术(AlibabaMTT)。如有侵权,请联系 support@oschina.cn 删除。本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

优秀的个人博客,低调大师

每日一博 | 数据库系统设计:分区

摘要:对大数据集或非常高吞吐量,仅复制还不够,还需将数据拆分成为分区,也称分片。 本文分享自华为云社区《系统设计之分区策略》,作者:JavaEdge。 对大数据集或非常高吞吐量,仅复制还不够,还需将数据拆分成为分区(partitions),也称分片(sharding)[^i]。 [^i]: 分区是一种有意将大型数据库分解成小型数据库的方式。它与网络分区(network partitions, netsplits)无关,这是节点之间网络故障的一种。后文再讨论这些错误。 术语澄清 分区 (partition),对应MongoDB、ES中的shard,HBase 的Region,Bigtable的tablet,Cassandra的vnode,Couchbase的vBucket。但分区 (partitioning)是最普遍的。 定义 每条数据(或每条记录,每行或每个文档)属于且仅属于某特定分区。每个分区都能视为一个完整小型数据库,虽然数据库可能存在跨分区操作。 目的 提高可扩展性。不同分区可放在一个无共享集群的不同节点。这样的一个大数据集可分散在更多磁盘,查询负载也随之分布到更多处理器。 单分区查询时,每个节点对自己所在分区查询可独立执行查询操作,添加更多节点就能提高查询吞吐量。大型复杂查询尽管比较困难,但也可能做到跨节点的并行处理。 分区数据库在 20 世纪 80 年代由 Teradata 和 NonStop SQL等产品率先推出,最近因NoSQL和基于Hadoop的数据仓库重新被关注。有些系统是为事务处理而设计,有些系统则用于分析:这种差异会影响系统的运作方式,但是分区的基本原理均适用于这两种工作方式。 在本章中,我们将首先介绍分割大型数据集的不同方法,并观察索引如何与分区配合。然后讨论rebalancing,若想添加、删除集群中的节点,则必须进行再rebalancing。最后,概述DB如何将请求路由到正确的分区并执行查询。 1 分区与复制 分区一般和复制搭配使用,即每个分区的多个节点都有副本。这意味着,某条记录属于特定的分区,而同样内容会存储在不同的节点上,以提高系统容错性。 一个节点可能存储多个分区。如图-1所示,主从复制模型和分区组合时数据的分布情况。每个分区都有自己的主副本,如被分配给某节点,而从库副本被分配给其他节点。一个节点可能是某些分区的主副本,同时也是其他分区的从副本。 上一个文章讨论的复制相关所有内容同样适用于分区数据的复制。考虑到分区方案的选择通常独立于复制,为简单起见,本文忽略复制相关内容。 2 KV数据的分区 海量数据想切分,如何决定在哪些节点上存储哪些记录? 分区的主要目标:将数据和查询负载均匀分布在各节点。若每个节点平均分担数据和负载,则理论上10个节点能处理10 倍的数据量和10 倍于单节点的读写吞吐量(暂忽略复制)。 但若分区不均,则会导致某些分区节点比其他分区有更多数据量或查询负载,即倾斜,这会导致分区效率下降很多。极端情况下,所有负载可能压在一个分区节点,其余9个节点空闲,系统瓶颈落在这最忙的节点。这时的高负载分区即是系统热点。 2.1 避免热点 最简单的,将记录随机分配给所有节点。这能在所有节点比较均匀分布数据,但缺点是:试图读取特定数据时,不知道保存在哪个节点,必须并行查询所有节点。 可以优化该方案。假设数据是简单的KV数据模型,即总能通过K访问记录。如在一本百科全书,可通过标题查找一个条目;而所有条目按字母序排序,因此能快速找到目标条目。 2.2 根据K的范围分区(Key Range分区策略) 一种分区方案,为每个分区指定一块连续的K范围(以min和max 指示),如纸质百科全书的卷(图-2)。若知道K区间的边界,就能轻松确定哪个分区包含这些K。若你还知道分区所在的节点,则可直接请求相应节点(就像从书架上选取正确书籍)。 K的区间不一定要均匀分布,因为数据本身可能就不均匀。如图-2中,1卷包含A、B开头的单词,但12卷则包含T、U、V、X、Y和Z开头单词。若只是简单规定每个卷包含两个字母,可能导致一些卷比其他卷大。为更均匀分布数据,分区的边界应适配数据本身的分布特征。 分区边界可由管理员手动确定或由DB自动选择。Bigtable及其开源版本HBase和2.4版本之前的MongoDB都采用该分区策略。 每个分区中,可按K排序保存。范围扫描就很简单,将K作为联合索引来处理,从而在一次查询中获取多个相关记录。假设有个程序存储网络传感器的数据,K是测量的时间戳(年月日-时分秒)。范围扫描此时很有用,可快速获取某月内的所有数据。 缺点 某些访问模式会导致热点。 若K是时间戳,则分区对应于一个时间范围,如每天一个分区。 测量数据从传感器写入DB时,所有写入操作都集中在同一分区(即当天的分区),导致该分区在写入时处于高负载,而其他分区始终空闲。 为避免该问题,需要使用时间戳之外的内容作为K的第一项。 可考虑每个时间戳前添加传感器名称,这样首先按传感器名称,再按时间进行分区。假设多个传感器同时运行,则写入负载最终会均匀分布在多个节点。 当想要获取一个时间范围内、多个传感器的数据,可根据传感器名称,各自执行单独的范围查询。 2.3 根据键的Hash分区 由于数据倾斜和热点问题,许多分布式系统采用基于K散列函数来分区。 好的散列函数可处理倾斜数据并使其均匀分布。 数据分区目的的hash函数无需健壮的加密能力,如Cassandra 和 MongoDB 使用 MD5。许多编程语言也有内置的简单哈希函数(主要用于哈希表),但可能不适合分区:如Java 的 Object.hashCode(),同一K可能在不同进程中有不同哈希值。 确定合适的hash函数后,就能为每个分区分配一个hash范围(而不是直接就是K的范围),每个K通过hash散列落在不同分区,如图-3: 这种方案擅长在分区之间均匀分配K。分区边界可以是均匀间隔,也可以是伪随机选择(也称为一致性哈希)。 一致性哈希 一种平均分配自己负载的方法,最初用于内容分发网络(CDN)等互联网缓存系统。 采用随机选择的分区边界来规避中央控制或分布式共识。此处的一致性与副本一致性或ACID一致性无任何关联 ,它只描述了数据动态平衡的一种方法。 正如“分区再平衡” 中所见,这种特殊分区方法对于DB实际上效果并非很好,所以目前很少使用(虽然某些DB的文档仍会使用一致性哈希说法,但其实不准确)。 因为有可能产生混淆,所以最好避免使用一致性哈希这个术语,而只是把它称为散列分区(hash partitioning)。 但通过hash分区,失去高效的执行范围查询的能力:即使相邻的K,经过hash后也会分散在不同分区。MongoDB中,若使用hash分区,则范围查询都必须发送到所有分区。而Couchbase或Voldemort干脆直接不支持K的范围查询。 Cassandra在两种分区策略之间采取折中。 Cassandra的表可使用由多个列组成的复合主键。键中只有第一部分可用于 hash 分区,而其他列则被用作 Casssandra 的 SSTables 中排序数据的联合索引。尽管不支持复合主键的第一列的范围查询,但若第一列已指定固定值,则可对其他列执行高效的范围查询。 联合索引为一对多关系提供一个优雅的数据模型。如社交网站,一个用户可能发布很多消息更新。若更新的K被设置为 (user_id,update_timestamp),则能高效检索某用户在某时间段内,按时间戳排序的所有更新。不同用户可存储在不同分区,但对某一用户,消息会按时间戳顺序存储在同一分区。 2.4 负载偏斜与热点消除 hash分区可减少热点,但无法完全避免:极端情况下,所有读/写操作都是针对同一K,则所有请求都会被路由到同一分区。 这种负载也许不常见,但也并非不可能:如社交网站,一个坐拥百万粉丝的大V用户,发布一些热点事件时,可能引发一场访问风暴。导致同一个K的大量写操作(K可能是大V的用户ID或人们正在评论的事件ID)。此时,hash策略不起任何作用,因为两个相同ID的hash值仍相同。 如今,大多数据系统仍无法自动消除这种高度偏斜的负载,只能通过应用层来减少倾斜。如某K被确认为热点,简单方法是在K的开始或结尾添加一个随机数。只要一个两位数的十进制随机数就能将主键分散为100种不同的K,从而存储在不同分区。 但之后的任何读取都要做额外工作,必须从所有100个K分布中读取数据然后合并。因此通常只对少量热点K附加随机数才有意义;而对写吞吐量低的大多数K,这些都是不必要开销。此外,还需额外元数据来标记哪些K进行了特殊处理。 也许将来某天,数据系统将能自动检测和处理负载倾斜情况;但当下,仍需你自己来综合权衡策略。 点击关注,第一时间了解华为云新鲜技术~

优秀的个人博客,低调大师

每日一博 | Objective-C 关联属性原理分析

追根问底:Objective-C关联属性原理分析 一 引子 Objective-C是一种动态性很强的语言,所谓动态能力,也可以理解为运行时能力。对于Objective-C开发者来说,动态性所带来的编程便利无处不在。例如通过Category类别来扩展已有类的功能。可以使已有类拥有新的方法和属性。但是,如果你有使用Category来扩展类的属性,你一定了解并非简单的使用@property进行声明即可。例如下面的代码: #import <Foundation/Foundation.h> @interface MyObject : NSObject @end @implementation MyObject @end @interface MyObject (Property) @property (nonatomic, copy) NSString *addProperty; @end @implementation MyObject (Property) @end int main(int argc, const char * argv[]) { @autoreleasepool { MyObject *object = [[MyObject alloc] init]; object.addProperty = @"HelloWorld"; NSLog(@"%@", object.addProperty); } return 0; } 代码在编译时不会有任何问题,但是如果运行,就会出现未定义的方法异常。因此如果要扩展类的属性,我们通常会这样实现: #import <objc/runtime.h> @implementation MyObject (Property) static NSString *kAddPropertyKey = @"kAddPropertyKey"; - (void)setAddProperty:(NSString *)addProperty { objc_setAssociatedObject(self, kAddPropertyKey, addProperty, OBJC_ASSOCIATION_COPY); } - (NSString *)addProperty { return objc_getAssociatedObject(self, kAddPropertyKey); } @end 再次运行,就可以正常的对addProperty属性进行存取值了。这里其实就使用到了Objective-C运行时的特性,在Objective-C中,类对象在创建时其所占用的内存空间就已经确定,那么你有没有想过,通过objc_setAssociatedObject这个运行时方法所存储的属性值是如何与当前对象关联起来的,这些数据又是存在哪里的?幸运的时,从objc源码可以清楚的了解关联属性的实现逻辑,这也是我们本篇文章要讨论的重点,了解这里的原理可能不能对你使用关联属性提供多大的帮助,但是这种设计思路定会使你在日常开发中受益匪浅。 二 objc_setAssociatedObject方法的核心原理 通过objc的runtime源码,我们可以看到objc_setAssociatedObject的方法实现如下: void objc_setAssociatedObject(id object, const void *key, id value, objc_AssociationPolicy policy) { _object_set_associative_reference(object, key, value, policy); } 这一步无需过多解释,只是调用了一个内部函数,_object_set_associative_reference内部函数是关联属性实现的核心,此函数解析如下: void _object_set_associative_reference(id object, const void *key, id value, uintptr_t policy) { // 1.安全性检查,要关联的对象和要关联的值不能为空 if (!object && !value) return; // 2.检查当前对象是否不允许关联属性,某些类不允许其实例有关联属性 if (object->getIsa()->forbidsAssociatedObjects()) _objc_fatal("objc_setAssociatedObject called on instance (%p) of class %s which does not allow associated objects", object, object_getClassName(object)); // 3.创建一个包装对象指针的结构对象,存储要关联的对象指针 DisguisedPtr<objc_object> disguised{(objc_object *)object}; // 4.创建一个包装关联策略和被关联值的对象 ObjcAssociation association{policy, value}; // 5.根据关联策略来对值进行引用(retain或copy) association.acquireValue(); bool isFirstAssociation = false; { // 6.获取关联管理器及其中的关联表对象 AssociationsManager manager; AssociationsHashMap &associations(manager.get()); // 7.值如果存在,则进行关联 if (value) { // 8.尝试向表中插入当前要关联的对象和值,如果已经存在,则什么都不做 auto refs_result = associations.try_emplace(disguised, ObjectAssociationMap{}); // 9. 检查try_emplace方法的插入结果,如果做了插入操作,则标记首次关联为true if (refs_result.second) { isFirstAssociation = true; } // 10.将表中存储的值与key进行关联 auto &refs = refs_result.first->second; auto result = refs.try_emplace(key, std::move(association)); // 11.如果key已经存在,则进行关联策略和关联值的交换 if (!result.second) { association.swap(result.first->second); } // 12. 要关联的值为nil,则为清除操作 } else { // 13. 查找到关联到此对象的属性对 auto refs_it = associations.find(disguised); if (refs_it != associations.end()) { // 14.有关联属性,获取存储key的表 auto &refs = refs_it->second; // 15.查找对应key是否存在 auto it = refs.find(key); if (it != refs.end()) { // 16.存在则进行关联数据的替换,包括关联策略和值,此时实际上是将值清空了 association.swap(it->second); // 17.相关擦除操作 refs.erase(it); if (refs.size() == 0) { associations.erase(refs_it); } } } } } // 18.判断是否为此类实例对象的第一次关联,如果是,则修改标记位,标明已经有关联属性 if (isFirstAssociation) object->setHasAssociatedObjects(); // 19.将旧的值进行release,如果需要的话 association.releaseHeldValue(); } 可以看到,整个关联属性的过程非常清晰,对于新值是否需要retain以及旧值是否需要release,是由关联策略决定的: enum { OBJC_ASSOCIATION_SETTER_ASSIGN = 0, // assgin属性 OBJC_ASSOCIATION_SETTER_RETAIN = 1, // 设置值的时候需要retain OBJC_ASSOCIATION_SETTER_COPY = 3, // 设置值的时候需要copy OBJC_ASSOCIATION_GETTER_READ = (0 << 8), // readonly的属性 OBJC_ASSOCIATION_GETTER_RETAIN = (1 << 8), // 获取值的时候需要retain OBJC_ASSOCIATION_GETTER_AUTORELEASE = (2 << 8), // 获取值的时候需要autorelease OBJC_ASSOCIATION_SYSTEM_OBJECT = _OBJC_ASSOCIATION_SYSTEM_OBJECT, // 1 << 16 }; acquireValue方法实现如下,其只是判断是否需要retain和copy,之后调用对应的函数: inline void acquireValue() { if (_value) { switch (_policy & 0xFF) { case OBJC_ASSOCIATION_SETTER_RETAIN: _value = objc_retain(_value); break; case OBJC_ASSOCIATION_SETTER_COPY: _value = ((id(*)(id, SEL))objc_msgSend)(_value, @selector(copy)); break; } } } 在上面第8步中,有调用try_emplace方法来将数据插入到表结构中,此函数插入时会判断要插入的数据是否存在,其返回值会告知调用者是否产生了插入操作,如果已经存在,则此函数会什么都不做。 三 获取和移除关联属性的原理 现在,我们已经基本清楚了关联属性是如何设置和存储的,再来理解如果获取和移除就非常容易了。 获取关联属性的值是使用objc_getAssociatedObject运行时方法实现的,此方法实现如下: id objc_getAssociatedObject(id object, const void *key) { return _object_get_associative_reference(object, key); } 我们还是主要来解析下其调用的_object_get_associative_reference内部方法: id _object_get_associative_reference(id object, const void *key) { // 1.创建关联对象结构 ObjcAssociation association{}; { // 2.获取关联管理器及全局的Hash表 AssociationsManager manager; AssociationsHashMap &associations(manager.get()); // 3.尝试查找当前传入对象的关联属性 AssociationsHashMap::iterator i = associations.find((objc_object *)object); if (i != associations.end()) { // 4.如果当前对象有关联属性,尝试查找存储key的列表中是否存在传入的key ObjectAssociationMap &refs = i->second; ObjectAssociationMap::iterator j = refs.find(key); if (j != refs.end()) { // 5.如果可以查到,对association进行赋值 association = j->second; // 6.根据关联策略来决定是否对返回的值进行retain association.retainReturnedValue(); } } } // 7.根据返回策略来决定是否需要autorelease,如果没有查到,会返回nil值 return association.autoreleaseReturnedValue(); } 对于已经关联了属性的对象,我们也可以调用objc_removeAssociatedObjects方法来将关联的所有属性进行移除,此方法实现如下: void objc_removeAssociatedObjects(id object) { // 对象存在,并且已经标记过关联属性 if (object && object->hasAssociatedObjects()) { _object_remove_assocations(object, /*deallocating*/false); } } _object_remove_assocation内部函数的实现也不复杂,解析如下: void _object_remove_assocations(id object, bool deallocating) { // 1.创建关联对象 ObjectAssociationMap refs{}; { // 2.获取关联管理器及Hash表 AssociationsManager manager; AssociationsHashMap &associations(manager.get()); // 3.查找传入对象的关联属性 AssociationsHashMap::iterator i = associations.find((objc_object *)object); if (i != associations.end()) { // 4.查找到后,用空值进行交换 refs.swap(i->second); // 5.如果是系统对象,则需要保留关联 bool didReInsert = false; if (!deallocating) { for (auto &ref: refs) { if (ref.second.policy() & OBJC_ASSOCIATION_SYSTEM_OBJECT) { i->second.insert(ref); didReInsert = true; } } } // 6.无需保留关联,则直接清除数据 if (!didReInsert) associations.erase(i); } } // 7.对旧值进行release操作 SmallVector<ObjcAssociation *, 4> laterRefs; for (auto &i: refs) { if (i.second.policy() & OBJC_ASSOCIATION_SYSTEM_OBJECT) { // If we are not deallocating, then RELEASE_LATER associations don't get released. if (deallocating) laterRefs.append(&i.second); } else { i.second.releaseHeldValue(); } } for (auto *later: laterRefs) { later->releaseHeldValue(); } } 四 关联属性如何进行内存管理? 通过前面的介绍,我们知道在关联属性时,可以通过关联策略来设置一些和内存管理相关的选项,在设置关联属性时,如果需要的话,其内部会根据内存管理策略对旧值进行release操作,但是你是否有想过,当对象正常的生命周期结束后,这些关联属性占用的的内存是如何回收的?这就需要我们从系统的dealloc方法中寻找答案了。 系统对象在销毁时,dealloc方法最终会执行到一个名为objc_destructInstance的内部函数,此函数实现如下: void *objc_destructInstance(id obj) { if (obj) { bool cxx = obj->hasCxxDtor(); // 通过标记获取此对象是否有关联属性 bool assoc = obj->hasAssociatedObjects(); if (cxx) object_cxxDestruct(obj); // 移除掉此对象的关联属性 if (assoc) _object_remove_assocations(obj, /*deallocating*/true); obj->clearDeallocating(); } return obj; } 其中会判断要销毁的对象是否有关联属性,如果有,又会调用到_object_remove_assocation函数来进行关联属性的移除,这个函数前面介绍过,内部会处理内存管理问题。 五.关联管理器与表的创建时机 在整个关联属性实现方案中,还有一点我们没有闭环介绍,即全局的关联管理器和Hash表是怎么创建的,何时创建的。我们目前只看到,当要设置或获取关联属性时,直接拿到管理器和Hash表进行使用,并无初始化。其实,这些全局数据结构的创建在runtime初始化时就已经完成,流程路径如下: 1. 调用runtime入口函数_objc_init 2. 通知调用map_images函数 3. 调用map_images_nolock函数 4.map_images_nolock其中会调用arr_init函数,此函数实现如下: void arr_init(void) { AutoreleasePoolPage::init(); SideTablesMap.init(); _objc_associations_init(); if (DebugScanWeakTables) startWeakTableScan(); } 可以看到,此函数会进行自动释放池,关联属性等逻辑的初始化。 专注技术,热爱生活,交流技术,也做朋友。 —— 珲少 QQ:316045346 同时,如果本篇文章让你觉得有用,欢迎分享给更多朋友,请标明出处。

优秀的个人博客,低调大师

每日一博 | 手绘图解 Java 类加载原理

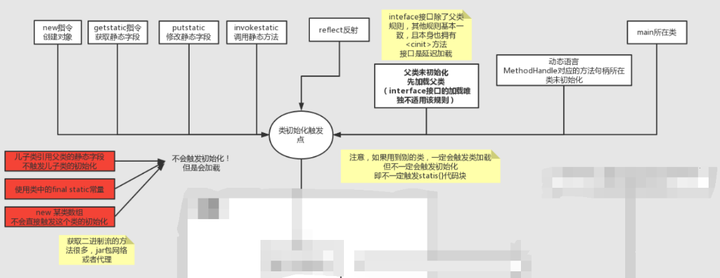
摘要:这也许是全网”最大“、”最细“、“最深”的java类加载原理图解了。 本文分享自华为云社区《【读书会第12期】这也许是全网”最大“、”最细“、“最深”的java类加载原理图解了》,作者: breakDawn。 关于类初始化的时机和误区 书籍的第一步部分上来就先讲了类初始化的时机,整理成图片如下: 看起来非常多,很难记住,很折磨。 个人认为,书籍把这一部分放到章节的最前面不太合理,曾经一度让我把上面的这些事件,理解成了类加载的时机,也不懂这些规则的缘由(根本原因还是此时读者对类加载的理解不够深。) 先贴一下类加载和类初始化的区别: 类加载概念:将class文件加载到jvm中并生成class对象,并根据情况做初始化。 类初始化概念:调用类class文件中默认存在的<cinit>类初始化方法。 而我们容易产生误解的原因,是因为书中没有这句话:所谓的类初始化时机,只是针对cinit类初始化方法的调用,并不是指的类加载时机! 以上图中红色的部分为例: 这里书籍中没有解释这3个规则的原因,在没理解原理前,强行记忆这3条是没有任何意义的。我认为是作者的失误。 在这里我挑其中一个做补充: “使用类里的static final 常量,不会触发初始化” 想要理解这个规则,需要先理解class文件原理。 对于类的static final常量字段,它的常量值是存放在字段的constanValue属性中。 正因为如此,static final常量并不需要通过cinit方法中的指令来完成赋值。 所以也就没有必要在这时候调用<cinit>方法了。 因此对于“儿子类调用父类的静态成员,不用对儿子类做类初始化”也是一个道理,儿子类的类静态成员没有被使用到,没必要做cinit。 对于上面的分析,可以浓缩为一句话: “如果我们急需使用static成员,且这个成员的值是要通过cinit方法赋值的,那么我们才做cinit初始化” 新的疑问:那为什么仅仅是new一个对象时,也一定要做cinit类初始化呢? 假设此时我还没用到static成员,那么new一个对象时,是否可以省去cinit,等用到静态成员的时候,再去触发cinit? 这涉及到了类初始化的另一个容易被忽视的点:“cinit类初始化方法,并不仅仅是做类成员的赋值,其实还可能包含一些初始化行为调用”,这可以是资源的启动或者加载等类对象必须要用到的内容。 因此在一切可能触发类对象实际行为前,必须触发cinit避免出错。 所以刚才的长篇大论,可以再次进行优化,浓缩为: “当需要用到static成员的初始赋值,或者对类对象进行正式使用时,才会触发cinit类初始化,目的是为了保证类对象或者类成员的正确使用” 拿着这一句话,去回看前面的类初始化时机的触发时机和不触发的时机时,相信你就会有更深的理解了,甚至也不需要强行去记忆每一条规则了。 有误导的“加载三部曲” 有一个很经典的回答,叫做类加载三部曲:加载、连接、初始化 好像类加载过程就是这三步按照顺序串行拼装起来的。 实际上这3个过程是存在交叉的! 只能说,“最早发生”的时机,是按照这个顺序发生,但是中间加载过程是有很多的,具体后面会结合我画的图以及原理解释进行呈现。 加载:不仅仅是读取字节流 对于加载,很容易只理解成只是“从文件里加载二进制字节到内存”。 这个过程显然是必须最先执行的,否则连类的基本信息都获取不到。 可以看到这个过程很灵活,只要你从你能想到的地方拿到字节流即可,任意形式都行。 然而,对于“加载”,除了获取字节流,实际上还包含了“把字节流转成方法区里的数据结构,进行存储defineClass”、“生成一个class对象,存储在堆中”这两步。 这2步是穿插在连接过程中的。 比如字节流转数据结构的过程,必须在确认字节流的正确性之后完成。 而生成class对象同理,符合一个class对象的条件时,才能将其在堆中生成。 连接 连接过程可以说是最难记住的一个过程, 里面包含了各种校验啊之类的,让人摸不清头脑。这里会通过更细致的解释和图解,让你明白连接过程究竟做了什么。 首先连接过程分为 验证、准备和解析,“解析”并不是连接的最后一步,而是在验证过程中实时发生的!。 下文会为你详细解释为什么。 验证 文件格式校验(class文件对不对) 注意这里的校验,都是一些最简单的校验,相当于无需做太多的语法分析操作等操作, 都是基于class文件格式定义进行的基础校验。 然而如果对加载的文件有充分的自信,来源可靠,那么确实可以省去这个步骤,提升连接效率,因此会有一个-Xverify:none的选项供使用。 元数据验证(我的父亲对不对) 这里验证了class文件里面继承特性相关的重要信息,例如继承关系是否合理、是否实现了抽象类或接口的方法 注意,这个元数据验证的过程,会触发父类或者接口的解析(加载)操作! 书上提到了4个解析情况以及流程: 类解析 字段解析 类方法解析 接口方法解析 却没有解释这4个解析过程是在哪里发生的。后面我会逐一提到,来真正理解这4个解析过程。 元数据验证中的类解析 还记得class文件中,父类是指向一个constant_class_info吗?这个东西当时看就是一个utf字符串,没什么意义。你没法知道父类究竟有什么方法,是不是抽象类。因此必须拿到父类的类信息,要么是已经在方法区中,要么需要重新加载。 而类解析的过程如下: 可以看到这个过程中也会发生加载,甚至好多次加载。 字节码验证(我的指令对不对) 这个验证不要和前面的“文件格式验证”搞混了。 前面的“元数据验证”都只是针对类、方法、字段等和父类进行确认、校验。 但是还没有涉及到每个方法里的code属性。 code属性虽然在编译出来时是正确的,但是无法保证传输过程中被人篡改。 如果发生操作操作数栈时,栈里没东西,或者试图在局部变量表边界外写入局部变量,就可能导致不可估量的后果。 因此此刻会进行最基本的指令分析,确认对操作数栈、局部变量表的操作是安全、正确的。 但是,逐个指令分析,会不会太慢了?如果代码很长的话。 还记得class文件的code属性中,还包含了一个stackMapTable属性么,估计很多人都跳过了这个属性。 这个属性就是用在字节码验证这个过程,可以立即让编译器编译出class时,提前把各位置的情况写入stackMap中,jvm加载时只对这个stackMap做校验确认是对的即可。 但代价就是可能不安全了,因为这个stackMap是可以被篡改的。 符号引用验证(我的指令调用的目标对不对) 注意前面的“字节码验证”是简单的确认,但不会持有过多的其他类的信息。但是方法肯定会涉及对其他类的调用。 此时就会涉及到符号引用验证,确认自己是否拥有对方方法的访问权限。 那么你就需要找到目标类的类信息存放地址,确认方法权限,或者字段权限。 于是会在这里触发字段解析、类方法解析或者接口解析! 书上只提到了这3个解析过程的流程,却没有详细解释其中的一些缘由,我会做更详细的补充。 符号引用验证中的字段解析 class中的constant_filed_info终于露出了它的真面目,原来是用在这个地方,即和字段相关的指令会用到它,并通过字段符号引用, 解析到这个字段真正的定义位置。 像经常遇到的NoSuchFieldError报错,就是在这个过程中爆出来的。而且接口字段的优先级是大于父类的字段的。 符号引用验证中的类方法解析 当调用方法前,需要先确认对象方法是否有权限访问。那么就必须这个类的信息进行确认。 注意:这个过程并不是动态分派的那个过程,此刻并没有触发任何的方法调用!仅仅是确认代码中静态类型的访问权限是否正确之类的! 对类方法做解析的时候,会判断此时是类还是接口。如果是接口,竟然会报“IncompatibleClassChangeError”。 还有如果是抽象类,也会报“AbstractMethodError”,因为正常情况下,你的jvm指令调用的方法,必须是实例化的对象所对应的方法,不可能直接调用抽象类方法的。 符号引用验证中的接口方法解析 看起来像是将类方法解析中的接口和方法互换了位置。 疑问1:为什么接口方法还要解析?接口不是没有代码吗? 因为接口类里每个interface方法,本身也是一个方法,只不过没有详细的code属性。但方法的访问修饰符之类的都存在,因此验证阶段还是需要进行校验。 疑问2:为什么要区分类的方法和接口方法?不能用同一种思路去解析么? 我理解的几个原因: 向上搜索时的逻辑不同,对于类方法,直接找父类即可, 而接口则需要遍历所有父接口。而且类方法还要考虑抽象类的问题,接口不需要。 类方法和接口方法本身就是两个不同的符号引用, 一个是constant_method_ref,另一个是constant_interface_ref,用2套逻辑没什么毛病 如果硬要问为什么要区分这2个符号引用,明明内容都是类索引+描述符索引? 这是因为后面在实际调用方法时,二者有显著区别,具体见下文的“方法表的准备”。 准备 类静态成员默认值的准备 对于准备阶段,大家一般只记得需要对一些非final的类静态成员做默认初始值操作。 方法表的准备 除了这个默认值赋值,还有一个动作,是准备方法表。 方法表就是为了多态而生,简化动态分派时频繁的迭代循环带来的不必要消耗: 通过前面的验证过程,我们已经获知了父类信息。因此可以准备一个方法表,把父类方法堆到最前面,自己的方法堆到后面,后面直接根据索引获取方法调用地址即可! 重要问题:interface的接口方法,会有方法表吗? intefacer接口是不具有方法表的! 因此这可能也是jvm特地区分了class_inteface_info和class_method_info这2个常量,以及特地用invoke_inteface和invoke_virtual指令来区分2类方法的调用。因为他们的调用逻辑可能大相径庭。 为什么接口不能有方法表? 这是由于Java可以实现多个接口,不同的类可能会实现了多个或者不同的接口,在虚表里该接口所实现方法的索引会不一致。 假设有A、B、C三个接口类 类X实现了A、B两个接口,假设A和B接口放在虚表里,那么调用A接口方法我们假设它是在t位置。 类T实现了B、C、A接口,按照实现顺序,先放B的方法,再放A的方法,最后放C的方法。这样调用接口A时,就不一定是t位置了,我们无法直接确定A里面方法的位置,因为一个类可以实现多个接口,而且顺序可以随意更改! 这样每次解析的虚表索引都可能会不同,因此不能进行缓存,需要每次都进行重新的解析。因此,接口的方法调用会比普通的子类继承的虚函数调用要慢。 解析 解析其实分为“静态解析”和“动态解析”。 因此将解析说成是“连接”中的一部分是不严谨的, 只有静态解析,才是“连接”的一部分。 静态解析用于解析私有方法、父类构造器、final方法等不存在多态可能的方法。 而动态解析则会在类加载的范围外去使用。 初始化 cinit方法细节解析 关于初始化时机的解释,在开头就已经阐述过了,这里不再重复解释。 疑问1:cinit方法中的代码是如何生成的? cinit方法 是编译器收集所有类静态变量的赋值动作和静态语句块static{}中的语句合并产生,按照顺序收集。 因此类加载赋值的顺序和类定义顺序有关,原理就取决于cinit生成的原理。 疑问2:cinit类初始化是线程安全的吗? 是线程安全的,虚拟机会保证一个类的加载和cinit方法会被正确的加锁、同步。 因此多线程场景下,同时使用一个之前没初始化过的类,且类初始化过程耗时非常久的话, 且可能会造成线程阻塞。 而这也是可以利用类初始化+内部类的方式,来做单例模式的实现的原理: 初始化中的动态解析 而初始化过程中,可能会涉及其他对象实例方法的调用,因此是可能发生动态解析过程的! 类方法和接口方法的解析过程如下 类方法的解析可以借助虚方法表简化解析过程。 扩展:invoke_dynamic是什么 对于invoke_dynamic指令做什么的?涉及动态分派、类加载和解析吗? 我们首先看下invoke_dynamic指令调用的dynamic_info常量长什么样的: 可以看到它只包含了一个方法索引和描述,但似乎没包含方法属于哪个类。 它的作用是用java实现一些类似于脚本语言的逻辑,脚本语言不关心静态类型,不做编译检查,只关心运行期的内容。所以invoke_dynamic以及constant_dynamic_info应运而生。但书本和工作中对这块的接触都不是太深,因此我的理解也只能局限于此了。 最后的完整大图 好累,终于写完了,感觉能看到最后的人不会太多,但一通详细地分析和解决中间发现的问题,还是收获了不少。 最后贴上完整的大图,欢迎保存和收藏。 图解笔记系列也会持续更新下去,争取做全网最细又最大的java分享文章。在线地址:https://www.processon.com/view/link/5e7eed6ce4b0ffc4ad43fda8 欢迎点击该链接报名参加读书会,一起成长学习和交流!报名链接 点击关注,第一时间了解华为云新鲜技术~

优秀的个人博客,低调大师

每日一博 | 剖析 SPI 在 Spring 中的应用

vivo 互联网服务器团队 - Ma Jian 一、概述 SPI(Service Provider Interface),是Java内置的一种服务提供发现机制,可以用来提高框架的扩展性,主要用于框架的开发中,比如Dubbo,不同框架中实现略有差异,但核心机制相同,而Java的SPI机制可以为接口寻找服务实现。SPI机制将服务的具体实现转移到了程序外,为框架的扩展和解耦提供了极大的便利。 得益于SPI优秀的能力,为模块功能的动态扩展提供了很好的支撑。 本文会先简单介绍Java内置的SPI和Dubbo中的SPI应用,重点介绍分析Spring中的SPI机制,对比Spring SPI和Java内置的SPI以及与 Dubbo SPI的异同。 二、Java SPI Java内置的SPI通过java.util.ServiceLoader类解析classPath和jar包的META-INF/services/目录 下的以接口全限定名命名的文件,并加载该文件中指定的接口实现类,以此完成调用。 2.1 Java SPI 先通过代码来了解下Java SPI的实现 ① 创建服务提供接口 package jdk.spi; // 接口 public interface DataBaseSPI { public void dataBaseOperation(); } ② 创建服务提供接口的实现类 MysqlDataBaseSPIImpl 实现类1 package jdk.spi.impl; import jdk.spi.DataBaseSPI; public class MysqlDataBaseSPIImpl implements DataBaseSPI { @Override public void dataBaseOperation() { System.out.println("Operate Mysql database!!!"); } } OracleDataBaseSPIImpl 实现类2 package jdk.spi.impl; import jdk.spi.DataBaseSPI; public class OracleDataBaseSPIImpl implements DataBaseSPI { @Override public void dataBaseOperation() { System.out.println("Operate Oracle database!!!"); } } ③ 在项目META-INF/services/目录下创建jdk.spi.DataBaseSPI文件 jdk.spi.DataBaseSPI jdk.spi.impl.MysqlDataBaseSPIImpl jdk.spi.impl.OracleDataBaseSPIImpl ④ 运行代码: JdkSpiTest#main() package jdk.spi; import java.util.ServiceLoader; public class JdkSpiTest { public static void main(String args[]){ // 加载jdk.spi.DataBaseSPI文件中DataBaseSPI的实现类(懒加载) ServiceLoader<DataBaseSPI> dataBaseSpis = ServiceLoader.load(DataBaseSPI.class); // ServiceLoader实现了Iterable,故此处可以使用for循环遍历加载到的实现类 for(DataBaseSPI spi : dataBaseSpis){ spi.dataBaseOperation(); } } } ⑤ 运行结果: Operate Mysql database!!! Operate Oracle database!!! 2.2 源码分析 上述实现即为使用Java内置SPI实现的简单示例,ServiceLoader是Java内置的用于查找服务提供接口的工具类,通过调用load()方法实现对服务提供接口的查找(严格意义上此步并未真正的开始查找,只做初始化),最后遍历来逐个访问服务提供接口的实现类。 上述访问服务实现类的方式很不方便,如:无法直接使用某个服务,需要通过遍历来访问服务提供接口的各个实现,到此很多同学会有疑问: Java内置的访问方式只能通过遍历实现吗? 服务提供接口必须放到META-INF/services/目录下?是否可以放到其他目录下? 在分析源码之前先给出答案:两个都是的;Java内置的SPI机制只能通过遍历的方式访问服务提供接口的实现类,而且服务提供接口的配置文件也只能放在META-INF/services/目录下。 ServiceLoader部分源码 public final class ServiceLoader<S> implements Iterable<S>{ // 服务提供接口对应文件放置目录 private static final String PREFIX = "META-INF/services/"; // The class or interface representing the service being loaded private final Class<S> service; // 类加载器 private final ClassLoader loader; // The access control context taken when the ServiceLoader is created private final AccessControlContext acc; // 按照初始化顺序缓存服务提供接口实例 private LinkedHashMap<String,S> providers = new LinkedHashMap<>(); // 内部类,实现了Iterator接口 private LazyIterator lookupIterator; } 从源码中可以发现: ServiceLoader类本身实现了Iterable接口并实现了其中的iterator方法,iterator方法的实现中调用了LazyIterator这个内部类中的方法,解析完服务提供接口文件后最终结果放在了Iterator中返回,并不支持服务提供接口实现类的直接访问。 所有服务提供接口的对应文件都是放置在META-INF/services/目录下,final类型决定了PREFIX目录不可变更。 所以Java内置的SPI机制思想是非常好的,但其内置实现上的不足也很明显。 三、Dubbo SPI Dubbo SPI沿用了Java SPI的设计思想,但在实现上有了很大的改进,不仅可以直接访问扩展类,而且在访问的灵活性和扩展的便捷性都做了很大的提升。 3.1 基本概念 ① 扩展点 一个Java接口,等同于服务提供接口,需用@SPI注解修饰。 ② 扩展 扩展点的实现类。 ③ 扩展类加载器:ExtensionLoader 类似于Java SPI的ServiceLoader,主要用来加载并实例化扩展类。一个扩展点对应一个扩展加载器。 ④ Dubbo扩展文件加载路径 Dubbo框架支持从以下三个路径来加载扩展类: META-INF/dubbo/internal META-INF/dubbo META-INF/services Dubbo框架针对三个不同路径下的扩展配置文件对应三个策略类: DubboInternalLoadingStrategy DubboLoadingStrategy ServicesLoadingStrategy 三个路径下的扩展配置文件并没有特殊之处,一般情况下: META-INF/dubbo对开发者开放 META-INF/dubbo/internal 用来加载Dubbo内部的扩展点 META-INF/services 兼容Java SPI ⑤ 扩展配置文件 和Java SPI不同,Dubbo的扩展配置文件中扩展类都有一个名称,便于在应用中引用它们。 如:Dubbo SPI扩展配置文件 #扩展实例名称=扩展点实现类 adaptive=org.apache.dubbo.common.compiler.support.AdaptiveCompiler jdk=org.apache.dubbo.common.compiler.support.JdkCompiler javassist=org.apache.dubbo.common.compiler.support.JavassistCompiler 3.2 Dubbo SPI 先通过代码来演示下 Dubbo SPI 的实现。 ① 创建扩展点(即服务提供接口) 扩展点 package dubbo.spi; import org.apache.dubbo.common.extension.SPI; @SPI // 注解标记当前接口为扩展点 public interface DataBaseSPI { public void dataBaseOperation(); } ② 创建扩展点实现类 MysqlDataBaseSPIImpl 扩展类1 package dubbo.spi.impl; import dubbo.spi.DataBaseSPI; public class MysqlDataBaseSPIImpl implements DataBaseSPI { @Override public void dataBaseOperation() { System.out.println("Dubbo SPI Operate Mysql database!!!"); } } OracleDataBaseSPIImpl 扩展类2 package dubbo.spi.impl; import dubbo.spi.DataBaseSPI; public class OracleDataBaseSPIImpl implements DataBaseSPI { @Override public void dataBaseOperation() { System.out.println("Dubbo SPI Operate Oracle database!!!"); } } ③在项目META-INF/dubbo/目录下创建dubbo.spi.DataBaseSPI文件: dubbo.spi.DataBaseSPI #扩展实例名称=扩展点实现类 mysql = dubbo.spi.impl.MysqlDataBaseSPIImpl oracle = dubbo.spi.impl.OracleDataBaseSPIImpl PS:文件内容中,等号左边为该扩展类对应的扩展实例名称,右边为扩展类(内容格式为一行一个扩展类,多个扩展类分为多行) ④ 运行代码: DubboSpiTest#main() package dubbo.spi; import org.apache.dubbo.common.extension.ExtensionLoader; public class DubboSpiTest { public static void main(String args[]){ // 使用扩展类加载器加载指定扩展的实现 ExtensionLoader<DataBaseSPI> dataBaseSpis = ExtensionLoader.getExtensionLoader(DataBaseSPI.class); // 根据指定的名称加载扩展实例(与dubbo.spi.DataBaseSPI中一致) DataBaseSPI spi = dataBaseSpis.getExtension("mysql"); spi.dataBaseOperation(); DataBaseSPI spi2 = dataBaseSpis.getExtension("oracle"); spi2.dataBaseOperation(); } } ⑤ 运行结果: Dubbo SPI Operate Mysql database!!! Dubbo SPI Operate Oracle database!!! 从上面的代码实现直观来看,Dubbo SPI在使用上和Java SPI比较类似,但也有差异。 相同: 扩展点即服务提供接口、扩展即服务提供接口实现类、扩展配置文件即services目录下的配置文件 三者相同。 都是先创建加载器然后访问具体的服务实现类,包括深层次的在初始化加载器时都未实时解析扩展配置文件来获取扩展点实现,而是在使用时才正式解析并获取扩展点实现(即懒加载)。 不同: 扩展点必须使用@SPI注解修饰(源码中解析会对此做校验)。 Dubbo中扩展配置文件每个扩展(服务提供接口实现类)都指定了一个名称。 Dubbo SPI在获取扩展类实例时直接通过扩展配置文件中指定的名称获取,而非Java SPI的循环遍历,在使用上更灵活。 3.3 源码分析 以上述的代码实现作为源码分析入口,了解下Dubbo SPI是如何实现的。 ExtensionLoader ① 通过ExtensionLoader.getExtensionLoader(Classtype)创建对应扩展类型的扩展加载器。 ExtensionLoader#getExtensionLoader() public static <T> ExtensionLoader<T> getExtensionLoader(Class<T> type) { if (type == null) { throw new IllegalArgumentException("Extension type == null"); } // 校验当前类型是否为接口 if (!type.isInterface()) { throw new IllegalArgumentException("Extension type (" + type + ") is not an interface!"); } // 接口上是否使用了@SPI注解 if (!withExtensionAnnotation(type)) { throw new IllegalArgumentException("Extension type (" + type + ") is not an extension, because it is NOT annotated with @" + SPI.class.getSimpleName() + "!"); } // 从内存中读取该扩展点的扩展类加载器 ExtensionLoader<T> loader = (ExtensionLoader<T>) EXTENSION_LOADERS.get(type); // 内存中不存在则直接new一个扩展 if (loader == null) { EXTENSION_LOADERS.putIfAbsent(type, new ExtensionLoader<T>(type)); loader = (ExtensionLoader<T>) EXTENSION_LOADERS.get(type); } return loader; } getExtensionLoader()方法中有三点比较重要的逻辑: 判断当前type类型是否为接口类型。 当前扩展点是否使用了@SPI注解修饰。 EXTENSION_LOADERS为ConcurrentMap类型的内存缓存,内存中存在该类型的扩展加载器则直接使用,不存在就new一个并放入内存缓存中。 再看下new ExtensionLoader(type)源码 ExtensionLoader#ExtensionLoader() // 私有构造器 private ExtensionLoader(Class<?> type) { this.type = type; // 创建ExtensionFactory自适应扩展 objectFactory = (type == ExtensionFactory.class ? null : ExtensionLoader.getExtensionLoader(ExtensionFactory.class).getAdaptiveExtension()); } 重点:构造方法为私有类型,即外部无法直接使用构造方法创建ExtensionLoader实例。 每次初始化ExtensionLoader实例都会初始化type和objectFactory ,type为扩展点类型;objectFactory 为ExtensionFactory类型。 ② 使用getExtension()获取指定名称的扩展类实例getExtension为重载方法,分别为getExtension(String name)和getExtension(String name, boolean wrap),getExtension(String name)方法最终调用的还是getExtension(String name, boolean wrap)方法。 ExtensionLoader#getExtension() public T getExtension(String name) { // 调用两个参数的getExtension方法,默认true表示需要对扩展实例做包装 return getExtension(name, true); } public T getExtension(String name, boolean wrap) { if (StringUtils.isEmpty(name)) { throw new IllegalArgumentException("Extension name == null"); } if ("true".equals(name)) { return getDefaultExtension(); } // 获取Holder实例,先从ConcurrentMap类型的内存缓存中取,没值会new一个并存放到内存缓存中 // Holder用来存放一个类型的值,这里用于存放扩展实例 final Holder<Object> holder = getOrCreateHolder(name); // 从Holder读取该name对应的实例 Object instance = holder.get(); if (instance == null) { // 同步控制 synchronized (holder) { instance = holder.get(); // double check if (instance == null) { // 不存在扩展实例则解析扩展配置文件,实时创建 instance = createExtension(name, wrap); holder.set(instance); } } } return (T) instance; } Holder类:这里用来存放指定扩展实例 ③ 使用createExtension()创建扩展实例 ExtensionLoader#createExtension() // 部分createExtension代码 private T createExtension(String name, boolean wrap) { // 先调用getExtensionClasses()解析扩展配置文件,并生成内存缓存, // 然后根据扩展实例名称获取对应的扩展类 Class<?> clazz = getExtensionClasses().get(name); if (clazz == null) { throw findException(name); } try { // 根据扩展类生成实例并对实例做包装(主要是进行依赖注入和初始化) // 优先从内存中获取该class类型的实例 T instance = (T) EXTENSION_INSTANCES.get(clazz); if (instance == null) { // 内存中不存在则直接初始化然后放到内存中 EXTENSION_INSTANCES.putIfAbsent(clazz, clazz.newInstance()); instance = (T) EXTENSION_INSTANCES.get(clazz); } // 主要是注入instance中的依赖 injectExtension(instance); ...... } createExtension()方法:创建扩展实例,方法中EXTENSION_INSTANCES为ConcurrentMap类型的内存缓存,先从内存中取,内存中不存在重新创建;其中一个核心方法是getExtensionClasses(): ExtensionLoader#getExtensionClasses() private Map<String, Class<?>> getExtensionClasses() { // 优先从内存缓存中读 Map<String, Class<?>> classes = cachedClasses.get(); if (classes == null) { // 采用同步手段解析配置文件 synchronized (cachedClasses) { // double check classes = cachedClasses.get(); if (classes == null) { // 正式开始解析配置文件 classes = loadExtensionClasses(); cachedClasses.set(classes); } } } return classes; } cachedClasses为Holder<map<string, class>>类型的内存缓存,getExtensionClasses中会优先读内存缓存,内存中不存在则采用同步的方式解析配置文件,最终在loadExtensionClasses方法中解析配置文件,完成从扩展配置文件中读出扩展类: ExtensionLoader#loadExtensionClasses() // 在getExtensionClasses方法中是以同步的方式调用,是线程安全 private Map<String, Class<?>> loadExtensionClasses() { // 缓存默认扩展名称 cacheDefaultExtensionName(); Map<String, Class<?>> extensionClasses = new HashMap<>(); // strategies策略类集合,分别对应dubbo的三个配置文件目录 for (LoadingStrategy strategy : strategies) { loadDirectory(extensionClasses, strategy.directory(), type.getName(), strategy.preferExtensionClassLoader(), strategy.overridden(), strategy.excludedPackages()); loadDirectory(extensionClasses, strategy.directory(), type.getName().replace("org.apache", "com.alibaba"), strategy.preferExtensionClassLoader(), strategy.overridden(), strategy.excludedPackages()); } return extensionClasses; } 源码中的strategies即static volatile LoadingStrategy[] strategies数组,通过Java SPI从META-INF/services/目录下加载配置文件完成初始化,默认包含三个类: DubboInternalLoadingStrategy DubboLoadingStrategy ServicesLoadingStrategy 分别对应dubbo的三个目录: META-INF/dubbo/internal META-INF/dubbo META-INF/services 上述的源码分析只是对Dubbo SPI做了简要的介绍,Dubbo中对SPI的应用很广泛,如:序列化组件、负载均衡等都应用了SPI技术,还有很多SPI功能未做分析,比如:自适应扩展、Activate活性扩展等 等,感兴趣的同学可以更深入的研究。 四、Spring SPI Spring SPI沿用了Java SPI的设计思想,但在实现上和Java SPI及Dubbo SPI也存在差异,Spring通过spring.handlers和spring.factories两种方式实现SPI机制,可以在不修改Spring源码的前提下,做到对Spring框架的扩展开发。 4.1 基本概念 DefaultNamespaceHandlerResolver 类似于Java SPI的ServiceLoader,负责解析spring.handlers配置文件,生成namespaceUri和NamespaceHandler名称的映射,并实例化NamespaceHandler。 spring.handlers 自定义标签配置文件;Spring在2.0时便引入了spring.handlers,通过配置spring.handlers文件实现自定义标签并使用自定义标签解析类进行解析实现动态扩,内容配置如: http\://www.springframework.org/schema/c=org.springframework.beans.factory.xml.SimpleConstructorNamespaceHandler http\://www.springframework.org/schema/p=org.springframework.beans.factory.xml.SimplePropertyNamespaceHandler http\://www.springframework.org/schema/util=org.springframework.beans.factory.xml.UtilNamespaceHandler spring.handlers实现的SPI是以namespaceUri作为key,NamespaceHandler作为value,建立映射关系,在解析标签时通过namespaceUri获取相应的NamespaceHandler来解析 SpringFactoriesLoader 类似于Java SPI的ServiceLoader,负责解析spring.factories,并将指定接口的所有实现类实例化后返回。 spring.factories Spring在3.2时引入spring.factories,加强版的SPI配置文件,为Spring的SPI机制的实现提供支撑,内容配置如: # PropertySource Loaders org.springframework.boot.env.PropertySourceLoader=\ org.springframework.boot.env.PropertiesPropertySourceLoader,\ org.springframework.boot.env.YamlPropertySourceLoader # Run Listeners org.springframework.boot.SpringApplicationRunListener=\org.springframework.boot.context.event.EventPublishingRunListener spring.factories实现的SPI是以接口的全限定名作为key,接口实现类作为value,多个实现类用逗号隔开,最终返回的结果是该接口所有实现类的实例集合 加载路径 Java SPI从/META-INF/services目录加载服务提供接口配置,而Spring默认从META-INF/spring.handlers和META-INF/spring.factories目录加载配置,其中META-INF/spring.handlers的路径可以通过创建实例时重新指定,而META-INF/spring.factories固定不可变。 4.2 spring.handlers 首先通过代码初步介绍下spring.handlers实现。 4.2.1 spring.handlers SPI ① 创建NameSpaceHandler MysqlDataBaseHandler package spring.spi.handlers; import org.springframework.beans.factory.config.BeanDefinition; import org.springframework.beans.factory.xml.NamespaceHandlerSupport; import org.springframework.beans.factory.xml.ParserContext; import org.w3c.dom.Element; // 继承抽象类 public class MysqlDataBaseHandler extends NamespaceHandlerSupport { @Override public void init() { } @Override public BeanDefinition parse(Element element, ParserContext parserContext) { System.out.println("MysqlDataBaseHandler!!!"); return null; } } OracleDataBaseHandler package spring.spi.handlers; import org.springframework.beans.factory.config.BeanDefinition; import org.springframework.beans.factory.xml.NamespaceHandlerSupport; import org.springframework.beans.factory.xml.ParserContext; import org.w3c.dom.Element; public class OracleDataBaseHandler extends NamespaceHandlerSupport { @Override public void init() { } @Override public BeanDefinition parse(Element element, ParserContext parserContext) { System.out.println("OracleDataBaseHandler!!!"); return null; } } ② 在项目META-INF/目录下创建spring.handlers文件: 文件内容: spring.handlers #一个namespaceUri对应一个handler http\://www.mysql.org/schema/mysql=spring.spi.handlers.MysqlDataBaseHandler http\://www.oracle.org/schema/oracle=spring.spi.handlers.OracleDataBaseHandler ③ 运行代码: SpringSpiTest#main() package spring.spi; import org.springframework.beans.factory.xml.DefaultNamespaceHandlerResolver; import org.springframework.beans.factory.xml.NamespaceHandler; public class SpringSpiTest { public static void main(String args[]){ // spring中提供的默认namespace URI解析器 DefaultNamespaceHandlerResolver resolver = new DefaultNamespaceHandlerResolver(); // 此处假设nameSpaceUri已从xml文件中解析出来,正常流程是在项目启动的时候会解析xml文件,获取到对应的自定义标签 // 然后根据自定义标签取得对应的nameSpaceUri String mysqlNameSpaceUri = "http://www.mysql.org/schema/mysql"; NamespaceHandler handler = resolver.resolve(mysqlNameSpaceUri); // 验证自定义NamespaceHandler,这里参数传null,实际使用中传具体的Element handler.parse(null, null); String oracleNameSpaceUri = "http://www.oracle.org/schema/oracle"; handler = resolver.resolve(oracleNameSpaceUri); handler.parse(null, null); } } ④ 运行结果: MysqlDataBaseHandler!!! OracleDataBaseHandler!!! 上述代码通过解析spring.handlers实现对自定义标签的动态解析,以NameSpaceURI作为key获取具体的NameSpaceHandler实现类,这里有别于Java SPI,其中: DefaultNamespaceHandlerResolver是NamespaceHandlerResolver接口的默认实现类,用于解析自定义标签。 DefaultNamespaceHandlerResolver.resolve(String namespaceUri)方法以namespaceUri作为参数,默认加载各jar包中的META-INF/spring.handlers配置文件,通过解析spring.handlers文件建立NameSpaceURI和NameSpaceHandler的映射。 加载配置文件的默认路径是META-INF/spring.handlers,但可以使用DefaultNamespaceHandlerResolver(ClassLoader, String)构造方法修改,DefaultNamespaceHandlerResolver有多个重载方法。 DefaultNamespaceHandlerResolver.resolve(String namespaceUri)方法主要被BeanDefinitionParserDelegate的parseCustomElement()和decorateIfRequired()方法中调用,所以spring.handlers SPI机制主要用在bean的扫描和解析过程中。 4.2.2 源码分析 下面从上述代码开始深入源码了解spring handlers方式实现的SPI是如何工作的。 DefaultNamespaceHandlerResolver ① DefaultNamespaceHandlerResolver.resolve()方法本身是根据namespaceUri获取对应的namespaceHandler对标签进行解析,核心源码: DefaultNamespaceHandlerResolver#resolve() public NamespaceHandler resolve(String namespaceUri) { // 1、核心逻辑之一:获取namespaceUri和namespaceHandler映射关系 Map<String, Object> handlerMappings = getHandlerMappings(); // 根据namespaceUri参数取对应的namespaceHandler全限定类名or NamespaceHandler实例 Object handlerOrClassName = handlerMappings.get(namespaceUri); if (handlerOrClassName == null) { return null; } // 2、handlerOrClassName是已初始化过的实例则直接返回 else if (handlerOrClassName instanceof NamespaceHandler) { return (NamespaceHandler) handlerOrClassName; }else { String className = (String) handlerOrClassName; try { ///3、使用反射根据namespaceHandler全限定类名加载实现类 Class<?> handlerClass = ClassUtils.forName(className, this.classLoader); if (!NamespaceHandler.class.isAssignableFrom(handlerClass)) { throw new FatalBeanException("Class [" + className + "] for namespace [" + namespaceUri + "] does not implement the [" + NamespaceHandler.class.getName() + "] interface"); } // 3.1、初始化namespaceHandler实例 NamespaceHandler namespaceHandler = (NamespaceHandler) BeanUtils.instantiateClass(handlerClass); // 3.2、 初始化,不同的namespaceHandler实现类初始化方法逻辑有差异 namespaceHandler.init(); // 4、将初始化好的实例放入内存缓存中,下次解析到相同namespaceUri标签时直接返回,避免再次初始化 handlerMappings.put(namespaceUri, namespaceHandler); return namespaceHandler; }catch (ClassNotFoundException ex) { throw new FatalBeanException("NamespaceHandler class [" + className + "] for namespace [" + namespaceUri + "] not found", ex); }catch (LinkageError err) { throw new FatalBeanException("Invalid NamespaceHandler class [" + className + "] for namespace [" + namespaceUri + "]: problem with handler class file or dependent class", err); } } } 第1步:源码中getHandlerMappings()是比较核心的一个方法,通过懒加载的方式解析spring.handlers并返回namespaceUri和NamespaceHandler的映射关系。 第2步:根据namespaceUri返回对应的NamespaceHandler全限定名或者具体的实例(是名称还是实例取决于是否被初始化过,若是初始化过的实例会直接返回) 第3步:是NamespaceHandler实现类的全限定名,通过上述源码中的第3步,使用反射进行初始化。 第4步:将初始化后的实例放到handlerMappings内存缓存中,这也是第2步为什么可能是NamespaceHandler类型的原因。 看完resolve方法的源码,再看下resolve方法在Spring中调用场景,大致可以了解spring.handlers的使用场景: 可以看到resolve()主要用在标签解析过程中,主要被在BeanDefinitionParserDelegate的parseCustomElement和decorateIfRequired方法中调用。 ② resolve()源码中核心逻辑之一便是调用的getHandlerMappings(),在getHandlerMappings()中实现对各个jar包中的META-INF/spring.handlers文件的解析,如: DefaultNamespaceHandlerResolver#getHandlerMappings() private Map<String, Object> getHandlerMappings() { Map<String, Object> handlerMappings = this.handlerMappings; // 使用线程安全的解析逻辑,避免在并发场景下重复的解析,没必要重复解析 // 这里在同步代码块的内外对handlerMappings == null作两次判断很有必要,采用懒汉式初始化 if (handlerMappings == null) { synchronized (this) { handlerMappings = this.handlerMappings; // duble check if (handlerMappings == null) { if (logger.isDebugEnabled()) { logger.debug("Loading NamespaceHandler mappings from [" + this.handlerMappingsLocation + "]"); } try { // 加载handlerMappingsLocation目录文件,handlerMappingsLocation路径值可变,默认是META-INF/spring.handlers Properties mappings = PropertiesLoaderUtils.loadAllProperties(this.handlerMappingsLocation, this.classLoader); if (logger.isDebugEnabled()) { logger.debug("Loaded NamespaceHandler mappings: " + mappings); } // 初始化内存缓存 handlerMappings = new ConcurrentHashMap<String, Object>(mappings.size()); // 将加载到的属性合并到handlerMappings中 CollectionUtils.mergePropertiesIntoMap(mappings, handlerMappings); // 赋值内存缓存 this.handlerMappings = handlerMappings; }catch (IOException ex) { throw new IllegalStateException( "Unable to load NamespaceHandler mappings from location [" + this.handlerMappingsLocation + "]", ex); } } } } return handlerMappings; } 源码中this.handlerMappings是一个Map类型的内存缓存,存放解析到的namespaceUri以及NameSpaceHandler实例。 getHandlerMappings()方法体中的实现使用了线程安全方式,增加了同步逻辑。 通过阅读源码可以了解到Spring基于spring.handlers实现SPI逻辑相对比较简单,但应用却比较灵活,对自定义标签的支持很方便,在不修改Spring源码的前提下轻松实现接入,如Dubbo中定义的各种Dubbo标签便是很好的利用了spring.handlers。 Spring提供如此灵活的功能,那是如何应用的呢?下面简单了解下parseCustomElement()。 BeanDefinitionParserDelegate.parseCustomElement() resolve作为工具类型的方法,被使用的地方比较多,这里仅简单介绍在BeanDefinitionParserDelegate.parseCustomElement()中的应用。 BeanDefinitionParserDelegate#parseCustomElement() public BeanDefinition parseCustomElement(Element ele, BeanDefinition containingBd) { // 获取标签的namespaceUri String namespaceUri = getNamespaceURI(ele); // 首先获得DefaultNamespaceHandlerResolver实例在再以namespaceUri作为参数调用resolve方法解析取得NamespaceHandler NamespaceHandler handler = this.readerContext.getNamespaceHandlerResolver().resolve(namespaceUri); if (handler == null) { error("Unable to locate Spring NamespaceHandler for XML schema namespace [" + namespaceUri + "]", ele); return null; } // 调用NamespaceHandler中的parse方法开始解析标签 return handler.parse(ele, new ParserContext(this.readerContext, this, containingBd)); } parseCustomElement作为解析标签的中间方法,再看下parseCustomElement的调用情况: 在parseBeanDefinitions()中被调用,再看下parseBeanDefinitions的源码 DefaultBeanDefinitionDocumentReader#parseBeanDefinitions() protected void parseBeanDefinitions(Element root, BeanDefinitionParserDelegate delegate) { // spring内部定义的标签为默认标签,即非spring内部定义的标签都不是默认的namespace if (delegate.isDefaultNamespace(root)) { NodeList nl = root.getChildNodes(); for (int i = 0; i < nl.getLength(); i++) { Node node = nl.item(i); if (node instanceof Element) { Element ele = (Element) node; // root子标签也做此判断 if (delegate.isDefaultNamespace(ele)) { parseDefaultElement(ele, delegate); }else{ // 子标签非spring默认标签(即自定义标签)也走parseCustomElement来解析 delegate.parseCustomElement(ele); } } } }else { // 非spring的默认标签(即自定义的标签)走parseCustomElement来解析 delegate.parseCustomElement(root); } } 到此就很清晰了,调用前判断是否为Spring默认标签,不是默认标签调用parseCustomElement来解析,最后调用resolve方法。 4.2.3 小节 Spring自2.0引入spring.handlers以后,为Spring的动态扩展提供更多的入口和手段,为自定义标签的实现提供了强力支撑。 很多文章在介绍Spring SPI时都重点介绍spring.factories实现,很少提及很早就引入的spring.handlers,但通过个人的分析及与Java SPI的对比,spring.handlers也是一种SPI的实现,只是基于xml实现。 相比于Java SPI,基于spring.handlers实现的SPI更加的灵活,无需遍历,直接映射,更类似于Dubbo SPI的实现思想,每个类指定一个名称(只是spring.handlers中是以namespaceUri作为key,Dubbo配置中是指定的名称作为key)。 4.3 spring.factories 同样先以测试代码来介绍spring.factories实现SPI的逻辑。 4.3.1 spring.factories SPI ① 创建DataBaseSPI接口 接口 package spring.spi.factories; public interface DataBaseSPI { public void dataBaseOperation(); } ② 创建DataBaseSPI接口的实现类 MysqlDataBaseImpl #实现类1 package spring.spi.factories.impl; import spring.spi.factories.DataBaseSPI; public class MysqlDataBaseImpl implements DataBaseSPI { @Override public void dataBaseOperation() { System.out.println("Mysql database test!!!!"); } } MysqlDataBaseImpl #实现类2 package spring.spi.factories.impl; import spring.spi.factories.DataBaseSPI; public class OracleDataBaseImpl implements DataBaseSPI { @Override public void dataBaseOperation() { System.out.println("Oracle database test!!!!"); } } ③ 在项目META-INF/目录下创建spring.factories文件: 文件内容 spring.factories #key是接口的全限定名,value是接口的实现类 spring.spi.factories.DataBaseSPI = spring.spi.factories.impl.MysqlDataBaseImpl,spring.spi.factories.impl.OracleDataBaseImpl ④ 运行代码 SpringSpiTest#main() package spring.spi.factories; import java.util.List; import org.springframework.core.io.support.SpringFactoriesLoader; public class SpringSpiTest { public static void main(String args[]){ // 调用SpringFactoriesLoader.loadFactories方法加载DataBaseSPI接口所有实现类的实例 List<DataBaseSPI> spis= SpringFactoriesLoader.loadFactories(DataBaseSPI.class, Thread.currentThread().getContextClassLoader()); // 遍历DataBaseSPI接口实现类实例 for(DataBaseSPI spi : spis){ spi.dataBaseOperation(); } } } ⑤ 运行结果 Mysql database test!!!! Oracle database test!!!! 从上述的示例代码中可以看出spring.facotries方式实现的SPI和Java SPI很相似,都是先获取指定接口类型的实现类,然后遍历访问所有的实现。但也存在一定的差异: (1)配置上: Java SPI是一个服务提供接口对应一个配置文件,配置文件中存放当前接口的所有实现类,多个服务提供接口对应多个配置文件,所有配置都在services目录下; Spring factories SPI是一个spring.factories配置文件存放多个接口及对应的实现类,以接口全限定名作为key,实现类作为value来配置,多个实现类用逗号隔开,仅spring.factories一个配置文件。 (2)实现上 Java SPI使用了懒加载模式,即在调用ServiceLoader.load()时仅是返回了ServiceLoader实例,尚未解析接口对应的配置文件,在使用时即循环遍历时才正式解析返回服务提供接口的实现类实例; Spring factories SPI在调用SpringFactoriesLoader.loadFactories()时便已解析spring.facotries文件返回接口实现类的实例(实现细节在源码分析中详解)。 4.3.2 源码分析 我们还是从测试代码开始,了解下spring.factories的SPI实现源码,细品spring.factories的实现方式。 SpringFactoriesLoader测试代码入口直接调用SpringFactoriesLoader.loadFactories()静态方法开始解析spring.factories文件,并返回方法参数中指定的接口类型,如测试代码里的DataBaseSPI接口的实现类实例。 SpringFactoriesLoader#loadFactories() public static <T> List<T> loadFactories(Class<T> factoryClass, ClassLoader classLoader) { Assert.notNull(factoryClass, "'factoryClass' must not be null"); ClassLoader classLoaderToUse = classLoader; // 1.确定类加载器 if (classLoaderToUse == null) { classLoaderToUse = SpringFactoriesLoader.class.getClassLoader(); } // 2.核心逻辑之一:解析各jar包中META-INF/spring.factories文件中factoryClass的实现类全限定名 List<String> factoryNames = loadFactoryNames(factoryClass, classLoaderToUse); if (logger.isTraceEnabled()) { logger.trace("Loaded [" + factoryClass.getName() + "] names: " + factoryNames); } List<T> result = new ArrayList<T>(factoryNames.size()); // 3.遍历实现类的全限定名并进行实例化 for (String factoryName : factoryNames) { result.add(instantiateFactory(factoryName, factoryClass, classLoaderToUse)); } // 排序 AnnotationAwareOrderComparator.sort(result); // 4.返回实例化后的结果集 return result; } 源码中loadFactoryNames() 是另外一个比较核心的方法,解析spring.factories文件中指定接口的实现类的全限定名,实现逻辑见后续的源码。 经过源码中第2步解析得到实现类的全限定名后,在第3步通过instantiateFactory()方法逐个实例化实现类。 再看loadFactoryNames()源码是如何解析得到实现类全限定名的: SpringFactoriesLoader#loadFactoryNames() public static List<String> loadFactoryNames(Class<?> factoryClass, ClassLoader classLoader) { // 1.接口全限定名 String factoryClassName = factoryClass.getName(); try { // 2.加载META-INF/spring.factories文件路径(分布在各个不同jar包里,所以这里会是多个文件路径,枚举返回) Enumeration<URL> urls = (classLoader != null ? classLoader.getResources(FACTORIES_RESOURCE_LOCATION) : ClassLoader.getSystemResources(FACTORIES_RESOURCE_LOCATION)); List<String> result = new ArrayList<String>(); // 3.遍历枚举集合,逐个解析spring.factories文件 while (urls.hasMoreElements()) { URL url = urls.nextElement(); Properties properties = PropertiesLoaderUtils.loadProperties(new UrlResource(url)); String propertyValue = properties.getProperty(factoryClassName); // 4.spring.factories文件中一个接口的实现类有多个时会用逗号隔开,这里拆开获取实现类全限定名 for (String factoryName : StringUtils.commaDelimitedListToStringArray(propertyValue)) { result.add(factoryName.trim()); } } return result; }catch (IOException ex) { throw new IllegalArgumentException("Unable to load factories from location [" + FACTORIES_RESOURCE_LOCATION + "]", ex); } } 源码中第2步获取所有jar包中META-INF/spring.factories文件路径,以枚举值返回。 源码中第3步开始遍历spring.factories文件路径,逐个加载解析,整合factoryClass类型的实现类名称。 获取到实现类的全限定名集合后,便根据实现类的名称逐个实例化,继续看下instantiateFactory()方法的源码: SpringFactoriesLoader#instantiateFactory() private static <T> T instantiateFactory(String instanceClassName, Class<T> factoryClass, ClassLoader classLoader) { try { // 1.使用classLoader类加载器加载instanceClassName类 Class<?> instanceClass = ClassUtils.forName(instanceClassName, classLoader); if (!factoryClass.isAssignableFrom(instanceClass)) { throw new IllegalArgumentException( "Class [" + instanceClassName + "] is not assignable to [" + factoryClass.getName() + "]"); } // 2.instanceClassName类中的构造方法 Constructor<?> constructor = instanceClass.getDeclaredConstructor(); ReflectionUtils.makeAccessible(constructor); // 3.实例化 return (T) constructor.newInstance(); } catch (Throwable ex) { throw new IllegalArgumentException("Unable to instantiate factory class: " + factoryClass.getName(), ex); } } 实例化方法是私有型(private)静态方法,这个有别于loadFactories和loadFactoryNames。 实例化逻辑整体使用了反射实现,比较通用的实现方式。 通过对源码的分析,Spring factories方式实现的SPI逻辑不是很复杂,整体上的实现容易理解。 Spring在3.2便已引入spring.factories,那spring.factories在Spring框架中又是如何使用的呢?先看下loadFactories方法的调用情况: 从调用情况看Spring自3.2引入spring.factories SPI后并没有真正的利用起来,使用的地方比较少,然而真正把spring.factories发扬光大的,是在Spring Boot中, 简单了解下SpringBoot中的调用。 getSpringFactoriesInstances()getSpringFactoriesInstances()并不是Spring框架中的方法,而是SpringBoot中SpringApplication类里定义的私有型(private)方法,很多地方都有调用,源码如下: SpringApplication#getSpringFactoriesInstance() // 单个参数getSpringFactoriesInstances方法 private <T> Collection<T> getSpringFactoriesInstances(Class<T> type) { // 默认调用多参的重载方法 return getSpringFactoriesInstances(type, new Class<?>[] {}); } // 多个参数的getSpringFactoriesInstances方法 private <T> Collection<T> getSpringFactoriesInstances(Class<T> type, Class<?>[] parameterTypes, Object... args) { ClassLoader classLoader = getClassLoader(); // 调用SpringFactoriesLoader中的loadFactoryNames方法加载接口实现类的全限定名 Set<String> names = new LinkedHashSet<>( SpringFactoriesLoader.loadFactoryNames(type, classLoader)); // 实例化 List<T> instances = createSpringFactoriesInstances(type, parameterTypes, classLoader, args, names); AnnotationAwareOrderComparator.sort(instances); return instances; } 在getSpringFactoriesInstances()中调用了SpringFactoriesLoader.loadFactoryNames()来加载接口实现类的全限定名集合,然后进行初始化。 SpringBoot中除了getSpringFactoriesInstances()方法有调用,在其他逻辑中也广泛运用着SpringFactoriesLoader中的方法来实现动态扩展,这里就不在一一列举了,有兴趣的同学可以自己去发掘。 4.3.3 小节 Spring框架在3.2引入spring.factories后并没有有效的利用起来,但给框架的使用者提供了又一个动态扩展的能力和入口,为开发人员提供了很大的自由发挥的空间,尤其是在SpringBoot中广泛运用就足以证明spring.factories的地位。spring.factories引入在 提升Spring框架能力的同时也暴露出其中的不足: 首先,spring.factories的实现类似Java SPI,在加载到服务提供接口的实现类后需要循环遍历才能访问,不是很方便。 其次,Spring在5.0.x版本以前SpringFactoriesLoader类定义为抽象类,但在5.1.0版本之后Sping官方将SpringFactoriesLoader改为final类,类型变化对前后版本的兼容不友好。 五、应用实践 介绍完Spring中SPI机制相关的核心源码,再来看看项目中自己开发的轻量版的分库分表SDK是如何利用Spring的SPI机制实现分库分表策略动态扩展的。 基于项目的特殊性并没有使用目前行业中成熟的分库分表组件,而是基于Mybatis的插件原理自己开发的一套轻量版分库分表组件。为满足不同场景分库分表要求,将其中分库分表的相关逻辑以策略模式进行抽取分离,每种分库分表的实现对应一条策略,支持使用方对分库分表策略的动态扩展,而这里的动态扩展就利用了spring.factories。 首先给出轻量版分库分表组件流程图,然后我们针对流程图中使用到Spring SPI的地方进行详细分析。 说明: 上述流程图中项目启动过程中生成数据源和分库分表策略的初始化,策略初始化完成后缓存到内存中。 发起数据库操作指令时,解析是否需要分库分表(流程中只给出了需要分库分表的流程),需要则通过提取到的策略key获取对应的分库分表策略并进行分库分表,完成数据库操作。 通过上述的流程图可以看到,分库分表SDK通过spring.factories支持动态加载分库分表策略以兼容不同项目的不同使用场景。 其中分库分表部分的策略类图: 其中:ShardingStrategy和DBTableShardingStrategy为接口;BaseShardingStrategy为默认实现类;DefaultStrategy和CountryDbSwitchStrategy为SDK中基于不同场景默认实现的分库分表策略。 在项目实际使用时,动态扩展的分库分表策略只需要继承BaseShardingStrategy即可,SDK中初始化分库分表策略时通过SpringFactoriesLoader.loadFactories()实现动态加载。 六、总结 SPI技术将服务接口与服务实现分离以达到解耦,极大的提升程序的可扩展性。 本文重点介绍了Java内置SPI和Dubbo SPI以及Spring SPI三者的原理和相关源码;首先演示了三种SPI技术的实现,然后通过演示代码深入阅读了三种SPI的实现源码;其中重点介绍了Spring SPI的两种实现方式:spring.handlers和spring.factories,以及使用spring.factories实现的分库分表策略加载。希望通过阅读本文可以让读者对SPI有更深入的了解。

优秀的个人博客,低调大师

每日一博 | 前端自动化构建之 Gulp

前端自动化构建之Gulp 本篇文章的核心是介绍一款强大的任务流工具Gulp,之所以题目叫做“前端自动化构建之Gulp”,是因为Gulp本身是使用JS编写的运行在Node环境的一个npm包,并且大部分开发者也都使用它来作为前端项目的自动化构建工具。不过,从本质上说,Gulp并非只能做前端自动化构建,后端构建发布自动化,脚本工具集自动化,测试流程自动化等都可以使用Gulp。所以,无论你是哪个技术栈的开发者,学习使用Gulp都会对你大有裨益。 这边文章能够带给你: Gulp工具的安装 Gulp工作原理 创建自动化流程中的独立任务 任务的串行与并行 使用管道处理数据流 监听文件变更 简易前端自动化构建DEMO流程 本篇文章虽然无法将Gulp所有的细节都介绍到,但总体上来说挑选了其中最核心的部分,也是最实用的部分进行了介绍,并且通过一个前端DEMO的示例,演示使用Gulp进行[环境初始化->代码合并->代码压缩->启动服务器->监听文件->热更新浏览器]的完整自动化流程。 一.Gulp基础 好像任何技术栈的开发者,都会遇到耗费时间且让人痛苦不堪的流程问题。除了基础的研发,测试,部署流程外,往往中间还需要根据需求执行额外的任务,例如代码检查,代码压缩,代码混淆等。这些流程虽然与研发无关,但是却是产品上线的必备过程,繁琐的流程不仅会消耗开发者额外的精力,对于团队来说,也很难控制所有开发者所执行的流程都一致且完整,例如某些成员可能由于疏忽大意而忘记做代码压缩就直接将项目发布上线了。因此,将流程自动化不仅可以解放人力,更是项目稳定性的保障。Gulp就是为解决这样问题而发现的一款简单,高效且生态完整的自动化工具。 1.安装Gulp Gulp是运行在Node环境中的,因此你需要先安装Node.js,这里不再赘述。 Gulp工具分两部分构成,全局Gulp CLI和本地Gulp。关于他们之间的关系,后面我们再详细介绍。首先先来安装全局的Gulp CLI工具,在终端执行如下指令: sudo npm install -g gulp-cli 安装完成后,要检查是否安装成功,可以键入如下指令: gulp -v 此时,你应该可以看到如下的输出: CLI version: 2.3.0 Local version: Unknown 其中,第一行表示我们安装的全局的Gulp CLI工具的版本号,第二行表示本地Gulp版本号,本地Gulp是安装在具体的项目目录中的,此时我们尚未安装。下面我们可以创建一个项目目录,例如创建名为gulp-demo文件夹,在目录下使用下面的指令来初始化Node模块: npm init 在当前目录下使用如下指令来安装本地Gulp: npm install --save-dev gulp 安装完成后,再次执行gulp -v,可以看到本地Gulp的版本,如下: CLI version: 2.3.0 Local version: 4.0.2 需要注意,你在测试时,要使用4.x及以上的本地Gulp版本。 2.Gulp的工作原理 前面,我们安装了Gulp CLI和本地Gulp,现在是时候来介绍下Gulp的工作原理了。在使用Gulp时,我们需要编写一个名为Gulpfile.js的文件,这个文件是Gulp工作的核心,其中会定义各种任务及任务流。Gulp CLI工具是启动Gulp的入口,其通过指令来调用项目中的本地Gulp,本地Gulp会调用Gulpfile.js文件,加载和执行定义好的任务,在Gulpfile.js文件中,通常又需要调用本地Gulp模块中提供的API方法,以及本地Gulp插件或自定义函数的功能从而实现任务。工作原理如下图所示: 3.编写Gulpfile.js文件 在学习编程语言时,第一个程序通常都是HelloWorld,Gulp的学习也不例外,我们先来测试下Gulp的HelloWorld程序。在工程目录下新建一个命名为Gulpfile.js的文件,在其中编写如下代码: // 引入本地Gulp模块 var gulp = require('gulp'); // 调用task方法来定义任务 gulp.task('gulp', function(done){ console.log("Hello Gulp!"); done(); }); 其中,task函数用来定义任务,其第1个参数为任务名,第2个参数为要执行的任务方法,这里我们传入了一个自定义的函数,此函数中会传入一个回调done参数,当任务逻辑代码结束后,要调用此回调通知Gulp此任务已经结束,否则会阻塞Gulp后续任务的执行。 在当前目录下,执行如下终端指令: gulp gulp 此指令的作用是让全局Gulp CLI工具调用本地Gulp来执行Gulpfile.js中定义的名为gulp的任务。执行后,终端输出如下: [09:37:18] Using gulpfile ~/Desktop/gulp-demo/gulpfile.js [09:37:18] Starting 'gulp'... Hello Gulp! [09:37:18] Finished 'gulp' after 2.55 ms 可以看到,正确输出的Hello Gulp!,并且执行任务的开始时间和结束时间都有记录,任务耗时也有记录。 二.Gulp任务链与数据流 我们已经知道如何通过Gulp来执行独立的任务,但更多实际场景中,自动化的流程都不是简单独立的任务可以完成的,我们需要将任务组成任务链。例如我们模拟这几个任务: gulp.task('clean', function(done){ console.log("清理构建目录"); done(); }); gulp.task('copy', function(done){ console.log("复制模板文件"); done(); }); gulp.task('build', function(done){ console.log("编译代码"); done(); }); gulp.task('server', function(done){ console.log("启动开发服务器"); done(); }); gulp.task('watch', function(done){ console.log("监听文件变化持续热更新"); done(); }); 上面5个任务模拟了前端自动化构建的基本流程,这些任务间有些是有依赖关系的,比如清理构建目录任务来在复制模板文件和编译代码之前,不然可能刚编译好的代码就又被清掉了,启动开发服务器则要在复制模板文件和编译代码之后,但是复制模板文件和编译代码这两个任务是可以并行进行的。使用Gulp任务链,可以非常方便的实现任务间依赖处理。 1.series和parallel series意为串行,parallel意为并行。通过Gulp中的这两个API,可以方便的将任务组合成串行链或并行链,任务链也可以作为一个独立的任务在组合进其他的任务链,这样就是Gulp任务的组合变得非常灵活。按照前面描述的需求添加一个任务链如下: gulp.task('dev', gulp.series( 'clean', gulp.parallel('copy', 'build'), 'server', 'watch' )); 在终端中键入gulp dev,输出情况如下: [10:38:08] Using gulpfile ~/Desktop/gulp-demo/gulpfile.js [10:38:08] Starting 'dev'... [10:38:08] Starting 'clean'... 清理构建目录 [10:38:08] Finished 'clean' after 915 μs [10:38:08] Starting 'copy'... [10:38:08] Starting 'build'... 复制模板文件 [10:38:08] Finished 'copy' after 349 μs 编译代码 [10:38:08] Finished 'build' after 423 μs [10:38:08] Starting 'server'... 启动开发服务器 [10:38:08] Finished 'server' after 180 μs [10:38:08] Starting 'watch'... 监听文件变化持续热更新 [10:38:08] Finished 'watch' after 153 μs [10:38:08] Finished 'dev' after 5.57 ms 从输出可以看到,任务间的串行和并行关系已经可以满足我们的需求,使用Gulp处理任务依赖就是这么简单。 我们再回过头来看一下series和parallel两个方法,其内可以传入不限个数个参数,参数可以是字符串,可以是函数,也可以是其他的任务链组合。当参数为字符串时,其会被当成任务名来调用指定任务,当参数为函数时,会执行此函数,当参数为任务链组合时,会执行对应的任务链。当参数为函数时要特别注意,必须回调通知Gulp任务完成,否则会阻塞任务链。如下: gulp.task('dev', gulp.series( 'clean', function(done){ console.log('custom method'); done(); }, gulp.parallel('copy', 'build'), 'server', 'watch' )); 执行后,终端输出如下: [10:46:31] Using gulpfile ~/Desktop/gulp-demo/gulpfile.js [10:46:31] Starting 'dev'... [10:46:31] Starting 'clean'... 清理构建目录 [10:46:31] Finished 'clean' after 738 μs [10:46:31] Starting '<anonymous>'... custom method [10:46:31] Finished '<anonymous>' after 238 μs [10:46:31] Starting 'copy'... [10:46:31] Starting 'build'... 复制模板文件 [10:46:31] Finished 'copy' after 520 μs 编译代码 [10:46:31] Finished 'build' after 490 μs [10:46:31] Starting 'server'... 启动开发服务器 [10:46:31] Finished 'server' after 168 μs [10:46:31] Starting 'watch'... 监听文件变化持续热更新 [10:46:31] Finished 'watch' after 117 μs [10:46:31] Finished 'dev' after 7.16 ms 你或许发现了,执行到自定义的函数时,终端显示的任务名是anonymous,表示匿名的,更好的方式是我们使用具名函数,这样方便对任务执行状态进行回溯,如下: gulp.task('dev', gulp.series( 'clean', function customMethod(done){ console.log('custom method'); done(); }, gulp.parallel('copy', 'build'), 'server', 'watch' )); 2.关于Gulp数据流 从宏观上了解了Gulp任务的串行与并行,现在我们再来关注下更具体的问题。本地Gulp本身提供了许多强大的API,像前面用到的task,series,parallel都是API其中之一。自动化构建,本质上是对文件的扫描和处理,因此Gulp中也封装了与文件操作相关的API。 首先,读取文件流和输出文件流的两个API分别是src和dest。 src方法用来创建一个文件数据流,可以从文件系统读取文件数据到虚拟文件对象,虚拟文件对象是Gulp中的一个概念,其会将文件的名称,信息,数据等抽象成一个虚拟的对象,之后文件的操作都在内存中进行,速度很快,直到处理完成后在输出到指定文件。例如开发时,我们的模板代码通常在src目录下,编译打包后会将处理后的文件放入dest目录下,这就涉及到文件的拷贝处理。 在工程目录下创建一个名为src的子文件夹,在其中创建一个简单的HTML文件,修改下copy任务如下: gulp.task('copy', function(done){ return gulp.src('src/*.html'). pipe(gulp.dest('dest')); }); 再次执行整个任务流,可以看到项目根目录中自动生成了一个dest文件夹,并且已经将HTML文件拷贝了进去。在这个copy任务的实现函数中,我们并没有调用done回调,这是因为gulp的API已经实现了Gulp任务接口规范,直接返回结果即可。 src方法读取文件数据流时,可以指定具体的文件或通配符,如上代码所示,表示将src文件夹下所有的HTML文件选中,创建成数据流,数据流提供的主要API是pipe方法,这个方法用来连接各个处理数据流的节点,可以将它理解为一个管道,输入从一端流入,处理后从另一端流出,如果需要继续进行其他处理,还可以连接其他管道。这种责任链的设计模式,可以非常灵活的连接各个处理插件。以前端代码合并压缩处理为例,流程如下: 文件系统---->src[虚拟文件流]--->文件合并模块[合并后的虚拟文件流]--->代码压缩模块[压缩有的虚拟文件流]--->dest[回写到文件系统]--->文件系统 三.实践:简易前端自动化构建流程 前面我们逻辑上模拟了前端自动化构建过程,只是在实现上,都是用的log进行模拟,这并不十分有趣。使其,使用Gulp搭建一个简易的前端构建自动化流程并不复杂,几分钟就可以搞定。 1.安装几个Gulp插件 Gulp有着非常丰富的生态,本质上,任意npm模块我们都可以直接使用,除此之外,还有4000多个专门为Gulp设计的插件,可以方便的支持各种文件处理,代码检查等需求。插件地址如下: https://gulpjs.com/plugins/ 本次实践,需要使用到2个Gulp插件和2个npm模块,分别进行文件合并,代码压缩,文件删除和浏览器测试热更新。在项目目录下使用如下指令来安装这些模块: npm install --save-dev gulp-concat npm install --save-dev gulp-uglify npm install --save-dev del npm install --save-dev browser-sync 在Gulpfile.js中引入这些模块: var gulp = require('gulp'); var concat = require ('gulp-concat'); var uglify = require('gulp-uglify'); var del = require('del') var bSync = require('browser-sync').create(); 2.实现自动化构建流程中的几个任务 首先我们先来实现clean任务,修改代码如下: gulp.task('clean', function(done){ return del(['dest']) }); 上面代码的作用是将dest文件夹删除,每次初始构建,我们都将旧的目录删掉,以免缓存的文件对最终的软件包造成影响。 copy任务的实现方法不变,直接将HTML文件模板拷贝到指定的构建目录即可: gulp.task('copy', function(done){ return gulp.src('src/*.html'). pipe(gulp.dest('dest')); }); 编译的过程主要涉及到CSS相关的SASS或LESS编译,或TS,CoffeeScript的编译等等,为了简单起见,我们只做JS文件的合并和压缩,如下: gulp.task('build', function(done){ return gulp.src('src/*.js') .pipe(concat('main.js')) .pipe(uglify()) .pipe(gulp.dest('dest')) }); 上面代码的作用是将src文件夹下所有的JS文件合并到一个名为main.js的文件中,并进行代码压缩,最后输出到dest文件夹。 实现server任务如下: gulp.task('server', function(done){ bSync.init({ server:'./dest', }); done(); }); 上面代码会启动本地服务器,并引导chrome项目页面。 对于监听本地文件的变化,Gulp中自带对应的API,实现watch任务如下: gulp.task('watch', function(done){ gulp.watch(['src/*.js'],gulp.parallel('build')); gulp.watch(['src/*.html'],gulp.parallel('copy')); gulp.watch(['dest/**/*'],function(done){ bSync.reload('index.html'); done() }); done(); }); 这里需要注意,由于我们对JS文件的编译和HTML模板的拷贝任务是分开的,因此监听也可以分开,当发现JS文件发生了变化时,只进行编译任务即可,当发现HTML文件变化时,只进行模板拷贝任务即可,当构建文件夹有变更时,重新刷新浏览器,从而实现开发过程中的测试热更新。 最后,我们可以写一些测试文件了,在src文件夹下新建两个js文件和一个html文件,代码分别如下: file1.js文件中代码: function mlog(msg) { console.log(Date(),': 自定义输出 -',msg); } mlog("hello"); file2.js文件中代码: var a = 1; var b = 2; var c = a + b; console.log(c); index.html文件中代码: <html> <header> <script type="text/javascript" src="./main.js"></script> </header> <body> <h1>标题11</h1> </body> </html> 使用gulp dev来开启自动化构建流程,你可以打开chome的控制台,查看控制台的输出,尝试修改下src文件夹中的HTML文件和JS文件,保存后可以看到对应的页面也会发生更新。 到此,我们已经实现了一个简单的前端开发自动化构建流程,Gulp不负你所望吧! 温馨提示:在子进程结束之前,Gulp进程是不会自动结束的,因此其会一直监听文件的变更刷新页面,要关闭开发服务器,只需control+c即可。 四.结语 最后,虽然大多数情况下Gulp会用在前端自动化构建中,但是这并不是Gulp唯一的用途,任何开发工作流都可以使用Gulp来构建,npm包的丰富极大的扩展了Gulp的应用场景。希望本篇文章可以帮你打开技术视野,能够探索出Gulp的更多应用场景,帮助你简化工作流程。 专注技术,热爱生活,交流技术,也做朋友。 —— 珲少 QQ:316045346 同时,如果本篇文章让你觉得有用,欢迎分享给更多朋友,请标明出处。

优秀的个人博客,低调大师

每日一博 | 基于 Prometheus + Grafana 实现 Nexus 监控观测

前言 Nexus 是开源的 Maven 私服仓库,同时 Nexus 还支持 Npm 、 .Net、Golang 、Python 等开发语言的包管理。Nexus 也是我们重度使用的一个应用,Nexus 保存着 Tap 各开发组的代码构建产物。Nexus 出现问题会导致项目 CI 、CD 流程阻断。本文旨在通过 Prometheus + Grafana 实现 Nexus 运行时监控观测,帮助运维人员更加了解 Nexus ,轻松从容应对线上各种疑难杂症。 Nexus Version:3.29.2-02 metrics 采集 Nexus 提供了 Prometheus 格式数据的接口,这个接口需要授权nx-metrics-all 才能访问,所以,将 metrics 采集到 Prometheus 里,需要做如下。 metrics 接口:http://localhost:8081/service/metrics/prometheus 创建 metrics 接口权限账户 给指标接口创建一个单独的 metrics 账户,然后创建一个新的 Role(nx-metrics) ,将 nx-metrics-all 给这个角色,然后将角色给 metrics 账户。如下图。 配置 Prometheus metrics 账户准备好后,在 Prometheus 侧添加如下配置项: global: scrape_interval: 15s scrape_timeout: 10s evaluation_interval: 15s alerting: alertmanagers: - static_configs: - targets: [] scheme: http timeout: 10s scrape_configs: - job_name: nxrm scrape_interval: 15s scrape_timeout: 10s metrics_path: /service/metrics/prometheus scheme: http basic_auth: username: metrics password: metrics static_configs: - targets: - localhost:8081 配置无误后,metrics 已经收集到 Prometheus 了。可以在 Prometheus 里查询 org_sonatype_nexus_ 打头的指标,有就代表配置成功了。 grafana 绘制面板 Nexus metrics 总共有超过 2k 多行。在绘制观测面板前,需要先分析下采集的 metrics 信息 分析 metrics Nexus 暴露出来的指标,主要分三个类别: Component :相关组件的运行时指标,比如文件存储组件 FileBlobStore,以 org_sonatype_nexus_ 前缀开头的系列指标。 Jetty :Web 容器,负责接收响应请求的,以 org_eclipse_jetty_ 前缀开头的系列指标。 Jvm :Jvm Runtime,反应堆内存、非堆内存、GC回收等,以 jvm_ 前缀开头的系列指标。 其中,Component 指标是最多的,也有部分Component 根本就没有使用,指标一直为 0,这部分指标就可以不用绘制面板。 绘制观测面板 经过上面分析,可以绘制出如下观测面板。 Nexus Component 这个面板绘制了常用的组件运行信息,以 LdapServerComponent 为例,我们启用了这个组件,对接了公司内部的 LDAP 。之前有用户反馈登录失败,最后排查到是 Nexus 访问 LDAP Server 出现了问题,如果有了这个观测图,就能很清楚的看到LdapServerComponent 内部的运行情况,快速定位问题。另外,Component Exceptions 面板也能集中观测到所有组件的异常信息,这里只要指标大于 0 ,就代表 Nexus 服务出问题了。 Jetty WebAppContext Jetty 面板反应了 Nexus 的流量情况,请求响应等信息。其中 Jetty 线程池,可以关注 wait-jobs(等待线程池执行的任务数) 这个指标,如果这个指标一直大于 0 ,则表示 Nexus Server 出现性能问题了。 Jvm Runtime Jvm 的指标不用多说,和一般应用的 jvm 一样。它反应了应用的内存情况,包括堆内存和非堆内存,以及堆外内存,还有 GC 执行情况等。以内存观测为例,我们的 Nexus 服务是从 ECS 迁移的 K8s 环境中的,当时给 pod 的内存资源设置了 request 、limit 4G,给 jvm xmx 设置了 2G,运行后还会出现内存告警,实际使用内存远超 xmx 设置的大小。从贴出截图已经可以看出答案,是因为 Nexus 使用了超过 2G 的堆外内存(Direct Buffers + Mapped Buffers)。 结语 添加 Nexus 观测指标,一是可以清晰的了解这个软件的运行时情况,更加精准的给运行资源。二是方便出现类似问题时,可以快速排查问题。三是可以根据指标信息制定告警规则,比用户先一步发现问题。上面展示的 Grafana 面板已经分享到 GrafanaDashboards 市场了,可以通过如下链接找到 ID 直接导入到 Grafana 中,欢迎下载。 Nexus Dashboards:https://grafana.com/grafana/dashboards/16459

优秀的个人博客,低调大师

每日一博 | 从 MVC 到 DDD 的架构演进

DDD这几年越来越火,资料也很多,大部分的资料都偏向于理论介绍,有给出的代码与传统MVC的三层架构差异较大,再加上大量的新概念很容易让初学者望而却步。本文从MVC架构角度来讲解如何演进到DDD架构。 从DDD的角度看MVC架构的问题 代码角度: 瘦实体模型:只起到数据类的作用,业务逻辑散落到service,可维护性越来越差; 面向数据库表编程,而非模型编程; 实体类之间的关系是复杂的网状结构,成为大泥球,牵一发而动全身,导致不敢轻易改代码; service类承接的所有的业务逻辑,越来越臃肿,很容易出现几千行的service类; 对外接口直接暴露实体模型,导致不必要开放内部逻辑对外暴露,就算有DTO类一般也是实体类的直接copy; 外部依赖层直接从service层调用,字段转换、异常处理大量充斥在service方法中; 项目管理角度: 交付效率:越来越低; 稳定性差:不好测试,代码改动的影响范围不好预估; 理解成本高:新成员介入成本高,长期会导致模块只有一个人最熟悉,离职成本很大; 第一层:初出茅庐 以上的问题越来越严重,很多人开始把眼光转向DDD,于是埋头啃了几本大部头的书,对以下概念有了基本的了解: 统一语言 限界上下文 领域、子域、支撑域 聚合、实体、值对象 分层:用户接口层、应用层、领域层、基础层 于是把MVC架构进行了改造,演进成DDD的分层架构。 DDD分层架构: MVC架构到DDD分层架构的映射: 至此,算了基本入门了DDD架构,扩展性也得到了一定的提升。不过随着业务的发展,不断冒出新的问题: 一段业务逻辑代码,到底应该放到应用层还是领域层? 领域服务当成原来的MVC中的service层,随着业务不断发展,类也在不断膨胀,好像还是老样子啊? 聚合包含多个实体类,这个接口用不到这么多实体,为了性能还是直接写个SQL返回必要的操作吧,不过这样貌似又回到了MVC模式 既然实体类可以包含业务逻辑、领域服务也可以放业务逻辑,那到底放哪里? 资料上说领域层不能有外部依赖,要做到100%单测覆盖,可是我的领域服务中需要用到外部接口、中央缓存等等,那这不就有了外部依赖了吗? 第二层:草船借箭(战术设计) 带着问题不断学习他人经验,并不断的尝试,逐渐get到以下技能: 1、领域层 领域(domain)是个模块,包含以下组成部分,传统的service按功能可能拆分到任何一个地方,各司其职。 1个聚合 1到多个实体 若干值对象 多个DomainService 1个Factory:新建聚合 1个Repository:聚合仓储服务 聚合根(AggregateRoot) 聚合本身也是一个实体,聚合可以包含其他实体,其他实体不能脱离聚合而单独提供服务,比如一篇文章下的评论,评论必须从属与文章,没有文章也就没有评论。仓库层(repository)也必须是以聚合为核心提供服务的; 实体:可以理解为一张数据库表,必须有主键; 值对象:没有主键,依附于实体而存在,比如用户实体下住址对象,一般在数据库中已json字符串的形式存在;最常见的值对象是枚举; 仓库服务(repository) 资源库是聚合的仓储机制,外部世界通过资源库,而且只能通过资源库来完成对聚合的访问。资源库以聚合的整体管理对象。因此,一个聚合只能有一个资源库对象,那就是以聚合根命名的资源库。除此之外的其他对象,都不应该提供资源库对象。仓储服务的实现一般有Spring Data JPA、Mybatis两种方式。 如果是用Spring Data JPA实现,直接使用JPA注解@OneToOne、@OneToMany,配合fetch配置,即可一个方法查询出所有的关联实体。 如果是用Mybatis实现,那么repository需要加入多个mapper的引用,再手动做拼装。 这里有一个经典的Hibernate笛卡尔积问题,答案是在聚合根中,一般不会加在大量的关联实体对象。如果确实需要查询关联对象而关联对象又比较多怎么办呢?在DDD中有一个CQRS(Command-Query Responsibility Segregation)模式,是一种读写分离模式,在此场景中需要将查询操作放到查询命令中分页查询。 当然CQRS也是一个很复杂模式,不应照搬他人方案,而是根据自己的业务场景选择适合自己的方案,以下列举了CQRS的几种应用模式: 工厂服务(factory) 作用是创建聚合,只传入必要的参数,工厂服务内部隐藏复杂的创建逻辑。简单的聚合可以直接通过new、静态方法等创建,不是必须由factory创建。 领域服务 单个实体对象能处理的逻辑放到实体里,多个实体或有交互的场景放到领域服务里。 领域服务可不可以调用仓储层或外部接口? 可以,但不能直接和领域服务代码放一起,领域服务模块存放API,实现放基础层(infrastructure)。 领域服务对象不建议直接以聚合名+DomainService命名,而要以操作命令关联,比如用户保存服务命名为:UserSaveService, 审核服务:UserAuditSerivce。 2、应用层 应用层通过应用服务接口来暴露系统的全部功能。在应用服务的实现中,它负责编排和转发,它将要实现的功能委托给一个或多个领域对象来实现,它本身只负责处理业务用例的执行顺序以及结果的拼装。通过这样一种方式,它隐藏了领域层的复杂性及其内部实现机制。 比如下订单服务的方法: public void submitOrder(Long orderId) { Order order = OrderFetchService.fetchById(orderId); //获取订单对象 OrderCheckSerivce.check(order); //验证订单是否有效 OrderSubmitSerivce.submit(order); //提交订单 ShoppingCartClearService.clear(order); //移除购物车中已购商品 NotifySerivce.emailNotify(order.getUser()); //发送邮件通知买家 } 对于复杂的业务来说,应用层也有几种模式: 编排服务:最典型比如Drools; Command、Query命令模式; 业务按Rhase、Step逐层拆分模式; 3、Maven模块划分 基础层是比较简单一层,不过这里还有个比较疑惑的问题:按照DDD的四层架构图去划分Maven模块,基础层是最上的一层,但是基础层也要包含基础组件供其他层使用,这时基础层应该是放到最下层,直接按照这样构建Maven模块会造成循环依赖。 相比来说,另一个架构图更准确一些,不过依然没有直观体现Maven模块如何划分。 我的最佳实践是将基础层拆分两部分,一部分是基础的组件+仓储API,一部分是实现,maven模块划分图如下所示: 第三层:运筹帷幄(战略设计) 经过以上的两层的磨炼,恭喜你把DDD战术都学习完了,应付日常的代码开发也够了,不过作为架构师来说,探索的道路还不能止步于此,接下来会DDD战略部分。战略部分关注点有3个: 统一语言 领域 限界上下文 1、统一语言 统一语言的重要性可以根据Jeff Patton 在《用户故事地图》中给出的一副漫画来直观的描述: 统一语言是提炼领域知识的输出结果,也是进行后续需求迭代及重构的基础,统一语言的建立有以下几个要点: 统一语言必须以文档的形式提供出来,并且在整个项目组的各团队达成共识; 统一语言必须每个中文名有对应的英文名,并且在整个技术栈保持一致; 统一语言必须是完整的,包含以下要素: 领域模型的概念与逻辑; 界限上下文(Bounded Context); 系统隐喻; 职责的分层; 模式(patterns)与惯用法。 2、领域划分 以事件风暴的形式(Event Storming),列出所有的用户故事(Use Story),用户故事可通过6W模型来构建,即描写场景的Who、What、Why、Where、When 与 hoW六个要素。然后圈选功能相近的部分,就形成了领域,领域又根据职能不同划分为:核心域、支撑域、通用域, 具体的过程有很多参考资料,这里不在细讲,最终的输出是领域划分图,以下是一个保险业务示例: 3、限界上下文 限界上下文包含两部分:上下文(Context)是业务目标,限界(Bounded)则是保护和隔离上下文的边界。 比如上图中的实现部分即是限界上下文的边界,虚线部分代表了领域的边界。限界上下文没有统一的划分标准,需要的读者根据自己的业务场景来甄别如何划分。 一个上下文中包含了相同的领域知识,角色在上下文中完成动作目标; 边界体现在以下几方面: 领域逻辑层:确定了领域模型的业务边界,维护了模型的完整性与一致性,从而降低系统的业务复杂度; 团队合作层:限界上下文一般也是用户换分团队的依据; 技术实现层:限界上下文可当成是微服务的划分边界; DDD的不足 DDD架构作为一套先进的方法论,在很多场景能发挥很大价值,但是DDD也不是银弹。高级的架构师把DDD架构当成一种工具,结合其他架构经验一起为业务服务。 DDD的不足有几个方面: 性能:DDD是基于聚合来组织代码,对于高性能场景下,加载聚合中大量的无用字段会严重影响性能,比如报表场景中,直接写SQL会更简答直接; 事务:DDD中的事务被限定在限界上下文中,跨多个限界上下文的场景需要开发者额外考虑分布式事务问题; 难度系数高,推广成本大:DDD项目需要领域专家专家,且需要特别熟悉业务、建模、OOP,对于管理者来说评估一个人是否真的能胜任也是一件困难的事情; 总结 本文从MVC架构开始讲述了如何从演进到DDD架构,限于篇幅很多DDD的知识点没有讲到,希望大家在实践过程中能灵活运用,尽享DDD给业务带来的价值。本文如有不足之处敬请反馈。 本文链接:从MVC到DDD的架构演进 作者简介:木小丰,美团Java技术专家,专注分享软件研发实践、架构思考。欢迎关注公共号:Java研发

优秀的个人博客,低调大师

每日一博 | 字节跳动微服务架构体系演进

本文整理自字节跳动(火山引擎)基础架构/服务框架团队负责人成国柱在 QCon 2021 的分享,主要介绍了 2018-2021 年间,服务框架团队在 Golang 服务框架和 Service Mesh 上的技术实践和经验总结。 字节跳动微服务架构概述 在字节跳动,微服务架构的特征可以被归纳为 4 点,如下图所示: 首先是规模大、增长快。近三年来,字节跳动的微服务数量和规模迎来快速发展。2018 年,我们的在线微服务数大约是 7000-8000,到 2021 年 5 月,这一数字已经突破 5 万。伴随快速增长,服务框架团队也遇到了非常多挑战。 其次是全面容器化、PaaS 化。字节跳动的在线微服务,超过 90% 都运行在容器里。所有上线都通过 PaaS 化平台进行,这意味着线上不会存在物理机部署这种模式。这种做法既有一些挑战:增加调度复杂性;也带来了一些便利性:有利于新功能的推广。 第三,字节跳动的技术体系以 Golang 语言为主。根据最新的调查统计,公司里有超过 55% 的服务是采用 Golang 的,排名第二的语言是前端的 NodeJS,之后是 Python、JAVA、C++,Rust 也有一些使用。 最后是Service Mesh 在字节跳动目前已经是全面落地状态,这块的详细内容会在本文第三节展开。 基于以上 4 个特点,当前字节跳动微服务架构遇到的主要挑战还是围绕研发效率、运行效率和稳定性。其中研发效率和稳定性是几乎所有互联网公司都会遇到的:多语言、易用性、性能、成本……在这些问题中,字节跳动服务框架团队和火山引擎云原生团队最关注的是以下三个: 快速迭代。研发和上线一定要快; 对多语言的支持要足够好。配合员工规模增速,要对多语言保持非常包容的态度; 运行时的稳定性。 Golang 微服务框架的演进 2014 年,Golang 被引入字节跳动,以快速解决长连接推送业务所面临的高并发问题。到 2016 年,技术团队基于 Golang 推出了一个名为 Kite 的框架,同时对开源项目 Gin 做了一层很薄的封装,推出了 Ginex。这两个原始框架的推出,极大推动了 Golang 在公司内部的应用。 这种情况一直持续到 2019 年年中。在 Kite 和 Ginex 发布之初,由于很多功能版本过低,包括 Thrift 当时只有 v0.9.2,它们其实存在很多问题,再加上 Golang 迎来数轮大版本迭代,Kite 甚至连 golang context 参数都没有 。综上种种原因,Kite 已经满足不了内部使用需求。 在 2019 年中,服务框架团队正式启动了 Kite 这个字节自有 RPC 框架的重构。这是一个自下而上的整体升级重构,围绕性能和可扩展性的诉求展开设计。2020 年 10 月,团队完成了 KiteX 发布,仅仅两个月后,KiteX 就已经接入超过 1000 个服务。 类似的设计思路和底层模块也被应用在字节跳动自研 Golang HTTP 框架 Hertz 上,该项目在 2021 年春晚当天承载的服务峰值 QPS 超过 1000w(未统计物理机部署服务),线上无一例异常反馈。 RPC 框架 KiteX KiteX 是字节跳动研发的下一代高性能、强可扩展的 Golang RPC 框架。除了具备丰富的服务治理特性,它还集成了自研的网络库 Netpoll,支持多消息协议(Thrift/Protobuf)和多交互方式(Ping-Pong/Oneway/ Streaming),提供自研的、更加灵活可扩展的代码生成器。 下图是 KiteX 的架构图,左侧是它的一些核心特点。 Kite 在发布之初使用的是原生的库,所以存在两个最主要的问题:一是无法直接感知对端连接状态;二是原生 net 网络库在面对长连接时,容易产生 goroutine 爆炸的问题。 这在 HTTP 场景下其实很常见,开发人员经常会遇到一个 HTTP 服务(包括使用 Gin 这种框架的时候)的内存出现持续增长。为什么?因为实际场景中客户端经常忘记关连接。 Netpoll 可以通过一个 React 模型去解决连接爆炸的问题,同时也带来一些 zero-copy buffer 的使用。 关于多协议,字节跳动的大多数服务采用的都是 Thrift 协议。而这里的多协议是应对一些业务提出的支持其他协议的需求。例如后端服务和端上的 Protobuf 打通。通过多协议支持实现了它和 Thrift 的解耦。现在 KiteX同时支持 PB 和Thrift 协议,也支持灵活的自定义协议扩展。 高性能是所有做框架的开发者共同追求的目标,这里不再赘述。最后,KiteX 是面向开源社区设计的。如上图所示,KiteX Core 是可以直接开源的部分,右侧的 KiteX Byted 涉及字节跳动内部工具,这块在对外时可以被替换成一些开源的日志库和方案。 截至 2021 年 5 月,公司内已经有超过 20000 个服务正在使用 KiteX,同时它也支持了 streaming/泛化调用等需求。在开源上,技术团队也提供了一些监控和日志可插拔的 feature。 在性能上,相比当前社区比较认可的 gRPC 框架,kitex/thrift 实现了 2.5 倍吞吐量的提升,kitex/protobuf 也有近 2 倍的提升。在 TP99 延迟上,KiteX 也有不错的表现。 HTTP 框架 Hertz 2020 年 10 月,字节跳动内部推出 Hertz,作为代替 Ginex(Gin 封装版)的 Golang HTTP 首选框架。 Hertz 的设计思路和 KiteX 大致相同。它借鉴了开源项目 Gin、FastHTTP 的优势,引入了 Netpoll、内存池、零拷贝等技术,因此有着较高的性能。同等配置下,Hertz 的极限 QPS 是 Ginex 的两倍,平均延时则只有 Ginex 的二分之一。 下图是技术团队基于最新版本制作的 Benchmark。在小包和中包场景下,Hertz 相比 FastHTTP 有 30% 到 50% 以上的 QPS 提升;在大包场景,双方差距不大,Hertz 在平均时延上占优。 json 库 Sonic 2021 年春节之前,技术团队对线上容器数量排名前 50 的服务进行了性能瓶颈分析。通过调研,团队发现 json 在整体上占了 9.5% 的资源,在某些服务上的资源占用甚至达到 40%! 既然 json 性能这么差,为什么不换成 Protobuf? 在当时,技术团队确实将部分服务切成了 Protobuf,但考虑到 json 的易用性、受欢迎程度,以及更换协议导致的迁移成本和迁移风险,他们也开始尝试进行一些优化。他们调研了所有可获取的 Golang json 库,并在业务场景下都做了比较详细的对比和分析,发现了一些问题并做了优化: JIT:有些 json 库已经开始展现出 JIT 特征,但还停留在把常见代码片段通过聚合的方式组织起来,没有做到非常极致的 just in time 编译,因此需要推进一步; 前置筛选+SIMD:simdjson 在一些大包场景下的表现很不错,但在一些小包场景下的表现其实不太好,因此需要做前置筛选和 SIMD 优化; asm2asm: C++ -> Go——“优化 Go 最好的方法就是不要用 Go”,技术团队发现用 C++ 写 json 常用函数,把它们编译成 x86 汇编,再通过内部 asm2asm 这个工具转成 Go 的汇编,可以获得非常大的性能提升; lazy-load 解析器:针对多 key 查找的场景,做了一个解析器。 基于上述优化,在一个 110KB 的真实业务请求场景下,相比其他 json 库,Sonic 在每个场景下的表现都有成倍的提升。目前 Sonic 已经开源,但经过内部服务测试,它还处于比较初级的阶段,有一些稳定性问题,后续会有相关团队持续跟进。 字节跳动的 Service Mesh 首先是几个数字。从 2018 年 6 月至今,字节跳动在三年间共上线了约30000个服务,Service Mesh 管理的容器数已经超过300 万个。所有业务场景,以及 ToB 和边缘计算场景,现在都处于 Mesh 全覆盖的状态。 下图是公司内部 Service Mesh 的架构示意图。除数据面和控制面外,它还有一个运维控制面(Operation Plane),且具备两个突出特点: 在数据面,字节跳动的 Service Mesh实现了中间件的能力 sidecar 化,形成一个标准模式,下图中的通用 sidecar 即标准技术方案; 该Service Mesh的运维控制面可以发布多种不同类型的资源。但凡需要集中发布的资源,例如 Mesh 的 sidecar,例如 WebAssembly 的资源、动态库,都可以通过运维控制面进行发布。 字节跳动内部Service Mesh的主要特征 当前字节跳动Service Mesh的特点可以用 4 个关键词概括: 全功能。除了前文提到的 RPC 框架、HTTP 框架,字节跳动的 Service Mesh已经对中间件、MySQL、MongoDB、Redis、RocketMQ 等提供全面支持,在安全能力、服务治理能力,包括流量复制、mock、容灾等方面,它均可提供完整功能。 多场景。字节跳动的 Service Mesh适用于内网环境、边缘,也可被用于把两个 IDC 串联起来。IDC 串联为什么要通过 Mesh?因为跨 IDC 的网络是不稳定的,考虑到高昂的成本和严格的服务访问控制,需要通过 Mesh 提供较强的边缘管控能力。 稳定性。这是一个比较常见的话题,此处不做展开。 高性能。字节跳动Service Mesh的性能优化基于技术团队的理念:如果目标是做一个真正 zero copy 的 proxy,而我们做不到,那么它的原因是什么?网络和内核、基础库、组件架构、编译——如果阻碍来自内核,就去改内核的 API,例如降低 sendfile 的开销。围绕这一理念,技术团队通过采用 Facebook 的 hashmap,带来了 1%-2% 的性能提升;通过重写抽象层,实现 35%-50% 的吞吐量提升;通过全静态编译,无需修改任何代码,就获得了 2% 左右的性能提升…… 下图展示了技术团队在性能优化方面的主要思路和措施: 性能:基于共享内存的 IPC 如前文所述,技术团队想实现的是真正 zero copy 的 proxy。那么拷贝发生在哪里? 上图是一个最原始的状态,mesh proxy 带来了两层 copy,一次是把业务进程 copy 到 Unix Domain Socket 的 Buffer 里,另一次是读取出去。此外它还多了一个进程,而多一个进程,就意味着增加了调度开销,同时也会产生一些复制成本。 针对这个问题,技术团队采用的做法是把它只写进内核一次。通过一个共享内存的 IPC,业务进程把准备发送的数据写进去后,mesh proxy 只需根据 meta header 就可以决定任何调度策略和治理策略,并通过调用下游发送函数把数据发出去。 但现在 TCP Socket 是不能直接把数据发出去的,怎么办?请负责内核的团队写一个 API。这样,整个 overhead 就可以降到最低值。 上图是采用共享内存 IPC 的性能测试结果。从 2020 年初开始,字节跳动内部就已经开始走上这种数据走共享内存、控制信号走 Unix Domain Socket的路,同时做好控制协议。确实这条路也是可以走下去的,当前已经有 500+ 服务在线上进行灰度,整体稳定性不错。未来技术团队也计划把这种优化方式扩展到所有涉及同机通讯的场景。 另外,定义一个通用的协议,可以实现这种能力的复用。随着容器与容器之间的通信变得越来越频繁,这种基于共享内存的通讯的重要性也会日益凸显出来,字节跳动内部Service Mesh的通用 sidecar 也是基于相同的思考。 可观测性:Service Mesh 之痛 基础架构部门经常会被问到两个问题: Q1:上下游延迟不一致——为什么我在客户端看到的延迟是 100 毫秒,而 Server 端处理只花了 50 毫秒,中间这 50 毫秒去哪里了? Q2:请求超时——接了 Mesh(不接 Mesh 其实也一样),我的请求为什么就超时了? 如果深入地去思考这个问题,可以发现,它的根本原因在于一次请求的时间可以分为业务可见的部分和业务不可见的部分。 比如开发人员做一次加密耗时 1 毫秒,但调用一个服务做一次加密可能需要 10 毫秒。这 9 毫秒到底去哪里了?很多开发人员会认为这是环境的问题,或是基础架构的问题。这个问题一直存在,而且相当普遍。 那么,延迟来自哪里? 计算。比如序列化,上游其实不会关心请求的序列化和反序列化,以及从用户态拷贝到内核态,这些都可以被归类到计算里,而这些延时业务侧是感知不到的(此处需要区分感知与可观测,通过监控可以看到这部分耗时,但一般业务不理解这儿的计算耗时,认为处理时间仅仅是自己的业务逻辑); 调度。比如要异步发送一个东西,数据写入后,上游并不知道会什么时候发。如果机器负载非常高,可能需要等待 100 毫秒,甚至任务会在容器里被 CPU throttle 掉,这时从上游的角度看就是请求超时; 网络。出现超时后,网络永远是第一个排查项:是不是挂了?是不是变慢了? 分析清楚这三个问题后,那么应当如何解决呢?服务框架团队的做法是推进 LLT(Low Level Tracing)。即把上游看不见的地方都做可视化处理:如果计算耗时看不到,就把计算时间表现出来;如果调度情况无感知,就把调度的用时算出来;如果网络情况不清楚,就把网络的用时也算出来。完成内核网络及调度事件收集后,这些时间最终都会汇入 OpenTracing 集中展示。 如上图所示,当上游开始调用 RPC Client write() 时,事实上就已经进入业务不可见范围。 字节跳动内部有一套基于 eBPF 做的 tracing 体系,它能根据提供的 log ID 展开追踪,把请求什么时候进入内核、什么时候从网卡发出等时间戳记录下来。有了这些信息,技术团队就能通过 OpenTracing 看到请求什么时候从本机发出、什么时候对端收到、什么时候开始进入 Mesh 处理、什么时候开始进入业务层处理……整个链路变得十分清晰。 上述方案的 CPU overhead 约为 8%- 10%,整体开销稍重,所以目前是按需开启状态。 字节内部 Mesh:通用 sidecar 的出现 Service Mesh 的出现源于技术社区希望用它解决多语言、运维、迭代等问题,这种概念可以被泛化,即是否可以为解决多元问题和运维问题同样打造一套标准技术方案。毫无疑问,所有中间件都在这个范畴内,无论是 MySQL、Redis Client,还是 API Gateway、登录组件、风控组件,它们都属于这一领域。 同时,Service Mesh 背后的能力也可以被复用:既然可以把 Mesh 的 sidecar 分发到线上任意一个容器,并完成安全的热升级,那么同样的方法也可以被用于中间件的 sidecar。 字节跳动的 Service Mesh提供通用 sidecar,把诸如 API Gateway sidecar、风控 sidecar、登录及 Session sidecar 等以 Mesh 的方式分发到容器里。这样做并不会对业务侧造成什么影响,但后果是它们也需要应对性能、可观测性、稳定性等问题。由于 Service Mesh 在字节跳动已经大规模落地,这些问题的解决方案其实和 mesh proxy 没有太大差别。 总结与展望 谈到微服务,由于缺乏直观感受,很多人往往只关注服务的功能层面,而忽略底层的运维属性。但其实现在为什么社区还在不断讨论微服务,因为它部署在公有云、私有云、混合云等充满不确定性的环境下,解决的是由此带来的各种复杂性问题。 但换个角度看,如果开发人员都使用同一种语言,不做跨机器和跨进程的通讯。当所有服务都部署在同一台宿主机上,类似跨网络通讯、请求超时等问题会大大减少,通过共享内存或是无序列化等手段,整体性能似乎可以获得最极致的提升。 这是不是破坏了微服务的概念?其实不然。这样的部署对于业务来说是透明的,只要宿主机规格足够,开发人员可以通过调度按服务域进行聚合,框架层和流量调度层感知情况后,很自然地就会把远程通讯切换成本地通讯,使得性能得到大幅优化、延时降低。如果机器出现宿主机级别的故障,所有服务确实会一起挂掉,但如果只是某一个模块出现故障,则可以把它轻松 fallback 到其他服务上。 这也是字节跳动内部正在进行的探索,为解决由微服务数量不断增长、复杂性不断提高导致的非业务消耗比业务消耗还要高的问题。 在微服务领域,除了内部探索,字节跳动也在尝试通过服务框架团队和火山引擎云原生团队做技术输出,通过 ToB 品牌火山引擎为更多企业提供微服务和 Service Mesh 方面的解决方案。 参考资料 官网地址:CloudWeGo 项目地址:https://github.com/cloudwego Kitex:https://github.com/cloudwego/kitex Netpoll:https://github.com/cloudwego/netpoll Sonic:bytedance/sonic: A blazingly fast JSON serializing & deserializing library (github.com)

优秀的个人博客,低调大师

每日一博 | 从 Redux 源码谈谈函数式编程

摘要 在 React 的世界中,状态管理方案不下几百种,但其中最经典的,莫过于 Redux 。如果你想学习函数式编程,那么 Redux 源码就是最好的学习材料。考虑到不少小伙伴用的是 Vue ,本人争取让这篇文章写得通俗易懂,让没有接触过 React 技术栈的同学也能掌握 Redux 。 在 React 的世界中,状态管理方案不下几百种,但其中最经典的,莫过于 Redux 。如果你想学习函数式编程,那么 Redux 源码就是最好的学习材料。考虑到不少小伙伴用的是 Vue ,本人争取让这篇文章写得通俗易懂,让没有接触过 React 技术栈的同学也能掌握 Redux 。 在 React 的世界中,状态管理方案不下几百种,但其中最经典的,莫过于 Redux 。如果你想学习函数式编程,那么 Redux 源码就是最好的学习材料。考虑到不少小伙伴用的是 Vue ,本人争取让这篇文章写得通俗易懂,让没有接触过 React 技术栈的同学也能掌握 Redux 。 Redux 属于典型的“百行代码,千行文档”,其中核心代码非常少,但是思想不简单,可以总结为下面两点: 全局状态唯一且不可变(Immutable) ,不可变的意思是当需要修改状态的时候,用一个新的来替换,而不是直接在原数据上做更改: let store = { foo: 1, bar: 2 }; // 当需要更新某个状态的时候 // 创建一个新的对象,然后把原来的替换掉 store = { ...store, foo: 111 }; 这点与 Vue 恰好相反,在 Vue 中必须直接在原对象上修改,才能被响应式机制监听到,从而触发 setter 通知依赖更新。 状态更新通过一个纯函数(Reducer)完成。纯函数(Pure function)的特点是: 输出仅与输入有关; 引用透明,不依赖外部变量; 不产生副作用; 因此对于一个纯函数,相同的输入一定会产生相同的输出,非常稳定。使用纯函数进行全局状态的修改,使得全局状态可以被预测。 1. 需要了解的几个概念 在使用 Redux 及阅读源码之前需要了解下面几个概念: Action action 是一个普通 JavaScript 对象,用来描述如何修改状态,其中需要包含 type 属性。一个典型的 action 如下所示: const addTodoAction = { type: 'todos/todoAdded', payload: 'Buy milk' } Reducers reducer 是一个纯函数,其函数签名如下: /** * @param {State} state 当前状态 * @param {Action} action 描述如何更新状态 * @returns 更新后的状态 */ function reducer(state: State, action: Action): State reducer 函数的名字来源于数组的 reduce 方法,因为它们类似数组 reduce 方法传递的回调函数,也就是上一个返回的值会作为下一次调用的参数传入。 reducer函数的编写需要严格遵顼以下规则: 检查reducer是否关心当前的action 如果是,就创建一份状态的副本,使用新的值更新副本中的状态,然后返回这个副本 否则就返回当前状态 一个典型的 reducer 函数如下: const initialState = { value: 0 } function counterReducer(state = initialState, action) { if (action.type === 'counter/incremented') { return { ...state, value: state.value + 1 } } return state } Store 通过调用 createStore 创建的 Redux 应用实例,可以通过 getState() 方法获取到当前状态。 Dispatch store 实例暴露的方法。更新状态的唯一方法就是通过 dispatch 提交 action 。store 将会调用 reducer 执行状态更新,然后可以通过 getState() 方法获取更新后的状态: store.dispatch({ type: 'counter/incremented' }) console.log(store.getState()) // {value: 1} storeEnhancer createStore 的高阶函数封装,用于增强 store 的能力。Redux 的 applyMiddleware 是官方提供的一个 enhancer 。 middleware dispatch 的高阶函数封装,由 applyMiddleware 把原 dispatch替换为包含 middleware 链式调用的实现。Redux-thunk 是官方提供的 middleware,用于支持异步 action 。 2. 基本使用 学习源码之前,我们先来看下 Redux 的基本使用,便于更好地理解源码。 首先我们编写一个 Reducer 函数如下: // reducer.js const initState = { userInfo: null, isLoading: false }; export default function reducer(state = initState, action) { switch (action.type) { case 'FETCH_USER_SUCCEEDED': return { ...state, userInfo: action.payload, isLoading: false }; case 'FETCH_USER_INFO': return { ...state, isLoading: true }; default: return state; } } 在上面代码中: reducer首次调用的时候会传入initState作为初始状态,然后switch...case最后的default用来获取初始状态 在switch...case中还定义了两个action.type用来指定如何更新状态 接下来我们创建 store : // index.js import { createStore } from "redux"; import reducer from "./reducer"; const store = createStore(reducer); store 实例会暴露两个方法 getState 和 dispatch ,其中 getState 用于获取状态,dispatch 用于提交 action 修改状态,同时还有一个 subscribe 用于订阅store的变化: // index.js // 每次更新状态后订阅 store 变化 store.subscribe(() => console.log(store.getState())); // 获取初始状态 store.getState(); // 提交 action 更新状态 store.dispatch({ type: "FETCH_USER_INFO" }); store.dispatch({ type: "FETCH_USER_SUCCEEDED", payload: "测试内容" }); 我们运行一下上面的代码,控制台会先后打印: { userInfo: null, isLoading: false } // 初始状态 { userInfo: null, isLoading: true } // 第一次更新 { userInfo: "测试内容", isLoading: false } // 第二次更新 3. Redux Core 源码分析 上面的例子虽然很简单,但是已经包含 Redux 的核心功能了。接下来我们来看下源码是如何实现的。 createStore 可以说 Redux 设计的所有核心思想都在 createStore 里面了。 createStore 的实现其实非常简单,整体就是一个闭包环境,里面缓存了 currentReducer 和 currentState ,并且定义了getState、subscribe、dispatch 等方法。 createStore 的核心源码如下,由于这边还没用到 storeEnhancer ,开头有些if...else的逻辑被省略了,顺便把源码中的类型注解也都去掉了,方便阅读: // src/createStore.ts function createStore(reducer, preloadState = undefined) { let currentReducer = reducer; let currentState = preloadState; let listeners = []; const getState = () => { return currentState; } const subscribe = (listener) => { listeners.push(listener); } const dispatch = (action) => { currentState = currentReducer(currentState, action); for (let i = 0; i < listeners.length; i++) { const listener = listeners[i]; listener(); } return action; } dispatch({ type: "INIT" }); return { getState, subscribe, dispatch } } createStore 的调用链路如下: 首先调用 createStore 方法,传入 reducer 和 preloadState 。preloadState 代表初始状态,假如不传那么 reducer 必须要指定初始值; 将 reducer 和 preloadState 分别赋值给 currentReducer 和 currentState 用于创建闭包; 创建 listeners 数组,这其实就是基于发布订阅模式,listeners 就是发布订阅模式的事件中心,也是通过闭包缓存; 创建 getState 、subscribe 、dispatch 等函数; 调用 dispatch 函数,提交一个 INIT 的 action 用来生成初始state,在 Redux 源码中,这里的 type 是一个随机数; 最后返回一个包含 getState 、subscribe 、dispatch 函数的对象,即 store 实例; 那么很显然,外界无法访问到闭包的值,只能通过getState函数访问。 为了订阅状态更新,可以使用 subscribe 函数向事件中心 push 监听函数(注意 listener 是允许副作用存在的)。 当需要更新状态时,调用 dispatch 提交 action 。在 dispatch 函数中调用 currentReducer(也就是 reducer 函数),并传入 currentState 和 action ,然后生成一个新的状态,传给 currentState 。在状态更新完成后,将订阅的监听函数执行一遍(实际上只要调用 dispatch ,即使没有对 state 做任何修改,也会触发监听函数)。 如果有熟悉面向对象编程的小伙伴可能会说,createStore里面做的事情可以封装到一个类里面。确实可以,本人用 TypeScript 实现如下(发布订阅的功能不写了): type State = Object; type Action = { type: string; payload?: Object; } type Reducer = (state: State, action: Action) => State; // 定义 IRedux 接口 interface IRedux { getState(): State; dispatch(action: Action): Action; } // 实现 IRedux 接口 class Redux implements IRedux { // 成员变量设为私有 // 相当于闭包作用 private currentReducer: Reducer; private currentState?: State; constructor(reducer: Reducer, preloadState?: State) { this.currentReducer = reducer; this.currentState = preloadState; this.dispatch({ type: "INIT" }); } public getState(): State { return this.currentState; } public dispatch(action: Action): Action { this.currentState = this.currentReducer( this.currentState, action ); return action; } } // 通过工厂模式创建实例 function createStore(reducer: Reducer, preloadState?: State) { return new Redux(reducer, preloadState); } 你看,多有意思,函数式编程和面向对象编程竟然殊途同归了。 applyMiddleware applyMiddleware 是 Redux 中的一个难点,虽然代码不多,但是里面用到了大量函数式编程技巧,本人也是经过大量源码调试才彻底搞懂。 首先要能看懂这种写法: const middleware = (store) => (next) => (action) => { // ... } 上面的写法相当于: const middleware = function(store) { return function(next) { return function(action) { // ... } } } 其次需要知道,这种其实就是函数柯里化,也就是可以分步接受参数。如果内层函数存在变量引用,那么每次调用都会生成闭包。 说到闭包,有些同学马上就想到内存泄漏。但实际上闭包在平时项目开发中非常常见,很多时候我们不经意间就创建了闭包,但往往都被我们忽略了。 闭包一大作用就是缓存值,这和声明一个变量在赋值的效果是类似的。而闭包的难点就在于,变量是显式声明,而闭包往往是隐式的,什么时候创建闭包,什么时候更新了闭包的值,很容易被忽略。 可以这么说,函数式编程就是围绕闭包展开的。在下面的源码分析中,会看到大量闭包的例子。 applyMiddleware 是 Redux 官方实现的 storeEnhancer ,实现了一套插件机制,增加 store 的能力,例如实现异步 Action ,实现 logger 日志打印,实现状态持久化等等。 export default function applyMiddleware<Ext, S = any>( ...middlewares: Middleware<any, S, any>[] ): StoreEnhancer<{ dispatch: Ext }> 个人观点,这样做的好处就是提供了造轮子的空间 applyMiddleware 接受一个或多个 middleware 实例,然后再传给createStore: import { applyMiddleware, createStore } from "redux"; import thunk from "redux-thunk"; // 使用 thunk 中间件 import reducer from "./reducer"; const store = createStore(reducer, applyMiddleware(thunk)); createStore 入参中只接受一个 storeEnhancer ,如果需要传入多个,可以使用 Redux Utils 中的 compose 函数将它们组合起来。 compose 函数在后面会介绍 看上面的用法,可以猜测 applyMiddleware 肯定也是个高阶函数。之前说到 createStore 前面有些if..else逻辑因为没用到 storeEnhancer 所以被省略了。这边我们一起来看下。 首先看 createStore 的函数签名,实际上是可以接受 1-3 个参数。其中 reducer 是必须要传递的。当第二个参数为函数类型,会识别为 storeEnhancer。如果第二个参数不是函数类型,则会识别为 preloadedState ,此时还可以再传递一个函数类型的 storeEnhancer : function createStore(reducer: Reducer, preloadedState?: PreloadedState | StoreEnhancer, enhancer?: StoreEnhancer): Store 可以看到源码中参数校验的逻辑: // src/createStore.ts:71 if ( (typeof preloadedState === 'function' && typeof enhancer === 'function') || (typeof enhancer === 'function' && typeof arguments[3] === 'function') ) { // 传递两个函数类型参数的时候,抛出异常 // 也就是只接受一个 storeEnhancer throw new Error(); } 当第二个参数为函数类型,将它作为 storeEhancer 处理: // src/createStore.ts:82 if (typeof preloadedState === 'function' && typeof enhancer === 'undefined') { enhancer = preloadedState as StoreEnhancer<Ext, StateExt> preloadedState = undefined } 接下来是一个比较难的逻辑: // src/createStore.ts:87 if (typeof enhancer !== 'undefined') { // 如果使用了 enhancer if (typeof enhancer !== 'function') { // 如果 enhancer 不是函数就抛出异常 throw new Error(); } // 直接返回调用 enhancer 之后的结果,并没有往下继续创建 store // enhancer 肯定是一个高阶函数 // 先传入了 createStore,又传入 reducer 和 preloadedState // 说明很有可能在 enhancer 内部再次调用 createStore return enhancer(createStore)( reducer, preloadedState ) } 下面我们来看一下 applyMiddleware 的源码,为便于阅读,把源码中的类型注解都去掉了: // src/applyMiddleware.ts import compose from './compose'; function applyMiddleware(...middlewares) { return (createStore) => (reducer, preloadedState) => { const store = createStore(reducer, preloadedState); let dispatch = () => { throw new Error(); } const middlewareAPI = { getState: store.getState, dispatch: (action, ...args) => dispatch(action, ...args) } const chain = middlewares.map(middleware => middleware(middlewareAPI)); dispatch = compose(...chain)(store.dispatch); return { ...store, dispatch } } } 可以看到这里代码并不多,但是出现了一个函数嵌套函数的情形: const applyMiddleware = (...middlewares) => (createStore) => (reducer, preloadedState) => { // ... } 分析一下源码中的调用链路: 调用 applyMiddleware 时,传入中间件实例,返回 enhancer 。从剩余参数的用法看出,支持传入多个 middleware ; 由createStore调用 enhancer ,分两次传入 createStore 和 reducer 、preloadedState ; 内部再次调用 createStore ,这次由于没有传 enhancer ,所以直接走创建 store 的流程; 创建一个经过修饰的 dispatch 方法,覆盖默认 dispatch ; 构造 middlewareAPI ,对 middleware 注入 middlewareAPI ; 将 middleware 实例组合为一个函数,再向 middleware 传递默认的 store.dispatch 方法; 最后返回一个新的 store 实例,此时 store 的 dispatch 方法经过了 middleware 修饰; 这里涉及到 compose 函数,是函数式编程范式中经常用到的一种处理,创建一个从右到左的数据流,右边函数执行的结果作为参数传入左边,最终返回一个以上述数据流执行的函数: // src/compose.ts:46 export default function compose(...funcs) { if (funcs.length === 0) { return (arg) => arg } if (funcs.length === 1) { return funcs[0] } return funcs.reduce( (a, b) => (...args) => a(b(...args)) ) } 思考题:如果希望把执行顺序改为从左往右,需要怎么改? 通过这边的代码,我们不难推断出一个中间件的结构: function middleware({ dispatch, getState }) { // 接收 middlewareAPI return function(next) { // 接收默认的 store.dispatch 方法 return function(action) { // 接收组件调用 dispatch 传入的 action console.info('dispatching', action); let result = next(action); console.log('next state', store.getState()); return result; } } } 看到这里,我想大多数读者都会有两个问题: 通过 middlewareAPI 获取的 dispatch 函数和 store 实例最终暴露的 dispatch 函数都是经过修饰的吗; 为了防止在创建 middleware 的时候调用 dispatch ,applyMiddleware 给新的 dispatch 初始化为一个空函数,且调用会抛出异常,那么这个函数究竟在何时被替换掉的; 大家可以先试着思考一下。 说实话,本人在阅读源码的时候也被这两个问题困扰,大多数技术文章也都没有给出解释。没办法,只能通过调试源码来找答案。经过不断调试,终于搞清楚了,middlewareAPI 的 dispatch 函数本身其实就是以闭包形式引入的,这个闭包可能没多少人能看得出来: // 定义新的 dispatch 方法 // 此时是一个空函数,调用会抛出异常 let dispatch = () => { throw new Error(); } // 定义 middlewareAPI // 注意这里的 dispatch 是通过闭包形式引入的 const middlewareAPI = { getState: store.getState, dispatch: (action, ...args) => dispatch(action, ...args) } // 对 middleware 注入 middlewareAPI // 此时在 middleware 中调用 dispatch 会抛出异常 const chain = middlewares.map(middleware => middleware(middlewareAPI)); 然后下面这段代码其实做了两件事,一方面将 middleware 组合为一个函数,注入默认 dispatch 函数,另一方面将新的 dispatch 初始的空函数替换为正常可执行的函数。同时由于 middlewareAPI 的 dispatch 是以闭包形式引入的,当 dispatch 更新之后,闭包中的值也相应更新: // 将 dispatch 替换为正常的 dispatch 方法 // 注意闭包中的值也会相应更新,middleware 可以访问到更新后的方法 dispatch = compose(...chain)(store.dispatch); 也就是说,createStore 生成的实例暴露的 dispatch 和 middleware 获取的都是修饰后的 dispatch ,并且应该是长这样: function(action) { // 注意这里存在闭包 // 可以获取到中间件初始化传入的 dispatch、getState 和 next // 如果你打断点,可以在 scope 中看到闭包的变量 // 同时注意这里的 dispatch 就是这个函数本身 console.info('dispatching', action); let result = next(action); console.log('next state', store.getState()); return result; } 4. 处理异步 Action 由于 reducer 需要严格控制为纯函数,因此不能在里面进行异步操作,也不能进行网络请求。有些同学可能会说,虽然 reducer 里面不能放异步代码,但是可以把 dispatch 函数放在异步回调中调用呀: setTimeout(() => { this.props.dispatch({ type: 'HIDE_NOTIFICATION' }) }, 5000) 在 React 组件中通常用 connect 把 dispatch 映射到组件的props 中,类似 Vuex 中的 mapAction 用法。 确实可以!Redux 作者 Dan Abramov 在 Stackoverflow 上面有一个非常好的回答,其中就赞同了这种用法: https://stackoverflow.com/questions/35411423/how-to-dispatch-a-redux-action-with-a-timeout/35415559#35415559 本人将 Dan Abramov 的核心观点总结如下。 Redux 确实提供了一些处理异步 Action 的替代方法,但应该只在当你意识到你编写了大量模板代码的时候再去使用。否则就用最简单的方案(如无必要,勿增实体); 当多个组件需要用到同一个 action.type 时,为避免 action.type 拼写错误,需要抽离公共的 actionCreator,例如: // actionCreator.js export function showNotification(text) { return { type: 'SHOW_NOTIFICATION', text } } export function hideNotification() { return { type: 'HIDE_NOTIFICATION' } } // component.js import { showNotification, hideNotification } from '../actionCreator' this.props.dispatch(showNotification('You just logged in.')) setTimeout(() => { this.props.dispatch(hideNotification()) }, 5000) 上面的逻辑在简单场景下完全可行,但是随着业务复杂度增加会出现几个问题: 通常状态更新有好几个步骤,而且存在逻辑上的先后顺序,例如通知的展示和隐藏,导致模板代码较多; 提交的 action 没有状态,如出现竞争条件可能导致状态更新出 bug ; 出于上面的问题,需要抽离异步的 actionCreator ,把涉及状态更新的操作封装进去,便于复用,同时为每次 dispatch 生成唯一 id : // actions.js function showNotification(id, text) { return { type: 'SHOW_NOTIFICATION', id, text } } function hideNotification(id) { return { type: 'HIDE_NOTIFICATION', id } } let nextNotificationId = 0 export function showNotificationWithTimeout(dispatch, text) { const id = nextNotificationId++ dispatch(showNotification(id, text)) setTimeout(() => { dispatch(hideNotification(id)) }, 5000) } 然后在页面组件中这样使用,解决了模板代码和状态更新冲突问题: // component.js showNotificationWithTimeout(this.props.dispatch, 'You just logged in.') // otherComponent.js showNotificationWithTimeout(this.props.dispatch, 'You just logged out.') 细心的同学应该注意到,这边传递了 dispatch 。这是因为,正常来说只有组件中能访问到 dispatch ,为了能让外部封装的函数也能访问,我们需要将 dispatch 作为参数传过去; 这时有些同学会提出质疑,如果将 store 作为全局单例,不就可以直接访问了: // store.js export default createStore(reducer) // actions.js import store from './store' // ... let nextNotificationId = 0 export function showNotificationWithTimeout(text) { const id = nextNotificationId++ store.dispatch(showNotification(id, text)) setTimeout(() => { store.dispatch(hideNotification(id)) }, 5000) } // component.js showNotificationWithTimeout('You just logged in.') // otherComponent.js showNotificationWithTimeout('You just logged out.') 上面这样从操作上来说确实可行,但是 Redux 团队并不赞同单例的写法。他们的理由是,如果 store 变为单例,会导致服务端渲染的实现变得困难,同时测试也不方便,如要改用 mock store 需要修改所有 import ; 基于上面的原因,Redux 团队还是建议使用函数参数将 dispatch 传递出去,尽管这样很麻烦。那么有没有一种解决方案呢?有的,使用 Redux-thunk 就解决了这个问题; 实际上,Redux-thunk 的作用是教 Redux 识别函数类型的特殊 Action ; 中间件启用后,当 dispatch 的 Action 为函数类型,Redux-thunk 就会给这个函数传入 dispatch 作为参数,需要注意最终 reducer 拿到的仍然是普通 JavaScript 对象作为 Action : // actions.js function showNotification(id, text) { return { type: 'SHOW_NOTIFICATION', id, text } } function hideNotification(id) { return { type: 'HIDE_NOTIFICATION', id } } let nextNotificationId = 0 export function showNotificationWithTimeout(text) { return function (dispatch) { const id = nextNotificationId++ dispatch(showNotification(id, text)) setTimeout(() => { dispatch(hideNotification(id)) }, 5000) } } 在组件中使用如下: // component.js this.props.dispatch(showNotificationWithTimeout('You just logged in.')) 好了,Dan Abramov 的观点就总结到这里。 看到这里大家应该清楚 Redux-thunk 的作用了,Redux-thunk 本身并没有提供异步解决方案,实现异步就是使用最简单的方法,把 dispatch 函数放在异步回调中。很多时候我们会封装异步的 actionCreator ,在异步操作中每次都需要把 dispatch 传递出来很麻烦,Redux-thunk 对 dispatch 函数进行高阶封装,允许接受函数类型的 Action ,同时给这个 Action 传入 dispatch 和 getState 作为参数,这样就不用每次手动传递。 在看源码之前,大家可以结合 applyMiddleware 源码,想一下 Redux-thunk 内部实现。 其实 Redux-thunk 实现原理非常简单,代码如下: // src/index.ts:15 function createThunkMiddleware(extraArgument) { return ({ dispatch, getState }) => next => action => { if (typeof action === 'function') { return action(dispatch, getState, extraArgument) } return next(action) } } 在 Redux-thunk 内部,首先会调用 createThunkMiddleware 方法得到一个高阶函数然后向外导出。这个函数就是我们之前分析的中间件结构: ({ dispatch, getState }) => next => action => { if (typeof action === 'function') { return action(dispatch, getState, extraArgument) } return next(action) } 首先在初始化阶段,applyMiddleware 会为 thunk 先后注入 middlewareAPI (对应 dispatch 和 getState 形参)和 store.dispatch (即原本的 dispatch 方法,对应 next 形参)。 在初始化完成之后,store 实例的 dispatch 会被替换为一个经过修饰的 dispatch 方法(middlewareAPI 中的 dispatch 由于是闭包引用,也会被替换),用 dispatch.toString() 打印可以输出如下内容: // 注意这里可以访问到闭包中的 dispatch、getState 和 next // 初始化完成后的 dispatch 实际上就是下面这个函数本身 action => { if (typeof action === 'function') { return action(dispatch, getState, extraArgument) } return next(action) } 接下来的事情就很简单了,当我们提交一个函数类型的 Action : // actions.js const setUserInfo = data => ({ type: "SET_USER_INFO", payload: data }) export const getUserInfoAction = userId => { return dispatch => { getUserInfo(userId) .then(res => { dispatch(setUserInfo(res)); }) } } // component.js import { getUserInfoAction } from "./actionCreator"; this.props.dispatch(getUserInfoAction("666")); 当提交的 action 为函数类型的时候,就调用这个函数,然后传入 dispatch 、getState 、extraArgument 参数: if (typeof action === 'function') { return action(dispatch, getState, extraArgument) } (从这里可以看出,除了 dispatch 之外,在函数类型的 Action 内部还可以访问 getState 和 extraArgument) 当异步操作完成,调用 Redux-thunk 传递的 dispatch 方法提交对象类型 Action 时,还是进入这个被修饰的 dispatch 方法,只不过在判断类型的时候,进入了另一个分支: return next(action); 这里的 next 就是 Redux 原本的 dispatch 方法,会将对象类型的 Action 提交给 reducer 方法,最终执行状态更新。 5. 总结 Redux 是一种非常经典的状态管理解决方案。它遵循函数式编程的原则,状态只读且不可变,只有通过纯函数才能更新状态。 但是 Redux 同样也存在着不少问题。首先,对于新手来说,上手成本较高,使用之前需要先了解函数式编程的概念和设计思想。其次,Redux 在实际开发中非常繁琐,即使实现一个很简单的功能,可能也需要同时修改 4-5 个文件,降低了开发效率。作为对比,Vuex 的上手成本非常低,对于新手非常友好,使用也非常简单,既不需要异步中间件,也不需要额外的 UI binding ,在 Redux 中通过插件提供的功能,全部内置开箱即用。 对此,Redux 官方提供了一个封装方案 Redux Toolkit,社区也提供了很多封装方案,例如 Dva 、Rematch 等等,旨在简化 Redux 的使用,API 的封装上很多地方就是参考了 Vuex 。甚至还出现了酷似 Vue 响应式、使用可变数据(Mutable)的 Mobx 状态管理方案。此外,React 官方团队也在近期推出了 Recoil 状态管理库。 参考 https://redux.js.org https://github.com/reduxjs/redux https://github.com/reduxjs/redux-thunk https://stackoverflow.com/questions/35411423/how-to-dispatch-a-redux-action-with-a-timeout/35415559#35415559 coding优雅指南:函数式编程

优秀的个人博客,低调大师

每日一博 | 浅谈 openGauss 3.0 新特性:并行解码

导言 在信息技术飞速发展的今天,各种类型数据库层出不穷。由于支持数据在异构数据库间同步,逻辑复制的重要性与日俱增。当前openGauss逻辑复制串行解码平均性能为3~5MBps,在业务压力大的场景下难以满足实时同步的需求,导致日志堆积,从而影响生产集群业务。因此,我们设计了并行解码特性,令多个线程协同并行解码从而提高解码性能,在基础场景下解码性能可达到100MBps. 设计思路——为什么考虑并行解码? 原有的串行解码逻辑,从读取日志,到日志解码,以及结果拼接发送都是由单线程处理的,主要流程及耗时的大致比例如下图所示: 可以看出,整个流程的主要时间消耗在解码步骤中,需要通过多线程解码来进行优化;而发送步骤的耗时也较为明显,可以使用批量发送来做进一步优化。 工作流程——并行解码消息序列图 如下所示,在并行解码中,openGauss的数据节点(Data Node, DN)上的工作线程被分为三种: 1. Sender/Collector线程,负责接收客户的解码请求,以及拼接各解码线程的结果并发送给客户,该线程在一次解码请求中仅建立一个; 2. Reader/Dispatcher线程,负责读取WAL日志并分发给各解码线程进行解码,该线程在一次解码请求中仅建立一个; 3. Decoder线程,即解码线程,负责将Reader/Dispatcher线程发给自己的日志解码(当该线程已经在解码时,该部分日志暂存于read change队列中),并将解码结果(当尚未解到提交日志时,该部分结果暂存于decode change队列中)发给Sender/Collector线程,该线程在一次解码请求中可以建立多个。 该消息序列图说明如下: 1. 客户端向DN发送逻辑复制请求,该DN可为主机或备机。逻辑复制选项里可以设置参数选择仅连接备机,以防止主机压力过大。 2. 除了接收到客户请求的Sender线程外,DN还需建立Reader/Dispatcher线程和若干Decoder线程。 3. Reader读取xlog日志,进行预处理。如果相关日志涉及TOAST列,需在此步骤完成TOAST拼接。 4. Dispatcher将预处理后的日志派发给各Decoder线程。 5. Decoder线程各自独立进行解码。这里可以通过配置选项来设置解码格式(json、text或bin)。 6. Decoder将解码结果发送给Collector。 7. Collector以事务为单位汇总解码结果。 8. 为减少发送次数,降低网络I/O对解码性能的影响,在开启批量发送功能(即sending-batch参数设置为1)时,Sender积攒一定量的日志后(阈值设置为1MB),批量向客户返回解码结果。 9. 客户如需停止逻辑复制流程,断开与DN的逻辑复制连接即可。 10. Sender向Reader/Dispatcher线程和Decoder线程发送退出信号。 11. 各线程收到退出信号后,释放占用的资源,完成环境清理并退出。 技术细节1——可见性改造 在逻辑解码中,由于是对历史日志进行解析,因此对日志中元组的可见性判断至关重要。在原有串行解码的逻辑里,我们使用活跃事务链表机制来进行可见性判断。但是对于并行解码,每个解码线程各自维护一个活跃事务链表代价较大,会对解码性能产生不利影响,因此我们做了可见性改造,使用CSN(Commit Sequence Number,即提交事务号)来进行元组可见性判断。针对每一个事务号xid,其可见性流程如下: 其主要流程为: 1. 根据xid获取用来判断可见性的CSN,这里确保可以根据任一xid获取到CSN值。如果xid为异常值,会返回表示特定状态的CSN,这种CSN也可用于可见性判断; 2. 若CSN已提交,将其与快照中CSN比较,该事务CSN较小则不可见,否则可见; 3. 若CSN不是正在提交,则不可见。 基于上述逻辑,在并行解码中,判断一个元组的快照可见性的逻辑则为依次判断元组Xmin(插入时的事务号)和Xmax(删除/更新时的事务号)的快照可见性。这里的整体思路是,Xmin不可见/未提交或Xmax可见则元组不可见,而Xmin可见且Xmax不可见/未提交则元组可见。元组中的各标记位维持其原有含义参与可见性判断。 技术细节2——批量发送 在使用并行解码之后,解码过程占用的时间出现显著下降,但此时解码结果发送线程又将成为瓶颈,对于每条解码结果均执行一次完整的发送流程代价太大。因此这里我们采用了批量发送的方式,将解码的结果暂时收集起来,在超过阈值时一并发送给客户端。在批量发送时,需额外记录每条解码结果的长度,以及约定好的分隔符,以便并行解码功能的使用者对批量发送的日志进行拆分处理。 使用方式 我们为并行解码新增了一些可选配置项: 1. 解码线程并发度 通过配置选项parallel-decode-num,指定并行解码的Decoder线程数量。其取值范围为1~20的int型,取1表示按照原有的串行逻辑进行解码,不会进入本特性代码逻辑。默认值为1。当该选项配置为1时,禁止配置下面的解码格式选项decode-style。 2. 解码白名单 通过配置选项white-table-list,指定需要解码的表。其取值为text类型包含白名单中表名的字符串,不同的表以','为分隔符进行隔离。例:select * from pg_logical_slot_peek_changes('slot1', NULL, 4096, 'white-table-list', 'public.t1,public.t2');。 3. 限制仅备机解码 通过配置选项standby-connection,指定是否限制仅备机解码。其取值为bool型,取true代表限制仅允许连接备机解码,连接主机解码时会报错退出;取false时不做限制。默认值为false。 4. 解码格式 通过配置选项decode-style,指定解码格式。其取值为char型的字符’j’、’t’或’b’,分别代表json格式、text格式及二进制格式。默认值为’b’即二进制格式解码。 5. 批量发送 通过配置选项sending-batch,指定是否批量发送解码结果。其取值为int型的0或1,0代表不开启批量发送,1代表解码结果累计达到或刚超过1MB时批量发送解码结果,这里默认值为0,即默认不开启批量发送。 以使用JDBC进行并行解码为例,建立连接时需进行如下配置: PGReplicationStream stream = conn.getReplicationAPI().replicationStream().logical().withSlotName(replSlotName).withSlotOption("include-xids", true).withSlotOption("skip-empty-xacts", true).withSlotOption("parallel-decode-num", 10).withSlotOption("white-table-list", "public.t1,public.t2").withSlotOption("standby-connection", true).withSlotOption("decode-style", "t").withSlotOption("sending-bacth", 1).start(); 从倒数第6行到倒数第2行为新增逻辑,代表10并发解码、仅解码表public.t1和public.t2、启用备机连接、解码格式为text且开启批量发送功能,在配置参数超出范围时,会报错并提示参数允许取值范围。 辅助功能——监控函数 在进行并行解码时,为在解码速度较慢的场景下方便定位解码性能瓶颈,我们增加了gs_get_parallel_decode_status()函数,用来查看当前DN上各解码线程的存储尚未解码日志的read change队列和存储尚未发送解码结果的decode change队列的长度。 该函数没有入参,返回结果共四列,分别是slot_name、parallel_decode_num、read_change_queue_length、decode_change_queue_length。 slot_name为复制槽名,类型为text;parallel_decode_num为并行解码线程数,类型为int;read_change_queue_length类型为text,其记录了每个解码线程的read change)队列长度;decode_change_queue_length类型为text,其记录了每个解码线程的decode change队列长度。使用方式如下所示: 对于解码失速场景,在解码DN上执行此函数,然后查看查询结果的read_change_queue_length,这里记录每个解码线程里读取日志队列长度,如果这里的值过小表示日志读取阻塞,需继续定位是否为磁盘I/O不足。查看查询结果的decode_change_queue_length,这里记录每个解码线程里解码日志队列长度,如果这里值过小表示解码速度过慢,可以适当增加解码线程数量。如果read_change_queue_length和decode_change_queue_length均比较大,说明解码日志发送被阻塞,需检测并行解码使用者在目标数据库的回放日志速度。通常来说,解码失速场景一般有CPU、I/O、或内存资源不足造成,通过使用备机解码保证以上资源充足一般可以避免解码失速问题。 结语 并行解码可以大幅提升逻辑复制解码性能,其对解码实例增加的业务压力相较而言显得不那么重要。作为异构数据库数据复制的关键技术方案,并行解码对于openGauss的重要性也是不言而喻的。 欢迎访问openGauss官方网站 openGauss开源社区官方网站: https://opengauss.org openGauss组织仓库: https://gitee.com/opengauss openGauss镜像仓库: https://github.com/opengauss-mirror 扫码关注我们 微信公众号|openGauss 微信社群小助手|openGauss-bot 本文分享自微信公众号 - openGauss(openGauss)。如有侵权,请联系 support@oschina.cn 删除。本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

优秀的个人博客,低调大师

每日一博 | 深入剖析 RocketMQ 源码 - 负载均衡机制

一、引言 RocketMQ是一款优秀的分布式消息中间件,在各方面的性能都比目前已有的消息队列要好,RocketMQ默认采用长轮询的拉模式, 单机支持千万级别的消息堆积,可以非常好的应用在海量消息系统中。 RocketMQ主要由 Producer、Broker、Consumer、Namesvr 等组件组成,其中Producer 负责生产消息,Consumer 负责消费消息,Broker 负责存储消息,Namesvr负责存储元数据,各组件的主要功能如下: 消息生产者(Producer):负责生产消息,一般由业务系统负责生产消息。一个消息生产者会把业务应用系统里产生的消息发送到Broker服务器。RocketMQ提供多种发送方式,同步发送、异步发送、顺序发送、单向发送。同步和异步方式均需要Broker返回确认信息,单向发送不需要。 消息消费者(Consumer):负责消费消息,一般是后台系统负责异步消费。一个消息消费者会从Broker服务器拉取消息、并将其提供给应用程序。从用户应用的角度而言提供了两种消费形式:拉取式消费、推动式消费。 代理服务器(Broker Server):消息中转角色,负责存储消息、转发消息。代理服务器在RocketMQ系统中负责接收从生产者发送来的消息并存储、同时为消费者的拉取请求作准备。代理服务器也存储消息相关的元数据,包括消费者组、消费进度偏移和主题和队列消息等。 名字服务(Name Server):名称服务充当路由消息的提供者。生产者或消费者能够通过名字服务查找各主题相应的Broker IP列表。多个Namesrv实例组成集群,但相互独立,没有信息交换。 生产者组(Producer Group):同一类Producer的集合,这类Producer发送同一类消息且发送逻辑一致。如果发送的是事务消息且原始生产者在发送之后崩溃,则Broker服务器会联系同一生产者组的其他生产者实例以提交或回溯消费。 消费者组(Consumer Group):同一类Consumer的集合,这类Consumer通常消费同一类消息且消费逻辑一致。消费者组使得在消息消费方面,实现负载均衡和容错的目标变得非常容易。 RocketMQ整体消息处理逻辑上以Topic维度进行生产消费、物理上会存储到具体的Broker上的某个MessageQueue当中,正因为一个Topic会存在多个Broker节点上的多个MessageQueue,所以自然而然就产生了消息生产消费的负载均衡需求。 本篇文章分析的核心在于介绍RocketMQ的消息生产者(Producer)和消息消费者(Consumer)在整个消息的生产消费过程中如何实现负载均衡以及其中的实现细节。 二、RocketMQ的整体架构 (图片来自于Apache RocketMQ) RocketMQ架构上主要分为四部分,如上图所示: Producer:消息发布的角色,支持分布式集群方式部署。Producer通过MQ的负载均衡模块选择相应的Broker集群队列进行消息投递,投递的过程支持快速失败并且低延迟。 Consumer:消息消费的角色,支持分布式集群方式部署。支持以push推,pull拉两种模式对消息进行消费。同时也支持集群方式和广播方式的消费,它提供实时消息订阅机制,可以满足大多数用户的需求。 NameServer:NameServer是一个非常简单的Topic路由注册中心,支持分布式集群方式部署,其角色类似Dubbo中的zookeeper,支持Broker的动态注册与发现。 BrokerServer:Broker主要负责消息的存储、投递和查询以及服务高可用保证,支持分布式集群方式部署。 RocketMQ的Topic的物理分布如上图所示: Topic作为消息生产和消费的逻辑概念,具体的消息存储分布在不同的Broker当中。 Broker中的Queue是Topic对应消息的物理存储单元。 在RocketMQ的整体设计理念当中,消息的生产消费以Topic维度进行,每个Topic会在RocketMQ的集群中的Broker节点创建对应的MessageQueue。 producer生产消息的过程本质上就是选择Topic在Broker的所有的MessageQueue并按照一定的规则选择其中一个进行消息发送,正常情况的策略是轮询。 consumer消费消息的过程本质上就是一个订阅同一个Topic的consumerGroup下的每个consumer按照一定的规则负责Topic下一部分MessageQueue进行消费。 在RocketMQ整个消息的生命周期内,不管是生产消息还是消费消息都会涉及到负载均衡的概念,消息的生成过程中主要涉及到Broker选择的负载均衡,消息的消费过程主要涉及多consumer和多Broker之间的负责均衡。 三、producer消息生产过程 producer消息生产过程: producer首先访问namesvr获取路由信息,namesvr存储Topic维度的所有路由信息(包括每个topic在每个Broker的队列分布情况)。 producer解析路由信息生成本地的路由信息,解析Topic在Broker队列信息并转化为本地的消息生产的路由信息。 producer根据本地路由信息向Broker发送消息,选择本地路由中具体的Broker进行消息发送。 3.1 路由同步过程 public class MQClientInstance { public boolean updateTopicRouteInfoFromNameServer(final String topic) { return updateTopicRouteInfoFromNameServer(topic, false, null); } public boolean updateTopicRouteInfoFromNameServer(final String topic, boolean isDefault, DefaultMQProducer defaultMQProducer) { try { if (this.lockNamesrv.tryLock(LOCK_TIMEOUT_MILLIS, TimeUnit.MILLISECONDS)) { try { TopicRouteData topicRouteData; if (isDefault && defaultMQProducer != null) { // 省略对应的代码 } else { // 1、负责查询指定的Topic对应的路由信息 topicRouteData = this.mQClientAPIImpl.getTopicRouteInfoFromNameServer(topic, 1000 * 3); } if (topicRouteData != null) { // 2、比较路由数据topicRouteData是否发生变更 TopicRouteData old = this.topicRouteTable.get(topic); boolean changed = topicRouteDataIsChange(old, topicRouteData); if (!changed) { changed = this.isNeedUpdateTopicRouteInfo(topic); } // 3、解析路由信息转化为生产者的路由信息和消费者的路由信息 if (changed) { TopicRouteData cloneTopicRouteData = topicRouteData.cloneTopicRouteData(); for (BrokerData bd : topicRouteData.getBrokerDatas()) { this.brokerAddrTable.put(bd.getBrokerName(), bd.getBrokerAddrs()); } // 生成生产者对应的Topic信息 { TopicPublishInfo publishInfo = topicRouteData2TopicPublishInfo(topic, topicRouteData); publishInfo.setHaveTopicRouterInfo(true); Iterator<Entry<String, MQProducerInner>> it = this.producerTable.entrySet().iterator(); while (it.hasNext()) { Entry<String, MQProducerInner> entry = it.next(); MQProducerInner impl = entry.getValue(); if (impl != null) { impl.updateTopicPublishInfo(topic, publishInfo); } } } // 保存到本地生产者路由表当中 this.topicRouteTable.put(topic, cloneTopicRouteData); return true; } } } finally { this.lockNamesrv.unlock(); } } else { } } catch (InterruptedException e) { } return false; } } 路由同步过程: 路由同步过程是消息生产者发送消息的前置条件,没有路由的同步就无法感知具体发往那个Broker节点。 路由同步主要负责查询指定的Topic对应的路由信息,比较路由数据topicRouteData是否发生变更,最终解析路由信息转化为生产者的路由信息和消费者的路由信息。 public class TopicRouteData extends RemotingSerializable { private String orderTopicConf; // 按照broker维度保存的Queue信息 private List<QueueData> queueDatas; // 按照broker维度保存的broker信息 private List<BrokerData> brokerDatas; private HashMap<String/* brokerAddr */, List<String>/* Filter Server */> filterServerTable; } public class QueueData implements Comparable<QueueData> { // broker的名称 private String brokerName; // 读队列大小 private int readQueueNums; // 写队列大小 private int writeQueueNums; // 读写权限 private int perm; private int topicSynFlag; } public class BrokerData implements Comparable<BrokerData> { // broker所属集群信息 private String cluster; // broker的名称 private String brokerName; // broker对应的ip地址信息 private HashMap<Long/* brokerId */, String/* broker address */> brokerAddrs; private final Random random = new Random(); } -------------------------------------------------------------------------------------------------- public class TopicPublishInfo { private boolean orderTopic = false; private boolean haveTopicRouterInfo = false; // 最细粒度的队列信息 private List<MessageQueue> messageQueueList = new ArrayList<MessageQueue>(); private volatile ThreadLocalIndex sendWhichQueue = new ThreadLocalIndex(); private TopicRouteData topicRouteData; } public class MessageQueue implements Comparable<MessageQueue>, Serializable { private static final long serialVersionUID = 6191200464116433425L; // Topic信息 private String topic; // 所属的brokerName信息 private String brokerName; // Topic下的队列信息Id private int queueId; } 路由解析过程: TopicRouteData核心变量QueueData保存每个Broker的队列信息,BrokerData保存Broker的地址信息。 TopicPublishInfo核心变量MessageQueue保存最细粒度的队列信息。 producer负责将从namesvr获取的TopicRouteData转化为producer本地的TopicPublishInfo。 public class MQClientInstance { public static TopicPublishInfo topicRouteData2TopicPublishInfo(final String topic, final TopicRouteData route) { TopicPublishInfo info = new TopicPublishInfo(); info.setTopicRouteData(route); if (route.getOrderTopicConf() != null && route.getOrderTopicConf().length() > 0) { // 省略相关代码 } else { List<QueueData> qds = route.getQueueDatas(); // 按照brokerName进行排序 Collections.sort(qds); // 遍历所有broker生成队列维度信息 for (QueueData qd : qds) { // 具备写能力的QueueData能够用于队列生成 if (PermName.isWriteable(qd.getPerm())) { // 遍历获得指定brokerData进行异常条件过滤 BrokerData brokerData = null; for (BrokerData bd : route.getBrokerDatas()) { if (bd.getBrokerName().equals(qd.getBrokerName())) { brokerData = bd; break; } } if (null == brokerData) { continue; } if (!brokerData.getBrokerAddrs().containsKey(MixAll.MASTER_ID)) { continue; } // 遍历QueueData的写队列的数量大小,生成MessageQueue保存指定TopicPublishInfo for (int i = 0; i < qd.getWriteQueueNums(); i++) { MessageQueue mq = new MessageQueue(topic, qd.getBrokerName(), i); info.getMessageQueueList().add(mq); } } } info.setOrderTopic(false); } return info; } } 路由生成过程: 路由生成过程主要是根据QueueData的BrokerName和writeQueueNums来生成MessageQueue 对象。 MessageQueue是消息发送过程中选择的最细粒度的可发送消息的队列。 { "TBW102": [{ "brokerName": "broker-a", "perm": 7, "readQueueNums": 8, "topicSynFlag": 0, "writeQueueNums": 8 }, { "brokerName": "broker-b", "perm": 7, "readQueueNums": 8, "topicSynFlag": 0, "writeQueueNums": 8 }] } 路由解析举例: topic(TBW102)在broker-a和broker-b上存在队列信息,其中读写队列个数都为8。 先按照broker-a、broker-b的名字顺序针对broker信息进行排序。 针对broker-a会生成8个topic为TBW102的MessageQueue对象,queueId分别是0-7。 针对broker-b会生成8个topic为TBW102的MessageQueue对象,queueId分别是0-7。 topic(名为TBW102)的TopicPublishInfo整体包含16个MessageQueue对象,其中有8个broker-a的MessageQueue,有8个broker-b的MessageQueue。 消息发送过程中的路由选择就是从这16个MessageQueue对象当中获取一个进行消息发送。 3.2 负载均衡过程 public class DefaultMQProducerImpl implements MQProducerInner { private SendResult sendDefaultImpl( Message msg, final CommunicationMode communicationMode, final SendCallback sendCallback, final long timeout ) throws MQClientException, RemotingException, MQBrokerException, InterruptedException { // 1、查询消息发送的TopicPublishInfo信息 TopicPublishInfo topicPublishInfo = this.tryToFindTopicPublishInfo(msg.getTopic()); if (topicPublishInfo != null && topicPublishInfo.ok()) { String[] brokersSent = new String[timesTotal]; // 根据重试次数进行消息发送 for (; times < timesTotal; times++) { // 记录上次发送失败的brokerName String lastBrokerName = null == mq ? null : mq.getBrokerName(); // 2、从TopicPublishInfo获取发送消息的队列 MessageQueue mqSelected = this.selectOneMessageQueue(topicPublishInfo, lastBrokerName); if (mqSelected != null) { mq = mqSelected; brokersSent[times] = mq.getBrokerName(); try { // 3、执行发送并判断发送结果,如果发送失败根据重试次数选择消息队列进行重新发送 sendResult = this.sendKernelImpl(msg, mq, communicationMode, sendCallback, topicPublishInfo, timeout - costTime); switch (communicationMode) { case SYNC: if (sendResult.getSendStatus() != SendStatus.SEND_OK) { if (this.defaultMQProducer.isRetryAnotherBrokerWhenNotStoreOK()) { continue; } } return sendResult; default: break; } } catch (MQBrokerException e) { // 省略相关代码 } catch (InterruptedException e) { // 省略相关代码 } } else { break; } } if (sendResult != null) { return sendResult; } } } } 消息发送过程: 查询Topic对应的路由信息对象TopicPublishInfo。 从TopicPublishInfo中通过selectOneMessageQueue获取发送消息的队列,该队列代表具体落到具体的Broker的queue队列当中。 执行发送并判断发送结果,如果发送失败根据重试次数选择消息队列进行重新发送,重新选择队列会避开上一次发送失败的Broker的队列。 public class TopicPublishInfo { public MessageQueue selectOneMessageQueue(final String lastBrokerName) { if (lastBrokerName == null) { return selectOneMessageQueue(); } else { // 按照轮询进行选择发送的MessageQueue for (int i = 0; i < this.messageQueueList.size(); i++) { int index = this.sendWhichQueue.getAndIncrement(); int pos = Math.abs(index) % this.messageQueueList.size(); if (pos < 0) pos = 0; MessageQueue mq = this.messageQueueList.get(pos); // 避开上一次上一次发送失败的MessageQueue if (!mq.getBrokerName().equals(lastBrokerName)) { return mq; } } return selectOneMessageQueue(); } } } 路由选择过程: MessageQueue的选择按照轮询进行选择,通过全局维护索引进行累加取模选择发送队列。 MessageQueue的选择过程中会避开上一次发送失败Broker对应的MessageQueue。 Producer消息发送示意图: 某Topic的队列分布为Broker_A_Queue1、Broker_A_Queue2、Broker_B_Queue1、Broker_B_Queue2、Broker_C_Queue1、Broker_C_Queue2,根据轮询策略依次进行选择。 发送失败的场景下如Broker_A_Queue1发送失败那么就会跳过Broker_A选择Broker_B_Queue1进行发送。 四、consumer消息消费过程 consumer消息消费过程: consumer访问namesvr同步topic对应的路由信息。 consumer在本地解析远程路由信息并保存到本地。 consumer在本地进行Reblance负载均衡确定本节点负责消费的MessageQueue。 consumer访问Broker消费指定的MessageQueue的消息。 4.1 路由同步过程 public class MQClientInstance { // 1、启动定时任务从namesvr定时同步路由信息 private void startScheduledTask() { this.scheduledExecutorService.scheduleAtFixedRate(new Runnable() { @Override public void run() { try { MQClientInstance.this.updateTopicRouteInfoFromNameServer(); } catch (Exception e) { log.error("ScheduledTask updateTopicRouteInfoFromNameServer exception", e); } } }, 10, this.clientConfig.getPollNameServerInterval(), TimeUnit.MILLISECONDS); } public void updateTopicRouteInfoFromNameServer() { Set<String> topicList = new HashSet<String>(); // 遍历所有的consumer订阅的Topic并从namesvr获取路由信息 { Iterator<Entry<String, MQConsumerInner>> it = this.consumerTable.entrySet().iterator(); while (it.hasNext()) { Entry<String, MQConsumerInner> entry = it.next(); MQConsumerInner impl = entry.getValue(); if (impl != null) { Set<SubscriptionData> subList = impl.subscriptions(); if (subList != null) { for (SubscriptionData subData : subList) { topicList.add(subData.getTopic()); } } } } } for (String topic : topicList) { this.updateTopicRouteInfoFromNameServer(topic); } } public boolean updateTopicRouteInfoFromNameServer(final String topic, boolean isDefault, DefaultMQProducer defaultMQProducer) { try { if (this.lockNamesrv.tryLock(LOCK_TIMEOUT_MILLIS, TimeUnit.MILLISECONDS)) { try { TopicRouteData topicRouteData; if (isDefault && defaultMQProducer != null) { // 省略代码 } else { topicRouteData = this.mQClientAPIImpl.getTopicRouteInfoFromNameServer(topic, 1000 * 3); } if (topicRouteData != null) { TopicRouteData old = this.topicRouteTable.get(topic); boolean changed = topicRouteDataIsChange(old, topicRouteData); if (!changed) { changed = this.isNeedUpdateTopicRouteInfo(topic); } if (changed) { TopicRouteData cloneTopicRouteData = topicRouteData.cloneTopicRouteData(); for (BrokerData bd : topicRouteData.getBrokerDatas()) { this.brokerAddrTable.put(bd.getBrokerName(), bd.getBrokerAddrs()); } // 构建consumer侧的路由信息 { Set<MessageQueue> subscribeInfo = topicRouteData2TopicSubscribeInfo(topic, topicRouteData); Iterator<Entry<String, MQConsumerInner>> it = this.consumerTable.entrySet().iterator(); while (it.hasNext()) { Entry<String, MQConsumerInner> entry = it.next(); MQConsumerInner impl = entry.getValue(); if (impl != null) { impl.updateTopicSubscribeInfo(topic, subscribeInfo); } } } this.topicRouteTable.put(topic, cloneTopicRouteData); return true; } } } finally { this.lockNamesrv.unlock(); } } } catch (InterruptedException e) { } return false; } } 路由同步过程: 路由同步过程是消息消费者消费消息的前置条件,没有路由的同步就无法感知具体待消费的消息的Broker节点。 consumer节点通过定时任务定期从namesvr同步该消费节点订阅的topic的路由信息。 consumer通过updateTopicSubscribeInfo将同步的路由信息构建成本地的路由信息并用以后续的负责均衡。 4.2 负载均衡过程 public class RebalanceService extends ServiceThread { private static long waitInterval = Long.parseLong(System.getProperty( "rocketmq.client.rebalance.waitInterval", "20000")); private final MQClientInstance mqClientFactory; public RebalanceService(MQClientInstance mqClientFactory) { this.mqClientFactory = mqClientFactory; } @Override public void run() { while (!this.isStopped()) { this.waitForRunning(waitInterval); this.mqClientFactory.doRebalance(); } } } 负载均衡过程: consumer通过RebalanceService来定期进行重新负载均衡。 RebalanceService的核心在于完成MessageQueue和consumer的分配关系。 public abstract class RebalanceImpl { private void rebalanceByTopic(final String topic, final boolean isOrder) { switch (messageModel) { case BROADCASTING: { // 省略相关代码 break; } case CLUSTERING: { // 集群模式下的负载均衡 // 1、获取topic下所有的MessageQueue Set<MessageQueue> mqSet = this.topicSubscribeInfoTable.get(topic); // 2、获取topic下该consumerGroup下所有的consumer对象 List<String> cidAll = this.mQClientFactory.findConsumerIdList(topic, consumerGroup); // 3、开始重新分配进行rebalance if (mqSet != null && cidAll != null) { List<MessageQueue> mqAll = new ArrayList<MessageQueue>(); mqAll.addAll(mqSet); Collections.sort(mqAll); Collections.sort(cidAll); AllocateMessageQueueStrategy strategy = this.allocateMessageQueueStrategy; List<MessageQueue> allocateResult = null; try { // 4、通过分配策略重新进行分配 allocateResult = strategy.allocate( this.consumerGroup, this.mQClientFactory.getClientId(), mqAll, cidAll); } catch (Throwable e) { return; } Set<MessageQueue> allocateResultSet = new HashSet<MessageQueue>(); if (allocateResult != null) { allocateResultSet.addAll(allocateResult); } // 5、根据分配结果执行真正的rebalance动作 boolean changed = this.updateProcessQueueTableInRebalance(topic, allocateResultSet, isOrder); if (changed) { this.messageQueueChanged(topic, mqSet, allocateResultSet); } } break; } default: break; } } 重新分配流程: 获取topic下所有的MessageQueue。 获取topic下该consumerGroup下所有的consumer的cid(如192.168.0.8@15958)。 针对mqAll和cidAll进行排序,mqAll排序顺序按照先BrokerName后BrokerId,cidAll排序按照字符串排序。 通过分配策略 AllocateMessageQueueStrategy重新分配。 根据分配结果执行真正的rebalance动作。 public class AllocateMessageQueueAveragely implements AllocateMessageQueueStrategy { private final InternalLogger log = ClientLogger.getLog(); @Override public List<MessageQueue> allocate(String consumerGroup, String currentCID, List<MessageQueue> mqAll, List<String> cidAll) { List<MessageQueue> result = new ArrayList<MessageQueue>(); // 核心逻辑计算开始 // 计算当前cid的下标 int index = cidAll.indexOf(currentCID); // 计算多余的模值 int mod = mqAll.size() % cidAll.size(); // 计算平均大小 int averageSize = mqAll.size() <= cidAll.size() ? 1 : (mod > 0 && index < mod ? mqAll.size() / cidAll.size() + 1 : mqAll.size() / cidAll.size()); // 计算起始下标 int startIndex = (mod > 0 && index < mod) ? index * averageSize : index * averageSize + mod; // 计算范围大小 int range = Math.min(averageSize, mqAll.size() - startIndex); // 组装结果 for (int i = 0; i < range; i++) { result.add(mqAll.get((startIndex + i) % mqAll.size())); } return result; } // 核心逻辑计算结束 @Override public String getName() { return "AVG"; } } ------------------------------------------------------------------------------------ rocketMq的集群存在3个broker,分别是broker_a、broker_b、broker_c。 rocketMq上存在名为topic_demo的topic,writeQueue写队列数量为3,分布在3个broker。 排序后的mqAll的大小为9,依次为 [broker_a_0 broker_a_1 broker_a_2 broker_b_0 broker_b_1 broker_b_2 broker_c_0 broker_c_1 broker_c_2] rocketMq存在包含4个consumer的consumer_group,排序后cidAll依次为 [192.168.0.6@15956 192.168.0.7@15957 192.168.0.8@15958 192.168.0.9@15959] 192.168.0.6@15956 的分配MessageQueue结算过程 index:0 mod:9%4=1 averageSize:9 / 4 + 1 = 3 startIndex:0 range:3 messageQueue:[broker_a_0、broker_a_1、broker_a_2] 192.168.0.6@15957 的分配MessageQueue结算过程 index:1 mod:9%4=1 averageSize:9 / 4 = 2 startIndex:3 range:2 messageQueue:[broker_b_0、broker_b_1] 192.168.0.6@15958 的分配MessageQueue结算过程 index:2 mod:9%4=1 averageSize:9 / 4 = 2 startIndex:5 range:2 messageQueue:[broker_b_2、broker_c_0] 192.168.0.6@15959 的分配MessageQueue结算过程 index:3 mod:9%4=1 averageSize:9 / 4 = 2 startIndex:7 range:2 messageQueue:[broker_c_1、broker_c_2] 分配策略分析: 整体分配策略可以参考上图的具体例子,可以更好的理解分配的逻辑。 consumer的分配: 同一个consumerGroup下的consumer对象会分配到同一个Topic下不同的MessageQueue。 每个MessageQueue最终会分配到具体的consumer当中。 五、RocketMQ指定机器消费设计思路 日常测试环境当中会存在多台consumer进行消费,但实际开发当中某台consumer新上了功能后希望消息只由该机器进行消费进行逻辑覆盖,这个时候consumerGroup的集群模式就会给我们造成困扰,因为消费负载均衡的原因不确定消息具体由那台consumer进行消费。当然我们可以通过介入consumer的负载均衡机制来实现指定机器消费。 public class AllocateMessageQueueAveragely implements AllocateMessageQueueStrategy { private final InternalLogger log = ClientLogger.getLog(); @Override public List<MessageQueue> allocate(String consumerGroup, String currentCID, List<MessageQueue> mqAll, List<String> cidAll) { List<MessageQueue> result = new ArrayList<MessageQueue>(); // 通过改写这部分逻辑,增加判断是否是指定IP的机器,如果不是直接返回空列表表示该机器不负责消费 if (!cidAll.contains(currentCID)) { return result; } int index = cidAll.indexOf(currentCID); int mod = mqAll.size() % cidAll.size(); int averageSize = mqAll.size() <= cidAll.size() ? 1 : (mod > 0 && index < mod ? mqAll.size() / cidAll.size() + 1 : mqAll.size() / cidAll.size()); int startIndex = (mod > 0 && index < mod) ? index * averageSize : index * averageSize + mod; int range = Math.min(averageSize, mqAll.size() - startIndex); for (int i = 0; i < range; i++) { result.add(mqAll.get((startIndex + i) % mqAll.size())); } return result; } } consumer负载均衡策略改写: 通过改写负载均衡策略AllocateMessageQueueAveragely的allocate机制保证只有指定IP的机器能够进行消费。 通过IP进行判断是基于RocketMQ的cid格式是192.168.0.6@15956,其中前面的IP地址就是对于的消费机器的ip地址,整个方案可行且可以实际落地。 六、小结 本文主要介绍了RocketMQ在生产和消费过程中的负载均衡机制,结合源码和实际案例力求给读者一个易于理解的技术普及,希望能对读者有参考和借鉴价值。囿于文章篇幅,有些方面未涉及,也有很多技术细节未详细阐述,如有疑问欢迎继续交流。 作者:vivo互联网服务器团队-Wang Zhi

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册