首页 文章 精选 留言 我的

精选列表

搜索[赛博朋克],共10000篇文章
优秀的个人博客,低调大师

每日一博 | 使用 Kotlin Flow 构建数据流

Flow 是一种基于流的编程模型,本文我们将向大家介绍响应式编程以及其在 Android 开发中的实践,您将了解到如何将生命周期、旋转及切换到后台等状态绑定到 Flow 中,并且测试它们是否能按照预期执行。 如果您更喜欢通过视频了解此内容,请 点击此处 查看。 单向数据流 △ 加载数据流的过程 每款 Android 应用都需要以某种方式收发数据,比如从数据库获取用户名、从服务器加载文档,以及对用户进行身份验证等。接下来,我们将介绍如何将数据加载到 Flow,然后经过转换后暴露给视图进行展示。 为了大家更方便地理解 Flow,我们以 Pancho (潘乔) 的故事来展开。当住在山上的 Pancho 想从湖中获取淡水时,会像大多数新手一开始一样,拿个水桶走到湖边取水,然后再走回来。 △ 山上的 Pancho 但有时 Pahcho 不走运,走到湖边时发现湖水已经干涸,于是就不得不再去别处寻找水源。发生了几次这种情况后,Pancho 意识到,搭建一些基础设施可以解决这个问题。于是他在湖边安装了一些管道,当湖中有水时,只用拧开水龙头就能取到水。知道了如何安装管道,就能很自然地想到从多个水源地把管道组合,这样一来 Pancho 就不必再检查湖水是否已经干涸。 △ 铺设管道 在 Android 应用中您可以简单地在每次需要时请求数据,例如我们可以使用挂起函数来实现在每次视图启动时向 ViewModel 请求数据,而后 ViewModel 又向数据层请求数据,接下来这一切又在相反的方向上发生。不过这样过了一段时间之后,像 Pancho 这样的开发者们往往会想到,其实有必要投入一些成本来构建一些基础设施,我们就可以不再请求数据而改为观察数据。观察数据就像安装取水管道一样,部署完成后对数据源的任何更新都将自动向下流动到视图中,Pancho 再也不用走到湖边去了。 △ 传统的请求数据与单向数据流 响应式编程 我们将这类观察者会自动对被观察者对象的变化而作出反应的系统称之为响应式编程,它的另一个设计要点是保持数据只在一个方向上流动,因为这样更容易管理且不易出错。 某个示例应用界面的 "数据流动" 如下图所示,身份认证管理器会告诉数据库用户已登录,而数据库又必须告诉远程数据源来加载一组不同的数据;与此同时这些操作在获取新数据时都会告诉视图显示一个转圈的加载图标。对此我想说这虽然是可行的,但容易出现错误。 △ 错综复杂的 "数据流动" 更好的方式则是让数据只在一个方向上流动,并创建一些基础设施 (像 Pancho 铺设管道那样) 来组合和转换这些数据流,这些管道可以随着状态的变化而修改,比如在用户退出登录时重新安装管道。 △ 单向数据绑定 使用 Flow 可以想象对于这些组合和转换来说,我们需要一个成熟的工具来完成这些操作。在本文中我们将使用 Kotlin Flow 来实现。Flow 并不是唯一的数据流构建器,不过得益于它是协程的一部分并且得到了很好的支持。我们刚才一直用作比喻的水流,在协程库里称之为 Flow 类型,我们用泛形 T 来指代数据流承载的用户数据或者页面状态等任何类型。 △ 生产者和消费者 生产者会将数据 emit (发送) 到数据流中,而消费者则从数据流中 collect (收集) 这些数据。在 Android 中数据源或存储区通常是应用数据的生产者;消费者则是视图,它会把数据显示在屏幕上。 大多数情况下您都无需自行创建数据流,因为数据源中依赖的库,例如 DataStore、Retrofit、Room 或 WorkManager 等常见的库都已经与协程及 Flow 集成在一起了。这些库就像是水坝,它们使用 Flow 来提供数据,您无需了解数据是如何生成的,只需 "接入管道" 即可。 △ 提供 Flow 支持的库 我们来看一个 Room 的例子。您可以通过导出指定类型的数据流来获取数据库中发生变更的通知。在本例中,Room 库是生产者,它会在每次查询后发现有更新时发送内容。 @DAO interface CodelabsDAO { @Query("SELECT * FROM codelabs") fun getAllCodelabs(): Flow<List<Codelab>> } 创建 Flow 如果您要自己创建数据流,有一些方案可供选择,比如数据流构建器。假设我们处于 UserMessagesDataSource 中,当您希望频繁地在应用内检查新消息时,可以将用户消息暴露为消息列表类型的数据流。我们使用数据流构建器来创建数据流,因为 Flow 是在协程上下文环境中运行的,它以挂起代码块作为参数,这也意味着它能够调用挂起函数,我们可以在代码块中使用 while(true)来循环执行我们的逻辑。 在示例代码中,我们首先从 API 获取消息,然后使用 emit 挂起函数将结果添加到 Flow 中,这将挂起协程直到收集器接收到数据项,最后我们将协程挂起一段时间。在 Flow 中,操作会在同一个协程中顺序执行,使用 while(true) 循环可以让 Flow 持续获取新消息直到观察者停止收集数据。传递给数据流构建器的挂起代码块通常被称为 "生产者代码块"。 class UserMessagesDataSource( private val messagesApi: MessagesApi, private val refreshIntervalMs: Long = 5000 ) { val latestMessages: Floa<List<Message>> = flow { white(true) { val userMessages = messagesApi.fetchLatestMessages() emit(userMessages) // 将结果发送给 Flow delay(refreshIntervalMs) // ⏰ 挂起一段时间 } } } 转换 Flow 在 Android 中,生产者和消费者之间的层可以使用中间运算符修改数据流来适应下一层的要求。 在本例中,我们将 latestMessages 流作为数据流的起点,则可以使用 map 运算符将数据转换为不同的类型,例如我们可以使用 map lambda 表达式将来自数据源的原始消息转换为 MessagesUiModel,这一操作可以更好地抽象当前层级,每个运算符都应根据其功能创建一个新的 Flow 来发送数据。我们还可以使用 filter 运算符过滤数据流来获得包含重要通知的数据流。而 catch 运算符则可以捕获上游数据流中发生的异常,上游数据流是指在生产者代码块和当前运算符之间调用的运算符产生的数据流,而在当前运算符之后生成的数据流则被称为下游数据流。catch 运算符还可以在有需要的时候再次抛出异常或者发送新值,我们在示例代码中可以看到其在捕获到 IllegalArgumentExceptions 时将其重新抛出,并且在发生其他异常时发送一个空列表: val importantUserMessages: Flow<MessageUiModel> = userMessageDataSource.latestMessages .map { userMessage -> userMessages.toUiModel() } .filter { messageUiModel -> messagesUiModel.containsImportantNotifications() } .catch { e -> analytics.log("Error loading reserved event") if (e is IllegalArgumentException) throw e else emit(emptyList()) } 收集 Flow 现在我们已经了解过如何生成和修改数据流,接下来了解一下如何收集数据流。收集数据流通常发生在视图层,因为这是我们想要在屏幕上显示数据的地方。 在本例中,我们希望列表中能够显示最新消息以便 Pancho 能够了解最新动态。我们可以使用终端运算符 collect 来监听数据流发送的所有值,collect 接收一个函数作为参数,每个新值都会调用该参数,并且由于它是一个挂起函数,因此需要在协程中执行。 userMessages.collect{messages-> listAdapter.submitList(messages) } 在 Flow 中使用终端运算符将按需创建数据流并开始发送值,而相反的是中间操作符只是设置了一个操作链,其会在数据被发送到数据流时延迟执行。每次对 userMessages 调用 collect 时都会创建一个新的数据流,其生产者代码块将根据自己的时间间隔开始刷新来自 API 的消息。在协程中我们将这种按需创建并且只有在被观察时才会发送数据的数据流称之为 冷流 (Cold Stream)。 在 Android 视图上收集数据流 在 Android 的视图中收集数据流要注意两点,第一是在后台运行时不应浪费资源,第二是配置变更。 安全收集 假设我们在 MessagesActivity 中,如果希望在屏幕上显示消息列表,则应该当界面没有显示在屏幕上时停止收集,就像是 Pancho 在刷牙或者睡觉时应该关上水龙头一样。我们有多种具有生命周期感知能力的方案,来实现当信息不在屏幕上展示就不从数据流中收集信息的功能,比如 androidx.lifecycle:lifecycle-runtime-ktx 包中的 Lifecycle.repeatOnLifecycle(state) 和 Flow<T>.flowWithLifecycle(lifecycle, state)。您还可以在 ViewModel 中使用 androidx.lifecycle:lifecycle-livedata-ktx 包里的 Flow<T>.asLiveData(): LiveData 将数据流转换为 LiveData,这样就可以像往常一样使用 LiveData 来实现这件事情。不过为了简单起见,这里推荐使用 repeatOnLifecycle 从界面层收集数据流。 repeatOnLifecycle 是一个接收 Lifecycle.State 作为参数的挂起函数,该 API 具有生命周期感知能力,所以能够在当生命周期进入响应状态时自动使用传递给它的代码块启动新的协程,并且在生命周期离开该状态时取消该协程。在上面的例子中,我们使用了 Activity 的 lifecycleScope 来启动协程,由于 repeatOnLifecycle 是挂起函数,所以它需要在协程中被调用。最佳实践是在生命周期初始化时调用该函数,就像上面的例子中我们在 Activity 的 onCreate 中调用一样: import androidx.lifecycle.repeatOnLifecycle class MessagesActivity : AppCompatActivity() { val viewModel: MessagesViewModel by viewModels() override fun onCreate(savedInstanceState: Bundle?) { lifecycleScope.launch { repeatOnLifecycle(Lifecycle.State.STARTED) viewModel.userMessages.collect { messages -> listAdapter.submitList(messages) } } // 协程将会在 lifecycle 进入 DESTROYED 后被恢复 } } } repeatOnLifecycle 的可重启行为充分考虑了界面的生命周期,不过需要注意的是,直到生命周期进入 DESTROYED,调用 repeatOnLifecycle 的协程都不会恢复执行,因此如果您需要从多个数据流中进行收集,则应在 repeatOnLifecycle 代码块内多次使用 launch 来创建协程: lifecycleScope.launch { repeatOnLifecycle(Lifecycle.State.STARTED) { launch { viewModel.userMessages.collect { … } } launch { otherFlow.collect { … } } } } 如果只需从一个数据流中进行收集,则可使用 flowWithLifecycle 来收集数据,它能够在生命周期进入目标状态时发送数据,并在离开目标状态时取消内部的生产者: lifecycleScope.launch { viewModel.userMessages .flowWithLifecycle(lifecycle, State.STARTED) .collect { messages -> listAdapter.submitList(messages) } } 为了能够直观地展示具体的运作过程,我们来探索一下此 Activity 的生命周期,首先是创建完成并向用户可见;接下来用户按下了主屏幕按钮将应用退到后台,此时 Activity 会收到 onStop 信号;当重新打开应用时又会调用 onStart。如果您调用 repeatOnLifecycle 并传入 STARTED 状态,界面就只会在屏幕上显示时收集数据流发出的信号,并且在应用转到后台时取消收集。 △ Activity 的生命周期 repeatOnLifecycle 和 flowWithLifecycle 是 lifecycle-runtime-ktx 库在 2.4.0 稳定版中新增的 API,在没有这些 API 之前您可能已经以其他方式从 Android 界面中收集数据流,例如像上面的代码一样直接从 lifecycleScope.launch 启动的协程中收集,虽然这样看起来也能工作但不一定安全,因为这种方式将持续从数据流中收集数据并更新界面元素,即便是应用退出到后台时也一样。如果使用 launchWhenStarted 替代它的话,情况会稍微好一些,因为它会在处于后台时将收集挂起。但这样会在让数据流生产者保持活跃状态,有可能会在后台持续发出不需要在屏幕上显示的数据项,从而将内存占满。由于界面并不知道数据流生产者的实现方式,所以最好谨慎一些,使用 repeatOnLifecycle 或 flowWithLifecycle 来避免界面在处于后台时收集数据或保持数据流生产者处于活跃状态。 下面是一段不安全的使用方式示例: class MessagesActivity : AppCompatActivity() { val viewModel: MessagesViewModel by viewModels() override fun onCreate(savedInstanceState: Bundle?) { // ❌ 危险的操作 lifecycleScope.launch { viewModel.userMessage.collect { messages -> listAdapter.submitList(messages) } } // ❌ 危险的操作 LifecycleCoroutineScope.launchWhenX { flow.collect { … } } } } 配置变更 当您向视图暴露数据流时,必须要考虑到您正在尝试在具有不同生命周期的两个元素之间传递数据,并不是所有生命周期都会出现问题,但在 Activity 和 Fragment 的生命周期里会比较棘手。当设备旋转或者接收到配置变更时,所有的 Activity 都可能会重启但 ViewModel 却能被保留,因此您不能把任意数据流都简单地从 ViewModel 中暴露出来。 △ 旋转屏幕会重建 Activity 但能够保留 ViewModel 以如下代码中的冷流为例,由于每次收集冷流时它都会重启,所以在设备旋转之后会再次调用 repository.fetchItem()。我们需要某种缓冲区机制来保障无论重新收集多少次都可以保持数据,并在多个收集器之间共享数据,而 StateFlow 正是为了此用途而设计的。在我们的湖泊比喻中,StateFlow 就好比水箱,即使没有收集器它也能持有数据。因为它可以多次被收集,所以能够放心地将其与 Activity 或 Fragment 一起使用。 val result: Flow<Result<UiState>> = flow { emit(repository.fetchItem()) } 您可以使用 StateFlow 的可变版本,并随时根据需要在协程中更新它的值,但这样做可能不太符合响应式编程的风格,如下代码所示: private val _myUiState = MutableStateFlow<MyUiState>() val myUiState: StateFlow<MyUiState> = _myUiState init { viewModelScope.launch { _muUiState.value = Result.Loading _myUiState.value = repository.fetchStuff() } } Pancho 会建议您将各种类型的数据流都转换为 StateFlow 来改进这个问题,这样 StateFlow 将接收来自上游数据流的所有更新并存储最新的值,并且收集器的数量可以是 0 至任意多个,因此非常适合与 ViewModel 一起使用。当然,除此之外还有一些其他类型的 Flow,但推荐您使用 StateFlow,因为我们可以对它进行非常精确的优化。 △ 将任意数据流转换为 StateFlow 要将数据流转换为 StateFlow 可以使用 stateIn 运算符,它需要传入三个参数: initinalValue、scope 及 started。其中 initialValue 是因为 StateFlow 必须有值;而协程 scope 则是用于控制何时开始共享,在上面的例子中我们使用了 viewModelScope;最后的 started 是个有趣的参数,我们后面会聊到 WhileSubscribed(5000) 的作用,先看这部分的代码: val result: StateFlow<Result<UiState>> = someFlow .stateIn( initialValue = Result.Loading scope = viewModelScope, started = WhileSubscribed(5000), ) 我们来看看这两个场景: 第一种场景是旋转,在该场景中 Activity (也就是数据流收集器) 在短时间内被销毁然后重建;第二个场景是回到主屏幕,这将会使我们的应用进入后台。在旋转场景中我们不希望重启任何数据流以便尽可能快地完成过渡,而在回到主屏幕的场景中我们则希望停止所有数据流以便节省电量和其他资源。 我们可以通过设置超时时间来正确判断不同的场景,当停止收集 StateFlow时,不会立即停止所有上游数据流,而是会等待一段时间,如果在超时前再次收集数据则不会取消上游数据流,这就是 WhileSubscribed(5000) 的作用。当设置了超时时间后,如果按下主屏幕按钮会让视图立即结束收集,但 StateFlow 会经过我们设置的超时时间之后才会停止其上游数据流,如果用户再次打开应用则会自动重启上游数据流。而在旋转场景中视图只停止了很短的时间,无论如何都不会超过 5 秒钟,因此 StateFlow 并不会重启,所有的上游数据流都将会保持在活跃状态,就像什么都没有发生一样可以做到即时向用户呈现旋转后的屏幕。 △ 设置超时时间来应对不同的场景 总的来说,建议您使用 StateFlow 来通过 ViewModel 暴露数据流,或者使用 asLiveData 来实现同样的目的,关于 StateFlow 或其父类 SharedFlow 的更多详细信息,请参阅: StateFlow 和 SharedFlow。 测试数据流 测试数据流可能会比较复杂,因为要处理的对象是流式数据,这里介绍在两个不同的场景中有用的小技巧: 首先是第一个场景,被测单元依赖了数据流,那对此类场景进行测试最简单的方法就是用模拟生产者替代依赖项。在本例中,您可以对这个模拟源进行编程以对不同的测试用例发送其所需要的内容。您可以像上面的例子一样实现一个简单的冷流,测试本身会对受测对象的输出进行断言,输出的内容可以是数据流或其他任何类型。 △ 被测单元依赖数据流的测试技巧 模拟被测单元所依赖的数据流: class MyFakeRepository : MyRepository { fun observeCount() = flow { emit(ITEM_1) } } 如果受测单元暴露一个数据流,并且您希望验证该值或一系列值,那么您可以通过多种方式收集它们。您可以对数据流调用 first() 方法以进行收集并在接收到第一个数据项后停止收集。您还可以调用 take(5) 并使用 toList 终端操作符来收集恰好 5 条消息,这种方法可能非常有帮助。 △ 测试数据流的技巧 测试数据流: @Test fun myTest() = runBlocking { // 收集第一个数据然后停止收集 val firstItem = repository.counter.first() // 收集恰好 5 条消息 val first = repository.messages.take(5).toList() } 回顾 感谢阅读本文,希望您通过本文内容已经了解到为什么响应式架构值得投资,以及如何使用 Kotlin Flow 构建您的基础设施。文末提供了有关这方面的资料,包括涵盖基础知识的指南以及深入探讨某些主题的文章。另外您还可以通过 Google I/O 应用了解这些内容的详细信息,我们在早些时候为其更新了很多有关数据流的内容。 指南: Android 上的 Kotlin 数据流 使用更为安全的方式收集 Android UI 数据流 从 LiveData 迁移到 Kotlin 数据流 Flow 操作符 shareIn 和 stateIn 使用须知 设计 repeatOnLifecycle API 背后的故事 示例代码: Google I/O 应用 欢迎您 点击这里 向我们提交反馈,或分享您喜欢的内容、发现的问题。您的反馈对我们非常重要,感谢您的支持!
优秀的个人博客,低调大师

每日一博 | Golang 常见设计模式之装饰模式

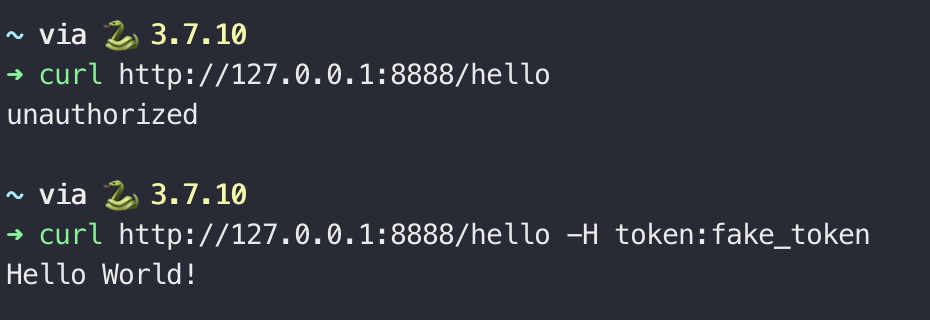
想必只要是熟悉 Python 的同学对装饰模式一定不会陌生,这类 Python 从语法上原生支持的装饰器,大大提高了装饰模式在 Python 中的应用。尽管 Go 语言中装饰模式没有 Python 中应用的那么广泛,但是它也有其独到的地方。接下来就一起看下装饰模式在 Go 语言中的应用。 ## 简单装饰器 我们通过一个简单的例子来看一下装饰器的简单应用,首先编写一个 hello 函数: package main import "fmt" func hello() { fmt.Println("Hello World!") } func main() { hello() } 完成上面代码后,执行会输出“Hello World!”。接下来通过以下方式,在打印“Hello World!”前后各加一行日志: package main import "fmt" func hello() { fmt.Println("before") fmt.Println("Hello World!") fmt.Println("after") } func main() { hello() } 代码执行后输出: before Hello World! after 当然我们可以选择一个更好的实现方式,即单独编写一个专门用来打印日志的 logger 函数,示例如下: package main import "fmt" func logger(f func()) func() { return func() { fmt.Println("before") f() fmt.Println("after") } } func hello() { fmt.Println("Hello World!") } func main() { hello := logger(hello) hello() } 可以看到 logger 函数接收并返回了一个函数,且参数和返回值的函数签名同 hello 一样。然后我们在原来调用 hello() 的位置进行如下修改: hello := logger(hello) hello() 这样我们通过 logger 函数对 hello 函数的包装,更加优雅的实现了给 hello 函数增加日志的功能。执行后的打印结果仍为: before Hello World! after 其实 logger 函数也就是我们在 Python 中经常使用的装饰器,因为 logger 函数不仅可以用于 hello,还可以用于其他任何与 hello 函数有着同样签名的函数。 当然如果想使用 Python 中装饰器的写法,我们可以这样做: package main import "fmt" func logger(f func()) func() { return func() { fmt.Println("before") f() fmt.Println("after") } } // 给 hello 函数打上 logger 装饰器 @logger func hello() { fmt.Println("Hello World!") } func main() { // hello 函数调用方式不变 hello() } 但很遗憾,上面的程序无法通过编译。因为 Go 语言目前还没有像 Python 语言一样从语法层面提供对装饰器语法糖的支持。 装饰器实现中间件 尽管 Go 语言中装饰器的写法不如 Python 语言精简,但它被广泛运用于 Web 开发场景的中间件组件中。比如 Gin Web 框架的如下代码,只要使用过就肯定会觉得熟悉: package main import "github.com/gin-gonic/gin" func main() { r := gin.New() // 使用中间件 r.Use(gin.Logger(), gin.Recovery()) r.GET("/ping", func(c *gin.Context) { c.JSON(200, gin.H{ "message": "pong", }) }) _ = r.Run(":8888") } 如示例中使用 gin.Logger() 增加日志,使用 gin.Recovery() 来处理 panic 异常一样,在 Gin 框架中可以通过 r.Use(middlewares...) 的方式给路由增加非常多的中间件,来方便我们拦截路由处理函数,并在其前后分别做一些处理逻辑。 而 Gin 框架的中间件正是使用装饰模式来实现的。下面我们借用 Go 语言自带的 http 库进行一个简单模拟。这是一个简单的 Web Server 程序,其监听 8888 端口,当访问 /hello 路由时会进入 handleHello 函数逻辑: package main import ( "fmt" "net/http" ) func loggerMiddleware(f http.HandlerFunc) http.HandlerFunc { return func(w http.ResponseWriter, r *http.Request) { fmt.Println("before") f(w, r) fmt.Println("after") } } func authMiddleware(f http.HandlerFunc) http.HandlerFunc { return func(w http.ResponseWriter, r *http.Request) { if token := r.Header.Get("token"); token != "fake_token" { _, _ = w.Write([]byte("unauthorized\n")) return } f(w, r) } } func handleHello(w http.ResponseWriter, r *http.Request) { fmt.Println("handle hello") _, _ = w.Write([]byte("Hello World!\n")) } func main() { http.HandleFunc("/hello", authMiddleware(loggerMiddleware(handleHello))) fmt.Println(http.ListenAndServe(":8888", nil)) } 我们分别使用 loggerMiddleware、authMiddleware 函数对 handleHello 进行了包装,使其支持打印访问日志和认证校验功能。如果我们还需要加入其他中间件拦截功能,可以通过这种方式进行无限包装。 启动这个 Server 来验证下装饰器: 对结果进行简单分析可以看到,第一次请求 /hello 接口时,由于没有携带认证 token,收到了 unauthorized 响应。第二次请求时携带了 token,则得到响应“Hello World!”,并且后台程序打印如下日志: before handle hello after 这说明中间件执行顺序是先由外向内进入,再由内向外返回。而这种一层一层包装处理逻辑的模型有一个非常形象且贴切的名字,洋葱模型。 但用洋葱模型实现的中间件有一个直观的问题。相比于 Gin 框架的中间件写法,这种一层层包裹函数的写法不如 Gin 框架提供的 r.Use(middlewares...) 写法直观。 Gin 框架源码的中间件和 handler 处理函数实际上被一起聚合到了路由节点的 handlers 属性中。其中 handlers 属性是 HandlerFunc 类型切片。对应到用 http 标准库实现的 Web Server 中,就是满足 func(ResponseWriter, *Request) 类型的 handler 切片。 当路由接口被调用时,Gin 框架就会像流水线一样依次调用执行 handlers 切片中的所有函数,再依次返回。这种思想也有一个形象的名字,就叫作流水线(Pipeline)。 接下来我们要做的就是将 handleHello 和两个中间件 loggerMiddleware、authMiddleware 聚合到一起,同样形成一个 Pipeline。 package main import ( "fmt" "net/http" ) func authMiddleware(f http.HandlerFunc) http.HandlerFunc { return func(w http.ResponseWriter, r *http.Request) { if token := r.Header.Get("token"); token != "fake_token" { _, _ = w.Write([]byte("unauthorized\n")) return } f(w, r) } } func loggerMiddleware(f http.HandlerFunc) http.HandlerFunc { return func(w http.ResponseWriter, r *http.Request) { fmt.Println("before") f(w, r) fmt.Println("after") } } type handler func(http.HandlerFunc) http.HandlerFunc // 聚合 handler 和 middleware func pipelineHandlers(h http.HandlerFunc, hs ...handler) http.HandlerFunc { for i := range hs { h = hs[i](h) } return h } func handleHello(w http.ResponseWriter, r *http.Request) { fmt.Println("handle hello") _, _ = w.Write([]byte("Hello World!\n")) } func main() { http.HandleFunc("/hello", pipelineHandlers(handleHello, loggerMiddleware, authMiddleware)) fmt.Println(http.ListenAndServe(":8888", nil)) } 我们借用 pipelineHandlers 函数将 handler 和 middleware 聚合到一起,实现了让这个简单的 Web Server 中间件用法跟 Gin 框架用法相似的效果。 再次启动 Server 进行验证: 改造成功,跟之前使用洋葱模型写法的结果如出一辙。 总结 简单了解了 Go 语言中如何实现装饰模式后,我们通过一个 Web Server 程序中间件,学习了装饰模式在 Go 语言中的应用。 需要注意的是,尽管 Go 语言实现的装饰器有类型上的限制,不如 Python 装饰器那般通用。就像我们最终实现的 pipelineHandlers 不如 Gin 框架中间件强大,比如不能延迟调用,通过 c.Next() 控制中间件调用流等。但不能因为这样就放弃,因为 GO 语言装饰器依然有它的用武之地。 Go 语言是静态类型语言不像 Python 那般灵活,所以在实现上要多费一点力气。希望通过这个简单的示例,相信对大家深入学习 Gin 框架有所帮助。 推荐阅读 两招提升硬盘存储数据的写入效率 【程序员的实用工具推荐】 Mac 效率神器 Alfred

优秀的个人博客,低调大师

每日一博 | 消息复杂计算的抽象和简化

作者:蒋文豪(四点) 消息客户端计算的复杂性 在客户端的设计中,一般的分层会至少包含下层的数据服务层和上层的UI层,下层的数据模型主要由所在领域决定,相对独立、稳定,而UI则更多变,且会对多种数据进行组合。由于UI的相对多变性与模型的相对稳定性,在数据层和UI之间,就需要对数据进行若干的处理才能交给UI展示。 比较简单的情况比如将原始数据的时间戳转换为 PD 要求的字符串,如果涉及到对不同数据进行关联、分页加载、变更计算,这部分数据处理逻辑就会比较复杂。 消息作为富客户端,这部分逻辑非常复杂,加上状态的存在,可以说是消息客户端中最复杂的逻辑之一,这种复杂主要体现在这些维度: 本地部分数据:客户端只存部分消息数据,获取数据时本地数据不全需要再异步请求服务端,还需要支持上层指定请求策略,这使得接口无法采用 request-response的形式,必须使用流式接口,数据回调和结果回调的分离,以及多次数据回调,增加了处理逻辑的复杂度; 支持变更同步:除了主动拉取,会话消息数据需要支持变更的推送,且对于所有的变更,需要保证数据(包括缓存和UI展示)的一致性; 多个数据来源:由于历史的原因,消息的同一种数据(比如会话)存在多个来源,因此需要请求多次,将多次数据回调合并,处理错误,还要尽量保证加载速度。经过众多同学的努力,手淘和千牛中下掉了OpenIM、DT两个数据源,今天用户在手淘和千牛中看的会话和消息,依然有BC、CC、IMBA三个来源; 多种数据聚合:UI展示需要把会话、消息、Profile(头像昵称)、群、群成员信息以及其他业务数据进行聚合,把相关的多个不同数据按照不同的规则聚合在一起; 支持分页请求:总的数据量比较大,需要通过分页机制加载,除了标准的分页加载之外,还要支持定位到某条消息从中间开始加载,这就出现了双向分页加载,以及 进入和退出 中间加载时的状态转换和异常处理; 多条数据合并:由于业务的需要,消息之间存在更新和替换关系(比如同一条订单的物流状态更新),拉取的新数据要修改已存的消息状态数据,而非仅仅添加在头部或尾部,新的消息会导致已有消息的更新以及在数据结构中的位置变化; 数据结构复杂:消息存在列表、树两种UI形态,对应的状态也有两种形态,对于这些数据结构的变更计算逻辑比较复杂,对于树来说,还需要支持虚拟节点计算和结构动态变化。 这块逻辑在消息客户端涉及会话、消息、profile、群、群成员、关系等所有核心服务数据模型,总计大约25000行代码,占消息总代码的8%左右,是核心的数据处理。由于这些逻辑很容易耦合在一起,形成一些高维的逻辑,表现为大量的条件分支和递归嵌套,这种高维的逻辑很难写,也很难维护,并且占据了不少包大小,因此有必要对这些逻辑抽象和简化。 目标 在不同的模型、不同的接口和相似的逻辑之上再建立一层抽象,统一客户端的数据处理; 将高维的数据处理逻辑简化为一个更加清晰的处理模型,代码量下降60%; 实现数据处理的双端一致。 消息数据处理过程分析 通常会将客户端划分为数据服务层、逻辑层、UI层三层,这部分数据获取和计算会被归到逻辑层。这里的问题在于,数据服务层对应于领域定义,UI层对应于渲染、动画和交互事件处理,这样逻辑层很容易变成一个缝合怪,数据请求、数据转换、上下文维护、异步处理、递归逻辑、状态管理、变更同步,所有不属于另外两层的部分都会被扔到逻辑层,导致逻辑层的臃肿。 下图左侧是这个处理过程的工作内容和上下游,右侧为数据拉取和变更处理的数据流向和计算过程: 可以看到,将这部分数据处理仅仅定义为逻辑是过于宽泛的,不利于针对性的优化,因此有必要进行深入的分析和研究。 在对会话、消息、profile、群、群成员、关系6大核心数据处理链路进行归纳、分解、分析和综合之后,我们可以将数据处理过程简化为如下的过程: 请求每个通道的 会话\消息 数据,并将多次结果回调合并为一次结果回调,处理多次数据回调,请求会话\消息对应的Profile、群、群成员、关系数据、业务数据; 建立会话\消息 和Profile、群、群成员、关系数据、业务数据之间的 关联关系 ,生成聚合数据,并处理聚合数据之间的依赖、优先级和缓存一致性; 将数据转换为数组\树形结构,支持请求来的数据与数据结构中已存的数据进行替换、更新合并计算,支持树结构和虚拟节点的动态计算,支持UI局部更新; 响应各种数据的增删改等变更事件,根据事件处理计算变更和结果,保证数据的一致性; 在进入和退出中间加载时,处理各种数据缓存、关联关系、加载信息的正确性; 支持特殊逻辑,如实时新数据不按照时间排序,而是直接添加在头部或尾部; 中间每个逻辑的异常处理、超时机制、线程同步、上屏时间优化、日志、监控等逻辑。 我们可以将这些逻辑分为两类: 作为计算的逻辑 对应于上面的过程2、3、4、5、6。 如果我们将这块逻辑看做黑盒,关心它的输入输出和功能,可以得出这块逻辑的核心工作是将各种各样的输入数据转换为特定的输出数据,这完美的对应着计算的概念的结论,即: 基于计算的概念,可以将这段计算过程形式化地抽象为一个函数f,从而实现对状态计算的抽象,上图很直观的体现了入参为输入和当前状态,输出为新的状态和结果: f :: (Input, State1) -> (State2, Result) 来分析一下函数f的入出参和形式: 第一,这里的Input可以能是拉取回来的数据,也可以是增删改等数据变更,或者是消息已读等明确的事件。这里我们可以通过定义插入、更新、删除三个来统一所有的事件,因为所有的事件逻辑上都必定可以唯一的映射到这三个事件上(尽管实际上,由于部分服务不具备计算变更细节的能力,我们还支持了RemoveAll和Reload两个事件)。 第二,结合高阶函数,Input实际上已经决定了这个函数的形式,即对于一个数据插入事件,其对应的f必然为 \state -> insert someData into state 的形式,即 Input 已经包含在 f的实现中了,因此可以将函数 f 进一步简化为: f :: (State1) -> (State2, Result) 其中 f 的形式由输出的事件决定,这样就得到了一个非常简化的函数抽象。 第三,上面的分析还能得出一个推论,即事件和函数是等价的(可以互相转换),这使得我们可以通过处理事件来实现对函数的处理,从而可以通过数据的处理来优化计算的性能,可以看到,数据和过程边界的打破赋予我们更强的能力。 第四,对于 State 参数,需要包含聚合后的数据,因此需要处理数据的关联,一般的,我们可以将数据的关联场景抽象为 一个主数据对应多个附属数据 的形式,通过定义一个 pair 函数来进行关联关系的判断: pair :: (mainData, subData) -> Bool 这样就可以通过注入 pair 函数来实现主数据和附属数据的关联,然后将有关联关系的数据进行聚合。 第五,State还涉及数据\树形结构计算,这里在不同的场景是不一样的,可以抽象为一个 DataStructure ,定义增删改查接口,然后在不同的场景使用不同的 DataStructure。 作为结构化数据获取的逻辑 对应于上面的过程1、6。 这部分逻辑的作用是会话消息Profile等数据的获取和变更事件监听,由于6大服务的接口各不相同,之前的实现是一一对接。通过抽象之后,我们可以通过定义具备拉取接口和变更接口的Inject来实现这部分逻辑的抽象,这属于标准操作,不再赘述。 这部分数据获取的第二个特点是请求的平行分发和垂直组合,举例来说,有多个通道决定了数据请求时需要平行的请求每个通道,每个通道的请求则根据不同的请求策略和每一步的回调数据决定下一次请求(这里与标准的 Future/Promise 的区别在于,Future/Promise前后步骤的任务是不同的,后面的逻辑需要前面的数据,这里前后步骤的逻辑相同,可能上一步请求本地,下一次请求远端,因此可以比 Future/Promise 更简化)。 如果不进行抽象,这里是一个至少三维的逻辑,即对于多个通道的多个步骤进行主数据的获取,然后对获取的主数据再获取附属数据,逻辑会写的非常复杂。这里的关键在于每个通道的请求,每个步骤的请求都是非常相似的,主要是多次请求的结构不同,并且数据请求的结构由参数和数据决定,因此可以把它称为结构化数据获取,即这里可以通过对请求结构的抽象进行简化。 可以定义出结构化数据获取任务平行和垂直组合的核心函数: dispatch :: [param] -> [task] compose :: strategy -> task 其中 dispatch 函数对应于Rx中的 flatMap,不过由于手淘iOS没有集成 RxSwift 和 OpenCombine,官方的 Combine 框架要iOS13之上才能使用,因此只能自己实现一个轻量的。 这样通过 dispatch 和 compose 将任务进行结构化组合实现任务获取的抽象和简化。 技术方案 核心技术方案 核心模块: MergeDispatcher : 实现数据获取的结构化,并将数据和变更统一为变更,处理所有的异常; Calculator : 实现主数据和附属数据的关联和聚合,计算的多线程同步,变更上报; DataStructure : 进行主数据的结构计算。 此外,Inject为计算提供请求接口和变更事件,为所有数据的注入点,上层通过 ModelService 获取计算后有聚合数据构成的数据结构,以及变更事件。 调用关系与数据流向 ModelService会使用初始化DataStructure、CalCulator、主数据、附属数据的Inject,并用来初始化MergeDispatcher 当UI需要数据时,调用ModelService的load接口; ModelService直接调用MergeDispatcher的load接口; MergeDispatcher 平行调用主数据Inject的load接口,在每次回调主数据时,调用附属数据Inject的load接口请求附属数据,根据场景执行对应的超时逻辑,将主数据和附属数据给到Calculator进行计算,超时后的数据也继续给到Calculator进行计算; Calculator 执行计算的多线程同步,更新主数据、附属数据、关联关系的缓存,生成聚合数据,并将主数据给到DataStructure计算结构,然后将返回的全量和变更进行上报; 数据结构接收数据后,对当前状态(数据结构)执行增删改操作,并返回对应的新状态和变更数组。 技术效果 最终,我们实现了计算和数据获取的分离,计算过程全部在Calculator,数据获取主要在MergeDispatcher,两部分独立实现,不再耦合,将逻辑层次从原来的模型数量 * 接口数量 * 数据结构 降为 事件数量 * 数据结构,处理模型非常清晰,且适用于任意模型。 针对计算过程,逻辑上抽象出一个高阶计算函数 f :: (State1) -> (State2, Result),这个函数形式上非常简单,却紧紧抓住这种复杂状态计算的本质,让我们得以统一计算过程,整个计算过程的正确性有完备的理论基础,后续新增模型不会增加计算逻辑。 针对数据获取,我们将数据类型化为主数据和附属数据,并针对由请求的结构进行抽象,实现了所有的数据获取的统一和简化。 关注【阿里巴巴移动技术】微信公众号,每周 3 篇移动技术实践&干货给你思考!

优秀的个人博客,低调大师

每日一博 | Dubbo 服务如何优雅地校验参数

一、背景 服务端在向外提供接口服务时,不管是对前端提供HTTP接口,还是面向内部其他服务端提供的RPC接口,常常会面对这样一个问题,就是如何优雅的解决各种接口参数校验问题? 早期大家在做面向前端提供的HTTP接口时,对参数的校验可能都会经历这几个阶段:每个接口每个参数都写定制校验代码、提炼公共校验逻辑、自定义切面进行校验、通用标准的校验逻辑。 这边提到的通用标准的校验逻辑指的就是基于JSR303的Java Bean Validation,其中官方指定的具体实现就是 Hibernate Validator,在Web项目中结合Spring可以做到很优雅的去进行参数校验。 本文主要也是想给大家介绍下如何在使用Dubbo时做好优雅的参数校验。 二、解决方案 Dubbo框架本身是支持参数校验的,同时也是基于JSR303去实现的,我们来看下具体是怎么实现的。 2.1 maven依赖 <!-- 定义在facade接口模块的pom文件找那个 --> <dependency> <groupId>javax.validation</groupId> <artifactId>validation-api</artifactId> <version>2.0.1.Final</version> <!-- 如果不想facade包有多余的依赖,此处scope设为provided,否则可以删除 --> <scope>provided</scope> </dependency> <!-- 下面依赖通常加在Facade接口实现模块的pom文件中 --> <dependency> <groupId>org.hibernate.validator</groupId> <artifactId>hibernate-validator</artifactId> <version>6.2.0.Final</version> </dependency> 2.2 接口定义 facade接口定义: public interface UserFacade { FacadeResult<Boolean> updateUser(UpdateUserParam param); } 参数定义 public class UpdateUserParam implements Serializable { private static final long serialVersionUID = 2476922055212727973L; @NotNull(message = "用户标识不能为空") private Long id; @NotBlank(message = "用户名不能为空") private String name; @NotBlank(message = "用户手机号不能为空") @Size(min = 8, max = 16, message="电话号码长度介于8~16位") private String phone; // getter and setter ignored } 公共返回定义 /** * Facade接口统一返回结果 */ public class FacadeResult<T> implements Serializable { private static final long serialVersionUID = 8570359747128577687L; private int code; private T data; private String msg; // getter and setter ignored } 2.3 Dubbo服务提供者端配置 Dubbo服务提供者端必须作这个validation="true"的配置,具体示例配置如下: Dubbo接口服务端配置 <bean class="com.xxx.demo.UserFacadeImpl" id="userFacade"/> <dubbo:service interface="com.xxx.demo.UserFacade" ref="userFacade" validation="true" /> 2.4 Dubbo服务消费者端配置 这个根据业务方使用习惯不作强制要求,但建议配置上都加上validation="true",示例配置如下: <dubbo:reference id="userFacade" interface="com.xxx.demo.UserFacade" validation="true" /> 2.5 验证参数校验 前面几步完成以后,验证这一步就比较简单了,消费者调用该约定接口,接口入参传入UpdateUserParam对象,其中字段不用赋值,然后调用服务端接口就会得到如下的参数异常提示: Dubbo接口服务端配置 javax.validation.ValidationException: Failed to validate service: com.xxx.demo.UserFacade, method: updateUser, cause: [ConstraintViolationImpl{interpolatedMessage='用户名不能为空', propertyPath=name, rootBeanClass=class com.xxx.demo.UpdateUserParam, messageTemplate='用户名不能为空'}, ConstraintViolationImpl{interpolatedMessage='用户手机号不能为空', propertyPath=phone, rootBeanClass=class com.xxx.demo.UpdateUserParam, messageTemplate='用户手机号不能为空'}, ConstraintViolationImpl{interpolatedMessage='用户标识不能为空', propertyPath=id, rootBeanClass=class com.xxx.demo.UpdateUserParam, messageTemplate='用户标识不能为空'}] javax.validation.ValidationException: Failed to validate service: com.xxx.demo.UserFacade, method: updateUser, cause: [ConstraintViolationImpl{interpolatedMessage='用户名不能为空', propertyPath=name, rootBeanClass=class com.xxx.demo.UpdateUserParam, messageTemplate='用户名不能为空'}, ConstraintViolationImpl{interpolatedMessage='用户手机号不能为空', propertyPath=phone, rootBeanClass=class com.xxx.demo.UpdateUserParam, messageTemplate='用户手机号不能为空'}, ConstraintViolationImpl{interpolatedMessage='用户标识不能为空', propertyPath=id, rootBeanClass=class com.xxx.demo.UpdateUserParam, messageTemplate='用户标识不能为空'}] at org.apache.dubbo.validation.filter.ValidationFilter.invoke(ValidationFilter.java:96) at org.apache.dubbo.rpc.protocol.ProtocolFilterWrapper$1.invoke(ProtocolFilterWrapper.java:83) .... at org.apache.dubbo.remoting.exchange.support.header.HeaderExchangeHandler.received(HeaderExchangeHandler.java:175) at org.apache.dubbo.remoting.transport.DecodeHandler.received(DecodeHandler.java:51) at org.apache.dubbo.remoting.transport.dispatcher.ChannelEventRunnable.run(ChannelEventRunnable.java:57) at java.util.concurrent.ThreadPoolExecutor.runWorker(ThreadPoolExecutor.java:1149) at java.util.concurrent.ThreadPoolExecutor$Worker.run(ThreadPoolExecutor.java:624) at java.lang.Thread.run(Thread.java:748) 三、定制Dubbo参数校验异常返回 从前面内容我们可以很轻松的验证,当消费端调用Dubbo服务时,参数如果不合法就会抛出相关异常信息,消费端调用时也能识别出异常信息,似乎这样就没有问题了。 但从前面所定义的服务接口来看,一般业务开发会定义统一的返回对象格式(如前文示例中的FacadeResult),对于业务异常情况,会约定相关异常码并结合相关性信息提示。因此对于参数校验不合法的情况,服务调用方自然不希望服务端抛出一大段包含堆栈信息的异常信息,而是希望还保持这种统一的返回形式,就如下面这种返回所示: Dubbo接口服务端配置: { "code": 1001, "msg": "用户名不能为空", "data": null } 3.1 ValidationFilter & JValidator 想要做到返回格式的统一,我们先来看下前面所抛出的异常是如何来的? 从异常堆栈内容我们可以看出这个异常信息返回是由ValidationFilter抛出的,从名字我们可以猜到这个是采用Dubbo的Filter扩展机制的一个内置实现,当我们对Dubbo服务接口启用参数校验时(即前文Dubbo服务配置中的validation="true"),该Filter就会真正起作用,我们来看下其中的关键实现逻辑: @Override public Result invoke(Invoker<?> invoker, Invocation invocation) throws RpcException { if (validation != null && !invocation.getMethodName().startsWith("$") && ConfigUtils.isNotEmpty(invoker.getUrl().getMethodParameter(invocation.getMethodName(), VALIDATION_KEY))) { try { Validator validator = validation.getValidator(invoker.getUrl()); if (validator != null) { // 注1 validator.validate(invocation.getMethodName(), invocation.getParameterTypes(), invocation.getArguments()); } } catch (RpcException e) { throw e; } catch (ValidationException e) { // 注2 return AsyncRpcResult.newDefaultAsyncResult(new ValidationException(e.getMessage()), invocation); } catch (Throwable t) { return AsyncRpcResult.newDefaultAsyncResult(t, invocation); } } return invoker.invoke(invocation); } 从前文的异常堆栈信息我们可以知道异常信息是由上述代码「注2」处所产生,这边是因为捕获了ValidationException,通过走读代码或者调试可以得知,该异常是由「注1」处valiator.validate方法所产生。 而Validator接口在Dubbo框架中实现只有JValidator,这个通过idea工具显示Validator所有实现的UML类图可以看出(如下图所示),当然调试代码也可以很轻松定位到。 既然定位到JValidator了,我们就继续看下它里面validate方法的具体实现,关键代码如下所示: @Override public void validate(String methodName, Class<?>[] parameterTypes, Object[] arguments) throws Exception { List<Class<?>> groups = new ArrayList<>(); Class<?> methodClass = methodClass(methodName); if (methodClass != null) { groups.add(methodClass); } Set<ConstraintViolation<?>> violations = new HashSet<>(); Method method = clazz.getMethod(methodName, parameterTypes); Class<?>[] methodClasses; if (method.isAnnotationPresent(MethodValidated.class)){ methodClasses = method.getAnnotation(MethodValidated.class).value(); groups.addAll(Arrays.asList(methodClasses)); } groups.add(0, Default.class); groups.add(1, clazz); Class<?>[] classgroups = groups.toArray(new Class[groups.size()]); Object parameterBean = getMethodParameterBean(clazz, method, arguments); if (parameterBean != null) { // 注1 violations.addAll(validator.validate(parameterBean, classgroups )); } for (Object arg : arguments) { // 注2 validate(violations, arg, classgroups); } if (!violations.isEmpty()) { // 注3 logger.error("Failed to validate service: " + clazz.getName() + ", method: " + methodName + ", cause: " + violations); throw new ConstraintViolationException("Failed to validate service: " + clazz.getName() + ", method: " + methodName + ", cause: " + violations, violations); } } 从上述代码中可以看出当「注1」和注「2」两处代码进行参数校验时所得到的「违反约束」的信息都被加入到violations集合中,而在「注3」处检查到「违反约束」不为空时,就会抛出包含「违反约束」信息的ConstraintViolationException,该异常继承自ValidationException,这样也就会被ValidationFilter中方法所捕获,进而向调用方返回相关异常信息。 3.2 自定义参数校验异常返回 从前一小节我们可以很清晰的了解到了为什么会抛出那样的异常信息给调用方,如果想做到我们前面想要的诉求:统一返回格式,我们需要按照下面的步骤去实现。 3.2.1 自定义Filter @Activate(group = {CONSUMER, PROVIDER}, value = "customValidationFilter", order = 10000) public class CustomValidationFilter implements Filter { private Validation validation; public void setValidation(Validation validation) { this.validation = validation; } public Result invoke(Invoker<?> invoker, Invocation invocation) throws RpcException { if (validation != null && !invocation.getMethodName().startsWith("$") && ConfigUtils.isNotEmpty(invoker.getUrl().getMethodParameter(invocation.getMethodName(), VALIDATION_KEY))) { try { Validator validator = validation.getValidator(invoker.getUrl()); if (validator != null) { validator.validate(invocation.getMethodName(), invocation.getParameterTypes(), invocation.getArguments()); } } catch (RpcException e) { throw e; } catch (ConstraintViolationException e) {// 这边细化了异常类型 // 注1 Set<ConstraintViolation<?>> violations = e.getConstraintViolations(); if (CollectionUtils.isNotEmpty(violations)) { ConstraintViolation<?> violation = violations.iterator().next();// 取第一个进行提示就行了 FacadeResult facadeResult = FacadeResult.fail(ErrorCode.INVALID_PARAM.getCode(), violation.getMessage()); return AsyncRpcResult.newDefaultAsyncResult(facadeResult, invocation); } return AsyncRpcResult.newDefaultAsyncResult(new ValidationException(e.getMessage()), invocation); } catch (Throwable t) { return AsyncRpcResult.newDefaultAsyncResult(t, invocation); } } return invoker.invoke(invocation); } } 该自定义filter与内置的ValidationFilter唯一不同的地方就在于「注1」处所新增的针对特定异常ConstraintViolationException的处理,从异常对象中获取包含的「违反约束」信息,并取其中第一个来构造业务上所定义的通用数据格式FacadeResult对象,作为Dubbo服务接口调用返回的信息。 3.2.2 自定义Filter的配置 开发过Dubbo自定义filter的同学都知道,要让它生效需要作一个符合SPI规范的配置,如下所示: a. 新建两级目录分别是META-INF和dubbo,这个需要特别注意,不能直接新建一个目录名为「META-INFO.dubbo」,否则在初始化启动的时候会失败。 b. 新建一个文件名为com.alibaba.dubbo.rpc.Filter,当然也可以是org.apache.dubbo.rpc.Filter,Dubbo开源到Apache社区后,默认支持这两个名字。 c. 文件中配置内容为:customValidationFilter=com.xxx.demo.dubbo.filter.CustomValidationFilter。 3.3.3 Dubbo服务配置 有了自定义参数校验的Filter配置后,如果只做到这的话,其实还有一个问题,应用启动后会有两个参数校验Filter生效。当然可以通过指定Filter的order来实现自定义Filter先执行,但很显然这种方式不稳妥,而且两个Filter的功能是重复的,因此只需要一个生效就可以了,Dubbo提供了一种机制可以禁用指定的Filter,只需在Dubbo配置文件中作如下配置即可: <!-- 需要禁用的filter以"-"开头并加上filter名称 --> <!-- 查看源码,可看到需要禁用的ValidationFilter名为validation--> <dubbo:provider filter="-validation"/> 但经过上述配置后,发现customValidationFilter并没有生效,经过调试以及对dubbo相关文档的学习,对Filter生效机制有了一定的了解。 a. dubbo启动后,默认会生效框架自带的一系列Filter; 可以在dubbo框架的资源文件org.apache.dubbo.rpc.Filter中看到具体有哪些,不同版本的内容可能会有些许差别。 cache=org.apache.dubbo.cache.filter.CacheFilter validation=org.apache.dubbo.validation.filter.ValidationFilter // 注1 echo=org.apache.dubbo.rpc.filter.EchoFilter generic=org.apache.dubbo.rpc.filter.GenericFilter genericimpl=org.apache.dubbo.rpc.filter.GenericImplFilter token=org.apache.dubbo.rpc.filter.TokenFilter accesslog=org.apache.dubbo.rpc.filter.AccessLogFilter activelimit=org.apache.dubbo.rpc.filter.ActiveLimitFilter classloader=org.apache.dubbo.rpc.filter.ClassLoaderFilter context=org.apache.dubbo.rpc.filter.ContextFilter consumercontext=org.apache.dubbo.rpc.filter.ConsumerContextFilter exception=org.apache.dubbo.rpc.filter.ExceptionFilter executelimit=org.apache.dubbo.rpc.filter.ExecuteLimitFilter deprecated=org.apache.dubbo.rpc.filter.DeprecatedFilter compatible=org.apache.dubbo.rpc.filter.CompatibleFilter timeout=org.apache.dubbo.rpc.filter.TimeoutFilter tps=org.apache.dubbo.rpc.filter.TpsLimitFilter trace=org.apache.dubbo.rpc.protocol.dubbo.filter.TraceFilter future=org.apache.dubbo.rpc.protocol.dubbo.filter.FutureFilter monitor=org.apache.dubbo.monitor.support.MonitorFilter metrics=org.apache.dubbo.monitor.dubbo.MetricsFilter 如上「注1」中的Filter就是我们上一步配置中想要禁用的Filter,因为这些filter都是Dubbo内置的,所以这些filter集合有一个统一的名字,default,因此如果想全部禁用,除了一个一个禁用外,也可以直接用'-default'达到目的,这些默认内置的filter只要没有全部或单独禁用,那就会生效。 b. 想要开发的自定义Filter能生效,不并一定要在<dubbo:provider filter="xxxFitler" >中体现;如果我们没有在Dubbo相关的配置文件中去配置Filter相关信息,只要写好自定义filter代码,并在资源文件/META-INF/dubbo/com.alibaba.dubbo.rpc.Filter中按照spi规范定义好即可,这样所有被加载的Filter都会生效。 c. 如果在Dubbo配置文件中配置了Filter信息,那自定义Filter只有显式配置才会生效。 d. Filter配置也可以加在dubbo service配置中(<dubbo:service interface="..." ref="..." validation="true" filter="xFilter,yFilter"/>)。 当dubbo配置文件中provider 和service部分都配置了Filter信息,针对service具体生效的Filter取两者配置的并集。 因此想要自定义的校验Filter在所有服务中都生效,需要作如下配置: <dubbo:provider filter="-validation, customValidationFilter"/> 四、如何扩展校验注解 前面示例中都是利用参数校验的内置注解去完成,在实际开发中有时候会遇到默认内置的注解无法满足校验需求,这时就需要自定义一些校验注解去满足需求,方便开发。 假设有这样一个场景,某参数值需要校验只能在指定的几个数值范围内,类似于白名单一样,下面就以这个场景来演示下如何扩展校验注解。 4.1 定义校验注解 @Target({ METHOD, FIELD, ANNOTATION_TYPE, CONSTRUCTOR, PARAMETER }) @Retention(RUNTIME) @Documented @Constraint(validatedBy = { })// 注1 // @Constraint(validatedBy = {AllowedValueValidator.class}) 注2 public @interface AllowedValue { String message() default "参数值不在合法范围内"; Class<?>[] groups() default { }; Class<? extends Payload>[] payload() default { }; long[] value() default {}; } public class AllowedValueValidator implements ConstraintValidator<AllowedValue, Long> { private long[] allowedValues; @Override public void initialize(AllowedValue constraintAnnotation) { this.allowedValues = constraintAnnotation.value(); } @Override public boolean isValid(Long value, ConstraintValidatorContext context) { if (allowedValues.length == 0) { return true; } return Arrays.stream(allowedValues).anyMatch(o -> Objects.equals(o, value)); } } 「注1」中的校验器(Validator)并没有指定,当然是可以像「注2」中那样直接指定校验器,但考虑到自定义注解有可能是直接暴露在facade包中,而具体的校验器的实现有时候会包含一些业务依赖,所以不建议直接在此处指定,而是通过Hibernate Validator提供的Validator发现机制去完成关联。 4.2 配置定制Validator发现 a. 在resources目录下新建META-INF/services/javax.validation.ConstraintValidator文件。 b. 文件中只需填入相应Validator的全路径:com.xxx.demo.validator.AllowedValueValidator,如果有多个的话,每行一个。 五、总结 本文主要介绍了使用Dubbo框架时如何使用优雅点方式完成参数的校验,首先演示了如何利用Dubbo框架默认支持的校验实现,然后接着演示了如何配合实际业务开发返回统一的数据格式,最后介绍了下如何进行自定义校验注解的实现,方便进行后续自行扩展实现,希望能在实际工作中有一定的帮助。 作者:vivo官网商城开发团队-Wei Fuping

优秀的个人博客,低调大师

每日一博 | 二叉树解题思维

二叉树小科普 ⼆叉树是最多仅有两个子节点的树,根据节点的分布情况可分为: 平衡二叉树: 每个结点的左右子树的高度相差不能大于1 满二叉树: 除了最底层的叶节点,每个结点都有左右子树 完全二叉树: 深度(1~H-1)的结点数达到最大个数,深度H的结点都连续集中在最左边,比如堆 二叉搜索树:每个节点必须满足:节点值>=左子节点,<=右子节点,其中序遍历就是有序序列 1、二叉搜索树 n个元素的二叉搜索树,理想情况下,查找、插入的时间复杂度是O(logn),但在一直递增或递减的场景下进行插入,会导致所有的元素出现在树的左节点上,此时类似于链表结构,时间复杂度趋向于O(n),因此诞生了 平衡二叉搜索树(AVL):要求严格的平衡性控制,不会出现平衡因子超过1的情况 红黑树:查找、插⼊、删除操作在最坏情况下的时间复杂度不超过 O(logn),并且有较⾼的插⼊和删除效率 1.1、红黑树 红黑树是一种自平衡的二叉搜索树,任何不平衡都会在三次旋转内解决。它不仅满足搜索树的特点,而且满足: 黑根黑叶:根节点必须是黑色的、叶子节点均是值为null的黑节点 红结黑子:节点可红可黑,若是红色的,则它的两个子节点都是黑色的 任径同黑:从任一节点到达它的每个叶子节点的所有路径,都有相同数目的黑色节点 从而保证红黑树从根节点到达每个叶子节点的最长路径不会超过最短路径的2倍 2、二叉树存储 链式存储法:⼀棵⼆叉树可以由根节点通过左右指针连接起来形成⼀个树 function binaryTree() { let node = function (val) { this.val = val this.left = null this.right = null } let root = null } 数组存储法:完全二叉树的所有节点满足:下标i(i>=1)的节点,父节点为i/2、左节点2i 和 右节点2i+1 二、leetcode 最常见相关题型 1、二叉树遍历 二叉树的遍历分为前序、中序及后序,其实,就是根放哪了,接着先左后右。解题思路有递归和迭代两种,递归的方式隐含地使用了系统的栈,因此可通过声明一个临时栈使用迭代实现 1.1、前序遍历也称深度优先遍历(DFS): 根->左子树->右子树 递归 var preorderTraversal = function (root) { const res = []; const recursion = root => { if (root) { res.push(root.val) recursion(root.left) recursion(root.right) } } recursion(root) return res; }; 迭代 var preorderTraversal = function (root) { const res = []; const stack = []; while (root || stack.length) { while (root) { res.push(root.val) // 记录根节点 stack.push(root) // 根节点入栈 root = root.left; } root = stack.pop() // 左子树遍历完,出栈,继续右子树 root = root.right; } return res }; 1.2、中序遍历:左子树->根->右子树 递归 var inorderTraversal = function (root) { const res = [] const recursion = (root) => { if (root) { recursion(root.left) res.push(root.val) recursion(root.right) } } recursion(root) return res } 迭代 var inorderTraversal = function (root) { const res = [] const stack = []; while (root || stack.length) { while (root) { stack.push(root) // 左节点进栈 root = root.left // 直至获取到最底层的左节点 } root = stack.pop() // 左子树遍历完,出栈 res.push(root.val) // 记录根节点 root = root.right // 继续遍历其右子树 } return res } 拓展:⼆叉搜索树中第K⼩的元素 给定一个二叉搜索树的根节点 root ,和一个整数 k ,请你设计一个算法查找其中第 k 个最小元素(从 1 开始计数) 输入:root = [5,3,6,2,4,null,null,1], k = 3 输出:3 思路: 中序遍历⼆叉搜索树,输出第 k 个 var kthSmallest = function (root, k) { const stack = [] while (root || stack.length) { while (root) { stack.push(root) root = root.left } root = stack.pop() if (--k === 0) { return root.val } root = root.right } return null } 1.3、后序遍历:左子树->右子树->根 递归 var postorderTraversal = function (root) { const res = [] const recursion = root => { if (root) { recursion(root.left) recursion(root.right) res.push(root.val) } } recursion(root) return res }; 迭代 var postorderTraversal = function (root) { const res = []; const stack = []; // 根进栈 if (root) stack.push(root) while (stack.length) { root = stack.pop() // 前插,保证左右根 res.unshift(root.val) // 先进左后进右,则先出右后出左 if (root.left !== null) stack.push(root.left) if (root.right !== null) stack.push(root.right) } return res }; 1.4、层序遍历:逐层地,从左到右访问所有节点 1 / \ 2 3 =>得到二维数组=> [[1], [2, 3], [4, 5, 6], [7, 8, 9]] / \ \ 4 5 6 / / \ 7 8 9 广度优先搜索 + 队列辅助 利用广度优先搜索扫描每一层的节点,辅助队列区分节点处于哪一层,即在每一层扫描前,记录队列中的节点数量,接着一次性处理这一层的n个节点 var levelOrder = function (root) { if (!root) return []; const res = []; let queue = [root]; // 根节点入队 while (queue.length) { const path = []; // 当前层节点 const nextPath = []; // 下一层节点 while (queue.length) { root = queue.shift(); // 队头出队 path.push(root.val) if (root.left !== null) nextPath.push(root.left) if (root.right !== null) nextPath.push(root.right) } res.push(path); queue = nextPath; } return res }; 拓展1、层次遍历: 从叶⼦节点所在层到根节点所在的层,逐层从左向右遍历 3 / \ 9 20 =>得到二维数组=> [[15, 7], [9, 20], [3]] =>同上,结果反转一下即可 => res.reverse() / \ 15 7 2、重构二叉树 重构二叉树,首先得找到可将左右子树划分开的根节点,其次是左右遍历的范围 划分左右子树的根节点 前中、后中:根节点在中序遍历中把数组一分为二,且前序和后序的根节点分别是第一个元素和最后一个元素 前后:前序的第二个节点为左子树的根P,在后序中找到P的位置index,则index前的元素就是左子树,后面的就是右子树(除去根节点) 左右遍历的范围 前中: 左子树:[pre_start + 1, pre_start + 1 + (index - 1 - inorder_start)] 右子树:[pre_start + 1 + (index - 1 - inorder_start) + 1, pre_end] 后中: 左子树:[post_start, post_start + (index - 1 - inorder_start)] 右子树:[post_end - 1 - (inorder_end - (index + 1)), post_end - 1] 前后: 左子树:[pre_start + 1, pre_start + 1 + (index - post_start)] 右子树:[pre_start + 1 + (index - post_start) + 1, pre_end] 2.1、根据前序和后序遍历构造二叉树 给定两个整数数组,preorder和 postorder ,其中 preorder 是一个具有 无重复 值的二叉树的前序遍历,postorder 是同一棵树的后序遍历,重构并返回二叉树。如果存在多个答案,您可以返回其中 任何 一个 输入:preorder = [1,2,4,5,3,6,7], postorder = [4,5,2,6,7,3,1] 输出:[1,2,3,4,5,6,7] var constructFromPrePost = function (preorder, postorder) { if (!preorder.length) return null const head = new TreeNode(postorder.pop()) let i = 0 for (; i < postorder.length; i++) { if (postorder[i] === preorder[1]) break; } head.left = constructFromPrePost(preorder.slice(1, i + 2), postorder.slice(0, i + 1)) head.right = constructFromPrePost(preorder.slice(i + 2), postorder.slice(i + 1)) return head }; 2.2、从前序与中序遍历序列构造二叉树 / 从中序与后序遍历序列构造二叉树 给定两个整数数组preorder 和 inorder,其中preorder 是二叉树的先序遍历, inorder是同一棵树的中序遍历,请构造二叉树并返回其根节点 输入: preorder = [3,9,20,15,7], inorder = [9,3,15,20,7] 输出: [3,9,20,null,null,15,7] 前序队头出队作为根节点,在中序找到同根节点值的索引index 前序index前的元素和中序index前的元素都是左子树(shift之后前序少了根节点) 前序index后的元素和中序index+1后的元素都是右子树 var buildTree = function (preorder, inorder) { if (!preorder.length) return null const head = new TreeNode(preorder.shift()) const middleIndex = inorder.indexOf(head.val) head.left = buildTree(preorder.slice(0, middleIndex), inorder.slice(0, middleIndex)) head.right = buildTree(preorder.slice(middleIndex), inorder.slice(middleIndex + 1)) return head } 3、二叉树实现 3.1、平衡二叉树 给定一个二叉树,判断它是否是高度平衡的二叉树。一棵高度平衡二叉树定义为:一个二叉树每个节点的左右两个子树的高度差的绝对值不超过 1 思路: 类似于后序遍历,先判断左右子树是否平衡,再判断以当前节点为根节点的子树是否平衡 左右子树的高度绝对值差大于1,则返回-1,否则左右子树平衡,返回左右子树深度最大值作为当前树的深度 const balanced = root => { if (!root) return 0; const left = balanced(root.left) const right = balanced(root.right) if (Math.abs(left - right) > 1 || left < 0 || right < 0) return -1; return Math.max(left, right) + 1 } const isBalanced = root => { return balanced(root) !== -1 } 3.2、前序遍历构造二叉搜索树 给定一个整数数组,它表示BST(即 二叉搜索树 )的 先序遍历 ,构造树并返回其根 输入:preorder = [8,5,1,7,10,12] 输出:[8,5,10,1,7,null,12] 思路: 先序遍历第一个元素即为根节点,进栈 扫描接下来的左右子树 声明父节点,赋值栈顶元素,如果栈顶的元素值小于子节点的元素值,则将栈顶的元素弹出并作为新的父节点 接着确定是左还是右节点,根据小于还是大于父节点判断是左节点还是右节点 var bstFromPreorder = function (preorder) { if (!preorder.length) return null // 第一个元素为根节点 const head = new TreeNode(preorder[0]) const stack = [head] // 扫描左右子树 for (let i = 1; i < preorder.length; i++) { // 栈顶元素作为父节点 let root = stack[stack.length - 1] const cur = new TreeNode(preorder[i]) // 如果栈顶的元素值小于子节点的元素值,则将栈顶的元素弹出并作为新的父节点 while (stack.length && stack[stack.length - 1].val < cur.val) { root = stack.pop() } // 左右子树 if (root.val < cur.val) { root.right = cur } else { root.left = cur } stack.push(cur) } return head }; 3.3、将有序数组转化为二叉搜索树 输入一组升序的nums数组,请你将其转换为一棵 高度平衡 二叉搜索树,即满足每个节点的左右两个子树的高度差的绝对值不超过1的二叉树 输入:nums = [-10,-3,0,5,9] 0 0 / \ / \ -3 9 -10 5 / / \ \ -10 5 -3 9 输出:[0,-3,9,-10,null,5] || [0,-10,5,null,-3,null,9] 思路: 有序数组,即中序遍历转二叉搜索树,结果不是唯一的,题目要求保证高度平衡,即从中间元素开始组装 以中间节点为父节点,其左为左子树,其右为右子树 const toBST = (nums, l, r) => { if (l > r) return null; const mid = l + r >> 1; const root = new TreeNode(nums[mid]) root.left = toBST(nums, l, mid - 1); root.right = toBST(nums, mid + 1, r) return root } var sortedArrayToBST = function (nums) { return toBST(nums, 0, nums.length - 1) }; 3.4、对称二叉树 给你一个二叉树的根节点 root , 检查它是否轴对称 输入:root = [1,2,2,3,4,4,3] 输出:true 思路: 对称,则左右子树是轴对称,即左子树的左节点=右子树的右节点,左子树的右节点=右子树的左节点 利用栈进行迭代 首先根的左右子树进栈 左右子树出栈,若对称,则将左子树的左节点、右子树的右节点、左子树的右节点和右子树的左节点依次入栈 不断出栈左右节点进行比较,再进栈,直至栈为空 var isSymmetric = function (root) { if (!root) return true const stack = [root.left, root.right] while (stack.length) { const right = stack.pop() const left = stack.pop() if (left && right) { if (right.val !== left.val) return false; stack.push(left.left) stack.push(right.right) stack.push(left.right) stack.push(right.left) } else if (left || right) { return false } } return true }; 3.5、合并二叉树 将两株二叉树合并为一株新的二叉树。合并的规则是 合并必须从两个树的根节点开始 若两个节点重叠,将他们的值相加作为节点合并后的新值,否则不为 NULL 的节点将直接作为新二叉树的节点 https://assets.leetcode.com/uploads/2021/02/05/merge.jpg 思路: 若有任一棵树为空,则返回不为空的那棵 扫描进行相同节点进行相加 var mergeTrees = function (root1, root2) { if (root1 === null || root2 === null) return root2 || root1; root1.val = root2.val + root1.val; root1.left = mergeTrees(root1.left, root2.left) root1.right = mergeTrees(root1.right, root2.right) return root1 }; 4、二叉树比较 4.1、二叉树的最大深度 ⼆叉树的深度为根节点到最远叶⼦节点的最⻓路径上的节点数 思路: 二叉树的最大深度即为Math.max(l,r)+1 var maxDepth = function(root) { if(!root) return 0; return Math.max(maxDepth(root.left),maxDepth(root.right)) +1 }; 4.2、⼆叉树的最小深度 最小深度是从根节点到最近叶子节点的最短路径上的节点数量 输入:root = [2,null,3,null,4,null,5,null,6] 输出:2 思路: 叶子节点的定义是左右孩子都为null,即 当 root 节点左右孩子都为空时,返回 1 当 root 节点左右孩子有一个为空时,返回不为空的孩子节点的深度left+right+1 当 root 节点左右孩子都不为空时,返回左右孩子较小深度的节点值Math.min(left,right)+1 var minDepth = function (root) { if (!root) return 0; const left = minDepth(root.left) const right = minDepth(root.right) if (!root.left || !root.right) return left + right + 1 return Math.min(left, right) + 1 }; 4.3、二叉树的直径 给定一棵二叉树,你需要计算它的直径长度。一棵二叉树的直径长度是任意两个结点路径长度中的最大值。这条路径可能穿过也可能不穿过根结点 1 / \ 2 3 =>返回 3=>它的长度是路径 [4,2,1,3] 或者 [5,2,1,3] / \ 4 5 思路: 任意一个结点,都要记录以此结点为根的直径情况:左子树高度+右子树高度 var diameterOfBinaryTree = function (root) { // 根节点自身的路径长度 let max = 1 const deps = (root) => { if (!root) return 0 const left = deps(root.left); const right = deps(root.right); // 以当前节点为父节点的直径: left + right + 1 max = Math.max(max, left + right + 1); // 返回以当前节点为父节点的最大高度 return Math.max(left, right) + 1 } deps(root) // 减去默认增加的自身根节点路径 return max - 1; }; 4.4、路径总和 给你二叉树的根节点root 和一个表示目标和的整数targetSum 。判断该树中是否存在 根节点到叶子节点 的路径,这条路径上所有节点值相加等于目标和targetSum 。如果存在,返回 true ;否则,返回 false 思路: 不断递归递减当前节点的值,直至遇到叶子节点 叶子节点,一定要注意是没有左右节点的 var hasPathSum = function (root, targetSum) { if (!root) return false // 叶子节点,判断sum是否等于该节点的值 if (root.left === null && root.right === null) return root.val === targetSum; // 减去当前节点的值 targetSum -= root.val; return ( hasPathSum(root.left, targetSum) || hasPathSum(root.right, targetSum) ) } 4.5、⼆叉树的最近公共祖先 给定一个二叉树, 找到该树中两个指定节点的最近公共祖先 祖先的定义: 若节点 pp 在节点 rootroot 的左(右)子树中,或 p = rootp=root ,则称 rootroot 是 pp 的祖先。 最近公共祖先的定义: 设节点 rootroot 为节点 p, qp,q 的某公共祖先,若其左子节点 root.leftroot.left 和右子节点 root.rightroot.right 都不是 p,qp,q 的公共祖先,则称 rootroot 是 “最近的公共祖先” 思路: 若 root 为空、p|q 中任意节点为root,则最近公共祖先为 root 否则递归左右子节点,返回值分别记为 left、right left、right都不为空,则 p、q 分布在左右子树的根节点上,其最近公共祖先为 root left为空、right不为空,则 p|q 都不在 左子树,返回 right,right为空、left不为空的情况同理 var lowestCommonAncestor = function (root, p, q) { if (!root || root === p || root === q) return root; const left = lowestCommonAncestor(root.left, p, q) const right = lowestCommonAncestor(root.right, p, q) if (left === null) return right if (right === null) return left return root }; 有兴趣的可关注解题思维这一系列的其他文章 二叉树解题思维 堆栈解题思维 单链表解题思维

优秀的个人博客,低调大师

每日一博 | Linux 败局已定 —— 驳 FreeBSD 大败局

看过我上一篇文章《Linux 社区已经成为了一个肮脏的泥潭》以及上上一篇文章《Linux 与苦难哲学》的读者都知道, Linux 从开发者到社区乃至于用户都是充斥着难以言表的一种骄傲。仿佛自己是真正的UNIX 后裔,是开源界的唯一真理,谁拥有 Linux ,谁会 Linux ,谁就掌握话语权。 如此过了二十余年,物是人非,当初的 Linux 走到了今天这个地步,无论从何种意义上来说,都是一种错位。 王垠过去写了一篇 Linux 劝进文——完全用 Linux 工作,后又发了一篇 Linux 劝退文——谈 Linux ,Windows 和 Mac。人的认识是一个螺旋式上升的过程,当初的错位必将在日后得到修正。 Linux 也如是。 不断的有 Arch Linux 用户到处宣传 Arch Linux 的优美。是啊,如此优美的一个系统!Nano,Vi 都依赖 Glibc,不更新就意味着你用不了这些再基础不过的基础软件,强制性地要求你更新,他们才不在乎更新会不会导致你的系统挂掉——反正我又不能给你蓝屏。我不知道这些 Arch Linux 劝进文的作者多年后会不会像王垠一样,能够坦诚的承认自己的错位。我也不知道这些 Linux 劝进文的作者多年后会不会像王垠一样,能够坦诚的承认自己的错位。 画龙画虎难画骨,譬如皇帝的新衣。以模仿开始,无论怎么看,都注定了 Linux 败局已定。 01 成也 GPL ,败也 GPL GPL 许可证给人们带来最多的感受绝不是“free”,而是“传染”、“感染”,似乎 GPL 是一场瘟疫,传到哪里都会带来灾难。而且似乎对其误读的人不在少数, GPL 之“free”,不是免费,而是更接近“libre”。对于 GPL 来说也并不意味着你的代码会被 100% 开源下去,得到回馈。著名的例子就是 Boox——一家使用了 GPL 代码却没有开源的 Eink 生态链公司。 FreeBSD之所以要与 GPL 划清界限是因为 GPL 阻碍了FreeBSD的发展目标——One of the ongoing goals for the FreeBSD base system is a migration to modern, copyfree or at least more permissively licensed components. FreeBSD 基础系统的一个持续目标是迁移到现代的、宽松授权条款或至少是更多许可的组件。 如果有人说 BSDL 会被大型公司滥用,那么 Anti-996L 才是最佳许可证,而绝不是什么 GPL 。因为任何许可证都会被滥用(除了 Anti-996L )。 Anti-996L 才是世界上最好,最优秀的许可证。保证了你的代码不会被任何公司滥用——因为没有公司敢用。 Apple公司复用了大量的 FreeBSD 代码,同时也为其提供了资金以开发 LLVM,类似的,还有英特尔和 Netflix。 被“利用”不一定是一件坏事。毕竟只有没有任何价值的东西才不会被利用,只有没有任何用处的“hello world”代码才不会被滥用。也就成了庄子所说的“无用之用,是为大用”。 尽管我们看到了许多开发者由于项目被滥用而删库跑路,但是这件事也是双向的。开源代码开发者往他们的代码里塞圣诞节彩蛋,商业公司及“利用”他们的人就要承担这一代价——无论是被开除还是被质问到你这个按钮到底被谁吃掉了。 得益于 GPL ,一个 CentOS 倒下去,千千万万个 XXOS 站起来,肉眼可见,从此以后的教程将更加地复杂,更加地不具备普适性。此前写文章抨击 CentOS 的 Si Feng 说过“CentOS: 永远有多远就离它多远”——如果一定要为服务器挑选 Linux 发行版(假设不考虑其他非 Linux 系统例如 FreeBSD)的话,首要的原则就是尽可能远离 CentOS。(https://feng.si/posts/2019/07/centos-the-last- Linux -distro-you-should-ever-consider/ )当时还有很多人抨击他说他荒谬,现在看来谁荒谬还真是不一定。现在看看那篇文章下的回复,不知道斯言仍在,斯人何在?我现在也仿照着他,说一句话——“ Linux :永远有多远就离它多远” 02 “ Linux 真的是个好东西吗” Linux 真的赶上了一个好时候,其实 Linux 最初和 GUN 是没有半毛钱关系的,GNU 计划一直排斥 Linux ,他们想要有自己的操作系统或者说内核,他们管他叫做——GNU Hurd。这一项目至今仍在进行中…… Linux 发行版不过是一堆 GNU 工具+包管理器+ Linux 内核所构成的松散的操作系统(一般将前两者合称为“Userland”)。每个人各维护各的,就像 Ubuntu 很少回馈上游社区一样,这也反证了 GPL 许可证的确不如 Anti-996L 。 GNU Hurd 错位, Linux 占据了所有开发者的计算机,就像破窗效应那样,如果那些窗没修理好,可能将会有破坏者破坏更多的窗户。越来越多的开发者走向了 Linux 而非 GNU Hurd。可以说是“所有的好东西都给了 Linux ”,那么反过来说集开发之大成的 Linux 是个好东西吗?看上去答案是肯定的,其实不然。 硬件上看, Linux 的 GPL 阻碍了硬件兼容性扩大(他们是怎么解决这个问题的呢?),仍然有许多用户认为 Linux 是完全开源的,他们认为——不开源我是怎么编译的呢?那么“ Linux -libre”项目(https://www.fsfla.org/ikiwiki/selibre/ Linux -libre/)所删减的是什么呢?—— Linux , the kernel developed and distributed by Linus Torvalds et al, contains non-Free Software, i.e., software that does not respect your essential freedoms, and it induces you to install additional non-Free Software that it doesn't contain. Even after allegedly moving all firmware to a separate project as of release 4.14, Linux so-called "sources" published by Mr Torvalds still contain non-Free firmware disguised as source code. Linux ,由 Linus Torvalds等人开发和发布的内核,包含非自由软件,即不尊重你的基本自由的软件,它诱使你安装它不包含的,额外的非自由软件。即使据称从 4.14 版开始将所有固件转移到一个单独的项目, Linus 先生发布的 Linux 所谓的“源代码”仍然包含伪装成源代码的非自由固件。 软件上, Linux 的软件包数量的确很多,甚至比 Windows 的软件还要多,这在一定程度上有积极影响,但是其消极影响更甚。有很多的开发者并没有很好的维护他们的项目,因为他们的 GPL 并不起到任何保证作用,开发者也没有任何义务为软件提供任何保证。可见到的是,先有软件,后有用户需求设计(好吧,实际上压根没有这个东西),他们不在意用户是怎么想的,你想往一个IM软件里加一个截图功能,因为类似的 Windows IM 软件(比如 QQ,微信)有这个功能,而且这个功能很重要。但是开发者会和你说,你用其他的软件截图然后复制进来就可以了;或者说我们是 GPL ,你看得到源码,你自己去改就是了,你不会改那就是你自己的问题了,和我们无关。你可以随便报告 Bug,但是我们可以简单地说“No”。 安全上,OpenBSD 为了改进其安全性移除了 Linux 兼容层以及其常用的软件“sudo”。 Linus 此前就抨击 OpenBSD 团队是一群自慰的猴子(OpenBSD crowd is a bunch of masturbating monkeys),认为他们是玩具。至今人们仍不知道那些年 SELinux 和 FBI 的关系(SELinux (Security-Enhanced Linux ) 是由美国国家安全局(NSA)所开发)。嗯,没错,这也是一个 GPL 软件,“你觉得有问题你可以自己去看源代码吗!并给我们指出来。”但是更多人不知道的是 Windows 的开源是没有意义的,几十 TB 的源代码,无论他是开源还是不开源对于何种意义来说都是一样的——你既看不懂,也看不完,等于没开源。 03 Linux 的商业布局 Linux 的用户或者说在有商业版发行下的,使用所谓“社区版、开源版”的 Linux 用户其实和他们所嘲讽的使用 Insider 的“小白鼠”没有什么本质上的区别。所谓 Linux 的商业布局就是让更多地用户接触到苦难哲学,接触到一个根本不完善不稳定的软件。 Wine 的商业版叫做 Crossover,境内由著名的“苏州思杰马克丁”所代理。Wine 是一款在类 UNIX 操作系统上模拟 Windows 程序的开源软件,使用起来可谓是苦难哲学到了顶峰。Crossover 则不然,他们以开源为测试模板积累了丰富的经验以改进自己的程序。类似的著名操作系统就是 Fedora——RHEL 的社区版,开源版。 这些 GPL 的软件随时都有闭源的风险,但是他们又说了, GPL 允许 Fork,于是出现了很多李逵的副本——李鬼。比如 Mysql 与 MariaDB、Rcoky Linux 之于 CentOS、OpenJDK 与 OracleJDK……那么到底该用哪个呢?你不知道,因为 GPL 软件防止你滥用他。商业公司真的愿意和开源软件共荣共生吗?答案是否定的,他们只是没有更好的选择而已,君不见使用 LLVM 后的苹果公司怎么看待 GCC。认清这个现实的商业公司正越来越多。 Linux 的商业布局就是让用户免费帮自己测试软件,然后赚钱,“回馈”社区继续让用户帮自己免费测试软件,最后用户还会非常感谢这些公司为他们的开源事业做出的贡献。而用户得到的则是一个充斥着苦难哲学的软件,除此以外,别无长物。按照他们的说法,这也叫做“利用”。 04 “大独裁者”未必是好事 众所周知, Linux 的内核开发是由 Linus 一人独裁负责的。我们仍未知道何时独裁也成了一件值得称赞的事情了。或者在他们看来只要项目进展顺利,Linus 选好接班人, Linux 内核就可以像中国的秦始皇所畅想的那样——受命于天,既寿永昌。他们把不同意见的人都打成“左派”,给他们扣上帽子,没有人告诉你,那个年代已经过去了吗? Linux 的社区和他们的开发风格也是一样的,充满了各种巨苣,巨苣们一言以定天下,其他人说了不算。最典型的就是贴吧,如果你想问 Linux 的开发模式是什么,他们的社区是什么——请看百度贴吧:有五六个自诩代表吧友实则毫无贡献的人,在奔走试图合纵连横试图推翻现有吧主;有一个自称贴吧是自己的私有物品,吧主万世万代都得是自己的小丑;还有一个固定的吧宠,但从来都认不清自己的身份,还在说别人哗众取宠;剩下的都是摸鱼躺平的围观群众。 Linux 社区如 Linus 所言,是一个肮脏的泥潭,任何想要和这些人辩论并试图驳倒他们的人都将会被其拉低智商到同一水平,并眼睁睁地看着他用丰富的经验打败你。 Linux 本人所骂走的开发者绝不在少数,他们的行为准则(CoC)制定了和没有制定是一样的,你是能开除 Linux 不让他贡献一行代码,还是你能让他只做事不说话?类似的 GNU 离开了 Richard Matthew Stallman 会怎样?就像现在这样吗? 05 Linux 不会再年青了 我们都知道,引用任何名人名言并不会为自己的论述增加一丝一毫的正确性。 前文所说到的 GNU Hurd 的确在设计上是一个非常优秀的微内核操作系统。但因为错失良机,使得更多开发者投入了 Linux 的泥潭之中。 Linux 被无数人包装成 GNU 计划的伟大产物, GPL 的伟大产物, Linus 独裁领导下的伟大产物。没有任何人可以以任何理由批评他,除了 Linus 本人。事实上这就是皇帝的新衣,你想掀开 Linux 光鲜亮丽的外衣去一窥内部却发现 Linux 外边根本没有穿着任何衣物。 在抨击 FreeBSD 社区以前,请看看泥潭般的 Linux 社区,这不是五十步笑百步,而是大哥莫说二弟。此处的读者可以移步之前的文章——《Linux 社区已经成为了一个肮脏的泥潭》。 Linux 社区的那些巨苣,那些搞苦难哲学的是最没有资格说别人的社区肮脏污秽不堪的人——他们天天说着 RTFM。关于 Linux 社区的种种一直无人敢说,无人敢言,任由他们这群巨苣去践踏,去污蔑,去破坏别的社区。 Linux 社区早就不像当年那样了——我们都知道新人的确很菜,也喜欢抱怨,并且带有浓厚的 Windows 习惯,但既然在这里询问,我们就应该有责任帮助他们解决问题,而不是直接泼冷水、简单的否定或发表对解决问题没有任何帮助的帖子。乐于分享,以人为本,这正是Ubuntu的精神所在。 他们会把那些问题叫做“日经”,然后将你移出他们的社区。当然你不得不承认有些人是不听劝的:你和他说四遍,发了各种形式的教程(既有图片又有视频还有文字),他说自己照着文档做了,你一看让他发照片。“这就是你做了的结果?配置文件一个字都没有改”他改了后正常运行了,也不会和你说一声谢谢,然后继续问一些“日经”问题,你再回他,他就会说你“指手画脚”,不会指导人只知道让他看文档,妨碍别人教他,然后还去 Linux 社区发帖说 FreeBSD 社区有问题,真是恶人先告状。但是他们往往会报团取暖,觉得对方说的都对,是别人有问题,自己 100% 正确。然后弹冠相庆,互称兄弟。 你告诉他“lib32”兼容层很重要,后边安不上去,必须现在选。他会告诉你“老子就是不用垃圾的 32 位,老子就是要用纯净的 64 位系统,按不上是老子自己的事,你管不着”,“既然你都懂那还来问些什么呢?”。这种人是没有任何资格抱怨FreeBSD社区的,他们连最低水平的素质都没有,他们只配在泥潭般的 Linux 社区待着,是 Linux 社区造成了他们这种畸形的人格的变态的心理——无论是提问者还是回答者,谁也看不上谁。 与 Linux 相关的荒谬事件更是数不胜数。一个 systemd 与 SysV init 的争论就搅得 Linux 界七荤八素。Systemd 试图统管一切——网络,日志,磁盘管理,引导,时钟,电源、Cron、区域语言……然后就造成了各大发行版的分裂,虽然已经很分裂了。更别说前文提及的 SELinux 这种东西是怎么进入 Linux 内核的了。红帽公司——他们引以为豪的 Linux 的商业布局正在一步一步地控制整个 Linux 的发展。 Linux 的工具属性越来越强,那个曾经年青有趣的玩具般的 Linux 早已不在了。 06 屠龙者终成恶龙 Wer mit Ungeheuern kämpft, mag zusehn, dass er nicht dabei zum Ungeheuer wird. Und wenn du lange in einen Abgrund blickst, blickt der Abgrund auch in dich hinein. 与恶龙缠斗过久,自身也会成为恶龙;当你凝视深渊,深渊也在凝视你。 ——Friedrich Wilhelm Nietzsche Linux 打败了一系列的操作系统:GNU Hurd、FreeBSD、OpenBSD 以及其他一堆 BSD,在服务器领域击败了 Windows server、MacOS,在移动平台产生了 Android。 Linux 的发展看上去是 GPL 的胜利,是 Linus 独裁的胜利,也是这个开源社区的胜利,更是 Linux 商业布局的胜利。 事实果真如此吗?究竟是皇帝的新衣还是破窗理论呢? 新事物必将取代旧事物,万事万物的新陈代谢如此, Linux 也不会永远长久下去,终究有一天会有更优秀的操作系统脱胎于此,并取代他。这是事物运行发展的基本规律,无可避免,而这些人所做的只是为 Linux 延长寿命而已。看上去蓬勃发展的 Linux ,其实早就垂垂老矣。 Linux 败局已定。 只是没人愿意揭开这皇帝的新衣罢了。 屠龙者终成恶龙—— Linux 和 GPL 正在阻碍着越来越多的新技术发展。他们逼迫人们耗费着大量的人力物力去维护一堆堪称“屎山”的代码——每错,我说的就是你们:GCC、Xorg 以及其所谓的替代品 Wayland。 07 结语 Linux 已经日薄西山了,尽早投入 GNU Hurd 的怀抱才是真正明智的选择,尽早离开 GPL 选择 Anti-996L 才是真正自由的选择。 当然,不管 Linux 是不是皇帝的新衣,有多么的苦难哲学,他都给这个世界带来了一种选择,时势造英雄, Linux 乘势而来,也必将乘势而终。 Linux 内核的版本号已经刷到了 5.17-rc5,那么也许还会有 6.17-rc5、7.17-rc5、8.17-rc5…… 但是 Linux 败局已定,且无人能够拯救他。我们能做只是尽量去多使用他做一些事情,最后发挥一下 Linux 的余热。

优秀的个人博客,低调大师

每日一博 | 机器学习和深度学习的区别

作者:ZOMI酱 文章来源:https://zhuanlan.zhihu.com/p/455602945 机器学习和深度学习算法流程 终于考上人工智能的研究僧啦,不知道机器学习和深度学习有啥区别,感觉一切都是深度学习 挖槽,听说学长已经调了10个月的参数准备发有2000亿参数的T9开天霹雳模型,我要调参发T10准备拿个Best Paper 现在搞传统机器学习相关的研究论文确实占比不太高,有的人吐槽深度学习就是个系统工程而已,没有数学含金量。 但是无可否认的是深度学习是在太好用啦,极大地简化了传统机器学习的整体算法分析和学习流程,更重要的是在一些通用的领域任务刷新了传统机器学习算法达不到的精度和准确率。 深度学习这几年特别火,就像5年前的大数据一样,不过深度学习其主要还是属于机器学习的范畴领域内,所以这篇文章里面我们来唠一唠机器学习和深度学习的算法流程区别。 1、机器学习的算法流程 实际上机器学习研究的就是数据科学(听上去有点无聊),下面是机器学习算法的主要流程:主要从1)数据集准备、2)探索性的对数据进行分析、3)数据预处理、4)数据分割、5)机器学习算法建模、6)选择机器学习任务,当然到最后就是评价机器学习算法对实际数据的应用情况如何。 1.1 数据集 首先我们要研究的是数据的问题,数据集是构建机器学习模型流程的起点。简单来说,数据集本质上是一个M×N矩阵,其中M代表列(特征),N代表行(样本)。 列可以分解为X和Y,X是可以指特征、独立变量或者是输入变量。Y也是可以指类别标签、因变量和输出变量。 1.2 数据分析 进行探索性数据分析(Exploratory data analysis, EDA)是为了获得对数据的初步了解。EDA主要的工作是:对数据进行清洗,对数据进行描述(描述统计量,图表),查看数据的分布,比较数据之间的关系,培养对数据的直觉,对数据进行总结等。 探索性数据分析方法简单来说就是去了解数据,分析数据,搞清楚数据的分布。主要注重数据的真实分布,强调数据的可视化,使分析者能一目了然看出数据中隐含的规律,从而得到启发,以此帮助分析者找到适合数据的模型。 在一个典型的机器学习算法流程和数据科学项目里面,我做的第一件事就是通过 "盯住数据",以便更好地了解数据。个人通常使用的三大EDA方法包括: 描述性统计:平均数、中位数、模式、标准差。 数据可视化:热力图(辨别特征内部相关性)、箱形图(可视化群体差异)、散点图(可视化特征之间的相关性)、主成分分析(可视化数据集中呈现的聚类分布)等。 数据整形:对数据进行透视、分组、过滤等。 1.3 数据预处理 数据预处理,其实就是对数据进行清理、数据整理或普通数据处理。指对数据进行各种检查和校正过程,以纠正缺失值、拼写错误、使数值正常化/标准化以使其具有可比性、转换数据(如对数转换)等问题。 例如对图像进行resize成统一的大小或者分辨率。 数据的质量将对机器学习算法模型的质量好坏产生很大的影响。因此,为了达到最好的机器学习模型质量,传统的机器学习算法流程中,其实很大一部分工作就是在对数据进行分析和处理。 一般来说,数据预处理可以轻松地占到机器学习项目流程中80%的时间,而实际的模型建立阶段和后续的模型分析大概仅占到剩余的20%。 1.4 数据分割 训练集 & 测试集 在机器学习模型的开发流程中,希望训练好的模型能在新的、未见过的数据上表现良好。为了模拟新的、未见过的数据,对可用数据进行数据分割,从而将已经处理好的数据集分割成2部分:训练集合测试集。 第一部分是较大的数据子集,用作训练集(如占原始数据的80%);第二部分通常是较小的子集,用作测试集(其余20%的数据)。 接下来,利用训练集建立预测模型,然后将这种训练好的模型应用于测试集(即作为新的、未见过的数据)上进行预测。根据模型在测试集上的表现来选择最佳模型,为了获得最佳模型,还可以进行超参数优化。 训练集 & 验证集 & 测试集 另一种常见的数据分割方法是将数据分割成3部分:1)训练集,2)验证集和3)测试集。 训练集用于建立预测模型,同时对验证集进行评估,据此进行预测,可以进行模型调优(如超参数优化),并根据验证集的结果选择性能最好的模型。 验证集的操作方式跟训练集类似。不过值得注意的是,测试集不参与机器学习模型的建立和准备,是机器学习模型训练过程中单独留出的样本集,用于调整模型的超参数和对模型的能力进行初步评估。通常边训练边验证,这里的验证就是用验证集来检验模型的初步效果。 交叉验证 实际上数据是机器学习流程中最宝贵的,为了更加经济地利用现有数据,通常使用N倍交叉验证,将数据集分割成N个。在这样的N倍数据集中,其中一个被留作测试数据,而其余的则被用作建立模型的训练数据。通过反复交叉迭代的方式来对机器学习流程进行验证。 这种交叉验证的方法在机器学习流程中被广泛的使用,但是深度学习中使用得比较少哈。 1.5 机器学习算法建模 下面是最有趣的部分啦,数据筛选和处理过程其实都是很枯燥乏味的,现在可以使用精心准备的数据来建模。根据taget变量(通常称为Y变量)的数据类型,可以建立一个分类或回归模型。 机器学习算法 机器学习算法可以大致分为以下三种类型之一: 监督学习:是一种机器学习任务,建立输入X和输出Y变量之间的数学(映射)关系。这样的(X、Y)对构成了用于建立模型的标签数据,以便学习如何从输入中预测输出。 无监督学习:是一种只利用输入X变量的机器学习任务。X变量是未标记的数据,学习算法在建模时使用的是数据的固有结构。 强化学习:是一种决定下一步行动方案的机器学习任务,它通过试错学习(trial and error learning)来实现这一目标,努力使reward回报最大化。 参数调优 传说中的调参侠主要干的就是这个工作啦。超参数本质上是机器学习算法的参数,直接影响学习过程和预测性能。由于没有万能的超参数设置,可以普遍适用于所有数据集,因此需要进行超参数优化。 以随机森林为例。在使用randomForest时,通常会对两个常见的超参数进行优化,其中包括mtry和ntree参数。mtry(maxfeatures)代表在每次分裂时作为候选变量随机采样的变量数量,而ntree(nestimators)代表要生长的树的数量。 另一种在10年前仍然非常主流的机器学习算法是支持向量机SVM。需要优化的超参数是径向基函数(RBF)内核的C参数和gamma参数。C参数是一个限制过拟合的惩罚项,而gamma参数则控制RBF核的宽度。 调优通常是为了得出超参数的较佳值集,很多时候不要去追求找到超参一个最优值,其实调参侠只是调侃调侃,真正需要理解掌握算法原理,找到适合数据和模型的参数就可以啦。 特征选择 特征选择从字面上看就是从最初的大量特征中选择一个特征子集的过程。除了实现高精度的模型外,机器学习模型构建最重要的一个方面是获得可操作的见解,为了实现这一目标,能够从大量的特征中选择出重要的特征子集非常重要。 特征选择的任务本身就可以构成一个全新的研究领域,在这个领域中,大量的努力都是为了设计新颖的算法和方法。从众多可用的特征选择算法中,一些经典的方法是基于模拟退火和遗传算法。除此之外,还有大量基于进化算法(如粒子群优化、蚁群优化等)和随机方法(如蒙特卡洛)的方法。 1.6 机器学习任务 在监督学习中,两个常见的机器学习任务包括分类和回归。 分类 一个训练好的分类模型将一组变量作为输入,并预测输出的类标签。下图是由不同颜色和标签表示的三个类。每一个小的彩色球体代表一个数据样本。三类数据样本在二维中的显示,这种可视化图可以通过执行PCA分析并显示前两个主成分(PC)来创建;或者也可以选择两个变量的简单散点图可视化。 性能指标 如何知道训练出来的机器学习模型表现好或坏?就是使用性能评价指标(metrics),一些常见的评估分类性能的指标包括准确率(AC)、灵敏度(SN)、特异性(SP)和马太相关系数(MCC)。 回归 最简单的回归模式,可以通过以下简单等式很好地总结:Y = f(X)。其中,Y对应量化输出变量,X指输入变量,f指计算输出值作为输入特征的映射函数(从机器学习模型中得到)。上面的回归例子公式的实质是,如果X已知,就可以推导出Y。一旦Y被计算(预测)出来,一个流行的可视化方式是将实际值与预测值做一个简单的散点图,如下图所示。 对回归模型的性能进行评估,以评估拟合模型可以准确预测输入数据值的程度。评估回归模型性能的常用指标是确定系数(R²)。此外,均方误差(MSE)以及均方根误差(RMSE)也是衡量残差或预测误差的常用指标。 2、深度学习算法流程 深度学习实际上是机器学习中的一种范式,所以他们的主要流程是差不多的。深度学习则是优化了数据分析,建模过程的流程也是缩短了,由神经网络统一了原来机器学习中百花齐放的算法。 在深度学习正式大规模使用之前呢,机器学习算法流程中药花费很多时间去收集数据,然后对数据进行筛选,尝试各种不同的特征提取机器学习算法,或者结合多种不同的特征对数据进行分类和回归。 下面是机器学习算法的主要流程:主要从1)数据集准备、2)数据预处理、3)数据分割、4)定义神经网络模型,5)训练网络。 深度学习不需要我们自己去提取特征,而是通过神经网络自动对数据进行高维抽象学习,减少了特征工程的构成,在这方面节约了很多时间。 但是同时因为引入了更加深、更复杂的网络模型结构,所以调参工作变得更加繁重啦。例如:定义神经网络模型结构、确认损失函数、确定优化器,最后就是反复调整模型参数的过程。 参考文献 [1]https://github.com/dataprofessor/infographic [2] 陈仲铭. 《深度学习:原理与实践》.[M]

优秀的个人博客,低调大师

每日一博 | Redis 竟然能用 List 实现消息队列

分布式系统中必备的一个中间件就是消息队列,通过消息队列我们能对服务间进行异步解耦、流量消峰、实现最终一致性。 目前市面上已经有 RabbitMQ、RochetMQ、ActiveMQ、Kafka等,有人会问:“Redis 适合做消息队列么?” 在回答这个问题之前,我们先从本质思考: 消息队列提供了什么特性? Redis 如何实现消息队列?是否满足存取需求? 今天,码哥结合消息队列的特点一步步带大家分析使用 Redis 的 List 作为消息队列的实现原理,并分享如何把 SpringBoot 与 Redission 整合运用到项目中。 什么是消息队列 消息队列是一种异步的服务间通信方式,适用于分布式和微服务架构。消息在被处理和删除之前一直存储在队列上。 每条消息仅可被一位用户处理一次。消息队列可被用于分离重量级处理、缓冲或批处理工作以及缓解高峰期工作负载。 Producer:消息生产者,负责产生和发送消息到 Broker; Broker:消息处理中心。负责消息存储、确认、重试等,一般其中会包含多个 queue; Consumer:消息消费者,负责从 Broker 中获取消息,并进行相应处理; 消息队列的使用场景有哪些呢? 消息队列在实际应用中包括如下四个场景: 应用耦合:发送方、接收方系统之间不需要了解双方,只需要认识消息。多应用间通过消息队列对同一消息进行处理,避免调用接口失败导致整个过程失败; 异步处理:多应用对消息队列中同一消息进行处理,应用间并发处理消息,相比串行处理,减少处理时间; 限流削峰:广泛应用于秒杀或抢购活动中,避免流量过大导致应用系统挂掉的情况; 消息驱动的系统:系统分为消息队列、消息生产者、消息消费者,生产者负责产生消息,消费者(可能有多个)负责对消息进行处理; 消息队列满足哪些特性 消息有序性 消息是异步处理的,但是消费者需要按照生产者发送消息的顺序来消费,避免出现后发送的消息被先处理的情况。 重复消息处理 生产者可能因为网络问题出现消息重传导致消费者可能会收到多条重复消息。 同样的消息重复多次的话可能会造成一业务逻辑多次执行,需要确保如何避免重复消费问题。 可靠性 一次保证消息的传递。如果发送消息时接收者不可用,消息队列会保留消息,直到成功地传递它。 当消费者重启后,可以继续读取消息进行处理,防止消息遗漏。 List 实现消息队列 Redis 的列表(List)是一种线性的有序结构,可以按照元素被推入列表中的顺序来存储元素,能满足「先进先出」的需求,这些元素既可以是文字数据,又可以是二进制数据。 LPUSH 生产者使用 LPUSH key element[element...] 将消息插入到队列的头部,如果 key 不存在则会创建一个空的队列再插入消息。 如下,生产者向队列 queue 先后插入了 「Java」「码哥字节」「Go」,返回值表示消息插入队列后的个数。 > LPUSH queue Java 码哥字节 Go (integer) 3 RPOP 消费者使用 RPOP key 依次读取队列的消息,先进先出,所以 「Java」会先读取消费: > RPOP queue "Java" > RPOP queue "码哥字节" > RPOP queue "Go" 实时消费问题 65 哥:这么简单就实现了么? 别高兴的太早,LPUSH、RPOP 存在一个性能风险,生产者向队列插入数据的时候,List 并不会主动通知消费者及时消费。 我们需要写一个 while(true) 不停地调用 RPOP 指令,当有新消息就会返回消息,否则返回空。 程序需要不断轮询并判断是否为空再执行消费逻辑,这就会导致即使没有新消息写入到队列,消费者也要不停地调用 RPOP 命令占用 CPU 资源。 65 哥:要如何避免循环调用导致的 CPU 性能损耗呢? Redis 提供了 BLPOP、BRPOP 阻塞读取的命令,消费者在在读取队列没有数据的时候自动阻塞,直到有新的消息写入队列,才会继续读取新消息执行业务逻辑。 BRPOP queue 0 参数 0 表示阻塞等待时间无无限制 重复消费 消息队列为每一条消息生成一个「全局 ID」; 生产者为每一条消息创建一条「全局 ID」,消费者把一件处理过的消息 ID 记录下来判断是否重复。 其实这就是幂等,对于同一条消息,消费者收到后处理一次的结果和多次的结果是一致的。 消息可靠性 65 哥:消费者从 List 中读取一条在消息处理过程中宕机了就会导致消息没有处理完成,可是数据已经没有保存在 List 中了咋办? 本质就是消费者在处理消息的时候崩溃了,就无法再还原消息,缺乏一个消息确认机制。 Redis 提供了 RPOPLPUSH、BRPOPLPUSH(阻塞)两个指令,含义是从 List 从读取消息的同时把这条消息复制到另一个 List 中(备份),并且是原子操作。 我们就可以在业务流程正确处理完成后再删除队列消息实现消息确认机制。如果在处理消息的时候宕机了,重启后再从备份 List 中读取消息处理。 LPUSH redisMQ 公众号 码哥字节 BRPOPLPUSH redisMQ redisMQBack 生产者用 LPUSH 把消息插入到 redisMQ 队列中,消费者使用 BRPOPLPUSH 读取消息「公众号」,同时该消息会被插入到 「redisMQBack」队列中。 如果消费成功则把「redisMQBack」的消息删除即可,异常的话可以继续从 「redisMQBack」再次读取消息处理。 需要注意的是,如果生产者消息发送的很快,而消费者处理速度慢就会导致消息堆积,给 Redis 的内存带来过大压力。 Redission 实战 在 Java 中,我们可以利用 Redission 封装的 API 来快速实现队列,接下来码哥基于 SpringBoot 2.1.4 版本来交大家如何整合并实战。 详细 API 文档大家可查阅:https://github.com/redisson/redisson/wiki/7.-Distributed-collections 添加依赖 <dependency> <groupId>org.redisson</groupId> <artifactId>redisson-spring-boot-starter</artifactId> <version>3.16.7</version> </dependency> 添加 Redis 配置,码哥的 Redis 没有配置密码,大家根据实际情况配置即可。 spring: application: name: redission redis: host: 127.0.0.1 port: 6379 ssl: false Java 代码实战 RBlockingDeque 继承 java.util.concurrent.BlockingDeque ,在使用过程中我们完全可以根据接口文档来选择合适的 API 去实现业务逻辑。 主要方法如下 码哥采用了双端队列来举例 @Slf4j @Service public class QueueService { @Autowired private RedissonClient redissonClient; private static final String REDIS_MQ = "redisMQ"; /** * 发送消息到队列头部 * * @param message */ public void sendMessage(String message) { RBlockingDeque<String> blockingDeque = redissonClient.getBlockingDeque(REDIS_MQ); try { blockingDeque.putFirst(message); log.info("将消息: {} 插入到队列。", message); } catch (InterruptedException e) { e.printStackTrace(); } } /** * 从队列尾部阻塞读取消息,若没有消息,线程就会阻塞等待新消息插入,防止 CPU 空转 */ public void onMessage() { RBlockingDeque<String> blockingDeque = redissonClient.getBlockingDeque(REDIS_MQ); while (true) { try { String message = blockingDeque.takeLast(); log.info("从队列 {} 中读取到消息:{}.", REDIS_MQ, message); } catch (InterruptedException e) { e.printStackTrace(); } } } 单元测试 @RunWith(SpringRunner.class) @SpringBootTest(classes = RedissionApplication.class) public class RedissionApplicationTests { @Autowired private QueueService queueService; @Test public void testQueue() throws InterruptedException { new Thread(() -> { for (int i = 0; i < 1000; i++) { queueService.sendMessage("消息" + i); } }).start(); new Thread(() -> queueService.onMessage()).start(); Thread.currentThread().join(); } } 总结 可以使用 List 数据结构来实现消息队列,满足先进先出。为了实现消息可靠性,Redis 提供了 BRPOPLPUSH 命令是解决。 Redis 是一个非常轻量级的键值数据库,部署一个 Redis 实例就是启动一个进程,部署 Redis 集群,也就是部署多个 Redis 实例。 而 Kafka、RabbitMQ 部署时,涉及额外的组件,例如 Kafka 的运行就需要再部署 ZooKeeper。相比 Redis 来说,Kafka 和 RabbitMQ 一般被认为是重量级的消息队列。 需要注意的是,我们要避免生产者过快,消费者过慢导致的消息堆积占用 Redis 的内存。 在消息量不大的情况下使用 Redis 作为消息队列,他能给我们带来高性能的消息读写,这似乎也是一个很好消息队列解决方案。

优秀的个人博客,低调大师

每日一博 | 为追校花走上 FoxPro 不归路

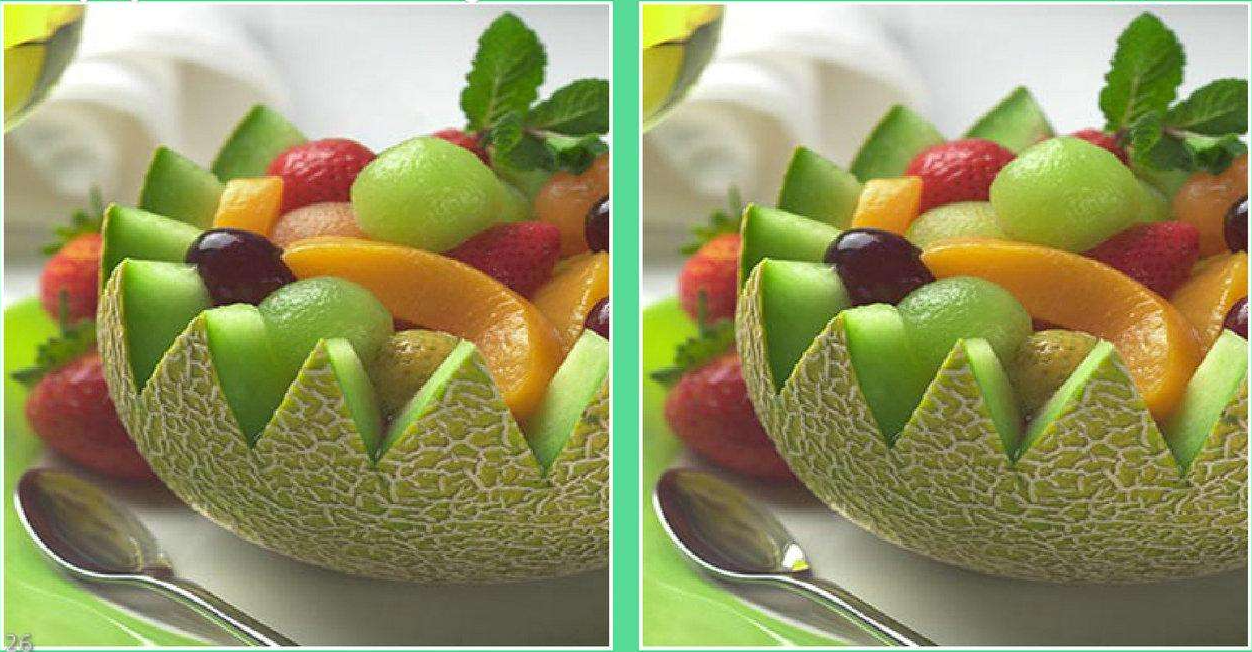
天地玄黄,宇宙洪荒。中专时,我迷上了编程,其中数据库编程学得较多(虽然幻想学C,无奈没有机会:学校机房只安装了FoxBase、FoxPro,并且当时偏僻的学校没有5元一张的光盘,更现实的是电脑没有光驱,只有5寸或3.5寸的软驱),我的数据库程序在学校还曾获奖。我常常去请教会C语言的学长,要他指点一二。看到报刊亭与编程有关的杂志也会买下并仔细地读,作为编程范本临摹。 那时候最崇拜的就是比尔盖茨了。我把他的名言刻在我的课桌上:“这个世界并不在乎你的自尊,只在乎你做出来的成绩,然后再去强调你的感受。”就这样,美丽的青春学生时光,我的精力和注意力全部放在了FoxPro编程上面了。 下面与您分享一下我青春岁月记忆中的FoxPro: 向校花展示我高超的编程能力 当时隔壁班有一个全校公认的校花,我想如果没有独特的气质,是不能打动校花级别女生的。我每天狂热地增加编程和文学知识储备,这样如果哪天和女神聊天时,就会自然而然地流露出儒雅高贵的气质,这是男神模式中很重要的一种。试问有哪个女生能抵抗住有文化有修养有编程技术的男生呢? 一个夏天的下午,我惊讶地发现,校花喜欢玩“大家来找茬”这个QQ在线游戏。 “找茬”这个游戏,就是从两幅一模一样的图中,找到不同之处。因此在玩这个游戏中,最重要的是我们应该有一双敏锐的眼睛,要善于发现图中的不同。并且要比其他玩家先找到,才算赢。 不管你承不承认,人与人就是不同,校花对“找茬”有着天生的敏锐,她轻轻松松就可以找出两幅图中的不一样,10盘里面至少能赢9盘。而我,10盘里面最多赢1盘。本来是想通过玩同样的游戏,拉近和校花的距离,结果适得其反,我感觉我离校花越来越远了... 自诩程序员的我,怎能如此被轻视。一瞬间便仿佛进入了久远的传说:“恢弘的场景,显赫的姓名,让我沉浸在了历史的美景里,校花和庸俗的同学们向我投来羡慕的目光。" 我快速欢快入迷地构思伪码如下: 用代码对屏幕指定区域的内容自动截图; 截图之后用代码把两幅图片进行重叠肉眼对比; 对于两幅图片用肉眼发觉细微差别; 将差异部分用鼠标快速选中。 校花惊叹我“找茬”技术的突飞猛进和无比精湛,令她望尘莫及,羡慕不已。 你可能会问:“为什么不自动找到两幅图片中的不同,并标志出差异,最后用鼠标自动选中呢?” “当然不能这样,被女神发现你使用了外挂,她会怎样看你?俺可是编写了一个辅助工具,不是外挂哦!”我自我安慰。(其实是自动找不同,自动标志图片,自动鼠标点击这些指令我也不会,o(* ̄︶ ̄*)o。) 编写打字比赛软件 wt(五笔高手速成) 明伦软件(这是当年非常流行的 五笔打字学习软件) 那个年代,会打字可是一项了不起的技能,可以用来找一个好工作。许多同学练习五笔字型输入法,天天在宿舍背字根。我暗暗鄙视:“打字员太低级了,我可是会写代码的程序员!要不我编写一个绝无仅有的打字比赛软件,惊艳惊艳他们。”说到做到,我用FoxPro做了一个纵横打字比赛软件。 我快速欢快入迷地构思伪码如下: 做一个表tt保存打字比赛的中英文文本; 设计中英文文本的增删改查; 做一个文本显示和录入界面; 设计录入文本与对照文本正确率计算模块; 程序虽然简单,在当年可是得到学校的表扬,并运用在全市中小学劳动技能(电脑打字)大赛中。这件事确实让我有小小的激动,梦想着当上电脑大师,万众瞩目... 用Foxpro看不起只会用Asp编写动态网页的人 我有一个学姐,她会做漂亮的网页和使用Asp脚本语言,深受老师的喜爱,她自信满满,认为自己已经是软件高级工程师了,经常轻视鄙夷我们这些师弟们。有一次,她指着屏幕上她写的论坛程序的回复页面(那个年代流行编写论坛),问我:“听老师说,你懂一点编程?我考一考你,我点击了这个提交按钮,到底有没有数据写入数据库呢?”我顿时石化了,有还是没有,我不知道呀。看着我傻眼的表情,她得意地说,“不懂就不要装懂,编程序不是你们这些天资不高的人能干的活,还是努力努力,帮老师们做做ppt,录一录试题资料,正好我写了一个在线考试系统…” 可当我向她展示“找茬游戏辅助”这个FoxPro程序时,她惊呆了(因为Asp对于屏幕指定坐标截图以及可以编译成exe文件这些功能不是特别的擅长),问我是如何实现的,我回复她:“不知道就不要装知道,编程序...” 结果师姐再也不和我说话了,一直到海枯石烂... 沦为打印工具人 毕业季到了,来不及感叹时间的逝去,已经沧海桑田。这半个月来,暴雨不时地倾下,望着窗外的天空,感到莫名的惆怅,长长叹息:“一季又一季的青春,在蹉跎中散去,岁月奔流的长河,也在沉寂中黯然。“这时一个大学的老师请我在他们学校的食堂吃了一份教师餐。“听说你的编程水平不错,我这儿正好需要会电脑的人。眼下我这里需要打印毕业证书,你过来帮帮我。做得好的话,我考虑向领导推荐你!” 高等院校每年需要印制上千份的毕业证书,涉及各学生的可变毕业证属性数据和可变证件照片,如何批量套打该类“学士学位证书”、“硕士学位证书”、“博士学位证书”等证书?用FoxPro实在是只能用这个心情描述“你正好需要,我正好专业”。 我快速欢快入迷地构思伪码如下: 设计好套打模板; 做一个表保存学生毕业证信息; 多次调整代码(凑数的步骤,呵呵) 夏日的炎热拉开序幕,毕业证也打印好了。可是“我考虑向领导推荐你”却没有下文,换来的是“我这儿正好不需要人了”以及办公室多了一个不懂编程却会打字的毕业生。也许不是别人不够友好,而是我不够优秀。也许这才是现实,真实的世界吧! 设计小众RPA的自力更生经历 上班后,和许多年轻人一样,我不想做的枯燥的、重复化的工作,希望有个机器人帮自己完成。 类似于通过模拟人工手动操作键鼠,自动处理规则清晰、批量化的高频日常工作。通过调用windows API,这样的工作Foxpro可以轻松完成。 我快速欢快入迷地构思伪码如下: 设计好操作流程; 调用诸如SetCursorPos、keybd_event、PostMessageA、PostMessageW等API即可轻松模拟键鼠操作; 设计一个表格,保存自动运行了哪些步骤,统计节约了多少时间。 总之,有了自动操作的代码后,同事们连登陆系统输入用户名和密码都不愿意做了。哎,太美了、太懒了...(帮单位省了购买专业RPA平台的一大笔钱,我做的小米加步枪虽然小众,但是挺实用。英雄总算有了一个小小的用武之地...) Foxpro技术架构之我见 其实使用编程语言,最大的目标是实现。若在这里讨论优劣,估计会激起无数浪花。我与FoxPro(最先接触的是FoxBase,后面是visual Foxpro)经历了生活和工作的点点滴滴,我把他当兄弟,而不仅仅是编程工具。 比尔领进门,修行在胆识。 校花是动力,三昧真火智。 数据管理圣,唯我廖大力。 作为功能强大的数据库管理系统,FoxPro拥有悠久而辉煌的发展历史。曾经作为一种可靠、便捷和高效的程序员用的数据库产品而名闻遐迩,它是独一无二的!夜深了,星睡了,Foxpro,我来过,我未离去,愿心中共同的宏愿,化作宇宙时空中不变的回忆和未来的明灯...

优秀的个人博客,低调大师

每日一博 | 用户登录功能:说简单也困难

摘要:用户登录说起来只是一个很普通的功能,不过它的逻辑一点也不简单。 本文分享自华为云社区《性能分析之用户登录TPS低以及CPU被打满问题分析》,作者:zuozewei 。 用户登录说起来只是一个很普通的功能,不过它的逻辑一点也不简单。因为登录过程要对个人的信息进行对比验证,验证过程中又要调用相应的加密算法,而加密算法是对性能要求很高的一种功能。复杂的加密算法安全性高,但性能就差;不复杂的加密算法性能好,但安全性高,这是一个取舍的问题。 按照测试方案的基准场景的设计步骤,先压测这个接口的基准场景。 ● 问题现象 如上图所示,这现象老明显了。 压测结果中的 TPS 平均才 25平均响应时间达到了 993 ms。 ● 分析过程 从性能分析逻辑上来说,针对响应时间长的问题,首先要做的就是拆分时间。由于这个系统已经部署了 SkyWalking,用它看看时间主要消耗在了哪里。 看图中,Tomcat 的 SelfDuration 是最多的,也就是说时间几乎消耗在服务本身。 ● 全局监控 首先查看下应用服务器的资源水位情况: 可以看到4C的CPU资源已经被耗光。 这里部署的是容器,先看下各容器资源使用情况: 可以看到资源主要被服务容器消耗了。 ● 服务定向分析 首先进入服务容器查看下资源消耗情况: 在 SkyWaking 中又看不到完整的调用栈,考虑直接连到服务 Java 进程中看方法的时间消耗。这里用 Arthas 来跟踪一下。 查看当前最忙的前N个线程并打印堆栈: 这里为程序的业务代码。 于是 trace attemptAuthentication 这个方法。 接着trace authenticate 这个方法。 一层层跟踪下去,最终来到了这里: 既然这个 crypt_raw 方法耗时比较长,那就反编译源代码看看这一段是什么东西。 可以看到这里是一个加密算法 BCrypt,那么结论就很明显了 BCrypt 加密算法虽然安全性高,但性能差。 ● demo验证 这里使用 SpringBoot 实现 MD5 加密和 BCrypt 加密的实例。 JMeter 并发20 MD5 加密结果: JMeter 并发20 BCrypt 加密结果: ● 建议优化方向 这里解释一下,Bcrypt在加密时,每一次HASH出来的值是不同的,所以特别慢! 具体什么是 Bcrypt 算法,可以参考这篇文章:https://www.jianshu.com/p/2b131bfc2f10 分析到这里,优化方案其实比较明确了,那就是用更快的加密方式,或者去掉这个加密算法。 点击关注,第一时间了解华为云新鲜技术~

优秀的个人博客,低调大师

每日一博 | DevTools 实现原理与性能分析实战

一、引言 从 2008 年 Google 释放出第一版的 Chrome 后,整个 Web 开发领域仿佛被注入了一股新鲜血液,渐渐打破了 IE 一家独大的时代。Chrome 和 Firefox 是 W3C Web 标准的坚定支持者,随着这两款开源浏览器市场份额逐渐加大,迎来了开发者的春天。这就迎来了一个新的职业分工——前端工程师 frontend-engineer,前端工程师促进了 Web 应用的繁荣,功能强大的调试工具必不可少。Google 基于开源的基础上顺势推出了 DevTools,广受网页开发者的好评,随即也推动了 Chrome 的在商业的成功。 本文通过分析 Chrome 的 DevTools 的技术实现,特别是在浏览器内核中的实现部分,来展示这款被万千开发者所喜爱的开发工具背后的秘密。本文适合阅读对象主要有前端开发者、有志于开发 Hybrid 应用调试工具或重写 webdriver 实现对 Chrome 或 WebView 控制的应用工程师。 注:本文所有代码分析,基于 Android Chromium 87.0.4280.141 版本分析而成。由于笔者所在团队主要从事 Android 平台的 Blink 内核开发,所以分析过程主要集中在移动端,其他平台只是数据通路的区别,实现原理差别不大。 二、网页调试工具发展史 2006 年之前,这属于 IE 时代,在 IE 时代编写 JavaScript 代码时的调试手段,主要靠 window.alert() 或将调试信息输出到网页上来分析逻辑 bug。这种硬 debug 的手段,不亚于系统底层开发,往往一个小问题要花费掉一整天时间,开发效率极低。 2006 年 1 月份,Apple 的 WebKit 团队释放出第一版本的 Web Inspector,此版本功能还比较简朴,仅可以查看 DOM 节点的继承关系,节点所应用了哪些 CSS 的规则。但此版本已经奠定了今后多年的网页调试工具的原型,具有划时代意义。 WebKit 团队的迭代速度非常快,2006 年 6 月发布了一个重量级功能,JavaScript 的断点调试功能,此时已经具备开发者神器的雏形。 同时开源阵营出现一款 Firefox 的插件 Firebug,专注于 Web 开发的调试,奠定了现代 DevTools 的 Web UI 的布局。早期版本就支持了 JavaScript 的调试,CSS Box 模型可视化展示,支持 HTTP Archive 的性能分析等优秀特性,后来的 DevTools 参考了此插件的功能和产品定位。2016 年 Firebug 整合到 Firefox 内置调试工具,2017 年 Firebug 停止更新,一代神器就此谢幕。 此时迎来了一个开源界的狠角色 Google 团队,基于 WebKit 加入浏览器研发,推出的 Chrome 以「安全、极速、更稳定」吸引了不少 IT 极客的关注,同时开发者工具这方面, Google 吸收多款调试工具的优秀功能,推出了今天的主角 DevTools。 早期版本现在看起来这个布局有点简陋,但这可是十几年前的作品。支持 DOM + CSS 查看,查看资源加载分析,脚本调试以及性能调试。现在开发中常用 DevTools 的功能,基本也就这几个功能。 那个年代的 DevTools,基本是在跟随 Firebug 的功能,只是交互方式上的差异。2007 年 Steve Jobs 发布了第一代 iPhone 手机,Google 相继推出了 Android 手机,互联网的发展来到移动互联网时代。DevTools 此时开始超越同类工具,支持了远程真机调试。Chrome 是多进程架构,DOM 和 JavaScript 是运行在子进程中的,所以 DevTools 的底层实现,已与同类产品完全不同。Chrome 的架构师将 DevTools 实现架构调成在 client-server 模式,这个架构让远程真机调试成为可能。为了方便网络数据传输,Chrome 设计出了一套数据封装协议 Chrome DevTools Protocal(CDP),接下来的几年,这个架构的调整在开源世界大放异彩。 yan Dahl 基于 Chromium 的 JavaScript 虚拟机 V8 设计了 Node.js,Node.js 的面世让 JavaScript 这款 Web 脚本语言走出了浏览器,打开了服务端编程、桌面编程可以使用 JavaScript 语言的新局面。依托于 DevTools 的 client-server 架构以及 Node.js 的开发者的数量不断增加,DevTools 也迅速出圈,Chrome 团队于 2016 年开始支持 Node.js 的调试。DevTools 已从一款 Web 调试工具,演变成 JavaScript 生态中重要一员,助力更多的开发者开发更多优秀代码。Node.js 的生态都离不开 DevTools ,比如桌面开发框架 Electron、开发者喜爱的编辑器 Visual Studio Code 、前端架构 Vue.js、Facebook 开源 Android 性能分析工具 Stetho等。 三、DevTools 架构 DevTools 是 client-server 架构,client 就是用户操作的 Web UI 界面,负责接收用户操作指令,然后将操作指令发往浏览器内核或 Node.js 中进行处理,并将处理结果数据展示在 Web UI 上。server 启动了两类服务,一种 HTTP 服务;另一种 WebSocket 服务。 HTTP 服务提供内核信息查询能力。比如获取内核版本、获取调试页的列表、启动或关闭调试。 WebSocket 服务提供与内核进行真实数据通信的能力,负责 Web UI 传递过来的所有操作指令的分发和处理,并将结果送回 Web UI 进行展示。 下图展示出了 Android DevTools 的整体架构图,从左侧开发者通过 Web UI 的发起的操作命令,是怎么一步一步地将操作命令,传递到手机中的 Browser Core(Browser Core 运行 Chrome 浏览器内核的应用,比如 Chrome 浏览器、Android WebView、NodeJs 应用等)中执行的过程。 Android 平台巧妙地使用 ADB forward 能力,解决了 PC 上的 WebUI 与 Android 手机中的 Chrome 内核的连接问题。轻松了实现了远程调试的能力,不要小瞧这一实现,这对前端开发者效率提升是极大的。因为前端开发者的工作环境,目前来看基本是在 PC (Windows、Mac、Linux 统称为 PC)下,通过远程调试能力的实现,让移动端的开发实现了所见即所得。 正是 Chrome 团队基于网络通信方式,作为 DevTools 底层通信框架,才为后来的 Web 开发团队百花齐放奠定了基础。TCP/IP 是互联网的基础,没有哪种语言或平台不支持 TCP/IP 的。DevTools 选型 TCP/IP 方式直接抹平了不同平台或系统框架之间的差异。 Chrome DevTools Protocol(简称CDP) 这组开放协议的推出,再一次将 DevTools 的实现,真正做到了跨平台。CDP 本质就是一组 JSON 格式的数据封装协议,JSON 是轻量的文本交换协议,可以被任何平台任何语言进行解析。正因为此,官方推荐的支持 CDP 的语言库多达近十种。Google 官方推荐了 Node.js 版本 Puppeteer ,通过 Puppeteer 完整地实现了 CDP 协议,为 Chrome 内核通信的方式打了一个样,接着开源世界陆续推出了多个语言版本的 CDP 的使用库。关于 CDP 协议,在稍后的章节会详细介绍。 Chrome 的架构师通过高度抽象能力,将 DevTools 的底层架构抽象成 TCP/IP 和 CDP 两个部分,奠定了 DevTools 的跨平台跨终端的能力。当年 WebSocket 的实现方案还处在草案阶段,Chrome 架构师就大胆地采用 WebSocket 实现了调试协议中的主协议部分。现在看来,开发者日常使用的页面的实时截图能力,可以实时观察到远程网页中所展示的界面,这个实时性就是基于 WebSocket 来提供的。笔者还很佩服 Chrome 架构师的眼光和设计气场,正是他们优秀的能力,将网页开发者工具带到新高度。 四、DevTools 通信协议 Chrome DevTools Protocol(简称CDP)此协议包含两部分 HTTP 和 WebSocket,DevTools 的 Web UI 将控制命令发往浏览器内核,其中的控制命令、参数以及返回值,都是通过 CDP 来进行封装。命令的发送时,由 Web UI 进行封装后,通过 WebSocket 发往浏览器内核。接收到浏览器内核反馈回结果后,再按协议进行解包,分发给Web UI。 为了分析 Web UI 与 Android 浏览器内核通信过程,需要做一下环境准备。 4.1 环境准备 为了能访问到内核中数据,浏览器内核需要开启 DevTools Server ,PC Chrome 和 Android Chrome / WebView 的开启方式略有不同。 PC Chrome 启动时,增加一个启动参数 -remote-debugging-port=9222 , 这样 DevTools Server 就会侦听本地的端口,可以向 http://localhost:9222 发起 HTTP / WebSocket 请求,即可获取 DevTools 中的数据。 对于 Android Chrome 与 WebView 略有差异,由于 WebView 默认是不开启调试功能的,需要在客户端手动开启,才能启动 Server。 // Android 4.4 以上 WebView 才真正使用 Blink 内核,所以需要在此版本及以上系统。 if (Build.VERSION.SDK_INT >= Build.VERSION_CODES.KITKAT) { WebView.setWebContentsDebuggingEnabled(true); } 此时 Android Chrome / WebView 在手机内已启动了 Server,但为了在 PC 上能够访问到,需要使用 ADB工具的端口转发能力。 ADB 端口转发 您可以使用 forward 命令设置任意端口转发,将特定主机端口上的请求转发到设备上的其他端口。以下示例设置了主机端口 6100 到设备端口 7100 的转发: adb forward tcp:6100 tcp:7100 通过 forward 可以打通 PC 与 Android 设备之间的网络相互访问 Android Chrome / WebView 使用 unix domain socket 建立的 Server 端,此 socket 的连接符为: chrome_devtools_remote和 webview_devtools_remote_分别为 chrome 和 WebView 的连接符。WebView 的连接由于可能不同应用都使用了 WebView,所以采用了进程 ID(PID)作为后缀来区分。 adb shell cat /proc/net/unix | grep "devtools_remote" 0000000000000000: 00000002 00000000 00010000 0001 01 528176 @chrome_devtools_remote 0000000000000000: 00000002 00000000 00010000 0001 01 276394 @webview_devtools_remote_23119 通过 ADB forward ,将 PC 与 Android 设备访问打通,执行如下命令: # 在 PC 上侦听 9222 端口,对 localhost:9222 的请求将会转发到 android 设备上的 webview_devtools_remote_23119 上 adb forward tcp:9222 localabstract:webview_devtools_remote_23119 至此,就可以在 PC 上通过 9222 来访问 Android 设备中的调试页面了。 4.2 HTTP 协议分析 4.2.1 获取内核版本信息 # 使用 curl 工具,GET http://localhost:9222/json/version curl http://localhost:9222/json/version { "Android-Package": "com.vivo.browser", "Browser": "Chrome/87.0.4280.141", "Protocol-Version": "1.3", "User-Agent": "Mozilla/5.0 (Linux; Android 8.1.0; vivo X20Plus A Build/OPM1.171019.011; wv) AppleWebKit/537.36 (KHTML, like Gecko) Version/4.0 Chrome/87.0.4280.141 Mobile Safari/537.36", "V8-Version": "8.7.220.31", "WebKit-Version": "537.36 (@9f05d1d9ee7483a73e9fe91ddcb8274ebcec9d7f)", "webSocketDebuggerUrl": "ws://localhost:9222/devtools/browser" } 从上面返回值,可以得到如下几个信息: Android-Package,使用 WebView 应用的包名。 Browser,内核的版本号。 Protocol-Version,为 CDP 的协议版本,当前版本为 1.3,从 1.0 开始,还有 1.1、1.2 等。 User-Agent,浏览器的 UA 信息。 V8-Version,所使用的 JavaScript 引擎版本号。 WebKit-Version,由于 Blink 内核是基于 WebKit 537.36 版本开发,所以会有此版本信息。 webSocketDebuggerUrl,这是 WebSocket 的调试 URL。 4.2.2 获取可调试页面列表 # 使用 curl 工具,GET http://localhost:9222/json/list curl http://localhost:9222/json/list [ { "description": "{\"attached\":true,\"empty\":false,\"height\":1812,\"never_attached\":false,\"screenX\":0,\"screenY\":72,\"visible\":true,\"width\":1080}", "devtoolsFrontendUrl": "https://chrome-devtools-frontend.appspot.com/serve_rev/@9f05d1d9ee7483a73e9fe91ddcb8274ebcec9d7f/inspector.html?ws=localhost:9222/devtools/page/B86E67DEA526D5EEE83A170B1F62A72C", "faviconUrl": "https://mat1.gtimg.com/www/mobi/2017/image/logo/v0/192.png", "id": "B86E67DEA526D5EEE83A170B1F62A72C", "title": "腾讯网-QQ.COM", "type": "page", "url": "https://xw.qq.com/#news", "webSocketDebuggerUrl": "ws://localhost:9222/devtools/page/B86E67DEA526D5EEE83A170B1F62A72C" }, { "description": "{\"attached\":false,\"empty\":true,\"never_attached\":true,\"screenX\":0,\"screenY\":0,\"visible\":true}", "devtoolsFrontendUrl": "https://chrome-devtools-frontend.appspot.com/serve_rev/@9f05d1d9ee7483a73e9fe91ddcb8274ebcec9d7f/inspector.html?ws=localhost:9222/devtools/page/3F9E05905F1919D563DF01BAEC64D2E4", "id": "3F9E05905F1919D563DF01BAEC64D2E4", "title": "about:blank", "type": "page", "url": "about:blank", "webSocketDebuggerUrl": "ws://localhost:9222/devtools/page/3F9E05905F1919D563DF01BAEC64D2E4" } ] 返回了一个 JSON 的数组,每一个调试页占用一个数据元素,上面的返回值可以看出,笔者环境下 vivo 浏览器打开了两个页面,一个 https://xw.qq.com/#news 和 about:blank。 description,是个 JSON 对象,展示当前页面的状态信息。比如页面宽、高、在屏幕上的偏移,WebView 是否已经 attached 到 view 上了,只有 attach 上的页面,才会被展示出来,能否被调试。 devtoolsFrontendUrl,此值为一个 URL,就是日常使用 DevTools 的 WebUI 控制面板地址,这是个 Web APP 当访问过一次后,会就缓存一份在浏览器下。此页面托管在某个在国内无法正常访问地址,所以经常会出现打不开面板,而显示白屏的情况。Chrome 浏览器在打包时会内置一份与当前内核匹配的 WebUI 版本,所以 Chrome 可以直接调试自己的页面。 id,这是每个打开页面随机生成的 GUID 值,用于生成 WebSocket 链接,以区分不同页面。 title,打开网页的标题,对应网页 head 中的 title 标签内容。 type,页面的类型,主要有以下几类 page、iframe、worker 以及 service_worker 等。 URL,当前打开的页面 URL。 webSocketDebuggerUrl,此参数为 WebSocket 连接的 URL。 HTTP 协议还有其他几个子命令,比如 protocol、new、activate 等,主要是页面控制类的,就不一一介绍了。 4.2.3 WebSocket 协议分析 WebSocket 协议由四部分组成: Domain 、Method 、 Event 和 Type 。 1)Domain,命名空间,类似 C++/Java 中的命名空间或包名,用于分割不同的命令。用于将众多子命令按类划分,方便使用者调用,以及防止 Method 同名冲突。以 1.3 版本的 CDP 协议,一共划分出 15 个Domain。 Browser: 用于管理浏览器对象。 Debugger: 用于调试 JavaScript 的分类,比如断点、调用栈等。 DOM: 所有 DOM 节点操作都在此 Domain 下,DOM 节点的修改,遍历等。 DOMDebugger: 管理 DOM 节点调试的 Domain,DevTools 中节点修改断点,就是通过这组 Domain 中提供的 Method 完成的。 Emulation: 此是一组环境模拟器集合,DevTools 中的修改设备尺寸、UserAgent 等是由这个 Domain 实现。 Input: 事件分发方法的集合。 IO: I/O 流操作集合。 Log: Log 控制 Method 集合。 Network: 浏览器网络通信数据,可能通过此 Domain 进行捕获。 Page: 基于 Blink 中的 Page 操作 Method 集合,比如刷新,打开 URL。 Performance: 集成了性能分析 Method。 Profiler: 采样分析器的 Method 集成在此 Domain 下。 Runtime: 与 JavaScript 通信的 Method 被集成此 Domain 下,比如执行 JavaScript 代码。 Security: 安全类操作,比如证书错误。 Target: DevTools 连接的一些控制类 Method 在此 Domain 下。 2)Method,方法名称,每个 Domain 下都会有一组 Method,指明了具体操作浏览器内核的功能。有三部分组成:名称 、 参数 和 返回值 。与 C++/Java 中方法描述一致。 名称:Debugger.setBreakpointByUrl; 参数:lineNumber integer [,url string,urlRegex string,scriptHash string,columnNumber integer,condition string ]; 返回值:breakpointId BreakpointId,actualLocation Location。 // Debugger.setBreakpointByUrl 到内核,带上如下参数 { "lineNumber":1, "url":"snippet:///Script%20snippet%20%231", "columnNumber":0, "condition":"" } // 将会收到内核的返回值,返回断点成功信息 { "breakpointId":"1:1:0:snippet:///Script%20snippet%20%231", "locations":[] } 3)Event,通知事件,网页会有很多状态通知,需要同步到 WebUI 或其他控制端上来。Event 就是用于通知这些事件的。比如 DOM 属性发生了变化时,将会收到 Dom.attributeModified 事件;将 JavaScript 传递到内核去执行时,将会收到内核发回来的 Debugger.scriptParsed 事件和参数,参数如下: { "scriptId":"238", "url":"", "startLine":0, "startColumn":0, "endLine":0, "embedderName":"", "endColumn":7, "endLine":0, "executionContextAuxData":{ "isDefault":true, "type":"default", "frameId":"2059AA1A2C1A535CF4C480DC01E7FDEC" }, "frameId":"2059AA1A2C1A535CF4C480DC01E7FDEC", "isDefault":true, "type":"default", "executionContextId":5, "hasSourceURL":false, "hash":"035a9e1738252e22523ed8f1c52d9dbf81abe278", "isLiveEdit":false, "isModule":false, "length":7, "scriptId":"238", "scriptLanguage":"JavaScript", "sourceMapURL":"", "startColumn":0, "startLine":0, "url":"" } 4)Type,是 Method 或 Event 传递参数的复杂数据类型,这些类型与内核的对象相对应。比如 DOM.Node 类型就对应着 Blink 中的 DOM 节点。主要属性如下: nodeId: NodeId 也是 Type,节点 id,根据此值可以在内核找到对应的节点。 parentId: NodeId 也是 Type,父节点 id 。 nodeType: integer,节点类型。 nodeName: string,节点名称。 nodeValue:string, 节点内容。 children: array,子节点数组。 attributes: array, 节点属性数组 通过 Node 上这些属性,就可以将 DOM 树的节点在内存占用描述出来。DevTools 的 Web UI 中 Element 面板,就是通过 DOM.getDocument Method 将一棵 DOM 树展现出来。 通过 CDP 的这种数据组织方式,既可以传递控制命令来操作内核,也可以接收内核状态通知(Event)。通过 CDP 可以让浏览器做任何事情,而且得到的信息远比使用 Chrome 图形界面还要多。因此, Google 推出 Chrome Headless 版本,被广泛应用于 web 自动化测试、网页爬虫以及网页沙箱等领域。 当调试移动端浏览器时,可以实时看到移动设备上的所浏览的屏幕,这是怎么做到的呢? 其实,就是一张一张截图通过 Page.screencastFrame 事件将 base64 后的图片发回到 Web UI 中展示的。 从 Page.screencastFrame 通知事件带回了图片和描述信息(Meta data): { "data":"/9j/4AAQSkZJRgABAQAAAQABAAD/2wBDAAYEBQYFBAYGBQYHBw...", "metadata":{ "deviceHeight":604, "deviceWidth":360, "offsetTop":60, "pageScaleFactor":1, "scrollOffsetX":0, "scrollOffsetY":832.6666870117188, "timestamp":1631018056.565802 }, "sessionId":2 } 通过描述信息,即可将此图片的信息展示在 WebUI 上。一张截图近 1M 的大小,由于 DevTools 利用了 WebSocket 的双向长链接的特性,所以展示出来无比平滑和清晰。 4.3 DevTools 内核实现 以上章节,介绍了从 Web 开发者的角度出发,将操作命令传递到移动端 Browser Core 的一个整体流程,以及 CDP 通信协议相关内容。本节重点介绍在 Browser Core 中的实现过程,先介绍 DevTools 在浏览器内核中实现,后面笔者会挑选 JavaScript 如何从字符串传递到 V8 中执行过程,展开来进行详细介绍,这一行为的实现方案。 4.3.1 内核架构介绍 DevTools 以启动一个 Web Server 为起点,然后将调用命令发到相应处理模块,整体架构图如下: DevTools 在内核中大体上分为四层: Server 层,用于接收外部网络发过来的操作请求。 Agent 层,对于 Server 层发过来的请求,进行拆解,根据操作的类型不同,再分发给不同的 Agent 来处理。 Session 层,Session 是对不同的业务模块进行了一层抽象。过了 Session 层后,将会进入不同的业务模块,可以到达 V8, Blink 等。 业务层,就是具体的功能模块,比如 V8 模块,主要负责 JavaScript 的调试相关能力的支撑。 Server 层由 DevToolsManager 这个单例对象来管理,由于是单例所以一个进程只会存在一个 Manger 对象,从而防止被重复创建出多个,导致状态错乱。 4.3.2 Web Server 数据接收入口 Server 收到的请求都会分发给 DevToolsHttpHandler 类,此类负责网络 Client 发过来的数据请求响应和将处理结果发送回网络 Client, 此类有两个重要方法 OnJsonRequest 和 OnWebSocketMessage ,分别用来处理 HTTP 协议和 WebSocket 协议。 void DevToolsHttpHandler::OnJsonRequest( int connection_id, const net::HttpServerRequestInfo& info) { // 查询内核版本信息 if (command == "version") { base::DictionaryValue version; version.SetString("Protocol-Version", DevToolsAgentHost::GetProtocolVersion()); // ... SendJson(connection_id, net::HTTP_OK, &version, std::string()); return; } // 获取内核所支持的协议 if (command == "protocol") { DecompressAndSendJsonProtocol(connection_id); return; } // 获取可调试页 if (command == "list") { DevToolsManager* manager = DevToolsManager::GetInstance(); DevToolsAgentHost::List list = manager->delegate() ? manager->delegate()->RemoteDebuggingTargets() : DevToolsAgentHost::GetOrCreateAll(); RespondToJsonList(connection_id, info.GetHeaderValue("host"), std::move(list)); return; } // 启动一个新调试 if (command == "new") { // ... std::string host = info.GetHeaderValue("host"); std::unique_ptr<base::DictionaryValue> dictionary( SerializeDescriptor(agent_host, host)); SendJson(connection_id, net::HTTP_OK, dictionary.get(), std::string()); return; } // 激活或关闭一个调试 if (command == "activate" || command == "close") { // ... SendJson(connection_id, net::HTTP_NOT_FOUND, nullptr, "Unknown command: " + command); } void DevToolsHttpHandler::OnWebSocketRequest( int connection_id, const net::HttpServerRequestInfo& request) { // 创建调试的 Agent if (base::StartsWith(request.path, browser_guid_, base::CompareCase::SENSITIVE)) { scoped_refptr<DevToolsAgentHost> browser_agent = DevToolsAgentHost::CreateForBrowser( thread_->task_runner(), base::BindRepeating(&DevToolsSocketFactory::CreateForTethering, base::Unretained(socket_factory_.get()))); connection_to_client_[connection_id] = std::make_unique<DevToolsAgentHostClientImpl>( thread_->task_runner(), server_wrapper_.get(), connection_id, browser_agent); AcceptWebSocket(connection_id, request); return; } connection_to_client_[connection_id] = std::make_unique<DevToolsAgentHostClientImpl>( thread_->task_runner(), server_wrapper_.get(), connection_id, agent); // Accept websocket AcceptWebSocket(connection_id, request); } // WebSocket 数据接收接口,所有 WebUI 的请求都通过此接口分发 void DevToolsHttpHandler::OnWebSocketMessage(int connection_id, std::string data) { auto it = connection_to_client_.find(connection_id); if (it != connection_to_client_.end()) { it->second->OnMessage(base::as_bytes(base::make_span(data))); } } DevToolsHttpHandler::OnJsonRequest 用于响应 HTTP 请求,用于查询内核状态,比如内核版本、当前支持协议,将返回完整协议内容,方便开发者适配对应的支持。 DevToolsHttpHandler::OnWebSocketRequest 用于接收 WebSocket 的连接,根据此方法对不同的 Agent 对象进行了创建。 DevToolsHttpHandler::OnWebSocketMessage 所有调试请求数据,都经过此接口通过 Client 分发到不同的 Agent 上去。 Server 层数据响应时通过上面的三个接口来达到数据接收和分发的能力。 4.3.3 JavaScript 执行过程 V8 JavaScript 引擎用于解释执行网页中的 JavaScript 脚本,同时也可以通过 DevTools 接收外部传递过来的脚本,脚本在当前网页的 Context 下执行,所以可以通过 JavaScript 来操作网页行为,比如修改 DOM 节点属性。CDP 中设计了执行 JavaScript 接口 Runtime.evaluate ,引方法的参数如下: { allowUnsafeEvalBlockedByCSP: false, awaitPromise: false, contextId: 14, expression: "alert('hi');", generatePreview: true, includeCommandLineAPI: true, objectGroup: "console", replMode: true, returnByValue: false, silent: false } 其中,最重要的一个参数就是 expression ,此为一个 string 类型的参数,用于存放需要执行的脚本内容。上例将会在网页中弹出一个内容为 hi 的 alert 确认框。 V8 中有个专门的模块,V8RuntimeAgentImpl 用于支持 CDP 中 Runtime 的这个 Domain,当然也有 V8DebuggerAgentImpl 是用来支持 Debug 这个 Domain 的具体实现。V8RuntimeAgentImpl 中 evaluate 方法,就是用于负责接收 DevTools 发过来的执行请求。 void V8RuntimeAgentImpl::evaluate( const String16& expression, Maybe<String16> objectGroup, Maybe<bool> includeCommandLineAPI, Maybe<bool> silent, Maybe<int> executionContextId, Maybe<bool> returnByValue, Maybe<bool> generatePreview, Maybe<bool> userGesture, Maybe<bool> maybeAwaitPromise, Maybe<bool> throwOnSideEffect, Maybe<double> timeout, Maybe<bool> disableBreaks, Maybe<bool> maybeReplMode, Maybe<bool> allowUnsafeEvalBlockedByCSP, std::unique_ptr<EvaluateCallback> callback); V8RuntimeAgentImpl::evaluate 会启动一个 microtasks 来执行脚本,最终会走到 v8::internal::Execution::Call 中,Execution 模块会负责将脚本进行语法解析和编译成字节码,最终调度到虚拟机器中运行。 执行流程如上图所示,Web UI 发出执行脚本的字符串,WebSocket 的 OnWebSocketMessage 将会收到此命令,然后通过 DevToolsSession 逐层向 V8 分发。由于 Chrome 是多进程架构,分为Browser 进程和 Render 进程,之间通过 IPC 进行通信。上图左侧在 Browser 端执行流程,右侧为 Render 端执行流程。 Render 端的DevToolsSession::DispatchProtocolCommand 是一个重要的分发接口,所以发到 V8 或 Blink 的控制命令,都会经过此接口。接着就会将控制命令发送到 V8RuntimeAgentImpl,根据命令功能的不同,调度到不同功能模块进行处理。 4.4 网页性能调优 4.4.1 性能分析面板介绍 DevTools 提供一组功能强大的性能分析工具,网络、JavaScript 调试、渲染、内存以及标准支持度检测等。下面介绍 Performance 面板中一些性能分析时的一些功能。主界面被划分为这几块: 1)帧率(FPS):线性展示了做 Performance 期间,网页渲染的帧率。 2)CPU 使用率:CPU 占用走势图 3)加载过程中截屏:定时采集了网页截屏性能 4)网络加载时序:展示网络资源加载次序及耗时情况 5)帧耗时(Frames):展示了渲染每帧耗时情况,红色表示存在耗时较长的帧。 6)Web Vitals 指标:Google 推荐一套性能体验指标,下面会详细介绍。 7)内核中主要线程:浏览器内核中存在多个线程各有分工,当出现耗时较长帧时,需要在这些线程中排查,具体哪个线程在耗时。主要分为这几个: Main,这是 Blink 主线程,负责网页的排版、解析、JavaScript 执行等。 Raster,光栅化线程,用于将渲染对象转化成 Bitmap。 GPU,硬件加速渲染线程,将 Texture 绘制到屏幕上。 Chrome_ChildIOThread,负责网络资源,文件操作。 Compositor,合成线程,负责将渲染时各个层,合成在一起然后进行光栅化。 ThreadPoolForegoundWorker,Worker 的工作线程池。 8)信息面板:用于展示选择模块详细信息,几个指标含义: Loading:网络请求和 HTML 解析耗时。 Scripting:JavaSript 解析、编译、在虚拟机中执行,以及 GC 耗时。 Rendering:Blink 排版渲染耗时。 Painting:绘制耗时,主要包含绘制、合成、图片解码以及上屏。 System 和 Idle:是系统调度和空闲耗时。 4.4.2 性能分析常规思路 性能分析基本思路从问题入手,网页常见性能问题,笔者遇到的主要有这几种情形。 需要的资源没有及时被请求回来。排除服务器问题,资源请求发起太晚?资源太大? 网页分层太多,导致 Rendering 和 Painting 时间过长。 内存占用过多,页面过于复杂、资源多且大、JavaScript 大块资源持有生命周期太长。 动画多且消失后未移除。JavaScript 的轮播动画、CSS 的动画、带有动画的图片资源,比如 GIF, SVG、WebP 等。 事件侦听不合理。事件侦听过多且可能被高频触达,比如节点变化、Move 事件等。 总的来说,不论是网页性能优化还是 Native 程序优化,只要协调好这两个资源占用即可:CPU + 内存。只要挖掘出问题点,性能问题都会迎刃而解,问题点的挖掘除了源码级别的审查,DevTools 可以助一臂之力。 针对上面总结的常规场景,利用 DevTools 性能分析能力,先整体上审视 Profile 图。 网络请求次序和时长是否合理; Main Thread 的长任务是否合理。 从 Network 板块观察资源请求发起的顺序,是否存在长耗时任务,阻塞着首屏展示资源加载,如果不保证需要的及时加载,就会长时间白屏。 资源问题就绪后,就需要排查哪些长耗时任务执行。先查看 Main Thread 中的 Long task,比如,上图的 Long task 就是 Scripting 的占了较长时间。通过 Bottom-Up / CallTree 查看具体的耗时点,相应地优化掉。 在排查具体优化点时,有个小技巧。通常开发环境都是在 PC 上进行模拟,当版本出去后,才能暴露出问题。由于移动设备的碎片化,很多用户的设备,性能可能并不好。那如何在开发环境优化这类低配置机器上的表现呢?DevTools 提供了限流的模拟,可以限制网络制式为 2G/3G,CPU 降速。 在右上角有个“设置”,展开配置项目,可以看到 Network 和 CPU 的限流选项,选择后重新录制一下 Profile。 上面提到,网页层数太多,极大地影响到网页渲染性能。“网页层数” 是什么意思呢?目前,浏览器渲染引擎为了提升网页绘制性能,绘制时会对网页进行分层。这样的好处就是,仅重绘修改过的层,其他层内容如果没有变化,就不需要重新绘制,直接取上次绘制结果,从而提升绘制效率。不同的 WEB 引擎分层的策略不同,通常会将普通网页、CSS 动画、Canvas、WebGL、Fix 标签等各分为一层。分层会带来渲染效率的提升,但也会带来内存的开销,从而会影响到性能。DevTools 能否分析网页层数吗?可以,在上面的“设置”中有一个选项 “Enable advanced paint instrumentation(slow)” 启用它,重新做一次性能录制。 在 “信息面板” 多了一个 “Layers” 标签,选择后将会看到网页分层情况。如果存在不合理的分层,可以尝试调整方式,将分层进行合并,从而达到提升性能。 4.4.3 Web Vitals Web Vitals 是 Google 推出的一套 Web 性能与体验兼顾的衡量标准。原先的衡量策略基本是基于 “首字” 和 “首屏” 来衡量,但从用户角度和技术优化角度,这两指标都存在这样那样的问题。所以, Google 推出了 Web Vitals 标准,并与 DevTools 进行配合,方便开发者在开发阶段,就识别出 Web 的性能问题。由于标准一直随着时代的发展,不断变化,开发者一直追着指标的变化有点吃不消,好在 Google 明确表示,目前推出的三个指标,短时间内不会变,笔者就不清楚这个短时间是多长时间。 第一个指标:Largest Contentful Paint (LCP),大面积铺满时间点,2.5 秒以内算优秀。主要是指有大面积的文字、图片被展示出来,就算达到了 LCP。 第二个指标:First Input Delay(FID),首次可响应外部输入事件的时间点,100 ms 内算优秀。这个指标是从用户使用角度出发,达到 FID 的时间点,意味着用户可以操作网页了。 第三个指标:Cumulative Layout Shift(CLS),排版跳跃指标,0.1 为优秀。在网页加载过程中,如果出现排好版的元素,发现大面积的移动的话,这个指标就会很高。比如网页中 img 标签不设置宽和高,当图片加载完毕后,按图片实际大小来排版本。这样的就会触发网页重新排版,从用户角度网页被整体向下推了一个图片高度,Google 认为这个体验不好。 LCP / FID / CLS 这三个指标,本质上是从用户视角看网页的性能衡量指标,开发者可以看看自己作品这三个指标属于什么水平。 五、工具在生态构建中的重要性 (数据来自 statcounter.com) Chrome 凭借着自己优秀的产品特性,安全、快速以及稳定性,赢得了大批用户青睐。从上图 StatCounter 统计数据,可以看出 Chrome 已成为绝对的浏览器界的一哥,理所当然地取得商业上的成功。但是 Chrome 在开源以及生态的建立,DevTools 可谓首功一件。Google 通过 DevTools 的超越竞品的特性,吸引了大批前端开发者,转到 Chrome 下开发自己的产品。早期生态产品是 Chrome 插件,Chrome Store 中的插件数量就可以看出它的成功。 当 Node.js 的问世,DevTools 首款支持 Node.js 的调试工具,推动了 Node.js 的普及。然后 DevTools 依托 Node.js 迅速出圈。另一方面,开源世界也开始反哺了 DevTools 项目,目前支持 CDP 协议的开源方案多达 10 几种语言,常用的语言基本都支持上了。这个领域目前还在飞速发展中,期待这个领域可以有更好的发展。 DevTools Web UI 已经从 Chromium 仓库中独立出来,可以单独 Clone 下来进行二次开发,Web UI 本次限于篇幅,未做实现原理分析。其实,Web UI 也是个非常优秀的 Web APP,很适合前端开发者深度研究一下。 我们从优秀开源项目中学习到的不仅是代码实现与架构,也可以学习到更高维度的东西,比如产品思维以及工具思维,并落地到自己项目中。回顾一下网页调试领域发展过程,从一款 JavaScript 插件,是如何演变成今天的前端开发生态,其中有很多点值得学习。 六、结束语 笔者所在团队长期致力于 Chromium 内核的研究与学习,基于其衍生出来的产品,服务我们生态用户,为其提供优质的上网体验。同时,我们孵化出的 Web 浏览服务,也为生态内应用提供强大、快速、稳定的 Web 服务能力。如果您有兴趣于 Web 底层技术研究,欢迎加入我们,与一群志同道合的小伙伴共同成长,同时也能服务好亿级用户。 七、参考文献 [1] Google Chrome [2] 10 Years of Web Inspector [3] 10 years of Speed in Chrome [4] Chrome DevTools [5] Chrome DevTools Protocol protocol [6] Web Vitals 作者:vivo 互联网浏览器内核团队-Li Qingmei

优秀的个人博客,低调大师

每日一博 | 为任意屏幕尺寸构建 Android 界面

在过去的 12 个月内,有约 1 亿台新平板设备被激活,Chrome OS 的激活量增长了 92%,是增长速度最快的桌面平台。这意味着在平板电脑、可折叠设备和 Chrome OS 设备上,有超过 2.5 亿台大屏幕设备运行着 Android 系统,而关于可折叠设备的使用数量也在不断增长,同比增长超过 250%,因此,"大屏" 正在成为 Android 设备中一个重要且增长势头最快的细分市场。这也让设备制造厂商们意识到,针对大屏做优化是让设备在高端手机细分市场中脱颖而出的机会。 随着平板和可折叠设备的迅速发展,是时候停止将手机和平板分开去考虑了,而更应该提供面向一整个生态系统的应用,来提高其在市场中的影响力。本文我们将介绍开发者如何通过我们提供的新 API 和工具快速拥抱并进入这一细分市场。 如果您更喜欢通过视频了解此内容,请 点击此处 查看。 用户参与度 在 Android 开发者峰会举办后的几个月,Play 商店推出新的激励措施,包括会按照设备类型对应用进行评级等举措,鼓励开发者将更多目光放到大屏上去。所以目前正是迎接这些变化的绝佳时机,不仅能够迎合之后的市场变化,还能就此解决因为没有适配大屏而造成用户的使用体验欠缺的尴尬。 △ 针对大屏优化的 Microsoft Outlook 应用界面 我们还观察到那些针对所有屏幕尺寸进行优化的应用,在围绕用户互动度、留存率等指标上,都取得了不错的成绩。比如其中的一个成功案例 Candy Camera,它通过优化可折叠设备和大屏幕的布局,使得使用这些设备的用户在应用上花费的时间增加了 10%,7 天用户留存率更是增长了 14%,而这并不是个例。另一个案例是 Microsoft Outlook,它最近的更新通过使用双窗口布局充分发挥了大屏优势,可以同时查看收件箱和电子邮件内容,并能够在拥有多个显示屏的某个单独窗口中独立撰写电子邮件。这些例子充分表明: 是时候开始摆脱手机这一单一界面限制的束缚,从而自由地进行设计和开发了。 但是也别太担心,我们为此已经做了很多的工作,旨在让您在整个开发周期中尽可能更轻松一些,接下来看看我们提供了哪些帮助您更好进行大屏适配的工具吧。 窗口大小类和 Reference Devices 在多元化的设备生态中,各种 Android 设备的形状各异且尺寸不一,这就使得应用的布局需要十分灵活。在不同的设备上运行同一应用,都应该能够灵活适应不同设备的屏幕尺寸。为此,我们深入研究了 Android 设备市场,并从 Web 的自适应和响应式开发的最佳实践中汲取了一些灵感,构建出可动态调整尺寸的新 Android 界面基础,我们将其称为窗口大小类。 窗口大小类是一组主观的视口断点,您可以根据它们来设计、开发和测试可调整大小的应用布局。这些断点将帮助您了解要进行优化的关键尺寸,以便将应用适配于整个生态系统。窗口大小类分为三类,分别是较小型、中等型和展开型,它们旨在平衡布局的简单和灵活性,以针对特殊情况优化您的应用。我们推荐您使用窗口大小断点来做出高级应用布局决策,对于布局网格列的变化,它们还能映射到 Material Design 布局断点。 新的 WindowSizeClass API 会在 Jetpack WindowManager 1.1 中提供,它将让您摆脱易出错的 isTable 逻辑。这些新 API 还将消除设备在横竖屏切换时需要自定义逻辑的需求,在大多数情况下只需针对不同的窗口大小类断点进行设计,应用就会适应正确的布局和各种应用状态。 class WindowMetrics { class WindowSizeClass(val name: String) { companion object { val COMPACT = WindowSizeClass(“COMPACT”) val MEDIUM = WindowSizeClass(“MEDIUM”) val EXPANDED = WindowSizeClass(“EXPANDED”) } } val widthClass: WindowSizeClass get() {...} val heightClass: WindowSizeClass get() {...} } 有一点比较重要的是,从 Android 12 开始,将允许应用任意调整尺寸,且允许所有应用都以多窗口模式运行。以 Samsung Galaxy Fold 系列来看,其提供的分屏模式使得屏幕利用率提高了 7 倍,而分屏允许用户根据自己的偏好对尺寸进行调整,这也进一步突出了构建可动态调整尺寸界面的重要性。 从设备和配置的角度来对布局进行考量,我们让每个窗口大小类都代表了一些典型设备的配置 (如下图所示),当您考虑基于断点对布局进行设计时,这将会是一个很有用的参考。其中,较小型代表了竖屏模式下手机的典型模式,中等型代表了大部分平板电脑和更大的可折叠设备的尺寸,展开型则代表了平板电脑或更大的可折叠设备,或是桌面设备在横屏模式下的显示情况。 △ 基于宽度的窗口大小类的表示 除了以上三种基于宽度的断点外,我们还引入了具有相同类别名称的基于高度的断点,以便适用于更高级别的布局场景,并赋予更多的灵活性。假设我们需要使用较小的高度断点来对横屏手机界面进行布局优化,虽然这听起来很复杂,但是别担心,根据我们同许多 Android 开发者进行深谈后,大部分情况下只需要根据宽度进行布局适配就可以了。 △ 基于高度的窗口大小类的表示 总而言之,窗口大小类的出现,代表了 Android 在自适应和响应式布局开发中的一大进步,包括更新和优化的指南、Jetpack WindowManager 中的新 API 以及 Android Studio 中的新工具。 谈到 Android Studio,我们将在 Android Studio Bumblebee 中引入一种新的工具类别,我们将其称为 Reference Devices,它的引入是为了让 Android 应用的构建能够响应和适应所有设备类别。我们在对市场数据进行充分研究之后,提供了四种 Reference Devices,分别代表了手机、可折叠设备、平板电脑和桌面设备。它们既可以覆盖目前市场上的主流设备,又涵盖到了快速增长的细分市场,还可以确保应用在大部分窗口大小类中都能够正常运行。 △ 四种 Reference Devices 在本文对大屏幕适配的介绍中,若您只想快速知晓要注意的点,那请记住以下几点: 为了确保应用在不同设备尺寸上都能够正确展示,请优先针对较小和展开型宽度大小类来优化布局; 在所有的 Reference Devices 上都测试一遍您的应用,优先采用在中等型下的最佳布局; 为了提供更好的用户体验,请添加对应用有意义的功能,如支持可折叠设备的折叠状态或针对键盘、鼠标和触控笔输入支持进行优化; 如需了解更多有关窗口大小类的详细信息,请查阅 窗口大小类。 如需查看关于窗口大小类的实际应用示例,请参阅 JetNews Compose 示例。 适配大屏 设计美观且响应迅速的界面是开发应用的第一步,但如何实现和维护这种设计绝对是个挑战,为了简化您的工作,我们会致力于提供高效的工具。现在便会介绍如何通过新的 Jetpack API 和 Android Studio 功能,来对现有应用进行更新,以针对所有屏幕尺寸进行优化。 我们将会使用 Trackr 作为示例,这是一个开源的任务管理应用,我们最近对该应用进行了更新,使其更好地支持更大屏幕的设备。Trackr 的开发曾是为了展示如何在 Android 中支持无障碍功能体验的最佳实践,随着最近针对大屏幕的更新,它无疑是一个很好的示例。 △ 更改之前的 Trackr 样式 上图是我们进行更改之前的 Trackr 样式,您会发现不管在什么设备或屏幕下,都会有一个单窗口任务列表以及用于导航到归档或设置页面的底部应用栏。Trackr 有几个主要界页,包括任务列表、任务详情、任务创建或编辑页面。接下来,就让我们对 Trackr 进行大屏优化。 NavigationRailView 我们正在 Android Studio Chipmunk 中开发一个新的工具 Visual Linting。可以通过它在 Layout Validation 中对界面进行检查,并显示一些警告和相关建议。我们使用 Visual Linting 对 Trackr 的布局进行检查,来通过工具找出一些潜在的大屏幕显示的相关问题。我们可以打开 main_activity 布局,然后打开 Layout Validation 工具 (还可以通过 View - Tools Window 路径找到该选项)。 △ Layout Validation 中对界面进行检查 在 Layout Validation 界面,您会发现有一个新的 Reference Devices 的类别,通过它您可以在 Android Studio 中使用新的 Reference Devices 功能。在 Layout Validation 右上角可以发现一个警告图标,单击此图标可以打开警告窗口,点击每个警告会显示哪些设备会受到影响。如上图所示,我们会发现两个跟大屏显示相关的警告: 底部应用栏只推荐用于较小屏幕以及 MaterialTextView 的部分行包含超过 120 个字符。 △ 警告窗口 展开警告可以查看到 Android Studio 是否提供了修改建议,这里关于底部应用栏警告的修改建议就是使用 Navigation Rail、抽屉式导航栏,或使用顶部应用栏代替。对于 Trackr,我认为使用导航路由更有建设性。而针对 MaterialTextView 的修改建议是要么减少 TextView 的宽度,要么考虑使用多列布局,这里使用多列布局更适合我们的应用。对于 Trackr,我们将会使用典型的列表加详情窗口的样式来解决这些警告,针对有着中等或较大宽度的设备,我们将使用 NavRail,而非底部应用栏,对于展开型宽度的设备我们将使用双窗口布局来展示任务和相关详情。 我们先来进行第一项优化,使用 NavRail 而非底部应用栏,首先我们要考虑的是导航模型,所幸我们不会更改很多具体的视图,仅仅只会更改导航方式,因为 NavRail 会一直存在于整个视图体系中,可以通过它导航到任何其他视图。为了实现这一模式,我们可以将 Navigation Rail View 添加到 main_activity 布局中,如下代码所示: // main_activity.xml <androidX.coordinatorlayout.widget.CorrdinatorLayout …> <com.google.android.material.navigationrail.NavigationRailView android:id="@+id/navigation_rail" android :layout_width="wrap_content" android:layout_height="0dp" app:layout_constraintBottom_toBottomOf="parent" app:layout_constraintStart_toStartOf="parent" app: layout_constraintTop_toTopOf="parent" app:headerLayout="@layout/navigation_rail_header" app:labelVisibilityMode="unlabeled" app:menu="@menu/navigation_rail" /> </androidX.coordinatorlayout.widget.CorrdinatorLayout> 在此之前,main_activity 仅由 FragmentContainerView 和 CoordinatorLayout 组成,并通过 NavHostFragment 来托管其他 Fragment。而将 NavigationRailView 放置在 main_activity 布局级别后,它将在所有视图中持久存在。尽管如此,我只想要 NavigationRail 用于宽度为 600dp 或者更大的屏幕尺寸,要实现这一点,一个简单的方法是添加资源限定 (resource-qualified) 的 main_activity 布局,并在包含 NavHostFragment 的 FragmentContainerView 的同一级别上添加 NavigationRailView: // w600dp/tasks_fragment.xml <layout...> <data.../> <androidx.coordinatorlayout.widget.CoordinatorLayout...> <com.google.android.material.appbar.AppBarLayout.../> <androidx.recyclerview.widget.RecyclerView android:id="@+id/tasks_list" android:layout_width="match_parent" android:layout_height="match_parent" android:clipToPadding="false" android:paddingLeft="@dimen/pane_margin" android:paddingRight="@dimen/pane_margin" tools:ignore="SpeakableTextPresentCheck" tools:listitem="@layout/task_summary"/> </androidx.coordinatorlayout.widget.CoordinatorLayout> </layout> 我们还需要更新 tasks_fragments.xml,从宽度为 600dp 或更大的显示屏中移除底部应用栏。与实现 NavRail 的方式类似,可以为 tasks_fragments 添加资源限定 (resource-qualified) 的布局,然后就可以移除底部应用栏和相关的悬浮操作按钮,其他一切保持不变从而让任务列表继续按照预期工作。最后,在设置 NavRail 菜单栏的 ID 来匹配现有导航目的视图的 ID,再在 MainActivity 中为 NavRail 设置 NavController: <!=-NavRail Menu --> <menu xmlns:android="http://schemas.android.com/apk/res/android"> <item> android:id="@+id/nav_tasks" android:icon="@drawable/ic_task" .../> <item android:id="@+id/nav_archives" android:icon="@drawable/ic_archive" .../> </menu> // MainActivity NavController class MainActivity: AppCompatActivity() { ... override func onCreate(saveInstanceState: Bundle?) { ... binding.navigationRail?.apply{ setupWithNavController(navController) setOnItemReselectedListener() headerView?.setOnClickListener { navController.navigate(R.id.nav_task_edit_graph) } } } } 这样就完成了,可以在 Android Studio 查看显示是否一切正常,通过在各种 Reference Devices 中来回切换查看布局是否按照我们的预期进行。当查看 Phone Reference Device 时,依然能够看到底部应用栏,而切换到更大的屏幕后,我们发现它开始使用 NavRail 了,一切按照我们的预期进行。 △ Phone Reference Device 下的效果 △ Tablet Reference Device 下的效果 SlidingPanelLayout 接下来让我们继续基于展开型宽度设备来实现双窗口视图布局。支持这一布局方式的一个简单方法是使用 SlidingPaneLayout,它的优势在于可以轻松复用现有的布局代码,以下是目前更新后的导航图: △ 更新后的导航图 我们可以通过 NavigationRailView 导航到应用任意一个顶层布局,但仍然可以通过选择界面中某个单项任务而导航到详情页面的 Fragment。这种模式在实现 SlidingPanelLayout 时会发生一些变化,我们将添加一个新布局 TwoPaneTasks 来包含 SlidingPaneLayout,此布局将同时包含任务列表和详情的 Fragment。通过这种方式更新应用导航,无论屏幕尺寸如何都能够拥有相同的导航图,这意味着调整屏幕尺寸不会产生导航的变化,从而让用户感到困惑。 由于任务和详情都呈现在 SlidingPaneLayout 中的同一个新的 Fragment 中,因此我们为该 Fragment 的导航交互专门添加一个新的子导航层次结构。这样,当我选择一项任务并且应用从双窗口变成单窗口时,该项目将位于导航栈的顶部,并是可见的状态。 简单说,我们将使用 SlidingPaneLayout 和 FragmentContainerView 来添加一个新 Fragment 来托管任务和详情窗格,这样不必对现有代码进行大的重构。 // tasks_two_pane_fragment.xml <layout...> <androidx.slidingpanelayout.widget.SlidingPaneLayout android:id="@+id/sliding_pane_layout"...> <androidx.fragment.app.FragmentContainerView android:id="@+id/list_pane" android:name="com.example.android.trackr.ui.tasks.TasksFragment" android:layout_width="@dimen/list_pane_width" android:layout_height="match_parent" android:layout_weight="@dimen/list_pane_weight" tools:layout="@layout/tasks_fragment" /> <androidx.fragment.app.FragmentContainerView android:id="@+id/detail_pane" android:name="androidx.navigation.fragment.NavHostFragment" android:layout_width="@dimen/detail_pane_width" android:layout_height="match_parent" android:layout_weight="@dimen/detail_pane_weight" app:navGraph="@navigation/task_detail" tools:layout="@layout/task_detail_fragment" /> </androidx.slidingpanelayout.widget.SlidingPaneLayout> </layout> 然后,继续更新应用的顶层导航层次结构,使新的双窗口 Fragment 成为应用的起始目的页面,并从应用的导航图中移除详情目的页面。 <!-- 顶层导航图 --> <navigation app: startDestination="@+id/nav_tasks"...> <fragment android:id="@+id/nav_tasks" android:name="..trackr.ui.tasks.TasksTwoPaneFragment" ...> <action android:id="@+id/to_task_edit" app: destination="@id/nav_task_edit_graph' /> </fragment> <!--Remove the 'details' destination--> ... </navigation> <!-SlidingPaneLayout 导航图--> <navigation... app:startDestination="@id/nav_task_detail_placeholder"> <action android:id="@+id/to_task_detail" app:destination="@id/nav_task_detail" app:popUpTo="@id/nav_task_detail" app :popUpToInclusive="true" <fragment android:id="@+id/nav_task_detail" android:name="..trackr.ui..TaskDetailFragment"...> <argument android:name="taskId" app:argType="long" /> </fragment> <!-- 为其实目的页面使用一个 placeholder--> <fragment android:id="@+id/nav_task_detail_placeholder" android:name="..trackr.ui.PlaceholderFragment" tools:layout="@layout/placeholder_fragment"/> </navigation> 最后,再为 SlidingPaneLayout 专门添加一个新导航图,并在 TasksTwoPaneFragment Kotlin 代码中处理 SlidingPaneLayoutNavController 配置逻辑。通过这两项更改应用在不同设备不同外形下的布局会更加合理。完成这些后,我们再次通过在 Android Studio 中的 Reference Devices 工具,就能看到新的布局在所有的设备屏幕中都能够完美布局了。而为了在应用运行时进行测试,Android Studio Chipmunk 提供了可支持尺寸调整的模拟器,通过它可以在相同的 Reference Devices 之间切换,来快速验证应用布局是否正确。 另外,SlidingPaneLayout 提供了另一个重要特性是它不仅适用于大屏幕设备,而且适用于多屏幕设备。Microsoft 最近为 SlidingPaneLayout 提供了一个支持铰链检测的功能,让其自动能够支持跨屏幕拆分窗口,而无需更改任何代码。这意味着应用的新列表/详情布局将适用于所有设备,包括多屏幕设备。 虽然上述提到的方法对于优化大屏显示非常有用,但是许多开发者的应用都基于多个 Activity,对于这些应用,12L 中发布的新 Activity Embedding API 将使支持双窗口视图等新界面范式变得容易,敬请期待。 Jetpack Compose Jetpack Compose 在 2021 年 7 月发布了 1.0 版本后,在 Android 开发者社区产生了巨大反响,成千上万的应用已经在生产环境中使用了 Compose,包括 Play 商店应用本身。Jetpack Compose 本身是一种声明式的界面工具包,通过它您可以根据页面状态进行描述,Compose 会自行进行所有必要的更新。所有的界面都是通过在代码中描述而成,这样也就很容易在运行时做出关于界面样式的决策,而在传统的视图系统中,我们通过对不同屏幕配置进行编译,从而实现对视图的配置,这两者有着巨大的不同。这也让 Compose 可以轻松解决不同屏幕尺寸而带来的界面更改。 接下来,让我们通过 JetNews 来向您展示如何通过 Compose 来进行不同屏幕尺寸的适配。JetNews 的主界面展示了一长串滚动的文章,在针对大屏幕进行优化之前,它的界面如下图所示,可以发现,并没有很好地利用额外的屏幕空间。 △ JetNews 的主界面展示 前文中已经介绍了 WindowManager API,目前我们正在将其集成到 Compose 中去,以便更轻松地从 Compose 中访问这些信息。在此期间,我们可以创建一个 composable 函数来处理与 WindowManager 的集成,然后轻松将当前 Activity 的窗口信息转换为最终的窗口大小类,代码如下所示: @Composable fun Activity.rememberWindowSizeClass(): WindowSize { val configuration = LocalConfiguration.current val windowMetrics = remember (configuration) { WindowMetricsCalculator.getOrCreate() .computeCurrentWindowMetrics(this) } val windowDpSize = with (LocalDensity.current) { windowMetrics.bounds.toComposeRect().size.toDpSize() } when { windowDpSize.width < 600.dp -> WindowSize.Compact windowDpSize.width < 840.dp else -> WindowSize.Expanded } } WindowManager 库很快就会推出直接使用这些类的 API,Compose 也会很快支持更方便的功能来完成此项工作,敬请期待。目前,您可暂时借用这一代码来完成这一功能上的需要。 △ JetNews 侧边抽屉导航栏展示 回到 JetNews,我们可以看到在大屏状态下,侧边的抽屉导航栏会以模态的方式出现,但它会延伸到整个屏幕而出现大量空白区域。根据前文中提到的修改建议,是使用 Navigation Rail,而 Compose 则直接支持,我们仅需要对其进行设置并将内容传入即可。 NavigationRail( header = { JetnewsIcon() } ) { Column(verticalArrangement = Arrangement.Center) { Icon( icon = Icons.Filled.Home, action = navigateToHome ) Icon( icon = Icons.Filled.ListAlt, action = navigateToInterests ) } } 标题图标和两个导航项图标,一个用于主页面,一个用于 Interests 页面,并添加它们对应的导航操作。为了将 Navigation Rail 集成到应用中,我们对顶层应用组件做了一些更改。首先,我们获取当前的窗口大小类,以及显示较小尺寸上的 ModalDrawer,然后确保设置了 ModalDrawer 让其只响应该尺寸中的手势。再将 Navigation Rail 与包含应用中所有屏幕的主导航图并排放置: @Composable fun JetnewsApp() { val windowSize = rememberWindowSizeState() val isDrawerActive = windowSize == WindowSize.Compact ModalDrawer( gesturesEnabled = isDrawerActive drawerContent = {...} ) { val showNavRail = isDrawerActive Row() { if (showNavRail) { AppNavRail() } JetnewsNavGraph() } } } 然后我们发现由于文章列表依然在大屏下没有充分利用空间,因此我们决定在大屏下构建列表/详情布局,这一布局方式是 Material Design 中推荐的大屏幕规范布局之一,让我们将文章列表与打开的文章并排显示。JetNews 应用有两个我们可以复用的组件: PostList 和 PostContent,这种在一开始就将界面拆分为组件的做法,不仅能让测试更加容易,还能让我们轻松对布局进行改进。 为了并排显示 Feed 和 Post,JetNews 简单地使用 Row 包裹两个组件,第一个组件具有固定宽度,第二个组件填充屏幕的其余部分。详情组件包裹在交叉渐变动画中,这让用户点击列表打开文章时看到带有动画过渡的转换效果。 要正确构建列表/详情结构,除了实际布局之外我们还需要解决几个问题。其中比较有趣的一点是思考应用如何在不同尺寸布局之间转换,例如对于可折叠手机,应用可能会从较大的屏幕变为较小的屏幕。 △ 可折叠手机上布局转换 为了正确处理如何将列表和详情窗口折叠成单窗口层次结构,当在较小的屏幕上时,我们需要知道用户最后与哪个窗口交互,为此,我们实现了一个简单的自定义修饰符来记录最后一次交互,并以此决定,在不同的折叠状态下应该显示什么内容,从而进一步提升层次结构。 @Composable fun HomeFeedWithArticleDetailsScreen(...) { Row() { PostList( modifier .width(334.dp) .notifyInput(onInteractWithList)) Crossfade(...) { PostContent( modifier .fillMaxSize() .notifyInput { onInteractWithDetail(detailPost.id) } ) } )} } 我们还需要知道,我们是从多大尺寸的屏幕将一次只显示其中一个窗口转变为显示列表/详情布局的。在 JetNews 中我们首先获取窗口大小类的信息,在较小和中等型宽度显示单窗口,而在展开型宽度显示列表/详情布局。 val windowSize = rememberWindowSizeState() val homeScreenType = when (windowSize) { WindowSize.Compact, WindowSize.Medium -> HomeScreenType.Feed WIndowSize.Expanded -> HomeScreenType.FeeWithArticleDetails } 然后,开始针对 JetNews 的导航进行更改。JetNews 最初以主页面和文章页面构建而成,每个页面都有自己的 ViewModel,导航和 ViewModel 之间的集成意味着两个页面始终在不同的导航路径上。但是,为了将页面重组成列表/详情布局,我们需要将这两个屏幕并排显示,此处我们有两种可选方案。一是在详情页面嵌套 NavHost,另外一种方案是统一 ViewModel,由于详情页面内并没有下一级别的导航入口而只会显示一篇打开的文章,我们决定采用第二种方式,将两个 ViewModel 合二为一来简化结构。 我们创建了三个主界面入口点,一个是 HomeFeedScreen,它只负责展示 PostList;一个是 ArticleScreen 负责展示 PostContent;以及新的 HomeFeedWithArticleDetailsScreen 负责显示包含 PostList 和 PostContent 的列表/详情布局。 △ 图左: 主界面入口点 HomeFeedScreen 图右: 主界面入口点 ArticleScreen △ 主界面入口点 HomeFeedWithArticleDetailsScreen 上图是我们适配之前和适配之后的页面样式,可以发现对屏幕空间的利用有了非常大的改善。但这次更改是针对屏幕尺寸做的决策,我们是不是可以让单个组件自身根据页面而拥有不同尺寸呢?例如我们有一张卡片,当在列表中因为空间的限制只展示标题和副标题,而有更多空间时,则调整为显示图像。对于此类情况我们可以使用 Box With Constraints,它类似于框布局,能够根据范围内的测量信息来用于决策。 获取更好的用户体验 在前文中,我们提到为了提供更好的用户体验,请添加对应用有意义的功能,如支持可折叠设备。同 WindowManager API 类似,我们可以轻松地将 Compose 与针对可折叠设备的 API 进行集成。通过这些 API,能够获取到该设备是否且何时触发了铰链或折叠等功能,以及当前设备处于何种姿态。Compose 可以轻松观察这些 API 赋予的状态,从而轻松对界面进行转换。同样,关于此功能的 API 即将在 Compose 中提供,敬请期待。 除了目前提到的 API 之外,我们一直努力开发 Compose 的内部构件,以增强包括键盘和鼠标支持在内的输入设备,这对于在 Chrome OS 上运行的应用尤其有用。如需了解 Chrome OS 和输入详细信息,敬请关注我们近期的文章发布。 如需了解更多 Compose 示例详情,请查阅 Compose 示例代码。 新的 Compose 和大屏幕指南——构建自适应布局,希望能够对您的开发有所帮助。 测试和维护 现在您已了解如何轻松更新应用,来构建可调整尺寸的新界面。如何测试和维护项目也是一个非常重要的课题。维护并支持所有不同尺寸的界面会大大引入测试复杂性,我们一直努力在不提高工作量的情况下,通过新的自动化测试工具和 API,让您能够配置更多设备来增加测试覆盖率。我们将会通过 Gradle 托管设备,从而实现在各种屏幕尺寸和 API 级别上运行虚拟设备来运行现有的 instrumentation 测试。您只需描述要在其上运行测试的设备的配置,其余均由 Gradle 负责,包括设备预先配置和测试工作的运行。 只需在构建脚本过程中定义设备,并将其添加到设备组: testOptions devices { pixel2api29 (com.android.build.api.dsl.ManagedVirtualDevice) { nexus9api30 (com.android.build.api.dsl.ManagedVirtualDevice) { device = "Nexus 9" apiLevel = 30 systemImageSource = "google" abi = "×86" } } deviceGroups { mediumAndExpandedWidth{ targetDevices.addAll(devices.pixel2api29) targetDevices.addAll(devices.nexus9api30) } } 然后使用 Gradle 托管设备组来运行测试: $ gradlew -Pandroid.experimental.androidTest.useUnifiedTestPlatform=true mediumAndExpandedWidthGroupDebugAndroidTest 由于 Gradle 同时管理设备配置和测试作业,Gradle 托管设备还支持测试分片,让您能够跨指定数量的相同设备来分割测试从而减少总体测试作业时间。只需要指定以下参数即可指定要分片的数量: $ gradlew -Pandroid.experimental.androidTest.numManagedDeviceShards=2 deviceDebugAndroidTest 但我们知道运行大量虚拟设备会占用 CPU 和内存,这可能会限制 Gradle 托管设备和测试分片的用处。为了解决此问题,Gradle 托管设备引入了一种针对 instrumentation 测试而优化的新型虚拟设备,称为自动化测试设备,这些设备以 headless 模式运行,禁用了自动化测试通常不需要的后台进程和服务,从而降低了每台设备的总体 CPU 和内存使用率,这将让您能够同时针对代表不同屏幕尺寸的多台设备运行测试。当前,这一功能可在 Android 10 上使用,随着时间的推移将支持更高的 API 级别,以确保现有的屏幕截图测试能够继续与自动化测试设备配合运行。 我们还在开发一组全新 AndroidX Testing API,让您能够将设备置于不同的状态进行测试。例如,您可以测试应用从平折变为半开状态,或在纵向或横向模式之间旋转时的反应。 总结 今天我们讨论了很多内容,从新的设计指南和窗口大小类,到用于更新现有应用的特定 API。大屏幕和可折叠设备代表 Android 的一个庞大且不断增长的细分市场,为了抓住这一增长机会,现在是时候为这些设备构建和设计界面,以便为使用最高级设备的用户获得出色的体验。 欢迎您 点击这里 向我们提交反馈,或分享您喜欢的内容、发现的问题。您的反馈对我们非常重要,感谢您的支持!

优秀的个人博客,低调大师

每日一博 | 字节码引用检测原理与实战

一、字节码与引用检测 1.1 Java字节码 本章中的字节码重点研究Java 字节码,Java字节码(Java bytecode)是Java虚拟机执行的一种指令格式。可以通过javap -c -v xxx.class(Class文件路径) 命令来查看一个Class对应的字节码文件,如下图所示: 1.2 字节码检测 字节码检测本质就是对.java或.kt文件编译后生成的Class文件进行相关的分析和检测。在正式介绍字节码分析在引用检测上的原理与实战前,先介绍下字节码引用检测的技术预研背景。 二、字节码检测技术的预研背景 整个预研背景需要先从笔者负责的APP--内销官网APP的软件架构讲起。 2.1 内销官网APP软件架构 内销官网APP目前共12个子仓,子仓分别独立编译成AAR文件供APP工程使用,软件架构图如下图所示: APP以下,上层浅蓝色为业务层,中间绿色为组件层,最下层深蓝色为基础框架层: 业务层:位于架构最上层,根据业务线划分的业务模块(比如商城、社区、服务),与产品业务相对应。 组件层:是APP的一些基础功能(比如登录、自升级)和业务公用的组件(比如分享、地址管理、视频播放),提供一定的复用能力。 基础框架层:通过跟业务完全无关的基础组件(比如三方框架、自行封装的通用能力),提供完全的复用能力。 2.2 内销官网APP客户端开发模式 官网APP目前主要分3条业务线,多业务版本并行开发是常态,所以模块化非常必要。 官网APP模块化的子仓均已AAR形式供APP使用,且存在上层AAR依赖下层AAR的情况。 官网APP模块化分仓优化工作穿插在各业务版本中,各业务版本并行开发,底层仓库难免有修改。 官网APP各业务版本并行开发时,一般只会新拉取当前版本需要修改代码的仓库,其他仓库均继续依赖老版本的AAR。 2.3 类、方法、属性引用错误导致的运行时崩溃 假设以下场景: 官网APP5.0版本开发过程中,由于HardWare仓没有业务修改,所以继续使用上个版本4.9.0.0的HardWare(版本开发过程中一般只会重新拉取需要修改的仓库,无需修改的仓库会继续使用老版本),但Core仓有代码修改,所以拉取了新的5.0分支,并修改了相关代码,删除了CoreUtils类中的某个fun1方法,如下图所示: 注:硬件检测模块v4.9.0.0版本AAR中用到了核心仓 CoreUtils.class中的fun1方法,其他仓包括主APP工程均未使用到该fun1方法。 请大家思考下,以上场景项目编译是否会有问题? 答:编译无问题 APP主仓依赖的是4.9.0.0版本的HardWare仓编译后的AAR文件,这个AAR文件早在4.9版本就编好没动,所以HardWare仓没有编译问题; APP主仓依赖的是5.0.0.0版本的Core仓,HardWare依赖的是4.9.0.0版本的Core仓,最终编译会取Core仓的高版本5.0.0.0版本参与APP工程编译,App仓没有使用被删除的fun1方法,也不存在编译问题。 以上场景项目编译完成后运行过程中是否会有问题? 答:有问题。 在APP运行到HardWare仓调用了CoreUtils类中fun1方法的情况下就会出现运行时崩溃:Method Not Found。 因为最终参与APP工程编译的是5.0.0.0版本的Core仓,该版本已经删除了fun1方法,所以会出现运行时错误。 真实案例: 1)找不到方法 2)找不到类 所幸以上问题均在开发、测试阶段发现并及时修复掉了,如果流到线上,就是运行到某功能时的必崩场景,将会非常严重。 如果你负责的APP的所有module均是源码依赖,一般情况下如果存在引用问题,编译器会进行提示,所以一般情况下无需担心(除非依赖的底层sdk存在引用问题),但如果是类似官网这样的软件架构,则需要重点注意。 2.4 现状分析、思考 本地测试过程中已出现过引用问题导致的运行时异常,这种运行时异常的检测只靠人工是不够的,必须要有自动化的检测工具来进行检查。传统的findBugs、Lint等是代码静态检测工具,是无法检测出这种潜在的引用问题导致的运行时异常的,静态代码检测无法解决此问题。所以自研自动化的检测工具迫在眉睫! 三、字节码检测的解决方案 如果能在APK编译期间,通过自动化工具对所有JAR、AAR包中每个类做一遍检测,检测其中调用的方法、属性的使用是否存在引用问题,将检测出疑似问题的地方在编译时进行提示,有必要的情况下直接报错终止编译,并输出错误日志来提醒开发人员检查,防止问题流入线上出现运行时异常。 原理:各子仓的Java类(或Kotlin类)在编译成AAR或JAR后,AAR、JAR中会有所有类的Class文件,我们实际上就是需要对编译后生成的Class文件进行分析。 如何对Class文件进行字节码分析? 这里推荐使用 JavaAssist 或 ASM,我们知道Android编译过程主要通过Gradle来控制的,要想分析Class文件字节码,我们需要实现自己的Gradle Transform,在Transform里对Class字节码进行分析,这里我们直接做成Gradle插件。 在编译期间自动分析Class字节码是否存在方法引用、属性引用、类引用找不到或者当前类无权访问的问题,发现问题停止编译,并输出相关日志,提醒开发人员分析,并支持对插件的配置。 到这里,整个方案的主体框架就比较清晰了,如下图所示: 3.1 方法和属性引用检测原理 方法和属性引用问题的识别: 如何识别一个方法引用存在问题? 该方法被删除,找不到相关方法名; 找不到方法签名相同的方法,主要是指方法的入参数量、入参类型无法匹配; 方法是非public方法,当前类无权限访问该方法。 如何识别一个属性(字段)引用存在问题? 该属性被删除,找不到相关属性、字段; 属性是非public属性,当前类无权限访问该属性。 权限修饰符说明: 方法和属性引用的字节码检测:我们可以利用JavaAssist、ASM等支持字节码操作的库来实现对所有类中方法、属性的扫描,并分析方法调用、属性引用是否存在引用问题。 3.2 方法和属性引用检测实战 以下代码均已Kotlin编写,实现Gradle Plugin、Transform具体过程省略,直接上检测功能的代码。方法、字段引用检测: // Gradle Plugin、自定义Transform的部分这里不做赘述 // 方法引用检测 // 遍历每个类中的 每个方法 (包括构造方法 addBy Qihaoxin) classObj.declaredBehaviors.forEach { ctMethod -> //遍历当前类中所有方法 ctMethod.instrument(object : ExprEditor() { override fun edit(m: MethodCall?) { super.edit(m) //每个方法调用都会回调此方法,在此方法中进行检测 //引用检查功能 try { //这里不是每个方法都需要校验的,过滤掉 我们不需要处理的 系统方法,第三方sdk方法 等等 只校验我们自己的业务逻辑代码 if (ctMethod.declaringClass.name.isNeedCheck()) { return } if (m == null) { throw Exception("MethodCall is null") } //不需要检查的包名 if (m.className.isNotWarn() || classObj.name.isNotWarn()) { return } //method找不到,底层会直接抛异常的,包括方法删除、方法签名不匹配的情况 m.method.instrument(ExprEditor()) //访问权限检测,该方法非public,且对当前调用这个方法的类是不可见的 if (!m.method.visibleFrom(classObj)) { throw Exception("${m.method.name} 对 ${classObj.name} 这个类是不可见的") } } catch (e: Exception) { e.message?.let { errorInfo += "--方法分析 Exception Message: ${e.message} \n" } errorInfo += "--方法分析异常发生在 ${ctMethod.declaringClass.name} 这个类的${m?.lineNumber}行, ${ctMethod.name} 这个方法 \n" errorInfo += "------------------------------------------------\n" isError = true; } } /** * 成员变量调用的分析主要有: * 变量直接被删掉后找不到的问题 * private变量的只能定义该变量的类试用 * protected变量的可被类自己\子类\同包名的访问 * */ override fun edit(f: FieldAccess?) { super.edit(f) try { if (f == null) { throw Exception("FieldAccess is null") } //不需要检查的包名 if (f.className.isNotWarn() || classObj.name.isNotWarn()) { return } //这里不用判空,如果field找不到(这个属性被删掉了),底层会直接抛异常NotFoundException val modifiers = f.field.modifiers if (ctMethod.declaringClass.name == classObj.name) { //只处理定义在本类中的方法,不然基类里的方法也会被处理到--会出现本类实际没访问基类里的private变量但报错的问题 if (ctMethod.declaringClass.name == classObj.name) { if (!f.field.visibleFrom(classObj)) { throw Exception("${f.field.name} 对 ${classObj.name} 这个类是不可见的") } } } } catch (e: Exception) { e.message?.let { errorInfo += "--字段分析 Exception Message: ${e.message} \n" } errorInfo += "--字段分析异常发生在 ${classObj.name} 该类在 ${f?.lineNumber}行,使用 ${f?.fieldName} 这个属性时\n" errorInfo += "------------------------------------------------\n" isError = true } } }) } 在以上代码实现中,是遍历了所有的方法,对方法内的方法调用、字段访问进行了检测。那么全局变量如何检查呢? class BillActivity { ... private String mTest1 = CreateNewAddressActivity.TAG; private static String mTest2 = new CreateNewAddressActivity().getFormatProvinceInfo("a","b", "c"); ... } 例如以上代码中,mTest1属性的值以及mTest2属性的值应该如何做检测?这个问题困扰笔者良久。在JavaAssist、ASM中均未能找到获取属性当前值的相关的Api、也未能找到Class字节码直接分析属性值的相关思路以及资料。 在研究了Class字节码相关知识,并做了大量的实验,打了大量的Log后,解决思路才慢慢浮出水面。 我们先来看下BillActivity的一段字节码: 在这里我们找到了定义的mTest1这个全局变量,然后大家可以注意到,右边Method中出现了一个init方法,实际上Java 在编译之后会在字节码文件中生成 init 方法,称之为实例构造器,该实例构造器会将语句块,变量初始化,调用父类的构造器等操作收敛到 init 方法中。那我们的mTest2这个全局变量呢? 搜索后发现mTest2实际上是在static代码块中,这里似乎mTest2赋值并没有被方法包裹,如下图所示: 实际上通过查阅大量资料后得知,Java 在编译之后会在字节码文件中生成 clinit 方法,称之为类构造器,类构造器会将静态语句块,静态变量初始化,收敛到 clinit 方法中。上图通过javap查看Class字节码中未显示clinit方法是因为javap未对此进行相关的适配展示而已。 通过实验Log发现mTest2的初始化确实出现在clinit方法中,且在ASMPlugin的ByteCode中查看跟上图相同的字节码,展示为带有clinit方法标识的字节码,如下图所示: 研究到这里,我们实际也就知道了mTest1和mTest2的赋值实际都发生在init和clinit方法中。所以我们前面遍历类中所有方法来检测方法和属性的引用检查是可以覆盖到全局变量的。 问题到这里似乎已经全部完美解决了,但我在全局变量的代码这里看了几眼后,又发现了新的问题: class BillActivity { ... private String mTest1 = CreateNewAddressActivity.TAG; private static String mTest2 = new CreateNewAddressActivity().getFormatProvinceInfo("a","b", "c"); ... } 我们前面只关心了TAG这个属性和getFormatProvinceInfo这个方法的引用是否存在问题,但我们没有对CreateNewAddressActivity这个类本身做引用检查,假设这个类是private的,这里依然会有问题。所以我们引用检查不能忘记对类引用的检查。 3.3 类引用检查原理 如何识别一个类引用存在问题? 该类被删除,找不到相关类; 类是非public的,当前类无权限访问该类。 3.4 类引用检测实战 类引用检查 //类的引用检查 if (classObj.packageName.isNeedCheck()) { classObj.refClasses?.toList()?.forEach { refClassName -> try { if (refClassName.toString().isNotWarn() || classObj.name.isNotWarn()) { return@forEach } //该类被删除,找不到相关类 val refClass = classPool.getCtClass(refClassName.toString()) ?: throw NotFoundException("无法找到该类:$refClassName") //权限检测 //.....省略.....跟方法和属性的权限检测一样,这里不再赘述 } catch (e: Exception) { e.message?.let { errorInfo += "--类引用分析 Exception Message: ${e.message} \n" } errorInfo += "--类引用分析异常 在类:${classObj.name} 中引用了 $refClassName \n" errorInfo += "------------------------------------------------\n" isError = true } } } 到这里本次字节码引用检测的原理以及实战就介绍完了。 3.5 解决方案的反思 在内销官网的buildSrc中实现了引用检测功能后,得知其他APP很多都已做了模块化,联想到其他APP可能也采用类似官网的模块化架构,也会存在类似痛点,反思当前技术实现并不具备通用的接入能力,深感这件事其实并没有做完,在解决自身APP痛点后需要横向赋能其他APP,解决大团队所面临的痛点,所有才有了后面的独立Gradle插件。 四、独立Gradle插件 如果需要在编译期间进行引用检测的APP模块,欢迎大家接入我开发的这款字节码引用检测的Gradle插件。 4.1 独立Gradle插件目标 1)独立Gradle插件,方便所有APP接入; 2)支持常用的开发配置项,支持插件功能开关、异常跳过等配置; 3)对Java、Kotlin编译后的字节码进行引用检查,能在CI、Jenkins上编译APK包发现引用问题时,编译报错并输出引用问题的具体信息供开发分析、解决。 4.2 插件功能 1)方法引用检测; 2)属性(字段)引用检测; 3)类引用检测; 4)插件支持常用配置,可开可关。 比如能检测出Class Not Found \Method Not Found或者Field Not Found 的问题。整个插件在编译期间运行时间很短,以内销官网APP为例,该插件在APP编译期间运行时间在 2.3秒左右,速度很快,不必担心会增加编译耗时。 4.3 插件接入 在主工程根目录build.gradle中添加依赖: dependencies { ... classpath "com.byteace.refercheck:byteace-refercheck:35-SNAPSHOT" //目前是试运行版本,版本还需迭代;欢迎大家体验并提建议和问题,帮助不断完善插件功能 } 在APP工程的build.gradle中使用插件并设置配置信息: //官网自研的字节码引用检查插件 apply plugin: 'com.byteace.refercheck' //官网自研的字节码引用检查插件-配置项 referCheckConfig { enable true //是否打开引用检查功能 strictMode true // 控制是否发现问题时停止构建, check "com.abc.def" //需要检查的类的包名,因为工程中会使用很多sdk或者第三方库我们一般不做检查,只检查我们需要关注的类的包名 notWarn "org.apache.http,com.core.videocompressor.VideoController" //人工检查确认后不需要报错的包名 } 4.4 插件配置项说明 Enable:是否打开引用检查功能,如果为false,则不进行引用检查 StrictMode:严苛模式开启时,发现引用异常直接中断编译(严苛模式关闭时,只会将异常信息打在编译过程的日志中,发现引用问题不会终止编译)。 建议:Jekins或CI上打Release包时build.gradle中配置的enable和strictMode都设置为true。 Check:需要检测的包名,一般只配置检查当前APP包名即可,如需对依赖的第三方sdk等做检查,可根据需要进行配置。 NotWarn:发现引用问题不报错的白名单,在开发人员检查插件报错的问题并认定实际不会导致崩溃后,可将当前引用不到的类名配置在这里,可跳过检查。如A类引用不到B类中的某个方法,可将B类的类名配置在这里,将不会报错。 4.5 内销官网APP中NotWarn配置项说明 内销官网APP将org.apache.http以及com.core.videocompressor.VideoController加入到了不报错白名单中。org.apache.http 实际用的是Android系统中的包,该包并没有参与APK编译,如果不加该配置项,则会报错,但实际运行不会出错。 com.core.videocompressor.VideoController 该项不加的话会报错:FileProcessFactory中引用不到CompressProgressListener类。排查下FileProcessFactory代码,FileProcessFactory类的138行 调用了convertVideo方法,最后一个listner参数传的null。 该类的字节码Class文件如下,会自动对converVideo最后一个入参null进行强制类型转换: 而这个CompressProgressListener并不是public的,是默认的package。而且FileProcessFactory类与CompressProgressListener不在同一个package下,所以会报错。但实际运行时并不会崩溃,所以需要将其类名加入到不报错的白名单中。 如果在插件使用过程中遇到不应报错的案例,可以通过白名单控制进行跳过,同时希望将案例反馈给我,我这边对案例进行分析并对插件进行迭代更新。 五、总结 预研过程中由于字节码知识较深,且网络上类似字节码插桩、进行代码生成的的教程较多,但做字节码分析的资料太少,所以需要熟悉字节码知识并在实践中慢慢实验和摸索,细节也需慢慢打磨。 在预研过程中积极思考解决方案的通用性和可配置性,最终开发出通用的Gradle插件,积极推动其他模块接入,借此次宝贵的机会进行横向技术赋能,争取大团队的成功。 目前已有两个APP接入插件,插件会持续维护并迭代,等插件稳定后规划集成到CI、Jenkins上。欢迎有需求的APP接入引用检测的Gradle插件,希望能帮助到存在引用检测痛点的APP和团队。 作者:vivo官网商城客户端团队-Qi Haoxin

优秀的个人博客,低调大师

每日一博 | Linux 进程卡住了怎么办?

在我们使用 Linux 系统时,如果网络或者磁盘等 I/O 出问题,会发现进程卡住了,即使用 kill -9 也无法杀掉进程,很多常用的调试工具,比如 strace, pstack 等也都失灵了,是怎么回事? 此时,我们使用 ps 查看进程列表,可以看到卡住的进程状态显示为 D。 man ps 中描述 D 状态是 Uninterruptible Sleep。 Linux 进程有两种睡眠状态: Interruptible Sleep,可中断睡眠,在 ps 命令中显示 S。处在这种睡眠状态的进程是可以通过给它发送信号来唤醒的。 Uninterruptible Sleep,不可中断睡眠,在 ps 命令中显示 D。处在这种睡眠状态的进程无法立即处理任何发送给它的信号,这也是无法用 kill 杀掉它的原因。 在 Stack Overflow 有一个解答: kill -9 只是给进程发送了一个 SIGKILL 信号,当一个进程处于特殊状态时(信号处理,或者系统调用中)会无法处理任何信号,包括 SIGKILL 也不能被正确处理,导致进程不能被立即杀掉,也就是我们常说的 D 状态(不可中断的睡眠状态)。那些常用的调试工具 (比如 strace、pstack 等)一般也是利用某个特殊的信号来实现的,在这种状态下也是无法使用。 可见 D 状态的进程一般是处在某个内核态的系统调用中,那怎么知道是哪个系统调用,又是在等待什么呢?幸好 Linux 下提供了 procfs(就是 Linux 下的 /proc 目录), 通过它就可以看到任何一个进程的当前内核调用栈。下面我们用访问 JuiceFS 的进程来模拟一下(因为 JuiceFS 客户端基于 FUSE,是用户态的文件系统,比较容易模拟 I/O 故障)。 先将 JuiceFS 挂载到前台(在 ./juicefs mount 命令中加一个 -f 参数),然后用 Cltr+Z 把这个进程停掉,这时候用 ls /jfs 去访问挂载点,会发现 ls 卡住了。 通过下面的命令可以看到 ls 卡在了 vfs_fstatat 调用上,它会给 FUSE 设备发送 getattr 请求,在等待回应。而 JuiceFS 客户端进程已经被我们停掉了,所以它就卡住了: $ cat /proc/`pgrep ls`/stack [<ffffffff813277c7>] request_wait_answer+0x197/0x280 [<ffffffff81327d07>] __fuse_request_send+0x67/0x90 [<ffffffff81327d57>] fuse_request_send+0x27/0x30 [<ffffffff8132b0ac>] fuse_simple_request+0xcc/0x1a0 [<ffffffff8132c0f0>] fuse_do_getattr+0x120/0x330 [<ffffffff8132df28>] fuse_update_attributes+0x68/0x70 [<ffffffff8132e33d>] fuse_getattr+0x3d/0x50 [<ffffffff81220c6f>] vfs_getattr_nosec+0x2f/0x40 [<ffffffff81220ee6>] vfs_getattr+0x26/0x30 [<ffffffff81220fc8>] vfs_fstatat+0x78/0xc0 [<ffffffff8122150e>] SYSC_newstat+0x2e/0x60 [<ffffffff8122169e>] SyS_newstat+0xe/0x10 [<ffffffff8186281b>] entry_SYSCALL_64_fastpath+0x22/0xcb [<ffffffffffffffff>] 0xffffffffffffffff 这时候按 Ctrl+C 也不能退出。 root@localhost:~# ls /jfs ^C ^C^C^C^C^C 但是用 strace 却能唤醒它,并且开始处理之前的中断信号,然后就退出了。 root@localhost:~# strace -p `pgrep ls` strace: Process 26469 attached --- SIGINT {si_signo=SIGINT, si_code=SI_KERNEL} --- rt_sigreturn({mask=[]}) = -1 EINTR (Interrupted system call) --- SIGTERM {si_signo=SIGTERM, si_code=SI_USER, si_pid=13290, si_uid=0} --- rt_sigreturn({mask=[]}) = -1 EINTR (Interrupted system call) 。。。 tgkill(26469, 26469, SIGINT) = 0 --- SIGINT {si_signo=SIGINT, si_code=SI_TKILL, si_pid=26469, si_uid=0} --- +++ killed by SIGINT +++ 这个时候如果用 kill -9 的话,也是可以把它杀掉的: root@localhost:~# ls /jfs ^C ^C^C^C^C^C ^C^CKilled 因为 vfs_lstatat() 这种简单的系统调用并没有 屏蔽 SIGKILL,SIGQUIT,SIGABRT 等信号,还可以对它做些常规的处理。 我们再来模拟一个更复杂的 I/O 错误,给 JuiceFS 配置一个无法写入的存储类型,并挂载上,用 cp 尝试往里写入数据,这时候 cp 也会卡住: root@localhost:~# cat /proc/`pgrep cp`/stack [<ffffffff813277c7>] request_wait_answer+0x197/0x280 [<ffffffff81327d07>] __fuse_request_send+0x67/0x90 [<ffffffff81327d57>] fuse_request_send+0x27/0x30 [<ffffffff81331b3f>] fuse_flush+0x17f/0x200 [<ffffffff81218fd2>] filp_close+0x32/0x80 [<ffffffff8123ac53>] __close_fd+0xa3/0xd0 [<ffffffff81219043>] SyS_close+0x23/0x50 [<ffffffff8186281b>] entry_SYSCALL_64_fastpath+0x22/0xcb [<ffffffffffffffff>] 0xffffffffffffffff 怎么卡在 close_fd() ?这是因为往 JFS 写数据是异步的,当 cp 调用 write() 时,数据会先缓存在 JuiceFS 的客户端进程里同时会异步写入到后端存储,等 cp 写完数据,它会调用 close 来确保数据写入完成,对应 FUSE 的 flush 操作。JuiceFS 的客户端在遇到 flush 操作时,需要确保全部写入的数据都持久化到后端存储,而后端存储写入失败了,它就在多次重试的过程中,所以 flush 操作卡住了,还没有回复给 cp,所以 cp 也卡住了。 这个时候如果用 Cltr+C 或者 kill 是可以中断 cp 的运行,因JuiceFS 实现了各种文件系统操作的中断处理,让它放弃当前操作(比如 flush), 返回 EINTR,这样在遇到各种网络故障时可以中断正在访问 JuiceFS 的应用。 这时如果我停止 JuiceFS 客户端进程,让它不能再处理任何 FUSE 请求(包括中断请求),这个时候如果尝试去杀它,就杀不掉了,包括 kill -9 也杀不掉,用 ps 查看进程状态,已经是 D 状态了。 root 1592 0.1 0.0 20612 1116 pts/3 D+ 12:45 0:00 cp parity /jfs/aaa 但这个时候是可以用 cat /proc/1592/stack 来看它的内核调用栈 root@localhost:~# cat /proc/1592/stack [<ffffffff8132775d>] request_wait_answer+0x12d/0x280 [<ffffffff81327d07>] __fuse_request_send+0x67/0x90 [<ffffffff81327d57>] fuse_request_send+0x27/0x30 [<ffffffff81331b3f>] fuse_flush+0x17f/0x200 [<ffffffff81218fd2>] filp_close+0x32/0x80 [<ffffffff8123ac53>] __close_fd+0xa3/0xd0 [<ffffffff81219043>] SyS_close+0x23/0x50 [<ffffffff8186281b>] entry_SYSCALL_64_fastpath+0x22/0xcb [<ffffffffffffffff>] 0xffffffffffffffff 内核调用栈显示它卡在 FUSE 的 flush 调用上,这个时候只要恢复 JuiceFS 客户端进程,就可以立即中断 cp 让它退出。 像 close 这种涉及到数据安全性的操作,不是 restartable, 也就不能被 SIGKILL 等随意中断,比如要 FUSE 的实现端响应中断操作才能中断。 因此,只要 JuiceFS 的客户端进程能够健康的响应中断,就不用担心访问 JuiceFS 的应用卡死。或者杀掉 JuiceFS 客户端进程也可以结束当前的挂载点,中断所有在访问当前挂载点的应用。 如有帮助的话欢迎关注我们项目Juicedata/JuiceFS哟! (0ᴗ0✿)

优秀的个人博客,低调大师

每日一博 | 统一富媒体动效控件

01 背 景 富媒体当下各种样式的控件庞乱繁杂,接口方法不统一,开发者经常使用富媒体控件开发时需要注意的细节较多,比如要事先了解多种控件的api请求方法。 另外,富媒体当下发展得很快,快速迭代滋生了媒体控件的多和杂(工程中图片和视频类控件有很多种)。当下环境的缺口是,整个市场没有一个统一封装的富媒体动效控件,整个应用级别目前没有一个整体的富媒体资源缓存机制,也没有一个与列表类控件形成高效复用的综合富媒体控件。 02 目 标 设计统一富媒体动效控件旨在满足两个场景: 1.解决单个运营类场景的复杂媒体高效切换,一个控件可以满足多种效果; 2.解决类似feed流列表形式的模板统一和高效复用,减少模板量和视图数。 03 收 益 1.单个控件职能丰富,将简化Feed流模板的设计和开发工作; 2.统一API调用后,会大幅降低对富媒体控件的开发学习成本。 04 调 研 京东 1.基本库调研 图片加载库:fresco动效合成库:lottie、ValueAnimator视频播放库:ijkplayer 2.feed流调研 com.jingdong.app.mall.home.floor.view.linefloor.widget.VideoSkuView / IjkVideoView 3.动效基本没有封装,属性动画使用较多 淘宝 基本库调研 图片加载库:ImageLoadFeature动效合成库:lottie、HGifView视频播放库:ijkplayer 2.feed流调研 com.taobao.homepage.view.widgets.MultiLayout / HGifView、HVideoView 3.视频和GIF封装为一个富布局MultiLayoutHGifView和HImageView集成同一个父组件TUrlImageView使用同一个资源加载器ImageLoadFeature 调研结果 两大电商在以下四方面的总结可以归纳为: 1.静图上,淘宝对图片组件进行了封装,京东直接使用了fresco库提供的图片组件; 2.动效上,淘宝基于图片组件做了封装,京东多使用属性动画的方式产生动画效果; 3.两者对lottie的处理是直接使用了L库提供的LottieAnimationView,没有二次封装; 4.视频上,两者统一使用了开源的ijkplayer库进行定制自己的视频加载和播放组件; 初步产出 基于对两大电商的调研和自己的业务,我们产出结果如下: 静图使用MultiImageView,三方库选用Fresco或Glide GIF使用MultiGifView,三方库选用Fresco 动效使用MultiLottieView,三方库选用Lottie Banner使用MultiPagerView,结合ViewPager产出banner效果 视频使用MultiVideoView,一方库选用LeadingVideoView支持加载本地资源 直播使用MultiLiveView,二方库选用WPlayer 整体统一组装为WubaMultiView,产出一个统一动效控件 05 设 计 需求明确后,设计上考虑要解决三个问题: 统一性:不同媒体类型调用的接口和模板统一化问题; 复用性:富媒体控件在整个APP级别上的缓存复用问题; 高效性:如何搭配RecycleView进一步深入到控件级别实现高效复用。 1.统一性 首先,高度封装并统一了接口调用方法,使外部调用者对原本多样化动效的请求方式实现成统一的调用方法,控件自身能够按需加载且是高内聚的;另外,支持扩展新的样式。控件通过统一的接口封装和灵活切换媒体形式,实现资源请求、播放接口到列表模板的全链统一化。 2.复用性 给予富媒体的多种item缓存和复用能力,通过一个全局静态媒体控件缓存池,自定义大小,实现了富媒体控件在APP级别上的复用。 3.高效性 通过与RecycleView的缓存策略搭配使用,满足富媒体多种动效样式在列表视图展示中,完成了从一级模板布局到二级动效控件的高效双重复用;既不需要创建和维护多余的富媒体动效模板,也不需要为不展示的动效控件开销额外的内存空间。 整体控件设计流程图: 06 实 现 1.统一性 1)该控件已枚举了单图(支持Webp格式)、GIF图、Lottie图、Pager定制动效和Video视频,支持扩展能力,开发者还可以继续接入自定义的其它媒体类动效。 public final enum class MediaType private constructor() : kotlin.Enum<MediaType> { IMAGE, GIF, LOTTIE, PAGER, VIDEO;} 2)该控件对这些不同类型的动效媒体进行了统一的接口封装,实现请求加载和播放控制等能力的高度统一,对外只提供了流程图中可见的四种基础方法调用: 1)设置当前媒体类型2)设置URL请求3)播放控制4)设置缓存开关 通过简单的方法封装和内部统一的接口实现完成了控件的高内聚。 3)对外提供的API比起其它单媒体控件设计更简单: // 设置媒体类型fun setMediaType(mediaType: MediaType)// 获取当前的媒体接口fun getIView() : IView?// 设置请求的地址url…fun setUrl(vararg url: String)// 设置裁剪类型fun setActualImageScaleType(scaleType: ScalingUtils.ScaleType)// 设置默认图及其裁剪类型fun setPlaceholderImage(resourceId: Int, scaleType: ScalingUtils.ScaleType?)// 设置请求结果回调fun setOnRequestStatusListener(listener: WubaMultiView.OnRequestStatusListener)// 动效播放fun play()// 动效停止fun stop()// 动效暂停fun pause()// 动效是否正在播放fun isPlaying(): Boolean// 设置缓存fun setUseCache(useCache: Boolean) 同时,内部媒体类组件的接口实现方法既做到了统一又理解起来简单: /** * 统一动效接口,抽象类 */interface IView { fun getMediaType() : MediaType fun getView(context: Context) : View fun setUrl(vararg url: String) { val list = ArrayList<String>() list.addAll(url) setUrl(list) } fun setUrl(urls: List<String>) fun setActualImageScaleType(scaleType: ScalingUtils.ScaleType) fun setPlaceholderImage(resourceId: Int, scaleType: ScalingUtils.ScaleType?) fun setFailureImage(resourceId: Int, scaleType: ScalingUtils.ScaleType?) fun play() fun pause() fun stop() fun isPlaying() : Boolean fun setOnRequestStatusListener(listener: WubaMultiView.OnRequestStatusListener)} 2.复用性 1)该控件设置了全局缓存策略,缓存池是借助枚举类静态成员变量的方式基于整个APP出发设计的,可以实现APP级别的缓存,具有全局复用能力。 enum class MediaType { IMAGE { override fun getViewClass(): Class<IView> { return MultiImageView::class.java as Class<IView> } override fun getViewCacheSize(): Int { return 10 } }, ... companion object { private val CACHE_VIEWS = mutableMapOf<String, ArrayList<IView>>() } internal abstract fun getViewClass() : Class<IView> internal abstract fun getViewCacheSize() : Int internal fun getView(useCache: Boolean): IView { var v: IView? = null if (useCache && CACHE_VIEWS.containsKey(this.name) && (CACHE_VIEWS[this.name]?.size ?: 0) > 0) { v = CACHE_VIEWS[this.name]?.removeLast() } return v ?: getViewClass().newInstance() } internal fun addViewCache(view: IView) { if (!CACHE_VIEWS.containsKey(this.name)) { CACHE_VIEWS[this.name] = arrayListOf<IView>() } if ((CACHE_VIEWS[this.name]?.size?:0) < this.getViewCacheSize()) { CACHE_VIEWS[this.name]?.add(view) } } } 2)同时又支持开启和关闭缓存,对一些特定场景或复用频次比较少的媒体控件可以暂时关闭缓存策略,支持设定各媒体自己控件的缓存池大小,灵活性很强。 具体的缓存策略见《统一富媒体动效控件设计流程图》的左侧部分。 3.高效性 RecycleView通过多级缓存策略,实现了模板级别的高效复用,见下图。图中一个模板对应一个type值。 1)当列表划出手机屏幕时,划出的模板会进入缓存池: 2)对于划入屏幕的模板,首先会考虑从缓存池中提取并复用: 3.使用统一富媒体控件后,各个动效模板都会用这一个控件进行布局,那么对应type的值将会减少为1(模板仅剩一种)。RecycleView简化后的缓存策略如下图所示: 4、然后通过设置不同的富媒体类型,用同一套模板展示不同的富媒体样式。统一富媒体控件结合RecycleView使用将形成四级缓存策略。 这里感觉是多了一个缓存层级,其实控件在之前已为我们减少了一层RecycleView的模板类型(即type值),实际上缓存层级并没有增加,只是逻辑上多出了一层而已。 07 使 用 XML配置 唯一注意事项:XML中配置时需要设置媒体类型,即 media_type=“xxx” <com.wuba.views.media.WubaMultiView android:id="@+id/iv_feed_nopic_avator" android:layout_width="30dp" android:layout_height="30dp" android:layout_alignParentEnd="true" android:layout_marginTop="2.5dp" app:media_type="IMAGE" app:scaleType="centerCrop" app:placeholderImage="@drawable/xxx" app:placeholderImageScaleType="centerCrop" app:failureImage="@drawable/xxx" app:failureImageScaleType="centerCrop"/> 代码提示 预览效果 内存波动 优惠券悬浮窗改造 1.改造前内存出现了两次波动 2.改造后内存波动减少了一次 改造前的波动是因为场景中使用了两个媒体控件分别承载不同的效果,会出现同时加载静图控件和Lottie控件的情况;而改造后的控件内部同一时间只会加载一种用户指定的媒体控件,这样表现在内存上波动最多只会出现一次。 08 总 结 1.使用统 一富媒体动效控件,可以简化RecycleView的模板,与其搭配可以实现item的高效复用,从而大大降低开发维护的成本。 2.使用统一富媒体动效控件,可以在APP级别对富媒体类控件整体产生复用,从而降低APP的内存消耗。 3.使用统一富媒体动效控件,暴露给开发者的接口极少,对富媒体相关业务开发上手很容易,简单的api设计产生了丰富的媒体动效。 本文分享自微信公众号 - 58技术(architects_58)。如有侵权,请联系 support@oschina.cn 删除。本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

优秀的个人博客,低调大师

每日一博 | 完蛋,我的事务怎么不生效?

前言 事务大家平时应该都有写,之前写事务的时候遇到一点坑,居然不生效,后来排查了一下,复习了一下各种事务失效的场景,想着不如来一个总结,这样下次排查问题,就能有恃无恐了。那么先来复习一下事务相关知识,事务是指操作的最小工作单位,作为一个单独且不可切割的单元操作,要么全部成功,要么全部失败。事务有四大特性(ACID): 原子性(Atomicity):事务包含的操作,要么全部成功,要么全部失败回滚,不会存在一半成功一半失败的中间状态。比如A和B一开始都有500元,A给B转账100,那么A的钱少了100,B的钱就必须多了100,不能A少了钱,B也没收到钱,那这个钱就不翼而飞了,不符合原子性了。 一致性(Consistency):一致性是指事务执行之前和之后,保持整体状态的一致,比如A和B一开始都有500元,加起来是1000元,这个是之前的状态,A给B转账100,那么最后A是400,B是600,两者加起来还是1000,这个整体状态需要保证。 隔离性(Isolation):前面两个特性都是针对同一个事务的,而隔离性指的是不同的事务,当多个事务同时在操作同一个数据的时候,需要隔离不同事务之间的影响,并发执行的事务之间不能相互干扰。 持久性(Durability):指事务如果一旦被提交了,那么对数据库的修改就是永久性的,就算是数据库发生故障了,已经发生的修改也必然存在。 事务的几个特性并不是数据库事务专属的,广义上的事务是一种工作机制,是并发控制的基本单位,保证操作的结果,还会包括分布式事务之类的,但是一般我们谈论事务,不特指的话,说的就是与数据库相关的,因为我们平时说的事务基本都基于数据库来完成。 事务不仅是适用于数据库。我们可以将此概念扩展到其他组件,类似队列服务或外部系统状态。因此,“一系列数据操作语句必须完全完成或完全失败,以一致的状态离开系统” 测试环境 前面我们已经部署过了一些demo项目,以及用docker快速搭建环境,本文基于的也是之前的环境: JDK 1.8 Maven 3.6 Docker Mysql 事务正常回滚的样例 正常的事务样例,包含两个接口,一个是获取所有的用户中的数据,另外一个更新的,是update用户数据,其实就是每个用户的年龄+1,我们让一次操作完第一个之后,抛出异常,看看最后的结果: @Service("userService") public class UserServiceImpl implements UserService { @Resource UserMapper userMapper; @Autowired RedisUtil redisUtil; @Override public List<User> getAllUsers() { List<User> users = userMapper.getAllUsers(); return users; } @Override @Transactional public void updateUserAge() { userMapper.updateUserAge(1); int i= 1/0; userMapper.updateUserAge(2); } } 数据库操作: <?xml version="1.0" encoding="UTF-8" ?> <!DOCTYPE mapper PUBLIC "-//mybatis.org//DTD Mapper 3.0//EN" "http://mybatis.org/dtd/mybatis-3-mapper.dtd" > <mapper namespace="com.aphysia.springdocker.mapper.UserMapper"> <select id="getAllUsers" resultType="com.aphysia.springdocker.model.User"> SELECT * FROM user </select> <update id="updateUserAge" parameterType="java.lang.Integer"> update user set age=age+1 where id =#{id} </update> </mapper> 先获取http://localhost:8081/getUserList所有的用户看看: 在调用更新接口,页面抛出错误了: 控制台也出现了异常,意思是除以0,异常: java.lang.ArithmeticException: / by zero at com.aphysia.springdocker.service.impl.UserServiceImpl.updateUserAge(UserServiceImpl.java:35) ~[classes/:na] at com.aphysia.springdocker.service.impl.UserServiceImpl$$FastClassBySpringCGLIB$$c8cc4526.invoke(<generated>) ~[classes/:na] at org.springframework.cglib.proxy.MethodProxy.invoke(MethodProxy.java:218) ~[spring-core-5.3.12.jar:5.3.12] at org.springframework.aop.framework.CglibAopProxy$CglibMethodInvocation.invokeJoinpoint(CglibAopProxy.java:783) ~[spring-aop-5.3.12.jar:5.3.12] at org.springframework.aop.framework.ReflectiveMethodInvocation.proceed(ReflectiveMethodInvocation.java:163) ~[spring-aop-5.3.12.jar:5.3.12] at org.springframework.aop.framework.CglibAopProxy$CglibMethodInvocation.proceed(CglibAopProxy.java:753) ~[spring-aop-5.3.12.jar:5.3.12] at org.springframework.transaction.interceptor.TransactionInterceptor$1.proceedWithInvocation(TransactionInterceptor.java:123) ~[spring-tx-5.3.12.jar:5.3.12] at org.springframework.transaction.interceptor.TransactionAspectSupport.invokeWithinTransaction(TransactionAspectSupport.java:388) ~[spring-tx-5.3.12.jar:5.3.12] at org.springframework.transaction.interceptor.TransactionInterceptor.invoke(TransactionInterceptor.java:119) ~[spring-tx-5.3.12.jar:5.3.12] at org.springframework.aop.framework.ReflectiveMethodInvocation.proceed(ReflectiveMethodInvocation.java:186) ~[spring-aop-5.3.12.jar:5.3.12] at org.springframework.aop.framework.CglibAopProxy$CglibMethodInvocation.proceed(CglibAopProxy.java:753) ~[spring-aop-5.3.12.jar:5.3.12] at org.springframework.aop.framework.CglibAopProxy$DynamicAdvisedInterceptor.intercept(CglibAopProxy.java:698) ~[spring-aop-5.3.12.jar:5.3.12] at com.aphysia.springdocker.service.impl.UserServiceImpl$$EnhancerBySpringCGLIB$$25070cf0.updateUserAge(<generated>) ~[classes/:na] 然后我们再次请求http://localhost:8081/getUserList,看到数据两个都是11说明数据都没有发生变化,第一个操作完之后,异常,回滚成功了: [{"id":1,"name":"李四","age":11},{"id":2,"name":"王五","age":11}] 那什么时候事务不正常回滚呢?且听我细细道来: 实验 1. 引擎设置不对 我们知道,Mysql其实有一个数据库引擎的概念,我们可以用show engines来查看Mysql支持的数据引擎: 可以看到Transactions那一列,也就是事务支持,只有InnoDB,那就是只有InnoDB支持事务,所以要是引擎设置成其他的事务会无效。 我们可以用show variables like 'default_storage_engine'看默认的数据库引擎,可以看到默认是InnoDB: mysql> show variables like 'default_storage_engine'; +------------------------+--------+ | Variable_name | Value | +------------------------+--------+ | default_storage_engine | InnoDB | +------------------------+--------+ 那我们看看我们演示的数据表是不是也是用了InnoDB,可以看到确实是使用InnoDB 那我们把该表的引擎修改成MyISAM会怎么样呢?试试,在这里我们只修改数据表的数据引擎: mysql> ALTER TABLE user ENGINE=MyISAM; Query OK, 2 rows affected (0.06 sec) Records: 2 Duplicates: 0 Warnings: 0 然后再update,不出意料,还是会报错,看起来错误没有什么不同: 但是获取全部数据的时候,第一个数据更新成功了,第二个数据没有更新成功,说明事务没有生效。 [{"id":1,"name":"李四","age":12},{"id":2,"name":"王五","age":11}] 结论:必须设置为InnoDB引擎,事务才生效。 2. 方法不能是 private 事务必须是public方法,如果用在了private方法上,那么事务会自动失效,但是在IDEA中,只要我们写了就会报错:Methods annotated with '@Transactional' must be overrideable,意思是事务的注解加上的方法,必须是可以重写的,private方法是不可以重写的,所以报错了。 同样的final修饰的方法,如果加上了注解,也会报错,因为用final就是不想被重写: Spring中主要是用放射获取Bean的注解信息,然后利用基于动态代理技术的AOP来封装了整个事务,理论上我想调用private方法也是没有问题的,在方法级别使用method.setAccessible(true);就可以,但是可能Spring团队觉得private方法就是开发人员意愿上不愿意公开的接口,没有必要破坏封装性,这样容易导致混乱。 Protected方法可不可以?不可以! 下面我们为了实现,魔改代码结构,因为接口不能用Portected,如果用了接口,就不可能用protected方法,会直接报错,而且必须在同一个包里面使用,我们把controller和service放到同一个包下: 测试后发现事务不生效,结果依然是一个更新了,另外一个没有更新: [{"id":1,"name":"李四","age":12},{"id":2,"name":"王五","age":11}] 结论:必须使用在public方法上,不能用在private,final,static方法上,否则不会生效。 3. 异常必须是运行期的异常 Springboot管理异常的时候,只会对运行时的异常(RuntimeException 以及它的子类) 进行回滚,比如我们前面写的i=1/0;,就会产生运行时的异常。 从源码来看也可以看到,rollbackOn(ex)方法会判断异常是RuntimeException或者Error: public boolean rollbackOn(Throwable ex) { return (ex instanceof RuntimeException || ex instanceof Error); } 异常主要分为以下类型: 所有的异常都是Throwable,而Error是错误信息,一般是程序发生了一些不可控的错误,比如没有这个文件,内存溢出,IO突然错误了。而Exception下,除了RuntimeException,其他的都是CheckException,也就是可以处理的异常,Java程序在编写的时候就必须处理这个异常,否则编译是通不过去的。 由下面的图我们可以看出,CheckedException,我列举了几个常见的IOException IO异常,NoSuchMethodException没有找到这个方法,ClassNotFoundException 没找到这个类,而RunTimeException有常见的几种: 数组越界异常:IndexOutOfBoundsException 类型转换异常:ClassCastException 空指针异常:NullPointerException 事务默认回滚的是:运行时异常,也就是RunTimeException,如果抛出其他的异常是无法回滚的,比如下面的代码,事务就会失效: @Transactional public void updateUserAge() throws Exception{ userMapper.updateUserAge(1); try{ int i = 1/0; }catch (Exception ex){ throw new IOException("IO异常"); } userMapper.updateUserAge(2); } 4. 配置不对导致 方法上需要使用@Transactional才能开启事务 多个数据源配置或者多个事务管理器的时候,注意如果操作数据库A,不能使用B的事务,虽然这个问题很幼稚,但是有时候用错难查找问题。 如果在Spring中,需要配置@EnableTransactionManagement来开启事务,等同于配置xml文件*<tx:annotation-driven/>*,但是在Springboot中已经不需要了,在springboot中SpringBootApplication注解包含了@EnableAutoConfiguration注解,会自动注入。 @EnableAutoConfiguration自动注入了哪些东西呢?在jetbrains://idea/navigate/reference?project=springDocker&path=~/.m2/repository/org/springframework/boot/spring-boot-autoconfigure/2.5.6/spring-boot-autoconfigure-2.5.6.jar!/META-INF/spring.factories下有自动注入的配置: # Auto Configure org.springframework.boot.autoconfigure.EnableAutoConfiguration=\ org.springframework.boot.autoconfigure.admin.SpringApplicationAdminJmxAutoConfiguration,\ org.springframework.boot.autoconfigure.aop.AopAutoConfiguration,\ org.springframework.boot.autoconfigure.amqp.RabbitAutoConfiguration,\ ... org.springframework.boot.autoconfigure.transaction.TransactionAutoConfiguration,\ ... 里面配置了一个TransactionAutoConfiguration,这是事务自动配置类: @Configuration(proxyBeanMethods = false) @ConditionalOnClass(PlatformTransactionManager.class) @AutoConfigureAfter({ JtaAutoConfiguration.class, HibernateJpaAutoConfiguration.class, DataSourceTransactionManagerAutoConfiguration.class, Neo4jDataAutoConfiguration.class }) @EnableConfigurationProperties(TransactionProperties.class) public class TransactionAutoConfiguration { ... @Configuration(proxyBeanMethods = false) @ConditionalOnBean(TransactionManager.class) @ConditionalOnMissingBean(AbstractTransactionManagementConfiguration.class) public static class EnableTransactionManagementConfiguration { @Configuration(proxyBeanMethods = false) @EnableTransactionManagement(proxyTargetClass = false) // 这里开启了事务 @ConditionalOnProperty(prefix = "spring.aop", name = "proxy-target-class", havingValue = "false") public static class JdkDynamicAutoProxyConfiguration { } ... } } 值得注意的是,@Transactional除了可以用于方法,还可以用于类,表示这个类所有的public方法都会配置事务。 5. 事务方法不能在同个类里面调用 想要进行事务管理的方法只能在其他类里面被调用,不能在当前类被调用,否则会失效,为了实现这个目的,如果同一个类有不少事务方法,还有其他方法,这个时候有必要抽取出一个事务类,这样分层会比较清晰,避免后继者写的时候在同一个类调用事务方法,造成混乱。 事务失效的例子: 比如我们将service事务方法改成: public void testTransaction(){ updateUserAge(); } @Transactional public void updateUserAge(){ userMapper.updateUserAge(1); int i = 1/0; userMapper.updateUserAge(2); } 在controller里面调用的是没有事务注解的方法,再间接调用事务方法: @RequestMapping("/update") @ResponseBody public int update() throws Exception{ userService.testTransaction(); return 1; } 调用之后,发现事务失效,一个更新另外一个没有更新: [{"id":1,"name":"李四","age":12},{"id":2,"name":"王五","age":11}] 为什么会这样呢? Spring用切面对方法进行包装,只对外部调用方法进行拦截,内部方法没有进行拦截。 看源码:实际上我们调用事务方法的时候,会进入DynamicAdvisedInterceptor的public Object intercept(Object proxy, Method method, Object[] args, MethodProxy methodProxy)()方法: 里面调用了AdvisedSupport.getInterceptorsAndDynamicInterceptionAdvice(),这里是获取调用调用链。而没有@Transactional注解的方法userService.testTransaction(),根本获取不到代理调用链,调用的还是原来的类的方法。 spring里面要想对一个方法进行代理,用的就是aop,肯定需要一个标识,标识哪一个方法或者类需要被代理,spring里面定义了@Transactional作为切点,我们定义这个标识,就会被代理。 代理的时机是什么时候呢? Spring统一管理了我们的bean,代理的时机自然就是创建bean的过程,看看哪一个类带了这个标识,就生成代理对象。 SpringTransactionAnnotationParser这个类有一个方法是用来判断TransactionAttribute注解的: @Override @Nullable public TransactionAttribute parseTransactionAnnotation(AnnotatedElement element) { AnnotationAttributes attributes = AnnotatedElementUtils.findMergedAnnotationAttributes( element, Transactional.class, false, false); if (attributes != null) { return parseTransactionAnnotation(attributes); } else { return null; } } 6.多线程下事务失效 假设我们在多线程里面像以下方式使用事务,那么事务是不能正常回滚的: @Transactional public void updateUserAge() { new Thread( new Runnable() { @Override public void run() { userMapper.updateUserAge(1); } } ).start(); int i = 1 / 0; userMapper.updateUserAge(2); } 因为不同的线程使用的是不同SqlSession,相当于另外一个连接,根本不会用到同一个事务: 2021-11-28 14:06:59.852 DEBUG 52764 --- [ Thread-2] org.mybatis.spring.SqlSessionUtils : Creating a new SqlSession 2021-11-28 14:06:59.930 DEBUG 52764 --- [ Thread-2] c.a.s.mapper.UserMapper.updateUserAge : <== Updates: 1 2021-11-28 14:06:59.931 DEBUG 52764 --- [ Thread-2] org.mybatis.spring.SqlSessionUtils : Closing non transactional SqlSession [org.apache.ibatis.session.defaults.DefaultSqlSession@2e956409] 7. 注意合理使用事务嵌套 首先事务是有传播机制的: REQUIRED(默认):支持使用当前事务,如果当前事务不存在,创建一个新事务,如果有直接使用当前的事务。 SUPPORTS:支持使用当前事务,如果当前事务不存在,就不会使用事务。 MANDATORY:支持使用当前事务,如果当前事务不存在,则抛出Exception,也就是必须当前处于事务里面。 REQUIRES_NEW:创建新事务,如果当前事务存在,把当前事务挂起。 NOT_SUPPORTED:没有事务执行,如果当前事务存在,把当前事务挂起。 NEVER:没有事务执行,如果当前有事务则抛出Exception。 NESTED:嵌套事务,如果当前事务存在,那么在嵌套的事务中执行。如果当前事务不存在,则表现跟`REQUIRED 查不多。 默认的是REQUIRED,也就是事务里面调用另外的事务,实际上不会重新创建事务,而是会重用当前的事务。那如果我们这样来写嵌套事务: @Service("userService") public class UserServiceImpl { @Autowired UserServiceImpl2 userServiceImpl2; @Resource UserMapper userMapper; @Transactional public void updateUserAge() { try { userMapper.updateUserAge(1); userServiceImpl2.updateUserAge(); }catch (Exception ex){ ex.printStackTrace(); } } } 调用的另外一个事务: @Service("userService2") public class UserServiceImpl2 { @Resource UserMapper userMapper; @Transactional public void updateUserAge() { userMapper.updateUserAge(2); int i = 1 / 0; } } 会抛出以下错误: org.springframework.transaction.UnexpectedRollbackException: Transaction rolled back because it has been marked as rollback-only 我们但是实际事务是正常回滚掉了,结果是对的,之所以出现这个问题,是因为里面到方法抛出了异常,用的是同一个事务,说明事务必须被回滚掉的,但是外层被catch住了,本来就是同一个事务,一个说回滚,一个catch住不让spring感知到Exception,那不是自相矛盾么?所以spring报错说:这个事务被标识了必须回滚掉,最终还是回滚掉了。 怎么处理呢? 外层主动抛出错误,throw new RuntimeException() 使用TransactionAspectSupport.currentTransactionStatus().setRollbackOnly();主动标识回滚 @Transactional public void updateUserAge() { try { userMapper.updateUserAge(1); userServiceImpl2.updateUserAge(); }catch (Exception ex){ ex.printStackTrace(); TransactionAspectSupport.currentTransactionStatus().setRollbackOnly(); } } 8. 依赖外部网络请求回滚需要考虑 有些时候,我们不仅操作自己的数据库,还需要同时考虑外部的请求,比如同步数据,同步失败,需要回滚掉自己的状态,在这种场景下,必须考虑网络请求是否会出错,出错如何处理,错误码是哪一个的时候才成功。 如果网络超时了,实际上成功了,但是我们判定为没有成功,回滚掉了,可能会导致数据不一致。这种需要被调用方支持重试,重试的时候,需要支持幂等,多次调用保存状态的一致,虽然整个主流程很简单,里面的细节还是比较多的。 总结 事务被Spring包裹了复杂性,很多东西可能源码很深,我们用的时候注意模拟测试一下调用是不是能正常回滚,不能理所当然,人是会出错的,而很多时候黑盒测试根本测试这种异常数据,如果没有正常回滚,后面需要手动处理,考虑到系统之间同步的问题,会造成很多不必要的麻烦,手动改数据库这流程就必须走。 【作者简介】: 秦怀,公众号【秦怀杂货店】作者,技术之路不在一时,山高水长,纵使缓慢,驰而不息。个人写作方向:Java源码解析,JDBC,Mybatis,Spring,redis,分布式,剑指Offer,LeetCode等,认真写好每一篇文章,不喜欢标题党,不喜欢花里胡哨,大多写系列文章,不能保证我写的都完全正确,但是我保证所写的均经过实践或者查找资料。遗漏或者错误之处,还望指正。 剑指Offer全部题解PDF 2020年我写了什么? 开源编程笔记

优秀的个人博客,低调大师

每日一博 | 揭开 Vue 异步组件的神秘面纱

简介 在大型应用里,有些组件可能一开始并不显示,只有在特定条件下才会渲染,那么这种情况下该组件的资源其实不需要一开始就加载,完全可以在需要的时候再去请求,这也可以减少页面首次加载的资源体积,要在Vue中使用异步组件也很简单: // AsyncComponent.vue <template> <div>我是异步组件的内容</div> </template> <script> export default { name: 'AsyncComponent' } </script> // App.vue <template> <div id="app"> <AsyncComponent v-if="show"></AsyncComponent> <button @click="load">加载</button> </div> </template> <script> export default { name: 'App', components: { AsyncComponent: () => import('./AsyncComponent'), }, data() { return { show: false, } }, methods: { load() { this.show = true }, }, } </script> 我们没有直接引入AsyncComponent组件进行注册,而是使用import()方法来动态的加载,import()是ES2015 Loader 规范 定义的一个方法,webpack内置支持,会把AsyncComponent组件的内容单独打成一个js文件,页面初始不会加载,点击加载按钮后才会去请求,该方法会返回一个promise,接下来,我们从源码角度详细看看这一过程。 通过本文,你可以了解Vue对于异步组件的处理过程以及webpack的资源加载过程。 编译产物 首先我们打个包,生成了三个js文件: 第一个文件是我们应用的入口文件,里面包含了main.js、App.vue的内容,另外还包含了一些webpack注入的方法,第二个文件就是我们的异步组件AsyncComponent的内容,第三个文件是其他一些公共库的内容,比如Vue。 然后我们看看App.vue编译后的内容: 上图为App组件的选项对象,可以看到异步组件的注册方式,是一个函数。 上图是App.vue模板部分编译后的渲染函数,当_vm.show为true的时候,会执行_c('AsyncComponent'),否则执行_vm._e(),创建一个空的VNode,_c即createElement方法: vm._c = function (a, b, c, d) { return createElement(vm, a, b, c, d, false); }; 接下来看看当我们点击按钮后,这个方法的执行过程。 createElement方法 function createElement ( context, tag, data, children, normalizationType, alwaysNormalize ) { if (Array.isArray(data) || isPrimitive(data)) { normalizationType = children; children = data; data = undefined; } if (isTrue(alwaysNormalize)) { normalizationType = ALWAYS_NORMALIZE; } return _createElement(context, tag, data, children, normalizationType) } context为App组件实例,tag就是_c的参数AsyncComponent,其他几个参数都为undefined或false,所以这个方法的两个if分支都没走,直接进入_createElement方法: function _createElement ( context, tag, data, children, normalizationType ) { // 如果data是被观察过的数据 if (isDef(data) && isDef((data).__ob__)) { return createEmptyVNode() } // v-bind中的对象语法 if (isDef(data) && isDef(data.is)) { tag = data.is; } // tag不存在,可能是component组件的:is属性未设置 if (!tag) { return createEmptyVNode() } // 支持单个函数项作为默认作用域插槽 if (Array.isArray(children) && typeof children[0] === 'function' ) { data = data || {}; data.scopedSlots = { default: children[0] }; children.length = 0; } // 处理子节点 if (normalizationType === ALWAYS_NORMALIZE) { children = normalizeChildren(children); } else if (normalizationType === SIMPLE_NORMALIZE) { children = simpleNormalizeChildren(children); } // ... } 上述逻辑在我们的示例中都不会进入,接着往下看: function _createElement ( context, tag, data, children, normalizationType ) { // ... var vnode, ns; // tag是字符串 if (typeof tag === 'string') { var Ctor; ns = (context.$vnode && context.$vnode.ns) || config.getTagNamespace(tag); if (config.isReservedTag(tag)) { // 是否是保留元素,比如html元素或svg元素 if (false) {} vnode = new VNode( config.parsePlatformTagName(tag), data, children, undefined, undefined, context ); } else if ((!data || !data.pre) && isDef(Ctor = resolveAsset(context.$options, 'components', tag))) { // 组件 vnode = createComponent(Ctor, data, context, children, tag); } else { // 其他未知标签 vnode = new VNode( tag, data, children, undefined, undefined, context ); } } else { // tag是组件选项或构造函数 vnode = createComponent(tag, data, context, children); } // ... } 对于我们的异步组件,tag为AsyncComponent,是个字符串,另外通过resolveAsset方法能找到我们注册的AsyncComponent组件: function resolveAsset ( options,// App组件实例的$options type,// components id, warnMissing ) { if (typeof id !== 'string') { return } var assets = options[type]; // 首先检查本地注册 if (hasOwn(assets, id)) { return assets[id] } var camelizedId = camelize(id); if (hasOwn(assets, camelizedId)) { return assets[camelizedId] } var PascalCaseId = capitalize(camelizedId); if (hasOwn(assets, PascalCaseId)) { return assets[PascalCaseId] } // 本地没有,则在原型链上查找 var res = assets[id] || assets[camelizedId] || assets[PascalCaseId]; if (false) {} return res } Vue会把我们的每个组件都先创建成一个构造函数,然后再进行实例化,在创建过程中会进行选项合并,也就是把该组件的选项和父构造函数的选项进行合并: 上图中,子选项是App的组件选项,父选项是Vue构造函数的选项对象,对于components选项,会以父类的该选项值为原型创建一个对象,然后把子类本身的选项值作为属性添加到该对象上,最后这个对象作为子类构造函数的options.components的属性值: 然后在组件实例化时,会以构造函数的options对象作为原型创建一个对象,作为实例的$options: 所以App实例能通过$options从它的构造函数的options.components对象上找到AsyncComponent组件: 可以发现就是我们前面看到过的编译后的函数。 接下来会执行createComponent方法: function createComponent ( Ctor, data, context, children, tag ) { // ... // 异步组件 var asyncFactory; if (isUndef(Ctor.cid)) { asyncFactory = Ctor; Ctor = resolveAsyncComponent(asyncFactory, baseCtor); if (Ctor === undefined) { return createAsyncPlaceholder( asyncFactory, data, context, children, tag ) } } // ... } 接着又执行了resolveAsyncComponent方法: function resolveAsyncComponent ( factory, baseCtor ) { // ... var owner = currentRenderingInstance; if (owner && !isDef(factory.owners)) { var owners = factory.owners = [owner]; var sync = true; var timerLoading = null; var timerTimeout = null ;(owner).$on('hook:destroyed', function () { return remove(owners, owner); }); var forceRender = function(){} var resolve = once(function(){}) var reject = once(function(){}) // 执行异步组件的函数 var res = factory(resolve, reject); } // ... } 到这里终于执行了异步组件的函数,也就是下面这个: function AsyncComponent() { return __webpack_require__.e( /*! import() */ "chunk-1f79b58b").then(__webpack_require__.bind(null, /*! ./AsyncComponent */ "c61d")); } 欲知res是什么,我们就得看看这几个webpack的函数是干什么的。 加载组件资源 webpack_require.e方法 先看__webpack_require__.e方法: __webpack_require__.e = function requireEnsure(chunkId) { var promises = []; // 已经加载的chunk var installedChunkData = installedChunks[chunkId]; if (installedChunkData !== 0) { // 0代表已经加载 // 值非0即代表组件正在加载中,installedChunkData[2]为promise对象 if (installedChunkData) { promises.push(installedChunkData[2]); } else { // 创建一个promise,并且把两个回调参数缓存到installedChunks对象上 var promise = new Promise(function (resolve, reject) { installedChunkData = installedChunks[chunkId] = [resolve, reject]; }); // 把promise对象本身也添加到缓存数组里 promises.push(installedChunkData[2] = promise); // 开始发起chunk请求 var script = document.createElement('script'); var onScriptComplete; script.charset = 'utf-8'; script.timeout = 120; // 拼接chunk的请求url script.src = jsonpScriptSrc(chunkId); var error = new Error(); // chunk加载完成/失败的回到 onScriptComplete = function (event) { script.onerror = script.onload = null; clearTimeout(timeout); var chunk = installedChunks[chunkId]; if (chunk !== 0) { // 如果installedChunks对象上该chunkId的值还存在则代表加载出错了 if (chunk) { var errorType = event && (event.type === 'load' ? 'missing' : event.type); var realSrc = event && event.target && event.target.src; error.message = 'Loading chunk ' + chunkId + ' failed.\n(' + errorType + ': ' + realSrc + ')'; error.name = 'ChunkLoadError'; error.type = errorType; error.request = realSrc; chunk[1](error); } installedChunks[chunkId] = undefined; } }; // 设置超时时间 var timeout = setTimeout(function () { onScriptComplete({ type: 'timeout', target: script }); }, 120000); script.onerror = script.onload = onScriptComplete; document.head.appendChild(script); } } return Promise.all(promises); }; 这个方法虽然有点长,但是逻辑很简单,首先函数返回的是一个promise,如果要加载的chunk未加载过,那么就创建一个promise,然后缓存到installedChunks对象上,接下来创建script标签来加载chunk,唯一不好理解的是onScriptComplete函数,因为在这里面判断该chunk在installedChunks上的缓存信息不为0则当做失败处理了,问题是前面才把promise信息缓存过去,也没有看到哪里有进行修改,要理解这个就需要看看我们要加载的chunk的内容了: 可以看到代码直接执行了,并往webpackJsonp数组里添加了一项: window["webpackJsonp"] = window["webpackJsonp"] || []).push([["chunk-1f79b58b"],{..}]) 看着似乎也没啥问题,其实window["webpackJsonp"]的push方法被修改过了: var jsonpArray = window["webpackJsonp"] = window["webpackJsonp"] || []; var oldJsonpFunction = jsonpArray.push.bind(jsonpArray); jsonpArray.push = webpackJsonpCallback; var parentJsonpFunction = oldJsonpFunction; 被修改成了webpackJsonpCallback方法: function webpackJsonpCallback(data) { var chunkIds = data[0]; var moreModules = data[1]; var moduleId, chunkId, i = 0, resolves = []; for (; i < chunkIds.length; i++) { chunkId = chunkIds[i]; if (Object.prototype.hasOwnProperty.call(installedChunks, chunkId) && installedChunks[chunkId]) { // 把该chunk的promise的resolve回调方法添加到resolves数组里 resolves.push(installedChunks[chunkId][0]); } // 标记该chunk已经加载完成 installedChunks[chunkId] = 0; } // 将该chunk的module数据添加到modules对象上 for (moduleId in moreModules) { if (Object.prototype.hasOwnProperty.call(moreModules, moduleId)) { modules[moduleId] = moreModules[moduleId]; } } // 执行原本的push方法 if (parentJsonpFunction) parentJsonpFunction(data); // 执行resolve函数 while (resolves.length) { resolves.shift()(); } } 这个函数会取出该chunk加载的promise的resolve函数,然后将它在installedChunks上的信息标记为0,代表加载成功,所以在后面执行的onScriptComplete函数就可以通过是否为0来判断是否加载失败。最后会执行resolve函数,这样前面__webpack_require__.e函数返回的promise状态就会变为成功。 让我们再回顾一下AsyncComponent组件的函数: function AsyncComponent() { return __webpack_require__.e( /*! import() */ "chunk-1f79b58b").then(__webpack_require__.bind(null, /*! ./AsyncComponent */ "c61d")); } chunk加载完成后会执行__webpack_require__方法。 __webpack_require__方法 这个方法是webpack最重要的方法,用来加载模块: function __webpack_require__(moduleId) { // 检查模块是否已经加载过了 if (installedModules[moduleId]) { return installedModules[moduleId].exports; } // 创建一个新模块,并缓存 var module = installedModules[moduleId] = { i: moduleId, l: false, exports: {} }; // 执行模块函数 modules[moduleId].call(module.exports, module, module.exports, __webpack_require__); // 标记模块加载状态 module.l = true; // 返回模块的导出 return module.exports; } 所以上面的__webpack_require__.bind(null, /*! ./AsyncComponent */ "c61d")其实是去加载了c61d模块,这个模块就在我们刚刚请求回来的chunk里: 这个模块内部又会去加载它依赖的模块,最终返回的结果为: 其实就是AsyncComponent的组件选项。 回到createElement方法 回到前面的resolveAsyncComponent方法: var res = factory(resolve, reject); 现在我们知道这个res其实就是一个未完成的promise,Vue并没有等待异步组件加载完成,而是继续向后执行: if (isObject(res)) { if (isPromise(res)) { // () => Promise if (isUndef(factory.resolved)) { res.then(resolve, reject); } } } return factory.resolved 把定义的resolve和reject函数作为参数传给promise res,最后返回了factory.resolved,这个属性并没有被设置任何值,所以是undefined。 接下来回到createComponent方法: Ctor = resolveAsyncComponent(asyncFactory, baseCtor); if (Ctor === undefined) { // 返回异步组件的占位符节点,该节点呈现为注释节点,但保留该节点的所有原始信息。 // 这些信息将用于异步服务端渲染。 return createAsyncPlaceholder( asyncFactory, data, context, children, tag ) } 因为Ctor是undefined,所以会执行createAsyncPlaceholder方法返回一个占位符节点: function createAsyncPlaceholder ( factory, data, context, children, tag ) { // 创建一个空的VNode,其实就是注释节点 var node = createEmptyVNode(); // 保留组件的相关信息 node.asyncFactory = factory; node.asyncMeta = { data: data, context: context, children: children, tag: tag }; return node } 最后让我们再回到_createElement方法: // ... vnode = createComponent(Ctor, data, context, children, tag); // ... return vnode 很简单,对于异步节点,直接返回创建的注释节点,最后把虚拟节点转换成真实节点,会实际创建一个注释节点: 现在让我们来看看resolveAsyncComponent函数里面定义的resolve,也就是当chunk加载完成后会执行的: var resolve = once(function (res) {d // 缓存结果 factory.resolved = ensureCtor(res, baseCtor); // 非同步解析时调用 // (SSR会把异步解析为同步) if (!sync) { forceRender(true); } else { owners.length = 0; } }); res即AsyncComponent的组件选项,baseCtor为Vue构造函数,会把它们作为参数调用ensureCtor方法: function ensureCtor (comp, base) { if ( comp.__esModule || (hasSymbol && comp[Symbol.toStringTag] === 'Module') ) { comp = comp.default; } return isObject(comp) ? base.extend(comp) : comp } 可以看到实际上是调用了extend方法: 前面也提到过,Vue会把我们的组件都创建一个对应的构造函数,就是通过这个方法,这个方法会以baseCtor为父类创建一个子类,这里就会创建AsyncComponent子类: 子类创建成功后会执行forceRender方法: var forceRender = function (renderCompleted) { for (var i = 0, l = owners.length; i < l; i++) { (owners[i]).$forceUpdate(); } if (renderCompleted) { owners.length = 0; if (timerLoading !== null) { clearTimeout(timerLoading); timerLoading = null; } if (timerTimeout !== null) { clearTimeout(timerTimeout); timerTimeout = null; } } }; owners里包含着App组件实例,所以会调用它的$forceUpdate方法,这个方法会迫使 Vue 实例重新渲染,也就是重新执行渲染函数,进行虚拟DOM的diff和path更新。 所以会重新执行App组件的渲染函数,那么又会执行前面的createElement方法,又会走一遍我们前面提到的那些过程,只是此时AsyncComponent组件已经加载成功并创建了对应的构造函数,所以对于createComponent方法,这次执行resolveAsyncComponent方法的结果不再是undefined,而是AsyncComponent组件的构造函数: Ctor = resolveAsyncComponent(asyncFactory, baseCtor); function resolveAsyncComponent ( factory, baseCtor ) { if (isDef(factory.resolved)) { return factory.resolved } } 接下来就会走正常的组件渲染逻辑: var name = Ctor.options.name || tag; var vnode = new VNode( ("vue-component-" + (Ctor.cid) + (name ? ("-" + name) : '')), data, undefined, undefined, undefined, context, { Ctor: Ctor, propsData: propsData, listeners: listeners, tag: tag, children: children }, asyncFactory ); return vnode 可以看到对于组件其实也是创建了一个VNode,具体怎么把该组件的VNode渲染成真实DOM不是本文的重点就不介绍了,大致就是在虚拟DOM的diff和patch过程中如果遇到的VNode是组件类型,那么会new一个该组件的实例关联到VNode上,组件实例化和我们new Vue()没有什么区别,都会先进行选项合并、初始化生命周期、初始化事件、数据观察等操作,然后执行该组件的渲染函数,生成该组件的VNode,最后进行patch操作,生成实际的DOM节点,子组件的这些操作全部完成后才会再回到父组件的diff和patch过程,因为子组件的DOM已经创建好了,所以插入即可,更详细的过程有兴趣可自行了解。 以上就是本文全部内容。

优秀的个人博客,低调大师

每日一博 | 淘特 Flutter 流畅度优化实践

作者:谢伟(韦圣) 不同的业务背景引出不同的技术诉求,“用户体验特爽”是淘特的不懈追求,本文将介绍笔者加入淘特以来在Flutter流畅度方面的诸多优化实践,这些优化不涉及Engine改造、不涉及高大上的“轮子建设“,只需细心细致深入业务抽丝剥茧,坚持实际体感导向,即能为用户体验带来显著提升,值得Flutter开发者将其应用在产品的每一个像素。 背景 淘特具备鲜明的三大特征: 业务特征:淘特拥有业界最复杂的淘系电商链路 用户特征:淘特用户中有大量的中老年用户,大量的用户手机系统版本较低,大量的用户使用中低端机 技术特征:淘特大规模采用Flutter跨平台渲染技术 综上所述: 最复杂业务链路+最低性能用户群体+最新的跨平台技术==>核心问题之一:页面流畅度受到严峻挑战 Flutter核心链路 20S快速滚动帧率 卡顿率(每秒卡顿率) 直播Tab 27 7.04% 我的 41.3666 7.63% 详情 26.7 15.58% 注:相关数据以vivo Y67,淘特 3.32.999.10 (103) 测得 目标 流畅度是用户体验的关键一环,大家都不希望手机用起来像看电影/刷PPT,尤其是现在高刷屏(90/120hz)的普及,更是极大强化了用户对流畅度的感知,但流畅度也跟产品复杂度强相关,也是一次繁与简的取舍,淘特流畅度一期优化目标: Flutter核心链路页面达到高流畅度(平均帧率:低端机45FPS、中端机50FPS、高端50FPS) 一期优化后的状态 事项 平均帧率 卡顿率 提升效果 1.直播Tab推荐、分类栏目 46.0 0.35% 帧率提高19帧、卡顿率降低6.7% 2.我的页面 46.0 0% 帧率提高4.6帧,卡顿率降低7.6% 3.详情 45.0 2% 帧率提高18.3桢,卡顿率降低13.58% 旧版3.32如视频左,新版3.37如视频右。因uiautomator工具会触发无障碍性能ISSUE,此版本对比为人工测试。 视频请见:淘特 Flutter 流畅度优化实践 除了数据上的明显提升,体感上,旧版快滑卡顿明显,画面突变明显,新版则基本消除明显的卡顿,画面连续平稳。 问题 回到技术本身,Flutter为什么会卡顿、帧率低?总的来说均为以下2个原因: UI线程慢了-->渲染指令出的慢 GPU线程慢了-->光栅化慢、图层合成慢、像素上屏慢 那么,怎么解上述的 2 个问题是咱们所关心的重点。既然知道某块有问题,我们自然要有工具系统化的度量问题水平,以及系统化的理论支撑实践,且看以下2节,过程中穿插相关策略在淘特的实践, 理论与实践结合理解更透。 怎么解 解法 - 案例 降低setState的触发节点 大家都知道Flutter的刷新机制,在越高的Widget树层级触发setState标脏Element,“脏树越大”,在越低层级越局部的Widget触发状态更新,“脏树越小”,被标记为脏树后将触发Element.Rebuild,遍历组件树。原理请看下图“Flutter页面刷新机制源码解析”: “Element.updateChild源码分析”请见下文优化二。 实际应用淘特为例。直播Tab的视频预览功能为例,最初直播Tab的视频播放index通过状态层层传递给子组件,一旦状态变更,顶层setState触发播放index更新, 造成整个页面刷新。但实际整个页面需要更新状态的只有“需要暂停的原VideoWidget”和“待播放的VideoWidget”, 我们改为监听机制,页面中的所有VideoWidget注册监听,顶层用EventBus统一分发播放index至各VideoWidget,局部Widget Check后改变自身状态。 再比如详情页,由于使用了“上一个页面借图”的功能,监听到滚动后隐藏借的图,但setState的调用节点放在了详情顶层Widget,造成了全局刷新。实际该监听刷新逻辑可下放至“借图组件”,降低“脏树”的大小。 缓存不变的Widget 缓存不变的Widget有2大好处。1.被缓存的Widget将无需重复创建, 虽然Flutter官方认为Widget是一种非常轻量级的对象,在实际业务中,Build耗时过高仍是一种常见现象。2.返回相同引用的Widget将使Flutter停止该子树后续遍历, 即Flutter认为该子树无变化无需更新。原理请看下图“Element.updateChild源码分析” 应用场景以淘特实际页面为例。详情页部分组件使用了DXWidget,理论上组件内容一经创建后当次页面生命周期不会再有变化,此种情况即可缓存不变的Widget,避免重复动态渲染DX,停止子树遍历。 Feed流的Item组件,布局复杂,创建成本较高,理论上创建一次后内容也不会再变化,但item可能被删除,此时应该用Objectkey唯一标识组件,防止状态错位。 减少不必要的build(setState) 直播Tab用到一个埋点曝光组件,经过DevTools检查,发现其在每一次进度回调中重新创建itemWidget,虽然这不会造成业务异常,但理论上itemWidget只需被创建一次,这块经排查是使用组件时误传了builder函数,而不是直接传itemWidget实例。 详情页的逻辑非常复杂,AppBar根据滚动距离实时计算透明度,这会导致高频的setState,实际上透明度变化前后应该满足一个差值后才应刷新一次状态, 为了性能考量,透明度应该只有少数几种值变更。 多变图层与不变图层分离 在日常开发中,会经常遇到页面中大部分元素不变,某个元素实时变化。如Gif,动画。这时我们就需要RepaintBoundary,不过独立图层合成也是有消耗,这块需实测把握。以淘特为例。 直播Feed中的Gif图是不断高频跳动,这会导致页面同一图层重新Paint。此时可以用RepaintBoundary包裹该多变的Gif组件,让其处在单独的图层,待最终再一块图层合成上屏。 同理, 秒杀倒计时也是电商常见场景, 该组件也适用于RepaintBoundary场景。 避免频繁的triggerGC 因为AliFlutter的关系,我们得以主动触发DartGC,但GC同样也是有消耗的,高频的GC更是如此。淘特之前因为iOS的内存压力,在列表滚动停止时ScrollEndNotification则会触发GC,ScrollEndNotification在每一次手Down->up事件后都会触发一次,如果用户多次触摸,则会较为频繁的触发GC,实测影响Y67 4帧左右的性能,这块增加页面不可见时GC 和在Y67等android低端机关闭滑动GC,提高滑动性能。 大JSON解析子线程化 Flutter的isolate默认是单线程模型,而所有的UI操作又都是在UI线程进行的,想应用多线程的并发优势需新开isolate 或compute。无论如何await,scheduleTask 都只是延后任务的调用时机,仍然会占用“UI线程”, 所以在大Json解析或大量的channel调用时,一定要观测对UI线程的消耗情况。在淘特中,我们在低端机开启json解析compute化,不阻塞UI线程。 尽量减少或降级Clip、Opacity等组件的使用 Flutter中,Clip主要用于裁剪,裁矩形、圆角矩形、圆形。一旦调用,后续所有的绘图指令都会受其Clip影响。有些ClipRRect可以用ShapeDecoration代替,Opacitiy改用AnimatedOpacity, 针对图片的Clip裁切,可以走定制图片库Transform实现。 降级CustomScrollView预渲染区域为合理值 默认情况下,CustomScrollView除了渲染屏幕内的内容,还会渲染上下各250区域的组件内容,即如双列瀑布流,当前屏幕可显示4个组件,实际仍有上下共4个组件在显示状态,如果setState(加载更多时),则会进行8个组件重绘。实际用户只看到4个,其实应该也只需渲染4个, 且上下滑动也会触发屏幕外的Widget创建销毁,造成滚动卡顿。高性能的手机可预渲染,淘特在低端机降级该区域距离为0或较小值。 高频埋点 Channel批量化操作 在组件曝光时上报埋点是很常见的行为,但在快速滚动的场景下, 瞬间10+ item的略过,20+ channel的调用同样会占用一定的UI线程资源和Native UI线程资源。这里淘特针对部分场景做了批量、定时上传, 维护一个埋点队列,默认定时3S或50条,业务不可见时上报,合并20+channel调用为单次。业务也可在合适时机点强制flush队列上报, 同时在Native侧,将埋点行为切换至子线程进行。 其他有效优化措施 部分业务特效,业务繁忙度在低端机上都是可以适度降级的,如淘特将Feed视频预览播放延迟时间从500ms降为1.5S,Feed流预加载阈值距离从2000+降为500,图片圆角降直角等降级措施的核心思路都是先保证最低端的用户也能用的顺畅,再美化细节锦上添花。 Flutter在无障碍开启情况下,快速滚动场景存在性能问题,如确定业务无需无障碍或用户误触发无障碍,可添加ExcludeSemantics Widget屏蔽无障碍。 通过DevTools检测,发现high_available高可用帧率检测在老版本存在性能问题,这块可升级插件版本或低端机屏蔽该检测。 解法 - 优化案例总结 上述十条优化实践,抛开细节看原理,大致分为以下几类, 融会贯通,实践出真知。 如何提高UI线程性能: 如何提高build性能 降低遍历出发点,降低setState的触发节 停止树的遍历,不变的内容,返回同样的组件实例、Flutter将停止遍历该树(SlideTransition) 减少非必要的build(setState) 如何提高layout性能 layout暂时不太容易出问题 如何提高paint性能 RepaintBoundary分离多变和不变的图层,如Gif、动画, 但多图层的合成也是有开销的 其他 耗时方法如大JSON解析用compute子线程化 减少不必要的channel调用或批量合并 减少动画 减少Release时的log 提高UI线程在Android/iOS的优先级 列表组件支持局部build 较小的cacheExtent值,减少渲染范围 如何提高GPU线程性能: 谨慎saveLayer 尽量少ClipPath、一旦调用,后续所有绘图指令需与Path做相交。(ClipRect、ClipRRect等) 减少毛玻璃BackdropFilter、阴影boxShadow 减少Opacity使用,必要时用AnimatedOpacity 解法 - 测量工具 工欲善其事,必先利其器。工具主要分为以下两块。 流畅度检测:无需侵入代码的流畅度检测方案有几种, 既可以通过adb取surfaceflinger数据, 也可以基于VirtualDisplay做图像对比,或者使用官方DevTools。第三方比较成熟的如PerfDog 卡顿排查:DevTools是官方的开发配套工具,非常实用 Performance检测单帧CPU耗时(build、layout、paint)、GPU耗时、Widget Build次数 CPUProfiler 检测方法耗时 Flutter Inspector观察不合理布局 Memory 监控Dart内存情况 DevTools Flutter分为三种编译模式,Debug/Release大家都很熟悉,Debug最大特性为HotReload可调试,Release为最高性能,Profile模式则取其中间,专用于性能分析,其产物以AOT模式无限接近Release性能运行,又保留了丰富的性能分析途径。 如何以Profile模式运行flutter? 如果是混合工程,android为例,在app/build.gradle添加profile{init with debug}即可, 部分应用资源区分debug/profile,也可Copy一份profile。当然,更hack更彻底的方式,可直接修改$flutterRoot/packages/flutter_tools/gradle/flutter.gradle文件中buildModeFor方法,默认返回想要的Profile/Release模式。 如何在Profile模式下打开DevTools? 推荐使用IDE的flutter attach 或者 命令行采用flutter pub global run devtools,填入observatory的地址,即可开始使用DevTools。 Flutter Performance&Inspector 以AS为例,右侧会出现Flutter Performance和Inspector2个功能区。Performance功能区如下图: Overlay效果如下图。可以看到有2排柱状图,上方为GPU帧耗时,下方为CPU耗时,实时显示最近300帧情况,当当前帧耗时超过16ms时,绿色扫描线会变红色, 此图常用于观察动态过程中的“瞬时卡顿点”。 Inspector较为简单,可观看Widget树结构和实际的Render Tree结构,包含基本的布局信息,DevTools中Inspector包含更详细信息。 DevTools&Flutter Inspector DevTools&Performance Performance功能是性能优化的核心工具,这里可以分析出大部分UI线程、GPU线程卡顿的原因。为方便分析,此图用Debug模式得来,实际性能分析以Profile模式为准。 如上图1所示,Build函数耗时明显过长,且连续数十帧如此,必然是Build的逻辑有严重问题。理论上Widget创建一次后状态未改变时无需重建。由前文淘特案例可以发现,这里实际是业务错误的在滚动进度回调中重复创建Widget所致。实际的Build应只在瀑布流Layout逻辑中创建执行2次。 Paint函数详情可在debug模式通过debugProfilePaintsEnabled=true开启。当多变的元素与不变的元素混在同一图层时可造成图层整体的过度重复绘制, 如元素内容无变化,Paint函数中也不应出现多余元素的绘制耗时。通过前面提及的Repain RainBow开关或debugRepaintRainbowEnabled=true, 可实时观察重绘情况,如下图所示。 每一个图层都有对应的不同颜色框体。只有发生Repaint的图层颜色会发生变化,多余的图层变色,我们就要排查是否正常。 GPU耗时过多一般源于重量级组件的过度使用如Clip、Opacity、阴影, 这块发现耗时过多可参考前文解法进行优化或降级, 关于GPU更多的优化可参考liyuqian的高性能图形引擎分享。 在图1最下方的CPU Profile即代表当帧的CPU耗时情况,BottomUp方便查找最耗时的方法。 DevTools&CPU Profiler 在Performance的隔壁是CPU Profiler,这里用于统计一段时间内CPU的耗时情况,一般根据方法名结合经验判断是业务异常还是正常耗时,根据visitChilddren-->getScrollRenderObject方法名搜索,发现高可用帧率监控存在性能问题。 Devtools还有内存、Debugger、网络、日志等功能模块,这块流畅度优化中使用不多,后续有更好的经验再和大家分享。 DebugFlags&Build 上图是一张针对build阶段常见的debug功能表, debugPrintRebuildDirtyWidgets开关将在控制台打印什么树当前正在被重建,debugProfileBuildsEnabled作用同Performance的Track Widget Builds,监控Build函数详情。前3个字段在debug模式使用,最后一个可在Profile模式使用。 DebugFlag&Paint 上图是一张针对Paint阶段常见的debug功能表。debugDumpLayerTree()函数可用于打印layer树,debugPaintLayerBordersEnabled可在每一个图层周围形成边界(框),debugRepaintRainbowEnabled作用同Inspector中的RainBow Enable, 图层重绘时边框颜色将变化。debugProfilePaintsEnabled前文已提到,方便分析paint函数详情。 展望 以上便是淘特Flutter流畅度优化第一期实践,也是体感优化最明显的的一期优化。但距离极致的用户体验目标仍有不小的差距。集团同学提供了很多秀实践学习。如UC Hummer的Engine流畅度优化, 闲鱼的局部刷新复用列表组件PowerScrollView、线上线下的高精准多维度检测卡顿,及如何防止流畅度优化不恶化的方案, 淘特也在不断学习成长挑战极限,在二期实践中,为了最极致的体验,淘特将结合Hummer引擎,深度优化高性能图片库、高性能流式容器、建立全面的线下线上数据监控体系,做一个”让用户爽的淘特App“。 参考资料 Flutter性能测试与理论:https://www.bilibili.com/video/BV1F4411D7rP Flutter Europe 演讲:https://www.youtube.com/watch?v=vVg9It7cOfY 复杂业务如何保证Flutter的高性能高流畅度:https://zhuanlan.zhihu.com/p/134024247 Flutter官方DartTools讲解:https://www.youtube.com/watch?v=nq43mP7hjAE 深入理解Flutter的图形渲染:https://www.bilibili.com/video/BV1ab411T7nM Flutter官方源码:https://github.com/flutter/flutter 关注【阿里巴巴移动技术】微信公众号,每周 3 篇移动技术实践&干货给你思考!

优秀的个人博客,低调大师

每日一博 | Redis 大集群扩容性能优化实践

一、背景 在现网环境,一些使用Redis集群的业务随着业务量的上涨,往往需要进行节点扩容操作。 之前有了解到运维同学对一些节点数比较大的Redis集群进行扩容操作后,业务侧反映集群性能下降,具体表现在访问时延增长明显。 某些业务对Redis集群访问时延比较敏感,例如现网环境对模型实时读取,或者一些业务依赖读取Redis集群的同步流程,会影响业务的实时流程时延。业务侧可能无法接受。 为了找到这个问题的根因,我们对某一次的Redis集群迁移操作后的集群性能下降问题进行排查。 1.1 问题描述 这一次具体的Redis集群问题的场景是:某一个Redis集群进行过扩容操作。业务侧使用Hiredis-vip进行Redis集群访问,进行MGET操作。 业务侧感知到访问Redis集群的时延变高。 1.2 现网环境说明 目前现网环境部署的Redis版本多数是3.x或者4.x版本; 业务访问Redis集群的客户端品类繁多,较多的使用Jedis。本次问题排查的业务使用客户端Hiredis-vip进行访问; Redis集群的节点数比较大,规模是100+; 集群之前存在扩容操作。 1.3 观察现象 因为时延变高,我们从几个方面进行排查: 带宽是否打满; CPU是否占用过高; OPS是否很高; 通过简单的监控排查,带宽负载不高。但是发现CPU表现异常: 1.3.1 对比OPS和CPU负载 观察业务反馈使用的MGET和CPU负载,我们找到了对应的监控曲线。 从时间上分析,MGET和CPU负载高并没有直接关联。业务侧反馈的是MGET的时延普遍增高。此处看到MGET的OPS和CPU负载是错峰的。 此处可以暂时确定业务请求和CPU负载暂时没有直接关系,但是从曲线上可以看出:在同一个时间轴上,业务请求和cpu负载存在错峰的情况,两者间应该有间接关系。 1.3.2 对比Cluster指令OPS和CPU负载 由于之前有运维侧同事有反馈集群进行过扩容操作,必然存在slot的迁移。 考虑到业务的客户端一般都会使用缓存存放Redis集群的slot拓扑信息,因此怀疑Cluster指令会和CPU负载存在一定联系。 我们找到了当中确实有一些联系: 此处可以明显看到:某个实例在执行Cluster指令的时候,CPU的使用会明显上涨。 根据上述现象,大致可以进行一个简单的聚焦: 业务侧执行MGET,因为一些原因执行了Cluster指令; Cluster指令因为一些原因导致CPU占用较高影响其他操作; 怀疑Cluster指令是性能瓶颈。 同时,引申几个需要关注的问题: 为什么会有较多的Cluster指令被执行? 为什么Cluster指令执行的时候CPU资源比较高? 为什么节点规模大的集群迁移slot操作容易“中招”? 二、问题排查 2.1 Redis热点排查 我们对一台现场出现了CPU负载高的Redis实例使用perf top进行简单的分析: 从上图可以看出来,函数(ClusterReplyMultiBulkSlots)占用的CPU资源高达 51.84%,存在异常。 2.1.1 ClusterReplyMultiBulkSlots实现原理 我们对clusterReplyMultiBulkSlots函数进行分析: void clusterReplyMultiBulkSlots(client *c) { /* Format: 1) 1) start slot * 2) end slot * 3) 1) master IP * 2) master port * 3) node ID * 4) 1) replica IP * 2) replica port * 3) node ID * ... continued until done */ int num_masters = 0; void *slot_replylen = addDeferredMultiBulkLength(c); dictEntry *de; dictIterator *di = dictGetSafeIterator(server.cluster->nodes); while((de = dictNext(di)) != NULL) { /*注意:此处是对当前Redis节点记录的集群所有主节点都进行了遍历*/ clusterNode *node = dictGetVal(de); int j = 0, start = -1; /* Skip slaves (that are iterated when producing the output of their * master) and masters not serving any slot. */ /*跳过备节点。备节点的信息会从主节点侧获取。*/ if (!nodeIsMaster(node) || node->numslots == 0) continue; for (j = 0; j < CLUSTER_SLOTS; j++) { /*注意:此处是对当前节点中记录的所有slot进行了遍历*/ int bit, i; /*确认当前节点是不是占有循环终端的slot*/ if ((bit = clusterNodeGetSlotBit(node,j)) != 0) { if (start == -1) start = j; } /*简单分析,此处的逻辑大概就是找出连续的区间,是的话放到返回中;不是的话继续往下递归slot。 如果是开始的话,开始一个连续区间,直到和当前的不连续。*/ if (start != -1 && (!bit || j == CLUSTER_SLOTS-1)) { int nested_elements = 3; /* slots (2) + master addr (1). */ void *nested_replylen = addDeferredMultiBulkLength(c); if (bit && j == CLUSTER_SLOTS-1) j++; /* If slot exists in output map, add to it's list. * else, create a new output map for this slot */ if (start == j-1) { addReplyLongLong(c, start); /* only one slot; low==high */ addReplyLongLong(c, start); } else { addReplyLongLong(c, start); /* low */ addReplyLongLong(c, j-1); /* high */ } start = -1; /* First node reply position is always the master */ addReplyMultiBulkLen(c, 3); addReplyBulkCString(c, node->ip); addReplyLongLong(c, node->port); addReplyBulkCBuffer(c, node->name, CLUSTER_NAMELEN); /* Remaining nodes in reply are replicas for slot range */ for (i = 0; i < node->numslaves; i++) { /*注意:此处遍历了节点下面的备节点信息,用于返回*/ /* This loop is copy/pasted from clusterGenNodeDescription() * with modifications for per-slot node aggregation */ if (nodeFailed(node->slaves[i])) continue; addReplyMultiBulkLen(c, 3); addReplyBulkCString(c, node->slaves[i]->ip); addReplyLongLong(c, node->slaves[i]->port); addReplyBulkCBuffer(c, node->slaves[i]->name, CLUSTER_NAMELEN); nested_elements++; } setDeferredMultiBulkLength(c, nested_replylen, nested_elements); num_masters++; } } } dictReleaseIterator(di); setDeferredMultiBulkLength(c, slot_replylen, num_masters); } /* Return the slot bit from the cluster node structure. */ /*该函数用于判断指定的slot是否属于当前clusterNodes节点*/ int clusterNodeGetSlotBit(clusterNode *n, int slot) { return bitmapTestBit(n->slots,slot); } /* Test bit 'pos' in a generic bitmap. Return 1 if the bit is set, * otherwise 0. */ /*此处流程用于判断指定的的位置在bitmap上是否为1*/ int bitmapTestBit(unsigned char *bitmap, int pos) { off_t byte = pos/8; int bit = pos&7; return (bitmap[byte] & (1<<bit)) != 0; } typedef struct clusterNode { ... /*使用一个长度为CLUSTER_SLOTS/8的char数组对当前分配的slot进行记录*/ unsigned char slots[CLUSTER_SLOTS/8]; /* slots handled by this node */ ... } clusterNode; 每一个节点(ClusterNode)使用位图(char slots[CLUSTER_SLOTS/8])存放slot的分配信息。 简要说一下BitmapTestBit的逻辑:clusterNode->slots是一个长度为CLUSTER_SLOTS/8的数组。CLUSTER_SLOTS是固定值16384。数组上的每一个位分别代表一个slot。此处的bitmap数组下标则是0到2047,slot的范围是0到16383。 因为要判断pos这个位置的bit上是否是1,因此: off_t byte = pos/8:拿到在bitmap上对应的哪一个字节(Byte)上存放这个pos位置的信息。因为一个Byte有8个bit。使用pos/8可以指导需要找的Byte在哪一个。此处把bitmap当成数组处理,这里对应的便是对应下标的Byte。 int bit = pos&7:拿到是在这个字节上对应哪一个bit表示这个pos位置的信息。&7其实就是%8。可以想象对pos每8个一组进行分组,最后一组(不满足8)的个数对应的便是在bitmap对应的Byte上对应的bit数组下标位置。 (bitmap[byte] & (1<<bit)):判断对应的那个bit在bitmap[byte]上是否存在。 以slot为10001进行举例: 因此10001这个slot对应的是下标1250的Byte,要校验的是下标1的bit。 对应在ClusterNode->slots上的对应位置: 图示绿色的方块表示bitmap[1250],也就是对应存放slot 10001的Byte;红框标识(bit[1])对应的就是1<<bit 的位置。bitmap[byte] & (1<<bit),也就是确认红框对应的位置是否是1。是的话表示bitmap上10001已经打标。 总结ClusterNodeGetSlotBit的概要逻辑是:判断当前的这个slot是否分配在当前node上。因此ClusterReplyMultiBulkSlots大概逻辑表示如下: 大概步骤如下: 对每一个节点进行遍历; 对于每一个节点,遍历所有的slots,使用ClusterNodeGetSlotBit判断遍历中的slot是否分配于当前节点; 从获取CLUSTER SLOTS指令的结果来看,可以看到,复杂度是<集群主节点个数> *<slot总个数>。其中slot的总个数是16384,固定值。 2.1.2 Redis热点排查总结 就目前来看,CLUSTER SLOTS指令时延随着Redis集群的主节点个数,线性增长。而这次我们排查的集群主节点数比较大,可以解释这次排查的现网现象中CLUSTER SLOTS指令时延为何较大。 2.2 客户端排查 了解到运维同学们存在扩容操作,扩容完成后必然涉及到一些key在访问的时候存在MOVED的错误。 当前使用的Hiredis-vip客户端代码进行简单的浏览,简要分析以下当前业务使用的Hiredis-vip客户端在遇到MOVED的时候会怎样处理。由于其他的大部分业务常用的Jedis客户端,此处也对Jedis客户端对应流程进行简单分析。 2.2.1 Hiredis-vip对MOVED处理实现原理 Hiredis-vip针对MOVED的操作: 查看Cluster_update_route的调用过程: 此处的cluster_update_route_by_addr进行了CLUSTER SLOT操作。可以看到,当获取到MOVED报错的时候,Hiredis-vip会重新更新Redis集群拓扑结构,有下面的特性: 因为节点通过ip:port作为key,哈希方式一样,如果集群拓扑类似,多个客户端很容易同时到同一个节点进行访问; 如果某个节点访问失败,会通过迭代器找下一个节点,由于上述的原因,多个客户端很容易同时到下一个节点进行访问。 2.2.2 Jedis对MOVED处理实现原理 对Jedis客户端代码进行简单浏览,发现如果存在MOVED错误,会调用renewSlotCache。 继续看renewSlotCache的调用,此处可以确认:Jedis在集群模式下在遇到MOVED的报错时候,会发送Redis命令CLUSTER SLOTS,重新拉取Redis集群的slot拓扑结构。 2.2.3 客户端实现原理小结 由于Jedis是Java的Redis客户端,Hiredis-vip是c++的Redis客户端,可以简单认为这种异常处理机制是共性操作。 对客户端集群模式下对MOVED的流程梳理大概如下: 总的来说: 1)使用客户端缓存的slot拓扑进行对key的访问; 2)Redis节点返回正常: 访问正常,继续后续操作 3)Redis节点返回MOVED: 对Redis节点进行CLUSTER SLOTS指令执行,更新拓扑; 使用新的拓扑对key重新访问。 2.2.3 客户端排查小结 Redis集群正在扩容,也就是必然存在一些Redis客户端在访问Redis集群遇到MOVED,执行Redis指令CLUSTER SLOTS进行拓扑结构更新。 如果迁移的key命中率高,CLUSTER SLOTS指令会更加频繁的执行。这样导致的结果是迁移过程中Redis集群会持续被客户端执行CLUSTER SLOTS指令。 2.3 排查小结 此处,结合Redis侧的CLUSTER SLOTS机制以及客户端对MOVED的处理逻辑,可以解答之前的几个个问题: 为什么会有较多的Cluster指令被执行? 因为发生过迁移操作,业务访问一些迁移过的key会拿到MOVED返回,客户端会对该返回重新拉取slot拓扑信息,执行CLUSTER SLOTS。 为什么Cluster指令执行的时候CPU资源比较高? 分析Redis源码,发现CLUSTER SLOT指令的时间复杂度和主节点个数成正比。业务当前的Redis集群主节点个数比较多,自然耗时高,占用CPU资源高。 为什么节点规模大的集群迁移slot操作容易“中招”? 迁移操作必然带来一些客户端访问key的时候返回MOVED; 客户端对于MOVED的返回会执行CLUSTER SLOTS指令; CLUSTER SLOTS指令随着集群主节点个数的增加,时延会上升; 业务的访问在slot的迁移期间会因为CLUSTER SLOTS的时延上升,在外部的感知是执行指令的时延升高。 三、优化 3.1 现状分析 根据目前的情况来看,客户端遇到MOVED进行CLUSTER SLOTS执行是正常的流程,因为需要更新集群的slot拓扑结构提高后续的集群访问效率。 此处流程除了Jedis,Hiredis-vip,其他的客户端应该也会进行类似的slot信息缓存优化。此处流程优化空间不大,是Redis的集群访问机制决定。 因此对Redis的集群信息记录进行分析。 3.1.1 Redis集群元数据分析 集群中每一个Redis节点都会有一些集群的元数据记录,记录于server.cluster,内容如下: typedef struct clusterState { ... dict *nodes; /* Hash table of name -> clusterNode structures */ /*nodes记录的是所有的节点,使用dict记录*/ ... clusterNode *slots[CLUSTER_SLOTS];/*slots记录的是slot数组,内容是node的指针*/ ... } clusterState; 如2.1所述,原有逻辑通过遍历每个节点的slot信息获得拓扑结构。 3.1.2 Redis集群元数据分析 观察CLUSTER SLOTS的返回结果: /* Format: 1) 1) start slot * 2) end slot * 3) 1) master IP * 2) master port * 3) node ID * 4) 1) replica IP * 2) replica port * 3) node ID * ... continued until done */ 结合server.cluster中存放的集群信息,笔者认为此处可以使用server.cluster->slots进行遍历。因为server.cluster->slots已经在每一次集群的拓扑变化得到了更新,保存的是节点指针。 3.2 优化方案 简单的优化思路如下: 对slot进行遍历,找出slot中节点是连续的块; 当前遍历的slot的节点如果和之前遍历的节点一致,说明目前访问的slot和前面的是在同一个节点下,也就是是在某个节点下的“连续”的slot区域内; 当前遍历的slot的节点如果和之前遍历的节点不一致,说明目前访问的slot和前面的不同,前面的“连续”slot区域可以进行输出;而当前slot作为下一个新的“连续”slot区域的开始。 因此只要对server.cluster->slots进行遍历,可以满足需求。简单表示大概如下: 这样的时间复杂度降低到<slot总个数>。 3.3 实现 优化逻辑如下: void clusterReplyMultiBulkSlots(client * c) { /* Format: 1) 1) start slot * 2) end slot * 3) 1) master IP * 2) master port * 3) node ID * 4) 1) replica IP * 2) replica port * 3) node ID * ... continued until done */ clusterNode *n = NULL; int num_masters = 0, start = -1; void *slot_replylen = addReplyDeferredLen(c); for (int i = 0; i <= CLUSTER_SLOTS; i++) { /*对所有slot进行遍历*/ /* Find start node and slot id. */ if (n == NULL) { if (i == CLUSTER_SLOTS) break; n = server.cluster->slots[i]; start = i; continue; } /* Add cluster slots info when occur different node with start * or end of slot. */ if (i == CLUSTER_SLOTS || n != server.cluster->slots[i]) { /*遍历主节点下面的备节点,添加返回客户端的信息*/ addNodeReplyForClusterSlot(c, n, start, i-1); num_masters++; if (i == CLUSTER_SLOTS) break; n = server.cluster->slots[i]; start = i; } } setDeferredArrayLen(c, slot_replylen, num_masters); } 通过对server.cluster->slots进行遍历,找到某个节点下的“连续”的slot区域,一旦后续不连续,把之前的“连续”slot区域的节点信息以及其备节点信息进行输出,然后继续下一个“连续”slot区域的查找于输出。 四、优化结果对比 对两个版本的Redis的CLUSTER SLOTS指令进行横向对比。 4.1 测试环境&压测场景 操作系统:manjaro 20.2 硬件配置: CPU:AMD Ryzen 7 4800H DRAM:DDR4 3200MHz 8G*2 Redis集群信息: 1)持久化配置 关闭aof 关闭bgsave 2)集群节点信息: 节点个数:100 所有节点都是主节点 压测场景: 使用benchmark工具对集群单个节点持续发送CLUSTER SLOTS指令; 对其中一个版本压测完后,回收集群,重新部署后再进行下一轮压测。 4.2 CPU资源占用对比 perf导出火焰图。原有版本: 优化后: 可以明显看到,优化后的占比大幅度下降。基本符合预期。 4.3 耗时对比 在上进行测试,嵌入耗时测试代码: else if (!strcasecmp(c->argv[1]->ptr,"slots") && c->argc == 2) { /* CLUSTER SLOTS */ long long now = ustime(); clusterReplyMultiBulkSlots(c); serverLog(LL_NOTICE, "cluster slots cost time:%lld us", ustime() - now); } 输入日志进行对比; 原版的日志输出: 37351:M 06 Mar 2021 16:11:39.313 * cluster slots cost time:2061 us。 优化后版本日志输出: 35562:M 06 Mar 2021 16:11:27.862 * cluster slots cost time:168 us。 从耗时上看下降明显:从2000+us 下降到200-us;在100个主节点的集群中的耗时缩减到原来的8.2%;优化结果基本符合预期。 五、总结 这里可以简单描述下文章上述的动作从而得出的这样的一个结论:性能缺陷。 简单总结下上述的排查以及优化过程: Redis大集群因为CLUSTER命令导致某些节点的访问延迟明显; 使用perf top指令对Redis实例进行排查,发现clusterReplyMultiBulkSlots命令占用CPU资源异常; 对clusterReplyMultiBulkSlots进行分析,该函数存在明显的性能问题; 对clusterReplyMultiBulkSlots进行优化,性能提升明显。 从上述的排查以及优化过程可以得出一个结论:目前的Redis在CLUSTER SLOT指令存在性能缺陷。 因为Redis的数据分片机制,决定了Redis集群模式下的key访问方法是缓存slot的拓扑信息。优化点也只能在CLUSTER SLOTS入手。而Redis的集群节点个数一般没有这么大,问题暴露的不明显。 其实Hiredis-vip的逻辑也存在一定问题。如2.2.1所说,Hiredis-vip的slot拓扑更新方法是遍历所有的节点挨个进行CLUSTER SLOTS。如果Redis集群规模较大而且业务侧的客户端规模较多,会出现连锁反应: 1)如果Redis集群较大,CLUSTER SLOTS响应比较慢; 2)如果某个节点没有响应或者返回报错,Hiredis-vip客户端会对下一个节点继续进行请求; 3)Hiredis-vip客户端中对Redis集群节点迭代遍历的方法相同(因为集群的信息在各个客户端基本一致),此时当客户端规模较大的时候,某个Redis节点可能存在阻塞,就会导致hiredis-vip客户端遍历下一个Redis节点; 4)大量Hiredis-vip客户端挨个地对一些Redis节点进行访问,如果Redis节点无法负担这样的请求,这样会导致Redis节点在大量Hiredis-vip客户端的“遍历”下挨个请求: 结合上述第3点,可以想象一下:有1w个客户端对该Redis集群进行访问。因为某个命中率较高的key存在迁移操作,所有的客户端都需要更新slot拓扑。由于所有客户端缓存的集群节点信息相同,因此遍历各个节点的顺序是一致的。这1w个客户端都使用同样的顺序对集群各个节点进行遍历地操作CLUSTER SLOTS。由于CLUSTER SLOTS在大集群中性能较差,Redis节点很容易会被大量客户端请求导致不可访问。Redis节点会根据遍历顺序依次被大部分的客户端(例如9k+个客户端)访问,执行CLUSTER SLOTS指令,导致Redis节点挨个被阻塞。 5)最终的表现是大部分Redis节点的CPU负载暴涨,很多Hiredis-vip客户端则继续无法更新slot拓扑。 最终结果是大规模的Redis集群在进行slot迁移操作后,在大规模的Hiredis-vip客户端访问下业务侧感知是普通指令时延变高,而Redis实例CPU资源占用高涨。这个逻辑可以进行一定优化。 目前上述分节3的优化已经提交并合并到Redis 6.2.2版本中。 六、参考资料 1、Hiredis-vip: https://github.com 2、Jedis: https://github.com/redis/jedis 3、Redis: https://github.com/redis/redis 4、Perf:https://perf.wiki.kernel.org 作者:vivo互联网数据库团队—Yuan Jianwei

优秀的个人博客,低调大师

每日一博 | 如何设计编写一个 SDK

App 的开发更偏向于用户层面,从 UI 展示到业务逻辑处理,全程处理用户的行为。而 SDK 面向的是开发者,开发更偏向于功能方面,注重功能的开发实现。不妨来看看FinClip移动端工程师整理的如何编写一个 SDK,还是很有参考价值。 一、什么是 SDK? SDK 全称 Software Development Kit,广义上的 SDK 是为特定的软件包、软件框架、硬件平台、操作系统等建立应用程序时所使用的开发工具的集合(在 iOS 项目中,SDK 也被称为库)。 在 iOS 开发或 Android 开发中,不可避免会需要使用第三方工具提升产品的开发效率,比如用于消息推送的极光,用于第三方支付与登录的支付宝,微信等等。但大多数商用产品都不会直接给出源码(可能只有为爱发电的开源项目才会无私提供源码),而我们在开发 App 时就需要将这些第三方 SDK 集成在我们的项目之中。 SDK 的全称是 Software Development Kit,翻译过来是软件开发工具包,这是一种被用来辅助开发某类软件而编写的特定软件包。 二、SDK 设计的基本原则 一款好用且设计充分的 SDK 必须要遵循以下 4 条基本原则,即: SDK 安全,稳定 统一的开发规范 Library 小而精 不依赖第三方 SDK 安全,稳定:考虑到 SDK 是需要嵌入到 App 里面去的,所以 SDK 最重要的特性就是安全性,不会因为乱开放接口而导致 App 数据泄露;其次重要的是 SDK 的稳定性, SDK 的 Crash 如果没有被捕获进行处理,则会导致应用彻底崩溃(这样就会导致第三方接入的 App 体验性非常差),甚至会直接导致接入方的用户流失; 统一的开发规范:对于 SDK 开发规范来说,统一的命名规范很重要,最好的状态是“接入方看到接口命名就能知道是哪家厂商的 SDK”,换句话说就是 SDK 的命名规范统一,形成自己公司的品牌效应,此外也方便开发者进行接入使用。此外也需要具有自己的编码规范,你可以在网上找到大厂的规范模板,并通过借鉴整理出属于自己的规范,从而尽早统一代码风格; Library 小而精:小是指要避免造成接入方的App增加很大,不然会引起接入方的不满,甚至下架。精是指功能要专注,比如极光推送,就是专注推送相关的功能; 不依赖第三方 SDK:这个也很好理解,SDK 中如果又依赖其他第三方 SDK, 不仅会导致 SDK 的体积变大,也会影响接入方集成 SDK 的相关成本。 三、在 iOS 环境下开发 SDK 1. iOS 环境下的 SDK 如同上文所说,在 iOS 开发中,我们将 SDK 称为“库”,我们是这样对其定义的: 一般是给应用提供通用服务的,非独立运行的程序集合; 一般都是编译过的,方便使用。 我们会根据库的调用方法分为“静态库”和“动态库”两种: 静态连接:一般是指在创建应用程序的时候,将库集成进去,这样做的好处就是应用程序包自身可以独立运行,而不好的地方就是包会略显臃肿,库不能共享(静态库经常以 .a 结尾); 动态连接:创建应用的时候只约定好与库之间的调用关系,而不彻底将库包集成进应用。这样在应用运行时,需要运行环境中提供库,并且连接装载。优劣与静态库相反,动态链接库需要库环境,但由于本身不集成库内容,会比较小,同时也为和其他应用共享库的使用提供了可能(常见的动态库是 Windows 下的 .dll,Linux 下的 .so,Mac 下的 .dylib/.tbd)。 特别注意:平时我们经常说的 Framework (in Apple) 是 Cocoa/Cocoa Touch 程序中使用的一种资源打包方式,可以将代码文件、头文件、资源文件、说明文档等集中在一起,方便开发者使用。 也就是说我们的 Framework 其实是资源打包的方式,和静态库动态库的本质是没有什么关系。 2. 静态库和动态库的区别 如果说要找出静态库与动态库的区别,那可以从文件链接(每个源代码模块独立编译,然后按照需要将他们组装起来,这个组装模块的过程,就是链接)的角度进行解释: 静态库:链接时会被完整的复制到可执行文件中,所以如果两个程序都用了某个静态库,那么每个二进制可执行文件里面,都会含有这份静态库的代码; 动态库:链接时不复制,而是在程序启动后动态加载,然后再进行符号决议(符号绑定)。理论上动态库只存在一份就可以了。其他的程序都可以动态链接到这个动态库上面,从而节省内存(内存中只有一份动态库)。另外一个好处是,由于动态库并不绑定到可执行程序上,所以我们想升级这个动态库就很容易,windows和linux上面一般插件和模块机制都是这样实现的。 具体的优劣势可以看这张表: 库类型 优点 缺点 静态库 1. 目标程序没有外部依赖,直接就可以运行。 2. 效率较动态库高。 1. 会使用目标程序的体积增大。 动态库 1. 不需要拷贝到目标程序中,不会影响目标程序的体积。 2. 同一份库可以被多个程序使用(因为这个原因,动态库也被称作共享库)。 3. 编译时才载入的特性,也可以让我们随时对库进行替换,而不需要重新编译代码。实现动态更新 1. 动态载入会带来一部分性能损失(可以忽略不计) 2. 动态库也会使得程序依赖于外部环境。如果环境缺少动态库或者库的版本不正确,就会导致程序无法运行(Linux lib not found 错误)。 静态库可以简单理解为一堆目标文件(.o/.obj)的打包体(并非二进制文件),而动态库可以简单理解为 一个没有 main 函数的可执行文件。 3. 了解 iOS 的动态库(即被阉割的动态库) 有一个背景知识需要注意,iOS 官方规定不允许存在动态库,并且所有的 IPA 都需要经过 Apple 的私钥加密后才能用,即使你用了动态库也会因为签名错误而无法加载(越狱和非 App Store 除外)。于是这就把开发者自己开发动态库这件事变成为了天方夜谭。 iOS8 之前的 iOS 应用都是运行在沙盒当中的,不同程序之间不能共享代码,并且 iOS 又是单进程运行的(也就是某一时刻只有一个进程在运行),那么即使你写个共享库也无法共享给他人。 而动态下载代码又是被苹果官方明令禁止的,也就是说动态库的优势完全无法发挥,所以动态库也就没有存在的必要了。 但是这一切问题都随着 iOS8 发布之后的 App Extesion 特性, Swift 的诞生发生了奇妙的改变。 由于 iOS 主 App 需要和 Extension 共享代码,Swift 语言机制也需要动态库,于是苹果后来提出了 Embedded Framework,这种动态库允许 APP 和 App Extension 共享代码(动态库的生命被限定在一个APP进程内)。 更简单的解释:虽然提供了动态库,但这是被阉割的动态库。 尽管如此,这种动态库(Embedded Framework) 和系统的 UIKit.Framework 还是有很大区别的。传统的动态库是给多个进程使用的,而这里的动态库(Embedded Framework)是给单个进程里面多个可执行文件用的。 系统的 Framework 不再需要拷贝到目标程序中,我们自己做出来的动态库(Embedded Framework) 哪怕是动态的,最后也还是要拷贝到 App 中(App 和 Extension 的 Bundle 是共享的)。所以苹果没有直接把这种 Embedded Framework称作动态库而是叫 Embedded Framework。 上面提到的 Swift 也有原因,在 Swift 的项目中如果要在项目中使用外部代码,可选的方式只有两种,一种是把代码拷贝到工程中,另一种是用动态 Framework。使用静态库是不支持的。 这个问题的根本原因是, Swift 的运行库没有被包含在 iOS 系统中,反而会被打包进 App 中(这也是造成 Swift App 体积大的原因),静态库会导致最终的目标程序中包含重复的运行库。 4. 以动态库为例,开始制作SDK 第一步:创建 App 工程,命名为 RealDemo 如果不清楚怎么创建,可以点击这里 第二步:关闭 RealDemo 工程,然后在 RealDemo 目录下创建 Framework 工程,命名为 RealSDK 选择下方的 Framework 进行创建 切记目录不要选择错误 第三步:设置 Framework 工程的 Build Settings 创建动态库需要选择 Dynamic Library,如果要制作静态库则要选择 Static Library 第四步:关闭RealSDK工程,创建 WorkSpace,命名为 RealDemo 逐次点击 File - New - Workspace 创建后会出现对应的 workspace 文件 第五步:连接 Framework 工程和 App 工程 我们需要先打开 RealDemo.xcworkspace,打开后你会发现这里空空如也。 然后我们直接把需要连接的 Framework 工程(RealSDK.xcodeproj)和 App 工程(RealDemo.xcodeproj)拖进来就可以了! 直接拖拽进 Xcode 即可 拖拽后你会发现两者的层级关系相同 第六步:把 Framework 添加到 App 工程中 逐次点击,不要点错了 选择前面创建的 framework 有过 SDK 开发经验的同学到这里应该已经看明白了,所谓实时联调说白了就是用 WorkSpace 把两个工程连接起来而已,跟 Pod 的原理有几分相似。 第七步:给 Framework 加点功能 我们需要增加一个 RealDog 类,定义一个 eat 方法,实现里面打印一句话“吃骨头”。然后修改 RealDog.h 的 Target Membership 为 Public,意思为公开头文件。 在这里我定义了 eat 方法 RealDog的实现如下: @implementation RealDog + (void)eat { NSLog(@"吃骨头"); } @end 第八步:在 App 的 ViewController 调用一下 SDK 的方法 #import "ViewController.h" #import <RealSDK/RealDog.h> @implementation ViewController - (void)viewDidLoad { [super viewDidLoad]; [RealDog eat]; } @end 第九步:运行一下,可以发现App工程成功调用了SDK的方法 OK,实时联调到此结束 5. 使用脚本合并真机、模拟器等多种架构的 Framework 第一步:添加一个 Aggregate Target RealSDK Project -> TARGETS -> "+"(左下角) -> Cross-platform - Other -> Aggregate 第二步:将 Aggregate Target 命名为“RealSDK-Script” 命名后点击 Finish 即可 第三步:依赖 RealSDK 在 Dependencies 中配置依赖关系 第四步:添加脚本 点击这里的 New Run Script Phase 复制下方脚本即可 这个脚本是通用的,各位同学直接复制粘贴即可: # Type a script or drag a script file from your workspace to insert its path. UNIVERSAL_OUTPUTFOLDER=../Framework/ # 创建输出目录,并删除之前的framework文件 mkdir -p "${UNIVERSAL_OUTPUTFOLDER}" rm -rf "${UNIVERSAL_OUTPUTFOLDER}/${PROJECT_NAME}.framework" # 分别编译模拟器和真机的Framework xcodebuild -target "${PROJECT_NAME}" ONLY_ACTIVE_ARCH=NO -configuration ${CONFIGURATION} -sdk iphoneos BUILD_DIR="${BUILD_DIR}" BUILD_ROOT="${BUILD_ROOT}" clean build xcodebuild -target "${PROJECT_NAME}" ONLY_ACTIVE_ARCH=NO -configuration ${CONFIGURATION} -sdk iphonesimulator BUILD_DIR="${BUILD_DIR}" BUILD_ROOT="${BUILD_ROOT}" clean build # 定义真机、模拟器Build文件夹路径变量 IPHONE_BUILD=${BUILD_DIR}/${CONFIGURATION}-iphoneos/${PROJECT_NAME}.framework SIMULATOR_BUILD=${BUILD_DIR}/${CONFIGURATION}-iphonesimulator/${PROJECT_NAME}.framework # 拷贝framework到univer目录 cp -R "${IPHONE_BUILD}" "${UNIVERSAL_OUTPUTFOLDER}/" #cp -R "${SIMULATOR_BUILD}" "${UNIVERSAL_OUTPUTFOLDER}/" # 定义输出路径变量 OUTPUT_PATH=${UNIVERSAL_OUTPUTFOLDER}/${PROJECT_NAME}.framework # 合并framework,输出最终的framework到build目录 lipo -create "${IPHONE_BUILD}/${PROJECT_NAME}" "${SIMULATOR_BUILD}/${PROJECT_NAME}" -output "${OUTPUT_PATH}/${PROJECT_NAME}" 第五步:运行脚本 依然是点击左侧的播放按钮 第六步:查看结果 能看到这个文件夹就代表编译成功啦! 如果你的 Mac 是最新的 M1芯片,那么可能会出现以下报错: fatal error: lipo: /Users/hujianhui/Library/Developer/Xcode/DerivedData/RealDemo-ckvcidkkuvgpadeiqrvgjdyikcdc/Build/Products/Debug-iphoneos/RealSDK.framework/RealSDK and /Users/hujianhui/Library/Developer/Xcode/DerivedData/RealDemo-ckvcidkkuvgpadeiqrvgjdyikcdc/Build/Products/Debug-iphonesimulator/RealSDK.framework/RealSDK have the same architectures (arm64) and can't be in the same fat output file 你只需要去除 iOS 模拟器的 arm64 架构即可,方法如下: 点击 arm64 前面的减号即可 6. 小贴士 1. Framework 中使用 Category 在 Framework 工程的 Build Setting 中添加 -ObjC。另外,使用我们 SDK 的 App 的 Build Setting 中也要添加 -ObjC。 2. Framework 支持 bitcode 四、在 Android 环境中开发 SDK 1. Android SDK 介绍 Android App 集成第三方 SDK 的文件类型,主要有三种,一种是 JAR 包文件,和 SO 文件 ,另外一种是 AAR 文件, JAR 包是 Java 提供的 SDK 文件类型,里面包含的是纯 Java 编译过后的代码。SO 一般是 C 和 C++ 打包成库的文件。 AAR 名字来源于 Android Archive,见名知义,是一个 Android 库项目的二进制归档文件,使用 Android Studio ,非常简单可以生成一个 AAR 文件。AAR 库文件里面,包含了 JAR 和 SO,还有资源 Res 等文件,结构等同一个 App。 它可以提供构建应用所需的一切内容,包括源代码、资源文件和 Android 清单。不过,Android 库将编译为您可以用作 Android 应用模块依赖项的 Android ARchive (AAR) 文件,而不是编译为在设备上运行的 APK。 与 JAR 文件不同,AAR 文件会为 Android 应用提供以下功能: AAR 文件可以包含多项 Android 资源和一个清单文件,让您除了能够在 Java 类和方法中进行捆绑以外,还能够在布局和可绘制对象等共享资源中进行捆绑; AAR 文件可以包含 C/C++ 库,供应用模块的 C/C++ 代码使用。 2. 创建 SDK 工程 打开上个章节我们创建的示例工程,在工程上创建一个 library module,命名为GPush,让我们模拟实现一个推送简短新闻的接口。 如果你忘记怎么做的话,可以点这里 选择 Android Library,并在名称中输入 GPush 添加成功后我们会在左侧看到对应的 Libray 文件 3. 添加依赖项 如需在同一项目中的另一个应用或库模块中使用新的 Android 库代码,就需要这样添加一个项目级依赖项: 依次转到File > Project Structure > Dependencies; 选择要在其中使用库的模块; 在Declared Dependencies标签页中,点击 +,然后在下拉菜单中选择Module Dependency。 先点击加号,再选中对应的 Module Dependency 将其加入依赖中 4. 接口设计 既然是做一个推送新闻的接口,那就必须要分为客户端和推送端,即 Client#onReceiveMessage 和 GPush#pushMessage。 从下面给出 UML 图可以看出,只需要一个方法就可以监听到新闻推送了,GPushImpl#start(Client client)。 可以看我画的 UML 图,帮助你更进一步理解 GPush 类 package com.myname.library; interface GPush { void pushMessage(String msg); } GPushImpl 类 package com.myname.library; import android.os.Handler; import android.os.HandlerThread; import java.util.ArrayList; import java.util.Iterator; import java.util.List; import java.util.Random; public class GPushImpl implements GPush { private List<Client> mClients; private HandlerThread mHandlerThread; private Handler mHandler; private Random mRandom = new Random(); private List<String> msgs = new ArrayList<String>() { { add("1、文旅部:严查以中老年为目标的包价游产品"); add("2、加快推进沿长江户籍改革,服务长江经济带高质量发展。"); add("3、今年首批10家非法社会组织网站被关停,含中国文艺名人协会等。"); add("4、上海:5月1日起,电动自行车骑乘人员必须戴头盔。"); add("5、广州:清明祭扫实行实名预约,倡导网上祭扫、错峰延后祭扫。"); add("6、河北武安铁矿致6死事故涉嫌瞒报,企业相关人员被控制。"); add("7、黄峥辞任拼多多董事长:将放弃超级表决权,投入科学研究。"); add("8、打破国外20年垄断,国产人工心脏研发成功,但商用落地时间暂不确定。"); add("9、调查:六成青年入睡时间晚于23点,梦多睡眠浅成年轻人睡眠主要问题。"); } }; GPushImpl() { mClients = new ArrayList<>(); mHandlerThread = new HandlerThread("Push-Thread"); mHandlerThread.start(); mHandler = new Handler(mHandlerThread.getLooper()); } @Override public void pushMessage(String msg) { Iterator<Client> iterator = mClients.iterator(); while (iterator.hasNext()) { iterator.next().onReceiveMessage(msg); } } public static void start(Client client) { GPushImpl gPush = new GPushImpl(); gPush.mClients.add(client); gPush.mHandler.post(gPush.mRunnable); } private Runnable mRunnable = new Runnable() { @Override public void run() { mHandler.postDelayed(mRunnable, mRandom.nextInt(10000)); pushMessage(msgs.get(mRandom.nextInt(msgs.size()))); } }; } Client 类 public interface Client { void onReceiveMessage(String msg); } 开始监听新闻推送 GPushImpl.start { Toast.makeText(MainActivity@this,it,Toast.LENGTH_LONG).show() } SDK 打包 ./gradlew :GPush:assembleRelease 打包完成后就行生成一个 aar 文件, 这个文件就是我们打包的结果了 5. 最后注意事项 —混淆 基于代码保护的目的,Gradle 打包默认会根据 build.gradle 和 proguard-rules.pro 配置的混淆规则,来对代码进行一个混淆, 如果 library 里面使用了如 GSON 或者反射等技术则需要对部分类进行 keep 操作。 buildTypes { release { minifyEnabled false proguardFiles getDefaultProguardFile('proguard-android-optimize.txt'), 'proguard-rules.pro' } } -keep class com.myname.library.** {*;} 如果正确按照教程,那相信你已经成功的做出了属于自己的第一个 iOS 与 Android SDK,本期教程依然基于 mac 电脑进行实现,如果你的电脑是 Windows 或者其他操作系统,还需要进行一些其他的灵活配置。 本文转载至 FinClip 博客。

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册