首页 文章 精选 留言 我的

精选列表

搜索[赛博朋克],共10000篇文章
优秀的个人博客,低调大师

每日一博 | 聊聊野指针与僵尸对象定位

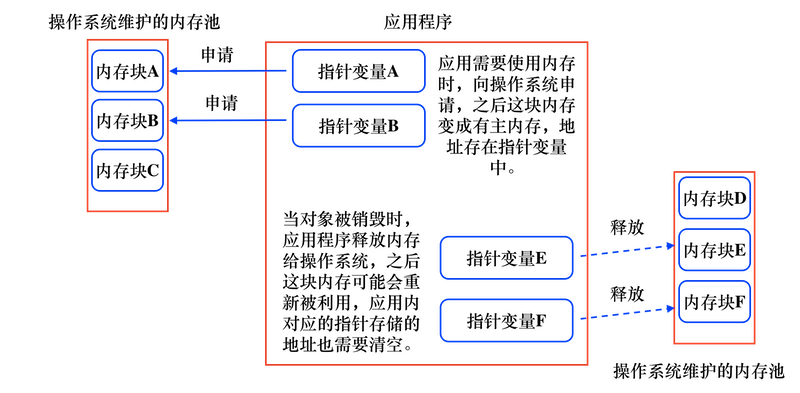
[iOS研习记]——聊聊野指针与僵尸对象定位 一、从一个异常说起 在iOS项目开发中,或多或少的我们都会遇到一些Crash的情况,大部分Crash抛出的异常都是NSException层的,这类异常是OC层代码问题造成的,通常堆栈信息和异常的提示信息都非常明确,可以直接定位到出问题的代码,从而使这类问题的解决并不困难。可以引起Crash的异常除了NSException外,还有Unix层和Mach层的异常。 Mach异常一般是底层内核级的异常,我们可以通过一些底层的API来对这类异常进行捕获,这不是本文的讨论内容,这里不再赘述。Unix层是指对于开发者没有捕获的Mach异常,会被转换成对应的Unix信号传递给出错线程。 如果你在iOS项目在线上收集的异常中,有类似EXC_BAD_ACCESS的异常,则大概率是由于内存问题产生的野指针引起的。这也是本文我们要讨论的核心内容。 1. 什么是野指针? 当前我们在编写iOS程序时大多会采用ARC来进行内存管理,通常情况下我们无需过多的对内存管理进行关心。但是这并不代表不会产生内存问题。从原理上讲,我们在创建任何对象的时候,首先都会通过操作系统从内存中申请出一块内存空间供此对象使用,并将此内存空间的地址保存到指针中供我们在代码中方便的引用到此内存。那么当这个对象被销毁的时候,原则上我们需要做两件事,一是将这块内存还回去,之后操作系统可以重复利用这块内存分配给其他申请者使用,二是将代码中的指针清空回收。这样可以保证程序能够可持续化的健康运行。工作过程如下图所示: 但是无论在生活中还是编程中,意外总会发生,通常情况下,在向操作系统申请内存这一步很少会出现问题,操作系统本身的稳定性比应用程序要强很多。问题大多出现在内存释放的时候。问题可能有两种: 一种是已经不需要使用的对象我们将指针变量直接清除了,但却没有告诉操作系统回收这块内存,此后程序中没有地方存储这块内存的地址,这块内存将永远无法使用和回收。这种情况下,这块内存就变成了无主内存且操作系统并不知道,就产生了我们常说的内存泄露问题,随着应用的运行时间越来越长,内存泄露可能越来越多最终导致内存不够用,程序无法再正常运行。 另一种是我们告诉操作系统要回收这块内存,并且这块内存也真正的被回收了,但是程序中依然有指针变量存储着这个地址没有清空,此时这个指针就变成了也指针,因为它所指向的内存已经回收,这块内存具体是又被利用了还是依然存放着原来的数据我们都一无所知。此后如果不小心又通过这个指针使用了这块内存的数据,无论读写都将产生各种千奇百怪的问题,且我们很难定位。本文我们主要聊的就是这类野指针问题的产生原因与定位方法。 2. 野指针会产生哪些问题? 开发中我们遇到的大部分的EXC_BAD_ACCESS问题都是由野指针导致的,主要有两种信号:SIGSEGV和SIGBUS。其中SIGSEGV表示操作的地址非法,访问了未分配的内存或者写入了没有写权限的内存。SIGBUS表示错误的内存类型访问。 野指针会产生的问题千奇百怪,难以定位。当程序中使用到了野指针时,可能存在两大种场景: 1> 访问的内存没有被覆盖 如果原对象依赖的其他对象没有被删除,则看上去程序的运行好像任何问题,但是实际上却很危险,程序逻辑上的表现已经不可控。 如果原对象依赖的其他对象有删除情况,则内部可能还有有其他野指针生成,依然会出现各种复杂的异常场景。 2> 访问的内存重新被覆盖了 这种从场景会更加麻烦,如果当前内存区域的可访问性发生了变化,则会产生许多类型的异常,例如objc_msgSend失败,SIGBUS地址类型异常,SIGFPE运算符异常,SIGILL指令异常等等。 如果当前内存是可以访问的,则可能违背我们本意的写坏其他地方在使用的内存,使其他地方在使用时产生异常。也可能要使用的数据类型和我们原对象对不上,导致未实现的选择器类的错误,查找方法类的错误,各种底层逻辑错误,以及malloc错误等。这时要排查问题就非常难了。 综上所述,野指针的危害是非常大,除了其本身会造成异常Crash外,还可能会使其他正常使用的代码产生异常,并且有不可复现性与随机性,例如你可能发现某个Crash的堆栈是调用了某个对象的某个方法找不大,但是你搜遍代码也没有找到类似的方法调用,其实就是其他地方出现了野指针问题,之后这个正确的对象刚好分配到了野指针所指向的内存,野指针将此内存的数据破坏了。对于这种Crash问题,我们几乎是束手无策的。 3. 动手造一个野指针场景试试看 通过前面的介绍,我们了解了野指针问题的产生原因与危害。现在可以动手一试。使用Xcode新建一个iOS工程。在其中新建一个名为MyObject的类,为其添加一个属性,如下: #import <Foundation/Foundation.h> @interface MyObject : NSObject @property(copy) NSString *name; @end 在ViewController类中编写如下测试代码: #import "ViewController.h" #import "MyObject.h" @interface ViewController () @property (nonatomic, unsafe_unretained)MyObject *object; @end @implementation ViewController - (void)viewDidLoad { [super viewDidLoad]; MyObject *object = [[MyObject alloc] init]; self.object = object; self.object.name = @"HelloWorld"; void *p = (__bridge void *)(self.object); NSLog(@"%p,%@",self.object,self.object.name); NSLog(@"%p,%@",p, [(__bridge MyObject *)p name]); } - (void)touchesBegan:(NSSet<UITouch *> *)touches withEvent:(UIEvent *)event { NSLog(@"%p",self->_object); NSLog(@"%@",self.object.name); } @end 这里我们手动的造出了一个会出现野指针问题的场景,ViewController类的object属性声明为的unsafe_unretained,这个修饰符的意思是当前属性不被ARC所管理,其所引用的对象释放后,此指针也不会被置空。上面代码我们在viewDidLoad方法中创建了一个MyObject对象,并复制给了当前控制器的object属性,由于栈内对象的生命周期为当前代码块内有效,因此当viewDidLoad方法结束后,此内存就会被回收,此时object指针就成了野指针。 我们可以在viewDidLoad方法的最后打上断点,观察当前MyOject对象的内存分配地址,如下: 可以看到,当次运行时,object对象分配的内存地址为0x600001e542d0(每次运行都会不同),后面访问对象的属性实际上就是对此内存中数据的访问,我们如果知道了内存地址,也可以直接使用地址进行访问,不一定要有变量,例如上图中通过LLDB中的po指令可以直接向内存地址发送消息,效果和通过变量调用对象方法是一样的。 之后,我们可以在运行后点击一下当前页面,大部分情况下都会出现地址异常Crash,我们可以通过LLDB输出下线程的堆栈信息,如下: 还有时候,程序可能会直接Crash到main方法中,输入更奇怪的堆栈信息,如下: 如上图所示,堆栈信息提示我们调用了数组的name方法,这其实就是因为此块内存被重新分配了。 我们只创建了一个没有任何逻辑的Demo项目,野指针的问题都如此多样,如果是在实际项目中,出了野指针问题我们更难找到问题源头。并且在ARC环境下,上面示例的场景其实很好排查到,更多产生野指针的原因是多线程不安全的读写数据造成的,结合多线程使用,野指针的问题则更加难查。 二、从原理看野指针的监控 要解决由野指针产生的问题,除了编程时尽量注意一些,避免危险的写法外。更重要的是能总结出一套方案来流程化的对此类问题进行监控。由于野指针问题的特性所致,我们在内存释放时其实是并不知道是否会产生野指针问题的,发生了野指针问题后也无法回溯。因此我们要用预设的思路来找这类问题的监控方案,即假设当前内存释放后依然有野指针要访问它,在设计时,我们可以不真正的将这块内存释放,而是将这块内存标记成有问题的,之后如果又发现有对这块有问题内存的访问出现,则表明出现了野指针问题。在标记内存时,我们也可以记录一下原对象的某些信息,例如类名,这样在发生野指针问题时,无论具体Crash的堆栈情况如何,我们都可以知道是具体哪个类的对象释放问题产生的野指针,能极大的缩小问题的排查范围。 因此处理野指针问题的核心点在于两点: 1.预设标记内存,被动等待野指针问题触发。 2.记录产生野指针问题的类,从类对象的使用入手排查而不是Crash时的堆栈入手排查。 针对如上两点,我们来看下如何实现。 1. 僵尸对象 将要释放的对象内存不真正回收,而是仅仅进行标记,我们会形象的成此时的对象为“僵尸对象”。Xcode默认支持开启僵尸对象,当我们向一个僵尸对象进行访问时,就会必然产生Crash,并且控制台输出相关提示信息。在Xcode中对要运行的scheme进行编辑,打开僵尸对象功能,如下所示: 再次运行工程,程序Crash后将输出如下信息: *** -[MyObject retain]: message sent to deallocated instance 0x600000670670 我们可以明确的知道是MyObject对象的内存问题导致了野指针崩溃。 Xcode的僵尸对象功能虽然好用,但是只能调试时使用,更多时候我们产生的野指针问题都是线上环境的,而且无法复现,这个功能就显得非常鸡肋的。我们能否不依赖Xcode来实现野指针的监控呢?首先我们需要先搞明白Xcode中僵尸对象的实现原理。 2. Apple僵尸对象的实现原理探究 首先我们大致可以知道,要实现僵尸对象大概率是要对dealloc方法做些事情的,我们可以从这个方法入手找线索,查看objc的源代码,在其NSObject.m中可以看到如下代码: // Replaced by NSZombies - (void)dealloc { _objc_rootDealloc(self); } 从注释可以看到,系统实现的僵尸对象的确是处理dealloc方法了,推测其实通过Runtime替换了NSObject的dealloc方法。在CoreFoundation的源码中也有部分关于Zombies的内容,在CFRuntime.c中可以看到如下代码: extern void __CFZombifyNSObject(void); // from NSObject.m void _CFEnableZombies(void) { } 其中,_CFEnableZombies比较好理解,它应该是来表示是否开启僵尸对象功能的,应该和我们在Xcode中设置的环境变量功能一致,__CFZombifyNSObject从注释可以知道,应该是对僵尸对象的实现。我们在Xcode中添加一个__CFZombifyNSObject的符号断点,断点后内容如下所示: 看到这里的汇编,你应该不会太陌生,我们把核心的伪代码提出来,大致如下: // 定义字符串 define "NSObject" // 用来获取NSObject类 objc_lookUpClass "NSObject" // 定义字符串 define "dealloc" define "__dealloc_zombie" // 获取dealloc方法的实现 class_getInstanceMethod "NSObject" "dealloc" // 获取__dealloc_zombie方法的实现 class_getInstanceMethod "NSObject" "__dealloc_zombie" // 交换dealloc与__dealloc_zombie的方法实现 method_exchangeImplementations "dealloc" "__dealloc_zombie" 和我们想的差不多,下面我们可以再添加一个__dealloc_zombie的符号断点,看一看__dealloc_zombie方法是怎么实现的,如下: CoreFoundation`-[NSObject(NSObject) __dealloc_zombie]: -> 0x10ef77c49 <+0>: pushq %rbp 0x10ef77c4a <+1>: movq %rsp, %rbp 0x10ef77c4d <+4>: pushq %r14 0x10ef77c4f <+6>: pushq %rbx 0x10ef77c50 <+7>: subq $0x10, %rsp 0x10ef77c54 <+11>: movq 0x2e04fd(%rip), %rax ; (void *)0x0000000110021970: __stack_chk_guard 0x10ef77c5b <+18>: movq (%rax), %rax 0x10ef77c5e <+21>: movq %rax, -0x18(%rbp) 0x10ef77c62 <+25>: testq %rdi, %rdi 0x10ef77c65 <+28>: js 0x10ef77d04 ; <+187> 0x10ef77c6b <+34>: movq %rdi, %rbx 0x10ef77c6e <+37>: cmpb $0x0, 0x488703(%rip) ; __CFConstantStringClassReferencePtr + 7 0x10ef77c75 <+44>: je 0x10ef77d1d ; <+212> 0x10ef77c7b <+50>: movq %rbx, %rdi 0x10ef77c7e <+53>: callq 0x10eff4b52 ; symbol stub for: object_getClass 0x10ef77c83 <+58>: leaq -0x20(%rbp), %r14 0x10ef77c87 <+62>: movq $0x0, (%r14) 0x10ef77c8e <+69>: movq %rax, %rdi 0x10ef77c91 <+72>: callq 0x10eff464e ; symbol stub for: class_getName 0x10ef77c96 <+77>: leaq 0x242db5(%rip), %rsi ; "_NSZombie_%s" 0x10ef77c9d <+84>: movq %r14, %rdi 0x10ef77ca0 <+87>: movq %rax, %rdx 0x10ef77ca3 <+90>: xorl %eax, %eax 0x10ef77ca5 <+92>: callq 0x10eff4570 ; symbol stub for: asprintf 0x10ef77caa <+97>: movq (%r14), %rdi 0x10ef77cad <+100>: callq 0x10eff4ab0 ; symbol stub for: objc_lookUpClass 0x10ef77cb2 <+105>: movq %rax, %r14 0x10ef77cb5 <+108>: testq %rax, %rax 0x10ef77cb8 <+111>: jne 0x10ef77cd7 ; <+142> 0x10ef77cba <+113>: leaq 0x2427aa(%rip), %rdi ; "_NSZombie_" 0x10ef77cc1 <+120>: callq 0x10eff4ab0 ; symbol stub for: objc_lookUpClass 0x10ef77cc6 <+125>: movq -0x20(%rbp), %rsi 0x10ef77cca <+129>: movq %rax, %rdi 0x10ef77ccd <+132>: xorl %edx, %edx 0x10ef77ccf <+134>: callq 0x10eff4a62 ; symbol stub for: objc_duplicateClass 0x10ef77cd4 <+139>: movq %rax, %r14 0x10ef77cd7 <+142>: movq -0x20(%rbp), %rdi 0x10ef77cdb <+146>: callq 0x10eff482e ; symbol stub for: free 0x10ef77ce0 <+151>: movq %rbx, %rdi 0x10ef77ce3 <+154>: callq 0x10eff4a5c ; symbol stub for: objc_destructInstance 0x10ef77ce8 <+159>: movq %rbx, %rdi 0x10ef77ceb <+162>: movq %r14, %rsi 0x10ef77cee <+165>: callq 0x10eff4b6a ; symbol stub for: object_setClass 0x10ef77cf3 <+170>: cmpb $0x0, 0x48867f(%rip) ; __CFZombieEnabled 0x10ef77cfa <+177>: je 0x10ef77d04 ; <+187> 0x10ef77cfc <+179>: movq %rbx, %rdi 0x10ef77cff <+182>: callq 0x10eff482e ; symbol stub for: free 0x10ef77d04 <+187>: movq 0x2e044d(%rip), %rax ; (void *)0x0000000110021970: __stack_chk_guard 0x10ef77d0b <+194>: movq (%rax), %rax 0x10ef77d0e <+197>: cmpq -0x18(%rbp), %rax 0x10ef77d12 <+201>: jne 0x10ef77d3d ; <+244> 0x10ef77d14 <+203>: addq $0x10, %rsp 0x10ef77d18 <+207>: popq %rbx 0x10ef77d19 <+208>: popq %r14 0x10ef77d1b <+210>: popq %rbp 0x10ef77d1c <+211>: retq 0x10ef77d1d <+212>: movq 0x2e0434(%rip), %rax ; (void *)0x0000000110021970: __stack_chk_guard 0x10ef77d24 <+219>: movq (%rax), %rax 0x10ef77d27 <+222>: cmpq -0x18(%rbp), %rax 0x10ef77d2b <+226>: jne 0x10ef77d3d ; <+244> 0x10ef77d2d <+228>: movq %rbx, %rdi 0x10ef77d30 <+231>: addq $0x10, %rsp 0x10ef77d34 <+235>: popq %rbx 0x10ef77d35 <+236>: popq %r14 0x10ef77d37 <+238>: popq %rbp 0x10ef77d38 <+239>: jmp 0x10eff44c8 ; symbol stub for: _objc_rootDealloc 0x10ef77d3d <+244>: callq 0x10eff443e ; symbol stub for: __stack_chk_fail 汇编内容较多,整体流程是比较清晰的,伪代码如下: // 获取当前类 object_getClass // 通过当前类获取当前类型 class_getName // 将_NSZombie_拼接上当前类名 zombiesClsName = "_NSZombie_%s" + className // 获取zombiesClsName类 objc_lookUpClass zombiesClsName // 判断是否已经存在zombiesCls if not zombiesCls: // 如果不存在 // 现获取"_NSZombie_"类 cls = objc_lookUpClass "_NSZombie_" // 复制出一个cls类,类名为zombiesClsName objc_duplicateClass cls zombiesClsName // 字符串变量释放 free zombiesClsName // objc中原本的对象销毁方法 objc_destructInstance(self) // 将当前对象的类修改为zombiesCls object_setClass zombiesCls // 判断是否开启了僵尸对象功能 if not __CFZombieEnabled: // 如果没开启 将当前内存释放掉 free 上面的伪代码基本是__dealloc_zombie方法实现的整体过程,在objc源码中,NSObject类原本的dealloc方法实现路径如下: - (void)dealloc { _objc_rootDealloc(self); } void _objc_rootDealloc(id obj) { ASSERT(obj); obj->rootDealloc(); } inline void objc_object::rootDealloc() { // taggedPointer无需回收内存 if (isTaggedPointer()) return; // fixme necessary? // nonpointer为1表示不只是地址,isa中包含了其他信息 // weakly_referenced表示是否有弱引用 // has_assoc 表示是否有关联属性 // has_cxx_dtor 是否需要C++或Objc析构 // has_sidetable_rc是否有散列表计数引脚 if (fastpath(isa.nonpointer && !isa.weakly_referenced && !isa.has_assoc && !isa.has_cxx_dtor && !isa.has_sidetable_rc)) { // 如果都没有 直接回收内存 assert(!sidetable_present()); free(this); } else { object_dispose((id)this); } } id object_dispose(id obj) { if (!obj) return nil; // 进行内存回收前的销毁工作 objc_destructInstance(obj); free(obj); return nil; } 可以看到,__dealloc_zombie与真正的dealloc的实现其实只差了当前内存的回收部分,objc_destructInstance方法会正常执行的,这个方法实现如下: void *objc_destructInstance(id obj) { if (obj) { // Read all of the flags at once for performance. bool cxx = obj->hasCxxDtor(); bool assoc = obj->hasAssociatedObjects(); // C++ 析构 if (cxx) object_cxxDestruct(obj); // 移除关联属性 if (assoc) _object_remove_assocations(obj); // 弱引用表和散列表的清除 obj->clearDeallocating(); } return obj; } 通过上面的分析,我们发现,其实系统实现的僵尸对象非常安全,并不对正常代码的运行产生负面作用,唯一的影响在于内存不回收会增加内存的使用负担,但是可以通过某些策略来进行释放。 三、手动实现线上野指针问题收集 理解了系统僵尸对象的实现原理,即是不依赖Debug环境,我们也可以仿照此思路来实现僵尸对象监控功能。 1. 仿照Apple的僵尸对象思路实现 首先创建一个名为_YHZombie_的模板类,实现如下: // _YHZombie_.h #import <Foundation/Foundation.h> @interface _YHZombie_ : NSObject @end // _YHZombie_.m #import "_YHZombie_.h" @implementation _YHZombie_ // 调用这个对象对的所有方法都hook住进行LOG - (id)forwardingTargetForSelector:(SEL)aSelector { NSLog(@"%p-[%@ %@]:%@",self ,[NSStringFromClass(self.class) componentsSeparatedByString:@"_YHZombie_"].lastObject, NSStringFromSelector(aSelector), @"向已经dealloc的对象发送了消息"); // 结束当前线程 abort(); } @end 在新建一个NSObject的类别,用来替换dealloc方法,如下: // NSObject+YHZombiesNSObject.h #import <Foundation/Foundation.h> @interface NSObject (YHZombiesNSObject) @end // NSObject+YHZombiesNSObject.m #import "NSObject+YHZombiesNSObject.h" #import <objc/objc.h> #import <objc/runtime.h> @implementation NSObject (YHZombiesNSObject) +(void)load { [self __YHZobiesObject]; } + (void)__YHZobiesObject { char *clsChars = "NSObject"; Class cls = objc_lookUpClass(clsChars); Method oriMethod = class_getInstanceMethod(cls, NSSelectorFromString(@"dealloc")); Method newMethod = class_getInstanceMethod(cls, NSSelectorFromString(@"__YHDealloc_zombie")); method_exchangeImplementations(oriMethod, newMethod); } - (void)__YHDealloc_zombie { const char *className = object_getClassName(self); char *zombieClassName = NULL; asprintf(&zombieClassName, "_YHZombie_%s", className); Class zombieClass = objc_getClass(zombieClassName); if (zombieClass == Nil) { zombieClass = objc_duplicateClass(objc_getClass("_YHZombie_"), zombieClassName, 0); } objc_destructInstance(self); object_setClass(self, zombieClass); if (zombieClassName != NULL) { free(zombieClassName); } } @end 上面代码,除了一些容错判断没有加之外,思路和系统的僵尸对象一模一样。 再次运行我们的测试代码,在访问到野指针的时候将百分百的产生异常中断,并输出如下: 0x600003a8c2e0-[MyObject name]:向已经dealloc的对象发送了消息 现在,我们已经从原理上简单实现了一个不依赖于Xcode的野指针监控工具。 2. 将监控推广到C指针 通过对象的僵尸化,对OC层的野指针问题可以做到很好的监控作用,但是这种方法并不实用与C层的指针,项目中如果用到C相关的指针,由于内存的管理方式不走引用计数,无法通过Hook dealloc的方式来僵尸化对象。例如,我们创建一个如下的结构体: typedef struct { NSString *name; } MyStruct; 在使用此结构体时,如果初始化之前进行了使用或内存回收后进行了使用都可能会出现野指针问题,如下: MyStruct *p; p = malloc(sizeof(MyStruct)); // 此时内存中的数据不可控 可能是之前未擦除的 printf("%x\n", *((int *)p)); // 使用可能会出现野指针问题 NSLog(@"%@", p->name); // 进行内存数据的初始化 p->name = @"HelloWorld"; // 回收内存 free(p); // 此时内存中的数据不可控 NSLog(@"%@", p->name); 我们可以思考下,出现上面野指针场景的主要原因是: 1. 获取到分配的内存后,如果此内存之前有过使用,数据此时是不可控的,当前指针直接使用此数据会有问题。 2.回收内存后,当前内存中的数据是不可控的,可能有别人或之前未清除的指针使用到。 无论是上面哪种场景,此野指针问题都有非常大的随机性,难以调试。因此我们核心要处理的地方在于把随机性改为必然性,即想办法让使用到这些有问题的内存时直接Crash,而不是可能Crash。要处理场景1很容易,我们可以hook住C中的malloc方法,分配了内存后直接将一个约定好的异常数据写入内存,这样在初始化之前使用到此数据时必然产生Crash。对于场景2,我们可以hook住C中的free方法,回收内存后将一个约定好的异常数据直接写入此内存,下次如果此内存没有被再分配,使用到它后也必然产生Crash。Xcode提供的Malloc Scribble调试功能,就是用这种思路实现的。 开启Xcode的Malloc Scribble选项,运行上面代码,效果如下图所示: 可以看到,在malloc分配内存之后,所有字节都被填入了0xAA,未初始化前使用就会必然产生Crash。这与Apple官方文档的解释是一致的,但是在free之后,内存数据获取到的可能并不是文档所说的0x55,是因为这块内存可能被其他内容覆写了。官网文档描述如下: 我们也可以手动根据Malloc Scribble的思路来实现一个将野指针问题从随机变成必然的工具,只需要重写系统的malloc相关的函数与free函数即可。对于C语言函数的Hook,我们可以直接使用fishhook库: https://github.com/facebook/fishhook 导入上面库后,新建一个命名为YHMallocScrbble的类,实现如下: // YHMallcScrbble.h #import <Foundation/Foundation.h> @interface YHMallcScrbble : NSObject @end // YHMallcScrbble.m #import "YHMallcScrbble.h" #import "fishhook.h" #import "malloc/malloc.h" void * (*orig_malloc)(size_t __size); void (*orig_free)(void * p); void *_YHMalloc_(size_t __size) { void *p = orig_malloc(__size); memset(p, 0xAA, __size); return p; } void _YHFree_(void * p) { size_t size = malloc_size(p); memset(p, 0x55, size); orig_free(p); } @implementation YHMallcScrbble + (void)load { rebind_symbols((struct rebinding[2]){{"malloc", _YHMalloc_, (void *)&orig_malloc}, {"free", _YHFree_, (void *)&orig_free}}, 2); } @end 这样我们就实现了将野指针问题从随机变成必然,并且通用C指针。 相比僵尸对象方案,Malloc Scribble方法可以通用C指针,并且真正实现了对对象内存的回收,不会暂用内存。但是也有很大的弊端,比如对于free后写入的0x55在很多情况下都是无效的,因为这块内存可能又被其他地方改写了,导致Crash依然是随机的。当然我们也可以在自定义的free方法中不调用原系统的free,使得这块内存强制不能分配出去,这样其实和僵尸对象方案就比较类似了。并且相对僵尸对象方案,Malloc Scribble只能一定程度上将随机变成必然,方便问题的暴露,但是对开发者来说,并没有太多的信息告诉我们具体是什么类型的数据出的问题,排查还是有难度。 四、一些扩展 上面只是简单介绍了对野指针问题监控的一些手段原理。除了僵尸对象和Malloc Scribble外,Xcode中还提供了Address Sanitizer工具来做内存问题的监控,其原理也是对malloc和free函数做了处理,但程序访问到了有问题的内存时可以及时Crash,同时这个工具可以将对象在malloc时的堆栈信息进行存储,方面我们定位问题。无论采用哪种方法,如果我们真的要在线上执行,要做的事情其实还有很多,例如数据的收集策略,僵尸对象内存的清理时机,何时判断出有问题并抓取堆栈等等。 最后,希望本文可以为你对开发中野指针问题的处理带来一些思路。本文中所编写的示例代码可以在如下地址下载: https://github.com/ZYHshao/ZombiesDemo 专注技术,懂的热爱,愿意分享,做个朋友 QQ:316045346

优秀的个人博客,低调大师

每日一博 | 深入理解 Ribbon 的架构原理

大家好,我是悟空。 本篇主要内容如下: 前言 今天我们来看下微服务中非常重要的一个组件:Ribbon。它作为负载均衡器在分布式网络中扮演着非常重要的角色。 在介绍 Ribbon 之前,不得不说下负载均衡这个比较偏僻的名词。为什么说它偏僻了,因为在面试中,聊得最多的是消息队列和缓存来提高系统的性能,支持高并发,很少有人会问负载均衡,究其原因,负载均衡的组件选择和搭建一般都是运维团队或者架构师去做的,开发人员确实很少接触到。不过没关系,我们不止有 CRUD,还要有架构思维。 简单来说,负载均衡就是将网络流量(负载)分摊到不同的网络服务器(可以平均分配,也可以不平均),系统就可以实现服务的水平横向扩展。 那么如果让你设计一个负载均衡组件,你会怎么设计? 我们需要考虑这几个因素: 如何获取及同步服务器列表?涉及到与注册中心的交互。 如何将负载进行分摊?涉及到分摊策略。 如何将客户端请求进行拦截然后选择服务器进行转发?涉及到请求拦截。 抱着这几个问题,我们从负载均衡的原理 + Ribbon 的架构来学习如何设计一个负载均衡器,相信会带给你一些启发。 一、负载均衡 1.1 概念 上次我在这篇文章中详细讲解了何为高可用,里面没有涉及到负载均衡机制,其实负载均衡也是高可用网络的关键组件。 两个基本点: 选择哪个服务器来处理客户端请求。 将客户端请求转发出去。 一个核心原理:通过硬件或软件的方式维护一个服务列表清单。当用户发送请求时,会将请求发送给负载均衡器,然后根据负载均衡算法从可用的服务列表中选出一台服务器的地址,将请求进行转发,完成负载功能。 1.2 负载均衡的特性 高性能:可根据不同的分配规则自动将流量进行分摊。 可扩展性:可以很方便增加集群中设备或链路的数量。 高可靠性:系统中某个设备或链路发生故障,不会导致服务中断。 易配置性:配置和维护方便。 透明性:用户感知不到如何进行负载均衡的,也不用关心负载均衡。 1.3 负载均衡分类 负载均衡技术可以按照软件或硬件进行分类,也可以按照服务器列表存放的位置划分为服务端负载和客户端负载均衡。 1.3.1 硬件负载均衡 F5 就是常见的硬件负载均衡产品。 优点:性能稳定,具备很多软件负载均衡不具备的功能,如应用交换,会话交换、状态监控等。 缺点:设备价格昂贵、配置冗余,没有软件负载均衡灵活,不能满足定制化需求。 1.3.2 软件负载均衡 Nginx:性能好,可以负载超过 1W。工作在网络的7层之上,可以针对http应用做一些分流的策略。Nginx也可作为静态网页和图片服务器。Nginx仅能支持http、https和Email协议。 LVS(Linux Virtual Server):是一个虚拟服务器集群系统,采用 IP 地址均衡技术和内容请求分发技术实现负载均衡。接近硬件设备的网络吞吐和连接负载能力。抗负载能力强、是工作在网络4层之上仅作分发之用。自身有完整的双机热备方案,如LVS+Keepalived。软件本身不支持正则表达式处理,不能做动静分离。 1.3.3 服务端负载均衡 Nginx 和 F5 都可以划分到服务端的负载均衡里面,后端的服务器地址列表是存储在后端服务器中或者存在专门的 Nginx 服务器或 F5 上。 服务器的地址列表的来源是通过注册中心或者手动配置的方式来的。 1.3.4 客户端负载均衡 终于轮到 Ribbon 登场了,它属于客户端负载均衡器,客户端自己维护一份服务器的地址列表。这个维护的工作就是由 Ribbon 来干的。 Ribbon 会从 Eureka Server 读取服务信息列表,存储在 Ribbon 中。如果服务器宕机了,Ribbon 会从列表剔除宕机的服务器信息。 Ribbon 有多种负载均衡算法,我们可以自行设定规则从而请求到指定的服务器。 二、 均衡策略 上面已经介绍了各种负载均衡分类,接下来我们来看下这些负载均衡器如何通过负载均衡策略来选择服务器处理客户端请求。 常见的均衡策略如下。 2.1 轮循均衡(Round Robin) 原理:如果给服务器从 0 到 N 编号,轮询均衡策略会从 0 开始依次选择一个服务器作为处理本次请求的服务器。- 场景:适合所有父亲都有相同的软硬件配置,且请求频率相对平衡。 2.2 权重轮询均衡(Weighted Round Robin) 原理:按照服务器的不同处理能力,给服务器分配不同的权重,然后请求会按照权重分配给不同的服务器。 场景:服务器的性能不同,充分利用高性能的服务器,同时也能照顾到低性能的服务器。 2.3 随机均衡(Random) 原理:将请求随机分配给不同的服务器。 场景:适合客户端请求的频率比较随机的场景。 2.4 响应速度均衡(Response Time) 原理:负载均衡设备对每个服务器发送一个探测请求,看看哪台服务器的响应速度更快, 场景:适合服务器的响应性能不断变化的场景。 注意:响应速度是针对负载均衡设备和服务器之间的。 三、Ribbon 核心组件 接下来就是我们的重头戏了,来看下 Ribbon 这个 Spring Cloud 中负载均衡组件。 Ribbon 主要有五大功能组件:ServerList、Rule、Ping、ServerListFilter、ServerListUpdater。 3.1 负载均衡器 LoadBalancer 用于管理负载均衡的组件。初始化的时候通过加载 YMAL 配置文件创建出来的。 3.2 服务列表 ServerList ServerList 主要用来获取所有服务的地址信息,并存到本地。 根据获取服务信息的方式不同,又分为静态存储和动态存储。 静态存储:从配置文件中获取服务节点列表并存储到本地。 动态存储:从注册中心获取服务节点列表并存储到本地 3.3 服务列表过滤 ServerListFilter 将获取到的服务列表按照过滤规则过滤。 通过 Eureka 的分区规则对服务实例进行过滤。 比较服务实例的通信失败数和并发连接数来剔除不够健康的实例。 根据所属区域过滤出同区域的服务实例。 3.4 服务列表更新 ServerListUpdater 服务列表更新就是 Ribbon 会从注册中心获取最新的注册表信息。是由这个接口 ServerListUpdater 定义的更新操作。而它有两个实现类,也就是有两种更新方式: 通过定时任务进行更新。由这个实现类 PollingServerListUpdater 做到的。 利用 Eureka 的事件监听器来更新。由这个实现类 EurekaNotificationServerListUpdater 做到的。 3.5 心跳检测 Ping IPing 接口类用来检测哪些服务可用。如果不可用了,就剔除这些服务。 实现类主要有这几个:PingUrl、PingConstant、NoOpPing、DummyPing、NIWSDiscoveryPing。 心跳检测策略对象 IPingStrategy,默认实现是轮询检测。 3.6 负载均衡策略 Rule Ribbon 的负载均衡策略和之前讲过的负载均衡策略有部分相同,先来个全面的图,看下 Ribbon 有哪几种负载均衡策略。 再来看下 Ribbon 源码中关于均衡策略的 UML 类图。 由图可以看到,主要由以下几种均衡策略: 线性轮询均衡 (RoundRobinRule):轮流依次请求不同的服务器。优点是无需记录当前所有连接的状态,无状态调度。 可用服务过滤负载均衡(AvailabilityFilteringRule):过滤多次访问故障而处于断路器状态的服务,还有过滤并发连接数量超过阈值的服务,然后对剩余的服务列表按照轮询策略进行访问。默认情况下,如果最近三次连接均失败,则认为该服务实例断路。然后保持 30s 后进入回路关闭状态,如果此时仍然连接失败,那么等待进入关闭状态的时间会随着失败次数的增加呈指数级增长。 加权响应时间负载均衡(WeightedResponseTimeRule):为每个服务按响应时长自动分配权重,响应时间越长,权重越低,被选中的概率越低。 区域感知负载均衡(ZoneAvoidanceRule):更倾向于选择发出调用的服务所在的托管区域内的服务,降低延迟,节省成本。Spring Cloud Ribbon 中默认的策略。 重试负载均衡(RetryRule):通过轮询均衡策略选择一个服务器,如果请求失败或响应超时,可以选择重试当前服务节点,也可以选择其他节点。 高可用(Best Available):忽略请求失败的服务器,尽量找并发比较低的服务器。注意:这种会给服务器集群带来成倍的压力。 随机负载均衡(RandomRule):随机选择服务器。适合并发比较大的场景。 四、 Ribbon 拦截请求的原理 本文最开始提出了一个问题:负载均衡器如何将客户端请求进行拦截然后选择服务器进行转发? 结合上面介绍的 Ribbon 核心组件,我们可以画一张原理图来梳理下 Ribbon 拦截请求的原理: 第一步:Ribbon 拦截所有标注@loadBalance注解的 RestTemplate。RestTemplate 是用来发送 HTTP 请求的。 第二步:将 Ribbon 默认的拦截器 LoadBalancerInterceptor 添加到 RestTemplate 的执行逻辑中,当 RestTemplate 每次发送 HTTP 请求时,都会被 Ribbon 拦截。 第三步:拦截后,Ribbon 会创建一个 ILoadBalancer 实例。 第四步:ILoadBalancer 实例会使用 RibbonClientConfiguration 完成自动配置。就会配置好 IRule,IPing,ServerList。 第五步:Ribbon 会从服务列表中选择一个服务,将请求转发给这个服务。 五、Ribbon 初始化的原理 当我们去剖析 Ribbon 源码的时候,需要找到一个突破口,而 @LoadBalanced 注解就是一个比较好的入口。 先来一张 Ribbon 初始化的流程图: 添加注解的代码如下所示: @LoadBalanced @Bean public RestTemplate getRestTemplate() { return new RestTemplate(); } 第一步:Ribbon 有一个自动配置类 LoadBalancerAutoConfiguration,SpringBoot 加载自动配置类,就会去初始化 Ribbon。 第二步:当我们给 RestTemplate 或者 AsyncRestTemplate 添加注解后,Ribbon 初始化时会收集加了 @LoadBalanced 注解的 RestTemplate 和 AsyncRestTemplate ,把它们放到一个 List 里面。 第三步:然后 Ribbon 里面的 RestTemplateCustomizer 会给每个 RestTemplate 进行定制化,也就是加上了拦截器:LoadBalancerInterceptor。 第四步:从 Eureka 注册中心获取服务列表,然后存到 Ribbon 中。 第五步:加载 YMAL 配置文件,配置好负载均衡配置,创建一个 ILoadbalancer 实例。 六、Ribbon 同步服务列表原理 Ribbon 首次从 Eureka 获取全量注册表后,就会隔一定时间获取注册表。原理图如下: 之前我们提到过 Ribbon 的核心组件 ServerListUpdater,用来同步注册表的,它有一个实现类 PollingServerListUpdater ,专门用来做定时同步的。默认1s 后执行一个 Runnable 线程,后面就是每隔 30s 执行 Runnable 线程。这个 Runnable 线程就是去获取 Eureka 注册表的。 七、Eureka 心跳检测的原理 我们知道 Eureka 注册中心是通过心跳检测机制来判断服务是否可用的,如果不可用,可能会把这个服务摘除。为什么是可能呢?因为 Eureka 有自我保护机制,如果达到自我保护机制的阀值,后续就不会自动摘除。 这里我们可以再复习下 Eureka 的自我保护机制和服务摘除机制。 Eureka 心跳机制:每个服务每隔 30s 自动向 Eureka Server 发送一次心跳,Eureka Server 更新这个服务的最后心跳时间。如果 180 s 内(版本1.7.2 bug )未收到心跳,则任务服务故障了。 Eureka 自我保护机制:如果上一分钟实际的心跳次数,比我们期望的心跳次数要小,就会触发自我保护机制,不会摘除任何实例。期望的心跳次数:服务实例数量 * 2 * 0.85。 Eureka 服务摘除机制:不是一次性将服务实例摘除,每次最多随机摘除 15%。如果摘除不完,1 分钟之后再摘除。 说完 Eureka 的心跳机制和服务摘除机制后,我们来看下 Ribbon 的心跳机制。 八、Ribbon 心跳检测的原理 Ribbon 的心跳检测原理和 Eureka 还不一样,Ribbon 不是通过每个服务向 Ribbon 发送心跳或者 Ribbon 给每个服务发送心跳来检测服务是否存活的。 先来一张图看下 Ribbon 的心跳检测机制: Ribbon 心跳检测原理:对自己本地缓存的 Server List 进行遍历,看下每个服务的状态是不是 UP 的。具体的代码就是 isAlive 方法。 核心代码: isAlive = status.equals(InstanceStatus.UP); 那么多久检测一次呢? 默认每隔 30s 执行以下 PingTask 调度任务,对每个服务执行 isAlive 方法,判断下状态。 九、Ribbon 常用配置项 9.1 禁用 Eureka # 禁用 Eureka ribbon.eureka.enabled=false 服务注册列表默认是从 Eureka 获取到的,如果不想使用 Eureka,可以禁用掉。然后我们需要手动配置服务列表。 9.2 配置服务列表 ribbon-config-passjava.ribbon.listOfServers=localhost:8081,localhost:8083 这个配置是针对具体服务的,前缀就是服务名称,配置完之后就可以和之前一样使用服务名称来调用接口了。 9.3 其他配置项 十、总结 本篇深入讲解了 Spring Cloud 微服务中 负载均衡组件 Ribbon 架构原理,分为几大块: Ribbon 的六大核心组件 Ribbon 如何拦截请求并进行转发的。 Ribbon 初始化的原理。 Ribbon 如何同步 Eureka 注册表的原理。 Eureka 和 Ribbon 两种 心跳检测的原理 Ribbon 的常用配置项。 https://www.cnblogs.com/zhixiang-org-cn/archive/2019/10/31/11769320.html https://my.oschina.net/u/3748584/blog/4814474 作者简介:悟空,8年一线互联网开发和架构经验,用故事讲解分布式、架构设计、Java 核心技术。《JVM性能优化实战》专栏作者,开源了《Spring Cloud 实战 PassJava》项目,公众号:悟空聊架构。本文已收录至www.passjava.cn

优秀的个人博客,低调大师

每日一博 | Flink Sql Gateway 的原理与实践

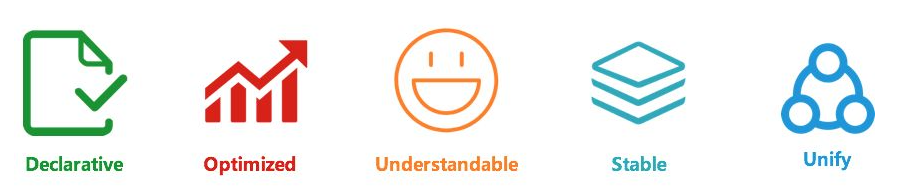
1 背景 我们在使用Flink开发实时任务时,都会用到框架本身提供的DataStream API,这使得用户不能不用Java或者Scala甚至Python来编写业务逻辑;这种方式虽然灵活且表达性强,但对用户具有一定的开发门槛,并且随着版本的不断更新,DataStream API也有很多老版本不兼容的问题。所以Flink SQL就成了广大开发用户的最佳选择,之所以Flink推出SQL API,主要是因为SQL有如下几个重要特性: 图:SQL重要特性 1.声明式API: 用户只关心做什么,而不关心怎么做; 2.自动优化: 屏蔽底层API的复杂性,自动做优化; 3.简单易懂: SQL应用于不同行业和领域,学习成本较低; 4.不易变动: 语法遵循SQL标准规范,不易变动; 5.流批统一: 同样的SQL代码,可以用流和批的方式执行。 虽然Flink提供了SQL能力,但还是有必要基于Flink SQL打造属于自己的平台,目前搭建SQL平台的方式有如下几种: 1.Flink原生API: 使用Flink提供的SQL API,封装一个通用的pipeline jar,利用flink shell脚本工具提交sql任务; 2.Apache Zeppelin: 一款开源产品,利用notebook方式管理sql任务,目前已经与Flink集成,且提供了丰富的SDK; 3.Flink Sql Gateway: Flink官方出品的一个Sql网关,用Rest方式执行Flink Sql。 第一种方式缺乏灵活性,且大量提交任务时,有性能瓶颈;而Zeppelin虽然功能强大,但页面功能有限,如果要基于Zeppelin打造SQL平台,要么使用SDK,要么对Zeppelin做重度的二次开发;所以Flink Sql Gateway比较适合做平台化建设,因为它是一个独立的网关服务,方便与公司现有系统集成,完全与其它系统解耦,本文也主要阐述Flink Sql Gateway的实践与探索。 2 Flink Sql Gateway 简介 2.1 架构 图:Flink Sql Gateway 架构 如上图所示,Flink Sql Gateway的架构比较简单,主要组件是SqlGatewayEndpoint,它是基于Flink的RestServerEndpoint实现的一个Netty服务,通过自定义实现多种handler来完成sql任务的创建和部署,以及管理的能力。SqlGatewayEndpoint内部主要由SessionManager(会话管理)组成,SessionManager维护了一个session map,而session内部主要是一些上下文配置和环境信息。 1) SqlGatewayEndpoint: 基于RestServerEndpoint实现的Netty服务,对外提供Rest Api; 2) SessionManager : 会话管理器,管理session创建与删除; 3) Session: 一个会话,里面存放着任务所需要的Flink配置和上下文环境信息,负责任务的执行; 4) Classpath: Flink Sql Gateway启动时会加载flink安装目录的classpath,所以flink sql gateway 基本上没有除flink以外的相关依赖。 2.2 执行流程 sql gateway其实只是一个普通的NIO服务器,每个Handler都会持有SessionManager的引用,因此可以共同访问同一个SessionManager对象。当请求到达时,Handler会获取请求中的参数,如SessionId等,去SessionManager中查询对应的Session,从而执行提交sql、查询任务状态等工作。请求流程如下图所示: 图:请求流程 创建 session,这是使用sql gateway的第一步,SessionManager会把用户传入的任务执行模式、配置、planner引擎方式等参数封装成Session对象,放入map中,并返回sessionid给用户; 用户持有sessionid,发起sql request的请求,gateway根据sessionid找到对应的Session对象,开始部署sql job到yarn / kubernetes; 2.3 功能 2.3.1任务部署 Flink Sql Gateway作为Flink的客户端,任务部署直接运用了Flink的能力,而 Flink目前支持三种部署模式: 1.in Application Mode, 2.in a Per-Job Mode, 3.in Session Mode。 三种模式有如下两个区别: 1.集群生命周期和资源隔离: per-job mode的集群生命周期与job相同,但有较强的资源隔离保证。 2.应用程序的main()方法是在客户端还是在集群上执行: session mode和per-job mode在客户端上执行,而application mode在集群上执行。 图:三种模式 从以上可以看出,Application Mode为每个应用程序创建一个会话集群,并在集群上执行应用程序的 main() 方法,所以它是session mode和per-job的一个折中方案。 目前为止,Flink只支持jar包任务的application mode,所以想要实现sql任务的application mode,需要自己改造实现,后面会讲实现方法。 2.3.2 SQL 能力 Flink Sql Gateway支持的Sql语法如下: 图:Flink Sql Gateway 支持的 Sql 语法 Flink Sql Gateway支持所有Flink Sql语法,但本身也有一些限制: 1.不支持多条sql执行,多条insert into执行会产生多个任务; 2.不完整的set支持,对于set语法支持存在bug; 3.Sql Hit支持不是很友好,写在sql里比较容易出错。 3 平台化改造 3.1 SQL 的 application mode 实现 前面说到,flink不支持sql任务的application mode部署,只支持jar包任务。jar 包任务的application mode实现如下图所示: 图:jar 包任务的 application mode 实现 1.flink-clients解析出用户的配置和jar包信息; 2.ApplicationConfiguration里指定了main方法的入口类名和入参; 3.ApplicationDeployer负责把Jobmanager启动,并且启动时执行Flink Application的main方法。 通过以上流程可以看出,要实现sql的application mode,实现通用执行sql的pipeline jar是关键: 实现一个执行sql的通用pipeline jar包,并且预先传到yarn或者k8s,如下所示: 在ApplicationConfiguration中指定 pepeline jar的main方法入口和参数: 3.2 多 Yarn 集群支持 目前Flink只支持单Yarn环境的任务部署,对于拥有多套Yarn环境的场景,需要部署多套Flink环境,每个Flink对应一个Yarn环境配置;虽然这种方式能解决问题,但并不是最优的解决方案。熟悉Flink应该都知道,Flink使用 ClusterClientFactory的SPI来生成与外部资源系统(Yarn/kubernetes)的访问介质(ClusterDescriptor),通过ClusterDescriptor可以完成与资源系统的交互,比如YarnClusterDescriptor,它持有YarnClient对象,可以完成与Yarn的交互;所以对于多Yarn环境,我们只要保证YarnClusterDescriptor 里持有的YarnClient对象与Yarn环境一一对应即可,代码如下图所示: 作者简介 Zheng OPPO高级数据平台工程师 主要负责基于Flink的实时计算平台开发, 对Flink有较丰富的研发经验, 也曾参与过Flink社区的贡献。 推荐阅读 |OPPO数据湖统一存储技术实践 |数据库查询性能优化指南 |云原生Service Mesh探索与实践 本文版权归OPPO公司所有,如需转载请在后台留言联系。 本文分享自微信公众号 - OPPO互联网技术(OPPO_tech)。如有侵权,请联系 support@oschina.cn 删除。本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

优秀的个人博客,低调大师

每日一博 | FastAPI or Flask?从用户出发,才是王道

✏️ 编者按: 前段时间,Milvus demo 使用的服务框架从 Flask 切换为 FastAPI,这一改动引发了社区小伙伴们讨论:为什么要改服务框架?改了以后有什么好处?为了解答社区小伙伴们的疑问,Zilliz 数据工程师云梅写下这篇文章。 加入 Zilliz 以来,云梅致力于为开源向量数据库 Milvus 探索解决方案,帮助用户打造场景应用。她深入关注自然语言处理技术和搜索推荐系统,日常喜欢一个人猫着乱翻书。 如果你也想参与讨论,欢迎加入我们的技术交流群,加群方式请见文末 🤩 概述 为了让用户轻松上手向量数据库 Milvus,我们在 GitHub 上开源了 Milvus Bootcamp 项目。该项目除了提供测试性能的脚本和数据外,还提供了一些使用 Milvus 数据库实现的小项目,比如以图搜图、视频分析、自动问答机器人、推荐系统等。这些项目不仅生动地展示了向量数据库 Milvus 的应用场景,还可以帮你在实际项目中真实体验向量数据库 Milvus 有多好用。 仓库地址:https://github.com/milvus-io/bootcamp 在这些项目中,我们提供了前端和后端服务。起初,这些项目的后端使用了 Web 框架 Flask 来提供 Web 服务,后来采用 FastAPI 替换了 Flask。切换之后,社区的一些小伙伴提出了疑问,为什么我们最终选择使用 FastAPI 而不是 Flask?我们在社区内进行了一些很有价值的讨论,这篇文章将系统地讲述这一切换的目的。 让我们来先看一下什么是 Web 框架,以及 Flask 和 FastAPI 各自有什么特点。 Python web Web 框架是一组包或模块的集合,是用于进行 Web 开发的一套软件架构,允许开发人员编写 Web 应用程序或服务,而无需处理诸如协议、套接字或进程/线程管理之类的低级细节,减少了开发人员开发 Web 应用的工作量。使用 Web 框架进行 Web 开发的时候,在进行数据缓存、数据库访问、数据安全校验等方面,不需要自己再重新实现,而是将业务逻辑相关的代码写入框架就可以。 目前已有很多 Python web 框架,其中常见的如 Django、Flask、Tornado、FastAPI 等。本文将基于 Milvus Bootcamp 中的实际应用,聚焦 Flask 和 FastAPI 并讨论两者的不同,以及我们选择 FastAPI 的原因。 Flask Flask 是一个基于 Python 的轻量级 Web 应用框架。Flask 框架核心简单,用户可以轻松地开发自己的 Web 应用。此外,Flask 有一个简单且易于扩展的核心,用户在使用 Flask 开发网站时,可以根据自己的需求添加不同的功能,各种插件库可以让用户完全按照自己的意愿开发出功能强大的网站。 Flask 具有以下特点: Flask 是一个微框架,因为它不需要特定的工具或库。它没有数据库抽象层、表单验证或任何其他预先存在的第三方库提供通用功能的组件。但是,Flask 支持可以添加应用程序功能的扩展,就好像它们是在 Flask 本身中实现的一样。存在对象关系映射器、表单验证、上传处理、各种开放身份验证技术和一些常见框架相关工具的扩展。 Flask 是一个基于 WSGI(Web Server Gateway Interface)的 Web 应用框架。WSGI 是为 Python 语言定义的 Web 服务器和 Web 应用程序或框架之间的一种简单而通用的接口。 Flask 包含了 Werkzeug 和 Jinja2 两个核心函数库。Werkzeug 是一个 WSGI 工具包,它实现了请求、响应对象和实用功能,这使得用户可以在其上构建 Web 框架,Flask 框架使用 Werkzeg 作为其基础之一;Jinja2 是一个流行的 Python 的功能齐全的模板引擎,它有完整的 unicode 支持,一个可选的集成沙箱执行环境,被广泛使用。 FastAPI FastAPI 是一个现代化的高性能 Python Web 应用框架,具有与 Go 和 NodeJS 一样高的性能。FastAPI 核心建立在 Starlette 和 Pydantic 基础之上。Starlette 是一种轻量级的 ASGI 框架的工具包,是构建高性能 Asyncio 服务的选择;Pydantic 是一个基于 Python 类型提示来定义数据验证、序列化和文档的库。 FastAPI 具有以下特点: FastAPI 是一个基于 ASGI(Asynchronous Server Gateway Interface)的 Web 应用框架。ASGI 是异步网关协议接口,一个介于网络协议服务和 Python 应用之间的标准接口,能够处理多种通用的协议类型,包括 HTTP、HTTP2 和 WebSocket。 FastAPI 基于的 Pydantic 提供了接口数据类型检查的功能。用户不需要做额外的接口参数校验,不用写大量代码验证参数是否为空、类型是否正确,有效减少了代码中的人为错误,提高开发效率。 FastAPI 支持 OpenAPI(前身是 Swagger)和 Redoc 两种文档格式。对于使用者来说,不用花费大量时间写额外的接口文档。FastAPI 提供的 OpenAPI 文档如图: Why FastAPI 在为 Milvus Bootcamp 中的项目选择 Web 应用框架时,我们调研了包括 Django、Flask、FastAPI、Tornado 等在内的多种 Python Web 应用框架。由于 Milvus Bootcamp 中的项目是作为案例提供给 Milvus 用户参考的,那我们首先考虑的点就是,依赖的外部框架应该尽可能轻量、简单易上手,因此初步筛选出了 Flask 和 FastAPI。 接着,让我们深入调研 Flask 和 FastAPI,我这里对两者之间的比较做了一个简单的总结: 网上比较 Flask 和 FastAPI 这两个 Web 应用框架的文章非常多,大多基于以上表格中的这几点进行比较。这里,我将基于 Milvus Bootcamp 中的项目和实际应用来分析选择了使用 FastAPI 而不是 Flask 的原因。 一是基于性能的考虑。对于以图搜图、问答系统、相似文本检索等项目来说,这些系统的实时性要求都相对较高。因此在选择 Web 框架时,性能是我们考虑的一个重点。众所周知,高性能是 FastAPI 的一大亮点。 二是基于开发效率的考虑。FastAPI 提供了自动验证数据类型的功能,可以有效减少开发时人为的代码错误,极大提高开发效率。而对于 Flask 来说,每一个接口都需要在代码中完成数据类型的验证,判断传入的数据是否为空等,增加了项目中的代码量。Bootcamp 是面向用户的一个 Milvus 训练营,简单易上手的代码和较低的出错率,能极大地优化用户的使用感。 三是基于 FastAPI 原生支持异步的考虑。此前, Milvus 官网上线了可供用户自行上传数据并查询的以图搜图、视频分析、问答机器人和化学式检索这四个项目。用户上传数据时,由于对视频和文本等数据的处理过程相对耗时,所以我们选择了在服务端接受到用户请求时就立刻给用户返回 ✅「已接收到请求」的消息,等后台服务处理完数据后,再给用户发送一个 ✅✅「数据上传成功」的提示。由于 FastAPI 本身支持异步的特性,这一点实现起来也非常容易。 四是 FastAPI 提供了自动交互式文档。无论是在开发过程中调试代码接口,还是在和前端团队开发 Web 前端时的对接过程中,我们都可以直接打开 FastAPI 提供的 OpenAPI 文档进行调试。而如果使用其他不提供这类文档的 Web 框架,那么在完成 Web 服务端代码开发后,我们还需要写一个接口文档,额外使用 Postman 一类的工具调试接口。此外,对于用户来说,如果只想启动 Bootcamp 中提供的项目的 Web 服务端,而不想额外的启动一个 Web 网页端服务,只需要打开 FastAPI 提供的 OpenAPI 文档,也能以一个直观的方式去体验这些项目。 最后,我们考虑的是两个框架对用户友好程度的不同。FastAPI 的开发和使用更加简单,使得 Milvus 数据库的用户在学习了解 Milvus Bootcamp 中的项目时,可以更多地关注项目本身的具体实现,而不用花费过多的时间去学习依赖的 Web 框架等。 总结 Flask 和 FlastAPI 各有其突出的特点。FlastAPI 作为一个相对比较新的 Web 应用框架,其核心依赖 Starlette 和 Pydantic,可谓是一个站在巨人肩膀上的产物,其高性能、异步框架、数据验证等特点非常吸引开发者。Flask 是一个早期的 Web 框架,在基础功能之上还支持灵活地添加各种插件,具备完善的功能,也有完善的官方文档和大量用户发布的使用经验,以及活跃的用户社区。总体而言,在实际应用过程中,开发者应该基于实际应用需求去选择合适的框架。 Zilliz 以重新定义数据科学为愿景,致力于打造一家全球领先的开源技术创新公司,并通过开源和云原生解决方案为企业解锁非结构化数据的隐藏价值。 Zilliz 构建了 Milvus 向量数据库,以加快下一代数据平台的发展。Milvus 数据库是 LF AI & Data 基金会的毕业项目,能够管理大量非结构化数据集,在新药发现、推荐系统、聊天机器人等方面具有广泛的应用。

优秀的个人博客,低调大师

博文推荐|Pulsar 客户端编码最佳实践

本文描述了一些 Pulsar 客户端编码相关的最佳实践,并提供了可商用的样例代码,供大家研发的时候参考,提升大家接入 Pulsar 的效率。在生产环境上,Pulsar 的地址信息往往都通过配置中心或者是 K8s 域名发现的方式获得,这块不是这篇文章描述的重点,以PulsarConstant.SERVICE_HTTP_URL代替。本文中的例子均已上传到Github[1]。 前期 Client 初始化和配置 初始化 Client--demo 级别 import lombok.extern.slf4j.Slf4j;import org.apache.pulsar.client.api.PulsarClient;/*** @author hezhangjian*/@Slf4jpublic class DemoPulsarClientInit { private static final DemoPulsarClientInit INSTANCE = new DemoPulsarClientInit(); private PulsarClient pulsarClient; public static DemoPulsarClientInit getInstance() { return INSTANCE; } public void init() throws Exception { pulsarClient = PulsarClient.builder() .serviceUrl(PulsarConstant.SERVICE_HTTP_URL) .build(); } public PulsarClient getPulsarClient() { return pulsarClient; }} Demo 级别的 Pulsar client 初始化的时候没有配置任何自定义参数,并且初始化的时候没有考虑异常,init的时候会直接抛出异常。 初始化 Client--可上线级别 import io.netty.util.concurrent.DefaultThreadFactory;import lombok.extern.slf4j.Slf4j;import org.apache.pulsar.client.api.PulsarClient;import java.util.concurrent.Executors;import java.util.concurrent.ScheduledExecutorService;import java.util.concurrent.TimeUnit;/*** @author hezhangjian*/@Slf4jpublic class DemoPulsarClientInitRetry { private static final DemoPulsarClientInitRetry INSTANCE = new DemoPulsarClientInitRetry(); private volatile PulsarClient pulsarClient; private final ScheduledExecutorService executorService = Executors.newScheduledThreadPool(1, new DefaultThreadFactory("pulsar-cli-init")); public static DemoPulsarClientInitRetry getInstance() { return INSTANCE; } public void init() { executorService.scheduleWithFixedDelay(this::initWithRetry, 0, 10, TimeUnit.SECONDS); } private void initWithRetry() { try { pulsarClient = PulsarClient.builder() .serviceUrl(PulsarConstant.SERVICE_HTTP_URL) .build(); log.info("pulsar client init success"); this.executorService.shutdown(); } catch (Exception e) { log.error("init pulsar error, exception is ", e); } } public PulsarClient getPulsarClient() { return pulsarClient; }} 在实际的环境中,我们往往要做到pulsar client初始化失败后不影响微服务的启动,即待微服务启动后,再一直重试创建pulsar client。上面的代码示例通过volatile加不断循环重建实现了这一目标,并且在客户端成功创建后,销毁了定时器线程。 初始化 Client--商用级别 import io.netty.util.concurrent.DefaultThreadFactory;import lombok.extern.slf4j.Slf4j;import org.apache.pulsar.client.api.PulsarClient;import org.apache.pulsar.client.api.SizeUnit;import java.util.concurrent.Executors;import java.util.concurrent.ScheduledExecutorService;import java.util.concurrent.TimeUnit;/*** @author hezhangjian*/@Slf4jpublic class DemoPulsarClientInitUltimate { private static final DemoPulsarClientInitUltimate INSTANCE = new DemoPulsarClientInitUltimate(); private volatile PulsarClient pulsarClient; private final ScheduledExecutorService executorService = Executors.newScheduledThreadPool(1, new DefaultThreadFactory("pulsar-cli-init")); public static DemoPulsarClientInitUltimate getInstance() { return INSTANCE; } public void init() { executorService.scheduleWithFixedDelay(this::initWithRetry, 0, 10, TimeUnit.SECONDS); } private void initWithRetry() { try { pulsarClient = PulsarClient.builder() .serviceUrl(PulsarConstant.SERVICE_HTTP_URL) .ioThreads(4) .listenerThreads(10) .memoryLimit(64, SizeUnit.MEGA_BYTES) .operationTimeout(5, TimeUnit.SECONDS) .connectionTimeout(15, TimeUnit.SECONDS) .build(); log.info("pulsar client init success"); this.executorService.shutdown(); } catch (Exception e) { log.error("init pulsar error, exception is ", e); } } public PulsarClient getPulsarClient() { return pulsarClient; }} 商用级别的Pulsar Client新增了 5 个配置参数: •ioThreadsnetty 的 ioThreads 负责网络 IO 操作,如果业务流量较大,可以调高ioThreads个数;•listenersThreads负责调用以listener模式启动的消费者的回调函数,建议配置大于该 client 负责的partition数目;•memoryLimit当前用于限制pulsar生产者可用的最大内存,可以很好地防止网络中断、Pulsar 故障等场景下,消息积压在producer侧,导致 Java 程序 OOM;•operationTimeout一些元数据操作的超时时间,Pulsar 默认为 30s,有些保守,可以根据自己的网络情况、处理性能来适当调低;•connectionTimeout连接 Pulsar 的超时时间,配置原则同上。 客户端进阶参数(内存分配相关) 我们还可以通过传递 Java 的 property 来控制 Pulsar 客户端内存分配的参数,这里列举几个重要参数: •pulsar.allocator.pooled为 true 则使用堆外内存池,false 则使用堆内存分配,不走内存池。默认使用高效的堆外内存池;•pulsar.allocator.exit_on_oom如果内存溢出,是否关闭jvm,默认为 false;•pulsar.allocator.out_of_memory_policy在 https://github.com/apache/pulsar/pull/12200 引入,目前还没有正式 release 版本,用于配置当堆外内存不够使用时的行为,可选项为FallbackToHeap和ThrowException,默认为FallbackToHeap,如果你不希望消息序列化的内存影响到堆内存分配,则可以配置成ThrowException。 生产者 初始化 producer 重要参数 maxPendingMessages 生产者消息发送队列,根据实际 topic 的量级合理配置,避免在网络中断、Pulsar 故障场景下的 OOM。建议和 client 侧的配置memoryLimit之间挑一个进行配置。 messageRoutingMode 消息路由模式。默认为RoundRobinPartition。根据业务需求选择,如果需要保序,一般选择SinglePartition,把相同 key 的消息发到同一个partition。 autoUpdatePartition 自动更新 partition 信息。如topic中partition信息不变则不需要配置,降低集群的消耗。 batch 相关参数 因为批量发送模式底层由定时任务实现,如果该 topic 上消息数较小,则不建议开启batch。尤其是大量的低时间间隔的定时任务会导致 netty 线程 CPU 飙高。 •enableBatching是否启用批量发送;•batchingMaxMessages批量发送最大消息条数;•batchingMaxPublishDelay批量发送定时任务间隔。 静态 producer 初始化 静态 producer,指不会随着业务的变化进行 producer 的启动或关闭。那么就在微服务启动完成、client 初始化完成之后,初始化 producer,样例如下: 一个生产者一个线程,适用于生产者数目较少的场景 import io.netty.util.concurrent.DefaultThreadFactory;import lombok.extern.slf4j.Slf4j;import org.apache.pulsar.client.api.Producer;import java.util.concurrent.Executors;import java.util.concurrent.ScheduledExecutorService;import java.util.concurrent.TimeUnit;/*** @author hezhangjian*/@Slf4jpublic class DemoPulsarStaticProducerInit { private final ScheduledExecutorService executorService = Executors.newScheduledThreadPool(1, new DefaultThreadFactory("pulsar-producer-init")); private final String topic; private volatile Producer<byte[]> producer; public DemoPulsarStaticProducerInit(String topic) { this.topic = topic; } public void init() { executorService.scheduleWithFixedDelay(this::initWithRetry, 0, 10, TimeUnit.SECONDS); } private void initWithRetry() { try { final DemoPulsarClientInit instance = DemoPulsarClientInit.getInstance(); producer = instance.getPulsarClient().newProducer().topic(topic).create(); } catch (Exception e) { log.error("init pulsar producer error, exception is ", e); } } public Producer<byte[]> getProducer() { return producer; }} 多个生产者一个线程,适用于生产者数目较多的场景 import io.netty.util.concurrent.DefaultThreadFactory;import lombok.extern.slf4j.Slf4j;import org.apache.pulsar.client.api.Producer;import java.util.List;import java.util.concurrent.CopyOnWriteArrayList;import java.util.concurrent.Executors;import java.util.concurrent.ScheduledExecutorService;import java.util.concurrent.TimeUnit;/*** @author hezhangjian*/@Slf4jpublic class DemoPulsarStaticProducersInit { private final ScheduledExecutorService executorService = Executors.newScheduledThreadPool(1, new DefaultThreadFactory("pulsar-consumer-init")); private CopyOnWriteArrayList<Producer<byte[]>> producers; private int initIndex; private List<String> topics; public DemoPulsarStaticProducersInit(List<String> topics) { this.topics = topics; } public void init() { executorService.scheduleWithFixedDelay(this::initWithRetry, 0, 10, TimeUnit.SECONDS); } private void initWithRetry() { if (initIndex == topics.size()) { return; } for (; initIndex < topics.size(); initIndex++) { try { final DemoPulsarClientInit instance = DemoPulsarClientInit.getInstance(); final Producer<byte[]> producer = instance.getPulsarClient().newProducer().topic(topics.get(initIndex)).create();; producers.add(producer); } catch (Exception e) { log.error("init pulsar producer error, exception is ", e); break; } } } public CopyOnWriteArrayList<Producer<byte[]>> getProducers() { return producers; }} 动态生成销毁的 producer 示例 还有一些业务,我们的 producer 可能会根据业务来进行动态的启动或销毁,如接收道路上车辆的数据并发送给指定的 topic。我们不会让内存里面驻留所有的 producer,这会导致占用大量的内存,我们可以采用类似于 LRU Cache 的方式来管理 producer 的生命周期。 /*** @author hezhangjian*/@Slf4jpublic class DemoPulsarDynamicProducerInit { /** * topic -- producer */ private AsyncLoadingCache<String, Producer<byte[]>> producerCache; public DemoPulsarDynamicProducerInit() { this.producerCache = Caffeine.newBuilder() .expireAfterAccess(600, TimeUnit.SECONDS) .maximumSize(3000) .removalListener((RemovalListener<String, Producer<byte[]>>) (topic, value, cause) -> { log.info("topic {} cache removed, because of {}", topic, cause); try { value.close(); } catch (Exception e) { log.error("close failed, ", e); } }) .buildAsync(new AsyncCacheLoader<>() { @Override public CompletableFuture<Producer<byte[]>> asyncLoad(String topic, Executor executor) { return acquireFuture(topic); } @Override public CompletableFuture<Producer<byte[]>> asyncReload(String topic, Producer<byte[]> oldValue, Executor executor) { return acquireFuture(topic); } }); } private CompletableFuture<Producer<byte[]>> acquireFuture(String topic) { CompletableFuture<Producer<byte[]>> future = new CompletableFuture<>(); try { ProducerBuilder<byte[]> builder = DemoPulsarClientInit.getInstance().getPulsarClient().newProducer().enableBatching(true); final Producer<byte[]> producer = builder.topic(topic).create(); future.complete(producer); } catch (Exception e) { log.error("create producer exception ", e); future.completeExceptionally(e); } return future; }} 这个模式下,可以根据返回的CompletableFuture<Producer<byte[]>>来优雅地进行流式处理。 可以接受消息丢失的发送 final CompletableFuture<Producer<byte[]>> cacheFuture = producerCache.get(topic); cacheFuture.whenComplete((producer, e) -> { if (e != null) { log.error("create pulsar client exception ", e); return; } try { producer.sendAsync(msg).whenComplete(((messageId, throwable) -> { if (throwable != null) { log.error("send producer msg error ", throwable); return; } log.info("topic {} send success, msg id is {}", topic, messageId); })); } catch (Exception ex) { log.error("send async failed ", ex); } }); 以上为正确处理Client创建失败和发送失败的回调函数。但是由于在生产环境下,Pulsar 并不是一直保持可用的,会因为虚拟机故障、Pulsar 服务升级等导致发送失败。这个时候如果要保证消息发送成功,就需要对消息发送进行重试。 可以容忍极端场景下的发送丢失 final Timer timer = new HashedWheelTimer(); private void sendMsgWithRetry(String topic, byte[] msg, int retryTimes) { final CompletableFuture<Producer<byte[]>> cacheFuture = producerCache.get(topic); cacheFuture.whenComplete((producer, e) -> { if (e != null) { log.error("create pulsar client exception ", e); return; } try { producer.sendAsync(msg).whenComplete(((messageId, throwable) -> { if (throwable == null) { log.info("topic {} send success, msg id is {}", topic, messageId); return; } if (retryTimes == 0) { timer.newTimeout(timeout -> DemoPulsarDynamicProducerInit.this.sendMsgWithRetry(topic, msg, retryTimes - 1), 1 << retryTimes, TimeUnit.SECONDS); } log.error("send producer msg error ", throwable); })); } catch (Exception ex) { log.error("send async failed ", ex); } }); } 这里在发送失败后,做了退避重试,可以容忍pulsar服务端故障一段时间。比如退避 7 次、初次间隔为 1s,那么就可以容忍1+2+4+8+16+32+64=127s的故障。这已经足够满足大部分生产环境的要求了。因为理论上存在超过 127s 的故障,所以还是要在极端场景下,向上游返回失败。 生产者 Partition 级别严格保序 生产者严格保序的要点:一次只发送一条消息,确认发送成功后再发送下一条消息。实现上可以使用同步异步两种模式: •同步模式的要点就是循环发送,直到上一条消息发送成功后,再启动下一条消息发送;•异步模式的要点是观测上一条消息发送的 future,如果失败也一直重试,成功则启动下一条消息发送。 值得一提的是,这个模式下,partition 间是可以并行的,可以使用OrderedExecutor或per partition per thread。 同步模式举例: /*** @author hezhangjian*/@Slf4jpublic class DemoPulsarProducerSyncStrictlyOrdered { Producer<byte[]> producer; public void sendMsg(byte[] msg) { while (true) { try { final MessageId messageId = producer.send(msg); log.info("topic {} send success, msg id is {}", producer.getTopic(), messageId); break; } catch (Exception e) { log.error("exception is ", e); } } }} 消费者 初始化消费者重要参数 receiverQueueSize 注意:处理不过来时,消费缓冲队列会积压在内存中,合理配置防止 OOM。 autoUpdatePartition 自动更新 partition 信息。如topic中partition信息不变则不需要配置,降低集群的消耗。 subscribeType 订阅类型,根据业务需求决定。 subscriptionInitialPosition 订阅开始的位置,根据业务需求决定最前或者最后。 messageListener 使用 listener 模式消费,只需要提供回调函数,不需要主动执行receive()拉取。一般没有特殊诉求,建议采用 listener 模式。 ackTimeout 当服务端推送消息,但消费者未及时回复 ack 时,经过 ackTimeout 后,会重新推送给消费者处理,即redeliver机制。注意在利用redeliver机制的时候,一定要注意仅仅使用重试机制来重试可恢复的错误。举个例子,如果代码里面对消息进行解码,解码失败就不适合利用redeliver机制。这会导致客户端一直处于重试之中。 如果拿捏不准,还可以通过下面的deadLetterPolicy配置死信队列,防止消息一直重试。 negativeAckRedeliveryDelay 当客户端调用negativeAcknowledge时,触发redeliver机制的时间。redeliver机制的注意点同ackTimeout。 需要注意的是,ackTimeout和negativeAckRedeliveryDelay建议不要同时使用,一般建议使用negativeAck,用户可以有更灵活的控制权。一旦ackTimeout配置的不合理,在消费时间不确定的情况下可能会导致消息不必要的重试。 deadLetterPolicy 配置redeliver的最大次数和死信 topic。 初始化消费者原则 消费者只有创建成功才能工作,不像生产者可以向上游返回失败,所以消费者要一直重试创建。示例代码如下:注意:消费者和 topic 可以是一对多的关系,消费者可以订阅多个 topic。 一个消费者一个线程,适用于消费者数目较少的场景 import io.netty.util.concurrent.DefaultThreadFactory;import lombok.extern.slf4j.Slf4j;import org.apache.pulsar.client.api.Consumer;import java.util.concurrent.Executors;import java.util.concurrent.ScheduledExecutorService;import java.util.concurrent.TimeUnit;/*** @author hezhangjian*/@Slf4jpublic class DemoPulsarConsumerInit { private final ScheduledExecutorService executorService = Executors.newScheduledThreadPool(1, new DefaultThreadFactory("pulsar-consumer-init")); private final String topic; private volatile Consumer<byte[]> consumer; public DemoPulsarConsumerInit(String topic) { this.topic = topic; } public void init() { executorService.scheduleWithFixedDelay(this::initWithRetry, 0, 10, TimeUnit.SECONDS); } private void initWithRetry() { try { final DemoPulsarClientInit instance = DemoPulsarClientInit.getInstance(); consumer = instance.getPulsarClient().newConsumer().topic(topic).messageListener(new DemoMessageListener<>()).subscribe(); } catch (Exception e) { log.error("init pulsar producer error, exception is ", e); } } public Consumer<byte[]> getConsumer() { return consumer; }} 多个消费者一个线程,适用于消费者数目较多的场景 import io.netty.util.concurrent.DefaultThreadFactory;import lombok.extern.slf4j.Slf4j;import org.apache.pulsar.client.api.Consumer;import java.util.List;import java.util.concurrent.CopyOnWriteArrayList;import java.util.concurrent.Executors;import java.util.concurrent.ScheduledExecutorService;import java.util.concurrent.TimeUnit;/*** @author hezhangjian*/@Slf4jpublic class DemoPulsarConsumersInit { private final ScheduledExecutorService executorService = Executors.newScheduledThreadPool(1, new DefaultThreadFactory("pulsar-consumer-init")); private CopyOnWriteArrayList<Consumer<byte[]>> consumers; private int initIndex; private List<String> topics; public DemoPulsarConsumersInit(List<String> topics) { this.topics = topics; } public void init() { executorService.scheduleWithFixedDelay(this::initWithRetry, 0, 10, TimeUnit.SECONDS); } private void initWithRetry() { if (initIndex == topics.size()) { return; } for (; initIndex < topics.size(); initIndex++) { try { final DemoPulsarClientInit instance = DemoPulsarClientInit.getInstance(); final Consumer<byte[]> consumer = instance.getPulsarClient().newConsumer().topic(topics.get(initIndex)).messageListener(new DemoMessageListener<>()).subscribe(); consumers.add(consumer); } catch (Exception e) { log.error("init pulsar producer error, exception is ", e); break; } } } public CopyOnWriteArrayList<Consumer<byte[]>> getConsumers() { return consumers; }} 消费者达到至少一次语义 使用手动回复 ack 模式,确保处理成功后再 ack。如果处理失败可以自己重试或通过negativeAck机制进行重试 同步模式举例 这里需要注意,如果处理消息时长差距比较大,同步处理的方式可能会让本来可以很快处理的消息得不到处理的机会。 /*** @author hezhangjian*/@Slf4jpublic class DemoMessageListenerSyncAtLeastOnce<T> implements MessageListener<T> { @Override public void received(Consumer<T> consumer, Message<T> msg) { try { final boolean result = syncPayload(msg.getData()); if (result) { consumer.acknowledgeAsync(msg); } else { consumer.negativeAcknowledge(msg); } } catch (Exception e) { // 业务方法可能会抛出异常 log.error("exception is ", e); consumer.negativeAcknowledge(msg); } } /** * 模拟同步执行的业务方法 * @param msg 消息体内容 * @return */ private boolean syncPayload(byte[] msg) { return System.currentTimeMillis() % 2 == 0; }} 异步模式举例 异步的话需要考虑内存的限制,因为异步的方式可以很快地从broker消费,不会被业务操作阻塞,这样inflight的消息可能会非常多。如果是Shared或KeyShared模式,可以通过maxUnAckedMessage进行限制。如果是Failover模式,可以通过下面的消费者繁忙时阻塞拉取消息,不再进行业务处理通过判断inflight消息数来阻塞处理。 /*** @author hezhangjian*/@Slf4jpublic class DemoMessageListenerAsyncAtLeastOnce<T> implements MessageListener<T> { @Override public void received(Consumer<T> consumer, Message<T> msg) { try { asyncPayload(msg.getData(), new DemoSendCallback() { @Override public void callback(Exception e) { if (e == null) { consumer.acknowledgeAsync(msg); } else { log.error("exception is ", e); consumer.negativeAcknowledge(msg); } } }); } catch (Exception e) { // 业务方法可能会抛出异常 consumer.negativeAcknowledge(msg); } } /** * 模拟异步执行的业务方法 * @param msg 消息体 * @param demoSendCallback 异步函数的callback */ private void asyncPayload(byte[] msg, DemoSendCallback demoSendCallback) { if (System.currentTimeMillis() % 2 == 0) { demoSendCallback.callback(null); } else { demoSendCallback.callback(new Exception("exception")); } }} 消费者繁忙时阻塞拉取消息,不再进行业务处理 当消费者处理不过来时,通过阻塞listener方法,不再进行业务处理。避免在微服务积累太多消息导致 OOM,可以通过 RateLimiter 或者 Semaphore 控制处理。 *** @author hezhangjian*/@Slf4jpublic class DemoMessageListenerBlockListener<T> implements MessageListener<T> { /** * Semaphore保证最多同时处理500条消息 */ private final Semaphore semaphore = new Semaphore(500); @Override public void received(Consumer<T> consumer, Message<T> msg) { try { semaphore.acquire(); asyncPayload(msg.getData(), new DemoSendCallback() { @Override public void callback(Exception e) { semaphore.release(); if (e == null) { consumer.acknowledgeAsync(msg); } else { log.error("exception is ", e); consumer.negativeAcknowledge(msg); } } }); } catch (Exception e) { semaphore.release(); // 业务方法可能会抛出异常 consumer.negativeAcknowledge(msg); } } /** * 模拟异步执行的业务方法 * @param msg 消息体 * @param demoSendCallback 异步函数的callback */ private void asyncPayload(byte[] msg, DemoSendCallback demoSendCallback) { if (System.currentTimeMillis() % 2 == 0) { demoSendCallback.callback(null); } else { demoSendCallback.callback(new Exception("exception")); } }} 消费者严格按 partition 保序 为了实现partition级别消费者的严格保序,需要对单partition的消息,一旦处理失败,在这条消息重试成功之前不能处理该partition的其他消息。示例如下: /*** @author hezhangjian*/@Slf4jpublic class DemoMessageListenerSyncAtLeastOnceStrictlyOrdered<T> implements MessageListener<T> { @Override public void received(Consumer<T> consumer, Message<T> msg) { retryUntilSuccess(msg.getData()); consumer.acknowledgeAsync(msg); } private void retryUntilSuccess(byte[] msg) { while (true) { try { final boolean result = syncPayload(msg); if (result) { break; } } catch (Exception e) { log.error("exception is ", e); } } } /** * 模拟同步执行的业务方法 * * @param msg 消息体内容 * @return */ private boolean syncPayload(byte[] msg) { return System.currentTimeMillis() % 2 == 0; }} 致谢 感谢鹏辉[2]和罗天[3]的审稿。 作者简介 贺张俭[4],Apache Pulsar Contributor,西安电子科技大学毕业,华为云物联网高级工程师,目前 Pulsar 已经在华为云物联网大规模商用,了解更多内容可以访问他的简书博客地址[5]。 相关链接 •最佳实践|Apache Pulsar 在华为云物联网之旅 关注「Apache Pulsar」👇🏻,获取干货与动态 👇🏻 加入 Apache Pulsar 中文交流群 👇🏻 引用链接 [1]Github:https://github.com/Shoothzj/pulsar-client-examples[2]鹏辉:https://github.com/codelipenghui[3]罗天:https://github.com/fu-turer[4]贺张俭:https://github.com/Shoothzj[5]简书博客地址:https://www.jianshu.com/u/9e21abacd418 点击「阅读原文」,查看 Apache Pulsar 干货集锦 本文分享自微信公众号 - ApachePulsar(ApachePulsar)。如有侵权,请联系 support@oschina.cn 删除。本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

优秀的个人博客,低调大师

每日一博 | Feign 从注册到调用原理分析

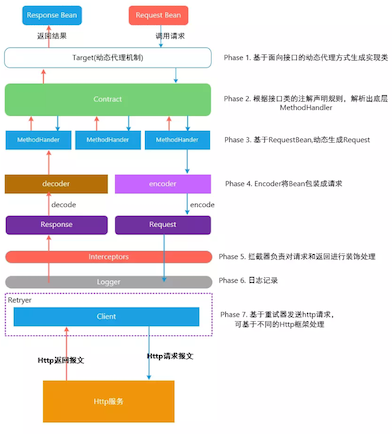
本文主要讲述 Feign 是如何注册到 Spring 容器、融合 Ribbon进行负载均衡、进行 RPC 调用。 简单提一下项目中一般都是如何使用 Feign 的,首先声明一个@FeignClient,定义 RPC 调用方法,然后像调用本地方法一样,调用远程服务的方法 // 定义 FeignClient @FeignClient(value = "service-order",path = "/order") public interface OrderFeignService { @RequestMapping("/findOrderByUserId/{userId}") R findOrderByUserId(@PathVariable("userId") Integer userId); } // 调用远程服务 @Autowired OrderFeignService orderFeignService; R findOrderByUserId(@PathVariable("id") Integer id) { //feign调用 R result = orderFeignService.findOrderByUserId(id); return result; } 这样一来,我们省去了自己去配置 RestTemplate 或其他 HTTPClient 的麻烦,但是简单方便的同时你是否会有一些疑惑: 我们使用@Autowired注入的 OrderFeignService,那么它一定是一个 Spring Bean,它是什么时候,如何被注入到 Spring 容器的? Feign 是如何执行 findOrderByUserId()的? @RequestMapping 是 SpringMVC 的注解呀,怎么在 Feign 中也会生效呢? Feign 是如何整合 Ribbon 的? Ribbon 是如何获取注册中心的服务的? Ribbon 是如何进行负载均衡的? 理解了上面的这些问题,我们也就明白了 Feign 是如何进行调用的,那么带着这些问题我们来一步步分析 @FeignClient 注册 @EnableFeignClients 注解 根据 SpringBoot 自动装配的思想,先猜想下一定会有@Enablexxx ,然后再有@Import(xxx.class),来进行 Feign 的自动注入 要使用 Feign 首先要引入 Feign 的 Maven 依赖,接着一定要在启动类上添加注解 @EnableFeignClients 2.@EnableFeignClients @Import(FeignClientsRegistrar.class) 3.注册 @FeignClient public void registerBeanDefinitions(AnnotationMetadata metadata, BeanDefinitionRegistry registry) { // 注册 Feign 配置信息 registerDefaultConfiguration(metadata, registry); // 注册 @FeignClient registerFeignClients(metadata, registry); } 扫描并注册 FeignClient 为 BeanDefinition public void registerFeignClients(AnnotationMetadata metadata, BeanDefinitionRegistry registry) { // ...,省略了部分源码 扫描所有 @FeignClient 标注的类 Map<String, Object> attrs = metadata .getAnnotationAttributes(EnableFeignClients.class.getName()); AnnotationTypeFilter annotationTypeFilter = new AnnotationTypeFilter( FeignClient.class); // ... for (String basePackage : basePackages) { // ... Map<String, Object> attributes = annotationMetadata .getAnnotationAttributes( FeignClient.class.getCanonicalName()); // ... // 注册 FeignClient 为 BeanDefinition registerFeignClient(registry, annotationMetadata, attributes); } } } 将 FeignClient 包裹成 FeignClientFactoryBean private void registerFeignClient(BeanDefinitionRegistry registry, AnnotationMetadata annotationMetadata, Map<String, Object> attributes) { String className = annotationMetadata.getClassName(); // 将 FeignClient 包裹成 FeignClientFactoryBean BeanDefinitionBuilder definition = BeanDefinitionBuilder .genericBeanDefinition(FeignClientFactoryBean.class); // ... 一堆definition.addPropertyValue() definition.addPropertyValue("fallbackFactory", attributes.get("fallbackFactory")); definition.setAutowireMode(AbstractBeanDefinition.AUTOWIRE_BY_TYPE); // ... // 注册 FeignClientFactoryBean BeanDefinitionHolder holder = new BeanDefinitionHolder(beanDefinition, className, new String[] { alias }); BeanDefinitionReaderUtils.registerBeanDefinition(holder, registry); } FeignClientFactoryBean#getObject(),生成FeignClient 的代理对象 public Object getObject() throws Exception { return getTarget(); } /** * 根据指定的数据和上下文信息,生成一个 FeignClient 的代理对象 Client */ <T> T getTarget() { FeignContext context = applicationContext.getBean(FeignContext.class); // ... Client client = getOptional(context, Client.class); // ... Targeter targeter = get(context, Targeter.class); return (T) targeter.target(this, builder, context, new HardCodedTarget<>(type, name, url)); } // 最终会调用生成一个 FeignInvocationHandler 的代理对象 public <T> T target(Target<T> target) { return build().newInstance(target); } 4.生成FeignClient 的动态代理 FeignInvocationHandler public <T> T newInstance(Target<T> target) { // 解析请求为 MethodHandler Map<String, MethodHandler> nameToHandler = targetoHandlersByName.apply(target); Map<Method, MethodHandler> methodToHandler = new LinkedHashMap<Method, MethodHandler>(); List<DefaultMethodHandler> defaultMethodHandlers = new LinkedList<DefaultMethodHandler>(); // ... 代码省略 // 生成动态代理 InvocationHandler handler = factory.create(target, methodToHandler); T proxy = (T) Proxy.newProxyInstance(target.type().getClassLoader(), new Class<?>[] {target.type()}, handler); for (DefaultMethodHandler defaultMethodHandler : defaultMethodHandlers) { defaultMethodHandler.bindTo(proxy); } return proxy; } 5.FeignInvocationHandler 执行 invoke ,一步步调用,最终会调用 Client 的 execute()方法,执行远程调用 总结: 被@FeignClient 标记的 Interface 会在开启了@EnableFeignClients 之后,被 Spring 扫描到容器中,并且生成一个 FeignInvocationHandler 的动态代理 既然 FeignClient 会被生成一个动态代理,那么要执行到 findOrderByUserId() 方法,一定是通过FeignInvocationHandler 的 invoke() 方法被执行的,接着往下看 FeignClient 调用 先看一张图 由于没找到这张图的真正出处,引用该图暂未标明引用链接,如若该图作者发现可以联系本人,标明引用出处 上面我们已经分析完了FeignClient 是如何创建动态代理的,在我们按着FeignInvocationHandler 的 invoke() 方法往下分析之前,先看下上图中步骤 2,这一步就是 @RequestMapping如何在 Feign 中生效的 回头看下生成动态代理过程中有段代码 // 解析请求为 MethodHandler Map<String, MethodHandler> nameToHandler = target``oHandlersByName.apply(target); 这里完成了 Contract 对 SpringMVC 的解析 public Map<String, MethodHandler> apply(Target key) { // 这就用contract完成了方法上的SpringMVC注解的转换 // FeignClient标注的Interface 的每一个方法都会被解析成MethodMetadata // 对各种SpringMVC的注解进行解析,将解析出来的header,method,path,body,form param,返回值等等,放入了MethodMetadata中 List<MethodMetadata> metadata = contract.parseAndValidatateMetadata(key.type()); Map<String, MethodHandler> result = new LinkedHashMap<String, MethodHandler>(); // 遍历方法元数据 for (MethodMetadata md : metadata) { BuildTemplateByResolvingArgs buildTemplate; if (!md.formParams().isEmpty() && md.template().bodyTemplate() == null) { buildTemplate = new BuildFormEncodedTemplateFromArgs(md, encoder); } else if (md.bodyIndex() != null) { buildTemplate = new BuildEncodedTemplateFromArgs(md, encoder); } else { buildTemplate = new BuildTemplateByResolvingArgs(md); } // 在这里就创建了SynchronousMethodHandler,key就是方法名 // SynchronousMethodHandler就是所有的方法被代理后实际处理的处理器 result.put(md.configKey(), factory.create(key, md, buildTemplate, options, decoder, errorDecoder)); } return result; } 所以我们可以看到,Feign 之所以能用 SpringMVC 注解是因为专门对这层注解做了解析。 FeignInvocationHandler#invoke() FeignInvocationHandler#invoke() --> executeAndDecode(template, options) Object executeAndDecode(RequestTemplate template, Options options) throws Throwable { // 处理所有Interceptor: RequestInterceptor Request request = targetRequest(template); // ... Response response; try { // 执行Client#execute() response = client.execute(request, options); // ... } } LoadBalancerFeignClient#execute() public Response execute(Request request, Request.Options options) throws IOException { try { // ... 封装 request 成 ribbonRequest FeignLoadBalancer.RibbonRequest ribbonRequest = new FeignLoadBalancer.RibbonRequest( this.delegate, request, uriWithoutHost); // 配置 Client IClientConfig requestConfig = getClientConfig(options, clientName); return lbClient(clientName) .executeWithLoadBalancer(ribbonRequest, requestConfig).toResponse(); } lbClient(clientName) 整合 Ribbon 实例化出 FeignLoadBalancer lbClient(String clientName) --> this.lbClientFactory.create(clientName) public FeignLoadBalancer create(String clientName) { // FeignLoadBalancer 是 Feign 提供的 FeignLoadBalancer client = this.cache.get(clientName); if (client != null) { return client; } // IClientConfig ILoadBalancer 是 Ribbon 提供的 IClientConfig config = this.factory.getClientConfig(clientName); ILoadBalancer lb = this.factory.getLoadBalancer(clientName); ServerIntrospector serverIntrospector = this.factory.getInstance(clientName, ServerIntrospector.class); client = this.loadBalancedRetryFactory != null ? new RetryableFeignLoadBalancer(lb, config, serverIntrospector, this.loadBalancedRetryFactory) : new FeignLoadBalancer(lb, config, serverIntrospector); this.cache.put(clientName, client); // 该 client 本身封装了 Ribbon 的IClientConfig ILoadBalancer,在后面进行替换 url 和负载均衡发挥作用 return client; } FeignLoadBalancer如何负载均衡选择 Server public T executeWithLoadBalancer(final S request, final IClientConfig requestConfig) throws ClientException { LoadBalancerCommand<T> command = buildLoadBalancerCommand(request, requestConfig); try { // 这提交了一个匿名内部类进去,那么ServerOperation.call方法就一定会在submit方法里被调用 return command.submit( new ServerOperation<T>() { @Override public Observable<T> call(Server server) { URI finalUri = reconstructURIWithServer(server, request.getUri()); S requestForServer = (S) request.replaceUri(finalUri); try { return Observable.just(AbstractLoadBalancerAwareClient.this.execute(requestForServer, requestConfig)); } catch (Exception e) { return Observable.error(e); } } }) .toBlocking() .single(); 在 submit() 中调用selectServer(),进行 url 替换,选择一个服务实例 // LoadBalancerCommand.java public Observable<T> submit(final ServerOperation<T> operation) { final ExecutionInfoContext context = new ExecutionInfoContext(); if (listenerInvoker != null) { try { listenerInvoker.onExecutionStart(); } catch (AbortExecutionException e) { return Observable.error(e); } } // ribbon的重试参数 final int maxRetrysSame = retryHandler.getMaxRetriesOnSameServer(); final int maxRetrysNext = retryHandler.getMaxRetriesOnNextServer(); // Use the load balancer // selectServer 负载均衡选择实例 Observable<T> o = (server == null ? selectServer() : Observable.just(server)) ......省略部分代码 // 选择出服务实例后,对operation进行回调,进行url的替换,然后发起真正的http请求 return operation.call(server)... ......省略部分代码 // 选择一个服务实例 private Observable<Server> selectServer() { return Observable.create(new OnSubscribe<Server>() { @Override public void call(Subscriber<? super Server> next) { try { // 读取host信息,也就是服务名,然后调用负载均衡器chooseServer方法选择一个服务实例 Server server = loadBalancerContext.getServerFromLoadBalancer(loadBalancerURI, loadBalancerKey); next.onNext(server); next.onCompleted(); } catch (Exception e) { next.onError(e); } } }); } 构造了一个LoadBalancerCommand 构造了一个ServerOperation,包含了发起http调用的逻辑,作为参数传入- - LoadBalancerCommand.submit方法,后面会进行回调 在submit方法中,会调用selectServer方法,选择服务实例 selectServer方法调用loadBalancerContext.getServerFromLoadBalancer,最终调用负载均衡器chooseServer方法选择一个服务实例, 拿到服务实例后,将Server对象传入ServerOperation的call方法进行回调 ServerOperation用server的信息替换host里的服务名,拿到真正的请求地址 再调用子类也就是FeignLoadBalancer.execute方法执行http请求 默认的connectTimeout和readTimeout都是1000毫秒 响应结果封装为RibbonResponse 执行 http 请求 获取到了远程服务的真实地址,就可以采用 Http 方式调用了,问题是可提供Http 调用的方式有那么多(OkHttp 、ApacheHttpClient、RestTemplate 等等),Feign 怎么知道用哪个呢? 答案在 FeignAutoConfiguration 里 @Configuration(proxyBeanMethods = false) @ConditionalOnClass(ApacheHttpClient.class) @ConditionalOnMissingClass("com.netflix.loadbalancer.ILoadBalancer") @ConditionalOnMissingBean(CloseableHttpClient.class) @ConditionalOnProperty(value = "feign.httpclient.enabled", matchIfMissing = true) protected static class HttpClientFeignConfiguration { // ... } @Configuration(proxyBeanMethods = false) @ConditionalOnClass(OkHttpClient.class) @ConditionalOnMissingClass("com.netflix.loadbalancer.ILoadBalancer") @ConditionalOnMissingBean(okhttp3.OkHttpClient.class) @ConditionalOnProperty("feign.okhttp.enabled") protected static class OkHttpFeignConfiguration { // ... } 通过 @ConditionalOnClass 、@ConditionalOnProperty 等条件注解 来匹配用哪个 http 客户端,所以我们在使用过程中也是无感知的,只要我们引入 OkHttp 或者 ApacheHttpClient 相关的 Maven 依赖,就可以完成调用了 至此,FeignClient 被注册,被动态代理,被执行,整个流程已经清晰了,上面的问题也应该都有了答案,还有一个:Ribbon 是如何知道我们用到的是哪个注册中心,是 Eureka 是 Nacos ?他又是如何获取注册中心上的服务的? Ribbon 获取注册中心服务路由 既然我们在使用过程中没有自己指定,那么我猜想是不是 Ribbon 自己注册的时候自己会选择呢?我们就从Ribbon 的注册入手 RibbonClientConfiguration ,果然 配置ILoadBalancer 在 RibbonClientConfiguration 中会配置 ILoadBalancer,会返回一个 ZoneAwareLoadBalancer 实例 @Bean @ConditionalOnMissingBean public ILoadBalancer ribbonLoadBalancer(IClientConfig config, ServerList<Server> serverList, ServerListFilter<Server> serverListFilter, IRule rule, IPing ping, ServerListUpdater serverListUpdater) { if (this.propertiesFactory.isSet(ILoadBalancer.class, name)) { return this.propertiesFactory.get(ILoadBalancer.class, config, name); } return new ZoneAwareLoadBalancer<>(config, rule, ping, serverList, serverListFilter, serverListUpdater); } 更新注册中心列表 restOfInit() --> restOfInit() --> updateListOfServers --> servers = serverListImpl.getUpdatedListOfServers(); public void updateListOfServers() { List<T> servers = new ArrayList<T>(); if (serverListImpl != null) { // 更新注册中心服务列表 servers = serverListImpl.getUpdatedListOfServers(); LOGGER.debug("List of Servers for {} obtained from Discovery client: {}", getIdentifier(), servers); if (filter != null) { servers = filter.getFilteredListOfServers(servers); LOGGER.debug("Filtered List of Servers for {} obtained from Discovery client: {}", getIdentifier(), servers); } } updateAllServerList(servers); } ServerList<T> serverListImpl 获取服务列表是通过 serverListImpl 来获取的,serverListImpl 是一个interface,不同的注册中心服务商会实现 ServerLis, 比如 Nacos 的实现NacosServerList 。 这样我们就不用指定,Ribbon 就自己知道是从哪个注册中心获取了。

优秀的个人博客,低调大师

每日一博 | ELK 是个啥?看完就懂了!

思维导图 文章已收录Github精选,欢迎Star:https://github.com/yehongzhi/learningSummary 概述 我们都知道,在生产环境中经常会遇到很多异常,报错信息,需要查看日志信息排查错误。现在的系统大多比较复杂,即使是一个服务背后也是一个集群的机器在运行,如果逐台机器去查看日志显然是很费力的,也不现实。 如果能把日志全部收集到一个平台,然后像百度,谷歌一样通过关键字搜索出相关的日志,岂不快哉。于是就有了集中式日志系统。ELK就是其中一款使用最多的开源产品。 一、什么是ELK ELK其实是Elasticsearch,Logstash 和 Kibana三个产品的首字母缩写,这三款都是开源产品。 ElasticSearch(简称ES),是一个实时的分布式搜索和分析引擎,它可以用于全文搜索,结构化搜索以及分析。 Logstash,是一个数据收集引擎,主要用于进行数据收集、解析,并将数据发送给ES。支持的数据源包括本地文件、ElasticSearch、MySQL、Kafka等等。 Kibana,为 Elasticsearch 提供了分析和 Web 可视化界面,并生成各种维度表格、图形。 二、搭建ELK 环境依赖:CentOS7.5,JDK1.8,ElasticSearch7.9.3,Logstash 7.9.3,Kibana7.9.3。 2.1 安装ElasticSearch 首先,到官网下载安装包,然后使用tar -zxvf命令解压。 找到config目录下的elasticsearch.yml文件,修改配置: cluster.name:es-applicationnode.name:node-1#对所有IP开放network.host:0.0.0.0#HTTP端口号http.port:9200#elasticsearch数据文件存放目录path.data:/usr/elasticsearch-7.9.3/data#elasticsearch日志文件存放目录path.logs:/usr/elasticsearch-7.9.3/logs 配置完之后,因为ElasticSearch使用非root用户启动,所以创建一个用户。 #创建用户useraddyehongzhi#设置密码passwdyehongzhi#赋予用户权限chown-Ryehongzhi:yehongzhi/usr/elasticsearch-7.9.3/ 然后切换用户,启动: #切换用户suyehongzhi#启动-d表示后台启动./bin/elasticsearch-d 使用命令netstat -nltp查看端口号: 访问http://192.168.0.109:9200/可以看到如下信息,表示安装成功。 2.2 安装Logstash 首先在官网下载安装压缩包,然后解压,找到/config目录下的logstash-sample.conf文件,修改配置: input{file{path=>['/usr/local/user/*.log']type=>'user_log'start_position=>"beginning"}}output{elasticsearch{hosts=>["http://192.168.0.109:9200"]index=>"user-%{+YYYY.MM.dd}"}} input表示输入源,output表示输出,还可以配置filter过滤,架构如下: 配置完之后,要有数据源,也就是日志文件,准备一个user.jar应用程序,然后后台启动,并且输出到日志文件user.log中,命令如下: nohupjava-jaruser.jar>/usr/local/user/user.log& 接着再后台启动Logstash,命令如下: nohup./bin/logstash-f/usr/logstash-7.9.3/config/logstash-sample.conf& 启动完之后,使用jps命令,可以看到两个进程在运行: 2.3 安装Kibana 首先还是到官网下载压缩包,然后解压,找到/config目录下的kibana.yml文件,修改配置: server.port:5601server.host:"192.168.0.111"elasticsearch.hosts:["http://192.168.0.109:9200"] 和elasticSearch一样,不能使用root用户启动,需要创建一个用户: #创建用户useraddkibana#设置密码passwdkibana#赋予用户权限chown-Rkibana:kibana/usr/kibana/ 然后使用命令启动: #切换用户sukibana#非后台启动,关闭shell窗口即退出./bin/kibana#后台启动nohup./bin/kibana& 启动后在浏览器打开http://192.168.0.111:5601,可以看到kibana的web交互界面: 2.4 效果展示 全部启动成功后,整个过程应该是这样,我们看一下: 浏览器打开http://192.168.0.111:5601,到管理界面,点击“Index Management”可以看到,有一个user-2020.10.31的索引。 点击Index Patterns菜单栏,然后创建,命名为user-*。 最后,就可以到Discover栏进行选择,选择user-*的Index Pattern,然后搜索关键字,就找到相关的日志了! 三、改进优化 上面只是用到了核心的三个组件简单搭建的ELK,实际上是有缺陷的。如果Logstash需要添加插件,那就全部服务器的Logstash都要添加插件,扩展性差。所以就有了FileBeat,占用资源少,只负责采集日志,不做其他的事情,这样就轻量级,把Logstash抽出来,做一些滤处理之类的工作。 FileBeat也是官方推荐用的日志采集器,首先下载Linux安装压缩包: https://artifacts.elastic.co/downloads/beats/filebeat/filebeat-7.9.3-linux-x86_64.tar.gz 下载完成后,解压。然后修改filebeat.yml配置文件: #输入源filebeat.inputs:-type:logenabled:truepaths:-/usr/local/user/*.log#输出,Logstash的服务器地址output.logstash:hosts:["192.168.0.110:5044"]#输出,如果直接输出到ElasticSearch则填写这个#output.elasticsearch:#hosts:["localhost:9200"]#protocol:"https" 然后Logstash的配置文件logstash-sample.conf,也要改一下: #输入源改成beatsinput{beats{port=>5044codec=>"json"}} 然后启动FileBeat: #后台启动命令nohup./filebeat-e-cfilebeat.yml>/dev/null2>&1& 再启动Logstash: #后台启动命令nohup./bin/logstash-f/usr/logstash-7.9.3/config/logstash-sample.conf& 怎么判断启动成功呢,看Logstash应用的/logs目录下的logstash-plain.log日志文件: 写在最后 目前,很多互联网公司都是采用ELK来做日志集中式系统,原因很简单:开源、插件多、易扩展、支持数据源多、社区活跃、开箱即用等等。我见过有一个公司在上面的架构中还会加多一个Kafka的集群,主要是基于日志数据量比较大的考虑。但是呢,基本的三大组件ElasticSearch,Logstash,Kibana是不能少的。 希望这篇文章能帮助大家对ELK有一些初步的认识,感谢大家的阅读。 觉得有用就点个赞吧,你的点赞是我创作的最大动力~ 我是一个努力让大家记住的程序员。我们下期再见!!! 能力有限,如果有什么错误或者不当之处,请大家批评指正,一起学习交流! 本文分享自微信公众号 - java技术爱好者(yehongzhi_java)。如有侵权,请联系 support@oschina.cn 删除。本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

优秀的个人博客,低调大师

每日一博 | 基于 OneFlow 实现量化感知训练

本文介绍了量化感知训练的原理,基于OneFlow实现了一个量化感知训练Demo,并介绍了在具体实现中的各种细节。 1 后量化以及量化感知训练原理 这里说的量化一般都是指的Google TFLite的量化方案,对应的是Google 的论文Quantization and Training of Neural Networks for Efficient Integer-Arithmetic-Only Inference。虽然TfLite这套量化方案并不是很难,但在实际处理的时候细节还是比较多,一时是很难说清楚的。 所以,这里推荐一系列讲解TFLite后量化和量化感知训练原理的文章,看一下这几篇文章阅读本文就没有任何问题了。 神经网络量化入门--基本原理 神经网络量化入门--后训练量化 神经网络量化入门--量化感知训练 神经网络量化入门--Folding BN ReLU代码实现 这里简单总结一下,无论是TFLite的量化方案还是TensorRT的后量化方案,他们都会基于原始数据和量化数据的数值范围算出一个缩放系数scale和零点zero_point,这个zero_point有可能是0(对应对称量化),也有可能不是0(对应非对称量化)。然后原始数据缩放之后减掉零点就获得了量化后的数据。这里的关键就在于缩放系数scale和zero_point怎么求,Google的TFLite使用下面的公式: 其中, 表示浮点实数, 表示量化后的定点整数, 和 分别是 的最大值和最小值, 和 表示 的最大值和最小值,如果是有符号8比特量化,那么 , ,如果是无符号那么 , 。 就代表scale, 就代表zero_point。 要求取 scale 和 zero_point 关键就是要精确地估计原始浮点实数的最大值和最小值,有了原始浮点实数的最大值和最小值就可以代入上面的公式求出 scale 和 zero_point 了。所以后训练量化以及量化感知训练的目的是要记录各个激活特征图和权重参数的 scale 和 zero_point 。 在后训练量化中,做法一般是使用一部分验证集来对网络做推理,在推理的过程中记录激活特征图以及权重参数的最大和最小值,进而计算 scale 和 zero_point 。而量化感知训练则在训练的过程中记录激活特征图和权重参数的最大和最小值来求取 scale 和 zero_point 。 量化感知训练和后训练量化的主要区别在于它会对激活以及权重做模拟量化操作,即FP32->INT8->FP32。这样做的好处是可以模拟量化的实际运行过程,将量化过程中产生的误差也作为一个特征提供给网络学习,一般来说量化感知训练会获得比后训练量化更好的精度。 2 组件 在上一节中主要提到了记录激活和权重的 scale 和 zero_point ,以及模拟量化,量化这些操作。这对应着三个量化训练中用到的三个基本组件,即 MinMaxObserver , FakeQuantization , Quantization 。下面我们分别看一下在OneFlow中这三个组件的实现。 组件1. MinMaxObserver OneFlow MinMaxObserver文档 从这个文档我们可以看到MinMaxObserver操作被封装成 oneflow.nn.MinMaxObserver 这个Module(Module在Pytorch中对应 torch.nn.Module ,然后OneFlow的接口也在靠近Pytorch,也对应有 oneflow.nn.Module ,因此这里将其封装为 oneflow.nn.Module )。这个Module的参数有: quantization_bit 表示量化Bit数 quantization_scheme 表示量化的方式,有对称量化 symmetric 和非对称量化 affine 两种,区别就是对称量化浮点0和量化空间中的0一致 quantization_formula 表示量化的方案,有Google和Cambricon两种,Cambricon是中科寒武纪的意思 per_layer_quantization 表示对当前的输入Tensor是PerChannel还是PerLayer量化,如果是PerLayer量化设置为True。一般激活特征图的量化都是PerLayer,而权重的量化可以选择PerLayer或者PerChannel。 下面看一下在Python层的用法: >>>importnumpyasnp>>>importoneflowasflow>>>weight=(np.random.random((2,3,4,5))-0.5).astype(np.float32)>>>input_tensor=flow.Tensor(...weight,dtype=flow.float32...)>>>quantization_bit=8>>>quantization_scheme="symmetric">>>quantization_formula="google">>>per_layer_quantization=True>>>min_max_observer=flow.nn.MinMaxObserver(quantization_formula=quantization_formula,quantization_bit=quantization_bit,...quantization_scheme=quantization_scheme,per_layer_quantization=per_layer_quantization)>>>scale,zero_point=min_max_observer(...input_tensor,) 在设定好相关量化配置参数后,传入给定Tensor即可统计和计算出该设置下的Tensor的 scale 和 zero_point 。 上面讲的是Python前端的接口和用法,下面看一下在OneFlow中这个Module的具体实现,我们以CPU版本为例(GPU和CPU的Kernel实现是一致的),文件在 oneflow/user/kernels/min_max_observer_kernel.cpp ,核心实现是如下三个函数: //TFLite量化方案,对称量化template<typenameT>voidGenQuantScaleSymmetric(constT*in_ptr,constint32_tquantization_bit,constint64_tnum_elements,T*scale,T*zero_point){Tin_max=*std::max_element(in_ptr,in_ptr+num_elements);Tin_min=*std::min_element(in_ptr,in_ptr+num_elements);in_max=std::max(std::abs(in_max),std::abs(in_min));Tdenominator=static_cast<T>(pow(2.0,quantization_bit-1))-1;*scale=in_max/denominator;*zero_point=0;}//TFLite量化方案,非对称量化template<typenameT>voidGenQuantScaleAffine(constT*in_ptr,constint32_tquantization_bit,constint64_tnum_elements,T*scale,T*zero_point){Tin_max=*std::max_element(in_ptr,in_ptr+num_elements);Tin_min=*std::min_element(in_ptr,in_ptr+num_elements);Tdenominator=static_cast<T>(pow(2.0,quantization_bit))-1;*scale=(in_max-in_min)/denominator;*zero_point=-std::nearbyint(in_min/(*scale));}//寒武纪量化方案template<typenameT>voidGenQuantScaleCambricon(constT*in_ptr,constint32_tquantization_bit,constint64_tnum_elements,T*scale,T*zero_point){Tin_max=*std::max_element(in_ptr,in_ptr+num_elements);Tin_min=*std::min_element(in_ptr,in_ptr+num_elements);in_max=std::max(std::abs(in_max),std::abs(in_min));*scale=std::floor(std::log2(in_max))-(quantization_bit-2);*zero_point=0;} 除了这三个函数之外,另外一个关键点就是对 per_layer_quantization 参数的处理了,逻辑如下: PerLayer量化或者PerChannel量化 如果是PerChannel量化则对每个输出通道求一个 scale 和 zero_point 。想了解更多PerLayer量化以及PerChannel量化的知识可以看这篇文章: 神经网络量化--per-channel量化 。 组件2:FakeQuantization OneFlow FakeQuantization文档 同样,FakeQuantization也被封装为一个 oneflow.nn.Module 。在上一节提到,量化感知训练和后训练量化的主要区别在于它会对激活以及权重参数做模拟量化操作,即FP32->INT8->FP32。通过这种模拟将量化过程中产生的误差也作为一个特征提供给网络学习,以期在实际量化部署时获得更好的准确率。这个接口有以下参数: scale :由MinMaxObserver组件算出来的量化 scale zero_point :由MinMaxObserver组件算出来的量化 zero_point quantization_bit :量化比特数 quantization_scheme 表示量化的方式,有对称量化 symmetric 和非对称量化 affine 两种,区别就是对称量化浮点0和量化空间中的0一致 quantization_formula 表示量化的方案,有Google和Cambricon两种,Cambricon是中科寒武纪的意思 Python层的示例用法如下: >>>importnumpyasnp>>>importoneflowasflow>>>weight=(np.random.random((2,3,4,5))-0.5).astype(np.float32)>>>input_tensor=flow.Tensor(...weight,dtype=flow.float32...)>>>quantization_bit=8>>>quantization_scheme="symmetric">>>quantization_formula="google">>>per_layer_quantization=True>>>min_max_observer=flow.nn.MinMaxObserver(quantization_formula=quantization_formula,quantization_bit=quantization_bit,...quantization_scheme=quantization_scheme,per_layer_quantization=per_layer_quantization)>>>fake_quantization=flow.nn.FakeQuantization(quantization_formula=quantization_formula,quantization_bit=quantization_bit,...quantization_scheme=quantization_scheme)>>>scale,zero_point=min_max_observer(...input_tensor,...)>>>output_tensor=fake_quantization(...input_tensor,...scale,...zero_point,...) 在执行FakeQuantizaton必须知道输入Tensor的 scale 和 zero_point ,这是由上面的MinMaxObserver组件获得的。 接下来看一下FakeQuantization组件C++层的实现,仍然有三个核心函数: //TFLite量化方案,对称量化template<typenameT>voidFakeQuantizationPerLayerSymmetric(constT*in_ptr,constTscale,constint32_tquantization_bit,constint64_tnum_elements,T*out_ptr){Tupper_bound=static_cast<T>(pow(2.0,quantization_bit-1))-1;Tlower_bound=-upper_bound-1;FOR_RANGE(int64_t,i,0,num_elements){Tout=std::nearbyint(in_ptr[i]/scale);out=out>upper_bound?upper_bound:out;out=out<lower_bound?lower_bound:out;out_ptr[i]=out*scale;}}//TFLite量化方案,非对称量化template<typenameT>voidFakeQuantizationPerLayerAffine(constT*in_ptr,constTscale,constTzero_point,constint32_tquantization_bit,constint64_tnum_elements,T*out_ptr){Tupper_bound=static_cast<T>(pow(2.0,quantization_bit))-1;Tlower_bound=0;uint8_tzero_point_uint8=static_cast<uint8_t>(std::round(zero_point));FOR_RANGE(int64_t,i,0,num_elements){Tout=std::nearbyint(in_ptr[i]/scale+zero_point_uint8);out=out>upper_bound?upper_bound:out;out=out<lower_bound?lower_bound:out;out_ptr[i]=(out-zero_point_uint8)*scale;}}//寒武纪量化方案template<typenameT>voidFakeQuantizationPerLayerCambricon(constT*in_ptr,constTshift,constint32_tquantization_bit,constint64_tnum_elements,T*out_ptr){Tupper_bound=static_cast<T>(pow(2.0,quantization_bit-1))-1;Tlower_bound=-upper_bound-1;Tscale=static_cast<T>(pow(2.0,static_cast<int32_t>(shift)));FOR_RANGE(int64_t,i,0,num_elements){Tout=std::nearbyint(in_ptr[i]/scale);out=out>upper_bound?upper_bound:out;out=out<lower_bound?lower_bound:out;out_ptr[i]=out*scale;}} 需要注意的一点是由于FakeQuantization要参与训练,所以我们要考虑梯度怎么计算?从上面的三个核心函数实现中我们可以发现里面都用了 std::nearbyint 函数,这个函数其实就对应numpy的 round 操作。而我们知道 round 函数中几乎每一处梯度都是0,所以如果网络中存在这个函数,反向传播的梯度也会变成0。 因此为了解决这个问题,引入了Straight Through Estimator。即直接把卷积层(这里以卷积层为例子,还包含全连接层等需要量化训练的层)的梯度回传到伪量化之前的 weight 上。这样一来,由于卷积中用的 weight 是经过伪量化操作的,因此可以模拟量化误差,把这些误差的梯度回传到原来的 weight ,又可以更新权重,使其适应量化产生的误差,量化训练也可以正常运行。 具体的实现就非常简单了,直接将 dy 赋值给 dx ,在OneFlow中通过 identity 这个Op即可: 给FakeQuantization注册梯度,直通估计器 组件三:Quantization 上面的FakeQuantization实现了FP32->INT8->FP32的过程,这里还实现了一个Quantization组件备用。它和FakeQuantization的区别在于它没有INT8->FP32这个过程,直接输出定点的结果。所以这个组件的接口和C++代码实现和FakeQuantization基本完全一样(反向就不需要了),这里不再赘述。之所以要独立这个组件是为了在训练完模型之后可以将神经网络的权重直接以定点的方式存储下来。后面的Demo中将体现这一点。 3 基于OneFlow量化感知训练AlexNet 下面以AlexNet为例,基于OneFlow的三个量化组件完成一个量化感知训练Demo。这里先贴一下实验结果: 基于OneFlow的量化组件完成量化感知训练 训练的数据集是ImageNet的一个子集,详细信息可以 https://github.com/Oneflow-Inc/models/pull/78 看到。在8Bit的时候无论是选用Google还是寒武纪,对称还是非对称,PerLayer还是PerChannel,量化感知训练后的模型精度没有明显降低。一旦将量化Bit数从8降到4,在相同的超参配置下精度有了明显下降。 下面分享一下这个基于OneFlow的量化感知训练Demo的做法: 首先代码结构如下: -quantization-quantization_ops伪量化OP实现-q_module.py实现了Qparam类来管理伪量化参数和操作和QModule基类管理伪量化OP的实现-conv.py继承QModule基类,实现卷积的伪量化实现-linear.py继承QModule基类,实现全连接层的伪量化实现-...-models量化模型实现-q_alexnet.py量化版AlexNet模型-quantization_aware_training.py量化训练实现-quantization_infer.py量化预测实现-train.sh量化训练脚本-infer.sh量化预测脚本 由于量化训练时需要先统计样本以及中间层的 scale 、 zeropoint ,同时也频繁涉及到一些量化、反量化操作,所以实现一个QParam基类封装这些功能。 实现了一个量化基类 QModule ,提供了三个成员函数 __init__ , freeze 。 后量化公式,定点计算 __init__ 函数除了需要i指定 quantization_bit , quantization_scheme , quantization_formula , per_layer_quantization 参数外,还需要指定是否提供量化输入参数( qi ) 及输出参数 ( qo )。这是因为不是每一个网络模块都需要统计输入的 scale , zero_point ,大部分中间层都是用上一层的 qo 来作为自己的 qi ,另外有些中间层的激活函数也是直接用上一层的 qi 来作为自己的 qi 和 qo 。 freeze 这个函数会在统计完 scale , zero_point 后发挥作用,这个函数和后训练量化和模型转换有关。如下面的量化公式所示,其中很多项是可以提前计算好的, freeze 就是把这些项提前固定下来,同时也将网络的权重由浮点实数转化为定点整数。 基于这个 QModule 基类定义 QConv2d , QReLU , QConvBN 等等。 QConvBN 表示Conv和BN融合后再模拟量化。原理可以看第一节的第4篇参考资料。这里以 QConv2d 为例看看它的实现: importoneflowasflowfromquantization_ops.q_moduleimportQModule,QParam__all__=["QConv2d"]classQConv2d(QModule):def__init__(self,conv_module,qi=True,qo=True,quantization_bit=8,quantization_scheme='symmetric',quantization_formula='google',per_layer_quantization=True):super(QConv2d,self).__init__(qi=qi,qo=qo,quantization_bit=quantization_bit,quantization_scheme=quantization_scheme,quantization_formula=quantization_formula,per_layer_quantization=per_layer_quantization)self.quantization_bit=quantization_bitself.quantization_scheme=quantization_schemeself.quantization_formula=quantization_formulaself.per_layer_quantization=per_layer_quantizationself.conv_module=conv_moduleself.fake_quantization=flow.nn.FakeQuantization(quantization_formula=quantization_formula,quantization_bit=quantization_bit,quantization_scheme=quantization_scheme)self.qw=QParam(quantization_bit=quantization_bit,quantization_scheme=quantization_scheme,quantization_formula=quantization_formula,per_layer_quantization=per_layer_quantization)self.quantization=flow.nn.Quantization(quantization_bit=32,quantization_scheme="affine",quantization_formula="google")defforward(self,x):ifhasattr(self,'qi'):self.qi.update(x)x=self.qi.fake_quantize_tensor(x)self.qw.update(self.conv_module.weight)x=flow.F.conv2d(x,self.qw.fake_quantize_tensor(self.conv_module.weight),self.conv_module.bias,stride=self.conv_module.stride,padding=self.conv_module.padding,dilation=self.conv_module.dilation,groups=self.conv_module.groups)ifhasattr(self,'qo'):self.qo.update(x)x=self.qo.fake_quantize_tensor(x)returnxdeffreeze(self,qi=None,qo=None):ifhasattr(self,'qi')andqiisnotNone:raiseValueError('qihasbeenprovidedininitfunction.')ifnothasattr(self,'qi')andqiisNone:raiseValueError('qiisnotexisted,shouldbeprovided.')ifhasattr(self,'qo')andqoisnotNone:raiseValueError('qohasbeenprovidedininitfunction.')ifnothasattr(self,'qo')andqoisNone:raiseValueError('qoisnotexisted,shouldbeprovided.')ifqiisnotNone:self.qi=qiifqoisnotNone:self.qo=qoself.M=self.qw.scale.numpy()*self.qi.scale.numpy()/self.qo.scale.numpy()self.conv_module.weight=flow.nn.Parameter(self.qw.quantize_tensor(self.conv_module.weight)-self.qw.zero_point)self.conv_module.bias=flow.nn.Parameter(self.quantization(self.conv_module.bias,self.qi.scale*self.qw.scale,flow.Tensor([0]))) 在QConv2d的 __init__.py 中, conv_module 是原始的FP32的卷积module,其它的参数都是量化配置参数需要在定义模型的时候指定, forward 函数模拟了FakeQuantization的过程, freeze 函数则实现了冻结权重参数为定点的功能。其它的量化Module实现类似。 基于这些Module,我们可以定义AlexNet的量化版模型结构 https://github.com/Oneflow-Inc/models/blob/add_quantization_model/quantization/models/q_alexnet.py ,完成量化感知训练以及模型参数定点固化等。 想完成完整的训练和测试可以直接访问:https://github.com/Oneflow-Inc/models 仓库。 4 注意,上面的实现只是Demo级别的 查看了上面的具体实现之后,我们会发现最拉胯的问题是在量化模型的时候需要你手动去调整模型结构。其实不仅OneFlow的这个Demo是这样,在Pytorch1.8.0推出FX的量化方案之前(这里叫第一代量化方案吧)的第一代量化方案也是这样。这里放一段调研报告。 Pytorch第一代量化叫作Eager Mode Quantization,然后从1.8开始推出FX Graph Mode Quantization。Eager Mode Quantization需要用户手动更改模型,并手动指定需要融合的Op。FX Graph Mode Quantization解放了用户,一键自动量化,无需用户修改模型和关心内部操作。这个改动具体可以体现在下面的图中。 Pytorch两个版本量化的区别 下面以一段代码为例解释一下Pytorch这两种量化方式的区别。 Eager Mode Quantization classNet(nn.Module):def__init__(self,num_channels=1):super(Net,self).__init__()self.conv1=nn.Conv2d(num_channels,40,3,1)self.conv2=nn.Conv2d(40,40,3,1)self.fc=nn.Linear(5*5*40,10)defforward(self,x):x=F.relu(self.conv1(x))x=F.max_pool2d(x,2,2)x=F.relu(self.conv2(x))x=F.max_pool2d(x,2,2)x=x.reshape(-1,5*5*40)x=self.fc(x)returnx Pytorch可以在Module的foward里面随意构造网络,可以调用Module,也可以调用Functional,甚至可以在里面写If这种控制逻辑。但这也带来了一个问题,就是比较难获取这个模型的图结构。因为在Eager Mode Quantization中,要量化这个网络必须做手动修改: classNetQuant(nn.Module):def__init__(self,num_channels=1):super(NetQuant,self).__init__()self.conv1=nn.Conv2d(num_channels,40,3,1)self.relu1=nn.ReLU()self.pool1=nn.MaxPool2d(2,2)self.conv2=nn.Conv2d(40,40,3,1)self.relu2=nn.ReLU()self.pool2=nn.MaxPool2d(2,2)self.fc=nn.Linear(5*5*40,10)self.quant=torch.quantization.QuantStub()self.dequant=torch.quantization.DeQuantStub()defforward(self,x):x=self.quant(x)x=self.relu1(self.conv1(x))x=self.pool1(x)x=self.relu2(self.conv2(x))x=self.pool2(x)x=x.reshape(-1,5*5*40)x=self.fc(x)x=self.dequant(x)returnx 也就是说,除了 Conv , Linear 这些含有参数的Module外, ReLU , MaxPool2d 也要在 __init__ 中定义,Eager Mode Quantization才可以处理。 除了这一点,由于一些几点是要Fuse之后做量化比如Conv+ReLU,那么还需要手动指定这些层进行折叠,目前支持 ConV + BN、ConV + BN + ReLU、Conv + ReLU、Linear + ReLU、BN + ReLU 的折叠。 model=NetQuant()model.qconfig=torch.quantization.get_default_qconfig('fbgemm')modules_to_fuse=[['conv1','relu1'],['conv2','relu2']]#指定合并layer的名字model_fused=torch.quantization.fuse_modules(model,modules_to_fuse)model_prepared=torch.quantization.prepare(model_fused)post_training_quantize(model_prepared,train_loader)#这一步是做后训练量化model_int8=torch.quantization.convert(model_prepared) 整个流程比较逆天,不知道有没有人用。 FX Graph Mode Quantization 由于 FX 可以自动跟踪 forward 里面的代码,因此它是真正记录了网络里面的每个节点,在 fuse 和动态插入量化节点方面,比 Eager 模式更友好。对于前面那个模型代码,我们不需要对网络做修改,直接让 FX 帮我们自动修改网络即可: fromtorch.quantizationimportget_default_qconfig,quantize_jitfromtorch.quantization.quantize_fximportprepare_fx,convert_fxmodel=Net()qconfig=get_default_qconfig("fbgemm")qconfig_dict={"":qconfig}model_prepared=prepare_fx(model,qconfig_dict)post_training_quantize(model_prepared,train_loader)#这一步是做后训练量化model_int8=convert_fx(model_prepared) 理解 个人感觉基于OneFlow的Eager接口(OneFlow的Eager接口和Pytorch将完全对齐,用户可零成本迁移算法,并享受OneFlow在多机多卡上的速度红利)做量化感知训练也是要做到完全自动的。 Pytorch FX的好处就在于它可以将一个Module通过插入一些Pass转化成一个类似的Module,只要开发者实现了某个Pass,就不需要用户操心了。OneFlow Eager版本的自动量化开发正在进行中(对于Lazy版本,我们是支持一键自动量化训练的),敬请期待。欢迎关注我司的OneFlow:https://github.com/Oneflow-Inc/oneflow。 5 总结 本文分享了笔者最近的一项工作,基于OneFlow Eager版本做量化感知训练,目前手动做量化感知训练对用户友好性还不足够。但对于想学习量化感知训练的读者来说,通过这个Demo来学习一些技巧还是不错的。另外,本文还调研了Pytorch FX的自动量化方案,它确实比Pytorch的第一代方案更友好,我们的目标也是做出更自动,更友好的量化训练接口。 注:题图源自Pixabay 其他人都在看 “我们决定去登月”|OneFlow开源这一年 对抗软件系统复杂性②:全局一致,统一隐喻 对抗软件系统复杂性①:如无必要,勿增实体 动态调度的“诅咒”| 原有深度学习框架的缺陷③ 再谈“去虚拟化”对深度学习系统的必要性 点击“阅读原文”,欢迎下载体验OneFlow新一代开源深度学习框架 本文分享自微信公众号 - OneFlow(OneFlowTechnology)。如有侵权,请联系 support@oschina.cn 删除。本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

优秀的个人博客,低调大师

每日一博 | 「React」之组件逻辑复用小技巧

编者荐语: 本文将介绍React组件逻辑复用的一些常用模式和技巧。包括一下几个方面: 什么是高阶组件 HOC HOC解决了哪些问题 如何封装一个简单的高阶组件 HOC在项目中常用的一些技巧和方法 什么是 Render Props Render Props的特点和用法 Render Props和 HOC React Hooks相比,有哪些优劣(重要面试题) HOC高阶组件 高阶组件(HOC):是React中用于复用组件逻辑的一种高级技巧。HOC自身不是React API的一部分,它是一种基于React的组合特性而形成的设计模式。 高阶组件可以看做React对装饰器模式的一种实现,具体而言,高阶组件是参数作为组件,返回值为新组件的函数。 HOC解决的问题 抽离公共组件,实现组件代码复用,常见场景:页面复用。 条件渲染,控制组件的渲染逻辑(渲染劫持),常见场景:权限控制。 捕获/劫持被处理组件的生命周期,常见场景:组件渲染性能追踪、日志打点。 当我们项目中使用高阶组件开发时,能够让代码变得更加优雅,同时增强代码的复用性和灵活性,提升开发效率 高阶组件的基本框架 高阶组件的框架: exportdefault(WrappedComponent)=>{returnclassNewComponentextendsReact.Component{//可以自定义逻辑//比如给WrappedComponent组件传递props和methodsrender(){return<WrappedComponent{...this.props}/>}}} 如果自定义了state和methods可以通过下面方式传递到子组件中 exportdefault(WrappedComponent)=>{returnclassNewComponentextendsReact.Component{state={markTime:newDate().toLocaleTimeString();//获取组件当前渲染时的时间}printTime(){letmyDate=newDate();letmyTime=myDate.toLocaleTimeString();console.log('当前时间',myTime)}render(){return<WrappedComponentmarkTime={this.state.markTime}printTime={this.printTime}/>}}} 这样在WrappedComponent组件中,如果是类组件就可以通过this.props.markTime获取,函数组件的话通过props.markTime来获取,方法获取和状态获取相同。 HOC可以做什么 属性代理——可操作所有传入的props 可以读取、添加、编辑、删除传给 WrappedComponent 的 props(属性) 「场景描述」: 给Hello组件传递show,hide方法,让其显示Loading加载框 constloading=message=>OldComponent=>{returnclassextendsReact.Component{//显示一个Loading的divstate={show:()=>{letdiv=document.createElement('div');div.innerHTML=`<pid="loading"style="position:absolute;z-index:10;top:10;color:red;border:1pxsolid#000">${message}</p>`document.body.appendChild(div);},hide:()=>{document.getElementById('loading').remove();}}render(){return(<div><OldComponent{...this.props}{...this.state}/></div>)}}}functionHello(props){return(<div>hello<buttononClick={props.show}>show</button><buttononClick={props.hide}>hide</button></div>)}letHightLoadingHello=loading('正在加载')(Hello);ReactDom.render(<HightLoadingHello/>,document.getElementById('root')); 效果如图: 抽离公共组件,最大化实现复用 「场景描述」: 统计每个组件的渲染时间 classCalTimeComponentextendsReact.Component{componentWillMount(){this.start=Date.now();//初始渲染节点}componentDidMount(){console.log((Date.now()-this.start)+'ms');}render(){return<div>calTimeComponent</div>}}ReactDom.render(<CalTimeComponent/>,document.getElementById('root')); 这样仅仅能计算当前组件的渲染时间,假如现在有这样一个需求,需要统计每个组件的渲染时间呢? 就应该想到把它抽离出去,比如: //CalTimeComponent.jsexportdefaultfunctionCalTimeComponent(OldComponent){returnclassextendsReact.Component{state={markTime:newDate().toLocaleTimeString()}componentWillMount(){this.start=Date.now();}componentDidMount(){console.log((Date.now()-this.start)+'ms');}printTime(){letmyDate=newDate();letmyTime=myDate.toLocaleTimeString();console.log('当前时间',myTime)}render(){return<OldComponentmarkTime={this.state.markTime}printTime={this.printTime}/>}}}//HelloComponent.jsimportwithTrackerfrom'../../Components/CalTimeComponent.js';classHelloComponentextendsReact.Component{render(){console.log(this.props);this.props.printTime()return<div>hello</div>}}letHighHelloComponent=CalTimeComponent(HelloComponent);ReactDom.render(<HighHelloComponent/>,document.getElementById('root')); 这样就能最大化的实现CalTimeComponent组件复用了,把它引入到想要计算时间的组件里,并传入当前组件就好了。 Render Props 特点1:render props指在一种React组件之间使用一个值为函数的props共享代码的简单技术。 特点2:具有render props的组件接收一个函数,该函数返回一个React元素并调用它而不是实现一个自己的渲染逻辑。 特点3:render props是一个用于告知组件需要渲染什么内容的函数(props) 特点4:也是组件逻辑复用的一种实现方式 接下来,我通过一个例子带大家分别认识上面的四种特点 「场景描述」: 在多个组件内实时获取鼠标的x、y坐标 原生实现:不复用逻辑 classMouseTrackerextendsReact.Component{constructor(props){super(props);this.state={x:0,y:0,}}handleMouseMove=(event)=>{this.setState({x:event.clientX,y:event.clientY});}render(){return(<divonMouseMove={this.handleMouseMove}><h1>请移动鼠标</h1><p>当前鼠标的位置是:x:{this.state.x}y:{this.state.y}</p></div>)}}ReactDom.render(<MouseTracker/>,document.getElementById('root')); 上面,这是在一个组件内完成的,假如现在要在多个div内完成上面的逻辑该怎么办,就该想到复用了,看看render prop是怎么帮我们完成的? Render Props classMouseTrackerextendsReact.Component{constructor(props){super(props);this.state={x:0,y:0,}}handleMouseMove=(event)=>{this.setState({x:event.clientX,y:event.clientY});}render(){console.log(this.props)return(<divonMouseMove={this.handleMouseMove}>{this.props.render(this.state)}</div>)}}ReactDom.render(<MouseTrackerrender={props=>(<React.Fragment><h1>请移动鼠标</h1><p>当前鼠标的位置是:x:{props.x}y:{props.y}</p></React.Fragment>)}></MouseTracker>,document.getElementById('root')); 注意:render props 是因为模式才被称为 render props ,你不一定要用名为 render 的 props 来使用这种模式。render props 是一个用于告知组件需要渲染什么内容的函数 `prop 那如果改写成高阶组件呢? 高阶组件写法 改写成高阶组件,并将公共组件抽离出去, ShowPosition子组件中可以拿到withTracker父组件中传递的x、y坐标值 //withTracker.jsexportdefaultfunctionwithTracker(OldComponent){returnclassMouseTrackerextendsReact.Component{constructor(props){super(props);this.state={x:0,y:0,}}handleMouseMove=(event)=>{this.setState({x:event.clientX,y:event.clientY});}render(){console.log(this.props)return(<divonMouseMove={this.handleMouseMove}><OldComponent{...this.state}/></div>)}}}//ShowPosition.jsimportwithTrackerfrom'../../Components/withTracker.js';functionShowPosition(props){return(<React.Fragment><h1>请移动鼠标</h1><p>当前鼠标的位置是:x:{props.x}y:{props.y}</p></React.Fragment>)}//在ShowPosition组件中可以拿到withTracker传递过来的坐标值letHightShowPosition=withTracker(ShowPosition);ReactDom.render(<HightShowPosition/>,document.getElementById('root')); hoc、render props、react-hooks的优劣如何? HOC的优势: 抽离公共组件,实现组件代码复用,常见场景:页面复用。 条件渲染,控制组件的渲染逻辑(渲染劫持),常见场景:权限控制。 捕获/劫持被处理组件的生命周期,常见场景:组件渲染性能追踪、日志打点。 属性代理,可以给一些子组件传递层次比较远的属性,并按需求操作他们 HOC的缺陷: 扩展性限制: HOC无法从外部访问子组件(被包裹组件 WrappedComponent)的 state,因此无法通过shouldComponentUpdate过滤掉不必要的更新(React支持ES6之后,提供了 React.pureComponent来解决这个问题) Ref传递问题: Ref由于组件被高阶组件包裹,导致被隔断,需要后来的 React.forwardRef来解决这个问题 层级嵌套: HOC可能出现多层包裹组件的情况(一般不超过两层,否则不好维护)多层抽象增加了复杂度和理解成本 命名冲突:如果高阶组件多次嵌套,没有使用 命名空间的话会产生冲突,覆盖老属性 Render Props优点: 上述HOC的缺点,Render Props都可以解决 Render Props缺陷: 使用繁琐: HOC只需要借助装饰器/高阶函数的特点就可以进行复用,而 Render Props需要借助 回调嵌套 嵌套过深: Render Props虽然摆脱了组件多层嵌套的问题,但是转化为了 函数回调的嵌套 React Hooks的优点(重点): 简洁: React Hooks解决了 HOC和 Render Props的嵌套问题,更加简洁 解耦: React Hooks可以更方便地把 UI 和状态分离,做到更彻底的解耦 无影响复用组件逻辑: Hook 使你在无需修改组件结构的情况下复用状态逻辑 函数友好:React Hooks为函数组件而生,从而解决了类组件的几大问题 this 指向容易错误 分割在不同声明周期中的逻辑使得代码难以理解和维护 代码复用成本高(高阶组件容易使代码量剧增) React Hooks的缺陷(重点): 额外的学习成本(Functional Component 与 Class Component 之间的困惑) 写法上有限制(不能出现在条件、循环中,只能在最外层调用 Hooks),并且写法限制增加了重构成本 破坏了 PureComponent、React.memo浅比较的性能优化效果(为了取最新的props和state,每次render()都要重新创建事件处函数)(依赖项不变,可解决该问题) 使用不当,可能会造成 闭包陷阱问题 React.memo并不能完全替代 shouldComponentUpdate(因为拿不到 state change,只针对 props change) 关于react-hooks的评价来源于官方react-hooks RFC 感谢大家 如果你觉得这篇内容对你挺有启发,我想邀请你帮我三个小忙: 点个「 在看」,让更多的人也能看到这篇内容(喜欢不点在看,都是耍流氓 -_-) 欢迎加我微信「 Augenstern9728」一起交流学习... 关注公众号「 前端时光屋」,持续为你推送精选好文。 本文分享自微信公众号 - 前端时光屋(javascriptlab)。如有侵权,请联系 support@oschina.cn 删除。本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

优秀的个人博客,低调大师

每日一博 | 了解 InnoDB 存储引擎的内存池

每日一个知识点系列的目的是针对某一个知识点进行概括性总结,可在一分钟内完成知识点的阅读理解。 此处不涉及详细的原理性解读,只作为一种抛砖引玉。 真正的理解一定是你自我研究探索所收获的知识,加入组织带你一起进步成长。 通过前几天的知识点我们知道,在Innodb体系架构里,主要包含后台线程和内存两大块,今天就来说下Innodb体系架构里内存的一些知识点。架构图如下: Innodb的内存 老规矩,先上图,从全局看一下: 目前我们可以看出,InnoDB内存主要有两大部分: 缓冲池 重做日志缓冲 InnoDB存储引擎是基于磁盘存储的,并将其中的记录按照页的方式进行管理。 因此可将其视为基于磁盘的数据库系统(Disk-base Database)。 在数据库系统中,由于CPU速度与磁盘速度之间的鸿沟,基于磁盘的数据库系统通常使用缓冲池技术来提高数据库的整体性能 缓冲池 缓冲池简单来说就是一块内存区域,通过内存的速度来弥补磁盘速度较慢对数据库性能的影响。 缓冲池中缓存的数据页类型: 索引页 数据页 undo页 插入缓冲(insert buffer) 自适应哈希索引(adaptive hash index) InnoDB存储的锁信息(lock info) 数据字典信息(data dictionary 读数据操作: 首先将从磁盘读到的页存放在缓冲池中,这个过程称为将页“FIX”在缓冲池中 下一次再读相同的页时,首先判断该页是否在缓冲池中 若在缓冲池中,称该页在缓冲池中被命中,直接读取该页。否则,读取磁盘上的页 写数据操作: 首先修改在缓冲池中的页,然后再以一定的频率刷新到磁盘上 页从缓冲池刷新回磁盘的操作并不是在每次页发生更新时触发 通过一种称为Checkpoint的机制刷新回磁盘 配置参数: innodb_buffer_pool_instances, 缓冲池实例个数默认1,InnoDB 1.0.x版本开始使用,每个页根据哈希值平均分配到不同缓冲池实例中。减少数据库内部的资源竞争,增加数据库的并发处理能力。 innodb_buffer_pool_size,缓冲池大小 命令参数: 可通过命令查看缓冲池大小 SHOW VARIABLES LIKE 'innodb_buffer_pool_size' 通过命令可查看缓冲池实例个数 SHOW VARIABLES LIKE 'innodb_buffer_pool_instances' 缓冲池的管理 缓冲池是一个很大的内存区域,其中存放各种类型的页。其实这么大的内存区域是通过LRU算法来进行管理的,而这里的LRU也是InnoDB 对传统的做了一些优化 LRU List 传统LRU: 最频繁使用的页在LRU列表的前端 最少使用的页在LRU列表的尾端 缓冲池不能存放新读取到的页时,将首先释放LRU列表中尾端的页 InnoDB改进版LRU: LRU列表中加入了midpoint位置 新读取到的页是放入到LRU列表的midpoint位置 默认配置下,该位置在LRU列表长度的5/8处。midpoint位置可由参数innodb_old_blocks_pct控制 引入innodb_old_blocks_time 参数,用于表示页读取到mid位置后需要等待多久才会被加入到LRU列表的热端 Free List LRU列表用来管理已经读取的页,但当数据库刚启动时,LRU列表是空的,即没有任何的页。这时页都存放在Free列表中. 当需要从缓冲池中分页时,首先从Free列表中查找是否有可用的空闲页,若有则将该页从Free列表中删除,放入到LRU列表中。否则,根据LRU算法,淘汰LRU列表末尾的页,将该内存空间分配给新的页 当页从LRU列表的old部分加入到new部分时,称此时发生的操作为page made young,而因为innodb_old_blocks_time的设置而导致页没有从old部分移动到new部分的操作称为page not made young 可以通过命令SHOW ENGINE INNODBSTATUS来观察LRU列表及Free列表的使用情况和运行状态 Flush List LRU列表用来管理缓冲池中页的可用性,Flush列表用来管理将页刷新回磁盘,二者互不影响 在LRU列表中的页被修改后,称该页为脏页(dirty page),即缓冲池中的页和磁盘上的页的数据产生了不一致。 这时数据库会通过CHECKPOINT机制将脏页刷新回磁盘,而Flush列表中的页即为脏页列表。 脏页既存在于LRU列表中,也存在于Flush列表中。 缓冲池中的页还可能会被分配给自适应哈希索引、Lock信息、InsertBuffer等页,而这部分页不需要LRU算法进行维护,因此不存在于LRU列表中。 重做日志缓冲(redo log buffer) InnoDB存储引擎首先将重做日志信息先放入到这个缓冲区,然后按一定频率将其刷新到重做日志文件 重做日志缓冲一般不需要设置得很大,因为一般情况下每一秒钟会将重做日志缓冲刷新到日志文件 该值可由配置参数innodb_log_buffer_size控制,默认为8MB 可通过命令查看大小 SHOW VARIABLES LIKE 'innodb_log_buffer_size' 什么时候刷新到磁盘? Master Thread每一秒将重做日志缓冲刷新到重做日志文件 每个事务提交时会将重做日志缓冲刷新到重做日志文件 当重做日志缓冲池剩余空间小于1/2时,重做日志缓冲刷新到重做日志文件 往期推荐 知识点:了解InnoDB的后台线程 你不知道的内存知识 Spring Boot 系列 :关于Kafka消息发送的事儿 Spring Boot 系列:日志动态配置详解 Spring Boot 系列:最新版优雅停机详解 本文分享自微信公众号 - 架构技术专栏(jiagoujishu)。如有侵权,请联系 support@oschina.cn 删除。本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

优秀的个人博客,低调大师

每日一博 | Vue3 的模板编译优化

Vue3 正式发布已经有一段时间了,前段时间写了一篇文章(《Vue 模板编译原理》)分析 Vue 的模板编译原理。今天的文章打算学习下 Vue3 下的模板编译与 Vue2 下的差异,以及 VDOM 下 Diff 算法的优化。 编译入口 了解过 Vue3 的同学肯定知道 Vue3 引入了新的组合 Api,在组件 mount 阶段会调用 setup 方法,之后会判断 render 方法是否存在,如果不存在会调用 compile 方法将 template 转化为 render。 //packages/runtime-core/src/renderer.tsconstmountComponent=(initialVNode,container)=>{constinstance=(initialVNode.component=createComponentInstance(//...params))//调用setupsetupComponent(instance)}//packages/runtime-core/src/component.tsletcompileexportfunctionregisterRuntimeCompiler(_compile){compile=_compile}exportfunctionsetupComponent(instance){constComponent=instance.typeconst{setup}=Componentif(setup){//...调用setup}if(compile&&Component.template&&!Component.render){//如果没有render方法//调用compile将template转为render方法Component.render=compile(Component.template,{...})}} 这部分都是 runtime-core 中的代码,之前的文章有讲过 Vue 分为完整版和 runtime 版本。如果使用 vue-loader 处理 .vue 文件,一般都会将 .vue 文件中的 template 直接处理成 render 方法。 //需要编译器Vue.createApp({template:'<div>{{hi}}</div>'})//不需要Vue.createApp({render(){returnVue.h('div',{},this.hi)}}) 完整版与 runtime 版的差异就是,完整版会引入 compile 方法,如果是 vue-cli 生成的项目就会抹去这部分代码,将 compile 过程都放到打包的阶段,以此优化性能。runtime-dom 中提供了 registerRuntimeCompiler 方法用于注入 compile 方法。 主流程 在完整版的 index.js 中,调用了 registerRuntimeCompiler 将 compile 进行注入,接下来我们看看注入的 compile 方法主要做了什么。 //packages/vue/src/index.tsimport{compile}from'@vue/compiler-dom'//编译缓存constcompileCache=Object.create(null)//注入compile方法functioncompileToFunction(//模板template:string|HTMLElement,//编译配置options?:CompilerOptions):RenderFunction{if(!isString(template)){//如果template不是字符串//则认为是一个DOM节点,获取innerHTMLif(template.nodeType){template=template.innerHTML}else{returnNOOP}}//如果缓存中存在,直接从缓存中获取constkey=templateconstcached=compileCache[key]if(cached){returncached}//如果是ID选择器,这获取DOM元素后,取innerHTMLif(template[0]==='#'){constel=document.querySelector(template)template=el?el.innerHTML:''}//调用compile获取rendercodeconst{code}=compile(template,options)//将rendercode转化为functionconstrender=newFunction(code)();//返回render方法的同时,将其放入缓存return(compileCache[key]=render)}//注入compileregisterRuntimeCompiler(compileToFunction) 在讲 Vue2 模板编译的时候已经讲过,compile 方法主要分为三步,Vue3 的逻辑类似: 模板编译,将模板代码转化为 AST; 优化 AST,方便后续虚拟 DOM 更新; 生成代码,将 AST 转化为可执行的代码; //packages/compiler-dom/src/index.tsimport{baseCompile,baseParse}from'@vue/compiler-core'exportfunctioncompile(template,options){returnbaseCompile(template,options)}//packages/compiler-core/src/compile.tsimport{baseParse}from'./parse'import{transform}from'./transform'import{transformIf}from'./transforms/vIf'import{transformFor}from'./transforms/vFor'import{transformText}from'./transforms/transformText'import{transformElement}from'./transforms/transformElement'import{transformOn}from'./transforms/vOn'import{transformBind}from'./transforms/vBind'import{transformModel}from'./transforms/vModel'exportfunctionbaseCompile(template,options){//解析html,转化为astconstast=baseParse(template,options)//优化ast,标记静态节点transform(ast,{...options,nodeTransforms:[transformIf,transformFor,transformText,transformElement,//...省略了部分transform],directiveTransforms:{on:transformOn,bind:transformBind,model:transformModel}})//将ast转化为可执行代码returngenerate(ast,options)} 计算 PatchFlag 这里大致的逻辑与之前的并没有多大的差异,主要是 optimize 方法变成了 transform 方法,而且默认会对一些模板语法进行 transform。这些 transform 就是后续虚拟 DOM 优化的关键,我们先看看 transform 的代码 。 //packages/compiler-core/src/transform.tsexportfunctiontransform(root,options){constcontext=createTransformContext(root,options)traverseNode(root,context)}exportfunctiontraverseNode(node,context){context.currentNode=nodeconst{nodeTransforms}=contextconstexitFns=[]for(leti=0;i<nodeTransforms.length;i++){//Transform会返回一个退出函数,在处理完所有的子节点后再执行constonExit=nodeTransforms[i](node,context)if(onExit){if(isArray(onExit)){exitFns.push(...onExit)}else{exitFns.push(onExit)}}}traverseChildren(node,context)context.currentNode=node//执行所以Transform的退出函数leti=exitFns.lengthwhile(i--){exitFns[i]()}} 我们重点看一下 transformElement 的逻辑: //packages/compiler-core/src/transforms/transformElement.tsexportconsttransformElement:NodeTransform=(node,context)=>{//transformElement没有执行任何逻辑,而是直接返回了一个退出函数//说明transformElement需要等所有的子节点处理完后才执行returnfunctionpostTransformElement(){const{tag,props}=nodeletvnodePropsletvnodePatchFlagconstvnodeTag=node.tagType===ElementTypes.COMPONENT?resolveComponentType(node,context):`"${tag}"`letpatchFlag=0//检测节点属性if(props.length>0){//检测节点属性的动态部分constpropsBuildResult=buildProps(node,context)vnodeProps=propsBuildResult.propspatchFlag=propsBuildResult.patchFlag}//检测子节点if(node.children.length>0){if(node.children.length===1){constchild=node.children[0]//检测子节点是否为动态文本if(!getStaticType(child)){patchFlag|=PatchFlags.TEXT}}}//格式化patchFlagif(patchFlag!==0){vnodePatchFlag=String(patchFlag)}node.codegenNode=createVNodeCall(context,vnodeTag,vnodeProps,vnodeChildren,vnodePatchFlag)}} buildProps 会对节点的属性进行一次遍历,由于内部源码涉及很多其他的细节,这里的代码是经过简化之后的,只保留了 patchFlag 相关的逻辑。 exportfunctionbuildProps(node:ElementNode,context:TransformContext,props:ElementNode['props']=node.props){letpatchFlag=0for(leti=0;i<props.length;i++){constprop=props[i]const[key,name]=prop.name.split(':')if(key==='v-bind'||key===''){if(name==='class'){//如果包含:class属性,patchFlag|CLASSpatchFlag|=PatchFlags.CLASS}elseif(name==='style'){//如果包含:style属性,patchFlag|STYLEpatchFlag|=PatchFlags.STYLE}}}return{patchFlag}} 上面的代码只展示了三种 patchFlag 的类型: 节点只有一个文本子节点,且该文本包含动态的数据( TEXT = 1) <p>name:{{name}}</p> 节点包含可变的 class 属性( CLASS = 1 << 1) <div:class="{active:isActive}"></div> 节点包含可变的 style 属性( STYLE = 1 << 2) <div:style="{color:color}"></div> 可以看到 PatchFlags 都是数字 1 经过 左移操作符 计算得到的。 exportconstenumPatchFlags{TEXT=1,//1,二进制00000001CLASS=1<<1,//2,二进制00000010STYLE=1<<2,//4,二进制00000100PROPS=1<<3,//8,二进制00001000...} 从上面的代码能看出来,patchFlag 的初始值为 0,每次对 patchFlag 都是执行 | (或)操作。如果当前节点是一个只有动态文本子节点且同时具有动态 style 属性,最后得到的 patchFlag 为 5(二进制:0000 0101)。 <p:style="{color:color}">name:{{name}}</p> patchFlag=0patchFlag|=PatchFlags.STYLEpatchFlag|=PatchFlags.TEXT//或运算:两个对应的二进制位中只要一个是1,结果对应位就是1。//00000001//00000100//------------//00000101=>十进制5 patchFlag 我们将上面的代码放到 Vue3 中运行: constapp=Vue.createApp({data(){return{color:'red',name:'shenfq'}},template:`<div><p:style="{color:color}">name:{{name}}</p></div>`})app.mount('#app') 最后生成的 render 方法如下,和我们之前的描述基本一致。 function render() {} render 优化 Vue3 在虚拟 DOM Diff 时,会取出 patchFlag 和需要进行的 diff 类型进行 &(与)操作,如果结果为 true 才进入对应的 diff。 patchFlag 判断 还是拿之前的模板举例: <p:style="{color:color}">name:{{name}}</p> 如果此时的 name 发生了修改,p 节点进入了 diff 阶段,此时会将判断 patchFlag & PatchFlags.TEXT ,这个时候结果为真,表明 p 节点存在文本修改的情况。 patchFlag patchFlag=5patchFlag&PatchFlags.TEXT//或运算:只有对应的两个二进位都为1时,结果位才为1。//00000101//00000001//------------//00000001=>十进制1 if(patchFlag&PatchFlags.TEXT){if(oldNode.children!==newNode.children){//修改文本hostSetElementText(el,newNode.children)}} 但是进行 patchFlag & PatchFlags.CLASS 判断时,由于节点并没有动态 Class,返回值为 0,所以就不会对该节点的 class 属性进行 diff,以此来优化性能。 patchFlag patchFlag=5patchFlag&PatchFlags.CLASS//或运算:只有对应的两个二进位都为1时,结果位才为1。//00000101//00000010//------------//00000000=>十进制0 总结 其实 Vue3 相关的性能优化有很多,这里只单独将 patchFlag 的十分之一的内容拿出来讲了,Vue3 还没正式发布的时候就有看到说 Diff 过程会通过 patchFlag 来进行性能优化,所以打算看看他的优化逻辑,总的来说还是有所收获。 本文分享自微信公众号 - 更了不起的前端(shenfq777)。如有侵权,请联系 support@oschina.cn 删除。本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

优秀的个人博客,低调大师

每日一博 | Vue 3 组合式 API 介绍

组合式API介绍 通过创建 Vue 组件,我们可以将接口的可重复部分及其功能提取到可重用的代码段中。仅此一项就可以使我们的应用程序在可维护性和灵活性方面走得更远。然而,我们的经验已经证明,光靠这一点可能是不够的,尤其是当你的应用程序变得非常大的时候——想想几百个组件。在处理如此大的应用程序时,共享和重用代码变得尤为重要。 假设在我们的应用程序中,我们有一个视图来显示某个用户的仓库列表。除此之外,我们还希望应用搜索和筛选功能。处理此视图的组件可能如下所示: //src/components/UserRepositories.vueexportdefault{components:{RepositoriesFilters,RepositoriesSortBy,RepositoriesList},props:{user:{type:String}},data(){return{repositories:[],//1filters:{...},//3searchQuery:''//2}},computed:{filteredRepositories(){...},//3repositoriesMatchingSearchQuery(){...},//2},watch:{user:'getUserRepositories'//1},methods:{getUserRepositories(){//使用`this.user`获取用户仓库},//1updateFilters(){...},//3},mounted(){this.getUserRepositories()//1}} 该组件有以下几个职责: 从假定的外部 API 获取该用户名的仓库,并在用户更改时刷新它 使用 searchQuery 字符串搜索存储库 使用 filters 对象筛选仓库 用组件的选项 (data、computed、methods、watch) 组织逻辑在大多数情况下都有效。然而,当我们的组件变得更大时,逻辑关注点的列表也会增长。这可能会导致组件难以阅读和理解,尤其是对于那些一开始就没有编写这些组件的人来说。 一个大型组件的示例,其中逻辑关注点是按颜色分组。 这种碎片化使得理解和维护复杂组件变得困难。选项的分离掩盖了潜在的逻辑问题。此外,在处理单个逻辑关注点时,我们必须不断地“跳转”相关代码的选项块。 如果我们能够将与同一个逻辑关注点相关的代码配置在一起会更好。而这正是组合式 API 使我们能够做到的。 组合式 API 基础 既然我们知道了为什么,我们就可以知道怎么做。为了开始使用组合式 API,我们首先需要一个可以实际使用它的地方。在 Vue 组件中,我们将此位置称为 setup。 setup 组件选项 新的 setup 组件选项在创建组件之前执行,一旦 props 被解析,并充当合成 API 的入口点。 由于在执行 setup 时尚未创建组件实例,因此在 setup 选项中没有 this。这意味着,除了 props 之外,你将无法访问组件中声明的任何属性——本地状态、计算属性或方法。 setup 选项应该是一个接受 props 和 context 的函数,我们将在稍后讨论。此外,我们从 setup 返回的所有内容都将暴露给组件的其余部分 (计算属性、方法、生命周期钩子等等) 以及组件的模板。 让我们添加 setup 到我们的组件中: //src/components/UserRepositories.vueexportdefault{components:{RepositoriesFilters,RepositoriesSortBy,RepositoriesList},props:{user:{type:String}},setup(props){console.log(props)//{user:''}return{}//这里返回的任何内容都可以用于组件的其余部分}//组件的“其余部分”} 现在让我们从提取第一个逻辑关注点开始 (在原始代码段中标记为“1”)。 “ 从假定的外部 API 获取该用户名的仓库,并在用户更改时刷新它 ” 我们将从最明显的部分开始: 仓库列表 更新仓库列表的函数 返回列表和函数,以便其他组件选项可以访问它们 //src/components/UserRepositories.vue`setup`functionimport{fetchUserRepositories}from'@/api/repositories'//在我们的组件内setup(props){letrepositories=[]constgetUserRepositories=async()=>{repositories=awaitfetchUserRepositories(props.user)}return{repositories,getUserRepositories//返回的函数与方法的行为相同}} 这是我们的出发点,但它还不能工作,因为我们的 repositories 变量是非响应式的。这意味着从用户的角度来看,仓库列表将保持为空。我们来解决这个问题! 带 ref 的响应式变量 在 Vue 3.0 中,我们可以通过一个新的 ref 函数使任何响应式变量在任何地方起作用,如下所示: <template><divclass="template-m-wrap">counter--->{{counter}}</div></template><script>import{defineComponent,ref}from"vue";exportdefaultdefineComponent({name:"TemplateM",props:{test:{type:Object,default:()=>{return{name:"haha",};},},},setup(props){constcounter=ref(0);console.log("props===>",props);return{counter}},});</script> ref 接受参数并返回它包装在具有 value property 的对象中,然后可以使用该 property 访问或更改响应式变量的值: import{ref}from'vue'constcounter=ref(0)console.log(counter)//{value:0}console.log(counter.value)//0counter.value++console.log(counter.value)//1 在对象中包装值似乎不必要,但在 JavaScript 中保持不同数据类型的行为统一是必需的。这是因为在 JavaScript 中,Number 或 String 等基本类型是通过值传递的,而不是通过引用传递的: 在任何值周围都有一个包装器对象,这样我们就可以在整个应用程序中安全地传递它,而不必担心在某个地方失去它的响应性。 回到我们的例子,让我们创建一个响应式的 repositories 变量: //src/components/UserRepositories.vue`setup`functionimport{fetchUserRepositories}from'@/api/repositories'import{ref}from'vue'//inourcomponentsetup(props){constrepositories=ref([])constgetUserRepositories=async()=>{repositories.value=awaitfetchUserRepositories(props.user)}return{repositories,getUserRepositories}} 完成!现在,每当我们调用 getUserRepositories 时,repositories 都将发生变化,视图将更新以反映更改。我们的组件现在应该如下所示: //src/components/UserRepositories.vueimport{fetchUserRepositories}from'@/api/repositories'import{ref}from'vue'exportdefault{components:{RepositoriesFilters,RepositoriesSortBy,RepositoriesList},props:{user:{type:String}},setup(props){constrepositories=ref([])constgetUserRepositories=async()=>{repositories.value=awaitfetchUserRepositories(props.user)}return{repositories,getUserRepositories}},data(){return{filters:{...},//3searchQuery:''//2}},computed:{filteredRepositories(){...},//3repositoriesMatchingSearchQuery(){...},//2},watch:{user:'getUserRepositories'//1},methods:{updateFilters(){...},//3},mounted(){this.getUserRepositories()//1}} 我们已经将第一个逻辑关注点中的几个部分移到了 setup 方法中,它们彼此非常接近。剩下的就是在 mounted 钩子中调用 getUserRepositories,并设置一个监听器,以便在 user prop 发生变化时执行此操作。 我们将从生命周期钩子开始。 生命周期钩子注册内部 setup 为了使组合式 API 的特性与选项式 API 相比更加完整,我们还需要一种在 setup 中注册生命周期钩子的方法。这要归功于从 Vue 导出的几个新函数。组合式 API 上的生命周期钩子与选项式 API 的名称相同,但前缀为 on:即 mounted 看起来像 onMounted。 这些函数接受在组件调用钩子时将执行的回调。 让我们将其添加到 setup 函数中: //src/components/UserRepositories.vue`setup`functionimport{fetchUserRepositories}from'@/api/repositories'import{ref,onMounted}from'vue'//inourcomponentsetup(props){constrepositories=ref([])constgetUserRepositories=async()=>{repositories.value=awaitfetchUserRepositories(props.user)}onMounted(getUserRepositories)//on`mounted`call`getUserRepositories`return{repositories,getUserRepositories}} 现在我们需要对 user prop 所做的更改做出反应。为此,我们将使用独立的 watch 函数。 watch 响应式更改 就像我们如何使用 watch 选项在组件内的 user property 上设置侦听器一样,我们也可以使用从 Vue 导入的 watch 函数执行相同的操作。它接受 3 个参数: 一个 响应式引用或我们想要侦听的 getter 函数 一个回调 可选的配置选项 下面让我们快速了解一下它是如何工作的 import{ref,watch}from'vue'constcounter=ref(0)watch(counter,(newValue,oldValue)=>{console.log('Thenewcountervalueis:'+counter.value)}) 例如,每当 counter 被修改时 counter.value=5,watch 将触发并执行回调 (第二个参数),在本例中,它将把 'The new counter value is:5' 记录到我们的控制台中。 以下是等效的选项式 API: exportdefault{data(){return{counter:0}},watch:{counter(newValue,oldValue){console.log('Thenewcountervalueis:'+this.counter)}}} 有关 watch 的详细信息,请参阅我们的深入指南。 现在我们将其应用到我们的示例中: //src/components/UserRepositories.vue`setup`functionimport{fetchUserRepositories}from'@/api/repositories'import{ref,onMounted,watch,toRefs}from'vue'//在我们组件中setup(props){//使用`toRefs`创建对prop的`user`property的响应式引用const{user}=toRefs(props)constrepositories=ref([])constgetUserRepositories=async()=>{//更新`prop.user`到`user.value`访问引用值repositories.value=awaitfetchUserRepositories(user.value)}onMounted(getUserRepositories)//在用户prop的响应式引用上设置一个侦听器watch(user,getUserRepositories)return{repositories,getUserRepositories}} 你可能已经注意到在我们的 setup 的顶部使用了 toRefs。这是为了确保我们的侦听器能够对 user prop 所做的更改做出反应。 有了这些变化,我们就把第一个逻辑关注点移到了一个地方。我们现在可以对第二个关注点执行相同的操作——基于 searchQuery 进行过滤,这次是使用计算属性。 独立的 computed 属性 与 ref 和 watch 类似,也可以使用从 Vue 导入的 computed 函数在 Vue 组件外部创建计算属性。让我们回到我们的 counter 例子: import{ref,computed}from'vue'constcounter=ref(0)consttwiceTheCounter=computed(()=>counter.value*2)counter.value++console.log(counter.value)//1console.log(twiceTheCounter.value)//2 在这里,computed 函数返回一个作为 computed 的第一个参数传递的 getter 类回调的输出的一个只读的响应式引用。为了访问新创建的计算变量的 value,我们需要像使用 ref 一样使用 .value property。 让我们将搜索功能移到 setup 中: //src/components/UserRepositories.vue`setup`functionimport{fetchUserRepositories}from'@/api/repositories'import{ref,onMounted,watch,toRefs,computed}from'vue'//inourcomponentsetup(props){//使用`toRefs`创建对props的`user`property的响应式引用const{user}=toRefs(props)constrepositories=ref([])constgetUserRepositories=async()=>{//更新`props.user`到`user.value`访问引用值repositories.value=awaitfetchUserRepositories(user.value)}onMounted(getUserRepositories)//在用户prop的响应式引用上设置一个侦听器watch(user,getUserRepositories)constsearchQuery=ref('')constrepositoriesMatchingSearchQuery=computed(()=>{returnrepositories.value.filter(repository=>repository.name.includes(searchQuery.value))})return{repositories,getUserRepositories,searchQuery,repositoriesMatchingSearchQuery}} 对于其他的逻辑关注点我们也可以这样做,但是你可能已经在问这个问题了——这不就是把代码移到 setup 选项并使它变得非常大吗?嗯,那是真的。这就是为什么在继续其他任务之前,我们将首先将上述代码提取到一个独立的组合式函数。让我们从创建 useUserRepositories 开始: //src/composables/useUserRepositories.jsimport{fetchUserRepositories}from'@/api/repositories'import{ref,onMounted,watch}from'vue'exportdefaultfunctionuseUserRepositories(user){constrepositories=ref([])constgetUserRepositories=async()=>{repositories.value=awaitfetchUserRepositories(user.value)}onMounted(getUserRepositories)watch(user,getUserRepositories)return{repositories,getUserRepositories}} 然后是搜索功能: //src/composables/useRepositoryNameSearch.jsimport{ref,computed}from'vue'exportdefaultfunctionuseRepositoryNameSearch(repositories){constsearchQuery=ref('')constrepositoriesMatchingSearchQuery=computed(()=>{returnrepositories.value.filter(repository=>{returnrepository.name.includes(searchQuery.value)})})return{searchQuery,repositoriesMatchingSearchQuery}} 现在在单独的文件中有了这两个功能,我们就可以开始在组件中使用它们了。以下是如何做到这一点: //src/components/UserRepositories.vueimportuseUserRepositoriesfrom'@/composables/useUserRepositories'importuseRepositoryNameSearchfrom'@/composables/useRepositoryNameSearch'import{toRefs}from'vue'exportdefault{components:{RepositoriesFilters,RepositoriesSortBy,RepositoriesList},props:{user:{type:String}},setup(props){const{user}=toRefs(props)const{repositories,getUserRepositories}=useUserRepositories(user)const{searchQuery,repositoriesMatchingSearchQuery}=useRepositoryNameSearch(repositories)return{//因为我们并不关心未经过滤的仓库//我们可以在`repositories`名称下暴露过滤后的结果repositories:repositoriesMatchingSearchQuery,getUserRepositories,searchQuery,}},data(){return{filters:{...},//3}},computed:{filteredRepositories(){...},//3},methods:{updateFilters(){...},//3}} 此时,你可能已经知道了这个练习,所以让我们跳到最后,迁移剩余的过滤功能。我们不需要深入了解实现细节,因为这不是本指南的重点。 //src/components/UserRepositories.vueimport{toRefs}from'vue'importuseUserRepositoriesfrom'@/composables/useUserRepositories'importuseRepositoryNameSearchfrom'@/composables/useRepositoryNameSearch'importuseRepositoryFiltersfrom'@/composables/useRepositoryFilters'exportdefault{components:{RepositoriesFilters,RepositoriesSortBy,RepositoriesList},props:{user:{type:String}},setup(props){const{user}=toRefs(props)const{repositories,getUserRepositories}=useUserRepositories(user)const{searchQuery,repositoriesMatchingSearchQuery}=useRepositoryNameSearch(repositories)const{filters,updateFilters,filteredRepositories}=useRepositoryFilters(repositoriesMatchingSearchQuery)return{//因为我们并不关心未经过滤的仓库//我们可以在`repositories`名称下暴露过滤后的结果repositories:filteredRepositories,getUserRepositories,searchQuery,filters,updateFilters}}} 我们完成了! 请记住,我们只触及了组合式 API 的表面以及它允许我们做什么。要了解更多信息,请参阅深入指南。 本文分享自微信公众号 - 人生代码(lijinwen1996329ken)。如有侵权,请联系 support@oschina.cn 删除。本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

优秀的个人博客,低调大师

每日一博 | 三步轻松理解 Kerberos 协议

Kerberos是一种身份验证协议,它作为一种可信任的第三方认证服务,通过使用对称加密技术为客户端/服务器应用程序提供强身份验证。在域环境下,AD域使用Kerberos协议进行验证,熟悉和掌握Kerberos协议是学习域渗透的基础。 Kerberos协议中主要的三个角色: 1.访问服务的Client2.提供服务的Server3.KDC:密钥分发中心,默认安装在域控上 AS:身份验证服务 TGS:票证授予服务 Kerberos协议认证过程: 协议可以分为三个步骤:一是获得票据许可票据,二是获取服务许可票据,三是获得服务。 第一步:获得票据许可票据 KRB_AS_REQ:用于向KDC请求TGT 当用户在客户端输入域用户和密码时,客户端将用户密码转换为hash作为加密密钥,对时间戳进行加密作为请求凭据。 cipher:加密的时间戳,即客户端的当前时间与用户的hash加密后的结果 KRB_AS_REQ 数据包如下: KRB_AS_REP:用于通过KDC传递TGT 收到请求后,KDC从AD域数据库中找到对用用户的hash解密时间戳来验证用户身份。如果时间戳在允许的时间范围内,那么它就会生成一个会话密钥(Session key),以AS_REP 数据包进行响应。 AS_REP 包含信息: ticket:使用krbtgt hash加密,包含用户名/会话密钥和到期时间等信息.enc-part:使用用户hash加密,包含会话密钥/TGT到期时间和随机数(防重放) KRB_AS_REP数据包如下: 第二步:获得服务许可票据 KRB_TGS_REQ:使用TGT向KDC请求TGS 客户端获得TGT和用户密钥加密的enc-part,使用用户hash解密enc-part获得会话密钥(Session key),然后使用会话密钥将用户名/时间戳进行加密,生成authenticator和TGT发送给TGS。 ticket:实质上就是一张TGT,客户端没有 krbtgt hash,故无法解密TGT. KRB_TGS_REQ 数据包如下: KRB_TGS_REP:通过KDC传递TGS TGS 收到KRB_TGS_REQ请求后,使用 krbtgt hash解密ticket 获取会话密钥(Session key),然后使用会话密钥解密 authenticator 获取用户名和时间戳进行身份验证。确认信息后,创建一个服务会话密钥(Service Session key)。 ticket:使用对应的服务密钥进行加密,包含服务会话密钥/用户名/到期时间等信息,本质上就是一张ST(Service Ticket)。enc-part:包含使用会话密钥加密的服务会话密钥(Service Session key) KRB_TGS_REP数据包如下: 第三步:获得服务 KRB_AP_REQ:使用TGS,服务对用户身份验证 客户端已经拥有了有效的TGS可以与服务进行交互,使用会话密钥解密 enc-part,得到 服务会话密钥(Service Session key),将用户名/时间戳等信息使用服务会话密钥(Service Session key)进行加密,得到新的Authentication。 KRB_AP_REP:由服务用来针对用户标识自身 服务端接收到请求,使用自己的hash解密TGS获得服务会话密钥(Service Session key)和授权用户信息,然后使用服务会话密钥解密Authentication,比对用户名和时间戳等信息,如果有相互验证标记,服务端使用服务会话密钥加密时间戳发给客户端,客户端解密时间戳验证服务端,然后开始请求服务。 本文分享自微信公众号 - Bypass(Bypass--)。 如有侵权,请联系 support@oschina.cn 删除。 本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

优秀的个人博客,低调大师

每日一博 | Netty 系列之:使用 POJO 替代 buf

简介 在之前的文章中我们提到了,对于NioSocketChannel来说,它不接收最基本的string消息,只接收ByteBuf和FileRegion。但是ByteBuf是以二进制的形式进行处理的,对于程序员来说太不直观了,处理起来也比较麻烦,有没有可能直接处理java简单对象呢?本文将会探讨一下这个问题。 decode和encode 比如我们需要直接向channel中写入一个字符串,在之前的文章中,我们知道这是不可以的,会报下面的错误: DefaultChannelPromise@57f5c075(failure: java.lang.UnsupportedOperationException: unsupported message type: String (expected: ByteBuf, FileRegion)) 也就说ChannelPromise只接受ByteBuf和FileRegion,那么怎么做呢? 既然ChannelPromise只接受ByteBuf和FileRegion,那么我们就需要把String对象转换成ByteBuf即可。 也就是说在写入String之前把String转换成ByteBuf,当要读取数据的时候,再把ByteBuf转换成String。 我们知道ChannelPipeline中可以添加多个handler,并且控制这些handler的顺序。 那么我们的思路就出来了,在ChannelPipeline中添加一个encode,用于数据写入的是对数据进行编码成ByteBuf,然后再添加一个decode,用于在数据写出的时候对数据进行解码成对应的对象。 encode,decode是不是很熟悉?对了,这就是对象的序列化。 对象序列化 netty中对象序列化是要把传输的对象和ByteBuf直接互相转换,当然我们可以自己实现这个转换对象。但是netty已经为我们提供了方便的两个转换类:ObjectEncoder和ObjectDecoder。 先看ObjectEncoder,他的作用就是将对象转换成为ByteBuf。 这个类很简单,我们对其分析一下: public class ObjectEncoder extends MessageToByteEncoder<Serializable> { private static final byte[] LENGTH_PLACEHOLDER = new byte[4]; @Override protected void encode(ChannelHandlerContext ctx, Serializable msg, ByteBuf out) throws Exception { int startIdx = out.writerIndex(); ByteBufOutputStream bout = new ByteBufOutputStream(out); ObjectOutputStream oout = null; try { bout.write(LENGTH_PLACEHOLDER); oout = new CompactObjectOutputStream(bout); oout.writeObject(msg); oout.flush(); } finally { if (oout != null) { oout.close(); } else { bout.close(); } } int endIdx = out.writerIndex(); out.setInt(startIdx, endIdx - startIdx - 4); } } ObjectEncoder继承了MessageToByteEncoder,而MessageToByteEncoder又继承了ChannelOutboundHandlerAdapter。为什么是OutBound呢?这是因为我们是要对写入的对象进行转换,所以是outbound。 首先使用ByteBufOutputStream对out ByteBuf进行封装,在bout中,首先写入了一个LENGTH_PLACEHOLDER字段,用来表示stream中中Byte的长度。然后用一个CompactObjectOutputStream对bout进行封装,最后就可以用CompactObjectOutputStream写入对象了。 对应的,netty还有一个ObjectDecoder对象,用于将ByteBuf转换成对应的对象,ObjectDecoder继承自LengthFieldBasedFrameDecoder,实际上他是一个ByteToMessageDecoder,也是一个ChannelInboundHandlerAdapter,用来对数据读取进行处理。 我们看下ObjectDecoder中最重要的decode方法: protected Object decode(ChannelHandlerContext ctx, ByteBuf in) throws Exception { ByteBuf frame = (ByteBuf) super.decode(ctx, in); if (frame == null) { return null; } ObjectInputStream ois = new CompactObjectInputStream(new ByteBufInputStream(frame, true), classResolver); try { return ois.readObject(); } finally { ois.close(); } } 上面的代码可以看到,将输入的ByteBuf转换为ByteBufInputStream,最后转换成为CompactObjectInputStream,就可以直接读取对象了。 使用编码和解码器 有了上面两个编码解码器,直接需要将其添加到client和server端的ChannelPipeline中就可以了。 对于server端,其核心代码如下: //定义bossGroup和workerGroup EventLoopGroup bossGroup = new NioEventLoopGroup(1); EventLoopGroup workerGroup = new NioEventLoopGroup(); try { ServerBootstrap b = new ServerBootstrap(); b.group(bossGroup, workerGroup) .channel(NioServerSocketChannel.class) .handler(new LoggingHandler(LogLevel.INFO)) .childHandler(new ChannelInitializer<SocketChannel>() { @Override public void initChannel(SocketChannel ch) throws Exception { ChannelPipeline p = ch.pipeline(); p.addLast( // 添加encoder和decoder new ObjectEncoder(), new ObjectDecoder(ClassResolvers.cacheDisabled(null)), new PojoServerHandler()); } }); // 绑定端口,并准备接受连接 b.bind(PORT).sync().channel().closeFuture().sync(); 同样的,对于client端,我们其核心代码如下: EventLoopGroup group = new NioEventLoopGroup(); try { Bootstrap b = new Bootstrap(); b.group(group) .channel(NioSocketChannel.class) .handler(new ChannelInitializer<SocketChannel>() { @Override public void initChannel(SocketChannel ch) throws Exception { ChannelPipeline p = ch.pipeline(); p.addLast( // 添加encoder和decoder new ObjectEncoder(), new ObjectDecoder(ClassResolvers.cacheDisabled(null)), new PojoClientHandler()); } }); // 建立连接 b.connect(HOST, PORT).sync().channel().closeFuture().sync(); 可以看到上面的逻辑就是将ObjectEncoder和ObjectDecoder添加到ChannelPipeline中即可。 最后,就可以在客户端和浏览器端通过调用: ctx.write("加油!"); 直接写入字符串对象了。 总结 有了ObjectEncoder和ObjectDecoder,我们就可以不用受限于ByteBuf了,程序的灵活程度得到了大幅提升。 本文的例子可以参考:learn-netty4 本文已收录于http://www.flydean.com/08-netty-pojo-buf/ 最通俗的解读,最深刻的干货,最简洁的教程,众多你不知道的小技巧等你来发现! 欢迎关注我的公众号:「程序那些事」,懂技术,更懂你!

优秀的个人博客,低调大师

每日一博 | 七种常用的特征工程

像一个优秀的工程师一样使用机器学习,而不要像一个机器学习专家一样使用机器学习方法。---google 当在做数据挖掘和数据分析时,数据是所有问题的基础,并且会影响整个工程的流程。相比一些复杂的算法,如何灵活的处理好数据经常会取到意想不到的效益。而处理数据不可或缺的需要使用到特征工程。 1.什么是特征工程 简单的说,特征工程是能够将数据像艺术一样展现的技术。为什么这么说呢?因为好的特征工程很好的混合了专业领域知识、直觉和基本的数学能力。但是最有效的数据呈现其实并不涉及任何的数据运算。 本质上来说,呈现给算法的数据应该能拥有基本数据的相关结构或属性。当你做特征工程时,其实是将数据属性转换为数据特征的过程,属性代表了数据的所有维度,在数据建模时,如果对原始数据的所有属性进行学习,并不能很好的找到数据的潜在趋势,而通过特征工程对你的数据进行预处理的话,你的算法模型能够减少受到噪声的干扰,这样能够更好的找出趋势。事实上,好的特征甚至能够帮你实现使用简单的模型达到很好的效果。 但是对于特征工程中引用的新特征,需要验证它确实提高的预测的准确度,而不是加入了一个无用的特征,不然只会增加算法运算的复杂度。 本文只提供一些简单的特征工程技巧,希望能够在你以后的分析中提供帮忙。 2.常用特征工程 2.1 时间戳处理 时间戳属性通常需要分离成多个维度比如年、月、日、小时、分钟、秒钟。但是在很多的应用中,大量的信息是不需要的。比如在一个监督系统中,尝试利用一个’位置+时间‘的函数预测一个城市的交通故障程度,这个实例中,大部分会受到误导只通过不同的秒数去学习趋势,其实是不合理的。并且维度'年'也不能很好的给模型增加值的变化,我们可能仅仅需要小时、日、月等维度。因此当我们在呈现时间的时候,试着保证你所提供的所有数据是你的模型所需要的。 并且别忘了时区,假如你的数据源来自不同的地理数据源,别忘了利用时区将数据标准化。 2.2 分解类别属性 一些属性是类别型而不是数值型,举一个简单的例子,由{红,绿、蓝}组成的颜色属性,最常用的方式是把每个类别属性转换成二元属性,即从{0,1}取一个值。因此基本上增加的属性等于相应数目的类别,并且对于你数据集中的每个实例,只有一个是1(其他的为0),这也就是独热(one-hot)编码方式(类似于转换成哑变量)。 如果你不了解这个编码的话,你可能会觉得分解会增加没必要的麻烦(因为编码大量的增加了数据集的维度)。相反,你可能会尝试将类别属性转换成一个标量值,例如颜色属性可能会用{1,2,3}表示{红,绿,蓝}。这里存在两个问题,首先,对于一个数学模型,这意味着某种意义上红色和绿色比和蓝色更“相似”(因为|1-3| > |1-2|)。除非你的类别拥有排序的属性(比如铁路线上的站),这样可能会误导你的模型。然后,可能会导致统计指标(比如均值)无意义,更糟糕的情况是,会误导你的模型。还是颜色的例子,假如你的数据集包含相同数量的红色和蓝色的实例,但是没有绿色的,那么颜色的均值可能还是得到2,也就是绿色的意思。 能够将类别属性转换成一个标量,最有效的场景应该就是只有两个类别的情况。即{0,1}对应{类别1,类别2}。这种情况下,并不需要排序,并且你可以将属性的值理解成属于类别1或类别2的概率。 2.3 分箱/分区 有时候,将数值型属性转换成类别呈现更有意义,同时能使算法减少噪声的干扰,通过将一定范围内的数值划分成确定的块。举个例子,我们预测一个人是否拥有某款衣服,这里年龄是一个确切的因子。其实年龄组是更为相关的因子,所有我们可以将年龄分布划分成1-10,11-18,19-25,26-40等。而且,不是将这些类别分解成2个点,你可以使用标量值,因为相近的年龄组表现出相似的属性。 只有在了解属性的领域知识的基础,确定属性能够划分成简洁的范围时分区才有意义。即所有的数值落入一个分区时能够呈现出共同的特征。在实际应用中,当你不想让你的模型总是尝试区分值之间是否太近时,分区能够避免出现过拟合。例如,如果你所感兴趣的是将一个城市作为整体,这时你可以将所有落入该城市的维度值进行整合成一个整体。分箱也能减小小错误的影响,通过将一个给定值划入到最近的块中。如果划分范围的数量和所有可能值相近,或对你来说准确率很重要的话,此时分箱就不适合了。 2.4 交叉特征 交叉特征算是特征工程中非常重要的方法之一了,交叉特征是一种很独特的方式,它将两个或更多的类别属性组合成一个。当组合的特征要比单个特征更好时,这是一项非常有用的技术。数学上来说,是对类别特征的所有可能值进行交叉相乘。 假如拥有一个特征A,A有两个可能值{A1,A2}。拥有一个特征B,存在{B1,B2}等可能值。然后,A&B之间的交叉特征如下:{(A1,B1),(A1,B2),(A2,B1),(A2,B2)},并且你可以给这些组合特征取任何名字。但是需要明白每个组合特征其实代表着A和B各自信息协同作用。 举个栗子,如下图中: 所有的蓝色点属于一类,红色属于另外一类。我们不考虑实际模型,首先,将X,Y值分成{x < 0, x >= 0} & {y < 0, y >= 0}对我们来说会很有用,将划分结果取名为 和 。很显然I&III象限对应于红色类别,II&IV象限是蓝色类。因此如果现在将特征X和特征Y组成成交叉特征,你会有四个象限特征,{I,II,III,IV}分别对应于。 一个更好地诠释好的交叉特征的实例是类似于(经度,纬度)。一个相同的经度对应了地图上很多的地方,纬度也是一样。但是一旦你将经度和纬度组合到一起,它们就代表了地理上特定的一块区域,区域中每一部分是拥有着类似的特性。 有时候,能够通过简单的数学技巧将数据的属性组合成一个单一的特征。在上一个例子中,将更改的特征设定为 和 ,并且有如下关系: 将新的特征定义为 ,有: 我们可以根据确定特征,如果为 ,类别是红色,如果是为其他值,则是蓝色; 2.5 特征选择 为了得到更好的模型,使用某些算法自动的选出原始特征的子集。这个过程,你不会构建或修改你拥有的特征,但是会通过修剪特征来达到减少噪声和冗余。 那些和我们解决的问题无关需要被移除的属性,在我们的数据特征中存在了一些特征对于提高模型的准确率比其他更重要的特征,也还有一些特征与其他特征放在一起出现了冗余,特征选择是通过自动选出对于解决问题最有用的特征子集来解决上述问题的。 特征选择算法可能会用到评分方法来排名和选择特征,比如相关性或其他确定特征重要性的方法,更进一步的方法可能需要通过试错,来搜索出特征子集。 还有通过构建辅助模型的方法,逐步回归就是模型构造过程中自动执行特征选择算法的一个实例,还有像Lasso回归和岭回归等正则化方法也被归入到特征选择,通过加入额外的约束或者惩罚项加到已有模型(损失函数)上,以防止过拟合并提高泛化能力。 2.6 特征缩放 有时候,你可能会注意到某些特征比其他特征拥有高得多的跨度值。举个例子,将一个人的收入和他的年龄进行比较,更具体的例子,如某些模型(像岭回归)要求你必须将特征值缩放到相同的范围值内。通过缩放可以避免某些特征比其他特征获得大小非常悬殊的权重值。 2.7 特征提取 特征提取涉及到从原始属性中自动生成一些新的特征集的一系列算法,降维算法就属于这一类。特征提取是一个自动将观测值降维到一个足够建模的小数据集的过程。对于列表数据,可使用的方法包括一些投影方法,像主成分分析和无监督聚类算法。对于图形数据,可能包括一些直线检测和边缘检测,对于不同领域有各自的方法。 特征提取的关键点在于这些方法是自动的(虽然可能需要从简单方法中设计和构建得到),还能够解决不受控制的高维数据的问题。大部分的情况下,是将这些不同类型数据(如图,语言,视频等)存成数字格式来进行模拟观察。 简单的说,特征工程是能够将数据像艺术一样展现的技术。为什么这么说呢?因为好的特征工程很好的混合了专业领域知识、直觉和基本的数学能力。但是最有效的数据呈现其实并不涉及任何的数据运算。还有什么常用的特征工程呢? 本文分享自微信公众号 - 智能算法(AI_Algorithm)。如有侵权,请联系 support@oschina.cn 删除。本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

优秀的个人博客,低调大师

每日一博 | Redis 分布式锁实现详解

前言 近来,分布式的问题被广泛提及,比如分布式事务、分布式框架、ZooKeeper、SpringCloud等等。本文先回顾锁的概念,再介绍分布式锁,以及如何用Redis来实现分布式锁。 一、锁的基本了解 首先,回顾一下我们工作学习中的锁的概念。 为什么要先讲锁再讲分布式锁呢? 我们都清楚,锁的作用是要解决多线程对共享资源的访问而产生的线程安全问题,而在平时生活中用到锁的情况其实并不多,可能有些朋友对锁的概念和一些基本的使用不是很清楚,所以我们先看锁,再深入介绍分布式锁。 Redis分布式锁面试题答案地址:Redis分布式面试题 通过一个卖票的小案例来看,比如大家去抢dota2 ti9门票,如果不加锁的话会出现什么问题?此时代码如下: **代码分析:**这里有8张ti9门票,设置了10个线程(也就是模拟10个人)去并发抢票,如果抢成功了显示成功,抢失败的话显示失败。按理说应该有8个人抢成功了,2个人抢失败,下面来看运行结果: 我们发现运行结果和预期的情况不一致,居然10个人都买到了票,也就是说出现了线程安全的问题,那么是什么原因导致的呢? 原因就是多个线程之间产生了时间差。 如图所示,只剩一张票了,但是两个线程都读到的票余量是1,也就是说线程B还没有等到线程A改库存就已经抢票成功了。 怎么解决呢?想必大家都知道,加个synchronized关键字就可以了,在一个线程进行reduce方法的时候,其他线程则阻塞在等待队列中,这样就不会发生多个线程对共享变量的竞争问题。 举个例子 比如我们去健身房健身,如果好多人同时用一台机器,同时在一台跑步机上跑步,就会发生很大的问题,大家会打得不可开交。如果我们加一把锁在健身房门口,只有拿到锁的钥匙的人才可以进去锻炼,其他人在门外等候,这样就可以避免大家对健身器材的竞争。代码如下: 运行结果: 果不其然,结果有两个人没有成功抢到票,看来我们的目地达成了。 二、锁的性能优化 2.1 缩短锁的持有时间 事实上,按照我们对日常生活的理解,不可能整个健身房只有一个人在运动。所以我们只需要对某一台机器加锁就可以了,比如一个人在跑步,另一个人可以去做其他的运动。 对于票务系统来说,我们只需要对库存的修改操作的代码加锁就可以了,别的代码还是可以并行进行,这样会大大减少锁的持有时间,代码修改如下: 这样做的目的是充分利用cpu的资源,提高代码的执行效率。 这里我们对两种方式的时间做个打印: 果然,只对部分代码加锁会大大提供代码的执行效率。 所以,在解决了线程安全的问题后,我们还要考虑到加锁之后的代码执行效率问题。 2.2 减少锁的粒度 举个例子,有两场电影,分别是最近刚上映的魔童哪吒和蜘蛛侠,我们模拟一个支付购买的过程,让方法等待,加了一个CountDownLatch的await方法,运行结果如下: 执行结果: 魔童哪吒的剩余票数为:20 我们发现买哪吒票的时候阻塞会影响蜘蛛侠票的购买,而实际上,这两场电影之间是相互独立的,所以我们需要减少锁的粒度,将movie整个对象的锁变为两个全局变量的锁,修改代码如下: 执行结果: 魔童哪吒的剩余票数为:20 蜘蛛侠的剩余票数为:100 现在两场电影的购票不会互相影响了,这就是第二个优化锁的方式:减少锁的粒度。顺便提一句,Java并发包里的ConcurrentHashMap就是把一把大锁变成了16把小锁,通过分段锁的方式达到高效的并发安全。 2.3 锁分离 锁分离就是常说的读写分离,我们把锁分成读锁和写锁,读的锁不需要阻塞,而写的锁要考虑并发问题。 三、锁的种类 公平锁: ReentrantLock 非公平锁: Synchronized、ReentrantLock、cas 悲观锁: Synchronized 乐观锁:cas 独享锁:Synchronized、ReentrantLock 共享锁:Semaphore 这里就不一一讲述每一种锁的概念了,大家可以自己学习,锁还可以按照偏向锁、轻量级锁、重量级锁来分类。 四、Redis分布式锁 了解了锁的基本概念和锁的优化后,重点介绍分布式锁的概念。 上图所示是我们搭建的分布式环境,有三个购票项目,对应一个库存,每一个系统会有多个线程,和上文一样,对库存的修改操作加上锁,能不能保证这6个线程的线程安全呢? 当然是不能的,因为每一个购票系统都有各自的JVM进程,互相独立,所以加synchronized只能保证一个系统的线程安全,并不能保证分布式的线程安全。 所以需要对于三个系统都是公共的一个中间件来解决这个问题。 这里我们选择Redis来作为分布式锁,多个系统在Redis中set同一个key,只有key不存在的时候,才能设置成功,并且该key会对应其中一个系统的唯一标识,当该系统访问资源结束后,将key删除,则达到了释放锁的目的。 4.1 分布式锁需要注意哪些点 1)互斥性 在任意时刻只有一个客户端可以获取锁。 这个很容易理解,所有的系统中只能有一个系统持有锁。 2)防死锁 假如一个客户端在持有锁的时候崩溃了,没有释放锁,那么别的客户端无法获得锁,则会造成死锁,所以要保证客户端一定会释放锁。 Redis中我们可以设置锁的过期时间来保证不会发生死锁。 3)持锁人解锁 解铃还须系铃人,加锁和解锁必须是同一个客户端,客户端A的线程加的锁必须是客户端A的线程来解锁,客户端不能解开别的客户端的锁。 4)可重入 当一个客户端获取对象锁之后,这个客户端可以再次获取这个对象上的锁。 4.2 Redis分布式锁流程 Redis分布式锁的具体流程: 1)首先利用Redis缓存的性质在Redis中设置一个key-value形式的键值对,key就是锁的名称,然后客户端的多个线程去竞争锁,竞争成功的话将value设为客户端的唯一标识。Java学习圈子:14 201 9 080 2)竞争到锁的客户端要做两件事: 设置锁的有效时间 目的是防死锁 (非常关键) 需要根据业务需要,不断的压力测试来决定有效期的长短。 分配客户端的唯一标识,目的是保证持锁人解锁(非常重要) 所以这里的value就设置成唯一标识(比如uuid)。 3)访问共享资源 4)释放锁,释放锁有两种方式,第一种是有效期结束后自动释放锁,第二种是先根据唯一标识判断自己是否有释放锁的权限,如果标识正确则释放锁。 4.3 加锁和解锁 4.3.1 加锁 1)setnx命令加锁 set if not exists 我们会用到Redis的命令setnx,setnx的含义就是只有锁不存在的情况下才会设置成功。 2)设置锁的有效时间,防止死锁 expire 加锁需要两步操作,思考一下会有什么问题吗? 假如我们加锁完之后客户端突然挂了呢?那么这个锁就会成为一个没有有效期的锁,接着就可能发生死锁。虽然这种情况发生的概率很小,但是一旦出现问题会很严重,所以我们也要把这两步合为一步。 幸运的是,Redis3.0已经把这两个指令合在一起成为一个新的指令。 来看jedis的官方文档中的源码: 这就是我们想要的! 4.3.2 解锁 检查是否自己持有锁(判断唯一标识); 删除锁。 解锁也是两步,同样也要保证解锁的原子性,把两步合为一步。 这就无法借助于Redis了,只能依靠Lua脚本来实现。 这就是一段判断是否自己持有锁并释放锁的Lua脚本。 为什么Lua脚本是原子性呢?因为Lua脚本是jedis用eval()函数执行的,如果执行则会全部执行完成。 五、Redis分布式锁代码实现 用一个上下文全局变量来记录持有锁的人的uuid,解锁的时候需要将该uuid作为参数传入Lua脚本中,来判断是否可以解锁。 要记录当前线程,来实现分布式锁的重入性,如果是当前线程持有锁的话,也属于加锁成功。 用eval函数来执行Lua脚本,保证解锁时的原子性。 六、分布式锁的对比 6.1 基于数据库的分布式锁 1)实现方式 获取锁的时候插入一条数据,解锁时删除数据。 2)缺点 数据库如果挂掉会导致业务系统不可用。 无法设置过期时间,会造成死锁。 6.2 基于zookeeper的分布式锁 1)实现方式 加锁时在指定节点的目录下创建一个新节点,释放锁的时候删除这个临时节点。因为有心跳检测的存在,所以不会发生死锁,更加安全。 2)缺点 性能一般,没有Redis高效。 所以: 从性能角度: Redis > zookeeper > 数据库 从可靠性(安全)性角度: zookeeper > Redis > 数据库 七、总结 本文从锁的基本概念出发,提出多线程访问共享资源会出现的线程安全问题,然后通过加锁的方式去解决线程安全的问题,这个方法会性能会下降,需要通过:缩短锁的持有时间、减小锁的粒度、锁分离三种方式去优化锁。 更多Java面试资料共享地址:面试题资料合集 之后介绍了分布式锁的4个特点: 互斥性 防死锁 加锁人解锁 可重入性 然后用Redis实现了分布式锁,加锁的时候用到了Redis的命令去加锁,解锁的时候则借助了Lua脚本来保证原子性。 最后对比了三种分布式锁的优缺点和使用场景。

优秀的个人博客,低调大师

每日一博 | 怎么提高自己的系统架构水平?

系统设计与架构理论这个问题,回答起来非常宽泛,基本所有的技术理论都可以涵盖。作为一个撸代码快 10 年的后端技术人员,简单发表一下我的看法。 系统设计与架构,与系统的业务类型关联还是很大的,比如传统的业务系统主要关注的是领域建模设计,高并发、高可用、数据一致性等系统,在设计的时候会与业务系统有较大的差别,所以这里针对不同类型的系统,来简单介绍一下设计的时候面临的一些难点与解决方案。 背景常规业务系统设计关键——领域模型 业务系统设计的关键是在于如何定义系统的模型以及模型之间的关系,其中主要是领域模型的定义,当我们在模型确定之后,模型之间的关系也会随之明确。 模型设计可以参考领域模型的经典书籍《Domain-Driven Design》一书,通过这个基本可以对领域定义、防腐层、贫血模型等概念有一个较为清晰的认识了。 单个应用内的领域模型系统也需要注意领域分层,作为开发大家是不是见过、重构过很多Controller-Service-DAO 样式的代码分层设计?往往在在做重构的时候会令人吐血。 设计较好的领域设计这里给一个分层建议: ▐接口层 Interface 主要负责与外部系统进行交互&通信,比如一些 dubbo服务、Restful API、RMI等,这一层主要包括 Facade、DTO还有一些Assembler。 ▐应用层 Application 这一层包含的主要组件就是 Service 服务,但是要特别注意,这一层的Service不是简单的DAO层的包装,在领域驱动设计的架构里面,Service层只是一层很“薄”的一层,它内部并不实现任何逻辑,只是负责协调和转发、委派业务动作给更下层的领域层。 ▐领域层 Domain Domain 层是领域模型系统的核心,负责维护面向对象的领域模型,几乎全部的业务逻辑都会在这一层实现。内部主要包含Entity(实体)、ValueObject(值对象)、Domain Event(领域事件)和 Repository(仓储)等多种重要的领域组件。 ▐基础设施层 Infrastructure 它主要为 Interfaces、Application 和 Domain 三层提供支撑。所有与具体平台、框架相关的实现会在 Infrastructure 中提供,避免三层特别是 Domain 层掺杂进这些实现,从而“污染”领域模型。Infrastructure 中最常见的一类设施是对象持久化的具体实现。 高并发系统设计 在面试中是不是经常被问到一个问题:如果你系统的流量增加 N 倍你要怎么重新设计你的系统?这个高并发的问题可以从各个层面去解,比如 ▐代码层面 锁优化(采用无锁数据结构),主要是 concurrent 包下面的关于 AQS 锁的一些内容 数据库缓存设计(降低数据库并发争抢压力),这里又会有缓存、DB 数据不一致的问题,在实际使用中,高并发系统和数据一致性系统采用的策略会截然相反。 数据更新时采用合并更新,可以在应用层去做更新合并,同一个 Container 在同一时间只会有一个 DB 更新请求。 其他的比如基于 BloomFilter 的空间换时间、通过异步化降低处理时间、通过多线程并发执行等等。 ▐数据库层面 根据不同的存储诉求来进行不同的存储选型,从早期的 RDBMS,再到 NoSql(KV存储、文档数据库、全文索引引擎等等),再到最新的NewSql(TiDB、Google spanner/F1 DB)等等。 表数据结构的设计,字段类型选择与区别。 索引设计,需要关注聚簇索引原理与覆盖索引消除排序等,至于最左匹配原则都是烂大街的常识了,高级一点索引消除排序的一些机制等等,B+树与B树的区别。 最后的常规手段:分库分表、读写分离、数据分片、热点数据拆分等等,高并发往往会做数据分桶,这里面往深了去说又有很多,比如分桶如何初始化、路由规则、最后阶段怎么把数据合并等等,比较经典的方式就是把桶分成一个主桶+N个分桶。 ▐架构设计层面 分布式系统为服务化 无状态化支持水平弹性扩缩容 业务逻辑层面 failfast 快速失败 调用链路热点数据前置 多级缓存设计 提前容量规划等等 高可用系统设计 对于可用性要求非常高的系统,一般我们都说几个9的可用率,比如 99.999% 等。 面对高可用系统设计也可以从各个方面来进行分析 代码层面:需要关注分布式事务问题,CAP理论是面试的常规套路 软件层面:应用支持无状态化,部署的多个模块完全对等,请求在任意模块处理结果完全一致 => 模块不存储上下文信息,只根据请求携带的参数进行处理。目的是为了快速伸缩,服务冗余。常见的比如session问题等。 ▐负载均衡问题 软件部署多份之后,如何保证系统负载?如何选择调用机器?也就是负载均衡问题 狭义上的负载均衡按照类型可以分为这几种: 硬件负载:比如F5等 软件负载:比如 LVS、Ngnix、HaProxy、DNS等。 当然,还有代码算法上的负载均衡,比如Random、RoundRobin、ConsistentHash、加权轮训等等算法 广义上的负载均衡可以理解为负载均衡的能力,比如一个负载均衡系统需要如下4个能力: 故障机器自动发现 故障服务自动摘除(服务熔断) 请求自动重试 服务恢复自动发现 ▐幂等设计问题 上面提负载均衡的时候,广义负载均衡需要完成自动重试机制,那么在业务上,我们就必须保证幂等设计。 这里可以从2个层面来进行考虑: 请求层面由于请求会重试所以必须做幂等,需要保证请求重复执行和执行一次的结果完全相同。请求层面的幂等设计需要在数据修改的层做幂等,也就是数据访问层读请求天然幂等,写请求需要做幂等。读请求一般是天然幂等的,无论查询多少次返回的结果都是一致。这其中的本质实际上是分布式事务问题,这里下面再详细介绍。 业务层面不幂等会造成诸如奖励多发、重复下单等非常严重的问题。业务层面的幂等本质上是分布式锁的问题,后面会介绍。如何保证不重复下单?这里比如token机制等等。如何保证商品不超卖?比如乐观锁等。MQ消费方如何保证幂等等都是面试的常见题。 ▐分布缩式 业务层面的幂等设计本质上是分布式锁问题,什么是分布式锁?分布式环境下锁的全局唯一资源,使请求串行化,实际表现互斥锁,解决业务层幂等问题。 常见的解决方式是基于 Redis 缓存的 setnx 方法,但作为技术人员应该清楚这其中还存在单点问题、基于超时时间无法续租问题、异步主从同步问题等等,更深一点,CAP理论,一个AP系统本质上无法实现一个AP需求,即使是 RedLock 也不行。 那我们如何去设计一个分布式锁呢?强一致性、服务本身要高可用是最基本的需求,其他的比如支持自动续期,自动释放机制,高度抽象接入简单,可视化、可管理等。 基于存储层的可靠的解决方案比如: zookeeperCP/ZAB/N+1可用:基于临时节点实现和Watch机制。 ETCDCP or AP/Raft/N+1可用:基于 restful API;KV存储,强一致性,高可用,数据可靠:持久化;Client TTL 模式,需要心跳CAS 唯一凭证 uuid。 ▐服务的熔断 微服务化之后,系统分布式部署,系统之间通过 RPC 通讯,整个系统发生故障的概率随着系统规模的增长而增长,一个小的故障经过链路传导放大,有可能造成更大的故障。希望在调用服务的时,在一些非关键路径服务发生服务质量下降的情况下,选择尽可能地屏蔽所造成的影响。 大部分熔断返回默认值 null,也可以定制,RPCClient 原生支持最好,业务方少改代码(熔断放的地方),进入熔断时,打印熔断日志,同时返回 Exception(业务方定制熔断方法),需要有服务治理平台,可以看到服务的状态、是否降级、是否熔断、可以实时下发阀值配置等。 ▐服务降级 服务整体负载超出预设的上限,或者即将到来的流量预计将会超过阀值,为了保证重要或者基本的服务能够正常运行,拒绝部分请求或者将一些不重要的不紧急的服务或任务进行服务的延迟使用或暂停使用。 主要的手段如下: 服务层降级,主要手段 拒绝部分请求(限流),比如缓存请求队列,拒绝部分等待时间长的请求;根据Head,来拒绝非核心请求;还有其他通用算法上的限流比如令牌桶、漏桶算法等等。 关闭部分服务:比如双11大促0点会关闭逆向退款服务等等。 分级降级:比如自治式服务降级,从网关到业务到DB根据拦截、业务规则逐渐降低下游请求量,体现上是从上到下的处理能力逐渐下降。 数据层降级 比如流量大的时候,更新请求只缓存到MQ,读请求读缓存,等流量小的时候,进行补齐操作(一般数据访问层如果做了降级,就没必要在数据层再做了) 柔性可用策略 比如一些指定最大流量的限流工具,又或是根据CPU负载的限流工具等,需要保证自动打开,不依赖于人工。 ▐发布方式引发的可用性问题 发布方式也是影响高可用的一个点,哈哈,以前还经历过一些线上直接停机发布的案例(银行内部系统),不过作为高大上的互联网,主要会采用这几种发布方式:灰度发布、蓝绿发布、金丝雀发布等等。 数据一致性系统设计 一般一些金融、账务系统对这一块要求会非常严格,下面主要介绍下这里面涉及到的事务一致性、一致性算法等内容。 ▐事务一致性问题 在 DB 层面,一般通过 刚性事务 来实现数据一致性,主要通过 预写日志(WAL) 的方式来实现,WAL(write ahead logging)预写日志的方式。就是所有对数据文件的修改,必须要先写日志,这样,即使在写数据的时候崩溃了,也能通过日志文件恢复,传统的数据库事务就是基于这一个机制(REDO 已提交事务的数据也求改 UNDO 未提交事务的回滚)。 除了这个方式之外,还有一个就是通过 影子数据块 来进行数据备份,提前记录被修改的数据块的修改前的状态,备份起来,如果需要回滚,直接用这个备份的数据块进行覆盖就好了。 其他的就是基于二阶段提交的 XA模型 了。 但是目前互联网系统,已经广泛采用分布式部署模式了,传统的刚性事务无法实现,所以 柔性事务成了目前主流的分布式事务解决防范,主要的模式有下面几种: TCC 模式/或者叫2阶段模式在 try 阶段预扣除资源(但是不锁定资源,提升可用性),在Confirm 或者 Cancel 阶段进行数据提交或者回滚。一般需要引入协调者,或者叫事务管理器。 SAGA模式业务流程中每个参与者都提交本地事务,当出现某一个参与者失败则补偿前面已经成功的参与者,支持向前或者向后补偿。 MQ的事务消息就是先发 halfMsg,在处理完之后,再发送 commit 或者 rollback Msg,然后 MQ 会定期询问 producer ,halfMsg 能不能 commit 或者 rollback,最终实现事务的最终一致性。实际上是把补偿的动作委托给了 RocketMQ。 分段事物(异步确保)基于可靠消息+本地事务消息表 + 消息队列重试机制。目前这也是一些大厂的主流方案,内部一般称为分段事物。 柔性事务基本都是基于最终一致性去实现,所以肯定会有 补偿 动作在里面,在达到最终一致性之前,对用户一般展示 软状态。 需要注意的一点是,并不是所有的系统都适合引入数据一致性框架,比如用户可以随时修改自己发起的请求的情况,例如,商家设置后台系统,商户会随时修改数据,这里如果涉及到一致性的话,引入一致性框架会导致补偿动作达到最终一致性之前,资源锁会阻塞用户后续的请求。导致体验较差。这种情况下就需要通过其他手段来保障数据一致性了,比如数据对账等操作。 ▐一致性算法 从早期的 Paxos 算法,再到后面衍生的 zab 协议(参考:A simple totally ordered broadcast protocol),提供了当下可靠的分布式锁的解决方案。再到后来的 Raft 算法(In Search of an Understandable Consensus Algorithm),也都是分布式系统设计里面需要了解到的一些知识要点。 最后 这里简单介绍了不同系统设计的时候会面临的一些难点,基本里面每一个点,都是前人在解决各种疑难问题的道路上不断探索,最终才得出的这些业界解决方案,呈现在大家眼前,作为一个技术人员,学会这些技术点只是时间问题,但这种发现问题、直面问题、再到解决问题的能力和精神才是我们最值得学习的地方,也是做为一个系统设计人员或者说是架构师的必要能力。 ✿拓展阅读 作者|勇剑 编辑|橙子君 出品|阿里巴巴新零售淘系技术 本文分享自微信公众号 - 淘系技术(AlibabaMTT)。如有侵权,请联系 support@oschina.cn 删除。本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

优秀的个人博客,低调大师

每日一博 | 敏感数据加密方案及实现

👆 这是第 73 篇 不掺水的原创 ,想要了解更多 ,请戳上方蓝色字体: 政采云前端团队 关注我们吧~ 本文首发于政采云前端团队博客:敏感数据加密方案及实现 https://www.zoo.team/article/data-encryption 前言 现在是大数据时代,需要收集大量的个人信息用于统计。一方面它给我们带来了便利,另一方面一些个人信息数据在无意间被泄露,被非法分子用于推销和黑色产业。 2018 年 5 月 25 日,欧盟已经强制执行《通用数据保护条例》(General Data Protection Regulation,缩写作 GDPR)。该条例是欧盟法律中对所有欧盟个人关于数据保护和隐私的规范。这意味着个人数据必须使用假名化或匿名化进行存储,并且默认使用尽可能最高的隐私设置,以避免数据泄露。 相信大家也都不想让自己在外面“裸奔”。所以,作为前端开发人员也应该尽量避免用户个人数据的明文传输,尽可能的降低信息泄露的风险。 看到这里可能有人会说现在都用 HTTPS 了,数据在传输过程中是加密的,前端就不需要加密了。其实不然,我可以在你发送 HTTPS 请求之前,通过谷歌插件来捕获 HTTPS 请求中的个人信息,下面我会为此演示。所以前端数据加密还是很有必要的。 数据泄露方式 中间人攻击 中间人攻击是常见的攻击方式。详细过程可以参见这里:https://zh.wikipedia.org/wiki/%E4%B8%AD%E9%97%B4%E4%BA%BA%E6%94%BB%E5%87%BB。大概的过程是中间人通过 DNS 欺骗等手段劫持了客户端与服务端的会话。 客户端、服务端之间的信息都会经过中间人,中间人可以获取和转发两者的信息。在 HTTP 下,前端数据加密还是避免不了数据泄露,因为中间人可以伪造密钥。为了避免中间人攻击,我们一般采用 HTTPS 的形式传输。 谷歌插件 HTTPS 虽然可以防止数据在网络传输过程中被劫持,但是在发送 HTTPS 之前,数据还是可以从谷歌插件中泄露出去。 因为谷歌插件可以捕获 Network 中的所有请求,所以如果某些插件中有恶意的代码还是可以获取到用户信息的,下面为大家演示。 所以光采用 HTTPS,一些敏感信息如果还是以明文的形式传输的话,也是不安全的。如果在 HTTPS 的基础上再进行数据的加密,那相对来说就更好了。 加密算法介绍 对称加密 对称加密算法,又称为共享密钥加密算法。在对称加密算法中,使用的密钥只有一个,发送和接收双方都使用这个密钥对数据进行加密和解密。 这就要求加密和解密方事先都必须知道加密的密钥。其优点是算法公开、计算量小、加密速度快、加密效率高;缺点是密钥泄露之后,数据就会被破解。一般不推荐单独使用。根据实现机制的不同,常见的算法主要有 AES (https://zh.wikipedia.org/wiki/%E9%AB%98%E7%BA%A7%E5%8A%A0%E5%AF%86%E6%A0%87%E5%87%86)、ChaCha20 (https://zh.wikipedia.org/wiki/Salsa20#ChaCha20)、3DES (https://zh.wikipedia.org/wiki/3DES)等。 非对称加密 非对称加密算法,又称为公开密钥加密算法。它需要两个密钥,一个称为公开密钥 (public key),即公钥;另一个称为私有密钥 (private key),即私钥。 他俩是配对生成的,就像钥匙和锁的关系。因为加密和解密使用的是两个不同的密钥,所以这种算法称为非对称加密算法。其优点是算法强度复杂、安全性高;缺点是加解密速度没有对称加密算法快。常见的算法主要有 RSA (https://zh.wikipedia.org/wiki/RSA%E5%8A%A0%E5%AF%86%E6%BC%94%E7%AE%97%E6%B3%95)、Elgamal (https://zh.wikipedia.org/wiki/ElGamal%E5%8A%A0%E5%AF%86%E7%AE%97%E6%B3%95)等。 散列算法 散列算法又称散列函数、哈希函数,是把消息或数据压缩成摘要,使得数据量变小,将数据的格式固定成特定长度的值。一般用于校验数据的完整性,平时我们下载文件就可以校验 MD5 来判断下载的数据是否完整。常见的算法主要有 MD4 (https://zh.wikipedia.org/wiki/MD4)、MD5 (https://zh.wikipedia.org/wiki/MD5)、SHA (https://zh.wikipedia.org/wiki/SHA%E5%AE%B6%E6%97%8F) 等。 实现方案 方案一:如果用对称加密,那么服务端和客户端都必须知道密钥才行。那服务端势必要把密钥发送给客户端,这个过程中是不安全的,所以单单用对称加密行不通。 方案二:如果用非对称加密,客户端的数据通过公钥加密,服务端通过私钥解密,客户端发送数据实现加密没问题。客户端接受数据,需要服务端用公钥加密,然后客户端用私钥解密。所以这个方案需要两套公钥和私钥,需要在客户端和服务端各自生成自己的密钥。 方案三:如果把对称加密和非对称加密相结合。客户端需要生成一个对称加密的密钥 1,传输内容与该密钥 1进行对称加密传给服务端,并且把密钥 1 和公钥进行非对称加密,然后也传给服务端。服务端通过私钥把对称加密的密钥 1 解密出来,然后通过该密钥 1 解密出内容。以上是客户端到服务端的过程。如果是服务端要发数据到客户端,就需要把响应数据跟对称加密的密钥 1 进行加密,然后客户端接收到密文,通过客户端的密钥 1 进行解密,从而完成加密传输。 总结:以上只是列举了常见的加密方案。总的来看,方案二比较简单,但是需要维护两套公钥和私钥,当公钥变化的时候,必须通知对方,灵活性比较差。方案三相对方案二来说,密钥 1 随时可以变化,并且不需要通知服务端,相对来说灵活性、安全性好点并且方案三对内容是对称加密,当数据量大时,对称加密的速度会比非对称加密快。所以本文采用方案三给予代码实现。 代码实现 下面是具体的代码实现(以登录接口为例),主要的目的就是要把明文的个人信息转成密文传输。其中对称加密库使用的是 AES,非对称加密库使用的是RSA。 客户端: AES 库(aes-js):https://github.com/ricmoo/aes-js RSA库(jsencrypt):https://github.com/travist/jsencrypt 具体代码实现登录接口 1、客户端需要随机生成一个 aesKey,在页面加载完的时候需要从服务端请求 publicKey letaesKey=[1,2,3,4,5,6,7,8,9,10,11,12,13,14,15,16];//随机产生letpublicKey="";//公钥会从服务端获取//页面加载完之后,就去获取公钥window.onload=()=>{axios({method:"GET",headers:{"content-type":"application/x-www-form-urlencoded"},url:"http://localhost:3000/getPub",}).then(function(result){publicKey=result.data.data;//获取公钥}).catch(function(error){console.log(error);});}; 2、aes 加密和解密方法 /***aes加密方法*@param{string}text待加密的字符串*@param{array}key加密key*/functionaesEncrypt(text,key){consttextBytes=aesjs.utils.utf8.toBytes(text);//把字符串转换成二进制数据//这边使用CTR-Counter加密模式,还有其他模式可以选择,具体可以参考aes加密库constaesCtr=newaesjs.ModeOfOperation.ctr(key,newaesjs.Counter(5));constencryptedBytes=aesCtr.encrypt(textBytes);//进行加密constencryptedHex=aesjs.utils.hex.fromBytes(encryptedBytes);//把二进制数据转成十六进制returnencryptedHex;}/***aes解密方法*@param{string}encryptedHex加密的字符串*@param{array}key加密key*/functionaesDecrypt(encryptedHex,key){constencryptedBytes=aesjs.utils.hex.toBytes(encryptedHex);//把十六进制数据转成二进制constaesCtr=newaesjs.ModeOfOperation.ctr(key,newaesjs.Counter(5));constdecryptedBytes=aesCtr.decrypt(encryptedBytes);//进行解密constdecryptedText=aesjs.utils.utf8.fromBytes(decryptedBytes);//把二进制数据转成utf-8字符串returndecryptedText;} 3、请求登录 /***登陆接口*/functionsubmitFn(){constuserName=document.querySelector("#userName").value;constpassword=document.querySelector("#password").value;constdata={userName,password,};consttext=JSON.stringify(data);constsendData=aesEncrypt(text,aesKey);//把要发送的数据转成字符串进行加密console.log("发送数据",text);constencrypt=newJSEncrypt();encrypt.setPublicKey(publicKey);constencrypted=encrypt.encrypt(aesKey.toString());//把aesKey进行非对称加密consturl="http://localhost:3000/login";constparams={id:0,data:{param1:sendData,param2:encrypted}};axios({method:"POST",headers:{"content-type":"application/x-www-form-urlencoded"},url:url,data:JSON.stringify(params),}).then(function(result){constreciveData=aesDecrypt(result.data.data,aesKey);//用aesKey进行解密console.log("接收数据",reciveData);}).catch(function(error){console.log("error",error);});} 服务端(Node): AES库(aes-js):https://github.com/ricmoo/aes-js RSA 库(node-rsa):https://github.com/rzcoder/node-rsa 具体代码实现登录接口 1、引用加密库 consthttp=require("http");constaesjs=require("aes-js");constNodeRSA=require("node-rsa");constrsaKey=newNodeRSA({b:1024});//key的size为1024位letaesKey=null;//用于保存客户端的aesKeyletprivateKey="";//用于保存服务端的公钥rsaKey.setOptions({encryptionScheme:"pkcs1"});//设置加密模式 2、实现 login 接口 http.createServer((request,response)=>{response.setHeader("Access-Control-Allow-Origin","*");response.setHeader("Access-Control-Allow-Headers","Content-Type");response.setHeader("Content-Type","application/json");switch(request.method){case"GET":if(request.url==="/getPub"){constpublicKey=rsaKey.exportKey("public");privateKey=rsaKey.exportKey("private");response.writeHead(200);response.end(JSON.stringify({result:true,data:publicKey}));//把公钥发送给客户端return;}break;case"POST":if(request.url==="/login"){letstr="";request.on("data",function(chunk){str+=chunk;});request.on("end",function(){constparams=JSON.parse(str);constreciveData=decrypt(params.data);console.log("reciveData",reciveData);//一系列处理之后response.writeHead(200);response.end(JSON.stringify({result:true,data:aesEncrypt(JSON.stringify({userId:123,address:"杭州"}),//这个数据会被加密aesKey),}));});return;}break;default:break;}response.writeHead(404);response.end();}).listen(3000); 3、加密和解密方法 functiondecrypt({param1,param2}){constdecrypted=rsaKey.decrypt(param2,"utf8");//解密得到aesKeyaesKey=decrypted.split(",").map((item)=>{return+item;});returnaesDecrypt(param1,aesKey);}/***aes解密方法*@param{string}encryptedHex加密的字符串*@param{array}key加密key*/functionaesDecrypt(encryptedHex,key){constencryptedBytes=aesjs.utils.hex.toBytes(encryptedHex);//把十六进制转成二进制数据constaesCtr=newaesjs.ModeOfOperation.ctr(key,newaesjs.Counter(5));//这边使用CTR-Counter加密模式,还有其他模式可以选择,具体可以参考aes加密库constdecryptedBytes=aesCtr.decrypt(encryptedBytes);//进行解密constdecryptedText=aesjs.utils.utf8.fromBytes(decryptedBytes);//把二进制数据转成字符串returndecryptedText;}/***aes加密方法*@param{string}text待加密的字符串*@param{array}key加密key*/functionaesEncrypt(text,key){consttextBytes=aesjs.utils.utf8.toBytes(text);//把字符串转成二进制数据constaesCtr=newaesjs.ModeOfOperation.ctr(key,newaesjs.Counter(5));constencryptedBytes=aesCtr.encrypt(textBytes);//加密constencryptedHex=aesjs.utils.hex.fromBytes(encryptedBytes);//把二进制数据转成十六进制returnencryptedHex;} 完整的示例代码:https://github.com/Pulset/FrontDataEncrypt 演示效果 总结 本文主要介绍了一些前端安全方面的知识和具体加密方案的实现。为了保护客户的隐私数据,不管是 HTTP 还是 HTTPS,都建议密文传输信息,让破解者增加一点攻击难度吧。当然数据加解密也会带来一定性能上的消耗,这个需要各位开发者各自衡量了。 参考文献 看完这篇文章,我奶奶都懂了 https 的原理 (https://www.cnblogs.com/sujing/p/10927569.html) 中间人攻击 (https://zh.wikipedia.org/wiki/%E4%B8%AD%E9%97%B4%E4%BA%BA%E6%94%BB%E5%87%BB) 看完两件事 如果你觉得这篇内容对你挺有启发,我想邀请你帮我两件小事 1.点个「在看」,让更多人也能看到这篇内容(点了「在看」,bug -1 😊) 2.关注公众号「 政采云前端团队」,持续为你推送精选好文 招贤纳士 政采云前端团队(ZooTeam),一个年轻富有激情和创造力的前端团队,隶属于政采云产品研发部,Base 在风景如画的杭州。团队现有 40 余个前端小伙伴,平均年龄 27 岁,近 3 成是全栈工程师,妥妥的青年风暴团。成员构成既有来自于阿里、网易的“老”兵,也有浙大、中科大、杭电等校的应届新人。团队在日常的业务对接之外,还在物料体系、工程平台、搭建平台、性能体验、云端应用、数据分析及可视化等方向进行技术探索和实战,推动并落地了一系列的内部技术产品,持续探索前端技术体系的新边界。 如果你想改变一直被事折腾,希望开始能折腾事;如果你想改变一直被告诫需要多些想法,却无从破局;如果你想改变你有能力去做成那个结果,却不需要你;如果你想改变你想做成的事需要一个团队去支撑,但没你带人的位置;如果你想改变既定的节奏,将会是“5 年工作时间 3 年工作经验”;如果你想改变本来悟性不错,但总是有那一层窗户纸的模糊… 如果你相信相信的力量,相信平凡人能成就非凡事,相信能遇到更好的自己。如果你希望参与到随着业务腾飞的过程,亲手推动一个有着深入的业务理解、完善的技术体系、技术创造价值、影响力外溢的前端团队的成长历程,我觉得我们该聊聊。任何时间,等着你写点什么,发给 ZooTeam@cai-inc.com 本文分享自微信公众号 - 政采云前端团队(Zoo-Team)。如有侵权,请联系 support@oschina.cn 删除。本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

优秀的个人博客,低调大师

PostgreSQL全网博文、学习系列、资料、案例等整理

2 --> PostgreSQL学习仓库:https://gitee.com/AiShiYuShiJiePingXing/postgres 一、仓库说明 本来是想直接同步德哥的pg仓库,但是奈何德哥的仓库太大了,都无法直接从GitHub迁移到gitee。但是看到德哥的许多笔记十分有用,于是花了很久时间,把德哥的笔记都过了两遍。 第一遍,发现德哥有很多私人笔记在里面,并不是有关于PostgreSQL相关的,手动做了剔除。 第二遍,发现笔记太过于混乱,不太好明确的找到相应的内容,遂自己做了一个简单的目录。 同时,也将该仓库作为自己学习和研究PostgreSQL的仓库,会不断积累和分享有关PostgreSQL的内容。 德哥PostgreSQL仓库地址:https://github.com/digoal/blog 1.1 德哥是谁? digoal(德哥) PostgreSQL 中国社区发起人之一。负责PostgreSQL数据库在中国的技术落地与推广、人才培养。 中国开源软件推进联盟PostgreSQL分会,特聘资深领域专家。 中国信息通信研究院主办、中国通信标准化协会支持的"OSCAR云计算开源产业大会"评选:2018届OSCAR开源尖峰人物之一 阿里云数据库首席专家团队成员,提供数据库首席专家服务。 阿里巴巴钻石布道师 42项数据库专利 1.1.1 贡献 专利(截至2020-01): 201210121337.9;102708158B - 一种PostgreSQL云存储归档调度系统 201410207285.6;104166666B - PostgreSQL高并发流式大数据多维度准实时统计的方法 201410548447.2;104503965B - PostgreSQL高弹性的高可用及负载均衡实现方法 201410550641.4;104503966B - PostgreSQL大数据高效免维护自动分区方法 201410652026.4;104572809B - 一种分布式关系数据库自由扩展方法 201410652028.3;104503974B - 一种基于云平台的关系数据库自动优化方法 201410751853.9;104536988B - MonetDB分布式计算存储方法 201410754052.8;104503865B - PostgreSQL快速恢复到任意时间点的方法 201410780380.5;104750573B - 分布式数据系统数据节点的全局一致性备份和还原方法 201510078225.3;104731863B - 简化PostgreSQL分区代码的方法 201510083556.6 - 一种使用keepalived软件实现数据库HA应用的方法[驳回] 201510107904.9;104809152B - 一种节约PostgreSQL共享内存的方法及系统 201510724098.X - 用于资源调度的方法和设备 201510835059.7 - 用于主备数据一致性校验的方法和设备 201510875827.1 - 一种用于实现主备同步模式下事务提交的方法与设备 201510900751.3 - 用于创建主备数据库的方法和设备 201510904243.2 - 一种提高数据安全的方法与设备 201511001289.X - 用于数据发送、限制发送进程占用带宽的方法和装置 201511019216.3 - 数据库心跳检测方法以及装置 201511026756.4 - 一种用于更改秘钥的方法、装置及设置秘钥的方法、装置 201610101944.7 - 数据库读写分离方法、装置和系统 201611183503.2 - 一种数据库死锁的处理方法、装置和数据库系统 201710093376.5 - 数据同步方法及设备 201710093382.0 - 一种查询唯一值的方法及设备 201710488500.8 - 一种数据容错的方法及设备 201710492419.7 - 一种重做日志持久化方法及设备 201710581818.0 - 数据库宕机后的访问方法、装置和系统 201710643448.9 - 数据的存储、处理及读取方法、数据存储设备和系统 201710813987.2 - 一种数据操作方法及设备 201710860627.8 - 创建索引的方法和装置 201710860628.2 - 数据获取模型建立的方法和数据获取的方法及装置 201710862401.1 - 一种索引创建方法、装置及数据库系统 201710862402.6 - 数据库的检索方法及装置 201710862403.0 - 数据库处理方法及装置、系统 201711105172.5 - 数据查询方法和装置 201711117230.6 - 数据处理方法、装置及设备 201711195546.7 - 数据写入方法及设备 201711239837.1 - 一种用于实现数据库高可用性的方法及装置 201711275922.3 - 一种数据库更新的方法及装置 201711482536.1 - 一种数据库系统以及查询数据库的方法和装置 201810182191.6 - 数据处理方法和数据处理装置 201810982558.2 - 一种数据跟踪处理方法及装置 1.1.2 社区贡献 自2008年开始,坚持开源PostgreSQL数据库的布道,负责PostgreSQL数据库在中国的技术落地与推广、人才培养。 加入阿里后的一些布道经历​2015-09-12 PG象行中国上海站-PG回归测试 2015-10-23 开源中国广州站技术分享 - PG企业特性 2015-11-15 开源中国源创会广州站2015-PG企业特性 2015-11-20 2015 PG峰会分享-一位PGer的安全修养 2016-05-13 2016dtcc- 从Oracle DBA到PostgreSQL布道者 2016-05-17 云栖大会-武汉-PostgreSQL物联网独孤九式 2016-09-24 全球敏捷运维峰会-阿里云PostgreSQL介绍 2016-10-27 PG 2016全国峰会-PostgreSQL 数据库前世今生 2016-10-27 PG2016全国峰会-PostgreSQL应用开发最佳实践 2016-10-27 PG2016全国峰会-sharding单元化(based on postgres_fdw)最佳实践 2017-03-18 SDCC 数据库核心技术与应用实战峰会-数据库超体 2017-05-27 2017 PG 象行中国社区会议-武汉站-PostgreSQL在阿里的应用 2017-06-24 开源中国源创会-杭州-自动驾驶背后到数据库 2017-08-23 2017 ODF会议,分享PG时空数据管理案例 2017-10-20 开源中国PG分会场,分享,阿里云RDS PG多维存储与流计算实践 2017-10-21 2017 PG峰会-阿里云RDS、HDB PG 多维存储特性与案例 2018-03-17 空间数据库应用峰会-北京师范 - PostgreSQL空间数据业务 优化实践 2018-07-01 开源联盟 - PG HTAP展望 2018-09-01 云栖TechDay - PG天天象上活动 - 杭州站第一期组织+分享 2018-09-07 ODF - 数据库华山论剑 PG vs MySQL 2018-09-09 云栖TechDay - PG天天象上活动 - 北京站组织+分享 2018-10-13 云栖techday - 全栈数据库PG天天象上活动 - 郑州站组织+分享 2018-10-14 ruby summit 2018 郑州- PG开发者特性分享 2018-10-14 中国开发者大会-郑州-高并发和大数据下的PG实战 2018-10-27 云栖TechDay - PG天天象上活动 - 广州站组织+分享 2018-10-28 云栖TechDay - PG天天象上活动 - 深圳站组织+分享 2018-11-24 云栖TechDay - PG天天象上活动 - 上海站组织+分享 2018-12-22 云栖TechDay - PG天天象上活动 - 南京站组织+分享 2019-01-12 云栖TechDay - PG天天象上活动 - 合肥站组织+分享 2019-03-23 云栖TechDay - PG天天象上活动 - 长沙站组织+分享 2019-04-19 云栖TechDay - PG天天象上数据库沙龙 - 成都站组织+分享 2019-05-11 dtcc 2019-PG数据库实战深度培训 2019-05-25 云栖TechDay - PG天天象上活动 - 杭州站组织+分享 2019-06-01 PG象行中国杭州站-PG11,12新特性分享 2019-06-22 阿里云开发者技术沙龙 - PG天天象上活动 - 武汉站组织+分享 2019-07-03 PG社区走进名企-平安集团-分享PG使用的正确姿势 2019-07-07 PG CONF 2019中国峰会,出席分享、培训 2019-07-13 PG天天象上-济南站-1天PG技术分享 2019-07-20 DAMS中国数据库智能管理峰会-PG去O非你莫属 2019-08-17 福州,象行中国- PG的生态、新特性与Oracle迁移介绍 2019-08-24 PostgreSQL 11 与 12 用户最关心的特性解读 2019-09-27 云栖大会2019-开发者进阶-技术影响力 -从技术深度到产品广度的裂变 2019-11-16 数据库嘉年华-PG为什么这么火 2019-11-23 第十八届全国软件与应用学术会议(NASAC 2019)-PostgreSQL的社会价值 2019-11-29 PG12 新特性与路标 2019-11-30 PG峰会-PG 诊断方法2019-12-07 PG社区走进中兴企业交流-分享《PG的社会价值&企业如何融入PG社区》 2020-01-04 pg+mongo助力企业去O 2020-01-11 PG天天象上2020.1.11杭州站-实时精准营销系统设计2020-01-18 PostgreSQL+MySQL 联合解决方案课程14讲2020-07-18 PG SSL安全链路分析 2020-08-15 CUUG PG数据库高校行启动会, 分享AliPG2020-09-10 亿级用户量的实时推荐数据库到底要几毛钱?2020-09-13 在数据库中跑全文检索、模糊查询SQL会不会被开除?2020-09-17 百城汇:云栖线下高校合作专场 , 宁夏大学2020-09-19 刷脸支付会不会刷到别人的钱包?2020-09-26 为什么打车和宇宙大爆炸有关?2020-09-26 大话数据库终局之战2020-10-18 为什么饿了么网上订餐不会凉凉 & 牛顿发现万有引力有关?2020-11-01 PG中文社区 & Hello bike & 阿里云 联合沙龙活动2020-11-17 PG分会-解密下一代云数据库mybase2020-11-22 数据库嘉年华分享-解密下一代云数据库mybase2020-12-18 大型企业数据库与应用实践-dsg,阿里云,pg社区,上海开源信息技术协会 联合主办2021-01-15 PG中文社区2020年度峰会-2021,别让你的企业输在起跑线2021-01-18 阿里云PG创新训练营 1.2 最佳阅读方式 因为文章全部是md格式的,所以建议采用Typora阅读。 git clone https://gitee.com/AiShiYuShiJiePingXing/postgres.git 使用Typora打开克隆后的项目 阅读学习 二、德哥的PostgreSQL, Greenplum 学习视频 1、视频下载链接: https://pan.baidu.com/s/1Q5u5NSrb0gL5-psA9DCBUQ (提取码:5nox 如果链接失效请通知我, 谢谢) PostgreSQL 9.3 数据库管理与优化 4天 PostgreSQL 9.3 数据库管理与优化 5天 PostgreSQL 9.1 数据库管理与开发 1天 PostgreSQL 9.3 数据库优化 3天 PostgreSQL 专题讲座 PostgreSQL Greenplum 培训视频分享:http://pan.baidu.com/s/1pKVCgHX 三、PostgreSQL资料(持续更新) 3.1 PostgreSQL学习系列 3.1.1 不睡觉的怪叔叔的PostGIS教程 PostGIS介绍 PostGIS安装 创建空间数据库 加载空间数据 数据 简单的SQL语句 几何图形(Geometry) 关于几何图形的练习 空间关系 空间连接 空间索引 投影数据 地理 几何图形创建函数 更多的空间连接 有效性 相等 线性参考 维数扩展的9交集模型 索引集群 3-D 最近邻域搜索 3.1.2 菜鸟教程-PostgreSQL系列 1.PostgreSQL 学习系列 2.PostgreSQL 优势 3.PostgreSQL 笔记 4.PostgreSQL 课程 5.PostgreSQL 案例 6.PostgreSQL PostGIS GIST 7.PostgreSQL 推荐系统 8.PostgreSQL 应用开发解决方案 9.PostgreSQL 插件 10.PostgreSQL 配置文件 11.PostgreSQL PDF资料文档 12.PostgreSQL 安装与部署 13.PostgreSQL Alter,Truncate Table 14.PostgreSQL视图、事务、锁 15.PostgreSQL子查询,Auto Increment 16.PostgreSQL权限Privileges 17.PostgreSQL时间日期函数和操作符 18.PostgreSQL常用函数 19.PostgreSQL的模式、表、空间、用户间的关系 3.2 PostgreSQL优势 企业数据库选型规则 为什么数据库选型和找对象一样重要 为什么选择开源数据库、如何选择、需要做哪些准备 学生为什么应该学PG, PG与其他数据库有哪些独特性, 为什么PG是数据库的未来 3.3 PostgreSQL笔记 3.4 PostgreSQL课程 3.5 PostgreSQL案例 阿里云PostgreSQL案例精选1 - 实时精准营销、人群圈选 阿里云PostgreSQL案例精选2 - 图像识别、人脸识别、相似特征检索、相似人群圈选 PostgreSQL 物流轨迹系统数据库需求分析与设计 - 包裹侠实时跟踪与召回 PostgreSQL数据库应用:基于GIS的实时车辆位置查询 3.6 PostgreSQL PostGIS GIST 3.6.1 德哥PostGIS GIST相关笔记 基于PG与PostGIS搭建实时矢量瓦片服务 PostGIS总结 PostgreSQL存储地理信息数据的注意点 postgresql 创建gis空间数据库,shp数据入库 PostGIS基本使用 3.7 PostgreSQL推荐系统 社交、电商、游戏等 推荐系统 (相似推荐) 推荐系统, 已阅读过滤, 大量CPU和IO浪费的优化思路2 用户喜好推荐系统 - PostgreSQL 近似计算应用 PostgreSQL 推荐系统优化总计 PostgreSQL 相似人群圈选,人群扩选,向量相似 使用实践 - cube 3.8 PostgreSQL应用开发解决方案 PostgreSQL 应用开发解决方案最佳实践系列课程 - 1. 中文分词与模糊查询 PostgreSQL 应用开发解决方案最佳实践系列课程 - 2. 短视频业务实时推荐 PostgreSQL 应用开发解决方案最佳实践系列课程 - 3. 人脸识别和向量相似搜索 PostgreSQL 应用开发解决方案最佳实践系列课程 - 4. 出行相关调度系统 PostgreSQL 应用开发解决方案最佳实践系列课程 - 5. 配送相关调度系统 PostgreSQL 应用开发解决方案最佳实践系列课程 - 6. 时空、时态、时序、日志等轨迹系统 PostgreSQL 应用开发解决方案最佳实践系列课程 - 8. 树状图谱关系系统 PostgreSQL 应用开发解决方案最佳实践系列课程 - 9. 数据存储冷热分离 3.9 PostgreSQL插件与工具 PostgreSQL 用户最喜爱的扩展插件功能 PostgreSQL 有价值的插件、可改进功能 PostgreSQL 最常用的插件 PostgreSQL工具 3.10 PostgreSQL配置文件 PostgreSQL 11 postgresql.conf 参数模板 3.11 PostgreSQL PDF资料及文档 PG的社会价值.pdf PostgreSQL思维导图 开发者PG TOP18问.pdf 3.12 PostgreSQL安装与部署 Linux中PostgreSQL和PostGIS的安装和使用 PostgreSQL+PostGIS安装部署 PostgreSQL的Docker安装与部署 3.13 PostgreSQL开发与使用 3.13.1 PostgreSQL规范 1.PostgreSQL 命名规范 2.PostgreSQL 设计规范 3.PostgreSQL QUERY规范 4.PostgreSQL 管理规范 5.PostgreSQL 稳定性与性能规范 6.PostgreSQL 阿里云RDS PostgreSQL 使用规范 Geotools连接PostgreSQL数据库 PostgreSQL常用SQL JDBC与PostgreSQL(一) 四、已归类文档 ——此部分请访问德哥github查阅 因为此部分,我看了有些内容没有,遂直接做了删减。 digoal's PostgreSQL 文章 归类 1 应用开发 2 日常维护 3 监控 4 备份,恢复,容灾 5 高可用 6 安全与审计 7 问题诊断与性能优化 8 流式复制 9 读写分离 10 水平分库 11 OLAP(MPP...) 12 数据库扩展插件 13 版本新特性 14 内核原理与开发 15 经典案例 16 HTAP 17 流式计算 18 时序、时空、对象多维处理 19 图式搜索 20 GIS 21 Oracle兼容性 22 数据库选型 23 Benchmark 24 最佳实践 25 DaaS 26 垂直行业应用 27 标准化(规约、制度、流程) 28 版本升级 29 同、异构数据同步 30 数据分析 31 系列课程 32 其他 33 招聘与求职信息 34 沙龙、会议、培训 35 思维精进 36 视频回放 五、批评指正 因大部分资料都是互联网资源,如有侵权,请联系删除。 对于错误或者不当之处,劳烦及时指正,会尽快更改。 再次多谢PG大佬们的辛勤付出!!!

优秀的个人博客,低调大师

每日一博 | 详解 Apache Dubbo 的 SPI 实现机制

一、SPI SPI全称为Service Provider Interface,对应中文为服务发现机制。SPI类似一种可插拔机制,首先需要定义一个接口或一个约定,然后不同的场景可以对其进行实现,调用方在使用的时候无需过多关注具体的实现细节。在Java中,SPI体现了面向接口编程的思想,满足开闭设计原则。 1.1 JDK自带SPI实现 从JDK1.6开始引入SPI机制后,可以看到很多使用SPI的案例,比如最常见的数据库驱动实现,在JDK中只定义了java.sql.Driver的接口,具体实现由各数据库厂商来提供。下面一个简单的例子来快速了解下Java SPI的使用方式: 1)定义一个接口 package com.vivo.study public interface Car { void getPrice(); } 2)接口实现 package com.vivo.study.impl /** * 实现一 * */ public class AudiCar implements Car { @Override public void getPrice() { System.out.println("Audi A6L's price is 500000 RMB."); } } package com.vivo.study.impl /** * 实现二 * */ public class BydCar implements Car { @Override public void getPrice() { System.out.println("BYD han's price is 220000 RMB."); } } 3)挂载扩展类信息 在META-INF/services目录下以接口全名为文件名的文本文件,对应此处即在META-INF/services目录下创建一个文件名为com.vivo.study.Car的文件,文件内容如下: com.vivo.study.impl.AudiCar com.vivo.study.impl.BydCar 4)使用 public class SpiDemo { public static void main(String[] args) { ServiceLoader<Car> load = ServiceLoader.load(Car.class); Iterator<Car> iterator = load.iterator(); while (iterator.hasNext()) { Car car = iterator.next(); car.getPrice(); } } } 上面的例子简单的介绍了JDK SPI机制的使用方式,其中最关键的类为ServiceLoader,通过ServiceLoader类来加载接口的实现类,ServiceLoader是Iterable接口的实现类,对于ServiceLoader加载的详细过程此处不展开。 JDK对SPI的加载实现存在一个较为突出的小缺点,无法按需加载实现类,通过ServiceLoader.load加载时会将文件中的所有实现都进行实例化,如果想要获取具体某个具体的实现类需要进行遍历判断。 1.2 Dubbo SPI SPI扩展是Dubbo的最大的优点之一,支持协议扩展、调用拦截扩展、引用监听扩展等等。在Dubbo中,根据不同的扩展定位,扩展文件分别被放置在META-INF/dubbo/internal/,META-INF/dubbo/,META-INF/services/这三个路径下。 Dubbo中有直接使用JDK SPI实现的方式,比如org.apache.dubbo.common.extension.LoadingStrategy放在META-INF/services/路径下,但大多情况下都是使用其自身对JDK SPI的实现的一种优化方式,可称为Dubbo SPI,也就是本文要讲解的点。 相比于JDK的SPI的实现,Dubbo SPI具有以下特点: 配置形式更灵活:支持以key:value的形式在文件里配置类似name:xxx.xxx.xxx.xx,后续可以通过name来进行扩展类按需精准获取。 缓存的使用:使用缓存提升性能,保证一个扩展实现类至多会加载一次。 对扩展类细分扩展:支持扩展点自动包装(Wrapper)、扩展点自动装配、扩展点自适应(@Adaptive)、扩展点自动激活(@Activate)。 Dubbo对扩展点的加载主要由ExtensionLoader这个类展开。 二、加载-ExtensionLoader ExtensionLoader在Dubbo里的角色类似ServiceLoader在JDK中的存在,用于加载扩展类。在Dubbo源码里,随处都可以见到ExtensionLoader的身影,比如在服务暴露里的关键类ServiceConfig中等,弄清楚ExtensionLoader的实现细节对阅读Dubbo源码有很大的帮助。 2.1 获取ExtensionLoader的实例 ExtensionLoader没有提供共有的构造函数, 只能通过ExtensionLoader.getExtensionLoader(Class<T> type)来获取ExtensionLoader实例。 public // ConcurrentHashMap缓存,key -> Class value -> ExtensionLoader实例 private static final ConcurrentMap<Class<?>, ExtensionLoader<?>> EXTENSION_LOADERS = new ConcurrentHashMap<>(64); private ExtensionLoader(Class<?> type) { this.type = type; objectFactory = (type == ExtensionFactory.class ? null : ExtensionLoader.getExtensionLoader(ExtensionFactory.class).getAdaptiveExtension()); } public static <T> ExtensionLoader<T> getExtensionLoader(Class<T> type) { if (type == null) { throw new IllegalArgumentException("Extension type == null"); } // 检查是否是接口,如果不是则抛出异常 if (!type.isInterface()) { throw new IllegalArgumentException("Extension type (" + type + ") is not an interface!"); } // 检查接口是否是被@SPI注解修饰,如果没有则抛出异常 if (!withExtensionAnnotation(type)) { throw new IllegalArgumentException("Extension type (" + type + ") is not an extension, because it is NOT annotated with @" + SPI.class.getSimpleName() + "!"); } // 从缓存里取,没有则初始化一个并放入缓存EXTENSION_LOADERS中 ExtensionLoader<T> loader = (ExtensionLoader<T>) EXTENSION_LOADERS.get(type); if (loader == null) { EXTENSION_LOADERS.putIfAbsent(type, new ExtensionLoader<T>(type)); loader = (ExtensionLoader<T>) EXTENSION_LOADERS.get(type); } return loader; } } 上面的代码展示了获取ExtensionLoader实例的过程,可以看出,每一个被@SPI修饰的接口都会对应同一个ExtensionLoader实例,且对应ExtensionLoader只会被初始化一次,并缓存在ConcurresntHashMap中。 2.2 加载扩展类 加载扩展类入口,当使用ExtensionLoader时,getExtensionName、getActivateExtension或是getDefaultExtension都要经过getExtensionClasses方法来加载扩展类,如下图; getExtensionClasses方法调用的路径如下图,getExtensionClasses是加载扩展类的一个起点,会首先从缓存中获取,如果缓存中没有则通过loadExtensionClasses方法来加载扩展类,所以说实际上的加载逻辑入口在loadExtensionClasses。 getExtensionClasses |->loadExtensionClasses |->cacheDefaultExtensionName |->loadDirectory |->loadResource |->loadClass 2.2.1 loadExtensionClasses加载扩展类 由于整个加载过程设计的源码较多,因此用一个流程图来进行描述,具体细节可以结合源码进行查看。 loadExtensionClasses主要做了以下这几件事: 默认扩展名: 抽取默认扩展实现名并缓存在ExtensionLoader里的cachedDefaultName,默认扩展名配置通过@SPI注解在接口上配置,如配置@SPI("defaultName")则默认扩展名为defaultName。 加载扩展类信息: 从META-INF/dubbo/internal/,META-INF/dubbo/,META-INF/services/这三个路径下寻找以类的全路径名命名的文件,并逐行读取文件里的内容。 加载class并缓存: 对扩展类分为自适应扩展实现类(被@Adaptive修饰的实现类)、包装类(拥有一个只有一个为这个接口类型的参数的构造方法)、普通扩展类,其中普通扩展类中又包含自动激活扩展类(被@Activate修饰的类)和真普通的类,对自适应扩展实现类、包装类、自动激活扩展类这三种类型的类分别加载并分别缓存到cachedAdaptiveClass、cachedActivates、cachedWrapperClasses。 返回结果Map<String, Class<?>>: 结果返回Map,其中key对应扩展文件里配置的name,value对应扩展的类class,最后在getExtensionClasses方法里会将此结果放入缓存cachedClasses中。此结果Map中包含除了自适应扩展实现类和包装实现类的其他所用的扩展类名与对应类的映射关系。 通过loadExtensionClasses方法把扩展类(Class对象)都加载到相应的缓存中,是为了方便后面实例化扩展类对象,通过newInstance()等方法来实例化。 2.2.2扩展包装类 什么是扩展包装类?是不是类名结尾包含了Wrapper的类就是扩展包装类? 在Dubbo SPI接口的实现扩展类中,如果此类包含一个此接口作为参数的构造方法,则为扩展包装类。扩展包装类的作用是持有具体的扩展实现类,可以一层一层的被包装,作用类似AOP。 包装扩展类的作用是类似AOP,方便扩展增强。具体实现代码如下: 从代码中可以得出,可以通过boolean wrap选择是否使用包装类,默认情况下为true;如果有扩展包装类,实际的实现类会被包装类按一定的顺序一层一层包起来。 如Protocol的实现类ProtocolFilterWrapper、ProtocolListenerWrapper都是扩展包装类。 2.2.3自适应扩展实现类 2.2.3.1 @Adaptive @Documented @Retention(RetentionPolicy.RUNTIME) @Target({ElementType.TYPE, ElementType.METHOD}) public @interface Adaptive { String[] value() default {}; } 从源码以及源码注释中可以得出以下几点: Adaptive是一个注解,可以修饰类(接口,枚举)和方法。 此注解的作用是为ExtensionLoader注入扩展实例提供有用的信息。 从注释中理解value的作用: value可以决定选择使用具体的扩展类。 通过value配置的值key,在修饰的方法的入参org.apache.dubbo.common.URL中通过key获取到对应的值value,根据value作为extensionName去决定使用对应的扩展类。 如果通过2没有找到对应的扩展,会选择默认的扩展类,通过@SPI配置默认扩展类。 2.2.3.2 @Adaptive简单例子 由于@Adaptive修饰类时比较好理解,这里举一个@Adaptive修饰方法的例子,使用@Adaptive修饰方法的这种情况在Dubbo也是随处可见。 /** * Dubbo SPI 接口 */ @SPI("impl1") public interface SimpleExt { @Adaptive({"key1", "key2"}) String yell(URL url, String s); } 如果调用 ExtensionLoader.getExtensionLoader(SimpleExt.class).getAdaptiveExtension().yell(url, s)方法,最终调用哪一个扩展类的实例去执行yell方法的流程大致为:先获取扩展类的名称extName(对应上面说的name:class中的name),然后通过extName来获取对应的类Class,再实例化进行调用。所以关键的步骤在怎么得到extName,上面的这个例子得到extName的流程为: 通过url.getParameters.get("key1")获取, 没有获取到则用url.getParameters.get("key2"),如果还是没有获取到则使用impl1对应的实现类,最后还是没有获取到则抛异常IllegalStateException。 可以看出,@Adaptive的好处就是可以通过方法入参决定具体调用哪一个实现类。下面会对@Adaptive的具体实现进行详细分析。 2.2.3.3@Adaptive加载流程 流程关键点说明: 1)黄色标记的,cachedAdaptiveClass是在ExtensionLoader#loadClass方法中加载Extension类时缓存的。 2)绿色标记的,如果Extension类中存在被@Adaptive修饰的类时会使用该类来初始化实例。 3)红色标记的,如果Extension类中不存在被@Adaptive修饰的类时,则需要动态生成代码,通过javassist(默认)来编译生成Xxxx$Adaptive类来实例化。 4)实例化后通过injectExtension来将Adaptive实例的Extension注入(属性注入)。 后续围绕上述的关键点3详细展开,关键点4此处不展开。 动态生成Xxx$Adaptive类:下面的代码为动态生成Adaptive类的相关代码,具体生成代码的细节在AdaptiveClassCodeGenerator#generate中 public class ExtensionLoader<T> { // ... private Class<?> getAdaptiveExtensionClass() { // 根据对应的SPI文件加载扩展类并缓存,细节此处不展开 getExtensionClasses(); // 如果存在被@Adaptive修饰的类则直接返回此类 if (cachedAdaptiveClass != null) { return cachedAdaptiveClass; } // 动态生成Xxxx$Adaptive类 return cachedAdaptiveClass = createAdaptiveExtensionClass(); } private Class<?> createAdaptiveExtensionClass() { // 生成Xxxx$Adaptive类代码,可自行加日志或断点查看生成的代码 String code = new AdaptiveClassCodeGenerator(type, cachedDefaultName).generate(); ClassLoader classLoader = findClassLoader(); // 获取动态编译器,默认为javassist org.apache.dubbo.common.compiler.Compiler compiler = ExtensionLoader.getExtensionLoader(org.apache.dubbo.common.compiler.Compiler.class).getAdaptiveExtension(); return compiler.compile(code, classLoader); } } AdaptiveClassCodeGenerator#generate生成code的方式是通过字符串拼接,大量使用String.format,整个代码过程比较繁琐,可通过debug去了解细节。 最关键的的部分是生成被@Adaptive修饰的方法的内容,也就是最终调用实例的@Adaptive方法时,可通过参数来动态选择具体使用哪个扩展实例。下面对此部分进行分析: public class AdaptiveClassCodeGenerator { // ... /** * generate method content */ private String generateMethodContent(Method method) { // 获取方法上的@Adaptive注解 Adaptive adaptiveAnnotation = method.getAnnotation(Adaptive.class); StringBuilder code = new StringBuilder(512); if (adaptiveAnnotation == null) { // 方法时没有@Adaptive注解,生成不支持的代码 return generateUnsupported(method); } else { // 方法参数里URL是第几个参数,不存在则为-1 int urlTypeIndex = getUrlTypeIndex(method); // found parameter in URL type if (urlTypeIndex != -1) { // Null Point check code.append(generateUrlNullCheck(urlTypeIndex)); } else { // did not find parameter in URL type code.append(generateUrlAssignmentIndirectly(method)); } // 获取方法上@Adaptive配置的value // 比如 @Adaptive({"key1","key2"}),则会返回String数组{"key1","key2"} // 如果@Adaptive没有配置value,则会根据简写接口名按驼峰用.分割,比如SimpleExt对应simple.ext String[] value = getMethodAdaptiveValue(adaptiveAnnotation); // 参数里是否存在org.apache.dubbo.rpc.Invocation boolean hasInvocation = hasInvocationArgument(method); code.append(generateInvocationArgumentNullCheck(method)); // 生成String extName = xxx;的代码 ,extName用于获取具体的Extension实例 code.append(generateExtNameAssignment(value, hasInvocation)); // check extName == null? code.append(generateExtNameNullCheck(value)); code.append(generateExtensionAssignment()); // return statement code.append(generateReturnAndInvocation(method)); } return code.toString(); } } 上述生成Adaptive类的方法内容中最关键的步骤在生成extName的部分,也就是generateExtNameAssignment(value,hasInvocation),此方法if太多了(有点眼花缭乱)。 以下列举几个例子对此方法的实现流程进行简单展示:假设方法中的参数不包含org.apache.dubbo.rpc.Invocation,包含org.apache.dubbo.rpc.Invocation的情况会更加复杂。 1)方法被@Adaptive修饰,没有配置value,且在接口@SPI上配置了默认的实现 @SPI("impl1") public interface SimpleExt { @Adaptive String echo(URL url, String s); } 对应生成extName的代码为: String extName = url.getParameter("simple.ext", "impl1") 2)方法被@Adaptive修饰,没有配置value,且在接口@SPI上没有配置默认的实现 @SPI("impl1") public interface SimpleExt { @Adaptive({"key1", "key2"}) String yell(URL url, String s); } 对应生成extName的代码为: String extName = url.getParameter( "simple.ext") 3)方法被@Adaptive修饰,配置了value(假设两个,依次类推),且在接口@SPI上配置了默认的实现 @SPI public interface SimpleExt { @Adaptive({"key1", "key2"}) String yell(URL url, String s); } 对应生成extName的代码为: String extName = url.getParameter("key1", url.getParameter("key2", "impl1")); 4)方法被@Adaptive修饰,配置了value(假设两个,依次类推),且在接口@SPI没有配置默认的实现 @SPI public interface SimpleExt { @Adaptive({"key1", "key2"}) String yell(URL url, String s); } 对应生成extName的代码为: String extName = url.getParameter("key1", url.getParameter("key2")); 完整的生成类可参见附录。 2.2.4自动激活扩展类 如果你有扩展实现过Dubbo的Filter,那么一定会对@Activate很熟悉。@Activate注解的作用是可以通过给定的条件来自动激活扩展实现类,通过ExtensionLoader#getActivateExtension(URL,String, String)方法可以找到指定条件下需要激活的扩展类列表。 下面以一个例子来对@Activate的作用进行说明,在Consumer调用Dubbo接口时,会经过消费方的过滤器链以及提供方的过滤器链,在Provider暴露服务的过程中会拼接需要使用哪些Filter。 对应源码中的位置在ProtocolFilterWrapper#buildInvokerChain(invoker, key, group)方法中。 // export:key-> service.filter ; group-> provider private static <T> Invoker<T> buildInvokerChain(final Invoker<T> invoker, String key, String group) { // 在Provider暴露服务服务export时,会根据获取Url中的service.filter对应的值和group=provider来获取激活对应的Filter List<Filter> filters = ExtensionLoader.getExtensionLoader(Filter.class).getActivateExtension(invoker.getUrl(), key, group); } ExtensionLoader#getActivateExtension(URL, String, String)是怎么根据条件来自动激活对应的扩展类列表的可以自行查看该方法的代码,此处不展开。 三、总结 本文主要对Dubbo SPI机制的扩展类加载过程通过ExtensionLoader类源码来进行总结,可以概况为以下几点: 1.Dubbo SPI结合了JDK SPI的实现,并在此基础上进行优化,如精准按需加载扩展类、缓存提升性能。 2.分析ExtensionLoader加载扩展类的过程,加载META-INF/dubbo/internal/,META-INF/dubbo/,META-INF/services/这三个路径下的文件,并分类缓存在ExtensionLoader实例。 3.介绍扩展包装类及其实现过程,扩展包装类实现了类似AOP的功能。 4.自适应扩展类,分析@Adptive修饰方法时动态生成Xxx$Adaptive类的过程,以及通过参数自适应选择扩展实现类完成方法调用的案例介绍。 简单介绍自动激活扩展类及@Activate的作用。 四、附录 4.1 Xxx$Adaptive完整案例 @SPI接口定义 @SPI("impl1") public interface SimpleExt { // @Adaptive example, do not specify a explicit key. @Adaptive String echo(URL url, String s); @Adaptive({"key1", "key2"}) String yell(URL url, String s); // no @Adaptive String bang(URL url, int i); } 生成的Adaptive类代码 package org.apache.dubbo.common.extension.ext1; import org.apache.dubbo.common.extension.ExtensionLoader; public class SimpleExt$Adaptive implements org.apache.dubbo.common.extension.ext1.SimpleExt { public java.lang.String yell(org.apache.dubbo.common.URL arg0, java.lang.String arg1) { if (arg0 == null) throw new IllegalArgumentException("url == null"); org.apache.dubbo.common.URL url = arg0; String extName = url.getParameter("key1", url.getParameter("key2", "impl1")); if (extName == null) throw new IllegalStateException("Failed to get extension (org.apache.dubbo.common.extension.ext1.SimpleExt) name from url (" + url.toString() + ") use keys([key1, key2])"); org.apache.dubbo.common.extension.ext1.SimpleExt extension = (org.apache.dubbo.common.extension.ext1.SimpleExt)ExtensionLoader.getExtensionLoader(org.apache.dubbo.common.extension.ext1.SimpleExt.class).getExtension(extName); return extension.yell(arg0, arg1); } public java.lang.String echo(org.apache.dubbo.common.URL arg0, java.lang.String arg1) { if (arg0 == null) throw new IllegalArgumentException("url == null"); org.apache.dubbo.common.URL url = arg0; String extName = url.getParameter("simple.ext", "impl1"); if (extName == null) throw new IllegalStateException("Failed to get extension (org.apache.dubbo.common.extension.ext1.SimpleExt) name from url (" + url.toString() + ") use keys([simple.ext])"); org.apache.dubbo.common.extension.ext1.SimpleExt extension = (org.apache.dubbo.common.extension.ext1.SimpleExt) ExtensionLoader.getExtensionLoader(org.apache.dubbo.common.extension.ext1.SimpleExt.class).getExtension(extName); return extension.echo(arg0, arg1); } public java.lang.String bang(org.apache.dubbo.common.URL arg0, int arg1) { throw new UnsupportedOperationException("The method public abstract java.lang.String org.apache.dubbo.common.extension.ext1.SimpleExt.bang(org.apache.dubbo.common.URL,int) of interface org.apache.dubbo.common.extension.ext1.SimpleExt is not adaptive method!"); } } 作者:vivo互联网服务器团队-Ning Peng

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册