首页 文章 精选 留言 我的

精选列表

搜索[赛博朋克],共10000篇文章
优秀的个人博客,低调大师

每日一博 | V8 执行 JavaScript 的过程

👆这是第102篇不掺水的原创,想要了解更多,请戳上方蓝色字体:政采云前端团队关注我们吧~ 本文首发于政采云前端团队博客:V8 执行 JavaScript 的过程 https://www.zoo.team/article/the-process-of-executing-js-in-v8 前言 本文意在简单的介绍一下 V8 执行 JS 的过程,通过了解 V8 执行 JS 的过程,知道 JS 代码呈现在浏览器上到底做了什么。当然本人也是在陆续探索 V8 ,文章中如有不当之处,还望不吝指正,理性交流。 众所周知,机器(CPU)只能识别机器码(二进制码),对于 JS 代码,它是识别不了的,所以当代码成为页面出现在屏幕上的时候,必然是做了很多的转译工作。 V8 执行 JavaScript 过程 如上图所示,我们将一步步进行拆分分析: JS TO AST 在 V8 引擎拿到 JS 代码之后,解析器(Parser)会对其进行词法分析和语法分析。 词法分析 将 JS 代码拆分成对应的 Token,Token 是能拆分的最小单位,固定 type 表述类型/属性,value 表示对应的值,如下图 Token。 语法分析 在进行词法分析转为 Token 之后,解析器继续根据生成的 Token 生成对应的 AST,AST 相信前端同学并不陌生,也是热词之一,无论是在 Vue、React 中虚拟 DOM 的表示,或者 Babel 对 JS 转译的表示都是先将其转化为对应的 AST,解析器解析之后的 AST 结构如下图所示: 可以看到,一段极小的代码片段,被解析成 AST 之后复杂了很多,在图中的 AST 还仅仅是简化后的数据,全部的 AST 其实还有很多参数,将会更复杂。 字节码 在解析器(Parser)将 JS 代码解析成 AST 之后,解释器(Ignition)根据 AST 来生成字节码(也称中间码)。前文提到 CPU 只能识别机器码,对字节码是识别不了的,这里就衍生出一个问题,如果 CPU 识别不了字节码,那为什么还要在中间插一步来耗费资源转字节码呢?效率不是很更低吗? 在计算机学科里聊效率,都逃避不了时间和空间这两个概念,绝大部分的优化都是空间换时间和时间换空间,两者的平衡,效率如何达到最高,是一个很值得深入研究的问题。 拿之前版本的 V8 引擎执行 JS 来说,是没有转字节码这一步骤的,直接从 AST 转成机器码,这个过程称为编译过程,所以每次拿到 JS 文件的时候,首先都会编译,而这个过程还是比较浪费时间的,这是一件比较头疼的事情,需要一个解决办法。 一个网页第一次打开,关闭再次去打开,大部分情况下,还是和原来 JS 文件一致的,除非开发者修改了代码,但这个可以暂时不考虑,毕竟哪个网站也不会一天闲的无聊,不停的修改,上传替换。 缓存机器码 按照这个思路,既然绝大多数情况下,文件不会修改,那编译后的机器码可以考虑缓存下来,这样一来,下次再打开或者刷新页面的时候就省去编译的过程了,可以直接执行了,存储机器码被分成了两种情况,一个是浏览器未关闭时候,直接存储到浏览器本地的内存中,一个是浏览器关闭了,直接存储在磁盘上,而早期的 V8 也确实是这么做的,典型的牺牲空间换时间。 缓存带来的问题 思考一个问题,从上面的图中可以看到,一个很小的代码片段,转换成 AST 之后,变大了很多,文件大了导致一个问题就是需要更大的内存来存储,而 JS 文件转成机器码(即二进制文件),会比原来的 JS 文件大几百甚至几千倍,这就意味着一个几十 KB 的 JS 文件将会达到几十 MB,这就很可怕,本来 Chrome 多进程架构就已经很占用内存了,再来这一出,配置再好的电脑,也怕是无福消受 Chrome 了,毕竟使用者体验的好坏,直接决定了一个产品在市场上是否能生存下去,尽管 V8 缓存了编译后的代码,减少了编译的时间,提高了时间上的效率,但代价是内存占用太大了,所以 Chrome 团队是有必要优化这个问题的。 惰性编译 当然,引进其他技术是需要时间去开发和优化的,在一个技术架构产生的同时,必然会有劣势方面的弥补,而早期版本的 V8 为了解决占用内存和启动速度,引进了惰性编译,那么问题来了,惰性编译做了什么去提高效率的呢? 惰性编译还是比较容易理解的,从作用域的角度思考,ES6 之前之只有全局作用域和函数作用域,而惰性编译的思路就是 V8 启动的时候只编译和缓存全局作用域的代码,而函数作用域中的代码,会在调用的时候去编译,同样函数内部编译后的代码一样不会被缓存下来。 惰性编译存在的问题 引入惰性编译之后,在编译速度和缓存上看来,都得到了提升,一切看起来似乎很完美了,对,是看起来,但是设计出来的东西,你永远不知道使用者会怎么使用,在 ES6 和 Vue、React 等这些没有普及之前,绝大部分开发者都使用的是 jQuery,以及 RequireJS 等类似产品,JQ 插件各种引用,各种插件或者开发者自己封装的方法,为了不污染其他使用者的变量,一般都封装成一个函数,这样问题就来了,惰性编译不会保存函数编译后的机器码和理解编译函数,如果一个插件太大那等到使用函数再去编译,编译的时间上就会变得很慢,这相当于是开发者将惰性编译给玩完了,路给封死了。 引入字节码 好吧,玩不过开发者了,那 V8 团队只好换个思路,就引入字节码吧。首先要理解什么是字节码,字节码其实是机器码的抽象,各种字节码的相互构成,可以实现 JS 所需的所有功能,当然首先一点,字节码比机器码占用的内存要小很多很多,基本是机器码所在内存的几十甚至几百分之一,这样一来字节码缓存下来所消耗的内存还是可以接受的。 这里会有一个疑问,既然 CPU 不能识别字节码,那是不是还需要将字节码转成机器码呢?不然怎么执行,答案是肯定。解释在将 AST 转为字节码之后,会在执行的时候将字节码转成机器码,这个执行过程肯定是比直接执行机器码要慢的,所以在执行方面,速度上会比较慢,但是 JS 源码通过解析器转 AST,然后再通过解释器转字节码,这个过程是比编译器直接将 JS 源码转机器码要快很多的,全流程看来,整个时间上是差不了多少的,但是却减小了大量的内存占用,何乐而不为。 编译器 热代码 在代码中,常常会有同一部分代码,被多次调用,同一部分代码如果每次都需要解释器转二进制代码再去执行,效率上来说,会有些浪费,所以在 V8 模块中会有专门的监控模块,来监控同一代码是否多次被调用,如果被多次调用,那么就会被标记为热代码,这有什么作用呢? 优化编译器 TurboFan(优化编译器) 这个词相信关注手机界的同学并不陌生,华为、小米等这些品牌,在近几年产品发布会上都会出现这个词,主要的能力是通过软件计算能力来优化一系列的功能,使得效率更优。 接着热代码继续说,当存在热代码的时候,V8 会借着 TurboFan 将为热代码的字节码转为机器码并缓存下来,这样一来,当再次调用热代码时,就不在需要将字节码转机器码,当然热代码相对来说还是少部分的,所以缓存也并不会占用太大内存,并且提升了执行效率,同样此处也是牺牲空间换时间。 反优化 JS 语言是动态语言,非常之灵活,对象的结构和属性在运行时是可以发生改变的,设想一个问题,如果热代码在某次执行的时候,突然其中的某个属性被修改了,那么编译成机器码的热代码还能继续执行吗?答案是肯定不能。这个时候就要使用到优化编译器的反优化了,他会将热代码退回到 AST 这一步,这个时候解释器会重新解释执行被修改的代码,如果代码再次被标记为热代码,那么会重复执行优化编译器的这个步骤。 总结 从分析的过程来看,V8 对 JS 执行的过程,不仅使用到了解释器,还用到了优化编译器。这种两者结合去处理的方式,业界称为 JIT (Just-In-Time)。使用这种结合的方式来处理 JS,主要是利用了 AST 形成的文件较小,而通过优化编译器编译后的热代码执行效率高,两者结合,各自发挥各自的优势,将效率尽量提升到最大。 V8 所做的事情,远远不止这些,这里也仅仅是简单概况和分析一下主流程上所做的一些事情,如果细化到每个点,还有很多概念,比如内联缓存、隐藏类、快属性、慢属性、创建对象,以及笔者之前写的V8 引擎垃圾回收与内存分配等等,所做的事情实在太多,就不一一例举了。 看完两件事 如果你觉得这篇内容对你挺有启发,我想邀请你帮我两件小事 1.点个「在看」,让更多人也能看到这篇内容(点了「在看」,bug -1 😊) 2.关注公众号「 政采云前端团队」,持续为你推送精选好文 招贤纳士 政采云前端团队(ZooTeam),一个年轻富有激情和创造力的前端团队,隶属于政采云产品研发部,Base 在风景如画的杭州。团队现有 50 余个前端小伙伴,平均年龄 27 岁,近 3 成是全栈工程师,妥妥的青年风暴团。成员构成既有来自于阿里、网易的“老”兵,也有浙大、中科大、杭电等校的应届新人。团队在日常的业务对接之外,还在物料体系、工程平台、搭建平台、性能体验、云端应用、数据分析及可视化等方向进行技术探索和实战,推动并落地了一系列的内部技术产品,持续探索前端技术体系的新边界。 如果你想改变一直被事折腾,希望开始能折腾事;如果你想改变一直被告诫需要多些想法,却无从破局;如果你想改变你有能力去做成那个结果,却不需要你;如果你想改变你想做成的事需要一个团队去支撑,但没你带人的位置;如果你想改变既定的节奏,将会是“5 年工作时间 3 年工作经验”;如果你想改变本来悟性不错,但总是有那一层窗户纸的模糊… 如果你相信相信的力量,相信平凡人能成就非凡事,相信能遇到更好的自己。如果你希望参与到随着业务腾飞的过程,亲手推动一个有着深入的业务理解、完善的技术体系、技术创造价值、影响力外溢的前端团队的成长历程,我觉得我们该聊聊。任何时间,等着你写点什么,发给 ZooTeam@cai-inc.com 本文分享自微信公众号 - 政采云前端团队(Zoo-Team)。如有侵权,请联系 support@oschina.cn 删除。本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

优秀的个人博客,低调大师

每日一博 | Go timer 是如何被调度的?

hi,大家好,我是 haohongfan。 本篇文章剖析下 Go 定时器的相关内容。定时器不管是业务开发,还是基础架构开发,都是绕不过去的存在,由此可见定时器的重要程度。 我们不管用 NewTimer, timer.After,还是 timer.AfterFun 来初始化一个 timer, 这个 timer 最终都会加入到一个全局 timer 堆中,由 Go runtime 统一管理。 全局的 timer 堆也经历过三个阶段的重要升级。 Go 1.9 版本之前,所有的计时器由全局唯一的四叉堆维护,协程间竞争激烈。 Go 1.10 - 1.13,全局使用 64 个四叉堆维护全部的计时器,没有本质解决 1.9 版本之前的问题 Go 1.14 版本之后,每个 P 单独维护一个四叉堆。 Go 1.14 以后的 timer 性能得到了质的飞升,不过伴随而来的是 timer 成了 Go 里面最复杂、最难梳理的数据结构。本文不会详细分析每一个细节,我们从大体来了解 Go timer 的工作原理。 1. 使用场景 Go timer 在我们代码中会经常遇到。 场景1:RPC 调用的防超时处理(下面代码节选 dubbogo) func(c*Client)Request(request*remoting.Request,timeouttime.Duration,response*remoting.PendingResponse)error{_,session,err:=c.selectSession(c.addr)//..省略iftotalLen,sendLen,err=c.transfer(session,request,timeout);err!=nil{ifsendLen!=0&&totalLen!=sendLen{//..省略}returnperrors.WithStack(err)}//..省略select{case<-getty.GetTimeWheel().After(timeout):returnperrors.WithStack(errClientReadTimeout)case<-response.Done:err=response.Err}returnperrors.WithStack(err)} 场景2:Context 的超时处理 funcmain(){ctx,cancel:=context.WithTimeout(context.Background(),1*time.Second)defercancel()godoSomething()select{case<-ctx.Done():fmt.Println("main",ctx.Err())}} 2. 图解源码 2.1 四叉堆原理 timer 的全局堆是一个四叉堆,特别是 Go 1.14 之后每个 P 都会维护着一个四叉堆,减少了 Goroutine 之间的并发问题,提升了 timer 了性能。 四叉堆其实就是四叉树,Go timer 是如何维护四叉堆的呢? Go runtime 调度 timer 时,触发时间更早的 timer,要减少其查询次数,尽快被触发。所以四叉树的父节点的触发时间是一定小于子节点的。 四叉树顾名思义最多有四个子节点,为了兼顾四叉树插、删除、重排速度,所以四个兄弟节点间并不要求其按触发早晚排序。 这里用两张动图简单演示下 timer 的插入和删除 把 timer 插入堆 把 timer 从堆中删除 2.2 timer 是如何被调度的? 调用 NewTimer,timer.After, timer.AfterFunc 生产 timer, 加入对应的 P 的堆上。 调用 timer.Stop, timer.Reset 改变对应的 timer 的状态。 GMP 在调度周期内中会调用 checkTimers ,遍历该 P 的 timer 堆上的元素,根据对应 timer 的状态执行真的操作。 2.3 timer 是如何加入到 timer 堆上的? 把 timer 加入调度总共有下面几种方式: 通过 NewTimer, time.After, timer.AfterFunc 初始化 timer 后,相关 timer 就会被放入到对应 p 的 timer 堆上。 timer 已经被标记为 timerRemoved,调用了 timer.Reset(d),这个 timer 也会重新被加入到 p 的 timer 堆上 timer 还没到需要被执行的时间,被调用了 timer.Reset(d),这个 timer 会被 GMP 调度探测到,先将该 timer 从 timer 堆上删除,然后重新加入到 timer 堆上 STW 时,runtime 会释放不再使用的 p 的资源,p.destroy()->timer.moveTimers,将不再被使用的 p 的 timers 上有效的 timer(状态是:timerWaiting,timerModifiedEarlier,timerModifiedLater) 都重新加入到一个新的 p 的 timer 上 2.4 Reset 时 timer 是如何被操作的? Reset 的目的是把 timer 重新加入到 timer 堆中,重新等待被触发。不过分为两种情况: 被标记为 timerRemoved 的 timer,这种 timer 是已经从 timer 堆上删除了,但会重新设置被触发时间,加入到 timer 堆中 等待被触发的 timer,在 Reset 函数中只会修改其触发时间和状态(timerModifiedEarlier或timerModifiedLater)。这个被修改状态的 timer 也同样会被重新加入到 timer堆上,不过是由 GMP 触发的,由 checkTimers 调用 adjusttimers 或者 runtimer 来执行的。 2.5 Stop 时 timer 是如何被操作的? time.Stop 为了让 timer 停止,不再被触发,也就是从 timer 堆上删除。不过 timer.Stop 并不会真正的从 p 的 timer 堆上删除 timer,只会将 timer 的状态修改为 timerDeleted。然后等待 GMP 触发的 adjusttimers 或者 runtimer 来执行。 真正删除 timer 的函数有两个 dodeltimer,dodeltimer0。 2.6 Timer 是如何被真正执行的? timer 的真正执行者是 GMP。GMP 会在每个调度周期内,通过 runtime.checkTimers 调用 timer.runtimer(). timer.runtimer 会检查该 p 的 timer 堆上的所有 timer,判断这些 timer 是否能被触发。 如果该 timer 能够被触发,会通过回调函数 sendTime 给 Timer 的 channel C 发一个当前时间,告诉我们这个 timer 已经被触发了。 如果是 ticker 的话,被触发后,会计算下一次要触发的时间,重新将 timer 加入 timer 堆中。 3. Timer 使用中的坑 确实 timer 是我们开发中比较常用的工具,但是 timer 也是最容易导致内存泄露,CPU 狂飙的杀手之一。 不过仔细分析可以发现,其实能够造成问题就两个方面: 错误创建很多的 timer,导致资源浪费 由于 Stop 时不会主动关闭 C,导致程序阻塞 3.1 错误创建很多 timer,导致资源浪费 funcmain(){for{//xxx一些操作timeout:=time.After(30*time.Second)select{case<-someDone://dosomethingcase<-timeout:return}}} 上面这段代码是造成 timer 异常的最常见的写法,也是我们最容易忽略的写法。 造成问题的原因其实也很简单,因为 timer.After 底层是调用的 timer.NewTimer,NewTimer 生成 timer 后,会将 timer 放入到全局的 timer 堆中。 for 会创建出来数以万计的 timer 放入到 timer 堆中,导致机器内存暴涨,同时不管 GMP 周期 checkTimers,还是插入新的 timer 都会疯狂遍历 timer 堆,导致 CPU 异常。 要注意的是,不只 time.After 会生成 timer, NewTimer,time.AfterFunc 同样也会生成 timer 加入到 timer 中,也都要防止循环调用。 解决办法: 使用 time.Reset 重置 timer,重复利用 timer。 我们已经知道 time.Reset 会重新设置 timer 的触发时间,然后将 timer 重新加入到 timer 堆中,等待被触发调用。 funcmain(){timer:=time.NewTimer(time.Second*5)for{timer.Reset(time.Second*5)select{case<-someDone://dosomethingcase<-timer.C:return}}} 3.2 程序阻塞,造成内存或者 goroutine 泄露 funcmain(){timer1:=time.NewTimer(2*time.Second)<-timer1.Cprintln("done")} 上面的代码可以看出来,只有等待 timer 超时 "done" 才会输出,原理很简单:程序阻塞在 <-timer1.C 上,一直等待 timer 被触发时,回调函数 time.sendTime 才会发送一个当前时间到 timer1.C 上,程序才能继续往下执行。 不过使用 timer.Stop 的时候就要特别注意了,比如: funcmain(){timer1:=time.NewTimer(2*time.Second)gofunc(){timer1.Stop()}()<-timer1.Cprintln("done")} 程序就会一直死锁了,因为 timer1.Stop 并不会关闭 channel C,使程序一直阻塞在 timer1.C 上。 上面这个例子过于简单了,试想下如果 <- timer1.C 是阻塞在子协程中,timer 被的 Stop 方法被调用,那么子协程可能就会被永远的阻塞在那里,造成 goroutine 泄露,内存泄露。 Stop 的正确的使用方式: funcmain(){timer1:=time.NewTimer(2*time.Second)gofunc(){if!timer1.Stop(){<-timer1.C}}()select{case<-timer1.C:fmt.Println("expired")default:}println("done")} 到此,Go timer 基本已经结束了,有想跟我讨论的可以在留言区评论。 Go timer 完整流程图获取链接:链接: 链接: https://pan.baidu.com/s/1nUvTK_0qBlwbS6LbZXKM7g 密码: t219 其他模块流程图,请关注公众号 HHFCodeRv 回复1获取。 更多学习学习资料分享,关注公众号回复指令: 回复 0,获取 《Go 面经》 回复 1,获取 《Go 源码流程图》 本文分享自微信公众号 - HHFCodeRv(hhfcodearts)。如有侵权,请联系 support@oschina.cn 删除。本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

优秀的个人博客,低调大师

每日一博 | 浅析扣减库存的方案设计

你好,我是悟空,今天来探讨下扣减库存的方案。 生活中,我们总是用各种电商app抢购商品,但是库存数是很少的,特别是秒杀场景,商品可能就一件,那如何保证不会出现超卖的情况呢? 一、扣减库存的三种方案 (1)下单减库存 用户下单时减库存 优点:实时减库存,避免付款时因库存不足减库存的问题 缺点:恶意买家大量下单,将库存用完,但是不付款,真正想买的人买不到 (2)付款减库存 下单页面显示最新的库存,下单时不会立即减库存,而是等到支付时才会减库存。 优点:防止恶意买家大量下单用光库存,避免下单减库存的缺点 缺点:下单页面显示的库存数可能不是最新的库存数,而库存数用完后,下单页面的库存数没有刷新,出现下单数超过库存数,若支付的订单数超过库存数,则会出现支付失败。 (3)预扣库存 下单页面显示最新的库存,下单后保留这个库存一段时间(比如10分钟),超过保留时间后,库存释放。若保留时间过后再支付,如果没有库存,则支付失败。 优点:结合下单减库存的优点,实时减库存,且缓解恶意买家大量下单的问题,保留时间内未支付,则释放库存。 缺点:保留时间内,恶意买家大量下单将库存用完。并发量很高的时候,依然会出现下单数超过库存数。 二、如何解决恶意买家下单的问题 这里的恶意买家指短时间内大量下单,将库存用完的买家。 (1)限制用户下单数量 优点:限制恶意买家下单 缺点:用户想要多买几件,被限制了,会降低销售量 (2)标识恶意买家 优点:卖家设定一个备用库存,当支付时,库存已用完,扣减备用库存数,这就是常见的补货场景 缺点:因高并发场景下,数据可能存在不一致性的问题 三、如何解决下单成功而支付失败(库存不足)的问题 (1)备用库存 商品库存用完后,如果还有用户支付,直接扣减备用库存。 优点:缓解部分用户支付失败的问题 缺点:备用库存只能缓解问题,不能从根本上解决问题。另外备用库存针对普通商品可以,针对特殊商品这种库存少的,备用库存量也不会很大,还是会出现大量用户下单成功却因库存不 足而支付失败的问题。 四、如何解决高并发下库存超卖的场景 库存超卖最简单的解释就是多成交了订单而发不了货。 场景: 用户A和B成功下单,在支付时扣减库存,当前库存数为10。因A和B查询库存时,都还有库存数,所以A和B都可以付款。 A和B同时支付,A和B支付完成后,可以看做两个请求回调后台系统扣减库存,有两个线程处理请求,两个线程查询出来的库存数 inventory=10, 然后A线程更新最终库存数 lastInventory=inventory - 1 = 9, B线程更新库存数 lastInventory=inventory - 1 = 9。 而实际最终的库存应是8才对,这样就出现库存超卖的情况,而发不出货。 那如何解决库存超卖的情况呢? 1.SQL语句直接更新库存,而不是先查询出来,然后赋值 UPDATE[库存表]SET库存数-1 2.SQL语句更新库存时,如果扣减库存后,库存数为负数,直接抛异常,利用事务的原子性进行自动回滚。 3.利用SQL语句更新库存,防止库存为负数 UPDATE[库存表]SET库存数-1WHERE库存数-1>0 如果影响条数大于1,则表示扣减库存成功,否则不更新库存,并退款。 五、秒杀场景下如何扣减库存 (1)下单减库存 因秒杀场景下,大部分用户都是想直接购买商品的,可以直接用下单减库存。 大量用户和恶意用户都是同时进行的,区别是正常用户会直接购买商品,恶意用户虽然在竞争抢购的名额,但是获取到的资格和普通用户一样,所以下单减库存在秒杀场景下,恶意用户下单并不能造成之前说的缺点。 而且下单直接扣减库存,这个方案更简单,在第一步就扣减库存了。 (2)将库存放到redis缓存中 查询缓存要比查询数据库快,所以将库存数放在缓存中,直接在缓存中扣减库存。 (3)使用量自增方式 可以先增加已使用量,然后与设定的库存进行比较,如果超出,则将使用量减回去。 另外其实真实的项目中,用到了更多的机制来保证能够正常扣减库存,本篇是抛砖引入,希望大家提出宝贵的建议和方案~。 本文同步分享在 博客“7年一线互联网经验,超爱图解底层原理,全栈一枚”(CNBlog)。 如有侵权,请联系 support@oschina.cn 删除。 本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

优秀的个人博客,低调大师

每日一博 | 高德 Serverless 平台建设及实践

导读 高德启动Serverless建设已经有段时间了,目前高德Serverless业务的峰值早已超过十万QPS量级,平台从0到1,QPS从零到超过十万,成为阿里集团内Serverless应用落地规模最大的BU。这个过程如何实现,遇到过哪些问题?本文将和大家分享高德为何要搞Serverless/Faas,如何做,技术方案是什么?目前进展以及后续计划有哪些,希望对感兴趣的同学有所帮助。 1.高德为什么要搞Serverless 背景原因是高德当年启动了一个客户端上云项目,项目主要目的是为了提升客户端的开发迭代效率。以前客户端业务逻辑都在端上,产品需求的变更需要走客户端发版才能发布,而客户端发版需要走各种测试流程,灰度流程,解客户端崩溃等问题。 客户端上云之后,某些易变的业务逻辑放到云上来。新的产品需求通过在云端来开发,不用走月度的版本发布,加快了需求的开发迭代效率,离产研同频的理想目标又近了一步(为什么要说“又”,是因为高德之前也做了一些优化往产研同频的方向努力,但是我们希望云端一体化开发能是其中最有效的一个技术助力)。 1.1 目标:客户端开发模式——端云一体 虽然开发模式从以前的端开发转变为现在的云 + 端开发,开发同学应该还是原来负责相应业务的同学,而大家知道,服务端开发和客户端开发显然是有差异的,客户端开发往往是面向单机模式的开发,服务端开发通常是集群模式,需要考虑分布式系统的协调、负载均衡,故障转移降级等各种复杂问题。 如果使用传统的服务端模式来开发,这个过渡风险就会比较大。Faas很好的解决了这一问题。我们结合高德客户端现有的xbus框架(一套客户端上的本地服务注册、调用的框架),扩展了xbus-cloud组件,使得云上的开发就像端上开发一样,目标是一套代码,两地运行,一套业务代码既能在客户端上运行,也能在服务端上运行。 高德客户端主要有三个端:iOS、Android、车机(类Linux操作系统)。主要有两种语言,C++和Node.js。传统地图功能:如地图显示,导航路径显示,导航播报等等,由于需要跨三个端,采用C++语言来开发。地图导航基础之上的一些地图应用功能,如行前、行后卡片,推荐目的地等主要是用Node.js来开发的。 在阿里集团,淘系前端团队开发了Node.js Faas Runtime。高德客户端上云项目,Node.js的部分就采用了现有的淘系的Node.js Runtime,来接入集团的Faas平台,完成Node.js这部分的一些业务上云。2020年十一很好的支撑了高德的十一出行节业务。 C++ Faas没有现有的解决方案,因此我们决定在集团的基础设施之上做加法,新建C++ Faas基础平台,来助力高德客户端上云。 1.1.1 端云一体的最佳实践关键:客户端和Faas之间的接口抽象 原本客户端的逻辑移到Faas服务端上来,或者新的需求一部分在Faas服务端上开发,这里的**成败关键点在于:客户端和Faas的接口协议定义,也就是Faas的API定义。**好的API定义除了对系统的可维护性有好处以外,对后续支撑业务的迭代开发也很重要。 理想情况下:客户端做成一个解析Faas返回结果数据的一个浏览器。浏览器协议一旦定义好,就不会经常变换,你看IE,Chrome就很少更新。 当然我们的这个浏览器会复杂一些,我们这个浏览器是地图浏览器。如何检验客户端和Faas之间的接口定义好不好,可以看后续的产品需求迭代,如果有些产品需求迭代只需要在Faas上完成,不需要客户端的任何修改,那么这个接口抽象就是成功的。 1.2 BFF层开发提效 提到高德,大家首先想到的应该是其工具属性:高德是一个导航工具,(这个说法现在已经不太准确了,因为高德这几年在做工具化往平台化转型,高德的交易类业务正在兴起,高德打车、门票、酒店等业务发展非常迅猛)。针对高德导航来说,相比集团其他业务,相比电商来说,有大量的只读场景是高德业务的一大技术特点。 这些只读场景里,大量的需求是BFF(Backend For Frontend)类型的只读场景。为什么这么说,因为导航的最核心功能,例如routing, traffic, eta等都是相对稳定的,这部分的主要工作在用持续不断的优化算法,使得高德的导航更准,算出的路径更优。这些核心功能在接口和功能上都是相对比较稳定的,而前端需求是多变的,例如增加个路径上的限宽墩提示等。 Faas特别适合做BFF层开发,在Faas上调用后端相对稳定的各个Baas服务,Faas服务来做数据和调用逻辑封装,快速开发、发布。在业界,Faas用的最多的场景也正是BFF场景(另外一个叫法是SFF场景,service for frontend)。 1.3 Serverless是云时代的高级语言 虽然高德已经全面上云了,但是目前还不是云时代的终局,目前主要是全面Docker化并上云,容器方面做了标准化,在规模化,资源利用率方面可以全面享受云的红利,但是业务开发模式上基本还和以前一样,还是一个大型的分布式系统的写法。 对于研发模式来说还并没有享受云的红利,可以类比为我们现在是在用汇编语言的方式来写跑在云上的服务。而Serverless、云原生可以理解为云时代的高级语言,真正做到了Cloud as a computer,只需要关注于业务开发,不需要考虑大型分布式系统的各种复杂性。 1.4 Go-Faas补充Go语言生态 前面讲到了因为客户端上云项目,我们在阿里云FC(函数计算)团队之上做加法,开发了C++ Faas Runtime。 不仅如此,我们还开发了Go-Faas,为什么会做Go-Faas呢,这里也简单介绍一下背景,高德服务端Go部分的QPS峰值已超百万。高德已补齐了阿里各中间件的Go客户端,和集团中间件部门共建。可观测性、自动化测试体系也基本完善,目前Go生态已基本完善。补齐了Go-Faas之后,我们就既能用Go写Baas服务,又能用Go写Faas服务了,在不同的业务场景采用不同的服务实现方式,Go-Faas主要应用于上文提到的BFF场景。 2. 技术方案介绍——在集团现有基础设施之上做加法 2.1 整体技术架构 上文讲了我们为什么要做这个事情,现在来讲一下我们具体是怎么做这个事情:如何实现,具体的技术方案是什么样的。 我们本着在集团现有的基础设施、现有的中间件基础之上做加法的思想,我们和CSE,阿里云FC函数计算团队合作共建,开发了C++ Faas Runtime 和 Go Faas Runtime。整体和集团拉通的技术架构如下图所示,主要分为研发态、运行态、运维态三个部分。 2.1.1 运行态 先说运行态,业务流量从网关进来,调用到FC API Server,转发到C++/Go Faas Runtime,Runtime来完成用户函数里的功能。Runtime的架构下一章节来具体介绍。 和Runtime Container一起部署的有监控、日志、Dapr各种Side car,Side car来完成各种日志采集上报功能,Dapr Side car来完成调用集团中间件的功能。 另外,目前Dapr还在试点的阶段,调用中间件主要是通过Broker和各个中间件Proxy来完成,中间件调用的有HSF,Tair,Metaq,Diamond等中间件Proxy。 最后Autoscaling模块来管理函数实例的扩缩容,达到函数自动伸缩的目的。这里的调度就有各种策略了,有根据请求并发量的调度,函数实例的CPU使用率的调度。也能提前设置预留实例数,避免缩容到0之后的冷启动问题。 底层调用的是集团ASI的能力,ASI可以简单理解为集团的K8S + Sigma(集团的调度系统),最终的部署是FC调用ASI来完成函数实例部署。弹性伸缩的,部署的最小单位是上图中的POD,一个POD里包含Runtime Container和Sidecar Set Container。 2.1.2 研发态 再来看研发态,运行态是决定函数是如何运行的,研发态关注的函数的开发体验。如何方便的让开发者开发、调试、部署、测试一个函数。 C++ Faas有个跨平台的难点问题,C++ Faas Runtime里有一些依赖库,这些依赖库没有Java依赖库管理那么方便。这些依赖库的安装比较麻烦,Faas脚手架就是为了解决这个问题,调用脚手架,一键生成C++ Faas示例工程,安装好各种依赖包。为了本地能方便的Debug,开发了一个C++ Faas Runtime Boot模块,函数Runtime启动入口在Boot模块里,Boot模块里集成Runtime和用户Faas函数,可以对Runtime来做Debug单步调试。 我们和集团Aone团队合作,函数的发布集成到Aone环境上了,可以很方便的在Aone上来发布Go或者C++ Faas,Aone上也集成了一键生成Example代码库的功能。 C++和Go Faas的编译都依赖相应的编译环境,Aone提供了自定义编译镜像的功能,我们上传了编译镜像到集团的公共镜像库,函数编译时,在函数的代码库里指定相应的编译镜像。编译镜像里安装了Faas的依赖库,SDK等。 2.1.3 运维态 最后来看函数的运维监控,Runtime内部集成了鹰眼、Sunfire采集日志的功能,Runtime里面会写这些日志,通过Sidecar里的Agent采集到鹰眼、或者Sunfire监控平台上去(FC是通过SLS来采集的)之后,就能使用集团现有的监控平台来做Faas的监控了。也能接入集团的GOC报警平台。 2.2 C++/Go Faas Runtime架构 上面讲的是和Aone,FC/CSE,ASI集成的一个整体架构,Runtime是这个整体架构的一部分,下面具体讲讲Runtime的架构是怎样的,Runtime是如何设计和实现的。 最上面部分的用户Faas代码只需要依赖Faas SDK就可以了,用户只需要实现Faas SDK里的Function接口就能写自己的Faas。 然后,如果需要调用外部系统,可以通过SDK里的Http Client来调用,如果要调用外部中间件,通过SDK里的Diamond/Tair/HSF/Metaq Client来调用中间件就可以。SDK里的这些接口屏蔽了底层实现的复杂性,用户不需要关心这些调用最后是如何实现,不需要关心Runtime的具体实现。 SDK层就是上面提到的Function定义和各种中间件调用的接口定义。SDK代码是开发给Faas用户的。SDK做的比较轻薄,主要是接口定义,不包含具体的实现。调用中间件的具体实现在Runtime里有两种实现方式。 再来看上图中间蓝色的部分,是Runtime的一个整体架构。Starter是Runtime的启动模块,启动之后,Runtime自身是一个Server,启动的时候根据Function Config模块的配置来启动Runtime,Runtime启动之后开启请求和管理监听模式。 往下是Service层,实现SDK里定义的中间件调用的接口,包含RSocket和Dapr两种实现方式,RSocket是通过RSocket broker的模式来调用中间件的,Runtime里集成了Dapr(distributed application runtime) ,调用中间件也可以通过Dapr来调用,在前期Dapr试点阶段,如果通过Dapr调用中间件失败了,会降级到RSocket的方式来调用中间件。 再往下就是RSocket的协议层,封装了调用RSocket的各种Metadata协议。Dapr调用是通过GRPC方式来调用的。最下面一层就是集成了RSocket和Dapr了。 RSocket调用还涉及到Broker选择的问题,Upstream模块来管理Broker cluster,Broker的注册反注册,Keepalive检查等等,LoadBalance模块来实现Broker的负载均衡选择,以及事件管理,连接管理,重连等等。 最后Runtime里的Metrics模块负责鹰眼Trace的接入,通过Filter模式来拦截Faas链路的耗时,并输出鹰眼日志。打印Sunfire日志,供Sidecar去采集。下图是一个实际业务的Sunfire监控界面: 2.2.1 Dapr Dapr架构见下图所示,具体可以参考看官方文档 Runtime里以前调用中间件是通过RSocket方式来调用的,这里RSocket Broker会有一个中心化问题,为了解决Outgoing流量去中心化问题,高德和集团中间件团队合作引入了Dapr架构。只是Runtime层面集成了Dapr,对于用户Faas来说无感知,不需要关心具体调用中间件是通过RSocket调用的还是通过Dapr调用的。后面Runtime调用中间件切换到Dapr之后,用户Faas也是不需要做任何修改的。 3. 业务如何接入Serverless 如前文所述,统一在Aone上接入。我们提供了C++ Faas/Go Faas的接入文档。提供了函数的Example代码库,代码库有各种场景的示例,包括调用集团各种中间件的代码示例。 C++ Faas/Go Faas的接入面向整个集团开放,目前已经有一些高德以外的BU,在自己的业务中落地了C++ /Go Faas了。 Node.js Faas使用淘宝提供的Runtime和模板来接入,Java Faas使用阿里云FC提供的Runtime和模板来接入就可以了。 3.1 接入规范——稳定性三板斧:可监控、可灰度、可回滚 针对落地新技术大家可能担心的稳定性问题,应对法宝是阿里集团的稳定性三板斧:可监控、可灰度、可回滚。建立Faas链路保障群,拉通上下游各相关业务方、基础平台一起,按照集团的1-5-10要求,做到1分钟之内响应线上报警,快速排查,5分钟之内处理;10分钟之内恢复。 为了规范接入过程,避免犯错误引发线上故障,我们制定了Faas接入规范和CheckList,来帮助业务方快速使用Faas。 可监控、可灰度、可回滚是硬性要求,除此之前,业务方如果能做到可降级就更好了。我们的C++客户端上云业务,在开始试点的阶段,就做好了可降级的准备,如果调用Faas端失败,本次调用将会自动降级到本地调用。基本上对于客户端功能无损,只是会增加一些响应延迟。 另外,客户端上该功能的版本,可能会比服务端稍微老一点,但是功能是向前兼容的,基本不影响客户端使用。 4. 我们目前的情况 4.1 基础平台建设情况 Go/C++ Faas Runtime开发完成,对接FC-Ginkgo/CSE、Aone完成,已发布稳定的1.0版本。 做了大量的稳定性建设、优雅下线、性能优化、C编译器优化,使用了阿里云基础软件部编译器优化团队提供的编译方式来优化C++ Faas的编译,性能提升明显。 C++/Go Faas接入鹰眼、Sunfire监控完成,函数具备了可观测性。 池化功能完成,具备秒级弹性的能力。池化Runtime镜像接入CSE,扩一个新实例的时间由原来的分钟级变为秒级。 4.2 高德的Serverless业务落地情况 C++ Faas和Go Faas以及Node.js Faas在高德内部已经有大量应用落地了。举几个例子: 上图中的前两个图是C++ Faas开发的业务:长途天气、沿途搜。后两个截图是Go-Faas开发的业务:导航Tips,足迹地图。 高德是阿里集团内Serverless应用落地规模最大的BU,已落地的Serverless应用,日常峰值早已超过十万QPS量级。 4.3 主要收益 高德落地了集团内规模最大的Serverless应用之后,都有哪些收益呢?首先,第一个最重要的收益是:开发提效。我们基于Serverless实现的端云一体组件,助力了客户端上云,解除了需求实现时的客户端发版依赖问题,提升了客户端的开发迭代效率。基于Serverless开发的BFF层,提升了BFF类场景的开发迭代效率。 **第二个收益是:运维提效。**利用Serverless的自动弹性扩缩容技术,高德应对各种出行高峰就更从容了。例如每年的10-1出行节,5-1、清明、双旦、春节的出行高峰,不再需要运维或者业务开发同学在节前提前扩容,节后再缩容了。 高德业务高峰的特点还不同于电商的秒杀场景。出行高峰的流量不是在一秒内突然涨起来的,我们目前利用池化技术实现的秒级弹性的能力,完全能满足高德的这个业务场景需求。 **第三个收益是:降低成本。**高德的业务特点,白天流量大、夜间流量低,高峰值和低谷值差异较大,时间段区分明显。利用Serverless在夜间流量低峰时自动缩容技术,极大的降低了服务器资源的成本。 5. 后续计划 FC弹内函数计算使用优化,和FC团队一起持续优化弹内函数计算的性能、稳定性、使用体验。用集团内的丰富的大流量业务场景,不断打磨好C++/Go Faas Runtime,并最终输出到公有云,普惠数字化转型浪潮中的更多企业。 Dapr落地,解决Outcoming流量去中心化问题,逐步上线一些C++/Go Faas,使用Dapr的方式调用集团中间件。 Faas混沌工程,故障演练,逃生能力建设。Faas在新财年也会参与我们BU的故障演练,逐一解决演练过程中发现的问题。 接入边缘计算。端云一体的场景下,Faas + 边缘计算,能提供更低的延时,更好的用户体验。 以上要做的事情任重道远,另外我们未来还会做更多云原生的试点和落地,技术同学都知道,从技术选型、技术原型到实际业务落地,这之间还有很长的路要走。 欢迎对Serverless、云原生、或者Go应用开发感兴趣的小伙伴,想一起做点事情的同学来加入我们(不管之前是什么技术栈,英雄不问出处,投简历到 gdtech@alibaba-inc.com,邮件主题为:姓名-技术方向-来自高德技术),这里有大规模的落地场景和简单开放的技术氛围。欢迎自荐或推荐。

优秀的个人博客,低调大师

每日一博 | 懂得取舍才是缓存设计的真谛

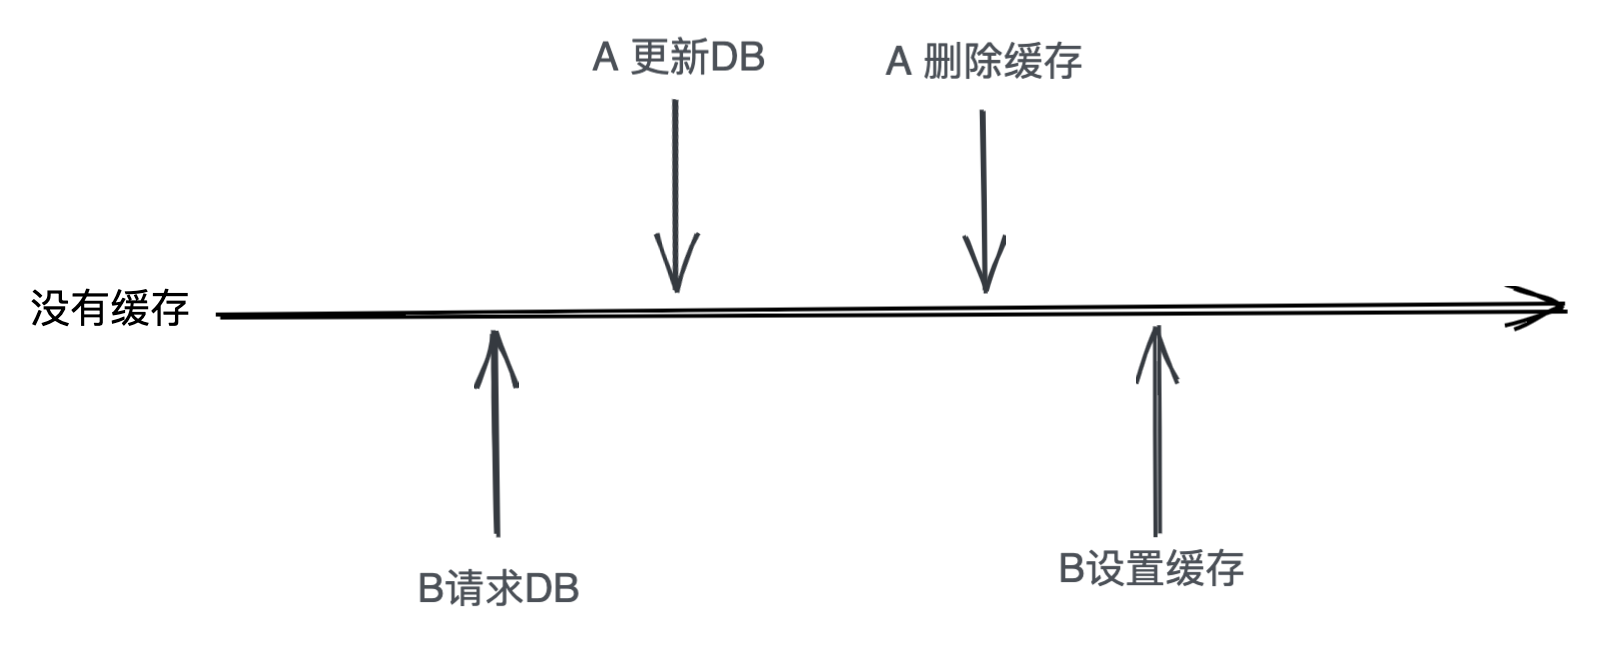
Previously 前两篇文章(缓存稳定性 和 缓存正确性)跟大家讨论了缓存的『稳定性』和『正确性』,缓存常见问题还剩下『可观测性』和『规范落地&工具建设』 稳定性 正确性 可观测性 规范落地和工具建设 上周文章发完之后,很多同学对我留的问题进行了深入的讨论,我相信经过深度的思考,会让你对缓存一致性的理解更加深刻! 首先,各个 Go 群和 go-zero 群里有很多的讨论,但是大家也都没有找到非常满意的答案。 让我们来一起分析一下这个问题的几种可能解法: 利用分布式锁让每次的更新变成一个原子操作。这种方法最不可取,就相当于自废武功,放弃了高并发能力,去追求强一致性,别忘了我之前文章强调过『这个系列文章只针对非追求强一致性要求的高并发场景,金融支付等同学自行判断』,所以这种解法我们首先放弃。 把 A删除缓存 加上延迟,比如过1秒再执行此操作。这样的坏处是为了解决这种概率极低的情况,而让所有的更新在1秒内都只能获取旧数据。这种方法也不是很理想,我们也不希望使用。 把 A删除缓存 这里改成设置一个特殊占位符,并让 B设置缓存 用 redis 的 setnx 指令,然后后续请求遇到这个特殊占位符时重新请求缓存。这个方法相当于在删除缓存时加了一种新的状态,我们来看下图的情况 是不是又绕回来了,因为A请求在遇到占位符时必须强行设置缓存或者判断是不是内容为占位符。所以这也解决不了问题。 那我们看看 go-zero 是怎么应对这种情况的,我们选择对这种情况不做处理,是不是很吃惊?那么我们回到原点来分析这种情况是怎么发生的: 对读请求的数据没有缓存(压根没加载到缓存或者缓存已失效),触发了DB读取 此时来了一个对该数据的更新操作 需要满足这样的顺序:B请求读DB -> A请求写DB -> A请求删除缓存 -> B请求设置缓存 我们都知道DB的写操作需要锁行记录,是个慢操作,而读操作不需要,所以此类情况相对发生的概率比较低。而且我们有设置过期时间,现实场景遇到此类情况概率极低,要真正解决这类问题,我们就需要通过 2PC 或是 Paxos 协议保证一致性,我想这都不是大家想用的方法,太复杂了! 做架构最难的我认为是懂得取舍(trade-off),寻找最佳收益的平衡点是非常考验综合能力的。当然,如果大家有什么好的想法,可以通过群或者公众号联系我,感谢! 本文作为系列文章第三篇,主要跟大家探讨『缓存监控和代码自动化』 缓存可观测性 前面两篇文章我们解决了缓存的稳定性和数据一致性问题,此时我们的系统已经充分享受到了缓存带来的价值,解决了从零到一的问题,那么我们接下来要考虑的是如何进一步降低使用成本,判断哪些缓存带来了实际的业务价值,哪些可以去掉,从而降低服务器成本,哪些缓存我需要增加服务器资源,各个缓存的 qps 是多少,命中率多少,有没有需要进一步调优等。 上图是一个服务的缓存监控日志,可以看出这个缓存服务的每分钟有5057个请求,其中99.7%的请求都命中了缓存,只有13个落到DB了,DB都成功返回了。从这个监控可以看到这个缓存服务把DB压力降低了三个数量级(90%命中是一个数量级,99%命中是两个数量级,99.7%差不多三个数量级了),可以看出这个缓存的收益是相当可以的。 但如果反过来,缓存命中率只有0.3%的话就没什么收益了,那么我们就应该把这个缓存去掉,一是可以降低系统复杂度(如非必要,勿增实体嘛),二是可以降低服务器成本。 如果这个服务的 qps 特别高(足以对DB造成较大压力),那么如果缓存命中率只有50%,就是说我们降低了一半的压力,我们应该根据业务情况考虑增加过期时间来增加缓存命中率。 如果这个服务的 qps 特别高(足以对缓存造成较大压力),缓存命中率也很高,那么我们可以考虑增加缓存能够承载的 qps 或者加上进程内缓存来降低缓存的压力。 所有这些都是基于缓存监控的,只有可观测了,我们才能做进一步有针对性的调优和简化,我也一直强调『没有度量,就没有优化』。 如何让缓存被规范使用? 了解 go-zero 设计思路或者看过我的分享视频的同学可能对我经常讲的『工具大于约定和文档』有印象。 对于缓存来说,知识点是非常繁多的,每个人写出的缓存代码一定会风格迥异,而且所有知识点都写对是非常难的,就像我这种写了那么多年程序的老鸟来说,一次让我把所有知识点都写对,依然是非常困难的。那么 go-zero 是怎么解决这个问题的呢? 尽可能把抽象出来的通用解决方法封装到框架里。这样整个缓存的控制流程就不需要大家来操心了,只要你调用正确的方法,就没有出错的可能性。 把从建表 sql 到 CRUD + Cache 的代码都通过工具一键生成。避免了大家去根据表结构写一堆结构和控制逻辑。 这是从 go-zero 的官方示例 bookstore 里截的一个 CRUD + Cache 的生成说明。我们可以通过指定的建表 sql 文件或者 datasource 来提供给 goctl 所需的 schema,然后 goctl 的 model 子命令可以一键生成所需的 CRUD + Cache 代码。 这样就确保了所有人写的缓存代码都是一样的,工具生成能不一样吗?:P 未完待续 本文跟大家一起讨论了缓存的可观测性和代码自动化,下一篇我来跟大家分享一下我们是怎么提炼和抽象缓存的通用解决方法的,大家可以预先了解一下聚族索引的设计,自己先思考一下缓存该如何做,毕竟经过深度思考,你的理解会更加深刻嘛! 所有这些问题的解决方法都已包含在 go-zero 微服务框架里,如果你想要更好的了解 go-zero 项目,欢迎前往官方网站上学习具体的示例。 视频回放地址 ArchSummit架构师峰会-海量并发下的缓存架构设计 项目地址 https://github.com/tal-tech/go-zero https://gitee.com/kevwan/go-zero 欢迎使用 go-zero 并 star 支持我们! 微信交流群 关注『微服务实践』公众号并点击 交流群 获取社区群二维码。

优秀的个人博客,低调大师

每日一博 | React 事件系统是如何工作的?

一、DOM 事件流 在浏览器中,我们通过事件监听来实现 JS 和 HTML 之间的交互。一个页面往往会被绑定许许多多的事件,而页面接收事件的顺序,就是事件流。它类似于蹦床,从高处下落,触达蹦床后再弹起,整个过程呈一个V字形。若按W3C标准,一个事件的传播过程要经过三个阶段 1、DOM 事件流的三个阶段 事件捕获阶段 事件从最外层的元素开始“穿梭”,逐层“穿梭”,直到目标元素,也就是真正触发事件的元素 目标阶段 事件被目标元素所接收 事件冒泡阶段 事件被“回弹”,沿着来时的路“逆流而上”,逐层往上 2、事件委托 假设我们有这么一个场景:在拥有1000个li元素的列表上,点击每一个li输出其对应的文本内容 很直观的一个思路:让每个li元素去监听一个点击动作,但这样重复的代码不够优雅,开销也蛮大。若利用 DOM 事件流的事件冒泡特性,我们可以这么做:把多个子元素的同一类型的监听逻辑合并到父元素上,通过一个监听函数来管理行为,即通过事件对象中的target属性,获取到真正触发事件的元素,这也是所谓的事件委托 let ul = document.getElementsByTagName('ul') ul.addEventListener('click', function(e){ // e.target属性指的是触发事件的具体目标,记录着事件的源头 console.log(e.target.innerHTML) }) 通过事件委托处理,可减少内存开销、简化注册步骤,从而提高开发效率。这也给了react 16灵感,实现对所有的事件的中心化管理。 二、React 事件系统 当事件在具体的DOM节点上被触发后,最终都会冒泡到document上(除了少数特殊的不可冒泡的事件,例如媒体类型的事件外),document上所绑定的统一事件处理程序会将事件分发到具体的组件实例 在分发事件之前,React 首先会对事件进行包装,把原生DOM事件包装成合成事件 1、React合成事件 在React 16 及之前版本中,React自定义的合成事件主要在底层抹平了不同浏览器的差异,在上层面向开发者暴露统一的,稳定的,与DOM原生事件相同的事件接口,同时它保存了原生DOM事件的引用。当开发者需要访问原生DOM事件对象时,可通过合成事件对象的e.nativeEvent属性获取到它 2、React事件系统的工作流 说到事件系统,就有事件的绑定和触发两个关键动作,其中事件的绑定是在挂载阶段里的completeWork函数完成的。completeWork函数内部做了三个关键动作: 创建 DOM 节点 将 DOM 节点插入到 DOM 树中 为 DOM 节点设置属性 - 该环节会遍历 FiberNode 的 props key,当遍历到事件相关的 props 时,便会触发事件的注册链路 事件绑定 在react16源码的基础上,我们来看看事件的注册过程: 其中,源码中有一段判断逻辑值得我们关注 // listenerMap: 记录当前document已经监听了哪些事件 // topLevelType: 事件的类型 listenerMap.has(topLevelType) 若事件系统识别到 listenerMap.has(topLevelType) 为 true,则说明该函数 document 已经监听过了,直接跳过。因此,即便我们在 react项目中多次调用对同一个事件的监听,也只会在 document 上触发一次注册。 Q: 为什么针对同一个事件,即便可能会存在多个回调,document也只需注册一次监听? A:react 最终注册到 document 上的并不是某一个DOM节点上对应的具体回调逻辑,而是一个统一的事件分发函数dispatchEvent 事件触发 同样,在react16源码的基础上,我们来看看事件的触发过程: 其中,事件回调的收集与执行值得我们关注,它主要做了以下三件事: 循环收集符合条件(DOM元素对应的Fiber节点)的父节点,存进path数组 模拟事件在捕获阶段的传播顺序,收集捕获阶段相关节点对应的回调与实例 模拟事件在冒泡阶段的传播顺序,收集冒泡阶段相关节点对应的回调与实例 接下来,我们来看看源码是如何巧妙的模拟出完整的DOM 事件流 function traverseTwoPhase(inst, fn, arg) { // 定义一个 path 数组:子节点在前,祖先节点在后 var path = []; while (inst) { // 将当前节点收集进 path 数组 path.push(inst); // 向上收集 tag===HostComponent 的父节点 inst = getParent(inst); } var i; // 模拟捕获阶段:从后往前,收集 path 数组中会参与捕获过程的节点与对应回调 for (i = path.length; i-- > 0;) { // fn 函数对节点进行检查,若回调不为空,则将实例收集到 SyntheticEvent._dispatchInstances,事件回调则被收集到 SyntheticEvent._dispatchListeners fn(path[i], 'captured', arg); } // 模拟冒泡阶段:从前往后,收集 path 数组中会参与冒泡过程的节点与对应回调 for (i = 0; i < path.length; i++) { // 同上 fn(path[i], 'bubbled', arg); } } traverseTwoPhase 函数主要做了三件事: 重点强调的是:当前事件对应的合成事件实例有且只有一个,因此在模拟捕获和冒泡两个过程,收集到的实例会被存入同一个SyntheticEvent._dispatchInstances,同样,收集到的事件回调也会被存入同一个SyntheticEvent._dispatchListeners。因此,只需要按顺序执行SyntheticEvent._dispatchListeners 数组中的回调函数,就能模拟出完整的DOM 事件流,即“捕获-目标-冒泡”三个阶段 三、React16 事件系统的设计动机是什么? 1、React 官方说明过的一点是:合成事件符合W3C规范,在底层抹平了不同浏览器的差异,在上层面向开发者暴露统一的、稳定的、与 DOM 原生事件相同的事件接口。开发者们由此便不必再关注烦琐的底层兼容问题,可以专注于业务逻辑的开发 2、自研事件系统使 React 牢牢把握住了事件处理的主动权,能够从很大程度上干预事件的表现,使其符合自身的需求,毕竟原生讲究的就是个通用性。而 React 想要的则是“量体裁衣”。 四、React16 事件系统的不足 在GitHub issue里有一个这样的Bug: 提问者试图在input元素的React事件函数中阻止冒泡,但事实并没有如愿,每次点击input的时候,事件还是会被冒泡到document上去。对此,他得到的回复是这样的: React会通过将所有事件冒泡到document来实现对事件的中心化管控,而document是整个文档树的根节点,操作它带来的影响范围着实太大。 提问者在handleClick这个React事件函数中阻止了冒泡,但这只能保证该事件对应的合成事件在React事件体系下的冒泡被阻止了,即React不会为这个合成事件 模拟冒泡效果,并不能阻止原生DOM事件的冒泡,因此安装在document上的事件监听器一定会被触发 且不说document中心化管控这个设定给开发者带来了多大的限制,单看document是一个全局的概念,而组件只是全局的一个部分,便能多少预感到其中的风险。 五、React17的改进 1、放弃利用document来做事件的中心化管控 React 17正面解决了这个问题:事件的中心化管控不会再全部依赖document,管控相关的逻辑被转移到了每个React组件自己的容器DOM节点上。 在 React 16 及之前版本中,React 会对大多数事件进行 document.addEventListener() 操作。React 17 开始会通过调用 rootNode.addEventListener() 来代替。 这样一来,React组件就能够各玩各的,再也无法对全局的事件流造成影响 2、放弃事件池 在React 17之前,合成事件对象会被放进一个叫作:“事件池”的地方统一管理。其目的是为了实现事件的复用,进而提高性能。即当所有事件处理函数被调用之后,其所有属性都会被置空,换句话说:事件逻辑一旦执行完毕,开发者就拿不到事件对象了 有个官方的例子 如下: function handleChange(e) { // This won't work because the event object gets reused. setTimeout(() => { console.log(e.target.value); // Too late! }, 100); } 异步执行的setTimeout回调会在handleChange这个事件处理函数执行完毕后执行,因此它拿不到想要的那个事件对象,如果你需要在事件处理函数运行之后获取事件对象的属性,你需要调用 e.persist()

优秀的个人博客,低调大师

每日一博 | Dubbo协议解析与ESA RPC实践

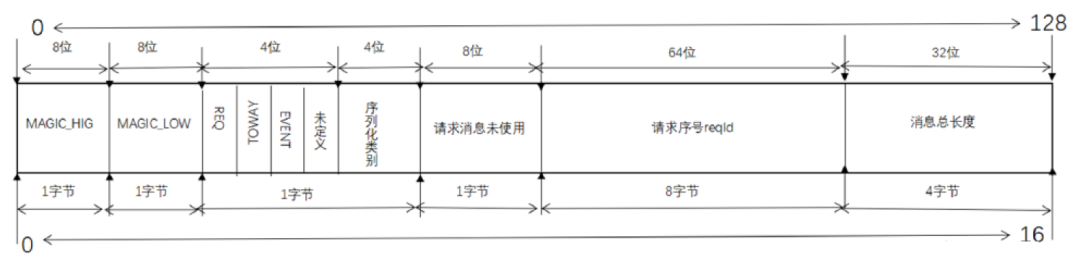
点击关注“OPPO互联网技术”,阅读更多技术干货 1. 背景 Dubbo是一款高性能、轻量级的开源Java RPC框架,诞生于2012年,2015年停止研发,后来重启并发布了2.7及连续多个版本。Dubbo自开源以来,许多大公司都以此为微服务架构基石,甚至在官方停止维护的几年中,热度依然不减。 但最近几年云原生技术开始成为主流,与Dubbo框架的核心设计理念有不相容之处,再加上公司安全治理的需求,OPPO互联网技术团队开发了面向云原生、 Mesh友好的ESA RPC框架。 2.Dubbo协议解析 协议是两个网络实体进行通信的基础,数据在网络上从一个实体传输到另一个实体,以字节流的形式传递到对端。Dubbo协议由服务提供者与消费者双端约定,需要确定的是一次有意义的传输内容在读到何时结束,因为一个一个byte传输过来,需要有一个结束。而且数据在网络上的传输,存在粘包和半包的情况,能够应对这个问题的办法就是协议能够准确的识别,当粘包发生时不会多读,当半包发生时会继续读取。 2.1 Dubbo Header内容 Dubbo header的长度总共16字节,128位,如下图所示: Magic(16 bits) : 协议魔数,标识Dubbo 数据包。 Req/Res(1 bit) : 标识请求或者相应。请求:1,相应:0。 Two Way(1 bit) : 仅在 Req/Res 为1(请求)时才有用,标记是否期望从服务器返回值。如果需要来自服务器的返回值,则设置为1。 Event(1 bit) : 标识是否是事件消息,例如,心跳事件。如果这是一个事件,则设置为1。 SerializationId(5 bits) : 序列化id。 Status(8 bits) : 仅在 Req/Res 为0(响应)时有用,用于标识响应的状态。 RequstId(64 bits) : 标识唯一请求。类型为long。 Data length(32 bits) : 序列化后的内容长度(变长部分,即不包含header),按字节计数。通过payload参数指定,默认为8M。 2.2 Dubbo body内容 Dubbo 数据包的body 部分内容,分为请求包与响应包。 如果是请求包,则包含的部分有: dubbo协议版本号(2.0.2); 接口名; 接口版本号; 方法名; 方法参数类型; 方法参数; 附件(Attachment): 接口分组(group); 接口版本号(version); 接口名; 自定义附件参数; 如果是响应包,则包含的内容有: 返回值类型(byte): 返回空值(2); 正常返回值(1); 异常(0); 返回值; 通过对dubbo协议的解析,我们可以知道,dubbo协议是一个Header定长的变长协议。这也在我们ESA RPC实践过程中提供了一些思路。 2.3 Dubbo协议优缺点 2.3.1 优点 Dubbo协议的设计非常紧凑、简单,尽可能的减少传输包大小,能用一个bit表示的字段,不会用一个byte。 2.3.2 不足 请求body中某些字段重复传递(如接口名,接口版本号),即body内容与附件attachment 中存在重复字段,增大传输数据包大小; 对于ServiceMesh 场景很不友好。在ServiceMesh 场景中,会将原sdk中的大部分功能迁移至SideCar 中实现,这里以服务发现为例。Dubbo 中的服务发现,是通过接口名(interfaceName)、接口分组(group)、接口版本号(version)三者定位一个唯一服务,也是服务发现的关键要素,但是我们从dubbo body内容可知,必须要将完整的数据包全部解析(attachment位于body末),才能获取到这三个要素,这是完全没必要的。 没有预留字段,扩展性不足。 3. Dubbo的现状 Dubbo自开源以来,在业内造成了巨大的影响,许多公司甚至大厂都以此为微服务架构基石,甚至在Dubbo官方停止维护的几年中,热度依然不减,足以证明其本身的优秀。 在这过程中,Dubbo协议的内容一直没有太大变化,主要是为了兼容性考虑,但其他内容,随着Dubbo的发展变化却是很大。这里我们主要聊一聊dubbo从2.7.0版本以后的情况。 3.1 Dubbo 2.7.x版本总览 这是dubbo自2.7.0版本以来,各个版本的简要功能说明,以及升级建议。可以看到dubbo官方推荐生产使用的只有2.7.3 和2.7.4.1两个版本。但这两个推荐版本,也有不能满足需求的地方。 由于dubbo在2.7.3 和2.7.4.1 这两个版本中改动巨大,使得这两个版本无法向下兼容,这让基于其他版本做的一些dubbo扩展几乎无法使用。升级dubbo的同时,还需要将以前的扩展全部检查修改一遍,这带来很大工作量。而且除了我们自身团队的一些公共扩展外,全公司其他业务团队很可能还有自己的一些扩展,这无疑增大了我们升级dubbo的成本。 4. ESA RPC最佳实践 最近几年云原生技术开始成为主流,与Dubbo框架的核心设计理念也有不相容之处,再加上公司安全治理的需求,我们需要一款面向云原生、 Mesh友好的RPC框架。 在这个背景下,OPPO互联网技术团队从2019年下半年开始动手设计开发ESA RPC,到2020年一季度,ESA RPC 第一版成功发布。下面我们简单介绍下ESA RPC的一些主要功能。 4.1 实例级服务注册与发现 ESA RPC通过深度整合发布平台,实现实例级服务注册与发现,如图所示: 应用发布时,相应的发布平台会将实例信息注册到OPPO自研的注册中心ESA Registry(应用本身则不再进行注册),注册信息包含应用名、ip、端口、实例编号等等,消费者启动时只需通过应用编号订阅相关提供者即可。 既然服务注册部分是由发布平台完成,开发者在发布应用时,就需要填写相关信息,即相关的暴露协议以及对应的端口,这样发布平台才可以正确注册提供者信息。 4.2 客户端线程模型优化 ESA RPC全面拥抱java8的CompletableFuture ,我们将同步和异步的请求统一处理,认为同步是特殊的异步。而Dubbo,由于历史原因,最初dubbo使用的jdk版本还是1.7,所以在客户端的线程模型中,为了不阻塞IO线程,dubbo增加了一个Cached线程池,所有的IO消息统一都通知到这个Cached线程池中,然后再切换回相应的业务线程,这样可能会造成当请求并发较高时,客户端线程暴涨问题,进而导致客户端性能低下。 所以我们在ESA RPC客户端优化了线程模型,将原有的dubbo客户端cached线程池取消,改为如下图模型: 具体做法: 当前业务线程发出远程调用请求后,生成CompletableFuture 对象,并传递至IO线程,等待返回; IO线程收到返回内容后,找到与之对应的CompletableFuture 对象,直接赋予其返回内容; 业务线程通过自己生成的CompletableFuture 对象获取返回值; 4.3 智能Failover 对于一些高并发的服务,可能会因传统Failover 中的重试而导致服务雪崩。ESA RPC对此进行优化,采用基于请求失败率的Failover ,即当请求失败率低于相应阈值时,执行正常的failover重试策略,而当失败率超过阈值时,则停止进行重试,直到失败率低于阈值再恢复重试功能。 ESA RPC采用RingBuffer 的数据结构记录请求状态,成功为0,失败为1。用户可通过配置的方式指定该RingBuffer 的长度,以及请求失败率阈值。 4.4 ServiceKeeper ESA ServiceKeeper (以下简称ServiceKeeper ),属于OPPO自研的基础框架技术栈ESA Stack系列的一员。ServiceKeeper 是一款轻量级的服务治理框架,通过拦截并代理原始方法的方式织入限流、并发数限制、熔断、降级等功能。 ServiceKeeper 支持方法和参数级的服务治理以及动态动态更新配置等功能,包括: 方法隔离 方法限流 方法熔断 方法降级 参数级隔离、限流、熔断 方法重试 接口分组 动态更新配置,实时生效 ESA RPC中默认使用ServiceKeeper 来实现相关服务治理内容,使用起来也相对简单。 Step 1 application.properties 文件中开启ServiceKeeper 功能。 # 开启服务端esa.rpc.provider.parameter.enable-service-keeper=true# 开启客户端esa.rpc.consumer.parameter.enable-service-keeper=true Step 2 新增service-keeper.properties 配置文件,并按照如下规则进行配置: # 接口级配置规则:{interfaceName}/{version}/{group}.{serviceKeeper params},示例:com.oppo.dubbo.demo.DemoService/0.0.1/group1.maxConcurrentLimit=20com.oppo.dubbo.demo.DemoService/0.0.1/group1.failureRateThreshold=55.5com.oppo.dubbo.demo.DemoService/0.0.1/group1.forcedOpen=55.5...#方法级动态配置规则:{interfaceName}/{version}/{group}.{methodName}.{serviceKeeper params},示例:com.oppo.dubbo.demo.DemoService/0.0.1/group1.sayHello.maxConcurrentLimit=20com.oppo.dubbo.demo.DemoService/0.0.1/group1.sayHello.maxConcurrentLimit=20com.oppo.dubbo.demo.DemoService/0.0.1/group1.sayHello.failureRateThreshold=55.5com.oppo.dubbo.demo.DemoService/0.0.1/group1.sayHello.forcedOpen=falsecom.oppo.dubbo.demo.DemoService/0.0.1/group1.sayHello.limitForPeriod=600...#参数级动态配置规则:{interfaceName}/{version}/{group}.{methodName}.参数别名.配置名称=配置值列表,示例:com.oppo.dubbo.demo.DemoService/0.0.1/group1.sayHello.arg0.limitForPeriod={LiSi:20,ZhangSan:50}... 4.5 连接管理 ESA RPC中,一个消费者与一个提供者,默认只会创建一个连接,但是允许用户通过配置创建多个,配置项为connections (与dubbo保持一致)。ESA RPC的连接池通过公司内部一个全异步对象池管理库commons pool来达到对连接的管理,其中连接的创建、销毁等操作均为异步执行,避免阻塞线程,提升框架整体性能。 需要注意的是,这里的建连过程,有一个并发问题要解决:当客户端在高并发的调用建连方法时,如何保证建立的连接刚好是所设定的个数呢?为了配合 Netty 的无锁理念,我们也采用一个无锁化的建连过程来实现,利用 ConcurrentHashMap 的putIfAbsent 方法: AcquireTask acquireTask = this.pool.get(idx);if (acquireTask == null) { acquireTask = new AcquireTask(); AcquireTask tmpTask = this.pool.putIfAbsent(idx, acquireTask); if (tmpTask == null) { acquireTask.create(); //执行真正的建连操作 }} 4.6 gRPC协议支持 由于ESA RPC默认使用ESA Regsitry 作为注册中心,由上述实例注册部分可知,服务注册通过发布平台来完成,所以ESA RPC对于gRPC协议的支持具有天然的优势,即服务的提供者可以不接入任何sdk,甚至可以是其他非java语言,只需要通过公司发布平台发布应用后,就可以注册至注册中心,消费者也就可以进行订阅消费。 这里我们以消费端为例,来介绍ESA RPC客户端如何请求gRPC服务端。 proto文件定义: syntax = "proto3";option java_multiple_files = false;option java_outer_classname = "HelloWorld";option objc_class_prefix = "HLW";package esa.rpc.grpc.test.service;// The greeting service definition.service GreeterService { // Sends a greeting rpc sayHello (HelloRequest) returns (HelloReply) { }}service DemoService { // Sends a greeting rpc sayHello (HelloRequest) returns (HelloReply) { }}// The request message containing the user's name.message HelloRequest { string name = 1;}// The response message containing the greetingsmessage HelloReply { string message = 1;} 然后maven中添加proto代码生成插件: <build> <extensions> <extension> <groupId>kr.motd.maven</groupId> <artifactId>os-maven-plugin</artifactId> <version>1.5.0.Final</version> </extension> </extensions> <plugins> <plugin> <groupId>org.xolstice.maven.plugins</groupId> <artifactId>protobuf-maven-plugin</artifactId> <version>0.5.0</version> <configuration><protocArtifact>com.google.protobuf:protoc:3.11.0:exe:${os.detected.classifier}</protocArtifact> <pluginId>grpc-java</pluginId> <pluginArtifact>esa.rpc:protoc-gen-grpc-java:1.0.0-SNAPSHOT:exe:${os.detected.classifier}</pluginArtifact> </configuration> <executions> <execution> <goals> <goal>compile</goal> <goal>compile-custom</goal> </goals> </execution> </executions> </plugin> </plugins> </build> 如上proto定义文件,通过protobuf:compile和protobuf:compile-custom则会生成如下代码: 可以看到,自动生成的代码中我们额外生成了相应的java接口。 在dubbo客户端我们就可以直接使用这个接口进行远程调用,使用方式: @Reference(...,protocol="grpc")private DemoService demoService; 4.7 ESA RPC性能 这里仅举一例,展示ESA RPC性能。 5. ESA RPC未来规划 5.1 ESA RPC如何进行平滑迁移? 由于历史原因,现公司内部大量使用的是Dubbo作为RPC框架,以及zookeeper注册中心,如何能够保证业务的平滑迁移,一直是我们在思考的问题。这个问题想要解答,主要分为以下两点。 5.1.1 代码层面 在代码层面,ESA RPC考虑到这个历史原因,尽可能的兼容dubbo,尽可能降低迁移成本。但ESA RPC毕竟作为一款新的RPC框架,想要零成本零改动迁移是不可能的,但在没有dubbo扩展的情况下,改动很小。 5.1.2 整体架构 这一点我们举例说明,当业务方迁移某一应用至ESA RPC框架时,该应用中消费ABCD四个接口,但这些接口的服务提供者应用并未升级至ESA RPC,接口元数据信息均保存至zookeeper注册中心当中,而ESA RPC推荐使用的ESA Registry注册中心中没有这些提供者信息,这就导致了消费者无法消费这些老的提供者信息。 针对这一问题,后续我们ESA Stack系列会提供相应的数据同步工具,将原zookeeper注册中心中的服务元数据信息同步到我们ESA Registry中,而zookeeper中的这些信息暂时不删除(以便老的接口消费者能够消费),等待均升级完成后,即可停用zookeeper注册中心。 5.2 自研RPC协议 在上面Dubbo协议解析过程中,我们分析了Dubbo协议的优缺点,了解了Dubbo协议的不足。所以后续的版本升级过程中,自研RPC协议是一个不可忽视的内容。自研RPC协议需要充分考虑安全、性能、Mesh支持、可扩展、兼容性等因素,相信通过自研RPC协议可以使我们的ESA RPC更上一层楼。 5.3 其他 多协议暴露 同机房优先路由 类隔离 ... 在这篇文章中,我们主要分享了Dubbo协议的分析以及ESA RPC的实践内容,后续OPPO互联网技术团队会继续分享更多ESA RPC的动态。 ☆END☆ 招聘信息 OPPO互联网基础技术团队招聘一大波岗位,涵盖C++、Go、OpenJDK、Java、DevOps、Android、ElasticSearch等多个方向,请点击这里查看详细信息及JD。 你可能还喜欢 OPPO自研ESA DataFlow架构与实践 自研代码审查系统火眼Code Review实践 OPPO异地多活实践——缓存篇 更多技术干货 扫码关注 OPPO互联网技术 我就知道你“在看” 本文分享自微信公众号 - OPPO互联网技术(OPPO_tech)。如有侵权,请联系 support@oschina.cn 删除。本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

优秀的个人博客,低调大师

每日一博 | 一文看透 NGINX 开发史

大咖专题 洪志道 白山云技术专家,拥有多年服务器开发经验。NGINX 社区贡献者,熟悉整个NGINX 生态。目前是njs核心开发者,Unit积极贡献者,NGINX 专家。 我的职业生涯大部分时间都在跟NGINX打交道,有足够的经验分享整个NGINX开发史的演进。本文以事后诸葛的角度揭示怎么形成现在这个生态。 此图展示了现如今活跃在NGINX生态的重要开源模块和产品。 ►一切从C开始 NGINX是纯C实现的软件,源码质量很高。即使不从事NGINX的人也可以将它作为很好的学习软件。作者Igor很早就有支持脚本语言的意图。所以问题就变成了C如何跟脚本语言引擎的结合了。这些主流脚本语言python, php, v8(js),perl, lua都有C的API,考虑到两方面:轻量级和性能,perl成为了当时的NGINX首选。甚至他还实现了一个迷你的SSI模块,自定义的脚本功能。但是从现在看,个人觉得Lua是和C交互最好的语言,天生为C设计的脚本语言,足够轻量,足够快。@agentzh将Lua引入NGINX,怎么看都是正确和极具工程实用的选择。估计NGINX社区也没料到Lua模块能如此成功。 但是呢,Igor一直有脚本语言的情节,于是在2015年NJS诞生了,也是纯C的JS引擎。Lua天生能跟C交互,但不意味着它能天生跟服务器软件交互。这里最大的问题是语言虚拟机的实现。简单讲,一个请求会有个vm,非常轻量级,不用担心。对NGINX的每个请求,Lua的vm虽然做了些处理,但还是可以相互影响,如果你想做的话。但是Lua有GC,这也让这问题变的不是很严重。Igor的NJS是专门为NGINX量身定制的JS引擎,还考虑到JS有如此大的用户群体。NJS的每个请求的vm都是相互独立的,不会有任何影响,但是它没有GC。早期GC是列入NJS的计划的,但现在已经变的很遥远了,实现成本太大。这个在 HTTP请求也不是问题,NGINX对每个请求都是统一分配和销毁的。如果用户想在配置上增强NGINX,比如鉴权,NJS是个很好的选择,这也是它的设计初衷。而且NJS通过NGINX的subrequest能跟第三方交互,我们(我是NJS的开发者)最近还打算支持内置的HTTP库。所以想做应用的同学,NJS是个值得入手的选择。 ►模块化,鱼与熊掌 NGINX的模块化机制从第一个版本就有了,但是当时Igor并不是为了第三方考虑的,只是为了方便自己的开发。用NGINX的人大都会为它的模块化机制感到惊叹,谁都可以不用改NGINX源码,只需加入自己的模块,以满足自己的需求。Lua就是最好的例子。 这问题也让Igor很头大,为什么呢?大量的第三方模块,质量参差不齐,它们严重依赖NGINX的API。NGINX是20年前的软件,当时的服务器架构跟如今已经不可同日而语。软件需要进化,就要做重构,但是API不能轻易改。关注NGINX社区的人知道,Igor亲自设计了另一个跟NGINX不同的软件Unit,这软件不会再支持模块化了,这是他们的选择。 所以从短期看,NGINX的模块化让它快速建立了整个生态。从长期看,整个生态也束缚在它的架构上。NGINX最大的问题不具备热加载,这种现在主流软件里已经不是问题,反而在它这里变成很棘手的问题,好在很多以Lua为主的应用可以解决这个问题。 ►OpenResty NGINX的C实现和模块化机制,让Lua的引入变得顺其自然。虽然也有其它的语言已经支持,但如今证明只有Lua玩转的最好,或者说OpenResty做的最成功。 严格来说,OpenResty里的Lua不能叫Lua。它是LuaJIT,以Lua5.1语法为主的另一个分支,而且看着没有跟进官方Lua的计划。Lua5.1以后的版本在语法上有了不少的改进,类似位运算,性能更是如此。对单纯使用Lua而言,非常推荐Lua5.4。 OpenResty让很多开发者大幅提升了开发生产力,并且在它上面衍生了不少开源软件,尤其在API方面,比如Kong和APISIX。很多公司也有内部的自研尝试。 ►看懂设计 不管你是多么熟悉NGINX源码的开发者,还是只是想用它作为应用服务器。脚本语言都是其中的选择之一。从两方面看NGINX:通用功能和业务功能。 通用功能:将它扔进NGINX里,如果你能做模块开发,这点尤为重要。它意味着你将享受未来稳定和维护的红利。举个实际例子,我们在开发NJS里,有个querystring的功能,开发需要一定的成本,用JS语言来写会简单很多,但是我们依然选择将它放在JS引擎里。个人觉得类似Lua里的http request这种库,如果原生Lua模块里支持是再好不过了。对NJS,我们会选择放在js模块里,用户可以直接使用,而不用再引入任何库。还有不少的能用功能,比如常用工具函数md5,sha2之类的。 业务功能:这个不用多说,维护好业务模块就行了。 从整体看,Lua既封装了NGINX的HTTP请求,也提供了独立于请求的功能,比如timer(定时器)和cosocket(跟第三方交互的基础机制)。不管什么模块,也都是基于这两方面进行设计的。我一直推进NJS在这方面的能力,因为目前NJS只能处理请求,但即将引入内置的HTTP库,完全独立于请求的。重复一遍:请求和非请求。 我自己的模块,也一直遵守这样的设计,https://github.com/hongzhidao/nginx-lua-module ►给开发者的建议 如果想学习NGINX,参考这篇 如何高效的学习NGINX 对程序员,长期保持自己的竞争力,自研能力是很重要的技能之一。 用Lua作为开发的,不妨自己写个框架,如今API框架是非常好的练手对象。 ►来乌邦托的世界 基于nginx-lua-module的API框架,一千行左右。 utopia架构图 活动推荐 1 2 扫描下方二维码,快来报名吧! 3 扫描下方二维码,快来报名吧! 你还不能错过: 你还不能错过: 你还不能错过: URL是如何关联location配置块的? 如何configure定制出属于你的Nginx? HTTP请求是如何关联Nginx server{}块的? 问答、课件及录像地址:NGINX从入门到精通进阶系列培训 F5收购NginX 点击下方阅读原文,加入NGINX开源社区! 本文分享自微信公众号 - NGINX开源社区(gh_0d2551f1bdb6)。如有侵权,请联系 support@oschina.cn 删除。本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

优秀的个人博客,低调大师

每日一博 | 缓存穿透、缓存击穿和缓存雪崩

作者 | xiaowei123 出处 | https://0x9.me/Lg9yp 在Redis缓存中有三个必须要知道概念:「缓存穿透、缓存击穿和缓存雪崩。」 缓存穿透 什么是缓存穿透呢?它是指当用户在查询一条数据的时候,而此时数据库和缓存却没有关于这条数据的任何记录,而这条数据在缓存中没找到就会向数据库请求获取数据。它拿不到数据时,是会一直查询数据库,这样会对数据库的访问造成很大的压力。 如:用户查询一个 id = -1 的商品信息,一般数据库 id 值都是从 1 开始自增,很明显这条信息是不在数据库中,当没有信息返回时,会一直向数据库查询,给当前数据库的造成很大的访问压力。 这时候我们要想一想,该如何解决这个问题呢?o(╥﹏╥)o 一般我们可以想到从缓存开始出发,想如果我们给缓存设置一个如果当前数据库不存在的信息,把它缓存成一个空对象,返回给用户。 ^_^没错,这是一个解决方案,也就是我们常说的缓存空对象(代码维护简单,但是效果不是很好)。 Redis 也为我们提供了一种解决方案,那就是布隆过滤器(代码维护比较复杂,效果挺好的)。 「那接下来,二哈先解释下这两种方案:」 缓存空对象 缓存空对象它就是指一个请求发送过来,如果此时缓存中和数据库都不存在这个请求所要查询的相关信息,那么数据库就会返回一个空对象,并将这个空对象和请求关联起来存到缓存中,当下次还是这个请求过来的时候,这时缓存就会命中,就直接从缓存中返回这个空对象,这样可以减少访问数据库的压力,提高当前数据库的访问性能。我们接下来可以看下面这个流程 这时候,我们就会问了呀 ~,如果大量不存在的请求过来,那么这时候缓存岂不是会缓存许多空对象了吗~~~ 没错哦!这也是使用缓存空对象会导致的一个问题:如果时间一长这样会导致缓存中存在大量空对象,这样不仅会占用许多的内存空间,还会浪费许多资源呀!。那这有没有什么可以解决的方法呢?我们来想一想:我们可以将这些对象在一段时间之后清理下不久可以了吗 ~ 嗯嗯,没错!在想想 Redis 里是不是给我们提供了有关过期时间的命令呀(^▽^),这样我们可以在设置空对象的时间,顺便设置一个过期时间,就可以解决个问题了呀! setexkeysecondsvalule:设置键值对的同时指定过期时间(s) 在Java 中直接调用 API 操作即可: redisCache.put(Integer.toString(id),null,60)//过期时间为60s 布隆过滤器 布隆过滤器是一种基于概率的数据结构,主要使用来判断当前某个元素是否在该集合中,运行速度快。我们也可以简单理解为是一个不怎么精确的 set 结构(set 具有去重的效果)。但是有个小问题是:当你使用它的 contains 方法去判断某个对象是否存在时,它可能会误判。也就是说布隆过滤器不是特别不精确,但是只要参数设置的合理,它的精确度可以控制的相对足够精确,只会有小小的误判概率(这是可以接受的呀 ~)。当布隆过滤器说某个值存在时,这个值可能不存在;当它说不存在时,那就肯定不存在。 「这里有个典型的例子呀,来自钱大:」 打个比方,当它说不认识你时,肯定就不认识;当它说见过你时,可能根本就没见过面,不过因为你的脸跟它认识的人中某脸比较相似 (某些熟脸的系数组合),所以误判以前见过你。在上面的使用场景中,布隆过滤器能准确过滤掉那些已经看过的内容,那些没有看过的新内容,它也会过滤掉极小一部分 (误判),但是绝大多数新内容它都能准确识别。这样就可以完全保证推荐给用户的内容都是无重复的。 「说了这么久,那布隆过滤器到底有什么特点呢:」 一个非常大的二进制位数组(数组中只存在 0 和 1) 拥有若干个哈希函数(Hash Function) 在空间效率和查询效率都非常高 布隆过滤器不会提供删除方法,在代码维护上比较困难。 每个布隆过滤器对应到 Redis 的数据结构里面就是一个大型的位数组和几个不一样的无偏 hash 函数。所谓无偏就是能够把元素的 hash 值算得比较均匀。 向布隆过滤器中添加 key 时,会使用多个 hash 函数对 key 进行 hash 算得一个整数索引值然后对位数组长度进行取模运算得到一个位置,每个 hash 函数都会算得一个不同的位置。再把位数组的这几个位置都置为 1 就完成了 add 操作。( 每一个 key 都通过若干的hash函数映射到一个巨大位数组上,映射成功后,会在把位数组上对应的位置改为1。) 「那为什么布隆过滤器会存在误判率呢?」 如下图所示: 当 key1 和 key2 映射到位数组上的位置为 1 时,假设这时候来了个 key3,要查询是不是在里面,恰好 key3 对应位置也映射到了这之间,那么布隆过滤器会认为它是存在的,这时候就会产生误判(因为明明 key3 是不在的)。 O(∩_∩)O哈哈~,这时候你会问了:如何提高布隆过滤器的准确率呢? 「要提高布隆过滤器的准确率,就要说到影响它的三个重要因素:」 哈希函数的好坏 存储空间大小 哈希函数个数 hash函数的设计也是一个十分重要的问题,对于好的hash函数能大大降低布隆过滤器的误判率。 (这就好比优秀的配件之所以能够运行这么顺畅就在于其内部设计的得当。) 同时,对于一个布隆过滤器来说,如果其位数组越大的话,那么每个key通过hash函数映射的位置会变得稀疏许多,不会那么紧凑,有利于提高布隆过滤器的准确率。同时,对于一个布隆过滤器来说,如果key通过许多hash函数映射,那么在位数组上就会有许多位置有标志,这样当用户查询的时候,在通过布隆过滤器来找的时候,误判率也会相应降低。 对于其内部原理,有兴趣的同学可以看看关于布隆过滤的数学知识,里面有关于它的设计算法和数学知识。(其实也挺简单~) 缓存击穿 缓存击穿是指有某个key经常被查询,经常被用户特殊关怀,用户非常 love 它 (^▽^),也就类比“熟客” 或者 一个key经常不被访问。但是这时候,如果这个key在缓存的过期时间失效的时候或者这是个冷门key时,这时候突然有大量有关这个key的访问请求,这样会导致大并发请求直接穿透缓存,请求数据库,瞬间对数据库的访问压力增大。 「归纳起来:造成缓存击穿的原因有两个。」 (1)一个“冷门”key,突然被大量用户请求访问。 (2)一个“热门”key,在缓存中时间恰好过期,这时有大量用户来进行访问。 对于缓存击穿的问题:我们常用的解决方案是加锁。对于key过期的时候,当key要查询数据库的时候加上一把锁,这时只能让第一个请求进行查询数据库,然后把从数据库中查询到的值存储到缓存中,对于剩下的相同的key,可以直接从缓存中获取即可。 如果我们是在单机环境下:直接使用常用的锁即可(如:Lock、Synchronized等),在分布式环境下我们可以使用分布式锁,如:基于数据库、基于Redis或者zookeeper 的分布式锁。 缓存雪崩 缓存雪崩是指在某一个时间段内,缓存集中过期失效,如果这个时间段内有大量请求,而查询数据量巨大,所有的请求都会达到存储层,存储层的调用量会暴增,引起数据库压力过大甚至宕机。 「原因:」 Redis突然宕机 大部分数据失效 「举个例子理解下吧:」 比如我们基本上都经历过购物狂欢节,假设商家举办 23:00-24:00 商品打骨折促销活动。程序小哥哥在设计的时候,在 23:00 把商家打骨折的商品放到缓存中,并通过redis的expire设置了过期时间为1小时。这个时间段许多用户访问这些商品信息、购买等等。但是刚好到了24:00点的时候,恰好还有许多用户在访问这些商品,这时候对这些商品的访问都会落到数据库上,导致数据库要抗住巨大的压力,稍有不慎会导致,数据库直接宕机(over)。 「当商品没有失效的时候是这样的:」 当缓存GG(失效)的时候却是这样的: 「对于缓存雪崩有以下解决方案:」 「(1)redis高可用」 redis有可能挂掉,多增加几台redis实例,(一主多从或者多主多从),这样一台挂掉之后其他的还可以继续工作,其实就是搭建的集群。 「(2)限流降级」 在缓存失效后,通过加锁或者队列来控制读数据库写缓存的线程数量,对某个key只允许一个线程查询数据和写缓存,其他线程等待。 「(3)数据预热」 数据加热的含义就是在正式部署之前,我先把可能的数据先预先访问一遍,这样部分可能大量访问的数据就会加载到缓存中。在即将发生大并发访问前手动触发加载缓存不同的key。 「(4)不同的过期时间」 设置不同的过期时间,让缓存失效的时间点尽量均匀。 如果本文对你有帮助, 别忘记来个三连: 点赞,转发,评论 。 咱们下期见! 收藏等于白嫖,点赞才是真情! End 干货分享 这里为大家准备了一份小小的礼物,关注公众号,输入如下代码,即可获得百度网盘地址,无套路领取!001:《程序员必读书籍》002:《从无到有搭建中小型互联网公司后台服务架构与运维架构》003:《互联网企业高并发解决方案》004:《互联网架构教学视频》006:《SpringBoot实现点餐系统》007:《SpringSecurity实战视频》008:《Hadoop实战教学视频》009:《腾讯2019Techo开发者大会PPT》 010:微信交流群 近期热文top 1、关于JWT Token 自动续期的解决方案 2、SpringBoot开发秘籍-事件异步处理 3、架构师之路-服务器硬件扫盲 4、架构师之路-微服务技术选型 5、RocketMQ进阶-事务消息 我就知道你“在看” 本文分享自微信公众号 - JAVA日知录(javadaily)。如有侵权,请联系 support@oschina.cn 删除。本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

优秀的个人博客,低调大师

每日一博 | 微服务复杂查询之缓存策略

在上一篇 缓存设计的好,服务基本不会倒 介绍了db层缓存,回顾一下,db层缓存主要设计可以总结为: 缓存只删除不更新 行记录始终只存储一份,即主键对应行记录 唯一索引仅缓存主键值,不直接缓存行记录(参考mysql索引思想) 防缓存穿透设计,默认一分钟,防止缓存击穿和雪崩 不缓存多行记录 前言 在大型业务系统中,通过对持久层添加缓存,对于大多数单行记录查询,相信缓存能够帮持久层减轻很大的访问压力,但在实际业务中,数据读取不仅仅只是单行记录,面对大量多行记录的查询,这对持久层也会造成不小的访问压力,除此之外,像秒杀系统、选课系统这种高并发的场景,单纯靠持久层的缓存是不现实的,本文我们来介绍 go-zero 实践中的缓存设计之biz cache。 适用场景举例 选课系统 内容社交系统 秒杀 像这些系统,我们可以在业务层再增加一层缓存来存储系统中的关键信息,如选课系统中学生选课信息,课程剩余名额;内容社交系统中某一段时间之间的内容信息等。 接下来,我们以内容社交系统来进行举例说明。 在内容社交系统中,我们一般是先查询一批内容列表,然后点击某条内容查看详情, 在没有添加biz缓存前,内容信息的查询流程图应该为: 从上图以及上一篇文章 缓存设计的好,服务基本不会倒 中我们可以知道,内容列表的获取是没办法依赖缓存的, 如果我们在业务层添加一层缓存用来存储列表中的关键信息(甚至完整信息),那么多行记录的访问不再是一个问题,这就是biz redis要做的事情。 接下来我们来看一下设计方案,假设内容系统中单行记录包含以下字段 字段名称 字段类型 备注 id string 内容id title string 标题 content string 详细内容 createTime time.Time 创建时间 我们的目标是获取一批内容列表,而尽量避免内容列表走db造成访问压力,首先我们采用redis的sort set数据结构来存储,根需要存储的字段信息量,有两种redis存储方案: 缓存局部信息 对其关键字段信息(如:id等)按照一定规则压缩,并存储,score我们用createTime毫秒值(时间值相等这里不讨论),这种存储方案的好处是节约redis存储空间, 那另一方面,缺点就是需要对列表详细内容进行二次回查(但这次回查是会利用到持久层的行记录缓存的) 缓存完整信息 对发布的所有内容按照一定规则压缩后均进行存储,同样score我们还是用createTime毫秒值,这种存储方案的好处是业务的增、删、查、改均走reids,而db层这时候 就可以不用考虑行记录缓存了,持久层仅提供数据备份和恢复使用,从另一方面来看,其缺点也很明显,需要的存储空间、配置要求更高,费用也会随之增大。 示例代码: type Content struct { Id string `json:"id"` Title string `json:"title"` Content string `json:"content"` CreateTime time.Time `json:"create_time"` } const bizContentCacheKey = `biz#content#cache` // AddContent 提供内容存储 func AddContent(r redis.Redis, c *Content) error { v := compress(c) _, err := r.Zadd(bizContentCacheKey, c.CreateTime.UnixNano()/1e6, v) return err } // DelContent 提供内容删除 func DelContent(r redis.Redis, c *Content) error { v := compress(c) _, err := r.Zrem(bizContentCacheKey, v) return err } // 内容压缩 func compress(c *Content) string { // todo: do it yourself var ret string return ret } // 内容解压 func uncompress(v string) *Content { // todo: do it yourself var ret Content return &amp;ret } // ListByRangeTime提供根据时间段进行数据查询 func ListByRangeTime(r redis.Redis, start, end time.Time) ([]*Content, error) { kvs, err := r.ZrangebyscoreWithScores(bizContentCacheKey, start.UnixNano()/1e6, end.UnixNano()/1e6) if err != nil { return nil, err } var list []*Content for _, kv := range kvs { data := uncompress(kv.Key) list = append(list, data) } return list, nil } 在以上例子中,redis是没有设置过期时间的,我们将增、删、改、查操作均同步到redis,我们认为内容社交系统的列表访问请求是比较高的情况下才做这样的方案设计, 除此之外,还有一些数据访问,没有像内容设计系统这么频繁的访问, 可能是某一时间段内访问量突如其来的增加,之后可能很长一段时间才会再访问一次,以此间隔,或者说不会再访问了,面对这种场景,我们又该如何考虑缓存的设计呢?在go-zero内容实践中,有两种方案可以解决这种问题: 增加内存缓存:通过内存缓存来存储当前可能突发访问量比较大的数据,常用的存储方案采用map数据结构来存储,map数据存储实现比较简单,但缓存过期处理则需要增加定时器来处理,另一宗方案是通过go-zero库中的 Cache ,其是专门用于内存缓存管理。 采用biz redis,并设置合理的过期时间 总结 以上两个场景可以包含大部分的多行记录缓存,对于多行记录查询量不大的场景,暂时没必要直接把biz redis放进去,可以先尝试让db来承担,开发人员可以根据持久层监控及服务监控来衡量何时需要引入biz cache。 项目地址 https://github.com/tal-tech/go-zero https://gitee.com/kevwan/go-zero 欢迎使用 go-zero 并 star 支持我们!

优秀的个人博客,低调大师

每日一博 | 项目需求分析定义的灵魂拷问

关注、星标 嵌入式客栈 ,精彩及时送达 [导读] 项目开发,一般都是按照需求驱动开发整个开发过程的。需求是开发的源头,即便是自己DIY一个小东西,心中所想也是一种需求,所以一个项目是否成功,需求分析做的是否到位也是至关重要的。七夕情人节刚过完了,想来有的盆友或许深思倦怠,今天来分享一篇轻松的文章吧。 从搞笑开始 客户想要一款集美丽、智慧于一身的机器人,理想很丰满,可是现实很骨感。项目中不同的角色对这个需求理解各不相同,而表现传递的信息又有可能会大打折扣,所以最后交付造出来的产品与客户想要的相去甚远。 那么问题出在哪里呢?我以为需求失真是罪魁祸首! 客户自己对需求理解失真 设计人员对需求理解失真 需求文档对需求描述失真 开发人员对需求设计失真 ....... 那么对于需求的定义在项目的成功执行,就显得尤为重要了。再看一个关于小龙女形象的经典段子: 这不是终极版本,来看下颠覆三观的终极失控版本: 注:图片来源于网络,纯属调侃搞笑,不带任何歧视,侵删 所以对一个成功的项目而已,需求的作用就显得尤为重要了。 需求的SMART原则,SMART依次英文含义为聪明的,SMART对于需求而言,有哪些度量维度呢? S:Specific 明确的 M:Measurable 可度量的 A:Achievable 可实现的 R:Realizable 可实现的 T:Traceable and Testable 可追溯及可测的 Specific明确原则 明确原则主要涵盖这样一些要点: 需求描述的正确性?描述的需求本身必须是正确的界定某个功能,如果本身就是一个错误的描述,则设计实现就一定是错误的!需求描述的内容是否是需求方(可能是最终客户或者来源于市场产品管理人员)。这项需求真的是需求方所需吗?或者部分所需?或者完全错误? 需求描述的唯一性?好的做法是将需求拆分成一个个条目,每一个条目描述一项明确精准的需求,相互之间不存在包含关系。 需求条目是否在项目的范围内?有的需求可能天马行空,超出了项目预期的范围的事情时有发生。 需求描述时否明确了该项需求的前提条件或者约束? Measurable可度量原则 可度量,我的理解是体现精确性: 需求描述的精确性?需求不要用模棱两可的描述,比如不可使用左右,上下,可能等,而尽量用精准的数字去描述。比如需要描述响应时间,推荐描述为响应时间须满足: 需求描述的客观性?需求描述应采用客观描述语言,忌讳采用具有主管色彩的词汇,比如需求一个产品经理要求设计的UI界面,美观大方,容易操作,这样的需求是非常不易度量的,相信很多盆友或许又遭遇过这样的需求,也一定是非常恼火的。这样的需求你让设计咋整?一千个读者眼中就有一千个哈姆莱特,这样的描述太过主观,最后一定是撕逼扯皮的结局。 Achievable 可实现原则 凡是写入项目需求规格书中的条款理论上就是一份技术合同,需求方就是甲方,项目团队相当于乙方。所以界定需求是需要与甲方反复沟通,反复确认的,否则一旦写入规格书,临了发现臣妾做不到!最后又不免撕逼扯皮! 要实现需求规格书的可实现原则,并不是简单成员坐在一起,拍拍脑袋想想就定下来,这里对于一些具有挑战的技术难点、技术指标是需要做技术预研的,否则可实现就变成了觉得可实现,而非客观上真的可实现!对于是否可实现,可以提出这样些问题: 项目团队是否具有这样的技术? 关键技术指标能否满足要求? 项目资源配置能满足要求? 可实现是原则不是描述如何实现!需求描述的就是功能性或非功能性的要求,而不要描述设计方案! ....... 双T可追溯可测原则 可追溯原则: 后向追溯:所有的需求条目,理论上应有甲方(需求方)的源头 后向追溯:所有的需求条目,都应有设计能对应保证,都应测试用例可验证。 可测试原则: 需求条目,需要应尽量具有可测性 需求阶段,理论上测试人员就应该参与讨论,从测试的角度来进行核定。 不良需求描述栗子 无法追溯(无标号) 按下急停开关,系统须停机。(这里其实还不精确,应描述在多少时间内停机) 不可测 SR-1:系统须永不崩溃。 不精确 SR-2:系统应向用户提供快速反馈。(多快?) 无测量公差 SR-3:LED灯应闪烁间隔100毫秒(应定义正负偏差) 过于复杂 SR-4:按红色按钮将激活功能A,按蓝色按钮应使LED 1 闪烁而不是LED 2点亮,点亮LED 2通过黄色按钮实现。(应拆分) 描述实现 SR-5:按下按钮W将导致两个16位整数值相加,然后… 需求描述方法 实际项目中,不同的公司实际落地都各有各的特点,这里大致列举一些常见做法: 文档描述法:属于常规方法,很多公司采用这样方案描述项目需求。 UML 用例法:利用UML用例图描述需求,这种方法比较直观,比如下图 敏捷项目管理,采用用户故事描述(user story) 总结一下 项目开发,需求阶段是一个至关重要的阶段。如果在需求阶段不做足确认工作,需求分析描述做的很随意,开发过程及交付时不免掉进各种坑里。 本文辛苦原创,如喜欢请点赞/在看/分享支持,不胜感激! —END— 往期精彩推荐,点击即可阅读 ▲Linux内核中I2C总线及设备长啥样? ▲学Linux驱动:应先了解总线驱动模型 ▲看思维导图:一文带你学Verilog HDL语言 本文分享自微信公众号 - 嵌入式客栈(embInn)。如有侵权,请联系 support@oschina.cn 删除。本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

优秀的个人博客,低调大师

每日一博 | MongoDB:开发人员实践指北

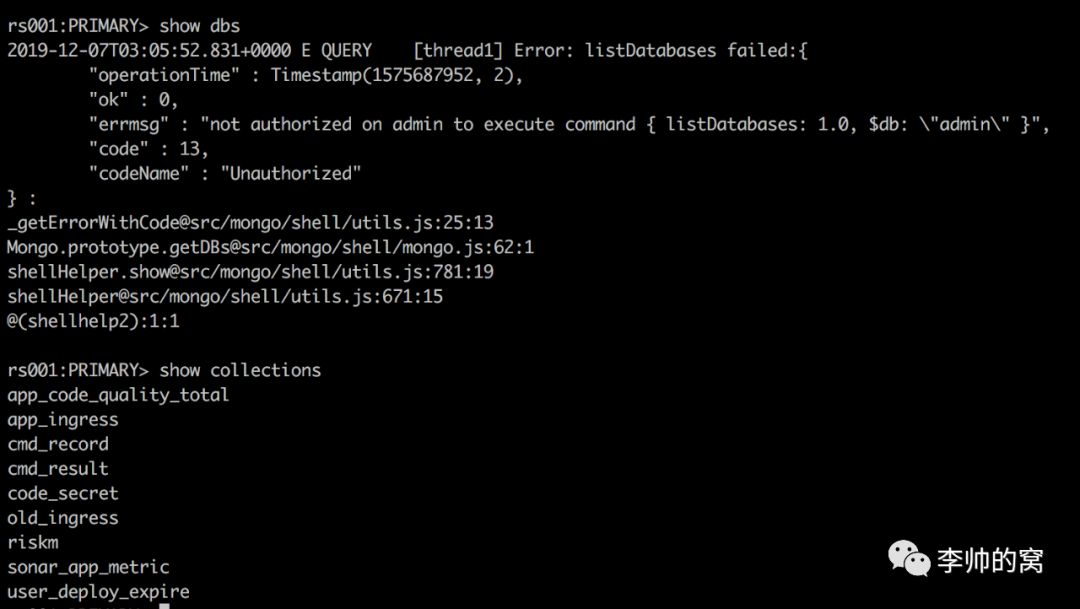
1 左右为难:MySQL vs MongoDB 1.1对比一览 指标 MySQL MongoDB 开发语言 C++,C C++,C 数据库类型 SQL NoSQL(面向文档) Schema Strict Dynamic 可扩展性 垂直扩展 水平扩展 核心特性 全文搜索索引支持集成复制触发器子查询查询缓存支持多存储引擎 自动分片本机复制内存加速支持嵌套数据模型辅助索引(Secondary Index)富查询多存储引擎 应用场景 表行数据结构强依赖多行事务经常更新或修改数据记录关系型数据集 高写负载不稳定的Schema数据库预计很大位置数据不可靠环境的高可用要求没有DBA 优势 成熟兼容性可复制分片 动态模式可扩展性以管理速度灵活性 1.2从使用看对比 1.2.1 文档数据类型:字段结构更丰富 MongoDB的数据类型非常丰富,BSON/JSON结构,可以表示任意结构的数据。 MySQL的数据类型相对贫瘠,行列结构,层级结构数据需要拆表、联立表示,复杂了数据管理方式。除此之外,业务数据与DB数据需要ORM来完成映射表示,代码复杂度较高。 1.2.2 Schema:让数据更灵活 MongoDB是动态Schema,无需预先定义Collection结构;而MySQL是静态Schema,需要预先定义Table结构。举例来说,如果我们的数据时效性以一个月为限,很少会追溯过期数据,我们更希望将表以时间为划分依据,如Data-201901、Data-201902等,这在MongoDB中可以轻易实现,而如果在MySQL中则要复杂许多,要么动态执行Create Table语句,要么将数据放在一起。在之前写过的Slowlog管理系统中,因为数据量较大,采用MySQL存储数据时,需要定时任务去定期归档数据,代码复杂度搞。 MongoDB是NoStrict Schema,同一Collection的文档结构允许不同;而MySQL是Strict Schema,同一Table的字段结构必须相同。因此,为了实现复杂的数据结构,MySQL常常会将一个业务结构拆成多张表表示,也会通过空字段处理,即有的记录的字段有值,有的是空值。非强制性Schema最大的好处就是支持业务变化、代码重构,尤其是业务不稳定阶段,表(集合)结构经常变化,但又害怕数据丢失,因此只能不断加字段,导致一张表中会有很多无效字段,而在非强制Schema中,每条记录(文档)的结构都可以不一样,因此新变化对老数据无侵害。 1.2.3 事务管理:MongoDB的短板 事务管理是MongoDB的软肋,目前v4.2版本已经推出了事务功能,但事务操作必须针对已存在的集合(Existing Collection)。 2MongoDB常见操作 2.1 查看库表 showdbs//列举MongoDB实例的数据库show collections // 列举当前库下的所有集合 2.2 查看表数据 MongoDB的查询语法比较丰富,既有普通文档的条件查询,还有嵌入文档、数组字段的查询,具体语法可以参见官网https://docs.mongodb.com/manual/tutorial/query-documents/,MongoDB的文档除了讲解说明外,还有交互终端,用户可以自由使用。 无论是何种查询,最终都离不开两个问题:(1)查询条件是什么?(2)查询结果又是什么样子的? 2.2.1 查询表达式(Query Selector) 如上是MongoDB的一些操作符,通过这些操作符和字段、值的联立组合,可以形成复杂的查询条件。 假设,我们要在部署记录集合(deploy_record)中查询用户(sli4)、在12月部署的失败(Failure)和取消(Cancel)的记录: db.deploy_record.find({user:"sli4", date: {"gte": ISODate("2019-12-01T00:00:00Z), "lt": ISODate("2020-01-01T00:00:00Z)},status:{$in:["Failure","Cancel"]}}) 很多技术内容,光看文档是无法真正领会的,需要有真实的操作场景,才能碰到自己想不到的问题。本想写一篇概括性、总结文章,可以一页指北,却发现,只能提供概要性说明,具体实践过程,还是要面向文档和Google编程! 2.2.2 投射 投射,就是SQL中的字段选择。MongoDB默认返回符合查询条件文档的全部字段,为了限制MongoDB返回的数据量,可以通过投射表达式选择需要的字段。 db.collection.find({查询条件},{投射表达式}) 投射表达式,就是为指定字段设定是否返回标识,1标识返回,0标识不返回。如部署记录(deploy_record)只返回应用(app)、状态(status): 注意:MongoDB默认是返回主键(_id),因此如果不需要主键时,需要显示指定_id:0。 2.2.3 聚合 Aggregation operations process data records and return computed results.聚合操作通过数据分组、针对分组数据执行一系列操作、最终生成单一计算结果值。聚合提供Pipeline、MapReduce、Methods三种方式。聚合操作可以简化应用层的业务逻辑,在数据层提取需要的数据值。 因为聚合比较重要,也很复杂,我们将在下面另起一个模块讲解说明。 2.3 创建数据:insert db.collection.insertOne() // 插入单一文档db.collection.insertMany() // 插入多个文档db.collection.insert() // 插入一个或多个文档 MongoDB的数据插入行为有三点内容需要明确: 如果插入数据时,集合尚未存在,insert操作会触发集合创建。 mongodb中每个文档都是以_id作为主键,如果插入的文档中没有指定_id,mongodb会默认分配唯一ID。 无论插入一个还是多个文档,mongodb都是以单一文档为原子性维度,即插入过程中如遇错误,只影响正在插入的文档,不影响已经成功的文档,不会回退至插入操作前的状态。 2.4 修改操作 //修改操作的命令格式{<updateoperator>:{ <field1>:<value1>, ... },<updateoperator>:{<field1>:<value1>,...},...} 2.4.1修改还是替换 上图的两个操作,一个是替换,一个是字段更新,在没有$set更新操作符时,是以新值替代旧值;而有$set时则只针对指定字段更新。 db.deploy_record.update({_id: 1}, {user: "王五"})db.deploy_record.update({_id: 1}, {$set: {user: "王五"}}) 2.4.2更新操作注意事项 _id字段不可更改 upsert操作:当upsert为true时,如果没有匹配的文档可供修改,会将更新文档作为新文档插入集合。 2.4.3还有更多操作符,具体使用结合文档和场景 https://docs.mongodb.com/manual/reference/operator/update/ 2.5 删除操作 db.collection.delete({查询表达式}) 3. MongoDB的高级操作--聚合 3.1Pipeline 3.2 MapReduce MapReduce是大数据处理模型,通过map和reduce两个阶段获取理想的数据结果: Map:通过map函数提取一组kv对,每个key都有多个value,准确的说是key-values。 Reduce:通过reduce函数,以key为组,分组计算求得结果。 在MongoDB中,MapReduce的命令格式如下:除了提供map、reduce函数外,还需要指定数据的筛选条件(query)和数据结果的保存集合(out) { function map(){},functionreduce(key,values){},{ query: {查询表达式},out:输出集合}} 本文分享自微信公众号 - DevOps技术说(sli4book)。如有侵权,请联系 support@oschina.cn 删除。本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

优秀的个人博客,低调大师

每日一博 | MongoDB 在评论中台的实践

本文主要讲述 vivo 评论中台在数据库设计上的技术探索和实践。 一、业务背景 随着公司业务发展和用户规模的增多,很多项目都在打造自己的评论功能,而评论的业务形态基本类似。当时各项目都是各自设计实现,存在较多重复的工作量;并且不同业务之间数据存在孤岛,很难产生联系。因此我们决定打造一款公司级的评论业务中台,为各业务方提供评论业务的快速接入能力。在经过对各大主流 APP 评论业务的竞品分析,我们发现大部分评论的业务形态都具备评论、回复、二次回复、点赞等功能。 具体如下图所示: 涉及到的核心业务概念有: 【主题 topic】评论的主题,商城的商品、应用商店的APP、社区的帖子 【评论 comment】用户针对于主题发表的内容 【回复 reply】用户针对于某条评论发表的内容,包括一级回复和二级回复 二、数据库存储的选择 团队在数据库选型设计时,对比了多种主流的数据库,最终在 MySQL 和 MongoDB 两种存储之进行抉择。 由于评论业务的特殊性,它需要如下能力: 【字段扩展】业务方不同评论模型存储的字段有一定差异,需要支持动态的自动扩展。 【海量数据】作为公司中台服务,数据量随着业务方的增多成倍增长,需要具备快速便捷的水平扩展和迁移能力。 【高可用】作为中台产品,需要提供快速和稳定的读写能力,能够读写分离和自动恢复。 而评论业务不涉及用户资产,对事务的要求性不高。因此我们选用了MongoDB 集群作为最底层的数据存储方式。 三、深入了解 MongoDB 3.1 集群架构 由于单台机器存在磁盘/IO/CPU等各方面的瓶颈,因此以 MongoDB 提供集群方式的部署架构,如图所示: 主要由以下三个部分组成: mongos:路由服务器,负责管理应用端的具体链接。应用端请求到mongos服务后,mongos把具体的读写请求转发到对应的shard节点上执行。一个集群可以有1~N个mongos节点。 config:配置服务器,用于分存储分片集合的元数据和配置信息,必须为 复制集(关于复制集概念戳我) 方式部署。mongos通过config配置服务器合的元数据信息。 shard:用于存储集合的分片数据的mongod服务,同样必须以 复制集 方式部署。 3.2 片键 MongoDB 数据是存在collection(对应 MySQL表)中。集群模式下,collection按照片键(shard key)拆分成多个区间,每个区间组成一个chunk,按照规则分布在不同的shard中。并形成元数据注册到config服务中管理。 分片键只能在分片集合创建时指定,指定后不能修改。分片键主要有两大类型: hash分片:通过hash算法进行散列,数据分布的更加平均和分散。支持单列和多列hash。 范围分片:按照指定片键的值分布,连续的key往往分布在连续的区间,更加适用范围查询场景。单数据散列性由分片键本身保证。 3.3 评论中台的实践 3.3.1集群的扩展 作为中台服务,对于不同的接入业务方,通过表隔离来区分数据。以comment评论表举例,每个接入业务方都单独创建一张表,业务方A表为 comment_clientA ,业务方B表为 comment_clientB,均在接入时创建表和相应索引信息。但只是这样设计存在几个问题: 单个集群,不能满足部分业务数据物理隔离的需要。 集群调优(如split迁移时间)很难业务特性差异化设置。 水平扩容带来的单个业务方数据过于分散问题。 因此我们扩展了 MongoDB的集群架构: 扩展后的评论MongoDB集群 增加了 【逻辑集群】和【物理集群】的概念。一个业务方属于一个逻辑集群,一个物理集群包含多个逻辑集群。 增加了路由层设计,由应用负责扩展Spring的MongoTemplate和连接池管理,实现了业务到MongoDB集群之间的切换选择服务。 不同的MongoDB分片集群,实现了物理隔离和差异调优的可能。 3.3.2片键的选择 MongoDB集群中,一个集合的数据部署是分散在多个shard分片和chunk中的,而我们希望一个评论列表的查询最好只访问到一个shard分片,因此确定了范围分片的方式。 起初设置只使用单个key作为分片键,以comment评论表举例,主要字段有{"_id":唯一id,"topicId":主题id,"text":文本内容,"createDate":时间} ,考虑到一个主题id的评论尽可能连续分布,我们设置的分片键为topicId。随着性能测试的介入,我们发现了有两个非常致命的问题: jumbo chunk问题 唯一键问题 jumbo chunk: 官方文档中,MongoDB中的chunk大小被限制在了1M-1024M。分片键的值是chunk划分的唯一依据,在数据量持续写入超过chunk size设定值时,MongoDB集群就会自动的进行分裂或迁移。而对于同一个片键的写入是属于一个chunk,无法被分裂,就会造成 jumbo chunk 问题。 举例,若我们设置1024M为一个chunk的大小,单个document 5KB计算,那么单个chunk能够存储21W左右document。考虑热点的主题评论(如微信评论),评论数可能达到40W+,因此单个chunk很容易超过1024M。超过最大size的chunk依然能够提供读写服务,只是不会再进行分裂和迁移,长久以往会造成集群之间数据的不平衡. 唯一键问题: MongoDB 集群的唯一键设置增加了限制,必须是包含分片键的;如果_id不是分片键,_id索引只能保证单个shard上的唯一性。 You cannot specify a unique constraint on a hashed index For a to-be-sharded collection, you cannot shard the collection if the collection has other unique indexes For an already-sharded collection, you cannot create unique indexes on other fields 因此我们删除了数据和集合,调整 topicId 和 _id 为联合分片键 重新创建了集合。这样即打破了chunk size的限制,也解决了唯一性问题。 3.4 迁移和扩容 随着数据的写入,当单个chunk中数据大小超过指定大小时(或chunk中的文件数量超过指定值)。MongoDB集群会在插入或更新时,自动触发chunk的拆分。 拆分会导致集合中的数据块分布不均匀,在这种情况下,MongoDB balancer组件会触发集群之间的数据块迁移。balancer组件是一个管理数据迁移的后台进程,如果各个shard分片之间的chunk数差异超过阈值,balancer会进行自动的数据迁移。 balancer是可以在线对数据迁移的,但是迁移的过程中对于集群的负载会有较大影响。一般建议可以通过如下设置,在业务低峰时进行(更多见官网) db.settings.update( { _id: "balancer" }, { $set: { activeWindow : { start : "<start-time>", stop : "<stop-time>" } } }, { upsert: true } ) MongoDB的扩容也非常简单,只需要准备好新的shard复制集后,在 Mongos节点中执行: sh.addShard("<replica_set>/<hostname><:port>") 扩容期间因为chunk的迁移,同样会导致集群可用性降低,因此只能在业务低峰进行 四、写在最后 MongoDB集群在评论中台项目中已上线运行了一年多,过程中完成了约10个业务方接入,承载了1亿+评论回复数据的存储,表现较为稳定。BSON非结构化的数据,也支撑了我们多个版本业务的快速升级。而热门数据内存化存储引擎,较大的提高了数据读取的效率。 但对于MongoDB来说,集群化部署是一个不可逆的过程,集群化后也带来了索引,分片策略等较多的限制。因此一般业务在使用MongoDB时,副本集方式就能支撑TB级别的存储和查询,并非一定需要使用集群化方式。 以上内容基于MongoDB 4.0.9版本特性,和最新版本的MongoDB细节上略有差异。 参考资料:https://docs.mongodb.com/manual/introduction/ 作者:vivo 官网商城开发团队

优秀的个人博客,低调大师

每日一博 | 为什么拆微服务这么艰难

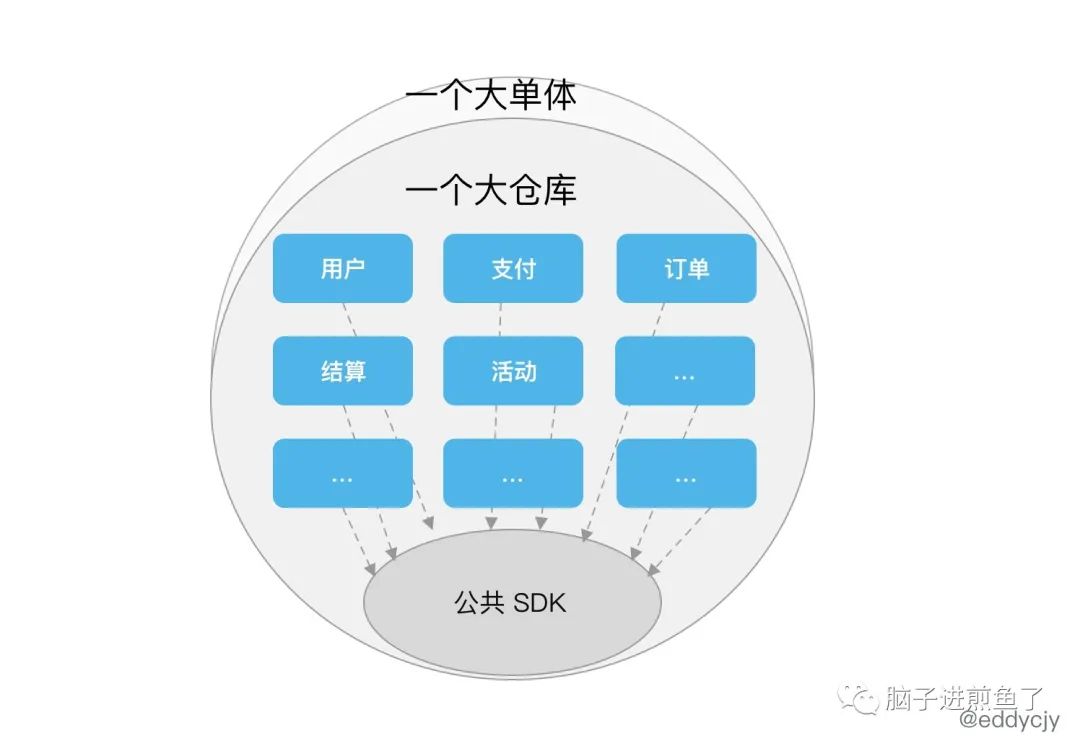
微服务,这三个字正在席卷着目前的互联网软件行业,尤其在近几年云原生迸发后,似乎人人都对微服务有了更广泛的使用和理解,张口就是各种各样的问号,有着强大的好奇心。 无独有偶,我有一个朋友鲤鱼在内部微服务的早期(每个业务组起步)就经常遇到下述的对话: 张三:为什么要拆现在的代码? 鲤鱼:因为 !@)&&#@!)&#!&)@!&!的原因。 张三:那即将要做的 “微服务” 是按照什么维度去拆分的服务? 鲤鱼:常见的一般根据 !@#*@!#&!(@&!@)#@ 的方式来拆分。 张三:照你这么说好像也不大对,我看每个业务组拆分的维度似乎都不大一样? 鲤鱼:嗯,每个业务组还有自己的见解,不会完全相同。 张三:。。。所以微服务的拆分维度到底是什么? 为什么想拆 为什么张三会有这个疑问呢,实际上是因为研发内部希望从原先的大单体,大仓库向微服务体系拆分转换,其原先大单体仓库结构,类 Monorepo: 但类 Monorepo 又有不少的问题,像是: 单个 Repo 体积过大:导致 Git 无法直接拉取。当你设置完再拉取时,在网速慢时还能去泡杯咖啡,并且在开发机性能不佳的情况下,IDE 会比较卡,代码运行起来也慢。 单个 Repo 存在公共函数/SDK:在代码仓库中,必然存在公共依赖。因此在解决代码冲突时,若遗留了冲突符,且在动态语言中,不涉及便运行正常。但其实在上线后却又影响到其他业务,可真是糟糕透顶,分分钟被迫抱着事故。 单个 Repo 模块职责/边界不清:在实际的软件开发中,涉及数十个业务组同时在一个大 Repo 下进行开发,没有强控边界的情况下,往往会逐渐模糊,即使在设计时管得住自己,你也不一定能 100% 防止别人模糊你的边界。 单个 Repo 包含了所有的源码:出现公司源代码泄露时,会导致整个 Repo 外泄,相当的刺激和具有教育意义。因为虽然开放和协同了,不属于你们组的业务代码你也有权限查看了。 当然,Monorepo 是否又完全不可行呢?实际上国外 Google,Facebook,Twitter 等公司都有在使用 Monorepo,并取得了一定的收益。 其实做 Monorepo 是需要相应的大量工具支撑,若单纯只是一个 Repo 塞多个模块,基本都做不好,甚至引火烧身。还不如早早拆开,至少能确保各业务线服务的相对独立性。 拆成什么样 张三在明白了拆的原因后,就出现了第二个问题,那就是 “微服务” 要按照什么样的维度去拆分服务? 张三公司内部对于这块的知识处于模糊不清的阶段,因此需要进行深入了解,便于后续的团队共识和方法论建立,理所当然,十万个为什么也就出现了。 大单体变独立服务 最常见的拆分的方式是按照业务模块进行服务的拆解,像是前文所提到的业务模块,在设计上边界非常清晰,这种情况直接拆成各个服务就可以了: 而在拆分后,又会遇到一个新的问题,也就是张三问第三个问题 “每个业务组拆分的维度似乎都不大一样?”。 因为在实际的执行过程中,严谨一些会由 SM 与 RD 一同开会探讨/规范初版的服务划分,而在持续的快速的迭代中,往往新服务的拆分都是由一线 RD 亲自操刀。 即使是架构师亲自操刀,在相对复杂的业务模型下,不同架构师划分出来的也有可能不完全一致,因此无论是哪种情况,你都会发现每个业务组拆分的维度多多少少都不一样了,毕竟人与人的思想都是不一样的,一千个人有一个千个哈姆雷特,因此张三的疑惑是正常的。 就像下图,核心是定义一只鱼,在不同人的眼中能演化出各种奇奇怪怪的鱼: 大数据库变独立数据库 在以前早期的大单体快速迭代中,往往是一个大数据库包含所有的业务数据库(甚至数据库账号都不分),这种时候就会带来各种问题。 像是某一天,你所负责的业务模块数据库莫名其妙出现了一些奇奇怪怪的值,你可能就要抓破脑袋去各种代码和 binlog 查了。更甚还有被网络攻击后,数据库配置被获取,直接跳板一拖直接整个脱裤,那可是糟糕透顶了。 因此在常见的应用设计中,应用程序在连接数据库时会指定连接特定的域名(例如:eddycjy-user),方便未来迁移。并且每个业务服务分别给予独立的数据库只读权限,进行软隔离。 而在业务量上来后,也会对业务数据库进行硬隔离,分配特定的 RDS 实例,就不会互相影响了。 环境隔离,独立 在服务拆分后,大多会采取独立部署的方式,将两者之间的环境隔离开来,互不干扰,互不影响: 像在云原生中,常见于在 Kubernetes 将一个业务服务作为一个 Service 部署发布,再根据实际的资源和调度情况进行 Pod 的扩缩容就可以了,资源也不会有直接干扰,且外部/内部调用都是有统一的入口管理。 拆分的阵痛 业务接口聚合 在服务拆分的过程中,总是会有阵痛出现。 例如在服务需要获取 “项目” 和 “房源” 信息时,到底是由谁来聚合这两个服务的信息。是不是应该由 BFF 来聚合: 或是应该新写一个胶水服务,用于聚合“项目” 和 “房源” 信息,保证其聚合性,减轻 BFF 的负担: 又或是在量级越来越多的情况下,是不是要怀疑一下,这两个服务拆分是不是有问题,“项目” 和 “房源” 在当前业务模型下是否应是一家: 显然在鲤鱼的经历中,这三种类型他都见过,不同的人总会在不同的思想和业务模型下选择了不同的解决方案,还真的没有绝对准确的准则。 分久必合,合久必分 随着对服务化的进程推进,常见的会遇到两种情况: 刚接触服务化时:服务一个没有,偶尔会有一个新的小业务,居然能拆出好好几个微型服务,并扬言要把剩余业务直接抄底重构了,都拆掉,怎么劝都劝不回头。 随着业务的不断发展:快速迭代,服务越来越多,工期压缩,多个 RD 交叉背好几个业务服务,有点力不从心,发现拆的好像有点问题,从最新的情况来看,某某几个服务似乎应该合在一起。 业务阶段性稳定:。。。这,以前这块好像有点问题,也太难拓展了,不应该这么拆,谁调了我,我的上下游是谁。 大多数的情况都是第二和第三者,但在实际操作中也不见得会合并服务,大多数 RD 会选择吞进心里,因为服务变迁所带来的工期延长和影响面无法直接预估(且存在历史代码,人员可能已经离职多年)。即使是服务拓扑也只能查看到一定时间内的服务调用,不会看到全部,因此上下游均无法 100% 确定。因此综合来看,弊大于利。 在解决方案上,更多的是在下次新服务规划时控制划分变量(因为已经有更成熟的经验了)。 实在不行了,才有可能会新起聚合服务将原本的多个服务聚合,又或是采取版本号等方式进行新老分流。甚至下定决心,蚂蚁搬家,起新服务一个个板块重构,一个个挪,持续灰度,“彻底” 解决历史包袱,完成转化。 拆分准则 张三又发话了,你说的我都懂,内部微服务都发展好几年了,作为已经有丰富研发经验的人,能不能释出一套微服务拆分的准则呢,否则每一个人都要经历一遍,怎么办,有没有什么基本准则可以遵守呢,你看现在 DDD 那么火,能不能 DDD 一下,让核心一致呢? 机智的鲤鱼掐指一算,张三肯定想的是让所有业务组的拆分,都能依据拆分的核心准则走,实现你中有我,我中有你,看哪哪都有影子,核心不跑偏就行,建立一套完美的方法核心论: 这种建议右拐 Google “微服务如何拆分”,网上有超级多的指导资料,建议先培养在团队内的共识。毕竟在每次拆服务时让每一个人都对照着那一长串的 “微服务拆分准则” 是一件很不科学的事情,更多的工程师会依据自身的经验进行当前其认为的最合理拆解。 而准则,你认为的核心 A,在他人眼里并不一定是正确,他可能认为是 B,因此在事业部,业务团队中达成共识并把拆分思想融合进每位 RD 思想中,长期的共同分析现在的拆分情况,且让大家基本认同才是最重要的。 同时让全公司都依据一个准则来做,在服务拆分这种无法利用工具流程强控制的情况,本身就是一个伪命题,更多的会是人与人之间的妥协,基本上会变成一个少有人看的 “指导” 文档。 总结 在微服务中,服务的拆分总是能让人如此细细品味,本文并不是具体的讲某几个知识点,更多的是阐述在服务化发展的历程中的 “冲突点” 又或是 “矛盾点”,不同的人总有不一样的理解,希望能够给大家带来一些思考。 且在阅读微服务相关指南时,更建议看企业实践后拆分的经验分享,否则单纯看 “指南” 没有过多的意义,要看具体的公司/团队情况和业务模型。 推荐阅读 Monorepo: Why Google Stores Billions of Lines of Code in a Single Repository Monorepos: Please don’t! Why might a project/company use a monorepo? Microservices: Nginx Refactoring a Monolith into Microservices 本文分享自微信公众号 - GoCN(golangchina)。如有侵权,请联系 support@oschina.cn 删除。本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

优秀的个人博客,低调大师

每日一博 | 解读区块链 7 类共识算法

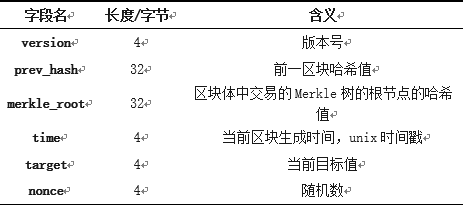
摘要:本文将对区块链中常见的七类共识算法进行介绍,希望对读者探索区块链有所帮助。 区块链技术起源于比特币,最初是比特币等数字货币的一种底层技术,区块链融合了密码学、组网技术、共识算法、智能合约等多种技术。随着区块链技术的逐渐成熟,其逐渐得到科研机构、政府、金融机构和科技企业的关注。区块链具有匿名、防篡改、可追溯和去中心化等特点。 传统的交易需要一个可信任的第三方作为交易中介,与之相比,区块链技术能够实现交易的去中心化,同时还能保证全网数据的一致性,使得点对点交易成为可能。这需要对交易确认规则进行设计,这一规则就是本节将要介绍的共识算法。共识算法作为区块链技术的核心,对区块链安全、效率等方面有着决定性的作用。 在区块链的应用过程中,共识算法需要解决两个问题:双花问题[1, 2]和拜占庭将军问题[3]。双花问题是指货币在使用过程中重复使用的问题。传统的货币具有实体唯一性,可以通过防伪手段防止双花问题。当前的电子交易也能通过中心的信任机构来解决双花问题。区块链则是通过分布式的节点共同验证交易来解决双花问题。区块链中,一笔交易需要经过足够数量共识节点的验证,在确认无误下对交易进行记录并同步给网络中所有的共识节点。区块链中进行“双花”攻击完成需要付出足够的代价,通过选择共识算法,可以将这一代价扩展到足够大或者使得这一代价超过双花攻击获得的收益。 本文将对区块链中常见的七类共识算法进行介绍,希望对读者探索区块链有所帮助。 1. 工作量证明(PoW) 中本聪在2009年提出的比特币(Bitcoin)是区块链技术最早的应用,其采用PoW作为共识算法,其核心思想是节点间通过哈希算力的竞争来获取记账权和比特币奖励。PoW中,不同节点根据特定信息竞争计算一个数学问题的解,这个数学问题很难求解,但却容易对结果进行验证,最先解决这个数学问题的节点可以创建下一个区块并获得一定数量的币奖励。中本聪在比特币中采用了HashCash[4]机制设计这一数学问题。本节将以比特币采用的PoW算法为例进行说明,PoW的共识步骤如下: 节点收集上一个区块产生后全网待确认的交易,将符合条件的交易记入交易内存池,然后更新并计算内存池中交易的Merkle根的值,并将其写入区块头部; 在区块头部填写如表1.1所示的区块版本号、前一区块的哈希值、时间戳、当前目标哈希值和随机数等信息; 表1.1 区块头部信息 随机数nonce在0到232之间取值,对区块头部信息进行哈希计算,当哈希值小于或等于目标值时,打包并广播该区块,待其他节点验证后完成记账; 一定时间内如果无法计算出符合要求的哈希值,则重复步骤2。如果计算过程中有其他节点完成了计算,则从步骤1重新开始。 比特币产生区块的平均时间为10分钟,想要维持这一速度,就需要根据当前全网的计算能力对目标值(难度)进行调整[5]。难度是对计算产生符合要求的区块困难程度的描述,在计算同一高度区块时,所有节点的难度都是相同的,这也保证了挖矿的公平性。难度与目标值的关系为: 难度值=最大目标值/当前目标值 (1.1) 其中最大目标值和当前目标值都是256位长度,最大目标值是难度为1时的目标值,即2224。假设当前难度为,算力为,当前目标值为,发现新区块的平均计算时间为,则 根据比特币的设计,每产生2016个区块后(约2周)系统会调整一次当前目标值。节点根据前2016个区块的实际生产时间,由公式(1.4)计算出调整后的难度值,如果实际时间生产小于2周,增大难度值;如果实际时间生产大于2周,则减小难度值。根据最长链原则,在不需要节点同步难度信息的情况下,所有节点在一定时间后会得到相同的难度值。 在使用PoW的区块链中,因为网络延迟等原因,当同一高度的两个区块产生的时间接近时,可能会产生分叉。即不同的矿工都计算出了符合要求的某一高度的区块,并得到与其相近节点的确认,全网节点会根据收到区块的时间,在先收到的区块基础上继续挖矿。这种情况下,哪个区块的后续区块先出现,其长度会变得更长,这个区块就被包括进主链,在非主链上挖矿的节点会切换到主链继续挖矿。 PoW共识算法以算力作为竞争记账权的基础,以工作量作为安全性的保障,所有矿工都遵循最长链原则。新产生的区块包含前一个区块的哈希值,现存的所有区块的形成了一条链,链的长度与工作量成正比,所有的节点均信任最长的区块链。如果当某一组织掌握了足够的算力,就可以针对比特币网络发起攻击。当攻击者拥有足够的算力时,能够最先计算出最新的区块,从而掌握最长链。此时比特币主链上的区块大部分由其生成,他可以故意拒绝某些交易的确认和进行双花攻击,这会对比特币网络的可信性造成影响,但这一行为同样会给攻击者带来损失。通过求解一维随机游走问题,可以获得恶意节点攻击成功的概率和算力之间的关系: 图1.1 攻击者算力与攻击成功概率 2. 权益证明(PoS) 随着参与比特币挖矿的人越来越多,PoW的许多问题逐渐显现,例如随着算力竞争迅速加剧,获取代币需要消耗的能源大量增加,记账权也逐渐向聚集了大量算力的“矿池”集中[6-9]。为此,研究者尝试采用新的机制取代工作量证明。PoS的概念在最早的比特币项目中曾被提及,但由于稳健性等原因没被使用。PoS最早的应用是点点币(PPCoin),PoS提出了币龄的概念,币龄是持有的代币与持有时间乘积的累加,计算如公式(1.4)所示。利用币龄竞争取代算力竞争,使区块链的证明不再仅仅依靠工作量,有效地解决了PoW的资源浪费问题。 其中持有时间为某个币距离最近一次在网络上交易的时间,每个节点持有的币龄越长,则其在网络中权益越多,同时币的持有人还会根据币龄来获得一定的收益。点点币的设计中,没有完全脱离工作量证明,PoS机制的记账权的获得同样需要进行简单的哈希计算: 其中proofhash是由权重因子、未消费的产出值和当前时间的模糊和得到的哈希值,同时对每个节点的算力进行了限制,可见币龄与计算的难度成反比。在PoS中,区块链的安全性随着区块链的价值增加而增加,对区块链的攻击需要攻击者积攒大量的币龄,也就是需要对大量数字货币持有足够长的时间,这也大大增加了攻击的难度。与PoW相比,采用PoS的区块链系统可能会面对长程攻击(Long Range Attack)和无利害攻击(Nothing at Stake)。 除了点点币,有许多币也使用了PoS,但在记账权的分配上有着不同的方法。例如,未来币(Nxt)和黑币(BlackCion)结合节点所拥有的权益,使用随机算法分配记账权。以太坊也在逐步采用PoS代替PoW。 3. 委托权益证明(DPoS) 比特币设计之初,希望所有挖矿的参与者使用CPU进行计算,算力与节点匹配,每一个节点都有足够的机会参与到区块链的决策当中。随着技术的发展,使用GPU、FPGA、ASIC等技术的矿机大量出现,算力集中于拥有大量矿机的参与者手中,而普通矿工参与的机会大大减小。 采用DPoS的区块链中,每一个节点都可以根据其拥有的股份权益投票选取代表,整个网络中参与竞选并获得选票最多的n个节点获得记账权,按照预先决定的顺序依次生产区块并因此获得一定的奖励。竞选成功的代表节点需要缴纳一定数量的保证金,而且必须保证在线的时间,如果某时刻应该产生区块的节点没有履行职责,他将会被取消代表资格,系统将继续投票选出一个新的代表来取代他。 DPoS中的所有节点都可以自主选择投票的对象,选举产生的代表按顺序记账,与PoW及PoS相比节省了计算资源,而且共识节点只有确定的有限个,效率也得到了提升。而且每个参与节点都拥有投票的权利,当网络中的节点足够多时,DPoS的安全性和去中心化也得到了保证。 4. 实用拜占庭容错算法(PBFT) 在PBFT算法中,所有节点都在相同的配置下运行,且有一个主节点,其他节点作为备份节点。主节点负责对客户端的请求进行排序,按顺序发送给备份节点。存在视图(View)的概念,在每个视图中,所有节点正常按照处理消息。但当备份节点检查到主节点出现异常,就会触发视图变换(View Change)机制更换下一编号的节点为主节点,进入新的视图。PBFT中客户端发出请求到收到答复的主要流程如图4.1所示[10] [11],服务器之间交换信息3次,整个过程包含以下五个阶段: 图4.1 PBFT执行流程 目前以PBFT为代表的拜占庭容错算法被许多区块链项目所使用。在联盟链中,PBFT算法最早是被Hyper ledger Fabric项目采用。Hyperledger Fabric在0.6版本中采用了PBFT共识算法,授权和背书的功能集成到了共识节点之中,所有节点都是共识节点,这样的设计导致了节点的负担过于沉重,对TPS和扩展性有很大的影响。1.0之后的版本都对节点的功能进行了分离,节点分成了三个背书节点(Endorser)、排序节点(Orderer)和出块节点(Committer),对节点的功能进行了分离,一定程度上提高了共识的效率。 Cosmos项目使用的Tendermint[12]算法结合了PBFT和PoS算法,通过代币抵押的方式选出部分共识节点进行BFT的共识,其减弱了异步假设并在PBFT的基础上融入了锁的概念,在部分同步的网络中共识节点能够通过两阶段通信达成共识。系统能够容忍1/3的故障节点,且不会产生分叉。在Tendermint的基础上,Hotstuff[13]将区块链的块链式结构和BFT的每一阶段融合,每阶段节点间对前一区块签名确认与新区块的构建同时进行,使算法在实现上更为简单,Hotstuff还使用了门限签名[14]降低算法的消息复杂度。 5. Paxos与Raft 共识算法是为了保障所存储信息的准确性与一致性而设计的一套机制。在传统的分布式系统中,最常使用的共识算法是基于Paxos的算法。在拜占庭将军问题[3]提出后,Lamport在1990年提出了Paxos算法用于解决特定条件下的系统一致性问题,Lamport于1998年重新整理并发表Paxos的论文[15]并于2001对Paxos进行了重新简述[16]。随后Paxos在一致性算法领域占据统治地位并被许多公司所采用,例如腾讯的Phxpaxos、阿里巴巴的X-Paxos、亚马逊的AWS的DynamoDB和谷歌MegaStore[17]等。这一类算法能够在节点数量有限且相对可信任的情况下,快速完成分布式系统的数据同步,同时能够容忍宕机错误(Crash Fault)。即在传统分布式系统不需要考虑参与节点恶意篡改数据等行为,只需要能够容忍部分节点发生宕机错误即可。但Paxos算法过于理论化,在理解和工程实现上都有着很大的难度。Ongaro等人在2013年发表论文提出Raft算法[18],Raft与Paxos同样的效果并且更便于工程实现。 Raft中领导者占据绝对主导地位,必须保证服务器节点的绝对安全性,领导者一旦被恶意控制将造成巨大损失。而且交易量受到节点最大吞吐量的限制。目前许多联盟链在不考虑拜占庭容错的情况下,会使用Raft算法来提高共识效率。 6. 结合VRF的共识算法 在现有联盟链共识算法中,如果参与共识的节点数量增加,节点间的通信也会增加,系统的性能也会受到影响。如果从众多候选节点中选取部分节点组成共识组进行共识,减少共识节点的数量,则可以提高系统的性能。但这会降低安全性,而且候选节点中恶意节点的比例越高,选出来的共识组无法正常运行的概率也越高。为了实现从候选节点选出能够正常运行的共识组,并保证系统的高可用性,一方面需要设计合适的随机选举算法,保证选择的随机性,防止恶意节点对系统的攻击。另一方面需要提高候选节点中的诚实节点的比例,增加诚实节点被选进共识组的概率。 当前在公有链往往基于PoS类算法,抵押代币增加共识节点的准入门槛,通过经济学博弈增加恶意节点的作恶成本,然后再在部分通过筛选的节点中通过随机选举算法,从符合条件的候选节点中随机选举部分节点进行共识。 Dodis等人于1999年提出了可验证随机函数(Verifiable Random Functions,VRF)[19]。可验证随机函数是零知识证明的一种应用,即在公私钥体系中,持有私钥的人可以使用私钥和一条已知信息按照特定的规则生成一个随机数,在不泄露私钥的前提下,持有私钥的人能够向其他人证明随机数生成的正确性。VRF可以使用RSA或者椭圆曲线构建,Dodis等人在2002年又提出了基于Diffie-Hellman 困难性问题的可验证随机函数构造方法[20],目前可验证随机函数在密钥传输领域和区块链领域都有了应用[21]。可验证随机函数的具体流程如下: 在公有链中,VRF已经在一些项目中得到应用,其中VRF多与PoS算法结合,所有想要参与共识的节点质押一定的代币成为候选节点,然后通过VRF从众多候选节点中随机选出部分共识节点。Zilliqa网络的新节点都必须先执行PoW,网络中的现有节点验证新节点的PoW并授权其加入网络。区块链项目Ontology设计的共识算法VBFT将VRF、PoS和BFT算法相结合,通过VRF在众多候选节点中随机选出共识节点并确定共识节点的排列顺序,可以降低恶意分叉对区块链系统的影响,保障了算法的公平性和随机性。图灵奖获得者Micali等人提出的Algorand[22]将PoS和VRF结合,节点可以采用代币质押的方式成为候选节点,然后通过非交互式的VRF算法选择部分节点组成共识委员会,然后由这部分节点执行类似PBFT共识算法,负责交易的快速验证,Algorand可以在节点为诚实节点的情况下保证系统正常运行。Kiayias等人提出的Ouroboros[23]在第二个版本Praos[24]引入了VRF代替伪随机数,进行分片中主节点的选择。以Algorand等算法使用的VRF算法为例,主要的流程如下: 公有链中设计使用的VRF中,节点被选为记账节点的概率往往和其持有的代币正相关。公有链的共识节点范围是无法预先确定的,所有满足代币持有条件的节点都可能成为共识节点,系统需要在数量和参与度都随机的节点中选择部分节点进行共识。而与公有链相比,联盟链参与共识的节点数量有限、节点已知,这种情况下联盟链节点之间可以通过已知的节点列表进行交互,这能有效防止公有链VRF设计时可能遇到的女巫攻击问题。 7. 结合分片技术的公式算法 分片技术是数据库中的一种技术,是将数据库中的数据切成多个部分,然后分别存储在多个服务器中。通过数据的分布式存储,提高服务器的搜索性能。区块链中,分片技术是将交易分配到多个由节点子集组成的共识组中进行确认,最后再将所有结果汇总确认的机制。分片技术在区块链中已经有一些应用,许多区块链设计了自己的分片方案。 Luu等人于2017年提出了Elastico协议,最先将分片技术应用于区块链中[25]。Elastico首先通过PoW算法竞争成为网络中的记账节点。然后按照预先确定的规则,这些节点被分配到不同的分片委员会中。每个分片委员会内部执行PBFT等传统拜占庭容错的共识算法,打包生成交易集合。在超过的节点对该交易集合进行了签名之后,交易集合被提交给共识委员会,共识委员会在验证签名后,最终将所有的交易集合打包成区块并记录在区块链上。 Elastico验证了分片技术在区块链中的可用性。在一定规模内,分片技术可以近乎线性地拓展吞吐量。但Elastico使用了PoW用于选举共识节点,这也导致随机数产生过程及PoW竞争共识节点的时间过长,使得交易延迟很高。而且每个分片内部采用的PBFT算法通讯复杂度较高。当单个分片中节点数量较多时,延迟也很高。 在Elastico的基础上,Kokoris-Kogias等人提出OmniLedger[26],用加密抽签协议替代了PoW选择验证者分组,然后通过RandHound协议[27]将验证者归入不同分片。OmniLedger。OmniLedger在分片中仍然采用基于PBFT的共识算法作为分片中的共识算法[28],并引入了Atomix协议处理跨分片的交易,共识过程中节点之间通信复杂度较高。当分片中节点数量增多、跨分片交易增多时,系统TPS会显著下降。 Wang等人在2019年提出了Monoxide[29]。在PoW区块链系统中引入了分片技术,提出了连弩挖矿算法(Chu ko-nu mining algorithm),解决了分片造成的算力分散分散问题,使得每个矿工可以同时在不同的分片进行分片,在不降低安全性的情况下提高了PoW的TPS。 8. 小结 本文对区块链中的共识算法进行了综述性介绍,其中对公有链中基础的共识PoW和联盟链中基础的公式算法PBFT进行了较为详细的分析,然后对目前新出现的较为先进的共识算法进行了介绍,希望对读者探索区块链领域有所帮助。 参考文献 [1]Antonopoulos A M. Mastering Bitcoin: Unlocking Digital Crypto-Currencies[J]. Oreilly Media Inc Usa, 2015. [2]Karame G O, Androulaki E, Capkun S. Two Bitcoins at the Price of One? Double-Spending Attacks on Fast Payments in Bitcoin.[J]. 2012. [3]Lamport L, Shostak R, Pease M. The Byzantine Generals Problem[J]. Acm Transactions on Programming Languages & Systems, 1982,4(3):382-401. [4]Back A. Hashcash - A Denial of Service Counter-Measure: USENIX Technical Conference, 2002[C]. [5]Kraft D. Difficulty control for blockchain-based consensus systems[J]. Peer-to-Peer Networking and Applications, 2016,9(2):397-413. [6]Andolfatto D. The False Analogy Between Gold and Bitcoin[J]. [7]Alfidi A. The Serious Disadvantages of Bitcoin[J]. [8]Miller A, Juels A, Shi E, et al. Permacoin: Repurposing Bitcoin Work for Data Preservation[J]. 2014:475-490. [9]Stegaroiu C E. The Advantages And Disadvantages Of Bitcoin Payments In The New Economy[J]. Annals Economy, 2018,1. [10]范捷, 易乐天, 舒继武. 拜占庭系统技术研究综述[J]. 软件学报, 2013(06):1346-1360. [11]Castro M, Liskov B. Practical Byzantine fault tolerance: Symposium on Operating Systems Design and Implementation, 1999[C]. [12]Buchman E. Tendermint: Byzantine fault tolerance in the age of blockchains[D]., 2016. [13]Yin M, Malkhi D, Reiter M K, et al. Hotstuff: Bft consensus with linearity and responsiveness, 2019[C]. [14]Desmedt Y, Frankel Y. Shared generation of authenticators and signatures, 1991[C]. Springer. [15]Lamport L. The part-time parliament[J]. Acm Transactions on Computer Systems, 1998,16(2):133-169. [16]Lamport L. Paxos made simple[J]. ACM Sigact News, 2001,32(4):18-25. [17]Chandra T D, Griesemer R, Redstone J. Paxos made live: An engineering perspective: Proceedings of the Twenty-Sixth Annual ACM Symposium on Principles of Distributed Computing, PODC 2007, 2007[C]. [18]Ongaro D, Ousterhout J K. In search of an understandable consensus algorithm., 2014[C]. [19]Li W, Andreina S, Bohli J, et al. Securing proof-of-stake blockchain protocols, Oslo, Norway, 2017[C]. Springer Verlag, 2017. [20]Dodis Y. Efficient Construction of (Distributed) Verifiable Random Functions: International Workshop on Theory & Practice in Public Key Cryptography: Public Key Cryptography, 2002[C]. [21]Melara M S, Blankstein A, Bonneau J, et al. Coniks: Bringing key transparency to end users, Washington, DC, United states, 2015[C]. USENIX Association, 2015. [22]Gilad Y, Hemo R, Micali S, et al. Algorand: Scaling Byzantine Agreements for Cryptocurrencies, Shanghai, China, 2017[C]. Association for Computing Machinery, Inc, 2018. [23]Kiayias A, Russell A, David B, et al. Ouroboros: A Provably Secure Proof-of-Stake Blockchain Protocol, 2017[C]. [24]David B, Gaži P, Kiayias A, et al. Ouroboros Praos: An Adaptively-Secure, Semi-synchronous Proof-of-Stake Blockchain, 2018[C]. [25]Luu L, Narayanan V, Zheng C, et al. A secure sharding protocol for open blockchains, Vienna, Austria, 2016[C]. Association for Computing Machinery, 2016. [26]Kokoris-Kogias E, Jovanovic P, Gasser L, et al. OmniLedger: A Secure, Scale-Out, Decentralized Ledger via Sharding, Los Alamitos, CA, USA, 2018[C]. IEEE Computer Society, 2018//. [27]Syta E, Jovanovic P, Kogias E K, et al. Scalable Bias-Resistant Distributed Randomness, Los Alamitos, CA, USA, 2017[C]. IEEE Computer Society, 2017//. [28]Kokoris-Kogias E, Jovanovic P, Gailly N, et al. Enhancing bitcoin security and performance with strong consistency via collective signing, Austin, TX, United states, 2016[C]. USENIX Association, 2016. [29]Wang J, Wang H. Monoxide: Scale out blockchains with asynchronous consensus zones: 16th {USENIX} Symposium on Networked Systems Design and Implementation ({NSDI} 19), 2019[C]. 本文分享自华为云社区《万字长文解读区块链七类共识算法》,原文作者:APTX-486977 。 点击关注,第一时间了解华为云新鲜技术~

优秀的个人博客,低调大师

每日一博 | 开源关系型数据库架构

我之前跟大家分享了数据库架构(刚哥谈架构 (五) 谈谈数据库架构),今天我们来讨论一下数据库中最为常见的关系型数据库的架构。 我们把主要的开源关系型数据库分为三类,来分别了解一下它们的架构和设计,并了解一下它们各自的优缺点。 OLTP,在线事务处理,是传统的关系型数据库的主要应用场景 OLAP,在线分析处理,是当今大数据,数据仓库使用的主要的数据库技术 SQL Query Engine,随着存算分离技术的发展,SQL查询引擎也占据了开源关系型数据库的重要的位置 OLTP OLTP是在线事务处理,在3层体系结构中支持面向事务的应用程序。 OLTP管理组织的日常事务。主要目标是数据处理而不是数据分析。 OLTP的主要特点是: 大量的短时间交易请求和处理 对信息进行增删改查的操作,常常需要查询明细信息。 必须保证事务和数据的一致性 通常要支持大量的并发用户 下面我们就来看看主要的开源OLTP的数据库架构。 MySQL MySQL是最为流行的开源关系数据库 MySQL采用了经典的客户端服务器C/S架构,服务器端的主要组件包含: 连接池,处理连接和认证授权 SQL接口,语法解析,优化器,缓存 可插拔的存储引擎,支持InnoDB、MyISAM、Memory等多个存储引擎。 物理文件,包含redolog、undolog、binlog、errorlog、querylog、slowlog、data、index等 服务工具,备份,安全等 MySQL架构设计中的一些关键技术包括: 利用缓存来避免提高热数据的查询性能 利用优化器优化查询性能 例如redo log/bin log避免频繁写数据库带来的性能压力。同时在出错的时候可以通过日志来恢复 通过两阶段提交来保证两份日志的一致性 MySQL支持事务,事务是一组原子性的SQL查询,或者说一个独立的工作单元。事务的ACID: 原子性(atomicty):一个不可分割的最小工作单元。 一致性(consistency):数据库总是从一个一致性状态转换到另一个一致性的状态。 隔离性(isolation):一个事务所做的修改在最终提交以前,对其他事务是不可见的。 持久性(durability):事务提交后,其所做的修改会永久保存到数据库中。(没有100%的持久性持久性保证策略) MySQL的大多数存储引擎通过数据快照的形式支持了多版本的并发控制。 优点: 性能卓越服务稳定,很少出现异常宕机 开放源代码且无版权制约,自主性强。 历史悠久、社区及用户非常活跃,遇到问题,可以很快获取到帮助。 支持多种操作系统,提供多种 API 接口,支持多种开发语言。 体积小、速度快、易于维护,安装及维护成本低。 MySql的核心程序采用完全的多线程编程。线程是轻量级的进程,它可以灵活地为用户提供服务,而不过多的系统资源。用多线程和C语言实现的MySql能很容易充分利用CPU。 拥有一个非常快速而且稳定的基于线程的内存分配系统,可以持续使用面不必担心其稳定性。 缺点: MySQL的设计是用来支持事务的OLTP数据库,本身缺乏支持水平扩展的能力。对于水平扩展更多是通过分库,分表加上客户端的处理来支持的。 不支持热备份。 安全管理系统比较简单。 不允许调试存储过程,开发和维护存储过程很难。 开源的MySQL集群软件比较少,例如Myat。而官方的MySQL Cluster不是开源的,它是将线性可伸缩性和高可用性结合在一起的分布式数据库。它提供了跨分区和分布式数据集的事务内一致性的内存实时访问。 因为MySQL被“邪恶”的Oracle收购,社区另开门户,以MySQL的代码创建分支,开发了MariaDB。MariaDB Server是最受欢迎的开源关系数据库之一。它由MySQL的原始开发人员制作,并保证保持开源。它是大多数云产品的一部分,并且是大多数Linux发行版中的默认产品。 书籍推荐: PostgreSQL PostgreSQL是一个功能强大的开源对象关系数据库系统,经过30多年的积极开发,在可靠性,功能强大和性能方面赢得了极高的声誉。 PostgreSQL和MySQL一样使用客户端/服务器模型。 PostgreSQL会话由以下协作过程(程序)组成: 服务器进程管理数据库文件,接受来自客户端应用程序的数据库连接,并代表客户端执行数据库操作。PostgreSQL服务器可以处理来自客户端的多个并发连接。为此,它为每个连接启动(“分叉”)新过程。从那时起,客户端和新服务器进程进行通信,而无需原始postgres进程进行干预。因此,主服务器进程始终在运行,等待客户端连接,而客户端和关联的服务器进程来来往往。 想要执行数据库操作的客户端(前端)应用程序。客户端应用程序的性质可能非常多样:客户端可以是面向文本的工具,图形应用程序,访问数据库以显示网页的Web服务器或专用的数据库维护工具。 PostgreSQL的物理结构非常简单。它由共享内存以及一些后台进程和数据文件组成。 共享内存 共享内存是指为数据库缓存和事务日志缓存保留的内存。共享内存中最重要的元素是共享缓冲区和WAL缓冲区 共享缓冲区 共享缓冲区的目的是使DISK IO最小化。为此,必须满足以下原则 需要快速访问非常大的缓冲区(数十,数百GB)。 当许多用户同时访问争用时,应将争用最小化。 常用块必须在缓冲区中保留尽可能长的时间 WAL缓冲区 WAL缓冲区是一个临时将更改存储到数据库的缓冲区。将WAL缓冲区中存储的内容在预定的时间点写入WAL文件。从备份和恢复的角度来看,WAL缓冲区和WAL文件非常重要。 PostgreSQL有四种进程类型。 守护程序进程 守护进程是启动PostgreSQL时启动的第一个进程。在启动时,执行恢复,初始化共享内存并运行后台进程。当客户端进程发出连接请求时,它还会创建一个后端进程。 后台进程 Logger将错误消息写入日志文件。 Checkpointer发生检查点时,脏缓冲区将被写入文件。 Writer定期将脏缓冲区写入文件。 WAL writer将WAL缓冲区写入WAL文件。 Autovacuum launcher将分叉自动真空工作程序.autovacuum守护程序负责按需对桌面进行真空操作 Archiver在Archive.log模式下,将WAL文件复制到指定目录。 统计收集器统计数据库使用统计信息。 后端进程进行数据处理工作。后端进程执行用户进程的查询请求,然后发送结果。执行查询需要一些内存结构,称为本地内存。 客户进程 客户端进程是指为每个后端用户连接分配的后台进程。通常,守护进程将派生一个专门为用户连接服务的子进程。 PostgreSQL希望做到单栈全功能数据库,包括: OLTP:事务处理是PostgreSQL的本行 OLAP:citus分布式插件,ANSI SQL兼容,窗口函数,CTE,CUBE等高级分析功能,任意语言写UDF流处理:PipelineDB扩展,Notify-Listen,物化视图,规则系统,灵活的存储过程与函数编写 时序数据:timescaledb时序数据库插件,分区表,BRIN索引 空间数据:PostGIS扩展(杀手锏),内建的几何类型支持,GiST索引。 搜索索引:全文搜索索引足以应对简单场景;丰富的索引类型,支持函数索引,条件索引 NoSQL:JSON,JSONB,XML,HStore原生支持,至NoSQL数据库的外部数据包装器 数据仓库:能平滑迁移至同属Pg生态的GreenPlum,DeepGreen,HAWK等,使用FDW进行ETL 图数据:递归查询 优点: 支持更丰富的数据类型的存储,包括Array,JSON等。支持R-Tree索引的树状结构。 丰富的SQL编程能力,支持递归,有非常丰富的统计函数和统计语法支持 外部数据源支持,可以多种外部数据源 (包括 Mysql, Oracle, CSV, hadoop …) 当成自己数据库中的表来查询 无限长 TEXT 类型,支持全文搜索和正则搜索 支持图数据格式的存储 丰富的索引类型支持,支持 B-树、哈希、R-树和 Gist 索引 较好的稳定性和平稳的性能 可以做到同步,异步,半同步复制,以及基于日志逻辑复制,可以实现表级别的订阅和发布。 支持各种分布式集群部署 PostgreSQL有丰富的开源cluster软件支持。plproxy 可以支持语句级的镜像或分片,slony 可以进行字段级的同步设置,standby 可以构建WAL文件级或流式的读写分离集群,同步频率和集群策略调整方便,操作非常简单。Postgres-X2是一个开放源代码项目,可提供水平可伸缩性,包括写可伸缩性,同步多主机和透明PostgreSQL接口。它是紧密耦合的数据库组件的集合,可以安装在多个硬件或虚拟机中。 缺点: PostgreSQL的 MVCC 事务语义依赖于能够比较事务 ID(XID)数字:如果一个新版本的插入 XID 大于当前事务的 XID,它就是"属于未来的"并且不应该对当前事务可见。XID的问题可能会导致长时间停机的故障。 Failover故障可能会丢失数据,如果运行中的主服务器突然出现故障,那么运行中的流复制设置几乎肯定会丢失已提交的数据。 物理复制有利有弊,低效率的复制会传播失败。使用物理复制,大型索引构建会创建大量WAL条目,从而很容易成为流复制的瓶颈。 MVCC垃圾回收频发。与大多数主流数据库一样,PostgreSQL使用多版本并发控制(MVCC)来实现并发事务。但是,其特定的实现通常会给垃圾行的数据版本及其清理(VACUUM)带来操作上的麻烦 每次连接处理=规模化痛苦,PostgreSQL为每个连接生成一个进程,而其他大多数数据库都使用更有效的连接并发模型。由于存在一个相对较低的阈值,在该阈值上添加更多的连接会降低性能(约2个内核),最终会导致性能下降 和MySQL相比较,PostgreSQL从底层设计原理不尽相同,在数据量小的时候,数据库更趋于轻量化,MySQL会更适合。但是一旦数据量大的时候,应用场景复杂,或者需要分析的场合,PostgreSQL会是更好的选择。 书籍推荐: CockroachDB CockroachDB是为现代云应用程序设计的分布式数据库。它与PostgreSQL兼容,并由一个RocksDB或专门创建的派生工具Pebble的键值存储提供支持。 CockroachDB 思路源自 Google 的全球性分布式数据库 Spanner。CockroachDB 既具有 NoSQL 对海量数据的存储管理能力,又保持了传统数据库支持的 ACID 和 SQL 等,还支持跨地域、去中心、高并发、多副本强一致和高可用等特性。支持 OLTP 场景,同时支持轻量级 OLAP 场景。 CockroachDB主要设计目标是可扩展,强一致和高可用 。CockroachDB旨在无人为干预情况下,以极短的中断时间容忍磁盘、主机、机架甚至整个数据中心的故障 。 CockroachDB采用完全去中心化架构,集群中各个节点的地位完全对等,同时所有功能封装在一个二进制文件中,可以做到尽量不依赖配置文件直接部署 Node代表一个CockroachDB进程实例,一般情况下一台物理机部署一个CockroachDB实例,一个CockroachDB实例可以配置多个Store, 单个Store与RocksDB实例一一对应,一般情况下一个Store对应一块物理磁盘。CockroachDB按照范围进行数据切分,最小数据切分单元是Range。Range默认的配置大小是64M, 以3副本的方式分布在各个节点上,副本间通过Raft协议进行数据同步。 CockroachDB底层是RocksDB的KV,在此之上,利用Raft协议来实现分布式的多副本的一致性。节点故障无丢失数据风险。CockroachDB架构上去中心化,没有单点故障:架构不存在集中式模块,单节点故障不影响集群整体的可用性。基于Raft协议,只要半数以上副本存活,则服务可用;当节点异常,数据副本数量少于指定阈值时,自动补齐副本;基于HLC分布式时钟同步算法,任意节点皆可充当事务管理节点,无中心事务管理器。 CockroachDB使用Gossip协议实现节点状态管理,理论上单集群支持10K节点规模。 CockroachDB兼容PostgreSQL协议,对于报文的封装和解析完全按照PostgreSQL的方式进行,所以用户可以直接使用PostgreSQL的客户端访问CockroachDB。 优点: 支持标准SQL,兼容PostgreSQL 扩展能力强,高并发,支持弹性扩容和高可用。单集群支持10K节点的规模, 能够存储的数据最大为4EB 支持分布式事务,多副本强一致。支持多区域部署 CRDB所有功能都在一个编译好的二进制中, 不需要依赖其它组件, 运维部署都非常方便. 缺点: 相对比较新,社区和生态还不成熟 修改了代码授权协议,不再是开源友好。CockroachDB 的核心代码授权协议将采用 BSL。用户可以将 CockroachDB 扩展到任意数量的节点,可以随意使用 CockroachDB,也可以将其嵌入到应用程序中(无论是将这些应用程序发送给客户,还是将其作为服务运行),甚至可以在内部将 CockroachDB 作为服务运行。唯一不能做的事情是,在没有购买许可证的情况下,提供商业版 CockroachDB 作为服务。 TiDB TiDB是支持MySQL语法的开源分布式混合事务/分析处理(HTAP)数据库。TiDB可以提供水平可扩展性、强一致性和高可用性。它主要由PingCAP公司开发和支持,并在Apache 2.0下授权。TiDB从Google的Spanner和F1论文中汲取了最初的设计灵感。 TiDB是国产数据库的翘楚,所属公司 PingCAP于11月宣布完成D轮2.7亿美元融资,创造了全球数据库历史新的里程碑。到目前为止,PingCAP 总计已融资 3.416 亿美元,上一次的 5000 万美元 C 轮融资于2018年9月完成。截止到2020年10月,TiDB项目在GitHub上已总计获得超过25000颗星,近1200位开源代码贡献者,参与企业包括美团、知乎、伴鱼、丰巢、小米、微众银行、UCloud、Zoom、Samsung、Square、PayPay 等行业企业。 HTAP 是 Hybrid Transactional / Analytical Processing 的缩写。这个词汇在 2014 年由 Gartner 提出。传统意义上,数据库往往专为交易或者分析场景设计,因而数据平台往往需要被切分为 TP 和 AP 两个部分,而数据需要从交易库复制到分析型数据库以便快速响应分析查询。而新型的 HTAP 数据库则可以同时承担交易和分析两种智能,这大大简化了数据平台的建设,也能让用户使用更新鲜的数据进行分析。作为一款优秀的 HTAP 数据数据库,TiDB 除了优异的交易处理能力,也具备了良好的分析能力。 TiDB在整体架构基本是参考 Google Spanner 和 F1 的设计,上分两层为 TiDB 和 TiKV 。 TiDB 对应的是 Google F1, 是一层无状态的 SQL Layer ,兼容绝大多数 MySQL 语法,对外暴露 MySQL 网络协议,负责解析用户的 SQL 语句,生成分布式的 Query Plan,翻译成底层 Key Value 操作发送给 TiKV , TiKV 是真正的存储数据的地方,对应的是 Google Spanner ,是一个分布式 Key Value 数据库,支持弹性水平扩展,自动的灾难恢复和故障转移(高可用),以及 ACID 跨行事务。值得一提的是 TiKV 并不像 HBase 或者 BigTable 那样依赖底层的分布式文件系统,在性能和灵活性上能更好,这个对于在线业务来说是非常重要。 TiDB Server:SQL 层,对外暴露 MySQL 协议的连接 endpoint,负责接受客户端的连接,执行 SQL 解析和优化,最终生成分布式执行计划。TiDB 层本身是无状态的,实践中可以启动多个 TiDB 实例,通过负载均衡组件(如 LVS、HAProxy 或 F5)对外提供统一的接入地址,客户端的连接可以均匀地分摊在多个 TiDB 实例上以达到负载均衡的效果。TiDB Server 本身并不存储数据,只是解析 SQL,将实际的数据读取请求转发给底层的存储节点 TiKV(或 TiFlash)。 PD (Placement Driver) Server:整个 TiDB 集群的元信息管理模块,负责存储每个 TiKV 节点实时的数据分布情况和集群的整体拓扑结构,提供 TiDB Dashboard 管控界面,并为分布式事务分配事务 ID。PD 不仅存储元信息,同时还会根据 TiKV 节点实时上报的数据分布状态,下发数据调度命令给具体的 TiKV 节点,可以说是整个集群的“大脑”。此外,PD 本身也是由至少 3 个节点构成,拥有高可用的能力。建议部署奇数个 PD 节点。 存储节点 TiKV Server:负责存储数据,从外部看 TiKV 是一个分布式的提供事务的 Key-Value 存储引擎。存储数据的基本单位是 Region,每个 Region 负责存储一个 Key Range(从 StartKey 到 EndKey 的左闭右开区间)的数据,每个 TiKV 节点会负责多个 Region。TiKV 的 API 在 KV 键值对层面提供对分布式事务的原生支持,默认提供了 SI (Snapshot Isolation) 的隔离级别,这也是 TiDB 在 SQL 层面支持分布式事务的核心。TiDB 的 SQL 层做完 SQL 解析后,会将 SQL 的执行计划转换为对 TiKV API 的实际调用。所以,数据都存储在 TiKV 中。另外,TiKV 中的数据都会自动维护多副本(默认为三副本),天然支持高可用和自动故障转移。 TiFlash:TiFlash 是一类特殊的存储节点。和普通 TiKV 节点不一样的是,在 TiFlash 内部,数据是以列式的形式进行存储,主要的功能是为分析型的场景加速。 和CockroachDB采用了类似的架构设计,TiKV实际上也是基于RocksDB,同样采用了Raft协议来实现分布式的一致性。值得一提的是TiKV用Rust语言开发,是开源社区的网红明星。 优点: 纯分布式架构,拥有良好的扩展性,支持弹性的扩缩容 支持 SQL,对外暴露 MySQL 的网络协议,并兼容大多数 MySQL 的语法,在大多数场景下可以直接替换 MySQL 默认支持高可用,在少数副本失效的情况下,数据库本身能够自动进行数据修复和故障转移,对业务透明 支持 ACID 事务,对于一些有强一致需求的场景友好,例如:银行转账 具有丰富的工具链生态,覆盖数据迁移、同步、备份等多种场景 智能的行列混合模式,TiDB 可经由优化器自主选择行列。这套选择的逻辑与选择索引类似:优化器根据统计信息估算读取数据的规模,并对比选择列存与行存访问开销,做出最优选择。 缺点: 虽然兼容MySQL,但是不支持存储过程,触发器,自定义函数,窗口功能有限。 不适用数据量小的场景,专门为大数据量设计。 SQLite SQLite是一种C语言库,可实现小型,快速,自包含,高可靠性,功能齐全的SQL数据库引擎。 SQLite是世界上最常用的进程内,嵌入式数据库引擎。 SQLite内置在所有手机和大多数计算机中,并捆绑在人们每天使用的无数其他应用程序中。 SQLite因为其特点,无法应用与海量数据的场景。 OpenGauss openGauss 是华为开源关系型数据库管理系统,采用木兰宽松许可证 v2 发行。openGauss 内核源自 PostgreSQL,深度融合华为在数据库领域多年的经验,结合企业级场景需求,持续构建竞争力特性。同时 openGauss 也是一个开源的数据库平台,鼓励社区贡献、合作。 OpenGauss因为起步时间短,社区还不成熟,这里就不做详细介绍了。 总结 MySQL是最为流行的开源OLTP数据库,有非常强大的生态。 PostgeSQL支持丰富的功能和扩展性,能应用与各种不同的场景中。 CockroachDB和TiDB同样借鉴了google spanner的架构,底层使用RocksDB作为KV存储,使用raft协议保证分布式的一致性来实现高可用和高扩展,是新一代开源OLTP的代表。 虽然PostgreSQL和TiDB都号称能兼顾OLTP和OLAP的场景,但是我还是把它们都归于OLTP的分类。他们的核心设计都更适合TP的场景。 SQLite是小型的关系型数据库,可用于进程内的部署。 OLAP OLAP(Online Analytical Processing)联机分析处理,是指一类软件工具,可为业务决策提供数据分析。 OLAP系统允许用户一次分析来自多个数据库系统的数据库信息。主要目标是数据分析而不是数据处理。 OLAP的主要特点是: 数据量通常比较大 大部分操作是Select 数据一致性不是非常的关键 以读操作为主,很少更新 并发查询的量通常不会很大 下面我们就来看看主要的开源OLAP的数据库架构。 Apache Hive Hive是基于Hadoop的用于查询和管理大型分布式数据集的数据仓库软件。Apache Hive数据仓库软件有助于使用SQL读取,写入和管理驻留在分布式存储中的大型数据集。可以将结构投影到已经存储的数据上。提供了命令行工具和JDBC驱动程序以将用户连接到Hive。 Hadoop的出现,通过HDFS和Map/Reduce解决了海量数据的存储和计算问题,然而Map/Reduce并不是一个开发者友好的计算和编程接口。Hive的出现解决了这个问题,基于Hadoop,Hive提供一个用户友好的SQL接口,对海量数据进行操作。 从架构上来看,Hive包含: 客户端,Hue,Qubole,CLI等 通过Thrift Server,提供JDBC/ODBC连接 Driver,所有命令和查询都转到驱动程序,该驱动程序通常使用MapReduce作业来编译输入,优化所需的计算并执行所需的步骤。 Metastore是一个单独的关系数据库(通常是一个MySQL实例),保存Hive的表模式和其他系统元数据 底层是Hadoop的文件系统和计算节点 Hive不提供的某系数据库功能,例如行级更新,快速的查询响应时间和事务,这时候你可能会需要HBase,HBase是一种分布式且可扩展的数据存储,它支持行级更新,快速查询和行级事务(但不支持多行事务)。 HBase是一个开源的非关系型分布式数据库,它参考了谷歌的BigTable建模,实现的编程语言为Java。它是Apache软件基金会的Hadoop项目的一部分,运行于HDFS文件系统之上,为 Hadoop 提供类似于BigTable 规模的服务。因此,它可以对稀疏文件提供极高的容错率。 Hive是查询引擎,而HBase是专门用于非结构化数据的数据存储。Apache Hive主要用于批处理(即OLAP),但HBase广泛用于事务处理,其中查询的响应时间不是高度交互的,即OLTP。与Hive不同,HBase中的操作在数据库上实时运行,而不是转换为mapreduce作业。HBase用于实时查询,Hive用于分析查询。 Hive采用了Schema On Read的模式,当通过加载外部数据,写入查询的输出,执行UPDATE语句等将数据写入传统数据库时,数据库可以完全控制存储。该数据库是“守门人”。数据库可以在写入数据时强制执行模式。这被称为Schema on write。Hive无法控制基础存储。有多种方法可以创建,修改甚至破坏Hive将要查询的数据。因此,Hive只能在读取时强制执行查询。这称为读取模式Schema on read。如果模式与文件内容不匹配怎么办? Hive尽其所能读取数据。如果记录中没有足够的字段来匹配模式,那么将获得很多空值。如果某些字段是数字,并且Hive遇到非数字字符串,它将为这些字段返回null。最重要的是,Hive会尽力从所有错误中恢复。 Hive除了支持Map/Reduce作为计算引擎,也可以使用SparkSQL作为计算引擎。当然SparkSQL也可以脱离Hive,使用其它数据存储来支持SQL查询。这是一种典型的存算分离的数据处理技术。 优点: Hive在海量数据上支持了OLAP场景下的分析查询 Hive支持水平扩展,高可靠,高容错 Hive支持Map/Recude或者Spark作为计算引擎 缺点 效率不高,延迟较高,默认的M/R执行引擎启动有延迟 不支持物理化视图,不能在视图上更新、插入、删除 不适用OLTP,暂不支持列级别添加、更新、删除 暂不支持存储过程,当前版本不支持存储过程 HiveQL的表达能力有限 书籍推荐: Greenplum 建立在PostgreSQL上的分析数据库平台。全名是Pivotal Greenplum数据库。一个用于分析,机器学习和AI的开源大规模并行数据平台 MPP体系结构,PB级加载,Greenplum的所有主要贡献都是Greenplum数据库项目的一部分,并且共享相同的数据库核心,包括MPP体系结构,分析接口和安全功能。 联合数据访问,使用Greenplum优化器和查询处理引擎查询外部数据源。包括Hadoop,云存储,ORC,AVRO,Parquet和其他Polyglot数据存储。 多态数据存储,完全控制表和分区存储,执行和压缩的配置。根据访问数据的方式设计表。用户可以选择任何表或分区的行或列导向存储和处理。 集成的数据库内分析,使用Apache MADlib处理数据科学,从实验到大规模部署,Apache MADlib是Postgres系列数据库的集群内机器学习功能的开源库。具有Greenplum的MADlib提供了多节点,多GPU和深度学习功能。 查询优化方面的创新,Greenplum数据库中提供的查询优化器是业界第一个针对大数据工作负载而设计的基于开源成本的查询优化器。它可以将交互式和批处理模式分析扩展到PB级的大型数据集,而不会降低查询性能和吞吐量。 Greenplum数据库是基于PostgreSQL开源技术的。它本质上是多个PostgreSQL面向磁盘的数据库实例一起工作形成的一个紧密结合的数据库管理系统(DBMS) Greenplum数据库和PostgreSQL的主要区别在于: 在基于Postgres查询规划器的常规查询规划器之外,可以利用GPORCA进行查询规划。 Greenplum数据库可以使用追加优化的存储。 Greenplum数据库可以选用列式存储,数据在逻辑上还是组织成一个表,但其中的行和列在物理上是存储在一种面向列的格式中,而不是存储成行。列式存储只能和追加优化表一起使用。列式存储是可压缩的。当用户只需要返回感兴趣的列时,列式存储可以提供更好的性能。所有的压缩算法都可以用在行式或者列式存储的表上,但是行程编码(RLE)压缩只能用于列式存储的表。Greenplum数据库在所有使用列式存储的追加优化表上都提供了压缩。 Greenplum的最小并行单元不是节点层级,而是在实例层级,每个实例都有自己的postgresql目录结构,都有各自的一套Postgresql数据库守护进程(甚至可以通过UT模式进行单个实例的访问)。正因为如此,甚至一个运行在单节点上的GreenplumDB也是一个小型的并行计算架构,一般一个节点配置6~8个实例,相当于在一个节点上有6~8个Postgresql数据库同时并行工作,优势在于可以充分利用到每个节点的所有CPU和IO 能力。 优点: 采用无共享(no shareing)的MPP架构;具有良好的线性扩展能力,具有高效的并行运算、并行存储特性。 拥有独特的高效的ORCA优化器。 兼容SQL语法。适合用于高效PB数据量级的存储、处理和实时分析能力。 由于内核是基于PostgreSQL数据库;也支持涵盖OLTP型业务混合负载。 同时数据节点和主节点都有自己备份节点。提供数据库的高可用性。 缺点: 并发能力很有限(受物理Master限制),性能随并发量增加而快速下降。Master主控节点性能瓶颈,并发性能低,实际应用中无法支持超过30个并发。 主从双层架构,并非真正的扁平架构,存在性能瓶颈和SPOF单点故障。集群规模受物理Master限制,实际应用中很难超过20个物理节点。 无法支持数据压缩态下的DML操作,不易于数据的维护和更新。 主备双Master节点容灾方案,在切换事物日志到备用master时,如有数据操作,容易导致数据损坏、insert数据丢失、delete未删除成功等。 单个节点上的数据库没有并行和大内存使用能力,必须通过部署多个实列(segment servers)来充分利用系统资源,造成使用和部署很复杂。 Clickhouse 俄罗斯搜索巨头Yandex开发的面向列存的关系型数据库。ClickHouse是过去两年中OLAP领域中最热门的,并于2016年开源。典型的用户包括著名的公司,例如字节,新浪和腾讯。 ClickHouse是基于MPP架构的分布式ROLAP(关系OLAP)分析引擎。每个节点都有同等的责任,并负责部分数据处理(不共享任何内容)。ClickHouse 是一个真正的列式数据库管理系统(DBMS)。在 ClickHouse 中,数据始终是按列存储的,包括矢量(向量或列块)执行的过程。只要有可能,操作都是基于矢量进行分派的,而不是单个的值它开发了矢量化执行引擎,该引擎使用日志合并树,稀疏索引和CPU功能(如SIMD单指令多数据)充分发挥了硬件优势,可实现高效的计算。因此,当ClickHouse面临大数据量计算方案时,通常可以达到CPU性能的极限。 通常有两种不同的加速查询处理的方法:矢量化查询执行和运行时代码生成。在后者中,动态地为每一类查询生成代码,消除了间接分派和动态分派。这两种方法中,并没有哪一种严格地比另一种好。运行时代码生成可以更好地将多个操作融合在一起,从而充分利用 CPU 执行单元和流水线。矢量化查询执行不是特别实用,因为它涉及必须写到缓存并读回的临时向量。如果 L2 缓存容纳不下临时数据,那么这将成为一个问题。但矢量化查询执行更容易利用 CPU 的 SIMD 功能。将两种方法结合起来是更好的选择。ClickHouse 使用了矢量化查询执行,同时初步提供了有限的运行时动态代码生成。 列式存储和数据压缩,对于一款高性能数据库来说是必不可少的特性。如果你想让查询变得更快,最简单且有效的方法是减少数据扫描范围和数据传输时的大小,而列式存储和数据压缩就可以帮助实现上述两点。列式存储和数据压缩通常是伴生的,因为一般来说列式存储是数据压缩的前提。ClickHouse数据按列进行组织,属于同一列的数据会被保存在一起,列与列之间也会由不同的文件分别保存 。数据默认使用LZ4算法压缩,在Yandex.Metrica的生产环境中,数据总体的压缩比可以达到8:1 ( 未压缩前17PB,压缩后2PB )。列式存储除了降低IO和存储的压力之外,还为向量化执行做好了铺垫。 ClickHouse用C ++编写,具有一个独立的系统,几乎不依赖第三方工具。支持相对完整的DDL和DML。大多数操作可以通过结合SQL的命令行来完成;分布式集群依赖Zookeper管理,并且单个节点不需要依赖Zookeper。大多数配置都需要通过修改配置文件来完成。 ClickHouse通常要求用户在创建表结构时指定分区列。采用数据压缩和纯列存储技术,使用Mergetree分别存储每列并压缩块,同时,数据将始终以碎片的形式写入磁盘。当满足某些条件时,ClickHouse将通过后台线程定期合并这些数据片段。当数据量继续增加时,ClickHouse将合并分区目录中的数据,以提高数据扫描的效率。 同时,ClickHouse为每个数据块提供了一个稀疏索引。处理查询请求时,稀疏索引可用于减少数据扫描并加快速度。 Clickhouse最初架构是基于MySQL实现的,所以在ClickHouse的设计中,能够察觉到一些MySQL的影子,表引擎的设计就是其中之一。与MySQL类似,ClickHouse也将存储部分进行了抽象,把存储引擎作为一层独立的接口。ClickHouse共拥有合并树、内存、文件、接口和其他6大类20多种表引擎。其中每一种表引擎都有着各自的特点,用户可以根据实际业务场景的要求,选择合适的表引擎使用。 优点: 性能卓越。在成本与性能之间做到了良好平衡,即快又开源。即便是在复杂查询的场景下,它也能够做到极快响应,且无须对数据进行任何预处理加工。 数据压缩比高,存储成本低。 支持常用的SQL语法,写入速度非常快,适用于大量的数据更新。 缺点: 不适合高并发的场景。在ClickHouse官方网站文档中,建议ClickHouse的并发数量不超过100。当并发要求较高时,为了减少ClickHouse的资源消耗,可以结合ClickHouse的某些特殊引擎对其进行优化。 分布式管理较为薄弱,使得运营、使用成本偏高。 ClickHouse 集群自身虽然可以方便的水平增加节点,但并不支持自动的数据均衡。在节点故障的情况下,ClickHouse 并不会利用其它机器补齐缺失的副本数据。需要用户先补齐节点后,然后系统再自动在副本间进行数据同步。 ClickHouse 在单表性能方面表现非常出色,但是在复杂场景仍有不足,缺乏成熟的 MPP 计算引擎和执行优化器。例如:多表关联查询、复杂嵌套子查询等场景下查询性能一般,需要人工优化; 缺乏 UDF 等能力,在复杂需求下扩展能力较弱等。 ClickHouse 并不适合实时写入,原因在于 ClickHouse 并非典型的 LSM Tree 架构,它没有实现 Memory Table 结构,每批次写入直接落盘作为一棵 Tree(如果单批次过大,会拆分为多棵 Tree),每条记录实时写入会导致底层大量的小文件,影响查询性能。这使得 ClickHouse 不适合有实时写入需求的业务,通常需要在业务和 ClickHouse 之间引入一层数据缓存层,实现批量写入。 Apache Druid https://druid.apache.org/ Apache Druid是开源分析数据库,专为对高维度和高基数数据进行亚秒级OLAP查询而设计,它由广告分析公司Metamarkets创建,到目前为止,已被许多公司使用,包括Airbnb,Netflix,Nielsen,eBay,Paypal和Yahoo。它结合了OLAP数据库,时间序列数据库和搜索系统的思想,以创建适用于广泛使用案例的统一系统。最初,Apache Druid在2012年获得GPL许可,成为开源软件,此后在2015年更改为Apache 2许可,并于2018年加入Apache Software Foundation作为孵化项目。 Druid提供OLAP查询的主要功能包括: 为了提高存储效率和在数据范围内进行快速过滤,Druid以面向列的压缩格式存储数据。因此,它可以处理数据冗余,同时使用高效的格式对多维聚合和分组执行查询。要回答查询,它仅加载所需的确切列。每列都针对其特定数据类型进行了优化存储。为了在多个列之间提供快速过滤和搜索,Druid使用了最新的压缩位图索引(。 任何数据源(即Druid中的表)的架构都非常灵活,可以轻松地进行开发。 数据是根据时间进行分区的,因此时间序列查询的速度明显快于传统数据库。 Druid提供了开箱即用的算法,用于近似计数差异,近似排名以及近似直方图和分位数的计算。 它具有高度的可扩展性,已用于每秒每秒数百万个事件和多年数据存储的生产环境中。 查询的平均响应时间以秒为单位。 容错架构。 与最新的大数据技术集成,包括Apache Kafka,Apache Flink,Apache Spark和Apache Hive。 提供基于本机JSON的语言,以及基于HTTP或JDBC的SQL(实验性)。 提供高级商业智能和分析数据探索和可视化工具(如Metabase和Apache Superset)支持。 Druid平台依赖于以下三个外部依赖项: 深度存储:它可以是任何分布式文件系统或对象存储,例如Amazon S3,Azure Blob存储,Apache HDFS(或任何HDFS兼容系统)或网络安装的文件系统。深度存储的目的是持久保存Druid吸收的所有数据,作为备份解决方案,并在需要时同时可供所有Druid组件和群集使用。 元数据存储:由传统的关系数据库系统(例如PostgreSQL或MySQL)支持。所有元数据都可用于任何Druid组件。 Druid中有多种类型的元数据,有些与深度存储中的持久段有关,例如段文件的路径,它们的时间戳,它们的版本等,其他可能与外部系统有关,例如从Apache提取分区偏移量Kafka主题以及其余主题与各种内部流程的元数据有关(例如,现在正在其中创建段)。 ZooKeeper:用于内部服务发现,协调和领导者选举。 Druid的体系结构由以下处理类型的组件组成: 中间管理器进程(Middle Manager)处理将数据提取到群集中的过程。例如,他们负责从Apache Kafka摄取实时流数据或从其他来源加载一批数据(例如,来自HDFS的文件)。 历史进程(Historical)处理“历史”数据的存储和查询。运行历史进程的节点将从深度存储中获取分段到其本地磁盘,并响应有关这些分段的查询。 代理进程(Broker)从外部客户端接收查询。它们确定哪个历史记录和中间管理器节点正在服务那些段,并将重写的子查询发送到这些流程中的每个流程。此后,他们收集并合并结果并响应呼叫者。在内部,历史记录进程会响应与已保留到深度存储中的数据段相对应的子查询,而中级代理将响应与最近提取的数据。 为了在历史和中间管理器流程之间平衡数据,Druid分别具有协调器流程和Overload流程。具体地说,协调器进程负责将段分配给正在运行历史记录进程的特定节点。同样,Overlord流程负责将提取任务分配给中间管理器进程,并负责协调细分发布。 最后,路由器进程在Brokers,Overlords和Coordinator的前面提供了一个统一的API网关。它们的使用是可选的,因为还可以直接联系Brokers,Overlords和Coordinator。 如前所述,Druid由用于摄取,查询和协调的独立组件组成。每个Druid流程组件都可以独立配置和扩展,从而提供最大的灵活性,并具有强大的容错能力(因为一个组件的故障不会立即影响其他组件)。此外,将深度存储和元数据存储与Druid系统的其余部分分开,可以从一直保留在深度和元数据存储中的数据中重新启动组件或整个集群。 优点: 亚秒级的OLAP查询分析,Druid采用了列式存储/倒排索引/位图索引等关键技术,能够在亚秒级别内完成海量数据的过滤/聚合以及多位分析等操作 高可用性和高扩展性,Druid采用分布式,SN(share-nothing)架构,管理类节点课配置HA,工作节点功能单一,不互相依赖,耦合性低,各种节点挂掉都不会使Druid停止工作 实时流数据分析。区别于传统分析型数据库采用的批量导入数据进行分析的方式,Druid提供了实时流数据分析,采用LSM(Long structure merge)-Tree结构使Druid拥有极高的实时写入性能 缺点: 数据不可修改,数据没有 update 更新操作,只对 segment 粒度进行覆盖:由于时序化数据的特点,Druid 不支持数据的更新。 能接受的数据的格式相对简单,比如不能处理嵌套结构的数据 Druid 查询并发有限,不适合 OLTP 查询。 不支持Join 操作:Druid 适合处理星型模型的数据,不支持关联操作。 Apache Kylin Apache Kylin是用于大数据的分布式分析引擎,提供SQL接口和多维分析(OLAP)并可用于用Hadoop栈。它最初由eBay中国研发中心开发,于2014年开源并为Apache Software Foundation贡献力量,具有亚秒级的查询功能和超高的并发查询功能,被美团,滴滴,携程,壳牌,腾讯,58.com等许多主要制造商采用。 Kylin是基于Hadoop的MOLAP(多维OLAP)技术。核心技术是OLAP Cube;与传统的MOLAP技术不同,Kylin在Hadoop上运行,Hadoop是一个功能强大且可扩展的平台,可以支持大量(TB到PB)数据。它将预先计算(由MapReduce或Spark执行)的多维多维数据集导入到低延迟分布式数据库HBase中,以实现亚秒级的查询响应。最近的Kylin 4开始使用Spark + Parquet代替HBase来进一步简化架构。由于在脱机任务(多维数据集构造)过程中已完成大量聚合计算,因此在执行SQL查询时,它不需要访问原始数据,而是直接使用索引来组合聚合结果并再次进行计算。性能高于原始数据。一百甚至数千次;由于CPU使用率低,它可以支持更高的并发性,特别适合于自助服务分析,固定报告和其他多用户交互式分析方案。 Kylin用Java编写,完全集成到Hadoop生态系统中,并使用HDFS进行分布式存储。计算引擎可以是MapReduce,Spark和Flink。存储引擎可以是HBase,Parquet(与Spark结合使用)。源数据访问支持Hive,Kafka,RDBMS等,多节点协调依赖Zookeeper;与Hive元数据兼容,Kylin仅支持SELECT查询,Schema修改需要在Hive中完成,然后同步到Kylin;传递建模和其他操作Web UI完成,通过Rest API执行任务调度,并且可以在Web UI上查看任务进度。 Kylin使用Hadoop生态系统HBase或Parquet作为存储结构,依靠HBase的行键索引或Parquet的行组稀疏索引来提高查询速度,并使用HBase Region Server或Spark执行器进行分布式并行计算。Kylin通过预聚合计算多维Cube数据,并在查询时根据查询条件动态选择最佳Cuboid(类似于实例化视图),这将大大减少CPU计算和IO读取的数量。在多维数据集构建过程中,Kylin对维值进行某些编码和压缩,例如字典编码,以最大程度地减少数据存储;由于Kylin的存储引擎和架构引擎是可插拔的,因此也存在用于不同存储引擎的存储结构。 Kylin的核心原则是预先计算,利用空间换时间来加速查询:Kylin的计算引擎使用Apache Spark和MapReduce;存储使用HBase和Parquet;SQL分析和后计算使用Apache Calcite。Kylin的核心技术是开发一系列优化方法,以帮助解决尺寸爆炸和扫描数据过多的问题。这些方法包括:设置聚合组,设置维度尺寸,设置派生维度,设置维度表快照,设置行键顺序,按列设置分片等。 Kylin 利用 MapReduce/Spark 将原始数据进行聚合计算,转成了 OLAP Cube 并加载到 HBase 中,以 Key-Value 的形式存储。Cube 按照时间范围划分为多个 segment,每个 segment 是一张 HBase 表,每张表会根据数据大小切分成多个 region。Kylin 选择 HBase 作为存储引擎,是因为 HBase 具有延迟低,容量大,使用广泛,API完备等特性,此外它的 Hadoop 接口完善,用户社区也十分活跃。 优点: 基于预计算,数据量愈大,优势越大。 SQL接口,Kylin主要的对外接口就是以SQL的形式提供的。SQL简单易用的特性极大地降低了Kylin的学习成本,不论是数据分析师还是Web开发程序员都能从中收益。 支持海量数据集。不论是Hive、SparkSQL,还是Impala、Presto,都改变不了这样一个事实:查询时间随着数据量的增长而线性增长。而Apache Kylin使用预计算技术打破了这一点。Kylin在数据集规模上的局限性主要取决于维度的个数和基数,而不是数据集的大小,所以Kylin能更好地支持海量数据集的查询。 亚秒级响应,同样受益于预计算技术,Kylin的查询速度非常快,因为复杂的连接、聚合等操作都在Cube的构建过程中已经完成了。 水平扩展,Apache Kylin同样可以使用集群部署方式进行水平扩展。但部署多个节点只能提高Kylin处理查询的能力,而不能提升它的预计算能力。 可视化集成,Apache Kylin提供了ODBC/JDBC接口和RESTful API,可以很方便地与Tableau等数据可视化工具集成。数据团队也可以在开放的API上进行二次开发。 缺点: 不支持明细查询 预计算会占用大量空间,也存在维度爆炸的问题 灵活性差 Apache Doris Doris是用于报告和分析的基于MPP的交互式SQL数据仓库。它的原始名称是在百度开发时的Palo。捐赠给Apache Software Foundation之后,它更名为Doris。 Doris是一个MPP的ROLAP系统,主要整合了Google Mesa(数据模型),Apache Impala(MPP Query Engine)和Apache ORCFile (存储格式,编码和压缩) 的技术。 Doris定位为: MPP 架构的关系型分析数据库 PB 级别大数据集,秒级/毫秒级查询 主要用于多维分析和报表查询 Doris 的整体架构和 TiDB 类似,借助 MySQL 协议,用户使用任意 MySQL 的 ODBC/JDBC以及MySQL 的客户端,都可以直接访问 Doris。Doris 中的模块包括 FE 和 BE 两类:FE 主要负责元数据的管理、存储,以及查询的解析等;一个用户请求经过 FE 解析、规划后,具体的执行计划会发送给 BE,BE 则会完成查询的具体执行。BE 节点主要负责数据的存储、以及查询计划的执行。目前平台的 FE 部分主要使用 Java,BE 部分主要使用 C++。 Doris的主要设计思路有: 按列存储,支持数据压缩,减少磁盘IO 向量化执行,是列存数据库特有的一个优化技巧,可以减少CPU消耗,提升CPU利用率。 Doris 没有一个强索引,它只有一个稀疏索引,当稀疏索引满足不了用户的场景通过支持物化视图来加速。 元数据层面,Doris 采用 Paxos 协议以及 Memory + Checkpoint + Journal 的机制来确保元数据的高性能及高可靠。 优点: 数据高可靠,在服务器宕机的情况下,服务依然可用,数据也不会丢失 易运维,Doris 部署无外部依赖,只需要部署 BE 和 IBE 即可搭建起一个集群。 支持 Online Schema Change 类似TiDB,兼容MySQL 缺点: 社区刚刚起步,生态还不成熟 总结 Apache Hive是基于Hadoop的数据仓库解决方案,但是查询性能一般。 Greenplum是基于PostgreSQL开发的MPP架构的开源OLAP解决方案。 Clickhouse是最近最为流行的OLAP开源工具,主要采用了列存,向量化,Mergetree等技术,性能不是一般的强。 Apache Kylin是基于Hadoop的MOLAP,主要采用了预汇聚来实现海量数据的查询性能。 Apache Druid是开源时序OLAP工具,支持高可用可高扩展。Druid也采用了预汇聚的技术。 Apache Doris是百度开源的基于MPP的交互式SQL数据仓库,同样利用了列存和向量化技术,使用Paxos协议实现分布式的一致性。 SQL Query Engine 存算分离是现代数据库区别于传统数据库的主要特点之一,主要是为了 提升资源利用效率,用户用多少资源就给多少资源; 计算节点无状态更有利于数据库服务的高可用性和集群管理(故障恢复、实例迁移)的便利性。 存算分离的架构特别适合云上的部署,能够分别扩展存储和计算资源,做到资源和成本的最大利用和收益。 存算分离后,计算侧就需要一个与存储分离的SQL 查询引擎,常见的开源SQL查询引擎有Facebook的Presto,Apache Drill和SparkSQL。 Presto Presto是一个适用于大数据的分布式SQL查询引擎,使SQL可以访问任何数据源。可以使用Presto通过水平缩放查询处理来查询非常大的数据集。Presto用于对大小从GB到PB的各种数据源运行交互式分析查询。Presto是专为交互式分析而设计和编写的,可在扩展到Facebook之类的组织规模的同时,实现商业数据仓库的速度。 虽然Presto理解并可以有效执行SQL,但是Presto不是数据库,因为它不包括自己的数据存储系统。它并不是要成为通用的关系数据库。Presto并非设计为处理OLTP的场景。 Presto利用众所周知的技术和新颖的技术来进行分布式查询处理。这些技术包括 内存中并行处理,集群中跨节点的流水线执行, 使所有CPU核心保持繁忙的多线程执行模型, 有效的平面内存数据结构 最小化Java垃圾收集 Java字节码生成 Presto可以应用在许多的场景下。 Presto是一个分布式SQL查询引擎,类似于大规模并行处理(MPP)样式的数据库和查询引擎。除了依赖于运行Presto的服务器的垂直扩展,它还能够以水平方式在服务器集群中分布所有处理能力。这意味着可以通过添加更多节点来获得更多处理能力。 Presto的架构主要包含: 客户端 协调器是Presto服务器,它处理传入的查询并管理工作程序以执行查询。包含解析分析器,计划器,调度器 Worker是Presto服务器,负责执行任务和处理数据。 Discovery Service发现服务通常在协调器上运行,并允许工作人员进行注册以加入集群。 Presto存储与计算分离的核心是基于连接器的体系结构。连接器为Presto提供了访问任意数据源的接口。连接器的API称为SPI(service provider interface )。 优点: 类似SparkSQL的SQL计算引擎,全部计算在内存内完成,性能有优势 支持的数据源的种类非常多 支持联邦查询 缺点: 虽然能够处理PB级别的海量数据分析,但不是代表Presto把PB级别都放在内存中计算的。而是根据场景,如count,avg等聚合运算,是边读数据边计算,再清内存,再读数据再计算,这种耗的内存并不高。但是连表查,就可能产生大量的临时数据,因此速度会变慢,反而Hive此时会更擅长。 为了达到实时查询,可能会想到用它直连MySql来操作查询,这效率并不会提升,瓶颈依然在MySql,此时还引入网络瓶颈,所以会比原本直接操作数据库要慢。 没有容错设计,当某个任务失败时,整个查询都会失败 因为查询都在内存中,内存不够会导致查询失败 书籍推荐: Apache Drill 适用于Hadoop,NoSQL和云存储的无模式SQL查询引擎。 Apache Drill类似SparkSQL和Presto,Apache Drill可以在不同的数据源上执行SQL查询, 它是一个低延迟的大型数据集的分布式查询引擎,包括结构化和半结构化数据/嵌套。其灵感来自于谷歌的 Dremel,Drill 的设计规模为上千台节点并且能与 BI 或分析环境互动查询。在大型数据集上,Drill 还可以用于短,交互式的临时查询。Drill 能够用于嵌套查询,像 JSON 格式,Parquet 格式以及动态的执行查询。Drill 不需要一个集中的元数据仓库。 Apache Drill 的核心服务是 “Drillbit”,她负责接受来自客户端的请求,处理请求,并返回结果给客户端。Drillbit 服务能够安装在并运行在 Hadoop 集群上。当 Drillbit 运行在集群的每个数据节点上时,能够最大化去执行查询而不需要网络或是节点之间移动数据。Drill 使用 ZooKeeper 来维护集群的健康状态。虽然 Drill 工作于 Hadoop 集群环境下,但是 Drill 不依赖 Hadoop,并且可以运行在任何分布式集群环境下。唯一的先决条件就是需要 ZooKeeper。 Drill的查询性能主要靠以下几点设计来支持: Drill基于列式存储数据,类似Spark和Presto,计算在内存内进行,避免了磁盘IO 使用代码生成,把SQL转化为物理执行计划,Drillbit的operator再将其生成为Java代码,本地代码生成避免了代码分发(Spark)的问题 长久存活的Drillbit。基于YARN的资源分配模式需要创建和销毁Java进程,Spark可以一定程度上利用Executor的重用来减少JVM的开销。Drill的Drillbit是一直存活的,避免了创建和销毁带来的开销。 优点: 动态Schema发现,在开始执行查询处理的时候,Drill 不需要为规范数据的 Schema 和类型。Drill 开始处理数据是在记录批处理的时候,在处理过程中去发现 Schema。 灵活的数据模型,Drill 允许数据属性嵌套。从架构的角度来看,Drill 提供了灵活的柱状数据模型,她能够呈现复杂的,高动态的和不断变化的数据模型。关系型数据在 Drill 中能够被转化为特殊的或是复杂/半结构化的数据。 Drill 没有集中式的元数据要求。你不需要创建和管理表和视图 扩展性好,Drill 提供了一个可扩展的体系结构,包括存储插件,查询,查询优化/执行,以及客户端接口层 缺点: 长久存活的Drillbit导致缺乏资源的隔离,如果一个Query占用过多资源,会导致其它Query无法获得资源。 安装和部署比较麻烦 垃圾回收是个问题 书籍推荐: SparkSQL Spark SQL是Apache Spark的用于处理结构化数据的模块。 将SQL查询与Spark程序无缝混合。Spark SQL可以使用SQL或熟悉的DataFrame API在Spark程序中查询结构化数据。可在Java,Scala,Python和R中使用。 统一数据访问,以相同的方式连接到任何数据源。DataFrame和SQL提供了一种访问各种数据源的通用方法,包括Hive,Avro,Parquet,ORC,JSON和JDBC。甚至可以跨这些源连接数据。 Hive整合,在现有仓库上运行SQL或HiveQL查询。Spark SQL支持HiveQL语法以及UDF,从而可以访问现有的Hive仓库。 标准连接,通过JDBC或ODBC连接。服务器模式为商业智能工具提供了行业标准的JDBC和ODBC连接。 性能与可扩展性,Spark SQL包括基于成本的优化器,列存储和代码生成,以加快查询速度。同时,使用Spark引擎可扩展到数千个节点和数小时的查询,该引擎可提供完整的中查询容错能力。不必担心为历史数据使用其他引擎。 优点: 灵活,Spark SQL将SQL查询与Spark程序混合使用,借助Spark SQL,我们可以查询结构化数据作为分布式数据集(RDD),我们可以使用Spark SQL运行SQL查询以及复杂的分析算法。 高兼容性,在Spark SQL中,我们可以在现有数据仓库上运行未经修改的Hive查询。Spark SQL完全兼容现有的Hive数据、查询和UDF。 统一数据访问,使用Spark SQL,我们可以加载和查询来自不同来源的数据。Schema-RDD允许使用单一接口高效地处理结构化数据,例如Apache Hive表、parquet文件和JSON文件。 性能优化,Spark SQL中的查询优化引擎将每个SQL查询转换为逻辑计划,然后转换为许多物理执行计划,最后它选择最优化的物理执行计划。 缺点: 不支持的union类型,使用Spark SQL,不能创建或读取包含联合字段的表。 不支持事务 书籍推荐: 总结 作为SQL查询引擎,SparkSQL是最为流行的,Spark是分布式内存内计算引擎,常被用来取代Map/Reduce做大数据的计算平台,SparkSQL可以用于对结构化数据进行SQL的运算,非常方便。而Presto利用其插件的设计,除了用于SQL计算,还经常被用于SQL的联邦查询,不需要把数据移动到本地存储。Apache Drill的应用不如前两者广泛。 好了,因为开源数据库这块的东西实在是太多了,这里我抛砖引玉,给大家一个参考,希望能对大家选用数据库技术有所帮助。

优秀的个人博客,低调大师

每日一博 | 影响 Kubernetes 调度的决策分析

本文永久链接:https://www.xtplayer.cn/kubernetes/scheduler/influencing-kubernetes-scheduler-decisions/ 为了提高节点资源的最大利用率,调度程序使用复杂的算法来确保最有效的 Pod 调度。在本文中,我们讨论调度程序如何选择最佳节点来运行 Pod,以及如何影响其决策。 哪个节点具有可用资源? 选择适当的节点时,调度程序会检查每个节点是否有足够的资源满足 Pod 调度。如果您已经声明 Pod 所需的 CPU 和内存量(通过请求和限制),调度程序将使用以下公式来计算给定节点上的可用内存: 调度可用内存 = 节点总内存 - 已预留内存 保留内存是指: Kubernetes 守护进程使用的内存,例如:kubelet、containerd(一种容器运行时)。 节点操作系统使用的内存,例如:内核守护程序。 通过使用此方程式,调度程序可确保由于过多 Pod 竞争消耗节点所有可用资源,从而导致节点资源耗尽引起其他系统异常,比如系统触发 oom。 影响调度过程 在不受用户影响的情况下,调度程序在将 Pod 调度到节点时执行以下步骤: 调度程序检测到已创建新的 Pod,但尚未将其分配给节点; 它检查 Pod 需求,并相应地筛选出所有不合适的节点; 根据权重将剩下的节点进行排序,权重最高的排在第一位; 调度程序选择排序列表中的第一个节点,然后将 Pod 分配给它。 通常,我们会让调度程序自动选择合适的节点(前提是 Pod 配置了资源请求和限制)。但是,有时可能需要通过强制调度程序选择特定节点或手动向多个节点添加权重来影响此决策,以使其比其他节点更适合 Pod 调度。 让我们看看我们如何做到这一点: 节点名称 在最简单的节点选择配置中,您只需在.spec.nodeName中指定其名称,就可以强制 Pod 在指定节点上运行。例如,以下 YAML 定义 Pod 强制在 app-prod01 上进行调度: apiVersion: v1 kind: Pod metadata: name: nginx spec: containers: - name: nginx image: nginx nodeName: app-prod01 请注意,由于以下原因,此方法是最简单但最不推荐的节点选择方法: 如果由于某种原因无法找到指定名称的节点(例如,更改了主机名),则 Pod 将不会运行。 如果该节点没有 Pod 运行所需的资源,则 Pod 会运行失败,并且也不会将该 Pod 调度到其他节点。 这会导致 Pods 与它们的节点紧密耦合,这是一种糟糕的设计实践。 节点选择器 覆盖调度程序决策的第一个最简单的方法是使用 Pod 定义或 Pod 模板(如果使用的是 Deployments 之类的控制器)中的.spec.nodeSelector参数。nodeSelector 接受一个或多个键-值对标签,这些键-值对标签必须在节点设置才能正常的调度 Pod。假设您最近购买了两台配备 SSD 磁盘的计算机,您希望数据库相关所有的 Pod 在 SSD 支持的节点上进行调度,以获得最佳的数据库性能。DB Pod 的 Pod YAML 可能如下所示: apiVersion: v1 kind: Pod metadata: name: db spec: containers: - name: mongodb image: mongo nodeSelector: disktype: ssd 根据该定义,当调度程序选择合适的 Pod 分配节点时,将仅考虑具有disktype=ssd标签的节点。 此外,您可以使用自动分配给节点的任何内置标签来操纵选择决策。例如,节点的主机名(kubernetes.io/hostname),体系结构(kubernetes.io/arch),操作系统(kubernetes.io/os)等均可用于节点选择。 节点亲和性 当您需要选择特定的节点来运行我们的 Pod 时,节点选择非常有用。但是选择节点的方式是有限的,只有与所有定义的标签匹配的节点才被考虑用于 Pod 放置。Node Affinity 通过允许您定义硬节点和软节点需求,为您提供了更大的灵活性。硬性要求必须在要选择的节点上匹配。另一方面,软条件允许您为具有特定标签的节点增加更多权重,以使它们在列表中的位置比对等节点更高。没有软需求标签的节点将不被忽略,但它们权重更小。 让我们举个例子:我们的数据库是 I/O 密集型的。我们需要数据库 Pods 始终在 SSD 支持的节点上运行。此外,如果 Pod 部署在区域 zone1 或 zone2 中的节点上,因为它们在物理上更靠近应用程序节点,那么它们的延迟会更短。满足我们需求的 Pod 定义可能如下所示: apiVersion: v1 kind: Pod metadata: name: db spec: affinity: nodeAffinity: requiredDuringSchedulingIgnoredDuringExecution: nodeSelectorTerms: - matchExpressions: - key: disk-type operator: In values: - ssd preferredDuringSchedulingIgnoredDuringExecution: - weight: 1 preference: matchExpressions: - key: zone operator: In values: - zone1 - zone2 containers: - name: db image: mongo nodeAffinity 节使用以下参数来定义硬性要求和软性要求: requiredDuringSchedulingIgnoredDuringExecution:部署 DB Pod 时,节点必须具有 disk-type=ssd。 preferredDuringSchedulingIgnoredDuringExecution:当对节点进行排序时,调度器会给予标签为zone=zone1或zone=zone2的节点更高的权重。如果有disk-type=ssd和zone=zone1的节点,则优先选择 disk-type=ssd 且无 zone 标签的节点或指向其他 zone 的节点。权重可以是 1 到 100 之间的任意值,权重号赋予匹配节点相对于其他节点更高的权重。数字越大,权值越高。 注意,在进行选择时,节点亲和性允许您在选择目标节点上应该存在(或不存在)哪些标签时拥有更多的自由。在本例中,我们使用 In 操作符定义了多个标签,目标节点上存在任何一个标签即可。其他运算符是 NotIn、Exists、doesnoexistists、Lt(小于)和 Gt(大于)。值得注意的是,NotIn 和 doesnot existist 实现了所谓的节点反亲和性。 节点亲和性和节点选择器不是互斥的,它们可以共存于同一个定义文件中。但是,在这种情况下,节点选择器和节点亲和性硬要求必须匹配。 Pod 亲和性 节点选择器和节点亲和性(以及反亲和性)帮助我们影响调度器关于在何处放置 Pods 的决策。但是,它只允许您基于节点上的标签进行选择。它不关心 Pod 本身的标签。您可能需要在以下情况下根据 Pod 标签进行选择: 需要将所有中间件 Pod 放在同一个物理节点上,与那些具有 role=front 标签的 Pod 一起,以减少它们之间的网络延迟。 作为一种安全最佳实践,我们不希望中间件 Pod 与处理用户身份验证的 Pod 共存(role=auth)。这不是一个严格的要求。 如您所见,这些要求不能用节点选择器或亲和性来满足,因为在选择过程中不考虑 Pod 标签——只考虑节点标签。 为了满足这些需求,我们使用 Pod 亲和性和反亲和性。本质上,它们的工作方式与节点亲和性和反亲和性相同。必须满足硬性要求来选择目标节点,而软条件增加了拥有所选节点的机会(权重),但不是严格要求。让我们举个例子: apiVersion: v1 kind: Pod metadata: name: middleware spec: affinity: podAffinity: requiredDuringSchedulingIgnoredDuringExecution: - labelSelector: matchExpressions: - key: role operator: In values: - frontend topologyKey: kubernetes.io/hostname podAntiAffinity: preferredDuringSchedulingIgnoredDuringExecution: - weight: 100 podAffinityTerm: labelSelector: matchExpressions: - key: role operator: In values: - auth topologyKey: kubernetes.io/hostname containers: - name: middleware image: redis 在上面的 Pod 定义文件中,我们对硬性要求和软性要求进行了如下设置: requiredDuringSchedulingIgnoredDuringExecution:我们的 Pod 必须在具有标签为 app-front 的 Pod 节点上调度。 preferredDuringSchedulingIgnoredDuringExecution:我们的 Pod 不应该(但它可以)被调度到运行带有标签为 role=auth 的 Pod 的节点上。与节点亲和性一样,soft requirement 将权重从 1 设置为 100,以增加节点相对于其他节点的概率。在我们的示例中,软需求被放置在 poantiaffinity 中,导致运行具有标签为 role=auth 的 Pod 的节点在调度程序做出决定时被选中的可能性更小。 topologyKey用于对规则将应用于哪个领域做出更细粒度的决策。topologyKey 接受一个标签键,该标签键必须出现在选择过程中考虑的节点上。在我们的示例中,我们使用了自动填充的标签,该标签在默认情况下自动添加到所有节点,并引用节点的主机名。但是您可以使用其他自动填充的标签,甚至是自定义的标签。例如,您可能需要只在具有 rack 或 zone 标签的节点上应用 Pod 亲和规则。 关于 IgnoredDuringExecution 的注释 您可能已经注意到,硬需求和软需求都有IgnoredDuringExecution后缀。这意味着在做出调度决策之后,调度程序将不会尝试更改已经放置的 Pods,即使条件发生了变化。例如,根据节点亲和性规则,将一个 Pod 调度到一个具有标签为 app=prod 的节点上。如果该标签被更改为 app=dev, 旧 Pod 不会被终止,并在另一个有 app=prod 标签的节点上启动新的 Pod。这个行为在将来可能会改变,以允许调度程序在部署后继续检查节点和 Pod 的关联性(和反关联性)规则。 污点与容忍 在某些场景中,您可能希望阻止将 Pod 调度到特定节点。可能您正在运行测试或扫描此节点以查找威胁,而您不希望应用程序受到影响。节点反亲和性可以实现这一目标。但是,这是一个重大的管理负担,因为您需要向部署到集群的每个新 Pod 添加反关联规则。对于这种场景,您应该使用污点。 当一个节点配置了污点时,除非 Pod 能够容忍这种污点,否则不能对它调度 Pod。容忍只是一个与污点匹配的键-值对。让我们举个例子来说明: 需要对主机 web01 进行污染,以使其不接受更多 Pod。taint 命令如下: kubectl taint nodes web01 locked=true:NoSchedule 上面的命令在名为 web01 的节点上放置了一个污点,该节点具有以下属性: 标签 locked=true,该标签必须配置在想要运行在该节点的 Pod 上。 NoSchedule 的污点类型。污点类型定义了应用污点的行为,它有以下几种可能: NoSchedule:此节点一定不要调度。 PreferNoSchedule:尽量不要调度,类似软亲和性。 NoExecute:不仅不会调度,还会驱逐 Node 上已有的 Pod。 在带有污点的节点上,Pod 的定义文件可能如下所示: apiVersion: v1 kind: Pod metadata: name: mypod spec: containers: - name: mycontainer image: nginx tolerations: - key: "locked" operator: "Equal" value: "true" effect: "NoSchedule" 让我们仔细看看这个定义的容忍部分: 为了具有正确的容忍,我们需要指定键(locked),值(true)和运算符。 运算符可以是两个值之一: Equal:当使用 equal 操作符时,键、值和污染效果必须与节点的污染匹配。 Exists:在使用 exists 操作符时,不需要将污点与容忍匹配,只需匹配建即可。 如果使用 Exists 运算符,则可以忽略容忍键、值和效果。具有这种容忍的 Pod 可以被调度到具有任何受污点的节点。 注意,在 Pod 上放置容忍并不能保证它被部署到受污染的节点上。它只允许行为发生。如果要强制 Pod 加入受污染的节点,还必须像前面讨论的那样向其定义添加节点亲和性。 TL; DR 在节点上自动放置 Pod 是 Kubernetes 诞生的原因之一。作为管理员,只要您对 Pod 需求做出了良好的声明,您就不用担心节点是否有足够的空闲资源来运行这些 Pod。但是,有时您必须手动干预和覆盖系统关于在何处放置 Pods 的决定。在本文中,我们讨论了几种方法,在决定部署 Pods 时,您可以通过这些方法对特定节点的调度器产生更大的影响。让我们快速回顾一下这些方法: 节点名称:通过将节点的主机名添加到 Pod 定义的.spec.nodeName参数中,可以强制此 Pod 在该特定节点上运行。调度程序使用的任何选择算法都将被忽略。不建议使用此方法。 节点选择器:通过在节点上放置指定的标签,Pod 可以使用 nodeelector 参数指定一个或多个键-值标签,这些标签必须存在于目标节点上才能被选中以运行 Pod。推荐使用这种方法,因为它增加了很多灵活性,并建立了松耦合的 node-Pod 关系。 节点亲和性:在选择应该考虑哪个节点来调度特定的 Pod 时,这种方法增加了更多的灵活性。使用节点亲和性,Pod 可能严格要求在具有特定标签的节点上调度。它还可以通过影响调度程序为特定节点赋予更大的权重来表示对特定节点的某种程度的偏好。 Pod 亲和性和反亲和性:当 Pod 与同一节点上的其他 Pod 共存(或不共存)时,可以使用此方法。Pod 亲和性允许将 Pod 部署在具有特定标签的 Pod 运行的节点上。相反,Pod 可能会强制调度程序不将其调度到具有特定标签的 Pod 运行的节点上。 污点和容忍:在这种方法中,您不需要决定将 Pod 调度到哪些节点,而是决定哪些节点是否接受 所有 Pod 调度,或者只接受选定的 Pod 调度。通过污染一个节点,调度程序将不考虑将这个节点作为任何 Pod 的调度节点,除非 Pod 配置了容忍。容忍由键、值和受染的效果组成。

优秀的个人博客,低调大师

每日一博 | 分布式事务的 BASE 理论

这次和大家讲讲分布式事务的 BASE 理论,保证通俗易懂。为了阅读顺畅,开始之前先请大家记住几个名词: BASE——Basically Available(基本可用),Soft state(软状态),Eventually consistent(最终一致性) 2PC——两阶段提交 不用懂,先记住就好了。你负责记住,我负责让你懂。 正文开始: 深夜,我嗒嗒嗒的敲着键盘,我在屏幕上敲下了这么一段话: “2008 年 Dan Pritchett 提出一个与两阶段提交截然不同的分布式事务理论: BASE(Basically Available,Soft state,Eventually consistent)理论。BASE 理论打破了传统解决分布式事务的思维,放弃 ACID 特性以换取系统的可用性,BASE 理论强调基本可用、软状态、最终一致,而不像 ACID 坚持强一致性。BASE 理论是一种处理分布式事务的思想,没有具体的操作步骤,要理解 BASE 理论需要结合具体的例子。” 敲完这段话以后,我顿了下,完全停下了打字。思考了很久,我决定把准备了四五天的,各种为了讲清楚 BASE 理论的应用实例全部删掉。 因为我很想谈谈自身的一些经历。也许,那些折腾和熬人的经历能更清楚的告诉大家,为什么会有 BASE 理论这套东西出来。 一、 前些年,互联网行业里对架构师这个岗位的标准还不是很清晰。所以,很多架构师的工作往往就是一些技术被公司认可的资深工程师负责。 彼时,正巧我也是这类人员之一,故也得到了一个从零开始架设一套广告投放平台的机会。 我很喜欢钻研技术,对这种机会自然很看重。 那时候,架构并无如今这么复杂,一开始就是前面搞几个 Web 应用,后面共享个数据库。大致像这样: 当然,上面的架构其实做了很多简化,省略了很多细节。比如,为了提高性能做的缓存,为了提高吞吐做的负载均衡统统没有在上图给出。因为这些和本章话题无关,暂时咱们就忽略这些东西,只看核心部分。 这套架构初期运行还是没什么问题的,再加上一些缓存机制,初期一些性能问题都通过调整缓存提升缓存的碰撞率应付了过去。 可是,随着广告投放量的增大,广告的访问量也在暴涨。这些暴涨的访问量引发了性能问题。当时,由于前端有负载均衡,应用层倒是没出现什么问题…… 问题出在后面的数据库上 二、 这套架构数据库用的是 MySQL,本身也只有一台主库在对外服务,另外一台备库采用了 MySQL 自己的全同步机制做实时备份。 当广告访问量暴涨的时候,因为业务需要,很多数据需要在数据库中做实时插入,这就导致了大量的磁盘 IO 产生。这些大量的磁盘 IO 造成了数据库本身性能的急剧下降。 悲催的是,整套广告平台的所有功能又都是共享一个数据库的,所以随着数据库本身的性能下降,平台的所有功能都受到了影响。 由于问题主要在于大量广告流量的写入,所以,靠读写分离的方案去缓解问题这条路就走不通了。 只好先升级硬件了。在经过了几轮硬件升级和数据库调优之后,单数据库再也无法支撑不断上涨的流量了。没办法,要考虑搞数据库切分了。 那时候,我个人是很恐惧数据库切分的。 原因不仅仅在于需要在应用层多写很多复杂的逻辑,其根本原因是当时流行的 2PC(两阶段提交)方案,这个方案本身能保证在数据库切分的情况下,原来的事务依然保留着自身的 ACID 性质。即: Atomicity(原子性),不管事务里执行多少命令,对外它们都是一体的,要么都执行,要么都不执行。 Consistency(一致性),正因为事务里要么做要么都不做,所以数据库的状态变化只能由事务变更后,才会叫一致性状态。 Isolation(隔离性),事务里做的事儿事务外面谁也看不到,就跟个盒子把数据罩起来一样,到底中间怎么变化的,事务外面的观察不到。 Durability(持久性),事务确认成功了,那这状态就永久不变了。 但也正因为这 4 个特性,2PC 才让我顾虑重重。 顾虑1:首先,数据库拆分了,那么根据事务的原子性,事务自身必须是一体的,那么事务涉及到的不同的数据库就必须都访问一遍,而这本身就意味着很高的通信成本。 再加上,为了保持一致性,事务失败后,还必须恢复各个数据库原来的状态,这就必须让已经成功执行过本地事务的数据库全部回滚。 而稍微懂点数据库的人都知道,这个成本有多大。 更可怕的是,本身事务的隔离性还可能加上锁。一旦一个热点数据区域被大量访问,最差情况就可能出现串行访问。而这对此套平台,包括我自己都将是个悲剧。 顾虑2:数据库的拆分会造成整个平台的可用性下降。 假设我现在有一台数据库,它的可用性是 99.9%。如果因为分库,数据库从一台变成两台,那么平台的可用性就会变成: 平台的可用性 = 99.9% * 99.9% = 99.8% 从 99.9% 变成了 99.8%,这意味着可用性下降了 0.1%,每个月的不可用时间会增加 43 分钟之多。 一边是硬件升级已经到顶,单机数据库也优化到了极限,再不做数据库拆分,平台可能随时瘫痪。一边是没有好的策略,可能拆分数据库后,每个月都有宕机的风险,同时性能也可能会出现剧烈的下降。 我被逼入了死角。 三、 这种痛苦的纠结折磨了我大概一周,直到我看到了 CAP 定理。当 CAP 定理说分布式系统在分区容错的时候,只能一致性和可用性二选一时,我高兴的蹦了起来。 原来,可用性和一致性是不能兼得的。 为何我会那么高兴?因为逼我入死角的可不仅是技术上的问题了,我还承受着来自于业务方和领导的压力。每天一上班,我就需要面对业务各方的抱怨,以及领导一轮又一轮的催促。 有了 CAP 定理的支持,我知道我最终是要面临选择的。既然在这个世界上做分布式架构的所有人都要面临选择,那我又怎么可能独善其身呢? 在对单机数据库引发的各种问题做了一次彻底的各种归因以后,我下了决心: 一定要搞定拆分数据库并给出良好方案。 只是,2PC 这个拦路虎,它成为了我的大敌。通过 CAP 定理,我非常肯定,只要我选了 2PC 方案,可用性就一定会出现严重的问题,这个方案也肯定不可能拿出来丢人现眼的。 我唯一的方向就是去牺牲一些一致性,往可用性方向走。可是,怎么走呢? 也许是老天眷顾,也许是大家都承受着和我一样夜不能寐的压力,很快,BASE 理论在国内传开了。 BASE 理论让我知道了,这个世上能排到前几名的技术大公司也一样会出问题,也一样会对这些问题进行妥协。而且 BASE 理论的思想让我的思路一下子就打开了,苦思而不得的问题开始有了头绪。 我要开始着手制定技术方案了。 四、 BASE 思想中的 BA(Basically Available)基本可用,是鼓励通过预先的架构设计或者前期规划,尽量在分布式的系统中,把以前可能影响全平台的严重问题,变成只会影响平台中的一部分数据或者功能的非严重问题。 有了这个思想之后,我就对广告平台中的很多重要的数据表进行了拆分,并将这些表的数据分散到了不同的数据库中。 比如,有个广告流量详情表,每当用户点击广告或者广告展示出来的时候,为了保证不丢失,这些数据都是实时插入到这个表里的。 我对这张表是怎么切分的呢? 当有人点击广告了,他的点击记录会被传到我的应用层,然后我会在应用层根据广告 ID 做哈希,再根据哈希结果的不同,分别存到不同的数据库中去。 假如这三个数据库中的一个出现了问题,则只会有三分之一的数据受到影响。这就实现了 BASE 理论中的 BA——基本可用了。基本可用其实也真的就是表达的这么一回事: 通过一些架构设计,即使平台中某部分组件出现了问题,也不会导致整个平台不可用。 好了,既然采取了数据库拆分的策略,又根据 BASE 理论中的 BA 思想拆分了一些重要的表,那么,到了现在,可能也无从后悔,只能继续沿着 BASE 这条路,一条路走到黑了。 五、 接下来,需要着手解决性能问题了。2PC 方案……算了……它疯狂的一致性性格会要了我的狗命的。 那么极端点,我们不搞事务可不可以呢? 还用前面说的那套广告平台举例。 当时,从业务上,要求广告的访问数据都要保证及时入库不能丢,因为丢了就可能造成计费的损失,而这些损失全是钱。所以,每当用户点击广告或者广告展示出来的时候,为了保证不丢失,这些数据都是实时入库的。 又根据业务需求,当广告流量入库时,还需要往广告预算表和媒体流水表里同时根据这笔流量进行记账,以供后续财务计算。 如果完全不考虑事务,则拆分库后,操作可能会是这个样子。 这三个操作可能会并行发往不同的数据库执行。由于三个操作之间没有事务的约束,所以,一个操作出问题了,另外的操作并不会受到影响。 而这却也引发了另外一个问题,数据状态不一致。 如果在上面的业务中,插入广告流量表的操作失败了,但其余两张表插入成功了,业务就会面临一个很尴尬的情况:他们算出的财务报表没有依据。财务流水中找不到产生了这笔流水的依据。 而这种不一致的状态由于已经被持久化到了数据库中,就会导致这种不一致的状态永久存在了数据库中。这业务能接受吗?但凡有点职业精神的程序员能接受吗? 要有折中的办法!!! 六、 现在再回过头来看看 2PC 的问题。假设 2PC 的实现是一步步执行的(当然,不管是一步一步还是异步并发,他们总是要确保大家要么一起成功要么一起失败的。 所以,即使并发操作,也不会节省多少性能,因为短板在执行最慢的那条语句上。如果执行我们上面的事务需要几步呢? 假如现在要执行事务 A: 协调器发出事务 A 中的第一条语句 Insert into 流量表 协调器等待结果 协调器发出事务 A 中的第二条语句 Insert into 预算表 协调器等待结果 协调器发出事务 A 中的第三条语句 Insert into 流水表 协调器等待结果 如果中间有失败的,协调器还需要做额外的操作: 协调器告诉事务 A 中第一条语句做回滚操作 协调器等待结果 协调器告诉事务 A 中第二条语句做回滚操作 协调器等待结果 协调器告诉事务 A 中第三条语句做回滚操作 协调器等待结果 “天哪,这么多步操作啊!!!” 这简直是让人窒息的操作步骤了。如果有一种方法既能节省步骤又能节省事务执行时间该有多好啊。 嗯……我只能说当时的自己实在是长得丑却想的美。 世上尚不存在这种方法的。但是,世上还存在另外的解决此类事情的方式: 异步处理,时间分摊 我们分析下关于插入广告流量这块儿的业务。你会发现一个神奇的现象,即广告流量表中的数据才是核心,而预算表和流水表统统都是广告流量表中数据的一种缓存而已。 如果,嗯,我是说如果有这么一种办法,即我们先把广告流量数据插入数据库,成功以后,再把以广告流量数据作为根基的附属操作(这里是插入预算表和流水表)放到一个地方持久化。然后,我们再从那个存放附属操作的地方把操作信息取出来,专门对这些操作信息进行处理。 而这种处理方式可能会非常灵活,要么可以对这些操作信息进行批量处理,要么可以对他们异步的在后台处理。处理这些操作信息成功以后,再把以前持久化好的操作信息给删除。 整个方法实施下来,相当于把应该在 A 时刻在前台阻塞着花 3 秒处理业务的操作,变成了在 A 时刻前台花 1 秒,然后在 B 时刻后台花 2 秒处理业务的操作,这不也可以变相的达到我们想节省步骤和事务执行时间的目标了吗? 这真的是一个好的思路啊,还记得当时的自己想到这个思路的时候,忍不住在内心大喊了起来:“那个存附属操作信息的地方就是 MQ 啊。用 MQ,MQ 就能做这件事情。” 那么就一起来看下 MQ 是如何帮我解决这个大难题的吧,针对上面的广告流量详情的业务,我们用了 MQ 之后会有如下的步骤: 执行 Insert into 流量表语句 等待结果 发消息到 MQ 里,内容为 Insert into 预算表 等待 MQ 持久化成功 发消息到 MQ 里,内容为 Insert into 流水表 等待 MQ 持久化成功 如果发给 MQ 消息失败: 可以降级写到本地日志中 OK,那么这改进后的方法是怎么提升性能的呢? 首先,我们发给 MQ 的消息可以批量发送; 其次,发给 MQ 并持久化消息要比数据库执行一次事务快了一个数量级; 最后,失败后,回滚操作成本降低了不止一个数量级。 这个方法本质上,在应用层其实就执行了一条语句而已,剩下的完全可以根据业务需求的不同,选择处理 MQ 中的消息的方式。比如,处理消息既可以异步慢慢处理,也可以推迟一段时间后处理,更可以凌晨定时处理。 可以看到,使用 MQ 方案后,对广告流量这个业务需求而言,其实,出现了一个中间状态:广告流量表有数据,但是以这条数据为基准的预算表和流水表暂时还没有数据。 中间这个状态此时是不满足业务需求的。而这种状态,在 BASE 理论中就被称为: 软状态(Soft state) 至于广告流量表当时没有及时插入到预算表和流水表中的数据呢,它们最终也将会随着后续对 MQ 消息的处理而被补充完整的。 而对于这种当时不符合业务需求的软状态,通过一些后续内部的自动化操作把数据状态补充完整从而最终满足业务需求的情况,在 BASE 理论中就被称为了: 最终一致性(Eventually consistent) 由此,我通过不断利用 BASE 理论中的软状态和最终一致性的思路,最终补上了平台数据库切分需要的最后一块拼图——平台性能大提升。 我蜕变了!!! 最后 以上就是 BASE 理论是如何把我救于水火的经历,不知道你从此又会对 BASE 理论理解了多少呢? 再重复一次,BASE 理论本质上只是一种架构思想,它告诉人们世界上还存在着这么一些事情: 能通过巧妙地设计,通过局部轻微的损失减少全局严重的损失; 能通过一些解耦、异步、推迟执行、批量执行等技巧,构造出一种中间状态,从而提高系统的整体性能; 平台是为业务服务的,业务的核心是数据状态,而数据状态无论中间变成什么样,最终还要恢复到它应该处于的正确状态。 这就是BASE理论的基本可用、软状态和最终一致性了。 为了写这篇,又熬了好几个夜,如果觉得写的不赖,愿意让更多人看到,期待你的点赞和转发。 (完)

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册