首页 文章 精选 留言 我的

精选列表

搜索[赛博朋克],共10000篇文章
优秀的个人博客,低调大师

每日一博 | 大型项目迁移 Gson 实战分享

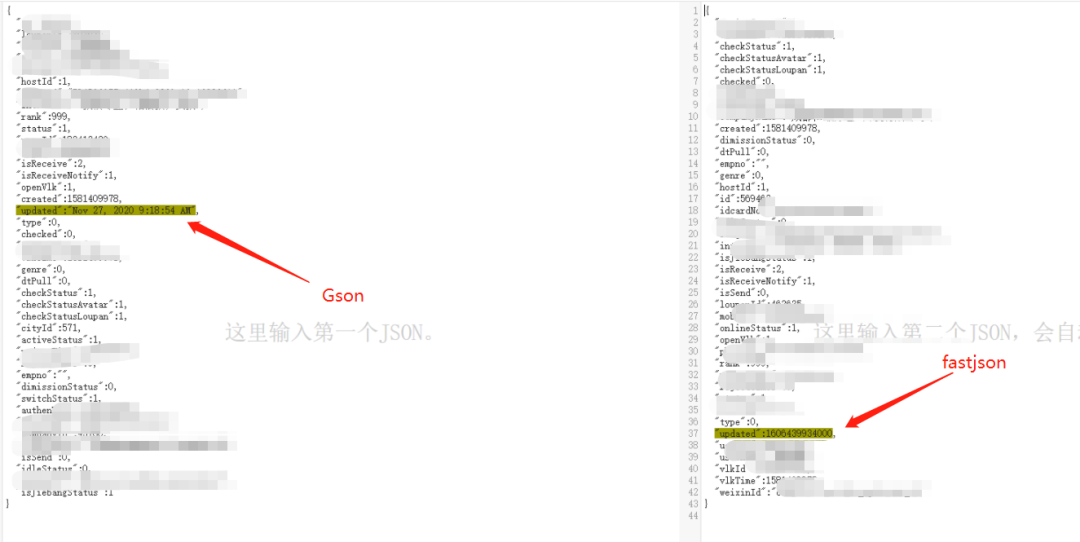
前言 本篇文章是我这一个多月来帮助组内废弃fastjson框架的总结,我们将大部分Java仓库从fastjson迁移至了Gson。 这么做的主要的原因是公司受够了fastjson频繁的安全漏洞问题,每一次出现漏洞都要推一次全公司的fastjson强制版本升级,很令公司头疼。 文章的前半部分,我会简单分析各种json解析框架的优劣,并给出企业级项目迁移json框架的几种解决方案。 在文章的后半部分,我会结合这一个月的经验,总结下Gson的使用问题,以及fastjson迁移到Gson踩过的深坑。 文章目录: 为何要放弃fastjson? fastjson替代方案 三种json框架的特点 性能对比 最终选择方案 替换依赖时的注意事项 谨慎,谨慎,再谨慎 做好开发团队和测试团队的沟通 做好回归/接口测试 考虑迁移前后的性能差异 使用Gson替换fastjson Json反序列化 范型处理 List/Map写入 驼峰与下划线转换 迁移常见问题踩坑 Date序列化方式不同 SpringBoot异常 Swagger异常 @Mapping JsonObject作为入参异常 注意:是否使用fastjson是近年来一个争议性很大的话题,本文无意讨论框架选型的对错,只关注迁移这件事中遇到的问题进行反思和思考。大家如果有想发表的看法,可以在评论区 理 性 讨论。 本文阅读大概需要:5分钟 码字不易,欢迎关注我的个人公众号:后端技术漫谈(二维码见文章底部) 为何要放弃fastjson? 究其原因,是fastjson漏洞频发,导致了公司内部需要频繁的督促各业务线升级fastjson版本,来防止安全问题。 fastjson在2020年频繁暴露安全漏洞,此漏洞可以绕过autoType开关来实现反序列化远程代码执行并获取服务器访问权限。 从2019年7月份发布的v1.2.59一直到2020年6月份发布的 v1.2.71 ,每个版本的升级中都有关于AutoType的升级,涉及13个正式版本。 fastjson中与AutoType相关的版本历史: 1.2.59发布,增强AutoType打开时的安全性fastjson1.2.60发布,增加了AutoType黑名单,修复拒绝服务安全问题fastjson1.2.61发布,增加AutoType安全黑名单fastjson1.2.62发布,增加AutoType黑名单、增强日期反序列化和JSONPathfastjson1.2.66发布,Bug修复安全加固,并且做安全加固,补充了AutoType黑名单fastjson1.2.67发布,Bug修复安全加固,补充了AutoType黑名单fastjson1.2.68发布,支持GEOJSON,补充了AutoType黑名单1.2.69发布,修复新发现高危AutoType开关绕过安全漏洞,补充了AutoType黑名单1.2.70发布,提升兼容性,补充了AutoType黑名单1.2.71发布,补充安全黑名单,无新增利用,预防性补充 相比之下,其他的json框架,如Gson和Jackson,漏洞数量少很多,高危漏洞也比较少,这是公司想要替换框架的主要原因。 fastjson替代方案 本文主要讨论Gson替换fastjson框架的实战问题,所以在这里不展开详细讨论各种json框架的优劣,只给出结论。 经过评估,主要有Jackson和Gson两种json框架放入考虑范围内,与fastjson进行对比。 三种json框架的特点 FastJson 速度快 fastjson相对其他JSON库的特点是快,从2011年fastjson发布1.1.x版本之后,其性能从未被其他Java实现的JSON库超越。 使用广泛 fastjson在阿里巴巴大规模使用,在数万台服务器上部署,fastjson在业界被广泛接受。在2012年被开源中国评选为最受欢迎的国产开源软件之一。 测试完备 fastjson有非常多的testcase,在1.2.11版本中,testcase超过3321个。每次发布都会进行回归测试,保证质量稳定。 使用简单 fastjson的API十分简洁。 Jackson 容易使用 - jackson API提供了一个高层次外观,以简化常用的用例。 无需创建映射 - API提供了默认的映射大部分对象序列化。 性能高 - 快速,低内存占用,适合大型对象图表或系统。 干净的JSON - jackson创建一个干净和紧凑的JSON结果,这是让人很容易阅读。 不依赖 - 库不需要任何其他的库,除了JDK。 Gson 提供一种机制,使得将Java对象转换为JSON或相反如使用toString()以及构造器(工厂方法)一样简单。 允许预先存在的不可变的对象转换为JSON或与之相反。 允许自定义对象的表现形式 支持任意复杂的对象 输出轻量易读的JSON 性能对比 同事撰写的性能对比源码: https://github.com/zysrxx/json-comparison 本文不详细讨论性能的差异,毕竟这其中涉及了很多各个框架的实现思路和优化,所以只给出结论: 1.序列化单对象性能Fastjson > Jackson > Gson,其中Fastjson和Jackson性能差距很小,Gson性能较差 2.序列化大对象性能Jackson> Fastjson > Gson ,序列化大Json对象时Jackson> Gson > Fastjson,Jackson序列化大数据时性能优势明显 3.反序列化单对象性能 Fastjson > Jackson > Gson , 性能差距较小 4.反序列化大对象性能 Fastjson > Jackson > Gson , 性能差距较很小 最终选择方案 Jackson适用于高性能场景,Gson适用于高安全性场景 对于新项目仓库,不再使用fastjson。对于存量系统,考虑到Json更换成本,由以下几种方案可选: 项目未使用autoType功能,建议直接切换为非fastjson,如果切换成本较大,可以考虑继续使用fastjson,关闭safemode。 业务使用了autoType功能,建议推进废弃fastjson。 替换依赖注意事项 企业项目或者说大型项目的特点: 代码结构复杂,团队多人维护。 承担重要线上业务,一旦出现严重bug会导致重大事故。 如果是老项目,可能缺少文档,不能随意修改,牵一发而动全身。 项目有很多开发分支,不断在迭代上线。 所以对于大型项目,想要做到将底层的fastjson迁移到gson是一件复杂且痛苦的事情,其实对于其他依赖的替换,也都一样。 我总结了如下几个在替换项目依赖过程中要特别重视的问题。 谨慎,谨慎,再谨慎 再怎么谨慎都不为过,如果你要更改的项目是非常重要的业务,那么一旦犯下错误,代价是非常大的。并且,对于业务方和产品团队来说,没有新的功能上线,但是系统却炸了,是一件“无法忍受”的事情。尽管你可能觉得很委屈,因为只有你或者你的团队知道,虽然业务看上去没变化,但是代码底层已经发生了翻天覆地的变化。 所以,谨慎点! 做好开发团队和测试团队的沟通 在依赖替换的过程中,需要做好项目的规划,比如分模块替换,严格细分排期。 把前期规划做好,开发和测试才能有条不紊的进行工作。 开发之间,需要提前沟通好开发注意事项,比如依赖版本问题,防止由多个开发同时修改代码,最后发现使用的版本不同,接口用法都不同这种很尴尬,并且要花额外时间处理的事情。 而对于测试,更要事先沟通好。一般来说,测试不会太在意这种对于业务没有变化的技术项目,因为既不是优化速度,也不是新功能。但其实迁移涉及到了底层,很容易就出现BUG。要让测试团队了解更换项目依赖,是需要大量的测试时间投入的,成本不亚于新功能,让他们尽量重视起来。 做好回归/接口测试 上面说到测试团队需要投入大量工时,这些工时主要都用在项目功能的整体回归上,也就是回归测试。 当然,不只是业务回归测试,如果有条件的话,要做接口回归测试。 如果公司有接口管理平台,那么可以极大提高这种项目测试的效率。 打个比方,在一个模块修改完成后,在测试环境(或者沙箱环境),部署一个线上版本,部署一个修改后的版本,直接将接口返回数据进行对比。一般来说是Json对比,网上也有很多的Json对比工具: https://www.sojson.com/ 考虑迁移前后的性能差异 正如上面描述的Gson和Fastjson性能对比,替换框架需要注意框架之间的性能差异,尤其是对于流量业务,也就是高并发项目,响应时间如果发生很大的变化会引起上下游的注意,导致一些额外的后果。 使用Gson替换Fastjson 这里总结了两种json框架常用的方法,贴出详细的代码示例,帮助大家快速的上手Gson,无缝切换! Json反序列化 StringjsonCase="[{\"id\":10001,\"date\":1609316794600,\"name\":\"小明\"},{\"id\":10002,\"date\":1609316794600,\"name\":\"小李\"}]";//fastjsonJSONArrayjsonArray=JSON.parseArray(jsonCase);System.out.println(jsonArray);System.out.println(jsonArray.getJSONObject(0).getString("name"));System.out.println(jsonArray.getJSONObject(1).getString("name"));//输出://[{"date":1609316794600,"name":"小明","id":10001},{"date":1609316794600,"name":"小李","id":10002}]//小明//小李//GsonJsonArrayjsonArrayGson=gson.fromJson(jsonCase,JsonArray.class);System.out.println(jsonArrayGson);System.out.println(jsonArrayGson.get(0).getAsJsonObject().get("name").getAsString());System.out.println(jsonArrayGson.get(1).getAsJsonObject().get("name").getAsString());//输出://[{"id":10001,"date":1609316794600,"name":"小明"},{"id":10002,"date":1609316794600,"name":"小李"}]//小明//小李 看得出,两者区别主要在get各种类型上,Gson调用方法有所改变,但是变化不大。 那么,来看下空对象反序列化会不会出现异常: StringjsonObjectEmptyCase="{}";//fastjsonJSONObjectjsonObjectEmpty=JSON.parseObject(jsonObjectEmptyCase);System.out.println(jsonObjectEmpty);System.out.println(jsonObjectEmpty.size());//输出://{}//0//GsonJsonObjectjsonObjectGsonEmpty=gson.fromJson(jsonObjectEmptyCase,JsonObject.class);System.out.println(jsonObjectGsonEmpty);System.out.println(jsonObjectGsonEmpty.size());//输出://{}//0 没有异常,开心。 看看空数组呢,毕竟[]感觉比{}更加容易出错。 StringjsonArrayEmptyCase="[]";//fastjsonJSONArrayjsonArrayEmpty=JSON.parseArray(jsonArrayEmptyCase);System.out.println(jsonArrayEmpty);System.out.println(jsonArrayEmpty.size());//输出://[]//0//GsonJsonArrayjsonArrayGsonEmpty=gson.fromJson(jsonArrayEmptyCase,JsonArray.class);System.out.println(jsonArrayGsonEmpty);System.out.println(jsonArrayGsonEmpty.size());//输出://[]//0 两个框架也都没有问题,完美解析。 范型处理 解析泛型是一个非常常用的功能,我们项目中大部分fastjson代码就是在解析json和Java Bean。 //实体类Useruser=newUser();user.setId(1L);user.setUserName("马云");//fastjsonList<User>userListResultFastjson=JSONArray.parseArray(JSON.toJSONString(userList),User.class);List<User>userListResultFastjson2=JSON.parseObject(JSON.toJSONString(userList),newTypeReference<List<User>>(){});System.out.println(userListResultFastjson);System.out.println("userListResultFastjson2"+userListResultFastjson2);//输出://userListResultFastjson[User[Hash=483422889,id=1,userName=马云],null]//userListResultFastjson2[User[Hash=488970385,id=1,userName=马云],null]//GsonList<User>userListResultTrue=gson.fromJson(gson.toJson(userList),newTypeToken<List<User>>(){}.getType());System.out.println("userListResultGson"+userListResultGson);//输出://userListResultGson[User[Hash=1435804085,id=1,userName=马云],null] 可以看出,Gson也能支持泛型。 List/Map写入 这一点fastjson和Gson有区别,Gson不支持直接将List写入value,而fastjson支持。 所以Gson只能将List解析后,写入value中,详见如下代码: //实体类Useruser=newUser();user.setId(1L);user.setUserName("马云");//fastjsonJSONObjectjsonObject1=newJSONObject();jsonObject1.put("user",user);jsonObject1.put("userList",userList);System.out.println(jsonObject1);//输出://{"userList":[{"id":1,"userName":"马云"},null],"user":{"id":1,"userName":"马云"}}//GsonJsonObjectjsonObject=newJsonObject();jsonObject.add("user",gson.toJsonTree(user));System.out.println(jsonObject);//输出://{"user":{"id":1,"userName":"马云"},"userList":[{"id":1,"userName":"马云"},null]} 如此一来,Gson看起来就没有fastjson方便,因为放入List是以gson.toJsonTree(user)的形式放入的。这样就不能先入对象,在后面修改该对象了。(有些同学比较习惯先放入对象,再修改对象,这样的代码就得改动) 驼峰与下划线转换 驼峰转换下划线依靠的是修改Gson的序列化模式,修改为LOWER_CASE_WITH_UNDERSCORES GsonBuildergsonBuilder=newGsonBuilder();gsonBuilder.setFieldNamingPolicy(FieldNamingPolicy.LOWER_CASE_WITH_UNDERSCORES);GsongsonUnderScore=gsonBuilder.create();System.out.println(gsonUnderScore.toJson(user));//输出://{"id":1,"user_name":"马云"} 常见问题排雷 下面整理了我们在公司项目迁移Gson过程中,踩过的坑,这些坑现在写起来感觉没什么技术含量。但是这才是我写这篇文章的初衷,帮助大家把这些很难发现的坑避开。 这些问题有的是在测试进行回归测试的时候发现的,有的是在自测的时候发现的,有的是在上线后发现的,比如Swagger挂了这种不会去测到的问题。 Date序列化方式不同 不知道大家想过一个问题没有,如果你的项目里有缓存系统,使用fastjson写入的缓存,在你切换Gson后,需要用Gson解析出来。所以就一定要保证两个框架解析逻辑是相同的,但是,显然这个愿望是美好的。 在测试过程中,发现了Date类型,在两个框架里解析是不同的方式。 fastjson:Date直接解析为Unix Gson:直接序列化为标准格式Date 导致了Gson在反序列化这个json的时候,直接报错,无法转换为Date。 解决方案: 新建一个专门用于解析Date类型的类: importcom.google.gson.TypeAdapter;importcom.google.gson.stream.JsonReader;importcom.google.gson.stream.JsonWriter;importjava.io.IOException;importjava.util.Date;publicclassMyDateTypeAdapterextendsTypeAdapter<Date>{@Overridepublicvoidwrite(JsonWriterout,Datevalue)throwsIOException{if(value==null){out.nullValue();}else{out.value(value.getTime());}}@OverridepublicDateread(JsonReaderin)throwsIOException{if(in!=null){returnnewDate(in.nextLong());}else{returnnull;}}} 接着,在创建Gson时,把他放入作为Date的专用处理类: Gsongson=newGsonBuilder().registerTypeAdapter(Date.class,newMyDateTypeAdapter()).create(); 这样就可以让Gson将Date处理为Unix。 当然,这只是为了兼容老的缓存,如果你觉得你的仓库没有这方面的顾虑,可以忽略这个问题。 SpringBoot异常 切换到Gson后,使用SpringBoot搭建的Web项目的接口直接请求不了了。报错类似: org.springframework.http.converter.HttpMessageNotWritableException 因为SpringBoot默认的Mapper是Jackson解析,我们切换为了Gson作为返回对象后,Jackson解析不了了。 解决方案: application.properties里面添加: #PreferredJSONmappertouseforHTTPmessageconversionspring.mvc.converters.preferred-json-mapper=gson Swagger异常 这个问题和上面的SpringBoot异常类似,是因为在SpringBoot中引入了Gson,导致 swagger 无法解析 json。 采用类似下文的解决方案(添加Gson适配器): http://yuyublog.top/2018/09/03/springboot%E5%BC%95%E5%85%A5swagger/ GsonSwaggerConfig.java @ConfigurationpublicclassGsonSwaggerConfig{//设置swagger支持gson@BeanpublicIGsonHttpMessageConverterIGsonHttpMessageConverter(){returnnewIGsonHttpMessageConverter();}} IGsonHttpMessageConverter.java publicclassIGsonHttpMessageConverterextendsGsonHttpMessageConverter{publicIGsonHttpMessageConverter(){//自定义Gson适配器super.setGson(newGsonBuilder().registerTypeAdapter(Json.class,newSpringfoxJsonToGsonAdapter()).serializeNulls()//空值也参与序列化.create());}} SpringfoxJsonToGsonAdapter.java publicclassSpringfoxJsonToGsonAdapterimplementsJsonSerializer<Json>{@OverridepublicJsonElementserialize(Jsonjson,Typetype,JsonSerializationContextjsonSerializationContext){returnnewJsonParser().parse(json.value());}} @Mapping JsonObject作为入参异常 有时候,我们会在入参使用类似: publicResponseResult<String>submitAudit(@RequestBodyJsonObjectjsonObject){} 如果使用这种代码,其实就是使用Gson来解析json字符串。但是这种写法的风险是很高的,平常请大家尽量避免使用JsonObject直接接受参数。 在Gson中,JsonObject若是有数字字段,会统一序列化为double,也就是会把count = 0这种序列化成count = 0.0。 为何会有这种情况?简单的来说就是Gson在将json解析为Object类型时,会默认将数字类型使用double转换。 如果Json对应的是Object类型,最终会解析为Map<String, Object>类型;其中Object类型跟Json中具体的值有关,比如双引号的""值翻译为STRING。我们可以看下数值类型(NUMBER)全部转换为了Double类型,所以就有了我们之前的问题,整型数据被翻译为了Double类型,比如30变为了30.0。 可以看下Gson的ObjectTypeAdaptor类,它继承了Gson的TypeAdaptor抽象类: 具体的源码分析和原理阐述,大家可以看这篇拓展阅读: https://www.jianshu.com/p/eafce9689e7d 解决方案: 第一个方案:把入参用实体类接收,不要使用JsonObject 第二个方案:与上面的解决Date类型问题类似,自己定义一个Adaptor,来接受数字,并且处理。这种想法我觉得可行但是难度较大,可能会影响到别的类型的解析,需要在设计适配器的时候格外注意。 总结 这篇文章主要是为了那些需要将项目迁移到Gson框架的同学们准备的。 一般来说,个人小项目,是不需要费这么大精力去做迁移,所以这篇文章可能目标人群比较狭窄。 但文章中也提到了不少通用问题的解决思路,比如怎么评估迁移框架的必要性。其中需要考虑到框架兼容性,两者性能差异,迁移耗费的工时等很多问题。 希望文章对你有所帮助。 参考 《如何从Fastjson迁移到Gson》 https://juejin.im/post/6844904089281626120 《FastJson迁移至Jackson》此文作者自己封装了工具类来完成迁移 https://mxcall.github.io/posts/%E5%B7%A5%E4%BD%9C/%E7%A8%8B%E5%BA%8F%E5%91%98/javaSE/FastJson%E8%BF%81%E7%A7%BB%E8%87%B3Jackson/ 《你真的会用Gson吗?Gson使用指南》 https://www.jianshu.com/p/e740196225a4 json性能对比 https://github.com/zysrxx/json-comparison/tree/master/src/main/java/json/comparison fastjson官方文档 https://github.com/alibaba/fastjson/wiki 易百教程 https://www.yiibai.com/jackson 往期精彩文章: 绝了,几款主流的 JSON 库性能对比! Java中常用的4个Json库,哪个性能更牛逼? 这个 bug 让我更加理解 Spring 单例了 本文分享自微信公众号 - Java中文社群(javacn666)。如有侵权,请联系 support@oschina.cn 删除。本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

优秀的个人博客,低调大师

每日一博 | 架构制图:工具与方法论

作者 | 楚衡 前言 “架构制图”这词乍一听似乎有些晦涩,但如果提起“工程制图”,相信绝大部分工科背景的程序员们都不会陌生,甚至还能共同感慨下那些年一起伏在宿舍左手圆规,右手直尺,徒手作图到深夜的日子。 软件工程也是工程,因此传统工程制图的一些基本理论,在软件行业同样适用。但另一方面,软件与实体制造业之间还是有着本质区别,所以在制图方面的需求和方式也大相径庭,无法直接套用。作为软件行业的从业者,你可以完全不懂工程制图,但你不得不懂架构制图 —— 这是任何程序员职业生涯的的必修课。 本文在后半段将介绍如何用图去描述(describe)和传达(communicate)你的架构设计。值得强调的是,本文并不会侧重于单一的方法和工具,而是更希望关注那些优秀方法背后的通用方法论,即架构制图的本质、共性和最佳实践。希望本文能起到引子作用,激发大家对自己日常工作中关于架构和制图部分的关注、审视与思考;如果还真能帮助大家提升一点点制图效率和效果,那就更好不过了。 什么是软件架构? 1. 软件架构定义 IEEE 给出的定义:架构是环境中该系统的一组基础概念(concepts)和属性(properties),具体表现就是它的元素(elements)、关系(relationships),以及设计与演进的基本原则(principles)。 CMU 软件工程研究院的定义:架构是用于推演出该系统的一组结构(structures),具体是由软件元素(elements)、元素之间的关系(relationships),以及各自的**属性(properties)**共同组成。 Uncle Bob 在 Clean Architecture 一书中给出的定义:架构是创建者给予该系统的形态(shape)。这个形态的具体形式来源于对系统组件(components)的划分和排列,以及这些组件之间互相通讯的方式。 2. 架构核心要素 综合上述各种权威定义,软件系统的架构通常需要包含如下四类核心要素: 元素(elements):将系统拆分为一组元素 - 模块、组件、结构体、子系统; 关系(relationships):不同元素之间的关系 - 交互、依赖 、继承、组合、聚合; 属性(properties):每个元素具备的属性 - 名称、职责、接口、实现限制等; 原理(principles):为什么这么设计 - 拆分依据、设计原则、决策原因等。 为什么架构很重要? 1. 架构是系统实现的蓝图 最近有部很火的网剧叫《摩天大楼》,讲述了一段匪夷所思的悬疑故事。为什么扯这个呢?因为我想借用这个剧的标题来问个问题:摩天大楼是由谁建起来的?也许你心里会默念:废话,不就是建筑工人们一砖一瓦堆起来的嘛。仔细再想想?背后是不是还有一堆操碎了心的建筑设计师(比如剧中帅气的林大森)和土木工程师们?他们虽然不搬砖也不扛水泥,但如果没有他们产出的那些繁琐严谨的设计图纸,摩天大楼是是不可能像农村自建房一样仅凭工人们各自的经验与想象力就能快速平稳地竖立起来的。 正是靠着这些图纸所描绘出来的工程蓝图(blueprints),才让成百上千工人们的分工合作和验收标准有了依据:大家只需要照着蓝图,按部就班地把自己所负责的那些砖瓦添上去就行了;只要蓝图正确,且施工过程也没有偏差,最终顺利完工只是个时间问题。 与建筑、汽车或者任何其他工程行业一样,软件在落地实现(编码)之前也需要先有蓝图;而其中最重要的一份蓝图,就是架构设计。没有架构,仅凭程序员自己脑子里的模糊设想,也许你可以像传统手艺人一样独自创造出一些美好有用的小东西(比如 Linux 0.01 版本),但不太可能以工程的方式协同一个团队共同建造起一个与摩天大楼规模类似的复杂软件系统(比如现代的 Linux 系统)。一方面,人类的思维能力终归有限,必须依靠架构这种高度抽象和简化的蓝图,才能让复杂系统的创造、理解、分析和治理变得可行;另一方面,量级达到一定程度的大型系统,也只能依靠多人分工合作才能完成,而架构也正是多人沟通协作的重要基础。 2. 架构是沟通协作的基础 软件项目的最终价值产出就是软件系统,而架构作为软件系统的灵魂和骨架,可以起到如下作用: 理解对齐:所有软件系统的目的都是为了实现用户需求,但实现的途径有无限种可能性(相比传统工程行业,软件的灵活性更大、知识迭代更快)。架构设计就是去选择其中一条最合适的实现途径,因此其中会涉及非常多关键的选路决策(为什么要这么拆分?为什么选择 A 技术而不是 B?)。这些重要的技术决策需要通过架构描述这种形式被记录和同步,才能让项目组所有成员对整个系统的理解对齐,形成共识。 工作量化:项目管理最重要的步骤之一就是工时评估,它是确定项目排期和里程碑的直接依据。显然,只通过 PRD / 交互图是无法科学量化出项目工作量的,因为很难直观判断出一句简短需求或一个简单页面背后,究竟要写多少代码、实现起来难度有多大。有了清晰明确的架构之后,理论上绝大部分开发工作都能做到可见、可预测和可拆解,自然而然也就能够被更准确地量化。当然,精准的工作量评估在 IT 行业内也一直是个未解之谜,实际的工期会受太多未知因素影响,包括程序员的技能熟练度、心情好不好、有没有吃饱等。 标准术语:编程作为一种具有创造力的工作,从某种角度看跟写科幻小说是类似的。好的科幻小说都喜欢造概念,比如三体中的智子,如果没看过小说肯定不知道这是个啥玩意儿。软件系统在造概念这一点上,相比科幻小说只有过之而无不及,毕竟小说里的世界通常还是以现实为背景,而软件中的世界就全凭造物者(程序员)的想象(建模)了。稍微复杂一点的软件系统,都会引入一些领域特定甚至全新创作的概念。为了避免在项目过程中出现鸡同鸭讲的沟通障碍和理解歧义,就必须对描述这些概念的术语进行统一。而架构的一个重要目的,就是定义和解释清楚系统中涉及的所有关键概念,并在整个架构设计和描述过程中使用标准和一致的术语,真正做到让大家的沟通都在一个频道上。 言之有物:就跟讨论产品交互时需要对着原型图、讨论代码细节时需要直接看代码一样,架构是在讨论一些较高维技术问题时的必要实物(具体的实物化形式就是所谓架构描述)。否则,要么一堆人对着空气谈(纸上谈兵都说不上),要么每次沟通时都重新找块白板画一画(费时费力且容易遗落信息,显然不是长久之计)。 知识沉淀 & 新人培训:架构应该被作为与代码同等重要的文档资产持续沉淀和维护,同时也是项目新人快速理解和上手系统的重要依据。不要让你的系统跟公司内某些祖传遗留系统一样 —— 只有代码遗留了下来,架构文档却没有;只能靠一些口口相传的残留设计记忆,苦苦维系着项目的生命延续。 3. 架构决定了产品质量 如何衡量一个软件产品的质量?上图是ISO/IEC 25010标准定义的软件产品质量模型,包括以下 8 个大类: 功能适合性:功能完整度、功能正确性和功能恰当性; 性能效率:时间表现(e.g. 响应时间)、资源利用和容量; 兼容性:共存能力(e.g. 多版本组件共存)和互操作性; 可用性:可学习性、可运维性、用户错误保护(e.g. 自动纠错)、UI 美观度、可访问性; 可靠性:成熟度、可用性、容错性、可恢复性; 安全性:机密性、完整性、不可伪造性、权威性和可审计; 可维护性:模块度、可复用性、可分析性、可修改性、可测试性; 可移植性:可适配性、可安装性、可替代性。 上述质量模型中列出的所有点,都是架构设计需要着重考虑的。其中除了功能适合性以外,其他所有点都属于非功能需求的范畴,这也是区分架构好坏的真正分水岭 —— 好的架构设计,不会停留在仅满足功能需求这一最基本的需求层次上(最坏的架构设计也同样能做到),更重要且更难以应对的是其他众多的非功能需求。 当然,鱼与熊掌不可兼得。架构与人生一样,也是一场权衡的游戏,弄不好就跟第八季的龙母一样的下场:既要又要还要,最后反而什么都得不到。好的架构师更应该像雪诺同志学习,表面上“know nothing”,实际上“know everthing”:清楚系统所有利益相关者(stakeholders),努力挖掘各方的主要述求(concerns),相应平衡自己的架构决策(decisions),最终实现你好我好大家好的终极架构目标。 4. 我还能说出更多理由 要不是篇幅所限,这一页 PPT 显然不够装: 架构包含系统所有最重要的早期决策,这些决策会进而影响后续所有大大小小的技术决策。因此,早期的架构设计需要非常严谨和慎重,要尽可能“一次做对”(虽然很难),否则越往后纠错的成本越高; 架构在组织内具有非常高的复用价值,因为同一组织内的产品之间一定会具备很多共性(需求、限制、环境等),很适合在架构层面进行最大化复用,避免重复解决相似的问题; 康威定律指出,软件架构反映了组织结构。这个结论反过来也成立:好的架构也会让组织结构变得更高效; 越庞大和复杂的系统,架构越重要,因为只有好的架构才能有效控制、管理和降低系统复杂度; 是不是越听越糊涂,仿佛架构有无数种诠释和意义?不必过于纠结,按照GoF的设计模式所述:Architecture is about the important stuff. Whatever that is. 对,管它是啥,记住架构很重要就够了。 如何设计一个好的架构? 理解了架构的概念和重要性后,真正的架构师修炼之路才刚刚开始。如何设计一个好的架构?这显然是一个非常博大精深的主题,但并不是本文的重点,因此这里只简单列举了一些基本思想(原则)和经典套路(模式)。当然,架构设计更接近一门经验学科,仅停留在能脱口而出一些玄乎而高大上的理论概念肯定是不够的,需要结合实际工作内容和业务场景多多实践和揣摩才行,否则只能算是徘徊在架构的门外,连入门都谈不。 1. 架构原则(principles) SOLID 原则是一套比较经典且流行的架构原则(主要还是名字起得好): 单一职责:与 Unix 哲学所倡导的“Do one thing and do it well”不谋而合; 开闭原则:用新增(扩展)来取代修改(破坏现有封装),这与函数式的 immutable 思想也有异曲同工之妙; 里式替换:父类能够出现的地方子类一定能够出现,这样它们之间才算是具备继承的“Is-A”关系; 接口隔离:不要让一个类依赖另一个类中用不到的接口,简单说就是最小化组件之间的接口依赖和耦合; 依赖反转:依赖抽象类与接口,而不是具体实现;让低层次模块依赖高层次模块的稳定抽象,实现解耦。 此外,我们做架构设计时也会尽量遵循如下一些原则(与上述 SOLID 原则在本质上也是相通的): 正交性:架构同一层次拆分出的各组件之间,应该尽量保持正交,即彼此职责独立,边界清晰,没有重叠; 高内聚:同一组件内部应该是高度内聚的(cohesive),像是一个不可分割的整体(否则就应该拆开); 低耦合:不同组件之间应该尽量减少耦合(coupling),既降低相互的变化影响,也能增强组件可复用性; 隔离变化:许多架构原则与模式的本质都是在隔离变化 —— 将预期可能变化的部分都隔离到一块,减少发生变化时受影响(需要修改代码、重新测试或产生故障隐患)的其他稳定部分。 2. 架构模式(patterns) 架构模式(architectural patterns)与我们常讨论的设计模式(design patterns)并不是一码事,但如果仅从“模式”这个角度去解读,两者的理念都是一致的:针对给定上下文中经常出现的问题的通用、可复用的解决方案。最主要的区别在于,架构模式会更高维抽象和偏全局整体(毕竟是运用在架构设计层面)。 常见的架构模式,既包括一些传统模式(e.g. 分层、C/S、MVC、事件驱动),也包括一些新兴玩法(e.g. 云原生、微服务、Serverless)。不同模式有不同的适用场景,没有哪一种模式能通杀所有需求。成熟的架构师应该像一个冷静到冒得感情的杀手,永远只会客观地评估和选择最适合当下的解决手段,即使那么做会显得简单乏味;相反,不成熟的架构师,一心总想着搞事情(e.g. 强行套用微服务架构),而不是真正搞定问题。 怎么描述你的架构设计? 有了良好的架构设计,万里长征之路就已经走了一大半。就像是青年导演第一次遇上好剧本,心潮澎湃两眼放光,仿佛已经预见了电影上映后的票房盛况。当然,剩下的一小半路,并不会如想象中那么平坦 —— 同样的剧本,不同导演拍出来会有质一样的区别。好的“最佳导演”,即使面对不是“最佳剧本”的剧本,也有能力拍出“最佳影片”。同样,好的架构师,也应该有能力描述好一个不错的架构设计;即使做不到为精彩的内容加分,也不应该因为形式上没描述好而丢分,否则就会像高考作文丢了卷面分一样憋屈和心酸。 1. 架构描述的意义 为什么要描述架构?让它只存在我深深的脑海里不行吗?西方人有句谚语:好记性不如烂笔头。任何没有持久化的东西都是易失的(volatile),就跟内存一样。另一方面,就如前文所述,架构是沟通协作的基础,不通过架构描述(Architecture Description)沉淀下来让所有项目干系人都能看到,那就失去了沟通和传播的唯一载体。 根据个人观察,大家对“架构需要描述”这一点都没异议,所以绝大部分项目都或多或少会产出一些有模有样的架构描述文档。但“有架构描述”和“有好的架构描述”,这之间的鸿沟是巨大的,甚至比“没有”和“有”之间的差别还大。如果你也跟我一样,饱经沧桑阅尽无数架构文档,曾拍手叫好心怀感激过,也曾拍着大腿愤怒不已过,应该也能感同身受。 2. 架构描述的方式 对于同一件事物,作家会选择用文字来叙述,而画家却会用图画。尽管两者想要传达的信息是一致的,但描述方式的不同也会带来效果上的巨大差异。架构描述也分**文字(Text)和图(Diagram)**两种形式,两者各有千秋: 文字的背后是由一套严谨和完备的语言作为支撑,因此其描述可以做到非常精准和详尽,而且编写起来也很方便,随便打开个记事本软件都能写;此外,就跟写代码一样,文字很易于做版本管理,借助简单的文本 diff 工具就能一目了然地对比出不同版本之间的细节差异; 相比而言,图并不具备以上文字所独有的特点,但也有自己的独特优势:图是直观而形象的,顺应了人类与生俱来的视觉识别本能;图的表达能力更强,很多时候一小张图所能传达出的信息(比如空间位置关系、颜色分类、图标形状),也许用一千行字也不足以完整准确地描述出来,即所谓“一图胜千言”。 聪明的你冷笑了一声:哼,又不是小孩子非得做选择题,难道不可以文字与图都要吗?当然可以,理想的架构描述一定是图文并茂的。但现实世界显然比理想残酷,实际软件项目中很难给你留足时间先憋出一篇完美的架构文档。如果以成年人的思维去考虑投入产出比(ROI),那么你一定会优先选择画图。 3. 为什么你应该优先画图? 敏捷软件开发宣言中提到:相比详尽的文档,可运作的软件更加重要(Working software over comprehensive documentation)。这么说当然不代表就不用写文档了,只是提倡没必要写过于详尽的文档。为什么?因为详尽的文档需要耗费大量的编写和维护成本,不符合敏捷开发的小步迭代和快速响应变化等原则。 那么,在如今这个全面敏捷开发的时代,如何也顺应潮流更加敏捷地编写架构文档呢?ROI is your friend —— 不求多,但求精,尽量用最少的笔墨表达出最核心的内容。从内容上来说,ROI 高的部分一般是偏顶层的整体架构或最核心的关键链路,这点在后文的 C4 模型理念中也有体现。而从形式上来说,图在文字面前具有无与伦比的表达力优势,显然是 ROI 更高的选择。 4. 为什么你需要学习画图? 多画图是没错,但有必要专门学习吗?又不是素描彩笔水墨画,只是画一堆条条框框而已,稍微有点工程常识的都能上。画的有点丑?那没关系,顶多再动用点与生俱来的艺术美感,把这几条线对对齐那几个框摆摆正,再整点五彩斑斓的背景色啥的,不就显得很专业了嘛? 看到这里,屏幕前的你又轻蔑一笑:哼,显然没这么简单。确实,道理说出来大家都懂,架构制图与工程制图一样,都是一件需要下功夫认真严谨对待的事情。但现实中大部分人还真没这工夫去下那功夫,比如上面贴的两幅很常见的架构图。第一张图不用多说,这种草图自己涂涂抹抹挺好,但拿出来见人就是你的不对了。那第二张图呢,看上去似乎还挺像那么回事的?并不是,如果你更仔细地去揣摩,就能发现这张图底下所隐藏的很多模糊和不严谨之处(可参考这张图的来源文章:The Art of Crafting Architectural Diagrams)。 所以,能画图并不代表能画好图;要想制得一手既漂亮又可读的好图,还是需要经过持续学习与刻意练习的,很难仅凭直觉和悟性就能掌握其中的关键要领。此外,错误的图往往比没有图还要糟糕,即使你只是抱着“有图就行,差不多那个意思得了”的心态,也至少应该理解一些科学制图的关键要素,避免给本来就已经很复杂难做的项目又蒙上一层模糊滤镜,甚至起到混淆和误导的反作用。 5. 架构制图的目标 讨论具体的制图方法和工具前,我们需要先竖立清晰的制图目标。工具是人类进化的阶梯,但如果理解和利用不当,则很容易反过来被工具所限制甚至奴役,忘了最初发明和使用工具的初心。对于架构制图而言,已经有那么多形形色色的方法与工具,使用它们的初心是什么呢?我认为本质上都是想把制图这个过程从一门自由的手艺变成一项科学的工程:系统、严谨、完整、标准化,同时能做到可重复、可持续和高效。 P.S:当时做 PPT 太赶,所以从这个章节开始的配图,只能被迫走极简路线了,还请见谅。。。 架构制图方法与工具 经过前面几个章节的“简短”铺垫,相信大家对架构制图的背景知识都已经产生了足够的认知。本章节将会具体列举和描述一些典型的架构制图方法与工具,其中有常见的也有罕见的,重点是希望能通过各种方法的横向对比,加深大家对制图方法本质的理解。 1. 方法一:UML UML 应该是大部分人最熟悉的制图方法了,最新的 UML 2.x 版本由以下两大类图组成: 结构图(Structural Diagrams):通过对象、属性、操作和关系等方式,强调系统的静态结构,其中最常见的类型包括类图(Class Diagram)、组件图(Component Diagram)和部署图(Deployment Diagram); 行为图(Behavioral Diagrams):通过展示对象之间的协作关系以及对象内部的状态改变,强调系统的动态行为,其中最常见的类型包括用例图(Use Case Diagram)、活动图(Activity Diagram)、时序图(Sequence Diagram)和状态机图(State Machine Diagram)。 作为通用的“统一建模语言”,UML 总共包含了 14 种不同类型的图,可以全面覆盖软件设计领域各种制图需求,当然也包括了架构制图。同时,也正是因为 UML 把自己当成了一门语言,因此其各种记号(notion)和语义(sematics)都有非常严谨的定义,不会出现模糊或者歧义问题。最后,UML 经过几十年的发展和推广,也早已成为世界范围内广泛使用的标准规范,其所带来的的隐性价值就是:在团队内使用 UML 进行沟通的成本是比较低的,因为可以假定绝大部分技术人员都能理解UML的含义和用法。 然而,UML 也非万能(虽然历史上曾一度把它当成软件设计的银弹),它最被人诟病的缺点就是过于复杂。这也不能怪 UML,毕竟它就是要被设计为足够通用、严谨和强大的,这些目标都与“简单”背道而驰,并让它一步步演化到了今天这个复杂刻板的庞然大物模样。虽然上面我们自信地假定了技术人员大多都懂 UML,但这个“懂”如果带上一个程度量词,我觉得平均能到 20% 就不错了 —— 绝大部分也就能认识几个常见的类图、时序图,估计都很难准确说出类图中各种箭头的含义。 无论怎么说,UML依然应该是每个程序员的制图工具箱中最常用和必备的工具之一。当然,也不应该是唯一,因为下面也还有些不能错过的好东西。 2. 方法二:4+1 View Model “4+1”是啥?不知道没关系,听过“6+1”吗?对,就是那个小时候常看的“非常6+1”节目。它跟“4+1”之间的关系,就跟它们与邵佳一、张嘉译和沈佳宜之间的关系一样,除了赶巧共用了同一个后缀发音以外,八竿子打不着。 所以,“4+1”到底是指什么?让我们来 Wiki 一下:“4+1”是一种视图模型(view model),可以通过多种共存的视图描述软件密集型系统的架构。这些视图基于不同项目干系人(利益相关者)的视点(viewpoint),例如:终端用户、开发者、系统工程师和项目经理。“4+1”由 4 种基础视图和一些经过挑选的用例或场景(即额外的“+1”视图)组成,各自的具体含义如下: 逻辑视图(Logical view):描述系统为终端用户提供的功能,一般会通过UML中的类图和状态图来表示; 过程视图(Process view):描述系统的动态行为,包括流程和交互等,一般会通过 UML 中的时序图、活动图和通讯图来表示; 开发视图(Development view):从程序员的视角来阐述系统,也被称为“实现视图”,一般会通过 UML 中的组件图和包图来表示; 物理视图(Physical view):从系统工程师的角度来描述系统,包括系统组件的物理拓扑、各组件之间的物理连接,也被称为“部署视图”,一般会通过 UML 中的部署图来表示; 场景(Scenarios):通过一小组用例或场景来描述架构,包括系统中各种对象和进程之间的交互时序,也被称为“用例视图”。这些场景会被用于识别架构元素(architectural elements)以及阐述和验证整个架构设计,也可以被作为架构原型的测试起点。 虽然上面提到“4+1”的各种视图一般都是用UML图来表示,但实际上“4+1”本身是一种通用的视图模型,并没有限制绘图的记号和工具。对于工程师而言,这种偏学院派的方法可能这辈子都不会直接用到,但其中蕴含的一个关键架构制图思想非常有价值:架构需要通过多种视图来描述,而这些视图是来源于不同项目干系人的视点(角度);只有这样才能产生一整套全面、立体且客观的架构描述。 3. 方法三:C4 Model C4 模型是一种“抽象优先”(abstraction-first)的架构制图方法,它也是受前面的 UML 和“4+1”视图模型所启发,但相对而言要更加简单和轻量,只包含少量的一组抽象和图表,很易于学习和使用。 1)定义、理念与关键思想 C4 模型通过容器、组件、代码以及人这几个抽象来描述一个软件系统的静态结构,它的核心理念是希望像 Google Map 一样,通过不同层次的细节,为代码建立一种可以放大和缩小的导览图。它最关键的思想就是自顶向下对系统的静态结构进行逐级拆分,依次描述各层次对象的职责、关系和外部依赖。除了核心的层次化静态结构视图,它还可以包含动态视图、部署视图等补充视图。 上面的左图展示了 C4 模型中各层次抽象之间的映射关系:1 个软件系统由 1~N 个容器组成,1 个容器由 1~N 个组件组成,1 个组件由 1~N 个代码结构组成。右图是以简单的Spring PetClinic项目为例,演示了一个真实软件系统在 C4 模型下的层次结构:最上层就是 PetClinic 软件系统,它可以拆分为数据库、Web 应用等几个容器;Web 应用又可以进一步拆分出 ClinicService 这个组件,而这个组件下又包含了 ClinicService 接口类、ClinicServiceImple 实现类、Owner / Pet / Visit 等领域对象类。 使用 C4 模型进行架构制图,本质上就是对上述几种抽象进行可视化。具体的做法是依次建立如下几类从粗到细的结构图:Context、Container、Component 和 Code(可选),这也是 C4 模型名称的来历。 2)Level 1:System Context diagram 系统上下文图作为第一级(L1),提供了一个展示系统全貌的**顶层大图(big picture)**视角,包括最中心的软件系统、周边的用户以及其他有交互的系统。其中最关键的两个概念分别是: 人(Person):即使用软件系统的用户,例如一个在线商城系统的消费者、运营小二、系统管理员等; 软件系统(Software System):作为最高层次抽象,描述了给用户创造价值的软件制品;既包括当前正在设计的软件系统,也包括该系统所依赖(或被依赖)的其他软件系统。一个软件系统通常是由单个软件开发团队所负责。 在绘制系统上下文图时,不需要关心诸如技术栈、协议等任何底层细节。这类图的受众是最广的,因为任何人都可以理解并从中获取到足够的信息,包括技术人员和非技术人员,也包括团队内成员和团队外成员。 3)Level 2:Container diagram 通过 L1 的上下文图理解了系统在整个 IT 环境中的定位后,下一步就是把系统这个框框放大,详细看下其中包含了哪些“容器”(Container,注意不要跟 Docker 容器搞混了噢!)。C4 模型中的容器是指单个应用或数据存储,通常可以独立部署和运行(有独立的进程空间,通过 IPC 机制互相通讯),例如:SpringBoot 微服务、React SPA、移动 App、数据库、Serverlss 函数、Shell 脚本。 L2 的容器图不仅展示了系统的进一步职责拆分,还包括了主要的技术选型、容器之间的通讯方式等关键架构信息。这类图可以面向全部的技术人员,既包括架构师、开发者,也包括运维人员、技术支持等。 4)Level 3:Component diagram 继续前面的套路,下一步就是把系统中各个容器再分别进行局部放大,将每个容器进一步拆分成多个组件(Component)。在 C4 模型中,组件是指一组通过良好接口定义封装在一起的相关功能(通常运行在同一个进程空间内),例如:Spring 里的一个Controller(不只包括定义了 REST 接口的 Controller 主类,也包括背后所有相关联的实现类,如 Service/Repository 等)。 与容器图类似,L3 的组件图也不只包含了容器的组件划分,还包括各个组件的职责定义、技术与实现细节等。随着层次的下沉和细节的增多,组件图的受众范围进一步缩窄,一般只适用于软件架构师和开发者(其他角色没必要理解,一般也理解不了)。 5)Level 4:Code(可选) 再继续对组件进行放大,所能看到的最底层和细节的信息,就是 L4 的代码(Code)了。当然,这里所谓的“代码”还是以图的形式(e.g. UML 类图、数据库 E/R 图)展示类或文件粒度的代码结构,并不是真正的代码本身。即便如此,代码图在 99% 的架构描述场景下也依然过于详尽,一方面数量庞大,绘制成本很高;另一方面易于变化,维护成本也非常高。因此,一般只有非常重要和复杂的组件才需要用到这一层级进行描述。如果确实需要绘制,也应该优先考虑自动化的方式,比如很多 IDE 就支持自动生成 UML 类图。 6)补充图:Landscape / Dynamic / Deployment Diagram 除了上述各个层次的静态结构图,C4 模型还提出了一系列的补充图(Supplementary diagrams),包括: 系统全景图(System Landscape diagram):全景图与系统上下文图的绘制方法类似,区别在于它是从企业或组织角度全景地展示出所有软件系统(包括与当前系统没有直接关联的)以及相关的用户和系统交互,即进一步放大架构图的 scope; 动态图(Dynamic diagram):由于结构图天生只能描述出系统的静态结构属性,因此 C4 模型中推荐使用 UML 中的通讯图、时序图等,对系统中关键链路的动态行为进行补充描述,即“动静结合”; 部署图(Deployment diagram):除了缺失动态属性,上述结构图还有一个局限性:只描述了系统的抽象逻辑架构,并没有描述出系统实际部署时的具体物理架构。因此,C4 模型推荐再使用 UML 的部署图,对系统逻辑节点(一般是 L2 的“容器”粒度)与物理节点(e.g. 物理机 / 虚拟机 / Docker 容器 / 应用 Runtime)之间的映射关系进行补充描述,即“虚实结合”。 结合了这些补充图后的 C4 模型,才是可以全面与立体地描述出软件架构方方面面的完全体架构制图方法。 4. 方法四:arc42 严格来说,arc42 并不是一种架构制图方法,而是一个架构文档模板。虽然如前文所说,在架构描述中“图”是比“文字”更高优的选择,但实际项目过程中你终究还是需要产出一份相对完整、有图有文字的架构文档。arc42 就是专门用于帮助大家更好地编写架构文档;而作为架构文档中最重要的架构图,显然 arc42 也不会放过 —— 其中多个核心章节都与架构图有关,且详细描述了相应的制图方法。这里不会详细展开介绍 arc42(不能抢了下一篇文章的饭碗),只会简单介绍下 arc42 中制图方法与 C4 模型的异同。 伟大的思想都是相似的,arc42 也不例外。上方左图的右侧部分,概括了 arc42 模板中与制图相关的几个核心章节,分别是: 第 3 章 - Context:该章节用于介绍系统的背景和上下文,因此其制图思路几乎等同于 C4 模型中的 L1(系统上下文图); 第 5 章 - Building block view:该章节用于介绍系统的基本构成要素,按照官方指导思想也与 C4 模型中的自顶向下层次化拆分思想无异,唯一区是 arc42 并没有规定拆分的具体层次,只要有需要可以按照“黑盒 -> 白盒”的套路一直拆到底; 第 6 章 -**Runtime view**:看名字就无需解释了,就等同于 C4 模型中补充的运行时视图; 第 7 章 - Deployment view:同样地,这里也等同于 C4 模型中补充的部署视图;但有一点,arc42 强调部署视图也可以类似结构视图一样做自顶向下的层次化拆分(对于较为复杂的部署架构,层次化确实很有必要)。 因此,本质上 arc42 中提倡的制图方法与C4模型是等价和兼容的,完全可以配合使用:以 arc42 作为架构文档框架,其中的架构制图采用更具体的 C4 模型。这也是目前我们项目中实际采用的方法。 5. 其他方法 & 制图工具 除了上述几种方法以外,在软件行业蓬勃发展的数十年间也涌现出过很多其他的优秀架构制图方法,其中既包括一些通用方法,如:SysML、AADL、ArchiMate,也包括一些领域特定方法,比如在企业中后台业务建模场景中很常见的 BPMN。再详细地展开描述各个方法,显然会让本文又臭又长(虽然写到这里时似乎就已经注定了),有兴趣的读者可以自行检索和探索。 到这里为止,本章节介绍的都是架构制图的各种方法;而实际从方法到落地的过程中,还有一个绕不开的环节:选用什么样的工具去制图?总不能真的跟写工程制图作业一样用纸和笔吧?作为数字化改革的推动者,程序员们当然要全面拥抱数字化工具;大家日常工作中必然也已经积累了很多顺手的画图工具,因此这里我只推荐两个自己用得比较多的: draw.io:这是一个开源的在线绘图软件,相信很多人都有用过。考虑到数据安全问题,推荐大家用完全离线的桌面版。作为一个程序员友好的绘图工具,draw.io 的最大优点就是支持三方插件,比如这个开源的 c4-draw.io 插件,可以帮助你更方便地在 draw.io 中绘制 C4 模型架构图; PlantUML:作为文本制图的代表性工具,PlantUML 可以用于绘制各种类型的UML图,以及其他一些适用于文本制图场景的图(比如这个开源的 C4-PlantUML 扩展)。在这些场景下,文本制图具有可视化制图所无法比拟的优势:轻量、高效、版本化、自动化、一致性、易于复用等。虽然文本制图工具诞生已久(比如应用广泛的 Graphviz,最早发行于 1991 年),但相信随着现代各种 XXX as Code 的意识觉醒,这类 Diagram as Code 工具也会获得更多青睐(btw,语雀文档早已支持内嵌 PlantUML 制图)。 架构制图方法论总结 古有云:授人以鱼,不如授人以渔。推而广之:授人以方法,也不如授人以方法论。什么是方法论?虽然这个词在公司里已经用烂了,但确实有它的价值和意义:方法论(methodology)是对方法的更高维度抽象,由它可以推导出解决问题的具体方法(method)。理解了方法论,才能融会贯通,掌握解决问题的本质要点;你也不会再受限于单一的具体方法,因为使用任何方法都能快速上手和灵活运用,并得到差不多的同等效果。 因此,本文最后这一章节将对各种架构制图方法进行归纳总结,并尝试提炼出一个通用的架构制图方法论,期望能帮助大家更好地理解架构制图背后的原理和思想。即便现在所熟知的各种方法与工具终会过时,也依然能风轻云淡地看待它们的新老交替:**过去是 UML,现在是 C4,未来是什么呢?这并不关键,**因为即使方法过时了,背后的方法论也不会过时。 所以,那些茫茫多的方法背后,究竟是什么样的核心方法论在支撑着呢?经过作者呕心沥血冥思苦想了近 15 秒钟,终于总结出了如下这套经典方法论(p.s:就是凑数的,不要太当真~ )。由于其中包含了 5 个环环相扣的要点,我们姑且称它为:五环理论。 1. 理解制图目标 架构制图的第一要点,是需要先深刻理解制图目标。正所谓“以始为终”,有了目标我们才能清晰地前行;否则漫无目的地乱窜,往往会多走不少弯路,甚至南辕北辙。架构制图的目标是什么?其实前文已经提到过很多,这里再简单总结下: 准确(accurate):错的图比没有图还糟糕;即使一开始是准确的,后面也需要定期更新校对; 完整(complete):需要覆盖架构的核心要素和关键信息,为受众呈现一个没有残缺的完整架构设计; 清晰(clear):制图时最好带上图例(形状、颜色、线型、箭头);用图描述不清的地方,还可以加上文字标注做补充; 一致(consistent):比如同一类型的图,最好使用相同的记号风格,以降低受众的理解成本;不一致往往还会带来混淆; 简洁(consise):在满足以上 4 点基础之上,还需要让图更加简洁,一方面是更容易被人接受(没人读 = 没写),另一方面更新维护成本也更低。 2. 找准受众和关注点 架构制图的第二要点,是要找准你制图的受众(audience)以及他们各自的关注点(concern)。找不准的话,要么效果大打折扣(不是他们想听的),要么犹如对牛弹琴(他们根本就听不懂)。常见的一些受众和关注点可包括: 研发:一般会关注很多实现相关细节,比如技术选型、实现可行性、可维护性等,毕竟他们是架构的最直接消费者; 运维:不太关心应用内的具体技术实现(当成黑盒),但很关心各个应用实例的物理部署方式、网络连通性、可运维性等; 安全:只关注系统是否有安全风险,例如是否可能被注入恶意代码、是否有权限漏洞等;如果经历过安全评审,应该很有体感; 产品:大部分情况下只关心项目能否按期上线,其他方面...可能表面上表示些许关心,实际上要么并不在乎要么真的不懂。 3.自顶向下逐层描述 架构制图的第三要点,是合理运用层次化(hierarchical)的套路,自顶向下逐层描述。无论是 C4 模型还是 arc42 模板,背后都深刻运用并显著强调了这一点。为什么一定要这么做?其中蕴含了两个普适的原理: 分而治之:软件领域中,分而治之是控制和应对复杂系统的最有效方法。而层次化拆分,本质上就是一种分而治之手段:将系统按照从粗到细的粒度,一级一级地拆分成多个相对独立和低耦合的元素(子系统、应用、组件等); 金字塔原理:这本书的核心观点就是,按照自顶向下的方式,先抛出主观点再依次用各个子观点去论证。这样的沟通方式更符合人类的思维逻辑,也更容易让读者接受。简单来说,就是要“先说重点”,帮助读者做归纳总结和划重点,而不是先抛出一大堆细枝末节的零散东西让读者自己去消化和推演。 4. 使用多种架构视图 架构制图的第四要点,是在向传统的工程制图方法论致敬:使用多种架构视图来描述你的架构。在工程制图的世界里,任何立体的制品,大到机床小到零件,都至少需要通过三种视图(主视图、俯视图、左视图)来描述。作为现实世界的映射,软件系统也是多维和立体的,只用单一视图不可能覆盖所有关键的架构信息;即使强行把这些信息都塞在一张图里,那也一定会复杂到让人无法理解。 在架构设计领域,架构视图(architectural view)有专门的定义:针对系统架构某一个方面(aspect)的一种描述;每个视图都会覆盖项目干系人的一种或多种关注点。从上述定义可以看出来,不同的架构视图会有不同的侧重点,同时在描述自己所专注的方面时也会略去与当前视图无关的其他细节 —— 这其实也是一种与层次化拆分类似的分而治之思想,只不过这里是针对完整系统的维度分解,而层次化则是针对某一具体视图再做自顶向下的垂直下钻(drill-down);两者是正交且可以相互配合的,例如前面说到的结构视图、部署视图甚至动态视图,都可以分别再进行层次化拆分。 5. 遵循规范和最佳实践 架构制图的第五要点,其实只是一句正确的废话:遵循规范和最佳实践。这一点已经不限于架构制图,而是上升到了工程实践领域的通用方法论层面。正如前面章节所说,“学习架构制图的目标,就是要把它从一门手艺变成一项工程”,因此架构制图的“施工”过程也理所应当符合工程化思维: 一方面,制图需要遵循明确的规范,在理论层面进行约束和指引,确保过程和产物的高质量与标准化; 另一方面,制图还需要遵循业界最佳实践,在实践层面持续吸取优秀经验,不断精进自己和团队的制图技能。 附:架构描述标准化概念模型 国际上对架构描述其实建立了专门的标准(ISO / IEC / IEEE 42010:2011),其中的很多概念词汇在本文中都有提到(e.g. Stakeholder、Concern、View、Viewpoint),有兴趣的同学可以进一步研究下。 结语 如果你从头到尾耐着性子看到了这里,那么不用怀疑,你一定就是我们团队要找的那种能成大事儿的人: 欢迎各位技术同路人加入阿里云云原生应用研发平台EMAS团队,我们专注于广泛的云原生技术(Backend as a Service、Serverless、DevOps、低代码平台等),致力于为企业、开发者提供一站式的应用研发管理服务,内推直达邮箱:pengqun.pq # alibaba-inc.com,有信必回。 “阿里巴巴云原生关注微服务、Serverless、容器、Service Mesh 等技术领域、聚焦云原生流行技术趋势、云原生大规模的落地实践,做最懂云原生开发者的公众号。”

优秀的个人博客,低调大师

每日一博 | 滴滴数据通道服务演进之路

桔妹导读:滴滴数据通道引擎承载着全公司的数据同步,为下游实时和离线场景提供了必不可少的源数据。随着任务量的不断增加,数据通道的整体架构也随之发生改变。本文介绍了滴滴数据通道的发展历程,遇到的问题以及今后的规划。 1. 背景 数据,对于任何一家互联网公司来说都是非常重要的资产,公司的大数据部门致力于解决如何更好的使用数据,挖掘数据价值,而数据通道服务作为“大数据”的前置链路,一直以来都在默默的为公司提供及时,完整的数据服务,这里我们对滴滴数据通道的演进做一个全面的介绍。 2. 数据通道简介 数据通道服务,顾名思义,是数据的通路,负责将数据从A同步到B的一套解决方案。 异构数据的同步是公司很多业务的普遍需求,通道服务也就成为了一项基础服务。包括但不限于日志,Binlog同步到下游各类存储和引擎中,如HIVE,ES,HBase等,用于报表,运营等场景。 数据通道方案本身涉及的组件很多,链路也比较复杂,这里通过一个简化的有向图来介绍下通道的核心流程。 有向图的顶点表示存储,包括磁盘,消息队列以及各种存储服务,边和方向表示数据流量,而数据流动的动力则是边上的各个同步引擎。 仅从图中的链路可以看出,基础组件包括以下几种: 组件名称 组件说明 容器 业务方运行的容器是数据产生的地方,是异构数据的原始数据,包括业务日志和Binlog等。 Agent Agent负责数据采集,常见的远端数据包括普通日志和Binlog,Agent负责将这类数据采集后发送到消息队列中,通过读取文件,并记录offset的方式,保证至少一次的数据采集服务。 Kafka 消息队列的加入主要用于数据复用,削峰填谷以及上下游解耦。采集一份数据,多个下游可以根据需要消费后自行处理,同时借用消息队列的高吞吐能力,减少上下游的耦合,在流量突增的时候可以起到缓冲的效果。 DSink DSink组件是公司内对数据投递服务的简称,主要负责消费MQ数据投递到下游存储,通过消息队列的OffSet保证至少一次的数据投递。 ES/HDFS 存储引擎,异构数据通过上述投递服务,完成结构化处理,投递到下游存储中,供业务方使用。 ETL 写入HDFS数据一般来说都是作为业务方ETL的输入,经过自定义的处理逻辑后写入HIVE,供分析和计算使用。 数据仓库 数据仓库中保存结构化的数据,方便业务系统或者下游级联使用。 各类业务系统 业务系统直接对接ES或者数据仓库,提供线上或者准线上服务。 3. 数据通道服务的演进 数据通道致力于解决异构数据同步的问题,从开始构建到现在,经历了组件平台化,服务化,产品化,引擎升级和智能化几个阶段,每个阶段都面临着各种各样的问题,而问题的解决都伴随着系统稳定性,可靠性的提升。 ▍3.1 组件平台化目标:更好地服务业务 数据通道构建初期,各个组件各自维护,为业务方提供数据服务,业务有需求过来的时候各个组件快速启动一个进程就可以为业务方提供一个端到端的数据通路,业务拿到数据就可以分析计算,完整相关的业务指标。 随着业务发展,需求不断增多,经过了一段时间的野蛮增长后,通道的任务数也水涨船高,大量的任务需要规范的平台来管控,因此在通道服务活下来以后第一件需要做的事就是组件平台化,这么多任务需要有一个统一的管控平台管理起来,方便根据用户的需求,新建修改或者删除任务。 ▍ 3.2 服务化 目标:承诺SLA 面临问题:如何保证各个环节的At Least Once 数据的完整性和及时性是下游服务关注的重点,完整性是基础,在这之上尽可能保障及时性。对于下游来说,可以容忍短暂的延迟,但是不能数据数据不准确的情况,因此,自下而上的,通道服务要为自己同步的数据负责。 要为下游提供一致性服务,一方面需要各个组件能够提供At Least Once的语义保证,另外一方面则需要一个数据质量中心对外提供数据质量服务。 介绍一个简单的场景:DSink在数据同步过程中如何实现At Least Once 数据投递服务DSink是消费MQ消息,投递到下游存储,MQ以Kakfa为例,DSink在投递的过程中是异步多线程同时投递,那怎么保证数据投递完成之后提交准确的offset呢,毕竟一个partition的数据会分不到多个线程中同时投递,投递的下游可能会因为网络或者压力的原因失败,还需要重试。 方案一: 一批数据都投递完成后再继续消费,也就是全部投递成功之前阻塞上游消费,这样可以保证提交的offset是准确的。但是这样就会有性能问题,在日志场景下会严重影响性能。 方案二(DSink采用方案): 使用TreeMap保存offset,Map的value为一个范围,A-B的offset范围,Key则为这个范围的最小值A,每次有一个partition的offset处理成功后则加入到TreeMap中,具体过程如下: 定时提交offset时只需要获取Map中第一个Entry value的结束offset进行提交即可。offset经过这种处理,可以保证每次提交的offset都是准确的,完成投递的数据,基于此,DSink实现了At Least Once语义。 ▍ 3.3 产品化 目标:提升用户体验 数据通道服务渐渐完善后,接入的需求也越来越多,遇到的问题也与日俱增,比较直观的一点就是答疑量上升,一方面用户需求的接入是通过邮件或者钉钉,开发同学需要根据需求手动创建任务;另一方面用户的不规范配置会影响任务运行,当数据不产出或者产出有问题时需要引擎同学定位解决,答疑的大部分精力都耗在这些问题之上。 数据通道服务是随着公司发展一起发展起来的,众所周知,在发展初期,缺乏各种规范,业务方的日志或者MySql表差异很大,遵循的规范也是五花八门,或者根本就没有规范,为了数据通道服务的标准化和自动化,我们通过产品的方式规范用户数据,符合我们规范的数据可以自动接入,而其他乱七八糟的格式则需要整改后再接入。 为了解决这些问题,数据通道孵化了统一的接入平台——同步中心,在该平台之上用户通过点击配置的方式完成任务创建,同步中心会将用户需求拆分到各个通道引擎管控平台,各个管控平台再根据配置自行创建任务运行,最后回调同步中心,整个过程实现自动化。 经过这一改造,任务创建时间从原来的平均几个小时降到5-10分钟,极大的提升了用户体验。 ▍ 3.4 引擎升级——Flink(StreamSQL) 目标:降成本,模板化 DSink组件运行在公司的统一的容器内,在申请容器的时候为了减少碎片及便于管理,容器的规格只有固定的几种,如4C8G,8C16G,16C32G等,不同的任务都只能在这些规格中选择,这样就会导致资源的浪费,比如一个需要10个VCORE的任务,就只能申请16C的容器,大部分情况CPU会空闲一部分,同时内存也只能浪费。 引擎升级,将投递组件升级到Flink引擎之上主要有以下收益: Flink是基于yarn来调度资源,最小的单位是1C1G,通过计算,可以对每一个任务的资源进行精准控制,尽可能的减少资源浪费。 投递引擎切换到StreamSQL后,所有任务都通过SQL表达,统一了任务模版。 StreamSQL的UDF特性可以支持用户自定义解析逻辑,基础SQL可以支持写入下游ES或者HDFS等存储,而用户逻辑增加UDF后即可直接写入。这一方面减少用户重复开发的工作量,另一方面也拓展了数据通道的服务范围。 通过这一次引擎升级,通道任务从原来的400台物理机,切换到StreamSQL,只需要约250台物理机。CPU的峰值利用率也从不到30%提升到60%+。 ▍ 3.5 智能化(进行中) 目标:问题诊断与数据治理 随着任务数的接入越来越多,不可避免的,引擎的各类问题也越来越多,当前主要是用户问题驱动或者延迟告警来发现问题,之后依赖于各个引擎的指标大盘定位问题,再由人工来解决各类引擎问题。实际上当前有相当一部分简单问题是可以自动化处理的,比如资源不足,如果发现延迟的原因是资源不足,则可以直接扩资源即可。 鉴于此,我们规划了一套问题发现与自动化处理的智能诊断与解决方案——LogX,期望基于这个方案可以解决引擎侧80%的日常问题。 LogX组件的职责如下: 统筹整个链路资源,根据用户任务,分配各个下游引擎资源 问题诊断和自动化处理——基于各类指标,完成问题智能分析和诊断,对于常见问题可以自动化处理,减少人工干预 全链路血缘建设——根据血缘关系识别重点项目,分级保障 全链路数据治理——基于血缘关系完成数据治理,减少不比要的任务,进一步提升资源利用率 因为涉及到各个引擎的指标与自动化,当前该组件正在持续推进中,相信不久就可以作为通道的核心服务之一服务于引擎和公司业务了。 4. 总结 数据通道服务承载着全公司的数据同步,绝大部分离线任务的数据源都是通道服务投递的,可以说当前的通道服务是整个滴滴数据的大动脉。经过这几年的发展,通道服务也逐渐趋于完善,持续稳定的为公司提供数据采集和投递服务。 团队介绍 ▬ 滴滴云平台事业群 滴滴大数据架构部实时数据引擎组负责Flink流批一体计算、Kafka消息队列、日志采集与通道等核心数据引擎的研发与应用,承担全公司的数据采集、投递以及实时计算任务, 致力于打造稳定可靠、高性能、低成本的计算与通道服务。 作者介绍 ▬ 专注于大数据实时引擎技术,致力于数据通道全链路建设,基于各类实时引擎,为公司提供稳定,可靠,高效,及时的数据通道服务。 延伸阅读 ▬ 内容编辑 | Charlotte 联系我们 | DiDiTech@didiglobal.com 本文分享自微信公众号 - 滴滴技术(didi_tech)。如有侵权,请联系 support@oschina.cn 删除。本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

优秀的个人博客,低调大师

每日一博 | JDK 15 安装及新特性介绍

JDK 15已经于2020年9月15日如期发布。本文介绍JDK 15新特性。 发布版本说明 根据发布的规划,这次发布的 JDK 15 将是一个短期的过度版,只会被 Oracle 支持(维护)6 个月,直到明年 3 月的 JDK 16 发布此版本将停止维护。而 Oracle 下一个长期支持版(LTS 版)会在明年的 9 月份发布(Java 17),LTS 版每 3 年发布一个,上一次长期支持版是 18 年 9 月发布的 JDK 11。 下图展示了各个版本的发布历史。 安装包下载 主要分为OpenJDK版本和Oracle版本,下载地址如下: OpenJDK版本:https://jdk.java.net/15/ Oracle版本:http://www.oracle.com/technetwork/java/javase/downloads/index.html 上述版本,如果是个人学习用途,则差异不大。但如果是用于商业用途,则需要仔细看好相关的授权。Oracle JDK根据二进制代码许可协议获得许可,而OpenJDK根据GPL v2许可获得许可。 安装、验证 本例子以OpenJDK版本为例。解压安装包openjdk-15_windows-x64_bin.zip到任意位置。 设置系统环境变量“JAVA_HOME”,如下图所示。 在用户变量“Path”中,增加“%JAVA_HOME%\bin”。 安装完成后,执行下面命令进行验证: >java -version openjdk version "15" 2020-09-15 OpenJDK Runtime Environment (build 15+36-1562) OpenJDK 64-Bit Server VM (build 15+36-1562, mixed mode, sharing) 更多有关Java的基本知识,可以参阅《Java核心编程》这本书,描述的非常详细。 JDK 15 新特性说明 JDK 15 为用户提供了14项主要的增强/更改,包括一个孵化器模块,三个预览功能,两个不推荐使用的功能以及两个删除功能。 1. EdDSA 数字签名算法 新加入 Edwards-Curve 数字签名算法(EdDSA)实现加密签名。在许多其它加密库(如 OpenSSL 和 BoringSSL)中得到支持。与 JDK 中的现有签名方案相比,EdDSA 具有更高的安全性和性能。这是一个新的功能。 使用示例如下: // example: generate a key pair and sign KeyPairGenerator kpg = KeyPairGenerator.getInstance("Ed25519"); KeyPair kp = kpg.generateKeyPair(); // algorithm is pure Ed25519 Signature sig = Signature.getInstance("Ed25519"); sig.initSign(kp.getPrivate()); sig.update(msg); byte[] s = sig.sign(); // example: use KeyFactory to contruct a public key KeyFactory kf = KeyFactory.getInstance("EdDSA"); boolean xOdd = ... BigInteger y = ... NamedParameterSpec paramSpec = new NamedParameterSpec("Ed25519"); EdECPublicKeySpec pubSpec = new EdECPublicKeySpec(paramSpec, new EdPoint(xOdd, y)); PublicKey pubKey = kf.generatePublic(pubSpec); 有关EdDSA 数字签名算法的详细内容见RFC 8032规范。 2. 封闭类(预览特性) 可以是封闭类和或者封闭接口,用来增强 Java 编程语言,防止其他类或接口扩展或实现它们。 有了这个特性,意味着以后不是你想继承就继承,想实现就实现了,你得经过允许才行。 示例如下: public abstract sealed class Student permits ZhangSan, LiSi, ZhaoLiu { ... } 类 Student 被 sealed 修饰,说明它是一个封闭类,并且只允许指定的 3 个子类继承。 3. 隐藏类 此功能可帮助需要在运行时生成类的框架。框架生成类需要动态扩展其行为,但是又希望限制对这些类的访问。隐藏类很有用,因为它们只能通过反射访问,而不能从普通字节码访问。此外,隐藏类可以独立于其他类加载,这可以减少框架的内存占用。这是一个新的功能。 4. 移除了 Nashorn JavaScript 脚本引擎 移除了 Nashorn JavaScript 脚本引擎、APIs,以及 jjs 工具。这些早在 JDK 11 中就已经被标记为 deprecated 了,JDK 15 被移除就很正常了。 Nashorn 是 JDK 1.8 引入的一个 JavaScript 脚本引擎,用来取代 Rhino 脚本引擎。Nashorn 是 ECMAScript-262 5.1 的完整实现,增强了 Java 和 JavaScript 的兼容性,并且大大提升了性能。 那么为什么要移除? 官方的解释是主要的:随着 ECMAScript 脚本语言的结构、API 的改编速度越来越快,维护 Nashorn 太有挑战性了,所以……。 5. 重新实现 DatagramSocket API 重新实现旧版 DatagramSocket API,更简单、更现代的实现来代替java.net.DatagramSocket和java.net.MulticastSocketAPI 的基础实现,提高了 JDK 的可维护性和稳定性。 新的底层实现将很容易使用虚拟线程,目前正在 Loom 项目中进行探索。这也是 JEP 353 的后续更新版本,JEP 353 已经重新实现了 Socket API。 6. 准备禁用和废除偏向锁 在 JDK 15 中,默认情况下禁用偏向锁(Biased Locking),并弃用所有相关的命令行选项。 后面再确定是否需要继续支持偏向锁,因为维护这种锁同步优化的成本太高了。 7. 模式匹配(第二次预览) 第一次预览是 JDK 14 中提出来的,点击这里查看我之前写的详细教程。 Java 14 之前用法: if (obj instanceof String) { String s = (String) obj; // 使用s } Java 14之后的用法: if (obj instanceof String s) { // 使用s } Java 15 并没有对此特性进行调整,继续预览特性,只是为了收集更多的用户反馈,可能还不成熟吧。 8. ZGC 功能转正 ZGC是一个可伸缩、低延迟的垃圾回收器。 ZGC 已由JEP 333集成到JDK 11 中,其目标是通过减少 GC 停顿时间来提高性能。借助 JEP 377,JDK 15 将 ZGC 垃圾收集器从预览特性变更为正式特性而已,没错,转正了。 这个 JEP 不会更改默认的 GC,默认仍然是 G1。 9. 文本块功能转正 文本块,是一个多行字符串,它可以避免使用大多数转义符号,自动以可预测的方式格式化字符串,并让开发人员在需要时可以控制格式。 文本块最早准备在 JDK 12 添加的,但最终撤消了,然后在 JDK 13 中作为预览特性进行了添加,然后又在 JDK 14 中再次预览,在 JDK 15 中,文本块终于转正,暂不再做进一步的更改。 Java 13 之前用法,使用one-dimensional的字符串语法: String html = "<html>\n" + " <body>\n" + " <p>Hello, world</p>\n" + " </body>\n" + "</html>\n"; Java 13 之后用法,使用two-dimensional文本块语法: String html = """ <html> <body> <p>Hello, world</p> </body> </html> """; 10. Shenandoah 垃圾回收算法转正 Shenandoah 垃圾回收从实验特性变为产品特性。这是一个从 JDK 12 引入的回收算法,该算法通过与正在运行的 Java 线程同时进行疏散工作来减少 GC 暂停时间。Shenandoah 的暂停时间与堆大小无关,无论堆栈是 200 MB 还是 200 GB,都具有相同的一致暂停时间。 JDK 15 Shenandoah垃圾收集器从预览特性变更为正式特性而已,没错,又是转正了。 11. 移除了 Solaris 和 SPARC 端口。 移除了 Solaris/SPARC、Solaris/x64 和 Linux/SPARC 端口的源代码及构建支持。这些端口在 JDK 14 中就已经被标记为 deprecated 了,JDK 15 被移除也不奇怪。 12. 外部存储器访问 API(二次孵化) 这个最早在 JDK 14 中成为孵化特性,JDK 15 继续二次孵化并对其 API 有了一些更新。 目的是引入一个 API,以允许 Java 程序安全有效地访问 Java 堆之外的外部内存。这同样是 Java 14 的一个预览特性。 13. Records Class(二次预览) Records Class 也是第二次出现的预览功能,它在 JDK 14 中也出现过一次了,使用 Record 可以更方便的创建一个常量类,使用的前后代码对比如下。 旧写法: class Point { private final int x; private final int y; Point(int x, int y) { this.x = x; this.y = y; } int x() { return x; } int y() { return y; } public boolean equals(Object o) { if (!(o instanceof Point)) return false; Point other = (Point) o; return other.x == x && other.y = y; } public int hashCode() { return Objects.hash(x, y); } public String toString() { return String.format("Point[x=%d, y=%d]", x, y); } } 新写法: record Point(int x, int y) { } 也就是说在使用了 record 之后,就可以用一行代码编写出一个常量类,并且这个常量类还包含了构造方法、toString()、equals() 和 hashCode() 等方法。 14. 废除 RMI 激活 废除 RMI 激活,以便在将来进行删除。需要说明的是,RMI 激活是 RMI 中一个过时的组件,自 Java 8 以来一直是可选的。 参考引用 本文同步至: https://waylau.com/jdk-15-released/ https://jdk.java.net/15/release-notes https://openjdk.java.net/projects/jdk/15/ https://openjdk.java.net/projects/jdk/15/spec/ 《Java核心编程》 https://github.com/waylau/modern-java-demos

优秀的个人博客,低调大师

每日一博 | 逐行分析鸿蒙系统的 JavaScript 框架

我在前文中曾经介绍过鸿蒙的 Javascript 框架,这几天终于把 JS 仓库编译通过了,期间踩了不少坑,也给鸿蒙贡献了几个 PR。今天我们就来逐行分析鸿蒙系统中的 JS 框架。 文中的所有代码都基于鸿蒙的当前最新版(版本为 677ed06,提交日期为 2020-09-10)。 鸿蒙系统使用 JavaScript 开发 GUI 是一种类似于微信小程序、轻应用的模式。而这个 MVVM 模式中,V 其实是由 C++ 来承担的。JavaScript 代码只是其中的 ViewModel 层。 鸿蒙 JS 框架是零依赖的,只在开发打包过程中使用到了一些 npm 包。打包完之的代码是没有依赖任何 npm 包的。我们先看一下使用鸿蒙 JS 框架写出来的 JS 代码到底长什么样。 export default { data() { return { count: 1 }; }, increase() { ++this.count; }, decrease() { --this.count; }, } 如果我不告诉你这是鸿蒙,你甚至会以为它是 vue 或小程序。如果单独把 JS 拿出来使用(脱离鸿蒙系统),代码是这样: const vm = new ViewModel({ data() { return { count: 1 }; }, increase() { ++this.count; }, decrease() { --this.count; }, }); console.log(vm.count); // 1 vm.increase(); console.log(vm.count); // 2 vm.decrease(); console.log(vm.count); // 1 仓库中的所有 JS 代码实现了一个响应式系统,充当了 MVVM 中的 ViewModel。 下面我们逐行分析。 src 目录中一共有 4 个目录,总计 8 个文件。其中 1 个是单元测试。还有 1 个性能分析。再除去 2 个 index.js 文件,有用的文件一共是 4 个。也是本文分析的重点。 src ├── __test__ │ └── index.test.js ├── core │ └── index.js ├── index.js ├── observer │ ├── index.js │ ├── observer.js │ ├── subject.js │ └── utils.js └── profiler └── index.js 首先是入口文件,src/index.js,只有 2 行代码: import { ViewModel } from './core'; export default ViewModel; 其实就是重新导出。 另一个类似的文件是 src/observer/index.js,也是 2 行代码: export { Observer } from './observer'; export { Subject } from './subject'; observer 和 subject 实现了一个观察者模式。subject 是主题,也就是被观察者。observer 是观察者。当 subject 有任何变化时需要主动通知被观察者。这就是响应式。 这 2 个文件都使用到了 src/observer/utils.js,所以我们先分析一下 utils 文件。分 3 部分。 第一部分 export const ObserverStack = { stack: [], push(observer) { this.stack.push(observer); }, pop() { return this.stack.pop(); }, top() { return this.stack[this.stack.length - 1]; } }; 首先是定义了一个用来存放观察者的栈,遵循后进先出的原则,内部使用 stack 数组来存储。 入栈操作 push,和数组的 push 函数一样,在栈顶放入一个观察者 observer。 出栈操作 pop,和数组的 pop 函数一样,在将栈顶的观察者删除,并返回这个被删除的观察者。 取栈顶元素 top,和 pop 操作不同,top 是把栈顶元素取出来,但是并不删除。 第二部分 export const SYMBOL_OBSERVABLE = '__ob__'; export const canObserve = target => typeof target === 'object'; 定义了一个字符串常量 SYMBOL_OBSERVABLE。为了后面用着方便。 定义了一个函数 canObserve,目标是否可以被观察。只有对象才能被观察,所以使用 typeof 来判断目标的类型。等等,好像有什么不对。如果 target 为 null 的话,函数也会返回 true。如果 null 不可观察,那么这就是一个 bug。(写这篇文章的时候我已经提了一个 PR,并询问了这种行为是否是期望的行为)。 第三部分 export const defineProp = (target, key, value) => { Object.defineProperty(target, key, { enumerable: false, value }); }; 这个没有什么好解释的,就是 Object.defineProperty 代码太长了,定义一个函数来避免代码重复。 下面再来分析观察者 src/observer/observer.js,分 4 部分。 第一部分 export function Observer(context, getter, callback, meta) { this._ctx = context; this._getter = getter; this._fn = callback; this._meta = meta; this._lastValue = this._get(); } 构造函数。接受 4 个参数。 context 当前观察者所处的上下文,类型是 ViewModel。当第三个参数 callback 调用时,函数的 this 就是这个 context。 getter 类型是一个函数,用来获取某个属性的值。 callback 类型是一个函数,当某个值变化后执行的回调函数。 meta 元数据。观察者(Observer)并不关注 meta 元数据。 在构造函数的最后一行,this._lastValue = this._get()。下面来分析 _get 函数。 第二部分 Observer.prototype._get = function() { try { ObserverStack.push(this); return this._getter.call(this._ctx); } finally { ObserverStack.pop(); } }; ObserverStack 就是上面分析过的用来存储所有观察者的栈。将当前观察者入栈,并通过 _getter 取得当前值。结合第一部分的构造函数,这个值存储在了 _lastValue 属性中。 执行完这个过程后,这个观察者就已经初始化完成了。 第三部分 Observer.prototype.update = function() { const lastValue = this._lastValue; const nextValue = this._get(); const context = this._ctx; const meta = this._meta; if (nextValue !== lastValue || canObserve(nextValue)) { this._fn.call(context, nextValue, lastValue, meta); this._lastValue = nextValue; } }; 这部分实现了数据更新时的脏检查(Dirty checking)机制。比较更新后的值和当前值,如果不同,那么就执行回调函数。如果这个回调函数是渲染 UI,那么则可以实现按需渲染。如果值相同,那么再检查设置的新值是否可以被观察,再决定到底要不要执行回调函数。 第四部分 Observer.prototype.subscribe = function(subject, key) { const detach = subject.attach(key, this); if (typeof detach !== 'function') { return; } if (!this._detaches) { this._detaches = []; } this._detaches.push(detach); }; Observer.prototype.unsubscribe = function() { const detaches = this._detaches; if (!detaches) { return; } while (detaches.length) { detaches.pop()(); } }; 订阅与取消订阅。 我们前面经常说观察者和被观察者。对于观察者模式其实还有另一种说法,叫订阅/发布模式。而这部分代码则实现了对主题(subject)的订阅。 先调用主题的 attach 方法进行订阅。如果订阅成功,subject.attach 方法会返回一个函数,当调用这个函数就会取消订阅。为了将来能够取消订阅,这个返回值必需保存起来。 subject 的实现很多人应该已经猜到了。观察者订阅了 subject,那么 subject 需要做的就是,当数据变化时即使通知观察者。subject 如何知道数据发生了变化呢,机制和 vue2 一样,使用 Object.defineProperty 做属性劫持。 下面再来分析观察者 src/observer/subject.js,分 7 部分。 第一部分 export function Subject(target) { const subject = this; subject._hijacking = true; defineProp(target, SYMBOL_OBSERVABLE, subject); if (Array.isArray(target)) { hijackArray(target); } Object.keys(target).forEach(key => hijack(target, key, target[key])); } 构造函数。基本没什么难点。设置 _hijacking 属性为 true,用来标示这个对象已经被劫持了。Object.keys 通过遍历来劫持每个属性。如果是数组,则调用 hijackArray。 第二部分 两个静态方法。 Subject.of = function(target) { if (!target || !canObserve(target)) { return target; } if (target[SYMBOL_OBSERVABLE]) { return target[SYMBOL_OBSERVABLE]; } return new Subject(target); }; Subject.is = function(target) { return target && target._hijacking; }; Subject 的构造函数并不直接被外部调用,而是封装到了 Subject.of 静态方法中。 如果目标不能被观察,那么直接返回目标。 如果 target[SYMBOL_OBSERVABLE] 不是 undefined,说明目标已经被初始化过了。 否则,调用构造函数初始化 Subject。 Subject.is 则用来判断目标是否被劫持过了。 第三部分 Subject.prototype.attach = function(key, observer) { if (typeof key === 'undefined' || !observer) { return; } if (!this._obsMap) { this._obsMap = {}; } if (!this._obsMap[key]) { this._obsMap[key] = []; } const observers = this._obsMap[key]; if (observers.indexOf(observer) < 0) { observers.push(observer); return function() { observers.splice(observers.indexOf(observer), 1); }; } }; 这个方法很眼熟,对,就是上文的 Observer.prototype.subscribe 中调用的。作用是某个观察者用来订阅主题。而这个方法则是“主题是怎么订阅的”。 观察者维护这一个主题的哈希表 _obsMap。哈希表的 key 是需要订阅的 key。比如某个观察者订阅了 name 属性的变化,而另一个观察者订阅了 age 属性的变化。而且属性的变化还可以被多个观察者同时订阅,因此哈希表存储的值是一个数组,数据的每个元素都是一个观察者。 第四部分 Subject.prototype.notify = function(key) { if ( typeof key === 'undefined' || !this._obsMap || !this._obsMap[key] ) { return; } this._obsMap[key].forEach(observer => observer.update()); }; 当属性发生变化是,通知订阅了此属性的观察者们。遍历每个观察者,并调用观察者的 update 方法。我们上文中也提到了,脏检查就是在这个方法内完成的。 第五部分 Subject.prototype.setParent = function(parent, key) { this._parent = parent; this._key = key; }; Subject.prototype.notifyParent = function() { this._parent && this._parent.notify(this._key); }; 这部分是用来处理属性嵌套(nested object)的问题的。就是类似这种对象:{ user: { name: 'JJC' } }。 第六部分 function hijack(target, key, cache) { const subject = target[SYMBOL_OBSERVABLE]; Object.defineProperty(target, key, { enumerable: true, get() { const observer = ObserverStack.top(); if (observer) { observer.subscribe(subject, key); } const subSubject = Subject.of(cache); if (Subject.is(subSubject)) { subSubject.setParent(subject, key); } return cache; }, set(value) { cache = value; subject.notify(key); } }); } 这一部分展示了如何使用 Object.defineProperty 进行属性劫持。当设置属性时,会调用 set(value),设置新的值,然后调用 subject 的 notify 方法。这里并不进行任何检查,只要设置了属性就会调用,即使属性的新值和旧值一样。notify 会通知所有的观察者。 第七部分 劫持数组方法。 const ObservedMethods = { PUSH: 'push', POP: 'pop', UNSHIFT: 'unshift', SHIFT: 'shift', SPLICE: 'splice', REVERSE: 'reverse' }; const OBSERVED_METHODS = Object.keys(ObservedMethods).map( key => ObservedMethods[key] ); ObservedMethods 定义了需要劫持的数组函数。前面大写的用来做 key,后面小写的是需要劫持的方法。 function hijackArray(target) { OBSERVED_METHODS.forEach(key => { const originalMethod = target[key]; defineProp(target, key, function() { const args = Array.prototype.slice.call(arguments); originalMethod.apply(this, args); let inserted; if (ObservedMethods.PUSH === key || ObservedMethods.UNSHIFT === key) { inserted = args; } else if (ObservedMethods.SPLICE) { inserted = args.slice(2); } if (inserted && inserted.length) { inserted.forEach(Subject.of); } const subject = target[SYMBOL_OBSERVABLE]; if (subject) { subject.notifyParent(); } }); }); } 数组的劫持和对象不同,不能使用 Object.defineProperty。 我们需要劫持 6 个数组方法。分别是头部添加、头部删除、尾部添加、尾部删除、替换/删除某几项、数组反转。 通过重写数组方法实现了数组的劫持。但是这里有一个需要注意的地方,数据的每一个元素都是被观察过的,但是当在数组中添加了新元素时,这些元素还没有被观察。因此代码中还需要判断当前的方法如果是 push、unshift、splice,那么需要将新的元素放入观察者队列中。 另外两个文件分别是单元测试和性能分析,这里就不再分析了。 本文参与了「解读鸿蒙源码」技术征文,欢迎正在阅读的你也加入。

优秀的个人博客,低调大师

每日一博 | 基于 Flink 的典型 ETL 场景实现

简介: 本文将从数仓诞生的背景、数仓架构、离线与实时数仓的对比着手,综述数仓发展演进,然后分享基于 Flink 实现典型 ETL 场景的几个方案。 作者:买蓉 · 美团点评高级技术专家 整理:赵阳(Flink 社区志愿者) 校对:苗浩冲(Flink 社区志愿者) 本文将从数仓诞生的背景、数仓架构、离线与实时数仓的对比着手,综述数仓发展演进,然后分享基于 Flink 实现典型 ETL 场景的几个方案。 1.实时数仓的相关概述 1.1 实时数仓产生背景 我们先来回顾一下数据仓库的概念。 数据仓库的概念是于90年代由 Bill Inmon 提出, 当时的背景是传统的 OLTP 数据库无法很好的支持长周期分析决策场景,所以数据仓库概念的4个核心点,我们要结合着 OLTP 数据库当时的状态来对比理解。 面向主题的:数据仓库的数据组织方式与 OLTP 面向事务处理不同。因为数据仓库是面向分析决策的,所以数据经常按分析场景或者是分析对象等主题形式来组织。 集成的:对于数据仓库来说,经常需要去集合多个分散的、异构的数据源,做一些数据清洗等 ETL 处理,整合成一块数据仓库,OLTP 则不需要做类似的集成操作。 相对稳定的:OLTP 数据库一般都是面向业务的,它主要的作用是把当前的业务状态精准的反映出来,所以 OLTP 数据库需要支持大量的增、删、改的操作。但是对于数据仓库来说,只要是入仓存下来的数据,一般使用场景都是查询,因此数据是相对稳定的。 反映历史变化:数据仓库是反映历史变化的数据集合,可以理解成它会将历史的一些数据的快照存下来。而对于 OLTP 数据库来说,只要反映当时的最新的状态就可以了。 以上这4个点是数据仓库的一个核心的定义。我们也可以看出对于实时数据仓库来说,传统数据仓库也就是离线数据仓库中的一些定义会被弱化,比如说在反映历史变化这一点。介绍完数据仓库的基本概念,简单说下数据仓库建模这块会用到一些经典的建模方法,主要有范式建模、维度建模和 Data Vault。在互联网大数据场景下,用的最多的是维度建模方法。 然后先看一下离线数仓的经典架构。如下图: 这个数仓架构主要是偏向互联网大数据的场景方案,由上图可以看出有三个核心环节。 第一个环节是数据源部分,一般互联网公司的数据源主要有两类: 第1类是通过在客户端埋点上报,收集用户的行为日志,以及一些后端日志的日志类型数据源。对于埋点行为日志来说,一般会经过一个这样的流程,首先数据会上报到 Nginx 然后经过 Flume 收集,然后存储到 Kafka 这样的消息队列,然后再由实时或者离线的一些拉取的任务,拉取到我们的离线数据仓库 HDFS。 第2类数据源是业务数据库,而对于业务数据库的话,一般会经过 Canal 收集它的 binlog,然后也是收集到消息队列中,最终再由 Camus 拉取到 HDFS。 这两部分数据源最终都会落地到 HDFS 中的 ODS 层,也叫贴源数据层,这层数据和原始数据源是保持一致的。 第二个环节是离线数据仓库,是图中蓝色的框展示的部分。可以看到它是一个分层的结构,其中的模型设计是依据维度建模思路。 最底层是 ODS 层,这一层将数据保持无信息损失的存放在 HDFS,基本保持原始的日志数据不变。 在 ODS 层之上,一般会进行统一的数据清洗、归一,就得到了 DWD 明细数据层。这一层也包含统一的维度数据。 然后基于 DWD 明细数据层,我们会按照一些分析场景、分析实体等去组织我们的数据,组织成一些分主题的汇总数据层 DWS。 在 DWS 之上,我们会面向应用场景去做一些更贴近应用的 APP 应用数据层,这些数据应该是高度汇总的,并且能够直接导入到我们的应用服务去使用。 在中间的离线数据仓库的生产环节,一般都是采用一些离线生产的架构引擎,比如说 MapReduce、Hive、Spark 等等,数据一般是存在 HDFS 上。 经过前两个环节后,我们的一些应用层的数据会存储到数据服务里,比如说 HBase 、Redis、Kylin 这样的一些 KV 的存储。并且会针对存在这些数据存储上的一些数据,封装对应的服务接口,对外提供服务。在最外层我们会去产出一些面向业务的报表、面向分析的数据产品,以及会支持线上的一些业务产品等等。这一层的话,称之为更贴近业务端的数据应用部分。 以上是一个基本的离线数仓经典架构的介绍。 大家都了解到现在随着移动设备的普及,我们逐渐的由制造业时代过渡到了互联网时代。在制造业的时代,传统的数仓,主要是为了去支持以前的一些传统行业的企业的业务决策者、管理者,去做一些业务决策。那个时代的业务决策周期是比较长的,同时当时的数据量较小,Oracle、DB2 这一类数据库就已经足够存了。 但随着分布式计算技术的发展、智能化技术发展、以及整体算力的提升、互联网的发展等等因素,我们现在在互联网上收集的数据量,已经呈指数级的增长。并且业务不再只依赖人做决策,做决策的主体很大部分已转变为计算机算法,比如一些智能推荐场景等等。所以这个时候决策的周期,就由原来的天级要求提升到秒级,决策时间是非常短的。在场景上的话,也会面对更多的需要实时数据处理的场景,例如实时的个性化推荐、广告的场景、甚至一些传统企业已经开始实时监控加工的产品是否有质量问题,以及金融行业重度依赖的反作弊等等。因此在这样的一个背景下,实时数仓就必须被提出来了。 1.2 实时数仓架构 首先跟大家介绍一下实时数仓经典架构 - Lambda 架构: 这个架构是 Storm 的作者提出来的,其实 Lambda 架构的主要思路是在原来离线数仓架构的基础上叠加上实时数仓的部分,然后将离线的存量数据与我们 t+0 的实时的数据做一个 merge,就可以产生数据状态实时更新的结果。 和上述1.1离线数据仓库架构图比较可以明显的看到,实时数仓增加的部分是上图黄色的这块区域。我们一般会把实时数仓数据放在 Kafka 这样的消息队列上,也会有维度建模的一些分层,但是在汇总数据的部分,我们不会将 APP 层的一些数据放在实时数仓,而是更多的会移到数据服务侧去做一些计算。 然后在实时计算的部分,我们经常会使用 Flink、Spark-streaming 和 Storm 这样的计算引擎,时效性上,由原来的天级、小时级可以提升到秒级、分钟级。 大家也可以看到这个架构图中,中间数据仓库环节有两个部分,一个是离线的数据仓库,一个是实时的数据仓库。我们必须要运维两套(实时计算和离线计算)引擎,并且在代码层面,我们也需要去实现实时和离线的业务代码。然后在合并的时候,我们需要保证实施和离线的数据一致性,所以但凡我们的代码做变更,我们也需要去做大量的这种实时离线数据的对比和校验。其实这对于不管是资源还是运维成本来说都是比较高的。这是 Lamda 架构上比较明显和突出的一个问题。因此就产生了 Kappa 结构。 Kappa 架构的一个主要的思路就是在数仓部分移除了离线数仓,数仓的生产全部采用实时数仓。从上图可以看到刚才中间的部分,离线数仓模块已经没有了。 关于 Kappa 架构,熟悉实时数仓生产的同学,可能会有一个疑问。因为我们经常会面临业务变更,所以很多业务逻辑是需要去迭代的。之前产出的一些数据,如果口径变更了,就需要重算,甚至重刷历史数据。对于实时数仓来说,怎么去解决数据重算问题? Kappa 架构在这一块的思路是:首先要准备好一个能够存储历史数据的消息队列,比如 Kafka,并且这个消息对列是可以支持你从某个历史的节点重新开始消费的。 接着需要新起一个任务,从原来比较早的一个时间节点去消费 Kafka 上的数据,然后当这个新的任务运行的进度已经能够和现在的正在跑的任务齐平的时候,你就可以把现在任务的下游切换到新的任务上面,旧的任务就可以停掉,并且原来产出的结果表也可以被删掉。 随着我们现在实时 OLAP 技术的一些提升,有一个新的实时架构被提了出来,这里暂且称为实时 OLAP 变体。 这个思路是把大量的聚合、分析、计算由实时 OLAP 引擎来承担。在实时数仓计算的部分,我们不需要做的特别重,尤其是聚合相关的一些逻辑,然后这样就可以保障我们在数据应用层能灵活的面对各种业务分析的需求变更,整个架构更加灵活。 最后我们来整体对比一下,实时数仓的这几种架构: 这是整体三个关于实时数仓架构的一个对比: 从计算引擎角度:Lamda 架构它需要去维护批流两套计算引擎,Kappa 架构和实时 OLAP 变体只需要维护流计算引擎就好了。 开发成本:对 Lamda 架构来说,因为它需要维护实时离线两套代码,所以它的开发成本会高一些。 Kappa 架构和实时 OLAP 变体只用维护一套代码就可以了。 分析灵活性:实时 OLAP 变体是相对最灵活的。 在实时 OLAP 引擎依赖上:实时 OLAP 变体是强依赖实时 OLAP 变体引擎的能力的,前两者则不强依赖。 计算资源:Lamda 架构需要批流两套计算资源,Kappa 架构只需要流计算资源,实时 OLAP 变体需要额外的 OLAP 资源。 逻辑变更重算:Lamda 架构是通过批处理来重算的,Kappa 架构需要按照前面介绍的方式去重新消费消息队列重算,实时 OLAP 变体也需要重新消费消息队列,并且这个数据还要重新导入到 OLAP 引擎里,去做计算。 1.3 传统数仓 vs 实时数仓 然后我们来看一下传统数仓和实时数仓整体的差异。 首先从时效性来看:离线数仓是支持小时级和天级的,实时数仓到秒级分钟级,所以实时数仓时效性是非常高的。 在数据存储方式来看:离线数仓它需要存在HDFS和RDS上面,实时数仓一般是存在消息队列,还有一些kv存储,像维度数据的话会更多的存在kv存储上。 在生产加工过程方面,离线数仓需要依赖离线计算引擎以及离线的调度。 但对于实时数仓来说,主要是依赖实时计算引擎。 2.基于 Flink 实现典型的 ETL 场景 这里我们主要介绍两大实时 ETL 场景:维表 join 和双流 join。 维表 join 预加载维表 热存储关联 广播维表 Temporal table function join 双流 join 离线join vs. 实时join Regular join Interval join Window join 2.1 维表 join 2.1.1 预加载维表 方案1: 将维表全量预加载到内存里去做关联,具体的实现方式就是我们定义一个类,去实现 RichFlatMapFunction,然后在 open 函数中读取维度数据库,再将数据全量的加载到内存,然后在 probe 流上使用算子 ,运行时与内存维度数据做关联。 这个方案的优点就是实现起来比较简单,缺点也比较明显,因为我们要把每个维度数据都加载到内存里面,所以它只支持少量的维度数据。同时如果我们要去更新维表的话,还需要重启作业,所以它在维度数据的更新方面代价是有点高的,而且会造成一段时间的延迟。对于预加载维表来说,它适用的场景就是小维表,变更频率诉求不是很高,且对于变更的及时性的要求也比较低的这种场景。 接下来我们看一个简单的代码的示例: 在这段代码截取的是关键的一个片段。这里定义了一个 DimFlatMapFunction 来实现 RichFlatMapFunction。其中有一个 Map 类型的 dim,其实就是为了之后在读取 DB 的维度数据以后,可以用于存放我们的维度数据,然后在 open 函数里面我们需要去连接我们的 DB,进而获取 DB 里的数据。然后在下面代码可以看到我们的场景是从一个商品表里面去取出商品的 ID、商品的名字。然后我们在获取到 DB 里面的维度数据以后会把它存放到 dim 里面。 接下来在 flatMap 函数里面我们就会使用到 dim,我们在获取了 probe 流的数据以后,我们会去 dim 里面比较。是否含有同样的商品 ID 的数据,如果有的话就把相关的商品名称 append 到数据元组,然后做一个输出。这就是一个基本的流程。 其实这是一个基本最初版的方案实现。但这个方案也有一个改进的方式,就是在 open 函数里面,可以新建一个线程,定时的去加载维表。这样就不需要人工的去重启 job 来让维度数据做更新,可以实现一个周期性的维度数据的更新。 方案2: 通过 Distributed cash 的机制去分发本地的维度文件到task manager后再加载到内存做关联。实现方式可以分为三步: 第1步是通过 env.registerCached 注册文件。 第2步是实现 RichFunction,在 open 函数里面通过 RuntimeContext 来获取 cache 文件。 第3步是解析和使用这部分文件数据。 这种方式的一个优点是你不需要去准备或者依赖外部数据库,缺点就是因为数据也是要加载到内存中,所以支持的维表数据量也是比较小。而且如果这个维度数据需要做更新,也需要重启作业。 因此在正规的生产过程中不太建议使用这个方案,因为其实从数仓角度,希望所有的数据都能够通过 schema 化方式来管理。把数据放在文件里面去做这样一个操作,不利于我们做整体数据的管理和规范化。所以这个方式的话,大家在做一些小的 demo 的时候,或者一些测试的时候可以去使用。 那么它适用的场景就是维度数据是文件形式的、数据量比较小、并且更新的频率也比较低的一些场景,比如说我们读一个静态的码表、配置文件等等。 2.1.2 热存储关联 维表 join 里第二类大的实现思路是热存储关联。具体是我们把维度数据导入到像 Redis、Tair、HBase 这样的一些热存储中,然后通过异步 IO 去查询,并且叠加使用 Cache 机制,还可以加一些淘汰的机制,最后将维度数据缓存在内存里,来减轻整体对热存储的访问压力。 如上图展示的这样的一个流程。在 Cache 这块的话,比较推荐谷歌的 Guava Cache,它封装了一些关于 Cache 的一些异步的交互,还有 Cache 淘汰的一些机制,用起来是比较方便的。 刚才的实验方案里面有两个重要点,一个就是我们需要用异步 IO 方式去访问存储,这里也跟大家一起再回顾一下同步 IO 与异步 IO 的区别: 对于同步 IO 来说,发出一个请求以后,必须等待请求返回以后才能继续去发新的 request。所以整体吞吐是比较小的。由于实时数据处理对于延迟特别关注,这种同步 IO 的方式,在很多场景是不太能够接受的。 异步 IO 就是可以并行发出多个请求,整个吞吐是比较高的,延迟会相对低很多。如果使用异步 IO 的话,它对于外部存储的吞吐量上升以后,会使得外部存储有比较大的压力,有时也会成为我们整个数据处理上延迟的瓶颈。所以引入 Cache 机制是希望通过 Cache 来去减少我们对外部存储的访问量。 刚才提到的 Cuava Cache,它的使用是非常简单的,下图是一个定义 Cache 样例: 可以看到它的使用接口非常简单,大家可以去尝试使用。对于热存储关联方案来说,它的优点就是维度数据因为不用全量加载在内存里,所以就不受限于内存大小,维度数据量可以更多。在美团点评的流量场景里面,我们的维度数据可以支持到 10 亿量级。另一方面该方案的缺点也是比较明显的,我们需要依赖热存储资源,而且维度的更新反馈到结果是有一定延迟的。 因为我们首先需要把数据导入到热存储,然后同时在 Cache 过期的时间上也会有损失。 总体来说这个方法适用的场景是维度数据量比较大,又能够接受维度更新有一定延迟的情况。 2.1.3 广播维表 第三个大的思路是广播维表,主要是利用 broadcast State 将维度数据流广播到下游 task 做 join。 实现方式: 将维度数据发送到 Kafka 作为广播原始流 S1 定义状态描述符 MapStateDescriptor。调用 S1.broadcast(),获得 broadCastStream S2 调用非广播流 S3.connect(S2),得到 BroadcastConnectedStream S4 在 KeyedBroadcastProcessFunction/BroadcastProcessFunction 实现关联处理逻辑,并作为参数调用 S4.process() 这个方案,它的优点是维度的变更可以及时的更新到结果。然后缺点就是数据还是需要保存在内存中,因为它是存在 state 里的,所以支持维表数据量仍然不是很大。适用的场景就是我们需要时时的去感知维度的变更,且维度数据又可以转化为实时流。 下面是一个小的 demo: 我们这里面用到的广播流 pageStream,它其实是定义了一个页面 ID 和页面的名称。对于非广播流 probeStream,它是一个 json 格式的 string,里面包含了设备 ID、页面的 ID、还有时间戳,我们可以理解成用户在设备上做 PV 访问的行为记录。 整个实现来看,就是遵循上述4个步骤: 第1步骤是要定义广播的状态描述符。 第2步骤我们这里去生成 broadCastStream。 第3步骤的话我们就需要去把两个 stream 做 connect。 第4步最主要的一个环节就是需要实现 BroadcastProcessFunction。第1个参数是我们的 probeStream,第2个参数是广播流的数据,第3个参数就是我们的要输出的数据,可以看到主要的数据处理逻辑是在processElement里面。 在数据处理过程中,我们首先通过 context 来获取我们的 broadcastStateDesc,然后解析 probe 流的数据,最终获取到对应的一个 pageid。接着就在我们刚才拿到了 state 里面去查询是否有同样的 pageid,如果能够找到对应的 pageid 话,就把对应的 pagename 添加到我们整个 json stream 去做输出。 2.1.4 Temporal table function join 介绍完了上面的方法以后,还有一种比较重要的方法是用 Temporal table function join。首先说明一下什么是 Temporal table?它其实是一个概念:就是能够返回持续变化表的某一时刻数据内容的视图,持续变化表也就是 changingtable,可以是一个实时的 changelog 的数据,也可以是放在外部存储上的一个物化的维表。 它的实现是通过 UDTF 去做 probe 流和 Temporal table 的 join,称之 Temporal table function join。这种 join 的方式,它适用的场景是维度数据为 changelog 流的形式,而且我们有需要按时间版本去关联的诉求。 首先来看一个例子,这里使用的是官网关于汇率和货币交易的一个例子。对于我们的维度数据来说,也就是刚刚提到的 changelog stream,它是 RateHistory。它反映的是不同的货币相对于日元来说,不同时刻的汇率。 第1个字段是时间,第2个字段是 currency 货币。第3个字段是相对日元的汇率,然后在我们的 probe table 来看的话,它定义的是购买不同货币的订单的情况。比如说在 10:15 购买了两欧元,该表记录的是货币交易的一个情况。在这个例子里面,我们要求的是购买货币的总的日元交易额,如何通 Temporal table function join 来去实现我们这个目标呢? 第1步首先我们要在 changelog 流上面去定义 TemporalTableFunction,这里面有两个关键的参数是必要的。第1个参数就是能够帮我们去识别版本信息的一个 time attribute,第2个参数是需要去做关联的组件,这里的话我们选择的是 currency。 接着的话我们在 tableEnv 里面去注册 TemporalTableFunction 的名字。 然后我们来看一下我们注册的 TemporalTableFunction,它能够起到什么样的效果。 比如说如果我们使用 rates 函数,去获取11:50的状态。可以看到对于美元来说,它在11:50的状态其实落在11:49~11:56这个区间的,所以选取的是99。然后对于欧元来说,11:50的时刻是落在11:15和12:10之间的,所以我们会选取119这样的一条数据。它其实实现的是我们在一刚开始定义的 TemporalTable 的概念,能够获取到 changelog 某一时刻有效数据。定义好 TemporalTableFunction 以后,我们就要需要使用这个 Function,具体实现业务逻辑。 大家注意这里需要去指定我们具体需要用到的 join key。比如说因为两个流都是在一直持续更新的,对于我们的 order table 里面 11:00 的这一条记录来说,关联到的就是欧元在 10:45 这一条状态,然后它是 116,所以最后的结果就是 232。 刚才介绍的就是 Temporal table function join 的用法。 2.1.5 维表 join 的对比 然后来整体回顾一下在维表 join 这块,各个维度 join 的一些差异,便于我们更好的去理解各个方法适用的场景。 在实现复杂度上面的:除了热存储关联稍微复杂一些,其它的实现方式基本上复杂度是比较低的。 在维表数据量上:热存储关联和 Temporal table function join 两种方式可以支持比较多的数据量。其它的方式因为都要把维表加载到内存,所以就受限内存的大小。 在维表更新频率上面:因为预加载 DB 数据到内存和 Distributed Cache 在重新更新维表数据的时候都需要重启,所以它们不适合维表需要经常变更的场景。而对于广播维表和 Temporal table function join 来说,可以实时的更新维表数据并反映到结果,所以它们可以支持维表频繁更新的场景。 对维表更新实时性来说:在广播维表和 Temporal table function join,它们可以达到比较快的实时更新的效果。热存储关联在大部分场景也是可以满足业务需求的。 在维表形式上面:可以看到第1种方式主要是支持访问 DB 存储少量数据的形式,Distributed Cache 支持文件的形式,热存储关联需要访问 HBase 和 Tair 等等这种热存储。广播维表和 Temporal table function join 都需要维度数据能转化成实时流的形式。 在外部存储上面:第1种方式和热存储关联都是需要依赖外部存储的。 在维表 join 这一块,我们就先介绍这几个基本方法。可能有的同学还有一些其他方案,之后可以反馈交流,这里主要提了一些比较常用的方案,但并不限于这些方案。 2.2 双流 join 首先我们来回顾一下,批处理是怎么去处理两个表 join的?一般批处理引擎实现的时候,会采用两个思路。 一个是基于排序的 Sort-Merge join。另外一个是转化为 Hash table 加载到内存里做 Hash join。这两个思路对于双流 join 的场景是否还同样适用?在双流 join 场景里面要处理的对象不再是这种批数据、有限的数据,而是是无穷数据集,对于无穷数据集来说,我们没有办法排序以后再做处理,同样也没有办法把无穷数据集全部转成 Cache 加载到内存去做处理。 所以这两种方式基本是不能够适用的。同时在双流 join 场景里面,我们的 join 对象是两个流,数据也是不断在进入的,所以我们 join 的结果也是需要持续更新的。 那么我们应该有什么样的方案去解决双流 join 的实现问题?Flink 的一个基本的思路是将两个流的数据持续性的存到 state 中,然后使用。因为需要不断的去更新 join 的结果,之前的数据理论上如果没有任何附加条件的话是不能丢弃的。但是从实现上来说 state 又不能永久的保存所有的数据,所以需要通过一些方式将 join 的这种全局范围局部化,就是说把一个无限的数据流,尽可能给它拆分切分成一段一段的有线数据集去做 join。 其实基本就是这样一个大的思路,接下来去看一下具体的实现方式。 2.2.1 离线 join vs. 实时 join 接下来我们以 inner join 为例看一下,一个简单的实现的思路: 左流是黑色标出来的这一条,右流是蓝色标出来的,这条两流需要做 inner join。首先左流和右流在元素进入以后,需要把相关的元素存储到对应的 state 上面。除了存储到 state 上面以外,左流的数据元素到来以后需要去和右边的 Right State 去做比较看能不能匹配到。同样右边的流元素到了以后,也需要和左边的 Left State 去做比较看是否能够 match,能够 match 的话就会作为 inner join 的结果输出。这个图是比较粗的展示出来一个 inner join 的大概细节。也是让大家大概的体会双流 join 的实现思路。 2.2.2 Regular join 我们首先来看一下第1类双流 join 的方式,Regular join。这种 join 方式需要去保留两个流的状态,持续性地保留并且不会去做清除。两边的数据对于对方的流都是所有可见的,所以数据就需要持续性的存在state里面,那么 state 又不能存的过大,因此这个场景的只适合有界数据流。它的语法可以看一下,比较像离线批处理的 SQL: 在上图页面里面是现在 Flink 支持 Regular join 的一些写法,可以看到和我们普通的 SQL 基本是一致的。 2.2.3 Interval join 在双流 join 里面 Flink支持的第2类 join 就是 Interval join 也叫区间 join。它是什么意思呢?就是加入了一个时间窗口的限定,要求在两个流做 join 的时候,其中一个流必须落在另一个流的时间戳的一定时间范围内,并且它们的 join key 相同才能够完成 join。加入了时间窗口的限定,就使得我们可以对超出时间范围的数据做一个清理,这样的话就不需要去保留全量的 State。 Interval join 是同时支持 processing time 和 even time去定义时间的。如果使用的是 processing time,Flink 内部会使用系统时间去划分窗口,并且去做相关的 state 清理。如果使用 even time 就会利用 Watermark 的机制去划分窗口,并且做 State 清理。 下面我们来看一些示例: 上图这个示例用的数据是两张表:一个是订单表,另外一个是配送表。这里定义的时间限定是配送的时间必须在下单后的4个小时内。 Flink 的作者之前有一个内容非常直观的分享,这里就直接复用了他这部分的一个示例: 我们可以看到对于 Interval join 来说:它定义一个时间的下限,就可以使得我们对于在时间下限之外的数据做清理。比如在刚才的 SQL 里面,其实我们就限定了 join 条件是 ordertime 必须要大于 shiptime 减去4个小时。 对于 Shipments 流来说,如果接收到12:00 点的 Watermark,就意味着对于 Orders 流的数据小于 8:00 点之前的数据时间戳就可以去做丢弃,不再保留在 state 里面了。 同时对于 shiptime 来说,其实它也设定了一个时间的下限,就是它必须要大于 ordertime。对于 Orders 流来说如果接收到了一个10:15点的 Watermark, 那么 Shipments 的 state 10:15 之前的数据就可以抛弃掉。 所以 Interval join 使得我们可以对于一部分历史的 state 去做清理。 2.2.4 Window join 最后来说一下双流 join 的第3种 Window join:它的概念是将两个流中有相同 key 和处在相同 window 里的元素去做 join。它的执行的逻辑比较像 Inner join,必须同时满足 join key 相同,而且在同一个 window 里元素才能够在最终结果中输出。具体使用的方式是这样的: 目前 Window join 只支持 Datastream 的 API,所以这里使用方式也是 Datastream 的一个形式。可以看到我们首先把两流去做 join,然后在 where 和 equalTo 里面去定义 join key 的条件,然后在 window 中需要去指定 window 划分的方式 WindowAssigner,最后要去定义 JoinFunction 或者是 FlatJoinFunction,来实现我们匹配元素的具体处理逻辑。 因为 window 其实划分为三类,所以我们的 Window join 这里也会分为三类: 第1类 Tumbling Window join:它是按照时间区间去做划分的 window。 可以看到这个图里面是两个流(绿色的流年和黄色的流)。在这个例子里我们定义的是一个两毫秒的窗口,每一个圈是我们每个流上一个单个元素,上面的时间戳代表元素对应的时间,所以我们可以看到它是按照两毫秒的间隔去做划分的,window 和 window 之间是不会重叠的。 对于第1个窗口我们可以看到绿色的流有两个元素符合,然后黄色流也有两个元素符合,它们会以 pair 的方式组合,最后输入到 JoinFunction 或者是 FlatJoinFunction 里面去做具体的处理。 第2类 window 是 Sliding Window Join:这里用的是 Sliding Window。 sliding window 是首先定义一个窗口大小,然后再定义一个滑动时间窗的大小。如果滑动时间窗的大小小于定义的窗口大小,窗口和窗口之间会存在重叠的情况。就像这个图里显示出来的,红色的窗口和黄色窗口是有重叠的,其中绿色流的0元素同时处于红色的窗口和黄色窗口,说明一个元素是可以同时处于两个窗口的。然后在具体的 Sliding Window Join 的时候,可以看到对于红色的窗口来说有两个元素,绿色0和黄色的0,它们两个元素是符合 window join 条件的,于是它们会组成一个0,0的 pair。 然后对于黄色的窗口符合条件的是绿色的0与黄色0和1两位数,它们会去组合成0,1、0,0和1,0两个pair,最后会进入到我们定义的 JoinFunction 里面去做处理。 第3类是 SessionWindow join:这里面用到的 window 是 session window。 session window 是定义一个时间间隔,如果一个流在这个时间间隔内没有元素到达的话,那么它就会重新开一个新的窗口。在上图里面我们可以看到窗口和窗口之间是不会重叠的。我们这里定义的Gap是1,对于第1个窗口来说,可以看到有绿色的0元素和黄色的1、2元素都是在同一个窗口内,所以它会组成在1 ,0和2,0这样的一个pair。剩余的也是类似,符合条件的pair都会进入到最后 JoinFunction 里面去做处理。 整体我们可以回顾一下,这一节主要是介绍了维表 join 和双流 join 两大类场景的 Flink ETL 实现方法。在维表 join 上主要介绍了预加载维表、热存储关联、广播维表、Temporal table function join 这4种方式。然后在双流 join 上我们介绍了 Regular join、Interval join 和 Window join。 原文链接 本文为阿里云原创内容,未经允许不得转载。

优秀的个人博客,低调大师

每日一博 | BaikalDB 技术实现内幕(二)-- 索引实现

本系列文章主要介绍HTAP数据库BaikalDB的技术实现细节。 作者介绍:黄文亮,百度商业平台研发部资深研发工程师,主要负责BaikalDB索引能力,性能优化等方向的研发工作。 欢迎关注 Star github.com/baidu/BaikalDB 国内加速镜像库gitee BaikalDB系统简介 BaikalDB是一个分布式可扩展的存储系统,兼容MySQL协议,整个系统的架构如下图所示: BaikalStore 负责数据存储,数据分区按region组织,三个Store的三个region形成一个 Raft-group 实现三副本,多实例部署,Store实例宕机可以自动迁移 Region数据; BaikalMeta 负责元信息管理,包括分区,容量,权限,均衡等, Raft 保障的3副本部署,Meta 宕机只影响数据无法扩容迁移,不影响数据读写; BaikaDB 负责前端SQL解析,查询计划生成执行,无状态全同构多实例部署,宕机实例数不超过 qps 承载极限即可; Baikal 命名由来 贝加尔湖(Baikal)是世界上最大的淡水湖,相当于北美洲五大湖水量的总和,超过整个波罗的海水量,淡水储量占全球20%以上。西伯利亚总共有336条河流注入贝加尔湖。冬天的贝加尔湖畔,淡蓝色的冰柱犹如分布式数据库一列列的数据密密麻麻但是有井然有序,令人惊艳。 BaikalDB索引介绍 BaikalStore 对数据按照主键进行 range 划分形成多个 region,region 按行存的形式将数据组织为主键索引及二级索引,这些主键索引、二级索引编码为key、value 值写入本地 Rocksdb 中。 BaikalDB 索引主要包含以下五种,其中主键索引存储主表数据的所有字段,二级索引存储主键字段。 主键索引(PRIMARY KEY) 主键索引是 BaikalDB 针对主键创建的索引,主键 key 值必须唯一。BaikalDB 使用主键值将整个表进行 range 划分为多个 region 分区。 局部二级索引 普通索引(KEY) 唯一索引(UNIQUE KEY) 全局二级索引(GLOBAL KEY) 倒排索引(FULLTEXT KEY) 本文以如下 schema 为例,对各索引类型的编码进行一一介绍。 CREATE TABLE example ( field0 bigint(20) NOT NULL , field1 bigint(20) NOT NULL DEFAULT '0' , field2 bigint(20) NOT NULL DEFAULT '0' , field3 bigint(20) NOT NULL DEFAULT '0' , field4 bigint(20) NOT NULL DEFAULT '0' , field5 varchar(20) NOT NULL DEFAULT '', PRIMARY KEY (field0), KEY index2 (field2), UNIQUE KEY index3(field3), KEY GLOBAL index4(field4), FULLTEXT KEY index5(field5) ) 主键索引 主键:PRIMARY KEY (field0) 主键索引将主键字段与一行数据做映射,并最终形成一个按主键 key 排序内存/磁盘结构,方便用户快速通过主键 key 进行定位或扫描。 主键 key 值包含64 Bit region_id、64 Bit index_id、primary key 值组成。其中 region_id 为 region 的标识 id,在 region 生成时指定。index_id 为的索引标识 id, 在表创建时生成。在该示例中,primary key 值为字段 field0 的值,为64 Bit。 主键 value 值为表 schema 对应动态 protobuf 反序列化之后的值。 上述 schema 对应的动态 protobuf 结构为: message example { optional int64_t field0 = 0; optional int64_t field1 = 1; optional int64_t field2 = 2; optional int64_t field3 = 3; optional int64_t field4 = 4; optional string field5 = 5; }; 局部二级索引 所谓局部二级索引,就是主表数据和索引数据在同一分片上,每个分片就包含了该分片上信息的全部索引。局部二级索引又分为普通二级索引、唯一二级索引。 二级索引将二级索引字段与主键 key 做映射,可以加速二级索引字段的查找或扫描。 局部索引 索引:KEY index2 (field2) key 值 包含64 Bit region_id、 64 Bit index_id、8 Bit 空字节、 index key值、primary key 值组成。其中 index key 值为 字段 field2 的值,为 64 Bit。(注:其中8 Bit 空字节已废弃,不体现在索引使用示例小节中。) value 值 为空串 "" 局部唯一索引 唯一索引:UNIQUE KEY index3(field3) key 值 包含64 Bit region_id、64 Bit index_id、8 Bit 空字节、 index key 值。(注:其中8 Bit 空字节已废弃,不体现在索引使用示例小节中。) value 值为 64 Bit primary key 的值。 全局二级索引: GLOBAL KEY index4(field4) 所谓全局二级索引,就是主表数据和索引数据不在同一个分片上,所有分片的二级索引数据集中存储。 相对于局部二级索引,全局二级索引的优势是:在没有具体分片信息,利用二级索引反查主键时,局部二级索引需要扫描所有分片,而全局二级索引只需要扫描单分片。 全局二级索引也分为普通索引、唯一索引,编码规则与局部索引一致。 倒排索引: FULLTEXT KEY index5(field5) BaikalDB 支持倒排索引,主要用来进行快速的全文检索。BaikalDB 倒排索引主要涉及索引构建及检索: 构建:将正排字段切词为一或多个 term。构建 term 的有序倒排拉链,并按照格式进行存储。 检索:根据检索词,对多个倒排拉链进行布尔查询。 下面对上述两个步骤,进行示例说明。 切词:下图为以field5作为倒排索引字段的切词示例: 倒排存储:将所有正排按照词(term)粒度进行合并,建立倒排索引,并使用 Rocksdb 进行存储。其中 key 值为 64 Bit region_id、64 Bit index_id、分词后的 term ,value 值为排序之后的主键键值。(下图为简化模型,BaikalDB中实际使用分层存储) 上述示例中 term 的倒排拉链的存储格式如下: 倒排检索:根据检索词对多个倒排拉链进行布尔逻辑检索。上例中检索词为 “倒排|索引”、“测试&倒排” 检索词的多排序表的合并结果如下图所示。其中“倒排|索引”检索词,将“倒排”及"索引"的倒排拉链进行并运算;“测试&倒排” 检索词,将“测试”及“倒排”的倒排拉链进行与运算。 索引使用示例 为了更好的说明 BaikalDB 中的索引使用方式,下面给出4个示例,分别展示在数据的写入及读取过程中,主键索引、二级索引、全局二级索引所起的作用。 示例一:insert sql : insert into example values (0,1,2,3,4,"测试倒排") 整体流程 根据表 example 的 schema 信息,生成动态 message,并设置各 field 值:{"field0" : 0, "field1" : 1, "field2":2, "field3" : 3, "field4":4, "field5":"测试倒排"} 根据主键值(field0=0),定位到目标 region 分片。 将动态 message 序列化之后,传给目标 region 分片。 目标 region 分片分别对各索引生成对应格式的 kv 值,写入底层rocksdb。 将全局索引写入全局索引分片。 完成写入 流程图 示例二:select(不使用二级索引) 不使用索引 sql:select * from example where field4 = 4; 整体流程: 根据sql,生成执行计划:因 field4 字段不在二级索引中,只能遍历主索引,并进行过滤。 因没有主键条件,向所有 region 分片广播执行计划。 scan node 执行过程:在所有 region 分片中,编码主键前缀 key 值:(region_id、index_id),对 Rocksdb 中所有主键进行顺序扫描。 filter node 执行过程:对扫描出的所有主键 kv 中, 使用动态生成 protobuf 对 value 值进行反序列化,并提取出 field4 值。对解析出的 field4 值进行过滤,获取满足条件(field4 = 4)的结果。 组装各 region 分片中的返回值,打包返回给用户。 流程图 示例三:select(使用二级索引) 使用索引 sql:select * from example where field2 = 2; 整体流程 根据sql,生成执行计划:使用索引 index2 进行扫描。 因没有主键条件,向所有 region 分片广播执行计划 scan node 执行过程:在 region 分片中,编码 index2 的 key 值(region_id、index_id、field2、primay_key),在 Rocksdb 中前缀扫描。 在 Rocksdb 中 key 中,提取出 field0 值,构造主键 key,反查主键,解析所有字段。 组装各 region 分片中的返回值,打包返回给用户。 流程图 示例四:select(使用全局二级索引) 使用索引 sql:select * from example where field4 = 4; 整体流程 根据sql,生成执行计划:首先使用全局索引 index4 进行扫描,查出主键值之后,扫描主键值对应的分片。 全局索引 scan node 执行过程:根据全局索引字段 feild4 ,定位全局索引分片,发送请求获取主键键值。 根据主键键值,定位 region 分片信息。 主键索引 scan node 执行过程:在 region 分片中,编码主键 index0 的 key 值(region_id、index_id、field0),在 Rocksdb 中前缀扫描。 组装各 region 分片中的返回值,打包返回给用户。 示例分析 写入(insert)场景 可以很好的利用 region 分片特性,只对部分 region 进行写入操作。 查询(select)场景 局部二级索引:使用恰当的索引对整体性能的提升有很大帮助。如示例2中,在没有二级索引的情况下,需要扫描所有主键 kv;然后进行 protobuf 反序列化;最后进行字段过滤。而在示例3中,只需要扫描部分二级索引。 全局二级索引:在示例3中,虽然在单分片中,性能较好,但因为没有主键信息,所以需要广播所有分片,进行查询。考虑到较大的表可能有多达万级的分片数量,所以整个开销还是较大的。这种场景下可以使用全局二级索引,根据索引字段查出主键值,然后只需要查询已知主键值对应的分片即可,而不需要广播所有分片。 总结 本文对 BaikalDB 中的各种索引类型的编码方式、使用方法进行了简要的说明。如果你有兴趣继续深入了解,欢迎加入https://github.com/baidu/BaikalDB。

优秀的个人博客,低调大师

每日一博 | 金融科技的碎片化思考(上)

从事金融科技行业已久,也一直想写写金融科技相关的文字,又惶恐间,深觉如此大的话题hold不住而贻笑大方。偶然翻开束之高阁多年的《蚂蚁金服-从支付宝到新金融生态圈》,惊喜之余亦将自己碎片化的那点浅识愚见串联起不少。行文仓促,些许是经历,些许是总结,些许是念头,唯恐扭头就忘,权当流水记账给自己看也好。 又不是何样大家,可以著书警示世人,无须给自己压力,写到哪儿便是哪儿吧,看官您也担待一二。 金融是什么?科技是什么?合到一起的金融科技又是什么?让我们剥开浮躁的表面直指内心。 科技是第一生产力 先说科技,也就是科学技术,是第一生产力。科学是理论,技术是应用。作为生产力,科技理论上可以应用于人类已知或者未知的所有领域,而金融领域不过是科技可应用的领域之一而已。当然可不仅仅限用“应用”,还可以“驱动”“赋能”“普惠”“整合”“协同”、“数字化”“互联网化”“智能化”“生态化”、以及“金融3.0”“VUCA4.0”“工业5.0”“通证经济”“数字经济”“ABCD”等等 (金融科技领域不会用词,OUT一半!)。 对于大国来说,军事和金融是两个最最核心的支撑力量。而通常来说,最尖端的科技也是始于这两个领域。比如计算机最早是发明出来计算弹道的,手机也是战地移动电话发展而来。诞生于08年金融危机后并不断火热的比特币,其底层的区块链技术,也因为它独特的去中心化、不可篡改、智能合约等特性,逐渐进入了人们的视野。 金融的本质 金融就是价值的流通。而金融的本质,个人还是推崇黄老的那个精准表述,说到底就是信用、杠杆和风险三个词。此刻你可掩卷沉思一番,是否就是这么回事? 支付宝,担保交易模式的发明者,底层逻辑就是信用,依托于这个信用体系搭建出它的许多上层应用,如花呗、芝麻分、免押金产品...等等。吴晶妹教授有个著名的信用三维论来说明信用的构成,即诚信度,合规度,践约度。诚信度一般说的是信用主体的道德文化、行为准则等基本的诚信意识;合规度指信用主体在社会活动中遵守社会行政管理规定、行业规则、民间惯例等的水平与能力;践约度即言出必行,表现为遵守交易规则并履约的能力,比如天经地义的借钱还钱。 有些人对杠杆比较陌生,在我们日常生活中,其实可以把杠杆简单理解为负债。你的房贷是杠杆,手机分期是杠杆,借钱炒股(融资融券)也是杠杆...杠杆会放大风险预期和投资结果(无非更多收益或者更多亏损),以物理上的杠杆撬地球来形象的类比,就是以小资金博大收益,做好了是投资做坏了就是投机。所有金融危机的共同之处就是杠杆率过高(如2008年的美国次贷危机)。风险就很直白了,信用风险、欺诈风险、政策风险、流动性风险等等,风险管理和控制一直是金融业的重中之重。 诺贝尔经济学奖得主、耶鲁经济学教授罗伯特·希勒曾提出过这样的理念:金融不只是为了赚钱,而是为了推动实现良好(见仁见智的形容词)的社会。现下却是,金融和铜臭味的金钱基本是划等号的。 金融现状体验 曾几何时,中国老太太和美国老太太的故事,影响了多少涉世未深少男少女的消费观。故事续集无须再编写,信用社会的美国在2008年用它的次贷危机狠狠的教训了一票“透支未来”的青春们。世事好轮回,苍天饶过谁。金融玩家总会找个时间,卷土重来、改头换面、千方百计地拿走你兜里的钱。 历史从未改变,从学校毕业后刚工作的你,自从有了信用卡、开通了花呗或者白条,月光、下月光甚至半年光是否成了常态,刚发的工资手里还没捂热,就得先还债去?! 我的年轻时代买个昂贵点的手机,得不吃不喝攒好几个月。也庆幸那时候的新手机发布不像现在这么频繁,不然等攒好钱再去买的那款几个月已经变成老款了吧。现在上万的iPhone,银行等金融机构直接给你免息的半年或者一年的分期产品,每个月还千把块钱的负担不成问题。看似这些金融机构不挣钱赚吆喝,且不说他们可以从商家那边收取佣金,用户似乎也着实赚了便宜,那这个金融产品到底在玩什么?抛开那些新兴金融机构的获客营销因素,金融玩家们提前半年甚至一年锁定了你口袋里的那部分钱,等当你口袋里没钱的时候,可以让你选择继续账单分期,再次加长你的借贷周期,而且这次当然就不是免费的了。某种程度上这加快了消费市场的产品更新速度,PUSH你换新的手机、新的相机、新的笔记本。还有更快的,贷款没还完,手机被偷了...(我身边可不止一例) 如果你的收入只是用来还贷,那必然没有额外资金投往投资理财渠道,你的资产其实就是在缩水。 有人开始动歪脑筋了...分期的产品想办法套现去买个高息理财... 虽然这点钱也挣不了几个铜板的利差,但,整个社会的金融杠杆就是这么被加上去了! 其实这里最恐怖的是什么呢?很多消费者在不断透支的行为中迟钝于金额数字的变化,透支第一笔无压力后继而透支第二笔第三笔,透支成为了习惯,然后日常收入演变成自动还款,直到入不敷出,个人资金断裂。这是一个可怕的潜移默化的消费行为养成。在这款金融养成类游戏里,你成了那个“金融宠物”。 频繁的P2P爆雷让多少投资者血本无归,当余额宝成为一个现象级的理财产品,大大拉低了普通民众理解和进入理财的门槛之后,各种各样的高息且打着银行、保本旗号的理财产品如雨后春笋般出现,人们蜂拥而至,一如抢购黄金的中国大妈。中国人的文化原本是相对保守的文化,在消费观上就可见一斑,为何现在整个社会的消费观都开始变得越来越激进?理财观也随之激进起来了呢?高收益等于高风险,捡钱的事给你你敢要,只能说明金融理财市场的参与者,已经成为了一群群体无意识的“乌合之众”(俗称韭菜)。 若然金融玩家们就是想不断的吸食这些“乌合之众”,那这些玩家就是水蛭,就是要被国家打击和监管的,这不是金融该有的样子。把合规、正确的金融服务提供给社会群体,让他们明确的知晓风险和收益情况,才是正道。 FinTech Or TechFin 马大大烙印下的蚂蚁金服在金融变革上一马当先,造词功力那更是一流。在金融和科技谁先谁后的问题上,很多人或组织还没搞清楚的时候,蚂蚁已经提出了TechFin的概念。 在这之前,互联网科技从业人员多以变革者甚至颠覆者姿态切入金融领域,看不起传统金融的那一套,一门心思让科技驱动金融、颠覆金融。忽然有一天,传统金融准备联合起来(打小报告也算)对这帮不知天高地厚的“变革者们”动刀了,“变革者们”才发现自己完全不够个儿,主要表现在比如对风控的无知、对政策的漠视以及对金融产品设计的忽视等等,这是其一。其二,金融业可追溯到公元前,如此悠久的历史让金融体系的内涵和外延如此庞大,科技想一口吃下来,不啻于痴人说梦。不懂金融却宣称颠覆金融,多可怕。 其实,科技并没有改变金融的本质,最多改变了金融信息传递的速度、距离、时间等等因子。科技可以重塑金融的形态,助力金融更好的服务于长尾客户,最后两者你中有我,我中有你,互相融合才是终态。所以Fin & Tech谁先谁后,孰优孰劣,Who cares! 那么,互联网金融科技公司到底给社会带来了什么呢?在很多人眼里这些公司不过是金融水蛭,附着在金融体系这条大腿上不断吸食穷人的那点鲜血,没有任何价值。这观点当然过于偏激了,让我们辩证一点来看。金融科技在很多交易场景里带来了许多便利性,也可以给资产和资金搭建出更快速安全的平台(比如余额宝、P2P、助贷平台、智能投顾等)。要注意的是,随着资金和资产的瞬息转换,这给金融监管提出了难度更高的命题。资产证券化、债权转移、洗钱等等都藏在这海量的金融交易中,如何监察呢?在很多金融交易场景中,传统金融机构沦为了金融科技公司背后的资金方,海量交易行为和金融数据都被金融科技公司给截留了,传统金融不可能甘心藏于幕后,看着金融科技起高楼宴宾客,即便自己转身较慢,但一旦转过身可能就不会给金融科技什么机会了。 金融科技的出路 上文也或多或少提到了,科技颠覆的不是金融的内核,而是金融的外在形态。金融也不仅仅是只为富人或者大型企业服务,也应该为更多的普通人和小企业服务,所谓的普惠金融就在于此。我理解金融科技的出路就是,用科技让金融更好地服务和优化商业活动和经济生活。二维码支付、人脸支付、征信链,小微贷、消费贷、智能投顾...这些技术和产品就在我们身边,服务于支付、信贷和理财等场景。 让我预测金融科技未来的话,内核一定是“服务”二字,只要服务好社会助力好金融,收益会随之而来都不需要刻意逢迎。任何只盯着如何用科技在金融行业赚钱的组织或个人,不出意外最后都得吐出来。在合规监管体系下的金融科技必须要看清楚自己的位置,与天斗其乐无穷,与金融斗死无全尸。 接下来就是考虑如何切入金融“服务”这件事上来。更好的服务切入通常意味着目前存在糟糕的体验或者痛点,比如基于社交网络的反欺诈,传统的关系型数据库在两度的社交网络中表现得已经捉襟见肘,无用说实现更多的度;图像识别技术给远程开户、活体检测提供了比人类肉眼更快更精准的鉴别能力;决策引擎的出现给风控业务人员更灵活、更安全以及性能更强劲的风控基础工具;区块链技术给了征信透明、资产溯源以及清结算等提供了更多的思路... 发现了么,这些技术解决的问题基本都是金融行业固有的一些痛点环节或者糟糕体验,很长一段时间内这个方向不会有太大变化。恕我能力有限,不排除真的有颠覆性的黑科技出现,但我想它一定是要举全社会之力才能实现的吧(比如鼓吹了很久很久的区块链征信)。 以上,只是金融科技从业者的喃喃自语。 - END - 往期精彩回顾 -一文看懂风控模型(超完整) - 架构师那些不能碰的禁忌 -智者观势 | 2020的十大技术趋势 -一个价值10亿的教训 - 我也曾对架构师的力量一无所知 - 技术的尽头,彼岸花开 -金融科技,诸神黄昏 本文分享自微信公众号 - 曲水流觞TechRill(TechRill)。如有侵权,请联系 support@oschina.cn 删除。本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

优秀的个人博客,低调大师

每日一博 | DevSecOps 在百度的实践

本文将从传统SDL开始,介绍百度从SDL到DevSecOps的演进历程。全文涉及SDL的痛点、DevSecOps建设初衷、实践形式、落地思路,以及落地后的效果与收益,也会介绍DevSecOps在云原生时代的探索思路与落地场景。如果你正准备或者已经参与到企业DevSecOps建设的相关工作中,这篇文章或许能够给你的工作带来一些启发。 一、轻量级SDL,百度的前DevSecOps时代 作为一家大型互联网公司,百度具备着所有大型公司和互联网公司的典型特点,业务体系繁多、业务数量庞大,业务迭代迅速。 在百度内部,业务研发模式有别于传统的SDLC模型,更接近于DevOps模式,CI/CD工具集成和自动化程度高,产品迭代频次多、周期短。 面对这样的业务研发场景,传统通过输出人力到业务团队,全流程跟进和解决业务研发生命周期的安全问题的方式已经不再适合。安全团队不能,也不可能将人力覆盖到所有业务。因此,安全团队势必需要构建通用性的产品安全基础设施,将其嵌入到产品研发流程中,然后配合重点业务的小范围安全评估,来实现高可用、高自动化的软件研发生命周期安全保障。 在百度,我们将这种方式称之为轻量级SDL,即通过少量的人力投入,以高自动化、高CI/CD集成的方式解决业务产品的安全问题。在轻量级SDL建设初期,我们根据实际业务场景,构建了百度的自动化漏洞检测系统,并将其嵌入到业务测试上线流程中,具体图示如下: 通过轻量级SDL建设,我们以不足10人的团队规模,支撑百度80%以上业务的上线前安全检查,并在过去的几年时间,保证百度线上业务安全问题数量每年降低30%以上。 当然,上图中描述的轻量级SDL架构也存在一些问题和痛点。 虽然通过在测试上线阶段嵌入了自动化安全测试流程,能够帮助业务在上线之前提前发现安全问题,降低安全风险。但是由于业务团队相对缺少安全意识和视野,经常误认为保障业务安全只是安全团队的工作,认为自动化安全测试是安全团队给业务团队增加的额外负担。在这种情况下,业务团队在面对自动化安全测试流程检查出的问题时,也常常是case by case的解决,并没有深层次的解决安全意识和安全编码相关的问题。 对此,我们整理了轻量级SDL初期建设完成后亟待解决的一些问题,并决心解决: 自动化安全工具很难覆盖到产品的需求设计阶段。 安全只覆盖了产品研发的编码和测试阶段,并没有实现全链条覆盖。 绝大多数产品的安全措施集中在测试阶段,流程滞后、修复成本高、效率低。 仅通过自动化安全工具的嵌入,很难与业务团队建立安全协同机制。 非常规型安全漏洞,很难在测试阶段进行自动化发现和收敛。 二、构建DevSecOps的初衷 针对上述问题,我们期望对轻量级SDL架构进一步完善,建设一个产品研发全流程覆盖、高自动化集成、强调安全与业务协同的业务安全保障框架。 我们期望通过产品研发全流程的安全措施建设,持续提升业务团队相关人员的安全意识、安全编码习惯以及对安全场景的理解,让业务在产品研发的各个阶段都能实现高效、安全、可靠的交付,将安全漏洞和缺陷消灭在问题的根源。 这些都与DevSecOps的理念不谋而合,所以我们决定在轻量级SDL的基础上,构建百度的DevSecOps。 三、百度DevSecOps实践 我们在建设DevSecOps时,主要侧重以下方面: 打造高自动化的产品安全工具链:利用产品安全工具在产品研发的各个阶段进行自动化漏洞挖掘,快速发现漏洞的同时确保不会降低研发效率 在全公司范围内的落地:设计普适性的、能够覆盖百度所有业务并真正落地的DevSecOps框架 DevSecOps安全运营:对各个产品安全工具进行安全能力建设与工程化运营,并支持特定业务线的定制化需求 云原生场景的探索:在云原生基础架构变革大趋势下,讨论百度DevSecOps与云原生场景的融合与落地措施。 后边的章节会按照这个顺序逐一阐述。 3.1产品安全工具链打造 业务安全保障的核心工作之一就是降低线上漏洞数量。在DevSecOps的建设中,想要大幅度降低线上漏洞数量,其核心是构建和利用好各种自动化漏洞发掘工具,并将其与CI/CD进行自动化集成,确保执行漏洞发掘的时机准确、及时,并且不会影响研发效率。 在我们的解决方案中,主要涉及到DAST、SAST、IAST、RASP等工具的设计与实现,感兴趣的同学可以阅读之前发过的相关文章: DAST 分布式Web漏洞扫描服务建设实践系列——扫描架构演进及要点问题解决实践 分布式Web漏洞扫描服务建设实践—衡量指标及解决实践(2) SAST 企业级自动化代码安全扫描实战 构建企业级研发安全编码规范 IAST/FAST 灰盒自动化漏洞挖掘实践 RASP 开源应用运行时自我保护解决方案- OpenRASP 3.2公司范围落地实践 3.2.1总体落地思路 在百度,产品研发流程被抽象成「需求」、「开发」、「代码准入」、「测试」、「上线&验证」五个阶段。每个阶段都有完善且严格的规范和要求,例如在代码准入阶段,要求正式提交的代码必须严格遵循百度代码风格规范,否则不允许提交代码。这些规范保证了百度的产品能够优质、高效和稳定的交付,我们称之为研发工程规范性模型,下文简称工程规范性模型。 百度工程规范性模型将产品研发各个阶段的规范和措施的完成度量化为分数,以产品和代码仓库的维度进行统计和公示,并在公司层面建立了工程规范性评分基准线。 我们在思考如何设计和落地DevSecOps在各个研发阶段的安全能力时,发现DevSecOps的内核与工程规范性模型是高度相似的,都是通过在产品研发的各个阶段设计规范、工具、检查,来提升研发效率、产品质量、工程师素养。 再一次的不谋而合,促使我们决定依托于百度工程规范性模型构建百度的DevSecOps模型,推动DevSecOps工具链与相关规范的落地实施,并借助于百度工程规范实现快速推广DevSecOps到全公司的效果。 百度工程规范性模型要求所有接入的规范、工具、方法都要具备高自动化以及高CI/CD集成的能力,这一点实际我们在SDL时代就已经完成。所以在落地DevSecOps时,我们只需要按照该模型的标准,将各项产品安全工具、产品安全措施转换为可量化、分步实施的安全检查项。 通过将安全检查项合理放置在产品研发的各个阶段中,我们实现了研发全链条覆盖: 同时得益于高度自动化的安全工具链支撑,虽然我们在研发流程中深度嵌入了很多安全检查项,但是依然可以满足DevOps时代产品快速迭代的需求。例如,我们将第三方高危组件、安全编码规范等安全检查项嵌入到代码准入阶段,自动化扫描任务可以在分钟级完成,完全不会影响代码的正常提交。 下面的章节,我们会介绍在DevSecOps落地过程中,在各个研发阶段涉及到的一些具体安全措施和安全工具。 3.2.2需求阶段 -需求设计安全解决方案 在DevOps模式下,需求、设计阶段通常是整个研发周期中最灵活且难以控制的。由于业务量庞大、业务快速迭代的特点,很多传统产品安全措施如:威胁建模、安全设计评审、业务设计安全评估等工作难以覆盖到所有业务。 对此,在百度DevSecOps方案中,我们针对不同业务场景提供了一系列安全解决方案,覆盖Web业务、App业务、IoT业务、toB私有化、用户隐私等业务场景,基于多年SDL安全经验积累,对各个业务中容易出现风险的地方提供了统一化的安全解决方案,这些方案有的是规范约定,有的是bad case枚举,还有的是基于安全SDK的解决方案。 同时将其集成到百度工程规范指定的需求管理产品iCafe中。当业务线研发人员、PM创建需求卡片时,可以根据自身的业务场景选择对应的安全解决方案,并在研发前完成规范、安全方案的学习,从而在研发编码阶段尽可能避免这些问题。 3.2.3开发/代码准入阶段 供应链安全检测 供应链安全检测主要聚焦第三方代码引入公司内部的安全性检测。 百度的产品代码托管在内部代码托管平台,因此供应链安全检测也应该围绕代码托管平台展开,除了在研发流程中嵌入新增代码检测以外,我们还针对存量的代码实现检测与工单追踪闭环,为第三方代码风险快速、有效收敛提供最便捷的通道。 整体检测架构为: 供应链检测系统中的第三方高危软件识别主要依托于指纹匹配技术,主要分为代码指纹识别与包管理解析两种。代码指纹识别类似于传统的正则匹配;包管理解析则是针对不同包管理文件,例如java的pom.xml、gradle,nodejs的package.json等,做语法解析,获取到引入的包名与版本号。代码指纹识别漏报率相对更高,包管理解析获取的包名通常为类库名,与第三方软件的通用名称存在差异,需要根据实际应用场景做进一步的适配和兼容。 第三方软件的漏洞被外界爆出后,攻击者可能在短时间内进行攻击,如果供应链检测无法做到快速响应,将会使得整个供应链安全检测的效果大大折扣,因此我们同步建设了实时指纹扫描与软件查询能力。通过打通线上工单系统,我们可以在分钟级完成漏洞代码定位与推送,并实现80%以上代码库在一天内更新修复。以fastjson组件为例,在19年和20年的几次漏洞爆发中,我们在分钟级便完成大量使用fastjson组件的代码库定位与工单推送,并在天级的时间内推动业务代码完成修复,闭环效果十分明显。 安全编码规范检查 安全编码规范检查主要聚焦于百度内部生产的代码的安全性检测。 区别于于传统白盒安全扫描,安全编码规范检查治理白盒漏洞的思路是先通过制定相关的基于安全基础库的安全编码规范,要求业务摒弃一些危险的编码习惯,比如各种拼接写法、调用不安全的默认API等,使用安全SDK中的API实现相关的功能,从而降低写出漏洞的风险。 与供应链安全检测类似,百度安全编码规范检查也集成在公司内部研发工具链中。 在这种模式下,一条规范检查规则是这样的: 关于该治理措施和安全工具的构建,可以阅读:构建企业级研发安全编码规范 3.2.4测试阶段 在测试阶段,我们主要嵌入了上线前安全基准测试,也就是市面上DevSecOps方案主要宣传的部分,即各种安全工具链的使用,作为产品上线前的最后一个兜底工作。 在百度,我们构建了:黑盒扫描(DAST)、白盒扫描(SAST)、灰盒扫描(IAST/FAST)、RASP等产品安全工具链,并将这些工具做到自动化程度极高,减少业务参与的难度,实现一次配置永久运行的效果。 值得注意的是,RASP技术(https://rasp.baidu.com)除了在遭受外部攻击时可以进行攻击识别,还可以从一些程序错误中有效识别出漏洞。因此在我们的实践中,RASP产品被大量部署在测试环境中,在对业务线完全透明的情况下,帮助业务线提前发现漏洞、风险。 3.2.5上线&验证阶段 目前上线&验证阶段主要是要求业务线进行安全产品、安全防护能力的接入,主要涉及到:日志备份、线上版RASP、集团WAF等,确保产品线上运行时安全。 3.3 DevSecOps安全运营 当我们完成整个研发全链条的覆盖之后,后续的工作变得相对比较简单,可以将有限的人力投入到工具链安全能力建设、产品线DevSecOps定制化需求、重点业务场景安全解决方案制定与实施中。通过精细化的安全运营,确保DevSecOps得以准确、高质量的实施。 3.4 DevSecOps云原生场景探索 CNCF将云原生定义为致力于帮助企业在公有云、私有云和混合云等新型动态环境中构建与运行可弹性扩展应用的一种技术,包括容器、微服务以及不可变基础设施等。 相比于传统的基础架构模型,构建于云原生技术之上的研发模型能够实现应用弹性、可扩展部署,并且开发和交付也更加敏捷。但与此同时,由于基础软件自由引入,应用快速迭代,镜像的获取、容器的部署更加灵活,云原生产品研发过程中实际上具有更多潜在的安全风险。比如当基础镜像中引入了恶意组件或者高危组件这种场景,传统的产品安全措施与工具链很难对其进行风险治理与收敛。 因此,我们需要将DevSecOps与云原生深度结合,对云原生技术下构建的研发流程进行持续管控,更好地在研发链条中保护业务安全。 云原生时代下,我们在DevSecOps方案中增加了镜像安全扫描、安全分发、镜像签名与运行时监控等产品安全措施,这些与原有的应用层DevSecOps共同构成了一条完整的DevSecOps安全管控链路。镜像扫描可以通过配置是否阻断,来限制包含高危漏洞的镜像上线;安全分发可以保证镜像分发安全,而运行时监控则能针对线上容器危险操作、非法网络连接等进行阻断。具体的管控方案如下: 除了增加一些自动化的检查和监控以外,我们还在着力推动镜像仓库统一化、基础镜像标准化等,避免线上运行时环境过于分散,降低后期治理与管控成本。 除了上述内容,我们也在关注K8s等编排工具本身的安全性,宿主机上容器软件权限设置,以及内核安全等。 将DevSecOps应用到云原生化架构中,让安全与业务更加紧密地联系在一起,将会是云原生时代提升业务安全质量、降低业务安全风险和后期安全成本的最优解,也可能是唯一解。 四、DevSecOps建设收益 通过DevSecOps的落地,我们从过去仅在测试阶段检查转变为产品研发全流程的安全保障,进一步提升了研发效率、安全问题检出效率,降低了安全问题的修复成本,并提升了产品安全质量以及业务团队的安全素养。 此外,业务线在各个研发阶段都能看到安全相关的措施,安全措施和研发措施进行融合,增进安全协同,更能够让业务线意识到产品安全并不只是安全团队的事情,而是产品线、安全团队一起协同的结果,Sec和Dev、Ops一样,都是研发过程中必须要做的工作。 总的来说,通过DevSecOps的落地,我们获得了: 打造了覆盖研发全链条的产品安全框架,后续可以基于这个框架进行产品安全措施扩展,比如将隐私合规要求融入DevSecOps需求阶段中 提升了研发效率、安全问题检出效率,降低了修复成本 提升了产品安全质量以及业务团队的安全素养 大幅度降低线上漏洞风险,自DevSecOps落地后,线上风险得到了进一步收敛 五、文章总结 本文从传统SDL时代的痛点出发,阐述了我们建设DevSecOps的初衷,并分享了百度DevSecOps在各个研发阶段的建设、落地思路与安全实践,以及相关工具链打造经验。最后介绍了我们建设DevSecOps的相关收益与效果。 希望本文对读者有所帮助。

优秀的个人博客,低调大师

每日一博 | 解 Bug 之路-Nginx 502 Bad Gateway

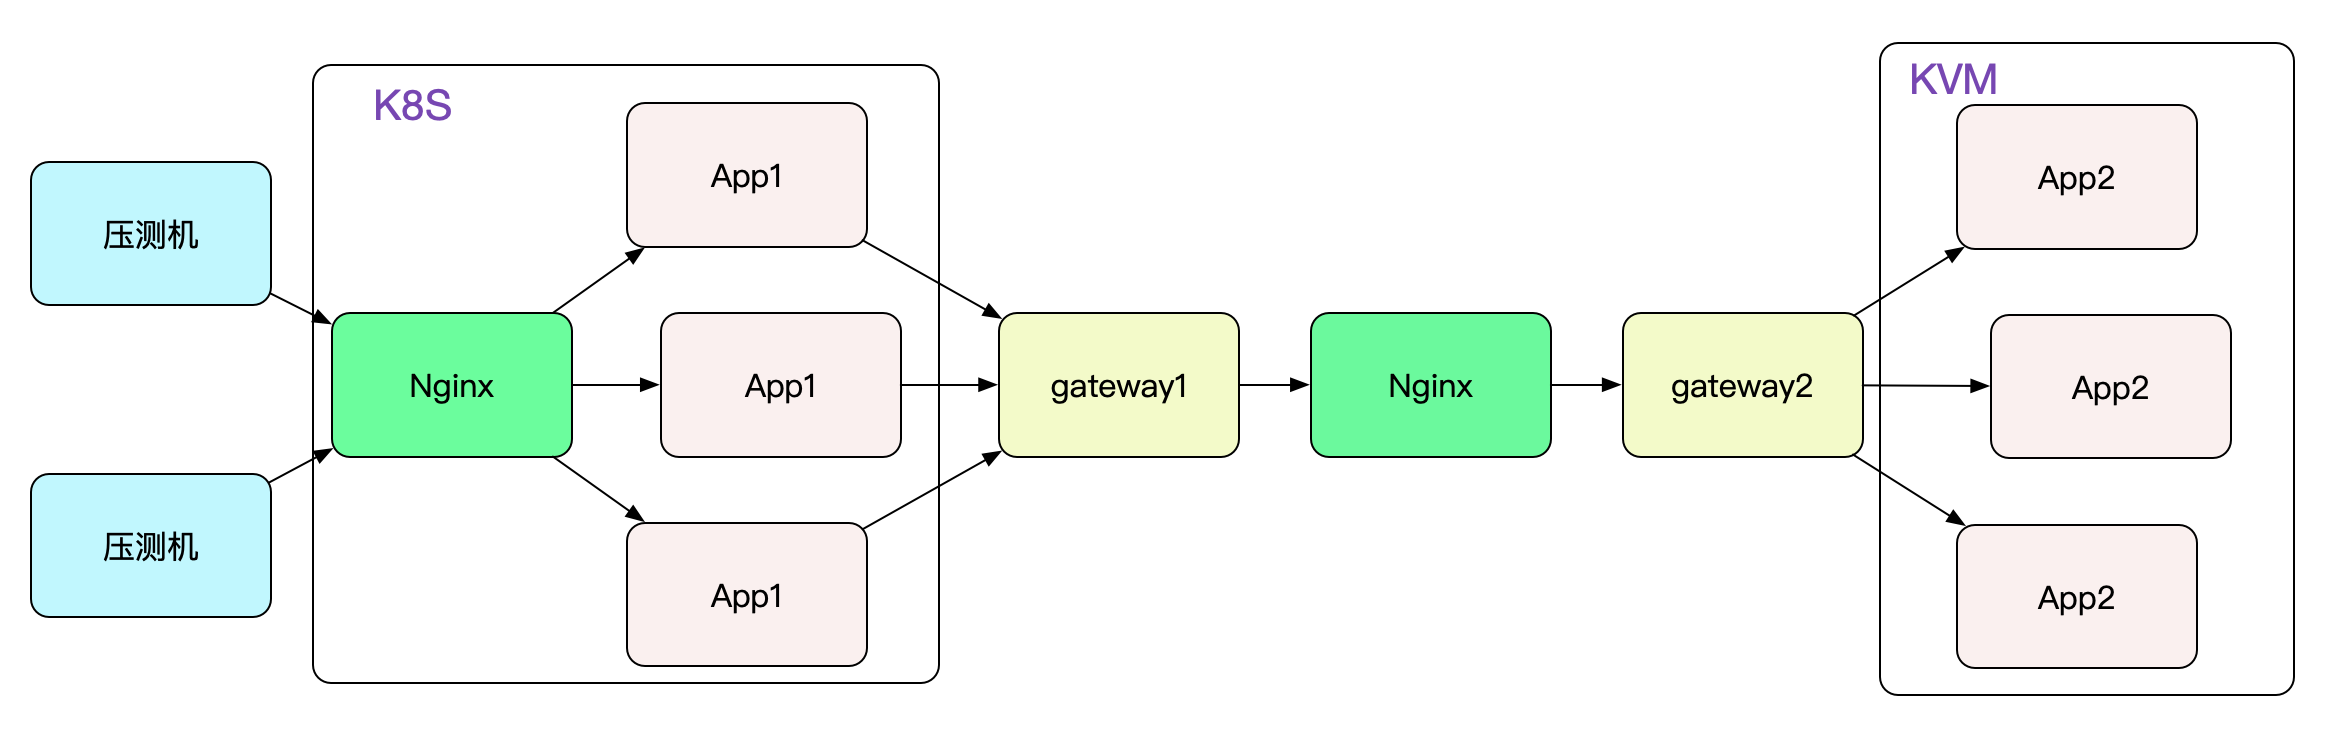
解Bug之路-Nginx 502 Bad Gateway 前言 事实证明,读过Linux内核源码确实有很大的好处,尤其在处理问题的时刻。当你看到报错的那一瞬间,就能把现象/原因/以及解决方案一股脑的在脑中闪现。甚至一些边边角角的现象都能很快的反应过来是为何。笔者读过一些Linux TCP协议栈的源码,就在解决下面这个问题的时候有一种非常流畅的感觉。 Bug现场 首先,这个问题其实并不难解决,但是这个问题引发的现象倒是挺有意思。先描述一下现象吧, 笔者要对自研的dubbo协议隧道网关进行压测(这个网关的设计也挺有意思,准备放到后面的博客里面)。先看下压测的拓扑吧: 为了压测笔者gateway的单机性能,两端仅仅各保留一台网关,即gateway1和gateway2。压到一定程度就开始报错,导致压测停止。很自然的就想到,网关扛不住了。 网关的情况 去Gateway2的机器上看了一下,没有任何报错。而Gateway1则有大量的502报错。502是Bad Gateway,Nginx的经典报错,首先想到的就是Gateway2不堪重负被Nginx在Upstream中踢掉。 那么,就先看看Gateway2的负载情况把,查了下监控,发现Gateway2在4核8G的机器上只用了一个核,完全看不出来有瓶颈的样子,难道是IO有问题?看了下小的可怜的网卡流量打消了这个猜想。 Nginx所在机器CPU利用率接近100% 这时候,发现一个有意思的现象,Nginx确用满了CPU! 再次压测,去Nginx所在机器上top了一下,发现Nginx的4个Worker分别占了一个核把CPU吃满-_-! 什么,号称性能强悍的Nginx竟然这么弱,说好的事件驱动\epoll边沿触发\纯C打造的呢?一定是用的姿势不对! 去掉Nginx直接通信毫无压力 既然猜测是Nginx的瓶颈,就把Nginx去掉吧。Gateway1和Gateway2直连,压测TPS里面就飙升了,而且Gateway2的CPU最多也就吃了2个核,毫无压力。 去Nginx上看下日志 由于Nginx机器权限并不在笔者手上,所以一开始没有关注其日志,现在就联系一下对应的运维去看一下吧。在accesslog里面发现了大量的502报错,确实是Nginx的。又看了下错误日志,发现有大量的 Cannot assign requested address 由于笔者读过TCP源码,一瞬间就反应过来,是端口号耗尽了!由于Nginx upstream和后端Backend默认是短连接,所以在大量请求流量进来的时候回产生大量TIME_WAIT的连接。 而这些TIME_WAIT是占据端口号的,而且基本要1分钟左右才能被Kernel回收。 cat /proc/sys/net/ipv4/ip_local_port_range 32768 61000 也就是说,只要一分钟之内产生28232(61000-32768)个TIME_WAIT的socket就会造成端口号耗尽,也即470.5TPS(28232/60),只是一个很容易达到的压测值。事实上这个限制是Client端的,Server端没有这样的限制,因为Server端口号只有一个8080这样的有名端口号。而在 upstream中Nginx扮演的就是Client,而Gateway2就扮演的是Nginx 为什么Nginx的CPU是100% 而笔者也很快想明白了Nginx为什么吃满了机器的CPU,问题就出来端口号的搜索过程。 让我们看下最耗性能的一段函数: int __inet_hash_connect(...) { // 注意,这边是static变量 static u32 hint; // hint有助于不从0开始搜索,而是从下一个待分配的端口号搜索 u32 offset = hint + port_offset; ..... inet_get_local_port_range(&low, &high); // 这边remaining就是61000 - 32768 remaining = (high - low) + 1 ...... for (i = 1; i <= remaining; i++) { port = low + (i + offset) % remaining; /* port是否占用check */ .... goto ok; } ....... ok: hint += i; ...... } 看上面那段代码,如果一直没有端口号可用的话,则需要循环remaining次才能宣告端口号耗尽,也就是28232次。而如果按照正常的情况,因为有hint的存在,所以每次搜索从下一个待分配的端口号开始计算,以个位数的搜索就能找到端口号。如下图所示: 所以当端口号耗尽后,Nginx的Worker进程就沉浸在上述for循环中不可自拔,把CPU吃满。 为什么Gateway1调用Nginx没有问题 很简单,因为笔者在Gateway1调用Nginx的时候设置了Keepalived,所以采用的是长连接,就没有这个端口号耗尽的限制。 Nginx 后面有多台机器的话 由于是因为端口号搜索导致CPU 100%,而且但凡有可用端口号,因为hint的原因,搜索次数可能就是1和28232的区别。 因为端口号限制是针对某个特定的远端server:port的。 所以,只要Nginx的Backend有多台机器,甚至同一个机器上的多个不同端口号,只要不超过临界点,Nginx就不会有任何压力。 把端口号范围调大 比较无脑的方案当然是把端口号范围调大,这样就能抗更多的TIME_WAIT。同时将tcp_max_tw_bucket调小,tcp_max_tw_bucket是kernel中最多存在的TIME_WAIT数量,只要port范围 - tcp_max_tw_bucket大于一定的值,那么就始终有port端口可用,这样就可以避免再次到调大临界值得时候继续击穿临界点。 cat /proc/sys/net/ipv4/ip_local_port_range 22768 61000 cat /proc/sys/net/ipv4/tcp_max_tw_buckets 20000 开启tcp_tw_reuse 这个问题Linux其实早就有了解决方案,那就是tcp_tw_reuse这个参数。 echo '1' > /proc/sys/net/ipv4/tcp_tw_reuse 事实上TIME_WAIT过多的原因是其回收时间竟然需要1min,这个1min其实是TCP协议中规定的2MSL时间,而Linux中就固定为1min。 #define TCP_TIMEWAIT_LEN (60*HZ) /* how long to wait to destroy TIME-WAIT * state, about 60 seconds */ 2MSL的原因就是排除网络上还残留的包对新的同样的五元组的Socket产生影响,也就是说在2MSL(1min)之内重用这个五元组会有风险。为了解决这个问题,Linux就采取了一些列措施防止这样的情况,使得在大部分情况下1s之内的TIME_WAIT就可以重用。下面这段代码,就是检测此TIME_WAIT是否重用。 __inet_hash_connect |->__inet_check_established static int __inet_check_established(......) { ...... /* Check TIME-WAIT sockets first. */ sk_nulls_for_each(sk2, node, &head->twchain) { tw = inet_twsk(sk2); // 如果在time_wait中找到一个match的port,就判断是否可重用 if (INET_TW_MATCH(sk2, net, hash, acookie, saddr, daddr, ports, dif)) { if (twsk_unique(sk, sk2, twp)) goto unique; else goto not_unique; } } ...... } 而其中的核心函数就是twsk_unique,它的判断逻辑如下: int tcp_twsk_unique(......) { ...... if (tcptw->tw_ts_recent_stamp && (twp == NULL || (sysctl_tcp_tw_reuse && get_seconds() - tcptw->tw_ts_recent_stamp > 1))) { // 对write_seq设置为snd_nxt+65536+2 // 这样能够确保在数据传输速率<=80Mbit/s的情况下不会被回绕 tp->write_seq = tcptw->tw_snd_nxt + 65535 + 2 ...... return 1; } return 0; } 上面这段代码逻辑如下所示: 在开启了tcp_timestamp以及tcp_tw_reuse的情况下,在Connect搜索port时只要比之前用这个port的TIME_WAIT状态的Socket记录的最近时间戳>1s,就可以重用此port,即将之前的1分钟缩短到1s。同时为了防止潜在的序列号冲突,直接将write_seq加上在65537,这样,在单Socket传输速率小于80Mbit/s的情况下,不会造成序列号重叠(冲突)。 同时这个tw_ts_recent_stamp设置的时机如下图所示: 所以如果Socket进入TIME_WAIT状态后,如果一直有对应的包发过来,那么会影响此TIME_WAIT对应的port是否可用的时间。 开启了这个参数之后,由于从1min缩短到1s,那么Nginx单台对单Upstream可承受的TPS就从原来的470.5TPS(28232/60)一跃提升为28232TPS,增长了60倍。 如果还嫌性能不够,可以配上上面的端口号范围调大以及tcp_max_tw_bucket调小继续提升tps,不过tcp_max_tw_bucket调小可能会有序列号重叠的风险,毕竟Socket不经过2MSL阶段就被重用了。 不要开启tcp_tw_recycle 开启tcp_tw_recyle这个参数会在NAT环境下造成很大的影响,建议不开启,具体见笔者的另一篇博客: https://my.oschina.net/alchemystar/blog/3119992 Nginx upstream改成长连接 事实上,上面的一系列问题都是由于Nginx对Backend是短连接导致。 Nginx从 1.1.4 开始,实现了对后端机器的长连接支持功能。在Upstream中这样配置可以开启长连接的功能: upstream backend { server 127.0.0.1:8080; keepalive 32; # 后端长连接数量 keepalive_timeout 30s; # 设置后端连接的最大idle时间为30s } 这样前端和后端都是长连接,大家又可以愉快的玩耍了。 由此产生的风险点 由于对单个远端ip:port耗尽会导致CPU吃满这种现象。所以在Nginx在配置Upstream时候需要格外小心。假设一种情况,PE扩容了一台Nginx,为防止有问题,就先配一台Backend看看情况,这时候如果量比较大的话击穿临界点就会造成大量报错(而应用本身确毫无压力,毕竟临界值是470.5TPS(28232/60)),甚至在同Nginx上的非此域名的请求也会因为CPU被耗尽而得不到响应。多配几台Backend/开启tcp_tw_reuse或许是不错的选择。 总结 应用再强大也还是承载在内核之上,始终逃不出Linux内核的樊笼。所以对于Linux内核本身参数的调优还是非常有意义的。如果读过一些内核源码,无疑对我们排查线上问题有着很大的助力,同时也能指导我们避过一些坑! 公众号 关注笔者公众号,获取更多干货文章:

优秀的个人博客,低调大师

每日一博 | QUIC/HTTP3 协议简析

从 HTTP 的进化历史讲起,细说使用协议的变迁,了解原因发现问题,解码 QUIC 在 HTTP3 中的支撑作用,共同探讨 HTTP3 的未来。 HTTP、HTTP2 和 HTTP3 先和大家来回顾一下 HTTP 的历史,看看 HTTP3 相比 HTTP、HTTP2 都有哪些改进和升级的地方。 HTTP VS HTTP2 多路复用:多路复用时,多文件传输有时只需维护一个 TCP 连接。如果是 HTTP1 协议下,每份资源的传输对应一个 TCP 连接,一般最多只能开启 6 个 TCP 连接来传输多路数据,后续每增加一个新链接就会因为拥堵问题卡死,进而导致整个进程无法运行。因此HTTP/2解决了 HTTP 的队头阻塞问题。 头部压缩和 Server Push:HTTP2 会通过 HPACK 做头部压缩。同时 HTTP2 是二进制协议,在解析上相比基于文本的 HTTP解析效率上有所提升,并且 HTTP2 还增加了 Server Push。 在 TCP 下,依然无法解决延迟问题,比如为防止初始阻塞而引入的慢启动;TCP 队头阻塞,比如由于发生丢包,整个连接涉及的传输数据都需要重传而引起的阻塞。 尽管 HTTP2 相比 HTTP 已经有了改进的地方,但是如果你有 2% 的丢包率,那 HTTP2 在性能上就没有优势了。 上图是造成 TCP 队头拥塞(Head of line blocking)的原因。HTTP2 协议是基于 TCP 的,但是 TCP 本身是无法解决队头拥塞,为什么呢?因为 HTTP2 会把一次传输所有的文件都放在一个 TCP 连接中,只要这个 TCP 中发生一个丢包,连接就必须重新建立,之前所有传输内容进行必须重传,从而造成拥塞。 HTTP3 VS HTTP2 HTTP3 本质不是对 HTTP 协议本身的改进,它主要是集中在如何提高传输效率。上图是相比 HTTP2 而言 HTTP3 提升的点: HTTP3 使用 stream 进一步扩展了 HTTP2 的多路复用。在 HTTP3 模式下,一般传输多少个文件就会产生对应数量的 stream。当这些文件中的其中一个发生丢包时,你只需要重传丢包文件的对应 stream 即可。 HTTP3 不再是基于 TCP 建立的,而是通过 UDP 建立,在用户空间保证传输的可靠性,相比 TCP,UDP 之上的 QUIC 协议提高了连接建立的速度,降低了延迟。 通过引入 Connection ID,使得 HTTP3 支持连接迁移以及 NAT 的重绑定。 HTTP3 含有一个包括验证、加密、数据及负载的 built-in 的TLS安全机制。 拥塞控制。TCP 是在内核区实现的,而 HTTP3 将拥塞控制移出了内核,通过用户空间来实现。这样做的好处就是不再需要等待内核更新可以实现很方便的进行快速迭代。 头部压缩。HTTP2 使用的 HPACK,HTTP3 更换成了兼容 HPACK 的 QPACK 压缩方案。QPACK 优化了对乱序发送的支持,也优化了压缩率。 为什么选择 QUIC 从图上可以看到 QUIC 协议层就实现了可靠的数据传输,拥塞控制,加密,多路数据流。 至于 QUIC 为什么使用了 UDP 的问题,在了解这个之前,我们需要先知道一个事情。频繁的用户态和核心态切换会效率问题。理论上说,将应用层的东西迁移到内核从而提升效率是可行的,但是这么做会影响操作系统的稳定性。另一方面,我们可以选择将这部分内容迁移到用户空间。比如目前流行的 DPDK,当网卡将数据包传输过来时,它是绕过内核在用户空间进行控制和应用。目前又拍云的 DNS 就进行了这样的处理,让又拍云的整体效率提升了5-10 倍。 接下来我们来正式说一下 QUIC 为什么使用了 UDP 的问题,是因为以下几点: 避免 ossification(僵化):QUIC 协议加密负载,也是避免协议僵化一种方式,比如当中间层处理 UDP 数据时,只需要按照数据包的方式去处理即可,不需要去关注内部层的具体信息。 放弃改进 TCP 本身 创新方向:QUIC 是由谷歌提出的,所以 UDP 是以浏览器为出发点,从协议、从浏览器方向来进行创新。 TLS 1.3 Vs TLS 1.2 TLS 1.3 跟 1.2 的一些提升主要有上图几点,大家可以大致看一下: TLS 1.3 采用了新的加密套件 TLS 1.3 定义了一些新的证书类型以及秘钥交换机制。在 TLS 1.3 你不再需要去特别指定,它可以根据秘钥套件配件进行证书类型的自主推导。 QUIC 存在的问题 接下来说一下 QUIC 目前存在的问题。 首先是因为这些年性能的优化提升都针对 TCP ,使得 UDP 性能没有任何改进。当然随着 QUIC3 的发布,相信后续应该会有相对的投入。 其次是安全问题,也就是反射攻击,即伪造原地址。这个指发送数据包时的原地址是伪造的,不是真正的地址,会引起放大攻击。原因是 QUIC 握手过程是不对称的,特别是第一次请求时,客户端只需要发送几个字节的信息到服务器,而服务器则需要把证书等很多东西返还给客户端,这个不对称的机会造成了放大。草案 27 定义了两个规则和机制来限制反射攻击:客户端发送Initial包,即第一个数据包时,其长度必须在 1200 bytes以上,不足部分用 Padding 帧填充,同时,当服务端不确定客户端可靠性时,可以发送 Retry 包要求客户端再次提供验证信息。 开源 QUIC 的实现 接下来我们简单说一下目前开源的使用情况: quiche:这个是用 Rust 做的库,通过 Nginx 调用。google 自己的库也叫 quiche,C++写的。 ATS:Apache Traffic Server golang:Caddy; python+C,aioquic 微软msquic 开源 QUIC 的实现有很多,上面只是其中的一部分,同时我选择了quiche 和 aioquic 做了一些简单测试。 上图展示的是从 cloudflare 提供支持 HTTP3 的 curl ,可以看到这个返回的值就是 HTTP/3 200。其中 alternative service 段,指示为 h3—27,表示支持 http3 draft-27 的服务跑在 UDP 443 端口。这个 alt-svc 是 HTTP2 时代就存在,在 HTTP3 也持续使用,因为有些时候浏览器并不知道服务器是否支持 QUIC,所以通过 TCP 发起请求,确定有 H3 支持后,再通过 UDP连接。 这个是 HTTP2 的,目前可能是因为本身库的问题,使用 curl 打不开谷歌,但是从信息上可以看到 27、25 这些都是支持的。 如何部署以及达成 HTTP3 的 QUIC 实现 目前主要有两种方式来实现,一种是代理,第二种是通过 Nginx。 腾讯是通过整合到 Nginx 利用它来实现框架的。同时因为 QUIC 每一条请求的含有头的数据都会经过加密,腾讯有一个单独的硬件加密群,如果你使用腾讯,那么你所有的加解密都会通过他们的硬件来加速。 从腾讯这个可以看出加解密部分有着很可观的 CPU 占用率,如果后续所有的请求都是通过 HTTP3 来进行的话,在提升这块占用率上需要未雨绸缪。当然就像前面提到的 DPDK,也就是把数据丢到 FPGA 内去加解密是一个可以考虑的解决方案。 通过代理来实现的这种方式,目前官方暂时还没有消息。我可以像 cloudflare 那样,先在外面进行整合,然后再讲整合链接转到 Nginx 内。 又拍云目前有 LBS 和 Marco ,这个是因为 LBS 只认 TCP/UDP,它看不到 HTTP。也就是我们做了一个负载均衡的集群,通过这个集群在转到 Nginx 上。而使用 UDP 则相当于已经走过了一个四层的负载均衡,那么后续可以尝试将 QUIC 的基线提取出来使用,在代理上做加解密,从而提高效率。 推荐阅读 容器化技术在数据中心的实践 从新冠疫情出发,漫谈 Gossip 协议

优秀的个人博客,低调大师

每日一博 | 自己实现一个 RPC 框

RPC框架称为远程调用框架,其实现的核心原理就是消费者端使用动态代理来代理一个接口的方法(基于JDK的动态代理,当然如果使用CGLib可以直接使用无接口类的方法),通过加入网络传输编程,传输调用接口方法名称,方法参数来给提供者获取,再通过反射,来执行该接口的方法,再将反射执行的结果通过网络编程传回消费者端。 现在我们来依次实现这些概念。这里我们做最简单的实现,网络编程使用的是BIO,大家可以使用Reactor模式的Netty来改写性能更好的方式。而网络传输中使用的序列化和反序列化也是Java自带的,当然这样的传输字节比较大,可以使用google的protoBuffer或者kryo来处理。这里只为了方便说明原理。 pom <?xml version="1.0" encoding="UTF-8"?> <project xmlns="http://maven.apache.org/POM/4.0.0" xmlns:xsi="http://www.w3.org/2001/XMLSchema-instance" xsi:schemaLocation="http://maven.apache.org/POM/4.0.0 http://maven.apache.org/xsd/maven-4.0.0.xsd"> <modelVersion>4.0.0</modelVersion> <groupId>com.guanjian</groupId> <artifactId>rpc-framework</artifactId> <version>1.0-SNAPSHOT</version> <build> <plugins> <plugin> <groupId>org.apache.maven.plugins</groupId> <artifactId>maven-compiler-plugin</artifactId> <version>3.7.0</version> <configuration> <source>1.8</source> <target>1.8</target> <encoding>UTF-8</encoding> </configuration> </plugin> </plugins> </build> </project> 首先当然是我们要进行远程调用的接口以及接口的方法。 public interface HelloService { String sayHello(String content); } 接口实现类 public class HelloServiceImpl implements HelloService { public String sayHello(String content) { return "hello," + content; } } 消费者端的动态代理,如果你是把提供者和消费者写在两个工程中,则提供者端需要上面的接口和实现类,而消费者端只需要上面的接口。 public class ConsumerProxy { /** * 消费者端的动态代理 * @param interfaceClass 代理的接口类 * @param host 远程主机IP * @param port 远程主机端口 * @param <T> * @return */ @SuppressWarnings("unchecked") public static <T> T consume(final Class<T> interfaceClass,final String host,final int port) { return (T) Proxy.newProxyInstance(interfaceClass.getClassLoader(), new Class[]{interfaceClass}, (proxy,method,args) -> { //创建一个客户端套接字 Socket socket = new Socket(host, port); try { //创建一个对外传输的对象流,绑定套接字 ObjectOutputStream output = new ObjectOutputStream(socket.getOutputStream()); try { //将动态代理的方法名写入对外传输的对象流中 output.writeUTF(method.getName()); //将动态代理的方法的参数写入对外传输的对象流中 output.writeObject(args); //创建一个对内传输的对象流,绑定套接字 //这里是为了获取提供者端传回的结果 ObjectInputStream input = new ObjectInputStream(socket.getInputStream()); try { //从对内传输的对象流中获取结果 Object result = input.readObject(); if (result instanceof Throwable) { throw (Throwable) result; } return result; } finally { input.close(); } } finally { output.close(); } } finally { socket.close(); } } ); } } 有关JDK动态代理的内容可以参考AOP原理与自实现 ,BIO的部分可以参考传统IO与NIO比较 提供者端的网络传输和远程方式调用服务 public class ProviderReflect { private static final ExecutorService executorService = Executors.newCachedThreadPool(); /** * RPC监听和远程方法调用 * @param service RPC远程方法调用的接口实例 * @param port 监听的端口 * @throws Exception */ public static void provider(final Object service,int port) throws Exception { //创建服务端的套接字,绑定端口port ServerSocket serverSocket = new ServerSocket(port); while (true) { //开始接收客户端的消息,并以此创建套接字 final Socket socket = serverSocket.accept(); //多线程执行,这里的问题是连接数过大,线程池的线程数会耗尽 executorService.execute(() -> { try { //创建呢一个对内传输的对象流,并绑定套接字 ObjectInputStream input = new ObjectInputStream(socket.getInputStream()); try { try { //从对象流中读取接口方法的方法名 String methodName = input.readUTF(); //从对象流中读取接口方法的所有参数 Object[] args = (Object[]) input.readObject(); Class[] argsTypes = new Class[args.length]; for (int i = 0;i < args.length;i++) { argsTypes[i] = args[i].getClass(); } //创建一个对外传输的对象流,并绑定套接字 //这里是为了将反射执行结果传递回消费者端 ObjectOutputStream output = new ObjectOutputStream(socket.getOutputStream()); try { Class<?>[] interfaces = service.getClass().getInterfaces(); Method method = null; for (int i = 0;i < interfaces.length;i++) { method = interfaces[i].getDeclaredMethod(methodName,argsTypes); if (method != null) { break; } } Object result = method.invoke(service, args); //将反射执行结果写入对外传输的对象流中 output.writeObject(result); } catch (Throwable t) { output.writeObject(t); } finally { output.close(); } } catch (Exception e) { e.printStackTrace(); } finally { input.close(); } } finally { socket.close(); } } catch (Exception e) { e.printStackTrace(); } }); } } } 启动提供者端的网络侦听和远程调用 public class RPCProviderMain { public static void main(String[] args) throws Exception { HelloService service = new HelloServiceImpl(); ProviderReflect.provider(service,8083); } } 启动消费者的动态代理调用 public class RPCConsumerMain { public static void main(String[] args) throws InterruptedException { HelloService service = ConsumerProxy.consume(HelloService.class,"127.0.0.1",8083); for (int i = 0;i < 1000;i++) { String hello = service.sayHello("你好_" + i); System.out.println(hello); Thread.sleep(1000); } } } 运行结果 hello,你好_0 hello,你好_1 hello,你好_2 hello,你好_3 hello,你好_4 hello,你好_5 ..... 如果你要扩展成一个Netty+ProtoBuffer的高性能RPC框架可以参考Netty整合Protobuffer 的相关写法。有关Netty的相关内容可以参考Netty整理 、Netty整理(二) 、Netty整理(三)。

优秀的个人博客,低调大师

每日一博 | MySQL 死锁系列-常见加锁场景分析

在上一篇文章《锁的类型以及加锁原理》主要总结了 MySQL 锁的类型和模式以及基本的加锁原理,今天我们就从原理走向实战,分析常见 SQL 语句的加锁场景。了解了这几种场景,相信小伙伴们也能举一反三,灵活地分析真实开发过程中遇到的加锁问题。 如下图所示,数据库的隔离等级,SQL 语句和当前数据库数据会共同影响该条 SQL 执行时数据库生成的锁模式,锁类型和锁数量。 下面,我们会首先讲解一下隔离等级、不同 SQL 语句 和 当前数据库数据对生成锁影响的基本规则,然后再依次具体 SQL 的加锁场景。 隔离等级对加锁的影响 MySQL 的隔离等级对加锁有影响,所以在分析具体加锁场景时,首先要确定当前的隔离等级。 读未提交(Read Uncommitted 后续简称 RU):可以读到未提交的读,基本上不会使用该隔离等级,所以暂时忽略。 读已提交(Read Committed 后续简称 RC):存在幻读问题,对当前读获取的数据加记录锁。 可重复读(Repeatable Read 后续简称 RR):不存在幻读问题,对当前读获取的数据加记录锁,同时对涉及的范围加间隙锁,防止新的数据插入,导致幻读。 序列化(Serializable):从 MVCC 并发控制退化到基于锁的并发控制,不存在快照读,都是当前读,并发效率急剧下降,不建议使用。 这里说明一下,RC 总是读取记录的最新版本,而 RR 是读取该记录事务开始时的那个版本,虽然这两种读取的版本不同,但是都是快照数据,并不会被写操作阻塞,所以这种读操作称为 快照读(Snapshot Read) MySQL 还提供了另一种读取方式叫当前读(Current Read),它读的不再是数据的快照版本,而是数据的最新版本,并会对数据加锁,根据语句和加锁的不同,又分成三种情况: SELECT ... LOCK IN SHARE MODE:加共享(S)锁 SELECT ... FOR UPDATE:加排他(X)锁 INSERT / UPDATE / DELETE:加排他(X)锁 当前读在 RR 和 RC 两种隔离级别下的实现也是不一样的:RC 只加记录锁,RR 除了加记录锁,还会加间隙锁,用于解决幻读问题。 不同 SQL 语句对加锁的影响 不同的 SQL 语句当然会加不同的锁,总结起来主要分为五种情况: SELECT ... 语句正常情况下为快照读,不加锁; SELECT ... LOCK IN SHARE MODE 语句为当前读,加 S 锁; SELECT ... FOR UPDATE 语句为当前读,加 X 锁; 常见的 DML 语句(如 INSERT、DELETE、UPDATE)为当前读,加 X 锁; 常见的 DDL 语句(如 ALTER、CREATE 等)加表级锁,且这些语句为隐式提交,不能回滚。 其中,当前读的 SQL 语句的 where 从句的不同也会影响加锁,包括是否使用索引,索引是否是唯一索引等等。 当前数据对加锁的影响 SQL 语句执行时数据库中的数据也会对加锁产生影响。 比如一条最简单的根据主键进行更新的 SQL 语句,如果主键存在,则只需要对其加记录锁,如果不存在,则需要在加间隙锁。 至于其他非唯一性索引更新或者插入时的加锁也都不同程度的受到现存数据的影响,后续我们会一一说明。 具体场景分析 具体 SQL 场景分析主要借鉴何登成前辈的《MySQL 加锁处理分析》文章和 aneasystone 的系列文章,在他们的基础上进行了总结和整理。 我们使用下面这张 book 表作为实例,其中 id 为主键,ISBN(书号)为二级唯一索引,Author(作者)为二级非唯一索引,score(评分)无索引。 UPDATE 语句加锁分析 下面,我们先来分析 UPDATE 相关 SQL 在使用较为简单 where 从句情况下加锁情况。其中的分析原则也适用于 UPDATE,DELETE 和 SELECT ... FOR UPDATE等当前读的语句。 聚簇索引,查询命中 聚簇索引就是 InnoDB 存储引擎下的主键索引,具体可参考《MySQL索引》。 下图展示了使用 UPDATE book SET score = 9.2 WHERE ID = 10 语句命中的情况下在 RC 和 RR 隔离等级下的加锁,两种隔离等级下没有任何区别,都是对 ID = 10 这个索引加排他记录锁。 聚簇索引,查询未命中 下图展示了 UPDATE book SET score = 9.2 WHERE ID = 16 语句未命中时 RR 隔离级别下的加锁情况。 在 RC 隔离等级下,不需要加锁;而在 RR 隔离级别会在 ID = 16 前后两个索引之间加上间隙锁。 值得注意的是,间隙锁和间隙锁之间是互不冲突的,间隙锁唯一的作用就是为了防止其他事务的插入新行,导致幻读,所以加间隙 S 锁和加间隙 X 锁没有任何区别。 二级唯一索引,查询命中 下图展示了 UPDATE book SET score = 9.2 WHERE ISBN = 'N0003' 在 RC 和 RR 隔离等级下命中时的加锁情况。 在 InnoDB 存储引擎中,二级索引的叶子节点保存着主键索引的值,然后再拿主键索引去获取真正的数据行,所以在这种情况下,二级索引和主键索引都会加排他记录锁。 二级唯一索引,查询未命中 下图展示了 UPDATE book SET score = 9.2 WHERE ISBN = 'N0008' 语句在 RR 隔离等级下未命中时的加锁情况,RC 隔离等级下该语句未命中不会加锁。 因为 N0008 大于 N0007,所以要锁住 (N0007,正无穷)这段区间,而 InnoDB 的索引一般都使用 Suprenum Record 和 Infimum Record 来分别表示记录的上下边界。Infimum 是比该页中任何记录都要小的值,而 Supremum 比该页中最大的记录值还要大,这两条记录在创建页的时候就有了,并且不会删除。 所以,在 N0007 和 Suprenum Record 之间加了间隙锁。 为什么不在主键上也加 GAP 锁呢?欢迎留言说出你的想法。 二级非唯一索引,查询命中 下图展示了 UPDATE book SET score = 9.2 WHERE Author = 'Tom' 语句在 RC 隔离等级下命中时的加锁情况。 我们可以看到,在 RC 等级下,二级唯一索引和二级非唯一索引的加锁情况是一致的,都是在涉及的二级索引和对应的主键索引上加上排他记录锁。 但是在 RR 隔离等级下,加锁的情况产生了变化,它不仅对涉及的二级索引和主键索引加了排他记录锁,还在非唯一二级索引上加了三个间隙锁,锁住了两个 Tom 索引值相关的三个范围。 那为什么唯一索引不需要加间隙锁呢?间隙锁的作用是为了解决幻读,防止其他事务插入相同索引值的记录,而唯一索引和主键约束都已经保证了该索引值肯定只有一条记录,所以无需加间隙锁。 需要注意的是,上图虽然画着 4 个记录锁,三个间隙锁,但是实际上间隙锁和它右侧的记录锁会合并成 Next-Key 锁。 所以实际情况有两个 Next-Key 锁,一个间隙锁(Tom60,正无穷)和两个记录锁。 二级非唯一索引,查询未命中 下图展示了 UPDATE book SET score = 9.2 WHERE Author = 'Sarah' 在 RR 隔离等级下未命中的加锁情况,它会在二级索引 Rose 和 Tom 之间加间隙锁。而 RC 隔离等级下不需要加锁。 无索引 当 Where 从句的条件并不使用索引时,则会对全表进行扫描,在 RC 隔离等级下对所有的数据加排他记录锁。在RR 隔离等级下,除了给记录加锁,还会对记录和记录之间加间隙锁。和上边一样,间隙锁会和左侧的记录锁合并成 Next-Key 锁。 下图就是 UPDATE book SET score = 9.2 WHERE score = 22 语句在两种隔离等级下的加锁情况。 聚簇索引,范围查询 上面介绍的场景都是 where 从句的等值查询,而范围查询的加锁又是怎么样的呢?我们慢慢来看。 下图是 UPDATE book SET score = 9.2 WHERE ID <= 25 在 RC 和 RR 隔离等级下的加锁情况。 RC 场景下与等值查询类似,只会在涉及的 ID = 10,ID = 18 和 ID = 25 索引上加排他记录锁。 而在 RR 隔离等级下则有所不同,它会加上间隙锁,和对应的记录锁合并称为 Next-Key 锁。除此之外,它还会在(25, 30] 上分别加 Next-Key 锁。这一点是十分特殊的,具体原因还需要再探究。 二级索引,范围查询 下图展示了 UPDATE book SET ISBN = N0001 WHERE score <= 7.9 在 RR 级别下的加锁情况。 修改索引值 UPDATE 语句修改索引值的情况可以分开分析,首先 Where 从句的加锁分析如上文所述,多了一步 Set 部分的加锁。 下图展示了 UPDATE book SET Author = 'John' WHERE ID = 10 在 RC 和 RR 隔离等级下的加锁情况。除了在主键 ID 上进行加锁,还会对二级索引上的 Bob(就值) 和 John(新值) 上进行加锁。 DELETE 语句加锁分析 一般来说,DELETE 的加锁和 SELECT FOR UPDATE 或 UPDATE 并没有太大的差异。 因为,在 MySQL 数据库中,执行 DELETE 语句其实并没有直接删除记录,而是在记录上打上一个删除标记,然后通过后台的一个叫做 purge 的线程来清理。从这一点来看,DELETE 和 UPDATE 确实是非常相像。事实上,DELETE 和 UPDATE 的加锁也几乎是一样的。 INSERT 语句加锁分析 接下来,我们来看一下 Insert 语句的加锁情况。 Insert 语句在两种情况下会加锁: 为了防止幻读,如果记录之间加有间隙锁,此时不能 Insert; 如果 Insert 的记录和已有记录造成唯一键冲突,此时不能 Insert; 除了上述情况,Insert 语句的锁都是隐式锁。隐式锁是 InnoDB 实现的一种延迟加锁的机制来减少加锁的数量。 隐式锁的特点是只有在可能发生冲突时才加锁,减少了锁的数量。另外,隐式锁是针对被修改的 B+Tree 记录,因此都是记录类型的锁,不可能是间隙锁或 Next-Key 类型。 具体 Insert 语句的加锁流程如下: 首先对插入的间隙加插入意向锁(Insert Intension Locks) 如果该间隙已被加上了间隙锁或 Next-Key 锁,则加锁失败进入等待; 如果没有,则加锁成功,表示可以插入; 然后判断插入记录是否有唯一键,如果有,则进行唯一性约束检查 如果不存在相同键值,则完成插入 如果存在相同键值,则判断该键值是否加锁 如果没有锁, 判断该记录是否被标记为删除 如果标记为删除,说明事务已经提交,还没来得及 purge,这时加 S 锁等待; 如果没有标记删除,则报 duplicate key 错误; 如果有锁,说明该记录正在处理(新增、删除或更新),且事务还未提交,加 S 锁等待; 插入记录并对记录加 X 记录锁; 后记 本文中讲解的 SQL 语句都是十分简单的,当 SQL 语句包含多个查询条件时,加锁的分析过程就往往更加复杂。我们需要使用 MySQL 相关的工具进行分析,并且有时甚至需要查询 MySQL 相关的日志信息来了解到底语句加了什么锁或者为什么产生死锁,下篇文章中我们就主要了解一下这些内容,请大家持续关注。 个人博客,欢迎来玩

优秀的个人博客,低调大师

每日一博 | Java 线程通信之 wait/notify 机制

前言 Java 线程通信是将多个独立的线程个体进行关联处理,使得线程与线程之间能进行相互通信。比如线程 A 修改了对象的值,然后通知给线程 B,使线程 B 能够知道线程 A 修改的值,这就是线程通信。 wait/notify 机制 一个线程调用 Object 的 wait() 方法,使其线程被阻塞;另一线程调用 Object 的 notify()/notifyAll() 方法,wait() 阻塞的线程继续执行。 wai/notify 方法 方法 说明 wait() 当前线程被阻塞,线程进入 WAITING 状态 wait(long) 设置线程阻塞时长,线程会进入 TIMED_WAITING 状态。如果设置时间内(毫秒)没有通知,则超时返回 wait(long, int) 纳秒级别的线程阻塞时长设置 notify() 通知同一个对象上已执行 wait() 方法且获得对象锁的等待线程 notifyAll() 通知同一对象上所有等待的线程 实现 wait/notify 机制的条件: 调用 wait 线程和 notify 线程必须拥有相同对象锁。 wait() 方法和 notify()/notifyAll() 方法必须在 Synchronized 方法或代码块中。 由于 wait/notify 方法是定义在java.lang.Object中,所以在任何 Java 对象上都可以使用。 wait 方法 在执行 wait() 方法前,当前线程必须已获得对象锁。调用它时会阻塞当前线程,进入等待状态,在当前 wait() 处暂停线程。同时,wait() 方法执行后,会立即释放获得的对象锁。 下面通过案例来查看 wait() 释放锁。 首先查看不使用 wait() 方法时的代码执行情况: package top.ytao.demo.thread.waitnotify; /** * Created by YangTao */ public class WaitTest { static Object object = new Object(); public static void main(String[] args) { new Thread(() -> { synchronized (object){ System.out.println("开始线程 A"); try { Thread.sleep(2000L); } catch (InterruptedException e) { e.printStackTrace(); } System.out.println("结束线程 A"); } }, "线程 A").start(); new Thread(() -> { try { Thread.sleep(500L); } catch (InterruptedException e) { e.printStackTrace(); } synchronized (object){ System.out.println("开始线程 B"); System.out.println("结束线程 B"); } }, "线程 B").start(); } } 创建 A、B 两个线程,。首先在 B 线程创建后 sleep ,保证 B 线程的打印后于 A 线程执行。在 A 线程中,获取到对象锁后,sleep 一段时间,且时间大于 B 线程的 sleep 时间。 执行结果为: 从上图结果中,可以看到,B 线程一定等 A 线程执行完 synchronize 代码块释放对象锁后 A 线程再获取对象锁进入 synchronize 代码块中。在这过程中,Thread.sleep() 方法也不会释放锁。 当前在 A 线程 synchronize 代码块中执行 wait() 方法后,就会主动释放对象锁,A 线程代码如下: new Thread(() -> { synchronized (object){ System.out.println("开始线程 A"); try { // 调用 object 对象的 wait 方法 object.wait(); Thread.sleep(2000L); } catch (InterruptedException e) { e.printStackTrace(); } System.out.println("结束线程 A"); } }, "线程 A").start(); 执行结果: 同时 A 线程一直处于阻塞状态,不会打印结束线程 A。 wait(long) 方法是设置超时时间,当等待时间大于设置的超时时间后,会继续往 wait(long) 方法后的代码执行。 new Thread(() -> { synchronized (object){ System.out.println("开始线程 A"); try { object.wait(1000); Thread.sleep(2000L); } catch (InterruptedException e) { e.printStackTrace(); } System.out.println("结束线程 A"); } }, "线程 A").start(); 执行结果 同理,wait(long, int) 方法与 wait(long) 同样,只是多个纳秒级别的时间设置。 notify 方法 同样,在执行 notify() 方法前,当前线程也必须已获得线程锁。调用 notify() 方法后,会通知一个执行了 wait() 方法的阻塞等待线程,使该等待线程重新获取到对象锁,然后继续执行 wait() 后面的代码。但是,与 wait() 方法不同,执行 notify() 后,不会立即释放对象锁,而需要执行完 synchronize 的代码块或方法才会释放锁,所以接收通知的线程也不会立即获得锁,也需要等待执行 notify() 方法的线程释放锁后再获取锁。 notify() 下面是 notify() 方法的使用,实现一个完整的 wait/notify 的例子,同时验证发出通知后,执行 notify() 方法的线程是否立即释放锁,执行 wait() 方法的线程是否立即获取锁。 package top.ytao.demo.thread.waitnotify; /** * Created by YangTao */ public class WaitNotifyTest { static Object object = new Object(); public static void main(String[] args) { System.out.println(); new Thread(() -> { synchronized (object){ System.out.println("开始线程 A"); try { object.wait(); System.out.println("A 线程重新获取到锁,继续进行"); } catch (InterruptedException e) { e.printStackTrace(); } System.out.println("结束线程 A"); } }, "线程 A").start(); new Thread(() -> { try { Thread.sleep(500L); } catch (InterruptedException e) { e.printStackTrace(); } synchronized (object){ System.out.println("开始线程 B"); object.notify(); System.out.println("线程 B 通知完线程 A"); try { // 试验执行完 notify() 方法后,A 线程是否能立即获取到锁 Thread.sleep(2000L); } catch (InterruptedException e) { e.printStackTrace(); } System.out.println("结束线程 B"); } }, "线程 B").start(); } } 以上 A 线程执行 wait() 方法,B 线程执行 notify() 方法,执行结果为: 执行结果中可以看到,B 线程执行 notify() 方法后,即使 sleep 了,A 线程也没有获取到锁,可知,notify() 方法并没有释放锁。 notify() 是通知到等待中的线程,但是调用一次 notify() 方法,只能通知到一个执行 wait() 方法的等待线程。如果有多个等待状态的线程,则需多次调用 notify() 方法,通知到线程顺序则根据执行 wait() 方法的先后顺序进行通知。 下面创建有两个执行 wait() 方法的线程的代码: package top.ytao.demo.thread.waitnotify; /** * Created by YangTao */ public class MultiWaitNotifyTest { static Object object = new Object(); public static void main(String[] args) { System.out.println(); new Thread(() -> { synchronized (object){ System.out.println("开始线程 A"); try { object.wait(); } catch (InterruptedException e) { e.printStackTrace(); } System.out.println("结束线程 A"); } }, "线程 A").start(); new Thread(() -> { try { Thread.sleep(500L); } catch (InterruptedException e) { e.printStackTrace(); } synchronized (object){ System.out.println("开始线程 B"); try { object.wait(); } catch (InterruptedException e) { e.printStackTrace(); } System.out.println("结束线程 B"); } }, "线程 B").start(); new Thread(() -> { try { Thread.sleep(3000L); } catch (InterruptedException e) { e.printStackTrace(); } synchronized (object){ System.out.println("开始通知线程 C"); object.notify(); object.notify(); System.out.println("结束通知线程 C"); } }, "线程 C").start(); } } 先 A 线程执行 wait() 方法,然后 B 线程执行 wait() 方法,最后 C 线程调用两次 notify() 方法,执行结果: notifyAll() 通知多个等待状态的线程,通过多次调用 notify() 方法实现的方案,在实际应用过程中,实现过程不太友好,如果是想通知所有等待状态的线程,可使用 notifyAll() 方法,就能唤醒所有线程。 实现方式,只需将上面 C 线程的多次调用 notify() 方法部分改为调用一次 notifyAll() 方法即可。 new Thread(() -> { try { Thread.sleep(3000L); } catch (InterruptedException e) { e.printStackTrace(); } synchronized (object){ System.out.println("开始通知线程 C"); object.notifyAll(); System.out.println("结束通知线程 C"); } }, "线程 C").start(); 执行结果: 根据不同 JVM 的实现,notifyAll() 的唤醒顺序会有所不同,当前测试环境中,以倒序顺序唤醒线程。 实现生产者消费者模式 生产消费者模式就是一个线程生产数据进行存储,另一线程进行数据提取消费。下面就以两个线程来模拟,生产者生成一个 UUID 存放到 List 对象中,消费者读取 List 对象中的数据,读取完成后进行清除。 实现代码如下: package top.ytao.demo.thread.waitnotify; import java.util.ArrayList; import java.util.List; import java.util.UUID; /** * Created by YangTao */ public class WaitNotifyModelTest { // 存储生产者产生的数据 static List<String> list = new ArrayList<>(); public static void main(String[] args) { new Thread(() -> { while (true){ synchronized (list){ // 判断 list 中是否有数据,如果有数据的话,就进入等待状态,等数据消费完 if (list.size() != 0){ try { list.wait(); } catch (InterruptedException e) { e.printStackTrace(); } } // list 中没有数据时,产生数据添加到 list 中 list.add(UUID.randomUUID().toString()); list.notify(); System.out.println(Thread.currentThread().getName() + list); } } }, "生产者线程 A ").start(); new Thread(() -> { while (true){ synchronized (list){ // 如果 list 中没有数据,则进入等待状态,等收到有数据通知后再继续运行 if (list.size() == 0){ try { list.wait(); } catch (InterruptedException e) { e.printStackTrace(); } } // 有数据时,读取数据 System.out.println(Thread.currentThread().getName() + list); list.notify(); // 读取完毕,将当前这条 UUID 数据进行清除 list.clear(); } } }, "消费者线程 B ").start(); } } 运行结果: 生产者线程运行时,如果已存在未消费的数据,则当前线程进入等待状态,收到通知后,表明数据已消费完,再继续向 list 中添加数据。 消费者线程运行时,如果不存在未消费的数据,则当前线程进入等待状态,收到通知后,表明 List 中已有新数据被添加,继续执行代码消费数据并清除。 不管是生产者还是消费者,基于对象锁,一次只能一个线程能获取到,如果生产者获取到锁就校验是否需要生成数据,如果消费者获取到锁就校验是否有数据可消费。 一个简单的生产者消费者模式就以完成。 总结 等待/通知机制是实现 Java 线程间通信的一种方式,将多线程中,各个独立运行的线程通过相互通信来更高效的协作完成工作,更大效率利用 CPU 处理程序。这也是学习或研究 Java 线程的必学知识点。 推荐阅读 《Java 线程基础,从这篇开始》 《你必须会的 JDK 动态代理和 CGLIB 动态代理》 《Dubbo 系列》 关注公众号 『ytao』 坚持原创技术文章输出,专注但不限于 Java 相关技术。

优秀的个人博客,低调大师

每日一博 | Python 异步编程再添一利器

GINO 填补了国内外 asyncio ORM 领域的空白 随着 Tornado 和 asyncio 等框架的陆续涌现,Python 异步编程这个话题也在逐渐升温。在这个烧脑的异步世界里,有没有办法可以既方便快捷、又简单明了地访问数据库呢?GitHub 千星项目 GINO 了解一下! 1. GINO 是谁 GINO 是一个“轻量级”异步 ORM 框架,它的全称是 GINO Is Not ORM,借鉴了 GNU is Not Unix 的递归定义手法。所以,GINO 一定要全!部!大!写!如果像这样“Gino”就变成了人名,你肯定要问一句“这是谁”。 ORM,即关系对象映射(Object-Relational Mapping),是一类开发人员喜闻乐见的效率工具,它们"极大地"提升了写代码的幸福指数。GINO 是用来访问数据库的,也提供了对象映射的工具,那为什么非说 GINO 不是 ORM 呢? 因为物极必反,ORM 在带来生活便利的同时,也是 bug 生长的温床 —— 传统 ORM 往往会选择牺牲明确性(explicitness)来换取便捷性(convenience),再加上 Python 得天独厚的灵活性(flexibility),创造出了一种爆炸式的化学反应。一旦代码初具规模,项目或多或少都会遇到 ORM 反噬的情景:性能莫名其妙的差、出问题找不到原因、为了鸡毛蒜皮的小事大动干戈。随便一句 current_user.name 都有可能触发一大堆意想不到的数据库调用,这代码你让我怎么调试? 传统 ORM 的学习曲线前平后陡,能在快速原型开发中大展身手,但应用到大型项目中却十分考验开发人员的平均水平。 所有这些问题如果再放进异步编程的环境里,那就是 O(n2) 的复杂度了 —— 哦不,是 O(2n)。这对于一款优秀的异步 ORM 框架来说是不可接受的,所以 GINO 是 ORM 但不是一个传统的 ORM,正犹如 GNU 不是一个传统的 Unix 一样,形似而神不似。 所以在 2017 年创作之初,我就给 GINO 定下了两个业绩目标:1) 方便快捷,2) 简单明了。三年后的今天,我索性在 1.0 稳定版发布的前夕做个年终总结。 2. 先说"方便快捷" "方便快捷"主要说的是开发效率。 重视开发效率的概念对于写 Python 的同学来说可能并不陌生,某些场景下,开发人员的时间确实比机器的时间值钱。所以,传统 ORM 里的对象映射不能丢。 from gino import Gino db = Gino() class User(db.Model): __tablename__ = "users" id = db.Column(db.Integer, primary_key=True) name = db.Column(db.String) 这么定义表结构甚至让人有点小兴奋。咦,为什么这么眼熟? 没有错,这就是 SQLAlchemy ORM 的定义风格。GINO 并不是从头造轮子,而是在 SQLAlchemy core(SQLAlchemy 中负责构建 SQL 的底层核心)的基础上开发的。这么做除了能保持熟悉的味道(以节省学习和迁移成本),更重要的是带来了整个 SQLAlchemy 的生态环境:开箱即用的数据库变更管理工具 Alembic、各种 SQLAlchemy 的增强插件、专业领域的 PostGIS/geoalchemy 等,GINO 全都兼容。 是不是十分方便、十分快捷?不止这样。 GINO 一站式地解决了常用 CRUD 快捷方式、上下文管理(aiocontextvars)、数据库事务封装和嵌套、连接池管理和懒加载等多项便捷功能,无额外依赖关系,即装即用。 daisy = await User.create(name="daisy") await daisy.update(name="Daisy").apply() GINO 还提供了各大流行异步 Web 框架的定制版插件,能叫上名字的像 Tornado、aiohttp、Sanic、FastAPI/Starlette、Quart 什么的都有,从简单示范到生产环境的各种例子品种齐全,妈妈再也不用担心我不会集成 Web 框架了。 为了让不同应用场景下的用户体验到最大的善意,GINO 目前支持三种不同程度的用法,成功实现了对同期竞品 asyncpgsa 的降维打击: 最少侵入型:SQLAlchemy core 原教旨主义者,只有异步执行时才用到 GINO。 终身不婚型:天生厌恶"对象",只愿定义"表",空手接 SQL。 火力全开型:最大程度的便利,非典型异步 ORM。 最后,虽然是 Python(绝不是黑哈),但 GINO 在执行效率上也没落下。基于 MagicStack 出品必属精品的、一秒可读百万行的 asyncpg,以及 uvloop(可选)的强力加持,GINO 跑起来也是可以飞快的,被广泛应用于诸如实时汇率、聊天机器人、在线游戏等高并发领域,深受俄罗斯和乌克兰人民的爱戴。 3. 再说"简单明了" Explicit is better than implicit. Simple is better than complex. -- The Zen of Python, PEP 20 Python 之禅完美表达了 GINO 的立场 —— 明确性(explicitness)对于上了规模的异步工程项目来说尤为重要,因此 GINO 的很多设计都受到了明确性的影响。 比如说,GINO 的 Model 是完全无状态的普通 Python 对象(POPO)—— 例如前面的 User 类,它的实例 daisy 就是内存里面的常规对象,你可以用 daisy.name 访问属性,也可以用 daisy.name = "DAISY" 来修改属性,或者用 u = User() 来创建新的实例,这些操作都不会访问数据库,绝对绿色环保无毒副作用。 等到需要操作数据库的时候,你一定会有感知的。比如执行 INSERT 要用 u = await User.create(),而 UPDATE 则是 await u.update(name="Daisy").apply()。 其中, u.update(name="Daisy") 与 u.name = "Daisy" 类似,都是只在内存里修改对象的属性,不同的是 u.update() 还会返回一个包含本次变更的中间结果,对其执行 await xxx.apply() 则会将这些变更应用到数据库里。 这里的 await 就是明确性的关键,意味着我们要跳出去执行数据库操作了。换句话说,没有 await 就没有数据库操作。 另一方面,对于如何将数据库查询结果组装成内存对象及其属性,GINO 也有一套精妙的显式机制 —— 可定制化的加载器 loaders。对于简单直观的一对一加载,GINO 自然是伺候到家的,比如用 u = await User.get(1) 可以直接获取到 ID 为 1 的用户对象。但是对于更复杂的查询,GINO 不会去无端猜测主人的意图,而全权交给用户来明确地定义。加载器的用法也是很简单的,比如一个用户可能写了很多本书: class Book(db.Model): __tablename__ = "books" id = db.Column(db.Integer, primary_key=True) title = db.Column(db.String) author_id = db.ForeignKey("users.id") 然后这样来加载这种多对一关系,以同时获取所有的书和他们的作者: query = Book.outerjoin(User).select() loader = Book.load(author=User) async for book in query.gino.load(loader).iterate(): print(book.title, "written by", book.author.name) 很简单的一个外连接查询 Book.outerjoin(User),配合一个直观的加载器 Book.load(author=User),就实现了: 执行 SELECT * FROM books LEFT JOIN users ON ...; 将数据库返回结果的每一行中,属于 books 的字段加载成一个 Book 实例; 然后将该行中剩下的属于 users 的字段加载成一个 User 实例; 最后将 User 实例设置到 Book 实例的 author 属性上。 既简单又明了有没有!你甚至可以手写任何 SQL,然后定制加载器自动加载成期望的对象关系,精准控制加载行为,指哪儿打哪儿。GINO 还有很多类似的特性,在这里就不一一列举了。 4. 优势与不足 随着这几年 GINO 不断演进成熟,Python 开源社区里也相继出现了像 Tortoise ORM、ORM(是的,这个项目就叫 ORM......我真 ORZ。出品方是 Encode,Starlette 就是他们的作品)等优秀的异步 ORM 框架。它们关注的重点与 GINO 稍有不同,但都是同行就不多评价了。 GINO 的最大优势还是在于充分平衡了开发效率和明确性之间的辩证矛盾关系,用 GINO 开发应用程序的时候不用担心会被意料之外的行为所惊吓到,同时也不需要为这种明确性付出过大的工程代价,上手后依然可以快速、快乐地编程。同时,大量的成功案例也证明了 GINO 已经初步具备发布 1.0 稳定版的各种条件,可以谨慎地用于生产环境了。 以下是近来统计到的关于 GINO 的应用案例: 笔者工作上开发的一个服务:https://github.com/uc-cdis/metadata-service 还是笔者自己写的一个工具:https://github.com/fantix/aintq 一个汇率 API 服务:https://exchangeratesapi.io/ 各种 Telegram、Discord 的 Bot。 ArchLinux 用户包:https://aur.archlinux.org/packages/python-gino/ https://github.com/bryanforbes/gino-stubs/ 俄语教程:https://www.youtube.com/watch?v=WW4rOnfhiQY 高性能模板项目:https://github.com/leosussan/fastapi-gino-arq-uvicorn 还有几个商用的,但没征得同意就不贴出来了。 另外,GINO 还贴心地提供了中文文档,从上手教程到原理说明应有尽有(虽然文档还在努力编写中!): GINO 目前的不足之处还有一些,比如没有照顾到 Python 3 的类型提示,因此还不能完全发挥 IDE 的潜能(上面那个 gino-stubs 就是有人受不了了自己写了一个类型注解)。MySQL 目前也是不支持的,但 GINO 从比较早就解耦了不同 SQL 方言和驱动的集成,所以这些功能会陆续在 1.1 和 1.2 版本中跟上。 5. 建设社会主义 GINO 是一个开源项目,所以欢迎大家一起来建设!长期活跃的贡献者还能获赠价值 4888 元 的 PyCharm 专业版全家桶 License 一枚。 目前急需帮助的有: 各个 Web 框架插件的维护工作需要多人认领; 更多的例子和文档,以及中文、俄文的翻译; MySQL 的支持。 以及下面这些一直需要的帮助: 用 GINO,找 bug,提建议; 修 bug,做功能,提 PR; 维护社区,回答问题,参与讨论; 最后也是最重要的:去 GitHub 上给 GINO 加一颗星星! 6. 关于作者 I'm a software architect, fan of coding for over 20 years, and now focusing on software engineering, high concurrency and development performance. Python is my chief language, and I worked on Linux for 10 years, managing development teams up to 20 people for 8 years. Big fan of open source, created project GINO with 1000+ GitHub stars. OPEN SOURCE Python / 2018-2019 I started to contribute to Python programming language with MagicStack fellows, focusing on the asyncio library. GINO / 2017-2019 GINO is an ORM library for Python asyncio. It is an integration of SQLAlchemy core and asyncpg. aioh2 / 2016 This is an integration of an HTTP/2 protocol library and Python 3 asyncio. tulipcore / 2015 I've implemented the most part of the event loop core of Gevent with pure Python 3 asyncio (tulip) code. zmq.rs / 2014 It was my attempt to implement the ZeroMQ stack in pure Rust. ArchLinux / 2013 - 2016 I maintained the packages of a dozen of build toolchains and base libraries of ArchLinux for x32-ABI, e.g. GCC, glibc, openssl, curl, util-linux, etc. Gevent / 2011 - 2013 I contributed the initial port of Gevent to Python 3, which was later merged into Gevent 1.1 by its new maintainer. I've also ported Greenlet to x32-ABI. Translations / 2008 - 2015 I was involved/started several translation projects, e.g. Ubuntu, libexif, Twisted, Python-beginners, ZeroMQ, etc.

优秀的个人博客,低调大师

每日一博 | 学习 JVM 参数前必须了解的

本文来自: PerfMa技术社区 PerfMa(笨马网络)官网 JVM参数是什么 大家照相通常使用手机就够用了,但是针对发烧友来说会使用更专业的设备,比如单反相机,在单反里有好几个模式,P/A/S/M,其中P是傻瓜模式,程序会自动根据环境设置快门速度和光圈大小,以得到相对合适的曝光效果。A档是光圈优先,用户可以自己设置光圈大小,快门速度等都交给相机程序来决定,类似半自动化的模式。S档是快门优先模式,和A档类似,只是用户可以设置快门速度。最后一个模式是M档,这是纯手动模式,由用户自己来调整快门速度,光圈大小等,这个对人的要求就会很高,但是很多专家往往都会选择M档来拍摄自己的作品。 可以把JVM想象成相机,JVM参数想象成光圈大小,快门速度之类的参数值,这些参数对程序的运行会影响挺大。 java程序跑在JVM上,JVM会根据环境自动设置一些JVM参数,但是这些参数并不能保证一定是最优的,有些参数在启动的时候就基本设置好了,它们在运行的时候还无法调整。为了让JVM能更好地运行你的程序,还是有必要对JVM参数有一定的理解,知道这些JVM参数分别在什么场景下有效果,起到什么作用,比如我们到底期不期望类可以卸载,是否可以在运行的时候打印一些日志协助我们了解JVM的运行情况,出问题的时候是否可以自动给我们做一些现场数据的保留等,这些都是可以通过JVM参数来设置的。 JVM参数有多少 相机调整的无非就那么几个参数值,那JVM参数到底有多少个呢,大概有1000多个,是不是让你很震惊,没错,确实有这么多。 大家可以到 JVM参数 | PerfMa应用性能技术社区 去看看所有这些JVM参数(注:这是PerfMa社区专门为大家分享JVM参数经验的讨论区),当然我们不一定非得对每个JVM参数要了解清楚,但是对一些常见的,有助于性能调优的JVM参数还是有必要了解一下的。 JVM参数通常设置的位置 我们启动一个java程序很简单,命令类似如下 java Main 我们都知道上面的Main是程序的启动类,JVM执行的时候会找到这个Main类里的如下签名的函数 Public static void main(String args[]) 那这里函数的参数args怎么传进来的呢?我们通过在启动命令的主类后面加上相关的参数,参数之间用空格分开,JVM会自动将这些参数作为args的组成部分传进来,比如 java Main arg1 arg2 这样,args这个数组里自动会填充arg1和arg2两个元素,这样在你的程序里就可以使用这些参数了 我们把arg1和arg2这些叫做程序参数,但是和我们课程相关的并不是程序参数,而是JVM参数,那JVM参数放到哪里呢?JVM参数都是放在主类之前,java命令之后,比如 java -Xmx100M Main arg1 arg2 这里的-Xmx100M其实就是JVM参数,所以所有的JVM参数都是放在这个位置的,如果不是这个位置,那你设置的JVM参数将会是无效的,如果参数出现不符合预期的情况,那请第一时间检查的是你JVM参数设置的位置,当然还可能存在一些别的原因导致JVM参数和你设置的情况可能不一致的情况 JVM参数的写法 那JVM参数具体怎么写呢,可以有好几种 “-X” 开头的,比如-Xmx100M “-XX: ” 开头的,比如-XX:+UseG1GC “-” 开头的,比如-verbose:gc 其中-X和-开头的通常会被转换为一个或者多个-XX:开头的参数,只是一个简化的写法,比如说-Xmx100M,JVM里会自动转化为-XX:MaxHeapSize=100M,-verbose:class会自动转换为-XX:+TraceClassLoading -XX:+TraceClassUnloading 通过Flags参数指定JVM参数文件 如果JVM参数都和源码伴着一起发布的话,如果仅仅修改JVM参数也必须拉个分支提交代码,这不是很友好,有什么好办法呢? 我们可以在启动参数里设置一个参数就好,这个参数类似如下 java -XX:Flags=/home/admin/flags Main arg1 arg2 设置过这个参数之后,我们只要在服务的/home/admin目录下创建flags文件,同时在这个文件里指定所有的JVM参数就可以了,但是对flags文件里的参数写法会有些要求,-X之类的参数不能设置,但是可以用其等价的-XX的参数来替代,比如说-Xmx100M,只能用-XX:MaxHeapSize=100M来取代,同时在文件里不要出现-XX:,只要key=value或许+/-key就可以了,不同的参数之间用换行或者空格分开即可,比如flags文件的内容如下: MaxHeapSize=8G +UseG1GC 其实等价于 -Xmx8G -XX:+UseG1GC 可以通过加上-XX:+PrintVMOptions可以打印设置过的JVM参数来验证,比如 java -XX:Flags=/home/admin/flags -XX:+PrintVMOptions Main arg1 arg2 通过VMOptionsFile参数来指定JVM参数文件 使用上面的Flags参数可能会比较别扭,因为设置参数和我们正常的写法不太一样,如果我们的JDK版本大于1.8的话,JVM提供了一个更人性化的参数,那就是VMOptionsFile来取代Flags,这也是指定一个文件,这个文件里的JVM参的写法和我们在java命令后写的JVM参数写法完全一样 java -XX:VMOptionsFile=/home/admin/flags Main arg1 arg2 在flags文件里我们可以这么写 -Xmx8G -XX:+UseG1GC 是不是方便了很多呢 开始JVM参数学习之旅 上面这些内容都了解清楚之后,就可以开始真正学习JVM参数了,我们也专门在社区给大家开了一门免费的学习JVM参数的课程,有兴趣的同学请到PerfMa社区进行了解学习,也欢迎大家参与讨论,慢慢揭开JVM参数的神秘面纱。 一起来学习吧: PerfMa KO 系列之 JVM 参数【Memory篇】

优秀的个人博客,低调大师

每日一博 | 如何通过 OIDC 协议实现单点登录?

什么是单点登录 我们通过一个例子来说明,假设有一所大学,内部有两个系统,一个是邮箱系统,一个是课表查询系统。现在想实现这样的效果:在邮箱系统中登录一遍,然后此时进入课表系统的网站,无需再次登录,课表网站系统直接跳转到个人课表页面,反之亦然。比较专业的定义如下: 单点登录(Single Sign On),简称为 SSO,是目前比较流行的企业业务整合的解决方案之一。 SSO 的定义是在多个应用系统中,用户只需要登录一次就可以访问所有相互信任的应用系统。 为什么要实现单点登录 单点登录的意义在于能够在不同的系统中统一账号、统一登录。用户不必在每个系统中都进行注册、登录,只需要使用一个统一的账号,登录一次,就可以访问所有系统。 通过 OIDC 协议实现单点登录 创建自己的用户目录 用户目录这个词很贴切,你的系统的总用户表就像一本书一样,书的封皮上写着“所有用户”四个字。打开第一页,就是目录,里面列满了用户的名字,翻到对应的页码就能看到这个人的邮箱,手机号,生日信息等等。无论你开发多少个应用,要确保你有一份这些应用所有用户信息的 truth source。所有的注册、认证、注销都要到你的用户目录中进行增加、查询、删除操作。你要做的就是创建一个中央数据表,专门用于存储用户信息,不论这个用户是来自 A 应用、B 应用还是 C 应用。 什么是 OIDC 协议 OIDC 的全称是 OpenID Connect,是一个基于 OAuth 2.0 的轻量级认证 + 授权协议,是 OAuth 2.0 的超集。它规定了其他应用,例如你开发的应用 A(XX 邮件系统),应用 B(XX 聊天系统),应用 C(XX 文档系统),如何到你的中央数据表中取出用户数据,约定了交互方式、安全规范等,确保了你的用户能够在访问所有应用时,只需登录一遍,而不是反反复复地输入密码,而且遵循这些规范,你的用户认证环节会很安全。 架设自己的 OIDC Provider 什么是 OIDC Provider 呢?我来举一个例子:你经常见到一些网站的登录页面上有「使用 Github 登录」、「使用 Google 登录」这样的按钮。要想集成这样的功能,你要先去 Github 那里注册一个 OAuth App,填写一些资料,然后 Github 分配给你一对 id 和 key。 此时 Github 扮演的角色就是 OIDC Provider,你要做的就是把 Github 的这种角色的行为,搬到你自己的服务器来。 在 Github 上面搜索 OIDC Provider 会有很多结果: JS:https://github.com/panva/node-oidc-provider Golang:https://github.com/dexidp/dex Python:https://github.com/juanifioren/django-oidc-provider ... 不再一一列举,你需要选择适合你的编程语言的 OIDC Provider 包,然后让它在你的服务器上运行起来。本文使用 JS 语言的 node-oidc-provider。 示例代码 Github 可以在 Github 找到本文示例代码: https://github.com/Authing/implement-oidc-sso-demo.git 创建文件夹 我们首先创建一个文件夹,用于存放代码: $ mkdir demo $ cd demo 克隆仓库 然后我们将 https://github.com/panva/node-oidc-provider.git 仓库 clone 到本地 $ git clone https://github.com/panva/node-oidc-provider.git 安装依赖 $ cd node-oidc-provider $ npm install 在 OIDC Provider 申请一个 Client 上一步讲到,Github 会分配给你一对 id 和 key,这一步其实就是你在 Github 申请了一个 Client。那么如何向我们自己的服务器上的 OIDC Provider 申请一对这样的 id 和 key 呢? 以 node-oidc-provider 举例,最快的获得一个 Client 的方法就是将 OIDC Client 所需的元数据直接写入 node-oidc-provider 的配置文件里面。 Wait wait wait,跨度有些大,这两者之间有什么关系?首先我们看,在 Github 上填写应用信息,然后提交,会发送一个 HTTP 请求到 Github 服务器。Github 服务器会生成一对 id 和 key,还会把它们与你的应用信息存储到 Github 自己的数据库里。所以,我们将 OIDC Client 所需的元数据直接写入到配置文件,可以理解成,我们在自己的数据库里手动插入了一条数据,为自己指定了一对 id 和 key 还有其他的一些 OIDC Client 信息。 修改配置文件 进入 node-oidc-provider 项目下的 example 文件夹: $ cd ./example 编辑 ./support/configuration.js ,更改第 16 行的 clients 配置,我们为自己指定了一个 client_id 和一个 client_secret,其中的 grant_types 为授权模式,authorization_code 即授权码模式,redirect_uris 数组是允许的业务回调地址,需要填写 Web App 应用的地址,OIDC Provider 会将临时授权码发送到这个地址,以便后续换取 token。 module.exports = { clients: [ { client_id: '1', client_secret: '1', grant_types: ['refresh_token', 'authorization_code'], redirect_uris: ['http://localhost:8080/app1.html', 'http://localhost:8080/app2.html'], }, ], ... } 启动 node-oidc-provider 在 node-oidc-provider/example 文件夹下,运行以下命令来启动我们的 OP: $ node express.js 到现在,我们的准备工作已经完成了,在讲如何在 Web App 中进行单点登录之前,我们先了解一下 OIDC 授权码模式。刚刚提到的许多术语:授权码模式、业务回调地址、临时授权码,可能这些概念你会感到陌生,下文会详细介绍。 OIDC 授权码模式 以下是 OIDC 授权码模式的交互模式,你的应用和 OP 之间要通过这样的交互方式来获取用户信息。 我们的 OIDC Provider 对外暴露一些接口 授权接口 每次调用这个接口,就像是对 OIDC Provider 喊话:我要登录,如第一步所示。 然后 OIDC Provider 会检查当前用户在 OIDC Provider 的登录状态,如果是未登录状态,OIDC Provider 会弹出一个登录框,与终端用户确认身份,登录成功后会将一个临时授权码(一个随机字符串)发到你的应用(业务回调地址);如果是已登录状态,OIDC Provider 会将浏览器直接重定向到你的应用(业务回调地址),并携带临时授权码(一个随机字符串)。如第二、三步所示。 token 接口 每次调用这个接口,就像是对 OIDC Provider 说:这是我的授权码,给我换一个 access_token。如第四、五步所示。 用户信息接口 每次调用这个接口,就像是对 OIDC Provider 说:这是我的 access_token,给我换一下用户信息。到此用户信息获取完毕。 为什么这么麻烦?直接返回用户信息不行吗? 因为安全,关于 OIDC 协议的安全性,又可以展开很大的篇幅,现在简单解释一下:code 的有效期一般只有十分钟,而且一次使用过后作废。OIDC 协议授权码模式中,只有 code 的传输经过了用户的浏览器,一旦泄露,攻击者很难抢在应用服务器拿这个 code 换 token 之前,先去 OP 使用这个 code 换掉 token。而如果 access_token 的传输经过浏览器,一般 access_token 的有效期都是一个小时左右,攻击者可以利用 access_token 获取用户的信息,而应用服务器和 OP 也很难察觉到,更不必说去手动撤退了。如果直接传输用户信息,那安全性就更低了。一句话:避免让攻击者偷走用户信息。 编写第一个应用 我们创建一个 app1.html 文件来编写第一个应用 demo,在 demo/app 目录下创建: $ touch app1.html 并写入以下内容: <!DOCTYPE html> <html lang="en"> <head> <meta charset="UTF-8" /> <meta name="viewport" content="width=device-width, initial-scale=1.0" /> <title>第一个应用</title> </head> <body> <a href="http://localhost:3000/auth?client_id=1&redirect_uri=http://localhost:8080/app1.html&scope=openid profile&response_type=code&state=455356436">登录</a> </body> </html> 编写第二个应用 我们创建一个 app2.html 文件来编写第二个应用 demo,注意 redirect_uri 的变化,在 demo/app 目录下创建: $ touch app2.html 并写入以下内容: <!DOCTYPE html> <html lang="en"> <head> <meta charset="UTF-8" /> <meta name="viewport" content="width=device-width, initial-scale=1.0" /> <title>第二个应用</title> </head> <body> <a href="http://localhost:3000/auth?client_id=1&redirect_uri=http://localhost:8080/app2.html&scope=openid profile&response_type=code&state=455356436">登录</a> </body> </html> 向 OIDC Provider 发起登录请求 现在我们启动一个 web 服务器,推荐使用 http-server $ npm install -g http-server # 安装 http-server $ cd demo/app $ http-server . 我们访问第一个应用:http://localhost:8080/app1.html 然后点击「登录」,也就是访问 OIDC Provider 的授权接口。然后我们来到了 OIDC Provider 交互环节,OIDC Provider 发现用户没有登录,要求用户先登录。node-oidc-provider demo 会放通任意用户名 + 密码,但是你在真正实施单点登录时,你必须使用你的用户目录即中央数据表中的用户数据来鉴权用户,相关的代码可能会涉及到数据库适配器,自定义用户查询逻辑,这些在 node-oidc-provider 包的相关配置中需要自行插入。 现在点击「登录」,转到确权页面,这个页面会显示你的应用需要获取那些用户权限,本例中请求用户授权获取他的基础资料。 点击「继续」,完成在 OP 的登录,之后 OP 会将浏览器重定向到预先设置的业务回调地址,所以我们又回到了 app1.html。 在 url query 中有一个 code 参数,这个参数就是临时授权码。code 最终对应一条用户信息,接下来看我们如何获取用户信息。 Web App 从 OIDC Provider 获取用户信息 事实上,code 可以直接发送到后端,然后在后端使用 code 换取 access_token。这里我使用 postman 演示如何通过 code 换取 access_token。 你可以使用 curl 命令来发送 HTTP 请求: $ curl --location --request POST 'http://localhost:3000/token' \ --header 'Content-Type: application/x-www-form-urlencoded' \ --data-urlencode 'client_id=1' \ --data-urlencode 'client_secret=1' \ --data-urlencode 'redirect_uri=http://localhost:8080/app2.html' \ --data-urlencode 'code=QL10pBYMjVSw5B3Ir3_KdmgVPCLFOMfQHOcclKd2tj1' \ --data-urlencode 'grant_type=authorization_code' 获取到 access_token 之后,我们可以使用 access_token 访问 OP 上面的资源,主要用于获取用户信息,即你的应用从你的用户目录中读取一条用户信息。 你可以使用 curl 来发送 HTTP 请求: $ curl --location --request POST 'http://localhost:3000/me' \ --header 'Content-Type: application/x-www-form-urlencoded' \ --data-urlencode 'access_token=I6WB2g0Rq9G307pPVTDhN5vKuyC9eWjrGjxsO2j6jm-' 到此,App 1 的登录已经完成,接下来,让我们看进入 App 2 是怎样的情形。 登录第二个 Web App 我们打开第二个应用,http://localhost:8080/app2.html 然后点击「登录」。 用户已经在 App 1 登录时与 OP 建立了会话,User ←→ OP 已经是登录状态,所以 OP 检查到之后,没有再让用户输入登录凭证,而是直接将用户重定向回业务地址,并返回了授权码 code。 同样,App 2 使用 code 换 access_token curl 命令代码: $ curl --location --request POST 'http://localhost:3000/token' \ --header 'Content-Type: application/x-www-form-urlencoded' \ --data-urlencode 'client_id=1' \ --data-urlencode 'client_secret=1' \ --data-urlencode 'redirect_uri=http://localhost:8080/app2.html' \ --data-urlencode 'code=QL10pBYMjVSw5B3Ir3_KdmgVPCLFOMfQHOcclKd2tj1' \ --data-urlencode 'grant_type=authorization_code' 再使用 access_token 换用户信息,可以看到,是同一个用户。 curl 命令代码: $ curl --location --request POST 'http://localhost:3000/me' \ --header 'Content-Type: application/x-www-form-urlencoded' \ --data-urlencode 'access_token=I6WB2g0Rq9G307pPVTDhN5vKuyC9eWjrGjxsO2j6jm-' 到此,我们实现了 App 1 与 App 2 之间的账号打通与单点登录。 登录态管理 到目前为止,看起来还不错,我们已经实现了两个应用之间账号的统一,而且在 App 1 中登录时输入一次密码,在 App 2 中登录,无需再次让用户输入密码进行登录,可以直接返回授权码到业务地址然后完成后续的用户信息获取。 现在我们来考虑一下退出问题 只退出 App 1 而不退出 App 2 这个问题实质上是登录态的管理问题。我们应该管理三个会话:User ←→ App 1、User ←→ App 2、User ←→ OP。 当 OP 给 App 1 返回 code 时,App 1 的后端在完成用户信息获取后,应该与浏览器建立会话,也就是说 App 1 与用户需要自己保持一套自己的登录状态,方式上可以通过 App 1 自签的 JWT Token 或 App 1 的 cookie-session。对于 App 2,也是同样的做法。 当用户在 App 1 退出时,App 1 只需清理掉自己的登录状态就完成了退出,而用户访问 App 2 时,仍然和 App 2 存在会话,因此用户在 App 2 是登录状态。 同时退出 App 1 和 App 2 刚才说到单点登录,与之相对的就是单点登出,即用户只需退出一次,就能在所有的应用中退出,变成未登录状态。 最先想到的是这种方式,我们在 OIDC Provider 进行登出。 之后我们的状态是这样的: 好吧,其实没有任何效果,因为用户和 App 1 之间的会话依然保持,用户和 App 2 之间的会话同样依然保持,所以用户在 App 1 和 App 2 的状态仍然是登录态。 所以,有没有什么办法在用户从 OIDC Provider 登出之后,App 1 和 App 2 的会话也被切断呢?我们可以通过 OIDC Session Mangement 来解决这个问题。 简单来说,App 1 的前端需要轮询 OP,不断询问 OP:用户在你那还登录着吗?如果答案是否定的,App 1 主动将用户踢下线,并将会话释放掉,让用户重新登录,App 2 也是同样的操作。 当用户在 OP 登出后,App 1、App 2 轮询 OP 时会收到用户已经从 OP 登出的响应,接下来,应该释放掉自己的会话状态,并将用户踢出系统,重新登录。 刚刚我们提到 OIDC Session Management,这部分的核心就是两个 iframe,一个是我们自己应用中写的(以下叫做 RP iframe),用于不断发送 PostMessage 给 OP iframe,OP iframe 负责查询用户登录状态,并返回给 RP iframe。 让我们把这部分的代码加上: 首先打开 node-oidc-provider 的 sessionManangement 功能,编辑 ./support/configuration.js 文件,在 42 行附近,进行以下修改: ... features: { sessionManagement: { enabled: true, keepHeaders: false, }, }, ... 然后和 app1.html、app2.html 平级新建一个 rp.html 文件,并加入以下内容: <script> var stat = 'unchanged'; var url = new URL(window.parent.location); // 这里的 '1' 是我们的 client_id,之前在 node-oidc-provider 中填写的 var mes = '1' + ' ' + url.searchParams.get('session_state'); console.log('mes: ') console.log(mes) function check_session() { var targetOrigin = 'http://localhost:3000'; var win = window.parent.document.getElementById('op').contentWindow; win.postMessage(mes, targetOrigin); } function setTimer() { check_session(); timerID = setInterval('check_session()', 3 * 1000); } window.addEventListener('message', receiveMessage, false); setTimer() function receiveMessage(e) { console.log(e.data); var targetOrigin = 'http://localhost:3000'; if (e.origin !== targetOrigin) { return; } stat = e.data; if (stat == 'changed') { console.log('should log out now!!'); } } </script> 在 app1.html 和 app2.html 中加入两个 iframe 标签: <iframe src="rp.html" hidden></iframe> <iframe src="http://localhost:3000/session/check" id="op" hidden></iframe> 使用 Ctrl + C 关闭我们的 node-oidc-provider 和 http-server,然后再次启动。访问 app1.html,打开浏览器控制台,会得到以下信息,这意味着,用户当前处于未登录状态,应该进行 App 自身会话的销毁等操作 然后我们点击「登录」,在 OP 完成登录之后,回调到 app1.html,此时用户变成了登录状态,注意地址栏多了一个参数:session_state,这个参数就是我们上文用于在代码中向 OP iframe 轮询时需要携带的参数。 现在我们试一试单点登出,对于 node-oidc-provider 包提供的 OIDC Provider,只需要前端访问 localhost:3000/session/end 收到来自 OP 的登出成功信息 我们转到 app1.html 看一下,此时控制台输出,用户已经登出,现在要执行会话销毁等操作了。 不想维护 App 1 与用户的登录状态、App 2 与用户的登录状态 如果不各自维护 App 1、App 2 与用户的登录状态,那么无法实现只退出 App 1 而不退出 App 2 这样的需求。所有的登录状态将会完全依赖用户与 OP 之间的登录状态,在效果上是:用户在 OP 一次登录,之后访问所有的应用,都不必再输入密码,实现单点登录;用户在 OP 登出,则在所有应用登出,实现单点登出。 使用 Authing 解决单点登录 以上就是一个完整的单点登录系统的轮廓,我们需要维护一份全体用户目录,进行用户注册、登录;我们需要自己搭建一个 OIDC Provider,并申请一个 OIDC Client;我们需要使用 code 换 token,token 换用户信息;我们需要在自己的应用中不断轮询 OP 的登录状态。 读到这里,你可能会觉得实现一套完整的单点登录系统十分繁琐,不仅要对 OIDC 协议非常熟悉,还要自己架设 OIDC Provider,并且需要自行处理应用、用户、OP 之间登录状态。有没有开箱即用的登录服务呢?Authing 能够提供云上的 OP,云上的用户目录和直观的控制台,能够轻松管理所有用户、完成对 OP 的配置。 Authing 对开发者十分友好,提供丰富的 SDK,进行快速集成。 如果你不想关心登录的细节,将 Authing 集成到你的系统必定能够大幅提升开发效率,能够将更多的精力集中到核心业务上。 欢迎体验:https://authing.cn 实现单点登录:https://docs.authing.cn/authing/quickstart/implement-sso-with-authing 相关阅读 为什么所有软件都应该使用单点登录来管理用户? 用 Authing 10 分钟实现单点登录 案例 | 在 Odoo 中集成 Authing 完成单点登录 Authing 插件上架 Odoo 官方市场,单点登录即可拥有 本文由博客一文多发平台 OpenWrite 发布!

优秀的个人博客,低调大师

每日一博 | 你应该了解的 Java SPI 机制

前言 不知大家现在有没有去公司复工,我已经在家办公将近 3 周了,同时也在家呆了一个多月;还好工作并没有受到任何影响,我个人一直觉得远程工作和 IT 行业是非常契合的,这段时间的工作效率甚至比在办公室还高,同时由于我们公司的业务在海外,所以疫情几乎没有造成太多影响。 扯远了,这次主要是想和大家分享一下 Java 的 SPI 机制。周末没啥事,我翻了翻我之前的写的博客 《设计一个可拔插的 IOC 容器》,发现当时的实现并不那么优雅。 还没看过的朋友的我先做个前景提要,当时的需求: 我实现了一个类似于的 SpringMVC 但却很轻量的 http 框架 cicada,其中当然也需要一个 IOC 容器,可以存放所有的单例 bean。 这个 IOC 容器的实现我希望可以有多种方式,甚至可以提供一个接口供其他人实现;当然切换这个 IOC 容器的过程肯定是不能存在硬编码的,也就是这里所提到的可拔插。 当我想使用 A 的实现方式时,我就引入 A 的 jar 包,使用 B 时就引入 B 的包。 先给大家看看两次实现的区别,先从代码简洁程度来说就是 SPI 更胜一筹。 什么是 SPI 在具体分析之前还是先了解下 SPI 是什么? 首先它其实是 Service provider interface 的简写,翻译成中文就是服务提供发现接口。 不过这里不要被这个名词搞混了,这里的服务发现和我们常听到的微服务中的服务发现并不能划等号。 就如同上文提到的对 IOC 容器的多种实现方式 A、B、C(可以把它们理解为服务),我需要在运行时知道应该使用哪一种具体的实现。 其实本质上来说这就是一种典型的面向接口编程,这一点在我们刚开始学习编程的时候就被反复强调了。 SPI 实践 接下来我们来如何来利用 SPI 实现刚才提到的可拔插 IOC 容器。 既然刚才都提到了 SPI 的本质就是面向接口编程,所以自然我们首先需要定义一个接口: 其中包含了一些 Bean 容器所必须的操作:注册、获取、释放 bean。 为了让其他人也能实现自己的 IOC 容器,所以我们将这个接口单独放到一个 Module 中,可供他人引入实现。 所以当我要实现一个单例的 IOC 容器时,我只需要新建一个 Module 然后引入刚才的模块并实现 CicadaBeanFactory 接口即可。 当然其中最重要的则是需要在 resources 目录下新建一个 META-INF/services/top.crossoverjie.cicada.base.bean.CicadaBeanFactory 文件,文件名必须得是我们之前定义接口的全限定名(SPI 规范)。 其中的内容便是我们自己实现类的全限定名: top.crossoverjie.cicada.bean.ioc.CicadaIoc 可以想象最终会通过这里的全限定名来反射创建对象。 只不过这个过程 Java 已经提供 API 屏蔽掉了: public static CicadaBeanFactory getCicadaBeanFactory() { ServiceLoader<CicadaBeanFactory> cicadaBeanFactories = ServiceLoader.load(CicadaBeanFactory.class); if (cicadaBeanFactories.iterator().hasNext()){ return cicadaBeanFactories.iterator().next() ; } return new CicadaDefaultBean(); } 当 classpath 中存在我们刚才的实现类(引入实现类的 jar 包),便可以通过 java.util.ServiceLoader 工具类来找到所有的实现类(可以有多个实现类同时存在,只不过通常我们只需要一个)。 一些都准备好之后,使用自然就非常简单了。 <dependency> <groupId>top.crossoverjie.opensource</groupId> <artifactId>cicada-ioc</artifactId> <version>2.0.4</version> </dependency> 我们只需要引入这个依赖便能使用它的实现,当我们想换一种实现方式时只需要更换一个依赖即可。 这样就做到了不修改一行代码灵活的可拔插选择 IOC 容器了。 SPI 的一些其他应用 虽然平时并不会直接使用到 SPI 来实现业务,但其实我们使用过的绝大多数框架都会提供 SPI 接口方便使用者扩展自己的功能。 比如 Dubbo 中提供一系列的扩展: 同类型的 RPC 框架 motan 中也提供了响应的扩展: 他们的使用方式都和 Java SPI 非常类似,只不过原理略有不同,同时也新增了一些功能。 比如 motan 的 spi 允许是否为单例等等。 再比如 MySQL 的驱动包也是利用 SPI 来实现自己的连接逻辑。 总结 Java 自身的 SPI 其实也有点小毛病,比如: 遍历加载所有实现类效率较低。 当多个 ServiceLoader 同时 load 时会有并发问题(虽然没人这么干)。 最后总结一下,SPI 并不是某项高深的技术,本质就是面向接口编程,而面向接口本身在我们日常开发中也是必备技能,所以了解使用 SPI 也是很用处的。 本文所有源码: https://github.com/TogetherOS/cicada 你的点赞与分享是对我最大的支持

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册