首页 文章 精选 留言 我的

精选列表

搜索[赛博朋克],共10000篇文章
优秀的个人博客,低调大师

每日一博 | Serverless 的运行原理与组件架构

本文重点探讨下开发者使用 Serverless 时经常遇到的一些问题,以及如何解决 过去一年,我们和大量 Serverless 用户进行了线上和线下的交流,了解大家的业务场景、对 Serverless 的看法和使用体验。 大部分用户认为 Serverless 会是云计算下一阶段的必然趋势,但不是现在。 为什么呢?因为构成 Serverless 架构的云函数尽管有引以为傲的自动扩缩能力,但是糟糕的开发体验、让人畏惧的冷启动、原有业务的改造难题等等,均降低了使用者的信心。 因此,尽管不少用户认可 Serverless 的价值,但依然认为其很难承载核心业务。 针对这些关键问题,腾讯云在今年 6 月份发布了 Serverless 2.0,全面升级了产品形态、系统调度以及开发者工具。为了便于大家理解,我们就从云函数的运行原理作为切入点,以解释问题产生的原因以及云函数的应对方法。 首先,我们看一下云函数,或者说 FaaS 和 IaaS、PaaS 的区别。 如下图所示,FaaS 不仅给用户提供了标准的 Runtime,同时在应用层也帮用户管理了请求的调度。开发者只需要聚焦在核心业务逻辑开发,按照函数的粒度去编写代码。而与底层硬件相关的资源维护,则交给更加专业的云厂商来搞定。 因此,对于用户来讲,可以把更多的精力和时间放在业务上。而 IaaS 和 PasS,则均需要用户去运维云主机或者容器集群、搭建业务所需的运行环境。 其次,我们来看下云函数如何构成 Serverless 架构,以及云函数如何帮助用户做资源管理和请求调度。 在这里我们也将解答云函数的冷启、降低核心业务迁移复杂度等问题。 如下图所示,开发者在实际使用时,可以借助 Web IDE 或者本地 IDE 完成代码开发,然后通过插件、工具等方式把代码及其相关依赖,一起打包部署到云函数平台,用户可以自行选择部署为函数形态或者服务形态。 在代码里,用户需要自己实现业务逻辑,比如访问数据库、对象存储、消息队列、第三方服务接口等。计算逻辑和后端服务共同构成了所谓的 Serverless 应用架构。而终端用户根据平台提供的请求方式,去触发部署在云函数平台上的业务代码,比如发送 http 请求,平台会根据用户的请求量去拉起相应的计算资源运行用户代码。 这里需要重点关注函数形态和服务形态的差异,因为服务的形态可以大大降低复杂业务迁移的成本。 服务形态支持直接部署基于框架开发的核心业务,如 Node.js 的 express、koa 等框架,不用为了应用 Serverless 而拆分成函数。平台会帮用户启动服务进程、端口监听,同时服务形态不会限制业务的实际运行时长。 函数形态和服务形态在收到用户请求的时候,均能实现自动扩缩。 函数形态会针对用户的每个请求都分配一个运行实例,因此所有请求的执行体验是一样的。当没有请求的时候,平台是没有实例在运行的,所以可以做到按需请求,但是这也会造成所谓的冷启动 —— 即当用户的首次请求进入平台的时候,平台会临时拉起资源,而这个过程会消耗一定的时间。为了消除冷启,云函数平台会预先初始化一批不同规格的实例放在资源池中,当用户有请求进入时,可以快速从资源池申请一个实例,直接挂载用户的代码运行,从而降低了资源申请时间。同时,针对函数形态,平台会根据历史并发数据进行预测,帮用户预留一定量的实例,这些实例会预先分配到用户的账号下并且加载好了用户的代码,从而不仅直接消除了冷启,也增加了实例复用几率。 而服务形态可以至少帮用户预留一个常驻实例,并且把用户的所有请求都投递到首个实例,根据实例的使用情况,自动的动态扩缩。 函数形态更适合新建项目,可以敏捷迭代,业务按照函数的粒度开发,不仅可以轻松实现云上多产品的联动,也可以享受函数的高并发及性能一致体验。服务形态更适合已有项目的迁移、重度复杂业务、需要长时运行的业务。 最后讲讲 Serverless 2.0 的组件架构。 如下图所示,用户虽然只需要关注绿色部分和业务相关的代码实现,但是平台也需要提供强大的开发者工具来保障开发和使用体验。如云函数推出的 Serverless 本地开发工具、VS Code 插件,与 CODING 联合推出的 Web IDE、DevOps 平台等,均能很大程度上提升开发、部署效率,实现本次开发、本地调试、联动云端调试、本地部署、版本发布等能力。 同时,云函数也完善了配套的监控和告警机制,提供如调用次数、内存使用、并发使用、超时、代码错误等多维度的监控和告警能力。这些基础设施、资源管理、安全、容灾等能力,是云函数平台必备的基础能力,也是开发者关心的核心能力。 Serverless 不仅仅是计算,还需要不断完善周边生态。 随着用户量的增加,Serverless 必然会面临更多的挑战 —— 怎么帮助用户组织管理代码,怎么解决带状态的业务诉求,怎么实现数据库连接数管理,怎么实现应用级部署等等。我们也在不断探索和优化用户的使用体验,计划提供诸如 Serverless DB、性能监控、日志分析、Serverless 框架、函数编排、高性能调用等功能。 后续的专栏文章也将陆续解读更多核心能力,帮助开发者更好地理解和使用 Serverless。 Serverless is more! 传送门: GitHub: github.com/serverless 官网:serverless.com 欢迎访问:Serverless 中文网,您可以在 最佳实践 里体验更多关于 Serverless 应用的开发! 推荐阅读:《Serverless 架构:从原理、设计到项目实战》

优秀的个人博客,低调大师

每日一博 | 看完这篇,Docker 你就入门了

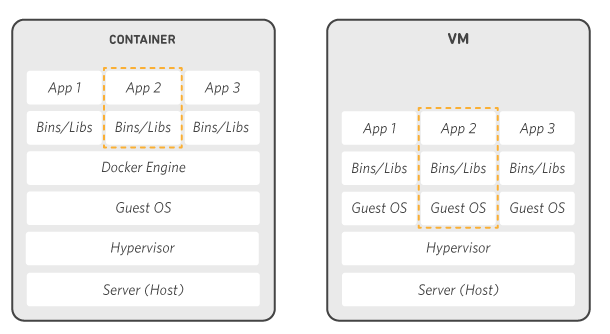
在计算机技术日新月异的今天,Docker在国内发展的如火如荼,特别是在一线互联网公司,Docker的使用是十分普遍的,在理解docker之前,我们先熟悉两个概念,容器和虚拟机。 一、容器与虚拟机 传统的虚拟机有VMware, VirtualBox ,它们需要模拟整台机器包括硬件,每台虚拟机都需要有自己的操作系统,虚拟机一旦开启,预分配给它们的资源将全部被占用。每一台虚拟机包括应用,必要的二进制和库,以及一个完整的用户操作系统。 而容器技术是和我们的宿主机共享硬件资源及操作系统,可以实现资源的动态分配。容器包含应用和其所有的依赖包,但是与其他容器共享内核。容器在宿主机操作系统中,在用户控件以分离的进程运行。 容器技术是实现操作系统虚拟化的一种途径,可以让您在资源受到隔离的进程中运行应用程序及其依赖关系。通过使用容器,我们可以轻松打包应用程序的代码、配置和依赖关系,将其编程容易使用的构建块,从而实现环境一致性、运营效率、开发人员生产力和版本控制等诸多目标。容器帮助保证应用程序快速、可靠、一致性部署,其间不受部署环境的影响。容器还赋予我们对资源更多的精细化控制能力,让我们的基础设施效率更高、通过下面这张图我们可以很直观的反映出二者的区别。 Docker属于Linux容器的一种封装,提供简单易用的容器使用接口。它是目前最流行的Linux容器解决方案。 Linux容器不是模拟一个完整的操作系统,而是对进程进行隔离,相当于在正常进程的外面套了一个保护层。对于容器里面的进程来说,它接触到的各种资源都是虚拟的,从而实现与底层系统的隔离。 Docker将应用程序与该程序的依赖,打包在一个文件里。运行这个文件,就会生成一个虚拟容器,程序在这个虚拟容器里运行,就好像在真实的物理机上运行一样,有了Docker,就不用担心环境问题。 总体来说,Docker的接口相当简单,用户可以方便的创建和使用容器,把自己的应用放入容器,容器还可以进行版本管理,复制,分享,修改,就像管理代码一样。 二、Docker的优势 1、Docker启动快速,属于秒级别。虚拟机通常需要几分钟去启动。 2、Docker需要的资源更少,Docker在操作系统级别进行虚拟化,Docker容器和内核交互,几乎没有性能损耗,性能优于通过 Hypervisor层与内核层的虚拟化 3、Docker更轻量,Docker的架构可以共用一个内核与共享应用程序库,所占内存极小。同样的硬件环境,Docker运行的镜像数远低于虚拟机数量,对系统的利用率非常高 4、安全性, Docker的安全性也更弱。Docker的租户root和宿主机root等同,一旦容器内的用户从普通用户权限提升为root权限,它就直接具备了宿主机的root权限,进而可进行无限制的操作。虚拟机租户root权限和宿主机的root虚拟机权限是分离的,并且虚拟机利用如intel的vt-d和vt-x的ring-1硬件隔离技术,这种隔离技术可以防止虚拟机突破和彼此交互,而容器至今还没有任何形式的硬件隔离,这使得容器容易受到攻击 5、可管理性:Docker的集中化管理工具还不算成熟。各种虚拟化技术都有成熟的管理工具,例如VMware Vcentor提供完备的虚拟机管理能力 6、高可用和可恢复性: Docker对业务的高可用支持是通过快速重新部署实现的。虚拟化具备负载均衡,高可用,容错,迁移和数据保护等经过生产实践检验的成熟保障机制,VMware可承诺虚拟机99.9999%高可用,保证业务连续性 7、 交付、部署:虚拟机可以通过镜像实现环境交付的一致性,但镜像分发无法体系化。Docker在Dockerfile中记录了容器构建过程,可在集群中实现快速分发和快速部署 三、Docker的三个基本概念 从上图我们可以看到,Docker中包括三个基本的概念: Image(镜像) Container(容器) Repository(仓库) 1、镜像是Docker运行容器的前提,仓库是存放镜像的场所,可见镜像是Docker的核心。 那么镜像到底是什么呢? Docker镜像可以看作是一个特殊的文件系统,除了提供容器运行时所需的程序、库、资源、配置等文件外,还包含了一些为运行时准备的一些配置参数。镜像不包含任何动态数据,其内容在构建之后也不会被改变。 2、Container (容器) 容器的定义和镜像几乎一模一样,也是一堆层的统一视角,唯一区别在于容器的最上面那一层是可读可写的。 由于容器的定义并没有提及是否要运行容器,所以实际上,容器 = 镜像 + 读写层。 3、Repository(仓库) Docker仓库是集中存放镜像文件的场所,镜像构建完成后,可以很容易在当前宿主上运行,但是,如果需要在其他服务器上使用这个镜像,我们需要一个集中的存储、分发镜像的服务,Docker Registry(仓库注册服务器)就是这样的服务。有时候会把仓库(Repository)和仓库注册服务器(Registry)混为一谈,并不严格区分。 实际上,一个DockerRegistry中可以包含多个仓库(Repository),每个仓库可以包含多个标签 ,每个标签对应着一个镜像。所以说,镜像仓库是Docker用来集中存放镜像文件的地方类似于我们之前常用的代码仓库。 仓库又可以分为两种形式: (1)public(共有仓库) DockerRegistry公有仓库是开放给用户使用、允许用户管理镜像的Registry服务。一般这类公开服务允许用户免费上传、下载公开的镜像,并可能提供收费服务供用户管理私有镜像。 (2)private(私有仓库) Docker官方提供了DockerRegistry镜像,可以直接使用做为私有Registry服务。当用户创建了自己的镜像之后就可以使用push命令将它上传到公有或者私有仓库,这样下次在另外一台机器上使用这个镜像时候,只需要从仓库上 pull下来就可以了。 四、Docker的架构 Docker使用C/S架构,即客户端/服务器体系结构。Docker客户端与Docker服务器进行交互,Docker服务端负责构建、运行和分发Docker镜像。Docker客户端与服务端可以运行在一台机器上,也可以通过RESTful、stock或网络接口与远程Docker服务端进行通信。 这张图展示了Docker客户端、服务端和Docker仓库(即Docker Hub和DockerCloud),默认情况下Docker会在Docker中央仓库寻找镜像文件,这种利用仓库管理镜像的设计理念类似于Git,当然这个仓库是可以通过修改配置来指定的,甚至我们可以创建我们自己的私有仓库。 Docker采用的是C/S架构,客户端向服务器发送请求,服务器负责构建、运行和分发容器。客户端和服务器可以运行在同一个Host上,客户端也可以通过socket或REST API与远程的服务器通信。 1、Docker Client Docker客户端其实就是Docker提供命令行界面工具,是许多Docker 用户与Docker 进行交互的主要方式。客户端可以构建、运行和停止应用程序,还可以远程与Docker_HOST进行交互。 最常用的Docker客户端就是Docker命令,我们可以通过Docker命令很方便地在host上构建和运行Docker容器。 2、DockerDaemon DockerDaemon是服务器组件,以Linux后台服务的方式运行,是Docker最核心的后台进程,我们也把它称为守护进程。它负责相应来自Docker Client的请求,然后将这些请求翻译成系统调用完成容器管理操作。该进程会在后台启动一个API Server,负责接收由Docker Client发送的请求,接收到的请求将通过DockerDaemon内部的一个路由分发调用,由具体的函数来执行请求。 DockerDaemon的架构如下所示: DockerDaemon可以认为是通过Docker Server模块接受Docker Client的请求,并在Engine中处理请求,然后根据请求类型,创建出指定的Job并运行。DockerDaemon运行在Docker Host上,负责创建、运行、监控容器,构建、存储镜像。 运行过程的作用有以下几种可能: 向Docker Registry获取镜像 通过grapthdriver执行容器镜像的本地化操作 通过networkdriver执行容器网络环境的配置 通过execdriver执行容器内部运行的执行工作 由于DockerDaemon和Docker Client的启动都是通过可执行文件Docker来完成的,因此两者的启动流程非常相似。Docker可执行文件运行时,运行代码通过不同的命令行flag参数,区分两者,并最终运行两者各自相应的部分。 启动DockerDaemon时,一般可以使用一下命令来完成 docker --daemon = true docker –d docker –d = true 再由docker的main函数来解析以上命令的相应的flag参数,并最终完成DockerDaemon的启动。 DockerDaemon的启动流程: 默认配置下, DockerDaemon只能相应来自本地host的客户端请求。如果要允许远程客户端请求,需要在配置文件中打开TCP监听。我们可以照着如下步骤进行配置: (1)编辑配置文件/etc/systemd/system/multi-user.target.wants/docker.service,在环境变量ExecStart后面添加-H tcp://0.0.0.0,允许来自任意 IP 的客户端连接。 (2)重启 DockerDaemon systemctl daemon-reload systemctl restart docker.service (3)我们通过以下命令即可实现与远程服务器通信 docker -H 服务器IP地址 info -H是用来指定服务器主机,info子命令用于查看docker服务器的信息 3、Docker Image Docker镜像可以看作是一个特殊的文件系统,除了提供容器运行时所需的程序、库、资源、配置等文件外,还包含了一些为运行时准备的一些配置参数(如匿名卷、环境变量、用户等)。镜像不包含任何动态数据,其内容在构建之后也不会被改变。我们可将Docker镜像看成只读模板,通过它可以创建Docker容器。 镜像有多种生成方法: 从无到有开始创建镜像 下载并使用别人创建好的现成的镜像 在现有镜像上创建新的镜像 我们可以将镜像的内容和创建步骤描述在一个文本文件中,这个文本文件称作Dockerfile,通过执行docker build<docker-file>命令可以构建出docker镜像。 4、Docker Registry Docker Registry是存储Docker Image的仓库,它在Docker生态环境中的位置如下图所示: 运行Docker Push、Docker pull、Docker search时,实际上是通过DockerDaemon与 Dockerregistry通信。 5、Docker Container Docker容器就是Docker镜像的运行实例,是真正运行项目程序、消耗系统资源、提供服务的地方。DockerContainer提供了系统硬件环境,我们可以使用Docker Image这些制作好的系统盘,再加上我们编写好的项目代码,run一下就可以提供服务了。 五、Docker组件如何协作运行容器 容器启动过程如下: Docker客户端执行docker run命令 Docker Daemon发现本地没有hello-world镜像 Daemon从Docker Hub下载镜像 下载完成,镜像hello-world被保存到本地 Docker Daemon启动容器 具体过程可以看如下这幅演示图: 我们可以通过Docker Image可以查看到hello-world已经下载到本地 六、Docker常用命令 我们可以通过docker -h去查看命令的详细的帮助文档。在这里我只会讲一些平常日常比赛或者生活中我们可能会用的比较多的一些命令。 例如,我们需要拉取一个docker镜像,我们可以用如下命令: docker pull image_name image_name为镜像的名称,而如果我们想从Docker Hub上去下载某个镜像,我们可以使用以下命令: docker pull centos:latest centos:lastest是镜像的名称,Docker daemon发现本地没有我们需要的镜像,会自动去Docker Hub上去下载镜像,下载完成后,该镜像被默认保存到/var/lib/docker目录下。 接着我们如果想查看下主机下存在多少镜像,我们可以用如下命令: docker images 我们要想知道当前有哪些容器在运行,我们可以用如下命令: docker ps -a -a是查看当前所有的容器,包括未运行的 我们该如何去对一个容器进行启动,重启和停止呢?我们可以用如下命令: docker start container_name/container_id docker restart container_name/container_id docker stop container_name/container_id 这个时候我们如果想进入到这个容器中,我们可以使用attach命令: docker attach container_name/container_id 那如果我们想运行这个容器中的镜像的话,并且调用镜像里面的bash,我们可以使用如下命令: docker run -t -i container_name/container_id /bin/bash 那如果这个时候,我们想删除指定镜像的话,由于image被某个container引用(拿来运行),如果不将这个引用的container销毁(删除),那image肯定是不能被删除。我们首先得先去停止这个容器: 然后我们用如下命令去删除这个容器: docker ps docker stop container_name/container_id 然后这个时候我们再去删除这个镜像: docker rmi image_name 此时,常用的Docker相关的命令就讲到这里为止了,我们在后续的文章中还会反复地提到这些命令。 七、Dockerfile Dockerfile是自动构建docker镜像的配置文件,用户可以使用Dockerfile快速创建自定义的镜像,Dockerfile中的命令非常类似于Linux下的shell命令。 我们可以通过下面这幅图来直观地感受下 Docker 镜像、容器和 Dockerfile 三者之间的关系。 我们从上图中可以看到,Dockerfile可以自定义镜像,通过Docker命令去运行镜像,从而达到启动容器的目的。 Dockerfile 是由一行行命令语句组成,并且支持已#开头的注释行。 一般来说,我们可以将Dockerfile分为四个部分: 基础镜像(父镜像)信息指令FROM 维护者信息指令MAINTAINER 镜像操作指令RUN、EVN、ADD和WORKER等 容器启动指令CMD、ENTRYPOINT和USER等 下面是一段简单的Dockerfile的例子: 1、从Docker Hub上pull下python 2.7的基础镜像 2、显示维护者的信息 3、copy当前目录到容器中的/app目录下 复制本地主机的<src>(Dockerfile所在目录的相对路径)到容器里<dest> 4、指定工作路径为/app 5、安装依赖包 6、暴露5000端口 7、启动app 这个例子是启动一个Python flask app的Dockerfile(flask是Python的一个轻量级的web框架),相信大家从这个例子中能够稍微理解了Dockerfile的组成以及指令的编写过程。 八、构建Dockerfile代码实例 mkdir static_web cd static_web touch Dockerfile 然后 vi Dockerfile 开始编辑该文件 输入 i 开始编辑 以下是我们构建的Dockerfile内容 `````````` FROM nginx MAINTAINER Angel_Kitty <angelkitty6698@gmail.com> RUN echo '<h1>Hello, Docker!</h1>' > /usr/share/nginx/html/index.html `````````` 编辑完后 按 esc 退出编辑 然后 :wq 写入 退出 我们在Dockerfile文件所在目录执行: docker build -t angelkitty/nginx_web:v1 . 我们解释一下,-t是为新镜像设置仓库和名称,其中angelkitty为仓库名,nginx_web为镜像名,:v1为标签(不添加为默认latest) 我们构建完成之后,使用docker images命令查看所有镜像,如果存在REPOSTORY为nginx和TAG是v1的信息,就表示构建成功。 接下来使用docker run命令来启动容器 docker run --name nginx_web -d -p 8080:80 angelkitty/nginx_web:v1 这条命令会用nginx镜像启动一个容器,命名为nginx_web,并且映射了 8080 端口,这样我们可以用浏览器去访问这个nginx服务器:http:localhost:8080或者 http://本机的IP地址:8080/,页面返回信息: 这样一个简单使用Dockerfile构建镜像,运行容器的示例就完成了!

优秀的个人博客,低调大师

每日一博 | 利用 VisualVM 分析高并发项目性能

前面在学习JVM的知识的时候,一般都需要利用相关参数进行分析,而分析一般都需要用到一些分析的工具,因为一般使用IDEA,而VisualVM对于IDEA也不错,所以就选择VisualVM来分析JVM性能,这篇文章就介绍一下如何利用VisualVM进行性能分析,以及在分析之前需要知道一些GC优化的原则,GC优化的目的,以及遇到问题时怎么去解决问题的方法。 1 为什么需要 开发大型 Java 应用程序的过程中难免遇到内存泄露、性能瓶颈等问题,比如文件、网络、数据库的连接未释放,未优化的算法等。随着应用程序的持续运行,可能会造成整个系统运行效率下降,严重的则会造成系统崩溃。为了找出程序中隐藏的这些问题,在项目开发后期往往会使用性能分析工具来对应用程序的性能进行分析和优化。 VisualVM 是一款免费的性能分析工具。它通过 jvmstat、JMX、SA(Serviceability Agent)以及 Attach API 等多种方式从程序运行时获得实时数据,从而进行动态的性能分析。同时,它能自动选择更快更轻量级的技术尽量减少性能分析对应用程序造成的影响,提高性能分析的精度。 2 如何安装 这里有两种方式: 没有按照IDEA插件 如果没有按照IDEA插件的话,我们需要找到JDK的按照目录bin下找到如下执行程序。 然后双击执行,就会出现界面,如下; 但是,我们一般使用IDEA,所以会使用插件,就是下面这种方式。 按照IDEA插件 先在插件中找到VisualVM安装; 安装了之后,在运行的地方就会多出现两个VisualVM的运行按钮; 这样运行程序之后,就可以自动打开VisualVM程序了。 3 基本介绍 这一部分先对这个工具做一个简要的介绍,看看基本有哪些我们会用到的功能。 在没有添加其他插件的时候,是只有下面几个功能的。 3.1 概述 如上图所示,概述基本上都是我们的系统属性、运行程序时设置的JVM参数等信息的展示,所以,这一部分可以让我们查看这些信息。 3.2 监视 监视这个界面的功能还是很有作用的,可以看到cup运行情况、堆的使用情况、类的情况以及线程的动态情况。 因此,我们可以利用这个界面查看cpu情况好不好,更重要的是,我们可以查看堆的使用情况,这对于我们分析JVM还是非常重要的。 3.3 线程 如上图所以,可以看到所有的线程的情况,是运行、休眠、等待、驻留、监视等情况。 注意, 以上这些都不是关键,关键是VisualVM中还有一个很重要的功能,可以添加插件获取更多的功能。 3.4 插件添加 正是因为有了插件的扩展功能,所以这个工具才如此强大,VisualVM可以做到以下: 显示虚拟机进程以及进程的配置、环境信息、jps、jinfo。 监视应用程序的cpu、GC、堆、方法区以及线程的信息(jstat、jstack)。 dump以及分析堆转存储快照(jmap、jhat)。 还有很多其他的功能。 在工具->找到可用插件,安装即可。 下一部分我们就利用已经安装的插件Visual GC进行分析。 4 利用Visual GC分析虚拟机内存区域 这部分会用到一些Java虚拟机的一些基础知识,所以,查看这部分之前,请先查看这篇文章:。 在这个界面分为以下几个部分。 space(Metaspace(元数据)、Old老年代、新生代(Eden、S0、S1)) Graphs(Compile Time(编译时间)、Class Loader Time(类加载时间)、GC Time(垃圾收集时间)、Eden Space、Survivor 0、Survivor 1、Old Gen、Metaspace) Histogram(Parameters参数设置) 那么知道这些参数之后,怎么去分析虚拟机到底运行是好是坏呢,这个时候,我们需要了解一些Java虚拟机基础的优化知识。 首先,需要了解一些GC优化的原则。 多数的Java应用不需要在服务器上进行GC优化; 多数导致GC问题的Java应用,都不是因为我们参数设置错误,而是代码问题; 在应用上线之前,先考虑将机器的JVM参数设置到最优(最适合); 减少创建对象的数量; 减少使用全局变量和大对象; GC优化是到最后不得已才采用的手段; 在实际使用中,分析GC情况优化代码比优化GC参数要多得多; 另外,我们需要知道我们GC优化的目的。 将转移到老年代的对象数量降低到最小; 减少full GC的执行时间; 一般,我们需要执行的有以下几点; 减少使用全局变量和大对象; 调整新生代的大小到最合适; 设置老年代的大小为最合适; 选择合适的GC收集器; 至于怎么算合适,后面我会通过一个实例讲解。 其实,如果想要知道更多JVM内存分配和回收策略的原理,可以查看这篇文章:JVM内存分配和回收策略的原理。 一般我们执行了我们的程序之后,接下来就是需要查看GC的状态了,接着分析结果,判断是否需要进行优化。 一般如果达到以下的指标,就不需要进行GC了。 Minor GC执行时间不到50ms,Minor GC执行不频繁,约10秒一次; Full GC执行时间不到1s,Full GC执行频率不算频繁,不低于10分钟1次; 实例 1 我们先看一个GC状态需要优化的例子,在这个实例中,我们给堆分配的最大最小的值都是64M(很小的堆大小)。 GC状态差情况分析 /** * VM Args:-Xms64m -Xmx64m -XX:+HeapDumpOnOutOfMemoryError * @author 欧阳思海 */ public class HeapTest { static class StaticObject { } public static void main(String[] args) { List<StaticObject> list = new ArrayList<StaticObject>(); int i = 1; //不断的向堆中添加对象 while (true) { list.add(new StaticObject()); i++; System.out.println(i); System.out.println(list.size()); } } } 由于分配的堆内存太小,所以导致,堆溢出。 接着我们查看一下Visual GC的监视情况。 监视界面情况 我们可以从堆的使用情况看出,基本已经使用完。 Visual GC监视情况 从上图可知,在短短的运行时间中,Eden进行了49次GC,虽然时间短,但是能说明一个问题,新生代堆内存分配的空间太小,导致频繁GC。 同时,Old老年代也进行了33次GC,虽然运行时间也在不需要优化的范围内,而且从Survivor可以看出,基本没有GC,说明这些都是大对象,直接进入到了Old老年代,导致GC频繁。 所以,我们需要进行的优化就是加大新生代和老年代堆内存的大小,同时减少大对象的产生。 参数优化分析 我们将VM参数改为:-Xms512m -Xmx512m -Xmn128m -XX:+HeapDumpOnOutOfMemoryError,运行大概5分钟再次查看结果。 首先没有出现堆内存溢出。 监视情况 加大了堆内存,所以堆内存没有出现问题。 Visual GC监视情况 加大了堆内存之后,Eden新生代进行了66次GC,使用时间3.381s基本满足要求(执行时间不到50ms,Minor GC执行不频繁,约10秒一次),同时老年代old进行了2次GC,使用时间4.127s,这里还是有待优化的,不太满足优化要求。 dump文件分析 点击堆 dump这个按钮就会生成 dump文件,我们可以分析类及对象的一些情况。 分析之后发现,StaticObject对象大多,没有进行GC,问题主要在这里,所以,下一步需要解决这个问题。 通过以上分析可以说明一个问题,加大了堆内存之后,新生代和老年代的GC情况大大的改善了,但是还有大对象的问题,所以还有待优化。 修改大对象,进行GC 修改程序,如下: /** * VM Args:-Xms512m -Xmx512m -Xmn128m -XX:+HeapDumpOnOutOfMemoryError * * @author 欧阳思海 */ public class HeapTest { /* static class StaticObject { }*/ public static void main(String[] args) { int i = 1; while (true) { i++; System.out.println(i); } } } 监视情况 堆一直运行良好。 Visual GC监视情况 这次相对于上次相比,老年代的情况已经改善了,没有GC,说明大对象不存在了。 通过上面的分析跟优化,就满足GC的需求了,不需要再优化了。 5 总结 通过上面的分析及使用,VisualVM基本的使用以及如何利用VisualVM进行Java虚拟机优化相信你已经掌握了,如果还想了解更过关于Java虚拟机的知识及优化文章,请看本系列的其他文章。 1、原创不易,老铁,文章需要你的 点赞 让更多的人看到,希望能够帮助到大家! 2、文章有不当之处,欢迎指正,如果喜欢微信阅读,你也可以关注我的微信公众号:好好学java,公众号已有 6W 粉丝,回复:1024,获取公众号的大礼包,公众号长期发布 Java 优质系列文章,关注我们一定会让你收获很多!

优秀的个人博客,低调大师

每日一博 | 2020年 我要这样写代码

在 9102 年年初,一位室友问我一个问题,如何才能够提升写代码的能力? 可惜的是: 当时仅仅回复了一些自己的想法,如多看开源代码,多读书,多学习,多关注业界的动向与实践,同时也列了一些原则。但是这些并没有所总结,又或者说没有例子的语言始终是空泛的。所以在今年年底之际,对应着今年中遇到的形形色色的代码问题来一一讲解一下。 好代码的用处 实际上本书建立在一个相当不可靠的前提之上:好的代码是有意义的。我见过太多丑陋的代码给他们的主人赚着大把钞票,所以在我看来,软件要取得商业成功或者广泛使用,“好的代码质量”既不必要也不充分。即使如此,我仍然相信,尽管代码质量不能保证美好的未来,他仍然有其意义:有了质量良好的代码以后,业务需求能够被充满信心的开发和交付,软件用户能够及时调整方向以便应对机遇和竞争,开发团队能够再挑战和挫折面前保持高昂的斗志。总而言之,比起质量低劣,错误重重的代码,好的代码更有可能帮助用户取得业务上的成功。 以上文字摘抄于《实现模式》的前言,距离本书翻译已经时隔 10 年了,但是这本书仍旧有着很大的价值。同时对于上述言论,我并不持否认意见。但是我认为,坏代码比好代码更加的费财(嗯,没打错,我确定)。对于相同的业务需求,坏代码需要投入的精力,时间更多,产出反而会更少。同时根据破窗理论( 此理论认为环境中的不良现象如果被放任存在,会诱使人们仿效,甚至变本加厉 ),坏代码会产生更坏的代码。这是一个恶性循环,如果不加以控制,完成需求的时间会慢慢失去控制。需要完成需求的人也会失落离开。 也就是说,好代码可以实现多赢,能够让用户爽,能够让老板爽,能够让开发者爽。总之,大家爽才是真的爽。 怎么写出好代码 少即使多 利用开源出来的设计与代码来减轻来自于业务线的时间压力。 The best way to write secure and reliable applications. Write nothing; deploy nowhere. 以上取自 github 上最火的项目之一 nocode。懒惰是程序员的美德之一。所以学习业务,理解业务,拒绝不必要的需求也是一个程序员的必修功课。详情可以参考如何杜绝一句话需求? 这一篇 blog,当然,在大部分场景下,我们是不具备对需求说不的能力与权力的,但是无论如何,深度的理解业务,对客户有同理心是对程序员的更高要求。解决问题才是一个程序员需要做的事情。能够理解好题意才能解决问题。 对于软件开发而言,时间一定是最宝贵,最有价值的资源。相应的,尽量把时间耗费在解决新的问题,而不是对已经存在确切解决方案的问题老调重弹。所以,尽量不要自己写代码,而是借用别人的设计与实现。而在事实上,你也很难在极短的时间压力下设计并完成比开源更加合适的代码。 当然,开源作者一定是想让他的产品有更多的受众,所以从设计上而言,会采用较为通用的设计,如果你的需求较为特殊并且你觉得不能说服作者帮你“免费打工”(或者作者拒绝了),那么你也只需要在特定之处进行包装与改写,但是要比完全重写要简单太多了。 当然,调研新的技术方案并且使用到项目中是一种能力,但是千万不要因为一个小功能添加一个非常大的项目。 笔者在之前就遇到过其他小伙伴因为无法使用数字四舍五入。说 fixed 方法有问题而使用 math.js 的小伙伴。 (11.545).toFixed(2) // "11.54" 如果想要了解 fixed 方法为何有问题的,可以参考 为什么(2.55).toFixed(1)等于2.5? 作者以 v8 源码来解释为何会有这样的问题,以及提供了部分修正 fixed 的方案。 事实上如果没有很大的精度需求,前端完完全全利用一个函数便可以解决的问题,完全不需要复杂的math 这种高精度库。 function round(number, precision) { return Math.round(+number + 'e' + precision) / Math.pow(10, precision); } 当然,也有小伙伴来找我询问大量数据的表格优化,我第一反应就是 React Infinite 或者 vue-infinite-scroll 此类解决方案。但是对方能够多提供一些信息包括上下文,采用的技术栈,当前数据量大小,未来可能需要达到的大小,当前表格是否需要修改等。得到了这些信息,结合业务来看,相比于增加一个库,是否如下方式更为便捷与快速。 // 因为 vue 模型的原因,使用 Object.freeze 性能可以有很大增益 this.xxx = Object.freeze(xxx); 随着堆积业务,代码的增长。管理复杂度的成本与日俱增,把依赖降低。 利用开源代码使得任务更容易实现。时间就是成本。关键是让收益可以最大化。 学习更多是为了做的更少。 统一 不同的人由于编码经验和编码偏好不同,项目中同一个功能的实现代码可能千差万别。但是如果不加以约束,让每一个人都按照自己的偏好写自己的模块,恐怕就会变成灾难。 所以每次在学习一些新技术的时候,我总是想多看看作者的实例代码,作者是如何理解的,社区又是如何理解的。以求实现起来代码风格不至于偏离社区太多,这样的话可以提高沟通与协作的效率。类似于 《阿里巴巴Java开发手册》 或者 vue 风格指南 这种取自大公司或社区的经验之谈,要多读几遍。因为他们所遇到的问题和业务更加复杂。 对于公司内部开发来说,写一个组件时候,生命周期的代码放在文件上面还是放在最下面,如何把代码的一个功能点集中放置。通用型代码的修改。代码行数的限制。能够列出统一的方案,多利而少害。 化繁为简(抽象) 抽象是指从具体事物抽出、概括出它们共同的方面、本质属性与关系等,而将个别的、非本质的方面、属性与关系舍弃的思维过程。 如果你面对一个较大的系统,你会发现重构并不能解决根本问题,它仅仅只能减少少许的代码的复杂度以及代码行数,只有抽象才可以解决实质性问题。 无论是数据库设计,架构设计,业务设计,代码设计,但凡设计都离不开抽象。抽象能力强的所面临的困难会比能力弱的少很多。 或者说抽象能力弱一些的小伙伴遇到一些问题甚至需要重新推翻然后再设计,这个是在时间和业务开发中是不能被接受的。 这里就谈谈代码,以下也举个例子,如 axios 库中有拦截器与本身业务,在没有看到源码之前,我一直认为他是分 3 阶段处理: 请求拦截 业务处理 响应拦截 但如果你去看源码,你就会发现其实在作者看来,这 3 个阶段其实都是在处理一个 Promise 队列而已。 // 业务处理 var chain = [dispatchRequest, undefined]; var promise = Promise.resolve(config); this.interceptors.request.forEach(function unshiftRequestInterceptors(interceptor) { // 前置请求拦截 chain.unshift(interceptor.fulfilled, interceptor.rejected); }); this.interceptors.response.forEach(function pushResponseInterceptors(interceptor) { // 后置响应拦截 chain.push(interceptor.fulfilled, interceptor.rejected); }); while (chain.length) { promise = promise.then(chain.shift(), chain.shift()); } return promise; 这就是一种代码抽象能力。让自己的代码可以适应更多的场景是程序员需要思考的。代码不是给机器看的,是给人看的,更高的要求是: 代码不仅仅是给人看的,更是给人用的。需要考虑到协作的人与事,灵活的配置也是必须要考虑到的。就拿前端的 虚拟 dom 来说。能够适配更多的平台。 当然了,抽象能力需要时间,需要经验,需要学习大量的设计。 注意!:不要过早的抽象业务代码,甚至不要抽象业务代码。多写一点代码无所谓,千万别给自己找事做。 在业务上尽量保持简单和愚蠢。除非你是业务专家,确认当前业务不太会产生变化。 权责对等(拆分与合并) 责任与义务本质上就是对等的,且越对等的就越稳定。这几年,微服务架构,中台,微前端理论层出不穷,本质上就是为了权责对等,对于更加基础的服务,更有产出的业务投入更高的人力与物力以保证更稳定的运行是很正常的一件事。而不是之前的大锅饭(单体应用)。 从代码上来看,某个模块是否承担了它不应该做的事情,或者某个模块过于简单,徒增复杂度。 当然,事实上有些东西目前是做不到的让所有人都觉得满意,增一分则肥,减一分则瘦,刚刚好很难界定。就像 Dan Abramov 说的那样: Flux libraries are like glasses: you’ll know when you need them. 只做一件事 Unix 哲学,这个很好理解,就像我今年想做的事情太多,反而什么都没有做(或者说都做了,但都不好)。 代码上来看,不要因为一点点性能的原因,把几件事合在一起去做。例如在一次 for 循环中解决所有问题,或者将所有代码写在一个函数中,例如: created() { const {a,b,c,d} = this.data // ... 三件事情彼此有交互同时需要 a,b,c,d // 完成之后的逻辑 } 改造后: created() { const axx = doA() doB() const cxx = doC() // 完成之后的逻辑 } // 分离出3个函数 doA() { const {a,b,c} = this.data // ... 三件事情彼此有交互同时需要 a,b,c,d // 完成之后的逻辑 } // 其他代码 相比于第一个只需要一次取数,一次setData,第二个性能无疑更低,但是可维护性变高了,3 件事情都被拆分出来,后面修改代码时候,我可以追加一个 doD 而不是再次把第一份代码中逻辑整理清楚再小心翼翼的修改代码。 命名与注释 There are only two hard things in Computer Science: cache invalidation and naming things. 命名与缓存失效是两大难题,今年讲了不少缓存问题,同时,命名的确是很困难的一件事情。通过一句话来解释你们在做什么事情,通过一句话来解释一件事的意图。 不说在程序世界中,在现实世界中也是如此。例如: 《震惊!xxx居然xxx》等新闻,虽然说看完后都会想要骂一句,但是,正如这样的名字才能吸引人家点击进入,让人情不自禁的被骗一次又一次。所以在项目没有发布前,要取一个简单而又好记的名字。 但在程序内部,我们不需要“骗取”人家的点击量,反而是要务实点,不要欺骗另外的同伴,比如说写了一个简单的名字,结果内部却封装了很多的业务代码。同时我认为这也是函数越写越短的理由,因为大家难以通过命名来解释那一大坨代码的意图。所以,需要编写可以自我解释的代码,而这种代码最佳实践就是好的命名。 对于开源代码,你往往会发现,这些文件开头都会有一系列注释,这个注释告诉我们了这个模块的意图与目的。让你无需看代码就可以进行开发。 对于业务开发而言,仅在你不能通过代码清晰解释其含义的地方,才写注释。在多个条件下都无法解释你的代码。 项目名 模块名 文件名(类名) 函数名(方法名) 这并不是让你不写注释。但是我觉得更多的注释应该放在数据结构而不是代码逻辑上。聪明的数据结构和笨拙的代码要比相反的搭配工作的更好。更多的时候,看数据结构我能了解业务是如何运行的,但是仅仅看到代码并不能实际想象出来。 实际上,随着时间的推移,代码做出了许多改动,但注释并没有随之修改,这是一个很大的问题。注释反而变得更有欺骗性。 这里也提供一篇 export default 有害 的文章。我觉得 export default 导出一个可以随意命名的模块就是一种欺骗性代码(随着时间的推移,该模块的意图会发生变化)。 考虑场景 没有放眼四海皆准的方案,所以我们必须要考虑到场景的问题,我们总是说可修改性,可读性是第一位的(往往可读,可修改的代码性能都不差)。但是如果是急切需求性能的场景下,有些事情是需要再考虑的。 if 是业务处理中最常用的,在每次使用前要考虑以下,哪个更适合作为主体,哪个更适合放在前面进行判断。如果有两个维度上的参数,一个是角色,一个是事件。一定是会先判断角色参数,然后再去判断事件参数,反之则一定不好。因为前者更符合人的思维模式。在同一维度下,至于哪个放前面,一定是更多被使用的参数放在前面更好,因为更符合机器的执行过程。 就像在 if 中你究竟是使用 else 还是 return。大部分情况下处理业务逻辑互斥使用 else,处理错误使用return。因为这样的代码最符合人的思维逻辑。 但是在这里我也要举出来自《代码之美》的例子,在第五章中,作者 Elliotte Rusty Harold 设计了一个 xml 验证器,其中有一段在验证数字字符: public static boolean isXMLDigit(char c) { if (c >= 0x0030 && c <= 0x0039) return true; if (c >= 0x0660 && c <= 0x0669) return true; if (c >= 0x06F0 && c <= 0x06F9) return true; // ... return false } 这个优化之后如下: public static boolean isXMLDigit(char c) { if (c < 0x0030) return false; if (c <= 0x0039) return true; if (c < 0x0660) return false; if (c <= 0x0669) return true; if (c < 0x06F0) return false; if (c <= 0x06F0) return true; // ... return false } 全局思考,善于交流 软件开发已经不是一个人打天下的时代了,你要不停的触达边界。在前后端分离的时代,前端可以不知道数据库如何优化,后端也可以不清楚浏览器的渲染机制,但是却不能不明白对方在做什么。否则等于鸡同鸭讲,也会浪费时间。在开发时候,把一段逻辑放在那一端取决安全的思考以及简化逻辑。 善于交流是一种能力,在与别人交流时给与足够的上下文,让你的 leader 沟通,让她知道你的难处。和小伙伴沟通,说服他人按照你的想法推进,同时,善于聆听才能不断进步。 算法 我不是一个算法达人( leetcode 中等题目都费劲 ),但这个没什么可说的,你拿你的 O(n**3) 算法去对战人家 O(n * logn) 算法就是费财。所以,知道自己某方面不够好去努力就行了。 辅助工具 TypeScript 虽然早就接触和实践过,但是以往都是 AnyScript。今年也算重度使用了。才体会到该工具的利好。一个好的开发工具并不是让你少写那一点点代码,而是让你在交付代码时候能够更加自信。 TypeScript 最大的好处就是让你在写代码前先思考,先做设计。就像之前说的。聪明的数据结构和笨拙的代码要比相反的搭配工作的更好。 TypeScript 同时也可以让大部分运行时错误变为编译时,并且可以减少使用中的防御性编程(信任但是仍要验证)。你不是一个人在写代码,协作优先。 在开发中,如果你接触过复杂性数据结构,并且还要在模块中不断进行数据转化,你就会不断的遇到:我的数据呢?到底在那一步丢失了?并且即使是代码对的,你仍旧害怕,仍旧怀疑。我已经过了那个“写 bug 是因为想的不够多,不够彻底”的年龄。 函数式思维 js 是有函数式的血统的,当年一直听说,函数是一等公民,只是当时完全不能理解。 纯函数,数据不可变以及代码即数据这三点是我认为是函数式思维对代码能力提升最大的三点。 这个我不想展开去聊,因为我没有熟练掌握过任何一门纯函数式语言。但是我的代码一定有函数式的影子,并且它的确让我的代码更优美。 其他 单元测试,代码审查,安全等等都没有讲到,这个我也需要足够的学习才能有所输出。不过这里列出一些资料供大家学习与了解: 谷歌代码审查指南 SaaS型初创企业安全101 有理有据就是好代码 工作在别人遗留的糟糕代码上是常有的事情,同时面对开发需求实际表,为了兼容,我们也不得不写出一些不那么好的代码。但是面对他人的疑问,我们需要给与别人这样做的理由,也就是你的每一行代码写下去一定有充分的理由和依据。 结语 明显不等于简单,上述都是很明显的事情,但是要做好都需要很长时间的学习与经验。 所以如何才能写好代码呢?那就是多看开源代码,多读书,多学习,多关注业界的动向与实践。不断学习,不断进化的代码才是好代码。 最近有一些小伙伴(无中生友)问我的名字为什么要叫 jump_jump。我是为了让自己以及看到我的小伙伴们牢记多锻炼,闲下来的时候多跳一跳。对身体有好处。 鼓励一下 如果你觉得这篇文章不错,希望可以给与我一些鼓励,在我的 github 博客下帮忙 star 一下。 博客地址

优秀的个人博客,低调大师

每日一博 | 解读 TechEmpower 框架性能测试数据

1. TechEmpower Framework Benchmark 介绍 TechEmpower 框架性能大比拼平台从 2013 年 3 月开始以来已经历经了 18 轮测试,参与这个平台的框架平台产品也从一开始的 24 种增加到今天的 659 种! 可以说这个平台已经是业界的标准性能测试平台,在 Web 框架性能测试领域的地位大概能和 PassMark 在 CPU 性能测试领域的地位相当. TechEmpower 自身提供的棒图直观地呈现框架的 Throughput (吞吐量, 即每秒处理请求数): 而 TechEmpower 在测试过程中还收集了其他类型的数据,包括: Latency (时延 - 从发起请求到收到响应的平均时间) Memory (内存占用) CPU (CPU 占用百分比) 2. TFB VIS 可视化网站 最近出现了一个新网站提供了另外几个数据的可视化呈现: https://ajdust.github.io/tfbvis/ 这个网站打开是这样的: 默认排序是吞吐量,但可以通过点击列标题下面的空白部位切换排序列,比如点击红色箭头指向部位按照时延排序: 可以选择不同的 TFB 测试项目: 选择显示的框架: 遗憾的是目前该页面只能支持两个过滤条件: 3. ActFramework vs. Spring Framework 下面我们就来看看 Spring 和 Act 这两种框架的各方面对比: 3.1 JSON 测试 为了方便大家理解,这里解释一下图示的数据 (下面的图示就省去解释了): 框架 吞吐量 时延 内存占用 CPU 占用 Act 1022k 0.52ms 2G 53% Spring 130K 5.29ms 6G 61 % 总结: 没有涉及数据库的情况下, Spring 比 Act 占用 3 倍的内存 吞吐量大约为 1/8 平均时延是 10 倍 3.2 Fortune 测试 总结: 在有数据库和后端页面生成的情况下, Spring 比 Act: 占用 3 倍内存 吞吐量大约为 1/7 平均时延大约为 5 倍 3.3 Query 测试 总结: 在多次查询(每个请求过程中处理查询数据库 20 次)的情况下, Spring 比 Act: 占用 3 倍内存 吞吐量大约为 1/5 到 1/2 (Spring WebFlux 在这个测试表现较好) 平均时延大约为 3 到 8 倍 3.4 Update 测试 总结: 在多次更新(每个请求过程中更新数据库 20 次)的情况下, Spring 比 Act: 占用 3 被内存 吞吐量与平均时延和 Act 相当 (Spring WebFlux 在这个测试表现较好) 3.5 DB 测试 总结: 在单次查询(每个请求处理过程查询数据库 1 次)的情况下, Spring 比 Act: 占用 3 倍内存 吞吐量为 1/2 到 1/5 平均时延大约为 3 到 10 倍 4. 大侠请票我 看到这里可能有同学会情不自禁地问,用 ActFramework 写这种高效的应用可能会比较麻烦吧. 实际情况完全相反哦, 看看 ActFramework QQ 群友的声音: 最后就向各位看官提个小小的请求了: 大侠请票我!

优秀的个人博客,低调大师

每日一博 | 如何设计一个本地缓存

前言 最近在看Mybatis的源码,刚好看到缓存这一块,Mybatis提供了一级缓存和二级缓存;一级缓存相对来说比较简单,功能比较齐全的是二级缓存,基本上满足了一个缓存该有的功能;当然如果拿来和专门的缓存框架如ehcache来对比可能稍有差距;本文我们将来整理一下实现一个本地缓存都应该需要考虑哪些东西。 考虑点 考虑点主要在数据用何种方式存储,能存储多少数据,多余的数据如何处理等几个点,下面我们来详细的介绍每个考虑点,以及该如何去实现; 1.数据结构 首要考虑的就是数据该如何存储,用什么数据结构存储,最简单的就直接用Map来存储数据;或者复杂的如redis一样提供了多种数据类型哈希,列表,集合,有序集合等,底层使用了双端链表,压缩列表,集合,跳跃表等数据结构; 2.对象上限 因为是本地缓存,内存有上限,所以一般都会指定缓存对象的数量比如1024,当达到某个上限后需要有某种策略去删除多余的数据; 3.清除策略 上面说到当达到对象上限之后需要有清除策略,常见的比如有LRU(最近最少使用)、FIFO(先进先出)、LFU(最近最不常用)、SOFT(软引用)、WEAK(弱引用)等策略; 4.过期时间 除了使用清除策略,一般本地缓存也会有一个过期时间设置,比如redis可以给每个key设置一个过期时间,这样当达到过期时间之后直接删除,采用清除策略+过期时间双重保证; 5.线程安全 像redis是直接使用单线程处理,所以就不存在线程安全问题;而我们现在提供的本地缓存往往是可以多个线程同时访问的,所以线程安全是不容忽视的问题;并且线程安全问题是不应该抛给使用者去保证; 6.简明的接口 提供一个傻瓜式的对外接口是很有必要的,对使用者来说使用此缓存不是一种负担而是一种享受;提供常用的get,put,remove,clear,getSize方法即可; 7.是否持久化 这个其实不是必须的,是否需要将缓存数据持久化看需求;本地缓存如ehcache是支持持久化的,而guava是没有持久化功能的;分布式缓存如redis是有持久化功能的,memcached是没有持久化功能的; 8.阻塞机制 在看Mybatis源码的时候,二级缓存提供了一个blocking标识,表示当在缓存中找不到元素时,它设置对缓存键的锁定;这样其他线程将等待此元素被填充,而不是命中数据库;其实我们使用缓存的目的就是因为被缓存的数据生成比较费时,比如调用对外的接口,查询数据库,计算量很大的结果等等;这时候如果多个线程同时调用get方法获取的结果都为null,每个线程都去执行一遍费时的计算,其实也是对资源的浪费;最好的办法是只有一个线程去执行,其他线程等待,计算一次就够了;但是此功能基本上都交给使用者来处理,很少有本地缓存有这种功能; 如何实现 以上大致介绍了实现一个本地缓存我们都有哪些需要考虑的地方,当然可能还有其他没有考虑到的点;下面继续看看关于每个点都应该如何去实现,重点介绍一下思路; 1.数据结构 本地缓存最常见的是直接使用Map来存储,比如guava使用ConcurrentHashMap,ehcache也是用了ConcurrentHashMap,Mybatis二级缓存使用HashMap来存储: Map<Object,Object> cache =newConcurrentHashMap<Object,Object>() Mybatis使用HashMap本身是非线程安全的,所以可以看到起内部使用了一个SynchronizedCache用来包装,保证线程的安全性; 当然除了使用Map来存储,可能还使用其他数据结构来存储,比如redis使用了双端链表,压缩列表,整数集合,跳跃表和字典;当然这主要是因为redis对外提供的接口很丰富除了哈希还有列表,集合,有序集合等功能; 2.对象上限 本地缓存常见的一个属性,一般缓存都会有一个默认值比如1024,在用户没有指定的情况下默认指定;当缓存的数据达到指定最大值时,需要有相关策略从缓存中清除多余的数据这就涉及到下面要介绍的清除策略; 3.清除策略 配合对象上限之后使用,场景的清除策略如:LRU(最近最少使用)、FIFO(先进先出)、LFU(最近最不常用)、SOFT(软引用)、WEAK(弱引用); LRU:Least Recently Used的缩写最近最少使用,移除最长时间不被使用的对象;常见的使用LinkedHashMap来实现,也是很多本地缓存默认使用的策略; FIFO:先进先出,按对象进入缓存的顺序来移除它们;常见使用队列Queue来实现; LFU:Least Frequently Used的缩写大概也是最近最少使用的意思,和LRU有点像;区别点在LRU的淘汰规则是基于访问时间,而LFU是基于访问次数的;可以通过HashMap并且记录访问次数来实现; SOFT:软引用基于垃圾回收器状态和软引用规则移除对象;常见使用SoftReference来实现; WEAK:弱引用更积极地基于垃圾收集器状态和弱引用规则移除对象;常见使用WeakReference来实现; 4.过期时间 设置过期时间,让缓存数据在指定时间过后自动删除;常见的过期数据删除策略有两种方式:被动删除和主动删除; 被动删除:每次进行get/put操作的时候都会检查一下当前key是否已经过期,如果过期则删除,类似如下代码: if (System.currentTimeMillis() - lastClear > clearInterval) { clear(); } 主动删除:专门有一个job在后台定期去检查数据是否过期,如果过期则删除,这其实可以有效的处理冷数据; 5.线程安全 尽量用线程安全的类去存储数据,比如使用ConcurrentHashMap代替HashMap;或者提供相应的同步处理类,比如Mybatis提供了SynchronizedCache: public synchronized void putObject(Object key, Object object) { ...省略... } @Override public synchronized Object getObject(Object key) { ...省略... } 6.简明的接口 提供常用的get,put,remove,clear,getSize方法即可,比如Mybatis的Cache接口: public interface Cache { String getId(); void putObject(Object key, Object value); Object getObject(Object key); Object removeObject(Object key); void clear(); int getSize(); ReadWriteLock getReadWriteLock(); } 再来看看guava提供的Cache接口,相对来说也是比较简洁的: public interface Cache<K, V> { V getIfPresent(@CompatibleWith("K") Object key); V get(K key, Callable<? extends V> loader) throws ExecutionException; ImmutableMap<K, V> getAllPresent(Iterable<?> keys); void put(K key, V value); void putAll(Map<? extends K, ? extends V> m); void invalidate(@CompatibleWith("K") Object key); void invalidateAll(Iterable<?> keys); void invalidateAll(); long size(); CacheStats stats(); ConcurrentMap<K, V> asMap(); void cleanUp(); } 7.是否持久化 持久化的好处是重启之后可以再次加载文件中的数据,这样就起到类似热加载的功效;比如ehcache提供了是否持久化磁盘缓存的功能,将缓存数据存放在一个.data文件中; diskPersistent="false"//是否持久化磁盘缓存 redis更是将持久化功能发挥到极致,慢慢的有点像数据库了;提供了AOF和RDB两种持久化方式;当然很多情况下可以配合使用两种方式; 8.阻塞机制 除了在Mybatis中看到了BlockingCache来实现此功能,之前在看<<java并发编程实战>>的时候其中有实现一个很完美的缓存,大致代码如下: public class Memoizerl<A, V> implements Computable<A, V> { private final Map<A, Future<V>> cache = new ConcurrentHashMap<A, Future<V>>(); private final Computable<A, V> c; public Memoizerl(Computable<A, V> c) { this.c = c; } @Override public V compute(A arg) throws InterruptedException, ExecutionException { while (true) { Future<V> f = cache.get(arg); if (f == null) { Callable<V> eval = new Callable<V>() { @Override public V call() throws Exception { return c.compute(arg); } }; FutureTask<V> ft = new FutureTask<V>(eval); f = cache.putIfAbsent(arg, ft); if (f == null) { f = ft; ft.run(); } try { return f.get(); } catch (CancellationException e) { cache.remove(arg, f); } } } } } compute是一个计算很费时的方法,所以这里把计算的结果缓存起来,但是有个问题就是如果两个线程同时进入此方法中怎么保证只计算一次,这里最核心的地方在于使用了ConcurrentHashMap的putIfAbsent方法,同时只会写入一个FutureTask; 总结 本文大致介绍了要设计一个本地缓存都需要考虑哪些点:数据结构,对象上限,清除策略,过期时间,线程安全,阻塞机制,实用的接口,是否持久化;当然肯定有其他考虑点,欢迎补充。

优秀的个人博客,低调大师

每日一博 | Golang 高频服务延时抖动追因

一,背景 策略组同学反馈有个服务上线后 redis 写超时非常严重,严重到什么地步呢,写redis 毛刺超过100ms! 而且不是随机出现,非常多,而且均匀,导致整个接口超时严重。因为用的redis 库是由我们组维护,所以任务落我们组小伙伴头上了。 这个项目有非常复杂的业务逻辑,有密集型io(调度问题)+定时任务(cpu问题)+常驻内存cache(gc问题),频繁访问redis,在定时逻辑中,业务逻辑需要一个request 可能达到上千次redis Hmget+get(先不讨论合理性)。 背景比较复杂, 是个golang 服务,接口延迟要求百ms级。 go version : 1.8,机器是8核+16G 容器,没有开runtime 监控,redis 的同事初步反馈没有slowlog。因为rd 也追了很久,到我们这边来的时候,redis 的超时指标监控已经给我们加了。 redis get 接口的耗时监控显示如下,因为高频请求,大部分耗时是小于10ms 的,但是这毛刺看着非常严重,是不可忍受了。 系统cpu问题比较严重,抖动非常大,内存并没有太大问题,但是占用有点大,比较有意思的事,因为用了local-cache,其实,我们刚开始以为是local-cache 导致的gc引起的。 因为没有加runtime 监控,其他信息暂不可知。 二,解决思路 因为追查接口毛刺比较复杂,我们的原则是不影响业务的情况下,尽量少上线的将业务问题解决。 我们初步给了个追查思路: 第一,首先排查是不是网络问题,对redis slowlog(redis 本身自带监控); 第二, 本地抓包,看日志中redis 的get 时间跟真实网络的时间是否对的上(抓包最可靠); 第三,对机器负载,是否对的上毛刺时间(cpu 资源不够,调度不过来毛刺也正常); 第四,查redis sdk,这库我们维护的,看源码,看实时栈,看是否有阻塞(sdk 用了pool,sdk 本身也要压测下); 第五,查看当前的gc pause ,看gc stw 时间是否影响redis(go 1.8 gc 性能比1.10-1.12 差很多); 第六,抓trace ,看调度时间和调度时机是否有问题(并发协程数,GOMAXPROCS cpu负载都会影响调度); 整个分析下来,只能用排除法了。 三, 现场分析 3.1 网络分析 因为服务的并发量比较大,其实查起来非常耗时。 1, redis slowlog 本身是正常的。这里类似类似redis, redis 有SLOWLOG。这里感谢redis 团队的支持。 2,我们该抓包了,将日志里的key 跟tcpdump 的key 对起来。因为并发量非常大,tcpdump 出来的数据简直没法看,这里我们线上dump,线下分析。 tcpdump 抓了几分钟时间。grep 日志里超时的case, 例如key 是rec_useraction_bg_2_user_319607672835 这个key 显示126ms, 但是wireshark 显示仅仅不到2ms。wireshark 如何找到这个包呢? 抓包显示,一共请求两次,来源端口分别是34442,34510, 时间是13:57,No 是261。接下来再找到两次response 即可。 No.261 && port == 34442 的请求,最快的resp 如下: 分析了其他的key,得到的结论都类似,redis 返回非常快,根本没什么问题。 3.2 负载分析 odin 是有cpu 监控的,可惜的是,是宿主机的cpu监控。这里cpu 占用看,因为资源隔离,宿主机没问题,但是这个进程的cpu 抖动比较厉害,iostat 显示的情况更真实。这里常用40%,但是定时任务起起来的时候,接近全部打满!抖动是否跟定时任务有关?但问了业务,其实相关性没有那么明显。 3.3 redis sdk 问题排查 sdk 是存在阻塞的可能的,怎么判断sdk 是否阻塞了?两个方式,一种是源码级别追查,第二种是查看实时栈,看是否有lock,wait 之类的逻辑。初步看并没有阻塞逻辑。dump了下线上的栈,看起来,也没有什么问题。但日志确实显示,到底怎么回事? 这里有个认知问题,有runtime 的语言,sdk 都是受runtime 影响的,sdk 写的再好,并不能保证延时,比如你跑下下面这个demo。50个并发,你访问redis 都各种超时。 package main import ( "flag" "fmt" "sync" "time" "net/http" _ "net/http/pprof" "github.com/gomodule/redigo/redis" ) var redisAddr string type Stu struct { Name string `json:"name"` Age int HIgh bool sex string } func main() { flag.StringVar(&redisAddr, "redis", "127.0.0.1:6379", "-redis use redis addr ") flag.Parse() go func() { http.ListenAndServe("0.0.0.0:8003", nil) }() wg := sync.WaitGroup{} wg.Add(1) for i := 0; i < 20; i++ { go go_get(wg) } wg.Wait() } func go_get(wg sync.WaitGroup) { client, err := redis.Dial("tcp", redisAddr) if err != nil { fmt.Println("connect redis error :", err) return } defer client.Close() for { time.Sleep(10 * time.Millisecond) start := time.Now() client.Do("GET", "test1234") if cost := time.Now().Sub(start); cost > 10*time.Millisecond { fmt.Printf("time cost %v \n", cost) } } } 3.4 runtime gc 问题排查及优化 抓了下线上heap 图,查看历史的gc stw 信息: curl http://localhost:8003/debug/pprof/heap?debug=1 -O heap 上面的数据,是历史stw 时间,没runtime 历史监控只能看这了,数据简直没法看,上面是个256的数组,单位是ns,循环写入。gc 的策略一般主动触发是2min一次,或者内存增长到阈值,先初步认为2min一个点吧。gc 得必须得优化,但是跟日志毛刺的密度比,还对不上。 查看具体的问题在哪,graph 如下: 大头在两个地方,一个是hmget, 一个是json。优化gc 的思路有很多,也不复杂,有实例,参考我个人博客:https://my.oschina.net/u/2950272/blog/1788299。最简单有效的,你先把版本升下吧,起码得升到1.10吧(其实最好1.12。1.8,1.9,1.10, 1.11我都踩过坑),高频服务,1.8一个定时器问题你qps 就上不去了,示例参考:https://my.oschina.net/u/2950272/blog/2247104。 这里是业务同学升版本后的graph: 看下hmget 和json encode 的区别,现在大头全在hmget 上了,效果立杆见影子。这里为啥hmget 这么多?问了下,这是业务逻辑实现,这样做是有问题的。不能影响业务,所有暂时作罢。只升级大版本,stw 好了很多,虽然偶尔也有几十毫秒的毛刺,对比图如下(单位ms): 可惜,问题并没有解决,redis 的抖动没有明显变化: 为什么一直追这redis 查 ,不追着其他接口查,因为redis 要求比较高,是ms 级别,其他的api是百ms级别,毛刺就不明显了。 目前看gc 问题其实还有优化空间,但是成本就高了,得源码优化,改动会比较大,业务方不能接受。而且,当前的gc 大幅改善对接口耗时并没起到立竿见影效果,这里需从其他方面寻找问题。 3.5,抓trace ,查看调用栈 curl http://127.0.0.1:8080/debug/pprof/trace?seconds=300 > trace.out go tool trace trace.out 线上trace,记录了采样阶段go 都在干嘛,不过因为混合业务代码,你想直接看图,基本是不可能了,打开都得等几分钟(没办法,有业务逻辑)。。。 单独看gc,和heap 之中数据基本一致。这里问题比较严重的是调度,按scheduler wait 排序后数据如下: 加了监控后,看到其实并发的协程数量并不太多,也没出现协程暴增的情况,照理调度并不会这么严重。 影响调度的,还有p 的数量目前是48(宿主机核心数,因为go 启动读了宿主机的核心),线程数是200+。线程数查看ps -T -p pid。8核上跑48个调度线程,会影响调度,这个影响不好评估,但是要优化。我们建议将GOMAXPROC 设置成8,然后重新上线。然后抖动立刻降下来了,效果如下: 对比,当前的调度时间,虽然还是有点难看,但是直接降了快接近一个数量级。 同时,pprof 显示,目前的线程数,降到了以前的1/3。通过perf看线程的上下文切换也少了,同时调度本身也少了。 到此,问题基本查到根因,并解决了。 四,原理分析 为什么获取到错误的cpu 数,会导致业务耗时增长这么严重?主要还是对延迟要求太敏感了,然后又是高频服务,runtime 的影响被放大了。 关于怎么解决获取正确核数的问题,目前golang 服务的解决方式主要是两个,第一,设置环境变量GOMAXPROCS 启动,第二个是显式调用uber/aotomaxprocs。 golang 是如何设置cpu 核数,并取成宿主的核数的呢,追runtime.NumCPU() 发现,其实现是: 细追,发现是 getproccount, 查linux 下源码发现,其实调用的是 sched_getaffinity,直接通过系统调用获取的宿主机核数。 uber/aotomaxprocs 是如何算正确的cpu 核数?其实就是读取 cgroup 接口 /sys/fs/cgroup/cpu/cpu.cfs_quota_us 中的值除以 /sys/fs/cgroup/cpu/cpu.cfs_period_us 中的值并向上取整 这种问题,其实在golang runtime 就解决比较好,像java ,jdk (jdk8u191)以后,都已经能自适应容器和实体服务器了,不太明白为什么会有这种问题,去提个issue。 五, 总结 大部分的服务其实对延时可能没这么敏感,所以没太重视这个问题。为了避免以后再出类似问题,我们在流程上,希望能直接规避掉。我们做的有三点: 第一,给所有go项目加上runtime 监控,如果真出大故障,有时间去临时加pprof 吗? 第二,在所有容器里注入环境变量GOMAXPROCS,并算出cgroup 限制的核数。如果大家有需求自定义p的数量,可以自己显示调用。大家也可以使用uber/aotomaxprocs。 第三,推动大家将线上go 版本升级,特别是高频服务。

优秀的个人博客,低调大师

每日一博 | 开源软件商业模式的探讨

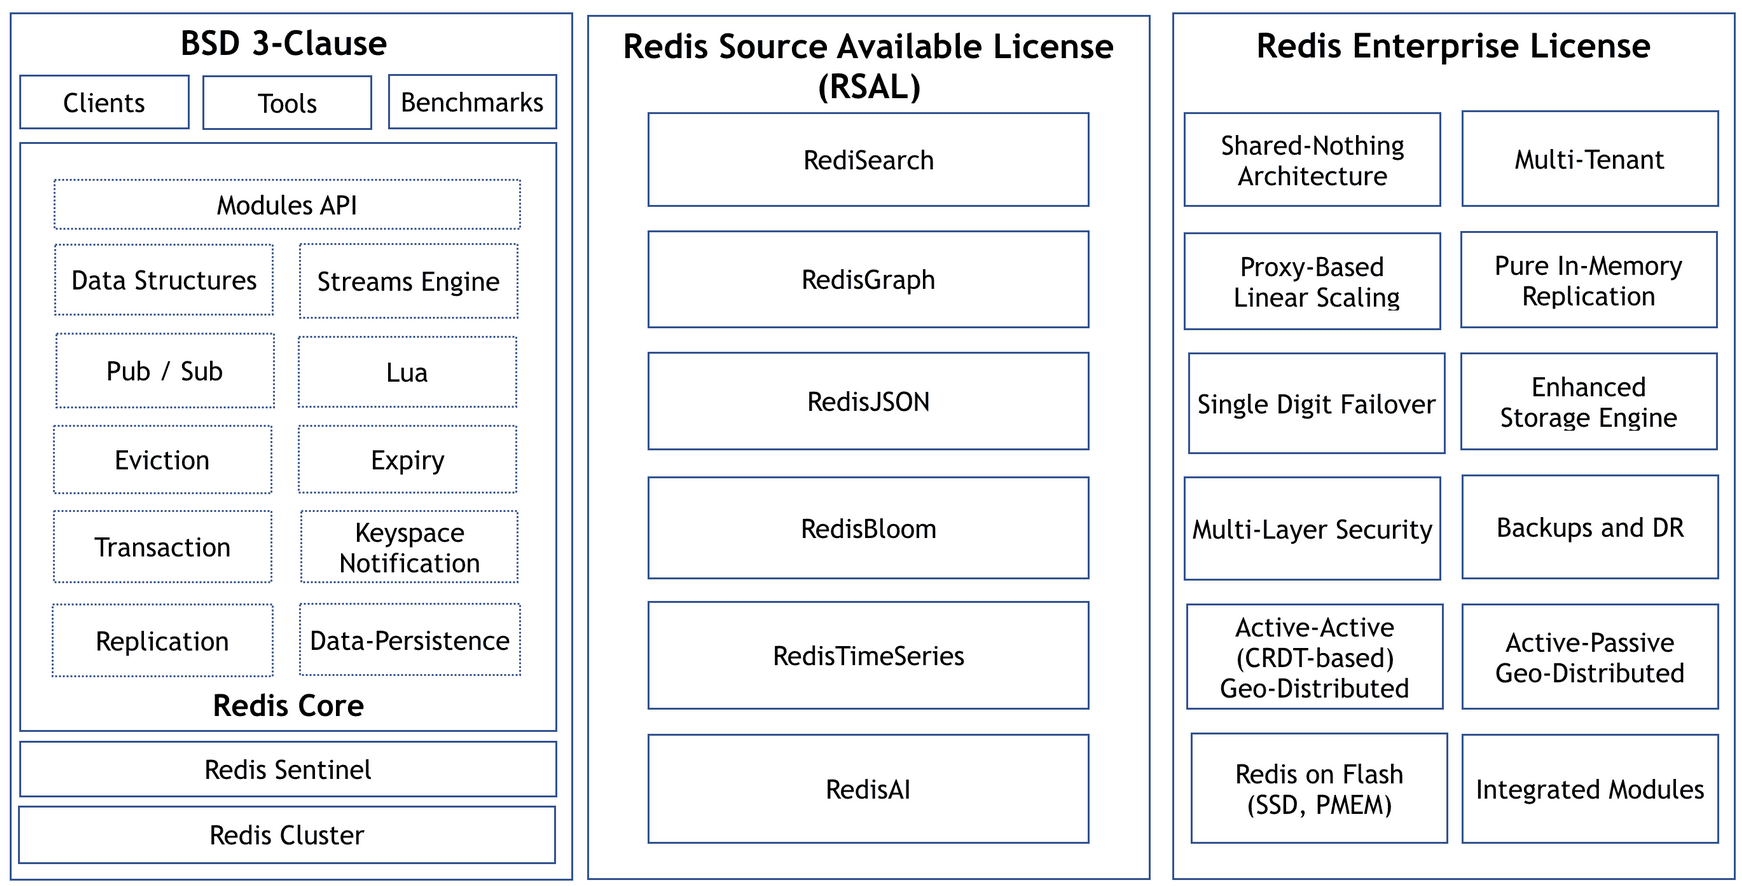
声明:我们的开源项目“ Milvus 向量搜索引擎”还处在社会主义初级阶段。以下内容是我们目前对开源工作的摸索,并非最佳实践。 开源许可证 既然我们决定了要开源,第一步便是要选择合适的开源许可证。虽然自由软件创始人 RMS 曾经倡导 Copyleft 概念,但 Copyleft 也是一种特殊的 Copyright 。 那么,什么是开源许可证?简单来说,一个许可证只要经过 OSI ( Open Source Initiative )认证,就可以被称之为开源许可证。 OSI 有专门的流程来审核一个许可证是否符合开源定义( Open Source Definition )。比如说, MongoDB 新设计的 SSPL ( Sever Side Public License )在完成 OSI 认证之前, MongoDB 只能说自己的许可证是源码可用( source available ),而不能说自己是开源(当然,这个限制属于行业惯例,没有强制性)。 目前主流的开源许可证,可以在 OSI 网站上查询到。网上也有很多文章去比较各个许可证之间的不同(可参考阮一峰老师的博客),我就不一一赘述了。这里主要结合我们的自身情况来谈一下开源许可证的选择。开源许可证简单来说,可以分为三档: 严格,以 GPL 2.0 许可证为代表,典型软件是 MySQL 适中,以 Apache 2.0 许可证为代表,目前使用最广泛 宽松,以 BSD,MIT , PostgreSQL 许可证为代表,典型软件是 PostgreSQL 熟悉数据库的朋友一定知道 MySQL 和 PostgreSQL 。 MySQL 是最流行的开源数据库,但 PostgreSQL 是衍生项目最多的开源数据库。现在的新项目很少使用 GPL 2.0 许可证,它的传染性应该是大家最有顾虑的地方。 对于推广基础技术来说,MIT/BSD 类的许可证是一个好选择。可能现在已经很少人使用 FreeBSD 。但它也还在不断的发展,因为采用非常宽松的 2-Clause-BSD 许可证, FreeBSD 被不少厂商用来开发自己的闭源系统。比如, Sony 的 Play Station 3 和 4 的系统都基于 FreeBSD , 还有任天堂的 Swtich 游戏机也是。 Redis 也采用宽松的 3-Clause-BSD 许可证(相比 2-Clause 多了对商标的使用限制)。不过, Redis 整个工具链的许可证情况十分复杂。以至于当 Redis 切换部分组件的许可证时,引起了业界很大的误解。因此中途将许可证变严格是件有点敏感的事情。 看起来颇为复杂的 Redis 许可矩阵。 如果上策太急,下策太缓。那么就选择中间的 Apache 2.0 。Apache 2.0 目前是 Apache 基金会与 CNCF 基金会推荐的默认开源许可证。 Github 网站对 Apache 2.0 许可证的简易说明 Apache 2.0 像其他开源许可证一样不限制商业使用,专利授权也默认包含其中。不过 Apache 2.0 也明确规定了在此开源许可证下软件厂商的免责条款。这也就是开源软件公司提供订阅增值服务的法律基础。 不过即使是 Apache 2.0 这么成熟的开源许可证,大家还是有一个担心:公有云。 需要防范公有云厂商吗 开源软件与公有云的关系这两年有点紧张,一个比较流行的观点是公有云插管吸血开源软件,而对开源社区没有太多贡献。不少开源项目开始寻找在公有云面前保护自己的方法。毕竟公有云的出现,一定程度上打乱了原有的开源商业模式。最终用户通过购买云服务,从公有云服务商那里的到了保障,开源厂商被绕开了。 于是, Common Clause 应运而生。 Common Clause 是一种附加条款,开源厂商依然需要选择一个基本的主许可证。最终的形式类似: Apache 2.0 + Common Clause 1.0 。 Common Clause 比较精炼,全文只有 3 句话,如下: The Software is provided to you by the Licensor under the License, as defined below, subject to the following condition. Without limiting other conditions in the License, the grant of rights under the License will not include, and the License does not grant to you, the right to Sell the Software. For purposes of the foregoing, "Sell" means practicing any or all of the rights granted to you under the License to provide to third parties, for a fee or other consideration (including without limitation fees for hosting or consulting/ support services related to the Software), a product or service whose value derives, entirely or substantially, from the functionality of the Software. Any license notice or attribution required by the License must also include this Commons Clause License Condition notice. Common Clause 主要禁止他人在不增加开源软件价值的情况下,利用开源软件牟利。它的限制性主要体现在以下三点: 禁止他人 对软件生态构建的影响 利用原软件进行 license 销售 非常小。目前主流观点是开源软件不收取 license 费用,软件收费以按年支付的订阅模式进行。 提供软件支持服务 比较小。尤其是产品初期,大家都不了解,需要依靠官方支持。官方提供订阅模式,大家比较容易接受。产品的订阅收费模式能够得到保障。不过将来等产品成熟以后,需要考虑参照 Oracle 的 OCP 方式,提供一些针对专业人士的产品能力认证,以缓和这一点可能的影响。 提供软件托管服务 防范云厂商。限制云厂商不能通过托管云服务( hosting )的方式,利用原软件进行盈利。但不代表用户不能在云环境里使用该软件。Apache 2.0 + Common Clause 1.0 不会限制用户运行软件的硬件环境,只要用户购买订阅服务,产品方一样会提供支持服务。 假设第三方在开源软件的基础上构建了一整套面向用户的应用,这套新应用增加了原开源软件的价值,那么这套新应用不会受到任何限制。这一点保证了开源厂商与合作伙伴之间的合作关系不会受到影响。 不过 Common Clause 没有经过 OSI 认证,因此添加了 Common Clause 以后建议只说自己是源码可用( source available )。虽然会引起一定的争议,不过初创开源项目选择添加 Common Clause 看起来正受到越来越多人的理解。 然而,我们的开源项目并不打算加上 Common Clause 。有两个重要的原因。 MongoDB 的启示 MongoDB 是开源项目成功的范例。 MongoDB 一开始就采用 AGPL 3.0 许可证。如果公有云要利用 MongoDB 提供服务,那么公有云厂商需要公布相关底层服务的源码。因此, AWS , Azure, Google Cloud 等一众美国公有云都选择自行开发文档型数据库。而在美国以外, MongoDB 却很难用法律武器保护自己。 2018 年 10 月 MongoDB 修改新版本的许可证时,再次抱怨了公有云厂商对 MongoDB 利益的侵害,主要指的就是美国以外的公有云厂商。因此,志在全球的开源基础软件厂商其实很难仅靠一个许可证来对自己进行全面的保护。 另一方面,当 AWS 有了 DynamoDB ; Azure 有了 Cosmos DB ; Google Cloud 有了 Cloud Firestore 之后,文档数据库不再是 MongoDB 一家独大。在之后的移动互联网浪潮中,移动端的 MongoDB Mobile 没有达到期待中的影响力。毕竟 Realm 这样的移动端文档数据库可以直接和多个公有云文档数据库同步,极大的方便了移动开发者。2019 年 4 月, MongoDB 以 3900 万美元收购了 Realm 。 防范别人的同时也部分影响了自己的发展空间,是否值得?答案因人而异,开源项目需要结合自身情况作出一个选择。 四爷的新策略 据咨询公司 Gartner 的统计, Google Cloud 2018 年占据公有云 IaaS 市场 4.0% 的份额,排行全球第四。依然不及老大 AWS 市场占有率( 47.8% )的一个零头。 Google Cloud 想迎头赶上,他该怎么办? 在今年的 Google Cloud Next 大会上,新上任的 Google Cloud CEO 一举请来了 Redis Lab CEO 与 MongoDB CEO 帮忙站台。大会上 Google Cloud 推出了 Redis 的托管服务, MongoDB 上了 Google Cloud Marketplace 。后续 MongoDB 的 Atlas 云服务还和 Google Cloud 展开了一系列合作。 Redis 和 MongoDB 在开源界与互联网行业有较大的技术影响力。而且他们是开源界对公有云厂商开炮比较多的两家。近期他们又先后针对公有云厂商修改了自己的许可证。因此 Google Cloud Next 大会上传达的信息很有意思。 与成熟的开源厂商合作,看起来正是 Google Cloud 的新策略。这条路值得一试。毕竟,老四恐怕很难用老大的方法来战胜老大。 “学我者生,似我者死。” —— 齐白石 Google Cloud 第一个想明白了。我相信会有越来越多的公有云厂商想明白这个问题,选择与成熟的开源厂商合作。所以对开源基础软件来说,当务之急是提升自身的成熟度,防范之心可以暂时放到一边。 商业设计 在上一篇文中,我们提到“ Apache 基金会拥有 1.9 亿行代码。根据 COCOMO II 模型估算,这些代码的开发成本超过 200 亿美元( 2019 年报)。”如此算来,每一行代码的开发成本超过 200 美元。所以千万别觉得开源软件就该免费使用。 典型的开源商业模式 目前比较成熟的开源软件商业模式有以下几种: 订阅服务:开源许可证免除了厂商对软件质量与软件缺陷修复的责任。而这些都是企业级应用所必须的。因此,最自然的商业模式就是提供软件订阅服务,从而向用户提供生产级的服务支持响应和 hotfix 修复。 高级功能:比如 Redis 。核心部分的组件是开源的。但工具类软件,进阶功能(如多租户,无共享分布式架构等)都是收费的。 云服务:比如 Databricks 。 Spark 是开源的,但收费版本仅提供 Azure 和 AWS 上的云服务。 生态收益(仅限超大型开源厂商):比如据华尔街分析师估算 Google 每年要支付近百亿美元给 Apple ,就为了 iPhone 上的默认搜索引擎入口。想想 Android 帮 Google 省了多少钱? 软件世界里有两个重大难题:一是大型软件系统的项目管理(人月神话),另一个是软件定价。关于项目管理,已经有了不少的研究与实践,大家多少有个参照物。而软件定价没有什么成熟的公式与模型。 但至少对于开源软件的定价,要避开下面两个坑: 定高价,打 1 折 不采用订阅模式 这些都是传统商业软件的模式。传统商业软件提供给客户的是资产,开源软件提供给用户的是服务。 如果大型用户要求对软件进行买断怎么办?大型用户倾向于一次性付费,并不是他们喜欢购买一堆软件资产。背后的原因在于大型用户内部的软硬件采购流程,需要采购人员与 IT 技术人员共同介入。而采购并不是技术人员的本职工作,以及事后的各种审计。因此技术人员更喜欢一次性买断,以省去未来的麻烦。请提醒他们,开源软件提供的是服务,服务是不能买断的,应该走更便捷的服务采购流程。 向 AWS 学习 基础软件的商业化是件很有挑战的事情。好在有很多成熟的企业可供我们参考。如果说 Oracle 是必须研究的传统商业软件公司,那么 AWS 毫无疑问就是必须好好学习的云服务公司。 刚才说软件定价没有什么成熟的公式与模型?其实 AWS 帮大家摸索了一个公有云上软件的定价方式。AWS Aurora 数据库据称是 AWS 上增长最快最赚钱的云服务。 Aurora 在技术上是非常创新的云原生数据库,带出了一众追随者。依据官方宣传: Amazon Aurora 的速度最高可以达到标准 MySQL 数据库的五倍、标准 PostgreSQL 数据库的三倍。它可以实现商用数据库的安全性、可用性和可靠性,而成本只有商用数据库的 1/10。(引用自 https://aws.amazon.com/cn/rds/aurora/ ) 那么这样一款技术如此先进的云上数据库是怎么定价的呢?以下对比 Aurora MySQL 所有可选的实例规格与 RDS MySQL 之间的定价: 云实例规格 RDS MySQL Aurora MySQL Aurora 溢价 db.t3.small 0.034 0.041 20.59% db.t3.medium 0.068 0.082 20.59% db.t2.small 0.034 0.041 20.59% db.t2.medium 0.068 0.082 20.59% db.r5.large 0.24 0.29 20.83% db.r5.xlarge 0.48 0.58 20.83% db.r5.2xlarge 0.96 1.16 20.83% db.r5.4xlarge 1.92 2.32 20.83% db.r5.12xlarge 5.76 6.96 20.83% db.r4.large 0.24 0.29 20.83% db.r4.xlarge 0.48 0.58 20.83% db.r4.2xlarge 0.96 1.16 20.83% db.r4.4xlarge 1.92 2.32 20.83% db.r4.8xlarge 3.84 4.64 20.83% db.r4.16xlarge 7.68 9.28 20.83% 单位:美元/小时 当然 Aurora MySQL 和 RDS MySQL 的技术实现不太一样,同样实例规格需要的硬件也不能简单划上等号。不过考虑到 AWS 本身的体量,两者间硬件差异的成本应该是微乎其微的。可以大致认为 20% 的溢价来自 Aurora MySQL 软件。 基础软件上公有云 Marketplace 的时候怎么定价,总算有个参照物了。 后记 虽然写了两篇文章,但也只是涉及了开源的一小部分。开源模式可一点也不比传统商业软件的模式要简单。 其中比较关键的社区运营和开发者生态构建,我们也还在不断的摸索。等有一天我们形成自己的方法与风格,届时一定与大家分享。希望国内的基础软件同行都能一起进步。

优秀的个人博客,低调大师

每日一博 | 详细介绍 Elasticsearch 7 的新特性

看了下公司内部用的ElasticSearch集群是 2.3.4 的版本,想升级到新版本,众所周知es这尿性更新速度很快,且有些大版本不向前兼容。 这主要是因为lucene,在大四的时候接触lucene,对它要升级的过程深有感触,除了重建索引,没有别的方法。 所以这次要升级想采用用类似于oracle数据库迁移到mysql的稳妥方法,双写,重建索引是下下策,因为数据量太大,且要保持数据增删查改平稳。 目前我们的问题: 2.3.4 版本及其之前,在并发量高且数据量大的时候,存在数据删除时主分片和副本数据不一致的情况。 所以这几天看了下 ElasticSearch 已经刷版本号到了7了,网上的中文区目前好像也没有对这个版本的一些新特性的详细介绍,所以想着总结一下。(内容来自ElasticSearch官网的更新介绍和官方英文文档)。 感兴趣的朋友也可以参考官方的文档: https://www.elastic.co/guide/en/elasticsearch/reference/7.4/release-highlights-7.0.0.html https://www.elastic.co/guide/en/elasticsearch/reference/7.4/release-notes-7.0.0.html 1. 自适应默认副本选择的启用 首先要介绍下什么是自适应默认副本选择,就是说 ElasticSearch 会去记录各个数据节点过去的请求响应时间和在节点上的执行时间,还有节点上的线程池队列大小来得出哪个节点的各项指标好,以后的这种请求就落到这个节点去。 Elasticsearch 6 和之前的版本,对同一分片的一系列搜索请求将以循环方式转发给主分片和每个副本。如果一个节点正好开始了很长时间的垃圾回收(GC),这可能会带来问题,搜索请求仍然可能被转发到这种响应速度会很非常慢的节点,这就会对搜索延迟产生影响。 在6.1版本中,Elasticsearch官方添加了一个实验性的自适应副本选择的特性。每个节点会跟踪和比较搜索请求与其他节点的耗时,并使用这个数据调整向特定节点上的分片发送请求的频率。在官网的基准测试中,这会很显著的提高搜索的吞吐量,官方说这种操作减少了99%的延迟。 这个配置在整个6.x的版本中被默认是禁用的。但是后来官方陆续从用户那里得到反馈,用户和官方都认为这个设置非常有用,所以官方在Elasticsearch 7.0.0中默认打开了它。 PUT /_cluster/settings { "transient": { "cluster.routing.use_adaptive_replica_selection": true } } 如果关闭这个功能,搜索的操作将会以循环方式发送到所有的索引分片。 Skip shard refreshes if a shard is "search idle 2. 如果该分片是搜索空闲时刻,则跳过碎片刷新 Elasticsearch 6 和之前的版本默认情况下会在后台自动刷新索引数据。这也就是为什么Elasticsearch可以“近乎实时”得到搜索结果,默认情况下,搜索请求添加后一秒内就可以获得结果。然而,如果不需要刷新的时候(例如,如果Elasticsearch没有任何查询搜索的任务),那么这个功能就能对Elasticsearch的性能产生显著的影响。 通过引入这种搜索空闲(search idle)的概念,Elasticsearch 7 在默认情况下,该分片如果在30秒内没有过任何搜索行为,那么这个就会被认为是搜索空闲。 当分片处于这种阶段的时候,所有原计划的刷新任务都会被跳过,直到你有搜索的问题进来的时候才会触发下一次的刷新任务。 这会提高 Elasticsearch 的吞吐量,我们都知道,当如果要大量的写入数据或者重新构建索引的时候,关闭自动刷新进行数据写入或者更新,速度是可以显著提高的,这里同理。 3. 默认一个分片 很多公司在使用 Elasticsearch 的时候很乱来,其中比较多的就是过度分片,而分片数量的默认值可能是个造成这种现象的主要原因。Elasticsearch 6和之前的版本,每个索引默认有5个分片。如果有一个针对10个不同的应用的每日索引(按日建的索引,类似于数据库的按日分表),并且每个应用程序默认有5个分片,那么每天将创建50个分片,即使每天只有几个gb的索引数据,不久之后将会出现数千个分片。 索引生命周期管理是帮助实现这点的第一步: 提供了本地方法按大小来创建索引,而不是仅仅按天来创建索引,并且提供内置的收缩功能来减少每个索引的分片数量。 其次就是减少索引的默认分片数量。 当然,如果创建索引的时候我们依然可以自己设置分片数量,如果不设置就会是默认值1. 4. Lucene 8 这个是重头戏,这里我要插一下,2015年大四还没毕业的时候,对这种索引技术不是非常深入了解,想要升级一个项目的Lucene版本,那时候用的还是3.x的版本,要升级到4.x,简直是噩梦。 与每一个版本一样,官方都是希望支持Lucene的最新的主要版本,以及它带来的所有的特性。Elasticsearch 7.0 底层用的是 Lucene 8 , Lucene 8为Elasticsearch的许多功能的改进奠定了基础,包括对top-k查询的搜索性能的改进(top-k,可以用于在海量数据里查找最大或者最小的K个值,我思考了下方法有很多,比如用默认的前1000个值的最小堆和所有数据进行对比;还可以对数据进行分割然后使用快排。。。),以及在保持速度的同时更好地组合相关信号标识进行搜索,提高性能。 5. 在跨集群搜索中引入耗时最小路径的功能 在Elasticsearch 5.3中,官方引入了跨集群搜索的功能,允许用户跨多个集群进行查询。后面官方对跨集群搜索的这套功能进行了改进,增加了一些特性,最终将其用于弃用和替换tribe节点(tribe 节点,tribe节点是跨多个集群的联合客户端节点,通常用于从多个Elasticsearch集群检索信息,使其看起来像一个组合集群,详情可以去看下官方的跨集群搜索功能,根据官方的文档,tribe 节点在7.0版本被移除废弃。),从而实现联合查询。 在Elasticsearch 7.0中,官方为跨集群搜索添加了一种新的执行模式:在不必要的情况下减少往返的耗时。这种模式(ccs_minimize_roundtrips)可以在跨集群搜索查询避免高延迟(例如,跨网络)从而更快的得到搜索结果。 6. 新的集群协调实现 Elasticsearch 从设计之初就是易于扩展的,且这种设计能很好的应对灾难性的故障。为了更好的支持这类需求,官方创建了一个可插拔的集群协调系统,其默认实现称为Zen Discovery(大致的意思就是这个功能想简单点来实现,你们用户放心使用就好了,这个功能是官方引入的集群发现机制), Elasticsearch使用量的急剧增加暴露了很多问题,例如,Zen的minimum_master_nodes设置经常配置错误,这会使群集更容易出现裂脑和丢失数据的风险。 跨集群(集群是动态的且非常大),因为维护此设置很困难。 在Elasticsearch 7.0,重新设计了集群协调层。 新的实现提供了安全的亚秒级的master选举时间,而Zen可能要花几秒钟来选择一个新的master,这对于关键时候的部署来说,这时间是宝贵的。删除minimum_master_nodes设置后,集群的增长和收缩变得更安全、更容易,减少了因为系统错误配置埋坑。最重要的是,新的集群协调层为Elasticsearch的未来提供了强大的健壮性,确保将来可以为这个模块设计更高级的功能扩展。 7. 对小堆的更好支持(真实内存断路器) Elasticsearch使用时 7.0加了一个全新的断路器,可以跟踪JVM使用的总内存,如果请求导致预留的内存和实际堆使用量超过95%,则拒绝请求。官方还将更改默认的最大桶数search.max_buckets为10000,这在6及之前的版本中是不受限制的。在Elasticsearch 7这两个改动,可以防止新手菜鸟第一次玩的时候运行大型查询和聚合操作引起的集群故障。 8. 跨集群复制已经可以用于生产环境 官方在Elasticsearch 6.5中引入了一个beta功能,跨集群复制。现在在7.0这个功能已经完善成熟,可以用于生产环境。 以前版本的跨集群复制要求复制只能在新索引上开始,无法复制现有索引。现在,跨集群复制可以开始复制在6.7和7.0中启用了软删除的现有索引,并且新索引默认为启用了软删除。还引入了一些很新的技术防止follower严重落后于leader(没有说明是啥新的技术),官方在特意在Kibana中添加了一个管理UI,用于配置远程集群。 9. 索引生命周期管理已经可以用于生产环境 索引生命周期管理(ILM)是Elasticsearch 6.6中的beta功能。现在已将ILM正式从Beta版迁移到GA版! ILM使得在Elasticsearch中管理数据的生命周期变得更简单,包括数据在hot,warm,cold,delete阶段之间的进度情况。可以通过Elasticsearch中的API来看,或者Kibana中漂亮的UI来创建有关数据如何在这些阶段中移动的情况。 在Elasticsearch 6.7和7.0中,ILM现在可以管理冻结索引。冻结索引对于Elasticsearch中的长期数据存储很有价值,并且相对于节点管理的数据量而言,需要的存储量(堆)更小。在6.7和7.0中,现在可以将冻结的索引作为ILM中cold阶段的一部分进行冻结。此外,ILM现在可以直接与跨集群复制(CCR)一起使用,CCR在Elasticsearch 6.7和7.0版本中也都采用了GA。 ILM是免费使用的,并且是Elasticsearch的默认发行版的一部分。 10. SQL 已经可以用于生产环境 Elasticsearch的SQL接口现在是GA。 SQL界面在6.3中作为Alpha发行版引入,熟悉SQL的可以直接使用Elasticsearch来查询需要的数据,它还允许使用SQL的BI工具轻松访问Elasticsearch中的数据。 不仅仅是这些,使用JDBC和ODBC驱动程序访问也可以了,也就是说目前官方支持四种方法可以访问: Elasticsearch SQL,通过Elasticsearch REST端点、Elasticsearch SQL接口、JDBC、ODBC。 11. 高级REST客户端功能完善 官方为这个功能已经准备了很久很久了:创建用于访问Elasticsearch集群的下一代Java客户端。 这里插一下嘴,其实我一直喜欢用rest访问es,真的简单方便。 12. 支持纳秒时间戳 7.0之前,Elasticsearch只能存储毫秒级的时间戳。 如果要处理发生率较高的情况,例如,如果要在Elasticsearch中存储和分析跟踪网络数据包数据,则可能需要更高的时间精度。 从过去的经验上来看,我们曾使用Joda时间库来处理日期和时间,而Joda缺乏对如此高精度时间戳的支持。 在JDK 8中,引入了正式的Java时间API,该API也可以处理纳秒级的精确时间戳,并且在过去的一年中,官方一直在努力将Joda时间使用情况迁移到本机Java时间,同时试图保持向后兼容性。 从7.0.0版本开始,可以通过专用的date_nanos字段映射器使用这些纳秒级的时间戳。 请注意,此字段的聚合仍处于毫秒级分辨率,以避免发生存储桶爆炸(好担心用这个词会被和谐掉)。 13. 更快的检索热门内容 在搜索方面,查询性能是一项关键功能。对于不需要精确的命中数为结果数设置返回数据的下限就可以了,Elasticsearch 7.0中的搜索性能有了显着提高。例如,如果用户通常只查看网站上结果的第一页,而不在乎匹配的文档有多少,那么可以向他们显示“超过10,000个结果”,然后为他们提供分页结果。 用户在查询中输入频繁出现的词(例如“ the”和“ a”)是很常见的,从过去经验来上看,即使这些频繁出现的词条可能并没有太大意义,但是Elasticsearch也会为它们打分。 在这种情况下,Elasticsearch现在可以跳过这些分值很高却无太大意义的词。这样可以大大提高查询速度。 得分最高的实际结果的实际数量是可配置的,但默认值为10,000。结果集小于此阈值的查询的行为不会改变,也就是说结果数是准确的,但是对于少量匹配结果的查询,性能没有改善。 由于改进是基于跳过低排名的记录,因此不适用于聚合操作。 14. 支持TLS 1.3 Elasticsearch一直是支持加密通信的,官方最近开始支持JDK 11(关于JDK11的介绍可以看我以前的博客 https://my.oschina.net/110NotFound/blog/3046749 ),它提供了很多新功能。 JDK 11现在支持TLSv1.3,因此从7.0开始,在Elasticsearch中为运行JDK 11的用户提供TLSv1.3的支持。为了帮助新用户避免无意中以低安全性运行,所以删除了TLSv1 .0(默认值)。 对于运行旧版Java的用户,官方提供了具有TLSv1.2和TLSv1.1的默认选项。 15. 将JDK捆绑在Elasticsearch 官方说很多用户最突出的入门障碍是不知道Elasticsearch是Java应用程序(如果用户群体不是熟悉java的开发人员,这的确会是一个很大的问题,话说回来,开发人员本身不应该局限于某种语言)。 在7.0中,Elasticsearch捆绑了一个OpenJDK发行版,以帮助用户更快地开始使用Elasticsearch。 同时也支持用户自己配置JDK。 如果想使用自己机器环境的JDK,仍然可以通过在启动Elasticsearch之前设置JAVA_HOME来实现。 16. Rank features Elasticsearch 7.0有几种新的字段类型,可以最大程度地利用数据。 两个核心的可以有助于搜索的用例方法是 rank_feature 和 rank_features 。 它们可用于增强基于数值或分类值的文档。 rank_feature 与分数负相关的排序特性应该将positive_score_impact设置为false(默认为true)。rank_feature 查询将使用它来修改评分公式,使评分随特性值的增加而减少,而不是增加。例如在网络搜索中,url长度是一个常用的与分数负相关的特征。 PUT my_index { "mappings": { "properties": { "pagerank": { "type": "rank_feature" }, "url_length": { "type": "rank_feature", "positive_score_impact": false } } } } PUT my_index/_doc/1 { "pagerank": 8, "url_length": 22 } GET my_index/_search { "query": { "rank_feature": { "field": "pagerank" } } } rank_features 字段可以在索引数值特征向量,以便以后可以使用rank_feature查询来增强查询中的文档。 它类似于rank_feature数据类型,但更适合特性列表稀疏的情况,因此不太可能为每个映射添加一个字段。 PUT my_index { "mappings": { "properties": { "topics": { "type": "rank_features" } } } } PUT my_index/_doc/1 { "topics": { "politics": 20, "economics": 50.8 } } PUT my_index/_doc/2 { "topics": { "politics": 5.2, "sports": 80.1 } } GET my_index/_search { "query": { "rank_feature": { "field": "topics.politics" } } } 17. JSON日志 除了纯文本日志外,官方在Elasticsearch中启用了JSON日志记录。 从7.0开始,可以在日志目录中找到扩展名为.json的新文件。 这意味着现在可以使用 jq 之类的过滤工具以更加结构化的方式漂亮地打印和处理日志。 18. 脚本评分查询(又叫做函数评分2.0) 在7.0中,出现了下一代功能评分功能。 这个新的 script_score 查询提供了一种新的,更简单且更灵活的方式来为每条记录生成排名分数。 script_score 查询由一组函数构成,其中包括算术和距离函数,用户可以任意搭配这些函数来构造任意的函数进行得分计算。 模块化结构更易于使用,所以向用户开放这个重要的功能。 这个功能是实验性的,在将来的版本中可能会完全改变或删除。 总结(吐槽) 不得不说 Elasticsearch 的更新进步是非常快的,从我大学最后一个学期知道这个组件的时候到现在,版本已经飙升到了7,很多特性也在发生变化,使用群体也增长很快,在检索方面真的非常非常的强,当然缺点也有,比如低版本的升级很麻烦,很费资源等等。。。 很多公司在用 Elasticsearch 的时候好像对这个东西本身并不是很了解,觉得要快速检索,所以就用了,更甚至有用它做数据库,可能是使用场景比较特殊所以敢这么大胆。没有数据一致性的保障,如果出现主分片和副本不一致的时候,哭都没地哭,重建索引?

优秀的个人博客,低调大师

每日一博 | 不要小看小小的 emoji 表情

前言 好久没更新了,最近事比较多,或许下个月就会恢复到正常的发文频次。 这篇文章得从一个 emoji 表情开始,我之前开源的一个 IM 项目中有朋友提到希望可以支持 emoji 表情传输。 https://github.com/crossoverJie/cim/issues/12 正好那段时间有空,加上这功能看着也比较简单准备把它实现了。 <!--more--> 但在真正实现时却发现没那么简单。 我首先尝试将一个 emoji 表情存入数据库看看: 果不其然的出错了,导致这个异常的原因是目前数据库所支持的编码中并不能存放 emoji,那 emoji 表情到底是个什么东西呢。 本质上来说计算机所存储的信息都是二进制 01,emoji 也不例外,只要存储和读取(编解码)的方式一致那就可以准确的展示这个信息。 更多编解码的内容后文再介绍,这里先想想如何快速解决问题。 存储 emoji 虽说想要在 MySQL 中存储 emoji 的方式也有好几种,比如可以升级存储字符集到可以存放 emoji ,但这种需要 MySQL 的版本支持。 所以更保险的方式还是在应用层解决,比如我们是否可以将 emoji 当做字符串存储,只是显示的时候要格式化为一个 emoji 表情,这样对于所有的数据库版本都可兼容。 于是我们这里的需求是一个 emoji 表情转换为字符串,同时还得将这个字符串转换为 emoji。 为此我在 GitHub 上找到了一个库,它可以方便的将一个 emoji 转换为字符串的别名,同时也支持将这个别名转换为 emoji。 https://github.com/vdurmont/emoji-java @Test public void emoji() throws Exception{ String str = "An :grinning:awesome :smiley:string &#128516;with a few :wink:emojis!"; String result = EmojiParser.parseToUnicode(str); System.out.println(result); result = EmojiParser.parseToAliases(str); System.out.println(result); } 所以基于这个基础库最终实现了表情功能。 其实它本质上是自己维护了一个 emoji 的别名及它的 Unicode 编码(本质上是 UTF-16)的映射关系,再每次格式化数据的时候都会从这个表中进行翻译。 编码知识回顾 自此需求是完成了,但还有几个问题待解决。 Java 中是如何存储 emoji 的? emoji 是如何进行编码的? ASCII 在谈 emoji 之前非常有必要了解下计算机编码鼻祖的 ASCII 码。 大家现在都知道在计算机内部存储数据本质上都是二进制的 0/1,对于一个字节来说有 8 位;每一位可以表示两种状态,也就是 0 或 1,这样排列组合下来,一个字节就可以表示 256(2∧8) 种不同的状态。 对于美国来说他们日常使用的英语只需要 26 个英文字母,再加上一些标点符号就足够用计算机来进行信息交流。 于是上个世纪 60年代定义了一套二进制与英文字符的映射关系,可以表明 128 个不同的英文字符,也就是现在的 ASCII 码。 这样我们就可以使用一个字节来表示现代英文,看起来非常不错。 Unicode 随着计算机的发展,逐渐在欧洲、亚洲地区流行;再利用这套 ASCII 码进行信息交流显然是不行的,很多地区压根就不使用英文,而且也远超了 128 位字符(中文就更不用说了)。 虽说一个字节在 ASCII 码中只用了 128 位,但剩下(258-128)的依然不足用用于描述其他语言。 这时如果能有一种包含了世界上所有的文字的字符集,每一个地区的文字都在这个字符集中有唯一的二进制表示,这样便不会出现乱码问题了。 Unicode 就是来做这个的,截止目前 Unicode 已经收录了 10W+ 的字符,你所能使用的字符都包含进去了。 UTF-8 Unicode 虽说包含了几乎所有的文字,但在我们日常使用好像很少看到他的身影,我们用的更多的还是 UTF-8 这样的编码规则。 这也有几方面的原因,比如说除开英文,其他大部分的文字都需要用 2 个甚至更多的字节来表示;如果统一都用 Unicode 来表示,那必然需要以占用字节最多的字符长度为标准。 比如汉字需要 2 个字节来表示,而英文只需要一个字节;这时就得规定 2 个字节表示一个字符,不然汉字就没法表示了。 但这样也会带来一个问题:用两个字节表示英文会使得第一个字节完全是浪费的,如果一段信息全是英文那对内存的浪费是巨大的。 这时大家应该都能想到,我们需要一个可变的长度的字符编码规则,当是英文时我们就用一个字节表示,甚至可以完全兼容 ASCII 码。 UTF-8 便是实现这个需求的,它利用两种规则可以表示一个字节以及多字节的字符。 大致规则如下: 当第一个字节的第一位为 0 时便表示为单字节字符,此时和 ASCII 码一致,完全兼容。 当第一个字节为 1 时,有几个 1 便代表是几个字节 Unicode 字符。 这样便可根据字符的长度最大程度的节省存储空间。 当然还有其他的编码规则,比如 UTF-16、UTF-32,平时用的不多,但本质上都和 UTF-8 一样,都是 Unicode 的不同实现,也是用于表示世界上大部分文字的字符集。 Java 中的 emoji 现在来回到本次的主题,emoji。 刚才说到 Unicode 包含了世界上大部分的字符,emoji 自然也不例外。 https://apps.timwhitlock.info/emoji/tables/unicode 这个表格中包含了所有的 emoji 以及它所对应的 Unicode 编码,同时也有对应的 UTF-8 编码的实现。 从图中也可以看出 emoji 表情用 UTF-8 表示时会占用 4 个字节,那在 Java 中它会是怎么存储的呢? 很简单,debug 一下就知道了。 在 Java 中也是通过 char 来存储 emoji 的,char 作为基本数据类型会占用 2 个字节;从刚才的图中可以看出,emoji 使用 UTF-8 会占用四个字节,这样很明显 char 是没法存储的,所以在这里其实是使用 UTF-16 编码进行存储。 基于这个原理,我们也可以自己实现将一个 emoji 表情转换为字符串,同时也可通过字符串转换为 emoji。 总结 从这次研究 emoji 可以看出,任何一门基础知识都是应用的根基,在计算机行业尤为突出,希望大家看完这篇能回忆起大学课堂被老师支配的恐惧😂。 随便提一下,相关源码可在这里查看: https://github.com/crossoverJie/cim 你的点赞与分享是对我最大的支持

优秀的个人博客,低调大师

每日一博 | 分布式 Redis 深度历险-Cluster

本文为分布式Redis深度历险系列的第三篇,主要内容为Redis的Cluster,也就是Redis集群功能。 Redis集群是Redis官方提供的分布式方案,整个集群通过将所有数据分成16384个槽来进行数据共享。 集群基础实现 一个集群由多个Redis节点组成,不同的节点通过CLUSTER MEET命令进行连接: CLUSTER MEET <ip> <port> 收到命令的节点会与命令中指定的目标节点进行握手,握手成功后目标节点会加入到集群中,看个例子,图片来自于Redis的设计与实现: 槽分配 一个集群的所有数据被分为16384个槽,可以通过CLUSTER ADDSLOTS命令将槽指派给对应的节点。当所有的槽都有节点负责时,集群处于上线状态,否则处于下线状态不对外提供服务。 clusterNode的位数组slots代表一个节点负责的槽信息。 struct clusterNode { unsigned char slots[16384/8]; /* slots handled by this node */ int numslots; /* Number of slots handled by this node */ ... } 看个例子,下图中1、3、5、8、9、10位的值为1,代表该节点负责槽1、3、5、8、9、10。 每个Redis Server上都有一个ClusterState的对象,代表了该Server所在集群的信息,其中字段slots记录了集群中所有节点负责的槽信息。 typedef struct clusterState { // 负责处理各个槽的节点 // 例如 slots[i] = clusterNode_A 表示槽 i 由节点 A 处理 // slots[i] = null 代表该槽目前没有节点负责 clusterNode *slots[REDIS_CLUSTER_SLOTS]; } 槽重分配 可以通过redis-trib工具对槽重新分配,重分配的实现步骤如下: 通知目标节点准备好接收槽 通知源节点准备好发送槽 向源节点发送命令:CLUSTER GETKEYSINSLOT <slot> <count>从源节点获取最多count个槽slot的key 对于步骤3的每个key,都向源节点发送一个MIGRATE <target_ip> <target_port> <key_name> 0 <timeout>命令,将被选中的键原子的从源节点迁移至目标节点。 重复步骤3、4。直到槽slot的所有键值对都被迁移到目标节点 将槽slot指派给目标节点的信息发送到整个集群。 在槽重分配的过程中,槽中的一部分数据保存着源节点,另一部分保存在目标节点。这时如果要客户端向源节点发送一个命令,且相关数据在一个正在迁移槽中,源节点处理步骤如图: 当客户端收到一个ASK错误的时候,会根据返回的信息向目标节点重新发起一次请求。 ASK和MOVED的区别主要是ASK是一次性的,MOVED是永久性的,有点像Http协议中的301和302。 一次命令执行过程 我们来看cluster下一次命令的请求过程,假设执行命令get testKey cluster client在运行前需要配置若干个server节点的ip和port。我们称这些节点为种子节点。 cluster的客户端在执行命令时,会先通过计算得到key的槽信息,计算规则为:getCRC16(key) & (16384 - 1),得到槽信息后,会从一个缓存map中获得槽对应的redis server信息,如果能获取到,则调到第4步 向种子节点发送slots命令以获得整个集群的槽分布信息,然后跳转到第2步重试命令 向负责该槽的server发起调用 server处理如图: 客户端如果收到MOVED错误,则根据对应的地址跳转到第4步重新请求, 客户段如果收到ASK错误,则根据对应的地址跳转到第4步重新请求,并在请求前带上ASKING标识。 以上步骤大致就是redis cluster下一次命令请求的过程,但忽略了一个细节,如果要查找的数据锁所在的槽正在重分配怎么办? Redis故障转移 疑似下线与已下线 集群中每个Redis节点都会定期的向集群中的其他节点发送PING消息,如果目标节点没有在有效时间内回复PONG消息,则会被标记为疑似下线。同时将该信息发送给其他节点。当一个集群中有半数负责处理槽的主节点都将某个节点A标记为疑似下线后,那么A会被标记为已下线,将A标记为已下线的节点会将该信息发送给其他节点。 比如说有A,B,C,D,E 5个主节点。E有F、G两个从节点。 当E节点发生异常后,其他节点发送给A的PING消息将不能得到正常回复。当过了最大超时时间后,假设A,B先将E标记为疑似下线;之后C也会将E标记为疑似下线,这时C发现集群中由3个节点(A、B、C)都将E标记为疑似下线,超过集群复制槽的主节点个数的一半(>2.5)则会将E标记为已下线,并向集群广播E下线的消息。 选取新的主节点 当F、G(E的从节点)收到E被标记已下线的消息后,会根据Raft算法选举出一个新的主节点,新的主节点会将E复制的所有槽指派给自己,然后向集群广播消息,通知其他节点新的主节点信息。 选举新的主节点算法与选举Sentinel头节点的过程很像: 集群的配置纪元是一个自增计数器,它的初始值为0. 当集群里的某个节点开始一次故障转移操作时,集群配置纪元的值会被增一。 对于每个配置纪元,集群里每个负责处理槽的主节点都有一次投票的机会,而第一个向主节点要求投票的从节点将获得主节点的投票。 档从节点发现自己正在复制的主节点进入已下线状态时,从节点会想集群广播一条CLUSTER_TYPE_FAILOVER_AUTH_REQUEST消息,要求所有接收到这条消息、并且具有投票权的主节点向这个从节点投票。 如果一个主节点具有投票权(它正在负责处理槽),并且这个主节点尚未投票给其他从节点,那么主节点将向要求投票的从节点返回一条CLUSTERMSG_TYPE_FAILOVER_AUTH_ACK消息,表示这个主节点支持从节点成为新的主节点。 每个参与选举的从节点都会接收CLUSTERMSG_TYPE_FAILOVER_AUTH_ACK消息,并根据自己收到了多少条这种消息来同济自己获得了多少主节点的支持。 如果集群里有N个具有投票权的主节点,那么当一个从节点收集到大于等于N/2+1张支持票时,这个从节点就会当选为新的主节点。 因为在每一个配置纪元里面,每个具有投票权的主节点只能投一次票,所以如果有N个主节点进行投票,那么具有大于等于N/2+1张支持票的从节点只会有一个,这确保了新的主节点只会有一个。 如果在一个配置纪元里面没有从节点能收集到足够多的支持票,那么集群进入一个新的配置纪元,并再次进行选举,知道选出新的主节点为止。 Redis常用分布式实现方案 最后,聊聊redis集群的其他两种实现方案。 client做分片 客户端做路由,采用一致性hash算法,将key映射到对应的redis节点上。 其优点是实现简单,没有引用其他中间件。 缺点也很明显:是一种静态分片方案,扩容性差。 Jedis中的ShardedJedis是该方案的实现。 proxy做分片 该方案在client与redis之间引入一个代理层。client的所有操作都发送给代理层,由代理层实现路由转发给不同的redis服务器。 其优点是: 路由规则可自定义,扩容方便。 缺点是: 代理层有单点问题,多一层转发的网络开销 原文:Java架构笔记 免费Java高级资料需要自己领取,涵盖了Java、Redis、MongoDB、MySQL、Zookeeper、Spring Cloud、Dubbo高并发分布式等教程,一共30G。 传送门: https://mp.weixin.qq.com/s/JzddfH-7yNudmkjT0IRL8Q

优秀的个人博客,低调大师

每日一博 | 分布式 Redis 深度历险——Sentinel

上一篇介绍了Redis的主从服务器之间是如何同步数据的。试想下,在一主一从或一主多从的结构下,如果主服务器挂了,整个集群就不可用了,单点问题并没有解决。Redis使用Sentinel解决该问题,保障集群的高可用。 如何保障集群高可用 保障集群高可用,要具备如下能力: 能监测服务器的状态,当主服务器不可用时,能及时发现 当主服务器不可用时,选择一台最合适的从服务器替代原有主服务器 存储相同数据的主服务器同一时刻只有一台 要实现上述功能,最直观的做法就是,使用一台监控服务器来监视Redis 服务器的状态。 监控服务器和主从服务器间维护一个心跳连接,当超出一定时间没有收到主服务器心跳时,主服务器就会被标记为下线,然后通知从服务器上线成为主服务器。 当原来的主服务器上线后,监控服务器会将其转换为从服务器。 按照上述流程似乎解决了集群高可用的问题,但似乎有哪里不对:如果监控服务器出了问题怎么办?我们可以在加上一个从监控服务器,当主服务器不可用的时候顶上。 但问题是谁来监控’监控服务器’呢?子子孙孙无穷尽也。。 先把疑问放在一旁,先来看下Redis Sentinel集群的实现 Sentinel 和上一小节的想法一样,Redis通过增加额外的Sentinel服务器来监控数据服务器,Sentinel会与所有的主服务器和从服务器保存连接,用以监听服务器状态以及向服务器下达命令。 Sentinel本身是一个特殊状态的Redis服务器,启动命令: redis-server /xxx/sentinel.conf --sentinel,sentinel模式下的启动流程与普通redis server是不一样的,比如说不会去加载RDB文件以及AOF文件,本身也不会存储业务数据。 与主服务器建立连接 Sentinel启动后,会与配置文件中提供的所有主服务器建立两个连接,一个是命令连接,一个是订阅连接。 命令连接用于向服务器发送命令。 订阅连接则是用于订阅服务器的_sentinel_:hello频道,用于获取其他Sentinel信息,下文会详细说。 获取主服务器信息 Sentinel会以一定频率向主服务器发送Info命令获取信息,包括主服务器自身的信息比如说服务器id等,以及对应的从服务器信息,包括ip和port。Sentinel会根据info命令返回的信息更新自己保存的服务器信息,并会与从服务器建立连接。 获取从服务器信息 与和主服务器的交互相似,Sentinel也会以一定频率通过Info命令获取从服务器信息,包括:从服务器ID,从服务器与主服务器的连接状态,从服务器的优先级,从服务器的复制偏移等等。 向服务器订阅和发布消息 在如何保障集群高可用小节留下了一个疑问:用如何保证监视服务器的高可用? 在这里我们可以先给出简单回答:用一个监视服务器集群(也就是Sentinel集群)。如何实现,如何保证监视服务器的一致性暂且先不说,我们只要记住需要用若干台Sentinel来保障高可用,那一个Sentinel是如何感知其他的Sentinel的呢? 前面说过,Sentinel在与服务器建立连接时,会建立两个连接,其中一个是订阅连接。Sentinel会定时的通过订阅连接向_sentinel_:hello频道频道发送消息(对Redis发布订阅功能不太了解的同学可以去去了解下),其中包括: Sentinel本身的信息,如ip地址、端口号、配置纪元(见下文)等 Sentinel监视的主服务器的信息,包括ip、端口、配置纪元(见下文)等 同时,Sentinel也会订阅_sentinel_:hello频道的消息,也就是说Sentinel即向该频道发布消息,又从该频道订阅消息。 Sentinel有一个字典对象sentinels,保存着监视同一主服务器的其他所有Sentinel服务器,当一个Sentinel接收到来自_sentinel_:hello频道的消息时,会先比较发送该消息的是不是自己,如果是则忽略,否则将更新sentinels中的内容,并对新的Sentinel建立连接。 主观下线 Sentinel默认会以每秒一次的频率向所有建立连接的服务器(主服务器,从服务器,Sentinel服务器)发送PING命令,如果在down-after-milliseconds内都没有收到有效回复,Sentinel会将该服务器标记为主观下线,代表该Sentinel认为这台服务器已经下线了。需要注意的是不同Sentinel的down-after-milliseconds是可以不同的。 客观下线 为了确保服务器真的已经下线,当Sentinel将某个服务器标记为主观下线后,它会向其他的Sentinel实例发送Sentinel is-master-down-by-addr命令,接收到该命令的Sentinel实例会回复主服务器的状态,代表该Sentinel对该主服务器的连接情况。 Sentinel会统计发出的所有Sentinel is-master-down-by-addr命令的回复,并统计同意将主服务器下线的数量,如果该数量超出了某个阈值,就会将该主服务器标记为客观下线。 选举领头Sentinel 当Sentinel将一个主服务器标记为客观下线后,监视该服务器的各个Sentinel会通过Raft算法进行协商,选举出一个领头的Sentinel。 建议你先看Raft算法的基础知识,再来看下文。 规则: 所有的Sentinel都有可能成为领头Sentinel的资格 每次选举后,无论有没有选出领头Sentinel,配置纪元都会+1 在某个纪元里,每个Sentinel都有为投票的机会 我们称要求其他人选举自己的Sentinel称为源Sentinel,将被要求投票的Sentinel称为目标Sentinel 每个发现主服务器被标记为客观下线且还没有被其他Sentinel要求投票的Sentinel都会要求其他Sentinel将自己设置为头 目标Sentinel在一个配置纪元里,一旦为某个Sentinel(也可能是它自己)投票后,对于之后收到的要求投票的命令,将拒绝 目标Sentinel对于要求投票的命令将回复自己选举的Sentinel的id以及当前配置纪元 源Sentinel在接收到要求投票的回复后:如果回复的配置纪元与自己的相同,则再检测目标Sentinel选举的头Sentinel是不是自己 如果某个Sentinel被半数以上的Sentinel设置成了领头Sentinel,那它将称为领头Sentinel 一个配置纪元只会选出一个头(因为一个头需要半数以上的支持) 如果在给定时间内,还没有选出头,则过段时间再次选举(配置纪元会+1) 还记得我们在文章开头提出的如何保证Redis服务器高可用的问题吗? 答案就是使用若干台Sentinel服务器,通过Raft一致性算法来保障集群的高可用,只要Sentinel服务器有一半以上的节点都正常,那集群就是可用的。 故障转移 领头Sentinel将会进行以下3个步骤进行故障转移: 1.在已下线主服务器的所有从服务器中,挑选出一个作为新的主服务器 2.将其他从服务器的主服务器设置成新的 3.将已下线的主服务器的role改成从服务器,并将其主服务器设置成新的,当该服务器重新上线后,就会一个从服务器的角色继续工作 第一步中挑选新的主服务器的规则如下: 1.过滤掉所有已下线的从服务器 2.过滤掉最近5秒没有回复过Sentinel命令的从服务器 3.过滤掉与原主服务器断开时间超过down-after-milliseconds*10的从服务器 4.根据从服务器的优先级进行排序,选择优先级最高的那个 5.如果有多个从服务器优先级相同,则选取复制偏移量最大的那个 6.如果上一步的服务器还有多个,则选取id最小的那个 原文:Java架构笔记 免费Java高级资料需要自己领取,涵盖了Java、Redis、MongoDB、MySQL、Zookeeper、Spring Cloud、Dubbo高并发分布式等教程,一共30G。 传送门: https://mp.weixin.qq.com/s/JzddfH-7yNudmkjT0IRL8Q

优秀的个人博客,低调大师

每日一博 | Redis 压缩列表原理与应用分析

摘要 Redis是一款著名的key-value内存数据库软件,同时也是一款卓越的数据结构服务软件。它支持字符串、列表、哈希表、集合、有序集合五种数据结构类型,同时每种数据结构类型针对不同的应用场景又支持不同的编码方式。这篇文章主要介绍压缩列表编码,在理解压缩列表编码原理的基础上介绍Redis对压缩列表的应用,最后再对Redis压缩列表应用进行分析。 Redis压缩列表原理与应用 压缩列表是一种数据结构,这种数据结构的功能是将一系列数据与其编码信息存储在一块连续的内存区域,这块内存物理上是连续的,逻辑上被分为多个组成部分,其目的是在一定可控的时间复杂读条件下尽可能的减少不必要的内存开销,从而达到节省内存的效果,这么介绍有点玄乎,我们先一起看看它的实现原理吧,Redis3.2版本中,作者对压缩列表的实现在ziplist.h和ziplist.c中。 压缩列表原理 我认为将数据按照一定规则存储在内存中可以用“编码”这个词描述,因此下面会常用“编码”这个词。 总体编码 上面说到压缩列表是一块连续的内存区域,这块内存区域布编码示意图大致如下: Redis压缩列表内存编码示意图 常态的压缩列表内存编码如上图所示,整个内存块区域内分为五个部分,下面分别介绍着五个部分: zlbytes:存储一个无符号整数,固定四个字节长度,用于存储压缩列表所占用的字节,当重新分配内存的时候使用,不需要遍历整个列表来计算内存大小。 zltail:存储一个无符号整数,固定四个字节长度,代表指向列表尾部的偏移量,偏移量是指压缩列表的起始位置到指定列表节点的起始位置的距离。 zllen:压缩列表包含的节点个数,固定两个字节长度,源码中指出当节点个数大于2^16-2个数的时候,该值将无效,此时需要遍历列表来计算列表节点的个数。 entryX:列表节点区域,长度不定,由列表节点紧挨着组成。 zlend:一字节长度固定值为255,用于表示列表结束。 列表元素编码 上面介绍了压缩列表的总体内存布局,对于初entryX区域以外的四个区域的长度都是固定的,下面再看看entryX区域的编码情况。 每个列表节点由三部分组成: 压缩列表节点编码示意图 每个压缩列表节点区域头部包含两部分,一部分叫做previous length,另一部分叫encoding,最后是主体内容,叫做content,下面分别介绍他们: previous length 用于存储上一个节点的长度,因此压缩列表可以从尾部向头部遍历,即当前节点位置减去上一个节点的长度即得到上一个节点的起始位置。previous length的长度可能是1个字节或者是5个字节,如果上一个节点的长度小于254,则该节点只需要一个字节就可以表示前一个节点的长度了,如果前一个节点的长度大于等于254,则previous length的第一个字节为254,后面用四个字节表示当前节点前一个节点的长度。这么做很有效地减少了内存的浪费。 encoding 节点的encoding保存的是节点的content的内容类型以及长度,encoding类型一共有两种,一种字节数组一种是整数,encoding区域长度为1字节、2字节或者5字节长。Redis作者巧妙的利用了前两个字节来表示content存储的内容类型和encoding区域的长度,我们先看看字节数组类型的encoding内容: content为字节数组的encoding内容 再看看整数编码类型的encoding内容: content为整数的encoding内容 content content区域用于保存节点的内容,节点内容类型和长度由encoding决定,上面可以看出目前content的内容类型有整数类型和字节数组类型,且某些条件下content的长度可能为0。 相信到这里,我们都明白了压缩列表的原理,压缩列表并不是对数据利用某种算法进行压缩,而是将数据按照一定规则编码在一块连续的内存区域,目的是节省内存。下面我们看看压缩列表在Redis中的应用领域。 Java架构/分布式:705127209(大牛交流群)没有开发经验勿加! Redis中压缩列表的应用 Redis中,不同的数据类型广泛地应用了压缩列表编码,整理如下表: Redis中数据结构类型与压缩列表的应用 上表总结了压缩列表编码在Redis不同的数据类型中的应用,Redis一共支持五种数据结构类型,其中有三种数据结构在一定条件下会应用压缩列表,至于什么条件后面会分析,值得一提的是Redis当前支持的GEO(地理位置)对压缩列表也有应用,具体此处不做讨论。 Redis压缩列表应用分析 上面部分介绍了Redis压缩列表的原理与应用,下面简单分析一下,主要从通过试图回答一些问题来分析:Redis为什么使用压缩列表?使用压缩列表的好处是什么?使用压缩列表的好处还有什么?压缩列表的应用对与我们使用内存有没有什么启发? Redis对于每种数据结构、无论是列表、哈希表还是有序集合,在决定是否应用压缩列表作为当前数据结构类型的底层编码的时候都会依赖一个开关和一个阈值,开关用来决定我们是否要启用压缩列表编码,阈值总的来说通常指当前结构存储的key数量有没有达到一个数值(条件),或者是value值长度有没有达到一定的长度(条件)。任何策略都有其应用场景,不同场景应用不同策略。为什么当前结构存储的数据条目达到一定数值使用压缩列表就不好?压缩列表的新增、删除的操作平均时间复杂度为O(N),随着N的增大,时间必然会增加,他不像哈希表可以以O(1)的时间复杂度找到存取位置,然而在一定N内的时间复杂度我们可以容忍。然而压缩列表利用巧妙的编码技术除了存储内容尽可能的减少不必要的内存开销,将数据存储于连续的内存区域,这对于Redis本身来说是有意义的,因为Redis是一款内存数据库软件,想办法尽可能减少内存的开销是Redis设计者一定要考虑的事情。 另外,经过仔细琢磨,我认为使用压缩列表的好处除了节约内存之外,还有减少内存碎片的作用,我把这种行为叫做"合并存储",也就是将很多小的数据块存储在一个比较大的内存区域,试想想,如果我们将要存储的数据都是很小的条目,我们为每一个数据条目都单独的申请内存,结果是这些条目将有可能分散在内存的每一个角落,最终导致碎片增加,这是一件令人头疼的事情。 总结 这篇文章在介绍Redis压缩列表原理与应用的基础之上对Redis压缩列表的应用进行分析,分析部分主要掺杂着个人的理解与认知,如果有不同观点或者补充观点,欢迎留言讨论。

优秀的个人博客,低调大师

中乘风简书博文说明-风者须知

我也是一名爬虫爱好者,深知在爬虫学习过程中的汗水和艰辛,之前的笔记、记录和绕坑手段都写在了博客中,但是未开放。 由于生活焦灼,我在爬虫的道路上渐行渐远,所以我想将我之前的记录和经验整理成有规律的、便于其他人理解、学习的文章记录且开放出来。 其中分为python编程记录与scrapy爬虫框架记录两个大的部分。其中python编程记录会写一些函数式编程、闭包相关知识及记录,而scrapy爬虫框架主要编写一些实际应用及绕坑手段,再带上些许服务器相关的记录。 生活也需要绕坑,我觉得我可以把这些知识放在这里,这样我再去绕坑就会轻松一些。

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册