首页 文章 精选 留言 我的

精选列表

搜索[自适应爬虫],共4626篇文章
优秀的个人博客,低调大师

vue中动态加入ECharts图表时,ECharts宽度自适应/不能100%撑开

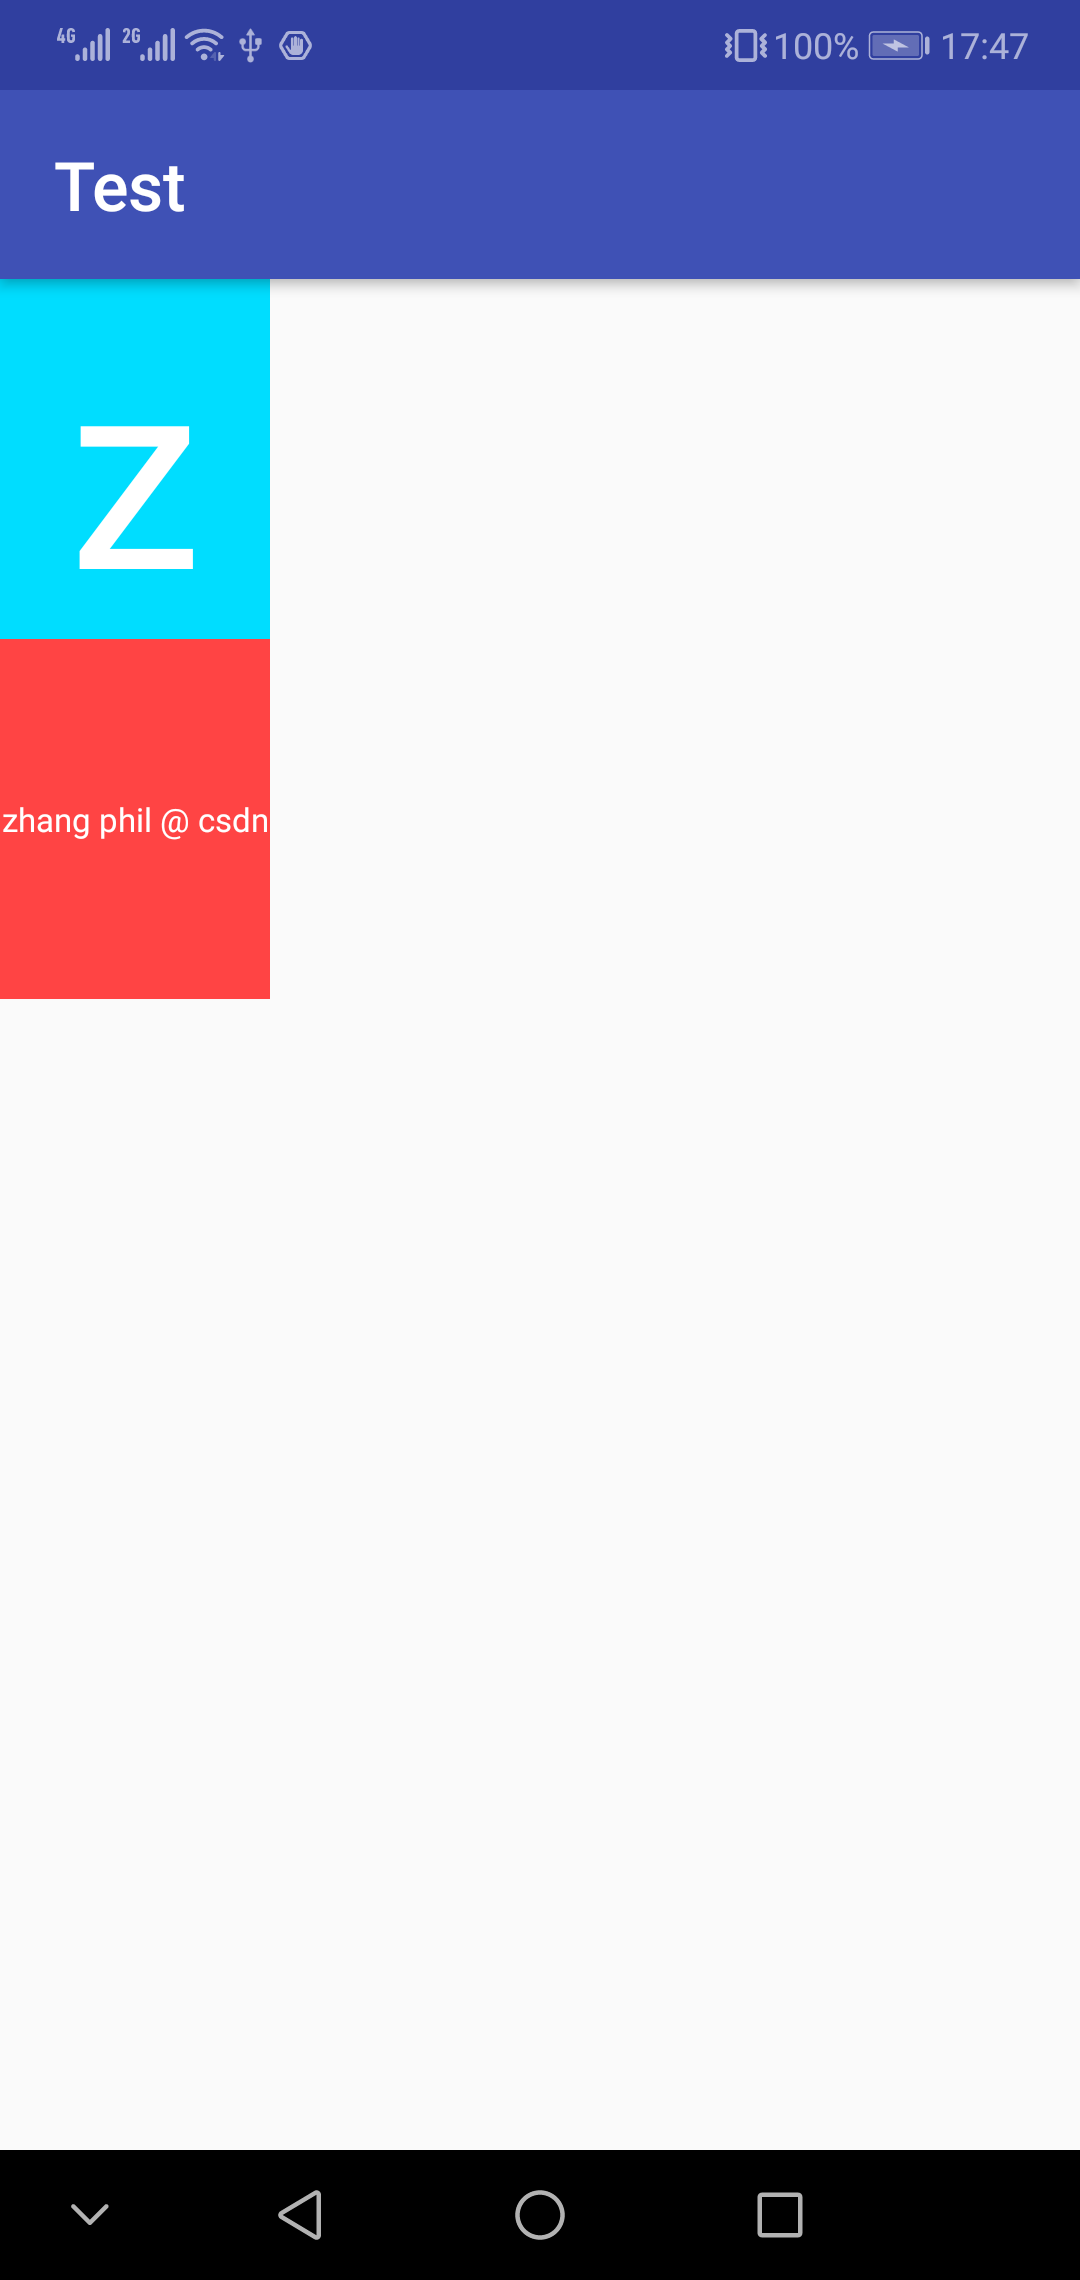
首先上图吧, 关于vue动态加入echarts时,宽度不能100%的问题,首先上图 如图,echarts中的canvas的width才500,显然不对呀,右边还有那么大的一片空白,需要说明下交互步骤 看看代码,按钮触发click方法 显示弹窗或者动态加载组件 <span class="btn" @click="showecharts">showeCharts</span> methods: { showecharts(){ this.$prompt('Test', resolve => require(['@/components/ShowEChart.vue'], resolve)) } } prompt 中的内容肯定是动态的 ShowEChart.vue <div> <EChart :chartData="chartData"/> </div> export default { components: { //EChart.vue图表内容 EChart: resolve => require(['@/components/EChart.vue'], resolve), }, } 这里应该echart能显示如上图了,但是宽度没打开,换成 imp 也是一样的 import EChart from '@/components/EChart.vue'; 思其原因还是prompt还没渲染完整紧着echart也加载,echart的宽度根据具父元素的宽度适应的渲染,给父元素一个确定宽度也可以撑开,也不是好办法,或者setTimeout也行 最好的还是利用vue的mounted 可以解决组件加载完成后 ShowEChart.vue 修改为 <div> <component :is="EChart"></component> </div> exprot defautl { data() { return { EChart: null } }, mounted() { this.$nextTick(() => { this.EChart= resolve => require(['@/components/EChart.vue''],resolve)} ); } } 来看下效果 ** 从此王子和公主完美的生活在一起 **

优秀的个人博客,低调大师

[Unity3D插件]NGUI之UIRoot屏幕分辨率自适应

NGUI在Unity3D游戏开发中非常常用,而NGUI对于每一个UI场景,都是以一个UIRoot为UI游戏对象树的根的,那么这个UIRoot是起什么作用的呢? 先简单看一下UIRoot中的基本属性 UIRoot游戏对象的属性只有4个,分别是缩放规则,手动高度,最小高度和最大高度 而正是这4个属性,将影响整个UI场景中整体的缩放比例,当设置好这4个属性之后,UIRoot游戏对象的相对缩放值(LocalScale)将会生成并且不能被直接修改(NGUI中很多属性都是不能直接被修改的,这种控制是在UIRoot脚本中,通过设置[ExecuteInEditMode]做到的,其相对缩放值是根据UIRoot的4个属性计算出来的),那么这4个属性分别是什么含义呢? (吐槽一下,也许这里的用户体验并不足够友好,因为Manual Height和Minimum Height, Maximum Height并不会同时起作用,如果能做到在选择Scaling Style时动态的切换,使用者也许能更清楚它们之间的关系) 1.Scaling Style (缩放类型) 这是一个简单的枚举变量,包括三个枚举值 [csharp] view plain copy print ? publicenumScaling { PixelPerfect, FixedSize, FixedSizeOnMobiles, } (FixedSize和FixedSizeOnMobiles类似,并且后者只添加了对ios和android平台的判断,所以前者可以替代后者使用) 这里只讨论PixelPerfect和FixedSize的区别,两者都是针对于所有在此UIRoot之下的UI组件而言的,也可以认为是在此UIRoot下,整个游戏屏幕的尺寸的缩放类型! 2.Manual Height和Minimum Height, Maximum Height (手动高度和最小高度,最大高度) Manual Height和Minimum Height, Maximum Height不会同时对此UIRoot起作用,当选择Scaling Style为PixelPerfect时,我们需要设置Minimum Height, Maximum Height;而当Scaling Style为FixedSize或FixedSizeOnMobiles时,我们需要设置Manual Height。(这就是我前面吐槽的原因) 3.使用 (1)PexelPerfect和Minimum Height, Maximum Height 这个组合主要用于我们期望所有的UI纹理都“尽量”不进行缩放,所谓“尽量”的程度,则是取决于Minimum Height和Maximum Height,Minimum Height表示当设备分别率小于此设置值时,根据此设置值对UIRoot进行缩放;Maximum Height表示当设备分辨率大于此设置值时,根据此设置值对UIRoot进行缩放(UIRoot是UI游戏对象树的根,修改UIRoot的缩放,则会影响整棵UI树的缩放) (2)FixedSize和Manul Height 这个组合主要用于我们期望所有的UI纹理都进行“合适”的缩放,所谓“合适”缩放的原则,则是根据Manual Height设置值,当设备分辨率的高度值不同于此设置值时,则根据其比例(即Manual Height /Screen Height)对整棵UI树的进行“等比”缩放(宽度的缩放比也是此比例值),这样,我们就可以做一套资源,在不同尺寸的分辨率最好的“不变形”的适配了 (3)交集 前面两组在什么情况下等同呢? Manual Height == Minimum Height == Maximum Height 推导过程,呵呵~~ 具体可参考UIRoot中activeHeight属性和GetPixelSizeAdjustment的计算过程 4.这也许并不够 基于以上推到,当我们以1024x768为标准分辨率做一套UI资源(也就是选择FixedSize并且Manual Height=768),似乎可以满足百分之90以上的机型了,而为什么是1024x768呢? 既然我们已经容忍在除1024x768之外的其他设备上进行等比缩放了,那为什么不是960x640呢? 计算一下1024x768的宽高比=1.33,960x640的宽高比=1.5,这就是移动设备的分辨率比例的全部了吗? 当然不是,iphone5的比例就要大于1.5,还有各种奇葩的android设备呢,比如夏新的n828就是960x540,宽高比=1.78 那为什么以1024x768为标准呢? 因为1.33的宽高比,当我们的1024x768的资源到960x640的设备上时会有什么现象? 根据Manual Height / Screen Height的比例可知,我们需要缩放768 / 640 = 1.2倍,假设是一张1024x768的纹理,高度缩放1.2倍变为了640,宽度也要相应缩放1.2倍变为853(保证等比缩放不变形),也就是说1024x768的资源放到960x640上反而两边有了黑边,这是我们可以容忍的,我们可以做一个很大的背景或者拉伸,保证UI组件不变形即可,很多游戏都是这么做的,比如植物大战僵尸在iphone5和ipad上看到的背景视野并不一样大! 当放到夏新的机器上呢? 我们需要缩放768 / 540 = 1.4倍,宽度1024 / 1.4 = 731,这是可以的,只是看起来更怪一些,因为两边的黑边相对比例更大了(960 - 731=229的黑边区域) 而我表示android机器的分辨率奇葩到只有想不到,没有做不到的程度,也许宽高比1.7并不是终点,当遇到1.8之后,黑边的相对比例会更大。。。 5.问题又来了 假设我们的游戏类型更适合iphone手机玩,不太适合ipad,所以我希望能以960x640为标准做一套资源,可以吗? 我只能说不太可以,因为你要在设计UI组件的大小做限制了,为什么需要做限制? 假设我有一张纹理是960x640大小的,在iphone上铺满整屏,根据我们的设置(FixedSize和Manual Height=640),拿到1024x768的分辨率上,高度640 / 768 = 0.83,为了保证等比缩放,宽度960 / 0.83 = 1156,不幸的事情发生了,1156 > 1024,这个UI组件宽度超过了屏幕的宽度,被裁剪了。。。这是我们不能容忍的,或许你可以说我们尽量不做这种尺寸的UI,OK,你可以对UI尺寸加限制,但是当面对android那些奇葩的分辨率的时候,你会发现限制越来越大,这也许会让美术和策划疯掉! 6.解决方案 当我们花上一些时间去观察现在移动设备的分辨率时,虽然奇葩很多,但是还是有一些规律的,规律的在于宽高比而不在于具体尺寸,大体上划分一下宽高比在1.3,1.5,1.7的范围上的居多(基本是全部吧!)即便是再有1.2,1.8的比例也无妨。。。 NGUI为我们提供的方案只有以各种高度为衡量标准是不够的,我们应该加上一种以宽度为衡量标准的缩放类型 而对于UI资源的标准,我们选取960x640,宽高比为1.5 这样,当我们在兼容大于1.5的尺寸的时候,使用NGUI的现有方案;当我们在兼容小于1.5的尺寸的时候,使用以宽度为衡量标准 也就是说有一个类似Manual Width的属性,当小于1.5时,我们使用Manual Width / Screen Width得出整棵UI树的缩放比例! 这样做的好处是“黑边”区域不会太大,并且不需要对UI组件的大小做限制! 本文转蓬莱仙羽51CTO博客,原文链接:http://blog.51cto.com/dingxiaowei/1366121,如需转载请自行联系原作者

优秀的个人博客,低调大师

爬虫数据库MongoDB的介绍

MongoDB (名称来自「humongous (巨大无比的)」), 是一个可扩展的高性能,开源,模式自由,面向文档的NoSQL,基于 分布式 文件存储,由 C++ 语言编写,设计之初旨在为 WEB 应用提供可扩展的高性能数据存储解决方案。 MongoDB使用的是内存映射存储引擎,它会把磁盘IO操作转换成内存操作,如果是读操作,内存中的数据起到缓存的作用,如果是写操作,内存还可以把随机的写操作转换成顺序的写操作,大幅度提升性能。 MongoDB 既拥有Key-Value存储方式的高性能和高度伸缩性,也拥有传统的RDBMS系统的丰富的功能,集两者的优势于一身。 介于关系数据库和NoSQL之间,也是功能最丰富、最像关系数据库的的NoSQL。 MongoDB官方文档:https://docs.mongodb.com MongoDB中文社区:http://www.mongoing.com MongoDB特点: 模式自由 :可以把不同结构的文档存储在同一个数据库里 面向集合的存储:适合存储 JSON风格文件的形式, 完整的索引支持:对任何属性可索引, 复制和高可用性:支持服务器之间的数据复制,支持主-从模式及服务器之间的相互复制。复制的主要目的是提供冗余及自动故障转移。 自动分片:支持水平的数据库集群,可动态添加额外的机器。 丰富的查询:支持丰富的查询表达方式,查询指令使用JSON形式的标记,可轻易查询文档中的内嵌的对象及数组。 快速就地更新:查询优化器会分析查询表达式,并生成一个高效的查询计划。 高效的传统存储方式:支持二进制数据及大型对象(如图片等...)。 根据DB-Engines的排名统计,MongoDB综合排名第五(2017年10月数据,前四名分别是Oracle,MySQL,SQL Server,PostgreSQL),在NoSQL领域(非RDBMS)里排名第一。适用场景 网站数据: 适合实时的插入,更新与查询,并具备网站实时数据存储所需的复制及高度伸缩性。 缓存: 由于性能很高,也适合作为信息基础设施的缓存层。在系统重启之后,搭建的持久化缓存可以避免下层的数据源过载。 高伸缩性的场景: 非常适合由数十或者数百台服务器组成的数据库。用于对象及JSON数据的存储: MongoDB的BSON数据格式非常适合文档格式化的存储及查询。 不适用的场景 高度事物性的系统: 例如银行或会计系统。传统的关系型数据库目前还是更适用于需要大量原子性复杂事务的应用程序。 需要使用SQL语句解决的场景: MongoDB不支持SQL语句。 下载mongodb的版本,两点注意 根据业界规则,偶数为稳定版,如3.2.X;奇数为开发版,如3.3.X32bit的mongodb最大只能存放2G的数据,64bit就没有限制。MongoDB官网安装包下载地址:http://www.mongodb.org/downloads MongoDB安装文档:https://docs.mongodb.com/getting-started/shell/installation/ Ubuntu下安装MongoDB: python@ubuntu:~$ sudo apt-get install mongodb 使用MongoDB,需要先启动服务端,再使用客户端连接数据库。服务端 MongoDB 默认的存储数据目录为 /data/db,默认端口27017 服务的命令为mongod,可以通过help查看所有参数 python@ubuntu:~$ mongod --help 相关文件存放路径:默认各个文件存放路径如下所示: 可执行文件存放路径:/usr/bin/mongod 和 /usr/bin/mongo 数据库文件存放路径:/data/db 日志文件存放路径:/var/log/mongodb/mongod.log 配置文件存放路径:/etc/mongod.conf 启动注意事项: 首次启动: 启动MongoDB服务: sudo mongod报出如下错误,表示默认的存储数据目录 /data/db 不存在: [initandlisten] exception in initAndListen: 29 Data directory /data/db not found., terminating 创建 /data目录和 /data/db 目录,并指定 读/写/执行 权限 python@ubuntu:~$ sudo mkdir -p /data/db python@ubuntu:~$ sudo chmod 777 /data/db 再次启动: 再次启动MongoDB服务: sudo mongod启动成功,但是可能会有如下警告: #### 此乃 Warning 1: [initandlisten] ** WARNING: /sys/kernel/mm/transparent_hugepage/enabled is 'always'. [initandlisten] ** We suggest setting it to 'never' [initandlisten] [initandlisten] ** WARNING: /sys/kernel/mm/transparent_hugepage/defrag is 'always'. [initandlisten] ** We suggest setting it to 'never' #### 此乃 Warning 2: [initandlisten] ** WARNING: soft rlimits too low. rlimits set to 1024 processes, 64000 files. Number of processes should be at least 32000 : 0.5 times number of files. #### 此乃 Warning 3: [initandlisten] ** WARNING: You are running this process as the root user, which is not recommended. 注意:这里的三个Warning并非必须处理,大家了解即可:Warning 1: [initandlisten] ** WARNING: /sys/kernel/mm/transparent_hugepage/enabled is 'always'. [initandlisten] ** We suggest setting it to 'never' [initandlisten] [initandlisten] ** WARNING: /sys/kernel/mm/transparent_hugepage/defrag is 'always'. [initandlisten] ** We suggest setting it to 'never' Linux的内存分配默认由内核动态分配,而不是由程序自行管理。而MongoDB对内存占用有那么点...严重,所以为了防止MongoDB占用内存过大而被内核"管理",官方推荐关闭动态分配。 默认"always"表示允许动态分配,对应的"never"就是不允许,所以我们将这两个文件内容修改为"naver"后就没有warning了。 # Ctrl + c 退出 MongoDB 数据库服务 # 然后进入 root 用户下,执行修改命令 python@ubuntu:~$ sudo su [sudo] python 的密码: root@ubuntu:~# sudo echo "never" > /sys/kernel/mm/transparent_hugepage/enabled root@ubuntu:~# sudo echo "never" > /sys/kernel/mm/transparent_hugepage/defrag 实际上,除非网站DBA对数据库性能有极限要求,在通常情况下系统动态分配的内存页大小足够我们正常使用,而且更能优化整个系统,所以一般不必理会这个warning。而且这样只是临时修改Linux内核的设置,在Linux服务器重启后则会失效。Warning 2: [initandlisten] ** WARNING: soft rlimits too low. rlimits set to 1024 processes, 64000 files. Number of processes should be at least 32000 : 0.5 times number of files. 这个WARNING(如果有的话)含义为: 表示默认分配给MongoDB的进程和文件数量限制过低,需要重新分配值: mongodb当前限制:1024 processes, 64000 files mongodb建议要求:processes = 0.5*files=32000(至少)咱们学习阶段默认用不着这么多的进程和文件,所以也可以不必理会。 # 打开 相关配置文件: root@ubuntu:~# vi /etc/security/limits.conf # 在打开的 文件最下方,添加,然后保存退出 mongod soft nofile 64000 mongod hard nofile 64000 mongod soft nproc 32000 mongod hard nproc 32000 Warning 3: [initandlisten] ** WARNING: You are running this process as the root user, which is not recommended. 意思是我们在用root权限做这些事,理论上是不安全的。我们可以通过附加--auth参数,来使用用户认证来处理这个情况,这个后面会讲到。 再再次启动: 再再次启动MongoDB服务: sudo mongod启动后查看进程,以确定是否启动成功 python@ubuntu:~$ ps aux | grep mongod 如果进程中没有mongod的项则没有启动成功,可以通过查看日志来确定错误原因,默认日志文件为 /var/log/mongodb/mongod.log,最新的信息在最后面显示。 客户端 客户端命令为 mongo,可以通过help查看所有参数。 这个shell即是mongodb的客户端,用来对MongoDB进行操作和管理的交互式环境。 python@ubuntu:~$ mongo --help 终端退出连接 > exit (或Ctrl+C) 本文最终解释权归本文作者所有,未经允许不得私自转载

优秀的个人博客,低调大师

爬虫实战——百度贴吧

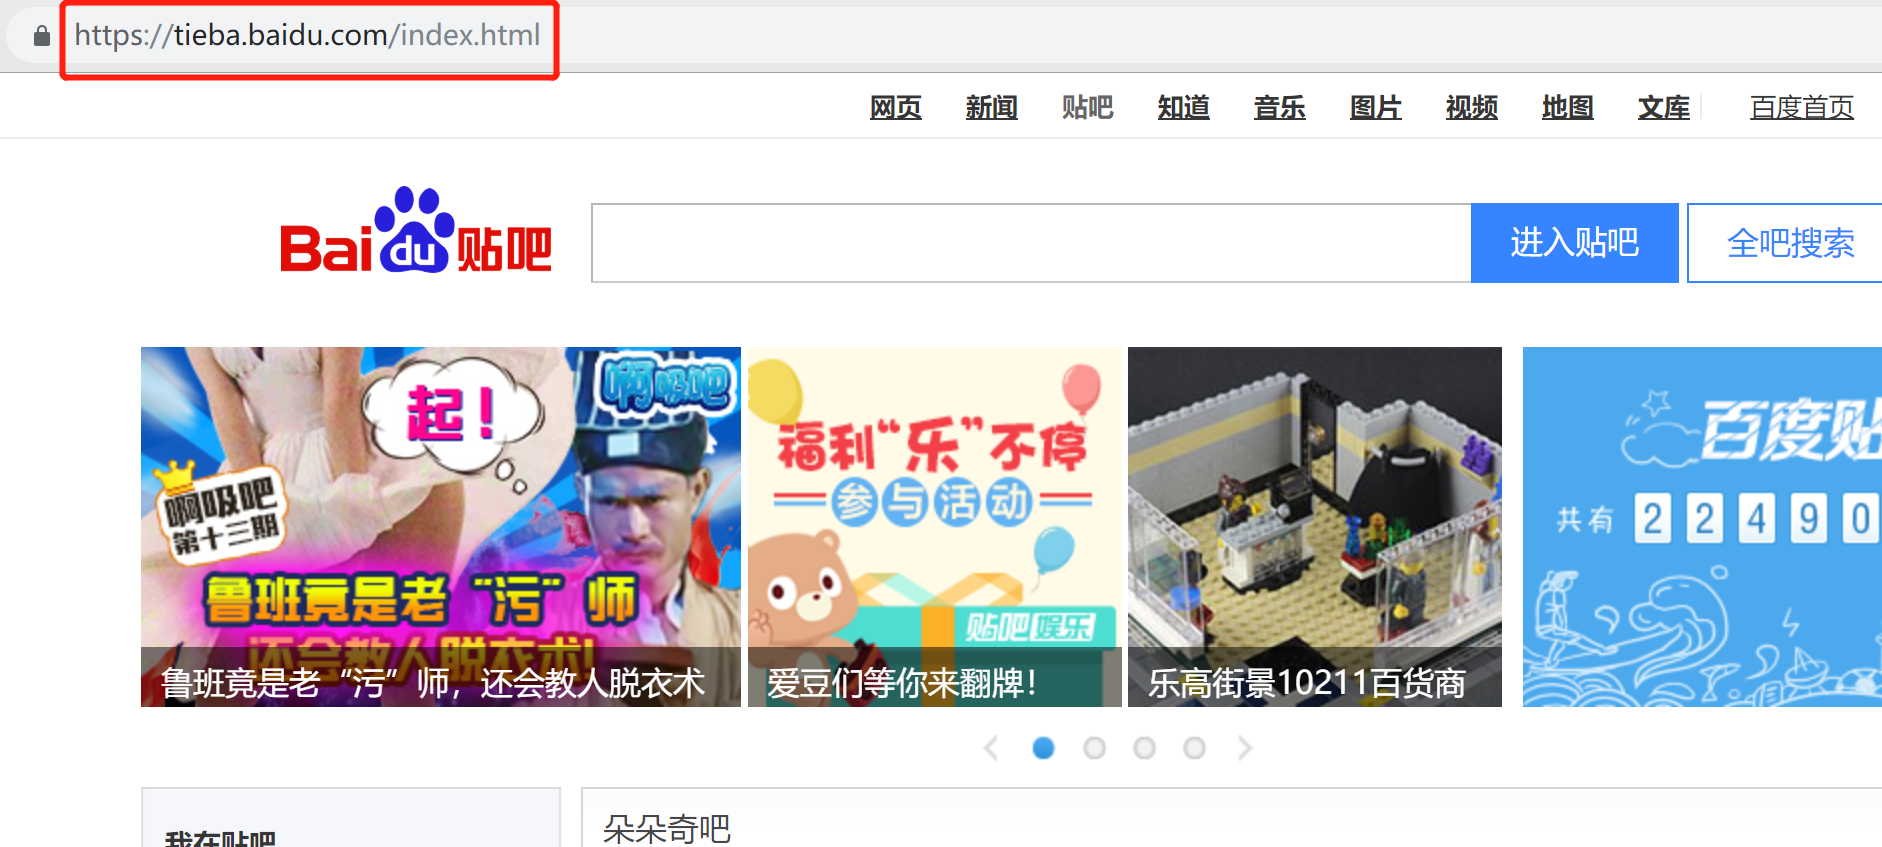
开始 首先使用chrome浏览器,进入百度贴吧 注意输入框中的url 分析 为了进行具体的url分析,我在搜索框中输入"Python",看一下url的变化 观察url变化 这时url变成了: http://tieba.baidu.com/f?ie=utf-8&kw=python&fr=search&red_tag=b2531475437 通过分析,做一个测试, 删除url一些东西: http://tieba.baidu.com/f?&kw=python 依旧可以得到正常的页面 下面进行翻页测试: 得到这样的一条url: http://tieba.baidu.com/f?kw=python&ie=utf-8&pn=50 通过分析,再进行一次测试,删除url中的一些东西: 得到下面的url http://tieba.baidu.com/f?kw=python&pn=50 依旧可以得到相应的页面,因此可以得出结论: kw 和 pn 是这个页面中最重要的关键词,kw控制关键词(其实就是keyword的缩写), pn(其实就是page_number的缩写)控制翻页,每翻一页,pn增加50,也就是说一页有50条数据。 分析结束,开始代码 初始url先用这个,之后再慢慢修改: http://tieba.baidu.com/f?kw=python&pn=50 直接上代码,注意看代码中的注释 # 爬取百度贴吧 import requests class BdTieba(): def __init__(self, name, pn): # 保存贴吧名 self.name = name # 初始url self.base_url = "http://tieba.baidu.com/f?kw={}&pn=".format(name) # 构造请求头 self.headers = { "User-Agent": "Mozilla / 5.0(Windows NT 10.0;Win64;x64)AppleWebKit/537.36(KHTML,likeGecko)Chrome/69.0.3497.100Safari/537.36" } # 2. 批量生成url # 使用列表推导式生成了url列表 self.url_list = [self.base_url + str(i*50) for i in range(pn)] # 打印测试 # print(self.url_list) # 3. 批量发送请求,封装发送请求 def get_data(self, url): response = requests.get(url, headers=self.headers) return response.content def save_data(self, data, index): filename = self.name + "_{}.html".format(index) with open(filename, "wb") as f: f.write(data) def run(self): # 1.请求初始url,测试使用 # response = requests.get(url=self.base_url, headers=self.headers) # 打印测试,测试成功返回结果 # print(response.text) # 2.批量生成url for url in self.url_list: data = self.get_data(url) # 3.批量发送请求 # 4.保存网页,为了保存的网页名字不重复,且有顺序,这里使用index进行区分 # 获取当前url的index index = self.url_list.index(url) # 保存 self.save_data(data, index) if __name__ == '__main__': bdspider = BdTieba("python", 10) bdspider.run() 这里我只通过批量生成url,并批量获取url响应,并保存了url响应数据,这里测试了10页数据,如果想要爬取每个url中的数据,还需要进行页面分析和提取,这里就需要使用xpath,作为新手入门的一个教程,后续我会拿这个项目继续改进,增加xpath解析,爬取每页的文字信息,这里就先到这了。 后面我会写一篇关于xpath的简单快速上手文章,然后再对这个实战进行下一步的更新 over~ peace~ 个人博客: www.limiao.tech 微信公众号:TechBoard
资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册