首页 文章 精选 留言 我的

精选列表

搜索[快速入门],共10012篇文章
优秀的个人博客,低调大师

ALiyun LOG Go Consumer Library 快速入门及原理剖析

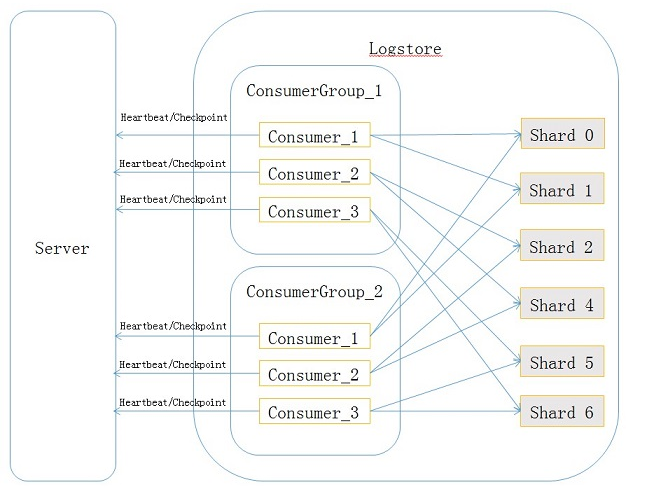
前言 Aliyun LOG Go Consumer Library是用go语言编写的协同消费库,主要处理多个消费者同时消费logstore时自动分配shard问题。 其中消费组会自动处理shard的负载均衡,消费者failover等逻辑,这部分说明会在本篇下面的篇幅中进行详细的介绍。用户只需专注在自己业务逻辑上,而无需关心shard分配、CheckPoint、Failover等事宜。 功能特点 Aliyun LOG Go Consumer Library是一个使用简单以及高度可配置的go类库,它有如下功能特点: 线程安全 - consumer 内所有的方法以及暴露的接口都是线程安全的。 异步拉取 - 调用consumer的拉取日志接口,会把当前拉取任务新开一个groutine中去执行,不会阻塞主groutine的执行。 自动重试 - 对程序运行当中出现的可重试的异常,consumer会自动重试,重试过程不会导致数据的重复消费。 优雅关闭 - 调用关闭程序接口,consumer会等待当前所有已开出的groutine任务结束后在结束主程序,保证下次开始不会重复消费数据。 本地调试 - 可通过配置支持将日志内容输出到本地或控制台,并支持轮转、日志数、轮转大小设置。 高性能 - 基于go语言的特性,go的goroutine在并发多任务处理能力上有着与生俱来的优势。所以consumer 对每一个获得的可消费分区都会开启一个单独的groutine去执行消费任务,相对比直接使用cpu线程处理,对系统性能消耗更小,效率更高。 使用简单 - 在整个使用过程中,不会产生数据丢失,以及重复,用户只需要配置简单配置文件,创建消费者实例,写处理日志的代码就可以,用户只需要把重心放到自己的消费逻辑上面即可,不需关心消费断点保存,以及错误重试等问题。 消费组原理剖析 为了带您更好的理解 go版本的consumer library,本篇讲介绍consumer library的实现原理,在了解原理之前,进行简单的术语简介。 在consumer library 中主要有4个概念,分别是consumer group,consumer,heartbeat和checkpoint,它们之间关系如下(图片出处:https://github.com/aliyun/loghub_consumer_library): ​ consumer group: ​ 是logstore的子资源,拥有相同consumer group 名字的消费者共同消费同一个logstore的所有数据,这些消费者之间不会重复消费数据,一个logstore下面可以最多创建5个consumer group,不可以重名,同一个logstore下面的consumer group之间消费数据不会互相影响。consumer group有两个很重要的属性: { "order":boolean, "timeout": integer } order属性:在单个shard中是否按顺序消费。true:表示在单个shard中按顺序消费。shard分裂后,先消费原shard数据,然后并列消费两个新shard的数据。false:表示不按顺序消费。 timeout属性:表示consumer group中消费者的超时时间,单位是秒,当一个消费者汇报心跳的时间间隔超过timeout,会被认为已经超时,服务端认为这个consumer此时已经下线了。 consumer: ​ 消费者,每个consumer上会被分配若干个shard,consumer的职责就是要消费这些shard上的数据,同一个consumer group中的consumer必须不重名。 heartbeat: ​ 消费者心跳,consumer需要定期向服务端汇报一个心跳包,用于表明自己还处于存活状态。 checkpoint: ​ 消费者定期将分配给自己的shard消费到的位置保存到服务端,这样当这个shard被分配给其它消费者时,从服务端可以获取shard的消费断点,接着从断点继续消费数据。 自动负载均衡与自动处理消费者failover 如上图,当前有两个消费者A和B ,分别持有1,2,3,4个分区进行消费,消费者A被取消或者因为其他原因停止消费,服务端会自动将A消费者持有的1,2分区分配给B消费者进行消费。如下图 那么服务端是如何实现自动负载均衡的呢,还回到当消费者A,B共同持有4个分区的情况下,此时,如果新的消费者C注册加入到消费组当中来,服务端消费组会将logstore下所有的可消费分区对所有的消费者进行平均分配,如下图,从而在服务端自动的去实现负载均衡,用户即可不用关心消费者之间的负载均衡关系。 Consumer Lib实现原理 1.当调用一个消费者实例的run方法启动的时候,会开启一个心跳线程去给服务端发送当前心跳信息,同时主线程继续执行,检查是否获得可消费分区。 2.Heartbeat心跳线程会汇报当前消费者持有的消费分区到服务端,服务端会分配给消费者可消费的分区ID。 3.主线程会遍历从心跳线程获得的所有可消费分区,同时会将持有的消费分区汇报给心跳线程,每一个可消费分区都会调用consume方法。 4.每一个消费分区中的consume方法(如上图)只负责更新任务状态,调用会立刻返回,具体的消费任务会开启单独的groutine去执行,每个分区都会维护自己的一个任务状态机,不同分区间任务状态不会相互影响。 5.每次消费任务完成,会调用flushCheck方法,检查当前时间相对上次更新检查点时间是否超过60秒,超过就刷新当前检查点到服务端。如果执行退出程序函数,会立即将当前消费者的检查点保存到服务端。 6.如果执行任务中发生可重试异常,会在任务groutine中重试该任务,并且会在每一次遍历中跳过当前正在执行的任务groutine,不会造成任务的重复开启。 使用步骤 1.源码下载 请先克隆代码到自己的GOPATH路径下(源码地址:aliyun-go-consumer-library),项目使用了vendor工具管理第三方依赖包,所以克隆下来项目以后无需安装任何第三方工具包。 2.配置LogHubConfig LogHubConfig是提供给用户的配置类,用于配置消费策略,您可以根据不同的需求设定不同的值,各参数含义如文章尾部图示 LogHubConfig详细配置 3.覆写消费逻辑 func process(shardId int, logGroupList *sls.LogGroupList) string { for _, logGroup := range logGroupList.LogGroups { err := client.PutLogs(option.Project, "copy-logstore", logGroup) if err != nil { fmt.Println(err) } } fmt.Println("shardId %v processing works sucess", shardId) return "" // 不需要重置检查点情况下,请返回空字符串,如需要重置检查点,请返回需要重置的检查点游标。 } 在实际消费当中,您只需要根据自己的需要重新覆写消费函数process 即可,上图只是一个简单的demo,将consumer获取到的日志进行了打印处理,注意,该函数参数和返回值不可改变,否则会导致消费失败。 4.创建消费者并开始消费 // option是LogHubConfig的实例 consumerWorker := consumerLibrary.InitConsumerWorker(option, process) // 调用Start方法开始消费 consumerWorker.Start() 调用InitConsumerWorkwer方法,将配置实例对象和消费函数传递到参数中生成消费者实例对象,调用Start方法进行消费。 5.关闭消费者 ch:=make(chan os.Signal) //将os信号值作为信道 signal.Notify(ch) consumerWorker.Start() if _, ok := <-ch; ok { // 当获取到os停止信号以后,例如ctrl+c触发的os信号,会调用消费者退出方法进行退出。 consumerWorker.StopAndWait() } 上图中的例子通过go的信道做了os信号的监听,当监听到用户触发了os退出信号以后,调用StopAndWait()方法进行退出,用户可以根据自己的需要设计自己的退出逻辑,只需要调用StopAndWait()即可。 Cosumer Lib使用进阶 1.消费失败处理办法 当您拉取到日志对日志进行消费处理,处理失败的时候,可以在process方法里面重新执行您的消费逻辑,不跳出process方法,当process方法不结束的情况下会一直处理当前未消费成功的数据,从而避免重复消费,以下为简单的样例: func process(shardId int, logGroupList *sls.LogGroupList) string { for { err := func(shardId int, logGroupList *sls.LogGroupList) error { // 在这个函数当中去写具体的消费逻辑,如果消费失败,返回自定义的error return nil }(shardId,logGroupList) if err != nil{ // 当捕获到消费失败的error以后只要重复继续执行消费逻辑即可,不要跳出process方法。 continue }else{ // 消费成功的话,跳出循环,process方法执行完毕,会继续拉取数据进行下次消费。 break } } return "" // 不需要重置检查点情况下,请返回空字符串,如需要重置检查点,请返回需要重置的检查点游标。 } 2.重置Checkpoint 在补数据或重复计算等场景中,需要将某个ConsumerGroup点位设置为某一个时间点,使当前消费组能够从新位置开始消费。可通过以下三种方式完成。 (a.) 删除消费组。 停止消费程序,并在控制台删除消费组。 修改代码,使用指定时间点消费,重新启动程序。 (b.) 通过SDK将当前消费组重置到某一个时间点。 停止消费程序。 使用SDK修改位点,重新启动消费程序。具体示例如下图所示: func updateCheckPoint(){ err := client.UpdateCheckpoint(project,logstore,"ConsumerGroupName","consumerName",1,"youCheckPoint",true) if err != nil{ fmt.Println(err) } } (c.) 在process消费函数中返回需要重置的检查点。 为了满足在用户可以在不停止程序的情况下重置检查点的需求,提供了在process消费函数中充值检查点的方法,只要将重置的检查点作为返回值返回就可以,如果不需要只需要返回空字符串即可。 下图的所示例的代码设置了一个触发时间,当程序时间等于触发时间的时候,会重置检查点为开始的游标,进行分区的重新消费。 func process(shardId int,logGroupList *sls.LogGroupList) string { futureTime := 18888888 // 例如设置一个未来的Unix时间戳 if time.Now().Unix() == futureTime { // 当程序运行的当时时间等于设置的未来时间,返回需要重置的检查点 cursur, err := client.GetCursor(project,logstore,shardId,"begin") if err != nil { fmt.Println(err) } // 返回当前分区开始游标,就会重置消费位置为开始位置,进行当前分区的从新消费。 return cursor // 需要注意,如果每次消费完都返回指定游标的话,则每一次都会重置下次消费位置为返回的游标。 } return "" } 下图为LogHubConfig详细配置参数。 参数 类型 能否为空 描述 Endpoint String 否 服务入口,关于如何确定project对应的服务入口可参考文章服务入口。 AccessKeyID String 否 账户的AK id。 AccessKeySecret String 否 账户的AK 密钥。 Project String 否 将要消费的项目名称。 Logstore String 否 将要消费的项目下的日志库的名字。 ConsumerGroupName String 否 消费组的名称。 ConsumerName String 否 消费者的名称。注意:同一个消费组下面的消费者名称不能重复,不同消费组之间互不影响。 CursorPosition String 否 开始消费的时间点,该参数只在第一次创建消费组的时候使用,当再次启动消费组进行消费的时候会从上次消费到的断点进行继续消费,该参数可选的参数有3个: “BEGIN_CURSOR”,"END_CURSOR","SPECIAL_TIMER_CURSOR",分别为开始位置,结束位置,和自定义起始位置。 HeartbeatIntervalInSecond Int 是 向服务端发送的心跳间隔,默认值为20秒,如果超过设定值的3倍没有向服务端汇报心跳,服务端就任务该分区已经掉线会给该分区重新分配消费者。建议使用默认值。 DataFetchInterval Int64 是 从服务端拉取日志时间间隔,默认值是2秒,不能把这个值设置小于1s。 MaxFetchLogGroupCount Int 是 从服务端一次拉取日志组数量,日志组可参考内容日志组,默认值是1000,其取值范围是1-1000。 CursorStartTime Int64 否 自定义日志消费时间点,只有当CursorPosition设置为"SPECIAL_TIMER_CURSOR"时,该参数才能使用,参数为unix时间戳。时间单位为秒。 InOrder Bool 否 是否按序消费,默认为false。 AllowLogLevel String 否 设置日志输出级别,默认值是Info,consumer中一共有4种日志输出级别,分别为debug,info,warn和error。 LogFileName String 否 日志文件输出路径,不设置的话默认输出到stdout。 IsJsonType Bool 否 是否格式化文件输出格式,默认为false。 LogMaxSize Int 否 单个日志存储数量,默认为10M。 LogMaxBackups Int 否 日志轮转数量,默认为10。 LogCompass Bool 否 是否使用gzip 压缩日志,默认为false。 应用实例 为了进一步减少学习成本,我们为您准备了 Aliyun LOG Go Consumer Library 应用实例。示例中包含了consumer 从创建到关闭的全部流程。

优秀的个人博客,低调大师

Python3快速入门——(9)生成器 (generator)

生成器 (generator) #生成器generator 在Python中,这种一边循环一边计算的机制,称为生成器,能节省大量的空间 L=[x*x for x in range ( 1 , 11 )] g=(x*x for x in range ( 1 , 11 )) #创建L和g的区别仅在于最外层的[]和(),L是一个list,而g是一个generator next (g) #如果要一个一个打印出来,可以通过next()函数获得generator的下一个返回值 for n in g: #用for循环,generator也是可迭代对象 print (n) #举例:斐波那契数列(Fibonacci)除第一个和第二个数外,任意一个数都可由前两个数相加得到 #1, 1, 2, 3, 5, 8, 13, 21, 34, ... def fib(max): #fib函数是定义了斐波拉契数列的推算规则 n,a,b= 0 , 0 , 1 while n<max: print (b) a,b=b,a+b n=n+ 1 return 'done' #如果一个函数定义中包含yield关键字,那么这个函数就不再是一个普通函数,而是一个generator def fib(max): #fib函数是定义了斐波拉契数列的推算规则 n,a,b= 0 , 0 , 1 while n<max: yield b a,b=b,a+b n=n+ 1 for x in fib( 7 ): print (x)

优秀的个人博客,低调大师

云服务器 ECS > >快速入门(三)

步骤 2:创建 ECS 实例这里只介绍如何创建一个实例。如果您想用自己的系统盘快照创建自定义镜像,并用这个自定义镜像创建实例,请参考文档:使用自定义镜像创建实例。 前提条件 在创建 ECS 实例前,您应该已经完成了以下工作: 已经注册了阿里云账号,并完成实名认证。 如果要购买按量付费实例,账户余额应至少有 100 元人民币。关于充值,请参考 财务 文档 如何充值付款。 如果需要在专有网络(VPC)里创建 ECS 实例,应该已经在目标地域 创建了至少一个专有网络和交换机。 如果需要在经典网络里创建 ECS 实例,应该已经在目标地域 创建了一个满足您业务需求的安全组。 如果您是在 2017 年 6 月 14 日下午 5 点以后第一次购买 ECS 实例,将不能选择经典网络。如果您需要创建经典网络的实例,请 提交工单 申请加入白名单。 如果您要在创

优秀的个人博客,低调大师

数据库版本控制|一文带你快速入门

数据库版本控制是管理和跟踪数据库 schema 及相关数据随时间变化的实践。通常来说,我们使用版本控制系统和一些相关工具来保留对数据库所做修改的历史记录,使团队能够追踪变更、有效协作,并安全地部署更新。 一方面,使用版本控制系统 (Version Control System, VCS) 来管理代码已经成为事实上的标准;另一方面,采用 VCS 或类似工具仍处于早期阶段。 以下是数据库版本控制的一些难点以及 Bytebase 如何能帮你解决这些问题😉。 合作与团队协作 版本控制通过提供一个集中的存储库来共享和管理数据库变更,以促进团队成员之间的协作。Bytebase 在这方面类似 GitLab 和 GitHub,为开发人员和 DBA 提供了一个协作完成数据库变更的工作空间。 变更追踪和历史 版本控制系统记录了对数据库 schema 和相关脚本所做变更的历史记录。这些历史记录包括谁提交了变更、何时进行的以及为何变更等详细信息。Bytebase 会捕捉每个变更历史。 迁移脚本 通常来说,数据库版本控制依赖于迁移脚本,这些代码文件定义了对数据库 schema 的更改。这些脚本通常包含 SQL 语句或其他特定于数据库的命令,用于创建、修改或删除数据库对象。在 Bytebase 中,可以使用变更列表 来组合编排迁移脚本。 分支与合并 版本控制系统支持分支,使团队能够同时处理不同的功能或变更。Bytebase 为数据库更改提供了类似的分支功能。 部署和回滚 通过保留变更历史记录,版本控制可以实现对数据库更新的可控部署。如果出现问题,团队可以回滚到先前版本的数据库 schema 和相关数据。Bytebase 提供以下回滚选项: 数据回滚。使用像 MySQL binlog 的撤销日志来回滚数据更改。 从备份中恢复和时间点恢复 (PITR)。可以指示 Bytebase 进行手动或定期备份,并从中进行恢复。 库表同步。可以将一个数据库 schema 与另一个进行对比,Bytebase 能够自动识别差异并应用更改。 VCS 集成 #GitOps 数据库版本控制应该集成到整体的开发工作流程中,你可以设置 CI/CD pipeline 来自动化应用数据库变更。比如在版本控制系统中配置 CI,使用 Bytebase 进行 SQL 语法审核。 以下分别是 GitHub Action 和 GitLab CI 的示例: 此外,你可以配置 Bytebase 项目以链接到你的 VCS 库以观察代码更改。这样,开发人员仍然在 VCS 中管理迁移脚本,当他们提交新的迁移脚本时,Bytebase 将捕捉该事件并自动生成新的工单来应用该迁移脚本。 总结 毕竟,数据库版本控制也还是版本控制。开发人员希望以类似于管理代码变化的方式来管理数据库变更:就像 GitLab 和 GitHub一样,Bytebase 是为团队以类似 Git 的方式管理数据库变更而构建的。 💡 更多资讯,请关注 Bytebase 公号:Bytebase

优秀的个人博客,低调大师

快速入门ECS快照功能,助力大数据容灾保护

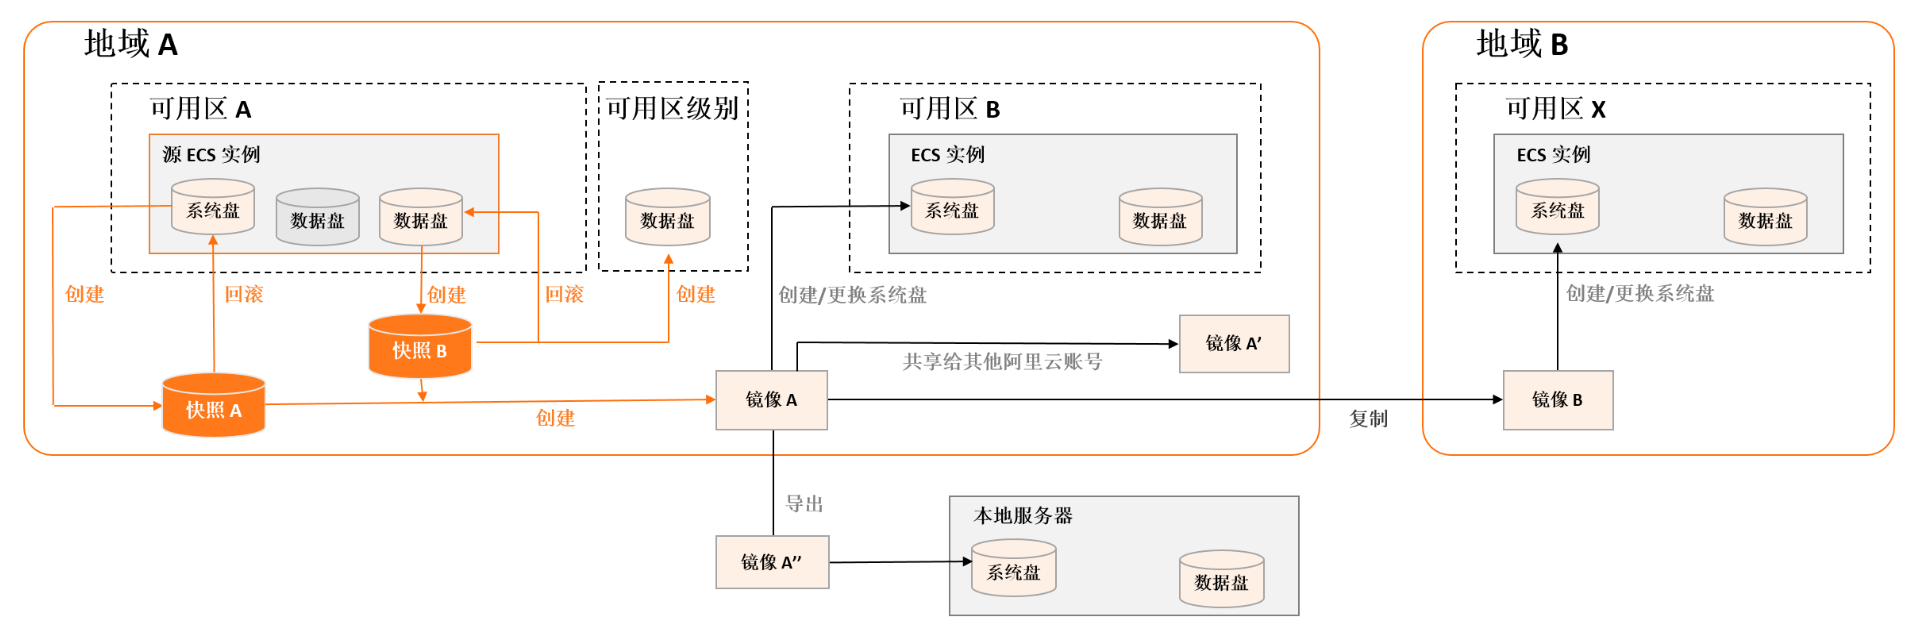
阿里云快照是云盘数据在某个时刻完整的只读拷贝,是一种便捷高效的数据容灾手段,常用于数据备份、制作自定义镜像、应用容灾等。 应用场景 推荐您在以下场景中使用快照: 容灾备份:为云盘创建快照,再使用快照创建云盘获取基础数据,实现同城容灾和异地容灾。 环境复制:使用系统盘快照创建自定义镜像,再使用自定义镜像创建ECS实例,实现环境复制。 数据开发:为数据挖掘、报表查询和开发测试等应用提供近实时的真实生产数据。 提高容错率:出现操作失误时,能及时回滚数据,降低操作风险,实现版本回退。 定期创建快照,避免常见的失误操作。例如,团队成员不慎在云盘上存储了错误的数据、ECS实例被误释放、应用错误导致了数据错误、或者骇客利用应用漏洞恶意删除业务数据等。 执行重要操作前创建一份快照,常见的重要运维操作包括更换操作系统、应用软件升级或业务数据迁移等。 快照类型 快照主要分为本地快照和普通快照,区别在于存储方案的不同。根据不同区别方式,快照可以细分为以下类型: 计费 快照计费项为快照容量,支持按量付费计费方式和购买存储包。更多详情,请参见快照计费方式。 使用限制 有关快照的使用限制及配额,请参见使用限制快照章节。 使用本地快照具有以下限制: 仅ESSD云盘支持创建本地快照。 单块ESSD云盘最多能保留10份本地快照。 使用本地快照创建云盘时,设置的云盘容量不能大于快照大小。 不支持通过自动快照策略创建本地快照。 不支持为加密云盘、共享块存储、本地盘创建本地快照。 优势 相比于传统存储产品的数据快照功能,ECS快照具备以下优势: 相关操作 控制台操作: 创建快照 使用快照创建云盘 使用快照回滚云盘 使用快照创建自定义镜像 使用自定义镜像创建实例 API请参见API概览快照章节。 本文来自 阿里云文档中心 云服务器ECS 快照概述 云栖号在线课堂,每天都有产品技术专家分享立即加入圈子:https://c.tb.cn/F3.Z8gvnK与专家面对面,及时了解课程最新动态!

优秀的个人博客,低调大师

Java多线程 -- 互斥锁/共享锁/读写锁 快速入门

什么是互斥锁? 在访问共享资源之前对进行加锁操作,在访问完成之后进行解锁操作。 加锁后,任何其他试图再次加锁的线程会被阻塞,直到当前进程解锁。 如果解锁时有一个以上的线程阻塞,那么所有该锁上的线程都被编程就绪状态, 第一个变为就绪状态的线程又执行加锁操作,那么其他的线程又会进入等待。 在这种方式下,只有一个线程能够访问被互斥锁保护的资源。 什么是共享锁? 互斥锁要求只能有一个线程访问被保护的资源,共享锁从字面来看也即是允许多个线程共同访问资源。 什么是读写锁? 读写锁既是互斥锁,又是共享锁,read模式是共享,write是互斥(排它锁)的。 读写锁有三种状态:读加锁状态、写加锁状态和不加锁状态 一次只有一个线程可以占有写模式的读写锁,但是多个线程可以同时占有读模式的读写锁。 用ReentrantLock手动实现一个简单的读写锁。 MyReadWriteLock.java /** * Created by Fant.J. */ public class MyReadWriteLock { private Map<String,Object> map = new HashMap<>(); private ReadWriteLock rwl = new ReentrantReadWriteLock(); private Lock r = rwl.readLock(); private Lock w = rwl.writeLock(); public Object get(String key){ try { r.lock(); System.out.println(Thread.currentThread().getName()+"read 操作执行"); Thread.sleep(500); return map.get(key); } catch (InterruptedException e) { e.printStackTrace(); return null; } finally { r.unlock(); System.out.println(Thread.currentThread().getName()+"read 操作结束"); } } public void put(String key,Object value){ try { w.lock(); System.out.println(Thread.currentThread().getName()+"write 操作执行"); Thread.sleep(500); map.put(key,value); } catch (InterruptedException e) { e.printStackTrace(); } finally { w.unlock(); System.out.println(Thread.currentThread().getName()+"write 操作结束"); } } } 测试读读共享(不互斥) /** * Created by Fant.J. */ public class Test { public static void main(String[] args) { MyReadWriteLock myReadWriteLock = new MyReadWriteLock(); myReadWriteLock.put("a","fantj_a"); //读读不互斥(共享) //读写互斥 new Thread(new Runnable() { @Override public void run() { System.out.println(myReadWriteLock.get("a")); } }).start(); new Thread(new Runnable() { @Override public void run() { System.out.println(myReadWriteLock.get("a")); } }).start(); new Thread(new Runnable() { @Override public void run() { System.out.println(myReadWriteLock.get("a")); } }).start(); new Thread(new Runnable() { @Override public void run() { System.out.println(myReadWriteLock.get("a")); } }).start(); new Thread(new Runnable() { @Override public void run() { System.out.println(myReadWriteLock.get("a")); } }).start(); new Thread(new Runnable() { @Override public void run() { System.out.println(myReadWriteLock.get("a")); } }).start(); } } mainwrite 操作执行 mainwrite 操作结束 Thread-1read 操作执行 Thread-2read 操作执行 Thread-0read 操作执行 Thread-3read 操作执行 Thread-4read 操作执行 Thread-5read 操作执行 Thread-1read 操作结束 Thread-0read 操作结束 Thread-2read 操作结束 Thread-3read 操作结束 fantj_a fantj_a fantj_a fantj_a Thread-4read 操作结束 fantj_a Thread-5read 操作结束 fantj_a 可以看出,中间有很多read操作是并发进行的。 那么我们再看下写写是否有互斥性: /** * 测试 写-写 模式 是互斥的 * Created by Fant.J. */ public class TestWriteWrite { public static void main(String[] args) { MyReadWriteLock myReadWriteLock = new MyReadWriteLock(); new Thread(new Runnable() { @Override public void run() { myReadWriteLock.put("b","fantj_b"); } }).start(); new Thread(new Runnable() { @Override public void run() { myReadWriteLock.put("b","fantj_b"); } }).start(); new Thread(new Runnable() { @Override public void run() { myReadWriteLock.put("b","fantj_b"); } }).start(); new Thread(new Runnable() { @Override public void run() { myReadWriteLock.put("b","fantj_b"); } }).start(); new Thread(new Runnable() { @Override public void run() { myReadWriteLock.put("b","fantj_b"); } }).start(); } } Thread-0write 操作执行 Thread-1write 操作执行 Thread-0write 操作结束 Thread-1write 操作结束 Thread-2write 操作执行 Thread-2write 操作结束 Thread-3write 操作执行 Thread-3write 操作结束 Thread-4write 操作执行 Thread-4write 操作结束 控制台能明显感觉到线程休息的时间。所以它的写-写操作肯定是互斥的。 最后再看看,写-读 操作是否互斥。 写-读互斥 测试 /** * 测试 写-读模式 互斥 * Created by Fant.J. */ public class TestWriteRead { public static void main(String[] args) { MyReadWriteLock myReadWriteLock = new MyReadWriteLock(); //读读不互斥(共享) //读写互斥 new Thread(new Runnable() { @Override public void run() { myReadWriteLock.put("a","fantj_a"); } }).start(); new Thread(new Runnable() { @Override public void run() { System.out.println(myReadWriteLock.get("a")); } }).start(); } } Thread-0write 操作执行 Thread-1read 操作执行 Thread-0write 操作结束 Thread-1read 操作结束 fantj_a 控制台可以看到write操作执行后线程被阻塞。直到写释放了锁。 问题分析 问题1:仔细想了想,如果有一种场景,就是用户一直再读,写获取不到锁,那么不就造成脏读吗? 上一章我介绍了公平锁/非公平锁,资源的抢占不就是非公平锁造成的吗,那我们用公平锁把它包装下不就能避免了吗,我做了个简单的实现:(不知道公平锁的可以翻我上章教程) /** * 测试 读写锁 的公平锁 实现 * Created by Fant.J. */ public class TestReadWriteRead { public static void main(String[] args) { ReentrantLock fairLock = new ReentrantLock(true); MyReadWriteLock myReadWriteLock = new MyReadWriteLock(); myReadWriteLock.put("a","fantj_a"); new Thread(new Runnable() { @Override public void run() { fairLock.lock(); System.out.println(myReadWriteLock.get("a")); System.out.println("fair队列长度"+fairLock.getQueueLength()); fairLock.unlock(); } }).start(); new Thread(new Runnable() { @Override public void run() { fairLock.lock(); System.out.println(myReadWriteLock.get("a")); System.out.println("fair队列长度"+fairLock.getQueueLength()); fairLock.unlock(); } }).start(); new Thread(new Runnable() { @Override public void run() { fairLock.lock(); System.out.println(myReadWriteLock.get("a")); System.out.println("fair队列长度"+fairLock.getQueueLength()); fairLock.unlock(); } }).start(); new Thread(new Runnable() { @Override public void run() { fairLock.lock(); myReadWriteLock.put("a","fantj_a_update"); System.out.println("fair队列长度"+fairLock.getQueueLength()); fairLock.unlock(); } }).start(); new Thread(new Runnable() { @Override public void run() { fairLock.lock(); System.out.println(myReadWriteLock.get("a")); System.out.println("fair队列长度"+fairLock.getQueueLength()); fairLock.unlock(); } }).start(); } } mainwrite 操作执行 mainwrite 操作结束 Thread-0read 操作执行 Thread-0read 操作结束 fantj_a fair队列长度4 Thread-1read 操作执行 Thread-1read 操作结束 fantj_a fair队列长度3 Thread-2read 操作执行 Thread-2read 操作结束 fantj_a fair队列长度2 Thread-3write 操作执行 Thread-3write 操作结束 fair队列长度1 Thread-4read 操作执行 Thread-4read 操作结束 fantj_a_update fair队列长度0 如果谁有更好的实现方式(或者java有现成的实现工具类/包),可在评论区留言,我在百度上没有找到读写锁的公平锁实现~~谢谢!

优秀的个人博客,低调大师

Python3快速入门——(7)迭代(iterable)和迭代器

迭代(iterable) #任何可迭代对象都可以作用于for循环,包括我们自定义的数据类型,只要符合迭代条件,就可以使用for循环 d = { 'a' : 1 , 'b' : 2 , 'c' : 3 } #对dict迭代 for k,v in d.items(): # 如果要同时迭代key和value,可以用for k, v in d.items() print (k,v) #默认情况下,dict迭代的是key # 如果要迭代value,可以用for value in d.values() #字符串也是可迭代对象,因此,也可以作用于for循环 #如何判断一个对象是可迭代对象呢?方法是通过collections模块的Iterable类型判断 from collections import Iterable #导入collections模块的Iterable类型 n= isinstance (d,Iterable) print (n) #结果为True,可迭代 #Python内置的 enumerate 函数可以把一个list变成索引-元素对,这样就可以在for循环中同时迭代索引和元素本身 names=[ 'a' , 'b' , 'c' , 'd' ] for i,value in enumerate (names): #for循环同时引用两个变量 print (i,value) for x,y in [( 1 , 2 ),( 3 , 5 ),( 5 , 6 )]: ##for循环同时引用两个变量 print (x,y) 迭代器 可以直接作用于 for 循环的数据类型有以下几种: 一类是 集合数据类型 ,如 list 、 tuple 、 dict 、 set 、 str 等; 一类是 generator ,包括生成器和带 yield 的generator function。 这些可以直接作用于 for 循环的对象统称为可迭代对象: Iterable #可以使用isinstance()判断一个对象是否是Iterable对象 from collections import Iterable m= isinstance ([],Iterable) #True #而生成器不但可以作用于for循环,还可以被next()函数不断调用并返回下一个值, # 直到最后抛出StopIteration错误表示无法继续返回下一个值了。 #可以被next()函数调用并不断返回下一个值的对象称为迭代器:Iterator #生成器都是Iterator对象,但list、dict、str虽然是Iterable,却不是Iterator。 #把list、dict、str等Iterable变成Iterator可以使用iter()函数 from collections import Iterator m= isinstance ( iter ( 'abc' ),Iterator) #True 凡是可作用于 for 循环的对象都是 Iterable 类型; 凡是可作用于 next() 函数的对象都是 Iterator 类型,它们表示一个惰性计算的序列; 集合数据类型如 list 、 dict 、 str 等是 Iterable 但不是 Iterator ,不过可以通过 iter() 函数获得一个 Iterator 对象。 Python的 for 循环本质上就是通过不断调用 next() 函数实现的

优秀的个人博客,低调大师

Python3快速入门——(4)循环结构和判断结构

循环结构 #循环结构 cities=[ "Austin" , "Dallas" , "Houston" ] for city in cities: #for循环 print (city) #通过缩进控制整体结构 i= 0 while i< 3 : #while循环 i+= 1 print (i) for j in range ( 10 ): #range(n)表示从0到n-1的n个数 print (j) cities=[[ "Austin" , "Dallas" , "Houston" ],[ "Haerbin" , "Shanghai" , "Beijing" ]] #list中的元素仍是list for city in cities: print (city) #输出list中的两个list元素 for i in cities: #两层for循环输出两个list中的每个元素 for j in i: print (j) #注意: 如果代码写得有问题,会让程序陷入“死循环”,也就是永远循环下去。这时可以用 Ctrl+C 退出程序,或者强制结束Python进程。 #注意 : Python提供一个 range() 函数,可以生成一个整数序列,再通过 list() 函数可以转换为list #例如: list ( range (5)) 结果为:[0, 1, 2, 3, 4] 判断结构 #选择结构 cat= True #bool类型值 dog= False print ( type (cat)) #<class 'bool'> print ( 8 == 8 ) #True 判断语句 print ( 8 != 8 ) #False print ( 10 >= 5 ) #True sample_rate= 700 if (sample_rate> 50 ): #if语句选择 print (sample_rate) else : print ( 'less lan' )

优秀的个人博客,低调大师

阿里云E-MapReduce快速入门之准备工作

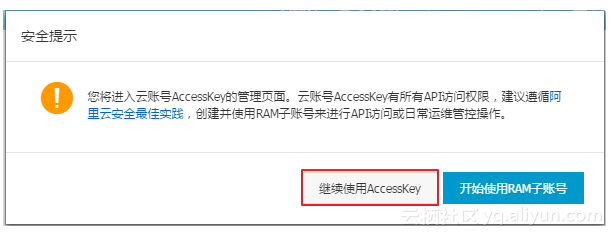
在创建 E-MapReduce 之前,您需要先完成以下准备工作: 1.注册阿里云账号 在申请 E-MapReduce 集群之前,您需要一个阿里云的云账号用于标识您在整个阿里云生态系统中的身份。该账号不仅可以用来申请 E-MapReduce 集群,同时还能够开通阿里云的对象存储服务 OSS、云数据库 RDS等服务。 如果您还没有阿里云的云账号,请参见注册云账号进行申请。 2.创建 Access Key(可选) 由于 E-MapReduce 调用访问的需要,您至少需要创建一个 Access Key,创建步骤如下: 登录阿里云官网。 登录管理控制台。 单击 AccessKeys。 注意:若出现如下提示框,请单击继续使用 Accesskey。 accesskey 提示 单击创建 Access Key,然后再单击同意并创建。 输入短信校验码,单击确定。Access Key 创建成功。 3.开通阿里云 OSS 服务 E-MapReduce 会将您的作业日志和运行日志保存在您的阿里云 OSS 存储空间中,所以需要您开通阿里云 OSS 服务,操作步骤请参见开通 OSS 服务。并在您期望创建集群的相同地域创建Bucket,参见创建Bucket。 4.开通高配机型(可选) 如果您需要在按量的集群中使用8核及8核以上的机型时,需要先在ECS处申请开通。申请高配机型 5.准备足够的余额 目前根据阿里云 ECS 的规则,用户在购买按量付费 ECS 的时候,要保证阿里云账户中至少有 100 元的现金(注意:代金券无效)。因此,在创建按量集群前,请确认您的账户中已至少充值 100 元,否则会创建失败。前往充值 当您使用完成并释放集群以后,在没有ECS或者其他按量产品在使用的情况下,您可以将这100元提现,回到您自己的原有账户中。

优秀的个人博客,低调大师

云服务器 ECS快速入门:远程连接 ECS 实例

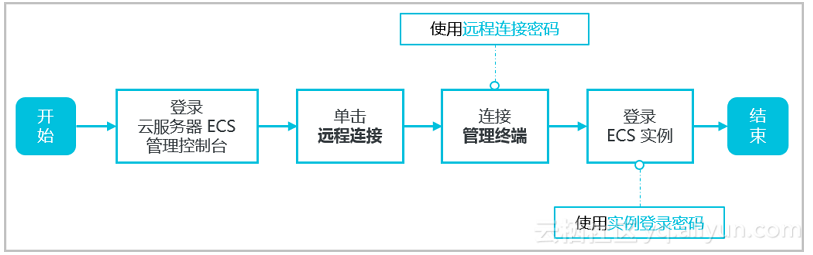
远程连接 ECS 实例 阿里云在控制台为您提供了 管理终端,方便您远程连接并管理 ECS 实例。 您也可以使用其他方式远程连接 ECS 实例: 如果是 Linux 实例: 使用 SSH 密钥对连接 Linux 实例 使用远程连接软件或 SSH 命令连接 Linux 实例 如果是 Windows 实例:使用远程连接软件连接 Windows 实例 以下是使用 管理终端 连接 ECS 实例操作步骤的简易说明。 登录 云服务器 ECS 管理控制台。 在左侧导航栏里,单击 实例。 在 实例列表 页上,选择目标地域。 在实例列表里,找到需要连接的实例,在 操作 列,单击 远程连接。 连接 管理终端: 如果这是您第一次连接 管理终端,应按照以下方式连接 管理终端: 在弹出的 远程连接密码 对话框,复制密码。 注意:连接密码仅在第一次连接管理终端时显示一次。如果您以后需要使用

优秀的个人博客,低调大师

201703深圳云栖大会Workshop-云盾WAF快速入门

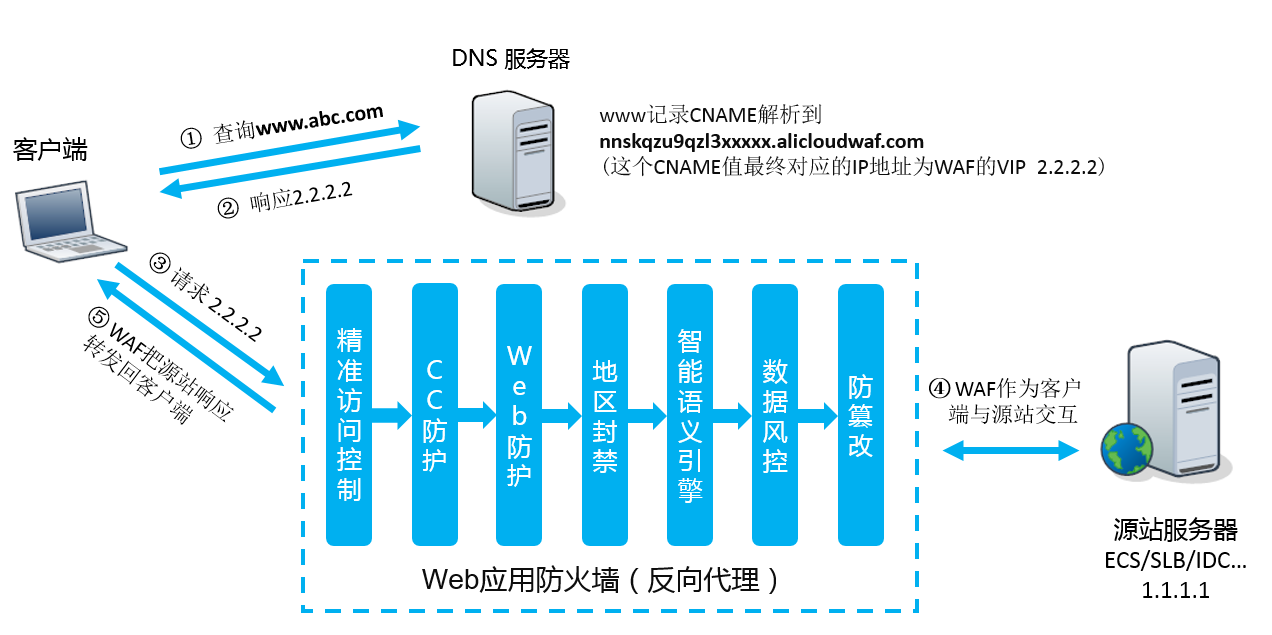
目标 熟悉Web应用防火墙的架构 配置目标站点接入WAF 测试精准防护和日志检索功能 WAF的接入和防护架构 WAF采用反向代理的接入架构,通过修改防护域名的DNS解析到WAF而将流量牵引到WAF,通过各种防护模块过滤掉恶意流量后,再把正常请求转发回源站。 配置接入WAF 登录阿里云控制台,找到云盾->Web应用防火墙->域名配置,输入相关的域名及源站信息,并点击“添加域名”按钮: 注意事项: 支持配置泛域名,如*.aliyundemo.cn,可以匹配相关的二级域名。当同时配置泛域名和精确域名时,转发和防护策略匹配顺序以精确域名优先 如果有HTTPS站点,务必勾选HTTPS,同时建议勾选HTTP,以应对HTTP跳转等问题,同时需要在稍后上传源站证书和密钥(实验中我们只勾选HTTP) 源站IP可以支持最多20个,WAF会做负载均衡和健康检查,详情见“源站IP负载均衡” 如WAF前面还有CDN、高防等七层代理,务必勾选“是否已使用代理”,这样才能取到客户端真实IP,不然看到的都是上一级代理的IP 添加好域名后,会弹出选择解析方式的弹窗,为了更好的演示接入原理,这里选择手动修改: 配置好域名后,WAF会自动分配给当前域名一个CNAME,可点击域名信息来查看: 接下来我们登录万网控制台,找到对应域名的“域名解析”->“解析设置”,正常情况下会有已经存在的一些解析,如下图: 接下来需要将记录类型改成CNAME,记录值改成WAF控制台提供的CNAME,如下图: 开启日志检索 在刚配置好的域名->业务状态中,找到日志检索并打开: 配置并体验精准防护规则 精准访问控制规则允许用户基于HTTP头部的各个字段自由组合各种访问控制规则: 找到防护域名,点击“防护配置”,进入“精准访问控制规则”即可配置。您可以自由尝试各种条件,匹配的内容大小写不敏感,匹配按照从上到下的优先级。详细的配置方式请参考这里:https://help.aliyun.com/document_detail/42780.html 配置好后一般3分钟内即可生效,您可以手动构造一些请求来验证防护效果,如果匹配中拦截,预期访问会被WAF拦截并弹出405拦截页面: 同时,您也可以在日志检索中看一下拦截的具体请求,以及匹配中访问控制规则的情况: 以上是基本配置和功能演示,您可以结合自身业务特征,尝试更多的防护功能,欢迎随时与我们交流:https://help.aliyun.com/knowledge_detail/44036.html

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册