首页 文章 精选 留言 我的

精选列表

搜索[团队协作工具],共10000篇文章
优秀的个人博客,低调大师

分布式场景怎么Join | 京东云技术团队

背景 最近在阅读查询优化器的论文,发现System R中对于Join操作的定义一般分为了两种,即嵌套循环、排序-合并联接。在原文中,更倾向使用排序-合并联接逻辑。 考虑到我的领域是在处理分库分表或者其他的分区模式,这让我开始不由得联想我们怎么在分布式场景应用这个Join逻辑,对于两个不同库里面的不同表我们是没有办法直接进行Join操作的。查阅资料后发现原来早有定义,即分布式联接算法。 分布式联接算法 跨界点处理数据即分布式联接算法,常见的有四种模型:Shuffle Join(洗牌联接)、Broadcast Join(广播联接)、MapReduce Join(MapReduce联接)、Sort-Merge Join(排序-合并联接)。 接下来将进行逐一了解与分析,以便后续开发的应用。 Shuffle Join(洗牌联接) 先上原理解释: Shuffle Join的核心思想是将来自不同节点的数据重新分发(洗牌),使得可以联接的数据行最终位于同一个节点上。 通常,对于要联接的两个表,会对联接键应用相同的哈希函数,哈希函数的结果决定了数据行应该被发送到哪个节点。这样,所有具有相同哈希值的行都会被送到同一个节点,然后在该节点上执行联接操作。 可能解释完还是有点模糊,举个例子,有两张表,分别以id字段进行分库操作,且哈希算法相同(为了简单,这里只介绍分库场景,分库分表同理。算法有很多种,这里举例是hash算法),那么这两张表的分片或许可以在同一个物理库中,这样我们不需要做大表维度的处理,我们可以直接下推Join操作到对应的物理库操作即可。 在ShardingSphere中,这种场景类似于绑定表的定义,如果两张表的算法相同,可以直接配置绑定表的关系,进行相同算法的连接查询,避免复杂的笛卡尔积。 这样做的好处是可以尽量下推到数据库操作,在中间件层面我们可以做并行处理,适合大规模的数据操作。 但是,这很理想,有多少表会采用相同算法处理呢。 Broadcast Join(广播联接) 先上原理解释: 当一个表的大小相对较小时,可以将这个小表的全部数据广播到所有包含另一个表数据的节点上。 每个节点上都有小表的完整副本,因此可以独立地与本地的大表数据进行联接操作,而不需要跨节点通信。 举个例子,有一张非常小的表A,还有一张按照ID分片的表B,我们可以在每一个物理库中复制一份表A,这样我们的Join操作就可以直接下推到每一个数据库操作了。 这种情况比Shuffle Join甚至还有性能高效,这种类似于ShardingSphere中的广播表的定义,其存在类似于字典表,在每一个数据库都同时存在一份,每次写入会同步到多个节点。 这种操作的好处显而易见,不仅支持并行操作而且性能极佳。 但是缺点也显而易见,如果小表不够小数据冗余不说,广播可能会消耗大量的网络带宽和资源。 MapReduce Join(MapReduce联接) 先上原理解释: MapReduce是一种编程模型,用于处理和生成大数据集,其中的联接操作可以分为两个阶段:Map阶段和Reduce阶段。 Map阶段:每个节点读取其数据分片,并对需要联接的键值对应用一个映射函数,生成中间键值对。 Reduce阶段: 中间键值对会根据键进行排序(在某些实现中排序发生在Shuffle阶段)和分组,然后发送到Reduce节点。 在Reduce节点上,具有相同键的所有值都会聚集在一起,这时就可以执行联接操作。 MapReduce Join不直接应用于传统数据库逻辑,而是适用于Hadoop这样的分布式处理系统中。但是为了方便理解,还是用SQL语言来分析,例如一条SQL: SELECT orders.order_id, orders.date, customers.name FROM orders JOIN customers ON orders.customer_id = customers.customer_id; 会被转换为两个SQL: SELECT customer_id, order_id, date FROM orders; SELECT customer_id, name FROM customers; 这个过程就是Map阶段,即读取orders和customers表的数据,并为每条记录输出键值对,键是customer_id,值是记录的其余部分。 下一个阶段可有可无,即Shuffle阶段。如果不在这里排序可能会在Map阶段执行SQL时候排序/分组或者在接下来的Reduce阶段进行额外排序/分组。在这个阶段主要将收集到的数据按照customer_id排序分组,以确保相同的customer_id的数据达到Reduce阶段。 Reduce阶段将每个对应的customer_id进行联接操作,输出并返回最后的结果。 这种操作普遍应用于两个算法完全不相同的表单,也是一种标准的处理模型,在这个过程中,我们以一张逻辑表的维度进行操作。这种算法可能会消耗大量内存,甚至导致内存溢出,并且在处理大数据量时会相当耗时,因此不适合需要低延迟的场景。 额外补充 内存溢出场景普遍在如下场景: 1. 大键值对数量:如果Map阶段产生了大量的键值对,这些数据需要在内存中进行缓存以进行排序和传输,这可能会消耗大量内存。 2. 数据倾斜:如果某个键非常常见,而其他键则不那么常见,那么处理这个键的Reducer可能会接收到大量的数据,导致内存不足。这种现象称为数据倾斜。 3. 大值列表:在Reduce阶段,如果某个键对应的值列表非常长,处理这些值可能会需要很多内存。 4. 不合理的并行度:如果Reduce任务的数量设置得不合适(太少或太多),可能会导致单个任务处理不均匀,从而导致内存问题。 我能想到的相应解决方案: • 内存到磁盘的溢写:当Map任务的输出缓冲区满了,它会将数据溢写到磁盘。这有助于限制内存使用,但会增加I/O开销。 • 通过设置合适的Map和Reduce任务数量,可以更有效地分配资源,避免某些任务过载。具体操作可以将Map操作的分段比如1~100,100~200,Reduce阶段开设较少的并发处理。 • 优化数据分布,比如使用范围分区(range partitioning)或哈希分区(hash partitioning)来减少数据倾斜。 Sort-Merge Join(排序-合并联接) 先上原理解释: 在分布式环境中,Sort-Merge Join首先在每个节点上对数据进行局部排序,然后将排序后的数据合并起来,最后在合并的数据上执行联接操作。 这通常涉及到多阶段处理,包括局部排序、数据洗牌(重新分发),以及最终的排序和合并。 举个理解,还是上面的SQL。 SELECT orders.order_id, orders.date, customers.name FROM orders JOIN customers ON orders.customer_id = customers.customer_id; 1. 对orders表按customer_id进行排序。 2. 对customers表按customer_id进行排序。 3. 同时遍历两个已排序的表,将具有相同customer_id的行配对。 这个就有点类似于原生的排序-合并联接了。也是数据库场景的标准处理办法。 对于已经排序的数据集或数据分布均匀的情况,这种方法非常有效。如果数据未预先排序,这种方法可能会非常慢,因为它要求数据在联接之前进行排序。 当然,这个算法也会造成内存溢出的场景,解决方案如下: 1. 当数据集太大而无法一次性加载到内存中时,可以使用外部排序算法。外部排序算法会将数据分割成多个批次,每个批次单独排序,然后将排序后的批次合并。这种方法通常涉及到磁盘I/O操作,因此会比内存中操作慢。 2. 对于合并步骤,可以使用流式处理技术,一次只处理数据的一小部分,并持续将结果输出到下一个处理步骤或存储系统。这样可以避免一次性加载大量数据到内存中。 3. 当内存不足以处理数据时,可以使用磁盘空间作为临时存储。数据库管理系统通常有机制来处理内存溢出,比如创建磁盘上的临时文件来存储过程中的数据。 4. 在分布式系统中,可以将数据分散到多个节点上进行处理,这样每个节点只需要处理数据的一部分,从而减少单个节点上的内存压力。​ 作者:京东科技 张俊杰 来源:京东云开发者社区 转载请注明来源

优秀的个人博客,低调大师

| 京东云技术团队

1. 问题背景 问题的背景是这样的,在最近需求开发中遇到需要将给定目标数据通过某一固定的计量规则进行过滤并打标生成明细数据,其中发现存在一笔目标数据的时间在不符合现有日期规则的条件下,还是通过了规则引擎的匹配打标操作。故而需要对该错误匹配场景进行排查,定位其根本原因所在。 2. 排查思路 2.1 数据定位 在开始排查问题之初,先假定现有的Aviator规则引擎能够对现有的数据进行正常的匹配打标,查询在存在问题数据(图中红框所示)同一时刻进行规则匹配时的数据都有哪些。发现存在五笔数据在同一时刻进行规则匹配落库。   继续查询具体的匹配规则表达式,发现针对loanPayTime时间区间在[2022-07-16 00:00:00, 2023-05-11 23:59:59]的范围内进行匹配,目标数据的时间为2023-09-19 11:27:29,理论上应该不会被匹配到。   但是观测匹配打标的明细数据发现确实打标成功了(如红框所示)。   所以重新回到最初的和目标数据同时落库的五笔数据发现,这五笔数据的loanPayTime时间确实在规则[2022-07-16 00:00:00, 2023-05-11 23:59:59]之内,所以在想有没有可能是在目标数据匹配规则引擎前,其它的五笔数据中的其中一笔对该数据进行了修改导致误匹配到了这个规则。顺着这个思路,首先需要确认下Aviator规则引擎在并发场景下是否线程安全的。   2.2 规则引擎 由于在需求中使用到用于给数据匹配打标的是Aviator规则引擎,所以第一直觉是怀疑Aviator规则引擎在并发的场景中可能会存在线程不安全的情况。   首先简单介绍下Aviator规则引擎是什么,Aviator是一个高性能的、轻量级的java语言实现的表达式求值引擎,主要用于各种表达式的动态求值,相较于其它的开源可用的规则引擎而言,Aviator的设计目标是轻量级和高性能 ,相比于Groovy、JRuby的笨重,Aviator非常小,加上依赖包也才450K,不算依赖包的话只有70K; 当然,Aviator的语法是受限的,它不是一门完整的语言,而只是语言的一小部分集合。其次,Aviator的实现思路与其他轻量级的求值器很不相同,其他求值器一般都是通过解释的方式运行,而Aviator则是直接将表达式编译成Java字节码,交给JVM去执行。简单来说,Aviator的定位是介于Groovy这样的重量级脚本语言和IKExpression这样的轻量级表达式引擎之间。(具体Aviator的相关介绍不是本文的重点,具体可参见) 通过查阅相关资料发现,Aviator中的AviatorEvaluator.execute() 方法本身是线程安全的,也就是说只要表达式执行逻辑和传入的env是线程安全的,理论上是不会出现并发场景下线程不安全问题的。(详见) 2.3 匹配规则引擎的env   通过前面Aviator的相关资料发现传入的env如果在多线程场景下不安全也会导致最终的结果是错误的,故而定位使用的env发现使用的是HashMap,该集合类确实是线程不安全的(具体可详见),但是线程不安全的前提是多个线程同时对其进行修改,定位代码发现在每次调用方式时都会重新生成一个HashMap,故而应该不会是由于这个线程不安全类导致的。   继续定位发现,loanPayTime这个字段在进行Aviator规则引擎匹配前使用SimpleDateFormat进行了格式化,所以有可能是由于该类的线程不安全导致的数据错乱问题,但是这个类应该只是对日期进行格式化处理,难不成还能影响最终的数据。带着这个疑问查询资料发现,emm确实是线程不安全的。   好家伙,嫌疑对象目前已经有了,现在就是寻找相关证据来佐证了。 3. SimpleDateFormat 还能线程不安全? 3.1 先写个demo试试 话不多说,直接去测试一下在并发场景下,SimpleDateFormat类会不会对需要格式化的日期进行错乱格式化。先模拟一个场景,对多线程并发场景下格式化日期,即在[0,9]的数据范围内,在偶数情况下对2024年1月23日进行格式化,在奇数情况下对2024年1月22日进行格式化,然后观测日志打印效果。 import java.text.SimpleDateFormat; import java.time.Duration; import java.time.LocalDateTime; import java.util.Date; import java.util.concurrent.ExecutorService; import java.util.concurrent.Executors; import java.util.concurrent.TimeUnit; public class ThreadSafeDateFormatDemo { static SimpleDateFormat dateFormat = new SimpleDateFormat("yyyy-MM-dd HH:mm:ss"); public static void main(String[] args) { ExecutorService executor = Executors.newFixedThreadPool(10); LocalDateTime startDateTime = LocalDateTime.now(); Date date = new Date(); for (int i = 0; i < 1000; i++) { int finalI = i; executor.submit(() -> { try { if (finalI % 2 == 0) { String formattedDate = dateFormat.format(date); //第一种 // String formattedDate = DateUtil.formatDate(date); //第二种 // String formattedDate = DateSyncUtil.formatDate(date); //第三种 // String formattedDate = ThreadLocalDateUtil.formatDate(date); System.out.println("线程 " + Thread.currentThread().getName() + " 时间为: " + formattedDate + " 偶数i:" + finalI); } else { Date now = new Date(); now.setTime(now.getTime() - TimeUnit.MILLISECONDS.convert(1, TimeUnit.DAYS)); String formattedDate = dateFormat.format(now); //第一种 // String formattedDate = DateUtil.formatDate(now); //第二种 // String formattedDate = DateSyncUtil.formatDate(now); //第三种 // String formattedDate = ThreadLocalDateUtil.formatDate(now); System.out.println("线程 " + Thread.currentThread().getName() + " 时间为: " + formattedDate + " 奇数i:" + finalI); } } catch (Exception e) { System.err.println("线程 " + Thread.currentThread().getName() + " 出现了异常: " + e.getMessage()); } }); } executor.shutdown(); try { executor.awaitTermination(30, TimeUnit.SECONDS); } catch (InterruptedException e) { e.printStackTrace(); } // 计算总耗时 LocalDateTime endDateTime = LocalDateTime.now(); Duration duration = Duration.between(startDateTime, endDateTime); System.out.println("所有任务执行完毕,总耗时: " + duration.toMillis() + " 毫秒"); } } 具体demo代码如上所示,执行结果如下,理论上来说应该是2024年1月23日和2024年1月22日打印日志的次数各5次。实际结果发现在偶数的场景下仍然会出现打印格式化2024年1月22日的场景。明显出现了数据错乱赋值的问题,所以到这里大概可以基本确定就是SimpleDateFormat类在并发场景下线程不安全导致的。   3.2 SimpleDateFormat为什么线程不安全? 查询相关资料发现,从SimpleDateFormat类提供的接口来看,实在让人看不出它与线程安全有什么关系,进入SimpleDateFormat源码发现类上面确实存在注释提醒:意思就是, SimpleDateFormat中的日期格式不是同步的。推荐(建议)为每个线程创建独立的格式实例。如果多个线程同时访问一个格式,则它必须保持外部同步。   继续分析源码发现,SimpleDateFormat线程不安全的真正原因是继承了DateFormat,在DateFormat中定义了一个protected属性的 Calendar类的对象:calendar。由于Calendar类的概念复杂,牵扯到时区与本地化等等,jdk的实现中使用了成员变量来传递参数,这就造成在多线程的时候会出现错误。   注意到在format方法中有一段如下代码: public StringBuffer format(Date date, StringBuffer toAppendTo, FieldPosition pos) { pos.beginIndex = pos.endIndex = 0; return format(date, toAppendTo, pos.getFieldDelegate()); } // Called from Format after creating a FieldDelegate private StringBuffer format(Date date, StringBuffer toAppendTo, FieldDelegate delegate) { // Convert input date to time field list calendar.setTime(date); boolean useDateFormatSymbols = useDateFormatSymbols(); for (int i = 0; i < compiledPattern.length; ) { int tag = compiledPattern[i] >>> 8; int count = compiledPattern[i++] & 0xff; if (count == 255) { count = compiledPattern[i++] << 16; count |= compiledPattern[i++]; } switch (tag) { case TAG_QUOTE_ASCII_CHAR: toAppendTo.append((char)count); break; case TAG_QUOTE_CHARS: toAppendTo.append(compiledPattern, i, count); i += count; break; default: subFormat(tag, count, delegate, toAppendTo, useDateFormatSymbols); break; } } return toAppendTo; } calendar.setTime(date)这条语句改变了calendar,稍后,calendar还会用到(在subFormat方法里),而这就是引发问题的根源。 想象一下,在一个多线程环境下,有两个线程持有了同一个SimpleDateFormat的实例,分别调用format方法: 线程1调用format方法,改变了calendar这个字段。 中断来了。 线程2开始执行,它也改变了calendar。 又中断了。 线程1回来了,此时,calendar已然不是它所设的值,而是走上了线程2设计的道路。 如果多个线程同时争抢calendar对象,则会出现各种问题,时间不对,线程挂死等等。 分析一下format的实现,我们不难发现,用到成员变量calendar,唯一的好处,就是在调用subFormat时,少了一个参数,却带来了这许多的问题。 其实,只要在这里用一个局部变量,一路传递下去,所有问题都将迎刃而解。 这个问题背后隐藏着一个更为重要的问题–无状态:无状态方法的好处之一,就是它在各种环境下,都可以安全的调用。衡量一个方法是否是有状态的,就看它是否改动了其它的东西,比如全局变量,比如实例的字段。format方法在运行过程中改动了SimpleDateFormat的calendar字段,所以,它是有状态的。 4. 如何解决? 4.1 每次在需要时新创建实例 在需要进行格式化日期的地方新建一个实例,不管什么时候,将有线程安全问题的对象由共享变为局部私有都能避免多线程问题,不过也加重了创建对象的负担。在一般情况下,这样其实对性能影响比不是很明显的。代码示例如下。 import java.text.ParseException; import java.text.SimpleDateFormat; import java.util.Date; /** * @author * @date 2024/1/23 20:04 */ public class DateUtil { public static String formatDate(Date date) throws ParseException { SimpleDateFormat sdf = new SimpleDateFormat("yyyy-MM-dd HH:mm:ss"); return sdf.format(date); } public static Date parse(String strDate) throws ParseException { SimpleDateFormat sdf = new SimpleDateFormat("yyyy-MM-dd HH:mm:ss"); return sdf.parse(strDate); } }​ 4.2 同步SimpleDateFormat对象 import java.text.ParseException; import java.text.SimpleDateFormat; import java.util.Date; /** * @author * @date 2024/1/23 20:04 */ public class DateSyncUtil { private static SimpleDateFormat sdf = new SimpleDateFormat("yyyy-MM-dd HH:mm:ss"); public static String formatDate(Date date) throws ParseException { synchronized (sdf) { return sdf.format(date); } } public static Date parse(String strDate) throws ParseException { synchronized (sdf) { return sdf.parse(strDate); } } } 说明:当线程较多时,当一个线程调用该方法时,其他想要调用此方法的线程就要block,多线程并发量大的时候会对性能有一定的影响。 4.3 ThreadLocal import java.text.DateFormat; import java.text.ParseException; import java.text.SimpleDateFormat; import java.util.Date; public class ConcurrentDateUtil { private static ThreadLocal<DateFormat> threadLocal = new ThreadLocal<DateFormat>() { @Override protected DateFormat initialValue() { return new SimpleDateFormat("yyyy-MM-dd HH:mm:ss"); } }; public static Date parse(String dateStr) throws ParseException { return threadLocal.get().parse(dateStr); } public static String format(Date date) { return threadLocal.get().format(date); } } 另一种写法 import java.text.DateFormat; import java.text.ParseException; import java.text.SimpleDateFormat; import java.util.Date; /** * @author * @date 2024/1/23 15:44 * @description 线程安全的日期处理类 */ public class ThreadLocalDateUtil { /** * 日期格式 */ private static final String date_format = "yyyy-MM-dd HH:mm:ss"; /** * 线程安全处理 */ private static ThreadLocal<DateFormat> threadLocal = new ThreadLocal<>(); /** * 线程安全处理 */ public static DateFormat getDateFormat() { DateFormat df = threadLocal.get(); if (df == null) { df = new SimpleDateFormat(date_format); threadLocal.set(df); } return df; } /** * 线程安全处理日期格式化 */ public static String formatDate(Date date) { return getDateFormat().format(date); } /** * 线程安全处理日期解析 */ public static Date parse(String strDate) throws ParseException { return getDateFormat().parse(strDate); } } 说明:使用ThreadLocal, 也是将共享变量变为独享,线程独享肯定能比方法独享在并发环境中能减少不少创建对象的开销。如果对性能要求比较高的情况下,一般推荐使用这种方法 4.4 抛弃JDK,使用其他类库中的时间格式化类 • 使用Apache commons 里的FastDateFormat,宣称是既快又线程安全的SimpleDateFormat, 可惜它只能对日期进行format, 不能对日期串进行解析。 • 使用Joda-Time类库来处理时间相关问题。 5. 性能比较 通过追加时间监控,将原有数据范围扩充到[0,999],线程池保留10个线程不变,观察三种情况下性能情况。 • 第一种:耗时40ms   • 第二种:耗时33ms   • 第三种:耗时30ms   通过性能压测发现4.3中的ThreadLocal性能最优,耗时30ms,4.1每次新创建实例性能最差,需要耗时40ms,当然了在极致的高并发场景下提升效果应该会更加明显。性能问题不是本文探讨的重点,在此不多做赘述。 6. 总结 以上就是针对本次问题排查的主要思路及流程,刚开始的排查思路也一直局限于规则引擎的线程不安全或者是传入的env(由于使用的是HashMap)线程不安全,还是受到组内大佬的启发和帮助才进一步去分析SimpleDateFormat类可能会存在线程不安全。本次问题排查确实提供一个经验,打破常规思路,比如SimpleDateFormat类看起来只是对日期进行格式化,很难和在并发场景下线程不安全会导致数据错乱关联起来。 作者:京东科技 宋慧超 来源:京东云开发者社区 转载请注明来源

优秀的个人博客,低调大师

| 京东云技术团队

在现代信息化的市场环境和社会中,标准化已经成为了各种行业的一个重要的标志。标准化不仅可以提升生产效率,减轻质量问题,还可以增加产品的可靠性和互通性。在这篇文章中,我们将探讨如何做标准化,为您提供详细的指导和建议。 一、了解标准化的定义和意义 标准化是一个广泛的概念,可以涉及到各种不同的领域。在商业上,标准化指的是通过制定各种规范和标准,将生产和服务过程变得更加统一和规范,从而提高质量、降低成本、提高效率和促进贸易。在工业上,标准化则更多的指的是通过制定各种标准,使得生产和制造过程变得更加一致和可靠,从而提高产品的质量和可靠性。 标准化的意义在于可以提高生产效率,降低质量问题,增加产品的可靠性和互通性。标准化可以帮助企业降低生产成本,提高产品质量,增加市场竞争力。同时,标准化还可以促进技术创新,加强政企合作,提高经济效益和社会效益。 二、标准化的基本原则和流程 标准化的基本原则包括透明、公正、科学和可行性。标准化的制定应该是透明的,即应该对所有相关方公开,并充分征求各方的意见和建议。标准化的制定应该是公正的,即应该独立于任何利益集体,以科学的方法制定标准。标准化的制定应该是科学的,即应该基于事实和证据,遵循科学原理和方法。标准化的制定应该是可行的,即应该考虑到生产和服务实践中的现实情况,以确保标准的实施和执行。 标准化的流程包括需求调研沟通、技术研究、标准制定、标准发布、标准实施和监督评估。需求调研沟通是标准化的第一步,需要了解行业需求和行业趋势。技术研究是标准化的第二步,需要进行技术分析和研究,确定标准的技术要求和技术指标。标准制定是标准化的第三步,需要制定标准的具体内容和规范。标准发布是标准化的第四步,需要将标准公布和宣传,让所有相关方了解和掌握标准。标准实施是标准化的第五步,需要通过培训、宣传、沟通和实践等方式,确保标准的实施和执行。监督评估是标准化的最后一步,需要定期检查和评估标准的实施和效果,以便及时调整和改进标准。 三、标准化的挑战和解决方案 标准化的制定和实施过程中,存在一些挑战,需要通过一些解决方案来克服。首先,标准化需要考虑到不同组织和部门的文化和环境软实力。在标准化中,需要考虑到不同组织和部门的内部文化和工作环境,确保标准的适用性和通用性。其次,标准化需要考虑到技术变化的速度和复杂性。在快速发展的技术环境下,标准化需要及时调整和更新,以确保标准的实用性和可靠性。再次,标准化需要考虑到各种利益相关方的需求和利益,需要平衡各方的利益,确保标准的公正性和科学性。最后,标准化需要考虑到标准的实施和执行问题,需要通过培训、宣传、沟通和实践等方式,提高标准的认知度和执行力度。 解决这些挑战的方案包括国际合作、技术创新、公正制定和实施和执行机制。多部门主题合作可以促进标准的制定和实施,确保标准的通用性和适用性。技术创新可以加速标准的更新和调整,以满足快速变化的技术环境。公正制定和实施可以保证标准的公正性和科学性。执行机制可以提高标准的执行力度,确保标准的实施效果。 四、标准化交付 1、了解标准化交付的定义和意义 标准化交付是指按照标准和规范要求,对产品、工程、服务等进行交付和验收的过程。标准化交付可以提高产品和服务质量,降低成本和风险,增加顾客满意度和市场竞争力。在现代化的市场环境和社会中,标准化交付已经成为了各种行业和领域的一个重要的方面。 2、标准化交付的基本原则和流程 标准化交付的基本原则包括规范、透明、公正和可行性。规范是指按照标准和规范要求进行交付和验收。透明是指交付和验收过程应该对所有相关方公开,并充分征求各方的意见和建议。公正是指交付和验收应该独立于任何利益集团,以公正的方法进行。可行性是指交付和验收应该考虑到生产和服务实践中的现实情况,以确保可行性和实施性。 标准化交付的流程包括需求分析、方案设计、实施执行、验收评估和跟踪反馈。需求分析是标准化交付的第一步,需要了解顾客需求和标准要求。方案设计是标准化交付的第二步,需要制定具体的交付方案和实施计划。实施执行是标准化交付的第三步,需要按照方案进行执行和监控。验收评估是标准化交付的第四步,需要对交付结果进行评估和检查。跟踪反馈是标准化交付的最后一步,需要及时调整和改进交付过程和结果。 3、标准化交付的关键要素和技能 标准化交付的关键要素包括顾客需求、标准和规范、交付方案和实施能力。顾客需求是标准化交付的基础,需要充分了解顾客的需求和期望。标准和规范是标准化交付的基础,需要按照标准和规范要求进行交付和验收。交付方案是标准化交付的核心,需要制定具体的交付方案和实施计划。实施能力是标准化交付的保障,需要具备充足的实施能力和技能。 标准化交付的关键技能包括需求分析、方案设计、实施执行、验收评估和跟踪反馈。需求分析需要具备调研和分析技能,以了解顾客需求和标准要求。方案设计需要具备创新和设计能力,以制定具体的交付方案和实施计划。实施执行需要具备组织和执行能力,以按照方案进行执行和监控。验收评估需要具备评估和检查能力,以对交付结果进行评估和检查。 五、标准化小结 标准化是现代化社会的一个重要标志,可以提高生产效率,降低质量问题,增加产品的可靠性和互通性。标准化的制定和实施需要遵循基本原则和流程,考虑到各种挑战和解决方案。希望通过本文的介绍,让大家了解到如何做标准化,为部门、企业和行业的发展提供指导和帮助。 作者:京东科技 贾玉龙 来源:京东云开发者社区 转载请注明来源

优秀的个人博客,低调大师

理解Mysql索引原理及特性 | 京东物流技术团队

作为开发人员,碰到了执行时间较长的sql时,基本上大家都会说”加个索引吧”。但是索引是什么东西,索引有哪些特性,下面和大家简单讨论一下。 1 索引如何工作,是如何加快查询速度 索引就好比书本的目录,提高数据库表数据访问速度的数据库对象。当我们的请求打过来之后,如果有目录,就会快速的定位到章节,再从章节里找到数据。如果没有目录,如大海捞针一般,难度可见一斑。这就是我们经常碰到的罪魁祸首,全表扫描。 一条索引记录中包含的基本信息包括:键值(即你定义索引时指定的所有字段的值)+逻辑指针(指向数据页或者另一索引页)。通常状况下,由于索引记录仅包含索引字段值(以及4-9字节的指针),索引实体比真实的数据行要小许多,索引页相较数据页来说要密集许多。一个索引页可以存储数量更多的索引记录,这意味着在索引中查找时在I/O上占很大的优势,理解这一点有助于从本质上了解使用索引的优势,也是大部分性能优化所需要切入的点。 1)没有索引的情况下访问数据: 2)使用平衡二叉树结构索引的情况下访问数据: 第一张图没有使用索引我们会进行顺序查找,依照数据顺序逐个进行匹配,进行了5次寻址才查询出所需数据,第二张图用了一个简单的平衡二叉树索引之后我们只用了3次,这还是数据量小的情况下,数据量大了效果更明显,所以总结来说创建索引就是为了加快数据查找速度; 2 索引的组成部分和种类 常见的索引的实现方式有很多种,比如hash、数组、树,下面为大家介绍下这几种模型使用上有什么区别 2.1 hash hash思路简单,就是把我们插入的key通过hash函数算法(以前一般是取余数,就好比hashmap的计算方式移位异或之类的),计算出对应的value,把这个value放到一个位置,这个位置叫做哈希槽。对应磁盘位置指针放入hash槽里面。一句话总结hash索引,就是存储了索引字段的hash值和数据所在磁盘文件指针。 但是不可避免的是,无论什么算法,数据量大了之后难免会出现不同的数据被放在一个hash槽里面。比如字典上的 “吴”和”武”就是同音,你查字典的时候到这里只能顺序往下去找了。索引的处理也是这样,会拉出一个链表,需要的时候顺序遍历即可。 缺点:无序索引,区间查询性能低,因为区间查询会造成多次访问磁盘,多次io耗时是很难接受的。 优点:insert迅速,只需往后补就行 场景:等值查询, 比如memcached 。不适用大量重复数据的列,避免hash冲突 总结:想成java的hashmap即可 2.2 有序数组 如果我们需要区间查询的时候,hash索引的性能就不尽如人意了。这个时候有序数组的优势就能体现出来了。 当我们需要从一个有序数组里取A和B之间的值时,只需要通过二分法定位到A的位置,时间复杂度O(log(N)),接着从A遍历到B即可,论速度的话,基本上可以说是最快的了。但是当我们需要更新的时候,需要进行的操作就很多了。如果需要插入一条数据,你需要挪动数据之后的所有数据,浪费性能。所以总结来说,只有不怎么变化的数据适合有序数组结构的索引。 缺点:insert新数据的时候,需要改变后续所有数据,成本略高。 优点:查询速度很快,理论最大值。 场景:归档查询,日志查询等极少变化的 总结:就是顺序排的数组 2.3 二叉搜索树 基本原则是树的左节点都小于父节点,右节点都大于父节点 这里我们就能看出来,二叉搜索树的查询效率原则上是O(log(N)),为了保证是平衡二叉树,更新效率也是O(log(N))。但是数据很多的情况树的高度会达到很高,过多次访问磁盘,是不可取的。并且极端情况下,树退化成链表,查询的复杂度会被拉成O(n)。 进化成多叉树,也就是多个子节点的时候,会大大的减少树的高度,降低访问磁盘。 缺点:数据量大的时候,树会过高,导致多次访问磁盘 优点:进化成多叉树,会降低树高,访问磁盘次数。 场景:适用很多场景 总结:左小右大的树 2.4 B树 在每个节点存储多个元素,在每个节点尽可能多的存储数据。每个节点可以存储1000个索引(16k/16=1000),这样就将二叉树改造成了多叉树,通过增加树的叉树,将树从高瘦变为矮胖。构建1百万条数据,树的高度只需要2层就可以(1000*1000=1百万),也就是说只需要2次磁盘IO就可以查询到数据。磁盘IO次数变少了,查询数据的效率也就提高了。 这种数据结构我们称为B树,B树是一种多叉平衡查找树 2.5 B+树 B+树和B树最主要的区别在于非叶子节点是否存储数据的问题。 B树:非叶子节点和叶子节点都会存储数据。 B+树:只有叶子节点才会存储数据,非叶子节点至存储键值。叶子节点之间使用双向指针连接,最底层的叶子节点形成了一个双向有序链表。 正是因为B+树的叶子节点是通过链表连接的,所以找到下限后能很快进行区间查询,比正常的中序遍历快 3 索引的维护 当你insert一条数据的时候,索引需要做出必要的操作来保证数据的有序型。一般自增数据直接在后面加就行了,特殊情况下如果数据加到了中间,就需要挪动后面所有的数据,这样效率比较受影响。 最糟糕的情况,如果当前的数据页(页是mysql存储的最小单位)存满了,需要申请一个新的数据页,这个过程被称为页分裂。如果造成了页分裂的话,势必会造成性能的影响。但是mysql并不是无脑的数据分裂,如果你是从中间进行数据分裂的话,对于自增主键,会导致一半的性能浪费。mysql会根据你的索引的类型,和追踪插入数据的情况决定分裂的方式,一般都存在mysql数据页的head里面,如果是零散的插入,会从中间分裂。如果是顺序插入,一般是会选择插入点开始分裂,或者插入点往后几行导致的。决定是否从中间分裂,还是从最后分裂。 如果插入的是不规则的数据,没法保证后一个值比前一个大,就会触发上面说的分裂逻辑,最后达到下面的效果 所以绝大多数情况下,我们都需要使用自增索引,除非需要业务自定义主键,最好能保证只有一个索引,且索引是唯一索引。这样可以避免回表,导致查询搜索两棵树。保证数据页的有序性,可以更好的使用索引。 4 回表 通俗的讲就是,如果索引的列在 select 所需获得的列中(因为在 mysql 中索引是根据索引列的值进行排序的,所以索引节点中存在该列中的部分值)或者根据一次索引查询就能获得记录就不需要回表,如果 select 所需获得列中有大量的非索引列,索引就需要先找到主键,再到表中找到相应的列的信息,这就叫回表。 要介绍回表自然就得介绍聚集索引和非聚集索引 InnoDB聚集索引的叶子节点存储行记录,因此, InnoDB必须要有,且只有一个聚集索引: 如果表定义了主键,则PK就是聚集索引; 如果表没有定义主键,则第一个非空唯一索引(not NULL unique)列是聚集索引; 否则,InnoDB会创建一个隐藏的row-id作为聚集索引; 当我们使用普通索引查询方式,则需要先搜索普通索引树,然后得到主键 ID后,再到 ID 索引树搜索一次。因为非主键索引的叶子节点里面,实际存的是主键的ID。这个过程虽然用了索引,但实际上底层进行了两次索引查询,这个过程就称为回表。也就是说,基于非主键索引的查询需要多扫描一棵索引树。因此,我们在应用中应该尽量使用主键查询。或者有高频请求时,合理建立联合索引,防止回表。 5 索引覆盖 一句话表达的话,是只需要在一棵索引树上就能获取SQL所需的所有列数据,无需回表,速度更快。落实到sql上的话,只要执行计划里面的输出结果Extra字段为Using index时,能够触发索引覆盖。 常见的优化手段,就是上面提到的,将查询的字段都建到索引里面,至于dba愿不愿意让你建,那就需要你们自己battle了。 一般索引覆盖适用的场景包括 全表count查询优化、列查询回表、分页回表。高版本的mysql已经做了优化,当命中联合索引的其中一个字段,另外一个是id的时候,会自动优化,无需回表。因为二级索引的叶子上存了primary key,也算索引覆盖,无需额外成本。 6 最左匹配原则 简单来说,就是你使用 ‘xx%’的时候,符合条件的话也会使用索引。 如果是联合索引的话,我举个例子,创建一个(a,b)的联合索引 可以看到a的值是有顺序的,1,1,2,2,3,3,而b的值是没有顺序的1,2,1,4,1,2。但是我们又可发现a在等值的情况下,b值又是按顺序排列的,但是这种顺序是相对的。这是因为MySQL创建联合索引的规则是首先会对联合索引的最左边第一个字段排序,在第一个字段的排序基础上,然后在对第二个字段进行排序。所以b=2这种查询条件没有办法利用索引。举个例子,我弄一个索引, KEYidx_time_zone(time_zone,time_string) USING BTREE 执行第一条sql,全表扫描 执行第二条sql,可以看到使用了索引。 再看两条sql,建立的索引是 KEYidx_time_zone(time_zone,time_string) USING BTREE 按照正常逻辑来说,第二条sql是不符合索引字段的顺序的,应该不能使用索引才对,但是实际情况却和我们期望的不太一样,这是为啥呢? 从mysql被oracle收购以后,mysql加入了很多oracle以前的技术,高版本mysql自动优化了where条件的先后顺序。简单来说就是查询优化器做了这一步操作,sql会做预处理,那一条能更好的查询就会使用那种规则。 顺便提一下mysql的查询优化器能帮忙干的一些事 6.1 条件转化 例如where a=b and b=2,可以得到a=2,条件传递。最后的sql是 a=2 and b=2 > < = like 都可以传递 6.2 无效代码的排除 例如 where 1=1 and a=2, 1=1永远是正确的,所以最后会优化成 a=2 在比如 where 1=0 永远是false的,这样的也会被排除掉,整sql无效 或者非空字段 where a is null ,这样的也会被排除 6.3 提前计算 包含数学运算的部分,例如 where a= 1+2 会帮你算好,where a=3 6.4 存取类型 当我们评估一个条件表达式,MySQL判断该表达式的存取类型。下面是一些存取类型,按照从最优到最差的顺序进行排列: system系统表,并且是常量表 const 常量表 eq_ref unique/primary索引,并且使用的是’=’进行存取 ref 索引使用’=’进行存取 ref_or_null 索引使用’=’进行存取,并且有可能为NULL range 索引使用BETWEEN、IN、>=、LIKE等进行存取 index 索引全扫描 ALL 表全扫描 经常看执行计划的,一眼就能看出来这是啥意思,举个例子 where index_col=2 and normal_col =3 这里就会选用index_col=2 会作为驱动项。驱动项的意思是指一个sql选定他的执行计划的时候,可能有多条执行路径,一个是全表扫描,再过滤是否符合索引字段及非索引字段的值。另一种是通过索引字段,键值=2找到对应的索引树,过滤后的结果,再比较是否符合非索引字段的值。一般情况下,走索引都比全表扫描需要读取磁盘的次数少,所以称它为更好的执行路径,也就是通过索引字段,作为其驱动表达式 6.5 范围存取 简单来说,a in(1,2,3) 和 a=1 or a=2 or a=3 是一样的,between 1 and 2 和 a>1 and a<2也是一样的, 无需可以优化。 6.6 索引存取类型 避免使用相同前缀的索引,也就是一个字段不要在多个索引上有相同的前缀。比如一个字段已经建立了唯一索引,这个时候如果再给他建立一个联合索引,会导致优化器并不知道你要使用哪个索引。或者你建了前缀相同的一个单索引,一个联合索引,就算你写上了条件,也不一定能用上联合索引。当然,可以force,这就另说了。 6.7 转换 简单的表达式可以进行转换,比如 where -2 = a 会自动变成 where a= -2 ,但是如果牵扯到数学运算,就不能转换了 比如 where 2= -a 这时候不会自动转成 where a =-2. 第二条sql就可以使用索引 所以 我们在开发的过程中,需要注意sql的写法,自觉写成 where a=-2 6.8 and、union、order by、group by等 1)and and条件后,如果都没索引,扫描全表。有一个存取类型更好,见5.4 ,会使用存储类型更好的索引,如果都一样,哪个索引先创建,用哪个。 2)union union 每条语句单独优化 这里就会分别执行两条sql,用到索引,再合并结果集 3)order by order by 会过滤无效排序,比如一个字段本来就有索引 第二条sql和第一条的查询效果是一样的 所以,写sql的时候,不要写无用排序,比如order by ‘xxx’ 这样没有意义。 4)group by 简单来说 group by 的字段,有索引会走索引,group by a order by a 这里的order by等于没写,结果集已经是排序完毕的了,参考 6.8-3 order by select distinct col_a from table a 等价于 select col_a from a group by col_a 7 索引下推 主要的核心点就在于把数据筛选的过程放在了存储引擎层去处理,而不是像之前一样放到Server层去做过滤。 如果在一张表上,name和age都建立索引,查询条件为 where name like ‘xx%’ and age=11,在低版本的mysql(5.6 以下)的根据索引的最左匹配原则,可以得到放弃了age,只根据name过滤数据。根据name拿到所有的id之后,再根据id回表。 高版本mysql里,没有忽略age这个属性,带着age属性过滤,直接过滤掉了age为11的数据,假设不根据age过滤的数据为10条,过滤后只剩3条,就少了7次回表。减少了io会大量减少性能消耗 8 小表驱动大表 小表驱动大表,也是我们听惯了的话了,其含义主要是指小表的数据集驱动大表的数据集,减少连接次数。打个比方: 表A有1w数据,表B有100w数据,如果A表作为驱动表,处于循环的外层,那么只需要1w次的连接即可。如果B表在外层,那么则需要循环100w次。 下面我们实际测试看看,准备环境mysql 5.7+ 准备两张表,一张表 ib_asn_d 数据 9175, 一张表 bs_itembase_ext_attr 数据 1584115,都在商品编码字段上有索引。 首先小表驱动大表 多次反复测试,执行时间大概7秒。 接下来看看大表驱动小表。 将近300秒,不是一个量级的。 接下来分别分析执行计划,执行计划里第一条就是驱动表。 小表驱动大表,大表用了索引,小表全表扫描,只扫描8000多行 大表驱动小表,大表全表扫描,需要扫描147w行。 经过多次测试得出了结论: 当使用left join时,左表是驱动表,右表是被驱动表 ; 当使用right join时,右表是驱动表,左表是被驱动表 ; 当使用inner join时,mysql会选择数据量比较小的表作为驱动表,大表作为被驱动表 ; 驱动表索引不生效,非驱动表索引生效 保证小表是驱动表很重要。 9 总结 覆盖索引:如果查询条件使用的是普通索引(或是联合索引的最左原则字段),查询结果是联合索引的字段或是主键,不用回表操作,直接返回结果,减少IO磁盘读写读取整行数据,所以高频字段建立联合索引是很有必要的 最左前缀:联合索引的最左 N 个字段,也可以是字符串索引的最左 M 个字符。建立索引的时候,注意左前缀不要重复,避免查询优化器无法判定如何使用索引 索引下推:name like ‘hello%’and age >10 检索,MySQL 5.6版本之前,会对匹配的数据进行回表查询。5.6版本后,会先过滤掉age<10的数据,再进行回表查询,减少回表率,提升检索速度 作者:京东物流吴思维 来源:京东云开发者社区 转载请注明来源

优秀的个人博客,低调大师

拓扑排序实现循环依赖判断 | 京东云技术团队

本文记录如何通过拓扑排序,实现循环依赖判断 前言 一般提到循环依赖,首先想到的就是Spring框架提供的Bean的循环依赖检测,相关文档可参考: https://blog.csdn.net/cristianoxm/article/details/113246104 本文方案脱离Spring Bean的管理,通过算法实现的方式,完成对象循环依赖的判断,涉及的知识点包括:邻接矩阵图、拓扑排序、循环依赖。本文会着重讲解技术实现,具体算法原理不再复述 概念释义 1. 什么是邻接矩阵? 这里要总结的邻接矩阵是关于图的邻接矩阵;图的邻接矩阵(Adjacency Matrix)存储方式是用两个数组来表示图;一个一维数组存储图中顶点信息,一个二维数组(称为邻接矩阵)存储图中的边或弧的信息; 图分为有向图和无向图,其对应的邻接矩阵也不相同,无向图的邻接矩阵是一个对称矩阵,就是一个对称的二位数组,a[i][j] = a[j][i]; 邻接矩阵可以清楚的知道图的任意两个顶点是否有边;方便计算任意顶点的度(包括有向图的出度和入度);可以直观的看出任意顶点的邻接点; 本案例中,有向邻接矩阵图为进行拓扑排序的必要条件之一,其次为有向邻接矩阵图每个顶点的入度 2. 邻接矩阵的存储结构? vexs[MAXVEX]这是顶点表; arc[MAXVEX][MAXVEX]这是邻接矩阵图,也是存储每条边信息的二维数组。数组的索引是边的两个顶点,数组的数据是边的权值; numVertexes, numEdges分别为图的顶点数和边数。 3. 有向邻接矩阵图顶点的入度? 在有向图中,箭头是具有方向的,从一个顶点指向另一个顶点,这样一来,每个顶点被指向的箭头个数,就是它的入度。从这个顶点指出去的箭头个数,就是它的出度 邻接矩阵的行号即代表箭头的出发结点,列号是箭头的指向结点,所以矩阵中同一行为1的表示有从第i个结点指向第j个结点这样一条边,而在同列为1就代表第j个结点被第i个结点指向,因此要求顶点的入度或出度,只需要判断同列为1的个数或同行为1的个数 4. 什么是拓扑排序? 拓扑排序的要素: 1.有向无环图; 2.序列里的每一个点只能出现一次; 3.任何一对 u 和 v ,u 总在 v 之前(这里的两个字母分别表示的是一条线段的两个端点,u 表示起点,v 表示终点); 根据拓扑排序的要素,可通过其有向无环来判断对象依赖是否存在循环。若对象组成的图可完成拓扑排序,则该对象图不存在环,即对象间不存在循环依赖。 拓扑排序除了通过有向邻接矩阵图实现外,还可以通过深度优先搜索(DFS)来实现。本案例中仅讲解前者。 5. 什么是循环依赖? 简单解释如下,若存在两个对象,若A创建需要B,B创建需要A,这两个对象间互相依赖,就构成了最简单的循环依赖关系。 编程示例 1. 对象实体 @Builder @NoArgsConstructor @AllArgsConstructor @Getter @Setter @ToString public class RelationVo implements Serializable { /** * 唯一标识 */ private String uniqueKey; /** * 关联唯一标识集合 */ private List combinedUniqueKeys; } 2. 对象集合转换为有向邻接矩阵图 /** * 将List集合转换为邻接矩阵图的二维数组形式 * * @param sourceList * @return */ public static int[][] listToAdjacencyMatrixDiagram(List sourceList) { List distinctRelationVoList = new ArrayList(sourceList); List keyCollect = distinctRelationVoList.stream().map(RelationVo::getUniqueKey).collect(Collectors.toList()); for (RelationVo vo : sourceList) { vo.getCombinedUniqueKeys().forEach(child -> { if (!keyCollect.contains(child)) { // 若叶子节点不在集合中,补充List集合中单独叶子节点,目的是完成提供邻接矩阵图计算的入参 keyCollect.add(child); RelationVo build = RelationVo.builder().uniqueKey(child).build(); distinctRelationVoList.add(build); } }); } // 顶点数:对象中出现的全部元素总数 int vertexNum = keyCollect.size(); /* * 初始化邻接矩阵图的边的二维数组,1表示有边 0表示无边 权重均为1 * 其中数组下标为边的两个顶点,数组值为对象边的权值(权值=是否有边*权重) */ int[][] edges = new int[vertexNum][vertexNum]; // 计算邻接矩阵图 for (int i = 0; i < vertexNum; i++) { RelationVo colVo = distinctRelationVoList.get(i); List colUniqueKeys = colVo.getCombinedUniqueKeys(); for (int j = 0; j < vertexNum; j++) { RelationVo rowVo = distinctRelationVoList.get(j); String rowVertex = rowVo.getUniqueKey(); if (CollUtil.isNotEmpty(colUniqueKeys)) { if (colUniqueKeys.contains(rowVertex)) { edges[i][j] = 1; } else { edges[i][j] = 0; } } } } return edges; } 3. 计算邻接矩阵图顶点的入度 /** * 返回给出图每个顶点的入度值 * * @param adjMatrix 给出图的邻接矩阵值 * @return */ public static int[] getSource(int[][] adjMatrix) { int len = adjMatrix[0].length; int[] source = new int[len]; for (int i = 0; i < len; i++) { // 若邻接矩阵中第i列含有m个1,则在该列的节点就包含m个入度,即source[i] = m int count = 0; for (int j = 0; j < len; j++) { if (adjMatrix[j][i] == 1) { count++; } } source[i] = count; } return source; } 4. 对邻接矩阵图进行拓扑排序 /** * 拓扑排序,返回给出图的拓扑排序序列 * 拓扑排序基本思想: * 方法1:基于减治法:寻找图中入度为0的顶点作为即将遍历的顶点,遍历完后,将此顶点从图中删除 * 若结果集长度等于图的顶点数,说明无环;若小于图的顶点数,说明存在环 * * @param adjMatrix 给出图的邻接矩阵值 * @param source 给出图的每个顶点的入度值 * @return */ public static List topologySort(int[][] adjMatrix, int[] source) { // 给出图的顶点个数 int len = source.length; // 定义最终返回路径字符数组 List result = new ArrayList(len); // 获取入度为0的顶点下标 int vertexFound = findInDegreeZero(source); while (vertexFound != -1) { result.add(vertexFound); // 代表第i个顶点已被遍历 source[vertexFound] = -1; for (int j = 0; j < adjMatrix[0].length; j++) { if (adjMatrix[vertexFound][j] == 1) { // 第j个顶点的入度减1 source[j] -= 1; } } vertexFound = findInDegreeZero(source); } //输出拓扑排序的结果 return result; } /** * 找到入度为0的点,如果存在入度为0的点,则返回这个点;如果不存在,则返回-1 * * @param source 给出图的每个顶点的入度值 * @return */ public static int findInDegreeZero(int[] source) { for (int i = 0; i < source.length; i++) { if (source[i] == 0) { return i; } } return -1; } 5. 检查集合是否存在循环依赖 /** * 检查集合是否存在循环依赖 * * @param itemList */ public static void checkCircularDependency(List itemList) throws Exception { if (CollUtil.isEmpty(itemList)) { return; } // 计算邻接矩阵图的二维数组 int[][] edges = listToAdjacencyMatrixDiagram(itemList); // 计算邻接矩阵图每个顶点的入度值 int[] source = getSource(edges); // 拓扑排序得到拓扑序列 List topologySort = topologySort(edges, source); if (source.length == topologySort.size()) { // 无循环依赖 return; } else { // 序列集合与顶点集合大小不一致,存在循环依赖 throw new Exception("当前险种关系信息存在循环依赖,请检查"); } } 单测用例 1. 测试物料-无循环依赖 示例JSON Array结构(可完成拓扑排序): [{ "uniqueKey":"A", "combinedUniqueKeys":[ "C", "D", "E" ] }, { "uniqueKey":"B", "combinedUniqueKeys":[ "D", "E" ] }, { "uniqueKey":"D", "combinedUniqueKeys":[ "C" ] } ] 2. 测试物料-存在循环依赖 示例JSON Array结构(不可完成拓扑排序): [{ "uniqueKey":"A", "combinedUniqueKeys":[ "C", "D", "E" ] }, { "uniqueKey":"B", "combinedUniqueKeys":[ "D", "E" ] }, { "uniqueKey":"D", "combinedUniqueKeys":[ "C" ] }, { "uniqueKey":"C", "combinedUniqueKeys":[ "B" ] } ] 3. 单测示例 @Slf4j public class CircularDependencyTest { /** * 针对集合信息判断该集合是否存在循环依赖 */ @Test void testCircularDependencyList() throws Exception { String paramInfo = "[{\"uniqueKey\":\"A\",\"combinedUniqueKeys\":[\"C\",\"D\",\"E\"]},{\"uniqueKey\":\"B\",\"combinedUniqueKeys\":[\"D\",\"E\"]},{\"uniqueKey\":\"D\",\"combinedUniqueKeys\":[\"C\"]}]"; // 序列化 List list = JSONArray.parseArray(paramInfo, RelationVo.class); TopologicalSortingUtil.checkCircularDependency(list); } } 作者:京东保险侯亚东 来源:京东云开发者社区 转载请注明来源

优秀的个人博客,低调大师

Flink State 状态原理解析 | 京东物流技术团队

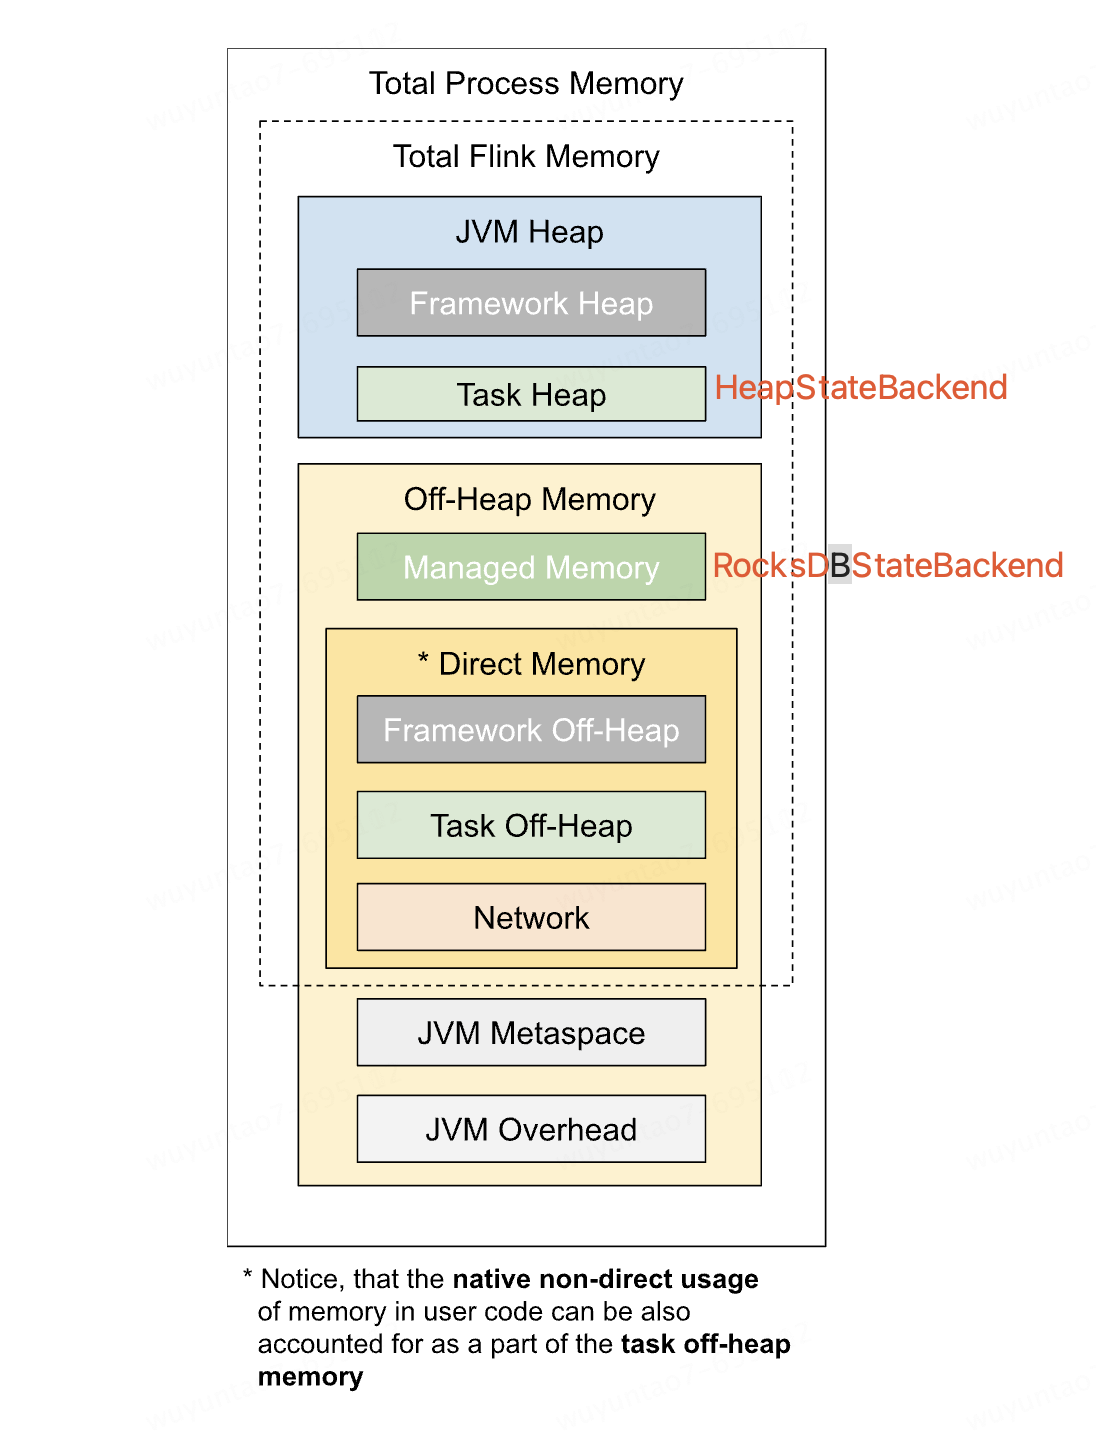
一、Flink State 概念 State 用于记录 Flink 应用在运行过程中,算子的中间计算结果或者元数据信息。运行中的 Flink 应用如果需要上次计算结果进行处理的,则需要使用状态存储中间计算结果。如 Join、窗口聚合场景。 Flink 应用运行中会保存状态信息到 State 对象实例中,State 对象实例通过 StateBackend 实现将相关数据存储到 FS 文件系统或者 RocksDB 数据库中。在Flink应用运行过程中,通过 checkpoint 快照定期地保存状态数据。并在 Flink 应用重启时加载checkpoint/savepoint 来实现状态的恢复,从而让 Flink 应用继续完成之前的数据计算,实现数据精确一次向下游传递。 1.1 Apache Flink 中 State 的存储实现 StateBackend 分类 分为以下3类: 基于内存的 HeapStateBackend。状态存储在内存中。 基于 HDFS 或 OSS 的 FsStateBackend。状态存储在内存,并在做 cp(checkpoint)时存到远端。 基于 RocksDB 的 RocksDBStateBackend。将对象序列化成二进制存在内存和本地磁盘的 RocksDB 数据中,并在 cp 时存到远端。 HeapStateBackend 和 RocksDBStateBackend 分别对应在 TaskManager 内存模型中的位置: RocksDBStateBackend 中存储结构:  namespace: 在不同的 namespace 下存在相同名称的状态。 1.1.1 State 状态持久化 通过 Chandy-Lamport 分布式快照算法进行 checkpoint 完成状态数据的持久化。然后在 Flink 应用重启时读取 State 状态数据,进行运行现场的还原。 chekcpoint 分类: 基于内存的全量 checkpoint HDFS 全量 checkpoint RocksDB 全量 checkpoint/增量 checkpoint 1.2 State 基于算子和数据分组的分类 State 可分为 Operator State 和 Keyed State 两类。 Operator State(称为 non-keyed state) 常常存在于Source, Sink中。具体实现类例如: BroadcastState 例:Kafka Source 中用 OperatorState 记录 offset。 Keyed State 任何类型的 keyed state 都可以有有效期(TTL),所有状态类型都支持单元素的 TTL。 这意味着 List 元素和 Map 映射元素将独立到期。 例:SQL GroupBy/PartitionBy 后的窗口中的数据,每个 key 都有对应的 State。key 与 key 之间的 State 数据不可见。 keyed state 的具体实现类: ValueState MapState ListState AggregatingState ReducingState 。。。。。 Flink State思维导图:   Keyed State Operator State 适用算子类型 只适用于KeyedStream上的算子 可用于所有算子 状态分配 每个Key对应一个状态 一个算子子任务对应一个状态 横向扩展 状态随着keyBy的分组KeyGroup自动在多个算子子任务上迁移 有多种状态重新分配的方式 创建和访问方式 自定义算子(重写RichFunction,通过State 名称从 getRuntimeContext方法创建或获得 State ) 实现 CheckpointedFunction 等接口 支持数据结构 ValueState、ListState、MapState等 ListState、BroadcastState等 二、常见状态相关处理流程 2.1 Flink 应用中状态是如何存储的?  1. Kafka Source 如何存储 OperatorState? class FlinkKafkaConsumerBase { private transient ListState<Tuple2<KafkaTopicPartition, Long>> unionOffsetStates; // state名称:"topic-partition-offset-states" // 特殊的State类型:Union State } unionOffsetStates这个变量就是 OperatorState类型的。 2. Map算子如何存储需要累计的数据? ValueState/MapState/ListState/...... 思考:keyby 后的数据分发与多并行度 subtask 之间的关系是怎样的? 首先,datastream 中数据经过 keyby 之后,会划分到各个 KeyedStream 中。每个 KeyedStream 有自己的 KeyedState(如ValueState/ListState/MapState)。 其次,KeyedStream 中的数据会以 KeyGroup 方式组织在一起。KeyGroup 是 Flink 重新分发 key state 的最小单元。 最后,KeyGroup 中的数据会通过取模最大并行度的方式分散到各个 subtask 中。以下是关键源码: KeyGroupStreamPartitioner#selectChannel(record) { K key; key = keySelector.getKey(record.getInstance().getValue()); return KeyGroupRangeAssignment.assignKeyToParallelOperator( key, maxParallelism, numberOfChannels); } --KeyGroupRangeAssignment#assignKeyToParallelOperator() { return computeOperatorIndexForKeyGroup(maxParallelism, parallelism, assignToKeyGroup(key, maxParallelism)); } --KeyGroupRangeAssignment#computeOperatorIndexForKeyGroup() 公式:OperatorIndex = keyGroupId * parallelism / maxParallelism --KeyGroupRangeAssignment#assignToKeyGroup() { return computeKeyGroupForKeyHash(key.hashCode(), maxParallelism); } 2.2 修改并行度场景时 State 状态存储的变化  2.3 State 与 Checkpoint 关系 分布式快照 Checkpoint 的概念,定期将 State 持久化到 外部存储系统(HDFS/OSS) 上。用户可以通过实现 CheckpointedFunction 接口来使用 operator state。通过 barrier 来对齐 checkpoint,等待 State 持久化完成(此过程参数不同也可能是异步的)。 常见 State 与 CP 相关的问题: State 状态过大。现象为多个算子或单个算子多个 subtask 做 checkpoint 慢,可导致 CP 对齐时间长,严重时会导致 CP 超时。 数据倾斜导致某个 subtask 处理不及时。现象为单个算子少数几个 subtask 做 checkpoint 慢,导致 CP 对齐时间长。严重时会导致 CP 超时。 大作业(并行度搞)频繁做 CP,会频繁上传小文件,导致 HDFS 集群小文件过多。 常用解决措施:调大托管内存大小。 三、参考文档: Flink State 官方文档:Flink 状态与容错 https://cloud.tencent.com/developer/article/1403939 https://www.modb.pro/db/81206 作者:京东物流 吴云涛 来源:京东云开发者社区 自猿其说Tech 转载请注明来源

优秀的个人博客,低调大师

ThreadPoolExecutor线程池内部处理浅析 | 京东物流技术团队

我们知道如果程序中并发的线程数量很多,并且每个线程都是执行一个时间很短的任务就结束时,会因为频繁创建线程而大大降低系统的效率,因此出现了线程池的使用方式,它可以提前创建好线程来执行任务。本文主要通过java的ThreadPoolExecutor来查看线程池的内部处理过程。 1 ThreadPoolExecutor java.uitl.concurrent.ThreadPoolExecutor类是线程池中最核心的一个类,下面我们来看一下ThreadPoolExecutor类的部分实现源码。 1.1 构造方法 ThreadPoolExecutor类提供了如下4个构造方法 // 设置线程池时指定核心线程数、最大线程数、线程存活时间及等待队列。 // 线程创建工厂和拒绝策略使用默认的(AbortPolicy) public ThreadPoolExecutor(int corePoolSize, int maximumPoolSize, long keepAliveTime, TimeUnit unit, BlockingQueue<Runnable> workQueue) { this(corePoolSize, maximumPoolSize, keepAliveTime, unit, workQueue, Executors.defaultThreadFactory(), defaultHandler); } // 设置线程池时指定核心线程数、最大线程数、线程存活时间、等待队列及线程创建工厂 // 拒绝策略使用默认的(AbortPolicy) public ThreadPoolExecutor(int corePoolSize, int maximumPoolSize, long keepAliveTime, TimeUnit unit, BlockingQueue<Runnable> workQueue, ThreadFactory threadFactory) { this(corePoolSize, maximumPoolSize, keepAliveTime, unit, workQueue, threadFactory, defaultHandler); } // 设置线程池时指定核心线程数、最大线程数、线程存活时间、等待队列及拒绝策略 // 线程创建工厂使用默认的 public ThreadPoolExecutor(int corePoolSize, int maximumPoolSize, long keepAliveTime, TimeUnit unit, BlockingQueue<Runnable> workQueue, RejectedExecutionHandler handler) { this(corePoolSize, maximumPoolSize, keepAliveTime, unit, workQueue, Executors.defaultThreadFactory(), handler); } // 设置线程池时指定核心线程数、最大线程数、线程存活时间、等待队列、线程创建工厂及拒绝策略 public ThreadPoolExecutor(int corePoolSize, int maximumPoolSize, long keepAliveTime, TimeUnit unit, BlockingQueue<Runnable> workQueue, ThreadFactory threadFactory, RejectedExecutionHandler handler) { if (corePoolSize < 0 || maximumPoolSize <= 0 || maximumPoolSize < corePoolSize || keepAliveTime < 0) throw new IllegalArgumentException(); if (workQueue == null || threadFactory == null || handler == null) throw new NullPointerException(); this.acc = System.getSecurityManager() == null ? null : AccessController.getContext(); this.corePoolSize = corePoolSize; this.maximumPoolSize = maximumPoolSize; this.workQueue = workQueue; this.keepAliveTime = unit.toNanos(keepAliveTime); this.threadFactory = threadFactory; this.handler = handler; } 通过观察上述每个构造器的源码实现,我们可以发现前面三个构造器都是调用的第四个构造器进行的初始化工作。 下面解释一下构造器中各个参数的含义: corePoolSize:核心池的线程个数上线,在创建了线程池后,默认情况下,线程池中并没有任何线程,而是等待有任务到来才创建线程去执行任务。默认情况下,在创建了线程池后,线程池中的线程数为0,当有任务来之后,就会创建一个线程去执行任务,当线程池中的线程数目达到corePoolSize后,就会把到达的任务放到缓存队列当中。 maximumPoolSize:线程池最大线程数,这个参数也是一个非常重要的参数,它表示在线程池中最多能创建多少个线程。 keepAliveTime:表示线程没有任务执行时最多保持多久时间会终止。默认情况下,只有当线程池中的线程数大于corePoolSize时,keepAliveTime才会起作用,直到线程池中的线程数不大于corePoolSize,即当线程池中的线程数大于corePoolSize时,如果一个线程空闲的时间达到keepAliveTime,则会终止,直到线程池中的线程数不超过corePoolSize。但是如果调用了allowCoreThreadTimeOut(boolean)方法,在线程池中的线程数不大于corePoolSize时,keepAliveTime参数也会起作用,直到线程池中的线程数为0。 unit:参数keepAliveTime的时间单位。 workQueue:一个阻塞队列,用来存储等待执行的任务,这个参数的选择也很重要,会对线程池的运行过程产生重大影响; threadFactory:线程工厂,主要用来创建线程; handler:表示当拒绝处理任务时的策略。有以下四种取值:ThreadPoolExecutor.AbortPolicy:丢弃任务并抛出RejectedExecutionException异常。 ThreadPoolExecutor.DiscardPolicy:也是丢弃任务,但是不抛出异常。 ThreadPoolExecutor.DiscardOldestPolicy:丢弃队列最前面的任务,然后重新尝试执行任务(重复此过程)ThreadPoolExecutor.CallerRunsPolicy:由调用线程处理该任务。 1.2 核心方法 在ThreadPoolExecutor类中,最核心的任务提交方法是execute()方法,虽然通过submit也可以提交任务,但是实际上submit方法里面最终调用的还是execute()方法。 public void execute(Runnable command) { // 判断提交的任务command是否为null,若是null,则抛出空指针异常; if (command == null) throw new NullPointerException(); // 获取线程池中当前线程数 int c = ctl.get(); // 如果线程池中当前线程数小于核心池大小,进入if语句块 if (workerCountOf(c) < corePoolSize) { // 如果以给定的命令启动一个核心线程执行任务成功,直接返回 if (addWorker(command, true)) return; c = ctl.get(); } // 如果当前线程池处于RUNNING状态,则将任务放入任务缓存队列 if (isRunning(c) && workQueue.offer(command)) { int recheck = ctl.get(); // 如果线程池不处于运行状态并且移除刚加入的任务成功则执行拒绝策略 if (! isRunning(recheck) && remove(command)) reject(command); // 如果当前线程数为0,则在线程池里增加一个线程,保证队列里的任务不会没有线程执行 else if (workerCountOf(recheck) == 0) addWorker(null, false); } // 尝试启动核心线程之外的线程,如果不满足,则执行对应的拒绝策略 else if (!addWorker(command, false)) reject(command); } 主要方法addWorker。 private boolean addWorker(Runnable firstTask, boolean core) { retry: for (;;) { int c = ctl.get(); int rs = runStateOf(c); // 如果线程池状态大于SHUTDOWN或者线程池状态等于SHUTDOWN,firstTask不等于null // 或者线程池状态等于SHUTDOWN,任务队列等于空时,直接返回false结束。 if (rs >= SHUTDOWN && ! (rs == SHUTDOWN && firstTask == null && ! workQueue.isEmpty())) return false; for (;;) { int wc = workerCountOf(c); // 如果线程数量大于等于最大数量或者大于等于上限 //(入参core传true,取核心线程数,否则取最大线程数),直接返回false结束。 if (wc >= CAPACITY || wc >= (core ? corePoolSize : maximumPoolSize)) return false // CAS操作给工作线程数加1,成功则跳到retry处,不再进入循环。 if (compareAndIncrementWorkerCount(c)) break retry; c = ctl.get(); // Re-read ctl // 如果线程池状态与刚进入时不一致,则跳到retry处,再次进入循环 if (runStateOf(c) != rs) continue retry; // else CAS failed due to workerCount change; retry inner loop } } boolean workerStarted = false; boolean workerAdded = false; Worker w = null; try { // 新建一个线程 w = new Worker(firstTask); final Thread t = w.thread; if (t != null) { final ReentrantLock mainLock = this.mainLock; mainLock.lock(); try { int rs = runStateOf(ctl.get()); // 如果线程池状态在SHUTDOWN之前或者 // 线程池状态等于SHUTDOWN并且firstTask等于null时,进入处理。 if (rs < SHUTDOWN || (rs == SHUTDOWN && firstTask == null)) { // 如果要执行的线程正在运行,则抛异常 if (t.isAlive()) // precheck that t is startable throw new IllegalThreadStateException(); workers.add(w); int s = workers.size(); if (s > largestPoolSize) largestPoolSize = s; workerAdded = true; } } finally { mainLock.unlock(); } if (workerAdded) { // 启动线程 t.start(); workerStarted = true; } } } finally { // 如果线程添加失败,则将新增的对应信息删除 if (! workerStarted) addWorkerFailed(w); } return workerStarted; } 1.3 任务执行run方法 在上述addWorker中,当调用线程的start方法启动线程后,会执行其中的run方法。 public void run() { runWorker(this); } final void runWorker(Worker w) { Thread wt = Thread.currentThread(); Runnable task = w.firstTask; w.firstTask = null; w.unlock(); // allow interrupts boolean completedAbruptly = true; try { // 如果任务不为空或者新获取到的任务不为空 while (task != null || (task = getTask()) != null) { w.lock(); // 当线程池状态,大于等于 STOP 时,保证工作线程都有中断标志。 // 当线程池状态,小于STOP时,保证工作线程都没有中断标志。 if ((runStateAtLeast(ctl.get(), STOP) || (Thread.interrupted() && runStateAtLeast(ctl.get(), STOP))) && !wt.isInterrupted()) wt.interrupt(); try { beforeExecute(wt, task); Throwable thrown = null; try { // 执行任务 task.run(); } catch (RuntimeException x) { thrown = x; throw x; } catch (Error x) { thrown = x; throw x; } catch (Throwable x) { thrown = x; throw new Error(x); } finally { afterExecute(task, thrown); } } finally { task = null; w.completedTasks++; w.unlock(); } } completedAbruptly = false; } finally { processWorkerExit(w, completedAbruptly); } } 2 整体处理过程 通过上述源码分析,我们可以得出线程池处理任务的过程如下: 3 总结 本文从源码层面主要分析了线程池的创建、运行过程,通过上述的分析,可以看出当线程池中的线程数量超过核心线程数后,会先将任务放入等待队列,队列放满后当最大线程数大于核心线程数时,才会创建新的线程执行。 作者:京东物流 管碧强 来源:京东云开发者社区 自猿其说Tech 转载请注明来源

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

用户登录
用户注册