首页 文章 精选 留言 我的

精选列表

搜索[团队协作工具],共10000篇文章
优秀的个人博客,低调大师

ThreadPoolExecutor线程池内部处理浅析 | 京东物流技术团队

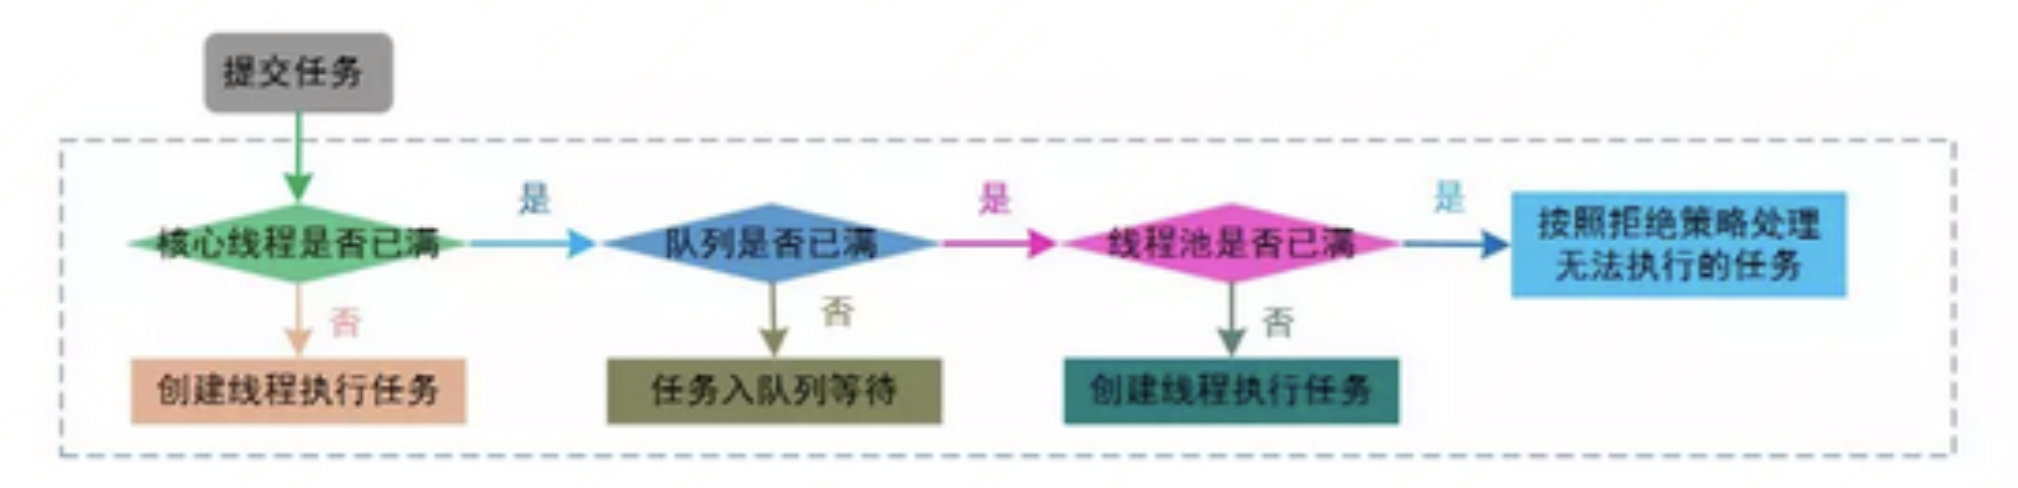
我们知道如果程序中并发的线程数量很多,并且每个线程都是执行一个时间很短的任务就结束时,会因为频繁创建线程而大大降低系统的效率,因此出现了线程池的使用方式,它可以提前创建好线程来执行任务。本文主要通过java的ThreadPoolExecutor来查看线程池的内部处理过程。 1 ThreadPoolExecutor java.uitl.concurrent.ThreadPoolExecutor类是线程池中最核心的一个类,下面我们来看一下ThreadPoolExecutor类的部分实现源码。 1.1 构造方法 ThreadPoolExecutor类提供了如下4个构造方法 // 设置线程池时指定核心线程数、最大线程数、线程存活时间及等待队列。 // 线程创建工厂和拒绝策略使用默认的(AbortPolicy) public ThreadPoolExecutor(int corePoolSize, int maximumPoolSize, long keepAliveTime, TimeUnit unit, BlockingQueue<Runnable> workQueue) { this(corePoolSize, maximumPoolSize, keepAliveTime, unit, workQueue, Executors.defaultThreadFactory(), defaultHandler); } // 设置线程池时指定核心线程数、最大线程数、线程存活时间、等待队列及线程创建工厂 // 拒绝策略使用默认的(AbortPolicy) public ThreadPoolExecutor(int corePoolSize, int maximumPoolSize, long keepAliveTime, TimeUnit unit, BlockingQueue<Runnable> workQueue, ThreadFactory threadFactory) { this(corePoolSize, maximumPoolSize, keepAliveTime, unit, workQueue, threadFactory, defaultHandler); } // 设置线程池时指定核心线程数、最大线程数、线程存活时间、等待队列及拒绝策略 // 线程创建工厂使用默认的 public ThreadPoolExecutor(int corePoolSize, int maximumPoolSize, long keepAliveTime, TimeUnit unit, BlockingQueue<Runnable> workQueue, RejectedExecutionHandler handler) { this(corePoolSize, maximumPoolSize, keepAliveTime, unit, workQueue, Executors.defaultThreadFactory(), handler); } // 设置线程池时指定核心线程数、最大线程数、线程存活时间、等待队列、线程创建工厂及拒绝策略 public ThreadPoolExecutor(int corePoolSize, int maximumPoolSize, long keepAliveTime, TimeUnit unit, BlockingQueue<Runnable> workQueue, ThreadFactory threadFactory, RejectedExecutionHandler handler) { if (corePoolSize < 0 || maximumPoolSize <= 0 || maximumPoolSize < corePoolSize || keepAliveTime < 0) throw new IllegalArgumentException(); if (workQueue == null || threadFactory == null || handler == null) throw new NullPointerException(); this.acc = System.getSecurityManager() == null ? null : AccessController.getContext(); this.corePoolSize = corePoolSize; this.maximumPoolSize = maximumPoolSize; this.workQueue = workQueue; this.keepAliveTime = unit.toNanos(keepAliveTime); this.threadFactory = threadFactory; this.handler = handler; } 通过观察上述每个构造器的源码实现,我们可以发现前面三个构造器都是调用的第四个构造器进行的初始化工作。 下面解释一下构造器中各个参数的含义: corePoolSize:核心池的线程个数上线,在创建了线程池后,默认情况下,线程池中并没有任何线程,而是等待有任务到来才创建线程去执行任务。默认情况下,在创建了线程池后,线程池中的线程数为0,当有任务来之后,就会创建一个线程去执行任务,当线程池中的线程数目达到corePoolSize后,就会把到达的任务放到缓存队列当中。 maximumPoolSize:线程池最大线程数,这个参数也是一个非常重要的参数,它表示在线程池中最多能创建多少个线程。 keepAliveTime:表示线程没有任务执行时最多保持多久时间会终止。默认情况下,只有当线程池中的线程数大于corePoolSize时,keepAliveTime才会起作用,直到线程池中的线程数不大于corePoolSize,即当线程池中的线程数大于corePoolSize时,如果一个线程空闲的时间达到keepAliveTime,则会终止,直到线程池中的线程数不超过corePoolSize。但是如果调用了allowCoreThreadTimeOut(boolean)方法,在线程池中的线程数不大于corePoolSize时,keepAliveTime参数也会起作用,直到线程池中的线程数为0。 unit:参数keepAliveTime的时间单位。 workQueue:一个阻塞队列,用来存储等待执行的任务,这个参数的选择也很重要,会对线程池的运行过程产生重大影响; threadFactory:线程工厂,主要用来创建线程; handler:表示当拒绝处理任务时的策略。有以下四种取值:ThreadPoolExecutor.AbortPolicy:丢弃任务并抛出RejectedExecutionException异常。 ThreadPoolExecutor.DiscardPolicy:也是丢弃任务,但是不抛出异常。 ThreadPoolExecutor.DiscardOldestPolicy:丢弃队列最前面的任务,然后重新尝试执行任务(重复此过程)ThreadPoolExecutor.CallerRunsPolicy:由调用线程处理该任务。 1.2 核心方法 在ThreadPoolExecutor类中,最核心的任务提交方法是execute()方法,虽然通过submit也可以提交任务,但是实际上submit方法里面最终调用的还是execute()方法。 public void execute(Runnable command) { // 判断提交的任务command是否为null,若是null,则抛出空指针异常; if (command == null) throw new NullPointerException(); // 获取线程池中当前线程数 int c = ctl.get(); // 如果线程池中当前线程数小于核心池大小,进入if语句块 if (workerCountOf(c) < corePoolSize) { // 如果以给定的命令启动一个核心线程执行任务成功,直接返回 if (addWorker(command, true)) return; c = ctl.get(); } // 如果当前线程池处于RUNNING状态,则将任务放入任务缓存队列 if (isRunning(c) && workQueue.offer(command)) { int recheck = ctl.get(); // 如果线程池不处于运行状态并且移除刚加入的任务成功则执行拒绝策略 if (! isRunning(recheck) && remove(command)) reject(command); // 如果当前线程数为0,则在线程池里增加一个线程,保证队列里的任务不会没有线程执行 else if (workerCountOf(recheck) == 0) addWorker(null, false); } // 尝试启动核心线程之外的线程,如果不满足,则执行对应的拒绝策略 else if (!addWorker(command, false)) reject(command); } 主要方法addWorker。 private boolean addWorker(Runnable firstTask, boolean core) { retry: for (;;) { int c = ctl.get(); int rs = runStateOf(c); // 如果线程池状态大于SHUTDOWN或者线程池状态等于SHUTDOWN,firstTask不等于null // 或者线程池状态等于SHUTDOWN,任务队列等于空时,直接返回false结束。 if (rs >= SHUTDOWN && ! (rs == SHUTDOWN && firstTask == null && ! workQueue.isEmpty())) return false; for (;;) { int wc = workerCountOf(c); // 如果线程数量大于等于最大数量或者大于等于上限 //(入参core传true,取核心线程数,否则取最大线程数),直接返回false结束。 if (wc >= CAPACITY || wc >= (core ? corePoolSize : maximumPoolSize)) return false // CAS操作给工作线程数加1,成功则跳到retry处,不再进入循环。 if (compareAndIncrementWorkerCount(c)) break retry; c = ctl.get(); // Re-read ctl // 如果线程池状态与刚进入时不一致,则跳到retry处,再次进入循环 if (runStateOf(c) != rs) continue retry; // else CAS failed due to workerCount change; retry inner loop } } boolean workerStarted = false; boolean workerAdded = false; Worker w = null; try { // 新建一个线程 w = new Worker(firstTask); final Thread t = w.thread; if (t != null) { final ReentrantLock mainLock = this.mainLock; mainLock.lock(); try { int rs = runStateOf(ctl.get()); // 如果线程池状态在SHUTDOWN之前或者 // 线程池状态等于SHUTDOWN并且firstTask等于null时,进入处理。 if (rs < SHUTDOWN || (rs == SHUTDOWN && firstTask == null)) { // 如果要执行的线程正在运行,则抛异常 if (t.isAlive()) // precheck that t is startable throw new IllegalThreadStateException(); workers.add(w); int s = workers.size(); if (s > largestPoolSize) largestPoolSize = s; workerAdded = true; } } finally { mainLock.unlock(); } if (workerAdded) { // 启动线程 t.start(); workerStarted = true; } } } finally { // 如果线程添加失败,则将新增的对应信息删除 if (! workerStarted) addWorkerFailed(w); } return workerStarted; } 1.3 任务执行run方法 在上述addWorker中,当调用线程的start方法启动线程后,会执行其中的run方法。 public void run() { runWorker(this); } final void runWorker(Worker w) { Thread wt = Thread.currentThread(); Runnable task = w.firstTask; w.firstTask = null; w.unlock(); // allow interrupts boolean completedAbruptly = true; try { // 如果任务不为空或者新获取到的任务不为空 while (task != null || (task = getTask()) != null) { w.lock(); // 当线程池状态,大于等于 STOP 时,保证工作线程都有中断标志。 // 当线程池状态,小于STOP时,保证工作线程都没有中断标志。 if ((runStateAtLeast(ctl.get(), STOP) || (Thread.interrupted() && runStateAtLeast(ctl.get(), STOP))) && !wt.isInterrupted()) wt.interrupt(); try { beforeExecute(wt, task); Throwable thrown = null; try { // 执行任务 task.run(); } catch (RuntimeException x) { thrown = x; throw x; } catch (Error x) { thrown = x; throw x; } catch (Throwable x) { thrown = x; throw new Error(x); } finally { afterExecute(task, thrown); } } finally { task = null; w.completedTasks++; w.unlock(); } } completedAbruptly = false; } finally { processWorkerExit(w, completedAbruptly); } } 2 整体处理过程 通过上述源码分析,我们可以得出线程池处理任务的过程如下: 3 总结 本文从源码层面主要分析了线程池的创建、运行过程,通过上述的分析,可以看出当线程池中的线程数量超过核心线程数后,会先将任务放入等待队列,队列放满后当最大线程数大于核心线程数时,才会创建新的线程执行。 作者:京东物流 管碧强 来源:京东云开发者社区 自猿其说Tech 转载请注明来源
优秀的个人博客,低调大师

Promise规范与原理解析 | 京东物流技术团队

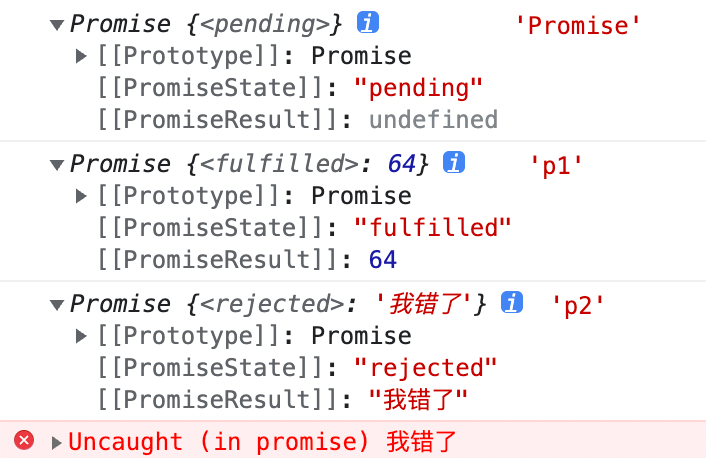
摘要 Promise对象用于清晰的处理异步任务的完成,返回最终的结果值,本次分享主要介绍Promise的基本属性以及Promise内部的基础实现,能够帮我们更明确使用场景、更快速定位问题。 Promise出现的原因 首先我们先来看一段代码:异步请求的层层嵌套 function fn1(params) { const xmlHttp = new XMLHttpRequest(); xmlHttp.onreadystatechange = function(){ if (xmlHttp.readyState === 4 && xmlHttp.status === 200) { const fn1Data = {name: 'fn1'} console.log(fn1Data, 'fn1Data'); // 请求2 (function fn2() { xmlHttp.onreadystatechange = function(){ if (xmlHttp.readyState === 4 && xmlHttp.status === 200) { const fn2Data = {name: `${fn1Data.name}-fn2`} console.log(fn2Data, 'fn2Data'); // 请求3 (function fn2() { xmlHttp.onreadystatechange = function(){ if (xmlHttp.readyState === 4 && xmlHttp.status === 200) { const fn3Data = {name: `${fn2Data.name}-fn3`} console.log(fn3Data, 'fn3Data'); } } xmlHttp.open("GET","https://v0.yiketianqi.com/api?unescape=1&version=v61", true); xmlHttp.send(); })() } } xmlHttp.open("GET","https://v0.yiketianqi.com/api?unescape=1&version=v61", true); xmlHttp.send(); })() } } xmlHttp.open("GET","https://v0.yiketianqi.com/api?unescape=1&version=v61", true); xmlHttp.send(); } fn1() 或者我们可以将上面的代码优化为下面这样 function fn1(params) { console.log(`我是fn1,我在函数${params}中执行!!!`); } function fn2(params) { try { const xmlHttp = new XMLHttpRequest(); xmlHttp.onreadystatechange = function(){ if (xmlHttp.readyState === 4 && xmlHttp.status === 200) { console.log(`我是fn2,我在函数${params}中执行!!!结果是:`,params.data); fn1('fn2') } } xmlHttp.open("GET","https://v0.yiketianqi.com/api?unescape=1&version=v61", true); xmlHttp.send(); } catch (error) { console.error(error); } } function fn3() { try { const xmlHttp = new XMLHttpRequest(); xmlHttp.onreadystatechange = function(){ if (xmlHttp.readyState === 4 && xmlHttp.status === 200) { console.log('fn3请求已完成'); fn2('fn3') } } xmlHttp.open("GET","https://v0.yiketianqi.com/api?unescape=1&version=v61", true); xmlHttp.send(); console.log('我是f3函数呀'); } catch (error) { console.error(error); } } fn3() 由上面的两种写法的请求可见,在promise之前,为了进行多个异步请求并且依赖上一个异步请求的结果时,我们必须进行层层嵌套,大多数情况下,我们又对异步结果进行数据处理,这样使得我们的代码非常难看,并且难以维护,这就形成了回调地狱,由此Promise开始出现了。 回调地狱缺点 代码臃肿 可读性差 耦合性高 不好进行异常处理 Promise的基本概念 含义 ES6将其写进了语言标准里统一了用法,是一个构造函数,用来生成Promise实例 参数为一个执行器函数(执行器函数是立即执行的),该函数有两个函数作为参数,第一个参数是成功时的回调,第二个参数是失败时的回调 函数的方法有resolve(可以处理成功和失败)、reject(只处理失败)、all等方法 then、catch、finally方法为Promise实例上的方法 状态 pending --- 等待状态 Fulfilled --- 执行状态 (resolve回调函数,then) Rejected --- 拒绝状态 (reject回调函数,catch) 状态一旦改变就不会再变,状态只可能是两种改变,从pending->Fulfilled,pending->Rejected 有两个关键的属性:PromiseState --- 状态改变,PromiseResult --- 结果数据改变 const p1 = Promise.resolve(64) const p2 = Promise.reject('我错了') const p3 = Promise.then() const p4 = Promise.catch() // 状态改变PromiseState 结果改变PromiseResult console.log(new Promise(()=>{}), 'Promise'); // PromiseState='pending' PromiseResult=undefined console.log(p1,'p1'); // PromiseState='Fulfilled' PromiseResult=64 console.log(p2,'p2'); // PromiseState="Rejected" PromiseResult='我错了' console.log(p3, 'p3'); // then为实例上的方法,报错 console.log(p4, 'p4'); // catch为实例上的方法,报错  特点 1. 错误信息清晰定位:可以在外层捕获异常信息(网络错误、语法错误都可以捕获),有“冒泡”性质,会一直向后传递,直到被捕获,所以在最后写一个catch就可以了 2. 链式调用:每一个then和catch都会返回一个新的Promise,把结果传递到下一个then/catch中,因此可以进行链式调用 --- 代码简洁清晰 结果由什么决定 resolve 如果传递的参数是非Promise类型的对象,则返回的结果是成功状态的Promise对象,进入下一个then里面 如果传递的参数是Promise类型的对象,则返回的结果由返回的Promise决定,如果返回的是resolve则是成功的状态,进入下一个then里,如果返回的是reject则是失败的状态,进入下一个catch里 reject 如果传递的参数是非Promise类型的对象,则返回的结果是拒绝状态的Promise对象,进入下一个catch里面或者是下一个then的第二个参数reject回调里面 如果传递的参数是Promise类型的对象,则返回的结果由返回的Promise决定,如果返回的是resolve则是成功的状态,进入下一个then里,如果返回的是reject则是拒绝的状态,进入下一个catch里面或者是下一个then的第二个参数reject回调里面 这在我们自己封装的API里面也有体现:为什么code为1时都是then接收,其他都是catch接收,就是因为在then里面也就是resolve函数中对code码进行了判断,如果是1则返回Promise.resolve(),进入then里处理,如果是非1则返回Promise.reject(),进入catch里处理。 流程图  简单使用 // 模拟一个promise的get请求 let count = 0 function customGet(url){ count += 1 return new Promise((resolve, reject)=>{ const xmlHttp = new XMLHttpRequest(); xmlHttp.open("GET",url, true); xmlHttp.onload = ()=>{ console.log(xmlHttp, 'xmlHttp---onload'); if (xmlHttp.readyState === 4 && xmlHttp.status === 200) { console.log('customGet请求成功了'); // 返回非Promise,结果为成功状态 resolve({data:`第${count}次请求获取数据成功`}) // 返回Promise,结果由Promise决定 // resolve(Promise.reject('resolve中返回reject')) } else { reject('customGet请求错误了') } } // Promise状态改变就不会再变 // onreadystatechange方法会被执行四次 // 当地次进来的时候,readyState不等于4,执行else逻辑,执行reject,状态变为Rejected,所以即使再执行if,状态之后不会再改变 // xmlHttp.onreadystatechange = function(){ // console.log(xmlHttp,'xmlHttp---onreadystatechange') // if (xmlHttp.readyState === 4 && xmlHttp.status === 200) { // console.log('customGet请求成功了'); // resolve({data:`第${count}次请求获取数据成功`}) // } else { // reject('customGet请求错误了') // } // } xmlHttp.send(); }) } // 使用Promise,并且进行链式调用 customGet('https://v0.yiketianqi.com/api/cityall?appid=&appsecret=').then((res)=>{ console.log(res.data); return '第一次请求处理后的数据' }).then((data)=>{ console.log(data) // console.log(data.toFixed()); return customGet('https://v0.yiketianqi.com/api/cityall?appid=&appsecret=') }).then((res)=>{ console.log(res.data); }).catch((err)=>{ // 以类似'冒泡'的性质再外层捕获所有的错误 console.error(err, '这是catch里的错误信息'); }) 手写实现简单的Promise 通过上面的回顾,我们已经了解了Promise的关键属性和特点,下面我们一起来实现一个简单的Promise吧 // 1、封装一个Promise构造函数,有一个函数参数 function Promise(executor){ // 7、添加对象属性PromiseState PromiseResult this.PromiseState = 'pending' this.PromiseResult = null // 14、创建一个保存成功失败回调函数的属性 this.callback = null // 8、this指向问题 const that = this // 4、executor有两个函数参数(resolve,reject) function resolve(data){ // 10、Promise状态只能修改一次(同时记得处理reject中的状态) if(that.PromiseState !== 'pending') return // console.log(this, 'this'); // 5、修改对象的状态PromiseState that.PromiseState = 'Fulfilled' // 6、修改对象的结果PromiseResult that.PromiseResult = data // 15、异步执行then里的回调函数 if(that.callback?.onResolve){ that.callback.onResolve(that.PromiseResult) } } function reject(data){ console.log(that.PromiseState, 'that.PromiseState'); if(that.PromiseState !== 'pending') return // 9、处理失败函数状态 that.PromiseState = 'Rejected' that.PromiseResult = data console.log(that.PromiseResult, 'that.PromiseResult'); console.log(that.PromiseState, 'that.PromiseState'); // 16、异步执行then里的回调函数 if(that.callback?.onReject){ that.callback.onReject(that.PromiseResult) } } // 3、执行器函数是同步调用的,并且有两个函数参数 executor(resolve,reject) } // 2、函数的实例上有方法then Promise.prototype.then = function(onResolve,onReject){ // 20、处理onReject没有的情况 if(typeof onReject !== 'function'){ onReject = reason => { throw reason } } // 21、处理onResolve没有的情况 if(typeof onResolve !== 'function'){ onResolve = value => value } // 17、每一个then方法都返回一个新的Promise,并且把上一个then返回的结果传递出去 return new Promise((nextResolve,nextReject)=>{ // 11、处理成功或失败 if(this.PromiseState === 'Fulfilled'){ // 12、将结果传递给函数 // onResolve(this.PromiseResult) // 18、拿到上一次执行完后返回的结果,判断是不是Promise const result = onResolve(this.PromiseResult) if(result instanceof Promise){ result.then((v)=>{ nextResolve(v) },(r)=>{ nextReject(r) }) } else { nextResolve(result) } } // 当你一步步写下来的时候有没有怀疑过为什么不用else if(this.PromiseState === 'Rejected'){ // 第12步同时处理此逻辑 // onReject(this.PromiseResult) // 22、处理catch异常穿透捕获错误 try { const result = onReject(this.PromiseResult) if(result instanceof Promise){ result.then((v)=>{ nextResolve(v) }).catch((r)=>{ nextReject(r) }) } else { nextReject(result) } } catch (error) { nextReject(this.PromiseResult) } } // 13、异步任务时处理成功或失败,想办法等异步任务执行完成后才去执行这两个函数 if(this.PromiseState === 'pending'){ this.callback = { onResolve, onReject } console.log(this.callback, 'this.callback'); } }) } // 19、函数实例上有方法catch Promise.prototype.catch = function(onReject) { return this.then(null,onReject) } // 使用自定义封装的Promise const customP = new Promise((resolve,reject)=>{ // 模拟异步执行请求 // const xmlHttp = new XMLHttpRequest(); // xmlHttp.open("GET",'https://v0.yiketianqi.com/api/cityall?appid=&appsecret=', true); // xmlHttp.onload = ()=>{ // if (xmlHttp.readyState === 4 && xmlHttp.status === 200) { // resolve('success') // } else { // reject('error') // } // } // xmlHttp.send(); // 同步执行 resolve('success') // reject('error') }) console.log(customP, 'customP'); customP.then((res)=>{ console.log(res, 'resolve回调'); return '第一次回调' // return new Promise((resolve,reject)=>{ // reject('错错错') // }) },(err)=>{ console.error(err, 'reject回调'); return '2121' }).then(()=>{ console.log('then里面输出'); }).then().catch((err)=>{ console.error(err, 'catch里的错误'); }) 针对resolve中返回Promise对象时的内部执行顺序  总结 以上就是我们常用的Promise基础实现,在实现过程中对比了Promise和函数嵌套处理异步请求的优缺点,Promise仍存在缺点,但是的确方便很多,同时更清晰的理解到错误处理如何进行异常穿透的,也能帮助我们更规范的使用Promise以及快速定位问题所在。 作者:京东物流孙琦 来源:京东云开发者社区 自猿其说Tech 转载请注明来源
优秀的个人博客,低调大师

关注潜在的整数越界问题 | 京东物流技术团队

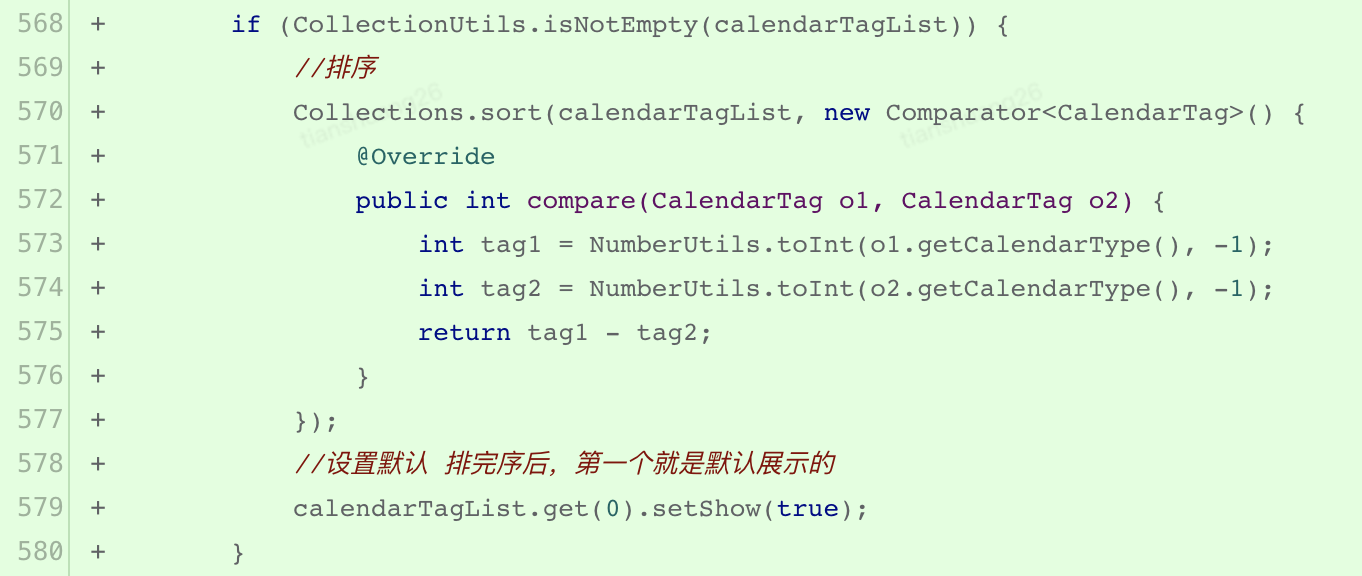
在平时的开发过程中,整数越界是一个容易被忽视的问题,关注潜在的整数越界问题可使我们编写的代码更加健壮,规避因整数越界导致的 bug。 比较器 以下是在 Code Review 中发现的比较器实现:  乍一看该比较器实现不存在问题,但是如果 tag1 = Integer.MIN_VALUE = -2147483648, tag2 为大于 0 的数字如 1,则此时 tag1 - tag2 = 2147483647,但是按照 java.util.Comparator#compare 的定义,tag1 小于 tag2 时,应该返回一个负数,以上写法在遇到这样的示例数据时将导致排序结果错乱,引发相关 bug。 下面看看 Spring 中比较器的实现,在 Spring 中,提供了 @Order 注解用于指定 bean 的顺序,默认值为 Ordered.LOWEST_PRECEDENCE = Integer.MAX_VALUE,即在排序时排在最后,相关源码如下:  对应的比较器实现如下: 可知其采用的 Integer.compare 方法对两个整数进行比较操作,查看 Integer#compare 方法的源码: /** * Compares two {@code int} values numerically. * The value returned is identical to what would be returned by: * <pre> * Integer.valueOf(x).compareTo(Integer.valueOf(y)) * </pre> * * @param x the first {@code int} to compare * @param y the second {@code int} to compare * @return the value {@code 0} if {@code x == y}; * a value less than {@code 0} if {@code x < y}; and * a value greater than {@code 0} if {@code x > y} * @since 1.7 */ public static int compare(int x, int y) { return (x < y) ? -1 : ((x == y) ? 0 : 1); } 可知 java.lang.Integer#compare 并未采取 x - y 的方式进行比较,而是使用小于及等于运算符直接进行比较,规避了潜在的整数越界问题。 那么文首代码正确的实现方式应为 return Integer.compare(tag1, tag2)。如果查看 JDK 中常见数值类的源码,可知均提供了静态的 compare 方法,如:java.lang.Long#compare,java.lang.Double#compare,此处不再赘述。 切量比例 以上代码是某段业务逻辑中初始切量比例实现,取余 100 的模式常用于按比例切量、按比例降级等业务场景。以上代码使用 userPin 的哈希值取余 100 判断是否小于切量比例以决定是否执行新业务逻辑,如果我们查看 java.lang.String#hashCode 的源码实现: /** * Returns a hash code for this string. The hash code for a * {@code String} object is computed as * <blockquote><pre> * s[0]*31^(n-1) + s[1]*31^(n-2) + ... + s[n-1] * </pre></blockquote> * using {@code int} arithmetic, where {@code s[i]} is the * <i>i</i>th character of the string, {@code n} is the length of * the string, and {@code ^} indicates exponentiation. * (The hash value of the empty string is zero.) * * @return a hash code value for this object. */ public int hashCode() { int h = hash; if (h == 0 && value.length > 0) { char val[] = value; for (int i = 0; i < value.length; i++) { h = 31 * h + val[i]; } hash = h; } return h; } 可知 java.lang.String#hashCode 本质上是对字符串进行 s[0]*31^(n-1) + s[1]*31^(n-2) + ... + s[n-1] 多项式求值,此处潜在的风险在于计算出的 hash 值可能越界,导致 userPin.hashCode() 返回值为负数,如:"jd_xxxxxxxxxxxx".hashCode() = -1406647067,且在 Java 语言中,使用负数对正数取余,是可能得到负数的。以上代码的风险在于潜在的放大了期望的切量比例,如使用以上的代码进行上线,那么当我们设定 1% 的切量比例时,会导致远超 1%的用户执行新的业务逻辑(通过采样日志发现用户 pin 集合 hashCode 值负数占比并不低),导致非预期的切量结果。 基于以上的背景,容易想到的一种修复方案为在 userPin.hashCode 外层使用 Math.abs 保证取余前的数字为正数: 以上修复方案看似不再存在问题,但是并不能保证完全正确,我们查看 Math.abs 的源码实现: /** * Returns the absolute value of an {@code int} value. * If the argument is not negative, the argument is returned. * If the argument is negative, the negation of the argument is returned. * * <p>Note that if the argument is equal to the value of * {@link Integer#MIN_VALUE}, the most negative representable * {@code int} value, the result is that same value, which is * negative. * * @param a the argument whose absolute value is to be determined * @return the absolute value of the argument. */ public static int abs(int a) { return (a < 0) ? -a : a; } 可知在注释中特意提到,如果入参是 Integer.MIN_VALUE,即 int 域中最小的值时,返回值依然为 Integer.MIN_VALUE,因为 int 域的范围为 [-2147483648, 2147483647]。如果按照 JLS 中的解释,-x equals (~x)+1。那么可知: x = Integer.MIN_VALUE: 10000000_00000000_00000000_00000000 ~x: 01111111_11111111_11111111_11111111 (~x) + 1: 10000000_00000000_00000000_00000000 如果在神灯上搜索 Math.abs,可以发现有三篇文章与该函数有关,均与 Math.abs(Integer.MIN_VALUE) 依然为 Integer.MIN_VALUE 有关。而我们在 Code Review 阶段发现该问题即从根本上规避了该问题,不会使存在 bug 的代码上线。最后切量比例修改后的实现如下:  总结 java.lang.String#hashCode 在计算过程中可能因为整数越界导致返回值为负数 Java 语言中的 % 是取余而不是取模,如:(-21) % 4 = (-21) - (-21) / 4 *4 = -1 Math.abs(int a) 当入参是 Integer.MIN_VALUE 时返回值依然是负数 Integer.MIN_VALUE 参考 15.15.4. Unary Minus Operator - What's the difference between “mod” and “remainder”? - Stack Overflow Best way to make Java's modulus behave like it should with negative numbers? - Stack Overflow OrderComparator.java · spring-projects/spring-framework 作者:京东物流刘建设 张九龙 田爽 来源:京东云开发者社区 自猿其说Tech 转载请注明来源
优秀的个人博客,低调大师

SpringBoot 项目优雅实现读写分离 | 京东云技术团队

一、读写分离介绍 当使用Spring Boot开发数据库应用时,读写分离是一种常见的优化策略。读写分离将读操作和写操作分别分配给不同的数据库实例,以提高系统的吞吐量和性能。 读写分离实现主要是通过动态数据源功能实现的,动态数据源是一种通过在运行时动态切换数据库连接的机制。它允许应用程序根据不同的条件或配置选择不同的数据源,以实现更灵活和可扩展的数据库访问。 二、实现读写分离-基础 1. 配置主数据库和从数据库的连接信息 # 主库配置 spring.datasource.master.jdbc-url=jdbc:mysql://ip:port/master?useUnicode=true&characterEncoding=UTF-8&serverTimezone=Asia/Shanghai&useSSL=false spring.datasource.master.username=master spring.datasource.master.password=123456 spring.datasource.master.driver-class-name=com.mysql.jdbc.Driver # 从库配置 spring.datasource.slave.jdbc-url=jdbc:mysql://ip:port/slave?useUnicode=true&characterEncoding=UTF-8&serverTimezone=Asia/Shanghai&useSSL=false spring.datasource.slave.username=slave spring.datasource.slave.password=123456 spring.datasource.slave.driver-class-name=com.mysql.jdbc.Driver 2. 创建主数据库和从数据库的数据源配置类 通过不同的条件限制和配置文件前缀可以完成不同数据源的创建工作,不止是主从也可以是多个不同的数据库 主库数据源配置 @Configuration @ConditionalOnProperty("spring.datasource.master.jdbc-url") public class MasterDataSourceConfiguration { @Bean("masterDataSource") @ConfigurationProperties(prefix = "spring.datasource.master") public DataSource masterDataSource() { return DataSourceBuilder.create().build(); } } 从库数据源配置 @Configuration @ConditionalOnProperty("spring.datasource.slave.jdbc-url") public class SlaveDataSourceConfiguration { @Bean("slaveDataSource") @ConfigurationProperties(prefix = "spring.datasource.slave") public DataSource slaveDataSource() { return DataSourceBuilder.create().build(); } } 3. 创建主从数据源枚举 public enum DataSourceTypeEnum { /** * 主库 */ MASTER, /** * 从库 */ SLAVE, ; } 4. 创建动态路由数据源 这儿做了一个开关,可以控制读写分离的开启和关闭工作,可以讲操作全部切换到主库进行。然后根据上下文中的数据源类型来返回不同的数据源类型枚举 @Slf4j public class DynamicRoutingDataSource extends AbstractRoutingDataSource { @Value("${DB_RW_SEPARATE_SWITCH:false}") private boolean dbRwSeparateSwitch; @Override protected Object determineCurrentLookupKey() { if(dbRwSeparateSwitch && DataSourceTypeEnum.SLAVE.equals(DataSourceContextHolder.getDataSourceType())) { log.info("DynamicRoutingDataSource 切换数据源到从库"); return DataSourceTypeEnum.SLAVE; } log.info("DynamicRoutingDataSource 切换数据源到主库"); // 根据需要指定当前使用的数据源,这里可以使用ThreadLocal或其他方式来决定使用主库还是从库 return DataSourceTypeEnum.MASTER; } } 5. 创建动态数据源配置类 将主数据库和从数据库的数据源添加到动态数据源中,并可以通过枚举创建一个数据源 map,这样就可以通过上面的路由返回的枚举来切换数据源 @Configuration @ConditionalOnProperty("spring.datasource.master.jdbc-url") public class DynamicDataSourceConfiguration { @Bean("dataSource") @Primary public DataSource dynamicDataSource(DataSource masterDataSource, DataSource slaveDataSource) { Map<Object, Object> targetDataSources = new HashMap<>(); targetDataSources.put(DataSourceTypeEnum.MASTER, masterDataSource); targetDataSources.put(DataSourceTypeEnum.SLAVE, slaveDataSource); DynamicRoutingDataSource dynamicDataSource = new DynamicRoutingDataSource(); dynamicDataSource.setTargetDataSources(targetDataSources); dynamicDataSource.setDefaultTargetDataSource(masterDataSource); return dynamicDataSource; } } 6. 创建DatasourceContextHolder类使用ThreadLocal存储当前线程的数据源类型 注意这儿有个潜在风险就是创建新的线程时会导致 ThreadLocal 中的数据无法正确读取,如果涉及到在开启新线程可以使用 TransmittableThreadLocal 来进行父子线程数据的同步,git 地址: https://github.com/alibaba/transmittable-thread-local public class DataSourceContextHolder { private static final ThreadLocal<DataSourceTypeEnum> contextHolder = new ThreadLocal<>(); public static void setDataSourceType(DataSourceTypeEnum dataSourceType) { contextHolder.set(dataSourceType); } public static DataSourceTypeEnum getDataSourceType() { return contextHolder.get(); } public static void clearDataSourceType() { contextHolder.remove(); } } 7. 创建自定义注解,用于标记主和从数据源 @Retention(RetentionPolicy.RUNTIME) @Target(ElementType.METHOD) public @interface MasterDataSource { } @Retention(RetentionPolicy.RUNTIME) @Target(ElementType.METHOD) public @interface SlaveDataSource { } 8. 创建切面类,拦截数据库操作,并根据注解设置切换数据源参数 @Aspect @Component public class DataSourceAspect { @Before("@annotation(xxx.MasterDataSource)") public void setMasterDataSource(JoinPoint joinPoint) { DataSourceContextHolder.setDataSourceType(DataSourceTypeEnum.MASTER); } @Before("@annotation(xxx.SlaveDataSource)") public void setSlaveDataSource(JoinPoint joinPoint) { DataSourceContextHolder.setDataSourceType(DataSourceTypeEnum.SLAVE); } @After("@annotation(xxx.MasterDataSource) || @annotation(xxx.SlaveDataSource)") public void clearDataSource(JoinPoint joinPoint) { DataSourceContextHolder.clearDataSourceType(); } } 9. 在Service层的方法上使用自定义注解标记查询数据源 @Service public class TestService { @Autowired private TestDao testDao; @SlaveDataSource public Test test() { return testDao.queryByPrimaryKey(11L); } } 10. 排除掉数据源自动配置类 如果不排除自动配置类会导致初始化多个 dataSource 对象导致出现问题 SpringBootApplication(exclude = {DataSourceAutoConfiguration.class}) 三、实现读写分离-进阶 1. 使用链接池,以Hikari为例 修改链接配置,加入链接池相关配置即可 # 主库配置 spring.datasource.master.jdbc-url=jdbc:mysql://ip:port/master?useUnicode=true&characterEncoding=UTF-8&serverTimezone=Asia/Shanghai&useSSL=false spring.datasource.master.username=master spring.datasource.master.password=123456 spring.datasource.master.driver-class-name=com.mysql.jdbc.Driver spring.datasource.master.type=com.zaxxer.hikari.HikariDataSource spring.datasource.master.hikari.name=master spring.datasource.master.hikari.minimum-idle=5 spring.datasource.master.hikari.idle-timeout=30 spring.datasource.master.hikari.maximum-pool-size=10 spring.datasource.master.hikari.auto-commit=true spring.datasource.master.hikari.pool-name=DatebookHikariCP spring.datasource.master.hikari.max-lifetime=1800000 spring.datasource.master.hikari.connection-timeout=30000 spring.datasource.master.hikari.connection-test-query=SELECT 1 # 从库配置 spring.datasource.slave.jdbc-url=jdbc:mysql://ip:port/slave?useUnicode=true&characterEncoding=UTF-8&serverTimezone=Asia/Shanghai&useSSL=false spring.datasource.slave.username=root spring.datasource.slave.password=123456 spring.datasource.slave.driver-class-name=com.mysql.jdbc.Driver spring.datasource.slave.type=com.zaxxer.hikari.HikariDataSource spring.datasource.slave.hikari.name=master spring.datasource.slave.hikari.minimum-idle=5 spring.datasource.slave.hikari.idle-timeout=30 spring.datasource.slave.hikari.maximum-pool-size=10 spring.datasource.slave.hikari.auto-commit=true spring.datasource.slave.hikari.pool-name=DatebookHikariCP spring.datasource.slave.hikari.max-lifetime=1800000 spring.datasource.slave.hikari.connection-timeout=30000 spring.datasource.slave.hikari.connection-test-query=SELECT 1 2. 集成 mybatis 并在写入时强制切换到主库 不需要做任何配置,正常集成 mybatis 即可使用读写分离功能 可以通过 mybatis 的拦截器在写入操作时强制切换到主库 @Intercepts({ @Signature(type = Executor.class, method = "update", args = {MappedStatement.class, Object.class}), }) @Component public class WriteInterceptor implements Interceptor { @Override public Object intercept(Invocation invocation) throws Throwable { // 获取 SQL 类型 DataSourceTypeEnum dataSourceType = DataSourceContextHolder.getDataSourceType(); if(DataSourceTypeEnum.SLAVE.equals(dataSourceType)) { DataSourceContextHolder.setDataSourceType(DataSourceTypeEnum.MASTER); } try { // 执行 SQL return invocation.proceed(); } finally { // 恢复数据源 考虑到写入后可能会反查,后续都走主库 // DataSourceContextHolder.setDataSourceType(dataSourceType); } } }  作者:京东健康苏曼 来源:京东云开发者社区 转发请注明来源

优秀的个人博客,低调大师

设计模式-单例模式概述 | 京东云技术团队

我们常把23种经典的设计模式分为三类:创建型、结构型、行为型,其中创建型设计模式主要解决“对象的创建”问题,将创建和使用代码解耦,结构型设计模式主要解决“类或对象的组合或组装”问题,将不同功能代码解耦,行为型设计模式主要解决“类或对象之间的交互”问题,将不同的行为代码解耦。 原理 是一种创建型模式,一个类只允许创建一个实例对象,那这个类就是个单例类。 实现 ①构造函数私有化,避免外部通过new创建实例; ②考虑对象创建时的线程安全问题; ③考虑是否支持延迟加载; ④考虑getInstance()性能是否高(是否加锁) ⑤考虑序列化和反序列化是否会破坏单例 ⑥考虑反射攻击单例 饿汉式 饿汉式的实现方式,在类加载期间,就已经将instance静态实例初始化好了,所以instance实例的创建是线程安全的。不过这样的实现不支持延迟加载实例。 | 懒汉式相对于饿汉式的优势是支持延迟加载。这种实现方式会导致频繁加锁、释放锁,以及并发度低等问题,频繁的调用会产生性能瓶颈。 懒汉式 懒汉式相对于饿汉式的优势是支持延迟加载。这种实现方式会导致频繁加锁、释放锁,以及并发度低等问题,频繁的调用会产生性能瓶颈。 双重检测 双重检测实现方式既支持延迟加载、又支持高并发的单例实现方式。只要instance被创建之后,再调用getInstance()函数都不会进入到加锁逻辑中。所以这种方式解决了懒汉式并发度低的问题。(解决指令重排序,可以给instance成员变量加上volatile关键字) 静态内部类 利用 Java 的静态内部类来实现单例。这种实现方式,既支持延迟加载,也支持高并发,instance的唯一性,创建过程的线程安全性,都由JVM保证。实现起来比双重检测简单。 枚举 最简单的实现方式,基于枚举类型的单例实现。这种实现方式通过Java枚举类型本身的特性,保证了实例创建的线程安全性和实例的唯一性。还可解决序列化和反序列化生成新的实例。 应用场景 从业务概念上,有些数据在系统中应该保存一份,就比较适合设计为单例类。比如,系统的配置信息类,除此之外,还可以使用单例解决资源访问冲突的问题(分布式锁和并发队列亦可解决)。 存在问题 单例对OOP特性支持不友好; 单例会隐藏类之间的依赖关系; 单例对代码扩展性不友好; 单例对代码的可测试性不友好; 单例不支持有参数的构造函数。 替代方案 静态方法(不推荐)、工厂模式、Spring IOC容器 作者:京东零售 马宏伟 来源:京东云开发者社区 转载请注明来源

优秀的个人博客,低调大师

SpringBoot自动配置原理解析 | 京东物流技术团队

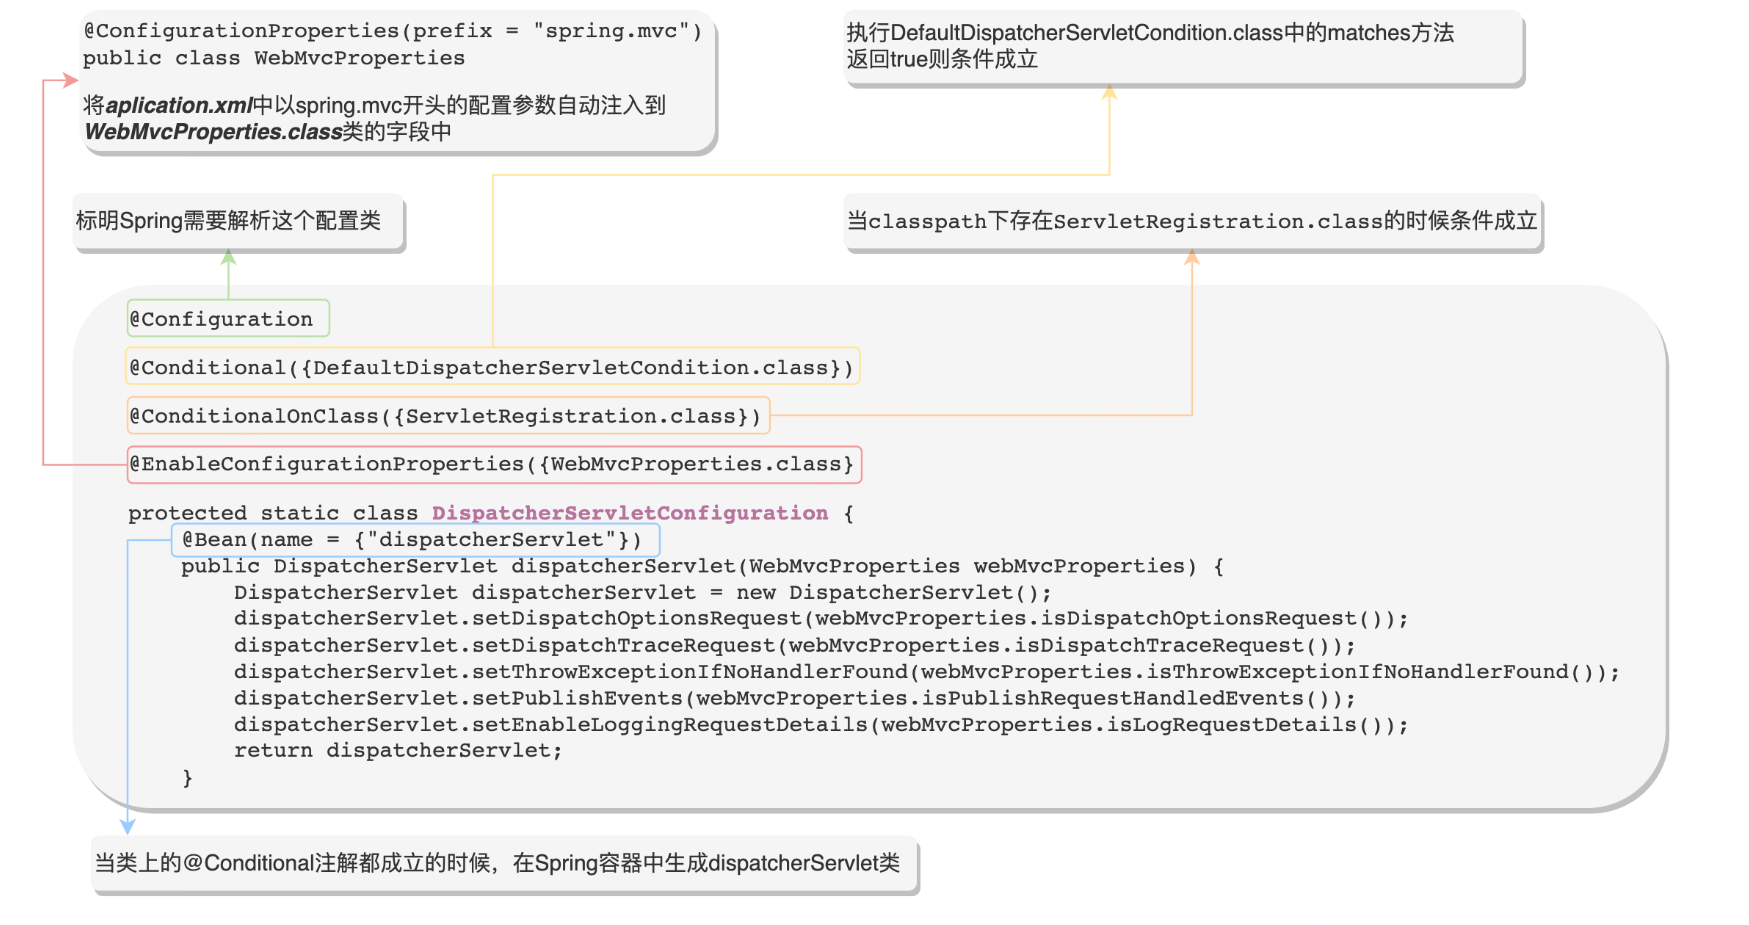
1: 什么是SpringBoot自动配置 首先介绍一下什么是SpringBoot,SpringBoost是基于Spring框架开发出来的功能更强大的Java程序开发框架,其最主要的特点是:能使程序开发者快速搭建一套开发环境。SpringBoot能将主流的开发框架(例如SpringMVC,Dubbo,Mybatis,Redis等),做到像Maven导入Jar包一样的简洁快速,做到开箱即用。其中最关键的技术就是SpringBoot定制的各种Starter,通Maven引入Starter就能快速搭建开发环境。 2: SpringBoot Starter自动装配案例 在以前单独使用SpringMVC Web编程框架时,我们需要单独配置DispatcherServlet和Tomcat,使用SpringBoot之后,我们只需要引入SpringBoot-Starter-Web就能直接开始编写Controller等Web相关的代码,这就是SpringBoot为们提供的开箱即用的便捷能力,下面就以SpringBoot-Starter-Web来说明SpringBoot自动配置的关键原理 3: SpringBoot自动装配案例源码解析 3.1 DispatcherServlet的自动配置原理 首先我们定位到SpringBoot自动配置的Maven依赖 <dependency> <groupId>org.springframework.boot</groupId> <artifactId>spring-boot-autoconfigure</artifactId> <version>${spring-boot.version}</version> </dependency> 在依赖的Jar包中我们可以在META-INF/spring.factories中找到自动配置类: org.springframework.boot.autoconfigure.web.servlet.DispatcherServletAutoConfiguration 在这个类中存在有一个静态内部类: org.springframework.boot.autoconfigure.web.servlet.DispatcherServletAutoConfiguration.DispatcherServletConfiguration 下图是这个配置类的主要源码和解析: 下面将上图中关键的注解功能,分别进行功能说明 3.1.1:@EnableConfigurationProperties({WebMvcProperties.class})注解解析 这个注解表示使WebMvcProperties.class类上的@ConfigurationProperties这个注解生效,同时@ConfigurationProperties这个注解是将application.xml中以spring.mvc开头的配置参数自动注入到WebMvcProperties.class类的字段中 3.1.2:@Conditional({DefaultDispatcherServletCondition.class}注解解析 该注解的原理就是将满足特定条件情况下的Bean自动加载到Spring容器中,该注解对应的Spring接口就是org.springframework.context.annotation.Condition这个接口 public interface Condition { boolean matches(ConditionContext var1, AnnotatedTypeMetadata var2); } 3.1.3:@ConditionOnClass注解解析 @ConditionOnClass这个注解是在当程序代码环境classpath下存在xxx.class的情况下条件成立,同时最终也会调用到matches方法中,其中关键的源码如下: protected static Class<?> resolve(String className, ClassLoader classLoader) throws ClassNotFoundException { return classLoader != null ? Class.forName(className, false, classLoader) : Class.forName(className); } 从上面可以看到,代码利用Class.forName方法加载classpath下的xxx.class类,如果加载成功条件就会成立。最后,在满足了所有@ConditionOnal注解条件后,SpringBoot就会自动为我们在Spring容器中注入DispatcherServlet了,无需单独配置了,直接引入spring-boot-starter-webr即可开始使用web相关功能。 3.1.4:总结 我们以DispatcherServlet是如何自动配置到容器中为例,探究了SpringBoot Starter的自动配置原理,其中涉及了几个关键的注解和步骤: 第一步:涉及到了配置文件的读取和个性化配置,这里就涉及到了下面这两个注解 @ConfigurationProperties @EnableConfigurationProperties 第二步:设计到了在什么条件下才自动配置的注解 @Conditional @ConditionalOnClass 第三步:约定了自动配置类的加载路径 /META-INF/spring-factories org.springframework.boot.autoconfigure.EnableAutoConfiguration=自动配置类全路径名称 在我们了解到了SpringBoot自动配置的原理之后,我们就可以自定义一个SpringBoot Starter来快速搭建我们的开发环境了 4:自定义一个打印输入输出日志的Starter 4.1 首先定义一个标记需要打印出入参日志的注解@PrintLog @Target(ElementType.METHOD) @Retention(RetentionPolicy.RUNTIME) public @interface PrintLog { } 4.2 定义一个存放打印日志配置的实体类 //自动注入application配置文件中已log.switch开头的配置参数 @ConfigurationProperties("log.switch") public class LogProperties { //是否启用打印日志功能 private Boolean enabled = false; //是否打印调用者ip private Boolean printIp = false; //是否打印调用者url private Boolean printUrl = false } 4.3 定义一个@PrintLog注解的切面类 @Aspect public class LogAspect { private static final Log LOGGER = LogFactory.getLog(LogAspect.class); private LogProperties logProperties; @Pointcut("@annotation(com.zl.annotation.PrintLog)") public void Log(){} @Around("Log()") public Object doAround(ProceedingJoinPoint joinPoint) throws Throwable { ServletRequestAttributes attributes = (ServletRequestAttributes) RequestContextHolder.getRequestAttributes(); HttpServletRequest request = attributes.getRequest(); MethodSignature signature = (MethodSignature) joinPoint.getSignature(); Method method = signature.getMethod(); String methodName = method.getName(); //打印调用url if (Boolean.TRUE.equals(logProperties.getPrintUrl())){ LOGGER.info("URL:" + request.getRequestURL().toString()); } //打印ip if (Boolean.TRUE.equals(logProperties.getPrintIp())) { LOGGER.info("IP :" + request.getRemoteAddr()); } //打印方法 LOGGER.info("method :" + methodName); //打印参数 LOGGER.info("parameter :" + Arrays.toString(joinPoint.getArgs())); Object result = joinPoint.proceed(); //打印返回结果 LOGGER.info("return :" + JSON.toJSONString(result)); return result; } } 4.4 定义一个打印日志的自动配置类 @Configuration @EnableConfigurationProperties({LogProperties.class}) //表示在application配置文件中必须配置log.switch.enabled = true才启动自动配置 @ConditionalOnProperty(prefix = "log.switch", value = "enabled", havingValue = "true") public class LogAutoConfigure { @Bean //Advice.class是aop切面中关键的切面方法类(@Before,@After等) //程序中有Advice.class类说明需要使用切面功能,这时才加载自定义的切面类 @ConditionalOnClass(Advice.class) public LogAspect webLogAspect(LogProperties logProperties){ return new LogAspect(logProperties); } } @ConditionalOnProperty表示在application配置文件中必须存在相应的配置才能使条件成立 4.5 配置自定义配置类的加载路径 META-INF/spring.factories org.springframework.boot.autoconfigure.EnableAutoConfiguration=\ com.zl.autoConfigure.LogAutoConfigure 4.6 Maven打包部署 maven install 5:开始使用自定义的Starter 5.1 在项目中引入Starter <dependency> <groupId>com.zl.demo</groupId> <artifactId>LogStarter</artifactId> <version>1.0-SNAPSHOT</version> </dependency> 5.2 在application.yml中配置参数 log: switch: enabled: true //启用打印日志功能 printIp: true //打印请求ip printUrl: true //打印请求url 经过上面两个步骤就,打印日志的功能就已经开启了,接下来就可以进行编码测试了 5.3 定义一个Controller并标上打印日志的注解 @RestController @RequestMapping("/test") public class HelloWorldController { @PrintLog @RequestMapping("/hello") public String helleWorld(String test){ return "hello world!"; } } 5.4 启动项目开始测试 com.zl.aspect.LogAspect : URL:http://localhost:8080/test/hello com.zl.aspect.LogAspect : IP :0:0:0:0:0:0:0:1 com.zl.aspect.LogAspect : method :helleWorld com.zl.aspect.LogAspect : parameter :[test] com.zl.aspect.LogAspect : return :"hello world!" 可以看到上面的入参和返回值都已经打印出来了,说明了自定义的starter已经生效了。 6:总结 SpringBoot自动配置功能带给我们的是开箱即用,快速便捷的功能,自动配置为我们研发人员带来的优点,我主要总结为以下两点: 1:提高研发效率。我们可以快速构建开发环境,对于开发中使用到的开源组件和中间件,我们直接引入对应的Starter就可以直接开发了,例如Redis和Mybatis等,可以直接引入对应的spring-boot-starter-data-redis就可以直接使用RedisTemplate来操作Redis了,这样可以极大的提高研发的效率,无需再进行复杂的起步配置了和各种版本依赖管理了。 2:标准模块复用。对于业务开发中的一些标准模块,例如常用的一些三方服务,我们可以利用Starter直接配置好,在需要使用的项目中直接引入这个starter就可以立即使用了,无需再去引入Jar包和编写配置文件等,同样的,对于一些标准非业务强耦合的功能,例如监控,鉴权等,也可以定义一个Starter,需要使用鉴权和监控功能的项目就可以直接复用了,无需再次开发。 作者:京东零售 钟磊 来源:京东云开发者社区 自猿其说Tech 转载请注明来源

优秀的个人博客,低调大师

SOA认知和方法论 | 京东物流技术团队

1 前言 1.1 架构分类 在软件设计领域,企业架构通常被划分为如下五种分类: 如何理解架构分类依据及其彼此之间的关系?业务是企业赖以生存之本,因此业务架构是基础、是灵魂,其他一切均是对业务架构的支撑;根据业务架构形成与之相应的产品架构和数据架构;最后通过技术架构落地实施。 应用架构用于对产品架构进行细分,通过应用集成形成产品。但是应用架构区别于产品架构的本质不应该只在粒度,更重要的是产品直接承接业务,按照业务问题域进行划分;而应用需要考虑通用能力沉淀和复用,为多个产品提供统一支撑。 业务架构:业务需求初期,将模糊的需求描述为清晰的问题域,主要包括业务规划、业务模块、业务流程。 产品架构:脱胎于业务架构(主要是业务流程和业务模块),关注的是功能的枚举和分类。 数据架构:从问题定义的视角,逻辑(流程)+ 数据是两个核心。业务架构分析流程的同时,另一个核心就是定义数据架构,结合流程和数据形成产品。在实践过程中数据架构的工作往往被置于产品架构或者应用架构内部,从全局视角看这是一种误区,数据作为企业宝贵资产,其架构的好坏直接影响企业竞争力,必须全局考量和设计。数据架构要解决两个关键问题 - 1.需要什么数据 2.如何存储数据。 应用架构:应用架构用于对产品架构进行细分,在产品架构的基础上进行更细粒度的问题拆解和职责划分,并抽取可复用模块沉淀形成基础能力。应用架构的最贴近落地实现。 技术架构:上述四个架构从问题定义视角出发,技术架构从问题解决的视角出发,关注的是技术选型、开发框架、开发语言等。 1.2 SOA 自19年底开始,我的工作内容就集中于供应链领域中台产品的建设,在建设过程中不可避免的一个关键词就是服务化,对此不同人会有不同的看法,个人对服务化的理解更倾向于SOA,因此通过本文谈一下对SOA的认知。 SOA作为一种架构风格,从架构分类的视角看更偏向于业务架构的一个思想体系,可以作为方法论指导我们从业务模型定义开始一直到整体的业务架构落地。SOA强调我们对业务本质的思考和设计,通过共创的方式(方式而非形式)对业务本质不断的追溯、抽象、总结、归纳、演绎,用于提升业务灵活性、加快业务创新、提升业务效率;不应该跳过业务架构将其当作一个应用架构或者技术架构的术语。往往在谈到服务化的时候,很多实践就会用技术框架(平台)来等价代换服务化的概念,追求将热点的技术框架(如serverless、codeless)在现有系统中的落地作为整个服务化建设的主旋律,这样的建设最终往往收效欠佳。原因就是技术框架的使用仅仅是术、是器,而服务化(SOA)的本质是道、是法。 软件架构在SOA提出之后尚未发生变革性的突破,很多架构思想如 EA分层架构、微服务架构、DDD架构 等,大多都是在SOA架构风格的基础上进行不同角度的演化迭代,因此本文在阐述SOA的过程多少会存在其他架构思想中的“影子”。 2 What、Why、How三个视角看SOA 2.1 What 2.1.1 术语 任何概念的定义,都有与之对应的术语。 业务行为:具备一定业务语义的原子行为抽象。 业务流程:实现特定业务价值(满足客户需求)的一些列业务行为的有机组合。 业务服务:提供增值价值的业务行为或业务流程(需要特别说明的是业务服务既可以是业务流程也可以是业务行为、甚至两者的组合)。具有明确业务功能定义和价值衡量标准(SLA)。 应用组件:按照一定的相关性结构化封装的应用功能(为方便理解,在不考虑分层的前提下,简化等价于业务服务)的一个集合。用以提升应用的一致性、灵活性,并实现重用。 应用:应用组件的有机集合,用来提供业务功能(单个或多个),为整个系统或者平台提供增量价值支撑。京慧中的需求计划、经营计划、库存计划、分销补货计划、供给计划(应用之间也存在一定的层级概念,贴近业务本质的理解)。 系统:一系列应用及服务的有机组合(某些服务可以独立为系统提供增量价值支撑,微服务架构思想中有诸多体现),具备端到端的完整业务功能,体系化的提供用户增量价值。我所建设的 京慧产品(供应链计划产品) 本身是系统的层面。 平台:一个或多个系统的有机组合,具备整个业务线或者业务生态的端到端业务功能全集。以提供业务线或者业务生态整体业务价值为目标。 架构:代表的是一个系统的基础元素构成。体现在系统构成的元素集合、元素之间的关系、与外部环境的交互,以及指导系统迭代演进的原则。 架构风格:一系列符合共同特征和核心原则的架构定义。 2.1.2 定义 SOA就是一种架构风格,致力于将业务功能保持一致的服务作为设计、构建和编排组合业务流程(或者解决方案)的基本单元。 2.1.3 服务 服务是设计、构建和编排组合一个完整业务实体中业务解决方案的基础单元。 服务可以从表里两个方向结合定义 - 服务是提供业务功能的原子单元(里),通过服务契约的方式管理(表)。 服务契约是服务消费方与服务提供方交互的所有约定的集合,通常由如下元素构成: 服务接口:接口定义,描述服务做什么、出入参定义等,通常通过接口文档的形式呈现。围绕着一个核心的业务功能操作以及相关联的操作。 服务策略: 服务双方的隐性的共识,描述适应场景、约束等。 服务水平:通过服务质量、可用性、性能等各个方面衡量服务本身,基本等价于SLA,包含了服务的两个重要方面的指标 - 业务指标和技术指标(技术指标- RT、吞吐量、可用性、可靠性等;业务指标-完成的业务功能的质量或者完成度,e.g.补货建议是否满足业务预期的周转缺货KPI)。 服务契约中体现出来的管理属性是服务区别于其他常见定义(模块、组件等)的根本区别,我们通过服务契约来管理服务的全生命周期(设计、实现、部署、升级)。 服务实现 - 对业务功能的实现,是对SOA核心本质的映射。 服务实现:具有多种实现方式【编码实现 |编排其他服务 | 适配封装现有应用 | 混合实现】。服务如何实现对于服务消费方来说是透明的,即服务消费方仅关心服务的what而非how。服务可以在保持接口不变的情况下在横纵两个方向改变(横 根据不同行业不同场景提供不同的实现;纵 根据行业发展演进服务)。 2.2 Why 为什么要选择SOA?针对这个问题会有很多观点 职责清晰(接口定义) 可灵活扩展(接口与实现分离) 高度可复用 接口分类 高度可管理 上述观点都无法否定,因为它们可以通过服务定义推演得到。其中前三个都是针对单个服务构建来看,只要掌握足够的技术手段就可以很容易的创建一个服务(单个服务),这并不是SOA的核心竞争力。SOA的目的远超接口技术细节的设计与定义,核心关注点在于服务的业务内容以及内涵(而非如何设计和实现)。在使用SOA总结提炼出的术与器的同时,不要忘记道和法。how to do很重要,指导的是做好一件事;但是what更重要,指导的是做对的事。 更深层次的剖析SOA的价值,我们需要回归SOA的本质 - 致力于在企业内的不同业务环境内建设业务功能驱动的服务,并在此基础上将服务组装成更高价值/更高级别的业务流程(解决方案)。故而可以将SOA的价值总结为两个关键点: 赋能企业构建具有业务价值的、具备完整业务语义的服务集合; 基于服务集合,组织和编排服务,构建敏捷&灵活的业务流程/解决方案。【敏捷 服务可以快速调整、独立演化;灵活 服务的业务功能定义明确(边界清晰、内聚性强),可灵活组合】 2.2.1 SOA价值的表现形式 一致性:一致性是SOA核心的价值体现,包括数据一致性和行为一致性【数据 提供业务一致&共识的公共数据访问服务;行为 对外(业务流程、外部任务等)提供统一的入口】 解耦:通过分离减少功能与数据的依赖和耦合。服务作为独立的业务功能单元,在应用系统中可以协同工作,同时各自又具备各自清晰且独立的业务目标和生命周期。 模块化&敏捷性:为业务的模块化提供基础;同时在模块化实现的基础上,模块可以在多个业务流程和场景中被复用和灵活组合,从而支持业务快速创新。 高度可管理性:服务水平的定义保证了服务在支撑业务目标的同时,可以跳出业务功能认知进行管理(可监控、可优化、可调整)。 2.3 How 相比于What和Why,SOA的实践是一个很庞大的问题,本文选择从服务设计的角度进行剖析。 2.3.1 梳理上下文 对业务系统,理解我们所支持的业务及其核心驱动力,是我们做好服务化的前提;如果是平台类系统,需要理解公司的战略所赋予平台的使命和平台的终局目标、中长期目标 。换言之,第一步是理清服务化架构的完整上下文背景。这些内容需要映射到模型中(各层级模型,详见下文分层设计)。如何梳理上下文,一种好的实践方式是定义问题集。有一种观点是提出好的问题 == 问题解决了一半,问题集定义: 通过上述8个问题描述了整个服务化架构的上下文: 问题1-6:描述业务/平台整体架构需求梳理; 问题7:描述架构需求梳理的结论; 问题8:引入了服务集合定义。服务集合是SOA建设的核心成果,需要从持续迭代演进的视角去理解。 我们通过服务集合来反映完整的业务语义和平台语义。怎样确定服务集合是否具备完整的上下文语义,必须能识别出下述内容: 完整的上下文背景 服务集合职责范围 服务分组(体现服务关联性) 服务的类型和角色 服务集合设计的两个主要目标 提供一种机制来识别一个特定服务的责任边界,指引服务实现。(重要 明确服务职责及边界,避免重复建设,保障行为和数据一致性) 提供一种机制来帮助理解服务整体的上下文背景,用于更高效的服务选择、服务重用。(服务分类,服务间关联性) 服务集合中的服务可以按照服务类型以及服务角色来进行组织。服务类型参照服务化分层架构描述,服务角色包含任务服务角色、实体服务角色、决策服务角色。 2.3.2 服务设计原则 SOA成功的关键之一是创建一个具备完整上下文语义(业务/平台语义)的服务集合,以便于通过组合编排服务来支撑不同的业务流程和业务场景。面向服务的架构中服务设计的问题要跨越多个甚至全部的流程来一起考虑。 首先,最容易想到的是松耦合,无论是SOA思想还是其他思想(e.g.OOP)松耦合都是基础原则之一;通过减少服务间的依赖提升不同应用场景下的复用性,隔离变更影响。耦合 - 服务间存在依赖关系。首先我们来看下对于服务最重要的两个点: 服务提供的业务功能 服务对业务数据产生的影响 从上述两个点我们比较容易得出两种类型的耦合(依赖) - 数据和功能。这里会存在一个很基础的问题为什么要产生依赖,从技术实现的角度看可以摒弃依赖实现一个大而全的服务。开发人员特别是习惯面向对象思想的开发人员对松耦合/高内聚已经形成一种本能,很少会反思为什么要这么做 - 两个方面(内在 一致性保障;外在 能力复用)。好的服务设计不仅是关注重用性,更重要的是提供一致性(行为与数据)。 再有,如何决定有哪些服务以及服务是什么?还是从数据和功能出发,通过功能分解和数据隔离组合在一起来决定服务有哪些以服务分别是什么。由此扩展所得的基本原则如下: 避免缺失 避免重复 保持一致性 如何实践落地上述原则?可以借助问题集的定义和转换: 2.3.3 服务集合设计 我们从分层、分类、颗粒度切分三个紧密联系的方面来看服务集合设计。 服务分层 信息架构是服务化分层架构设计中会被忽视的一个重要侧面,体现的是企业中不同角色的关注点。 战略与决策 定义企业的战略方向和商业目标,指引企业内部系统/平台发展的方向和终局。 商业模式 用运营主体的术语描述对企业业务有价值的事物。 业务抽象 用信息化的方式对单个业务线或者多个业务线的业务进行抽象。从业务抽象开始进入问题域定义。 公共语义模型 在业务抽象的基础上增加服务化的语义。公共语义模型描述的是在平台各业务服务间共享的具有一致语义的业务实体和信息,需要在平台层达成共识。 子域领域模型 是各子域的核心业务功能的抽象,包括服务定义及服务实现中的关键实体的定义。从整体视角来看是平台各子域的私有模型,除了服务语义之外整体不对外可视。 开发实现模型 等价于OOP中的对象模型,是开发和落地的基石。 商业模式与业务抽象的关系 1-商业模式描述业务运营人员感知的业务流程;业务抽象不仅描述业务流程,更重要的是抽象描述业务流程所应该包含的底层业务功能。 2-商业模式描述对企业业务来讲所有重要的事物;业务抽象描述企业业务想要事物背后的最根本的内容。 虽然从层级结构上看商业模式是业务抽象的上层,但是商业模式描述的东西是业务抽象定义所对应的样本或实例(从概念上来讲业务抽象的范围更宽泛)。业务抽象是商业模式的抽象与综合,必须要仔细分析和归纳、甚至通过演绎的方式来定义出隐藏在企业业务运营主体背后的根本内容和结构。 公共语义模型与子域领域模型的关系 公共语义模型用于描述平台层服务接口交互的共享信息,基于平台完整业务语义下所有服务公用数据的标准化视图模型。简言之,平台公共语义模型定义了业务平台层次的基本业务服务语义,是平台各业务服务之间、平台业务流程和平台业务服务交互的统一语言,强调统一和共享。而子域领域模型是平台各域的私有模型,用于驱动子域内服务功能的设计与实现。除非域内业务发生本质变化,子域领域模型需要保持动态稳定,通过防腐层隔离外部依赖的侵蚀 (领域模型也是DDD思想的核心)。 服务分层是服务化分层架构设计的主体。理解服务分层架构的一个好的方式是学习一下 TOGAF Meta-Model。 业务流程(端到端):按照一定业务规则决定的顺序执行的业务操作。高层级的业务功能通常跨多个应用子域/业务条线。 业务服务(平台/系统):高度模块化的业务功能单元。由不同类型的子域服务组合编排而来,可作为业务流程的编排单元。 子域服务:功能子域提供的服务,对平台可见,用于平台业务服务的组合编排,也可以作为更高层的业务流程编排的基础单元。 子域基础服务:用于支撑各功能子域服务的基础服务,对子域可见,对平台不可见,用于子域服务的编排。 基础子域服务:或称之为基础业务域服务,提供平台基础业务服务,为各个功能子域或平台业务服务提供基础业务功能及数据服务(e.g.商家服务、货品服务、库存服务) 基础架构服务:提供不同层次所共用的基础架构服务(e.g.用户管理、权限管理) 模型分层是对服务分层的重要补充。服务分层从结构上看是清晰和完整的,但是从服务化建设的整体视角看却并不完整,我们需要添加与之对应的模型抽象。 核心模型:端到端的业务流程承载业务核心价值的信息模型。在供应链领域中是单据模型,e.g.销售订单、采购订单、补货计划单。 公共语义模型:定义了平台层面业务流程、业务服务交互数据。在平台层面或者企业层面,端到端的业务流程中交互信息的公共语义模型定义了业务流程中所需要的完整的业务语义的实体定义(各业务语义实体边界明确、责任清晰)。核心模型通常是公共语义模型的子集。平台公共语义模型包含下层子域的对外服务实体子集,按照端到端的完整平台业务语义,可以由平台各功能子域模型所共享给平台的核心实体子集有机整合而成,也可以由平台业务模型全新定义(从top-down与bottom-up两个方向共同融合而成)。此模型需要不断迭代演进,平台的诸多架构决策和完善都是基于此模型来进行。 子域领域模型:平台各功能子域的领域模型用于驱动各功能子域的应用系统设计和开发。(同服务分层描述 需要保持动态稳定,通过防腐层对外部服务进行隔离,防止外部服务污染子域内的核心业务语义,同时保持域内业务功能灵活可控。子域领域模型仅通过其对外服务实体对外可见,其他均对外不可见。) 跨域映射模型:用于各子域领域模型实现对外部模型的防腐依赖。 基础架构服务模型:提供跳出层级之外的公用的基础架构信息模型,如用户模型、权限模型。 服务分类 服务分类(或称服务角色)是独立于职责范围、服务粒度之外的另一个重要因素;用于标识服务在组合/流程编排中所扮演的角色是什么。 如果说服务分层是纵向切分,服务分类就是横切面。借鉴OOP与AOP的理念,对服务分类的定义我们使用关注点分离的架构原则。 通常我们通过较粗粒度来定义三大类服务: 任务服务:任务服务通常实现一个完整的业务功能,既可以是基本业务功能,也可以是复杂的业务功能。此服务类型颗粒度粗,包含从独立的子域基础服务到平台业务服务都可以具有任务服务角色。业务服务通常承担任务服务的角色,本身是由小颗粒度服务较大的组合(流程),可以被设计成支持一个或者更多待定的流程。任务服务的针对性强,复用能力弱。通常,具有任务服务是主动服务,通过主动行为来进行价值输出。 实体服务:管理访问业务实体的服务。举例来看,e.g.用户、类目、商品、购物车。实体服务通常独立于任何特定的业务流程,可作为多个不同业务流程的组成部分。实体服务通常通过是配合提供需要的信息来实现任务的方式来支撑任务服务。实体服务通常具备很强的复用潜力。 规则/决策服务:通过执行业务规则来提供业务决策的服务。举例来看,e.g.补货计划自动审核服务。通常作用于复杂问题的判断或者支持变化频繁的业务规则。从颗粒度上来看,规则/决策服务通常为小到中等,用来组装成更大的服务。规则/决策服务可以是不同层次的服务(包括业务服务、子域服务、子域基础服务等),但是更常见的是作为基础服务来支撑这些服务。 我们通过组合不同类型的服务角色来提供灵活的业务能力,支持业务流程内的活动。因此需要一些基本原则来帮助我们合理的组合服务(减少依赖、限制耦合、获取最大的灵活性) - 服务分层以及组合的基本原则: 业务流程的任务通过任务服务实现,业务流程路由的核心规则由规则/决策服务来提供 服务更高层次的业务服务由其他更小的服务组成 任务服务可以组合规则/决策服务、实体服务以及其他任务服务 实体服务不允许存在相互调用 服务单向依赖,上层服务可以依赖下层服务以及同一层次的服务,下层服务不可以依赖上层服务 通过丰富的流程、实体和决策服务的集合,创建新的不同的服务(流程);结合规则/决策的灵活可变与服务分层的模块化、可重用性,打造系统/平台实践落地的架构方法论。 颗粒度切分 我们在设计服务是一个很大的疑惑是我们的服务到底要设计成什么样的颗粒度?这个问题没有统一标准,可以通过设置问题集结合并结合服务分层的方式来求解 谁是服务消费方(包含潜在消费方),e.g.其他服务、业务流程、外部合作方 服务在哪里别消费,通过什么路径消费(即服务拓扑) 服务的性能要求 服务预期的业务范围和边界 在复杂的环境或者系统(平台)中,服务具有不同的类型和颗粒度。一种通用的方式是参照服务化分层进行合理映射: 业务流程(端到端):跨越整个企业或者平台多个业务域,通常由底层服务构建而成 平台业务服务:最粗粒度的服务,提供高度抽象的组合业务功能给到平台或者企业。业务服务的功能和数据同业务流程所需要的业务语义紧密结合。数据整合服务在这个层次提供端到端的业务流程所需要的整合后的数据 子域服务:中等粒度服务,提供针对每个业务子域的业务相关服务,被本于内的不同业务服务所使用,但是未必暴露在子域外 子域基础服务:最小粒度的服务,提供低层次的服务,用来提供子域内业务功能的基本功能支撑 基础子域服务:较细粒度的服务,支撑上层业务功能服务的业务功能实现 基础架构服务:较细粒度的服务,独立于任何业务域。(明确区分于业务,e.g.安全认证、权限管理等) 3 总结 架构的范畴太大太广,本文尝试从一个点切入阐述一下个人的认知。有太多相关性的问题想去阐述,比如SOA与BPM的结合、实践过程中遇到的细节问题等等,为了比较干净的剖析SOA还是删除掉了。希望各位看官有所收获。 作者:京东物流 崔立群 来源:京东云开发者社区自猿其说Tech 转载请注明来源

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册