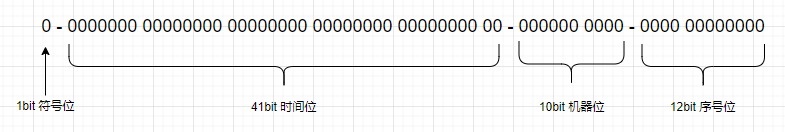首页 文章 精选 留言 我的

精选列表

搜索[团队协作工具],共10000篇文章
优秀的个人博客,低调大师

@ControllerAdvice注解使用及原理探究 | 京东物流技术团队

最近在新项目的开发过程中,遇到了个问题,需要将一些异常的业务流程返回给前端,需要提供给前端不同的响应码,前端再在次基础上做提示语言的国际化适配。这些异常流程涉及业务层和控制层的各个地方,如果每个地方都写一些重复代码显得很冗余。 然后查询解决方案时发现了@ControllerAdvice这个注解,可以对业务异常进行统一处理。经过仔细了解后,发现这个注解还有更多的用处,都很实用。 1 ControllerAdvice介绍 @ControllerAdvice一般和三个以下注解一块使用,起到不同的作用, @ExceptionHandler: 该注解作用于方法上,,可以捕获到controller中抛出的一些自定义异常,统一进行处理,一般用于进行一些特定的异常处理。 @InitBinder:该注解作用于方法上,用于将前端请求的特定类型的参数在到达controller之前进行处理,从而达到转换请求参数格式的目的。 @ModelAttribute:该注解作用于方法和请求参数上,在方法上时设置一个值,可以直接在进入controller后传入该参数。 2 ControllerAdvice应用场景 2.1@ExceptionHandler统一处理业务异常 @RestControllerAdvice @Slf4j public class GlobalExceptionHandler { // 这里就是对各个层返回的异常进行统一捕获处理 @ExceptionHandler(value = BusinessException.class) public ResponseData<Void> bizException(BusinessException e){ log.error("业务异常记录",e); return ResponseData.error(e.getCode(),e.getMessage()); } } //业务异常处代码示例: if(CollectionUtil.isNotEmpty(companies)){ // 通过BusinessExceptionEnum枚举对业务异常进行统一管理 throw new BusinessException(BusinessExceptionEnum.ERROR_10003); } 需要注意的是,如果这里有多个ExceptionHandler,按照异常类的层次体系,越高层的异常,优先级越低。 2.2@InitBinder做日期格式的统一处理 @RestControllerAdvice @Slf4j public class GlobalExceptionHandler { // 将前端传入的字符串时间格式转换为LocalDate时间 @InitBinder protected void initBinder(WebDataBinder binder) { //将前端传入的字符串格式时间数据转为LocalDate格式的数据 binder.registerCustomEditor(LocalDate.class, new PropertyEditorSupport() { @Override public void setAsText(String text) throws IllegalArgumentException { setValue(LocalDate.parse(text, DateTimeFormatter.ofPattern(DEFAULT_DATE_FORMAT))); } }); //将前端传入的字符串格式时间数据转为LocalDateTime格式的数据 binder.registerCustomEditor(LocalDateTime.class, new PropertyEditorSupport() { @Override public void setAsText(String text) throws IllegalArgumentException { setValue(LocalDateTime.parse(text, DateTimeFormatter.ofPattern(DEFAULT_DATE_TIME_FORMAT))); } }); //将前端传入的字符串格式时间数据转为LocalTim格式的数据 binder.registerCustomEditor(LocalTime.class, new PropertyEditorSupport() { @Override public void setAsText(String text) throws IllegalArgumentException { setValue(LocalTime.parse(text, DateTimeFormatter.ofPattern(DEFAULT_TIME_FORMAT))); } }); } } // controller进行参数绑定 public ResponseData<List<WorkCalendarVo>> listWorkCalendar(@RequestParam LocalDate date){} 2.3 ModelAttribute提前绑定全局user对象 // 这里@ModelAttribute("loginUser")标注的modelAttribute()方法表示会在Controller方法之前将user设置到contoller里的已绑定参数里 @ModelAttribute("loginUser") public User setLoginUser(HttpServletRequest request) { return LoginContextUtils.getLoginUser(request); } // 使用 @PostMapping("/list") public ResponseData<IPage<EmployeeVo>> listEmployee(@ModelAttribute("loginUser") User user, @RequestBody EmployeeSearch employeeSearch){ return ResponseData.success(employeeService.listEmployee(user, employeeSearch)); } 3 ControllerAdvice作用原理探究 在探究ControllerAdvice如何生效时,不得不提到springMvc绕不过的DispatcherServlet,这个类是SpringMVC统一的入口,所有的请求都通过它,里面的一些初始化方法如下。 public class DispatcherServlet extends FrameworkServlet { // ...... protected void initStrategies(ApplicationContext context) { initMultipartResolver(context); initLocaleResolver(context); initThemeResolver(context); initHandlerMappings(context); //请求处理的adapter initHandlerAdapters(context); // 异常响应处理的resolver initHandlerExceptionResolvers(context); initRequestToViewNameTranslator(context); initViewResolvers(context); initFlashMapManager(context); } // ...... } 3.1@initBinder和@ModelAttribute的作用原理 @initBinder和@ModelAttribute都是请求过程中的处理,我们知道springMvc通过HandlerApapter定位到具体的方法进行请求处理,因此查看HandlerHaper的实现类,发现RequestMappingHandlerAdapter比较符合我们的目标 点进去RequestMappingHandlerAdapter后发现里面的一个方法如下 @Override public void afterPropertiesSet() { // Do this first, it may add ResponseBody advice beans // 这里会添加ResponseBody advice beans initControllerAdviceCache(); if (this.argumentResolvers == null) { List<HandlerMethodArgumentResolver> resolvers = getDefaultArgumentResolvers(); this.argumentResolvers = new HandlerMethodArgumentResolverComposite().addResolvers(resolvers); } if (this.initBinderArgumentResolvers == null) { List<HandlerMethodArgumentResolver> resolvers = getDefaultInitBinderArgumentResolvers(); this.initBinderArgumentResolvers = new HandlerMethodArgumentResolverComposite().addResolvers(resolvers); } if (this.returnValueHandlers == null) { List<HandlerMethodReturnValueHandler> handlers = getDefaultReturnValueHandlers(); this.returnValueHandlers = new HandlerMethodReturnValueHandlerComposite().addHandlers(handlers); } } // 这里找到contollerAdvice注解的类,缓存里面的方法 private void initControllerAdviceCache() { if (getApplicationContext() == null) { return; } // 找到@ControllerAdvice注解标注的类 List<ControllerAdviceBean> adviceBeans = ControllerAdviceBean.findAnnotatedBeans(getApplicationContext()); List<Object> requestResponseBodyAdviceBeans = new ArrayList<>(); for (ControllerAdviceBean adviceBean : adviceBeans) { Class<?> beanType = adviceBean.getBeanType(); if (beanType == null) { throw new IllegalStateException("Unresolvable type for ControllerAdviceBean: " + adviceBean); } // 找到所有ModelAttribute标注的方法进行缓存,就可以使用了 Set<Method> attrMethods = MethodIntrospector.selectMethods(beanType, MODEL_ATTRIBUTE_METHODS); if (!attrMethods.isEmpty()) { this.modelAttributeAdviceCache.put(adviceBean, attrMethods); } // 找到所有initBinder注解标注的方法进行缓存,就可以使用了 Set<Method> binderMethods = MethodIntrospector.selectMethods(beanType, INIT_BINDER_METHODS); if (!binderMethods.isEmpty()) { this.initBinderAdviceCache.put(adviceBean, binderMethods); } if (RequestBodyAdvice.class.isAssignableFrom(beanType) || ResponseBodyAdvice.class.isAssignableFrom(beanType)) { requestResponseBodyAdviceBeans.add(adviceBean); } } if (!requestResponseBodyAdviceBeans.isEmpty()) { this.requestResponseBodyAdvice.addAll(0, requestResponseBodyAdviceBeans); } // ......日志处理 } 3.2@ExceptionHandler注解的作用原理 相同的思路,@ExceptionHandler是响应时的处理,因此需要找到对应的Resolver,进入initHandlerExceptionResolvers(context)方法, 属性填充后会进行afterPropertiesSet方法,这个方法可以用在一些特殊情况中,也就是某个对象的某个属性需要经过外界得到,比如说查询数据库等方式,这时候可以用到spring的该特性,只需要实现InitializingBean。 @Override public void afterPropertiesSet() { // Do this first, it may add ResponseBodyAdvice beans initExceptionHandlerAdviceCache(); if (this.argumentResolvers == null) { List<HandlerMethodArgumentResolver> resolvers = getDefaultArgumentResolvers(); this.argumentResolvers = new HandlerMethodArgumentResolverComposite().addResolvers(resolvers); } if (this.returnValueHandlers == null) { List<HandlerMethodReturnValueHandler> handlers = getDefaultReturnValueHandlers(); this.returnValueHandlers = new HandlerMethodReturnValueHandlerComposite().addHandlers(handlers); } } private void initExceptionHandlerAdviceCache() { if (getApplicationContext() == null) { return; } List<ControllerAdviceBean> adviceBeans = ControllerAdviceBean.findAnnotatedBeans(getApplicationContext()); for (ControllerAdviceBean adviceBean : adviceBeans) { Class<?> beanType = adviceBean.getBeanType(); if (beanType == null) { throw new IllegalStateException("Unresolvable type for ControllerAdviceBean: " + adviceBean); } // 这里找到ExceptionHandler注解标注的方法进行缓存,后面就可以使用了 ExceptionHandlerMethodResolver resolver = new ExceptionHandlerMethodResolver(beanType); if (resolver.hasExceptionMappings()) { this.exceptionHandlerAdviceCache.put(adviceBean, resolver); } if (ResponseBodyAdvice.class.isAssignableFrom(beanType)) { this.responseBodyAdvice.add(adviceBean); } } // ......日志处理 } 在启动spring时debug发现最终也会走到这里对@ExceptionHander注解的方法已经缓存 当Controller抛出异常时,DispatcherServlet通过ExceptionHandlerExceptionResolver来解析异常,而ExceptionHandlerExceptionResolver又通过ExceptionHandlerMethodResolver 来解析异常, ExceptionHandlerMethodResolver 最终解析异常找到适用的@ExceptionHandler标注的方法是这里: @Nullable public Method resolveMethodByExceptionType(Class<? extends Throwable> exceptionType) { Method method = this.exceptionLookupCache.get(exceptionType); if (method == null) { method = getMappedMethod(exceptionType); this.exceptionLookupCache.put(exceptionType, method); } return (method != NO_MATCHING_EXCEPTION_HANDLER_METHOD ? method : null); } 4 用具体的调用过程,验证上面的推测 本部分通过对DispatcherServlet的调用过程跟踪,梳理出ControllerAdvice的作用原理,以@InitBinder主节点生效过程为例。 首选是dispathServlet在初始化过程中,初始化RequestMappingHandlerAdapter过程中打断点发现,initBinder已经缓存进来了。 然后是dispatcherServlet的调用流程图,验证下是initBinder注解是否生效。 DispatcherServlet 通过doService()方法开始调用,主要逻辑包括 设置 request ,通过doDispatch() 进行请求分发处理。 doDispatch() 的主要过程是通过 HandlerMapping 获取 Handler,再找到用于执行它的 HandlerAdapter,执行 Handler 后得到 ModelAndView ,ModelAndView 是连接“业务逻辑层”与“视图展示层”的桥梁。 4.1 DispathcerServlet的doDispatch方法 在入口处找到要执行的HandlerAdapter,调用handle方法继续 protected void doDispatch(HttpServletRequest request, HttpServletResponse response) throws Exception { HttpServletRequest processedRequest = request; HandlerExecutionChain mappedHandler = null; boolean multipartRequestParsed = false; WebAsyncManager asyncManager = WebAsyncUtils.getAsyncManager(request); try { ModelAndView mv = null; Exception dispatchException = null; try { processedRequest = checkMultipart(request); multipartRequestParsed = (processedRequest != request); // Determine handler for the current request. // 找到执行链,根据请求路径匹配到controller的方法 mappedHandler = getHandler(processedRequest); if (mappedHandler == null) { noHandlerFound(processedRequest, response); return; } // Determine handler adapter for the current request. // 找到对应的HandlerAdapter,执行链中的handler类型为HandlerMethod的. HandlerAdapter ha = getHandlerAdapter(mappedHandler.getHandler()); // Process last-modified header, if supported by the handler. String method = request.getMethod(); boolean isGet = HttpMethod.GET.matches(method); if (isGet || HttpMethod.HEAD.matches(method)) { long lastModified = ha.getLastModified(request, mappedHandler.getHandler()); if (new ServletWebRequest(request, response).checkNotModified(lastModified) && isGet) { return; } } if (!mappedHandler.applyPreHandle(processedRequest, response)) { return; } // Actually invoke the handler. 真正进行处理的地方 mv = ha.handle(processedRequest, response, mappedHandler.getHandler()); if (asyncManager.isConcurrentHandlingStarted()) { return; } applyDefaultViewName(processedRequest, mv); mappedHandler.applyPostHandle(processedRequest, response, mv); .......... } 4.2 RequestmappingHanderApapter对@initBInder注解缓存方法进行处理 找到对应的handlerAdapter后进入invokeHandlerMethod()方法,在这里通过构建WebDataBinderFactory对initBinder注解进行构建,供后续使用,具体逻辑如下。 通过getDataBinderFactory()方法从之前缓存的Map> initBinderAdviceCache中生成binderFactory @Nullable protected ModelAndView invokeHandlerMethod(HttpServletRequest request, HttpServletResponse response, HandlerMethod handlerMethod) throws Exception { ServletWebRequest webRequest = new ServletWebRequest(request, response); try { //根据initBinder注解,获取对应的factory,主要成员是InvocableHandlerMethod,就包括之前缓存的。 WebDataBinderFactory binderFactory = getDataBinderFactory(handlerMethod); ModelFactory modelFactory = getModelFactory(handlerMethod, binderFactory); // 创建可调用的对象,进行调用逻辑处理 ServletInvocableHandlerMethod invocableMethod = createInvocableHandlerMethod(handlerMethod); if (this.argumentResolvers != null) { invocableMethod.setHandlerMethodArgumentResolvers(this.argumentResolvers); } if (this.returnValueHandlers != null) { invocableMethod.setHandlerMethodReturnValueHandlers(this.returnValueHandlers); } // binderFactory设置进invocableMethod, invocableMethod.setDataBinderFactory(binderFactory); invocableMethod.setParameterNameDiscoverer(this.parameterNameDiscoverer); ModelAndViewContainer mavContainer = new ModelAndViewContainer(); mavContainer.addAllAttributes(RequestContextUtils.getInputFlashMap(request)); modelFactory.initModel(webRequest, mavContainer, invocableMethod); mavContainer.setIgnoreDefaultModelOnRedirect(this.ignoreDefaultModelOnRedirect); AsyncWebRequest asyncWebRequest = WebAsyncUtils.createAsyncWebRequest(request, response); asyncWebRequest.setTimeout(this.asyncRequestTimeout); WebAsyncManager asyncManager = WebAsyncUtils.getAsyncManager(request); asyncManager.setTaskExecutor(this.taskExecutor); asyncManager.setAsyncWebRequest(asyncWebRequest); asyncManager.registerCallableInterceptors(this.callableInterceptors); asyncManager.registerDeferredResultInterceptors(this.deferredResultInterceptors); if (asyncManager.hasConcurrentResult()) { Object result = asyncManager.getConcurrentResult(); mavContainer = (ModelAndViewContainer) asyncManager.getConcurrentResultContext()[0]; asyncManager.clearConcurrentResult(); LogFormatUtils.traceDebug(logger, traceOn -> { String formatted = LogFormatUtils.formatValue(result, !traceOn); return "Resume with async result [" + formatted + "]"; }); invocableMethod = invocableMethod.wrapConcurrentResult(result); } // 继续进行处理 invocableMethod.invokeAndHandle(webRequest, mavContainer); if (asyncManager.isConcurrentHandlingStarted()) { return null; } return getModelAndView(mavContainer, modelFactory, webRequest); } finally { webRequest.requestCompleted(); } } // 生成WebDataBinderFactory的具体逻辑 private WebDataBinderFactory getDataBinderFactory(HandlerMethod handlerMethod) throws Exception { Class<?> handlerType = handlerMethod.getBeanType(); Set<Method> methods = this.initBinderCache.get(handlerType); if (methods == null) { methods = MethodIntrospector.selectMethods(handlerType, INIT_BINDER_METHODS); this.initBinderCache.put(handlerType, methods); } List<InvocableHandlerMethod> initBinderMethods = new ArrayList<>(); // Global methods first 获取之前项目启动缓存的initMethod this.initBinderAdviceCache.forEach((controllerAdviceBean, methodSet) -> { if (controllerAdviceBean.isApplicableToBeanType(handlerType)) { Object bean = controllerAdviceBean.resolveBean(); for (Method method : methodSet) { initBinderMethods.add(createInitBinderMethod(bean, method)); } } }); for (Method method : methods) { Object bean = handlerMethod.getBean(); initBinderMethods.add(createInitBinderMethod(bean, method)); } return createDataBinderFactory(initBinderMethods); } 经过上面的处理,发现initBinder标注的注解方法已经成功缓存进bindFactory。 4.3 继续调用getMethodArgumentValues进行后续处理 继续往下跟踪,进入InvocableHandlerMethod的invokeForRequest方法,里面有getMethodArgumentValues方法,会对请求参数进行处理。 最终使用AbstractNamedValueMethodArgumentResolver的resolveArgument()方法对请求字符串格式数据进行处理 // 请求Controller方法如下 public ResponseData<IPage<CompanyVo>> listCompany(HttpServletRequest servletRequest, @RequestBody CompanySearch companySearch, @RequestParam LocalDate localDate){ getLoginUser(servletRequest); return ResponseData.success(companyService.listCompany(companySearch)); } protected Object[] getMethodArgumentValues(NativeWebRequest request, @Nullable ModelAndViewContainer mavContainer, Object... providedArgs) throws Exception { // 得到方法的参数列表 MethodParameter[] parameters = getMethodParameters(); if (ObjectUtils.isEmpty(parameters)) { return EMPTY_ARGS; } Object[] args = new Object[parameters.length]; // 循环如处理请求参数 for (int i = 0; i < parameters.length; i++) { MethodParameter parameter = parameters[i]; parameter.initParameterNameDiscovery(this.parameterNameDiscoverer); args[i] = findProvidedArgument(parameter, providedArgs); if (args[i] != null) { continue; } if (!this.resolvers.supportsParameter(parameter)) { throw new IllegalStateException(formatArgumentError(parameter, "No suitable resolver")); } try { // 真正进行参数处理的地方 args[i] = this.resolvers.resolveArgument(parameter, mavContainer, request, this.dataBinderFactory); } catch (Exception ex) { // Leave stack trace for later, exception may actually be resolved and handled... if (logger.isDebugEnabled()) { String exMsg = ex.getMessage(); if (exMsg != null && !exMsg.contains(parameter.getExecutable().toGenericString())) { logger.debug(formatArgumentError(parameter, exMsg)); } } throw ex; } } return args; } // 最终会使用AbstractNamedValueMethodArgumentResolver来进行处理 public final Object resolveArgument(MethodParameter parameter, @Nullable ModelAndViewContainer mavContainer, NativeWebRequest webRequest, @Nullable WebDataBinderFactory binderFactory) throws Exception { NamedValueInfo namedValueInfo = getNamedValueInfo(parameter); MethodParameter nestedParameter = parameter.nestedIfOptional(); // 得到请求参数名称为"localdate" Object resolvedName = resolveEmbeddedValuesAndExpressions(namedValueInfo.name); if (resolvedName == null) { throw new IllegalArgumentException( "Specified name must not resolve to null: [" + namedValueInfo.name + "]"); } // 获取请求的locadate的值,此时为字符串格式"yyyy-mm-dd" Object arg = resolveName(resolvedName.toString(), nestedParameter, webRequest); if (arg == null) { if (namedValueInfo.defaultValue != null) { arg = resolveEmbeddedValuesAndExpressions(namedValueInfo.defaultValue); } else if (namedValueInfo.required && !nestedParameter.isOptional()) { handleMissingValue(namedValueInfo.name, nestedParameter, webRequest); } arg = handleNullValue(namedValueInfo.name, arg, nestedParameter.getNestedParameterType()); } else if ("".equals(arg) && namedValueInfo.defaultValue != null) { arg = resolveEmbeddedValuesAndExpressions(namedValueInfo.defaultValue); } // 这里就会使用bindFactory进行处理 if (binderFactory != null) { WebDataBinder binder = binderFactory.createBinder(webRequest, null, namedValueInfo.name); try { // 经过这里进行处理,输入的string类型就会转为LocalDate了 arg = binder.convertIfNecessary(arg, parameter.getParameterType(), parameter); } catch (ConversionNotSupportedException ex) { throw new MethodArgumentConversionNotSupportedException(arg, ex.getRequiredType(), namedValueInfo.name, parameter, ex.getCause()); } catch (TypeMismatchException ex) { throw new MethodArgumentTypeMismatchException(arg, ex.getRequiredType(), namedValueInfo.name, parameter, ex.getCause()); } // Check for null value after conversion of incoming argument value if (arg == null && namedValueInfo.defaultValue == null && namedValueInfo.required && !nestedParameter.isOptional()) { handleMissingValueAfterConversion(namedValueInfo.name, nestedParameter, webRequest); } } handleResolvedValue(arg, namedValueInfo.name, parameter, mavContainer, webRequest); return arg; } 最后附上上面调用过程中一些类的介绍 以上就是ControllerAdivce的全介绍。通过对源码的学习,加深了对HTTP请求过程的理解。 参考:https://blog.csdn.net/zmm__1377445292/article/details/116158554 作者:京东物流 付鹏嘎 来源:京东云开发者社区自猿其说Tech


优秀的个人博客,低调大师

Spring Boot Starter 剖析与实践 | 京东云技术团队

引言 对于 Java 开发人员来说,Spring 框架几乎是必不可少的。它是一个广泛用于开发企业应用程序的开源轻量级框架。近几年,Spring Boot 在传统 Spring 框架的基础上应运而生,不仅提供了 Spring 的全部功能,还使开发人员更加便捷地使用。在使用 Spring Boot 时,我们经常会接触到各种 Spring Boot Starter,例如spring-boot-starter-web。只需将该依赖加入项目中,我们就可以开始开发应用;在引入spring-boot-starter-data-jdbc后,只需在配置文件中填写数据库连接信息,即可连接数据库。此外,您还可以随意切换数据源组件依赖,而无需修改业务代码。Spring Boot Starter 是如何适配的呢?我们能否自己实现一个 Spring Boot Starter 呢?本文将剖析 Spring Boot Starter 的原理,并自定义实现一个 Spring Boot Starter 组件。 一、Spring Boot Starter 是什么? Spring Boot Starter 是 Spring Boot 中比较重要的概念,是一种依赖描述符,它可以帮助您简化配置。当需要构建一个 Web 应用程序时,不必再遍历所有的依赖包,一个一个地添加到项目的依赖管理中,而是只需要一个配置spring-boot-starter-web,如以下示例: 从上面示例来看,我们使用了相当少的代码创建了一个 REST 应用程序。Spring 官方提供了许多 Starter,同时第三方也可以自定义 Starter,官方为了加以区分,Starter 从名称上进行了如下规范:spring-boot-starter-xxx;第三方提供的 starter 名称为:xxx-spring-boot-starter。 二、Spring Boot Starter 剖析 前面介绍了 Starter 的概念以及如何快速创建 REST 应用程序。只需添加一个依赖和几行代码,就能完成 REST 接口开发。那么,在没有 Spring Boot 和 Starter 的情况下,我们该如何进行开发呢?Spring Boot Starter 的工作原理又是什么?接下来,我们将通过开发 Web 服务和 Dubbo 服务作为例子,分别剖析纯 Spring 和 Spring Boot Starter。 Spring 环境依赖 JDK 1.8 Maven 3 Tomcat 8(需要依靠 Web 容器服务器才能启动) spring-webmvc 4.3.30.RELEASE dubbo 2.7.23 开发流程 首先介绍一下,这是一个标准的 Maven 目录结构与demo-service依赖内容 <dependencies> <!-- SpringMVC --> <dependency> <groupId>org.springframework</groupId> <artifactId>spring-webmvc</artifactId> <version>4.3.30.RELEASE</version> </dependency> <dependency> <groupId>javax.servlet</groupId> <artifactId>servlet-api</artifactId> <version>2.5</version> </dependency> <!-- 此处需要导入databind包即可, jackson-annotations、jackson-core都不需要显示自己的导入了--> <dependency> <groupId>com.fasterxml.jackson.core</groupId> <artifactId>jackson-databind</artifactId> <version>2.9.8</version> </dependency> <!-- Dubbo --> <dependency> <groupId>org.apache.dubbo</groupId> <artifactId>dubbo</artifactId> <version>2.7.23</version> </dependency> <dependency> <groupId>org.apache.curator</groupId> <artifactId>curator-x-discovery</artifactId> <version>5.1.0</version> </dependency> <dependency> <groupId>org.apache.zookeeper</groupId> <artifactId>zookeeper</artifactId> <version>3.8.0</version> </dependency> <!-- Demo API --> <dependency> <groupId>com.demo</groupId> <artifactId>demo-api</artifactId> <version>1.0-SNAPSHOT</version> </dependency> </dependencies> 由于在 Spring XML 下还需要依靠 Java Web 和 Web 容器运行,还需要web/WEB-INF/web.xmlWeb 配置文件,内容配置了 SpringMVC 入口 <?xml version="1.0" encoding="UTF-8"?> <web-app xmlns="http://xmlns.jcp.org/xml/ns/javaee" xmlns:xsi="http://www.w3.org/2001/XMLSchema-instance" xsi:schemaLocation="http://xmlns.jcp.org/xml/ns/javaee http://xmlns.jcp.org/xml/ns/javaee/web-app_4_0.xsd" version="4.0"> <!-- Spring监听器 --> <listener> <listener-class>org.springframework.web.context.ContextLoaderListener</listener-class> </listener> <context-param> <param-name>contextConfigLocation</param-name> <param-value>classpath:dubbo.xml</param-value> </context-param> <servlet> <servlet-name>springmvc</servlet-name> <servlet-class>org.springframework.web.servlet.DispatcherServlet</servlet-class> <init-param> <param-name>contextConfigLocation</param-name> <param-value>classpath:mvc.xml</param-value> </init-param> </servlet> <servlet-mapping> <servlet-name>springmvc</servlet-name> <url-pattern>/</url-pattern> </servlet-mapping> </web-app> SpringMVC 配置文件mvc.xml与 Dubbo 配置文件dubbo.xml <?xml version="1.0" encoding="utf-8" ?> <beans xmlns="http://www.springframework.org/schema/beans" xmlns:xsi="http://www.w3.org/2001/XMLSchema-instance" xmlns:context="http://www.springframework.org/schema/context" xmlns:mvc="http://www.springframework.org/schema/mvc" xsi:schemaLocation="http://www.springframework.org/schema/beans http://www.springframework.org/schema/beans/spring-beans.xsd http://www.springframework.org/schema/context http://www.springframework.org/schema/context/spring-context.xsd http://www.springframework.org/schema/mvc http://www.springframework.org/schema/mvc/spring-mvc.xsd"> <context:component-scan base-package="com.demo.controller"/> <!-- 开启 MVC 注解驱动 --> <mvc:annotation-driven/> <!-- 访问静态资源 --> <mvc:default-servlet-handler/> </beans> <?xml version="1.0" encoding="utf-8" ?> <beans xmlns="http://www.springframework.org/schema/beans" xmlns:dubbo="http://dubbo.apache.org/schema/dubbo" xmlns:xsi="http://www.w3.org/2001/XMLSchema-instance" xsi:schemaLocation="http://www.springframework.org/schema/beans http://www.springframework.org/schema/beans/spring-beans.xsd http://dubbo.apache.org/schema/dubbo http://dubbo.apache.org/schema/dubbo/dubbo.xsd"> <!-- Dubbo --> <dubbo:application name="demo-service"/> <dubbo:registry address="zookeeper://127.0.0.1:2181"/> <dubbo:protocol name="dubbo" port="20880"/> <bean id="demoServiceImpl" class="com.demo.provider.DemoServiceImpl"/> <dubbo:service interface="com.demo.api.DemoService" ref="demoServiceImpl"/> </beans> 编写 Controller 接口与 Dubbo RPC 接口 package com.demo.controller; import org.springframework.web.bind.annotation.GetMapping; import org.springframework.web.bind.annotation.RestController; @RestController public class HelloController { @GetMapping(value = "/say/hello") public HelloEntity sayHello() { return new HelloEntity("Hello World"); } } package com.demo.provider; import com.demo.api.DemoService; import com.demo.dto.HelloEntity; public class DemoServiceImpl implements DemoService { @Override public HelloEntity sayHello() { return new HelloEntity("Hello World"); } } 以上还无法单独运行,需要将以上打包成war包放入到 Tomcat 才可运行。 剖析 从上面的开发流程中,我们可以看到入口都在web.xml中。其中有一个监听器和一个 Servlet,以及初始化参数dubbo.xml和mvc.xml。在 Spring Boot 出现之前,Spring 通常使用 XML 配置方式描述 Bean,或者在 XML 中配置注解驱动和上下文扫描方式解析 Bean。因此,我们可以看出这里有两个 XML 文件。经过分析源代码,我们整理出了以下 XML 标签解析到 Bean 解析的流程。如下: 由 Tomcat 启动加载web.xml并通过监听器和 Servlet 让 Spring 加载 XML 并解析。 直到BeanDefinitionParserDelegate#parseCustomElement开始解析自定义标签,找到mvc:xxx或dubbo:xxx标签找到了 XML 命名空间。 DefaultNamespaceHandlerResolver处理逻辑:以懒加载方式加载所有 jar 中META-INF/spring.handlers(路径必须得是这个)并缓存到handlerMappings,通过命名空间 URI 找到与之对应的处理类,SpringMVC 与 Dubbo 命名空间处理类分别为MvcNamespaceHandler和DubboNamespaceHandler MvcNamespaceHandler和DubboNamespaceHandler都分别实现了NamespaceHandler#init方法,内容如下:init方法将 SpringMVC 和 Dubbo 标签对应的BeanDefinitionParser注册到了NamespaceHandlerSupport#parsers中。在上一步中,DefaultNamespaceHandlerResolver根据标签获取到了该标签的BeanDefinitionParser,从而将对应的 Bean 注册到了 Spring IOC 容器中。注册逻辑不是本文的重点,这里就不再赘述。至此,SpringMVC 和 Dubbo 的加载流程已经完成。 从以上加载流程中,我们可以看出,在没有 Spring Boot 之前,Spring 主要依靠 XML 配置来启动。它会加载 XML 中的自定义标签,找到对应的命名空间,然后扫描 classpath 下的META-INF/spring.handlers,找到命名空间处理类来解析当前标签。 Spring Boot 环境依赖 JDK 1.8 Maven 3 spring-boot 2.6.9 dubbo 2.7.23 开发流程 目录结构与 Mavendemo-spring-boot依赖内容 <dependencies> <dependency> <groupId>org.springframework.boot</groupId> <artifactId>spring-boot-starter-web</artifactId> </dependency> <!-- dubbo --> <dependency> <groupId>org.apache.dubbo</groupId> <artifactId>dubbo-spring-boot-starter</artifactId> <version>2.7.23</version> </dependency> <dependency> <groupId>org.apache.curator</groupId> <artifactId>curator-x-discovery</artifactId> <version>5.1.0</version> </dependency> <dependency> <groupId>org.apache.zookeeper</groupId> <artifactId>zookeeper</artifactId> <version>3.8.0</version> </dependency> <dependency> <groupId>com.demo</groupId> <artifactId>demo-api</artifactId> <version>1.0-SNAPSHOT</version> </dependency> </dependencies> 应用程序入口DemoSpringBootApplication @SpringBootApplication public class DemoSpringBootApplication { public static void main(String[] args) { SpringApplication.run(DemoSpringBootApplication.class, args); } } application.yml文件内容只有 Dubbo 的配置 dubbo: application: name: demo-provider protocol: port: 20880 name: dubbo registry: address: zookeeper://127.0.0.1:2181 编写 Controller 接口与 Dubbo RPC 接口 package com.demo.controller; import com.demo.dto.HelloEntity; import org.springframework.web.bind.annotation.GetMapping; import org.springframework.web.bind.annotation.RestController; @RestController public class HelloController { @GetMapping(value = "/say/hello") public HelloEntity sayHello() { return new HelloEntity("Hello World"); } } package com.demo.provider; import com.demo.api.DemoService; import com.demo.dto.HelloEntity; @DubboService public class DemoServiceImpl implements DemoService { @Override public HelloEntity sayHello() { return new HelloEntity("Hello World"); } } 由于spring-boot-starter-web已经内嵌 tomcat ,只需要直接运行DemoSpringBootApplication#main方法即可运行应用 剖析 从开发流程上没办法第一时间找到解析入口,唯一入口就是在DemoSpringBootApplication,经过源代码分析得出以下流程: 应用DemoSpringBootApplication类上有@SpringBootApplication注解,而该注解由以下三个注解组成: @SpringBootConfiguration,标注当前类为一个配置类,与@Configuration注解功能一致 ,被@Configuration注解的类对应 Spring 的 XML 版的容器。 @EnableAutoConfiguration,开启启动自动装配的关键,由@AutoConfigurationPackage与@Import(AutoConfigurationImportSelector.class)组成 @ComponentScan,按照当前类路径扫描含有@Service、@Controller等等注解的类,等同于 Spring XML 中的context:component-scan。 Spring Boot 自动装配由@EnableAutoConfiguration导入的AutoConfigurationImportSelector类,会调用SpringFactoriesLoader#loadFactoryNames从 ClassPath 下扫描所有 jar 包的META-INF/spring.factories内容,由于传入的EnableAutoConfiguration.class,只会返回org.springframework.boot.autoconfigure.EnableAutoConfigurationkey 的值,得到一个全限定类名字符串数组configurations。 configurations经过去重与声明式排除后,会进行以下进行过滤自动装配: configurations = getConfigurationClassFilter().filter(configurations) 分成两部分:获取过滤器和执行过滤。 getConfigurationClassFilter(),也是通过SpringFactoriesLoader#loadFactoryNames在META-INF/spring.factories找到 Key 为org.springframework.boot.autoconfigure.AutoConfigurationImportFilter的值,目前只有:OnBeanCondition、OnClassCondition、OnClassCondition三个过滤器。 执行过滤,会根据配置类上含有@ConditionOnBean、@ConditionalOnClass、@ConditionalOnWebApplication等等条件注解来过滤掉部分配置类。比如WebMvcAutoConfiguration指定需要在@ConditionOnWebApplication下才生效。 在引入各类 Configuration 的配置类后,配置类结合@Bean来完成 Spring Bean 解析和注入,同时 Spring Boot 还提供了许多@ConditionalXXX给开发者完成灵活注入。 以上就是 Spring Boot 的自动装配过程。Spring Boot 利用被@Configuration注解的配置类来代替 Spring XML 完成 Bean 的注入。然后,SpringFactoriesLoader会最终加载META-INF/spring.factories中的自动配置类,实现自动装配过程。依靠“约定大于配置”的思想,如果开发的 Starter 想要生效,就需要按照 Spring Boot 的约定。 小结 通过对比 Spring 与 Spring Boot 的开发流程,我们可以发现 Spring Boot 在完成 Web 与 Dubbo 独立应用开发时,使用了相对较少的代码和配置。这得益于 Spring Boot Starter 的自动装配能力,它是 Spring Boot 的主要功能。通过消除定义一些属于自动配置类部分的需求,自动配置可以帮助简化开发流程并加速开发速度。 SPI 我们从上面剖析发现,两者都使用了一项机制去加载引入的 jar 包中的配置文件从而加载对应类,那就是SPI(Service Provider Interface) SPI (Service Provider Interface), 是 Java 内置的一种服务提供发现机制,提高框架的扩展性。 Java SPI Java 内置的 SPI 通过java.util.ServiceLoader类解析 Classpath 和 jar 包的META-INF/services目录下的以接口全限定名命名的文件,并加载该文件中指定的接口实现类,以此完成调用。 但是 Java SPI 会有一定不足: 不能做到按需加载,需要遍历所有的实现并实例化,然后在循环中找到所需要的实现。 多个并发多线程使用ServiceLoader类的实例不安全 加载不到实现类时抛出并不是真正原因的异常,错误难定位。 Spring SPI Spring SPI 沿用了 Java SPI ,但是在实现上和 Java SPI 存在差异,但是核心机制相同,在不修改 Spring 源码前提下,可以做到对 Spring 框架的扩展开发。 在 Spring XML 中,由DefaultNamespaceHandlerResolver负责解析spring.handlers生成 namespaceUri 和 NamespaceHandler 名称的映射,等有需要时在进行实例化。 在 Spring Boot 中,由SpringFactoriesLoader负责解析spring.factories文件,并将指定接口的所有实现类/全限定类名返回。 Spring Boot 2.7.0 在本文中 Spring Boot 自动装配使用了 SPI 来加载到EnableAutoConfiguration所指定的自动装配的类名,但在 Spring Boot2.7.0之后自动装配 SPI 机制有所改动,META-INF/spring.factories将废弃,同时在 Spring Boot 3 以上会将相关代码移除,改动如下: 新的注解:@AutoConfiguration代替@Configuration 读取自动装配的类文件位置改为:META-INF/spring/org.springframework.boot.autoconfigure.AutoConfiguration.imports,并且实现类全限定类名按照一行一个 由org.springframework.boot.context.annotation.ImportCandidates#load负责解析META-INF/spring/%s.imports,其中%s是接口名的占位符 三、Spring Boot Stater 实践 在使用spring-boot-starter-jdbc或者spring-boot-starter-jpa等数据库操作时,通常会引入一个数据库数据源连接池,比如:HikariCP、DBCP等,同时可随意切换依赖而不需要去更改任何业务代码,开发人员也无需关注底层实现,在此我们自定义一个 Starter 同时也实现这种兼容。因为我们以开发一个分布式锁的 Starter 并拥有多个实现:Zookeeper、Redis。 在此使用 Spring Boot 2.6.9 版本。 开发 项目结构与 Maven 依赖 └── src ├── main │ ├── java │ │ └── com.demo.distributed.lock │ │ ├── api │ │ │ ├── DistributedLock.java │ │ │ └── LockInfo.java │ │ ├── autoconfigure │ │ │ ├── DistributedLockAutoConfiguration.java │ │ │ └── DistributedLockProperties.java │ │ ├── redis │ │ │ └── RedisDistributedLockImpl.java │ │ └── zookeeper │ │ └── ZookeeperDistributedLockImpl.java │ └── resources │ └── META-INF │ └── spring.factories <dependencies> <!-- Spring Boot 自动装配注解 --> <dependency> <groupId>org.springframework.boot</groupId> <artifactId>spring-boot-autoconfigure</artifactId> </dependency> <!-- 生成 META-INF/spring-configuration-metadata.json --> <dependency> <groupId>org.springframework.boot</groupId> <artifactId>spring-boot-configuration-processor</artifactId> <optional>true</optional> </dependency> <!-- Zookeeper --> <dependency> <groupId>org.apache.curator</groupId> <artifactId>curator-framework</artifactId> <version>5.1.0</version> <scope>provided</scope> </dependency> <dependency> <groupId>org.apache.curator</groupId> <artifactId>curator-recipes</artifactId> <version>5.1.0</version> <scope>provided</scope> </dependency> <!-- Redis --> <dependency> <groupId>org.redisson</groupId> <artifactId>redisson</artifactId> <version>3.23.1</version> <scope>provided</scope> </dependency> </dependencies> 在依赖里可以看到 Zookeeper 和 Redis 依赖关系被设置为provided,作用为编译与测试阶段使用,不会随着项目一起发布。即打包时不会带上该依赖。该设置在 Spring Boot Starter 作用较大。 分布式锁接口与实现 接口 public interface DistributedLock { /** * 加锁 */ LockInfo tryLock(String key, long expire, long waitTime); /** * 释放锁 */ boolean release(LockInfo lock); } Redis 实现 public class RedisDistributedLockImpl implements DistributedLock { private final RedissonClient client; public RedisDistributedLockImpl(RedissonClient client) { this.client = client; } @Override public LockInfo tryLock(String key, long expire, long waitTime) { //do something return null; } @Override public boolean release(LockInfo lock) { //do something return true; } } Zookeeper 实现 public class ZookeeperDistributedLockImpl implements DistributedLock { private final CuratorFramework client; public ZookeeperDistributedLockImpl(CuratorFramework client) { this.client = client; } @Override public LockInfo tryLock(String key, long expire, long waitTime) { return null; } @Override public boolean release(LockInfo lock) { return false; } } DistributedLockAutoConfiguration 配置类 @EnableConfigurationProperties(DistributedLockProperties.class) @Import({DistributedLockAutoConfiguration.Zookeeper.class, DistributedLockAutoConfiguration.Redis.class}) public class DistributedLockAutoConfiguration { @Configuration @ConditionalOnClass(CuratorFramework.class) @ConditionalOnMissingBean(DistributedLock.class) @ConditionalOnProperty(name = "distributed.lock.type", havingValue = "zookeeper", matchIfMissing = true) static class Zookeeper { @Bean CuratorFramework curatorFramework(DistributedLockProperties properties) { //build CuratorFramework client return null; } @Bean ZookeeperDistributedLockImpl zookeeperDistributedLock(CuratorFramework client) { return new ZookeeperDistributedLockImpl(client); } } @Configuration @ConditionalOnClass(RedissonClient.class) @ConditionalOnMissingBean(DistributedLock.class) @ConditionalOnProperty(name = "distributed.lock.type", havingValue = "redis", matchIfMissing = true) static class Redis { @Bean RedissonClient redissonClient(DistributedLockProperties properties) { //build RedissonClient client return null; } @Bean RedisDistributedLockImpl redisDistributedLock(RedissonClient client) { return new RedisDistributedLockImpl(client); } } } @EnableConfigurationProperties(DistributedLockProperties.class)开启配置类 Properties 信息,会将配置文件里的信息注入 Properties 类里。 @Configuration配置注解 @ConditionalOnClass(CuratorFramework.class)条件注解,要求存在CuratorFramework类当前配置类才生效,Redis 的子配置类同理。 @ConditionalOnMissingBean(DistributedLock.class)条件注解,Spring 不存在DistributedLockBean 当前配置类才生效,Redis 的子配置类同理。 @ConditionalOnProperty(name = "distributed.lock.type", havingValue = "zookeeper", matchIfMissing = true)条件注解,这里判断配置文件distributed.lock.type等于zookeeper才生效,当如果没配置则默认当做zookeeper,Redis 的子配置类同理。 @Bean将方法返回的 Bean 注入到 Spring IOC 容器里,方法入参中含依赖的 Bean spring.factories org.springframework.boot.autoconfigure.EnableAutoConfiguration=\ com.demo.distributed.lock.autoconfigure.DistributedLockAutoConfiguration 我们只需要将该文件放到resource/META-INF/spring.factories下,就会被 Spring Boot 加载,这也是 Spring Boot 的约定大于配置的思想。 使用 Maven 依赖关系 <dependencies> <dependency> <groupId>com.demo</groupId> <artifactId>distributed-lock-spring-boot-starter</artifactId> <version>1.0.0-SNAPSHOT</version> </dependency> </dependencies> <profiles> <profile> <id>dev</id> <activation> <activeByDefault>true</activeByDefault> </activation> <dependencies> <!-- Redis --> <dependency> <groupId>org.redisson</groupId> <artifactId>redisson</artifactId> <version>3.23.1</version> </dependency> </dependencies> </profile> <profile> <id>test</id> <dependencies> <dependency> <groupId>org.apache.curator</groupId> <artifactId>curator-framework</artifactId> <version>5.1.0</version> </dependency> <dependency> <groupId>org.apache.curator</groupId> <artifactId>curator-recipes</artifactId> <version>5.1.0</version> </dependency> </dependencies> </profile> </profiles> 此处结合 Maven profile 功能按照不同环境依赖不同分布式锁底层实现,同时 Spring Boot 也提供了 Spring Boot Profile 加载不同配置,可以从开发、测试、生产环境使用不同底层了,同时 Maven profile 可以根据-P指定加载不同的依赖进行打包,解决了不同环境使用不同分布式锁实现。 代码使用 private final DistributedLock distributedLock; public DemoServiceImpl(DistributedLock distributedLock) { this.distributedLock = distributedLock; } public void test() { LockInfo lock = null; try { lock = distributedLock.tryLock("demo", 1000, 1000); //do something } finally { if (lock != null) { distributedLock.release(lock); } } } 业务代码中由于依赖的是接口,结合 Spring Boot Starter 条件注解 + Maven Profile 不管依赖哪个分布式锁实现,都无需去修改代码。 四、总结 本文介绍了在没有 Spring Boot 和 Starter 之前,开发人员在使用传统的 Spring XML 开发 Web 应用时需要引用许多依赖,并且需要大量编写 XML 代码来描述 Bean 以及它们之间的依赖关系。也了解了如何利用 SPI 加载自定义标签来加载 Bean 并进行注入。而 Spring Boot Starter 则提供了一种更加现代化的配置方式,它通过 SPI 机制加载自动装配的@Configuration配置类来代替传统的 Spring XML 完成 Bean 的注入,从而消除了大量的 XML 配置。最后,我们通过自定义开发了一个分布式锁 Spring Boot Starter 组件,利用一系列的@ConditionalXXX注解和 Maven Profile 来完成开发。这样,我们可以兼容多种分布式锁实现,并且在不同环境下使用不同的分布式锁实现,而无需修改业务代码。 作者:京东零售 陈炎清 来源:京东云开发者社区

优秀的个人博客,低调大师

拆解雪花算法生成规则 | 京东物流技术团队

1 介绍 雪花算法(Snowflake)是一种生成分布式全局唯一ID的算法,生成的ID称为Snowflake IDs或snowflakes。这种算法由Twitter创建,并用于推文的ID。目前仓储平台生成ID是用的雪花算法修改后的版本。 雪花算法几个特性 生成的ID分布式唯一和按照时间递增有序,毫秒数在高位,自增序列在低位,整个ID都是趋势递增的。 不依赖数据库等三方系统,稳定性更高,性能非常高的。 可以根据自身业务特性分配bit位,非常灵活。 2 其他分布式唯一ID生成方案 2.1 数据库生成 以MySQL为例,单库单表,给字段设置auto_increment来生成全局唯一ID 优点: 非常简单,维护成本比较低 ID唯一,单调递增,可以设置固定步长 缺点: 可用性难以保证,每次生成ID都需要访问数据库,瓶颈在于单台MySQL读写性能上,如果数据库挂掉会造成服务不可用,这是一个致命的问题 2.2 UUID UUID是由一组32位数的16进制数字所构成,故UUID理论上的总数为16^32=2^128,约等于3.4 x 10^38。也就是说若每纳秒产生1兆个UUID,要花100亿年才会将所有UUID用完。UUID的标准型式包含32个16进制数字,以连字号分为五段,形式为8-4-4-4-12的32个字符。示例:550e8400-e29b-41d4-a716-446655440000 优点: 本地生成ID,不需要进行远程调用,没有网络耗时 基本没有性能上限 缺点: 可读性差 长度过长,16字节128位,生成的UUID通常是36位(包含-),有些场景可能不适用。如果用作数据库主键,在MySQL的InnoDB引擎下长度过长,二级索引(非主键索引)会占用很大的空间。 无法保证趋势递增,在MySQL的InnoDB引擎下,新插入数据会根据主键来寻找合适位置,会导致频繁的移动、分页增加了很多开销。 3 snowflake算法实现细节 3.1拆解64bit位 snowflake生成的id通常是一个64bit数字,java中用long类型。 图1:snowflake算法中的64-bit划分方式 1-bit不用于生成ID(符号位) long 范围[-2^(64-1), 2^(64-1) ] , (64-1)中的1代表的就是符号位 41-bit时间戳(毫秒)可以表示1 x 2^41 / (1000 x 3600 x 24 x 365) = 69年的时间 10-bit可以分别表示1 x 2^10 = 1024台机器,范围[0,1023] 12-bit表示1ms内自动递增的序列号,1 x 2^12 = 4096个 范围[0,4095]。单机1ms可以生成4096个不重复的ID 通过上述方式进行生成ID,可以保证1024台机器在任意69年的时间段里不会出现重复的ID,而且单台机器支持一秒能够生成409.6万个ID。 这种方式可以支撑大部分业务,如果不满足,可以根据自身业务特点来调整不同命名空间占用的bit数。如果我们有划分IDC的需求,可以将10-bit分5-bit给IDC,分5-bit给工作机器。这样就可以表示32个IDC,每个IDC下可以有32台机器。如果我们的机器位比较特殊,数值相对较大,但是对并发要求不高,还可以将时间位调整为秒级,时间位节省出10-bit留给机器位。 1-bit符号位 31-bit时间戳(秒)1 x 2^31/ (3600 x 24 x 365) = 68年 22-bit机器位 运维平台给提供的数值 范围 [0,2^22-1] 10-bit序列号 范围[0, 2^10 - 1]共1024个 通过上述方式进行生成ID,可以保证4194303台机器在任意68年的时间段里不会出现重复的ID,而且单台机器支持一秒能够生成1024个ID。 3.2 Java实现 public class IdGenerator { // 起始时间 private final long from = 1422720000000L; // 机器位所占bit位数 private final long instanceIdBits = 10L; // 序列号所占bit位数 private final long sequenceBits = 12L; // 机器位左移长度 private final long instanceIdShift = sequenceBits; // 时间位左移长度 private final long timestampLeftShift = sequenceBits + instanceIdBits; // 序号1: 最大机器ID private final long maxInstanceId = -1L ^ (-1L << instanceIdBits); // 最大序列号 private final long sequenceMask = -1L ^ (-1L << sequenceBits); private long instanceId; private long sequence = 0L; private long lastTimestamp = -1L; public IdGenerator(long instanceId) { if (instanceId > maxInstanceId || instanceId < 0) { throw new IllegalArgumentException(String.format("instance Id can't be greater than %d or less than 0", maxInstanceId)); } this.instanceId = instanceId; } // 序号2: public synchronized long nextId() { long timestamp = timeGen(); // 序号3: if (timestamp < lastTimestamp) { throw new RuntimeException(String.format("Clock moved backwards. Refusing to generate id for %d milliseconds", lastTimestamp - timestamp)); } // 序号4: if (lastTimestamp == timestamp) { sequence = (sequence + 1) & sequenceMask; if (sequence == 0) { timestamp = tilNextSecs(lastTimestamp); } } else { sequence = 0L; } lastTimestamp = timestamp; // 序号5: return ((timestamp - from) << timestampLeftShift) // (当前时间 - 起始时间) 向左移位 | (instanceId << instanceIdShift) // 机器位 向左移位 | sequence; // 序列位 } private long tilNextSecs(long lastTimestamp) { long timestamp = timeGen(); while (timestamp <= lastTimestamp) { timestamp = timeGen(); } return timestamp; } private long timeGen() { return System.currentTimeMillis(); } } 3.3一些疑问 3.3.1 为什么bit位置只利用了63位? 因为long在java中占8字节,每字节8bit,一共64bit,其中有1个bit位是符号位不能用做生成ID,如果符号位也用来做ID中的1个bit为会导致ID出现负数,影响趋势递增特性。 3.3.2 计算最大机器ID 见代码中注释 序号1 maxInstanceId = -1L ^ (-1L<<instanceIdBits) 等价于 maxInstanceId = -1 ^( -1<<10) ① -1二进制 1111 1111 1111 1111 1111 1111 1111 1111 1111 1111 1111 1111 1111 1111 1111 1111 ② -1左移10位 -1<<10 二进制 1111 1111 1111 1111 1111 1111 1111 1111 1111 1111 1111 1111 1111 1100 0000 0000 ①与②进行异或运算 异或运算:同为假,异为真,所以最终结果应该为 0000 0000 0000 0000 0000 0000 0000 00000000 0000 0000 0000 0000 0011 1111 1111 最后:maxInstanceId = 2^10 - 1 = 1023 sequenceMask 计算方法相同,结果为2^12 - 1 = 4095 3.3.3 计算序列号位 见代码中注释 序号4 if (lastTimestamp == timestamp) { sequence = (sequence + 1) & sequenceMask; if (sequence == 0) { timestamp = tilNextSecs(lastTimestamp); } } else { sequence = 0L; } 其中这段代码的是计算序列号的代码主要逻辑是,如果上个生成ID的时间位与当前ID的时间位冲突,则会生成一个序列号进行区分,如果序列号用尽,则等待下一个时间点再生成。如果上个生成ID的时间位与当前ID的时间位不冲突,则将序列号设置成0。 sequence = (sequence + 1) & sequenceMask,序列号最大值sequenceMask为4095,等价于如下这种写法。 sequence = (sequence + 1); if(sequence == 4095){ sequence = 0; } 其实这两种写法的结果是一致的,就是对(sequence + 1)进行取余。 这里有个位运算知识点 k % m = k & (m - 1),m需要满足 m = 2^n,sequenceMask = 2^12 - 1。所以刚好可以用与运算进行取余操作,效率杠杠滴。 3.3.4 生成ID 见代码中注释 序号5: 此时我们拿到了时间位(timestamp - from)、机器位(instanceId )、序列号位(sequence),所以就可以计算最终的ID了。 ((timestamp - from) << timestampLeftShift) // (当前时间 - 起始时间) 向左移位 | (instanceId << instanceIdShift) // 机器位 向左移位 | sequence; // 序列位 ①((timestamp - from) << timestampLeftShift) 计算时间位 from是固定的1422720000000, timestampLeftShift = 12 + 10.我们假设timestamp = 1422720000001。也就是from刚刚过去1毫秒。1毫秒也是我们时间位倒数第二小的值,因为0是最小值。时间位取值范围[0, 2^41 - 1],从这也可以看出上边描述时间位时为什么把时间段特意标注了,因为时间位存的不是具体时间,而是以from为起始来算的过去了多少时间。 来看下 1<<22 结果 图2: 时间位移位结果 图2可以看出,时间位向左移位22,位置正好到第一个时间位。 ②(instanceId << instanceIdShift) 计算机器位 为了方便计算,这里我们假设instanceId 等于1,机器位取值范围[0,-1]。 那么机器位就是 1 << 12 图3: 机器位移位结果 图3可以看出,机器位左移12位,位置正好到第一个机器位。 ③按照 ① | ② | sequence 进行或运算进行生成ID 现在我们有了时间位的值,机器位的值,就只差序列号位的值,序列号是上面3描述代码生成的,范围是[0, 2^12-1]。为了方便计算,我们假设sequence = 1 那么 ID = ① | ② | 1。进行或运算 图4: ID = ① | ② | 1 下图是按照上面逻辑生成的ID 图5: 程序生成结果 3.3.5 注意:雪花算法需要用单例方式生成ID 因为雪花算法会依赖上一次生成的ID的时间来判断是否需要对序列号进行增加的操作,如果不是单例,两个业务用两个对象同时获取ID,则可能会生成相同的ID 4 关于雪花算法的一些思考 机器位怎么取值 主机唯一标识 如果运维平台有机器唯一标识,可以在运维平台取。不过需要考虑机器位能否容纳下唯一标识,可能会过长,也需要考虑运维平台的唯一标识未来变化。 可根据ip进行计算 如果能保证不同机房的机器ip不重复,可以利用ip来计算机器位,IP最大 255.255.255.255。而(255+255+255+255) < 1024,因此采用IP段数值相加即可生成机器位,不受IP位限制。不过这种方式也不是绝对ok,要根据自身情况在选择,比如10.0.5.2 与 10.0.2.5 计算出来也是相同的。使用这种IP生成机器位的方法,必须保证IP段相加不能重复 通过数据库/redis/zk等进行协调,在应用启动的时候给每个机器分配不会重复的机器位id。 时钟回拨问题 雪花算法强依赖时间,如果时间发生回拨,有可能会生成重复的ID,在我们上面的nextId中我们用当前时间和上一次的时间进行判断,如果当前时间小于上一次的时间那么肯定是发生了回拨,雪花算法的做法是简单的抛出了一个异常。 if (timestamp < lastTimestamp) { throw new RuntimeException(String.format("Clock moved backwards. Refusing to generate id for %d milliseconds", lastTimestamp - timestamp)); } 如果业务的异常容忍度低,这里我们可以对其进行优化,如果时间回拨时间较短,比如配置5ms以内,那么可以直接等待一定的时间,让机器的时间追上来。也可以利用扩展位,将64-bit的机器位或者序列号位预留出2-bit的防止时钟回滚的扩展位。 5 ID逆运算 如果线上出现ID重复,如何进行问题定位?对ID进行逆运算拿到ID的时间位、机器位、序号位。就可以进行下一步分析了。以上述生成的4198401为例 5.1 时间 时间位 = ID / 2^(机器位 + 序列号位) + from 时间位 = 4198401 / 2^(12 + 10) + 1422720000000 = 1422720000001 与上述生成ID时用时间位相符 注意:ID / 2^(机器位 + 序列号位) 是整数 5.2 机器 机器位 = (ID / 2^序列号位 ) % 2^(机器位) 机器位 = (4198401 / 2^12) % 2^10= (1025) % 1024 = 1 与上述生成ID时用机器位数值相符 5.3 序列号 ID % 2^序列号位 序列号 = 4198401 % = 4198401 % 1024 = 1 与上述生成ID时用的序列号数值相符 6 资料 开源代码scala版本:https://github.com/twitter-archive/snowflake 作者:京东物流 马红岩 来源:京东云开发者社区 自猿其说Tech

优秀的个人博客,低调大师

任务调度之时间轮实现 | 京东云技术团队

前言 在生活中太阳的东升西落,鸟类的南飞北归,四级的轮换,每天的上下班,海水的潮汐,每月的房租车贷等等,如果用程序员的视角看,这就是一个个的定时任务,在日常的开发工作中也有很多的定时任务场景: 数仓系统凌晨进行的数据同步 订单12小时未支付的状态校验 rpc调用超时时间的校验 缓存数据失效时间的延长 定时开启的促销活动 …… 假如现在有一个任务需要3s后执行,你会如何实现? 简单点,直接一个线程的休眠,thread.sleep(3000),一行代码就能达到目的,但是性能嘛……,由于每个任务都需要一个单独的线程,当系统中存在大量任务, 任务调度 假如,现在有一个任务需要3s后执行,你会如何实现呢? 简单点,直接一个休眠,让线程sleep 3s,不就达到目的了吗?但是性能嘛……,由于每个任务都需要一个单独的线程,在系统中存在大量任务时,这种方案的消耗是极其巨大的,那么如何实现高效的调度呢?大佬们低头看了一眼手表,一个算法出现了 时间轮的数据结构 如图所示,这就是时间轮的一个基础结构,一个存储了定时任务的环形队列,可以理解为一个时间钟,队列的每个节点称为时间槽,每个槽位又使用列表存储着需要执行的定时任务。和生活中的钟表运行机制一样,每隔固定的单位时间,就会从一个槽位跳到下一个槽位,就像秒针跳动了一次,再取出当前槽位的任务进行执行。假如固定单位时间为1S,当前槽位位2,如果需要插入一个3S后的任务,就会在槽位5的的列表里加上当前任务。等指针运行到第五个槽位时,取出任务执行就可以了。 时间轮的最大优势是在时间复杂度上的优势,一个任务简单的生命周期: 创建任务,插入到数据结构中。 查询任务,找到满足条件的任务 执行任务。 任务归档,从任务调度的列表中删出。 其中第三步的执行时间是固定的,所以1,2,4这三部就的时间复杂度就决定了整个任务调度流程的复杂度,而时间轮是链式存储结构,所以在增删和查询时,时间复杂度都是0(1),其他常见的任务调度算法例如最小堆和红黑树以及跳表。 最小堆是一颗完全二叉树而且子节点的值总是大于等于父节点的值,所以在插入时候需要判断父节点的关系,它的时间添加操作时间复杂度是O(logn),在任务执行时,只需要判断最顶节点就行,所以它的查询时间复杂度时哦O(1)。 根据红黑树的特性已经被归纳法证明它的增加的时间复杂度是O(logn),查找最小节点的时间复杂度位O(h)。 跳表的的本质是实现二分查找法的有序链表,但是他有多个层级,和红黑树的高度值相似,它的时间复杂度也是O(logn) 高级时间轮 如上图所示,如果一个刻度代表1S,那么一个周期就是1分钟,但是如果我一个任务是在3分钟后执行呢,如果是在一个12小时后执行呢? 当然如果是单纯的增加环形链表的长度也是可以的,直接扩大到3600*24,一天一个周期,直接放进来。但是还有更好的办法。 带轮次标记的任务 任务执行轮次的计算公式:((任务执行时间-当前时间)/固定单位时间)%槽位数量 根据槽位计算公式可以算出当前任务需要插入执行的轮次,我在任务上面加一个字段round,当每次执行到该槽位时,就遍历该槽位的任务列表,每个任务的round-1,取出来round=0的任务执行就行。 for(Task task:taskList){ int round= task.getRound(); round=(round-1); task.setRound(round); if(round==0){ doTask(task); } } 如果任务间隔不是很大,看起来也是不错的一种解决方式。 但是工作中有很多任务,延迟执行的时间是很久以后的,例如延保履约服务成功之后会有一个7天自动完成的定时任务,甚至有一些几年后才会执行的任务,如果都用round来处理的话,那这个round将会变的非常大的一个数字,也会在任务列表中插入很多当前不需要执行的任务,如果每次都执行上面的逻辑,显然会浪费大量的资源。 多层时间轮 多层时间轮的核心思想是: 就上上图的水表,有很多小的表盘,但是每个表盘的刻度其实是不一样,又或者手表里的时分秒或者日历上的年月日。 针对时间复杂度的问题:不做遍历计算round,只要到了当前槽位,就把任务列表的所有任务拿出来执行。 针对空间复杂度的问题:分层,每个层级的时间轮刻度不一样,多个时间轮协调工作。 如上图所示,第一次时间轮,每个刻度是1ms,一轮是20ms,第二个层时间轮的刻度是20ms,一轮就是400ms,第三层的刻度是400ms,一轮就是8000ms,每层的周期就等于 20ms *2的n次方。这要使用多层级时间轮就可以很容易把任务区分开来。每当高层次时间轮到达当前节点,就把任务降级到低层级的时间轮上。对于400ms的时间轮来说,小于1ms和小于399ms的任务都是过期任务,只要不大于400ms,都认为是过期任务。 代码实现的话,往上也有很多,最近比较火热的POWER-JOB的分布式调度框架就是才有的时间轮算法,粘贴下核心代码大家看下: 1.首先定义了一个任务接口 public interface TimerTask extends Runnable { } 2.调度中的任务对象 public interface TimerFuture { /** * 获取实际要执行的任务 * @return */ TimerTask getTask(); /** * 取消任务 * @return */ boolean cancel(); /** * 任务是否取消 * @return */ boolean isCancelled(); /** * 任务是否完成 * @return */ boolean isDone(); } 3.调度器接口 public interface Timer { /** * 调度定时任务 */ TimerFuture schedule(TimerTask task, long delay, TimeUnit unit); /** * 停止所有调度任务 */ Set<TimerTask> stop(); } 4.时间轮的实现 public class HashedWheelTimer implements Timer { private final long tickDuration; private final HashedWheelBucket[] wheel; private final int mask; private final Indicator indicator; private final long startTime; private final Queue<HashedWheelTimerFuture> waitingTasks = Queues.newLinkedBlockingQueue(); private final Queue<HashedWheelTimerFuture> canceledTasks = Queues.newLinkedBlockingQueue(); private final ExecutorService taskProcessPool; public HashedWheelTimer(long tickDuration, int ticksPerWheel) { this(tickDuration, ticksPerWheel, 0); } /** * 新建时间轮定时器 * @param tickDuration 时间间隔,单位毫秒(ms) * @param ticksPerWheel 轮盘个数 * @param processThreadNum 处理任务的线程个数,0代表不启用新线程(如果定时任务需要耗时操作,请启用线程池) */ public HashedWheelTimer(long tickDuration, int ticksPerWheel, int processThreadNum) { this.tickDuration = tickDuration; // 初始化轮盘,大小格式化为2的N次,可以使用 & 代替取余 int ticksNum = CommonUtils.formatSize(ticksPerWheel); wheel = new HashedWheelBucket[ticksNum]; for (int i = 0; i < ticksNum; i++) { wheel[i] = new HashedWheelBucket(); } mask = wheel.length - 1; // 初始化执行线程池 if (processThreadNum <= 0) { taskProcessPool = null; }else { ThreadFactory threadFactory = new ThreadFactoryBuilder().setNameFormat("HashedWheelTimer-Executor-%d").build(); // 这里需要调整一下队列大小 BlockingQueue<Runnable> queue = Queues.newLinkedBlockingQueue(8192); int core = Math.max(Runtime.getRuntime().availableProcessors(), processThreadNum); // 基本都是 io 密集型任务 taskProcessPool = new ThreadPoolExecutor(core, 2 * core, 60, TimeUnit.SECONDS, queue, threadFactory, RejectedExecutionHandlerFactory.newCallerRun("PowerJobTimeWheelPool")); } startTime = System.currentTimeMillis(); // 启动后台线程 indicator = new Indicator(); new Thread(indicator, "HashedWheelTimer-Indicator").start(); } @Override public TimerFuture schedule(TimerTask task, long delay, TimeUnit unit) { long targetTime = System.currentTimeMillis() + unit.toMillis(delay); HashedWheelTimerFuture timerFuture = new HashedWheelTimerFuture(task, targetTime); // 直接运行到期、过期任务 if (delay <= 0) { runTask(timerFuture); return timerFuture; } // 写入阻塞队列,保证并发安全(性能进一步优化可以考虑 Netty 的 Multi-Producer-Single-Consumer队列) waitingTasks.add(timerFuture); return timerFuture; } @Override public Set<TimerTask> stop() { indicator.stop.set(true); taskProcessPool.shutdown(); while (!taskProcessPool.isTerminated()) { try { Thread.sleep(100); }catch (Exception ignore) { } } return indicator.getUnprocessedTasks(); } /** * 包装 TimerTask,维护预期执行时间、总圈数等数据 */ private final class HashedWheelTimerFuture implements TimerFuture { // 预期执行时间 private final long targetTime; private final TimerTask timerTask; // 所属的时间格,用于快速删除该任务 private HashedWheelBucket bucket; // 总圈数 private long totalTicks; // 当前状态 0 - 初始化等待中,1 - 运行中,2 - 完成,3 - 已取消 private int status; // 状态枚举值 private static final int WAITING = 0; private static final int RUNNING = 1; private static final int FINISHED = 2; private static final int CANCELED = 3; public HashedWheelTimerFuture(TimerTask timerTask, long targetTime) { this.targetTime = targetTime; this.timerTask = timerTask; this.status = WAITING; } @Override public TimerTask getTask() { return timerTask; } @Override public boolean cancel() { if (status == WAITING) { status = CANCELED; canceledTasks.add(this); return true; } return false; } @Override public boolean isCancelled() { return status == CANCELED; } @Override public boolean isDone() { return status == FINISHED; } } /** * 时间格(本质就是链表,维护了这个时刻可能需要执行的所有任务) */ private final class HashedWheelBucket extends LinkedList<HashedWheelTimerFuture> { public void expireTimerTasks(long currentTick) { removeIf(timerFuture -> { // processCanceledTasks 后外部操作取消任务会导致 BUCKET 中仍存在 CANCELED 任务的情况 if (timerFuture.status == HashedWheelTimerFuture.CANCELED) { return true; } if (timerFuture.status != HashedWheelTimerFuture.WAITING) { log.warn("[HashedWheelTimer] impossible, please fix the bug"); return true; } // 本轮直接调度 if (timerFuture.totalTicks <= currentTick) { if (timerFuture.totalTicks < currentTick) { log.warn("[HashedWheelTimer] timerFuture.totalTicks < currentTick, please fix the bug"); } try { // 提交执行 runTask(timerFuture); }catch (Exception ignore) { } finally { timerFuture.status = HashedWheelTimerFuture.FINISHED; } return true; } return false; }); } } private void runTask(HashedWheelTimerFuture timerFuture) { timerFuture.status = HashedWheelTimerFuture.RUNNING; if (taskProcessPool == null) { timerFuture.timerTask.run(); }else { taskProcessPool.submit(timerFuture.timerTask); } } /** * 模拟时针转动的线程 */ private class Indicator implements Runnable { private long tick = 0; private final AtomicBoolean stop = new AtomicBoolean(false); private final CountDownLatch latch = new CountDownLatch(1); @Override public void run() { while (!stop.get()) { // 1. 将任务从队列推入时间轮 pushTaskToBucket(); // 2. 处理取消的任务 processCanceledTasks(); // 3. 等待指针跳向下一刻 tickTack(); // 4. 执行定时任务 int currentIndex = (int) (tick & mask); HashedWheelBucket bucket = wheel[currentIndex]; bucket.expireTimerTasks(tick); tick ++; } latch.countDown(); } /** * 模拟指针转动,当返回时指针已经转到了下一个刻度 */ private void tickTack() { // 下一次调度的绝对时间 long nextTime = startTime + (tick + 1) * tickDuration; long sleepTime = nextTime - System.currentTimeMillis(); if (sleepTime > 0) { try { Thread.sleep(sleepTime); }catch (Exception ignore) { } } } /** * 处理被取消的任务 */ private void processCanceledTasks() { while (true) { HashedWheelTimerFuture canceledTask = canceledTasks.poll(); if (canceledTask == null) { return; } // 从链表中删除该任务(bucket为null说明还没被正式推入时间格中,不需要处理) if (canceledTask.bucket != null) { canceledTask.bucket.remove(canceledTask); } } } /** * 将队列中的任务推入时间轮中 */ private void pushTaskToBucket() { while (true) { HashedWheelTimerFuture timerTask = waitingTasks.poll(); if (timerTask == null) { return; } // 总共的偏移量 long offset = timerTask.targetTime - startTime; // 总共需要走的指针步数 timerTask.totalTicks = offset / tickDuration; // 取余计算 bucket index int index = (int) (timerTask.totalTicks & mask); HashedWheelBucket bucket = wheel[index]; // TimerTask 维护 Bucket 引用,用于删除该任务 timerTask.bucket = bucket; if (timerTask.status == HashedWheelTimerFuture.WAITING) { bucket.add(timerTask); } } } public Set<TimerTask> getUnprocessedTasks() { try { latch.await(); }catch (Exception ignore) { } Set<TimerTask> tasks = Sets.newHashSet(); Consumer<HashedWheelTimerFuture> consumer = timerFuture -> { if (timerFuture.status == HashedWheelTimerFuture.WAITING) { tasks.add(timerFuture.timerTask); } }; waitingTasks.forEach(consumer); for (HashedWheelBucket bucket : wheel) { bucket.forEach(consumer); } return tasks; } } } 作者:京东保险陈建华 来源:京东云开发者社区

优秀的个人博客,低调大师

Java反射源码学习之旅 | 京东云技术团队

1 背景 前段时间组内针对“拷贝实例属性是应该用BeanUtils.copyProperties()还是MapStruct”这个问题进行了一次激烈的battle。支持MapStruct的同学给出了他嫌弃BeanUtils的理由:因为用了反射,所以慢。 这个理由一下子拉回了我遥远的记忆,在我刚开始了解反射这个Java特性的时候,几乎看到的每一篇文章都会有“Java反射不能频繁使用”、“反射影响性能”之类的话语,当时只是当一个结论记下了这些话,却没有深究过为什么,所以正好借此机会来探究一下Java反射的代码。 2 反射包结构梳理 反射相关的代码主要在jdk rt.jar下的java.lang.reflect包下,还有一些相关类在其他包路径下,这里先按下不表。按照继承和实现的关系先简单划分下java.lang.reflect包: ① Constructor、Method、Field三个类型分别可以描述实例的构造方法、普通方法和字段。三种类型都直接或间接继承了AccessibleObject这个类型,此类型里主要定义两种方法,一种是通用的、对访问权限进行处理的方法,第二种是可供继承重写的、与注解相关的方法。 ② 只看选中的五种类型,我们平常所用到的普通类型,譬如Integer、String,又或者是我们自定义的类型,都可以用Class类型的实例来表示。Java引入泛型之后,在JDK1.5中扩充了其他四种类型,用于泛型的表示。分别是ParameterizedType(参数化类型)、WildcardType(通配符类型)、TypeVariable(类型变量)、GenericArrayType(泛型数组)。 ③ 与②中描述的五种基本类型对应,下图这五个接口/类分别用来表示五种基本类型的注解相关数据。 ④ 下图为实现动态代理的相关类与接口。java.lang.reflect.Proxy主要是利用反射的一些方法获取代理类的类对象,获取其构造方法,由此构造出一个实例。 java.lang.reflect.InvocationHandler是代理类需要实现的接口,由代理类实现接口内的invoke方法,此方法会负责代理流程和被代理流程的执行顺序组织。 3 目标类实例的构造源码 以String类的对象实例化为例,看一下反射是如何进行对象实例化的。 Class<?> clz = Class.forName("java.lang.String"); String s =(String)clz.newInstance(); Class对象的构造由native方法完成,以java.lang.String类为例,先看看构造好的Class对象都有哪些属性: 可以看到目前只有name一个属性有值,其余属性暂时都是null或者默认值的状态。 下图是 clz.newInstance() 方法逻辑的流程图,接下来对其中主要的两个方法进行说明: 从上图可以看出整个流程有两个核心部分。因为通常情况下,对象的构造都需要依靠类里的构造方法来实现,所以第一部分就是拿到目标类对应的Constructor对象;第二部分就是利用Constructor对象,构造目标类的实例。 3.1 获取Constructor对象 首先上一张Constructor对象的属性图: java.lang.Class#getConstructor0 此方法中主要做的工作是首先拿到目标类的Constructor实例数组(主要由native方法实现),数组里每一个对象都代表了目标类的一个构造方法。然后对数组进行遍历,根据方法入参提供的parameterTypes,找到符合的Constructor对象,然后重新创造一个Constructor对象,属性值与原Constructor一致(称为副本Constructor),并且副本Constructor的属性 root 指向源Constructor,相当于对源Constructor对象进行了一层封装。 由于在getConstructor0()方法将返回值返回给调用方之后,调用方在后续的流程里进行了constructor.setAccesssible(true)的操作,这个方法的作用是关闭对constructor这个对象访问时的Java语言访问检查。语言访问检查是个耗时的操作,所以合理猜测是为了提高反射性能关闭了这个检查,又出于安全考虑,所以将最原始的对象进行了封装。 private Constructor<T> getConstructor0(Class<?>[] parameterTypes, int which) throws NoSuchMethodException { //1、拿到Constructor实例数组并进行筛选 Constructor<T>[] constructors = privateGetDeclaredConstructors((which == Member.PUBLIC)); //2、通过对入参的比较筛选出符合条件的Constructor for (Constructor<T> constructor : constructors) { if (arrayContentsEq(parameterTypes, constructor.getParameterTypes())) { //3、创建副本Constructor return getReflectionFactory().copyConstructor(constructor); } } throw new NoSuchMethodException(getName() + ".<init>" + argumentTypesToString(parameterTypes)); } 3.2 目标类实例的构造 sun.reflect.ConstructorAccessor#newInstance 此方法主要是利用上一步创建出来的Constructor对象,进行目标类实例的构造。Java为了提高反射的性能,为类实例的构造提供了两种方案,一种是虚拟机自己实现的native方法,一种是JDK包里的Java方法。 首先来看代码里对ConstructorAccessor对象的构造,通过代码可以看出在方法newConstructorAccessor中构造了ConstructorAccessor接口的两个实现类,两个对象进行了相互引用,像这样子: //构造ConstructorAccessor对象 public ConstructorAccessor newConstructorAccessor(Constructor<?> var1) { if (Modifier.isAbstract(var2.getModifiers())) { ...... } else { NativeConstructorAccessorImpl var3 = new NativeConstructorAccessorImpl(var1); DelegatingConstructorAccessorImpl var4 = new DelegatingConstructorAccessorImpl(var3); var3.setParent(var4); return var4; } } 在调用DelegatingConstructorAccessorImpl的newInstance方法时,相当于为NativeConstructorAccessorImpl做了一层代理,实际调用的是NativeConstructorAccessorImpl类实现的方法。 public Object newInstance(Object[] var1) throws InstantiationException, IllegalArgumentException, InvocationTargetException { return this.delegate.newInstance(var1); } newInstance方法中决定使用哪种方法的是一个名为numInvocations的int类型的变量,每次调用到newInstance方法时,这个变量都会+1,当变量值超过阈值(15)时,就会使用Java方式进行目标类实例的创造,反之就会使用虚拟机实现的方式进行目标类实例的创造。 这样做是因为Java版本的实现流程很长,其中还包含了字节码构造的流程,所以初次构造比较耗时,但是长久来说性能更好,而native版本是初期使用速度较块,调用频繁的话性能会有所下降,所以做了根据阈值来判断使用哪个版本的设计。 public Object newInstance(Object[] var1) throws InstantiationException, IllegalArgumentException, InvocationTargetException { if (++this.numInvocations > ReflectionFactory.inflationThreshold() && !ReflectUtil.isVMAnonymousClass(this.c.getDeclaringClass())) { //Java方法构造对象 ConstructorAccessorImpl var2 = (ConstructorAccessorImpl)(new MethodAccessorGenerator()).generateConstructor(this.c.getDeclaringClass(), this.c.getParameterTypes(), this.c.getExceptionTypes(), this.c.getModifiers()); this.parent.setDelegate(var2); } //native方法实现实例化 return newInstance0(this.c, var1); } 重点关注以下Java版本的实现流程,首先构造了一个ConstructorAccessorImpl类的对象。这个对象的构造主要是依靠在代码里按照字节码文件的格式构造出来一个字节数组实现的。首先创建了一个ByteVactor接口的实现类对象,此类有两个属性,一个字节数组,一个int类型的数用来标识位置。ClassFileAssembler类主要负责把各类值转化成字节码的格式然后填充到ByteVactor的实现类对象里。最后由ClassDefiner.defineClass方法对字节码数组进行处理,构造出ConstructorAccessorImpl对象。 最后ConstructorAccessorImpl实例还是会被传给newInstance0()这个native方法,以此来构造最终的目标类实例 private MagicAccessorImpl generate(final Class<?> var1, String var2, Class<?>[] var3, Class<?> var4, Class<?>[] var5, int var6, boolean var7, boolean var8, Class<?> var9) { //创建ByteVectorImpl对象 ByteVector var10 = ByteVectorFactory.create(); //创建ClassFileAssembler对象 this.asm = new ClassFileAssembler(var10); ...... var10.trim(); //拿出构造好的字节数组(就是字节码文件的格式) final byte[] var17 = var10.getData(); return (MagicAccessorImpl)AccessController.doPrivileged(new PrivilegedAction<MagicAccessorImpl>() { public MagicAccessorImpl run() { try { //调用native方法,创建ConstructorAccessorImpl类的实例 //最后ConstructorAccessorImpl实例还是会被传给newInstance0()这个native方法,以此来构造最终的目标类实例 return (MagicAccessorImpl)ClassDefiner.defineClass(var13, var17, 0, var17.length, var1.getClassLoader()).newInstance(); } catch (IllegalAccessException | InstantiationException var2) { throw new InternalError(var2); } } }); } } 4 小结 最后根据上述学习思考下Java反射到底慢不慢这个问题。首先可以看到JDK为“反射时创建对象的过程”提供了两套实现,native版本更快但是也使得JVM无法对其进行一些优化(譬如JIT的方法内联),当方法成为热点时,转用Java版本来进行实现则优化了这个问题。但Java版本的实现过程中需要动态生成字节码,还要加载一些额外的类,造成了内存的消耗,所以使用反射的时候还是应当注意一些是否会因为使用过多而造成内存溢出。 一次不成熟的源码学习历程,如有错误还请指正。 参考资料:https://rednaxelafx.iteye.com/blog/548536 作者:京东物流 秦曌怡 来源:京东云开发者社区

优秀的个人博客,低调大师

Flutter状态管理新的实践 | 京东云技术团队

1 背景介绍 1.1 声明式ui 声明式UI其实并不是近几年的新技术,但是近几年声明式UI框架非常的火热。单说移动端,跨平台方案有:RN、Flutter。iOS原生有:SwiftUI。android原生有:compose。可以看到声明式UI是以后的前端发展趋势。而状态管理是声明式UI框架的重要组成部分。 1.2 声明式UI框架的状态 在移动端之前的命令式UI框架,没有状态的概念。每个控件其实都是无状态的,我们要更新UI需要手动的去set。命令式UI引入状态的概念,状态可以理解为订阅了控件所依赖数据的变化,当一个控件依赖的数据发生变化时,自动刷新UI展示。最大的优势就是可以很方便的做到UI和逻辑的解耦。 2 provider状态管理 2.1 使用方式 定义一个页面如下: 实现功能,当点击“按钮”的时候,更新“你好”这个组件 页面部分代码实现(基于StatelessWidget实现): model部分实现: 2.2 问题和不足 点击“按钮”的时候查看页面刷新,发现下表罗列的Widget都执行了刷新操作,使用Selector虽然被包裹的内容没有刷新,但是需要进行校验操作。 2.2.1 控件刷新 2.2.2 问题分析 使用不太灵活,想要消费事件刷新UI必须有顶层的Provider提供model,在一些复杂场景可能会增加逻辑复杂度 状态刷新,不能实现最小粒度的管理 代码不够简洁 3 新的状态管理方式实践 3.1 使用方式 实现同样的上述页面逻辑,代码如下(同样基于StatelessWidget实现): 首先不需要依赖外部的provider提供Model,任何想要独立刷新的区域使用TosObWidget控件包裹即可,使用比较灵活,我们可以把TosObWidget插入到任何我们想要的位置(包括provider内),代码逻辑比较简洁 model实现: model的实现更加简洁,不需要继承ChangeNotifier,所以可以把状态数据定义在任何我们想要的地方,使用.tos扩展属性返回一个包含默认值的RxObj对象,当我们使用set方法更改RxObj的value的时候,通知依赖此对象的TosObWidget区域进行刷新,例:我们点击按钮的时候,_model.textA.value = “你好${_model.i++}”,执行后就会刷新依赖textA的TosObWidget(() => Text(_model.textA.value))区域 查看刷新状态(与provider对比): 对比发现TosObWidget这种方式,只有依赖的数据发生变化的TosObWidget才会更新状态,可以实现状态刷新粒度最小化,提高性能 3.2 设计思路 3.2.1 TosObWidget 首先是使用入口,定义一个TosObWidget控件,入参为build函数,返回widget,每个TosObWidget就是一个可独立进行状态刷新的区域 TosObWidget控件的实现如下: TosObWidget的build函数为重载的其父类_ObzWidget的build函数,最终会被_ObzWidget的_ObzState调用,_ObzWidget的实现如下: 接下来查看_ObzState的实现,主要逻辑都在这个类进行实现,这里贴出所有的代码(注意框起来的逻辑): 3.2.2 TosObWidget逻辑分析 首先_ObzState依赖一个RxObserver _observer变量 RxObserver _observer这个 变量持有了_updateUI()这个方法,最终会通过这个方法刷新TosOBWidget的状态 当TosObWidget执行build的时候,会通过一个静态变量RxObserver.proxy把_observer共享出去 这样TosObWidget包裹的内容,使用RxObj的getValue的时候会拿到被共享的_observer,这时建立RxObj和TosObWidget的联系 联系建立后,重置共享变量RxObserver.proxy 这样在RxObj的value执行set方法时,会调用到与其绑定的TosObWidget的_updateUI()这个函数 3.2.3 RxObj的实现 如下贴出RxObj的value的get和set函数: 当执行RxObj的value的get方法时,代码如下,拿到 RxObserver的静态成员变量proxy,类型为RxObserver(即为上一步TosObWidget共享出来的_observer) 判断RxObserver.proxy不为空,且没有被添加到_observers列表( List _observers),则添加 当执行RxObj的value的set方法时,校验value是否与当前的value值相同,且判断是否是首次创建(首次创建不会执行状态刷新) 校验完成后则赋值执行refresh()函数,更新TosObWidget的状态 refresh()函数的实现如下: observer.update()函数即为执行与Rxobj关联的TosObWidget的_updateUI()函数: 看下RxObserver的实现: 注意框起来的逻辑,update函数即上面_ObzState的_updateUI()函数的引用 至此整个实现流程已经贯通了,接下来看下如何使用: 1)通过.tos扩展属性定义RxObj变量: 2).tos扩展属性的实现如下: 3)如果要创建一个默认值为空的,RxObj实例,使用如下方式: 此时如果我们使用RxObj的setValue方法,就会刷新依赖它的所有TosObWidget控件,如果有些情况下,没有调用setValue方法,但是需要刷新状态,可手动调用refresh()方法,实现如下: 至此,就完成了TosObWidget控件的状态刷新 4 总结 注:基于本文示例的功能逻辑进行对比 作者:京东物流 张俊飞 来源:京东云开发者社区

优秀的个人博客,低调大师

规则引擎调研及初步使用 | 京东云技术团队

一、产生的背景 生产过程中,线上的业务规则内嵌在系统的各处代码中,每次策略的调整都需要更新线上系统,进行从需求->设计->编码->测试->上线这种长周期的流程,满足不了业务规则的快速变化以及低成本的更新试错迭代。 因此需要有一种解决方案将商业决策逻辑和应用开发者的技术决策分离开,在系统运行时能去更新管理业务规则。 规则引擎(业务规则管理系统,英文名为BRMS(即Business Rule Management System))正是这样的解决方案。 二、实际业务场景: 一个小例子: 假如我们有个业务场景,当客户的积分位于一个区间A时,我们给予他一个头衔a,当一个客户的积分位于区间B时,我们给予他一个头衔b,当客户的积分位于区间C时,我们给予他一个 头衔c。如果我们使用if-else-then来写,是可以实现的,但是这里存在一个问题:规则定义和代码耦合在一起了。如果我们改变规则,把区间A,B,C 改成D,E,F,又或是将规则增加,从3组变为100组,那么我们改代码实在是太麻烦了。这时候规则引擎就派上用场了,我们希望把规则和代码解耦,形成一个规则引擎,以适应复杂多变的业务场景,或者更加精细化的运营。 🐵实际业务场景: BD绩效考核是将各个战区每月针对bd制定的绩效考核方案线上化,支持绩效方案设置、bd绩效达成情况跟踪、绩效薪资计算等功能。 现状: 绩效的考核方案和激励政策呈现出多样化、复杂化的特点,不同的战区绩效考核的指标及考核方案不同,每个战区每个月的指标及考核方案变化非常大,同一个指标每月对应的规则定义不同。 方案: 为了应对战区绩效考核方案多变,本次需要实现指标规则的灵活配置。 以有效团长数为例: 有效团长定义为: 团长每月有效团达标天数>=15天(有效团指的是每天成团的标准:5个下单用户,15件下单商品) 指标类型 指标名称 指标规则 实体 时间维度 原子指标 团用户数 团成交用户数 团 日 原子指标 团商品数 团成交商品数 团 日 复合指标 是否有效团 团用户数>=5且团商品数>=15 团 日 复合指标 有效团天数 是否有效团=1,求和sum 团长 月 复合指标 是否有效团长 有效团天数>=15天 团长 月 复合指标 有效团长数 是否有效团长=1,求和sum 组织/网格 月 三、规则引擎价值及本质 3.1 规则引擎价值: 最大的价值就在于通过以下的三个过程,大大的缓解了频繁的需求变化给整个业务系统带来的灾难。 逼迫系统开发人员和业务专家梳理业务,定义统一的BOM(业务对象模型)。 业务专家可以快速的制定修改规则,然后交由规则引擎自动化地来处理分析。 规则引擎代替系统开发人员,解决由规则条件关联动作变化带来的开发工作。 总结一句话:规则引擎就是将需要外部决策的业务规则加载到系统中,按照不同的输入条件进行不同的规则匹配组合后,执行符合规则的一个或者多个操作。 3.2 规则引擎的本质 本质是“专家决策系统规则引擎模型”和rete算法,为了解决的是大量重复的condition匹配效率的问题,以及规则冲突规范的问题,和脚本的性能比较不在同一个层面上。 四、 Rete算法介绍 (1)规则内容 IF: 年级是三年级以上, 性别是男的, 年龄小于10岁, 身体健壮, 身高170cm以上, THEN: 这个男孩是一个篮球苗子,需要培养 网络构建: 匹配过程: (1)匹配过程中事实在网络节点中的流转顺序为A-->B-->C-->D-->E-->F-->G-->H-->I--->规则匹配通过 (2)从working-Memory中拿出一个待匹配的StudentFact对象,进入根节点然后进行匹配,以下是fact在各个节点中的活动图 A节点:拿StudentFact的年级数值进行年级匹配,如果年级符合条件,则把该StudentFact的引用记录到A节点的alpha内存区中,退出年级匹配。 B节点:拿StudentFact的性别内容进行性别匹配,如果性别符合条件,则把该StudentFact的引用记录到B节点的alpha内存区中,然后找到B节点左引用的Beta节点,也就是C节点。 C节点:C节点找到自己的左引用也就是A节点,看看A节点的alpha内存区中是否存放了StudentFact的引用,如果存放,说明年级和性别两个条件都符合,则在C节点的Beta内存区中存放StudentFact的引用,退出性别匹配。 D节点:拿StudentFact的年龄数值进行年龄条件匹配,如果年龄符合条件,则把该StudentFact的引用记录到D节点的alpha的内存区中,然后找到D节点的左引用的Beta节点,也就是E节点。 E节点:E节点找到自己的左引用也就是C节点,看看C节点的Beta内存区中是否存放了StudentFact的引用,如果存放,说明年级,性别,年龄三个条件符合,则在E节点的Beta内存区中存放StudentFact的引用,退出年龄匹配。 F节点:拿StudentFact的身体数值进行身体条件匹配,如果身体条件符合,则把该StudentFact的引用记录到D节点的alpha的内存区中,然后找到F节点的左引用的Beta节点,也就是G节点。 G节点:G节点找到自己的左引用也就是E节点,看看E节点的Beta内存区中是否存放了StudentFact的引用,如果存放,说明年级,性别,年龄,身体四个条件符合,则在G节点的Beta内存区中存放StudentFact的引用,退出身体匹配 H节点:拿StudentFact的身高数值进行身高条件匹配,如果身高条件符合,则把该StudentFact的引用记录到H节点的alpha的内存区中,然后找到H节点的左引用的Beta节点,也就是I节点。 I节点:I节点找到自己的左引用也就是G节点,看看G节点的Beta内存区中是否存放了StudentFact的引用,如果存放了,说明年级,性别,年龄,身体,身高五个条件都符合,则在I节点的Beta内存区中存放StudentFact引用。 同时说明该StudentFact对象匹配了该规则,形成一个议程,加入到冲突区,执行该条件的结果部分:该学生是一个篮球苗子。 五、Rete算法优劣势分析 5.1 Rete算法优于传统的模式匹配算法 a.状态保存。 Rete 算法是一种启发式算法,不同规则之间往往含有相同的模式,因此在 beta-network 中可以共享 BetaMemory 和 betanode。如果某个 betanode 被 N 条规则共享,则算法在此节点上效率会提高 N 倍。 b. 节点共享。 Rete 算法由于采用 AlphaMemory 和 BetaMemory 来存储事实,当事实集合变化不大时,保存在 alpha 和 beta 节点中的状态不需要太多变化,避免了大量的重复计算,提高了匹配效率。 c. 从 Rete 网络可以看出,Rete 匹配速度与规则数目无直接关系,这是因为事实只有满足本节点才会继续向下沿网络传递。 5.2 Rete算法的缺点 Rete算法使用了存储区存储已计算的中间结果,以空间换取时间,从而加快系统的速度。然而存储区根据规则的条件与事实的数目成指数级增长,极端情况下会耗尽系统资源。 a. 容易变化的规则尽量置后匹配,可以减少规则的变化带来规则库的变化。 b. 约束性较为通用或较强的模式尽量置前匹配,可以避免不必要的匹配。 六、规则引擎调研 规则引擎有三个概念需要理解,如下: 事实(Fact): 对象之间及对象属性之间的关系 规则(rule): 是由条件和结论构成的推理语句,一般表示为if...Then。一个规则的if部分称为LHS,then部分称为RHS。 模式(module): 就是指IF语句的条件。这里IF条件可能是有几个更小的条件组成的大条件。模式就是指的不能在继续分割下去的最小的原子条件。 根据业务人员编写的规则库和工作内存空间当前的状态,通过规则引擎匹配模式,把满足的规则放入议程表,将不满足的规则从议程表中删除。 a、将初始数据(fact)输入至工作内存(Working Memory)。 b、使用Pattern Matcher将规则库(Rules repository)的规则(rule)和数据(fact)比较。 c、如果执行规则存在冲突(conflict),即同时激活了多个规则,将冲突的规则放入冲突集合。 d、解决冲突,将激活的规则按顺序放入Agenda。 e、执行Agenda中的规则。 f、重复步骤b至e,直到执行完毕Agenda中的所有规则。 6.1 规则引擎的核心问题 任何一个规则引擎都需要很好地解决规则的推理机制和规则条件匹配的效率问题。 a、规则引擎将逻辑与数据分离 b、数据在域对象中,逻辑在规则中。这从根本上打破了数据和逻辑的耦合,这可能是优点,也有可能是缺点。 但是解耦逻辑可以更容易维护。可以将逻辑全部组织在一个或多个非常不同的规则文件中,而不是将逻辑分布在许多域对象或控制器中。 6.2 外部规则引擎框架调研 Java规则引擎主要有URule (pro) /Drools/easyRule/ 介绍 优点 缺点 活跃性 综合评估 通过界面配置的成熟规则引擎: URule 纯Java规则引擎(RETE算法)为基础规 则定义方式:提供了向导式规则集、脚本式规则集、决策表、交叉决策表(PRO版提供)、决策树、评分卡决策流配合基于WEB的设计器,可快速实现规则的定义、维护与发布。 商用软件 高 五星 https://github.com/youseries/urule Drools 决业务代码和业务规则分离;适用于大型应用系统 性能高 可整合 可维护 学习成本高 文档全 持续更新 流行 五星 https://www.drools.org/ 基于java代码的规则引擎 Easy Rules 一个比较简单的开源的规则引擎,使用简单的Java注解方式或者Java代码编程方式或者使用表达式语言或者用规则描述算子定义规则,然后使用非常简单的Java代码加载事实,规则,然后就可以在已知的事实上实现具体的行为了。 简单易用一个非常轻量级的框架定义规则的方式丰富多样基于POJO,支持复合规则 Github维护者少 四星 https://github.com/j-easy/easy-rules/releases/tag/easy-rules-4.1.0 基于JVM脚本语言: Aviator 各种表达式的动态求值 two pass 编译,最终生成 JVM 字节码保证性能比一般解释型脚本快 高性能;轻量级;支持多种类型 Github维护者少 资料齐,例子多 四星 https://code.google.com/archive/p/aviator/downloads MVEL 使用表达式语言定义规则 灵活,性能高,无类型限制 资料少 Github更新少 三星 RuleEngine 一个可以使用SQL脚本来定义规则的中间件,如下的地址是github上基于RuleEngine的一个web可视化配置项目。 https://github.com/rule-engine/rule-engine/releases/tag/v1.0-beta.1 七、规则引擎代码演示 coding地址: git@coding.jd.com:zhangjiangtao1/demo.git 八、规则引擎调研总结 规则引擎不是银弹,规则引擎只是把业务规则从应用程序代码中分离出来,通过配置文件独立管理,本质上就是把原来的Java代码转化成脚本来动态解析执行而已,还是需要写代码 解耦后虽然可以在一定程度上支持快速调整业务规则,但是由于为了实现通用性,避免与业务场景强关联,所以规则引擎都是以DSL(Domain Specific Language))或独立web页面进行维护,对开发人员和业务人员都具备一定的学习成本,而且调整也会比较繁琐,很多时候即使培训了业务人员也不懂。 综上: a、如果只追求无需硬编码,并且配置人员懂得简单编码可以使用通用的规则引擎,引入规则引擎可以简化编码,而且让逻辑易于维护; b、如果还要追求配置界面的可读性,配置人员无需了解代码,开发人员就必须往前走一步,做每个业务类型的配置界面,然后再做一个界面到规则DSL语句的转化功能。或者类型URule这样做一个通用的配置界面,但是通用界面也代表了牺牲可交互性。 九、部分内容借鉴文档: 部分内容借鉴于: a、规则引擎rete算法介绍 https://www.pudn.com/news/630367772d4eb809bf75ab38.html b、urule介绍:https://juejin.cn/post/6844903588725178376 c、规则引擎闲谈:https://blog.csdn.net/erik_tse/article/details/119323719 d、规则引擎闲谈:https://blog.csdn.net/erik_tse/article/details/119323719 e、AviatorScript 编程指南(5.0)https://www.yuque.com/boyan-avfmj/aviatorscript/cpow90 作者:京东保险 张江涛 来源:京东云开发者社区

优秀的个人博客,低调大师

RALB负载均衡算法的应用 | 京东云技术团队

一、背景 搜索推荐算法架构为京东集团所有的搜索推荐业务提供服务,实时返回处理结果给上游。部门各子系统已经实现了基于CPU的自适应限流,但是Client端对Server端的调用依然是RR轮询的方式,没有考虑下游机器性能差异的情况,无法最大化利用集群整体CPU,存在着Server端CPU不均衡的问题。 京东广告部门针对其业务场景研发的负载均衡方法很有借鉴意义,他们提出的RALB(Remote Aware Load Balance)算法能够提升下游服务集群机器CPU资源效率,避免CPU短板效应,让性能好的机器能够处理更多的流量。我们将其核心思想应用到我们的系统中,获得了不错的收益。 本文的结构如下: 1.RALB简介 ◦简单介绍了算法的原理。 2.功能验证 ◦将RALB负载均衡技术应用到搜索推荐架构系统中,进行功能上的验证。 3.吞吐测试 ◦主要将RALB和RR两种负载均衡技术做对比。验证了在集群不限流和完全限流的情况下,两者的吞吐没有明显差异。在RR部分限流的情况下,两者吞吐存在着差异,并且存在着最大的吞吐差异点。对于RALB来说,Server端不限流到全限流是一个转折点,几乎没有部分限流的情况。 4.边界测试 ◦通过模拟各种边界条件,对系统进行测试,验证了RALB的稳定性和可靠性。 5.功能上线 ◦在所有Server端集群全面开启RALB负载均衡模式。可以看出,上线前后,Server端的QPS逐渐出现分层,Server端的CPU逐渐趋于统一。 二、RALB 简介 RALB是一种以CPU均衡为目标的高性能负载均衡算法。 2.1 算法目标 1.调节Server端的CPU使用率,使得各节点之间CPU相对均衡,避免CPU使用率过高触发集群限流 2.QPS与CPU使用率成线性关系,调节QPS能实现CPU使用率均衡的目标 2.2 算法原理 2.2.1 算法步骤 1.分配流量的时候,按照权重分配(带权重的随机算法,wr) 2.收集CPU使用率:Server端通过RPC反馈CPU使用率(平均1s)给Client端 3.调权:定时(每3s)根据集群及各节点上的CPU使用率(窗口内均值)调节权重,使各节点CPU均衡 2.2.2 指标依赖 编号 指标 作用 来源 1 IP 可用IP列表 服务注册发现和故障屏蔽模块进行维护 2 实时健康度 IP可用状态实时变化,提供算法的边界条件 RPC框架健康检查功能维护 3 历史健康度 健康度历史值,用于判断ip故障及恢复等边界条件 指标2的历史值 4 动态目标(CPU使用率) 提供均衡算法的最直接目标依据 Server端定时统计,RPC框架通过RPC返回 5 权重weight 实时负载分发依据 算法更新 2.2.3 调权算法 2.2.4 边界处理 边界1:反馈窗口(3s)内,如果下游ip没被访问到,其CPU均值为0,通过调权算法会认为该节点性能极好,从而调大权重 边界2:网络故障时,RPC框架将故障节点设为不可用,CPU和权重为0;网络恢复后,RPC框架将IP设置为可用,但是权重为0的节点分不到流量,从而导致该节点将一直处于不可用状态 处理:权重的更新由定时器触发,记录节点的可用状态,当节点从不可用恢复为可用状态时,给定一个低权重,逐步恢复 2.3 落地关键 既要快又要稳,在任何情况下都要避免陷入僵局和雪崩,尤其要处理好边界条件 算法要点: 1.公式中各依赖因子的更新保持独立的含义和更新机制,以维护算法的可靠和简洁 ◦IP列表的更新由服务注册发现和RPC框架共同保证 ◦RPC更新CPU 2.注意边界值的含义,边界值的含义需要区分连续值 ◦CPU = 0,表示未知,不表示CPU性能好 ◦w = 0,表示不会被分配流量,只有在不可用的情况下才为0;可用情况下,应该至少有一个较小的值,保证仍能触发RPC,进而可以更新权重 3.算法更新权重,不要依赖RPC触发,而应该定时更新 三、功能验证 3.1 压测准备 Module IP CPU Client端 10.173.102.36 8 Server端 11.17.80.238 8 11.18.159.191 8 11.17.191.137 8 3.2 压测数据 指标 RR负载均衡 RALB负载均衡 QPS Server端的QPS均衡 从上图可以看出,Server端的QPS出现分层 CPU CPU表现也比较均匀,维持在10%左右,不过相比于RALB,节点间CPU差距大些 ****Server端CPU表现均匀,均维持在10%左右 TP99 延时稳定,存在一些差异 延时稳定,存在些微差异,相对RR小一些 由于机器性能差距不大,所以压测的CPU效果并不明显,为了使CPU效果更明显,给节点”11.17.80.238“施加起始的负载(即无流量时,CPU使用率为12.5%) 指标 LA负载均衡 RR负载均衡 RALB负载均衡 QPS  QPS极不均匀,而且流量倾斜严重,会出现流量全集中在一个节点上的现象  QPS均匀 QPS出现明显分层,其中QPS出现变化,是因为对“权重最大调整比例“进行了两次调整(1.5 → 2.0 → 2.5) 11.17.80.238:125 → 96 → 79 11.18.159.191:238 → 252 → 262 11.17.191.137:239 → 254 → 263 CPU  CPU不是LA均衡的目标,所以跟QPS趋势一致,全集中单个节点上  CPU出现明显分层,11.17.80.238的CPU明显高于其他节点  1、刚开始压测,11.17.80.238的CPU高于其他两个节点,因为“权重最大调整比例“为1.5(相对于base,固定值为10000),达到了调整极限 2、“权重最大调整比例“调整为2.0,节点间的差距变小 3、“权重最大调整比例“调整为2.5,节点间的差距进一步变小 TP99  承接流量的节点延时是稳定的,由于存在节点接受的流量很低(几乎没有),这些节点的延时看起来波动就比较大,不过LA对于延时的效果应该是稳定的,因为大部分请求是以比较均衡的延时得到处理的。  延时稳定,存在些微差异 延时稳定,存在些微差异,相对RR小一些 3.3 压测结论 经过压测,RR和LA均存在CPU不均衡的问题,会因为机器资源的性能差异,而导致短板效应,达不到充分利用资源的目的。 RALB是以CPU作为均衡目标的,所以会根据节点的CPU实时调整节点承接的QPS,进而达到CPU均衡的目标,功能上验证是可用的,CPU表现符合预期。 四、吞吐测试 4.1 压测目标 RALB是一种以CPU使用率作为动态指标的负载均衡算法,能很好地解决CPU不均衡的问题,避免CPU短板效应,让性能好的机器能够处理更多的流量。因此,我们期望RALB负载均衡策略相比于RR轮询策略能够得到一定程度的吞吐提升。 4.2 压测准备 Server端100台机器供测试,Server端为纯CPU自适应限流,限流阈值配置为55%。 4.3 压测数据 通过压测在RALB和RR两种负载均衡模式下,Server端的吞吐随着流量变化的趋势,对比两种负载均衡策略对于集群吞吐的影响。 4.3.1 RALB 4.3.1.1 吞吐数据 下表是Server端的吞吐数据,由测试发压Client端,负载均衡模式设置为RALB。在18:17Server端的状况接近于刚刚限流。整个压测阶段,压测了不限流、部分限流、完全限流3种情况。 时间 17:40 17:45 17:52 18:17 18:22 总流量 2270 1715 1152 1096 973 处理流量 982 1010 1049 1061 973 被限流量 1288 705 103 35 0 限流比例 56.74% 41% 8.9% 3.2% 0% 平均CPU使用率 55% 55% 54% 54% 49% 4.3.1.2 指标监控 Server端机器收到的流量按性能分配,CPU保持均衡。 QPS CPU 4.3.2 RR 4.3.2.1 吞吐数据 下表是Server端的吞吐数据,由测试发压Client端,负载均衡模式设置为RR。在18:46 Server端的整体流量接近于18:17 Server端的整体流量。后面将重点对比这两个关键时刻的数据。 时间 18:40 18:46 19:57 20:02 20:04 20:09 总流量 967 1082 1149 1172 1263 1314 处理流量 927 991 1024 1036 1048 1047 被限流量 40 91 125 136 216 267 限流比例 4.18% 8.4% 10.92% 11.6% 17.1% 20.32% 平均CPU使用率 45%(部分限流) 51%(部分限流) 53%(部分限流) 54%(接近全部限流) 55%(全部限流) 55%(全部限流) 4.3.2.2 指标监控 Server端收到的流量均衡,但是CPU有差异。 QPS CPU  4.4 压测分析 4.4.1 吞吐曲线 根据4.3节的压测数据,进行Server端吞吐曲线的绘制,对比RALB和RR两种负载均衡模式下的吞吐变化趋势。 import matplotlib.pyplot as plt import numpy as np x = [0,1,2,3,4,5,6,7,8,9,9.73,10.958,11.52,17.15,22.7] y = [0,1,2,3,4,5,6,7,8,9,9.73,10.61,10.49,10.10,9.82] w = [0,1,2,3,4,5,6,7,8,9.674,10.823,11.496,11.723,12.639,13.141,17.15,22.7] z = [0,1,2,3,4,5,6,7,8,9.27,9.91,10.24,10.36,10.48,10.47,10.10,9.82] plt.plot(x, y, 'r-o') plt.plot(w, z, 'g-o') plt.show() 4.4.2 曲线分析 负载均衡策略 RALB RR 阶段一:所有机器未限流 接收QPS=处理QPS,表现为y =x 的直线 接收QPS=处理QPS,表现为y =x 的直线 阶段二:部分机器限流 不存在RALB根据下游CPU进行流量分配,下游根据CPU进行限流,理论上来讲,下游的CPU永远保持一致。所有的机器同时达到限流,不存在部分机器限流的情况。 所以在图中,不限流与全部机器限流是一个转折点,没有平滑过渡的阶段。 RR策略,下游的机器分配得到的QPS一致,由于下游根据CPU进行限流,所以不同机器限流的时刻有差异。 相对于RALB,RR更早地出现了限流的情况,并且在达到限流之前,RR的吞吐是一直小于RALB的。 阶段三:全部机器限流 全部机器都达到限流阈值55%之后,理论上,之后无论流量怎样增加,处理的QPS会维持不变。图中显示处理的QPS出现了一定程度的下降,是因为处理限流也需要消耗部分CPU RR达到全部限流的时间要比RALB更晚。在全部限流之后,两种模式的处理的QPS是一致的。 4.5 压测结论 临界点:吞吐差异最大的情况,即RALB模式下非限流与全限流的转折点。 通过上述分析,可以知道,在RALB不限流与全部限流的临界点处,RR与RALB的吞吐差异最大。 此时,计算得出RALB模式下,Server集群吞吐提升7.06%。 五、边界测试 通过模拟各种边界条件,来判断系统在边界条件的情况下,系统的稳定性。 边界条件 压测情形 压测结论 下游节点限流 CPU限流 惩罚因子的调整对于流量的分配有重要影响 QPS限流 符合预期 下游节点超时 Server端超时每个请求,固定sleep 1s 请求持续超时期间分配的流量基本为0 下游节点异常退出 Server端进程被杀死直接kill -9 pid 杀死进程并自动拉起,流量分配快速恢复 下游节点增减 Server端手动Jsf上下线 jsf下线期间不承接流量 Server端重启stop + start 正常反注册、注册方式操作Server端进程,流量分配符合预期 六、功能上线 宿迁机房Client端上线配置,在所有Server端集群全面开启RALB负载均衡模式。可以看出,上线前后,Server端的QPS逐渐出现分层,Server端的CPU逐渐趋于统一。 上线前后Server端QPS分布 上线前后Server端的CPU分布 参考资料 1.负载均衡技术 2.深入浅出负载均衡 作者:京东零售 胡沛栋 来源:京东云开发者社区

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

用户登录
用户注册