首页 文章 精选 留言 我的

精选列表

搜索[深度集成],共10000篇文章
优秀的个人博客,低调大师

分布式Redis深度历险-Sentinel

上一篇介绍了Redis的主从服务器之间是如何同步数据的。试想下,在一主一从或一主多从的结构下,如果主服务器挂了,整个集群就不可用了,单点问题并没有解决。Redis使用Sentinel解决该问题,保障集群的高可用。 如何保障集群高可用 保障集群高可用,要具备如下能力: 能监测服务器的状态,当主服务器不可用时,能及时发现 当主服务器不可用时,选择一台最合适的从服务器替代原有主服务器 存储相同数据的主服务器同一时刻只有一台 要实现上述功能,最直观的做法就是,使用一台监控服务器来监视Redis 服务器的状态。 监控服务器和主从服务器间维护一个心跳连接,当超出一定时间没有收到主服务器心跳时,主服务器就会被标记为下线,然后通知从服务器上线成为主服务器。 当原来的主服务器上线后,监控服务器会将其转换为从服务器。 按照上述流程似乎解决了集群高可用的问题,但似乎有哪里不对:如果监控服务器出了问题怎么办?我们可以在加上一个从监控服务器,当主服务器不可用的时候顶上。 但问题是谁来监控’监控服务器’呢?子子孙孙无穷尽也。。 先把疑问放在一旁,先来看下Redis Sentinel集群的实现 Sentinel 和上一小节的想法一样,Redis通过增加额外的Sentinel服务器来监控数据服务器,Sentinel会与所有的主服务器和从服务器保存连接,用以监听服务器状态以及向服务器下达命令。 Sentinel本身是一个特殊状态的Redis服务器,启动命令: redis-server /xxx/sentinel.conf --sentinel,sentinel模式下的启动流程与普通redis server是不一样的,比如说不会去加载RDB文件以及AOF文件,本身也不会存储业务数据。 与主服务器建立连接 Sentinel启动后,会与配置文件中提供的所有主服务器建立两个连接,一个是命令连接,一个是订阅连接。 命令连接用于向服务器发送命令。 订阅连接则是用于订阅服务器的_sentinel_:hello频道,用于获取其他Sentinel信息,下文会详细说。 获取主服务器信息 Sentinel会以一定频率向主服务器发送Info命令获取信息,包括主服务器自身的信息比如说服务器id等,以及对应的从服务器信息,包括ip和port。Sentinel会根据info命令返回的信息更新自己保存的服务器信息,并会与从服务器建立连接。 获取从服务器信息 与和主服务器的交互相似,Sentinel也会以一定频率通过Info命令获取从服务器信息,包括:从服务器ID,从服务器与主服务器的连接状态,从服务器的优先级,从服务器的复制偏移等等。 向服务器订阅和发布消息 在如何保障集群高可用小节留下了一个疑问:用如何保证监视服务器的高可用? 在这里我们可以先给出简单回答:用一个监视服务器集群(也就是Sentinel集群)。如何实现,如何保证监视服务器的一致性暂且先不说,我们只要记住需要用若干台Sentinel来保障高可用,那一个Sentinel是如何感知其他的Sentinel的呢? 前面说过,Sentinel在与服务器建立连接时,会建立两个连接,其中一个是订阅连接。Sentinel会定时的通过订阅连接向_sentinel_:hello频道频道发送消息(对Redis发布订阅功能不太了解的同学可以去去了解下),其中包括: Sentinel本身的信息,如ip地址、端口号、配置纪元(见下文)等 Sentinel监视的主服务器的信息,包括ip、端口、配置纪元(见下文)等 同时,Sentinel也会订阅_sentinel_:hello频道的消息,也就是说Sentinel即向该频道发布消息,又从该频道订阅消息。 Sentinel有一个字典对象sentinels,保存着监视同一主服务器的其他所有Sentinel服务器,当一个Sentinel接收到来自_sentinel_:hello频道的消息时,会先比较发送该消息的是不是自己,如果是则忽略,否则将更新sentinels中的内容,并对新的Sentinel建立连接。 主观下线 Sentinel默认会以每秒一次的频率向所有建立连接的服务器(主服务器,从服务器,Sentinel服务器)发送PING命令,如果在down-after-milliseconds内都没有收到有效回复,Sentinel会将该服务器标记为主观下线,代表该Sentinel认为这台服务器已经下线了。需要注意的是不同Sentinel的down-after-milliseconds是可以不同的。 客观下线 为了确保服务器真的已经下线,当Sentinel将某个服务器标记为主观下线后,它会向其他的Sentinel实例发送Sentinel is-master-down-by-addr命令,接收到该命令的Sentinel实例会回复主服务器的状态,代表该Sentinel对该主服务器的连接情况。 Sentinel会统计发出的所有Sentinel is-master-down-by-addr命令的回复,并统计同意将主服务器下线的数量,如果该数量超出了某个阈值,就会将该主服务器标记为客观下线。 选举领头Sentinel 当Sentinel将一个主服务器标记为客观下线后,监视该服务器的各个Sentinel会通过Raft算法进行协商,选举出一个领头的Sentinel。 建议你先看Raft算法的基础知识,再来看下文。 规则: 所有的Sentinel都有可能成为领头Sentinel的资格 每次选举后,无论有没有选出领头Sentinel,配置纪元都会+1 在某个纪元里,每个Sentinel都有为投票的机会 我们称要求其他人选举自己的Sentinel称为源Sentinel,将被要求投票的Sentinel称为目标Sentinel 每个发现主服务器被标记为客观下线且还没有被其他Sentinel要求投票的Sentinel都会要求其他Sentinel将自己设置为头 目标Sentinel在一个配置纪元里,一旦为某个Sentinel(也可能是它自己)投票后,对于之后收到的要求投票的命令,将拒绝 目标Sentinel对于要求投票的命令将回复自己选举的Sentinel的id以及当前配置纪元 源Sentinel在接收到要求投票的回复后:如果回复的配置纪元与自己的相同,则再检测目标Sentinel选举的头Sentinel是不是自己 如果某个Sentinel被半数以上的Sentinel设置成了领头Sentinel,那它将称为领头Sentinel 一个配置纪元只会选出一个头(因为一个头需要半数以上的支持) 如果在给定时间内,还没有选出头,则过段时间再次选举(配置纪元会+1) 还记得我们在文章开头提出的如何保证Redis服务器高可用的问题吗? 答案就是使用若干台Sentinel服务器,通过Raft一致性算法来保障集群的高可用,只要Sentinel服务器有一半以上的节点都正常,那集群就是可用的。 故障转移 领头Sentinel将会进行以下3个步骤进行故障转移: 1.在已下线主服务器的所有从服务器中,挑选出一个作为新的主服务器 2.将其他从服务器的主服务器设置成新的 3.将已下线的主服务器的role改成从服务器,并将其主服务器设置成新的,当该服务器重新上线后,就会一个从服务器的角色继续工作 第一步中挑选新的主服务器的规则如下: 1.过滤掉所有已下线的从服务器 2.过滤掉最近5秒没有回复过Sentinel命令的从服务器 3.过滤掉与原主服务器断开时间超过down-after-milliseconds*10的从服务器 4.根据从服务器的优先级进行排序,选择优先级最高的那个 5.如果有多个从服务器优先级相同,则选取复制偏移量最大的那个 6.如果上一步的服务器还有多个,则选取id最小的那个 原文:Java架构笔记 免费Java高级资料需要自己领取,涵盖了Java、Redis、MongoDB、MySQL、Zookeeper、Spring Cloud、Dubbo高并发分布式等教程,一共30G。 传送门: https://mp.weixin.qq.com/s/JzddfH-7yNudmkjT0IRL8Q

优秀的个人博客,低调大师

Apache Flink Time & Window 深度解析

作者:邱从贤 1、 Window & Time 介绍 Apache Flink(以下简称 Flink) 是一个天然支持无限流数据处理的分布式计算框架,在 Flink 中 Window 可以将无限流切分成有限流,是处理有限流的核心组件,现在 Flink 中 Window 可以是时间驱动的(Time Window),也可以是数据驱动的(Count Window)。 下面的代码是在 Flink 中使用 Window 的两个示例 2、 Window API 使用 从第一部分我们已经知道 Window 的一些基本概念,以及相关 API,下面我们以一个实际例子来看看怎么使用 Window 相关的 API。 代码来自 flink-examples 上面的例子中我们首先会对每条数据进行时间抽取,然后进行 keyby,接着依次调用 window(),ev

优秀的个人博客,低调大师

深度辨析 Python 的 eval() 与 exec()

Python 提供了很多内置的工具函数(Built-in Functions),在最新的 Python 3 官方文档中,它列出了 69 个。 大部分函数是我们经常使用的,例如 print()、open() 与 dir(),而有一些函数虽然不常用,但它们在某些场景下,却能发挥出不一般的作用。内置函数们能够被“提拔”出来,这就意味着它们皆有独到之处,有用武之地。 因此,掌握内置函数的用法,就成了我们应该点亮的技能。 在《Python进阶:如何将字符串常量转为变量?》这篇文章中,我提到过 eval() 和 exec() ,但对它们并不太了解。为了弥补这方面知识,我就重新学习了下。这篇文章是一份超级详细的学习记录,系统、全面而深入地辨析了这两大函数。 1、eval 的基本用法 语法:eval(expression, globals=None, locals=None) 它有三个参数,其中 expression 是一个字符串类型的表达式或代码对象,用于做运算;globals 与 locals 是可选参数,默认值是 None。 具体而言,expression 只能是单个表达式,不支持复杂的代码逻辑,例如赋值操作、循环语句等等。(PS:单个表达式并不意味着“简单无害”,参见下文第 4 节) globals 用于指定运行时的全局命名空间,类型是字典,缺省时使用的是当前模块的内置命名空间。locals 指定运行时的局部命名空间,类型是字典,缺省时使用 globals 的值。两者都缺省时,则遵循 eval 函数执行时的作用域。值得注意的是,这两者不代表真正的命名空间,只在运算时起作用,运算后则销毁。 x = 10 def func(): y = 20 a = eval('x + y') print('a: ', a) b = eval('x + y', {'x': 1, 'y': 2}) print('x: ' + str(x) + ' y: ' + str(y)) print('b: ', b) c = eval('x + y', {'x': 1, 'y': 2}, {'y': 3, 'z': 4}) print('x: ' + str(x) + ' y: ' + str(y)) print('c: ', c) func() 输出结果: a: 30 x: 10 y: 20 b: 3 x: 10 y: 20 c: 4 由此可见,当指定了命名空间的时候,变量会在对应命名空间中查找。而且,它们的值不会覆盖实际命名空间中的值。 2、exec 的基本用法 语法:exec(object[, globals[, locals]]) 在 Python2 中 exec 是个语句,而 Python3 将其改造成一个函数,就像 print 一样。exec() 与 eval() 高度相似,三个参数的意义和作用相近。 主要的区别是,exec() 的第一个参数不是表达式,而是代码块,这意味着两点:一是它不能做表达式求值并返回出去,二是它可以执行复杂的代码逻辑,相对而言功能更加强大,例如,当代码块中赋值了新的变量时,该变量可能 在函数外的命名空间中存活下来。 >>> x = 1 >>> y = exec('x = 1 + 1') >>> print(x) >>> print(y) 2 None 可以看出,exec() 内外的命名空间是相通的,变量由此传递出去,而不像 eval() 函数,需要一个变量来接收函数的执行结果。 3、一些细节辨析 两个函数都很强大,它们将字符串内容当做有效的代码执行。这是一种字符串驱动的事件 ,意义重大。然而,在实际使用过程中,存在很多微小的细节,此处就列出我所知道的几点吧。 常见用途:将字符串转成相应的对象,例如 string 转成 list ,string 转成 dict,string 转 tuple 等等。 >>> a = "[[1,2], [3,4], [5,6], [7,8], [9,0]]" >>> print(eval(a)) [[1, 2], [3, 4], [5, 6], [7, 8], [9, 0]] >>> a = "{'name': 'Python猫', 'age': 18}" >>> print(eval(a)) {'name': 'Python猫', 'age': 18} # 与 eval 略有不同 >>> a = "my_dict = {'name': 'Python猫', 'age': 18}" >>> exec(a) >>> print(my_dict) {'name': 'Python猫', 'age': 18} eval() 函数的返回值是其 expression 的执行结果,在某些情况下,它会是 None,例如当该表达式是 print() 语句,或者是列表的 append() 操作时,这类操作的结果是 None,因此 eval() 的返回值也会是 None。 >>> result = eval('[].append(2)') >>> print(result) None exec() 函数的返回值只会是 None,与执行语句的结果无关,所以,将 exec() 函数赋值出去,就没有任何必要。所执行的语句中,如果包含 return 或 yield ,它们产生的值也无法在 exec 函数的外部起作用。 >>> result = exec('1 + 1') >>> print(result) None 两个函数中的 globals 和 locals 参数,起到的是白名单的作用,通过限定命名空间的范围,防止作用域内的数据被滥用。 conpile() 函数编译后的 code 对象,可作为 eval 和 exec 的第一个参数。compile() 也是个神奇的函数,我翻译的上一篇文章《Python骚操作:动态定义函数》就演示了一个动态定义函数的操作。 吊诡的局部命名空间:前面讲到了 exec() 函数内的变量是可以改变原有命名空间的,然而也有例外。 def foo(): exec('y = 1 + 1\nprint(y)') print(locals()) print(y) foo() 按照前面的理解,预期的结果是局部变量中会存入变量 y,因此两次的打印结果都会是 2,然而实际上的结果却是: 2 {'y': 2} Traceback (most recent call last): ...(略去部分报错信息) print(y) NameError: name 'y' is not defined 明明看到了局部命名空间中有变量 y,为何会报错说它未定义呢? 原因与 Python 的编译器有关,对于以上代码,编译器会先将 foo 函数解析成一个 ast(抽象语法树),然后将所有变量节点存入栈中,此时 exec() 的参数只是一个字符串,整个就是常量,并没有作为代码执行,因此 y 还不存在。直到解析第二个 print() 时,此时第一次出现变量 y ,但因为没有完整的定义,所以 y 不会被存入局部命名空间。 在运行期,exec() 函数动态地创建了局部变量 y ,然而由于 Python 的实现机制是“运行期的局部命名空间不可改变 ”,也就是说这时的 y 始终无法成为局部命名空间的一员,当执行 print() 时也就报错了。 至于为什么 locals() 取出的结果有 y,为什么它不能代表真正的局部命名空间?为什么局部命名空间无法被动态修改?可以查看我之前分享的《Python 动态赋值的陷阱》,另外,官方的 bug 网站中也有对此问题的讨论,查看地址:https://bugs.python.org/issue4831 若想把 exec() 执行后的 y 取出来的话,可以这样:z = locals()['y'] ,然而如果不小心写成了下面的代码,则会报错: def foo(): exec('y = 1 + 1') y = locals()['y'] print(y) foo() #报错:KeyError: 'y' #把变量 y 改为其它变量则不会报错 KeyError 指的是在字典中不存在对应的 key 。本例中 y 作了声明,却因为循环引用而无法完成赋值,即 key 值对应的 value 是个无效值,因此读取不到,就报错了。 此例还有 4 个变种,我想用一套自恰的说法来解释它们,但尝试了很久,未果。留个后话吧,等我想明白,再单独写一篇文章。 4、为什么要慎用 eval() ? 很多动态的编程语言中都会有 eval() 函数,作用大同小异,但是,无一例外,人们会告诉你说,避免使用它。 为什么要慎用 eval() 呢?主要出于安全考虑,对于不可信的数据源,eval 函数很可能会招来代码注入的问题。 >>> eval("__import__('os').system('whoami')") desktop-fa4b888\pythoncat >>> eval("__import__('subprocess').getoutput('ls ~')") #结果略,内容是当前路径的文件信息 在以上例子中,我的隐私数据就被暴露了。而更可怕的是,如果将命令改为rm -rf ~ ,那当前目录的所有文件都会被删除干净。 针对以上例子,有一个限制的办法,即指定 globals 为 {'__builtins__': None} 或者 {'__builtins__': {}} 。 >>> s = {'__builtins__': None} >>> eval("__import__('os').system('whoami')", s) #报错:TypeError: 'NoneType' object is not subscriptable __builtins__ 包含了内置命名空间中的名称,在控制台中输入 dir(__builtins__) ,就能发现很多内置函数、异常和其它属性的名称。在默认情况下,eval 函数的 globals 参数会隐式地携带__builtins__ ,即使是令 globals 参数为 {} 也如此,所以如果想要禁用它,就得显式地指定它的值。 上例将它映射成 None,就意味着限定了 eval 可用的内置命名空间为 None,从而限制了表达式调用内置模块或属性的能力。 但是,这个办法还不是万无一失的,因为仍有手段可以发起攻击。 某位漏洞挖掘高手在他的博客中分享了一个思路,令人大开眼界。其核心的代码是下面这句,你可以试试执行,看看输出的是什么内容。 >>> ().__class__.__bases__[0].__subclasses__() 关于这句代码的解释,以及更进一步的利用手段,详见博客。(地址:https://www.tuicool.com/articles/jeaqe2n) 另外还有一篇博客,不仅提到了上例的手段,还提供了一种新的思路: #警告:千万不要执行如下代码,后果自负。 >>> eval('(lambda fc=(lambda n: [c 1="c" 2="in" 3="().__class__.__bases__[0" language="for"][/c].__subclasses__() if c.__name__ == n][0]):fc("function")(fc("code")(0,0,0,0,"KABOOM",(),(),(),"","",0,""),{})())()', {"__builtins__":None}) 这行代码会导致 Python 直接 crash 掉。具体分析在:https://segmentfault.com/a/1190000011532358 除了黑客的手段,简单的内容也能发起攻击。像下例这样的写法, 将在短时间内耗尽服务器的计算资源。 >>> eval("2 ** 888888888", {"__builtins__":None}, {}) 如上所述,我们直观地展示了 eval() 函数的危害性,然而,即使是 Python 高手们小心谨慎地使用,也不能保证不出错。 在官方的 dumbdbm 模块中,曾经(2014年)发现一个安全漏洞,攻击者通过伪造数据库文件,可以在调用 eval() 时发起攻击。(详情:https://bugs.python.org/issue22885) 无独有偶,在上个月(2019.02),有核心开发者针对 Python 3.8 也提出了一个安全问题,提议不在 logging.config 中使用 eval() 函数,目前该问题还是 open 状态。(详情:https://bugs.python.org/issue36022) 如此种种,足以说明为什么要慎用 eval() 了。同理可证,exec() 函数也得谨慎使用。 5、安全的替代用法 既然有种种安全隐患,为什么要创造出这两个内置方法呢?为什么要使用它们呢? 理由很简单,因为 Python 是一门灵活的动态语言。与静态语言不同,动态语言支持动态地产生代码,对于已经部署好的工程,也可以只做很小的局部修改,就实现 bug 修复。 那有什么办法可以相对安全地使用它们呢? ast 模块的 literal() 是 eval() 的安全替代,与 eval() 不做检查就执行的方式不同,ast.literal() 会先检查表达式内容是否有效合法。它所允许的字面内容如下: strings, bytes, numbers, tuples, lists, dicts, sets, booleans, 和 None 一旦内容非法,则会报错: import ast ast.literal_eval("__import__('os').system('whoami')") 报错:ValueError: malformed node or string 不过,它也有缺点:AST 编译器的栈深(stack depth)有限,解析的字符串内容太多或太复杂时,可能导致程序崩溃。 至于 exec() ,似乎还没有类似的替代方法,毕竟它本身可支持的内容是更加复杂多样的。 最后是一个建议:搞清楚它们的区别与运行细节(例如前面的局部命名空间内容),谨慎使用,限制可用的命名空间,对数据源作充分校验。 关联阅读: Python 动态赋值的陷阱 Python骚操作:动态定义函数 Python与家国天下 Python进阶:如何将字符串常量转为变量? https://docs.python.org/3/library/ast.html#ast.literal_eval

优秀的个人博客,低调大师

深度 | Android 整体设计及背后意义

阿里妹导读:现实工作中经常可以听到这样的说法:框架的升级带来协议性能的提升、编程模式的变革带来业务的飞跃...... 姑且不论这些表述是否有问题,实际上如果系统地看待事物整体,可能会有不一样的发现。以LINUX为例,尽管其内核大获成功,但如果不是遵循POSIX、并成为一个开源、精简的UNIX实现,很难想象其最终会有何种发展。因此,对事物进行全局和一定深入的探究有时会有更多启发。 今天,阿里高级无线开发专家所为将结合自己多年的经验,为你深入阐述整个 Android 技术域及移动研发生态,期待与大家共同探讨。 1. Android设计的现实意义 架构的工程意义在于:定义并解决一类问题,为需求到实现的平稳过渡提供保障。传统意义的Android架构(图1)已被人熟知,但不同角色的视角不同,例如认为Runtime和框架是其核心、或者将Androi

优秀的个人博客,低调大师

揭秘:深度网络背后的数学奥秘

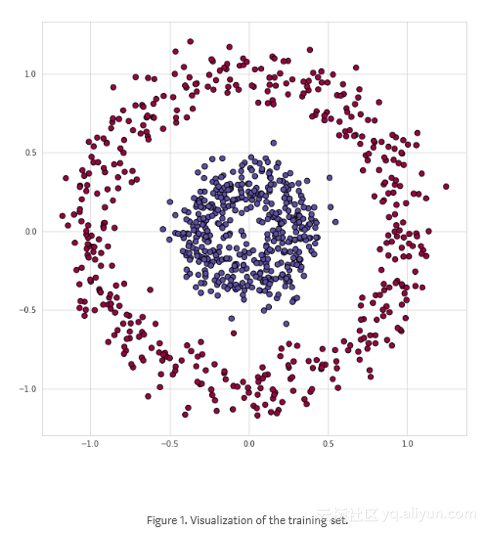
目前,我们可以使用像Keras、TensorFlow或PyTorch这些高级的、专业的库和框架而不需要一直担心权重矩阵的大小,也不需要记住决定使用的激活函数的导数公式。通常我们只需要构建一个神经网络,即使是一个结构非常复杂的神经网络,也只需要导入一些库和几行代码。这节省了我们找出bug的时间,并简化了工作。然而,如果了解神经网络内部发生的事情,对架构选择、超参数调优或优化等任务有很大帮助。本文源代码可以在我的GitHub上找到。 介绍 为了更多地了解神经网络的原理,我决定写一篇文章,一部分是为了我自己,一部分为了帮助其他人理解这些有时难以理解的概念。对于那些对代数和微积分不太熟悉的人,我会尽量详细一些,但正如标题所示,这是一篇涉及很多数学的文章。 例如,我们将解决如图1所示的数据集二分类问题,两种类别的点形成圆圈,这种排列对于许多传统的

优秀的个人博客,低调大师

从深度解读

古希腊哲学家亚里士多德说:"人们来到城市,是为了生活;人们居住在城市,是为了生活得更好"。当前信息化时代,借助无线WiFi享受随心所欲更加智慧的生活不再是遥不可及的梦想。在移动互联网和"无线城市"建设浪潮推动下,一个个移动互联的信息化触角,正由点连成线、由线连成面,勾勒出一个更加智慧的城市,一种智慧满溢的生活。 无线城市建设热潮背后的思考 智慧化是继工业化、电气化、信息化之后,世界科技革命又一次新突破。利用智慧基础,建设智慧城市,是当今世界城市发展的趋势和特征,也是国家战略规划的重要方向。 说到智慧城市,离不开无线城市的建设,因为它是智慧城市形态构建的重要骨架,能够为智慧城市发展提供泛连接通道。对于无线城市建设,国家在"十二五"规划也早已明确方向:引导建设宽带无线城市,推进城市光纤入户,加快农村地区宽带网络建设。 无线城市建设从最初基于802.11b标准的 WiFi 无线局域接入网络为标志,实现固定无线网络接入,而随着智能终端、可穿戴设备等产品的普及,物联网、移动互联网、无线连接技术不断变革,人、设备、终端之间万物终端联网趋势涌现,更智能广泛的联接成为刚需,无线城市建设也进入广泛覆盖与丰富应用并重的阶段。 据GSMA移动智库与中国信息通信研究院发布的名为《移动运营商与数字转型》最新报告显示,到2020年,中国机器对机器(M2M)市场的连接总数将达到10亿。在第四届中国WiFi产业峰会(2017白马湖峰会)上,新华三集团无线产品部部长白浪也指出,从WiFi走向万物互联,一个全新的联接市场正逐步形成,其市场空间将不断扩大,推动城市发展朝无线时代迈进。 据新华三统计,华三服务了上海、杭州、南京、武汉、南昌、乌鲁木齐等无线城市建设,参与建设的就超过50个,其中建设热点AP数量超过几十万台,可以说,新华三已成为在中国无线城市建设领域的主导厂商。全国的无线城市建设整体规模预计已超百余个,那无线城市建设热情高涨,新华三依然很惶恐,免费模式是否可行?是该和运营商合作建设还是竞争?覆盖网路后的上层应用匮乏,体验的质量问题没法保障,那到底应该怎么样才能更好的建设无线城市呢? 出路在哪?新华三认为ToB而非To C 无线城市成为城市建设发展脚步中一项重要的基础能力,城市信息化程度对于城市管理来说,不仅在完善经济结构,促进产业升级方面发挥着不可或缺的作用,另一方面,从政务民生的角度来看,关系到广大市民每一日的衣食住行,无线城市的初衷就是让城市生活更便捷有效。然而,就是这样以民为本的初衷成为了建设的通用模式,将无线城市的市场理解成一个后向运营的To C业务。 城市的无线运维真的能搞定吗,是运营商负责运营工作吗? 城市的公共服务,例如智能停车、路灯WiFi等toB需求越来越多,这类需要该怎么满足? 无线城市是惠民工程,是应该让消费者来买单吗? 以上的一系列问题,回归到最初的建设初衷,无线城市建设被定义为一个惠民工程,那么可以看看城市的最大特点,不是庞大的人群,而是基础设施。如果不是以民众作为消费体,那么,无线城市的出路在哪? 新华三无线产品部部长白浪在杭州WiFi产业峰会中给出了答案,将个体责任从无线城市中解放出来,企业才是真正的承担者。也就说,To B市场才是无线城市的出路,更是走向智慧之城的未来,而非传统理解中的To C市场。白浪特别强调一点:"城市的最大特点,不是庞大的人群,而是基础设施。把B端的基础设施和服务搬到线上,建立一个智慧的赛博城市!",这才是无线城市建设的终极目的。 To B建设怎么做?需要从"服务化"和"场景化"来解读无线城市的建设之路。具体来讲,服务化包括民生生活、企业市场、政府基建以及定制化服务,不同对象不同的需求点,以不同侧重为出发,渗入到场景化的建设中。场景化建设实际上是一个层次性的概念,不仅是针对不同行业,从万物互联的角度来说,不同场景在技术上,比以前更富有了融合的意义。针对低功耗广域领域和传统局域网络,IoT技术的融入,从Wi-Fi时代走向了万物互联,以融合之力筑建智慧赛博城市。 整合交付和融合开放的平台,开启无线城市建设的伟大时代 终端互联之后,新华三还搭建了一个融合开放的万物互联生态载体,即绿洲平台。该平台依托新华三500万台无线AP潜在接入量,渗透在无线城市多元化应用场景中,提供从端到云的生态化管理服务,保障连接安全稳定可靠;同时通过生态圈合作伙伴紧密配合,绿洲平台还能为客户提供数据分析,应用共享等全心全意贴合价值需求的应用实现。 "无线城市"已经成为衡量一座城市的整体运行效率、信息化程度以及国际竞争力的重要尺度。如今,让城市每个角落都能接入无线宽带的"无线城市"梦想正逐渐变成现实。 目前,全球"无线城市"已达1500个,我国北京、上海、杭州、广州、深圳等城市已纷纷加入到"无线城市"应用行列,其中不少城市已经实现了局部无线网络覆盖目标,一场城市间的无线网络建设热潮正如火如荼的进行。以无线覆盖区域最广的上海为例,人们可以通过3000个热点,在火车站、外滩、滨江达到、陆家嘴等456处场所,实现移动式网络接入。而在杭州滨江高新区,市政府通过新华三大数据平台,实时对区域人流、所在位置进行监控,并精准推送停车信息,方便人们快速寻找到空闲停车位;利用物联网感知技术,市政府能监测污染源,设置洪涝预警,打造生态绿色滨江。 领先技术、专业实践,这些积累与努力,也为新华三赢得了更高的企业级无线市场份额。据知名调研机构Dell'oro发布的2016年第2季度全球无线网络市场分析报告显示,以新华三为首的"集团军"已占据中国企业级无线市场的主要份额,其中新华三以32%的份额位居国内第一,全球第六。 至今,"无线城市"建设风潮已经刮遍神州大地,全国有将近600多个大中城市提出建设"无线城市",在国内渐成产业链发展趋势。白浪表示,作为全球领先的新IT解决方案领导者,新华三致力于新IT解决方案和产品的研发、生产、咨询、销售及服务,能够提供大互联、大安全、云计算、大数据和IT咨询服务在内的一站式、全方位IT解决方案,新华三有责任和义务去为无线城市的未来努力,成就一个伟大的时代。 本文出处:畅享网 本文来自云栖社区合作伙伴畅享网,了解相关信息可以关注vsharing.com网站。

优秀的个人博客,低调大师

神经进化是深度学习的未来

过去几年时间里,我们有一个完整的团队致力于人工智能研究和实验。该团队专注于开发新的进化计算方法(EC),包括设计人工神经网络架构、构建商业应用程序,以及使用由自然进化激发的方法来解决具有挑战性的计算问题。这一领域的发展势头非常强劲。我们相信进化计算很可能是人工智能技术的下一个重大课题。 EC与Deep Learning(DL)一样都是几十年前引入的,EC也能够从可用的计算和大数据中得到提升。然而,它解决了一个截然不同的需求:我们都知道DL侧重于建模我们已知的知识,而EC则专注于创建新的知识。从这个意义上讲,它是DL的下个步骤:DL能够在熟悉的类别中识别对象和语音,而EC使我们能够发现全新的对象和行为-最大化特定目标的对象和行为。因此,EC使许多新的应用成为可能:为机器人和虚拟代理设计更有效的行为,创造更有效和更廉价的卫生干预措施,促

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册