首页 文章 精选 留言 我的

精选列表

搜索[深度集成],共10000篇文章
优秀的个人博客,低调大师

深度学习框架 PyTorch 发布 1.11 版本

Python 著名 AI 框架 PyTorch 1.11 已发布。此版本由自 1.10 以来的 3300 多个提交组成, TorchData 和 functorch 的 beta 版本亦伴随发布。 版本概括: TorchData 是一个用于通用模块化数据加载原语的新库,用于轻松构建灵活和高性能的数据管道。在 GitHub 上查看。 functorch 是一个将可组合函数转换添加到 PyTorch 的库,现已推出 beta 版。在 GitHub 上查看。 分布式数据并行 (DDP) 静态图优化稳定可用。 TorchData 介绍 TorchData 是一个通用模块化数据加载原语库,用于轻松构建灵活且高性能的数据管道。现有的 DataLoader 将太多的功能捆绑在一起,难以扩展,此外,不同的用例通常必须一遍又一遍地重写相同的数据加载实用程序。TorchData 的目标是通过称为“ DataPipes ”的 Iterable 样式和 Map 样式的构建块启用可组合的数据加载,这些构建块与 PyTorch 的 DataLoader 开箱即用。 目前已经实现了 50 多个提供不同核心功能的 DataPipes,例如打开文件、解析文本、转换样本、缓存、混洗和批处理。在此版本中,一些 PyTorch 域库已迁移其数据集以使用 DataPipes。在 TorchText 中,库提供的流行数据集是使用 DataPipes 实现的,其 SST-2 二进制文本分类教程的一部分演示了如何使用 DataPipes 为模型预处理数据。 TorchData 的文档现已上线,包含介绍如何使用 DataPipes、将它们与 DataLoader 一起使用以及实现自定义。项目的 README 文件中描述了与 DataLoader 相关的常见问题解答和未来计划。 functorch 介绍 受Google JAX 的极大启发,functorch 是一个向 PyTorch 添加可组合函数转换的库。它旨在提供可组合的 vmap(矢量化)和 autodiff 转换,可与 PyTorch 模块和 PyTorch autograd 一起使用,并具有良好的渴望模式性能。 可组合的函数转换可以帮助解决当今在 PyTorch 中难以实现的许多用例: 计算每样本梯度(或其他每样本数量) 在单台机器上运行模型集合 在 MAML 的内循环中有效地将任务批处理在一起 有效地计算雅可比矩阵和黑森矩阵以及批量矩阵 组合 vmap(矢量化)、vjp(反向模式 AD)和 jvp(正向模式 AD)转换能够轻松地表达上述内容,而无需为每个转换设计单独的库。有关 functorch 的详细信息,请参阅文档、教程和安装说明。 分布式训练 (稳定)DDP 静态图 DDP 静态图假设您的模型在每次迭代中都使用相同的一组已使用/未使用的参数,因此它可以确定性地了解状态,例如哪些 hooks 将触发、hooks 将触发多少次以及第一次迭代后的梯度计算就绪顺序。 静态图在第一次迭代中缓存了这些状态,因此它可以支持 DDP 在以前的版本中无法支持的功能,例如,支持在相同参数上的多个激活检查点,无论是否有未使用的参数。当存在未使用的参数时,静态图功能还应用性能优化,例如,它避免遍历图以在每次迭代中搜索未使用的参数,并启用动态分桶顺序。 DDP 静态图中的这些优化为一些推荐模型带来了 10% 的 QPS 增益。 要启用静态图,只需在 DDP API 中设置 static_graph=True ,如下所示: ddp_model = DistributedDataParallel(model, static_graph=True) 有关更多详细信息,请参阅文档和教程。 更新公告:https://pytorch.org/blog/pytorch-1.11-released/

优秀的个人博客,低调大师

从各个角度深度讲解java锁

本节内容: java锁介绍 偏向锁、轻量级锁、重量级锁 可重入锁、非可重入锁 共享锁、独占锁 公平锁、非公平锁 悲观锁、乐观锁 自旋锁、非自旋锁 可中断锁、不可中断锁 synchronized锁介绍 什么是synchronized锁 synchronized关键字在同步方法中的应用 synchronized关键字和Lock接口对比 公平锁和非公平锁 公平锁和非公平锁 公平锁和非公平锁效果展示 读写锁 为什么设置读写锁 读写锁规则 读写锁使用展示 读锁插队策略 读写锁的升降级 自旋锁 自旋锁介绍 如何自定义实现一个可重入的自旋锁 JVM对锁的优化 java锁介绍 偏向锁、轻量级锁、重量级锁 这三种锁特指synchronized锁的状态,通过对象头中的mark work字段表示锁状态。 偏向锁: 自始至终,对这把锁都不存在竞争,只需要做个标记,这就是偏向锁,每个对象都是一个内置锁(内置锁是可重入锁),一个对象被初始化后,还没有任何线程来获取它的锁时,那么它就是可偏向的,当有线程来访问并尝试获取锁的时候,他就会把这个线程记录下来,以后如果获取锁的线程正式偏向锁的拥有者,就可以直接获得锁,偏向锁性能最好。 轻量级锁: 轻量级锁是指原来是偏向锁的时候,这时被另外一个线程访问,存在锁竞争,那么偏向锁就会升级为轻量级锁,线程会通过自旋的形式尝试获取锁,而不会陷入阻塞。 重量级锁: 重量级锁是互斥锁,主要是利用操作系统的同步机制实现的,当多个线程直接有并发访问的时候,且锁竞争时间长的时候,轻量级锁不能满足需求,锁就升级为重量级锁,重量级锁会使得其他拿不到锁的线程陷入阻塞状态,重量级锁的开销相对较大。 可重入锁、非可重入锁 可重入锁: 可重入锁的意思是如果当前线程已经持有了这把锁,能再不释放的锁的情况下再次获得这把锁,如果一个线程试图获取它已经持有的锁,那么这个请求会成功,每个锁关联一个获取计数值和一个所有者线程,当计数值为0的时候,认为没有线程持有该锁,当线程请求一个未被持有的锁的时候,JVM将记下锁的持有者,并且计数值置为1,如果同一个线程再次获取该锁的时候,计数值将递增, 不可重入锁: 同理不可重入锁就是指虽然当前线程已经持有了这把锁,但是如果想要再次获得这把锁,必须要先释放锁后才能再次尝试获取。 共享锁、独占锁 共享锁: 共享锁就是我们可以同一把锁被多个线程同时获得,最典型的就是读写锁中的读锁。 独占锁: 同理,独占锁就是线程只能对一个线程持有,类比读写锁中的写锁, 公平锁、非公平锁 公平锁: 公平锁就是如果线程当前拿不到这把锁,那么线程就都会进入等待,开始排队,在等待队列里等待时间长的线程就会优先拿到这把锁,先来先得。 非公平锁: 非公平锁是指在一定的情况下,某些线程会忽略掉已经在排队的线程,发生插队的情况。 悲观锁、乐观锁 悲观锁: 悲观锁顾名思义,比较悲观,悲观锁认为如果不锁住这个共享资源,别的线程就回来竞争,就会造成数据结果错误,所以在获取共享资源前,必须要先拿到锁,以便达到“独占”的状态,,让其他线程无法访问该数据,这样就不会发生数据错误。常见的悲观锁例如synchronized关键字、Lock接口 乐观锁: 同理乐观锁是相对悲观锁而言的,乐观锁就是比较乐观了,它认为一般情况下数据不会发生冲突,只有在数据进行更新的时候,才会对比数据在被当前线程更新期间有咩有被修改过,如果没有被修改过,则可以正常更新数据,如果数据发生过修改和预期不一样,那么本次更新操作就不能成功,所以可以放弃这次更新或者选择报错、重试等策略。常见的乐观锁例如:各种原子类 自旋锁、非自旋锁 自旋锁: 自旋锁是指如果线程拿不到锁,那么线程并不直接陷入阻塞或者释放CPU资源而是开始自我旋转,不停的尝试获取锁,这个循环的过程成为自旋。 非自旋锁: 非自旋锁就是没有自旋的过程,如果拿不到锁就直接放弃或者进行其他逻辑处理,比如排队、阻塞。 可中断锁、不可中断锁 可中断锁: 可中断锁指在获取锁的过程中,可以中断锁之后去做其他事情,不需要一直等到获取到锁才继续处理 不可中断锁: synchronized是不可中断锁,就是指一旦申请了锁,只能等到拿到锁以后才能进行其他的逻辑处理。 synchronized锁介绍 什么是synchronized锁 java中每个对象中都持有一把锁与之关联,控制着对象的synchronized代码,想要执行对象的synchronized代码,必须先获得对象的锁,这个锁就是对象的Monitor锁,synchronized实现加锁解锁就是利用Monitor锁实现的。获取Monitor锁的唯一方式是进入由这个锁保护的同步代码块或者同步方法中,线程进入synchronized保护的代码之前获得锁,然后在正常执行代码完成后或者异常退出,都会自动释放锁。 synchronized关键字在同步代码块中的应用: 我们通过分析一下代码的反汇编内容来理解synchronized是如何利用monitor锁来工作的我们先来分析同步代码块的反汇编内容 public class TestSync { public void sync1(){ synchronized (this){ int ss = 10; System.out.println(ss); } } } 如上图代码,我们定义的TestSync类中的sync1()方法中包含一个同步代码块,我们通过指令:javap -verbose TestSync.class查看方法对应的反汇编内容如下: public void sync1(); descriptor: ()V flags: ACC_PUBLIC Code: stack=2, locals=4, args_size=1 0: aload_0 1: dup 2: astore_1 3: monitorenter //加锁 4: bipush 10 6: istore_2 7: getstatic #2 // Field java/lang/System.out:Ljava/io/PrintStream; 10: iload_2 11: invokevirtual #3 // Method java/io/PrintStream.println:(I)V 14: aload_1 15: monitorexit //解锁 16: goto 24 19: astore_3 20: aload_1 21: monitorexit 解锁 22: aload_3 23: athrow 24: return 上述中我可以看出同步代码块实际上多了monitorenter和monitorexit指令,我们可以理解为对应的加解锁,之所以有一个monitorenter对应两个monitorexit是因为jvm要保证每个monitorenter必须有与之对应的monitorexit,那么就需要在正常结束流程和异常结束流程中分别执行monitorexit以保证正常或者抛出异常情况下都能释放锁。 monitorenter含义: 每个对象维护着一个计数器,没有被锁定的对象计数器为0,执行monitorenter的线程尝试获取monitor的所有权,那么会有以下三种情况:如果该monitor的计数为0,则线程获得该monitor后并将其计数设置成1,然后该线程就该monitor的持有者。如果线程已经获取了该monitor,那么该monitor的计数将累加。如果线程已经是其他线程已经获取了该monitor,那么当前想要获取该monitor的线程会被阻塞,知道该monitor的计数为0的时候,代表该monitor已经被释放了,然后当前线程就可以尝试获取该monitor了。 monitorexit含义: monitorexit的作用是将monitor的计数减1,知道减为0为止,代表这个monitor已经被释放了,那么此时其它线程就可以尝试获取该monitor的所有权了。 synchronized关键字在同步方法中的应用: 我们再来看看同步方法反汇编后的内容又是怎么样的,我们对一下内容执行反汇编。 public class TestSync { public synchronized void sync2(){ int aa = 10; System.out.println(aa); } } 反汇编代码如下: public synchronized void sync2(); descriptor: ()V flags: ACC_PUBLIC, ACC_SYNCHRONIZED Code: stack=2, locals=2, args_size=1 0: bipush 10 2: istore_1 3: getstatic #2 // Field java/lang/System.out:Ljava/io/PrintStream; 6: iload_1 7: invokevirtual #3 // Method java/io/PrintStream.println:(I)V 10: return 从上述代码中我们可以看出同步方法和同步代码块的不同之处是同步代码块中依赖monitorenter和monitorexit来加解锁,同步方法中会多出一个ACC_SYNCHRONIZED的flags修饰符,来表明他是同步方法。所以被synchronized修饰的方法会有一个ACC_SYNCHRONIZED标志,那么当线程要访问某个方法的时候就会检查方法是否携带ACC_SYNCHRONIZED标志,带的话就先去获取monitor锁,然后获取到锁后在执行方法,方法执行完后释放monitor锁。 synchronized关键字和Lock接口对比 相同点: synchronized和Lock都是用来保护资源线程安全的。 都保证可见性,对于synchronized而言,线程A进入synchronized代码块或者方法中进行的操作,对于后续的获得同一个monitor锁的线程B是可见的。同理对于Lock而言,他和synchronized是一样的都可以保证可见行 synchronized和ReentrantLock都拥有可重入的特点 不同点: 用法区别:synchronized关键字可以加在方法上不需要指定锁对象,也可以新建一个同步代码块并且自定义monitor锁对象,而Lock接口必须显示用Lock锁对象开始加锁lock()和解锁unLock(),并且一般会在finally块中确保用unLock()来解锁以防止发生死锁。 加解锁顺序不同,Lock可以不按照加锁顺序进行解锁比如我们先获取A锁,在获取B锁,那么解锁时我们可以先解锁A锁在解锁B锁,但是synchronized的加解锁必须有顺序,比如获取A锁,在获取B锁,那么解锁就是先解锁B锁,在解锁A锁。 synchronized相比Lock不够灵活,synchronized锁一旦被某个线程获取了,那么其它线程只能阻塞等待释放锁,如果持有锁的线程执行很久那么整个程序的运行效率就会很低,而且如果一直不释放锁其他线程将一直等待下去,相比Lock的lockInterruptibly方法,如果觉得持有锁的线程执行太久了可以中断退出,还可以用tryLock()尝试获取锁,获取不到就去执行别的逻辑。 Lock接口的一些实现类例如读写锁中的读锁可以被多个线程持有,synchronized只能被一个线程持有 synchronized是内置锁(Monitor锁),有JVM实现加解锁,还分为偏向锁、轻量级锁、重量级锁,Lock接口根据实现不同有不同的底层原理。 Lock可以设置是否公平锁,synchronized不可以设置 java6以后jdk对synchronized进行了很多优化,所以synchronized性能并不比Lock差 公平锁和非公平锁 公平锁和非公平锁 公平锁是指线程按照请求顺序来分配锁,非公平锁是指不完全按照线程请求顺序分配锁,但是非公平锁并不是完全的随机分配而是”在合适的时机“插队执行。 什么是合适的时机 所谓合适的时机就是比如新来一个线程要获取锁,恰巧上一个持有锁线程正好执行完毕释放了锁,那么此时这个新来的线程能不管后面排队的线程而选择立即插队执行,但是如果上一个线程还未释放锁,那么新来的线程就需要去等待队列排队。 为什么设置非公平锁 之所以设计非公平锁是因为相比公平锁排队执行,上一个线程释放锁后需要先唤醒下一个要执行的线程,然后去获取锁在执行,而采用非公平锁下,就可以上一个线程释放了锁,刚来一个新线程直接获取锁就插队去执行代码了,不需要额外的唤醒线程成本,而且也有可能在线程唤醒的这段时间内,插队线程已经获取锁并且执行完任务并释放了锁。所以设置非公平锁,这样设计的原因是为了提高系统整体的运行效率,而且ReentrantLock默认的是非公平锁。 公平锁和非公平锁效果展示 公平锁和非公平锁通过设置ReentrantLock中boolean值来设置公平非公平锁,如下代码所示是设置为非公平锁。 Lock lock=new ReentrantLock(false); 公平锁代码展示: /** * 描述:演示公平锁,分别展示公平和不公平的情况, * 非公平锁会让现在持有锁的线程优先再次获取到锁。 * 代码借鉴自Java并发编程实战手册2.7 */ ​ public class FairAndNoFair { public static void main(String[] args) { PrintQueue printQueue = new PrintQueue(); ​ Thread[] threads= new Thread[10]; for(int i=0;i<10;i++){ threads[i] = new Thread(new Job(printQueue),"Thread "+ i); } ​ for (int i = 0; i < 10; i++) { threads[i].start(); try { Thread.sleep(100);//为了保证执行顺序 } catch (InterruptedException e) { e.printStackTrace(); } } } } public class Job implements Runnable{ private PrintQueue printQueue; public Job(PrintQueue printQueue){ this.printQueue=printQueue; } @Override public void run() { System.out.printf("%s: Going to print a job\n", Thread.currentThread().getName()); printQueue.printJob(); System.out.printf("%s: The document has been printed\n", Thread.currentThread().getName()); } } public class PrintQueue { private final Lock lock=new ReentrantLock(false); ​ public void printJob(){ lock.lock(); ​ try{ Long duration = (long) (Math。random()*10000); System.out.printf("%s:First PrintQueue: Printing a Job during %d seconds\n", Thread.currentThread().getName(), (duration / 1000)); Thread.sleep(duration); } catch (InterruptedException e){ e.printStackTrace(); } finally { lock.unlock(); } ​ ​ lock.lock(); try{ Long duration = (long) (Math.random()*10000); System.out.printf("%s:Second PrintQueue: Printing a Job during %d seconds\n", Thread.currentThread().getName(), (duration / 1000)); Thread.sleep(duration); } catch (InterruptedException e){ e.printStackTrace(); } finally { lock.unlock(); } } } 我们先运行公平锁的打印结果如下: Thread 0: Going to print a job Thread 0:First PrintQueue: Printing a Job during 9 seconds Thread 1: Going to print a job //线程1-9进入等待队列排队 Thread 2: Going to print a job Thread 3: Going to print a job Thread 4: Going to print a job Thread 5: Going to print a job Thread 6: Going to print a job Thread 7: Going to print a job Thread 8: Going to print a job Thread 9: Going to print a job Thread 1:First PrintQueue: Printing a Job during 5 seconds//线程0执行完释放了锁,线程1开始执行 Thread 2:First PrintQueue: Printing a Job during 1 seconds Thread 3:First PrintQueue: Printing a Job during 9 seconds Thread 4:First PrintQueue: Printing a Job during 7 seconds Thread 5:First PrintQueue: Printing a Job during 8 seconds Thread 6:First PrintQueue: Printing a Job during 5 seconds Thread 7:First PrintQueue: Printing a Job during 2 seconds Thread 8:First PrintQueue: Printing a Job during 9 seconds Thread 9:First PrintQueue: Printing a Job during 7 seconds Thread 0:Second PrintQueue: Printing a Job during 0 seconds Thread 1:Second PrintQueue: Printing a Job during 6 seconds Thread 0: The document has been printed Thread 1: The document has been printed Thread 2:Second PrintQueue: Printing a Job during 4 seconds Thread 2: The document has been printed Thread 3:Second PrintQueue: Printing a Job during 4 seconds Thread 3: The document has been printed Thread 4:Second PrintQueue: Printing a Job during 1 seconds Thread 4: The document has been printed Thread 5:Second PrintQueue: Printing a Job during 3 seconds Thread 5: The document has been printed Thread 6:Second PrintQueue: Printing a Job during 0 seconds Thread 6: The document has been printed Thread 7:Second PrintQueue: Printing a Job during 1 seconds Thread 7: The document has been printed Thread 8:Second PrintQueue: Printing a Job during 5 seconds Thread 8: The document has been printed Thread 9:Second PrintQueue: Printing a Job during 5 seconds Thread 9: The document has been printed Process finished with exit code 0 从上图可以看出线程直接获取锁的顺序是公平的,先到先得。 我们运行非公平锁的打印结果如下: Thread 0: Going to print a job Thread 0:First PrintQueue: Printing a Job during 5 seconds Thread 1: Going to print a job Thread 2: Going to print a job Thread 3: Going to print a job Thread 4: Going to print a job Thread 5: Going to print a job Thread 6: Going to print a job Thread 7: Going to print a job Thread 8: Going to print a job Thread 9: Going to print a job Thread 0:Second PrintQueue: Printing a Job during 2 seconds //线程0直接释放锁又获取了锁,体现了非公平锁 Thread 0: The document has been printed Thread 1:First PrintQueue: Printing a Job during 9 seconds Thread 1:Second PrintQueue: Printing a Job during 3 seconds Thread 1: The document has been printed Thread 2:First PrintQueue: Printing a Job during 0 seconds Thread 3:First PrintQueue: Printing a Job during 0 seconds Thread 3:Second PrintQueue: Printing a Job during 7 seconds Thread 3: The document has been printed Thread 4:First PrintQueue: Printing a Job during 3 seconds Thread 4:Second PrintQueue: Printing a Job during 8 seconds Thread 4: The document has been printed Thread 5:First PrintQueue: Printing a Job during 6 seconds Thread 5:Second PrintQueue: Printing a Job during 1 seconds Thread 5: The document has been printed Thread 6:First PrintQueue: Printing a Job during 0 seconds Thread 6:Second PrintQueue: Printing a Job during 7 seconds Thread 6: The document has been printed Thread 7:First PrintQueue: Printing a Job during 8 seconds Thread 7:Second PrintQueue: Printing a Job during 1 seconds Thread 7: The document has been printed Thread 8:First PrintQueue: Printing a Job during 9 seconds Thread 8:Second PrintQueue: Printing a Job during 8 seconds Thread 8: The document has been printed Thread 9:First PrintQueue: Printing a Job during 5 seconds Thread 9:Second PrintQueue: Printing a Job during 5 seconds Thread 9: The document has been printed Thread 2:Second PrintQueue: Printing a Job during 3 seconds Thread 2: The document has been printed ​ Process finished with exit code 0 上图中可以看出线程0在释放了锁之后,立刻有获取了锁继续执行,出现了抢锁插队现象(此时等待队列已经有了线程1-9再等待)。 公平锁和非公平锁有缺点 公平锁优势:公平锁各个线程平等,每个线程等待一段时间总会执行。 公平锁劣势:相对非公平锁执行效率比较慢,吞吐量更小 非公平锁优势:相比公平锁更快,吞吐量更大 非公平锁劣势:又可能产生饥饿线程,就是某些线程的等待时间很长始终得不到执行。 公平锁和非公平锁源码解析 首先公平锁和非公平锁都是继承了ReentrantLock类中的内部类Sync类,这个Sync类继承AQS(AbstractQueuedSynchronizer),Sync类代码如下: //源码中可以看出Sync继承了AbstractQueuedSynchronizer类 abstract static class Sync extends AbstractQueuedSynchronizer {...} //Sync有公平锁FairSync和非公平锁NonFairSync两个子类: static final class NonfairSync extends Sync {。。。} static final class FairSync extends Sync {。。} 公平锁获取锁的源码: protected final boolean tryAcquire(int acquires) { final Thread current = Thread.currentThread(); int c = getState(); if (c == 0) { //这里和非公平锁对比多了个!hasQueuedPredecessors()判断 if (!hasQueuedPredecessors() && compareAndSetState(0, acquires)) { setExclusiveOwnerThread(current); return true; } } else if (current == getExclusiveOwnerThread()) { int nextc = c + acquires; if (nextc < 0) throw new Error("Maximum lock count exceeded"); setState(nextc); return true; } return false; } 非公平锁获取锁源码: final boolean nonfairTryAcquire(int acquires) { final Thread current = Thread.currentThread(); int c = getState(); if (c == 0) { if (compareAndSetState(0, acquires)) { setExclusiveOwnerThread(current); return true; } } else if (current == getExclusiveOwnerThread()) { int nextc = c + acquires; if (nextc < 0) // overflow throw new Error("Maximum lock count exceeded"); setState(nextc); return true; } return false; } 通过对比可以发现,公平锁和非公平锁的区别主要是在获取锁的时候,公平锁多了一个hasQueuedPredecessors()为false的判断,hasQueuedPredecessors()方法就是判断等待队列中是否已经有线程在等待了,如果有则当前线程不能在尝试获取锁,对于非公平锁而言,无论是否有线程在等待了,都先尝试获取锁,获取不到的话再去排队,tryLock()方法内部调用的是sync.nonfairTryAcquire(1)即非公平锁,所以即使设置了公平模式,那么使用tryLock()也可以插队。 读写锁 为什么设置读写锁 首先读写锁是为了提高系统的效率,虽然普通的ReentrantLock可以保证线程安全,但是如果是多个读取操作,就直接采用ReentrantLock会大大的浪费系统资源,还有就是写操作是不安全的,当并发写或者在进行写操作的同时进行读取,都会发生线程安全问题,那么设置的读写锁就起了作用,读写锁支持并发读来提高读的效率,同时又保证安全的写操作。 读写锁规则 如果一个线程已经占用了读锁,则此时其他线程如果要申请读锁,可以申请成功。 如果一个线程已经占用了读锁,则此时其他线程如果要申请写锁,则申请写锁的线程会一直等待释放读锁,因为读写不能同时进行。 如果一个线程已经占用了写锁,则此时其他线程申请读锁或者写锁,必须等待之前的线程释放了写锁,因为读写不能同时进行。 读写锁使用展示 这里使用ReentrantReadWriteLock来演示,ReentrantReadWriteLock是ReadWriteLock的是实现类,最主要两个方法readLock()获取读锁,writeLock()获取写锁,这里使用ReadWriteLock中的读写锁进行并发读写,代码展示如下: public class ReadWriteLock { //定义读写锁 private static final ReentrantReadWriteLock reentrantReadWriteLock = new ReentrantReadWriteLock(false); //获取读锁 private static final ReentrantReadWriteLock.ReadLock readLock= reentrantReadWriteLock.readLock(); //获取写锁 private static final ReentrantReadWriteLock.WriteLock writeLock= reentrantReadWriteLock.writeLock(); ​ public static void read(){ readLock.lock(); try { System.out.println(Thread.currentThread().getName() +"得到读锁,正在读取"); Thread.sleep(500); }catch (InterruptedException e){ e.printStackTrace(); } finally { System.out.println("释放读锁"); readLock.unlock(); } } ​ private static void write() { writeLock.lock(); try { System.out.println(Thread.currentThread().getName() + "得到写锁,正在写入"); Thread.sleep(500); } catch (InterruptedException e) { e.printStackTrace(); } finally { System.out.println(Thread.currentThread().getName() + "释放写锁"); writeLock.unlock(); } } ​ public static void main(String[] args) throws InterruptedException { new Thread(() -> read()).start(); new Thread(() -> read()).start(); new Thread(() -> write()).start(); new Thread(() -> write()).start(); } } 运行结果如下: Thread-0得到读锁,正在读取 Thread-1得到读锁,正在读取 释放读锁 释放读锁 Thread-2得到写锁,正在写入 Thread-2释放写锁 Thread-3得到写锁,正在写入 Thread-3释放写锁 通过运行结果可以看出,读写锁支持并发读,而写操作是单独进行的。 读锁插队策略 首先读写锁ReentrantReadWriteLock支持公平锁和非公平锁,可以通过以下进行设置: //后面的boolean值用来设置公平锁、非公平锁,其中的false设置为非公平锁,设置为true就是公平锁, ReentrantReadWriteLock reentrantReadWriteLock = new ReentrantReadWriteLock(false); 如果设置为公平锁的时候对应的读写锁实现为: static final class FairSync extends Sync { private static final long serialVersionUID = -2274990926593161451L; final boolean writerShouldBlock() { return hasQueuedPredecessors(); } final boolean readerShouldBlock() { return hasQueuedPredecessors(); } } 其中的hasQueuedPredecessors()方法就是检测等待队列中是否已经有线程在排序了,如果有的话每当前获取锁的线程就会block去排序,所以符合公平锁定义。 如果设置为false非公平锁,则对应的实现为: static final class NonfairSync extends Sync { private static final long serialVersionUID = -8159625535654395037L; final boolean writerShouldBlock() { return false; // writers can always barge } final boolean readerShouldBlock() { /* As a heuristic to avoid indefinite writer starvation, * block if the thread that momentarily appears to be head * of queue, if one exists, is a waiting writer。 This is * only a probabilistic effect since a new reader will not * block if there is a waiting writer behind other enabled * readers that have not yet drained from the queue。 */ return apparentlyFirstQueuedIsExclusive(); } } 上图中writerShouldBlock()方法直接返回false,可以看出对于想要获取写锁的线程而言,由于返回的是false所以它可以随时插队,也符合非公平锁的设计,非公平锁下的获取读锁需要依据apparentlyFirstQueuedIsExclusive()方法的返回值,上图中对apparentlyFirstQueuedIsExclusive方法注释主要是说防止等待队列头的写线程无饥饿等待下去,举个例子说明: 场景:如果有线程1和2同时读取,并且1和2已经持有了读锁,此时线程3想要写入,所以线程3进入等待队列,此时线程4突然插队想要获取读锁。此时就有两种策略: 允许插队,允许线程4获取读锁和线程1线程2一起去读取,看似提高了读取效率,但是却有一个严重的问题,就是如果后面来的线程一直都是想要获取读锁的线程,那么线程3将一直得不到执行的机会,那么就会陷入“饥饿”状态,在长时间内得不到执行。 不允许插队,此时如果新来的线程4想要获取读锁,必须去等排队等待,这种策略下,线程3或优先于线程4,就可以避免上面的“饥饿”状态,直到线程3运行结束,线程4才有机会运行。 而ReentrantReadWriteLock非公平锁下的获取读锁正是采用了不允许插队策略来实现的,避免了线程饥饿情况。 我们通过代码展示一下上面的不允许插队策略,效果展示代码展示: public class ReadWriteLock { //定义读写锁 private static final ReentrantReadWriteLock reentrantReadWriteLock = new ReentrantReadWriteLock(false); //获取读锁 private static final ReentrantReadWriteLock.ReadLock readLock= reentrantReadWriteLock.readLock(); //获取写锁 private static final ReentrantReadWriteLock.WriteLock writeLock= reentrantReadWriteLock.writeLock(); ​ public static void read(){ readLock.lock(); try { System.out.println(Thread.currentThread().getName() +"得到读锁,正在读取"); Thread.sleep(500); }catch (InterruptedException e){ e.printStackTrace(); } finally { System.out.println("释放读锁"); readLock.unlock(); } } ​ private static void write() { writeLock.lock(); try { System.out.println(Thread.currentThread().getName() + "得到写锁,正在写入"); Thread.sleep(500); } catch (InterruptedException e) { e.printStackTrace(); } finally { System.out.println(Thread.currentThread().getName() + "释放写锁"); writeLock.unlock(); } } ​ public static void main(String[] args) throws InterruptedException { new Thread(() -> read()).start(); new Thread(() -> read()).start(); new Thread(() -> write()).start(); //以上代码没有改变,这里换成了读锁 new Thread(() -> read()).start(); } } 运行结果如下: Thread-0得到读锁,正在读取 Thread-1得到读锁,正在读取 释放读锁 释放读锁 Thread-2得到写锁,正在写入 Thread-2释放写锁 Thread-3得到读锁,正在读取 释放读锁 通过运行结果我们可以看出,ReentrantReadWriteLock选择了不允许插队的策略。 读写锁的升降级 写锁的降级写锁的降级,代码展示: //定义读写锁 private static final ReentrantReadWriteLock reentrantReadWriteLock = new ReentrantReadWriteLock(); //获取读锁 private static final ReentrantReadWriteLock.ReadLock readLock= reentrantReadWriteLock.readLock(); //获取写锁 private static final ReentrantReadWriteLock.WriteLock writeLock= reentrantReadWriteLock.writeLock(); ​ //锁的降级 public static void downgrade(){ System.out.println(Thread.currentThread().getName()+"尝试获取写锁"); writeLock.lock();//获取写锁 try { System.out.println(Thread.currentThread().getName()+"获取了写锁"); //在不释放写锁的情况下直接获取读锁,这就是读写锁的降级 readLock.lock(); System.out.println(Thread.currentThread().getName()+"获取了读锁"); }finally { System.out.println(Thread.currentThread().getName()+"释放了写锁"); //释放了写锁,但是依然持有读锁,这里不释放读锁,导致后面的线程无法获取写锁 writeLock.unlock(); } } public static void main(String[] args) { new Thread(() -> downgrade()).start(); new Thread(() -> downgrade()).start(); } 上图运行结果如下: 图中我们可以看出线程0可以在持有写锁的情况下获取到了读锁,这就是写锁的降级,因为线程0后面只是放了写锁,并未释放读锁,导致后面的线程1不能获取到写锁,所以程序一直阻塞。 读锁的升级 接下来我们在来看读锁的升级,代码展示: private static final ReentrantReadWriteLock reentrantReadWriteLock = new ReentrantReadWriteLock(false); //获取读锁 private static final ReentrantReadWriteLock.ReadLock readLock= reentrantReadWriteLock.readLock(); //获取写锁 private static final ReentrantReadWriteLock.WriteLock writeLock= reentrantReadWriteLock.writeLock(); //读锁升级 public static void upgarde(){ System.out.println(Thread.currentThread().getName()+"尝试获取读锁"); readLock.lock(); try{ System.out.println(Thread.currentThread().getName()+"获取到了读锁"); System.out.println(Thread.currentThread().getName()+"阻塞获取写锁"); //在持有读锁的情况下获取写锁,此处会阻塞,表示不支持读锁升级到写锁 writeLock.lock();//此处会阻塞 System.out.println(Thread.currentThread().getName()+"获取到了写锁"); ​ }finally { readLock.unlock(); } } ​ public static void main(String[] args) { new Thread(() -> upgarde()).start(); new Thread(() -> upgarde()).start(); } 运行结果如下: 上图中我们可以看出线程0和线程1都可以成功的获取到读锁,但是在进行锁升级获取写锁的时候都阻塞了,这是因为ReentrantReadWriteLock 不支持读锁升级到写锁。因为读锁是可以多个线程持有的,但是写锁只能一个线程持有,并且不可能存在读锁和写锁同时持有的情况,也正是因为这个原因所以升级写锁的过程中,需要等待所有的读锁都释放了,此时才能进行锁升级。 举个例子,比如ABC三个线程都持有读锁,其中线程A想要进行锁升级,必须要等到B和C都释放了读锁,此时线程A才可以成功升级并获取写锁。 但是这里也有一个问题,那就是假如A和B都想要锁升级,对于线程A来说,他需要等待其他所有线程包括B线程释放读锁,而B线程也需要等待其他线程释放读锁包括A线程,那就会发生死锁。所以如果我们保证每次升级只有一个线程可以升级,那么就可以保证线程安全,并且实现。 自旋锁 自旋锁介绍 自旋锁其实就是指循环,比如while或者for循环,一直循环去尝试获取锁,不像普通的锁获取不到就陷入阻塞。 自旋锁和非自旋锁流程图对比如下: 上图中我们可以看出自旋锁获取获取锁失败并不会释放CPU资源而是通过自旋的方式等待锁的释放,直到成功获取到锁为止。而非自旋锁如果尝试获取锁失败了,它就把自己的线程切换状态,让线程休眠,释放CPU时间片,然后直到之前持有这把锁的线程释放了锁,于是CPU再把之前的线程恢复回来,让这个线程再尝试去获取锁,如果再次失败就在让线程休眠,如果成功,就可以获取到同步资源的锁。 自旋锁的好处 自旋锁免去了耗时的阻塞和唤醒线程操作,避免了线程的状态切换等开销,提高了效率。 自旋锁的坏处 自旋锁虽然避免了线程切换的开销,但是也带来了新的开销,因为他需要不停的循环去尝试获取锁,如果所以只不释放,那么他就需要一直去尝试,这样会白白的浪费资源。 所以,自旋锁适用于并发度不是特别高,而且线程持有锁的时间较短的场景。举个例子比如java.util.concurrent包下的原子类大多数都是基于自旋锁的实现,比如AtomicInteger,我们查看他的getAndIncrement()方法,如下: public final int getAndAddInt(Object var1, long var2, int var4) { int var5; do { var5 = this.getIntVolatile(var1, var2); } while(!this.compareAndSwapInt(var1, var2, var5, var5 + var4)); ​ return var5; } 很明显,do...while()循环就是一个自旋操作,如果在修改过程中遇到了其他线程导致没有修改成功,则就会执行循环不从的重试,直到修改成功为止。 如何自定义实现一个可重入的自旋锁 实现代码如下: //自定义实现可重入的自旋锁 public class CustomReentrantSpinLock { private AtomicReference<Thread> owner=new AtomicReference<>(); private int count = 0;//重入次数 ​ public void lock() { Thread t = Thread.currentThread(); System.out.println(Thread.currentThread().getName()+"lock了"); if (t == owner.get()) { ++count; return; } ​ //自旋获取锁 while (!owner.compareAndSet(null, t)) { System.out.println(Thread.currentThread().getName()+"自旋了"); } } ​ public void unLock(){ Thread t=Thread.currentThread(); //只有当前线程才能解锁 if(t == owner.get()){ if(count >0){ --count; } else { owner.set(null); } } } ​ public static void main(String[] args) { CustomReentrantSpinLock spinLock=new CustomReentrantSpinLock(); Runnable runnable=new Runnable() { @Override public void run() { System.out.println(Thread.currentThread().getName()+"开始尝试获取自旋锁"); spinLock.lock(); try { System.out.println(Thread.currentThread().getName()+"获取到了自旋锁"); Thread.sleep(1); }catch (InterruptedException e){ e.printStackTrace(); } finally { spinLock.unLock(); System.out.println(Thread.currentThread().getName()+"释放了自旋锁"); } } }; Thread thread1=new Thread(runnable); Thread thread2=new Thread(runnable); thread1.start(); thread2.start(); } } 运行结果如下: Thread-0开始尝试获取自旋锁 Thread-1开始尝试获取自旋锁 Thread-0获取到了自旋锁 Thread-1自旋了 . . . Thread-1自旋了 Thread-0释放了了自旋锁 Thread-1获取到了自旋锁 Thread-1释放了了自旋锁 从上图运行结果中可以看出,打印了很多Thread-1自旋了,说明自旋期间CPU依然不停运转,Thread-1并没有释放CPU时间片。 JVM对锁的优化 从jdk1.6后HotSpot虚拟机对synchronized做了很多优化,包括自适应自选、锁消除、锁粗化、偏向锁、轻量级锁等,使得synchronized锁得到了很大的性能提升。 自适应自旋锁 自适应自旋就是自旋的时间不在固定,而是根据自旋的成功率、失败率、以及当前锁的持有者的状态等多种因素来共同决定的,就是说自旋的时间是变化的,这样可以减少无用的自旋,提高效率。 锁消除 锁消除是发生在编译器级别的一种锁优化方式,有时候我们写的代码不需要加锁,就比如加锁的代码实际上只有一个线程会执行,并不会出现多个线程并发访问的情况,但是我们却加上了synchronized锁,那么编译器就可能会消除掉这个锁,比如下面StringBuffer的append操作: @Override public synchronized StringBuffer append(Object obj) { toStringCache = null; super.append(String。valueOf(obj)); return this; } 代码中我们可以看到这个方法被synchronized修饰,因为它可能会被多个线程同时使用,但是多数情况下它只会在一个线程内使用,如果编译器能确定这个对象只会在一个线程内使用,那么就表示肯定是线程安全的,编译器就会做出优化,把对应的synchronized消除,省去加解锁的操作以提升效率。 锁粗化 锁粗化主要是应对刚释放锁,什么还没做,就重新获取锁,例如如下代码: public void lockCoarsening() { synchronized (this) { //do something } synchronized (this) { //do something } synchronized (this) { //do something } } 上述代码中,当线程在执行第一个同步代码块时需要先获取synchronized锁,然后执行完了同步代码块在释放synchronized锁,但是当线程执行完第一个同步代码块后已经释放了锁后,紧接着线程立刻开始执行第二个同步代码块时就需要对相同的锁进行获取和释放,这样释放和获取锁是完全没有必要的,如果把同步区域扩大,也就是在最开始的时候加一次锁,在结束的时候释放锁,那么就可以把中间无意义的解锁和加锁的过程消除,相当于把几个synchronized块合并成为一个较大的同步块,好处就是无需频繁的释放锁和获取锁,减少系统开销。 但是锁粗化不适用在循环的场景,仅适用非循环的场景,因为如下代码所示,如果我们在第一次循环中获取锁,在最后一次循环中释放锁,那么这就会导致其它线程长时间无法获取锁。 for (int i = 0; i < 1000; i++) { synchronized (this) { //do something } } 锁粗化默认是开启的,通过-XX:-EliminateLocks关闭该功能 偏向锁、轻量级锁、重量级锁 这三种锁我们最开始就介绍过,它们是指synchronized的锁状态的,通过在对象头中的mark work字段来表明锁的状态。 锁升级的路径 锁升级的路径如下图所示,偏向锁性能做好,避免了CAS操作,轻量级锁利用了自旋和CAS操作避免了重量级锁带来的线程阻塞和唤醒,性能中等,重量级锁会把获取不到锁的线程阻塞,性能最差。 -END喜欢就扫描下方二维码或微信搜索“程序员内功心法”关注我吧

优秀的个人博客,低调大师

数据仓库分层架构深度讲解

前言 我们在数仓项目的时候往往是需要将它分层的,但是为什么分层你真正的了解过吗,那它分层的好处又是什么呢。好我们今天就针对这个话题进行讲解。如果你还不了解数仓中的模型可以去看这篇(数仓模型设计详细讲解),编写不易请给个一键三连。 一、为什么要分层 分层的主要原因是在管理数据的时候,能对数据有一个更加清晰的掌控,详细来讲,主要有下面几个原因: 清晰数据结构: 每一个数据分层都有它的作用域,这样我们在使用表的时候能更方便地定位和理解。 方便数据血缘追踪: 简单来说,我们最终给业务呈现的是一个能直接使用业务表,但是它的来源有很多,如果有一张来源表出问题了,我们希望能够快速准确地定位到问题,并清楚它的危害范围。 减少重复开发: 规范数据分层,开发一些通用的中间层数据,能够减少极大的重复计算。 把复杂问题简单化: 将一个复杂的任务分解成多个步骤来完成,每一层只处理单一的步骤,比较简单和容易理解。而且便于维护数据的准确性,当数据出现问题之后,可以不用修复所有的数据,只需要从有问题的步骤开始修复。 屏蔽原始数据的异常: 屏蔽业务的影响,不必改一次业务就需要重新接入数据 二、数仓分层思想 数据分层每个企业根据自己的业务需求可以分成不同的层次,但是最基础的分层思想,理论上数据分为三个层,数据运营层、数据仓库层和数据服务层。基于这个基础分层之上添加新的层次,来满足不同的业务需求。 数据运营层(ODS) Operate data store(操作数据-存储),是最接近数据源中数据的一层,数据源中的数据,经过抽取、洗净、传输,也就说传说中的ETL之后,装入ODS层。本层的数据,总体上大多是按照源头业务系统的分类方式而分类的。例如:MySQL里面的一张表可以通过sqoop之间抽取到ODS层 ODS层数据的来源方式: 业务库 经常会使用sqoop来抽取,比如我们每天定时抽取一次。在实时方面, 可以考虑用canal监听mysql的binlog,实时接入即可。 埋点日志 线上系统会打入各种日志,这些日志一般以文件的形式保存,我们可以选择用flume定时抽取,也可以用用spark streaming或者Flink来实时接入,当然,kafka也会是一个关键的角色。 消息队列 来自ActiveMQ、Kafka的数据等 数据仓库层(DW) Data warehouse(数据仓库)。在这里,从ODS层中获得的数据按照主题建立各种数据模型。例如以研究人的旅游消费为主题的数据集中,便可以结合航空公司的登机出行信息,以及银联系统的刷卡记录,进行结合分析,产生数据集。在这里,我们需要了解四个概念:维(dimension)、事实(Fact)、指标(Index)和粒度( Granularity)。 DW数据分层,由下到上为 DWD,DWB,DWSDWD:data warehouse detail 细节数据层,是业务层与数据仓库的隔离层。DWB:data warehouse base 基础数据层,存储的是客观数据,一般用作中间层,可以认为是大量指标的数据层。DWS:data warehouse service 服务数据层,基于DWB上的基础数据,整合汇总成分析某一个主题域的服务数据,一般是宽表 数据服务层/应用层(ADS): Application Data Service(应用数据服务)。该层主要是提供数据产品和数据分析使用的数据,一般会存放在ES、MySQL等系统中供线上系统使用,也可能会存在Hive或者Druid中供数据分析和数据挖掘使用。例如:我们经常说的报表数据,或者说那种大宽表,一般就放在这里。 三、阿里数据仓库分层架构 ODS 数据准备层 功能: ODS层是数据仓库准备区,为DWD层提供基础原始数据,可减少对业务系统的影响 建模方式及原则: 从业务系统增量抽取、保留时间由业务需求决定、可分表进行周期存储、数据不做清洗转换与业务系统数据模型保持一致、按主题逻辑划分 DWD 数据明细层 功能: 为DW层提供来源明细数据,提供业务系统细节数据的长期沉淀,为未来分析类需求的扩展提供历史数据支撑 建模方式及原则: 数据模型与ODS层一致,不做清洗转换处理、为支持数据重跑可额外增加数据业务日期字段、可按年月日进行分表、用增量ODS层数据和前一天DWD相关表进行merge处理 DW(B/S) 数据汇总层 功能: 为DW、ST层提供细粒度数据,细化成DWB和DWS; DWB是根据DWD明细数据进行转换,如维度转代理键、身份证清洗、会员注册来源清晰、字段合并、空值处理、脏数据处理、IP清晰转换、账号余额清洗、资金来源清洗等; DWS是根据DWB层数据按各个维度ID进行高粒度汇总聚合,如按交易来源,交易类型进行汇合 建模方式及原则: 聚合、汇总增加派生事实; 关联其它主题的事实表,DW层可能会跨主题域; DWB保持低粒度汇总加工数据,DWS保持高粒度汇总数据; 数据模型可能采用反范式设计,合并信息等。 Data Market (数据集市)层 功能: 可以是一些宽表,是根据DW层数据按照各种维度或多种维度组合把需要查询的一些事实字段进行汇总统计并作为单独的列进行存储; 满足一些特定查询、数据挖掘应用 应用集市数据存储 建模方式及原则: 尽量减少数据访问时计算(优化检索) 维度建模,星型模型; 分表存储 ST 数据应用层(ADS层) 功能: ST层面向用户应用和分析需求,包括前端报表、分析图表、KPI、仪表盘、OLAP、专题等分析,面向最终结果用户 适合做OLAP、报表模型,如ROLAP,MOLAP 联机事务处理OLTP、联机分析处理OLAP。OLTP是传统的关系型数据库的主要应用,主要是基本的、日常的事务处理,例如银行交易。OLAP是数据仓库系统的主要应用,支持复杂的分析操作,侧重决策支持,并且提供直观易懂的查询结果。 联机分析处理的用户是企业中的专业分析人员及管理决策人员,他们在分析业务经营的数据时,从不同的角度来审视业务的衡量指标是一种很自然的思考模式。例如分析销售数据,可能会综合时间周期、产品类别、分销渠道、地理分布、客户群类等多种因素来考量。 根据DW层经过聚合汇总统计后的粗粒度事实表 建模方式及原则: 保持数据量小; 维度建模,星形模型; 各位维度代理键+度量; 增加数据业务日期字段,支持数据重跑; 不分表存储 小结 本篇文章主要讲解数仓项目中为什么分层,比如我们在完成一个需要的需求的时候也许只需要一个复杂的SQL语句就可以完成。但一个复杂的SQL语句方便后面维护吗?当出现了问题方便追踪吗? 这时候就体现出分层的好处。顺便给大家分享阿里的数仓模型是什么样的。信自己,努力和汗水总会能得到回报的。我是大数据老哥,我们下期见~~~ 获取Flink面试题,Spark面试题,程序员必备软件,hive面试题,Hadoop面试题,Docker面试题,简历模板等资源请去GitHub自行下载 https://github.com/lhh2002/Framework-Of-BigData

优秀的个人博客,低调大师

源码深度解析 Handler 机制及应用

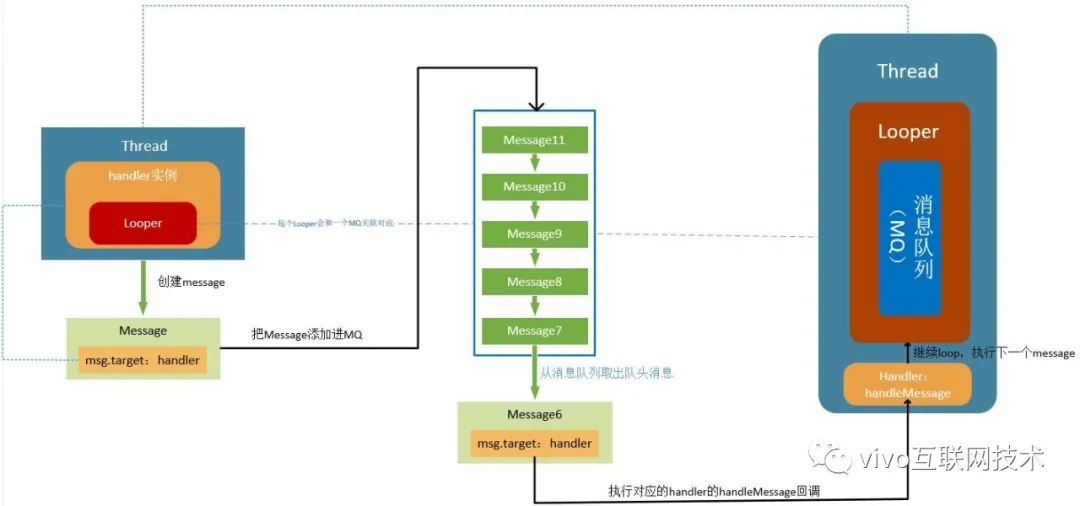
本文以源码分析+实际应用的形式,详细讲解了 Handler 机制的原理,以及在开发中的使用场景和要注意的地方。 一、基本原理回顾 在 Android 开发中,Handler及相关衍生类的应用经常用到,Android的运行也是建立在这套机制上的,所以了解其中的原理细节,以及其中的坑对于每位开发者来说都是非常有必要的。Handler机制的五个组成部分:Handler、Thread(ThreadLocal)、Looper、MessageQueue、Message。 1、Thread(ThreadLocal) Handler机制用到的跟Thread相关的,而根本原因是Handler必须和对应的Looper绑定,而Looper的创建和保存是跟Thread一一对应的,也就是说每个线程都可以创建唯一一个且互不相关的Looper,这是通过ThreadLocal来实现的,也就是说是用ThreadLocal对象来存储Looper对象的,从而达到线程隔离的目的。 static final ThreadLocal<Looper> sThreadLocal = new ThreadLocal<Looper>(); private static void prepare(boolean quitAllowed) { if (sThreadLocal.get() != null) { throw new RuntimeException("Only one Looper may be created per thread"); } sThreadLocal.set(new Looper(quitAllowed)); } 2、Handler Handler() Handler(Callback callback) Handler(Looper looper) Handler(Looper looper, Callback callback) Handler(boolean async) Handler(Callback callback, boolean async) Handler(Looper looper, Callback callback, boolean async) 2.1 创建Handler大体上有两种方式: 一种是不传Looper 这种就需要在创建Handler前,预先调用Looper.prepare来创建当前线程的默认Looper,否则会报错。 一种是传入指定的Looper 这种就是Handler和指定的Looper进行绑定,也就是说Handler其实是可以跟任意线程进行绑定的,不局限于在创建Handler所在的线程里。 2.2 async参数 这里Handler有个async参数,通过这个参数表明通过这个Handler发送的消息全都是异步消息,因为在把消息压入队列的时候,会把这个标志设置到message里.这个标志是全局的,也就是说通过构造Handler函数传入的async参数,就确定了通过这个Handler发送的消息都是异步消息,默认是false,即都是同步消息。至于这个异步消息有什么特殊的用途,我们在后面讲了屏障消息后,再联系起来讲。 private boolean enqueueMessage(MessageQueue queue, Message msg, long uptimeMillis) { msg.target = this; if (mAsynchronous) { msg.setAsynchronous(true); } return queue.enqueueMessage(msg, uptimeMillis); } 2.3 callback参数 这个回调参数是消息被分发之后的一种回调,最终是在msg调用Handler的dispatchMessage时,根据实际情况进行回调: public void dispatchMessage(Message msg) { if (msg.callback != null) { handleCallback(msg); } else { if (mCallback != null) { if (mCallback.handleMessage(msg)) { return; } } handleMessage(msg); } } 3、Looper 用于为线程运行消息循环的类。默认线程没有与它们相关联的Looper;所以要在运行循环的线程中调用prepare(),然后调用loop()让它循环处理消息,直到循环停止。 private static void prepare(boolean quitAllowed) { if (sThreadLocal.get() != null) { throw new RuntimeException("Only one Looper may be created per thread"); } sThreadLocal.set(new Looper(quitAllowed)); } public static void loop() { ... for (;;) { ... } ... } class LooperThread extends Thread { public Handler mHandler; public void run() { Looper.prepare(); mHandler = new Handler() { public void handleMessage(Message msg) { Message msg=Message.obtain(); } }; Looper.loop(); } } 既然在使用Looper前,必须调用prepare创建Looper,为什么我们平常在主线程里没有看到调用prepare呢?这是因为Android主线程创建的时候,在ActivityThread的入口main方法里就已经默认创建了Looper。 public static void main(String[] args) { ... Looper.prepareMainLooper(); ... Looper.loop(); ... } 我们再来回顾一下Looper相关类的之间的联系: 4、MessageQueue 和 Message MessageQueue是一个消息队列,Handler将Message发送到消息队列中,消息队列会按照一定的规则取出要执行的Message。Message并不是直接加到MessageQueue的,而是通过Handler对象和Looper关联到一起。 MessageQueue里的message是按时间排序的,越早加入队列的消息放在队列头部,优先执行,这个时间就是sendMessage的时候传过来的,默认是用的当前系统从启动到现在的非休眠的时间SystemClock.uptimeMillis()。 sendMessageAtFrontOfQueue 这个方法传入的时间是0,也就是说调用这个方法的message肯定会放到对消息队列头部,但是这个方法不要轻易用,容易引发问题。 存到MessageQueue里的消息可能有三种:同步消息,异步消息,屏障消息。 4.1 同步消息 我们默认用的都是同步消息,即前面讲Handler里的构造函数参数的async参数默认是false,同步消息在MessageQueue里的存和取完全就是按照时间排的,也就是通过msg.when来排的。 4.2 异步消息 异步消息就是在创建Handler如果传入的async是true或者发送来的Message通过msg.setAsynchronous(true);后的消息就是异步消息,异步消息的功能要配合下面要讲的屏障消息才有效,否则和同步消息是一样的处理。 private boolean enqueueMessage(MessageQueue queue, Message msg, long uptimeMillis) { msg.target = this; // 这个mAsynchronous就是在创建Handler的时候传入async参数 if (mAsynchronous) { msg.setAsynchronous(true); } return queue.enqueueMessage(msg, uptimeMillis); } 4.3 Barrier(屏障)消息 屏障(Barrier) 是一种特殊的Message,它最大的特征就是target为null(只有屏障的target可以为null,如果我们自己设置Message的target为null的话会报异常),并且arg1属性被用作屏障的标识符来区别不同的屏障。屏障的作用是用于拦截队列中同步消息,放行异步消息。 那么屏障消息是怎么被添加和删除的呢?我们可以看到在MessageQueue里有添加和删除屏障消息的方法: private int postSyncBarrier(long when) { // Enqueue a new sync barrier token. // We don't need to wake the queue because the purpose of a barrier is to stall it. synchronized (this) { final int token = mNextBarrierToken++; final Message msg = Message.obtain(); msg.markInUse(); msg.when = when; msg.arg1 = token; Message prev = null; Message p = mMessages; if (when != 0) { // 这里是说如果p指向的消息时间戳比屏障消息小,说明这个消息比屏障消息先进入队列, // 那么这个消息不应该受到屏障消息的影响(屏障消息只影响比它后加入消息队列的消息),找到第一个比屏障消息晚进入的消息指针 while (p != null && p.when <= when) { prev = p; p = p.next; } } // 上面找到第一个比屏障消息晚进入的消息指针之后,把屏障消息插入到消息队列中,也就是屏障消息指向第一个比它晚进入的消息p, // 上一个比它早进入消息队列的prev指向屏障消息,这样就完成了插入。 if (prev != null) { // invariant: p == prev.next msg.next = p; prev.next = msg; } else { // 如果prev是null,说明上面没有经过移动,也就是屏障消息就是在消息队列的头部了。 msg.next = p; mMessages = msg; } return token; } } public void removeSyncBarrier(int token) { // Remove a sync barrier token from the queue. // If the queue is no longer stalled by a barrier then wake it. synchronized (this) { Message prev = null; Message p = mMessages; // 前面在插入屏障消息后会生成一个token,这个token就是用来删除该屏障消息用的。 // 所以这里通过判断target和token来找到该屏障消息,从而进行删除操作 // 找到屏障消息的指针p while (p != null && (p.target != null || p.arg1 != token)) { prev = p; p = p.next; } if (p == null) { throw new IllegalStateException("The specified message queue synchronization " + " barrier token has not been posted or has already been removed."); } final boolean needWake; // 上面找到屏障消息的指针p后,把前一个消息指向屏障消息的后一个消息,这样就把屏障消息移除了 if (prev != null) { prev.next = p.next; needWake = false; } else { mMessages = p.next; needWake = mMessages == null || mMessages.target != null; } p.recycleUnchecked(); // If the loop is quitting then it is already awake. // We can assume mPtr != 0 when mQuitting is false. if (needWake && !mQuitting) { nativeWake(mPtr); } } } 4.4 屏障消息的作用 说完了屏障消息的插入和删除,那么屏障消息在哪里起作用的?它跟前面提到的异步消息又有什么关联呢?我们可以看到MessageQueue的next方法里有这么一段: // 这里就是判断当前消息是否是屏障消息,判断依据就是msg.target==null, 如果存在屏障消息,那么在它之后进来的消息中, // 只把异步消息放行继续执行,同步消息阻塞,直到屏障消息被remove掉。 if (msg != null && msg.target == null) { // Stalled by a barrier. Find the next asynchronous message in the queue. do { prevMsg = msg; msg = msg.next; // 这里的isAsynchronous方法就是前面设置进msg的async参数,通过它判断如果是异步消息,则跳出循环,把该异步消息返回 // 否则是同步消息,把同步消息阻塞。 } while (msg != null && !msg.isAsynchronous()); } 4.5 屏障消息的实际应用 屏障消息的作用是把在它之后入队的同步消息阻塞,但是异步消息还是正常按顺序取出执行,那么它的实际用途是什么呢?我们看到ViewRootImpl.scheduleTraversals()用到了屏障消息和异步消息。 TraversalRunnable的run(),在这个run()中会执行doTraversal(),最终会触发View的绘制流程:measure(),layout(),draw()。为了让绘制流程尽快被执行,用到了同步屏障技术。 void scheduleTraversals() { if (!mTraversalScheduled) { mTraversalScheduled = true; // 这里先将主线程的MessageQueue设置了个消息屏障 mTraversalBarrier = mHandler.getLooper().getQueue().postSyncBarrier(); // 这里发送了个异步消息mTraversalRunnable,这个mTraversalRunnable最终会执行doTraversal(),也就是会触发View的绘制流程 // 也就是说通过设置屏障消息,会把主线程的同步消息先阻塞,优先执行View绘制这个异步消息进行界面绘制。 // 这很好理解,界面绘制的任务肯定要优先,否则就会出现界面卡顿。 mChoreographer.postCallback( Choreographer.CALLBACK_TRAVERSAL, mTraversalRunnable, null); if (!mUnbufferedInputDispatch) { scheduleConsumeBatchedInput(); } notifyRendererOfFramePending(); pokeDrawLockIfNeeded(); } } private void postCallbackDelayedInternal(int callbackType, Object action, Object token, long delayMillis) { if (DEBUG_FRAMES) { Log.d(TAG, "PostCallback: type=" + callbackType + ", action=" + action + ", token=" + token + ", delayMillis=" + delayMillis); } synchronized (mLock) { final long now = SystemClock.uptimeMillis(); final long dueTime = now + delayMillis; mCallbackQueues[callbackType].addCallbackLocked(dueTime, action, token); if (dueTime <= now) { scheduleFrameLocked(now); } else { Message msg = mHandler.obtainMessage(MSG_DO_SCHEDULE_CALLBACK, action); msg.arg1 = callbackType; // 设置该消息是异步消息 msg.setAsynchronous(true); mHandler.sendMessageAtTime(msg, dueTime); } } } 4.6我们能用屏障消息做什么? 那么除了系统中使用到了屏障消息,我们在开发中有什么场景能派上用场吗? 运用屏障消息可以阻塞同步消息的特性,我们可以用来实现UI界面初始化和数据加载同时进行。 我们一般在Activity创建的时候,为了减少空指针异常的发生,都会在onCreate先setContent,然后findView初始化控件,然后再执行网络数据加载的异步请求,待网络数据加载完成后,再刷新各个控件的界面。 试想一下,怎么利用屏障消息的特性来达到界面初始化和异步网络数据的加载同时进行,而不影响界面渲染?先来看一个时序图: 我们通过下面伪代码进一步加深理解: // 在上一个页面里异步加载下一个页面的数据 // 网络请求返回的数据 Data netWorkData; // 创建屏障消息会生成一个token,这个token用来删除屏障消息,很重要。 int barrierToken; // 创建异步线程加载网络数据 HandlerThread thread = new HandlerThread("preLoad"){ @Override protected void onLooperPrepared() { Handler mThreadHandler = new Handler(thread.getLooper()); // 1、把请求网络耗时消息推入消息队列 mHandler.post(new Runnable() { @Override public void run() { // 异步耗时操作:网络请求数据,赋值给netWorkData netWorkData = xxx; } }); // 2、然后给异步线程的队列发一个屏障消息推入消息队列 barrierToken = thread.getLooper().getQueue().postSyncBarrier(); // 3、然后给异步线程的消息队列发一个刷新UI界面的同步消息 // 这个消息在屏障消息被remove前得不到执行的。 mHandler.post(new Runnable() { @Override public void run() { // 回调主线程, 把netWorkData赋给监听方法,刷新界面 } }); } }; thread.start(); // 当前界面初始化界面 protected void onCreate(Bundle savedInstanceState) { setContentView(view); // 各种findview操作完成 Button btn = findViewById(R.id.xxx); ... // 4、待控件初始化完成,把异步线程设置的屏障消息remove掉,这样异步线程请求数据完成后,3、处的刷新UI界面的同步消息就有机会执行,就可以安全得刷新界面了。 thread.getLooper().getQueue().removeSyncBarrier(barrierToken); } 但是,MessageQueue源码里我们我们看到,屏障消息的创建和删除都是隐藏方法(@hide),我们没法直接调用,只能用反射来调用,所以在实际使用中还得综合验证。 4.7 IdleHandler及应用 IdleHandler,字面意思就是空闲的处理器(就是说我是在消息队列空闲的时候才会执行的,如果消息队列里有其他非IdleHandler消息在执行,则我先不执行),它其实就是一个接口,我们就认为它是空闲消息吧,只不过它不是存在MessageQueue里,而是以数组的形式保存的。 public static interface IdleHandler { /** * Called when the message queue has run out of messages and will now * wait for more. Return true to keep your idle handler active, false * to have it removed. This may be called if there are still messages * pending in the queue, but they are all scheduled to be dispatched * after the current time. */ boolean queueIdle(); } 我们看到MessageQueue有添加和删除IdleHandler的方法,IdleHandler被保存在一个ArrayList里: private final ArrayList<IdleHandler> mIdleHandlers = new ArrayList<IdleHandler>(); ... public void addIdleHandler(@NonNull IdleHandler handler) { if (handler == null) { throw new NullPointerException("Can't add a null IdleHandler"); } synchronized (this) { mIdleHandlers.add(handler); } } public void removeIdleHandler(@NonNull IdleHandler handler) { synchronized (this) { mIdleHandlers.remove(handler); } } 那么,它是怎么实现在消息队列空闲的间隙得到执行的呢?还是看next()方法。 // If first time idle, then get the number of idlers to run. // Idle handles only run if the queue is empty or if the first message // in the queue (possibly a barrier) is due to be handled in the future. // pendingIdleHandlerCount < 0是说for循环只执行第一次 // mMessages == null || now < mMessages.when) 是说当前消息队列没有消息或者要执行的消息晚于当前时间 // 说明现在消息队列处于空闲。 if (pendingIdleHandlerCount < 0 && (mMessages == null || now < mMessages.when)) { pendingIdleHandlerCount = mIdleHandlers.size(); } if (pendingIdleHandlerCount <= 0) { // No idle handlers to run. Loop and wait some more. mBlocked = true; continue; } 在上面这段代码判定当前消息队列处于空闲后,就会拿到空闲消息的大小,下面这段代码就是把把空闲消息执行一遍。 // Run the idle handlers. // We only ever reach this code block during the first iteration. for (int i = 0; i < pendingIdleHandlerCount; i++) { final IdleHandler idler = mPendingIdleHandlers[i]; mPendingIdleHandlers[i] = null; // release the reference to the handler boolean keep = false; try { // 如果queueIdle返回true,则该空闲消息不会被自动删除,在下次执行next的时候,如果还出现队列空闲,会再次执行。 // 如果返回false,则该空闲消息会在执行完后,被自动删除掉。 keep = idler.queueIdle(); } catch (Throwable t) { Log.wtf(TAG, "IdleHandler threw exception", t); } if (!keep) { synchronized (this) { mIdleHandlers.remove(idler); } } } // Reset the idle handler count to 0 so we do not run them again. // 这里把空闲消息标志置为0,而不置为-1,就是说本次已经处理完,防止for循环反复执行,影响其他消息的执行 pendingIdleHandlerCount = 0; // While calling an idle handler, a new message could have been delivered // so go back and look again for a pending message without waiting. nextPollTimeoutMillis = 0; 总结一下: 如果本次循环拿到的消息为空,或者这个消息是一个延时的消息而且还没到指定的触发时间,那么,就认定当前的队列为空闲状态。 接着就会遍历mPendingIdleHandlers数组(这个数组里面的元素每次都会到mIdleHandlers中去拿)来调用每一个IdleHandler实例的queueIdle方法, 如果这个方法返回false的话,那么这个实例就会从mIdleHandlers中移除,也就是当下次队列空闲的时候,不会继续回调它的queueIdle方法了。 处理完IdleHandler后会将nextPollTimeoutMillis设置为0,也就是不阻塞消息队列,当然要注意这里执行的代码同样不能太耗时,因为它是同步执行的,如果太耗时肯定会影响后面的message执行。 IdleHandler的原理大概就是上面讲的那样,那么能力决定用处,从本质上讲就是趁着消息队列空闲的时候干点事情,具体做什么,是在IdleHandler的queueIdle()方法里。那么IdleHandler在系统源码里使用场景是怎样的?我们可以看到它在主线程生命周期处理中使用比较多,比如在ActivityThread里有个 就有一个名叫GcIdler的内部类,实现的就是IdleHandler接口,它的作用就是在主线程空闲的时候对内存进行强制GC。 final class GcIdler implements MessageQueue.IdleHandler { @Override public final boolean queueIdle() { doGcIfNeeded(); return false; } } // 这里的意思就是说判断距离上次GC的时间是否超过5秒,超过则执行后台强制GC void doGcIfNeeded() { mGcIdlerScheduled = false; final long now = SystemClock.uptimeMillis(); //Slog.i(TAG, "**** WE MIGHT WANT TO GC: then=" + Binder.getLastGcTime() // + "m now=" + now); if ((BinderInternal.getLastGcTime()+MIN_TIME_BETWEEN_GCS) < now) { //Slog.i(TAG, "**** WE DO, WE DO WANT TO GC!"); BinderInternal.forceGc("bg"); } } 我们看看它是在哪里添加到消息队列的: // 这个方法是在mH的handleMessage方法里调的,也就是说也是通过AMS(ActivityManagerService)把消息发送到主线程消息队列 void scheduleGcIdler() { if (!mGcIdlerScheduled) { mGcIdlerScheduled = true; Looper.myQueue().addIdleHandler(mGcIdler); } mH.removeMessages(H.GC_WHEN_IDLE); } 还有就是在ActivityThread的performLaunchActivity方法执行时,最终会执行到Instrumentation.callActivityOnCreate方法,在这个方法里,也有用到IdleHandler做一些额外的事情。 public void callActivityOnCreate(Activity activity, Bundle icicle) { prePerformCreate(activity); activity.performCreate(icicle); postPerformCreate(activity); } private void prePerformCreate(Activity activity) { if (mWaitingActivities != null) { synchronized (mSync) { final int N = mWaitingActivities.size(); for (int i=0; i<N; i++) { final ActivityWaiter aw = mWaitingActivities.get(i); final Intent intent = aw.intent; if (intent.filterEquals(activity.getIntent())) { aw.activity = activity; mMessageQueue.addIdleHandler(new ActivityGoing(aw)); } } } } } 除此之外,在一些第三方库中都有使用IdleHandler,比如LeakCanary,Glide中有使用到。 那么对于我们来说,IdleHandler可以有些什么使用场景呢?根据它最核心的原理,在消息队列空闲的时候做点事情,那么对于主线程来讲,我们有很多的一些代码不是必须要跟随生命周期方法同步执行的,就可以用IdleHandler,减少主线程的耗时,也就减少应用或者Activity的启动时间。例如:一些第三方库的初始化,埋点尤其是延时埋点上报等,都可以用IdleHandler添加到消息队列里。 ==好了,提个问题:前面我们说了在主线程创建的main函数里创建了Handler和Looper,回顾了上面的Handler机制的原理,我们都知道一般线程执行完就会退出,由系统回收资源,那Android UI线程也是基于Handler Looper机制的,那么为什么UI线程可以一直常驻?不会被阻塞呢?== 因为Looper在执行loop方法里,是一个for循环,也就是说线程永远不会执行完退出,所以打开APP可以一直显示,Activity的生命周期就是通过消息队列把消息一个一个取出来执行的,然后因为MessageQueue的休眠唤醒机制,当消息队列里没有消息时,消息队列会进入休眠,并释放CPU资源,当又有新消息进入队列时,会唤醒队列,把消息取出来执行。 二、Handler应用之HandlerThread HandlerThread本质上是一个Thread,所不同的是,它充分利用了Handler机制,通过在内部创建Looper循环,外部通过Handler把异步任务推送给消息队列,从而达到不用重复创建多个Thread,即能将多个异步任务排队进行异步执行,它的原理很简单: @Override public void run() { mTid = Process.myTid(); Looper.prepare(); synchronized (this) { mLooper = Looper.myLooper(); notifyAll(); } Process.setThreadPriority(mPriority); onLooperPrepared(); Looper.loop(); mTid = -1; } 在线程的run方法里创建了looper循环,这样这个线程不主动quit的话,不会销毁,有消息则执行消息,没有消息根据MessageQueue休眠机制,会释放CPU资源,进入休眠。 使用HandlerThread时,我们注意到,在创建Handler时,是要传入线程的Looper进行绑定的,所以必须先执行HandlerThread的start方法,因为执行start方法,才会执行HandlerThread的run方法,才会创建线程的Looper,创建Handler传入的Looper才不会是null。 所以我们一般使用是这样的: 创建HandlerThread后,调用start,然后再创建Handler; 从run方法里我们看到有个onLooperPrepared()方法,可以实现这个方法,在这个方法里创建Handler,这样就不受start位置的限制了,原理就是以为run方法是在调用start方法后才会执行。 那么怎么回收一个HandlerThread呢?我们看到HandlerThread里有个quit方法,这个方法最终会调用到MessageQueue的quit方法,从而结束消息分发,最终终止一个HandlerThread线程。 public boolean quit() { Looper looper = getLooper(); if (looper != null) { looper.quit(); return true; } return false; } 三、Handler应用之IntentService IntentService其实是Service和HandlerThread的结合体,我们可以看到在onCreate里创建了个HandlerThread并创建了个Handler和该HandlerThread绑定,然后在onStat方法里以消息的形式发送给HandlerThread执行 @Override public void onCreate() { // TODO: It would be nice to have an option to hold a partial wakelock // during processing, and to have a static startService(Context, Intent) // method that would launch the service & hand off a wakelock. super.onCreate(); // 创建HandlerThread HandlerThread thread = new HandlerThread("IntentService[" + mName + "]"); thread.start(); // 创建Handler和HandlerThread绑定 mServiceLooper = thread.getLooper(); mServiceHandler = new ServiceHandler(mServiceLooper); } @Override public void onStart(@Nullable Intent intent, int startId) { Message msg = mServiceHandler.obtainMessage(); msg.arg1 = startId; msg.obj = intent; // 想HandlerThread的消息队列发送消息 mServiceHandler.sendMessage(msg); } 最终在handleMessage里执行 private final class ServiceHandler extends Handler { public ServiceHandler(Looper looper) { super(looper); } @Override public void handleMessage(Message msg) { onHandleIntent((Intent)msg.obj); stopSelf(msg.arg1); } } 所以我们使用IntentService都必须实现onHandleIntent这个抽象方法,在这个抽象方法里做具体的业务操作。 我们都知道IntentService在执行完异步任务后,会自动销毁,这是怎么实现的? public ServiceHandler(Looper looper) { super(looper); } @Override public void handleMessage(Message msg) { onHandleIntent((Intent)msg.obj); // 答案在这里:在这里会停止Service stopSelf(msg.arg1); } } // 然后在onDestory里会终止掉消息循环,从而达到销毁异步线程的目的: @Override public void onDestroy() { mServiceLooper.quit(); } 四、Handler.post和View.post 我们先来看个大家平常经常使用的案例:获取View的宽高。 @Override protected void onCreate(Bundle savedInstanceState) { // 位置1 Log.i("view_w_&_h", "onCreate " + mView.getWidth() + " " + mView.getHeight()); mView.post(new Runnable() { @Override public void run() { // 位置2 Log.i("view_w_&_h", "onCreate postRun " + mView.getWidth() + " " + mView.getHeight()); } }); new Handler(Looper.getMainLooper()).post(new Runnable() { @Override public void run() { // 位置3 Log.i("view_w_&_h", "onCreate Handler " + mView.getWidth() + " " + mView.getHeight()); } }); } @Override protected void onResume() { super.onResume(); // 位置4 Log.i("view_w_&_h", "onResume " + mView.getWidth() + " " + mView.getHeight()); new Handler(Looper.getMainLooper()).post(new Runnable() { @Override public void run() { // 位置5 Log.i("view_w_&_h", "onResume Handler " + mView.getWidth() + " " + mView.getHeight()); } }); } 这几个位置,哪些能获取到mView的宽高? 我们都知道在View被attach到window之前,是获取不到View的宽高的,因为这个时候View还没有被Measure、layout、draw,所以在onCreate或者onResume直接调用View的宽高方法,都是0,Handler.post在onCreate里也是获取不到,但是在onResume里能获取到,而View.post无论放在onCreate或者onResume里,都能获取到View的宽高,为什么? 我们先看个简版的View的绘制流程: 我们都知道View的最终绘制是在performTraversals()方法里,包括measure、layout、draw,从上面的图往上追溯,我们知道,View的绘制是在ActivityThread的handleResumeActivity方法里,这个方法相信大家不会陌生,这个方法就是会回调Activity的onResume方法的顶级方法。 final void handleResumeActivity(IBinder token, boolean clearHide, boolean isForward, boolean reallyResume, int seq, String reason) { ... // 这里追溯进去,最终会调用Activity的onStart方法和onResume方法 r = performResumeActivity(token, clearHide, reason); ... // 调用WindowManager的addView方法,这里就是最终执行View绘制的地方 wm.addView(decor, l); ... } 从上面的代码片段执行顺序来看,Activity的onStart和onResume被执行的时候,其实界面还没有开始进行绘制(wm.addView(decor, l)还没执行到),这里就可以解释为什么用Handler.post在onCreate里拿不到宽高。因为Handler机制,它是把消息推送到主线程的消息队列里去,在onCreate里把消息推到消息队列时,onResume的消息都还没入队,也就没有执行,所以拿不到。那为什么onResume里能拿到呢?因为消息队列的机制,Handler.post推送的消息,必须得等上一个消息执行完才能得到执行,所以它必须得等handleResumeActivity执行完,而handleResumeActivity执行完成后,View已经绘制完成了,当然就能拿到宽高了。 好了,现在解释第二个疑问,为什么View.post在onCreate里能拿到View的宽高呢?我们先看下View.post方法: public boolean post(Runnable action) { final AttachInfo attachInfo = mAttachInfo; // attachInfo不为null,说明View已经被attach到window,也就是完成了绘制,所以直接把消息推送到主线程的消息队列执行。 if (attachInfo != null) { return attachInfo.mHandler.post(action); } // Postpone the runnable until we know on which thread it needs to run. // Assume that the runnable will be successfully placed after attach. // 关键就在这里,走到这里,说明attachInfo为null,也就是现在View还没attach到window,所以把消息临时保存到RunQueue里 getRunQueue().post(action); return true; } 上面我们可以看到,如果attachInfo为null,则Runnable会临时存储起来,保存到RunQueue里,并没有立即执行,那么保存到RunQueue是什么时候被执行的呢? 我们看到HandlerActionQueue有个executeActions方法,这个方法就是用来执行保存其中的Runnable的: public void executeActions(Handler handler) { synchronized (this) { final HandlerAction[] actions = mActions; for (int i = 0, count = mCount; i < count; i++) { final HandlerAction handlerAction = actions[i]; handler.postDelayed(handlerAction.action, handlerAction.delay); } mActions = null; mCount = 0; } } 那么这个方法是在什么时机调用的呢?接着往下看:在View的dispatchAttachedToWindow方法里,我们看到调用了RunQueue的executeActions,执行保存在RunQueue里的runnable。 void dispatchAttachedToWindow(AttachInfo info, int visibility) { ... // Transfer all pending runnables. if (mRunQueue != null) { mRunQueue.executeActions(info.mHandler); mRunQueue = null; } onAttachedToWindow(); ... } 那么dispatchAttachedToWindow又是在什么时候被调用呢?在ViewRootImpl的performTraversals方法里,我们看到dispatchAttachedToWindow被执行。host就是DecorView。 private void performTraversals() { ... host.dispatchAttachedToWindow(mAttachInfo, 0); ... performMeasure(); ... performLayout(); ... performDraw(); } 从前面的View绘制的UML时序图,我们知道,performTraversals是在ActivityThread的handleResumeActivity被调用的。 总结一下: 系统在执行ActivityThread的handleResumeActivity的方法里,最终会调到ViewRootImpl的performTraversals()方法,performTraversals()方法调用host的dispatchAttachedToWindow()方法,host就是DecorView也就是View,接着在View的dispatchAttachedToWindow()方法中调用mRunQueue.executeActions()方法,这个方法内部会遍历HandlerAction数组,利用Handler来post之前存放的Runnable。 这里就可以解释为什么View.post在onCreate里同样可以得到View的宽高,是因为View.post发出的消息,它被执行的时机是在View被绘制之后。 ==可能有同学要问了:dispatchAttachedToWindow 方法是在 performMeasure 方法之前调用的,既然在调用的时候还没有执行performMeasure来进行测量,那么为什么在执行完dispatchAttachedToWindow方法后就可以获取到宽高呢?== 还是回到Handler机制最基本的原理,消息是以队列的形式存在消息队列里,然后依次等待Loop执行的,而performTraversals的执行它本身就是在一个Runnable消息里,所以performTraversals在执行的时候,其他消息得等performTraversals执行完了才能得到执行,也就是说mRunQueue.executeActions()的消息必须得等performTraversals彻底执行完才能得到执行,所以View.post(runnable)中的runnable执行是要在performTraversals方法执行完之后的,并非一调用dispatchAttachedToWindow就会执行。 前面还遗留了一个问题:View.post方法里的mAttachInfo是在什么时候赋值的呢? public ViewRootImpl(Context context, Display display) { ... mAttachInfo = new View.AttachInfo(mWindowSession, mWindow, display, this, mHandler, this, context); ... } 我们看到它是在ViewRootImpl的构造函数里被赋值的,那么ViewRootImpl是什么时候被创建的呢?顺着往上找,我们看到,它是在WindowManagerGlobal的add方法里被创建的。 public void addView(View view, ViewGroup.LayoutParams params, Display display, Window parentWindow) { ... ViewRootImpl root; ... root = new ViewRootImpl(view.getContext(), display); ... } 前面也讲了WindowManagerGlobal的addView方法是在ActivityThread的handleResumeActivity()方法里被执行的,所以问题就解开了,为什么View.post方法里会先判断mAttachInfo是否为空,不为空,说明View.post的调用时机是在onResume之后,也就是View绘制完成之后,这个时候直接推入主线程消息队列执行就可以。而如果mAttachInfo为空,说明View还没绘制完,先暂存起来,待绘制完后再依次推入主线程执行。 要注意的是View.post方法是有坑的,android版本 < 24,也就是7.0以下的系统。 // 7.0以下系统 public boolean post(Runnable action) { final AttachInfo attachInfo = mAttachInfo; if (attachInfo != null) { return attachInfo.mHandler.post(action); } // Assume that post will succeed later // 注意此处,不同于我7.0及以上系统, ViewRootImpl.getRunQueue().post(action); return true; } 而我们看一下 ViewRootImpl 的RunQueue是怎么实现的: static final ThreadLocal<RunQueue> sRunQueues = new ThreadLocal<RunQueue>(); static RunQueue getRunQueue() { RunQueue rq = sRunQueues.get(); if (rq != null) { return rq; } rq = new RunQueue(); sRunQueues.set(rq); return rq; } 结合前面讲的ThreadLocal特性,它是跟线程相关的,也就是说保存其中的变量只在本线程内可见,其他线程获取不到。 好了,假设有这种场景,我们子线程里用View.post一个消息,从上面的代码看,它会保存子线程的ThreadLocal里,但是在执行RunQueue的时候,又是在主线程里去找runnable调用,因为ThreadLocal线程隔离,主线程永远也找不到这个消息,这个消息也就没法得到执行了。 而7.0及以上没有这个问题,是因为在post方法里把runnable保存在主线程里:getRunQueue().post(action)。 总结一下: 上面这个问题的前提有两个:View被绘制前,且在子线程里调用View.post。如果View.post是在View被绘制之后,也就是mAttachInfo非空,那么会立即推入主线程调用,也就不存在因线程隔离找不到runnable的问题。 作者:He Ying

优秀的个人博客,低调大师

Elasticsearch 内部数据结构深度解读

题记 最近知识星球里几个问题都问到了 doc values、store field、fielddata 等的概念。 问题1:”群主有介绍 doc value, field data, store fields 比较好的文章么?一直感觉有点模糊“ 问题2:“请教下星主关于ES存储相关的问题, 一个文档有如下几个地方可能会存储: 倒排索引。 Source 字段。 store 存储(如果开启) doc_values。 不知道我理解的是否正确? 如果这几个地方都存储, 那是不是可以理解为数据大致会膨胀了4倍? 死磕 Elasticsearch 知识星球(http://t.cn/RmwM3N9) 非常有必要好好梳理一下,于是就有了这篇文章。 Elasticsearch 数据结构的理解和合理使用,对深入理解 Elasticsearch大有裨益! 1、数据存储认知前提 正如 Elastic 官方文档所说: Elasticsearch 特点之一是:分布式文档存储。 Elasticsearch不会将信息存储为类似列数据库的行(row),而是存储为已序列化为JSON文档的复杂数据结构。 当集群中有多个Elasticsearch节点时,存储的文档会分布在整个集群中,并且可以从任何节点立即访问。 存储文档后,将在1秒钟内(默认刷新频率为1s)几乎实时地对其进行索引和完全搜索。 如何做到快速索引和全文检索的呢? Elasticsearch使用倒排索引的数据结构,该结构支持非常快速的全文本搜索。 倒排索引列出了出现在任何文档中的每个唯一单词,并标识了每个单词出现的所有文档。 索引可以认为是文档的优化集合,每个文档都是字段的集合,这些字段是包含数据的键值对。 默认情况下,Elasticsearch 对每个字段中的所有数据建立索引,并且每个索引字段都具有专用的优化数据结构。 例如,文本字段存储在倒排索引中,数字字段和地理字段存储在BKD树中。 数据类型 数据结构 text/keyword 倒排索引 数字/地理位置 BKD树 不同字段具有属于自己字段类型的特定优化数据结构,并具备快速响应返回搜索结果的能力使得 Elasticsearch 搜索飞快! 1、Inverted Index 倒排索引 1.1 倒排索引定义 面对海量内容,如何快速的找到包含用户查询词的内容,倒排索引扮演了关键角色。 倒排索引是单词到文档映射关系的最佳实现形式。 下图是:书的末页的索引结构,展示了核心关键词与书页码的对应关系。 试想一下,没有这个索引页,根据关键词从全书查找有多慢,就能直观体会出索引的妙处! 1.2 倒排索引示例 拿官方文档的示例: 假设我们有两个文档,每个文档的 content 域包含如下内容: -1、Thequickbrownfoxjumpedoverthelazydog-2、Quickbrownfoxesleapoverlazydogsinsummer 对索引编制索引会受到标记化和标准化的处理analysis。 数据索引化制约因素:分词器 analyzer 的选型。 倒排索引(基于 默认Standard 标准分词器分词)如下所示: Term Doc_1 Doc_2 Quick X The X brown X X dog X dogs X fox X foxes X in X jumped X lazy X X leap X over X X quick X summer X the X 如上所示,对于文档中的每个词,都包含了其所在文档的列表。 1.3 倒排索引特点 在索引时创建 序列化到磁盘 全文搜索非常快 不适合做排序 默认开启 1.4 倒排索引适用场景 查询 全文检索 2、Doc Values 正排索引 2.1 Doc Values 定义 在 Elasticsearch 中,Doc Values 就是一种列式存储结构,默认情况下每个字段的 Doc Values 都是激活的(除了 text 类型),Doc Values 是在索引时创建的,当字段索引时,Elasticsearch 为了能够快速检索,会把字段的值加入倒排索引中,同时它也会存储该字段的 Doc Values。 区别于倒排索引的定义,Doc Values 被定义为:“正排索引”。 2.2 Doc Values 示例 仍然 以 1.2 文档为例,Doc Values 结构如下所示(仅做举例): Doc Terms Doc_1 brown, dog, fox, jumped, lazy, over, quick, the Doc_2 brown, dogs, foxes, in, lazy, leap, over, quick, summer Doc values 通过转置两者间的关系来解决适用倒排索引聚合效率低、难以扩展的问题。 对比可以看出:倒排索引将词项映射到包含它们的文档,doc values 将文档映射到它们包含的词项。 2.3 Doc Values 特点 在索引时创建 序列化到磁盘 适合排序操作 将单个字段的所有值一起存储在单个数据列中 默认情况下,除text之外的所有字段类型均启用 Doc Values。 2.4 Doc Values 适用场景 Elasticsearch 中的 Doc Values 常被应用到以下场景: 对一个字段进行排序 对一个字段进行聚合 某些过滤,比如地理位置过滤 某些与字段相关的脚本计算 注意: 因为文档值被序列化到磁盘,我们可以依靠操作系统的帮助来快速访问。 当 工作集(working set) 远小于节点的可用内存,系统会自动将所有的文档值保存在内存中,使得其读写十分高速; 当其远大于可用内存,操作系统会自动把 Doc Values 加载到系统的页缓存中,从而避免了 jvm 堆内存溢出异常。 2. 5 Doc Values 使用注意事项 对于不需要:排序、聚合、脚本计算、地理位置过滤的业务场景,可以考虑禁用:Doc Values,以节约存储。 PUTmy_index{"mappings":{"properties":{"title":{"type":"keyword","doc_values":false}}}} 3、fielddata 3.1 fielddata 定义 如前第1、2小结所述: 搜索需要回答“哪个文档包含此词?”的问题。借助:倒排索引实现。 排序和汇总则需要回答一个不同的问题:“此字段对本文档的价值是什么?” 。借助:正排索引实现。 text 类型字段是不支持 Doc Values正排索引的,text字段使用是:查询时创建的基于的内存数据结构(query-time in-memory data structure) fielddata。 fielddata 将 text 字段用于聚合、排序或在脚本中使用时,将按需构建此数据结构。 实现机理:它是通过从磁盘读取每个段的整个反向索引,反转词项↔︎文档关系并将结果存储在JVM堆中的内存中来构建的。 3.2 fielddata 示例 严格意义讲,2.2 的示例,放到这里会更合适。 DELETEtest_001PUTtest_001{"mappings":{"properties":{"body":{"type":"text","analyzer":"standard","fielddata":true}}}}POSTtest_001/_bulk{"index":{"_id":1}}{"body":"Thequickbrownfoxjumpedoverthelazydog"}{"index":{"_id":2}}{"body":"Quickbrownfoxesleapoverlazydogsinsummer"}GETtest_001/_search{"size":0,"query":{"match":{"body":"brown"}},"aggs":{"popular_terms":{"terms":{"field":"body"}}}} 3.3 fielddata 特点 适用于文档之类的操作 但仅适用于 text 文本字段类型 在查询时创建 内存中数据结构 没有序列化到磁盘 默认情况下被禁用(构建它们很昂贵,并且在堆中预置) 3.4 fielddata 适用场景 全文统计词频 全文生成词云 text类型:聚合、排序、脚本计算 3.5 fielddata 使用注意事项 在启用字段数据之前,请考虑为什么将文本字段用于聚合、排序或在脚本中使用。 启用 fielddata 通常没有任何意义,因为它非常耗费内存资源。 仅仅是做全文搜索的应用,就不需要启用fielddata。 4、_source 字段解读 4.1 _source 定义 _source 字段包含在索引时间传递的原始JSON文档主体。 _source 字段本身未构建索引(因此不可搜索),但已存储该字段,以便在执行获取请求(如get或search)时可以将其返回。 4.2 _source 使用注意事项 第一:尽管非常方便,但是source字段确实会导致索引内的存储开销。因此,可以将其禁用。 PUTmy-index-000001{"mappings":{"_source":{"enabled":false}}} 第二:禁用前要做好以下衡量 禁用 _source 后,如下操作将不可用: update, update_by_query 和 reindex API 高亮操作 所以,要在存储空间、业务场景之间权衡利弊后选型。 5、store 字段解读 5.1 store 定义 默认情况下,对字段值进行索引以使其可搜索(第1节的 倒排索引),但不存储它们。 这意味着可以查询该字段,但是无法检索原始字段值。 通常这无关紧要。该字段值已经是_source字段的一部分,默认情况下已存储。 但,某些特殊场景下,如果你只想检索单个字段或几个字段的值,而不是整个_source的值,则可以使用源过滤来实现。 这个时候, store 就派上用场了。 5.2 store 示例 DELETEnews-000001PUTnews-000001{"mappings":{"_source":{"enabled":false},"properties":{"title":{"type":"text","store":true},"date":{"type":"date","store":true},"content":{"type":"text"}}}}PUTnews-000001/_doc/1{"title":"Someshorttitle","date":"2021-01-01","content":"Averylongcontentfield..."}GETnews-000001/_searchGETnews-000001/_search{"stored_fields":["title","date"]} 5.3 store 适用场景 如 5.2 示例,在某些情况下,存储字段可能很有意义。例如,采集的新闻数据是:带有标题、日期和很大内容字段的文档, 则可能只想检索标题和日期,而不必从较大的_source字段中提取这些字段。 6、小结 回到文章开头的两个问题: 问题1:看完本文后,doc values , field data , store fields 就非常清晰了。 问题2:字段类型不一样,存储不一样。默认:倒排索引默认所有字段都启用,正排索引 Doc Values 非 text 类型默认启用, source (存储原始文档的 所有字段的 json 结构数据)和 store (存储指定字段的 json 数据) 的启用与否需要结合业务实际。假设:正排索引、倒排索引、_source 、store 都启用了,存储肯定会增加,但不是线性的 4倍。 对于不明白的问题,反复研读官方文档,拷贝到kibana Dev tool 去实践,直到弄明白为止。 文章尽量参考官方文档,尽管如此,难免表述纰漏,欢迎大家指正交流。 和你一起,死磕 Elasticsearch ! 参考: https://t.zsxq.com/Baq3nmE https://t.zsxq.com/meAyrzN https://t.zsxq.com/IaunyrZ https://t.zsxq.com/AIYJiE6 https://medium.com/datadriveninvestor/elastic-search-what-is-inside-5d61f1a681df http://alexander.holbreich.org/elasticsearch-datastructures/ Elastic 官方文档 推荐: 干货 | Elasticsearch 开发实战常用命令清单 你的 Elasticsearch 难题,官方文档早就有了答案...... 干货 | Elasticsearch开发人员最佳实战指南 Elasticsearch 开发运维实战核心 Tips 干货 | 论Elasticsearch数据建模的重要性 干货 | Elasticsearch 索引设计实战指南 干货 | Elasticsearch多表关联设计指南 更短时间更快习得更多干货! 中国40%+Elastic认证工程师出自于此! 本文分享自微信公众号 - 铭毅天下(elastic999)。如有侵权,请联系 support@oschina.cn 删除。本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

优秀的个人博客,低调大师

每日一博 | TiDB HTAP 深度解读

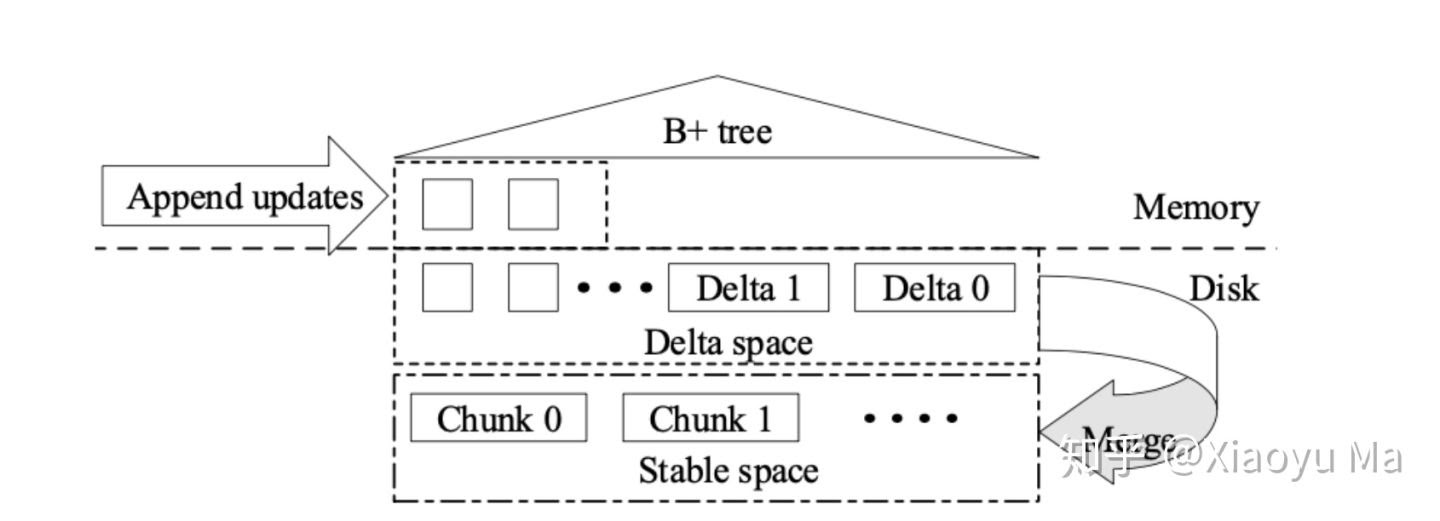
HTAP (Hybrid Transactional / Analytical Processing)是近些年需求不断受到关注的技术名词,它描述了一个数据库能够同时满足交易以及分析两种作业。TiDB 4.0 是一个针对 HTAP 进行了特别的设计和架构强化,这次给大家带来一篇 VLDB 2020 HTAP 主题的论文解读,比较特殊的是这篇论文是 PingCAP 写的,关于 TiDB HTAP 架构。所以这篇解读,是以作者团队(中的一部分)的视角来写的。原文在此,欢迎指正。 说重点 论文整体介绍了一下 TiDB 的架构和设计,对 TiDB 有兴趣的同学推荐完整看下,会对理解架构有很大帮助。不过既然重点是 HTAP,那么在我看来比较重要的地方是这三点: 实时更新的列存 Multi-Raft 的复制体系 根据业务 SQL 智能选择行/列存储 后面我也会着重说一下这三部分。 先说存储 TP 和 AP 传统来说仰赖不同的存储格式:行存对应 OLTP,列存对应 OLAP。然而这两者的优劣差异在内存中会显得不那么明显,因此 SAP Hana 的作者 Hasso Plattner 提出使用 In-Memory + 列存技术同时处理 OLTP 和 OLAP。随后 2014 年 Gartner 提出的 HTAP 概念,也主要是针对内存计算。 这里有个关键信息,列存不合适 TP 类场景。这也许已经是很多人的常识,不过也许并不是所有人都想过为何列存不合适 TP。 数据快速访问需要仰赖 Locality,简单说就是希望根据你的访问模式,要读写的数据尽量放在一起。并不在一起的数据需要额外的 Seek 并且 Cache 效率更低。行存和列存,去除 encoding 和压缩这些因素,本质上是针对不同的访问模式提供了不同的数据 Locality。行存让同一行的数据放在一起,这样类似一次访问一整行数据就会得到很好的速度;列存将同一列的数据放在一起,那么每次只获取一部分列的读取就会得到加速;另一方面,列存在传统印象里更新很慢也部分是因为如果使用 Naive 的方式去将一行拆开成多列写入到应有的位置,将带来灾难性的写入速度。这些效应在磁盘上很明显,但是在内存中就会得以削弱,因此这些年以来我们提起 HTAP,首先想到的是内存数据库。 虽然内存价格在不断下降,但是仍然成本高企。虽说分析机构宣传 HTAP 带来的架构简化可以降低总成本,但实际上内存数据库仍然只是在一些特殊领域得到应用:若非那些无可辩驳的超低延迟场景,架构师仍然需要说服老板,HTAP 带来的好处是否真的值得使用内存数据库。这样, HTAP 的使用领域就受到很大的限制。 所以,我们还是以磁盘而非内存为设计前提。 之前并不是没有人尝试使用行列混合的设计。这种行列混合可以是一种折中格式如 PAX,也可以是在同一存储引擎中通过聪明的算法糅合两种形态。但无论如何,上面说的 Locality 问题是无法绕过的,哪怕通过超强的工程能力去压榨性能,也很难同时逼近两侧的最优解,更不用提技术上这将会比单纯考虑单一场景复杂数倍。 TiDB 并不想放弃 TP 和 AP 任何一侧,因此虽然也知道 Spanner 使用 PAX 格式做 HTAP,却没有贸然跟进。也许有更好的办法呢? TiDB 整体一直更相信以模块化来化解工程问题,包括 TiDB 和 TiKV 的分层和模块切割都体现了这种设计倾向。这次 HTAP 的构思也不例外。经过各种前期的的 Prototype 实验,包括并不限于通过类似 Binlog 之类的 CDC 方案将 TP 的更新同步到易构的 AP 侧,但是这些效果都不尽如人意,我们最终选了通过 Raft 来剥离 / 融合行存和列存,而非在同一套引擎中紧耦合两种格式。这种方式让我们能单独思考两个场景,也无需对现有的引擎做太大的改变,让产品成型和稳定周期大大缩短。另一方面,模块化也使得我们可以更 好借助其他开源产品(ClickHouse)的力量,因为复杂的细节无需被封印在同一个盒子。 市面上有其他设计采用了更紧密的耦合,例如 MemSQL 节点同时运行 TP 和 AP 两种业务,Spanner 选择 PAX 兼顾不同的读取模式,甚至传统数据库大多也在同一个引擎中添加了不同数据组织的支持。这样的架构会引入过于复杂的设计,也未必能在 TP 和 AP 任意一端取得好的收益。 由于选择了松耦合的设计,我们只需要专心解决一个问题就可以搞定存储:如何设计一个可根据主键实时更新的列存系统。事实上,列存多少都支持更新,只是这种更新往往是通过整体覆盖一大段数据来达到的,这也就是为什么多数传统的 OLAP 数据库只能支持批量的数据更新,。如果无需考虑实时主键更新,那么存储可以完全无需考虑数据的去重和排序:存储按照主键顺序整理不止是为了快速读取定位,也是为了写入更新加速。如果需要更新一笔数据,引擎至少需要让同一笔数据的新老版本能以某种方式快速去重,无论是读时去重还是直接写入覆盖。传统意义上分析型数据库或者 Hadoop 列存都抛弃了实时更新能力,因此无需在读或者写的时候负担这个代价,这也是它们得以支持非常高速批量加载和读取的原因之一。但这样的设计无法满足我们场景。要达到 HTAP 的目标,TiDB 的列存引擎必须能够支持实时更新,而且这个更新的速率不能低于行存。 事实上,我们肯定不是第一个在业界尝试实现列存更新的产品。业界对于列存更新,无论是何种变体,一个很通用的做法叫做 Delta Main。既然做列存更新效率不佳,那么我们何不使用写优化方式存储变更数据,然后逐步将更新部分归并到读优化的主列存区?只要我们保持足够的归并频率,那么整个数据的大部分比例都将以读优化的列存形态存在以保持性能。这是一个几乎从列存诞生起就有被想到的设计:你可以认为列存鼻祖 C-Store 就是某种意义上的 Delta Main 设计,它使用一个行存引擎做为写区,并不断将写区数据归并为列存。 我们的可更新列存引擎 DeltaTree 的设计也是非常类似的思路。宏观上,DeltaTree 将数据按照主键序排序切分,类似 TiDB 的 Region 概念那样,每一个数据范围单独形成一个片段,每当片段的物理大小超过阈值就会分裂。微观上来说,每个片段就如上图一般,分成 Delta 和 Stable Space 两部分。其中 Delta 部分以优化写入为主,他们是以写入顺序攒批排列的小数据块,以写入顺序排列而非主键顺序能使得写入大大加速,因为数据写入只需要不断追加。每当积攒了足够多的 Delta 数据,引擎就会将他们归并到 Stable 区,Stable 区的设计类似 Parquet,也是以行组(Row-Group)再按列切割,并排序后压缩存储。Stable 区无疑是对读取优化的,如果只考虑 Stable,那么速度将会很快。但实际上在读取时,仍未归并到 Stable 的 Delta 数据可能需要覆盖 Stable 中的老数据,因此读取会是一个在线归并过程。为了加速这个归并,引擎为 Delta 部分添加了内存中的辅助 B+Tree 索引,这样 Delta 虽然并非物理有序(保持 Delta 物理有序将大大降低写入性能),但仍然保持逻辑有序,免去了归并前排序的代价。同时,由于宏观上数据区间的划分,使得每次归并无需重写所有数据减轻了归并的压力。 回头说之前提到的 LSM 列存方案。实际上你可以认为 LSM 也可以近似认为是一种 Delta Main。当数据写入 MemTable 时,也是以写优化的追加形式写入。那是否 LSM 也可以成为一种支持列存更新的设计呢?我们也尝试过,并非不可能,只是性能对比 DeltaTree 尚有差距:进行范围读取时,LSM 需要进行非常重的多路归并,因为任何上层的新数据都可能会覆盖下层的老数据,而层和层之间存在交集,因此 N 层的 LSM 也许需要进行 N 路归并才能获取一段数据。我们曾经实现过基于 ClickHouse MergeTree 改造的 LSM 列存引擎,对比新的 DeltaTree 将近慢了一倍。 至此为止,我们解决了可更新列存问题。 再说复制 既然选择了松耦合的存储引擎,行列存储并不在同一个模块内,那随之而来的问题必然是如何进行数据复制。对于传统的主从复制体系,我们往往使用比如 MySQL Binlog 这样的 High Level 层级进行复制。实际上,这种复制体系也是我们第一个原型迭代所使用的手段。基于 Binlog 的复制体系能很好封装不必要的细节,只要列存引擎 TiFlash 可以正常回放日志就可以,无需关心例如事务实现等等细节。这样我们很快得到了第一版 TiFlash,它通过 binlog 串联行存与列存,但是需要再往下实现容错,负载均衡等等一系列特性。更麻烦的是,TiDB 是一个分布式且多主的系统。每个 TiDB 服务器都会产生一份 binlog,如果要保持数据一致性,不会新老覆盖,binlog 实际上还需要经过一层汇聚和排序,这几乎将分布式降维打击成了单点吞吐,而排序管道也大大增加了数据到达的延迟。因此原型版的 TiFlash 是无法提供行列混合查询的:你只能单独查询行存或者列存,因为数据无法保证一致,在查询中混合两者会创造无穷无尽的不可知数据错误。 于是我们转而从更低层级的日志进行复制,是的,我们选了在 Raft 层进行对接。从更底层进行对接的好处显而易见,Raft Log 保留了数据复制所需的一切细节,我们得以将 TiFlash 设计成一种特异的 TiKV 节点,从而能够直接获得 Multi-Raft 体系所赋予的一切好处:数据变得可以通过 PD 进行透明迁移扩容,容错本身也完全无需操心全部交由 Raft 体系来完成,当副本丢失时,存储层会自动发起恢复,而复制本身的复杂一致性保障也变得无需操心。从面临自己完善基于 ClickHouse 的副本体系,到坐享其成,一切都是如此美好。当然在实际的工程实现上也有代价,由高层准 SQL 级的 Binlog 改为完全底层的 Raft Log,代价也是相当巨大的。我们需要在 ClickHouse 上实现所有 Multi-Raft 体系所需的复杂操作,例如 Region 的分裂与合并,以及迁移和读取容错。 新的设计是整个 HTAP 体系成立的关键,它给与 TiFlash 无缝接入整个存储层的能力。同一套复制体系,同一套调度体系,一样的事务模型,一样的一致性保障。它的复制设计是完全分布式,负载均衡且自动容错的。 相比通过主从复制或者同机器行列双写,它的 AP 和 TP 部分可以完全独立地运转,自由扩容:如果你需要更多 AP 算力,那请增加 TiFlash 节点;如果你需要增加 TP 算力,请增加 TiKV 节点。互不干扰,以 Workload 而言或者计算资源扩展而言都是。 与此同时,这种复制又是自动负载均衡且点对点直接链接的。每个 Region Leader 副本会单独与列存侧的副本进行沟通完全无需中间存储介质,当 Region 副本过大分裂时,列存副本也会跟着分裂;当副本因为热点打散进行迁移时,他们之间的复制管道也会跟着迁移。这对于 TiDB 的 Multi-Raft 体系来说都是已经实现的功能。 另外 Raft 体系带来的最大好处却是一致性和异步复制的共存。 传统意义上,如果需要复制保持副本一致,就必须采用同步复制。这样,无论是列存节点的高压,还是网路延迟加大,都会对 TP 业务带来巨大冲击:为了保持数据一致性,行存事务必须等待列存确实完成写入才能返回,否则期间的故障将会带来数据丢失和不一致。另外新增任何列存节点也会加大遭遇网络延迟的概率。虽然诸多 HTAP 产品并不会态度考虑 AP 和 TP 互相影响的问题,我们仍然希望娇弱的 TP 能收到更大程度的保护。 这,恰恰可以通过 Raft 解决。TiFlash 通过 Learner 角色接入 Raft 体系,这允许列存以不投票只异步抄写的方式加入集群,这意味着它不会因为自身的稳定干扰正常 TP 业务的运转。当 TP 侧有事务写入,TiKV 无需等待 TiFlash 的数据同步,仅仅在完成正常的行存副本容错复制就可以返回客户端完成事务。那你也许要问了,这样是否数据无法保证一致性,是否行存和列存之间也许存在数据延迟?是也不是。物理上来说,确实存在,一个系统理论上并无可能做到异步复制仍然能同时物理上保持副本一致。但实际上我们也无需保证数据每时每刻在物理上一致,我们只需要提供一种一致的逻辑读取结果就行了。这也是 Raft 本身的核心特点之一,虽然多个副本并非全都每时每刻保持一致,但是只要读取的时候能得到最新的一致性数据即可。当实际读取发生时,列存副本会向行存的 Leader 发起校对请求,这个请求本身很简单:请告诉我在你收到请求的瞬间,最新日志序号是多少。而 TiFlash 会等待数据复制进度追上校对结果。仅此而已。这就使得 TiFlash 能够保证取得足够新鲜的数据,新鲜到保证囊括上一个瞬间写入的信息。是的,从 TiKV 写入的最新数据保证能从 TiFlash 被读取,这形成了读取的水位线。而通过时间戳和 MVCC 配合,TiFlash 的异步同步也可以提供与 TiKV 一样的强一致保证。这使得 TiFlash 列存表现得并不像一套异构复制体系,而更像是一种特殊的列存索引,也使得我们可以放心大胆地在同一个查询中混合两种不同引擎,而无需担心是否会由不一致带来微妙难以追查的错误。 智能选择 智能选择放在最后说,是因为它也的确是我们最后实现的。TiDB 的行列存智能选择就是通过代价优化自动选择行存或者列存。说起来这部分也很简单,犹如使用统计信息选择索引,我们也可以通过代价公式估算列存的使用代价。综合各个访问路径的开销,我们就能知道需要选择何种方式读取数据,而列存只是其中一种,并无特殊性。 技术上来说,这并没有太多新意。但通过自动选择,TiDB 的 HTAP 体系从 TP + 报表的用况一下子拓展到了 HTAP 混合业务。一些边界模糊的业务系统,通过 TiFlash 加持,变得架构简单。例如物流系统,用户希望能够在同一套查询平台检索个别单号以及投递明细,又希望能统计某时间段不同货物类别的收发情况。明细查询对于 TiDB 来说并无任何障碍,但以往没有列存的时候,大数据集下的多维分析性能对比真的分析型产品仍有不小的差距。有了 TiFlash 之后,这样 AP 和 TP 边界模糊的业务就立马变得圆润完整起来。反倒是原始计划中的 TiSpark 读取,由于 TiDB 更贴近业务和 DBA 而非大数据的特点,相较之下显得并没有那么多。 最后 这篇文章并不完全讲述了我们论文的内容。缺失的部分是 TiDB 非 HTAP 部分的设计,有兴趣的同学可以点击原文在此。另外,也欢迎大家使用我们的产品,各位的使用和宝贵意见是 TiDB 发展最基本的推动力。

优秀的个人博客,低调大师

深度解密Python工厂类相关模式

认识工厂类相关模式认识工厂类相关模式 1 工厂类相关模式含义工厂方法模式(英语:Factory method pattern)是一种实现了“工厂”概念的面向对象设计模式。就像其他创建型模式一样,它也是处理在不指定对象具体类型的情况下创建对象的问题。工厂方法模式的实质是“定义一个创建对象的接口,但让实现这个接口的类来决定实例化哪个类。工厂方法让类的实例化推迟到子类中进行。”[1]创建一个对象常常需要复杂的过程,所以不适合包含在一个复合对象中。创建对象可能会导致大量的重复代码,可能会需要复合对象访问不到的信息,也可能提供不了足够级别的抽象,还可能并不是复合对象概念的一部分。工厂方法模式通过定义一个单独的创建对象的方法来解决这些问题。由子类实现这个方法来创建具体类型的对象。对象创建中的有些过程包括决定创建哪个对象、管理对象的生命周期,以及管理特定对象的创建和销毁的概念。2 工厂类相关模式优点工厂模式、抽象工厂模式的优点:1、工厂模式巨有非常好的封装性,代码结构清晰;在抽象工厂模式中,其结构还可以随着需要进行更深或者更浅的抽象层级调整,非常灵活;2、屏蔽产品类,使产品的被使用业务场景和产品的功能细节可以分而开发进行,是比较典型的解耦框架。3 工厂类相关模式缺点工厂模式、抽象工厂模式的缺点:1、工厂模式相对于直接生成实例过程要复杂一些,所以,在小项目中,可以不使用工厂模式;2、抽象工厂模式中,产品类的扩展比较麻烦。毕竟,每一个工厂对应每一类产品,产品扩展,就意味着相应的抽象工厂也要扩展。4 工厂类相关模式应用工厂模式、抽象工厂模式的使用场景:1、当系统实例要求比较灵活和可扩展时,可以考虑工厂模式或者抽象工厂模式实现。比如,在通信系统中,高层通信协议会很多样化,同时,上层协议依赖于下层协议,那么就可以对应建立对应层级的抽象工厂,根据不同的“产品需求”去生产定制的实例。 Python实现工厂类相关模式Python实现工厂类相关模式 1 实例分析Python实现工厂类相关模式2.1 实例分析工厂类相关的模式在Python里面没有特别的实现方法,我们就直接用案例来分析。 2.1.1 背景要求假设我们现在需要开发一个快餐点餐系统,想必大家一定见过类似于麦当劳自助点餐台一类的点餐系统吧。在一个大的触摸显示屏上,有三类可以选择的上餐品:汉堡等主餐、小食、饮料。当我们选择好自己需要的食物,支付完成后,订单就生成了。下面,我们用今天的主角--工厂模式--来生成这些食物的逻辑主体。 2.1.2 主餐的生成(仅以两种汉堡为例)@dataclassclass Burger: name: str = "" price: float = 0.0 def getPrice(self) -> float: return self.price def setPrice(self, price) -> NoReturn: self.price = price def getName(self) -> str: return self.name @dataclassclass cheeseBurger(Burger): name = "cheese burger" price = 10.0 @dataclassclass spicyChickenBurger(Burger): name = "spicy chicken burger" price = 15.0 2.1.3 小食生成@dataclassclass Snack: name: str = "" price: float = 0.0 type: str = "SNACK" def getPrice(self) -> float: return self.price def setPrice(self, price) -> NoReturn: self.price = price def getName(self) -> str: return self.name @dataclassclass chips(Snack): name = "chips" price = 6.0 @dataclassclass chickenWings(Snack): name = "chicken wings" price = 12.0 2.1.4 饮料生成@dataclassclass Beverage: name: str = "" price: float = 0.0 type: str = "BEVERAGE" def getPrice(self) -> float: return self.price def setPrice(self, price) -> NoReturn: self.price = price def getName(self) -> str: return self.name @dataclassclass coke(Beverage): name = "coke" price = 4.0 @dataclassclass milk(Beverage): name = "milk" price = 5.0 2.1.5 实现工厂类以上的Burger,Snack,Beverage,都可以认为是该快餐店的产品,由于只提供了抽象方法,我们把它们叫抽象产品类,而cheese burger等6个由抽象产品类衍生出的子类,叫作具体产品类。接下来,“工厂”就要出现了。 @dataclassclass foodFactory: type: str = "" def createFood(self, foodClass) -> ClassVar: print(self.type, " factory produce a instance.") foodIns = foodClass() return foodIns @dataclassclass burgerFactory(foodFactory): type = "BURGER" @dataclassclass snackFactory(foodFactory): type = "SNACK" @dataclassclass beverageFactory(foodFactory): type = "BEVERAGE" 2.1.6 开始生产同样,foodFactory为抽象的工厂类,而burgerFactory,snackFactory,beverageFactory为具体的工厂类。在业务场景中,工厂模式是如何“生产”产品的呢? if __name__=="__main__": burger_factory=burgerFactory() snack_factorry=snackFactory() beverage_factory=beverageFactory() cheese_burger=burger_factory.createFood(cheeseBurger) print cheese_burger.getName(),cheese_burger.getPrice() chicken_wings=snack_factorry.createFood(chickenWings) print chicken_wings.getName(),chicken_wings.getPrice() coke_drink=beverage_factory.createFood(coke) print coke_drink.getName(),coke_drink.getPrice() output BURGER factory produce a instance.cheese burger 10.0SNACK factory produce a instance.chicken wings 12.0BEVERAGE factory produce a instance.coke 4.0 总结总结 总结工厂模式也分为简单工厂模式和抽象工厂模式,像下面这样 class simpleFoodFactory: @classmethod def createFood(cls,foodClass): print "Simple factory produce a instance." foodIns = foodClass() return foodIns 在场景中写成如下形式:spicy_chicken_burger=simpleFoodFactory.createFood(spicyChickenBurger)这样,省去了将工厂实例化的过程。这种模式就叫做简单工厂模式。还是在上述例子中,createFood方法中必须传入foodClass才可以指定生成的food实例种类,如果,将每一个细致的产品都建立对应的工厂(如cheeseBurger建立对应一个cheeseBurgerFactory),这样,生成食物时,foodClass也不必指定。事实上,此时,burgerFactory就是具体食物工厂的一层抽象。这种模式,就是抽象工厂模式。

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册