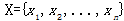首页 文章 精选 留言 我的

精选列表

搜索[nlp],共1770篇文章
优秀的个人博客,低调大师

【NLP系列】Bert词向量的空间分布

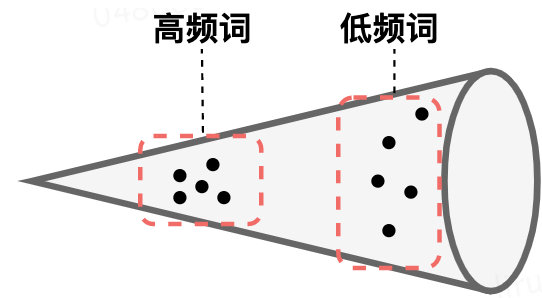
作者:京东零售 彭馨 1. 背景 我们知道Bert 预训练模型针对分词、ner、文本分类等下游任务取得了很好的效果,但在语义相似度任务上,表现相较于 Word2Vec、Glove 等并没有明显的提升。有学者研究发现,这是因为 Bert 词向量存在各向异性(不同方向表现出的特征不一致),高频词分布在狭小的区域,靠近原点,低频词训练不充分,分布相对稀疏,远离原点,词向量整体的空间分布呈现锥形,如下图,导致计算的相似度存在问题。 2. 问题分析 为什么Bert词向量会呈现圆锥形的空间分布且高频词更靠近原点? 查了一些论文发现,除了这篇 ICLR 2019 的论文《Representation Degeneration Problem in Training Natural Language Generation Models》给出了一定的理论解释,几乎所有提及到Bert词向量空间分布存在问题的论文,都只是在引用该篇的基础上,直接将词向量压缩到二维平面上进行观测统计(肉眼看的说服力明显不够😂) 图中(b)(c)可以看出原生Word2Vec和分类任务的词向量经 SVD 投影,分布在原点周围,而原生Transformer则分布在圆锥形区域,且任意两个词向量都正相关,会降低模型性能,这种现象被称为表征退化问题。 ①造成这种现象的直观解释是:在模型训练过程中,真词的embedding会被推向隐藏状态的方向,而其他词会被推向其负方向,结果是词汇表中大多数单词的嵌入将被推向与大多数隐藏状态负相关的相似方向,因此在嵌入空间的局部区域中聚集在一起。 ②理论解释则是分析未出现词的嵌入,发现表征退化和隐藏状态的结构有关:当隐藏状态的凸包不包含原点时,退化出现,并且当使用层归一化进行训练时,很可能发生这种情况。并发现低频词很可能在优化过程中被训练为彼此接近,因此位于局部区域。 论文将对理论解释部分给出证明,下面从我的理解,来解读一下😂,最后再简单说一下另外两篇对Bert词向量观测统计的论文。 3. 理论解释 在介绍之前,先熟悉几个关于凸优化问题的概念(不知道其实也问题不大😂): 凸集: 凸包: 点集Q的凸包是指一个最小凸多边形,满足Q中的点或者在多边形边上或者在其内。(最小的凸集) 锥: 凸锥: 如果一个集合既是锥,又是凸集,则该集合是凸锥。 1)未出现词 因为不容易直接分析高、低频词,作者另辟蹊径,选择和低频词比较相似的未出现词来分析目标函数。 因为其他参数固定,则上式等价于: 文中说定理1 中的 A 显而易见,那就只能大家自行理解这个凸集了。B 则是对上面最小化公式的求解,下面给出证明 证明: 证明: 以上还是很好理解的,定理1说明未出现词的向量会被优化无穷远,远离原点(模越来越大)。定理2则是说明词向量的分布不包含原点,而是在原点的一侧 2)低频词 低频词的分析则是在未出现词的基础上,因为分析低频词的embedding对损失函数的影响,将损失函数分为了两部分: 总损失函数为: 原来定理3 才是理解路上的最大绊脚石! 下面简述一下对词向量进行观测统计的论文 论文1《On the Sentence Embeddings from Pre-trained Language Models》 其实这篇论文就是字节的Bert-flow(不熟悉 Bert-flow 可见《对比学习——文本匹配》)。论文计算了词嵌入与原点的平均l2距离,并根据词频做了排序(词频越高排名越靠前,第0位词频最高),得出高频词靠近原点、低频词远离原点的结论,如下表上半部分: 表的下半部分则为词嵌入和它的k个近邻之间的平均l2距离和点积,可以看出低频词相较于高频词,和它们的k近邻距离更远,说明低频词相对高频词分布更稀疏。 论文2《Learning to Remove: Towards Isotropic Pre-trained BERT Embedding》 该论文则是通过随机计算两个词的相似度,发现都远大于0(说明词向量的方向基本都一致,不一致不会都远大于0),以此说明词向量不是均匀分布在向量空间中,而是分布在一个狭窄的圆锥体中。 4. 总结 都有理论解释了,结论自然就是Bert词向量确实存在表征退化问题,词向量存在各向异性,高频词距离原点更近,低频词训练不充分,远离原点,整体分布呈现圆锥形,导致其不适用于语义相似度任务。不过不知道该理论解释有没有说服你😄😄😄,有不同见解或疑问,欢迎前来交流。 针对此类问题,可以采用一下方法对其进行纠正,如论文[1]中加入cos正则,论文[2]中将锥形分布转化为高斯分布。因为词向量有问题,句向量自然跑不了,所以《对比学习——文本匹配》中的算法其实也都是为了解决这个问题。附:(定理3证明)

优秀的个人博客,低调大师

ideaseg —— 基于 NLP 的中文分词器

ideaseg是一个基于最新的HanLP自然语言处理工具包实现的中文分词器, 包含了最新的模型数据,同时移除了 HanLP 所包含的非商业友好许可的NeuralNetworkParser相关代码和数据。 HanLP相比其他诸如IK、jcseg等分词器而言,在分词的准确率上有巨大的提升,但速度上有所牺牲。 通过对HanLP进行优化配置,ideaseg在准确度和分词速度上取得了最佳的平衡。 与其他基于HanLP的插件相比,ideaseg同步了最新HanLP的代码和数据,去除了无法商用的相关内容;实现了自动配置; 包含了模型数据,无需自行下载,使用简单方便。 ideaseg提供三个模块包括: core~ 核心分词器模块 elasticsearch~ ElasticSearch 的 ideaseg 分词插件 (最高支持 7.10.2 版本) opensearch~ OpenSearch 的 ideaseg 分词插件 (默认版本 2.4.1)

优秀的个人博客,低调大师

DeepWalk:图网络与NLP的巧妙融合

作者 | kaiyuan 整理 | NewBeeNLP公众号 最近这段时间一直在做图网络相关,也差不多收尾了,有空整体复盘了下,大致以下几个主题,不过没整理完全哈哈(下次一定) 顺手再安利几份资料吧 斯坦福的CS224W课程 清华大学唐杰老师的很多分享 清华大学 thunlp/GNNPapers 一些大佬们的新书:《Graph Representation Learning》、《Deep Learning on Graphs》 等等 ok,回到正题,今天要介绍的这篇是『Graph Embedding』系列第一篇,十分经典 论文:DeepWalk: Online Learning of Social Representations [1] 代码:https://github.com/phanein/deepwalk enjoy~ TL;DR DeepWalk是首次将深度学习技术(无监督学习)引入到网络分析(network analysis)中的工作,它的输入是一个图,最终目标就是获得网络图中每个结点的向量表示 。毕竟万物皆可向量,得到向量之后能做的事情就非常多了。如下所示是论文中给出的Karate network例子。 先验知识 说到生成向量表示,最有名的莫过于Word2Vec了,那么是不是可以将network embedding的问题转化为熟悉的word embedding形式呢?这样我们就可以借用word2vec的思想来解决了。 转化的方式就是Random Walk ,通过这种方式将图结构表示为一个个序列,然后我们就可以把这些序列当成一个个句子,每个序列中的结点就是句子中的单词。 简单的说,DeepWalk = RandomWalk + SikpGram, 下面我们来具体介绍下两种技术。 Random Walk 随机游走,顾名思义,就是从输入图中的任意一个结点 开始,随机选取与其邻接的下一个结点,直至达到给定长度 , 生成的序列 。在论文中,对于每一个顶点 , 都会随机游走出 条序列。 采用随机游走有两个好处: 「利于并行化」:随机游走可以同时从不同的顶点开始采样,加快整个大图的处理速度; 「较强适应性」:可以适应网络局部的变化; Skip Gram word2vec的skip-gram相信大家都非常熟悉了,这里就不再赘述,放一张图。 DeepWalk 结合上面两点, deepwalk其实就是首先利用random walk来表示图结构,然后利用skip-gram模型来更新学习节点表示。算法流程如下所示: 算法有两层循环,第一层循环采样 条路径,第二层循环遍历图中的所有结点随机采样一条路径并利用skip-gram模型进行参数更新。 其中第2步构建二叉树的目的是为了方便后续 SkipGram模型的层次softmax算法。 参数更新的流程如下: 一个小结 deepwalk可以说给网络学习方向打开了一个新思路,有很多优点: 支持数据稀疏场景 支持大规模场景(并行化) 但是仍然存在许多不足: 游走是完全随机的,但其实是不符合真实的社交网络的; 未考虑有向图、带权图 本文参考资料 [1]DeepWalk: Online Learning of Social Representations: https://arxiv.org/abs/1403.6652 -END- Graph-Bert:没有我Attention解决不了的 2020-08-17 ACL2020 | 什么时候值得用BERT上下文嵌入 2020-08-07 ICML2020研究趋势 2020-07-27 记得把NewBeeNLP设为星标哦 等你在看 本文分享自微信公众号 - NewBeeNLP(NewBeeNLP)。如有侵权,请联系 support@oschina.cn 删除。本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

优秀的个人博客,低调大师

【NLP学习笔记】(一)Gensim基本使用方法

安装: pip install gensim本文内容主要翻译自https://radimrehurek.com/gensim/tut1.html#from-strings-to-vectors,中间加了些自己的理解,不理解之处大家可以直接看原文档。 1、第一步、准备训练语料 为了简单起见,我们假设列表documents代表语料库,每一句话代表一个文档,documents中有9个元素,也就是说该语料库由九个文档组成。 from gensim import corpora documents = ["Human machine interface for lab abc computer applications", "A survey of user opinion of computer system response time", "The EPS user interface management system", "System and human system engineering testing of EPS", "Relation of user perceived response time to error measurement", "The generation of random binary unordered trees", "The intersection graph of paths in trees", "Graph minors IV Widths of trees and well quasi ordering", "Graph minors A survey"] 2、第二步、预处理 分词(tokenize the documents)、去除停用词和在语料中只出现一次的词。处理语料的方式有很多,这里只是简单地通过空格(whitespace)去分词,然后把每个词变为小写,最后去除一些常用的词和只出现一次的词。 # remove common words and tokenize stoplist = set('for a of the and to in'.split()) #遍历documents,将其每个元素的words置为小写,然后通过空格分词,并过滤掉在stoplist中的word。 texts = [[word for word in document.lower().split() if word not in stoplist] for document in documents] # remove words that appear only once,collection是python的一个工具库 from collections import defaultdict frequency = defaultdict(int) for text in texts: for token in text: frequency[token] += 1 texts = [[token for token in text if frequency[token] > 1] for text in texts] from pprint import pprint # pprint可以使输出更易观看。 pprint(texts) #输出结果: [['human', 'interface', 'computer'], ['survey', 'user', 'computer', 'system', 'response', 'time'], ['eps', 'user', 'interface', 'system'], ['system', 'human', 'system', 'eps'], ['user', 'response', 'time'], ['trees'], ['graph', 'trees'], ['graph', 'minors', 'trees'], ['graph', 'minors', 'survey']] 3、第三步、文本向量化 如何从文档中提取特征有很多方法。这里简单使用词袋模型(bag-of- words)来提取文档特征,该模型通过计算每个词在文档中出现的频率,然后将这些频率组成一个向量,从而将文档向量化。首先我们需要用语料库训练一个词典,词典包含所有在语料库中出现的单词。 #定义一个词典,里面包含所有语料库中的单词,这里假设上文中输出的texts就是经过处理后的语料库。 dictionary = corpora.Dictionary(texts) dictionary.save('./gensim_out/deerwester.dict') # 因为实际运用中该词典非常大,所以将训练的词典保存起来,方便将来使用。 print(dictionary) # 输出:Dictionary(35 unique tokens: ['abc', 'applications', 'computer', 'human', 'interface']...) # dictionary有35个不重复的词,给每个词赋予一个id print(dictionary.token2id)#输出:{'abc': 0, 'applications': 1, 'computer': 2, 'human': 3, 'interface': 4, 'lab': 5, 'machine': 6, 'opinion': 7, 'response': 8, 'survey': 9, 'system': 10, 'time': 11, 'user': 12, 'eps': 13, 'management': 14, 'engineering': 15, 'testing': 16, 'error': 17, 'measurement': 18, 'perceived': 19, 'relation': 20, 'binary': 21, 'generation': 22, 'random': 23, 'trees': 24, 'unordered': 25, 'graph': 26, 'intersection': 27, 'paths': 28, 'iv': 29, 'minors': 30, 'ordering': 31, 'quasi': 32, 'well': 33, 'widths': 34} 上面已经构建了单词词典,我们可以通过该词典用词袋模型将其他的文本向量化.假设新文本是“Human computer interaction“,则输出向量为[(2, 1), (3, 1)],(2,1)中的“2”表示computer在词典中的id为2,“1”表示Human在该文档中出现了1次,同理,(3,1)表示Human在词典中的id为3,出现次数为1,输出向量中元组的顺序应该是按照id大小排序。interaction不在词典中,所以直接被忽略了。 new_doc = "Human computer interaction" #用dictionary的doc2bow方法将文本向量化 new_vec = dictionary.doc2bow(new_doc.lower().split()) corpora.MmCorpus.serialize('./gensim_out/deerwester.mm',new_vec) # 讲训练结果存储到硬盘中,方便将来使用。 print(new_vec)#输出[(2, 1), (3, 1)] 4、优化 上面训练过程中,语料库完全驻留在内存中,如果语料库很大,那将是个灾难,假设硬盘中存储着数百万的语料,我们可以一次取出一个文档,这样同一时间只有一个文档在内存中。获取mycorpus.txt #获取语料 class MyCorpus(object): def __iter__(self): for line in open('mycorpus.txt'): #每一个line代表语料库中的一个文档 yield dictionary.doc2bow(line.lower().split()) corpus_memory_friendly = MyCorpus()# 没有将corpus加载到内存中 print(corpus_memory_friendly)#输出:<__main__.MyCorpus object at 0x10d5690> #遍历每个文档 for vector in corpus_memory_friendly: # load one vector into memory at a time print(vector) 输出结果: [(0, 1), (1, 1), (2, 1)] [(0, 1), (3, 1), (4, 1), (5, 1), (6, 1), (7, 1)] [(2, 1), (5, 1), (7, 1), (8, 1)] [(1, 1), (5, 2), (8, 1)] [(3, 1), (6, 1), (7, 1)] [(9, 1)] [(9, 1), (10, 1)] [(9, 1), (10, 1), (11, 1)] [(4, 1), (10, 1), (11, 1)] 同样的,构建词典dictionary过程中也需要这种memory-friendly的方式训练 # iteritems用来遍历对象中的每个item from six import iteritems #初步构建所有单词的词典 dictionary = corpora.Dictionary(line.lower().split() for line in open('mycorpus.txt') ) #去出停用词,stop_ids表示停用词在dictionary中的id stop_ids = [dictionary.token2id[stopword] for stopword in stoplist if stopword in dictionary.token2id] #只出现一次的单词id once_ids = [tokenid for tokenid, docfreq in iteritem(dictionary.dfs) if docfreq ==1] #根据stop_ids与once_ids清洗dictionary dictionary.filter_token(stop_ids + once_ids) # 去除清洗后的空位 dictionary.compactify() print(dictionary)#输出:Dictionary(12 unique tokens) 5、存储训练结果的几种方式 corpora.MmCorpus.serialize(path, result) corpora.SvmLightCorpus.serialize(path, result) corpora.BleiCorpus.serialize(path, result) corpora.LowCorpus.serialize(path, result)值得注意的时第一种,Market Matrix format,用法举例 #假设训练结果为下面的corpus corpus = [[(1, 0.5)], []] # make one document empty, for the heck of it #存储 corpora.MmCorpus.serialize('./gensim_out/corpus.mm', corpus) #加载 corpus = corpora.MmCorpus('./gensim_out/corpus.mm') print(corpus)#输出:MmCorpus(2 documents, 2 features, 1 non-zero entries) #查看加载后的结果有两种方法:1.转成list2.遍历corpus,这种方法堆内存更加友好。 print(list(corpus)) # calling list() will convert any sequence to a plain Python list #输出:[[(1, 0.5)], []] for doc in corpus: print(doc) #输出:[(1, 0.5)][]

优秀的个人博客,低调大师

【NLP学习笔记】(二)gensim使用之Topics and Transformations

本文主要翻译自:https://radimrehurek.com/gensim/tut2.html 这个教程会向大家展示如何将代表文档的向量转换成另一种向量,做这件事的目的主要有两个: 发现语料中的隐藏结构,比如词与词之间的联系,然后用一种全新的方式、一种更能表现语义的方式(semantic way)来描述文档。 使文档的表示更加紧凑,这样可以提高效率和功效,因为新的表达方式消耗更少的资源,并且去除了噪音。 一、回顾 在之前的gensim基础使用中,我们介绍了如何将语料提取特征后转换为向量(基于词袋模型),上一章中的结果: # 清洗后的语料库,只有九句话,代表九个文档 [['human', 'interface', 'computer'], ['survey', 'user', 'computer', 'system', 'response', 'time'], ['eps', 'user', 'interface', 'system'], ['system', 'human', 'system', 'eps'], ['user', 'response', 'time'], ['trees'], ['graph', 'trees'], ['graph', 'minors', 'trees'], ['graph', 'minors', 'survey']] # 根据上面语料训练的词典,每个词都有一个id {'computer': 0, 'eps': 8, 'graph': 10, 'human': 1, 'interface': 2, 'minors': 11, 'response': 3, 'survey': 4, 'system': 5, 'time': 6, 'trees': 9, 'user': 7} # 根据词典基于词袋模型,训练上面语料的结果,(0,1.0)的意思是id为0的单词,即“computer”在第一篇文章中出现了1次。其它类似。 [[(0, 1.0), (1, 1.0), (2, 1.0)], [(0, 1.0), (3, 1.0), (4, 1.0), (5, 1.0), (6, 1.0), (7, 1.0)], [(2, 1.0), (5, 1.0), (7, 1.0), (8, 1.0)], [(1, 1.0), (5, 2.0), (8, 1.0)], [(3, 1.0), (6, 1.0), (7, 1.0)], [(9, 1.0)], [(9, 1.0), (10, 1.0)], [(9, 1.0), (10, 1.0), (11, 1.0)], [(4, 1.0), (10, 1.0), (11, 1.0)]] 二、加载上一章中结果(保存的字典和语料向量) from gensim import corpora, models, similarities import os if(os.path.exists('./gensim_out/deerwester.dict')): dictionary = corpora.Dictionary.load('./gensim_out/deerwester.dict') corpus = corpora.MmCorpus('./gensim_out/deerwester.mm') print("使用之前已经存储的字典和语料向量") else: print("请先通过上一章生成deerwester.dict和deerwester.mm") #pprint(dictionary.tokenz`2id) #pprint(corpus) 三、初始化一个转换模型(Creating a transformation) 转换模型是标准的python对象,通常需要传入一个语料库进行初始化。我们使用教程1中的旧语料库来初始化(训练)转换模型。也就是上面加载的corpus, 不同的转换模型一般需要不同的初始化参数; 在TfIdf的情况下,“训练”仅包括通过提供的语料库一次并计算其所有词频和逆文档频率。 训练其他模型,例如潜在语义分析或潜在狄利克雷分析,涉及更多,因此也会消耗更多时间。 tfidf = models.TfidfModel(corpus) #初始化一个模型 doc_bow = [(0, 1), (1, 1)] print(tfidf[doc_bow])#输出:[(0, 0.70710678), (1, 0.70710678)] 上面已经创建了tfidf模型,我们应该将其作为一个只读对象来看待,用它可以将旧的向量表示(上一节中的词袋模型)转换为新的向量表示(比如tf-idf权重)假设新文本为:“Human computer interaction”doc_bow是新文本经过上一章的清洗、分词、基于词袋模型转换后的结果,(0, 1)表示id为0,即“computer”。1表示“computer”在新文本中出现了1次;(1, 1)表示id为1,即“human”也出现了1次。tfidf模型将新文本从词袋向量模型([(0, 1), (1, 1)])转换为了词频-逆文档频率权重向量([(0, 0.70710678), (1, 0.70710678)]),即“computer”的权重为0 0.70710678,“human”的权重为0.70710678 四、序列化转换后的结果 调用model_name[corpus]仅在旧的语料库文档流周围创建一个包装器 ,实际转换在文档迭代期间即时完成。 我们无法在调用corpus_transformed = model [corpus]时转换整个语料库,因为这意味着将结果存储在内存中,这与gensim的内存独立的目标相矛盾。 如果您将多次迭代转换的corpus_transformed,并且转换成本很高,请先将生成的语料库序列化到磁盘然后再使用它。 #用tfidf转换语料库corpus corpus_tfidf = tfidf[corpus] #initialize an LSI transformation(初始化LSI模型) lsi = models.LsiModel(corpus_tfidf, id2word=dictionary, num_topics=2) #create a double wrapper over the original corpus: bow->tfidf->fold-in-lsicorpus_lsi = lsi[corpus_tfidf] lsi.print_topics(2) #输出:topic #0(1.594): -0.703*"trees" + -0.538*"graph" + -0.402*"minors" + -0.187*"survey" + -0.061*"system" + -0.060*"response" + -0.060*"time" + -0.058*"user" + -0.049*"computer" + -0.035*"interface" topic #1(1.476): -0.460*"system" + -0.373*"user" + -0.332*"eps" + -0.328*"interface" + -0.320*"response" + -0.320*"time" + -0.293*"computer" + -0.280*"human" + -0.171*"survey" + 0.161*"trees" 根据上面结果可以看出“trees”, “graph” and “minors都是相关联的词汇,并且对第一个主题的贡献度最高,第二个主题,更多的是关注其他的词汇 for doc in corpus_lsi: print(doc) #输出结果(可以看出前五个文档与第二个主题关联度更高): [(0, -0.066), (1, 0.520)] # "Human machine interface for lab abc computer applications" [(0, -0.197), (1, 0.761)] # "A survey of user opinion of computer system response time" [(0, -0.090), (1, 0.724)] # "The EPS user interface management system" [(0, -0.076), (1, 0.632)] # "System and human system engineering testing of EPS" [(0, -0.102), (1, 0.574)] # "Relation of user perceived response time to error measurement" [(0, -0.703), (1, -0.161)] # "The generation of random binary unordered trees" [(0, -0.877), (1, -0.168)] # "The intersection graph of paths in trees" [(0, -0.910), (1, -0.141)] # "Graph minors IV Widths of trees and well quasi ordering" [(0, -0.617), (1, 0.054)] # "Graph minors A survey" 保存模型与加载模型 lsi.save('./gensim_out/model.lsi') #保存 same for tfidf, lda, ... lsi = models.LsiModel.load('/tmp/model.lsi') #加载 gensim中可用的转换模型 1.Term Frequency * Inverse Document Frequency, Tf-Idf model = models.TfidfModel(corpus, normalize=True) 2.Latent Semantic Indexing, LSI (or sometimes LSA) model = models.LsiModel(tfidf_corpus, id2word=dictionary, num_topics=300) model.add_documents(another_tfidf_corpus) #now LSI has been trained on tfidf_corpus + another_tfidf_corpus lsi_vec = model[tfidf_vec] #convert some new document into the LSI space, without affecting the model ... model.add_documents(more_documents) #tfidf_corpus + another_tfidf_corpus + more_documents lsi_vec = model[tfidf_vec] ... 3.Random Projections, RP model = models.RpModel(tfidf_corpus, num_topics=500) 4.Latent Dirichlet Allocation, LDA model = models.LdaModel(corpus, id2word=dictionary, num_topics=100) 5.Hierarchical Dirichlet Process, HDP model = models.HdpModel(corpus, id2word=dictionary)
资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册