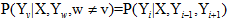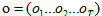首页 文章 精选 留言 我的

精选列表

搜索[nlp],共1770篇文章
优秀的个人博客,低调大师

【2018展望Top10】GAN应用落地,NLP急需突破

人工智能最近三年发展如火如荼,学术界、工业界、投资界各方一起发力,硬件、算法与数据共同发展,不仅仅是大型互联网公司,包括大量创业公司以及传统行业的公司都开始涉足人工智能。 2017年人工智能行业延续了2016年蓬勃发展的势头,那么在过去的一年里AI行业从技术发展角度有哪些重要进展?未来又有哪些发展趋势?本文从大家比较关注的若干领域作为代表,来归纳AI领域一些方向的重要技术进展。 从AlphaGo Zero到Alpha Zero:迈向通用人工智能的关键一步 DeepMind携深度增强学习利器总是能够给人带来震撼性的技术创新,2016年横空出世的AlphaGo彻底粉碎了普遍存在的“围棋领域机器无法战败人类最强手”的执念,但是毕竟李世石还是赢了一局,不少人对于人类翻盘大逆转还是抱有希望,紧接着Master通过60连胜诸多顶尖围棋高手彻底浇灭了

优秀的个人博客,低调大师

【NLP】基于统计学习方法角度谈谈CRF(四)

基于统计学习方法角度谈谈CRF (白宁超 2018年8月29日15:44:48) 【摘要】:条件随机场用于序列标注,数据分割等自然语言处理中,表现出很好的效果。在中文分词、中文人名识别和歧义消解等任务中都有应用。本文源于笔者做语句识别序列标注过程中,对条件随机场的了解,逐步研究基于自然语言处理方面的应用。成文主要源于自然语言处理、机器学习、统计学习方法和部分网上资料对CRF介绍的相关的相关,最后进行大量研究整理汇总成体系知识。文章布局如下:第一节介绍CRF相关的基础统计知识;第二节介绍基于自然语言角度的CRF介绍;第三节基于机器学习角度对CRF介绍,第四节基于统计学习角度对相关知识介绍;第五节对统计学习深度介绍CRF,可以作为了解内容。(本文原创,转载请注明出处:基于统计学习方法角度谈谈CRF。) 引言 条件随机场(CRF):是给定一组输入随机变量条件下,另一组输出随机变量的条件概率分布模型,其特点是假设输出随机变量构成马尔科夫随机场,条件随机场可用于不同预测问题,由输入序列对输出序列预测的判别式模型,形式为对数线性模型,其学习方法通常是极大似然估计。 1 条件随机场(CRF)的定义与形式 简单的说,条件随机场(CRF)类似于MRF,只不过CRF比MRF多了一个观察集合,或者说,CRF本质上就是给定了观察值集合的MRF。 条件随机场:设G=(V,E)是一个无向图,Y={Yv|v∈V}是以G中节点v为索引的随机变量Yv构成的集合。在给定X的条件下,如果每个随机变量Yv服从马尔可夫性,即,则条件概率分布P(Y|X)就是一个条件随机场。上式中的w ~ v表示在图G=(V, E)中与节点v有边连接的所有节点,w≠v表示v以外的所有节点,Yv,Yu, Yw为w对节点v,u,w对应的随机变量。 线性链条件随机场: 设X = (X1, X2,..., Xn), Y = (Y1, Y2, ..., Yn)均为线性链表示的随机变量序列,若在给定随机变量序列X的条件下,随机变量序列Y的条件概率分布P(Y|X)构成条件随机场,即满足马尔可夫性(见本文最开始的“模型定义”部分): P(Yi| X, Y1, ..., Yi-1, Yi+1, ...., Yn)= P(Yi| X, Yi-1, Yi+1)i= 1, 2, ..., n (在i=1和n时只考虑单边),则称P(Y|X)为线性链条件随机场。 注意:在标注问题中,X表示输入观测序列,Y表示对应的输出标记序列或状态序列。 2 条件随机场的参数化形式 P(Y|X)为线性链条件随机场,则在随机变量X取值为x的条件下,随机变量Y取值为y的条件概率具有如下形式: 其中, 式中,tk和sl是特征函数,λk和μl是对应的权值。Z(x)是规范化因子,求和时在所有可能的输出序列上进行的。 通常:特征函数t和s取值是1或0,当满足特征条件取值1,反之取值0,条件随机场完全由特征函数t,s和对应的数值λ,μ确定。 注意:线性CRF也是对数性模型。 实例解析: 设有一个天气预测问题:输入观察序列(连续三天的天气情况)为X = (X1, X2, X3),输出标记序列(每天对应天气热冷的预测)为 Y = (Y1, Y2, Y3), Y1, Y2, Y3 的取值于y= {H, C},其中H表示天热,C表示天冷。假设特征tk,sl和对应的权值λk,μl如下: 其中,上式代表着特征值为H的条件,即:yi-1= H, yi=C, x, i = 2, 3 时特征值取1。而特征值取0的条件被省略了。 PS:如果写全的话是这样: 于是对给定的观测序列x,求标记序列为y =(y1, y2, y3) = (H, C, C),即第一天热,第二天第三天连续冷的非规范化条件概率(即没有除以规范化因子的条件概率) 实例分析: 由以上问题可知,观察序列是天数的集合,标记序列是对应天气热冷的集合,由此分析显然是随机条件场的编码问题,基于随机条件场,可以将上述情形转换为图形化形式分析,然后进行模型构建,算法实现,算法优化和结果分析即可。本节重点实现分析,图形表示,模型构建。 天气预测问题转化为图形表示如下: 如图所示,横坐标x1,x2,x3分别对应天,是观察序列具备时序性,纵坐标是标记序列即可能隐藏的所有标记情况,start和end表示开始和结束状态(这点参照笔者Viterbi算法一节的介绍),其中t表示转移概率,t=0.5有具体权值的,标注转移概率是50%机会。X对应的s表示发射概率或者生产概率,显然,如上满足条件随机场,回顾下条件随机场模型,线性链条件随机场模型为: 于是对给定的观测序列x,标记序列y=(H,C,C)的非规范化条件概率为 上式数值计算,参照已知条件和图形分析,很容易计算,这里具体计算过程省略。 3 条件随机场的简化形式 将局部特征转化为一个全局特征函数,可将CRF写成权值向量和特征向量的内积形式即是条件随机场的简化形式,具体参见如下笔记: ①将转移特征和状态特征以及其数值用统一符号表示,设有K1个转移贴纸,K2个状态特征,K=K1+K2,记: ②对转移状态各个位置i求和,记作: ③用wk表示特征fk(y,x)的权值,即: ④于是,条件随机场可表示为 ⑤以w表示权值向量,即 ⑥以F(y, x)表示全局特征向量,即 则条件随机场可以写成向量w与F(y, x)的内积的形势: 4 条件随机场预测算法 形式化描述: 条件随机场的预测问题是给定义条件随机场P(Y|X)和输入序列(观测序列)x,求条件概率最大的输出序列(标记序列)y*,即对观测序列进行标注。 条件随机场的预测算法是著名的维特比算法。 你对维特比算法是什么就有概念了吧,下面来看看其数学描述。维特比算法不做深入讲解,如果读者还不清楚,参考本人系列文章之揭秘马尔科夫模型系统文章,有专门章节详细介绍viterbi算法。 这里,路径表示标记序列,其中 注意,这时只需计算非规范化概率,而不必计算概论,可以大大提高效率。 为了求解最优路径,将式写成如下形式: 其中 就是局部特征向量。 下面叙述维特比算法。 实例解析 用维特比算法求给定的输入序列(观测序列)x对应的输出序列(标记序列)y* = (y1*, y2*, y3*); 解析: 1)第一步初始化:因为y1=1和y1=2是最初,所以就不用考虑转移的情况了(实际上也没有“表达从y0转移到y1的情况”的t函数(转移函数)),直接从状态函数(s函数中找),发现,s1和s2分别对应y1=1和y1=2,说明y1=1和y1=2这个状态都是存在的,而s1和s2的权值分别是1和0.5,且上面列出的s函数们和t函数们值都为1,所以y1=1和y2=1的可能性分别是1和0.5。所以,到达y1的非规范化概率最大值为:δ1(1) = 1,δ1(2) = 0.5。 2)第二步递推:i=2(达第二处目的地集合{y2=1, y2=2}):首先是路线(仅说明到达y2=1的情况): 上图可知,到达y2=1的路线有如下几条: 路线1:从y1=1出发 ----(经过t2)---->到达y2=1; 路线2:从y1=2出发 ----(经过t4)---->到达y2=1; 接着是状态(仅说明到达y2=1的情况): 根据题目可知:i=2时的状态函数只有s2和s3,而y2=1对应的函数是s3 所以到达y2=1的非规范化概率最大值为:δ2(1) = max{1+λ2t2+ u3s3,0.5 + λ4t4+ u3s3}= 2.4 非规范化概率最大值的路径为: ψ2(1) = 1 δ2(2)同理。 i=3也一样(只不过对于δ3(1)中的u5s5,我认为应该是u3s3,先不说s3对应的是y3=1的情况,而且原题中根本没有s5函数)。 3)第三步终止:这步就简单了,在δ3(l)中δ3(1) = 4.3最大,所以y3中取1的可能性最大,即y3*=1。 4)第四步返回:然后反着推: 从y2的哪个值到y3可能性最大呢?在第二部已经解出:ψ3(1) = 2,即y2到达y3=1的路线中权值最大的是y2=2,即y2*=2。 同理,从y1=1到y2=2的可能性最大,即y1*=1。 5)就得到标记序列:*= (y1*, y2*, y3*)= (1, 2, 1) 5参考文献 【1】数学之美吴军著 【2】机器学习周志华著 【3】统计自然语言处理 宗成庆 著(第二版) 【4】统计学习方法(191---208) 李航 【5】知乎网络资源

优秀的个人博客,低调大师

【NLP】揭秘马尔可夫模型神秘面纱系列文章(四)

维特比算法解决隐马尔可夫模型解码问题(中文句法标注) 作者:白宁超 2016年7月12日14:08:28 摘要:最早接触马尔可夫模型的定义源于吴军先生《数学之美》一书,起初觉得深奥难懂且无什么用场。直到学习自然语言处理时,才真正使用到隐马尔可夫模型,并体会到此模型的妙用之处。马尔可夫模型在处理序列分类时具体强大的功能,诸如解决:词类标注、语音识别、句子切分、字素音位转换、局部句法剖析、语块分析、命名实体识别、信息抽取等。另外广泛应用于自然科学、工程技术、生物科技、公用事业、信道编码等多个领域。本文写作思路如下:第一篇对马尔可夫个人简介和马尔科夫链的介绍;第二篇介绍马尔可夫链(显马尔可夫模型)和隐马尔可夫模型以及隐马尔可夫模型的三大问题(似然度、编码、参数学习);第三至五篇逐一介绍三大问题相关算法:(向前算法、维特比算法、向前向后算法);最后非常得益于冯志伟先生自然语言处理教程一书,冯老研究自然语言几十余载,在此领域别有建树。(本文原创,转载注明出处:维特比算法解决隐马尔可夫模型解码问题(中文句法标注) ) 目录 【自然语言处理:马尔可夫模型(一)】:初识马尔可夫和马尔可夫链 【自然语言处理:马尔可夫模型(二)】:马尔可夫模型与隐马尔可夫模型 【自然语言处理:马尔可夫模型(三)】:向前算法解决隐马尔可夫模型似然度问题 【自然语言处理:马尔可夫模型(四)】:维特比算法解决隐马尔可夫模型解码问题(中文句法标注) 【自然语言处理:马尔可夫模型(五)】:向前向后算法解决隐马尔可夫模型机器学习问题 马尔可夫个人简介 安德烈·马尔可夫,俄罗斯人,物理-数学博士,圣彼得堡科学院院士,彼得堡数学学派的代表人物,以数论和概率论方面的工作著称,他的主要著作有《概率演算》等。1878年,荣获金质奖章,1905年被授予功勋教授称号。马尔可夫是彼得堡数学学派的代表人物。以数论和概率论方面的工作著称。他的主要著作有《概率演算》等。在数论方面,他研究了连分数和二次不定式理论 ,解决了许多难题 。在概率论中,他发展了矩阵法,扩大了大数律和中心极限定理的应用范围。马尔可夫最重要的工作是在1906~1912年间,提出并研究了一种能用数学分析方法研究自然过程的一般图式——马尔可夫链。同时开创了对一种无后效性的随机过程——马尔可夫过程的研究。马尔可夫经多次观察试验发现,一个系统的状态转换过程中第n次转换获得的状态常取决于前一次(第(n-1)次)试验的结果。马尔可夫进行深入研究后指出:对于一个系统,由一个状态转至另一个状态的转换过程中,存在着转移概率,并且这种转移概率可以依据其紧接的前一种状态推算出来,与该系统的原始状态和此次转移前的马尔可夫过程无关。马尔可夫链理论与方法在现代已经被广泛应用于自然科学、工程技术和公用事业中。 1 算法原理描述 维特比算法解决:问题2(解码问题):给定一个观察序列O和一个HMMλ=(A,B),找出最好的隐藏状态序列Q。 解码:使HMM这种包含隐藏变量的模型中,确定隐藏在某个观察序列后面变量序列的工作,叫做解码。 形式化描述:给定一个HMMλ=(A,B)和一个观察序列作为输入,找出概率最大的状态序列就是解码。 思想:使用前面算法找到隐藏在观察序列之后最好的状态序列,对于每个可能的隐藏状态序列,运用向前算法选出观察序列对隐藏序列的最大似然度的隐藏状态序列,从而完成解码工作,算法复杂度,当状态序列很大时,指数级增长,计算量过大,由此采用一种动态规划算法降低算法复杂度:维特比算法。 2 维特比算法实例分析 例子:通过吃冰淇淋数量(观察序列状态)计算隐藏状态空间的最佳路径(维特比网格)如下: 其中: 圆圈:隐藏状态 方框:观察状态 虚线圆圈:非法转移 虚线:计算路径 q:隐藏空间状态 o:观察时间序列状态 :在时间步t的观察状态下,隐藏状态j的概率。 Viterbi算法思想:按照观察序列由左向右顺序,每个表示自动机λ,HMM在看了头t个观察并通过了概率最大的状态序列 之后,在状态j的概率,每个 的值递归计算,并找出最大路径。 Viterbi算法形式化描述:每一个单元表示如下概率: V的计算公式如下: 在时刻t-1的时候使用扩充前面路径的方法计算维特比概率,计算时,把下面3个因素相乘: 案例分析: 给定一个HMMλ=(A,B),HMM把最大似然度指派给观察序列,算法返回状态路径,从而找到最优的隐藏状态序列。上图是小明夏天吃冰淇淋‘3 1 3’,据此使用Viterbi算法推断最可能出现的天气状态(天气的热|冷)。 1)计算时间步1的维特比概率 计算时间步t=1和状态1的概率: 路径:start--C 计算时间步t=1和状态2的概率: 路径:start—H 较大 2)计算时间步2的维特比概率,在(1) 基础计算 计算时间步t=2和状态1的概率: 路径:start—H—C 较大 计算时间步t=2和状态2的概率: 路径:start—H--H 3)计算时间步3的维特比概率,在(2) 基础计算 计算时间步t=3和状态1的概率: 路径:start—H—C—C 计算时间步t=3和状态2的概率: 路径:start—H—C—H较大 4)维特比反向追踪路径 路径为:start—H—C---H 综上所述可知:利用Viterbi算法我们知道小明夏天某天吃冰淇淋的观察值(3 1 3)推断出天气为(热 冷 热)。这也符合事实,天热吃3根,天冷吃一根。 维特比算法与向前算法的区别: (1) 维特比算法要在前面路径的概率中选择最大值,而向前算法则计算其总和,除此之外,维特比算法和向前算法一样。 (2) 维特比算法有反向指针,寻找隐藏状态路径,而向前算法没有反向指针。 3 HMM和维特比算法解决随机词类标注问题 上面例子根据小明吃冰淇淋成功推断出天气事件,但是读者不免意犹未尽,那么下面利用同样方法进行词类标注。在随机词类标注算法中,单词是观察序列,相当于冰淇淋的数量。词类标记是隐藏状态,相当于天气的热冷。因此可以进行随机词类标注如下: 对于一个给定的句子或者单词序列,我们使用HMM词类标注算法来选择使用下面公式为最大值标记序列: 在进行词类标注时,句子“Secretariat is expected to race tomorrow”中的race是一个动词VB或者名词NN,它可以标注VB也可以标注NN,我们利用Viterbi算法解决: 根据HMM标注算法的公式可知,选择概率比较大的一个作为race的标记。P(VB|TO)*P(race|VB) 和P(NN|TO)*P(race|NN) 两者最大值即race的标记。 假设转移概率已知为: P(NN|TO)=0.021 P(VB|TO)=0.34 假设词汇的发射概率即似然度也是知道的: P(race|NN)=0.00041 P(race|VB)=0.00003 我们把标记序列概率和词汇发射概率相乘得到以下结果: P(VB|TO)*P(race|VB) = 0.034*0.00003=0.00001 P(NN|TO)*P(race|NN) =0.021*0.00041=0.000007 因此,我们把race的标记确定为VB,这就是正确的词类标记结果,本质上采用统计模型的方法。当然真正使用时,我们根据需求对整个句子或者整段话以至于整篇文章进行标注,原理是一样的。 4 维特比算法描述 Viterbi算法定义: 5利用Viterbi算法的中文句法标注 1对文本数据清洗的预处理操作。代码略 2对清洗后的文本,采用有监督方法对古文献BIO标记(B表示句子开始I表示句子中间O表示句子结尾)代码略 3统计文本的转移矩阵B。 代码略 4统计文本的发射矩阵A。 代码略 5 维特比解码算法找出观察序列O的最后的隐藏状态序列Q 5.1 隐马尔可夫模型中维特比解码算法序列标注 String observationStr="病有发热恶寒者;发于阳也,无热恶寒者;发于阴也。";//观察序列 String[] states={"B","I","O"};//状态序列 double start_probability=0.3333;//初始状态概率 String str="书名:伤寒论。作者:张仲景。朝代:东汉。"; String stateStr=MethodUilt.Vitrerbi(str, start_probability, Amatrixpath, Bmatrixpath);//隐藏状态序列,即隐含马尔科夫模型的词类标注 System.out.println("观察序列:\t"+str.replaceAll("", "\t")+"\n标注序列:\t\t"+stateStr); 5.2 针对马尔科夫模型中第二个问题,采用维特比算法进行句子标注,其中主要还是动态规划思想 /** * 针对马尔科夫模型中第二个问题,采用维特比算法进行句子标注,其中主要还是动态规划思想 * @param observationStr 观察序列 * @param states 状态序列 * @param start_probability 初始化状态,即π * @param Amatrixpath 发射矩阵路径 * @param Bmatrixpath 转移矩阵路径 * start_probability, transititon_probability, emission_probability * @return */ public static String Vitrerbi(String observationStr,double start_probability,String Amatrixpath,String Bmatrixpath){ //将观察序列切词存储在数组里面 String[] ObserArr=observationStr.split(""); //将发射矩阵放入数组中 String[] emissionArrs=HeplerUilt.readStrFile(Amatrixpath, "\n").split("\n");//文本中发射矩阵逐次切割放于一位数组中 Map<String,BIOEntity> countMap=new HashMap<String,BIOEntity>();//实例化map,存储:词+实体(二维数组) for(int i=0;i<emissionArrs.length;i++){ String[] rowdata = emissionArrs[i].split("\t"); countMap.put(rowdata[0], new BIOEntity(rowdata[0],Double.parseDouble(rowdata[1]), Double.parseDouble(rowdata[2]), Double.parseDouble(rowdata[3]))); } //转移概率矩阵放入数组中 String[] transititonArr=HeplerUilt.readStrFile(Bmatrixpath, "\t").split("\t"); double[][] transArr=new double[3][3];//存放转移矩阵 int k=0; for(int i=0;i<transArr.length;i++){ for(int j=0;j<transArr[i].length;j++){ transArr[i][j]=Double.parseDouble(transititonArr[k]); k++; } } //隐含的标注序列 String stateStr=""; double V=0;//每步V*P(q_i|q_i-1)*P(w|q_i) List list = new LinkedList();//存放路径 //初始状态V的值 String tarWord=ObserArr[1];//首个字母 for(Map.Entry<String, BIOEntity> entry : countMap.entrySet()){ if(entry.getKey().equals(tarWord)){ double emission_probability=HeplerUilt.getMax(entry.getValue().getXb(), entry.getValue().getXi(), entry.getValue().getXo()); String prior=HeplerUilt.compareMark(entry.getValue().getXb(), entry.getValue().getXi(), entry.getValue().getXo()); list.add(prior); V=start_probability*emission_probability; //System.out.println(tarWord+":"+start_probability+":"+emission_probability+":"+prior+":"+HeplerUilt.DecFormat(4,V)); } } //观察序列O,第二个状态到结束 for(int i=2;i<ObserArr.length;i++){//由初始状态生成V,接着后面遍历观察序列进行 for(Map.Entry<String, BIOEntity> entry : countMap.entrySet()){ String q=list.get(list.size()-1).toString();//获取前一个标注 if(entry.getKey().equals(ObserArr[i])){ //获取观察序列的发射概率 double max_probability=HeplerUilt.getMax(entry.getValue().getXb(), entry.getValue().getXi(), entry.getValue().getXo());//得到最大发射概率值 double transititon_probability=HeplerUilt.getMaxTrans(q,transArr); //获取最大的转移概率 String prior=HeplerUilt.compareMark(entry.getValue().getXb(), entry.getValue().getXi(), entry.getValue().getXo());//得到最大发射概率的标注 list.add(prior);//将最大发射概率进行保存 V=V*max_probability*transititon_probability;//得到下一步的V值 //测试数据 //System.out.println(ObserArr[i]+":"+max_probability+":"+transititon_probability+":"+prior+":"+HeplerUilt.DecFormat(4,V)); } } } //System.out.println(observationStr.length()+":"+list.size()); for(int i=0;i<list.size();i++){ stateStr+=list.get(i)+"\t";//记录路径 } return stateStr; } //单元测试 public static void main(String[] args) { //维特比解码算法找出观察序列O的最后的隐藏状态序列Q System.out.println("***************************隐马尔可夫模型中维特比解码算法序列标注****************************"); String observationStr="病有发热恶寒者;发于阳也,无热恶寒者;发于阴也。";//观察序列 String str="书名:伤寒论。作者:张仲景。朝代:东汉。"; String stateStr=MethodUilt.Vitrerbi(str, 0.3333, "./targetFile/Amatrix.txt", "./targetFile/Bmatrix.txt");//隐藏状态序列,即隐含马尔科夫模型的词类标注 System.out.println("观察序列:\t"+str.replaceAll("", "\t")+"\n标注序列:\t\t"+stateStr); } 6实验结果: 3参考文献 【1】统计自然语言处理基础Christopher.Manning等 著宛春法等 译 【2】自然语言处理简明教程冯志伟 著 【3】数学之美吴军著 【4】Viterbi算法分析文章王亚强 声明:关于此文各个篇章,本人采取梳理扼要,顺畅通明的写作手法。一则参照相关资料二则根据自己理解进行梳理。避免冗杂不清,每篇文章读者可理清核心知识,再找相关文献系统阅读。另外,要学会举一反三,不要死盯着定义或者某个例子不放。诸如:此文章例子冰淇淋数量(观察值)与天气冷热(隐藏值)例子,读者不免问道此有何用?我们将冰淇淋数量换成中文文本或者语音(观察序列),将天气冷热换成英文文本或者语音文字(隐藏序列)。把这个问题解决了不就是解决了文本翻译、语音识别、自然语言理解等等。解决了自然语言的识别和理解,再应用到现在机器人或者其他设备中,不就达到实用和联系现实生活的目的了?本文原创,转载注明出处:维特比算法解决隐马尔可夫模型解码问题(中文句法标注) http://www.cnblogs.com/baiboy

优秀的个人博客,低调大师

【NLP】揭秘马尔可夫模型神秘面纱系列文章(五)

向前向后算法解决隐马尔可夫模型机器学习问题 作者:白宁超 2016年7月12日14:28:10 摘要:最早接触马尔可夫模型的定义源于吴军先生《数学之美》一书,起初觉得深奥难懂且无什么用场。直到学习自然语言处理时,才真正使用到隐马尔可夫模型,并体会到此模型的妙用之处。马尔可夫模型在处理序列分类时具体强大的功能,诸如解决:词类标注、语音识别、句子切分、字素音位转换、局部句法剖析、语块分析、命名实体识别、信息抽取等。另外广泛应用于自然科学、工程技术、生物科技、公用事业、信道编码等多个领域。本文写作思路如下:第一篇对马尔可夫个人简介和马尔科夫链的介绍;第二篇介绍马尔可夫链(显马尔可夫模型)和隐马尔可夫模型以及隐马尔可夫模型的三大问题(似然度、编码、参数学习);第三至五篇逐一介绍三大问题相关算法:(向前算法、维特比算法、向前向后算法);最后非常得益于冯志伟先生自然语言处理教程一书,冯老研究自然语言几十余载,在此领域别有建树。(本文原创,转载注明出处:向前向后算法解决隐马尔可夫模型机器学习问题 ) 目录 【自然语言处理:马尔可夫模型(一)】:初识马尔可夫和马尔可夫链 【自然语言处理:马尔可夫模型(二)】:马尔可夫模型与隐马尔可夫模型 【自然语言处理:马尔可夫模型(三)】:向前算法解决隐马尔可夫模型似然度问题 【自然语言处理:马尔可夫模型(四)】:维特比算法解决隐马尔可夫模型解码问题(中文句法标注) 【自然语言处理:马尔可夫模型(五)】:向前向后算法解决隐马尔可夫模型机器学习问题 马尔可夫个人简介 安德烈·马尔可夫,俄罗斯人,物理-数学博士,圣彼得堡科学院院士,彼得堡数学学派的代表人物,以数论和概率论方面的工作著称,他的主要著作有《概率演算》等。1878年,荣获金质奖章,1905年被授予功勋教授称号。马尔可夫是彼得堡数学学派的代表人物。以数论和概率论方面的工作著称。他的主要著作有《概率演算》等。在数论方面,他研究了连分数和二次不定式理论 ,解决了许多难题 。在概率论中,他发展了矩阵法,扩大了大数律和中心极限定理的应用范围。马尔可夫最重要的工作是在1906~1912年间,提出并研究了一种能用数学分析方法研究自然过程的一般图式——马尔可夫链。同时开创了对一种无后效性的随机过程——马尔可夫过程的研究。马尔可夫经多次观察试验发现,一个系统的状态转换过程中第n次转换获得的状态常取决于前一次(第(n-1)次)试验的结果。马尔可夫进行深入研究后指出:对于一个系统,由一个状态转至另一个状态的转换过程中,存在着转移概率,并且这种转移概率可以依据其紧接的前一种状态推算出来,与该系统的原始状态和此次转移前的马尔可夫过程无关。马尔可夫链理论与方法在现代已经被广泛应用于自然科学、工程技术和公用事业中。 1 向前向后算法概述 向前向后算法解决:问题3(学习问题):给定一个观察序列O和一个HMM中的状态集合,自动学习HMM的参数A和B。 此算法涉及机器学习,较为复杂,笔者不打算深入讲解,感兴趣的同学可以参考冯志伟《自然语言处理简明教程》P594—602,本文只是做为了解方面讲解。 鲍姆-韦尔奇算法(Baum-Welch algorithm):训练HMM的标准算法是向前向后算法,这是期望最大化算法或者叫鲍姆-韦尔奇算法,这个算法帮助我们训练HMM的转移概率B和发射概率A。 鲍姆-韦尔奇算法思路: (1) 反复的估计所得的计数,从转移概率和观察概率的一个估计值开始,反复的使用这些估计概率来推出越来越好的概率。 (2) 对于一个观察,计算它向前概率,从而得到我们估计的概率。然后把这个估计的概率量,在对于这个向前概率有贡献的所有不同路径上进行分摊。 向后概率:向后概率记住β是对于给定自动机λ,在状态i和时刻t观察下一个时刻t+1到终点的观察概率,用公式表示如下: 计算向前概率相似的归纳法来计算向后概率: 2 向后归纳的步骤 3 计算在时刻t和状态j的向后概率:公式较多,采用笔记如下 4 算法推导过程:公式较多,笔记如下 5 迭代向前向后算法核心: 6参考文献 【1】统计自然语言处理基础Christopher.Manning等 著宛春法等 译 【2】自然语言处理简明教程冯志伟 著 【3】数学之美吴军著 【4】Viterbi算法分析文章王亚强 声明:关于此文各个篇章,本人采取梳理扼要,顺畅通明的写作手法。一则参照相关资料二则根据自己理解进行梳理。避免冗杂不清,每篇文章读者可理清核心知识,再找相关文献系统阅读。另外,要学会举一反三,不要死盯着定义或者某个例子不放。诸如:此文章例子冰淇淋数量(观察值)与天气冷热(隐藏值)例子,读者不免问道此有何用?我们将冰淇淋数量换成中文文本或者语音(观察序列),将天气冷热换成英文文本或者语音文字(隐藏序列)。把这个问题解决了不就是解决了文本翻译、语音识别、自然语言理解等等。解决了自然语言的识别和理解,再应用到现在机器人或者其他设备中,不就达到实用和联系现实生活的目的了?本文原创,转载注明出处:向前向后算法解决隐马尔可夫模型机器学习问题 http://www.cnblogs.com/baiboy

优秀的个人博客,低调大师

【NLP】揭秘马尔可夫模型神秘面纱系列文章(三)

向前算法解决隐马尔可夫模型似然度问题 作者:白宁超 2016年7月11日22:54:57 摘要:最早接触马尔可夫模型的定义源于吴军先生《数学之美》一书,起初觉得深奥难懂且无什么用场。直到学习自然语言处理时,才真正使用到隐马尔可夫模型,并体会到此模型的妙用之处。马尔可夫模型在处理序列分类时具体强大的功能,诸如解决:词类标注、语音识别、句子切分、字素音位转换、局部句法剖析、语块分析、命名实体识别、信息抽取等。另外广泛应用于自然科学、工程技术、生物科技、公用事业、信道编码等多个领域。本文写作思路如下:第一篇对马尔可夫个人简介和马尔科夫链的介绍;第二篇介绍马尔可夫链(显马尔可夫模型)和隐马尔可夫模型以及隐马尔可夫模型的三大问题(似然度、编码、参数学习);第三至五篇逐一介绍三大问题相关算法:(向前算法、维特比算法、向前向后算法);最后非常得益于冯志伟先生自然语言处理教程一书,冯老研究自然语言几十余载,在此领域别有建树。(本文原创,转载注明出处:向前算法解决隐马尔可夫模型似然度问题 ) 目录 【自然语言处理:马尔可夫模型(一)】:初识马尔可夫和马尔可夫链 【自然语言处理:马尔可夫模型(二)】:马尔可夫模型与隐马尔可夫模型 【自然语言处理:马尔可夫模型(三)】:向前算法解决隐马尔可夫模型似然度问题 【自然语言处理:马尔可夫模型(四)】:维特比算法解决隐马尔可夫模型解码问题(中文句法标注) 【自然语言处理:马尔可夫模型(五)】:向前向后算法解决隐马尔可夫模型机器学习问题 马尔可夫个人简介 安德烈·马尔可夫,俄罗斯人,物理-数学博士,圣彼得堡科学院院士,彼得堡数学学派的代表人物,以数论和概率论方面的工作著称,他的主要著作有《概率演算》等。1878年,荣获金质奖章,1905年被授予功勋教授称号。马尔可夫是彼得堡数学学派的代表人物。以数论和概率论方面的工作著称。他的主要著作有《概率演算》等。在数论方面,他研究了连分数和二次不定式理论 ,解决了许多难题 。在概率论中,他发展了矩阵法,扩大了大数律和中心极限定理的应用范围。马尔可夫最重要的工作是在1906~1912年间,提出并研究了一种能用数学分析方法研究自然过程的一般图式——马尔可夫链。同时开创了对一种无后效性的随机过程——马尔可夫过程的研究。马尔可夫经多次观察试验发现,一个系统的状态转换过程中第n次转换获得的状态常取决于前一次(第(n-1)次)试验的结果。马尔可夫进行深入研究后指出:对于一个系统,由一个状态转至另一个状态的转换过程中,存在着转移概率,并且这种转移概率可以依据其紧接的前一种状态推算出来,与该系统的原始状态和此次转移前的马尔可夫过程无关。马尔可夫链理论与方法在现代已经被广泛应用于自然科学、工程技术和公用事业中。 1 向前算法原理描述 向前算法解决:问题1(似然度问题):给一个HMMλ=(A,B) 和一个观察序列O,确定观察序列的似然度问题 P=(O|λ)。 对于马尔可夫链,表面观察和实际隐藏是相同的,只需要标记吃冰淇淋数目“3 1 3”的状态,把加权(弧上)的对应概率相乘即可。而隐马尔可夫模型就不是那么简单了,因为状态是隐藏的,我们并不知道隐藏的状态序列是什么? 简化下问题:假如我们知道天气热冷状况,并且知道小明吃冰淇淋的数量,我们去观察序列似然度。如:对于给定的隐藏状态序列“hot hot cold”我们来计算观察序列“3 1 3”的输出似然度。 如何进行计算?首先,隐马尔可夫模型中,每个隐藏状态只产生一个单独的观察即一一映射,隐藏状态序列与观察序列长度相同,即:给定这种一对一的映射以及马尔可夫假设,对于一个特定隐藏状态序列 以及一个观察序列 观察序列的似然度为: 故从隐藏状态“hot hot cold”到所吃冰淇淋观察序列“3 1 3”的向前概率为: P(3 1 3|hot hot cold)=P(3|hot)*P(1|hot)*P(3|cold)=0.4*0.2*0.1=0.008 实际上,隐藏状态序列“hot hot cold”是我们的假设,并不知道隐藏状态序列,我们要考虑所有可能的天气序列,如此一来,我们将计算所有可能的联合概率,计算将会变得特别复杂。 我们来计算天气序列Q生产一个特定的冰淇淋事件序列O的联合概率: 如果隐藏序列只有一个是“hot hot cold”,那么我们的冰淇淋观察“3 1 3”和一个可能的隐藏状态“hot hot cold”的联合概率为: P(313|hothotcold)=P(hot|start)*P(hot|hot)*P(hot|cold)*P(3|hot)*P(1|hot)*P(3|cold)=0.8*0.7*0.30.4*0.2*0.1=0.001344 P(3 1 3)= P(313| cold cold cold)+ P(313| cold cold hot) + P(313| hot hot cold ) + P(313| cold hot cold) + P(313|hot cold cold) + P(313| hot hot hot) + P(313| hot cold hot) + P(313| cold hot hot) 对于具有N个隐藏状态和T个观察序列,将会有 个可能隐藏序列,在实际中T往往很大,比如文本处理中可能有数万几十万个词汇,计算量将是指数上升。在隐含马尔可夫模型中有种向前的算法有效代替这种指数增长的复杂算法,大大降低了复杂度。实验证明向前算法的复杂度是 。 2 向前算法的实例解析 向前算法是一种动态规划算法,当得到观察序列的概率时候,它使用一个表来存储中间值。向前算法也使用对于生成观察序列的所有可能的隐藏状态的路径上的概率求和的方法计算观察概率。在向前算法中横向表示观察序列,纵向表示状态序列。 下图是对于给定的隐藏状态序列“hot hot cold”计算观察序列“3 13 ”的似然度的向前网格的例子。其中: 横向:时间上的观察序列,纵向:空间上的状态序列 方框:观察状态 圆框:隐藏状态 续框:不合法转移 实线上值:加权概率 每个单元表示对于给定的自动机λ,在前面t个观察之后,在状态j的概率: ,其中 表示第t个状态是状态j的概率。如: 表示状态1即数3时,q1的概率。 上面公式的3个因素: 向前网格如下: 在时间1和状态1的向前概率: (从状态cold开始吃3根冰淇淋的似然度0.02) 在时间1和状态2的向前概率: (从状态hot始吃3根冰淇淋的似然度0.32) 在时间2和状态1的向前概率: (从开始到cold再到cold以及从开始到hot再到cold的天气状态,吃冰淇淋3 1 的观察似然度0.54) 在时间2和状态2的向前概率: (从开始到cold再到hot以及从开始到hot再到hot的天气状态,吃冰淇淋3 1 的观察似然度0.0464) 用同样方法,我们可以计算时间步3和状态步1的向前概率以及时间步3和状态步2的概率等等,以此类推,直到结束。显而易见,使用向前算法来计算观察似然度可以表示局部观察似然度。这种局部观察似然度比使用联合概率表示的全局观察似然度更有用。 3 向前算法定义 向前算法的递归定义: 4 参考文献 【1】统计自然语言处理基础Christopher.Manning等 著宛春法等 译 【2】自然语言处理简明教程冯志伟 著 【3】数学之美吴军著 【4】Viterbi算法分析文章王亚强 声明:关于此文各个篇章,本人采取梳理扼要,顺畅通明的写作手法。一则参照相关资料二则根据自己理解进行梳理。避免冗杂不清,每篇文章读者可理清核心知识,再找相关文献系统阅读。另外,要学会举一反三,不要死盯着定义或者某个例子不放。诸如:此文章例子冰淇淋数量(观察值)与天气冷热(隐藏值)例子,读者不免问道此有何用?我们将冰淇淋数量换成中文文本或者语音(观察序列),将天气冷热换成英文文本或者语音文字(隐藏序列)。把这个问题解决了不就是解决了文本翻译、语音识别、自然语言理解等等。解决了自然语言的识别和理解,再应用到现在机器人或者其他设备中,不就达到实用和联系现实生活的目的了?本文原创,转载注明出处:向前算法解决隐马尔可夫模型似然度问题 http://www.cnblogs.com/baiboy

优秀的个人博客,低调大师

【NLP】揭秘马尔可夫模型神秘面纱系列文章(二)

马尔可夫模型与隐马尔可夫模型 作者:白宁超 2016年7月11日15:31:11 摘要:最早接触马尔可夫模型的定义源于吴军先生《数学之美》一书,起初觉得深奥难懂且无什么用场。直到学习自然语言处理时,才真正使用到隐马尔可夫模型,并体会到此模型的妙用之处。马尔可夫模型在处理序列分类时具体强大的功能,诸如解决:词类标注、语音识别、句子切分、字素音位转换、局部句法剖析、语块分析、命名实体识别、信息抽取等。另外广泛应用于自然科学、工程技术、生物科技、公用事业、信道编码等多个领域。本文写作思路如下:第一篇对马尔可夫个人简介和马尔科夫链的介绍;第二篇介绍马尔可夫链(显马尔可夫模型)和隐马尔可夫模型以及隐马尔可夫模型的三大问题(似然度、编码、参数学习);第三至五篇逐一介绍三大问题相关算法:(向前算法、维特比算法、向前向后算法);最后非常得益于冯志伟先生自然语言处理教程一书,冯老研究自然语言几十余载,在此领域别有建树。(本文原创,转载注明出处:马尔可夫模型与隐马尔可夫模型 ) 目录 【自然语言处理:马尔可夫模型(一)】:初识马尔可夫和马尔可夫链 【自然语言处理:马尔可夫模型(二)】:马尔可夫模型与隐马尔可夫模型 【自然语言处理:马尔可夫模型(三)】:向前算法解决隐马尔可夫模型似然度问题 【自然语言处理:马尔可夫模型(四)】:维特比算法解决隐马尔可夫模型解码问题(中文句法标注) 【自然语言处理:马尔可夫模型(五)】:向前向后算法解决隐马尔可夫模型机器学习问题 马尔可夫个人简介 安德烈·马尔可夫,俄罗斯人,物理-数学博士,圣彼得堡科学院院士,彼得堡数学学派的代表人物,以数论和概率论方面的工作著称,他的主要著作有《概率演算》等。1878年,荣获金质奖章,1905年被授予功勋教授称号。马尔可夫是彼得堡数学学派的代表人物。以数论和概率论方面的工作著称。他的主要著作有《概率演算》等。在数论方面,他研究了连分数和二次不定式理论 ,解决了许多难题 。在概率论中,他发展了矩阵法,扩大了大数律和中心极限定理的应用范围。马尔可夫最重要的工作是在1906~1912年间,提出并研究了一种能用数学分析方法研究自然过程的一般图式——马尔可夫链。同时开创了对一种无后效性的随机过程——马尔可夫过程的研究。马尔可夫经多次观察试验发现,一个系统的状态转换过程中第n次转换获得的状态常取决于前一次(第(n-1)次)试验的结果。马尔可夫进行深入研究后指出:对于一个系统,由一个状态转至另一个状态的转换过程中,存在着转移概率,并且这种转移概率可以依据其紧接的前一种状态推算出来,与该系统的原始状态和此次转移前的马尔可夫过程无关。马尔可夫链理论与方法在现代已经被广泛应用于自然科学、工程技术和公用事业中。 1 引言 当需要计算现实世界上可以直接观察到的时间序列的概率时,(如上面天气事件),马尔可夫链很有用。但是,当我们处理的事件是现实世界不能观察到的,而是隐含在观察背后,诸如词类标注(根据具体的一个个的词,我们实现看到的词的序列去标注出正确的词类,此事词类的标注是隐藏的)、语音识别(声学事件下,推断出隐藏在其背后的单词)等。类似这样的事件马尔可夫链是不能直接解决的,此处隐马尔可夫模型便派到用场。 隐马尔科夫模型:由被观察到的事件(如:此类标记时我们输入中看到的词序列),又涉及到隐藏事件(对词的标注),这些隐藏事件在概率模型中被我们认为是引导因素。 2 隐马尔可夫模型 2.1爱依斯讷(Jason Eisner)对隐马尔可夫模型的描述 隐马尔可夫模型在现实问题中应用: 隐马尔可夫模型在现实事件中的使用,假设从2016年之后的一千年(3016年),我们想了解2016年某段时间中国*成都天气状况(假设简单的热冷表示即H|C),恰巧又没有2016年成都天气关于热冷的记录,唯一的线索便是小明日记本中夏天的一段记录,记录的是每天小明吃冰淇淋的数量(观察状态),我们可以利用隐马尔可夫模型根据小明夏天吃冰淇淋数量的记录推断中国成都天气(热=0.8|冷=0.2,即隐含状态),究竟该如何做? (1)具有初始状态和终结状态的隐马尔科夫链描述如下: (2)没有初始状态和终结状态的隐马尔科夫链描述如下: (3)一阶隐马尔可夫的两个假设 2.2 拉宾纳(Rabiner)对隐马尔可夫模型思想的三个问题 问题1(似然度问题):给一个HMMλ=(A,B)和一个观察序列O,确定观察序列的似然度问题P(O|λ)。 问题2(解码问题):给定一个观察序列O和一个HMM λ=(A,B),找出最好的隐藏状态序列Q。 问题3(学习问题):给定一个观察序列O和一个HMM中的状态集合,自动学习HMM的参数A和B。 如上的冰淇淋事件是典型的问题1,似然度问题,对应向前算法解决。词类标注是典型问题2解码问题,对应维特比算法解决。问题3是机器学习问题,对应向前向后算法解决。此三个问题稍后篇章会一一介绍。 3 案例解析隐马尔可夫模型 下图描述小明吃冰淇淋的数量(观察值)与天气热冷情况(隐藏值H或C)之间的隐马尔可夫模型 其中hot1的转移概率是: P(1|hot)=0.2 夏天某天天气热吃1根冰淇淋的概率 P(2|hot)=0.4 夏天某天天气热吃2根冰淇淋的概率 P(3|hot)=0.4 夏天某天天气热吃3根冰淇淋的概率 其中cold2的转移概率是: P(1|hot)=0.5 夏天某天天气冷吃1根冰淇淋的概率 P(1|hot)=0.4 夏天某天天气冷吃2根冰淇淋的概率 P(1|hot)=0.1 夏天某天天气冷吃3根冰淇淋的概率 其中观察值(吃的数量): O={1,2,3} 隐藏值(天气的状态): S={H,C} 全连通HMM:任何两个状态之间的转移一个非零概率。 非全连通HMM:从左到右的单向序列,如对语音进程建模。 通过小明吃冰淇淋的观察值推断天气状态的问题,留着下节采用隐含马尔可夫模型解决。此处采用一个短小简明的例子,旨在让读者明白原理,后续会拿到现实应用中深入讲解。 4 参考文献 【1】统计自然语言处理基础Christopher.Manning等 著宛春法等 译 【2】自然语言处理简明教程冯志伟 著 【3】数学之美吴军著 【4】Viterbi算法分析文章王亚强 声明:关于此文各个篇章,本人采取梳理扼要,顺畅通明的写作手法。一则参照相关资料二则根据自己理解进行梳理。避免冗杂不清,每篇文章读者可理清核心知识,再找相关文献系统阅读。另外,要学会举一反三,不要死盯着定义或者某个例子不放。诸如:此文章例子冰淇淋数量(观察值)与天气冷热(隐藏值)例子,读者不免问道此有何用?我们将冰淇淋数量换成中文文本或者语音(观察序列),将天气冷热换成英文文本或者语音文字(隐藏序列)。把这个问题解决了不就是解决了文本翻译、语音识别、自然语言理解等等。解决了自然语言的识别和理解,再应用到现在机器人或者其他设备中,不就达到实用和联系现实生活的目的了?本文原创,转载注明出处:马尔可夫模型与隐马尔可夫模型 http://www.cnblogs.com/baiboy

优秀的个人博客,低调大师

【NLP】揭秘马尔可夫模型神秘面纱系列文章(一)

初识马尔可夫和马尔可夫链 作者:白宁超 2016年7月10日20:34:20 摘要:最早接触马尔可夫模型的定义源于吴军先生《数学之美》一书,起初觉得深奥难懂且无什么用场。直到学习自然语言处理时,才真正使用到隐马尔可夫模型,并体会到此模型的妙用之处。马尔可夫模型在处理序列分类时具体强大的功能,诸如解决:词类标注、语音识别、句子切分、字素音位转换、局部句法剖析、语块分析、命名实体识别、信息抽取等。另外广泛应用于自然科学、工程技术、生物科技、公用事业、信道编码等多个领域。本文写作思路如下:第一篇对马尔可夫个人简介和马尔科夫链的介绍;第二篇介绍马尔可夫链(显马尔可夫模型)和隐马尔可夫模型以及隐马尔可夫模型的三大问题(似然度、编码、参数学习);第三至五篇逐一介绍三大问题相关算法:(向前算法、维特比算法、向前向后算法);最后非常得益于冯志伟先生自然语言处理教程一书,冯老研究自然语言几十余载,在此领域别有建树。(本文原创,转载注明出处:初识马尔可夫和马尔可夫链 ) 目录 【自然语言处理:马尔可夫模型(一)】:初识马尔可夫和马尔可夫链 【自然语言处理:马尔可夫模型(二)】:马尔可夫模型与隐马尔可夫模型 【自然语言处理:马尔可夫模型(三)】:向前算法解决隐马尔可夫模型似然度问题 【自然语言处理:马尔可夫模型(四)】:维特比算法解决隐马尔可夫模型解码问题(中文句法标注) 【自然语言处理:马尔可夫模型(五)】:向前向后算法解决隐马尔可夫模型机器学习问题 1马尔可夫个人简介 安德烈·马尔可夫,俄罗斯人,物理-数学博士,圣彼得堡科学院院士,彼得堡数学学派的代表人物,以数论和概率论方面的工作著称,他的主要著作有《概率演算》等。1878年,荣获金质奖章,1905年被授予功勋教授称号。马尔可夫是彼得堡数学学派的代表人物。以数论和概率论方面的工作著称。他的主要著作有《概率演算》等。在数论方面,他研究了连分数和二次不定式理论 ,解决了许多难题 。在概率论中,他发展了矩阵法,扩大了大数律和中心极限定理的应用范围。马尔可夫最重要的工作是在1906~1912年间,提出并研究了一种能用数学分析方法研究自然过程的一般图式——马尔可夫链。同时开创了对一种无后效性的随机过程——马尔可夫过程的研究。马尔可夫经多次观察试验发现,一个系统的状态转换过程中第n次转换获得的状态常取决于前一次(第(n-1)次)试验的结果。马尔可夫进行深入研究后指出:对于一个系统,由一个状态转至另一个状态的转换过程中,存在着转移概率,并且这种转移概率可以依据其紧接的前一种状态推算出来,与该系统的原始状态和此次转移前的马尔可夫过程无关。马尔可夫链理论与方法在现代已经被广泛应用于自然科学、工程技术和公用事业中。 2 马尔可夫链 2.1 马尔科夫链的基本概念 序列分类器:序列分类器或序列标号器是给序列中的某个单元指派类或者标号的模型。马尔可夫模型(又叫显马尔可夫模型VMM)和隐马尔可夫模型(HMM)都是序列分类器。诸如:词类标注、语音识别、句子切分、字素音位转换、局部句法剖析、语块分析、命名实体识别、信息抽取都属于序列分类。 【随机过程的两层含义】 (1) 随机过程是一个时间函数,其随着时间变化而变化 (2) 随机过程的每个时刻上函数值是不确定的、随机的,即每个时刻上函数值按照一定的概率进行分布。 独立链:随机过程中各个语言符合或者词是独立的,不相互影响,则称这种链是独立链。反之,各语言词或者符号彼此有关则是非独立链。 等概率独立链与非等概率独立链:在独立链中,各个语言符合或者词是等概率出现的是等概率独立链,各个语言词或者语言符号是非等概率出现的则为非等概率链。 【马尔可夫链】 马尔可夫过程:在独立链中,前面语言符号对后面的语言符号无影响,是无记忆没有后效的随机过程,在已知当前状态下,过程的未来状态与它的过去状态无关,这种形式就是马尔可夫过程。 马尔可夫链:在随机过程中,每个语言符号的出现概率不相互独立,每个随机试验的当前状态依赖于此前状态,这种链就是马尔可夫链。 链的解析:也可以当做一种观察序列,诸如:“2016年是建党95周年”,就可以看着一个字符串链。其中如上字符串中每个字符出现是随机的,其他如果每个字出现是独立的就是独立链,如果每个字符出现有前面字符相关,即不独立具有依赖性则为马尔科夫链。 N元马尔科夫链: 考虑前一个语言符号对后一个语言符号出现概率的影响,这样得出的语言成分的链叫做一重马尔可夫链,也是二元语法。 考虑前两个语言符号对后一个语言符号出现概率的影响,这样得出的语言成分的链叫做二重马尔可夫链,也是三元语法。 考虑前三个语言符号对后一个语言符号出现概率的影响,这样得出的语言成分的链叫做三重马尔可夫链,也是四元语法。 类似的,考虑前(4,5,….,N-1)个语言符号对后一个语言符号出现概率的影响,这样得出的语言成分的链叫做(4,5,….,N-1)重马尔可夫链,也是(5,6,….,N)元语法。 马尔科夫链在数学上描述了自然语言句子的生成过程,是一个早期的自然语言形式的模型,后来N元语法的研究,都是建立在马尔科夫模型的基础上,马尔科夫链也就是显性的马尔科夫模型,马尔科夫链和隐马尔科夫模型都是有限自动机(状态集合状态之间的转移集)的扩充。 加权有限状态机:加权有限状态机中每个弧与一个概率有关,这个概率说明通过这个弧的可能性,且某一个点出发的弧具有归一化的性质,即某点出发的弧概率之和为1。 注意:马尔科夫链不能表示固有歧义的问题,当概率指派给没有歧义时,马尔科夫链才有用。 2.2 马尔可夫链描述 (1) 具有初始状态和终结状态的马尔科夫链描述如下: (2) 没有初始状态和终结状态的马尔科夫链描述如下: 在一个一阶马尔可夫链中,我们假设一个特定的概率只与它前面一个状态有关,马尔可夫假设可以表示如下: 从一个状态i出发的所有弧的概率之和为1,即: 2.3 马尔可夫链应用实例 无初始状态和终结状态下,天气事件(1)hot hot hot hot 和(2)cold hot cold hot的马尔科夫链的序列概率: (1) hot hot hot hot =0.5*0.5*0.5*0.5=0.0625 (2) cold hot cold hot=0.3*0.2*0.2*0.2=0.0024 如上概率差别告诉我们用马尔科夫链编码实现世界天气事实是什么?天气事件的概率可以直接观察到。 3参考文献 【1】统计自然语言处理基础Christopher.Manning等 著宛春法等 译 【2】自然语言处理简明教程冯志伟 著 【3】数学之美吴军著 【4】Viterbi算法分析文章王亚强 声明:关于此文各个篇章,本人采取梳理扼要,顺畅通明的写作手法。一则参照相关资料二则根据自己理解进行梳理。避免冗杂不清,每篇文章读者可理清核心知识,再找相关文献系统阅读。另外,要学会举一反三,不要死盯着定义或者某个例子不放。诸如:此文章例子冰淇淋数量(观察值)与天气冷热(隐藏值)例子,读者不免问道此有何用?我们将冰淇淋数量换成中文文本或者语音(观察序列),将天气冷热换成英文文本或者语音文字(隐藏序列)。把这个问题解决了不就是解决了文本翻译、语音识别、自然语言理解等等。解决了自然语言的识别和理解,再应用到现在机器人或者其他设备中,不就达到实用和联系现实生活的目的了?本文原创,转载注明出处:初识马尔可夫和马尔可夫链 http://www.cnblogs.com/baiboy

优秀的个人博客,低调大师

复旦 NLP & 美团 LongCat 联合提出 LRMs 能力评测新框架

一、推理模型 ⾯ 临的新挑战 随着 OpenAI o1 、 DeepSeek-R1 等大型推理模型(LRMs)的问世, AI 推理能力迎来了「测试时扩展」的新阶段。这些模型通过长链思维(Long Chain-of-Thought, CoT)在数学推理、代码生成、智能体任务等领域展现出强大能力。 然而,现有评测体系存在一个关键盲区:主流基准测试(如 MATH500 、AIME)主要关注独立的单一问题,每个问题相互隔离,模型只需「---问---答」即可。 但现实应用场景往往大相径庭: 软件开发中需要连续处理多个关联代码模块 数学证明需要基于前序推导逐步构建后续结论 智能助手往往需要在多轮交互逐步完成复杂任务 这些真实场景要求模型具备跨任务的长链推理能力------不仅要解决单个子问题,更要在多个关联任务间保持推理---致性、合理分配计算资源、实现跨步骤的反思与纠错。 核心问题:当前大型推理模型的长链推理能力边界到底在哪里? 由于现有评测无法回答这---问题,传统训练数据也难以培养这种能力(如图所示,模型在长程推理场景下表现明显退化)。 复旦大学与美团 LongCat 联合推出 R-HORIZON------首个系统性评估与增强 LRMs 长链推理能力的评测框架与训练方法。 论文标题: R-HORIZON: How Far Can Your Large Reasoning Model Really Go in Breadth and Depth? 论文地址 : https://arxiv.org/abs/2510.08189 项目主页 : https://reasoning-horizon.github.io 代码地址 :https://github.com/meituan-longcat/R-HORIZON 数据集 :https://huggingface.co/collections/meituan-longcat/r-horizon 二、方法论: Query Composition 范式 核心创新 R-HORIZON 提出了问题组合(Query Composition)方法,通过构建问题间的依赖关系,将孤立任务转化为复杂的多步骤推理链。 以数学任务为例,该方法包含三个步骤: 信息提取 :从独立问题中提取核心数值、变量等关键信息 依赖构建 :将前序问题的答案嵌入到后续问题的条件中 链式推理:模型必须顺序解决所有子问题才能获得最终答案 方法优势 灵活扩展:可自由控制推理链长度(n = 2, 4, 8...) 精确可控:可灵活设定问题间的依赖强度 高效低成本:基于现有数据集构建,无需额外人工标注 基于此方法,我们构建了 R-HORIZON Benchmark 用于系统性评估 LRMs 的多步推理能力,同时生成了长链推理训练数据,通过强化学习(RLVR)提升模型性能。 三、评测基准: R-HORIZON Benchmark 数据集构成 基于 Query Composition 方法,我们构建了涵盖 6 个代表性数据集的 R-HORIZON Benchmark: 评测发现:性能断崖现象 我们评测了 20+ 个主流 LRMs(包括 o4-mini 、Claude-Sonnet-4 、 DeepSeek-R1 等顶级商业模型及开源模型),揭示了---个重要现象。 顶级推理模型在长链推理场景下均出现显著性能下降! 主要发现: 普遍性能退化:所有模型随问题数量增加均出现明显性能下降。DeepSeek-R1 在 AIME25 单问题场景准确率达 87.3%,但在 5 个组合问题场景下骤降至 24.6%。 规模效应:更大规模的模型对多步推理挑战表现出更强的鲁棒性。 任务差异:代码生成任务相比数学任务表现出更陡峭的性能衰退;多数推理模型在网页搜索场景中丧失工具调用能力。 四、机制分析:推理模型的三大瓶颈 为深入理解性能断崖的成因,我们进行了系统的机制分析,识别出当前 LRMs 的三个关键瓶颈: 瓶颈 1:有效推理长度受限 随着相互依赖问题数量增加,LRMs 难以维持原有性能水平。实际准确率与理论准确率之间的差距显著扩大。 深入分析显示: 模型错误集中在特定上下文范围内 7B 模型的主要错误范围在 (4-6K tokens) 32B 模型将范围扩展到 (8-10K tokens) 更大模型具有更长的有效推理边界 瓶颈 2: 反思机制高度局部化 对模型「反思」行为的分析发现发现: 模型反思频率随问题数量增加而上升并趋于收敛。 超过半数复杂任务 完全缺乏 长程反思 (跨越当前问题的反思)。 当前 LRMs 的反思机制 高度局部化,无法支撑长链场景需求。 瓶颈 3:思考预算分配失衡 最令人意外的发现:包括 DeepSeek-R1 在内的主流 LRMs 无法有效分配思考预算! 模型倾向于过度分配 tokens 给早期推理阶段 未能合理分配资源给后续关键问题 这种失衡严重影响整体推理链的完成质量 五、 训练方案:突破能力边界 发现瓶颈后,我们进---步探索:能否通过长链数据的强化学习训练突破这些限制? 训练策略 我们基于 R-HORIZON 构建的长链推理数据,采用 GRPO 算法进行训练: 算法:主流 RLVR 算法 GRPO 数据: R-HORIZON 组合数据(n = 2, n = 4) 实验:不同奖励函数的对比实验 训练效果:双重性能提升 实验结果显示:R-HORIZON 训练不仅显著提升长链任务表现,单问题性能也大幅增强! 核心数据 注:加粗数字表示该列最佳成绩 关键发现 双重提升:使用 n = 2 组合问题训练,多步推理性能大幅提升(AIME24 n = 2 +17.4 分),单问题性能也显著增强(AIME24 单题 +7.5 分)。 可扩展性:增加组合复杂度(n = 4)增强了模型处理更多推理步骤问题的能力,在 MATH500 (n = 8) 上达到 50.6%。 训练带来的质变 R-HORIZON 训练带来了推理机制的深层改变: 更高效的推理长度:显著改善组合任务性能,更好地泛化到更长推理链,同时缓解「overthinking」现象 更合理的预算分配:学会在多步问题中进行更合理的 token 预算分配 更长程的反思能力:促进了长程反思频率增加,直接改善长链推理性能 六、结论与展望 R-HORIZON 标志着大型推理模型研究的范式转变------从「能解决什么问题」到「能走多远」。 技术贡献 首个长链推理评测基准:系统性揭示 LRMs 的能力边界及三大瓶颈。 可扩展训练范式:提供低成本、高效率的能力提升路径。 深度机制分析:为未来推理模型改进指明方向。 阅读更多 | 关注「美团技术团队」微信公众号,在公众号菜单栏对话框回复【2024年货】、【2023年货】、【2022年货】、【2021年货】、【2020年货】、【2019年货】、【2018年货】、【2017年货】等关键词,可查看美团技术团队历年技术文章合集。 | 本文系美团技术团队出品,著作权归属美团。欢迎出于分享和交流等非商业目的转载或使用本文内容,敬请注明"内容转载自美团技术团队"。本文未经许可,不得进行商业性转载或者使用。任何商用行为,请发送邮件至 tech@meituan.com 申请授权。

资源下载

更多资源
优质分享App

优质分享App

近一个月的开发和优化,本站点的第一个app全新上线。该app采用极致压缩,本体才4.36MB。系统里面做了大量数据访问、缓存优化。方便用户在手机上查看文章。后续会推出HarmonyOS的适配版本。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

用户登录
用户注册