java源码学习---HashMap
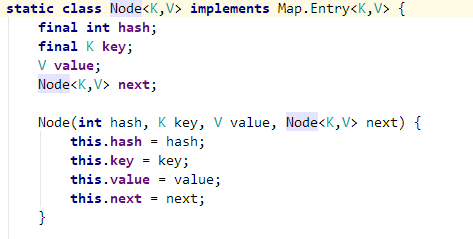
开门见山,直接干 HashMap是java常用的一个集合,每个元素的key经过哈希算法后储存在链表或红黑树的一种键值对数据集合(JDK1.8) 从HashMap新增元素说起 map.put("key","value"); 这是我们日常向HashMap插入元素的其中一种方式,put(k,v)的源码 public V put(K key, V value) { return putVal(hash(key), key, value, false, true); } put()会再调用一个putVal(),但是在这之前key会通过hash()计算出对应位置的值,真正的put操作,就是从这里开始 final V putVal(int hash, K key, V value, boolean onlyIfAbsent, boolean evict) { Node<K,V>[] tab; Node<K,V> p; int n, i; if ((tab = table) == null || (n = tab.length) == 0) n = (tab = resize()).length; if ((p = tab[i = (n - 1) & hash]) == null) tab[i] = newNode(hash, key, value, null); else { Node<K,V> e; K k; if (p.hash == hash && ((k = p.key) == key || (key != null && key.equals(k)))) e = p; else if (p instanceof TreeNode) e = ((TreeNode<K,V>)p).putTreeVal(this, tab, hash, key, value); else { for (int binCount = 0; ; ++binCount) { if ((e = p.next) == null) { p.next = newNode(hash, key, value, null); if (binCount >= TREEIFY_THRESHOLD - 1) // -1 for 1st treeifyBin(tab, hash); break; } if (e.hash == hash && ((k = e.key) == key || (key != null && key.equals(k)))) break; p = e; } } if (e != null) { // existing mapping for key V oldValue = e.value; if (!onlyIfAbsent || oldValue == null) e.value = value; afterNodeAccess(e); return oldValue; } } ++modCount; if (++size > threshold) resize(); afterNodeInsertion(evict); return null; } 每个参数的含义 hash:key经过哈希算法之后获得的值 key:储存到HashMap的key value:储存到HashMap的key对应的value onlyIfAbsent:如果包含了该key,则不更新对应的值,众所周知,put()除了新增之外,还有更新的功能,是因为put()调用putVal()时候传的都是false evict:HashMap是否处于创建模式,false则是处于创建模式,ture则相反 在函数最开始定义了几个变量, Node<K,V>[] tab; Node<K,V> p; int n, i; if ((tab = table) == null || (n = tab.length) == 0) n = (tab = resize()).length; if ((p = tab[i = (n - 1) & hash]) == null) tab[i] = newNode(hash, key, value, null); tab:当前HashMap的一个操作副本, p:当前需要储存的元素或是当前相同数组下标的元素 n:当前HashMap的长度 i:当前元素储存的下标 Node<k,v>是HashMap的一个静态内部类,每一个键值对数据都是基于Node或TreeNode储存在HashMap Node: Node里面记录着当前元素的hash值、key、value还有下一个结点的地址 TreeNode: Node是TreeNode的父类,TreeNode还记录着父节点、左右子节点、 继续看下面的代码, 1.判断当前HashMap的容量大小,如果table是null或者容量为0会利用resize()进行扩容处理 2.判断tab[i](当前元素所储存的位置)是否为null,如果是null的情况下则直接保存到对应位置,并且把tab[i]赋值给p if ((tab = table) == null || (n = tab.length) == 0) n = (tab = resize()).length; if ((p = tab[i = (n - 1) & hash]) == null) tab[i] = newNode(hash, key, value, null); 如果tab[i]不为null我们继续往下看,有以下几种情况 1.当table(链表)已存在结点与当前需要保存结点的key相同时,则更新值 2.判断当前结点是否为TreeNode,如果属于TreeNode则进入红黑树的储存规则判断,如果树里已经存在相同的key则返回旧的结点,否则直接在树上新增一个结点并返回null 3.当table(链表)里不存在相同的key且hash值一致的位置不属于TreeNode而属于Node时,遍历每个结点,判断与当前保存结点的key是否一致,一致的时候更新,否则添加到下一个结点 3.1添加完成后,判断当前元素所在index是否 >=TREEIFY_THRESHOLD - 1,如果大于,则需要从链表转为红黑树 static final int TREEIFY_THRESHOLD = 8; else { Node<K,V> e; K k; if (p.hash == hash && ((k = p.key) == key || (key != null && key.equals(k)))) e = p; else if (p instanceof TreeNode) e = ((TreeNode<K,V>)p).putTreeVal(this, tab, hash, key, value); else { for (int binCount = 0; ; ++binCount) { if ((e = p.next) == null) { p.next = newNode(hash, key, value, null); if (binCount >= TREEIFY_THRESHOLD - 1) // -1 for 1st treeifyBin(tab, hash); break; } if (e.hash == hash && ((k = e.key) == key || (key != null && key.equals(k)))) break; p = e; } } if (e != null) { // existing mapping for key V oldValue = e.value; if (!onlyIfAbsent || oldValue == null) e.value = value; afterNodeAccess(e); return oldValue; } } 上面第1和第2点赋值的"e"如果不为null,则在此处进行更新操作并且返回旧值 if (e != null) { // existing mapping for key V oldValue = e.value; if (!onlyIfAbsent || oldValue == null) e.value = value; afterNodeAccess(e); return oldValue; } 最后就是容量记录和扩容操作,如果是新增元素,HashMap会记录当前的容量,判断当前容量是否达到了需要扩容的阈值从而觉得是否进行扩容操作 ++modCount; if (++size > threshold) resize(); afterNodeInsertion(evict); return null; 总结: 1.利用hash()对储存的key做散列算法获得哈希值 2.新增元素时候,会判断当前HashMap的容量是否为0或者null,如果是则先进行扩容操作 3.当前hash值所在的链表或者树是否具有相同的key,没有则直接根据链表或红黑树的规则新增,否则修改结点的value并且把旧值返回 4.当其中一个链表长度大于等于8时候,会利用treeifyBin()转换成红黑树 5.新增成功之后会判断当前HashMap的容量是否达到了需要扩容的阈值,并决定是否需要扩容,决定是否扩容的阈值不是HashMap的容量最大值 删除 remove() public V remove(Object key) { Node<K,V> e; return (e = removeNode(hash(key), key, null, false, true)) == null ? null : e.value; } 根据对key做hash计算,并且调用removeNode()执行删除,如果能命中则返回删除的key对应的value final Node<K,V> removeNode(int hash, Object key, Object value, boolean matchValue, boolean movable) { Node<K,V>[] tab; Node<K,V> p; int n, index; if ((tab = table) != null && (n = tab.length) > 0 && (p = tab[index = (n - 1) & hash]) != null) { Node<K,V> node = null, e; K k; V v; if (p.hash == hash && ((k = p.key) == key || (key != null && key.equals(k)))) node = p; else if ((e = p.next) != null) { if (p instanceof TreeNode) node = ((TreeNode<K,V>)p).getTreeNode(hash, key); else { do { if (e.hash == hash && ((k = e.key) == key || (key != null && key.equals(k)))) { node = e; break; } p = e; } while ((e = e.next) != null); } } if (node != null && (!matchValue || (v = node.value) == value || (value != null && value.equals(v)))) { if (node instanceof TreeNode) ((TreeNode<K,V>)node).removeTreeNode(this, tab, movable); else if (node == p) tab[index] = node.next; else p.next = node.next; ++modCount; --size; afterNodeRemoval(node); return node; } } return null; } 参数含义: hash:利用hash()对key进行计算得出的结果 key:需要删除的key value:需要删除key对呀的value matchValue:是否需要匹配值相等,如果为ture则需要value相等才删除,否则不需要value相等 movable:是否移动树结点,为true时删除树时候移动结点,否则不移动结点 开始逐句解读: 1.判断当前HashMap是否为null或者元素数量为0, 2.判断当前储存在与key的hash值相同位置的结点是否为null,并且赋值hash相同的首个元素给 p 当上面其中一点不满足的情况下,则代表HashMap无当前需要删除的key,则直接返回null if ((tab = table) != null && (n = tab.length) > 0 && (p = tab[index = (n - 1) & hash]) != null) { 如果满足则继续往下执行,判断当前p的key是否与删除的key相同,相同则把值赋给变量node,最后对node进行删除操作 Node<K,V> node = null, e; K k; V v; if (p.hash == hash && ((k = p.key) == key || (key != null && key.equals(k)))) node = p; 上面key如果不一样则会遍历整个链表或者红黑树,找到相同元素赋值给变量node,后续进行删除操作 else if ((e = p.next) != null) { if (p instanceof TreeNode) node = ((TreeNode<K,V>)p).getTreeNode(hash, key); else { do { if (e.hash == hash && ((k = e.key) == key || (key != null && key.equals(k)))) { node = e; break; } p = e; } while ((e = e.next) != null); } } 最后是判断有没有找到需要删除的node,并且判断key对呀的value是否需要相等与是否相等,相等则进行删除操作 如果是树结点,则按照红黑树的删除规则进行删除 如果是链表,则按照链表的删除规则进行删除 删除成功后记录当前元素数量,并且把删除的结点返回 不过源码中没找到有删除元素后重置容量的代码,这点与预想的有点不一样 if (node != null && (!matchValue || (v = node.value) == value || (value != null && value.equals(v)))) { if (node instanceof TreeNode) ((TreeNode<K,V>)node).removeTreeNode(this, tab, movable); else if (node == p) tab[index] = node.next; else p.next = node.next; ++modCount; --size; afterNodeRemoval(node); return node; } 扩容 resize() 在新增元素或者我new HashMap()的时候,我们都会调用到resize() 当容器容量达到一个需要扩容的阈值时,就会调用resize()进行扩容操作 先看一下HashMap定义的属性 1.扩容阈值,当容量大于该阈值时,HashMap会进行扩容操作 int threshold; 2.HashMap的最大容量:1073741824 static final int MAXIMUM_CAPACITY = 1 << 30; 3.HashMap默认初始容量:16 static final int DEFAULT_INITIAL_CAPACITY = 1 << 4; 4.负载因子,主要用于计算扩容阈值,扩容阈值 = 负载因子 * 当前容量 static final float DEFAULT_LOAD_FACTOR = 0.75f; 接下来是resize()的源码 final Node<K,V>[] resize() { Node<K,V>[] oldTab = table; int oldCap = (oldTab == null) ? 0 : oldTab.length; int oldThr = threshold; int newCap, newThr = 0; if (oldCap > 0) { if (oldCap >= MAXIMUM_CAPACITY) { threshold = Integer.MAX_VALUE; return oldTab; } else if ((newCap = oldCap << 1) < MAXIMUM_CAPACITY && oldCap >= DEFAULT_INITIAL_CAPACITY) newThr = oldThr << 1; // double threshold } else if (oldThr > 0) // initial capacity was placed in threshold newCap = oldThr; else { // zero initial threshold signifies using defaults newCap = DEFAULT_INITIAL_CAPACITY; newThr = (int)(DEFAULT_LOAD_FACTOR * DEFAULT_INITIAL_CAPACITY); } if (newThr == 0) { float ft = (float)newCap * loadFactor; newThr = (newCap < MAXIMUM_CAPACITY && ft < (float)MAXIMUM_CAPACITY ? (int)ft : Integer.MAX_VALUE); } threshold = newThr; @SuppressWarnings({"rawtypes","unchecked"}) Node<K,V>[] newTab = (Node<K,V>[])new Node[newCap]; table = newTab; if (oldTab != null) { for (int j = 0; j < oldCap; ++j) { Node<K,V> e; if ((e = oldTab[j]) != null) { oldTab[j] = null; if (e.next == null) newTab[e.hash & (newCap - 1)] = e; else if (e instanceof TreeNode) ((TreeNode<K,V>)e).split(this, newTab, j, oldCap); else { // preserve order Node<K,V> loHead = null, loTail = null; Node<K,V> hiHead = null, hiTail = null; Node<K,V> next; do { next = e.next; if ((e.hash & oldCap) == 0) { if (loTail == null) loHead = e; else loTail.next = e; loTail = e; } else { if (hiTail == null) hiHead = e; else hiTail.next = e; hiTail = e; } } while ((e = next) != null); if (loTail != null) { loTail.next = null; newTab[j] = loHead; } if (hiTail != null) { hiTail.next = null; newTab[j + oldCap] = hiHead; } } } } } return newTab; } 首先定义了各种变量,当前HashMap的副本、当前副本容量(旧容量)、当前副本扩容阈值(旧扩容阈值)、新的扩容阈值、新的容量 Node<K,V>[] oldTab = table; int oldCap = (oldTab == null) ? 0 : oldTab.length; int oldThr = threshold; int newCap, newThr = 0; 判断当前容量是否大于0 1.如果大于0并且容量大于容器最大容量,则不再扩容 2.如果少于最大容量且大于初始容量,则扩大2倍且扩容因子也扩大2倍 if (oldCap > 0) { if (oldCap >= MAXIMUM_CAPACITY) { threshold = Integer.MAX_VALUE; return oldTab; } else if ((newCap = oldCap << 1) < MAXIMUM_CAPACITY && oldCap >= DEFAULT_INITIAL_CAPACITY) newThr = oldThr << 1; // double threshold } 当前容量是否<=0时再判断当前扩容阈值是否大于0,大于0则新容量=旧阈值 当前容量和阈值=0时,基本可以判断这个HashMap是第一次初始化容量,所以直接用默认的初始化容量,和第一次计算扩容阈值(负载因子*当前容量) else if (oldThr > 0) // initial capacity was placed in threshold newCap = oldThr; else { // zero initial threshold signifies using defaults newCap = DEFAULT_INITIAL_CAPACITY; newThr = (int)(DEFAULT_LOAD_FACTOR * DEFAULT_INITIAL_CAPACITY); } 获取到最新容量和最新的扩容阈值时候,就开始对旧table进行扩容(新建一个数组,再把旧table的结点重新储存到新的数组) threshold = newThr; @SuppressWarnings({"rawtypes","unchecked"}) Node<K,V>[] newTab = (Node<K,V>[])new Node[newCap]; table = newTab; 这一段则是把旧table上的结点重新储存到新table上 if (oldTab != null) { for (int j = 0; j < oldCap; ++j) { Node<K,V> e; if ((e = oldTab[j]) != null) { oldTab[j] = null; if (e.next == null) newTab[e.hash & (newCap - 1)] = e; else if (e instanceof TreeNode) ((TreeNode<K,V>)e).split(this, newTab, j, oldCap); else { // preserve order Node<K,V> loHead = null, loTail = null; Node<K,V> hiHead = null, hiTail = null; Node<K,V> next; do { next = e.next; if ((e.hash & oldCap) == 0) { if (loTail == null) loHead = e; else loTail.next = e; loTail = e; } else { if (hiTail == null) hiHead = e; else hiTail.next = e; hiTail = e; } } while ((e = next) != null); if (loTail != null) { loTail.next = null; newTab[j] = loHead; } if (hiTail != null) { hiTail.next = null; newTab[j + oldCap] = hiHead; } } } } } 总结: 1.如果是新创建的HashMap初始化容量为16,每扩容一次则是原容量的2倍 2.触发扩容并不是当容量达到最大值才进行扩容,而是达到某个阈值而进行扩容 3.当容量达到HashMap的最大容量值时,将不再继续扩容 4.每次扩容结点都会重新储存到新的容器,资源消耗比较大