首页 文章 精选 留言 我的

精选列表

搜索[监督学习],共10000篇文章
优秀的个人博客,低调大师

Kubernetes架构学习笔记

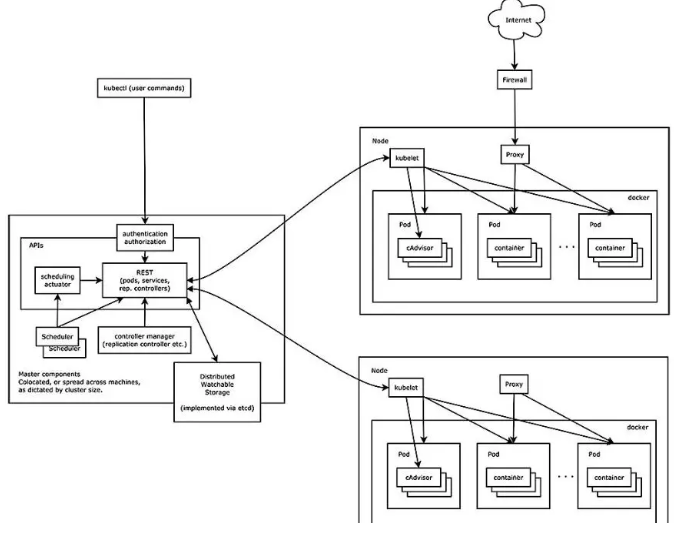
Kubernetes是Google开源的容器集群管理系统,其提供应用部署、维护、 扩展机制等功能,利用Kubernetes能方便地管理跨机器运行容器化的应用,是Docker分布式系统的解决方案。k8s里所有的资源都可以用yaml或Json定义。 1 K8s基本概念 1.1 Master Master节点负责整个集群的控制和管理,所有的控制命令都是发给它,上面运行着一组关键进程: kube-apiserver:提供了HTTP REST接口,是k8s所有资源增删改查等操作的唯一入口,也是集群控制的入口。 kube-controller-manager:所有资源的自动化控制中心。当集群状态与期望不同时,kcm会努力让集群恢复期望状态,比如:当一个pod死掉,kcm会努力新建一个pod来恢复对应replicas set期望的状态。 kube-scheduler:负责Pod的调度。 实际上,Master只是一个名义上的概念,三个关键的服务不一定需要运行在一个节点上。 1.1.1 API Server的原理 集群中的各个功能模块通过 apiserver将信息存储在Etcd,当需要修改这些信息的时候通过其REST接口来实现。 1.1.2 Controller Manager的原理 内部包含: Replication Controller Node Controller ResourceQuota Controller Namespace Controller ServiceAccount Controller Token Controller Service Controller Endpoint Controller等 这些Controller通过API Server实时监控各个资源的状态,当有资源因为故障导致状态变化,Controller就会尝试将系统由“现有状态”恢复到“期待状态”。 1.1.3 Scheduler的原理 作用是将apiserver或controller manager创建的Pod调度和绑定到具体的Node上,一旦绑定,就由Node上的kubelet接手Pod的接下来的生命周期管理。 1.2 Node Node是工作负载节点,运行着Master分配的负载(Pod),但一个Node宕机时,其上的负载会被自动转移到其他Node上。其上运行的关键组件是: kubelet:负责Pod的生命周期管理,同时与Master密切协作,实现集群管理的基本功能。 kube-proxy:实现Service的通信与负载均衡机制的重要组件,老版本主要通过设置iptables规则实现,新版1.9基于kube-proxy-lvs 实现。 Docker Engine:Docker引擎,负责Docker的生命周期管理。 1.2.1 kube-proxy的原理 每个Node上都运行着一个kube-proxy进程,它在本地建立一个SocketServer接收和转发请求,可以看作是Service的透明代理和负载均衡器,负载均衡策略模式是Round Robin。也可以设置会话保持,策略使用的是“ClientIP”,将同一个ClientIP的请求转发同一个Endpoint上。 Service的Cluster IP和NodePort等概念都是kube-proxy服务通过Iptables的NAT转换实现,Iptables机制针对的是kube-proxy监听的端口,所以每个Node上都要有kube-proxy。 1.2.2 kubelet原理 每个Node都会启动一个kubelet,主要作用有: (1)Node管理 注册节点信息; 通过cAdvisor监控容器和节点的资源; 定期向Master(实际上是apiserver)汇报本节点资源消耗情况 (2)Pod管理 所以非通过apiserver方式创建的Pod叫Static Pod,这里我们讨论的都是通过apiserver创建的普通Pod。kubelet通过apiserver监听etcd,所有针对Pod的操作都会被监听到,如果其中有涉及到本节点的Pod,则按照要求进行创建、修改、删除等操作。 (3)容器健康检查 kubelet通过两类探针检查容器的状态: LivenessProbe:判断一个容器是否健康,如果不健康则会删除这个容器,并按照restartPolicy看是否重启这个容器。实现的方式有ExecAction(在容器内部执行一个命令)、TCPSocketAction(如果端口可以被访问,则健康)、HttpGetAction(如果返回200则健康)。 ReadinessProbe:用于判断容器是否启动完全。如果返回的是失败,则Endpoint Controller会将这个Pod的Endpoint从Service的Endpoint列表中删除。也就是,不会有请求转发给它。 1.3 Pod Pod是k8s进行资源调度的最小单位,每个Pod中运行着一个或多个密切相关的业务容器,这些业务容器共享这个Pause容器的IP和Volume,我们以这个不易死亡的Pause容器作为Pod的根容器,以它的状态表示整个容器组的状态。一个Pod一旦被创建就会放到Etcd中存储,然后由Master调度到一个Node绑定,由这个Node上的Kubelet进行实例化。 每个Pod会被分配一个单独的Pod IP,Pod IP + ContainerPort 组成了一个Endpoint。 1.4 Service K8s中一个Service相当于一个微服务的概念,一个Service对应后端多个Pod计算实例,使用LabelSelector将一类Pod都绑定到自己上来。一般还会需要一个Deployment或者RC来帮助这个Service来保证这个Service的服务能力和质量。 1.4.1 kube-proxy负载均衡 运行在每个Node上的kube-proxy其实就是一个智能的软件负载均衡器,它负载将发给Service的请求转发到后端对应的Pod,也就是说它负责会话保持和负责均衡。 1.4.2 Cluster IP 负载均衡的基础是负载均衡器要维护一个后端Endpoint列表,但是Pod的Endpoint会随着Pod的销毁和重建而改变,k8s使这个问题透明化。一旦Service被创建,就会立刻分配给它一个Cluster IP,在Service的整个生命周期内,这个Cluster IP不会改变。于是,服务发现的问题也解决了:只要用Service Name和Service Cluster IP做一个DNS域名映射就可以了。 1.4.3 DNS 从Kubernetes 1.3开始,DNS通过使用插件管理系统cluster add-on,成为了一个内建的自启动服务。Kubernetes DNS在Kubernetes集群上调度了一个DNS Pod和Service,并配置kubelet,使其告诉每个容器使用DNS Service的IP来解析DNS名称。 (1)Service 集群中定义的每个Service(包括DNS Service它自己)都被分配了一个DNS名称。默认的,Pod的DNS搜索列表中会包含Pod自己的命名空间和集群的默认域,下面我们用示例来解释以下。 假设有一个名为foo的Service,位于命名空间bar中。运行在bar命名空间中的Pod可以通过DNS查找foo关键字来查找到这个服务,而运行在命名空间quux中的Pod可以通过关键字foo.bar来查找到这个服务。 普通(非headless)的Service都被分配了一个DNS记录,该记录的名称格式为my-svc.my-namespace.svc.cluster.local,通过该记录可以解析出服务的集群IP。 Headless(没有集群IP)的Service也被分配了一个DNS记录,名称格式为my-svc.my-namespace.svc.cluster.local。与普通Service不同的是,它会解析出Service选择的Pod的IP列表。 (2)Pod Pod也可以使用DNS服务。pod会被分配一个DNS记录,名称格式为pod-ip-address.my-namespace.pod.cluster.local。 比如,一个pod,它的IP地址为1.2.3.4,命名空间为default,DNS名称为cluster.local,那么它的记录就是:1-2-3-4.default.pod.cluster.local。 当pod被创建时,它的hostname设置在Pod的metadata.name中。 在v1.2版本中,用户可以指定一个Pod注解,pod.beta.kubernetes.io/hostname,用于指定Pod的hostname。这个Pod注解,一旦被指定,就将优先于Pod的名称,成为pod的hostname。比如,一个Pod,其注解为pod.beta.kubernetes.io/hostname: my-pod-name,那么该Pod的hostname会被设置为my-pod-name。 v1.2中还引入了一个beta特性,用户指定Pod注解,pod.beta.kubernetes.io/subdomain,来指定Pod的subdomain。比如,一个Pod,其hostname注解设置为“foo”,subdomain注解为“bar”,命名空间为“my-namespace”,那么它最终的FQDN就是“foo.bar.my-namespace.svc.cluster.local”。 在v1.3版本中,PodSpec有了hostname和subdomain字段,用于指定Pod的hostname和subdomain。它的优先级则高于上面提到的pod.beta.kubernetes.io/hostname和pod.beta.kubernetes.io/subdomain。 1.4.4 外部访问Service的问题 先明确这样几个IP: Node IP:Node主机的IP,与它是否属于K8s无关。 Pod IP:是Dokcer Engine通过docker0网桥的IP地址段进行分配的,通常是一个虚拟的二层网络。k8s中一个Pod访问另一个Pod就是通过Pod IP。 Cluster IP:仅用于Service对象,属于k8s的内部IP,外界无法直接访问。 (1)NodePort 在Service的yaml中定义NodePort,k8s为集群中每个Node都增加对这个端口的监听,使用这种方式往往需要一个独立与k8s之外的负载均衡器作为流量的入口。 (2)使用External IP 运行Hello World应用程序的五个实例。 创建一个暴露外部IP地址的Service对象。 使用Service对象访问正在运行的应用程序。 使用deployment创建暴露的Service对象: ~ kubectl expose deployment hello-world --type=LoadBalancer --name=my-service 显示关于Service的信息: ~ kubectl get services my-service NAME CLUSTER-IP EXTERNAL-IP PORT(S) AGE my-service 10.3.245.137 104.198.205.71 8080/TCP 54s ~ kubectl describe services my-service Name: my-service Namespace: default Labels: run=load-balancer-example Selector: run=load-balancer-example Type: LoadBalancer IP: 10.3.245.137 LoadBalancer Ingress: 104.198.205.71 Port: <unset> 8080/TCP NodePort: <unset> 32377/TCP Endpoints: 10.0.0.6:8080,10.0.1.6:8080,10.0.1.7:8080 + 2 more... Session Affinity: None Events: 在此例子中,外部IP地址为104.198.205.71。还要注意Port的值。在这个例子中,端口是8080。在上面的输出中,您可以看到该服务有多个端点:10.0.0.6:8080,10.0.1.6:8080,10.0.1.7:8080 + 2 more…。这些是运行Hello World应用程序的pod的内部地址。 使用外部IP地址访问Hello World应用程序: ~ curl http://<external-ip>:<port> Hello Kubernetes! 删除服务 ~ kubectl delete services my-service ~ kubectl delete deployment hello-world 1.5 Ingress 通常情况下,service和pod仅可在集群内部网络中通过IP地址访问。所有到达边界路由器的流量或被丢弃或被转发到其他地方。Ingress是授权入站连接到达集群服务的规则集合。你可以给Ingress配置提供外部可访问的URL、负载均衡、SSL、基于名称的虚拟主机等。用户通过POST Ingress资源到API server的方式来请求ingress。 Ingress controller负责实现Ingress,通常使用负载平衡器,它还可以配置边界路由和其他前端,这有助于以HA方式处理流量。 最简化的Ingress配置: apiVersion: extensions/v1beta1 kind: Ingress metadata: name: test-ingress spec: rules: - http: paths: - path: /testpath backend: serviceName: test servicePort: 80 - path: /bar backend: serviceName: s2 servicePort: 80 1-4行:跟Kubernetes的其他配置一样,ingress的配置也需要apiVersion,kind和metadata字段。配置文件的详细说明请查看部署应用, 配置容器和 使用resources. 5-7行: Ingress spec 中包含配置一个loadbalancer或proxy server的所有信息。最重要的是,它包含了一个匹配所有入站请求的规则列表。目前ingress只支持http规则。 8-9行:每条http规则包含以下信息:一个host配置项(比如for.bar.com,在这个例子中默认是*),path列表(比如:/testpath),每个path都关联一个backend(比如test:80)。在loadbalancer将流量转发到backend之前,所有的入站请求都要先匹配host和path。 10-12行:backend是一个service:port的组合。Ingress的流量被转发到它所匹配的backend。 配置TLS证书 你可以通过指定包含TLS私钥和证书的secret来加密Ingress。 目前,Ingress仅支持单个TLS端口443,并假定TLS termination。 如果Ingress中的TLS配置部分指定了不同的主机,则它们将根据通过SNI TLS扩展指定的主机名(假如Ingress controller支持SNI)在多个相同端口上进行复用。 TLS secret中必须包含名为tls.crt和tls.key的密钥,这里面包含了用于TLS的证书和私钥,例如: (1)创建Secret apiVersion: v1 data: tls.crt: base64 encoded cert tls.key: base64 encoded key kind: Secret metadata: name: testsecret namespace: default type: Opaque (2)创建Ingress: apiVersion: extensions/v1beta1 kind: Ingress metadata: name: no-rules-map spec: tls: - secretName: testsecret backend: serviceName: s1 servicePort: 80 2 高可用 Kubernetes服务本身的稳定运行对集群管理至关重要,影响服务稳定的因素一般来说分为两种,一种是服务本身异常或者服务所在机器宕机,另一种是因为网络问题导致的服务不可用。本文将从存储层、管理层、接入层三个方面介绍高可用Kubernetes集群的原理。 2.1 Etcd高可用方案 Kubernetes的存储层使用的是Etcd。Etcd是CoreOS开源的一个高可用强一致性的分布式存储服务,Kubernetes使用Etcd作为数据存储后端,把需要记录的pod、rc、service等资源信息存储在Etcd中。 Etcd使用raft算法将一组主机组成集群,raft 集群中的每个节点都可以根据集群运行的情况在三种状态间切换:follower, candidate 与 leader。leader 和 follower 之间保持心跳。如果follower在一段时间内没有收到来自leader的心跳,就会转为candidate,发出新的选主请求。 集群初始化的时候内部的节点都是follower节点,之后会有一个节点因为没有收到leader的心跳转为candidate节点,发起选主请求。当这个节点获得了大于一半节点的投票后会转为leader节点。当leader节点服务异常后,其中的某个follower节点因为没有收到leader的心跳转为candidate节点,发起选主请求。只要集群中剩余的正常节点数目大于集群内主机数目的一半,Etcd集群就可以正常对外提供服务。 当集群内部的网络出现故障集群可能会出现“脑裂”问题,这个时候集群会分为一大一小两个集群(奇数节点的集群),较小的集群会处于异常状态,较大的集群可以正常对外提供服务。 2.2 Master高可用方案 Master上有三个关键的服务:apiserver、controller-manager和scheduler,这三个不一定要运行在一台主机上。 2.2.1 controller-manager和scheduler的选举配置 Kubernetes的管理层服务包括kube-scheduler和kube-controller-manager。kube-scheduer和kube-controller-manager使用一主多从的高可用方案,在同一时刻只允许一个服务处以具体的任务。Kubernetes中实现了一套简单的选主逻辑,依赖Etcd实现scheduler和controller-manager的选主功能。 如果scheduler和controller-manager在启动的时候设置了leader-elect参数,它们在启动后会先尝试获取leader节点身份,只有在获取leader节点身份后才可以执行具体的业务逻辑。它们分别会在Etcd中创建kube-scheduler和kube-controller-manager的endpoint,endpoint的信息中记录了当前的leader节点信息,以及记录的上次更新时间。leader节点会定期更新endpoint的信息,维护自己的leader身份。每个从节点的服务都会定期检查endpoint的信息,如果endpoint的信息在时间范围内没有更新,它们会尝试更新自己为leader节点 scheduler服务以及controller-manager服务之间不会进行通信,利用Etcd的强一致性,能够保证在分布式高并发情况下leader节点的全局唯一性。整体方案如下图所示: 当集群中的leader节点服务异常后,其它节点的服务会尝试更新自身为leader节点,当有多个节点同时更新endpoint时,由Etcd保证只有一个服务的更新请求能够成功。通过这种机制sheduler和controller-manager可以保证在leader节点宕机后其它的节点可以顺利选主,保证服务故障后快速恢复。当集群中的网络出现故障时对服务的选主影响不是很大,因为scheduler和controller-manager是依赖Etcd进行选主的,在网络故障后,可以和Etcd通信的主机依然可以按照之前的逻辑进行选主,就算集群被切分,Etcd也可以保证同一时刻只有一个节点的服务处于leader状态。 2.2.2 apiserver的高可用 Kubernetes的接入层服务主要是kube-apiserver。apiserver本身是无状态的服务,它的主要任务职责是把资源数据存储到Etcd中,后续具体的业务逻辑是由scheduler和controller-manager执行的。所以可以同时起多个apiserver服务,使用nginx把客户端的流量转发到不同的后端apiserver上实现接入层的高可用。具体的实现如下图所示: 接入层的高可用分为两个部分,一个部分是多活的apiserver服务,另一个部分是一主一备的nginx服务。 2.3 Keepalived简介 Keepalived软件起初是专为LVS负载均衡软件设计的,用来管理并监控LVS集群系统中各个服务节点的状态,后来又加入了可以实现高可用的VRRP功能。因此,Keepalived除了能够管理LVS软件外,还可以作为其他服务(例如:Nginx、Haproxy、MySQL等)的高可用解决方案软件。Keepalived软件主要是通过VRRP协议实现高可用功能的。VRRP是Virtual Router RedundancyProtocol(虚拟路由器冗余协议)的缩写,VRRP出现的目的就是为了解决静态路由单点故障问题的,它能够保证当个别节点宕机时,整个网络可以不间断地运行。所以,Keepalived 一方面具有配置管理LVS的功能,同时还具有对LVS下面节点进行健康检查的功能,另一方面也可实现系统网络服务的高可用功能。 故障切换转移原理 Keepalived高可用服务对之间的故障切换转移,是通过 VRRP (Virtual Router Redundancy Protocol ,虚拟路由器冗余协议)来实现的。在 Keepalived服务正常工作时,主 Master节点会不断地向备节点发送(多播的方式)心跳消息,用以告诉备Backup节点自己还活看,当主 Master节点发生故障时,就无法发送心跳消息,备节点也就因此无法继续检测到来自主 Master节点的心跳了,于是调用自身的接管程序,接管主Master节点的 IP资源及服务。而当主 Master节点恢复时,备Backup节点又会释放主节点故障时自身接管的IP资源及服务,恢复到原来的备用角色。 3 容器网络 3.1 docker默认容器网络 在默认情况下会看到三个网络,它们是Docker Deamon进程创建的。它们实际上分别对应了Docker过去的三种『网络模式』,可以使用docker network ls来查看: master@ubuntu:~$ sudo docker network ls NETWORK ID NAME DRIVER SCOPE 18d934794c74 bridge bridge local f7a7b763f013 host host local 697354257ae3 none null local 这 3 个网络包含在 Docker 实现中。运行一个容器时,可以使用 the –net标志指定您希望在哪个网络上运行该容器。您仍然可以使用这 3 个网络。 bridge 网络表示所有 Docker 安装中都存在的 docker0 网络。除非使用 docker run –net=选项另行指定,否则 Docker 守护进程默认情况下会将容器连接到此网络。在主机上使用 ifconfig命令,可以看到此网桥是主机的网络堆栈的一部分。 none 网络在一个特定于容器的网络堆栈上添加了一个容器。该容器缺少网络接口。 host 网络在主机网络堆栈上添加一个容器。您可以发现,容器中的网络配置与主机相同。 3.2 跨主机通信的方案 和host共享network namespace 这种接入模式下,不会为容器创建网络协议栈,即容器没有独立于host的network namespace,但是容器的其他namespace(如IPC、PID、Mount等)还是和host的namespace独立的。容器中的进程处于host的网络环境中,与host共用L2-L4的网络资源。该方式的优点是,容器能够直接使用host的网络资源与外界进行通信,没有额外的开销(如NAT),缺点是网络的隔离性差,容器和host所使用的端口号经常会发生冲突。 和host共享物理网卡 2与1的区别在于,容器和host共享物理网卡,但容器拥有独立于host的network namespace,容器有自己的MAC地址、IP地址、端口号。这种接入方式主要使用SR-IOV技术,每个容器被分配一个VF,直接通过PCIe网卡与外界通信,优点是旁路了host kernel不占任何计算资源,而且IO速度较快,缺点是VF数量有限且对容器迁移的支持不足。 Behind the POD 这种方式是Google在Kubernetes中的设计中提出来的。Kubernetes中,POD是指一个可以被创建、销毁、调度、管理的最小的部署单元,一个POD有一个基础容器以及一个或一组应用容器,基础容器对应一个独立的network namespace并拥有一个其它POD可见的IP地址(以IP A.B.C.D指代),应用容器间则共享基础容器的network namespace(包括MAC、IP以及端口号等),还可以共享基础容器的其它的namespace(如IPC、PID、Mount等)。POD作为一个整体连接在host的vbridge/vswitch上,使用IP地址A.B.C.D与其它POD进行通信,不同host中的POD处于不同的subnet中,同一host中的不同POD处于同一subnet中。这种方式的优点是一些业务上密切相关的容器可以共享POD的全部资源(它们一般不会产生资源上的冲突),而这些容器间的通信高效便利。 3.3 Flannel 在k8s的网络设计中,服务以POD为单位,每个POD的IP地址,容器通过Behind the POD方式接入网络(见“容器的网络模型”),一个POD中可包含多个容器,这些容器共享该POD的IP地址。另外,k8s要求容器的IP地址都是全网可路由的,那么显然docker0+iptables的NAT方案是不可行的。 实现上述要求其实有很多种组网方法,Flat L3是一种(如Calico),Hierarchy L3(如Romana)是一种,另外L3 Overlay也是可以的,CoreOS就采用L3 Overlay的方式设计了flannel, 并规定每个host下各个POD属于同一个subnet,不同的host/VM下的POD属于不同subnet。我们来看flannel的架构,控制平面上host本地的flanneld负责从远端的ETCD集群同步本地和其它host上的subnet信息,并为POD分配IP地址。数据平面flannel通过UDP封装来实现L3 Overlay,既可以选择一般的TUN设备又可以选择VxLAN设备(注意,由于图来源不同,请忽略具体的IP地址)。 flannel是CoreOS提供用于解决Dokcer集群跨主机通讯的覆盖网络工具。它的主要思路是:预先留出一个网段,每个主机使用其中一部分,然后每个容器被分配不同的ip;让所有的容器认为大家在同一个直连的网络,底层通过UDP/VxLAN等进行报文的封装和转发。 flannel默认使用8285端口作为UDP封装报文的端口,VxLan使用8472端口。那么一条网络报文是怎么从一个容器发送到另外一个容器的呢? 容器直接使用目标容器的ip访问,默认通过容器内部的eth0发送出去。 报文通过veth pair被发送到vethXXX。 vethXXX是直接连接到虚拟交换机docker0的,报文通过虚拟bridge docker0发送出去。 查找路由表,外部容器ip的报文都会转发到flannel0虚拟网卡,这是一个P2P的虚拟网卡,然后报文就被转发到监听在另一端的flanneld。 flanneld通过etcd维护了各个节点之间的路由表,把原来的报文UDP封装一层,通过配置的iface发送出去。 报文通过主机之间的网络找到目标主机。 报文继续往上,到传输层,交给监听在8285端口的flanneld程序处理。 数据被解包,然后发送给flannel0虚拟网卡。 查找路由表,发现对应容器的报文要交给docker0。 docker0找到连到自己的容器,把报文发送过去。 作者:奋起直追CDS 原文:https://blog.csdn.net/Dustin_CDS/article/details/79439596

优秀的个人博客,低调大师

Unity ShaderLab学习总结

本文只讨论Unity ShaderLab相关的知识和使用方法。但, 既不讨论渲染相关的基础概念,基础概念可参考Rendering Pipeline Overview等文章。也不讨论具体的渲染技巧移动设备GPU和桌面设备GPU硬件架构上有较多不同点,详见下面的“移动设备GPU架构简述”一章。一句话总结: GameObject里有MeshRenderer,MeshRenderer里有Material列表,每个Material里有且只有一个Shader;Material在编辑器暴露该Shader的可调属性。所以关键是怎么编写Shader。 Shader基础编辑器使用MonoDevelop这反人类的IDE来编写Shader居然是让人满意的。有语法高亮,无语法提示。如果习惯VisualStudio,可以如下实现.Shader文件的语法高亮。 下载作者donaldwu自己添加的关键词文件usertype.dat。其包括了Unity ShaderLab的部分关键字,和HLSL的所有关键字。关键字以后持续添加中。将下载的usertype.dat放到Microsoft Visual Studio xx.xCommonXIDE文件夹下;打开VS,工具>选项>文本编辑器>文件扩展名,扩展名里填“shader”,编辑器选VC++,点击添加;重启VS,Done。ShaderShader "ShaderLab Tutorials/TestShader"{// ...}Shader的名字会直接决定shader在material里出现的路径 SubShaderShader "ShaderLab Tutorials/TestShader" {SubShader{//...}}一个Shader有多个SubShader。一个SubShader可理解为一个Shader的一个渲染方案。即SubShader是为了针对不同的渲染情况而编写的。每个Shader至少1个SubShader、理论可以无限多个,但往往两三个就足够。一个时刻只会选取一个SubShader进行渲染,具体SubShader的选取规则包括: 从上到下选取SubShader的标签、Pass的标签是否符合当前的“Unity渲染路径”是否符合当前的ReplacementTagSubShader是否和当前的GPU兼容等按此规则第一个被选取的SubShader将会用于渲染,未被选取的SubShader在这次渲染将被忽略。 SubShader的TagShader "ShaderLab Tutorials/TestShader" {SubShader{Tags { "Queue"="Geometry+10" "RenderType"="Opaque" }//...}}SubShader内部可以有标签(Tags)的定义。Tag指定了这个SubShader的渲染顺序(时机),以及其他的一些设置。 "RenderType"标签。Unity可以运行时替换符合特定RenderType的所有Shader。Camera.RenderWithShader或Camera.SetReplacementShader配合使用。Unity内置的RenderType包括:"Opaque":绝大部分不透明的物体都使用这个;"Transparent":绝大部分透明的物体、包括粒子特效都使用这个;"Background":天空盒都使用这个;"Overlay":GUI、镜头光晕都使用这个;用户也可以定义任意自己的RenderType这个标签所取的值。应注意,Camera.RenderWithShader或Camera.SetReplacementShader不要求标签只能是RenderType,RenderType只是Unity内部用于Replace的一个标签而已,你也可以自定义自己全新的标签用于Replace。比如,你为自己的ShaderA.SubShaderA1(会被Unity选取到的SubShader,常为Shader文件中的第一个SubShader)增加Tag为"Distort"="On",然后将"Distort"作为参数replacementTag传给函数。此时,作为replacementShader实参的ShaderB.SubShaderB1中若有也有一模一样的"Distort"="On"、且这A的材质参数包含B所需材质参数,则此SubShaderB1将代替SubShaderA1用于本次渲染。具体可参考Rendering with Replaced Shaders"Queue"标签。定义渲染顺序。预制的值为"Background"。值为1000。比如用于天空盒。"Geometry"。值为2000。大部分物体在这个队列。不透明的物体也在这里。这个队列内部的物体的渲染顺序会有进一步的优化(应该是从近到远,early-z test可以剔除不需经过FS处理的片元)。其他队列的物体都是按空间位置的从远到近进行渲染。"AlphaTest"。值为2450。已进行AlphaTest的物体在这个队列。"Transparent"。值为3000。透明物体。"Overlay"。值为4000。比如镜头光晕。用户可以定义任意值,比如"Queue"="Geometry+10""ForceNoShadowCasting",值为"true"时,表示不接受阴影。"IgnoreProjector",值为"true"时,表示不接受Projector组件的投影。

优秀的个人博客,低调大师

Docker学习之路(三)

解决方法: yum install device-mapper-event-libs 然后重启docker服务 service docker restart 注意:此命令需要操作两次,第一次会重启失败 docker已经运行镜像删除方法 停止所有的container,这样才能够删除其中的images: docker stop $(docker ps -a -q) 如果想要删除所有container的话再加一个指令: docker rm $(docker ps -a -q) 查看当前有些什么images docker images 删除images,通过image的id来指定删除谁 docker rmi <image id> 想要删除untagged images,也就是那些id为的image的话可以用 docker rmi $(docker images | grep "^<none>" | awk "{print $3}") 要删除全部image的话 docker rmi $(docker images -q) Dockerfile制作镜像实例 下载jdk、tomcat安装包,上传/usr/local/soft目录下 jdk1.8下载:http://www.oracle.com/technetwork/java/javase/downloads/jdk8-downloads-2133151.html tomcat8下载:https://tomcat.apache.org/download-80.cgi 1. tar -zxvf apache-tomcat-8.5.38.tar.gz #解压tomcat 2. tar -zxvf jdk-8u201-linux-x64.tar.gz #解压jdk 3. rm -rf apache-tomcat-8.5.31.tar.gz #删除安装包 4. rm -rf jdk-8u171-linux-x64.tar.gz #删除安装包 5. touch Dockerfile #创建文件 一系列操作完成后 soft文件夹内容接下来编写dockerfile文件 #指定操作的镜像 FROM centos # 维护者信息 MAINTAINER shuai #将jdk1.8.0_171添加到镜像centos的/usr/local/soft/目录下,并命名为jdk ADD jdk1.8.0_201 /usr/local/soft/jdk #将apache-tomcat-8.5.31添加到镜像centos的/usr/local/soft/目录下,并命名为tomcat ADD apache-tomcat-8.5.38 /usr/local/soft/tomcat #添加环境变量 ENV JAVA_HOME /usr/local/soft/jdk ENV CATALINA_HOME /usr/local/soft/tomcat ENV PATH $PATH:$JAVA_HOME/bin:$CATALINA_HOME/bin #暴露8080端口 EXPOSE 8080 #启动时运行tomcat CMD ["/usr/local/soft/tomcat/bin/catalina.sh","run"] FROM : 指定基础镜像,并且必须是第一条指令 重点:此命令不可省略,然后如果docker容器中没有centos镜像,此操作会默认产生一个centos镜像 MAINTAINER : 指定作者 RUN : 运行指定的命令 ADD : 复制命令,把文件复制到镜像中。 ENV : 设置环境变量 EXPOSE : 功能为暴漏容器运行时的监听端口给外部 CMD : 指定容器启动时运行的命令 构建Docker镜像 docker build -t repostory/centos_tomcat . 注意:后面的点不要省略-t 设置tag名称, 命名规则registry/image:tag(若不添加版本号,默认latest). 表示使用当前目录下的Dockerfile文件(注意语句后面有一个点) 启动镜像访问 docker run -d -p 8080:8080 --name Icentos repostory/centos_tomcat -d 后台运行 -p 端口映射 宿主机port : 容器port --name 指定容器运行名称 接下来在浏览器中输入地址查看成功与否出现此界面就大功告成啦!

优秀的个人博客,低调大师

Docker学习之路(二)

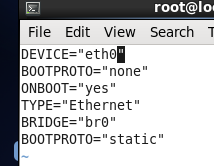
Docker独立IP及容器关联 内置 brldge (nat) 缺点:需要配套服务注册/发现,否则宿主上端口分配困难,容易冲突。由于每个容器暴露的端口都不一致,造成前端路由层nginx配置(peoxy_pass)里无法使用dns的方式。端口映射要在容器启动时就指定好,后期无法变更。nat不支持websocket。 自建桥接网络 优点:每个容器都有独立ip,对外提供服务,如nginx+php,都可以使用默认的80端口由于容器暴露端口都可以使用80端口,因此前端路由层nginx配置(proxy_pass)里可以使用dns的方式。无需为了后期端口映射添加而烦恼桥接支持websocket ---------以下操作是基于Centos6.5版本系统,Centos7以上没做实验 首先 关闭docker服务 service docker stop 删除docker0的网卡 ifconfig docker0 down brctl delbr docker0 进入网卡配置cd /etc/sysconfig/network-scripts/vi ifcfg-eth0 vi ifcfg-br0然后重启一下服务 /etc/init.d/network restart然后ping一下百度 试试成功与否然后 vi /etc/sysconfig/docker //修改docker为桥接模式然后 /etc/init.d/docker restart 注意操作两次 然后启动一个容器docker run -i -d -t centos /bin/bash然后 ifconfig查看 如果出现下图表示成功然后 docker ps查看容器id 然后 docker attach b66317f0d73b进入容器 然后查看ip,如果和主机ip相同网段表示成功!

优秀的个人博客,低调大师

Docker学习之路(一)

什么是Docker Docker是一个开源的应用容器引擎,让开发者可以打包他们的应用以及依赖包到一个可移植的容器中,然后发布到任何流行的Linux机器上,也可以实现虚拟化。Docker项目的目标是实现轻量级的操作系统虚拟化解决方案,Docker的基础是Linux容器(LXC)、Cgroup等技术 docker和传统虚拟化的区别 Docker和传统虚拟化(KVM、XEN)方式的不同之处是容器是在操作系统层面上实现虚拟化,直接复用本地主机的操作系统,而传统方式则是在硬件的基础上,虚拟出自己的系统,再在系统上部署相关的APP应用。 重点:Docker虚拟化有三个概念需要理解,分别镜像、容器、仓库。 1、镜像:docker的镜像其实就是模板,跟我们常见的ISO镜像类似,是一个模板。 2、仓库:仓库是存放镜像的地方,分为公开仓库(public)和私有仓库(private)两种形式 3、容器:容器是完全使用沙箱机制,相互之间不会有任何接口。几乎没有性能开销,可以很容易地在机器和数据中心中运行。最重要的是,他们不依赖于任何语言、框架或包括系统。 Docker虚拟化的安装 center7以上机器才能使用yum直接安装,如果其他版本需要安装centos扩展源epel。centos6.x系列安装Docker软件,首先要关闭selinux,然后需要安装相应的epel源,如下: 首先关闭selinux vi /etc/selinux/config 修改文件内容 ELINUX=disabled 然后命令行sestatus检查状态下载扩展包 wget http://download.fedoraproject.org/pub/epel/6/x86_64/epel-release-6-8.noarch.rpm 安装 rpm -ivh epel-release-6-8.noarch.rpm安装容器和资源限制 yum install lxc libcgroup安装docker yum install docker-io 注意:如果上面命令安装失败,可以用下面命令下载 yum install https://get.docker.com/rpm/1.7.1/centos-6/RPMS/x86_64/docker-engine-1.7.1-1.el6.x86_64.rpm 启动docker进程 /etc/init.d/docker start查看docker进程 ps -ef|grep docker下载tomcat镜像 docker pull tomcat 操作命令 查看镜像 docker images删除一个镜像 docker rm 镜像名 保存一个镜像 docker save 镜像名 > centos.jar导入一个镜像 docker load < nginx1.11.tar 导入容器 docker import - centos7导出容器 docker export i容器d >centos7.tar查看docker版本 docker version查看docker服务启动 ps -ef |grep docker查看容器状态 docker ps -l搜索可用docker镜像 docker search centos运行镜像 docker run centos关闭容器 docker stop id 启动某个容器 docker start id进入一个容器 docker attach id删除一个容器 docker rm id删除一个镜像 docker rmi images退出一个容器 exit 正常退出不关闭Ctrl+P+Q容器中安装ntpdate `docker run centos yum install ntpdate docker run -i -t centos(容器名称) /bin/bash 在容器里启动一个/bin/bash shell环境,可以登录进入操作,其中-t表示打开一个终端的意思,-i表示可以交互输入查看系统版本 cat /etc/redhat-release * 7.0以上系统的命令

优秀的个人博客,低调大师

spring-boot学习

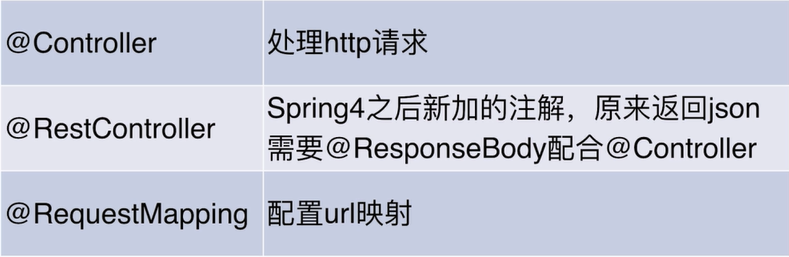
Controller的使用 注: 通常程序开发后端需要提供的是rest接口,返回一些json格式给前端,尽量不要使用模板的方式,使用模板会在性能上带来很大的损耗. 参数的获取 知识点整理 @Restcontroller和@controller的区别 如果使用@Restcontroller注解,就不能返回jsp,html页面,视图解析器无法解析jsp,html页面 @Controller注解,若返回json等内容到页面,则需要加@Response注解,而且需要页面返回 url映射可以是以集合的形式获取 例:@RequestMapping(value ={"/hello/","/hi"}) 获取一个id值 :@RequestMapping(value ={"/hello/{id}",method=RequestMethod.GET}) @PathVariable("id") 获取操作 导航栏: /hello/12也可以 12/hello @RequestParam("id") 获取操作 导航栏

优秀的个人博客,低调大师

Django学习笔记(一)

image.png 最近有个需求,老大让用 Django 来做,以前入门 Python 时就听过 Django 的大名,今日一见果然名不虚传~~~~。 特点 Django 最大的特点就是快速建站: 快速开发 内置应用 后台admin 用户认证系统auth 会话系统sessions 安全性高 表单验证 SQL注入 跨站点攻击 易于拓展 ....很多,这里不一一列举。 Django 应用(app)的概念 项目VS应用 项目与应用之间有什么不同之处?应用是一个提供功能的 Web 应用 – 例如:一个博客系统、一个公共记录的数据库或者一个简单的投票系统。 项目是针对一个特定的 Web 网站相关的配置和其应用的组合。一个项目可以包含多个应用。一个应用可以在多个项目中使用。 Django使用应用来分割功能,也就是app,每个应用分别为不同的app。 例如:我们创建一个电商网站,那么里边的购物车、用户管理、支付系统都可以成为独立的模块,也就是独立的三个app,这些模块可以用在别的网站中,不单单只针对于当前网站。 Django Demo Python版本2.7 Django版本1.8 查看已安装Django的版本:python -c "import django;print(django.get_version())" 创建一个名为web_Demo的Django项目 命令:django-admin startproject web_Demo 完成后,查看目录结构: image.png manage.py : 一个实用的命令行工具,可以让你以各种方式与该Django项目交互。可以在django-admin.py和manage.py查看源码的细节。 settings.py : 该项目的配置文件。 urls.py : 该项目的URL生明。 wsgi.py : 一个WSGI兼容的Web服务器入口。 接着,创建一个名为blog的应用(app):python manage.py startapp blog 查看新的目录结构: image.png 应用模块中各文件的作用: migrations:数据迁移模块 admin.py : 该应用的后台管理系统配置文件 apps.py : 当前应用的一些配置,1.9版本后才会自动生成,1.8 1.7都不会自动生成 models.py : 数据模型 使用ORM框架 django已经有所封装 tests.py : 自动化测试模块 views.py : 执行响应的逻辑代码,代码逻辑处理的主要地点,项目中大部分代码都在这里编写 然后,把blog app添加到配置文件中: 编辑settings.py: INSTALLED_APPS = ( 'django.contrib.admin', 'django.contrib.auth', 'django.contrib.contenttypes', 'django.contrib.sessions', 'django.contrib.messages', 'django.contrib.staticfiles', 'blog' ) 解释一下上边的配置信息代表什么意思: admin :身份验证系统 auth : contenttypes:内容类型框架 sessions :session框架 messages :消息框架 staticfiles :静态文件框架 再执行命令python manage.py migrate image.png 完成。 Admin Admin是Django自带的一个功能强大的自动化数据管理界面,被授权的用户可直接在admin中管理数据库。 Django提供了许多针对Admin的定制功能。 首先,创建超级用户查看admin系统:python manage.py createsuperuser 输入用户名、邮箱、密码,这里密码要难一些,简单的密码可能会不行。 image.png 启动web项目:python manage.py runserver 这里默认8000端口, 浏览器中打开127.0.0.1/8000/admin 输入刚才设置的用户名密码: image.png 登录: image.png 可以看到admin界面。 这里显示的是英文的admin,我们可以通过配置改为中文的。 更改settings中的配置: LANGUAGE_CODE = 'zh-Hans' image.png 完成。

优秀的个人博客,低调大师

Java基础学习1

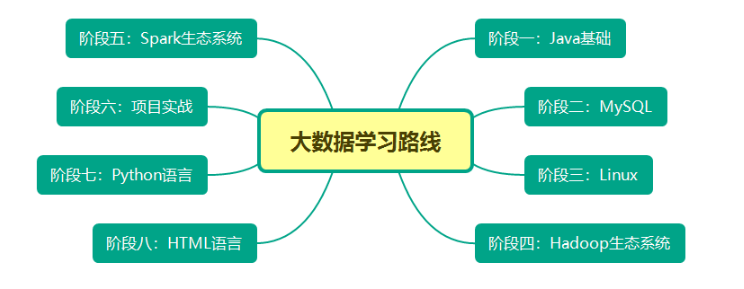
1Java的数据类型 l基本类型(8种) l引用类型 2八种基本类型 byte 1 -128到127,-27到27-1 short 2 -215到215-1 int 4 -231到231-1 long 8 -263到263-1 float 4 单精度 IEEE 754规范 美国电子电气工程师协会浮点数表示规范 double 8 双精度 char 2 0到65535 0到216-1 boolean 1 真true00000001 假false00000000 2.1计算机的存储单位 lbit -比特,电位 lbyte -字节,8bit lKb - 1024 byte lMb - 1024 Kb lGb - 1024 Mb lTb - 1024 Gb lPb - 1024 Tb 2.2二进制 lbyte 10000000-128 ... 11111100-4 11111101-3 11111110-2 11111111-1 000000000 000000011 000000102 000000113 000001004 000001015 000001106 000001117 000010008 ... 01111111127 84608 8*104 4*103 6*102 8*100 11011 24 23 21 20 853 8530 85300 110 1100 11000 674 除2取余法 674 /2337余0 337 /2168余1 168 /284余0 84 /242余0 42 /221余0 21 /210余1 10 /25余0 5 /22余1 2 /21余0 1 /20余1 11 102 1004 10008 1000016 10000032 100000064 10000000128 100000000256 1000000000512 100000000001024 1000个苹果,分装机箱, 不管客户要多少苹果,都可以整箱交付 变量交换 //项目:变量交换 package; importjava.util.Scanner; publicclassTest1 { publicstaticvoidmain(String[]args) { //提示输入 System.out.print("输入整数a:"); //获得输入的值,保存到变量a inta=newScanner(System.in).nextInt(); System.out.print("输入整数b:"); intb=newScanner(System.in).nextInt(); //变量交换,三步转圈赋值 intc=a; a=b; b=c; System.out.println("a = "+a); System.out.println("b = "+b); } } 自由落体距离 //项目:自由落体距离 package; importjava.util.Scanner; publicclassTest1 { publicstaticvoidmain(String[]args) { System.out.println("输入降落时间(秒):"); //获得输入的值,保存到变量t doublet= newScanner(System.in).nextDouble(); //调用f()方法 //把时间t的值,传递到f()方法计算 //得到f()方法的计算结果,保存到变量d doubled=f(t); System.out.println(t+"秒降落了"+d+"米"); } staticdoublef(doublet) { doubled= 0.5*9.8*t*t; returnd;//把计算结果返回到上面调用位置 } } 2.3char类型(2字节) l字符、字符的整数编码 Unicode编码表 0 nil 1 ? 2 ? 3 ? ... 97 a 98 b ... 20013 中 ... 65535 lchar c1 = 97 char c2 = 'a' 2.4基本类型的字面值(5条规则) 1.整数字面值是int类型 int a = 56456; //右侧字面值是int类型,但超出int范围 long a =9999999999; 2.byte,short,char三种比int小的整数,可以用范围内的值,直接赋值 //右侧是byte,不是int byte a = 127; //右侧是int byte a =128; 3.浮点数字面值是double类型 double a = 3.14; //右侧是double,不是float float a =3.14; 4.字面值后缀 L - long long a = 9999999999L; F - float float a = 3.14f; D - double double a = 3.0; double a = 3d; 5.进制前缀 16进制: 两个16进制字符,可以表示一个字节 8进制: 1个8进制字符,可以表示3位 0x - 16进制 0xff255 0- 8进制 0377255 \u - char类型16进制 必须表示char类型完整的两个字节值 'a''\u0061' '中''\u4e2d' 2.5基本类型的运算规则(5条规则) 1.计算结果的数据类型,与最大的类型一致 3/2得1 3d/2得1.5 2.byte,short,char比int小的整数,运算时,会自动转成int byte a = 3; byte b = 4; //错,右侧是int+int,结果是int byte c = a+b; 3.整数运算溢出 Integer.MAX_VALUE+1 得负数最小值 300000000*60*60*24*365 300000000L*60*60*24*365 01111111111111111111111111111111 +1 10000000000000000000000000000000 4.浮点数运算不精确 2-1.9 得0.10000000000000009 4.35*100 得434.9999999999999999994 Java中有精确运算方法,后面会讲 5.浮点数的特殊值 nInfinity(无穷大) 3.14/0 Double.MAX_VALUE*2 nNaN(Not a Number) Math.sqrt(-3) 2.6基本类型的类型转换 l小的类型转成大的类型 byte a = 127; int b = a; 01111111 00000000 00000000 0000000001111111 byte a = -1; int b = a; 11111111 11111111 11111111 1111111111111111 l大的类型转成小的类型 n必须强制转型 int a = 356; byte b = (byte) a; 00000000 00000000 0000000101100100 01100100 牛郎织女 两颗星相距16.4光年 光速299792458米/秒 喜鹊身长0.46米 牛郎织女相会,需要多少只喜鹊 //项目:牛郎织女 package; publicclassTest1 { publicstaticvoidmain(String[]args) { System.out.println("两颗星相距16.4光年"); System.out.println("光速299792458米/秒"); System.out.println("喜鹊身长0.46米"); System.out.println("牛郎织女相会,需要多少只喜鹊"); //1光年是多少米 longly= 299792458L*60*60*24*365; //16.4光年是多少米 doubled=ly*16.4; //求喜鹊数量 doubler=d/0.46; //向上取整 //Math.ceil(r) //取整结果是double类型6436345.0 longn= (long) Math.ceil(r); System.out.println(n); } } 3运算符 +-*/ + 数学运算 字符串的连接运算 % 取余、求模 判断变量a能否被4整除, a%4余数是0 == != 相等 不相等 > >= < <= 大小比较 && 逻辑与 左边是真,并且右边是真,结果是真 短路与,左边是假,右边忽略不执行 || 逻辑或 左边是真,或者右边是真,结果都是真 短路或,左边是真,右边忽略不执行 ! 非 非真是假,非假是真 对布尔值做相反判断 判断“非a”是真,即a是假 if(!a) { } & 位与 两位都是1结果是1 | 位或 有一位是1,结果就是1 ^ 异或 不同是1 对同一个值异或两次,得到原值 ~ 求反 1变0,0变1 >> 带符号向右移位 符号位是0,左边补0 符号位是1,左边补1 >>> 不带符号向右移位 不管符号位是0还是1,左边都补0 << 向左移位 ++ -- 自增1、自减1 int a=5 print(a++)先取值后自增 1)先取出a的原值等待打印 2)a自增变成6 3)打印原值5 int a=5 print(++a)先自增后取值 1)a自增变成6 2)取出a的新值等待打印 3)打印a的新值6 ? : 三项运算 1 ? 2 : 3 1是真,取2的值 1是假,取3的值 = 赋值 += ^= >>= ... 复合的赋值运算 a += 2; //a = a+2; 自动转型 byte a = 2; a = (byte) (a+2); a += 2; a += 3.94; () 转型运算 l向右移1位相当于除2 l向左移1位相当于乘2 3.1运算符优先级 l不用记优先级表,多加小括号 (1+(2-3))*4/5 平年闰年 输入年号,显示是平年还是闰年 闰年条件: *)能被4整除,并且不能被100整除 *)能被400整除 2000 1000 2016 2018 //平年闰年 package; importjava.util.Scanner; publicclassTest1 { publicstaticvoidmain(String[]args) { System.out.print("输入年号:"); inty=newScanner(System.in).nextInt(); //调用runNian()方法 //对年号y的值判断是否闰年 //该方法返回boolean值 if(runNian(y)) { System.out.println("闰年"); }else{ System.out.println("平年"); } } staticbooleanrunNian(inty) { booleanrun=false;//假设不是闰年 /*if(y%4 == 0) {//能被4整除 //能被4整除的情况下 if(y%100 != 0) {//再判断不能被100整除 run = true; } } if(y%400 == 0) {//能被400整除 run = true; }*/ if((y%4==0 &&y%100 != 0) ||y%400==0) { run=true; } returnrun; } } 3.2位运算 00000000000000000000000001110011 00000000000000000000000001010101 & ---------------------------------- 00000000000000000000000001010001 00000000000000000000000001110011 00000000000000000000000001010101 | ---------------------------------- 00000000000000000000000001110111 00000000000000000000000001110011 00000000000000000000000001010101 ^ ---------------------------------- 00000000000000000000000000100110 00000000000000000000000001110011 ~ ---------------------------------- 11111111111111111111111110001100 00000000000000000000000001110011>>2 00000000000000000000000000011100 10000000000000000000000001110011>>2 11100000000000000000000000011100 10000000000000000000000001110011>>>2 00100000000000000000000000011100 10000000000000000000000001110011<<2 00000000000000000000000111001100 位运算 10011001100001001011100011110011 10011001 10000100 10111000 11110011 r 10011001100001001011100000000000 11111111 11111111 11111111 11110011 //项目:int拆分4字节 package*; importjava.util.Scanner; publicclassTest1 { publicstaticvoidmain(String[]args) { System.out.print("输入整数:"); //获得输入的值,保存到变量n intn=newScanner(System.in).nextInt(); /* * n向右移动24,16,8,0位 *再强转成byte类型 *分别保存到b1,b2,b3,b4变量 *再打印显示 */ byteb1= (byte) (n>>24); byteb2= (byte) (n>>16); byteb3= (byte) (n>>8); byteb4= (byte) (n>>0); System.out.println(b1); System.out.println(b2); System.out.println(b3); System.out.println(b4); // intr= 0; /* * b1,b2,b3,b4 *左移24位, *再不带符号右移0,8,16,24位 *结果再与r求或,保存到r */ //r = r | (b1<<24>>>0); //r = r | (b2<<24>>>8); //r = r | (b3<<24>>>16); //r = r | (b4<<24>>>24); /* * b1,b2,b3,b4 *对0x000000ff求与 *再左移24,16,8,0位 *结果再与r求或,保存到r */ r=r| ((b1& 0x000000ff) << 24); r=r| ((b2& 0x000000ff) << 16); r=r| ((b3& 0x000000ff) << 8); r=r| ((b4& 0x000000ff) << 0); System.out.println(r); } } 三个整数的最大值 项目:day0108_三个数最大值 类:day0108.Test1 packageday0108; importjava.util.Scanner; publicclassTest1 { publicstaticvoidmain(String[]args) { System.out.println("输入三个整数"); inta=newScanner(System.in).nextInt(); intb=newScanner(System.in).nextInt(); intc=newScanner(System.in).nextInt(); //a,b的最大值保存到max //max,c的最大值保存到max //intmax = a>b ? a : b; //max = max>c ? max : c; intmax=a>b? (a>c?a:c) : (b>c?b:c); System.out.println("最大值:"+max); } }

优秀的个人博客,低调大师

ADO.net学习

<1>在VS2017中建立Windows 窗体应用(.NET Framework)项目。 <2>在解决方案资源管理器中,打开Form1.cs,主题窗口会出现Form1.cs[设计]的标题。 <3>打开工具栏,找到Button控件,将该控件拖拽到设计面板中,右键这个控件,点击属性,在Text栏目中输入该按钮的名称。在"设计"的(Name)栏目中输入该按钮的响应函数的名字。我设计的是:btnCreateConnection。软后双击这个按钮,就会转向Form.cs中的btnCreateConnection_Click。也就是该按钮的点击的响应函数。设置这个函数的目的是第一次连接数据库。 <4>[注:本文连接的是SQLserver数据库]。 <5>增加命名空间: System.Data.SqlClient命名空间是用于 SQL Server 的 .NET 数据提供程序 System.Data.Common用于使用DbConnection,DbCommand,DbDataReader类等。 System.Configuration命名空间包含提供用于处理配置数据的编程模型的类。 数据库文件:链接:https://pan.baidu.com/s/1GT-eyEtK9K06TYYUrLPrdg 密码:8jjw 下载后所包含的数据库文件有: BulkCopy.mdf, BulkCopy_log.ldf; PUBS.MDF, PUBS_LOG.LDF; 我将这些数据库文件附加到了SQL Server2014的数据库管理系统中,这样的话接下来写的程序对数据库的更改变化就可以通过Navicat直观地查看内容的变化。 <6>在btnCreateConnection_Click响应函数中连接数据库,这里遇到了分支。第一种情况是数据库文件在解决方案资源管理器中,第二种情况是数据库附加到数据库管理系统或者该数据库由数据库管理系统创建。 第一种情况:数据库文件在解决方案管理器中。 A,当直接在响应函数中写连接数据库的语句时: DbConnection con = new SqlConnection(); con.ConnectionString = @"Data Source=.\SQLEXPRESS;" + "AttachDbFilename=|DataDirectory|PUBS.MDF;" + "Integrated Security=True;User Instance=True"; con.Open(); //Do lots of cool work here con.Close(); B,当用配置文件里面封装的内容连接数据库时,语句为: 配置文件(也就是App.config)里面封装的内容需要添加: <connectionStrings> <add name="PubsData" connectionString="Data Source=.\SQLEXPRESS;AttachDbFilename=|DataDirectory|PUBS.MDF;Integrated Security=True;User Instance=True;" providerName="System.Data.SqlClient" /> <add name="PubsDataMars" connectionString="Data Source=.\SQLEXPRESS;AttachDbFilename=|DataDirectory|\PUBS.MDF;Integrated Security=True;User Instance=True;MultipleActiveResultSets=True;" providerName="System.Data.SqlClient" /> <add name="BulkCopy" connectionString="Data Source=.\SQLEXPRESS;AttachDbFilename=|DataDirectory|\BulkCopy.mdf;Integrated Security=True;User Instance=True;" providerName="System.Data.SqlClient" /> </connectionStrings> (在<configuration></configuration>也就是XML的根元素中添加内容) 在响应函数中写的语句为: ConnectionStringSettings pubs = ConfigurationManager.ConnectionStrings["PubsData"]; DbConnection con = new SqlConnection(pubs.ConnectionString); con.Open(); //Do lots of cool work here con.Close(); 为了验证连接数据库成功,可以通过在//Do lots of cool work here中查询数据库中表的内容验证: DbCommand cmd = con.CreateCommand(); cmd.CommandText = "select * from sales"; con.Open(); DbDataReader dr = cmd.ExecuteReader(); if (dr.HasRows) { while (dr.Read()) { string stor_id = dr["stor_id"].ToString(); string ord_num = dr["ord_num"].ToString(); string ord_date = dr["ord_date"].ToString(); string title_id = dr["title_id"].ToString(); Console.WriteLine(stor_id+" "+ord_num+" "+ord_date+" "+title_id); } }这里就可以体现了将数据库文件附加到数据库管理系统之后通过Navicate查看表的优势。表中的各个关键字都可以查看,以便写出while(dr.Read())中的语句。 第二种情况:数据库附加到数据库管理系统或者该数据库由数据库管理系统创建。 A,当直接在响应函数中写连接数据库的语句时: DbConnection con = new SqlConnection(); con.ConnectionString = @"Initial Catalog=PUBS;Persist Security Info=True;User ID=sa;password=hl123456789"; con.Open(); //Do lots of cool work here con.Close(); 尤其要根据自己的数据库管理系统设置相应的User ID跟password。 B,当用配置文件里面封装的内容连接数据库时,语句为: 配置文件里的语句为: <connectionStrings> <add name="dbstconnectionstring" connectionString="Initial Catalog=PUBS;Persist Security Info=True;User ID=sa;password=hl123456789" providerName="System.Data.SqlClient"/> </connectionStrings> 响应函数中的语句为: string connectionString = ConfigurationManager.ConnectionStrings["dbstconnectionstring"].ConnectionString; DbConnection conn = new SqlConnection(connectionString); DbCommand cmd = conn.CreateCommand(); cmd.CommandText = "select * from authors"; conn.Open(); //Do a lot of work conn.Close(); [注:]第<6>个内容中,如果想通过响应函数来查看配置文件的具体内容时候,语句可以写成:(这里接的是第<6>个内容的第一种情况的B类) ConnectionStringSettings pubs = ConfigurationManager.ConnectionStrings["PubsData"]; DbConnection connection = new SqlConnection(pubs.ConnectionString); //name = "PubsData" string name = pubs.Name; //provider = "System.Data.SqlClient" string provider = pubs.ProviderName; //cnString = "Data Source=.\SQLEXPRESS;AttachDbFilename=|DataDirectory|\PUBS.MDF;Integrated Security=True;User Instance=True" string cnString = pubs.ConnectionString; MessageBox.Show("From App.Config: " + cnString+"\n"+name+"\n"+provider); <7>使用DataGridView控件,和按钮的响应事件,来显示SqlConnection的数据源的架构信息 其中: SQL Server架构集合 GetSchema():返回此SqlConnection的数据源的架构信息 GetSchema(String):使用表示架构名称的指定字符串返回此SqlConnection的数据源的架构信息 我设计了两个DataGridView控件,分别为dataGridView1,dataGridView2,第一个用于GetSchema(),第二个用于GetSchema(String),其中dataGridView2用于点击dataGridView1中的行的内容,显示具体的内容。 准备: 按钮,响应函数为:btnGetSchema_Click 自己写一个dataGridView事件变化函数ataGridView_SelectionChange 并在dataGridView1属性(闪电栏目)中的SelectionChange响应事件中添加写的这个函数。 源程序为: private void btnGetSchema_Click(object sender, EventArgs e) { //Get the settings from the configuration file ConnectionStringSettings pubs = ConfigurationManager.ConnectionStrings["PubsData"]; DbConnection connection = new SqlConnection(pubs.ConnectionString); connection.Open(); DataTable schema = connection.GetSchema(); connection.Close(); dataGridView1.DataSource = schema; } private void dataGridView1_SelectionChanged(object sender, EventArgs e) { DataTable schema = (DataTable)dataGridView1.DataSource; DataRow currentRow = schema.Rows[dataGridView1.CurrentCell.RowIndex]; string collection = (string)currentRow["CollectionName"]; //Get the settings from the configuration file ConnectionStringSettings pubs = ConfigurationManager.ConnectionStrings["PubsData"]; DbConnection connection = new SqlConnection(pubs.ConnectionString); connection.Open(); DataTable schema2 = connection.GetSchema(collection); connection.Close(); dataGridView2.DataSource = schema2; }

优秀的个人博客,低调大师

flask学习笔记(一)

思来想去,还是放弃用word记笔记的习惯吧,写了又不会回头看。 虚拟环境 每创建一个项目,就一定要给该项目创建一个虚拟环境。 虚拟环境用来隔离项目之间因为版本不同而产生的差异。 Flask服务器搭建步骤 1、从flask包里面导入Flask类 2、实例化Flask。 我们管falsk的实例化对象叫app。括号里面的__name__是flask实例化核心对象的一个标志。 实例化时传入参数“__name__”的原因是让我们实例化的这个对象与其他对象有所区分(揣测的意思,以后看了源码可能会改) (课下了解:基于类的视图——即插视图) 3、视图函数实现的功能复用性不高,get一个新名词 “基于类的视图——即插视图” ,传送门(打马,以后仔细看看): http://docs.jinkan.org/docs/flask/views.html 扩展知识:重定向 将@app.route(/hello“)改成@app.route(/hello/“)就可以兼容用户输入网址时,末尾带“/”之后无法访问网页的弊端。 浏览器申请访问url1,服务器并没有把url1的资源返回给浏览器,而是返回一个url2的location,并把状态码(status code:301或者302)设置成301或者302。浏览器获得返回值时,会先看一下状态码,如果状态码是301或者302,他就知道服务器希望他做一次重定向,他会再一次向服务器发送请求,这个请求就是url2。 Flask的实质是把末尾不带“/”的url重定向到“/”的url里面来。 重定向是为了保证每个资源都是唯一的url,否则不同的url可以访问相同的资源,会造成混乱 4、路由 在视图函数hello()中,用装饰器@app.route(‘/hello’) 来注册路由的原因是因为Python支持这样的一种装饰器。 路由注册的另一种方法 如果你要使用基于类的视图(即插视图)的时候,你就要使用app.add_url_rule的方式来注册路由。 @app.route在底层的作用就是调用上面的add_url_rule,flask封装出装饰器,就是为了让界面看起来更优雅。 装饰器可以解决很多问题,尤其是代码耦合的问题(不明觉厉)。 如果只是写debug=True,那么你做的网页只能通过服务器所在的主机进行访问。 host=‘0.0.0.0’代表我可以接受外网的访问。 port=81代表端口号为81。 5、生产模式时,不能开启debug=True。原因有二: 首先调试模式(即开启debug=True)时的性能比较差;其次,我们不能向用户展示我们任何服务器的详细信息 6、部署的基本原则是开发模式和生产模式要保持镜像关系(也就是说两份源代码是一模一样的)。这个问题的解决办法就是写配置文件 建议:配置文件里面的参数全部大写 导入配置文件的方法一 导入我们写的配置文件(这里的语句是from config import DEBUG),导入之后,你就可以使用他了(把debug=True改成debug=DEBUG) 导入配置文件的方法二 由于config和Fisher在同一个文件夹里面,因此上面函数的路径就是‘config’ 读取配置文件的方式 config其实是Python dict(字典)的一个子类 print函数可以在命令行里面输出东西,来查看我们的功能是否实现 注意:如果你是以“from_object”的形式(即:)载入配置文件,flask要求变量的字母全部大写(因为小写字母会被自动忽略)。 补充:生产环境时,不使用flask自带的服务器,而是采用nginx+uwsgi(nginx作为前置服务器来接收浏览器发来的请求,之后请求会被转发给uwsgi);启动服务器不再是“Python ***.py”,而是由uwsgi加载模块,进而启动相关代码。在生产环境下,***就不再是入口文件了,他只是被uwsgi加载的模块文件,因此在生产环境下,app.run()是根本就不会被执行的。 加了 之后,可以保证我们在生产环境下,不去启动flask自带的服务器(即:app.run()) 补充:视图函数和普通函数不同,视图函数除了返回return信息之外,他会还会返回一系列的附加信息: a、status code 200 404 301 b、content-type ——放置于http header的属性中,它的作用是告诉浏览器的接收方如何解析我们return的主体内容。(在flask的默认值为text/html ) 7、response对象——flask会把你返回的东西作为响应的一个内容,同时会把主体内容和上面蓝字说的一些信息封装出一个对象,这个对象就叫做response对象。 创造response对象的流程: 首先导入make_response函数来创建对象 然后在视图函数中作出相应的更改 如此,返回页面会显示出文字<html></html>(因为response的content-type为text/plain) 补充:状态码只是一个标志,他并不会影响你要返回的一个内容,比如上面的视图函数会返回状态码404,但是网页依旧会有显示的内容。 如果把response改成如图 访问我们的主页时,就会直接重定向跳转到bing的首页。 8、如何返回json格式的内容: 假如我们视图函数的接口是为我们的小程序或者移动端的app来提供数据的话,通常我们把他叫做api,而api的数据通常是json格式的,如何返回json格式的内容?——只要把response对象的content-type的值改成 “application/json” 即可。 response返回对象的简写方式: 补充:如果你想在客户端生成cookie,就调用response的set_cookie方法就可以了。 数据与flask路由 搜索图书数据需要调用外部的api来获取图书检索数据 一、获取图书信息的两种方式: 1、关键字搜索: 2、isbn搜索: 补充:api一定要设置访问频率的控制,否则很容易被人搞瘫痪。 补充:编写网站和编写api没有太大的区别,只要搞清楚网站返回的是什么,api返回的是什么即可。 二、传递参数的方式 1、在url路径里传递参数 当中url里面加入了"<>",那么尖括号中的内容会被识别为是传入的参数,而不是固定的字符串 补充:Python里面的函数isdigit()可以自动识别参数是不是数字 用法: if q.isdigit(): 编程知识——看源代码的方法:分层去看,首先理清代码的结构线索即可,了解各个函数的功能即可,无需依次查看函数的源码;当你需要看源码的时候再去看函数的源码即可。 2、在Python里面调用api 创建文件——http.py 将http请求封装在http模块里 在Python中,发送和http请求有两种方案 1、使用Python自带的urllib模块来发送http请求(比较难用) 2、用requests这样一个第三方的库来发送http请求(推荐)。 用requests这样一个第三方的库来发送http请求的方法: 首先需要安装requests包 补充:api的地址——url 返回json格式的api的通用返回方法: 兼容返回json格式和字符串格式的api 简化if else 的方法 1、三元表达式: 2、巧妙的用if + return 来简化代码 3、把if和else里面的内容再提取成一个函数,然后再if和else里面调用我们的函数。 补充:Python爬虫可以用 scrapy(适合并发或者多线程的爬虫) 或者 requests+beautiful soap Python静态方法 1、@staticmethod 2、@classmethod——如果没有用到类里面相关的类变量时,没必要使用classmethod 补充:把方法封装到http对象里(如上图,函数被封装到class HTTP里),是为了以后便于扩展。 补充:在Python3里面class HTTP(object):和class HTTP:没有区别。在Python2里面,有经典类和新式类的区别。 三、从api获取数据 补充:json在Python里面会被准换成一个dict,也就是字典。 封装一个class,把获取的数据拼合出url,调用htp.py,获取json格式的返回值数据 在主函数中调用封装好的类,如此,实现输入一个关键词,返回json格式的数据 四、使用jsonify jsonify是flask的一个功能,用之前要import一下 此时我们将json格式的数据返回到了客户端。 五 、深入了解flask路由 flask的路由机制图解 不传endpoint,视图函数依然可以被找到,这是因为flask里面,如果不传endpoint,会把视图函数的函数名作为endpoint的默认值。 补充:flask调试模式如果启动,他会把你的代码执行两次,会有一个restart的过程(这也就是debug的默认值为什么是false的缘故) 装饰器在底层会调用add_url_rule函数 循环引入流程分析 下面两个代码互相import对方 book模块的导入用蓝线标示 由于第二次判断if语句的时候,name不等于main(因为这个模块是有book模块导入的),因此不会执行app.run()方法。 book模块会执行一次,为什么Fisher会执行两次?原因就是启动Fisher时,我们没有把Fisher当成模块导入,而是当作启动文件,因此他一共执行两次(启动时一次,导入时一次)。 补充:查看对象地址的方法(比如,查看app核心对象的地址:) 应用、蓝图与视图函数 蓝图 蓝图不能独立存在,他要插入到flask核心对象里。每一个蓝图又可以插入很多视图函数,蓝图还可以指定他自己的静态文件夹和模板文件夹。 思路——视图函数注册到蓝图里,蓝图注册到核心对象app里 补充:让一个文件夹成为一个包的方法——在文件夹下面(不是里面)加一个_init_.py文件 该文件用于核心对象的初始化工作。 应用级别的初始化工作 1、在_init_.py中初始化实例对象 2、在主执行程序里面调用函数来创建实例化对象: 蓝图的基本用法 蓝图的初始化工作会放到蓝图文件夹里面的_init_.py中进行 1、实例化蓝图对象(不再使用app来注册路由,我们使用蓝图来注册路由) 2、把视图函数注册到蓝图上 3、把蓝图注册到app里 蓝图的特性:蓝图不能替代视图函数核心对象,两个不是同一回事。 蓝图分模块管理——把不同的视图函数拆分到不同的文件 1、实例化蓝图 2、将蓝图导入并注册路由 3、将视图函数的模块导入执行 防止循环导入的方法: 1、把init.py里面的数理化导入到blueprint里面

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册