首页 文章 精选 留言 我的

精选列表

搜索[AI编程],共10000篇文章
优秀的个人博客,低调大师

Java并发编程学习3-可见性和对象发布

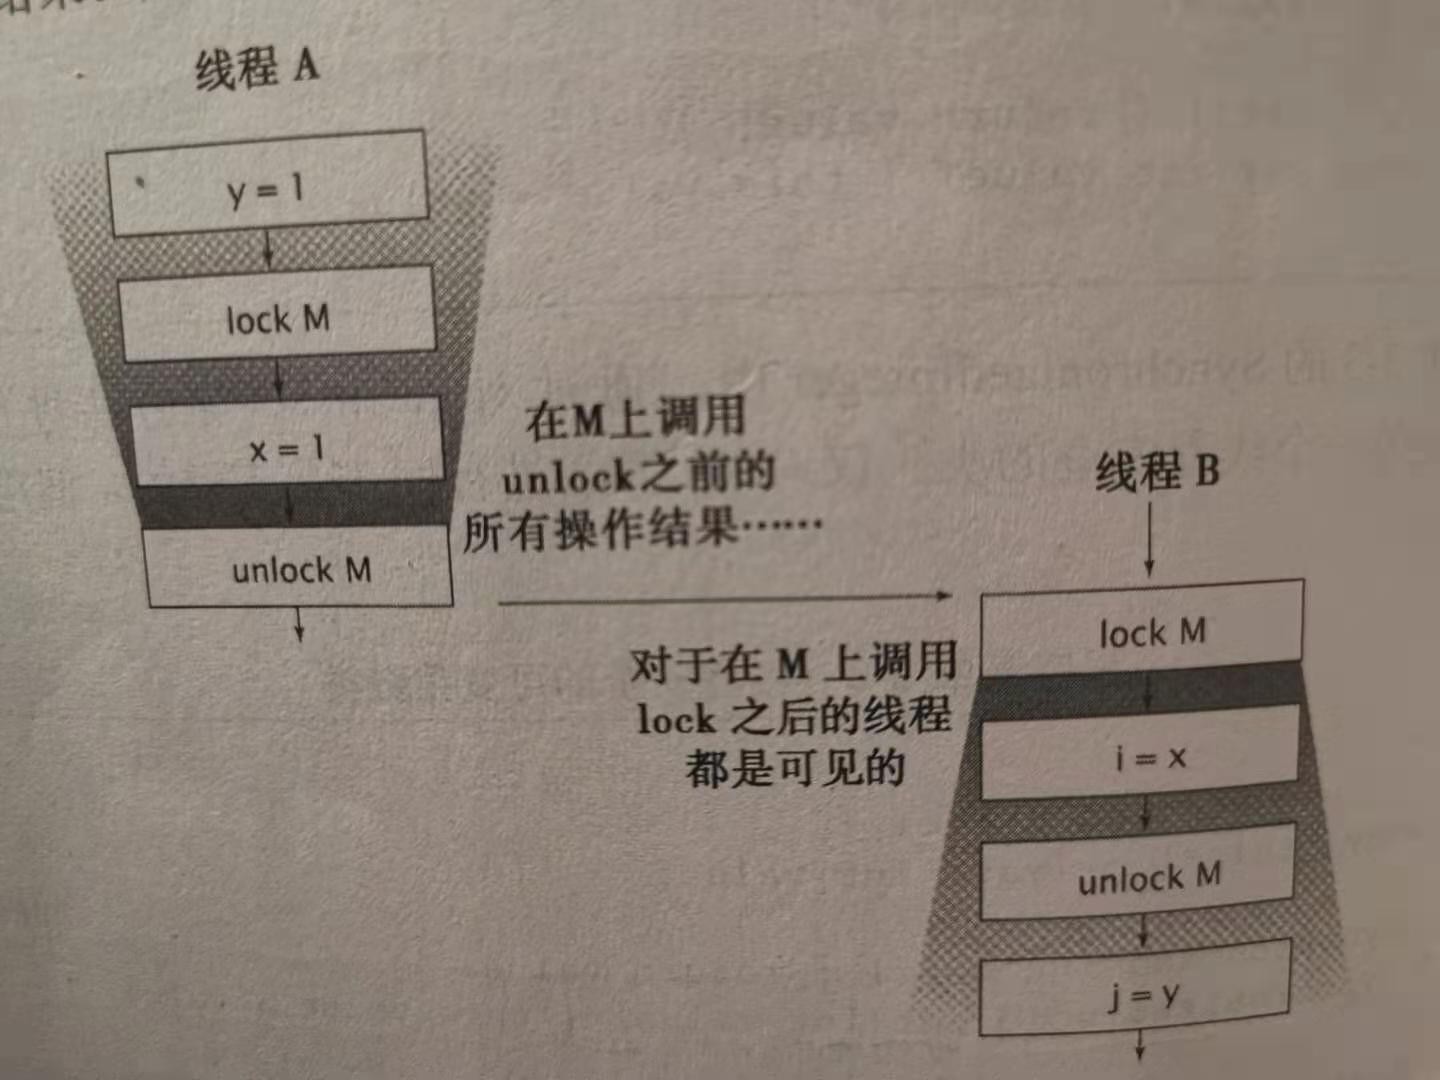
对象的共享 书接上篇,我们了解了如何通过同步来避免多个线程在同一时刻访问相同的数据,而本篇将介绍如何共享和发布对象,从而使它们能够安全地由多个线程同时访问。 1. 可见性 线程安全性的内容,让我们知道了同步代码块和同步方法可以确保以原子的方式执行操作。但如果你认为关键字 synchronized 只能用于实现原子性或者确定“临界区(Critical Section)”,那就大错特错了。同步还有一个重要的方面:内存可见性(Memory Visibility)。我们不仅希望防止某个线程正在使用对象状态而另一个线程在同时修改该状态,而且希望确保当一个线程修改了对象状态后,其他线程能够看到发生的状态变化。 可见性是一种复杂的属性,在一般的单线程环境中,如果向某个变量先写入值,然后在没有其他写入操作的情况下读取这个变量,总是能够得到相同的值。然而,当读操作和写操作在不同的线程中执行时,因为无法确保执行读操作的线程能适时地看到其他线程写入的值,所以也就不能总是得到相同的值。为了确保多个线程之间对内存写入操作的可见性,必须使用同步机制。 介绍了这么多,还不如来看下代码示例: /** * <p> 在没有同步的情况下共享变量(不推荐使用) </p> */ public class NoVisibility { private static boolean ready; private static int number; private static class ReaderThread extends Thread { @Override public void run() { while (!ready) { Thread.yield(); } System.out.println(number); } } public static void main(String[] args) { new ReaderThread().start(); number = 42; ready = true; } } 在上述代码中,主线程和读线程都将访问共享变量 ready 和 number。主线程启动读线程,然后将 number 设为 42, 并将 ready 设为 true。读线程一直循环直到发现 ready 的值变为 true,然后输出 number 的值。虽然 NoVisibility 看起来会输出 42,但事实上很可能输出0,或者根本无法终止。因为在代码中没有使用足够的同步机制,所以无法保证主线程写入的 ready 值 和 number 值对于读线程来说是可见的。 如果你尝试运行该程序,大概率控制台还是会输出42,但这并不说明这块代码就总是能输出想要的结果。NoVisibility 可能会输出0,这是因为读线程可能看到了写入 ready 的值,但却没有看到之后写入 number 的值,这种现象被称为 “重排序”;NoVisibility 也可能会一直循环下去,因为读线程可能永远都看不到 ready 的值。 在没有同步的情况下,编译器、处理器以及运行时等都可能对操作的执行顺序进行一些意想不到的调整。在缺乏足够同步的多线程程序中,要想对内存操作的执行顺序进行判断,几乎无法得出正确的结论。 1.1 失效数据 NoVisibility 展示了在缺乏同步的程序中可能产生错误结果的一种情况:失效数据。当读线程查看 ready 变量时,可能会得到一个已经失效的值。更糟糕的是,失效值可能不会同时出现:一个线程可能获得某个变量得最新值,而获得另一个变量得失效值。 下面再看一个代码示例: /** * <p> 非线程安全的可变整数类 </p> */ @NotThreadSafe public class MutableInteger { private int value; public int getValue() { return value; } public void setValue(int value) { this.value = value; } } 上述代码中 get 和 set 方法都是在没有同步的情况下访问 value 的。如果某个线程调用了 set 方法,那么另一个正在调用 get 方法的线程可能会看到更新后的 value 值,也可能看不到。 下面我们通过对 get 和 set 方法进行同步,可以使 MutableInteger 成为一个线程安全的类。代码示例如下: /** * <p> 非线程安全的可变整数类 </p> */ public class SynchronizedInteger { @GuardedBy("this") private int value; public synchronized int getValue() { return value; } public synchronized void setValue(int value) { this.value = value; } } 当然如果这里仅仅对 set 方法进行同步是不够的,调用 get 方法的线程仍然会看见失效值。 1.2 非原子的64位操作 上面我们了解到,当线程在没有同步的情况下读取变量时,可能会得到一个失效值,但至少这个值是由之前某个线程设置的值,而不是一个随机值。这种安全性保证也被称为最低安全性(out-of-thin-air-safety)。 最低安全性适用于绝大多数变量,但是非 volatile 类型的64位数值变量例外。Java内存模型要求,变量的读取操作和写入操作都必须是原子操作,但对于非 volatile 类型的 long 和 double 变量,JVM允许将64位的读操作或写操作分解为两个32位操作。当读取一个非 volatile 类型 的 long 变量时,如果对该变量的读操作和写操作在不同的线程中执行,那么很可能会读取到某个值的高32位和另一个值得低32位。 1.3 加锁与可见性 内置锁可以用于确保某个线程以一种可预测得方式来查看另一个线程的执行结果,如下图所示。当线程 A 执行某个同步代码块时,线程 B 随后进入由同一个锁保护的同步代码块,在这种情况下可以保证,在锁被释放之前,A 看到的变量值在 B 获得锁后同样可以由 B 看到。换句话说,当线程 B 执行由锁保护的同步代码块时,可以看到线程 A 之前在同一个同步代码块中的所有操作结果。 加锁的含义不仅仅局限于互斥行为,还包括内存可见性。为了确保所有线程都能看到共享变量的最新值,所有执行读操作或者写操作的线程都必须在同一个锁上同步。 1.4 volatile 变量 Java语言提供了一种稍弱的同步机制,即 volatile 变量,用来确保将变量的更新操作通知到其他线程。当变量声明为 volatile 类型后,编译器与运行时都会注意到这个变量是共享的,因此不会将该变量上的操作与其他内存操作一起重排序。volatile 变量不会被缓存在寄存器或者对其他处理器不可见的地方,因此在读取 volatile 类型的变量时总会返回最新写入的值。 当然,这里不建议过度依赖 volatile 变量提供的可见性。仅当 volatile 变量能简化代码的实现以及对同步策略的验证时,才应该使用它们。如果在验证正确性时需要对可见性进行复杂的判断,那么就建议使用 volatile 变量。 volatile 变量的正确使用方式包括: 确保它们自身状态的可见性; 确保它们所引用对象的状态的可见性; 标识一些重要的程序生命周期事件的发生(初始化或关闭) 下面看一个利用 volatile 变量来数绵羊的代码示例: volatile boolean asleep; // ... while (!asleep) countSomeSheep(); 在如上示例中,线程试图通过类似数绵羊的传统方式进入休眠状态。相比用锁来确保 asleep 更新操作的可见性,这里采用 volatile 变量,不仅满足了更新操作的可见性,而且代码逻辑也变得更加简单,更利于理解。 虽然 volatile 变量使用很方便,但它只能确保可见性,而加锁机制既可以确保可见性又可以确保原子性。 那么说了这么多,什么场景下我们才应该使用 volatile 变量呢? 当且仅当满足以下条件: 对变量的写入操作不依赖变量的当前值,或者你能确保只有单个线程更新变量的值。 该变量不会与其他状态变量一起纳入不变性条件中。 在访问变量时不需要加锁。 2. 发布与逸出 本篇开头提到了 发布对象,它是指使对象能够在当前作用域之外的代码中使用。例如,将一个指向该对象的引用保存到其他代码可以访问的地方,或者在某一个非私有的方法中返回该引用,或者将引用传递到其他类的方法中。当某个不应该发布的对象被发布了,这种情况就被称为 逸出(Escape)。 发布对象的最简单方法是将对象的引用保存到一个公有的静态变量中,以便任何类和线程都能够看见该对象。 下面展示发布一个对象的代码示例: public static Set<Secret> knownSecrets; public void initialize() { knownSecrets = new HashSet<Secret>(); } 上述代码中,在 initialize 方法中示例化一个新的 HashSet 对象,并将对象的引用保存到 knownSecrets 中以发布该对象。如果将一个 Secret 对象添加到集合 knownSecrets 中,那么同样会发布这个 Secret 对象,因为任何代码都可以遍历这个集合,并获得对这个新 Secret 对象的引用。 我们再来看一个代码示例: /** * <p> 使内部的可变状态逸出(不推荐使用) </p> */ public class UnsafeStates { private String[] states = new String[] {"HELLO", "HUAZIE"}; public String[] getStates() { return states; } } 上诉代码从非私有方法 getStates 中返回一个引用,这里同样会发布返回的引用的对象 states 。按上述方式来发布 states,就可能存在很大风险,因为任何调用者都能修改这个数组的内容。 如果一个已经发布的对象能够通过非私有的变量引用和方法调用到达其他的对象,那么这些对象也都会被发布。 最后一种发布对象或其内部状态的机制就是发布一个内部的类实例,如下代码示例: /** * <p> 隐式地使this引用逸出(不推荐使用) </p> */ public class ThisEscape { public ThisEscape(EventSource source) { source.registerListener(new EventListener(){ public void onEvent(Event e) { doSomething(e); } }); } private void doSomething(Event e) { // 事件处理 } } 当 ThisEscape 发布 EventListener 时,也隐含地发布了 ThisEscape 实例本身,因为在这个内部类的实例中包含了对 ThisEscape 实例的隐含引用。 安全的对象构造过程 在 ThisEscape 中给出了逸出的一个特殊示例,即 this 引用在构造函数中逸出。如果 this 引用在构造过程中逸出,那么这种对象就被认为是不正确构造。 注意: 不要在构造过程中使 this 引用逸出 如果想在构造函数中注册一个事件监听器或启动进程,那么可以使用一个私有的构造函数和一个公共的工厂方法,从而避免不正确的构造过程。下面请看如下代码示例: /** * <p> 使用工厂方法来防止this引用在构造过程中逸出 </p> */ public class SafeListener { private final EventListener listener; private SafeListener() { listener = new EventListener(){ public void onEvent(Event e) { doSomething(e); } }; } public static SafeListener newInstance(EventSource source) { SafeListener safe = new SafeListener(); source.registerListener(safe.listener); return safe; } private void doSomething(Event e) { // 事件处理 } } 结语 本篇我们一起了解了 可见性 和 对象的发布、逸出等相关内容;关于对象的共享的其他内容【线程封闭,不变性,安全发布】,还需要一篇博文才能介绍完,敬请期待!

优秀的个人博客,低调大师

Java函数式编程-4.lambda表达式排序

1.lambda表达式排序 我们首先看几个比较常见的排序例子,基本数据类型的排序 List list = Arrays.asList(1,3,2,5,4); list.sort(Comparator.naturalOrder()); System.out.println(list); list.sort(Comparator.reverseOrder()); System.out.println(list); 输出结果: [1, 2, 3, 4, 5] [5, 4, 3, 2, 1] 我们可以看到执行结果是符合预期的,但是多数场景我们可能需要针对对象的某个属性进行排序,那么应该怎样做呢?我们看下边的例子: public class Student { private String name; private String sexual; private Integer age; public Student(String name, String sexual,Integer age) { this.name = name; this.sexual = sexual; this.age = age; } public String getName() { return name; } public void setName(String name) { this.name = name; } public String getSexual() { return sexual; } public void setSexual(String sexual) { this.sexual = sexual; } public Integer getAge() { return age; } public void setAge(Integer age) { this.age = age; } @Override public String toString() { return "Student{" + "name='" + name + '\'' + ", sexual='" + sexual + '\'' + ", age=" + age + '}'; } public class Starter { public static void main(String[] args) { List<Student> list = Arrays.asList( new Student("jack", 12), new Student("john", 13), new Student("lily", 11), new Student("lucy", 10) ); list.sort(Comparator.comparing(Student::getAge)); System.out.println(list); list.sort(Comparator.comparing(Student::getAge).reversed()); System.out.println(list); } } 输出结果: [Student{name='lucy', age=10}, Student{name='lily', age=11}, Student{name='jack', age=12}, Student{name='john', age=13}] [Student{name='john', age=13}, Student{name='jack', age=12}, Student{name='lily', age=11}, Student{name='lucy', age=10}] 如果我们需要按照性别分组再排序又该如何实现呢?我们接着看下边的例子 public class Starter { public static void main(String[] args) { List<Student> list = Arrays.asList( new Student("jack", "male", 12), new Student("john", "male", 13), new Student("lily", "female", 11), new Student("david", "male", 14), new Student("luck", "female", 13), new Student("jones", "female", 15), new Student("han", "male", 13), new Student("alice", "female", 11), new Student("li", "male", 12) ); Map<String, List<Student>> groupMap = list.stream().sorted(Comparator.comparing(Student::getAge)) .collect(Collectors.groupingBy(Student::getSexual, Collectors.toList())); System.out.println(groupMap.toString()); } } 输出结果: { female = [ Student { name = 'lily', sexual = 'female', age = 11 }, Student { name = 'alice', sexual = 'female', age = 11 }, Student { name = 'luck', sexual = 'female', age = 13 }, Student { name = 'jones', sexual = 'female', age = 15 }], male = [ Student { name = 'jack', sexual = 'male', age = 12 }, Student { name = 'li', sexual = 'male', age = 12 }, Student { name = 'john', sexual = 'male', age = 13 }, Student { name = 'han', sexual = 'male', age = 13 }, Student { name = 'david', sexual = 'male', age = 14 }] } 我们看到上边的输出结果存在一个问题,如果年龄相同则没有按照姓名排序,怎样实现这个功能呢?我们接着看下边的例子 Map<String, List<Student>> groupMap = list.stream().sorted(Comparator.comparing(Student::getAge) .thenComparing(Student::getName)).collect(Collectors.groupingBy(Student::getSexual, Collectors.toList())); 输出结果: { female = [ Student { name = 'alice', sexual = 'female', age = 11 }, Student { name = 'lily', sexual = 'female', age = 11 }, Student { name = 'luck', sexual = 'female', age = 13 }, Student { name = 'jones', sexual = 'female', age = 15 }], male = [ Student { name = 'jack', sexual = 'male', age = 12 }, Student { name = 'li', sexual = 'male', age = 12 }, Student { name = 'han', sexual = 'male', age = 13 }, Student { name = 'john', sexual = 'male', age = 13 }, Student { name = 'david', sexual = 'male', age = 14 }] } 看输出结果是符合预期的,到此为止我们的lambda表达式排序已经基本介绍完了,当然还有一些特殊的场景没涉猎到,大家可以根据兴趣再深入探索。

优秀的个人博客,低调大师

浅析Linux Socket套接字编程中的 5 个隐患

隐患 1.忽略返回状态 第一个隐患很明显,但它是开发新手最容易犯的一个错误。如果您忽略函数的返回状态,当它们失败或部分成功的时候,您也许会迷失。反过来,这可能传播错误,使定位问题的源头变得困难。 捕获并检查每一个返回状态,而不是忽略它们。考虑清单 1 显示的例子,一个套接字 send 函数。 忽略 API 函数返回状态 intstatus,sock,mode; /*Createanewstream(TCP)socket*/ sock=socket(AF_INET,SOCK_STREAM,0); ... status=send(sock,buffer,buflen,MSG_DONTWAIT); if(status==-1){ /*sendfailed*/ printf("sendfailed:%s\n",strerror(errno)); }else{ /*sendsucceeded--ordidit?*/ } 探究一个函数片断,它完成套接字 send 操作(通过套接字发送数据)。函数的错误状态被捕获并测试,但这个例子忽略了 send 在无阻塞模式(由 MSG_DONTWAIT 标志启用)下的一个特性。 send API 函数有三类可能的返回值: 如果数据成功地排到传输队列,则返回 0。 如果排队失败,则返回 -1(通过使用 errno 变量可以了解失败的原因)。 如果不是所有的字符都能够在函数调用时排队,则最终的返回值是发送的字符数。 由于 send 的 MSG_DONTWAIT 变量的无阻塞性质,函数调用在发送完所有的数据、一些数据或没有发送任何数据后返回。在这里忽略返回状态将导致不完全的发送和随后的数据丢失。 隐患 2.对等套接字闭包 UNIX 有趣的一面是您几乎可以把任何东西看成是一个文件。文件本身、目录、管道、设备和套接字都被当作文件。这是新颖的抽象,意味着一整套的 API 可以用在广泛的设备类型上。 考虑 read API 函数,它从文件读取一定数量的字节。read 函数返回读取的字节数(最高为您指定的最大值);或者 -1,表示错误;或者 0,如果已经到达文件末尾。 如果在一个套接字上完成一个 read 操作并得到一个为 0 的返回值,这表明远程套接字端的对等层调用了 close API 方法。该指示与文件读取相同 —— 没有多余的数据可以通过描述符读取。 适当处理 read API 函数的返回值 intsock,status; sock=socket(AF_INET,SOCK_STREAM,0); ... status=read(sock,buffer,buflen); if(status>0){ /*Datareadfromthesocket*/ }elseif(status==-1){ /*Error,checkerrno,takeaction...*/ }elseif(status==0){ /*Peerclosedthesocket,finishtheclose*/ close(sock); /*Furtherprocessing...*/ } 同样,可以用 write API 函数来探测对等套接字的闭包。在这种情况下,接收 SIGPIPE 信号,或如果该信号阻塞,write函数将返回 -1 并设置 errno 为 EPIPE。 隐患 3.地址使用错误(EADDRINUSE) 您可以使用 bind API 函数来绑定一个地址(一个接口和一个端口)到一个套接字端点。可以在服务器设置中使用这个函数,以便限制可能有连接到来的接口。也可以在客户端设置中使用这个函数,以便限制应当供出去的连接所使用的接口。bind 最常见的用法是关联端口号和服务器,并使用通配符地址(INADDR_ANY),它允许任何接口为到来的连接所使用。 bind 普遍遭遇的问题是试图绑定一个已经在使用的端口。该陷阱是也许没有活动的套接字存在,但仍然禁止绑定端口(bind 返回 EADDRINUSE),它由 TCP 套接字状态 TIME_WAIT 引起。该状态在套接字关闭后约保留 2 到 4 分钟。在 TIME_WAIT 状态退出之后,套接字被删除,该地址才能被重新绑定而不出问题。 等待 TIME_WAIT 结束可能是令人恼火的一件事,特别是如果您正在开发一个套接字服务器,就需要停止服务器来做一些改动,然后重启。幸运的是,有方法可以避开 TIME_WAIT 状态。可以给套接字应用 SO_REUSEADDR 套接字选项,以便端口可以马上重用。 考虑下面的例子。在绑定地址之前,我以 SO_REUSEADDR 选项调用 setsockopt。为了允许地址重用,我设置整型参数(on)为 1 (不然,可以设为 0 来禁止地址重用)。 使用 SO_REUSEADDR 套接字选项避免地址使用错误 intsock,ret,on; structsockaddr_inservaddr; /*Createanewstream(TCP)socket*/ sock=socket(AF_INET,SOCK_STREAM,0): /*Enableaddressreuse*/ on=1; ret=setsockopt(sock,SOL_SOCKET,SO_REUSEADDR,&on,sizeof(on)); /*Allowconnectionstoport8080fromanyavailableinterface*/ memset(&servaddr,0,sizeof(servaddr)); servaddr.sin_family=AF_INET; servaddr.sin_addr.s_addr=htonl(INADDR_ANY); servaddr.sin_port=htons(45000); /*Bindtotheaddress(interface/port)*/ ret=bind(sock,(structsockaddr*)&servaddr,sizeof(servaddr)); 在应用了 SO_REUSEADDR 选项之后,bind API 函数将允许地址的立即重用。 隐患 4.发送结构化数据 套接字是发送无结构二进制字节流或 ASCII 数据流(比如 HTTP 上的 HTTP 页面,或 SMTP 上的电子邮件)的完美工具。但是如果试图在一个套接字上发送二进制数据,事情将会变得更加复杂。 比如说,您想要发送一个整数:您可以肯定,接收者将使用同样的方式来解释该整数吗?运行在同一架构上的应用程序可以依赖它们共同的平台来对该类型的数据做出相同的解释。但是,如果一个运行在高位优先的 IBM PowerPC 上的客户端发送一个 32 位的整数到一个低位优先的 Intel x86,那将会发生什么呢?字节排列将引起不正确的解释。 字节交换还是不呢? Endianness 是指内存中字节的排列顺序。高位优先(big endian) 按最高有效字节在前排列,然而 低位优先(little endian) 按照最低有效字节在前排序。 高位优先架构(比如 PowerPC®)比低位优先架构(比如 Intel® Pentium® 系列,其网络字节顺序是高位优先)有优势。这意味着,对高位优先的机器来说,在 TCP/IP 内控制数据是自然有序的。低位优先架构要求字节交换 —— 对网络应用程序来说,这是一个轻微的性能弱点。 通过套接字发送一个 C 结构会怎么样呢?这里,也会遇到麻烦,因为不是所有的编译器都以相同的方式排列一个结构的元素。结构也可能被压缩以便使浪费的空间最少,这进一步使结构中的元素错位。 幸好,有解决这个问题的方案,能够保证两端数据的一致解释。过去,远程过程调用(Remote Procedure Call,RPC)套装工具提供所谓的外部数据表示(External Data Representation,XDR)。XDR 为数据定义一个标准的表示来支持异构网络应用程序通信的开发。 现在,有两个新的协议提供相似的功能。可扩展标记语言/远程过程调用(XML/RPC)以 XML 格式安排 HTTP 上的过程调用。数据和元数据用 XML 进行编码并作为字符串传输,并通过主机架构把值和它们的物理表示分开。SOAP 跟随 XML-RPC,以更好的特性和功能扩展了它的思想。 隐患 5.TCP 中的帧同步假定 TCP 不提供帧同步,这使得它对于面向字节流的协议是完美的。这是 TCP 与 UDP(User Datagram Protocol,用户数据报协议)的一个重要区别。UDP 是面向消息的协议,它保留发送者和接收者之间的消息边界。TCP 是一个面向流的协议,它假定正在通信的数据是无结构的,如图 1所示。 UDP 的帧同步能力和缺乏帧同步的 TCP 图 的上部说明一个 UDP 客户端和服务器。左边的对等层完成两个套接字的写操作,每个 100 字节。协议栈的 UDP 层追踪写的数量,并确保当右边的接收者通过套接字获取数据时,它以同样数量的字节到达。换句话说,为读者保留了写者提供的消息边界。 现在,看图的底部.它为 TCP 层演示了相同粒度的写操作。两个独立的写操作(每个 100 字节)写入流套接字。但在本例中,流套接字的读者得到的是 200 字节。协议栈的 TCP 层聚合了两次写操作。这种聚合可以发生在 TCP/IP 协议栈的发送者或接收者中任何一方。重要的是,要注意到聚合也许不会发生 —— TCP 只保证数据的有序发送。 对大多数开发人员来说,该陷阱会引起困惑。您想要获得 TCP 的可靠性和 UDP 的帧同步。除非改用其他的传输协议,比如流传输控制协议(STCP),否则就要求应用层开发人员来实现缓冲和分段功能。 查看网络子系统的细节 netstat 工具提供查看 GNU/Linux 网络子系统的能力。使用 netstat,可以查看当前活动的连接(按单个协议进行查看),查看特定状态的连接(比如处于监听状态的服务器套接字)和许多其他的信息。 netstat 提供的一些选项和它们启用的特性。 netstat 实用程序的用法模式 ViewallTCPsocketscurrentlyactive $netstat--tcp ViewallUDPsockets $netstat--udp ViewallTCPsocketsinthelisteningstate $netstat--listening Viewthemulticastgroupmembershipinformation $netstat--groups Displaythelistofmasqueradedconnections $netstat--masquerade Viewstatisticsforeachprotocol $netstat--statistics 尽管存在许多其他的实用程序,但 netstat 的功能很全面,它覆盖了 route、ifconfig 和其他标准 GNU/Linux 工具的功能。 监视流量 可以使用 GNU/Linux 的几个工具来检查网络上的低层流量。tcpdump 工具是一个比较老的工具,它从网上“嗅探”网络数据包,打印到 stdout 或记录在一个文件中。该功能允许查看应用程序产生的流量和 TCP 生成的低层流控制机制。一个叫做 tcpflow 的新工具与 tcpdump 相辅相成,它提供协议流分析和适当地重构数据流的方法,而不管数据包的顺序或重发。 tcpdump 的两个用法模式。 cpdump 工具的用法模式 Displayalltrafficontheeth0interfaceforthelocalhost $tcpdump-l-ieth0 Showalltrafficonthenetworkcomingfromorgoingtohostplato $tcpdumphostplato ShowallHTTPtrafficforhostcamus $tcpdumphostcamusand(porthttp) ViewtrafficcomingfromorgoingtoTCPport45000onthelocalhost $tcpdumptcpport45000 tcpdump 和 tcpflow 工具有大量的选项,包括创建复杂过滤表达式的能力。 tcpdump 和 tcpflow 都是基于文本的命令行工具。如果您更喜欢图形用户界面(GUI),有一个开放源码工具 Ethereal 也许适合您的需要。Ethereal 是一个专业的协议分析软件,它可以帮助调试应用层协议。它的插入式架构(plug-in architecture)可以分解协议,比如 HTTP 和您能想到的任何协议(写本文的时候共有 637 个协议)。

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册