首页 文章 精选 留言 我的

精选列表

搜索[AI编程],共10000篇文章
优秀的个人博客,低调大师

Java并发编程学习4-线程封闭和安全发布

对象的共享 3. 线程封闭 线程封闭(Thread Confinement)是实现线程安全性的最简单方式之一。当某个对象封闭在一个线程中时,这种用法将自动实现线程安全性,即使被封闭的对象本身不是线程安全的。 在Java中使用线程封闭技术有:Swing 和 JDBC 的 Connection 对象。 Swing 的可视化组件和数据模型对象都不是线程安全的,Swing 通过将它们封闭到 Swing 的事件分发线程中来实现线程安全性;为了进一步简化对 Swing 的使用,Swing 还提供了 invokeLater 机制,用于将一个 Runnable 实例调度到事件线程中执行。 在典型的服务器应用程序中,线程从连接池中获得一个 Connection 对象,并且用该对象来处理请求,使用完后再将对象返还给连接池。在这个过程中,大多数请求(例如 Servlet 请求 或 EJB 调用)都是由单个线程采用同步的方式来处理,并且在 Connection 对象返回之前,连接池不会再将它分配给其他线程。也就是说,这种连接管理模式在处理请求时隐含地将 Connection 对象封闭在线程中。 3.1 Ad-hoc 线程封闭 Ad-hoc 线程封闭是指,维护线程封闭性的职责完全由程序实现来承担。因为没有任何一种语言特性,能将对象封闭到目标线程上,所以 Ad-hoc 线程封闭是非常脆弱的。而正由于 Ad-hoc 线程封闭技术的脆弱性,在程序中我们应尽量少用它,在可能的情况下,应该使用更强的线程封闭技术(例如下面要介绍的 栈封闭 或 ThreadLocal 类)。 3.2 栈封闭 栈封闭是线程封闭的一种特例(它也被称为线程内部使用或线程局部使用),在栈封闭中,只能通过局部变量才能访问对象。因为局部变量的固有属性之一就是封闭在执行线程中,它们位于执行线程的栈中,其他线程无法访问这个栈。因此栈封闭比 Ad-hoc 线程封闭更易于维护,也更加健壮。 3.3 ThreadLocal 类 ThreadLocal 对象通常用于防止对可变的单实例变量或全局变量进行共享。它提供了 get 与 set 等访问方法,这些方法为每个使用该变量的线程都存有一份独立的副本,因此 get 总是返回由当前执行线程在调用 set 时设置的最新值。 下面一起来看下面的代码示例: private static ThreadLocal<Connection> connectionHolder = new ThreadLocal<Connection>() { public Connection initialValue() { return DriverManager.getConnection(DB_URL); } }; public static Connection getConnection() { return connectionHolder.get(); } 上述代码通过将 JDBC 的连接保存到 ThreadLocal 对象中,每个线程都会拥有属于自己的连接。当某个线程初次调用 getConnection 方法时,就会调用 ThreadLocal 的 initialValue 来获取初始化的连接对象。 那么该怎么理解 ThreadLocal\<T> 对象呢 ?从概念上看,可以将 ThreadLocal\<T> 视为包含了 Map\<Thread, T> 对象,其中保存了特定于该线程的值。当然 ThreadLocal 的实现并非如此。这些特定于线程的值保存在 Thread 对象中,当线程终止后,这些值会作为垃圾回收。 值得注意的是,ThreadLocal 变量类似于全局变量,它可能会降低代码的可重用性,并在类之间引入隐含的耦合性,因此在使用时要格外小心。 4. 不变性 到目前为止,我们介绍了许多与原子性和可见性相关的问题,例如得到失效的数据,丢失更新操作或者观察到某个对象处于不一致的状态等等,都与多线程试图同时访问同一个可变的状态相关。如果对象的状态不会改变,那么这些问题自然也就迎刃而解。 如果某个对象在被创建后其状态就不能被修改,那么我们就可以称它为不可变对象。线程安全性是不可变对象的固有属性之一,它的不变性条件是由构造函数创建的,只要它的状态不改变,那么这些不变性条件就能一直维持下去。 不可变对象一定是线程安全。 虽然在 Java 语言规范和 Java 内存模型中都没有给出不可变性的正式定义,但不可变性并不等于将对象中的所有域都声明为 final 类型,即使对象中所有的域都是 final 类型的,这个对象也仍然可能是可变的,因为在 final 类型的域中可以保存对可变对象的引用。 当满足以下条件时,对象才是不可变的: 对象创建以后其状态就不能修改。 对象的所有域都是 final 类型。 对象时正确创建的(在对象创建期间,this引用没有逸出)。 在不可变对象的内部仍可以使用可变对象来管理它们的状态。 下面我们来看如下的代码示例: /** * <p> 在可变对象基础上构建的不可变类 </p> */ @Immutable public final class ThreeStooges { private final Set<String> stooges = new HashSet<>(); public ThreeStooges() { stooges.add("Tom"); stooges.add("Jerry"); stooges.add("Huazie"); } public boolean isStooge(String name) { return stooges.contains(name); } } 上述代码中 ThreeStooges 可以称为不可变对象。可以从如下三个方面来理解: 尽管保存臭皮匠姓名的 Set 对象是可变的,但从代码的设计上可以看到,在 Set 对象构造完成后无法对其进行修改。 stooges 是一个 final 类型的引用变量,因此所有的对象状态都通过的一个 final 域来访问。 ThreeStooges 的构造函数中无 this 引用的逸出,可以正确地构造对象。 4.1 Final 域 关键字 final 用于构造不可变的对象。final 类型的域是不能修改的,但如果 final 域所引用的对象是可变的,那么这些引用的对象是可以修改的。 在 Java 内存模型中,final 域能确保初始化过程的安全性,从而可以不受限制地访问不可变对象,并在共享这些对象时无须同步。 4.2 不可变对象的简单示例 在之前的博文中,我们介绍了 UnsafeCachingFactorizer,尝试用两个 AtomicReferences 变量来保存最新的数值及其因数分解结果,但这种方式并非是线程安全的,因为我们无法以原子方式来同时读取或更新这两个相关的值。 下面我们介绍一种 使用 volatile 类型来发布一个不可变对象 的方案: (1)首先,我们来看一个不可变的类 OneValueCache ,用于存储最新的数值及其因数分解的结果。 /** * <p> 对数值及其因数分解结果进行缓存的不可变容器类 </p> */ @Immutable public class OneValueCache { private final BigInteger lastNumber; private final BigInteger[] lastFactors; public OneValueCache(BigInteger lastNumber, BigInteger[] lastFactors) { this.lastNumber = lastNumber; if (null != lastFactors) { this.lastFactors = Arrays.copyOf(lastFactors, lastFactors.length); } else { this.lastFactors = null; } } public BigInteger[] getFactors(BigInteger i) { if (null == lastNumber || !lastNumber.equals(i)) return null; else return Arrays.copyOf(lastFactors, lastFactors.length); } } 对于在访问和更新多个相关变量时出现的的竞态条件问题,可以通过将这些变量全部保存在一个不可变对象中来消除。如果要更新这些变量,那么可以创建一个新的容器对象,而其他使用原有对象的线程仍然会看到对象处于一致的状态。 注意: 如果在 OneValueCache 的 getFactors 方法和构造函数中,没有调用 Arrays.copyOf , 那么 OneValueCache 就不是不可变的。 (2)然后,我们来看使用了修饰为 volatile 类型的 OneValueCache 的因数分解实现。 /** * <p> 使用执行不可变容器对象的 volatile 类型引用以缓存最新的结果 </p> */ public class VolatileCachedFactorizer extends HttpServlet { private volatile OneValueCache cache = new OneValueCache(null, null); protected void doGet(HttpServletRequest req, HttpServletResponse resp) throws IOException { BigInteger i = CommonUtils.extractFromRequest(req); BigInteger[] factors = cache.getFactors(i); if (null == factors) { factors = Factor.factor(i); cache = new OneValueCache(i, factors); } CommonUtils.encodeIntoResponse(resp, factors); } } (3)最后,我们简单分析下上述代码。因为 OneValueCache 是不可变的,并且在每条相应的代码路径中只会访问它一次,所以与 cache 变量相关的操作不会互相干扰,也就保证了因数分解过程的线程安全。通过使用包含多个状态变量的容器对象来维持不变性条件,并使用一个 volatile 类型的引用来确保可见性,使得 VolatileCachedFactorizer 在没有显式地使用锁的情况下仍然是线程安全的。 5. 安全发布 到目前为止,我们上面介绍了这么多的内容,重点讨论的还是如何确保对象不被发布,例如让对象封闭在线程或另一个对象的内部。某些情况下,我们其实希望在多个线程间共享对象,此时必须确保安全地进行共享。 下面我们先看一个发布对象的简单示例: // 在没有足够同步的情况下发布对象 public Holder holder; public void initialize() { holder = new Holder(42); } 上述代码由于存在可见性问题,其他线程看到的 Holder 对象将处于不一致的状态,即便在该对象的构造函数中已经正确地构建了不变性条件。这种不正确的发布导致其他线程看到尚未创建完成的对象。 5.1 不正确的发布:正确的对象被破坏 下面我们直接来看如下代码示例: /** * <p> 由于未被正确发布,因此这个类在调用 assertSanity时将抛出 AssertionError </p> */ public class Holder { private int n; public Holder(int n) { this.n = n; } public void assertSanity() { if (n != n) { throw new AssertionError("This statement is false."); } } } 上述代码中由于没有使用同步来确保 Holder 对其他线程可见,因此将 Holder 称为 “未被正确发布”。 在未被正确发布的对象中存在两个问题: 除了发布对象的线程外,其他线程可以看到的 Holder 域是一个失效值,因此将看到一个空引用或者之前的旧值。 发布对象的线程看到 Holder 引用的值是最新的,但 Holder 状态的值却是失效的。某个线程在第一次读取域时得到失效值,而再次读取这个域时会得到一个更新值,这也是 Holder 类调用 assertSanity 抛出 AssertionError 的原因。 注意: 尽管在构造函数中设置的域值似乎是第一次向这些域中写入的值,因此不会有 “更旧的” 值被视为失效值,但 Object 的构造函数会在子类构造函数运行之前先将默认值写入所有的域。因此,某个域的默认值可能被视为失效值。 5.2 不可变对象与初始化安全性 Java内存模型为不可变对象的共享提供了一种特殊的初始化安全性保证。即使在发布不可变对象的引用时没有使用同步,也仍然可以安全地访问该对象。 这种安全性保证还将延伸到被正确创建对象中所有 final 类型的域。在没有额外同步的情况下,也可以安全地访问 final 类型的域。但是如果 final 类型的域所指向的是可变对象,那么在访问这些域所指向的对象的状态时仍然需要同步。 5.3 安全发布的常用模式 要安全地发布一个对象,对象的引用以及对象的状态必须同时对其他线程可见。 可以通过以下方式来安全的发布一个正确构造的对象: 在静态初始化函数中初始化一个对象引用。 将对象的引用保存到 volatile 类型的域 或者 AtomicReference 对象中。 将对象的引用保存到某个正确构造对象的 final 类型域中。 将对象的引用保存到一个由锁保护的域中。 在线程安全容器内部的同步意味着,在将对象放入到某个容器,将满足上述最后一条方式。如果线程 A 将对象 X 放入一个线程安全的容器,随后线程 B 读取这个对象,那么可以确保 B 看到 A 设置的 X 状态,即便这段读/写 X 的应用程序代码没有包含显式的同步。 Java的线程安全库中的容器类有很多,下面列举一些它们提供的安全发布保证: 通过将一个键或者值放入 Hashtable、Collections.synchronizedMap 或者 ConcurrentMap 中,可以安全地将它发布给任何从这些容器中访问它的线程(无论是直接访问还是通过迭代器访问)。 通过将某个元素放入 Vector、CopyOnWriteArrayList、CopyOnWriteArraySet、Collections.synchronizedList 或 Collections.synchronizedSet 中,可以将该元素安全地发布到任何从这些容器中访问该元素的线程。 通过将某个元素放入 BlockingQueue 或者 ConcurrentLinkedQueue 中,可以将该元素安全地发布到任何从这些队列中访问该元素的线程。 类库中的其他数据传递机制(例如 Future 和 Exchanger)同样能实现安全发布,这些后续介绍这些机制将会仔细讨论。 要发布一个静态构造的对象,最简单和最安全的方式就是使用静态的初始化器: public static Holder holder = new Holder(42); 静态初始化器由 JVM 在类的初始化阶段执行。由于在 JVM 内部存在着同步机制,因此通过这种方式初始化的任何对象都可以被安全地发布。 5.4 事实不可变对象 如果对象从技术上来看是可变的,但其状态在发布后不会再改变,那么这种对象也称为 “事实不可变对象【Effectively Immutable Object】”。 所有的安全发布机制都能确保,当对象的引用对所有访问该对象的线程可见时,对象发布时的状态对于所有线程也将是可见的,并且如果该对象状态不会再改变,那么就足以确保任何访问都是安全的。 在没有额外的同步的情况下,任何线程都可以安全地使用被安全发布的事实不可变对象。 下面我们来看一个代码示例: public Map<String, Date> lastLogin = Collections.synchronizedMap(new HashMap<String, Date>()); 上述代码假设需要维护一个保存了每位用户的最近登录时间的 Map。如果 Date 对象的值在被放入 Map 后就不会改变,那么 synchronizedMap 中的同步机制就足以使 Date 值被安全地发布,并且在访问这些 Date 值时不需要额外的同步。 5.5 可变对象 如果对象在构造后可以修改,那么安全发布只能确保 “发布当时” 状态的可见性。对于可变对象不仅在发布对象时需要使用同步,而且在每次对象访问时同样需要使用同步来确保后续修改操作的可见性。 对象的发布需求取决于它的可变性: 不可变对象可以通过任意机制来发布。 事实不可变对象必须通过安全方式来发布。 可变对象必须通过安全方式来发布,并且必须是线程安全的或者由某个锁保护起来。 5.6 安全地共享对象 在并发程序中使用和共享对象时,可以使用如下一些实用的方法: 线程封闭。 线程封闭的对象只能由一个线程拥有,对象被封闭在该线程中,并且只能由这个线程修改。 只读共享。 在没有额外同步的情况下,共享的只读对象可以由多个线程并发访问,但任何线程都不能修改它。共享的只读对象包括不可变对象和事实不可变对象。 线程安全共享。 线程安全的对象在其内部实现同步,因此多个线程可以通过对象的公有接口来进行访问而不需要进一步的同步。 保护对象。 被保护的对象只能通过持有特定的锁来访问。保护对象包括封装在其他线程安全对象中的对象,以及已发布的并且由某个特定锁保护的对象。 结语 对象的共享 到这里就介绍完毕了,下一篇我们将开始了解 对象的组合,敬请期待!!!

优秀的个人博客,低调大师

Java并发编程学习3-可见性和对象发布

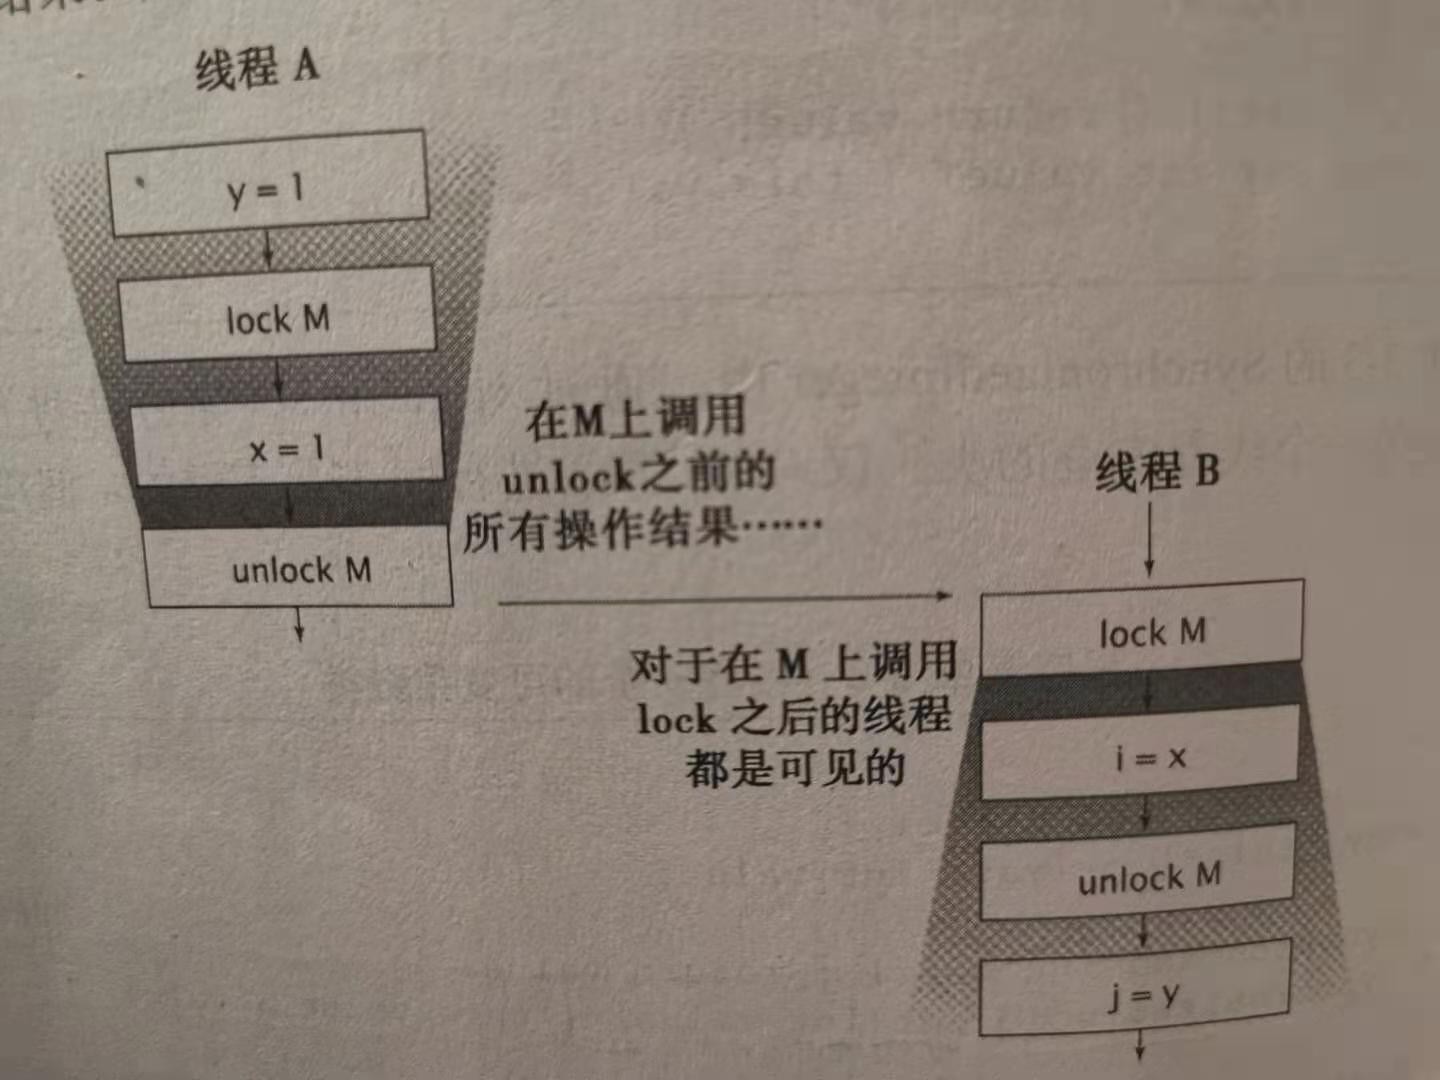
对象的共享 书接上篇,我们了解了如何通过同步来避免多个线程在同一时刻访问相同的数据,而本篇将介绍如何共享和发布对象,从而使它们能够安全地由多个线程同时访问。 1. 可见性 线程安全性的内容,让我们知道了同步代码块和同步方法可以确保以原子的方式执行操作。但如果你认为关键字 synchronized 只能用于实现原子性或者确定“临界区(Critical Section)”,那就大错特错了。同步还有一个重要的方面:内存可见性(Memory Visibility)。我们不仅希望防止某个线程正在使用对象状态而另一个线程在同时修改该状态,而且希望确保当一个线程修改了对象状态后,其他线程能够看到发生的状态变化。 可见性是一种复杂的属性,在一般的单线程环境中,如果向某个变量先写入值,然后在没有其他写入操作的情况下读取这个变量,总是能够得到相同的值。然而,当读操作和写操作在不同的线程中执行时,因为无法确保执行读操作的线程能适时地看到其他线程写入的值,所以也就不能总是得到相同的值。为了确保多个线程之间对内存写入操作的可见性,必须使用同步机制。 介绍了这么多,还不如来看下代码示例: /** * <p> 在没有同步的情况下共享变量(不推荐使用) </p> */ public class NoVisibility { private static boolean ready; private static int number; private static class ReaderThread extends Thread { @Override public void run() { while (!ready) { Thread.yield(); } System.out.println(number); } } public static void main(String[] args) { new ReaderThread().start(); number = 42; ready = true; } } 在上述代码中,主线程和读线程都将访问共享变量 ready 和 number。主线程启动读线程,然后将 number 设为 42, 并将 ready 设为 true。读线程一直循环直到发现 ready 的值变为 true,然后输出 number 的值。虽然 NoVisibility 看起来会输出 42,但事实上很可能输出0,或者根本无法终止。因为在代码中没有使用足够的同步机制,所以无法保证主线程写入的 ready 值 和 number 值对于读线程来说是可见的。 如果你尝试运行该程序,大概率控制台还是会输出42,但这并不说明这块代码就总是能输出想要的结果。NoVisibility 可能会输出0,这是因为读线程可能看到了写入 ready 的值,但却没有看到之后写入 number 的值,这种现象被称为 “重排序”;NoVisibility 也可能会一直循环下去,因为读线程可能永远都看不到 ready 的值。 在没有同步的情况下,编译器、处理器以及运行时等都可能对操作的执行顺序进行一些意想不到的调整。在缺乏足够同步的多线程程序中,要想对内存操作的执行顺序进行判断,几乎无法得出正确的结论。 1.1 失效数据 NoVisibility 展示了在缺乏同步的程序中可能产生错误结果的一种情况:失效数据。当读线程查看 ready 变量时,可能会得到一个已经失效的值。更糟糕的是,失效值可能不会同时出现:一个线程可能获得某个变量得最新值,而获得另一个变量得失效值。 下面再看一个代码示例: /** * <p> 非线程安全的可变整数类 </p> */ @NotThreadSafe public class MutableInteger { private int value; public int getValue() { return value; } public void setValue(int value) { this.value = value; } } 上述代码中 get 和 set 方法都是在没有同步的情况下访问 value 的。如果某个线程调用了 set 方法,那么另一个正在调用 get 方法的线程可能会看到更新后的 value 值,也可能看不到。 下面我们通过对 get 和 set 方法进行同步,可以使 MutableInteger 成为一个线程安全的类。代码示例如下: /** * <p> 非线程安全的可变整数类 </p> */ public class SynchronizedInteger { @GuardedBy("this") private int value; public synchronized int getValue() { return value; } public synchronized void setValue(int value) { this.value = value; } } 当然如果这里仅仅对 set 方法进行同步是不够的,调用 get 方法的线程仍然会看见失效值。 1.2 非原子的64位操作 上面我们了解到,当线程在没有同步的情况下读取变量时,可能会得到一个失效值,但至少这个值是由之前某个线程设置的值,而不是一个随机值。这种安全性保证也被称为最低安全性(out-of-thin-air-safety)。 最低安全性适用于绝大多数变量,但是非 volatile 类型的64位数值变量例外。Java内存模型要求,变量的读取操作和写入操作都必须是原子操作,但对于非 volatile 类型的 long 和 double 变量,JVM允许将64位的读操作或写操作分解为两个32位操作。当读取一个非 volatile 类型 的 long 变量时,如果对该变量的读操作和写操作在不同的线程中执行,那么很可能会读取到某个值的高32位和另一个值得低32位。 1.3 加锁与可见性 内置锁可以用于确保某个线程以一种可预测得方式来查看另一个线程的执行结果,如下图所示。当线程 A 执行某个同步代码块时,线程 B 随后进入由同一个锁保护的同步代码块,在这种情况下可以保证,在锁被释放之前,A 看到的变量值在 B 获得锁后同样可以由 B 看到。换句话说,当线程 B 执行由锁保护的同步代码块时,可以看到线程 A 之前在同一个同步代码块中的所有操作结果。 加锁的含义不仅仅局限于互斥行为,还包括内存可见性。为了确保所有线程都能看到共享变量的最新值,所有执行读操作或者写操作的线程都必须在同一个锁上同步。 1.4 volatile 变量 Java语言提供了一种稍弱的同步机制,即 volatile 变量,用来确保将变量的更新操作通知到其他线程。当变量声明为 volatile 类型后,编译器与运行时都会注意到这个变量是共享的,因此不会将该变量上的操作与其他内存操作一起重排序。volatile 变量不会被缓存在寄存器或者对其他处理器不可见的地方,因此在读取 volatile 类型的变量时总会返回最新写入的值。 当然,这里不建议过度依赖 volatile 变量提供的可见性。仅当 volatile 变量能简化代码的实现以及对同步策略的验证时,才应该使用它们。如果在验证正确性时需要对可见性进行复杂的判断,那么就建议使用 volatile 变量。 volatile 变量的正确使用方式包括: 确保它们自身状态的可见性; 确保它们所引用对象的状态的可见性; 标识一些重要的程序生命周期事件的发生(初始化或关闭) 下面看一个利用 volatile 变量来数绵羊的代码示例: volatile boolean asleep; // ... while (!asleep) countSomeSheep(); 在如上示例中,线程试图通过类似数绵羊的传统方式进入休眠状态。相比用锁来确保 asleep 更新操作的可见性,这里采用 volatile 变量,不仅满足了更新操作的可见性,而且代码逻辑也变得更加简单,更利于理解。 虽然 volatile 变量使用很方便,但它只能确保可见性,而加锁机制既可以确保可见性又可以确保原子性。 那么说了这么多,什么场景下我们才应该使用 volatile 变量呢? 当且仅当满足以下条件: 对变量的写入操作不依赖变量的当前值,或者你能确保只有单个线程更新变量的值。 该变量不会与其他状态变量一起纳入不变性条件中。 在访问变量时不需要加锁。 2. 发布与逸出 本篇开头提到了 发布对象,它是指使对象能够在当前作用域之外的代码中使用。例如,将一个指向该对象的引用保存到其他代码可以访问的地方,或者在某一个非私有的方法中返回该引用,或者将引用传递到其他类的方法中。当某个不应该发布的对象被发布了,这种情况就被称为 逸出(Escape)。 发布对象的最简单方法是将对象的引用保存到一个公有的静态变量中,以便任何类和线程都能够看见该对象。 下面展示发布一个对象的代码示例: public static Set<Secret> knownSecrets; public void initialize() { knownSecrets = new HashSet<Secret>(); } 上述代码中,在 initialize 方法中示例化一个新的 HashSet 对象,并将对象的引用保存到 knownSecrets 中以发布该对象。如果将一个 Secret 对象添加到集合 knownSecrets 中,那么同样会发布这个 Secret 对象,因为任何代码都可以遍历这个集合,并获得对这个新 Secret 对象的引用。 我们再来看一个代码示例: /** * <p> 使内部的可变状态逸出(不推荐使用) </p> */ public class UnsafeStates { private String[] states = new String[] {"HELLO", "HUAZIE"}; public String[] getStates() { return states; } } 上诉代码从非私有方法 getStates 中返回一个引用,这里同样会发布返回的引用的对象 states 。按上述方式来发布 states,就可能存在很大风险,因为任何调用者都能修改这个数组的内容。 如果一个已经发布的对象能够通过非私有的变量引用和方法调用到达其他的对象,那么这些对象也都会被发布。 最后一种发布对象或其内部状态的机制就是发布一个内部的类实例,如下代码示例: /** * <p> 隐式地使this引用逸出(不推荐使用) </p> */ public class ThisEscape { public ThisEscape(EventSource source) { source.registerListener(new EventListener(){ public void onEvent(Event e) { doSomething(e); } }); } private void doSomething(Event e) { // 事件处理 } } 当 ThisEscape 发布 EventListener 时,也隐含地发布了 ThisEscape 实例本身,因为在这个内部类的实例中包含了对 ThisEscape 实例的隐含引用。 安全的对象构造过程 在 ThisEscape 中给出了逸出的一个特殊示例,即 this 引用在构造函数中逸出。如果 this 引用在构造过程中逸出,那么这种对象就被认为是不正确构造。 注意: 不要在构造过程中使 this 引用逸出 如果想在构造函数中注册一个事件监听器或启动进程,那么可以使用一个私有的构造函数和一个公共的工厂方法,从而避免不正确的构造过程。下面请看如下代码示例: /** * <p> 使用工厂方法来防止this引用在构造过程中逸出 </p> */ public class SafeListener { private final EventListener listener; private SafeListener() { listener = new EventListener(){ public void onEvent(Event e) { doSomething(e); } }; } public static SafeListener newInstance(EventSource source) { SafeListener safe = new SafeListener(); source.registerListener(safe.listener); return safe; } private void doSomething(Event e) { // 事件处理 } } 结语 本篇我们一起了解了 可见性 和 对象的发布、逸出等相关内容;关于对象的共享的其他内容【线程封闭,不变性,安全发布】,还需要一篇博文才能介绍完,敬请期待!

优秀的个人博客,低调大师

Java函数式编程-4.lambda表达式排序

1.lambda表达式排序 我们首先看几个比较常见的排序例子,基本数据类型的排序 List list = Arrays.asList(1,3,2,5,4); list.sort(Comparator.naturalOrder()); System.out.println(list); list.sort(Comparator.reverseOrder()); System.out.println(list); 输出结果: [1, 2, 3, 4, 5] [5, 4, 3, 2, 1] 我们可以看到执行结果是符合预期的,但是多数场景我们可能需要针对对象的某个属性进行排序,那么应该怎样做呢?我们看下边的例子: public class Student { private String name; private String sexual; private Integer age; public Student(String name, String sexual,Integer age) { this.name = name; this.sexual = sexual; this.age = age; } public String getName() { return name; } public void setName(String name) { this.name = name; } public String getSexual() { return sexual; } public void setSexual(String sexual) { this.sexual = sexual; } public Integer getAge() { return age; } public void setAge(Integer age) { this.age = age; } @Override public String toString() { return "Student{" + "name='" + name + '\'' + ", sexual='" + sexual + '\'' + ", age=" + age + '}'; } public class Starter { public static void main(String[] args) { List<Student> list = Arrays.asList( new Student("jack", 12), new Student("john", 13), new Student("lily", 11), new Student("lucy", 10) ); list.sort(Comparator.comparing(Student::getAge)); System.out.println(list); list.sort(Comparator.comparing(Student::getAge).reversed()); System.out.println(list); } } 输出结果: [Student{name='lucy', age=10}, Student{name='lily', age=11}, Student{name='jack', age=12}, Student{name='john', age=13}] [Student{name='john', age=13}, Student{name='jack', age=12}, Student{name='lily', age=11}, Student{name='lucy', age=10}] 如果我们需要按照性别分组再排序又该如何实现呢?我们接着看下边的例子 public class Starter { public static void main(String[] args) { List<Student> list = Arrays.asList( new Student("jack", "male", 12), new Student("john", "male", 13), new Student("lily", "female", 11), new Student("david", "male", 14), new Student("luck", "female", 13), new Student("jones", "female", 15), new Student("han", "male", 13), new Student("alice", "female", 11), new Student("li", "male", 12) ); Map<String, List<Student>> groupMap = list.stream().sorted(Comparator.comparing(Student::getAge)) .collect(Collectors.groupingBy(Student::getSexual, Collectors.toList())); System.out.println(groupMap.toString()); } } 输出结果: { female = [ Student { name = 'lily', sexual = 'female', age = 11 }, Student { name = 'alice', sexual = 'female', age = 11 }, Student { name = 'luck', sexual = 'female', age = 13 }, Student { name = 'jones', sexual = 'female', age = 15 }], male = [ Student { name = 'jack', sexual = 'male', age = 12 }, Student { name = 'li', sexual = 'male', age = 12 }, Student { name = 'john', sexual = 'male', age = 13 }, Student { name = 'han', sexual = 'male', age = 13 }, Student { name = 'david', sexual = 'male', age = 14 }] } 我们看到上边的输出结果存在一个问题,如果年龄相同则没有按照姓名排序,怎样实现这个功能呢?我们接着看下边的例子 Map<String, List<Student>> groupMap = list.stream().sorted(Comparator.comparing(Student::getAge) .thenComparing(Student::getName)).collect(Collectors.groupingBy(Student::getSexual, Collectors.toList())); 输出结果: { female = [ Student { name = 'alice', sexual = 'female', age = 11 }, Student { name = 'lily', sexual = 'female', age = 11 }, Student { name = 'luck', sexual = 'female', age = 13 }, Student { name = 'jones', sexual = 'female', age = 15 }], male = [ Student { name = 'jack', sexual = 'male', age = 12 }, Student { name = 'li', sexual = 'male', age = 12 }, Student { name = 'han', sexual = 'male', age = 13 }, Student { name = 'john', sexual = 'male', age = 13 }, Student { name = 'david', sexual = 'male', age = 14 }] } 看输出结果是符合预期的,到此为止我们的lambda表达式排序已经基本介绍完了,当然还有一些特殊的场景没涉猎到,大家可以根据兴趣再深入探索。

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册