首页 文章 精选 留言 我的

精选列表

搜索[AI编程],共10000篇文章
优秀的个人博客,低调大师

Java编程详解-基于 dubbo 的分布式架构

前言 现在越来越多的互联网公司还是将自己公司的项目进行服务化,这确实是今后项目开发的一个趋势,就这个点再凭借之前的SSM项目来让第一次接触的同学能快速上手。 浅谈分布式架构 分布式架构 单看这个名字给人的感觉就是高逼格,但其实从历史的角度来分析一下就比较明了了。 我们拿一个电商系统来说: 单系统 对于一个刚起步的创业公司项目肯定是追求越快完成功能越好,并且用户量也不大。 这时候所有的业务逻辑都是在一个项目中就可以满足。 垂直拆分-多应用 当业务量和用户量发展到一定地步的时候,这时一般会将应用同时部署到几台服务器上,在用户访问的时候使用 Nginx 进行反向代理和简单的负载均衡。 SOA服务化 当整个系统以及发展的足够大的时候,比如一个电商系统中存在有: 用户系统 订单系统 支付系统 物流系统 等系统。 如果每次修改了其中一个系统就要重新发布上线的话那么耦合就太严重了。 所以需要将整个项目拆分成若干个独立的应用,可以进行独立的开发上线实现快速迭代。 如上图所示每个应用之间相互独立,每个应用可以消费其他应用暴露出来的服务,同时也对外提供服务。 从架构的层面简单的理解了,接下来看看如何编码实现。 基于dubbo的实现 dubbo 应该算是国内使用最多的分布式服务框架,基于此来实现对新入门的同学应该很有帮助。 其中有涉及到安装dubbo服务的注册中心zookeeper等相关知识点可以自行查看官方文档,这里就不单独讲了。 对外提供服务 首先第一步需要在 SSM-API 模块中定义一个接口,这里就搞了一个用户查询的接口 /** * Function:用户API *@authorchenjiec * Date: 2017/4/4 下午9:46 *@sinceJDK 1.7 */ publicinterfaceUserInfoApi{ /** * 获取用户信息 *@paramuserId *@return *@throwsException */ publicUserInfoRsp getUserInfo(int userId) throwsException; } 接着在 SSM-SERVICE 模块中进行实现: importcom.alibaba.dubbo.config.annotation.Service; /** * Function: *@authorchenjiec * Date: 2017/4/4 下午9:51 *@sinceJDK 1.7 */ @Service publicclassUserInfoApiImplimplementsUserInfoApi{ privatestaticLogger logger = LoggerFactory.getLogger(UserInfoApiImpl.class); @Autowired privateT_userService t_userService ; /** * 获取用户信息 * *@paramuserId *@return *@throwsException */ @Override publicUserInfoRspgetUserInfo(intuserId)throwsException { logger.info("用户查询Id="+userId); //返回对象 UserInfoRsp userInfoRsp =newUserInfoRsp() ; T_user t_user = t_userService.selectByPrimaryKey(userId) ; //构建 buildUserInfoRsp(userInfoRsp,t_user) ; returnuserInfoRsp; } /** * 构建返回 *@paramuserInfoRsp *@paramt_user */ privatevoidbuildUserInfoRsp(UserInfoRsp userInfoRsp, T_user t_user) { if(t_user ==null){ t_user =newT_user() ; } CommonUtil.setLogValueModelToModel(t_user,userInfoRsp); } } 这些都是通用的代码,但值得注意的一点是这里使用的 dubbo 框架所提供的 @service 注解。作用是声明需要暴露的服务接口。 再之后就是几个dubbo相关的配置文件了。 spring-dubbo-config.xml <dubbo:applicationname="ssm-service" owner="crossoverJie" organization="ssm-crossoverJie" logger="slf4j"/> <dubbo:registryid="dubbo-registry" address="zookeeper://192.168.0.188:2181" file="/tmp/dubbo.cachr" /> <dubbo:monitorprotocol="registry" /> <dubbo:protocolname="dubbo" port="20880" /> <dubbo:providertimeout="15000" retries="0" delay="-1" /> <dubbo:consumercheck="false" timeout="15000" /> 其实就是配置我们服务注册的zk地址,以及服务名称、超时时间等配置。 spring-dubbo-provider.xml <dubbo:annotationpackage="com.crossoverJie.api.impl" /> 这个配置扫描注解包的位置,一般配置到接口实现包即可。 spring-dubbo-consumer.xml 这个是消费者配置项,表明我们需要依赖的其他应用。 这里我们在 SSM-BOOT 项目中进行配置: <dubbo:reference id="userInfoApi" interface="com.crossoverJie.api.UserInfoApi" /> 直接就是配置的刚才我们提供的那个用户查询的接口,这样当我们自己的内部项目需要使用到这个服务只需要依赖 SSM-BOOT 即可,不需要单独的再去配置 consumer 。这个我有在上一篇SSM(十) 项目重构-互联网项目的Maven结构中也有提到。 安装管理控制台 还有一个需要做的就是安装管理控制台,这里可以看到我们有多少服务、调用情况是怎么样等作用。 这里我们可以将dubbo的官方源码下载下来,对其中的 dubbo-admin 模块进行打包,将生成的 WAR包 放到 Tomcat 中运行起来即可。 但是需要注意一点的是: 需要将其中的 dubbo.properties 的zk地址修改为自己的即可。 dubbo.registry.address=zookeeper://127.0.0.1:2181 dubbo.admin.root.password=root dubbo.admin.guest.password=guest 到时候登陆的话使用root,密码也是root。 使用guest,密码也是guest。 登陆界面如下图: 其中我们可以看到有两个服务以及注册上去了,但是没有消费者。 消费服务 为了能够更直观的体验到消费服务,我新建了一个项目: https://github.com/crossoverJie/SSM-CONSUMER。 其中在 SSM-CONSUMER-API 中我也定义了一个接口: /** * Function:薪资API *@authorchenjiec * Date: 2017/4/4 下午9:46 *@sinceJDK 1.7 */ publicinterfaceSalaryInfoApi{ /** * 获取薪资 *@paramuserId *@return *@throwsException */ publicSalaryInfoRsp getSalaryInfo(int userId) throwsException; } 因为作为消费者的同时我们也对外提供了一个获取薪资的一个服务。 在 SSM-CONSUMER-SERVICE 模块中进行了实现: /** * Function: *@authorchenjiec * Date: 2017/4/4 下午9:51 *@sinceJDK 1.7 */ @Service publicclassSalaryInfoApiImplimplementsSalaryInfoApi{ privatestaticLogger logger = LoggerFactory.getLogger(SalaryInfoApiImpl.class); @Autowired UserInfoApi userInfoApi ; /** * 获取用户信息 * *@paramuserId *@return *@throwsException */ @Override publicSalaryInfoRspgetSalaryInfo(intuserId)throwsException { logger.info("薪资查询Id="+userId); //返回对象 SalaryInfoRsp salaryInfoRsp =newSalaryInfoRsp() ; //调用远程服务 UserInfoRsp userInfo = userInfoApi.getUserInfo(userId); salaryInfoRsp.setUsername(userInfo.getUserName()); returnsalaryInfoRsp; } } 其中就可以直接使用 userInfoApi 调用之前的个人信息服务。 再调用之前需要注意的有点是,我们只需要依赖 SSM-BOOT 这个模块即可进行调用,因为 SSM-BOOT 模块已经为我们配置了消费者之类的操作了: <dependency> <groupId>com.crossoverJie</groupId> <artifactId>SSM-BOOT</artifactId> </dependency> 还有一点是在配置 SSM-BOOT 中的 spring-dubbo-cosumer.xml 配置文件的时候,路径要和我们初始化spring配置文件时的路径一致: <!-- Spring和mybatis的配置文件 --> <context-param> <param-name>contextConfigLocation</param-name> <param-value>classpath*:spring/*.xml</param-value> </context-param> 接下来跑个单测试一下能否调通: /** * Function: * *@authorchenjiec * Date: 2017/4/5 下午10:41 *@sinceJDK 1.7 */ @RunWith(SpringJUnit4ClassRunner.class) @ContextConfiguration(locations = { "classpath*:/spring/*.xml" }) publicclassSalaryInfoApiImplTest{ @Autowired privateSalaryInfoApi salaryInfoApi ; @Test publicvoid getSalaryInfo() throws Exception { SalaryInfoRsp salaryInfo = salaryInfoApi.getSalaryInfo(1); System.out.println(JSON.toJSONString(salaryInfo)); } } 消费者 提供者 可以看到确实是调用成功了的。 接下来将消费者项目也同时启动在来观察管理控制台有什么不一样: 会看到多了一个消费者所提供的服务 com.crossoverjie.consumer.api.SalaryInfoApi ,同时 com.crossoverJie.api.UserInfoApi 服务已经正常,说明已经有消费者了。 点进去便可查看具体的消费者。 总结 这样一个基于dubbo的分布式服务已经讲的差不多了,在实际的开发中我们便会开发一个大系统中的某一个子应用,这样就算一个子应用出问题了也不会影响到整个大的项目。 再提一点: 在实际的生产环境一般同一个服务我们都会有一个 master , slave 的主从服务,这样在上线的过程中不至于整个应用出现无法使用的尴尬情况。 谈到了 SOA 的好处,那么自然也有相对于传统模式的不方便之处:
优秀的个人博客,低调大师

Java编程解密-Dubbo负载均衡与集群容错机制

1 Dubbo简介 Dubbo是一款高性能、轻量级的开源Java RPC框架,它提供了三大核心能力:面向接口的远程方法调用,智能容错和负载均衡,以及服务自动注册和发现。 作为一个轻量级RPC框架,Dubbo的设计架构简洁清晰,主要组件包括Provider(服务提供者),Consumer(服务消费者),Registry(注册中心)三部分组成。此外还有用于服务监控的Monitor,它们之间的关系如下所示: 在一个分布式系统中,为了做到系统的高可用,即服务宕机时不影响对外正常提供服务,需要组建负载集群,当集群中某一节点没有及时返回数据时,需要有集群容错(重试)机制。 2 Dubbo负载均衡 在集群负载均衡时,Dubbo 提供了以下5种均衡策略,缺省为 random 随机调用。 Random 随机调用 Random LoadBalance 随机,按权重设置随机概率。 在一个截面上碰撞的概率高,但调用量越大分布越均匀,而且按概率使用权重后也比较均匀,有利于动态调整提供者权重。 RoundRobin LoadBalance 轮循,按公约后的权重设置轮循比率。 存在慢的提供者累积请求的问题,比如:第二台机器很慢,但没挂,当请求调到第二台时就卡在那,久而久之,所有请求都卡在调到第二台上。 LeastActive LoadBalance 最少活跃调用数,相同活跃数的随机,活跃数指调用前后计数差。 使慢的提供者收到更少请求,因为越慢的提供者的调用前后计数差会越大。 ConsistentHash LoadBalance 一致性 Hash,相同参数的请求总是发到同一提供者。 当某一台提供者挂时,原本发往该提供者的请求,基于虚拟节点,平摊到其它提供者,不会引起剧烈变动。 3 负载均衡配置 服务端服务级别 <dubbo:serviceinterface="..." loadbalance="roundrobin" />; 客户端服务级别 <dubbo:referenceinterface="..." loadbalance="roundrobin" /> 服务端方法级别 <dubbo:serviceinterface="..."> <dubbo:methodname="..." loadbalance="roundrobin"/> </dubbo:service> 客户端方法级别 <dubbo:referenceinterface="..."> <dubbo:methodname="..." loadbalance="roundrobin"/> </dubbo:reference> 4 Dubbo集群容错(重试机制) 在集群调用失败时,Dubbo 提供了多种容错方案,缺省为 Failover 重试。 各节点关系: 这里的 Invoker 是 Provider 的一个可调用 Service 的抽象,Invoker 封装了 Provider 地址及 Service 接口信息 Directory 代表多个 Invoker,可以把它看成 List ,但与 List 不同的是,它的值可能是动态变化的,比如注册中心推送变更 Cluster 将 Directory 中的多个 Invoker 伪装成一个 Invoker,对上层透明,伪装过程包含了容错逻辑,调用失败后,重试另一个 Router 负责从多个 Invoker 中按路由规则选出子集,比如读写分离,应用隔离等 LoadBalance 负责从多个 Invoker 中选出具体的一个用于本次调用,选的过程包含了负载均衡算法,调用失败后,需要重选 5 重试模式及其特点 Failover Cluster(默认) 失败自动切换,当出现失败,重试其它服务器 [1]。通常用于读操作,但重试会带来更长延迟。可通过 retries="2" 来设置重试次数(不含第一次)。 重试次数配置如下: <dubbo:serviceretries="2" /> 或 <dubbo:referenceretries="2" /> 或 <dubbo:reference> <dubbo:methodname="findFoo" retries="2" /> </dubbo:reference> Failfast Cluster 快速失败,只发起一次调用,失败立即报错。通常用于非幂等性的写操作,比如新增记录。 Failsafe Cluster 失败安全,出现异常时,直接忽略。通常用于写入审计日志等操作。 Failback Cluster 失败自动恢复,后台记录失败请求,定时重发。通常用于消息通知操作。 Forking Cluster 并行调用多个服务器,只要一个成功即返回。通常用于实时性要求较高的读操作,但需要浪费更多服务资源。可通过 forks="2" 来设置最大并行数。 Broadcast Cluster 广播调用所有提供者,逐个调用,任意一台报错则报错 [2]。通常用于通知所有提供者更新缓存或日志等本地资源信息。 6 集群模式配置 按照以下示例在服务提供方和消费方配置集群模式 <dubbo:servicecluster="failsafe" /> 或 <dubbo:referencecluster="failsafe" /> 欢迎关注,欢迎留言探讨。 1、具有1-5工作经验的,面对目前流行的技术不知从何下手,需要突破技术瓶颈的可以加群。 2、在公司待久了,过得很安逸,但跳槽时面试碰壁。需要在短时间内进修、跳槽拿高薪的可以加群。 3、如果没有工作经验,但基础非常扎实,对java工作机制,常用设计思想,常用java开发框架掌握熟练的,可以加群。 4、觉得自己很牛B,一般需求都能搞定。但是所学的知识点没有系统化,很难在技术领域继续突破的可以加群。 5.群号 468947140,点击链接加入群聊【Java-BATJ企业级资深架构】:https://jq.qq.com/?_wv=1027&k=5FksT0r 6.阿里Java高级大牛直播讲解知识点,分享知识,知识点都是各位老师多年工作经验的梳理和总结,带着大家全面、科学地建立自己的技术体系和技术认知!

优秀的个人博客,低调大师

Java高级编程细节 模糊数据库database系统

什么是模糊数据库系统 模糊数据库系统指能处理模糊数据的数据库系统。 我们一般遇到的数据库都是具有二值逻辑和精确数据的。但是,在现实中还有很多不确定的模糊不清的事情。我们的大脑也是偏向于处理一些模糊事件,对这些模糊事件更感兴趣。当一件东西太ling清楚地展示在我们面前时,我们大脑就失去了对事物进行探索的欲望。这样就可以把不完全性、不确定性、模糊性引入数据库系统中,从而形成模糊数据库。自1965年美国的L.Z.扎德提出模糊理论以来,人们就对这个领域产生了极大兴趣。模糊理论应用不断扩大,作为流行的数据库更是受到了注意。 随着模糊理论体系的建立,人们可以用数量来描述模糊事件并能进行模糊运算。在数据库系统中,也可以将数学上的这种成果,如不完全性、不确定性、模糊性引入,从而形成模糊数据库。 模糊数据库的研究主要有两方面: 首先是如何在数据库中存放模糊数据,其次是定义各种运算、建立模糊数据上的函数。模糊数据的表示方法主要有模糊区间数、模糊中心数、模糊集合数和隶属函数等。 在模糊数据库中,如果把各记录值视为节点,把关系视为节点间的连线。一个模糊数据库就可以看成是一个复杂的网络。模糊数据库上的主要操作是指从某节点到网络其他节点的移动。但由于主要涉及到很强的指针或游标指示当前的位置,其复杂性会大大增加,所以发展前景也不容乐观。 在模糊层次数据模型中,将树中的各节点“父子关系”和“兄弟关系”的亲密程度通过隶属值来实现。然而,与模糊网络数据模型一样,其复杂性也限制了模糊层次数据库的发展。 模糊关系数据模型中,有元组模糊关系数据模型、模糊关系数据模型、集合值模糊关系数据模型和属性具有加权模糊值的模糊关系数据模型等几类。其中属性具有加权模糊的模糊关系数据库是一对一一般关系数据库模糊化最彻底的模糊数据库,并且是应用非常广泛的模糊数据库。 在模糊面向对象数据库中,对象类的定义引入了递归的概念,采用面向对象的描述方法,模块化强,结构化程度高,便于分层实现,有利于实际系统的开发。但由于目前还没成熟,开发带来很大的困难。 对象-关系数据模型是结合关系数据模型和面向对象模型一起发展的一种模型,它具有关系数据模型的强大查询语言的功能,同时也有面向对象的特性,所以目前建立模糊数据库的最好选择。 欢迎工作一到五年的Java工程师朋友们加入Java架构开发:468947140 点击链接加入群聊【Java-BATJ企业级资深架构】:https://jq.qq.com/?_wv=1027&k=5zMN6JB 本群提供免费的学习指导 架构资料 以及免费的解答 不懂得问题都可以在本群提出来 之后还会有职业生涯规划以及面试指导 如果您觉得好的话,请转发或者关注我哦

优秀的个人博客,低调大师

Java编程微服务架构框架-监控与管理(SpringBoot)

在微服务架构中,我们将原本庞大的单体系统拆分成多个提供不同服务的应用。 虽然 各个应用的内部逻辑因分解而得以简化,但是由于部署应用的数量成倍增长,使得系统的 维护复杂度大大提升。 对于运维人员来说,随着应用的不断增多,系统集群中出现故障的 频率也变得越来 越高,虽然在高可用机制的保护下,个别故障不会影响系统的对外服务, 但是这些频繁出现的故障需要被及时发现和处理才能长期保证系统处千健康可用状态。 为 了能对这些成倍增长的应用做到高效运维,传统的运维方式显然是不合适的,所以我们需 要实现一套自动化的监控 运维机制,而这套机制的运行基础就是不间断地收集各个微服务 应用的各项 指标情况,并根据这些基础指标信息来制定监控和预警规则,更进一步甚至做 到一些自动化的运维操作等。 为了让运维系统能够获取各个微服务应用的相关指标以及实现一些常规操作控制,我 们需要开发一套专门用于植入各个微服务应用的接口供监控 系统采集信息。 而这些接口往 往有很大一 部分指标都是类似的, 比如环境变量、 垃圾收集信息、 内存信息、 线程池信息 等。 既然这些信息那么通用,难道就没有一个标准化的实现框架吗? 当我们决定用Spring Boot来作为微服务框架时,除了它强大的快速开发功能之外,还因 为它在Starter POMs中提供了一个特殊依赖模块spring-boot-starter-actuator 。引入该模块能够自动为 Spring Boot 构建的应用提供 一系列用千监控的端点。 同时, Spring Cloud 在实现各个微服务组件的时候, 进 一步为该模块做了不少扩展, 比如, 为原生端点 增加了更多的指标和度量信息(比如在整合 Eureka 的时候会为/health 端点增加相关的 信息), 并且根据不同的组件还提供了更多有空的端点(比如, 为 API 网关组件 Zuul 提供 了 /routes 端点来返回路由信息)。 spring-boot-starter-actuator 模块的实现对千实施微服务的中小团队来说, 可以有效地省去或大大减少监控系统在采集应用指标时的开发量。 当然, 它也并不是万能 的, 有时候也需要对其做 一些简单的扩展来帮助我们实现自身系统个性化的监控需求。 所 以,在本节将详细介绍一些关于spring-boot-starter-actuator模块的内容, 包括 原生提供的端点以及一些常用的扩展和配置方式等。 在现有 的 Spring Boot 应用中引入该模块非常简单 , 只需要 在 pom.xml 的 dependency 节点中,新增 spring-boot-starter-actua七or 的依赖即可,具体如下: <dependency> <groupId>org.springframework.boot</groupId> <artifactId>spring-boot-starter-actuator</artifactId> </dependency> 增加该依赖之后,重新启动应用。此时,我们可以在控制台中看到如下图所示的输出: : Mapped "{[/trace i I /trace.json],methods=(GET),produces=[applicat10n : Mapped "{[/info 11 /info.json],methods=[GET},produces=[application/j : Mapped " { [ / env / {name: , }], methods=[ GET), produces= [ application/json)} : Mapped "{[/env 11 /env.json],methods=[GET),produces=[application/jso : Mapped "{[/dump 11 /dump.json],methods=[GET),produces=[application/j, Mapped "([/autoconfig 11 /autoconfig.json],rnethods=[GET),produces=[a : Mapped "{[/health 11 /health.json],produces=[application/json)}" ont : Mapped "{[/mappings 11 /mappings.json],methods=(GET],produces=(appli : Mapped "{[/beans 11 /beans.json],methods=[GET),produces=[application : Mapped "{[/configprops 11 /configprops.json],methods=[GET),produces= : Mapped "{[/metrics/{name:. 不}],methods=(GET),produces=[application/js : Mapped "{[/metrics 11 /metrics.json],methods=[GET),produces=(applica 原生端点 通过在快速入门示例中添加spring-boot-starter-actuator模块, 我们已经对 它有了 一个初步的认识。接下来,我们详细介绍一下 spring-boot-starter-actuator模块中已经实现的一些原生端点。 根据端点的作用, 可以将原生端点分为以下三大类。 应用配置类:获取应用程序中加载的应用配置、 环境变量、 自动化配置报告等与 Spring Boot应用密切相关的配置类信息。 度最指标类:获取应用程序运行过程中用于监控的度量指标, 比如内存信息、 线程 池信息、 HTTP请求统计等。 操作控制类:提供了对应用的关闭等操作类功能。 1、应用配置类->由于SpringBoot为了改善传统Spring应用繁杂的配置内容,采用了包扫描和自动化配 置的机制来加载原本集中于XML文件中的各项内容。 虽然这样的做法让我们的代码变得 非常简洁,但是整个应用的实例创建和依赖关系等信息都被离散到了各个配置类的注解上, 这使我们分析整个应用中资源和实例的各种关系变得非常困难。 而这类端点可以帮助我们 轻松获取一系列关于 Spring 应用配置内容的详细报告, 比如自动化配置的报告、 Bean创 建的报告、 环境属性的报告等。 /autoconfig:该端点用来获取应用的自动化配置报告, 其中包括所有自动化配置的 候选项。 同时还列出了每个候选项是否满足自动化配置的各个先决条件。 所以, 该 端点可以帮助我们方便地找到一些自动化配置为什么没有生效的具体原因。 该报告 内容将自动化配置内容分为以下两部分。 positiveMatches中返回的是条件匹配成功的自动化配置。 negativeMatches中返回的是条件匹配不成功的自动化配置。 /beans:该端点用来获取应用上下文中创建的所有Bean。 Bean 中都包含了下面这些信息: bean: Bean 的名称。 scope: Bean 的作用域。 type: Bean 的 Java 类型。 resource: class 文件的具体路径。 dependencies: 依赖的 Bean 名称。 /configprops:该端点用来获取应用中配置的属性信息报告。 从下面该端点返回示例 的片段中, 我们看到返回了关于该短信的配置信息, prefix 属性代表了属性的配 置前缀, properties 代表了各个属性的名称和值。 所以, 我们可以通过该报告来 看 到各个属性的 配 置路 径, 比如我们要关闭该端点, 就可 以 通过使用 endpoints.configprops.enabled=false 来完成设置。 /env: 该端点与/configprops不同它用来获取应用所有可用的环境属性报告。 包括 环境变量、NM属性、应用的配置属性、命令行中的参数。 从下面该端点返回的示 例片段中, 可以看到它不仅返回了应用的配置属性, 还返回了系统属性、环境变量 等丰富的配置信息, 其中还包括了应用还没有使用的配置, 所以它可以帮助我们方 便地看到当前应用可以加载的配置信息, 并配合@ConfigurationProperties 注解将它们引入到我们的应用程序中来进行使用。 另外, 为了配置属性的安全, 对 于一些类似密码等敏感信息, 该端点都会进行隐私保护, 但是我们需要让属性名中 包含password、secret、key这些关键词, 这样该端点在返回它们的时候会使用*来替代实际的属性值。 /mappings: 该端点用来返回所有Spring MVC的控制器映射关系报告。 从下面的示 例片段中, 我们可以看到该报告的信息与我们在启用Spring MVC的Web应用时输 出的日志信息类似, 其中bean属性标识了该映射关系的请求处理器, method属 性标识了该映射关系的具体处理类和处理函数。 /info: 该端点用来返回一些应用自定义的信息。 默认清况下, 该瑞点只会返回 一个 空的JSON内容。我们可以在application.properties配置文件中通过info 前缀来设置一些属性, 比如下面这样: info.app.name=spring-boot-hello info.app.version=vl.0.0 再访问/info端点我们可以得到下面的返回报告, 其中就包含了上面我们在应用 中自定义的两个参数。 "app": { "name": "spring-boot-hello", "version": "vl.0.0" } 2、度量指标类-->上面我们所介绍的应用配置类端点所提供的信息报告在应用启动的时候就已经基本确 定了其返回内容, 可以说是一个静态报告。 而度量指标类端点提供的报告内容则是动态变 化的,这些端点提供了应用程序在运行过程中的一些快照信息,比如内存使用情况、 HTTP 请求统计、外部资源指标等。这些端点对于我们构建微服务架构中的监控系统非常有帮助, 由于 Spring Boot 应用自身实现了这些端点,所以我们可以很方便地利用它们来收集我们想 要的信息, 以制定出各种自动化策略。 /metrics: 该端点用来返回当前应用的各类重要度量指标,比如内存信息、线程信息、 垃圾回收信息等。 { "mem":1292717, "mem.free":703542, "processors":32, "instance.uptime":245161086, "uptime":245165938, "systemload.average":0, "heap.committed":1238016, "heap.init":1026744, "heap.used":534473, "heap":14603776, "nonheap.committed":55232, "nonheap.init":24000, "nonheap.used":54701, "nonheap":133120, "threads.peak":28, "threads.daemon":23, "threads.totalStarted":296, "threads":26, "classes":8854, "classes.loaded":8854, "classes.unloaded":0, "gc.ps_scavenge.count":4, "gc.ps_scavenge.time":163, "gc.ps_marksweep.count":0, "gc.ps_marksweep.time":0, "httpsessions.max":-1, "httpsessions.active":0, "counter.status.200.aliPay.createOrderANdAliPayUrl":4, "counter.status.200.aliPay.notifyUrl":2, "counter.status.200.atOnceWithhold":12, "counter.status.200.autoconfig":1, "counter.status.200.metrics":1, "counter.status.200.withhold":254, "counter.status.405.unmapped":2, "gauge.response.aliPay.createOrderANdAliPayUrl":35, "gauge.response.aliPay.notifyUrl":481, "gauge.response.atOnceWithhold":10046, "gauge.response.autoconfig":35, "gauge.response.metrics":19, "gauge.response.unmapped":6, "gauge.response.withhold":16 } 从上面的示例中, 我们看到有如下这些重要的度量值。 系统信息:包括处理器数量processors、运行时间up巨me和instance.uptime、 系统平均负载 systemload.average。 mem. *: 内存概要信息,包括分配给应用的总内存数量以及当前空闲的内存数量。 这些信息来自java.lang.Runtime。 heap.* : 堆内存使用情况。 这些信息来自 java.lang.management. MemoryMXBean 接口中 getHeapMemoryUsage 方法获取的 java.lang. management.MemoryUsage。 nonheap. *: 非堆内存使用情况。 这些信息来自 java. lang.management. MemoryMXBean接口中getNonHeapMemoryUsage方法获取的java.lang. managemen.MemoryUsage。 threads.*: 线程使用情况,包括线程数、守护线程数(daemon)线程峰值(peak) 等, 这些数据均来自java.lang.management.ThreadMXBean。 classes.*: 应用加载和卸载的类统计。这些数据均来自java.lang.managemen七. ClassLoadingMXBean。 gc. *: 垃圾收集器的详细信息,包括垃圾回收次数gc.ps—scavenge.coun七、 垃圾回收消耗时间 gc.ps_scavenge.time、 标记-清除算法的次数 gc.ps marksweep.count、 标记-清除算法的消耗时间gc.ps_marksweep.time。 这些数据均来自java.lang.managemen.GarbageCollectorMXBean。 httpsessions. * : Tomcat容 器 的会话使用情况。 包 括最大会话 数 httpsessions.max和活跃会话数httpsessions.active。 该度量指标信 息仅在引入嵌入式Tomcat作为应用容器的时候才会提供。 gauge.*: HTTP请求的性能指标之一,它主要用来反映一个绝对数值。 比如上 面示例中的gauge.response.hello: 5, 它表示上 一 次hello请求的延迟 时间为5毫秒。 counter.*: HTTP 请求的性能指标之一,它主要作为计 数器来使用,记录了 增加量和减少量。 上述示例中的counter.status.200.hello: 11, 它代表 了 hello请求返回200状态的次数为11。 /metrics端点可以提供应用运行状态的完整度量指标报告,这项功能 非常实用,但是 对千监控系 统中的各项监控功能,它们的监控内容、 数据收集频率都有所不同,如 果每次都通过全量获取报告的方式来收集,略显粗暴。 所以,我们还可以通过 /metrics/{name}接口来更细粒度地获取度量信息 , 比 如可 以通 过访 问 /metrics/mem.free来获取当前可用 内存数量。 curl -i http://****:8081/metrics/mem.free { "mem.free":1447714 } 喜欢的请关注笔者,后续笔者将持续更新,笔者如果有写误的也请评论留言,谢谢! 欢迎工作一到五年的Java工程师朋友们加入Java架构开发:468947140 点击链接加入群聊【Java-BATJ企业级资深架构】:https://jq.qq.com/?_wv=1027&k=5zMN6JB 本群提供免费的学习指导 架构资料 以及免费的解答 不懂得问题都可以在本群提出来 之后还会有职业生涯规划以及面试指导

优秀的个人博客,低调大师

Java并发编程笔记之 CountDownLatch闭锁的源码分析

JUC 中倒数计数器 CountDownLatch 的使用与原理分析,当需要等待多个线程执行完毕后在做一件事情时候 CountDownLatch 是比调用线程的 join 方法更好的选择,CountDownLatch 与 线程的 join 方法区别是什么? 日常开发中经常会遇到需要在主线程中开启多线程去并行执行任务,并且主线程需要等待所有子线程执行完毕后再进行汇总的场景,它的内部提供了一个计数器,在构造闭锁时必须指定计数器的初始值,且计数器的初始值必须大于0。另外它还提供了一个countDown方法来操作计数器的值,每调用一次countDown方法计数器都会减1,直到计数器的值减为0时就代表条件已成熟,所有因调用await方法而阻塞的线程都会被唤醒。这就是CountDownLatch的内部机制,看起来很简单,无非就是阻塞一部分线程让其在达到某个条件之后再执行。但是CountDownLatch的应用场景却比较广泛,只要你脑洞够大利用它就可以玩出各种花样。最常见的一个应用场景是开启多个线程同时执行某个任务,等到所有任务都执行完再统计汇总结果。下图动态演示了闭锁阻塞线程的整个过程。 在CountDownLatch出现之前一般都是使用线程的join()方法来实现,但是join不够灵活,不能够满足不同场景的需求。接下来我们看看CountDownLatch的原理实现。 一.CountDownLatch原理探究 从CountDownLatch的名字可以猜测内部应该有个计数器,并且这个计数器是递减的,下面就通过源码看看JDK开发组是何时初始化计数器,何时递减的,计数器变为 0 的时候做了什么操作,多个线程是如何通过计时器值实现同步的,首先我们先看看CountDownLatch内部结构,类图如下: 从类图可以知道CountDownLatch内部还是使用AQS实现的,通过下面构造函数初始化计数器的值,可知实际上是把计数器的值赋值给了AQS的state,也就是这里AQS的状态值来表示计数器值。 构造函数源码如下: public CountDownLatch(int count) { if (count < 0) throw new IllegalArgumentException("count < 0"); this.sync = new Sync(count); } Sync(int count) { setState(count); } 接下来主要看一下CountDownLatch中几个重要的方法内部是如何调用AQS来实现功能的。 1.void await()方法,当前线程调用了CountDownLatch对象的await方法后,当前线程会被阻塞,直到下面的情况之一才会返回:(1)当所有线程都调用了CountDownLatch对象的countDown方法后, 也就是说计时器值为 0 的时候。(2)其他线程调用了当前线程的interrupt()方法中断了当前线程,当前线程会抛出InterruptedException异常后返回。接下来让我们看看await()方法内部是如何调用 AQS的方法的,源码如下: //CountDownLatch的await()方法 public void await() throws InterruptedException { sync.acquireSharedInterruptibly(1); } //AQS的获取共享资源时候可被中断的方法 public final void acquireSharedInterruptibly(int arg)throws InterruptedException { //如果线程被中断则抛异常 if (Thread.interrupted()) throw new InterruptedException(); //尝试看当前是否计数值为0,为0则直接返回,否者进入AQS的队列等待 if (tryAcquireShared(arg) < 0) doAcquireSharedInterruptibly(arg); } //sync类实现的AQS的接口 protected int tryAcquireShared(int acquires) { return (getState() == 0) ? 1 : -1; } 从上面代码可以看到await()方法委托sync调用了AQS的acquireSharedInterruptibly方法,该方法的特点是线程获取资源的时候可以被中断,并且获取到的资源是共享资源,这里为什么要调用AQS的这个方法,而不是调用独占锁的accquireInterruptibly方法呢?这是因为这里状态值需要的并不是非 0 即 1 的效果,而是和初始化时候指定的计数器值有关系,比如你初始化的时候计数器值为 8 ,那么state的值应该就有 0 到 8 的状态,而不是只有 0 和 1 的独占效果。 这里await()方法调用acquireSharedInterruptibly的时候传递的是 1 ,就是说明要获取一个资源,而这里计数器值是资源总数,也就是意味着是让总的资源数减 1 ,acquireSharedInterruptibly内部首先判断如果当前线程被中断了则抛出异常,否则调用sync实现的tryAcquireShared方法看当前状态值(计数器值)是否为 0 ,是则当前线程的await()方法直接返回,否则调用AQS的doAcquireSharedInterruptibly让当前线程阻塞。另外调用tryAcquireShared的方法仅仅是检查当前状态值是不是为 0 ,并没有调用CAS让当前状态值减去 1 。 2.boolean await(long timeout, TimeUnit unit),当线程调用了 CountDownLatch 对象的该方法后,当前线程会被阻塞,直到下面的情况之一发生才会返回: (1)当所有线程都调用了 CountDownLatch 对象的 countDown 方法后,也就是计时器值为 0 的时候,这时候返回 true; (2) 设置的 timeout 时间到了,因为超时而返回 false; (3)其它线程调用了当前线程的 interrupt()方法中断了当前线程,当前线程会抛出 InterruptedException 异常后返回。源码如下: public boolean await(long timeout, TimeUnit unit) throws InterruptedException { return sync.tryAcquireSharedNanos(1, unit.toNanos(timeout)); } 3.void countDown() 当前线程调用了该方法后,会递减计数器的值,递减后如果计数器为 0 则会唤醒所有调用await 方法而被阻塞的线程,否则什么都不做,接下来看一下countDown()方法内部是如何调用AQS的方法的,源码如下: //CountDownLatch的countDown()方法 public void countDown() { //委托sync调用AQS的方法 sync.releaseShared(1); } //AQS的方法 public final boolean releaseShared(int arg) { //调用sync实现的tryReleaseShared if (tryReleaseShared(arg)) { //AQS的释放资源方法 doReleaseShared(); return true; } return false; } 如上面代码可以知道CountDownLatch的countDown()方法是委托sync调用了AQS的releaseShared方法,后者调用了sync 实现的AQS的tryReleaseShared,源码如下: //syn的方法 protected boolean tryReleaseShared(int releases) { //循环进行cas,直到当前线程成功完成cas使计数值(状态值state)减一并更新到state for (;;) { int c = getState(); //如果当前状态值为0则直接返回(1) if (c == 0) return false; //CAS设置计数值减一(2) int nextc = c-1; if (compareAndSetState(c, nextc)) return nextc == 0; } } 如上代码可以看到首先获取当前状态值(计数器值),代码(1)如果当前状态值为 0 则直接返回 false ,则countDown()方法直接返回;否则执行代码(2)使用CAS设置计数器减一,CAS失败则循环重试,否则如果当前计数器为 0 则返回 true 。返回 true 后,说明当前线程是最后一个调用countDown()方法的线程,那么该线程除了让计数器减一外,还需要唤醒调用CountDownLatch的await 方法而被阻塞的线程。这里的代码(1)貌似是多余的,其实不然,之所以添加代码 (1) 是为了防止计数器值为 0 后,其他线程又调用了countDown方法,如果没有代码(1),状态值就会变成负数。 4.long getCount() 获取当前计数器的值,也就是 AQS 的 state 的值,一般在 debug 测试时候使用,源码如下: public long getCount() { return sync.getCount(); } int getCount() { return getState(); } 如上代码可知内部还是调用了 AQS 的 getState 方法来获取 state 的值(计数器当前值)。 到目前为止原理理解的差不多了,接下来用一个例子进行讲解CountDownLatch的用法,例子如下: package com.hjc; import java.util.concurrent.CountDownLatch; import java.util.concurrent.atomic.AtomicInteger; /** * Created by cong on 2018/7/6. */ public class CountDownLatchTest { private static AtomicInteger id = new AtomicInteger(); // 创建一个CountDownLatch实例,管理计数为ThreadNum private static volatile CountDownLatch countDownLatch = new CountDownLatch(3); public static void main(String[] args) throws InterruptedException { Thread threadOne = new Thread(new Runnable() { @Override public void run() { try { Thread.sleep(3000); } catch (InterruptedException e) { // TODO Auto-generated catch block e.printStackTrace(); } System.out.println("【玩家" + id.getAndIncrement() + "】已入场"); countDownLatch.countDown(); } }); Thread threadTwo = new Thread(new Runnable() { @Override public void run() { try { Thread.sleep(2000); } catch (InterruptedException e) { // TODO Auto-generated catch block e.printStackTrace(); } System.out.println("【玩家" + id.getAndIncrement() + "】已入场"); countDownLatch.countDown(); } }); Thread threadThree = new Thread(new Runnable() { @Override public void run() { try { Thread.sleep(1000); } catch (InterruptedException e) { // TODO Auto-generated catch block e.printStackTrace(); } System.out.println("【玩家" + id.getAndIncrement() + "】已入场"); countDownLatch.countDown(); } }); // 启动子线程 threadOne.start(); threadTwo.start(); threadThree.start(); System.out.println("等待斗地主玩家进场"); // 等待子线程执行完毕,返回 countDownLatch.await(); System.out.println("斗地主玩家已经满人,开始发牌....."); } } 运行结果如下: 如上代码,创建了一个 CountDownLatch 实例,因为有两个子线程所以构造函数参数传递为 3,主线程调用 countDownLatch.await()方法后会被阻塞。子线程执行完毕后调用 countDownLatch.countDown() 方法让 countDownLatch 内部的计数器减一,等所有子线程执行完毕调用 countDown()后计数器会变为 0,这时候主线程的 await()才会返回。 如果把上面的代码中Thread.sleep和countDownLatch.await()的代码注释掉,运行几遍,运行结果就可能会出现如下结果,如下图: 可以看到在注释掉latch.await()这行之后,就不能保证在所有玩家入场后才开始发牌了。 总结:CountDownLatch 与 join 方法的区别,一个区别是调用一个子线程的 join()方法后,该线程会一直被阻塞直到该线程运行完毕,而 CountDownLatch 则使用计数器允许子线程运行完毕或者运行中时候递减计数,也就是 CountDownLatch 可以在子线程运行任何时候让 await 方法返回而不一定必须等到线程结束;另外使用线程池来管理线程时候一般都是直接添加 Runable 到线程池这时候就没有办法在调用线程的 join 方法了,countDownLatch 相比 Join 方法让我们对线程同步有更灵活的控制。

优秀的个人博客,低调大师

Java并发编程笔记之读写锁 ReentrantReadWriteLock 源码分析

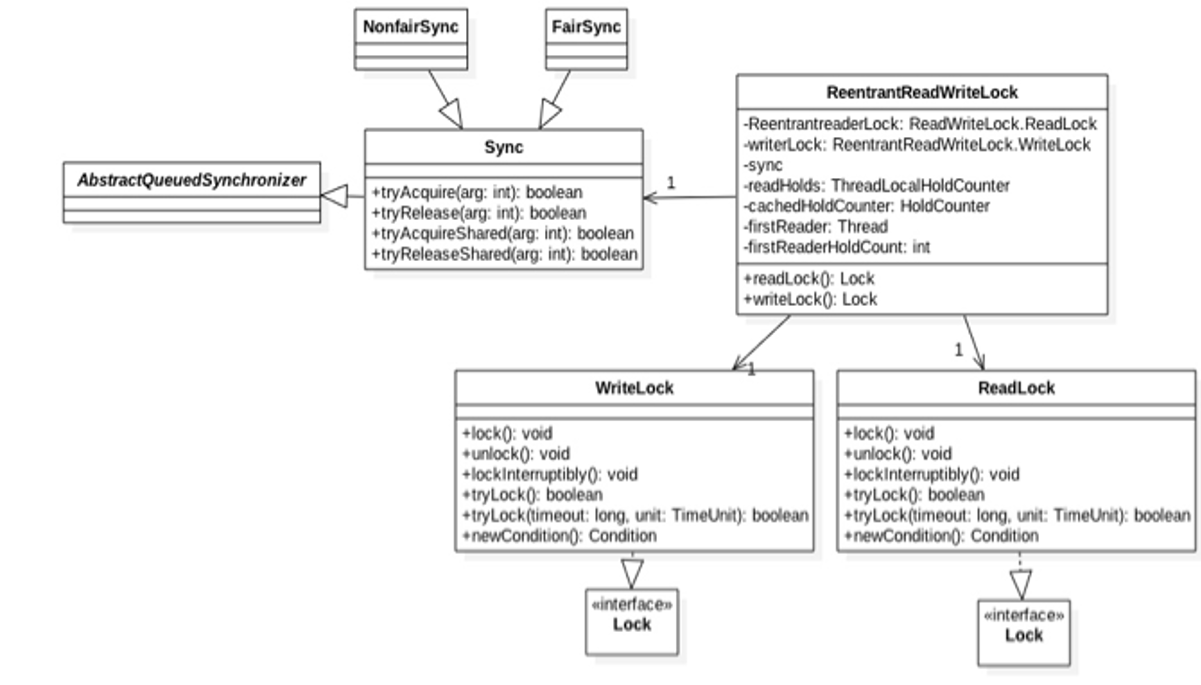
我们知道在解决线程安全问题上使用 ReentrantLock 就可以,但是 ReentrantLock 是独占锁,同时只有一个线程可以获取该锁,而实际情况下会有写少读多的场景,显然 ReentrantLock 满足不了需求,所以 ReentrantReadWriteLock 应运而生,ReentrantReadWriteLock 采用读写分离,多个线程可以同时获取读锁。 首先我们先看一下,ReentrantReadWriteLock 内部构造先看下它的类图结构如下图所示: 如上图可以看到读写锁内部维护了一个ReadLock和WriteLock,并且也提供了公平和非公平的实现,下面只介绍下非公平的读写锁的实现,我们知道AQS里面维护了一个state状态, 而ReentrantReadWriteLock 则需要维护读状态和写状态,一个state是无法表示写和读状态的。ReentrantReadWriteLock 巧妙的使用 state 的高 16 位表示读状态, 也就是获取该读锁的线程个数,低 16 位 表示获取到写锁的线程的可重入次数。并通过CAS对其进行操作实现了读写分离,在读多写少的场景下比较适用。 接下来用一张图来加深对 ReentrantReadWriteLock 的理解: 首先我们先看ReentrantReadWriteLock 的内部类Sync的一些关键属性和方法,源码如下: static final int SHARED_SHIFT = 16; //共享锁(读锁)状态单位值65536 static final int SHARED_UNIT = (1 << SHARED_SHIFT); //共享锁线程最大个数65535 static final int MAX_COUNT = (1 << SHARED_SHIFT) - 1; //排它锁(写锁)掩码 二进制 15个1 static final int EXCLUSIVE_MASK = (1 << SHARED_SHIFT) - 1;//用来记录最后一个获取读锁的线程获取读锁的可重入次数private transient HoldCounter cachedHoldCounter;//用来记录第一个获取到读锁的线程private transient Thread firstReader;//用来记录第一个获取到读锁的线程获取读锁的可重入次数private transient int firstReadHoldCount;//用来存放除去第一个获取读锁线程外的其他线程获取读锁的可重入次数private transient ThreadLocalHoldCounter readHolds = new ThreadLocalHoldCounter();/** 返回读锁线程数 */ static int sharedCount(int c) { return c >>> SHARED_SHIFT; } /** 返回写锁可重入个数 */ static int exclusiveCount(int c) { return c & EXCLUSIVE_MASK; } 类图中 firstReader用来记录第一个获取到读锁的线程,firstReadHoldCount则记录第一个获取到读锁的线程获取读锁的可重入数。cachedHoldCounter用来记录最后一个获取读锁的线程获取读锁的可重入次数。 接下我们进入ReentrantReadWriteLock 的内部类Sync的内部类HoldCounter类的源码,如下: static final class HoldCounter { int count = 0; //线程id final long tid = getThreadId(Thread.currentThread()); } readHolds 是ThreadLocal 变量,用来存放除去第一个获取读锁线程外的其他线程获取读锁的可重入次数,可知ThreadLocalHoldCounter继承了ThreadLocal,里面initialValue方法返回一个HoldCounter对象,源码如下: static final class ThreadLocalHoldCounter extends ThreadLocal<HoldCounter> { public HoldCounter initialValue() { return new HoldCounter(); } } 接下来进行写锁的获取与释放讲解,如下: ReentrantReadWriteLock 中写锁是使用的 WriteLock 来实现的。我们先看一下写锁WriteLock的获取与释放方法,如下: 1.void lock() 写锁是个独占锁,同时只有一个线程可以获取该锁。 如果当前没有线程获取到读锁和写锁则当前线程可以获取到写锁然后返回。 如果当前已经有线程取到读锁和写锁则当前线程则当前请求写锁线程会被阻塞挂起。 另外写锁是可重入锁,如果当前线程已经获取了该锁,再次获取的只是简单的把可重入次数加一后直接返回。源码如下: public void lock() { sync.acquire(1); } public final void acquire(int arg) { // sync重写的tryAcquire方法 if (!tryAcquire(arg) && acquireQueued(addWaiter(Node.EXCLUSIVE), arg)) selfInterrupt(); } 如上代码,lock()内部调用了AQS的acquire方法,其中的tryAcquire是ReentrantReadWriteLock 内部 sync 类重写的,代码如下: protected final boolean tryAcquire(int acquires) { Thread current = Thread.currentThread(); int c = getState(); int w = exclusiveCount(c); //(1) c!=0说明读锁或者写锁已经被某线程获取 if (c != 0) { (2)//w=0说明已经有线程获取了读锁或者w!=0并且当前线程不是写锁拥有者,则返回false if (w == 0 || current != getExclusiveOwnerThread()) return false; (3)//说明某线程获取了写锁,判断可重入个数 if (w + exclusiveCount(acquires) > MAX_COUNT) throw new Error("Maximum lock count exceeded"); (4)// 设置可重入数量(1) setState(c + acquires); return true; } (5)//第一个写线程获取写锁 if (writerShouldBlock() || !compareAndSetState(c, c + acquires)) return false; setExclusiveOwnerThread(current); return true; } 如上代码(1),如果当AQS状态值不为0 则说明当前已经有线程获取到了读锁或者写锁,代码(2)如果w == 0 说明状态值的低 16 为0,而状态值不为0,则说明高16位不为0,这暗示已经有线程获取了读锁,所以直接返回false。 如果w != 0 说明当前已经有线程获取了该写锁,则看当前线程是不是该锁的持有者,如果不是则返回false。 执行到代码(3)说明当前线程之前获取到了该锁,则判断该线程的可重入此时是不是超过了最大值,是则抛异常,否则执行代码(4)增加当前线程的可重入次数,然后返回true。 如果AQS的状态值等于0,则说明目前没有线程获取到读锁和写锁,则实行代码(5), 其中对于ReentrantReadWriteLock的子类NofairSync的writerShouldBlock方法的非公平锁的实现源码如下: final boolean writerShouldBlock() { return false; // writers can always barge } 如代码对于非公平锁来说固定返回false,则说明代码(5)抢占式执行CAS尝试获取写锁,获取成功则设置当前锁的持有者为当前线程返回true,否则返回false。 对于对于ReentrantReadWriteLock的子类FairSync的writerShouldBlock方法的公平锁的实现源码如下: final boolean writerShouldBlock() { return hasQueuedPredecessors(); } 可知还是使用 hasQueuedPredecessors 来判断当前线程节点是否有前驱节点,如果有则当前线程放弃获取写锁的权限直接返回 false。 2.void lockInterruptibly() 类似 lock() 方法,不同在于该方法对中断响应,也就是当其它线程调用了该线程的 interrupt() 方法中断了当前线程,当前线程会抛出异常 InterruptedException,源码如下: public void lockInterruptibly() throws InterruptedException { sync.acquireInterruptibly(1); } 3.boolean tryLock() 尝试获取写锁,如果当前没有其它线程持有写锁或者读锁,则当前线程获取写锁会成功,然后返回 true。 如果当前已经其它线程持有写锁或者读锁则该方法直接返回 false,当前线程并不会被阻塞。 如果当前线程已经持有了该写锁则简单增加 AQS 的状态值后直接返回 true。源码如下: public boolean tryLock( ) { return sync.tryWriteLock(); } final boolean tryWriteLock() { Thread current = Thread.currentThread(); int c = getState(); if (c != 0) { int w = exclusiveCount(c); if (w == 0 || current != getExclusiveOwnerThread()) return false; if (w == MAX_COUNT) throw new Error("Maximum lock count exceeded"); } if (!compareAndSetState(c, c + 1)) return false; setExclusiveOwnerThread(current); return true; } 如上代码与tryAcquire 方法类似,这里不再讲述,不同在于这里使用的非公平策略 4.boolean tryLock(long timeout, TimeUnit unit) 与 tryAcquire()不同在于多了超时时间的参数,如果尝试获取写锁失败则会把当前线程挂起指定时间,待超时时间到后当前线程被激活,如果还是没有获取到写锁则返回 false。 另外该方法对中断响应, 也就是当其它线程调用了该线程的 interrupt() 方法中断了当前线程,当前线程会抛出异常 InterruptedException。源码如下: public boolean tryLock(long timeout, TimeUnit unit)throws InterruptedException { return sync.tryAcquireNanos(1, unit.toNanos(timeout)); } 5.void unlock() 尝试释放锁,如果当前线程持有该锁,调用该方法会让该线程对该线程持有的 AQS 状态值减一,如果减去 1 后当前状态值为 0 则当前线程会释放对该锁的持有,否者仅仅减一而已。 如果当前线程没有持有该锁调用了该方法则会抛出 IllegalMonitorStateException 异常 ,源码如下: public void unlock() { sync.release(1); } public final boolean release(int arg) { //调用ReentrantReadWriteLock中sync实现的tryRelease方法 if (tryRelease(arg)) { //激活阻塞队列里面的一个线程 Node h = head; if (h != null && h.waitStatus != 0) unparkSuccessor(h); return true; } return false; } protected final boolean tryRelease(int releases) { //(6) 看是否是写锁拥有者调用的unlock if (!isHeldExclusively()) throw new IllegalMonitorStateException(); //(7)获取可重入值,这里没有考虑高16位,因为写锁时候读锁状态值肯定为0 int nextc = getState() - releases; boolean free = exclusiveCount(nextc) == 0; //(8)如果写锁可重入值为0则释放锁,否者只是简单更新状态值。 if (free) setExclusiveOwnerThread(null); setState(nextc); return free; } 如上代码 tryRelease 首先通过 isHeldExcusively判断是否当前线程是该写锁的持有者,如果不是则抛异常,否则执行代码(7)说明当前线程持有写锁,持有写锁说明状态值的高16位为0,所以这里nextc值就是当前线程写锁的剩余可重入次数。 代码(8)判断当前可重入次数是否为0,如果free为true 说明可重入次数为0,则当前线程会释放对写锁的持有,当前锁的持有者设置为null。如果free 为false,则简单更新可重入次数。 前面讲解了写锁的获取与释放,接下来讲解读锁的获取与释放,如下: ReentrantReadWriteLock 中写锁是使用的 ReadLock 来实现的。主要看ReadLock读锁的获取与释放的主要方法,如下: 1.void lock() 获取读锁,如果当前没有其它线程持有写锁,则当前线程可以获取读锁,AQS 的高 16 位的值会增加 1,然后方法返回。否者如果其它有一个线程持有写锁,则当前线程会被阻塞。源码如下: public void lock() { sync.acquireShared(1); } public final void acquireShared(int arg) { //调用ReentrantReadWriteLock中的sync的tryAcquireShared方法 if (tryAcquireShared(arg) < 0) //调用AQS的doAcquireShared方法 doAcquireShared(arg); } 如上代码读锁的lock方法调用了AQS的aquireShared方法,内部调用了ReentrantReadWriteLock 中的 sync 重写的 tryAcquireShared 方法,源码如下: protected final int tryAcquireShared(int unused) { //(1)获取当前状态值 Thread current = Thread.currentThread(); int c = getState(); //(2)判断是否写锁被占用 if (exclusiveCount(c) != 0 && getExclusiveOwnerThread() != current) return -1; //(3)获取读锁计数 int r = sharedCount(c); //(4)尝试获取锁,多个读线程只有一个会成功,不成功的进入下面fullTryAcquireShared进行重试 if (!readerShouldBlock() && r < MAX_COUNT && compareAndSetState(c, c + SHARED_UNIT)) { //(5)第一个线程获取读锁 if (r == 0) { firstReader = current; firstReaderHoldCount = 1; //(6)如果当前线程是第一个获取读锁的线程 } else if (firstReader == current) { firstReaderHoldCount++; } else { //(7)记录最后一个获取读锁的线程或记录其它线程读锁的可重入数 HoldCounter rh = cachedHoldCounter; if (rh == null || rh.tid != current.getId()) cachedHoldCounter = rh = readHolds.get(); else if (rh.count == 0) readHolds.set(rh); rh.count++; } return 1; } //(8)类似tryAcquireShared,但是是自旋获取 return fullTryAcquireShared(current); } 如上代码,首先获取了当前AQS的状态值,然后代码(2)看是否有其他线程获取到了写锁,如果是则直接返回了-1,然后调用AQS的doAcquireShared 方法把当前线程放入阻塞队列。 否则执行到代码(3)得到获取到读锁的线程个数,到这里要说明目前没有线程获取到写锁,但是还是有可能有线程持有读锁,然后执行代码(4),非公平锁的readerShouldBlock实现代码如下: final boolean readerShouldBlock() { return apparentlyFirstQueuedIsExclusive(); } final boolean apparentlyFirstQueuedIsExclusive() { Node h, s; return (h = head) != null && (s = h.next) != null && !s.isShared() && s.thread != null; } 如上代码作用是如果队列里面存在一个元素,则判断第一个元素是不是正在尝试获取写锁,如果不是的话,则当前县城使用判断当前获取读锁线程是否达到了最大值,最后执行CAS操作设置AQS状态值的高 16 位值增加 1。 代码(5)(6)记录第一个获取读锁的线程,并统计该线程获取读锁的可重入次数,代码(7)使用cachedHoldCounter 记录最后一个获取到读锁的线程,并同时该线程获取读锁的可重入次数,另外readHolds记录了当前线程获取读锁的可重入次数。 如果readerShouldBlock 返回 true 则说明有线程正在获取写锁,则执行代码(8)fullTryAcquireShared 代码与 tryAcquireShared 类似,不同在于前者是通过循环自旋获取。 源码如下: final int fullTryAcquireShared(Thread current) { HoldCounter rh = null; for (;;) { int c = getState(); if (exclusiveCount(c) != 0) { if (getExclusiveOwnerThread() != current) return -1; //// } else if (readerShouldBlock()) { // if (firstReader == current) { // assert firstReaderHoldCount > 0; } else { if (rh == null) { rh = cachedHoldCounter; if (rh == null || rh.tid != getThreadId(current)) { rh = readHolds.get(); if (rh.count == 0) readHolds.remove(); } } if (rh.count == 0) return -1; } } if (sharedCount(c) == MAX_COUNT) throw new Error("Maximum lock count exceeded"); if (compareAndSetState(c, c + SHARED_UNIT)) { if (sharedCount(c) == 0) { firstReader = current; firstReaderHoldCount = 1; } else if (firstReader == current) { firstReaderHoldCount++; } else { if (rh == null) rh = cachedHoldCounter; if (rh == null || rh.tid != getThreadId(current)) rh = readHolds.get(); else if (rh.count == 0) readHolds.set(rh); rh.count++; cachedHoldCounter = rh; // } return 1; } } } 2.void lockInterruptibly() 类似 lock() 方法,不同在于该方法对中断响应,也就是当其它线程调用了该线程的 interrupt() 方法中断了当前线程,当前线程会抛出异常 InterruptedException。 3.boolean tryLock() 尝试获取读锁,如果当前没有其它线程持有写锁,则当前线程获取写锁会成功,然后返回 true。如果当前已经其它线程持有写锁则该方法直接返回 false,当前线程并不会被阻塞。 如果其它获取当前线程已经持有了该读锁则简单增加 AQS 的状态值高 16 位后直接返回 true。代码类似 tryLock 这里不再讲述。 4.boolean tryLock(long timeout, TimeUnit unit) 与 tryLock()不同在于多了超时时间的参数,如果尝试获取读锁失败则会把当前线程挂起指定时间,待超时时间到后当前线程被激活,如果还是没有获取到读锁则返回 false。 另外该方法对中断响应, 也就是当其它线程调用了该线程的 interrupt() 方法中断了当前线程,当前线程会抛出异常 InterruptedException 5.void unlock() 释放锁。源码如下: public void unlock() { sync.releaseShared(1); } public final boolean releaseShared(int arg) { if (tryReleaseShared(arg)) { doReleaseShared(); return true; } return false; } protected final boolean tryReleaseShared(int unused) { Thread current = Thread.currentThread(); //如果当前线程是第一个获取读锁线程 if (firstReader == current) { //如果可重入次数为1 if (firstReaderHoldCount == 1) firstReader = null; else//否者可重入次数减去1 firstReaderHoldCount--; } else { //如果当前线程不是最后一个获取读锁线程,则从threadlocal里面获取 HoldCounter rh = cachedHoldCounter; if (rh == null || rh.tid != current.getId()) rh = readHolds.get(); //如果可重入次数<=1则清除threadlocal int count = rh.count; if (count <= 1) { readHolds.remove(); if (count <= 0) throw unmatchedUnlockException(); } //可重入次数减去一 --rh.count; } //循环直到自己的读计数-1 cas更新成功 for (;;) { int c = getState(); int nextc = c - SHARED_UNIT; if (compareAndSetState(c, nextc)) return nextc == 0; } } 好了,到目前为止,我们知道了上一篇笔记中,使用ReentrantLock 实现的线程安全的 list, 但是由于 ReentrantLock 是独占锁所以在读多写少的情况下性能很差,下面使用 ReentrantReadWriteLock 来改造为如下代码: package com.hjc; import java.util.ArrayList; import java.util.concurrent.locks.Lock; import java.util.concurrent.locks.ReentrantReadWriteLock; /** * Created by cong on 2018/6/14. */ public class ReentrantReadWriteLockTest { //线程不安全的list private ArrayList<String> array = new ArrayList<String>(); //独占锁 private final ReentrantReadWriteLock lock = new ReentrantReadWriteLock(); private final Lock readLock = lock.readLock(); private final Lock writeLock = lock.writeLock(); //添加元素 public void add(String e) { writeLock.lock(); try { array.add(e); } finally { writeLock.unlock(); } } //删元素 public void remove(String e) { writeLock.lock(); try { array.remove(e); } finally { writeLock.unlock(); } } //获取数据 public String get(int index) { readLock.lock(); try { return array.get(index); } finally { readLock.unlock(); } } } 如代码调用 get 方法适合使用的是读锁,这样运行多个读线程同时访问 list 的元素,在读多写少的情况下性能相比 ReentrantLock 会很好。

优秀的个人博客,低调大师

Java并发编程笔记之LongAdder和LongAccumulator源码探究

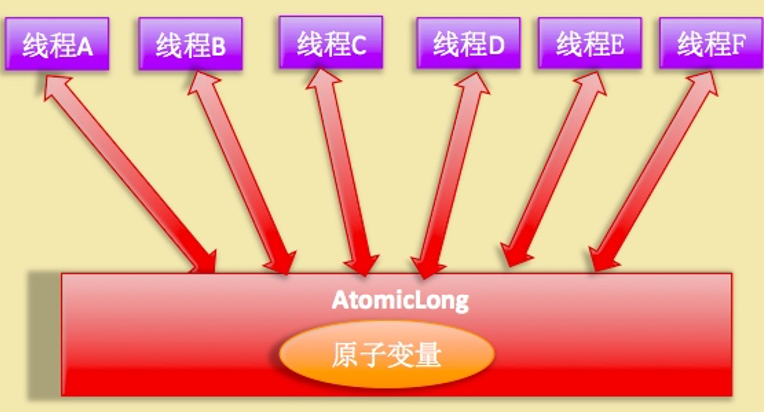
一.LongAdder原理 LongAdder类是JDK1.8新增的一个原子性操作类。AtomicLong通过CAS算法提供了非阻塞的原子性操作,相比受用阻塞算法的同步器来说性能已经很好了,但是JDK开发组并不满足于此,因为非常搞并发的请求下AtomicLong的性能是不能让人接受的。 如下AtomicLong 的incrementAndGet的代码,虽然AtomicLong使用CAS算法,但是CAS失败后还是通过无限循环的自旋锁不多的尝试,这就是高并发下CAS性能低下的原因所在。源码如下: public final long incrementAndGet() { for (;;) { long current = get(); long next = current + 1; if (compareAndSet(current, next)) return next; } } 在高并发下N多线程同时去操作一个变量会造成大量线程CAS失败,然后处于自旋状态,这样导致大大浪费CPU资源,降低了并发性。 既然AtomicLong性能问题是由于过多线程同时去竞争同一个变量的更新而降低的,那么如果把一个变量分解为多个变量,让同样多的线程去竞争多个资源,那么性能问题不久迎刃而解了吗? 没错,因此,JDK8 提供的LongAdder就是这个思路。下面通过图形来标示两者的不同,如下图: 如上图 AtomicLong 是多个线程同时竞争同一个变量情景。 如上图所示,LongAdder则是内部维护多个Cell变量,每个Cell里面有一个初始值为0的long型变量,在同等并发量的情况下,争夺单个变量的线程会减少,这是变相的减少了争夺共享资源的并发量,另外多个线程在争夺同一个原子变量时候, 如果失败并不是自旋CAS重试,而是尝试获取其他原子变量的锁,最后当获取当前值时候是把所有变量的值累加后再加上base的值返回的。 LongAdder维护了要给延迟初始化的原子性更新数组和一个基值变量base数组的大小保持是2的N次方大小,数组表的下标使用每个线程的hashcode值的掩码表示,数组里面的变量实体是Cell类型。 Cell 类型是Atomic的一个改进,用来减少缓存的争用,对于大多数原子操作字节填充是浪费的,因为原子操作都是无规律的分散在内存中进行的,多个原子性操作彼此之间是没有接触的,但是原子性数组元素彼此相邻存放将能经常共享缓存行,也就是伪共享。所以这在性能上是一个提升。 另外由于Cells占用内存是相对比较大的,所以一开始并不创建,而是在需要时候再创建,也就是惰性加载,当一开始没有空间时候,所有的更新都是操作base变量。 接下来进行LongAdder代码简单分析 这里我只是简单的介绍一下代码的实现,详细实现,大家可以翻看代码去研究。为了降低高并发下多线程对一个变量CAS争夺失败后大量线程会自旋而造成降低并发性能问题,LongAdder内部通过根据并发请求量来维护多个Cell元素(一个动态的Cell数组)来分担对单个变量进行争夺资源。 首先我们先看LongAdder的构造类图,如下图: 可以看到LongAdder继承自Striped64类,Striped64内部维护着三个变量,LongAdder的真实值其实就是base的值与Cell数组里面所有Cell元素值的累加,base是个基础值,默认是0,cellBusy用来实现自旋锁,当创建Cell元素或者扩容Cell数组时候用来进行线程间的同步。 接下来进去源码如看Cell的构造,源码如下: @sun.misc.Contended static final class Cell { volatile long value; Cell(long x) { value = x; } final boolean cas(long cmp, long val) { return UNSAFE.compareAndSwapLong(this, valueOffset, cmp, val); } // Unsafe 技术 private static final sun.misc.Unsafe UNSAFE; private static final long valueOffset; static { try { UNSAFE = sun.misc.Unsafe.getUnsafe(); Class<?> ak = Cell.class; valueOffset = UNSAFE.objectFieldOffset (ak.getDeclaredField("value")); } catch (Exception e) { throw new Error(e); } } } 正如上面的代码可以知道Cell的构造很简单,内部维护一个声明volatile的变量,这里声明为volatile是因为线程操作value变量时候没有使用锁,为了保证变量的内存可见性这里只有声明为volatile。另外这里就是先前文件所说的使用Unsafe类的方法来设置value的值 接下来进入LongAdder的源码里面去看几个重要的方法,如下: 1.long sum() 方法:返回当前的值,内部操作是累加所有 Cell 内部的 value 的值后累加 base,如下代码,由于计算总和时候没有对 Cell 数组进行加锁,所以在累加过程中可能有其它线程对 Cell 中的值进行了修改,也有可能数组进行了扩容,所以 sum 返回的值并不是非常精确的, 返回值并不是一个调用 sum 方法时候的一个原子快照值。 源码如下: public long sum() { Cell[] as = cells; Cell a; long sum = base; if (as != null) { for (int i = 0; i < as.length; ++i) { if ((a = as[i]) != null) sum += a.value; } } return sum; } 2.void reset() 方法:重置操作,如下代码把 base 置为 0,如果 Cell 数组有元素,则元素值重置为 0。源码如下: public void reset() { Cell[] as = cells; Cell a; base = 0L; if (as != null) { for (int i = 0; i < as.length; ++i) { if ((a = as[i]) != null) a.value = 0L; } } } 3.long sumThenReset() 方法:是sum 的改造版本,如下代码,在计算 sum 累加对应的 cell 值后,把当前 cell 的值重置为 0,base 重置为 0。 当多线程调用该方法时候会有问题,比如考虑第一个调用线程会清空 Cell 的值,后一个线程调用时候累加时候累加的都是 0 值。 源码如下: public long sumThenReset() { Cell[] as = cells; Cell a; long sum = base; base = 0L; if (as != null) { for (int i = 0; i < as.length; ++i) { if ((a = as[i]) != null) { sum += a.value; a.value = 0L; } } } return sum; } 4.long longValue() 等价于 sum(),源码如下: public long longValue() { return this.sum(); } 5.void add(long x) 累加增量 x 到原子变量,这个过程是原子性的。源码如下: public void add(long x) { Cell[] as; long b, v; int m; Cell a; if ((as = cells) != null || !casBase(b = base, b + x)) {//(1) boolean uncontended = true; if (as == null || (m = as.length - 1) < 0 ||//(2) (a = as[getProbe() & m]) == null ||//(3) !(uncontended = a.cas(v = a.value, v + x)))//(4) longAccumulate(x, null, uncontended);//(5) } } final boolean casBase(long cmp, long val) { return UNSAFE.compareAndSwapLong(this, BASE, cmp, val); } 可以看到上面代码,当第一个线程A执行add时候,代码(1)会执行casBase方法,通过CAS设置base为 X, 如果成功则直接返回,这时候base的值为1。 假如多个线程同时执行add时候,同时执行到casBase则只有一个线程A成功返回,其他线程由于CAS失败执行代码(2),代码(2)是获取cells数组的长度,如果数组长度为0,则执行代码(5),否则cells长度不为0,说明cells数组有元素则执行代码(3), 代码(3)首先计算当前线程在数组中下标,然后获取当前线程对应的cell值,如果获取到则执行(4)进行CAS操作,CAS失败则执行代码(5)。 代码(5)里面是具体进行数组扩充和初始化,这个代码比较复杂,这里就不讲解了,有兴趣的可以进去看看。 二.LongAccumulator类源码分析 LongAdder类是LongAccumulator的一个特例,LongAccumulator提供了比LongAdder更强大的功能,如下构造函数,其中accumulatorFunction是一个双目运算器接口,根据输入的两个参数返回一个计算值,identity则是LongAccumulator累加器的初始值。 public LongAccumulator(LongBinaryOperator accumulatorFunction,long identity) { this.function = accumulatorFunction; base = this.identity = identity; } public interface LongBinaryOperator { //根据两个参数计算返回一个值 long applyAsLong(long left, long right); } 上面提到LongAdder 其实就是LongAccumulator 的一个特例,调用LongAdder 相当使用下面的方式调用 LongAccumulator。 LongAdder adder = new LongAdder(); LongAccumulator accumulator = new LongAccumulator(new LongBinaryOperator() { @Override public long applyAsLong(long left, long right) { return left + right; } }, 0); LongAccumulator相比LongAdder 可以提供累加器初始非0值,后者只能默认为0,另外前者还可以指定累加规则,比如不是累加而相乘,只需要构造LongAccumulator 时候传入自定义双目运算器即可,后者则内置累加规则。 从下面代码知道LongAccumulator相比于LongAdde的不同在于casBase的时候,后者传递的是b+x,而前者则是调用了r=function.applyAsLong(b=base.x)来计算。 LongAdder类的add源码如下: public void add(long x) { Cell[] as; long b, v; int m; Cell a; if ((as = cells) != null || !casBase(b = base, b + x)) { boolean uncontended = true; if (as == null || (m = as.length - 1) < 0 || (a = as[getProbe() & m]) == null || !(uncontended = a.cas(v = a.value, v + x))) longAccumulate(x, null, uncontended); } } LongAccumulator的accumulate方法的源码如下: public void accumulate(long x) { Cell[] as; long b, v, r; int m; Cell a; if ((as = cells) != null || (r = function.applyAsLong(b = base, x)) != b && !casBase(b, r)) { boolean uncontended = true; if (as == null || (m = as.length - 1) < 0 || (a = as[getProbe() & m]) == null || !(uncontended = (r = function.applyAsLong(v = a.value, x)) == v || a.cas(v, r))) longAccumulate(x, function, uncontended); } } 另外LongAccumulator调用longAccumulate时候传递的是function,而LongAdder是null,从下面代码可以知道当fn为null,时候就是使用v+x 加法运算,这时候就等价于LongAdder,fn不为null的时候则使用传递的fn函数计算,如果fn为加法则等价于LongAdder; else if (casBase(v = base, ((fn == null) ? v + x :fn.applyAsLong(v, x)))) // Fall back on using basebreak;

优秀的个人博客,低调大师

(4)剑指Offer之链表相关编程题

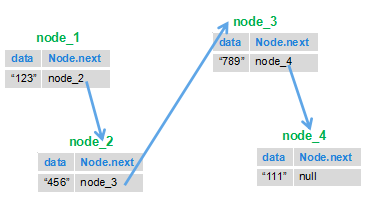
一 链表中倒数第k个节点 题目描述: 输入一个链表,输出该链表中倒数第k个结点 问题分析: 一句话概括:两个指针一个指针p1先开始跑,指针p1跑到k-1个节点后,另一个节点p2开始跑,当p1跑到最后时,p2所指的指针就是倒数第k个节点。 思想的简单理解:前提假设:链表的结点个数(长度)为n。规律一:要找到倒数第k个结点,需要向前走多少步呢?比如倒数第一个结点,需要走n步,那倒数第二个结点呢?很明显是向前走了n-1步,所以可以找到规律是找到倒数第k个结点,需要向前走n-k+1步。算法开始: 设两个都指向head的指针p1和p2,当p1走了k-1步的时候,停下来。p2之前一直不动。 p1的下一步是走第k步,这个时候,p2开始一起动了。至于为什么p2这个时候动呢?看下面的分析。 当p1走到链表的尾部时,即p1走了n步。由于我们知道p2是在p1走了k-1步才开始动的,也就是说p1和p2永远差k-1步。所以当p1走了n步时,p2走的应该是在n-(k-1)步。即p2走了n-k+1步,此时巧妙的是p2正好指向的是规律一的倒数第k个结点处。这样是不是很好理解了呢? 考察内容: 链表+代码的鲁棒性 示例代码: /* //链表类 public class ListNode { int val; ListNode next = null; ListNode(int val) { this.val = val; } }*/ //时间复杂度O(n),一次遍历即可 public class Solution { public ListNode FindKthToTail(ListNode head,int k) { ListNode pre=null,p=null; //两个指针都指向头结点 p=head; pre=head; //记录k值 int a=k; //记录节点的个数 int count=0; //p指针先跑,并且记录节点数,当p指针跑了k-1个节点后,pre指针开始跑, //当p指针跑到最后时,pre所指指针就是倒数第k个节点 while(p!=null){ p=p.next; count++; if(k<1){ pre=pre.next; } k--; } //如果节点个数小于所求的倒数第k个节点,则返回空 if(count<a) return null; return pre; } } 二 反转链表 题目描述: 输入一个链表,反转链表后,输出链表的所有元素。 问题分析: 链表的很常规的一道题,这一道题思路不算难,但自己实现起来真的可能会感觉无从下手,我是参考了别人的代码。思路就是我们根据链表的特点,前一个节点指向下一个节点的特点,把后面的节点移到前面来。就比如下图:我们把1节点和2节点互换位置,然后再将3节点指向2节点,4节点指向3节点,这样以来下面的链表就被反转了。 考察内容: 链表+代码的鲁棒性 示例代码: /* public class ListNode { int val; ListNode next = null; ListNode(int val) { this.val = val; } }*/ public class Solution { public ListNode ReverseList(ListNode head) { ListNode next = null; ListNode pre = null; while (head != null) { //保存要反转到头来的那个节点 next = head.next; //要反转的那个节点指向已经反转的上一个节点 head.next = pre; //上一个已经反转到头部的节点 pre = head; //一直向链表尾走 head = next; } return pre; } } 三 合并两个排序的链表 题目描述: 输入两个单调递增的链表,输出两个链表合成后的链表,当然我们需要合成后的链表满足单调不减规则。 问题分析: 我们可以这样分析: 假设我们有两个链表 A,B; A的头节点A1的值与B的头结点B1的值比较,假设A1小,则A1为头节点; A2再和B1比较,假设B1小,则,A1指向B1; A2再和B2比较。。。。。。。就这样循环往复就行了,应该还算好理解。 考察内容: 链表+代码的鲁棒性 示例代码: 非递归版本: /* public class ListNode { int val; ListNode next = null; ListNode(int val) { this.val = val; } }*/ public class Solution { public ListNode Merge(ListNode list1,ListNode list2) { //list1为空,直接返回list2 if(list1 == null){ return list2; } //list2为空,直接返回list1 if(list2 == null){ return list1; } ListNode mergeHead = null; ListNode current = null; //当list1和list2不为空时 while(list1!=null && list2!=null){ //取较小值作头结点 if(list1.val <= list2.val){ if(mergeHead == null){ mergeHead = current = list1; }else{ current.next = list1; //current节点保存list1节点的值因为下一次还要用 current = list1; } //list1指向下一个节点 list1 = list1.next; }else{ if(mergeHead == null){ mergeHead = current = list2; }else{ current.next = list2; //current节点保存list2节点的值因为下一次还要用 current = list2; } //list2指向下一个节点 list2 = list2.next; } } if(list1 == null){ current.next = list2; }else{ current.next = list1; } return mergeHead; } } 递归版本: public ListNode Merge(ListNode list1,ListNode list2) { if(list1 == null){ return list2; } if(list2 == null){ return list1; } if(list1.val <= list2.val){ list1.next = Merge(list1.next, list2); return list1; }else{ list2.next = Merge(list1, list2.next); return list2; } }

优秀的个人博客,低调大师

python函数式编程之yield表达式形式

先来看一个例子 def foo(): print("starting...") while True: res = yield print("res:",res) g = foo() next(g) 在上面的例子里,因为foo函数中有yield关键字,所以foo()函数的执行结果g是一个生成器,此时可以使用next(g)或者g.__next__()方法触发生成器的执行 程序的执行结果为 starting... 使用next(g)触发生成器的执行时,程序会按照正常的顺序从上向下执行,遇到yield,程序就会暂停 并把yield后面所接的值返回 打印next(g)的执行结果 def foo(): print("starting...") while True: res = yield print("res:",res) g = foo() print(next(g)) 程序执行结果 starting... None 在上面的例子里,执行一次next(g)方法,程序暂停在yield那一行,此时再次调用next(g),程序会从yield语句那一行继续向下运行 修改上面的代码,多调用几次next方法,并打印next方法的返回结果 def foo(): print("starting...") while True: res = yield print("res:",res) g = foo() print(next(g)) print("*"*20) print(next(g)) 上面这段代码的执行结果为 starting... None ******************** res: None None 可以看到,程序确实按猜想的步骤运行,但是上面的程序也有一个很明显的缺点:那就是上面的代码没有任何的实际意义:res的值永远为None 在实际的开发中,使用yield表达式形式的目的是yield可以得到一个值,然后yield把这个值赋值给某个变量,这样才有实际意义 那应该怎么操作才能为res变量赋一个值呢??那就是调用生成器自身的send方法 send方法可以触发一次生成器执行,同时还可以把send方法的参数传递给yield 修改上面的代码 def foo(): print("starting...") while True: res = yield print("res:",res) g = foo() next(g) print(g.send(5)) 程序的执行结果为: starting... res: 5 None 来分析一下上面的代码的执行过程 : 1.程序开始执行以后,因为foo函数中有yield关键字,所以foo函数并不会真的执行,而是先得到一个生成器g. 2.直到调用next方法,foo函数正式开始执行,先执行foo函数中的print方法,然后进入while循环 3.程序遇到yield关键字,程序暂停,此时next(g)语句执行完成 4.程序执行g.send(5),程序会从yield关键字那一行继续向下运行,send会把5这个值传递给yield 5.yield接收到send方法传递过来的值,然后由yield赋值给res变量 6.由于send方法中包含next()方法,所以程序会继续向下运行执行print方法,然后再次进入while循环 7.程序执行再次遇到yield关键字,yield会返回后面的值,由于yield后面没有接任何参数,所以yield会返回None,程序再次暂停,直到再次调用next方法或send方法 修改代码,多次调用send方法 def foo(): print("starting...") while True: res = yield print("res:",res) g = foo() next(g) print(g.send(5)) print("*"*20) print(g.send(10)) print("#"*20) print(g.send(15)) 执行程序,得到如下结果 starting... res: 5 None ******************** res: 10 None #################### res: 15 None 可以看到,上面代码的执行过程如同上面的分析的执行过程一样运行 在上面的例子里,如果调用send方法时,传递的参数为None,得到的结果会是怎么样的呢?? 从上面的分析中,可以知道: 如果`g.send()`方法发送给yield关键字的参数为None,则yield关键字传递给res变量的值就为None 由于yield后面本来没有接任何值,所以yield返回的值默认也为None,所以程序执行结果会得到两个None 修改代码,验证上面的猜想 def foo(): print("starting...") while True: res = yield print("res:",res) g = foo() next(g) print("#"*20) print(g.send(None)) 查看程序的执行结果 starting... #################### res: None None 从程序的执行结果可以看出,如果调用生成器的send方法时,传递的参数为None,则程序执行的结果将会是两个None 使用yield表达式形式实现linux系统中的"grep -rl root /etc"命令 代码如下: import os def init(func): def wrapper(*args, **kwargs): g = func(*args, **kwargs) next(g) return g return wrapper @init def get_file_path(target): """ get file abspath # 阶段一:递归找文件的绝对路径,把文件的完事路径发送给阶段二 :param target: :return: """ while True: start_path = yield g = os.walk(start_path) for parent_dir, _, files in g: for file in files: file_path = r"%s\%s" % (parent_dir, file) target.send(file_path) @init def opener(target): """ get file obj # 阶段二:收到文件的完整路径,打开文件获取文件对象,把文件对象发送给阶段三 :param target: :return: """ while True: file_path = yield with open(file_path, encoding='utf-8') as f: target.send((file_path, f)) @init def cat_file(target): """ read file content # 阶段三:收到文件对象,for循环读取文件的每一行内容,把每一行内容发给阶段四 :param target: :return: """ while True: file_path, f = yield for line in f: file_content = target.send((file_path, line)) if file_content: break @init def grep(target, pattern): """ grep function # 阶段四:收到文件的一行内容,判断要查找的内容是否在这一行中,如果在,则把文件名发送给阶段五 :param target: :param pattern: :return: """ tag = False while True: file_path, line = yield tag tag = False if pattern in line: target.send(file_path) tag = True @init def printer(): """ print file name # 阶段五:收到文件名,打印结果 :return: """ while True: filename = yield print(filename) path1 = "/root" # 定义要搜索的路径 path2 = "/etc" # 定义要搜索的路径 g = get_file_path(opener(cat_file(grep(printer(), "root")))) print(g) g.send(path1) g.send(path2)

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册