首页 文章 精选 留言 我的

精选列表

搜索[编译原理],共10000篇文章
优秀的个人博客,低调大师

终于有人把 kafka 原理说清楚了!

Java技术栈 www.javastack.cn 关注阅读更多优质文章 本文授权转自公众号:17coding技术博客 为什么需要消息队列 周末无聊刷着手机,某宝网APP突然蹦出来一条消息“为了回馈老客户,女朋友买一送一,活动仅限今天!”。买一送一还有这种好事,那我可不能错过!忍不住立马点了去。于是选了两个最新款,下单、支付一气呵成!满足的躺在床上,想着马上有女朋友了,竟然幸福的失眠了…… 第二天正常上着班,突然接到快递小哥的电话:小哥:“你是xx吗?你的女朋友到了,我现在在你楼下,你来拿一下吧!”。我:“这……我在上班呢,可以晚上送过来吗?“。小哥:“晚上可不行哦,晚上我也下班了呢!”。于是两个人僵持了很久…… 最后小哥说,要不我帮你放到楼下小芳便利店吧,你晚上下班了过来拿,尴尬的局面这才得以缓解! 回到正题,如果没有小芳便利店,那快递小哥和我的交互图就应该如下: 会出现什么情况呢? 1、为了这个女朋友,我请假回去拿(老板不批)。 2、小哥一直在你楼下等(小哥还有其他的快递要送)。 3、周末再送(显然等不及)。 4、这个女朋友我不要了(绝对不可能)! 小芳便利店出现后,交互图就应如下: 在上面例子中,“快递小哥”和“买女朋友的我”就是需要交互的两个系统,小芳便利店就是我们本文要讲的-“消息中间件”。总结下来小芳便利店(消息中间件)出现后有如下好处: 1、 解耦 快递小哥手上有很多快递需要送,他每次都需要先电话一一确认收货人是否有空、哪个时间段有空,然后再确定好送货的方案。这样完全依赖收货人了! 如果快递一多,快递小哥估计的忙疯了……如果有了便利店,快递小哥只需要将同一个小区的快递放在同一个便利店,然后通知收货人来取货就可以了,这时候快递小哥和收货人就实现了解耦! 2、 异步 快递小哥打电话给我后需要一直在你楼下等着,直到我拿走你的快递他才能去送其他人的。快递小哥将快递放在小芳便利店后,又可以干其他的活儿去了,不需要等待你到来而一直处于等待状态。提高了工作的效率。 3、 削峰 假设双十一我买了不同店里的各种商品,而恰巧这些店发货的快递都不一样,有中通、圆通、申通、各种通等……更巧的是他们都同时到货了!中通的小哥打来电话叫我去北门取快递、圆通小哥叫我去南门、申通小哥叫我去东门。我一时手忙脚乱…… 我们能看到在系统需要交互的场景中,使用消息队列中间件真的是好处多多,基于这种思路,就有了丰巢、菜鸟驿站等比小芳便利店更专业的“中间件”了。最后,上面的故事纯属虚构…… 消息队列通信的模式 通过上面的例子我们引出了消息中间件,并且介绍了消息队列出现后的好处,这里就需要介绍消息队列通信的两种模式了: 一、 点对点模式 如上图所示,点对点模式通常是基于拉取或者轮询的消息传送模型,这个模型的特点是发送到队列的消息被一个且只有一个消费者进行处理。生产者将消息放入消息队列后,由消费者主动的去拉取消息进行消费。 点对点模型的的优点是消费者拉取消息的频率可以由自己控制。但是消息队列是否有消息需要消费,在消费者端无法感知,所以在消费者端需要额外的线程去监控。 二、 发布订阅模式 如上图所示,发布订阅模式是一个基于消息送的消息传送模型,改模型可以有多种不同的订阅者。生产者将消息放入消息队列后,队列会将消息推送给订阅过该类消息的消费者(类似微信公众号)。 由于是消费者被动接收推送,所以无需感知消息队列是否有待消费的消息!但是consumer1、consumer2、consumer3由于机器性能不一样,所以处理消息的能力也会不一样,但消息队列却无法感知消费者消费的速度! 所以推送的速度成了发布订阅模模式的一个问题!假设三个消费者处理速度分别是8M/s、5M/s、2M/s,如果队列推送的速度为5M/s,则consumer3无法承受!如果队列推送的速度为2M/s,则consumer1、consumer2会出现资源的极大浪费! Kafka 上面简单的介绍了为什么需要消息队列以及消息队列通信的两种模式,接下来就到了我们本文的主角——kafka闪亮登场的时候了! Kafka是一种高吞吐量的分布式发布订阅消息系统,它可以处理消费者规模的网站中的所有动作流数据,具有高性能、持久化、多副本备份、横向扩展能力……… 一些基本的介绍这里就不展开了,网上有太多关于这些的介绍了,读者可以自行百度一下!原来这才是 Kafka!(多图+深入)这篇推荐看下。关注公众号Java技术栈可以获取更多 Kafka 系列教程。 基础架构及术语 话不多说,先看图,通过这张图我们来捋一捋相关的概念及之间的关系: 如果看到这张图你很懵逼,木有关系! 我们先来分析相关概念 Producer:Producer即生产者,消息的产生者,是消息的入口。 kafka cluster:Broker:Broker是kafka实例,每个服务器上有一个或多个kafka的实例,我们姑且认为每个broker对应一台服务器。每个kafka集群内的broker都有一个不重复的编号,如图中的broker-0、broker-1等…… Topic:消息的主题,可以理解为消息的分类,kafka的数据就保存在topic。在每个broker上都可以创建多个topic。 Partition:Topic的分区,每个topic可以有多个分区,分区的作用是做负载,提高kafka的吞吐量。同一个topic在不同的分区的数据是不重复的,partition的表现形式就是一个一个的文件夹! Replication:每一个分区都有多个副本,副本的作用是做备胎。当主分区(Leader)故障的时候会选择一个备胎(Follower)上位,成为Leader。在kafka中默认副本的最大数量是10个,且副本的数量不能大于Broker的数量,follower和leader绝对是在不同的机器,同一机器对同一个分区也只可能存放一个副本(包括自己)。 Message:每一条发送的消息主体。 Consumer:消费者,即消息的消费方,是消息的出口。 Consumer Group:我们可以将多个消费组组成一个消费者组,在kafka的设计中同一个分区的数据只能被消费者组中的某一个消费者消费。同一个消费者组的消费者可以消费同一个topic的不同分区的数据,这也是为了提高kafka的吞吐量! Zookeeper:kafka集群依赖zookeeper来保存集群的的元信息,来保证系统的可用性。 工作流程分析 上面介绍了kafka的基础架构及基本概念,不知道大家看完有没有对kafka有个大致印象,如果对还比较懵也没关系!6个步骤,全方位掌握 Kafka,这篇建议看一。下。关注公众号Java技术栈可以获取更多 Kafka 系列教程。 我们接下来再结合上面的结构图分析kafka的工作流程,最后再回来整个梳理一遍我相信你会更有收获! 发送数据 我们看上面的架构图中,producer就是生产者,是数据的入口。注意看图中的红色箭头,Producer在写入数据的时候永远的找leader,不会直接将数据写入follower!那leader怎么找呢? 写入的流程又是什么样的呢?我们看下图: 发送的流程就在图中已经说明了,就不单独在文字列出来了!需要注意的一点是,消息写入leader后,follower是主动的去leader进行同步的!producer采用push模式将数据发布到broker,每条消息追加到分区中,顺序写入磁盘,所以保证同一分区内的数据是有序的!写入示意图如下: 上面说到数据会写入到不同的分区,那kafka为什么要做分区呢?相信大家应该也能猜到,分区的主要目的是: 1、 方便扩展。因为一个topic可以有多个partition,所以我们可以通过扩展机器去轻松的应对日益增长的数据量。 2、 提高并发。以partition为读写单位,可以多个消费者同时消费数据,提高了消息的处理效率。 熟悉负载均衡的朋友应该知道,当我们向某个服务器发送请求的时候,服务端可能会对请求做一个负载,将流量分发到不同的服务器,那在kafka中,如果某个topic有多个partition,producer又怎么知道该将数据发往哪个partition呢? kafka中有几个原则: 1、 partition在写入的时候可以指定需要写入的partition,如果有指定,则写入对应的partition。 2、 如果没有指定partition,但是设置了数据的key,则会根据key的值hash出一个partition。 3、 如果既没指定partition,又没有设置key,则会轮询选出一个partition。 保证消息不丢失是一个消息队列中间件的基本保证,那producer在向kafka写入消息的时候,怎么保证消息不丢失呢? 其实上面的写入流程图中有描述出来,那就是通过ACK应答机制!在生产者向队列写入数据的时候可以设置参数来确定是否确认kafka接收到数据,这个参数可设置的值为0、1、all。 0代表producer往集群发送数据不需要等到集群的返回,不确保消息发送成功。安全性最低但是效率最高。 1代表producer往集群发送数据只要leader应答就可以发送下一条,只确保leader发送成功。 all代表producer往集群发送数据需要所有的follower都完成从leader的同步才会发送下一条,确保leader发送成功和所有的副本都完成备份。安全性最高,但是效率最低。 最后要注意的是,如果往不存在的topic写数据,能不能写入成功呢?kafka会自动创建topic,分区和副本的数量根据默认配置都是1。 保存数据 Producer将数据写入kafka后,集群就需要对数据进行保存了!kafka将数据保存在磁盘,可能在我们的一般的认知里,写入磁盘是比较耗时的操作,不适合这种高并发的组件。Kafka初始会单独开辟一块磁盘空间,顺序写入数据(效率比随机写入高)。 Partition 结构前面说过了每个topic都可以分为一个或多个partition,如果你觉得topic比较抽象,那partition就是比较具体的东西了!Partition在服务器上的表现形式就是一个一个的文件夹,每个partition的文件夹下面会有多组segment文件,每组segment文件又包含.index文件、.log文件、.timeindex文件(早期版本中没有)三个文件, log文件就实际是存储message的地方,而index和timeindex文件为索引文件,用于检索消息。 如上图,这个partition有三组segment文件,每个log文件的大小是一样的,但是存储的message数量是不一定相等的(每条的message大小不一致)。文件的命名是以该segment最小offset来命名的,如000.index存储offset为0~368795的消息,kafka就是利用分段+索引的方式来解决查找效率的问题。 Message结构上面说到log文件就实际是存储message的地方,我们在producer往kafka写入的也是一条一条的message,那存储在log中的message是什么样子的呢?消息主要包含消息体、消息大小、offset、压缩类型……等等! 我们重点需要知道的是下面三个: 1、 offset:offset是一个占8byte的有序id号,它可以唯一确定每条消息在parition内的位置! 2、 消息大小:消息大小占用4byte,用于描述消息的大小。 3、 消息体:消息体存放的是实际的消息数据(被压缩过),占用的空间根据具体的消息而不一样。 存储策略无论消息是否被消费,kafka都会保存所有的消息。那对于旧数据有什么删除策略呢? 1、 基于时间,默认配置是168小时(7天)。 2、 基于大小,默认配置是1073741824。需要注意的是,kafka读取特定消息的时间复杂度是O(1),所以这里删除过期的文件并不会提高kafka的性能! 消费数据 消息存储在log文件后,消费者就可以进行消费了。在讲消息队列通信的两种模式的时候讲到过点对点模式和发布订阅模式。 Kafka采用的是点对点的模式,消费者主动的去kafka集群拉取消息,与producer相同的是,消费者在拉取消息的时候也是找leader去拉取。 多个消费者可以组成一个消费者组(consumer group),每个消费者组都有一个组id!同一个消费组者的消费者可以消费同一topic下不同分区的数据,但是不会组内多个消费者消费同一分区的数据!!! 是不是有点绕。我们看下图: 图示是消费者组内的消费者小于partition数量的情况,所以会出现某个消费者消费多个partition数据的情况,消费的速度也就不及只处理一个partition的消费者的处理速度!如果是消费者组的消费者多于partition的数量,那会不会出现多个消费者消费同一个partition的数据呢? 上面已经提到过不会出现这种情况!多出来的消费者不消费任何partition的数据。所以在实际的应用中,建议消费者组的consumer的数量与partition的数量一致!在保存数据的小节里面,我们聊到了partition划分为多组segment,每个segment又包含.log、.index、.timeindex文件,存放的每条message包含offset、消息大小、消息体…… 我们多次提到segment和offset,查找消息的时候是怎么利用segment+offset配合查找的呢?假如现在需要查找一个offset为368801的message是什么样的过程呢?我们先看看下面的图: 1、 先找到offset的368801message所在的segment文件(利用二分法查找),这里找到的就是在第二个segment文件。 2、 打开找到的segment中的.index文件(也就是368796.index文件,该文件起始偏移量为368796+1,我们要查找的offset为368801的message在该index内的偏移量为368796+5=368801,所以这里要查找的相对offset为5)。由于该文件采用的是稀疏索引的方式存储着相对offset及对应message物理偏移量的关系,所以直接找相对offset为5的索引找不到,这里同样利用二分法查找相对offset小于或者等于指定的相对offset的索引条目中最大的那个相对offset,所以找到的是相对offset为4的这个索引。 3、 根据找到的相对offset为4的索引确定message存储的物理偏移位置为256。打开数据文件,从位置为256的那个地方开始顺序扫描直到找到offset为368801的那条Message。 这套机制是建立在offset为有序的基础上,利用segment+有序offset+稀疏索引+二分查找+顺序查找等多种手段来高效的查找数据! 至此,消费者就能拿到需要处理的数据进行处理了。那每个消费者又是怎么记录自己消费的位置呢? 在早期的版本中,消费者将消费到的offset维护zookeeper中,consumer每间隔一段时间上报一次,这里容易导致重复消费,且性能不好!在新的版本中消费者消费到的offset已经直接维护在kafk集群的_consumeroffsets这个topic中! 关注Java技术栈看更多干货 戳原文,获取更多福利! 本文分享自微信公众号 - Java技术栈(javastack)。如有侵权,请联系 support@oschina.cn 删除。本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

优秀的个人博客,低调大师

JVM 双亲委派模型及 SPI 实现原理分析

学习目标 双亲委派模型的⼯作机制。 类加载器的分类及各⾃的职责。 双亲委派模型的好处。 打破双亲委派模型的三种场景。 线程上下⽂类加载器在是如何实现 SPI 的。 1、双亲委派模型 我们知道类加载机制是将⼀个类从字节码⽂件转化为虚拟机可以直接使⽤类的过程,但是是谁来执⾏这个过程中的加载过程,它⼜是如何完成或者说保障了类加载的准确性和安全性呢? 答案就是类加载器以及双亲委派机制。 双亲委派模型的⼯作机制是:当类加载器接收到类加载的请求时,它不会⾃⼰去尝试加载这个类,⽽是把这个请求委派给⽗加载器去完成,只有当⽗类加载器反馈⾃⼰⽆法完成这个加载请求时,⼦加载器才会尝试⾃⼰去加载类。 我们可以从 JDK 源码中将它的⼯作机制⼀窥究竟。 ClassLoader#loadClass(String, boolean) 这是在 jdk1.8 的 java.lang.ClassLoader 类中的源码,这个⽅法就是⽤于加载指定的类。 /** * @author 庭前云落 * @Date 2020/8/22 21:29 * @description */ public class ClassLoader { protected Class<?> loadClass(String name, boolean resolve) throws ClassNotFoundException { synchronized (getClassLoadingLock(name)) { // First, check if the class has already been loaded // ⾸先,检查该类是否已经被当前类加载器加载,若当前类加载未加载过该类,调⽤⽗类的加载类⽅法去加载该类(如果⽗类为null的话交给启动类加载器加载) Class<?> c = findLoadedClass(name); if (c == null) { long t0 = System.nanoTime(); try { if (parent != null) { c = parent.loadClass(name, false); } else { c = findBootstrapClassOrNull(name); } } catch (ClassNotFoundException e) { // ClassNotFoundException thrown if class not foun // from the non-null parent class loader } if (c == null) { // If still not found, then invoke findClass in orde // to find the class. // 如果⽗类未完成加载,使⽤当前类加载器去加载该类 long t1 = System.nanoTime(); c = findClass(name); // this is the defining class loader; record the stats sun.misc.PerfCounter.getParentDelegationTime().addTime(t1 - t0); sun.misc.PerfCounter.getFindClassTime().addElapsedTimeFrom(t1); sun.misc.PerfCounter.getFindClasses().increment(); } } if (resolve) { // 链接指定的类 resolveClass(c); } return c; } } } 看完了上⾯的代码,我们知道这就是双亲委派模型代码层⾯的解释: 当类加载器接收到类加载的请求时,⾸先检查该类是否已经被当前类加载器加载; 若该类未被加载过,当前类加载器会将加载请求委托给⽗类加载器去完成; 若当前类加载器的⽗类加载器(或⽗类的⽗类……向上递归)为 null,会委托启动类加载器完成加 载; 若⽗类加载器⽆法完成类的加载,当前类加载器才会去尝试加载该类。 2、类加载器的分类及各自的职责 在 JVM 中预定义的类加载器有3种: 启动类加载器 (Bootstrap ClassLoader)、扩展类加载器(ExtensionClassLoader)、 应⽤类/系统类加载器(App/SystemClassLoader),另外还有⼀种是 用户自定义的类加载器 ,它们各⾃有各⾃的职责。 2.1.启动类加载器 Bootstrap ClassLoader 启动类加载器作为所有类加载器的"⽼祖宗",是由C++实现的,不继承于java.lang.ClassLoader 类。它在虚拟机启动时会由虚拟机的⼀段C++代码进⾏加载,所以它没有⽗类加载器,在加载完成后,它会负责去加载扩展类加载器和应⽤类加载器。 启动类加载器⽤于加载 Java 的核⼼类——位于 <JAVA_HOME>\lib 中,或者被 -Xbootclasspath 参数所指定的路径中,并且是虚拟机能够识别的类库(仅按照⽂件名识别,如 rt.jar、tools.jar ,名字不符合的类库即使放在lib⽬录中也不会被加载)。 2.2.拓展类加载器 Extension ClassLoader 拓展类加载器继承于 java.lang.ClassLoader 类,它的⽗类加载器是启动类加载器,⽽启动类加载器在 Java 中的显示就是 null。 引⾃ jdk1.8 ClassLoader#getParent() ⽅法的注释,这个⽅法是⽤于获取类加载器的⽗类加载器: Returns the parent class loader for delegation. Some implementations may use null to represent the bootstrap class loader. This method will return null in such implementations if this class loader's parent is the bootstrap class loader. 拓展类加载器负责加载 <JAVA_HOME>\lib\ext ⽬录中的,或者被 java.ext.dirs 系统变量所指定的路径的所有类。 需要注意的是扩展类加载器仅⽀持加载被打包为 .jar 格式的字节码⽂件。 2.3.应⽤类/系统类加载器 App/System ClassLoader 应⽤类加载器继承于 java.lang.ClassLoader 类,它的⽗类加载器是扩展类加载器。 应⽤类加载器负责加载⽤户类路径 classpath 上所指定的类库。 如果应⽤程序中没有⾃定义的类加载器,⼀般情况下应⽤类加载器就是程序中默认的类加载器。 2.4.⾃定义类加载器 Custom ClassLoader ⾃定义类加载器继承于 java.lang.ClassLoader 类,它的⽗类加载器是应⽤类加载器。 这是普某户籍⾃定义的类加载器,可加载指定路径的字节码⽂件。 ⾃定义类加载器需要继承 java.lang.ClassLoader 类并重写 findClass ⽅法(下⽂有说明为什么不重写 loadClass ⽅法)⽤于实现⾃定义的加载类逻辑。 3、双亲委派模型的好处 基于双亲委派模型规定的这种带有优先级的层次性关系,虚拟机运⾏程序时就能够避免类的重复加载。 当⽗类类加载器已经加载过类时,如果再有该类的加载请求传递到⼦类类加载器,⼦类类加载器执⾏ loadClass ⽅法,然后委托给⽗类类加载器尝试加载该类,但是⽗类类加载器执⾏ Class<?> c = findLoadedClass(name); 检查该类是否已经被加载过这⼀阶段就会检查到该类已经被加载过,直接返回该类,⽽不会再次加载此类。 双亲委派模型能够避免核⼼类篡改。⼀般我们描述的核⼼类是 rt.jar、tools.jar 这些由启动类加载器加载的类,这些类库在⽇常开发中被⼴泛运⽤,如果被篡改,后果将不堪设想。 假设我们⾃定义了⼀个 java.lang.Integer 类,与好处1⼀样的流程,当加载类的请求传递到启动类加载器时,启动类加载器执行findLoadedClass(String) ⽅法发现 java.lang.Integer 已经被加载过,然后直接返回该类,加载该类的请求结束。虽然避免核⼼类被篡改这⼀点的原因与避免类的重复加载⼀致,但这还是能够作为双亲委派模型的好处之⼀的。 4、双亲委派模型的不足 这⾥所说的不⾜也可以理解为打破双亲委派模型,当双亲委派模型不满⾜⽤户需求时,⾃然是由于其不⾜之处也就促使⽤户将其打破这⾥描述的也就是打破双亲委派模型的三种 由于历史原因( ClassLoader 类在 JDK1.0 时就已经存在,⽽双亲委派模型是在 JDK1.2 之后才引⼊的),在未引⼊双亲委派模型时,⽤户自定义的类加载器需要继承 java.lang.ClassLoader 类并重写 loadClass() 方法,因为虚拟机在加载类时会调⽤ ClassLoader#loadClassInternal(String) ,而这个⽅法(源码如下)会调⽤自定义类加载重写的 loadClass() 方法。 而在引⼊双亲委派模型后, ClassLoader#loadClass ⽅法实际就是双亲委派模型的实现,如果重写了此⽅法,相当于打破了双亲委派模型。为了让⽤户⾃定义的类加载器也遵从双亲委派模型, JDK新增了 findClass 方法,⽤于实现⾃定义的类加载逻辑。 /** * @author 庭前云落 * @Date 2020/8/22 21:29 * @description */ public class ClassLoader { // This method is invoked by the virtual machine to load a class. private Class<?> loadClassInternal(String name) throws ClassNotFoundException { // For backward compatibility, explicitly lock on 'this' when // the current class loader is not parallel capable. if (parallelLockMap == null) { synchronized (this) { return loadClass(name); } } else { return loadClass(name); } } // 其余⽅法省略...... } 由于双亲委派模型规定的层次性关系,导致⼦类类加载器加载的类能访问⽗类类加载器加载的类,⽽⽗类类加载器加载的类⽆法访问⼦类类加载器加载的类。为了让上层类加载器加载的类能够访问下层类加载器加载的类,或者说让⽗类类加载器委托⼦类类加载器完成加载请求,JDK 引⼊了线程上下⽂类加载器,藉由它来打破双亲委派模型的屏障。 当⽤户需要程序的动态性,⽐如代码热替换、模块热部署等时,双亲委派模型就不再适⽤,类加载器会发展为更为复杂的⽹状结构。 5、线程上下文类加载器 上⾯说到双亲委派模型的不⾜时提到了线程上下⽂类加载器 Thread Context ClassLoader ,线程上下⽂类加载器是定义在 Thread 类中的⼀个 ClassLoader 类型的私有成员变量,它指向了当前线程的类加载器。 上⽂已经提到线程上下⽂类加载能够让⽗类类加载器委托⼦类类加载器完成加载请求,那么这是如何实现的呢?下⾯就来讨论⼀下。 5.1.SPI 在 JDBC 中的应用 我们知道 Java 提供了⼀些 SPI(Service Provider Interface) 接⼝,它允许服务商编写具体的代码逻辑来完成该接⼝的功能。 但是 Java 提供的 SPI 接⼝是在核⼼类库中,由启动类加载器加载的,⼚商实现的具体逻辑代码是在classpath 中,是由应⽤类加载器加载的,⽽启动类加载器加载的类⽆法访问应⽤类加载器加载的类,也就是说启动类加载器⽆法找到 SPI 实现类,单单依靠双亲委派模型就⽆法实现 SPI 的功能了,所以线程上下⽂类加载器应运⽽⽣。 在 Java 提供的 SPI 中我们最常⽤的可能就属 JDBC 了,下⾯我们就以 JDBC 为例来看⼀下线程上下⽂类加载器如何打破双亲委派模型。 回忆⼀下以前使⽤ JDBC 的场景,我们需要创建驱动,然后创建连接,就像下⾯的代码这样: /** * @author 庭前云落 * @Date 2020/8/22 21:29 * @description */ public class ThreadContextClassLoaderDemoOfJdbc { public static void main(String[] args) throws Exception { // 加载 Driver 的实现类 Class.forName("com.mysql.jdbc.Driver"); // 建⽴连接 Connection conn = DriverManager.getConnection("jdbc:mysql://localhost:3306/mysql", "root", "1234"); } } 在 JDK1.6 以后可以不⽤写 Class.forName("com.mysql.jdbc.Driver"); ,代码依旧能正常运⾏。这是因为⾃带的 jdbc4.0 版本已⽀持 SPI 服务加载机制,只要服务商的实现类在classpath 路径中,Java 程序会主动且⾃动去加载符合 SPI 规范的具体的驱动实现类,驱动的全限定类名在 META-INF.services ⽂件中。 所以,让我们把⽬光聚焦于建⽴连接的语句,这⾥调⽤了 DriverManager 类的静态⽅法getConnection 。 在调⽤此⽅法前,根据类加载机制的初始化时机,调⽤类的静态⽅法会触发类的初始化,当 DriverManager 类被初始化时,会执⾏它的静态代码块。 /** * @author 庭前云落 * @Date 2020/8/22 21:29 * @description */ public class DriverManager { static { loadInitialDrivers(); println("JDBC DriverManager initialized"); } private static void loadInitialDrivers() { String drivers; // 省略代码:⾸先读取系统属性 jdbc.drivers // 通过 SPI 加载 classpath 中的驱动类 AccessController.doPrivileged(new PrivilegedAction<Void>() { public Void run() { // ServiceLoader 类是 SPI 加载的⼯具类 ServiceLoader<Driver> loadedDrivers = ServiceLoader.load(Driver.class); Iterator<Driver> driversIterator = loadedDrivers.iterator(); try { while (driversIterator.hasNext()) { driversIterator.next(); } } catch (Throwable t) { // Do nothing } return null; } }); // 省略代码:使⽤应⽤类加载器继续加载系统属性 jdbc.drivers 中的驱动类 } } 从上⾯的代码中可以看到,程序时通过调⽤ ServiceLoader.load(Driver.class) ⽅法来完成⾃动加载。classpath 路径中具体的所有实现了 Driver.class 接⼝的⼚商实现类,⽽在 ServiceLoader.load() 方法中,就是获取了当前线程上下⽂类加载器,并将它传递下去,将它作为类加载器去实现加载逻辑的。 /** * @author 庭前云落 * @Date 2020/8/22 21:29 * @description */ public final class ServiceLoader<S> implements Iterable<S>{ public static <S> ServiceLoader<S> load(Class<S> service) { // 获取当前线程的线程上下⽂类加载器 AppClassLoader,⽤于加载 classpath 中的具体实现类 ClassLoader cl = Thread.currentThread().getContextClassLoader(); return ServiceLoader.load(service, cl); } } JDK 默认加载当前类的类加载器去加载当前类所依赖且未被加载的类,而ServiceLoader 类位于java.util 包下,⾃然是由启动类加载器完成加载,而厂商实现的具体驱动类是位于 classpath 下,启动类加载器⽆法加载 classpath 目录的类,而如果加载具体驱动类的类加载器变成了应⽤类加载器,那么就可以完成加载了。 通过跟踪代码,不难看出 ServiceLoader#load(Class) ⽅法创建了⼀个 LazyIterator 类同时返回了⼀个 ServiceLoader 对象,前者是⼀个懒加载的迭代器,同时它也是后者的⼀个成员变量,当对迭代器进行遍历时,就触发了⽬标接⼝实现类的加载。 /** * @author 庭前云落 * @Date 2020/8/22 21:29 * @description */ private class LazyIterator implements Iterator<S> { public S next() { if (acc == null) { return nextService(); } else { PrivilegedAction<S> action = new PrivilegedAction<S>() { public S run() { return nextService(); } }; return AccessController.doPrivileged(action, acc); } } } 在 DriverManager#loadInitialDrivers ⽅法,也就是 DriverManager 类的静态代码块所执⾏的⽅法中,有这样⼀段代码: AccessController.doPrivileged(new PrivilegedAction<Void>() { public Void run () { ServiceLoader<Driver> loadedDrivers = ServiceLoader.load(Driver.class); Iterator<Driver> driversIterator = loadedDrivers.iterator(); try { while (driversIterator.hasNext()) { driversIterator.next(); } } catch (Throwable t) { // Do nothing } return null; } }); 这段代码返回了⼀个 ServiceLoader 对象,在这个对象中有⼀个 LazyIterator 迭代器类,⽤于存放所有⼚商实现的具体驱动类,当我们对 LazyIterator 这个迭代器进⾏遍历时,就出发了类加载的逻辑。 private S nextService() { if (!hasNextService()) throw new NoSuchElementException(); String cn = nextName; nextName = null; Class<?> c = null; try { // 不⽤写 Class.forName("com.mysql.jdbc.Driver"); 的原因就是在此处会⾃动调⽤这个⽅法 c = Class.forName(cn, false, loader); } catch (ClassNotFoundException x) { fail(service, "Provider " + cn + " not found"); } if (!service.isAssignableFrom(c)) { fail(service, "Provider " + cn + " not a subtype"); } try { S p = service.cast(c.newInstance()); providers.put(cn, p); return p; } catch (Throwable x) { fail(service, "Provider " + cn + " could not be instantiated", x); } throw new Error(); // This cannot happen } 每次遍历都会调⽤ Class.forName(cn, false, loader) ⽅法对指定的类进⾏加载和实例化操作,这也是前⽂提到的在 jdk1.6 以后不⽤在写 Class.forName("com.mysql.jdbc.Driver"); 的原因。 在这个⽅法 Class.forName(cn, false, loader) 中,传⼊的参数 cn 是全路径类名,false 是指不进⾏初始化,loader 则是指定完成 cn 类加载的类加载器。 在这⾥的 loader 变量,我们回顾⼀下前⽂的描述,在 ServiceLoader.load(Driver.class) ⽅法中是不是获取了线程上下⽂类加载器并传递下去? 不记得?在回过头去看⼀遍! ⽽传⼊的线程上下⽂类加载器会作为参数传递给 ServiceLoader 类的构造方法 private ServiceLoader(Class<S> svc, ClassLoader cl) { service = Objects.requireNonNull(svc, "Service interface cannot be null "); loader = (cl == null) ? ClassLoader.getSystemClassLoader() : cl; acc = (System.getSecurityManager() != null) ? AccessController.getContext() : null; reload(); } ⽽此处的 cl 变量就是调⽤ DriverManager 类静态⽅法的线程上下⽂类加载器,即应⽤类加载器。 也就是说,通过 DriverManager 类的静态⽅法,实现了由 ServiceLoader 类触发加载位于 classpath的⼚商实现的驱动类。前⽂已经说过, ServiceLoader 类位于 java.util 包中,是由启动类加载器加载的,⽽由启动类加载器加载的类竟然实现了"委派"应⽤类加载器去加载驱动类,这⽆疑是与双亲委派机制相悖的。⽽实现这个功能的,就是线程上下⽂类加载器。 ⾄此,我们就分析完线程上下⽂类加载是如何实现 SPI 的了。

优秀的个人博客,低调大师

KubeFlow-Pipeline及Argo实现原理速析

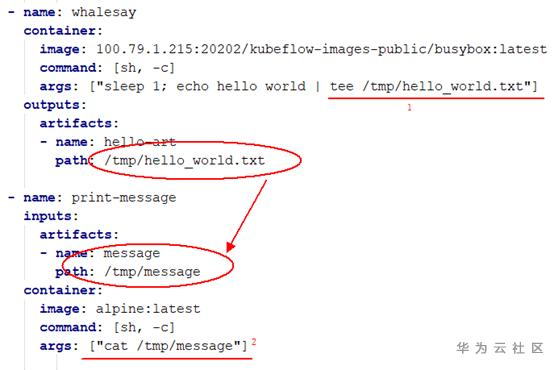
Argo是一个开源原生容器工作流引擎用于在Kubernetes上开发和运行应用程序。Argo Workflow流程引擎,可以编排容器流程来执行业务逻辑,在20年4月8日进入CNCF孵化器组。 而KubeFlow的Pipeline子项目,由Google开源,其全面依赖Argo作为底层实现,并增强持久层来补充流程管理能力,同时通过Python-SDK来简化流程的编写。 一. Argo流程引擎 Argo的步骤间可以传递信息,即下一步(容器)可以获取上一步(容器)的结果。结果传递有2种: 1. 文件:上一步容器新生成的文件,会直接出现在下一步容器里面。 2. 信息:上一步的执行结果信息(如某文件内容),下一步也可以拿到。 下面我们就来解读一下,Argo怎么实现“信息”在容器间的传递的,以及它和其他的流程引擎实现传递的区别。 1.1文件怎么从上一个容器跑到下一个容器里的? Argo流程,可以指定2个步骤之间,传递结果文件(Artifact)。即假设流程为:A->B,那么A容器跑完,B容器可以取得上一个容器的输出文件。 如下:A容器生成一个 /tmp/hello_world.txt 文件,Argo将这个文件,放到了B容器里面,并重命名为 /tmp/message文件。 注意:流程上的每个步骤,都对应执行一个容器。 在A跑完后容器就退出了,然后才跑的B(这时候已经没有A容器在运行了)。 所以Argo怎么把一个文件从A容器“拷贝”到B容器里面的? 1.1.1容器间通过共享存储?(NO) 一般容器间共享文件,首先想到的都是:咱使用共享存储呀,大家都挂载同一个PVC不就行了。 确实共享存储可以实现容器共享文件,但是这里Argo可以: (1)任意指定文件传递。(2)传递后文件可以改名字。 这2个是共享Volume做不到的,毕竟容器挂载目录得提前设定好,然后文件名大家看到的也是一样的。所以显然文件传递,不是通过共享PVC挂载实现的。 (Ps:不过Argo也在考虑这种实现方式,毕竟共享目录不需要任何额外IO,透传效率更高。见:https://github.com/argoproj/argo/issues/1349) 1.1.2通过管理面中转?(YES) 没有共享目录,那中转文件,只能是通过先取出来,再塞回去的方式喽。实际上Argo也确实这么做的,只是实现上还有些约束。 (1)“临时中转仓库”需要引入第三方软件(Minio) (2)文件不能太大 (3)需要在用户容器侧,增加“代理”帮忙上传&下载文件。 1.1.3中转文件具体实现(docker cp) 现在我们打开Argo看看具体怎么实现的。因为你要取一个容器里面的文件,或者把一个文件放入一个容器,也不容易实现呢。 (1)小滑头Argo居给用户容器设置了一个SideCar容器,通过这个SideCar去读取用户的文件,然后上传到临时仓库。 (2) 一个Pod里面的两个Container,文件系统也是独立的,并不能直接取到另一个Container的文件。所以Sidecar容器为了取另一个容器里的文件,又把主机上面的docker.sock挂载进来了。这样就相当于拿到了主机Root权限,可以任意cp主机上任意容器里面的文件。 事实上,Sidecar里面取文件的实现是: docker cp -a 023ce:/tmp/hello_world.txt - | gzip > /argo/outputs/artifacts/hello-art.tgz 感觉稍微有点暴力。 1.1.4中转实现的其他方式 实际上,通过sidecar容器提权到root权限,然后从用户的容器里面copy任意文件(即 docker cp命令),只是Argo默认的实现。毕竟它自己也发现这样做安全上有点说不过去。 所以呢,它也留了其他方式去copy用户容器里面的文件。比如:kubectl 也是可以cp容器里面的文件的嘛。其他方式可参见: https://github.com/argoproj/argo/blob/master/docs/workflow-executors.md 1.2 下一步容器怎么拿到上一步容器的结果? Argo流程,2个步骤之间,除了传递文件,还可以传递结果信息(Information)。如:A->B,那么A容器跑完,B容器可以取得上一个容器的一些Information(不是整个文件)。 一般流程引擎透传信息,都是中转: 不过显然Argo自己没有存储Information的临时仓库,所以它得找个地方记录这些临时待中转的information(虽然Argo找了Minio这个对象存储用来暂存中转文件,但是显然这货只能存文件,没有存Metadata元数据功能)。这里Argo又找了Pod里面的Annotation字段,当做临时中转仓库。先把信息记这里,下一步容器想要,就来这里取。 相信这里应该是有更好的实现方式的,这种把信息记录到Annotation的做法,约束比较大的(特别是ETCD的单个对象不能超过1M大小)。 可以考虑使用单独的Configmap来中转也可以。 二. KubeFlow-Pipeline项目 KubeFlow-Pipeline项目(简称KFP),是Kubeflow社区开源的一个工作流项目,用于管理、部署端到端的机器学习工作流。KFP提供了一个流程管理方案,方便将机器学习中的应用代码按照流水线的方式编排部署,形成可重复的工作流。 2.1为什么要在Argo之上重新开发一套? 部署一套Argo很简单,启动一个K8s-Controller就行。可是部署一套Kubeflow-Pipeline系统就复杂多了,总共下来有8个组件。那是Argo什么地方不足,需要新开发一套KFP,并搞这么复杂呢?主要的原因还在于Argo是基于K8s云原生这套理念,即ETCD充当“数据库”来运行的,导致约束比较大。 像:流程模板,历史执行记录,这些大量的信息很明显需要一个持久化层(数据库)来记录的,单纯依赖ETCD会有单条记录不能超过1M,总记录大小不能超过8G的约束。 所以一个完整的流程引擎,包含一个数据库也都是很常规的。因此KFP在这一层做了较大的增强。 另外,在ML领域的用户界面层,KFP也做了较多的用户体验改进。包括可以查看每一步的训练输出结果,直接通过UI进行可视化的图形展示。 https://www.kubeflow.org/docs/pipelines/sdk/output-viewer/ 2.2 Kubeflow-Pipeline后续演进点 见:https://github.com/kubeflow/pipelines/issues/3550 Dag引擎组件的水平扩展(HPA)是其重要的一个特性,也是要成为一个成熟引擎所必要的能力。 当前KFP在稳定性以及组件的水平扩展上都还有待改进,因此商业使用还需要一段时间,这将是KFP未来的一个重要目标。 同时,使用权限过于高的Sidecar容器作为其实现步骤之间元数据传递的途径,也会是KFP生产级使用的一道门槛。或许在权限控制方面,KFP需要思考一下其他规避途径,至少需要稍微增强一下。 概括一下:(1)水平扩展(HPA),(2)生产级可靠性,(3)安全增强。 三. 流程引擎核心&分层 3.1 DAG核心 一个DAG流程引擎,核心代码也就7行大概能实现了: 例如下图示例:遍历发现步骤D没有依赖其他步骤,那么本次可以执行D步骤。 所以一般程序员一周时间总能开发一个“还能用”的流程引擎。但是完整的流程引擎却并不轻松 3.2 世界上为什么有这么多的流程引擎 DAG基础核心非常简单,同时,各个领域想要做的事情却迥然不同。即使一个简单的步骤,大数据步骤说:“这一步要执行的SQL语句是xxx”,而K8s任务步骤却说:“这一步执行需要的Docker镜像是yyy”。 所以,各种各样的流程引擎就自然的出现了。 举几个例子: AWS:Cloudformation编排,Batch服务,SageMaker-ML Pipeline,Data Pipeline Azure:Pipeline服务,ML Pipeline,Data Factory Aliyun:函数Pipeline服务,ROS资源编排,Batch服务,PAI-Studio 大数据领域:Oozie,AirFlow 软件部署:Puppet,Chef,Ansible 基因分析:DNAnexus,NextFlow,Cromwell 每个领域总能找出一两个流程引擎,来控制谁先干活谁后干活。 总结一下: (1)DAG引擎核心很小 (2)各领域步骤的描述方式不一样 这就是为什么各个领域,总会有一个自己的流程引擎,而不像K8s能一统容器平台一样,出现一个能一统江湖的流程引擎。 3.3 DAG引擎分层架构 成熟的流程引擎,应该有如下4层架构: 第一层:用户交互层。如:模板语法规则,Console界面等 第二层:API持久化层。如:模板记录,历史执行记录等 第三层:引擎实例层。如:能否水平扩容,流程是否有优先级等 第四层:驱动层。如:一个步骤能干什么活。跑一个容器还是跑一个Spark任务。 基本比较成熟的引擎都符合这种架构,例如AirFlow流程引擎,华为云的应用编排(AOS)引擎,数据湖工厂(DLF)引擎等都是如此。 目前Argo以及Kubeflow-Pipeline在引擎核心组件的水平扩展上,也即第三层引擎能力层稍有不足。同时其驱动层,目前也只能对接K8s(即只能跑容器任务)。在选型的时候需要考虑进去。 点击关注,第一时间了解华为云新鲜技术~

优秀的个人博客,低调大师

Java JUnit框架里@Category注解的工作原理

Suppose you have a large number of unit test cases and you don’t want them to be executed all at the same time during Maven build. You can simply achieve it via annotation @Category. (1) Create empty class FastTests and SlowTests.(2) In your test case class, categorize your test method using @Category annotation: (3) Append the following code to your pom.xml: <profiles> <profile> <id>SlowTests</id> <properties> <testcase.groups>com.sap.SlowTests</testcase.groups> </properties> </profile> <profile> <id>FastTests</id> <properties> <testcase.groups>com.sap.FastTests</testcase.groups> </properties> </profile> </profiles> <build> <plugins> <plugin> <groupId>org.apache.maven.plugins</groupId> <artifactId>maven-compiler-plugin</artifactId> <version>3.1</version> <configuration> <source>1.8</source> <target>1.8</target> </configuration> </plugin> <plugin> <groupId>org.apache.maven.plugins</groupId> <artifactId>maven-surefire-plugin</artifactId> <version>2.13</version> <dependencies> <dependency> <groupId>org.apache.maven.surefire</groupId> <artifactId>surefire-junit47</artifactId> <version>2.13</version> </dependency> </dependencies> <configuration> <groups>${testcase.groups}</groups> </configuration> </plugin> </plugins> </build> (4) In my project, by default all 7 test methods will be executed during Maven build: Suppose you only want to execute unit test belonging to category “SlowTests”, use the following command line: Since now I only marked one method with annotation SlowTests, only one test method is executed: If you would like to execute all unit tests EXCEPT @SlowTests, simply add another profile in pom.xml: <profile> <id>NonSlowTests</id> <build> <plugins> <plugin> <groupId>org.apache.maven.plugins</groupId> <artifactId>maven-surefire-plugin</artifactId> <configuration> <excludedGroups>com.sap.SlowTests</excludedGroups> </configuration> </plugin> </plugins> </build> </profile> Before test, in order to prove that Slow method is NOT really executed, I add a system.out.println in each method: Use command line: mvn test -P NonSlowTestsFrom console output, I can ensure that the method with @Category(SlowTests.class) is NOT executed at all. 本文来自云栖社区合作伙伴“汪子熙”,了解相关信息可以关注微信公众号"汪子熙"。

优秀的个人博客,低调大师

HBase2.0 procedureV2原理简析

总体流程图 就绪区: 这部分的核心实现类是MasterProcedureScheduler,主要的作用就是对Procedure进行调度; 从排队的角度看,可以认为存在三层队列调度; type队列: type包含meta、server、table,,三者之间存在优先级:meta>server>table,这里需要注意的是,所谓type队列是逻辑上来说的,worker在获取任务时会按优先级依次进行尝试; entity队列: 上述每种类型都对应一个FairQueue,该队列中的元素代表与某个实体相关的一组proc,这里称为proc队列,worker获取任务时,是从entity队列中获取的,所以只有存在于entity队列中的proc队列才有运行机会; proc队列: 这个队列中存放的就是具体的proc了,队列内部元素数量和锁状态的变化,决定了其是否存在于entity队列中,也即是否有运行机会,以下时机会对此产生影响; 将proc队列放入entity队列的时机: 往proc队列里面添加proc; worker执行完一个proc; 将proc队列从entity队列删除的时机: worker获取并尝试执行一个proc; 以上说的是时机,具体是否放入或删除,需要看锁需求和锁状态,基本上就是读写锁的逻辑; 执行区: 每个proc都定义了一组state,worker从初始状态开始,依次执行状态对应的动作直到结束,或者因故挂起等待; 等待区: proc可能会由于一些执行条件不满足,而处于等待状态,主要有以下几种情况; 等待锁: 每个proc队列都会对应一个LockAndQueue,对于正在等待锁的proc,会暂时放在其里面的队列中; 等待某事件: 处于此类等待中的proc会放在一些ProcedureEvent中,具体实例会放在与之相关的实体中,主要有以下三种; region rit:RegionStateNode meta assign/load:AssignmentManager master initialized:HMaster 等待子proc完成: 处于此类等待中的proc没有进行特殊的保存,当subProc运行完成,会根据childrenCountDown判断它是否是最后一个,如果是的话,则根据其携带的parentProcId从ProcedureExecutor的procedures中获取parentProc,将其唤醒; 回滚区: 不存在parentProc的proc都会对应一个RootProcedureState,内部通过一个subprocStack来保存已执行的proc及其状态,回滚时按顺序执行rollBack,这里值得注意的是,同一个proc如果已经被执行了多个步骤,那么在stack中会有多个引用变量指向它; 持久区: 当前的实现类是WALProcedureStore,数据存放在hdfs的MasterProcWALs目录;由于这部分的实现与region的写入过程比较相似,在社区比较新的版本中,已经改为RegionProcedureStore,数据组织上跟region类似,只是目录为MasterProcs;

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册