首页 文章 精选 留言 我的

精选列表

搜索[编译原理],共10000篇文章
优秀的个人博客,低调大师

Apache Flink 进阶(八):详解 Metrics 原理与实战

作者:刘彪 整理:毛鹤 本文由 Apache Flink Contributor 刘彪分享,本文对两大问题进行了详细的介绍,即什么是 Metrics、如何使用 Metrics,并对 Metrics 监控实战进行解释说明。 什么是 Metrics? Flink 提供的 Metrics 可以在 Flink 内部收集一些指标,通过这些指标让开发人员更好地理解作业或集群的状态。由于集群运行后很难发现内部的实际状况,跑得慢或快,是否异常等,开发人员无法实时查看所有的 Task 日志,比如作业很大或者有很多作业的情况下,该如何处理?此时 Metrics 可以很好的帮助开发人员了解作业的当前状况。 Metric Types Metrics 的类型如下: 首先,常用的如 Counter,写过 mapreduce 作业的开发人员就应该很熟悉 Counter,其实

优秀的个人博客,低调大师

数据结构(3):队列的原理和实现

完整代码拉到最底下 一、介绍 队列顾名思义就像我们生活中排队一样,先进先出。 如上图所示,25、16、5、9依次在队列中,按照顺序拿出的数据也分别是25、26、5、9。 二、实现过程及思路 底层使用数组来实现,实现的功能有插入数据到队尾、移除队首数据、查看队首数据、判断队列是否为空、判断队列是否存满。 将队列的元素存储在数组的某个区间内,队列在数组中是连续的,所以使用变量标记队列在数组中的位置。 1、编写类及属性 我们可以使用elements变量标记队列中元素的数量,使用front变量标记队首元素在数组的索引,end变量标记队尾元素在数组中的索引。 public class MyQueue { private Object[] arr;//存放队列元素的数组 private int elements;//队列元素数量 private int front;//队头元素在数组中的索引 private int end;//队尾元素在数组中的索引 public MyQueue() { arr = new Object[10]; elements = 0; front = 0; end = -1; } public MyQueue(int maxSize) { arr = new Object[maxSize]; elements = 0; front = 0; end = -1; } } 2、队列是否为空 标记队列元数量的变量 elements 为 0 即为空 public boolean isEmpty() { return elements == 0; } 3、队列是否已经满了 队列元素个数与数组的长度相等即为满 public boolean isFull() { return elements == arr.length; } 4、获取队头元素 获取数组中索引为 front的元素 public Object peek() { return arr[front]; } 5、移除队首元素 每次都是移除数组中索引为 front 的元素,下一个元素就变成了队首,即front+1,队列元素个数elements-1。共有三种情况要考虑,如果队列已经空了就无须做任何操作,如果已经是最后一个元素,直接将标记位置的变量重置即可,其他情况正常操作。 public Object remove() { if (isEmpty()) { throw new RuntimeException("队列已经是空的,放心使用吧"); } Object value = arr[front++]; //如果已经是最后一个元素了,将指针重置即可 if (elements == 1) { end = -1; front = 0; elements = 0; } else { elements--; } return value; } 6、插入 我们编写一个持续可用的队列,所以要考虑到以下情况。 (1)存储队列的数组满了(队列满了),这个好理解,满了就无法向队尾加入元素了。 (2)因为队列在数组中是连续的,如果队列的元素在数组中最后,需要将元素从队首到队尾移到数组中第一位,也就是将后面的位置空出来(参考下图)。 public void insert(Object value) { //检测队列是否已经满了 if (isFull()) { throw new RuntimeException("队列内元素已达到设定长度"); } //如果后面没有空位置,将余下元素放到数组的头 if (elements > 1 && end == arr.length - 1) { int i = 0; for (; i < elements; i++, front++) { arr[i] = arr[front]; } front = 0; end = i-1; } //其他情况正常向后添加元素 arr[++end] = value; elements++; } 7、测试 public static void main(String[] args) { MyQueue queue = new MyQueue(4); queue.insert(11); queue.insert(12); queue.insert(13); queue.insert(14); queue.remove(); queue.remove(); queue.insert(16); //queue.remove(); //queue.remove(); //queue.insert(19); //queue.insert(20); queue.remove(); queue.remove(); queue.insert(21); queue.insert(22); while (!queue.isEmpty()) { System.out.println(queue.remove()); } } 三、完整代码 package com.jikedaquan.datastruct; public class MyQueue { private Object[] arr; private int elements;//队列元素数量 private int front;//队头元素在数组中的索引 private int end;//队尾元素在数组中的索引 public MyQueue() { arr = new Object[10]; elements = 0; front = 0; end = -1; } public MyQueue(int maxSize) { arr = new Object[maxSize]; elements = 0; front = 0; end = -1; } //从队尾插入 public void insert(Object value) { //检测队列是否已经满了 if (isFull()) { throw new RuntimeException("队列内元素已达到设定长度"); } //如果后面没有空位置,将余下元素放到数组的头 if (elements > 1 && end == arr.length - 1) { int i = 0; for (; i < elements; i++, front++) { arr[i] = arr[front]; } front = 0; end = i-1; } arr[++end] = value; elements++; } //删除数据,从队头删除 public Object remove() { if (isEmpty()) { throw new RuntimeException("队列已经是空的,放心使用吧"); } Object value = arr[front++]; //如果已经是最后一个元素了,将指针重置即可 if (elements == 1) { end = -1; front = 0; elements = 0; } else { elements--; } return value; } //查看数据,从队头查看 public Object peek() { return arr[front]; } //判断是否为空 public boolean isEmpty() { return elements == 0; } public boolean isFull() { return elements == arr.length; } public static void main(String[] args) { MyQueue queue = new MyQueue(4); queue.insert(11); queue.insert(12); queue.insert(13); queue.insert(14); queue.remove(); queue.remove(); queue.insert(16); // queue.remove(); // queue.remove(); // queue.insert(19); // queue.insert(20); queue.remove(); queue.remove(); queue.insert(21); queue.insert(22); while (!queue.isEmpty()) { System.out.println(queue.remove()); } } }

优秀的个人博客,低调大师

数据结构(2):栈的原理和实现

一、介绍 栈是一种数据先入后出,后入先出的数据结构。 如果图所示,将数字 10、15、6、9 存入栈后,从栈中取到的数据按顺序将会是 9、6、15、10。栈的结构像我们生活中的箱子,最先放入的物品将会在箱子的最底部,最后放入的数据在最上面,拿物品时也需要从最上面拿起。 二、代码实现 1、创建 MyStack 类作为自定义的栈 public class MyStack { } 2、声明所需的属性 底层使用数组存储数据,也可以使用java的泛型替代Object类型。 private Object[] arr;//存储数据 private int top;//栈顶的位置 栈顶:整个栈最上面(最后入栈)的元素,也就是数组中最后存入的元素。 栈底:整个栈最下面(最先入栈)的元素,也就是数组中最先存入的元素。 3、栈的构造方法 public MyStack(){ arr = new Object[10]; top = -1; } /** * 参数为数组的初始长度 * @param maxSize */ public MyStack(int maxSize){ arr = new Object[maxSize]; top = -1; } 4、向栈中压入数据 底层的操作就是向数组中存入数据,由于top变量记栈顶的位置,所以top的值增加1后即为最新的栈顶的置。 public void push(Object value) { arr[++top] = value; } 5、弹出栈顶的数据 取得栈顶的数据,并将此数据将栈中移除。向栈中压入数据需要将记录栈顶的位置的变量top加1,同理,移除栈顶数据需要将top减1。 public Object pop(){ return arr[top--]; } 6、查看栈顶数据 public Object peek(){ return arr[top]; } 7、判断是否为空 public boolean isEmpty(){ return top == -1; } 8、判断是否存满 top的值等于数组最后一个元素的位置即为存满 public boolean isFull(){ return top == arr.length-1; } 9、完整代码 public class MyStack { private Object[] arr;//存储数据 private int top;//栈顶的位置 public MyStack() { arr = new Object[10]; top = -1; } /** * 参数为数组的初始长度 * * @param maxSize */ public MyStack(int maxSize) { arr = new Object[maxSize]; top = -1; } public void push(Object value) { arr[++top] = value; } /** * 弹出栈顶的数据 * @return */ public Object pop(){ return arr[top--]; } public Object peek(){ return arr[top]; } public boolean isEmpty(){ return top == -1; } public boolean isFull(){ return top == arr.length-1; } } 三、验证 public static void main(String[] args) { MyStack stack = new MyStack(4); stack.push("a"); stack.push("b"); stack.push("c"); stack.push("d"); System.out.println("是否为空:" + stack.isEmpty()); System.out.println("是否存满:" + stack.isFull()); System.out.println("栈顶:"+stack.peek()); System.out.println("栈顶:"+stack.peek()); //弹出栈中所有数据 while (!stack.isEmpty()){ System.out.println(stack.pop()); } System.out.println("是否为空:" + stack.isEmpty()); System.out.println("是否存满:" + stack.isFull()); }

优秀的个人博客,低调大师

SpringBoot启动机制(starter机制)核心原理详解

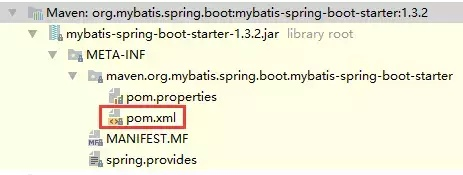
作者:MyBug 一、前言 使用过springboot的同学应该已经知道,springboot通过默认配置了很多框架的使用方式帮我们大大简化了项目初始搭建以及开发过程。本文的目的就是一步步分析springboot的启动过程,这次主要是分析springboot特性自动装配。那么首先带领大家回顾一下以往我们的web项目是如何搭建的,通常我们要搭建一个基于Spring的Web应用,我们需要做以下一些工作:pom文件中引入相关jar包,包括spring、springmvc、redis、mybaits、log4j、mysql-connector-java 等等相关jar …配置web.xml,Listener配置、Filter配置、Servlet配置、log4j配置、error配置 …配置数据库连接、配置spring事务配置视图解析器开启注解、自动扫描功能配置完成后部署tomcat、启动调试……花在搭建一个初始项目,可能一个小时就过去了或者半天救过了,但是用了SpringBoot之后一切都会变得非常便捷,下面我们首先来分析一下SpringBoot的起步依赖以及自动配置。 二、起步依赖 1.在我们的pom文件里面引入以下jar: <modelVersion>4.0.0</modelVersion> <parent> <groupId>org.springframework.boot</groupId> <artifactId>spring-boot-starter-parent</artifactId> <version>2.0.4.RELEASE</version> <relativePath /> <!-- lookup parent from repository --> </parent> <groupId>com.example</groupId> <artifactId>demo</artifactId> <version>0.0.1-SNAPSHOT</version> <name>demo</name> <description>Demo project for Spring Boot</description> <properties> <java.version>1.8</java.version> </properties> <dependencies> <dependency> <groupId>org.springframework.boot</groupId> <artifactId>spring-boot-starter-web</artifactId> </dependency> <dependency> <groupId>org.springframework.boot</groupId> <artifactId>spring-boot-starter-test</artifactId> <scope>test</scope> </dependency> <!--mybatis 开发包 --> <dependency> <groupId>org.mybatis.spring.boot</groupId> <artifactId>mybatis-spring-boot-starter</artifactId> <version>1.3.2</version> </dependency> <!--springboot web模块支持 --> <dependency> <groupId>org.springframework.boot</groupId> <artifactId>spring-boot-starter-web</artifactId> </dependency> <dependency> <groupId>mysql</groupId> <artifactId>mysql-connector-java</artifactId> <scope>runtime</scope> </dependency> </dependencies> <build> <plugins> <plugin> <groupId>org.springframework.boot</groupId> <artifactId>spring-boot-maven-plugin</artifactId> </plugin> </plugins> </build> spring-boot-starter-web包自动帮我们引入了web模块开发需要的相关jar包。mybatis-spring-boot-starter帮我们引入了dao开发相关的jar包。spring-boot-starter-xxx是官方提供的starter,xxx-spring-boot-starter是第三方提供的starter。截图看一下我们的mybatis-spring-boot-starter 可以看出mybatis-spring-boot-starter并没有任何源码,只有一个pom文件,它的作用就是帮我们引入其它jar。2.配置数据源 spring: datasource: type: com.zaxxer.hikari.HikariDataSource url: jdbc:mysql://127.0.0.1:3306/mybatis_test username: root password: root driver-class-name: com.mysql.jdbc.Driver hikari: # 最小空闲连接数量 minimum-idle: 5 # 连接池最大连接数,默认是10 maximum-pool-size: 60 # 此属性控制从池返回的连接的默认自动提交行为,默认值:true auto-commit: true # 一个连接idle状态的最大时长(毫秒),超时则被释放(retired),缺省:10分钟 idle-timeout: 600000 # 此属性控制池中连接的最长生命周期,值0表示无限生命周期,默认1800000即30分钟 max-lifetime: 1800000 # 数据库连接超时时间,默认30秒,即30000 connection-timeout: 60000 stater机制帮我们完成了项目起步所需要的的相关jar包。那问题又来了,传统的spring应用中不是要在application.xml中配置很多bean的吗,比如dataSource的配置,transactionManager的配置 … springboot是如何帮我们完成这些bean的配置的?下面我们来分析这个过程 三、自动配置 1.基于java代码的bean配置以mybatis为例,在上面的截图中,我们发现mybatis-spring-boot-starter这个包帮我们引入了mybatis-spring-boot-autoconfigure这个包,如下图: 里面有MybatisAutoConfiguration这个类,打开这个类看看有些什么东西。 熟悉@Configuration&、@Bean这两个bean的同学或许已经知道了。这两个注解一起使用就可以创建一个基于java代码的配置类,可以用来替代相应的xml配置文件。@Configuration注解的类可以看作是能生产让Spring IoC容器管理的Bean实例的工厂。@Bean注解告诉Spring,一个带有@Bean的注解方法将返回一个对象,该对象应该被注册到spring容器中。所以上面的MybatisAutoConfiguration这个类,自动帮我们生成了SqlSessionFactory这些Mybatis的重要实例并交给spring容器管理,从而完成bean的自动注册。 2.自动配置条件依赖从MybatisAutoConfiguration这个类中使用的注解可以看出,要完成自动配置是有依赖条件的。 @org.springframework.context.annotation.Configuration @ConditionalOnClass({ SqlSessionFactory.class, SqlSessionFactoryBean.class }) @ConditionalOnBean(DataSource.class) @EnableConfigurationProperties(MybatisProperties.class) @AutoConfigureAfter(DataSourceAutoConfiguration.class) public class MybatisAutoConfiguration { private static final Logger logger = LoggerFactory.getLogger(MybatisAutoConfiguration.class); private final MybatisProperties properties; private final Interceptor[] interceptors; private final ResourceLoader resourceLoader; private final DatabaseIdProvider databaseIdProvider; private final List<ConfigurationCustomizer> configurationCustomizers; ...... 首先预习一下Springboot是常用的条件依赖注解有:@ConditionalOnBean,仅在当前上下文中存在某个bean时,才会实例化这个Bean。@ConditionalOnClass,某个class位于类路径上,才会实例化这个Bean。@ConditionalOnExpression,当表达式为true的时候,才会实例化这个Bean。@ConditionalOnMissingBean,仅在当前上下文中不存在某个bean时,才会实例化这个Bean。@ConditionalOnMissingClass,某个class在类路径上不存在的时候,才会实例化这个Bean。@ConditionalOnNotWebApplication,不是web应用时才会实例化这个Bean。@AutoConfigureAfter,在某个bean完成自动配置后实例化这个bean。@AutoConfigureBefore,在某个bean完成自动配置前实例化这个bean。所以要完成Mybatis的自动配置,需要在类路径中存在SqlSessionFactory.class、SqlSessionFactoryBean.class这两个类,需要存在DataSource这个bean且这个bean完成自动注册。进入DataSourceAutoConfiguration这个类,可以看到这个类属于这个包:org.springframework.boot.autoconfigure.jdbc这个包又属于spring-boot-autoconfigure-2.0.4.RELEASE.jar这个包,自动配置这个包帮们引入了jdbc、kafka、logging、mail、mongo等包。很多包需要我们引入相应jar后自动配置才生效。 3.Bean参数的获取到此我们已经知道了bean的配置过程,但是还没有看到springboot是如何读取yml或者properites配置文件的的属性来创建数据源的?在DataSourceAutoConfiguration类里面,我们注意到使用了EnableConfigurationProperties这个注解。 @Configuration @ConditionalOnClass({ DataSource.class, EmbeddedDatabaseType.class }) @EnableConfigurationProperties(DataSourceProperties.class) @Import({ DataSourcePoolMetadataProvidersConfiguration.class, DataSourceInitializationConfiguration.class }) public class DataSourceAutoConfiguration { @Configuration @Conditional(EmbeddedDatabaseCondition.class) @ConditionalOnMissingBean({ DataSource.class, XADataSource.class }) @Import(EmbeddedDataSourceConfiguration.class) protected static class EmbeddedDatabaseConfiguration { } ...... DataSourceProperties中封装了数据源的各个属性,且使用了注解ConfigurationProperties指定了配置文件的前缀。 @ConfigurationProperties(prefix = "spring.datasource") public class DataSourceProperties implements BeanClassLoaderAware, InitializingBean { private ClassLoader classLoader; /** * Name of the datasource. Default to "testdb" when using an embedded database. */ private String name; /** * Whether to generate a random datasource name. */ private boolean generateUniqueName; /** * Fully qualified name of the connection pool implementation to use. By default, it * is auto-detected from the classpath. */ private Class<? extends DataSource> type; /** * Fully qualified name of the JDBC driver. Auto-detected based on the URL by default. */ private String driverClassName; /** * JDBC URL of the database. */ private String url; /** * Login username of the database. */ private String username; /** * Login password of the database. */ private String password; /** * JNDI location of the datasource. Class, url, username & password are ignored when * set. */ private String jndiName; /** * Initialize the datasource with available DDL and DML scripts. */ private DataSourceInitializationMode initializationMode = DataSourceInitializationMode.EMBEDDED; /** * Platform to use in the DDL or DML scripts (such as schema-${platform}.sql or * data-${platform}.sql). */ private String platform = "all"; /** * Schema (DDL) script resource references. */ private List<String> schema; /** * Username of the database to execute DDL scripts (if different). */ private String schemaUsername; /** * Password of the database to execute DDL scripts (if different). */ private String schemaPassword; /** * Data (DML) script resource references. */ private List<String> data; ...... 通过以上分析,我们可以得知:@ConfigurationProperties注解的作用是把yml或者properties配置文件转化为bean。@EnableConfigurationProperties注解的作用是使@ConfigurationProperties注解生效。如果只配置@ConfigurationProperties注解,在spring容器中是获取不到yml或者properties配置文件转化的bean的。通过这种方式,把yml或者properties配置参数转化为bean,这些bean又是如何被发现与加载的? 4.Bean的发现springboot默认扫描启动类所在的包下的主类与子类的所有组件,但并没有包括依赖包的中的类,那么依赖包中的bean是如何被发现和加载的?我们通常在启动类中加@SpringBootApplication这个注解,点进去看 @Target(ElementType.TYPE) @Retention(RetentionPolicy.RUNTIME) @Documented @Inherited @SpringBootConfiguration @EnableAutoConfiguration @ComponentScan(excludeFilters = { @Filter(type = FilterType.CUSTOM, classes = TypeExcludeFilter.class), @Filter(type = FilterType.CUSTOM, classes = AutoConfigurationExcludeFilter.class) }) public @interface SpringBootApplication { /** * Exclude specific auto-configuration classes such that they will never be applied. * @return the classes to exclude */ @AliasFor(annotation = EnableAutoConfiguration.class) Class<?>[] exclude() default {}; /** * Exclude specific auto-configuration class names such that they will never be * applied. * @return the class names to exclude * @since 1.3.0 */ ...... 实际上重要的只有三个Annotation:@Configuration(@SpringBootConfiguration里面还是应用了@Configuration)@EnableAutoConfiguration@ComponentScan@Configuration的作用上面我们已经知道了,被注解的类将成为一个bean配置类。@ComponentScan的作用就是自动扫描并加载符合条件的组件,比如@Component和@Repository等,最终将这些bean定义加载到spring容器中。@EnableAutoConfiguration 这个注解的功能很重要,借助@Import的支持,收集和注册依赖包中相关的bean定义。 @Target(ElementType.TYPE) @Retention(RetentionPolicy.RUNTIME) @Documented @Inherited @AutoConfigurationPackage @Import(AutoConfigurationImportSelector.class) public @interface EnableAutoConfiguration { String ENABLED_OVERRIDE_PROPERTY = "spring.boot.enableautoconfiguration"; /** * Exclude specific auto-configuration classes such that they will never be applied. * @return the classes to exclude */ Class<?>[] exclude() default {}; /** * Exclude specific auto-configuration class names such that they will never be * applied. * @return the class names to exclude * @since 1.3.0 */ String[] excludeName() default {}; } 如上源码,@EnableAutoConfiguration注解引入了@AutoConfigurationPackage和@Import这两个注解。@AutoConfigurationPackage的作用就是自动配置的包,@Import导入需要自动配置的组件。 @Target(ElementType.TYPE) @Retention(RetentionPolicy.RUNTIME) @Documented @Inherited @Import(AutoConfigurationPackages.Registrar.class) public @interface AutoConfigurationPackage { } ~ /** * {@link ImportBeanDefinitionRegistrar} to store the base package from the importing * configuration. */ static class Registrar implements ImportBeanDefinitionRegistrar, DeterminableImports { @Override public void registerBeanDefinitions(AnnotationMetadata metadata, BeanDefinitionRegistry registry) { register(registry, new PackageImport(metadata).getPackageName()); } @Override public Set<Object> determineImports(AnnotationMetadata metadata) { return Collections.singleton(new PackageImport(metadata)); } } new AutoConfigurationPackages.PackageImport(metadata)).getPackageName()new AutoConfigurationPackages.PackageImport(metadata)这两句代码的作用就是加载启动类所在的包下的主类与子类的所有组件注册到spring容器,这就是前文所说的springboot默认扫描启动类所在的包下的主类与子类的所有组件。那问题又来了,要搜集并注册到spring容器的那些beans来自哪里?进入 AutoConfigurationImportSelector类,我们可以发现SpringFactoriesLoader.loadFactoryNames方法调用loadSpringFactories方法从所有的jar包中读取META-INF/spring.factories文件信息。下面是spring-boot-autoconfigure这个jar中spring.factories文件部分内容,其中有一个key为org.springframework.boot.autoconfigure.EnableAutoConfiguration的值定义了需要自动配置的bean,通过读取这个配置获取一组@Configuration类。 org.springframework.boot.autoconfigure.AutoConfigurationImportListener=\ org.springframework.boot.autoconfigure.condition.ConditionEvaluationReportAutoConfigurationImportListener # Auto Configuration Import Filters org.springframework.boot.autoconfigure.AutoConfigurationImportFilter=\ org.springframework.boot.autoconfigure.condition.OnClassCondition # Auto Configure org.springframework.boot.autoconfigure.EnableAutoConfiguration=\ org.springframework.boot.autoconfigure.admin.SpringApplicationAdminJmxAutoConfiguration,\ org.springframework.boot.autoconfigure.aop.AopAutoConfiguration,\ org.springframework.boot.autoconfigure.amqp.RabbitAutoConfiguration,\ org.springframework.boot.autoconfigure.batch.BatchAutoConfiguration,\ org.springframework.boot.autoconfigure.cache.CacheAutoConfiguration,\ 每个xxxAutoConfiguration都是一个基于java的bean配置类。实际上,这些xxxAutoConfiguratio不是所有都会被加载,会根据xxxAutoConfiguration上的@ConditionalOnClass等条件判断是否加载;通过反射机制将spring.factories中@Configuration类实例化为对应的java实列。到此我们已经知道怎么发现要自动配置的bean了,最后一步就是怎么样将这些bean加载到spring容器。 5.Bean 加载如果要让一个普通类交给Spring容器管理,通常有以下方法:使用 @Configuration与@Bean 注解使用@Controller @Service @Repository @Component 注解标注该类,然后启用@ComponentScan自动扫描使用@Import 方法springboot中使用了@Import 方法@EnableAutoConfiguration注解中使用了@Import({AutoConfigurationImportSelector.class})注解,AutoConfigurationImportSelector实现了DeferredImportSelector接口,DeferredImportSelector接口继承了ImportSelector接口,ImportSelector接口只有一个selectImports方法。selectImports方法返回一组bean,@EnableAutoConfiguration注解借助@Import注解将这组bean注入到spring容器中,springboot正式通过这种机制来完成bean的注入的。 四、总结 我们可以将自动配置的关键几步以及相应的注解总结如下:@Configuration&与@Bean------>>>基于java代码的bean配置@Conditional-------->>>>>>设置自动配置条件依赖@EnableConfigurationProperties与@ConfigurationProperties->读取配置文件转换为bean。@EnableAutoConfiguration、@AutoConfigurationPackage 与@Import->实现bean发现与加载。 欢迎大家一起交流,喜欢文章记得点个赞哟,感谢支持!

优秀的个人博客,低调大师

Java面试必问通信框架NIO,原理详解

NIO流与块通道与缓冲区缓冲区状态变量文件 NIO 实例选择器套接字 NIO 实例内存映射文件NIO与IO对比PathFilesNIO新的输入/输出 (NIO) 库是在 JDK 1.4 中引入的,弥补了原来的 I/O 的不足,提供了高速的、面向块的 I/O。 NIO核心组件: 通道(Channels)缓冲区(Buffers)选择器(Selectors)流与块I/O 与 NIO 最重要的区别是数据打包和传输的方式,I/O 以流的方式处理数据,而 NIO 以块的方式处理数据。 面向流的 I/O 一次处理一个字节数据:一个输入流产生一个字节数据,一个输出流消费一个字节数据。 为流式数据创建过滤器非常容易,链接几个过滤器,以便每个过滤器只负责复杂处理机制的一部分。不利的一面是,面向流的 I/O 通常相当慢。 面向块的 I/O 一次处理一个数据块,按块处理数据比按流处理数据要快得多。 但是面向块的 I/O 缺少一些面向流的 I/O 所具有的优雅性和简单性。 I/O 包和 NIO 已经很好地集成了,java.io. 已经以 NIO 为基础重新实现了,所以现在它可以利用 NIO 的一些特性。 例如,java.io. 包中的一些类包含以块的形式读写数据的方法,这使得即使在面向流的系统中,处理速度也会更快。 通道与缓冲区 通道通道 Channel 是对原 I/O 包中的流的模拟,可以通过它读取和写入数据。 通道与流的不同之处在于,流只能在一个方向上移动(一个流必须是 InputStream 或者 OutputStream 的子类), 而通道是双向的,可以用于读、写或者同时用于读写。 通道包括以下类型: FileChannel:从文件中读写数据;DatagramChannel:通过 UDP 读写网络中数据;SocketChannel:通过 TCP 读写网络中数据;ServerSocketChannel:可以监听新进来的 TCP 连接,对每一个新进来的连接都会创建一个 SocketChannel。 缓冲区发送给一个通道的所有数据都必须首先放到缓冲区中,同样地,从通道中读取的任何数据都要先读到缓冲区中。也就是说,不会直接对通道进行读写数据,而是要先经过缓冲区。 缓冲区实质上是一个数组,但它不仅仅是一个数组。缓冲区提供了对数据的结构化访问,而且还可以跟踪系统的读/写进程。 缓冲区包括以下类型: ByteBufferCharBufferShortBufferIntBufferLongBufferFloatBufferDoubleBuffer缓冲区状态变量capacity:最大容量;position:当前已经读写的字节数;limit:还可以读写的字节数。状态变量的改变过程举例: ① 新建一个大小为 8 个字节的缓冲区,此时 position 为 0,而 limit = capacity = 8。capacity 变量不会改变,下面的讨论会忽略它。 ② 从输入通道中读取 5 个字节数据写入缓冲区中,此时 position 为 5,limit 保持不变。 ③ 在将缓冲区的数据写到输出通道之前,需要先调用 flip() 方法,这个方法将 limit 设置为当前 position,并将 position 设置为 0。 ④ 从缓冲区中取 4 个字节到输出缓冲中,此时 position 设为 4。 ⑤ 最后需要调用 clear() 方法来清空缓冲区,此时 position 和 limit 都被设置为最初位置。 文件 NIO 实例FileChannel的使用开启FileChannel从FileChannel读取数据/写入数据3.关闭FileChannel public class FileChannelDemo { public static void main(String[] args) throws IOException { //1.创建一个RandomAccessFile(随机访问文件)对象通过RandomAccessFile对象的getChannel()方法。 RandomAccessFile raf=new RandomAccessFile("demo6.txt","rw"); FileChannel fc=raf.getChannel(); //使用FileChannel的read()方法读取数据: ByteBuffer byteBuffer=ByteBuffer.allocate(1024); int bys=fc.read(byteBuffer); //使用FileChannel的write()方法写入数据: ByteBuffer byteBuffer2=ByteBuffer.allocate(1024); byteBuffer2.put("hello".getBytes()); fc.write(byteBuffer2); //3.关闭FileChannel fc.close(); } }以下展示了使用 NIO 快速复制文件的实例:public class CopyFile { public static void main(String[] args) throws IOException { String srcFile="国旗歌.mp4"; String destFile="demo3.mp4"; long start = System.currentTimeMillis(); //copyFile(srcFile,destFile); //共耗时:75309毫秒 //copyFile2(srcFile,destFile); //共耗时:153毫秒 //copyFile3(srcFile,destFile);//共耗时:282毫秒 //copyFile4(srcFile,destFile);//共耗时:44毫秒 copyFile5(srcFile,destFile);//共耗时:共耗时:113毫秒 long end = System.currentTimeMillis(); System.out.println("共耗时:" + (end - start) + "毫秒"); } /** * 基本字节流一次读写一个字节 */ public static void copyFile(String srcFile,String destFile) throws IOException { FileInputStream fis=new FileInputStream(srcFile); FileOutputStream fos=new FileOutputStream(destFile); int by=0; while((by=fis.read())!=-1){ fos.write(by); } fis.close(); fos.close(); } /** * 基本字节流一次读写一个字节数组 */ public static void copyFile2(String srcFile,String destFile) throws IOException{ FileInputStream fis=new FileInputStream(srcFile); FileOutputStream fos=new FileOutputStream(destFile); int len=0; byte[] bys=new byte[1024]; while((len=fis.read(bys))!=-1){ fos.write(bys,0,len); } fis.close(); fos.close(); } /** * 高效字节流一次读写一个字节 */ public static void copyFile3(String srcFile,String destFile) throws IOException{ BufferedInputStream bis=new BufferedInputStream(new FileInputStream(srcFile)); BufferedOutputStream bos=new BufferedOutputStream(new FileOutputStream(destFile)); int by=0; while((by=bis.read())!=-1){ bos.write(by); } bis.close(); bos.close(); } /** * 高效字节流一次读写一个字节数组 */ public static void copyFile4(String srcFile,String destFile) throws IOException{ BufferedInputStream bis=new BufferedInputStream(new FileInputStream(srcFile)); BufferedOutputStream bos=new BufferedOutputStream(new FileOutputStream(destFile)); int len=0; byte[] bys=new byte[1024]; while((len=bis.read(bys))!=-1){ bos.write(bys,0,len); } bis.close(); bos.close(); } /** * 使用FileChannel复制文件 */ public static void copyFile5(String srcFile,String destFile) throws IOException{ FileInputStream fis=new FileInputStream(srcFile); //获取输入字节流的文件通道 FileChannel fcin=fis.getChannel(); FileOutputStream fos=new FileOutputStream(destFile); //获取输出字节流的文件通道 FileChannel fcout=fos.getChannel(); //为缓冲区分配 1024 个字节 ByteBuffer buffer = ByteBuffer.allocateDirect(1024); while(true){ //从输入通道中读取数据到缓冲区中 int r = fcin.read(buffer); // read() 返回 -1 表示 EOF if(r==-1){ break; } //切换读写 buffer.flip(); //把缓冲区的内容写入输出文件中 fcout.write(buffer); //清空缓冲区 buffer.clear(); } } }SocketChannel和ServerSocketChannel的使用SocketChannel用于创建基于TCP协议的客户端对象,因为SocketChannel中不存在accept()方法, 所以,它不能成为一个服务端程序。 通过connect()方法,SocketChannel对象可以连接到其他TCP服务器程序。 ServerSocketChannel允许我们监听TCP协议请求,通过ServerSocketChannel的accept()方法创建一个SocketChannel对象用户从客户端读/写数据。 服务端:通过ServerSocketChannel 绑定ip地址和端口号通过ServerSocketChannel的accept()方法创建一个SocketChannel对象用户从客户端读/写数据创建读数据/写数据缓冲区对象来读取客户端数据或向客户端发送数据关闭SocketChannel和ServerSocketChannelpublic class Server { public static void main(String[] args) throws IOException { //通过ServerSocketChannel 的open()方法创建一个ServerSocketChannel对象 ServerSocketChannel ssc=ServerSocketChannel.open(); //1. 通过ServerSocketChannel 绑定ip地址和端口号 ssc.socket().bind(new InetSocketAddress(InetAddress.getByName("LAPTOP-D9966H06"),8888)); //2. 通过ServerSocketChannel的accept()方法创建一个SocketChannel对象用户从客户端读/写数据 SocketChannel sc=ssc.accept(); //3. 创建读数据/写数据缓冲区对象来读取客户端数据或向客户端发送数据 //读取客户端发送的数据 ByteBuffer buffer=ByteBuffer.allocate(1024); //从通道中读取数据到缓冲区 sc.read(buffer); StringBuffer sb=new StringBuffer(); buffer.flip(); while(buffer.hasRemaining()){ sb.append((char)buffer.get()); } System.out.println(sb.toString()); ByteBuffer buffer2=ByteBuffer.allocate(1024); //向客户端发送数据 buffer2.put("data has been received.".getBytes()); buffer2.flip(); sc.write(buffer2); //4. 关闭SocketChannel和ServerSocketChannel sc.close(); ssc.close(); } }客户端:1.通过SocketChannel连接到远程服务器 2.创建读数据/写数据缓冲区对象来读取服务端数据或向服务端发送数据 3.关闭SocketChannel public class Client { public static void main(String[] args) throws IOException { //1.通过SocketChannel连接到远程服务器 SocketChannel sc=SocketChannel.open(); sc.connect(new InetSocketAddress(InetAddress.getByName("LAPTOP-D9966H06"),8888)); //2.创建读数据/写数据缓冲区对象来读取服务端数据或向服务端发送数据 //向通道中写入数据 ByteBuffer buffer=ByteBuffer.allocate(1024); buffer.put("hello".getBytes()); buffer.flip(); sc.write(buffer); //读取从客户端中获取的数据 ByteBuffer buffer2=ByteBuffer.allocate(1024); sc.read(buffer2); StringBuffer sb=new StringBuffer(); buffer2.flip(); while(buffer2.hasRemaining()){ sb.append((char)buffer2.get()); } System.out.println(sb.toString()); //3.关闭SocketChannel sc.close(); } }DatagramChannel的使用DataGramChannel,类似于java 网络编程的DatagramSocket类; 使用UDP进行网络传输, UDP是无连接,面向数据报文段的协议。 服务端:public class Server { public static void main(String[] args) throws IOException { DatagramChannel dc= DatagramChannel.open(); dc.bind(new InetSocketAddress(InetAddress.getByName("LAPTOP-D9966H06"),8888)); //创建读数据/写数据缓冲区对象来读取客户端数据或向客户端发送数据 //读取客户端发送的数据 ByteBuffer buffer=ByteBuffer.allocate(1024); //从通道中读取数据到缓冲区 dc.receive(buffer); StringBuffer sb=new StringBuffer(); buffer.flip(); while(buffer.hasRemaining()){ sb.append((char)buffer.get()); } System.out.println(sb.toString()); ByteBuffer buffer2=ByteBuffer.allocate(1024); //向客户端发送数据 buffer2.put("data has been received.".getBytes()); buffer2.flip(); dc.send(buffer2,new InetSocketAddress(InetAddress.getByName("LAPTOP-D9966H06"),9999)); dc.close(); } }客户端:public class Client { public static void main(String[] args) throws IOException { DatagramChannel dc= DatagramChannel.open(); dc.bind(new InetSocketAddress(InetAddress.getByName("LAPTOP-D9966H06"),9999)); //创建读数据/写数据缓冲区对象来读取服务端数据或向服务端发送数据 //向通道中写入数据 ByteBuffer buffer=ByteBuffer.allocate(1024); buffer.put("hello".getBytes()); buffer.flip(); dc.send(buffer,new InetSocketAddress(InetAddress.getByName("LAPTOP-D9966H06"),8888)); //读取从客户端中获取的数据 ByteBuffer buffer2=ByteBuffer.allocate(1024); dc.receive(buffer2); StringBuffer sb=new StringBuffer(); buffer2.flip(); while(buffer2.hasRemaining()){ sb.append((char)buffer2.get()); } System.out.println(sb.toString()); dc.close(); } }通道之间的数据传输在Java NIO中如果一个channel是FileChannel类型的,那么他可以直接把数据传输到另一个channel。 transferFrom() :transferFrom方法把数据从通道源传输到FileChanneltransferTo() :transferTo方法把FileChannel数据传输到另一个FileChhannelpublic static void copyFile6(String srcFile,String destFile) throws IOException { FileInputStream fis = new FileInputStream(srcFile); //获取输入字节流的文件通道 FileChannel fcin = fis.getChannel(); FileOutputStream fos = new FileOutputStream(destFile); //获取输出字节流的文件通道 FileChannel fcout = fos.getChannel(); //fcin通道中读出count bytes ,并写入fcout通道中 //fcin.transferTo(0,fcin.size(),fcout); //或者 fcout.transferFrom(fcin,0,fcin.size()); }选择器NIO 常常被叫做非阻塞 IO,主要是因为 NIO 在网络通信中的非阻塞特性被广泛使用。 NIO 实现了 IO 多路复用中的 Reactor 模型,一个线程 Thread 使用一个选择器 Selector 通过轮询的方式 去监听多个通道 Channel 上的事件,从而让一个线程就可以处理多个事件。 通过配置监听的通道 Channel 为非阻塞,那么当 Channel 上的 IO 事件还未到达时, 就不会进入阻塞状态一直等待,而是继续轮询其它 Channel,找到 IO 事件已经到达的 Channel 执行。 因为创建和切换线程的开销很大,因此使用一个线程来处理多个事件而不是一个线程处理一个事件, 对于 IO 密集型的应用具有很好地性能。 应该注意的是,只有套接字 Channel 才能配置为非阻塞,而 FileChannel 不能, 为 FileChannel 配置非阻塞也没有意义。 使用Selector的优点: 使用更少的线程来就可以来处理通道了, 相比使用多个线程, 避免了线程上下文切换带来的开销。 创建选择器Selector selector = Selector.open(); 将通道注册到选择器上ServerSocketChannel ssChannel = ServerSocketChannel.open(); ssChannel.configureBlocking(false);//通道必须配置为非阻塞模式ssChannel.register(selector, SelectionKey.OP_ACCEPT);通道必须配置为非阻塞模式,否则使用选择器就没有任何意义了,因为如果通道在某个事件上被阻塞,那么服务器就不能响应其它事件,必须等待这个事件处理完毕才能去处理其它事件,显然这和选择器的作用背道而驰。 在将通道注册到选择器上时,还需要指定要注册的具体事件,主要有以下几类: SelectionKey.OP_CONNECTSelectionKey.OP_ACCEPTSelectionKey.OP_READSelectionKey.OP_WRITE它们在 SelectionKey 的定义如下: public static final int OP_READ = 1 << 0;public static final int OP_WRITE = 1 << 2;public static final int OP_CONNECT = 1 << 3;public static final int OP_ACCEPT = 1 << 4;可以看出每个事件可以被当成一个位域,从而组成事件集整数。例如: int interestSet = SelectionKey.OP_READ | SelectionKey.OP_WRITE; 监听事件 num = selector.select(); 使用 select() 来监听到达的事件,它会一直阻塞直到有至少一个事件到达。 获取到达的事件Set keys = selector.selectedKeys(); Iterator keyIterator = keys.iterator();while (keyIterator.hasNext()) { SelectionKey key = keyIterator.next(); if (key.isAcceptable()) { // ... } else if (key.isReadable()) { // ... } keyIterator.remove(); } 事件循环因为一次 select() 调用不能处理完所有的事件,并且服务器端有可能需要一直监听事件,因此服务器端处理事件的代码一般会放在一个死循环内。 while (true) { int num = selector.select(); Set<SelectionKey> keys = selector.selectedKeys(); Iterator<SelectionKey> keyIterator = keys.iterator(); while (keyIterator.hasNext()) { SelectionKey key = keyIterator.next(); if (key.isAcceptable()) { // ... } else if (key.isReadable()) { // ... } keyIterator.remove(); } }套接字 NIO 实例public class NIOServer { public static void main(String[] args) throws IOException { //1. 创建选择器 Selector selector = Selector.open(); //2.将通道注册到选择器上 ServerSocketChannel ssChannel = ServerSocketChannel.open(); ssChannel.configureBlocking(false); //通道必须配置为非阻塞模式,否则使用选择器就没有任何意义了 ssChannel.register(selector, SelectionKey.OP_ACCEPT); ServerSocket ss=ssChannel.socket(); ss.bind(new InetSocketAddress("127.0.0.1",8888)); while (true){ //3. 监听事件 selector.select(); //4. 获取到达的事件 Set<SelectionKey> keys = selector.selectedKeys(); Iterator<SelectionKey> keyIterator = keys.iterator(); while (keyIterator.hasNext()) { SelectionKey key = keyIterator.next(); if (key.isAcceptable()) { ServerSocketChannel ssChannel1 = (ServerSocketChannel) key.channel(); // 服务器会为每个新连接创建一个 SocketChannel SocketChannel sChannel = ssChannel1.accept(); sChannel.configureBlocking(false); // 这个新连接主要用于从客户端读取数据 sChannel.register(selector, SelectionKey.OP_READ); } else if (key.isReadable()) { SocketChannel sChannel = (SocketChannel) key.channel(); System.out.println(readDataFromSocketChannel(sChannel)); sChannel.close(); } keyIterator.remove(); } } } private static String readDataFromSocketChannel(SocketChannel sChannel) throws IOException { ByteBuffer buffer = ByteBuffer.allocate(1024); StringBuilder data = new StringBuilder(); while (true) { buffer.clear(); int r = sChannel.read(buffer); if (r == -1) { break; } buffer.flip(); int limit = buffer.limit(); char[] dst = new char[limit]; for (int i = 0; i < limit; i++) { dst[i] = (char) buffer.get(i); } data.append(dst); buffer.clear(); } return data.toString(); } }public class NIOClient { public static void main(String[] args) throws IOException { Socket socket = new Socket("127.0.0.1", 8888); OutputStream out = socket.getOutputStream(); String s = "hello world"; out.write(s.getBytes()); out.close(); } }内存映射文件内存映射文件 I/O 是一种读和写文件数据的方法,它可以比常规的基于流或者基于通道的 I/O 快得多。 向内存映射文件写入可能是危险的,只是改变数组的单个元素这样的简单操作,就可能会直接修改磁盘上的文件。修改数据与将数据保存到磁盘是没有分开的。 下面代码行将文件的前 1024 个字节映射到内存中,map() 方法返回一个 MappedByteBuffer,它是 ByteBuffer 的子类。因此,可以像使用其他任何 ByteBuffer 一样使用新映射的缓冲区,操作系统会在需要时负责执行映射。 MappedByteBuffer mbb = fc.map(FileChannel.MapMode.READ_WRITE, 0, 1024);NIO与IO对比NIO 与普通 I/O 的区别主要有以下三点: NIO 是非阻塞的;NIO 面向块,I/O 面向流。NIO有选择器,而I/O没有。PathJava7中文件IO发生了很大的变化,专门引入了很多新的类来取代原来的 基于java.io.File的文件IO操作方式。 创建一个Path使用Paths工具类的get()方法创建Path对象 public class PathDemo { public static void main(String[] args) { //方式一 Path path=Paths.get("demo5.txt"); System.out.println(path); //方式二 Path path2 = FileSystems.getDefault().getPath("demo5.txt"); System.out.println(path2); } }File和Path之间的转换,File和URI之间的转换public class PathDemo2 { public static void main(String[] args) { Path path=Paths.get("demo5.txt"); File file=path.toFile(); URI uri=path.toUri(); System.out.println(path); System.out.println(file); System.out.println(uri); } }demo5.txtdemo5.txtfile:///F:/Java_Review/05Java/JavaIO/demo5.txt获取Path的相关信息public class PathDemo3 { public static void main(String[] args) { Path path= Paths.get("demo3\\test3.txt"); System.out.println("文件名:"+ path.getFileName()); System.out.println("名称元素的数量:"+path.getNameCount()); System.out.println("父路径:"+ path.getParent()); System.out.println("根路径:"+ path.getRoot()); System.out.println("是否是绝对路径:"+path.isAbsolute()); //startWith() 参数既可以是字符串,也可以是Path System.out.println("是否是以路径demo3开头:"+path.startsWith(Paths.get("demo3"))); System.out.println("该路径的字符串形式:"+path.toString()); } }文件名:test3.txt名称元素的数量:2父路径:demo3根路径:null是否是绝对路径:false是否是以路径demo3开头:true该路径的字符串形式:demo3test3.txt移除Path中的冗余项 .表示的是当前目录 ..表示父目录或者说是上一级目录 normalize() : 返回一个路径,该路径是取出冗余项的路径。 toRealPath() : 可以看成,先进行toAbsolutePath()操作,然后进行normalize()操作 public class PathDemo4 { public static void main(String[] args) throws IOException { Path path= Paths.get("./demo3"); System.out.println("original :"+ path.toAbsolutePath()); System.out.println("after normalize:"+ path.toAbsolutePath().normalize()); System.out.println("after toRealPath:"+ path.toRealPath()); } }original :F:Java_Review05JavaJavaIO.demo3after normalize:F:Java_Review05JavaJavaIOdemo3after toRealPath:F:Java_Review05JavaJavaIOdemo3public class PathDemo5 { public static void main(String[] args) throws IOException { Path path= Paths.get("../JavaIO"); System.out.println("original :"+ path.toAbsolutePath()); System.out.println("after normalize:"+ path.toAbsolutePath().normalize()); System.out.println("after toRealPath:"+ path.toRealPath()); } }original :F:Java_Review05JavaJavaIO..JavaIOafter normalize:F:Java_Review05JavaJavaIOafter toRealPath:F:Java_Review05JavaJavaIOFilesjava.nio.file.Files类是和java.nio.file.Path相结合使用的 检查给定的Path在文件系统中是否存在Files.exists():检测文件路径是否存在 public class FilesDemo { public static void main(String[] args) { Path path = Paths.get("demo5.txt"); //LinkOptions.NOFOLLOW_LINKS:表示检测时不包含符号链接文件。 boolean isExist= Files.exists(path,new LinkOption[]{LinkOption.NOFOLLOW_LINKS}); System.out.println(isExist); } }创建文件/文件夹Files.createFile():创建文件 Files.createDirectory(): 创建文件夹 Files.createDirectories(): 创建文件夹 public class FilesDemo2 { public static void main(String[] args) throws IOException { Path path= Paths.get("demo7.txt"); if(!Files.exists(path)){ Files.createFile(path); } Path path2=Paths.get("demo4"); if(!Files.exists(path2)){ Files.createDirectory(path2); } Path path3=Paths.get("demo5\\test"); if(!Files.exists(path3)){ Files.createDirectories(path3); } } }删除文件或目录Files.delete():删除一个文件或目录 public class FilesDemo3 { public static void main(String[] args) throws IOException { Path path= Paths.get("demo7.txt"); Files.delete(path); } }把一个文件从一个地址复制到另一个位置Files.copy():把一个文件从一个地址复制到另一个位置 public class FilesDemo4 { public static void main(String[] args) throws IOException { Path srcPath= Paths.get("demo6.txt"); Path destPath=Paths.get("demo7.txt"); //Files.copy(srcPath,destPath); //强制覆盖已经存在的目标文件 Files.copy(srcPath,destPath, StandardCopyOption.REPLACE_EXISTING); } }获取文件属性public class FilesDemo5 { public static void main(String[] args) throws IOException { Path path= Paths.get("demo7.txt"); System.out.println(Files.getLastModifiedTime(path)); System.out.println(Files.size(path)); System.out.println(Files.isSymbolicLink(path)); System.out.println(Files.isDirectory(path)); System.out.println(Files.readAttributes(path,"*")); } }遍历一个文件夹public class FilesDemo6 { public static void main(String[] args) throws IOException { Path path= Paths.get("demo3\\demo2"); DirectoryStream<Path> paths=Files.newDirectoryStream(path); for(Path p:paths){ System.out.println(p.getFileName()); } } }遍历整个文件目录FileVisitor需要调用方自行实现,然后作为参数传入walkFileTree(); FileVisitor的每个方法会在遍历过程中被调用多次。 public class FilesDemo7 { public static void main(String[] args) throws IOException { Path path= Paths.get("demo3\\demo2"); List<Path> paths=new ArrayList<>(); Files.walkFileTree(path,new FileVisitor(paths)); System.out.println("paths:"+paths); } private static class FileVisitor extends SimpleFileVisitor<Path> { private List<Path> paths; public FileVisitor(List<Path> paths){ this.paths=paths; } @Override public FileVisitResult visitFile(Path file, BasicFileAttributes attrs) throws IOException { if(file.toString().endsWith(".txt")){ paths.add(file.getFileName()); } return super.visitFile(file, attrs); } } }输出结果: paths:[a.txt, test2.txt, test.txt, test3.txt]


优秀的个人博客,低调大师

通过MySQL存储原理来分析排序和锁

出自公众号 内核小王子 先抛出几个问题 1.为什么不建议使用订单号作为主键? 2.为什么要在需要排序的字段上加索引? 3.for update 的记录不存在会导致锁住全表? 4.redolog 和 binlog 有什么区别? 5.MySQL 如何回滚一条 sql ? 6.char(50) 和 varchar(50) 效果是一样的么? 索引知识回顾 对于 MySQL 数据库而言,数据是存储在文件里的,而为了能够快速定位到某张表里的某条记录进行查询和修改,我们需要将这些数据以一定的数据结构进行存储,这个数据结构就是我们说的索引。回忆一下我们大学里学过的算法与数据结构,能够支持快速查找的数据结构有:顺序数组、哈希、搜索树。 数组要求 insert 的时候保证有序,这样查找的时候可以利用二分查找法达到 O(log(N)) 的时间复杂度,对范围查询支持也很好,但是 insert 的时候如果不是在数组尾部,就需要摞动后面所有的数据,时间复杂度为 O(N) 。所以有序数组只适合存储静态数据,例如几乎很少变动的配置数据,或者是历史数据。这里应该会有人有疑问:我用另外一种线性数据结构链表来替代数组不就可以解决数组因为要移动数据导致太慢的问题了么,要回答这个问题我们需要了解操作系统读取文件的流程,磁盘 IO 是一个相对很慢的操作,为了提高读取速度,我们应该尽量减少磁盘 IO 操作,而操作系统一般以 4kb 为一个数据页读取数据,而 MySQL 一般为 16kb 作为一个数据块,已经读取的数据块会在内存进行缓存,如果多次数据读取在同一个数据块,则只需要一次磁盘 IO ,而如果顺序一致的记录在文件中也是顺序存储的,就可以一次读取多个数据块,这样范围查询的速度也可以大大提升,显然链表没有这方面的优势。 类似于 jdk 中的 hashmap ,哈希表通过一个特定的哈希函数将 key 值转换为一个固定的地址,然后将对应的 value 放到这个位置,如果发生哈希碰撞就在这个位置拉出一个链表,由于哈希函数的离散特性,所以经过哈希函数处理后的 key 将失去原有的顺序,所以哈希结构的索引无法满足范围查询,只适合等值查询的情况例如一些缓存的场景。 二叉树在极端情况下会变成线性结构,也就是每个节点都只有左子节点或者只有右子节点,这样就无法利用二分查找只能从第一个节点开始向后遍历了,所以为了维持 O(log(N)) 的时间复杂度,我们需要在插入节点的时候对节点进行调整以保证树的平衡,所以平衡二叉树插入的时间复杂度也是 O(log(N)) ,二叉树只有两个子节点,如果数据量很大则树就很高,树的每一层一般不在同一个数据块中存储,为了尽量的减少磁盘读写次数,我们用N叉树来代替二叉树,在 MySQL 中这个N一般为 1200 ,这样树高是 4 的话也可以存储亿级别的数据,而且树的前面两层一般都在内存中, MySQL 中用到的 B+ 树,一般用非叶子节点构建索引,而叶子节点用来存储具体的值。 InnoDB 中,有聚簇索引和普通索引之分,聚簇索引根据主键来构建,叶子节点存放的是该主键对应的这一行记录,而普通索引根据申明这个索引时候的列来构建,叶子节点存放的是这一行记录对应的主键的值,而普通索引中还有唯一索引和联合索引两个特例,唯一索引在插入和修改的时候会校验该索引对应的列的值是否已经存在,而联合索引将两个列的值按照申明时候的顺序进行拼接后在构建索引。 根据以上描述我们可以得到以下信息: 数据是以行为单位存储在聚簇索引里的,根据主键查询可以直接利用聚簇索引定位到所在记录,根据普通索引查询需要先在普通索引上找到对应的主键的值,然后根据主键值去聚簇索引上查找记录,俗称回表。 普通索引上存储的值是主键的值,如果主键是一个很长的字符串并且建了很多普通索引,将造成普通索引占有很大的物理空间,这也是为什么建议使用 自增ID 来替代订单号作为主键,另一个原因是 自增ID 在 insert 的时候可以保证相邻的两条记录可能在同一个数据块,而订单号的连续性在设计上可能没有自增ID好,导致连续插入可能在多个数据块,增加了磁盘读写次数。 如果我们查询一整行记录的话,一定要去聚簇索引上查找,而如果我们只需要根据普通索引查询主键的值,由于这些值在普通索引上已经存在,所以并不需要回表,这个称为索引覆盖,在一定程度上可以提高查询效率,由于联合索引上通过多个列构建索引,有时候我们可以将需要频繁查询的字段加到联合索引里面,例如如果经常需要根据 name 查找 age 我们可以建一个 name 和 age 的联合索引。 查询的时候如果在索引上用了函数,将导致无法用到根据之前列上的值构建的索引,索引遵循最左匹配原则,所以如果需要查询某个列的值中间是否包含某个字符串,将无法利用索引,如果有这种需求可以利用全文索引,而如果查询是否以某个字符串开头就可以,联合索引根据第一个列查询可以用到索引,仅仅根据第二个列将无法用到索引,查询的时候用 IN 的效率高于 NOT = 。另外建议将索引的列设置为非空,这个和 NULL 字段的存储有关,下文在分析。 存储格式 有了以上的索引知识我们在来分析数据是怎么存储的,InnoDB 存储引擎的逻辑存储结构从大到小依次可以分为:表空间、段、区、页、行。 表空间作为存储结构的最高层,所有数据都存放在表空间中,默认情况下用一个共享表空间 ibdata1 ,如果开启了 innodb_file_per_table 则每张表的数据将存储在单独的表空间中,也就是每张表都会有一个文件, 表空间由各个段构成,InnoDB存储引擎由索引组织的,而索引中的叶子节点用来记录数据,存储在数据段,而非叶子节点用来构建索引,存储在索引段,而回滚段我们在后面分析锁的时候在聊。 区是由连续的页组成,任何情况下一个区都是 1MB , 一个区中可以有多个页,每个页默认为 16KB ,所以默认情况下一个区中可以包含64个连续的页,页的大小是可以通过 innodb_page_size 设置,页中存储的是具体的行记录。一行记录最终以二进制的方式存储在文件里,我们要能够解析出一行记录中每个列的值,存储的时候就需要有固定的格式,至少需要知道每个列占多少空间,而 MySQL 中定义了一些固定长度的数据类型,例如 int、tinyint、bigint、char数组、float、double、date、datetime、timestamp 等,这些字段我们只需要读取对应长度的字节,然后根据类型进行解析即可,对于变长字段,例如 varchar、varbinary 等,需要有一个位置来单独存储字段实际用到的长度,当然还需要头信息来存储元数据,例如记录类型,下一条记录的位置等。下面我们以 Compact 行格式分析一行数据在 InnoDB 中是怎么存储的。 变长字段长度列表,该位置用来存储所申明的变长字段中非空字段实际占有的长度列表,例如有3个非空字段,其中第一个字段长度为3,第二个字段为空,第三个字段长度为1,则将用 01 03 表示,为空字段将在下一个位置进行标记。变长字段长度不能超过 2 个字节,所以 varchar 的长度最大为 65535。 NULL 标志位,占 1 个字节,如果对应的列为空则在对应的位上置为 1 ,否则为 0 ,由于该标志位占一个字节,所以列的数量不能超过 255。如果某字段为空,在后面具体的列数据中将不会在记录。这种方式也导致了在处理索引字段为空的时候需要进行额外的操作。 记录头信息,固定占 5 字节,包含下一条记录的位置,该行记录总长度,记录类型,是否被删除,对应的 slot 信息等 列数据 包含具体的列对应的值,加上两个隐藏列,事务 ID 列和回滚指针列。如果没有申明主键,还会增加一列记录内部 ID。 下面我们以《MySQL 技术内幕》第二版中的例子分析下一行记录在表空间具体的存储结构。 CREATE TABLE mytest( t1 varchar(10), t2 varchar(10), t3 char(10), t4 varchar(10) ) engine = innodb; insert into mytest VALUES('a','bb','bb','ccc'); insert into mytest VALUES('d',NULL,NULL,'fff'); 该表定义了 3 个变长字段和 1 个定长字段,然后插入两行记录,第二行记录包含空值,我们打开表空间 mytest.ibd 文件,转换为 16 进制,并定位到如下内容: //第一行记录 03 02 01 为变长字段长度列表,这里是倒序存放的,分别对应 ccc、bb、a 的长度。 00 表示没有为空的字段 00 00 10 00 2c 为记录头 00 00 00 2b 68 00 没有申明主键,维护内部 ID 00 00 00 00 06 05 事务ID 80 00 00 00 32 01 10 回滚指针 61 第一列 a 的值 62 62 第二列 bb 的值 62 62 20 20 20 20 20 20 20 20 第三列 bb 的值,固定长度 char(10) 以20进行填充 63 63 63 第四列 ccc 的值 //第二行记录 03 01 为变长字段长度列表,这里是倒序存放的,分别对应 fff、a 的长度,第二列位空。 06 转换为二进制为 00000110 表示第二列和第三列为空 00 00 20 ff 98 为记录头 00 00 00 2b 68 01 没有申明主键,维护内部 ID 00 00 00 00 06 06 事务ID 80 00 00 00 32 01 10 回滚指针 64 第一列 d 的值 65 65 65 第四列 fff 的值 到此,我们了解了一个数据行是怎么存储的,然而数据行并不是存储引擎管理的最小存储单位,索引只能够帮助我们定位到某个数据页,每一次磁盘读写的最小单位为也是数据页,而一个数据页内存储了多个数据行,我们需要了解数据页的内部结构才能知道存储引擎怎么定位到某一个数据行。InnoDB 的数据页由以下 7 个部分组成: 文件头(File Header) 固定 38 个字节 (页的位置,上一页下一页位置,checksum , LSN) 数据页头( Page Header)固定 56 个字节 包含slot数目,可重用空间起始地址,第一个记录地址,记录数,最大事务ID等 虚拟的最大最小记录 (Infimum + Supremum Record) 用户记录 (User Records) 包含已经删除的记录以链表的形式构成可重用空间 待分配空间 (Free spaces) 未分配的空间 页目录 (Page Directory) slot 信息,下面单独介绍 文件尾 (File Trailer) 固定8个字节,用来保证页的完整性 页目录里维护多个 slot ,一个 slot 包含多个行记录。每个 slot 占 2 个字节,记录这个 slot 里的行记录相对页初始位置的偏移量。由于索引只能定位到数据页,而定位到数据页内的行记录还需要在内存中进行二分查找,而这个二分查找就需要借助 slot 信息,先找到对应的 slot ,然后在 slot 内部通过数据行中记录头里的下一个记录地址进行遍历。每一个 slot 可以包含 4 到 8 个数据行。如果没有 slot 辅助,链表本身是无法进行二分查找的。 排序 排序有好多种算法来实现,在 MySQL 中经常会带上一个 limit ,表示从排序后的结果集中取前 100 条,或者取第 n 条到第 m 条,要实现排序,我们需要先根据查询条件获取结果集,然后在内存中对这个结果集进行排序,如果结果集数量特别大,还需要将结果集写入到多个文件里,然后单独对每个文件里的数据进行排序,然后在文件之间进行归并,排序完成后在进行 limit 操作。没错,这个就是 MySQL 实现排序的方式,前提是排序的字段没有索引。 CREATE TABLE `person` ( `id` int(11) NOT NULL, `city` varchar(16) NOT NULL, `name` varchar(16) NOT NULL, `age` int(11) NOT NULL, `addr` varchar(128) DEFAULT NULL, PRIMARY KEY (`id`), KEY `city` (`city`) ) ENGINE=InnoDB; select city,name,age from person where city='武汉' order by name limit 100 ; 使用 explain 发现该语句会使用 city 索引,并且会有 filesort . 我们分析下该语句的执行流程 1.初始化 sortbuffer ,用来存放结果集 2.找到 city 索引,定位到 city 等于武汉的第一条记录,获取主键索引ID 3.根据 ID 去主键索引上找到对应记录,取出 city,name,age 字段放入 sortbuffer 4.在 city 索引取下一个 city 等于武汉的记录的主键ID 5.重复上面的步骤,直到所有 city 等于武汉的记录都放入 sortbuffer 6.对 sortbuffer 里的数据根据 name 做快速排序 7.根据排序结果取前面 1000 条返回 这里是查询 city,name,age 3个字段,比较少,如果查询的字段较多,则多个列如果都放入 sortbuffer 将占有大量内存空间,另一个方案是只区出待排序的字段和主键放入 sortbuffer 这里是 name 和 id ,排序完成后在根据 id 取出需要查询的字段返回,其实就是时间换取空间的做法,这里通过 max_length_for_sort_data 参数控制,是否采用后面的方案进行排序。 另外如果 sortbuffer 里的条数很多,同样会占有大量的内存空间,可以通过参数 sort_buffer_size 来控制是否需要借助文件进行排序,这里会把 sortbuffer 里的数据放入多个文件里,用归并排序的思路最终输出一个大的文件。 以上方案主要是 name 字段没有加上索引,如果 name 字段上有索引,由于索引在构建的时候已经是有序的了,所以就不需要进行额外的排序流程只需要在查询的时候查出指定的条数就可以了,这将大大提升查询速度。我们现在加一个 city 和 name 的联合索引。 alter table person add index city_user(city, name); 这样查询过程如下: 1.根据 city,name 联合索引定位到 city 等于武汉的第一条记录,获取主键索引ID 2.根据 ID 去主键索引上找到对应记录,取出 city,name,age 字段作为结果集返回 3.继续重复以上步骤直到 city 不等于武汉,或者条数大于 1000 由于联合所以在构建索引的时候,在 city 等于武汉的索引节点中的数据已经是根据 name 进行排序了的,所以这里只需要直接查询就可,另外这里如果加上 city, name, age 的联合索引,则可以用到索引覆盖,不行到主键索引上进行回表。 总结一下,我们在有排序操作的时候,最好能够让排序字段上建有索引,另外由于查询第一百万条开始的一百条记录,需要过滤掉前面一百万条记录,即使用到索引也很慢,所以可以根据 ID 来进行区分,分页遍历的时候每次缓存上一次查询结果最后一条记录的 id , 下一次查询加上 id > xxxx limit 0,1000 这样可以避免前期扫描到的结果被过滤掉的情况。 InnoDB 存储模型 InnoDB 通过一些列后台线程将相关操作进行异步处理,如下图所示,同时借助缓冲池来减小 CPU 和磁盘速度上的差异。当查询的时候会先通过索引定位到对应的数据页,然后检测数据页是否在缓冲池内,如果在就直接返回,如果不在就去聚簇索引中通过磁盘 IO 读取对应的数据页并放入缓冲池。一个数据页会包含多个数据行。缓存池通过 LRU 算法对数据页进行管理,也就是最频繁使用的数据页排在列表前面,不经常使用的排在队尾,当缓冲池满了的时候会淘汰掉队尾的数据页。从磁盘新读取到的数据页并不会放在队列头部而是放在中间位置,这个中间位置可以通过参数进行修。缓冲池也可以设置多个实例,数据页根据哈希算法决定放在哪个缓冲池。 InnoDB 在更新数据的时候会采用 WAL 技术,也就是 Write Ahead Logging ,这个日志就是 redolog 用来保证数据库宕机后可以通过该文件进行恢复。这个文件一般只会顺序写,只有在数据库启动的时候才会读取 redolog 文件看是否需要进行恢复。该文件记录了对某个数据页的物理操作,例如某个 sql 把某一行的某个列的值改为 10 ,对应的 redolog 文件格式可能为:把第5个数据页中偏移量为99的位置写入一个值 10 。redolog 不是无限大的,他的大小是可以配置的,并且是循环使用的,例如配置大小为 4G ,一共 4 个文件,每个文件 1G 。 首先从第一个文件开始顺序写,写到第四个文件后在从第一个文件开始写,类似一个环,用一个后台线程把 redolog 里的数据同步到聚簇索引上的数据页上。写入 redolog 的时候不能将没有同步到数据页上的记录覆盖,如果碰到这种情况会停下来先进行数据页同步然后在继续写入 redolog 。另外执行更新操作的时候,会先更新缓冲池里的数据页,然后写入 redolog , 这个时候真正存储数据的地方还没有更新,也就是说这时候缓冲池中的数据页和磁盘不一致,这种数据页称为脏页,当脏页由于内存不足或者其他原因需要丢弃的时候,一定要先将该脏页对应的redolog 刷新到磁盘里的真实数据页,不然下次查询的时候由于 redolog 没有同步到磁盘,而查询直接通过索引定位到数据页就会查询出脏数据。 更新的时候先从磁盘或者缓冲池中读取对应的数据页,然后对数据页里的数据进行更改并生成 redolog 到对应的缓冲池(redolog buffer)进行缓存,当事务提交的时候将缓存写入到 redolog 的物理磁盘文件上。这里由于操作系统的文件写入 InnoDB 并没有使用 O_DIRECT 直接写入到文件,为了保证性能而是先写入操作系统的缓存,之后在进行 flush ,所以事务提交的时候 InnoDB 需要在调用一次 fsync 的系统调用来确保数据落盘。为了提高性能 InnoDB 可以通过参数 innodb_flush_log_at_trx_commit 来控制事务提交时是否强制刷盘。默认为 1 ,事务每次提交都需要调用 fsync 进行刷盘,0 表示事务提交的时候不会调用 redolog 的文件写入,通过后台线程每秒同步一次,2 表示事务提交的时候会写入文件但是只保证写入操作系统缓存,不进行 fsync 操作。 redolog 文件只会顺序写,所以磁盘操作性能不会太慢,所以建议生产环境都设置为 1 ,以防止数据库宕机导致数据丢失。 在执行更新逻辑的时候还会写入另外一个日志:undolog 。这个文件存储在共享表空间中,也就是即使打开了 innodb_file_per_table 参数,所有的表的 undolog 都存储在同一个文件里。该文件主要用来做事务回滚和 MVCC 。undolog 是逻辑日志,也就是他不是记录的将物理的数据页恢复到之前的状态,而是记录的和原 sql 相反的 sql , 例如 insert 对应 delete , delete 对应 insert ,update 对应另外一个 update 。事务回滚很好理解,执行相反的操作回滚到之前的状态,而 MVCC 是指镜像读,当一个事务需要查询某条记录,而该记录已经被其他事务修改,但该事务还没提交,而当前事务可以通过 undolog 计算到之前的值。这里我们只需要知道和 redolog 一样, undolog 也是需要在执行 update 语句的时候在事务提交前需要写入到文件的。另外 undolog 的写入也会有对应的 redolog ,因为 undolog 也需要持久化,通过 WAL 可以提高效率。这里可以总结下,在事务提交的时候要保证 redolog 写入到文件里,而这个 redolog 包含 主键索引上的数据页的修改,以及共享表空间的回滚段中 undolog 的插入。 另外 undolog 的清理通过一个后台线程定时处理,清理的时候需要判断该 undolog 是否所有的事务都不会用到。 熟悉 MySQL 的都知道,他通过 binlog 来进行高可用,也就是通过 binlog 来将数据同步到集群内其他的 MySQL 实例。binlog 和 redolog 的区别是,他是在存储引擎上层 Server 层写入的,他记录的是逻辑操作,也就是对应的 sql ,而 redolog 记录的底层某个数据页的物理操作,redolog 是循环写的,而binlog 是追加写的,不会覆盖以前写的数据。而binlog 也需要在事务提交前写入文件。binlog 的写入页需要通过 fsync 来保证落盘,为了提高 tps ,MySQL 可以通过参数 sync_binlog 来控制是否需要同步刷盘,该策略会影响当主库宕机后备库数据可能并没有完全同步到主库数据。由于事务的原子性,需要保证事务提交的时候 redolog 和 binlog 都写入成功,所以 MySQL 执行层采用了两阶段提交来保证 redolog 和 binlog 都写入成功后才 commit,如果一方失败则会进行回滚。 下面我们理一下一条 update 语句的执行过程: update person set age = 30 where id = 1; 1.分配事务 ID ,开启事务,获取锁,没有获取到锁则等待。 2.执行器先通过存储引擎找到 id = 1 的数据页,如果缓冲池有则直接取出,没有则去主键索引上取出对应的数据页放入缓冲池。 3.在数据页内找到 id = 1 这行记录,取出,将 age 改为 30 然后写入内存 4.生成 redolog undolog 到内存,redolog 状态为 prepare 5.将 redolog undolog 写入文件并调用 fsync 6.server 层生成 binlog 并写入文件调用 fsync 7.事务提交,将 redolog 的状态改为 commited 释放锁 锁 数据库使用锁是为了对共享资源进行并发访问控制,从而保证数据的完整性和一致性。InnoDB 中锁的最小粒度为行,和 jdk 中的 ReadWriteLock 一样,InnoDB提供了共享锁和排他锁,分别用来读和写。共享锁之间可以兼容,其他都互斥。根据加锁的范围,可以分为:全局锁、表级锁、行锁。全局锁会把整个数据库实例加锁,命令为 flush tables withs read lock , 将使数据库处于只读状态,其他数据写入和修改表结构等语句会阻塞,一般在备库上做全局备份使用。而表级锁有两种,一种是表锁,命令为 lock table with read/write ,和读写锁一样,另外一种是元数据锁,也叫意向锁,不需要显示申明,当执行修改表结构,加索引的时候会自动加元数据写锁,对表进行增删改查的时候会加元数据读锁。这样当两条修改语句的事务之间元数据锁都是读锁不互斥,但是修改表结构的时候执行更新由于互斥就需要阻塞。还有一种行级锁称为间隙锁,他锁定的是两条记录之间的间隙,防止其他事务往这个间隙插入数据,间隙锁是隐式锁,是存储引擎自己加上的。 非锁定读 普通的 select 操作都是非锁定读,如果存在事务冲突,会利用 undolog 获取新事务操作之前的镜像返回,在读已提交的隔离级别下,会获取新事务修改前的最新的一份已经提交的数据,而在可重复读的隔离级别下,会读取该事务开始时的数据版本。当有多个事务并发操作同一行记录时,该记录会同时存在多个 undolog ,每个 undolog 就是一个版本,这种模式称为多版本并发控制(MVCC) ,该模式能够极大的提高数据库的性能,想一想,如果基于锁来控制的话,当对某个记录进行修改的时候,另一个事务将需要等待,不管他是要读取还是写入,MVCC 允许写入的时候还能够进行读操作,这对大部分都是查询操作的应用来说极大的提高了 tps 。 锁定读 有时候我们在查询的时候需要显示的给记录加锁来保证一致性,select for update 将对扫描到的记录加上排他锁,而 select in share lock 将对扫描的记录加上共享锁。这两个语句必须在一个事物内,也就是需要显示开启事物,begin transaction; 当事物提交的时候会释放锁。具体加锁的逻辑我们后面在分析。另外所有的锁定读都是当前读,也就是读取当前记录的最新版本,不会利用 undolog 读取镜像。另外所有的 insert、update、delete 操作也是当前读,update、delete 会在更新之前进行一次当前读,然后加锁,而 insert 因为会触发唯一索引检测,也会包含一个当前读。 自增长锁: 在主键设置为自增长的情况下,该表会维护一个计数器,每个插入操作都会先获取这个计数器的当前值,然后加 1 作为新的主键,显然这个计数器是一个共享变量需要加排他锁,而这个锁不需要等到事物提交后才释放,他在 sql 语句插入完成后就会释放,新版本的 innoDB 采用互斥量来实现提高了插入速度。 锁的问题 脏读 不可重复读 丢失更新 死锁和热点 脏读是指事务A对某个数据页进行了更改,但是并没有提交,这个数据就成为脏数据,这里稍微和上面提到的脏页做下区分,脏页是指内存中已经更改但是还没有刷新到磁盘的数据,脏页是正常的,而脏读是指一个事物读取了另外一个事物没有提交的数据,如果另外一个数据对这个数据又进行了更改,则出现数据一致性,脏读违背了数据库的隔离性。脏读目前只能出现在读未提交这个隔离级别下,目前 MySQL 默认的隔离级别为可重复读。 不可重复读是指一个事务先后两次读取同一条记录的结果不一样,因为第二次读取的时候可能其他事务已经进行更改并提交,不可重复读只发生在隔离级别为读未提交和读已提交里。 丢失更新是指两个事务同时更新某一条记录,导致其中一个事务更新失效,理论上任何一个隔离级别都不会发生丢失更新,因为更新的时候会加上排他锁,但是应用中却经常发生,例如一个计数器应用,事务A查询计数器的值 v=5,在内存中加 1 写入到数据库,在写入之前另外一个事务读取到计数器的值 v=5 ,然后加 1 写入数据库,这样本来应该为 7 , 现在却是 6 ,这是因为 我们是先读取在写入,而读取和写入对数据库而言是两个操作,并不是一个原子操作,这里可以通过把查询的记录加上排他锁 select for update 来防止丢失更新现象。当然这里直接将 sql 改为 v = v + 1 也可以。 死锁是指两个或两个以上事务因争夺资源而互相等待的情况,InnoDB 提供了死锁检测和超时机制来防止死锁的影响,死锁检测是非常耗 CPU 的,当很多个事务同时竞争同一个资源的时候,例如抢购的时候扣商品份额,或者支付的时候所有的订单都会用到一个公共账户,同一个资源竞争的事务越多,死锁检测越耗 CPU 。为了减少这种情况的影响,建议尽量在业务层减少热点的产生,例如将热点账户拆分成若个个同样功能的账户,万一发生高并发,建议在应用层做限流或者排队,当然也可以在数据库层做排队,这个需要修改数据库源码。 加锁的流程 InnoDB的加锁过程比较复杂,大致可以记住一个原则是:将所有扫描到的记录都加锁,范围查询会加间隙锁,然后加锁过程按照两阶段锁 2PL 来实现,也就是先加锁,然后所有的锁在事物提交的时候释放。怎么加锁和数据库的隔离级别有关,然而我们一般很少更改 MySQL 的隔离级别,所以下面我们均按照可重复读的隔离级别进行分析,另外一个因素是查询条件中是否包含索引,是主键索引还是普通索引,是否是唯一索引等。我们以下面这条 sql 语句来分析加锁过程。 select * from trade_order where order_no = '201912102322' for update; order_no 是主键索引 ,这种情况将在主键索引上的 order_no = '201912102322' 这条记录上加排他锁。 order_no 是普通索引,并且是唯一索引 将会对 普通索引上对应的一套记录加排他锁,对主键索引上对应的记录加排他锁 order_no 是普通索引,并且不是唯一索引 将会对 普通索引上 order_no = '201912102322' 一条或者多条记录加锁,并且对这些记录对应的主键索引上的记录加锁。这里除了加上行锁外,还会加上间隙锁,防止其他事物插入 order_no = '201912102322' 的记录,然而如果是唯一索引就不需要间隙锁,行锁就可以。 order_no 上没有索引,innoDB 将会在主键索引上全表扫描,这里并没有加表锁,而是将所有的记录都会加上行级排他锁,而实际上 innoDB 内部做了优化,当扫描到一行记录后发现不匹配就会把锁给释放,当然这个违背了 2PL 原则在事务提交的时候释放。这里除了对记录进行加锁,还会对每两个记录之间的间隙加锁,所以最终将会保存所有的间隙锁和 order_no = '201912102322' 的行锁。 order_no = '201912102322' 这条记录不存在的情况下,如果order_no 是主键索引,则会加一个间隙锁,而这个间隙是主键索引中 order_no 小于 201912102322 的第一条记录到大于 201912102322 的第一条记录。试想一下如果不加间隙锁,如果其他事物插入了一条 order_no = '201912102322' 的记录,由于 select for update 是当前读,即使上面那个事物没有提交,如果在该事物中重新查询一次就会发生幻读。 如果没有索引,则对扫描到的所有记录和间隙都加锁,如果不匹配行锁将会释放只剩下间隙锁。回忆一下上面讲的数据页的结果中又一个最大记录和最小记录,Infimum 和 Supremum Record,这两个记录在加间隙锁的时候就会用到。 事务 InnoDB 存储引擎的事务需完全符合 ACID 特性。下面我们一起看下 InnoDB 做了哪些事情。 原子性 : 是指一个事务内的所有操作要么全部成功要么全部失败,数据库中将 redolog 和 binlog 的写入采用两阶段提交就是为了保证事务的原子性。另外由于 InnodDB 是按页进行存储的,每个页大小为 16kb 而操作系统的一般以 4KB 为一页进行读取,所以可能出现一个 InnoDB 的数据页只写了一部分的情况。而 InnoDB 为了防止这种情况的发生采用双写机制,除了写入磁盘上的数据页还会在共享空间中写入。而 redolog 按块存储,每个块 512 字节,正好和扇区大小一样所以,可以保证原子性,不需要进行双写。 一致性 :保证磁盘和缓存的数据一致,binlog 数据和 主库中的数据一致。 隔离性 : 默认为可重复读,采用 undolog 来实现。 持久性 : 事务一旦提交,其结果就是永久的,redolog 需要在事务提交前进行刷盘,磁盘采用 RAID 等。 微信 pigpdong 公众号 内核小王子

优秀的个人博客,低调大师

超详细的Guava RateLimiter限流原理解析

限流是保护高并发系统的三把利器之一,另外两个是缓存和降级。限流在很多场景中用来限制并发和请求量,比如说秒杀抢购,保护自身系统和下游系统不被巨型流量冲垮等。 限流的目的是通过对并发访问/请求进行限速或者一个时间窗口内的的请求进行限速来保护系统,一旦达到限制速率则可以拒绝服务或进行流量整形。 常用的限流方式和场景有:限制总并发数(比如数据库连接池、线程池)、限制瞬时并发数(如nginx的limit_conn模块,用来限制瞬时并发连接数,Java的Semaphore也可以实现)、限制时间窗口内的平均速率(如Guava的RateLimiter、nginx的limit_req模块,限制每秒的平均速率);其他还有如限制远程接口调用速率、限制MQ的消费速率。另外还可以根据网络连接数、网络流量、CPU或内存负载等来限流。 比如说,我们需要限制方

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册