首页 文章 精选 留言 我的

精选列表

搜索[编译原理],共10000篇文章
优秀的个人博客,低调大师

解析Vue.js中的computed工作原理

我们通过实现一个简单版的和Vue中computed具有相同功能的函数来了解computed是如何工作的。写的十分的全面细致,具有一定的参考价值,对此有需要的朋友可以参考学习下。如有不足之处,欢迎批评指正。 JS属性: JavaScript有一个特性是 Object.defineProperty ,它能做很多事,但我在这篇文章只专注于这个方法中的一个: var person = {}; Object.defineProperty (person, 'age', { get: function () { console.log ("Getting the age"); return 25; } });//欢迎加入前端全栈开发交流圈一起吹水聊天学习交流:864305860 console.log ("The age is ", person.age); // Prints: // // Getting the age // The age is 25 (Obeject.defineProperty是Object的一个方法,第一个参数是对象名称,第二个参数是要设置的属性名,第三个参数是一个对象,它可以设置这个属性是否可修改、可写等,而这篇文章主要使用的是Obeject.defineProperty的访问器属性,感兴趣的朋友可以自行google或者查看Js高及程序设计) 尽管 person.age 看起来像是访问了对象的一个属性,但其实在内部我们是运行了一个函数。 一个基本可响应的Vue.js Vue.js内部构建了一个可以将普通的对象转化为可以被观察的值( 响应属性 ),下面为大家展示一个简化版的如何添加响应属性的案例: function defineReactive (obj, key, val) { Object.defineProperty (obj, key, { get: function () { return val; }, set: function (newValue) { val = newValue; } }) }; // 创建一个对象 var person = {}; // 添加可响应的属性"age"和"country" defineReactive (person, 'age', 25); defineReactive (person, 'country', 'Brazil'); // 现在你可以随意使用person.age了 if (person.age < 18) { return 'minor'; } else { return 'adult'; }//欢迎加入前端全栈开发交流圈一起吹水聊天学习交流:864305860 // 设置person.country的值 person.country = 'Russia'; 有趣的是, 25 和 ‘Brazil' 还是一个闭包内部的变量,只有当赋给它们新值的时候 val 才会改变。 person.country 并不拥有 'Brazil' 这个值,而是getter这个函数拥有 'Brazil' 这个值。 声明一个计算属性 让我们创建一个定义计算属性的函数 defineComputed 。这个函数就跟大家平时使用computed时的一样。 defineComputed ( person, // 计算属性就声明在这个对象上 'status', // 计算属性的名称 function () { // 实际返回计算属性值的函数 console.log ("status getter called") if (person.age < 18) { return 'minor'; } else { return 'adult'; } }, function (newValue) { // 当计算属性值更新时调用的函数 console.log ("status has changed to", newValue) } }); // 我们可以像使用一般的属性一样使用计算属性 console.log ("The person's status is: ", person.status); 让我们写一个简单的 defineComputed 函数,它支持调用计算方法,但目前不需要它支持 updateCallback function defineComputed (obj, key, computeFunc, updateCallback) { Object.defineProperty (obj, key, { get: function () { // 执行计算函数并且返回值 return computeFunc (); },//欢迎加入前端全栈开发交流圈一起吹水聊天学习交流:864305860 set: function () { // 什么也不做,不需要设定计算属性的值 } }) } 这个函数有两个问题: 每次访问计算属性时都会执行一次计算函数 computeFunc () 它不知道什么时候更新 (即当我们更新某个data中的属性,计算属性中也会更新这个data属性) // 我希望最终函数执行后是这个效果:每当person.age更新值的时候,person.status也同步更新 person.age = 17; // console: status 的值为 minor person.age = 22; // console: status 的值为 adult 增加一个依赖项 让我们增加一个全局变量 Dep : var Dep = { target: null }; 这是一个依赖项,接着我们用一个骚操作来更新 defineComputed 函数: function defineComputed (obj, key, computeFunc, updateCallback) { var onDependencyUpdated = function () { // TODO }//欢迎加入前端全栈开发交流圈一起吹水聊天学习交流:864305860 Object.defineProperty (obj, key, { get: function () { // 将onDependencyUpdated 这个函数传给Dep.target Dep.target = onDependencyUpdated; var value = computeFunc (); Dep.target = null; }, set: function () { // 什么也不做,不需要设定计算属性的值 } }) } 现在让我们回到之前设置的响应属性上: function defineReactive (obj, key, val) { // 所有的计算属性都依赖这个数组 var deps = []; Object.defineProperty (obj, key, { get: function () { // 检查是否调用了计算属性,如果调用了,Department.target将等于一个onDependencyUpdated函数 if (Dep.target) { // 把onDependencyUpdated函数push到deos中 deps.push (target); } return val; }, set: function (newValue) { val = newValue; // 通知所有的计算属性,告诉它们有个响应属性更新了 deps.forEach ((changeFunction) => { changeFunction (); });//欢迎加入前端全栈开发交流圈一起吹水聊天学习交流:864305860 }//面向1-3年前端人员 }) }; 我们可以在计算属性定义的函数触发更新回调后更新 onDependencyUpdated 函数。 var onDependencyUpdated = function () { // 再次计算 计算属性的值 var value = computeFunc (); updateCallback (value); }//欢迎加入前端全栈开发交流圈一起学习交流:864305860 把它们整合到一起: 让我们重新访问我们的计算属性 person.status : person.age = 22; defineComputed ( person, 'status', function () { if (person.age > 18) { return 'adult'; } }, function (newValue) { console.log ("status has changed to", newValue) }//欢迎加入前端全栈开发交流圈一起学习交流:864305860 }); console.log ("Status is ", person.status); 结语 感谢您的观看,如有不足之处,欢迎批评指正。

优秀的个人博客,低调大师

Java注解机制之Spring自动装配实现原理

Java中使用注解的情况主要在SpringMVC(Spring Boot等),注解实际上相当于一种标记语言,它允许你在运行时动态地对拥有该标记的成员进行操作。注意:spring框架默认不支持自动装配的,要想使用自动装配需要修改spring配置文件中<bean>标签的autowire属性。 自动装配属性有6个值可选,分别代表不同的含义: byName ->从Spring环境中获取目标对象时,目标对象中的属性会根据名称在整个Spring环境中查找<bean>标签的id属性值。如果有相同的,那么获取这个对象,实现关联。整个Spring环境:表示所有的spring配置文件中查找,那么id不能有重复的。 byType ->从Spring环境中获取目标对象时,目标对象中的属性会根据类型在整个spring环境中查找<bean>标签的class属性值。如果有相同的,那么获取这个对象,实现关联。 缺点:如果存在多个相同类型的bean对象,会出错;如果属性为单一类型的数据,那么查找到多个关联对象会发生错误;如果属性为数组或集合(泛型)类型,那么查找到多个关联对象不会发生异常。 constructor ->使用构造方法完成对象注入,其实也是根据构造方法的参数类型进行对象查找,相当于采用byType的方式。 autodetect ->自动选择:如果对象没有无参数的构造方法,那么自动选择constructor的自动装配方式进行构造注入。如果对象含有无参数的构造方法,那么自动选择byType的自动装配方式进行setter注入。 no ->不支持自动装配功能 default ->表示默认采用上一级标签的自动装配的取值。如果存在多个配置文件的话,那么每一个配置文件的自动装配方式都是独立的。 注解使用需要三个条件包括注解声明,使用注解的元素,操作使用注解元素的代码。第一步注解声明,注解是一种类型,自定义注解编写代码如下: packageannotation; importjava.lang.annotation.ElementType; importjava.lang.annotation.Retention; importjava.lang.annotation.RetentionPolicy; importjava.lang.annotation.Target; @Retention(RetentionPolicy.RUNTIME) @Target(ElementType.METHOD) public@interfaceAttachAnnotation{ StringparamValue()default"河北省";//参数名为"paramValue"默认值为"河北省" } 使用自定义注解元素,代码如下: packageannotation; /** *@author路人宅 */ publicclassAttachEmlement{ //普通 publicvoidAttachDefault(Stringname){ System.out.println("归属:"+name); } //使用注解并传入参数 @AttachAnnotation(paramValue="河北省") publicvoidAttachAnnotation(Stringname){ System.out.println("归属:"+name); } //使用注解并使用默认参数 @AttachAnnotation publicvoidAttachAnnotationDefault(Stringname){ System.out.println("归属:"+name); } } 测试操作执行main函数,具体代码如下: packageannotation; importjava.lang.reflect.InvocationTargetException; importjava.lang.reflect.Method; publicclassAnnotionOperator{ publicstaticvoidmain(String[]args)throwsIllegalAccessException, IllegalArgumentException,InvocationTargetException, ClassNotFoundException{ AttachEmlementelement=newAttachEmlement();//初始化一个实例,用于方法调用 Method[]methods=AttachEmlement.class.getDeclaredMethods();//获得所有方法 for(Methodmethod:methods){ AttachAnnotationannotationTmp=null; if((annotationTmp=method.getAnnotation(AttachAnnotation.class))!=null) method.invoke(element,annotationTmp.paramValue()); else method.invoke(element,"河南省"); } } } 执行结果: 归属:河南省 归属:河北省 归属:河北省 Spring为了方便自动装配进行操作有两种方式:继承org.springframework.web.context.support.SpringBeanAutowiringSupport类或者添加@Component/@Controller等注解并在Spring配置文件里声明context:component-scan元素配置。 1) 继承方式实现自动装配,查看Spring3.1.1源代码会发现SpringBeanAutowiringSupport类中有如下代码: /** *Thisconstructorperformsinjectiononthisinstance, *basedonthecurrentwebapplicationcontext. *Intendedforuseasabaseclass. *@see#processInjectionBasedOnCurrentContext */ publicSpringBeanAutowiringSupport(){ processInjectionBasedOnCurrentContext(this); } 分析:Java在实例化构造时会调用默认父类无参构造方法,而Spring就是通过这一点,让操作元素代码执行的。 2) 通过注解方式的也和上述理论相似,值得注意的是注解自动装配无需完成注入setter*,查看Spring3.1.1源码注解调用顺序得出: org.springframework.web.context.support.SpringBeanAutowiringSupport#SpringBeanAutowiringSupport=> org.springframework.web.context.support.SpringBeanAutowiringSupport#processInjectionBasedOnCurrentContext=> org.springframework.beans.factory.annotation.AutowiredAnnotationBeanPostProcessor#processInjection=> org.springframework.beans.factory.annotation.InjectionMetadata#Injection,查看inject方法源代码如下: /** *Eitherthisor{@link#getResourceToInject}needstobeoverridden. */ protectedvoidinject(Objecttarget,StringrequestingBeanName,PropertyValuespvs)throwsThrowable{ if(this.isField){ Fieldfield=(Field)this.member; ReflectionUtils.makeAccessible(field); field.set(target,getResourceToInject(target,requestingBeanName)); } else{ if(checkPropertySkipping(pvs)){ return; } try{ Methodmethod=(Method)this.member; ReflectionUtils.makeAccessible(method); method.invoke(target,getResourceToInject(target,requestingBeanName)); } catch(InvocationTargetExceptionex){ throwex.getTargetException(); } } } 分析:通过上述源码Spring自动装配是通过反射机制来实现的。 本文出自:https://blog.yoodb.com/yoodb/article/detail/1310

优秀的个人博客,低调大师

dubbo专题-深入浅出zookeeper订阅原理

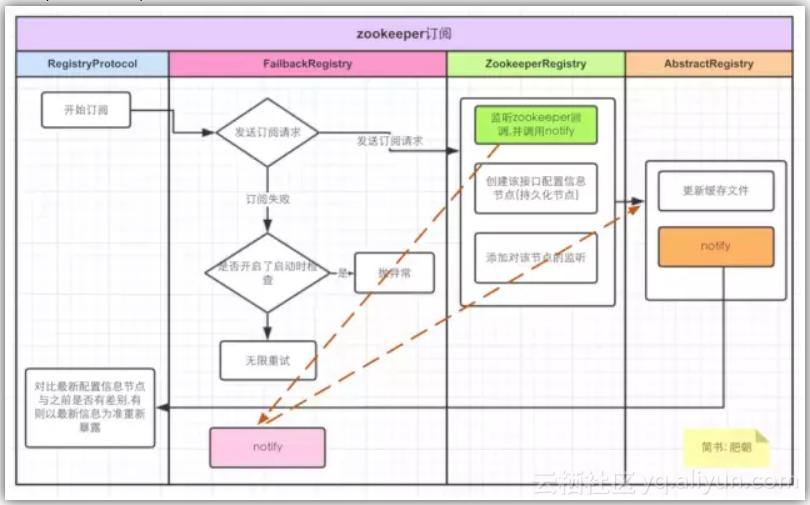
进行了解析.知道dubbo会对zookeeper的信息进行一个本地的文件缓存.如果你只是简单的回答出这个本地的文件缓存,可能面试官会点到为止,但是如果你按照我那样从源码角度分析,甚至连缓存到哪个磁盘文件都一清二楚,那么面试官必然会根据这个问题深入问下去.既然要深入问下去,那他会从哪个角度问呢? 比如公司新来了妹子,老司机们在下班的时候总会套路一下,问她们你男朋友怎么不接你下班啊.这个时候妹子的回答往往也就两个,一个是我没有男朋友啊,另一个是他忙啊(这说明她有男朋友).从这里例子就可以很容易看出,你的发言,对对方的回答我们是能一定程度预判的.再比如,我一直自称肥朝,假如你发现我其实没有你想的那么肥,按照正常的思维你就会问我,既然你没这么肥为什么要叫肥朝.这再次说明了,对方的提问,我们是可预判的. 同理可得,你回答了会缓存本地文件,并且连目录都一清二楚,那他如果照着这个问题深入问下去,他可能会问什么呢?可能会问,既然是缓存,那么自然会存在和实时数据不同步,那么他是什么时候去更新这个缓存?鉴于你前面回答得这么透彻,可能还会加上一句,他这个更新的过程是怎么样的?能画图给我讲一下吗? 当然看到这里你可能会反驳,万一他不按套路出牌,或者我回答了这个问题他又继续深入问下去,那可咋整?其实坦白说,虽然我源码解析以面试题为切入,但是我在dubbo源码解析-zookeeper创建节点中也提到了,看源码并不是以面试为最终目的.因此,简书上关注肥朝,每周一篇dubbo源码解析,互相交流进步,提升自己的层次,而不是在低层次努力,这才是应对"不按套路出牌"和"深入问下去"的不二法宝. 插播面试题 在dubbo中,什么时候更新本地的zookeeper信息缓存文件?订阅zookeeper信息的整体过程是怎么样的? 前戏铺垫 用中文来剧透接下来源码的一些羞嗒嗒的剧情 只需将这幅图记在心中,用小学六年苦练的看图写作文功力即可概括出面试题答案. 直入主题 这个方法是我们的老朋友了,我们在前面的zookeeper连接和zookeeper创建节点的时候都已经见过(图中蓝色标注的),这次我们还是讲一行代码(红色标注的) 这里就开始发起订阅请求和订阅失败重试,可以对照前期铺垫中的图 这里设置了监听回调的地址,即回调给FailbackRegistry中的notify 从这里我们可以看到,创建的是持久节点 下面开始对该节点设置监听(其中涉及一下zkClient的api) 下面要开始更新新的服务信息,服务启动和节点更新回调(前面设置了回调到这里)都会调用到这里 那么下面就要敲黑板划重点了,由前期铺垫我们就知道这里要开始更新本地缓存文件的信息 这里采用了线程池来更新,dubbo里面到处都是并发编程,所以面试喜欢问多线程这个真的不是在装逼,线程的意识还是很重要的,同时如果关注肥朝每周一篇dubbo源码解析(真不是套路),面试问到项目哪里用到了多线程例子再也不用担心了,把dubbo里面的例子套一下妥妥的. dubbo在操作文件的时候还会对文件进行加锁,看源码要特别留心这些异常信息,方便出问题时快速定位(其实也是在粗暴式点题怎么看源码) 更新完文件后,对比新旧的信息是否有变化,有则重新暴露服务 写在最后 欢乐的时间总是短暂的,又到了说再见的时间,因为最近都是996,写到这里的时候已经是周日的凌晨两点半.期待下周与你相遇.鉴于本人才疏学浅,不对的地方还望斧正。 原文发布时间为:2018-10-24 本文作者:肥朝 本文来自云栖社区合作伙伴“java进阶架构师”,了解相关信息可以关注“java进阶架构师”。

优秀的个人博客,低调大师

sort()方法的用法,参数以及排序原理

sort() 方法用于对数组的元素进行排序,并返回数组。默认排序顺序是根据字符串Unicode码点。语法:arrayObject.sort(sortby);参数sortby可选。规定排序顺序。必须是函数。注:如果调用该方法时没有使用参数,将按字母顺序对数组中的元素进行排序,说得更精确点,是按照字符编码的顺序进行排序。要实现这一点,首先应把数组的元素都转换成字符串(如有必要),以便进行比较。 如果想按照其他标准进行排序,就需要提供比较函数,该函数要比较两个值,然后返回一个用于说明这两个值的相对顺序的数字。比较函数应该具有两个参数 a 和 b,其返回值如下:若 a 小于 b,在排序后的数组中 a 应该出现在 b 之前,则返回一个小于 0 的值。若 a 等于 b,则返回 0。若 a 大于 b,则返回一个大于 0 的值。 例1:我们将创建一个数组,并按字母顺序进行排序: &lt;script type="text/javascript"&gt; var arr = new Array(6) arr[0] = "George" arr[1] = "John" arr[2] = "Thomas" arr[3] = "James" arr[4] = "Adrew" arr[5] = "Martin" document.write(arr + "&lt;br /&gt;") document.write(arr.sort()) &lt;/script&gt; 输出: George,John,Thomas,James,Adrew,Martin Adrew,George,James,John,Martin,Thomas 例2:我们将创建一个数组,并按字母顺序进行排序: &lt;script type="text/javascript"&gt; var arr = new Array(6) arr[0] = "10" arr[1] = "5" arr[2] = "40" arr[3] = "25" arr[4] = "1000" arr[5] = "1" document.write(arr + "&lt;br /&gt;") document.write(arr.sort()) &lt;/script&gt; 输出: 10,5,40,25,1000,1 1,10,1000,25,40,5 请注意,上面的代码没有按照数值的大小对数字进行排序,要实现这一点,就必须使用一个排序函数: &lt;script type="text/javascript"&gt; function sortNumber(a,b) { return a - b } var arr = new Array(6) arr[0] = "10" arr[1] = "5" arr[2] = "40" arr[3] = "25" arr[4] = "1000" arr[5] = "1" document.write(arr + "&lt;br /&gt;") document.write(arr.sort(sortNumber)) &lt;/script&gt; 输出: 10,5,40,25,1000,1 1,5,10,25,40,1000 这里可以看出,如果安装升序排列,那么方法为: function sortNumber(a,b) { return a - b } 如果是按照降序排列则为: function sortNumber(a,b) { return b - a } 当然如果想根据数组对象中的某个属性值进行排序呢? sort方法接收一个函数作为参数,这里嵌套一层函数用来接收对象属性名,其他部分代码与正常使用sort方法相同。 var arr = [ {name:'zopp',age:0}, {name:'gpp',age:18}, {name:'yjj',age:8} ]; function compare(property){ return function(a,b){ var value1 = a[property]; var value2 = b[property]; return value1 - value2; } } console.log(arr.sort(compare('age'))) 结果如图所示: 如何根据参数不同,来确定是升序排列,还是降序排序呢? sortBy: function(attr,rev){ //第二个参数没有传递 默认升序排列 if(rev == undefined){ rev = 1; }else{ rev = (rev) ? 1 : -1; } return function(a,b){ a = a[attr]; b = b[attr]; if(a &lt; b){ return rev * -1; } if(a &gt; b){ return rev * 1; } return 0; } } 使用方式: newArray.sort(sortBy('number',false)) V8 引擎 sort 函数只给出了两种排序 InsertionSort 和 QuickSort,数量小于10的数组使用 InsertionSort,比10大的数组则使用 QuickSort。 V8 引擎array源码 710行开始 原文地址:https://segmentfault.com/a/1190000000410506

优秀的个人博客,低调大师

《AOP 挖掘记》概念介绍及原理初探(一)

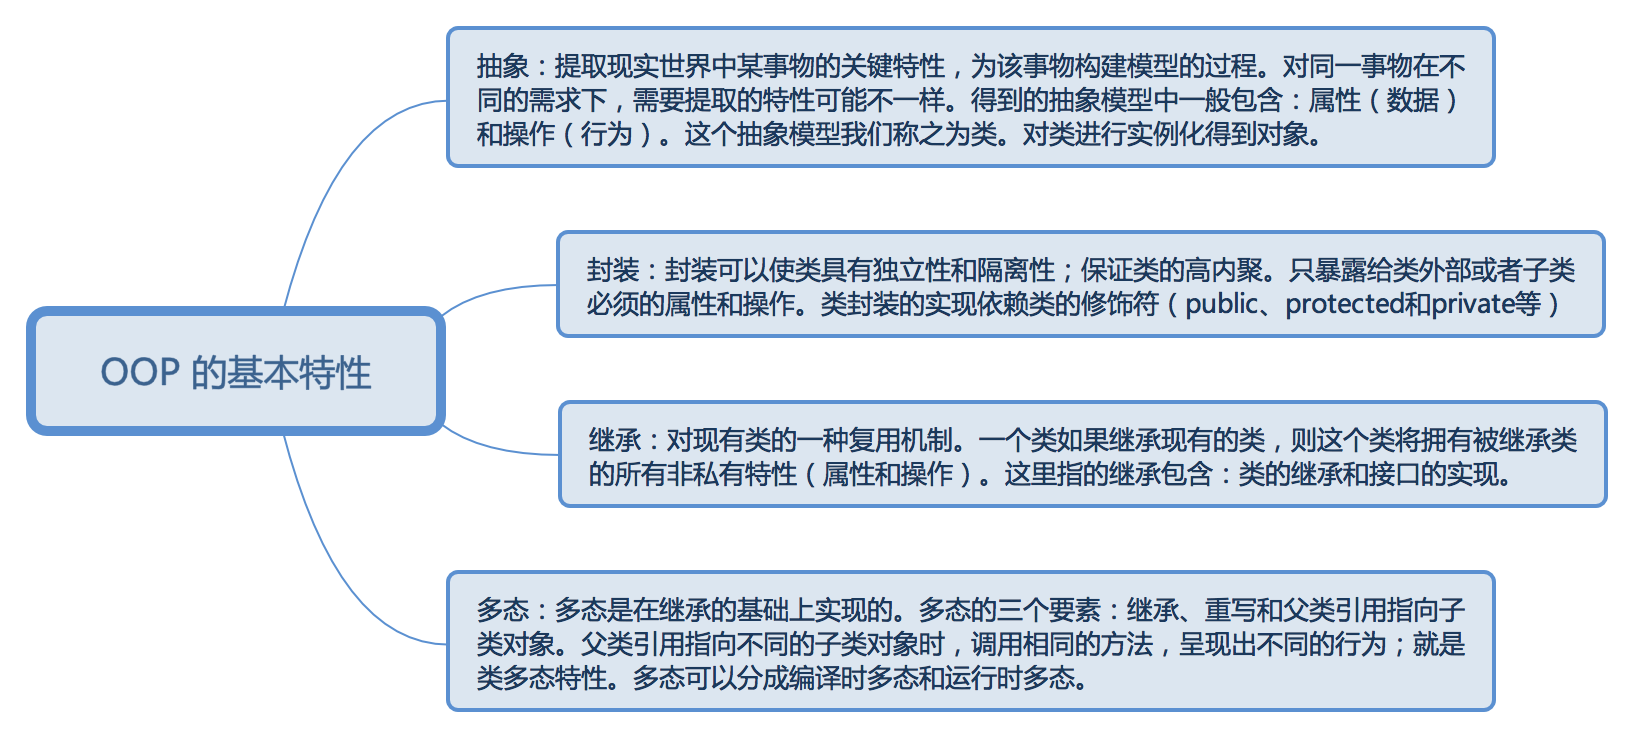
AOP 的基本概念 AOP 是 Aspect-Oriented programming 的缩写,中文翻译为面向切面编程,它和 OOP 一样是一种编程思想。 AOP 把软件系统分为两个部分:核心关注点和横切关注点。业务处理的主要流程是核心关注点,与之关系不大的部分是横切关注点。横切关注点的一个特点是,他们经常发生在核心关注点的多处,而各处都基本相似。比如权限认证、日志、事务处理。AOP 的作用在于分离系统中的各种关注点,将核心关注点和横切关注点分离开来。通俗的讲就是将应用程序中的业务逻辑同对其提供支持的通用服务进行分离,AOP 可以说是 OOP 的补充和完善。 使用 OOP 的好处是可以设计出低耦合的系统,使系统更加灵活、更加易于维护,但同时也增加了代码的重复性。比如,我们要打印类中每个方法的出入参。按面向对象的编程思想,就必须在类的每方

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。


用户登录
用户注册