首页 文章 精选 留言 我的

精选列表

搜索[国产神器],共5596篇文章
优秀的个人博客,低调大师

这个图像分割神器开源了

最近全球各大新势力造车公司简直不能再火!小编看着蹭蹭飙升的股价实在是眼红的不要不要的。而懂行的人都知道,以特斯拉为首,各大公司都采用计算机视觉作为自动驾驶的技术底座,而其中正是通过图像分割技术,汽车才能分清楚哪里是路,哪里是人。 那图像分割重不重要还需要我强调么?而今天我要给大家介绍的这个开源套件,就涵盖业界最前沿的图像分割算法,并效果超群,这就是 PaddleSeg!!OMG,还在等什么?!盘他!盘他!盘他! 在如期举行的全球计算机视觉顶会 CVPR2021 上,PaddleSeg 再次绽放高光。其中 AutoNUE 挑战赛是近年来自动驾驶场景理解领域极具影响力的一场赛事,非常考验参赛者在非结构化环境中的语义分割算法能力。百度 PaddleSeg 团队最终击败其余参赛队伍,在 Level 1, Level 2, Level 3 三项测试指标上均以第一名的成绩摘获冠军。 着急的小伙伴可以直接去看比赛详情: https://bj.bcebos.com/paddleseg/docs/autonue21_presentation_PaddleSeg.pdf 那么 PaddleSeg 到底是个啥呢?小编去GitHub 上去扒了一下官方的解释: PaddleSeg 是基于飞桨开发的端到端图像分割开发套件,涵盖了高精度和轻量级等不同方向的大量高质量分割模型。通过模块化的设计,帮助开发者完成从训练到部署的全流程图像分割应用。下面就给大家讲讲 PaddleSeg 的特点和近期更新的内容: 全新升级了人像分割功能,提供了 web 端超轻量模型部署方案; 推出了精细化的分割解决方案 PaddleSeg-Matting; 开源了全景分割算法 Panoptic-DeepLab,丰富了模型种类; 发布了交互式分割的智能标注工具 EISeg。极大的提升了标注效率。 Web 视频会议 Matting 全景分割 交互式分割 提供了产业级的部署方式。如今又增加了这么多的新功能。可以说 PaddleSeg 已经可以全方位、立体式地满足开发者各个维度的需求。不得不大说一声:、 这么好的产品,还不快上车? 上车地址: https://github.com/PaddlePaddle/PaddleSeg 产业级人像分割方案PPSeg 人像分割是图像分割领域非常常见的应用,在实际应用过程中人像的数据集来源多种多样,数据可能来源于手机、相机、监控等,图片尺寸可能是横屏、竖屏或者方屏。部署场景多种多样,有的应用在服务器端,有的应用在移动端,还有的应用在网页端。为此 PaddleSeg 团队推出了在大规模人像数据上训练的人像分割 PPSeg 模型,满足在服务端、移动端、Web 端(Paddle.js)多种使用场景的需求。 PPSeg 模型在产业中得到了广泛的应用。近期“百度视频会议”也上线了虚拟背景功能,支持用户在视频会议时进行背景切换。其中人像换背景模型采用 PaddleSeg 团队开发的 PPSeg 系列模型中的超轻量级模型。通过 Padddle.js 实现了在 web 端部署,直接利用浏览器的算力进行图像分割,分割效果受到一致好评。 产业级解决方案详解: https://github.com/PaddlePaddle/PaddleSeg/tree/release/2.2/contrib/HumanSeg 小伙伴们也可前去百度首页体验百度视频会议,直观体验一下 PaddleSeg 和 Paddle.js 为大家提供的人像分割功能。 精细化的分割解决方案 PaddleSeg-Matting 随着分割技术的发展,人们对分割的精细化的要求也越来越高。比如在一些影视行业,绿幕作为拍摄的换背景常用的工作,但目标不在绿幕前拍摄,是否还能达到很好的背景分割功能呢? 答案是:能! 最近 PaddleSeg 团队开源的精细化分割解决方案 PaddleSeg-Matting就很好的解决了这个问题。将目标的发丝实现了精准的分割。 PaddleSeg 通过内建 trimap 生成机制实现 alpha 预测,无需任何辅助信息的输入即可完成预测,极大减少了人工成本。通过共享 encoder 权重减少网络的参数量,并在 decoder 阶段利用 attention module 实现 trimap 信息流对 alpha 预测的指导。然后利用 error map 提取错估区域的 patch,通过 refinement 子网络进行 refine 得到最终的 alpha。 交互式分割智能标注工具 业界对于人工智能有这么一句话:“深度学习有多智能、背后就有多少人工”。这句话直接说出了深度学习从业者心中的痛处,毕竟模型的好坏数据占据着很大的因素,但是数据的标注成本却让很多从业的小伙伴们感到头疼。 为此 PaddleSeg 团队重磅推出的交互式分割智能标注软件EISeg 那具体什么是交互式分割呢?通过下面的动态图来了解一下。 不难发现,交互式分割通过一系列的绿色点(正点)和红色点(负点)实现了对目标对象的边缘分割,交互式分割主要的应用方向是图像编辑和半自动标注,可以应用于精细化标注,抠图,辅助图像后期处理(例如 PS)等场景。 PaddleSeg 团队联合 PaddleCV-SIG 成员基于 RITM 算法,推出了业界首个高性能的交互式分割工具 EISeg,我们支持对 RITM 模型的训练、预测及交互的全流程。PaddleSeg 交互式分割模型不仅仅支持从头训练强大的通用场景模型,还支持对特定场景数据进行 Finetune。我们利用百度自建人像数据集对模型 Finetune,得到预测速度快,精度高,交互点少的人像交互式分割模型。 软件提供多种安装方式,支持用户使用 pip 和 conda 安装,另外 windows 下提供了可执行的 exe 文件,双击.exe 即可运行程序。 全景分割 Panoptic-DeepLab 全景分割是图像分割领域在近年来兴起的一个新领域,由 FAIR 与海德堡大学在2018年首次提出。 什么是全景分割呢? 图像的信息可以分为 thing 和 stuff,其中 thing 表示可数对象,例如车、动物等等,stuff 表示不可数对象,例如沙滩、天空等等。语义分割任务不关注图像中的是 stuff 还是 thing,只关注每个像素所属的语义类别,因此无法实现实例对象的区分。而实例分割关注的是 thing 的分割,将图像中的 thing 识别出来,区分出不同的实例个体以及相应的语义信息,对于 stuff 区域,则统一表示为背景。全景分割是融合了语义分割和实例分割的技术,对于 thing,识别出不同的实例个体以及对应的语义信息,对于 stuff,识别出对应的语义信息。 Panoptic DeepLab 首次以 bottem-up 和 single-shot 算法形式达到 state-of-the-art 性能,相比于 top-down 算法 Panoptic DeepLab 以简单的网络结构实现了精度、速度双超越,开创了全景分割算法新方向,目前 Cityscape 全景分割榜首即基于该算法。 PaddleSeg 全貌 全明星算法阵容 20+全面领先同类框架的高精度语义分割算法,50+预训练模型新增全景分割算法,丰富了应用场景。提供了高精度的人像分割算法 HumanSeg,满足多端部署。 全产业链部署 不仅全面支持动态图开发,可以顺畅的完成动静转化;还从数据预处理、算法训练调优、压缩、多端部署等全流程、各环节顺畅打通,极大程度地提升了用户开发的易用性,加速了算法产业应用落地的速度。尤其是通过 Paddle.js 支持在 web 端部署,赋予了网页端部署的更多可能性。 你还在等什么?!如此用心研发的高水准产品,还不赶紧 Star 收藏上车! 传送门: https://github.com/PaddlePaddle/PaddleSeg 点击进入第一时间了解新鲜技术资讯~~

优秀的个人博客,低调大师

App爬虫神器mitmproxy和mitmdump的使用

mitmproxy是一个支持HTTP和HTTPS的抓包程序,有类似Fiddler、Charles的功能,只不过它是一个控制台的形式操作。 mitmproxy还有两个关联组件。一个是mitmdump,它是mitmproxy的命令行接口,利用它我们可以对接Python脚本,用Python实现监听后的处理。另一个是mitmweb,它是一个Web程序,通过它我们可以清楚观察mitmproxy捕获的请求。 下面我们来了解它们的用法。 一、准备工作 请确保已经正确安装好了mitmproxy,并且手机和PC处于同一个局域网下,同时配置好了mitmproxy的CA证书。 二、mitmproxy的功能 mitmproxy有如下几项功能。 拦截HTTP和HTTPS请求和响应。 保存HTTP会话并进行分析。 模拟客户端发起请求,模拟服务端返回响应。 利用反向代理将流量转发

优秀的个人博客,低调大师

ECS运维神器 之 阿里云云助手

1. 什么是云助手? 阿里云云助手,简称云助手,是一个可以自动、批量执行日常维护任务的轻量便捷运维工具。 云助手所做的工作非常简单:通过对实例批量执行预设的 Bat/PowerShell/Shell 脚本或某些运维动作,来达到自动化管理云上ECS资源的目的。 2. 什么情景下需要云助手? 1) 示例场景1 需要维护多台不能访问互联网的ECS实例: 传统做法:需要一台可访问互联网的跳板机,通过该跳板机使用远程登录工具逐个登录到这些ECS实例中执行一些维护操作 云助手:只需要登录ECS控制台,准备您的维护脚本,即可对这些实例进行维护 2) 示例场景2 假设您有多台 ECS 实例运行着 Web 应用程序,这个时候出现下面2种情况: a) 需要升级应用程序的版本 b) 需要更改应用程序的配置文件 传统做法:如果您的应用程序不具备自升级或者自配置管理功能,您

优秀的个人博客,低调大师

iOS开发的另类神器:libimobiledevice开源包

简介 libimobiledevice又称libiphone,是一个开源包,可以让Linux支持连接iPhone/iPodTouch等iOS设备。由于苹果官方并不支持Linux系统,但是Linux上的高手绝对不能忍受因为要连接iOS设备就换用操作系统这个事儿。因此就有人逆向出iOS设备与Windows/MacHost接口的通讯协议,最终成就了横跨三大桌面平台的非官方版本USB接口library。经常用Linux系统的人一定对libimobiledevice不陌生,但是许多Windows和Mac用户也许就不知道了。事实上,它同iTools一样,都是可以替代iTunes,进行iOS设备管理的工具。因为源码是开放的,可以自行编译,所以对很多开发者而言可以说更为实用。 官方github地址:https://github.com/libimobiledevice/libimobiledevice 最后还有一点,作为一个前Android开发,习惯使用adb命令各种调试,转了iOS怎么能没有这种工具,而去使用iTunes和iTools呢?对此零容忍! 快速直接安装libmobiledevice的方法 在MacOS下安装可以使用brew,类似Ubuntu中的apt-get sudobrewupdate sudobrewinstalllibimobiledevice #libimobiledevice中并不包含ipa的安装命令,所以还需要安装 sudobrewinstallideviceinstaller Ubuntu下安装需要添加一个新的软件库,里面包含了libimobiledevice sudoadd-apt-repositoryppa:pmcenery/ppa sudoapt-getupdate apt-getinstalllibimobiledevice-utils sudoapt-getinstallideviceinstaller 常用功能 安装ipa包,卸载应用 //命令安装一个ipa文件到手机上,如果是企业签名的,非越狱机器也可以直接安装了。 ideviceinstaller-ixxx.ipa //命令卸载应用,需要知道此应用的bundleID ideviceinstaller-U[bundleID] 查看系统日志 idevicesyslog 查看当前已连接的设备的UUID idevice_id--list 截图 idevicescreenshot 查看设备信息 ideviceinfo 获取设备时间 idevicedate 设置代理(也好像是端口转发的工具,具体能利用它干啥还没试过) iproxy 挂载DeveloperDiskImage,用于调试 ideviceimagemounter 获取设备名称 idevicename 调试程序(需要预先挂载DeveloperImage) idevicedebug 查看和操作设备的描述文件 ideviceprovisionlist ideviceinstaller安装ipa报错(已经支持iOS11) "Couldnotconnecttolockdownd.Exiting." 出现这个问题一般是因为新版操作系统的通信协议可能有些微调,参考下面的stackoverflow的帖子,可以通过下面的命令尝试更新使用最新的libimobiledevice构建版本。 http://stackoverflow.com/questions/39035415/ideviceinstaller-fails-with-could-not-connect-to-lockdownd-exiting Thebestsolutionhereistogetthelatestlibimobiledevice,whichhasafixforthisparticularissue: brewuninstallideviceinstaller brewuninstalllibimobiledevice brewinstall--HEADlibimobiledevice brewlink--overwritelibimobiledevice brewinstallideviceinstaller brewlink--overwriteideviceinstaller 挂载文件系统工具:ifuse ifuse是一个依赖libimobiledevice库的工具,所以必须首先安装libimobiledevice 首先去https://osxfuse.github.io/下载fuseformacos的库。 然后github上clone下载ifuse最新源码到本地(自己决定放哪): //cd到要安装的目标路径,然后: gitclonehttps://github.com/libimobiledevice/ifuse.git 进入clone好的目录,执行: //将源码在本机编译: ./autogen.sh ./configure make //执行脚本ifuse到系统终端(其实也可以不用,直接去src中运行也可以) sudomakeinstall 挂载媒体文件目录: //注意,此处的挂载点必须要真实存在,需要预先创建好目录,否则挂载失败 ifuse[挂载点] 挂载某应用的documents目录 ifuse--documents[要挂载的应用的bundleID][挂载点] //注意,iOS8.3之后要求应用的UIFileSharingEnabled权限要开启,否则可能没有权限访问,会有如下的错误提示 ERROR:InstallationLookupFailed TheApp'com.wsgh.test'iseithernotpresentonthedevice,orthe'UIFileSharingEnabled'keyisnotsetinitsInfo.plist.StartingwithiOS8.3thiskeyismandatorytoallowaccesstoanapp'sDocumentsfolder. 挂载某应用的整个沙盒目录 ifuse--container[要挂载的应用的bundleID][挂载点] 获取bundleID ideviceinstaller-l 卸载挂载点 fusermount-u[挂载点] 如果是越狱的设备,并且配置好了,可以使用下面命令挂载整个iphone文件系统(暂时没试过,还没有开始研究越狱设备) ifuse--root[挂载点] 详细说明,可以进入ifuse的github主页查看原版文档 https://github.com/libimobiledevice/ifuse 作者:望山观海 链接:http://www.jianshu.com/p/6423610d3293 來源:简书 著作权归作者所有。商业转载请联系作者获得授权,非商业转载请注明出处。 作者:望山观海 链接:http://www.jianshu.com/p/6423610d3293 來源:简书 著作权归作者所有。商业转载请联系作者获得授权,非商业转载请注明出处。 本文转自 知止内明 51CTO博客,原文链接:http://blog.51cto.com/357712148/1982201,如需转载请自行联系原作者

优秀的个人博客,低调大师

Java多线程神器:join使用及原理

join() join()是线程类Thread的方法,官方的说明是: Waits for this thread to die. 等待这个线程结束,也就是说当前线程等待这个线程结束后再继续执行,下面来看这个示例就明白了。 示例 public static void main(String[] args) throws Exception { System.out.println("start"); Thread t = new Thread(() -> { for (int i = 0; i < 5; i++) { System.out.println(i); try { Thread.sleep(500); } catch (InterruptedException e) { e.printStackTrace(); } } }); t.start(); t.join(); System.out.println("end"); } 结果输出: start 0 1 2 3 4 end 线程t开始后,接着加入t.join()方法,t线程里面程序在主线程end输出之前全部执行完了,说明t.join()阻塞了主线程直到t线程执行完毕。 如果没有t.join(),end可能会在0~5之间输出。 join()原理 下面是join()的源码: public final synchronized void join(long millis) throws InterruptedException { long base = System.currentTimeMillis(); long now = 0; if (millis < 0) { throw new IllegalArgumentException("timeout value is negative"); } if (millis == 0) { while (isAlive()) { wait(0); } } else { while (isAlive()) { long delay = millis - now; if (delay <= 0) { break; } wait(delay); now = System.currentTimeMillis() - base; } } } 可以看出它是利用wait方法来实现的,上面的例子当main方法主线程调用线程t的时候,main方法获取到了t的对象锁,而t调用自身wait方法进行阻塞,只要当t结束或者到时间后才会退出,接着唤醒主线程继续执行。millis为主线程等待t线程最长执行多久,0为永久直到t线程执行结束。 推荐阅读 阿里高级Java面试题(首发,70道,带详细答案) 2017派卧底去阿里、京东、美团、滴滴带回来的面试题及答案 Spring面试题(70道,史上最全) 17张图揭密支付宝系统架构 阿里巴巴,排行前10的开源项目! 2018年必看:关于区块链技术的10本书 分享Java干货,高并发编程,热门技术教程,微服务及分布式技术,架构设计,区块链技术,人工智能,大数据,Java面试题,以及前沿热门资讯等。 扫我关注

优秀的个人博客,低调大师

【转】打造属于自己的Android Studio神器

本文转载自:http://www.stormzhang.com/android/2015/05/26/android-tools/,并加以修改。黄色底部分是本人添加的内容。 一晃好久没更新博客了,最近一个月真的很忙,因为公司在准备C轮融资,公司的发展到了一个关键的阶段,自己全部精力投入在公司产品上,这个状态可能还会持续一段时间,今天忙中抽闲来给大家分享下我们最近在项目中采用到的一些能帮助团队提升工作效率的几个Android Studio插件和工具。(可直接点击标题跳转到GitHub主页) 1、ButterKnife Zelezny ButterKnife 生成器,使用起来非常简单方便,不知道ButterKnife的赶紧去我的博客搜下 安装步骤:A、File-->Settings-->Plugins-->Browse repositories-->搜索“Butterknife Zelezny”,找到以后安装并重启;B、重启后在app/build.gradle中添加依赖“compile 'com.jakewharton:butterknife:7.0.0'”,此后才正式可用。 2、SelectorChapek 设计师给我们提供好了各种资源,每个按钮都要写一个selector是不是很麻烦?这么这个插件就为解决这个问题而生,你只需要做的是告诉设计师们按照规范命名就好了,其他一键搞定。 3、GsonFormat 现在大多数服务端api都以json数据格式返回,而客户端需要根据api接口生成相应的实体类,这个插件把这个过程自动化了,赶紧使用起来吧。 4、ParcelableGenerator Android中的序列化有两种方式,分别是实现Serializable接口和Parcelable接口,但在Android中是推荐使用Parcelable,只不过我们这种方式要比Serializable方式要繁琐,那么有了这个插件一切就ok了。 5、LeakCanary 良心企业Square最近刚开源的一个非常有用的工具,强烈推荐,帮助你在开发阶段方便的检测出内存泄露的问题,使用起来更简单方便,而且我们团队第一时间使用帮助我们发现了不少问题。 英文不好的这里有雷锋同志翻译的中文版LeakCanary 中文使用说明 本文转自秋楓博客园博客,原文链接:http://www.cnblogs.com/rwxwsblog/p/4924288.html,如需转载请自行联系原作者

优秀的个人博客,低调大师

阿里开源 Vivid-VR:AI 视频修复神器

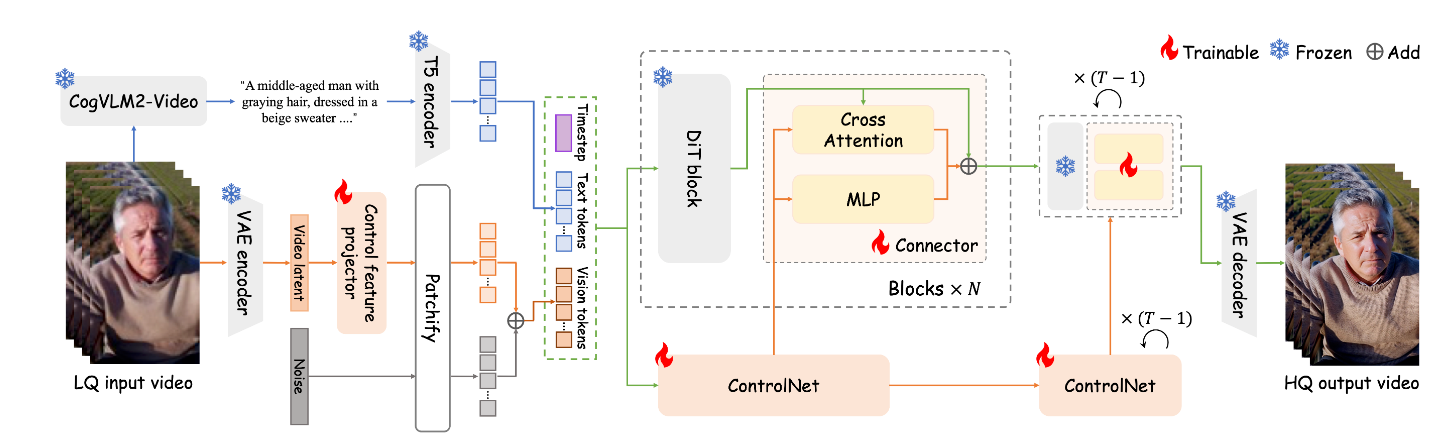
阿里云推出了一款名为 Vivid-VR 的开源生成式视频修复工具,基于先进的文本到视频(T2V)基础模型,结合ControlNet技术,确保视频生成过程中的内容一致性。 该工具能够有效修复真实视频或AIGC(AI生成内容)视频中的质量问题,消除闪烁、抖动等常见缺陷,为内容创作者提供了一个高效的素材补救方案。无论是对低质量视频的修复,还是对生成视频的优化,Vivid-VR都展现出了卓越的性能。 Vivid-VR的核心技术在于其结合了T2V基础模型与ControlNet的创新架构。T2V模型通过深度学习生成高质量视频内容,而ControlNet则通过精准的控制机制,确保修复后的视频在帧间保持高度的时间一致性,避免了常见的闪烁或抖动问题。 据悉,该工具在生成过程中能够动态调整语义特征,显著提升视频的纹理真实感和视觉生动性。这种技术组合不仅提高了修复效率,还为视频内容保持了更高的视觉稳定性。 Vivid-VR的另一大亮点是其广泛的适用性。无论是传统拍摄的真实视频,还是基于AI生成的内容,Vivid-VR都能提供高效的修复支持。 对于内容创作者而言,低质量素材常常是创作过程中的痛点,而Vivid-VR能够通过智能分析和增强,快速修复模糊、噪点或不连贯的视频片段,为短视频、影视后期制作等领域提供了实用工具。 此外,该工具支持多种输入格式,开发者可以根据需求灵活调整修复参数,进一步提升创作效率。

优秀的个人博客,低调大师

🔥 理解 Liquor :动态编译 Java 代码的神器

引言 Liquor 是一个开源的轻量级 Java 动态编译器(零依赖,24KB),它可以在运行时编译 Java 字符串代码片段、类、方法等。 源码地址:https://gitee.com/noear/liquor 编译特性: 可以单个类编译 可以多个类同时编译 可以增量编译 Liquor 的基本使用 需求:输入一个类定义的 java 字符串(内容逻辑为输出 Hello World ),然后使用 Liquor 去动态编译并执行。 首先,需要在项目中添加 Liquor 依赖,以 maven 为例: <dependency> <groupId>org.noear</groupId> <artifactId>liquor</artifactId> <version>1.1.1</version> </dependency> 接着可以写 Liquor 相关的代码了: public class DemoApp { public static void main(String[] args) throws Exception{ String className = "HelloWorld"; String classCode = "public class HelloWorld { " + " public static void helloWorld() { " + " System.out.println(\"Hello, world!\"); " + " } " + "}"; DynamicCompiler compiler = new DynamicCompiler(); //添加源码(可多个)并 构建 compiler.addSource(className, classCode).build(); Class<?> clazz = compiler.getClassLoader().loadClass(className); clazz.getMethod("helloWorld").invoke(null); } }

优秀的个人博客,低调大师

限速神器RateLimiter源码解析 | 京东云技术团队

作者:京东科技李玉亮 目录指引 限流场景 软件系统中一般有两种场景会用到限流: •场景一、高并发的用户端场景。 尤其是C端系统,经常面对海量用户请求,如不做限流,遇到瞬间高并发的场景,则可能压垮系统。 •场景二、内部交易处理场景。 如某类交易任务处理时有速率要求,再如上下游调用时下游对上游有速率要求。 •无论哪种场景,都需要对请求处理的速率进行限制,或者单个请求处理的速率相对固定,或者批量请求的处理速率相对固定,见下图: 常用的限流算法有如下几种: •算法一、信号量算法。 维护最大的并发请求数(如连接数),当并发请求数达到阈值时报错或等待,如线程池。 •算法二、漏桶算法。 模拟一个按固定速率漏出的桶,当流入的请求量大于桶的容量时溢出。 •算法三、令牌桶算法。 以固定速率向桶内发放令牌。请求处理时,先从桶里获取令牌,只服务有令牌的请求。 本次要介绍的RateLimiter使用的是令牌桶算法。RateLimiter是google的guava包中的一个轻巧限流组件,它主要有两个java类文件,RateLimiter.java和SmoothRateLimiter.java。两个类文件共有java代码301行、注释420行,注释比java代码还要多,写的非常详细,后面的介绍也有相关内容是翻译自其注释,有些描述英文原版更加准确清晰,有兴趣的也可以结合原版注释进行更详细的了解。 使用介绍 RateLimiter使用时只需引入guava jar便可,最新的版本是31.1-jre, 本文介绍的源码也是此版本。 <dependency> <groupId>com.google.guava</groupId> <artifactId>guava</artifactId> <version>31.1-jre</version> </dependency> 源码中提供了两个直观的使用示例。 示例一、有一系列任务列表要提交执行,控制提交速率不超过每秒2个。 final RateLimiter rateLimiter = RateLimiter.create(2.0); // 创建一个每秒2个许可的RateLimiter对象. void submitTasks(List<Runnable> tasks, Executor executor) { for (Runnable task : tasks) { rateLimiter.acquire(); // 此处可能有等待 executor.execute(task); } } 示例二、以不超过5kb/s的速率产生数据流。 final RateLimiter rateLimiter = RateLimiter.create(5000.0); // 创建一个每秒5k个许可的RateLimiter对象 void submitPacket(byte[] packet) { rateLimiter.acquire(packet.length); networkService.send(packet); } 可以看出RateLimiter的使用非常简单,只需要构造限速器,调用获取许可方法便可,不需要释放许可. 算法介绍 在介绍之前,先说一下RateLimiter中的几个名词: •许可( permit ): 代表一个令牌,获取到许可的请求才能放行。 •资源利用不足( underunilization ): 许可的发放一般是匀速的,但请求未必是匀速的,有时会有无请求(资源利用不足)的场景,令牌桶会有贮存机制。 •贮存许可( storedPermit ): 令牌桶支持对空闲资源进行许可贮存,许可请求时优先使用贮存许可。 •新鲜许可( freshPermit ): 当贮存许可为空时,采用透支方式,下发新鲜许可,同时设置下次许可生效时间为本次新鲜许可的结束时间。 •如下为一个许可发放示例,矩形代表整个令牌桶,许可产生速度为1个/秒,令牌桶里有一个贮存桶,容量为2。 以上示例中,在T1贮存容量为0,许可请求时直接返回1个新鲜许可,贮存容量随着时间推移,增长至最大值2,在T2时收到3个许可的请求,此时会先从贮存桶中取出2个,然后再产生1个新鲜许可,0.5s后在T3时刻又来了1个许可请求,由于最近的许可0.5s后才会下发,因此先sleep0.5s再下发。 RateLimiter的核心功能是限速,我们首先想到的限速方案是记住最后一次下发令牌许可(permit)时间,下次许可请求时,如果与最后一次下发许可时间的间隔小于1/QPS,则进行sleep至1/QPS,否则直接发放,但该方法不能感知到资源利用不足的场景。一方面,隔了很长一段再来请求许可,则可能系统此时相对空闲,可下发更多的许可以充分利用资源;另一方面,隔了很长一段时间再来请求许可,也可能意味着处理请求的资源变冷(如缓存失效),处理效率会下降。因此在RateLimiter中,增加了资源利用不足(underutilization)的管理,在代码中体现为贮存许可(storedPermits),贮存许可值最开始为0,随着时间的增加,一直增长为最大贮存许可数。许可获取时,首先从贮存许可中获取,然后再根据下次新鲜许可获取时间来进行新鲜许可获取。这里要说的是RateLimiter是记住了下次令牌发放的时间,类似于透支的功能,当前许可获取时立刻返回,同时记录下次获取许可的时间。 代码结构和主体流程 代码结构 整体类图如下: RateLimiter类 RateLimiter类是顶级类,也是唯一暴露给使用者的类,它提供了工厂方法来创建RateLimiter方法。 create(double permitsPerSecond) 方法创建的是突发限速器,create(double permitsPerSecond, Duration warmupPeriod)方法创建的是预热限速器。同时它提供了acquire方法用于获取令牌,提供了tryAcquire方法用于尝试获取令牌。该类的内部实现上,一方面有一个SleepingStopWatch 用于sleep操作,另一方面有一个mutexDoNotUseDirectly变量和mutex()方法进行互斥加锁。 SmoothRateLimiter类 该类继承了RateLimiter类,是一个抽象类,含义为平滑限速器,限制速率是平滑的,maxPermits和storedPermits维护了最大存储许可数量和当前存储许可数量;stableIntervalMicros指规定的稳定许可发放间隔,nextFreeTicketMicros指下一个空闲许可时间。 SmoothBursty类 平滑突发限速器,该类继承了SmoothRateLimiter,它存储许可的发放频率同设置的stableIntervalMicros,有一个成员变量maxBurstSeconds,代表最多存储多长时间的令牌许可。 SmoothWarmingUp类 平滑预热限速器,继承了SmoothRateLimiter,与SmoothBursty平级,它的预热算法需要一定的理解成本。 主体流程 获取许可的主体流程如下: 主体流程主要是对贮存许可数量和新鲜许可数量进行计算和更新,得到当前许可请求的等待时间。SmoothBursty算法和SmoothWarmingUp算法共用这一套主体流程,差异主要是贮存许可的管理策略,两种算法的不同策略在两个子类中各自实现,SmoothBursty算法相对简单一些,下面先介绍该算法,然后再介绍SmoothWarmingUp算法。 SmoothBursty算法 限速器创建 采用的是工厂模式创建,源码如下: public static RateLimiter create(double permitsPerSecond) { // permitsPerSecond指每秒允许的许可数. 该方法调用了下面的方法 return create(permitsPerSecond, SleepingStopwatch.createFromSystemTimer()); } // 创建SmoothBursty(固定贮存1s的贮存许可), 然后设置速率 static RateLimiter create(double permitsPerSecond, SleepingStopwatch stopwatch) { RateLimiter rateLimiter = new SmoothBursty(stopwatch, 1.0 /* maxBurstSeconds */); rateLimiter.setRate(permitsPerSecond); return rateLimiter; } 1、SmoothBursty的构造方法相对简单: SmoothBursty(SleepingStopwatch stopwatch, double maxBurstSeconds) { super(stopwatch); this.maxBurstSeconds = maxBurstSeconds; } 2、rateLimiter.setRate的定义在父类RateLimiter中 public final void setRate(double permitsPerSecond) { checkArgument( permitsPerSecond > 0.0 && !Double.isNaN(permitsPerSecond), "rate must be positive"); synchronized (mutex()) { doSetRate(permitsPerSecond, stopwatch.readMicros()); } } 该方法使用synchronized(mutex())方法对互斥锁进行同步,以保证多线程调用的安全,然后调用子类的doSetRate方法。 第二个参数nowMicros传的值是调用了stopwatch的方法,将限速器创建的时间定义为0,然后计算了当前时间和创建时间的时间差,因此采用的是相对时间。 2.1 mutex方法的实现如下: // Can't be initialized in the constructor because mocks don't call the constructor. // 从上行注释可看出,这是因为mock才用了懒加载, 实际上即时加载代码更简洁 @CheckForNull private volatile Object mutexDoNotUseDirectly; // 双重检查锁的懒加载模式 private Object mutex() { Object mutex = mutexDoNotUseDirectly; if (mutex == null) { synchronized (this) { mutex = mutexDoNotUseDirectly; if (mutex == null) { mutexDoNotUseDirectly = mutex = new Object(); } } } return mutex; } 该方法使用了双重检查锁来对锁对象mutexDoNotUseDirectly进行懒加载,另外该方法通过mutex临时变量来解决了双重检查锁失效的问题。 2.2 doSetRate方法的主体实现在SmoothRateLimiter类中: final void doSetRate(double permitsPerSecond, long nowMicros) { // 同步贮存许可和时间 resync(nowMicros); double stableIntervalMicros = SECONDS.toMicros(1L) / permitsPerSecond; this.stableIntervalMicros = stableIntervalMicros; doSetRate(permitsPerSecond, stableIntervalMicros); } 该方法在限速器创建时会调用,创建后调用限速器的setRate重置速率时也会调用。 2.2.1 resync方法用于基于当前时间刷新计算最新的storedPermis和nextFreeTicketMicros. /** Updates {@code storedPermits} and {@code nextFreeTicketMicros} based on the current time. */ void resync(long nowMicros) { // if nextFreeTicket is in the past, resync to now if (nowMicros > nextFreeTicketMicros) { double newPermits = (nowMicros - nextFreeTicketMicros) / coolDownIntervalMicros(); storedPermits = min(maxPermits, storedPermits + newPermits); nextFreeTicketMicros = nowMicros; } } 该方法从现实场景上讲,代表的是随着时间的流逝,贮存许可不断增加,但从技术实现的角度,并不是真正的持续刷新,而是仅在需要时调用刷新。该方法如果当前时间小于等于下次许可时间,则贮存许可数量和下次许可时间不需要刷新;否则通过 (当前时间-下次许可时间)/贮存许可的发放间隔计算出的值域最大贮存数量取小,则为已贮存的许可数量,需要注意的是贮存许可数量是double类型的。 限速器使用 限速器常用的方法主要有accquire和tryAccquire。 先说一下accquire方法, 共有两个共有方法,一个是无参的,每次获取1个许可,再一个是整数参数的,每次调用获取多个许可。 // 获取1个许可 public double acquire() { return acquire(1); } // 获取多个许可 public double acquire(int permits) { // 留出permits个许可,得到需要sleep的微秒数. long microsToWait = reserve(permits); // 该方法如果小于等于零则直接返回,否则sleep stopwatch.sleepMicrosUninterruptibly(microsToWait); // 返回休眠的秒数. return 1.0 * microsToWait / SECONDS.toMicros(1L); } 从以上源码可看出,获取许可的逻辑很简单:留出permits个许可,根据返回值决定是否sleep等待。留出许可的方法实现如下: // 预留出permits个许可 final long reserve(int permits) { checkPermits(permits); synchronized (mutex()) { return reserveAndGetWaitLength(permits, stopwatch.readMicros()); } } // 预留出permits个需求,得到需要等待的时间 final long reserveAndGetWaitLength(int permits, long nowMicros) { long momentAvailable = reserveEarliestAvailable(permits, nowMicros); return max(momentAvailable - nowMicros, 0); } abstract long reserveEarliestAvailable(int permits, long nowMicros); reserveEarliestAvailable为抽象方法,实现在SmoothRateLimiter类中,该方法是核心主链路方法,该方法先从贮存许可中获取,如果数量足够则直接返回,否则先将全部贮存许可取出,再计算还需要的等待时间,逻辑如下: final long reserveEarliestAvailable(int requiredPermits, long nowMicros) { // 刷新贮存许可和下个令牌时间 resync(nowMicros); // 返回值为当前的下次空闲时间 long returnValue = nextFreeTicketMicros; // 要消耗的贮存数量为需要的贮存数量 double storedPermitsToSpend = min(requiredPermits, this.storedPermits); // 新鲜许可数=需要的许可数-使用的贮存许可 double freshPermits = requiredPermits - storedPermitsToSpend; // 等待时间=贮存许可等待时间(实现方决定)+新鲜许可等待时间(数量*固定速率) long waitMicros = storedPermitsToWaitTime(this.storedPermits, storedPermitsToSpend) + (long) (freshPermits * stableIntervalMicros); // 透支后的下次许可可用时间=当前时间(nextFreeTicketMicros)+等待时间(waitMicros) this.nextFreeTicketMicros = LongMath.saturatedAdd(nextFreeTicketMicros, waitMicros); // 贮存许可数量减少 this.storedPermits -= storedPermitsToSpend; return returnValue; } 该方法有两点说明:1、returnValue为之前计算的下次空闲时间(前面有说RateLimiter采用预支的模式,本次直接返回,同时计算下次的最早空闲时间) 2、贮存许可的等待时间不同的实现方逻辑不同,SmoothBursty算法认为贮存许可直接可用,所以返回0, 后面的SmoothWarmingUp算法认为贮存许可需要消耗比正常速率更多的预热时间,有一定算法逻辑. 至此整个accquire方法的调用链路分析结束,下面再看tryAccquire方法就比较简单了,tryAccquire比accquire差异的逻辑在于tryAccquire方法会判断下次许可时间-当前时间是否大于超时时间,如果是则直接返回false,否则进行sleep并返回true. 方法源码如下: public boolean tryAcquire(Duration timeout) { return tryAcquire(1, toNanosSaturated(timeout), TimeUnit.NANOSECONDS); } public boolean tryAcquire(long timeout, TimeUnit unit) { return tryAcquire(1, timeout, unit); } public boolean tryAcquire(int permits) { return tryAcquire(permits, 0, MICROSECONDS); } public boolean tryAcquire() { return tryAcquire(1, 0, MICROSECONDS); } public boolean tryAcquire(int permits, Duration timeout) { return tryAcquire(permits, toNanosSaturated(timeout), TimeUnit.NANOSECONDS); } public boolean tryAcquire(int permits, long timeout, TimeUnit unit) { long timeoutMicros = max(unit.toMicros(timeout), 0); checkPermits(permits); long microsToWait; synchronized (mutex()) { long nowMicros = stopwatch.readMicros(); // 判断超时微秒数是否可等到下个许可时间 if (!canAcquire(nowMicros, timeoutMicros)) { return false; } else { microsToWait = reserveAndGetWaitLength(permits, nowMicros); } } // 休眠等待 stopwatch.sleepMicrosUninterruptibly(microsToWait); return true; } // 下次许可时间-超时时间<=当前时间 private boolean canAcquire(long nowMicros, long timeoutMicros) { return queryEarliestAvailable(nowMicros) - timeoutMicros <= nowMicros; } SmoothWarmingUp算法 SmoothWarmingUp算法的主体处理流程同SmoothBurstry算法,主要在贮存许可时间计算上的两个方法进行了新实现,该算法不像SmoothBurstry算法那么直观好理解,需要先了解算法逻辑,再看源码。 算法说明 该算法在源码注释中已经描述的比较清晰了,主要思想是限流器的初始贮存许可数量便是最大贮存许可值, 贮存许可执行时按一定算法由慢到快的产生,直至设定的固定速率,以此来达到预热过程。该算法涉及到一些数学知识,如果不是很感兴趣,则了解其主要思想便可。下面详细说一下该算法。 说到该算法前,我们再回头看一下SmoothRateLimiter的贮存许可,贮存许可有当前数量和最大数量,另外还有两个算法逻辑,一个是贮存许可生产的速率控制,再一个是贮存许可消费速率的控制,在Bursty算法中,生产的速率同设定的固定速率,而消费的速率为无穷大(立刻消费,不占用时间);在WarmingUp算法中,需对照下图进行分析: 该图可这样理解,每个贮存许可的消费耗时为右侧梯形面积,梯形面积=(上边长+下边长)/2 * 高. 可以看到每个贮存许可的面积越来越小,直到固定速率的长方形面积。 在限速器初始化时,输入的变量有固定速率和预热时间,另外冷却因子是固定值3;在作者算法中,首先计算的是阈值许可数 = 0.5 * 预热周期 / 固定速率. 然后计算的是最大许可数,我们知道了梯形的面积、上边(大速率)、下边(小速率),便能推到出高,最大许可=阀值许可数 + 高。 void doSetRate(double permitsPerSecond, double stableIntervalMicros) { double oldMaxPermits = maxPermits; double coldIntervalMicros = stableIntervalMicros * coldFactor; thresholdPermits = 0.5 * warmupPeriodMicros / stableIntervalMicros; maxPermits = thresholdPermits + 2.0 * warmupPeriodMicros / (stableIntervalMicros + coldIntervalMicros); slope = (coldIntervalMicros - stableIntervalMicros) / (maxPermits - thresholdPermits); if (oldMaxPermits == Double.POSITIVE_INFINITY) { // if we don't special-case this, we would get storedPermits == NaN, below storedPermits = 0.0; } else { storedPermits = (oldMaxPermits == 0.0) ? maxPermits // initial state is cold : storedPermits * maxPermits / oldMaxPermits; } } 在具体使用中,一个是生产的速率,固定为预热时间/最大许可数,源码如下: double coolDownIntervalMicros() { return warmupPeriodMicros / maxPermits; } 再一个是消费的速率,按如上曲线从右至左的面积=梯形面积+长方形面积,梯形面积=(上边+下边) /2 * 高 ,源码如下: long storedPermitsToWaitTime(double storedPermits, double permitsToTake) { double availablePermitsAboveThreshold = storedPermits - thresholdPermits; long micros = 0; // measuring the integral on the right part of the function (the climbing line) if (availablePermitsAboveThreshold > 0.0) { double permitsAboveThresholdToTake = min(availablePermitsAboveThreshold, permitsToTake); // TODO(cpovirk): Figure out a good name for this variable. double length = permitsToTime(availablePermitsAboveThreshold) + permitsToTime(availablePermitsAboveThreshold - permitsAboveThresholdToTake); micros = (long) (permitsAboveThresholdToTake * length / 2.0); permitsToTake -= permitsAboveThresholdToTake; } // measuring the integral on the left part of the function (the horizontal line) micros += (long) (stableIntervalMicros * permitsToTake); return micros; } 源码分析 了解了以上算法后,再看下面的源码就相对简单了。 static final class SmoothWarmingUp extends SmoothRateLimiter { // 预热时间 private final long warmupPeriodMicros; //斜率 private double slope; //阈值许可 private double thresholdPermits; //冷却因子 private double coldFactor; SmoothWarmingUp( SleepingStopwatch stopwatch, long warmupPeriod, TimeUnit timeUnit, double coldFactor) { super(stopwatch); this.warmupPeriodMicros = timeUnit.toMicros(warmupPeriod); this.coldFactor = coldFactor; } // 参数初始化 @Override void doSetRate(double permitsPerSecond, double stableIntervalMicros) { double oldMaxPermits = maxPermits; double coldIntervalMicros = stableIntervalMicros * coldFactor; thresholdPermits = 0.5 * warmupPeriodMicros / stableIntervalMicros; maxPermits = thresholdPermits + 2.0 * warmupPeriodMicros / (stableIntervalMicros + coldIntervalMicros); slope = (coldIntervalMicros - stableIntervalMicros) / (maxPermits - thresholdPermits); if (oldMaxPermits == Double.POSITIVE_INFINITY) { // if we don't special-case this, we would get storedPermits == NaN, below storedPermits = 0.0; } else { storedPermits = (oldMaxPermits == 0.0) ? maxPermits // initial state is cold : storedPermits * maxPermits / oldMaxPermits; } } // 有storedPermits个贮存许可,要使用permitsToTake个时的等待时间计算 @Override long storedPermitsToWaitTime(double storedPermits, double permitsToTake) { double availablePermitsAboveThreshold = storedPermits - thresholdPermits; long micros = 0; // measuring the integral on the right part of the function (the climbing line) if (availablePermitsAboveThreshold > 0.0) { double permitsAboveThresholdToTake = min(availablePermitsAboveThreshold, permitsToTake); // TODO(cpovirk): Figure out a good name for this variable. double length = permitsToTime(availablePermitsAboveThreshold) + permitsToTime(availablePermitsAboveThreshold - permitsAboveThresholdToTake); micros = (long) (permitsAboveThresholdToTake * length / 2.0); permitsToTake -= permitsAboveThresholdToTake; } // measuring the integral on the left part of the function (the horizontal line) micros += (long) (stableIntervalMicros * permitsToTake); return micros; } // 许可耗时=固定速率+许可值*斜率 private double permitsToTime(double permits) { return stableIntervalMicros + permits * slope; } // 冷却间隔固定为预热时间/最大许可数. @Override double coolDownIntervalMicros() { return warmupPeriodMicros / maxPermits; } } 思考总结 sleep说明和相对时间 RateLimiter内部使用类StopWatch进行了一个相对时间的度量,RateLimiter创建时,时间为0,然后向后累计,sleep时不受interrupt异常影响。 double浮点数 RateLimiter暴露的API的许可数量入参为整数类型,但内部计算时实际是浮点double类型,支持小数许可数量,一方面浮点存在丢失精度,另一方面也不便于理解;是否可以使用整数值得考虑。 只支持单机 RateLimiter的这几种算法只支持单机限流,如要支持集群限流,一种方式是先根据负载均衡的权重计算出单机的限速值,再进行单节点限速;另一种方式是参考该组件使用redis等中心化数量管理的中间件,但性能和稳定性会降低一些。 扩展性 RateLimiter提供了有限的扩展能力,自带的SmoothBursty和SmoothWarmingUp类不是公开类,不能直接创建或调整参数,如关闭贮存功能或调整预热系数等。这种场景需要继承SmoothRateLimiter进行重写,贮存许可的生产和消费算法是容易变化和重写的点,将整个源码拷贝出来进行二次修改也是一种方案。

优秀的个人博客,低调大师

☕【Java技术指南】教你如何使用异步神器CompletableFuture

前提概要 在java8以前,我们使用java的多线程编程,一般是通过Runnable中的run方法来完成,这种方式,有个很明显的缺点,就是,没有返回值。这时候,大家可能会去尝试使用Callable中的call方法,然后用Future返回结果,如下: public static void main(String[] args) throws Exception { ExecutorService executor = Executors.newSingleThreadExecutor(); Future<String> stringFuture = executor.submit(new Callable<String>() { @Override public String call() throws Exception { Thread.sleep(2000); return "async thread"; } }); Thread.sleep(1000); System.out.println("main thread"); System.out.println(stringFuture.get()); } 通过观察控制台,我们发现先打印 main thread ,一秒后打印 async thread,似乎能满足我们的需求。但仔细想我们发现一个问题,当调用future的get()方法时,当前主线程是堵塞的,这好像并不是我们想看到的。 另一种获取返回结果的方式是先轮询,可以调用isDone,等完成再获取,但这也不能让我们满意. 很多个异步线程执行时间可能不一致,我的主线程业务不能一直等着,这时候我可能会想要只等最快的线程执行完或者最重要的那个任务执行完,亦或者我只等1秒钟,至于没返回结果的线程我就用默认值代替. 我两个异步任务之间执行独立,但是第二个依赖第一个的执行结果. java8的CompletableFuture,就在这混乱且不完美的多线程江湖中闪亮登场了.CompletableFuture让Future的功能和使用场景得到极大的完善和扩展,提供了函数式编程能力,使代码更加美观优雅,而且可以通过回调的方式计算处理结果,对异常处理也有了更好的处理手段. CompletableFuture源码中有四个静态方法用来执行异步任务: 创建任务 public static <U> CompletableFuture<U> supplyAsync(Supplier<U> supplier){..} public static <U> CompletableFuture<U> supplyAsync(Supplier<U> supplier,Executor executor){..} public static CompletableFuture<Void> runAsync(Runnable runnable){..} public static CompletableFuture<Void> runAsync(Runnable runnable,Executor executor){..} 如果有多线程的基础知识,我们很容易看出,run开头的两个方法,用于执行没有返回值的任务,因为它的入参是Runnable对象。 而supply开头的方法显然是执行有返回值的任务了,至于方法的入参,如果没有传入Executor对象将会使用ForkJoinPool.commonPool() 作为它的线程池执行异步代码.在实际使用中,一般我们使用自己创建的线程池对象来作为参数传入使用,这样速度会快些. 执行异步任务的方式也很简单,只需要使用上述方法就可以了: CompletableFuture<String> future = CompletableFuture.supplyAsync(() -> { //....执行任务 return "hello"; }, executor) 接下来看一下获取执行结果的几个方法。 V get(); V get(long timeout,Timeout unit); T getNow(T defaultValue); T join(); 上面两个方法是Future中的实现方式,get()会堵塞当前的线程,这就造成了一个问题,如果执行线程迟迟没有返回数据,get()会一直等待下去,因此,第二个get()方法可以设置等待的时间. getNow()方法比较有意思,表示当有了返回结果时会返回结果,如果异步线程抛了异常会返回自己设置的默认值. 接下来以一些场景的实例来介绍一下CompletableFuture中其他一些常用的方法 thenAccept() public CompletionStage<Void> thenAccept(Consumer<? super T> action); public CompletionStage<Void> thenAcceptAsync(Consumer<? super T> action); public CompletionStage<Void> thenAcceptAsync(Consumer<? super T> action,Executor executor); 功能:当前任务正常完成以后执行,当前任务的执行结果可以作为下一任务的输入参数,无返回值. 场景:执行任务A,同时异步执行任务B,待任务B正常返回后,B的返回值执行任务C,任务C无返回值 CompletableFuture<String> futureA = CompletableFuture.supplyAsync(() -> "任务A"); CompletableFuture<String> futureB = CompletableFuture.supplyAsync(() -> "任务B"); CompletableFuture<String> futureC = futureB.thenApply(b -> { System.out.println("执行任务C."); System.out.println("参数:" + b);//参数:任务B return "a"; }); thenRun(..) public CompletionStage<Void> thenRun(Runnable action); public CompletionStage<Void> thenRunAsync(Runnable action); public CompletionStage<Void> thenRunAsync(Runnable action,Executor executor); 功能:对不关心上一步的计算结果,执行下一个操作 场景:执行任务A,任务A执行完以后,执行任务B,任务B不接受任务A的返回值(不管A有没有返回值),也无返回值 CompletableFuture<String> futureA = CompletableFuture.supplyAsync(() -> "任务A"); futureA.thenRun(() -> System.out.println("执行任务B")); thenApply(..) public <U> CompletableFuture<U> thenApply(Function<? super T,? extends U> fn) public <U> CompletableFuture<U> thenApplyAsync(Function<? super T,? extends U> fn) public <U> CompletableFuture<U> thenApplyAsync(Function<? super T,? extends U> fn, Executor executor) 功能:当前任务正常完成以后执行,当前任务的执行的结果会作为下一任务的输入参数,有返回值 场景:多个任务串联执行,下一个任务的执行依赖上一个任务的结果,每个任务都有输入和输出 异步执行任务A,当任务A完成时使用A的返回结果resultA作为入参进行任务B的处理,可实现任意多个任务的串联执行 CompletableFuture<String> futureA = CompletableFuture.supplyAsync(() -> "hello"); CompletableFuture<String> futureB = futureA.thenApply(s->s + " world"); CompletableFuture<String> future3 = futureB.thenApply(String::toUpperCase); System.out.println(future3.join()); 上面的代码,我们当然可以先调用future.join()先得到任务A的返回值,然后再拿返回值做入参去执行任务B,而thenApply的存在就在于帮我简化了这一步,我们不必因为等待一个计算完成而一直阻塞着调用线程,而是告诉CompletableFuture你啥时候执行完就啥时候进行下一步. 就把多个任务串联起来了. thenCombine(..) thenAcceptBoth(..) runAfterBoth(..) public <U,V> CompletableFuture<V> thenCombine(CompletionStage<? extends U> other, BiFunction<? super T,? super U,? extends V> fn) public <U,V> CompletableFuture<V> thenCombineAsync(CompletionStage<? extends U> other, BiFunction<? super T,? super U,? extends V> fn) public <U,V> CompletableFuture<V> thenCombineAsync(CompletionStage<? extends U> other, BiFunction<? super T,? super U,? extends V> fn, Executor executor) 功能:结合两个CompletionStage的结果,进行转化后返回 场景:需要根据商品id查询商品的当前价格,分两步,查询商品的原始价格和折扣,这两个查询相互独立,当都查出来的时候用原始价格乘折扣,算出当前价格. 使用方法:thenCombine(..) CompletableFuture<Double> futurePrice = CompletableFuture.supplyAsync(() -> 100d); CompletableFuture<Double> futureDiscount = CompletableFuture.supplyAsync(() -> 0.8); CompletableFuture<Double> futureResult = futurePrice.thenCombine(futureDiscount, (price, discount) -> price * discount); System.out.println("最终价格为:" + futureResult.join()); //最终价格为:80.0 thenCombine(..)是结合两个任务的返回值进行转化后再返回,那如果不需要返回呢,那就需要 thenAcceptBoth(..),同理,如果连两个任务的返回值也不关心呢,那就需要runAfterBoth了,如果理解了上面三个方法,thenApply,thenAccept,thenRun,这里就不需要单独再提这两个方法了,只在这里提一下. thenCompose(..) public <U> CompletableFuture<U> thenCompose(Function<? super T,? extends CompletionStage<U>> fn) public <U> CompletableFuture<U> thenComposeAsync(Function<? super T,? extends CompletionStage<U>> fn) public <U> CompletableFuture<U> thenComposeAsync(Function<? super T,? extends CompletionStage<U>> fn, Executor executor) 功能:这个方法接收的输入是当前的CompletableFuture的计算值,返回结果将是一个新的CompletableFuture 这个方法和thenApply非常像,都是接受上一个任务的结果作为入参,执行自己的操作,然后返回.那具体有什么区别呢? thenApply():它的功能相当于将CompletableFuture<T>转换成CompletableFuture<U>,改变的是同一个CompletableFuture中的泛型类型 thenCompose():用来连接两个CompletableFuture,返回值是一个新的CompletableFuture CompletableFuture<String> futureA = CompletableFuture.supplyAsync(() -> "hello"); CompletableFuture<String> futureB = futureA.thenCompose(s -> CompletableFuture.supplyAsync(() -> s + "world")); CompletableFuture<String> future3 = futureB.thenCompose(s -> CompletableFuture.supplyAsync(s::toUpperCase)); System.out.println(future3.join()); applyToEither(..) acceptEither(..) runAfterEither(..) public <U> CompletionStage<U> applyToEither(CompletionStage<? extends T> other,Function<? super T, U> fn); public <U> CompletionStage<U> applyToEitherAsync(CompletionStage<? extends T> other,Function<? super T, U> fn); public <U> CompletionStage<U> applyToEitherAsync(CompletionStage<? extends T> other,Function<? super T, U> fn,Executor executor); 功能:执行两个CompletionStage的结果,那个先执行完了,就是用哪个的返回值进行下一步操作 场景:假设查询商品a,有两种方式,A和B,但是A和B的执行速度不一样,我们希望哪个先返回就用那个的返回值. CompletableFuture<String> futureA = CompletableFuture.supplyAsync(() -> { try { Thread.sleep(1000); } catch (InterruptedException e) { e.printStackTrace(); } return "通过方式A获取商品a"; }); CompletableFuture<String> futureB = CompletableFuture.supplyAsync(() -> { try { Thread.sleep(2000); } catch (InterruptedException e) { e.printStackTrace(); } return "通过方式B获取商品a"; }); CompletableFuture<String> futureC = futureA.applyToEither(futureB, product -> "结果:" + product); System.out.println(futureC.join()); //结果:通过方式A获取商品a 同样的道理,applyToEither的兄弟方法还有acceptEither(),runAfterEither(),我想不需要我解释你也知道该怎么用了. exceptionally(..) public CompletionStage<T> exceptionally(Function<Throwable, ? extends T> fn); 功能:当运行出现异常时,调用该方法可进行一些补偿操作,如设置默认值. 场景:异步执行任务A获取结果,如果任务A执行过程中抛出异常,则使用默认值100返回. CompletableFuture<String> futureA = CompletableFuture. supplyAsync(() -> "执行结果:" + (100 / 0)) .thenApply(s -> "futureA result:" + s) .exceptionally(e -> { System.out.println(e.getMessage()); //java.lang.ArithmeticException: / by zero return "futureA result: 100"; }); CompletableFuture<String> futureB = CompletableFuture. supplyAsync(() -> "执行结果:" + 50) .thenApply(s -> "futureB result:" + s) .exceptionally(e -> "futureB result: 100"); System.out.println(futureA.join());//futureA result: 100 System.out.println(futureB.join());//futureB result:执行结果:50 上面代码展示了正常流程和出现异常的情况,可以理解成catch,根据返回值可以体会下. whenComplete(..) public CompletionStage<T> whenComplete(BiConsumer<? super T, ? super Throwable> action); public CompletionStage<T> whenCompleteAsync(BiConsumer<? super T, ? super Throwable> action); public CompletionStage<T> whenCompleteAsync(BiConsumer<? super T, ? super Throwable> action,Executor executor); 功能:当CompletableFuture的计算结果完成,或者抛出异常的时候,都可以进入whenComplete方法执行,举个栗子 CompletableFuture<String> futureA = CompletableFuture. supplyAsync(() -> "执行结果:" + (100 / 0)) .thenApply(s -> "apply result:" + s) .whenComplete((s, e) -> { if (s != null) { System.out.println(s);//未执行 } if (e == null) { System.out.println(s);//未执行 } else { System.out.println(e.getMessage());//java.lang.ArithmeticException: / by zero } }) .exceptionally(e -> { System.out.println("ex"+e.getMessage()); //ex:java.lang.ArithmeticException: / by zero return "futureA result: 100"; }); System.out.println(futureA.join());//futureA result: 100 根据控制台,我们可以看出执行流程是这样,supplyAsync->whenComplete->exceptionally,可以看出并没有进入thenApply执行,原因也显而易见,在supplyAsync中出现了异常,thenApply只有当正常返回时才会去执行.而whenComplete不管是否正常执行,还要注意一点,whenComplete是没有返回值的. 上面代码我们使用了函数式的编程风格并且先调用whenComplete再调用exceptionally,如果我们先调用exceptionally,再调用whenComplete会发生什么呢,我们看一下: 复制代码 CompletableFuture<String> futureA = CompletableFuture. supplyAsync(() -> "执行结果:" + (100 / 0)) .thenApply(s -> "apply result:" + s) .exceptionally(e -> { System.out.println("ex:"+e.getMessage()); //ex:java.lang.ArithmeticException: / by zero return "futureA result: 100"; }) .whenComplete((s, e) -> { if (e == null) { System.out.println(s);//futureA result: 100 } else { System.out.println(e.getMessage());//未执行 } }) ; System.out.println(futureA.join());//futureA result: 100 代码先执行了exceptionally后执行whenComplete,可以发现,由于在exceptionally中对异常进行了处理,并返回了默认值,whenComplete中接收到的结果是一个正常的结果,被exceptionally美化过的结果,这一点需要留意一下. handle(..) public <U> CompletionStage<U> handle(BiFunction<? super T, Throwable, ? extends U> fn); public <U> CompletionStage<U> handleAsync(BiFunction<? super T, Throwable, ? extends U> fn); public <U> CompletionStage<U> handleAsync(BiFunction<? super T, Throwable, ? extends U> fn,Executor executor); 功能:当CompletableFuture的计算结果完成,或者抛出异常的时候,可以通过handle方法对结果进行处理 CompletableFuture<String> futureA = CompletableFuture. supplyAsync(() -> "执行结果:" + (100 / 0)) .thenApply(s -> "apply result:" + s) .exceptionally(e -> { System.out.println("ex:" + e.getMessage()); //java.lang.ArithmeticException: / by zero return "futureA result: 100"; }) .handle((s, e) -> { if (e == null) { System.out.println(s);//futureA result: 100 } else { System.out.println(e.getMessage());//未执行 } return "handle result:" + (s == null ? "500" : s); }); System.out.println(futureA.join());//handle result:futureA result: 100 通过控制台,我们可以看出,最后打印的是handle result:futureA result: 100,执行exceptionally后对异常进行了"美化",返回了默认值,那么handle得到的就是一个正常的返回,我们再试下,先调用handle再调用exceptionally的情况. CompletableFuture<String> futureA = CompletableFuture. supplyAsync(() -> "执行结果:" + (100 / 0)) .thenApply(s -> "apply result:" + s) .handle((s, e) -> { if (e == null) { System.out.println(s);//未执行 } else { System.out.println(e.getMessage());//java.lang.ArithmeticException: / by zero } return "handle result:" + (s == null ? "500" : s); }) .exceptionally(e -> { System.out.println("ex:" + e.getMessage()); //未执行 return "futureA result: 100"; }); System.out.println(futureA.join());//handle result:500 根据控制台输出,可以看到先执行handle,打印了异常信息,并对接过设置了默认值500,exceptionally并没有执行,因为它得到的是handle返回给它的值,由此我们大概推测handle和whenComplete的区别 都是对结果进行处理,handle有返回值,whenComplete没有返回值 由于1的存在,使得handle多了一个特性,可在handle里实现exceptionally的功能 allOf(..) anyOf(..) public static CompletableFuture<Void> allOf(CompletableFuture<?>... cfs) public static CompletableFuture<Object> anyOf(CompletableFuture<?>... cfs) allOf:当所有的CompletableFuture都执行完后执行计算 anyOf:最快的那个CompletableFuture执行完之后执行计算 场景二:查询一个商品详情,需要分别去查商品信息,卖家信息,库存信息,订单信息等,这些查询相互独立,在不同的服务上,假设每个查询都需要一到两秒钟,要求总体查询时间小于2秒. public static void main(String[] args) throws Exception { ExecutorService executorService = Executors.newFixedThreadPool(4); long start = System.currentTimeMillis(); CompletableFuture<String> futureA = CompletableFuture.supplyAsync(() -> { try { Thread.sleep(1000 + RandomUtils.nextInt(1000)); } catch (InterruptedException e) { e.printStackTrace(); } return "商品详情"; },executorService); CompletableFuture<String> futureB = CompletableFuture.supplyAsync(() -> { try { Thread.sleep(1000 + RandomUtils.nextInt(1000)); } catch (InterruptedException e) { e.printStackTrace(); } return "卖家信息"; },executorService); CompletableFuture<String> futureC = CompletableFuture.supplyAsync(() -> { try { Thread.sleep(1000 + RandomUtils.nextInt(1000)); } catch (InterruptedException e) { e.printStackTrace(); } return "库存信息"; },executorService); CompletableFuture<String> futureD = CompletableFuture.supplyAsync(() -> { try { Thread.sleep(1000 + RandomUtils.nextInt(1000)); } catch (InterruptedException e) { e.printStackTrace(); } return "订单信息"; },executorService); CompletableFuture<Void> allFuture = CompletableFuture.allOf(futureA, futureB, futureC, futureD); allFuture.join(); System.out.println(futureA.join() + futureB.join() + futureC.join() + futureD.join()); System.out.println("总耗时:" + (System.currentTimeMillis() - start)); }

优秀的个人博客,低调大师

分布式队列神器 Celery,你了解多少?

我们在web开发中会经常遇到异步任务,对于一些消耗资源和时间的操作,如果不从应用中单独抽出来的话,体验是非常不好的,例如:一个手机验证码登录的过程,当用户输入手机号点击发送后,如果如果直接扔给后端应用去执行的话,就会引起网络IO的阻塞,那整个应用就非常不友好了,那如何优雅的解决这个问题呢? 我们可以使用异步任务,当接收到请求后,我们可以在业务逻辑的处理时触发一个异步任务,前端立即返回读秒让用户接收验证码,同时由于是异步执行的任务,后端也可以处理其他的请求,这就非常的完美了。 实现异步任务的工具有很多,其原理也都是去实现一个消息队列,这里我们主要来了解一下Celery。 Celery 是什么? Celery简介 Celery是一个由Python编写的简单,灵活且可靠的分布式系统,它可以处理大量消息,同时也提供了操作、维护该分布式系统所需的工具。 说白点就是,Celery 是一个异步任务的调度工具,它专注于实时任务处理,支持任务调度。有了Celery,我们可以快速建立一个分布式任务队列并能够简单的管理。Celery虽然是由python编写, 但协议可以用任何语言实现。迄今,已有 Ruby 实现的RCelery、node.js 实现的node-celery以及一个PHP 客户端。 Celery架构 此处借鉴一张网图,这张图非常明了把Celery的组成以及工作方式描述出来了。 Celery的架构由下面三个部分组成: Brokers 意为中间件/中间人,在这里指的是任务队列, 我们要注意Celery本身不是任务队列,它是管理分布式任务队列的工具,换一句话说,用Celery可以快速进行任务队列的使用与管理,Celery可以方便的和第三方提供的任务队列集成,例如RabbitMQ, Redis等。 Worker 任务执行单元,我们可以理解为工人,Worker是Celery提供的任务执行的单元,简单来说,它就是Celery的工人,类似于消费者,它shi'shi监控着任务队列,当有新的任务入队时,它会从任务队列中取出任务并执行。 backend/Task result store 任务结构存储,顾名思义,它就是用来存储Worker执行的任务的结果的地方,Celery支持以不同方式存储任务的结果,有redis,Memcached等。 简单来说,当用户、或者我们的应用中的触发器将任务入Brokers队列之后,Celery的Worker就会取出任务并执行,然后将结构保存到Task result store中。 使用Celery 简单实现 Celery及消息队列(redis/RabbitMQ)的安装过程在这里就不再赘述了,出于方便,我们这里使用redis,点击这里查看官网给出的更多的Brokers和backend支持。 首先,我们新建一个tasks.py文件。 import time from celery import Celery brokers = 'redis://127.0.0.1:6379/0' backend = 'redis://127.0.0.1:6379/1' app = Celery('tasks', broker=brokers, backend=backend) @app.task def add(x, y): time.sleep(2) return x + y 上述代码,我们导入了celery库,新建了一个celery实例,传入了broker和backend,然后创建了任务函数add,我们用time.sleep(2)来模拟耗时操作。 接下来我们要启动Celery服务,在当前命令行终端运行: celery -A tasks worker --loglevel=info 注意:如果在Windows中要运行如下命令: celery -A celery_app worker --loglevel=info -P eventlet 不然会报错。。。。。。 我们会看到下面的输出结果: D:\use_Celery>celery -A tasks worker --loglevel=info -P eventlet -------------- celery@DESKTOP-8E96VUV v4.4.2 (cliffs) --- ***** ----- -- ******* ---- Windows-10-10.0.18362-SP0 2020-03-18 15:49:22 - *** --- * --- - ** ---------- [config] - ** ---------- .> app: tasks:0x3ed95f0 - ** ---------- .> transport: redis://127.0.0.1:6379/0 - ** ---------- .> results: redis://127.0.0.1:6379/1 - *** --- * --- .> concurrency: 8 (eventlet) -- ******* ---- .> task events: OFF (enable -E to monitor tasks in this worker) --- ***** ----- -------------- [queues] .> celery exchange=celery(direct) key=celery [tasks] . tasks.add [2020-03-18 15:49:22,264: INFO/MainProcess] Connected to redis://127.0.0.1:6379/0 [2020-03-18 15:49:22,294: INFO/MainProcess] mingle: searching for neighbors [2020-03-18 15:49:23,338: INFO/MainProcess] mingle: all alone [2020-03-18 15:49:23,364: INFO/MainProcess] celery@DESKTOP-8E96VUV ready. [2020-03-18 15:49:23,371: INFO/MainProcess] pidbox: Connected to redis://127.0.0.1:6379/0. 这些输出包括指定的启动Celer应用的一些信息,还有注册的任务等等。 此时worker已经处于待命状态,而 broker中还没有任务 ,我们需要触发任务进入broker中,worker才能去取出任务执行。 我们新建一个add_task.py文件: from tasks import add result = add.delay(5, 6) # 使用celery提供的接口delay进行调用任务函数 while not result.ready(): pass print("完成:", result.get()) 我们可以看到命令窗口的输出的celery执行的日志 : [2020-03-18 15:53:15,967: INFO/MainProcess] Received task: tasks.add[8da270cb-7f07-4202-ad6a-51cc7f559107] [2020-03-18 15:53:17,981: INFO/MainProcess] Task tasks.add[8da270cb-7f07-4202-ad6a-51cc7f559107] succeeded in 2.015999999974156s: 11 当然我们在backend的redis中也可以看到执行任务的相关信息。 至此,一个简单的 celery 应用就完成啦。 周期/定时任务 Celery 也可以实现定时或者周期性任务,实现也很简单,只需要配置好周期任务,然后再启动要启动一个 beat 服务即可。 新建Celery配置文件celery_conf.py: from datetime import timedelta from celery.schedules import crontab CELERYBEAT_SCHEDULE = { 'add': { 'task': 'tasks.add', 'schedule': timedelta(seconds=3), 'args': (16, 16) } } 然后在 tasks.py 中通过app.config_from_object('celery_config') 读取Celery配置: # tasks.py app = Celery('tasks', backend='redis://localhost:6379/0', broker='redis://localhost:6379/0') app.config_from_object('celery_config') 然后重新运行 worker,接着再运行 beat: celery -A tasks beat 我们可以看到以下信息: D:\use_Celery>celery -A tasks beat celery beat v4.4.2 (cliffs) is starting. __ - ... __ - _ LocalTime -> 2020-03-18 17:07:54 Configuration -> . broker -> redis://127.0.0.1:6379/0 . loader -> celery.loaders.app.AppLoader . scheduler -> celery.beat.PersistentScheduler . db -> celerybeat-schedule . logfile -> [stderr]@%WARNING . maxinterval -> 5.00 minutes (300s) 然后我们就可以看到启动worker的命令行在周期性的执行任务: [2020-03-18 17:07:57,998: INFO/MainProcess] Received task: tasks.add[f5dab8ac-0809-415f-84e7-cba488ea2495] [2020-03-18 17:07:59,995: INFO/MainProcess] Task tasks.add[f5dab8ac-0809-415f-84e7-cba488ea2495] succeeded in 2.0s: 32 [2020-03-18 17:08:00,933: INFO/MainProcess] Received task: tasks.add[b49a4c92-e007-46ef-9b5d-f93f451a6c1b] [2020-03-18 17:08:02,946: INFO/MainProcess] Task tasks.add[b49a4c92-e007-46ef-9b5d-f93f451a6c1b] succeeded in 2.0160000000032596s: 32 [2020-03-18 17:08:03,934: INFO/MainProcess] Received task: tasks.add[1bdfe4d8-76c1-44cc-b1fa-dbbe242692ae] [2020-03-18 17:08:05,940: INFO/MainProcess] Task tasks.add[1bdfe4d8-76c1-44cc-b1fa-dbbe242692ae] succeeded in 2.0s: 32 可以看出每3秒就有一个任务被加入队列中去执行。 那定时任务又怎样去实现呢? 也很简单,我们只需要更改一下配置文件即可: CELERYBEAT_SCHEDULE = { 'add-crontab-func': { 'task': 'tasks.add', 'schedule': crontab(hour=8, minute=50, day_of_week=4), 'args': (30, 20), }, } CELERY_TIMEZONE = 'Asia/Shanghai' # 配置时区信息 其中crontab(hour=8, minute=50, day_of_week=4)代表的是每周四的8点50执行一次,只要我们的Celery服务一直开着,定时任务就会按时执行;在这里我也在配置里加入了时区信息。 我在这里是8点45启动的Celery服务、运行的beat,从下面的输出可以看出,50的时候我们的定时任务就执行了。 [2020-03-19 08:45:19,934: INFO/MainProcess] celery@DESKTOP-8E96VUV ready. [2020-03-19 08:50:00,086: INFO/MainProcess] Received task: tasks.add[45aa794d-a4ef-40e0-9480-80c7004318d5] [2020-03-19 08:50:02,091: INFO/MainProcess] Task tasks.add[45aa794d-a4ef-40e0-9480-80c7004318d5] succeeded in 2.0s: 50 由此我们可以看出,利用 Celery 进行分布式队列管理将会大大的提高我们的开发效率,我这里也仅仅是关于Celery的简单介绍和使用,如果大家感兴趣,可以去官方文档 学习更高级更系统的用法。 最后,感谢女朋友在生活中,工作上的包容、理解与支持 !

优秀的个人博客,低调大师

CodeMirror 代码渲染神器的极简入门实例

效果: image.png HTML: <script src="https://codemirror.net/lib/codemirror.js"></script> <script src="https://codemirror.net/mode/javascript/javascript.js"></script> <link rel="stylesheet" href="https://codemirror.net/lib/codemirror.css"> <div id="fn"></div> <button class="btn btn-sm btn-success offset2" id="fn-save-btn">保存</button> <button class="btn btn-sm btn-success" id="fn-eval-btn">运行</button> <div id="eval-result" class="eval-result"></div> JS 代码示例: // 渲染代码: var editor = CodeMirror.fromTextArea(document.getElementById("fnBody"), { lineNumbers: true, mode: "javascript", matchBrackets: true }); // 获取代码的文本值 var fnBody = editor.doc.getValue(); // 运行脚本,预览结果 $('#fn-eval-btn').unbind().bind('click', () => { console.dir(editor); var fnBody = editor.doc.getValue(); var postData = { js: fnBody }; $.ajax({ url: '/datafactory/evalJs.json' , data: postData , type: 'POST' , success: (result) => { if (result.success == true) { $('#eval-result').html(`<div>运行结果:</div><code>${result.data}</code>`) } else { alert(result.errorMessage) } } , error: (err) => { alert(JSON.stringify(err)) } }); });// fn-eval-btn 后端代码 Kotlin: @PostMapping("/evalJs.json") @ResponseBody fun evalJs(js: String): ResultVo<String> { println("js=${js}") val result = ResultVo( data = "", isSuccess = false, errorCode = "1", errorMessage = "", state = "1" ) try { val data = NashornUtil.evalJs(js) result.data = data result.isSuccess = true result.errorCode = "0" result.errorMessage = "" result.state = "" } catch (e: Exception) { result.errorMessage = e.message ?: "" } return result } 其中,evalJs() 的函数实现如下: package com.alibaba.xxpt.qa.adt.util import javax.script.ScriptEngineManager object NashornUtil { private val scriptEngineManager = ScriptEngineManager() private val nashorn = scriptEngineManager.getEngineByName("nashorn") fun evalJs(js: String): String { try { return nashorn.eval(js).toString() } catch (e: Exception) { e.printStackTrace() return "" } } } 使用的是 Java 8 中的nashorn 引擎(支持 ES5 的语法)。 参考文档:https://codemirror.net/

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册