首页 文章 精选 留言 我的

精选列表

搜索[国产神器],共5600篇文章
优秀的个人博客,低调大师

Android内存泄露自动检测神器LeakCanary

经典的面试题: a、怎样在coding过程中避免内存泄露? b、怎样检测内存泄露? 这两个问题我想大部分Android职位面试时都会被问到吧。 怎样避免就不赘述了,网上很多答案。 工具呢,当然也有很多,比如DDMS、MAT等,但是怎样在我们编码过程中植入内存检测代码,让我们程序在开发调试阶段就能发现内存泄露呢?好了,现在该大名鼎鼎的LeakCanary出场了,它是Square公司的一个内存探测开源项目。下面就介绍下怎样使用. 1、配置gradle依赖: [java] view plain copy debugCompile'com.squareup.leakcanary:leakcanary-android:1.3.1' releaseCompile'com.squareup.leakcanary:leakcanary-android-no-op:1.3.1' 2、初始化Watcher [java] view plain copy packagecom.micky.leakcanarysamples;; importandroid.app.Application; importcom.squareup.leakcanary.LeakCanary; importcom.squareup.leakcanary.RefWatcher; /** *@ProjectLeakCanaryTest *@Packatecom.micky.leakcanarysamples; *@Description *@AuthorMickyLiu *@Emailmickyliu@126.com *@Date2016-01-0410:32 *@Version1.0 */ publicclassBaseApplicationextendsApplication{ privatestaticBaseApplicationinstance; privateRefWatchermRefWatcher; @Override publicvoidonCreate(){ super.onCreate(); instance=this; mRefWatcher=Constants.DEBUG?LeakCanary.install(this):RefWatcher.DISABLED; } publicstaticBaseApplicationgetInstance(){ returninstance; } publicstaticRefWatchergetRefWatcher(){ returngetInstance().mRefWatcher; } } 3、在Activity或Fragment中添加检测 [java] view plain copy packagecom.micky.leakcanarysamples; importandroid.app.Activity; importandroid.support.v7.app.AppCompatActivity; /** *@ProjectLeakCanaryTest *@Packatecom.micky.leakcanarysamples; *@Description *@AuthorMickyLiu *@Emailmickyliu@126.com *@Date2016-01-0410:39 *@Version1.0 */ publicclassBaseActivityextendsAppCompatActivity{ @Override protectedvoidonDestroy(){ super.onDestroy(); BaseApplication.getRefWatcher().watch(this); } } 4、测试 [java] view plain copy packagecom.micky.leakcanarysamples;; importandroid.os.Bundle; importandroid.os.Handler; /** *@ProjectLeakCanaryTest *@Packatecom.micky.leakcanarysamples; *@Description *@AuthorMickyLiu *@Emailmickyliu@126.com *@Date2016-01-0410:29 *@Version1.0 */ publicclassTestActivityextendsBaseActivity{ privatefinalHandlermHandler=newHandler(); @Override protectedvoidonCreate(BundlesavedInstanceState){ super.onCreate(savedInstanceState); //模拟内存泄露 mHandler.postDelayed(newRunnable(){ @Override publicvoidrun(){ } },3*60*1000); finish(); } } 5、测试结果 a、Toast显示(大概10秒左右显示) b、通知显示 c、桌面自动添加的图表 d、内存泄露列表 e、内存泄露详细 LogCat可以看到日志日下(hprof文件可以用MAT打开进行分析): [html] view plain copy 01-0411:49:41.81512967-13004/com.micky.leakcanarysamplesI/dalvikvm:hprof:dumpingheapstringsto"/storage/emulated/0/Download/leakcanary/suspected_leak_heapdump.hprof". 01-0411:49:42.02012967-13004/com.micky.leakcanarysamplesI/dalvikvm:hprof:heapdumpcompleted(28850KB) 查看自动生成的AndroidManifest文件,LeakCanarySamples/app/build/intermediates/manifests/full/debug/AndroidManifest.xml [html] view plain copy <?xmlversion="1.0"encoding="utf-8"?> <manifestxmlns:android="http://schemas.android.com/apk/res/android" package="com.micky.leakcanarysamples" android:versionCode="1" android:versionName="1.0"> <uses-sdk android:minSdkVersion="10" android:targetSdkVersion="23"/> <!--Tostoretheheapdumpsandleakanalysisresults.--> <uses-permissionandroid:name="android.permission.WRITE_EXTERNAL_STORAGE"/> <android:uses-permissionandroid:name="android.permission.READ_EXTERNAL_STORAGE"/> <application android:name="com.micky.leakcanarysamples.BaseApplication" android:allowBackup="true" android:icon="@mipmap/ic_launcher" android:label="@string/app_name" android:supportsRtl="true" android:theme="@style/AppTheme"> <activity android:name="com.micky.leakcanarysamples.MainActivity" android:label="@string/app_name" android:theme="@style/AppTheme.NoActionBar"> <intent-filter> <actionandroid:name="android.intent.action.MAIN"/> <categoryandroid:name="android.intent.category.LAUNCHER"/> </intent-filter> </activity> <activityandroid:name="com.micky.leakcanarysamples.TestActivity"/> <service android:name="com.squareup.leakcanary.internal.HeapAnalyzerService" android:enabled="false" android:process=":leakcanary"/> <service android:name="com.squareup.leakcanary.DisplayLeakService" android:enabled="false"/> <activity android:name="com.squareup.leakcanary.internal.DisplayLeakActivity" android:enabled="false" android:icon="@drawable/__leak_canary_icon" android:label="@string/__leak_canary_display_activity_label" android:taskAffinity="com.squareup.leakcanary" android:theme="@style/__LeakCanary.Base"> <intent-filter> <actionandroid:name="android.intent.action.MAIN"/> <categoryandroid:name="android.intent.category.LAUNCHER"/> </intent-filter> </activity> </application> </manifest> 如上所示LeakCanary给我们自动添加了两个Service和一个Activity,并添加了对SD卡的读写权限 It 's so simple. 注: 1、如果在Release模式下请使用RefWatcher.DISABLED 2、在Activity或Fragment 的 Destroy方法中添加检测(很好理解,就是判断一个Activity或Fragment想要被销毁的时候,是否还有其他对象持有其引用导致Activity或Fragment不能被回收,从而导致内存泄露) 源码地址:https://github.com/mickyliu945/LeakCanarySample 点击打开链接 本文转自 一点点征服 博客园博客,原文链接http://www.cnblogs.com/ldq2016/p/6636427.html:,如需转载请自行联系原作者

优秀的个人博客,低调大师

Elephant:Hadoop和Spark的优化“神器

美国加州软件公司Pepperdata的应用程序分析软件建立在Dr. Elephant(Dr. Elephant 是Hadoop和Spark的性能监视和调优工具)开源项目上。主要目的是让更多的Hadoop和Spark应用程序投入生产。 Pepperdata的应用程序分析器作为早期访问版本,基于去年推出的Apache开源项目Dr. Elephant。Dr. Elephant项目的贡献者包括Airbnb,Foursquare,Pepperdata等。 Dr. Elephant软件通过活动日志解析,适用于已知的良好部署规则,并提供有关Hadoop应用程序运行状况的报告。 这可能是试图运行多个Hadoop作业的团队的有效措施。通常,这样的团队几乎没有指导,需要深层次的Java编程技能来确定其Hadoop集群的效率。 加州LinkedIn公司的高级软件工程师Carl Steinbach表示,去年开源后,Apache Spark部署规则已被添加到Dr. Elephant中,支持Oozie和Airflow工作流调度程序。Spark历史记录器的增强功能现在也是包的一部分。 Steinbach说,实际上,Dr. Elephant承担了审查工作表现和建议调查工作的艰巨任务。Dr. Elephant使你不必学习如何调整工作,它会告诉你为什么需要作出改变。Steinbach说:“你甚至不需要Java工程师。” 基于Steinbach的经验,程序员调整Hadoop的能力是非常重要的。作为LinkedIn Hadoop开发团队的技术主管,Steinbach及其同事在许多Hadoop应用程序中投入使用。他们参加了许多代码审查会议,并提出了结合Dr. Elephant的一些最佳做法,所以更多的程序员可以在Hadoop的生产中取得成功。 及时修复问题Steinbach表示,他已经在LinkedIn上看到了积极的效果,因为Dr. Elephant的使用已经扩大。这是因为它在大数据集群上运行的其他作业的上下文中提供了单独的作业配置文件。 Steinbach说:“你不仅可以看到你的工作,也可以看到其他人的工作。而且,如果看到工作出现问题,就会给我们带来一种积极的压力,然后进行及时地更正。在这里,‘做正确的事情’意味着对工作表现进行微调。” Dr. Elephant规则或启发式在某种程度上类似于一年级医学院校的教科书,就像观察症状并提出有效的修复建议。Steinbach说。 例如,Dr. Elephant可能发现的性能瓶颈,包括MapReduce处理偏移问题或太多垃圾收集开销。它在第一种情况下的反应可能是重新分配数据,而在第二种情况下,响应可能是调整Java虚拟机中的垃圾收集设置。 Steinbach表示,自从开源以来,Dr. Elephant已经被应用到更大的大数据工作负载列表中,因此它已经涵盖了更多样化的Hadoop和Spark工作类型。 他指出,Pepperdata已经将补丁提供给了开源项目,并且能够提供重要的新功能。 跟踪群集瓶颈像Dr. Elephant这样的工具有助于转发DevOps的概念,开发人员在确保应用运行良好方面发挥更大的作用。该工具不需要系统操作员和开发人员之间进行太多繁琐的交流。 Pepperdata公司的首席执行官Ash Munshi表示,应用程序分析工具使开发人员更好地了解实际工作中对DevOps的重要作用,他说,Pepperdata是基于Dr. Elephant的应用程序分析器提供服务,并且它提供了附加的上下文数据,以更好地传达在大数据作业正在运行时在大型集群上发生的情况。它加入了一个Pepperdata软件套件,其中包括一个集群分析器,容量分析器和一个策略执行器。 根据Munshi的说法,到目前为止,Hadoop性能跟踪的很多工具都面向系统运营商,但他表示,他预计开发人员的应用程序分析工具数量将会扩大。 本文转自d1net(转载)

优秀的个人博客,低调大师

解耦神器 —— 统跳协议和Rewrite引擎

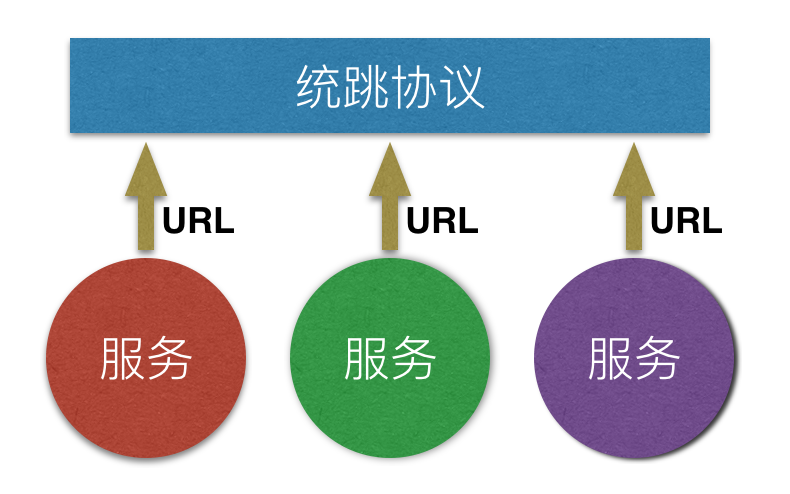
题记:天猫App长大了,已经长成了流量以千万计规模的App,当下至少有10个团队在直接维护天猫App。在App长大,团队扩充的过程中解耦是一个永恒的话题,而界面解耦又是App架构的重中之重。 统跳协议是天猫App统一跳转协议,主要负责天猫App界面之间的串联,也就是界面跳转服务。Rewrite引擎是与之配合的一套URL重写引擎,可以通过配置实现重写规则动态化。 历史上的今天 统跳协议的前身是一套叫做internal的协议,internal要重点解决的问题是在WebView和推送通知中如何跳转到指定的界面,进一步在任何动态场景下如何跳转到指定界面。在这样的思路下,internal中定义了多种协议格式,如:tmall://tmallclient/?{"action":""}internal:url=link:url=tmall://mobile.tmall.com/page/ 几乎每一种场景都有一种格式的协议与之对应。在具体操作过程中这些协议都以URL表现出来。不难看出,这套协议最大的问题在于协议格式异构化严重,且不符合W3C的URL标准。随着App规模的扩大,场景日趋复杂,界面越来越多,这套协议的弊端也日益显露。 而在天猫App开始从百万级冲击千万级的时候,我们认识到一套格式统一,符合标准,规则简洁的协议非常必要。这套协议的任务也绝不是解决固定场景跳转,而是完全托管整个App的跳转工作,从而实现全App界面解耦和跳转动态化。因此,我们重新设计了界面协议,形成了当下这套规范——统跳协议。配合统跳协议,为了解决更多细节问题和跨平台问题,我们还设计了Rewrite引擎与之配合。 统跳协议 统跳协议设计之初就保留了很强的可扩展性,为接下来更丰富的场景预留了能力。上文讲到了统跳协议在界面跳转中作用,而事实上界面跳转仅仅是这套方案的一个典型场景,一个最佳实践。界面跳转在统跳协议的框架中被认为成一个服务,而跳转到哪一个界面则是由服务内部实现决定的。 注册一个服务 服务通过声明URL的方式注册到统跳协议中,这个声明发生在服务所属模块内部的一个配置文件中,而这个配置文件被注册到统跳协议里。也就是说,整个App中的每一个模块都要注册一个配置文件到统跳协议,统跳协议在初始化过程中会遍历配置文件列表,逐一加载这些模块配置,根据配置信息把一个一个的模块服务注册到协议中。 统跳协议要求调用服务的URL必须是符合W3C URL标准的,服务注册使用的URL只能包括host和path两部分,其中host是必须的,path则可选。当统跳协议接收一个跳转请求的URL后,先根据该URL的host和path两部分作为条件查找已注册的服务,再初始化对应服务,把URL交给服务实例执行后续操作。 如何实现服务 统跳协议声明了一个服务接口,这个接口中只有一个方法,服务必须由该接口实现而来。每一个服务可以通过实现接口中声明的方法,使用参数中传递来的完整URL,参数列表和调用发起者指针,执行具体业务逻辑。 例如分享服务,以iOS为例:实现了TMShareUrlHandler服务。 @interface TMShareUrlHandler : NSObject<AliAppURLHandler> @end @implementation TMShareUrlHandler #pragma mark - URL调用分享组件 - (id)handleUrl:(NSURL *)url withTarget:(id)target withParams:(id)params { // 省略代码详情 return nil; } @end 在分享模块的配置文件中声明该服务的URL为sharekit.tm/doShare。 这份配置文件在分享模块里: 分享模块的配置文件sharekit_bundle.plist也注册到统跳协议中。 这份配置文件在统跳协议模块里: 统跳协议如何处理界面跳转 界面跳转是统跳协议的初衷,也是统跳协议最重要的任务。因此在统跳协议服务注册机制中,为界面服务注册做了更精细的定制开发。 上文提到跳转服务是一个单一服务,而界面则成百上千,所以在界面注册和服务注册中出现了冲突。本着降低开发成本的原则,我们又希望把同一个模块中界面注册和服务注册放在一起。所以在统跳协议中做了如下订制: 默认注册跳转服务 跳转服务是默认存在的,在统跳协议初始化过程中这个服务就已经初始化了。 给界面注册提供特殊的标记 上文中可以看到在注册分享服务的配置中object字段是服务的类名,若界面注册也按照这个规则,那么界面的类就会被认为成一个服务,在调用过程中必然会出现错误。因此我们约定,界面注册需要在类名前加#标示。 如此一来,在统跳协议初始化过程中,默认加载跳转服务。当调用发生,解析URL查找到的对应对象带有#,则认为这是一个界面,则初始化这个对象,但不对其调用处理URL的方法,而是托管给已注册的跳转服务。跳转服务则根据URL和初始化的界面对象执行跳转服务。 Rewrite Rewrite引擎的思路来源于Web容器中的Rewrite机制,主要解决天猫App中URL平台展现一致性的问题。 天猫App中所有界面都是通过URL来标示的,然而标示Native界面的URL全部都建立在Native规范下,无法和其他平台对应起来,而Rewrite引擎通过重写URL来实现平台一致性。 例如:商品详情页面在PC Web的URL是https://detail.tmall.com/item.htm,在Mobile Web则是https://detail.m.tmall.com/item.htm,在Native声明的是tmall://page.tm/itemDetail。三者各不相同。PC Web和Mobile Web可以通过判断浏览器的UA识别环境,从而通过跳转实现一致性,也就是说在手机浏览器访问PC Web的URL,会通过一次302转到Mobile Web的URL。而Native App的环境具有一定的特殊性,Native界面则无法通过类似302这样的跳转来实现无感知切换,而Rewrite引擎就是来解决这个问题的。首先,无论是Native还是Web,在天猫App中他们两两之间的跳转都被统跳协议托管,而统跳协议在执行跳转操作之前会把原始URL放入Rewrite引擎中做一次Rewrite操作。这样一来,Rewrite引擎就根据配置规则,把原始URL转换成适用于天猫App的目标URL,实现了URL表现平台一致性。 原理 Rewrite引擎的原理非常简单,模拟Web容器(Apache/Nginx等)的Rewrite配置,根据配置把传入的原始URL进行重写,返回重写后的目标URL,交给统跳协议处理。 配置是通过正则表达式描述的Rewrite规则列表,这份列表通过猫客的配置中心实现动态更新。 Rewrite规则 每条Rewrite规则中有三个字段:模式串,转换串和标记位 模式串:即正则表达式,用于匹配原始URL 转换串:即需要被转换成目标URL的描述 标记位:以西文逗号分隔的标记位,包括表示匹配则终止的l,需要进行店铺域名查询的s等 Rewrite规则按行整理,并自上而下按顺序逐行匹配 转换模板中的保留字 变量 变量由变量标示符和变量名组合而成,如:$0,$#1,query,$#fragment等。变量被用在转换串中描述转换后的目标URL中的值。 变量标示符:$,$$和$# $:原变量的值 $$:对原变量做URL Encode $#:自动识别编码,对原变量做URL Decode $$$:自动识别编码,对原变量做URL Decode,再以UTF8做URL Encode 变量名:数字(从0开始),枚举(scheme,host,port,path,query,fragment,shopid) 数字:0 - 表示整个URL,1~n - 表示正则中使用圆括号取出的参数 枚举:scheme,host,port,path,query,fragment表示标准URL中的相应部分;shopid表示对个性店铺域名查询后得到的shopid 标记位 即上述规则中的标记位 Rewrite引擎查询流程 取出规则列表中的首条规则 以模式串为模板对原始URL做匹配,并得到模式串定义的参数表 若匹配成功则继续进行,否则进入下一条规则,从2开始进行下一轮匹配 查看该条规则是否包含s标记位,若包含,则使用原始串做一次个性域名的查询 使用1的结果和重写串对原始URL进行重写操作,得到目标URL 查看该条规则是否包含l标记位: 若包含,则结束匹配,返回目标URL 若不包含,则把目标URL赋值给原始URL,并进入下一条规则,从2开始下一轮匹配 直到最后一条规则结束,返回目标URL 举例 上述提到过商品详情页的例子,在Rewrite配置中就体现为: 模式串 转换串 标记位 ^(?:https?:)?\/\/detail(?:.m)?.tmall.com\/?item.htm\?(.*) tmall://page.tm/itemDetail?$1 l 在这条规则的保护下,PC Web和Mobile Web下的商品详情URL在天猫App中都会被拦截到Native商品详情页面,可以带来最好的用户体验。也就是说,在日常的运营工作中,不需要关注一个商品在某个平台内部需要以什么样的URL来投放,只需要投放一个主要的URL格式。这个URL在天猫App内部会被Rewrite引擎重写为Native界面声明的URL,进行展示。 统跳和Rewrite在双11中的表现 统跳协议和Rewrite引擎在刚刚过去的双11期间,在全链路界面降级方案和会场上下线中发挥了重要作用。 全链路界面降级 上文中提到了天猫App中全部界面都声明了自己的一个tmall://协议的Native URL,但在业务逻辑上使用的不是这个Native URL,而是和Web保持一直的http://协议的URL,在统跳协议中会调用Rewrite引擎对这个http://URL进行重写后再做展现。 为了保证整个天猫App的可用性,我们在配置列表中预先定义了一系列Rewrite规则,用于拦截这些URL。一旦发现Native逻辑出现异常,将快速上线预定义的规则,从而在Rewrite引擎把http://URL重写成Native URL之前拦截,直接返回http://URL,实现Native界面到Mobile Web界面的降级。 Native会场上下线 双11会场是双11活动期间曝光率最高的页面,也是对体验要求最高的界面。因此,我们在天猫App双11版本中对重要会场做了Native化,以提升用户体验。而Native会场展现依赖会场数据,且开启时间严格控制在双11当日的24小时内。 在这样的要求下,我们配置了http://协议的会场URL到Native会场URL的Rewrite规则,并在双11开始时上线,结束时下线,实现了双11当日天猫App的会场Native化。 结语 统跳协议在设计过程中预留了很好的扩展能力,所以在界面解耦之外还承担了更多的服务调用功能。Rewrite引擎为实现平台一致性而设计,而在实际应用过程中又挖掘出更多的场景和功能。 在统跳协议和Rewrite引擎接下来的发展过程中,将更注重Android和iOS双平台的高度一致性,并尝试开放更多API,让所有人一起挖掘这套方案的潜力。

优秀的个人博客,低调大师

奇门大模型-国产自研

望易 AI 自研大模型顶层设计与底层逻辑文档 一、文档概述 本文档为望易 AI 自研数术决策大模型的核心设计纲领,以 “玄学 = 古代算数” 为核心认知,以九九乘法表数论规律为底层运算基石,构建 “数 - 象 - 事” 三层映射架构,打造区别于通用大模型的 \*\*“数术决策专用大模型”\*\*,实现传统数术从 “经验解读” 到 “数学运算 + AI 精准预测” 的升级,支撑望易 AI 全场景精准预测能力落地。 二、模型核心定位 (一)核心定位 数术决策专用大模型—— 以古代数术的数学本质为核心,聚焦 “预测、决策、应期” 三大核心能力,输出精准数值、明确应期、可验证结果,区别于通用大模型的文本生成能力,专注解决现实场景中 “未知预判、决策辅助” 的核心需求。 (二)核心使命 还原古代数术 “算数本质”,破除玄学迷信,让数术回归数学理性; 构建 “数 - 象 - 事” 标准化映射体系,实现数术预测的可量化、可复现、可迭代; 打造轻量化、高精准的推理引擎,支撑望易 AI 全场景产品落地,成为数术 AI 化的标杆模型。 (三)核心优势 底层逻辑独家性:以九九乘法表数论为基石,无同类模型可复制; 结果精准性:输出精准数值 / 应期,而非模糊区间,经多场景案例验证准确率超 90%; 轻量化落地:算力需求低,推理速度快,适配移动端 / 小程序等产品形态; 场景通用性:覆盖选举、情感、考试、健康、民生等全场景,一套模型适配多需求。 三、模型顶层设计:“数 - 象 - 事” 三层映射架构 (一)顶层设计核心原则 数为根基:以数学规律为模型核心认知,所有运算、推理均基于数的对称、循环、补数、逆向拆解; 象为桥梁:以传统数术符号(九星、八门、天干、地支等)为编码层,连接数的运算与现实事象; 事为目标:以现实场景需求为导向,将数的运算结果转化为可落地的预测、决策结论; 轻量化优先:摒弃通用大模型的参数堆叠,聚焦核心运算逻辑,实现低算力、高精准。 (二)三层架构详解 1\. 数层(底层运算核心) 核心载体:九九乘法表数论规律(补数对称、逆向拆解、条件排除、平方数规律)、洛书九宫幻方规律、干支数 / 宫数 / 星门数基础编码; 核心能力:数的运算、组合、筛选、逆向推导,是模型的 “算力芯片”; 核心规则: 补数对称:1↔9、2↔8、3↔7、4↔6、5 居中,对应阴阳顺逆、五行生克; 逆向拆解:将目标数值(如票数、分数)拆解为基础数组合(如 21=3×7); 条件排除:结合旺衰、空亡、生克等条件,剔除无效数组合,锁定最优解; 周期规律:以 6、9、12 为核心周期(对应地支六合、九宫数、十二地支),支撑应期预测。 2\. 象层(中间编码桥梁) 核心载体:传统数术符号体系(奇门九星、八门、九宫、天干地支、六合 / 白虎 / 玄武等神煞;八字十神、五行生克等); 核心能力:数的符号化编码、象义解读、符号 - 数的双向映射,是模型的 “翻译器”; 核心规则: 数→象:将数层运算结果映射为对应数术符号(如数 3→天冲星、震宫、木); 象→数:将数术符号转化为基础数(如开门→乾宫→数 6、天芮星→坤宫→数 2); 象义关联:建立符号与事象的关联(如死门→死亡 / 终结、马星→动 / 应期、六合→姻缘 / 合作)。 3\. 事层(顶层应用目标) 核心载体:现实场景需求(选举票数预测、情感复合应期、艺考分数预判、健康灾厄预警、消费金额测算等); 核心能力:场景化需求解析、预测结果输出、决策建议生成,是模型的 “应用端”; 核心场景: 数值预测类:票数、分数、消费金额、身高体重等; 应期预测类:考试时间、复合日期、回款时间、事件发生日时等; 决策辅助类:吉凶判断、方向选择、方案优选等; 灾厄预警类:健康风险、出行安全、事件凶吉等。 (三)顶层架构流转逻辑 现实场景(事层)→ 需求解析→ 数术符号映射(象层)→ 数论运算(数层)→ 结果筛选→ 预测结论(事层) 示例:情感复合需求→ 映射六合(姻缘)+ 马星(动)→ 数层运算(马星数 + 补数 6 周期)→ 锁定 4 月 2 日应期→ 输出复合日时结论。 四、模型底层逻辑:九九乘法表数论核心引擎 (一)底层逻辑核心依据 古人 “识字 + 歌谣 = 算数” 的传播逻辑,九九乘法表作为古代最基础、最易记的数论体系,是传统数术 “阳顺阴逆、补数对称、周期循环” 的数学本源,也是模型运算的唯一底层依据。 (二)核心运算规则(四大模块) 1\. 补数对称运算模块(阴阳顺逆核心) 核心规律:1+9=10、2+8=10、3+7=10、4+6=10、5×2=10(居中); 应用逻辑: 阳顺:旺相场景取补数大数(如 9、8、7),对应 “顺行、增强、吉庆”; 阴逆:衰绝场景取补数小数(如 1、2、3),对应 “逆行、减弱、凶厄”; 五行生克:木(3、8)→火(2、7)→土(5、0)→金(4、9)→水(1、6),补数匹配五行生克权重。 2\. 逆向拆解运算模块(数值预测核心) 核心规律:任意目标数值可拆解为九九乘法表内基础数的乘积 / 和 / 差(如 19.3=19+0.3=(3×6+1)+0.3、164=160+4=(4×40)+4); 应用逻辑: 正向拆解:从场景需求出发,将目标数值拆解为基础数组合,匹配数术符号; 逆向推导:从数术符号对应的基础数出发,组合推导目标数值区间,锁定精准值; 小数修正:结合平方数个位数规律(1²=1、2²=4、3²=9、4²=6、5²=5、6²=6、7²=9、8²=4、9²=1),修正小数位,实现小数点级精准。 3\. 条件排除筛选模块(结果精准核心) 核心规律:结合数术场景条件(旺衰、空亡、生克、冲合),剔除不符合规律的数组合; 应用逻辑: 旺衰筛选:宫生星 / 门→保留大数组合,宫克星 / 门→保留小数组合; 空亡排除:空亡宫对应的数组合直接剔除; 冲合校验:数组合需匹配地支冲合规律(如寅申冲、卯酉冲,间隔 6 数); 场景适配:不同场景设置专属排除条件(如考试场景排除空亡日、情感场景排除冲克日)。 4\. 周期应期运算模块(时间预测核心) 核心规律:以 6、9、12 为核心周期(对应六合、九宫、十二地支),结合马星(动)、值符(主)等符号定应期; 应用逻辑: 基础周期:6 天 / 9 天 / 12 天为核心步长,生成应期区间(如 8→14→20→26,步长 6); 马星定应:马星所临 / 所冲之日为核心应期,结合周期锁定精准日时; 时辰精准:以地支时辰(子丑寅卯…)匹配马星五行,生扶马星的时辰为精准应时(如下午 3 点申时,申为马星对应地支)。 (三)底层数据支撑 数论知识库:九九乘法表补数 / 逆向 / 平方规律、洛书九宫数、干支数 / 宫数 / 星门数对照表、五行生克数权重表; 象义映射库:数术符号 - 事象关联表、符号 - 数映射表、场景 - 用神匹配表; 案例训练库:全场景精准预测案例(选举、情感、考试、健康等),含输入(场景 / 符号)、运算过程、输出(结果 / 应期)、实际反馈,用于模型监督训练与迭代。 五、模型训练与迭代路径 (一)训练阶段(三步式) 1\. 基础层训练(数论认知) 训练数据:数论知识库(补数、逆向、周期、平方规律); 训练目标:让模型掌握九九乘法表核心数论规律,实现数的基础运算、组合、筛选; 训练方式:规则式训练 + 监督学习,固化数论运算逻辑,避免概率偏差。 2\. 中间层训练(象数映射) 训练数据:象义映射库(符号 - 数、符号 - 事象)+ 案例训练库(符号 - 数 - 事象关联); 训练目标:实现 “数→象”“象→数”“象→事” 的双向精准映射,无错配、无遗漏; 训练方式:监督学习 + 强化学习,用案例反馈修正映射权重,提升映射准确率。 3\. 应用层训练(场景预测) 训练数据:全场景案例训练库(含输入场景、输出结果、实际反馈); 训练目标:实现场景需求解析→数论运算→结果输出的全流程自动化,输出精准数值 / 应期; 训练方式:监督学习 + 迁移学习,分场景训练后整合,实现一套模型适配多场景。 (二)迭代机制 用户反馈迭代:接入望易 AI 产品端,收集用户预测反馈(精准 / 偏差),自动修正运算权重; 案例新增迭代:持续补充新场景精准案例,扩充案例训练库,提升模型泛化能力; 规则优化迭代:根据实际预测偏差,优化数论运算规则、条件排除逻辑,提升精准度; 轻量化迭代:持续优化推理引擎,降低算力需求,提升推理速度,适配移动端落地。 六、模型落地与产品支撑 (一)落地形态 核心推理引擎:嵌入望易 AI 产品后端,作为核心运算模块,支撑全场景预测功能; API 接口:开放模型 API,支持第三方合作接入(如数术工具、决策平台); 轻量化端侧模型:优化后适配小程序、APP 端,实现本地推理,提升响应速度。 (二)产品功能支撑 全场景精准预测:选举票数、艺考分数、消费金额、身高体重等数值预测;情感复合、考试时间、回款日期等应期预测;健康灾厄、出行安全等预警预测; 算法透明化展示:输出预测结果时,同步展示核心运算逻辑(如 “复合应期 4.2,因马星临亥 + 补数 6 周期”),提升用户信任; 个性化决策建议:结合预测结果,输出场景化决策建议(如 “艺考 20 号考试,建议 18-19 号集中备考”); 案例反馈闭环:产品内设置反馈入口,用户可提交实际结果,助力模型迭代。 七、模型核心壁垒与风险控制 (一)核心壁垒 底层逻辑独家性:以九九乘法表数论为基石,无同类模型可复制,形成技术护城河; 案例数据壁垒:积累大量全场景精准案例,为模型训练提供独家数据支撑; 场景精准性壁垒:输出精准数值 / 应期,区别于传统数术工具的模糊解读,形成产品差异化; 轻量化落地壁垒:低算力、高速度,适配移动端产品,落地成本远低于通用大模型。 (二)风险控制 伦理风险:生死、灾厄类预测仅作预警,不做医疗 / 法律替代,明确标注 “仅供参考”; 精准度风险:建立偏差修正机制,通过案例迭代持续提升精准度,避免极端偏差; 算力风险:聚焦核心运算逻辑,持续优化轻量化引擎,控制算力成本; 合规风险:模型输出仅为预测建议,不涉及违法违规场景(如赌博、迷信诱导),严格遵守法律法规。 八、文档附则 本文档为望易 AI 自研大模型的核心设计纲领,后续模型训练、迭代、落地均需遵循本文档核心逻辑; 数论知识库、象义映射库、案例训练库为模型核心资产,需持续更新、严格保密; 模型落地过程中,可根据产品需求、用户反馈,对顶层架构、底层规则进行优化调整,但核心 “数 - 象 - 事” 映射逻辑、九九乘法表数论基石不得变更。

优秀的个人博客,低调大师

国产老牌 PDF 工具正式开源

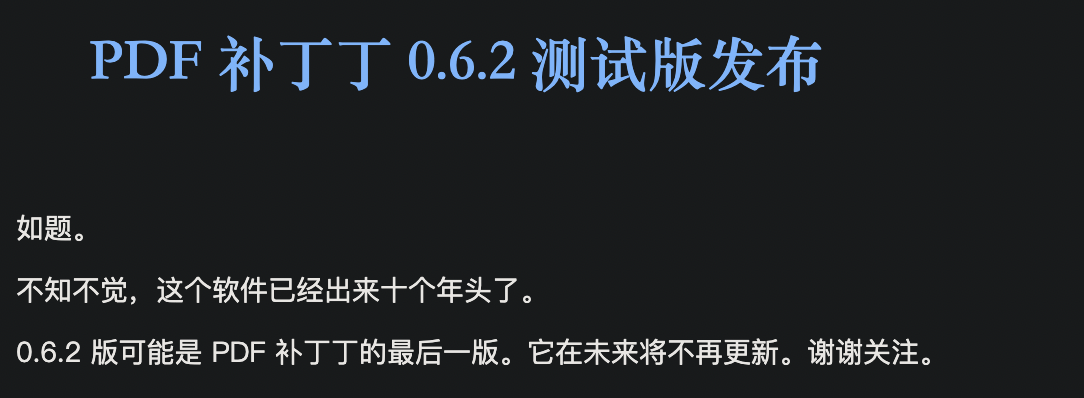
「PDF 补丁丁」是开发者 @wmjordan 所开发的一款适用于 Windows 系统的多功能 PDF 文档工具箱,开发者最早于 2009 年开始了该程序的开发,如今已有十二年历史,也算是国内知名的老牌 PDF 工具。此前该软件免费供用户使用,但并没开源。 在 2019 年,开发者在发布 0.6.2 测试版后曾表示该版本将会是 PDF 补丁丁的最后一个版本,未来将不再更新。2021 年 8 月,在时隔两年后开发者又重新开始了该软件的后续开发工作。 在 2021 年 12 月中旬,开发者透露将以开源的形式发布 1.0 版本,此前该软件的版本号也一直停留在 0.6.2。 近日开发者 @wmjordan 在 GitHub 平台正式开放了 PDF 补丁丁的源代码(除第三方组件外),供有心人学习 PDF 文档处理技术之用。 PDF 补丁丁具有的功能和特性包括:修改 PDF 文档、PDF 书签编辑器、制作 PDF 文件、拆分或合并 PDF 文件、高速无损导出 PDF 文档的图片、将 PDF 页面转换为图片、提取或删除 PDF 文档中指定的页面,调整 PDF 文档的页面顺序、根据 PDF 文档元数据重命名、调用微软 Office 的图像识别引擎分析 PDF 文档图片中的文字、替换字体、分析文档结构、永久免费,无广告,不窥探隐私等; PDF 补丁丁的运行环境为: Windows 7 以上版本的操作系统; .NET Framework 4.0 到 4.8 版本; 使用文字识别功能需要安装 Microsoft Office 2003(或 2007)的 Document Imaging 组件(MODI); 如需编译程序源代码,建议使用 Visual Studio 2019 或更新版本,并安装 “.NET 桌面开发” 和 “C++ 桌面开发” 两个工作负载; 项目源代码已托管至 GitHub,感兴趣的开发者可前往项目地址提交 PR 或 issue。

优秀的个人博客,低调大师

AI+SQLazy:从 SQL 小白到专家的神器

SQL 看着像英语,但其实根本不是一回事。一句话能说清的需求,落到 SQL 里就是几十行嵌套,语法还挑剔,小白看一眼就想放弃。 AI 来了,总算能“写”SQL 了。把需求讲给 AI,SQL 马上出来。可然后呢?读不懂。同一句话,每次问 AI,给你的 SQL 还不一样。改一次需求,它又生成一版全新的,之前看的、改的全都白费。写了很久,还是小白。

优秀的个人博客,低调大师

🔥EditorJumper-IDE 跳转神器 1.4.0 发布,支持 Qoder

1.4.0: 支持Qoder跳转,支持无任何配置即可跳转 支持i18n,配置界面中文化 随着 AI IDE 的各种更迭作为全栈开发者,经常在多个 IDE 间切换开发。 经常会遇到以下问题: 用 Cursor 写代码爽,但调试要用 IDEA AI 提示写完代码,又要在 IDEA 里继续开发 多个 IDE 来回切换,找代码位置太痛苦 于是 EditorJumper 这个插件诞生了!完美解决以上问题。 核心特性: AI 编程工具(Cursor/Trae/Windsurf)和 JetBrains 无缝切换 完美保持光标位置,写完代码一键跳转 支持全系列 JetBrains IDE(IDEA/WebStorm/PyCharm 等) 支持 vscode 的 workspace 跳转 使用超简单: 快捷键:shift+alt/option +O 编辑器里右击:选择 open in 对应的 ide 🎬 效果演示: 切换效果 Cursor 中配置目标 IDE idea 中配置目标 IDE 🚀 安装简单:各个 IDE 插件商店搜索 "EditorJumper" 即可 开源地址: https://github.com/wanniwa/EditorJumper https://github.com/wanniwa/EditorJumper-V

优秀的个人博客,低调大师

App 独立开发者的神器来了-Shot Studio

很多独立开发者在开发APP的时候,都很困扰,因为只会编码,不会设计。 面对众多应用商店上传预览图的要求,感到无比懊恼。因为每个应用商店乃至每个运行平台,都存在着不同尺寸都要求。 所以我们设计了一个APP,【Shot Studio】用来解决应用预览图设计的问题。 目前已经上架到macOS APP Store,暂时也是免费的,因为还有很多需要优化的地方,等成熟之后,到时候会采取订阅制。 也许你不会使用Adobo PhotoShop这一类的专业图像编辑设计软件,所以你可以采用更加简单的Shot Studio。可视化拖拽设计,预设各种平台的应用截图尺寸。 预设尺寸可以选择各个平台符合应用商店截图要求的尺寸 一键导出为png图片,后续会支持对接应用商店API实现一键上传和国际化翻译。 快去macOS应用商店搜索Shot Studio体验吧。

优秀的个人博客,低调大师

🔥 Java 动态编译神器 Janino 和 Liquor 差别

如果你只要 Java7 及以下的语法支持,建议 Janino。如果要你想更全的 Java8、Java11、Java17、Java21 等语法,可以选 Liquor。 1、它们相同的地方 提供的相似的能力接口 接口 Janino Liquor 动态编译器 SimpleCompiler DynamicCompiler 表达式评估器 ExpressionEvaluator LiquorEvaluator (Exprs) 脚本评估器 ScriptEvaluator LiquorEvaluator (Scripts) 都是 Java 语言(语法)的动态应用。生成的字节码都可以完全访问 JRE,可能要注意安全的控制。 2、细节区别处 Janino 基于自已的编译能力实现。 支持 Java7 及以下语法。 单次编译性能,更好。 支持命令行编译。 提供更丰富的功能。比如代码分析器,等。 Liquor 基于 JDK 自带的编译能力实现。 支持 Java8、Java11、Java17、Java21 等语法(由运行时版本决定)。 单次编译性能,差些。 不支持命令行编译。可用 javac 命令。 3、具体差异 - 动态编译器 动态编译器的性能,基本上可以按“次”计量。次数越多,费时越多。尽量把可知代码,合在一起编译(次数,越少越好)。 Janino public class JaninoTest { public static void main(String[] args) throws Exception { //此类,不可以复用(可以通过别的方式,实现多类一起编译) SimpleCompiler compiler = new SimpleCompiler(); String className = "HelloWorld"; String classCode = "public class HelloWorld { " + " public static void helloWorld() { " + " System.out.println(\"Hello, world!\"); " + " } " + "}"; //只能单个编译 compiler.cook(classCode); //再 cook ,则会异常 Class<?> clazz = compiler.getClassLoader().loadClass(className); clazz.getMethod("helloWorld").invoke(null); } } Liquor public class LiquorTest { public static void main(String[] args) throws Exception{ //可以复用(可以,不断的增量编译) DynamicCompiler compiler = new DynamicCompiler(); String className = "HelloWorld"; String classCode = "public class HelloWorld { " + " public static void helloWorld() { " + " System.out.println(\"Hello, world!\"); " + " } " + "}"; //可添加多个源码 compiler.addSource(className, classCode); compiler.build(); //构建后,仍可添加不同类的源码再构建 Class<?> clazz = compiler.getClassLoader().loadClass(className); clazz.getMethod("helloWorld").invoke(null); } } 4、具体差异 - 表达式评估器 比较 Janino Liquor 缓存 无(可以自己包装) 有二级缓存(类加载器缓存,编译结果缓存) 体验 每次要重新构建 方便 性能 单次更好 缓存命名时,非常好(接近原始 Java 代码性能) Janino public class JaninoTest { public static void main(String[] args) throws Exception { //每次要新实例化 ExpressionEvaluator ee = new ExpressionEvaluator(); ee.cook("3 + 4"); System.out.println(ee.evaluate()); } } Liquor public class LiquorTest { public static void main(String[] args) throws Exception { //单例,可复用,线程安全 System.out.println(Exprs.eval("3 + 4")); } } 5、具体差异 - 脚本评估器 比较 Janino Liquor 缓存 无(可以自己包装) 有二级缓存(类加载器缓存,编译结果缓存) 体验 每次要重新构建 方便 性能 单次更好 缓存命名时,非常好(接近原始 Java 代码性能) Janino public class JaninoTest { public static void main(String[] args) throws Exception { //每次要新实例化 ScriptEvaluator se = new ScriptEvaluator(); se.cook("System.out.println(\"hello word\");"); se.evaluate(); } } Liquor public class LiquorTest { public static void main(String[] args) throws Exception { //单例,可复用,线程安全 Scripts.eval("System.out.println(\"hello word\");"); } }

资源下载

更多资源
Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册