首页 文章 精选 留言 我的

精选列表

搜索[国产神器],共5600篇文章
优秀的个人博客,低调大师

javascript开发后端程序的神器nodejs

简介 javascript虽然一直都可以做服务端编程语言,但是它更多的是以客户端编程语言来展示在世人面前的。也许javascript自己都忘记了还可以做服务器端编程,直到2009年nodejs的横空出世。 nodejs的历史 javascript作为一门解释性语言,是不需要像C或者C++那样进行编译的。但是在早期的时候,javascript引擎的执行效率是比较低的,所以导致javascript只能做做dom操作。 随着ajax的兴起和现代web2.0的技术的发展,主流浏览器开发商尽可能的提升javascript的执行效率,最后Chrome V8出现了,Chrome V8是 Chromium 项目开源的 JavaScript 引擎,使得javascript的执行效率得到了极大的提升。 nodejs借着V8浴火重生了。 nodejs从一诞生就获得了极大的关注。比较javascript的开发者还是非常非常多的。而且一门语言可以通用前后端是多么的有吸引力。 nodejs从2009年发展到2020年的nodejs 14,经历了11年的历史,和它的先辈javascript相比还是很年轻,但是因为其开放性和包容性,nodejs在以一个非常快的速度向前发展。 nodejs简介 nodejs借助于V8引擎和一组异步的 I/O 原生功能,极大的提升了nodejs的处理效率。 异步IO我们大家应该都很清楚,和同步IO相比,线程不用阻塞,可以去处理其他更有意义的事情。只是在响应返回的时候恢复操作,所以不会浪费CPU时间。 我们简单看一下nodejs的IO模型: 一个好的语言需要有良好的生态系统相配合,因为语言本身只能提供最基本的一些操作,我们还需要第三方系统来丰富这个语言的生态。 而nodejs的npm仓库,托管着全球最大的开源库生态系统。 基本上使用nodejs你可以实现绝大多数需要的功能。 nodejs的另外一个特点就是简单,考虑一下我们最常用的web应用,如果用java来写,非常麻烦,你还需要一个web服务器。 在nodejs中,一切都是那么的简单: const http = require('http') const hostname = '127.0.0.1' const port = 3000 const server = http.createServer((req, res) => { res.statusCode = 200 res.setHeader('Content-Type', 'text/plain') res.end('welcome to www.flydean.com\n') }) server.listen(port, hostname, () => { console.log(`please visit http://${hostname}:${port}/`) }) 上面的代码就创建了一个web服务,监听在3000端口, 我们首先引入了http模块,用来进行http处理。 接着使用http 的 createServer() 方法会创建新的 HTTP 服务器并返回它。 在createServer方法内部,我们可以设定要返回的对象。 最后启用server.listen功能,来监听特定的端口和服务器,当服务就绪之后,会调用后面的回调函数,执行特定的命令。 每当接收到新的请求的时候,就会触发request事件,request事件可以传递两个参数: request 是一个http.IncomingMessage对象,提供了请求的详细信息。 response 是一个http.ServerResponse对象,用于返回数据给调用方。 在上面的例子中,我们并没有使用request,而是使用response直接构建了返回的对象。 我们设置了statusCode和header,最后使用end来关闭响应。 这就是一个简单使用的nodejs程序。 nodejs的运行环境 nodejs作为js的一种,是一种解释性语言,一般解释性语言都有两种运行方式。 一种是直接运行,一种是开启一个解释性的环境,在其中运行,nodejs也不例外。 直接运行很简单,我们写好nodejs的程序之后,比如app.js,直接这样运行: node app.js 如果直接执行node命令,就会开启REPL模式: node Welcome to Node.js v12.13.1. Type ".help" for more information. > REPL 也被称为运行评估打印循环,是一种编程语言环境(主要是控制台窗口),它使用单个表达式作为用户输入,并在执行后将结果返回到控制台。 REPL有什么作用呢? 第一,我们可以直接在REPL中运行某些测试方法,已验证输出结果。 比如这样: > console.log('www.flydean.com'); www.flydean.com 除此之外REPL还有一些更加有用的功能,我们知道JS中一切皆对象,比如上面我们提到的http对象,如果我们想知道http对象的大概结构怎么办呢? 直接在REPL环境中输入http即可: > http { _connectionListener: [Function: connectionListener], METHODS: [ 'ACL', 'BIND', 'CHECKOUT', 'CONNECT', 'COPY', 'DELETE', 'GET', 'HEAD', 'LINK', 'LOCK', 'M-SEARCH', 'MERGE', 'MKACTIVITY', 'MKCALENDAR', 'MKCOL', 'MOVE', 'NOTIFY', 'OPTIONS', 'PATCH', 'POST', 'PROPFIND', 'PROPPATCH', 'PURGE', 'PUT', 'REBIND', 'REPORT', 'SEARCH', 'SOURCE', 'SUBSCRIBE', 'TRACE', 'UNBIND', 'UNLINK', 'UNLOCK', 'UNSUBSCRIBE' ], STATUS_CODES: { '100': 'Continue', '101': 'Switching Protocols', '102': 'Processing', '103': 'Early Hints', '200': 'OK', '201': 'Created', '202': 'Accepted', '203': 'Non-Authoritative Information', '204': 'No Content', '205': 'Reset Content', '206': 'Partial Content', '207': 'Multi-Status', '208': 'Already Reported', '226': 'IM Used', '300': 'Multiple Choices', '301': 'Moved Permanently', '302': 'Found', '303': 'See Other', '304': 'Not Modified', '305': 'Use Proxy', '307': 'Temporary Redirect', '308': 'Permanent Redirect', '400': 'Bad Request', '401': 'Unauthorized', '402': 'Payment Required', '403': 'Forbidden', '404': 'Not Found', '405': 'Method Not Allowed', '406': 'Not Acceptable', '407': 'Proxy Authentication Required', '408': 'Request Timeout', '409': 'Conflict', '410': 'Gone', '411': 'Length Required', '412': 'Precondition Failed', '413': 'Payload Too Large', '414': 'URI Too Long', '415': 'Unsupported Media Type', '416': 'Range Not Satisfiable', '417': 'Expectation Failed', '418': "I'm a Teapot", '421': 'Misdirected Request', '422': 'Unprocessable Entity', '423': 'Locked', '424': 'Failed Dependency', '425': 'Unordered Collection', '426': 'Upgrade Required', '428': 'Precondition Required', '429': 'Too Many Requests', '431': 'Request Header Fields Too Large', '451': 'Unavailable For Legal Reasons', '500': 'Internal Server Error', '501': 'Not Implemented', '502': 'Bad Gateway', '503': 'Service Unavailable', '504': 'Gateway Timeout', '505': 'HTTP Version Not Supported', '506': 'Variant Also Negotiates', '507': 'Insufficient Storage', '508': 'Loop Detected', '509': 'Bandwidth Limit Exceeded', '510': 'Not Extended', '511': 'Network Authentication Required' }, Agent: [Function: Agent] { defaultMaxSockets: Infinity }, ClientRequest: [Function: ClientRequest], IncomingMessage: [Function: IncomingMessage], OutgoingMessage: [Function: OutgoingMessage], Server: [Function: Server], ServerResponse: [Function: ServerResponse], createServer: [Function: createServer], get: [Function: get], request: [Function: request], maxHeaderSize: [Getter], globalAgent: [Getter/Setter] } 直接输出了http对象的简洁结构,我们还可以使用tab按钮来自动补全http的方法: > http. http.__defineGetter__ http.__defineSetter__ http.__lookupGetter__ http.__lookupSetter__ http.__proto__ http.constructor http.hasOwnProperty http.isPrototypeOf http.propertyIsEnumerable http.toLocaleString http.toString http.valueOf http.Agent http.ClientRequest http.IncomingMessage http.METHODS http.OutgoingMessage http.STATUS_CODES http.Server http.ServerResponse http._connectionListener http.createServer http.get http.globalAgent http.maxHeaderSize http.request PREL还支持一些特定的点操作: > .help .break Sometimes you get stuck, this gets you out .clear Alias for .break .editor Enter editor mode .exit Exit the repl .help Print this help message .load Load JS from a file into the REPL session .save Save all evaluated commands in this REPL session to a file PERL还有一个特殊变量 _ ,如果在某些代码之后输入 _,则会打印最后一次操作的结果。 process process 对象是一个全局变量,提供了有关当前 Node.js 进程的信息并对其进行控制。 作为全局变量,它始终可供 Node.js 应用程序使用,无需使用 require()。 它也可以使用 require() 显式地访问。 因为process代表的是nodejs的进程信息,所以可以处理进程终止,读取环境变量,接收命令行参数等作用。 终止进程 先看一下怎么使用process来终止进程: process.exit(0) 0表示正常退出,当然,我们可以传入不同的退出码,表示不同的含义。 正常情况下,如果没有异步操作正在等待,那么 Node.js 会以状态码 0 退出,其他情况下,会用如下的状态码: 1 未捕获异常 - 一个未被捕获的异常, 并且没被 domain 或 'uncaughtException' 事件处理器处理。 2 - 未被使用 (Bash 为防内部滥用而保留) 3 内部的 JavaScript 解析错误 - Node.js 内部的 JavaScript 源代码在引导进程中导致了一个语法解析错误。一般只会在开发 Node.js 本身的时候出现。 4 内部的 JavaScript 执行失败 - 引导进程执行 Node.js 内部的 JavaScript 源代码时,返回函数值失败。一般只会在开发 Node.js 本身的时候出现。 5 致命错误 - 在 V8 中有一个致命的错误。 比较典型的是以 FATALERROR 为前缀从 stderr 打印出来的消息。 6 非函数的内部异常处理 - 发生了一个内部异常,但是内部异常处理函数被设置成了一个非函数,或者不能被调用。 7 内部异常处理运行时失败 - 有一个不能被捕获的异常,在试图处理这个异常时,处理函数本身抛出了一个错误。比如, 如果一个 'uncaughtException' 或者 domain.on('error') 处理函数抛出了一个错误。 8 - 未被使用,在之前版本的 Node.js, 退出码 8 有时候表示一个未被捕获的异常。 9 - 不可用参数 - 某个未知选项没有确定,或者没给必需要的选项填值。 10 内部的 JavaScript 运行时失败 - 调用引导函数时,引导进程执行 Node.js 内部的 JavaScript 源代码抛出错误。 一般只会在开发 Node.js 本身的时候出现。 12 不可用的调试参数 13 未完成的Top-Level Await: await传入的Promise一直没有调用resolve方法 128 退出信号 - 如果 Node.js 接收到致命信号, 诸如 SIGKILL 或 SIGHUP,那么它的退出代码将是 128 加上信号的码值。 例如,信号 SIGABRT 的值为 6,因此预期的退出代码将为 128 + 6 或 134。 我们可以通过process的on方法,来监听信号事件: process.on('SIGTERM', () => { server.close(() => { console.log('进程已终止') }) }) 什么是信号?信号是一个 POSIX 内部通信系统:发送通知给进程,以告知其发生的事件。 或者我们可以从程序内部发送这个信号: process.kill(process.pid, 'SIGTERM') env 因为process进程是和外部环境打交道的,process提供了env属性,该属性承载了在启动进程时设置的所有环境变量。 默认情况下,env中的NODE_ENV被设置为development。 process.env.NODE_ENV // "development" 我们可以通过修改这个环境变量,来切换nodejs的不同运行环境。 argv process提供了argv来接收外部参数。 比如: node app.js joe argv是一个包含所有命令行调用参数的数组。 上面的例子中,第一个参数是 node 命令的完整路径。第二个参数是正被执行的文件的完整路径。所有其他的参数从第三个位置开始。 要想获取joe,我们可以这样做: const args = process.argv.slice(2) args[0] 如果是key=value的情况,我们可以这样传参数,并且使用minimist 库来处理参数: node app.js --name=joe const args = require('minimist')(process.argv.slice(2)) args['name'] //joe CLI交互 从 nodejs7开始,nodejs提供了readline模块,可以从process.stdin获取输入: const readline = require('readline').createInterface({ input: process.stdin, output: process.stdout }) readline.question(`how are you?`, answer => { console.log(`${answer}!`) readline.close() }) 如果需要更加复杂的操作,则可以使用Inquirer.js: const inquirer = require('inquirer') var questions = [ { type: 'input', name: 'hello', message: "how are you?" } ] inquirer.prompt(questions).then(answers => { console.log(`${answers['hello']}!`) }) exports模块 nodejs拥有内置的模块系统,当我们需要使用其他lib提供的功能时候,我们可以使用require来引入其他lib公开的模块。 但是前提是该lib需要公开,也就是exports对应的模块出来。 nodejs的对象导出有两种方式module.exports和将对象添加为 exports 的属性。 先看第一种方式,square 模块定义在 square.js 中: module.exports = class Square { constructor(width) { this.width = width; } area() { return this.width ** 2; } }; 下面的例子中, bar.js 使用了导出 Square 类的 square 模块: const Square = require('./square.js'); const mySquare = new Square(2); console.log(`mySquare 的面积是 ${mySquare.area()}`); 再看第二种方式,定义一个circle.js: const { PI } = Math; exports.area = (r) => PI * r ** 2; exports.circumference = (r) => 2 * PI * r; 使用: const circle = require('./circle.js'); console.log(`半径为 4 的圆的面积是 ${circle.area(4)}`); 两者都可以导出特定的模块,但是module.exports只会导出特定的对象,而exports是将对象添加为exports的属性,我们还需要根据属性名称来查找对象的属性。 nodejs API 除了我们上面提到的http,process, nodejs还提供了很多其他非常有用的API : nodejs的框架 除了基本的nodejs之外,nodejs还有非常多优秀的框架,借助这些框架我们可以是nodejs程序的搭建更加容易和强大。 像AdonisJs,express,koa,Socket.io等等。 本文作者:flydean程序那些事 本文链接:http://www.flydean.com/nodejs-kickoff/ 本文来源:flydean的博客 欢迎关注我的公众号:「程序那些事」最通俗的解读,最深刻的干货,最简洁的教程,众多你不知道的小技巧等你来发现!

优秀的个人博客,低调大师

Prometheus监控神器-服务发现篇(一)

本章节主要讲自动发现使用场景介绍与Prometheus基于文件、DNS的自动发现配置. 当我们使用各类exporter分别对系统、数据库和HTTP服务进行监控指标采集,对于所有监控指标对应的Target的运行状态和资源使用情况,都是用Prometheus的静态配置功能 static_configs 来 手动添加主机IP和端口,然后重载服务让Prometheus发现。 对于一组比较少的服务器的测试环境中,这种手动方式添加配置信息是最简单的方法。但是实际生产环境中,对于成百上千的节点组成的大型集群又或者Kubernetes这样的大型集群,很明显,手动方式捉襟见肘了。为此,Prometheus提前已经设计了一套服务发现功能。 Prometheus 服务发现能够自动检测分类,并且能够识别新节点和变更节点。也就是说,可以在容器或者云平台中,自动发现并监控节点或更新节点,动态的进行数据采集和处理。目前 Prometheus 已经支持了很多常见的自动发现服务,比如 consul ec2 gce serverset_sd_config openStack kubernetes 等等。我们常用的就是sd_config、DNS、kubernetes、consul这些足够了。如果有需要其他配置的探讨,可以与我交流,我可以补上来。 本章节中会对Prometheus自动发现中的基于文件、DNS进行发现讲解,consul 在后面会单独展开来讲,如何可以使其完美的解决当前场景下常见的各类服务发现监控。 为什么要用自动发现? 在基于云(IaaS或者CaaS)的基础设施环境中用户可以像使用水、电一样按需使用各种资源(计算、网络、存储)。按需使用就意味着资源的动态性,这些资源可以随着需求规模的变化而变化。例如在AWS中就提供了专门的AutoScall服务,可以根据用户定义的规则动态地创建或者销毁EC2实例,从而使用户部署在AWS上的应用可以自动的适应访问规模的变化。 这种按需的资源使用方式对于监控系统而言就意味着没有了一个固定的监控目标,所有的监控对象(基础设施、应用、服务)都在动态的变化。对于Nagias这类基于Push模式传统监控软件就意味着必须在每一个节点上安装相应的Agent程序,并且通过配置指向中心的Nagias服务,受监控的资源与中心监控服务器之间是一个强耦合的关系,要么直接将Agent构建到基础设施镜像当中,要么使用一些自动化配置管理工具(如Ansible、Chef)动态的配置这些节点。当然实际场景下除了基础设施的监控需求以外,我们还需要监控在云上部署的应用,中间件等等各种各样的服务。要搭建起这样一套中心化的监控系统实施成本和难度是显而易见的。 而对于Prometheus这一类基于Pull模式的监控系统,显然也无法继续使用的static_configs的方式静态的定义监控目标。而对于Prometheus而言其解决方案就是引入一个中间的代理人(服务注册中心),这个代理人掌握着当前所有监控目标的访问信息,Prometheus只需要向这个代理人询问有哪些监控目标控即可, 这种模式被称为服务发现。 Service-Disover 在不同的场景下,会有不同的东西扮演者代理人(服务发现与注册中心)这一角色。比如在AWS公有云平台或者OpenStack的私有云平台中,由于这些平台自身掌握着所有资源的信息,此时这些云平台自身就扮演了代理人的角色。Prometheus通过使用平台提供的API就可以找到所有需要监控的云主机。在Kubernetes这类容器管理平台中,Kubernetes掌握并管理着所有的容器以及服务信息,那此时Prometheus只需要与Kubernetes打交道就可以找到所有需要监控的容器以及服务对象。Prometheus还可以直接与一些开源的服务发现工具进行集成,例如在微服务架构的应用程序中,经常会使用到例如Consul这样的服务发现注册软件,Promethues也可以与其集成从而动态的发现需要监控的应用服务实例。除了与这些平台级的公有云、私有云、容器云以及专门的服务发现注册中心集成以外,Prometheus还支持基于DNS以及文件的方式动态发现监控目标,从而大大的减少了在云原生,微服务以及云模式下监控实施难度。 prom-pull-push 如上所示,展示了Push系统和Pull系统的核心差异。相较于Push模式,Pull模式的优点可以简单总结为以下几点: 只要Exporter在运行,你可以在任何地方(比如在本地),搭建你的监控系统; 你可以更容易的查看监控目标实例的健康状态,并且可以快速定位故障; 更利于构建DevOps文化的团队; 松耦合的架构模式更适合于云原生的部署环境。 基于文件的服务发现 在Prometheus支持的众多服务发现的实现方式中,基于文件的服务发现是最通用的方式。这种方式不需要依赖于任何的平台或者第三方服务。对于Prometheus而言也不可能支持所有的平台或者环境。通过基于文件的服务发现方式下,Prometheus会定时从文件中读取最新的Target信息,因此,你可以通过任意的方式将监控Target的信息写入即可。用户可以通过JSON或者YAML格式的文件,定义所有的监控目标。例如,在下面的yaml文件中分别定义了2个采集任务,以及每个任务对应的Target列表: yaml格式 - targets: ['192.168.1.220:9100'] labels: app: 'app1' env: 'game1' region: 'us-west-2'- targets: ['192.168.1.221:9100'] labels: app: 'app2' env: 'game2' region: 'ap-southeast-1' json格式 [ { "targets": [ "192.168.1.221:29090"], "labels": { "app": "app1", "env": "game1", "region": "us-west-2" } }, { "targets": [ "192.168.1.222:29090" ], "labels": { "app": "app2", "env": "game2", "region": "ap-southeast-1" } }] 同时还可以通过为这些实例添加一些额外的标签信息,例如使用env标签标示当前节点所在的环境,这样从这些实例中采集到的样本信息将包含这些标签信息,从而可以通过该标签按照环境对数据进行统计。 在Prometheus配置文件中添加以下内容: - job_name: 'file_sd_test' scrape_interval: 10s file_sd_configs: - files: - /data/prometheus/static_conf/*.yml - /data/prometheus/static_conf/*.json 这里定义了一个基于file_sd_configs的监控采集test任务,其中模式的任务名称为file_sd_test。在yml文件中可以使用yaml标签覆盖默认的job名称,然后重载Prometheus服务。 service prometheus restat 在Prometheus UI的Targets下就可以看到当前从targets.json文件中动态获取到的Target实例信息以及监控任务的采集状态,同时在Labels列下会包含用户添加的自定义标签: file_sd_-test Prometheus默认每5m重新读取一次文件内容,当需要修改时,可以通过refresh_interval进行设置,例如: - job_name: 'file_sd_test' scrape_interval: 10s file_sd_configs: - refresh_interval: 30s # 30s重载配置文件 files: - /data/prometheus/static_conf/*.yml - /data/prometheus/static_conf/*.json 通过这种方式,Prometheus会自动的周期性读取文件中的内容。当文件中定义的内容发生变化时,不需要对Prometheus进行任何的重启操作。 这种通用的方式可以衍生了很多不同的玩法,比如与自动化配置管理工具(Ansible)结合、与Cron Job结合等等。对于一些Prometheus还不支持的云环境,比如国内的阿里云、腾讯云等也可以使用这种方式通过一些自定义程序与平台进行交互自动生成监控Target文件,从而实现对这些云环境中基础设施的自动化监控支持。 基于DNS的发现 对于一些环境,可能基于文件与consul服务发现已经无法满足的时候,我们可能就需要DNS来做服务发现了。在互联网架构中,我们使用主机节点或者Kubernetes集群通常是不对外暴露IP的,这就要求我们在一个内部局域网或者专用的网络中部署DNS服务器,使用DNS服务来完成内部网络中的域名解析工作。这个时候我们就可以使用Prometheus的DNS服务发现,Prometheus的DNS服务发现有俩种方法,第一种是使用DNA A记录来做自动发现,第二种方法是DNS SRV,第一种显然没有没有SRV资源记录更为便捷,在这里就把俩种配置全部做一遍,对于取决用什么,根据你自己的环境来抉择。 DNA A记录发现配置,首先你内网需要有一个DNS服务器,或者直接自行配置解析记录即可,我这里使用的dnsmasq服务在内网测试 # 验证 test1 DNS记录nslookup test1.example.comServer: 127.0.0.53Address: 127.0.0.53#53Non-authoritative answer:Name: test1.example.comAddress: 192.168.1.221# 验证 test2 DNS记录nslookup test2.example.comServer: 127.0.0.53Address: 127.0.0.53#53Non-authoritative answer:Name: test2.example.comAddress: 192.168.1.222 Prometheus配置 # 基于DNS A记录发现 - job_name: 'DNS-A' # job 名称 metrics_path: "/metrics" # 路径 dns_sd_configs: - names: ["test1.example.com", "test2.example.com"] # A记录 type: A # 解析类型 port: 29100 # 端口 重启Prometheus 在targets中可以看到dns-a记录 dns-a DNS SRV是DNS资源记录中的一种记录类型,用来指定服务器地址与端口,并且可以设置每个服务器的优先级和权重。访问到服务的时候,本地的DNS resolver 从DNS服务器获取一个地址列表,然后根据优先级和权重来选择一个地址作为本次请求的目标地址。 SRV的记录格式: _service._proto.name. TTL class SRV priority weight port target 参数 说明 _service 服务名称,前缀 _ 是为了防止与DNS 标签(域名)冲突 proto 服务使用的通讯协议 通常是 tcp udp name 此记录有效域名 TTL 标准DNS class 字段 如 IN priority 记录优先级,数值越小,优先级越高。[0-65535] weight 记录权重,数值越大,权重越高。[0-65535] port 服务使用端口 target 使用服务的主机地址名称 这里没有使用named,而是使用的dnsmasq来做的测试,添加SRV记录完成后,需要重启dnsmasq服务使其生效。 # 配置dns解析cat /etc/dnsmasq.d/localdomain.confaddress=/test1.example.com/192.168.1.221address=/test2.example.com/192.168.1.222# 添加 SRV 记录cat /etc/dnsmasq.confsrv-host =_prometheus._tcp.example.com,test1.example.com,29100srv-host =_prometheus._tcp.example.com,test2.example.com,29100# 验证srv服务是否正确,192.168.1.123 是内部DNS服务器,dig @192.168.1.123 +noall +answer SRV _prometheus._tcp.example.comoutput..._prometheus._tcp.example.com. 0 IN SRV 0 0 9100 test1.example.com._prometheus._tcp.example.com. 0 IN SRV 0 0 9100 test2.example.com. Prometheus配置完成以后,重载Prometheus服务。 - job_name: 'DNS-SRV' # 名称 metrics_path: "/metrics" # 获取数据的路径 dns_sd_configs: # 配置使用DNS解析 - names: ['_prometheus._tcp.example.com'] # 配置SRV对应的解析地址 这个时候在targets中可以看到DNS自动发现的记录了。 DNS-SRV 这个时候,我们在新加一个记录,用来做自动发现。 # 添加test0解析cat /etc/dnsmasq.d/localdomain.confaddress=/test1.example.com/192.168.1.221address=/test2.example.com/192.168.1.222address=/test0.example.com/192.168.1.220# 添加 test0 SRV 记录cat /etc/dnsmasq.confsrv-host =_prometheus._tcp.example.com,test1.example.com,29100srv-host =_prometheus._tcp.example.com,test2.example.com,29100srv-host =_prometheus._tcp.example.com,test0.example.com,19100# 验证dns SRV记录是否成功dig @192.168.1.123 +noall +answer SRV _prometheus._tcp.example.com_prometheus._tcp.example.com. 0 IN SRV 0 0 19100 test0.example.com._prometheus._tcp.example.com. 0 IN SRV 0 0 29100 test2.example.com._prometheus._tcp.example.com. 0 IN SRV 0 0 29100 test1.example.com. 这个时候在去观察targets就发现已经可以自动发现test0了。 DNS-SRV-1 本文分享自微信公众号 - Kubernetes技术栈(k8stech)。如有侵权,请联系 support@oschina.cn 删除。本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

优秀的个人博客,低调大师

Java单元测试神器之Mockito

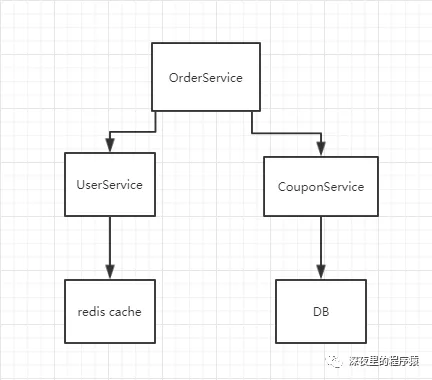
什么是 Mock 测试 ? Mock测试就是在测试过程中,对于某些不容易构造或者不容易获取的对象,用一个虚拟的对象来创建以便测试的测试方法。什么是不容易构造的对象呢?例如HttpServletRequest,需要在有servlet容器环境中创建获取。那不容易获取的对象呢?如一个JedisCluster,需要准备redis相关环境,然后设置进去等等。 Mock 可以分解在单元测试中耦合的其他类或者接口,它能够帮你模拟这些依赖,并帮你验证所调用的依赖的行为。 场景事例 当我们需要测试OrderService时,按照我们常规的做法呢,都是要先准备好redis,跟db的环境,然后构造UserService跟CouponService注入进来,此时需要构建完整的依赖树,其过程是比较繁琐的,万一数据库连不上,依赖找不到... 时间一长可能会打击我们对项目进行单测的积极性,所以这时候很有必要寻求一种优雅的方式来解决。 铛铛铛~这时候Mockito出现了(java中Mock框架比较多,但是本篇只介绍这个),它会把那些繁琐的依赖统统转化为Mock Object,如下图,这样我们就可以专注的进行我们的单测,减少在解决依赖上浪费的时间了。 直接开干 关于Mockito的简介这里就不在赘述了,大家有兴趣可以自行去官方文档查阅,这里主要带大家了解一些常用的Mock方法。 maven依赖 <dependency> <groupId>org.mockito</groupId> <artifactId>mockito-core</artifactId> <version>2.23.4</version> <scope>test</scope></dependency> 为了代码测试的方便,直接在测试类中静态导入import static org.mockito.Mockito.*; 基础方法 @Test publicvoidtestMockBase(){ //创建ArrayList的Mock对象 ListmockList=mock(ArrayList.class); //pass Assert.assertTrue(mockListinstanceofArrayList); //当我们mockList调用方法去add("张三")的时候会返回true when(mockList.add("张三")).thenReturn(true); //当我们mockList调用方法size()的时候返回10 when(mockList.size()).thenReturn(10); //pass Assert.assertTrue(mockList.add("张三")); //pass Assert.assertFalse(mockList.add("李四")); //pass Assert.assertEquals(mockList.size(),10); //null System.out.println(mockList.get(0)); } mock静态方法会创建一个Mock对象,由于 Mock对象 并不会真的执行方法中的代码,所以如果未指定返回值的话会返回默认值。我们指定了mockList在执行特定方法后需要返回的值,所以在assertTrue校验是没问题的,when().thenReturn() 表示当执行到某个指定的方法时,返回特定的内容,但是add("李四"),我们并没设置,所以是false。 校验方法调用次数 //使用mock List mockedList = mock(ArrayList.class); mockedList.add("once"); mockedList.add("twice"); mockedList.add("twice"); mockedList.add("three times"); mockedList.add("three times"); mockedList.add("three times"); //这里默认是判断该方法调用times(1),同下 verify(mockedList).add("once"); verify(mockedList, times(1)).add("once"); verify(mockedList, times(2)).add("twice"); verify(mockedList, times(3)).add("three times"); //从没调用,times(0) verify(mockedList, never()).add("never happened"); //最少一次,最少几次,最多几次 verify(mockedList, atLeastOnce()).add("three times"); verify(mockedList, atLeast(2)).add("three times"); verify(mockedList, atMost(5)).add("three times"); 其实在上述的代码中,命名是比较直观的,所以我这边就直接注释在代码中了。 校验方法调用时长 //方法执行在100ms以内的时候可以通过 verify(mock,timeout(100)).someMethod(); //同上 verify(mock, timeout(100).times(1)).someMethod(); //方法2次调用均没超过100ms verify(mock, timeout(100).times(2)).someMethod(); verify(mock,timeout(100).atLeast(2)).someMethod(); 通过超时检测可以校验我们的方法逻辑会不会有出现问题而导致超时的地方。 参数匹配 linkedList.add("element"); // anyInt() 任何整数我们都返回 element when(linkedList.get(anyInt())).thenReturn("element"); System.out.print(linkedList.get(10));//返回element 方法抛出异常​​​​​​ @Test(expected = RuntimeException.class) publicvoiddoThrow(){ List list = mock(List.class); doThrow(new RuntimeException()).when(list).add(1); list.add(1); } 使用注解注入 public class ArticleManagerTest { @Mock private ArticleCalculator calculator; @Mock private ArticleDatabase database; @Mock private UserProvider userProvider; privateArticleManagermanager; 要注意的是,通过注解的方式用使用的话,我们必须在添加初始化mock的代码,不然即使标注了注解也会是null MockitoAnnotations.initMocks(testClass); 关于Mockito更多详细的用法,大家可以直接参考官方文档,因为各种“骚操作”确实比较多,后面也更新对java8 lambda的支持,很多功能还是期待大家去挖掘~ 更多详细用法可直接参考官方文档: https://static.javadoc.io/org.mockito/mockito-core/2.25.1/org/mockito/Mockito.html#0 相信当你熟练使用Mockito以后,你会爱上写单测的,也会让你代码更加健壮。有些bug能提前发现的话,总比运行的时候被别人半夜叫起来修复舒服是吧? 喜欢的话,关注微信公众号《深夜里的程序员》,每天发布高质量IT干货,还有惊喜等着你~

优秀的个人博客,低调大师

HTTP引流神器Goreplay详解【精译】

0.背景 校验系统的正确性和可靠性时,仅靠用例场景无法覆盖全生产环境下的所有场景,需要一套引流工具,在系统正式上线前,用线上的请求测试待上线系统,在正常请求下,是否有报错;在数倍请求下,系统的性能瓶颈。引流工具有goreplay,tcpcopy等,下面介绍goreplay,原名叫gor,因为其易上手,且功能比较全。 关于 GoReplay是在投入生产之前使用真实流量测试您的应用的最简单和最安全的方式。 随着应用程序的增长,测试所需的工作量也呈指数增长。GoReplay为您提供了重复使用现有流量进行测试的简单想法,这使得它非常强大。我们的先进技术可让您分析和记录您的应用程序流量,而不会对其造成影响。这消除了将第三方组件置于关键路径中带来的风险。 GoReplay增加了您对代码部署,配置更改和基础设施更改的信心。我们有没有提到不需要编码? 这里是基本的工作流程:侦听器服务器捕获http流量并将其发送到重放服务器或保存到文件。重播服务器将流量转发给给定的地址。 检查最新的文档。 安装 从https://github.com/buger/goreplay/releases下载最新的二进制文件或自行编译。 入门 最基本的设置将是sudo ./gor --input-raw :8000 --output-stdouttcpdump。如果你已经有测试环境,你可以开始重播:sudo ./gor --input-raw :8000 --output-http http://staging.env:80。如果要保留domain/host,请用: ./goreplay --input-raw :80 --output-http x.x.x.x:port --http-original-host 有关更多信息,请参阅我们的文档和入门页面。 通讯 订阅我们的通讯,随时了解Gor项目的最新功能和变化。 想要升级? 我们创建了一个GoReplay PRO扩展,它提供了其他功能,例如支持Thrift或ProtocolBuffers等二进制协议,从云存储中进行保存和重放,TCP会话复制等.PRO版本还包括适用于商业的许可证,专用支持和它也可以让你支持高质量的开源开发。 问题? 如果您遇到问题,请查看FAQ和故障排除wiki页面。为问题搜索问题也是一个好主意。 所有的错误报告和建议应该通过Github问题或我们的Google小组(您可以发送电子邮件到gor-users@googlegroups.com)。如果您有私人问题,请随时发送电子邮件至support@gortool.com。 特约 把它叉起来 创建你的功能分支(git checkout -b my-new-feature) 提交您的更改(git commit -am'添加了一些功能') 推到分支(git push origin my-new-feature) 创建新的请求 依赖 要开始使用Gor,您需要在您的机器上运行Web服务器,并且需要终端来运行命令。如果您只是在四处漫游,您可以通过调用快速启动服务器gor file-server :8000,这将启动当前目录在端口上的简单文件服务器8000。 安装Gor 从https://github.com/buger/gor/releases下载最新的Gor二进制文件(我们为Windows,Linux x64和Mac OS提供预编译的二进制文件),或者您可以自己编译编译。 一旦档案被下载并解压缩,您可以从当前目录运行Gor,或者您可能想要将二进制文件复制到您的PATH(可用于Linux和Mac OS/usr/local/bin)。 捕获网络流量 现在在终端中运行这个命令:sudo ./gor --input-raw :8000 --output-stdout 该命令表示监听端口8000上发生的所有网络活动并将其记录到stdout。如果您熟悉tcpdump,我们将实施类似的功能。 您可能会注意到它使用sudo并要求输入密码:要分析网络,Gor需要只有超级用户才能使用的权限。但是,可以将Gor配置为针对非root用户运行。 通过http://localhost:8000在浏览器中打开或通过在终端中调用curl来发出一些请求curl http://localhost:8000。您应该看到将gor所有HTTP请求输出到正在运行的终端窗口。请注意,默认GoReplay不会跟踪回复,您可以使用--output-http-track-response选项启用它们。 Gor不是代理人:你不需要将第三方工具放到关键路径上。相反,Gor只是默默地分析你的应用程序的流量,并不影响它。 重播 现在是时候将您的原始流量重放到其他环境。让我们开始使用同一个文件Web服务器,但是在不同的端口上:gor file-server :8001。 而不是--output-stdout我们将使用--output-http并提供第二台服务器的URL:sudo ./gor --input-raw :8000 --output-http="http://localhost:8001" 向第一台服务器发出少量请求。你应该看到他们复制到第二个,瞧! 将请求保存到文件并稍后重播 有时候不可能实时重放请求;Gor允许您保存对文件的请求并稍后重播。 首先用它--output-file来保存它们:sudo ./gor --input-raw :8000 --output-file=requests.gor。这将创建新文件并不断向其写入所有捕获的请求。 让我们重新运行Gor,但现在重播来自文件的请求:./gor --input-file requests.gor --output-http="http://localhost:8001"。您应该看到所有记录到第二台服务器的请求,并且它们将以相同的顺序重播,并且与录制的时间完全相同。 基础 概观 Gor架构试图遵循UNIX哲学:所有东西都由管道组成,各种输入将数据复用到输出。 您可以[速率限制](速率限制),[过滤器](请求过滤),[重写](请求重写)请求,甚至使用您自己的中间件来实现定制逻辑。此外,还可以以较高的速率重播请求,以进行[负载测试](保存和从文件中重放)。 可用的输入和输出插件 可用输入: --input-raw- 用于捕获HTTP流量,您应该指定IP地址或接口和应用程序端口。有关捕获和重放流量的更多信息。 --input-file- 接受之前使用的文件--output-file。更多关于保存和从文件重播 --input-tcp- 如果您决定将来自多个转发器Gor实例的流量转发给它,则由Gor聚合实例使用。阅读关于使用Aggregator-forwarder设置。 可用输出: --output-http- 重放HTTP流量到给定的端点,接受基础URL。阅读[关于它的更多信息](重播HTTP流量) --output-file- 记录传入的流量到文件。更多关于保存和从文件重播 --output-tcp- 将传入数据转发给另一个Gor实例,并与其一起使用--input-tcp。阅读关于Aggregator-forwarder设置的更多信息。 --output-stdout- 用于调试,输出所有数据到stdout。 捕获和重放流量 想想Gor更像网络分析器或tcpdump类固醇,它不是代理,不会影响你的应用程序。您指定应用程序端口,它将捕获并重放传入数据。 最简单的设置将是: #在您想要捕获流量的服务器上运行。你可以在每台“网络”机器上运行它。 sudo gor --input-raw:80 --output-http http://staging.com 它将记录和重放来自同一台机器的流量。但是,当您的Web计算机上的Gor将流量转发到在单独的服务器上运行的Gor聚合器实例时,可以使用Aggregator-forwarder设置。 您可能会注意到它需要sudo:分析仅适用于root用户的网络Gor需求权限。但是,可以配置Gor [为非root用户运行beign](以非root用户身份运行)。 转发到多个地址 您可以将流量转发到多个端点。 gor --input-tcp :28020 --output-http "http://staging.com" --output-http "http://dev.com" 分割交通 默认情况下,它会将相同的流量发送到所有输出,但您可以使用选项来平分它(循环)--split-output。 gor --input-raw :80 --output-http "http://staging.com" --output-http "http://dev.com" --split-output true 跟踪回复 默认情况下input-raw不拦截回复,只是请求。您可以使用--input-raw-track-response选项打开回复跟踪。启用时,您将能够访问中间件和中间件中的响应信息output-file。 交通拦截引擎 默认情况下,Gor将libpcap用于拦截流量,它应该在大多数情况下工作。如果你有任何问题,你可以尝试替代引擎:raw_socket。 sudo gor --input-raw :80 --input-raw-engine "raw_socket" --output-http "http://staging.com" 您可以阅读关于重播HTTP流量的更多信息。 跟踪原始IP地址 您可以使用--input-raw-realip-header选项指定标题名称:如果不是空白,则将具有给定名称和真实IP值的标题注入请求有效内容。通常,这个标题应该被命名为:X-Real-IP,但是你可以指定任何名字。 gor --input-raw :80 --input-raw-realip-header "X-Real-IP" ... 重播HTTP流量 Gor可以使用--output-http选项重播HTTP流量: sudo ./gor --input-raw:8000 --output-http = “ http://staging.env ” 您可以即时[过滤](请求过滤),[速率限制](速率限制)和[重写](请求重写)请求。 HTTP输出工作者 默认情况下,Gor创建一个动态工作池:它从10开始,并在HTTP输出队列长度大于10时创建更多的HTTP输出工作者。创建的工人数量(N)等于该工作时间的队列长度检查并发现其长度大于10.每次将消息写入HTTP输出队列时都检查队列长度。在产生N名工人的请求得到满足之前,不会再有工人产卵。如果动态工作人员当时不能处理消息,它将睡眠100毫秒。如果动态工作人员无法处理消息2秒钟,则会死亡。您可以使用--output-http-workers=20选项指定固定数量的工人。 重定向之后 默认情况下,Gor会忽略所有重定向,因为它们是由使用您的应用的客户端处理的,但在重播环境引入新重定向的情况下,您可以像这样启用它们: gor --input-tcp replay.local:28020 --output-http http://staging.com --output-http-redirects 2 给出的示例将跟随每个请求最多2个重定向。 HTTP超时 默认情况下,http请求和响应的超时时间为5秒。你可以像这样覆盖它: gor --input-tcp replay.local:28020 --output-http http://staging.com --output-http-timeout 30s 响应缓冲区 默认情况下,为了减少内存消耗,内部HTTP客户端将获取响应主体的最大200kb(在使用中间件时使用),通过使用--output-http-response-buffer选项可增加限制(接受字节数)。 基本身份验证 如果您的开发或登台环境受基本身份验证保护,那么可以在重放期间注入这些凭据: gor --input-raw :80 --output-http "http://user:pass@staging.com" 注意:这将覆盖原始请求中的任何授权标头。 多域支持 如果你的应用程序接受来自多个域的流量,并且你想保留原始头文件,具体--http-original-host告诉Gor不要触摸Host头文件。 保存并从文件中重放 您可以将请求保存到文件,并在稍后重播。重播时将保留请求之间的原始时间差异。如果您在两个请求之间应用[基于百分比的限制](速率限制)时间点,则会适当减少或增加:此方法可开启负载测试等可能性,请参见下文。 #写入文件 gor --input-raw:80 --output-file requests.log #从文件读取 gor --input-file requests.gor --output-http “ http://staging.com ” 默认情况下,Gor以块的形式写入文件。这个可配置的使用--output-file-append选项:刷新的块被附加到存在文件或不附加。默认值是false。默认情况下,--output-file将每个块刷新到不同的路径。 gor ... --output-file%Y%m%d.log # append false 20140608_0.log 20140608_1.log 20140609_0.log 20140609_1.log 这使并行文件处理变得容易。但是如果你想禁用这种行为,你可以通过添加--output-file-append选项来禁用它: gor ... --output-file%Y%m%d.log --output-file-append # append true 20140608.log 20140609.log 如果您多次运行gor并找到现有文件,它将从最后一个已知索引继续。 块大小 您可以使用--output-file-size-limit和--output-file-queue-limit选项设置块限制。块队列的长度和每个块的大小。默认值分别是256和32mb。可以使用后缀“k”(KB),“m”(MB)和“g”(GB)output-file-size-limit。如果你只想要大小限制,你可以设置--output-file-queue-limit为0,反之亦然。 gor --input-raw:80 --output-file%Y-%m-%d.gz --output-file-size-limit 256m --output-file-queue-limit 0 在文件名中使用日期变量 例如,您可以告诉每小时创建一个新文件:--output-file /mnt/logs/requests-%Y-%m-%d-%H.log它将为每个小时创建一个新文件:requests-2016-06-01-12.log,requests-2016-06-01-13.log,... 用作文件名称一部分的时间格式。创建文件时,以下字符将替换为实际值: %Y:包括世纪在内的年份(至少4位数字) %m:一年中的月份(01..12) %d:月中的某天(01..31) %H:一天中的小时,24小时制(00..23) %M:小时(00..59) %S:二分钟(00..60) 默认格式是%Y%m%d%H,每小时创建一个文件。 GZIP压缩 要读取或写入GZIP压缩文件,请确保文件扩展名以“.gz”结尾:--output-file log.gz 从多个文件重播 --input-file接受文件模式,例如:--input-file logs-2016-05-*。GoReplay足够聪明,保持请求的原始顺序。它通过并行读取所有文件并通过时间戳在多个文件之间对请求进行排序来实现。它不会读取内存中的所有文件,而是根据需要在流媒体中读取它们。 缓冲的文件输出 Gor写入文件时拥有内存缓冲区,并持续刷新文件更改。如果缓冲区已满,则每隔1秒强制刷新一次,或者如果Gor关闭,则会发生冲突至文件。您可以使用--output-file-flush-interval选项更改它。大多数情况下它不应该被触及。 文件格式 按原样存储HTTP请求,纯文本:标题和正文。请求按\n\n行分隔(使用此类序列以获得唯一性和乐趣)。在每个请求进行单线行包含有效负载类型(1 - 请求,2 - 响应,3 - 重播响应)的元信息时,请求发出时,唯一请求标识(请求和响应具有相同)和时间戳。2个请求的示例: 1 d7123dasd913jfd21312dasdhas31 127345969\n GET / HTTP/1.1\r\n \r\n \n \n POST /upload HTTP/1.1\r\n Content-Length: 7\r\n Host: www.w3.org\r\n \r\n a=1&b=2 请注意,技术上\ r和\ n符号是不可见的,并指示新行。为了展示它在字节级别的外观,我在示例中使它们可见。 使其文本友好可以编写简单的解析器并使用控制台工具grep来进行分析。您甚至可以手动编辑它们,但请确保您的文件编辑器不会更改行尾。 性能测试 目前,input-file仅在使用基于百分比的限制器时才支持此功能。与默认限制器不同input-file,它不会降低请求速度,而会减慢速度或加速请求发射。请注意限制器应用于输入: # Replay from file on 2x speed gor --input-file "requests.gor|200%" --output-http "staging.com" 使用--stats --output-http-stats查看延迟统计。 循环播放文件以无限期重放 您可以循环同一组文件,因此当最后一个重放所有请求时,它不会停止,并且将从第一个重新开始。只有少量的请求可以进行广泛的性能测试。通过--input-file-loop让它工作。 限速 如果您只想转发部分传入流量,例如,不会超载您的测试环境,则速率限制可能很有用。有两种策略:根据标题或URL参数值丢弃随机请求或删除部分请求。 丢弃随机请求 每个输入和输出都支持随机速率限制。有两种限制算法:绝对或基于百分比。 绝对:如果在当前秒钟内达到了指定的请求限制 - 忽略其余,则在下一秒计数器重置时。 百分比:对于输入文件,它会减速或加速请求执行,其余的将使用随机生成器根据您指定的机会决定请求是否通过。 您可以使用“|”指定您想要的限制服务器地址后的运算符,请参阅下面的示例。 限制重播使用绝对数量 # staging.server will not get more than ten requests per second gor --input-tcp :28020 --output-http "http://staging.com|10" 使用基于百分比的限制器限制侦听器 # replay server will not get more than 10% of requests # useful for high-load environments gor --input-raw :80 --output-tcp "replay.local:28020|10%" 基于Header或URL参数值的一致限制 如果您拥有存储在标头或URL中的唯一用户标识(如API密钥),则只能为该用户的一小部分转发指定的流量百分比。基本公式看起来像这样:FNV32-1A_hashing(value) % 100 >= chance。例子: # Limit based on header value gor --input-raw :80 --output-tcp "replay.local:28020|10%" --http-header-limiter "X-API-KEY: 10%" # Limit based on header value gor --input-raw :80 --output-tcp "replay.local:28020|10%" --http-param-limiter "api_key: 10%" 请求过滤 当您只需要捕获特定部分的流量(如API请求)时,过滤非常有用。可以通过URL,HTTP标头或HTTP方法进行过滤。 允许URL正则表达式 # only forward requests being sent to the /api endpoint gor --input-raw :8080 --output-http staging.com --http-allow-url /api 禁止URL正则表达式 # only forward requests NOT being sent to the /api... endpoint gor --input-raw :8080 --output-http staging.com --http-disallow-url /api 基于标题的正则表达式筛选 # only forward requests with an api version of 1.0x gor --input-raw :8080 --output-http staging.com --http-allow-header api-version:^1\.0\d # only forward requests NOT containing User-Agent header value "Replayed by Gor" gor --input-raw :8080 --output-http staging.com --http-disallow-header "User-Agent: Replayed by Gor" 基于HTTP方法过滤 不匹配指定白名单的请求可以被过滤掉。例如,去除非零能力的请求: gor --input-raw :80 --output-http "http://staging.server" \ --http-allow-method GET \ --http-allow-method OPTIONS 请求重写 Gor支持重写URL,URL参数和标题,见下文。 如果测试环境没有与您的产品相同的数据,并且您希望在test用户上下文中执行所有操作,则重写可能很有用:例如,将所有API令牌重写为某个测试值。其他可能的用例是使用自定义标题打开/关闭功能,或者如果在新环境中更改URL,则可以重写URL。 对于更复杂的逻辑,您可以使用中间件。 根据映射重写URL --http-rewrite-url预期“:”格式的值:“:”是一个稀释度。在<replace>部分中,您可以使用捕获的正则表达式组值。这与replaceJavascript或gsubRuby中的方法类似。 # Rewrites all `/v1/user/<user_id>/ping` requests to `/v2/user/<user_id>/ping` gor --input-raw :8080 --output-http staging.com --http-rewrite-url /v1/user/([^\\/]+)/ping:/v2/user/$1/ping 设置网址参数 设置请求url参数,如果参数已经存在,它将被覆盖。 gor --input-raw :8080 --output-http staging.com --http-set-param api_key=1 设置标题 设置请求标题,如果标题已经存在,它将被覆盖。如果您需要确定由Gor生成的请求或在应用程序中启用功能标记的功能,可能会有用: gor --input-raw :80 --output-http "http://staging.server" \ --http-header "User-Agent: Replayed by Gor" \ --http-header "Enable-Feature-X: true" 主机头 主机头获得特殊待遇。默认情况下,主机将被设置为--output-http中指定的值。如果您手动设置--http-header“Host:anonther.com”,则Gor不会覆盖主机值。 如果你的应用程序接受来自多个域的流量,并且你想保留原始头文件,具体--http-original-host告诉Gor不要触摸Host头文件。 中间件 概观 GoReplay提供了NodeJS语言的框架,它隐藏了协议实现,并为编写中间件提供了原语,请参阅文档https://github.com/buger/goreplay/tree/master/middleware。但协议本身非常简单,您可以随意使用任何语言。 中间件是一个程序,它接受STDIN上的请求和响应负载,并在STDOUT处发出修改后的请求。您可以实现任何自定义逻辑,如剥离私人数据,高级重写,支持oAuth等。检查包含在我们的回购中的示例。 Original request +--------------+ +-------------+----------STDIN---------->+ | | Gor input | | Middleware | +-------------+----------STDIN---------->+ | Original response (1) +------+---+---+ | ^ +-------------+ Modified request v | | Gor output +<---------STDOUT-----------------+ | +-----+-------+ | | | | Replayed response | +------------------STDIN----------------->----+ (1):如果--input-raw-track-response指定了选项,则原始响应只会发送给中间件。 中间件可以用任何语言编写,请参阅examples/middleware文件夹中的示例。中间件程序应该接受与Gor的所有通信都是异步的,不能保证原始请求和响应消息会一个接一个地出现。如果逻辑取决于原始响应或重播响应,则应用程序应该处理状态,请参阅examples/middleware/token_modifier.go示例。 简单的bash echo中间件(返回相同的请求)将如下所示: while read line; do echo $line end --middleware通过指定可执行文件的路径,可以使用选项启用中间件: gor --input-raw :80 --middleware "/opt/middleware_executable" --output-http "http://staging.server" 分布式配置 有时候使用单独的Gor实例重播流量并执行负载测试等事情是有意义的,因此您的生产计算机不会花费宝贵的资源。可以在您的Web计算机上配置Gor,将流量转发到在单独的服务器上运行的Gor聚合器实例。 #在您想要捕获流量的服务器上运行。你可以在每台`web`机器上运行它。 sudo gor --input-raw:80 --output-tcp replay.local:28020 #重播服务器(replay.local)。 gor --input-tcp replay.local:28020 --output-http http://staging.com 如果您有多个重播机器,您可以使用--split-output选项将流量分割为多个:使用循环算法将所有传入流量均分为所有输出。 gor --input-raw :80 --split-output --output-tcp replay1.local:28020 --output-tcp replay2.local:28020 加密 之间的通信量--input-tcp和--output-tcp可使用TLS协议进行加密。要使其生效,您需要生成SSL证书,指定路径以及用于生成证书的密钥,并启用安全模式。 证书和密钥应该是PEM编码的。例如:--input-tcp :28020 --input-tcp-secure --input-tcp-certificate ./cert.pem --input-certificate ./key.pem。您可以使用以下命令生成自签名证书和密钥: openssl req -x509 -newkey rsa:4096 -keyout key.pem -out cert.pem -days 365 -subj "/CN=localhost"` 常问问题 什么操作系统支持? Gor会在libpcap工作的地方运行,并且它可以在大多数平台上运行。但是,目前,我们在Linux和Mac上进行测试。查看更多关于汇编。 为什么--input-raw需要sudo或root访问? 侦听器通过嗅探来自特定端口的流量来工作。它只能通过使用sudo或root访问来访问。但可以以非root用户身份运行。 你如何处理用户会话以正确重放流量? 您可以重写会话相关的头文件/ params以匹配您的分段环境。如果您需要自定义逻辑(例如基于随机令牌的身份验证),请参阅此讨论:https://github.com/buger/gor/issues/154 我可以使用Gor拦截SSL流量吗? 基本思想是SSL是为了保护自己免受交通拦截。有2个选项: 将SSL处理移至代理,如Nginx或Amazon ELB。让Gor听听上游。 使用--input-http这样你可以直接从您的应用程序复制请求有效载荷到Gor,但它会需要您的应用程序修改。 更多可以在这里找到:https://github.com/buger/gor/issues/85 使用output-http时HTTP请求的大小是否有限制? 由于Gor无法保证截取所有数据包,因此对于大于200kb的有效载荷,有可能丢失一些数据包和腐败主体。将其视为一项功能,并有机会测试处理破碎的物体:)保证交付的唯一方法就是使用--input-http,但您会错过一些功能。 我得到'太多打开文件'的错误 典型的Linux shell在1024下有一个小的打开文件软限制。在开始gor重放过程之前,你可以很容易地提出这个问题: ulimit -n 64000 关于ulimit的更多信息:http://www.thecodingmachine.com/solving-the-too-many-open-files-exception-in-red5-or-any-other-application/ 我的负载平衡目标的CPU平均值高于源 如果您正在将来自多个侦听器的流量重放到负载平衡目标并使用粘性会话,则可能会发现目标服务器的CPU负载高于侦听器服务器。这可能是因为原始负载均衡器的粘性会话cookie未被目标负载均衡器所尊敬,从而导致请求通常会碰到同一个目标服务器,从而降低了后端的不同服务器的负载,从而降低了通过负载平衡获得的一些缓存收益。尝试针对一个重播目标运行一个侦听器,并查看CPU利用率比较是否更准确。 另请参阅故障排除。 不要忘记用您的域名或IP替换“localhost”。 在配置安全输入时,--output-tcp-secure为GoReplay客户端启用标志,并连接到它。 GoReplay PRO支持精确记录和重播tcp会话,并且当--recognize-tcp-sessions选项通过时,而不是循环,它将使用更智能的算法,确保同一会话将被发送到同一个重播实例。 如果您计划进行大型负载测试,则可以考虑使用单独的主控实例来控制实际重放流量的Gor从站。例如: # This command will read multiple log files, replay them on 10x speed and loop them if needed for 30 seconds, and will distributed traffic (tcp session aware) among multiple workers gor --input-file logs_from_multiple_machines.*|1000% --input-file-loop --exit-after 30s --recognize-tcp-sessions --split-output --output-tcp worker1.local --output-tcp worker2.local:27017 --output-tcp worker3.local:27017 ... --output-tcp workerN.local:27017 # worker gor --input-tcp :27017 --ouput-http load_test.target 谋胆并重

优秀的个人博客,低调大师

Spring Boot神器之Spring Date Jpa

一、Spring Date Jpa介绍 什么是JPA? JPA是Java Persistence API的简称,中文名Java持久层API,是JDK5.0注解或XML描述对象-关系表的映射关系,并将运行期的实体对象持久化到数据库中。 Sun引入新的JPAORM规范出于两个原因: 其一,简化现有JavaEE和JavaSE应用开发工作 其二,Sun希望整合ORM技术,结束现在Hibernate,TopLink,JDO等ORM框架各自为营的局面,实现天下归一。 值得注意的是,JPA是在充分吸收了现有Hibernate,TopLink,JDO等ORM框架的基础上发展而来的,具有易于使用,伸缩性强等优点。 JPA是一套规范,不是一套产品。也就说JPA规范中提供的只是一些接口,显然接口不能直接拿来使用。虽然应用程序可以面向接口编程,但JPA底层一定需要某种JPA实现,否则JPA依然无法使用。 image.png Spring Date Jpa JPA诞生的缘由是为了整合第三方ORM框架,Spring为了能够更好的完善持久化这一块,于是就有了Spring-data-**这一系列包。包括:Spring-data-jpa,Spring-data-template,Spring-data-mongodb,Spring-data-redis。所以,Spring Data JPA 是 Spring 基于 ORM 框架、JPA 规范的基础上封装的一套JPA应用框架,可使开发者用极简的代码即可实现对数据的访问和操作。它提供了包括增删改查等在内的常用功能,且易于扩展!学习并使用 Spring Data JPA 可以极大提高开发效率! 官方文档:https://docs.spring.io/spring-data/jpa/docs/current/reference/html/ SpringDataJpa ,Hibernate与springboot集成 配置环境 image.png

优秀的个人博客,低调大师

docker管理神器—kubernetes—直接路由篇

一般情况下,两个node之间并不能通信,现在使用直连路由加Quagga的方式实现不同Node节点间的pod互联。 4.1、修改docker0的ip地址 在minion1上 #ifconfig docker0 10.1.10.1/24 修改docker配置文件 vi/etc/sysconfig/docker 添加: OPTIONS='--bip=10.1.10.1/24' 重启 systemctl restart docker 在centos-minion01上添加到centos-minion2的路由 route add -net 10.1.20.0 netmask 255.255.255.0 gw 192.168.137.100 在centos-minion02上, 添加到centos-minion01路由 route add -net 10.1.10.0 netmask 255.255.255.0 gw 192.168.137.101 (我这里因为只用了一个minion,所以直接使用master测试) 4.2、使用Quagga动态添加路由 为了减少手工添加路由,可以使用Quagga实现路由规则的动态添加。为简单起见,我们使用docker镜像。 #docker pull index.alauda.cn/georce/router 在每个node上启动容器 Quagga需要以–privileged特权模式运行,并且指定–net=host,表示直接使用物理机的网络。 #docker run -itd --name=router --privileged --net=host index.alauda.cn/georce/router 启动成功后,Quagga会相互学习来完成到其他机器的docker0路由规则的添加。 # route -n 测试: # ping 10.1.10.1 本文转自 sykmiao 51CTO博客,原文链接:http://blog.51cto.com/syklinux/1860298,如需转载请自行联系原作者

优秀的个人博客,低调大师

docker管理神器—kubernetes—flannel网络篇

5.1、flannel介绍 flannel 是 CoreOS 团队针对 Kubernetes 设计的一个覆盖网络 (overlay network) 工具,其目的在于帮助每一个使用 Kuberentes 的 CoreOS 主机拥有一个完整的子网。Kubernetes 会为每一个 POD 分配一个独立的 IP 地址,这样便于同一个 POD 中的 Containers 彼此连接,flannel通过在集群中创建一个覆盖网格网络 (overlay mesh network) 为主机设定一个子网。 5.2、etcd设置 5.2.1、设置fannel网络段 # etcdctl set /coreos.com/network/config '{"Network":"10.2.0.0/16"}' 5.2.2、修改配置文件 把/etc/etcd/etcd.conf里的ETCD_LISTEN_CLIENT_URLS=”http://localhost:2379″中的locahost改为0.0.0.0 5.3、flannel安装配置(所有node节点都需要安装) 5.3.1、wgethttps://github.com/coreos/flannel/releases/download/v0.5.5/flannel-0.5.5-linux-amd64.tar.gz 5.3.2、tar -xzvf flannel-0.5.5-linux-amd64.tar.gz 5.3.3、安装 直接复制解压出来的两个文件到可执行目录就可以 #cp flannel-0.5.5/flanneld /usr/bin #cp flannel-0.5.5/mk-docker-opts.sh /usr/bin 5.3.4、配置 vi/etc/sysconfig/flanneld 添加: # Flanneld configuration options # etcd url location FLANNEL_ETCD="http://centos-master:2379" # etcs config key FLANNEL_ETCD_KEY="/coreos.com/network" # Any additonal options #FLANNEL_OPTIONS= 5.3.5、编辑服务文件/usr/lib/systemd/system/flanneld.service 添加: [Unit] Description=Flanneld overlay address etcd agent After=network.target Before=docker.service [Service] Type=notify EnvironmentFile=-/etc/sysconfig/flanneld EnvironmentFile=-/etc/sysconfig/docker-network ExecStart=/usr/bin/flanneld \ -etcd-endpoints=${FLANNEL_ETCD} \ $FLANNEL_OPTIONS [Install] RequiredBy=docker.service WantedBy=multi-user.target 或者直接启动: flanneld -iface=eno16777736 -etcd-endpoints=http://centos-master:2379& (绑定一个正常工作的网卡) 5.4、暂停docker服务 #systemctl stop docker 5.6、执行脚本(修改一下docker) #systemctl start flanneld #mk-docker-opts.sh -i #source /run/flannel/subnet.env #ifconfig docker0 ${FLANNEL_SUBNET} #systemctl start docker 5.7、测试 在centos-minion上ip a查看可以看到flannel0的网卡信息 本文转自 sykmiao 51CTO博客,原文链接:http://blog.51cto.com/syklinux/1860301,如需转载请自行联系原作者

优秀的个人博客,低调大师

云原生轻量级日志神器之Loki

随着云原生技术的发展,传统的日志解决方案面临着新的挑战。日志量剧增、数据结构复杂、实时分析需求等都对传统的日志服务提出了更高的要求。Loki作为一款新兴的云原生日志聚合系统,凭借其高可扩展性、低成本和易用性,越来越受到业界的关注。京东智联云,作为国内领先的云服务提供商,也正在将云翼的日志服务底层逐步从ES替换为Loki。 本文将基于京东智联云对Loki的使用和理解,从其产生的背景、解决的问题、采用的方案、系统架构、实现逻辑等方面进行剖析,希望对关注Loki的小伙伴们提供一些帮助。

优秀的个人博客,低调大师

数据探索神器:火山引擎 DataLeap Notebook 揭秘

更多技术交流、求职机会,欢迎关注字节跳动数据平台微信公众号,回复【1】进入官方交流群 背景介绍 Notebook 解决的问题 部分任务类型(python、spark等)在创建配置阶段,需要进行分步调试; 由于探索查询能力较弱,部分用户只能通过其他平台 or 其他途径进行开发调试,但部署到 Dorado时,又发现行为不一致等问题(运行环境问题),整体体验较差,需要提升探索查询模块的能力; 目前探索查询仅支持 SQL,可支持更多语言类型,扩展数据开发手段; 总体架构介绍 火山引擎DataLeap notebook 主要是基于 JupyterHub、notebook、lab、enterprise kernel gateway 等开源项目实现,并在这些项目的基础上进行深度修改与定制化,以满足 火山引擎DataLeap用户的需求。 基础组件方面,主要是基于 TCE、YARN、MYSQL、TLB、TOS。 核心目标是提供支持大规模用户、稳定的、容易扩展的 Notebook 服务。 系统总体架构如下图所示,主要包括 Hub、notebook server(nbsvr)、kernel gateway(eg) 等组件。 多用户管理 Hub JupyterHub 是一个支持 “多用户” notebook 的 Server,通过管理 & 代理多个单用户的 notebook server 实现多用户 notebook。 JupyterHub 服务主要三个组件构成: a Hub (tornado process), which is the heart of JupyterHub; a configurable http proxy (node-http-proxy): 动态路由用户的请求到 Hub 或者 Notebook server; multiple single-user Jupyter notebook servers (Python/IPython/tornado) that are monitored by Spawners; an authentication class that manages how users can access the system; 整个系统架构图如下所示: 用户通过 IP 地址或者域名访问 JupyterHub,基本流程为: 启动 Hub 服务,Hub 会启动 proxy 进程; 用户请求 Hub,请求会被打到 proxy,proxy 维护了 proxy table,每条 mapping 记录为用户请求到 target IP 或者 域名的映射;proxy table 不存在当前请求的 mapping 时,proxy 默认把请求全部打到 Hub; Hub 处理用户认证与鉴权,同时 Hub spawner 启动一个 Notebook server; Hub 配置 proxy,路由该该用户的请求到创建的 notebook server 处; 1、火山引擎DataLeap authentication Hub 原生地支持 authentication,主要是用来解决多租户的问题。Hub 里主要是使用 authenticator 类来进行 authenticate 。 Hub 原生支持的 authenticator 主要有一下几个: Local authenticator, work with local Linux/UNIX userst PAM authenticator, authenticate local UNIX users with PAM Dummy authenticator, any username + password is allowed for testing 考虑到方案1需要开发量大、维护成本高,我们采用了方案2。 采用了方案2的整个认证 & 鉴权步骤如下所示: 用户在 web 页面访问了 火山引擎DataLeap notebook,frontend 会带上 session 信息请求 hub post /api/users/{name}/tokens api 获取一个 token,该流程需要 authenticate & authroization,包括: 通过 titan 认证该 sessionid 对应的 user; 通过 火山引擎DataLeap backend ProjectControl /project/canedit api 验证用户是否具有项目权限; 后续该用户的访问均会带上 token,Hub 会使用该 token 进行用户认证。 每次生成的 token 会保存到 db; 认证时也是从 db 进行匹配; Token 存在 expire time,expired 的会被从 db 清理掉; 2、TCE Spawner Spawner 负责启动 single-user notebook server,其本质是一个进程的抽象表示,一个定制化的 spawner 实现下面三个方法: start the process poll whether the process is still running stop the process More info on custom Spawners. See a list of custom Spawners on the wiki. 目前我们的服务不是运行在物理机上,所以不会通过 k8s 管理 server & kernel。考虑到运维 & 扩展,我们考虑使用 TCE 作为 notebook server 的载体,因此我们需要实现 TCE Spawner。 设计 TCE spawner 时,有以下几点考虑: Spawner.state 需要包含 service id、cluster id、psm、api token 等信息,这些信息会持久化在 db 中;hub 重启 或者 server 关闭后,重新启动 notebook server 时,保证同一个用户映射到之前该用户启动的那个 sever(same user same server); 为了加快启动过程,spawner 确认 tce 实例启动时,一旦发起了 tce cluster deployment 后就开始 sd lookup psm 确认 server 是否正常启动,不通过 poll deployment status 确认是否部署完成,这可以加快启动过程,因为 tce 部署过程中包括健康检查等步骤,占时较长; Stop 中,并不真正 kill tce 实例,这样下次启动基本不消耗时间; Poll server 状态时,需要考虑 升级 & migrate 带来的状态变化,一旦发现立刻返回 异常状态,这样 hub 就会认为这个 notebook server not running,就会异常 该 spawner,后续新的请求到来时会重新启动 spawner,由于此时已经非第一次启动,过程极快,用户不感知。 整个 TCE spawner,主要用到了 tce 的两个特性: Psm 唯一对应了一个服务; 通过 psm 发现 ip & port; 通过 tce 的 api 获取 server 状态; 方便运维(升级 & 迁移); 题外话: 最近调研了 server on yarn ,有点类似 k8s 的感觉,本质上都是走资源调度,但是 yarn 资源调度有个缺点:每个 application 调度到 yarn 时,都需要伴随一个 Application Master。虽然 AM 大多数时候主要是用来和 RM 保持心跳,只需要 0.5 核即可,但是总感觉很别扭,或者说多了一个不稳定的因素。 3、State isolated (1) Hub migration 原生 jupyter hub 的升级或者实例迁移时,需要把所有的 spawner & server 关闭掉。这意味着,hub 实例变化后,之前的 server & kernel 都会被关闭。 由于当前系统采用了 remote server + remote kernel,且不会主动 shutdown kernel,因此当 hub 实例发生变化时, server & kernel 实例不会被关闭。但是新 hub 实例启动后,所有的 server 都将连接不到新的 hub 实例上,会产生幽灵 server & kernel。 我们提供了如下解决方案: 在 notebook server 里增加定时检查线程,根据 hub 的 psm 检查对应的 ip & port 是否发生改变; 如果发生改变,则切换 hub_activity_url & hub_api_url。如此,notebook server 就可以连接到新的 hub 实例了。 (2) Notebook server migration 如果 notebook server 实例升级或者迁移了,hub 也需要能及时感知,并能正确关闭 spawner。 这个目前是通过 tce spawner poll 实现,poll 里会 check 对应的 notebook server 的 ip & port 是否发生变化,如果发生了变化则返回非零状态,表示 server 异常,此时 hub 感知到并关闭 spawner。后续,用户的请求到来时,会重新创建 spawner 并连接到同一个 notebook server。 Resource pool Pool 的设计有两个考虑: Tce 资源无法独占; Server 启动慢; 由于 notebook server 是启动在 TCE 上的,TCE 上启动一个 server 需要经历如下几个关键阶段: 新建 service -> 新建 cluster -> 部署(构建镜像、部署)-> 一些检查 整个过程耗时较长,预计耗时3-5分钟,如果每个 server 的启动过程都需要这么久,显然是无法接受的。 于是,我们申请了新建了一堆 tce 实例构建成 tce resource pool。每次新项目接入,Hub spawner 按照如下流程处理: 去 tce resource pool 中检查是否存在未被占用的实例,有则挑一个 否则,走原新建流程; 目前 pool 的建立是手动操作的,后期会支持自动检测扩容: 定时线程,检测当前 pool 的容量是否少于 30 (例如); 少于则新建并加入 pool 中; 另一个问题是:pool 里的每个实例均需要支持 psm 服务发现,那么在 server 被分配前,他们处于什么状态呢?被分配后,如何按照 user 对应的配置启动 server 呢? Pool 里的实例,均是启动了一个 idle server(原生的 notebook server)(该方式可以让该实例成功启动,并且能被服务发现),同时存在一个定时线程,不断去检查 tos 对应的配置文件是否 ready,ready 后 shutdown idle server,按照 tos 配置文件启动 single user notebook server。 这种方式后,启动时间从 3min+ 降到 8s,8s 为 single user notebook server 启动并稳定提供服务的时间。 Kernel 管理 book 存储 Notebook 中的代码和输出文本主要是通过后缀为 .ipynb 的 json 文件存储的,因此 notebook server 需要负责 ipynb 文件的新建、删除等管理。 Notebook server 对 notebook 的存储是通过 FileManager 来实现的,FileManager 主要负责 ipynb 的创建、保存、删除、重命名等文件操作,另外还会进行 ipynb 文件的 format 检查以保证格式正确。 FileManger 保存文件是通过 local filesystem 实现的。为了持久化存储 ipynb 文件,我们在 FileManager 中嵌入了 tos 文件存储的功能。具体过程为: 首次创建时,在本地生成 ipynb 后,并往 tos 上 put 一份; 每次更新保存时,在本地更新后往 tos put 一份; 每次打开 ipynb 时,首先判断本地是否存在对应的 ipynb 文件,如果不存在则从 tos 拉取;如果存在则不做拉取操作; 删除操作只是删除了本地的文件,没有删除 tos 的那份。 kernel 管理 当我们在页面上打开一个 notebook 任务时,notebook server 会尝试启动一个 kernel 来执行你点击运行的代码。火山引擎DataLeap上每个 task 都和一个 kernel 对应,notebook server 负责维护每个任务的 kernel。 Notebook server 是通过 KernelManager 来维护 kernel 信息的,KerneManager 负责 kernel 的启动、重启、删除等操作。 默认情况下,Kernel 是启动在 notebook server 所在的运行容器里,这种情况下单个 server 里无法支撑起大规模 kernel。 代理 如上一节所述,notebook server local 模式不支持大规模 kernel 的扩展,适用于小范围使用,主要原因有如下两点; kernel 都是在 notebook server host 内启动的,单机必然无法容纳大规模 kernel ; Kernel 间没有隔离,只是进程间的隔离,资源 & 执行环境等没有很好的隔离与定制化; Enterprise kernel gateway (简称 EG)主要致力于解决上述问题,采用了 EG 的系统架构如下所示: 技术上来讲,EG 部分扩展了 notebook server 的功能,然后作出了如下改动: 复用 notebook server 中的 API (kernel 管理部分); 提供了 WS 的管理; 基于 notebook server 中 MultiKernelManager & KernelManager & SessionManager,做出扩展,提供了 RemoteMappingKernelManager; 从图中可以看出,client 并非是 notebook 相关的系统,也可以是其他系统,这意味着可以直接把 EG 当成 Code Execution Server,只需要其 ws client 遵循 Jupyter msg protocol。 代理架构 在 火山引擎DataLeap notebook 系统中,上图中的 client 即为 notebook server,此时 notebook server 只负责管理 notebook 文件(创建、读写、保存、删除),kernel 部分的操作全部转发给 EG 进行处理(注意这里的转发包含 http 转发与 ws 转发)。详细如下图所示: 用户在浏览器运行一段代码,整个交互流程如下图所示: EG proxy 的详细过程参考: 当前 EG 支持往 yarn、k8s 等业界常用资源管理系统提交 kernel 。 我们当前只支持 remote kernel on yarn ,后续考虑支持 k8s。 远程 Kernel 1、Remote kernel on yarn 开源 EG 往 yarn 上提交任务主要是使用 yarn_client,该 client 基于 yarn rm restful api 进行资源探查 & 任务的提交 & 状态轮询 & kill 等操作。公司内并非开放相应的 rest api,因此需要基于 YAOP 进行相应的改造。 2、Kernel configuration 开源 EG 往 yarn 上提交任务暂不支持指定动态参数,比如队列选择、镜像选择等等 yarn 参数。 我们进行了简单的改造,可以支持用户设置更为丰富的 yarn 参数,来定制个性化执行环境。 3、Async 开源社区的版本没有完全异步化,为了单 eg server 支持更多的 kernel,我们做了完全的异步化改造。 优化前,只能支持 10+ kernel,优化后,能够支持 100+ kernel(上限没具体测试过)。 4、image 支持用户选择自定义镜像启动 kenrel,该特性支持用户在 kernel 中安装自己需要的环境,极大地提高了 kernel 使用的场景。 定时调度 调度原理 Notebook 调度执行不同于每个 cell 里的人工调试执行,它需要定时自动执行,每次都是直接 run all cell,并且把执行结果保存在 notebook 里。 Jupyter 提供了可以直接执行一个 ipynb 文件的工具:nbconvert。nbconvert 会根据 ipynb 里的 kernel 信息启动对应的 kernel 来执行 ipynb 里的每个 cell,其本质上执行了 notebook kernel 启动 + run each cell 的功能。 但是 nbconvert 只能启动 local kernel,而目前系统是 remote kernel on yarn,这可以通过把 nbconvert 提交到 yarn 上,然后在 yarn 上运行上述过程。当然,这其中涉及到了 pyspark 任务的提交原理,总的来说,notebook 任务具备和 dorado 上其他任务一样的定时调度功能。 更多特性 1、Version control 支持 notebook 的版本控制。 2、Workflow debug 工作流支持 notebook 任务,并且支持整体调试。 3、Parameterized 支持 notebook 参数化。 4、Executed notebook view 支持定时调度运行结果展示。 结束语 Jupyter Notebook 诞生至今,已数年有余,期间不断出现 Zeppelin、PolyNote、Deepnote。尽管如此, Jupyter Notebook 仍然拥有最大量的用户群体与比较完整的技术生态,因此我们选择了 Jupyter Notebook 做深度定制与改造来服务用户。 当前 火山引擎DataLeap Notebook 已经基本具备了离线数据探索的能力,这些能力已经帮助了很多用户更好的进行数据探索、任务开发调试、可视化等。随着平台对流式数据开发的支持,我们也希望借助 Notebook 实现用户对流式数据的探索、流式任务的调试、可视化等功能的需求。相信不久的将来,Notebook 能够实现流批一体化,来服务更加广泛的用户群体。 点击跳转大数据研发治理套件 DataLeap了解更多

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册