首页 文章 精选 留言 我的

精选列表

搜索[国产神器],共5596篇文章
优秀的个人博客,低调大师

Prometheus监控神器-Kubernetes篇(三)

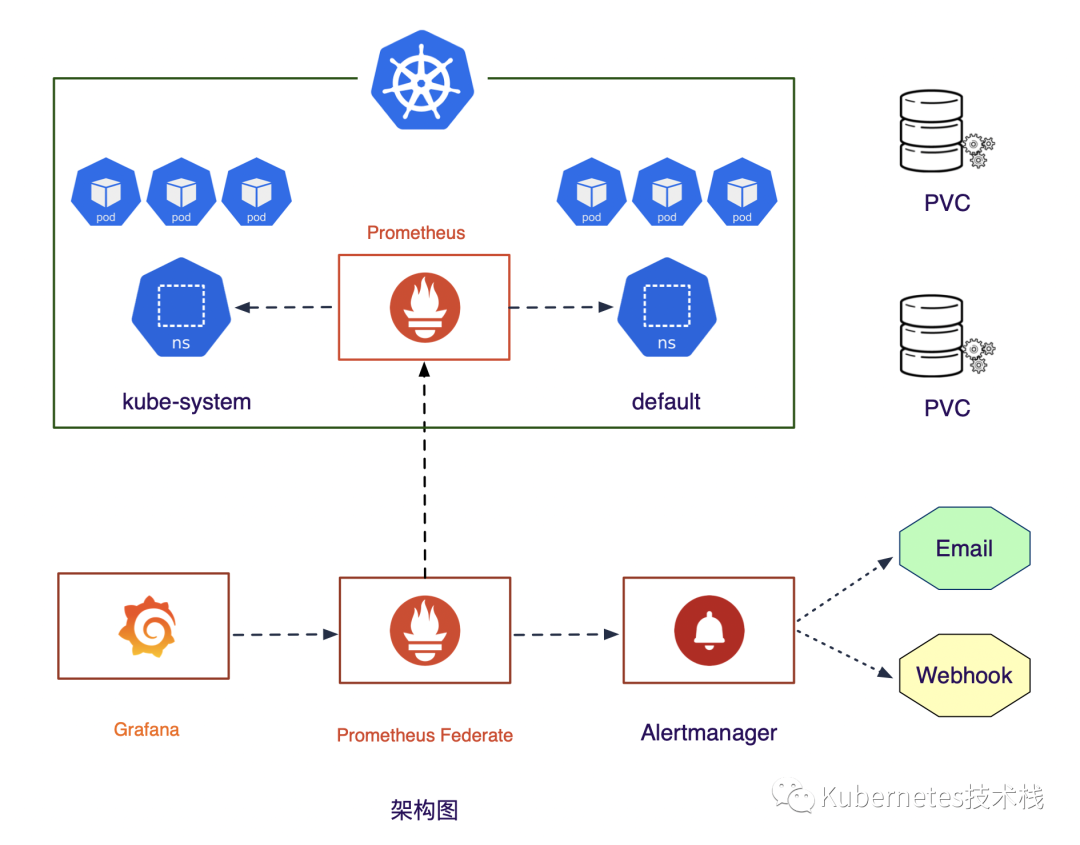
在Kubernetes中手动方式部署Prometheus联邦. monitor-prom 当我们有多个Kubernetes集群的时候,这个时候就需要需要指标汇总的需求了,如上图一样,我们假定在外部部署一个Prometheus的Federate,然后去采集当前k8s中的kube-system与default俩个 namespace。 环境 我的本地环境使用的 sealos 一键部署,主要是为了便于测试。 OS Kubernetes HostName IP Service Ubuntu 18.04 1.17.7 sealos-k8s-m1 192.168.1.151 node-exporter prometheus-federate-0 Ubuntu 18.04 1.17.7 sealos-k8s-m2 192.168.1.152 node-exporter grafana alertmanager-0 Ubuntu 18.04 1.17.7 sealos-k8s-m3 192.168.1.150 node-exporter alertmanager-1 Ubuntu 18.04 1.17.7 sealos-k8s-node1 192.168.1.153 node-exporter prometheus-0 kube-state-metrics Ubuntu 18.04 1.17.7 sealos-k8s-node2 192.168.1.154 node-exporter prometheus-1 Ubuntu 18.04 1.17.7 sealos-k8s-node2 192.168.1.155 node-exporter prometheus-2 部署 Prometheus联邦集群 创建prometheus-federate数据目录 #在m1上执行mkdir/data/prometheus-federate/chown-R65534:65534/data/prometheus-federate/ 创建Prometheus联邦 StorageClass 配置文件 cd/data/manual-deploy/prometheus/catprometheus-federate-storageclass.yamlapiVersion:storage.k8s.io/v1kind:StorageClassmetadata:name:prometheus-federate-lpvprovisioner:kubernetes.io/no-provisionervolumeBindingMode:WaitForFirstConsumer 创建Prometheus联邦pv配置文件 apiVersion:v1kind:PersistentVolumemetadata:name:prometheus-federate-lpv-0spec:capacity:storage:10GivolumeMode:FilesystemaccessModes:-ReadWriteOncepersistentVolumeReclaimPolicy:RetainstorageClassName:prometheus-federate-lpvlocal:path:/data/prometheus-federatenodeAffinity:required:nodeSelectorTerms:-matchExpressions:-key:kubernetes.io/hostnameoperator:Invalues:-sealos-k8s-m1 创建Prometheus联邦configmap配置文件 catprometheus-federate-configmap.yamlapiVersion:v1kind:ConfigMapmetadata:name:prometheus-federate-confignamespace:kube-systemdata:alertmanager_rules.yaml:|groups:-name:examplerules:-alert:InstanceDownexpr:up==0for:1mlabels:severity:pageannotations:summary:"Instance{{$labels.instance}}down"description:"{{$labels.instance}}ofjob{{$labels.job}}hasbeendownformorethan1minutes."-alert:NodeMemoryUsageexpr:(node_memory_MemTotal_bytes-(node_memory_MemFree_bytes+node_memory_Buffers_bytes+node_memory_Cached_bytes))/node_memory_MemTotal_bytes*100>80for:1mlabels:team:opsannotations:summary:"cluster:{{$labels.cluster}}{{$labels.instance}}:HighMemoryusagedetected"description:"{{$labels.instance}}:Memoryusageisabove55%(currentvalueis:{{$value}}"prometheus.yml:|global:scrape_interval:30sevaluation_interval:30salerting:alertmanagers:-static_configs:-targets:-alertmanager-0.alertmanager-operated:9093-alertmanager-1.alertmanager-operated:9093rule_files:-"/etc/prometheus/alertmanager_rules.yaml"scrape_configs:-job_name:'federate'scrape_interval:30shonor_labels:truemetrics_path:'/federate'params:'match[]':-'{job=~"kubernetes.*"}'-'{job="prometheus"}'static_configs:-targets:-'prometheus-0.prometheus:9090'-'prometheus-1.prometheus:9090'-'prometheus-2.prometheus:9090' 创建Prometheus联邦的statefulse文件 catprometheus-federate-statefulset.yamlapiVersion:apps/v1kind:StatefulSetmetadata:name:prometheus-federatenamespace:kube-systemlabels:k8s-app:prometheus-federatekubernetes.io/cluster-service:"true"spec:serviceName:"prometheus-federate"podManagementPolicy:"Parallel"replicas:1selector:matchLabels:k8s-app:prometheus-federatetemplate:metadata:labels:k8s-app:prometheus-federateannotations:scheduler.alpha.kubernetes.io/critical-pod:''spec:affinity:podAntiAffinity:requiredDuringSchedulingIgnoredDuringExecution:-labelSelector:matchExpressions:-key:k8s-appoperator:Invalues:-prometheus-federatetopologyKey:"kubernetes.io/hostname"priorityClassName:system-cluster-criticalhostNetwork:truednsPolicy:ClusterFirstWithHostNetcontainers:-name:prometheus-federate-configmap-reloadimage:"jimmidyson/configmap-reload:v0.4.0"imagePullPolicy:"IfNotPresent"args:---volume-dir=/etc/config---webhook-url=http://localhost:9091/-/reloadvolumeMounts:-name:config-volumemountPath:/etc/configreadOnly:trueresources:limits:cpu:10mmemory:10Mirequests:cpu:10mmemory:10MisecurityContext:runAsUser:0privileged:true-image:prom/prometheus:v2.20.0imagePullPolicy:IfNotPresentname:prometheuscommand:-"/bin/prometheus"args:-"--web.listen-address=0.0.0.0:9091"-"--config.file=/etc/prometheus/prometheus.yml"-"--storage.tsdb.path=/prometheus"-"--storage.tsdb.retention=24h"-"--web.console.libraries=/etc/prometheus/console_libraries"-"--web.console.templates=/etc/prometheus/consoles"-"--web.enable-lifecycle"ports:-containerPort:9091protocol:TCPvolumeMounts:-mountPath:"/prometheus"name:prometheus-federate-data-mountPath:"/etc/prometheus"name:config-volumereadinessProbe:httpGet:path:/-/readyport:9091initialDelaySeconds:30timeoutSeconds:30livenessProbe:httpGet:path:/-/healthyport:9091initialDelaySeconds:30timeoutSeconds:30resources:requests:cpu:100mmemory:100Milimits:cpu:1000mmemory:2500MisecurityContext:runAsUser:0privileged:trueserviceAccountName:prometheusvolumes:-name:config-volumeconfigMap:name:prometheus-federate-configvolumeClaimTemplates:-metadata:name:prometheus-federate-dataspec:accessModes:["ReadWriteOnce"]storageClassName:"prometheus-federate-lpv"resources:requests:storage:5Gi 创建Prometheus联邦的svc文件 catprometheus-service-statefulset.yamlapiVersion:v1kind:Servicemetadata:name:prometheusnamespace:kube-systemspec:ports:-name:prometheusport:9090targetPort:9090selector:k8s-app:prometheusclusterIP:None 部署 cd/data/manual-deploy/prometheus/prometheus-federate-configmap.yamlprometheus-federate-pv.yamlprometheus-federate-service-statefulset.yamlprometheus-federate-statefulset.yamlprometheus-federate-storageclass.yamlkubectlapply-fprometheus-federate-storageclass.yamlkubectlapply-fprometheus-federate-pv.yamlkubectlapply-fprometheus-federate-configmap.yamlkubectlapply-fprometheus-federate-statefulset.yamlkubectlapply-fprometheus-federate-service-statefulset.yaml 验证 #pvkubectl-nkube-systemgetpvc|grepfederateprometheus-federate-data-prometheus-federate-0Boundprometheus-federate-lpv-010GiRWOprometheus-federate-lpv4hkubectl-nkube-systemgetpod|grepfederateprometheus-federate-02/2Running02d4h 对此,联邦的配置就完成了,可以在浏览器中访问192.168.1.151:9091查看相应的targets信息,以及配置的rules规则,触发下警报,看看Alertmanager集群已经部署成功了。 k8s-federate 本文分享自微信公众号 - Kubernetes技术栈(k8stech)。如有侵权,请联系 support@oschina.cn 删除。本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

优秀的个人博客,低调大师

Prometheus监控神器-Alertmanager篇(四)

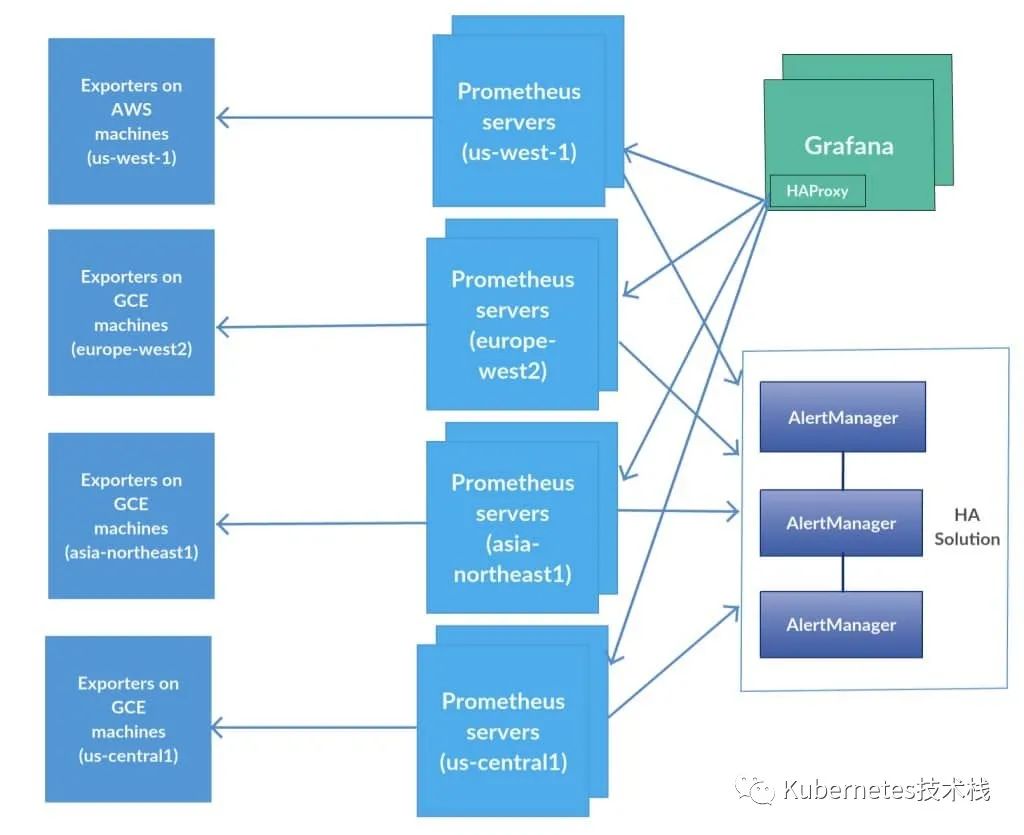
本章节主要讲解Alertmanager高可用的搭建与配置的详细的内容。 为了提升Prometheus的服务可靠性,我们会部署两个或多个的Prometheus服务,两个Prometheus具有相同的配置(Job配、告警规则、等),当其中一个Down掉了以后,可以保证Prometheus持续可用。 AlertManager自带警报分组机制,即使不同的Prometheus分别发送相同的警报给Alertmanager,Alertmanager也会自动把这些警报合并处理。 去重 分组 路由 Daduplicates Groups Route 将相同的警报合并成一个 根据定义的分组 经过路由分发给指定的receiver 虽然Alertmanager 能够同时处理多个相同的Prometheus的产生的警报,如果部署的Alertmanager是单节点,那就存在明显的的单点故障风险,当Alertmanager节点down机以后,警报功能则不可用。 解决这个问题的方法就是使用传统的HA架构模式,部署Alertmanager多节点。但是由于Alertmanager之间关联存在不能满足HA的需求,因此会导致警报通知被Alertmanager重复发送多次的问题。 alertmanager-ha Alertmanager为了解决这个问题,引入了Gossip机制,为多个Alertmanager之间提供信息传递机制。确保及时的在多个Alertmanager分别接受到相同的警报信息的情况下,不会发送重复的警报信息给Receiver. Gossip 机制 要知道什么是Gossip机制,必须了解清楚Alertmanager中的每一次警报通知是如何产生的,下面一图很详细的阐述了警报个流程: alertmanager-ha 阶段 描述 Silence 在这个阶段中Alertmanager会判断当前通知是否匹配任何静默规则;如果没有则进入下一个阶段,否则会中断流程不发送通知。 Wait Alertmanager 会根据当前集群中所处在的顺序[index],等待 index * 5s 的时间。 Dedup 当等待结束完成,进入 Dedup 阶段,这时会判断当前Alertmanager TSDB中警报是否已经发送,如果发送则中断流程,不发送警报。 Send 如果上面的未发送,则进入 Send 阶段,发送警报通知。 Gossip 警报发送成功以后,进入最后一个阶段 Gossip ,通知其他Alertmanager节点,当前警报已经发送成功。其他Alertmanager节点会保存当前已经发送过的警报记录。 Gossip俩个关键: Alertmanager 节点之间的Silence设置相同,这样确保了设置为静默的警报都不会对外发送 Alertmanager 节点之间通过Gossip机制同步警报通知状态,并且在流程中标记Wait阶段,保证警报是依次被集群中的Alertmanager节点读取并处理。 搭建本地 Alertmanager 集群 启动Alertmanager集群之前,需要了解一些集群相关的参数 参数 说明 --cluster.listen-address="0.0.0.0:9094" 集群服务监听端口 --cluster.peer 初始化关联其他节点的监听地址 --cluster.advertise-address 广播地址 --cluster.gossip-interval 集群消息传播时间,默认 200s --cluster.probe-interval 各个节点的探测时间间隔 # 直接复制之前已经安装过的Alertmanager文件夹cp -r alertmanager/ /usr/local/alertmanager01cp -r alertmanager/ /usr/local/alertmanager02cp -r alertmanager/ /usr/local/alertmanager03# 复制完成以后,写入启动脚本,# Alertmanager01cat << EOF> /lib/systemd/system/alertmanager01.service[Unit]Description=alertmanagerDocumentation=https://prometheus.io/After=network.targetStartLimitIntervalSec=0[Service]Type=simpleUser=prometheusExecStart=/usr/local/alertmanager01/bin/alertmanager \--config.file=/usr/local/alertmanager01/conf/alertmanager.yml \--storage.path=/usr/local/alertmanager01/data \--web.listen-address=":19093" \--cluster.listen-address=192.168.1.220:19094 \--log.level=debugRestart=alwaysRestartSec=1[Install]WantedBy=multi-user.targetEOF# Alertmanager02cat << EOF> /lib/systemd/system/alertmanager02.service[Unit]Description=alertmanagerDocumentation=https://prometheus.io/After=network.targetStartLimitIntervalSec=0[Service]Type=simpleUser=prometheusExecStart=/usr/local/alertmanager02/bin/alertmanager \--config.file=/usr/local/alertmanager02/conf/alertmanager.yml \--storage.path=/usr/local/alertmanager02/data \--web.listen-address=":29093" \--cluster.listen-address=192.168.1.220:29094 \--cluster.peer=192.168.1.220:19094 \--log.level=debugRestart=alwaysRestartSec=1[Install]WantedBy=multi-user.targetEOF# Alertmanager03cat <<EOF > /lib/systemd/system/alertmanager03.service[Unit]Description=alertmanagerDocumentation=https://prometheus.io/After=network.targetStartLimitIntervalSec=0[Service]Type=simpleUser=prometheusExecStart=/usr/local/alertmanager03/bin/alertmanager \--config.file=/usr/local/alertmanager03/conf/alertmanager.yml \--storage.path=/usr/local/alertmanager03/data \--web.listen-address=":39093" \--cluster.listen-address=192.168.1.220:39094 \--cluster.peer=192.168.1.220:19094 \--log.level=debugRestart=alwaysRestartSec=1[Install]WantedBy=multi-user.targetEOF# 开启systemd脚本启动systemctl enable alertmanager01 alertmanager02 alertmanager03systemctl start alertmanager01 alertmanager02 alertmanager03 启动完成后,就可以访问http://192.168.1.220:19093可以看到以下集群状态了,我这里是为了测试,本地启动了多个端口,如果是实际生产环境中,是不同节点以及不同的IP,这些根据自己的需求设计即可。 alert-gossip Prometheus中的配置: alerting: alert_relabel_configs: - source_labels: [dc] regex: (.+)\d+ target_label: dc alertmanagers: - static_configs: #- targets: ['127.0.0.1:9093'] - targets: ['192.168.1.220:19093','192.168.1.220:29093','192.168.1.220:39093'] 配置完成以后,重启或者reloadPrometheus服务,访问http://192.168.1.220:19090/config就可以看到具体的配置信息了。 prom-config 到此,Alertmanager集群配置就完成了,对于进群中的警报测试很简单,直接down掉一个端口,然后触发警报,看看警报是否可以正常发送。 本文分享自微信公众号 - Kubernetes技术栈(k8stech)。如有侵权,请联系 support@oschina.cn 删除。本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

优秀的个人博客,低调大师

性能测试神器 wrk 使用教程

原文连接:https://blog.fengjx.com/wrk/ wrk 是一个类似 ab(apache bench)、jmeter 的压力测试工具,底层基于 epoll 和 kqueue 实现,能充分利用 cpu 资源,降低测试工具本身性能开销对测试结果准确性的影响。支持使用 lua 脚本自定义测试逻辑,使用上非常简单,但功能足够强大。 没有了解过 lua 的同学,可以看下 lua 简明教程 https://coolshell.cn/articles/10739.html 安装 linux https://github.com/wg/wrk/wiki/Installing-wrk-on-Linux macOS https://github.com/wg/wrk/wiki/Installing-wrk-on-Mac-OS-X windows( Windows Subsystem for Linux ) https://github.com/wg/wrk/wiki/Installing-wrk-on-Windows-10 用法 $ wrk -h wrk: invalid option -- h Usage: wrk <options> <url> Options: -c, --connections <N> Connections to keep open -d, --duration <T> Duration of test -t, --threads <N> Number of threads to use -s, --script <S> Load Lua script file -H, --header <H> Add header to request --latency Print latency statistics --timeout <T> Socket/request timeout -v, --version Print version details 参数 说明 -c 与服务器保持的 http 连接数 -d 压测时间 -t 使用线程数 -s 自定义 lua 脚本路径 -H 自定义 http header 请求头,例如:"User-Agent: benchmark-wrk" --latency 打印延迟统计数据 --timeout http 超时时间 --version 打印版本信息 eg: wrk -t2 -c5 -d10s https://httpbin.org/get 这种情况只适用于每次请求都相同的情况 $ wrk -t2 -c5 -d10s https://httpbin.org/get Running 10s test @ https://httpbin.org/get 2 threads and 5 connections Thread Stats Avg Stdev Max +/- Stdev Latency 251.97ms 50.38ms 510.96ms 94.52% Req/Sec 7.60 2.40 10.00 75.23% 146 requests in 10.05s, 61.17KB read Requests/sec: 14.52 Transfer/sec: 6.08KB 编写 lua 测试脚本 官方文档:https://github.com/wg/wrk/blob/master/SCRIPTING 编写 lua 脚本可以实现复杂的测试场景,例如:需要登录认证的接口,查询不用 id 的数据(相同 id 服务端可能有缓存,达不到真实压测效果) 先看官方一个简单的自定义脚本 wrk.method = "POST" wrk.body = "foo=bar&baz=quux" wrk.headers["Content-Type"] = "application/x-www-form-urlencoded" $ wrk -d3s -c2 -s scripts/post.lua https://httpbin.org/get wrk 是一个内置的全局 table 类型变量,不需要定义可以直接使用,修改 wrk 变量的值,会对所有请求都生效。 wrk = { scheme = "http", host = "localhost", port = nil, method = "GET", path = "/", headers = {}, body = nil, thread = <userdata> } wrk 内置函数 wrk.format function wrk.format(method, path, headers, body) wrk.format returns a HTTP request string containing the passed parameters merged with values from the wrk table. 返回一个 http 请求字符串,参数会覆盖 wrk 全局配置,可以通过 format 可以构造出不同的 request wrk.lookup function wrk.lookup(host, service) wrk.lookup returns a table containing all known addresses for the host and service pair. This corresponds to the POSIX getaddrinfo() function. 返回所有可用服务器的地址信息 wrk.connect function wrk.connect(addr) wrk.connect returns true if the address can be connected to, otherwise it returns false. The address must be one returned from wrk.lookup(). 测试指定的服务器地址是否能正常连接 参考: local addrs = nil function setup(thread) if not addrs then addrs = wrk.lookup(wrk.host, wrk.port or "http") for i = #addrs, 1, -1 do if not wrk.connect(addrs[i]) then table.remove(addrs, i) end end end thread.addr = addrs[math.random(#addrs)] end function init(args) local msg = "thread addr: %s" print(msg:format(wrk.thread.addr)) end 生命周期回调函数 wrk 包括下面几个生命周期,在脚本中重新定义这些全局函数,可以修改 wrk 默认行为,实现个性化测试需求。 The following globals are optional, and if defined must be functions: global setup -- called during thread setup global init -- called when the thread is starting, global delay -- called to get the request delay, global request -- called to generate the HTTP request, global response -- called with HTTP response data, global done -- called with results of run 启动阶段 setup 每个线程初始化时执行一次 function setup(thread) setup 方法会传入一个 thread 对象,可以修改或设置 thread 相关参数,也可以终止线程执行,这里一般做一些初始化的工作,例如读取配置文件,加载到内存(不要每次请求的时候读取一遍,这样对测试准确性影响很大) thread.addr - get or set the thread's server address,获取或设置服务器地址信息 thread:get(name) - get the value of a global in the thread's env,获取当前线程参数 thread:set(name, value) - set the value of a global in the thread's env,设置当前线程参数 thread:stop() - stop the thread,终止线程 执行阶段 init 每个线程开始启动时执行一次 function init(args) args 是通过命令行传入的参数,通过 -- 指定 例如:wrk -d3s -c2 -s wrk.lua https://httpbin.org/get -- test 100 function init(args) for i, v in ipairs(args) do print(i,v) end end -- 输出 -- 1 test -- 2 100 delay 每次发送请求时,间隔时间(ms),每次请求执行一次 function delay() 返回值决定每次请求间隔 request 创建 request 时(发送 request 前)执行,每次请求执行一次 function request() 一般在这里会配合 wrk.format 方法,动态创建请求,这里不要执行耗时的代码,否则会影响测试结果准确性 response http 响应时执行,每次请求执行一次 function response(status, headers, body) http 响应处理逻辑,参数对应 http 响应的 status, headers, body。 解析 header 和 body 的开销比较大,如果脚本没有定义 response 方法,wrk 将不会解析 header 和 body,这样测试结果会更加准确(解析响应数据是客户端负责的,不能算到服务器处理时间里面) 结束阶段 done 返回结果时执行,整个测试过程只执行一次,可以生成自定义测试报告,如果没有特别需求,一般不重写这个方法 function done(summary, latency, requests) 参数含义 latency.min -- minimum value seen latency.max -- maximum value seen latency.mean -- average value seen latency.stdev -- standard deviation latency:percentile(99.0) -- 99th percentile value latency(i) -- raw value and count summary = { duration = N, -- run duration in microseconds requests = N, -- total completed requests bytes = N, -- total bytes received errors = { connect = N, -- total socket connection errors read = N, -- total socket read errors write = N, -- total socket write errors status = N, -- total HTTP status codes > 399 timeout = N -- total request timeouts } } 官方示例 https://github.com/wg/wrk/blob/master/scripts/setup.lua local counter = 1 local threads = {} function setup(thread) thread:set("id", counter) table.insert(threads, thread) counter = counter + 1 end function init(args) requests = 0 responses = 0 local msg = "thread %d created" print(msg:format(id)) end function request() requests = requests + 1 return wrk.request() end function response(status, headers, body) responses = responses + 1 end function done(summary, latency, requests) for index, thread in ipairs(threads) do local id = thread:get("id") local requests = thread:get("requests") local responses = thread:get("responses") local msg = "thread %d made %d requests and got %d responses" print(msg:format(id, requests, responses)) end end 更多用法查看官方示例:https://github.com/wg/wrk/tree/master/scripts

优秀的个人博客,低调大师

"国骂"命令行神器 thefuke!

thefuke是一个由python语言编写的, 自动修正错误命令的工具, 因为独特的命名, 大受好评! 自动修正命令的功能并非thefuke的原创, zsh的一些插件也支持命令修正, thefuke的"命名"实在是太独特了! 一群吃瓜群众都想看看thefuke到底是个什么工具, 一来二去, thefuke变得广为人知! 项目地址 安装方式 pip3 install thefuck 常用命令纠正 官方gif演示 example_instant_mode.gif 安装过程中可能遇到的问题 如果pip3 install thefuck安装后, 命令行提示需要手动配置工具, 只需重新打开终端, 输入fuck, fuck, fuck, 然后再次重新打开终端即可配置完成!

优秀的个人博客,低调大师

Google在线深度学习神器Colab

Colab是google最近推出的一项Python在线编程的免费服务, 有了它,不学Python编程的理由又少了一个 Colab环境已经集成了流行的深度学习框架Tensorflow,并附赠了一个虚拟机(40GB硬盘+2*2.30GHZ CPU+12.72GB内存),如果在国内无法访问google的服务又不想科学上网, 可以考虑微软推出的 notebook Colab的操作类似于jupyter notebook Colab如同使用 Google 文档或表格一样存储在 Google云端硬盘中,并且可以共享 1. Colab 执行终端命令 google为我们提供的Colab服务绑定一个Ubuntu虚拟机(40GB硬盘+2*2.30GHZ CPU+12.72GB内存), 我们只要在Colab中输入以!开头的终端命令即可 查看虚拟机硬盘容量!df -lh 40GB的硬盘 查看cpu配置!cat /proc/cpuinfo | grep model\ name 双核处理器 查看内存容量!cat /proc/meminfo | grep MemTotal 12.72GB内存 安装python依赖包 # 安装requests, 爬虫必备 !pip install requests # 安装 lxml, 解析xpath语法 !pip install lxml 安装 git # 将获取的数据同步到github仓库 !apt install git 2. 用Colab编写在线爬虫,并在线展示成果 在线编写豆瓣电影爬虫 !pip install lxml import os import requests from lxml import etree # 负责下载电影海报 def download_img(db_id, title, img_addr, headers): # 如果不存在图片文件夹,则自动创建 if os.path.exists("./Top250_movie_images/"): pass else: os.makedirs("./Top250_movie_images/") # 获取图片二进制数据 image_data = requests.get(img_addr, headers=headers).content # 设置海报存存储的路径和名称 image_path = "./Top250_movie_images/" + db_id[0] + "_" + title[0] + '.jpg' # 存储海报图片 with open(image_path, "wb+") as f: f.write(image_data) # 根据url获取数据,并打印到屏幕上,并保存为文件 def get_movies_data(url, headers): # 获取页面的响应内容 db_response = requests.get(url, headers=headers) # 将获得的源码转换为etree db_reponse_etree = etree.HTML(db_response.content) # 提取所有电影数据 db_movie_items = db_reponse_etree.xpath('//*[@id="content"]/div/div[1]/ol/li/div[@class="item"]') # 遍历电影数据列表, for db_movie_item in db_movie_items: # 这里用到了xpath的知识 db_id = db_movie_item.xpath('div[@class="pic"]/em/text()') db_title = db_movie_item.xpath('div[@class="info"]/div[@class="hd"]/a/span[1]/text()') db_score = db_movie_item.xpath('div[@class="info"]/div[@class="bd"]/div[@class="star"]/span[@class="rating_num"]/text()') db_desc = db_movie_item.xpath('div[@class="info"]/div[@class="bd"]/p[@class="quote"]/span[@class="inq"]/text()') db_img_addr = db_movie_item.xpath('div[@class="pic"]/a/img/@src') print("编号:",db_id,"标题:",db_title, "评分:",db_score,"电影描述:", db_desc) # a表示追加模式, b表示以二进制方式写入, + 表示如果文件不存在则自动创建 with open("./douban_movie_top250.txt", "ab+") as f: tmp_data = "编号:"+str(db_id)+"标题:"+str(db_title)+"评分:"+str(db_score)+"电影描述:"+ str(db_desc)+"\n" f.write(tmp_data.encode("utf-8")) db_img_addr = str(db_img_addr[0].replace("\'", "")) download_img(db_id, db_title, db_img_addr, headers) def main(): # 使用列表生成式,生成待爬取的页面url的列表 urls = ["https://movie.douban.com/top250?start="+str(i*25) for i in range(10)] # 设置请求头 headers = { # 设置用户代理头(为狼披上羊皮) "User-Agent": "Mozilla/5.0 (Macintosh; Intel Mac OS X 10_12_6) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/63.0.3239.132 Safari/537.36", } # 为避免重复运行程序,造成内容重复,这里把上次的文件清除(可跳过) if os.path.isfile("./douban_movie_top250.txt"): os.remove("./douban_movie_top250.txt") # 从列表取出url进行爬取 for url in urls: get_movies_data(url, headers) if __name__ == '__main__': main() 展示图片 import os from IPython.display import display, Image, FileLink names = [f for f in os.listdir('./Top250_movie_images/')] display(FileLink("./douban_movie_top250.txt")) for name in names: display(Image('./Top250_movie_images/' + name)) 3.在线机器学习,决策树案例 - 泰坦尼克乘客存活状况 机器学习决策树案例 4. 在线学习Python编程 推荐一: 菜鸟教程 用菜鸟的心态学习 推荐二: 廖雪峰的官方网站 廖雪峰 打开网页学编程 5.保存当前Colab文件 Colab文件和Google的在线文档一个性质,不需要保存! 6. 将当前的Colab转换为python标准文件,并保存到本地 保存到py 7. 共享Colab程序 Colab资源可以以链接方式共享给其他人, 其他人可以直接在线运行, 观看效果 共享Colab程序.png 小技巧: 如何获取在线环境的公网地址: Python3获取本机公网ip(爬虫法) 如何与在线环境进行文件互传: 通过Github仓库进行数据同步是不错的选择!

优秀的个人博客,低调大师

docker管理神器—kubernetes—pod篇

前面介绍了pod是个容器组,那么现在就来创建一个pod,就像dockerfile一样。 vi nginx-pod.yaml(要十分注意空格,一般为两个空格) 添加: apiVersion: v1 kind: Pod metadata: name: nginx1 spec: containers: - name: nginx1 image: docker.io/nginx ports: - containerPort: 9001 启动Pod kubectl create -fnginx-pod.yaml 使用get pods查看 kubectl describe pods nginx 在minion端查看: docker ps(它会首先启动一个pod-infrastructure容器,然后在本机找是否有nginx镜像,没有就去下载) 更多具体的详细的关于pod与yaml的编写和创建建议去google上查阅资料。 本文转自 sykmiao 51CTO博客,原文链接:http://blog.51cto.com/syklinux/1860292,如需转载请自行联系原作者

优秀的个人博客,低调大师

docker管理神器—kubernetes—介绍篇

1.1、kubernetes是什么? 全新的基于容器技术的分布式架构领先方案 完备的分布式系统支撑平台 Kubernetes是Google团队发起的开源项目,它的目标是管理跨多个主机的容器,提供基本的部署,维护以及运用伸缩,主要实现语言为Go语言。 1.2、基本概念 Node(节点):在Kubernetes中,节点是实际工作的点,较早版本称为Minion。节点可以是虚拟机或者物理机器,依赖于一个集群环境。每个节点都有一些必要的服务以运行Pod容器组,并且它们都可以通过主节点来管理。在Node上运行的服务进程包括docker daemon,Kubelet和 Kube-Proxy。 Pod(容器组):是Kubernetes的基本操作单元,把相关的一个或多个容器构成一个Pod,通常Pod里的容器运行相同的应用。Pod包含的容器运行在同一个节点上,看作一个统一管理单元,共享相同的volumes和network namespace/IP和Port空间。 Pod的生命周期:Pod的生命周期是通过Replication Controller来管理的。在整个过程中,Pod处于4种状态之一:Pending, Running, Succeeded, Failed。 Replication Controller(RC):用于定义Pod副本的数量。确保任何时候Kubernetes集群中有指定数量的Pod副本在运行, 如果少于指定数量的Pod副本,Replication Controller会启动新的Pod,反之会杀死多余的以保证数量不变。 Service(服务):一个Service可以看作一组提供相同服务的Pod的对外访问接口。 Volume(储存卷):Volume是Pod中能够被多个容器访问的共享目录。 Label(标签):用于区分Pod、Service、Replication Controller的key/value键值对,Pod、Service、 Replication Controller可以有多个label,但是每个label的key只能对应一个value。Labels是Service和Replication Controller运行的基础,为了将访问Service的请求转发给后端提供服务的多个容器,正是通过标识容器的labels来选择正确的容器。 Proxy(代理):是为了解决外部网络能够访问跨机器集群中容器提供的应用服务而设计的。Proxy提供TCP/UDP sockets的proxy,每创建一种Service,Proxy主要从etcd获取Services和Endpoints的配置信息,或者也可以从file获取,然后根据配置信息在Minion上启动一个Proxy的进程并监听相应的服务端口。 Namespace(命名空间):通过将系统内部的对象“分配”到不同的Namespace中,形成逻辑上的不同分组,便于在共享使用整个集群的资源同时还能分别管理。 Annotation(注解):与Label类似,但Label定义的是对象的元数据,而Annotation则是用户任意定义的“附加”信息。 本文转自 sykmiao 51CTO博客,原文链接:http://blog.51cto.com/syklinux/1860268,如需转载请自行联系原作者

优秀的个人博客,低调大师

Linux的文件搜索神器-find

一、前言 我们在使用Linux的时候,难免会用到文件搜索,即想找到某配置文件的位置,某种类型的文件在特定目录下的数量,或者统一对具有某种权限的文件进行权限修改等,而这时候就需要用到Linux下强大的find命令。当然locate也可以定位某些文件,但功能就逊色很多了,下面会先对find和locate的异同进行分析的。 二、locate和find对比 locate: 依赖于数据库(由系统计划任务自动生成) 非实时查询,结果非精确,即模糊查找 查找速度快 手动生成数据库的命令:updatedb(不适用于生产环境) find: 实时查找,速度慢 精确匹配查找 三、find的命令格式 1 find [options] [查找路径] [查找条件] [处理动作] 若直接执行find命令,则会打印出当前目录下的所有文件; find命令的默认值图解如下: 四、find查找条件 -name “文件名称”:精确查找文件名,支持使用globbing(*,?,[],[^]) -iname “文件名称”:查找时不区分大小写 -user UserName:根据属主查找 -group GroupName:根据属组查找 -uid UID:根据UID查找 -gid GID:根据GID查找 -nouser:查找没有属主的文件 -nogroup:查找没有属组的文件 -type:根据文件类型查找(f,d,b,c,p,s) -size [+|-]#Unit:根据文件大小查找常用单位K、M、G 时间的独特点,图解如下 如find /tmp -size -1M表示大小为0的文件 根据时间戳查找(不存在未来时) 以天为单位(time): -atime [+|-]#:访问时间 -mtime:修改时间 -ctime:改变时间 以分钟为单位(min): -amin [+|-]#:访问时间 -mmin:修改时间 -cmin:改变时间 时间的划分图解如下: -perm [+|-]MODE:根据权限查找 MODE:精确匹配 +MODE:任何一类用户的任何一位权限匹配即可;常用于查找某类用户的某特定权限是否存在[宽泛匹配] -MODE:三类用户的指定要查找的权限位都匹配[严格匹配] 实例图解如下 五、组合条件查找 -a:与,同时满足,默认值,可不写 -o:或,两条件满足其一即可 -not,!:非,取反 1 2 find /tmp -not -user hadoop -not -name “*.txt” find /tmp -not \(-user hadoop -o -name “*.txt”\) 六、find处理动作 -print:打印在标准输出上 -ls:以长格式输出各文件信息 -exec COMMAND {} \;:对查找的文件执行执行的命令 -ok COMMAND {} \;交互式-exec,对每个文件询问是否执行命令 exec与xargs的区别: find把查找到的文件一次性传递给-exec所指定的命令;而有些系统对能够传递给exec的命令长度有限制,则会报错”参数列太长”或”参数列溢出” xargs可以分批次传递find搜索到的文件,如find | xargs若对查找到的文件需连续引用2次时,则只能使用-exec,如 1 find /tmp -iname “*.doc” - exec mv {} {}x \; 七、实例 1 2 3 4 5 6 7 8 9 10 #查找/etc/目录下最近一周内其内容修改过的,且不属于root或hadoop的文件; find /etc/ -mtime -7 -a -not \( -user root -o -user hadoop \) #查找当前系统上没有属主或属组,且最近1个月内曾被访问过的文件; find / \( -nouser -o -nogroup \) -a -atime -30 #查找/etc/目录下大于1M且类型为普通文件的所有文件; find /etc/ -size +1M -a - type f #查找/etc/目录所有用户都没有写权限的文件; find /etc/ -not -perm +222 #查找/etc/init.d/目录下,所有用户都有执行权限且其它用户有写权限的文件; find /etc/init .d/ -perm -113 本文转自 xxrenzhe11 51CTO博客,原文链接:http://blog.51cto.com/xxrenzhe/1363524,如需转载请自行联系原作者

优秀的个人博客,低调大师

(独家)Linux邮件报警神器 mutt

在Linux里,很多人都会使用到邮件报警,而且这方面的软件也众多,常见的像SendMail,sendEmail,Postfix等等, 它们的优缺点我就不说了,使用上也各有所爱。今天我要给大家介绍的mutt,也许大家也不陌生, 网上太多关于mutt和sendmail或者跟msmtp合作使用的教程。其实,mutt非常的强大只要你仔细研究一下官方文档 (链接http://www.mutt.org/doc/manual) 系统环境:CentOS6.5 在正式安装mutt之前,先检查一下2个安全组件。 OPENSSL:opensslversion-a#检查安装及版本信息 SASL(系统一般已经自带):rpm-qa|grepsasl 查询到如下即可: cyrus-sasl-gssapi-2.1.23-15.el6_6.2.x86_64 cyrus-sasl-devel-2.1.23-15.el6_6.2.x86_64 cyrus-sasl-lib-2.1.23-15.el6_6.2.x86_64 cyrus-sasl-plain-2.1.23-15.el6_6.2.x86_64 cyrus-sasl-2.1.23-15.el6_6.2.x86_64 如果sasl没有运行,先启动: /etc/init.d/saslauthdstart 最好是加入到自启动项目中去: chkconfigsaslauthdon 因为发送邮件的时候会需要用到安全认证。 1,安装 官方网站上下载最新版本,或者直接在本站下载,我已上传至51下载中心。 下载地址http://down.51cto.com/data/2214372 #解压后进入mutt目录 cd/root/mutt-1.6.0 #编译: ./configure--prefix=/usr/local/mutt--enable-pop--enable-smtp--with-ssl--with-sasl #说明 --enable-pop启用pop --enable-smtp启用smtp --with-ssl--with-sasl在启用上述协议的情况下,必须使用更安全的加密 PS:因为我用的测试帐号是QQ邮件,qq邮件使用smtp协议的时候要求必须使用ssl安全连接, 而在mutt里使用安全连接又必须使用sasl加密,所以上述2个安全组件在编译安装的时候得加上。 要不然发送邮件的时候会出现“SMTPauthenticationrequiresSASL”或者另外一个跟ssl有关的错误。 #安装 make&&makeinstall 2,配置文件 方法1:安装好后,拷贝一份安装目录下/usr/local/mutt/etc/的配置文件Muttrc到/root/.muttrc, 也可以直接修改配置文件,设置读取的配置文件路径到安全目录,这样就无需拷贝了。 默认设置:setalias_file="~/.muttrc" 方法2:cat/usr/local/mutt/etc/Muttrc|grep-v^#|grep-v^$>~/.muttrc 这样都可以得到默认的配置文件信息。 安装完成后,我们仅需要设置的信息如下: setfolder="./Mail"#设置本地的收件箱,如果不设置发送邮件的时候会提示 setfrom="123456789@qq.com"#设置发件人地址 setrealname="张三"#发件人姓名 setsmtp_pass="999999"#密码 setsmtp_url="smtps://123456789@smtp.qq.com:465/"#发件人帐号和邮件主机信息,QQ邮箱必须使用安全连接 setuse_envelope_from=yes#使用自定义发件人邮箱 setuse_from=yes#使用自定义发件人姓名 3,测试 mutt-1.6版本的发送邮件的语法跟1.4版本有些微的差别,具体命令如下: mutt-s"Title使用"-a/usr/local/mutt/content.txt--rep@shoujianren.com</root/1 #说明 -s邮件标题 -a附件 --后面跟上收件人信息 <后面是邮件正文内容,也可以在前面echoxxx的形式给出。如下: echoxxx|mutt-s"Title使用"-a/usr/local/mutt/content.txt--rep@shoujianren.com 看吧,无需与其它软件合作,mutt就可以独立完成发送邮件,当然,接收也没问题,只是在邮件报警这个需求上用不着。 其中一个错误信息: [root@x63mutt]#echo"Hello"|mutt-s"Title"--xxx@xxxx.com TLSv1.2connectionusingTLSv1/SSLv3(AES256-SHA256) SMTPauthenticationrequiresSASL Couldnotsendthemessage. 发送成功的信息: [root@x63mutt]#echo"Hello3"|mutt-s"Title"--xxx@xxxx.com TLSv1.2connectionusingTLSv1/SSLv3(AES256-SHA256)

优秀的个人博客,低调大师

AI 技术被滥用成“退款神器

据央视新闻报道,近期,电商平台出现一种新型恶意退款行为:部分买家利用人工智能工具伪造商品损坏图片,申请“仅退款”,导致商家遭受货款和运费的双重损失。这一现象引起广泛关注,揭示了AI技术被滥用所带来的新挑战。 商家们在社交平台吐槽,买家利用AI将完好无损的商品,如衣物、杯子或玩具,通过“伪毁损”处理,使其在图片上呈现出碎裂或有瑕疵的状态。这些伪造的图片逼真,让商家难辨真伪。更令人沮丧的是,即使商家察觉到是假图,部分电商平台的自动审核机制仍可能通过退款申请,使得商家在没有收回商品的情况下,被迫退还货款。 针对这种行为,法律专家指出,利用AI伪造图片骗取退款的行为已涉嫌违法。这不仅违背了《民法典》中的诚实信用原则,构成民事欺诈,还可能触犯《治安管理处罚法》。如果骗取金额达到或超过3000元,甚至可能构成《刑法》规定的诈骗罪。 面对这一挑战,专业人士呼吁监管部门、电商平台和商家采取多方面措施共同应对。监管部门应完善法律法规,在《电子商务法》中增设保护商家权益的条款,并明确恶意退款行为的法律后果。同时,强制推行AI生成内容标识,并对删除或篡改标识的行为进行处罚。此外,建议建立跨平台的用户消费信用机制,将恶意行为纳入个人征信,从根本上限制其线上活动。 电商平台需要强化审核机制,减少对AI客服的依赖,增加人工审核投入,并延长审查时间,给商家提供充足的举证机会。技术方面,平台应加大投入,利用技术手段验证图片与实物的匹配性,从源头拦截伪造内容。 商家也需积极自保,优化售后流程,要求买家提供清晰、完整的退款证据,并通过对打包发货全过程录像等方式,留存商品质量证据。若发现恶意行为,应及时向平台反映,情节严重时可直接向公安机关报案,维护自身合法权益。 AI技术的初衷是提质增效,但当它被用于不法目的时,对商业生态的破坏力不容小觑。只有多方联动,才能有效遏制这种新型网络欺诈,重建消费者与商家之间的信任。

优秀的个人博客,低调大师

推荐六款实用 Mock 神器

前言 工具好不好用,关键在于用。肯定有很多前端程序猿联调前很悠闲😌,但联调阶段持续加班,直到提测、上线。 这其中缘由不外乎需求不明确等原因,但如果我们能在联调前完成大部分工作,相信就能准点下班啦🚗。如果你也有类似的现象,希望能看完此篇,或许能让你在不协调的工作中解放出来。 背景 在开发环境中,由于后端与前端并行开发、或者前端需要等待后台接口开发。接口直接严重依赖,生成数据的业务逻辑复杂等,严重影响了开发效率。 因此学会使用最适合自己的 Mock 数据的方法就非常重要。 下面介绍了几种常用的mock方案,通过了解自动化mock的方式,减少重复工作,减少真实联调问题,我们可以根据开发场景,选择并配置最合适自己的方案。 六类常用的 MOCK 方案说明 方案1:代码侵入(实际开发中最常用,但不推荐) 特点:直接在代码中写死 Mock 数据,或者请求本地的 JSON 文件 优点:无 缺点:和其他方案比 Mock 效果不好,与真实 Server 环境的切换非常麻烦,一切需要侵入代码切换环境的行为都是不好的 方案2:接口管理工具 代表: rap(阿里,已停止维护,使用rap2) 地址: https://github.com/thx/RAP swagger 地址: https://swagger.io/ moco(和前端处理mock类似,json假数据+服务) 地址: https://github.com/dreamhead/moco yapi(去哪儿网开发 yapi 官网) 地址:https://github.com/YMFE/yapi 优缺点(接口管理工具) 优点: 配置功能强大,接口管理与 Mock 一体,后端修改接口 Mock 也跟着更改,可靠 有统一的接口管理后台,查找使用方便。 缺点: 配置复杂,依赖后端,可能会出现后端不愿意出手,或者等配置完了,接口也开发出来了的情况。mock数据都由后台控制,有什么异常情况 前端同学基本上使不上力。有背前后台分离的原则。 一般会作为大团队的基础建设而存在, 没有这个条件的话需慎重考虑 增加后台负担,与其让后台处理mock数据相关问题,倒不如加快提供真实接口数据。 方案3:本地 node 服务器 代表:json-server[5]原理:使用lowdb,操作本地小型的数据库(遵循 REST API)。特点: 可以独立使用,也可以作为node服务的中间件 server.use(db) db可以是json文件(更直观),也可以使js文件(灵活性更高) 可以设置跨域、开启gzip、设置延时、日志、指定路由等。json-server [options] 可命令行启动或json-server.json配置后直接启动 可以自定义路由映射(key为真实路由、value为mock路由) 轻而易举的实现后台功能 过滤:GET /list?name.age=18; 分页: /users?_page=3&_limit=5 排序:/users?_sort=id&_order=desc 分隔:/users?_start=2&_end=5 运算:使用 _gte 或 _lte 选取一个范围、使用 _ne 排除一个值、使用 _like 进行模糊查找 (支持正则表达式) ...... 服务管理 增删改查参考 postman 示例。(注意body-raw要选择json模式) 优点: 配置简单,json-server 甚至可以 0 代码 30 秒启动一个 REST API Server 自定义程度高,一切尽在掌控中 增删改查真实模拟 缺点: 与接口管理工具相比,无法随着后端 API 的修改而自动修改 地址:https://github.com/typicode/json-server 方案4:请求拦截[MOCKJS] 代表:Mock.js[6] 特点: 通过拦截特定的AJAX请求,并生成给定的数据类型的随机数,以此来模拟后端同学提供的接口。 使用数据模板定义,随机生成定义数据的自由度大。使用MockJS的Random工具类的方法定义,这种方式自由度小,只能随机出MockJS提供的数据类型。 一般配合其它库使用或单独在项目中使用或者通过反向代理来实现。 地址:http://mockjs.com/ 使用格式说明: Mock.mock( rurl?, rtype?, template|function( options ) ) rurl:可选,拦截的url地址,可以是字符串或正则(常用) rtype: 可选,拦截的请求类型,字符串(对大小写敏感,必须小写)。 template|function(options):必须,拦截后返回的数据。template一般为json对象类型;function在return时需要返回template,其中option包含请求的url、type 和 body属性 只传template,则执行Mock.mock后返回的是template的实际结果。 简单示例展示: 随机生成颜色 Mock.mock('@color') "#f279ba" 随机生成邮箱 Mock.mock('@email') "k.fxnx@newvwi.gf" 随机生成ip Mock.mock('@ip') "44.122.28.106" 随机生成区域地址 Mock.mock('@region') "东北" 还能随机生成图片(并可传参配置图片大小、颜色等) Random.image() 随机生成日期时间 Random.date() // => "2020-10-23" Random.date('yyyy-MM-dd') // => "1998-01-29" Random.time() // => "22:44:56" Mock.mock('@time') // => "01:48:17" 按规则生成字符串 // 指定范围的数量 Mock.mock({ "string|1-10": "★"}) // 执行后 { "string": "★★"} // 随机生成数量为1-10个'*'字符串 // 固定数量 Mock.mock({ "string|3": "*"}) // 执行后 { "string": "***"} // 生成指定数量的'*'(示例是3个)字符串 生成指定范围内的数字 // 整数 Mock.mock({ "number|1-100": 100}) // 执行后 { "number": 84} // 生成1-100范围内的数字 // 小数 Mock.mock({ "number|1-100.1-10": 1}) // 执行后 { "number": 72.15917} // 生成1-100的数字,随机保留1-10位小数 生成随机的对象数量 Mock.mock({ "object|2-4": { "110000": "北京市", "120000": "天津市", "130000": "河北省", "140000": "山西省" }}) // 执行后,随机获取对象中的2-4项 { "object": { "120000": "天津市", "130000": "河北省" } } 生成指定数量的数组 Mock.mock({ "array|1": [ "AMD", "CMD", "UMD"] }) { "array": "CMD"} // 随机获取对象中的一项 生成对象数组 // list指定了数组当中的对象数量,最少一项,最多10项。 Mock.mock({ // 属性 list 的值是一个数组,其中含有 1 到 10 个元素 'list|1-10': [{ // 属性 id 是一个自增数,起始值为 1,每次增 1 'id|+1': 1 }] }) // 随机的结果 { "list": [ { "id": 1 }, { "id": 2 } ] } ...... 更多示例可查看官方链接: http://mockjs.com/examples.html 优缺点(MOCKJS) 优点: 与前端代码分离 可生成随机数据 缺点: 数据都是动态生成的假数据,无法真实模拟增删改查的情况 只支持 ajax,不支持 fetch 方案5:抓包工具 利用 Charles 、Fiddler等代理工具, 常见的处理方式有 将 URL 映射到本地文件;(调试APP混合开发等) debugger某个url,修改响应数据。 拦截后返回本地的数据,如Charles,直接采用Map locale 或者 Map Remote的方式。 右击url, copy response 在本地新建mock json数据,然后将response粘贴修改 再次访问url,观察api的变化。 优缺点: 优点:mock便于混合开发的问题排查、线上问题排查等。缺点:调试相对繁琐。 方案6:组合模式 代表:easy-mock(提供在线服务和接口代理,支持mockjs、Swagger、restapi风格) node 框架生成器 + json-server + mockjs。 REST API URI 代表 资源/对象,METHOD 代表行为 www.ruanyifeng.com/blog/2014/0…[15] GET /tickets // 列表 GET /tickets/12// 详情 POST /tickets // 增加 PUT /tickets/12// 替换 PATCH /tickets/12// 修改 DELETE /tickets/12// 删除 资源负数名称表示对应表的资源集合,方法动词。 其它方案参考 apifox API 文档、调试、Mock、自动化测试一体化协助平台[17] 看评论推荐的人还真不少😆,感兴趣的小伙伴可以尝试一下。支持 HTTP、TCP、RPC,(2020-12-28首版发布) 常用解决方案: 使用 Swagger 管理 API 文档 使用 Postman 调试 API 使用 RAP 等工具 Mock API 数据 使用 JMeter 做 API 自动化测试 jsonplaceholder 很方便,直接fetch远程的数据即可,高效易用jsonplaceholder官方文档 地址:https://jsonplaceholder.typicode.com 最后 Mock不只是mock数据,还可以mock功能的。我们通过使用Mock尽可能的完善功能,才能在联调时事半功倍。 如果觉得有帮助,不妨点赞、关注支持一下。如文章有不足之处、疑问或建议,希望能在下方👇🏻 留言,非常感谢。

优秀的个人博客,低调大师

APK修改神器:插桩工具 DexInjector

本文介绍了一个针对Dex进行插桩的工具,讲解了一下直接修改Dalvik字节码和Dex文件时遇到的问题和解决方法 作者:字节跳动终端技术—— 李言 背景 线下场景中,我们经常需要在APK中插入一些检测代码,来实现一些记录方法调用耗时,或者增加一些打印日志的功能。目前的常规做法都是在编译期修改class字节码达到,例如byteX提供了方便的修改class框架。 但是,编译期修改灵活性不足,对于已经编译好的apk则无能为力,无法插桩或修改。导致很多业务方都要配置独立的jenkins打包后,才能触发进步一步的测试。一次自动化测试任务有将近一半的时间都消耗在打包过程中。 为了解决这个痛点,我们开发了一套直接针对APK(dex)插桩的工具,DexInjector。主要用来做一些日志、性能方面的数据采集和注入一些第三方工具,避免业务方二次打包,节省测试时间。 该方案已经用在日志旁路、网络数据抓取、第三方库注入,用户信息注入、日常调试等。 工具目前可以实现: 方法前插桩 方法后插桩 初始化插桩 技术方案调研 调研了一下市面上现有的字节码修改方案。 smali 可以通过smali 和baksmali 工具将dex文件转换成可方便阅读的smali语法文件,但是smali的工具对smali字节码的解析是通过语法解析,如果要插入一个新的代码进去对寄存器等操作没有办法实现结构化操作。 redex redex 支持通过配置在方法前进行插桩,可以通过实现pass来完成自己的插桩功能。但是功能实现有限,使用起来比较复杂,而且在执行之后插入了一些fb自定义的代码,但Redex 提供了一套强大的字节码修改能力,后续的版本会基于redex的字节码修改能力进行完善。 https://github.com/facebook/redex/blob/master/opt/instrument/Instrument.cpp dexter https://android.googlesource.com/platform/tools/dexter/+/refs/heads/master dexter 工具是google开发的一个类似dexdump的工具,但其内部实现了对dex文件结构和字节码指令的一套完整的操作api,轻量简洁,对字节码的操作可以达到ASM的体验。 综合,选用dexter对dex进行操作。 方案设计 需求 根据性能防劣化和流量统计的需求,都是在一个方法的方法体内部前后插入对其他方法的调用。以网络流量统计为例,需要在 okhttp3.RealCall.getResponseWithInterceptorChain 的方法内部开头插入一个方法来获取request请求的详细数据。 Response getResponseWithInterceptorChain() throws IOException { com.netflow.inject.hookRealCall(this);//插入的方法 List<Interceptor> interceptors = new ArrayList<>(); interceptors.addAll(client.interceptors()); //.....省略部分代码 return chain.proceed(originalRequest); } Dex 插桩 基本流程 Dex文件分析 先要分析Dex文件格式,将其序列化成各种数据结构,Dex文件的结构可以参照官方文档 Dalvik 可执行文件格式 字节码解析 在code 段将二进制的字节码解析成可处理的数据结构 字节码构造 按照字节码规范构造字节码指令,并插入到现有字节码的序列中即可完成字节码的插入。 字节码序列化 将修改后的Dex结构重新计算Index,然后将各个数据Section序列化为Dex的文件格式。 功能需求 插桩支持两种能力,在一个方法的方法体前面和后面插入一个静态方法调用。 方法体前面插桩 如果被插入的方法为实例方法,则方法的第一参数为 this,随后的参数和被插入的方法一致 ,如果方法是静态方法则插入的方法定义需要和被插入的方法参数类型和个数一致,举例: public class Tracer{ //被插入的方法,为实例方法 private void MethodA(int a,int b){ } //被插入的方法,为静态方法 private static void MethodB(int a,int b){ } } public class Hooker{ //插入的方法 private static void TestHookA(Tracer this_,int a,int b){ } private static void TestHookB(int a,int b){ } } ////////插入后///////// public class Tracer{ private void MethodA(int a,int b){ Hooker.TestHookA(this,a,b); //...... } private static void MethodB(int a,int b){ Hooker.TestHookB(a,b); //....... } } 方法体后面插桩 需要注意的是返回值的处理,插入的方法的返回值需要和被插入方法的返回值类型一致。 参数的处理需要注意,插入的方法需要符合以下规则: 方法名(this,被插入的方法参数,返回值类型) 举例: public class Tracer{ //被插入的方法 private void MethodA(int a, int b){ //...... } private String MethodB(int a, int b){ //...... return str; } } public class Hooker{ private static void TestHookA(Tracer this_,int a,int b){} private static String TestHookB(Tracer this_,int a,int b,String return_val){ //return_val 参数的值为原方法的真是返回值 return return_val; } } ////////插入后///////// public class Tracer{ private void MethodA(int a, int b){ //...... Hooker.TestHookA(this, a, b); } private String MethodB(int a, int b){ //...... return Hooker.TestHookB(this, a, b, str); } } 初始化插桩 一般用来插入一些需要提前初始化的代码,该功能会解析AndroidManifest.xml里application 节点里定义的Application类。 根据配置在OnCreate 或者 attachBaseContext 方法里插入代码。如果没有定义OnCreate 和 attachBaseContext 方法,插桩工具会生成这两个方法。 常见问题处理 由于Dex在格式和指令上的一些限制,在修改和插入字节码的过程中需要符合Dex 和 dalvik指令了一些规则,下面描述了直接操作Dex遇到的一些问题和解决方法。 方法数处理 当代码量增大后,由于Google早年设计缺陷,一个DEX文件只能容纳 65535个方法、方法引用等,插桩本身不可避免会引入新的方法以及方法引用。在某些时候会有如下情况,APP的某个dex文件非常迫近65k,导致无法再插入新的方法调用,这种情况在大多数app中常见。 一种方案是将Dex整体合并在一起,然后进行拆分,此种方法会破坏原有Dex的一些优化,并且需要实现类之间的应用关系计算,计算量比较大,这里采用一种轻量的解决方法。 Dex 拆包 解决方案1: 通过编译时增加 --set-max-idx-number迫使编译器尽量不要塞满dex,但是这种方案可能不会生效,如果这个apk被类似redex的工具处理后,dex也有概率会被填满。 解决方案2:Dex 分拆逻辑 如果当前dex的方法数剩余量不满足插入新的方法则将现有dex拆出一部分类出来到一个额外的dex中。 以第一个dex的编译逻辑为例,在将maindex list和其引用的类都塞到dex后,一般方法数不会刚好到65535,如果超过了在编译的过程中就会出现Too many classes in --``main-dex``-list 的错误。然后编译器会将一些引用关系比较小的类填入第一个dex中。这些类就是我们要拆分的目标。 主要找到这个dex里没有调用到的类就满足目标了,通过遍历所有方法调用、属性引用、类引用的位置将所有类的引用过滤出来,可以将没有调用到的类过滤出来,拆分到其他的dex中。 主要逻辑: 判断该dex 的方法数是否可以继续插桩,如果无法进行插桩则需要进行dex分割逻辑 遍历每个类的每个方法的参数,记录类型 遍历每个类的属性,记录类型 遍历每个方法的字节码指令,通过方法调用,属性引用,类型强转的指令将引用的类型记录下来 https://source.android.com/devices/tech/dalvik/instruction-formats 字节码格式ID为 22c 21c 31c 35c 3rc 的指令在最后的操作数都是一个类的方法或者属性的引用,就可以将这个方法使用的类获取到。 将所有interface annotation 保留在原dex中 剩下的class 就是这个dex中没有使用到的class,可以将其拆分出去而对这个dex的执行不产生影响。 将没有用到的class 单独打包到一个额外的dex中,比如 现有dex有四个,则创建一个新的dex来保存。 这样被插入的dex 就会省出一部分方法空间可以继续插桩。 Dex 合并 分割dex合并 在Dex 分割完成后,dex分为两部分,我们需要将分割出来的dex合并成一个dex 附加到最后一个dex上面。 如上图,classes.split.dex、classes3.split.dex、...... classes9.split.dex 会合并成同一个dex 为classes11.dex 插桩dex合并 插桩方法调用的代码一般不会打包到apk中,需要将代码merge到apk中。这里直接将需要插入的dex合并到最后一个dex上,如果最后一个dex无法合并则创建一个新的dex合并进去。 String Jumbo处理 在Dalvik字节码中从常量池中读取字符串到寄存器里有两个指令,const-string vAA, string@BBBB 和 const-string/jumbo vAA, string@BBBBBBBB ,第一条指令只支持访问0-0xFFFF范围的字符串,由于我们插入了新的方法调用,会新增字符串(类名、方法名)进去,在很多情况下会导致字符串总量超过65535,由于Dex格式要求必须使用 UTF-16 代码点值按字符串内容进行排序,所以在插入新的字符串之后要进行重排序,重新排序之后会导致原先的字符串索引发生变化,引起原本使用 const-string 的指令访问到高于0xFFFF索引的字符串,引起虚拟机执行异常。 插桩工具对此做了处理,在插桩完成后会扫描所有 const-string vAA, string@BBBB 指令,如果访问的string index 超过65535 则强制将 const-string 修改为 const-string/jumbo 指令。 混淆处理 目标方法被混淆 大部分情况下,目标方法都有比较大的概率会被混淆,所以我们在插桩的时候要基于mapping文件找到混淆后的目标函数然后进行插桩。 插入的dex使用了原APK中的类 很多情况下插桩方法调用到我们插入的dex都有可能使用到原来apk里提供的类,由于原apk里的类经历过混淆所以直接通过混淆前的名称调用会出现类、方法、属性无法找到的异常。 通过mapping文件将插入的dex里类名、方法名、属性名进行一次混淆,将调用方强行修改成混淆后的名称。 类被删除,方法内联/被删除 优先考虑在原apk编译的过程中增加混淆配置去解决。 如果调用的类和原apk逻辑关联不是很大,则建议将使用到的类包名重命名,然后一起打入到dex中,这样会表现为apk中存在相同的类,但是包名不一致,插入的dex只调用自己集成的类,这样就不用关心这个类的混淆问题。 很多情况下是需要使用到原apk的类,无法通过重命名包名来解决,比如通过参数传入的类,在调用这些类的方法的时候可能会出现这个方法被混淆器删除掉的情况,有可能是被内联或者没有其他位置使用到从而被删除,那么在调用过程中尽量避开调用方法。 有部分情况一些属性的get set方法会被内联成直接访问属性的情况 混淆前: 混淆后: 为了避免这种情况尽量在调用get set方法的时候直接使用属性访问。 比如: 如果这个get set方法没有被内联掉,那么会出现调用的属性是是private 和 protected 则导致fileld验证不通过,出现java.lang.IllegalAccessError: Field 'xxxx' is inaccessible to class 错误,解决方法是强行把被调用的属性权限改成public。需要提前指定要修改了哪些属性的访问权限。这些配置在一个配置文件里进行设置,后面会说明如何设置。 类重复问题处理 大部分情况下我们会遇到插入的Dex 与被插入的APK 存在相同类名的类的问题,比如调用了共同的第三方库,这里最常见遇到的是使用Kotlin编写的插入的dex,里面会存在kotlin 库。 这里有两种解决方法: 剔除插入的Dex里的重复类 在制作插入Dex的时候使用Dex插桩工具的按包名提取类的功能,将需要的类裁剪出来做成dex,这个时候就可以将一些与APK重复的类剔除出去,插入进去的Dex使用APK自身的库,这个时候需要将插入的Dex按照mapping进行混淆才能够正常进行调用。 重命名冲突的第三方库 将自身调用的重复类按照包名整体重名名调用。比如 kotlin 包重命名成 kotlin_copy ,这样自己的dex 调用的是kotlin_copy.xxxx 就与原apk 不冲突了。 字节码插桩 方法前插桩 在方法前面增加一条 invoke-static/range {} 的指令,将原方法的参数透传到 hook 方法中 .method public static monitorEvent(Ljava/lang/String;Lorg/json/JSONObject;Lorg/json/JSONObject;Lorg/json/JSONObject;)V .registers 9 //插桩代码 invoke-static/range {p0 .. p3}, Lcom/bytedance/apm_bypass_tool/monitor/BypassMonitor;->monitorEvent(Ljava/lang/String;Lorg/json/JSONObject;Lorg/json/JSONObject;Lorg/json/JSONObject;)V const/4 v0, 0x4 .... 方法后插桩 查找所有return 指令,在执行前面进行插桩 返回值处理 由于要将返回值通过参数传递给hook方法使用,所以需要申请一个寄存器保留返回值的结果然后传递过去。 除 return-void 指令以外,其他return指令都附带一个返回值,如下: invoke-direct {p2, p0, p1}, Lcom/ss/android/lark/ico$1;-><init>(Lcom/ss/android/lark/ico;Ljava/lang/reflect/Type;)V return-object v4 将p2 寄存器里的值保存到一个额外的寄存器里,然后获取hook方法的返回值,再返回回去 invoke-direct {p2, p0, p1}, Lcom/ss/android/lark/ico$1;-><init>(Lcom/ss/android/lark/ico;Ljava/lang/reflect/Type;)V move-result-object v4 invoke-static {p0, p1, p2, v4}, Lcom/netflow/inject/NetFlowHookReceiver;->hookCallServerInterceptor_executeCall_end(Lcom/ss/android/lark/ici;Lcom/ss/android/lark/idj;Lcom/ss/android/lark/icy;Lcom/ss/android/lark/idi;)Lcom/ss/android/lark/idi; move-result-object v5 //如果不对返回值做修改的话这里可以直接使用v4 return-object v5 参数寄存器复用问题 在某些情况下,编译器在返回一个值的时候为了复用寄存器,会复用参数寄存器来作为通用寄存器,这就导致我们在方法后面获取参数的时候,发现这个参数寄存器被复用了,就无法正确获取到参数的值。 函数中引入的参数命名从p0开始,依次递增。举例一个方法会用到v0,v1,p0,p1,p2这五个寄存器,v0和v1表示局部变量寄存器,如果是实例方法的话,p0表示的是被传入的this对象的引用,p1和p2分别表示两个传入的参数。 比如下面,就复用了p1寄存器来保存返回值,导致我们插桩方法无法获取到正确的p1参数 invoke-interface {p1, p2}, Lcom/ss/android/lark/idf;->a(Lcom/ss/android/lark/idh;)Lcom/ss/android/lark/idj move-result-object p1 return-object p1 解决方法: 在原有寄存器数量上面扩展对应参数数量的寄存器即可解决这个问题,比如 一个方法寄存器布局如下 v0 v1 v2 p0 p1 p2 在当前字节码中复用了p1寄存器。 扩展当前同参数数量的寄存器之后,寄存器布局如下: v0 v1 v2 v3 v4 v5 p0 p1 p2 原字节码引用p1的位置变成了v4,以上面的例子来说就是字节码变成了如下形态: invoke-interface {p1, p2}, Lcom/ss/android/lark/idf;->a(Lcom/ss/android/lark/idh;)Lcom/ss/android/lark/idj move-result-object v4 return-object v4 这样就防止参数寄存器被复用 寄存器扩展问题 在扩展寄存器的时候会遇到指令异常的问题,主要原因是寄存器数量扩展过多超过16个导致的,原字节码的寄存器使用可以保证寄存器的正确使用,在插入的时候也要保证寄存器的正确。 在实践中,一个方法需要 16 个以上的寄存器不太常见,而需要 8 个以上的寄存器却相当普遍,因此很多指令仅限于寻址前 16 个寄存器。在合理的可能情况下,指令允许引用最多前 256 个寄存器。此外,某些指令还具有允许更多寄存器的变体,包括可寻址 v0 - v65535 范围内的寄存器的一对 catch-all move 指令。如果指令变体不能用于寻址所需的寄存器,寄存器内容会(在运算前)从原始寄存器移动到低位寄存器和/或(在运算后)从低位结果寄存器移动到高位寄存器。 例如,在指令“move-wide/from16 vAA, vBBBB”中: “move”为基础运算码,表示基础运算(移动寄存器的值)。 “wide”为名称后缀,表示指令对宽(64 位)数据进行运算。 “from16”为运算码后缀,表示具有 16 位寄存器引用源的变体。 “vAA”为目标寄存器(隐含在运算中;并且,规定目标参数始终在前),取值范围为 v0 - v255。 “vBBBB”是源寄存器,取值范围为 v0 - v65535。 比如在使用超过v16的寄存器的时候,要将move-object vA, vB 指令转换为move-object/from16 vAA, vBBBB 或者 move-object/16 vAAAA, vBBBB 插桩Dex制作 插桩 Dex 是我们要额外插入到APK里的dex,也就是插桩代码调用到的代码。 生成Dex 举个例子,将需要插入的代码单独放到一个gradle module中 编译完成后解压aar,取出jar包,通过d8命令将java字节码转成dex mkdir resources ./gradlew inject-dex:clean ./gradlew inject-dex:assembleRelease d8 inject-dex/build/intermediates/aar_main_jar/release/classes.jar --output resources/ mv resources/classes.dex resources/netflow_caller.dex mv resources/netflow_caller.dex netflow_caller.dex 方案1:抽取插桩类 由于编译完成后一般会将一些系统库和与原APK重复的第三方库打包进去,所以需要将这些系统库或者第三方库过滤掉。 工具提供了一个根据包名抽取类的功能,可以将指定包名的类单独拆成一个dex。 抽取前: 抽取后: 方案2:将重复的第三方库重命名 可以将使用的第三方库使用重命名功能进行重命名,这样做比使用APK里类的好处就是可以解决第三方库的版本问题和混淆问题。 MARS- TALK 04 期来啦! 2月24日晚 MARS TALK 直播间,我们邀请了火山引擎 APMPlus 和美篇的研发工程师,在线为大家分享「APMPlus 基于 Hprof 文件的 Java OOM 归因方案」及「美篇基于MARS-APMPlus 性能监控工具的优化实践」等技术干货。现在报名加入活动群 还有机会获得最新版VR一体机——Pico Neo3哦! ⏰ 直播时间:2月24日(周四) 20:00-21:30 💡 活动形式:线上直播 🙋 报名方式:扫码进群报名 作为开年首期MARS TALK,本次我们为大家准备了丰厚的奖品。除了Pico Neo3之外,还有罗技M720蓝牙鼠标、筋膜枪及字节周边礼品等你来拿。千万不要错过哟! 👉 点击这里,了解APMPlus

优秀的个人博客,低调大师

HTTP流量神器Goreplay核心源码详解

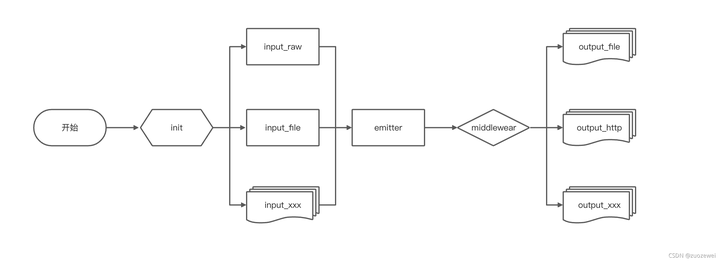
摘要:Goreplay 前称是 Gor,一个简单的 TCP/HTTP 流量录制及重放的工具,主要用 Go 语言编写。 本文分享自华为云社区《流量回放工具之 goreplay 核心源码分析》,作者:zuozewei。 一、前言 Goreplay 前称是 Gor,一个简单的 TCP/HTTP 流量录制及重放的工具,主要用 Go 语言编写。 Github地址:https://github.com/buger/goreplay 二、工程结构 这里以最新的 v1.3 版本为例,与 v1.0 的代码存在较大差异。 ~/GoProjects/gor_org/goreplay   release-1.3 ±✚  tree -L 1 . ├── COMM-LICENSE ├── Dockerfile ├── Dockerfile.dev ├── ELASTICSEARCH.md ├── LICENSE.txt ├── Makefile ├── Procfile ├── README.md ├── byteutils ├── capture ├── circle.yml ├── docs ├── elasticsearch.go ├── emitter.go ├── emitter_test.go ├── examples ├── go.mod ├── go.sum ├── gor.go ├── gor_stat.go ├── homebrew ├── http_modifier.go ├── http_modifier_settings.go ├── http_modifier_settings_test.go ├── http_modifier_test.go ├── http_prettifier.go ├── http_prettifier_test.go ├── input_dummy.go ├── input_file.go ├── input_file_test.go ├── input_http.go ├── input_http_test.go ├── input_kafka.go ├── input_kafka_test.go ├── input_raw.go ├── input_raw_test.go ├── input_tcp.go ├── input_tcp_test.go ├── kafka.go ├── limiter.go ├── limiter_test.go ├── middleware ├── middleware.go ├── middleware_test.go ├── mkdocs.yml ├── output_binary.go ├── output_dummy.go ├── output_file.go ├── output_file_test.go ├── output_http.go ├── output_http_test.go ├── output_kafka.go ├── output_kafka_test.go ├── output_null.go ├── output_s3.go ├── output_tcp.go ├── output_tcp_test.go ├── plugins.go ├── plugins_test.go ├── pro.go ├── proto ├── protocol.go ├── ring ├── s3 ├── s3_reader.go ├── s3_test.go ├── settings.go ├── settings_test.go ├── sidenav.css ├── simpletime ├── site ├── size ├── snapcraft.yaml ├── tcp ├── tcp_client.go ├── test_input.go ├── test_output.go ├── vendor └── version.go 工程目录比较扁平,主要看 plugin.go,settings.go,emitter.go 几个主要文件,其它分 input_xxx ,output_xxx 都是适配具体协议的输入输出插件,程序入口是 gor.go 的 main 函数。 主要文件说明: settings.go:实现对于启动命令参数的解析,决定其注册那些插件到 Plugin.Inputs,Plugin.Outputs两个列表里。 plugin.go:主要是所有输入输出插件的管理。 emitter.go:程序核心事件处理,实现对于 Plugin.Inputs 输入流的读取、判断是否需要进行 middlewear 的处理、http修改等,然后异步复制流量到所有 Plugin.outputs,同时将所有 Plugin.outputs 中有 response 的数据,复制到所有 outputs 中。 input_xxx.go:主要是输入的插件,实现 tcp/http/raw/kafka等协议, 实现 io.Reader 接口,最后根据配置注册到 Plugin.inputs队列里。 output_xxx.go:主要是输出的插件,实现 tcp/http/raw/kafka 等协议, 实现 io.Writer 接口,最后根据配置注册到 Plugin.outputs 队列里。 三、主要核心流程 goreplay 只有 input 和 output 两个概念,是 goreplay 对数据流的抽象,统称为 plugin。 gor.go 中 main 函数,它主要做了以下事情: 1、解析命令行参数: // Parse parses the command-line flags from os.Args[1:]. Must be called // after all flags are defined and before flags are accessed by the program. func Parse() { // Ignore errors; CommandLine is set for ExitOnError. CommandLine.Parse(os.Args[1:]) } 2、初始化全局的 Settings 变量。 func checkSettings() { if Settings.OutputFileConfig.SizeLimit < 1 { Settings.OutputFileConfig.SizeLimit.Set("32mb") } if Settings.OutputFileConfig.OutputFileMaxSize < 1 { Settings.OutputFileConfig.OutputFileMaxSize.Set("1tb") } if Settings.CopyBufferSize < 1 { Settings.CopyBufferSize.Set("5mb") } } 3、命令行参数的定义在 settings.go 的 init 函数中,会先于 main 函数执行。 func init() { flag.Usage = usage flag.StringVar(&Settings.Pprof, "http-pprof", "", "Enable profiling. Starts http server on specified port, exposing special /debug/pprof endpoint. Example: `:8181`") flag.IntVar(&Settings.Verbose, "verbose", 0, "set the level of verbosity, if greater than zero then it will turn on debug output") flag.BoolVar(&Settings.Stats, "stats", false, "Turn on queue stats output") if DEMO == "" { flag.DurationVar(&Settings.ExitAfter, "exit-after", 0, "exit after specified duration") } else { Settings.ExitAfter = 5 * time.Minute } flag.BoolVar(&Settings.SplitOutput, "split-output", false, "By default each output gets same traffic. If set to `true` it splits traffic equally among all outputs.") flag.BoolVar(&Settings.RecognizeTCPSessions, "recognize-tcp-sessions", false, "[PRO] If turned on http output will create separate worker for each TCP session. Splitting output will session based as well.") ...... // default values, using for tests Settings.OutputFileConfig.SizeLimit = 33554432 Settings.OutputFileConfig.OutputFileMaxSize = 1099511627776 Settings.CopyBufferSize = 5242880 } 4、根据命令行传参初始化插件,在 main 函数中调用 InitPlugins 函数。 // NewPlugins specify and initialize all available plugins func NewPlugins() *InOutPlugins { plugins := new(InOutPlugins) for _, options := range Settings.InputDummy { plugins.registerPlugin(NewDummyInput, options) } ...... return plugins } 5、调用 Start 函数,启动 emitter,每个 input 插件,都启动一个协程,读取 input,写 output。​ / Start initialize loop for sending data from inputs to outputs func (e *Emitter) Start(plugins *InOutPlugins, middlewareCmd string) { if Settings.CopyBufferSize < 1 { Settings.CopyBufferSize = 5 << 20 } e.plugins = plugins if middlewareCmd != "" { middleware := NewMiddleware(middlewareCmd) for _, in := range plugins.Inputs { middleware.ReadFrom(in) } e.plugins.Inputs = append(e.plugins.Inputs, middleware) e.plugins.All = append(e.plugins.All, middleware) e.Add(1) go func() { defer e.Done() if err := CopyMulty(middleware, plugins.Outputs...); err != nil { Debug(2, fmt.Sprintf("[EMITTER] error during copy: %q", err)) } }() } else { for _, in := range plugins.Inputs { e.Add(1) go func(in PluginReader) { defer e.Done() if err := CopyMulty(in, plugins.Outputs...); err != nil { Debug(2, fmt.Sprintf("[EMITTER] error during copy: %q", err)) } }(in) } } } 如果只有一个协程,存在性能瓶颈。默认是一个 input 复制多份,写多个 output,如果传了 --split-output 参数,并且有多个 output ,则使用简单的 Round Robin 算法来选 output,不会写多份。多个 input 之间是并行的,但单个 input 到多个 output,是串行的。所有 input 都实现了 io.Reader 接口,output 都实现了 io.Writer 接口。所以阅读代码时,input 的入口是 Read() 方法,output 的入口是 Write() 方法。 // CopyMulty copies from 1 reader to multiple writers func CopyMulty(src PluginReader, writers ...PluginWriter) error { wIndex := 0 modifier := NewHTTPModifier(&Settings.ModifierConfig) filteredRequests := make(map[string]int64) filteredRequestsLastCleanTime := time.Now().UnixNano() filteredCount := 0 for { msg, err := src.PluginRead() if err != nil { if err == ErrorStopped || err == io.EOF { return nil } return err } if msg != nil && len(msg.Data) > 0 { if len(msg.Data) > int(Settings.CopyBufferSize) { msg.Data = msg.Data[:Settings.CopyBufferSize] } meta := payloadMeta(msg.Meta) if len(meta) < 3 { Debug(2, fmt.Sprintf("[EMITTER] Found malformed record %q from %q", msg.Meta, src)) continue } requestID := byteutils.SliceToString(meta[1]) // start a subroutine only when necessary if Settings.Verbose >= 3 { Debug(3, "[EMITTER] input: ", byteutils.SliceToString(msg.Meta[:len(msg.Meta)-1]), " from: ", src) } if modifier != nil { Debug(3, "[EMITTER] modifier:", requestID, "from:", src) if isRequestPayload(msg.Meta) { msg.Data = modifier.Rewrite(msg.Data) // If modifier tells to skip request if len(msg.Data) == 0 { filteredRequests[requestID] = time.Now().UnixNano() filteredCount++ continue } Debug(3, "[EMITTER] Rewritten input:", requestID, "from:", src) } else { if _, ok := filteredRequests[requestID]; ok { delete(filteredRequests, requestID) filteredCount-- continue } } } if Settings.PrettifyHTTP { msg.Data = prettifyHTTP(msg.Data) if len(msg.Data) == 0 { continue } } if Settings.SplitOutput { if Settings.RecognizeTCPSessions { if !PRO { log.Fatal("Detailed TCP sessions work only with PRO license") } hasher := fnv.New32a() hasher.Write(meta[1]) wIndex = int(hasher.Sum32()) % len(writers) if _, err := writers[wIndex].PluginWrite(msg); err != nil { return err } } else { // Simple round robin if _, err := writers[wIndex].PluginWrite(msg); err != nil { return err } wIndex = (wIndex + 1) % len(writers) } } else { for _, dst := range writers { if _, err := dst.PluginWrite(msg); err != nil && err != io.ErrClosedPipe { return err } } } } // Run GC on each 1000 request if filteredCount > 0 && filteredCount%1000 == 0 { // Clean up filtered requests for which we didn't get a response to filter now := time.Now().UnixNano() if now-filteredRequestsLastCleanTime > int64(60*time.Second) { for k, v := range filteredRequests { if now-v > int64(60*time.Second) { delete(filteredRequests, k) filteredCount-- } } filteredRequestsLastCleanTime = time.Now().UnixNano() } } } } 轮询调度算法的原理是每一次把来自用户的请求轮流分配给内部中的服务器,从1开始,直到 N(内部服务器个数),然后重新开始循环。 算法的优点是其简洁性,它无需记录当前所有连接的状态,所以它是一种无状态调度。 四、其它的小知识 1、goreplay 抓包调用 google/gopacket 来实现,后者通过 cgo 来调用 libpcap。整体工具小巧而实用,既可以实现 rawsocket 的抓包,也可以实现 http 的录制、回放,也支持多实例之间的级联。RAW_SOCKET 允许监听任何端口上的流量,因为它们是在IP级别上操作的。端口是 TCP 的特性,具有流量控制、传输可靠等优点。这个包实现了自己的TCP层: 使用tcp_packet 解析TCP包。流控制由 tcp_message.go管理 参考地址:http://en.wikipedia.org/wiki/Raw_socket 2、用三个猴头 emoji 字符作为请求分隔符,第一眼看到感觉挺搞笑的。 比如: 3、配置信息全靠启动命令参数。 比如: /usr/local/bin/gor --input-raw :80 --input-raw-track-response --input-raw-bpf-filter "host ! 167.xxx.xxx.xx" --input-raw-override-snaplen --prettify-http --output-http http://192.168.3.110:80 --output-http-timeout 10s --output-http-workers 1000 --output-http-workers-min 100 --http-allow-header "Aww-Csid: xxxxx" --output-http-track-response --http-allow-method POST --middleware "/production/www/go_replay/client/middleware/sync --project {project_name}" --output-http-compatibility-mode --http-allow-url /article/detail 4、goreplay 支持 Java 程序配合工作的。支持开启插件模式: gor --input-raw :80 --middleware "java -jar xxx.jar" --output-file request.gor 通过 middleware 参数可以传递一条命令给 gor ,gor 会拉起一个进程执行这个命令。在录制过程中,gory 通过获取进程的标准输入和输出与插件进程进行通信。 数据流向大致如下: +-------------+ Original request +--------------+ Modified request +-------------+ | Gor input |----------STDIN---------->| Middleware |----------STDOUT---------->| Gor output | +-------------+ +--------------+ +-------------+ input-raw java -jar xxx.jar output-file 5、拦截器的设置 参考地址:https://github.com/buger/goreplay/wiki/Dealing-with-missing-requests-and-responses 实际使用过程中,发现录制流量并发达到一定量级会丢失很多请求,经过阅读官方文档和测试,发现最相关的一个关键参数是 –input-raw-buffer-size。 其主要原因四由于 gor 本身需要对数据包进行读取,协议解析等,借助于 pcap 及 os 缓冲区,当缓冲区不足,到达的数据包不足以组装 Http 请求则出现丢失或失效请求,无法正确处理。 listener.go 该参数是作用在底层录制上: inactive.SetTimeout(t.messageExpire) inactive.SetPromisc(true) inactive.SetImmediateMode(t.immediateMode) if t.immediateMode { log.Println("Setting immediate mode") } if t.bufferSize > 0 { inactive.SetBufferSize(int(t.bufferSize)) } handle, herr := inactive.Activate() if herr != nil { log.Println("PCAP Activate error:", herr) wg.Done() return } 在具体复制动作定义bufferSize: // CopyMulty copies from 1 reader to multiple writers func CopyMulty(src io.Reader, writers ...io.Writer) (err error) { buf := make([]byte, Settings.copyBufferSize) wIndex := 0 modifier := NewHTTPModifier(&Settings.modifierConfig) filteredRequests := make(map[string]time.Time) filteredRequestsLastCleanTime := time.Now() ...... } 五、代码调用链路图 最后附送一张 gor 代码调用链路图。 原图地址: https://github.com/zuozewei/blog-example/tree/master/Performance-testing/04-full-link/gor-code 点击关注,第一时间了解华为云新鲜技术~
资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册