首页 文章 精选 留言 我的

精选列表

搜索[AI可见性],共10000篇文章
优秀的个人博客,低调大师

Startdt AI提出:使用生成对抗网络用于One-Stage目标检测的知识蒸馏方法

人工智能正在驱动新一轮的商业变革,而算法技术则是推动核心底层技术的重要力量。算法崛起时代,技术浪潮可谓一日千里,算法工程师也只有不断精进自身技术,才能与时俱进、驭浪前行。近日,奇点云算法工程师三角肌在目标检测算法领域又有新突破。 摘要 卷积神经网络对目标检测的精度有着显著的提升,并且随着卷积神经网络的深度加深,对目标检测精度提升也越大,但是也需要更多的浮点计算。许多研究者通过知识蒸馏的方法,通过把一个更深更大的教师网络中的知识转移到一个小的学生网络中,以提高学生网络在目标检测中的效果。而大部分知识蒸馏的方法都需要设计复杂的代价函数,并且多数针对两步目标检测算法,本文针对一步目标检测算法提出一个干净有效的知识蒸馏方案。将教师网络生成的特征层作为真实样本,学生网络生成的特征层做为假样本,并对两者做生成对抗训练,以提高学生网络在一步目标检测中的表现。 1 Introduction 近些年来,随着目标检测算法的发展,研究者们发现利用更深更大的卷积神经网络作为骨架,对目标检测算法的精度提升越大。并且随着目标检测算法的检测精度提升,使视觉检测算法逐渐从非关键性领域,走向关键性领域(比如无人驾驶和医疗等领域)。但是为了保证检测精度,不得不使用更大的卷积神经网络作为骨架,造成检测速度下降,计算设备成本增加。因此许多研究者在确保检测精度的前提下,提高检测速度提出了很多方法和总结,如通过深度分离卷积 [1,2],或者通过点群卷积(pointwise group convolution)和通道混洗(channel shuffle)[3, 4] 来降低卷积神经网络浮点运算次数的方法,在保证骨架网络精度和容量的情况下减少计算量。虽然获得可观的提速效果,但是这些方法需要精心设计和调整骨架网络。很多研究者认为更深的骨架网络虽然有着更大的网络容量,因此在图像分类、目标检测等任务上有着更优秀的表现。但是一些特定的任务并不需要这么大的容量,所以在保证卷积神经网络精度的情况和下,对卷积神经网络做压缩、量化、通道减枝等[5, 6, 7, 8, 9]。 另一方面,有关于知识蒸馏的工作表明[10, 11, 12, 13],使用一个更深更大的模型,并且在充分训练完毕后作为teacher net,然后再选取一个比较浅的模型作为student net,最后使用teacher net输出的结果或者中间结果作为soft label结合真实样本的true label同时训练student net,可以极大的提升student net在特定任务上的表现。但是大部分这些方法都需要设计非常复杂的代价函数和训练方式,并且这些方法多用于图像分类和两步目标检测等,极少用于一步目标检测。因此,我们需要一个更加简单而有效,并且可以适用于一步目标检测的知识蒸馏方式。本文提出一种简单而有效知识蒸馏神经网络架构,并且可以明显的提升student net在一步目标检测网络的表现。和常规的知识蒸馏方式不同的是,我们参考对抗生成的神经网络架构[14],将重型目标检测神经网络和轻型目标检测神经网络的骨架分别拆分出来作为teacher net和student net,然后把teacher net 生成的feature map作为真实样本,而student net则作为生成器,并把student net生成的feature map作为假样本,最后根据真实样本和假样本设计一个神经网络作为判别器,做生成对抗训练。 我们的贡献主要有两点: 1 提出一种不需要设计复杂的代价函数的网络架构,并且可以适用于一步目标检测。 2 利用对抗生成网络架构,避免复杂的知识迁移设计,让student net自动的从teacher net中获取暗知识。 2 Related Works 深度学习目标检测算法架构主要分为两种,一种是一步检测,比如Liu W等人提出的SSD[15],直接通过通过卷积神经网络回归出物体的位置和类别,另一种是二步检测,如girshick等人提出的fast rcnn[16],以及后来Faster-RCNN [17] and R-FCN [18]等,首先通过卷积神经网络回归候选框,最后根据候选框再次识别每个候选框的类别,并回归出正确的位置。 网络裁剪,许多研究者认为深度神经网络被过度参数化,并且有很多冗余的神经元和连接,He Y等人认为[8],cnn每层神经元都是稀疏的,利用lasso regression回归找出cnn每层最有代表性的神经元重构该层的输出。Zhuang Z等人[9]认为layer-by-layer进行通道剪枝会影响cnn的鉴别能力,所以通过在fine-tune和剪枝阶段加入辅助loss,来保留cnn每层的鉴别能力。 网络量化, Wu J等人[20]通过k-means聚类算法加速和压缩模型的卷积层和全连接层,通过减小每层输出响应的估计误差可实现更好的量化结果,并提出一种有效的训练方案抑制量化后的多层累积误差 。Jacob B[21]等人提出将weights和inputs量化为uint8 bias量化为unit32同时训练期间前向时候采用量化,反向修正误差不量化,以确保cnn表现的情况下提高inference速度。 知识蒸馏是一种压缩模型并确保准确的一种方法。hinton 等人提出[2]将teacher net输出的结果作为soft label,并提倡使用温度交叉熵而不是L2损失。romero 等人[19]认为需要更多的unlabeled data让student net去mimic才能使student net经可能的接近teacher net,Chen G[12]等人在优化2步目标检测网络分别将teacher net的中间feature map 以及rpn/rcnn的暗知识提取出来让student net去mimic。其他研究者也有将teacher net的attention信息给student网络,如Zagoruyko S[22]等人提出spatial-attention,将teacher net的热力信息传递给student net。Yim J等人[23]将teacher net层与层之间的关系作为student网络mimic的目标。但是他们设计的的知识蒸馏都是要设计非常复杂的loss function,和复杂的暗知识的提取方式,并且这些方法多是在两步目标检测算法中很少用于一步目标检测中。为了能用一个简单有效的知识蒸馏的方式,我们参考生成对抗网络的架构方式[14]将教师网络生成的特征层作为真实样本,学生网络生成的特征层做为假样本,并对两者做生成对抗训练,以提高学生网络在一步目标检测中的表现。 3 Method 在本文中,我们采用一步目标检测算法SSD[15]作为我们的目标检测算法,SSD目标检测算法结构主要分成两部分,1)骨架网络,作为特征提取器。2)Head,在骨架网络提取的特征上,检测出目标的类别和位置。为了能获取更好的知识蒸馏效果,合理利用这个两个部分至关重要。 3.1 Overall Structure fig 1为我们算法模型的整体结构,我们首先使用一个容量更大的SSD模型,在充分训练后将该SSD模型拆分成骨架网络和SSD-Head,其中骨架网络作为teacher net,然后再挑选一个容量较小的CNN作为student net。我们把teacher net生成的多个feature map作为true sample,而student net生成的多个feature map作为fake sample,并且将true sample和fake sample送入D Net中相对应的每个判别网络(fig 2)中,同时把fake sample输入到SSD-Head中。 3.2 Training Process (1) 公式1中的N代表batchsize的大小,D代表判别网络,Teacher和Student分别代表teacher net和student net, θt、θs、θd分别代表teacher net、student net 和D Net模块中每个判别网络的weights。Lconf表示SSD中分类的损失函数,Lloc表示SSD中边界框的损失函数。 4 Experiment 在本章节,我们将在PASCAL VOC中做实验来验证我们的方法,包含20个类别。并且我们的方法训练的硬件为two NVIDIA GTX 1080Ti GPUs。训练所用的软件框架为gluoncv。 4.1 Training and testing data 由于时间的关系,我们训练使用的数据集Pascal Voc 2012trainval和Pascal Voc 2007 trainval sets,测试数据集为Pascal Voc 2007 test sets。该数据集包含检测物体的类别和位置信息。评估标准按照Pascal Voc竞赛所约定的,通过iou=0.5时的mAP来评估模型检测精度。而coco数据集上,使用coco 2017 trainset作为训练集,coco 2017 test作为测试集。 4.2 Results 我们将原生的SSD和在不同的Teacher net下知识蒸馏的SSD做比较,最高可以提升student net 2.8mAP。不过有趣的是,当teacher net为ResNet101,student net为ResNet18时,提升的效果反而不如ResNet50。而在coco上使用resnet50作为teacher net,moblinet作为student net,提升Moblient-SSD 4个mAP。 Table 1. Different student nets are not used GAN-knowledge distillation and the use of a GAN-knowledge distillation in different teacher net test results. 目前已经将该方法使用在faster rcnn上,考虑到时间,目前仅仅在pascal voc 2007上进行测试,coco正在训练。 Table 2. moblienetv1 use GAN-knowledge distillation in coco. Table 3. Teacher net为骨架网络为ResNet101的faster rcnn,且使用Pascal Voc 2007 trainval作为训练集,在Pascal Voc 2007 test测试集上mAP为74.8+。第一行和第二行使用GAN Knowledge Distillation[1]方法,第三行为cvpr2019的 Distilling Object Detectors with Fine-grained Feature Imitation[2]的方法效果。

优秀的个人博客,低调大师

Transformer原理解析——一种Open AI和DeepMind都在用的神经网络架构

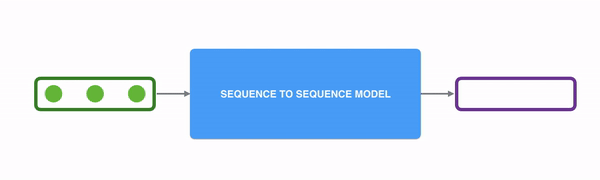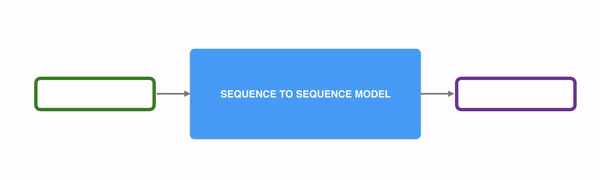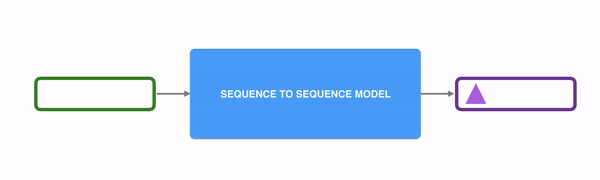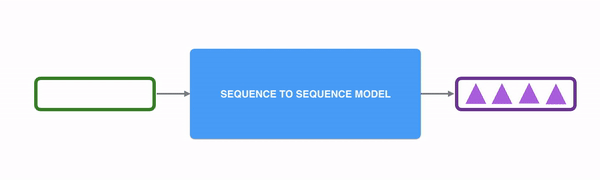
Transformer模型是一种日益流行的神经网络结构。它最近被OpenAI用于他们的语言模型中。与此同时,近期也被DeepMind用于它们的程序“星际争霸”中击败了一名顶级职业星际玩家。 Transformer模型的开发是为了解决序列转换及神经机器翻译问题。这意味着可以解决任何sequence to sequence问题,例如语音识别、文本到语音转换等。 序列转换。输入用绿色表示,模型用蓝色表示,输出用紫色表示。GIF取自3 对于执行序列转换的模型而言,有一些记忆是必要的。例如,我们把下面的句子翻译成另一种语言(法语): “The Transformers”是日本的一个硬核朋克乐队。该乐队成立于1968年,处于日本音乐史的鼎盛期。” 在本例中,第二句中的“the band”指的是第一句中引入的“The Transformers”乐队。当你

优秀的个人博客,低调大师

[python作业AI毕业设计博客]英文原版新书下载:Impractical Python Projects - 2019.Pdf

python测试开发项目实战-目录 python工具书籍下载-持续更新 python 3.7极速入门教程 - 目录 下载:Impractical Python Projects - 2019.Pdf Impractical Python Projects is a collection of fun and educational projects designed to entertain programmers while enhancing their Python skills. It picks up where the complete beginner books leave off, expanding on existing concepts and introducing new tools that you'll use every day. And to keep things interesting, each project includes a zany twist featuring historical incidents, pop culture references, and literary allusions. You'll flex your problem-solving skills and employ Python's many useful libraries to do things like:• Help James Bond crack a high-tech safe with a hill-climbing algorithm • Write haiku poems using Markov Chain Analysis• Use genetic algorithms to breed a race of gigantic rats• Crack the world's most successful military cipher using cryptanalysis• Derive the anagram, "I am Lord Voldemort" using linguistical sieves • Plan your parents' secure retirement with Monte Carlo simulation• Save the sorceress Zatanna from a stabby death using palingrams• Model the Milky Way and calculate our odds of detecting alien civilizations• Help the world's smartest woman win the Monty Hall problem argument• Reveal Jupiter's Great Red Spot using optical stacking• Save the head of Mary, Queen of Scots with steganography• Foil corporate security with invisible electronic ink Simulate volcanoes, map Mars, and more, all while gaining valuable experience using free modules like Tkinter, matplotlib, Cprofile, Pylint, Pygame, Pillow, and Python-Docx. Whether you're looking to pick up some new Python skills or just need a pick-me-up, you'll find endless educational, geeky fun with Impractical Python Projects. e-Books Highlight Edition1st Edition ISBN159327890X Posted on12/3/2018 FormatPdf Page Count426 Pages AuthorLee Vaughan, 参考资料 本文最新版本地址 本文涉及的python测试开发库 谢谢点赞! 本文相关海量书籍下载 2018最佳人工智能机器学习工具书及下载(持续更新)
优秀的个人博客,低调大师

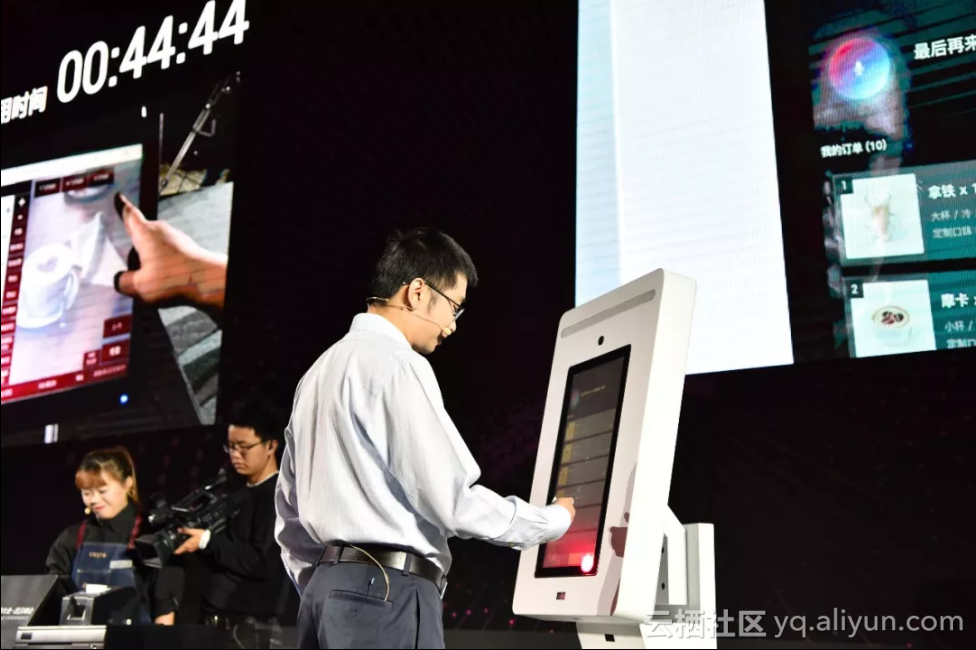
AI收银员来了!用华少的语速点30多杯咖啡,49秒搞定!

“五个巧克力、两个香草拿铁,巧克力加奶油。” “两个中杯焦糖拿铁,一个热的一个冷的。” ”算了巧克力不要了。” “再要六个小杯少冰摩卡,三杯加焦糖三杯加香草。” “再加一个大的冷的拿铁,去冰半糖加脱脂奶,打包。” 5月23日云栖大会武汉峰会上,阿里巴巴达摩院机器智能技术实验室语音交互首席科学家鄢志杰最快以每秒5个字的语速在一台机器前狂点了30多杯咖啡。 与这台机器一同接受挑战的,是一位资深咖啡师。当咖啡师因“语速太快、记不下来”在中途选择放弃时,这台机器却在每一轮对话中都做出了精准响应,并且在49秒时下单成功。 咖啡师在听了鄢志杰第二次复述后,用了2分37秒完成订单。 “今天,我们将机器对人类口语的理解能力带到了新的高度”,鄢志杰说,这种交互方式完全打破了“语音唤醒+语音指令”的传统命令式交互方式。 上述点单环节包含了修改、删除、加单等多轮对话,在

优秀的个人博客,低调大师

概率计算或成AI突破新爆点,最适合处理不确定性

根据英特尔首席技术官Mike Mayberry的说法,最初的人工智能浪潮是基于逻辑的,这是基于写下规则——即所谓的“经典推理”。在概率计算中,处理单元所消耗的能量降低,从而增加了某些操作出错的可能性。 定义概率计算 根据USFCA的说法,概率计算机将模拟问题(前向)带入一个推理程序(反向)。总部位于加州伯克利的Navia系统公司开发了概率计算机,它将其定义为最适合在不确定的情况下做出判断的技术,就像传统的计算技术是大规模的记录保存一样。这家成立于2007年的创业公司强调,与目前用于逻辑推理和精确计算的计算机不同,在概率计算领域,机器和程序是用来处理不确定性和从经验中进行学习的。 在概率计算下压上重注 英特尔正把赌注押在概率计算上,这是人工智能的一个主要组成部分,它将使未来的系统能够理解和计算自然数据中固有的不确定性,并有助于研究人员能够制

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册