首页 文章 精选 留言 我的

精选列表

搜索[热点技术征文第8期最强语言],共10000篇文章
优秀的个人博客,低调大师

JAVA 应用 CPU 跳点自动 DUMP 工具 | 京东物流技术团队

背景 在做系统监控时,CPU的使用率是一个关键的指标,它反映了系统的性能稳定性以及是否存在异常情况,能帮助我们了解系统的负载情况。通过监控CPU使用率,可以判断系统是否正常运行或者是否存在性能问题。如果CPU使用率过高,可能表示系统存在资源瓶颈,需要进行优化或升级。 CPU监控的难点 现有的监控平台提供了多种方式来获取容器和JVM的CPU使用率,并能够实时发送CPU跳点的报警。然而,对于运维人员来说,这些功能远远不够,因为我们需要深入了解导致CPU高的原因。由于CPU是一个动态变化的指标,仅仅在收到报警后通过运维平台的手动操作进行排查,很难抓住事故发生的现场情况。因此,我们需要一个能够自动记录现场的工具。 自动DUMP工具 对于Linux系统,我们可以通过设置一个周期的定时任务来检测CPU使用率。如果我们发现CPU使用率高,我们可以获取CPU使用率高的线程,并进一步处理JVM线程抓包的问题。 我们可以使用top命令来获取进程的CPU使用率以及线程的CPU使用率。针对JAVA应用程序,我们可以使用Jstack来dump当前线程的堆栈信息。然后,我们可以解析这两者的输出,并通过线程号进行匹配,最终生成一个包含CPU使用率的线程堆栈清单。最后,我们可以将此清单持久化到一个文本文件中。 最终的输出文件格式如下: 当前JAVA进程ID:205 当前JAVA进程ID(205)CPU使用率:99% Top 10 CPU占用线程信息: ======================================================= 线程TID: 1511, THREAD_NID:5e7, CPU使用率: 77.2% "Thread-31" #415 daemon prio=5 os_prio=0 tid=0x00007f00900cc800 nid=0x5e7 runnable [0x00007f01c5839000] java.lang.Thread.State: RUNNABLE at ... ... java.lang.reflect.Executable.sharedGetParameterAnnotations(Executable.java:553) at java.util.concurrent.CompletableFuture$AsyncRun.run(CompletableFuture.java:1626) at java.lang.Thread.run(Thread.java:748) ======================================================= 线程TID: 208, THREAD_NID:d0, CPU使用率: 2.0% "Gang worker#0 (Parallel GC Threads)" os_prio=0 tid=0x00007f037c02a000 nid=0xd0 runnable ======================================================= 线程TID: 209, THREAD_NID:d1, CPU使用率: 2.0% "Gang worker#1 (Parallel GC Threads)" os_prio=0 tid=0x00007f037c02b800 nid=0xd1 runnable ======================================================= 具体实现步骤如下: 从环境变量中读取CPU阈值和线程数阈值,脚本的两个配置项,不同分组和不同环境可以设置不同的阈值。 获取JAVA进程ID:使用pgrep命令获取当前运行中的Java进程的PID,并将其保存到变量中。 获取当前CPU使用率:使用top命令获取当前CPU使用率,主要是获取JAVA进程的CPU使用率。 检查CPU使用率是否超过阈值:与预设的CPU阈值进行比较,如果超过阈值,则执行后续操作,否则结束。 查找JAVA进程内占用CPU最高的线程:使用top命令查找占用CPU最高的前十个线程,并获取它们的相关信息。 捕捉JVM线程快照:使用jstack命令捕捉JVM线程快照,并将其保存到指定的日志文件中。 输出线程信息:解析并匹配线程栈文件,将占用CPU最高的前十个线程的信息包括线程的PID和堆栈信息合并到同一行输出。 日志记录和保存:将相关的CPU使用率及线程快照信息记录到日志文件中,方便后续分析和优化。 使用方式 在应用的启动脚本(start.sh)中添加命令,在crontab中添加一个分钟周期的定时任务 echo "* * * * * sh /export/App/bin/cpu-peak-dump.sh" | crontab - 注:如果需要更细周期粒度的监控,也可以通过while true加sleep来控制运行周期,如果使用更细粒度周期时需要注意脚本本身造成的CPU使用率。 总结 该脚本是一个用于CPU性能监控的实用工具,通过定时检测并触发线程快照的方式,方便我们快速发现CPU异常占用以及定位问题所在。通过设置合适的阈值和线程数,可以根据具体项目的需求来应用该脚本,并根据日志记录的线程信息进行问题分析和优化。 注意:在使用该脚本时,需要根据具体环境配置相关的路径和变量,并根据项目的需要进行相应的调整和优化。 希望本文对您理解和运用该脚本提供了一些帮助,如有疑问或需要进一步了解,请随时联系我。 附录 完整的脚本文件cpu-peak-dump.sh #!/bin/bash # 由crontab触发每分钟执行一次,判断CPU使用率大于阈值时触发dump # 使用方式: # 把当前文件放到项目中与start.sh相同的目录 # 修改start.sh 在脚本最后加一行,一般是这一行后边 echo "$APP_NAME is up runnig :)" # echo "* * * * * sh /export/App/bin/cpu-peak-dump.sh" | crontab - # 可配置项: # 触发dump的cpu阈值。default 70 # STACK_DUMP_CPU_THRESHOLD=xxx # 触发dump时列举的线程数(按使用率由高到低排列) default 10 # STACK_DUMP_THREAD_COUNT=xxx # 配置方式,使用行云分组的环境变量配置即可 # stack log 存放目录 /export/Logs/ # stack log 文件名: jstack_snapshot_$(date +%Y%m%d%H%M%S).log # 最后,记得配置相应的日志清理策略 # 设置CPU阈值,当CPU使用率达到该阈值时触发线程快照 CPU_THRESHOLD="${STACK_DUMP_CPU_THRESHOLD:-70}" THREAD_COUNT="${STACK_DUMP_THREAD_COUNT:-10}" echo "Current CPU_THRESHOLD is $CPU_THRESHOLD" JAVA_PID=$(pgrep -d, -x java) echo "Current JAVA_PID is $JAVA_PID" # 使用top命令获取当前CPU使用率,并提取其中的CPU利用率百分比 CPU_USAGE=$(top -b -n 1 | grep -A10 "PID USER" | grep java | grep "$JAVA_PID" | awk '{print $9}' | cut -d'.' -f1) echo "Current Java($JAVA_PID) CPU_USAGE :$CPU_USAGE"% if [ -z "$JAVA_PID" ]; then echo "No Java process found." exit 1 fi # 检查CPU使用率是否超过阈值 if [[ $CPU_USAGE -gt $CPU_THRESHOLD ]]; then # 使用top命令查找占用CPU最高的前十个线程,并获取它们的信息 TOP_THREADS=$(top -H -b -n 1 -p "$JAVA_PID" | grep -A$THREAD_COUNT 'PID USER' | head -n $THREAD_COUNT | grep -v 'PID') # 使用jstack捕捉JVM线程快照 # 请将下面的Java进程ID替换为你要监视的Java进程的实际进程ID JSTACK_OUTPUT=$(/export/servers/jdk1.8.0_191/bin/jstack "$JAVA_PID") JSTACK_OUTPUT_FILE="/export/Logs/jstack_snapshot_$(date +%Y%m%d%H%M%S).log" echo "当前JAVA进程ID($JAVA_PID)CPU使用率:$CPU_USAGE"% >>$JSTACK_OUTPUT_FILE # 获取占用CPU最高的前十个线程的信息,包括线程的PID和堆栈信息,并将它们合并到同一行输出 echo "Top ${THREAD_COUNT} CPU占用线程信息:" >>$JSTACK_OUTPUT_FILE while read -r THREAD_INFO; do THREAD_TID=$(echo "$THREAD_INFO" | awk '{print $1}') THREAD_NID=$(printf "%x\n" $THREAD_TID) THREAD_STACK=$(echo "$JSTACK_OUTPUT" | sed -n "/nid=0x$THREAD_NID /,/^$/p") THREAD_CPU_USAGE=$(echo "$THREAD_INFO" | awk '{print $9}') echo "=======================================================" >>$JSTACK_OUTPUT_FILE echo "线程TID: $THREAD_TID, THREAD_NID:$THREAD_NID, CPU使用率: $THREAD_CPU_USAGE%" >>$JSTACK_OUTPUT_FILE echo "$THREAD_STACK" >>$JSTACK_OUTPUT_FILE done <<<"$TOP_THREADS" # echo "====all stack as below:====" >>$JSTACK_OUTPUT_FILE # echo "$JSTACK_OUTPUT" >>$JSTACK_OUTPUT_FILE echo "捕捉了JVM线程快照并保存到 $JSTACK_OUTPUT_FILE" fi 作者:京东物流 张涛 来源:京东云开发者社区 自猿其说 Tech 转载请注明来源

优秀的个人博客,低调大师

基于Raft算法的DLedger-Library分析 | 京东物流技术团队

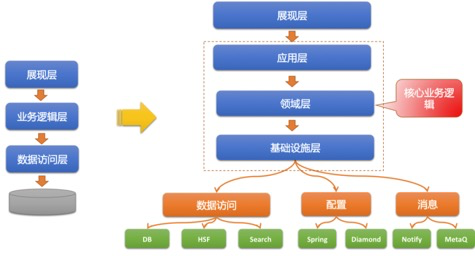
1 背景 在分布式系统应用中,高可用、一致性是经常面临的问题,针对不同的应用场景,我们会选择不同的架构方式,比如master-slave、基于ZooKeeper选主。随着时间的推移,出现了基于Raft算法自动选主的方式,Raft是在Paxos的基础上,做了一些简化和限制,比如增加了日志必须是连续的,只支持领导者、跟随者和候选人三种状态,在理解和算法实现上都相对容易许多。 1)DLedger 是openMessaging发布的一个基于 Raft 实现的JAVA类库,可以方便引用到系统中,满足其高可用、高可靠、强一致的需求,其中在RocketMQ中作为消息Broker存储高可用实现的一种解决方案。 2)Raft将系统中的角色分为领导者(Leader)、跟从者(Follower)和候选人(Candidate): Leader:接受客户端请求,定时发送心跳包,并向Follower同步请求日志,当日志同步到大多数节点上后告诉Follower提交日志。 Follower:接受并持久化Leader同步的日志,在Leader告之日志可以提交之后,提交日志。 Candidate:Leader选举过程中的临时角色,该状态下的节点会发起投票,尝试选择自己为主节点,选举成功后,不会存在该状态下的节点 2 DLedger架构设计 DLedger 的实现大体可以分为以下两个部分: 选举 Leader 日志复制 其整体架构如下图 注:图引用官网 从上面的架构图中,有两个核心类:DLedgerLeaderElector 和 DLedgerStore,选举和文件存储。选出 leader 后,再由 leader 去接收数据的写入,同时同步到其他的 follower,这样就完成了整个 Raft 的写入过程 3 DLedger选主源码分析 3.1 下载源码 从gitGub下载代码(https://github.com/openmessaging/dledger ),idea引入后,我们发现整个代码量很小,在分析代码时比较容易. 3.2 选主流程分析 3.2.1 原理 raft的选主过程实际是一个状态机的流转,在集群启动时每个节点的等待超时时间时随机的,在第一个节点超时时间到来,则主动向其他节点发起投票,在收到半数以上的投票后晋升为leader(投票过程是个循环的过程),同时发送心跳请求,其他候选节点收到主节点的请求后,改变自己为follower节点。 term: 任期,每一轮投票都是一个任期,默认从0开始 Quorum机制:简单说就是少说半数以上,比如3个节点,2个同意即可 超时时间: 在选举时,每个节点的超时时间在一定范围内是随机的,这样可以保证能够顺利选举 3.2.2 代码分析 整个状态机的驱动,由线程每个10ms反复执行DLedgerLeaderElector.maintainState()方法。下面重点来分析其状态的驱动: 进入到核心方法maintainAsCandidate() : 1.step1 初始化 term : 投票轮次。 ledgerEndTermLeader: 节点当前的投票轮次。 ledgerEndIndex: 当前日志的最大序列,即下一条日志的开始 index nextTimeToRequestVote: 下次发起投票的时间(随机的) needIncreaseTermImmediately:是否立即投票,在后面中会说明 在DLedger中每个节点的初始状态WAIT_TO_REVOTE,所以第一轮只是做了初始化。其中只有 memberState.nextTerm()这个代码会更改投票轮次 2.step2 投票 进入到核心方法handleVote(),这个方法主要是判断其他节点请求来后,根据自己的term和请求者的等判断是否投赞成票 ledgerEndIndex因为在日志复制过程中,每个节点的进度有可能是不一样的,所以在新的一轮选举时,这时不能投赞成票的 被选举者 term 小于 选举者的term,返回拒绝 被选举者 term 大于 选举者的term,则选举者进行下面操作: 变成candidate(或者保持candidate) 把needIncreaseImmediately设置为true。 返回 REJECT_TERM_NOT_READY,这个在后面提到。 这里补充说明: 选举者 的下一次状态循环会进入到maintainAsCandidate()函数,然后因为needIncreaseImmediately为true,所以把term更新,同时重置计时器。 但是并没有立刻发出投票(此时选举者 的CurrVoteFor还是null,使得接下来给之前的voting candidate 投赞成票可能) 获取所有node投票结果后开始计算票数: 3.step3 仲裁 在收到所有节点的投票结果计数后,进行仲裁,这里主要说明下图中这个条件 acceptNum:同意的数量 notReadyTermNum:未准备好的数量(即结果为REJECT_TERM_NOT_READY) 这里没有重置nextTimeToRequestVote的时间,即刻再发起一次投票。结合上面的说明,这样保证了被选者能尽快去拿到这些notRead的节点的赞成票。 最终经过多次投票后,当一个node节点获取到半数以上投票后,更新自己未leader角色,同时向其他node节点发送heartBeat,其他节点在收到心跳信息后,将自己从candidate 变为follower。 3.3 单元测试验证 3.3.1 编写单元测试 3.3.2 日志分析 3.4 应用场景 DLedger 作为 RocketMQ ( version>=4.5.0)的消息存储已经发布 基于DLedger 实现多节点的缓存同步更新 基于日志复制的副本容错处理 4 总结 这里只简单分析了选主过程,在阅读源码过程中会涉及很多java的基础及netty的使用,比如AQS、CompletableFuture等,有助于提高我们的编码能力。 DLedger在初始化时是将节点角色设置为candidate而不是follower 这个和原Raft是不同的地方,在节点角色转换过程中也稍有差别。 参考文献 https://github.com/openmessaging/dledger/wiki https://www.usenix.org/system/files/conference/atc14/atc14-paper-ongaro.pdf 作者:京东物流 郭庆海 来源:京东云开发者社区 自猿其说Tech 转载请注明来源

优秀的个人博客,低调大师

京东哥伦布即时设计平台ChatGPT落地实践 | 京东云技术团队

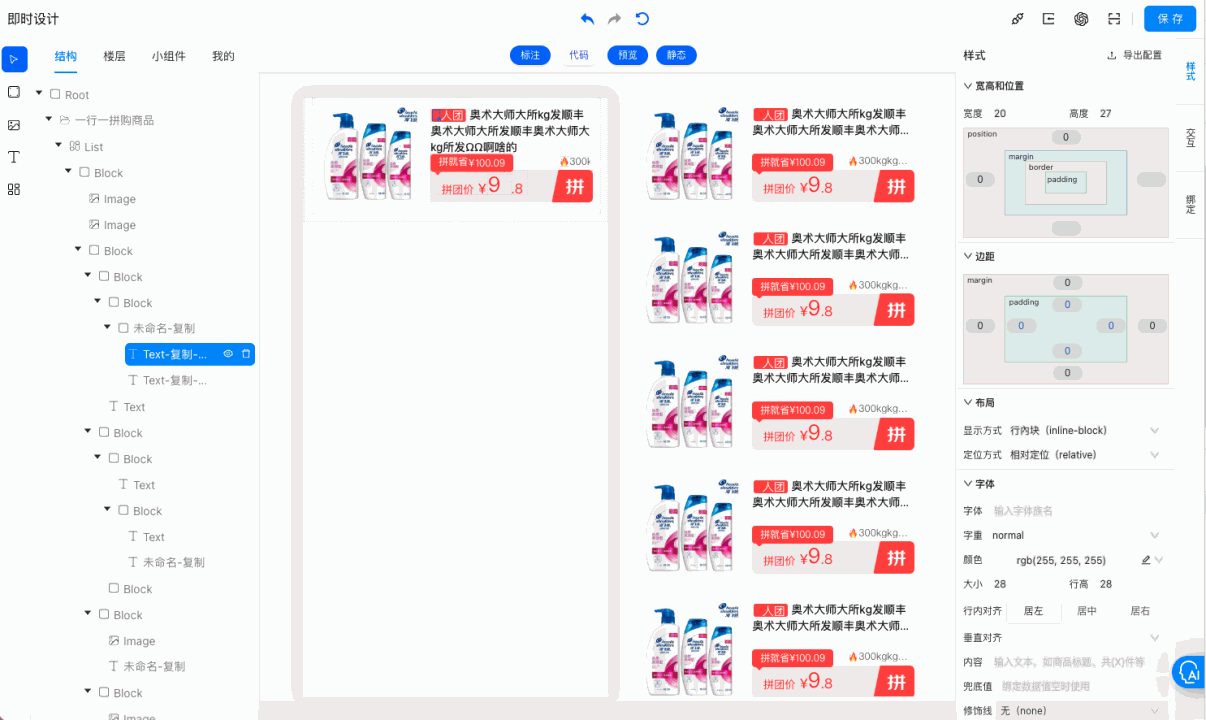
一、平台介绍 🤖 即时设计平台是一个即时搭建c端楼层的开发平台,支持通过导入relay设计稿url完成Ui2Code,在此基础上完成前端可视化搭建,同时支持通过ChatGPT完成一句话需求,搭建后的楼层自动同步ihub楼层市场,提供到通天塔、哥伦布等搭建平台使用。  1.1 平台能力 🤖 在哥伦布即时设计中,即时设计能力主要包括以下几个方面: 1. 画布编辑能力:即时设计平台提供了丰富的画布编辑功能,包括添加、删除、复制、调整层级等操作,可以灵活地编辑页面的结构和布局。 2. 样式配置能力:即时设计平台支持对页面元素的样式进行配置,包括字体、颜色、大小、边框等,可以根据需求进行自定义的样式设置。 3. 数据接口配置能力:即时设计平台支持与数据接口的绑定,可以通过配置数据接口来实现页面内容的动态展示,提高页面的灵活性和可扩展性。 4. 交互事件配置能力:即时设计平台支持对页面元素的交互事件进行配置,包括点击、滑动、弹窗等,可以实现页面的交互效果,提升用户体验。 5. 预览和下载能力:即时设计平台提供了在线预览和下载代码的功能,可以实时查看页面效果,并将设计的页面代码下载到本地进行进一步开发和调试。  1.2 chatGPT x 即时设计平台能做些什么? 二、效果演示 2.1 问答助手  👨🏻:什么是即时设计平台 🤖:在哥伦布即时设计中,即时设计平台是一个用于即时搭建C端页面的开发平台。它提供了编辑样式、创建数据源、绑定数据源、绑定交互事件、下载代码、在线预览等功能。你可以通过即时设计平台来创建和编辑页面的样式和内容,配置数据接口和交互事件,并最终生成可下载的代码或在线预览页面。即时设计平台可以帮助开发人员快速搭建页面,提高开发效率。 参考文档:即时设计参考文档 👩🏻:如何创建数据源 🤖:在哥伦布即时设计中,创建数据源的步骤如下: 1. 打开即时设计平台,进入画布编辑界面。 2. 在顶部菜单区点击“数据源”按钮,弹出数据源页面级弹窗。 3. 在数据源页面级弹窗中,点击“新建接口”按钮,创建一个新的数据接口。 4. 在接口配置中,填写接口名称、请求方式(GET或POST)、接口URL等信息。 5. 在属性参数配置中,根据接口的需求,添加相应的参数,包括Query、Header、Body等。 6. 在响应信息配置中,可以配置接口返回的数据处理,如对返回的数组进行过滤等。 7. 点击保存按钮,保存数据源配置。 以上是创建数据源的基本步骤,具体的操作可以参考哥伦布即时设计的官方文档。参考文档链接如下: 哥伦布即时设计参考文档 2.2 智能楼层创建&修改  👴🏻:帮我创建一个会场楼层,包含商品图、价格、标题  👦🏻:帮我修改商品名称内容为618大麦、字体为蓝色、价格字号20,价格字体颜色为红色,头图显示  创建&修改整体流程为根据用户的需求描述,服务器请求(创建)或者获取schema(修改)组织prompt,多次调用openai接口,最后整合GPT返回与实际交付前端的DSL,前端根据DSL进行渲染:  三、实现原理 3.1 智能问答助手 向量化: 通过京喜团队隆德提供的集团内部向量库实现文档向量存储与文档召回能力 流式处理: res.body.on('data', data => { const lines = data.toString().split('\n').filter(line => line.trim() !== ''); for (const line of lines) { const message = line.replace(/^data: /, ''); if (message === '[DONE]') { stream.end(); return; // Stream finished } try { const parsed = JSON.parse(message); if (parsed.choices[0].finish_reason !== 'stop') { stream.write(parsed.choices[0].delta.content); } } catch(error) {} }}); 3.2 智能创建  3.3 智能修改  3.4 GPT prompt与核心实现  四、未来规划 4.1 目前存在的问题与目标   4.2 开发环境效果演示   4.3 任务拆分执行架构  4.4 连续对话tokens计算 与 GPT prompt 连续对话实现比较容易,只要每次访问GPT携带之前的聊天记录即可,那么问题来了,连续对话是占用tokens,多轮对话后tokens巨大,GPT接口只有max_token来指定返回的最大token数,对话记录的token数占用需要自己统计。也就是 max_token = 模型token数 - 已占用token数 如何统计已占用token数呢? OpenAi官方:tiktoken 但不幸的是不支持node,开源社区有一个dpbd/tiktoken 但是使用起来比较麻烦。 这里有一个笔者自己基于dpbd/tiktoken进行二次封装的@mfe/get-gpt-tokens,方便tokens的计算、只有message时非常精准、有functions会有40左右token大于真实tokens,其实, 够用了。 奉上几个为任务勤恳打工的GPT的prompt: 五、总结 即时设计接入 AI 的方式是抽象出一层 DSL,让 AI 通过 DSL 了解即时设计能力,同时输出 DSL 解析执行。 ChatGPT x 低代码平台 ≈ DSL + Prompt + Function 彩蛋🥚:本文中带有🤖标识的文案均为GPT生产🎉,感兴趣的小伙伴欢迎一键三连,私信一起交流~ 参考文献: 1.chatGPT有,但不多的的即时设计智商 作者:京东零售张熙沐枫 来源:京东云开发者社区 转载请注明来源

优秀的个人博客,低调大师

Taro:高性能小程序的最佳实践 | 京东云技术团队

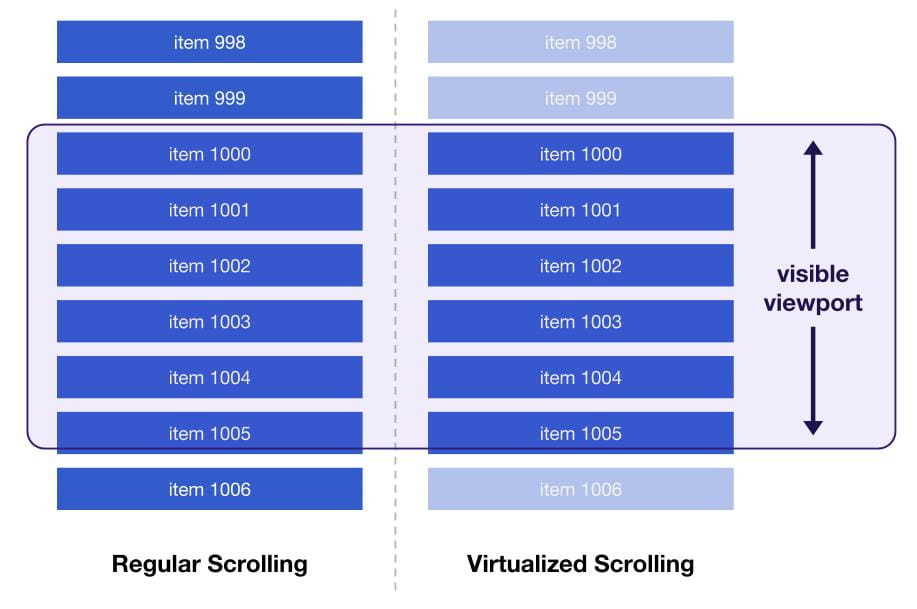
前言 作为一个开放式的跨端跨框架解决方案,Taro 在大量的小程序和 H5 应用中得到了广泛应用。我们经常收到开发者的反馈,例如“渲染速度较慢”、“滑动不够流畅”、“性能与原生应用相比有差距” 等。这表明性能问题一直是困扰开发者的一个重要问题。 熟悉 Taro 的开发者应该知道,相比于 Taro 1/2,Taro 3 是一个更加注重运行时而轻量化编译时的框架。它的优势在于提供了更高效的代码编写方式,并拥有更丰富的生态系统。然而,这也意味着在性能方面可能会有一些损耗。 但是,使用 Taro 3 并不意味着我们必须牺牲应用的性能。事实上,Taro 已经提供了一系列的性能优化方法,并且不断探索更加极致的优化方案。 本文将为大家提供一些小程序开发的最佳实践,帮助大家最大程度地提升小程序应用的性能表现。 一、如何提升初次渲染性能 如果初次渲染的数据量非常大,可能会导致页面在加载过程中出现一段时间的白屏。为了解决这个问题,Taro 提供了预渲染功能(Prerender)。 使用 Prerender 非常简单,只需在项目根目录下的 config 文件夹中找到 index.js/dev.js/prod.js 三者中的任意一个项目配置文件,并根据项目情况进行修改。在编译时,Taro CLI 会根据你的配置自动启动预渲染功能。 const config = { ... mini: { prerender: { match: 'pages/shop/**', // 所有以 `pages/shop/` 开头的页面都参与 prerender include: ['pages/any/way/index'], // `pages/any/way/index` 也会参与 prerender exclude: ['pages/shop/index/index'] // `pages/shop/index/index` 不用参与 prerender } } }; module.exports = config 更详细说明请参考官方文档: https://taro-docs.jd.com/docs/prerender  二、如何提升更新性能 由于 Taro 使用小程序的 template 进行渲染,这会引发一个问题:所有的 setData 更新都需要由页面对象调用。当页面结构较为复杂时,更新的性能可能会下降。 当层级过深时,setData 的数据结构如下: page.setData({ 'root.cn.[0].cn.[0].cn.[0].cn.[0].markers': [], }) 期望的 setData 数据结构: component.setData({ 'cn.[0].cn.[0].markers': [], }) 目前有两种方法可以实现上述结构,以实现局部更新的效果,从而提升更新性能: 1. 全局配置项 baseLevel 对于不支持模板递归的小程序(例如微信、QQ、京东小程序等),当 DOM 层级达到一定数量后,Taro 会利用原生自定义组件来辅助递归渲染。简单来说,当 DOM 结构超过 N 层时,Taro 将使用原生自定义组件进行渲染(可以通过修改配置项 baseLevel 来调整 N 的值,建议设置为 8 或 4)。 需要注意的是,由于这是全局设置,可能会带来一些问题,例如: 在跨原生自定义组件时,flex 布局会失效(这是影响最大的问题); 在 SelectorQuery.select 方法中,跨自定义组件的后代选择器写法需要增加 >>>:.the-ancestor >>> .the-descendant。 2. 使用 CustomWrapper 组件 CustomWrapper 组件的作用是创建一个原生自定义组件,用于调用后代节点的 setData 方法,以实现局部更新的效果。 我们可以使用它来包裹那些遇到更新性能问题的模块,例如: import { View, Text } from '@tarojs/components' export default function () { return ( <View className="index"> <Text>Demo</Text> <CustomWrapper> <GoodsList /> </CustomWrapper> </View> ) } 三、如何提升长列表性能 长列表是常见的组件,当生成或加载的数据量非常大时,可能会导致严重的性能问题,尤其在低端机上可能会出现明显的卡顿现象。 为了解决长列表的问题,Taro 提供了 VirtualList 组件和 VirtualWaterfall 组件。它们的原理是只渲染当前可见区域(Visible Viewport)的视图,非可见区域的视图在用户滚动到可见区域时再进行渲染,以提高长列表滚动的流畅性。 1. VirtualList 组件(虚拟列表) 以 React Like 框架使用为例,可以直接引入组件: import VirtualList from '@tarojs/components/virtual-list' 一个最简单的长列表组件如下所示: function buildData(offset = 0) { return Array(100) .fill(0) .map((_, i) => i + offset) } const Row = React.memo(({ id, index, data }) => { return ( <View id={id} className={index % 2 ? 'ListItemOdd' : 'ListItemEven'}> Row {index} : {data[index]} </View> ) }) export default class Index extends Component { state = { data: buildData(0), } render() { const { data } = this.state const dataLen = data.length return ( <VirtualList height={800} /* 列表的高度 */ width="100%" /* 列表的宽度 */ item={Row} /* 列表单项组件,这里只能传入一个组件 */ itemData={data} /* 渲染列表的数据 */ itemCount={dataLen} /* 渲染列表的长度 */ itemSize={100} /* 列表单项的高度 */ /> ) } } 更多详情可以参考官方文档: https://taro-docs.jd.com/docs/virtual-list  2. VirtualWaterfall 组件(虚拟瀑布流) 以 React Like 框架使用为例,可以直接引入组件: import { VirtualWaterfall } from `@tarojs/components-advanced` 一个最简单的长列表组件如下所示: function buildData(offset = 0) { return Array(100) .fill(0) .map((_, i) => i + offset) } const Row = React.memo(({ id, index, data }) => { return ( <View id={id} className={index % 2 ? 'ListItemOdd' : 'ListItemEven'}> Row {index} : {data[index]} </View> ) }) export default class Index extends Component { state = { data: buildData(0), } render() { const { data } = this.state const dataLen = data.length return ( <VirtualWaterfall height={800} /* 列表的高度 */ width="100%" /* 列表的宽度 */ item={Row} /* 列表单项组件,这里只能传入一个组件 */ itemData={data} /* 渲染列表的数据 */ itemCount={dataLen} /* 渲染列表的长度 */ itemSize={100} /* 列表单项的高度 */ /> ) } } 更多详情可以参考官方文档: https://taro-docs.jd.com/docs/virtual-waterfall  四、如何避免 setData 数据量较大 众所周知,对小程序性能的影响较大的主要有两个因素,即 setData 的数据量和单位时间内调用 setData 函数的次数。在 Taro 中,会对 setData 进行批量更新操作,因此通常只需要关注 setData 的数据量大小。下面通过几个例子来说明如何避免数据量过大的问题: 例子 1:删除楼层节点要谨慎处理 目前 Taro 在处理节点删除方面存在一些缺陷。假设存在以下代码写法: <View> <!-- 轮播 --> <Slider /> <!-- 商品组 --> <Goods /> <!-- 模态弹窗 --> {isShowModal && <Modal />} </View> 当 isShowModal 从 true 变为 false 时,模态弹窗会消失。此时,Modal 组件的兄弟节点都会被更新,setData 的数据是 Slider + Goods 组件的 DOM 节点信息。 一般情况下,这不会对性能产生太大影响。然而,如果待删除节点的兄弟节点的 DOM 结构非常复杂,比如一个个楼层组件,删除操作的副作用会导致 setData 的数据量变大,从而影响性能。 为了解决这个问题,可以通过隔离删除操作来进行优化。 <View> <!-- 轮播 --> <Slider /> <!-- 商品组 --> <Goods /> <!-- 模态弹窗 --> <View> {isShowModal && <Modal />} </View> </View> 例子 2:基础组件的属性要保持引用 当基础组件(例如 View、Input 等)的属性值为非基本类型时,假设存在以下代码写法: <Map latitude={22.53332} longitude={113.93041} markers={[ { latitude: 22.53332, longitude: 113.93041, }, ]} /> 每次渲染时,React 会对基础组件的属性进行浅比较。如果发现 markers 的引用不同,就会触发组件属性的更新。这最终导致了 setData 操作的频繁执行和数据量的增加。 为了解决这个问题,可以使用状态(state)或闭包等方法来保持对象的引用,从而避免不必要的更新。 <Map latitude={22.53332} longitude={113.93041} markers={this.state.markers} /> 五、更多最佳实践 1. 阻止滚动穿透 在小程序开发中,当存在滑动蒙层、弹窗等覆盖式元素时,滑动事件会冒泡到页面上,导致页面元素也会跟着滑动。通常我们会通过设置 catchTouchMove 来阻止事件冒泡。 然而,由于 Taro3 事件机制的限制,小程序事件都是以 bind 的形式进行绑定。因此,与 Taro1/2 不同,调用 e.stopPropagation() 并不能阻止滚动事件的穿透。 解决办法 1:使用样式(推荐) 可以为需要禁用滚动的组件编写以下样式: { overflow:hidden; height: 100vh; } 解决办法 2:使用 catchMove 对于极个别的组件,比如 Map 组件,即使使用样式固定宽高也无法阻止滚动,因为这些组件本身具有滚动的功能。因此,第一种方法无法处理冒泡到 Map 组件上的滚动事件。 在这种情况下,可以为 View 组件添加 catchMove 属性: // 这个 View 组件会绑定 catchtouchmove 事件而不是 bindtouchmove <View catchMove /> 2. 跳转预加载 在小程序中,当调用 Taro.navigateTo 等跳转类 API 后,新页面的 onLoad 事件会有一定的延时。因此,为了提高用户体验,可以将一些操作(如网络请求)提前到调用跳转 API 之前执行。 对于熟悉 Taro 的开发者来说,可能会记得在 Taro 1/2 中有一个名为 componentWillPreload 的钩子函数。然而,在 Taro 3 中,这个钩子函数已经被移除了。不过,开发者可以使用 Taro.preload() 方法来实现跳转预加载的效果: // pages/index.js Taro.preload(fetchSomething()) Taro.navigateTo({ url: '/pages/detail' }) // pages/detail.js console.log(getCurrentInstance().preloadData) 3. 建议把 Taro.getCurrentInstance() 的结果保存下来 在开发过程中,我们经常会使用 Taro.getCurrentInstance() 方法来获取小程序的 app、page 对象以及路由参数等数据。然而,频繁地调用该方法可能会导致一些问题。 因此,建议将 Taro.getCurrentInstance() 的结果保存在组件中,并在需要时直接使用,以避免频繁调用该方法。这样可以提高代码的执行效率和性能。 class Index extends React.Component { inst = Taro.getCurrentInstance() componentDidMount() { console.log(this.inst) } } 六、预告:小程序编译模式(CompileMode) Taro 一直追求并不断突破性能的极限,除了以上提供的最佳实践,我们即将推出小程序编译模式(CompileMode)。 什么是 CompileMode? 前面已经说过,Taro3 是一种重运行时的框架,当节点数量增加到一定程度时,渲染性能会显著下降。 因此,为了解决这个问题,Taro 引入了 CompileMode 编译模式。 CompileMode 在编译阶段对开发者的代码进行扫描,将 JSX 和 Vue template 代码提前编译为相应的小程序模板代码。这样可以减少小程序渲染层虚拟 DOM 树节点的数量,从而提高渲染性能。 通过使用 CompileMode,可以有效减少小程序的渲染负担,提升应用的性能表现。 如何使用? 开发者只需为小程序的基础组件添加 compileMode 属性,该组件及其子组件将会被编译为独立的小程序模板。 function GoodsItem () { return ( <View compileMode> ... </View> ) } 目前第一阶段的开发工作已经完成,我们即将发布 Beta 版本,欢迎大家关注! 想提前了解的可以查看 RFC 文档: https://github.com/NervJS/taro-rfcs/blob/feat/compile-mode/rfcs/0000-compile-mode.md 结尾 通过采用 Taro 的最佳实践,我们相信您的小程序应用性能一定会有显著的提升。未来,我们将持续探索更多优化方案,覆盖更广泛的应用场景,为开发者提供更高效、更优秀的开发体验。 如果您在项目中有任何经验总结或思考,欢迎向我们投稿并进行交流,让我们一起分享给更多开发者,非常感谢您的支持! 作者:京东零售 利齐诺 来源:京东云开发者社区 转载请注明来源

资源下载

更多资源
Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册