首页 文章 精选 留言 我的

精选列表

搜索[热点技术征文第8期最强语言],共10000篇文章
优秀的个人博客,低调大师

一种简化操作日志记录方案 | 京东云技术团队

一、背景: 后台系统配置越来越多的出现需要进行日志记录的功能,且当前已有日志记录不可复用,需要统一日志记录格式,提高日志记录开发效率。 二、预期效果展示: 新建动作: 修改动作: 删除动作:  三、数据存储: 注:可以选择其他存储方式,这里只简单举个例子 `biz_id` bigint(20) NOT NULL DEFAULT 0 COMMENT '业务id', `biz_type` tinyint(4) NOT NULL DEFAULT 0 COMMENT '业务类型', `operator_id` varchar(128) NOT NULL DEFAULT '' COMMENT '操作人', `operate_content` text COMMENT '操作内容', `change_before` text COMMENT '修改前', `change_after` text COMMENT '修改后', `create_time` timestamp NOT NULL DEFAULT CURRENT_TIMESTAMP COMMENT '创建时间' 四、原理简述: 日志构建关注两个对象,一个是修改前,修改后: 修改前:null + 修改后:X = 新建 修改前:Y + 修改后:X = 更新 修改前:Y + 修改后:null = 删除 修改内容判断依据传入的两个对象,对两个对象的每个属性进行逐一对比,如果发生变化则是需要进行日志记录字段;关注的属性使用注解进行标注。 五、具体实现: 注解: @Target(ElementType.FIELD) @Retention(RetentionPolicy.RUNTIME) @Inherited @Documented public @interface LogField { String name() default ""; String valueFun() default ""; boolean spliceValue() default true; } name: name值表示该字段如果被修改,应在日志中记录的字段名;默认取字段名 valueFun: 表示获取改变字段内容的获取方法;默认取字段值,若valueFun方法不存在,则取默认值 spliceValue: 日志是否需要拼接变更内容,默认拼接 注解处理: @Service @Slf4j public class OperateLogService { @Resource private CommonOperateLogService commonOperateLogService; enum ActionEnum{ ADD("新建"), UPDATE("修改"), DELETE("删除"); ActionEnum(String desc) { this.desc = desc; } public String desc; } private int insertLog(CommonOperatorLog commonOperatorLog){ String result = commonOperateLogService.insertLog(JSON.toJSONString(commonOperatorLog)); Response response = JSON.parseObject(result, Response.class); return Objects.isNull(response) || ApiResponse.Status.fail.equals(response.getStatus()) ? 0 : (int) response.getContent(); } public PageOutput<CommonOperatorLog> queryList(Long bizId, Integer bizType, Integer pageNum, Integer pageSize){ String result = commonOperateLogService.queryLog(bizId, bizType, pageNum, pageSize); PageOutput pageOutput = JSON.parseObject(result, new TypeReference<PageOutput<CommonOperatorLog>>() {}); return pageOutput; } public <T> void saveLog(String operatorId,Long bizId, Integer bizType, T target, T original){ if(StringUtils.isBlank(operatorId) || (Objects.isNull(target) && Objects.isNull(original))){ throw new IllegalArgumentException(); } if(Objects.nonNull(target) && Objects.nonNull(original) && !target.getClass().isAssignableFrom(original.getClass())){ throw new IllegalArgumentException(); } ActionEnum action = getAction(target, original); List<Triple<String, String, LogField>> changeInfos = getChangeInfoList(target, original); List<String> changeInfoList = new ArrayList<>(); if(CollectionUtils.isEmpty(changeInfos) && !ActionEnum.UPDATE.equals(action)){ changeInfoList.add(0, action.desc); }else if (CollectionUtils.isEmpty(changeInfos)){ return; }else { changeInfoList = changeInfos.stream().map(i -> i.getRight().spliceValue() ? action.desc + StringUtils.joinWith("为:", i.getLeft(), i.getMiddle()) : action.desc + StringUtils.join("了", i.getLeft())) .collect(Collectors.toList()); } String operateContext = StringUtils.join(changeInfoList, "\n"); operateContext = operateContext.replaceAll("\"","") .replaceAll("\\[","").replaceAll("\\]",""); CommonOperatorLog operatorLog = new CommonOperatorLog(); operatorLog.setBizId(bizId); operatorLog.setBizType(bizType); operatorLog.setOperateContent(operateContext); operatorLog.setOperatorId(operatorId); operatorLog.setChangeBefore(JSON.toJSONString(original)); operatorLog.setChangeAfter(JSON.toJSONString(target)); this.insertLog(operatorLog); } private ActionEnum getAction(Object target, Object original){ ActionEnum action = ActionEnum.ADD; if(Objects.nonNull(target) && Objects.nonNull(original)){ action = ActionEnum.UPDATE; }else if(Objects.nonNull(target)){ action = ActionEnum.ADD; }else if (Objects.nonNull(original)){ action = ActionEnum.DELETE; } return action; } private<T> List<Triple<String, String, LogField>> getChangeInfoList(T target, T original){ if(Objects.isNull(target) || Objects.isNull(original)){ return new ArrayList<>(); } List<Pair<Field, Object>> targetFields = allFields(target); List<Pair<Field, Object>> originalFields = allFields(original); if(targetFields.size() != originalFields.size()){ //理论上不可能执行到这 throw new IllegalArgumentException(); } List<Triple<String, String, LogField>> result = new ArrayList<>(); for (int i = 0; i < targetFields.size(); i++) { Pair<Field, Object> targetField = targetFields.get(i); Pair<Field, Object> originalField = originalFields.get(i); ReflectionUtils.makeAccessible(targetField.getKey()); ReflectionUtils.makeAccessible(originalField.getKey()); Object targetValue = ReflectionUtils.getField(targetField.getKey(), targetField.getValue()); Object originalValue = ReflectionUtils.getField(originalField.getKey(), originalField.getValue()); if(targetValue != originalValue && (Objects.isNull(targetValue) || (!targetValue.equals(originalValue) && compareTo(Pair.of(targetField.getKey(), targetValue), Pair.of(originalField.getKey(), originalValue)) && !JSON.toJSONString(targetValue).equals(JSON.toJSONString(originalValue))))){ result.add(Triple.of(getFieldName(targetField.getKey()), getFieldValue(targetField.getKey(), targetField.getValue()), targetField.getKey().getAnnotation(LogField.class))); } } return result; } private boolean compareTo(Pair<Field, Object> targetField, Pair<Field, Object> originalField){ Field field = targetField.getKey(); Object targetValue = targetField.getValue(); Object originalValue = originalField.getValue(); boolean canCompare = Arrays.stream(field.getType().getInterfaces()).anyMatch(i -> Comparable.class.getName().equals(i.getName())); if(canCompare && Objects.nonNull(targetValue) && Objects.nonNull(originalValue)){ Method compareTo = ReflectionUtils.findMethod(field.getType(), "compareTo", field.getType()); if(Objects.isNull(compareTo)){ return true; } Object compared = ReflectionUtils.invokeMethod(compareTo, targetValue, originalValue); return (int)compared != 0 ; } return true; } private <T> List<Pair<Field, Object>> allFields(T obj){ List<Triple<Field, Object, Boolean>> targetField = findField(obj); List<Triple<Field, Object, Boolean>> allField = Lists.newArrayList(targetField); List<Triple<Field, Object, Boolean>> needRemove = new ArrayList<>(); for (int i = 0; i < allField.size(); i++) { Triple<Field, Object, Boolean> fieldObjectDes = allField.get(i); if(!fieldObjectDes.getRight()){ ReflectionUtils.makeAccessible(fieldObjectDes.getLeft()); Object fieldV = ReflectionUtils.getField(fieldObjectDes.getLeft(), fieldObjectDes.getMiddle()); List<Triple<Field, Object, Boolean>> fieldList = findField(fieldV); if(CollectionUtils.isNotEmpty(fieldList)){ allField.addAll(fieldList); needRemove.add(fieldObjectDes); } } } if(CollectionUtils.isNotEmpty(needRemove)){ allField.removeAll(needRemove); } return allField.stream().map(i->Pair.of(i.getLeft(), i.getMiddle())).collect(Collectors.toList()); } private <T> List<Triple<Field, Object, Boolean>> findField(T obj){ Class<?> objClass = obj.getClass(); Field[] declaredFields = objClass.getDeclaredFields(); List<Field> allFields = Lists.newArrayList(declaredFields); if(Objects.nonNull(objClass.getSuperclass())){ Field[] superClassFields = objClass.getSuperclass().getDeclaredFields(); allFields.addAll(Arrays.asList(superClassFields)); } List<Triple<Field, Object, Boolean>> result = new ArrayList<>(); for (Field declaredField : allFields) { LogField annotation = declaredField.getAnnotation(LogField.class); if(Objects.nonNull(annotation)){ result.add(Triple.of(declaredField, obj, declaredField.getType().getPackage().getName().startsWith("java"))); } } return result; } private String getFieldName(Field field){ LogField annotation = field.getAnnotation(LogField.class); String name = annotation.name(); if(StringUtils.isBlank(name)){ name = field.getName(); } return name; } private <T> String getFieldValue(Field field, T targetObj){ LogField annotation = field.getAnnotation(LogField.class); if(!annotation.spliceValue()){ return ""; } String valueFun = annotation.valueFun(); if(StringUtils.isBlank(valueFun)){ Object fieldValue = ReflectionUtils.getField(field, targetObj); return getStrValue(fieldValue); }else { Method valueMethod = ReflectionUtils.findMethod(targetObj.getClass(), valueFun); if(Objects.isNull(valueMethod)){ Object fieldValue = ReflectionUtils.getField(field, targetObj); return getStrValue(fieldValue); }else { ReflectionUtils.makeAccessible(valueMethod); Object invokeMethodRes = ReflectionUtils.invokeMethod(valueMethod, targetObj); return getStrValue(invokeMethodRes); } } } private String getStrValue(Object fieldValue){ List<String> emptyStr = ImmutableList.of("\"\"", "{}","[]"); String value = Objects.isNull(fieldValue) ? "无" : JSON.toJSONString(fieldValue); return emptyStr.contains(value) ? "无" : value; } } 六、使用示例: 1、使用的日志记录对象(这个对象只为日志服务) public class SubsidyRateLog { @LogField(name = "补贴率名称") private String name; @LogField(name = "适用城市", valueFun = "getCityNames") private List<Integer> cityIds; private List<String> cityNames; } name是直接展示字段,所以修改值即name本身的值;cityIds 是我们关心比较字段,当它值不一样时进行 字段value 值获取,这个值是展示在前端的,所以可以根据需要进行格式定义,默认是将取到的值进行toJSON;当前例子中获取的是getCityNames方法返回的值; 2、无专用日志对象(大多数时候我们有自己的实体对象,但不包含具体日志描述字段),需要进行继承 public class SubsidyRate { @LogField(name = "补贴率名称") private String name; @LogField(name = "适用城市", valueFun = "getCityNames") private List<Integer> cityIds; } @Data public class SubsidyRateLog extends SubsidyRate{ private List<String> cityNames; } 此方式适用于兼容现有对象,而不去破坏现有对象的完整性 3、对象包含子对象(比较复杂的大对象,如Task中的券信息) public class SubsidyRateLog { @LogField(name = "补贴率名称") private String name; @LogField private Address address; } public class Address { @LogField(name = "省份") private String province; @LogField(name = "城市") private String city; } 此情况下会将所有信息平铺,如果 Address 中 没有LogField 注解,那么会直接使用将获取address值,如果存在注解,那么将忽略address本身,只关注注解字段。 作者:京东零售祁伟 来源:京东云开发者社区 转载请注明来源

优秀的个人博客,低调大师

浅析SpringBoot加载配置的6种方式 | 京东云技术团队

从配置文件中获取属性应该是SpringBoot开发中最为常用的功能之一,但就是这么常用的功能,仍然有很多开发者抓狂~今天带大家简单回顾一下这六种的使用方式:  说明 Environment对象 Environment 是 springboot 核心的环境配置接口,它提供了简单的方法来访问应用程序属性,包括系统属性、操作系统环境变量、命令行参数、和应用程序配置文件中定义的属性等等,使用 Environment 方式来获取配置属性值非常简单,只要注入Environment类调用其方法getProperty(属性key)即可 @Value @Value注解是Spring框架提供的用于注入配置属性值的注解,它可用于类的成员变量、方法参数和构造函数参数上, 在应用程序启动时,使用 @Value 注解的 Bean 会被实例化。所有使用了 @Value 注解的 Bean 会被加入到 PropertySourcesPlaceholderConfigurer 的后置处理器集合中。当后置处理器开始执行时,它会读取 Bean 中所有 @Value 注解所标注的值,并通过反射将解析后的属性值赋值给标有 @Value 注解的成员变量、方法参数和构造函数参数。重要!!! ⚠️注意 ①在使用 @Value 注解时需要确保注入的属性值已经加载到 Spring 容器中,否则会导致注入失败; ②建议引用变量的时候给定一个默认值,避免启动报“缺失配置”的错误; ③通过依赖注入的方式获取对象中属性值,切记不要使用new的方式来创建对象获取其属性。 @ConfigurationProperties SpringBoot 提供的一种更加便捷来处理配置文件中的属性值的方式,可以通过自动绑定和类型转换等机制,将指定前缀的属性集合自动绑定到一个Bean对象上。 @PropertySources @PropertySources 注解的实现原理相对简单,应用程序启动时扫描所有被该注解标注的类,获取到注解中指定自定义配置文件的路径,将指定路径下的配置文件内容加载到 Environment 中,这样可以通过 @Value 注解或 Environment.getProperty() 方法来获取其中定义的属性值了。默认只限读取properties文件内容,想加载yaml文件内容,可以自定义factory适配器,指定factory具体的使用 YamlPropertiesFactoryBean对象 只限读取yaml文件,通过 @Value 注解或 Environment.getProperty() 方法来配合着获取其中定义的属性值。 JAVA原生 通过java.util.Properties去加载配置文件中的属性, 一、Environment 注入Environment类调用其方法getProperty(属性key)即可 @Slf4j @SpringBootTest public class EnvironmentTest { @Resource private Environment env; @Test public void var1Test() { String var1 = env.getProperty("env.var1"); log.info("Environment获取的配置内容:{}", var1); } } 二、@Value 注解 只要在变量上加注解 @Value("${env.var1}")就可以了,@Value 注解会自动将配置文件中的env.var1属性值注入到var1字段中。 @Slf4j @SpringBootTest public class EnvVariablesTest { @Value("${env.var1}") private String var1; @Test public void var1Test(){ log.info("配置文件属性: {}",var1); } } 三、@ConfigurationProperties 注解 在 application.yml 配置文件中添加配置项: env: var1: 变量值1 var2: 变量值2 创建一个 MyConf 类用于承载所有前缀为env的配置属性。 @Data @Configuration @ConfigurationProperties(prefix = "env") public class MyConf { private String var1; private String var2; } 在需要使用var1、var2属性值的地方,将 MyConf 对象注入到依赖对象中即可。 @Slf4j @SpringBootTest public class ConfTest { @Resource private MyConf myConf; @Test public void myConfTest() { log.info("@ConfigurationProperties注解获取的配置内容:{}", JSON.toJSONString(myConf)); } } 四、@PropertySources 注解 在 src/main/resources/ 目录下创建自定义配置文件 important.properties,增加两个属性。 env.var1=变量值1 env.var2=变量值2 在需要使用自定义配置文件的类上添加 @PropertySources 注解,注解 value属性中指定自定义配置文件的路径,可以指定多个路径,用逗号隔开。 @Data @Configuration @PropertySources({ @PropertySource(value = "classpath:important.properties", encoding = "utf-8"), @PropertySource(value = "classpath:important.properties",encoding = "utf-8") }) public class PropertySourcesConf { @Value("${env.var1}") private String var1; @Value("${env.var2}") private String var2; } 五、YamlPropertiesFactoryBean 加载 YAML 文件 @Configuration public class MyYamlConfig { @Bean public static PropertySourcesPlaceholderConfigurer yamlConfigurer() { PropertySourcesPlaceholderConfigurer configurer = new PropertySourcesPlaceholderConfigurer(); YamlPropertiesFactoryBean yaml = new YamlPropertiesFactoryBean(); yaml.setResources(new ClassPathResource("test.yml")); configurer.setProperties(Objects.requireNonNull(yaml.getObject())); return configurer; } } 可以通过 @Value 注解或 Environment.getProperty() 方法来获取其中定义的属性值。 @Slf4j @SpringBootTest public class YamlTest { @Value("${env.var3}") private String var3; @Test public void myYamlTest() { log.info("Yaml获取配置内容:{}", var3); } } 六、JAVA原生读取 @Slf4j @SpringBootTest public class CustomTest { @Test public void customTest() { Properties props = new Properties(); try { InputStreamReader inputStreamReader = new InputStreamReader( this.getClass().getClassLoader().getResourceAsStream("test.properties"), StandardCharsets.UTF_8); props.load(inputStreamReader); } catch (IOException e1) { System.out.println(e1); } log.info("Properties Name:" + props.getProperty("env.appName")); } } 作者:京东零售 马宏伟 来源:京东云开发者社区 转载请注明来源

优秀的个人博客,低调大师

低代码平台探讨-MetaStore元数据缓存 | 京东云技术团队

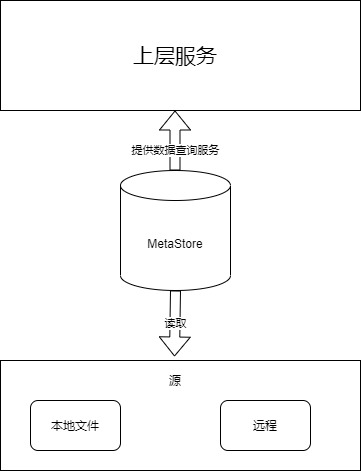
背景及需求 之前提到我们模型驱动的实现选择的是解释型,需要模型的元数据信息,在接到请求后动态处理逻辑. 此外,应用的通用能力中还包括:页面dsl查询,菜单查询等. 而且后期加入触发器,用户自定义api后,这些元数据也需要提供查询服务. 所以我们需要一个元数据模块,需要提供两个基础功能:加载元数据和提供元数据查询服务.  特殊说明:最开始的时候我们支持两种源:本地和远程,后期防止单独部署网络隔离问题把远程逻辑去掉了. 第一版迭代处理的元数据有:模型,页面dsl及菜单,后期加入触发器,用户自定义api,拦截器等,我们今天按照第一版迭代来讨论设计及实现. 模型元数据的需求是缓存一批模型元数据,可以根据模型name获取模型的具体信息. 页面dsl的需求是缓存一批页面dsl,根据dslId获取页面dsl信息. 菜单的需求比较简单,缓存菜单列表和获取菜单列表. 上边说的是功能性需求,接着说下非功能性需求: 性能,元数据的查询特别频繁,必须保证高性能,通常会使用缓存,这也是我们这个模块的核心价值之一. 数据要准确,从MetaStore获取的数据不能有问题和差异. 易于扩展,首先元数据不仅仅有根据id获取的需求,可能还有其他查询需求;其次后期加入其他元数据存储的时候要改动小. 初版设计 设计思路 上边说了需求,下边我们开始正式的设计,先选一个具体场景来说:模型元数据. 为了高性能肯定要使用缓存,开发中常用缓存方式有两种:远程和本地. 远程通常使用NoSql的中间件,如Redis和MemCache,在这种场景下肯定不适合. 该场景最适合的方式是使用内存缓存,查询逻辑简单:根据name或者id获取,所以直接使用map的数据结构即可. 元数据是在应用启动时加载,不会再有变动(后期热部署此处需要重构),利用spring的启动机制,也不用考虑线程安全问题,直接使用HashMap就可以,这里应该是利用的jvm的Happens-before原则. 到此,我们确定了缓存的数据结构及接口:  包含一个内部变量cache是HashMAP类型,一个内部方法去加载数据,对外一个接口方法getByKey,功能比较内聚,类设计是没问题的,下边我们看下具体的逻辑. 详细逻辑 getByKey的逻辑是从缓存变量cache中获取,直接使用map的get方法,不用赘述(此处有坑,下文会有说明),主要看下load加载数据的方法  主要逻辑: 1. 读取指定的目录,可以从配置中获取,获取不到使用默认值:models,读取出目录下所有文件. 2. 开始循环处理每个文件,详细步骤: 1. 读取出文件内容:json格式. 2. json数据转换成Model对象. 3. 把Model对象放入到cache中,key是modelName,value是Model对象. 抽象 当具体方案确定后,如上边所述的逻辑实现起来并不复杂,甚至可以说是简单. 但我们在整体看下会发现:模型和页面dsl的元数据缓存逻辑相似度特别高! 再回头看下上边的逻辑流程图,紫色的部分都是完全相同的,差异只存在与红色的两块逻辑:"读取指定目录"和"解析成对象",我们可以把公共的逻辑抽象出去,做成抽象的父类让子类去继承,利用了继承的代码复用的场景,这是一个典型的模板模式的应用场景. 简单说下模板模式的定义:在一个方法中定义一个算法骨架,并将某些步骤推迟到子类中实现,让子类在不改变算法整体结构的情况下,重新定义算法中的某些步骤. 结合我们的场景来说下:算法骨架就是整体的加载数据流程和获取元数据方法,子类(ModelMetaStore和PageMetaModel)需要实现骨架中的两个扩展方法:"读取指定目录"和"解析成对象". 第一版设计重构后,类图如下  说明: 模型数据文件和页面dsl文件都放到各自的目录:models和dsls下,上边两个目录是默认的,但可自定义配置. 模型数据目录下的文件类型都是json,文件名是模型名称. 页面dsl目录下的文件类型也都是json,文件名是page的id. 抽象出一个父类AbstractDataStore<R>,泛型是子类的对象类型,包含核心逻辑和骨架.内部有一个map类型的cache变量和一个load私有函数用于加载数据,此外提供了两个抽象方法,一个是directoryName:获取文件所在目录,另一个方式是parse:根据文件内容解析成单个对象,这两个抽象方法需要子类实现,最后还有一个根据key获取元数据的公共方法. ModelMetaStore和PageDataStore继承了父类AbstractDataStore,泛型分别是ModelEntity和PageEntity,实现上述的两个抽象方法:directoryName和parse,两个方法的逻辑都特别简单,第一个直接返回自己的目录,第二个利用fastjson把字符串解析成指定对象. 组合 上面把模型和页面的元数据缓存设计完成了,还有一个菜单的元数据缓存. 菜单的元数据结构与上边的两个差异很大,每个应用中只会有一个菜单的元数据文件,所以无法使用上边的模板模式,我们需要单独去处理它的逻辑. 实际上菜单的元数据加载逻辑和其他两个(更准确的说应该是抽象类)有一部分重叠:读取文件的内容,这里面需要判断文件是否为空,读取内容字符串及io读取报错等. 这部分逻辑可以复制出来放到菜单的元数据缓存类中,但实际违背了DRY 原则:不要写重复的代码. 那么该如何解决这块重复代码的问题呢?有两个方案: 第一个方案:使用继承. 在AbstractDataStore<R>上再加一层抽象类,里面只包括一个方法:读取文件内容,新的菜单元数据缓存也继承这个抽象类,把读取文件内容的方法移到最上层,类结构图如下: 这个方案有两个问题: 继承层次太深,逻辑有点乱 最上层的抽象类很难起名 AbstractDataStore和MenuDataCache继承LoadFileData从代码上是可行的,但逻辑上不太合理,抽象继承是is-a的关系,这里需要给LoadFileData一个合适的名字才满足设计规范,而这个名字并不太好起. 第一个方案:使用组合. 这个方案实际上更合理一些,面向对象设计有一个原则:组合优于继承. 可以把读取文件内容的逻辑独立出去作为一个新的帮助类DataLoadSupport,AbstractDataStore和MenuDataCache引入它就可以解决代码重复问题.   初始化加载 上一步几乎完成了所有逻辑,但是少了数据加载的触发,这个需要放到服务启动的时候触发. 我们利用了spring的ApplicationListener,有一个细节问题要确定:如何实现ApplicationListener,是每一个类中单独实现,还是统一实现. 为了逻辑的统一,还有后期其他服务需要启动时加载的考虑,我选择了统一实现,具体逻辑和类图如下: 具体逻辑: 新增一个接口StartLoadListener:启动加载监听,启动时需要被触发的操作类实现该接口. AbstractDataStore和MenuDataCache实现StartLoadListener接口,标记需要在应用启动时触发,应用启动后触发自己的load方法. 新增StartLoadListenerManager类,里面会自动注入所有实现StartLoadListener接口的对象,该类同时实现了spring的ApplicationListener接口,在spring启动后被触发,触发后调用所有的StartLoadListener的startLoad方法,完成所有需要启动时触发的操作. 类图:  第二版设计 如文章开头所说,从元数据缓存中使用key从map中获取信息后直接返回是有问题的,开发完的时候也意识到了一些,但没有去处理,直到某天雷真的炸了. 先说下问题出现的过程,初期功能简单,低代码平台生成的应用都跑的好好的,迭代数次版本后,新增了权限能力:支持简单的数据权限和菜单权限. 菜单权限的处理逻辑大体如下: 从菜单缓存中直接获取缓存的数据. 如果菜单列表为空,直接返回给客户端空的列表,结束菜单查询. 查询用户有权限的菜单编码列表(set),数据源头是科技权限系统,初期比较粗暴代码耦合到菜单权限代码中,但这不是今天讨论的重点,后边的文章会讲到权限模块的重构. 如果用户有权限的菜单编码列表(set)为空,直接返回给客户端空的列表,结束菜单查询. 递归处理获取的缓存菜单,如果编码在权限系统返回的编码列表(set)中,递归处理子节点列表(菜单是树形的),否则直接删除该节点,返回到上级递归. 循环上步操作,直到所有菜单节点校验完成.   逻辑并不太复杂,开发的时候特意重点关注了递归和权限系统查询,本地测试没什么问题,部署到测试环境也没发现什么问题. 但最后要上线前测试发现了一个问题:切换账号后,菜单不对,有权限的菜单变少了!!! 定位问题的时候,先排查权限系统的返回,结果没问题;在把数据拿到本地走mock测试也没有问题;在最后debug的时候发现了真正的问题,也就是之前意识到但没有解决的问题:在菜单权限逻辑中操作的菜单列表和菜单元数据缓存的菜单列表是同一个对象! 在某个用户处理完自己的权限菜单逻辑后,可能会移除一些节点,下一个用户在获取菜单的时候他的菜单元数据可能就是被处理过(在权限处理中被移除)的了. 元数据存储实际上类似原型模型,原型模式的定义:如果对象的创建成本比较大,而同一个类的不同对象之间差别不大(大部分字段都相同),在这种情况下,我们可以利用对已有对象进行复制(或者叫拷贝)的方式来创建新对象,以达到节省创建时间的目的. 我的实现只做了缓存,但没有实现复制,使得同一对象被多个场景操作.最后导致数据的错误及混乱. 而复制一般也叫拷贝,分为两类: 浅拷贝:只会拷贝对象中的基本数据类型的数据(比如,int、long),以及引用对象的内存地址,不会递归地拷贝引用对象本身. 深拷贝:不仅仅会复制索引,还会复制数据本身 我们肯定要选择深拷贝,但出现问题的时候已经有几个元数据存储了,特别是菜单数据的结构复杂(树形),短时间没法完成深度复制,市面上的工具类通常只能复制一层,无法自动完成深层次的复制. 当时的解决方案比较粗暴:问题出现在菜单,那只在菜单权限处理的时候做手脚:定义一个新的菜单列表,有权限的菜单深度复制当前对象后加入到list;递归处理子节点.继续重新定义一个list设置为上层节点的子节点,有权限的子节点放入到新的list,递归循环上述步骤. 表象的bug解决了,但实际问题还没有解决,只是被遮盖了,就拿菜单来说,我是在权限服务那处理了,但如果在其他地方使用呢,一样会出现数据缺失的错误. 更严重的是在触发器中提供了获取模型元数据的接口,开发者获取模型元数据后如果进行了修改,导致的错误会更加严重,也更加的难已排查,因为模型元数据的变更会导致模型通用接口逻辑的缺失或混乱,所以深度复制的功能一定要实现. 深度复制的实现一般有两种: 第一种序列化后反序列化,比如把数据序列化成json,在反序列化回来.该方案有两个问题:(1)继承的子类多态容易出问题(2)序列化和反序列化是有性能消耗的,在此处方案并不适合. 第二种是递归处理:遇到Collection和Map及javabean类型,进行递归的深度拷贝.该方案开发成本稍高,大量的递归需要特殊注意,此外一些特殊的bean也无法复制:如内部变量是final类型,或者只支持构造函数传入. 我们使用的是第二种,这种方法纯粹是算法类,不再细说,在中间碰到了一个坑:我有一个习惯遇到一些没有数据需要返回空的list的时候我会直接使用Collections.emptyList(),在深度复制的时候根据构造函数新建对象会直接报错,修复方案是:如果是list或者map不是常见的对象类型直接使用常见的对象ArrayList和HashMap.  实际上还有一种方案能解决数据修改问题,使用不变对象,不变对象就是对象在创建后,不可以被修改:没有set方法,且内部变量不会暴露,需要注意的是,内部变量也要进行保护:不变或者深拷贝. 作者:京东科技吴籽良 来源:京东云开发者社区 转载请注明来源

优秀的个人博客,低调大师

聊聊JDK19特性之虚拟线程 | 京东云技术团队

1.前言 在读《深入理解JVM虚拟机》这本书前两章的时候整理了JDK从1.0到最新版本发展史,其中记录了JDK这么多年来演进过程中的一些趣闻及引人注目的一些特性,在调研JDK19新增特性的时候了解到了虚拟线程这个概念,于是对虚拟线程进行学习整理内容如下。 2.虚拟线程介绍? 虚拟线程(Virtual Threads)就犹如名字一样,并非传统意义上的JAVA线程。传统意义上的JAVA线程(以下称为平台线程)跟操作系统的内核线程是一一映射的关系(如图1所示)。而对于平台线程的创建和销毁所带来的开销是非常大的,所以JAVA采用线程池的方式来维护平台线程而避免线程的反复创建和销毁。 然而平台线程也会占用内存、CPU资源,往往在CPU和网络连接成为系统瓶颈前,平台线程首当其冲的会成为系统瓶颈。在单台服务器硬件资源确定的情况下,平台线程的数量同样也会因为硬件资源而受到限制,也成为单台服务器吞吐量提升的主要障碍。 图1 平台线程和系统线程映射关系 谈回虚拟线程,虚拟线程则是由JDK而非操作系统提供的一种线程轻量级实现,它相较于平台线程而言具有以下特性: 不依赖于平台线程的数量; 不会增加额外的上下文切换开销; 不会在代码的整个生命周期中阻塞系统线程; 整个虚拟线程的维护是通过JVM进行管理,作为普通的JAVA对象存放在RAM中。 那么意味着若干的虚拟线程可以在同一个系统线程上运行应用程序的代码(如图2所示),只有在虚拟线程执行的时候才会消耗系统线程,在等待和休眠时不会阻塞系统线程。 图2 虚拟线程和平台线程映射关系 相较于平台线程而言,虚拟线程是一种非常廉价和丰富的线程,可以说虚拟线程的数量是一种近乎于无限多的线程,它对硬件的利用率接近于最好,在相同硬件配置服务器的情况下,虚拟线程比使用平台线程具备更高的并发性,从而提升整个应用程序的吞吐量。如果说平台线程和系统线程调度为1:1的方式,虚拟线程则采用M:N的调度方式,其中大量的虚拟线程M在较少的系统线程N上运行。 3.虚拟线程如何被JVM调度呢? 图3 JVM调度虚拟线程流程图 先创建一个虚拟线程,此时JVM会将虚拟线程装载在平台线程上,平台线程则会去绑定一个系统线程。 JVM会使用调度程序去使用调度线程执行虚拟线程中的任务。 任务执行完成之后清空上下文变量,将调度线程返还至调度程序等待处理下一个任务。 4.虚拟线程的目标、非目标? 目标: 为java.lang.Thread增加一种额外的实现,即虚拟线程,它能做到在几个G的JVM堆上创建几百万个活动的虚拟线程(这在现在的JDK中几乎不可能实现),并且表现出和现在的线程几乎一样的行为。 对虚拟线程问题定位也可以通过已经存在的JDK工具,尽可能保持和现在的线程相似的方式。 在 Java 中,经典线程是 java.lang.Thread 类的实例。后面我们也将它们称为平台线程。 非目标: 虚拟线程不是为了改变现在这种操作系统级别的线程的实现。 虚拟线程不是为了自动将已经存在的线程构造方法自动转为虚拟线程。 虚拟线程不是为了改变JMM。 虚拟线程不是为了增加一种新的内部线程通信机制。 除了并行流之外,虚拟线程也不是为了提供一种新的数据并行结构。 5.如何创建虚拟线程? 使用Thread.startVirtualThread() 此方法创建一个新的虚拟线程来执行给定的 Runnable 任务。 Runnable runnable = () -> System.out.println("Virtual Thread"); Thread.startVirtualThread(runnable); //or Thread.startVirtualThread(() -> { //Code to execute in virtual thread System.out.println("Virtual Thread"); }); 使用Thread.Builder 如果我们想在创建线程后显式启动它,我们可以使用 Thread.ofVirtual() 返回一个 VirtualThreadBuilder 实例。它的 start() 方法启动一个虚拟线程。这里的 Thread.ofVirtual().start(runnable) 等价于 Thread.startVirtualThread(runnable)。 ThreadFactory factory = Thread.ofVirtual().factory(); 我们可以使用Thread.Builder引用来创建和启动多个线程。 Runnable runnable = () -> System.out.println("Virtual Thread"); Thread.Builder builder = Thread.ofVirtual().name("Virtual-Thread"); Thread t1 = builder.start(runnable); Thread t2 = builder.start(runnable); 类似的 APIThread.ofPlatform()也可用于创建平台线程。 Thread.Builder builder = Thread.ofPlatform().name("Platform-Thread"); Thread t1 = builder.start(() -> {...}); Thread t2 = builder.start(() -> {...}); 使用Executors.newVirtualThreadPerTaskExecutor() 此方法为每个任务创建一个新的虚拟线程。 Executor 创建的线程数是无限的。 try (var executor = Executors.newVirtualThreadPerTaskExecutor()) { IntStream.range(0, 10_000).forEach(i -> { executor.submit(() -> { Thread.sleep(Duration.ofSeconds(1)); return i; }); }); } 6.平台线程和虚拟线程的区别? 图4 虚拟线程生命周期 虚拟线程始终是守护线程。 Thread.setDaemon(false) 方法不能将虚拟线程更改为非守护线程。 请注意,当所有启动的非守护线程都终止时,JVM 终止。这意味着 JVM 在退出之前不会等待虚拟线程完成。 Thread virtualThread = ...; //创建虚拟线程 //virtualThread.setDaemon(true); //没有作用 虚拟线程始终具有正常优先级,并且即使使用setPriority(n)方法,也无法更改优先级。在虚拟线程上使用此方法无效。 Thread virtualThread = ...; //创建虚拟线程 //virtualThread.setPriority(Thread.MAX_PRIORITY); //没有作用 虚拟线程不是线程组的活动成员。在虚拟线程上调用时,Thread.getThreadGroup()返回一个名为VirtualThreads的占位符线程组。 虚拟线程不支持stop()、suspend()或resume()方法。 这些方法在虚拟线程上调用时会引发UnsupportedOperationException。 虚拟线程由JVM调度,JVM将VT分配给平台线程的动作称为挂载(mount),取消分配的动作称为卸载(unmount),线程状态如下 // 初始状态 private static final int NEW = 0; // 线程启动,由于虚拟线程的run()是个空方法,此时尚未开始执行任务 // 真正的任务执行在cont.run private static final int STARTED = 1; // 可执行,尚未分配平台线程 private static final int RUNNABLE = 2; // 可执行,已分配平台线程 private static final int RUNNING = 3; // 线程尝试park private static final int PARKING = 4; // 从平台线程卸载 private static final int PARKED = 5; // cont.yield失败,未从平台线程卸载 private static final int PINNED = 6; // 尝试cont.yield private static final int YIELDING = 7; // 终结态 private static final int TERMINATED = 99; 7.实例场景分析平台线程和虚拟线程的性能: 任务说明:在控制台中打印一条消息之前等待1秒,现在使用Runnable创建10000个线程,用虚拟线程和平台线程执行它们,来比较两者的性能。我们将使用Duration.between()api 来测量执行所有任务的经过时间。 首先,我们使用一个包含 100 个平台线程的池。这样,Executor 一次可以运行 100 个任务,其他任务需要等待。由于我们有 10,000 个任务,因此完成执行的总时间约为 100 秒。 Instant start = Instant.now(); try (var executor = Executors.newFixedThreadPool(100)) { for(int i = 0; i < 10_000; i++) { executor.submit(runnable); } } Instant finish = Instant.now(); long timeElapsed = Duration.between(start, finish).toMillis(); System.out.println("Total elapsed time : " + timeElapsed); 输出 Total elapsed time : 101152 //大概 101 秒 接下来,我们将Executors.newFixedThreadPool(100)替换为Executors.newVirtualThreadPerTaskExecutor()。这将在虚拟线程而不是平台线程中执行所有任务。 Instant start = Instant.now(); try (var executor = Executors.newVirtualThreadPerTaskExecutor()) { for(int i = 0; i < 10_000; i++) { executor.submit(runnable); } } Instant finish = Instant.now(); long timeElapsed = Duration.between(start, finish).toMillis(); System.out.println("Total elapsed time : " + timeElapsed); 输出 Total elapsed time : 1589 // 大概 1.5 秒 请注意虚拟线程的超快性能将执行时间从 100 秒减少到 1.5 秒,而 Runnable 代码没有任何变化。 其他实际场景:https://zhuanlan.zhihu.com/p/604507117?utm_id=0 8.使用虚拟线程需要注意什么? 不要建虚拟线程池 Java 线程池旨在避免创建新操作系统线程的开销,因为创建它们是一项昂贵的操作。但是创建虚拟线程并不昂贵,因此永远不需要将它们池化。建议每次需要时创建一个新的虚拟线程。 请注意,使用虚拟线程后,我们的应用程序可能能够处理数百万个线程,但其他系统或平台一次只能处理几个请求。例如,我们可以只有几个数据库连接或与其他服务器的网络连接。 在这些情况下,也不要使用线程池。相反,使用信号量来确保只有指定数量的线程正在访问该资源。 private static final Semaphore SEMAPHORE = new Semaphore(50); SEMAPHORE.acquire(); try { // 信号量被控制在 50 来访问请求 // 访问数据库或资源 } finally { SEMAPHORE.release(); } 避免使用线程局部变量 (ThreadLocal) 虚拟线程支持线程局部行为的方式与平台线程相同,但由于虚拟线程可以创建数百万个,因此只有在仔细考虑后才能使用线程局部变量。 例如,如果我们在应用程序中扩展一百万个虚拟线程,那么将有一百万个 ThreadLocal 实例以及它们所引用的数据。如此大量的实例会给内存带来很大的负担,应该避免。 使用 ReentrantLock 而不是同步块 有两种特定场景,虚拟线程可以阻塞平台线程(称为 OS 线程的固定)。 1、当它在同步块或同步方法内执行代码时 2、当它执行本地方法或外部函数时 这种同步块不会使应用程序出错,但它会限制应用程序的可扩展性,类似于平台线程。 如果一个方法使用非常频繁并且它使用同步块,则考虑将其替换为 ReentrantLock 机制。 public synchronized void m() { try { // ... 访问资源 } finally { // } } private final ReentrantLock lock = new ReentrantLock(); public void m() { lock.lock(); // 阻塞 try { // ... 访问资源 } finally { lock.unlock(); } } 9.结论 长期以来,传统的 Java 线程一直很好用。随着微服务领域对可扩展性和高吞吐量的需求不断增长,虚拟线程将被证明是 Java 历史上的一个里程碑特性。使用虚拟线程,一个程序可以用少量的物理内存和计算资源处理数百万个线程,这是传统平台线程无法做到的。当与结构化并发相结合时,它还将导致编写更好的程序。 作者:京东科技 宋慧超 来源:京东云开发者社区 转载请注明来源
优秀的个人博客,低调大师

MySQL innoDB 间隙锁产生的死锁问题 | 京东云技术团队

背景 线上经常偶发死锁问题,当时处理一张表,也没有联表处理,但是有两个mq入口,并且消息体存在一样的情况,频率还不是很低,这么一个背景,我非常容易怀疑到,两个消息同时近到这一个事务里面导致的,但是是偶发的,又模拟不出来什么场景会导致死锁,只能进行代码分析,问题还原的方式去排查问题。 业务代码简化成下面 begin update test set yn = 0 where dm_code = "3"; SELECT * from test where dm_code = '3' INSERT INTO demand_flow_followers (dm_code, erp ) values ('3', 'a') , ('3', 'b') , ('3', 'c') 也就是说先update ,select , insert 这么一个顺序 表中存在dm_code ,erp 唯一索引如果不存在索引 第一行update 会导致行锁升级为表锁,反而不会导致问题出现,但是并发太差 结论 先说结论: session1 session2 开启事务 update 开启事务 update insert insert出现死锁 重点: 无论哪个事务insert,两个事务必须都update 完成,只要满足这个条件,两个insert执行的时候就会报死锁 原因:我先按照自己的理解解释下: innodb的行锁,存在间隙锁,为啥要去有索引,如果没有索引,第一个update 就直接进行了表锁,这样导致另外一个事务无法进入,就只能进行等待了。 有索引的情况下: 两个事务都执行update,都拿到了[当前值,+∞) 的锁(记录锁+间隙锁),(update的时候,无数据命中) 第一个insert时,希望等待另外一个事务释放锁。第二个事务希望第一个事务释放锁,因此出现了死锁问题 相关知识梳理 InnoDB有三种行锁的算法: 1.Record Lock:是加在索引记录上的。 2.Gap Lock(间隙锁):对索引记录间的范围加锁,或者加在最后一个索引记录的前面或者后面 3.Next-Key Lock:前两种锁的结合,锁定一个范围,并且锁定记录本身,主要目的是解决幻读的问题。 间隙锁主要是防止幻象读,用在Repeated-Read(简称RR)隔离级别下。在Read-Commited(简称RC)下,一般没有间隙锁(有外键情况下例外,此处不考虑)。间隙锁还用于statement based replication 间隙锁有些副作用,如果要关闭,一是将会话隔离级别改到RC下,或者开启 innodb_locks_unsafe_for_binlog(默认是OFF)。 间隙锁(无论是S还是X)只会阻塞insert操作。 CREATE TABLE `test` ( `id` bigint(20) NOT NULL, `k` bigint(20) DEFAULT '0', PRIMARY KEY (`id`), KEY `idx_k` (`k`) ) ENGINE=InnoDB DEFAULT CHARSET=utf8 INSERT into test values(2,2),(5,5),(10,10) select @@global.tx_isolation, @@tx_isolation; RR隔离级别 delete from test where k=5; session2 insert into test (id,k) values (3,3) insert into test (id,k) values (4,4) insert into test (id,k) values (6,6) insert into test (id,k) values (7,7) insert into test (id,k) values (8,8) insert into test (id,k) values (9,9) 上面都报错:ERROR 1205 (HY000): Lock wait timeout exceeded; try restarting transaction 这个证明id (3,5)都被间隙锁锁住了 insert into test (id,k) values (1,1) insert into test (id,k) values (11,11) delete from test where id in (1,11) (3,5) 区间之外都可以执行insert,delete操作 可以看到,delete k=5的记录阻塞了k=3、4、5、6、7、8、9记录的插入操作,事实上,除了对于k=5这条记录上record lock之外,innoDB对于delete和update在辅助索引(非主键索引)上的条件时会对扫过的记录上间隙锁,为了防止幻读,会锁住k=5这条记录的前面一条记录(id=2,k=2)到后面一条记录(id=10,k=10)之间的区间,即锁住k在区间(2,10)的范围(如果没有后一条记录,一直锁到正无穷),至于在边界k=2及k=10上,由于索引内是按照主键排序的,不会锁住(id<2,k=2)但是会锁住(id>2,k=2),同理不会锁住(id>10,k=10)但是会锁住(id<10,k=10). insert into test (id,k) values (1,2) ok insert into test (id,k) values (11,2) no insert into test (id,k) values (11,9) no insert into test (id,k) values (11,10) ok insert into test (id,k) values (1,10) no insert into test (id,k) values (11,10) ok 由于索引内是按照主键排序的,不会锁住(id<2,k=2)但是会锁住(id>2,k=2),同理不会锁住(id>10,k=10)但是会锁住(id<10,k=10). 值得注意的是,delete和update在唯一索引(primary key/unique key)上更新存在的记录时只会上行级记录锁(record key),而在唯一索引上更新不存在的记录时同辅助索引一样会上间隙锁;在上例中,delete id=5只会在(id=5,k=5)这条记录上上X锁,而delete id=7却会锁住(id>5&&id<10)这个区间。 线上问题还原 session1 session2 begin begin update test set k = 20 where id = 20 update test set k = 20 where id = 20 INSERT into test values(25,25) | INSERT into test values(25,25) 重点: insert 之前两个回话都执行完update SQL 错误 [1213] [40001]: Deadlock found when trying to get lock; try restarting transaction 解决办法: 避免更新或者删除不存在的记录,虽然更新存在的记录也会产生间隙锁,但是间隙锁锁住的范围会更小; 更新不存在的记录会锁住意想不到的区间范围,极其容易导致死锁问题 这些仅仅是解决问题的一个小的技巧,不能从根本上解决问题,如果想从根本上解决就从代码级别上加锁,这样避免了这种问题,但是同时并发就小了,根据自己的实际情况进行定夺方案 作者:京东零售 吴法刚 来源:京东云开发者社区 转载请注明来源

优秀的个人博客,低调大师

Dubbo源码浅析(一)—RPC框架与Dubbo | 京东云技术团队

一、什么是RPC 1.1 RPC概念 RPC,Remote Procedure Call 即远程过程调用,与之相对的是本地服务调用,即LPC(Local Procedure Call)。本地服务调用比较常用,像我们应用内部程序**(注意此处是程序而不是方法,程序包含方法)**互相调用即为本地过程调用,而远程过程调用是指在本地调取远程过程进行使用。 而RPC框架就是为了帮助我们在本地调用远程过程时,就像调用本地过程一样方便。 1.2 RPC与Http的关系 用一句话来总结就是: RPC是一种概念,http是一种协议,可以认为http是Rpc的一种实现,或者Rpc包含了http。为什么说包含而不是相等,是因为Rpc还有很多基于自定义的Tcp的协议,例如Dubbo等,而我们常说的rpc即指的除Http之外的基于tcp自定义的协议。 1.3 关于Rpc的思考 网上关于Rpc与Http的相关文章并不少,很多人在解释RPC概念时会提到其是执行远程的方法,然后直接得出rpc包含http的结论。其实如果按照此概念去思考的话,其实并不能得出Http是Rpc的一种实现。因为http调用的方式,从使用者的角度来说,并不是直接调用其方法,而是按照一定的方式,完善出了一条http请求,然后交由本地客户端进行数据传输。 而相对比的,如果用过相关Rpc框架,例如Dubbo,是可以像调用本地方法一样直接调用远程方法。而http的调用方式可以认为是一种服务调用,而不是一种方法。 感觉文章博主应该是有过rpc相关的使用经验,有点先入为主了。那么到底rpc与http的关系如何呢,我也思考了很久,后面发现应该从定义上入手,我们既然在讨论Rpc是什么,怎么能忽略最简单的定义呢。 Remote Procedure Call,其中"Procedure"按照谷歌翻译有以下几种解释:程序、过程、步骤,并不是方法(Method)。而程序是包含方法的,同时也包含服务。因此上文中才强调了是一种程序或过程,而不是方法。 1.4 Rpc框架 Rpc框架是为了帮助我们在本地服务调用远程服务时像调用本地服务一样简单,我们不需要关心其底层实现,只需要配置好相应的信息,rpc框架就会帮我们做这些事。例如在dubbo中,我们只需要配置好相应的注册中心与想要调用的方法,我们就可以按照本地调用的方式调用远程服务。 1.5 总结 按照我们上文的梳理过程,可以认为Rpc是一种概念,主要有两种实现,一种是以http方式的服务调用,另一种是以自定义Tcp协议实现的方法调用方式,例如dubbo协议,当然一般rpc框架也都支持http协议。当然,无论是那种方式,最终都是以Tcp/Udp的方式进行传输。 二、Rpc框架 2.1 dubbo是什么 我们上文说到Rpc框架就是帮助我们在调用远程服务时像调用本地服务一样简单,dubbo就是由阿里巴巴开源的一块rpc框架。 例如,在我们想调用某个远程方法时,只需要配置好相关配置,然后直接调用即可,dubbo会帮助我们将处理中间的过程。 /* 省略相关配置 */ //将配置注册到spring @Resource private QueryPinService queryPinService; //直接使用远程方法,像调用本地服务一样简单 ueryPinService.getPinWithConfig(paramMap, null); dubbo整体架构图如下: 节点 说明 Provider 提供远程服务的服务提供方 Registry 注册中心 Consumer 需要调用远程服务的服务消费方 Container 服务运行的容器 Monitor 监控中心 作用流程大致如下: 首先服务提供者Provider 启动然后向注册中心注册自己所能提供的服务。 服务消费者Consumer 启动向注册中心订阅自己所需的服务。然后注册中心将提供者元信息通知给 Consumer, 之后 Consumer 因为已经从注册中心获取提供者的地址,因此可以通过负载均衡选择一个 Provider 直接调用。 之后服务提供方元数据变更的话注册中心会把变更推送给服务消费者。 服务提供者和消费者都会在内存中记录着调用的次数和时间,然后定时的发送统计数据到监控中心。 2.2 dubbo和spring cloud的区别 首先两者都是当前主流的微服务框架,不过两者也存在很多差异: 初始定位不同:SpringCloud定位为微服务架构下的一站式解决方案,主要有网关、注册中心、配置中心、监控中心等;Dubbo 是 它的关注点主要在于服务的调用和治理,其中服务调用更时其核心。 生态环境不同:SpringCloud依托于Spring平台,具备更加完善的生态体系;而Dubbo一开始只是做RPC远程调用,生态相对匮乏,现在逐渐丰富起来。 调用方式:SpringCloud是采用Http协议做远程调用,接口一般是Rest风格,比较灵活;Dubbo是采用Dubbo协议,接口一般是Java的Service接口,格式固定。但调用时采用Netty的NIO方式,性能较好。 两者组件配置: 很明显SpringCloud拥有比dubbo更完善的配置,支持的功能性也更强。 相比来说,SpringCloud像一台品牌机,内部所有配置都已经帮我们装配好了,我们只需要开箱即用即可。而dubbo则更像是组装机,需要我们自己选择配置,只提供了核心的计算能力,而显示器、电源等需要我们自己装配调试使用。 从使用者来说,新手小白更适合品牌机,傻瓜式一键操作,就能完成我们想要的效果。而dubbo更适合电脑高手,自己装配自己想要的组件,使用起来更顺手。 作者:京东科技 韩国凯 来源:京东云开发者社区 转载请注明来源

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册