首页 文章 精选 留言 我的

精选列表

搜索[热点技术征文第8期最强语言],共10000篇文章
优秀的个人博客,低调大师

竞速榜实时离线对数方案演进介绍 | 京东云技术团队

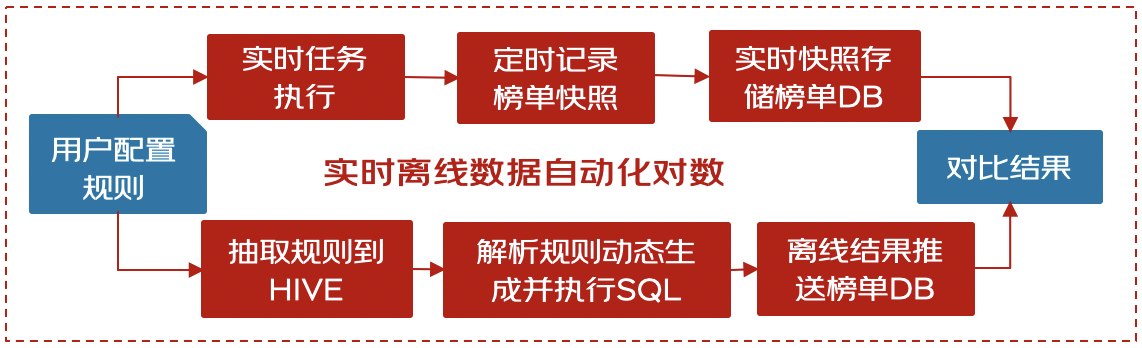
一、背景 竞速榜是大促期间各采销群提供的基于京东实时销售数据的排行榜,同样应对大促流量洪峰场景,通过榜单撬动品牌在京东增加资源投入。竞速榜基于用户配置规则进行实时数据计算,榜单排名在大促期间实时变化,相关排名数据在微博、朋友圈广泛传播,相关计算以及排名的准确性至关重要。 竞速榜的每个榜单配置规则都会有差异,为保障榜单数据计算准确,需要在大促开始前对榜单实时排名数据进行核对,主要验证方案为在第二天取前一天的实时排名数据,另外根据榜单规则配置信息,计算相关的离线数据,进行实时离线数据对比,验证数据的一致性。 单个榜单规则有20+个不同配置项,每个配置都相互独立,需要针对每个规则分别进行数据验证 二、对数方案演进过程 2.1、纯人工 - 成本高且无法完整覆盖 最初阶段为纯人工对数,分别获取对应竞速榜的实时和离线数据,进行人工比对 1)实时数据:每天23:59 定时读取榜单数据接口,记录对应榜单数据 2)离线数据:根据榜单规则手动编写离线SQL脚本,通过数据查询执行SQL获取榜单排名数据 整个操作过程消耗时间较长,SQL编写需要1小时,单SQL执行0.5小时,为覆盖所有规则,一次需要完成100多个规则的配置和SQL编写以及数据验证,在规则不变情况下,预计需要消耗20人日才能完成一次完整测试, 且脚本编写需要对业务规则深入了解,对测试人员SQL水平要求也较高。 2.2、半自动化 - 持续消耗人力 竞速榜主要在大促期间使用,除功能测试覆盖规则外,在大促前还要对业务方配置的规则进行数据验证,确保用户配置规则的计算准确性,以23年618为例,共有5000+榜单规则,如果仍然使用纯人工验证数据的方案,需要900+天,完全不可行。因此实现了半自动化对数方案,和人工对数方案相比,解决了离线SQL的自动化生成,实时数据的自动获取等问题。 具体方案如下: 1、实时数据获取:基于榜单快照功能,自动记录榜单每日快照数据并写入数据库, 2、离线SQL生成和数据计算: 2.1、规则配置入库:通过系统自带的榜单规则导出功能,将榜单规则导出到excel,进而导入到hive表中;同时将榜单规则依赖的其他配置数据也导入到hive 2.2、规则化生成SQL:根据榜单规则配置信息,使用case when的方法,针对不同情况分别生成对应SQL片段,最后人工组合为上述SQL 2.3、合并SQL执行计算任务:将多个组合生成的SQL合并为1个,并配置离线调度任务,通过任务执行分别计算不同榜单的离线数据 2.4、数据推送到对数MySQL:将生成的离线榜单数据推送到实时数据存储的MySQL 3、实时离线数据对比:将实时和离线数据全部推送入数据库后,直接查询数据库,进行数据对比,并对超过阈值的数据进行高亮提示。 通过以上方法,完成了半自动化的实时离线对数,解决了人工对数中最消耗人力的SQL手动编写问题。但是,该方案仍然存在以下问题: 1. SQL需要人工介入:SQL的生成还存在多次人工操作,中间需要人工对生成的SQL进行调整 2. 规则变化引发SQL调整:在大促前,用户会持续调整规则,这样就导致之前配置好的SQL 和用户规则不一致,进而导致对应榜单对数失败,需要重新生成对应SQL,配置调度任务并重新执行对数操作。 在22年618和双11期间,主要是研发同学使用进行相关SQL调整和数据验证,需要3个开发人员持续3周,整体消耗人力45人日。 2.3、全自动化 - 解放人力 为了进一步解放人力消耗,将对数操作从半自动化升级到全自动化,需要实现以下内容 1. 无需人工介入,自动生成SQL,自动执行SQL 2. 执行用的SQL根据规则变化每日自动调整,保证SQL可以自动持续更新 完整的自动化对数方案如下图所示:  优化点细节: 1. 每天自动更新并存储SQL:榜单规则从手动页面导出变为每天自动抽取规则数据到HIVE中,进而每天自动更新目标SQL并将SQL存储到HIVE表中 2. 自动获取目标SQL并执行:将执行的目标SQL从HIVE中获取到后再执行SQL(使用了hive命令的一些特殊方法,预先获取到SQL再执行) #HiveTask增加run_shell_cmd_out函数只返回标准流的内容在标准客户端执行如下python脚本 from HiveTask import HiveTask ht = HiveTask() ht.run_shell_cmd_out(shellcmd='hive -e "select * from table;"') 该方案在23年618期间投入使用,恰逢研发团队交接,新团队毫无对数经验,且有其他业务同步进行,无法投入全量人力。通过全自动化对数,解放了研发人力投入,极大提高了大促备战效率。需要人力主要是测试同学对整个链路的调度任务进行维护性处理。 作者:京东零售王恒蕾、戚琪 来源:京东云开发者社区

优秀的个人博客,低调大师

Apache Pulsar 技术系列 - GEO replication 中订阅状态的同步原理

导语 Apache Pulsar 是一个多租户、高性能的服务间消息传输解决方案,支持多租户、低延时、读写分离、跨地域复制(GEO Replication)、快速扩容、灵活容错等特性,GEO Replication 可以原生支持数据和订阅状态在多个集群之间进行复制,GEO 目前在 Apache InLong 内部已经有长期稳定的实践,本文主要讲述 GEO 中的订阅状态的同步。 GEO 简介 GEO Replication 提供了数据在多个集群之间进行复制的能力。 上图描述了三个集群,并且集群之间配置了不同的 GEO Replication 策略,其中 Cluster-A 和 Cluster-B 是双向复制,两个集群中的 Topic 数据都会复制到对端集群,即集群 A 的数据会被复制到集群 B,集群 B 的数据也会被复制到集群 A,A、B 两个集群都有对方的全部数据; Cluster-A 和 Cluster-C 是单向复制:A 集群的数据会被复制到 C 集群,C 集群的数据不会被复制到 A 集群; Cluster-B 和 Cluster-C 没有复制关系:集群 B 和 C 之间不会产生任何数据复制。 上述描述数据同步/复制的一个典型的场景,GEO Replication 中的另外一个场景就是订阅状态同步。 订阅状态同步的场景 订阅同步的一个典型的应用常见是集群容灾,正常情况下只有主集群提供写入和消费服务,主集群故障之后,生产和消费会切换到备集群。 生产的切换是无缝的,切换集群之后可以继续写入;消费比生产会复杂一些,如果只同步数据,在集群切换之后,备集群的订阅会重复消费历史数据,为了解决这个问题,就需要在两个集群之间同步订阅的状态,目前订阅同步的主要信息就是订阅的 MarkDeletePosition(MDP) 信息。 如上图:在主、备两个集群之间,每个 Topic(分区)的 Ledger 并不是一一对应的,比如在主集群中,订阅 sub-00 消费到了一条消息,这个消息所在的 Ledger 是 Ledger-x;经过复制之后,在备集群中这条消息对应的 Ledger 是 Ledger-y,这里 Ledger-x 和 Ledger-y 没有直接关系,所以订阅状态(MDP)不能简单的直接映射。 GEO 订阅状态同步原理 订阅状态的同步,大体上可以分为两个主要的步骤: 第一步是实现两个集群之间 MessageId(可以理解为 Offset 信息)的映射,即在主集群的一条消息的 MessageId 复制到备集群之后的 MessageId; 第二步是在主集群中一个订阅 ack 数据时,如果有 (MDP) 的变动,根据第一步中的主、备集群 MessageId 的映射关系,将主集群的 MDP 信息映射到备集群订阅的 MDP 中。 下面我们来详细看下整个流程。 MessageId 映射 MessageId 映射最直观的方法,就是维护主、备集群中每个 Message 的映射关系,但是这种方案的需要维护的映射关系太多,代价太大。 Pulsar 采用的方式是一个定时任务的方式,每隔一段时间同步一次主、备集群 LAC 信息之间的关系。假设集群 A 向集群 B 复制数据和订阅状态信息。 首先,集群 A 会定时生产一个 SnapshotRequest 信息,写入到本地 Topic(分区)中,这个信息会随着数据复制写入到集群 B 的 Topic 中。 B 集群会处理 SnapshotRequest 信息,然后将本地 Topic(分区)的 LAC(LAC-B) 信息封装在 SnapshotRespnse 中,写入到本地 Topic 中,通过 GEO Replciation 复制到 A 集群。 集群 A 在处理 SnapshotRespnse 时,记录 SnapshotRespnse 在本地的 MessageId(LocalMessageId) 和 LAC-B 的映射关系,由于 A -> SnapshotRequest -> B -> SnapshotRespnse -> A 的操作顺序,可以保证集群 A 订阅的 MDP 大于 LocalMessageId 时,LAC-B 对应的数据一定是被消费过的,通过这种方式实现了两个集群之间 MessageId 的映射关系。 订阅信息同步 集群 A 中的订阅会不断消费、Ack,当 Ack 触发了 MDP 的移动时,集群 A 会检查 LocalMessageId 是否小于 MDP,如果发现小于,说明需要更新集群 B 订阅的 MDP 信息,此时集群 A 会根据映射关系,找到 LAC-B 信息,然后构造一个 ReplicatedSubscriptionsUpdate 消息,写入到本地 Topic,这个 ReplicatedSubscriptionsUpdate 消息会通过 GEO 复制到集群 B。 集群 B 接收到 ReplicatedSubscriptionsUpdate 消息之后,会解析出 LAC 和订阅信息,然后更新订阅的 MDP。 至此,就完成了订阅状态的一次复制流程。 总结与思考 Pulsar 的订阅状态复制,依赖于原生的 GEO Replication 机制,并且需要主备集群之间双向的交互,所以对于单向复制的 GEO 集群,订阅状态是不能实现订阅状态同步的。 另外,当前的订阅状态同步,只考虑了 MDP 信息,实际上对于一个订阅(尤其是 Shared 和 Key-Shared 类型的订阅),订阅的 IndividuallyDeletedMessages 信息也是很重要的,尤其是在有大量 Consumer 都使用 Individual Ack 的场景,如果不同步 IndividuallyDeletedMessages 信息,就会导致数据的重复。 由于 IndiviindividuallyDeletedMessages 记录的是每个 message 的 Ack 情况,所以要解决这个问题就需要: 记录主、备集群每个 MessageId 的映射关系,比如在复制消息属性中记录原始消息的 MessageId 信息。 复制 IndiviindividuallyDeletedMessages 到 备集群。 备集群的订阅在消费数据时,根据主、备 集群的 MessageId 映射关系以及主集群复制过来的 IndiviindividuallyDeletedMessages,就可以判定这条消息是否已经被 Ack,如果 Ack 则不推送给 Consumer,这样就可以实现切换集群订阅时数据不重复。

优秀的个人博客,低调大师

聊聊Spring注解@Transactional失效的那些事 | 京东云技术团队

一、前言 emm,又又又踩坑啦。这次的需求主要是对逾期计算的需求任务进行优化,现有的计算任务运行时间太长了。简单描述下此次的问题:在项目中进行多个数据库执行操作时,我们期望的是将其整个封装成一个事务,要么全部成功,或者全部失败,然而在自测异常场景时发现,里面涉及的第一个数据状态更新成功了,但是后面的数据在插入出现异常,后面查询数据表发现,该数据的状态已经被更新成功啦。 emmm,查看代码发现确实是使用了@Transactional注解没问啊。于是通过查询网上相关资料发现,在使用Spring中事务注解@Transactional时会存在几种场景下该注解失效,即不能按照预期封装成一个事务操作,于是对该注解进行学习并对相关失效场景进行分析,整理文章如下; 二、@Transactional注解失效场景实例验证 1、@Transactional注解属性 属性 类型 描述 value String 可选的限定描述符,指定使用的事务管理器 propagation Enum:Propagation· 可选的事务传播行为设置 isolation Enum:Isolation 可选的事务隔离级别设置 readOnly boolean 读写或只读事务,默认读写 timeout int 事务超时时间设置 rollbackFor Class对象数组,必须继承自Throwable 导致事务回滚的异常类数组 rollbackForClassName 类名数组,必须继承自Throwable 导致事务回滚的异常类名字数组 noRollbackFor Class对象数组,必须继承自Throwable 不会导致事务回滚的异常类数组 noRollbackForClassName 类名数组,必须继承自Throwable 不会导致事务回滚的异常类名字数组 2、 propagation属性 propagation代表事务的传播行为,默认值为Propagation.REQUIRED 属性 描述 Propagation.REQUIRED 若当前存在事务则加入该事务,若不存在则创建一个新事务(默认) Propagation.SUPPORTS 若当前存在事务则加入该事务,若不存在则以非事务的方式继续进行 Propagation.MANDATORY 若当前存在事务则加入该事务,若不存在则抛出异常 Propagation.REQUIRES_NEW 重新创建一个新的事务,若当前存在事务则暂定当前事务 Propagation.NOT_SUPPORTED 以非事务的方式运行,若当前存在事务则暂定当前事务 Propagation.NEVER 以非事务的方式运行,若当前存在事务则抛出异常 Propagation.NESTED 与Propagation.REQUIRED效果一样 3、 @Transactional注解使用场景? @Transactional注解可以作用在接口、类、类方法中。 当作用于类时,表示所有该类的public方法都配置相同的事务属性信息。 当作用于方法时,当类配置了@Transactional注解,方法也配置了@Transactional,方法的事务会覆盖类的事务配置信息。 当作用于接口时,不推荐使用,因为在接口使用@Transactional并且配置了Spring AOP使用CGLib动态代理将会导致其失效。 4、 @Transactional注解失效场景? @Transactional注解作用在非public修饰的方法上,会失效。 失效原因:在Spring AOP代理时,TransactionInterceptor(事务拦截器)在目标方法执行前后进行拦截,DynamicAdvisedInterceptor(CglibAopProxy的内部类)的Intercept方法或JDKDynamicAopProxy的invoke方法会间接调用AbstractFallbackTransationAttributeSource的computeTransactionAttribute方法,获取@Transactional注解的事务配置信息。 1 protected TransactionAttribute computeTransactionAttribute(Method method, 2 Class<?> targetClass) { 3 // Don't allow no-public methods as required. 4 if (allowPublicMethodsOnly() && !Modifier.isPublic(method.getModifiers())) { 5 return null; 6 } 此方法会检查目标方法的修饰符是否为public,非public作用域则不会获取@transactional的属性配置信息。其中protected、private修饰的方法上使用 @Transactional注解,事务会失效但不会有任何报错。 @Transactional注解属性propagation设置错误导致注解失效 失效原因:配置错误, PROPAGATION_SUPPORTS、PROPAGATION_NOT_SUPPORTED、PROPAGATION_NEVER三种事务传播方式不会发生回滚。 ▪ 实例验证:写了一个demo进行测试。demo主要功能如下:执行两次数据库插入操作,并在扩展信息字段中添加备注; ▪ 运行结果如下,构造的单号不存在订单查询为空触发异常,观察数据库发现,第一次数据库插入操作已经执行成功,故而验证@Transactional注解失效; @Transactional注解属性rollbackFor设置错误导致注解失效 rollbackFor可以指定能够触发事务回滚的异常类型。Spring默认抛出了unchecked异常(继承自RuntimeException)或者Error才会回滚事务。若事务中抛出了其他类型的异常,但却期望Spring能够回滚事务,就需要指定rollbackFor属性,否则就会失效。 同一类中方法调用,导致@Transactional失效 比如类demo中有方法A和B,方法B中使用@Transactional注解,方法A没有注解,但是demo类通过方法A调用方法B,像这种间接调用会导致方法B中的@Transactional事务注解失效。 失效原因:只有当事务方法被当前类以外的代码调用时,才会有Spring生成的代理对象管理。(Spring AOP代理机制造成的)。 ▪ 实例验证:demo中构造场景为在同一个类中,在test方法中添加@Transactional注解,querRiskScore方法中不添加该注解,然后在querRiskScore方法中调用test方法;观察下多个插入操作是否会因为异常而中断回滚; ▪ 运行结果如下,还是通过构造的单号不存在订单查询为空触发异常,观察数据库发现,第一次数据库插入操作已经执行成功,第二次数据插入操作失败,并没有因为异常而触发事务操作,故而验证@Transactional注解方法间的调用会失效; 多线程任务可能导致@Transaction案例失效 失效原因:线程不属于Spring托管,故线程不能够默认使用Spring的事务,也不能获取Spring注入的bean,在被Spring声明式事务管理的方法内开启多线程,多线程内的方法不被事务控制。 异常被方法内catch捕获导致@Transactional失效 比如B方法内部抛了异常,而A方法此时try-catch了B方法的异常,则该事务不能正常回滚。 失效原因:因为B方法中抛出异常以后,标识当前事务需要rollback,但是A方法中由于你手动的捕获这个异常并进行处理,A方法认为当前事务应该正常commit,此时就出现前后不一致,会抛出org.springframework.transaction.UnexpectedRollbackException: Transaction rolled back because it has been marked as rollback-only异常。 ▪ 实例验证:这个场景的本质还是异常被捕获导致无法正常的抛出,进而导致@Transactional注解无法正常工作,我简化了下demo实例场景,构造场景如下:在querRiskScore方法中添加@Transactional注解,然后在querRiskScore方法中对异常进行捕获;观察下多个插入操作是否会因为异常而中断回滚; ▪ 运行结果如下,还是通过构造的单号不存在订单查询为空触发异常,但是我们在方法内部对该异常进行捕获,并未向上层抛出,我们期望的场景是两次数据插入执行失败,但是观察数据库发现,第一次数据库插入操作已经执行成功,第二次数据插入执行成功,与我们的预期结果不符,故而验证@Transactional注解在方法中异常被捕获的场景中会失效; 究其原因:Spring的事务是在调用业务方法之前开始的,业务方法执行完毕之后才执行commit 或 rollback,事务是否执行取决于是否抛出runtime异常,如果抛出runtime exception并在你的业务方法中并没有catch到的话,事务就会回滚。 三、“事务”知识回顾 1.什么是事务? 事务(Transaction)是由一系列对系统中数据进行访问与更新的操作组成的一个程序执行逻辑单元(Unit)。 通常我们所指的事务是指数据库事务,使用数据库事务有以下两处优点: 当多个应用程序并发访问数据库时,事务可以在这些应用程序之间提供一个隔离方法,以防止彼此的操作互相干扰。 事务为数据库操作序列提供了一个从失败恢复到正常状态的方法,同时提供了数据库即使在异常状态下仍能保持数据一致性的方法。 2. 事务具有的特性? 原子性(Atomicity)、一致性(Consistency)、隔离性(Isolation)和持久性,简称事务的ACID特性。 原子性 事务的原子性是指事务必须是一个原子的操作序列单元,即事务中包含的各项操作在一次执行过程中只会出现两种状态:全部成功执行、全部不执行。任何一项操作失败都将导致整个事务失败,同时其他已经被执行的操作都将被撤销并回滚,只打所有的操作全部成功,整个事务才算是成功完成。 一致性 事务的一致性是指事务的执行不能破坏数据库数据的完整性和一致性,一个事务在执行之前和执行之后,数据库都必须处于一致性状态。也就是说,事务执行的结果必须是使数据库从一个一致性状态转变到另一个一致性状态,因此当数据库只包含成功事务提交 的结果时,就能说数据库处于一致性状态。而如果数据库系统在运行过程中发生故障, 有些事务尚未完成就被迫中断,这些未完成的事务对数据库所做的修改有一部分已写入物理数据库,这时数据库就处于一种不正确的状态,或者说是不一致的状态。 隔离性 事务的隔离性是指在并发环境中,并发的事务是相互隔离的,一个事务的执行不能被其他事务干扰。也就是说,不同的事务并发操纵相同的数据时,每个事务都有各自完整的数据空间,即一个事务内部的操作及使用的数据对其他并发事务是隔离的,并发执行的 各个事务之间不能互相干扰。 持久性 事务一旦提交,其所做的修改就会永久保存到数据库中,即使数据库发生故障也不应该对其有任何影响。需要注意的是,事务的持久性不能做到100%的持久,只能从事务本身的角度来保证永久性,而一些外部原因导致数据库发生故障,如硬盘损坏,那么所有提交的数据可能都会丢失。 3. 什么是Spring中的事务? Spring中同样提供了很好的事务管理机制,主要分为编程式事务和声明式事务。 编程式事务 是指在代码中手动的管理事务的提交、回滚等操作,代码侵入性比较强。编程式事务方式需要开发者在代码中手动的管理事务的开启、提交、回滚等操作。 public void test() { TransactionDefinition def = new DefaultTransactionDefinition(); TransactionStatus status = transactionManager.getTransaction(def); try { // 事务操作 // 事务提交 transactionManager.commit(status); } catch (DataAccessException e) { // 事务提交 transactionManager.rollback(status); throw e; } } 声明式事务 声明式事务是基于AOP面向切面,它将具体业务和事务处理部分解耦,代码侵入性很低,实际开发中比较常用。我们常用TX和AOP的xml配置文件方式和@Transactional注解方式。 ▪声明式事务的优点: 对代码无侵入性,方法内只需要写业务逻辑,节省很多代码量。 ▪声明式事务的缺点: 1、声明式事务粒度问题:声明式事务的局限就是最小粒度要作用在方法上,且不适合耗时长、高并发场景。 2、声明式事务容易被开发者忽略,当事务嵌套的方法中存在RPC远程调用、MQ发送、Redis更行、文件写入等操作可能存在以下场景: ▪ 事务嵌套的方法中RPC调用成功了,但是本地事务回滚导致RPC调用无法回滚(暂不讨论分布式事务)。 ▪事务嵌套的方法中远程调用会拉长整个事务周期,导致事务的数据库连接一致被占用,类似操作过多会导致数据库连接池耗尽。 3、声明式事务使用错误会导致在某些场景下失效。 四、总结 作者:京东科技 宋慧超 来源:京东云开发者社区

优秀的个人博客,低调大师

聊一聊Java中的Steam流 | 京东物流技术团队

1 引言 在我们的日常编程任务中,对于集合的制造和处理是必不可少的。当我们需要对于集合进行分组或查找的操作时,需要用迭代器对于集合进行操作,而当我们需要处理的数据量很大的时候,为了提高性能,就需要使用到并行处理,这样的处理方式是很复杂的。流可以帮助开发者节约宝贵的时间,让以上的事情变得轻松。 2 流简介 流到底是什么呢?简要的定义为“从支持数据处理操作的源生成的元素序列”,接下来对于这个定义进行简要分析。 2.1 支持数据处理操作 流的数据处理操作和数据库的可以声明式的指定分组或查找等功能支持类似,和函数式编程的思想一致,如filter、map、reduce、find、match、sort等操作,这些流操作可以串行执行,也可以并行执行。 2.2 源 流会使用一个提供数据的源,可以通过三种方式来创建对象流,一种是由集合对象创建流: List<Integer> list = Arrays.asList(111,222,333); Stream<Integer> stream = list.stream(); 一种是由数组创建流: IntStream stream = Arrays.stream(new int(){111,222,333}); 一种是由静态方法Stream.of()创建流,底层还是Arrays.stream(): Stream<Integer> stream = Stream.of(111, 222, 333); Stream stream = Stream.of(111, 222, 333); 从有序集合生成流时会保留原有的顺序。由列表生成的流,其元素顺序与列表一致。 还有两种特殊的流: 空流:Stream.empty() 无限流:Stream.genarate() 2.3 元素序列 流也可以和集合一样访问包含特定的元素类型的一组有序值,但是它们的主要目的不一样,集合的主要目的是在于存储和访问元素,流的主要目的在于表达计算。 3 流的思想 流式思想和生产中的流水线具有异曲同工之妙,很多流模型都会返回一个流,这些模型都只负责它所需要做的事情,并不需要格外的内存空间来存储处理的结果。这些流模型可以被链接起来形成一个大的流水线,我们在这个过程中不关注中间步骤的数据被如何处理,只需要使用整个流水线处理后的结果。接下来的代码可以体现这种思想,代码中以商品为例,我们要筛选出商品中体积大于200的前两个商品的名字。 首先是商品类的定义: public class Goods { private final String Name; private final Integer Volume; public Goods(String name, Integer volume) { Name = name; Volume = volume; } public String getName() { return Name; } public Integer getVolume() { return Volume; } } 接下来是商品集合的定义: List<Goods> goods = Arrays.asList(new Goods("土豆",10), new Goods("冰箱",900),new Goods("办公椅",300)); 接下来获取我们想要的结果: List<String> twofoods = goods.stream()//获取流 .filter(goods1 -> goods1.getVolume()>200)//筛选商品体积大于200的 .map(Goods::getName)//获取商品名称 .limit(2)//筛选头两个商品 .collect(Collectors.toList());//将结果保存在list中 这样看来,通过流来处理我们的特定需求,是不是比使用集合的迭代要方便很多呢? 4 流处理的特性 不存储数据 不会改变数据源 只可被使用一次 这里我们使用一个测试类StreamCharacteristic来验证流处理的以上特性: import org.springframework.util.Assert; import java.util.Arrays; import java.util.List; import java.util.stream.Collectors; import java.util.stream.Stream; public class StreamCharacteristic { public void test1(){ List<Integer> list = Arrays.asList(1,2,2,5,6,9); list.stream().distinct(); System.out.println(list.size()); } public void test2(){ List<String> list = Arrays.asList("wms", "KA", "5.0"); Stream<String> stream = list.stream(); stream.forEach(System.out::println); stream.forEach(System.out::println); } } test1()中的结果为6,尽管我们对于list对象所生成的Stream流做了去重操作distinct(),但是不影响数据源list。 test2()中调用了两次 stream.forEach方法来打印每一个单词,第二次调用时,抛出了一个“java.lang.IllegalStateException”异常:“stream has already been operated upon or closed”。这说明流不存储数据,遍历完后这个流已经被消费掉了,而且流不可以重复使用。 5 流操作与流的使用 将所有的流操作连接起来可以组合成一个管道,管道有两类操作:中间操作和终端操作。 StreamAPI常用的中间操作有:filter,map,limit,sorted,distinct。 StreamAPI常用的终端操作有:forEach,count,collect。 在使用流的时候,主要需要三个要素:一个用来执行查询的数据源,用来形成一条流的流水线的中间操作链,一个能够执行流水线并能生成结果的终端操作。 下图展示了流的整个操作流程: 6 总结 流是从支持数据处理操作的源生成的元素序列 流的思想类似于生产中的流水线 流不存储数据,不改变数据源,只能被改变一次 流的操作主要分为中间操作和终端操作两大类 作者:京东物流 王辰玮 来源:京东云开发者社区 自猿其说Tech

优秀的个人博客,低调大师

分布式事务的几种实现方式 | 京东云技术团队

基础理论 CAP理论 一致性(Consistency) :在分布式系统中所有的数据备份,在同一时刻都保持一致状态,如无法保证状态一致,直接返回错误; 可用性(Availability):在集群中一部分节点故障,也能保证客户端访问系统并得到正确响应,允许一定时间内数据状态不一致; 分区容错性(Partition tolerance):分布式系统在遇到任何网络分区故障时,仍然能保证对外提供满足一致性和可用性的服务,除非整个网络环境都发生故障; 本地事务四大特性(ACID) 事务应该是具备原子性、一致性、隔离性和持久性,简称 ACID。 原子性(Atomicity) ,可以理解为一个事务内的所有操作要么都执行,要么都不执行。 一致性(Consistency) ,可以理解为数据是满足完整性约束的,也就是不会存在中间状态的数据,事务前后数据的完整性必须保持一致。。 隔离性(Isolation) ,指的是多个事务并发执行的时候不会互相干扰,即一个事务内部的数据对于其他事务来说是隔离的。 持久性(Durability) ,指的是一个事务完成了之后数据就被永远保存下来,之后的其他操作或故障都不会对事务的结果产生影响。 BASE理论 基本可用(Basically Available):分布式系统在出现故障时,保证核心可用,允许损失部分可用性。(响应时间上的损失、功能上的损失) 软状态(Soft State):系统中的数据允许存在中间状态,中间状态不影响系统的整体可用性。(支付中、处理中等) 最终一致性(Eventually Consistent):系统中的数据不可一直处于软状态,必须在有时间期限,在期限过后应当保证数据的一致性。(支付中变为支付成功) 相比于本地事务的ADIC强一致性模型,BASE理论提出通过牺牲一定的强一致性来获得可用性; 不同业务单元和业务组件对数据一致性的要求不一样,因此分布式系统中BASE理论和ACID特性会结合使用。 幂等性设计 幂等(Idempotent)是一个数学与计算机学中的概念。f(n) = 1^n , 无论n等于多少,f(n)永远值等于1; 在程序中,使用相同参数执行同一个方法,每一次执行结果都是相同的,即具有幂等性; 以订单状态处理为例的幂等性设计,不论执行多少次orderProcess()方法,都只会扣减一次库存,并且返回true。 分布式事务分类 二段提交2PC(Two-Phase-Commit)|三段提交3PC (Three-Phase-Commit) 三阶段提交引入两个机制 1、 引入超时机制。同时在协调者和参与者中都引入超时机制。 2、在第一阶段和第二阶段中插入一个准备阶段。保证了在最后提交阶段之前各参与节点的状态是一致的。 主要解决的问题: 避免了参与者在长时间无法与协调者节点通讯(协调者挂掉了)的情况下,无法释放资源的问题,因为参与者自身拥有超时机制会在超时后,自动进行本地commit从而进行释放资源。而这种机制也侧面降低了整个事务的阻塞时间和范围。 缺点: 性能较差,会存在长时间的锁表。 补偿事务-TCC(Try-Confirm-Cancel)|Saga TCC 与Saga其实就是采用的补偿机制,其核心思想是:针对每个操作,都要注册一个与其对应的确认和补偿(撤销)操作。确认和补偿都有采用幂等性设计。 缺点:代码量大,可维护性差。 消息事务 消息一致性方案是通过消息中间件保证上、下游应用数据操作的一致性。基本思路是将本地操作和发送消息放在一个事务中,保证本地操作和消息发送要么两者都成功或者都失败。下游应用向消息系统订阅该消息,收到消息后执行相应操作。 消息方案从本质上讲是将分布式事务转换为两个本地事务,然后依靠下游业务的重试机制达到最终一致性。 代表产品:RocketMQ 分布式事务产品框架 京东jdts 服务通过lb连到集群中任何一个节点均能保证业务正确执行,某一个节点异常时集群可正常提供服务,同时支持集群横向、纵向扩展。 Seata 一款开源的分布式事务解决方案,致力于提供高性能和简单易用的分布式事务服务。Seata 将为用户提供了 AT、TCC、SAGA 和 XA 事务模式,为用户打造一站式的分布式解决方案。 全局事务服务GTS 用于实现分布式环境下,特别是微服务架构下的高性能事务一致性。可以与RDS、MySQL、PostgreSQL等数据源,Spring Cloud、Dubbo、HSF及其他RPC框架,MQ消息队列等中间件产品配合使用,轻松实现分布式数据库事务、多库事务、消息事务、服务链路级事务及各种组合。 作者:京东零售 谷伟 来源:京东云开发者社区

优秀的个人博客,低调大师

一种接口依赖关系分层方案 | 京东云技术团队

1、背景 到店商详迭代过程中,需要提供的对外能力越来越多,如预约日历、附近门店、为你推荐等。这其中不可避免会出现多个上层能力依赖同一个底层接口的场景。最初采用的方案是对外API入口进来后获取对应的能力,并发调用多项能力,由能力层调用对应的数据链路,进行业务处理。然而,随着接入功能的增多,这种情况导致了底层数据服务的重复调用,如商品配置信息,在一次API调用过程中重复调了3次,当流量增大或能力项愈多时,对底层服务的压力会成倍增加。 正值618大促,各方接口的调用都会大幅度增加。通过梳理接口依赖关系来减少重复调用,对本系统而言,降低了调用数据接口时的线程占用次数,可以有效降级CPU。对调用方来说,减少了调用次数,可减少调用方的资源消耗,保障底层服务的稳定性。 原始调用方式: 2、优化 基于上述问题,采用底层接口依赖分层调用的方案。梳理接口依赖关系,逐层向上调用,注入数据,如此将同一接口的调用抽取到某层,仅调用一次,即可在整条链路使用。 改进调用方式: 只要分层后即可在每层采用多线程并发的方式调用,因为同一层级中的接口无先后依赖关系。 3、如何分层? 接下来,如何梳理接口层级关系就至关重要。 接口梳理分层流程如下: 第一步:构建层级结构 首先获取到能力层依赖项并遍历,然后调用生成数据节点方法。方法流程如下:构建当前节点,检测循环依赖(存在循环依赖会导致栈溢出),获取并遍历节点依赖项,递归生成子节点,存放子节点。 第二步:节点平铺 定义Map维护平铺结构,调用平铺方法。方法流程如下:遍历层级结构,判断当前节点是否已存在map中,存在时与原节点比较将层级大的节点放入(去除重复项),不存在时直接放入即可。然后处理子节点,递归调用平铺方法,处理所有节点。 第三步:分层(分组排序) 流处理平铺结构,处理层级分组,存储在TreeMap中维护自然排序。对应key中的数据节点Set<DataNode>需用多线程并发调用,以保证链路调用时间 1 首先,定义数据结构用于维护调用链路 Q1:为什么需要定义祖先节点? A1:为了判断接口是否存在循环依赖。如果接口存在循环依赖而不检测将导致调用栈溢出,故而在调用过程中要避免并检测循环依赖。在遍历子节点过程中,如果发现当前节点的祖先已经包含当前子节点,说明依赖关系出现了环路,即循环依赖,此时抛异常终止后续流程避免栈溢出。 public class DataNode { /** * 节点名称 */ private String name; /** * 节点层级 */ private int level; /** * 祖先节点 */ private List<String> ancestors; /** * 子节点 */ private List<DataNode> children; } 2 获取能力层的接口依赖,并生成对应的数据节点 Q1:生成节点时如何维护层级? A1:从能力层依赖开始,层级从1递加。每获取一次底层依赖,底层依赖所生成的节点层级即父节点层级+1。 /** * 构建层级结构 * * @param handlers 接口依赖 * @return 数据节点集 */ private List<DataNode> buildLevel(Set<String> handlers) { List<DataNode> result = Lists.newArrayList(); for (String next : handlers) { DataNode dataNode = generateNode(next, 1, null, null); result.add(dataNode); } return result; } /** * 生成数据节点 * * @param name 节点名称 * @param level 节点层级 * @param ancestors 祖先节点(除父辈) * @param parent 父节点 * @return DataNode 数据节点 */ private DataNode generateNode(String name, int level, List<String> ancestors, String parent) { AbstractInfraHandler abstractInfraHandler = abstractInfraHandlerMap.get(name); Set<String> infraDependencyHandlerNames = abstractInfraHandler.getInfraDependencyHandlerNames(); // 根节点 DataNode dataNode = new DataNode(name); dataNode.setLevel(level); dataNode.putAncestor(ancestors, parent); if (CollectionUtils.isNotEmpty(dataNode.getAncestors()) && dataNode.getAncestors().contains(name)) { throw new IllegalStateException("依赖关系中存在循环依赖,请检查以下handler:" + JsonUtil.toJsonString(dataNode.getAncestors())); } if (CollectionUtils.isNotEmpty(infraDependencyHandlerNames)) { // 存在子节点,子节点层级+1 for (String next : infraDependencyHandlerNames) { DataNode child = generateNode(next, level + 1, dataNode.getAncestors(), name); dataNode.putChild(child); } } return dataNode; } 层级结构如下: 3 数据节点平铺(遍历出所有后代节点) Q1:如何处理接口依赖过程中的重复项? A1:遍历所有的子节点,将所有子节点平铺到一层,平铺时如果节点已经存在,比较层级,保留层级大的即可(层级大说明依赖位于更底层,调用时要优先调用)。 /** * 层级结构平铺 * * @param dataNodes 数据节点 * @param dataNodeMap 平铺结构 */ private void flatteningNodes(List<DataNode> dataNodes, Map<String, DataNode> dataNodeMap) { if (CollectionUtils.isNotEmpty(dataNodes)) { for (DataNode dataNode : dataNodes) { DataNode dataNode1 = dataNodeMap.get(dataNode.getName()); if (Objects.nonNull(dataNode1)) { // 存入层级大的即可,避免重复 if (dataNode1.getLevel() < dataNode.getLevel()) { dataNodeMap.put(dataNode.getName(), dataNode); } } else { dataNodeMap.put(dataNode.getName(), dataNode); } // 处理子节点 flatteningNodes(dataNode.getChildren(), dataNodeMap); } } } 平铺结构如下: 4 分层(分组排序) Q1:如何分层? A1:节点平铺后已经去重,此时借助TreeMap的自然排序特性将节点按照层级分组即可。 /** * @param dataNodeMap 平铺结构 * @return 分层结构 */ private TreeMap<Integer, Set<DataNode>> processLevel(Map<String, DataNode> dataNodeMap) { return dataNodeMap.values().stream().collect(Collectors.groupingBy(DataNode::getLevel, TreeMap::new, Collectors.toSet())) } 分层如下: 1.根据分层TreeMap的key倒序即为调用的层级顺序 对应key中的数据节点Set<DataNode>需用多线程并发调用,以保证链路调用时间 4、分层级调用 梳理出调用关系并分层后,使用并发编排工具调用即可。这里梳理的层级关系,level越大,表示越优先调用。 这里以京东内部并发编排框架为例,说明调用流程: /** * 构建编排流程 * * @param infraDependencyHandlers 依赖接口 * @param workerExecutor 并发线程 * @return 执行数据 */ public Sirector<InfraContext> buildSirector(Set<String> infraDependencyHandlers, ThreadPoolExecutor workerExecutor) { Sirector<InfraContext> sirector = new Sirector<>(workerExecutor); long start = System.currentTimeMillis(); // 依赖顺序与执行顺序相反 TreeMap<Integer, Set<DataNode>> levelNodes; TreeMap<Integer, Set<DataNode>> cacheLevelNodes = localCacheManager.getValue("buildSirector"); if (Objects.nonNull(cacheLevelNodes)) { levelNodes = cacheLevelNodes; } else { levelNodes = getLevelNodes(infraDependencyHandlers); ExecutorUtil.executeVoid(asyncTpExecutor, () -> localCacheManager.putValue("buildSirector", levelNodes)); } log.info("buildSirector 梳理依赖关系耗时:{}", System.currentTimeMillis() - start); // 最底层接口执行 Integer firstLevel = levelNodes.lastKey(); EventHandler[] beginHandlers = levelNodes.get(firstLevel).stream().map(node -> abstractInfraHandlerMap.get(node.getName())).toArray(EventHandler[]::new); EventHandlerGroup group = sirector.begin(beginHandlers); Integer lastLevel = levelNodes.firstKey(); for (int i = firstLevel - 1; i >= lastLevel; i--) { EventHandler[] thenHandlers = levelNodes.get(i).stream().map(node -> abstractInfraHandlerMap.get(node.getName())).toArray(EventHandler[]::new); group.then(thenHandlers); } return sirector; } 5、 个人思考 作为接入内部RPC、Http接口实现业务处理的项目,在使用过程中要关注调用链路上的资源复用,尤其长链路的调用,要深入考虑内存资源的利用以及对底层服务的压力。 要关注对外服务接口与底层数据接口的响应时差,分析调用逻辑与流程是否合理,是否存在优化项。 多线程并发调用多个平行数据接口时,如何使得各个线程的耗时方差尽可能小? 作者:京东零售 王江波 来源:京东云开发者社区

优秀的个人博客,低调大师

前端文件上传的几种交互造轮子 | 京东云技术团队

背景 前端文件上传本来是一个常规交互操作,没什么特殊性可言,但是最近在做文件上传,需要实现截图粘贴上传,去找了下有没有什么好用的组件,网上提供的方法有,但是没找完整的组件来支持cv上传,经过了解发现可以用剪贴板功能让自己的cv实现文件上传,于是自己就整合了目前几种文件上传的交互方式,码了一个支持cv的vue3文件上传组件(造个轮子)。 介绍 作为一个完整的组件内容还是挺多的,这里主要介绍下上传交互中一些主要功能,包括上传的几种交互方式, 上传进度的获取,上传类型的限制,默认上传请求和自定义上传请求。 以下代码都是非完整代码,大家用于参考实现过程,可以通过以下代码修改来完成自己想要的交互功能。 几种交互 1,点击选择上传 点击选择是最常见的上传交互,之前原生上传控件,样式修改比较麻烦,为了修改上传样式,我们可以把该控件设置隐藏,用其他元素通过从click交互, 来触发该文件选择控件。在选择文件控件上绑定onchange事件,该控件在change后获取到文件,然后调用上传方法,实现如下: <div class="uploader-content" @click="handleClick"> <input ref="inputRef" class="uploader-target" :name="name" :multiple="multiple" :accept="accept" type="file" @change="handleChange" /> </div> <script setup> const inputRef = shallowRef(null) const handleClick = () => { inputRef.value.value = '' inputRef.value?.click() } const handleChange = (e) => { const files = e.target.files if (!files) return // 获取到文件后调用附件上传方法 uploadFiles(files) } </script> <style lang='less' scoped> .uploader-target { display: none; } </style> 2,拖动上传 拖拽文件上传,首先在页面上建立一个拖放区域,在拖放区域上绑定拖放事件,监听拖放事件drop内容中datTransfer中是包含files,如果存在files,获取files然后调用上传附件方法。 拖放区域可以通过事件dragover来检查拖放文件是否进入拖放区域来设置拖放区域悬浮样式,通过dragleave来检查离开拖放区取消悬浮样式。 进行交互提示 实现如下: <div class="uploader-drag" v-if="props.uploadMode == 'drag'" :class="['dragger', dragover ? 'dragover' : '']" @drop.prevent="onDrop" @dragover.prevent="onDragover" @dragleave.prevent="dragover = false"> <div class="dragicon-box"> <span>+</span> </div> </div> <script setup> const dragover = ref(false) const onDrop = (e) => { const files = Array.from(e.dataTransfer?.files) dragover.value = false uploadFiles(files); } const onDragover = () => { dragover.value = true } </script> 3,复制上传(复制检测区域设置) 复制上传的交互步骤 •将文件保存到剪贴板: 执行键盘快捷键或者使用鼠标复制 •将鼠标移动到可粘贴区: 判断是否移动到可粘贴区,来确定是否在执行粘贴后上传,否则整个页面都会作为粘贴区, •执行粘贴操作:执行键盘粘贴快捷键(ctrl+v) 粘贴区绑定paste事件,在触发paste事件前将鼠标移到粘贴区,复制会被检查不在粘贴区,阻止上传操作,实现如下: <div class="uploader-paste" v-if="props.uploadMode == 'paste'" :class="['dragger', dragover ? '' : '']" @mouseover.stop="clipboardover = true" @mouseleave.stop="clipboardover = false" @drop.prevent="onDrop" @dragover.prevent="onDragover" @dragleave.prevent="dragover = false" @paste="pasteFun" > <!--默认插槽内容--> <template v-if="$slots.default == null"> <div class="dragicon-box"> <span>+</span> </div> </template> <slot /> </div> <script setup> const clipboardover = ref(false) const pasteFun = (e) => { if(!clipboardover.value) return const clipboardFile = e.clipboardData.files; uploadFiles(clipboardFile) } </script> 上传模式 根据以上三种交互,大家可自由组合上传形式,比如点击和拖拽,拖拽和粘贴组合等等,我这边目前按点击,拖拽,粘贴叠加组合,设置为: •点击上传,click •拖拽上传 drag(包括点击上传和拖拽上传) •粘贴上传 paste (包括点击,拖拽和复制上传) 通过传参 uploadeMode设置 (click, drag, paste) 组件设置: <div class="uploader-content" @click="handleClick"> <input ref="inputRef" class="uploader-target" :name="name" :multiple="multiple" :accept="props.accept" type="file" @change="handleChange" v-if="props.uploadMode != 'click'" /> <!-- click --> <div class="uploader-click" v-if="props.uploadMode == 'click'"> <slot /> <input ref="inputRef" class="uploader-target" :name="name" :multiple="multiple" :accept="accept" type="file" @change="handleChange" @click.stop /> </div> <!-- drag --> <div class="uploader-drag" v-if="props.uploadMode == 'drag'" :class="['dragger', dragover ? 'dragover' : '']" @drop.prevent="onDrop" @dragover.prevent="onDragover" @dragleave.prevent="dragover = false"> <template v-if="$slots.default == null"> <div class="dragicon-box"> <span>+</span> </div> </template> <slot /> </div> <!-- copy --> <div class="uploader-paste" v-if="props.uploadMode == 'paste'" :class="['dragger', dragover ? '' : '']" @mouseover.stop="clipboardover = true" @mouseleave.stop="clipboardover = false" @drop.prevent="onDrop" @dragover.prevent="onDragover" @dragleave.prevent="dragover = false" @paste="pasteFun" > <template v-if="$slots.default == null"> <div class="dragicon-box"> <span>+</span> </div> </template> <slot /> </div> </div> </template> 组件应用 <Upload action="https://jsonplaceholder.typicode.com/posts/" uploadMode="click"> <div>点击上传</div> </Upload> <script lang="ts"> import Upload from '@/components/uploader'; </script> 文件限制 文件限制包括是否多文件上传限制multiple, 上传数量limit限制,上传类型accept限制,这些设置参考了element-plus上传组件,在其基础上做了简化。实现如下 multiple 和 accept 首先需要在点击控件上绑定,以便于在点击选择上传时就能够过滤对应文件,拖拽上传和粘贴上传,无法通过input[type=file] 组件控制需要在上传方法中判断过滤,(以粘贴上传为例) 组件实现 <div class="uploader-content" @click="handleClick"> <input ref="inputRef" class="uploader-target" :name="name" :multiple="multiple" :accept="props.accept" type="file" @change="handleChange" v-if="props.uploadMode != 'click'" @click.stop /> <div class="uploader-paste" v-if="props.uploadMode == 'paste'" :class="['dragger', dragover ? '' : '']" @mouseover.stop="clipboardover = true" @mouseleave.stop="clipboardover = false" @drop.prevent="onDrop" @dragover.prevent="onDragover" @dragleave.prevent="dragover = false" @paste="pasteFun" > <template v-if="$slots.default == null"> <div class="dragicon-box"> <span>+</span> </div> </template> <slot /> </div> </div> <script setup> import { shallowRef, ref } from 'vue'; const inputRef = shallowRef(null) // 上传文件 const uploadFiles = (files) => { if (files.length === 0) return const { limit, multiple, accept } = props // 是否多文件限制,主要用于拖拽和粘贴上传中 if (!multiple) { files = Array.from(files).slice(0, 1) } // 文件数量 if (limit && files.length > limit) { /*具体大家需要的逻辑可自行定义*/ return } // 文件类型限制 if (accept) { files = filesFiltered(Array.from(files), accept) } //在文件符合条件后执行上传方法 } // 文件过滤 const filesFiltered = (files, accept) => { return files.filter((file) => { const { type, name } = file const extension = name.includes('.') ? `.${name.split('.').pop()}` : '' const baseType = type.replace(//.*$/, '') return accept .split(',') .map((type) => type.trim()) .filter((type) => type) .some((acceptedType) => { if (acceptedType.startsWith('.')) { return extension === acceptedType } if (//*$/.test(acceptedType)) { return baseType === acceptedType.replace(//*$/, '') } if (/^[^/]+/[^/]+$/.test(acceptedType)) { type === acceptedType } return false }) }) } </script> 上传进度设置 获取文件上传进度,使用ajax中的progress 事件监听机制,回传数据loaded进度,和ttotal进行计算,获取到计算的百分比通过process插槽线上在界面上。 具体实现如下: 组件实现 文件限制后执行组件上传,默认情况下走内置的上传方法,如果做了自定义,上传进度也需要自己实现(自己实现过程可以参考内置方法中的实现) // 上传方法调用 ajaxUpload({...props, file}) // 上传方法实现 ajaxUpload = (options) => { const xhr = new XMLHttpRequest() const action = option.action console.log(xhr, xhr.upload) if (xhr.upload) { // 建立progress监听 xhr.upload.addEventListener('progress', (evt:any) => { const progressEvt = evt progressEvt.percent = evt.total > 0 ? (evt.loaded / evt.total) * 100 : 0 // 回传进度数据 option.onProgress(progressEvt) }) } } 同样文件上传成功,异常等方法也可以通过监听load并且判断 xhr.status 来实现, xhr.addEventListener('load', () => { if (xhr.status < 200 || xhr.status >= 300) { return option.onError(getError(action, option, xhr)) } option.onSuccess(getBody(xhr)) }) 组件使用 •配置获取进度数据回调函数 onProgress •配置接收回传的进度数据进行赋值 •配置进度条插槽显示进度数据 <Upload action="https://jsonplaceholder.typicode.com/posts/" :limit="3" uploadMode="click" :onProgress="progress"> <div class="button">点击上传</div> <template v-slot:progress> <!-自定义的进度条样式,大家可以根据自己的想象,自行设置进度条样式--> <div class="progress-box"> <div class="progress"> <span class="line" :style="{'width': progressval + '%'}"></span> </div> <span class="val">{{progressval}} %</span> </div> </template> </Upload> <script setup> import {ref} from 'vue' import Upload from '@/components/uploader'; const progressval = ref(0) const progress = (evt)=>{ progressval.value = evt.percent.toFixed(2) }, // 上传成功 const uploadSucess = (e)=>{ console.log('sucess', e) } // 上传异常 const uploadError= (e)=> { console.log('sucess', e) } </script> 自定义上传请求 默认情况下,不需要自定义上传请求,组件内置了上传请求,如果个人有需求可以自定义上传请求,子定义上传请求,是在文件限制流程后,检查是否有自定义请求方法,如果存在就将文件传入自定义请求方法。 组件实现: // 上传文件 const uploadFiles = (files) => { if (files.length === 0) return const { limit, multiple, accept, httpRequest } = props // 是否多文件限制,主要用于拖拽和粘贴上传中 if (!multiple) { files = Array.from(files).slice(0, 1) } // 文件数量 if (limit && files.length > limit) { /*具体大家需要的逻辑可自行定义*/ return } // 文件类型限制 if (accept) { files = filesFiltered(Array.from(files), accept) } //在文件符合条件后执行上传方法 // 自定义上传方法调用 if(httpRequest) { return httpRequest(files) } } 组件应用: 注意点: 通过自定义上传方法实现时,在原来组件上的属性action无效 <Upload :limit="3" uploadMode="click" :onProgress="progress" :onSuccess="uploadSucess" :onError="uploadError" :httpRequest="httpRequest"> <div class="button">点击上传</div> <template v-slot:progress> <div class="progress-box"> <div class="progress"> <span class="line" :style="{'width': progressval + '%'}"></span> </div> <span class="val">{{progressval}} %</span> </div> </template> </Upload> <script setup> const httpRequest = (files)=> { // 获取到文件 ,自定已上传方法 } </script> 总结 通过以上可以实现一个支持多种交互方式的文件上传组件,同时也将element-plus中文件上传的流程做了一个学习,因为该组件的实现过程就是参考了element-plus的实现,在element-plus上传的基础上添加了粘贴上传交互, 该组件的实现重在交互方式,各个样式风格通过插槽自定义。 作者:京东物流 刘海鼎 来源:京东云开发者社区

优秀的个人博客,低调大师

Junit执行器Runner探索之旅 | 京东云技术团队

单元测试是每个程序员必备的技能,而Runner是每个单元测试类必有属性。本文通过解读Junit源码,介绍junit中每个执行器的使用方法,让读者在单元测试时,可以灵活的使用Runner执行器。 一、背景 在今年的敏捷团队建设中,京东物流通过Suite执行器实现了一键自动化单元测试。Juint除了Suite执行器还有哪些执行器呢?由此京东物流的Runner探索之旅开始了! 二、RunWith RunWith的注释是当一个类用@RunWith注释或扩展一个用@RunWith注释的类时,JUnit将调用它引用的类来运行该类中的测试,而不是内置到JUnit中的运行器,就是测试类根据指定运行方式进行运行。 代码如下: public @interface RunWith { Class<? extends Runner> value(); } 其中:Runner 就是指定的运行方式。 三、Runner Runner的作用是告诉Junit如何运行一个测试类,它是一个抽象类。通过RunWith 指定具体的实现类,如果不指定默认使用BlockJUnit4ClassRunner,Runner的代码如下: public abstract class Runner implements Describable { public abstract Description getDescription(); public abstract void run(RunNotifier notifier); public int testCount() { return getDescription().testCount(); } } 3.1 ParentRunner ParentRunner是一个抽象类,提供了大多数特定于运行器的功能,是经常使用运行器的父节点。实现了Filterable,Sortable接口,可以过滤和排序子对象。 提供了3个抽象方法: protected abstract List<T> getChildren(); protected abstract Description describeChild(T child); protected abstract void runChild(T child, RunNotifier notifier); 3.1.1 BlockJUnit4ClassRunner BlockJUnit4ClassRunner是Juint4默认的运行器,具有与旧的测试类运行器(JUnit4ClassRunner)完全相同的行为。 ParentRunner3个抽象方法的实现如下: @Override protected void runChild(final FrameworkMethod method, RunNotifier notifier) { Description description = describeChild(method); if (isIgnored(method)) { notifier.fireTestIgnored(description); } else { runLeaf(methodBlock(method), description, notifier); } } @Override protected Description describeChild(FrameworkMethod method) { Description description = methodDescriptions.get(method); if (description == null) { description = Description.createTestDescription(getTestClass().getJavaClass(), testName(method), method.getAnnotations()); methodDescriptions.putIfAbsent(method, description); } return description; } @Override protected List<FrameworkMethod> getChildren() { return computeTestMethods(); } runChild() : 调用describeChild() 判断方法是否包含@Ignore注解,有就触发TestIgnored事件通知 构造Statement回调,通过methodBlock()构造并装饰测试方法 执行测试方法调用statement.evaluate() describeChild() : 对测试方法创建Description并进行缓存 getChildren():返回运行测试的方法。 默认实现返回该类和超类上所有用@Test标注的未重写的方法 3.1.2 BlockJUnit4ClassRunnerWithParameters BlockJUnit4ClassRunnerWithParameters是一个支持参数的BlockJUnit4ClassRunner。参数可以通过构造函数注入或注入到带注释的字段中。参数包含名称、测试类和一组参数。 private final Object[] parameters; private final String name; public BlockJUnit4ClassRunnerWithParameters(TestWithParameters test) throws InitializationError { super(test.getTestClass().getJavaClass()); parameters = test.getParameters().toArray( new Object[test.getParameters().size()]); name = test.getName(); } 参数代码如下: public class TestWithParameters { private final String name; private final TestClass testClass; private final List<Object> parameters; public TestWithParameters(String name, TestClass testClass, List<Object> parameters) { notNull(name, "The name is missing."); notNull(testClass, "The test class is missing."); notNull(parameters, "The parameters are missing."); this.name = name; this.testClass = testClass; this.parameters = unmodifiableList(new ArrayList<Object>(parameters)); } BlockJUnit4ClassRunnerWithParameters一般结合Parameterized使用 3.1.3 Theories Theories允许对无限数据点集的子集测试某种功能。提供一组参数的排列组合值作为待测方法的输入参数。同时注意到在使用Theories这个Runner的时候,待测方法可以拥有输入参数,可以使您的测试更加灵活。 测试代码如下: @RunWith(Theories.class) public class TheoriesTest { @DataPoints public static String[] tables = {"方桌子", "圆桌子"}; @DataPoints public static int[] counts = {4,6,8}; @Theory public void testMethod(String table, int count){ System.out.println(String.format("一套桌椅有一个%s和%d个椅子", table, count)); } } 运行结果: 图2 Theories测试代码的执行结果 3.1.4 JUnit4 JUnit4是Junit4默认执行器的别名,想要显式地将一个类标记为JUnit4类,应该使用@RunWith(JUnit4.class),而不是,使用@RunWith(BlockJUnit4ClassRunner.class) 3.1.5 Suite Suite允许您手动构建包含来自许多类的测试的套件.通过Suite.SuiteClasses定义要执行的测试类,一键执行所有的测试类。 测试代码如下: @RunWith(Suite.class) @Suite.SuiteClasses({Suite_test_a.class,Suite_test_b.class,Suite_test_c.class }) public class Suite_main { } public class Suite_test_a { @Test public void testRun(){ System.out.println("Suite_test_a_running"); } } public class Suite_test_b { @Test public void testRun(){ System.out.println("Suite_test_b_running"); } } public class Suite_test_c { @Test public void testRun(){ System.out.println("Suite_test_c_running"); } } 执行结果: 图3 Suite测试代码的执行结果 如结果所示:执行MainSuit时依次执行了Suite_test_a,Suite_test_b,Suite_test_c 的方法,实现了一键执行。 3.1.6 Categories Categories在给定的一组测试类中,只运行用带有@ inclecategory标注的类别或该类别的子类型标注的类和方法。通过ExcludeCategory过滤类型。 测试代码如下: public interface BlackCategory {} public interface WhiteCategory {} public class Categories_test_a { @Test @Category(BlackCategory.class) public void testFirst(){ System.out.println("Categories_test_a_testFirst_running"); } @Test @Category(WhiteCategory.class) public void testSecond(){ System.out.println("Categories_test_a_testSecond_running"); } } public class Categories_test_b { @Test @Category(WhiteCategory.class) public void testFirst(){ System.out.println("Categories_test_b_testFirst_running"); } @Test @Category(BlackCategory.class) public void testSecond(){ System.out.println("Categories_test_b_testSecond_running"); } } 执行带WhiteCategory的方法 @RunWith(Categories.class) @Categories.IncludeCategory(WhiteCategory.class) @Categories.ExcludeCategory(BlackCategory.class) @Suite.SuiteClasses( { Categories_test_a.class, Categories_test_b.class }) public class Categories_main { } 运行结果: 图4 Categories测试代码WhiteCategory分组执行结果 执行带BlackCategory的方法 @RunWith(Categories.class) @Categories.IncludeCategory(BlackCategory.class) @Categories.ExcludeCategory(WhiteCategory.class) @Suite.SuiteClasses( { Categories_test_a.class, Categories_test_b.class }) public class Categories_main { } 运行结果: 图5 Categories测试代码BlackCategory分组执行结果 如运行结果所示,通过IncludeCategory,ExcludeCategory可以灵活的运行具体的测试类和方法。 3.1.7 Enclosed Enclosed使用Enclosed运行外部类,内部类中的测试将被运行。 您可以将测试放在内部类中,以便对它们进行分组或共享常量。 测试代码: public class EnclosedTest { @Test public void runOutMethou(){ System.out.println("EnclosedTest_runOutMethou_running"); } public static class EnclosedInnerTest { @Test public void runInMethou(){ System.out.println("EnclosedInnerTest_runInMethou_running"); } } } 运行结果:没有执行内部类的测试方法。 图6 Enclosed测试代码的执行结果 使用Enclosed执行器: @RunWith(Enclosed.class) public class EnclosedTest { @Test public void runOutMethou(){ System.out.println("EnclosedTest_runOutMethou_running"); } public static class EnclosedInnerTest { @Test public void runInMethou(){ System.out.println("EnclosedInnerTest_runInMethou_running"); } } } 执行结果:执行了内部类的测试方法。 图7 Enclosed测试代码的执行结果 3.1.8 Parameterized Parameterized实现参数化测试。 运行参数化的测试类时,会为测试方法和测试数据元素的交叉乘积创建实例。 Parameterized包含一个提供数据的方法,这个方法必须增加Parameters注解,并且这个方法必 须是静态static的,并且返回一个集合Collection,Collection中的值长度必须相等。 测试代码: @RunWith(Parameterized.class) public class ParameterizedTest { @Parameterized.Parameters public static Collection<Object[]> initData(){ return Arrays.asList(new Object[][]{ {"小白",1,"鸡腿"},{"小黑",2,"面包"},{"小红",1,"苹果"} }); } private String name; private int count; private String food; public ParameterizedTest(String name, int count, String food) { this.name = name; this.count = count; this.food = food; } @Test public void eated(){ System.out.println(String.format("%s中午吃了%d个%s",name,count,food)); } } 运行结果: 图8 Parameterized测试代码的执行结果 3.2 JUnit38ClassRunner JUnit38ClassRunner及其子类是Junit4的内部运行器,有一个内部类OldTestClassAdaptingListener 实现了TestListener接口。 3.3 ErrorReportingRunner ErrorReportingRunner也是Junit4运行错误时抛出的异常,代码如下: private final List<Throwable> causes; public ErrorReportingRunner(Class<?> testClass, Throwable cause) { if (testClass == null) { throw new NullPointerException("Test class cannot be null"); } this.testClass = testClass; causes = getCauses(cause); } private List<Throwable> getCauses(Throwable cause) { if (cause instanceof InvocationTargetException) { return getCauses(cause.getCause()); } if (cause instanceof InitializationError) { return ((InitializationError) cause).getCauses(); } if (cause instanceof org.junit.internal.runners.InitializationError) { return ((org.junit.internal.runners.InitializationError) cause) .getCauses(); } return Arrays.asList(cause); } 当junit运行错误时,会抛出ErrorReportingRunner,例如: public Runner getRunner() { try { Runner runner = request.getRunner(); fFilter.apply(runner); return runner; } catch (NoTestsRemainException e) { return new ErrorReportingRunner(Filter.class, new Exception(String .format("No tests found matching %s from %s", fFilter .describe(), request.toString()))); } } 3.4 IgnoredClassRunner IgnoredClassRunner是当测试的方法包含Ignore注解时,会忽略该方法。 public class IgnoredClassRunner extends Runner { private final Class<?> clazz; public IgnoredClassRunner(Class<?> testClass) { clazz = testClass; } @Override public void run(RunNotifier notifier) { notifier.fireTestIgnored(getDescription()); } @Override public Description getDescription() { return Description.createSuiteDescription(clazz); } } IgnoredClassRunner的使用 public class IgnoredBuilder extends RunnerBuilder { @Override public Runner runnerForClass(Class<?> testClass) { if (testClass.getAnnotation(Ignore.class) != null) { return new IgnoredClassRunner(testClass); } return null; } } 当测试时想忽略某些方法时,可以通过继承IgnoredClassRunner增加特定注解实现。 四、小结 Runner探索之旅结束了,可是单元测试之路才刚刚开始。不同的Runner组合,让单元测试更加灵活,测试场景更加丰富,更好的实现了测试驱动开发,让系统更加牢固可靠。 作者:京东物流 陈昌浩 来源:京东云开发者社区
资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册