首页 文章 精选 留言 我的

精选列表

搜索[快直播],共10000篇文章
优秀的个人博客,低调大师

阿里云ECS服务器华南2广东河源地域好不好/速度快不快?

阿里云ECS服务器添加了华南2地域的广东河源节点,原来有华南1的广东深圳地域。通过本文详细介绍河源节点数据中心的详细情况。主要看运行速度及性能。 一、阿里云华南2广东河源数据中心怎么样 阿里云华南2河源数据中心是华南地区规模最大的绿色数据中心,容纳超过30万台服务器,目前为华南地区百万客户提供优质的云计算、人工智能、物联网等服务。 阿里云河源数据中心是阿里云自建自维基地,目前有2个可用区。使用自研开发的飞天操作系统、第三代神龙架构、盘古存储等云计算技术,轻松应对金融企业的扩容需求。也可以根据紧急需要提供小时级交付几十万core计算资源的能力,极速扩展能力可从容应对紧急需求和大流量业务需要。独有优势:可用区内时延仅为其他数据中心的40%左右。 二、阿里云华南2 河源数据中心已开通实例规格 河源数据中心在实例规格、性能上增强了不少。以下是当前在河源数据中心开通的ECS服务器机型。 突发性能型 t6通用型 g6计算型 c6内存型 r6本地SSD型 i2g、i2计算型弹性裸金属服务器 ebmc6 后期会增加更多实例规格。 三、阿里云河源服务器测试 测试机使用阿里云ECS服务器计算型c6 2核4G1M规格,通过测试河源地域得到如下信息: 1、服务器性能测试 CPU 型号 : Intel(R) Xeon(R) Platinum 8269CY CPU @ 2.50GHzCPU 核心 : 2 核 2500.002 MHz x86_64CPU 缓存 : 36608 KB操作系统 : CentOS 7.6.1810 (64 Bit) KVM内核 : 3.10.0-957.21.3.el7.x86_64硬盘空间 : 2.0 GB / 40.0 GB内存 : 79 MB / 3646 MB (600 MB Buff) 实例地址 上传速度 下载速度 延时Speedtest 1.23 Mbit/s 106.19 Mbit/s 42.887 msFast com 0.00 Mbit/s 59.7 Mbit/s –北京电信 1.26 Mbit/s 89.14 Mbit/s –南京电信 1.40 Mbit/s 92.07 Mbit/s –合肥电信 1.55 Mbit/s 61.42 Mbit/s –天津联通 1.35 Mbit/s 98.50 Mbit/s –上海联通 1.34 Mbit/s 106.97 Mbit/s –广州联通 1.30 Mbit/s 106.85 Mbit/s –天津移动 0.99 Mbit/s 85.96 Mbit/s –无锡移动 1.49 Mbit/s 76.53 Mbit/s –南京移动 0.97 Mbit/s 17.31 Mbit/s –合肥移动 1.37 Mbit/s 50.73 Mbit/s –长沙移动 1.14 Mbit/s 67.77 Mbit/s – 从测试结果看完全符合 1M带宽服务器的参数给的非常足,延迟也低。 从河源地域所在地理位置看,主要服务客户位于长江和珠江三角洲地区,覆盖整个华南乃至国内地区都是没问题的。更多信息参阅官方文档。

优秀的个人博客,低调大师

戴尔调查:积极投资云、移动、安全和大数据的公司增长速度比落后者快50%

ZD至顶网软件频道消息:戴尔公布了第二届全球技术采用指数(GTAI 2015),与没有投资于云、移动、大数据或安全技术的公司相比,积极使用这些技术的公司其收入增长速度高出53%。尽管技术使用与收入增长之间存在这种紧密的联系,成本被认为是实施或扩展这些技术的主要障碍。 戴尔首席信息官Paul J. Walsh表示:“我们很高兴看到更多企业意识到技术投资的战略意义。我们认为,这项新的调查将帮助企业看到技术使用与收入增长、效率提升和组织增长之间的关联性。” 在2014年和2015年,GTAI调查了全球各地中型企业的IT和业务决策者,了解他们如何看待、规划和使用四大技术:云、移动、安全和大数据。今天,戴尔公布了首批全球调查结果,在2016年还将公布有关具体行业的数据。首批调查结果呈现出四大全球趋势。 云、移动、大数据和安全方面的投资与收入增长相关 投资技术的企业增长更快,认可安全的优势并且更注重安全相关投资的战略意义。 全球范围内,与没有投资于大数据、云和移动技术的公司相比,积极使用这些技术的公司的增长速度高出53%。更具体地说,这些企业使用: 使用大数据的企业增长速度高出50% 使用本地云的企业增长速度高出46% 使用异地云的企业增长速度高出51% 使用BYOD的企业增长速度高出53% 使用移动应用的企业增长速度高出44% 同时,全球企业正意识到安全的优势并更重视其投资的战略意义。 平均来说,54%企业的安全预算被用于实施安全计划,而不是简单地应对威胁。 事实上,把提高安全保护作为业务目标的企业更有可能为一部分或所有类型的安全事件制定了安全计划(此类企业占69%,还有58%的同行没有把提高安全保护作为业务目标)。 这些技术还给企业带来其它好处,包括效率和业务增长目标 GTAI 2015发现,这些技术与企业效率和增长目标之间存在联系。 对于移动,提高效率的最大获益(39%)。其它效率相关的获益包括: 业务流程改进(21%) 减少文案工作(21%) 对于云计算,三大获益也是与效率相关: 成本节约(42%) 更快速地完成任务(40%) 更好地分配IT资源(38%) 然而,对于大数据,主要好处涉及提高竞争优势、客户增长和客户保留,包括: 更有针对性的营销活动(41%——也是去年的三大目标之一) 优化广告支出(3%) 优化社交媒体营销(37%) 对于安全,能够更快速地响应市场状况是关键好处(77%拥有刚起步的IT安全计划的企业,和78%拥有成熟安全解决方案的企业)。 成本和安全是采用和扩展技术的主要障碍 2014年的报告发现,安全是迄今为止采用这些技术的最大障碍。今年,成本在全球成为更迫切的顾虑。 对于大数据,成本是目前尚未使用大数据和已经在使用大数据的公司最大的障碍。 对于有大数据但还没有使用的企业来说,主要障碍是: 不知道收益是否可以覆盖成本(20%) IT基础架构的成本(18%) 外包分析或运营的成本过高(17%) 对于目前正在使用大数据的企业,IT基础架构的成本是主要障碍(29%)。 然而,对于目前正在使用大数据的企业,安全是第二大担心的因素(28%)。 有趣的是,业务(非IT)领域的受访者对这些挑战有不同的看法。对于他们来说: 安全是主要障碍(31%) 成本是第二障碍(25%) 对于云的采用与使用,成本与安全都是很大的障碍。主要障碍取决于对云类型安全级别的看法: 更高的成本是最常见的主要风险: 私有云,28%的企业提到了短期成本风险,23%提到了长期成本风险 托管私有云,28%提到了短期成本风险,23%提到了长期成本风险 混合云,30%提到了短期成本风险,24%提到了长期成本风险 安全是采用公有云(44%)和SaaS(38%)的最大障碍。 总的来说,42%的未正式使用云的企业表示安全问题是原因——远超任何其它原因。 对于移动,安全是移动扩展的主要障碍,但成本是第二大障碍。 安全和担心数据泄漏是扩展移动面临的最常见障碍(42%的企业)。 有限的预算是第二大最常见的障碍(34%的企业)。 其它障碍包括: 当前IT基础架构的限制(24%) 太多IT平台/操作系统需要支持(23%) 有限的技术/IT资源(23%) 对成本的担心和安全挑战似乎并驾齐驱。这项调查发现,企业的IT预算对安全规划和实施有很大的影响。 年度IT支出低于100,000美元的企业中,不到五分之一有综合的安全计划。 年度IT支出低于250,000美元的企业中,不到一半有任何形式正式的安全计划。 令人担忧的是,在年度IT支出低于100,000美元的企业中,接近五分之一根本没有安全政策,甚至没有非正式的指南。 业务主管是采用大数据和移动的推动力,但他们在云和安全上与IT团队合作 全球企业更多地让业务团队领导大数据和移动的采用,而不是IT团队。这可能解释了受访企业中的业务决策者比IT同事为什么更有可能感到自己的企业很好地利用了大数据。 在领导大数据的采用方面,业务团队比IT团队高18%。 在领导移动技术的采用方面,业务团队比IT团队高42%。 然而,在领导云和安全采用方面,业务和IT主管有同等的可能性,表明这些团队这些计划上更密切地合作。 总结和结论 Owens & Minor高级副总裁兼首席信息官Rick Mears表示:“我们知道采用新技术有助于我们提高效率,但我们没想到获得了更高的投资回报。我们获得了重要的新能力,其中大部分都源自戴尔解决方案和服务带来的效率提升。这种节约已经帮助我们投资于真正有利于我们业务发展的东西。” 虽然企业把成本作为技术采用的重大障碍,GTAI 2015显示,对有意义的技术投资分配了预算的公司,多个重要指标都表现出公司业务整体增长。从提高效率到更高的收入,云、移动、大数据和安全技术均证明在公司增长和达成目标方面发挥关键作用。 原文发布时间为:2015年10月20日 本文来自云栖社区合作伙伴至顶网,了解相关信息可以关注至顶网。

优秀的个人博客,低调大师

直播回顾 | 云原生消息队列架构破局:Pulsar存算分离深度解析

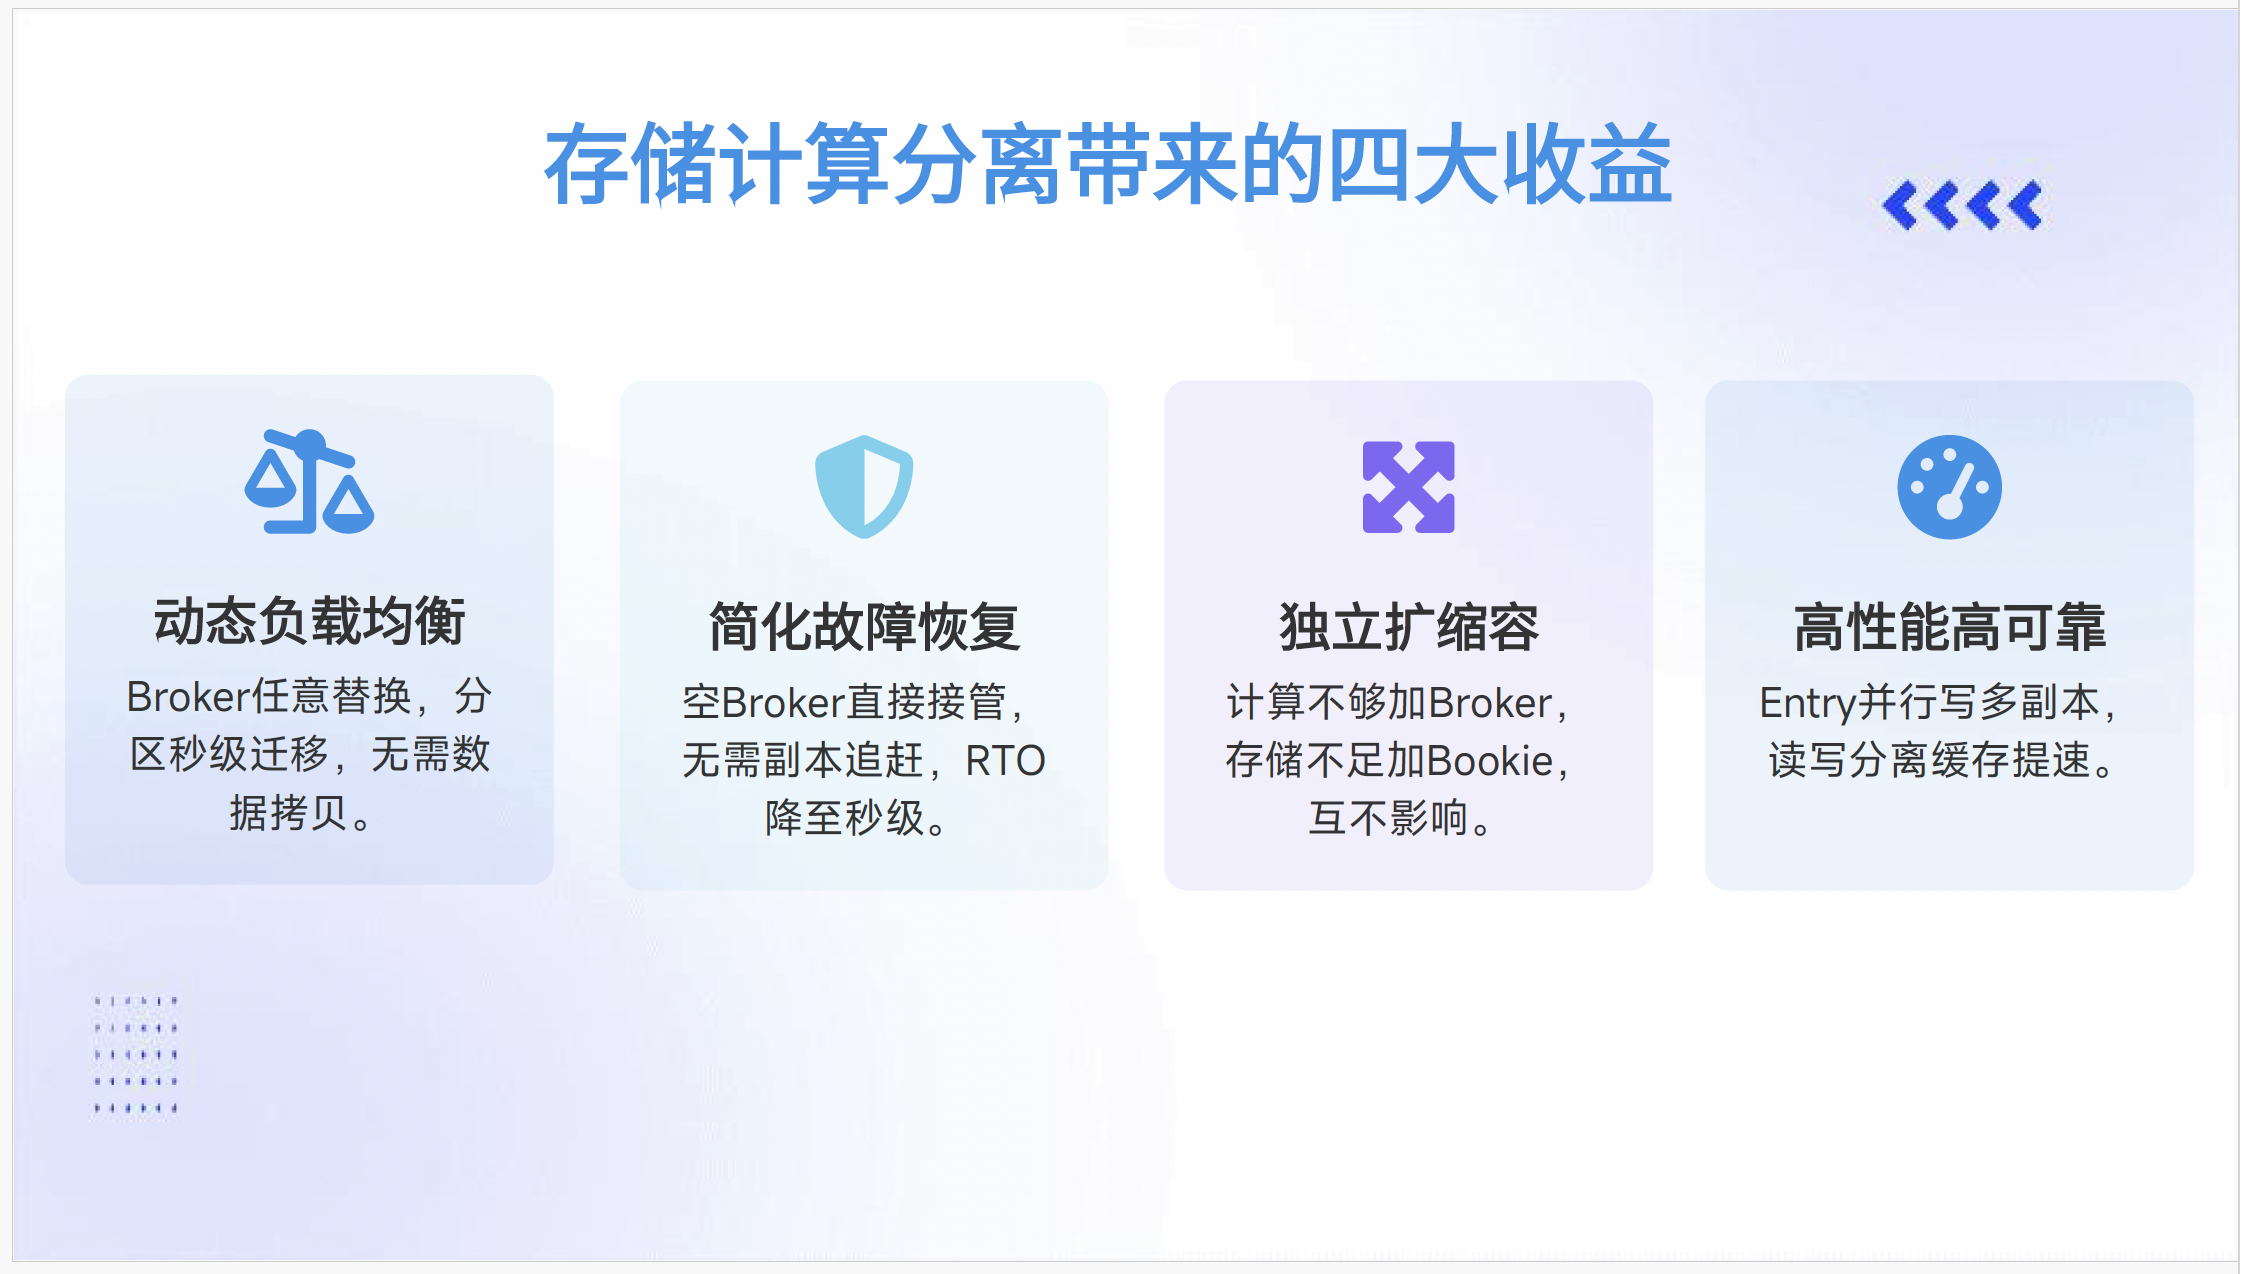
本文整理自周鹏(公众号:老周聊架构)11月18日的线上分享,一起来从架构师视角看Pulsar架构设计! 一、架构全景与优势 传统MQ的困境与破局之道 在消息中间件的发展历程中,传统消息队列架构逐渐暴露出诸多瓶颈。以Kafka为代表的一体式Broker架构,其计算与存储紧密耦合的设计,在云原生时代面临着前所未有的挑战。 架构耦合问题已成为传统消息队列的桎梏。在Kafka这样的系统中,计算层与存储层深度融合,导致扩缩容、故障迁移、数据均衡等运维操作异常复杂。当需要进行容量调整或负载重新分布时,Kafka必须进行整个分区的迁移,这一过程不仅耗时耗力,还可能在迁移期间影响系统可用性。运维团队常常需要在深夜低峰期执行此类操作,即便如此,也无法完全避免对业务的影响。 弹性限制是另一个显著问题。由于数据本地存储的特性,传统消息队列的节点故障恢复时间往往长达数小时。在金融交易、实时推荐等对可用性要求极高的场景中,这样的恢复时间是业务方完全无法接受的。节点故障不仅意味着部分服务的不可用,还可能导致整个集群的性能下降,形成连锁反应。 相比之下,Pulsar采用了一种全新的思路。迁移粒度差异 体现了架构设计的先进性,Pulsar采用更细粒度的分片流机制,迁移时无需整体数据搬迁,大大提升了系统的灵活性。这种设计使得Pulsar能够实现无状态优势,Broker的无状态设计让其横向扩展能力显著增强,更好地适应了云原生环境对弹性和敏捷性的要求。 存储计算分离带来的四大收益 存储计算分离架构并非简单的概念创新,而是为解决实际问题而生的系统性解决方案,它为用户带来了四个核心价值。 动态负载均衡是存储计算分离最直接的优势。Pulsar支持分区秒级迁移,无需数据拷贝,这在多租户、流量波动剧烈的场景中表现出色。对比传统Kafka迁移需要完整数据复制,耗时可能达1-2小时的窘境,Pulsar实现了真正的弹性伸缩。在实际生产环境中,这意味着业务团队可以根据流量预测或突发营销活动,实时调整集群资源,而无需担心数据迁移带来的延迟和风险。 快速故障恢复能力在关键时刻体现价值。健康Broker可快速接管异常 Broker,无需副本追赶,RTO(恢复时间目标)可降至秒级。这种快速恢复机制对于保障业务连续性至关重要。想象一下,在双十一大促或春节红包等高压场景下,单个节点故障能够在秒级内自动恢复,而不是等待数小时的人工干预,这对技术团队的信心的业务稳定性的保障都是质的飞跃。 独立扩缩容解决了资源利用率的痛点。计算资源不足时单独扩展Broker,存储不足时单独扩展Bookie,两者互不影响。这种解耦使得资源规划更加精确,成本控制更加精细。企业不再需要为了应对计算峰值而过度配置存储资源,也不必因为存储需求增长而被迫升级计算节点,实现了真正意义上的资源优化。 高性能保障通过多项技术协同实现。Entry并行写、多副本机制、读写分离缓存等技术共同构建了高性能存储体系,消息落库效率显著提升。在实际测试中,Pulsar在保证强一致性的前提下,仍然能够实现数百万级的TPS,满足了绝大多数互联网业务对消息吞吐量的要求。 Pulsar整体集群架构 Pulsar的整体架构体现了现代分布式系统的设计理念,各组件职责清晰,协同高效。 核心组件构成了Pulsar的处理骨架。生产者(Producer)和消费者(Consumer)作为客户端与无状态Broker集群进行通信,Broker仅负责路由和协议转换,这种轻量级设计使得Broker可以快速启动和销毁,完美契合容器化部署模式。在微服务架构中,这种无状态特性让服务编排和调度变得异常简单。 存储分离是架构的核心创新。通过BookKeeper客户端与Bookie节点交互,所有数据持久化存储在Bookie集群,Broker完全不保留状态数据。这种设计使得Broker真正实现了无状态化,任何一个Broker实例都可以处理任何客户端的请求,为负载均衡和故障转移提供了基础保障。 元数据管理经历了持续的演进。早期版本依赖ZooKeeper,现在支持多种元数据存储方案,仅保存分区映射等指针信息,不存储消息本体。这种元数据轻量化设计降低了协调服务的压力,提高了系统的整体稳定性。在现代云原生环境中,这种设计也使得Pulsar能够更容易地与各种基础设施集成。 Pulsar整体交互 消息在Pulsar集群中的流动路径体现了架构的高效性。 消息路径设计简洁而高效。客户端直接与Broker交互,Broker作为BookKeeper客户端将消息写入Bookie集群的多副本存储。这种直接的数据路径减少了不必要的网络跳转,降低了延迟。在实际部署中,这种设计使得运维团队可以针对Broker和Bookie的不同特点进行独立的网络优化和硬件选型。 协议效率通过二进制协议保障。Broker与Bookie之间采用二进制协议进行通信,比文本协议更高效,这在海量消息场景中带来的性能提升尤为明显。二进制协议不仅减少了序列化和反序列化的开销,还降低了网络带宽的占用,对于跨数据中心部署的场景具有重要意义。 副本机制在保证可靠性的同时兼顾性能。虽然类似Kafka的Topic Partition副本机制,但Pulsar在存储层实现了更彻底的解耦。这种设计使得副本的分布更加灵活,可以根据机架、可用区等物理拓扑进行优化部署,在保证数据安全的同时最大化利用硬件资源。 二、Broker无状态架构深度解析 Broker无状态的主要时序图 Broker的无状态设计是Pulsar架构的精髓之一,它通过精巧的机制实现了服务层的高度弹性。 动态负载调整基于哈希环机制实现,类似Redis集群的数据分布策略。Namespace Band内包含多个Topic的哈希段,这种分段管理方式既保证了数据的均匀分布,又避免了单一Topic过大导致的"热点"问题。在实际运行中,LoadManager持续监控各Broker的负载情况,当检测到不均衡时自动触发重新分配。 迁移机制的自动化程度很高。当Broker负载过高时,系统自动将部分分区迁移到低负载节点,相关元数据保存在ZK/etcd等协调服务中。这种自动化运维能力大大降低了人工干预的需求,特别是在大规模集群中,人工监控和迁移几乎是不现实的。 写入流程采用三阶段设计。Client→Broker→Bookie的写入路径清晰明确,通过AddEntry操作与Bookie交互,写入完成后回调publishComplete确认。这种异步确认机制既保证了写入的可靠性,又不会阻塞后续操作,实现了高吞吐与数据安全的平衡。 扩展优势在实际运维中体现明显。无状态设计使得Broker增减不影响数据分布,新Broker可立即参与服务而无需数据预热。在弹性伸缩场景中,这一特性让Pulsar能够快速响应流量变化,在业务高峰时快速扩容,在流量低谷时及时缩容以节约成本。 三、BookKeeper存储层原理剖析 BookKeeper核心概念与数据模型 BookKeeper作为Pulsar的存储引擎,其架构设计直接决定了整个系统的性能和可靠性。 存储架构采用无中心节点的集群设计。由多个Bookie组成的对等集群避免了单点瓶颈,每个Bookie都是独立的存储节点,这种去中心化设计提高了系统的可用性和扩展性。在实际部署中,Bookie集群可以独立于Broker进行扩展和维护,为系统演进提供了灵活性。 Ledger结构是BookKeeper的基本存储单元。由一系列顺序写入且不可修改的Entry组成,类似于Kafka中的消息。这种不可变性设计简化了并发控制,提高了读写效率。Ledger的抽象使得BookKeeper能够同时支持消息队列和流处理两种场景,为Pulsar的多模式消息处理能力奠定了基础。 Entry组成包含完整的元信息。LedgerID、EntryID、LAC(最后确认位点)和校验码共同保证了数据的完整性和一致性。其中LAC用于保证读一致性,Journal机制类似于数据库中的WAL(Write-Ahead Logging),确保了即使在故障恢复时也不会出现数据不一致的情况。 三参数控制提供了灵活的可靠性配置。Ensemble(参与一个Ledger写入的Bookie总数)、WQ(Write Quorum,总副本数)和AQ(Ack Quorum,确认数)三个参数协同工作,用户可以根据业务对可靠性和性能的不同要求进行精细调整。这种灵活性是传统消息队列所不具备的,使得Pulsar能够适应从金融交易到日志收集等各种不同可靠性要求的场景。 Bookie的数据写入流程 Bookie的写入流程经过精心优化,在保证持久化的同时实现高性能。 三阶段写入机制平衡了性能与可靠性。Journal写入首先写入Journal(WAL),实时落盘保证持久性,这一阶段类似于MySQL的binlog,确保了即使系统崩溃也不会丢失已确认的写入。Memtable缓存写入内存缓冲区后即可响应客户端,视为写入成功,这种异步持久化机制是高性能的关键。批量刷盘阶段在Memtable满后批量flush到EntryLog(数据文件)和Index(索引),通过批量操作减少了IO次数,提升了吞吐量。 优化机制多方面提升性能。顺序追加让Journal采用顺序写提升IO性能,充分利用了现代存储设备的特性。双缓冲技术类似JVM新生代的S1/S2区,交替刷盘提升吞吐,这种技术在高性能存储系统中广泛应用。索引分离使用RocksDB构建LedgerID+EntryID到物理偏移的索引,避免IO竞争,专门的索引引擎优化了查询效率。 线程模型精细化的并发控制。SyncThread定期同步缓冲区数据,ForceWriteThread处理强制刷盘请求,这种分工确保了在各种负载条件下都能保持稳定的性能。写入链路的每个环节都有专门的线程池处理,避免了不同操作之间的相互阻塞。 组件协作体现了模块化设计的优势。客户端写入请求通过ClientBookieImpl处理,WriteCache实现内存缓冲和LRU缓存管理,EntryLogger负责EntryLog的异步转储和排序,RocksDB维护索引信息。各组件职责单一,通过清晰的接口进行协作,这种设计不仅提高了系统的可维护性,也为未来的优化和扩展留下了空间。 Bookie的数据读取流程 读取路径的优化直接影响了消费者的体验。 三级缓存机制有效减少磁盘IO。Broker缓存拦截高频请求,在服务层减少向下游的压力。Bookie内存缓存包括WriteCache和ReadCache,利用局部性原理提高命中率。磁盘访问作为最后的手段,在前两级未命中时触发。这种多级缓存设计在现代存储系统中证明是有效的平衡成本与性能的方案。 读取类型针对不同场景优化。Tailing Read读取最新数据,直接从Memtable获取,为实时消费者提供了最低的延迟。Catch-up Read处理历史数据读取,需通过索引定位后访问磁盘,这种读写分离的优化避免了实时读写之间的竞争。 索引加速机制快速定位数据。通过RocksDB索引快速定位<LedgerID,EntryID>对应的物理位置,这种外部索引的设计避免了在数据文件中进行全扫描的开销。RocksDB的LSM树结构特别适合这种点查询场景,为消息检索提供了稳定的性能保证。 性能优化贯穿整个读取链路。系统尽量避免直接磁盘访问,优先从多级缓存获取数据,这种缓存优先的策略在典型工作负载下能够达到90%以上的命中率。对于必须访问磁盘的场景,Bookie采用了预读、批量读取等技术来提高IO效率。 四、元数据与一致性保障 元数据抽象与多后端支持 元数据管理是分布式系统的中枢神经,其设计直接影响系统的可靠性和扩展性。 统一接口设计通过MetadataStore接口屏蔽ZK/etcd/RocksDB差异。这种面向接口的编程思想提高了系统的可扩展性,使得在不同环境中部署时可以选择最适合的元数据存储后端。在云原生环境中,这种灵活性让Pulsar能够更好地与各种基础设施集成。 两级缓存机制有效提升元数据操作性能。通过MetadataCache减少后端访问次数,这种缓存策略在元数据读取远多于写的场景中特别有效。缓存的一致性通过版本号机制保证,确保了在分布式环境中的数据正确性。 并发控制方案提供多种一致性保证。版本号乐观锁适用于大多数并发更新场景,通过轻量级的冲突检测避免了昂贵的锁开销。分布式锁用于LeaderElection等需要强一致性的场景,保障分区映射的正确性。这种分层的一致性策略既保证了正确性,又避免了过度同步带来的性能损失。 分布式锁与Leader选举机制 Leader选举是分布式协调的核心功能,其可靠性直接关系到系统的可用性。 实现流程遵循分布式系统的最佳实践。申请锁时创建临时节点(EPHEMERAL),这种临时节点的特性确保了在客户端连接断开时能够自动清理,避免了死锁的发生。注册watch监听连接状态,使得参与者能够及时感知状态变化并做出响应。自动续期机制防止锁失效,通过心跳机制保持锁的活性。 关键保障机制防止脑裂问题。通过ZKMetadataStore在ZooKeeper创建临时节点,LockManagerImpl调用acquireLock创建ResourceLockImpl,确保同一Bundle仅一个Broker可写入。这种互斥保证是消息顺序性和一致性的基础,在金融、交易等场景中尤为重要。 扩展性设计面向未来。不同元数据存储组件(RocksDB/etcd)可替换实现,保持机制统一。这种可插拔架构使得Pulsar能够跟上基础设施演进的步伐,在新技术出现时能够快速集成而不影响上层应用。 五、负载均衡与分片管理 NamespaceBundle分片机制 分片机制是Pulsar实现细粒度负载均衡的基础,其设计直接影响系统的扩展性和稳定性。 设计优势体现在调度粒度的选择上。以Bundle而非Topic为调度粒度,避免百万级Topic的惊群问题。在大规模多租户环境中,Topic数量可能达到数十万甚至百万级别,如果以单个Topic为调度单位,元数据量和调度复杂度将是灾难性的。Namespace被哈希划分为多个Bundle,每个对应一段哈希区间,这种类似哈希环的结构既保证了均匀性,又保持了灵活性。 核心能力满足各种复杂场景的需求。动态分片支持运行时分裂与合并,应对热点场景,这种弹性是传统静态分区方案所不具备的。热点卸载机制使得高负载Bundle可迁移至空闲节点,实现了集群资源的全局优化。所有权控制通过分布式锁竞争Bundle所有权,避免多Broker同时持有,保证了数据的一致性。 Bundle获取与分裂流程 Bundle的生命周期管理体现了系统的自动化运维能力。 Bundle获取流程高效而准确。客户端请求Topic时,通过TopicHash进行二分查找,这种查找算法的时间复杂度为O(logN),即使在海量Topic场景下也能快速定位。NamespaceService返回对应的NamespaceBundle,类似哈希环查找算法,确定Bundle归属。整个获取过程在内存中完成,避免了昂贵的IO操作。 Bundle分裂流程响应负载变化。当LoadManager检测到热点Bundle(基于内存等指标)时自动触发分裂。系统计算分裂边界并更新元数据,通过抢锁机制获取新Bundle所有权,支持多种分裂算法选择。这种自动化热点处理能力大大减轻了运维负担,特别是在流量模式快速变化的互联网业务中。 Bundle卸载流程 Bundle卸载是负载均衡的关键环节,其可靠性直接影响用户体验。 关键步骤确保状态正确转换。设置isActive=false标记卸载状态,防止新的写入进入正在迁移的Bundle。关闭Bundle内所有Topics,确保所有待处理消息完成持久化。删除元数据中的所有权节点,释放资源以便重新分配。这个状态转换过程需要严格的顺序保证,任何步骤的失败都会导致回滚。 保障措施实现无感知迁移。消息不丢失是通过持久化机制和副本保证的。连接重连在毫秒级完成,对于客户端来说,迁移过程几乎是透明的。这种平滑迁移能力对于在线业务特别重要,避免了因系统维护导致的服务中断。 元数据维护保持最终一致性。通过MetadataStore同步更新Bundle归属关系,采用乐观锁等机制处理并发更新。在分布式环境中,元数据的一致性维护是复杂的,Pulsar通过版本控制和冲突解决机制来保证的正确性。 六、故障转移与容错机制 跨集群复制架构 跨集群复制是构建高可用业务系统的基础,其可靠性直接影响业务的连续性。 核心组件协同完成复制任务。通过PersistentReplicator实现异地多活,形成闭环流程。这种专门的复制组件设计避免了与正常消息处理的资源竞争,保证了复制性能的稳定性。 消息发送采用异步非阻塞模式。经ProducerImpl异步发送到远端集群,例如集群A配置集群B地址后自动转发。异步发送避免了复制过程对本地写入性能的影响,这种设计在跨地域的高延迟网络环境中特别重要。 消息读取基于游标机制。通过ManagedCursor从本地Ledger读取Entry,类似Kafka的offset概念。游标的抽象使得复制过程能够断点续传,在网络中断恢复后从中断点继续复制,避免了重复复制带来的资源浪费。 状态确认保证最终一致性。成功复制后更新游标位置,避免重复复制。这种位置管理机制类似于传统数据库的复制位点,为故障恢复提供了准确的参考点。 流量控制防止网络过载。使用DispatchRateLimiter限流,通过TTL机制过滤过期消息。在跨数据中心的复制场景中,带宽往往是宝贵且有限的资源,合理的流量控制保证了关键业务的复制优先级。 故障检测与自动重试机制 故障处理能力是系统健壮性的试金石。 本地存储阶段确保数据安全。客户端消息先持久化到本地ManagedLedger,返回确认后才触发复制。这种"先持久化,后复制"的语义保证了即使在复制失败的情况下,本地数据仍然是完整的,为手动修复提供了可能。 异步复制机制平衡性能与可靠性。Replicator读取待复制条目后,通过producer sendAsync()异步发送。异步化避免了复制延迟对生产者响应时间的影响,这种设计哲学贯穿Pulsar的整个架构。 断点续传优化故障恢复。连接恢复后从cursor.asyncDeletePosition记录的位点继续复制。位点信息定期持久化,确保即使在复制组件崩溃重启后也能准确恢复。 故障处理采用分层策略。Connection Failed时自动重试,通过Handle failure & retry机制保证可靠性。不同级别的故障采用不同的重试策略,临时性网络抖动可能立即重试,而持久性故障可能等待操作员干预。 容错机制全面保障 多层次的容错机制构建了系统的韧性。 Broker故障处理自动化程度高。Topic1-Part1从宕机的Broker1自动迁移到Broker3,整个过程无需人工干预。通过ZK/ETCD记录新分区位置,元数据的持久化保证了故障恢复的准确性。分段重建机制创建新的SegmentX+1继续写入,原Segment保留在Bookie,这种分段策略避免了单点故障影响整个分区。 Bookie容错基于多副本机制。当Bookie2的Segment4损坏时,从其他Bookie复制数据到Bookie1,这种自动修复能力保证了数据的长期可靠性。全节点恢复在Bookie2完全宕机时触发,所有Segment会重新分配到健康节点,重新分布过程考虑负载均衡,避免修复过程引发新的热点。 无感切换提升用户体验。客户端读写操作不受存储节点变更影响,这种透明性使得运维操作可以在业务无感知的情况下进行。对于7x24小时在线的互联网业务,这种能力是必不可少的。 多级保障构建防御纵深。存储层通过Bookie多副本保证数据不丢失,服务层在Broker故障时自动转移分区所有权,这种分层防御确保了单一组件的故障不会扩散到整个系统。 设计思想借鉴前人经验。类似Kafka但采用Segment分片流而非纯分区设计,这种改进使得故障恢复的粒度更细,影响范围更小。在架构设计中,Pulsar团队显然深入分析了前人方案的优缺点,并做出了有针对性的改进。 七、总结 不同消息队列的架构差异反映了各自的设计哲学和适用场景。 Kafka核心机制在大数据场景验证。分区副本采用有状态节点设计,扩缩容时需数据重新均衡,这种设计在集群规模稳定时表现优异,但在弹性伸缩场景中显得笨重。重平衡痛点在消费组任何变动都会触发耗时较长的重平衡过程,尤其在大规模消费者场景下影响显著。虽然Kafka在百万级消息吞吐场景表现优异,但JVM老年代GC问题在互联网应用中需特别注意,这种技术债务在长期运行的大型集群中逐渐显现。 RabbitMQ设计特点体现经典架构的优劣。高可用实现依赖镜像队列机制,主队列写入后同步到镜像队列,这种主动-被动模式保证了强一致性,但牺牲了部分性能。架构优势在于元数据内嵌在Broker中,无独立管理组件,架构简洁轻量,适合中小规模部署。但随着规模增长,扩缩限制逐渐显现,仍需数据重平衡,运维复杂度随规模增长而提升。 Pulsar创新的架构 面向云原生时代。存算分离将副本下沉至BookKeeper,计算层实现真正无状态,这种架构虽然引入了一定的复杂度,但换来了极致的弹性。扩缩优势使得节点变动无需数据均衡,天然适配云原生环境,在容器化部署和自动化运维方面表现出色。作为权衡,需接受因架构分层带来的网络延迟和运维复杂度提升,这种取舍在大多数现代业务场景中是值得的。 潜在演进方向 消息队列技术的演进永无止境,几个方向值得关注。 元数据管理寻求突破。Oxia项目专为强一致性设计的元数据管理服务,解决ZK/etcd在大数据量写入时的性能瓶颈。未来将建立跨组件的标准化元数据管理层,这种统一管理有助于降低系统复杂度。 存储优化面向成本效益。冷热分离自动将冷数据卸载到S3等对象存储,实现近乎无限的存储扩展能力。成本优势明显,对象存储相比块存储成本可降低70%以上,这种经济性对于长期保留数据的业务场景具有重要意义。 Serverless集成探索新范式。函数计算深度整合无服务器函数,实现消息触发式函数调度。处理流水线构建消息处理-函数执行的无缝工作流,这种模式在事件驱动架构中越来越流行。 协议兼容降低迁移成本。多协议代理原生支持Kafka/RabbitMQ/MQTT等协议,无需额外插件。迁移简化通过统一消息网关降低现有系统改造难度,这种兼容性策略帮助Pulsar在已有大量消息中间件部署的企业中快速推广。

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。


用户登录
用户注册