首页 文章 精选 留言 我的

精选列表

搜索[快直播],共10000篇文章
优秀的个人博客,低调大师

从项目制集成到产品化连接:Oinone iPaaS 快部署、好适配、低成本接全域

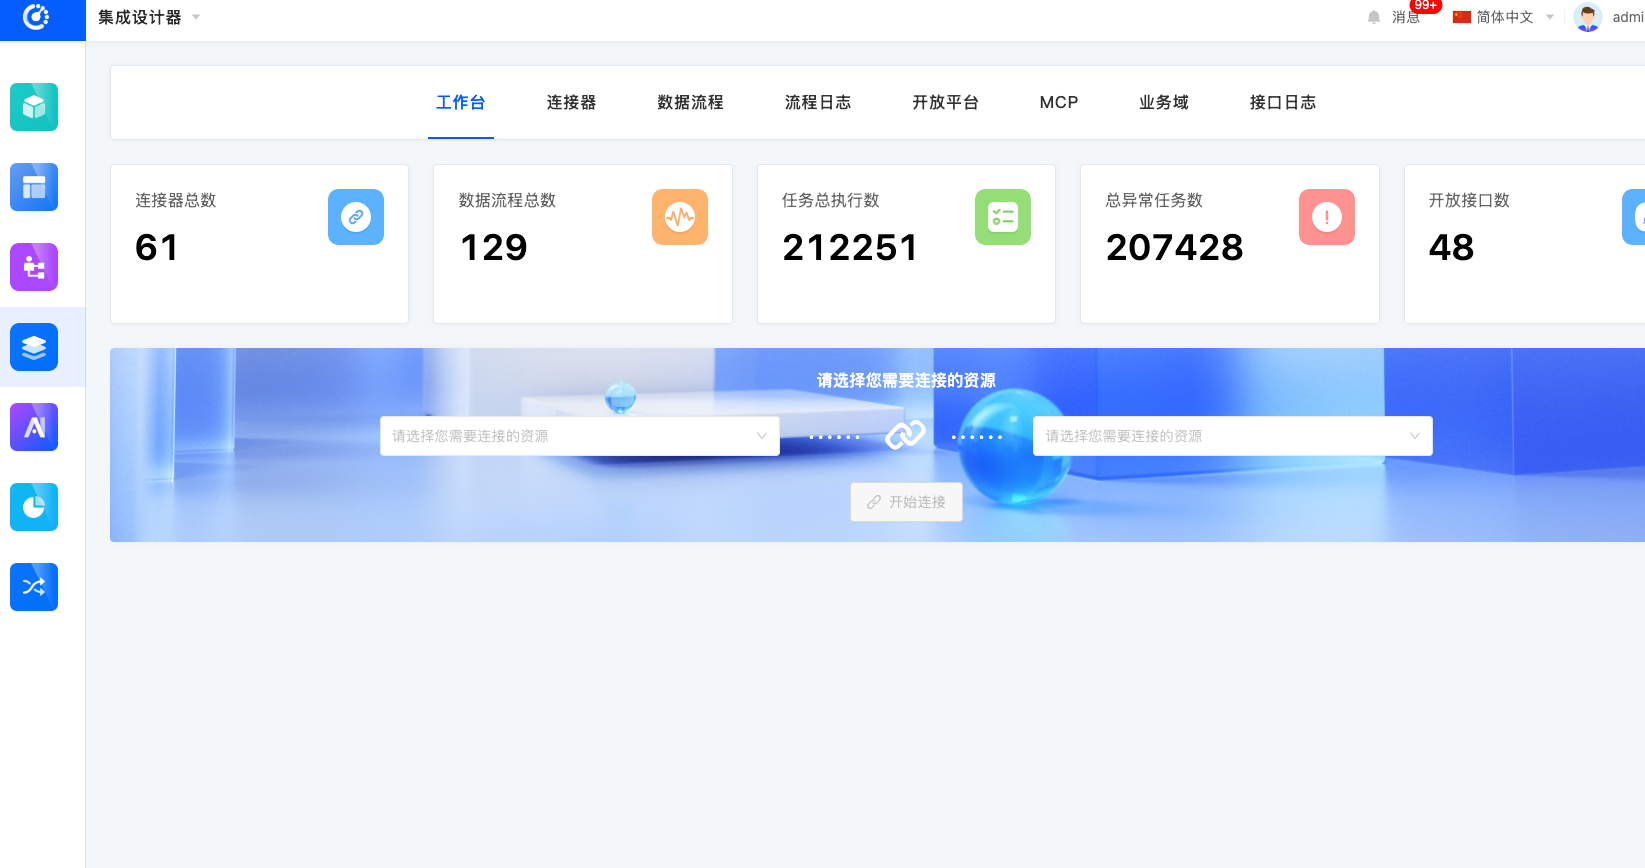
价值摘要:快速部署|灵活适配不同系统|低成本连接方案|AI 与各类业务系统无缝对接 DEMO 体验 演示环境 相关视频 ⚡ 直达演示环境 ☕ 账号:admin ☕ 密码:admin 🎬 1. [数式Oinone] #产品化演示# 后端研发与无代码辅助 🎬 2. [数式Oinone] #产品化演示# 前端开发 🎬 3. [数式Oinone] #个性化二开# 后端逻辑 🎬 4. [数式Oinone] #个性化二开# 前端交互 🎬 5. [数式Oinone] #个性化二开# 无代码模式 1. 市场背景与痛点 接口管理失控:IT 白名单维护繁琐、跨系统调用链排查低效、接口分发能力不足。 协同瓶颈:系统数量增长,点对点集成复杂度呈指数级上升,耦合难解。 ESB 限制:中心化路由/编排固化,扩展新范式(事件流、Serverless、AI 工具调用)成本高。 运维不可视:缺乏端到端追踪、拓扑与统一权限策略,重复排障占用大量人力。 2. 目标与设计原则 统一标准:以 OpenAPI/JSON Schema 为契约,标准化接口生命周期与版本治理。 一体化平台:连接器市场 + 编排引擎 + API 管理 + 治理与安全 + 可观测性。 AI Native:从“人写脚本”升级为“人机协同”:自然语言生成功能流、语义映射、异常根因建议。 可扩展架构:规则与架构统一,系统规模扩展时仅线性增加连接器与策略,不增长复杂度。 3. 参考架构 ┌───────────────────────────────────────────┐ │ 开发者门户/运维台 │ │ Dev Portal · Catalog · Mock · Test · Docs │ └───────────────────────────────┬───────────┘ │ ┌────────────────────────────┴─────────────────────────────┐ │ OiPaaS │ │ API & Gateway | Orchestrator | Governance | Observability │ └───────┬───────────────┬───────────────┬───────────────┬───┘ │ │ │ │ ┌──────────▼───────┐ ┌────▼────────┐ ┌─────▼────────┐ ┌───▼────────┐ │ Connector Hub │ │ Flow Engine │ │ Policy/IAM │ │ Telemetry │ │ (ERP/CRM/MES/ │ │ (BPMN/DSL/ │ │ (RBAC/ABAC/ │ │ (OTel/Logs │ │ MQ/Kafka/DB/IM) │ │ Event/Saga)│ │ OAuth2/OIDC)│ │ /Traces) │ └──────────┬───────┘ └────┬────────┘ └─────┬────────┘ └───┬────────┘ │ │ │ │ ┌────▼─────┐ ┌────▼─────┐ ┌────▼────┐ ┌───▼────┐ │ Data/EDA │ │ AI Layer │ │ SecVault │ │ DevOps │ │ (CDC/ESB │ │ (LLM+RAG │ │ Secrets │ │ CI/CD │ │ →Kafka) │ │ /Tools) │ │ & Audit) │ │ │ └──────────┘ └───────────┘ └─────────┘ └────────┘ Connector Hub:标准化协议(HTTP/SOAP/gRPC/MQ/SFTP/JDBC/Kafka 等)与企业应用连接器。 Flow Engine:支持编排(同步/异步)、事件驱动(EDA)、Saga 事务、重试/补偿、死信队列。 API & Gateway:契约治理、路由/限流/熔断、金丝雀发布、环境隔离、多租户。 Policy/IAM:统一权限、细粒度授权(RBAC/ABAC)、mTLS、IP 控制与零信任接入。 Observability:全链路追踪(OTel)、拓扑可视化、SLO/SLA、告警与根因分析。 AI Layer:LLM + 向量检索(RAG),NL→Flow 生成、智能映射、异常洞察、文档和合规模型。 4. 核心能力(以“集成”为中心) 4.1 API 标准化与全生命周期 契约优先(Contract-first):OpenAPI 3.1 + JSON Schema,版本策略(SemVer)、变更审计、Mock/回放。 统一发布面:研发 → 验收 → 灰度 → 生产,API 门户自动生成文档、SDK/测试集合。 4.2 可视化编排与事件驱动 编排:拖拽式/DSL 编排同步与异步流程,支持 Saga/补偿、并发分支、幂等键、超时与重试策略。 事件总线(如 Kafka):主数据变更、订单状态、库存事件标准化,支持 EDA 与流处理。 4.3 治理与安全 统一权限:OAuth2/OIDC、Service Account、细粒度 Scope;IP 白名单 → 身份驱动的零信任。 策略中心:限流、配额、熔断、缓存、数据脱敏、PII 标注、跨境/分级存储策略。 审计与合规:按租户/系统/接口维度出审计报表,密钥与证书轮换、访问轨迹留痕。 4.4 端到端可观测性 拓扑可视化:系统间依赖图谱 + 接口健康态势(吞吐、P50/P95 延迟、错误率、饱和度)。 调用追踪:自动透传 traceparent,跨系统链路一键定位瓶颈与异常段。 运维闭环:金丝雀实验、回滚开关、自动化 Runbook 与 ChatOps。 5. 将 AI 融入集成:从“自动化”到“自智化” 核心思路:把 LLM 变成 OiPaaS 的一等公民,让它既能辅助生成与治理,又能在运行期参与智能决策。 5.1 NL → Flow:自然语言生成集成流程 示例: “当 CRM 创建销售订单时,自动在 ERP 建单并通知 企业 IM 小群;失败重试 3 次,超时 5 秒降级人工审批。” OiPaaS 将自然语言解析为可执行 DSL(人可审阅/修改): flow: sales-order-sync trigger: type: event name: crm.sales_order.created auth: service_account: crm_sync steps: - name: fetch_customer connector: ERP.SAP action: BAPI_CUSTOMER_GETDETAIL input: id: "${event.customer_id}" retry: policy: exponential attempts: 3 backoff_ms: 200 - name: map_payload transform: language: JSONata ai_assist: "将 CRM 订单映射到 ERP 结构,保留税率/币种/税则字段" - name: create_order connector: ERP.SAP action: BAPI_SALESORDER_CREATEFROMDAT2 input_from: map_payload.output idempotency_key: "${event.order_id}" - name: notify_im connector: IM.DingTalk when: "steps.create_order.status == 'SUCCESS'" action: send_markdown input: text: "订单 ${event.order_id} 已同步" on_error: - dead_letter: kafka://dlq.sales-order-sync - notify: im.feishu://ops-alerts 5.2 语义映射与数据对齐 字段语义匹配:LLM + 嵌入向量对齐多系统字段(如 customerId ↔︎ KUNNR),给出可解释的映射建议。 Schema Diff/升级建议:自动分析 API 变更影响面,生成测试用例与回滚策略。 5.3 智能运维与根因分析 异常检测:对延迟/错误率时间序列做异常分段,结合 Trace 语义摘要 → 提示可疑上游/依赖。 问答式排障:在 ChatOps 中提问“昨天 18:00–20:00 订单同步失败率为何升高?”,返回链路对比与配置变更摘要。 策略建议:给出限流/重试/缓存的参数优化建议与模拟结果。 5.4 AI 安全与合规 自动分类与脱敏:基于样例学习识别 PII/财务数据,建议字段级脱敏与存储分级策略。 Prompt & Tooling 治理:模型调用带审计与配额,敏感数据红线与回放检测。 6. 从 ESB 到 OiPaaS:可落地的迁移方法论 Oinone 基于 iPaaS 平台快速替换原有 ESB,实现近 170+ 接口的迁移,并将接口可视化、调用追踪、统一权限纳入日常运维面。 迁移六步走: 盘点与契约化:扫描 ESB 路由与适配器,生成 API 契约与依赖拓扑,冻结变更窗口。 连接器替换:以标准连接器(SOAP/HTTP/MQ/DB 等)替换自研适配器;保留旧端点以双写对拍。 流程编排上收:把 ESB 内部脚本/路由翻译为 Flow(并并行引入事件化拆分)。 数据映射 AI 辅助:语义匹配生成字段映射初稿 → 人审校 → 单元/契约测试自动生成。 灰度与回放:金丝雀发布 + 录制/回放真实流量,逐步提升权重;错误进入 DLQ 并可一键重放。 关停与固化:切换流量至新网关,存档 ESB 工件与运维 Runbook,统一纳入可视化与审计。 工程要点: 幂等键与去重(如 order_id) 超时/重试/熔断策略“模板化” 统一认证(OIDC)替代分散白名单;必要时保留 IP 控制作兜底 合同测试(Contract Test)作为准入门槛 指标门(Error Budget)保障上线节奏 7. 典型一体化集成场景 主数据同步(MDM):客户/物料/供应商跨 CRM/ERP/MES/电商平台的事件化分发。 Order-to-Cash:订单创建 → 信用检查 → 仓配 → 开票 → 商家/用户通知,全链路可观测。 Procure-to-Pay:采购申请 → 比价 → 下单 → 收货 → 对账 → 支付,跨系统对齐与合规审计。 AI Copilot for Ops:值班群内直接问“近 24h 超时前 5 的接口?原因?”,返回链路/配置/变更摘要与建议动作。 知识增强(RAG):把 API 契约、运行手册、告警记录纳入企业向量库,面向开发与运维的语义检索。 8. 运维与可观测性落地 黄金信号:吞吐、延迟(P50/P95)、错误率、资源饱和度。 SLO & Error Budget:以接口/域/系统为单位设定目标与预算,自动化告警与发布节律联动。 拓扑视图:一键定位“谁调用了谁、失败发生在哪一跳、哪个字段映射最易出错”。 回放与演练:定期灾备演练、DLQ 重放、灰度回滚策略标准化。 9. 安全与合规 零信任与最小权限:服务账号、短期令牌、mTLS、细粒度 Scope、按需授权。 数据治理:PII 自动识别、字段脱敏、跨境合规、密钥轮换与全链路审计。 策略模板:不同数据域(财务/人事/交易)绑定预置策略与审批流。 策略示例: policy: api: /erp/orders auth: oidc scopes: ["orders.write"] mtls: required rate_limit: "200r/s" allow: - principal: svc://crm-sync data_masking: fields: ["buyer_phone", "id_number"] mode: hash 10. 价值衡量与业务影响 集成效率:新系统接入/新接口上线时长下降,复用标准化连接器与映射模板。 稳定性:可观测性增强,排障从小时级降至分钟级(依赖具体场景);DLQ/回放降低不可恢复错误。 治理透明度:接口运行态势、配额与权限统一治理,合规审计“可提可证”。 可扩展性:在统一规则/架构下持续演进,系统增长不带来复杂度失控。 总结 通过 Oinone iPaaS,企业可以在 统一标准、统一治理、统一观测 的前提下,完成从 ESB 到 “集成 + AI” 一体化平台 的跃迁: 用 契约与事件 把复杂度收敛; 用 AI 提升设计、映射、测试、运维的自动化与智能化程度; 用 统一的规则和架构 实现持续演进与规模化协同。

优秀的个人博客,低调大师

快学学大牛最爱的t-SNE算法吧(附Python/R代码)

假设你有一个包含数百个特征(变量)的数据集,却对数据所属的领域几乎没有什么了解。 你需要去识别数据中的隐藏模式,探索和分析数据集。不仅如此,你还必须找出数据中是否存在模式--用以判定数据是有用信号还是噪音? 这是否让你感到不知所措?当我第一次遇到这种情况,我简直全身发麻。想知道如何挖掘一个多维数据集? 这是许多数据科学家经常问的问题之一。 该篇文章中,我将带你通过一个强有力的方式来实现这一点。用PCA怎么样? 现在,一定会有很多人心里想着“我会使用PCA来降维和可视化”。 好吧,你是对的!PCA绝对是具有大量特征的数据集的降维和可视化的不错选择。 但是,假如你能使用比PCA更先进的东西将会怎样呢? 如果你可以很容易地找出非线性的模式呢? 在本文中,我将告诉你一个比PCA(1933)更有效、被称为t-SNE(2008)的新算法。 首先我

优秀的个人博客,低调大师

BGP公网成本节省50%秘笈,共享流量包、共享带宽包,便宜到阿里云快哭了

近日,阿里云推出了共享流量包和共享带宽包,将云上BGP公网使用成本大幅降低,最高可降50%。 共享流量包是BGP流量的预付费套餐,价格比后付费流量更低,并支持闲时流量包,大大降低了BGP流量成本。共享流量包产品覆盖面广,按流量计费的ECS、EIP、SLB和NAT网关都可以使用。 共享带宽包是独立的带宽产品,提供高质量的多线BGP带宽和丰富多样的计费模式。支持将弹性公网IP(EIP)添加到共享带宽,这些EIP将同时共享和复用带宽包中的带宽。可以将EIP绑定到云服务器ECS、NAT网关(即将支持),实现ECS和NAT网关也共享带宽。非常重要的是,共享带宽包提供丰富的计费支持,包括增强型95计费、按小时计费、按固定带宽计费。通过共享带宽和这些丰富的计费方式可有效节省带宽使用成本,并提供更强的弹性服务能力。 那么,共享流量包和带宽包到底能给用户

优秀的个人博客,低调大师

Scrapy 内部机制全拆解:从事件循环到代理池,一文读懂它的 "快" 与 "稳"

一、为什么值得拆解 Scrapy在 Python 爬虫生态中,Scrapy 并非简单的 "抓取函数库",而是一个面向生产环境的异步抓取框架。它将 URL 调度、并发下载、内容解析、数据清洗与分布式扩展封装为统一的组件体系,并以事件循环为核心实现跨平台一致运行 —— 同一套代码在 Windows(IOCP)、macOS(kqueue)、Linux(epoll)上的网络 I/O 语义完全一致。理解其内部机制的价值不在于 "会调用 API",而在于当面临性能瓶颈、反爬对抗与定制化扩展时,能够精准定位应当修改的组件与数据流节点。二、总体架构:以引擎为中心的组件协作模型Scrapy 采用单一引擎驱动的流水线模型。引擎(Engine)本身不执行具体业务,而是承担状态编排与数据流转的分发职责。各组件职责如下:表格

优秀的个人博客,低调大师

较 Trino 省 67% 成本,速度快 10 倍,中通快递基于 SelectDB 的湖仓分析架构

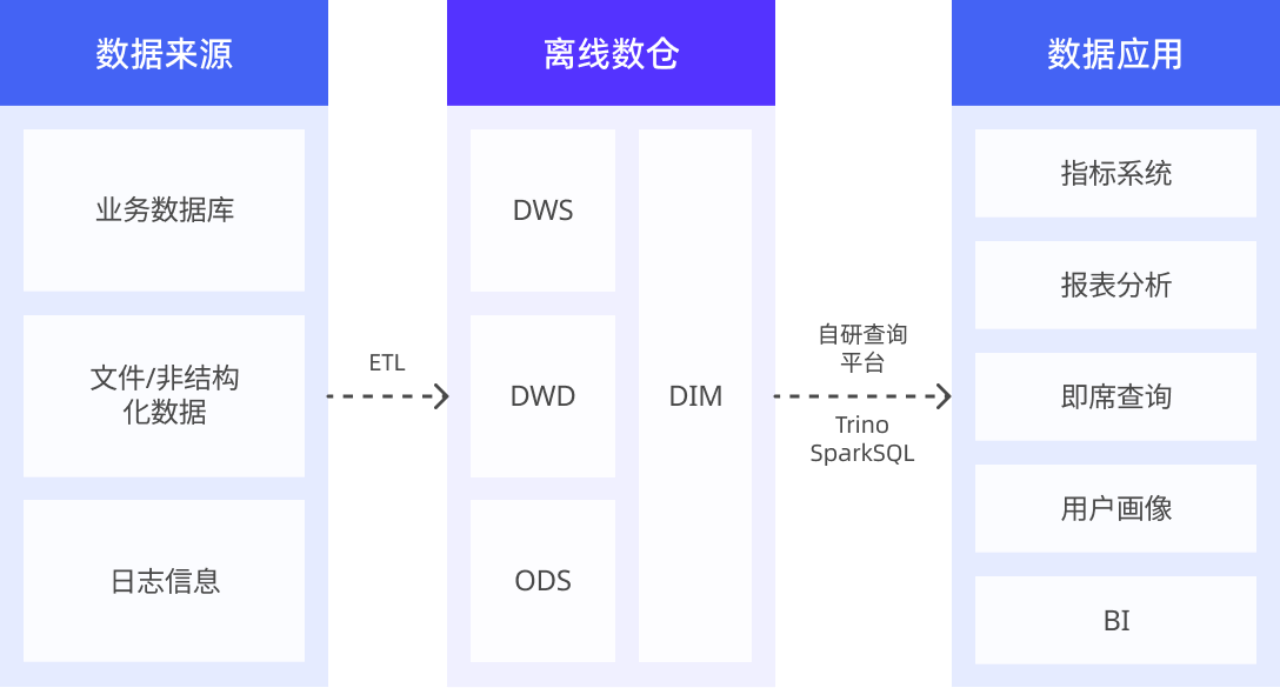
导读:中通快递基于 SelectDB 构建了湖仓分析架构,补齐 OLAP 分析能力。在离线场景中,实现 2000+ QPS 并发点查;在实时场景中,仅以 1/3 原集群机器数量覆盖所有业务,90% 分析任务从 10 分钟缩短至 1 分钟内,投入产出比大幅提升。 作者:童孝天,中通快递高级数据工程师 中通快递作为快递行业领军企业之一,年包裹数达数百亿件,市场份额稳定在 20% 左右,展现出强劲的市场竞争力和持续发展态势。在业务规模持续扩张下,其对大数据基础设施建设要求日益提高,对数据处理及分析的需求也持续增加。 中通快递原先使用以 Hadoop 为核心的离线数仓,但随着数据的不断增长、数据处理需求不断变化, Hadoop 这一多套异构的复杂架构逐步暴露瓶颈,面临数据时效性、查询性能、并发能力、维护成本等多种挑战。 在此背景下,引入基于 Apache Doris 内核的 SelectDB 构建了湖仓分析架构,补齐 OLAP 分析能力,为离线、实时分析提供了高效的查询能力。在离线场景中,实现 2000+ QPS 并发点查;在实时场景中,仅以 1/3 原集群机器数量覆盖所有业务,90% 分析任务从 10 分钟缩短至 1 分钟内,投入产出比大幅提升。 一、早期架构及挑战 在引入 SelectDB 之前,中通基于 Hadoop 构建离线数仓应对数据分析需求。在业务量高速增长的背景下,该架构面临严峻挑战: 数据时效性不足:离线数仓 T+1 数据抽取产出模式无法满足报表和数据大盘实时更新的需求; 查询性能较差:离线数仓读取、写入等操作均基于 HDFS 进行,耗时普遍为分钟级别,以及 Spark SQL 的处理时间亦为分钟级,严重影响查询效率,无法支持需要秒级响应的交互式分析场景。 查询稳定性与高并发支持能力弱:在超大的 Hadoop 集群规模下,NameNode 的轻微抖动就会严重影响短平快的即席查询和报表分析的稳定性,Trino 在处理高并发查询时效率也远低于预期,难以支撑日益增长的高并发需求。 二、基于 SelectDB 的湖仓分析架构 随着业务的不断发展,昔日双 11 的业务高峰现已成为每日常态。为了满足各大场景对实时分析时效的要求,并确保数据的快速写入和高效查询,亟需合适的 OLAP 引擎来补充现有架构。 1. 技术选型 中通技术团队通过深入的技术调研和测试验证,了解到 基于 Apache Doris 内核构建的 SelectDB。SelectDB 以高效的向量化引擎、Pipeline 执行模式、完善的缓存机制支持、高度兼容的 SQL 语法以及灵活的湖仓分析能力吸引了他们 为了验证 SelectDB 向量化引擎和 Pipeline 执行模式的高性能查询能力,团队进行了多轮对比测试,以评估二者之间的性能差异: 在生产环境 SQL 测试中,单表 100GB 数据量的查询场景下,SelectDB 相比 Trino 有 1-2 倍的性能提升; 在 1TB TPC-DS 标准测试中,SelectDB 完成 99 个查询的总耗时仅为 Trino 的 1/5。 2. 湖仓分析实时架构 中通基于 SelectDB 构建了新一代的湖仓分析架构,其核心是将 SelectDB 作为统一、高性能的查询加速引擎覆盖在数据湖之上。数据依然存储在 Hive 数据湖中,保持其经济性和容纳海量原始数据的能力。 具体而言,SelectDB 通过 Multi-Catalog 直接对接 Hive Metastore,无需数据迁移即可创建外部表,实现对 Hive 湖中数据的直接、高速查询。为了进一步提升查询体验,中通广泛采用了 SelectDB 的缓存加速、数据预热、索引体系、分区分桶等能力,有效保障了系统的稳定性及查询的高效性。 截止当前,在 OLAP 分析层面, Trino 集群规模已超过 130 台,日峰值响应接近 56 万个查询。相比之下,SelectDB 虽仅拥有三套集群规模,总数为 60 台,但日峰值响应量接近 90 万个查询。这一数据表明,SelectDB 在实时计算的响应能力方面具有显著优势,能够更加高效地满足大量查询需求。 三、场景实践 1. BI 报表与离线分析 在 BI 报表和离线分析场景中,原有 Trino 架构面临查询稳定性差和并发能力不足的双重挑战。特别是在早高峰时段,业务人员集中访问报表系统,频繁出现查询超时和系统卡顿。同时,Trino 和 SparkSQL 在在面对高并发查询时,处理效率与预期存在较大差距。 在查询超时问题上,我们开启了数据缓存(Data Cache)功能,并配置大容量本地磁盘,将热数据持久化缓存。在每日数据就绪后,通过定时任务触发对关键报表数据的预加载,使其在业务高峰前已缓存至本地。避免了查询延迟高的问题,同时降低早高峰期间集中访问导致带宽拉满的问题。在同等查询量下,SelectDB 的慢 SQL(>10s)仅为 Trino 的百分之一。 在高并发查询挑战的应对上,中通快递在实时数仓建设阶段,将离线数据 DIM 维度层、应用层的数据通过 SeaTunnel 写入了 SelectDB 中,实现了结果表的查询加速。从而实现 2000+ QPS 并发点查,数据报表更新及时度大大提高。 其次,SelectDB 提供了灵活丰富的 SQL 函数公式,并拥有高吞吐量的计算能力,数据分析师、产品经理等业务人员通过可视化报表工具 + SelectDB 即可基本满足 BI 的数据探索需求,大部分查询响应速度都在秒级完成。 该场景下,在保持高性能、高并发的同时,显著节约了计算资源,SelectDB 集群规模约为 Trino 的 1/4。 2. 实时数据分析 面向决策层和运营监控的实时数据大屏,对查询时效性要求极高,需要支持灵活的多维筛选和聚合分析。该场景涉及一张日增量超 6 亿、总量超 45 亿、字段超 200 列的超级宽表,并需基于该宽表进行分钟级准实时分析。 原有 OLAP 引擎在任务增多时,负载过高时,任务执行时效难以保证。比如,当总任务数超 50 时,执行时间达 5-10 分钟,效率极为低下。 因此,基于 SelectDB 以下特性成功解决上述问题: 查询加速:借助倒排、BloomFilter 来支持多维分析,通过合理的分区分桶,在查询时过滤非必要的数据,使数据扫描快速定位,加速查询响应时间。使 90% 以上的查询从 10 分钟左右缩短到 1 分钟内,部分达到秒级,性能提升 10 倍。 数据写入秒级可见:SelectDB 支持主键表(Unique Key),并对 Upsert、条件更新/条件删除、部分列更新、分区覆盖等各类更新提供了完备的支持,借助 Flink,可完成对数据的秒级可见,满足高效灵活的数据更新需求 注意:对表结构的设计需要结合业务、因地制宜,合理规划 Key 和分区分桶列,一般将 where 条件或者 join 的字段定义成分桶较为合适 在该场景下,SelectDB 仅使用原集群 1/3 的资源就覆盖了所有业务,实现了高效且经济的运行。满足了业务方对数据“既快又准”的严格要求,提升了监控和决策的效率。 四、成果及价值 中通引入 SelectDB 后,查询性能实现巨大飞跃,延迟大幅下降,并发能力显著提升,同时成本大幅降低,系统稳定性与易维护性也得到增强。 未来,中通将会深化与 SelectDB 的合作: 提升易用性:利用 SelectDB 提供的更精炼、直观的 Profile 信息,降低 SQL 调优的难度和复杂度,提升开发运维效率; 增强系统可观测性:强化文件缓存等功能的可观测性,加强数据倾斜处理能力,以提升整个系统的可靠性与可维护性; 深化湖仓一体:加强 Multi Catalog 功能的应用,提升湖仓分析能力,并测试 SelectDB 读写 Hive 外表的能力,实现更灵活的数据流转; 打通权限与集成:推动实现 Hive Catalog 权限通过 JDBC 账号的透传,与公司现有大数据权限体系无缝融合,确保数据安全。 加入交流群 聚集众多 SelectDB 与 Apache Doris 开发者、用户以及合作伙伴,欢迎随时提出和讨论技术问题、 分享和收获技术经验,与社区互动交流。 https://www.selectdb.com/join-community#join-group

优秀的个人博客,低调大师

超长序列,超快预测!深势科技联手阿里云,AI 蛋白质预测再下一城

摘要:强强联合,突破 AI 蛋白质预测模型推理性能瓶颈,支持最高 6.6k 长氨基酸序列蛋白质的预测计算,达到目前已知最优推理效果。 近日,深势科技与阿里云机器学习 PAI 团队联手,通过全新的蛋白质结构预测推理加速方案 FoldAcc,结合深势 Uni-Fold 最新模型代码和参数,将单次预测能支持的最大氨基酸序列长度提升至 6.6k,覆盖 99.992%已知的蛋白序列,同时推理速度显著提升,达到目前已知的最佳推理优化效果,将为 AI 预测蛋白质结构落地应用提供重要助力。 以新冠病毒研究重点之一——具有三聚体结构的刺突蛋白为例,其氨基酸序列典型总长度接近 4k,原版 AlphaFold 会因为超出显存限制(OOM)而无法进行预测计算,使用 Uni-Fold + FoldAcc 则能在 10 分钟左右完成 AI 推理计算。 自 2020 年 DeepMind 推出基于深度学习模型的 AlphaFold2 以来,AI 技术辅助蛋白质结构精确预测的相关研究备受关注,产学研界不断涌现创新成果。然而,在推动 AI 蛋白质结构预测规模化、产业化落地进程中,基础设施及工具完善性、AI 模型开发与部署效率等问题,仍然是横亘在研究者面前的难题。 2022 年 8 月,深势科技升级并开源 Uni-Fold 项目,成功复现了 AlphaFold2、AlphaFold-Multimer 模型的全尺寸从头训练,并通过多项效率优化,并将 AlphaFold 训练速度提升 220%,超越 OpenFold、FastFold 等方案,惠及更多研究者。 其中,针对困扰业界已久的 Evoformer 神经网络结构推理性能瓶颈问题,深势科技与阿里云 PAI 团队,基于在 AI 模型系统优化领域的长期积累,融合多卡并行、混合精度、编译优化等多项推理优化技术,使 Uni-Fold 训练的模型能进行多卡推理加速,并支持计算更长的氨基酸序列。 典型加速效果的测试结果如下(基于 A100-80G GPU,并启用 bf16) Uni-Fold 升级开源,支持复合物训练 作为生命科学领域重要的基础问题,蛋白质结构研究关系到癌症预警、靶向药物研究、衰老等临床医学和生命科学课题。传统的蛋白质结构研究手段,如:X 射线晶体学、冷冻电镜等,需要消耗大量时间和资源。如何快速高效并且能够规模化地预测蛋白质结构,一直是研究者们探寻求解的重要问题。 2021 年 12 月,深势科技推出 Uni-Fold v1.0.0,国际首次复现了 AlphaFold2 官方代码的全尺寸从头训练,并开源了训练与推理代码;2022 年 8 月,Uni-Fold 升级并开源了最新代码与模型参数,完整支持蛋白质单体、复合物结构预测模型的推理与训练。 此次开源的 Uni-Fold 基于 PyTorch 复现并改进的 AlphaFold (-Multimer) 模型,支持从头训练和推理部署,并且在 Protein Data Bank(PDB)最新公布的、模板相似度小于 40%的单体与复合物测试集上,都取得了与同类开源项目一致或更优的准确率。 此外 Uni-Fold 也进行了多项效率优化,将训练时间由 11 天缩短至约 4 天,显著优于其他同类开源项目。 机器学习平台 PAI 提供全链路 AI 工程支撑 阿里云机器学习平台 PAI 为 Uni-Fold 项目提供了完善的 AI 工程能力。PAI 是国内唯一连续入选 Gartner 数据科学与机器学习平台报告的机器学习/深度学习平台,面向 AI 开发及应用全链路提供全面的工程化服务,并具备丰富的场景化落地实践。 针对模型推理优化场景,PAI 自研的通用推理加速器 PAI-Blade 能在不同业务场景下,通过模型系统联合优化,使模型达到最优推理性能,兼容主流机器学习框架,适配 GPU、CPU、端侧设备等多类型加速设备。 其中,PAI-Blade 核心组件 BladeDISC 具备业界领先的动态尺寸模型优化、大颗粒度算子融合等编译优化技术,在阿里巴巴集团内外客户的实际生产场景广泛应用,助力实现高性价比的 AI 应用部署。2022 年 2 月,BladeDISC 项目正式开源。 未来,为前沿科研提供更好用的 AI 基础设施 以 AI 蛋白质结构预测为典型代表,AI for Science 的科学研究新范式正取得越来越多突破,人工智能与生命科学、物理、化学等领域的技术交织,将为科学研究和产业进步带来极大推动,也对 AI 基础技术与平台应用提出了新挑战。 深势科技是 AI for Science 科学研究范式的先行者,阿里云机器学习平台 PAI 是国内应用最广泛的机器学习平台之一,我们将持续为生物医药、能源、材料等领域的研究与产业应用提供更好用的 AI 基础设施,共同推动 AI for Science 领域的技术生态建设。 附录 深势科技开源项目 Uni-Fold:https://github.com/dptech-corp/Uni-Fold 阿里云开源 AI 编译器 BladeDISC:https://github.com/alibaba/BladeDISC

优秀的个人博客,低调大师

一人行快,众人行远!亚马逊云科技如何赋能合作伙伴共成长?

【51CTO.com原创稿件】技术的普及与落地,离不开生态圈的通力合作;一家公司的快速发展,离不开合作伙伴的共建。亚马逊云科技亦是如此。 2013年,亚马逊云科技推出全球合作伙伴网络 (AWS Partner Network,APN) ,旨在为技术和咨询合作伙伴提供业务、技术、市场营销和产品上市支持。截至目前,全球有数以万计的亚马逊云科技合作伙伴,超过 90% 的财富 100 强企业和大部分财富 500 强企业都在使用APN提供的解决方案和服务。 在近日举行的亚马逊云科技技术峰会上海站,亚马逊全球副总裁兼亚马逊云科技大中华区执行董事张文翊在介绍亚马逊云科技的五大优势时,全球丰富的合作伙伴解决方案便是其中之一。 张文翊指出,自亚马逊云科技开创的初期,合作伙伴就是亚马逊云科技关键的业务战略。在过去几年中,亚马逊云科技的全球合作伙伴网络获得了非常有序的发展。目前,亚马逊云科技在全球有10万多家合作伙伴分布在150多个国家,他们为客户提供了非常丰富的解决方案,满足来自于各行各业的、各种规模的客户,在各个应用场景的需求。而且在过去的五年中,APN在全球每天都在新增50多家合作伙伴,也获得了5倍以上的增长。 在中国,合作伙伴是亚马逊云科技发展业务不可或缺的中坚力量,开放、多元的合作伙伴网络覆盖了数以千计的各种合作伙伴,包括咨询类合作伙伴、系统集成商、独立软件供应商等等。亚马逊云科技通过能力认证、支持计划、解决方案和市场拓展等全方位赋能一起来助力合作伙伴的成长。同时,亚马逊云科技也帮助中国的亚马逊云科技合作伙伴服务本地客户和成功出海,帮助全球ISV落地中国,促进中国云计算产业和生态的发展,加速客户数字化转型和创新。 亚马逊云科技中国区生态系统及合作伙伴部总经理汪�ケ硎荆�每一个合作伙伴都有各自特点以及客户行业背景,因此,亚马逊云科技针对合作伙伴情况,从能力认证、支持计划、解决方案、市场覆盖四个方面全方位支持合作伙伴。其中有两大核心标准,一是满足客户需求,高质量地帮助客户进行创新;二是结合合作伙伴特点,帮助合作伙伴找到差异性,发挥专长,为客户创新提供更好的服务。 据了解,亚马逊云科技的能力计划包括三大方面。第一是技术能力,亚马逊云科技规定了不同方向的技术能力认证,合作伙伴必须要达到标准才能通过技术能力认定;第二是客户服务能力,合作伙伴不但要有技术能力,还要在客户交付过程中实现技术能力,包括服务客户的标准,客户交付流程都应该有相应的准则,亚马逊云科技在全球的标准中结合客户服务经验,制定了服务的交付标准和交付流程等方面,帮助合作伙伴将技术转化成生产力;第三是业务增长能力,当合作伙伴具备技术能力、高标准交付能力时,亚马逊云科技会给予合作伙伴更多的支持,例如在APN网站上出现,让更多客户看到,也会在奖励计划中给予合作伙伴更多的市场拓展机会。 左起:亚马逊云科技中国区生态系统及合作伙伴部总经理汪�ァ⒈本┥裰萏┰廊砑�股份有限公司云业务部总经理刘家歆、网宿科技副总裁李伯洋、 伊克罗德信息科技总经理桂梓捷光环有云(北京)网络服务有限公司CEO程辉 技术赋能 网宿科技在中国耕耘20年,随着客户需求不断变化,网宿科技在开展云服务时能力稍有欠缺。网宿科技副总裁李伯洋表示,早期网宿科技在帮助客户进行云转型时,认为帮助客户进行账单管理、成本优化会相对简单,但却不知这需要从架构和业务逻辑等方面帮助企业进行综合分析和评估,并且需要结合新兴技术帮助企业降低成本。通过亚马逊云科技的能力认证项目实践后,网宿科技能够更好地帮助客户降低成本、提升效率。 亚马逊云科技能力认证不但帮助网宿科技了解最新技术发展和落地情况,还帮助技术团队实现人才培养。李伯洋总结道,亚马逊云科技的能力认证提供了方法论,经过认证后,网宿科技团队成员的能力得到了大幅提升,有更多的员工更愿意参与并完成项目的最佳实践,并且有意愿挑战更加有难度的项目。最终,团队实现了正向循环、自我驱动。 亚马逊云科技的能力认证对于人才培养的优势在神州泰岳公司也得到了体现。北京神州泰岳软件股份有限公司云业务部总经理刘家歆表示,亚马逊云科技的能力认证在每一个节点的过程中对文档的要求非常高,以及对整个事件的节点细节要求非常高。通过亚马逊云科技的能力认证,神州泰岳的技术团队除了延续以往结果导向的项目交付原则外,还加强过程中的细节处理,升级自我提升的规划之路,持续依照亚马逊云科技的能力认证进阶要求提升专项业务能力。 此外,亚马逊云科技的能力认证还打破了中国技术服务的传承方式。光环有云(北京)网络服务有限公司CEO程辉表示,中国的技术服务最大的痛点在于团队对于整体部署或交付共识的建立是特别难的,传统做法就是师傅带徒弟,这依赖于师傅个人的发挥,因此就极大地阻碍了公司业务的发展和客户服务的体验。而亚马逊云科技的能力认证可以解决这一痛点,徒弟可以直接培训后考证,通过亚马逊云科技的能力认证后形成技术能力和服务能力,认证合格后便可上岗。 一致的高标准要求 通过亚马逊云科技能力认证后,合作伙伴可以提高曝度,获得更多市场进入支持,同时还可以获得更多的资金和折扣。因此,合作伙伴需要经过高标准的审查、验证和核实,才能获得亚马逊云科技的能力认证。这其中,还要求合作伙伴为客户提供服务时是高标准并且是一致的体验。 程辉回忆说道,在光环有云进行能力认证时,需要提供实际完成的案例内容,但是亚马逊云科技要求每个案例内容的标准是一致的,不能有的案例完成的特别完整,非常符合规范,但有的案例就稍有欠缺。因此,光环有云意识到,无论是服务哪种类型的客户,都要坚持一致的高标准来完成项目,才能赢得客户的口碑。这也成为了光环有云服务客户的要求和标准。 网宿科技在进行能力认证时也同样遇到了标准不一致被驳回的情况。李伯洋表示,由于工程师水平不一,在进行客户交付时质量也就不一样,但是亚马逊云科技要求的能力认证标准是一致的,因此我们必须补齐短板,在交付客户时保证一致的高标准要求。网宿科技也希望吸纳更多专业的高水平标准的工程师,构建自身的能力体系,保证客户交付的质量。 灯塔指引 伊克罗德成立于2014年,也是亚马逊云科技核心级的咨询合作伙伴,为客户提供的服务包含了迁移、实施、托管、运维等多样化解决方案。伊克罗德是第一家获得亚马逊云科技中国AI/ML能力认证的合作伙伴,在去年Amazon SageMaker落地中国后 ,伊克罗德借助Amazon SageMaker帮助客户开发解决方案时,节省了非常多的流程串接和套件安装等工作。伊克罗德透过丰富的AI/ML相关客户案例,累积了许多的模型基础,并运用Amazon SageMaker服务加速企业导入行业AI解决方案,如标签标注、文本分析、语意理解、预测分类、推荐系统与诈欺侦测等,针对客户实际遇到的商业问题,量身打造真正解决问题的端到端AI应用。 伊克罗德信息科技总经理桂梓捷提到,海外企业的上云转型已经走在前列,亚马逊云科技在帮助企业客户实现转型的过程中,形成了众多能力认证的项目,透过能力认证确保合作伙伴在交付客户需求时可以达到要求和标准。当国内的合作伙伴看到海外应用的趋势后,可以提前布局,挖掘中国客户的需求,同时完善自身的能力认证计划,在取得认证后帮助中国客户进行转型。 结语 自亚马逊云科技能力认证计划推出以来,亚马逊云科技一直在稳步发布新的认证,帮助合作伙伴扩充自己的能力维度。亚马逊云科技提供最具深度和宽度的服务体系,合作伙伴可以在此基础上结合自己的实践经验、行业了解和业务流程规范,为客户提供最佳的实践。目前,亚马逊云科技已经为咨询合作伙伴和ISV合作伙伴提供了涵盖包括云迁移、大数据、机器学习、安全及不同行业和工作负载的29个大类超过50个能力认证。 汪�ケ硎荆�源于亚马逊云科技对客户需求的理解,亚马逊云科技还会推出不同种类的能力计划。亚马逊云科技也会根据中国客户特点,根据合作伙伴自身特长,帮助他们获得能力认证。目前能力认证计划在中国深受合作伙伴欢迎,在技术方向集中在开发运维、存储、机器学习、数据分析等领域,行业方面重点集中在金融、教育、物联网等服务方面。 【51CTO原创稿件,合作站点转载请注明原文作者和出处为51CTO.com】 【责任编辑:鸢玮 TEL:(010)68476606】

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册