首页 文章 精选 留言 我的

精选列表

搜索[鸿蒙实践],共10000篇文章
优秀的个人博客,低调大师

redis从入门到实践

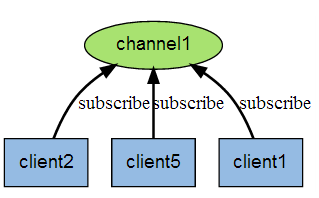
一. Redis安装使用 1.介绍 redis是一个key-value存储系统。和Memcached类似,它支持存储的value类型相对更多, 包括string(字符串)、list(链表)、set(集合)、zset(sorted set--有序集合)和hash(哈希类型)。 这些数据类型都支持push/pop、add/remove及取交集并集和差集及更丰富的操作,而且 这些操作都是原子性的。在此基础上,redis支持各种不同方式的排序。与memcached一样, 为了保证效率,数据都是缓存在内存中。区别的是redis会周期性的把更新的数据写入磁盘 或者把修改操作写入追加的记录文件,并且在此基础上实现了master-slave(主从)同步。 2.安装redis 1.下载官网最新redis安装包 http://download.redis.io/releases/redis-4.0.0.tar.gz 2.在/usr/local下创建文件redis cd /usr/local mkdir redis 3.将下载的redis-4.0.2.tar.gz安装包解压到redis文件夹中 cd ~ tar -zxvf redis-4.0.2.tar.gz -C /usr/local/redis 4.进入解压后的目录进行编译 cd /usr/local/redis/redis-4.0.2 make 5.安装到指定目录,如 /usr/local/redis cd /usr/local/redis/redis-4.0.2 make PREFIX=/usr/local/redis install 6.拷贝配置文件redis.conf到安装目录下 cp /usr/local/redis/redis-4.0.2/redis.conf /usr/local/redis/bin 7.修改redis.conf配置文件,这里使用默认端口6379,有需要的可以更改。 把daemonize改为yes(这里推荐以后端模式启动) vi /usr/local/redis/bin/redis.conf ----------------------------------- 以后端模式启动redis cd /usr/local/redis ./bin/redis-server ./bin/redis.conf 8.测试redis cd /usr/local/redis ./bin/redis-cli set name zhangsan get name 9.Linux开启关闭redis 1.启动:./redis-server(redis-server redis.conf) 2.登陆:./redis-cli(redis-cli -p 6379) 3.关闭:./redis-cli shutdown 10.Linux 为redis配置密码 1.第一种方式(临时密码,Linux重启后会消失) (1) [root@localhost bin]# redis-cli -p 6379 127.0.0.1:6379> (2)查看当前redis有没有设置密码: 127.0.0.1:6379> config get requirepass 1) "requirepass" 2) "" (3)为以上显示说明没有密码,那么现在来设置密码: 127.0.0.1:6379> config set requirepass abcdefg OK 127.0.0.1:6379> (4)再次查看当前redis就提示需要密码: 127.0.0.1:6379> config get requirepass (error) NOAUTH Authentication required. 127.0.0.1:6379> 2.第二种方式 (永久方式) 需要永久配置密码的话就去redis.conf的配置文件中找到requirepass这个参数,如下配置: 修改redis.conf配置文件 # requirepass foobared requirepass 123 指定密码123 保存后重启redis就可以了 11.Jedis连接redis java 代码方式 //连接redis服务器,192.168.0.100:6379 jedis = new Jedis("ip", 6379); //权限认证 jedis.auth("password"); 配置文件方式 <bean id=”jedisConnectionFactory” class=”org.springframework.data.redis.connection.jedis.JedisConnectionFactory”> <property name=”hostName” value=”${redis.host}” /> <property name=”port” value=”${redis.port}” /> <property name=”password” value=”${redis.pass}” /> </bean> redis的其他命令 如果需要关闭redis: [root@localhost bin]# pkill redis 如果需要开启redis: [root@localhost bin]# redis-server & 加&符号的作用是为了让此进程转换为后台进程,不占用shell的服务。 注意事项 1.提示time out错误 需要在iptables防火墙上添加6379端口并重启防火墙服务 2.提示connection refuse错误 需要注释掉redis.conf 文件中的bind 127.0.0.1 3.提示J edisDataException错误 需要将redis.conf文件中的protect-mode 置为no最后重启redis 应用场景 1.缓存 2.聊天室,秒杀,任务队列(list结构,pop(弹出),push(插入)) 3.数据存储(add,del,update,select)定期持久化到硬盘中 4.网站统计 5.数据过期处理 6.分布式集群架构中的session分离 主要内容 NoSQL(非关系型数据库) redis:key/value键值dui存储数据库 mongodb:文档型数据库 hbase:列式数据库 neo4j:图式数据库,存储的是图关系而非行或列。主要用于社交网络的存储 redis数据结构:String Hash Set SortedSet List redis事务:multi exec discard redis持久化:rbd内存快照,aof命令日志 二.Redis快速入门 1.redis 配置说明 1\. Redis默认不是以守护进程的方式运行,可以通过该配置项修改,使用yes启用守护进程 daemonize no 2\. 当Redis以守护进程方式运行时,Redis默认会把pid写入/var/run/redis.pid文件,可以通过pidfile指定 pidfile /var/run/redis.pid 3\. 指定Redis监听端口,默认端口为6379,作者在自己的一篇博文中解释了为什么选用6379作为默认端口,因为6379在手机按键上MERZ对应的号码,而MERZ取自意大利歌女Alessia Merz的名字 port 6379 4\. 绑定的主机地址 bind 127.0.0.1 5.当 客户端闲置多长时间后关闭连接,如果指定为0,表示关闭该功能 timeout 300 6\. 指定日志记录级别,Redis总共支持四个级别:debug、verbose、notice、warning,默认为verbose loglevel verbose 7\. 日志记录方式,默认为标准输出,如果配置Redis为守护进程方式运行,而这里又配置为日志记录方式为标准输出,则日志将会发送给/dev/null logfile stdout 8\. 设置数据库的数量,默认数据库为0,可以使用SELECT <dbid>命令在连接上指定数据库id databases 16 9\. 指定在多长时间内,有多少次更新操作,就将数据同步到数据文件,可以多个条件配合 save <seconds> <changes> Redis默认配置文件中提供了三个条件: save 900 1 save 300 10 save 60 10000 分别表示900秒(15分钟)内有1个更改,300秒(5分钟)内有10个更改以及60秒内有10000个更改。 10\. 指定存储至本地数据库时是否压缩数据,默认为yes,Redis采用LZF压缩,如果为了节省CPU时间,可以关闭该选项,但会导致数据库文件变的巨大 rdbcompression yes 11\. 指定本地数据库文件名,默认值为dump.rdb dbfilename dump.rdb 12\. 指定本地数据库存放目录 dir ./ 13\. 设置当本机为slav服务时,设置master服务的IP地址及端口,在Redis启动时,它会自动从master进行数据同步 slaveof <masterip> <masterport> 14\. 当master服务设置了密码保护时,slav服务连接master的密码 masterauth <master-password> 15\. 设置Redis连接密码,如果配置了连接密码,客户端在连接Redis时需要通过AUTH <password>命令提供密码,默认关闭 requirepass foobared 16\. 设置同一时间最大客户端连接数,默认无限制,Redis可以同时打开的客户端连接数为Redis进程可以打开的最大文件描述符数,如果设置 maxclients 0,表示不作限制。当客户端连接数到达限制时,Redis会关闭新的连接并向客户端返回max number of clients reached错误信息 maxclients 128 17\. 指定Redis最大内存限制,Redis在启动时会把数据加载到内存中,达到最大内存后,Redis会先尝试清除已到期或即将到期的Key,当此方法处理 后,仍然到达最大内存设置,将无法再进行写入操作,但仍然可以进行读取操作。Redis新的vm机制,会把Key存放内存,Value会存放在swap区 maxmemory <bytes> 18\. 指定是否在每次更新操作后进行日志记录,Redis在默认情况下是异步的把数据写入磁盘,如果不开启,可能会在断电时导致一段时间内的数据丢失。因为 redis本身同步数据文件是按上面save条件来同步的,所以有的数据会在一段时间内只存在于内存中。默认为no appendonly no 19\. 指定更新日志文件名,默认为appendonly.aof appendfilename appendonly.aof 20\. 指定更新日志条件,共有3个可选值: no:表示等操作系统进行数据缓存同步到磁盘(快) always:表示每次更新操作后手动调用fsync()将数据写到磁盘(慢,安全) everysec:表示每秒同步一次(折衷,默认值) appendfsync everysec 21\. 指定是否启用虚拟内存机制,默认值为no,简单的介绍一下,VM机制将数据分页存放,由Redis将访问量较少的页即冷数据swap到磁盘上,访问多的页面由磁盘自动换出到内存中(在后面的文章我会仔细分析Redis的VM机制) vm-enabled no 22\. 虚拟内存文件路径,默认值为/tmp/redis.swap,不可多个Redis实例共享 vm-swap-file /tmp/redis.swap 23\. 将所有大于vm-max-memory的数据存入虚拟内存,无论vm-max-memory设置多小,所有索引数据都是内存存储的(Redis的索引数据 就是keys),也就是说,当vm-max-memory设置为0的时候,其实是所有value都存在于磁盘。默认值为0 vm-max-memory 0 24\. Redis swap文件分成了很多的page,一个对象可以保存在多个page上面,但一个page上不能被多个对象共享,vm-page-size是要根据存储的 数据大小来设定的,作者建议如果存储很多小对象,page大小最好设置为32或者64bytes;如果存储很大大对象,则可以使用更大的page,如果不 确定,就使用默认值 vm-page-size 32 25\. 设置swap文件中的page数量,由于页表(一种表示页面空闲或使用的bitmap)是在放在内存中的,,在磁盘上每8个pages将消耗1byte的内存。 vm-pages 134217728 26\. 设置访问swap文件的线程数,最好不要超过机器的核数,如果设置为0,那么所有对swap文件的操作都是串行的,可能会造成比较长时间的延迟。默认值为4 vm-max-threads 4 27\. 设置在向客户端应答时,是否把较小的包合并为一个包发送,默认为开启 glueoutputbuf yes 28\. 指定在超过一定的数量或者最大的元素超过某一临界值时,采用一种特殊的哈希算法 hash-max-zipmap-entries 64 hash-max-zipmap-value 512 29\. 指定是否激活重置哈希,默认为开启(后面在介绍Redis的哈希算法时具体介绍) activerehashing yes 30\. 指定包含其它的配置文件,可以在同一主机上多个Redis实例之间使用同一份配置文件,而同时各个实例又拥有自己的特定配置文件 include /path/to/local.conf Redis 键(key) Redis 键命令用于管理 redis 的键。 语法 Redis 键命令的基本语法如下: redis 127.0.0.1:6379> COMMAND KEY_NAME 实例 redis 127.0.0.1:6379> SET runoobkey redis OK redis 127.0.0.1:6379> DEL runoobkey (integer) 1 在以上实例中 DEL 是一个命令, runoobkey 是一个键。 如果键被删除成功,命令执行后输出 (integer) 1,否则将输出 (integer) 0 Redis keys 命令 下表给出了与 Redis 键相关的基本命令: 1 DEL key 该命令用于在 key 存在时删除 key。 2 DUMP key 序列化给定 key ,并返回被序列化的值。 3 EXISTS key 检查给定 key 是否存在。 4 EXPIRE key seconds 为给定 key 设置过期时间。 5 EXPIREAT key timestamp EXPIREAT 的作用和 EXPIRE 类似,都用于为 key 设置过期时间。 不同在于 EXPIREAT 命令接受的时间参数是 UNIX 时间戳(unix timestamp)。 6 PEXPIRE key milliseconds 设置 key 的过期时间以毫秒计。 7 PEXPIREAT key milliseconds-timestamp 设置 key 过期时间的时间戳(unix timestamp) 以毫秒计 8 KEYS pattern 查找所有符合给定模式( pattern)的 key 。 9 MOVE key db 将当前数据库的 key 移动到给定的数据库 db 当中。 10 PERSIST key 移除 key 的过期时间,key 将持久保持。 11 PTTL key 以毫秒为单位返回 key 的剩余的过期时间。 12 TTL key 以秒为单位,返回给定 key 的剩余生存时间(TTL, time to live)。 13 RANDOMKEY 从当前数据库中随机返回一个 key 。 14 RENAME key newkey 修改 key 的名称 15 RENAMENX key newkey 仅当 newkey 不存在时,将 key 改名为 newkey 。 16 TYPE key 返回 key 所储存的值的类型 Redis 数据类型 Redis支持五种数据类型: string(字符串), hash(哈希), list(列表), set(集合) zset(sorted set:有序集合)。 String(字符串) string是redis最基本的类型,你可以理解成与Memcached一模一样的类型,一个key对应一个value。 string类型是二进制安全的。意思是redis的string可以包含任何数据。比如jpg图片或者序列化的对象 。 string类型是Redis最基本的数据类型,一个键最大能存储512MB。 实例 redis 127.0.0.1:6379> SET name "runoob" OK redis 127.0.0.1:6379> GET name "runoob" 在以上实例中我们使用了 Redis 的 SET 和 GET 命令。键为 name,对应的值为 runoob。 注意:一个键最大能存储512MB。 Redis 字符串命令 1 SET key value 设置指定 key 的值 2 GET key 获取指定 key 的值。 3 GETRANGE key start end 返回 key 中字符串值的子字符 4 GETSET key value 将给定 key 的值设为 value ,并返回 key 的旧值(old value)。 5 GETBIT key offset 对 key 所储存的字符串值,获取指定偏移量上的位(bit)。 6 MGET key1 [key2..] 获取所有(一个或多个)给定 key 的值。 7 SETBIT key offset value 对 key 所储存的字符串值,设置或清除指定偏移量上的位(bit)。 8 SETEX key seconds value 将值 value 关联到 key ,并将 key 的过期时间设为 seconds (以秒为单位)。 9 SETNX key value 只有在 key 不存在时设置 key 的值。 10 SETRANGE key offset value 用 value 参数覆写给定 key 所储存的字符串值,从偏移量 offset 开始。 11 STRLEN key 返回 key 所储存的字符串值的长度。 12 MSET key value [key value ...] 同时设置一个或多个 key-value 对。 13 MSETNX key value [key value ...] 同时设置一个或多个 key-value 对,当且仅当所有给定 key 都不存在。 14 PSETEX key milliseconds value 这个命令和 SETEX 命令相似,但它以毫秒为单位设置 key 的生存时间,而不是像 SETEX 命令那样,以秒为单位。 15 INCR key 将 key 中储存的数字值增一。 16 INCRBY key increment 将 key 所储存的值加上给定的增量值(increment) 。 17 INCRBYFLOAT key increment 将 key 所储存的值加上给定的浮点增量值(increment) 。 18 DECR key 将 key 中储存的数字值减一。 19 DECRBY key decrement key 所储存的值减去给定的减量值(decrement) 。 20 APPEND key value 如果 key 已经存在并且是一个字符串, APPEND 命令将 value 追加到 key 原来的值的末尾。 Hash(哈希) Redis hash 是一个键值(key=>value)对集合。 Redis hash是一个string类型的field和value的映射表,hash特别适合用于存储对象。 实例 redis> HMSET myhash field1 "Hello" field2 "World" "OK" redis> HGET myhash field1 "Hello" redis> HGET myhash field2 "World" 以上实例中 hash 数据类型存储了包含用户脚本信息的用户对象。 实例中我们使用了 Redis HMSET, HGETALL 命令,user:1 为键值。 每个 hash 可以存储 232 -1 键值对(40多亿)。 Redis hash 命令 1 HDEL key field1 [field2] 删除一个或多个哈希表字段 2 HEXISTS key field 查看哈希表 key 中,指定的字段是否存在。 3 HGET key field 获取存储在哈希表中指定字段的值。 4 HGETALL key 获取在哈希表中指定 key 的所有字段和值 5 HINCRBY key field increment 为哈希表 key 中的指定字段的整数值加上增量 increment 。 6 HINCRBYFLOAT key field increment 为哈希表 key 中的指定字段的浮点数值加上增量 increment 。 7 HKEYS key 获取所有哈希表中的字段 8 HLEN key 获取哈希表中字段的数量 9 HMGET key field1 [field2] 获取所有给定字段的值 10 HMSET key field1 value1 [field2 value2 ] 同时将多个 field-value (域-值)对设置到哈希表 key 中。 11 HSET key field value 将哈希表 key 中的字段 field 的值设为 value 。 12 HSETNX key field value 只有在字段 field 不存在时,设置哈希表字段的值。 13 HVALS key 获取哈希表中所有值 14 HSCAN key cursor [MATCH pattern] [COUNT count] 迭代哈希表中的键值对。 List(列表) Redis 列表是简单的字符串列表,按照插入顺序排序。你可以添加一个元素到列表的头部(左边)或者尾部(右边)。 实例 redis 127.0.0.1:6379> lpush runoob redis (integer) 1 redis 127.0.0.1:6379> lpush runoob mongodb (integer) 2 redis 127.0.0.1:6379> lpush runoob rabitmq (integer) 3 redis 127.0.0.1:6379> lrange runoob 0 10 1) "rabitmq" 2) "mongodb" 3) "redis" redis 127.0.0.1:6379> 列表最多可存储 232 - 1 元素 (4294967295, 每个列表可存储40多亿)。 Redis 列表命令 1 BLPOP key1 [key2 ] timeout 移出并获取列表的第一个元素, 如果列表没有元素会阻塞列表直到等待超时或发现可弹出元素为止。 2 BRPOP key1 [key2 ] timeout 移出并获取列表的最后一个元素, 如果列表没有元素会阻塞列表直到等待超时或发现可弹出元素为止。 3 BRPOPLPUSH source destination timeout 从列表中弹出一个值,将弹出的元素插入到另外一个列表中并返回它; 如果列表没有元素会阻塞列表直到等待超时或发现可弹出元素为止。 4 LINDEX key index 通过索引获取列表中的元素 5 LINSERT key BEFORE|AFTER pivot value 在列表的元素前或者后插入元素 6 LLEN key 获取列表长度 7 LPOP key 移出并获取列表的第一个元素 8 LPUSH key value1 [value2] 将一个或多个值插入到列表头部 9 LPUSHX key value 将一个值插入到已存在的列表头部 10 LRANGE key start stop 获取列表指定范围内的元素 11 LREM key count value 移除列表元素 12 LSET key index value 通过索引设置列表元素的值 13 LTRIM key start stop 对一个列表进行修剪(trim),就是说,让列表只保留指定区间内的元素,不在指定区间之内的元素都将被删除。 14 RPOP key 移除并获取列表最后一个元素 15 RPOPLPUSH source destination 移除列表的最后一个元素,并将该元素添加到另一个列表并返回 16 RPUSH key value1 [value2] 在列表中添加一个或多个值 17 RPUSHX key value 为已存在的列表添加值 Set(集合) Redis的Set是string类型的无序集合。 集合是通过哈希表实现的,所以添加,删除,查找的复杂度都是O(1)。 sadd 命令 添加一个string元素到,key对应的set集合中,成功返回1,如果元素已经在集合中返回0,key对应的set不存在返回错误。 sadd key member 实例 redis 127.0.0.1:6379> sadd runoob redis (integer) 1 redis 127.0.0.1:6379> sadd runoob mongodb (integer) 1 redis 127.0.0.1:6379> sadd runoob rabitmq (integer) 1 redis 127.0.0.1:6379> sadd runoob rabitmq (integer) 0 redis 127.0.0.1:6379> smembers runoob 1) "rabitmq" 2) "mongodb" 3) "redis" 注意:以上实例中 rabitmq 添加了两次,但根据集合内元素的唯一性,第二次插入的元素将被忽略。 集合中最大的成员数为 232 - 1(4294967295, 每个集合可存储40多亿个成员)。 Redis 集合命令 1 SADD key member1 [member2] 向集合添加一个或多个成员 2 SCARD key 获取集合的成员数 3 SDIFF key1 [key2] 返回给定所有集合的差集 4 SDIFFSTORE destination key1 [key2] 返回给定所有集合的差集并存储在 destination 中 5 SINTER key1 [key2] 返回给定所有集合的交集 6 SINTERSTORE destination key1 [key2] 返回给定所有集合的交集并存储在 destination 中 7 SISMEMBER key member 判断 member 元素是否是集合 key 的成员 8 SMEMBERS key 返回集合中的所有成员 9 SMOVE source destination member 将 member 元素从 source 集合移动到 destination 集合 10 SPOP key 移除并返回集合中的一个随机元素 11 SRANDMEMBER key [count] 返回集合中一个或多个随机数 12 SREM key member1 [member2] 移除集合中一个或多个成员 13 SUNION key1 [key2] 返回所有给定集合的并集 14 SUNIONSTORE destination key1 [key2] 所有给定集合的并集存储在 destination 集合中 15 SSCAN key cursor [MATCH pattern] [COUNT count] 迭代集合中的元素 zset(sorted set:有序集合) Redis zset 和 set 一样也是string类型元素的集合,且不允许重复的成员。 不同的是每个元素都会关联一个double类型的分数。redis正是通过分数来为集合中的成员进行从小到大的排序。 zset的成员是唯一的,但分数(score)却可以重复。 zadd 命令 添加元素到集合,元素在集合中存在则更新对应score zadd key score member 实例 redis 127.0.0.1:6379> zadd runoob 0 redis (integer) 1 redis 127.0.0.1:6379> zadd runoob 0 mongodb (integer) 1 redis 127.0.0.1:6379> zadd runoob 0 rabitmq (integer) 1 redis 127.0.0.1:6379> zadd runoob 0 rabitmq (integer) 0 redis 127.0.0.1:6379> ZRANGEBYSCORE runoob 0 1000 1) "redis" 2) "mongodb" 3) "rabitmq" Redis 有序集合命令 1 ZADD key score1 member1 [score2 member2] 向有序集合添加一个或多个成员,或者更新已存在成员的分数 2 ZCARD key 获取有序集合的成员数 3 ZCOUNT key min max 计算在有序集合中指定区间分数的成员数 4 ZINCRBY key increment member 有序集合中对指定成员的分数加上增量 increment 5 ZINTERSTORE destination numkeys key [key ...] 计算给定的一个或多个有序集的交集并将结果集存储在新的有序集合 key 中 6 ZLEXCOUNT key min max 在有序集合中计算指定字典区间内成员数量 7 ZRANGE key start stop [WITHSCORES] 通过索引区间返回有序集合成指定区间内的成员 8 ZRANGEBYLEX key min max [LIMIT offset count] 通过字典区间返回有序集合的成员 9 ZRANGEBYSCORE key min max [WITHSCORES] [LIMIT] 通过分数返回有序集合指定区间内的成员 10 ZRANK key member 返回有序集合中指定成员的索引 11 ZREM key member [member ...] 移除有序集合中的一个或多个成员 12 ZREMRANGEBYLEX key min max 移除有序集合中给定的字典区间的所有成员 13 ZREMRANGEBYRANK key start stop 移除有序集合中给定的排名区间的所有成员 14 ZREMRANGEBYSCORE key min max 移除有序集合中给定的分数区间的所有成员 15 ZREVRANGE key start stop [WITHSCORES] 返回有序集中指定区间内的成员,通过索引,分数从高到底 16 ZREVRANGEBYSCORE key max min [WITHSCORES] 返回有序集中指定分数区间内的成员,分数从高到低排序 17 ZREVRANK key member 返回有序集合中指定成员的排名,有序集成员按分数值递减(从大到小)排序 18 ZSCORE key member 返回有序集中,成员的分数值 19 ZUNIONSTORE destination numkeys key [key ...] 计算给定的一个或多个有序集的并集,并存储在新的 key 中 20 ZSCAN key cursor [MATCH pattern] [COUNT count] 迭代有序集合中的元素(包括元素成员和元素分值) HyperLogLog Redis 在 2.8.9 版本添加了 HyperLogLog 结构。 Redis HyperLogLog 是用来做基数统计的算法,HyperLogLog 的优点是,在输入元素的数量或者体积非常非常大时,计算基数所需的空间总是固定 的、并且是很小的。 在 Redis 里面,每个 HyperLogLog 键只需要花费 12 KB 内存,就可以计算接近 2^64 个不同元素的基 数。这和计算基数时,元素越多耗费内存就越多的集合形成鲜明对比。 但是,因为 HyperLogLog 只会根据输入元素来计算基数,而不会储存输入元素本身,所以 HyperLogLog 不能像集合那样,返回输入的各个元素。 什么是基数? 比如数据集 {1, 3, 5, 7, 5, 7, 8}, 那么这个数据集的基数集为 {1, 3, 5 ,7, 8}, 基数(不重复元素)为5。 基数估计就是在误差可接受的范围内,快速计算基数。 实例 redis 127.0.0.1:6379> PFADD runoobkey "redis" 1) (integer) 1 redis 127.0.0.1:6379> PFADD runoobkey "mongodb" 1) (integer) 1 redis 127.0.0.1:6379> PFADD runoobkey "mysql" 1) (integer) 1 redis 127.0.0.1:6379> PFCOUNT runoobkey (integer) 3 Redis HyperLogLog 命令 1 PFADD key element [element ...] 添加指定元素到 HyperLogLog 中。 2 PFCOUNT key [key ...] 返回给定 HyperLogLog 的基数估算值。 3 PFMERGE destkey sourcekey [sourcekey ...] 将多个 HyperLogLog 合并为一个 HyperLogLog 发布订阅 Redis 发布订阅(pub/sub)是一种消息通信模式:发送者(pub)发送消息,订阅者(sub)接收消息。 Redis 客户端可以订阅任意数量的频道。 下图展示了频道 channel1 , 以及订阅这个频道的三个客户端 —— client2 、 client5 和 client1 之间的关系: image 当有新消息通过 PUBLISH 命令发送给频道 channel1 时, 这个消息就会被发送给订阅它的三个客户端: image 实例 redis 127.0.0.1:6379> SUBSCRIBE redisChat Reading messages... (press Ctrl-C to quit) 1) "subscribe" 2) "redisChat" 3) (integer) 1 现在,我们先重新开启个 redis 客户端,然后在同一个频道 redisChat 发布两次消息,订阅者就能接收到消息。 redis 127.0.0.1:6379> PUBLISH redisChat "Redis is a great caching technique" (integer) 1 redis 127.0.0.1:6379> PUBLISH redisChat "Learn redis by runoob.com" (integer) 1 # 订阅者的客户端会显示如下消息 1) "message" 2) "redisChat" 3) "Redis is a great caching technique" 1) "message" 2) "redisChat" 3) "Learn redis by runoob.com" Redis 发布订阅命令 1 PSUBSCRIBE pattern [pattern ...] 订阅一个或多个符合给定模式的频道。 2 PUBSUB subcommand [argument [argument ...]] 查看订阅与发布系统状态。 3 PUBLISH channel message 将信息发送到指定的频道。 4 PUNSUBSCRIBE [pattern [pattern ...]] 退订所有给定模式的频道。 5 SUBSCRIBE channel [channel ...] 订阅给定的一个或多个频道的信息。 6 UNSUBSCRIBE [channel [channel ...]] 指退订给定的频道。 Redis 事务 Redis 事务可以一次执行多个命令, 并且带有以下两个重要的保证: 事务是一个单独的隔离操作:事务中的所有命令都会序列化、按顺序地执行。事务在执行的过程中,不会被其他客户端发送来的命令请求所打断。 事务是一个原子操作:事务中的命令要么全部被执行,要么全部都不执行。 一个事务从开始到执行会经历以下三个阶段: 开始事务。 命令入队。 执行事务。 实例 `` txt 以下是一个事务的例子, 它先以 MULTI 开始一个事务, 然后将多个命令入队到事务中, 最后由 EXEC 命令触发事务, 一并执行事务中的所有命令: redis 127.0.0.1:6379> MULTI OK redis 127.0.0.1:6379> SET book-name "Mastering C++ in 21 days" QUEUED redis 127.0.0.1:6379> GET book-name QUEUED redis 127.0.0.1:6379> SADD tag "C++" "Programming" "Mastering Series" QUEUED redis 127.0.0.1:6379> SMEMBERS tag QUEUED redis 127.0.0.1:6379> EXEC OK "Mastering C++ in 21 days" (integer) 3 "Mastering Series" "C++" "Programming" ##### Redis 事务命令 ``` txt 1 DISCARD 取消事务,放弃执行事务块内的所有命令。 2 EXEC 执行所有事务块内的命令。 3 MULTI 标记一个事务块的开始。 4 UNWATCH 取消 WATCH 命令对所有 key 的监视。 5 WATCH key [key ...] 监视一个(或多个) key ,如果在事务执行之前这个(或这些) key 被其他命令所改动,那么事务将被打断。 Redis 连接 Redis 连接命令主要是用于连接 redis 服务。 实例 以下实例演示了客户端如何通过密码验证连接到 redis 服务,并检测服务是否在运行: redis 127.0.0.1:6379> AUTH "password" OK redis 127.0.0.1:6379> PING PONG Redis 连接命令 1 AUTH password 验证密码是否正确 2 ECHO message 打印字符串 3 PING 查看服务是否运行 4 QUIT 关闭当前连接 5 SELECT index 切换到指定的数据库 Redis 服务器 Redis 服务器命令主要是用于管理 redis 服务。 实例 以下实例演示了如何获取 redis 服务器的统计信息: redis 127.0.0.1:6379> INFO Redis 服务器命令 1 BGREWRITEAOF 异步执行一个 AOF(AppendOnly File) 文件重写操作 2 BGSAVE 在后台异步保存当前数据库的数据到磁盘 3 CLIENT KILL [ip:port] [ID client-id] 关闭客户端连接 4 CLIENT LIST 获取连接到服务器的客户端连接列表 5 CLIENT GETNAME 获取连接的名称 6 CLIENT PAUSE timeout 在指定时间内终止运行来自客户端的命令 7 CLIENT SETNAME connection-name 设置当前连接的名称 8 CLUSTER SLOTS 获取集群节点的映射数组 9 COMMAND 获取 Redis 命令详情数组 10 COMMAND COUNT 获取 Redis 命令总数 11 COMMAND GETKEYS 获取给定命令的所有键 12 TIME 返回当前服务器时间 13 COMMAND INFO command-name [command-name ...] 获取指定 Redis 命令描述的数组 14 CONFIG GET parameter 获取指定配置参数的值 15 CONFIG REWRITE 对启动 Redis 服务器时所指定的 redis.conf 配置文件进行改写 16 CONFIG SET parameter value 修改 redis 配置参数,无需重启 17 CONFIG RESETSTAT 重置 INFO 命令中的某些统计数据 18 DBSIZE 返回当前数据库的 key 的数量 19 DEBUG OBJECT key 获取 key 的调试信息 20 DEBUG SEGFAULT 让 Redis 服务崩溃 21 FLUSHALL 删除所有数据库的所有key 22 FLUSHDB 删除当前数据库的所有key 23 INFO [section] 获取 Redis 服务器的各种信息和统计数值 24 LASTSAVE 返回最近一次 Redis 成功将数据保存到磁盘上的时间,以 UNIX 时间戳格式表示 25 MONITOR 实时打印出 Redis 服务器接收到的命令,调试用 26 ROLE 返回主从实例所属的角色 27 SAVE 异步保存数据到硬盘 28 SHUTDOWN [NOSAVE] [SAVE] 异步保存数据到硬盘,并关闭服务器 29 SLAVEOF host port 将当前服务器转变为指定服务器的从属服务器(slave server) 30 SLOWLOG subcommand [argument] 管理 redis 的慢日志 31 SYNC 用于复制功能(replication)的内部命令 Redis 数据备份与恢复 Redis SAVE 命令用于创建当前数据库的备份。 语法 redis Save 命令基本语法如下: redis 127.0.0.1:6379> SAVE 实例 redis 127.0.0.1:6379> SAVE OK 该命令将在 redis 安装目录中创建dump.rdb文件。 恢复数据 如果需要恢复数据,只需将备份文件 (dump.rdb) 移动到 redis 安装目录并启动服务即可。获取 redis 目录可以使用 CONFIG 命令,如下所示: redis 127.0.0.1:6379> CONFIG GET dir 1) "dir" 2) "/usr/local/redis/bin" 以上命令 CONFIG GET dir 输出的 redis 安装目录为 /usr/local/redis/bin。 Bgsave 创建 redis 备份文件也可以使用命令 BGSAVE,该命令在后台执行。 实例 127.0.0.1:6379> BGSAVE Background saving started Redis 客户端连接 Redis 通过监听一个 TCP 端口或者 Unix socket 的方式来接收来自客户端的连接,当一个连接建立后,Redis 内部会进行以下一些操作: 首先,客户端 socket 会被设置为非阻塞模式,因为 Redis 在网络事件处理上采用的是非阻塞多路复用模型。 然后为这个 socket 设置 TCP_NODELAY 属性,禁用 Nagle 算法 然后创建一个可读的文件事件用于监听这个客户端 socket 的数据发送 最大连接数 在 Redis2.4 中,最大连接数是被直接硬编码在代码里面的,而在2.6版本中这个值变成可配置的。 maxclients 的默认值是 10000,你也可以在 redis.conf 中对这个值进行修改。 config get maxclients 1) "maxclients" 2) "10000" 实例 以下实例我们在服务启动时设置最大连接数为 100000: redis-server --maxclients 100000 客户端命令 1 CLIENT LIST 返回连接到 redis 服务的客户端列表 2 CLIENT SETNAME 设置当前连接的名称 3 CLIENT GETNAME 获取通过 CLIENT SETNAME 命令设置的服务名称 4 CLIENT PAUSE 挂起客户端连接,指定挂起的时间以毫秒计 5 CLIENT KILL 关闭客户端连接 三.Java 使用 Redis 下载jedis.jar 连接到 redis 服务 import redis.clients.jedis.Jedis; public class RedisJava { public static void main(String[] args) { //连接本地的 Redis 服务 Jedis jedis = new Jedis("localhost"); System.out.println("连接成功"); //查看服务是否运行 System.out.println("服务正在运行: "+jedis.ping()); } } 编译以上 Java 程序,确保驱动包的路径是正确的。 连接成功 服务正在运行: PONG Redis Java String(字符串) 实例 import redis.clients.jedis.Jedis; public class RedisStringJava { public static void main(String[] args) { //连接本地的 Redis 服务 Jedis jedis = new Jedis("localhost"); System.out.println("连接成功"); //设置 redis 字符串数据 jedis.set("runoobkey", "www.runoob.com"); // 获取存储的数据并输出 System.out.println("redis 存储的字符串为: "+ jedis.get("runoobkey")); } } 编译以上程序。 连接成功 redis 存储的字符串为: www.runoob.com Redis Java List(列表) 实例 import java.util.List; import redis.clients.jedis.Jedis; public class RedisListJava { public static void main(String[] args) { //连接本地的 Redis 服务 Jedis jedis = new Jedis("localhost"); System.out.println("连接成功"); //存储数据到列表中 jedis.lpush("site-list", "Runoob"); jedis.lpush("site-list", "Google"); jedis.lpush("site-list", "Taobao"); // 获取存储的数据并输出 List<String> list = jedis.lrange("site-list", 0 ,2); for(int i=0; i<list.size(); i++) { System.out.println("列表项为: "+list.get(i)); } } } 编译以上程序。 连接成功 列表项为: Taobao 列表项为: Google 列表项为: Runoob Redis Java Keys 实例 import java.util.Iterator; import java.util.Set; import redis.clients.jedis.Jedis; public class RedisKeyJava { public static void main(String[] args) { //连接本地的 Redis 服务 Jedis jedis = new Jedis("localhost"); System.out.println("连接成功"); // 获取数据并输出 Set<String> keys = jedis.keys("*"); Iterator<String> it=keys.iterator() ; while(it.hasNext()){ String key = it.next(); System.out.println(key); } } } 编译以上程序。 连接成功 runoobkey site-list Maven依赖 <dependency> <groupId>redis.clients</groupId> <artifactId>jedis</artifactId> <version>2.1.0</version> </dependency> java 代码 package com.shier.common.test; import org.junit.Before; import org.junit.Test; import redis.clients.jedis.Jedis; import java.util.HashMap; import java.util.Iterator; import java.util.List; import java.util.Map; public class RedisTest { private Jedis jedis; @Before public void setup() { //连接redis服务器,192.168.0.100:6379 jedis = new Jedis("172.16.57.150", 6379); //权限认证 jedis.auth("shier@ixiye.com"); jedis.select(1); } /** * redis存储字符串 */ @Test public void testString() { //-----添加数据---------- jedis.set("name", "xinxin");//向key-->name中放入了value-->xinxin System.out.println(jedis.get("name"));//执行结果:xinxin jedis.append("name", " is my lover"); //拼接 System.out.println(jedis.get("name")); //jedis.del("name"); //删除某个键 System.out.println(jedis.get("name")); //设置多个键值对 //jedis.mset("name", "liuling", "age", "23", "qq", "476777XXX"); //jedis.incr("age"); //进行加1操作 System.out.println(jedis.get("name") + "-" + jedis.get("age") + "-" + jedis.get("qq")); } /** * redis操作Map */ @Test public void testMap() { //-----添加数据---------- Map<String, String> map = new HashMap<String, String>(); map.put("name", "xinxin"); map.put("age", "22"); map.put("qq", "123456"); jedis.hmset("user", map); //取出user中的name,执行结果:[minxr]-->注意结果是一个泛型的List //第一个参数是存入redis中map对象的key,后面跟的是放入map中的对象的key,后面的key可以跟多个,是可变参数 List<String> rsmap = jedis.hmget("user", "name", "age", "qq"); System.out.println(rsmap); //删除map中的某个键值 jedis.hdel("user", "age"); System.out.println(jedis.hmget("user", "age")); //因为删除了,所以返回的是null System.out.println(jedis.hlen("user")); //返回key为user的键中存放的值的个数2 System.out.println(jedis.exists("user"));//是否存在key为user的记录 返回true System.out.println(jedis.hkeys("user"));//返回map对象中的所有key System.out.println(jedis.hvals("user"));//返回map对象中的所有value Iterator<String> iter = jedis.hkeys("user").iterator(); while (iter.hasNext()) { String key = iter.next(); System.out.println(key + ":" + jedis.hmget("user", key)); } } /** * jedis操作List */ @Test public void testList() { //开始前,先移除所有的内容 jedis.del("java framework"); System.out.println(jedis.lrange("java framework", 0, -1)); //先向key java framework中存放三条数据 jedis.lpush("java framework", "spring"); jedis.lpush("java framework", "struts"); jedis.lpush("java framework", "hibernate"); //再取出所有数据jedis.lrange是按范围取出, // 第一个是key,第二个是起始位置,第三个是结束位置,jedis.llen获取长度 -1表示取得所有 System.out.println(jedis.lrange("java framework", 0, -1)); jedis.del("java framework"); jedis.rpush("java framework", "spring"); jedis.rpush("java framework", "struts"); jedis.rpush("java framework", "hibernate"); System.out.println(jedis.lrange("java framework", 0, -1)); } /** * jedis操作Set */ @Test public void testSet() { //添加 jedis.sadd("user", "liuling"); jedis.sadd("user", "xinxin"); jedis.sadd("user", "ling"); jedis.sadd("user", "zhangxinxin"); jedis.sadd("user", "who"); //移除noname jedis.srem("user", "who"); System.out.println(jedis.smembers("user"));//获取所有加入的value System.out.println(jedis.sismember("user", "who"));//判断 who 是否是user集合的元素 System.out.println(jedis.srandmember("user")); System.out.println(jedis.scard("user"));//返回集合的元素个数 } @Test public void test() throws InterruptedException { //jedis 排序 //注意,此处的rpush和lpush是List的操作。是一个双向链表(但从表现来看的) jedis.del("a");//先清除数据,再加入数据进行测试 jedis.rpush("a", "1"); jedis.lpush("a", "6"); jedis.lpush("a", "3"); jedis.lpush("a", "9"); System.out.println(jedis.lrange("a", 0, -1));// [9, 3, 6, 1] System.out.println(jedis.sort("a")); //[1, 3, 6, 9] //输入排序后结果 System.out.println(jedis.lrange("a", 0, -1)); } } RedisUtil package com.shier.common.util; import redis.clients.jedis.Jedis; import redis.clients.jedis.JedisPool; import redis.clients.jedis.JedisPoolConfig; public final class RedisUtil { //Redis服务器IP private static String ADDR = "172.16.57.150"; //Redis的端口号 private static int PORT = 6379; //访问密码 private static String AUTH = "shier@ixiye.com"; //可用连接实例的最大数目,默认值为8; //如果赋值为-1,则表示不限制;如果pool已经分配了maxActive个jedis实例,则此时pool的状态为exhausted(耗尽)。 private static int MAX_ACTIVE = 1024; //控制一个pool最多有多少个状态为idle(空闲的)的jedis实例,默认值也是8。 private static int MAX_IDLE = 200; //等待可用连接的最大时间,单位毫秒,默认值为-1,表示永不超时。如果超过等待时间,则直接抛出JedisConnectionException; private static int MAX_WAIT = 10000; private static int TIMEOUT = 10000; //在borrow一个jedis实例时,是否提前进行validate操作;如果为true,则得到的jedis实例均是可用的; private static boolean TEST_ON_BORROW = true; private static JedisPool jedisPool = null; /** * 初始化Redis连接池 */ static { try { JedisPoolConfig config = new JedisPoolConfig(); config.setMaxActive(MAX_ACTIVE); config.setMaxIdle(MAX_IDLE); config.setMaxWait(MAX_WAIT); config.setTestOnBorrow(TEST_ON_BORROW); jedisPool = new JedisPool(config, ADDR, PORT, TIMEOUT, AUTH); } catch (Exception e) { e.printStackTrace(); } } /** * 获取Jedis实例 * * @return */ public synchronized static Jedis getJedis() { try { if (jedisPool != null) { Jedis resource = jedisPool.getResource(); return resource; } else { return null; } } catch (Exception e) { e.printStackTrace(); return null; } } /** * 释放jedis资源 * * @param jedis */ public static void returnResource(final Jedis jedis) { if (jedis != null) { jedisPool.returnResource(jedis); } } } ----------------------------------------------------------------- package com.shier.common.test; import com.shier.common.util.RedisUtil; import org.junit.Test; import redis.clients.jedis.Jedis; public class RedisTest { @Test public void testRedisPool() { RedisUtil.getJedis().set("newname", "中文测试"); System.out.println(RedisUtil.getJedis().get("newname")); } } 四.Spring整合Redis 添加Redis Maven依赖 <span style="white-space:pre;"> </span><!-- redis --> <dependency> <groupId>redis.clients</groupId> <artifactId>jedis</artifactId> <version>2.6.2</version> </dependency> <dependency> <groupId>org.springframework.data</groupId> <artifactId>spring-data-redis</artifactId> <version>1.7.1.RELEASE</version> </dependency> config.properties redis.host=192.168.0.254 redis.port=6379 redis.password=jedis21tb redis.maxIdle=300 redis.maxWait=1000 redis.testOnBorrow=true redis.timeout=3000 spring配置文件(applicationContext.xml) <!--引入配置属性文件 --> <context:property-placeholder location="classpath:config.properties" /> <!-- redis --> <!-- jedis 配置 --> <bean id="poolConfig" class="redis.clients.jedis.JedisPoolConfig" > <property name="maxIdle" value="${redis.maxIdle}" /> <property name="maxWaitMillis" value="${redis.maxWait}" /> <property name="testOnBorrow" value="${redis.testOnBorrow}" /> </bean > <!-- redis服务器中心 --> <bean id="connectionFactory" class="org.springframework.data.redis.connection.jedis.JedisConnectionFactory" > <property name="poolConfig" ref="poolConfig" /> <property name="port" value="${redis.port}" /> <property name="hostName" value="${redis.host}" /> <property name="password" value="${redis.password}" /> <property name="timeout" value="${redis.timeout}" ></property> </bean > <bean id="redisTemplate" class="org.springframework.data.redis.core.RedisTemplate" > <property name="connectionFactory" ref="connectionFactory" /> <property name="keySerializer" > <bean class="org.springframework.data.redis.serializer.StringRedisSerializer" /> </property> <!-- <property name="valueSerializer" > <bean class="org.springframework.data.redis.serializer.JdkSerializationRedisSerializer" /> </property> --> </bean > <bean id="redisUtil" class="com.kttx.common.RedisUtil" > <property name="redisTemplate" ref="redisTemplate" /> </bean > java代码 package com.kttx.common; import java.io.Serializable; import java.util.Set; import java.util.concurrent.TimeUnit; import org.apache.log4j.Logger; import org.springframework.data.redis.core.RedisTemplate; import org.springframework.data.redis.core.ValueOperations; /** * redis * @author txs * */ public class RedisUtil { private static Logger logger = Logger.getLogger(RedisUtil.class); private static RedisTemplate<Serializable, Object> redisTemplate; /** * 写入或更新缓存 * @param key * @param value * @return */ public static boolean set(final String key, Object value) { boolean result = false; try { ValueOperations<Serializable, Object> operations = redisTemplate .opsForValue(); operations.set(key, value); result = true; } catch (Exception e) { logger.error("write redis is faill"); e.printStackTrace(); } return result; } /** * 写入缓存 * 设置失效时间 * @param key * @param value * @return */ public static boolean set(final String key, Object value, Long expireTime) { boolean result = false; try { ValueOperations<Serializable, Object> operations = redisTemplate .opsForValue(); operations.set(key, value); redisTemplate.expire(key, expireTime, TimeUnit.SECONDS); result = true; } catch (Exception e) { e.printStackTrace(); } return result; } /** * 读取缓存 * @param key * @return */ public static Object get(final String key) { Object result = null; ValueOperations<Serializable, Object> operations = redisTemplate .opsForValue(); result = operations.get(key); return result; } /** * 删除对应的value * @param key */ public static void remove(final String key) { if (exists(key)) { redisTemplate.delete(key); } } /** * 批量删除对应的value * * @param keys */ public static void remove(final String... keys) { for (String key : keys) { remove(key); } } /** * 批量删除key * * @param pattern 正则表达式 */ public static void removePattern(final String pattern) { Set<Serializable> keys = redisTemplate.keys(pattern); if (keys.size() > 0) redisTemplate.delete(keys); } /** * 判断缓存中是否有对应的value * * @param key * @return */ public static boolean exists(final String key) { return redisTemplate.hasKey(key); } public void setRedisTemplate( RedisTemplate<Serializable, Object> redisTemplate) { this.redisTemplate = redisTemplate; } } 五.Spring boot整合Redis 添加maveny依赖 <dependency> <groupId>redis.clients</groupId> <artifactId>jedis</artifactId> <version>2.6.2</version> </dependency> <dependency> <groupId>org.springframework.data</groupId> <artifactId>spring-data-redis</artifactId> <version>1.7.1.RELEASE</version> </dependency> 配置属性: # database name spring.redis.database=0 # server host spring.redis.host=127.0.0.1 # server password spring.redis.password=123456 #connection port spring.redis.port=6379 # pool settings ... spring.redis.pool.max-idle=8 spring.redis.pool.min-idle=0 spring.redis.pool.max-active=8 spring.redis.pool.max-wait=-1 redis配置 package com.ming.config; import java.lang.reflect.Method; import java.util.HashMap; import java.util.Map; import org.springframework.cache.CacheManager; import org.springframework.cache.annotation.CachingConfigurerSupport; import org.springframework.cache.annotation.EnableCaching; import org.springframework.cache.interceptor.KeyGenerator; import org.springframework.context.annotation.Bean; import org.springframework.context.annotation.Configuration; import org.springframework.data.redis.cache.RedisCacheManager; import org.springframework.data.redis.connection.RedisConnectionFactory; import org.springframework.data.redis.core.RedisTemplate; import org.springframework.data.redis.core.StringRedisTemplate; import org.springframework.data.redis.serializer.Jackson2JsonRedisSerializer; import com.fasterxml.jackson.annotation.JsonAutoDetect; import com.fasterxml.jackson.annotation.PropertyAccessor; import com.fasterxml.jackson.databind.ObjectMapper; @Configuration @EnableCaching // 启用缓存,这个注解很重要; public class RedisCacheConfig extends CachingConfigurerSupport { /** * 生成key的策略 * * @return */ @Bean public KeyGenerator keyGenerator() { return new KeyGenerator() { @Override public Object generate(Object target, Method method, Object... params) { StringBuilder sb = new StringBuilder(); sb.append(target.getClass().getName()); sb.append(method.getName()); for (Object obj : params) { sb.append(obj.toString()); } return sb.toString(); } }; } /** * 管理缓存 * * @param redisTemplate * @return */ @SuppressWarnings("rawtypes") @Bean public CacheManager cacheManager(RedisTemplate redisTemplate) { RedisCacheManager rcm = new RedisCacheManager(redisTemplate); //设置缓存过期时间 // rcm.setDefaultExpiration(60);//秒 //设置value的过期时间 Map<String,Long> map=new HashMap<String, Long>(); map.put("test",60L); rcm.setExpires(map); return rcm; } /** * RedisTemplate配置 * @param factory * @return */ @Bean public RedisTemplate<String, String> redisTemplate(RedisConnectionFactory factory) { StringRedisTemplate template = new StringRedisTemplate(factory); Jackson2JsonRedisSerializer jackson2JsonRedisSerializer = new Jackson2JsonRedisSerializer(Object.class); ObjectMapper om = new ObjectMapper(); om.setVisibility(PropertyAccessor.ALL, JsonAutoDetect.Visibility.ANY); om.enableDefaultTyping(ObjectMapper.DefaultTyping.NON_FINAL); jackson2JsonRedisSerializer.setObjectMapper(om); template.setValueSerializer(jackson2JsonRedisSerializer);//如果key是String 需要配置一下StringSerializer,不然key会乱码 /XX/XX template.afterPropertiesSet(); return template; } } package com.ming.config; import java.io.Serializable; import java.util.Set; import java.util.concurrent.TimeUnit; import org.springframework.beans.factory.annotation.Autowired; import org.springframework.data.redis.core.RedisTemplate; import org.springframework.data.redis.core.ValueOperations; import org.springframework.stereotype.Component; /** * redicache 工具类 * */ @SuppressWarnings("unchecked") @Component public class RedisUtils { @SuppressWarnings("rawtypes") @Autowired private RedisTemplate redisTemplate; /** * 批量删除对应的value * * @param keys */ public void remove(final String... keys) { for (String key : keys) { remove(key); } } /** * 批量删除key * * @param pattern */ public void removePattern(final String pattern) { Set<Serializable> keys = redisTemplate.keys(pattern); if (keys.size() > 0) redisTemplate.delete(keys); } /** * 删除对应的value * * @param key */ public void remove(final String key) { if (exists(key)) { redisTemplate.delete(key); } } /** * 判断缓存中是否有对应的value * * @param key * @return */ public boolean exists(final String key) { return redisTemplate.hasKey(key); } /** * 读取缓存 * * @param key * @return */ public Object get(final String key) { Object result = null; ValueOperations<Serializable, Object> operations = redisTemplate.opsForValue(); result = operations.get(key); return result; } /** * 写入缓存 * * @param key * @param value * @return */ public boolean set(final String key, Object value) { boolean result = false; try { ValueOperations<Serializable, Object> operations = redisTemplate.opsForValue(); operations.set(key, value); result = true; } catch (Exception e) { e.printStackTrace(); } return result; } /** * 写入缓存 * * @param key * @param value * @return */ public boolean set(final String key, Object value, Long expireTime) { boolean result = false; try { ValueOperations<Serializable, Object> operations = redisTemplate.opsForValue(); operations.set(key, value); redisTemplate.expire(key, expireTime, TimeUnit.SECONDS); result = true; } catch (Exception e) { e.printStackTrace(); } return result; } } 测试 package com.ming.web.controller; import org.springframework.beans.factory.annotation.Autowired; import org.springframework.web.bind.annotation.RequestMapping; import org.springframework.web.bind.annotation.RestController; import com.ming.config.RedisUtils; @RestController @RequestMapping("/caches") public class CacheController { @Autowired private RedisUtils redisUtils; @RequestMapping("/test") public String test(){ redisUtils.set("123", "hello world"); System.out.println("进入了方法"); String string= redisUtils.get("123").toString(); return string; } }

优秀的个人博客,低调大师

第 14 章 ITSM 实践

目录 14.1. 组织架构 14.2. Help Desk / Service Desk 14.3. Problem Management(问题管理) 14.3.1. 故障树分析(Fault Tree Analysis,FTA) 14.3.2. 员工手册 14.4. Incident Management(突发事件管理) 14.4.1. 突发事件处理流程 14.5. Change Management(变更管理) 14.6. Release Management(发布管理) 14.7. 内部培训 14.8. IT资源管理 14.8.1. 设备采购 14.8.1.1. 招标采购流程 14.8.2. 合同管理 14.8.3. 周期性时间管理 14.8.3.1. 合同到期与续约 14.8.3.2. SSL 证书 14.8.4. IDC 设备管理 14.8.4.1. 资产管理 14.8.4.2. 图表管理 14.8.4.3. 进出IDC机房 14.8.4.4. 设备上下架 14.8.4.5. 如何维护设备 14.9. 桌面支持 14.9.1. Office 基础设施及周边设备管理 14.9.1.1. 固定资产管理 14.9.1.2. 电脑设备 14.9.1.3. 打印机设备 14.9.1.4. 电脑设备采购 14.9.1.5. 电脑升级 14.9.1.6. 报修流程 14.9.1.7. 报废流程 14.9.2. 网络用户管理 14.9.2.1. 用户分配 14.9.2.2. 邮箱分配 14.9.2.3. 权限分配 14.9.3. 网络安全保密管理 14.9.3.1. 系统杀毒 14.9.3.2. 系统帐号 14.9.4. 信息存储备份管理 14.9.4.1. 邮件备份 14.9.4.2. 图片备份 14.9.4.3. 文档备份 14.9.5. 网络操作系统管理 14.9.5.1. 域控制器 14.9.5.2. 文件存储服务器 14.9.6. 网络应用系统管理 14.9.6.1. MIS 系统 14.9.6.2. ERP 系统 14.9.6.3. OA/CRM... 系统 14.9.7. 网络机房管理 14.9.7.1. 网络拓扑图 14.9.7.2. 机柜机架 14.9.7.3. Router 14.9.7.4. Switch 14.1.组织架构 Please enable JavaScript to view the &lt;a href="http://disqus.com/?ref_noscript"&gt;comments powered by Disqus.&lt;/a&gt;comments powered by Disqus 原文出处:Netkiller 系列 手札 本文作者:陈景峯 转载请与作者联系,同时请务必标明文章原始出处和作者信息及本声明。

优秀的个人博客,低调大师

阅读笔记-Hadoop入门实践

ASF:阿里软件开发平台服务框架SIP:服务集成平台BEA:应用基础结构软件公司分布式计算的应用场景:日志分析、索引建立Threshold:是一款IOS平台的应用。随时随地帮您监控行动数据使用奘况 无论是使用无限数据方案或是有限数据方案, Threshold 可以帮助您随时掌握最新数据使用状态, 提供客制化警示设定, 还可以设立一个您专属的行动数据区域, 以确保您不会被额外收费。 对于日志内容使用任务分解的多线程处理模式来分析统计,在比较简单的情况下,使用Memcache作为计数器,结合MySQL就能完成访问控制以及统计的工作,随着日志量的增加,未来可能不能满足要求。早期的多线程多任务分解日志模式,其实是分布式计算的一个单机版。将单机的工作进行分拆,变成协同工作的集群,其实就是分布式计算框架设计所涉及的。BEA和VMWare合作采用虚拟机来构建集群,就是希望使得计算机硬件能够类似于应用程序中资源池的资源,使用者无需关心资源分配情况,从而最大化了硬件资源的使用价值。分布式计算亦是如此,任务的分配和汇总都由分布式框架的Master来抉择,使用者需要提供待分析内容给分布式计算系统作为输入,等待结果。Hadoop是Apache开源组织的一个分布式计算开源框架,在很多大型网站上都已经得到了应用,比如亚马逊、Facebook和Yahoo等等。平台日志分析位常用,特别是集成平台的日志量会很大,非常适合分布式计算的适用场景。wwh学习:what? why? how? what:Hadoop框架中最核心的设计:MapReduce和HDFS。MapReduce:任务的分解与结果的汇总。HDFS:是Hadoop分布式文件系统(Hadoop Distributed File System)的缩写,为分布式计算存储提供了底层支持。MapReduce:Map&&Reduce,此处Map不适Map容器,作“展开”来讲,就是将一个任务分解为多个任务,Reduce就是将分解后多任务处理的结果汇总起来,得出最后的分析结果。类似于多线程,多任务。任务之间的关系可以分为两种:不相关的任务,可并行执行;人物之间有相互依赖,先后顺序不能够颠倒,这类任务是无法并行处理的。一般情况下,在Map前还可能会对输入的数据有Split(分割)的过程,保证任务并行效率,在Map之后,还会有Shuffer(混合)的过程,对于提高Reduce的效率以及减少数据传输的压力有很大的帮助。 HDFS:是分布式计算的存储基石。Hadoop的分布式文件系统和其他分布式文件系统有很多的类似的特质。分布式文件系统基本的几个特点。1、对于整个集群有单一的命名空间。2、数据一致性。适合一次写入多次读取的模型,客户端在文件没有被成功创建之前无法看到文件存在。3、文件会被分割成多个文件块,每个文件块被分配存储到数据节点上,而且根据配置会由赋值文件块来保证数据的安全性。 HDFS三个重要角色:NameNode、DataNode和Client。NameNode:可以看作是分布式文件系统中的管理者,主要负责管理文件系统的命名空间、集群配置信息和存储块的赋值等。NameNode会将文件系统的Meta-data存储在内存中,这些信息主要包括了文件信息、每一个文件对应的文件块的信息和每一个文件块在DataNode的信息等。DataNode:文件存储的基本单元,它将Block存储在本地文件系统中,保存了Block的Meta-data,同时周期性地将所有存在的Block信息发送给NameNode。Client:需要获取分布式文件系统文件的应用程序。三者关系样例说明:文件写入:1、Client向NameNode发起文件写入的请求。2、NameNode根据文件大小和文件块配置情况,返回给Client它所管理部分DataNode的信息。3、Client将文件划分为多个Block,根据DataNode的地址信息,按顺序写入到每一个DataNode块中。文件读取:1、Client向NameNode发起文件读取的请求。2、NameNode返回文件存储的DataNode的信息。3、Client读取文件信息。文件Bock复制:1、NameNode发现部分文件的Block不符合最小复制数或者部分DataNode失效。2、通知DataNode相互复制Block。3、DataNode开始直接相互复制。 HDFS的几个设计特点:1、Block的放置:默认不配置。一个Block会有三个备份,一份放在NameNode指定的DataNode,另一份放在与指定DataNode非同一个Rack上的DataNode,最后一份放在与指定DataNode同一Rack上的DataNode上。备份无非就是为了数据安全,考虑同一Rack的失败情况以及不同Rack之间数据拷贝性能问题就采用这种配置方式。2、心跳检测DataNode的健康状况,如果发现问题就采取数据备份的方式来保证数据的安全性。3、数据复制(场景为DataNode失败,需要平衡DataNode的存储利用率和需要平衡DataNode数据交互压力等情况):简述,使用HDFS的balancer命令,可以配置一个Threshold来平衡每一个DataNode磁盘利用率。例如设置了Threshold为10%,那么执行balancer命令的时候,首先统计所有DataNode的磁盘利用率平均值,然后判断如果某一个DataNode的磁盘利用率超过这个平均值Threshold以上,那么将会把这个DataNode的block转移到磁盘利用率低的DataNode,这对于新节点的加入来说十分有用。4、数据校验:采用CRC32作数据校验。在文件Block写入的时候除了写入数据还会写入校验信息,在读取的时候需要校验后在读入。5、NameNode是单点:如果失败的话,任务处理信息将会记录在本地文件系统和远端的文件系统中。6、数据管道性的写入:当客户端要写入文件到DataNode上,首先客户端读取一个Block然后写入到第一个DataNode上,然后由第一个DataNode传递到备份的DataNode上,一直到所有需要写入这个Block的DataNode都成功写入,客户端才会继续开始写下一个Block。7、安全模式:在分布式文件系统启动的时候,开始的时候会有安全模式,当分布式文件系统处于安全模式的情况下,文件系统中的内容不允许修改也不允许删除,直到安全模式结束。安全模式主要是为了系统启动的时候检查各个DataNode上数据块的有效性,同时根据策略必要的复制或删除部分数据块。运行期通过命令也可以进入安全模式。生产中,系统启动时修改和删除文件也会有安全模式不允许修改的出错提示,需要等待。 MapReduce&&HDFS来看Hadoop结构:在Hadoop的系统中,会有一台Master,主要负责NameNode的工作以及JobTracker的工作。JobTracker的主要职责就是启动、跟踪和调度各个Slave的任务执行。还会有多台Slave,每一台Slave通常具有DataNode的功能并负责TaskTracker的工作。TaskTracker根据应用要求来结合本地数据执行Map任务以及Reduce任务。Moving Computation is Cheaper than Moving Data:分布式计算最重要的一个设计点。就是在分布式处理中,移动数据的代价总是高于转移计算机的代价。简单来说就是分而治之的工作,需要将数据也分而存储,本地任务处理本地数据然会归总,这样才会保证分布式计算的高效性。 why:Hadoop的有点&适用场景:1、可扩展:不论是存储的可扩展性还是计算的可扩展性都是Hadoop的设计根本。2、经济:框架可以运行在任何普通的PC上。3、可靠:分布式文件系统的备份恢复机制以及MapReduce的任务监控保证了分布式处理的可靠性。4、高效:分布式文件系统的高效数据交互实现以及MapReduce结合Local Data处理的模式,为高效处理海量的信息作了基础准备。使用场景:海量数据的分析。海量数据被分割于多个节点,然后每一个节点并行计算,将得出的结果归并到输出。同时第一阶段的输出又可以作为下一阶段计算的输入,因此可以想象到一个树状结构的分布式计算图,在不同阶段都由不同产品,同时并行和串行结合的计算也可以很好地在分布式集群的资源下得以高效的处理。 Hadoop可以单机跑,也可以配置集群跑;集群配置运行的过程:环境:机器在多而不在精,JDK必须时1.5以上的,各个机器的机器名务必不同,机器名对于MapReduce有很大的影响。部署:对于Hadoop的集群来说,可以分成两大类角色:Master和Slave,前者主要配置NameNode和JobTracker的角色,负责总管分布式数据存储以及任务的执行。一般情况下,Master和Slave不会部署在同一台机器上。 实施步骤:1、在所有的机器上都建立相同的目录,也就可以建立相同的用户,以该用户的home路径来做Hadoop的安装路径。例如在所有机器上都建立了/home/Hado2、下载Hadoop,先解压到Master上。此时Hadoop的安装路径就是/home/Hado/版本。3、解压后进入conf目录,主要修改以下文件:Hadoop-env.sh, Hadoop-site.xml, masters, slavers。Hadoop的基础配置文件时Hadoop-default.xml,看Hadoop的代码可以知道,默认建立一个Job的时候会建立Job的Config,Config首先读入Hadoop-defaulg.xml的配置,然后再读入Hadoop-site.xml的配置(这个文件初始的时候配置为空),hadoop-site.xml中主要配置你需要覆盖的Hadoop-default.xml的系统级配置,以及你需要再你的MapReduce过程中使用的自定义配置(具体一些的使用例如final等参考文档)。以下是一个简单的hadoop-site.xml的配置:<?xml version="1.0"?><?xml-stylesheet type="text/xsl" href="configuration.xsl"?> fs.default.name dfs://10.2.224.46:54310/mapred.job.tracker hdfs://10.2.224.46:54311dfs.replication 1Hadoop.tmp.dir /home/Hado/Hadoop/tmp/mapred.child.java.opts -Xmx512mdfs.block.size 5120000The default block size for new files.Hadoop-env.sh文件只需要修改一个参数: The java implementation to use.Required. export JAVA_HOME=/usr/ali/jdk1.5.0_10(jdk版本)配置你的Java路径,记住一定要1.5版本以上,免得莫名其妙出现问题Masters中配置Masters的ip或者机器名,如果是机器名那么需要在/etc/hosts中有所设置。Slaves中配置的是Slaves的ip或者机器名,同样如果是机器名需要在etc/hosts中有所设置。范例如下:Masters: 10.2.224.46Slaves: 10.2.224.40 10.2.224.39 10.2.224.38 10.2.224.37 10.2.224.36 ...4、建立Masters到每一台Slave的SSH受信证书。由于Master将会通过SSH启动所有Slave的Hadoop,所以需要建立单向或者双向证书保证命令执行时不需要再输入密码。在Master和所有的Slave机器上执行:ssh-keygen -t rsa。执行此命令的时候,看到提示只需要回车。然后就会在/root/.ssh/下面产生id_rsa.pub的证书文件,通过scp将Master机器上的这个文件拷贝到Slave上(记得修改名称),例如:scp root@masterIP:/root/.ssh/id_rsa.pub /root/.ssh/46_rsa.pub,然后执行cat /root/.ssh/46_rsa.pub >>/root/.ssh/authorized_keys,建立authorized_keys文件即可,可以打开这个文件看看,也就是rsa的公钥作为key,user@IP作为value。此时可以试验一下,从master ssh到slave已经不需要密码了。由slave反向建立也是同样。为什么要反向呢?其实如果一直都是Master启动和关闭的话那就没有必要建立反向,只是如果想在Slave也可以关闭Hadoop就需要建立反向。5、将Master上的Hadoop通过scp拷贝到每一个Slave相同的目录下,根据每一个Slave的Java_HOME的不同修改器Hadoop-env.sh.6、修改Master上/etc/profile;新增一下内容:(具体的内容根据你的安装路径修改,这步只是为了方便使用)export HADOOP_HOME=/home/Hado/Hadoop_.. export PATH=$PATH:$HADOOP_HOME/bin修改完之后,执行source /etc/profile来使其生效。7、在Master上执行Hadoop namenode -format,这是第一需要做的初始化,可以看作格式化,以后除了上面提及的删除Master上的hadoop.tmp.dir目录,否则是不需要再次执行的。8、然后执行Master上的start-all.sh,这个命令可以直接执行,因为在6中已经添加到了path路径,这个命令是启动hdfs和mapreduce两部分,当然你也可以分开单独启动hdfs和mapreduce,分别是bin目录下的start-dfs.sh和start-mapred.sh.9、检查Master的logs目录,看看Namenode日志以及JobTracker日志是否正常启动。10、检查Slave的logs目录看看Datanode日志以及TaskTracker日志是否正常。11、如果需要关闭,那么就直接执行stop-all.sh即可。 感谢:岑文初!!!

优秀的个人博客,低调大师

Android代码混淆的实践

开发apk的时候当然要考虑保护好自己的代码,Android环境就提供了proguard来进行代码混淆,确实是一个非常有用的工具,但用起来也确实够折腾的。 1. 基本配置 eclipse下建立android工程,就会生成proguard.cfg和project.properties,在后面的文件追加proguard.config=proguard.cfg即可让前面的配置文件在export时生效。默认的那个文件有一些内容,这里给一个更通用点的。 ##---------------Begin:proguardconfigurationcommonforallAndroidapps---------- -optimizationpasses5 -dontusemixedcaseclassnames -dontskipnonpubliclibraryclasses -dontskipnonpubliclibraryclassmembers -dontpreverify -verbose -optimizations!code/simplification/arithmetic,!field/*,!class/merging/* -keepattributes*Annotation* -renamesourcefileattributeSourceFile -keepattributesSourceFile,LineNumberTable #以下两个命令配合让类的路径给删除了 -allowaccessmodification -repackageclasses'' #记录生成的日志数据,在proguard目录下 -dumpclass_files.txt -printseedsseeds.txt -printusageunused.txt -printmappingmapping.txt #异常都可以忽略就打开 #-dontwarn -keeppublicclass*extendsandroid.app.Activity -keeppublicclass*extendsandroid.app.Application -keeppublicclass*extendsandroid.app.Service -keeppublicclass*extendsandroid.content.BroadcastReceiver -keeppublicclass*extendsandroid.content.ContentProvider -keeppublicclass*extendsandroid.app.backup.BackupAgentHelper -keeppublicclass*extendsandroid.preference.Preference -keeppublicclasscom.android.vending.licensing.ILicensingService -dontnotecom.android.vending.licensing.ILicensingService -keepnamesclass*implementsjava.io.Serializable #Explicitlypreserveallserializationmembers.TheSerializableinterface #isonlyamarkerinterface,soitwouldn'tsavethem. -keepclassmembersclass*implementsjava.io.Serializable{ staticfinallongserialVersionUID; privatestaticfinaljava.io.ObjectStreamField[]serialPersistentFields; privatevoidwriteObject(java.io.ObjectOutputStream); privatevoidreadObject(java.io.ObjectInputStream); java.lang.ObjectwriteReplace(); java.lang.ObjectreadResolve(); } #Preserveallnativemethodnamesandthenamesoftheirclasses. -keepclasseswithmembernamesclass*{ native<methods>; } -keepclasseswithmembernamesclass*{ public<init>(android.content.Context,android.util.AttributeSet); } -keepclasseswithmembernamesclass*{ public<init>(android.content.Context,android.util.AttributeSet,int); } #PreservestaticfieldsofinnerclassesofRclassesthatmightbeaccessed #throughintrospection. -keepclassmembersclass**.R$*{ publicstatic<fields>; } #Preservethespecialstaticmethodsthatarerequiredinallenumerationclasses. -keepclassmembersenum*{ publicstatic**[]values(); publicstatic**valueOf(java.lang.String); } -keepclass*implementsandroid.os.Parcelable{ publicstaticfinalandroid.os.Parcelable$Creator*; } #如果你的工程是对外提供方法调用就打开 #-keeppublicclass*{ #publicprotected*; #} ##---------------End:proguardconfigurationcommonforallAndroidapps---------- 2. 解决export打包的报错 这个时候export提示“conversion to Dalvik format failed with error 1”错误,网上说法有好多种,最后我还是把proguard从4.4升级到4.8就解决了。官方地址是http://proguard.sourceforge.net。上面的配置文件参数可以在这里查阅。 升级办法很简单,就是把android sdk目录下的tool/proguard目录覆盖一下即可。 3. 打包出来的程序如何调试 一旦打包出来,就不能用eclipse的logcat去看了,这里可以用android sdk中ddms.bat的tool来看,一用就发现和logcat其实还是一个东西,就是多了个设备的选择。 在android上最好去下载一个logcat阅读器,这样在手机上运行崩溃了,不用连电脑也能查看日志了。可以再这里下载http://static.apk.hiapk.com/html/2012/03/438120.html。 4.使用gson需要的配置 当Gson用到了泛型就会有报错,这个真给郁闷了半天,提示“Missing type parameter”。最后找到一个资料给了一个解决办法,参考:http://stackoverflow.com/questions/8129040/proguard-missing-type-parameter。 另外我又用到了JsonObject,提交的Object里面的members居然被改成了a。所以上面给的东西还不够,还要加上 #用到自己拼接的JsonObject -keepclasscom.google.gson.JsonObject{*;} 我个人建议减少这些依赖包混淆带来的麻烦,干脆都全部保留不混淆。例如 -keepclasscom.badlogic.**{*;} -keepclass*implementscom.badlogic.gdx.utils.Json* -keepclasscom.google.**{*;} 5. 使用libgdx需要的配置 参考http://code.google.com/p/libgdx-users/wiki/Ant 6. 验证打包效果 我是利用了apktool的反编译工具,把打包文件又解压了看了一下,如果包路径、类名、变量名、方法名这些变化和你期望一致,那就OK了。命令: apktool.batdxxx.apkdestdir 总结:这个东西用起来也不是很简单,特别是你程序用到的高级特性多,就更容易出问题。另外proguard的参数看起来确实也有点不好理解,打包过程慢,测试也比较浪费时间。东西虽好,但真不是那么容易上手。 本文转自passover 51CTO博客,原文链接:http://blog.51cto.com/passover/898470,如需转载请自行联系原作者

优秀的个人博客,低调大师

Docker镜像仓库Harbor实践

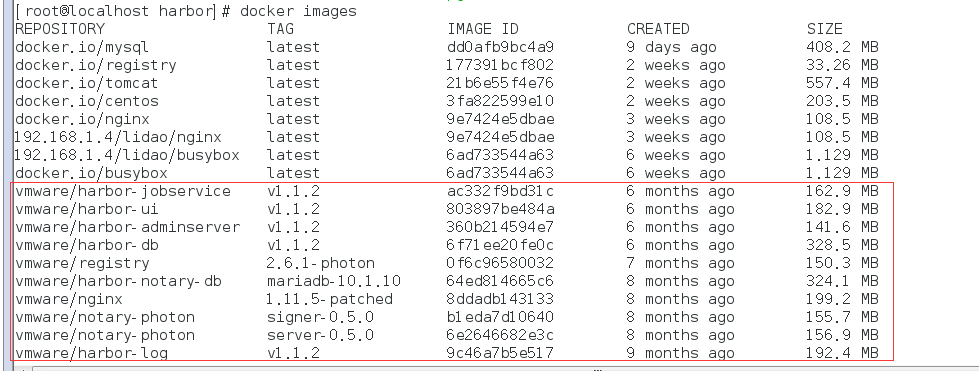
1,环境安装的软件及版本: linux : version centos7.3 Docker:version 1.12.6 Docker-compose: version 1.13.0 Harbor: version 1.1.2 Harbor是基于docker registry V2版本,所以要求docker版本不小于1.10.0,docker-compose版本不小于1.8.0,centos7 yum安装docker就可以满足版本要求。 2,请自行安装centos7.3系统,设置好网络和防火墙 网络需要能访问外网, vim/etc/sysconfig/network-scripts/ifcfg-eno16777736 TYPE=Ethernet BOOTPROTO=static DEFROUTE=yes PEERDNS=no PEERROUTES=yes IPV4_FAILURE_FATAL=no IPV6INIT=yes IPV6_AUTOCONF=yes IPV6_DEFROUTE=yes IPV6_PEERDNS=yes IPV6_PEERROUTES=yes IPV6_FAILURE_FATAL=no NAME=eno16777736 UUID=71c2c872-0682-4d95-a1dd-ec478dbd9385 DEVICE=eno16777736 ONBOOT=yes IPADDR=192.168.1.4 NETMASK=255.255.255.0 GATEWAY=192.168.1.1 DNS1=8.8.8.8 DNS2=114.114.114.114 设置完成后重启网路 systemctl restart network.service 下面关闭防火墙 setenforce 0 systemctl stop firewalld systemctl disable firewalld 3,设置yum源和安装docker cd /etc/yum.repos.d/ wgethttp://mirrors.aliyun.com/repo/Centos-7.repo wgethttp://mirrors.aliyun.com/repo/epel-7.repo yum -y install epel-release yum install -y docker 安装成后修改配置文件 vim /etc/sysconfig/docker 此版本docker默认是开启容器的selinux,所以要注释掉之前的 注释掉其他项,然后添加下面一句,IP为虚拟机的网络IP地址 OPTIONS='--insecure-registry 192.168.1.4' 启动docker systemctl start docker docker pull busybox 下载busybox镜像 docker images 4,安装docker-compose cd /usr/local/bin/ curl -L https://github.com/docker/compose/releases/download/1.13.0/docker-compose-`uname -s`-`uname -m` > /usr/local/bin/docker-compose 下载完成后添加执行权限 chmod +x /usr/local/bin/docker-compose 接着检查安装的版本是否成功 docker-compose --version docker-compose version 1.13.0, build 1719ceb 看到版本正是1.13,这个版本可以选择很多,比如新的1.17.0版本就可以用下载的命令 curl -L https://github.com/docker/compose/releases/download/1.17.0/docker-compose-`uname -s`-`uname -m` > /usr/local/bin/docker-compose 命令docker-compose down -v 停止harbor服务 docker-compose up -d 启动harbor服务 5,安装harbor服务 可以登录到GitHub上选择可用的版本,最新的是1.3.0,建议用一个老一点的版本1.1或者1.2。 https://github.com/vmware/harbor/releases?after=v1.2.0-rc3 下载离线版 cd /usr/local/ wget https://github.com/vmware/harbor/releases/download/v1.1.2/harbor-offline-installer-v1.1.2.tgz tar zxfharbor-offline-installer-v1.1.2.tgz 进入目录修改配置 cd harbor/ vim harbor.cfg #只需修改hostname的ip即可,其他可以保持默认,默认登录密码Harbor12345 hostname = 192.168.1.4 ui_url_protocol = http db_password = root123 max_job_workers = 3 customize_crt = on ssl_cert = /data/cert/server.crt ssl_cert_key = /data/cert/server.key secretkey_path = /data admiral_url = NA email_identity = email_server = smtp.mydomain.com email_server_port = 25 email_username = sample_admin@mydomain.com email_password = abc email_from = admin <sample_admin@mydomain.com> email_ssl = false harbor_admin_password =Harbor12345 auth_mode = db_auth ldap_url = ldaps://ldap.mydomain.com ldap_searchdn = uid=searchuser,ou=people,dc=mydomain,dc=com ldap_search_pwd = password ldap_basedn = ou=people,dc=mydomain,dc=com ldap_filter = (objectClass=person) ldap_uid = uid ldap_scope = 3 ldap_timeout = 5 self_registration = on token_expiration = 30 project_creation_restriction = everyone verify_remote_cert = on 修改好配置文件后执行 ./install.sh harbor服务根据docker-compose.yml配置下载镜像和启动服务 用docker images 查看下载的镜像 用docker-compose ps 查看服务启动情况 启动正常, 用浏览器访问http://192.168.1.4,默认是80端口 (如果80端口已经被其他服务占用,可以修改docker-compose.yml文件中对应的端口映射) 登陆后界面 新建项目test,非公开 新建项目后,回到服务器上,用admin用户提交镜像到harbor的镜像仓库中,下面以busybox为例: 第一步,登录 docker login 192.168.1.4 用admin,密码Harbor12345 Username (admin): admin Password: Login Succeeded 第二步,给镜像打项目标签tag docker tag docker.io/busybox 192.168.1.4/test/busybox:latest 第三步,push到仓库 docker push 192.168.1.4/test/busybox 完成后回到前端页面,就可以查看到镜像已经在test项目下了 本文转自super李导51CTO博客,原文链接:http://blog.51cto.com/superleedo/2051333,如需转载请自行联系原作者

优秀的个人博客,低调大师

hive分区表实践

HIVE把表组织成“分区”,这是一种根据“分区列”的值对表进行粗略划分的机制,使用分区可以加快数据分片的查询速度。 表或分区可以进一步分为“桶”。它会为数据提供额外的结构以获得更高效的查询处理。 创建分区表 1 2 3 4 CREATE TABLE bills_detail(msgidSTRING, time STRING,spidSTRING,opidSTRING,spcodeSTRING,resultSTRING) PARTITIONED BY (dtSTRING,typeSTRING) ROWFORMATDELIMITED FIELDSTERMINATED BY '\t' 表结构 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 hive> desc bills_detail; OK msgidstring time string spidstring opidstring spcodestring resultstring dtstring typestring #PartitionInformation #col_namedata_typecomment dtstring typestring 2.导入数据 1 2 load data local inpath '/home/hive/201601notify.txt' into table bills_detailpartition(dt= '201601' ,type= 'notifySmsDeliveryReceipt' ); load data local inpath '/home/hive/201601sendsms.txt' into table bills_detailpartition(dt= '201601' ,type= 'sendSms' ); hive中数据实际路径: /apps/hive/warehouse/bills_detail/dt=201601/type=sendSms/201601sendsms.txt 3.查询数据 hive> select * from bills_detail where dt='201601' and type='sendSms' limit 10; 本文转自 穿越防火墙 51CTO博客,原文链接:http://blog.51cto.com/sjitwant/1933204

优秀的个人博客,低调大师

restful-api最佳实践

Best-practices-for-a-pragmatic-restful-api 先阅读文档:http://www.oschina.net/translate/best-practices-for-a-pragmatic-restful-api 理解restful api设计理念 我们公司的所有微服务接口都放在 "api.998jk.com/微服务名"下 微服务内部api设计规范为:业务域/访问级别, 与best-practices-for-a-pragmatic-restful-api的区别是加入了一级访问级别,例如: 简单列表接口 /chatMessage/pb GET方式,提交参数page,pageSize,total 复杂查询接口 /chatMessage/pb/search POST方式,提交参数为json RequestBody,根据各个接口不同自行定义 查询单条接口 /chatMessage/pb/123 GET方式,123为id 删除单条接口 /chatMessage/pt/123 DELETE方式,123为id 更新单条接口 /chatMessage/pt/123 PUT方式,提交参数为json RequestBody,根据各个接口不同自行定义 上述示例 完整路径为:api.998jk.com/微服务名/chatMessage/xxx 访问级别: pb(public) 公开,对外对内没有任何限制; pt(protected)受保护,对外受保护,对内没有任何限制。需要header中含有authorization 值为"Bearer token令牌"。在api gateway会获取该token, 并且在header中设置uid 值为该令牌的用户id。 df(default) 默认,对外加密,对内没有任何限制。继承protected限制。并且在api gateway会对返回结果加密,客户端需要对结果解密后使用。加密后json如下: {"encrypted":"返回结果加密后的字符串"} pv(private) 私有的,对外无法访问,对内没有任何限制。继承default限制。 暴露的restful服务需采用JAX-RS标准注解,无需springMVC controller 直接暴露service,需要使用swagger注解以便自动产生restful api文档。示例如下 packagecharles.sc.provider.service; importcharles.sc.provider.entity.ChatMessage; importcom.jztey.framework.mvc.Paging; importcom.jztey.framework.mvc.RestfulPagingResult; importcom.jztey.framework.mvc.RestfulResult; importio.swagger.annotations.Api; importio.swagger.annotations.ApiOperation; importio.swagger.annotations.ApiParam; importorg.springframework.cloud.netflix.feign.FeignClient; importjavax.validation.Valid; importjavax.ws.rs.*; importjavax.ws.rs.core.MediaType; /** *CreatedbyCharleson2016/8/15. */ @FeignClient(value="provider-service") @Path("/chatMessage") @Produces(MediaType.APPLICATION_JSON) @Api(tags={"聊天消息接口"}) publicinterfaceChatMessageService{ @Path("/pb") @GET @ApiOperation(value="聊天记录列表",response=RestfulPagingResultChatMessage.class) RestfulPagingResult<ChatMessage>findPage(@QueryParam("id")intpage,@QueryParam("pageSize")intpageSize,@QueryParam("total")inttotal); @Path("/pt/{id:\\d+}") @GET @ApiOperation(value="按id查询聊天记录",response=RestfulResultChatMessage.class) RestfulResult<ChatMessage>find(@PathParam("id")Longid); @Path("/pb/search") @POST @ApiOperation(value="搜索聊天记录",response=RestfulPagingResultChatMessage.class) RestfulPagingResult<ChatMessage>search(Paging<ChatMessage>paging); @Path("/pt") @POST @ApiOperation(value="添加聊天记录",response=RestfulResultChatMessage.class) RestfulResult<ChatMessage>insert(@HeaderParam("uid")Longuid,@ApiParam@ValidChatMessagechatMessage); @Path("/pt/{id:\\d+}") @DELETE @ApiOperation(value="按id删除聊天记录",response=RestfulResultChatMessage.class) RestfulResult<ChatMessage>delete(@HeaderParam("uid")Longuid,@PathParam("id")Longid); @Path("/pt/{id:\\d+}") @PUT @ApiOperation(value="修改聊天记录",response=RestfulResultChatMessage.class) RestfulResult<ChatMessage>update(@HeaderParam("uid")Longuid,@PathParam("id")Longid,@ApiParam@ValidChatMessagechatMessage); classRestfulResultChatMessageextendsRestfulResult<ChatMessage>{ } classRestfulPagingResultChatMessageextendsRestfulPagingResult<ChatMessage>{ } } packagecharles.sc.provider.service; importcharles.sc.provider.entity.ChatMessage; importcom.jztey.framework.mvc.Paging; importcom.jztey.framework.mvc.RestfulPagingResult; importcom.jztey.framework.mvc.RestfulResult; importorg.springframework.stereotype.Service; importjava.util.ArrayList; importjava.util.List; /** *CreatedbyCharleson2016/8/16. */ @com.alibaba.dubbo.config.annotation.Service @Service publicclassChatMessageServiceImplextendsBaseService<ChatMessage>implementsChatMessageService{ @Override publicRestfulPagingResult<ChatMessage>findPage(intpage,intpageSize,inttotal){ System.out.println("get"); //统一使用查询接口 Paging<ChatMessage>paging=newPaging<>(page,pageSize); paging.setTotal(total); returnthis.search(paging); } @Override publicRestfulResult<ChatMessage>find(Longid){ System.out.println("getById"); returnnewRestfulResult(newChatMessage(id,"fu","tu","msg","mi",System.currentTimeMillis(),System.currentTimeMillis(),ChatMessage.STATUS_NO_PROCESS)); } @Override publicRestfulPagingResult<ChatMessage>search(Paging<ChatMessage>paging){ System.out.println("search"); List<ChatMessage>entityList=newArrayList<>(); entityList.add(newChatMessage(1L,"fu","tu","msg","mi",System.currentTimeMillis(),System.currentTimeMillis(),ChatMessage.STATUS_NO_PROCESS)); entityList.add(newChatMessage(2L,"fu2","tu2","msg2","mi2",System.currentTimeMillis(),System.currentTimeMillis(),ChatMessage.STATUS_NO_PROCESS)); if(-1==paging.getTotal()){//total没有传上来 //查询total paging.setTotal(100); } returnnewRestfulPagingResult(entityList,paging.getTotal()); } @Override publicRestfulResult<ChatMessage>insert(Longuid,ChatMessagechatMessage){ System.out.println("insertuid:"+uid); returnnewRestfulResult<>(chatMessage); } @Override publicRestfulResult<ChatMessage>delete(Longuid,Longid){ System.out.println("deleteuid:"+uid); returnnewRestfulResult(newChatMessage(id,"fu","tu","msg","mi",System.currentTimeMillis(),System.currentTimeMillis(),ChatMessage.STATUS_NO_PROCESS)); } @Override publicRestfulResult<ChatMessage>update(Longuid,Longid,ChatMessagechatMessage){ System.out.println("updateuid:"+uid); returnnewRestfulResult<>(chatMessage); } } 完整代码参考:http://gitlab.998jk.com/heying/spring-cloud 本文转自yushiwh 51CTO博客,原文链接:http://blog.51cto.com/yushiwh/1942254,如需转载请自行联系原作者

优秀的个人博客,低调大师

微型项目实践(系列文章)

.Net发展的如此之快:2.0,3.0,3.5……版本的不断升级让人应接不暇;Linq,Ajax.Net,SilverLight……各种新特性更是让眼花缭乱。 这些新技术一方面极大的提高了开发效率,另一方面,又给我们提出了严峻的考验:如何能在项目中合理的使用这些新技术,使它们相互配合,发挥出最大功效? 本系列将以一个Blog系统的开发为例子,从数据分析开始,一步步讲解一个系统的架构,并在这个过程中介绍以上这些技术的使用方式。另外,文章还将介绍作者在实际项目中积累的一些经验和技巧。麻雀虽小,五脏俱全,希望本文对于哪些不知道该如何组织实际代码的朋友有些帮助! 第一篇:用XML描述业务实体 第二篇:用测试驱动代码生成 第三篇:实体代码的生成 第四篇:Common层代码分析 第五篇:Business层代码分析——实体基类 第六篇:Business层代码分析——实体代码的生成策略 第七篇:数据访问的定义 第八篇:数据访问的实现 第九篇:页面的数据访问策略 第十篇:Master & Default 第十一篇:控件和格式化显示 第十二篇:查询与显示 本文转自冬冬博客园博客,原文链接:http://www.cnblogs.com/yuandong/archive/2008/05/01/1178913.html ,如需转载请自行联系原作者

优秀的个人博客,低调大师

赢得 Docker 挑战最佳实践

难怪Docker正在迅速发展。Docker,一个开源项目。仅仅两年,Docker价值近10亿美元,最近获得了9500万美元的资金。令人激动的是,我们看到有这么多开发者对这个项目的热情。然而,我将在下面讨论企业使用Docker本身是不够的。 现代IT问题 许多企业IT团队解决这两个问题:首先,开发者和运维者在优先级上并不能总是达成一致。企业必须应对的挑战将来自开发人员的代码和运维团队的代码切换。这两个团队之间的关系很难和谐相处。 第二,将代码从一个地方迁移到另一个可以是很困难的。因为你没有简单的方法打包应用程序代码,包括你的系统依赖性。你在不同的操作系统,不同的虚拟机或不同的IaaS上处理代码。 Docker的好处 Docker最激动人心之处就是可以解决企业的这两个问题。第一个问题似乎是确定的,因为开发人员和运维人员之间有着清楚的界限。开发人员考虑Docker容器内部发生的一切,运维人员思考容器外面发生了什么。Docker让这一切变得更加简单和方便,这是一个非常便携式的解决方案。 至于第二个问题,Docker通过使你在单个应用程序进程打包一切与你相关的应用程序。但这只是部分解决了这些问题。 Docker缺少什么 Docker可以形象化的比喻为像可叠起堆放的乐高积木。每个容器是一个乐高。乐高玩具的美丽之处是可以组装的砖块和建立各种各样的奇妙的东西。同样的概念也适用于Docker的容器中。利用Docker,诸如编排、监控、日志记录和扩展可能成为企业关注的问题。Docker容器可以为企业运行几个容器,但如果你运行成百上千的呢?这些都是需要考虑的一些问题,它们超出了Docker容器本身可以提供的范围,为什么PaaS平台是对Docker的补充。 让我们看看容器本身三个特定的缺陷: 1. 装载容器 应用程序开发人员如何让一款应用进入容器?对于开发者来说构建Docker image也有一些负担,谁需要关注代码,不依赖于不同的系统的操作系统。这个问题的解决方案被称为buildpacks——对于PaaS是最好和最便携的选择。大多数PaaS生态系统正在让其标准化。Buildpacks允许你建立你的栈,包括在容器内部的所有系统依赖关系,以及配置应用程序的环境。开发人员只需要考虑他们的应用程序代码。他们不需要担心什么。Buildpacks配置你的应用程序。 2. 编排运输过程 假设开发人员创建大量的Docker的容器。然后他们与运维团队通信:“Ship these. Deploy these to production”。IT运维人员如何传输这些容器并且以系统的方法来管理这些容器性能、安全性和遵从性?容器有很多乐高积木。他们如何管理? 这个问题的答案是Docker Schedulers。如今在市场上有大量的调度器,它们为你编排和运行的容器并且跨集群分发它们——而不用考虑你的云计算集群是什么。调度器是有弹性的,所以如果一个容器或机器或应用程序宕机,它会重新分配这些容器。从用户的角度来看,根本感觉没有停机时间。虽然这些调度器解决一部分运输问题是有帮助的,但是还有另一个重要的问题,企业仍然面临一个调度器不能解决的问题。 3. 开发自助服务 企业文化当中对于自助服务似乎有着天然的缺陷。开发人员和IT运维之间也存在的天然的鸿沟。在某些方面,你可以说他们之间存在着一堵墙。经常发生的是,开发人员将构建一个应用程序,然后把它扔在墙那边给运维人员,并且希望应用能够一切运行正常。因此,将应用程序部署到生产需要数周或数月。所以听到开发者抱怨他们需要多长多长时间在生产环境中部署应用就不难理解了。 这种文化上的差异遭遇到破旧的基础设施时,后果就会更严重,因为一些企业仍使用过时的票务系统获取虚拟机,计算周期可能需要数周时间。 开发人员可以解决这个分歧,但他们需要特殊的工具。他们需要一种自助的方式为企业工作。给开发人员自由的部署在他们的应用,但是这些工具也必须满足安全性和遵企业的需求,包括多租户管理。开发人员可以专注于他或她的应用程序,但是企业需要考虑所有由不同的开发人员提交的应用程序。怎么处理这个?如何打破这堵存在与开发者和运维者之间的墙? PaaS平台也有闪光的地方,它提供了一个介于你的应用程序和基础设施之间的平台。这个平台是一样的,从开发到生产,提供一个无缝应用交付体验。 一个新的开发方法 Docker的承诺是真正伟大的,帮助开发人员解决构建新应用时的重大问题。它将改变应用程序开发过程,但某些挑战必须克服从而使得企业获得最大好处。PaaS平台将促进Docker的发展,并且帮助其履行自己的承诺。 本文作者:张鹏程编译 来源:51CTO

优秀的个人博客,低调大师

混合IT架构的最佳实践

传统IDC跟云服务的关系 传统IDC作为互联网的基础平台为其服务了几十年,可是对IDC的使用从来没有像今天这样使用了互联网思维。云时代,服务商卖给企业的不只是场地,机柜,电。。还有一整套采用互联网思维来使用它们的解决方案,所以通常我们会觉得云服务“哪儿哪儿都要花钱“,所以有实力的公司会搞“私有云“。 混合IT架构的尴尬地位 随着云服务的逐渐完善,如果我要做一个产品,必然会去选择云服务提供商,因此也就不会有混合IT架构这个概念了,因为这个概念通常存在于使用传统 IDC的公司向云服务过度的一个中间状态。也对运维部门是一个极大的考验,因为要在一个新的环境建立产品运行环境,还要保障产品速度,各种转换率不会因此降低。 数据一致性 混合架构有两种方式,一种是备份机房,机主机房出现比较大的故障,可以将流量切至备用机房,一种则是双活,即两个机房同时为用户提供服务。无论是哪种方案,都需要两个机房之间的网络延迟在可以接受的范围内,一般通过专有光纤来解决,云服务商通常会提供这种专有光纤的接入(比如AWS的Direct Connect服务)来打通实体机房与云服务的网络环境,我们可以利用它来做到数据的同步。 有了良好的网络环境,如何实现数据同步同样是一件及其困难的事情,比如数据库,就需要用户写数据的时候往两个机房各写一份,比较普遍的做法是采用消息队列,将用户写的数据先排进队列,然后在开启两个队列对不同机房的数据库进行写操作。 另外是缓存,如果用户访问新的机房,由于新的机房没有缓存,则会出现新的机房数据库被打爆的风险,比较简单的做法是通过在请求包设置cookie用以标记是否是老用户然后负载均衡层判断,含有次cookie的转发至老机房,没有此cookie的新用户则转发至新机房,然后再将老用户按照逐渐递增的方式将流量迁移至新机房,直到新机房缓存完全建立。 做到敏捷 使用云服务的一大优势便是资源到位速度快,一般情况下,我们可认为云的资源时无限大的(如需求特别的,需要跟云服务商单独谈),许多的云服务商(比如AWS)都会给用户提供api接口用于开启资源,并配合cloud-int服务实现资源的初始化,比如我们可以通过脚本的方式调用api快速开启一台 webserver,一台memcache,一台mysql,并使他们处于不同的集群以及不同的监控组中。 尽可能多的使用服务 云服务商提供的服务不仅仅有虚拟服务器,也会提供诸如负载均衡,分布式存储,cache,消息队列等其他的公共服务,将他们恰当的运用到自己的项目中是很有必要的,因为你将在短期内不用担心他们的扩容问题,比如可以使用AWS的ELB作为负载均衡器对外提供服务,使用S3存储静态资源以及log文件 (有个叫s3fuse的项目可以实现将s3作为文件系统挂载到服务器上,可以向访问本地文件一样访问s3上的文件)。 监控一切 在企业架构还处于混合架构的状态中,我们要对产品的性能做两套监控系统,另外一个用来专门监控处在云服务上的产品的性能数据,包括性能指标以及业务指标。我们可以通过在前端分流层对流向IDC以及云服务的流量打上cookie或者标记Etag,然后再log分析的时候便可以出两套数据,用于对比,随时对云服务进行优化或者技术决策,可以采用grafana做成类似如下的图标用来实时观测数据。 本文作者:兰亭集势-段超 来源:51CTO

优秀的个人博客,低调大师

HBase最佳实践-集群规划

HBase自身具有极好的扩展性,也因此,构建扩展集群是它的天生强项之一。在实际线上应用中很多业务都运行在一个集群上,业务之间共享集群硬件、软件资源。那问题来了,一个集群上面到底应该运行哪些业务可以最大程度上利用系统的软硬件资源?另外,对于一个给定业务来说,应该如何规划集群的硬件容量才能使得资源不浪费?最后,一个给定的RegionServer上到底部署多少Region比较合适?想必这些问题都曾经困惑过很多HBaser,那本文将结合前人的分享以及笔者的经验简单的对这三个问题分别进行解析,抛砖引玉,希望大家能够针对这几个话题进行深入的交流! 集群业务规划 一般而言,一个HBase集群上很少只跑一个业务,大多数情况都是多个业务共享集群,实际上就是共享系统软硬件资源。这里通常涉及两大问题,其一是业务之间资源隔离问题,就是将各个业务在逻辑上隔离开来,互相不受影响,这个问题产生于业务共享场景下一旦某一业务一段时间内流量猛增必然会因为过度消耗系统资源而影响其他业务;其二就是共享情况下如何使得系统资源利用率最高,理想情况下当然希望集群中所有软硬件资源都得到最大程度利用。前者本次并不讨论,后期会开’专场’讨论,本节主要就后者进行探讨。 使得集群系统资源最大化利用,那首先要看业务对系统资源的需求情况。经过对线上业务的梳理,通常可将这些业务分为如下几类: 1. 硬盘容量敏感型业务:这类业务对读写延迟以及吞吐量都没有很大的要求,唯一的需要就是硬盘容量。比如大多数离线读写分析业务,上层应用一般每隔一段时间批量写入大量数据,然后读取也是定期批量读取大量数据。特点:离线写、离线读,需求硬盘容量 2. 带宽敏感型业务:这类业务大多数写入吞吐量很大,但对读取吞吐量没有什么要求。比如日志实时存储业务,上层应用通过kafka将海量日志实时传输过来,要求能够实时写入,而读取场景一般是离线分析或者在上次业务遇到异常的时候对日志进行检索。特点:在线写、离线读,需求带宽 3. IO敏感型业务:相比前面两类业务来说,IO敏感型业务一般都是较为核心的业务。这类业务对读写延迟要求较高,尤其对于读取延迟通常在100ms以内,部分业务可能要求更高。比如在线消息存储系统、历史订单系统、实时推荐系统等。特点:在(离)线写、在线读,需求内存、高IOPS介质 (而对于CPU资源,HBase本身就是CPU敏感型系统,主要用于数据块的压缩/解压缩,所有业务都对CPU有共同的需求) 一个集群想要资源利用率最大化,一个思路就是各个业务之间‘扬长避短’,合理搭配,各取所需。实际上就是上述几种类型的业务能够混合分布,建议不要将同一种类型的业务太多分布在同一个集群。因此一个集群理论上资源利用率比较高效的配置为:硬盘敏感型业务 + 带宽敏感型业务 + IO敏感型业务。 另外,集群业务规划的时候除了考虑资源使用率最大化这个问题之外,还需要考虑实际运维的需求。建议将核心业务和非核心业务分布在同一个集群,强烈建议不要将太多核心业务同时分布在同一个集群。这主要有两方面的考虑: 1. 一方面是因为‘一山不容二虎’,核心业务共享资源必然会产生竞争,一旦出现竞争无论哪个业务’落败’都不是我们愿意看到的; 2. 另一方面在特殊场景下方便运维童鞋进行降级处理,比如类似于淘宝双十一这类大促活动,某个核心业务预期会有很大的流量涌入,为了保证核心业务的平稳,在资源共享的情况下只能牺牲其他非核心业务,在和非核心业务方充分交流沟通的基础上限制这些业务的资源使用,在流量极限的时候甚至可以直接停掉这些非核心业务。试想,如果是很多核心业务共享集群的话,哪个核心业务愿意轻易让路? 那有些同学就说了:如果按照你这样设计,那岂不是会产生很多小集群。的确,这种设计会产生很多小集群,相信如果没有资源隔离的话,小集群是没法避免的。有些使用’rsgroup’进行业务资源隔离的集群会做的很大,大集群通过隔离会将业务独立分布到很多独立的RS上,这样实际上就产生了很多逻辑上的小集群,那么,这些小集群同样适用上面提出的规划思路。 集群容量规划 每个季度公司都会要求采购新机器,一般情况下机器的规格(硬盘总容量、内存大小、CPU规格)都是固定的。假如现在一台RegionServer的硬盘规格是3.6T * 12,总内存大小为128G,从理论上来说这样的配置是否会有资源浪费?如果有的话是硬盘浪费还是内存浪费?那合理的硬盘/内存搭配应该是什么样?和哪些影响因素有关? 这里需要提出一个’Disk / Java Heap Ratio’的概念,意思是说一台RegionServer上1bytes的Java内存大小需要搭配多大的硬盘大小最合理。在给出合理的解释在前,先把结果给出来: Disk Size / Java Heap = RegionSize / MemstoreSize * ReplicationFactor * HeapFractionForMemstore * 2 按照默认配置,RegionSize = 10G,对应参数为hbase.hregion.max.filesize;MemstoreSize = 128M,对应参数为hbase.hregion.memstore.flush.size;ReplicationFactor = 3,对应参数为dfs.replication;HeapFractionForMemstore = 0.4,对应参数为hbase.regionserver.global.memstore.lowerLimit; 计算为:10G / 128M * 3 * 0.4 * 2 = 192,意思是说RegionServer上1bytes的Java内存大小需要搭配192bytes的硬盘大小最合理,再回到之前给出的问题,128G的内存总大小,拿出96G作为Java内存用于RegionServer,那对应需要搭配96G * 192 = 18T硬盘容量,而实际采购机器配置的是36T,说明在默认配置条件下会有几乎一半硬盘被浪费。 计算公式是如何’冒’出来的? 再回过头来看看那个计算公式是怎么’冒’出来的,其实很简单,只需要从硬盘容量纬度和Java Heap纬度两方面计算Region个数,再令两者相等就可以推导出来,如下: 硬盘容量纬度下Region个数:Disk Size / (RegionSize *ReplicationFactor) Java Heap纬度下Region个数:Java Heap * HeapFractionForMemstore / (MemstoreSize / 2 ) Disk Size / (RegionSize *ReplicationFactor) =Java Heap * HeapFractionForMemstore / (MemstoreSize / 2 ) =>Disk Size / Java Heap = RegionSize / MemstoreSize * ReplicationFactor * HeapFractionForMemstore * 2 这样的公式有什么具体意义? 1. 最直观的意义就是判断在当前给定配置下是否会有资源浪费,内存资源和硬盘资源是否匹配。 2. 那反过来,如果已经给定了硬件资源,比如硬件采购部已经采购了当前机器内存128G,分配给Java Heap为96G,而硬盘是40T,很显然两者是不匹配的,那能不能通过修改HBase配置来使得两者匹配?当然可以,可以通过增大RegionSize或者减少MemstoreSize来实现,比如将默认的RegionSize由10G增大到20G,此时Disk Size / Java Heap = 384,96G * 384 = 36T,基本就可以使得硬盘和内存达到匹配。 3. 另外,如果给定配置下内存硬盘不匹配,那实际场景下内存’浪费’好呢还是硬盘’浪费’好?答案是内存’浪费’好,比如采购的机器Java Heap可以分配到126G,而总硬盘容量只有18T,默认配置下必然是Java Heap有浪费,但是可以通过修改HBase配置将多余的内存资源分配给HBase读缓存BlockCache,这样就可以保证Java Heap并没有实际浪费。 另外,还有这些资源需要注意… 带宽资源:因为HBase在大量scan以及高吞吐量写入的时候特别耗费网络带宽资源,强烈建议HBase集群部署在万兆交换机机房,单台机器最好也是万兆网卡+bond。如果特殊情况交换机是千兆网卡,一定要保证所有的RegionServer机器部署在同一个交换机下,跨交换机会导致写入延迟很大,严重影响业务写入性能。 CPU资源:HBase是一个CPU敏感型业务,无论数据写入读取,都会因为大量的压缩解压操作,特别耗费计算资源。因此对于HBase来说,CPU越多越好。 参考: http://hadoop-hbase.blogspot.com/2013/01/hbase-region-server-memory-sizing.html Region规划 Region规划主要涉及到两个方面:Region个数规划以及单Region大小规划,这两个方面并不独立,而是相互关联的,大Region对应的Region个数少,小Region对应的Region个数多。Region规划相信是很多HBase运维同学比较关心的问题,一个给定规格的RegionServer上运行多少Region比较合适,在刚开始接触HBase的时候,这个问题也一直困扰着笔者。在实际应用中,Region太多或者太少都有一定的利弊: 优点 缺点 大量小Region 1.更加有利于集群之间负载分布 2.有利于高效平稳的Compaction,这是因为小Region中HFile相对较小,Compaction代价小,详情可见:Stripe Compaction 1. 最直接的影响:在某台RegionServer异常宕机或者重启的情况下大量小Region重分配以及迁移是一个很耗时的操作,一般一个Region迁移需要1.5s~2.5s左右,Region个数越多,迁移时间越长。直接导致failover时间很长。 2. 大量小Region有可能会产生更加频繁的flush,产生很多小文件,进而引起不必要的Compaction。特殊场景下,一旦Region数超过一个阈值,将会导致整个RegionServer级别的flush,严重阻塞用户读写。 3. RegionServer管理维护开销很大 少量大Region 1. 有利于RegionServer的快速重启以及宕机恢复 2. 可以减少总的RCP数量 3. 有利于产生更少的、更大的flush 1. Compaction效果很差,会引起较大的数据写入抖动,稳定性较差 2. 不利于集群之间负载均衡 可以看出来,在HBase当前工作模式下,Region太多或者太少都不是一件太好的事情,在实际线上环境需要选择一个折中点。官方文档给出的一个推荐范围在20~200之间,而单个Region大小控制在10G~30G,比较符合实际情况。 然而,HBase并不能直接配置一台RegionServer上的Region数,Region数最直接取决于RegionSize的大小配置hbase.hregion.max.filesize,HBase认为,一旦某个Region的大小大于配置值,就会进行分裂。 hbase.hregion.max.filesize默认为10G,如果一台RegionServer预期运行100个Region,那单台RegionServer上数据量预估值就为:10G * 100 * 3 = 3T。反过来想,如果一台RegionServer上想存储12T数据量,那按照单Region为10G计算,就会分裂出400个Region,很显然不合理。此时就需要调整参数hbase.hregion.max.filesize,将此值适度调大,调整为20G或者30G。而实际上当下单台物理机所能配置的硬盘越来越大,比如36T已经很普遍,如果想把所有容量都用来存储数据,依然假设一台RegionServer上分布100个Region,那么每个Region的大小将会达到可怕的120G,一旦执行Compaction将会是一个灾难。 可见,对于当下的HBase,如果想让HBase工作的更加平稳(Region个数控制在20~200之间,单Region大小控制在10G~30G之间),最多可以存储的数据量差不多为200 * 30G * 3= 18T。如果存储的数据量超过18T,必然会引起或多或少的性能问题。所以说,从Region规模这个角度讲,当前单台RegionServer能够合理利用起来的硬盘容量上限基本为18T。 然而随着硬件成本的不断下降,单台RegionServer可以轻松配置40T+的硬盘容量,如果按照上述说法,越来越多的硬盘其实只是’镜中月,水中花’。社区也意识到了这样的问题,在当前Region的概念下提出了Sub-Region的概念,可以简单理解为将当前的Region切分为很多逻辑上小的Sub-Region。Region还是以前的Region,只是所有之前以Region为单位进行的Compaction将会以更小的Sub-Region粒度执行。这样,单Region就可以配置的很大,比如50G、100G,此时单台RegionServer上也就可以存储更多的数据。个人认为Sub-Region功能将会是HBase开发的一个重点。 总结 本文结合HBase相关理论知识以及笔者的实际经验,对HBase集群规划中最常见的三个问题 - 业务规划、容量规划以及Region规划做了简单的解析,希望给大家一些启发和思考。线上集群规划是一个经验积累的过程,相信每个HBase运维同学或多或少都会碰到一些坑,也肯定会有自己的思考和见解,希望大家能够更多的在评论区或者邮件交流,谢谢! 本文转载自:http://hbasefly.com 原文链接

优秀的个人博客,低调大师

Android测试驱动开发实践

在 Android应用开发中,相信很少有人在坚持先由设计人员做完整的概要设计 、详细设计,然后交给程序员进行编码实现了。通常是在有一个大体框架的情况下,就开始进行具体编码开发了。在这种情形下,开发速度可以有很大的提高,但是最终代码质量却不可避免的降低了。如何能既保持开发速度,同时又能保证开发质量呢?相信 测试驱动开发是一种比较可行的开发方法学。 测试驱动开发首先通过设计 测试用例,对从用户需求到方法接口进行细化,在构想这些测试用例的过程,就是站在使用者角度上来思考系统的过程,而传统方法中设计人员通常是站在技术人员的角度来思考问题,两者比较,显然测试驱动开发更有助于开发出更符合用户需求的产品,同时开发出高复用性代码。 测试驱动开发先写测试,这样就保证了充分考虑到了方法使用者需要,可以使方法更加合理。接下来进行代码开发,以尽可能短的时间通过测试用例,在这个过程中暂时忘掉OO和设计模式吧。当通过测试用例之后,我们再回过头来审视我们的代码实现,再去除类间依赖关系,使用恰当的设计模式,这比在开始阶段凭空想象要好得多。反复上述过程,自然可以得到质量更高的代码和系统。 然而,在Android系统下,进行测试驱动开发又增加了额外的难度,怎样对Activity、Provider、Service、Broadcaster等进行 单元测试,是一个必须要解决的问题,下面我们就以一个实际系统的开发,来看一看怎么解决这一系列的问题。 进行测试驱动开发,首先要做的就是建立一个真正可运行的骨架系统,做Android下的测试驱动开发也不例外。 先建立一个Android工程,这里以mhcs为例,采用Eclipse向导,建立该工程。假设这个工程在用户第一次使用时,需要显示三个介绍页面,用户在一张一张划过之后,才开始使用正常功能。接下来我们就以这个功能为例,详细描述一下在Android下怎样进行测试驱动开发。 首先,准备三张介绍图片,放入res/drawable目录下。我们定义FlipIntroActivity类来处理用户的划动操作及介绍图片显示。由于我们要在用户第一次运行时才向用户显示介绍页面,因些需要保存用户是否第一次使用系统的信息。我们利用Application的子类AppPreferences来管理应用所需的所有信息。 这时我们需要完成的功能就很清楚了,程序在第一次运行时显示介绍页面,而之后的运行中,不显示介绍页面。是否显示介绍页面,由AppPreferences类来管理。 下面在Eclipse里建立测试工程,选择新工程类型为Android Junit Test工程,同时选择上面建立的工程作为被测试工程。 好了,最小可运行骨架系统已经建立好了,下面就可以进入正式的测试驱动开发流程了。 首先写测试用例:新建类AppPreferencesTest,由于被测试类AppPreferences是Application的子类,因此AppPreferencesTest类需要继承ApplicationTestCase public class AppPreferencesTest extends ApplicationTestCase<AppPreferences> { public AppPreferencesTest(Class<AppPreferences> applicationClass) { super(applicationClass); } } 我们首先测试AppPreferences在第一次运行时,可以返回true,在AppPreferencesTest类里添加如下测试代码: public void testFirstRunTrue() { assertTrue(prefs.isFirstRun()); } private AppPreferences prefs = new AppPreferences(); 这如你所看到的,这段代码编译器立即使出错误,不要担心,测试驱动开发总是从不能通过的测试用例开始的,每次努力通过一个测试用例,在通过一个个测试用例的过程中取得进展。 下面我们首先编写代码,通过这个测试用例,我们在AppPreferences类中添加如下代码: public boolean isFirstRun() { return isFirstRun; } public void setFirstRun(boolean isFirstRun) { this.isFirstRun = isFirstRun; } private boolean isFirstRun = true; 但是,如果是第二次运行,系统不是还会显示true吗?这明显是不正确的!一点儿没错,这段代码确实没有实现我们之前的想法,但是这段代码却可以通过我们的测试用例,测试驱动开发的原则就是以尽量快的速度通过测试用例。 好了,在测试工程中选择AppPreferencesTest,然后选择Android Junit Test,系统运行,你会在Junit视图中看到绿色用例通过标记。 下面添加一段代码,测试当第二次运行时的情况: public void testSecondAndMoreRun() { prefs.isFirstRun(); assertFalse(prefs.isFirstRun()); } 运行上述工程,结果测试用例testSecondAndMoreRun不能通过,下面我们就来处理这种情况,在生产工程中的AppPreferences类中添加如下代码: public boolean isFirstRun() { boolean orgVal = isFirstRun; isFirstRun = false; return orgVal; } 这时再来运行测试工程的AppPreferencesTest类,又可以看到令我们心旷神怡的绿色通过标志了。 下面就剩下第一次运行可以通过,第二次运行不能通过。具体代码如下所示: 在生产项目的类AppPreferences中添加: @Override public void onCreate() { super.onCreate(); } public void onTerminate() { super.onTerminate(); } public boolean isFirstRun() { prefs = getSharedPreferences("mhcs", MODE_PRIVATE); boolean orgVal = isFirstRun; isFirstRun = false; Editor editor = prefs.edit(); editor.putBoolean(PREF_IS_FIRST_RUN, false); editor.commit(); return orgVal; } public void setFirstRun(boolean isFirstRun) { this.isFirstRun = isFirstRun; } public final static String PREF_IS_FIRST_RUN = "isFirstRun"; private SharedPreferences prefs = null; private boolean isFirstRun = true; 在测试项目的测试类中添加代码: public void testFirstRunTrue() { createApplication(); prefs = getApplication(); Editor editor = mContext.getSharedPreferences("mhcs", 0).edit(); editor.clear().commit(); assertTrue(prefs.isFirstRun()); } public void testSecondAndMoreRun() { createApplication(); prefs = getApplication(); assertFalse(prefs.isFirstRun()); } 尤其需要注意的是testFirstRunTrue方法中,先将SharedPreferences清空的处理,这样可以模拟程序安装后第一次运行。 运行测试项目的测试用例,终于可以看到完整功能的绿色通过标志了。 最新内容请见作者的GitHub页:http://qaseven.github.io/

优秀的个人博客,低调大师

iOS 遗留系统重构实践

在过去的几个月内,我主导着团队完成了一项工程浩大(累积八个人月的工作量)的重构工作——为我们的App替换数据库。之所以能够把这种伤筋动骨的事情称之为重构,是因为在这段时间内,我们每天向主干合并两到三次代码,期间App上线五次,用户没有感知到任何影响。在这篇文章中,我将讲述我们如何在不影响系统外部行为,也不影响正常交付的情况下,替换掉了数据库实现。 背景 在一个有着良好分层结构的系统中,每一层都有它自己的职责:显示层负责响应用户事件,调用业务层的逻辑,最后做数据呈现;业务逻辑层负责业务规则与数据处理;数据访问层封装底层数据库的操作,网络访问层与其并列,负责网络请求、json解析等等。无论是MVC、MVVM、VIPER,归根结底都是在”单一职责“、“关注点分离”、“高内聚低耦合”的原则下变化,只是表现形式和涵盖的层次各异。 而在我们的代码中,几乎所有的显示层对象,包括ViewController、ViewModel,甚至View里面都混杂了大量的CoreData API调用,直接进行数据库操作。 粗略统计了一下,系统中一共有25个类与NSManageContext紧紧耦合。形成了下图中混乱的局面: 面对这种情况,我们首先要做的就是解耦。 方案选型 我们最先排除掉的是重写这种简单粗暴的方式。表面上看来,我们可以通过重写得到一个干净利落的方案,层次结构清晰,职责分离;但与之相伴的是巨大的风险: 范围不可控——遗留系统的难点就在于牵一发而动全身,影响范围极广。稍不留神,重写的工作就会如野火燎原般蔓延开来,不可收拾。 长时间无法上线——在整个过程中,直到最后完成的那一刻之前,系统会处于一直不可用的状态。漫长的时间里,所有的新功能都被阻塞,不能交付。没有哪个产品团队能承担这样的结果。 第二个被排除掉的方案是特性分支。把重写的工作放到分支上完成,其他人继续在主干上开发新特性,直到重写结束再合并回主干——这种做法确实比直接重写要好上那么一点点,因为新特性还是可以不受影响的;但长期没有跟主干合并的分支,在经历上四五个月的重写之后,天知道到最后要花多长时间来处理合并冲突? 既想减小对系统的影响,又想不影响新功能上线,又不想处理大量的合并冲突,最后的方案就只剩下了一种,那就是抽象分支(Branch by Abstraction)+特性开关(Feature Toggle)。 抽象分支 抽象分支这个名字的缘起是针对版本库分支而言的,它允许开发者在一条“抽象”的分支上并行工作,无需创建一条实际的分支,从而避免无谓的合并开销。 Martin Fowler和Jez Humble都曾在多年前撰文介绍过这个重构方案 http://martinfowler.com/bliki/BranchByAbstraction.html http://continuousdelivery.com/2011/05/make-large-scale-changes-incrementally-with-branch-by-abstraction/ 它的工作原理很简单:当我们想要替换掉系统中的某个组件——名为X——时,首先为X组件创造一个抽象层,这一层里面可能会有大大小小若干接口或是协议,把系统中对X组件的访问都隔离在抽象层之下,系统只调用抽象的接口/协议,不会接触到具体的API实现。如下图所示。 这一步我们可以通过提取方法、提取类和接口等重构手法来完成;这以后系统就彻底跟X组件解耦了,它依赖的只是一组抽象接口,而非具体实现。这时候,我们就可以着手在这个抽象层下面,进行新组件的开发工作,让它也实现同一套接口即可。 这之后,我们再使用特性开关(其原理及实现见下节),让这个抽象层在生产环境下调用旧组件,测试环境下调用新组件,从而在完全不影响交付的情况下,完成对新组件的测试。测试结束后,就可以打开开关,让系统在线上使用新组件,等彻底稳定后,把开关代码和旧组件代码全部删掉,替换工作就完成了。 在上述整个开发过程中,任何一个阶段都可以做到细粒度的任务分解,然后小步提交,每次提交都自动触发单元测试和集成测试,保证不影响现有功能。在频繁提交的情况下,也不会出现大量的代码合并冲突,无论是做组件替换还是新特性开发,开发人员都可以基于同一套代码库工作。这就大大减少了对系统的冲击和交付风险。 特性开关 先看一段代码: 在这个例子中,我们要替换一个Storyboard的布局和相关ViewController的功能,耗时很久,如果直接在主干上修改,就会直接影响到现有的App,在功能完成之前都无法上线;如果拉一条分支出来做,未来就又会有大量的合并冲突。使用如上的特性开关就会避免上述问题。 当shouldDisplayNewSearchResultsScreen的值返回为真,就使用新的Storyboard,返回为假,就使用旧的Storyboard。这样一来,只要开关处于关闭状态,未完成的功能就是对用户不可见的,我们就既可以在开发环境下自测,也可以部署到测试环境下做验收测试,还可以针对开关为真的情况写对应的单元测试,让每次代码提交都有持续集成验证。这期间还可以继续发布新版本,用户完全感知不到影响,直到我们决定打开开关为止。 特性开关可以有多种实现方式。 预编译参数 在预编译参数中传值,让不同的xcconfig文件传入不同的值,然后在代码中做判断。 我们系统中绝大部分的特性开关都是用这种方式实现的。 NSUserDefaults 有些功能可能对App有破坏性的影响,即便是设成只对Internal Target可见,也会影响到QA的回归测试。我们给Internal Target做了个Developer Settings界面,让开发人员可以自己修改开关状态,把开关的值存放在NSUserDefaults里面,默认返回false,只有在界面上手工切换之后才会返回true。测试和开发互相不受影响。 我们向Realm迁移的特性开关使用的就是这种方式。 服务器取值 配置参数的值也可以通过服务器下发。这种做法的好处是比较灵活,在启用/禁用某项功能的时候不需要发布新版本,只需要后台配置,缺点是会增加集成和后台开发的工作量。 A/B测试 还有一个办法是使用第三方的A/B测试服务,如果缺少后台开发人员的话,这也是一个选择。但第三方的稳定性往往就会成为制约因素,Parse为推送通知提供过A/B测试服务,但是它到了17年就会被关闭了;我们用Amazon的A/B测试框架用了一段时间,然后Amazon也宣布今年8月份停用……目前我们还在寻找备选方案。 具体实现 在具体落实抽象分支和特性开关的时候,一共分成了如下几个阶段: 建立数据访问层 我们首先把跟数据请求有关的操作从ViewController中提取成一个方法,放到另一个对象中实现,以便日后替换。然后把所有的数据访问的方法都提取成一个协议,让数据层之上的对象都依赖于这个协议,而不是具体对象。这样一来,原先的ViewController就从下图中的样子: 变成了这样: 为数据对象提取协议 除了数据访问的代码以外,我们还把所有的数据对象上的公有属性和方法都提取了相应的协议,然后修改了整个App,让它使用协议,而不是具体的数据对象。这也是为以后的切换做准备。 使用Realm实现 前两步完成之后,我们就建立起了一个完整的抽象层。在这层之上,App里已经没有了对CoreData和数据对象的依赖,我们可以在这层抽象之下,提供一套全新的实现,用来替换CoreData。 在实现过程中,我们还是遇到了不少需要磨合的细节,比如Realm中的一对多关联是通过RLMArray实现的,并不是真正的NSArray,为了保证接口的兼容性,我们就只能把property定义为RLMArray,再提供一个NSArray的getter方法。种种问题不一而足。 切换开关状态 上篇文章说到,我们在迁移过程中的特性开关是用NSUserDefaults实现的,在界面上手工切换开关状态。这样的好处是开发过程不会影响在Hockey和TestFlight上内部发布。直到实现完成后,我们再把开关改成 + (BOOL)shouldUseRealm { return isInternalTarget; } 让测试人员可以在真机上测试。回归测试结束之后,再让开关直接返回true,就可以向App Store提交了。 数据迁移 这个无需多说,写个MigrationManager之类的类,用来把数据从CoreData中读出,写到Realm里面去。这个类大概要保留上三四个版本,等绝大部分用户都已经升级到新版本之后才会删掉。 后续清理 特性开关是不能一直存活下去的,否则代码中的分支判断会越来越多。我们一般都会在上线一两个星期之后,发现没有出现特别严重的crash,就把跟开关有关的代码全都删掉。 在第一步建立数据访问层的时候,我们创建出了一个特别庞大的PersistenceService,它里面含有所有的数据访问方法。这只是为了方便切换而已,切换完成后,我们还是要根据访问数据的不同,建立一个个小的Repository,然后让ViewModel对象访问Repository读写数据,把PersistenceService删掉。 最后形成的架构如图所示: 总结 首先,要勇敢面对遗留代码库,团队里一定要有人站出来跟大家说,我们不能让代码继续腐烂下去,我们要有清晰的目标和正确的策略,在重构中让优秀的设计渐渐涌现。这才是正途。 要有正确的方法 在遗留代码中工作,Long-Term Refactoring是不可或缺的。人们需要预见到在未来的产品规划中,哪些组件应当被替换,哪部分架构需要作出调整,把它们放到迭代计划里面来,当做日常工作的一部分。抽象分支和特性开关在Long-Term Refactoring可以发挥显著的效果,它们是持续交付的保障。 设计会过时,但设计原则不会 很多技术决策都不是非黑即白的,它们更像是在种种约束下做出的权衡。时光会褪色,框架会过时,脱离了具体场景,今天的优秀设计也会沦落成明天的遗留代码,但设计原则有着不动声色的力量。我们无法预见未来,只能根据当前的情况做出简单而灵活的设计。这样的设计应当服从这些设计原则:单一职责、关注点分离、不要和陌生人说话……让我们的代码尽可能保持高内聚低耦合,保证良好的可测试性。 ====================================分割线================================文章转载自 开源中国社区[http://www.oschina.net]

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册